Dynamic Chunking for End-to-End Hierarchical Sequence Modeling | 요약
10 Jul 2025 | Paper Review Sequence Modeling Tokenization State Space Models목차
판본 안내. 이 글은 2025-W28에 선정된 논문을 수동으로 다시 살펴보며 2025년 7월 15일자 arXiv v2를 기준으로 작성했다. v2는 선정 주간이 지난 뒤 공개된 개정판이다.
이 글은 Sukjun Hwang, Brandon Wang, Albert Gu의 Dynamic Chunking for End-to-End Hierarchical Sequence Modeling을 설명한다.
- 2025-07-10 (최초 arXiv 공개)
- Carnegie Mellon University, Cartesia AI
- 논문, arXiv v2
이미지 출처. Sukjun Hwang, Brandon Wang, Albert Gu, Dynamic Chunking for End-to-End Hierarchical Sequence Modeling, arXiv:2507.07955v2. arXiv 기록에는 논문 라이선스가 CC BY 4.0으로 표시되어 있다. 이미지는 원문 PDF의 Figures 1, 2(각각 3, 7쪽)와 Table 2(13쪽)에서 잘라냈다.
요약
- H-Net은 고정된 토크나이저 대신 바이트 시퀀스를 압축할 경계를 학습한다. 인코더가 세밀한 표현을 만들고 라우터가 문맥에 따른 청크 경계를 선택한다. 주 네트워크가 짧아진 시퀀스를 처리한 뒤 디코더가 원래 해상도로 복원한다.
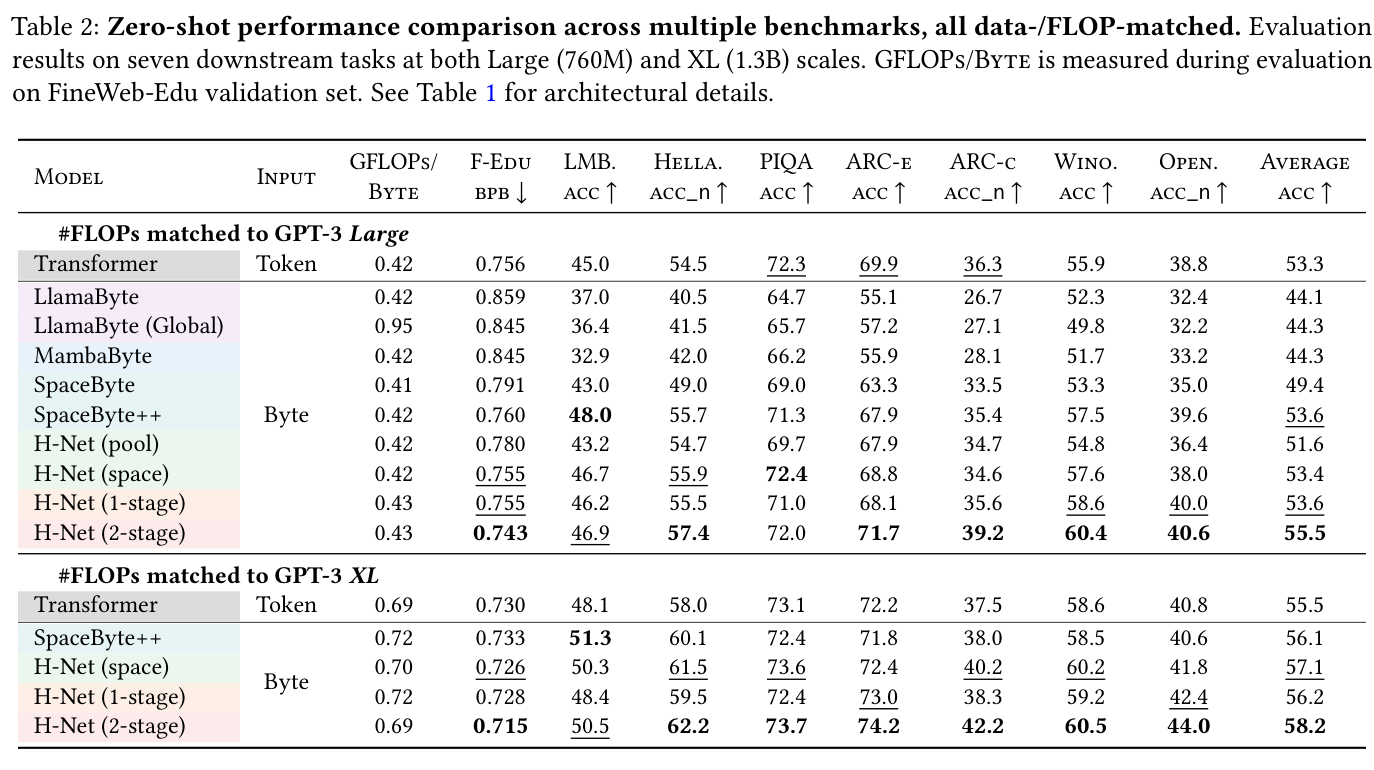
- 학습 데이터와 FLOPs를 맞춘 Table 2에서 2단계 H-Net의 FineWeb-Edu 검증 bits per byte(BPB)는 Large 조건에서 0.743, BPE Transformer는 0.756이다. XL에서는 각각 0.715와 0.730이다. BPB는 낮을수록 좋다. 7개 다운스트림 과제 평균은 각각 55.5 대 53.3, 58.2 대 55.5다.
- 실험은 문자 교란, 중국어, 코드와 DNA도 다룬다. 저자들은 학습 속도와 메모리 비용을 보고한다. 주 실험에서 가장 큰 2단계 H-Net은 1.6B 파라미터를 가지며 1.3B Transformer와 FLOPs를 맞춰 비교했다. 더 큰 모델을 처음부터 학습할 때의 확장 성능은 이 실험만으로 확인할 수 없다.
1 Introduction
Byte-pair encoding(BPE)은 텍스트를 더 짧은 시퀀스로 압축해 언어 모델의 학습 비용을 줄인다. 다만 어휘와 분할 방식이 모델 학습 전에 고정되므로 모든 언어와 데이터 유형에 같은 방식이 적합한 것은 아니다. 바이트를 직접 처리하는 모델은 이 전처리를 피하지만 더 긴 시퀀스를 다뤄야 한다. 기존 계층형 접근은 고정 풀링이나 사람이 정한 경계 규칙으로 시퀀스를 줄였다. 이 논문은 경계도 과제 학습과 함께 배울 수 있는지 묻는다.
H-Net은 계층형 처리와 동적 청킹을 결합한다. 주 네트워크는 압축된 시퀀스를 처리하고, 작은 바깥쪽 네트워크는 원래 해상도의 세부 정보를 유지한다. 주 실험은 한 단계와 두 단계 압축을 다루며, 분할 정답을 별도로 제공하지 않고 경계를 학습한다.
2 H-Net Architecture
2.1 Architectural overview
각 단계에는 인코더, 청킹 계층, 디청킹 계층과 디코더가 있다. 인코더가 입력을 처리하면 청킹 계층이 다음 단계 또는 주 네트워크에 보낼 더 짧은 시퀀스를 고른다. 디청킹 계층은 주 네트워크의 출력을 다시 늘리고 인코더 잔차를 투영해 더한 다음 디코더에 전달한다. 이 구조를 반복하면 여러 압축 계층을 만들 수 있다. 3쪽 Figure 1은 2단계 모델을 보여준다.
왼쪽은 두 단계에서 압축과 복원이 이뤄지는 경로다. 오른쪽은 경계 라우팅과 다운샘플링, 스무딩과 업샘플링을 구분해 보여준다.
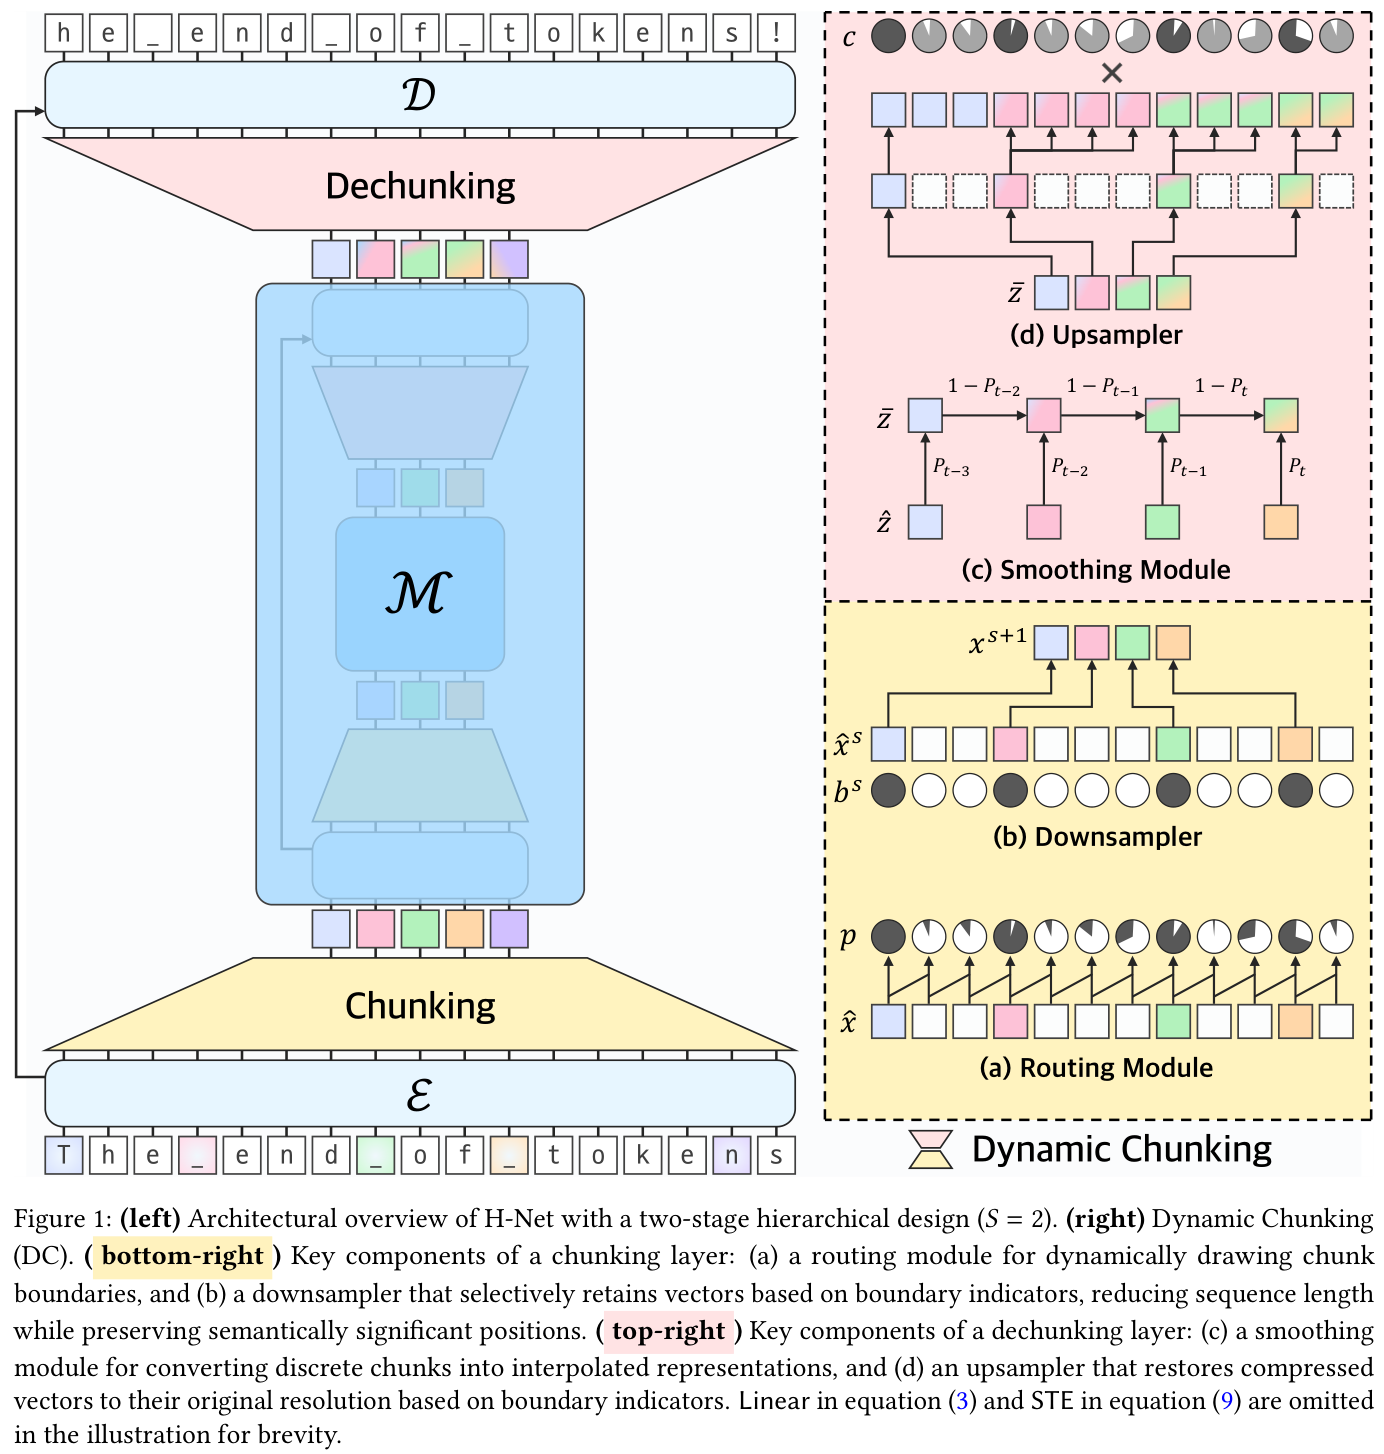
논문은 긴 시퀀스를 처리하는 인코더와 디코더에 Mamba-2 상태 공간 계층을 쓰고, 주 네트워크의 기본 구조로 Transformer를 사용한다. 대부분의 파라미터는 압축된 주 단계에 배치한다. 주 네트워크는 다른 시퀀스 모델로 교체할 수도 있다.
2.2 Dynamic chunking
라우터는 인접한 인코더 표현에 각각 별도로 학습된 투영을 적용하고 그 결과의 코사인 유사도를 계산한다. 투영된 표현 사이의 유사도가 낮을수록 경계 점수가 높아지므로 데이터와 문맥에 따라 분할이 달라진다. 다운샘플러는 선택된 경계의 표현을 다음 단계로 보낸다. 별도의 보조 손실은 목표 압축률을 유도하지만 단어 경계 정답을 제공하지는 않는다.
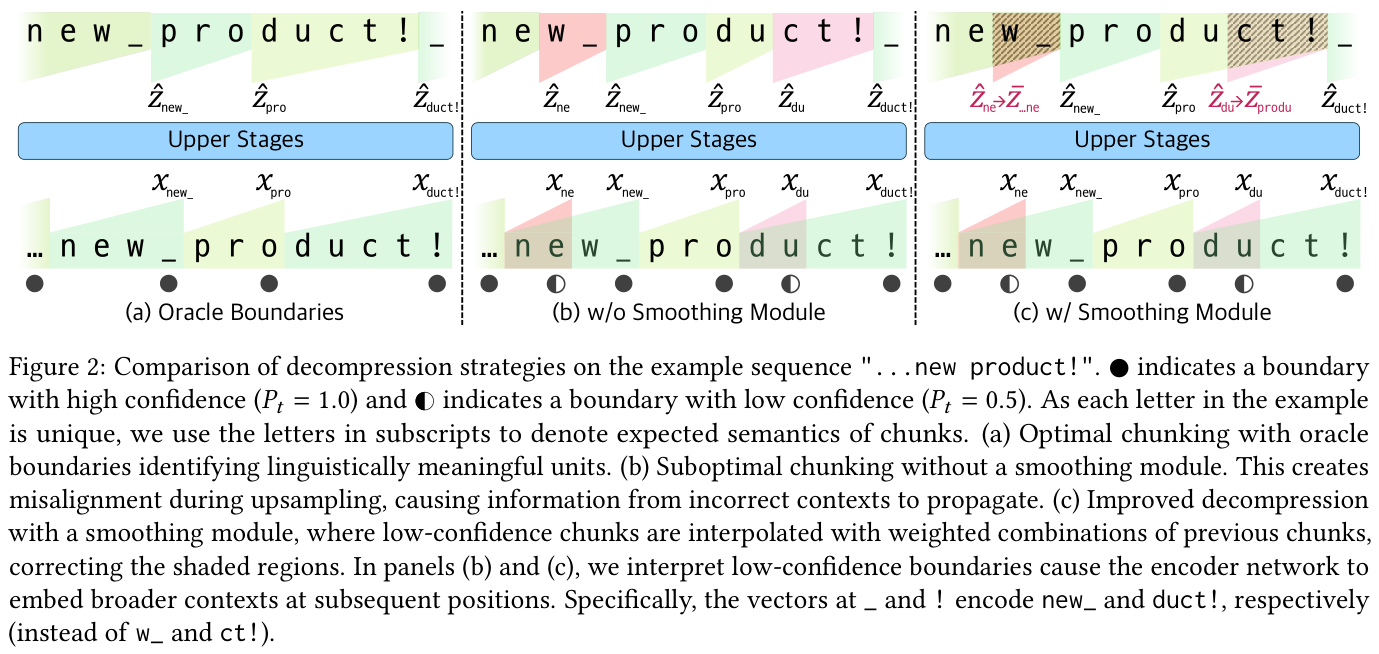
디청킹은 정보를 원래 위치마다 다시 전달해야 한다. 스무딩 모듈은 경계 신뢰도에 따라 이전 청크 표현과 현재 표현을 보간한다. 신뢰도가 낮은 경계는 신뢰도가 높은 경계보다 완만하게 반영된다. 7쪽 Figure 2는 정렬 오류와 스무딩 효과를 설명한다. Straight-Through Estimator는 순전파에서 이산 선택을 유지하면서 라우터에 그래디언트 신호가 전달되도록 한다.
이 예시는 이상적인 경계와 불확실한 경계에서 스무딩을 사용하기 전후를 비교한다. 채워진 원은 높은 경계 신뢰도를, 반쯤 채워진 원은 낮은 신뢰도를 뜻한다.
2.3 Stable hierarchical training
저자들은 네트워크 사이의 신호 균형을 맞추려고 투영층과 정규화층의 위치를 조정한다. 계층별 너비와 압축 단계에서 달라지는 유효 배치 크기에 맞춰 최적화 설정도 조정한다. 이는 바깥쪽 네트워크와 더 많은 파라미터를 가진 주 네트워크의 상호작용을 다루는 학습 설정이다.
2.4 Autoregressive training and inference
모델은 시퀀스를 자기회귀 방식으로 예측한다. 추론 시 라우팅은 새 위치에서 압축된 주 단계의 계산이 필요한지 결정하고, 바깥쪽 네트워크는 원래 해상도에서 계속 동작한다. 청킹과 디청킹은 예측에 미래 입력이 들어가지 않도록 인과성을 유지한다.
3 Experiments
3.1 Language modeling and robustness
영어 실험은 학습 데이터와 연산 예산을 맞춰 모델을 비교한다. FLOPs는 GPT-3 Large(760M 파라미터)와 GPT-3 XL(1.3B 파라미터)에 각각 맞췄다. 학습에는 100B 토큰 분량의 FineWeb-Edu 부분 집합과 배치 크기 256을 사용한다. 시퀀스는 바이트 모델에서 UTF-8 바이트 8,192개, 기준 모델에서 GPT-2 토큰 1,792개로 구성하며 바이트 기준으로는 대략 같은 길이다. Table 2는 FineWeb-Edu 검증 BPB와 7개 다운스트림 과제의 zero-shot 결과를 함께 보고한다. Large에서 2단계 H-Net은 BPB 0.743, 과제 평균 55.5를 기록했고 토큰 기반 Transformer는 0.756과 53.3을 기록했다. XL에서는 각각 0.715와 58.2, 0.730과 55.5다.
저자들은 BPE 기준 모델의 BPB가 greedy 토큰화의 확률을 문자열 확률의 근사치로 사용한다는 한계를 밝힌다. 같은 문자열을 표현할 수 있는 다른 토큰화도 있으므로 이 추정치는 BPE BPB를 과대평가하며, 실험 조건에서 정확한 계산은 어렵다. 다운스트림 과제 결과는 별도의 측정값이다.
두 모델 규모에서 같은 학습 예산으로 검증 BPB와 7개 다운스트림 과제 점수를 비교한다. BPB는 낮을수록, 과제 정확도는 높을수록 좋다.
저자들은 노이즈를 추가하지 않은 깨끗한 데이터로 학습한 체크포인트를 HellaSwag에 다섯 가지 문자 교란을 적용해 평가했다. Table 3에서 Large H-Net의 평균은 38.0, 강건성 점수는 39.0이며 Transformer는 각각 30.9와 20.2다. XL에서는 H-Net이 40.9와 42.8, Transformer가 32.3과 22.2다. 강건성 점수는 논문에서 정의한 지표이며 평균 정확도와 구분해야 한다.
학습된 경계의 시각화에는 공백 주변의 경계뿐 아니라 문맥에 따라 여러 단어를 묶는 사례도 나타난다. 이는 학습된 동작의 예시이며 모든 청크가 언어학적 단위와 일치한다는 증거는 아니다.
3.2 Other languages and modalities
Table 4의 중국어 검증 BPB는 H-Net이 0.7032, BPE Transformer가 0.7404이고 XW-zh 점수는 각각 0.663과 0.599다. 코드의 BPB는 각각 0.3161과 0.3376이다. 이 비교는 논문에서 사용한 데이터와 같은 예산 조건에 한정된다.
HG38 DNA 실험의 Table 5에서 H-Net의 perplexity는 2.705와 2.697이고 Transformer와 Mamba-2는 각각 2.769와 2.757이다. Figure 6 캡션은 안정적인 학습 구간에서 비슷한 성능에 필요한 데이터가 약 3.6배 적다고 추정한다. 인접 본문은 “3.6× the amount of data”라고 쓰며 “less”를 포함하지 않아 두 표현이 일치하지 않는다. 서론과 Appendix E.3은 데이터 효율이 3.6배 향상됐다고 설명한다. H-Net 두 모델은 각각 64M과 66M 파라미터를 가지며 Transformer는 29M, Mamba-2는 33M이다. 따라서 파라미터 수를 동일하게 맞춘 비교는 아니다. 이 결과는 해당 DNA 실험의 비교이며 모든 생물학적 시퀀스에 대한 일반적 보장은 아니다.
3.3 Ablations
소거 실험은 인코더와 디코더 선택, 청킹 방식, 스무딩과 계층 수를 살펴본다. 보고된 비교는 실험 조건에서 상태 공간 모델을 바깥쪽에 두고 학습된 청킹을 결합한 설계를 뒷받침한다. 고정 풀링과 공백 기반 경계도 비교 기준으로 사용했다. 결과는 토크나이저 제거만이 아니라 구조와 학습된 압축 방식의 조합에 달려 있다.
4 Discussion
시퀀스 길이가 동적으로 달라지면 배치 구성과 메모리 할당이 복잡해진다. 저자들은 현재 구현이 동일 구조를 반복하는 isotropic 모델보다 학습 시 최대 약 2배 느릴 수 있고, 긴 배치에서 메모리 부족이 발생할 수 있다고 보고한다. 3단계 계층과 더 큰 주 실험 모델을 처음부터 학습하는 설정은 실험하지 않았다. Appendix F는 고정된 Llama 3.2 3B 주 네트워크와 경계 감독을 사용하는 증류 실험을 별도로 다루며, 주 실험과는 다른 조건이다. 데이터 확장 비교도 전체 scaling-law 연구가 아니라 안정 구간을 대리지표로 사용했다.
5 Conclusion
H-Net은 분할을 시퀀스 모델과 함께 학습하고 압축된 표현에 계산을 집중하는 방법을 제시한다. 같은 예산에서 수행한 실험은 명시된 토큰 기반 기준 모델보다 여러 조건에서 좋은 결과를 보였지만, 학습 비용과 검증 규모의 한계도 함께 고려해야 한다.