


MoBluRF: Motion Deblurring Neural Radiance Fields for Blurry Monocular Video 요약 설명
21 Dec 2023 | Paper Review Neural Radiance Fields Motion Deblurring Novel View Synthesis목차
이번 글에서는 MoBluRF: Motion Deblurring Neural Radiance Fields for Blurry Monocular Video 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 12월 21일(Arxiv)
- Bui, Minh-Quan Viet, Park, Jongmin, Oh, Jihyong, Kim, Munchurl.
- School of Electrical Engineering, Korea Advanced Institute of Science and Technology, Department of Imaging Science, GSAIM, Chung-Ang University
- 논문 링크
요약
- MoBluRF는 카메라와 물체의 움직임으로 흐려진 단안 비디오에서 새로운 시점과 시간의 선명한 이미지를 복원한다. 시퀀스 7개로 구성된 Blurry iPhone 벤치마크에서 평균 co-visibility-masked peak signal-to-noise ratio는 17.33으로, 비디오 디블러링과 동적 장면 복원을 순차적으로 수행하는 GShiftNet + T-NeRF의 16.22보다 높다. 이 지표는 학습 중 관측하지 못한 테스트 영역을 제외하고 복원 품질을 측정한다. MoBluRF에는 합성한 부정확한 카메라 포즈를 사용하고, 비교 파이프라인에는 원본 포즈를 제공한다.
- 이 방법은 장면의 색상과 밀도를 신경망으로 표현하는 neural radiance field(NeRF)를 2단계로 학습한다. Base Ray Initialization(BRI)은 부정확한 카메라 포즈에서 얻은 관측 광선을 보정한다. Motion Decomposition-based Deblurring(MDD)은 잠재 선명 광선을 예측하고 렌더링 색상을 평균하여 블러를 재현한다. 별도의 손실 함수로 움직임 마스크의 감독 없이 정적 성분과 동적 성분을 분리하도록 유도하고, 사전 학습된 단일 이미지 깊이 추정값으로 기하 구조를 정규화한다.
- Stereo Blur에서 MoBluRF는 평균 peak signal-to-noise ratio를 DyBluRF의 25.14에서 25.69로 높이고, 지각적 거리를 측정하는 learned perceptual image patch similarity를 0.082에서 0.078로 낮춘다. RTX 3090 Ti 1대에서 480 × 360 프레임을 렌더링하는 데 9.1초가 걸린다. 논문은 학습 데이터의 조명이 불균형할 때 발생하는 외관 오류도 제시한다.
I. Introduction
새로운 카메라 시점과 시간의 이미지를 생성하는 novel view synthesis(NVS)는 노출 중 카메라 흔들림과 물체 움직임이 누적되어 관측 이미지가 흐려지면 어려워진다. MoBluRF: Motion Deblurring Neural Radiance Fields for Blurry Monocular Video는 서로 연관된 3가지 문제를 다룬다. 디블러링 중 일관된 3차원 기하 구조를 유지하고, 카메라와 물체의 움직임을 모두 표현하며, 부정확한 카메라 위치와 방향이 복원을 불안정하게 만드는 현상을 방지하는 문제다.
- 복원 전에 개별 프레임을 디블러링하면 시점 간 불일치가 발생할 수 있으며, 이후 장면 모델이 이를 바로잡지 못할 수 있다.
- 논문은 2단계 최적화 절차, 잠재 선명 광선을 통한 블러 모델링, 정규화 기법 2개, 합성한 Blurry iPhone 평가 데이터셋을 제시한다.
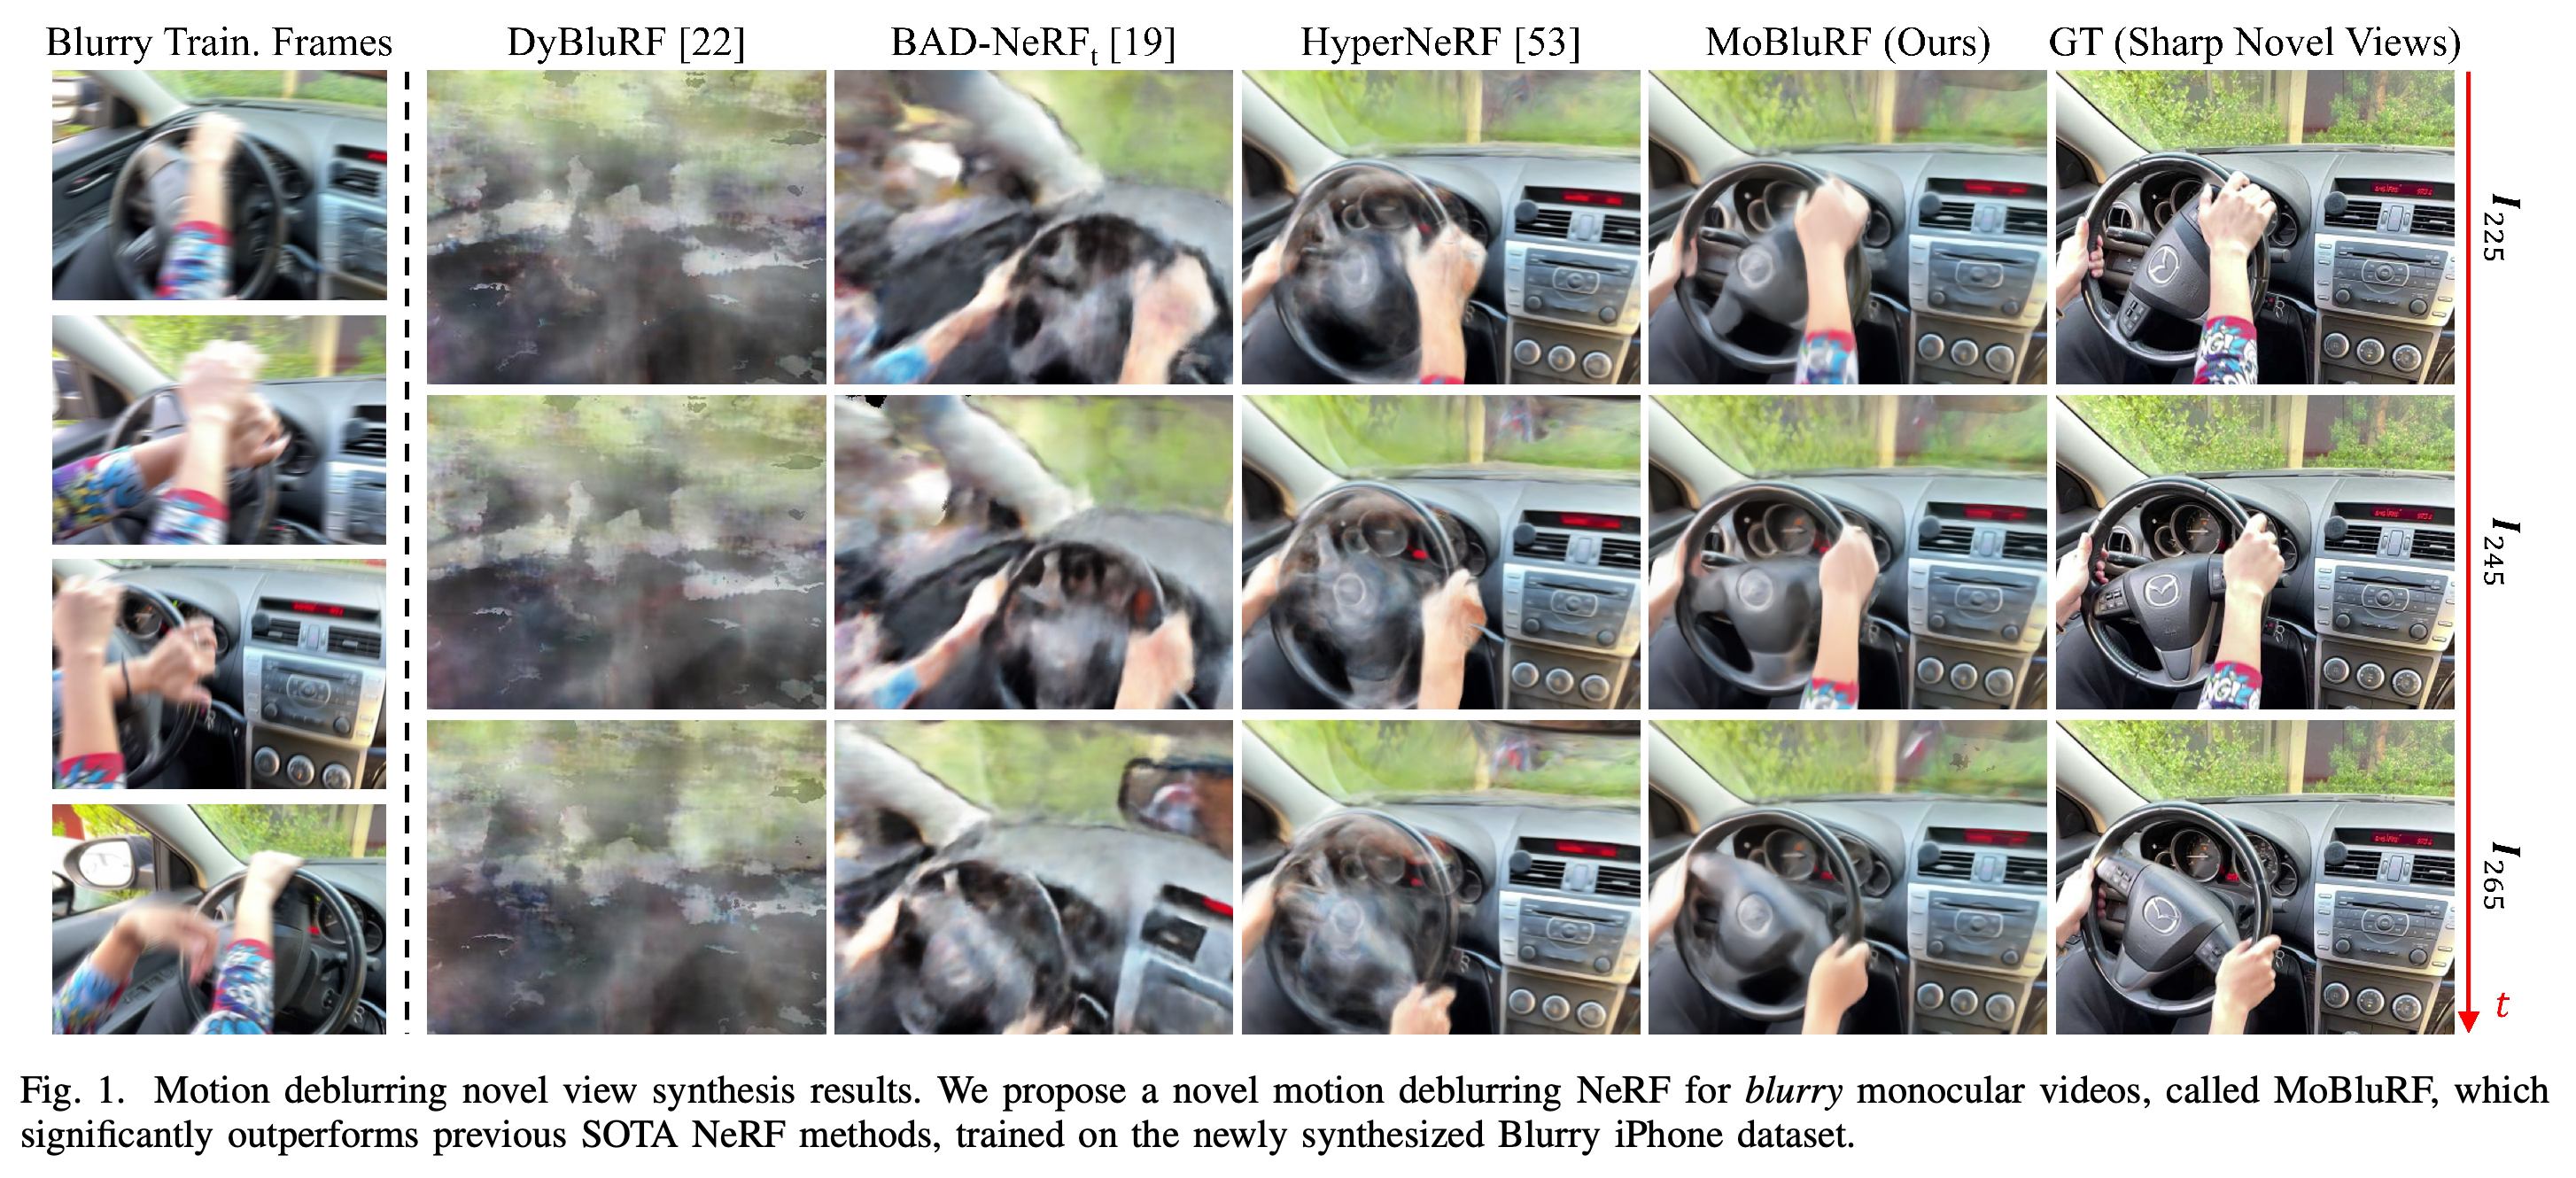
운전대 시퀀스에는 손의 움직임과 카메라 시점 변화가 함께 나타난다. MoBluRF는 제시된 비교 방법보다 손과 대시보드의 구조를 더 일관되게 보존한다. 이는 정성적 근거를 제공하지만 수치적 격차를 입증하지는 않는다.
II. Related Work
관련 연구에서는 동적 장면 복원 방법과 흐려진 관측을 명시적으로 모델링하는 방법을 구분한다. 이러한 연구를 바탕으로 시간에 따라 변하는 장면 표현에 움직임을 고려한 디블러링과 별도의 초기화 단계를 결합한다.
A. NVS for Dynamic Scenes
동적 장면을 다루는 방법은 3차원 점의 이동을 나타내는 scene flow, 관측을 공통 기준 공간에 대응시키는 canonical field, 또는 시간에 직접 의존하는 radiance field로 움직임을 표현한다. 공간상의 Gaussian 요소로 장면을 표현하고 렌더링하는 Gaussian Splatting을 사용하는 방법도 있다. 논문은 이러한 방법으로 흐려진 입력에서 선명한 장면을 복원하려면 별도의 블러 모델이 필요하다고 주장한다.
- NSFF, DynamicNeRF, DynIBaR는 정적 장면과 동적 장면의 표현에 움직임 또는 기하 제약을 결합한다.
- T-NeRF, HyperNeRF, TiNeuVox는 관측 공간에서 canonical space로의 변환을 학습하며, Gaussian 기반 방법은 시간에 따라 변하는 장면 속성을 모델링한다.
B. Deblurring NVS
정적 장면의 디블러링 방법은 선명한 관측들이 결합되는 방식을 나타내는 블러 커널이나 노출 중 카메라 궤적을 추정하지만, 원래의 정식화로는 단안 비디오에서 변형되는 장면을 다루지 못한다. DyBluRF는 노출 구간의 선명한 렌더링을 평균하고 물체 궤적을 모델링한다. 저자들은 자신들이 평가한 더 길고 복잡한 시퀀스에서 부정확한 포즈로부터 궤적을 직접 추정하는 방식과 외부 움직임 마스크, 깊이, optical flow에 의존하는 점을 약점으로 지적한다. Optical flow는 이미지 사이에서 나타나는 겉보기 움직임을 뜻한다.
- MoBluRF는 디블러링 전에 기준 관측 광선을 초기화하고, 움직임 마스크를 내부적으로 학습한다.
- 기하 정규화에는 여전히 사전 학습된 깊이 추정값을 사용하므로, 움직임 마스크의 감독을 제거해도 모든 외부 사전 정보를 제거하는 것은 아니다.
III. Proposed Method: MoBluRF
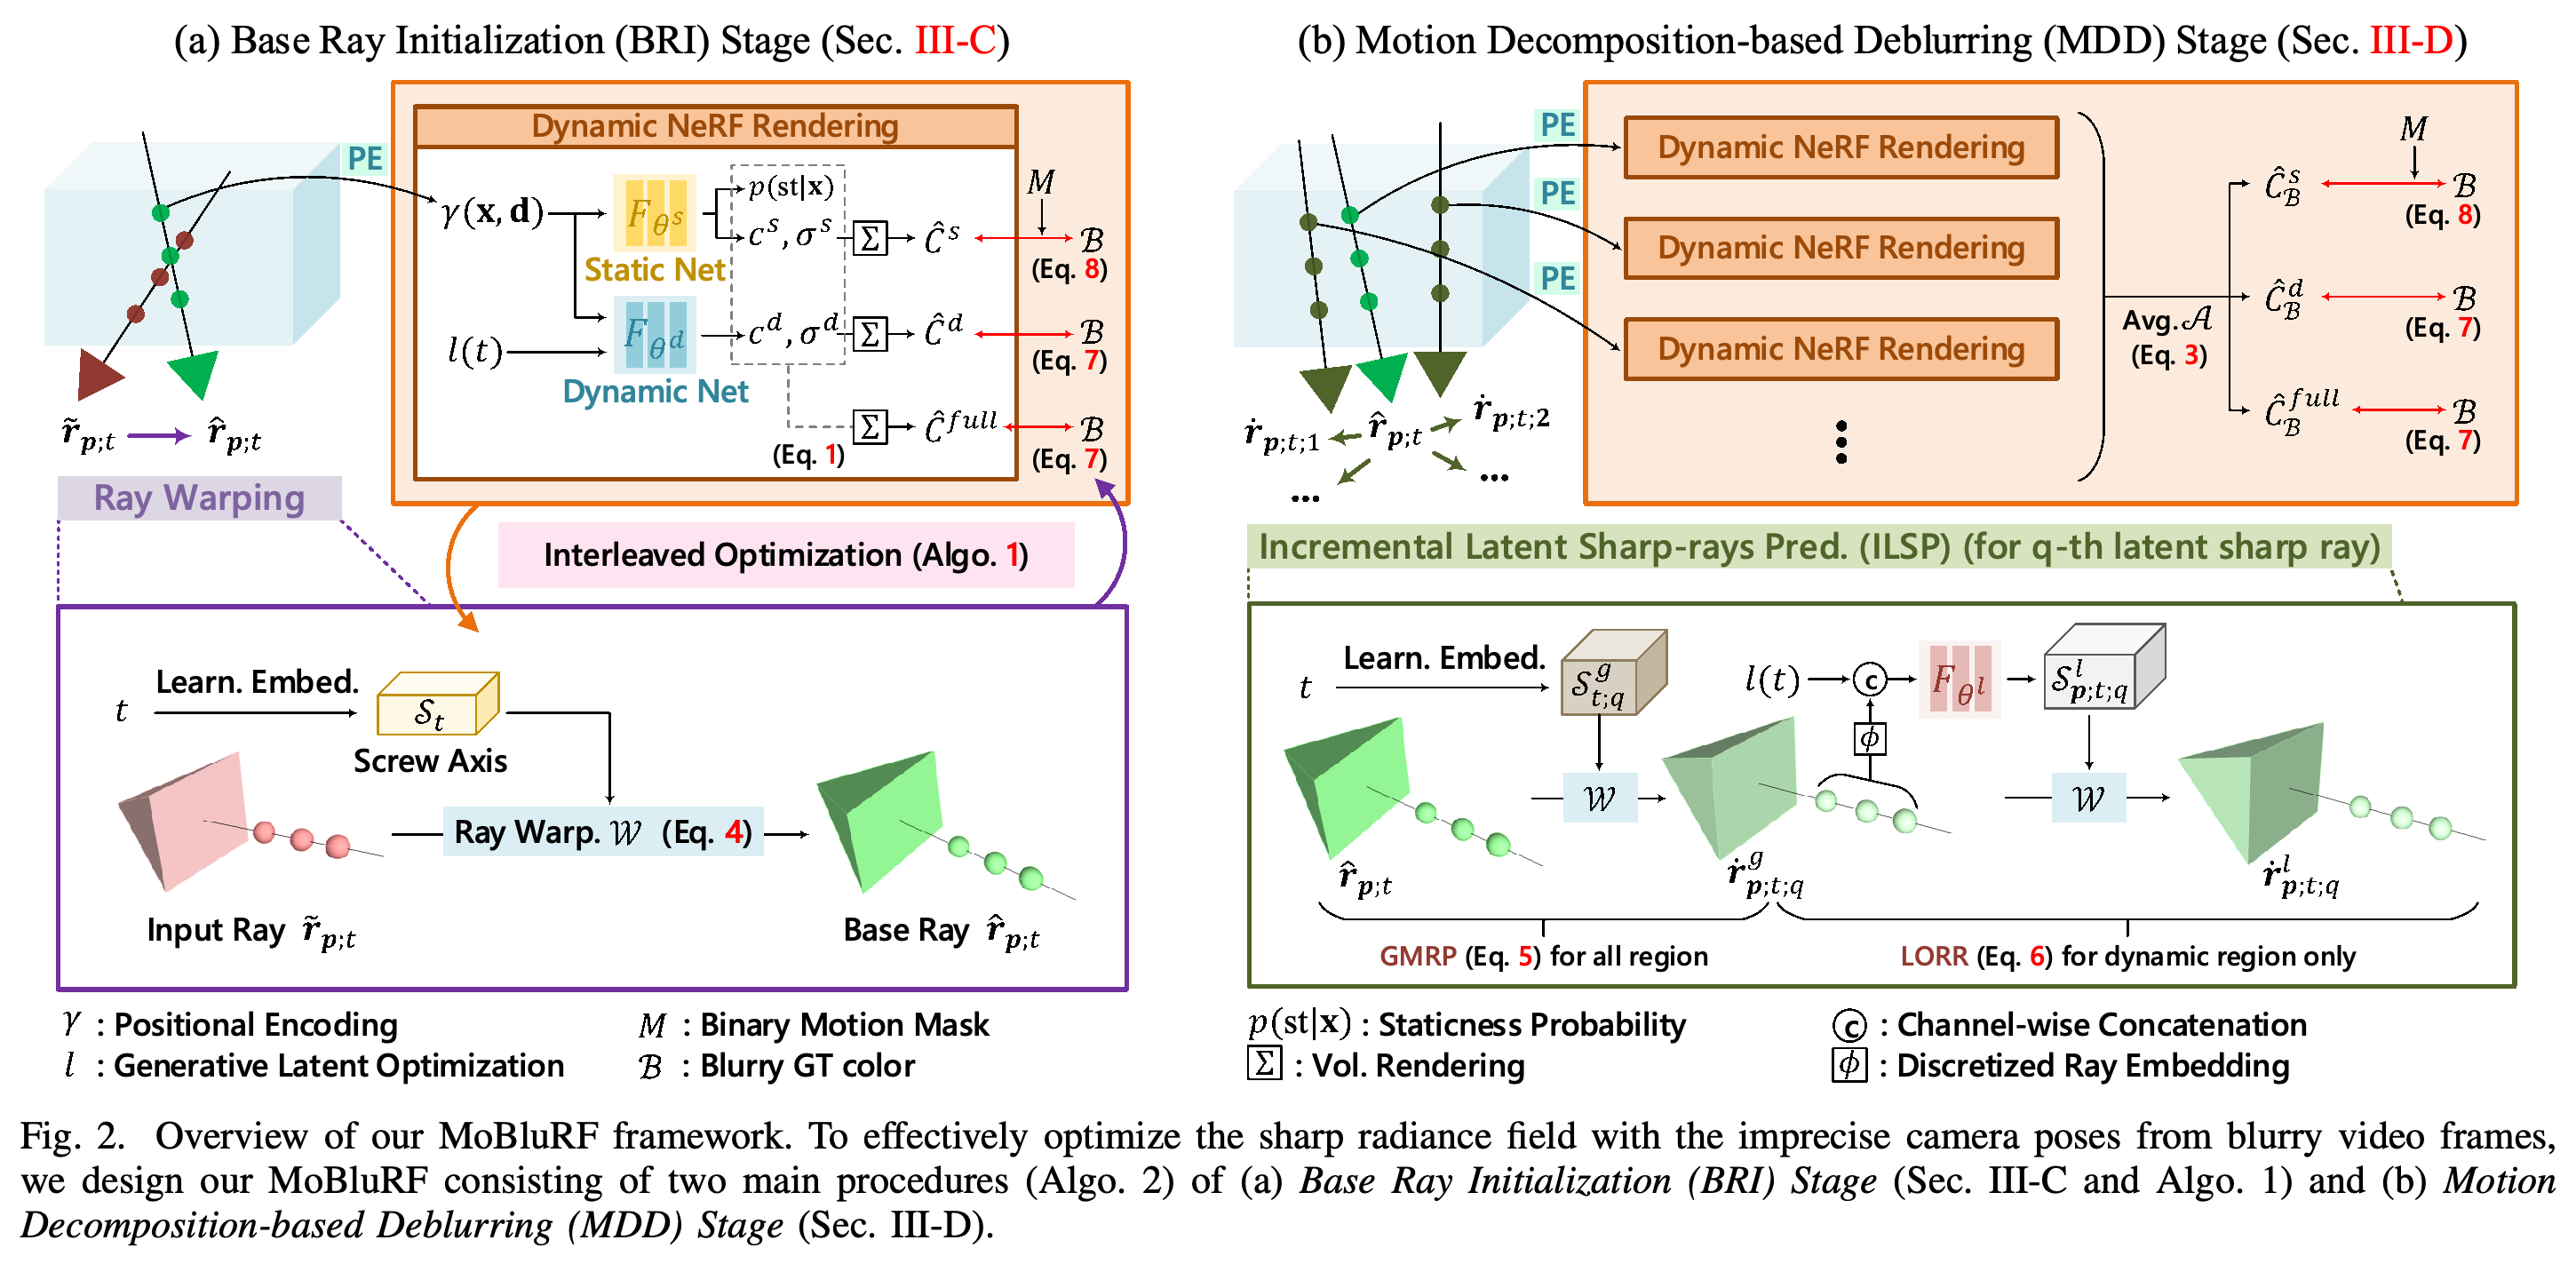
MoBluRF는 먼저 입력 광선을 보정하면서 대략적인 동적 장면을 복원한 뒤, 초기화된 광선으로 블러를 고려한 선명한 장면을 학습한다. Figure 2와 Algorithms 1–3은 초기화, 블러를 고려한 학습, 선명한 새 시점 영상의 추론을 구분하여 제시한다.
BRI는 장면을 복원하면서 기준 광선을 보정하고, MDD는 이 광선을 노출에 기여하는 광선들로 확장한다. 동적 영역 분기는 전역 예측 이후 국소 보정을 적용할 위치를 나타낸다.
A. Design Considerations
기준 광선은 모델이 잠재 선명 광선을 예측할 때 기준으로 삼는 관측 광선이다. 잠재 선명 광선은 관측된 흐릿한 픽셀을 구성하는 렌더링에 사용되는 숨겨진 광선을 뜻한다. 기준 광선이 부정확한 카메라 포즈를 그대로 반영하면, 동적 네트워크가 포즈 오류를 물체 변형으로 설명하여 잘못된 기하 구조와 노출 중 궤적을 만들 수 있다.
- BRI는 블러 모델을 도입하기 전에 정적 장면의 단서로 기준 광선의 초기화를 개선한다.
- 이후 MDD는 초기화된 광선에서 전역 움직임과 국소 물체 움직임의 보정값을 예측한다.
B. Preliminaries
Static Net은 3차원 점의 색상, 밀도, 정적일 확률을 예측한다. Dynamic Net은 시간에 대응하는 수치 표현인 학습된 시간 임베딩도 입력받아 시간에 따른 색상과 밀도를 예측한다. 확률적 볼륨 렌더링은 밀도에 따른 가중치로 광선을 따라 색상을 누적하고, 네트워크의 출력을 결합하여 전체 이미지를 생성한다.
- 각 광선을 따라 누적한 동적 확률이 0.5보다 큰지를 기준으로 이진 움직임 마스크를 얻는다.
- Equation (3)은 기준 광선의 렌더링과 Nb개 잠재 선명 광선의 렌더링을 균등하게 평균하여 흐릿한 픽셀을 모델링한다. 따라서 기여 항은 Nb + 1개다.
- 블러 모델은 학습 중에 사용하며, 추론에서는 픽셀마다 선명한 목표 광선 1개를 렌더링한다.
C. Base Ray Initialization (BRI) Stage
BRI는 프레임 시간에 대응하는 학습된 6차원 screw axis를 통해 입력 광선을 변환한다. Screw axis는 회전과 평행이동을 매개변수화한 표현이다. 교차 최적화는 포즈 관련 매개변수와 동적 네트워크를 번갈아 갱신하여 포즈 오류를 겉보기 물체 변형으로 설명하는 경향을 줄인다.
- 반복 인덱스가 짝수일 때는 렌더링 색상의 오차를 측정하는 정적 영역의 광도 손실로 Static Net과 광선 변환 매개변수를 갱신한다.
- 반복 인덱스가 홀수일 때는 광선 변환 매개변수를 고정하고 장면 네트워크 2개를 모두 갱신한다.
- BRI는 2 × 10^5회 반복하며, 학습된 기준 광선의 보정값은 MDD 동안 고정한다.
D. Motion Decomposition-based Deblurring (MDD) Stage
MDD는 노출 중 광선을 전역 예측 후 국소 보정하는 순서로 추정하는 Incremental Latent Sharp-rays Prediction(ILSP)을 사용한다. Global Motion-aware Ray Prediction(GMRP)은 학습된 시간별 변환으로 모든 장면 영역에 대해 여러 광선을 생성한다. Local Object-motion-aware Ray Refinement(LORR)은 동적이라고 예측한 영역에만 픽셀별 보정값을 추가한다.
- GMRP는 초기화된 각 기준 광선을 Nb개 잠재 광선으로 변환하며, 카메라와 물체의 움직임을 전역 수준에서 반영한다.
- LORR은 순방향 신경망인 multilayer perceptron(MLP)을 사용하여 이산화된 광선 임베딩과 시간 임베딩에서 추가 screw-axis 변환을 예측한다. 이산화된 광선 임베딩은 광선을 따라 샘플링한 표현이다.
- 정적 영역에는 전역적으로 예측한 광선을 사용하고, 동적 영역에는 국소적으로 보정한 광선을 사용한다. 이 광선들의 렌더링 색상을 기준 광선의 색상과 평균한 뒤 흐릿한 입력과 비교한다.
E. Loss Functions
광도 손실은 제곱 오차로 렌더링 색상과 관측 색상을 비교하며, 정적 네트워크의 손실에서는 동적이라고 예측한 영역을 제외한다. Unsupervised Staticness Maximization은 정적일 확률의 로그 절댓값에 페널티를 부과하여 동적 네트워크가 전체 장면을 설명하는 붕괴 현상을 억제한다.
- Local Geometry Variance Distillation은 렌더링한 깊이와 사전 학습된 깊이 추정값에서 국소 3차원 기하 구조의 미분을 구하고, 그 외적을 정규화하여 비교한다.
- 저자들은 깊이의 이동 모호성과 스케일 모호성을 각각 미분과 정규화로 처리한다고 설명하며, 이 정규화 기법을 기존 깊이 손실과 비교한다.
- 깊이 사전 정보는 논문에서 인용한 사전 학습 단일 이미지 깊이 추정기 DPT에서 얻는다. 이는 측정된 장면 깊이가 아니라 보조 감독 신호다.
IV. Experiments
MoBluRF의 구현에는 수치 계산 프레임워크 JAX와 장면 복원 코드베이스 Dycheck를 사용한다. 투사한 광선마다 샘플 128개를 사용하며, BRI는 2 × 10^5회, MDD는 1 × 10^5회 반복한다. 기본 설정은 잠재 선명 광선 Nb = 6, 기하 손실 가중치 0.075, 정적성 손실 가중치 0.002이며, 지수 학습률 스케줄과 Adam 옵티마이저를 사용한다.
- Screw-axis 임베딩의 학습률 범위는 10^-4에서 10^-6이며, 나머지 신경망의 학습률 범위는 10^-3에서 10^-4다.
- Trunk, 밀도, 색상 네트워크는 각각 9, 1, 2개 층으로 구성하며, trunk와 색상 네트워크의 은닉 차원은 각각 256과 128이다.
- 국소 물체 움직임 네트워크는 너비 128인 8개 층으로 구성한다. 위치와 관측 방향 인코딩에는 각각 8개와 4개 주파수를 사용하고, 시간 임베딩의 차원은 8이며, 이산화된 광선 임베딩에는 샘플 32개를 사용한다.
1) Blurry iPhone Dataset: 저자들은 시퀀스당 평균 365프레임인 iPhone 시퀀스 7개에서 흐릿한 관측을 합성한다. 중간 프레임을 생성하는 비디오 프레임 보간으로 프레임률을 8× 높인 뒤, 보간한 프레임과 원본 중앙 프레임을 평균한다. 원본의 선명한 프레임과 카메라 포즈는 평가에 사용한다.
- 학습용 카메라 포즈도 합성한다. 회전에는 방향을 보간하는 quaternion spherical linear interpolation을 적용한 뒤 평균하고, 평행이동에는 선형 보간과 평균을 적용한다.
- 합성한 포즈는 원본 중앙 프레임의 포즈와 다르므로, 이미지 블러와 함께 통제된 포즈 초기화 문제를 추가한다.
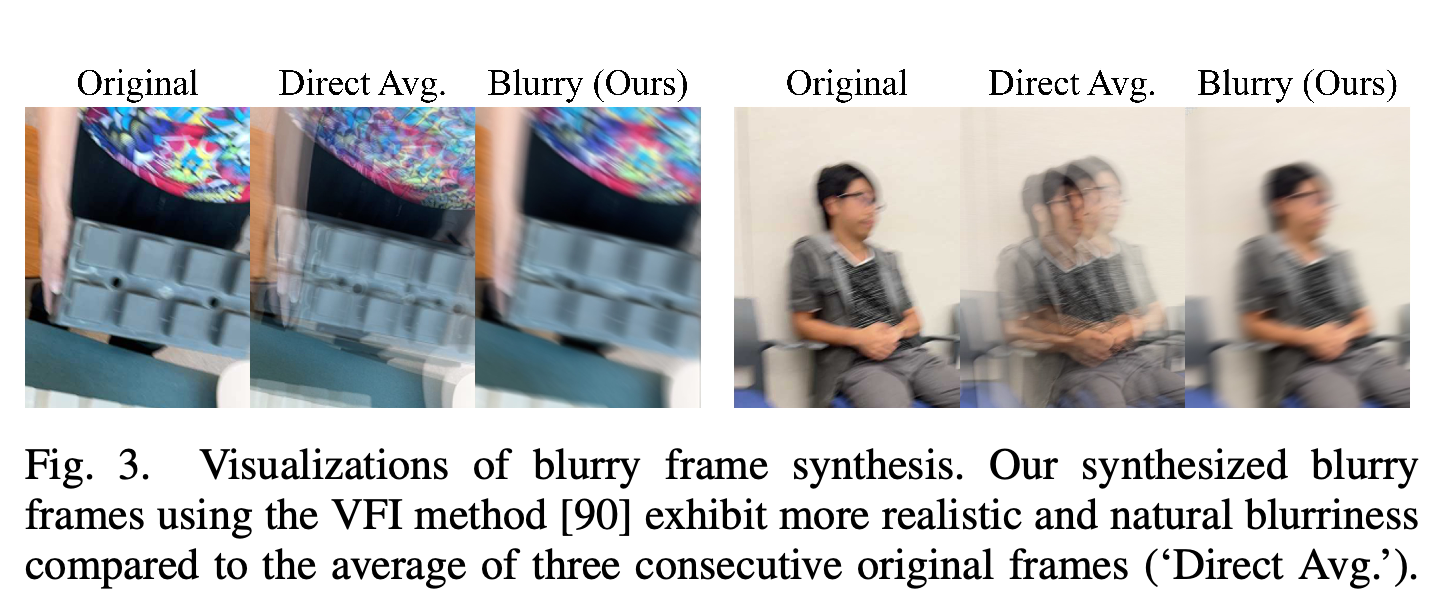
- Figure 3은 이 합성 방식을 원본의 연속 프레임 3개를 직접 평균하는 방식과 비교한다.
프레임을 직접 평균하면 움직이는 대상의 모습이 분리되어 남지만, 보간 후 평균하면 더 부드러운 움직임의 잔상이 생긴다. 이 사례들은 합성 방식의 선택을 뒷받침하지만 실제 카메라 노출과의 동등성을 입증하지는 않는다.
2) Stereo Blur Dataset: 장면 6개에 대해 흐릿한 왼쪽 시점 비디오와 이에 대응하는 선명한 오른쪽 시점 비디오를 제공한다. 원본 비디오는 60 fps로 촬영했으며, 480 fps로 보간한 뒤 평균하여 블러를 생성한다. 실험에서는 장면마다 24프레임을 추출하고, 카메라 복원 시스템 COLMAP으로 카메라 매개변수를 추정한다.
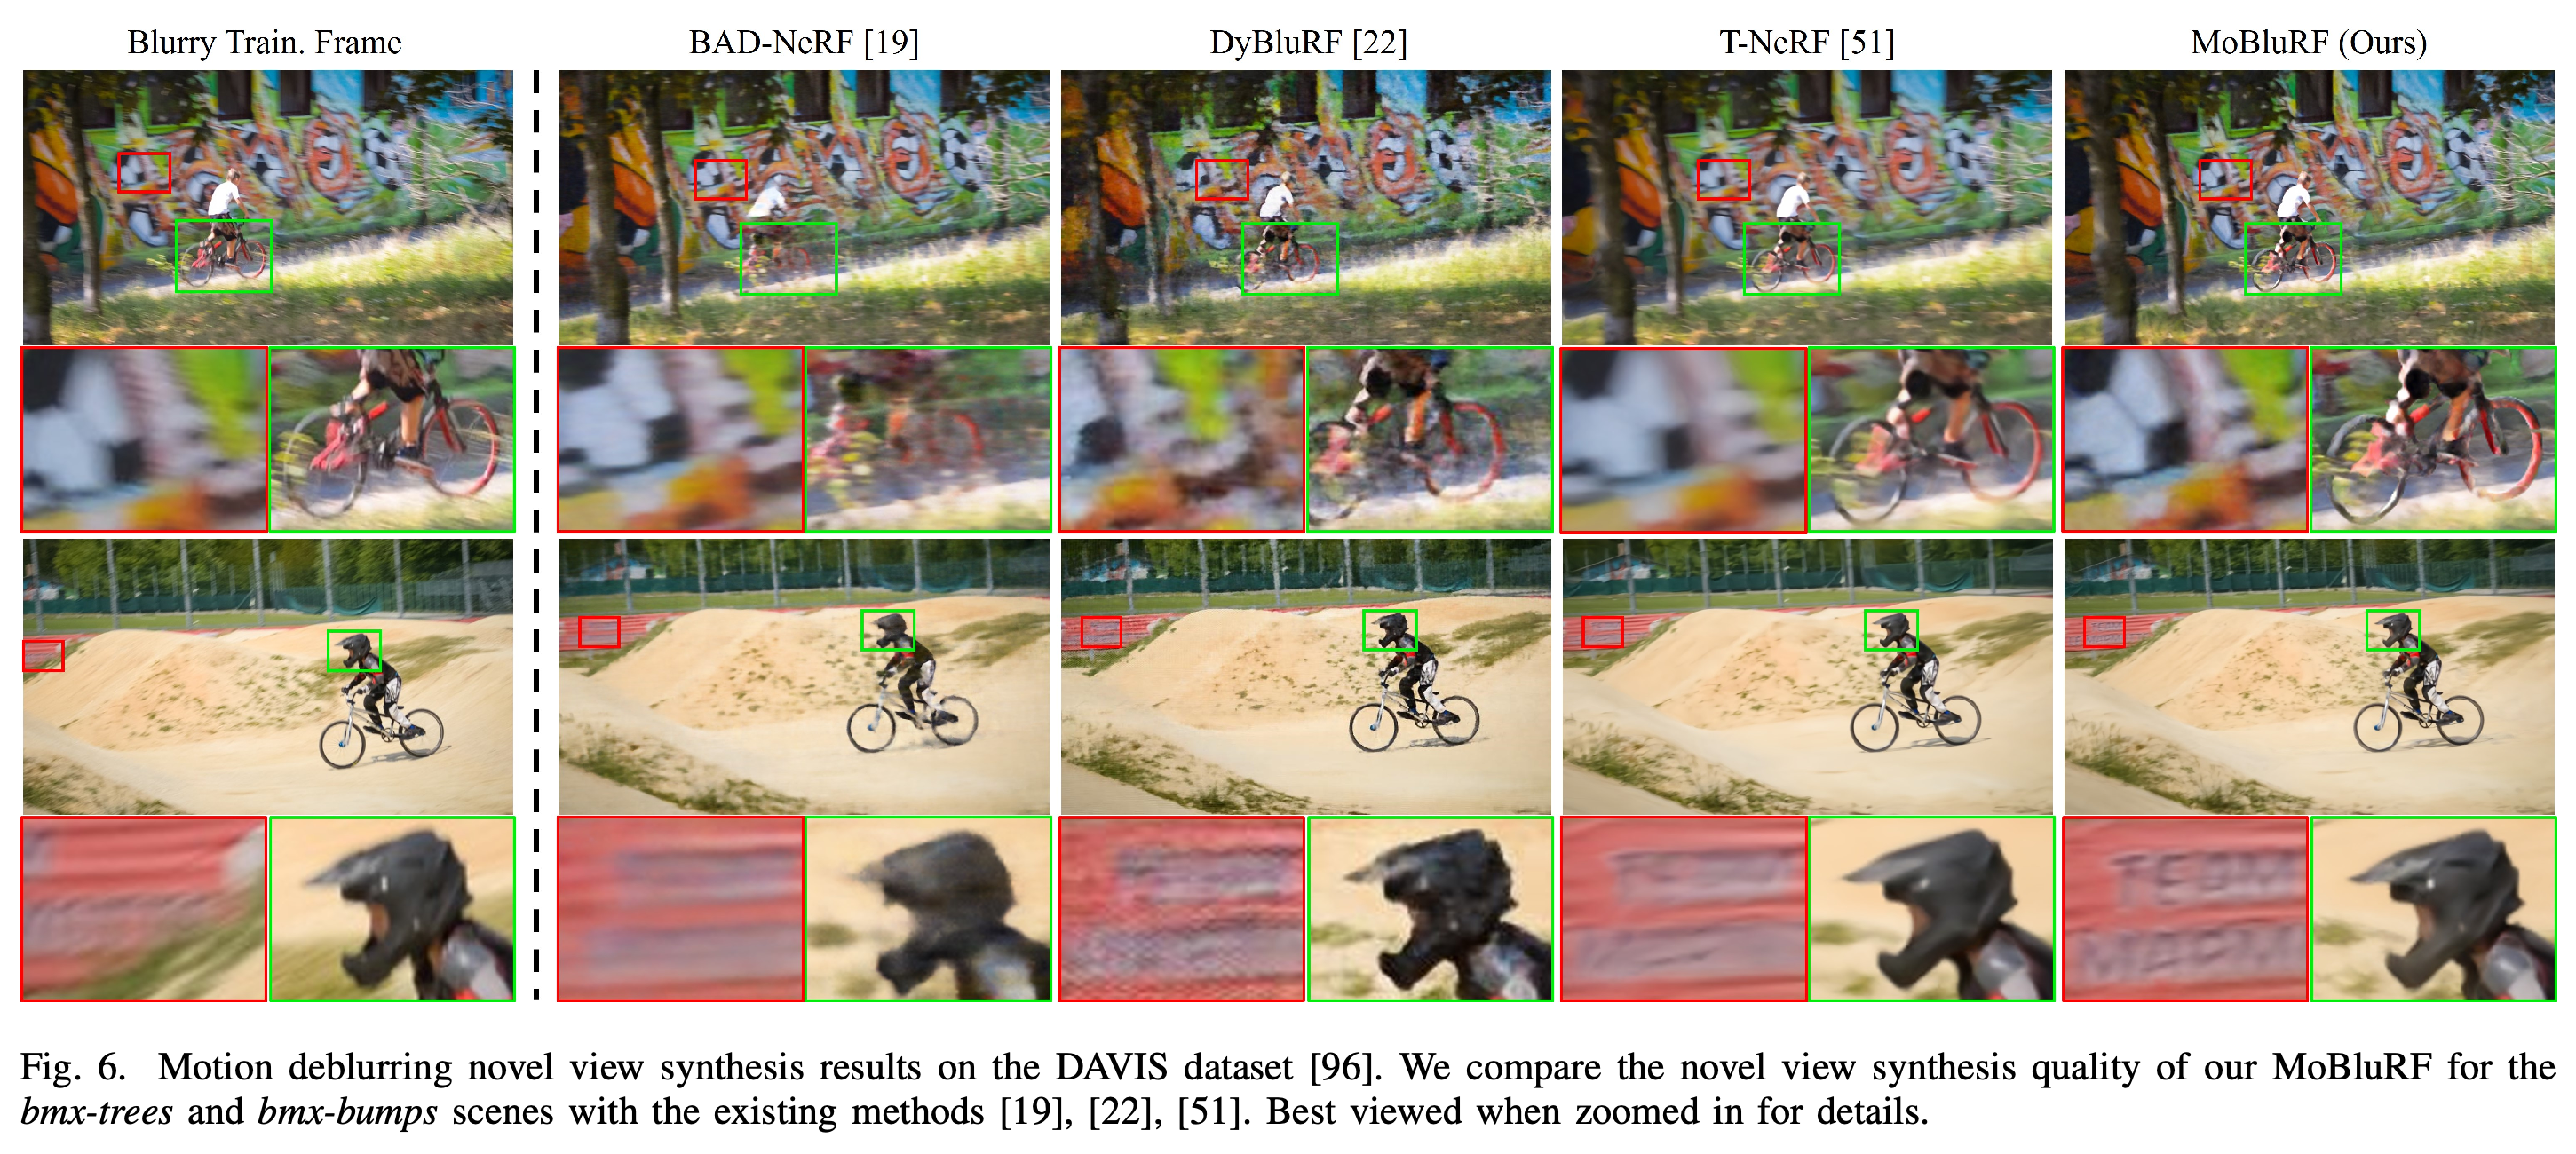
3) DAVIS Dataset: 장면당 평균 69.7프레임인 실제 환경의 단안 시퀀스로 실제 모션 블러에 대한 정성 평가를 수행한다. 이 조건에서는 COLMAP이 적절한 포즈를 산출하지 못하므로 참고문헌 [69]의 전략으로 카메라 매개변수를 구한다. 평가에는 Blurry iPhone의 마스킹된 이미지 지표, Stereo Blur의 마스킹하지 않은 이미지 지표, 복원 프레임 간 일관성을 측정하는 시간적 optical-flow 지표인 tOF를 사용한다.
- 마스킹된 지표는 학습 중 관측하지 못한 테스트 영역을 제외한다. mPSNR은 peak signal-to-noise ratio, mSSIM은 structural similarity, mLPIPS는 learned perceptual image patch similarity를 측정한다.
- PSNR과 SSIM은 높을수록 좋고, LPIPS와 tOF는 낮을수록 좋다.
- 이 PDF에서 DAVIS에 대한 근거는 정량 벤치마크 표가 아니라 시각적 비교다.
A. Experimental Results
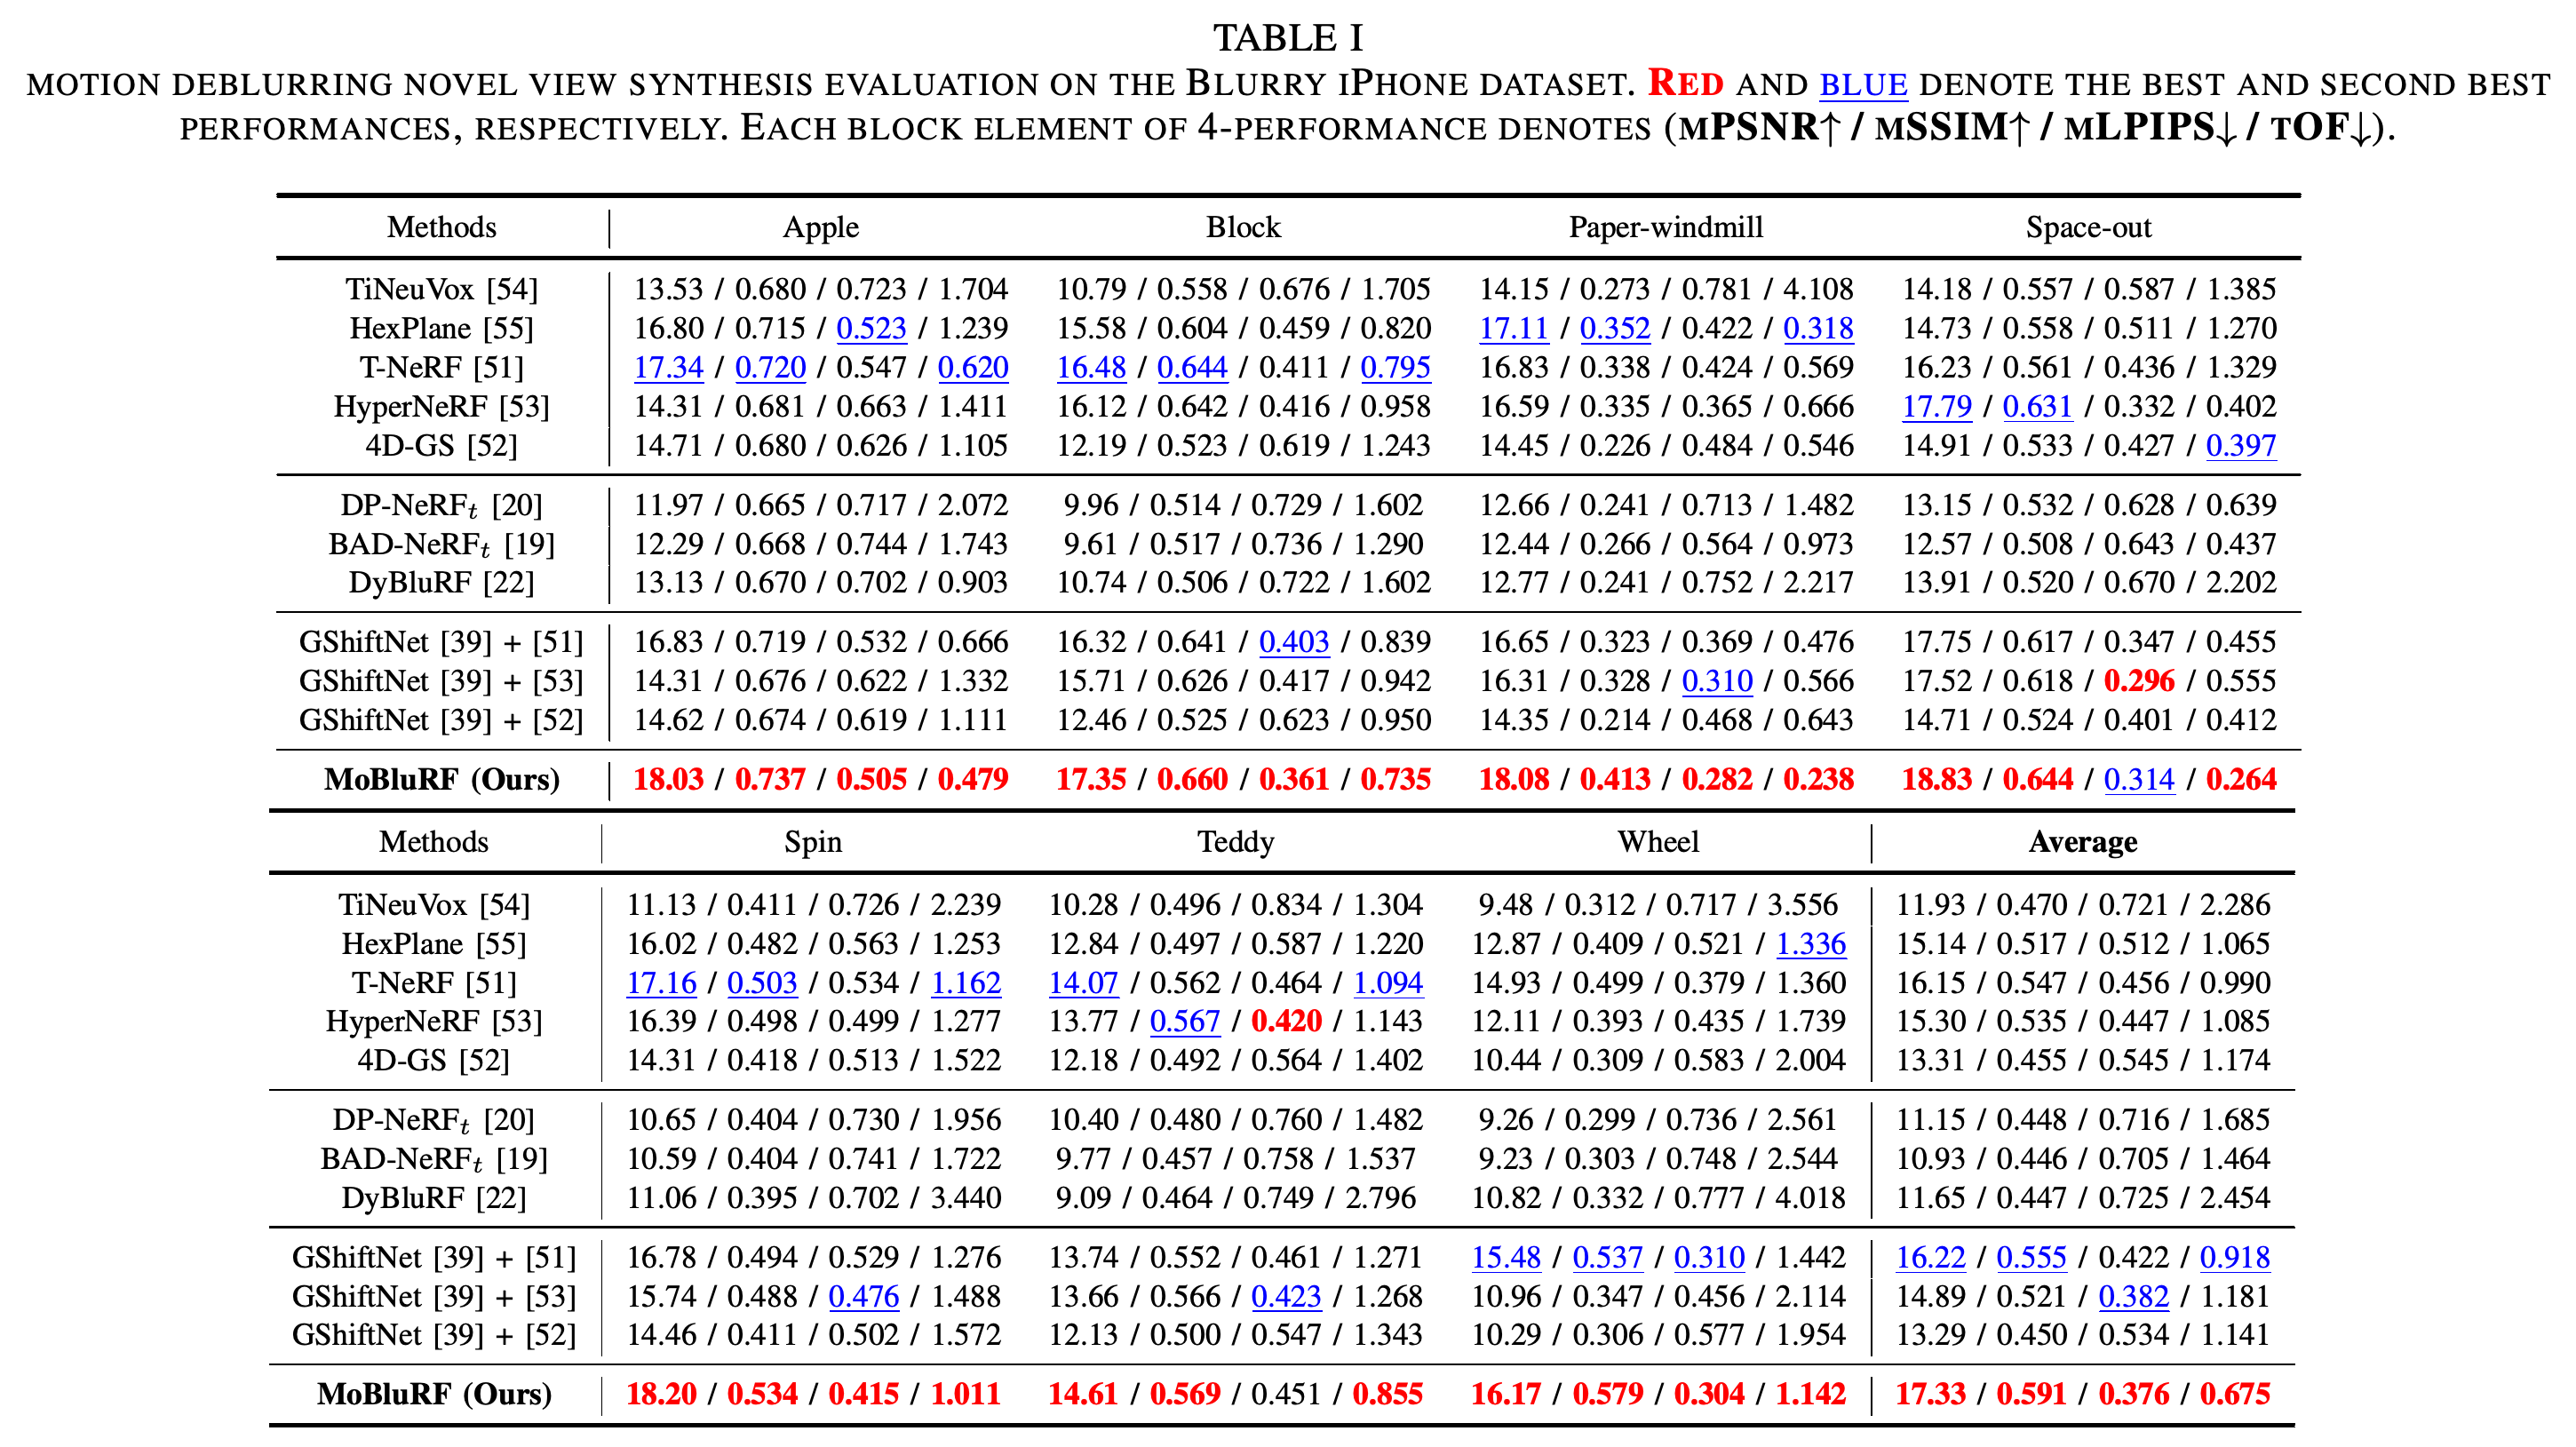
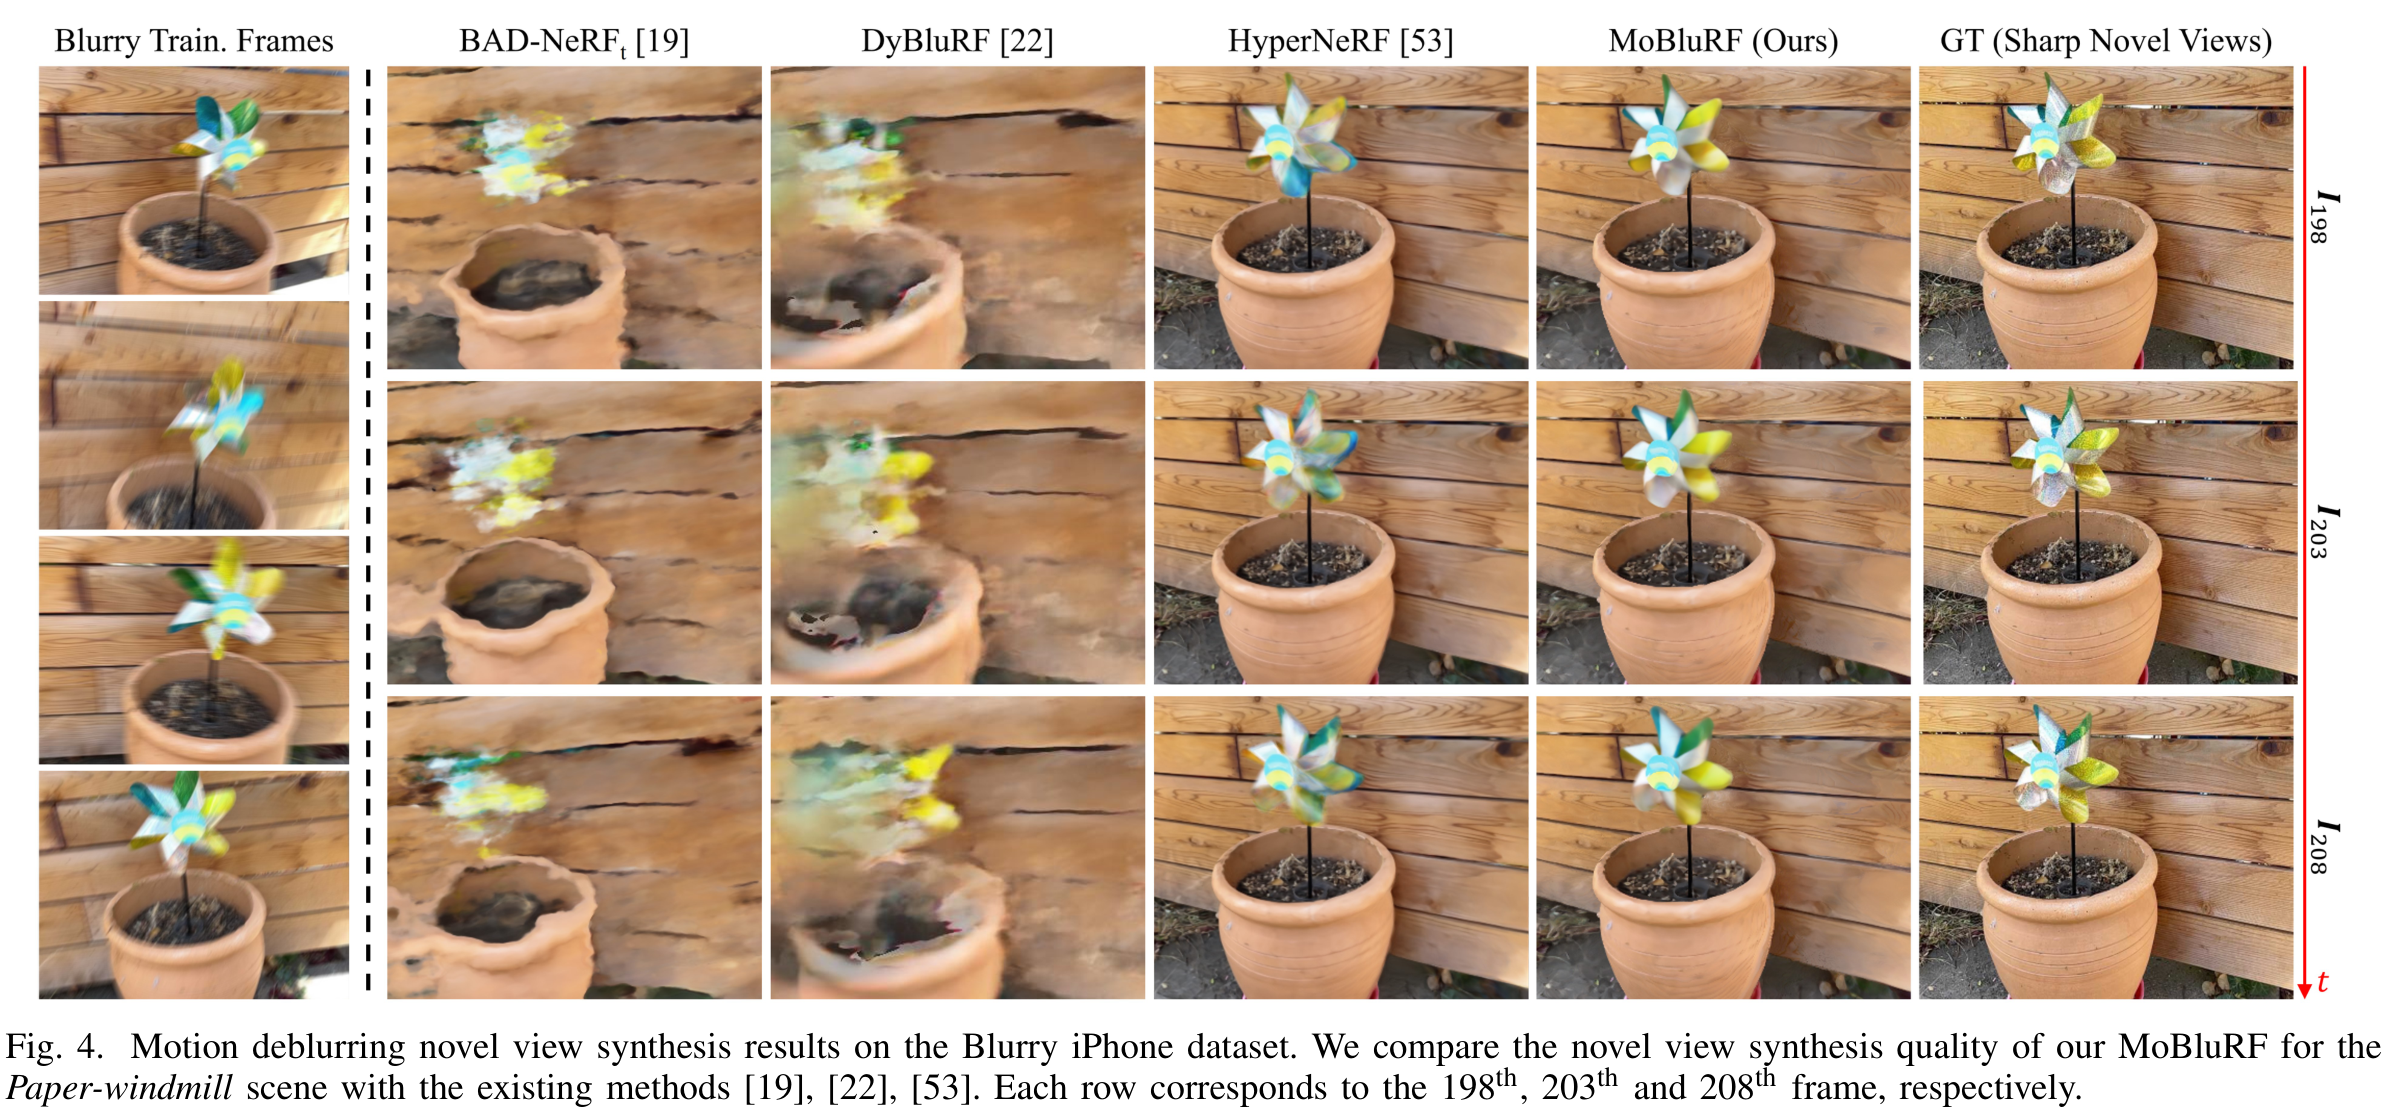
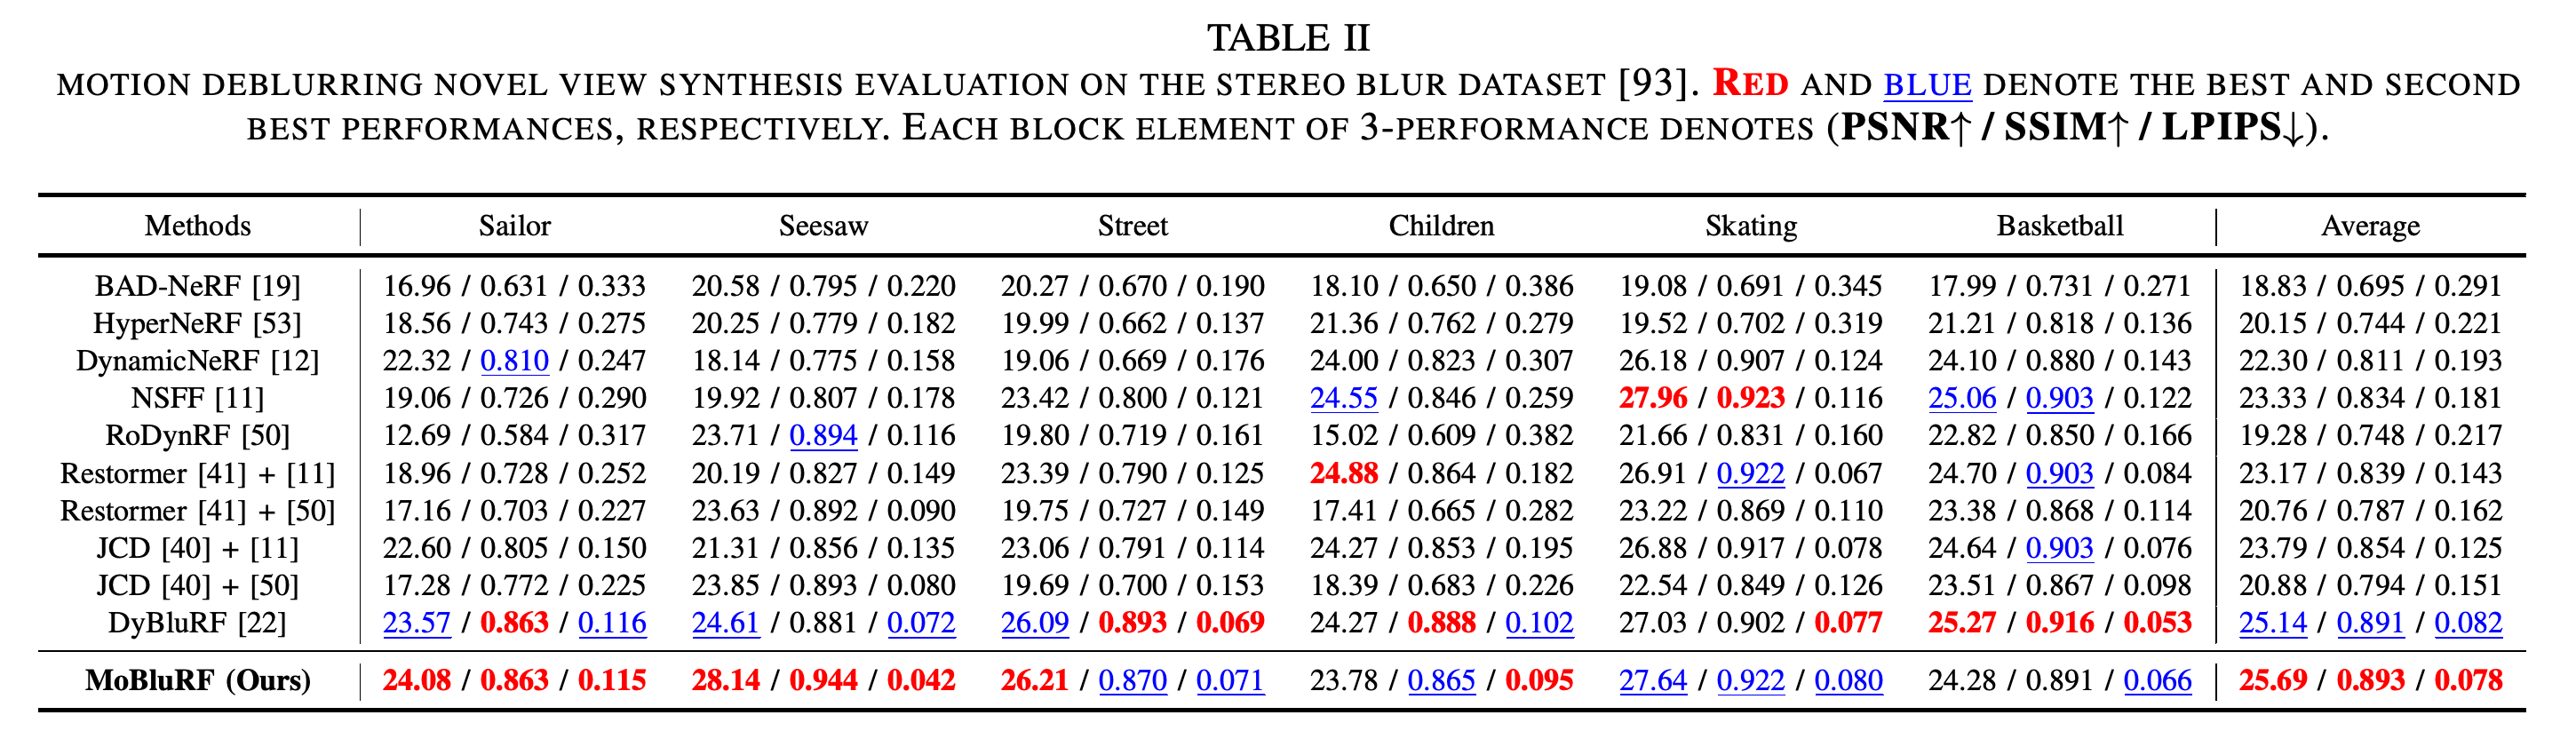
1) Motion Deblurring Novel View Synthesis: Table I에서 Blurry iPhone의 평균 mPSNR / mSSIM / mLPIPS / tOF는 17.33 / 0.591 / 0.376 / 0.675로, 제시된 방법 중 모든 평균 지표가 가장 좋다. Table II에서 Stereo Blur의 평균 PSNR / SSIM / LPIPS는 25.69 / 0.893 / 0.078이며, DyBluRF는 25.14 / 0.891 / 0.082다.
- Blurry iPhone 비교에서는 정적 디블러링 베이스라인 BAD-NeRF와 DP-NeRF에 시간 임베딩을 추가하여 BAD-NeRFt와 DP-NeRFt로 사용한다.
- GShiftNet 전처리 파이프라인에는 합성한 부정확한 포즈 대신 원본 카메라 포즈를 사용한다. GShiftNet + T-NeRF는 16.22 / 0.555 / 0.422 / 0.918을 기록하며, 경쟁 방법 중 평균 mPSNR, mSSIM, tOF가 가장 좋다. 경쟁 방법 중 평균 mLPIPS는 GShiftNet + HyperNeRF가 0.382로 가장 좋다.
- 데이터셋 평균이 가장 좋다고 모든 장면에서 가장 좋은 것은 아니다. Stereo Blur에서 MoBluRF는 Children의 PSNR과 SSIM, Basketball의 PSNR, SSIM, LPIPS에서 DyBluRF보다 낮은 성능을 보인다.
MoBluRF는 데이터셋 평균 지표 4개 모두에서 17.33 / 0.591 / 0.376 / 0.675로 가장 좋은 결과를 보인다. 개별 장면에는 예외가 있으며, Space-out에서는 GShiftNet + HyperNeRF가, Teddy에서는 HyperNeRF가 더 좋은 지각적 거리를 기록한다.
회전하는 바람개비를 통해 정적인 화분 및 나무 배경과 함께 전경의 복원 품질을 확인한다. MoBluRF는 제시된 3개 시간에서 날개 경계를 더 선명하게 보존하고 주변 기하 구조를 더 일관되게 복원한다.
DyBluRF와 비교하면 평균 PSNR은 25.14에서 25.69로, SSIM은 0.891에서 0.893으로 높아지고, LPIPS는 0.082에서 0.078로 낮아진다. 개선 폭은 장면마다 다르다. Seesaw에서는 PSNR이 크게 향상되지만 Children과 Basketball에서는 PSNR이 낮아진다.
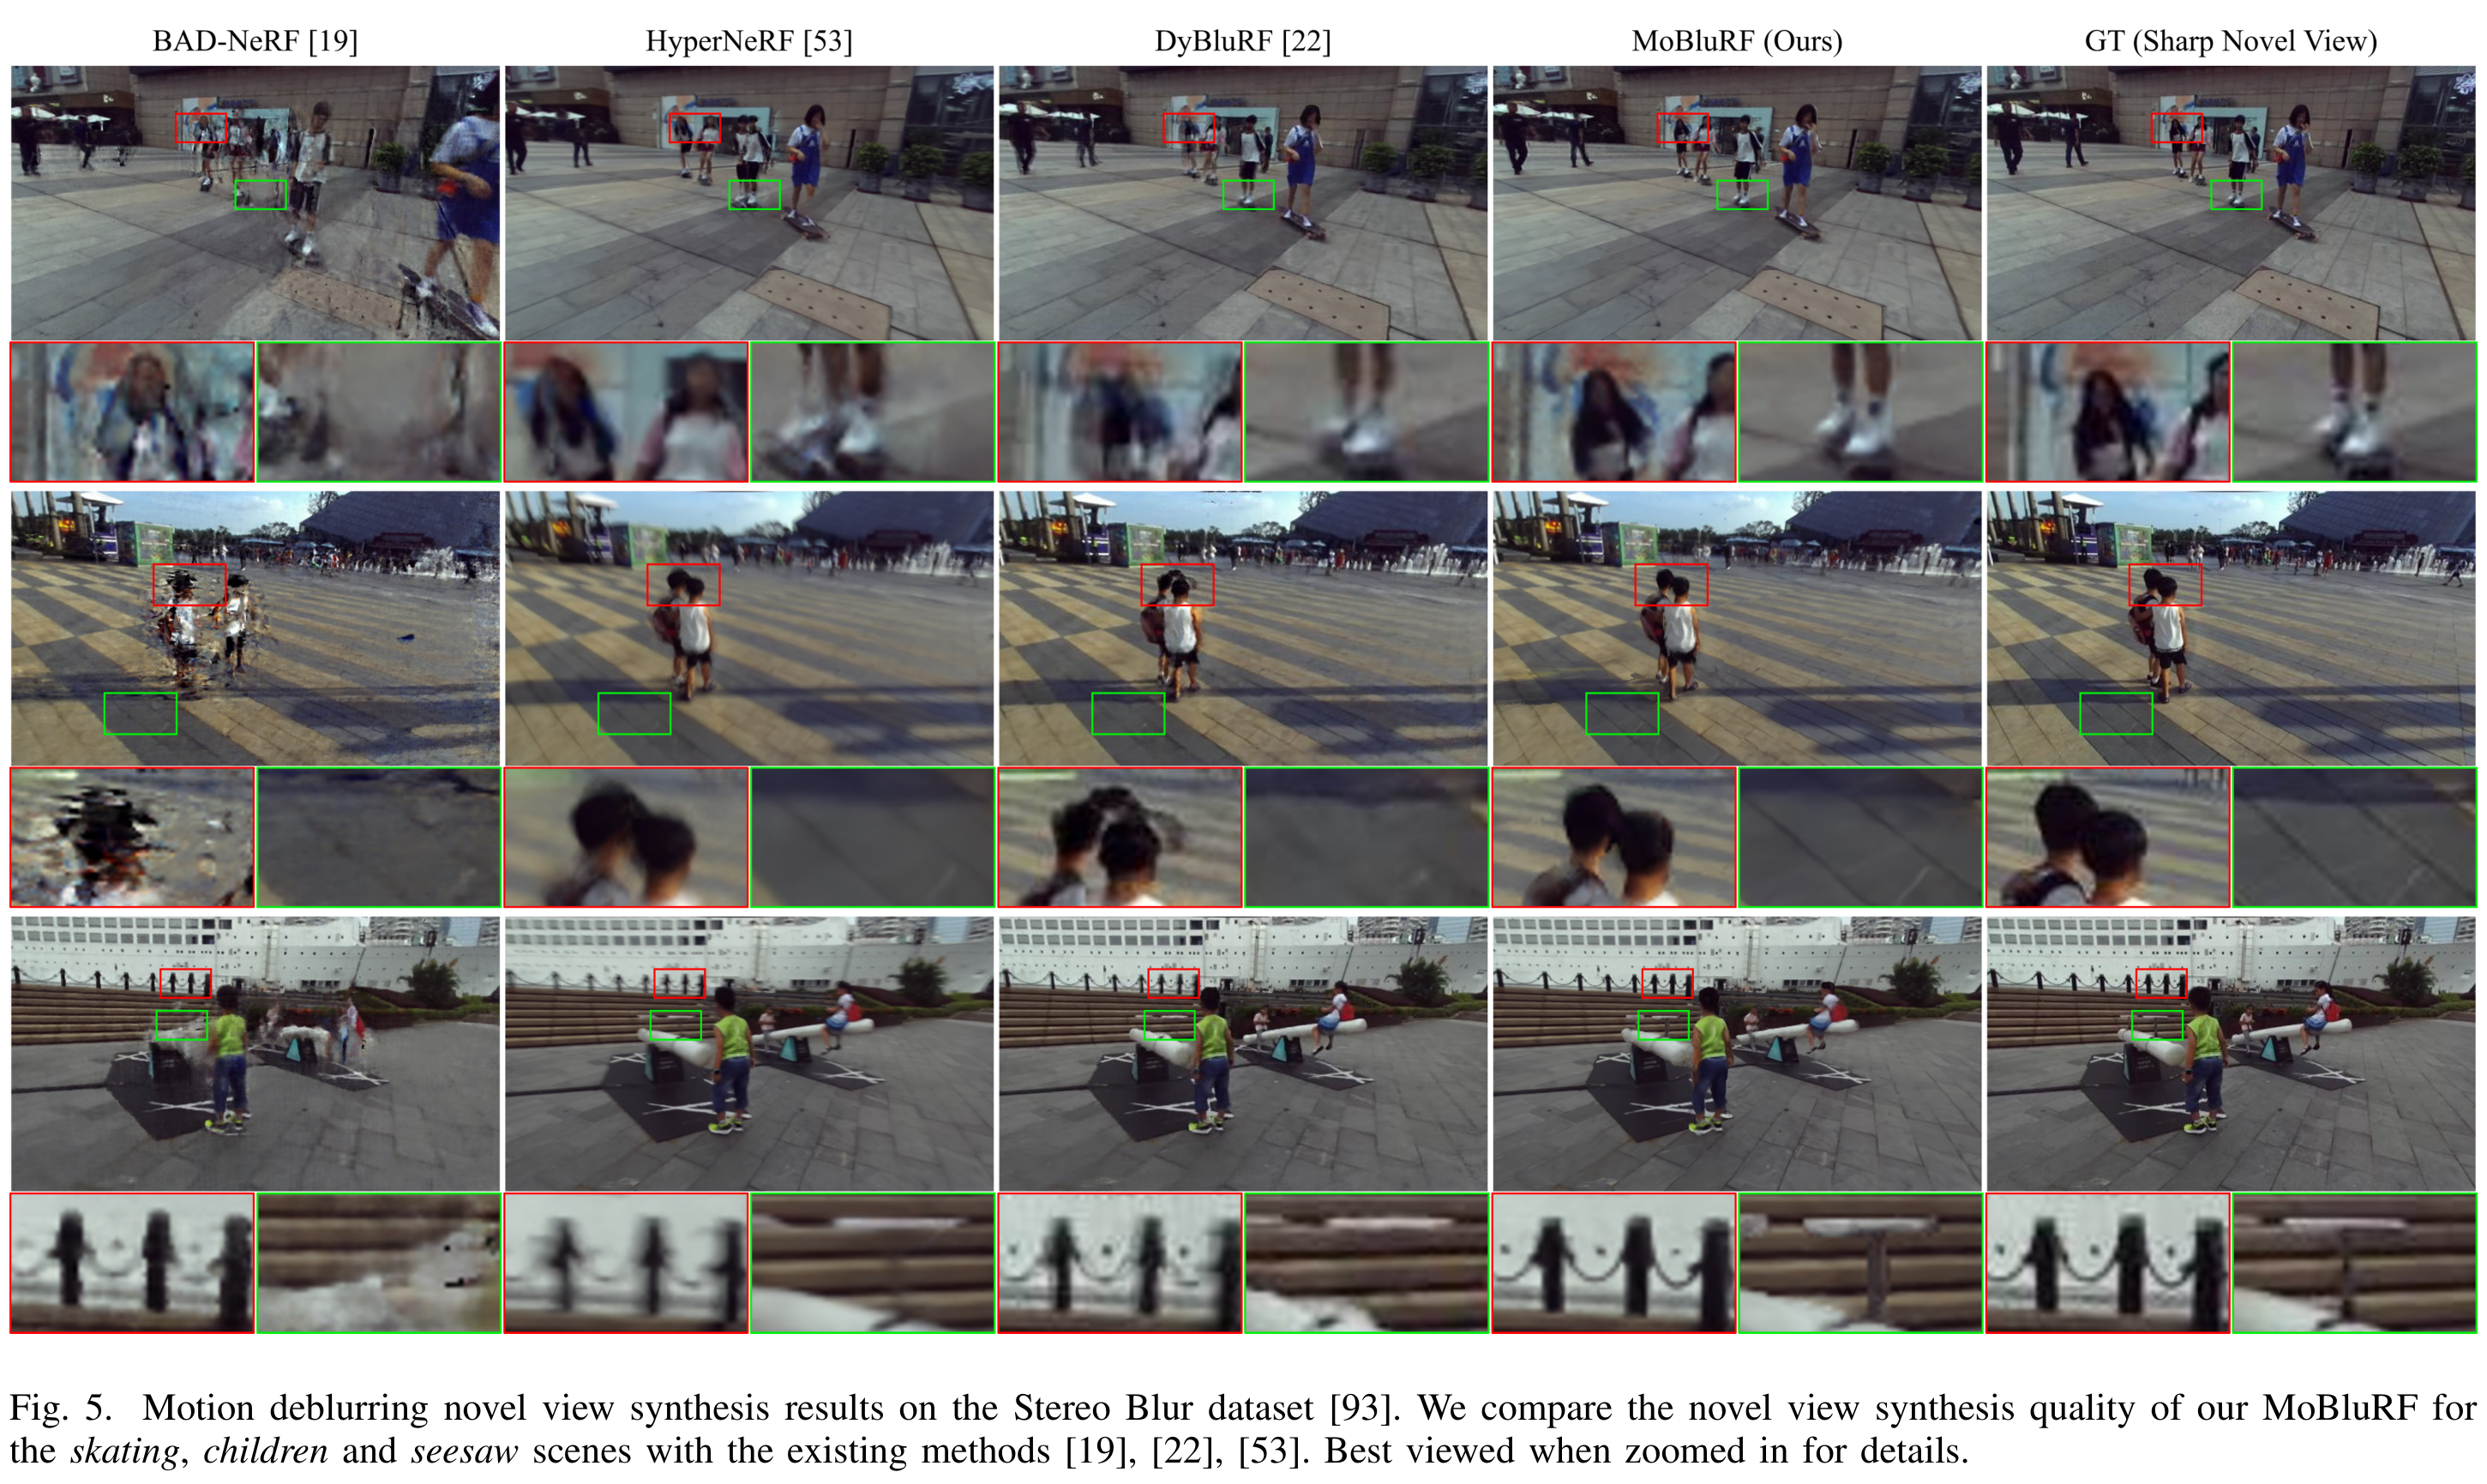
확대한 인물 및 배경 영역을 통해 전경 디블러링과 정적 장면 복원 품질을 구분하여 살펴볼 수 있다. MoBluRF는 제시된 여러 확대 영역에서 더 선명한 세부 묘사를 보여 평균 지표를 보완하지만, 모든 장면에서의 우위를 입증하지는 않는다.
자전거 시퀀스는 시각적 평가를 자연적으로 흐려진 비디오로 확장한다. MoBluRF의 출력에서 헬멧과 자전거의 세부 구조가 더 선명하게 보이지만, 이 비교에는 정량 평가에 필요한 선명한 새 시점의 참조 이미지가 없다.
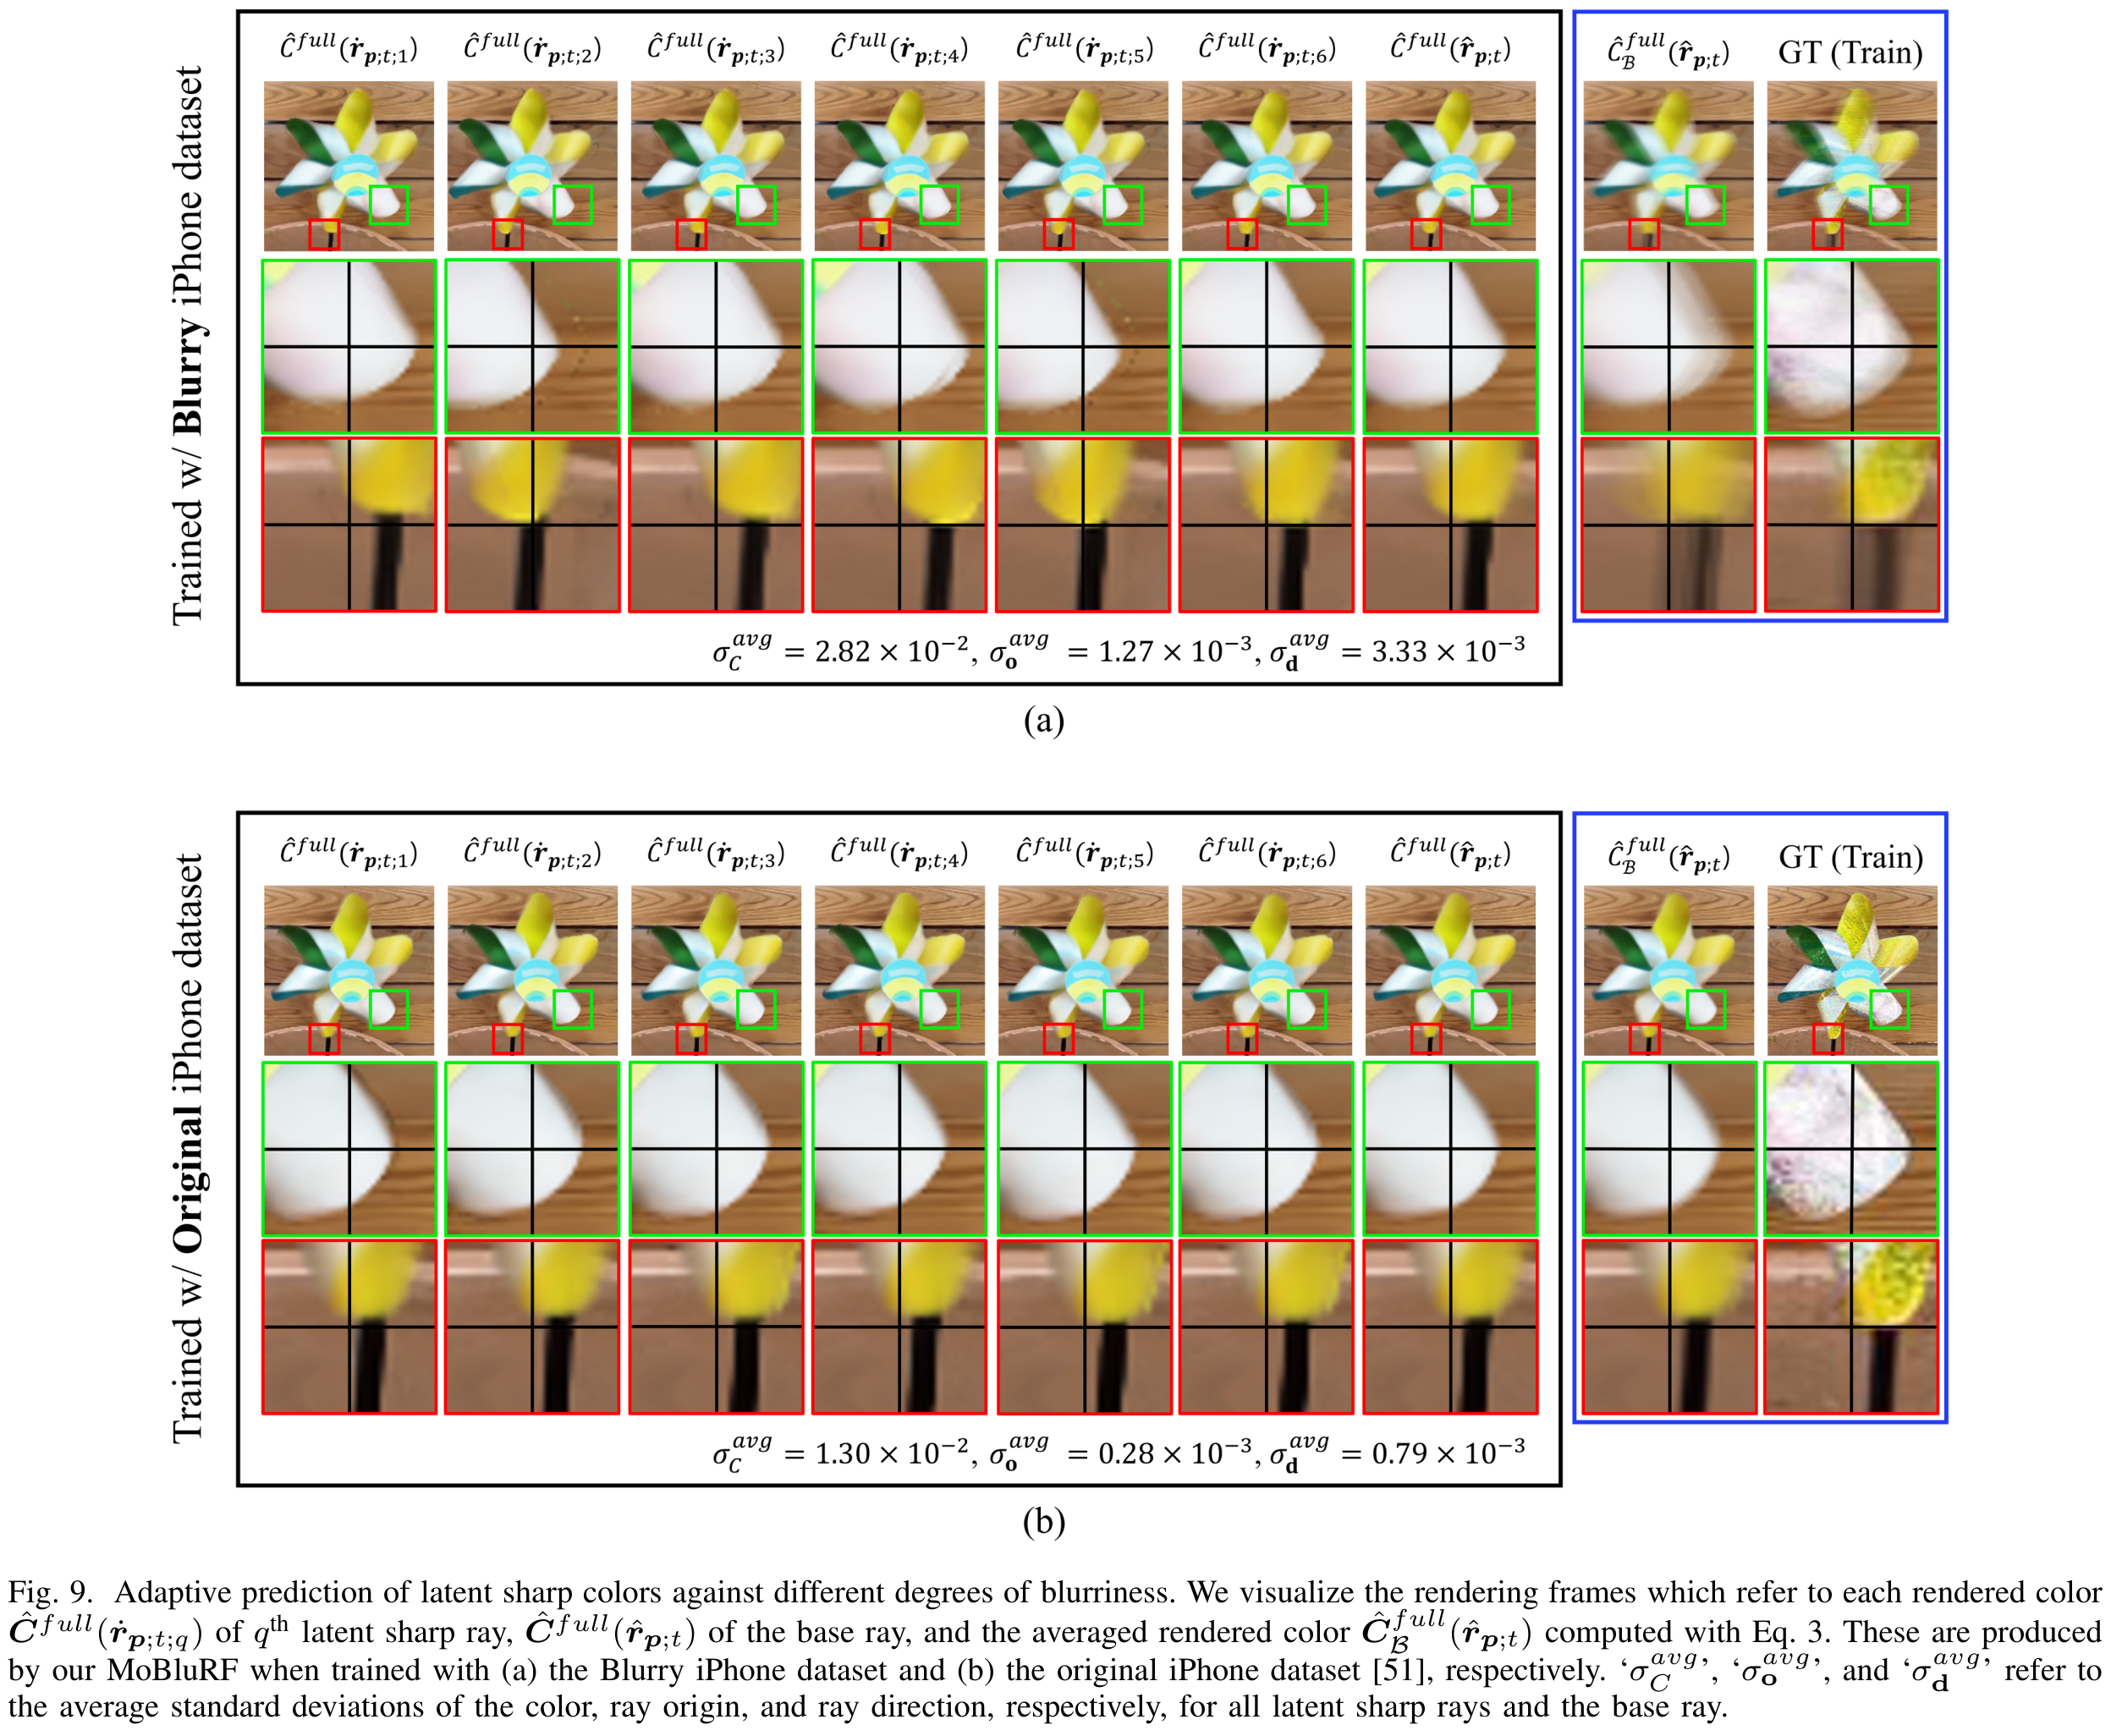
2) Robustness of MoBluRF for Different Degrees of Blurriness: 원본 iPhone 비디오 대신 합성한 흐릿한 비디오로 학습하면 MoBluRF의 평균 mPSNR은 17.37에서 17.33으로, mSSIM은 0.591에서 0.591로, mLPIPS는 0.373에서 0.376으로, tOF는 0.664에서 0.675로 변한다. 동일한 원본 대비 흐릿한 비디오 비교에서 T-NeRF와 HyperNeRF의 mPSNR은 각각 0.81과 1.51 감소한다.
- Figures 7과 8에서 MoBluRF는 학습 조건 2개 모두에서 비슷하게 선명한 복원을 보이는 반면, 제시된 베이스라인에는 더 많은 블러나 정렬 오류가 나타난다.
- Figure 9에서는 흐릿한 프레임으로 학습할 때 예측된 잠재 광선 간 변화가 더 크게 나타난다. 이는 블러 모델이 관측에 맞춰 광선의 기여를 조정한다는 설명과 부합한다.
- 이 실험은 데이터셋 조건 2개를 비교하며, 임의의 노출 시간이나 카메라 블러 과정 전반에 대한 강건성을 입증하지는 않는다.
원본 입력과 합성한 흐릿한 입력에서 MoBluRF의 결과가 거의 달라지지 않는다는 점은 이 학습 조건 비교 안에서의 강건성을 뒷받침한다. HyperNeRF와 T-NeRF는 더 크게 저하되며, DyBluRF는 조건 2개 모두에서 성능이 낮다.
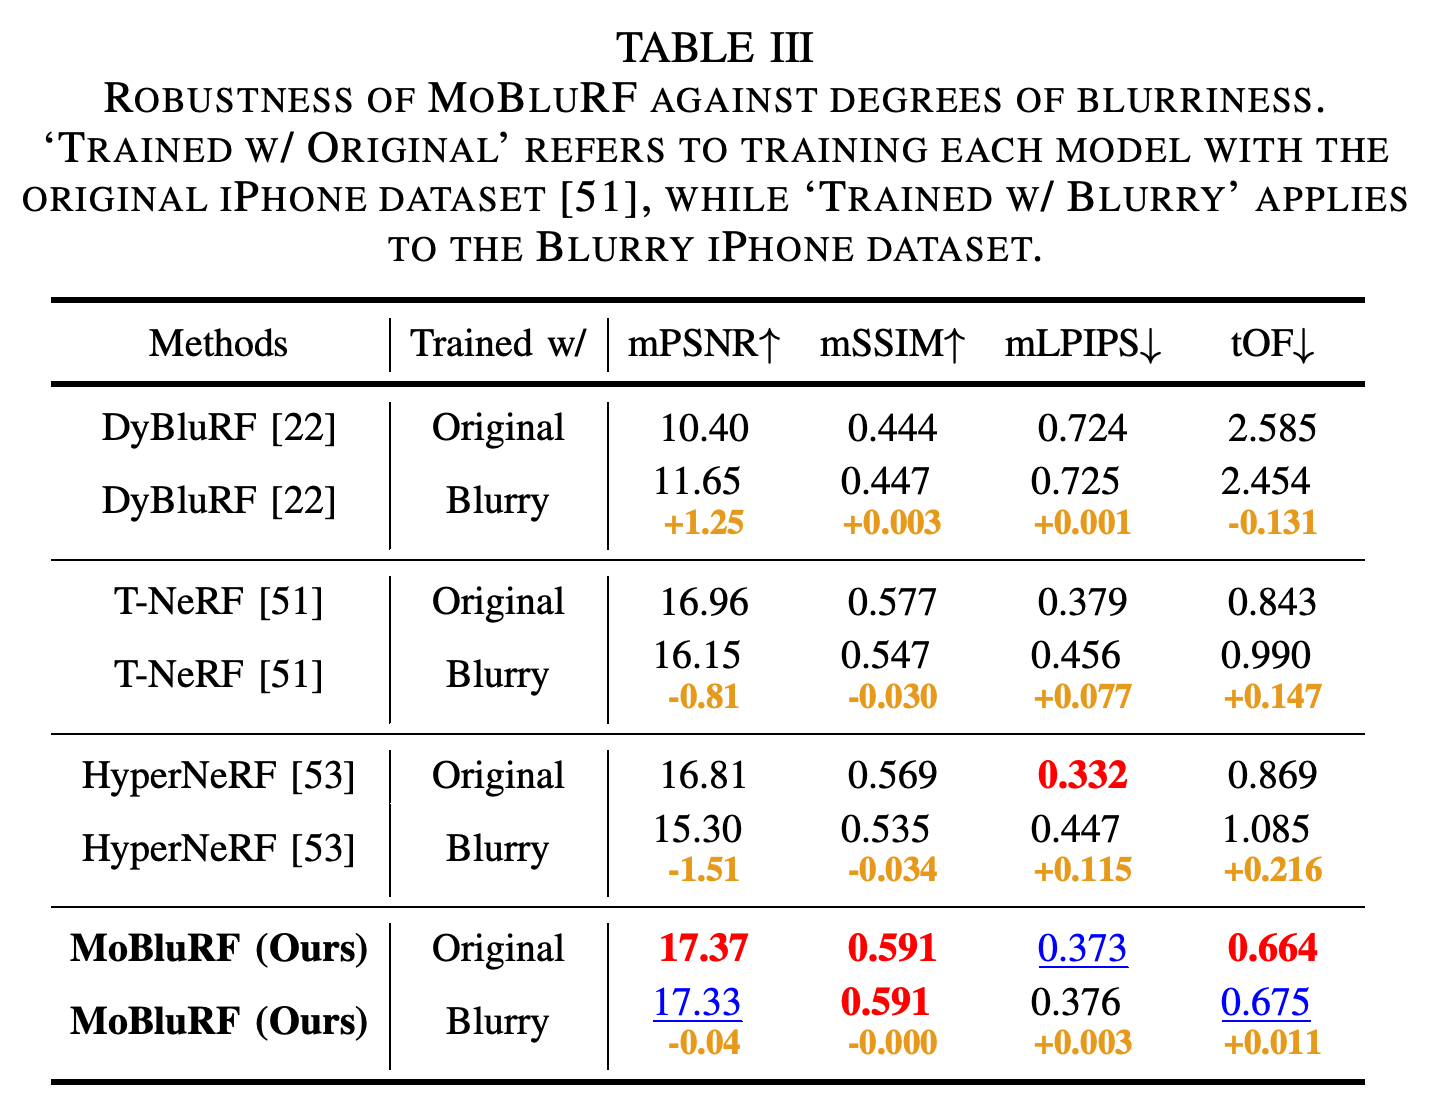
MoBluRF는 Apple과 Spin에서 학습 조건 2개 모두 비슷한 물체 구조를 유지한다. 선택된 사례에서 HyperNeRF는 블러가 더 심하고, DyBluRF는 더 심각한 복원 실패를 보인다.
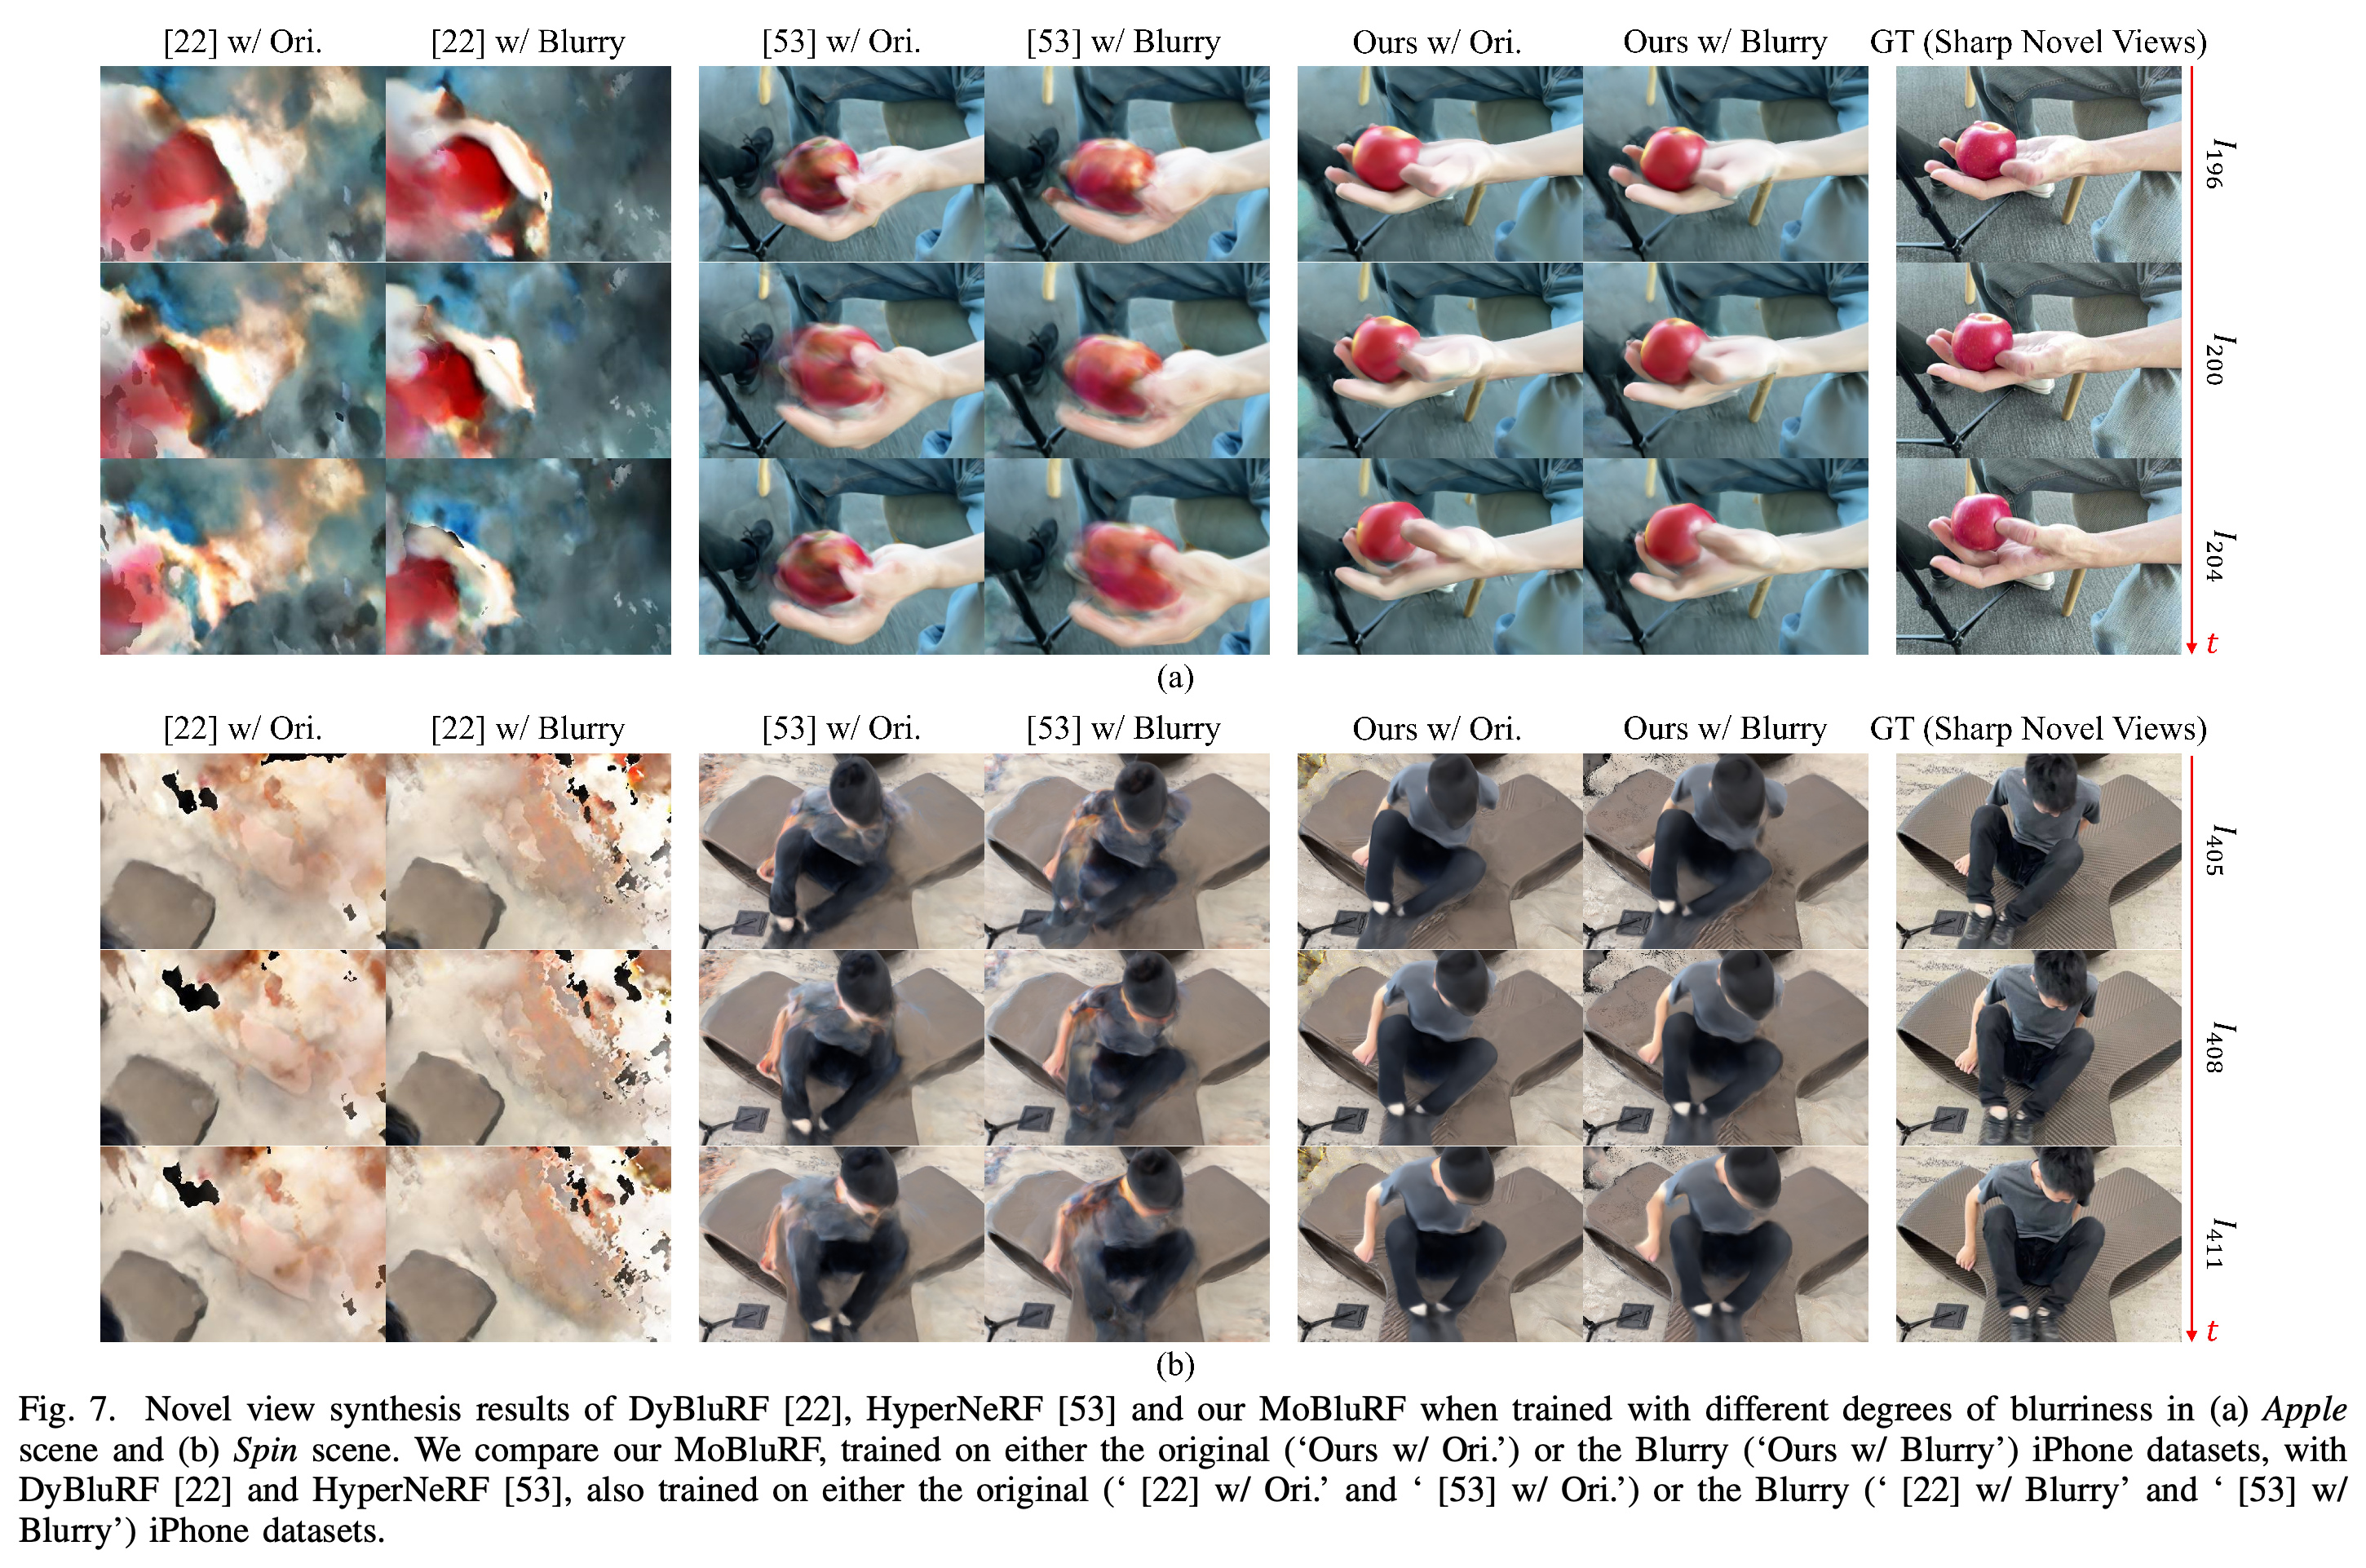
이 비교는 선명한 기준 광선 렌더링과 흐릿한 관측을 설명하기 위한 평균 렌더링을 구분한다. 이들의 외관 차이는 학습 과정이 더 선명한 내부 장면을 유지하면서도 블러를 재현할 수 있음을 보여준다.
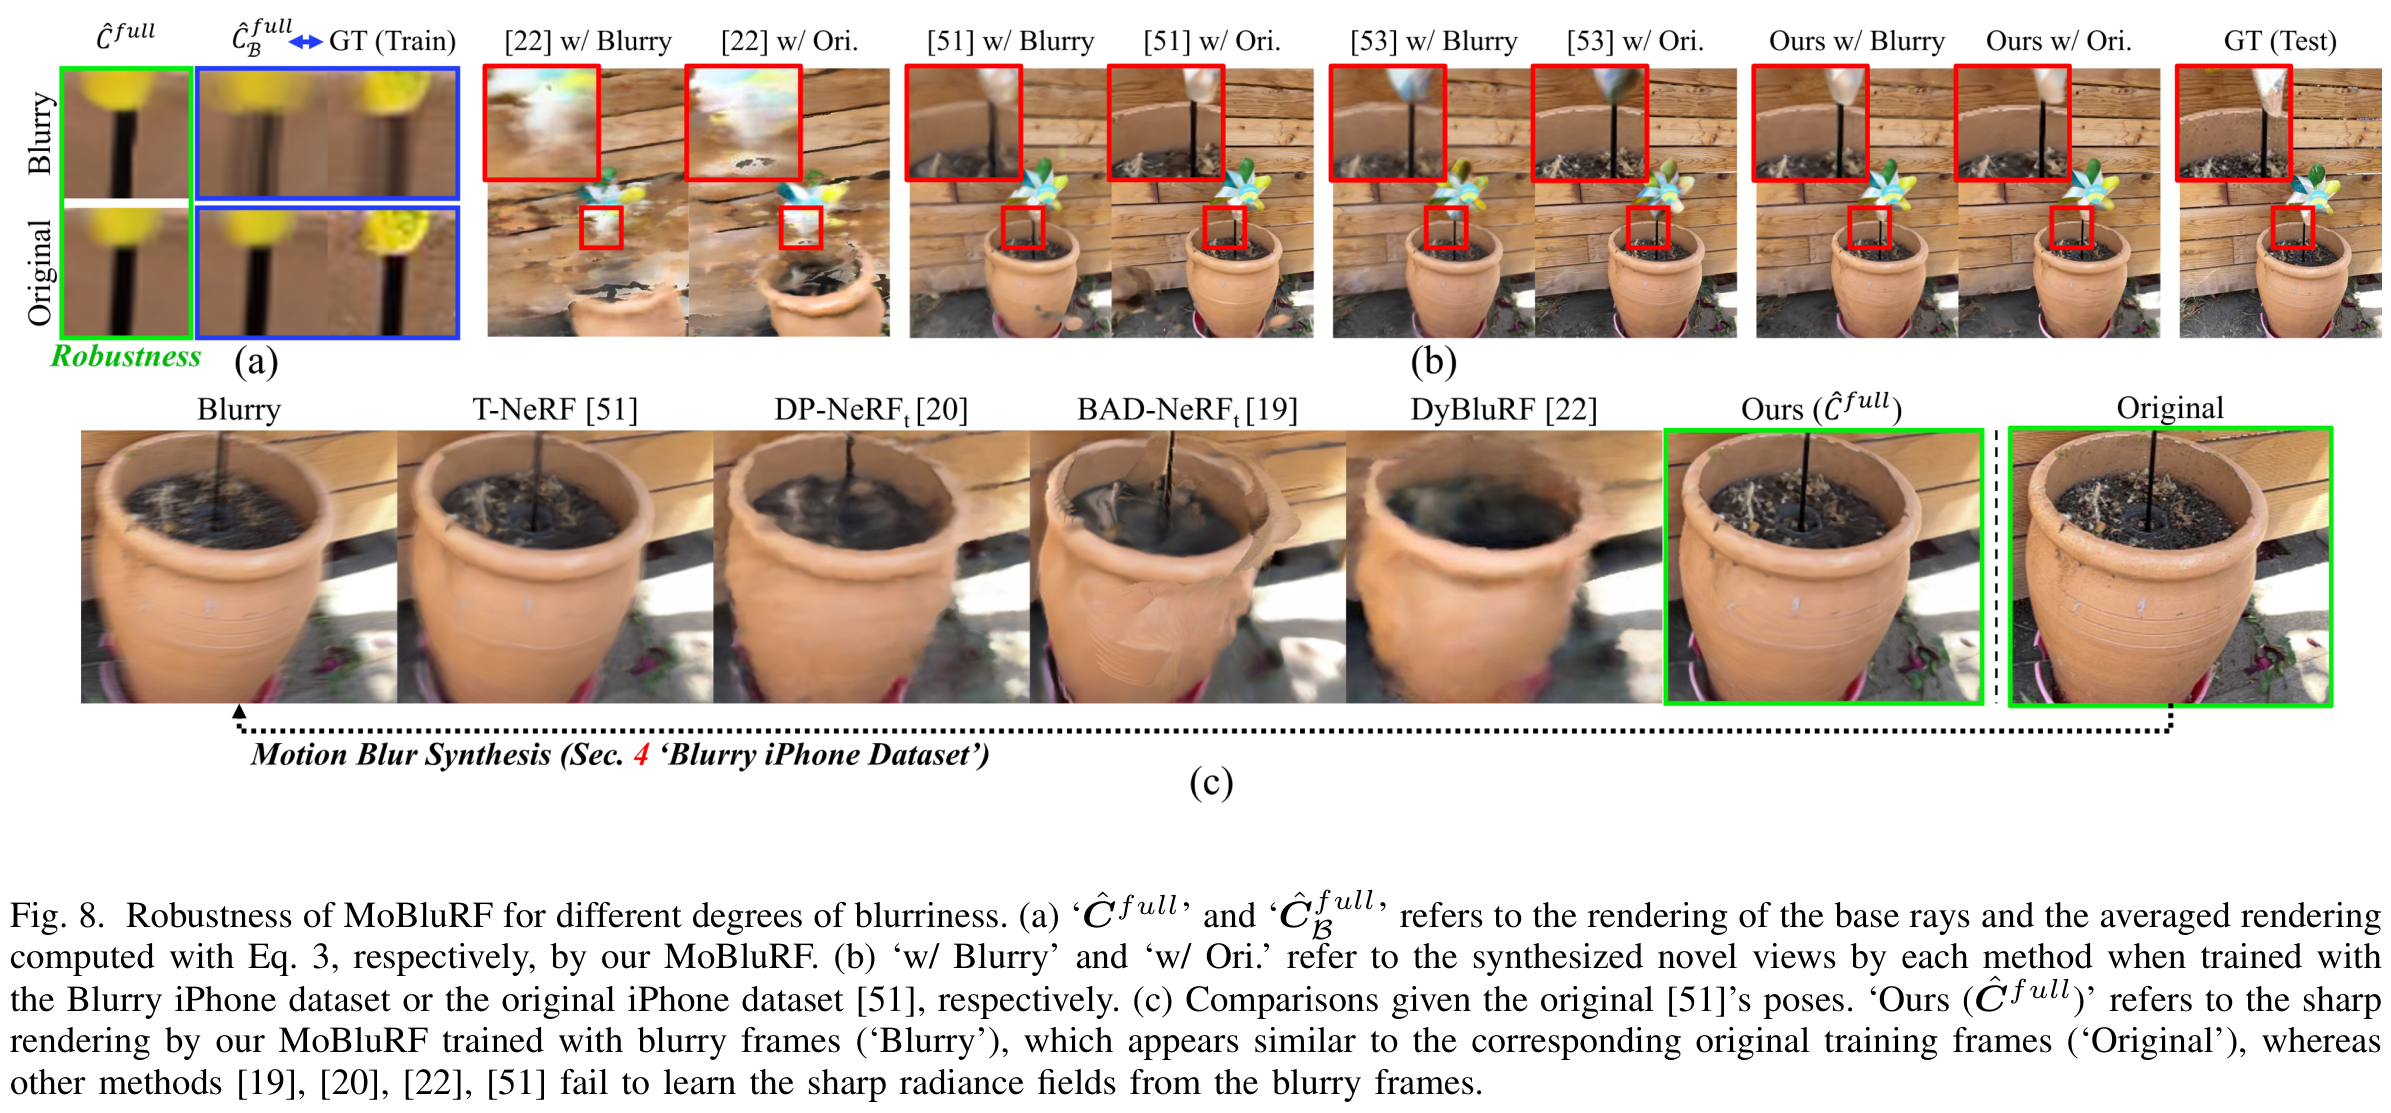
예측된 광선의 렌더링은 원본으로 학습할 때보다 흐릿한 영상으로 학습할 때 서로 더 크게 달라진다. 평균 색상 표준편차는 각각 2.82 × 10^-2와 1.30 × 10^-2다. 이는 흐릿한 관측을 설명하기 위해 더 다양한 광선의 기여를 사용한다는 설명과 부합한다.
B. Ablation Study on Blurry iPhone dataset
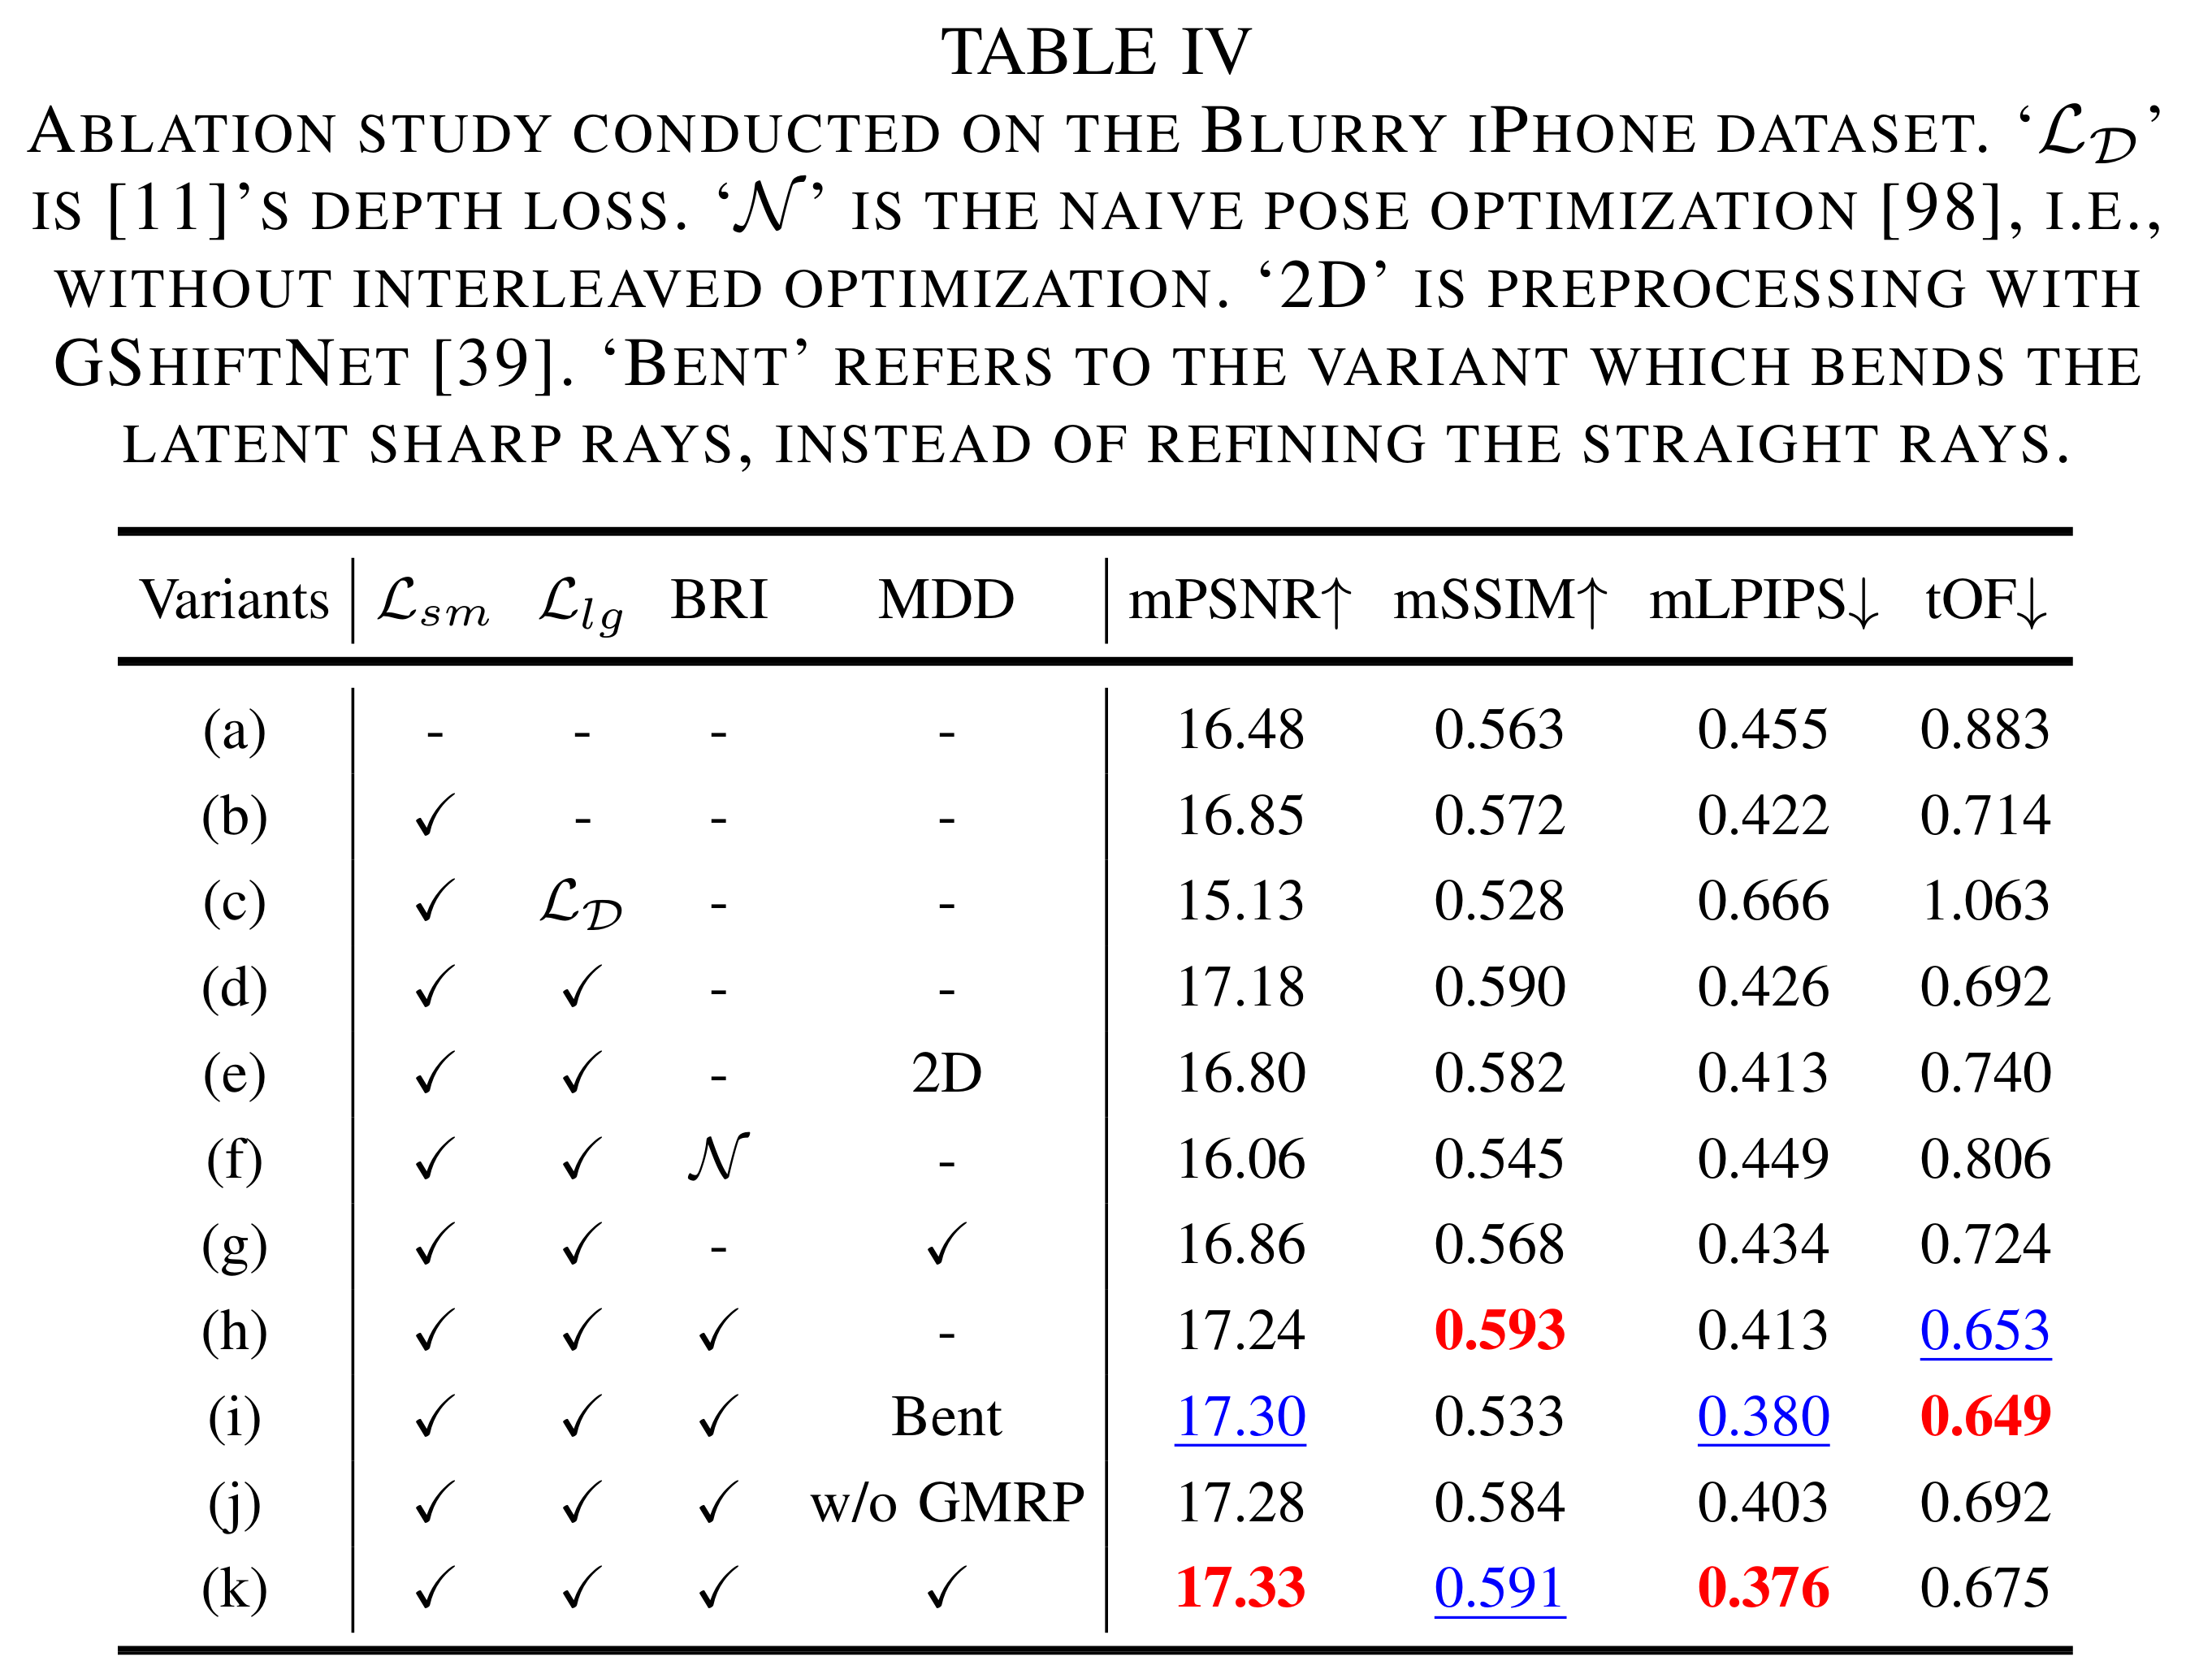
Table IV는 손실 함수와 학습 단계의 영향을 분리하여 비교한다. 정적성 손실을 추가하면 베이스라인의 mPSNR / mSSIM / mLPIPS / tOF가 16.48 / 0.563 / 0.455 / 0.883에서 16.85 / 0.572 / 0.422 / 0.714로 변한다. 여기에 제안한 기하 손실을 추가하면 17.18 / 0.590 / 0.426 / 0.692가 되어 지표 3개가 개선되지만 지각적 거리는 약간 나빠진다.
- 기하 정규화를 인용된 깊이 손실로 대체하면 15.13 / 0.528 / 0.666 / 1.063을 기록하므로, 이 평가 조건에서는 제안한 정규화 기법이 더 효과적이다.
- BRI만 사용한 변형은 17.24 / 0.593 / 0.413 / 0.653을 기록한다. MDD를 추가하면 17.33 / 0.591 / 0.376 / 0.675가 되어 지각적 거리는 개선되지만 구조적 유사도와 시간적 일관성은 약간 나빠진다.
- BRI 없이 MDD를 사용하면 mPSNR 16.86과 mLPIPS 0.434를 기록하며, 교차 갱신 없이 단순하게 포즈를 최적화하면 mPSNR 16.06을 기록한다. 이 방법 2개는 모두 전체 단계별 절차보다 성능이 낮다.
전체 모델은 mPSNR과 mLPIPS가 가장 좋지만, BRI만 사용한 변형은 mSSIM이 더 높고 tOF가 더 낮다. 단순한 포즈 최적화와 BRI 없는 MDD는 전체 단계별 절차보다 성능이 낮다.
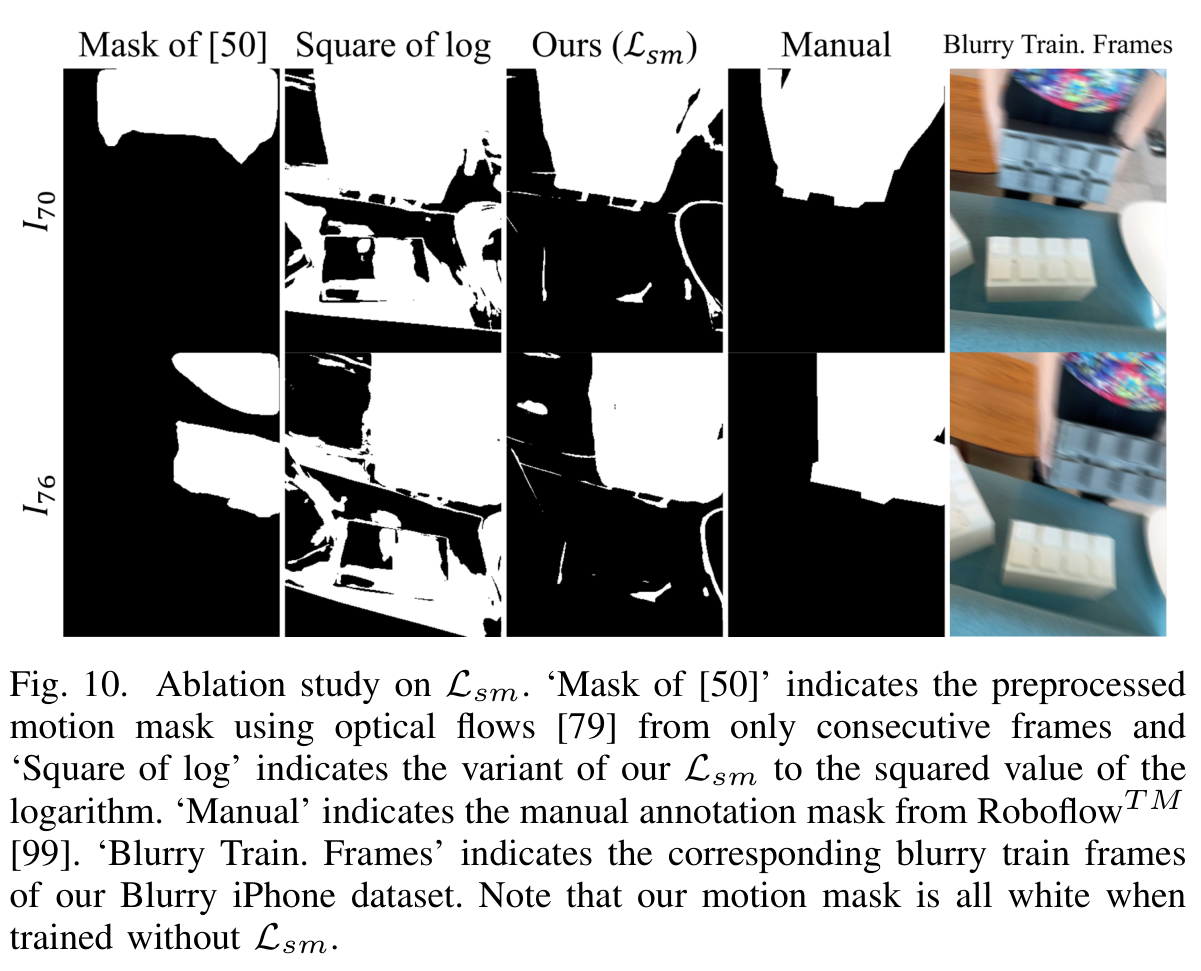
제안한 정적성 손실은 제시된 optical flow 기반 대안과 로그 제곱 대안보다 더 깔끔한 마스크를 생성한다. 이 사례들은 분리 방식을 정성적으로 뒷받침하며, 전체 분할 정확도는 보고하지 않는다.
제안한 기하 정규화는 정규화하지 않은 변형과 기존 깊이 손실을 사용한 변형보다 앉아 있는 사람의 구조를 더 일관되게 보존한다. 새 시점의 참조 깊이가 없으므로 이 그림은 깊이 오차를 직접 측정하지 않는다.
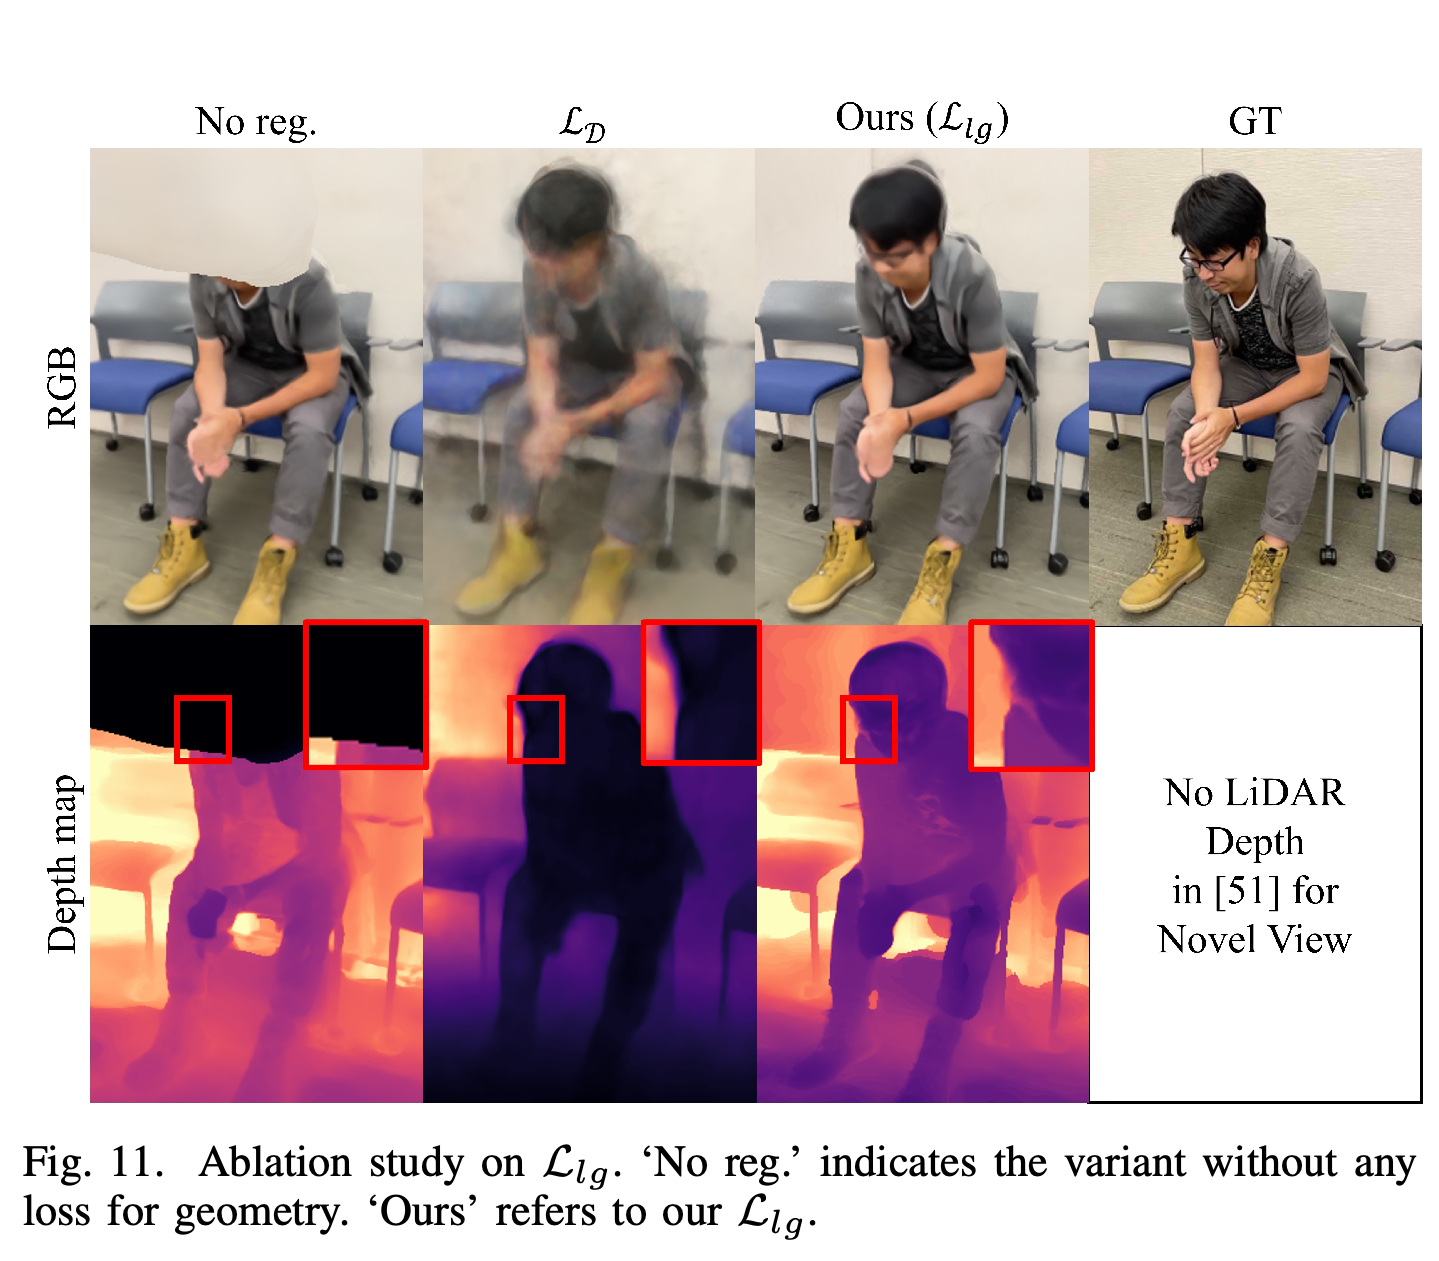
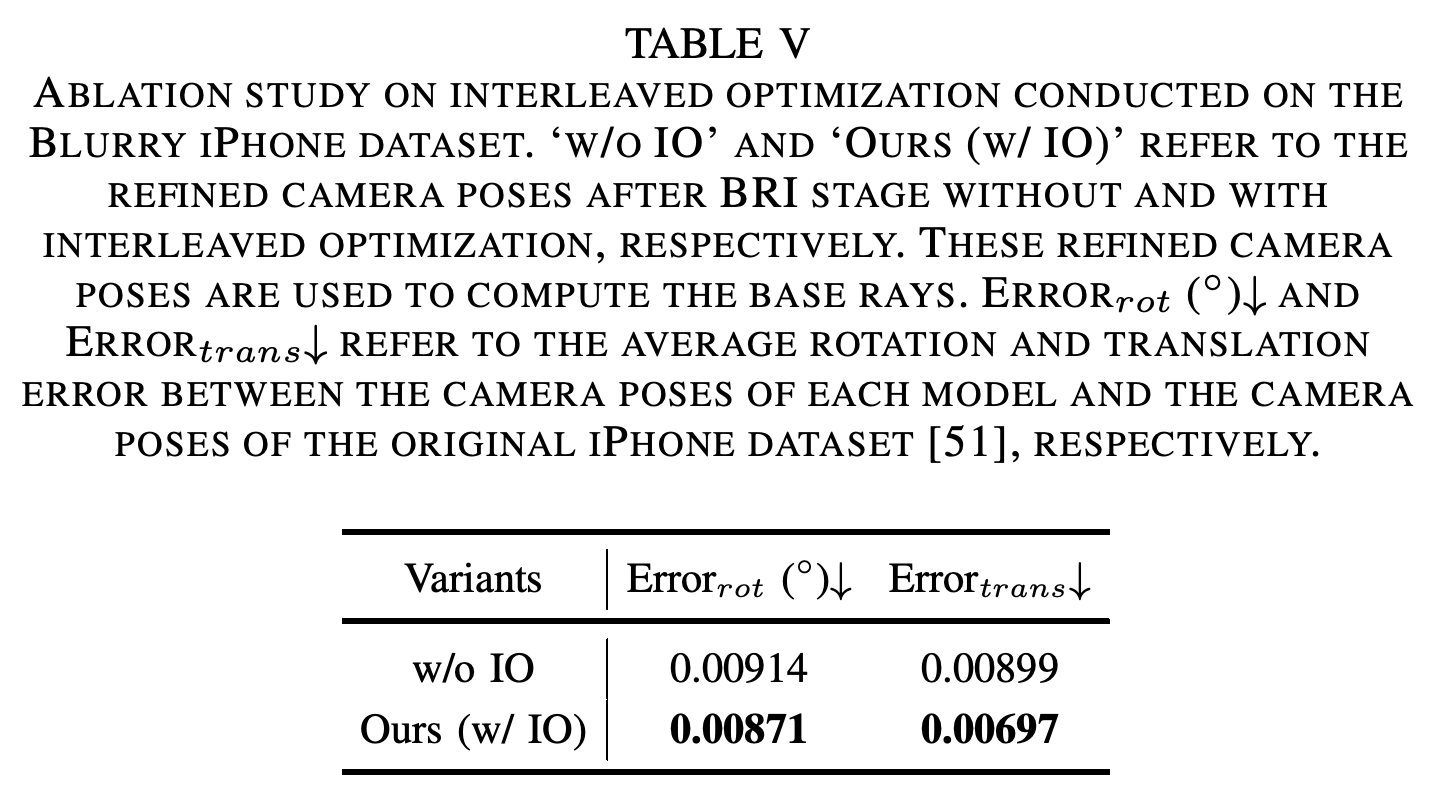
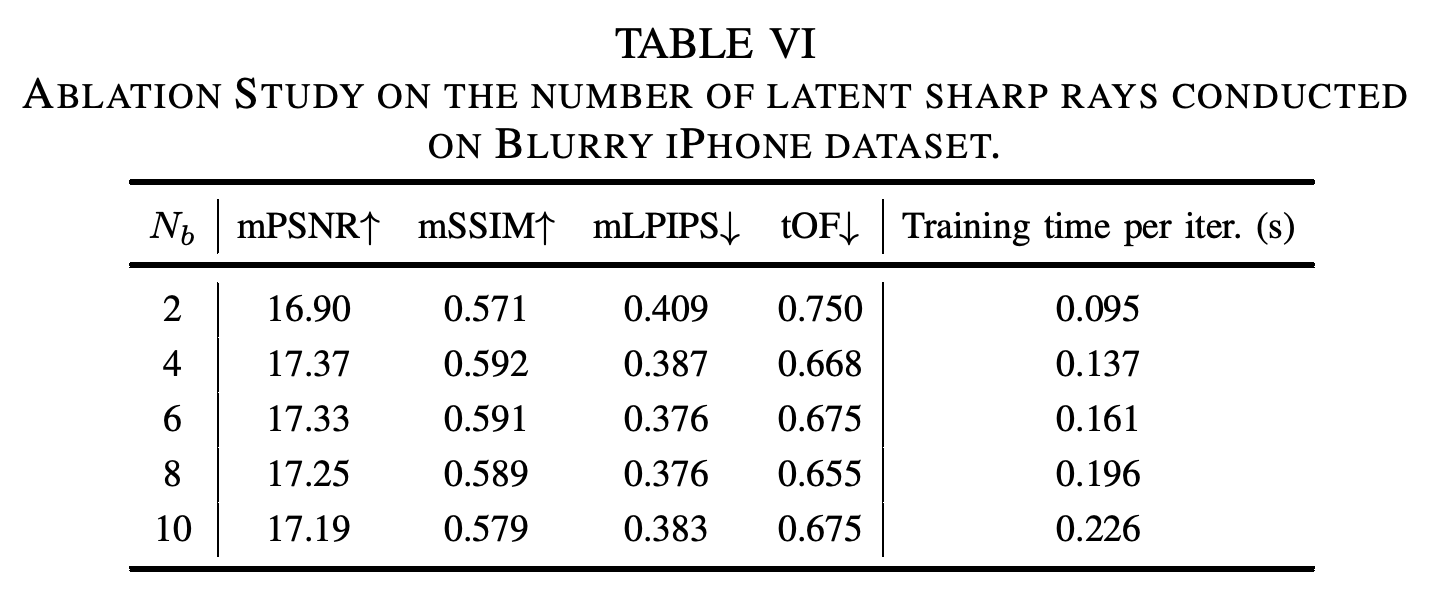
Table V에서 교차 최적화를 사용하면 평균 포즈 오차가 감소한다. 회전 오차는 0.00914°에서 0.00871°로, 평행이동 오차는 0.00899에서 0.00697로 감소하며, 평행이동의 물리적 단위는 명시하지 않는다. Table VI는 잠재 광선 6개가 모든 지표에서 최선인 설정은 아니며, 품질과 학습 비용을 절충한 설정임을 보여준다.
- Nb = 2, 4, 6, 8, 10일 때 RTX 3090 Ti 1대와 배치 크기 128에서 반복당 학습 시간은 각각 0.095, 0.137, 0.161, 0.196, 0.226초다.
- Nb = 4의 mPSNR이 17.37로 가장 높다. Nb = 6과 8의 mLPIPS는 0.376으로 같고, Nb = 8의 tOF가 0.655로 가장 낮다.
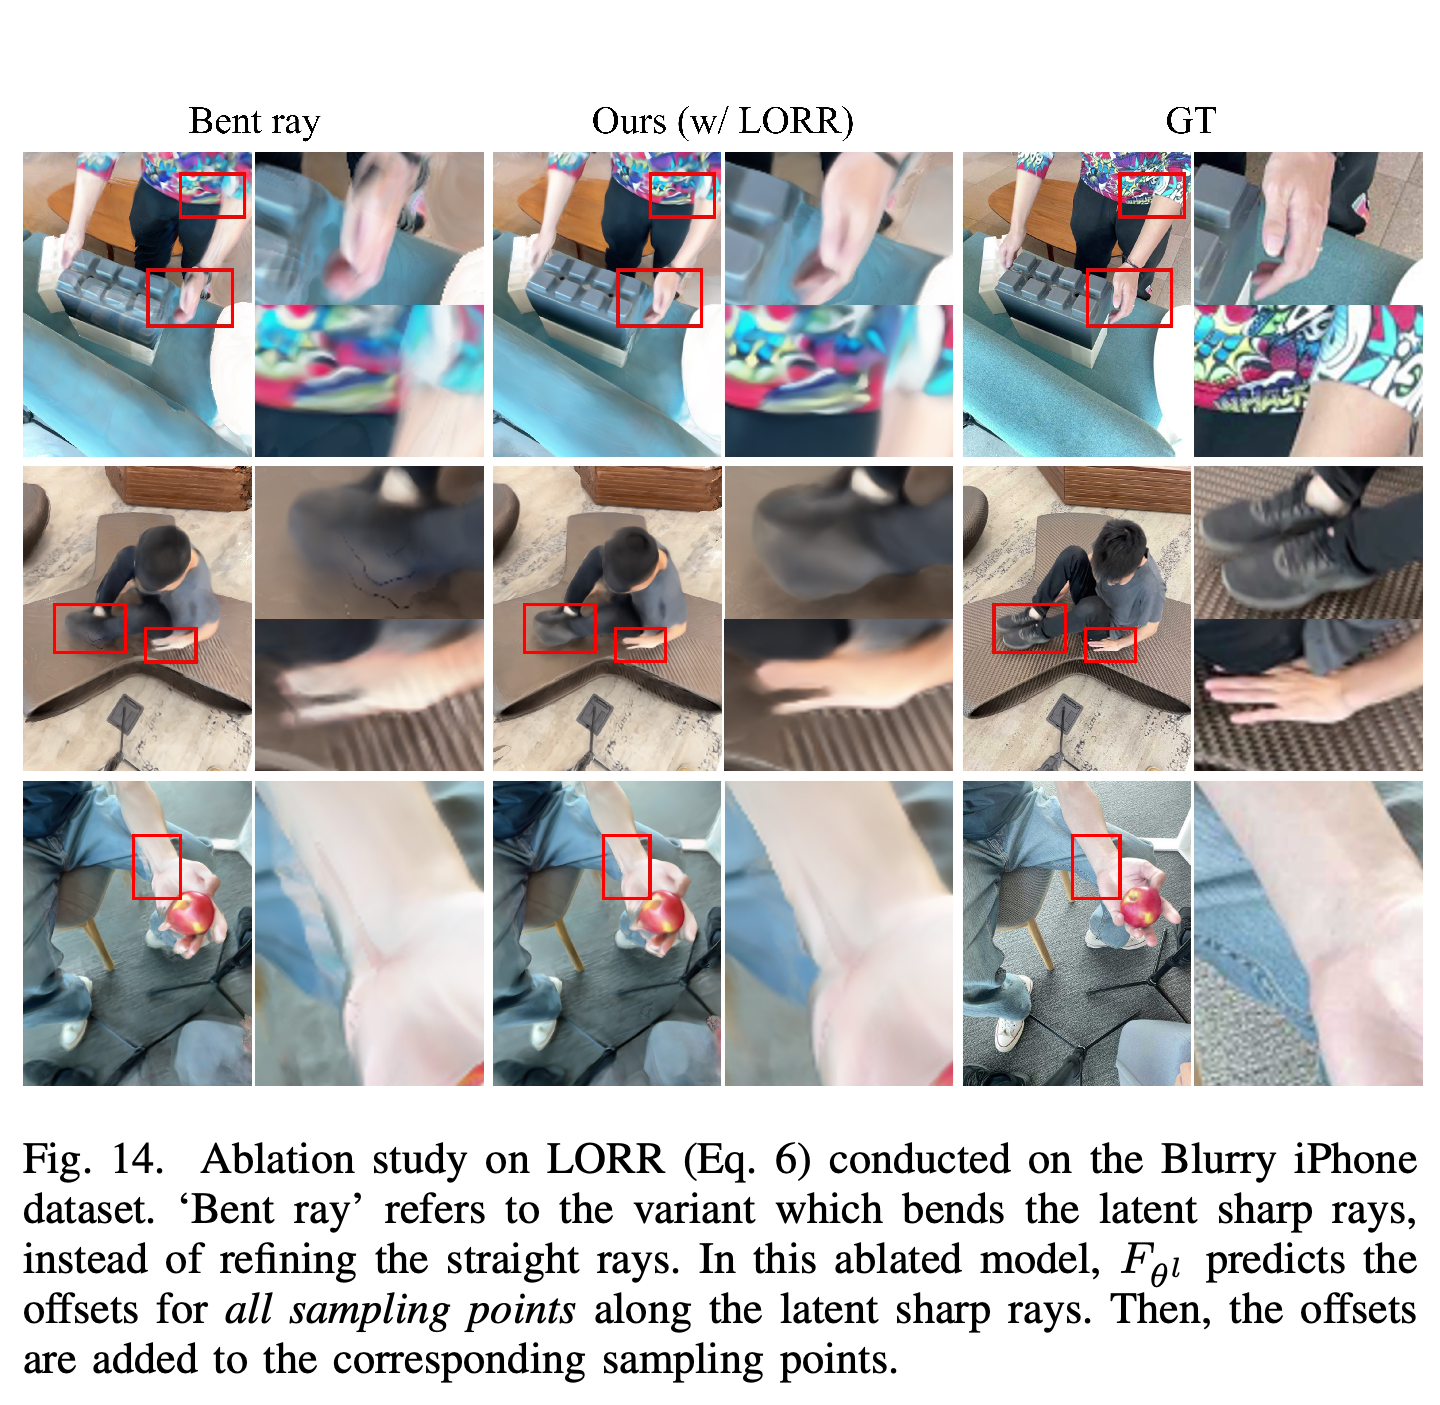
- 굽은 광선 변형의 mSSIM은 0.533으로, 전체 직선 광선 보정 모델의 0.591보다 낮다. 그러나 tOF는 0.649로 전체 모델의 0.675보다 좋다. GMRP를 제거하면 mLPIPS가 0.376에서 0.403으로 나빠진다.
추정한 카메라 궤적과 원본 궤적은 교차 갱신이 포즈 보정에 미치는 효과를 보여준다. Table V는 겹쳐 표시한 궤적에서 보이는 작은 차이에 대한 정량적 근거를 제공한다.
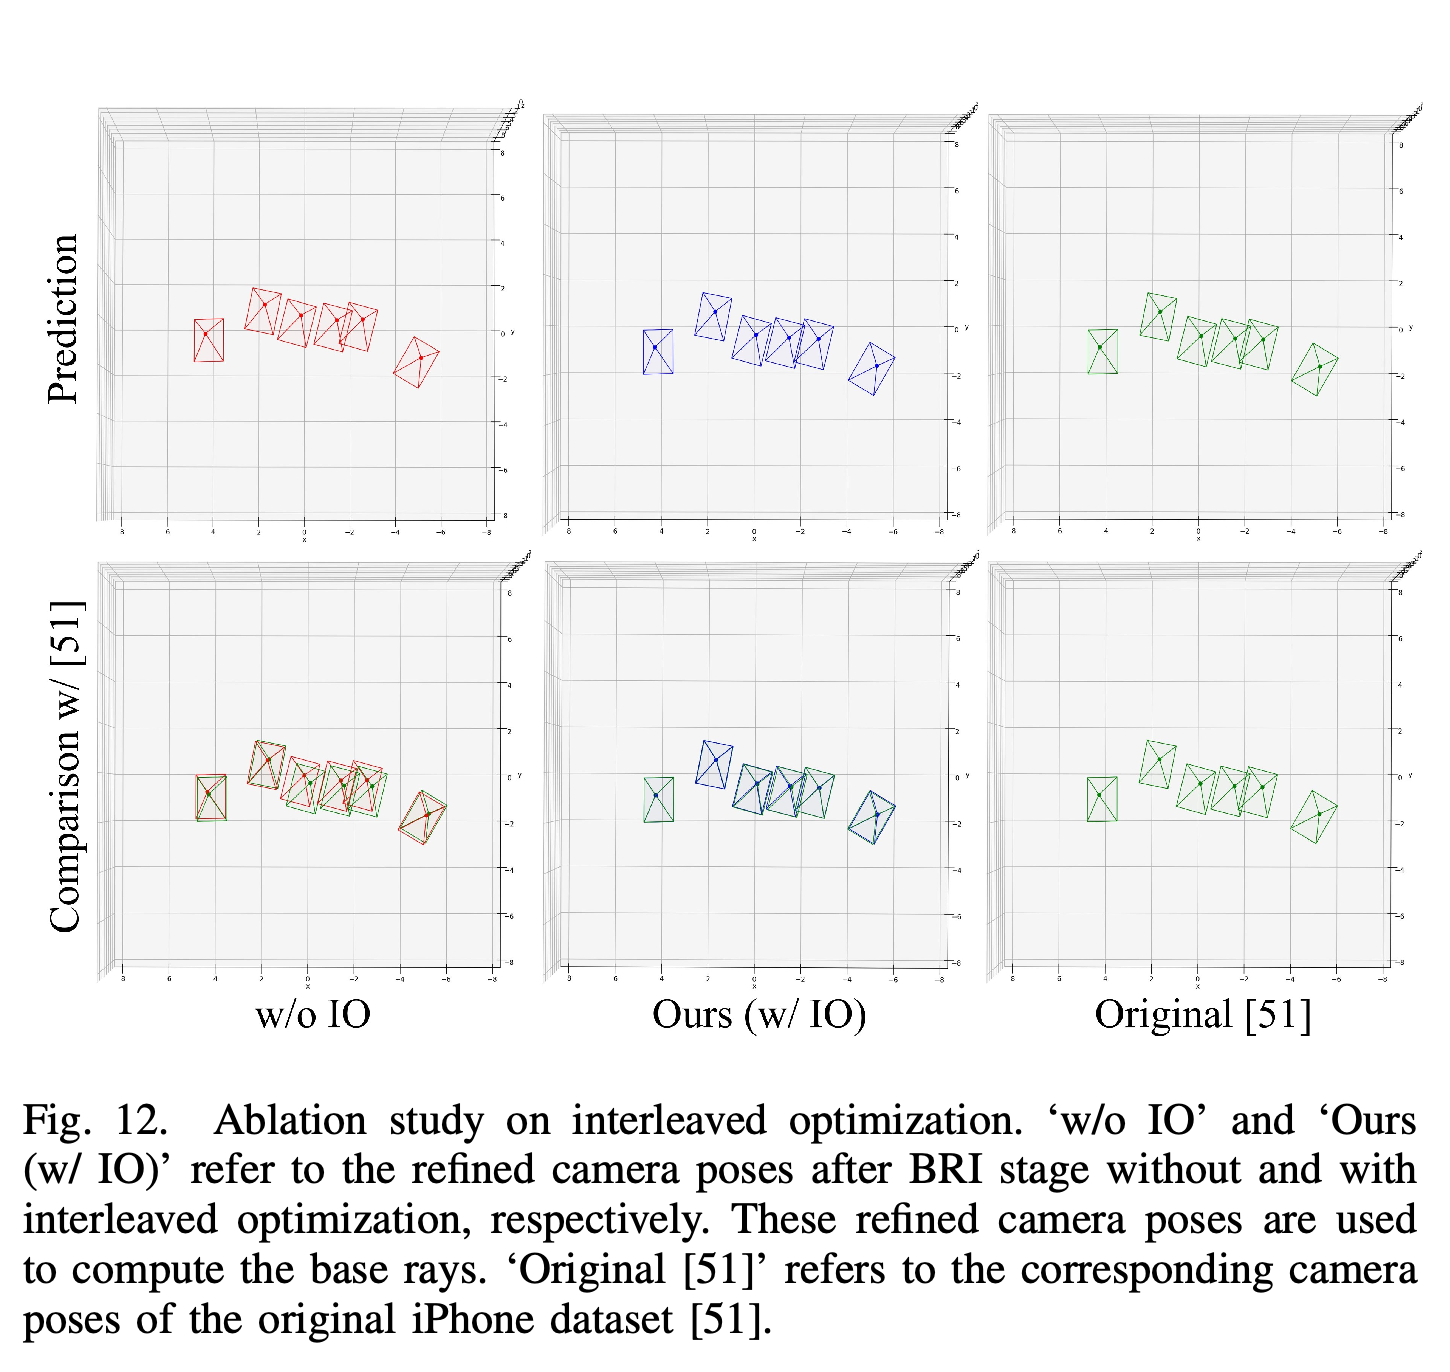
교차 최적화를 적용하면 회전 오차는 0.00914°에서 0.00871°로, 평행이동 오차는 0.00899에서 0.00697로 감소한다. 평행이동의 물리적 단위는 명시하지 않는다.
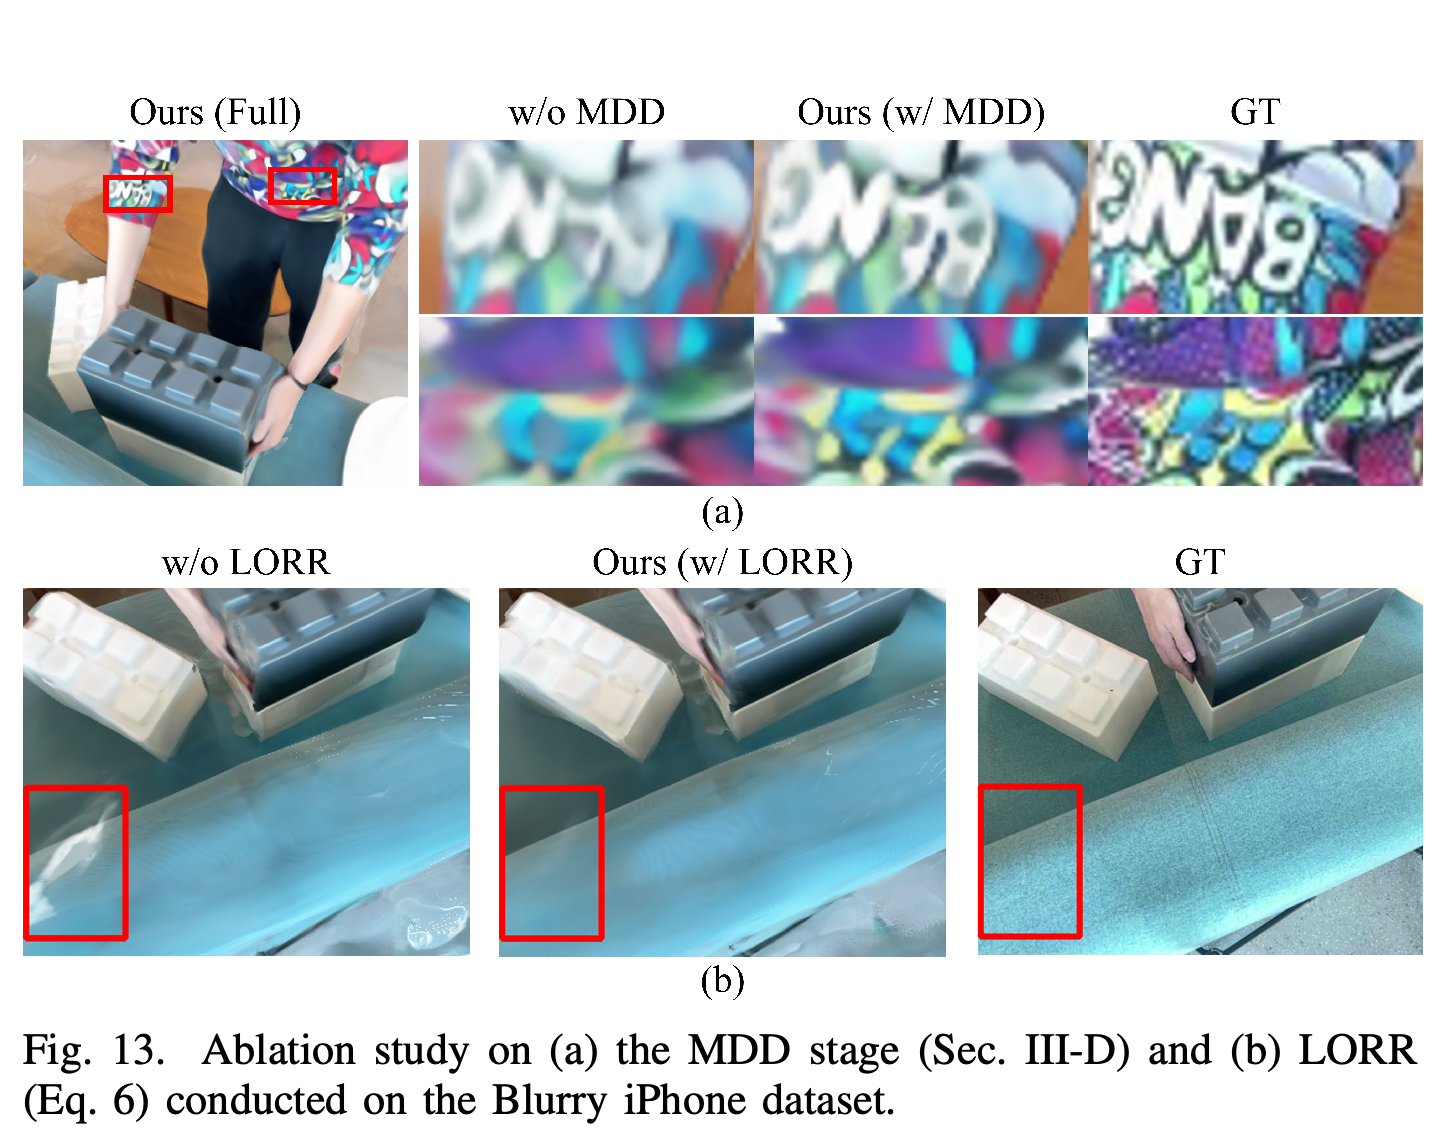
첫 번째 비교에서는 MDD를 적용했을 때 질감이 더 선명하고, 두 번째 비교에서는 LORR을 적용했을 때 물체의 잔상이 줄어든다. 이는 명시적인 블러 모델링과 국소 움직임 보정의 기여를 각각 보여준다.
선택된 확대 영역에서 직선 광선 보정은 굽은 광선 변형보다 움직이는 물체의 경계를 더 깔끔하게 복원한다. 이는 Table IV의 mSSIM 차이와 부합하지만, tOF는 굽은 광선 변형이 더 좋다.
광선 수가 늘어나면 학습 시간은 꾸준히 증가하지만, 품질이 계속 좋아지지는 않는다. 광선 6개와 8개는 최저 mLPIPS가 같고, 4개는 mPSNR이 가장 높으며, 8개는 tOF가 가장 낮다.
C. Ablation Study on Stereo Blur dataset
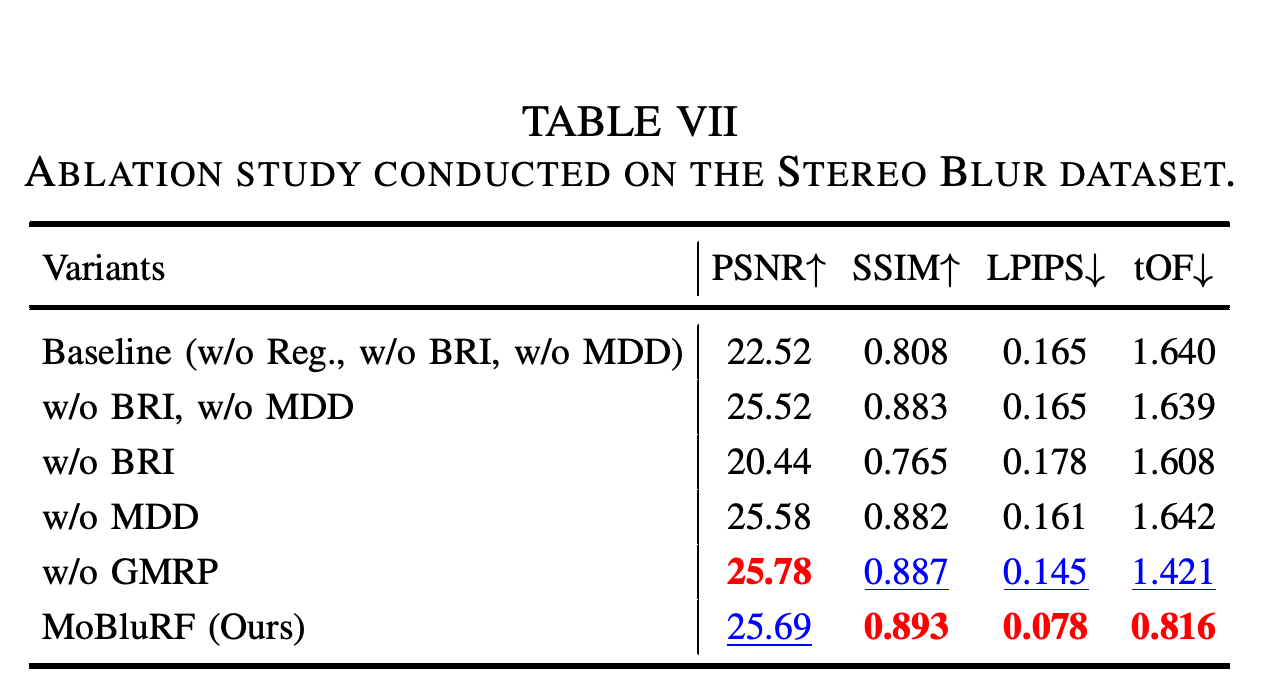
Stereo Blur의 구성 요소 제거 실험은 초기화와 명시적 디블러링의 역할을 뒷받침한다. BRI를 제거하면 PSNR이 20.44로 낮아진다. MDD를 제거하면 PSNR은 25.58이지만 LPIPS는 0.161, tOF는 1.642로 나빠지며, 전체 모델은 각각 25.69, 0.078, 0.816을 기록한다.
- 초기화와 디블러링 단계를 모두 사용하지 않는 상태에서 정규화 기법을 추가하면 PSNR이 정규화하지 않은 베이스라인의 22.52에서 25.52로 개선되지만, LPIPS는 0.165로 유지된다.
- GMRP를 제거하면 PSNR은 25.78로 높아지지만 SSIM은 0.887로 낮아지고, LPIPS / tOF는 0.145 / 1.421로 나빠진다.
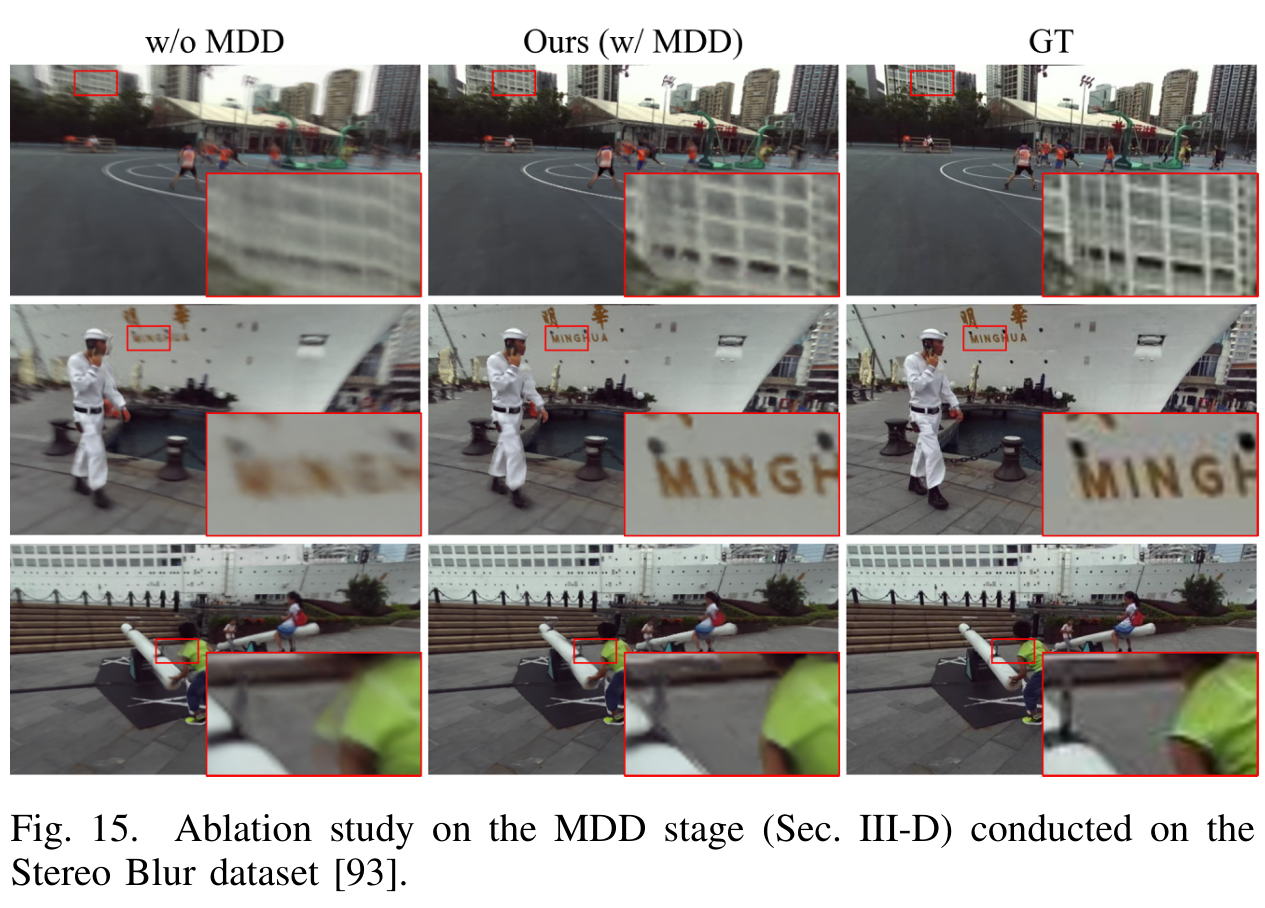
- Figure 15에서는 MDD를 적용했을 때 배경 구조와 전경 경계가 더 선명하게 나타난다.
전체 모델의 LPIPS / tOF는 0.078 / 0.816이며, MDD가 없으면 0.161 / 1.642다. GMRP를 제거하면 PSNR은 조금 높아지지만 지각적 거리와 시간적 일관성은 크게 나빠진다.
MDD를 적용한 뒤 확대된 울타리, 글자, 전경 경계 영역이 더 선명하게 보인다. 이 사례들은 Table VII의 지각적 개선이 실제 영상에서 어떤 세부 구조로 나타나는지 보여준다.
D. Complexity Comparison
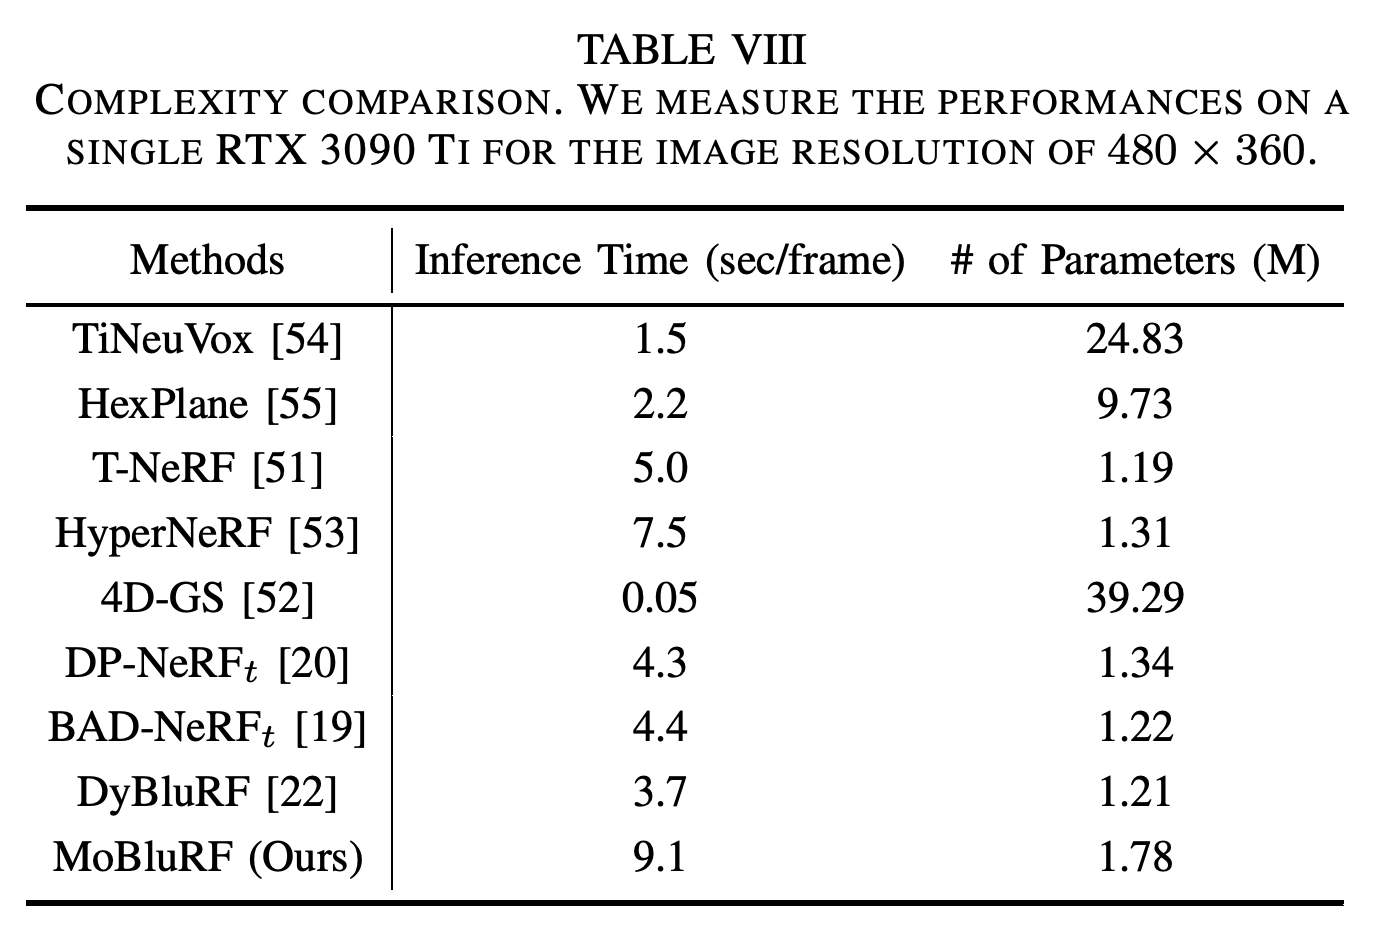
RTX 3090 Ti 1대에서 480 × 360 해상도로 렌더링할 때 MoBluRF의 매개변수 수는 1.78 million이며, 프레임당 9.1초가 걸린다. DyBluRF의 매개변수 수는 1.21 million이며, 프레임당 3.7초가 걸린다. 함께 제시된 4D-GS 베이스라인은 매개변수 39.29 million으로 프레임당 0.05초에 렌더링한다. 이 비교에서 MoBluRF의 추론 시간이 가장 길다.
- 잠재 선명 광선의 수는 학습 비용에 영향을 주지만, 추론에서는 픽셀마다 목표 광선 1개를 렌더링하므로 추론 비용에는 영향을 주지 않는다.
- 논문은 렌더링 속도보다 모션 블러를 처리하는 데 우선순위를 둔다.
MoBluRF의 매개변수 수는 1.78 million이지만, 추론 시간은 프레임당 9.1초로 제시된 방법 중 가장 길다. 이 결과는 매개변수 수만으로 렌더링 비용을 설명할 수 없음을 보여준다.
E. Limitations and Future Work
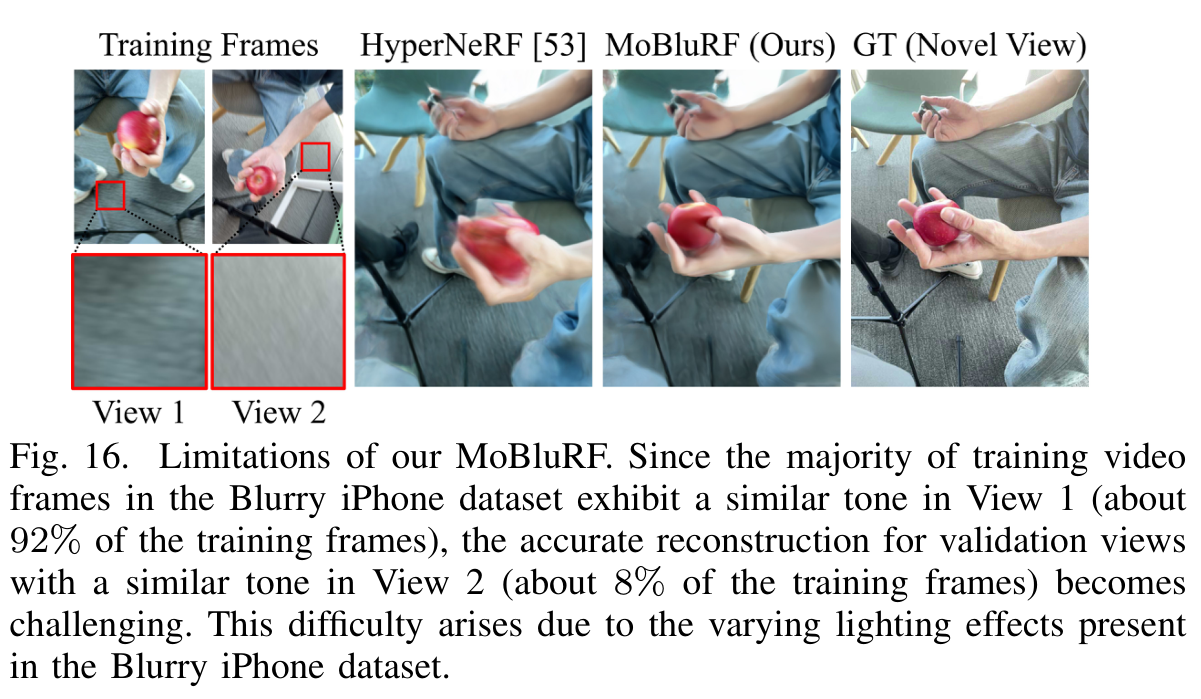
Blurry iPhone 평가 절차는 장면마다 연속된 단안 비디오 1개로 학습하고, 새로운 시점에 고정된 카메라 2대로 평가한다. 따라서 시점에 따라 달라지는 조명을 충분히 표현하지 못할 수 있다. Figure 16은 학습 영상의 색조가 약 92% 대 8%로 불균형할 때 복원이 우세한 외관을 따르는 사례를 보여준다.
- 저자들은 향후 방향으로 표면이 조명에 반응하는 방식을 모델링하는 반사 특성 기반 재조명이나 더 균형 잡힌 학습 데이터를 제안한다.
- 효율성을 높이기 위해 디블러링 프레임워크에 Gaussian Splatting을 통합하는 방안도 제안하지만, 논문에서는 이 통합을 평가하지 않는다.
- 정량 평가에는 합성 블러를 사용하며, 자연적으로 흐려진 DAVIS 시퀀스는 정성적 근거를 제공한다.
MoBluRF와 HyperNeRF는 검증 시점의 색조 중 학습 데이터에서 드물게 관측된 색조를 재현하기보다 학습 데이터의 우세한 외관을 따른다. 약 92% 대 8%의 불균형은 모션 디블러링 외에도 다양한 외관을 충분히 관측하지 못하는 한계가 있음을 보여준다.
V. Conclusion
논문은 노출 중 광선 변환을 학습하기 전에 기준 광선을 초기화하면 흐릿한 단안 비디오에서 선명한 동적 장면을 더 잘 복원할 수 있다고 결론짓는다. 실험은 BRI, MDD, 학습된 정적/동적 분리, 기하 정규화의 결합을 뒷받침한다. 동시에 개별 구성 요소가 복원 지표, 지각 지표, 시간적 지표에 서로 다른 영향을 준다는 점도 보여준다.
부록
- 제공된 18페이지 PDF에는 부록이 없다. 본문 뒤에는 참고문헌과 저자 약력이 이어지며, 첨부된 버전은 2025년 6월 3일자 arXiv:2312.13528v3이다.
짧은 생각
포즈 갱신 순서는 직접적인 구성 요소 제거 실험으로 뒷받침된다. 단순한 포즈 최적화와 BRI 없는 디블러링 2개 방법 모두 전체 단계별 방법보다 성능이 낮다. MDD 비교는 지각적 선명도와 다른 목표를 구분할 필요도 보여준다. 지각적 거리가 개선되어도 구조적 유사도나 시간적 일관성은 소폭 나빠질 수 있다. 보고된 품질 향상은 오프라인 복원에 적합하지만, 측정된 프레임당 9.1초의 처리 시간은 상호작용형 사용을 제약한다. Blurry iPhone의 성능 향상은 합성 블러와 포즈 교란 조건을 함께 고려하여 해석해야 한다. Stereo Blur의 결과와 DAVIS의 정성적 사례가 근거의 범위를 넓히지만, PDF는 불확실성 구간이나 반복 실행 간 변동성을 보고하지 않는다.