


Prospective Learning: Principled Extrapolation to the Future 요약 설명
19 Jan 2022 | Paper Review Prospective Learning Out-of-Distribution Generalization Online Learning목차
이번 글에서는 Prospective Learning: Principled Extrapolation to the Future 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 19일(Arxiv), 2nd Conference on Lifelong Learning Agents (CoLLAs), 2023
- De Silva, Ashwin, Ramesh, Rahul, Ungar, Lyle, Shuler, Marshall Hussain, Cowan, Noah J., Platt, Michael, Li, Chen, Isik, Leyla, Roh, Seung-Eon, Charles, Adam, et al.
- Johns Hopkins University, University of Pennsylvania, Carnegie Mellon University, Morgan State University, Howard Hughes Medical Institute, University of California, San Diego, MindX, Microsoft Research, DeepMind
- 논문 링크, arXiv v2 (2023-07-13)
요약
- 이 논문은 데이터 분포가 시간에 따라 부분적으로 예측 가능한 방식으로 변할 때의 예측 문제를 다룬다. 저자들은 분류 태스크가 번갈아 나타나는 예시에서 전환 패턴을 아는 학습기는 전환 시점에 새로운 샘플 없이 적절한 분류기를 선택할 수 있지만, 단일 고정 분류기는 2개 태스크 모두에서 오차를 임의로 작게 만들 수 없다고 주장한다.
- Prospective learning은 과거 데이터로 시간별 결정 규칙을 학습하여 미래 태스크에서 기준 시퀀스에 가까운 성능을 시간 평균으로 달성하는 방법이다. 논문은 정의와 추측을 제안하지만 prospective learner를 구현하거나 평가하지는 않는다.
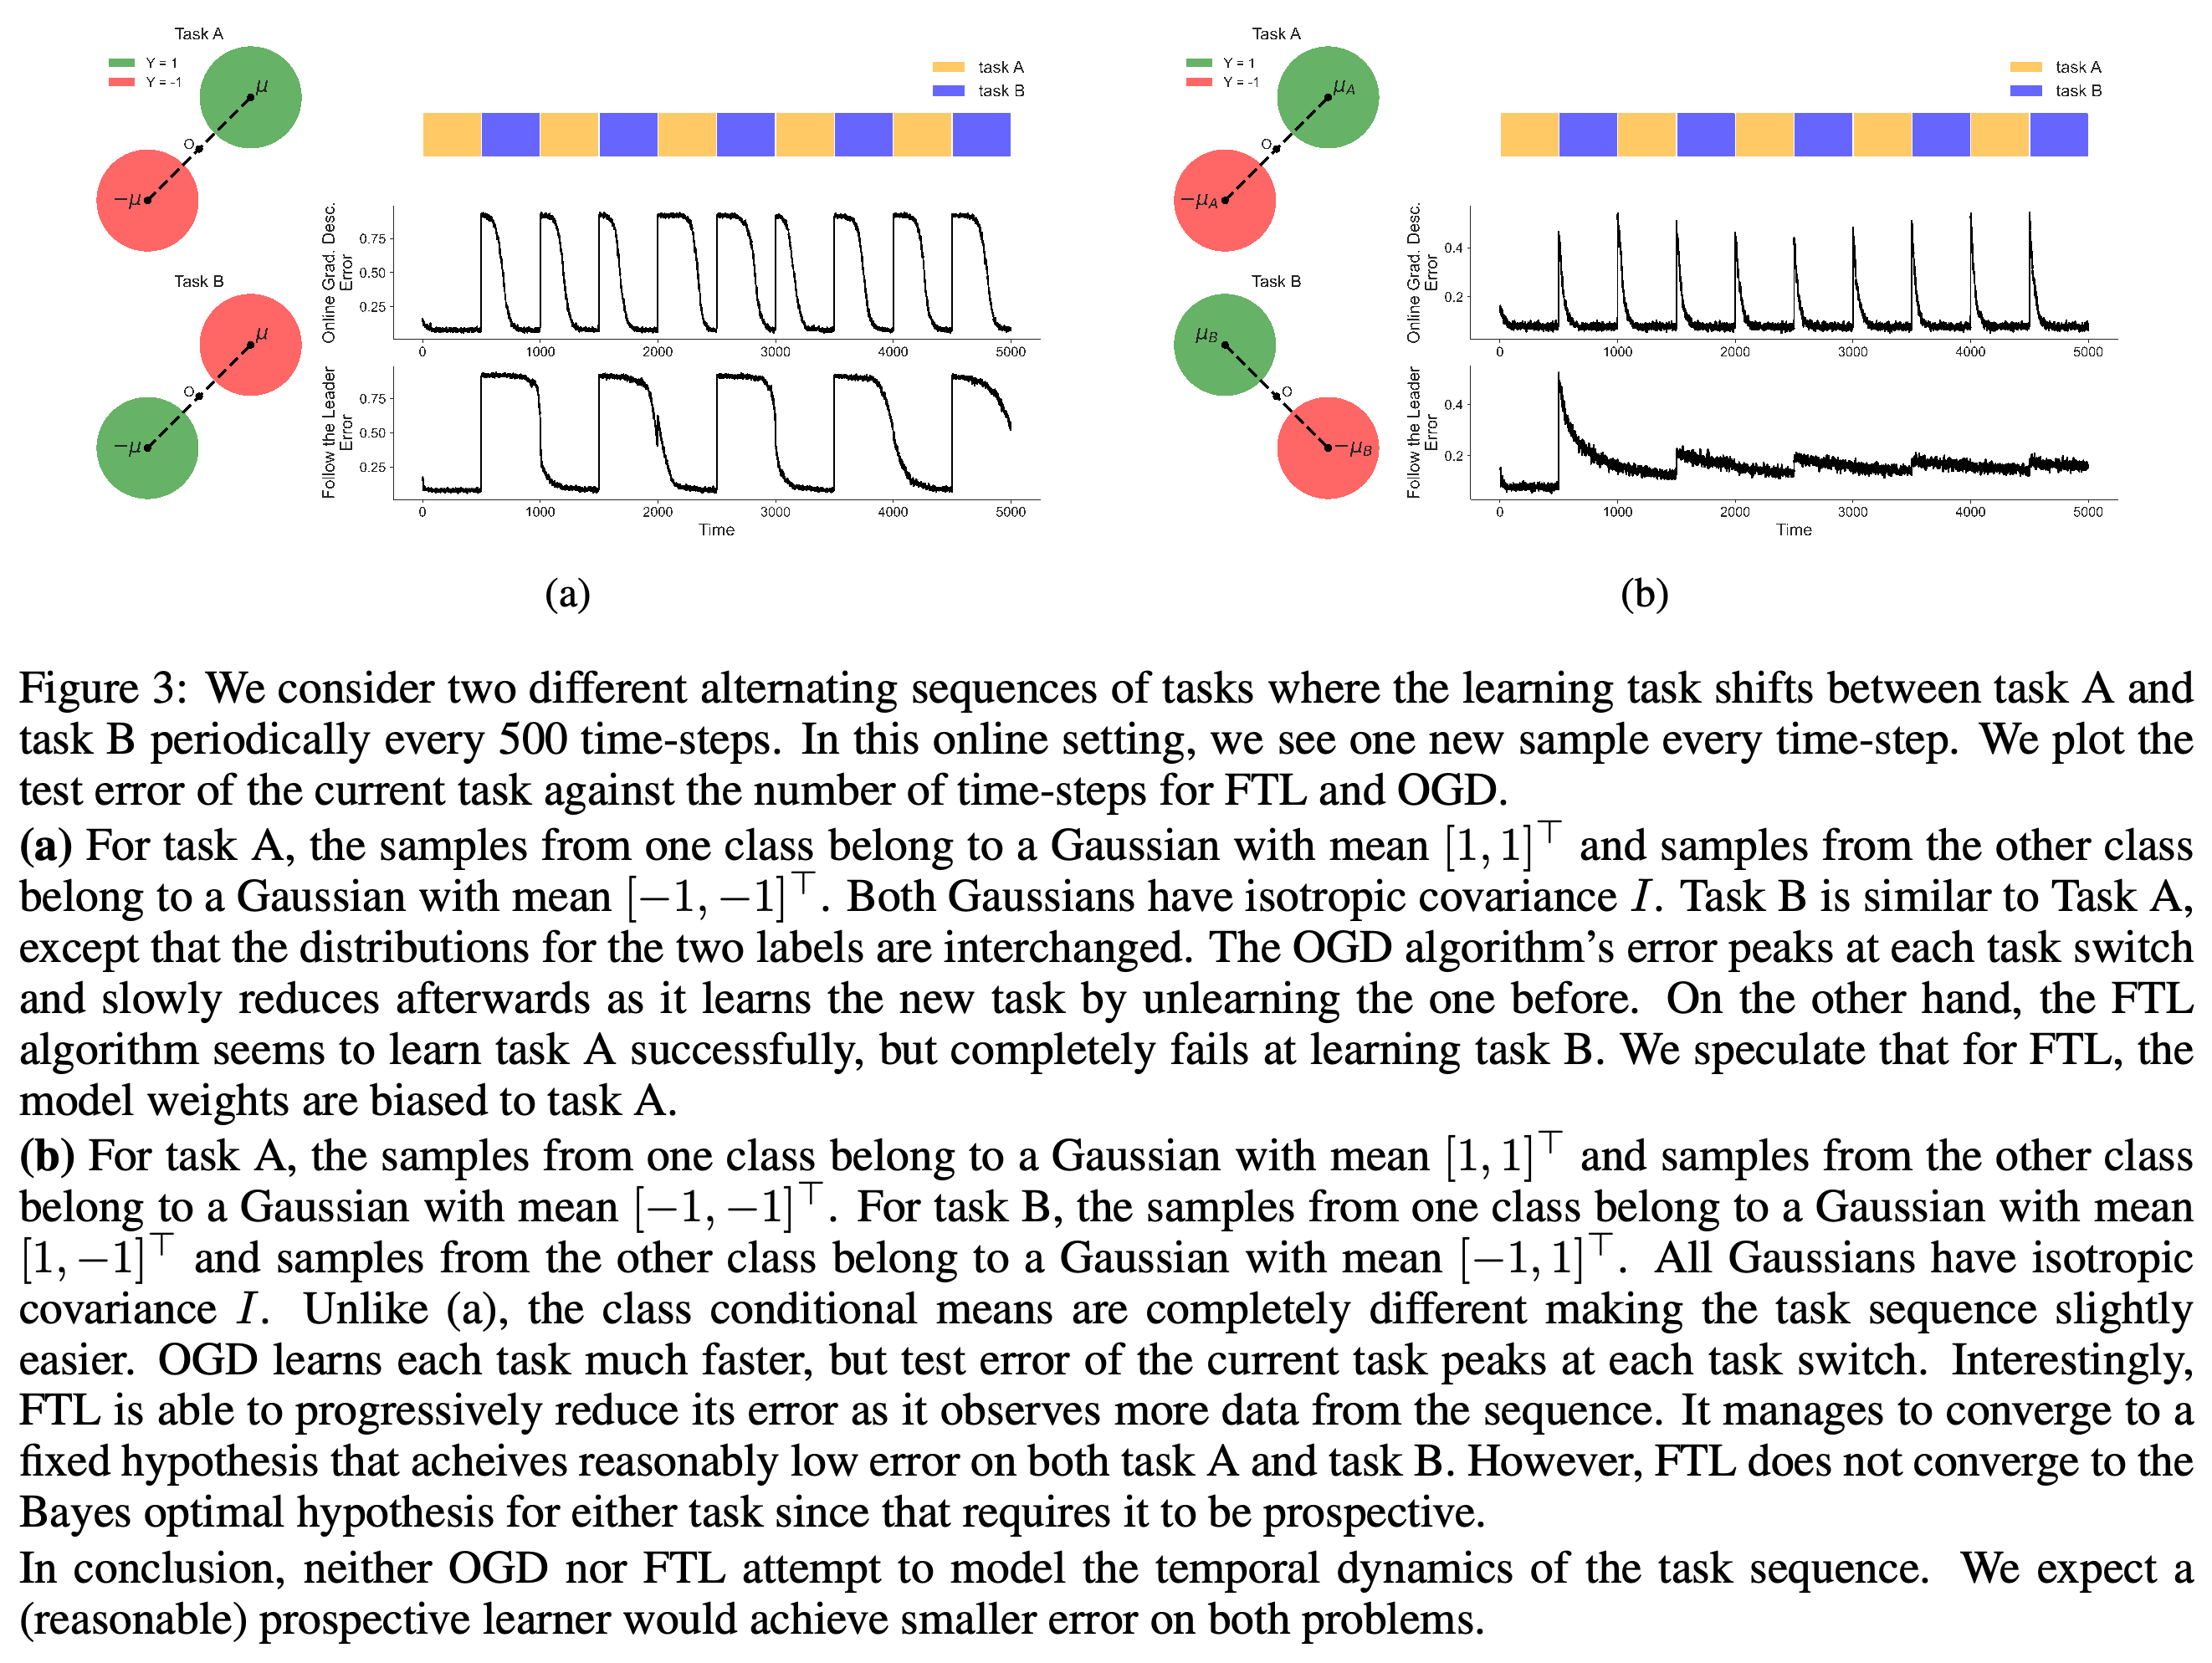
- 500 time-steps마다 태스크가 전환되고 매 스텝마다 새로운 샘플 1개가 주어지는 합성 실험 2개에서, 샘플이 도착할 때마다 모델을 갱신하는 online gradient descent는 전환 시점에 오차가 급증한다. 과거 성능을 기준으로 모델을 선택하는 follow-the-leader는 레이블을 뒤집은 태스크 1개에서 실패하지만, 2번째 설정에서는 유용한 고정 분류기를 찾는다.
1 Introduction
저자들은 과거 데이터에 맞춰 표현을 최적화하는 방법을 retrospective learner라고 부른다. 또한 과거와 미래의 분포가 동일하고 시간에 따라 변하지 않는다는 가정을 완화하여, 미래 태스크에서 나타나는 구조적인 변화를 예측할 것을 제안한다.
2 A Failure Mode of Retrospective Learning
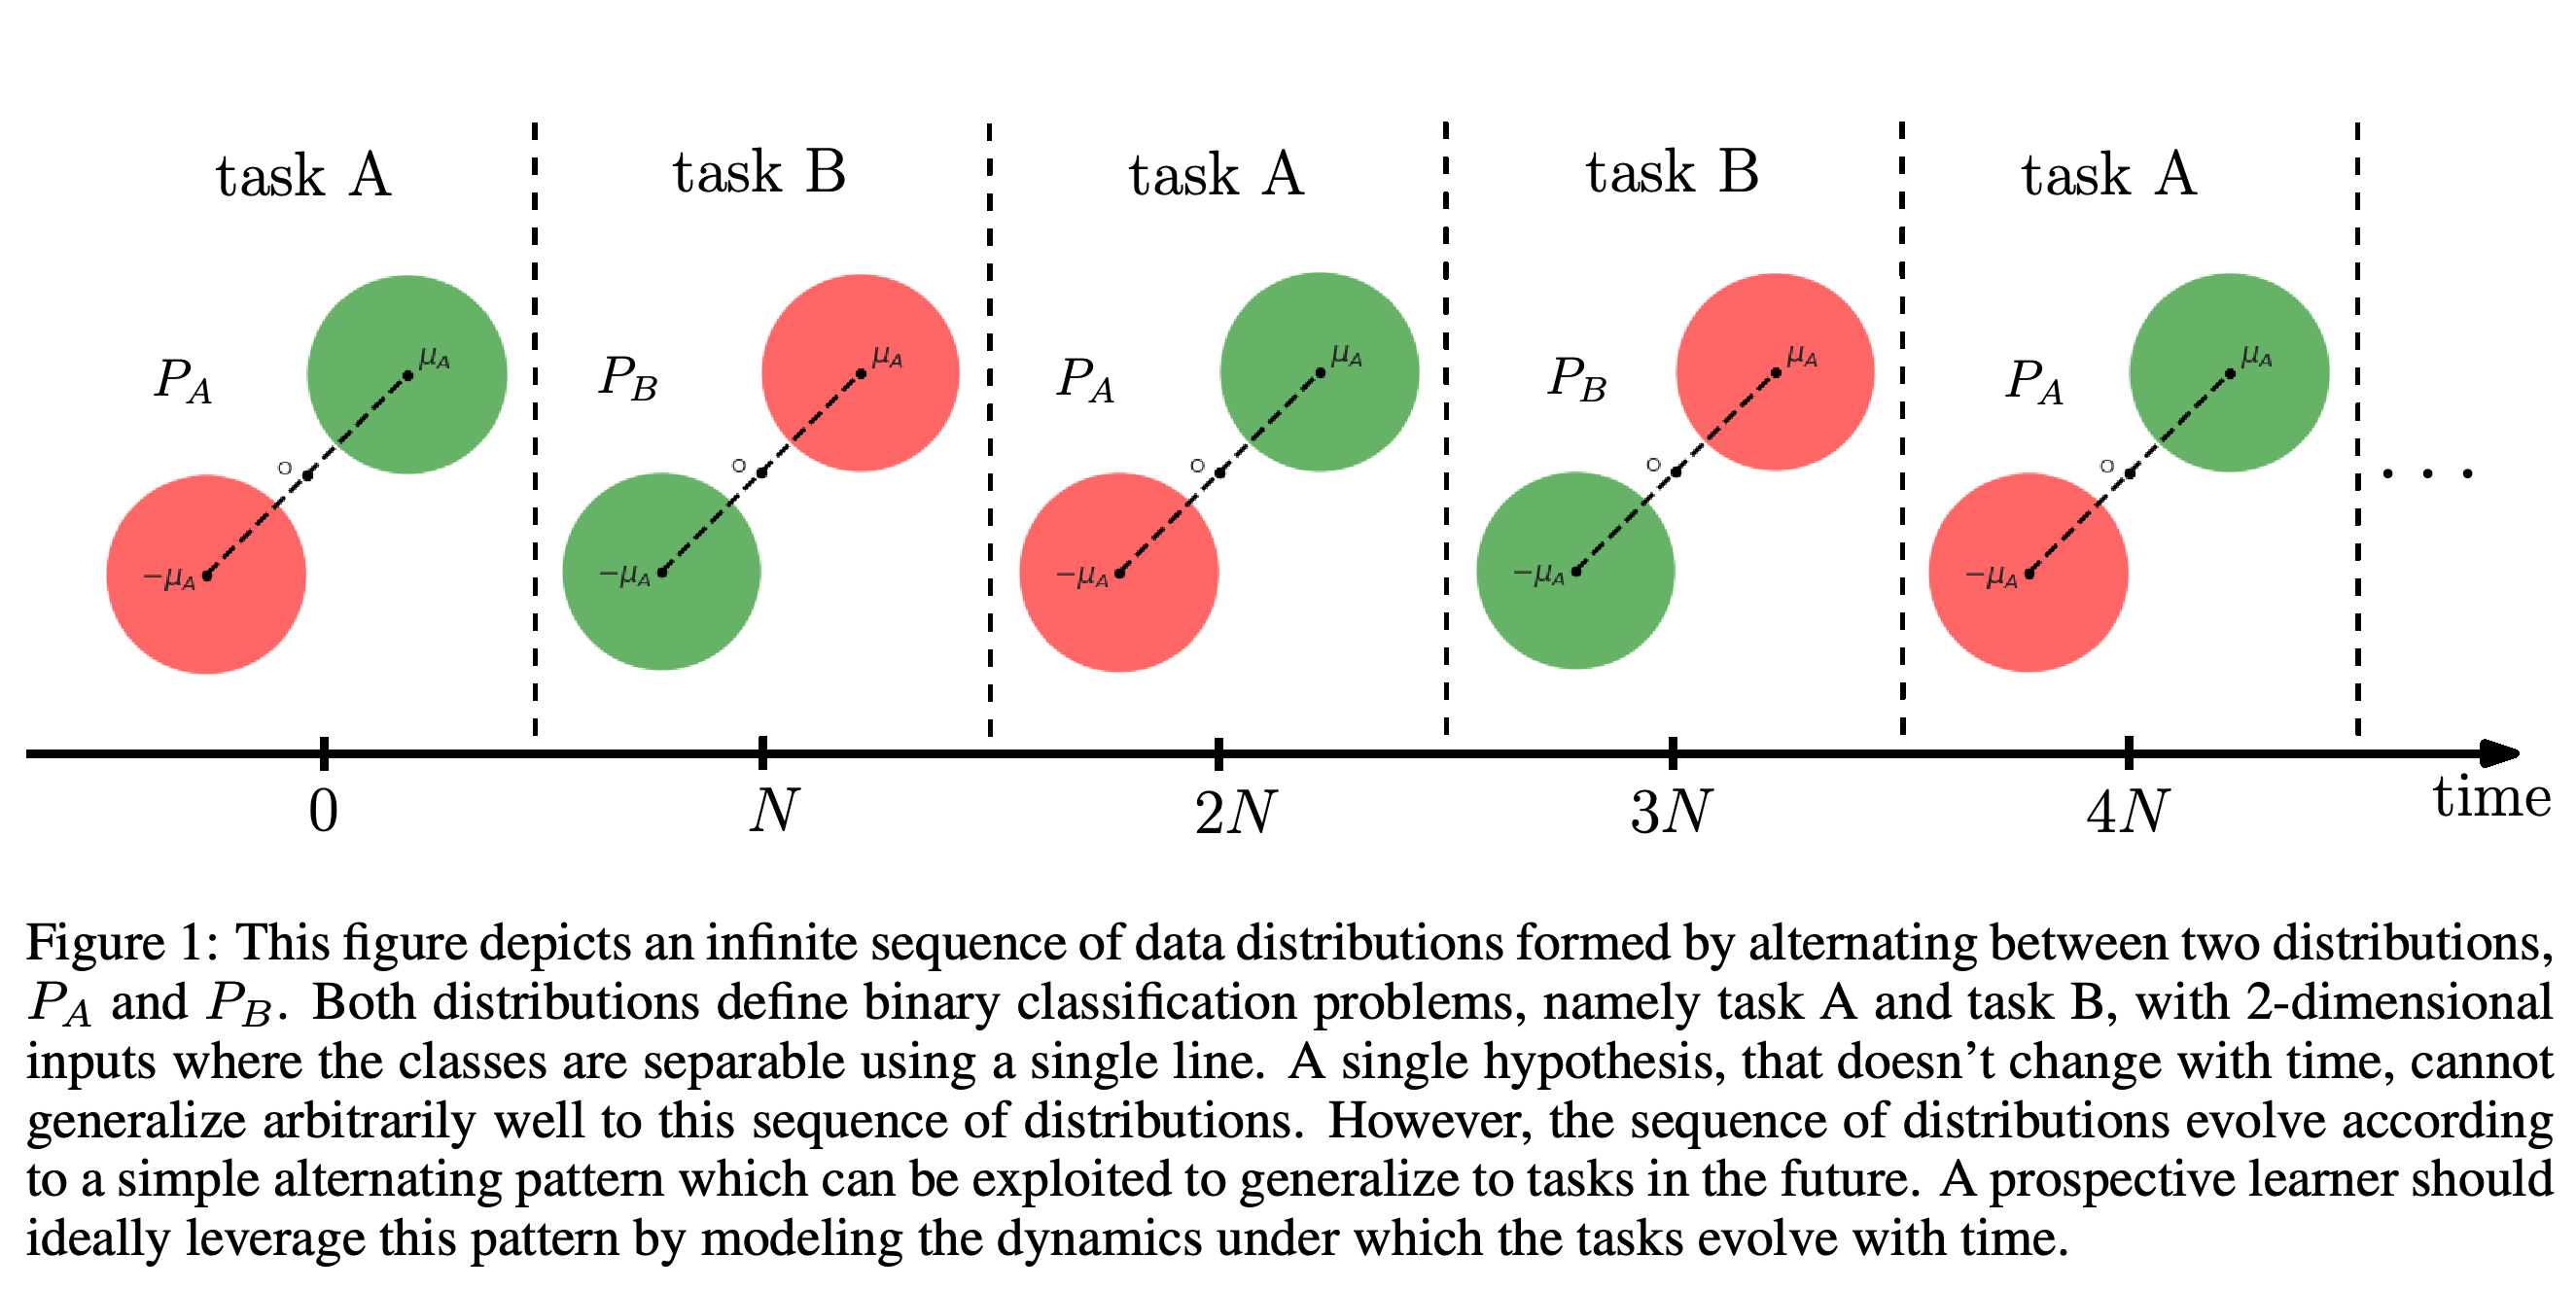
2차원 입력을 가진 이진 분류 태스크 2개가 N time-steps마다 번갈아 나타난다. 각 태스크는 직선으로 분리할 수 있지만 레이블이 반대이므로 단일 고정 결정 규칙으로 2개 태스크 모두에서 오차를 임의로 작게 만들 수 없다. 교대 일정이 알려져 있다면 규칙 2개를 유지하고 전환하여 매 전환 시점에 추가 샘플을 수집하지 않고도 태스크를 예측할 수 있다.
태스크 A와 B 사이에서 클래스 레이블이 반전되므로, 각 태스크를 개별적으로 선형 분리할 수 있어도 동일한 고정 결정 규칙으로 2개 태스크 모두를 정확히 분류할 수 없다. 규칙적인 일정은 시간에 따라 달라지는 규칙이 활용할 수 있는 정보를 제공한다.
3 The Theoretical Foundations for Prospective Learning
이론적 프레임워크는 태스크를 데이터 분포로 표현하고, 후보 결정 규칙의 집합인 가설 클래스와 기대 손실인 위험 함수를 고정한다. 이 프레임워크는 고정 가설 1개를 학습하는 방식과 시간별 가설 시퀀스를 학습하는 방식을 비교한다.
3.1 Retrospective Learning
Probably approximately correct (PAC) learning에서 학습기는 고정된 태스크에서 독립적이고 동일한 분포를 따르는 샘플을 받아, 해당 클래스의 최적 가설과 위험 차이가 ε보다 작은 가설을 최소 1 − δ의 확률로 생성하고자 한다. 논문은 샘플 복잡도가 ε⁻¹과 δ⁻¹에 대해 다항식일 때 학습기가 효율적이라고 부른다 (Valiant, 1984; Kearns & Vazirani, 1994).
3.2 Prospective Learning
Prospective learner는 시점 t′까지 관찰한 데이터를 받아 미래 가설의 시퀀스를 출력한다. 정의 2는 충분한 샘플이 주어졌을 때, 유한한 관찰 임계 시점 이후의 모든 t′에 대해 학습기의 위험이 선택한 기준 시퀀스의 위험에서 ε 이내에 있을 확률을 무한한 미래에 걸쳐 시간 평균한 값이 최소 1 − δ여야 한다고 요구한다.
점선 경계는 관찰된 분포와 미래 분포를 구분한다. 학습기는 t′까지 수집한 데이터셋을 사용하여 미래 결정 함수의 시퀀스를 생성한다.
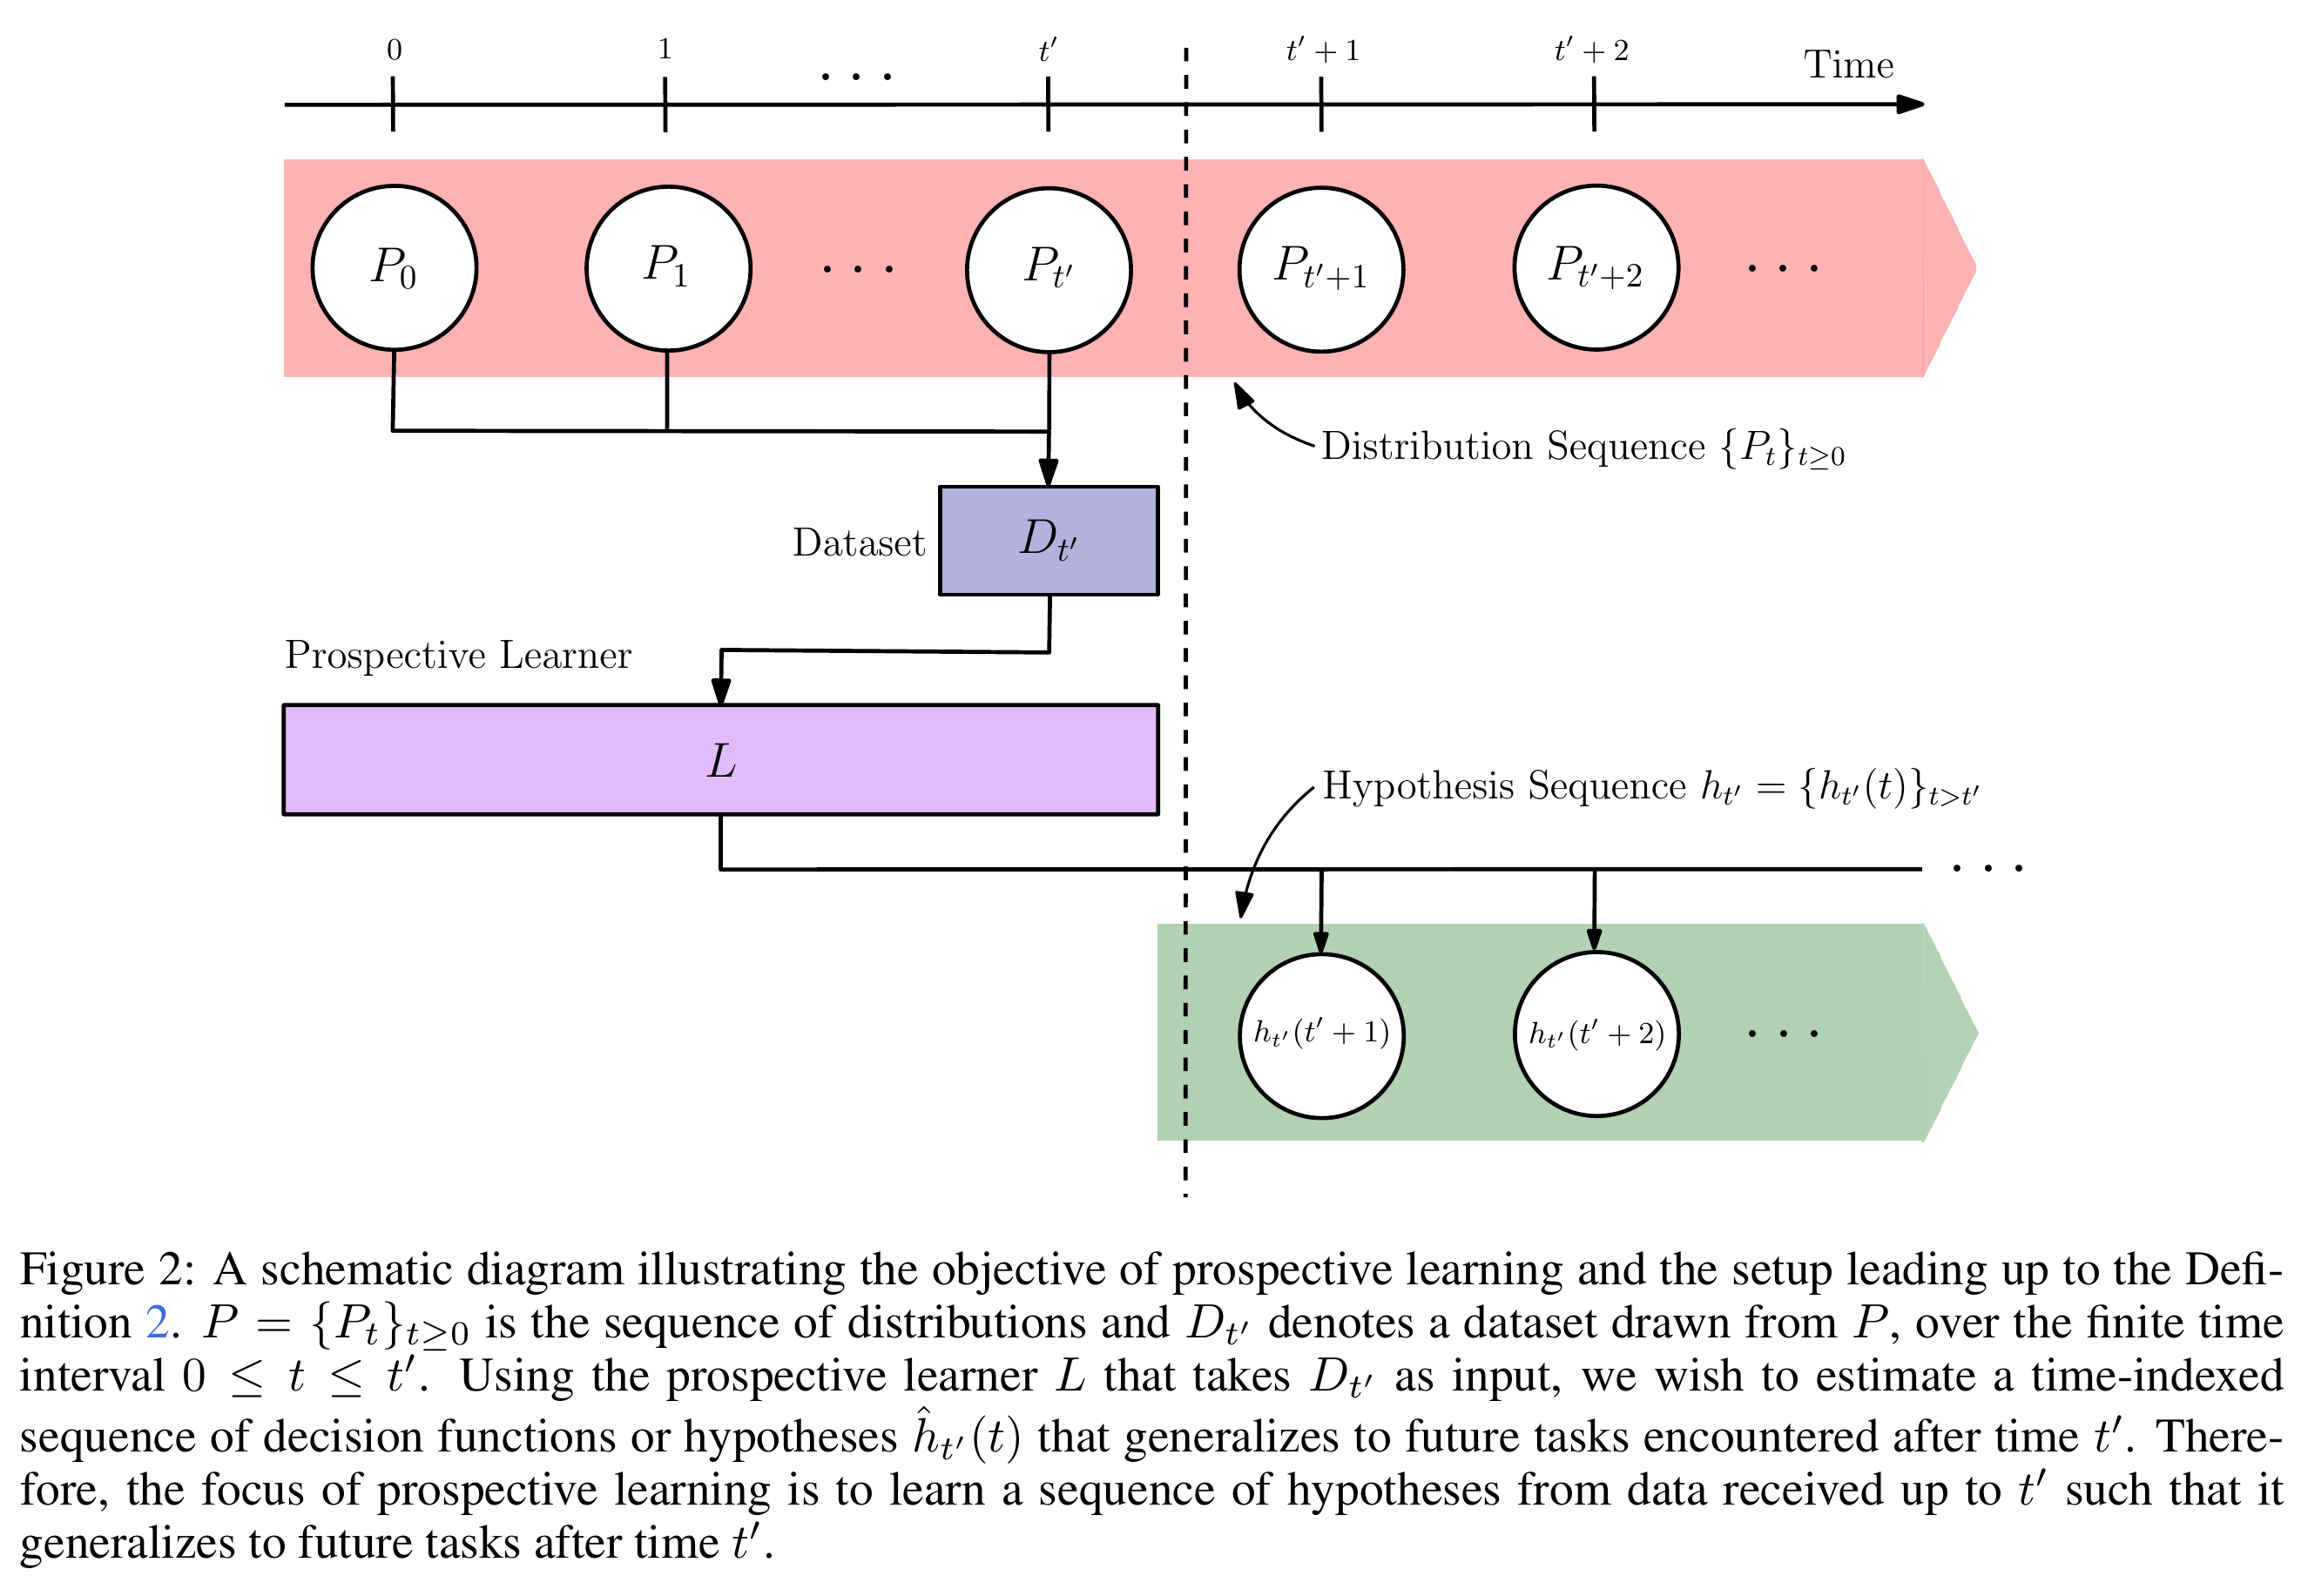
기준으로 각 시점의 최적 가설이나 무작위 추측 가설을 선택할 수 있으며, 선택에 따라 학습 가능성의 기준이 달라진다. 저자들은 PAC 학습 가능, prospective 학습 가능, prospective 학습 불가능이라는 3개 클래스를 추측하지만 복잡도 척도를 제시하거나 그 추측을 증명하지는 않는다.
4 Related Work
논문은 prospective learning을 일련의 태스크에서 학습기를 갱신하는 online learning과 비교하고, online meta-learning, continual learning, streaming learning, out-of-distribution generalization, few-shot learning과도 비교한다. Prospective learning은 시간적 구조를 이용해 미래 태스크를 예측하는 데 목적이 있다. 저자들은 형식적 정의가 서로 다르거나 없기 때문에 직접 비교에 한계가 있다고 지적한다.
합성 실험에서 follow-the-leader (FTL)와 online gradient descent (OGD)는 time-step마다 샘플 1개를 받는다. 레이블을 바꾼 설정에서는 전환 시점에 OGD의 오차가 급증하고 FTL은 태스크 B에서 실패한다. 클래스 평균이 다른 설정에서는 FTL이 2개 태스크 모두에서 적절히 작동하는 고정 가설로 수렴하지만, OGD의 오차는 여전히 전환 시점에 급증한다.
패널 2개 모두 주기적인 태스크 전환 전후의 오차를 보여 준다. 레이블을 뒤집은 경우에는 FTL이 태스크 B에서 지속적으로 실패하지만, 평균이 다른 경우에는 유용한 FTL 고정 가설이 존재한다. Prospective learner의 결과는 표시되지 않는다.
5 Discussion
논문은 prospective learning을 예측 가능한 관계를 가진 과거와 미래 분포를 연구하는 방법으로 설명하고, 자연 지능과 인공 지능을 대상으로 실험할 것을 제안한다. 저자들은 prospective learning의 구현 방법이 대부분 미해결 상태임을 명시한다.
짧은 생각
번갈아 나타나는 태스크의 예시는 사전 예측을 구체적으로 보여 주며, 베이스라인 실험은 전환 후에 대응하면 오차가 발생할 수 있는 이유를 보여 준다. 제시된 근거는 개념적 프레임워크와 합성 데이터에서 수행한 베이스라인 실험으로 구성된다. 논문은 prospective 알고리즘, 실제 환경 평가 또는 제안된 복잡도 클래스의 증명을 제시하지 않는다.