


VOS: Learning What You Don't Know by Virtual Outlier Synthesis 요약 설명
02 Feb 2022 | Paper Review Out-of-Distribution Detection Synthetic Training Data Object Detection목차
이번 글에서는 VOS: Learning What You Don't Know by Virtual Outlier Synthesis 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 2월 2일(Arxiv), ICLR 2022
- Du, Xuefeng, Wang, Zhaoning, Cai, Mu, Li, Yixuan.
- Department of Computer Sciences, University of Wisconsin - Madison
- 논문 링크 (검토 원문: v4 (2022-05-09))
요약
- 신경망은 학습 과정에서 분포 외(out-of-distribution, OOD) 입력에 대한 감독이 부족하므로 낯선 객체를 높은 확신으로 잘못 분류할 수 있다. OOD 입력의 범주는 학습 레이블에 포함되지 않는다. Virtual Outlier Synthesis(VOS)는 실제 이상치 데이터 없이 학습한 ResNet-50 기반 객체 탐지 베이스라인 중 논문에 제시된 최고 성능 모델보다 FPR95를 최대 9.36%p 낮춘다.
- VOS는 추정한 클래스 조건부 Gaussian 분포에서 가능도가 낮은 특징 벡터를 샘플링하고, 이를 분포 내(in-distribution, ID) 또는 알려진 클래스의 예제와 구별하도록 불확실성 분기를 학습한다. 별도의 실제 이상치 데이터셋을 사용하지 않으며 객체 탐지와 이미지 분류에 적용할 수 있다.
- PASCAL-VOC를 ID 데이터로, MS-COCO를 OOD 데이터로 사용했을 때 ResNet-50 기반 VOS는 FPR95 47.53%, 평균 정밀도(mAP) 48.9%를 달성한다. FPR95는 ID 샘플의 진양성률이 95%일 때 OOD 샘플의 거짓 양성률이며, mAP는 객체 탐지 정확도 지표다. Energy score 베이스라인은 FPR95 56.89%, mAP 48.7%를 기록한다. 별도의 실제 이상치 노출 비교에서는 ID와 OOD의 분리 성능을 나타내는 수신자 동작 특성 곡선 아래 면적(AUROC)이 VOS보다 높다.
1 Introduction
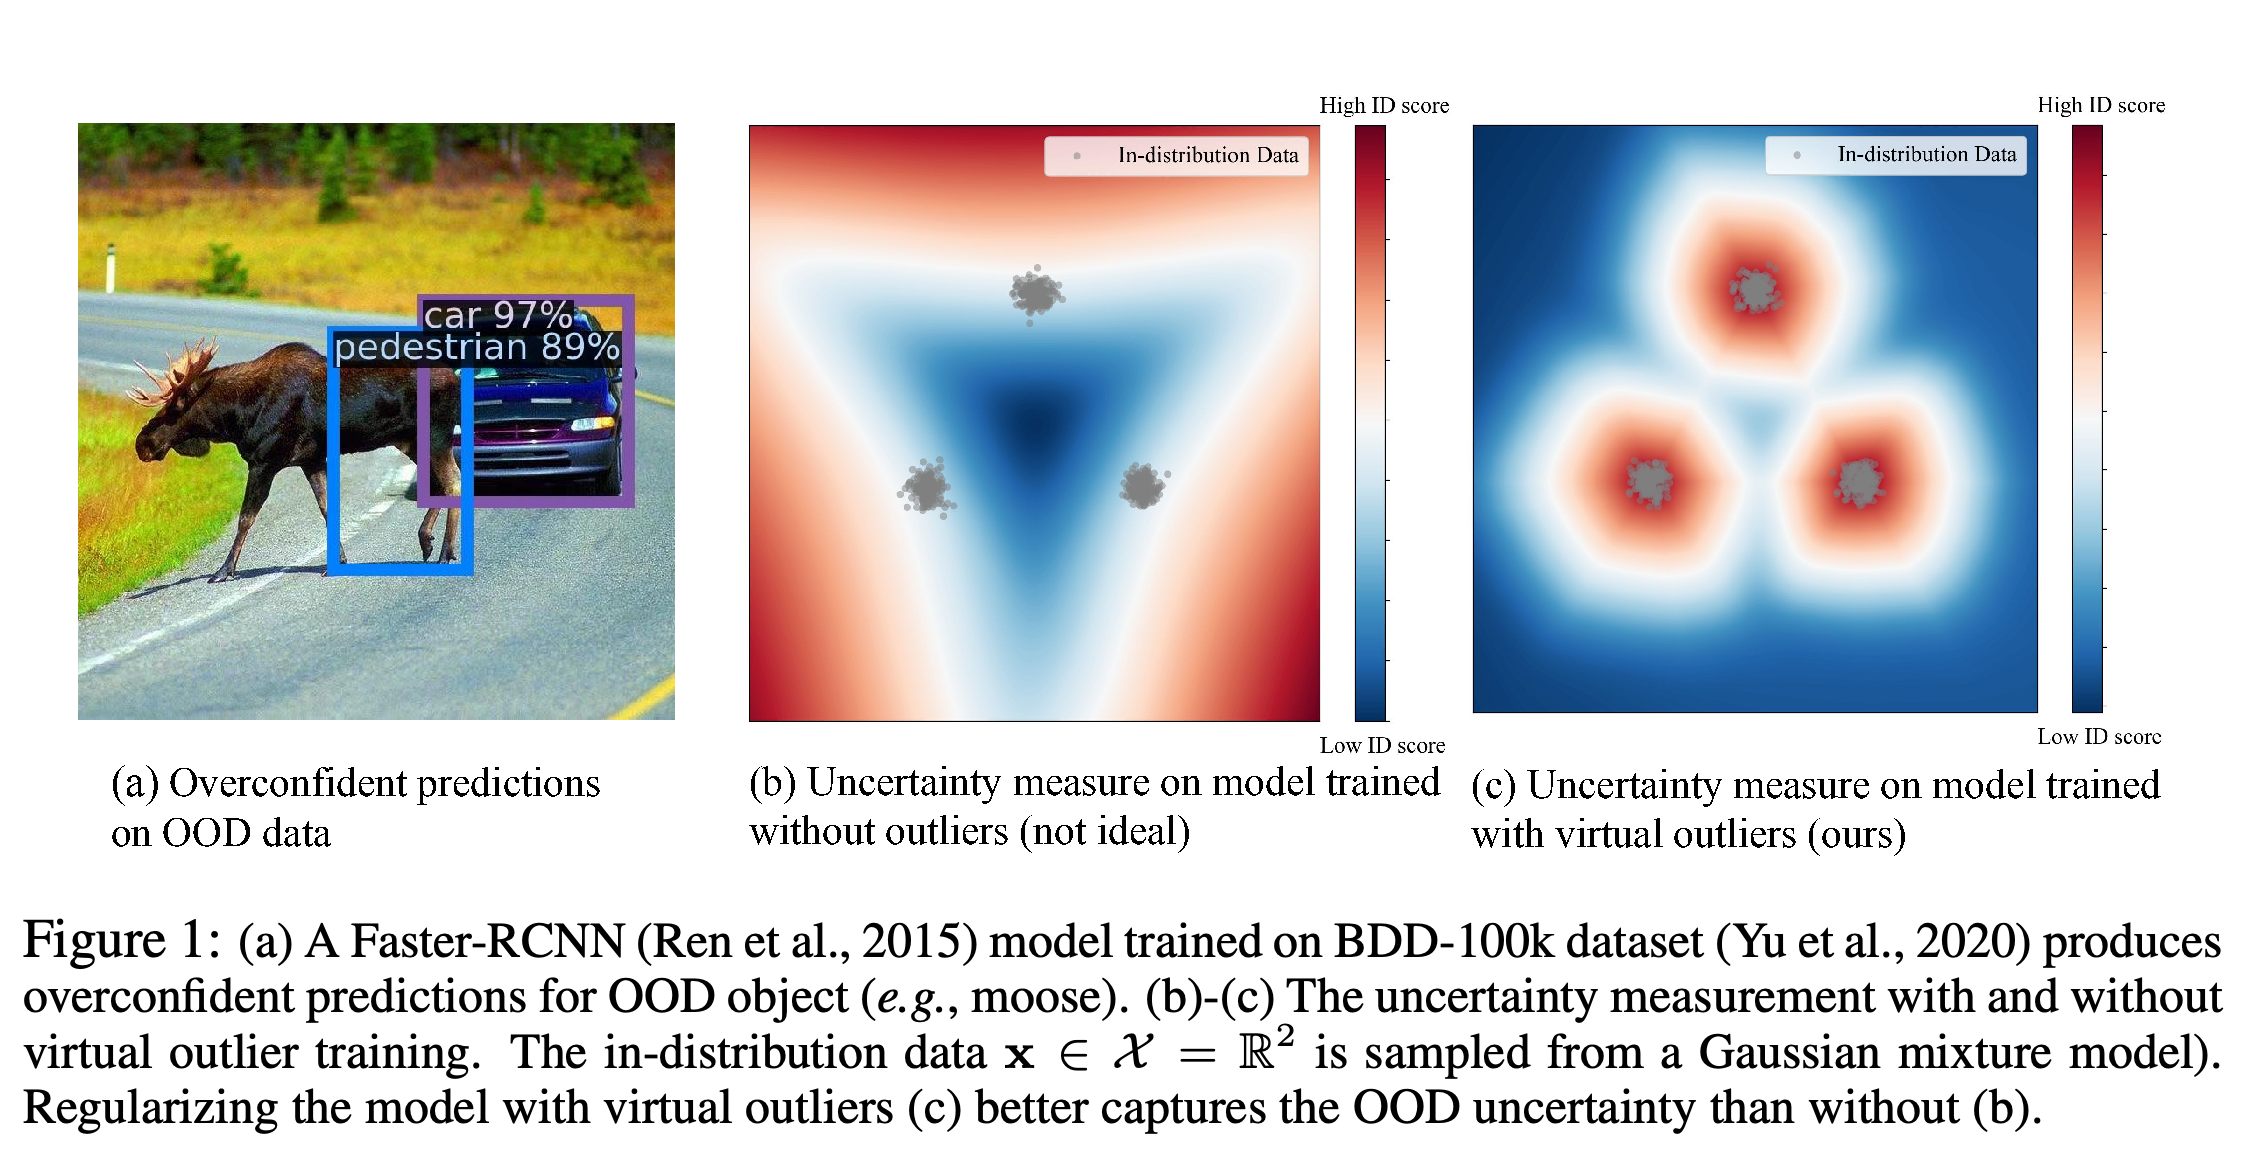
알려진 범주로만 학습한 모델은 낯선 객체에 높은 확신을 부여할 수 있다. 탐지기가 말코손바닥사슴을 보행자로 분류한 사례가 이를 보여준다. 논문은 미지의 입력에 대한 학습 신호를 생성해 ID 특징 주위에 더 조밀한 경계를 형성하고자 한다.
합성 예제에서 이상치 학습을 하지 않으면 높은 ID 점수가 학습 군집에서 멀리 떨어진 곳까지 나타나는 반면, VOS는 높은 점수를 군집 근처에 집중시킨다. 말코손바닥사슴 사례는 이에 대응하는 탐지 실패를 보여준다.
2 Problem Setup
객체 수준 과제에서는 예측한 각 bounding box를 ID 또는 OOD로 판정하므로 같은 이미지의 영역을 서로 다르게 처리할 수 있다. 탐지된 객체의 의미 범주가 학습 레이블 집합에 없으면 OOD로 간주한다. 이미지 분류는 box가 이미지 전체를 덮는 특수한 경우다. bounding box에 대해서는 Detecting Twenty-thousand Classes using Image-level Supervision 요약 설명 글을 참조하라.
3 Method
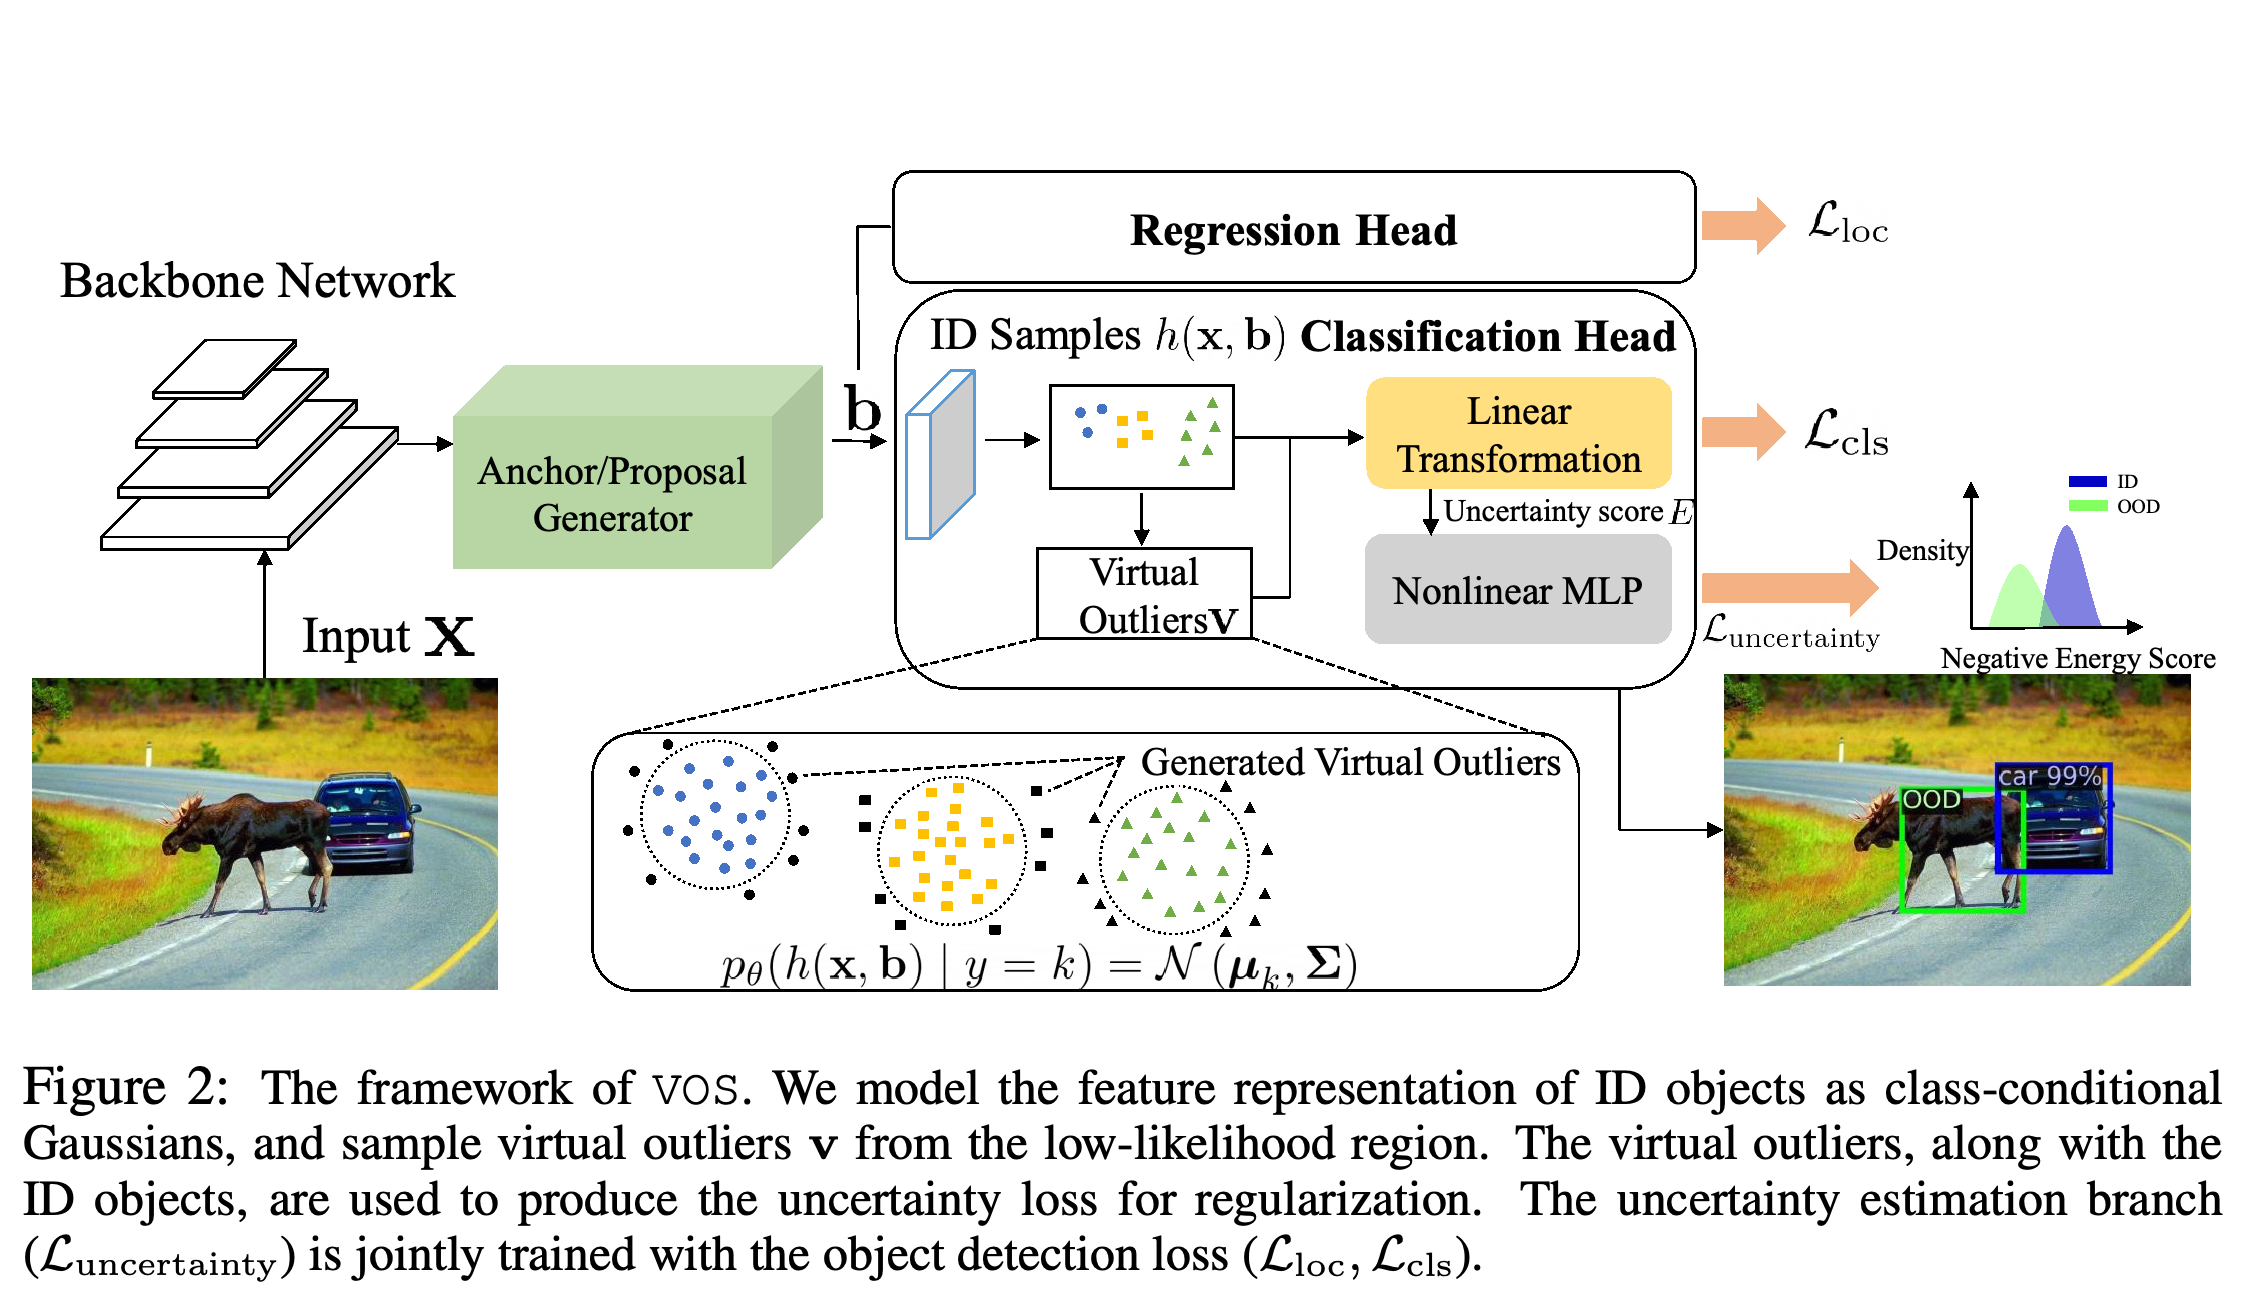
VOS는 특징 공간에서 이상치를 합성하고, 인식 과제와 함께 학습하는 불확실성 정규화 항과 추론 시 임계값을 적용하는 불확실성 점수를 결합한다.
그림은 클래스 조건부 특징 샘플링을 분류 및 위치 추정과 함께 학습하는 불확실성 분기에 연결해 VOS가 객체 탐지기에 통합되는 방식을 보여준다.
3.1 VOS: VIRTUAL OUTLIER SYNTHESIS
이 방법은 마지막 직전 계층의 객체 특징을 클래스별 평균과 공유 공분산을 갖는 클래스 조건부 다변량 Gaussian으로 모델링한다. 이 분포는 클래스별 큐를 이용해 온라인으로 추정한다. 각 Gaussian에서 샘플링한 벡터 중 가능도가 임계값보다 낮은 벡터를 선택하고, 이 가상 이상치를 분류기의 마지막 선형 계층에 전달한다.
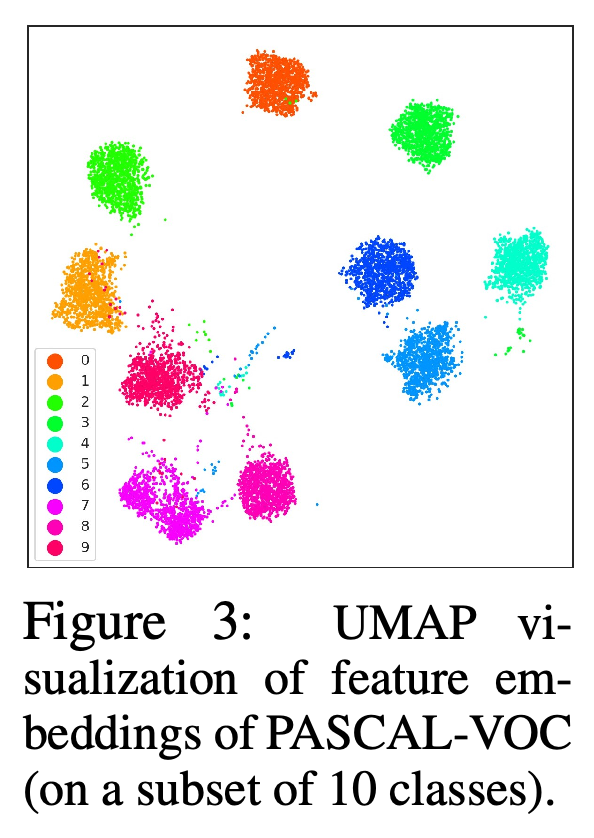
표시된 2차원 특징 투영에는 PASCAL-VOC 클래스 일부가 구분된 군집으로 나타나 클래스 조건부 모델링의 동기를 제공한다. 다만 원래 특징이 정확히 Gaussian 분포를 따른다는 것을 입증하지는 않는다.
3.2 Unknown-Aware Training Objective
이진 sigmoid 손실은 분류기 출력에서 얻은 energy score를 입력받는 작은 신경망인 비선형 다층 퍼셉트론(MLP)을 학습한다. 이 MLP는 ID 특징에 높은 ID 확률을, 가상 이상치에 낮은 ID 확률을 부여한다. 객체 탐지에서는 학습 가능한 클래스 가중치로 energy를 계산하고, 불확실성 손실에 가중치 β를 곱해 분류 및 box 회귀 손실에 더한다.
3.3 Inference-time OOD Detection
추론 시 탐지기는 학습된 불확실성 분기로 예측한 각 box의 점수를 계산하고 ID 확률을 임계값 γ와 비교한다. 임계값은 ID 예제의 95%를 유지하도록 선택할 수 있다.
4 EXPERIMENTAL RESULTS
실험에서는 객체 수준 OOD 탐지와 이미지 수준 분류를 평가하고, OOD 분리 성능과 원래 ID 과제의 성능을 함께 측정한다.
4.1 Evaluation on Object Detection
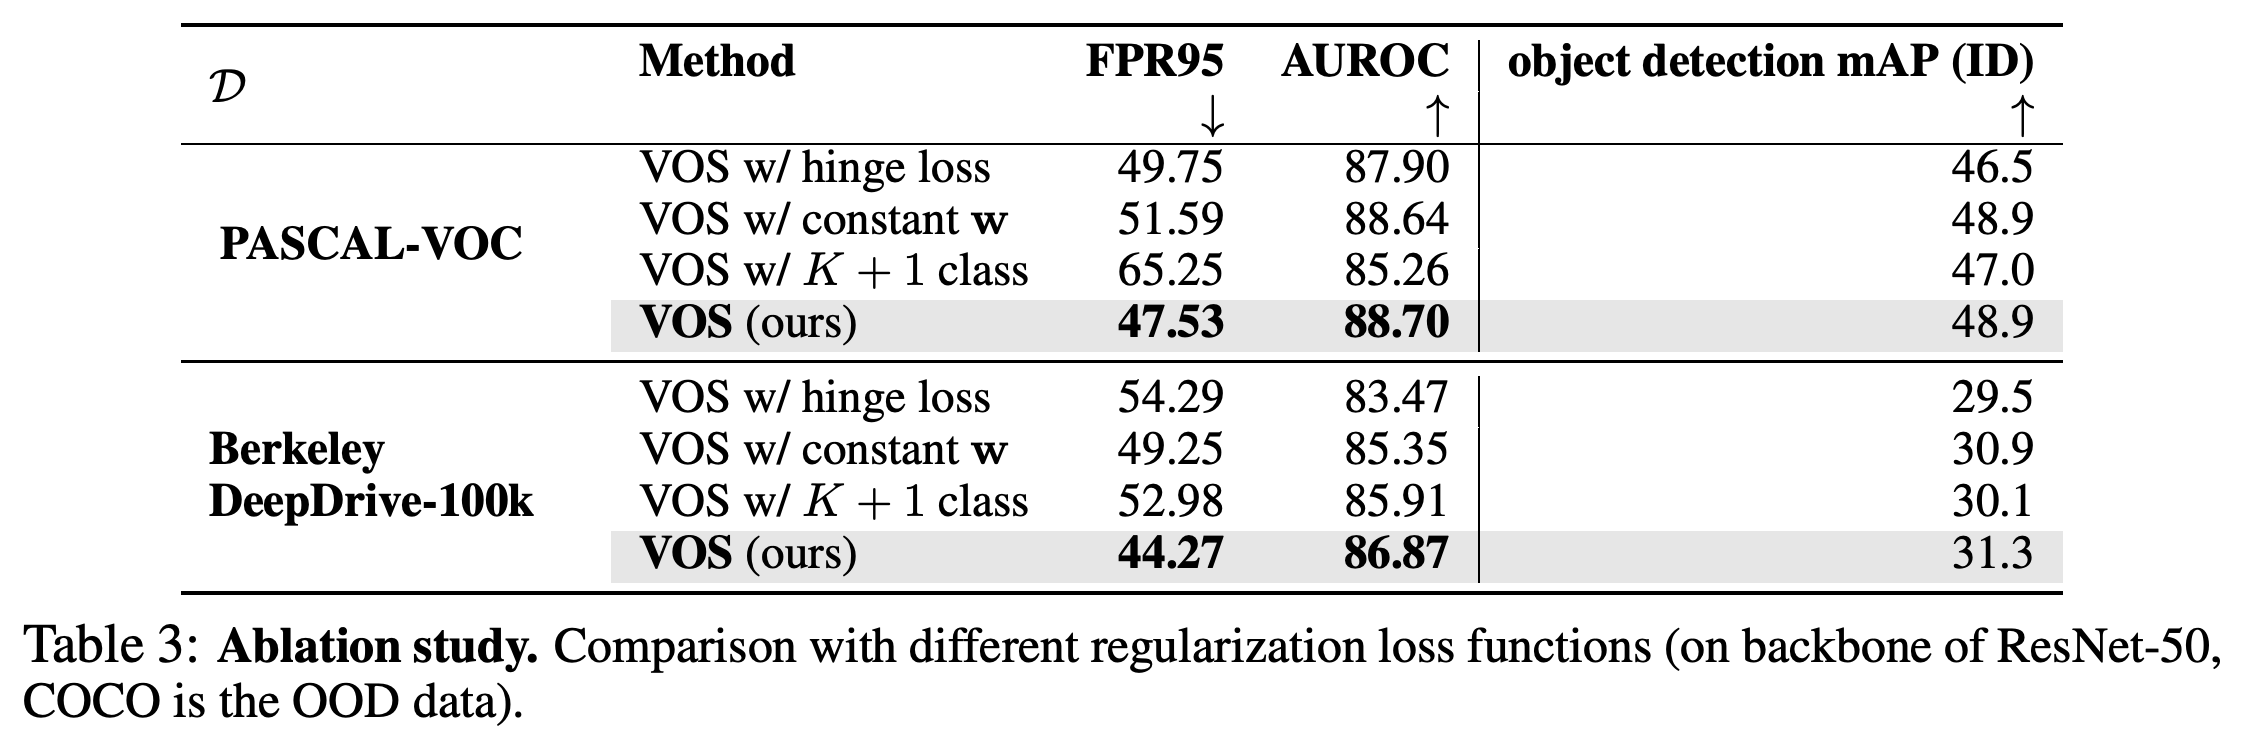
탐지기 실험은 PASCAL-VOC 또는 Berkeley DeepDrive(BDD-100k)로 학습하고, 사람이 직접 선별한 MS-COCO와 OpenImages의 부분 집합을 OOD 데이터로 사용한다. ResNet-50과 MS-COCO OOD 데이터를 사용했을 때 VOS의 FPR95는 PASCAL-VOC에서 47.53%, BDD-100k에서 44.27%다. 논문에 제시된 최고 성능 베이스라인의 해당 값은 각각 56.89%와 47.10%다.
VOS-ResNet50은 논문에 제시된 ResNet-50 기반 베이스라인보다 OOD 분리 성능을 높이면서 비슷한 ID mAP를 유지한다. VOS-RegX4.0은 다른 backbone을 사용하므로 성능 향상에는 구조 변경의 영향도 반영된다.
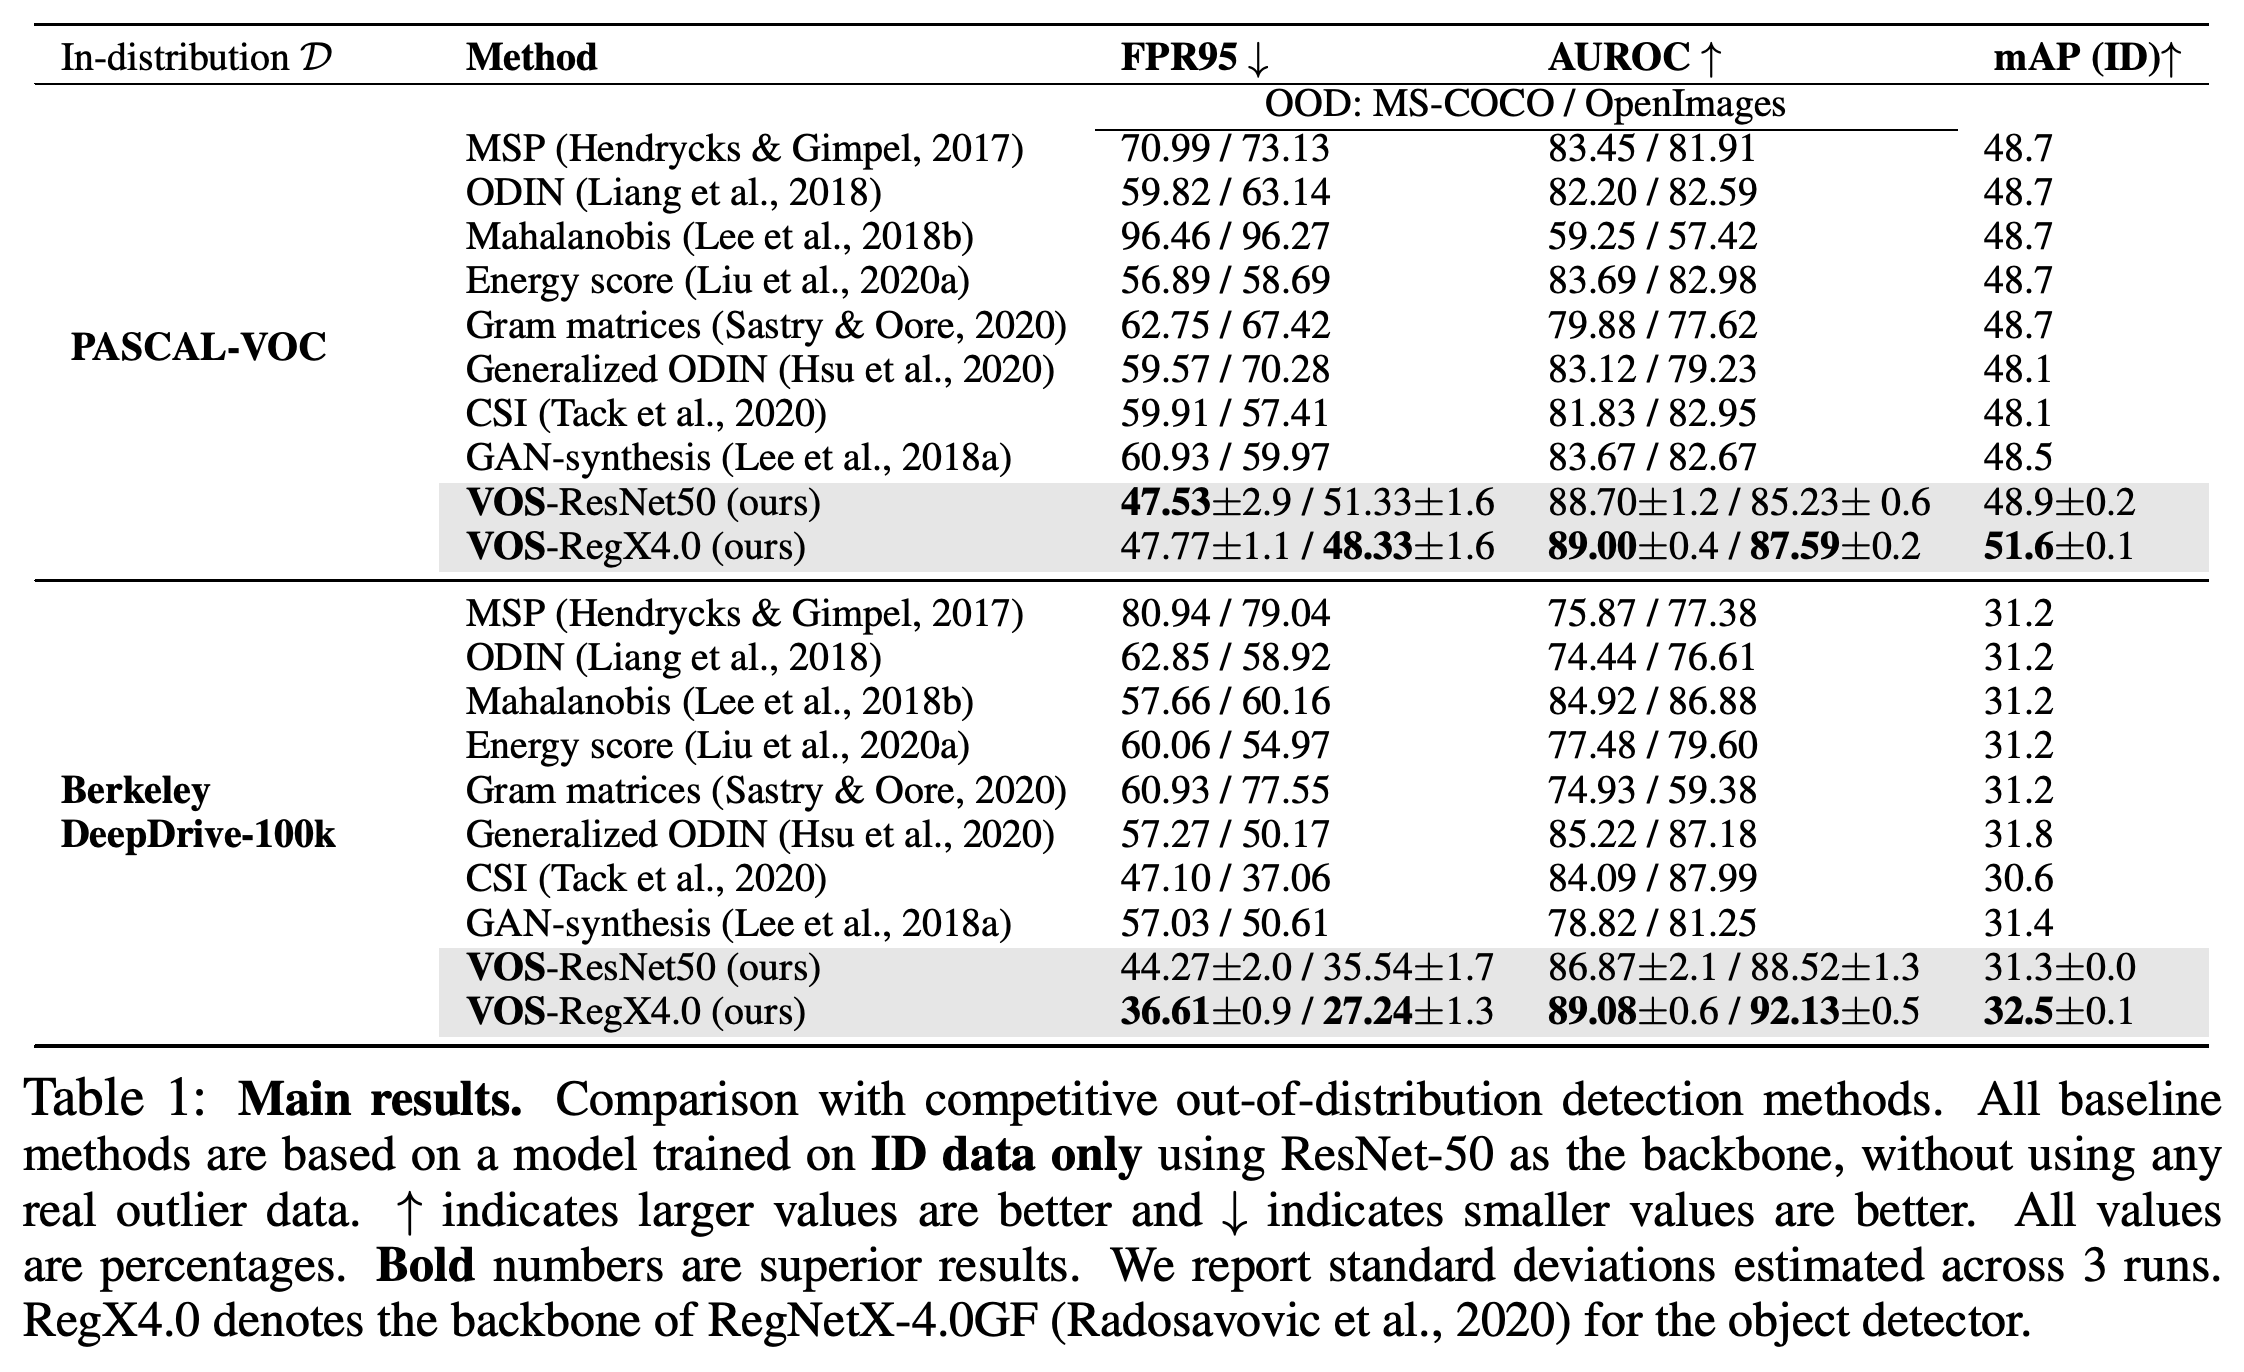
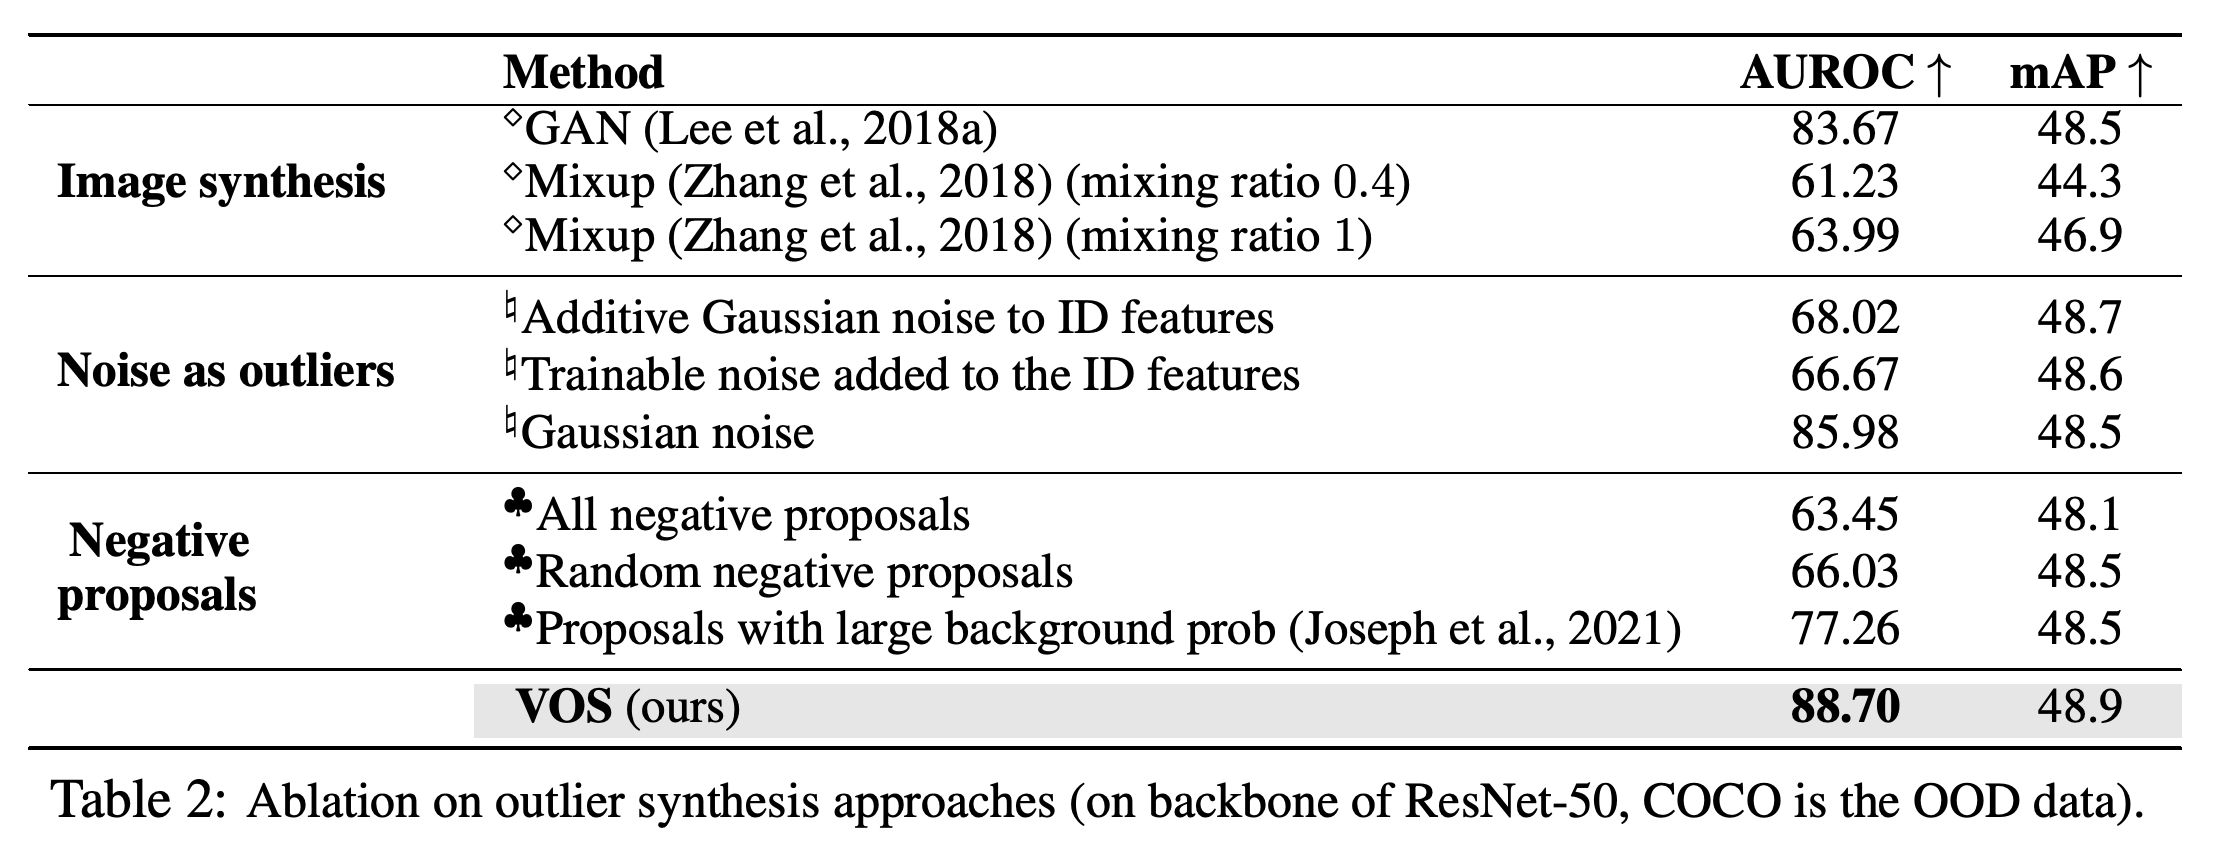
PASCAL-VOC와 MS-COCO 설정에서 가상 특징 이상치의 AUROC는 88.70%로, Gaussian noise의 85.98%와 생성적 적대 신경망(GAN)이 생성한 이미지의 83.67%보다 높다. BDD-100k에서 제안한 불확실성 손실의 FPR95는 44.27%로, 제곱 hinge loss 변형의 54.29%보다 낮다. 실제 이상치로 학습하는 Outlier Exposure는 PASCAL-VOC와 COCO에서 AUROC 90.18%를 기록해 VOS의 88.70%보다 높다. 생성적 적대 신경망(GAN)에 대해서는 DCGAN(Deep Convolutional GAN, DCGAN 논문 설명) 글을 참조하라.
동일한 PASCAL-VOC와 COCO 평가에서 VOS는 제시된 이미지 합성, noise, 음성 제안 영역 방법보다 높은 AUROC를 기록하면서 mAP 48.9%를 유지한다.
제안한 손실은 ID 데이터셋 2개 모두에서 hinge loss, 고정 energy 가중치, 추가 이상치 클래스를 사용한 경우보다 FPR95가 낮다.
4.2 Evaluation on Image Classification
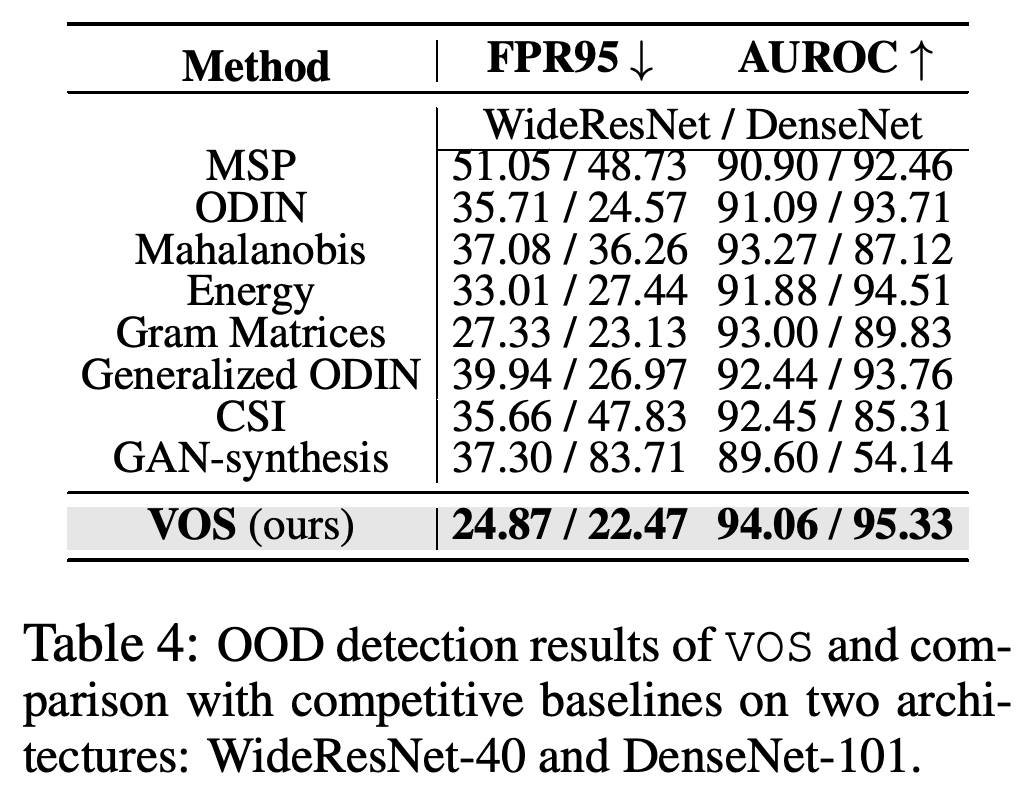
CIFAR-10을 ID 데이터로 사용하고 Textures, SVHN, Places365, LSUN-C, LSUN-Resize, iSUN의 결과를 평균하면 VOS의 FPR95는 WideResNet-40에서 24.87%, DenseNet-101에서 22.47%다. WideResNet의 ID 정확도는 VOS 적용 시 94.68%, 사전 학습 모델에서는 94.84%다.
OOD 데이터셋 6개의 평균에서 VOS는 WideResNet-40과 DenseNet-101 모두에서 보고된 FPR95가 가장 낮고 AUROC가 가장 높다.
4.3 Qualitative Analysis
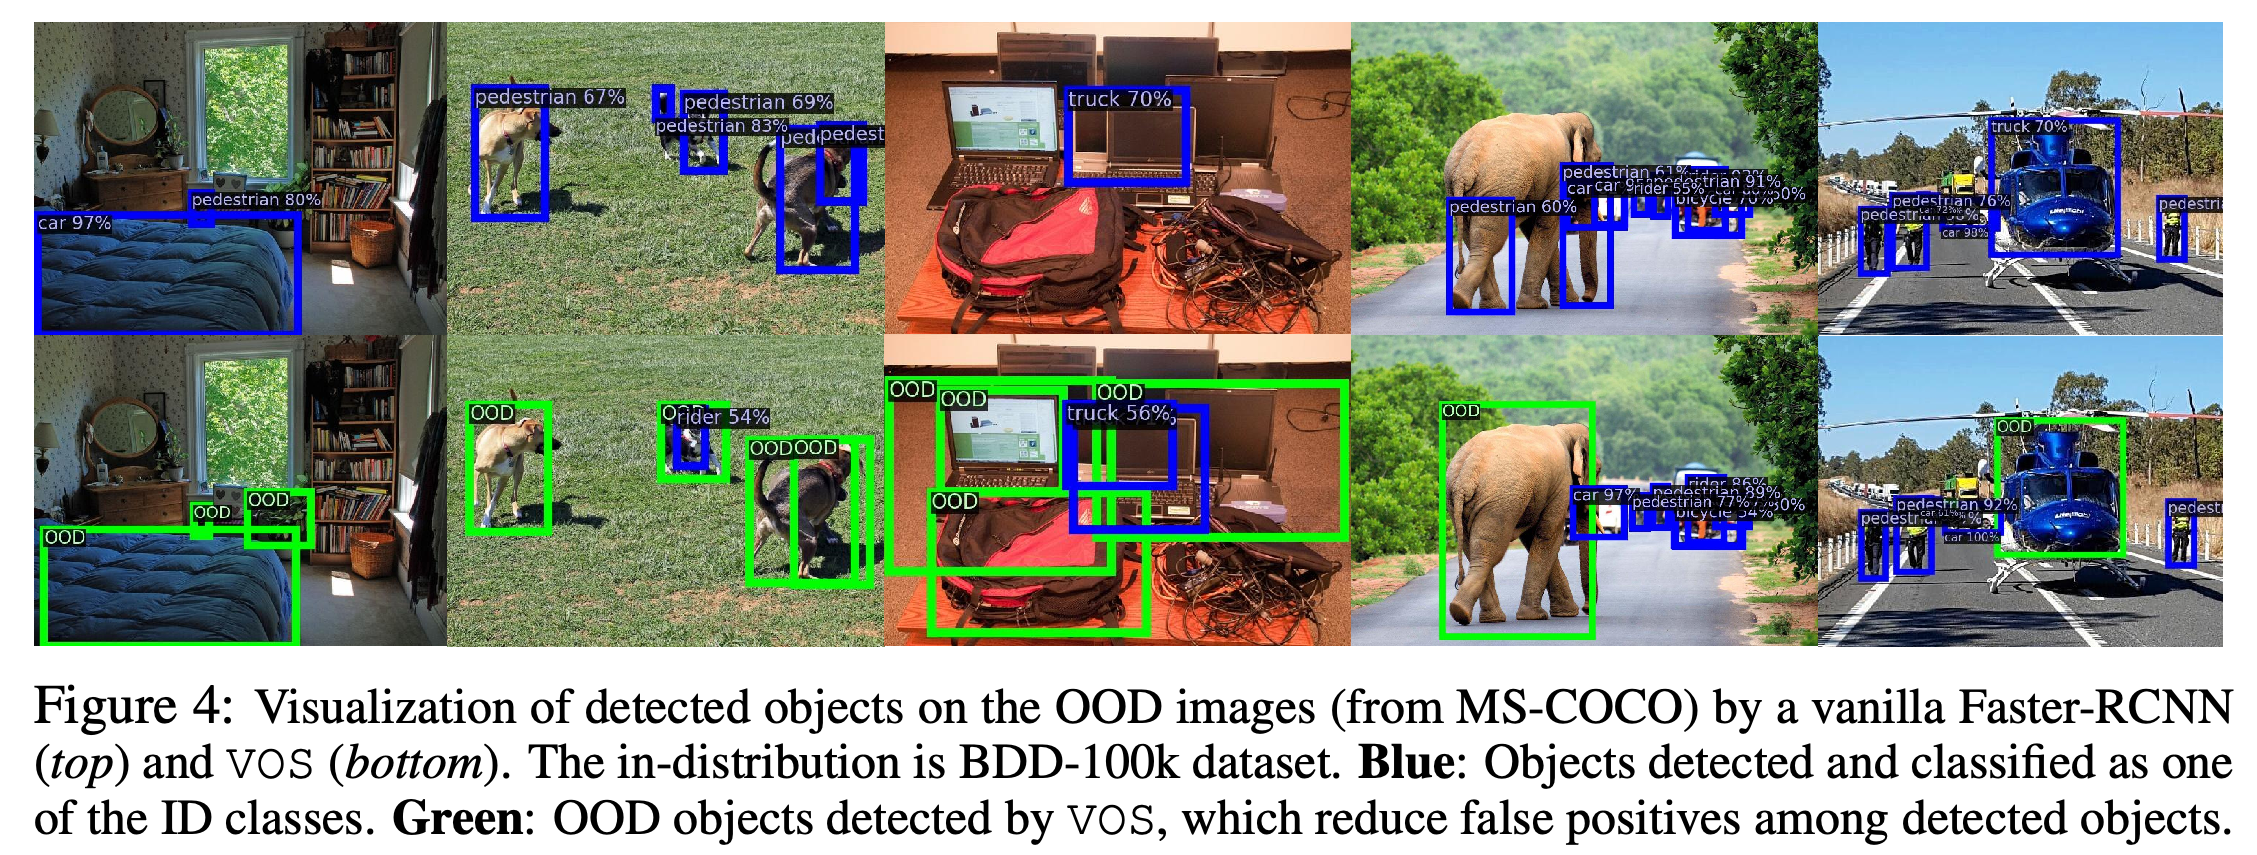
정성적 비교에서 BDD-100k-trained Faster-RCNN이 알려진 클래스 레이블을 부여한 낯선 MS-COCO 객체들을 VOS는 OOD로 표시한다. VOS에서도 확신도가 더 낮은 트럭 예측을 비롯해 일부 거짓 양성은 남는다.
나란히 제시된 예측은 베이스라인이 알려진 BDD-100k 클래스로 분류한 낯선 객체를 VOS가 거부할 수 있음을 보여준다. 다만 알려진 클래스로 분류한 예측도 일부 남는다.
5 Related Work
논문은 VOS를 사후 불확실성 점수, 실제 또는 생성된 이상치를 이용한 정규화, 객체 수준 불확실성 방법과 비교한다. VOS의 클래스 조건부 Gaussian 추정치는 학습 중 갱신되는 반면, 비교 대상인 Mahalanobis 방법은 특징 분포를 사후 탐지에 사용한다(Lee et al., 2018b).
6 Conclusion
저자들은 가능도가 낮은 특징을 합성하면 평가한 탐지기와 분류기에서 ID 과제의 성능을 유지하면서 OOD 분리 성능을 개선할 수 있다고 결론 내린다.
Reproducibility Statement
논문은 공개 데이터셋, 베이스라인 설정, 학습 세부 사항과 의사코드를 명시하고 구현을 https://github.com/deeplearning-wisc/vos 에 제공한다. 객체 탐지 학습에는 Detectron2를 사용한다: https://github.com/facebookresearch/detectron2.
Ethics Statement
저자들은 이 연구가 자율주행과 같은 응용 분야의 신뢰성을 높이는 데 기여한다고 설명하며, 연구에 인간 대상자가 참여하지 않았다고 밝힌다.
부록
- A EXPERIMENTAL DETAILS와 B SOFTWARE AND HARDWARE: PASCAL-VOC와 BDD-100k 모델은 각각 18,000회와 90,000회 반복 학습한다. 불확실성 정규화는 전체 학습의 2/3가 지난 후 β = 0.1로 시작한다. 실험에는 Python 3.8.5, PyTorch 1.7.0, NVIDIA GeForce RTX 2080Ti GPU를 사용한다.
- C EFFECT OF HYPERPARAMETERS: 저자들은 클래스별 후보 10,000개에서 가능도가 가장 낮은 샘플 1개를 사용하며, 큐 크기는 PASCAL에서 1,000, BDD-100k에서 300이다. 민감도 실험은 주요 OOD 테스트 데이터셋 대신 speckle noise를 추가한 PASCAL-VOC 검증 데이터를 사용한다. β = 0.5일 때 mAP는 36.4로 낮아지고 FPR95는 99.33%로 높아진다.
- D ADDITIONAL VISUALIZATION RESULTS와 E BASELINES는 추가 사례와 구현 설정을 제공한다. ODIN과 Mahalanobis에서는 영역 자르기와 탐지기의 영역 특징 추출 연산인 ROIAlign 때문에 종단 간 미분이 불가능하므로 입력 noise를 0으로 설정한다.
- F VIRTUAL OUTLIER SYNTHESIS USING EARLIER LAYER는 마지막 직전 계층이 그 앞 계층보다 우수하다는 결과를 제시한다. BDD-100k와 COCO OOD 데이터에서 FPR95는 각각 44.27%와 49.66%다. G는 학습된 energy 가중치와 클래스 빈도의 관계를 살펴보고, H는 2차원 UMAP 특징 투영을 사용해 Person 특징 군집 주변의 가상 이상치를 시각화한다.
- I Discussion on the detected, rejected and ignored OOD objects during inference는 VOS가 탐지된 box의 분류를 대상으로 한다는 점을 강조한다. 저자들은 ResNet backbone을 사용하는 BDD-100k 실험에서 동일한 기본 임계값을 적용했을 때, 일반 Faster-RCNN보다 탐지된 OOD box가 25% 많고 거부된 OOD 샘플이 63% 많다고 보고한다.
짧은 생각
동일 backbone을 사용한 비교와 합성 방법의 소거 실험은 특징 공간 이상치의 유용성을 뒷받침하지만, 성능은 데이터셋에 따라 달라진다. PASCAL-VOC ResNet-50 모델의 COCO FPR95는 47.53%다. Gaussian 가정과 탐지기의 제안 영역에 대한 의존성 때문에, 이 실험만으로는 제안되지 않은 낯선 객체나 테스트한 OOD 집합과 다른 객체에 대한 성능을 확인하기 어렵다.