


Aristotle: IMO-level Automated Theorem Proving 요약 설명
01 Oct 2025 | Paper Review Mathematical Reasoning Formal Verification Reinforcement Learning Test-Time Adaptation목차
이번 글에서는 Aristotle: IMO-level Automated Theorem Proving 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 1일(Arxiv)
- Achim, Tudor, Best, Alex, Bietti, Alberto, Der, Kevin, Fédérico, Mathïs, Gukov, Sergei, Halpern-Leistner, Daniel, Henningsgard, Kirsten, Kudryashov, Yury, Meiburg, Alexander, et al.
- Harmonic, California Institute of Technology, Cornell University, University of Waterloo and Perimeter Institute, University of Southern California
- 논문 링크
- Project Page
요약
- 자동 정리 증명은 정확성을 자동으로 검증할 수 있는 어려운 수학적 증명을 생성하는 작업이다. Aristotle은 2025 International Mathematical Olympiad (IMO)의 6개 문제 중 5개에 대해 기계로 검증한 풀이를 생성했다. 이는 인간 참가자가 5개 문제를 완벽하게 풀면 금메달에 해당한다는 논문의 비교 기준과 일치한다.
- 이 시스템은 기계로 검증할 수 있는 증명 언어인 Lean 4에서의 증명 탐색, 보조정리를 생성하고 형식화하는 비형식 추론 파이프라인, 별도의 기하 문제 해결기를 결합한다. 보조정리는 목표 정리를 증명하는 데 쓰이는 중간 수학 명제다. 학습된 모델은 증명 단계를 제안하고 성공 가능성을 추정하며 형식 검증 피드백은 탐색과 수정을 안내한다.
- IMO 평가에서는 사람이 형식화한 문제 명제, 매개변수가 200B개를 넘는 탐색 모델, 병렬 추론 파이프라인, 반복적인 피드백, test-time training을 사용했다. Test-time training은 추론 중 수집한 경험으로 모델을 다시 학습하는 방법이다. 보고서는 검증된 증명 결과물과 일부 수학적 응용 사례를 제시하지만 평가에 사용한 총 연산량, 경과 시간, 각 구성 요소가 개별적으로 기여한 성능 향상은 정량화하지 않는다.
1 Introduction
논문은 자동 검증이 신뢰할 수 있는 학습 신호를 제공하고 생성된 논증을 확인하는 부담을 줄인다는 점에서 형식 수학 추론에 주목한다. 기하 외 문제의 풀이는 Lean의 수학 라이브러리인 Mathlib을 사용하는 완전한 Lean 4 증명이어야 한다. 증명에는 논리적 공백이나 미완성 증명과 관련된 공리인 sorryAx처럼 건전하지 않은 공리가 없어야 한다. 기하 문제는 별도로 처리하지만 이 경우에도 기계 검증이 필요하다.
- 3개 하위 시스템은 병렬 Lean 증명 탐색, 반복적인 비형식 추론과 보조정리 형식화, Olympiad 기하 문제를 푸는 시스템인 AlphaGeometry에 기반한 평면기하 문제 해결기다.
- 평가한 시스템은 경시대회 수학에 맞게 fine-tuning했으며 더 넓은 범위의 형식 수학으로도 학습했다. 공개한 IMO 증명 저장소는 https://github.com/harmonic-ai/IMO2025 이다.
2.1 Search Algorithm
증명 탐색 구성 요소는 Lean 코드 블록을 받아 미완성 증명을 나타내는 자리표시자 sorry를 모두 검증된 코드로 대체하려 한다. 샘플링한 행동과 추정값으로 탐색을 안내하는 Monte Carlo Tree Search (MCTS)를 기반으로 하며, 1개 모델이 tactic 생성과 가치 추정을 모두 수행한다.
- Tactic은 증명 목표를 바꾸거나 해결하는 Lean 명령이다. 행동을 제안하는 모델의 절차인 생성 정책은 탐색이 진행될수록 샘플링할 행동 집합을 확장하는 progressive widening으로 tactic을 샘플링한다. 이때 증명 상태, 행동 이력, 사용 가능한 비형식 증명을 조건으로 삼는다.
- 같은 모델과 거의 같은 프롬프트가 정책 작업과 가치 추정 작업에 쓰이며 작업 토큰으로 둘을 구분한다. 가치 함수는 증명 상태의 성공 가능성을 추정해 탐색을 안내한다. 탐색은 독립적으로 실행하거나 외부 추론 과정이 제공한 증명 개요를 완성할 수 있다.
2.1.1 States and Actions
탐색은 초기 Lean 코드 조각을 실행해 얻은 증명 상태에서 시작한다. 증명 상태는 목표와 사용 가능한 가정의 집합이다. 여러 목표에 metavariable이 없으면 목표를 별도 상태로 나눈다. Metavariable은 목표들을 서로 연결할 수 있는 미해결 변수다. Metavariable이 있으면 목표들을 함께 유지한다. 다만 명시적인 sorry 자리표시자로 도입한 목표는 반드시 분리해야 하며 metavariable을 포함할 수 없다.
- 행동은 1개 또는 여러 tactic을 포함하는 Lean 코드 조각이며 비형식 주석을 포함할 수도 있다. 행동이 여러 후속 상태를 만들 수 있으므로 탐색은 hypertree를 형성한다. Hypertree는 행동이 여러 필수 하위 목표로 분기할 수 있는 트리다.
- 프롬프트에는 행동 이력이 포함된다. 저자들은 행동 이력이 순환하는 탐색 경로를 줄이고 일관된 증명 전략을 유지하는 데 도움이 된다고 보고한다. 참조할 자연어 증명이 있으면 함께 포함한다.
2.1.2 Equivalences and Graph Search
Aristotle은 목표 표현식, 로컬 문맥의 표현식, 로컬 변수 이름이 같은 상태를 병합하고 결과 전이가 동등한 행동도 병합한다. 이러한 재사용으로 hypertree가 hypergraph로 바뀐다. Hypergraph는 행동이 여러 후속 상태에 연결될 수 있는 그래프다. 따라서 이 알고리즘은 Monte Carlo Graph Search (MCGS)의 한 형태다.
- 자동 Lean 증명 탐색 tactic인 aesop처럼 전역 상태에 영향을 받는 tactic이 있어, 초기 상태가 동등해도 결과가 항상 동등하지는 않다. 보고서는 실제로 이 문제를 처리한다고 설명하지만 우회 방법은 구체적으로 밝히지 않는다.
- 단계별 최악의 시간 복잡도는 트리의 O(D)에서 그래프의 O(V)로 바뀐다. D는 그래프의 지름이고 V는 정점 수다. 저자들은 실제로 다룬 그래프에서는 CPU 병목이 없었다고 보고한다.
2.1.3 Search Strategy
탐색은 추정한 행동 품질과 사전 정책으로 가중한 탐색 사이에서 균형을 잡는 규칙인 Predictor Upper Confidence bound applied to Trees (PUCT)의 변형을 사용한다. Aristotle은 샘플링한 행동의 경험적 빈도로 사전 정책을 추정한다. 같은 행동을 여러 동등한 텍스트 형태로 표현할 수 있을 때 불이익을 줄 수 있는 시퀀스 로그 확률은 사용하지 않는다.
- 상태는 어떤 행동이든 해당 상태를 증명하면 성공하지만 행동은 그 결과로 생긴 모든 상태가 증명되어야 성공한다. 이 AND/OR 구조에 따라 알고리즘은 신뢰 상한이 가장 높은 행동을 선택한 뒤 신뢰 하한이 가장 낮은 후속 상태를 우선 처리한다.
- 단일 목표 상태에는 목표의 논리적 부정에 해당하는 전이도 추가한다. 탐색은 이 전이에 예산을 사용해 명제를 반증하고 상태를 가지치기할 수 있다.
2.1.4 Interleaving Informal Reasoning
모델은 형식 Lean 코드와 함께 비형식 주석을 생성하고 행동을 선택하기 전에 숨겨진 추론 기록을 사용한다. 이때 사고 예산을 동적으로 선택한다. 주석은 이후 증명 문맥에서도 사용할 수 있지만 숨겨진 추론 기록에는 나중에 접근할 수 없다.
- 형식 코드, 주석, 숨겨진 추론을 함께 학습한다. 초기에는 주석 생성을 수동으로 강제하며 이후에는 탐색 결과의 피드백으로 학습하는 강화학습에서도 주석 생성이 유지된다.
- 저자들은 주석 생성이 계속 유지된다는 점을 비형식 추론이 탐색에 도움이 된다는 근거로 해석한다. 또한 동적 예산을 활용해 학습에 유용한 추론 기록을 선택한다. 보고서는 구성 요소의 기여를 분리하는 통제된 ablation 실험으로 이러한 효과를 측정하지 않는다.
2.1.5 Postprocessing
탐색이 끝나면 Aristotle은 자동 코드 품질 권고인 linter 제안을 적용하고 tactic 코드를 정리한다. 추가 오프라인 연산으로 증명을 더 짧고 간단하게 만든다. 완성된 증명은 시작 상태가 1개인 비순환 부분 그래프이며 포함된 각 상태에는 성공한 행동이 1개씩 있다. 선택한 행동이 요구하는 모든 후속 상태도 포함된다.
- 상태에는 비용이 서로 다른 여러 증명이 존재할 수 있다. 후처리로 불필요한 행동 시퀀스를 제거하거나 더 효율적인 증명을 만들 수 있다.
2.1.6 Reinforcement Learning
학습은 사전 학습된 대규모 언어 모델에서 시작해 expert iteration으로 진행한다. 탐색으로 생성한 풀이를 반복적으로 사용해 이후 탐색을 안내하는 모델을 개선한다. 수학 명제는 오픈소스 데이터와 자체 데이터에서 가져온다. 명제를 자동으로 형식화하고 Lean 코드를 실행해 증명 상태를 확인하는 인터페이스인 Lean read-eval-print loop (REPL)에서 얻은 신호로 판정한 뒤 수정한다.
- 정책은 탐색으로 발견한 증명 중 자명하지 않은 증명을 선별해 학습한다. 가치 함수는 증명된 상태와 그 주변에서 반증되었거나 상당한 노력을 들인 뒤에도 증명되지 않은 상태로 학습한다.
- 비형식 증명이 있으면 판정기가 이를 충실히 따르지 않는 형식 증명을 걸러낸다. 중간 상태의 증명도 독립적인 학습 문제로 재사용한다. 이는 달성한 중간 목표를 학습 대상으로 재사용하는 Hindsight Experience Replay와 유사하다.
2.1.7 Test-Time Training
Test-time training (TTT)은 목표 문제와 생성한 보조정리의 증명 시도를 수행한 뒤, 목표가 해결되지 않으면 추출한 탐색 기록으로 재학습하는 과정을 번갈아 반복한다. 저자들은 같은 탐색 예산에서 기본 모델이 풀지 못한 어려운 문제를 IMO 이전에 TTT로 해결했다고 보고하지만 문제 수나 추가 학습 비용은 제시하지 않는다.
- 저자들은 IMO 평가에서 TTT가 보조정리 처리를 가속하고 서로 다른 증명 개요 사이에 유용한 경험을 전달했다고 보고한다.
- TTT는 초기 시도에서 기본 명령의 유용한 조합을 학습해, 모델이 익숙하지 않은 Lean 추상화를 다루는 데도 도움이 된다.
2.2 Lemma-based Reasoning
외부 추론 시스템은 목표 정리에 맞춘 후보 보조정리를 탐색 알고리즘에 제공한다. 탐색은 이미 증명된 배경 결과가 포함된 Lean 코드를 입력으로 받을 수 있으므로, 완성된 보조정리는 이후 증명 단계의 문맥이 된다.
- 어려운 목표를 더 작은 형식 증명 작업의 연속으로 바꾸는 것이 목적이다. 저자들은 탐색만 사용할 때보다 개선되었다고 보고하지만 이 보고서에는 수치 비교가 없다.
2.2.1 Lemma Generation Pipeline
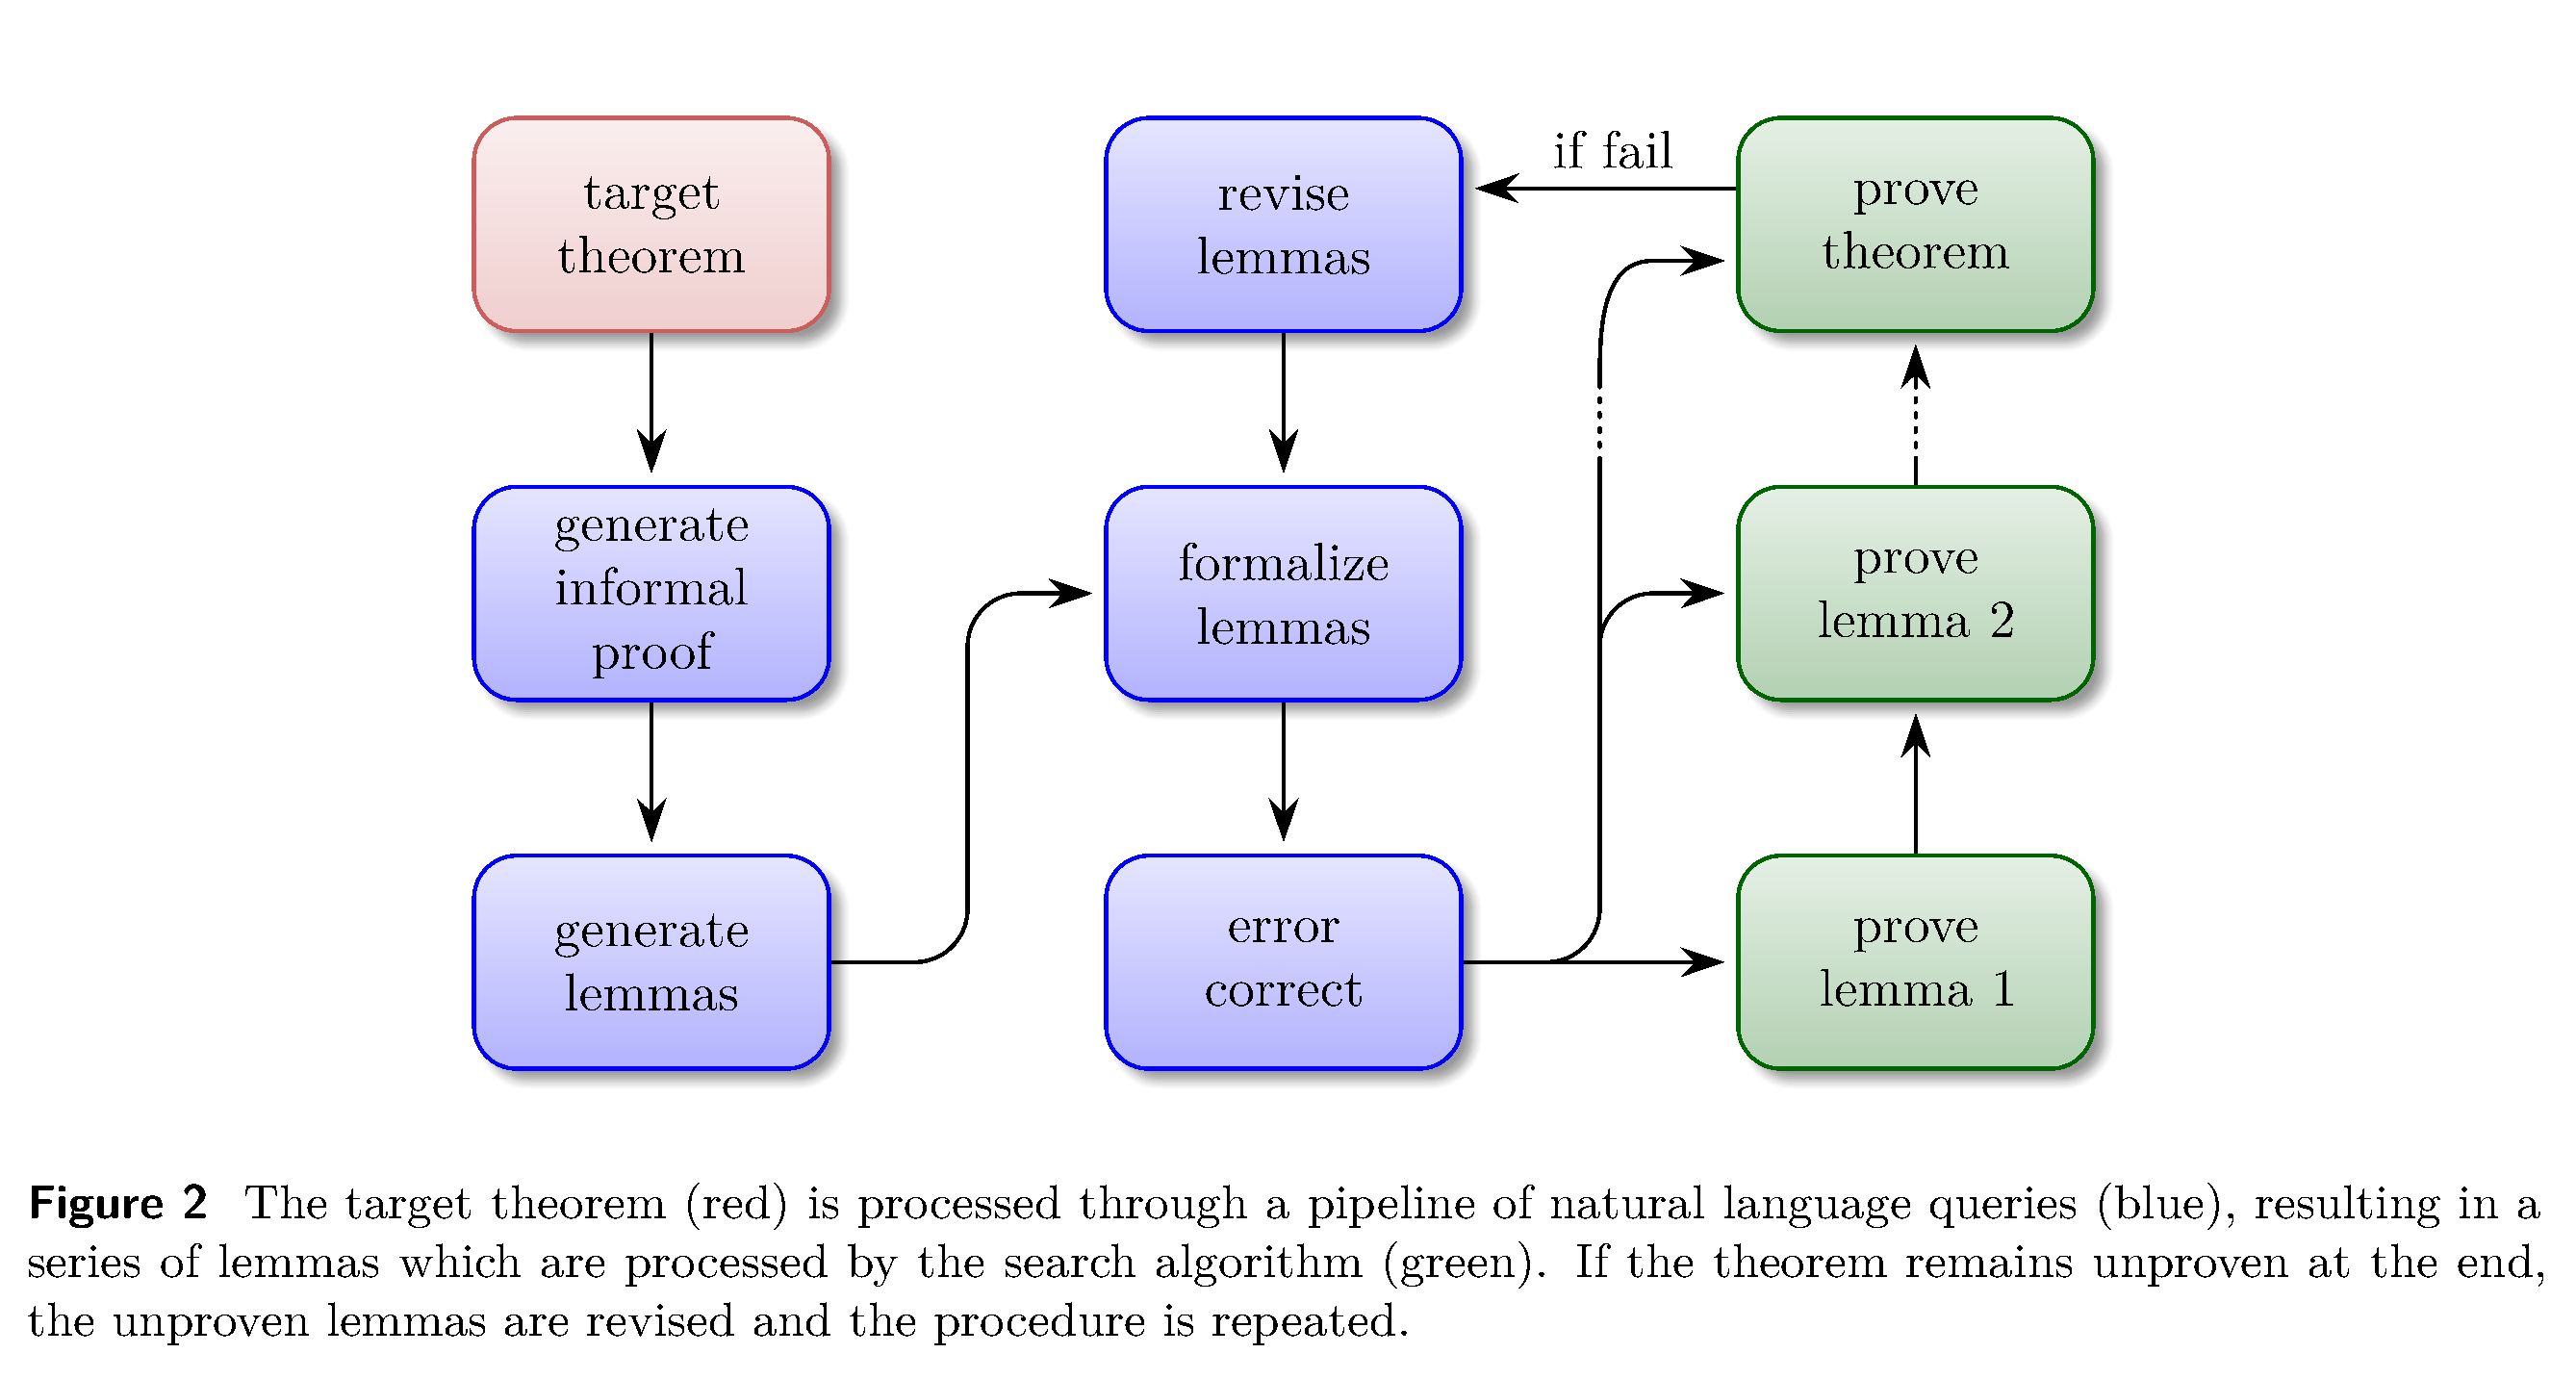
파이프라인은 먼저 비형식 증명을 생성하고 서로 의존하면서 개별 증명이 짧은 보조정리의 연속으로 재구성한다. 이어서 보조정리 명제를 형식화하고 Lean REPL이 반환한 오류를 수정한다. 각 단계에는 검토와 수정을 위한 여러 하위 질의가 포함된다.
- 비형식 증명에는 논리적 공백이 있을 수 있고, 수정한 뒤에도 보조정리 명제가 잘못 형식화된 채 남을 수 있다. 저자들은 탐색을 개선할 만큼 유용하고 올바르게 형식화된 보조정리가 충분히 남는다고 보고한다.
- Figure 2는 파이프라인과 피드백 루프를 보여준다. 해당 절에서 Figure 1을 참조한 부분은 번호 오류로 보인다. Figure 1은 명제 논리 증명을 보여주기 때문이다.
2.2.2 Iteration with Formal Feedback
목표가 증명되지 않으면 Aristotle은 시도한 보조정리를 증명 여부에 따라 표시하고 증명된 보조정리를 유지한 채 추가 보조정리를 제안한다. 이후 새 명제를 형식화하고 수정한 뒤 다시 증명을 시도한다.
- 수정 과정에서는 실패 원인으로 2가지 설명을 고려한다. 비형식 전략 자체가 실행 불가능하거나, 타당한 전략이지만 보조정리를 더 세밀하게 나눠야 할 수 있다. 수정 프롬프트는 모델에 두 가능성을 모두 검토하도록 요청한다.
도표는 비형식 계획 및 명제 수정과 형식 증명 탐색을 구분한다. 실패 루프는 목표 증명에 실패하면 보조정리를 수정해 다시 시도하는 과정을 보여준다. 완성된 보조정리는 이후 증명 의무를 해결하는 데 쓰인다.
2.3 Geometry
별도의 기하 하위 시스템은 Yuclid를 사용한다. Yuclid는 기하 규칙과 대수적 추론을 결합하는 C++ deductive database and algebraic reasoning (DD/AR) 엔진이다. 저자들은 AlphaGeometry-1 대비 최대 500x의 속도 향상을 보고하며 Yuclid를 Apache 2.0으로 공개한다.
- Yuclid는 Lean 외부에서 평면기하를 처리하는 전용 방법을 제공한다. 속도 향상 주장은 이 엔진에 대한 것이며 보고서는 Aristotle 전체 시스템에서도 같은 속도 향상이 발생함을 입증하지 않는다.
2.3.1 Performance Optimizations
Yuclid는 수치적 규칙 매칭, 명제별 진행 기록 공유, 기존 소거 결과를 재사용하며 선형 시스템을 푸는 점진적 Gaussian elimination, 부분적으로 소거한 방정식 저장으로 반복 작업을 줄인다. 수치 도형을 미리 구성한 조건에서, 이 평가에 사용한 기하 문제 집합 AG-30의 30개 문제 중 17개를 해결한다. 나머지 문제에서는 가능한 추론을 모두 소진하는 포화 상태에 도달하며 전체 과정은 단일 3.1GHz 코어에서 약 0.4s가 걸린다.
- 수치 매칭기는 연역 전에 가정과 결론이 수치적으로 성립하는 구성을 찾는다. 딕셔너리는 반복되는 명제의 진행 상황을 공유한다. 캐시한 축약 선형 시스템과 방정식 덕분에 대수적 추론을 처음부터 다시 시작하지 않고 이어서 진행할 수 있다.
- 처리 대기 중인 방정식은 중앙에 저장하며 raw pointer로 참조한다. 제시한 시간에는 수치 도형을 구성하는 시간이 포함되지 않는다.
2.3.2 Other Features
Yuclid는 기존 길이 및 로그 길이 테이블에 제곱 길이의 대수 테이블을 추가해 AB ⟂ CD ⇔ AC² + BD² = AD² + BC² 관계를 사용할 수 있게 한다. 방정식을 명제로 표현할 수 있으므로 규칙별 predicate를 도입하지 않고도 기하 법칙을 추가할 수 있다.
- 삼각형의 변 길이와 맞은편 각의 사인을 연결하는 선택적 사인 법칙 확장은 DD/AR로 AG-30 문제 1개를 추가로 해결한다. 다만 Yuclid를 약 10x 느리게 하므로 권장 구성에서는 이 확장을 비활성화한다.
- 저자들은 최대 4 points로 구성되고 보조 구성이 필요한 생성 문제에서 새로운 규칙도 도출한다. 대부분의 확장은 AlphaGeometry-2에서 도입한 확장과 다르다.
3.1 IMO 2025
Aristotle은 IMO 2025의 Problems 1–5에 대해 형식 검증된 풀이를 생성했으며 Problem 6은 해결하지 못했다. 사람이 각 원래 문제 명제를 형식 명제로 옮겼다. 보고된 인간의 형식화 단계는 이것뿐이며 보조정리 명제는 자동으로 형식화했다.
- 미지의 대상을 찾아야 하는 문제에서는 기본적인 수학 프로그래밍 도구를 갖춘 언어 모델이 먼저 후보를 생성했다. 여기에는 Problem 3의 c = 4가 포함된다.
- 최고 성능을 위해 매개변수가 200B개를 넘는 탐색 모델, 다수의 병렬 보조정리 파이프라인, 반복적인 형식 검증 피드백, TTT를 사용했다. 보고서는 총 연산량, 실제 경과 시간, 인간 경시대회의 제한 시간에 맞춰 추론을 수행했는지를 밝히지 않는다.
3.1.1 Problem 1: Sunny Lines
Sunny Lines에서 Aristotle은 직선이 삼각형의 변과 어떻게 교차하는지를 다루는 기하 논증을 피했다. 저자들은 이 논증을 Lean으로 형식화하기가 번거롭다고 설명한다. 대신 고정점이 없는 순열인 derangement를 사용해 대수적 증명을 만들었다. 또한 n = 5까지의 점을 조사해 명시적인 반례를 찾았으며 이 반례로 더 큰 모든 n에서 해당 구성이 불가능함을 보였다.
- 생성한 증명은 논문에서 언급한 기하 형식화의 어려움을 피하는 대수적 접근을 사용해, 일반적인 인간의 전략과 다른 방법을 택했다.
3.1.2 Problem 3: Bonza Functions
Bonza Functions는 bᵃ ≡ f(b)ᶠ⁽ᵃ⁾ (mod f(a))를 만족하는 함수를 특징짓는 문제다. 이 조건은 2개 식을 f(a)로 나눈 나머지가 같다는 뜻이다. Aristotle은 문제 명제에서 제안하지 않은 보조 집합 S를 도입하고 최종 보조정리 증명 여러 곳에서 사용했다.
- 형식 정의는 def S (f : ℕ+ → ℕ+) : Set ℕ+ := {p | Nat.Prime (p : ℕ) ∧ f (p) > 1} 이다. 이 집합은 함수값이 1보다 큰 양의 소수 입력을 모은다.
- 이 사례는 증명 안에서 보조 정의를 만들고 사용하는 과정을 보여준다. 보고서는 이 문제 해결 맥락을 넘어 해당 정의가 새로운 것임을 입증하지 않는다.
3.1.3 Problem 4: Sums of Three Divisors
Sums of Three Divisors는 수 자체보다 작은 약수인 진약수가 포함된 점화식을 따르는 무한 수열 문제다. 비형식 초안은 엄격히 감소하는 수열, 약하게 감소하는 수열, 어느 시점에 감소하는 수열을 혼동했다. 또한 양의 정수로 이루어진 무한 엄격 감소 수열이 결국 상수로 유지될 수 있다고 잘못 설명했다.
- 형식화 과정에서 Aristotle은 초안의 유용한 아이디어를 유지하면서 이 오류와 관련 논리적 공백을 수정했다. 최종 비형식 주석은 검증된 Lean 증명의 구조를 따랐다.
- 이 사례는 형식화 과정에서 잘못된 비형식 논증을 수정한 과정을 보여준다.
3.1.4 Problem 5: Inekoalaty Game
Inekoalaty Game에서 Aristotle은 승리와 무승부를 결정하는 전략을 찾아 형식화하고 보조 함수 f(k) := k√2/(2k − 1)를 도입했다. 문제 명제는 이 함수를 제안하지 않았지만 해당 함수는 관련 증명 단계에서 보존되는 양인 유용한 불변량으로 쓰였다.
- lemBazzaObjectiveUpperBound의 초기 증명은 미분을 사용해 Φ(k, q) = √((k − 1)q) + √(2k − q)의 상한을 구했다. 이후에는 Lean의 비선형 산술 tactic인 nlinarith를 사용하는 더 직접적인 증명으로 대체했다.
- Aristotle은 Mathlib에서 극한을 표현하는 filter를 다루는 tactic인 filter_upwards를 사용해 f(k)가 1/√2에 수렴함을 증명했다. 이 사례들은 고등학교 수준의 풀이에 필요한 범위를 넘어서는 수학 기법을 활용했음을 보여준다.
3.2 Other Results
보고서는 경시대회 문제 외에도 Niven’s theorem, Gauss-Lucas theorem, 고유값과 특성다항식의 근 사이의 관계 등 Mathlib에 없던 결과의 증명을 설명한다. 또한 Polynomial Freiman-Ruzsa 형식화 프로젝트에 기여한 보조정리 2개와 Generalized Quantum Stein’s Lemma 프로젝트에 기여한 여러 보조정리를 보고한다.
- 선별한 고급 사례는 Appendix C에 나온다. 이 증명들은 예시이며 연구 수준 수학을 체계적으로 평가한 결과는 아니다.
- Terence Tao의 Lean 기반 Analysis I 교재에서 여러 장을 대상으로 평가한 결과, Aristotle은 명시적 반례를 통해 잘못된 연습문제 4개를 찾고 불필요한 가정이 있는 연습문제 2개를 찾았다. 제시된 나머지 연습문제는 모두 증명했다. 평가한 연습문제의 총수는 제시하지 않는다.
4 Related Work
Seed-Prover도 IMO 2025에서 금메달 수준의 형식 증명 성능을 달성했다. 보조정리 분해, 형식 검증 피드백, 해결한 보조정리 재사용, 전용 기하 하위 시스템을 사용한다는 점이 공통적이다. Seed-Prover의 핵심 증명 생성 방식은 전체 증명을 생성하고 수정하는 반면, Aristotle은 모델이 안내하는 단계별 탐색으로 증명을 구성한다.
- 논문은 IMO 2025에서 자연어 증명으로 풀이를 제시하고 인간 심사위원의 평가를 받은 OpenAI와 Google DeepMind 시스템도 논의한다. 이들의 검증 절차는 Aristotle의 기계 검증 결과물과 다르다.
- 보고서는 아키텍처를 비교하지만 데이터, 연산량, 추론 예산을 동일하게 맞춘 통제된 평가는 수행하지 않는다.
5 Conclusion
논문은 비형식 추론, 형식 증명 탐색, 생성한 보조정리를 통합해 금메달에 해당하는 IMO 성능을 달성할 수 있다고 결론짓는다. Mathlib 기여와 선별한 고급 증명은 경시대회 수학 외에도 활용할 수 있다는 추가 근거를 제공한다. 더 넓은 범위의 수학 연구 지원은 향후 방향으로 제안한다.
부록
- A Contributors and Acknowledgements는 Harmonic 팀의 기여자를 나열하고 여러 학술기관 소속을 밝히며, 외부 기여자와 Lean 커뮤니티에 감사를 표한다.
- B Lean Interaction은 Lean으로 작성한 REPL을 설명한다. 이 REPL은 미완성 파일에서 목표를 초기화하고 개별 상태에 tactic을 실행한다. 완성된 증명은 독립적으로 실행할 수 있는 Lean 파일로 출력한다. Lean의 신뢰할 수 있는 증명 검사기인 kernel에서 오류를 확인하고 사용한 공리와 필요한 보조정리도 검사한다. 탐색 중에는 추가 타입 검사도 수행한다. 상태를 저장하지 않는 요청은 증명 상태를 재구성하는 데 필요한 정보를 담는다. 요청은 GKE에 호스팅된 CPU 전용 머신에서 실행하며 논문은 이 호스팅 플랫폼이 수요에 따른 확장과 요청별 라우팅을 지원한다고 설명한다.
- C Example Proofs는 대수 구조 사이의 사상에 관한 호몰로지 대수 연습문제 formal_2068504를 제시한다. 이 증명은 짧은 완전열의 가환 도표에서 바깥쪽 수직 사상들이 전단사이면 가운데 수직 사상도 전단사임을 보인다. 가환 도표에서는 서로 다른 경로의 합성이 일치하며 완전열에서는 각 사상의 상이 다음 사상의 핵과 같다. 2번째 예시인 formal_2210385는 예시에 제시된 격자 기반 합인 Eisenstein series를 사용한다. 주어진 정의와 τ ≠ 0 조건에서 판별식 변환 Δ(−1/τ) = (τ/i)¹²Δ(τ)를 증명하며 여기서 Δ = g₂³ − 27g₃²이고 i는 허수 단위다.
- D Analysis I Examples는 잘못된 명제 4개에 대한 명시적 반증을 제공한다. 반증 대상은 미분의 특성화에 쓰인 엄격 부등식, 특이점에서의 미분 주장, 고립점 주장, 공집합에서 성립하지 않는 유계 집합 명제다. 또한 Exercise 9.1.7에서는 n ≥ 1이 불필요하고 Exercise 9.1.9에서는 x가 X의 폐포에 속한다는 가정인 AdherentPt x X가 불필요함을 보인다. 추가 코드는 2개 정수 사이에 가능한 3가지 순서 관계를 제시하는 Int.trichotomous’를 증명한다. 또한 교재의 자체 정수 표현에 대해 순서, 덧셈, 곱셈을 보존하는 동치인 Int.equivInt_ordered_ring을 구성한다.
짧은 생각
검증할 수 있는 증명 결과물은 보고된 풀이가 성립함을 입증한다. Problem 4는 형식화 중 결함이 있는 비형식 논증을 수정한 과정을 보여준다. 이 사례는 형식 증명 구성이 최종 정확성 검증을 제공할 뿐 아니라 논증 자체를 개선할 수도 있음을 보여준다.
보고서는 효율성과 각 구성 요소의 기여를 규명하지 않는다. 사람이 입력을 형식화했다는 점, 200B-parameter를 넘는 탐색 모델, 명시하지 않은 병렬 처리 규모, 정량화하지 않은 TTT 비용 때문에 인간 경시대회 조건이나 다른 시스템과의 비교에는 한계가 있다. 통제된 ablation 실험과 명시적인 자원 예산이 있으면 규모 확장에 관한 주장을 더 쉽게 평가할 수 있다.