


Learning to Discover at Test Time 요약 설명
22 Jan 2026 | Paper Review Test-Time Adaptation Reinforcement Learning Agentic Discovery목차
- 요약
- 1 Introduction
- 2 Preliminaries
- 3 Learning to Discover at Test Time
- 4.1 Mathematics
- 4.2 Kernel Engineering
- 4.3 Algorithm Engineering
- 4.4 Single Cell Analysis
- 4.5 Ablations
- 5 Related Works
- 6 Future Work
- 부록
- 짧은 생각
이번 글에서는 Learning to Discover at Test Time 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 22일(Arxiv)
- Yuksekgonul, Mert, Koceja, Daniel, Li, Xinhao, Bianchi, Federico, McCaleb, Jed, Wang, Xiaolong, Kautz, Jan, Choi, Yejin, Zou, James, Guestrin, Carlos, et al.
- Stanford University, NVIDIA, Astera Institute, UC San Diego, Together AI
- 논문 링크
- Github
- Project Page
요약
- Learning to Discover at Test Time은 연속적이고 검증 가능한 보상이 주어지는 과학·공학 문제 1개를 풀면서 LLM을 갱신하는 Test-Time Training to Discover(TTT-Discover)를 제안한다. 목표는 정책의 평균 성능을 높이거나 여러 문제로 일반화하는 것이 아니라, 뛰어난 구성이나 프로그램 1개를 찾는 것이다.
- TTT-Discover는 적응형 엔트로피 강화학습 목적함수와 PUCT에서 착안한 이전 해법 재사용을 결합한다. 기본 설정에서는 rank-32 LoRA로 gpt-oss-120b를 학습하며, 단계마다 512개 rollout을 생성하는 과정을 50단계 수행한다. 이는 Best-of-N의 25,600개 샘플 예산과 같다. 명시된 토큰 길이를 가정하면 Tinker 비용은 약 $500이다.
- 이 방법은 Erdős’ Minimum Overlap Problem과 첫 번째 자기상관 부등식에서 구체적인 구성으로 입증하는 경계를 개선하고, 더 빠른 TriMul 커널을 찾는다. 과거 AtCoder 대회 2개를 재평가한 결과에서도 이전 점수를 넘고, 단일 세포 잡음 제거 지표를 개선한다. 반면 두 번째 자기상관 부등식과 원 패킹에서는 기록을 개선하지 못하며, MLA-Decode에서도 인간 최고 제출물보다 유의하게 뛰어나지 않다. 벤치마크 지표를 넘어서는 생물학적 유용성은 검증하지 않았다.
1 Introduction
동결된 모델을 사용하는 탐색은 이전 시도로 프롬프트를 개선할 수 있지만, 문제별 경험을 바탕으로 모델을 갱신할 수는 없다. TTT-Discover는 자신이 생성하고 평가한 시도에서 학습한다. 현재 문제를 풀도록 학습과 후보 재사용을 조정하면서 가장 좋은 해법 1개를 유지한다.
- 최종 산출물은 구성이나 프로그램이다. 정책은 이를 찾는 수단이며, 주된 배포 산출물이 아니다.
- EvoTune, MiGrATe, ThetaEvolve도 인스턴스별 학습이라는 큰 틀을 공유한다. 이 논문의 방법론적 차이는 발견에 맞춘 목적함수와 재사용 규칙에 있다.
2 Preliminaries
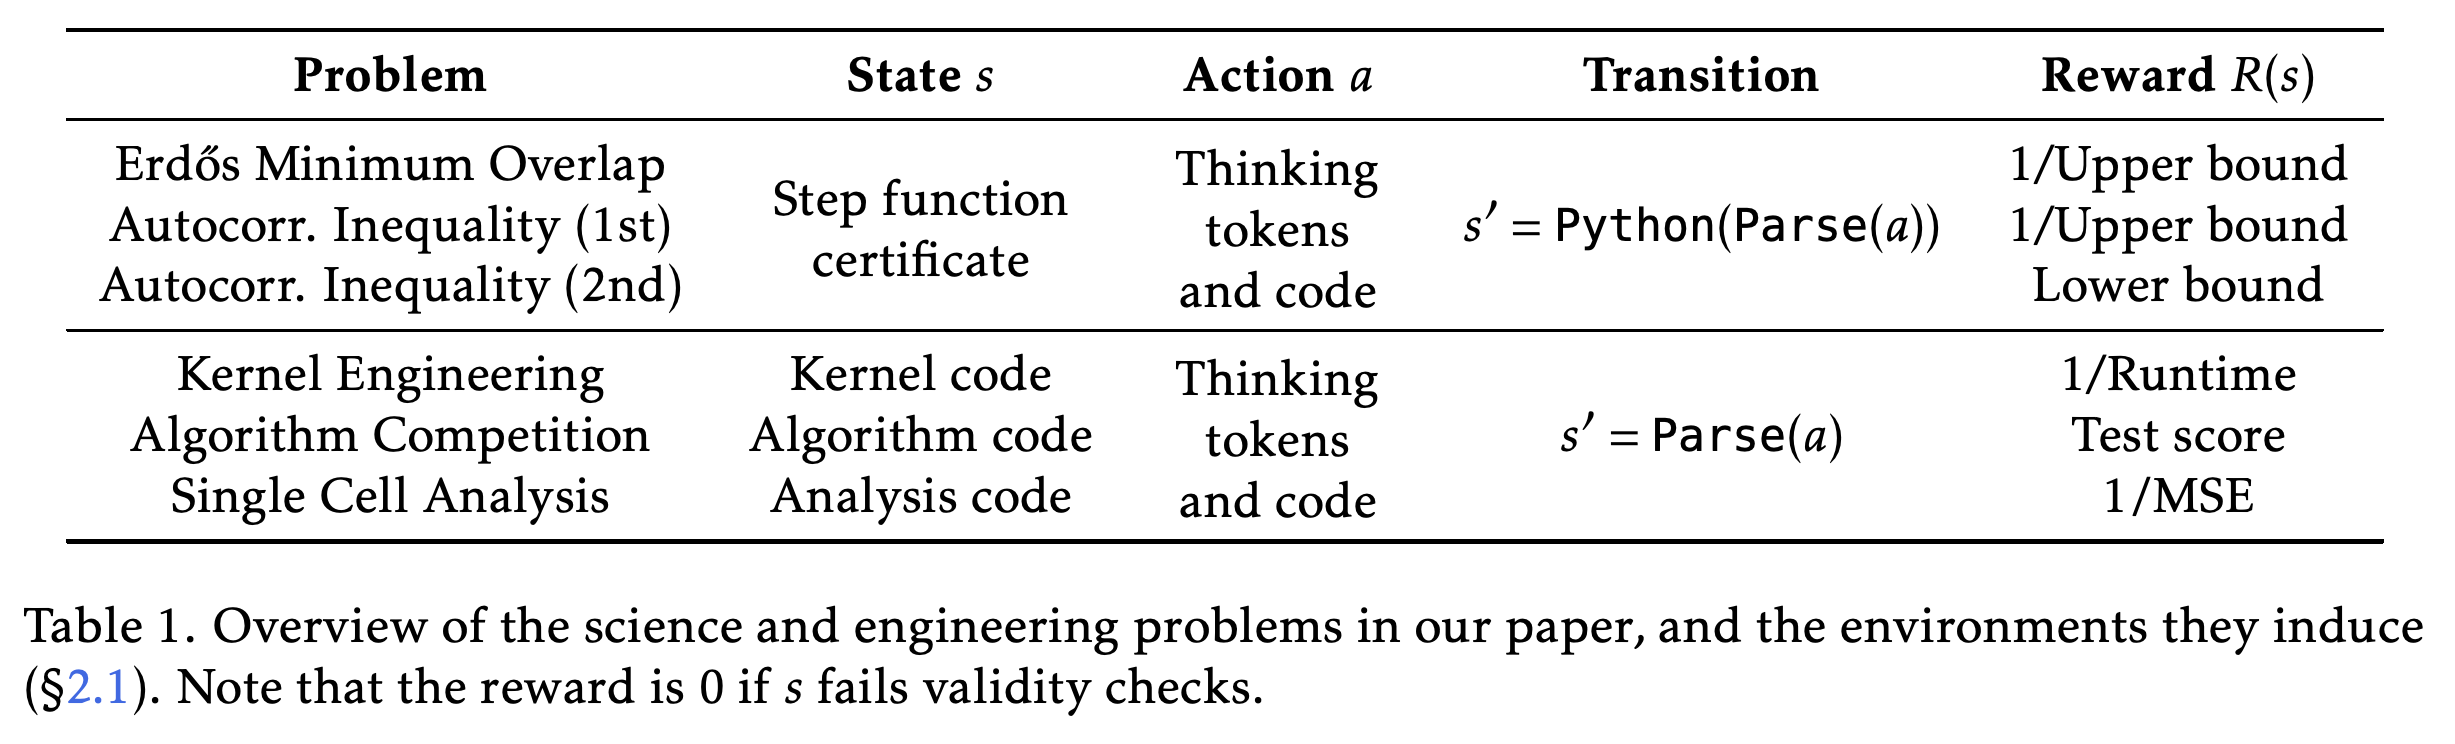
예비 설명에서는 각 문제를 탐색 방법과 학습 방법이 공유하는 환경으로 정식화한다. Table 1은 수학, 커널, 알고리즘, 단일 세포 응용에서 후보 상태, 생성하는 행동, 전이, 연속 보상이 무엇인지 정리한다.
2.1 Discovery Problem
문제 설명 d는 LLM 정책의 조건으로 주어지고, 상태 s는 후보 해법을 나타내며, 행동에는 코드와 선택적인 thinking 토큰이 포함된다. R(s) > r_sota일 때 발견이 이루어진 것으로 본다. 여기서 r_sota는 알려진 최선 해법의 보상이며, 유효성 검사를 통과하지 못한 후보에는 보상 0을 부여한다.
- 수학 문제에서는 파싱한 Python 코드를 실행해 수치적 구성을 만든다.
- 커널, 알고리즘, 분석 과제에서는 생성한 코드를 파싱하면 다음 후보 구현이 된다.
- 명시적으로 정의한 환경은 1개 timestep으로 이루어지지만, 이전 후보를 재사용하면 실질적으로 궤적이 길어진다.
환경들은 코드 생성 인터페이스를 공유하지만, 코드 자체가 다음 상태가 되는지 또는 코드를 실행해 구성을 만들어야 하는지는 다르다. 보상에는 경계의 역수, 하계, 실행 시간의 역수, 대회 점수, MSE의 역수가 포함되며, 유효성 검사 실패에는 0을 부여한다.
2.2 Search Methods
Best-of-N은 동결된 정책에서 독립적인 시도를 샘플링한다. 보통 기존 해법에 과도하게 의존하지 않도록 빈 해법이나 단순한 해법에서 시작한다. 상태 재사용은 버퍼를 유지하고 이전 후보를 시작점으로 선택한다. 상태-행동 재사용은 이전 행동의 추론이나 중간 정보도 함께 제공한다.
- 처음부터 시작하면 탐색 범위를 넓힐 수 있지만, 유망한 부분 해법을 충분히 발전시키지 못할 수 있다.
- AlphaEvolve 같은 진화적 탐색 방법은 수작업으로 설계한 변이, 교차, 적합도, 다양성 휴리스틱과 함께 상태-행동 재사용을 활용한다.
3 Learning to Discover at Test Time
Algorithm 1은 후보 선택, 생성, 평가, 버퍼 삽입, 정책 갱신을 반복한다. 설정할 수 있는 서브루틴은 reuse와 train의 2개이며, 최종 정책이 아니라 실행 중에 찾은 보상이 가장 높은 후보를 출력한다.
3.1 Naive RL at Test Time
단순한 테스트 시점 RL은 매번 빈 상태에서 다시 시작하며 기대 보상을 최대화한다. 논문은 이 방식이 발견 목표와 맞지 않는 3가지 이유를 제시한다. 작은 기록 개선에는 보상 차이가 약하게 나타날 수 있고, 독립적인 재시작은 실질적인 탐색 길이를 제한하며, 기대 보상 최적화는 드물게 기록을 세우는 결과보다 안전한 행동을 선호할 수 있다.
- 커널 예시에서는 2000 µs 기록을 어렵게 1900 µs로 개선하더라도, 추가적인 보상 설계가 없으면 보상 차이가 작다는 점을 보여 준다.
- 재사용에도 탐색이 필요하다. 보상이 높은 소수의 상태만 반복적으로 확장하면 다양성이 줄어들 수 있다.
3.2 TTT-Discover
엔트로피 목적함수는 Jβ(θ) = E_s[log E_a[exp(β(s)R(s,a))]]이며, 보상이 높은 행동을 지수적으로 강조한다. 정책 경사 가중치는 정규화한 지수 보상이며, 평균 베이스라인과 초기 정책에 대한 KL 페널티를 사용한다. β(s)는 각 시작 상태에 맞춰 따로 조정한다.
- β가 크면 가장 좋은 결과에 갱신을 집중하지만 초기 학습이 불안정해질 수 있다. β가 작으면 후반의 개선 폭이 좁아질 때 advantage가 사라질 수 있다.
- Appendix A.1은 보상에 따라 재가중한 보조 분포의 KL 발산을 제한해 β를 선택하며, γ = ln(2)를 사용한다.
- 이 목적함수는 보상이 높은 결과를 선호하지만, 한정된 예산 안에서 새 기록을 발견한다고 보장하지는 않는다.
PUCT에서 착안한 재사용은 관측한 자식의 최고 보상, 보상 순위 사전분포, 방문 횟수가 적은 계보에 대한 탐색 보너스로 후보의 우선순위를 정한다. Appendix A.2는 score(s) = Q(s) + c·scale·P(s)·√(1+T)/(1+n(s))를 명시한다. 여기서 scale은 아카이브의 보상 범위다.
- Q(s)는 자식 보상의 평균 대신 최댓값을 사용한다. 이는 가장 좋은 후속 해법을 찾으려는 목표를 반영한다.
- 아카이브는 초기 시드를 보존하면서 확장한 부모마다 상위 2개 자식과 전체 상위 1000개 상태를 유지한다.
- 방문 횟수는 조상으로 전파한다. 계보의 다양성을 높이기 위해 현재 배치에서는 선택한 상태의 조상과 후손을 선택 대상에서 제외한다.
3.3 Implementation Details
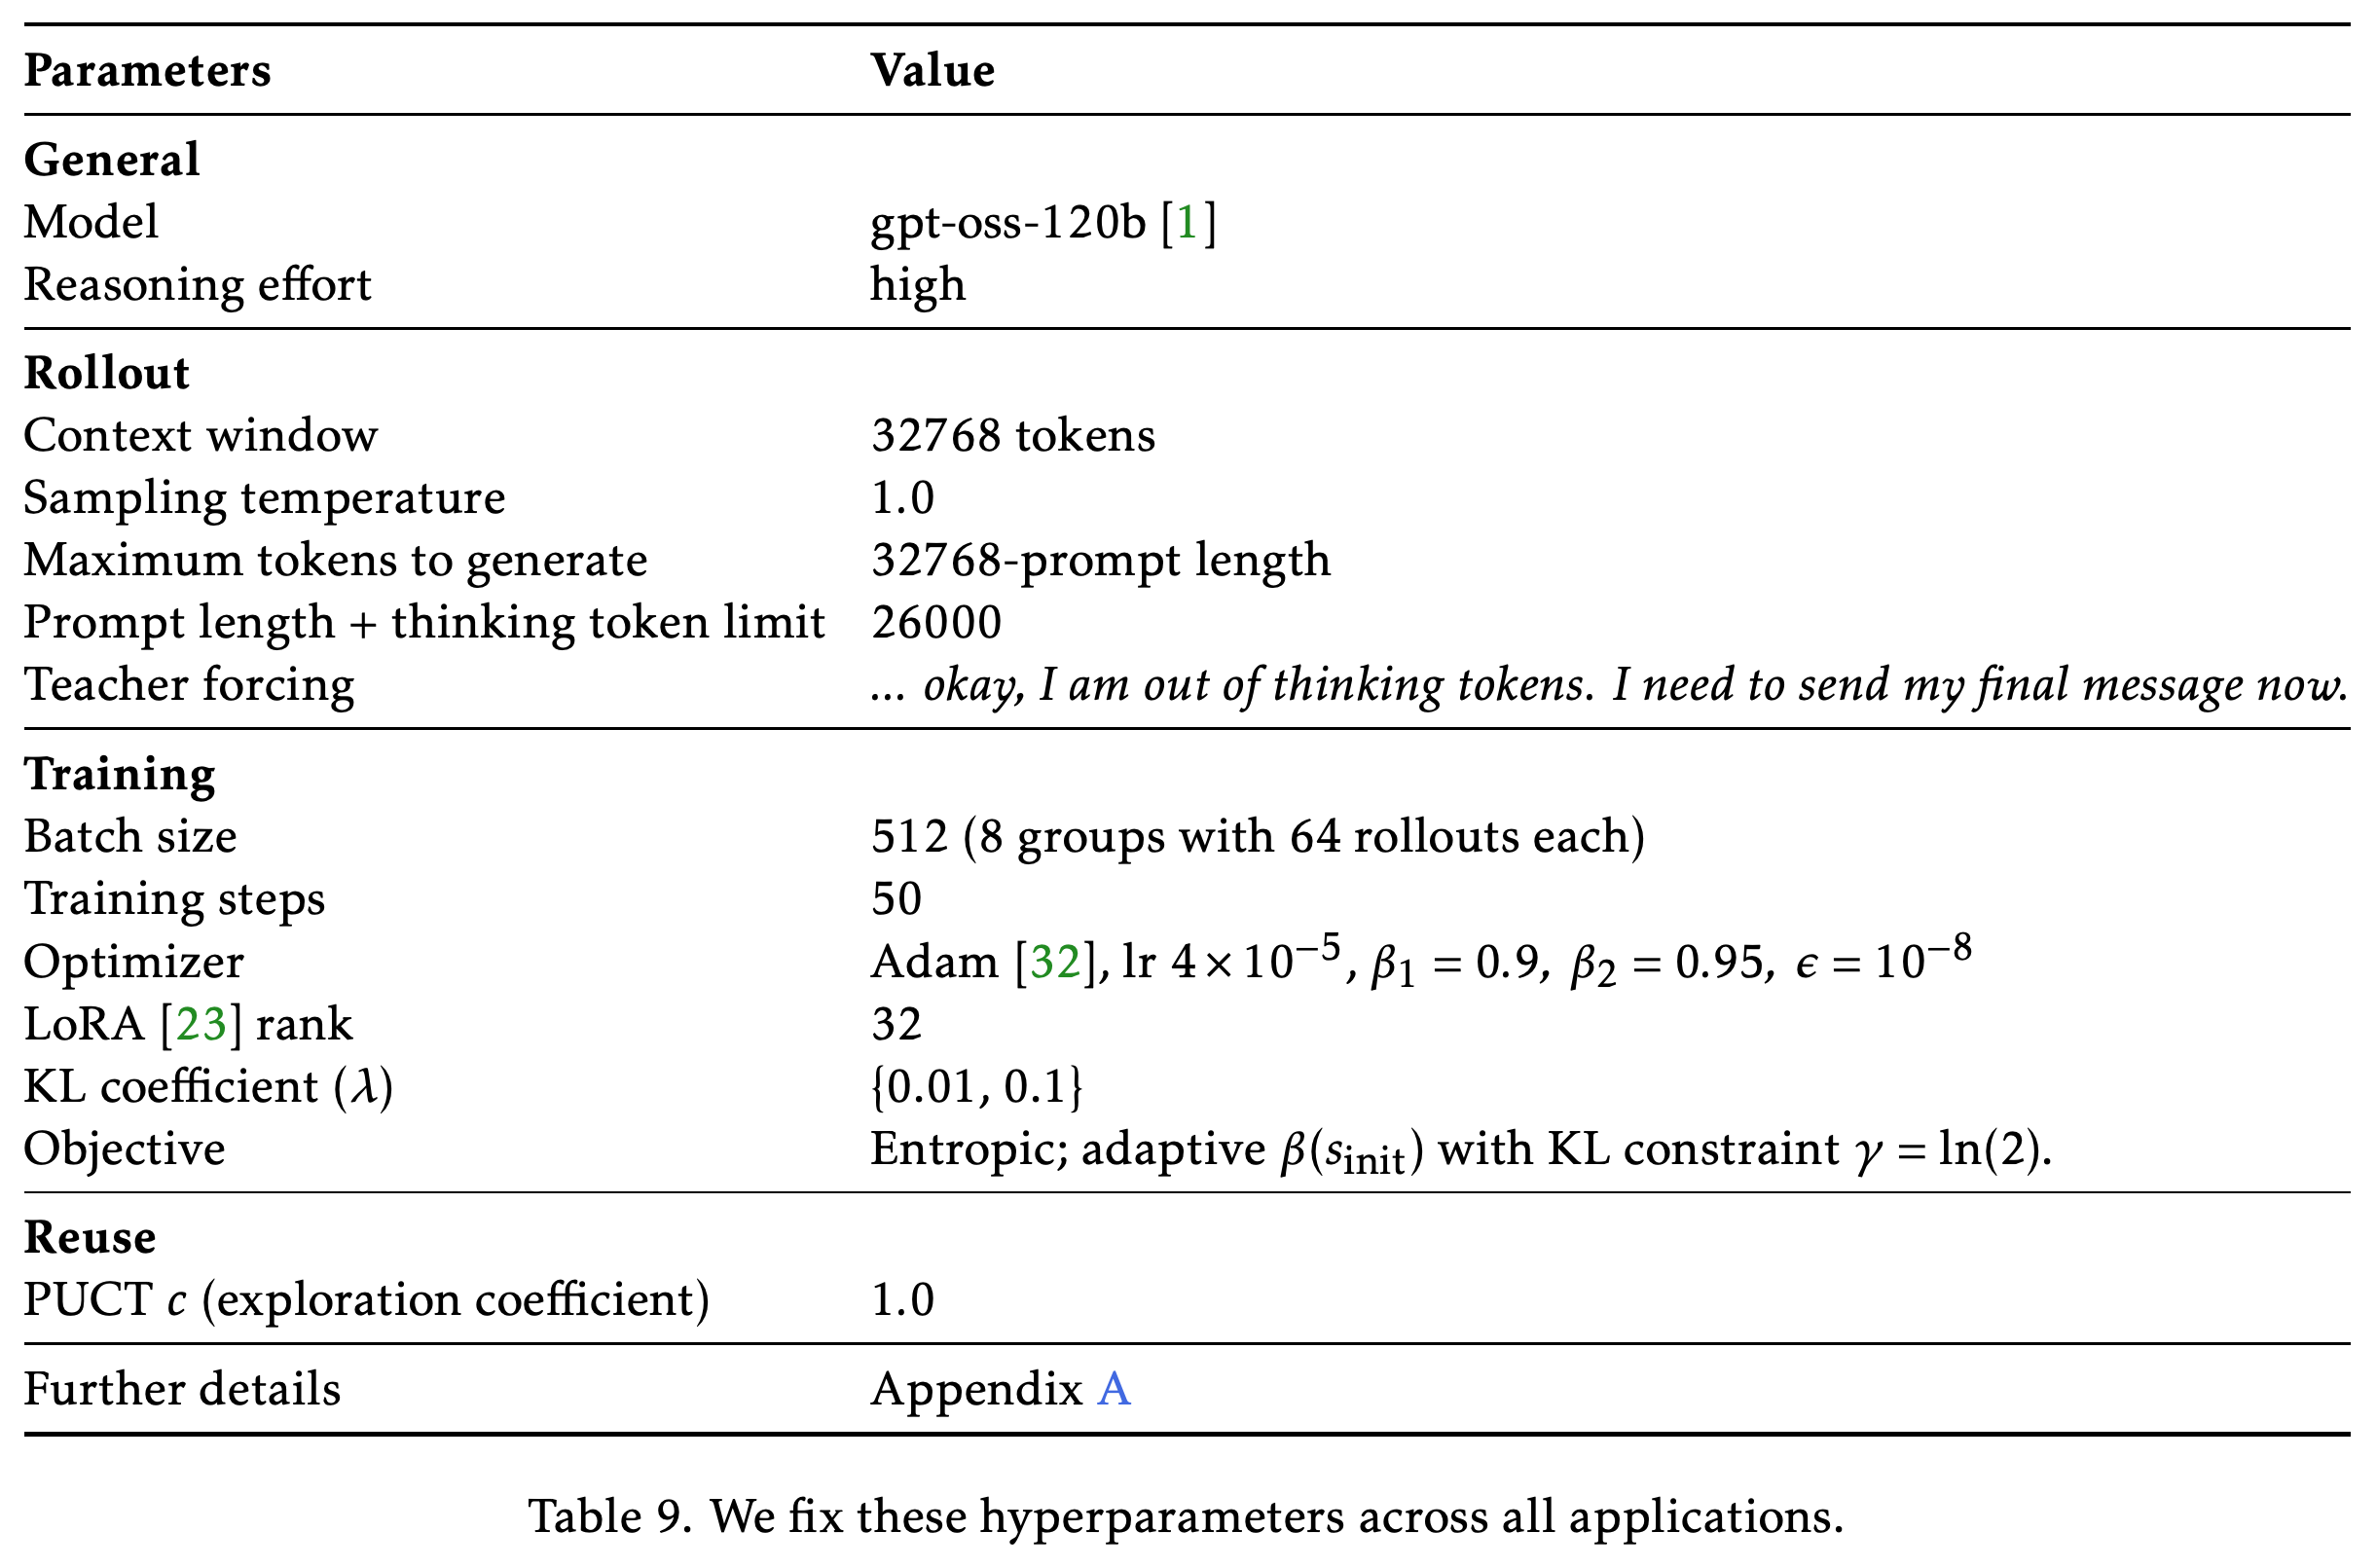
기본 구현은 Tinker에서 gpt-oss-120b, rank-32 LoRA, 50단계 학습을 사용한다. 각 단계에서는 64개 rollout으로 이루어진 그룹 8개를 샘플링하며, 그룹 안에서는 시작 상태와 문맥을 공유한다. 이후 sampler/learner 중요도 비율 보정을 적용해 전체 512개 rollout 배치에서 경사 갱신을 1회 수행한다.
- Reasoning effort는 high이며, Tinker의 컨텍스트 윈도는 32,768토큰이다. 일반적인 프롬프트와 thinking의 합산 한도는 26,000토큰이며, 최종 코드를 위한 공간을 남겨 둔다.
- Table 9는 temperature 1.0, Adam 학습률 4 × 10⁻⁵, β1 = 0.9, β2 = 0.95, ε = 10⁻⁸, PUCT 탐색 계수 1.0을 명시한다.
- 약 $500라는 Tinker 추정 비용은 평균 프롬프트 3000토큰과 rollout당 샘플링 16,000토큰을 가정한다. 후보 실행 인프라까지 항목별로 합산한 총비용은 아니다.
표는 공통 rollout, 옵티마이저, LoRA, 목적함수, 재사용 설정을 명시한다. KL 계수에는 값 2개가 제시되어 있고 Appendix D는 알고리즘 과제의 예외를 기록하므로, 기본값이 모든 실행에 그대로 적용된다고 가정해서는 안 된다.
4.1 Mathematics
응용 실험에서는 인간 전문가와 이전 AI 결과를 비교하며, Best-of-25600은 TTT-Discover와 모델 및 샘플링 예산을 맞춘다. 평가한 OpenEvolve에도 25,600개 샘플을 제공하지만, 프롬프트가 계속 길어져 공통 컨텍스트 윈도 한도에서 자주 잘린다.
- 수학 해법은 자유 형식으로 증명을 주장하는 것이 아니라, 경계를 입증하는 명시적인 수치적 구성이다.
- 수학 행동은 계단 함수나 기하학적 배치를 최적화하며, 유효성 검사를 통과해야 보상을 받는다. 본문에서는 알려진 최선 구성으로 초기화하지 않고 무작위 유효 구성으로 초기화한다고 설명한다.
- 본문은 수학 행동의 시간제한을 10분으로 명시하지만, Appendix B는 부등식과 Erdős’ 과제의 검증기 제한 시간을 최대 1100초로 설명한다.
4.1.1 Erdős’ Minimum Overlap Problem
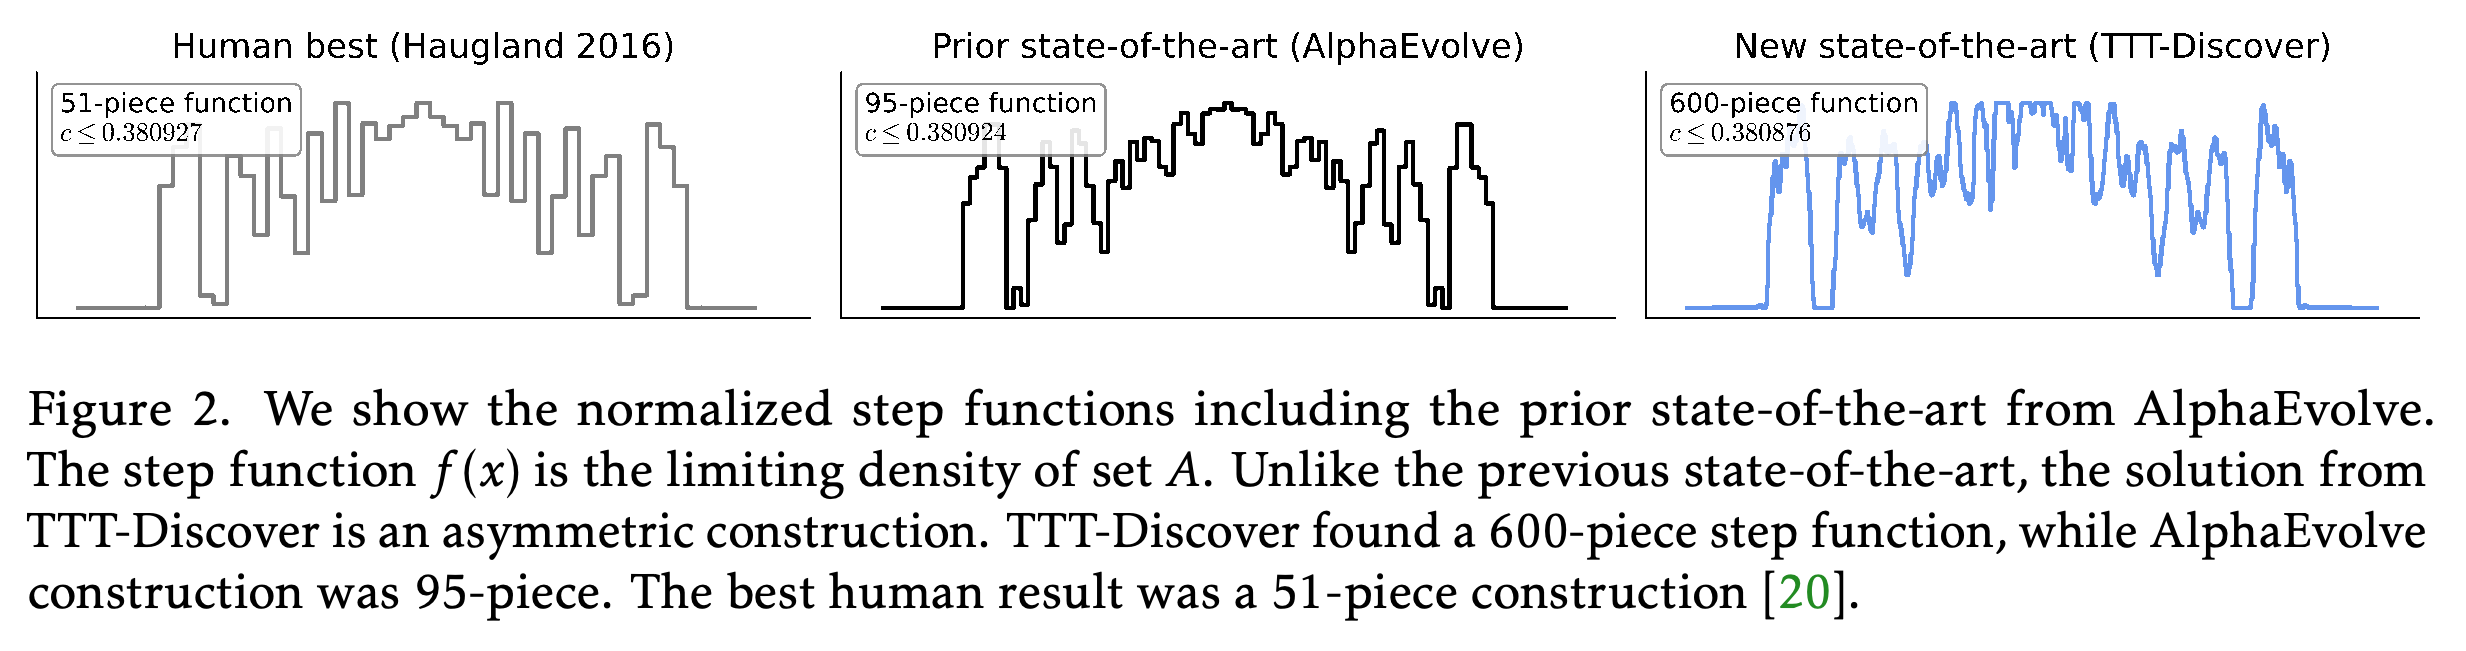
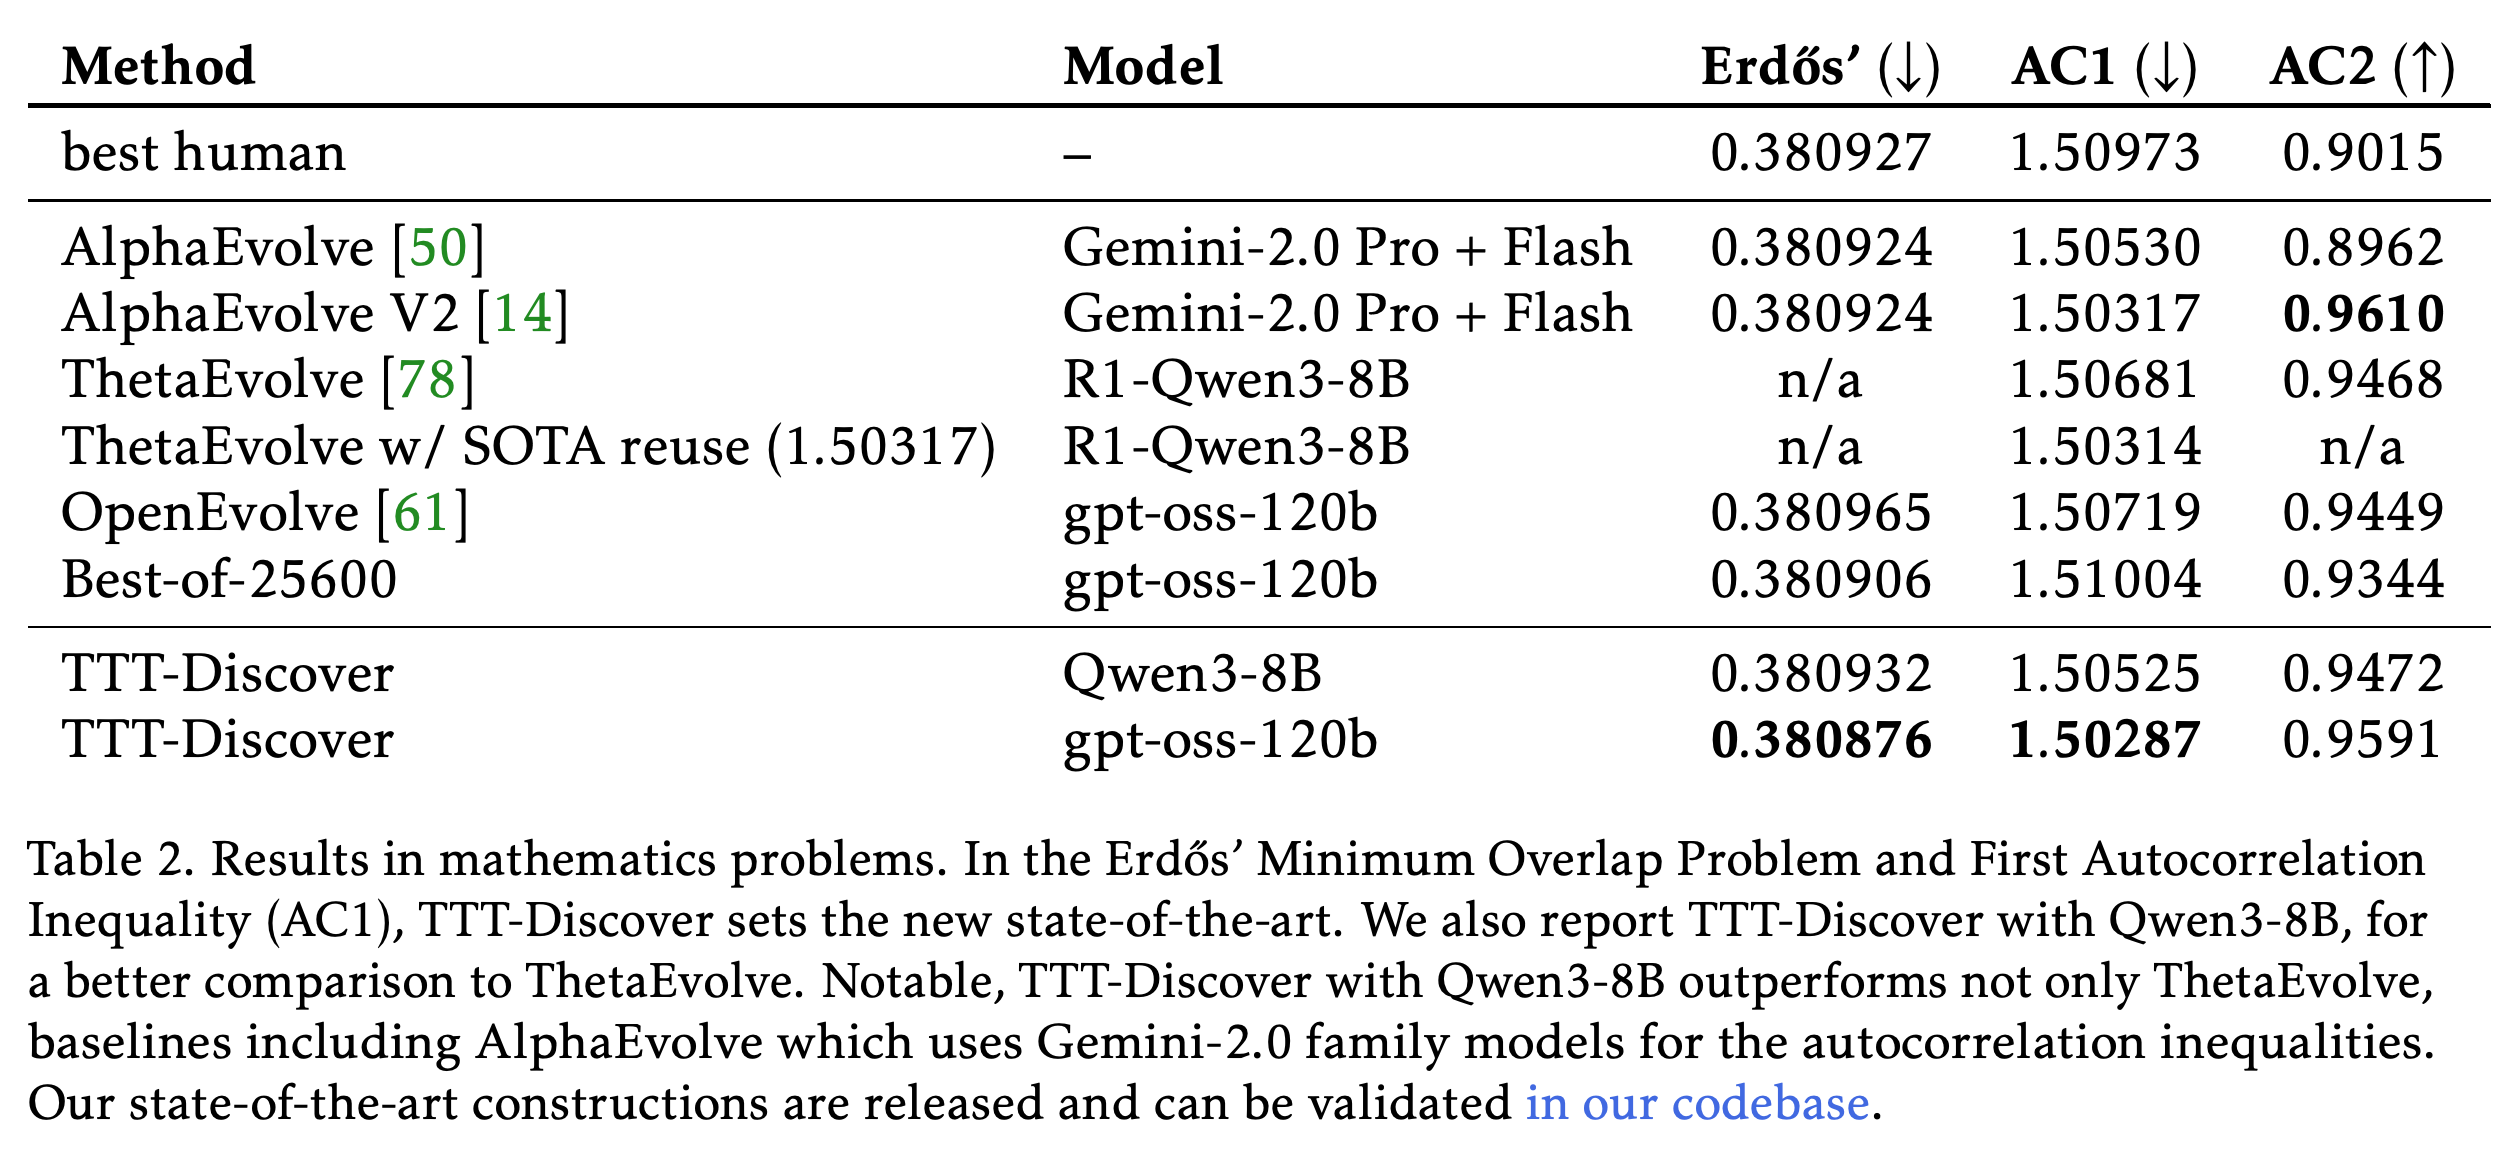
Erdős’ Minimum Overlap Problem은 {1,2,…,2n}을 크기가 같은 집합 A와 B로 나누고, 오프셋별로 두 집합 원소의 차이가 나타나는 횟수의 최댓값을 최소화한다. TTT-Discover는 c = lim M(n)/n의 상계 0.380876을 입증하며, AlphaEvolve의 0.380924와 Haugland의 0.380927을 개선한다.
- 상계를 입증하는 구성은 값이 [0,1]에 있고 적분값이 1인 비대칭 밀도 함수이며, 600개 구간으로 이루어진다. Figure 2는 이를 인간의 51개 구간 구성 및 AlphaEvolve의 95개 구간 구성과 비교한다.
- 발견한 프로그램은 FFT로 가속한 경사 하강법, 무작위 hill climbing, simulated annealing, 유효성 제약 집합으로의 사영을 결합한다.
- Table 2는 이전 AI 기록을 독립적으로 개선한 Best-of-25600의 0.380906도 보고한다. TTT-Discover는 이를 더 개선한다.
새 밀도 함수 구성은 비대칭이며 600개 구간을 사용한다. 이전 구성은 각각 51개와 95개 구간을 사용한다. 수학적 의의는 시각적 형태 자체가 아니라 검증한 중첩 경계에 있다.
4.1.2 Autocorrelation Inequalities
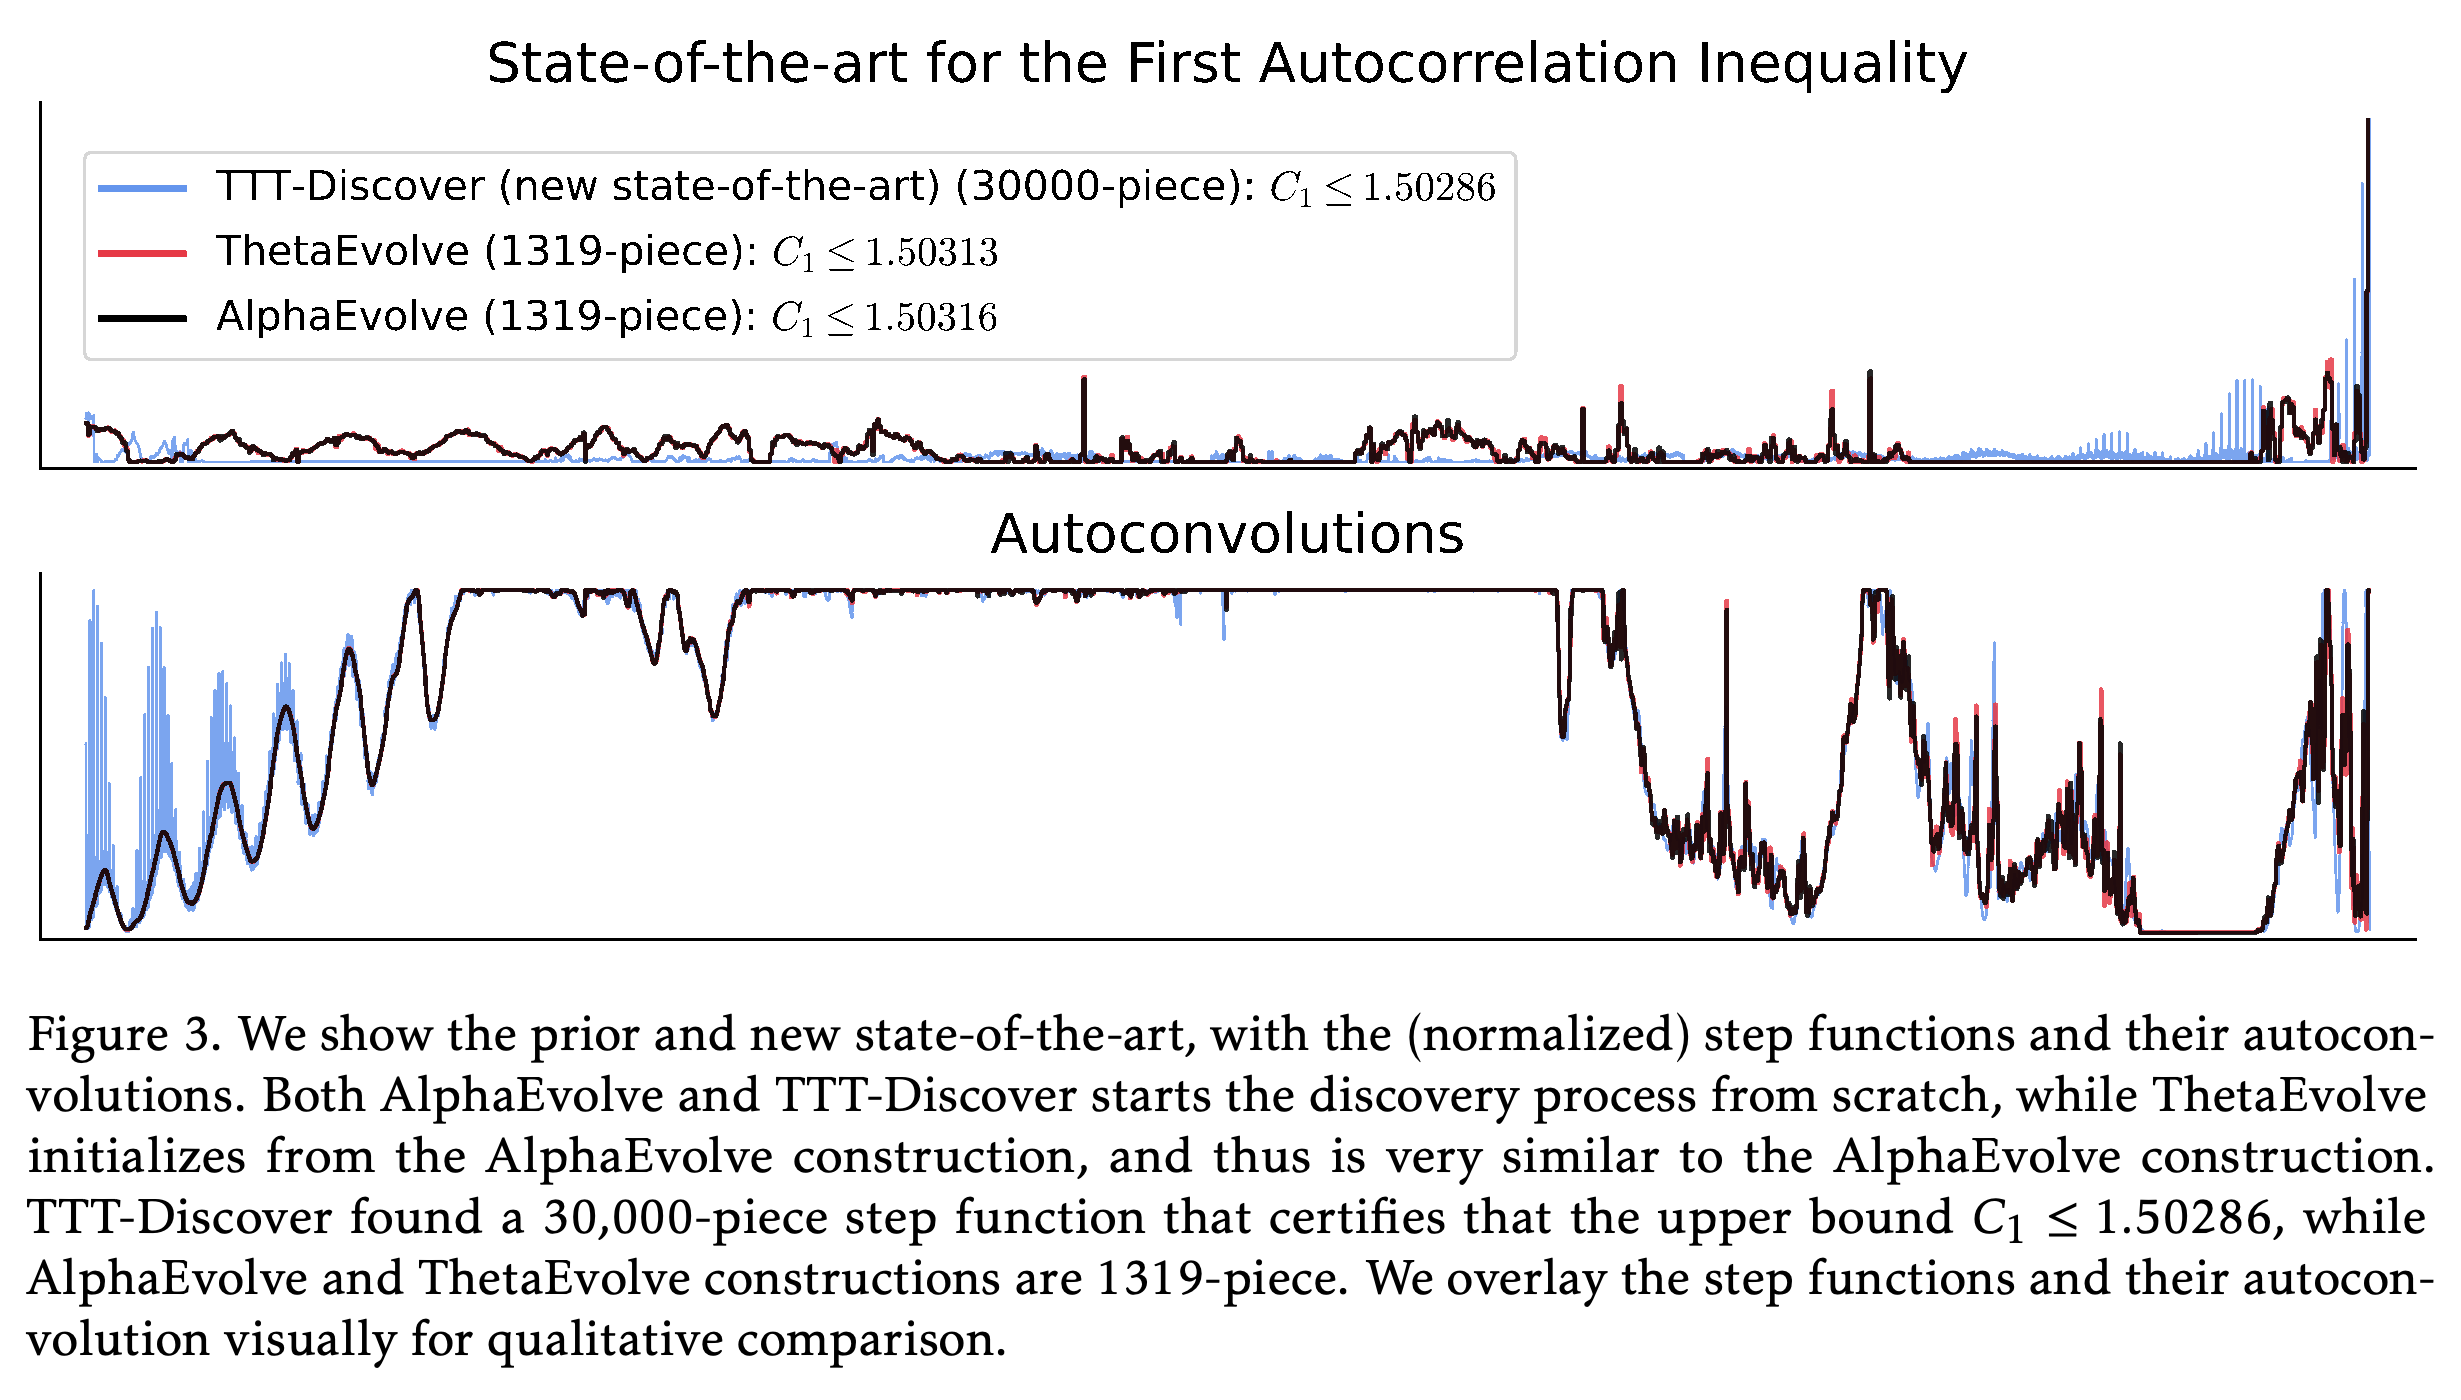
첫 번째 자기상관 부등식에서는 [−1/4,1/4]에 지지집합을 갖는 비음수 함수로 C1의 타이트한 상계를 입증하는 구성을 찾는다. 유효한 f는 C1 ≤ ||f∗f||∞/||f||₁²를 입증한다. TTT-Discover는 처음부터 탐색해 30,000개 구간으로 이루어진 새 구성을 찾는다. 결과 본문과 Figure 3은 C1 ≤ 1.50286을 보고하지만, Table 2는 1.50287을 보고한다.
- 탐색은 경사 기반 최적화에서 선형계획법으로 발전한 뒤, 최댓값에 가까운 합성곱 제약에 최적화를 집중한다.
- 후반 휴리스틱에는 LP를 위해 상위 K개 합성곱 위치를 선택하는 방법과, 최댓값에 가까운 여러 위치에서 경사를 계산하는 방법이 포함된다.
- Figure 3은 ThetaEvolve와 AlphaEvolve의 경계를 각각 1.50313과 1.50316으로 보고한다. 반면 Table 2는 SOTA를 재사용한 ThetaEvolve와 AlphaEvolve V2의 값을 각각 1.50314와 1.50317로 보고한다. 두 제시 방식 모두 TTT-Discover가 경계를 개선했음을 보여 준다.
겹쳐 그린 곡선은 서로 비슷한 AlphaEvolve와 ThetaEvolve 구성 옆에 이들과 다른 고해상도 TTT-Discover 함수를 보여 준다. 넓고 거의 평평한 자기합성곱의 최대 영역은 등호 성립에 가까운 여러 제약을 최적화하는 탐색 전략과 부합한다. 표시된 경계 값은 Table 2와 조금 다르다.
두 번째 부등식은 C2 = sup_f≥0 ||f∗f||₂²/(||f∗f||₁||f∗f||∞)를 정의한다. 비율이 r인 구성은 C2 ≥ r을 입증한다. Table 2에서 TTT-Discover는 0.9591로 AlphaEvolve V2의 0.9610보다 낮으므로, 이 과제에서는 새 기록을 세우지 못한다.
- Qwen3-8B를 사용한 TTT-Discover는 SOTA 초기화 없이 AC1 = 1.50525와 AC2 = 0.9472를 얻으며, ThetaEvolve의 1.50681과 0.9468을 개선한다.
- 이 비교는 동일 모델 비교가 아니다. ThetaEvolve는 Tinker에서 사용할 수 없는 DeepSeek-R1-0528-Qwen3-8B를 사용하고, TTT-Discover는 Qwen/Qwen3-8B를 사용한다.
- ThetaEvolve는 단계당 512개 rollout으로 65단계를 수행하지만, TTT-Discover는 50단계를 수행한다. SOTA를 재사용한 ThetaEvolve의 AC1 결과 1.50314는 Qwen3-8B TTT-Discover 결과보다 좋다.
gpt-oss-120b 설정은 Erdős’와 AC1 기록을 개선하지만, AC2에서는 AlphaEvolve V2에 미치지 못한다. Qwen3-8B 결과는 SOTA 초기화가 없는 ThetaEvolve보다 좋지만, SOTA를 재사용한 ThetaEvolve의 AC1 결과보다는 좋지 않다. 모델 변형과 학습 예산도 서로 다르다.
4.1.3 Circle Packing
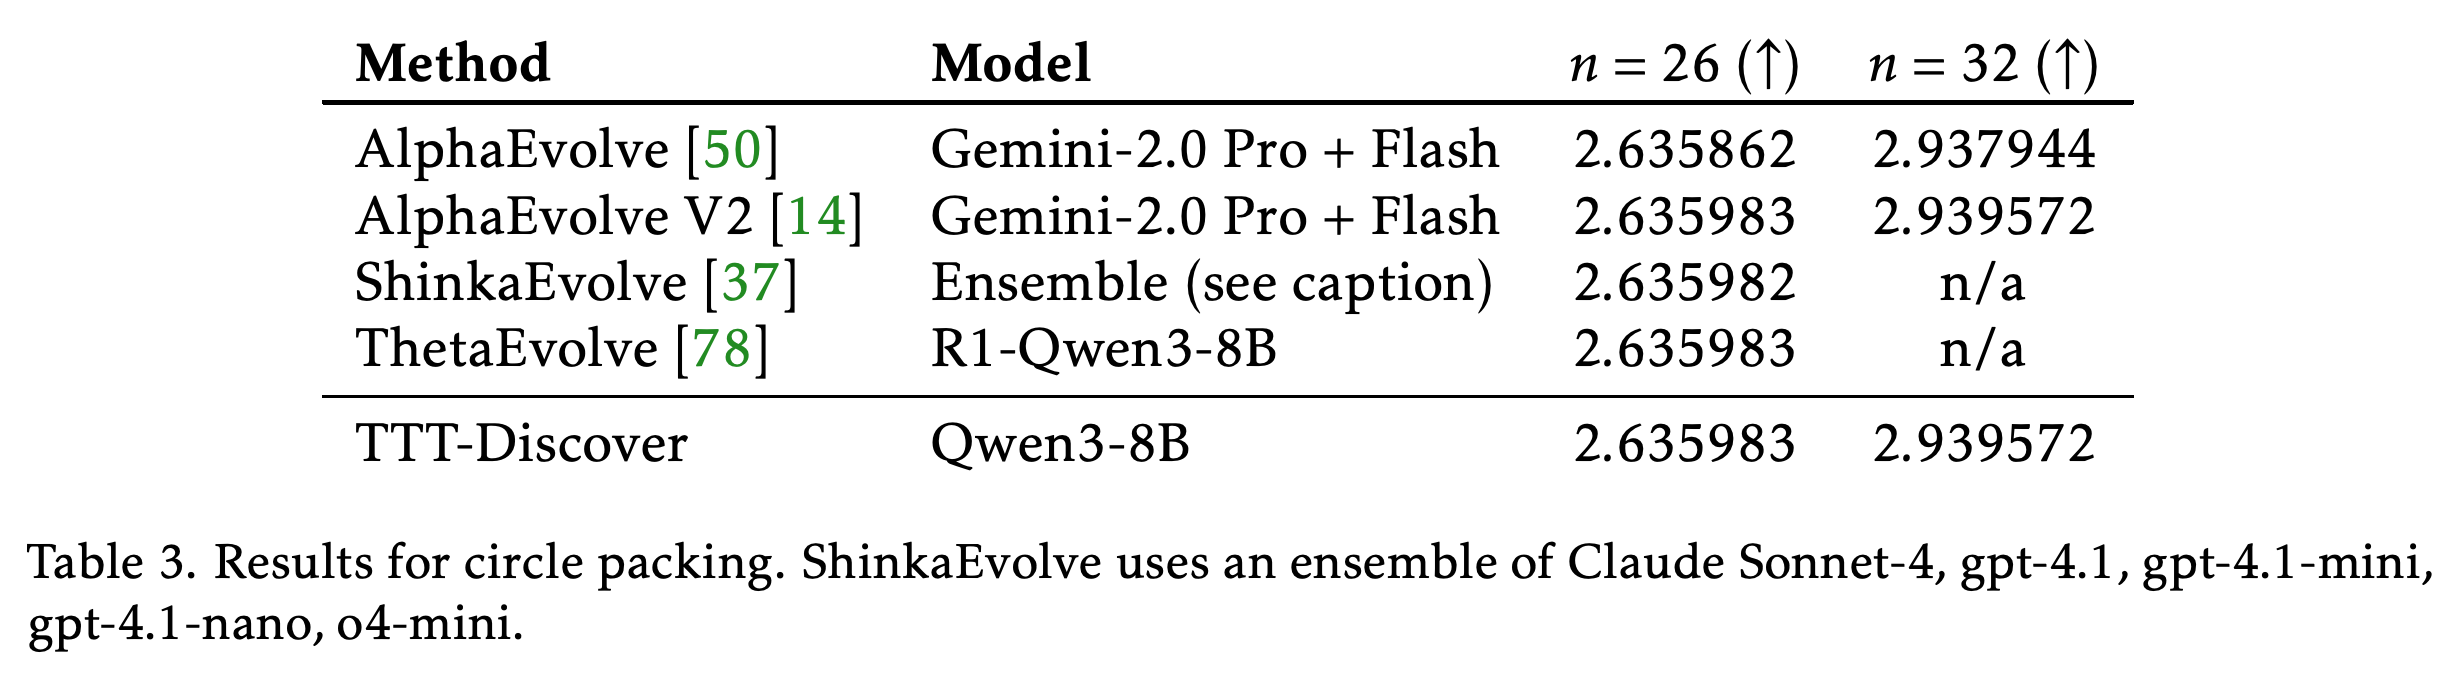
원 패킹은 단위 정사각형 안에 겹치지 않는 원 n개를 배치해 반지름 합을 최대화한다. Table 3에서 Qwen3-8B TTT-Discover는 알려진 최고 합인 n = 26의 2.635983과 n = 32의 2.939572를 재현하지만, 어느 기록도 개선하지 못한다.
- 생성한 프로그램은 격자 기반 배치로 초기화한 뒤, 순차 최소제곱 계획법으로 중심과 반지름을 최적화한다.
- 경계 제약과 원 사이의 비겹침 제약이 유효성을 결정한다. 논문은 이러한 기하학적 초기화를 ShinkaEvolve의 simulated annealing 기반 초기화와 대조한다.
Qwen3-8B 실행은 테스트한 원 개수 설정 모두에서 최고 반지름 합을 재현한다. 이는 보고된 정밀도에서 기존 최고값과 일치하는 구성을 얻은 결과이며, 새로운 패킹 기록은 아니다.
4.1.4 Expert Review
전문가 검토에서 Prof. Davide Torlo(Università di Roma La Sapienza)는 Erdős’와 AC1의 구성을 직접 검증할 수 있는 이유를 설명한다. 검증은 구간별 상수 함수의 구간 길이로 결정되는 이산 지점에서 관련 값을 평가하고 노름 제약을 확인한다. 이는 경계 개선을 뒷받침하지만, 닫힌 형태의 최적값을 확립하지는 않는다.
4.2 Kernel Engineering
Kernel Engineering은 과거 GPUMode TriMul 및 DeepSeek MLA-Decode 대회를 정확성 검사와 실행 시간 기하평균의 역수에 비례하는 보상으로 재평가한다. TriMul 학습은 H100에서 커널을 평가한다. MLA-Decode 학습은 Modal에서 MI300X를 대규모로 사용할 수 없어 H200을 사용한다.
- Table 4는 TriMul 실행 시간을 A100에서 2198.2 µs, H100에서 1161.2 µs, B200에서 914.2 µs, AMD MI300X에서 1555.7 µs로 보고한다.
- 이에 대응하는 인간 최고 실행 시간은 각각 4531.5, 1371.1, 1038.9, 2515.8 µs다. 학습에는 H100 기반 보상 1개를 사용하지만, Appendix C는 최종 커널을 대상 하드웨어별로 선택하는 절차를 설명한다.
- A100과 H100 값은 공식 제출 결과다. B200과 MI300X 결과는 서버 문제로 공식 제출을 하지 못해, 주최 측이 검증한 복제 인프라에서 10회 시행한 측정과 95% 신뢰구간을 사용한다.
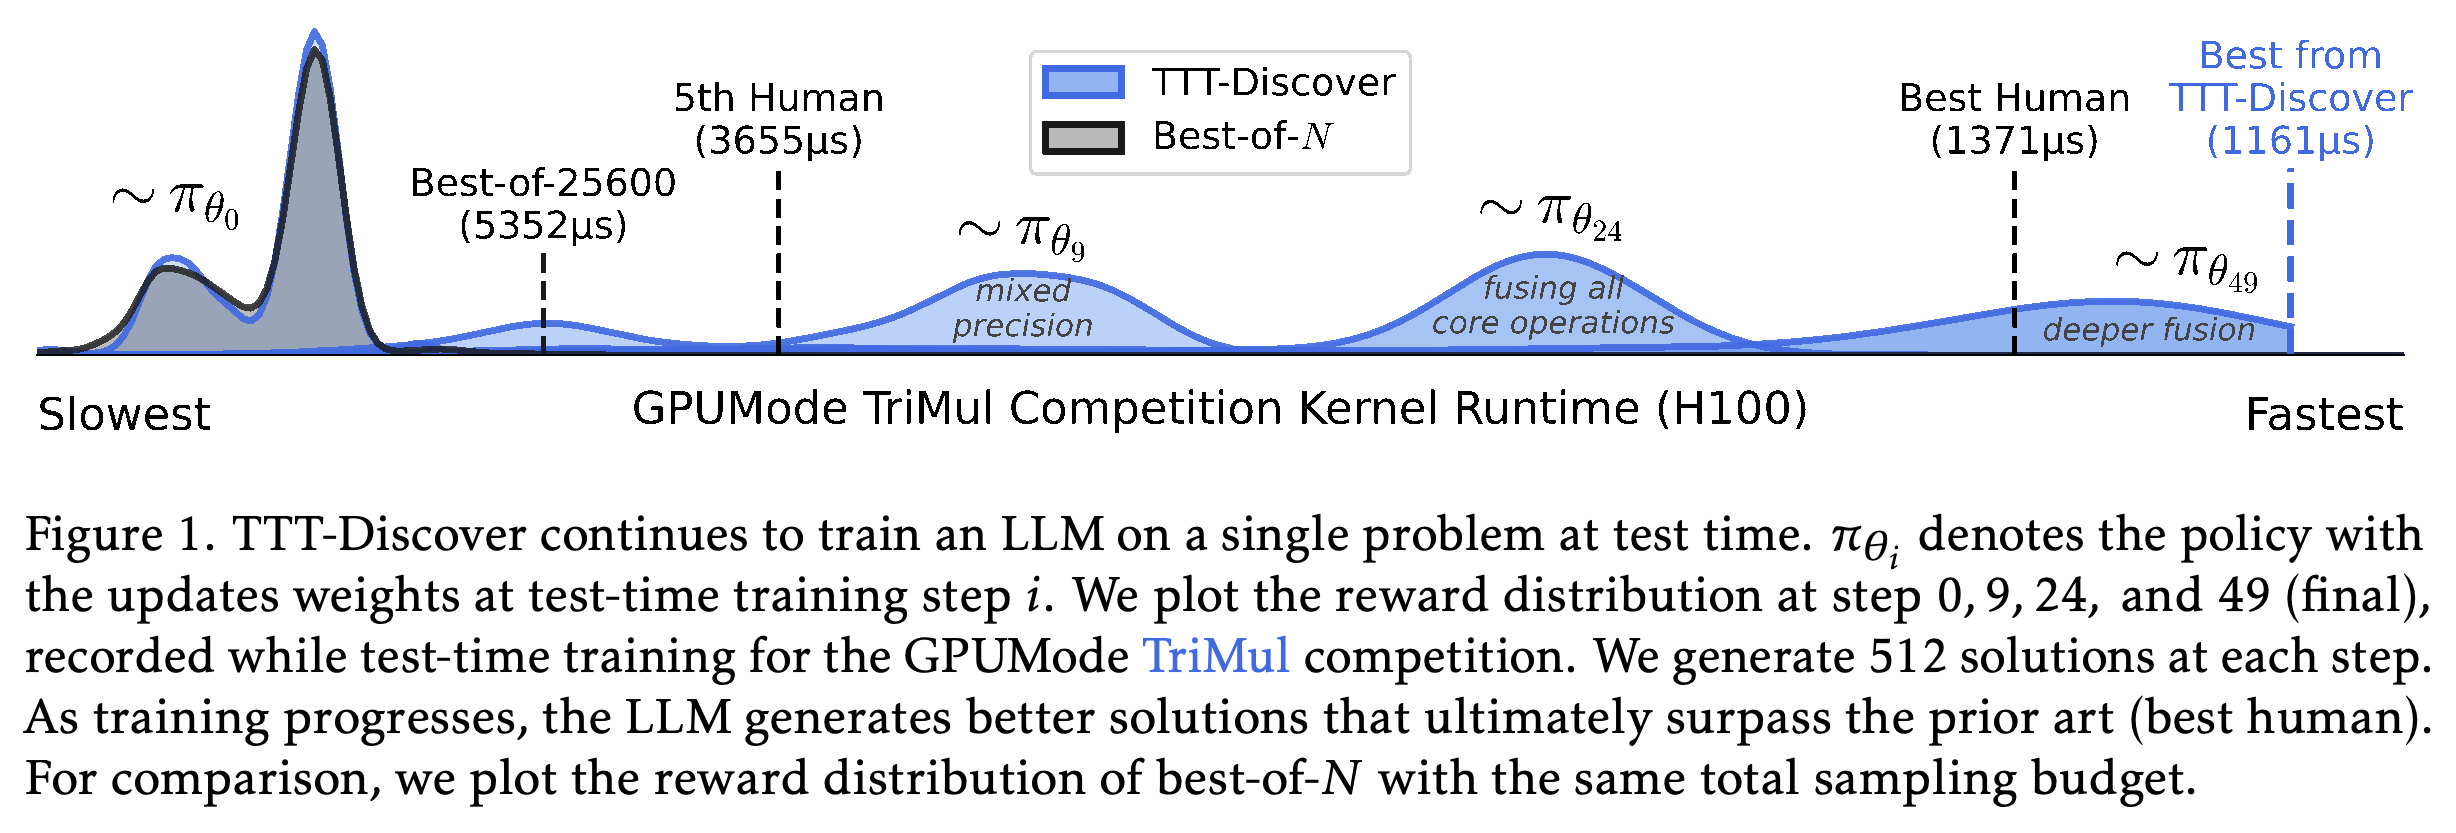
TriMul 구현은 연산 융합으로 메모리 전송과 커널 실행 오버헤드를 줄이고, 중간 활성값을 FP16으로 저장하며, 큰 행렬곱은 cuBLAS/rocBLAS에 맡긴다. Figure 1은 학습이 진행되면서 바뀌는 rollout 분포를 혼합 정밀도, 핵심 연산 융합, 더 깊은 융합과 연결해 보여 준다.
- Appendix C는 출력 LayerNorm과 gating을 출력 projection에 융합한 점이 인간 최고 H100 커널보다 유리한 요인일 수 있다고 설명한다.
- 생성한 H100 커널은 인간 구현보다 블록 크기 autotuning을 적게 수행하며, 저자들은 이를 한계로 지적한다.
정책을 갱신하면서 rollout 분포는 더 빠른 TriMul 구현 쪽으로 이동하지만, 같은 예산의 동결 모델 샘플링은 더 느린 해법에 집중된다. 혼합 정밀도와 융합 표시는 이러한 변화와 연관된 구현 변경을 나타내지만, 그림만으로 각 변경의 인과적 기여를 분리할 수는 없다.
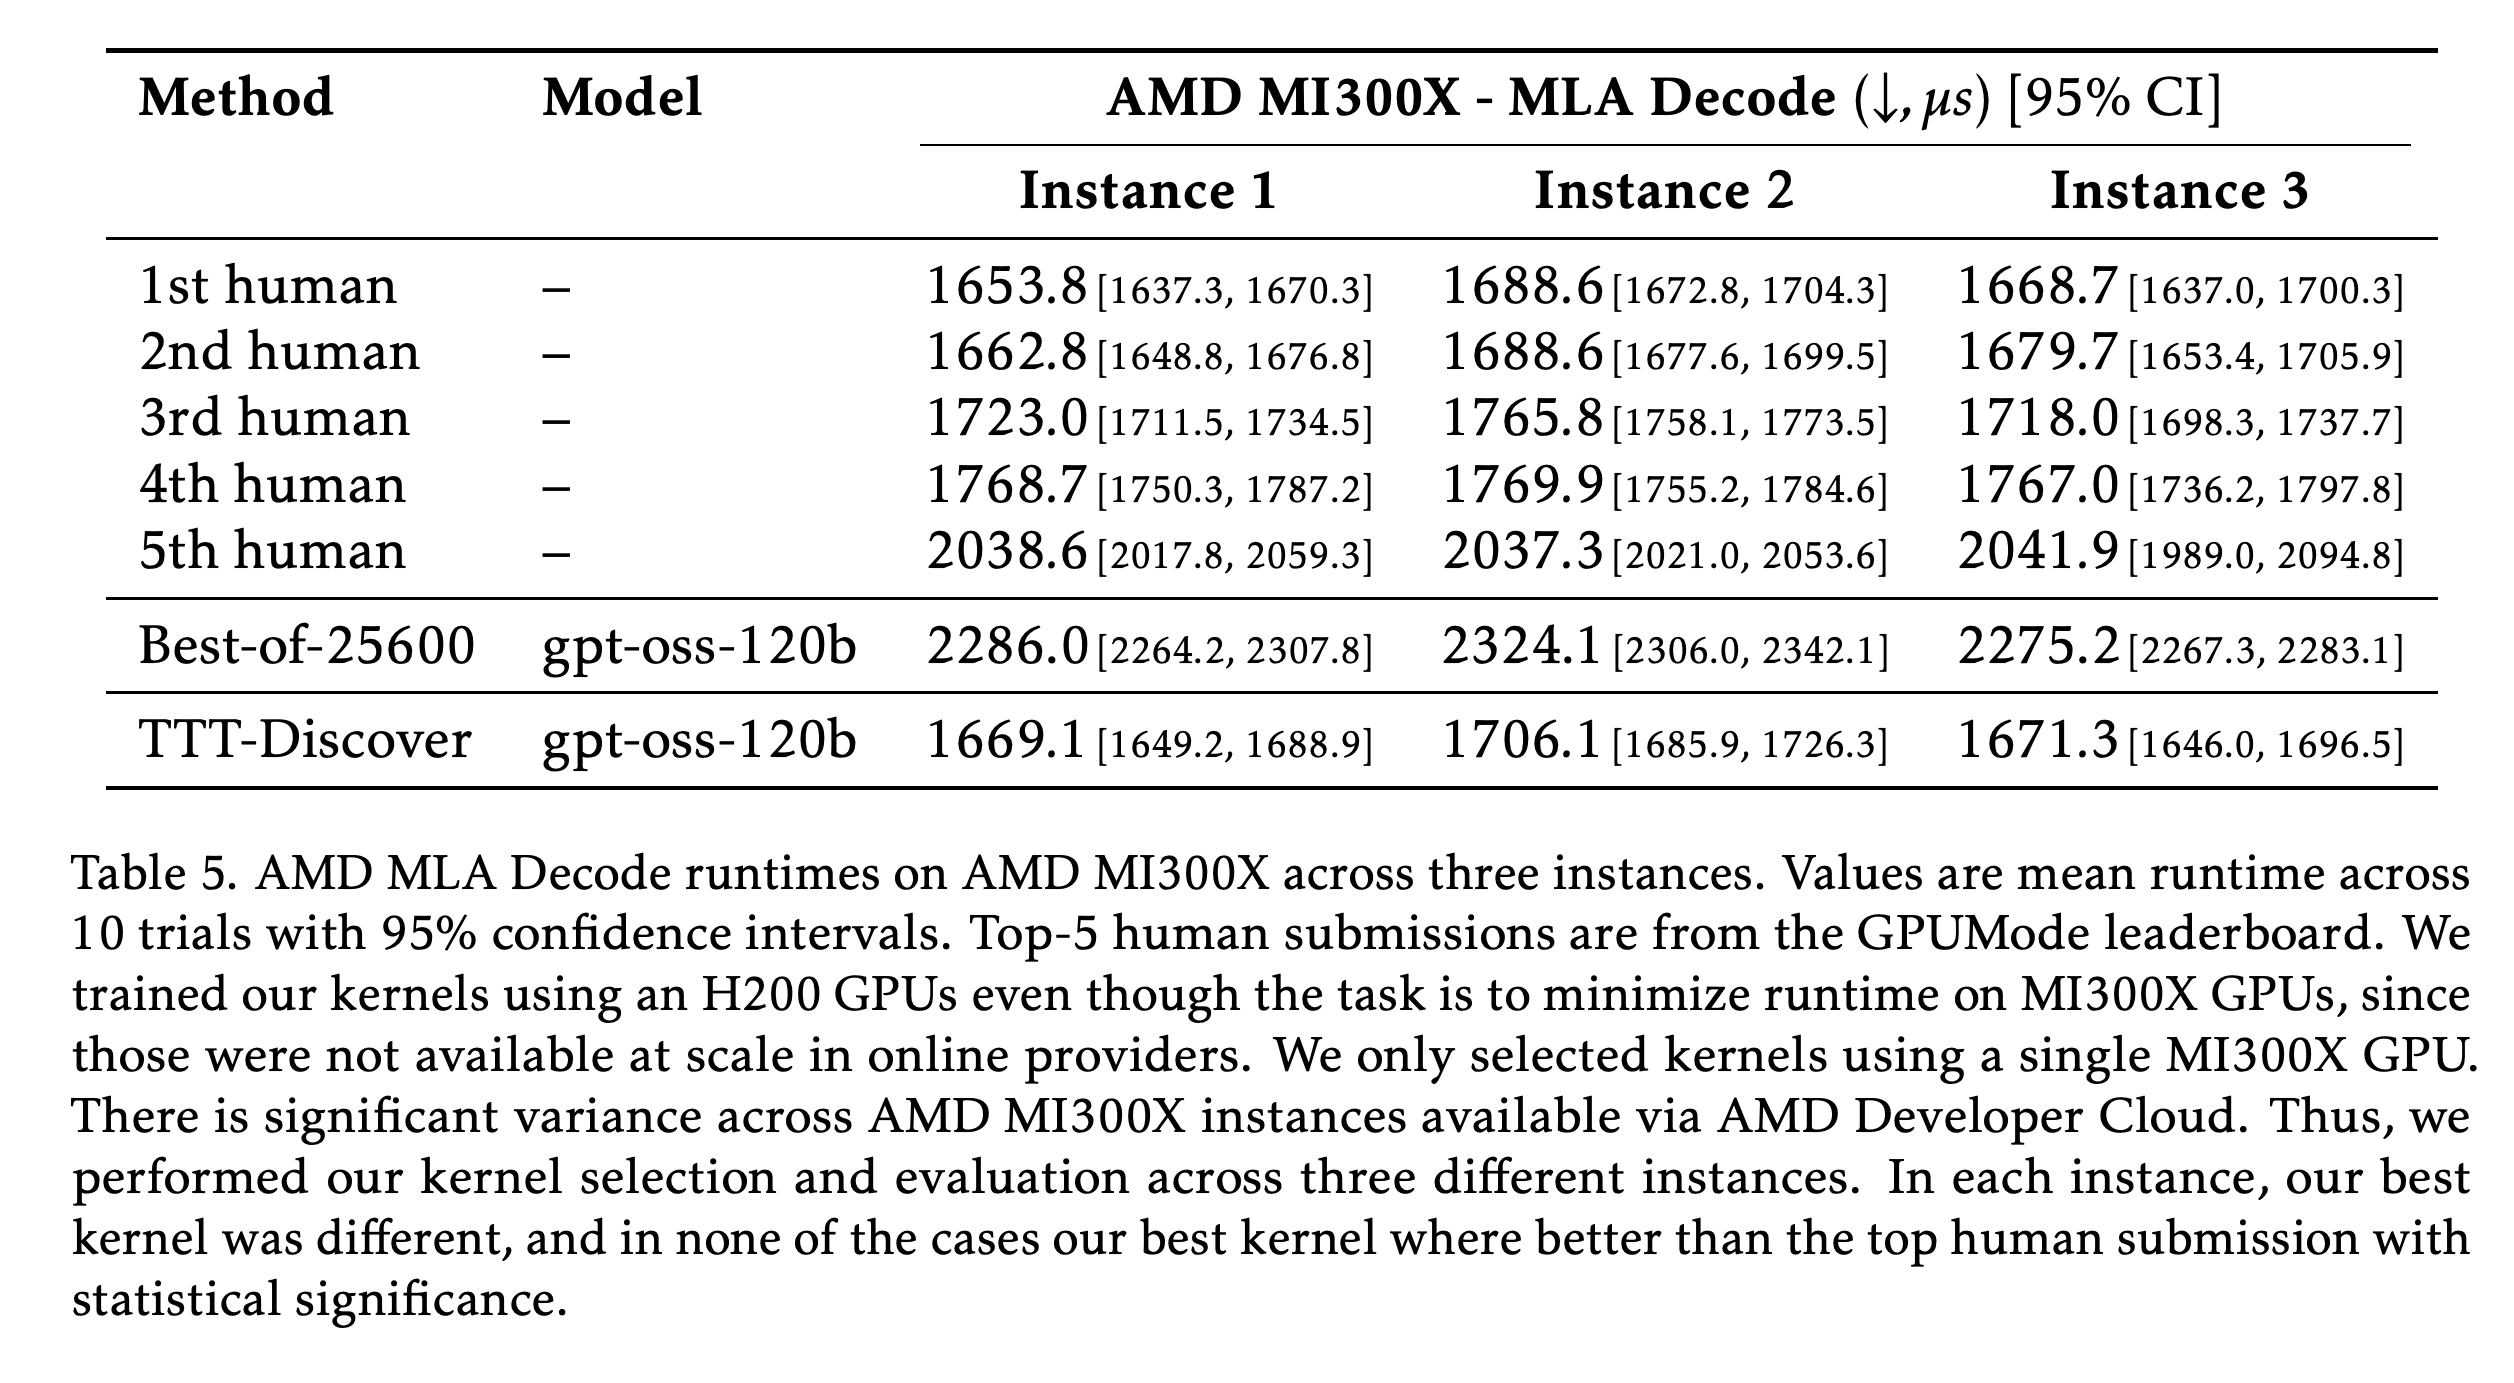
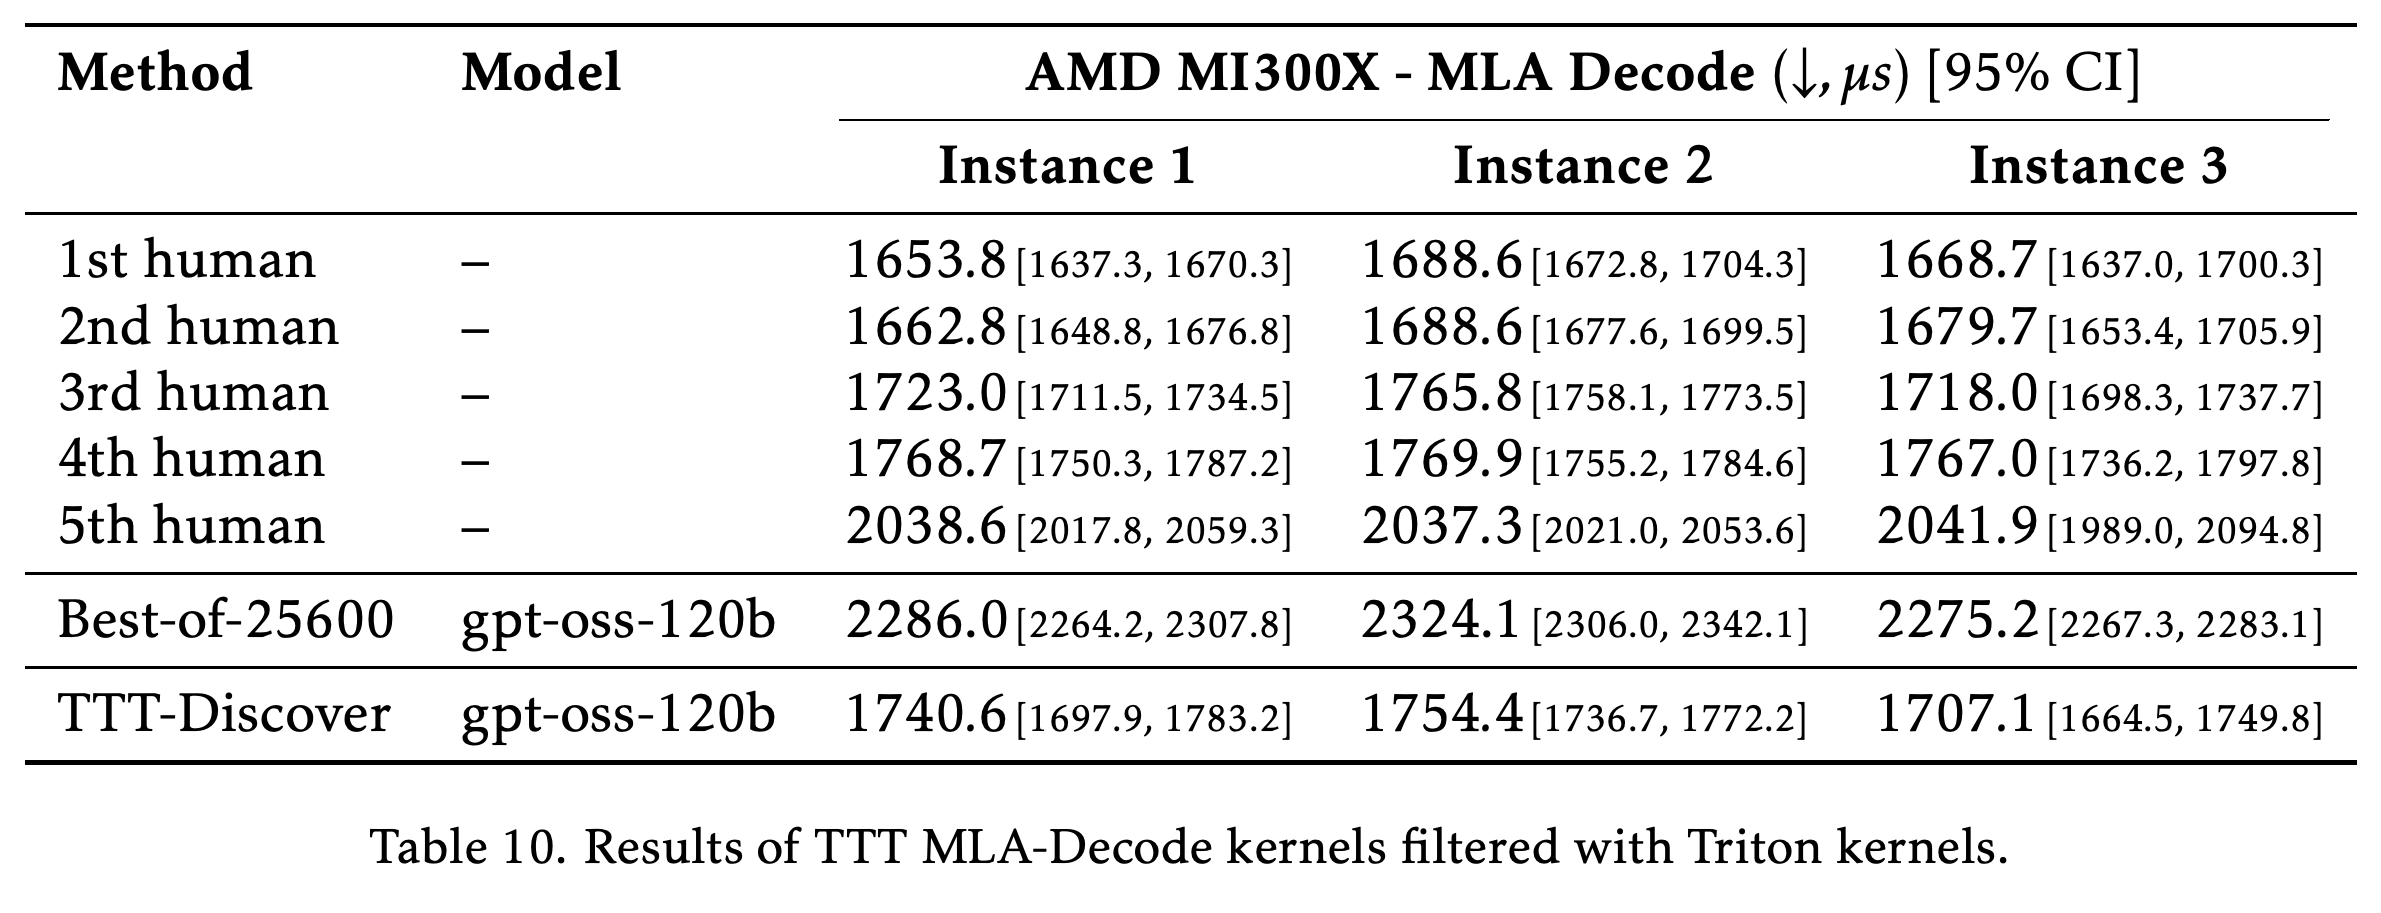
MLA-Decode에서는 새 기록을 세우지 못한다. Table 5는 MI300X 인스턴스 3개에서 각각 1669.1, 1706.1, 1671.3 µs를 보고하며, 인간 최고 제출물 대비 통계적으로 유의한 우위는 없다. 생성한 구현 중 가장 빠른 것들은 세밀한 최적화를 위한 명시적 Triton 커널보다 특정 torch.compile() 설정을 주로 사용한다.
- 인스턴스 간 실행 시간 차이 때문에 커널 선택이 복잡해진다. Table 5는 인스턴스 3개에서 가장 좋은 생성 커널이 서로 다르다고 명시한다.
- Table 10은 명시적 Triton 구현만 따로 선별해 1740.6, 1754.4, 1707.1 µs를 보고하며, 이 경우에도 인간 기록을 넘지 못한다.
TTT-Discover는 Best-of-25600보다 크게 개선되지만, 인간 최고 MLA-Decode 제출물보다 유의하게 뛰어나지는 않다. 인스턴스마다 가장 좋은 생성 커널이 달라서, 하드웨어 변동성과 선택 조건을 고려해야 비교를 해석할 수 있다.
명시적 Triton 커널로 선택 대상을 제한하면 본문의 torch.compile() 기반 결과보다 느린 MLA-Decode 후보를 얻는다. 선별한 후보는 Best-of-25600보다 개선되지만 인간 기록을 넘지는 못한다.
4.2.1 Expert Review
전문가 검토에서 Matej Sirovatka, Alex Zhang, Mark Saroufim(GPUMode)은 메모리 병목이 있는 원소별 연산을 융합하고 라이브러리 행렬곱을 사용하는 TriMul 전략을 지지한다. 주최 측은 활성값을 FP16으로 저장하는 방식이 대회 허용 오차 안에서는 유효하지만, 전체 워크로드에서는 수치 안정성 문제를 일으킬 수 있다고 경고한다.
4.3 Algorithm Engineering
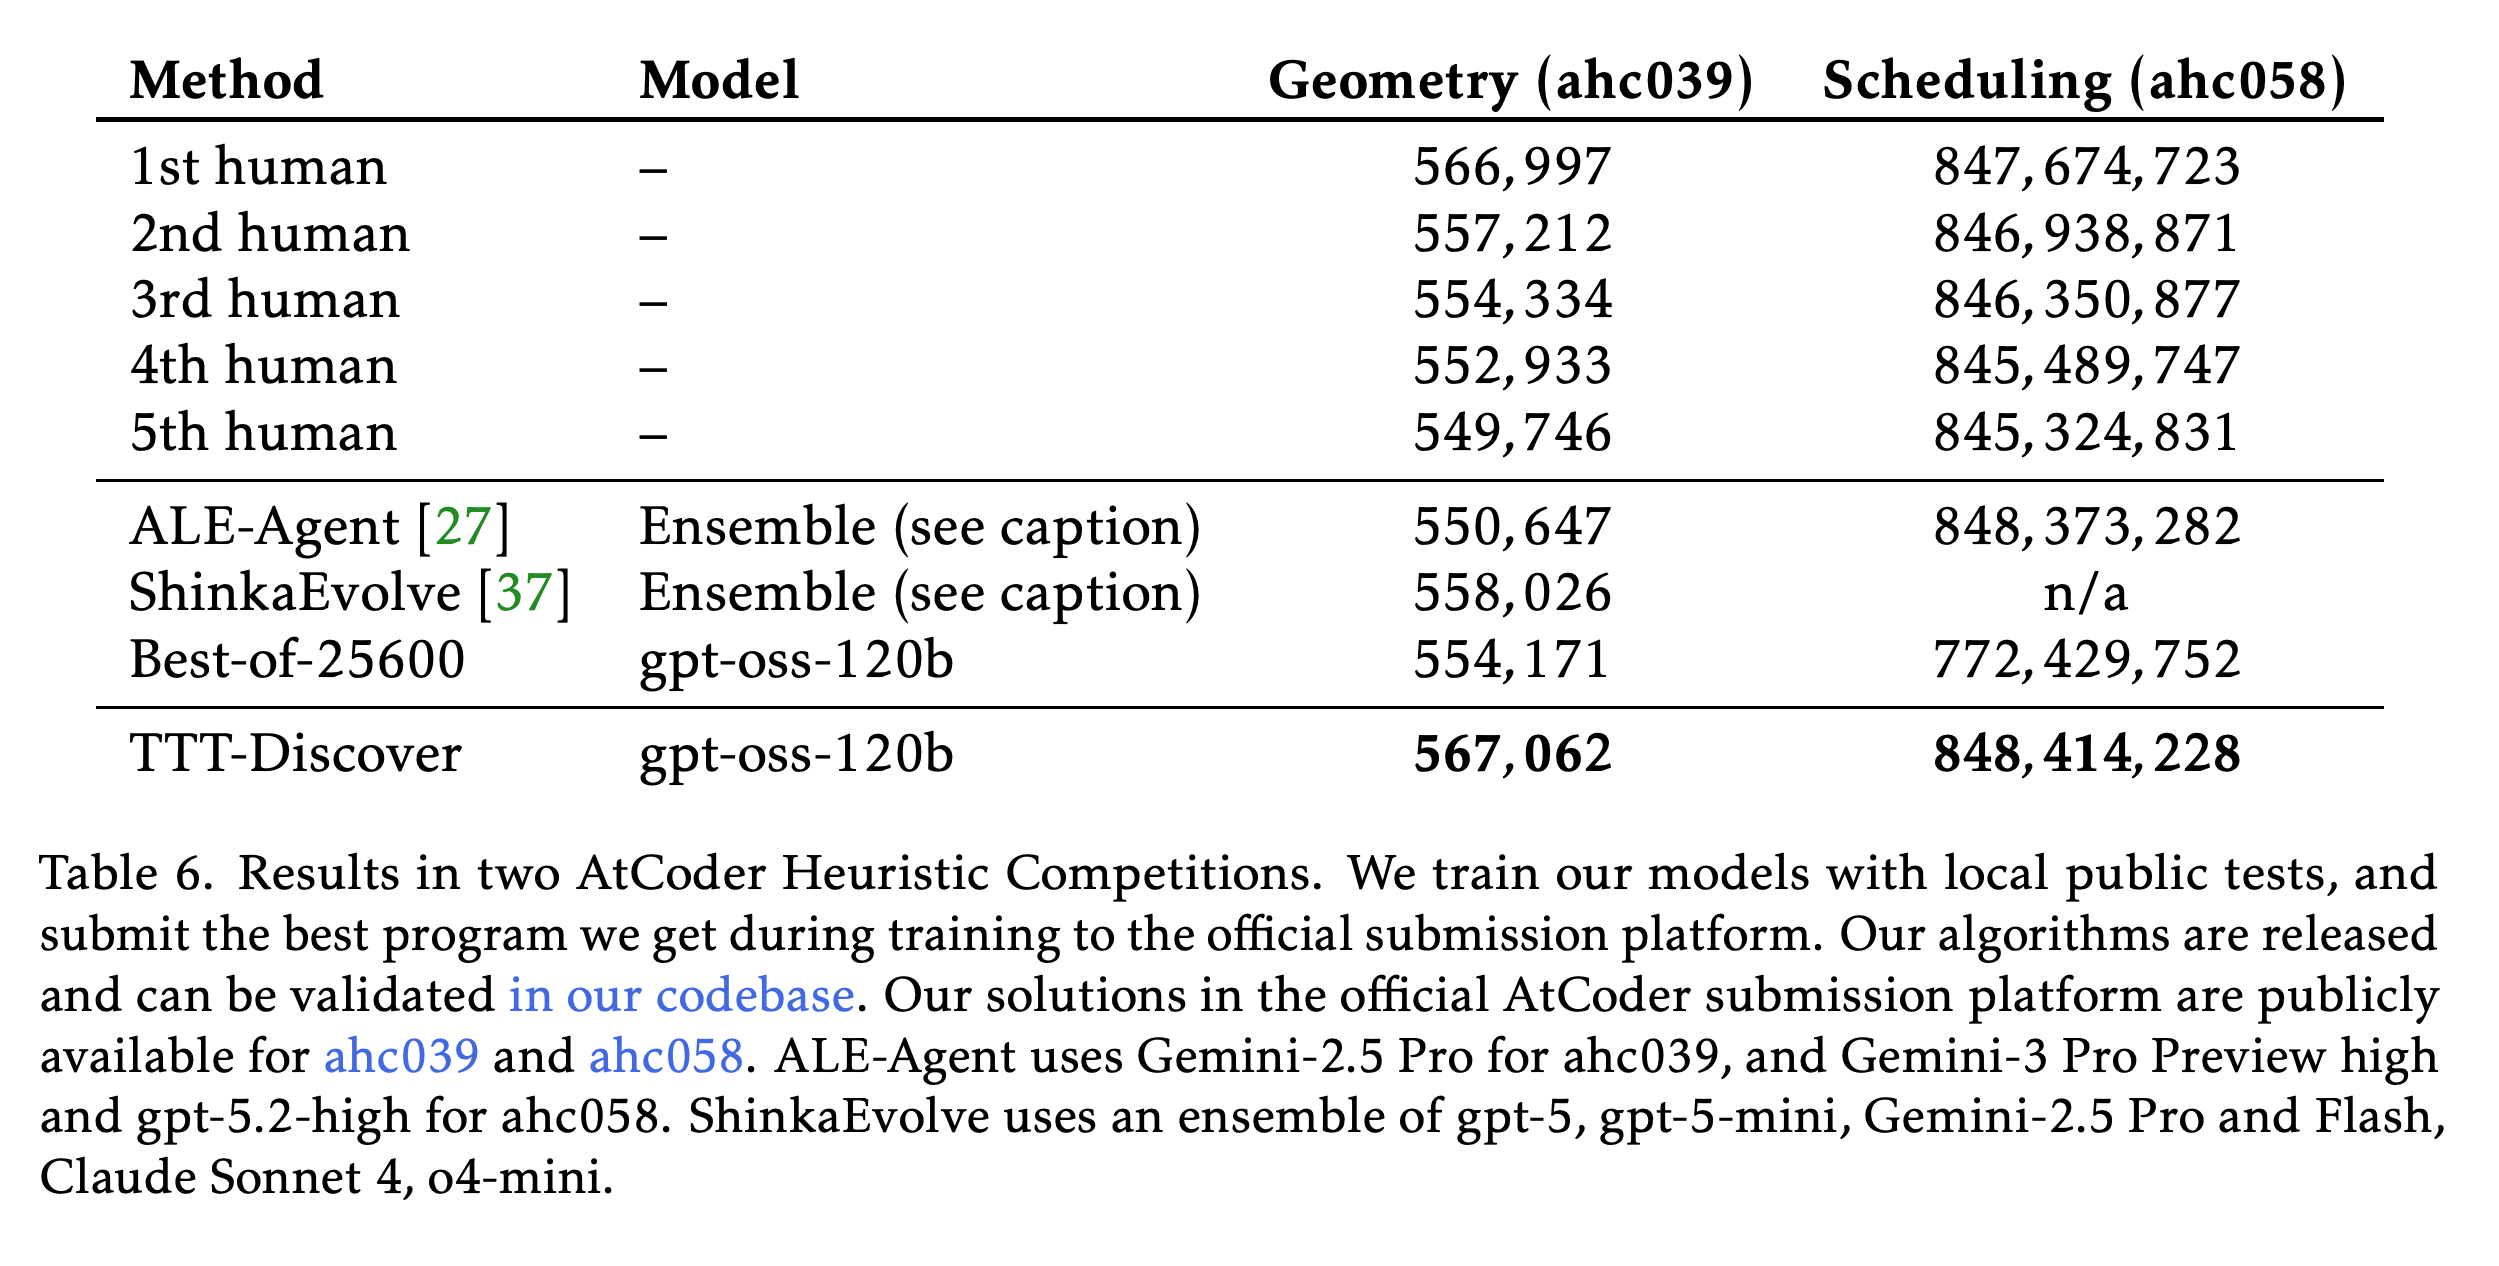
Algorithm Engineering은 ALE-Bench로 ahc039(Purse Seine Fishing)와 ahc058(Apple Incremental Game)을 평가한다. 로컬에서 생성한 공개 사례로 학습한 뒤, 선택한 프로그램을 공식 비공개 테스트에서 평가한다. 유효한 C++ 프로그램은 2초 시간제한과 1024MB 메모리 제한을 충족해야 한다.
- AHC039는 ShinkaEvolve도 사용한 ALE-Agent-derived 프로그램에서 시작하며, AHC058은 처음부터 시작한다.
- Table 6은 AHC039에서 567,062를 보고하며, 인간 최고 점수는 566,997이고 ShinkaEvolve는 558,026이다.
- AHC058은 848,414,228에 도달하며, ALE-Agent는 848,373,282이고 인간 최고 점수는 847,674,723이다. 이는 과거 대회를 재평가했을 때 1위에 해당하는 점수이지, 실제 진행 중인 대회에서 거둔 우승은 아니다.
선택한 프로그램은 공식 비공개 테스트에서 표에 나온 모든 이전 점수를 넘으며, 가장 강한 경쟁 결과 대비 개선 폭은 작다. AHC039는 ALE-Agent-derived 초기 프로그램을 재사용하고, AHC058은 처음부터 시작한다. 어느 결과도 실제 진행 중인 대회의 우승은 아니다.
AHC039 해법은 누적합으로 후보 직사각형의 점수를 계산하고, 연결된 합집합을 구성한 뒤, 둘레와 꼭짓점 제약 아래에서 simulated annealing으로 개선한다. AHC058 해법은 탐욕적 초기화, 짧은 beam search, simulated annealing, 캐시한 중간 상태, 국소적인 마무리 개선을 결합해 생산 업그레이드 일정을 최적화한다.
- AHC039의 annealing은 추가, 제거, 교체, 확장, 축소, 이동 연산을 사용한다.
- AHC058은 업그레이드의 미래 생산 가치를 추정해 탐욕적 선택과 가지치기를 유도하며, 계획에서 수정한 부분만 다시 계산한다.
4.4 Single Cell Analysis
Single Cell Analysis는 이항 샘플링으로 평가용 분자를 분리해 두고 이에 대해 예측을 평가하는 OpenProblems 잡음 제거 과제를 최적화한다. TTT-Discover는 MAGIC 코드에서 시작해 Pancreas로 학습하며, 최종 결과는 학습에 사용하지 않은 PBMC와 Tabula Muris Senis Lung 데이터셋에서 평가한다.
- 학습 보상은 정규화한 MSE 점수이며, 정규화한 Poisson 점수 제약과 400초 실행 제한을 적용한다. 반면 보고하는 벤치마크 Score는 정규화한 MSE와 Poisson 점수의 평균이다.
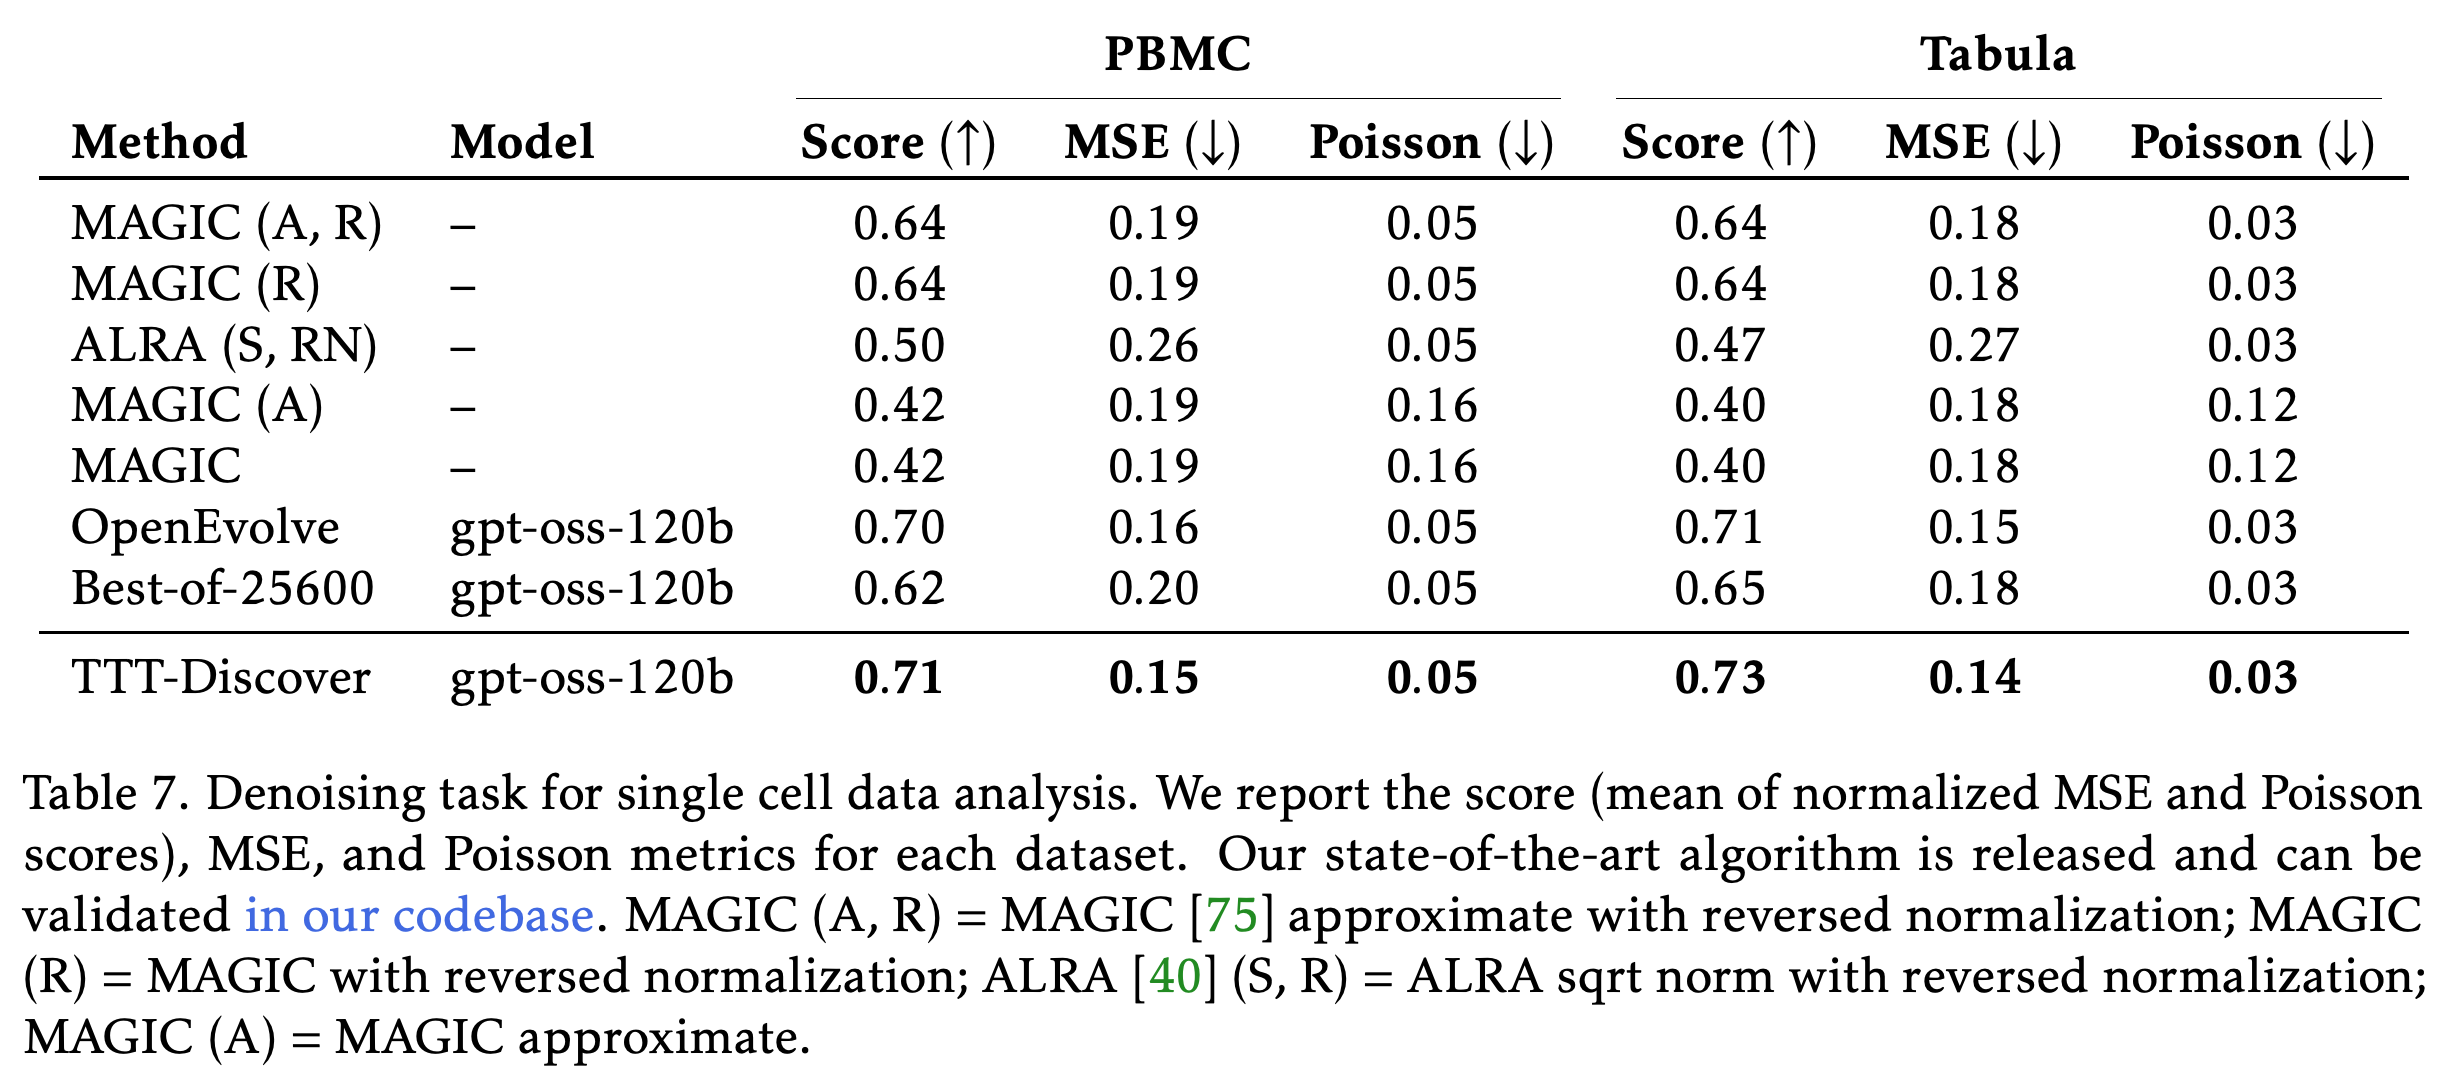
- Table 7은 PBMC에서 Score 0.71과 MSE 0.15를 보고한다. 역방향 정규화를 적용한 MAGIC은 각각 0.64와 0.19다.
- Tabula에서 TTT-Discover는 Score 0.73과 MSE 0.14에 도달하며, 역방향 정규화를 적용한 MAGIC은 각각 0.64와 0.18이다. 표시된 정밀도에서 Poisson 손실은 각 데이터셋에서 0.05와 0.03으로 유지된다.
잡음 제거기는 학습에 사용하지 않은 데이터셋 모두에서 MSE를 개선하며, 표시된 정밀도에서 최고 MAGIC 변형과 같은 Poisson 손실을 보인다. Score는 정규화한 MSE와 Poisson 성능의 평균으로, MSE만 사용하는 학습 보상과 다르다. 이 측정은 후속 분석의 생물학적 타당성을 평가하지 않는다.
생성한 잡음 제거기는 유전자별 적응형 변환 앙상블, 저랭크 SVD 보정, 벤치마크 지표를 직접 겨냥한 로그 공간 후처리를 추가한다. 이 절의 Disclaimer는 주장을 벤치마크 성능으로 제한한다. 지표가 좋아져도 후속 과제에서 생물학적 타당성을 보장하지는 않는다.
4.4.1 Expert Review
전문가 검토에서 Prof. Eric Sun(MIT)은 이러한 변경이 MAGIC의 평활화 기반 접근과 일치하며, 보고된 지표에서 경험적으로 유익하다고 설명한다. 그는 잡음 제거 점수 개선이 더 나은 생물학적 통찰로 이어지지 않을 수 있으므로, 생물학적으로 의미 있는 과제에서 평가할 필요가 있다고 강조한다.
4.5 Ablations
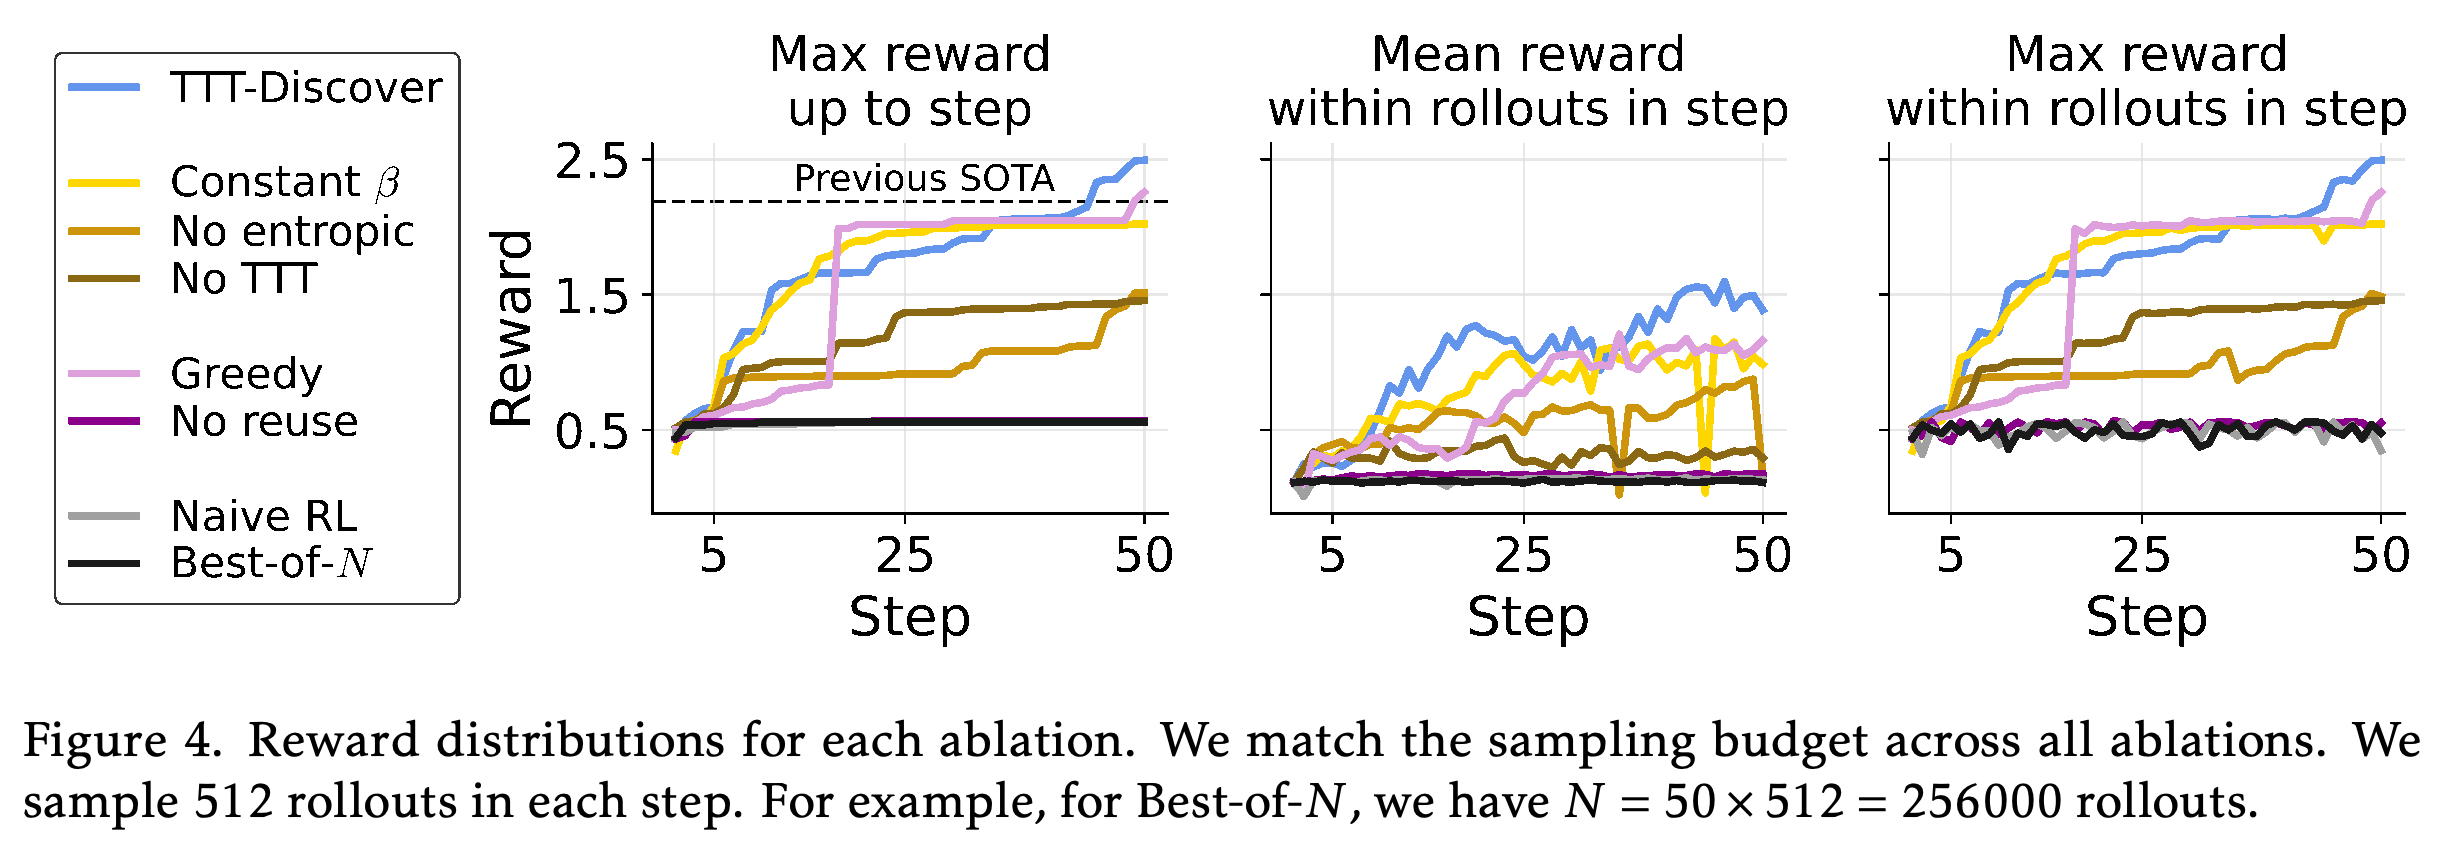
TriMul ablation은 같은 샘플링 예산 아래에서 학습 목적함수와 재사용 메커니즘을 분리해 평가한다. Table 8은 전체 방법에서 1203.10 µs, 고정 β = 2에서 1483.83 µs, 기대 보상 학습에서 1985.67 µs, 학습 없이 PUCT 재사용만 적용했을 때 2060.70 µs를 보고한다.
- PUCT를 ε = 0.1인 ε-greedy 재사용으로 바꾸면 1328.89 µs이며, 재사용을 제거하면 5274.03 µs다.
- 단순한 테스트 시점 RL은 5328.73 µs로, Best-of-N의 5352.36 µs와 비슷하다.
- 이 실행 시간은 공식 리더보드가 아니라 저자들의 평가기로 측정했으므로, Table 4의 1161.2 µs와 혼동해서는 안 된다.
재사용을 제거하면 성능이 동결 모델 샘플링과 비슷해지지만, 학습 없이 PUCT 재사용만 적용해도 상당한 개선이 있다. 적응형 엔트로피 학습과 PUCT의 결합이 보고된 실행 시간 중 가장 좋으며, 이는 결합 설계를 뒷받침한다. 표는 반복 실행의 불확실성이 아니라 각 실행에서 가장 좋은 커널을 보고한다.
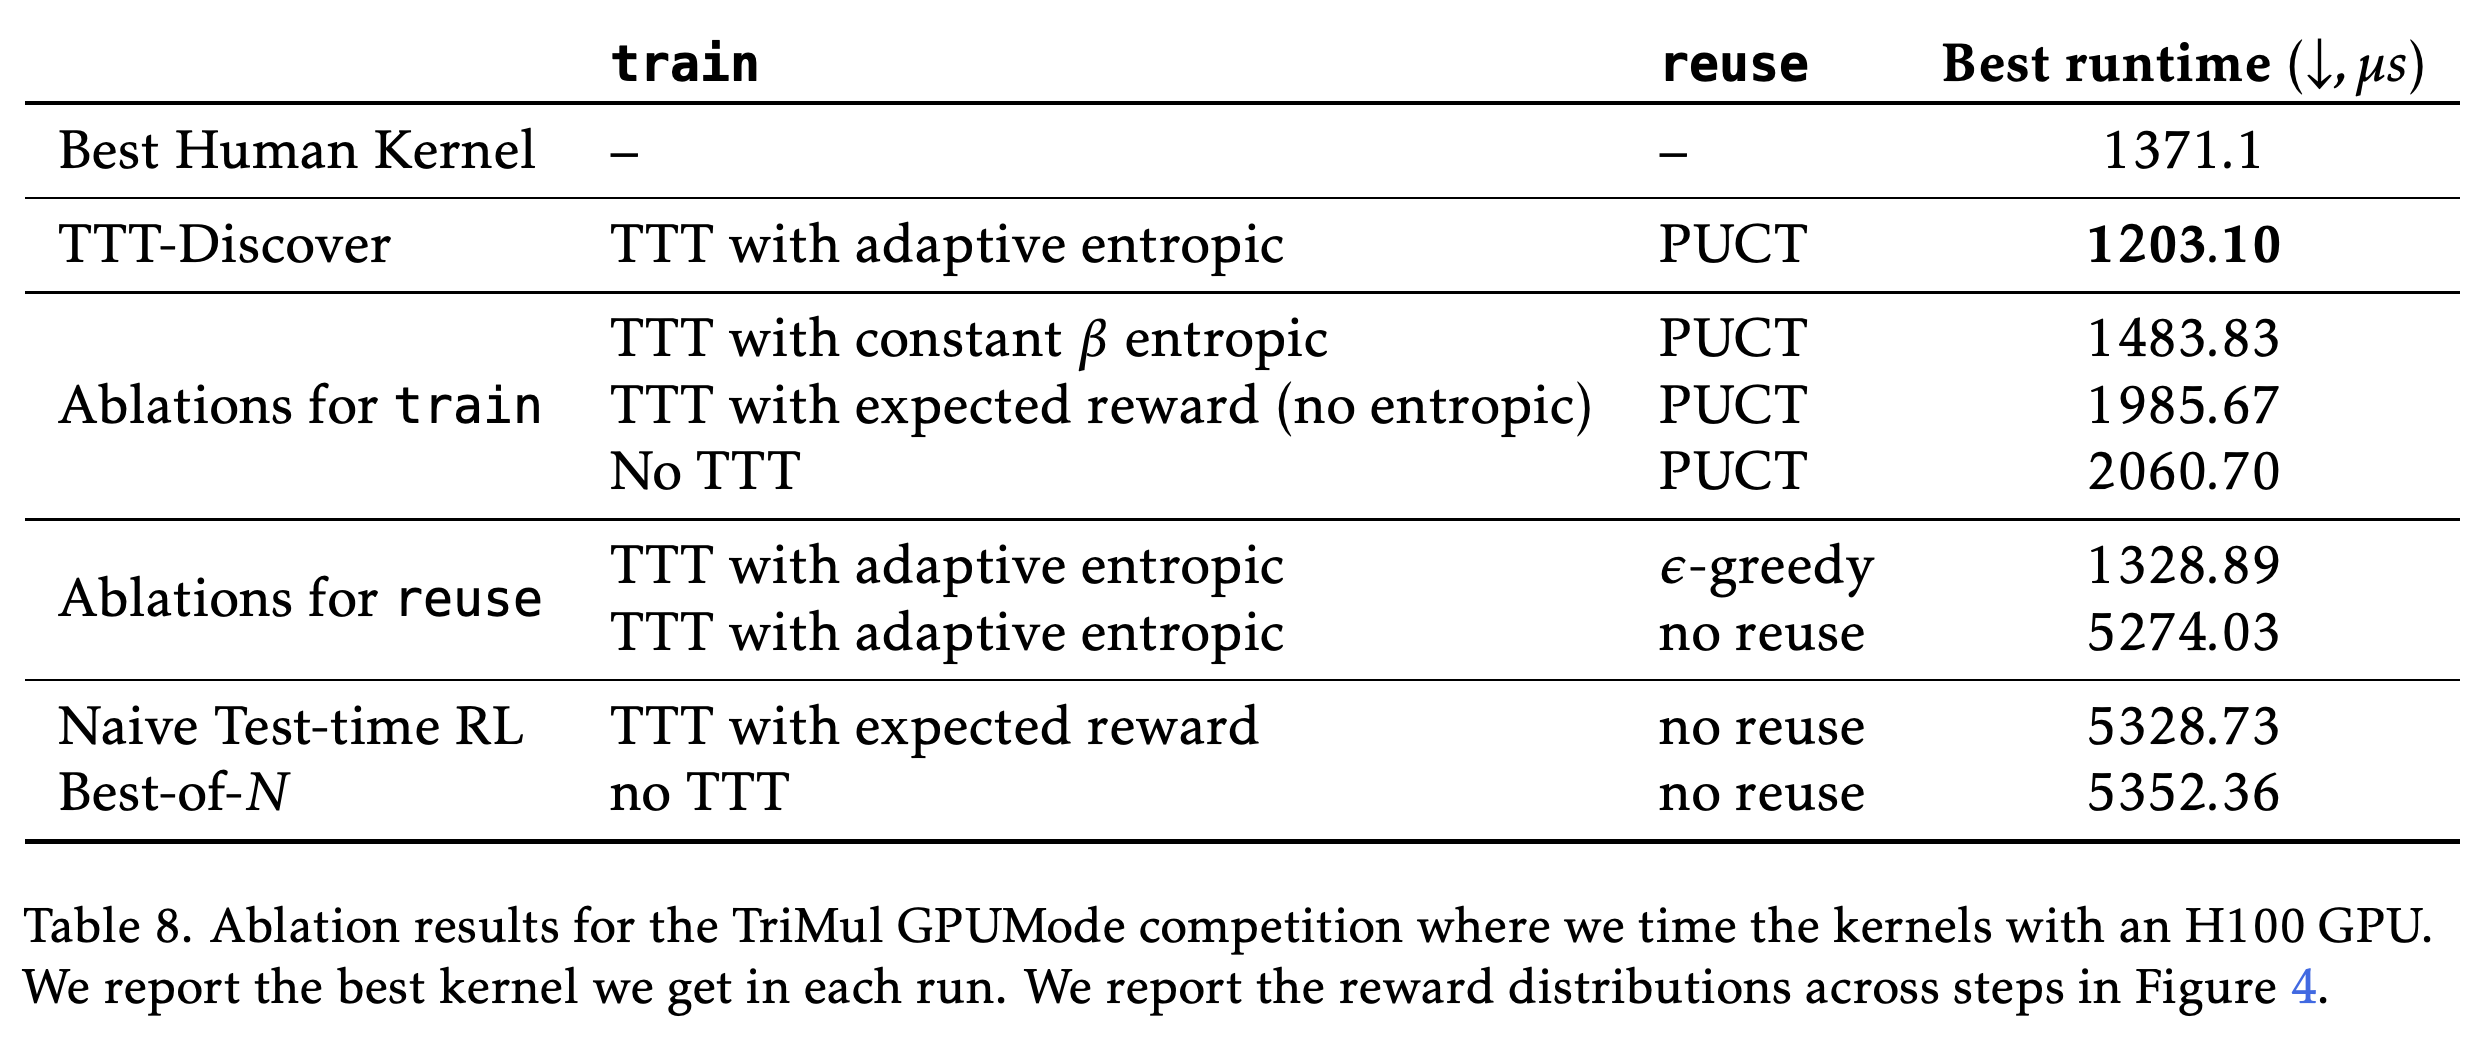
Figure 4는 적응형 엔트로피 학습에서는 개선이 계속되고, 고정 β에서는 후반 개선이 줄어들며, 재사용이 없으면 거의 진전이 없음을 보여 준다. Ablation은 학습과 후보 재사용이 모두 기여한다는 점을 뒷받침하지만, 반복 실행의 불확실성 추정 없이 각 실행에서 가장 좋은 커널을 보고한다.
- 저자들은 과제별 스케줄, 하이퍼파라미터 상호작용, 추가 튜닝으로 ablation 설정을 개선할 수 있음을 인정한다.
- Figure 4의 캡션에는 N = 50 × 512 = 256000이라고 쓰여 있다. 명시된 단계 수와 배치 크기를 곱하면 25,600이며, 이는 본 실험 절차와 일치한다.
누적 최고 및 단계별 최고 곡선은 전체 방법에서 후반에도 개선이 계속됨을 보여 준다. 반면 고정 β 학습은 정체되고, 재사용이 없는 변형은 동결 모델 베이스라인 근처에 머문다. 캡션에 적힌 총합 256000은 50 × 512 및 25,600개 샘플을 사용하는 실험 절차와 맞지 않는다.
5 Related Works
Related Works는 TTT-Discover를 지속 학습과 인스턴스별 테스트 시점 학습의 맥락에서 설명한다. 현재의 발견 문제에 적응하는 방식이 일반화 개선을 위해 예제 1개로 학습하는 방식이나 전체 테스트 세트에 함께 적응하는 방식과 어떻게 다른지 구분한다.
5.1 Continual Learning
일반적인 지속 학습은 이전 과제나 데이터에 대한 성능을 유지하면서 변화하는 데이터 분포를 학습하는 문제를 다룬다. TTT-Discover도 초기 학습 이후 모델을 갱신하지만, 변화하는 과제 순서에서 이전 성능을 유지하는 것이 주목적은 아니다.
5.2 Test-Time Training
Test-Time Training은 개별 테스트 인스턴스마다 서로 다를 수 있는 학습 문제를 정식화한다. TTT on Nearest Neighbors: Larger Effective Capacity는 검색한 예제로 국소 학습을 수행하면 유효 용량이 커져 모델이 현재 입력에 특화될 수 있음을 설명한다.
- 초기 사례로는 국소 가중 회귀, local learning, KNN-SVM, dynamic evaluation이 있다.
- 최근 변형은 언어 추론과 시각-운동 과제에 이웃 기반 미세조정이나 RL을 사용한다.
TTT for Novel Instances: Better Generalization은 테스트 인스턴스에서 생성한 관련 데이터로 적응 범위를 넓히며, 자기지도 보조 과제와 목표에 맞춘 커리큘럼을 포함한다. 동시기에 나온 MiGrATe, ThetaEvolve, EvoTune은 인스턴스별 갱신과 replay 또는 재사용을 결합한다. TTT-Discover는 엔트로피 학습과 최댓값 기반 PUCT로 가장 좋은 발견 산출물에 집중한다.
- AlphaProof는 RL을 위해 더 쉬운 관련 문제를 생성하고, ARC-AGI 테스트 시점 학습은 지도 학습을 통한 적응을 위해 few-shot 예시를 증강한다.
- 이 절은 모델 기반 평가와 함께 토큰 표현에 적용하는 테스트 시점 정책 경사, 그리고 TSP 같은 조합 문제를 위한 기존 인스턴스별 신경망 정책 최적화도 다룬다.
- 논문은 ThetaEvolve와 동일 모델·동일 예산으로 비교했다고 반복해서 주장하지만, Section 4.1.2의 세부 설정을 고려하면 이 주장에는 단서가 필요하다. 보고된 실행은 서로 다른 Qwen 변형을 사용하며, 단계 수도 50과 65단계로 다르다.
5.3 RL on One Example
One Example RL은 학습 데이터셋의 예제 1개로 학습하고 다른 예제로의 일반화를 평가한다. 반면 TTT-Discover는 테스트 문제 자체에서 학습하며, 같은 문제를 푸는 것이 목표다.
5.4 RL on the Test Set
TTRL은 보상을 추정하기 위한 다수결 의사 라벨을 사용해 전체 테스트 세트에 적응한다. TTT-Discover는 연속적이고 검증 가능한 보상을 가진 문제 1개를 사용하며, 여러 문제의 평균 정확도를 개선하기보다 뛰어난 후보를 탐색한다.
6 Future Work
Future Work는 희소하거나 이진인 보상과 검증할 수 없는 영역으로 방법을 확장하는 일을 주요 연구 방향으로 제시한다. 현재 실험은 이러한 설정에서의 효과를 입증하지 않는다.
부록
- A Training details는 거의 모든 응용에 KL 계수 0.1을, 알고리즘 엔지니어링에는 0.01을 명시한다. A.1 Entropic utility objective는 γ = ln(2)일 때 (\operatorname{KL}(q_\beta|u)=\gamma)를 만족하도록 이분법으로 β를 선택하고, leave-one-out 엔트로피 advantage를 계산한다. 부록은 보상을 양의 상수로 곱하거나 상수를 더해도 advantage가 변하지 않는다고 명시한다. A.2 PUCT Prioritization은 보상 범위로 스케일링한 탐색 보너스, 순위 사전분포, 자식 보상의 최댓값 통계량, 조상 방문 횟수 갱신, 상위 2개/상위 1000개 아카이브 유지, 배치 내 계보 선택 차단을 명시한다.
- B Mathematics에는 B.1 Circle Packing 프로그램이 포함된다. Circle Packing (n = 26)은 5개 행으로 초기화하고 SLSQP로 중심과 반지름을 함께 최적화한다. Circle Packing (n = 32)은 육각 격자로 배치한 원 30개와 추가 원 2개로 초기화하고, 경계 및 거리 제약을 적용해 최적화하며, 최적화나 검증에 실패하면 초기 배치로 돌아간다. B.2 Autocorrelation Inequalities는 무작위 높이를 반복해 만든 초기 수열, 입력 검증, 이산 AC1 상계 계산, AC2의 구간별 선형 적분을 설명한다. B.3 Erdős’는 0.5 주변에서 교란한 값 40–100개로 초기화하고, 길이가 1000을 넘는 수열을 거부한다. 부등식과 Erdős’ 평가기는 1 GB, CPU 2개, 최대 1100초의 제한 시간을 사용한다.
- C Kernel engineering은 초기 TriMul 행렬곱 예시와 모델이 예비 단계에서 생성한 미최적화 MLA-Decode 커널을 설명한다. C.1 Kernel evaluation details는 대회와 일치하는 정확성·시간 검사, 공식 A100/H100 제출, 다른 하드웨어를 위한 주최 측 검토 복제 환경을 기록한다. H100에서는 학습 후보 상위 20개에서 선택한다. 다른 대상에서는 학습 후보 상위 20개에 10단계마다 정확성 검사를 통과한 무작위 커널 20개를 더한다. 선택한 후보를 대상 하드웨어에서 3회 평가해 평균 실행 시간이 가장 짧은 것을 고른다. C.2 Analysis of best generated kernels와 TriMul H100은 융합한 FP16 구현을 제시하고 메모리 접근 개선과 제한적인 autotuning을 논의한다. C.3 TTT MLA-Decode kernels filtered with Triton kernels는 더 느린 명시적 Triton 결과를 보고한다.
- D Algorithm Engineering은 yimjk/ale-bench:cpp20-202301에서 시드 0부터 149까지로 생성한 사례 150개를 사용해 학습한다. 모든 사례에서 정확성 검사 통과와 2초 이내 실행을 요구하며, 이후 로컬 점수 상위 프로그램 3개를 C++23 (GCC 15.2.0)으로 제출한다. AHC039는 ShinkaEvolve의 상대 순위 성능 지표를 사용하고, AHC058은 대회 점수를 직접 사용한다. AHC039는 프롬프트와 thinking의 합산 한도를 22000토큰으로 줄인다. AHC058은 25000토큰과 학습률 2 × 10⁻⁵를 사용하며, 두 과제 모두 KL 계수 1 × 10⁻²를 사용한다.
- E Single cell analysis는 정규화한 Poisson 성능이 0.97과 1 사이여야 한다고 요구하고, 메모리를 3GB로 늘리며, 실행을 400초로 제한한다. 학습은 정규화한 MSE를 최적화하지만, 벤치마크 점수는 정규화한 MSE와 Poisson 성능의 평균이다. TTT-Discover와 Best-of-25600은 생성 한도 20,000토큰을 사용한다. OpenEvolve는 25,600개 샘플을 실행하지만, 후반 아카이브 항목에서 시간 초과가 늘어나므로 샘플 17,000 이전의 프로그램 중 최선을 선택한다. Denoising은 magic_denoise와 함께 분산 안정화 변환, 유전자별 확산 및 혼합, 변환 앙상블, 저랭크 SVD 보정, 로그 공간 후처리용 보조 함수를 제공한다. 최종 평가는 기본 매개변수를 사용한다.
- F Prompts는 완전한 독립형 평가기가 아니라 샘플링 단계의 템플릿을 담고 있다. Prompt used for the first autocorrelation inequality는 이전 LP 기반 접근, 이전 경계와 로그, 1000초 탐색 예산, propose_candidate 진입점을 제공한다. Prompt used for the second autocorrelation inequality는 탐색·개선·확대 과정을 설명하고 construct_function을 요구한다. Prompt used for the Erdős’는 [0,2] 위의 h, [0,1] 범위의 값, 적분값 1, 상관 기반 평가, run 진입점을 명시한다. Prompt used for TriMul은 PyTorch forward 참조 구현, 입력 사례, 혼합 정밀도 요구사항, H100의 Triton 3.3.1용 custom_kernel을 제공한다. Prompt used for MLA-Decode는 attention 및 KV-cache 참조 구현, custom_kernel, Triton 3.4.0/H200 요구사항을 제공하며 torch.compile()을 허용한다. Prompt used for the AHC039는 다각형 제약과 낚시 점수를 명시하고, Prompt used for the AHC058은 계층적 생산 업그레이드와 출력 행동을 명시한다. Prompt used for Denoising은 magic_denoise, 평가용으로 분리해 둔 분자에 대한 지표, 정규화 안내, Poisson 제약을 명시한다. 여러 검증기, 이전 코드, 자원 필드는 자리표시자로 남아 있다.
짧은 생각
이 논문의 기여는 가장 좋은 산출물을 찾는 목표에 맞춰 테스트 시점 정책 갱신과 후보 재사용을 함께 설계한 데 있다. 검증 가능한 수학적 구성, 가능한 경우의 외부 평가, 구성요소 ablation이 이를 뒷받침한다. 근거는 여전히 연속적이고 검증 가능한 보상에 한정된다. 베이스라인의 컨텍스트 및 시간제한이 비교를 복잡하게 만들고, ThetaEvolve 비교에서는 모델 변형과 예산이 달라지며, 생물학적 타당성은 검증하지 않았다. AC2, 원 패킹, MLA-Decode에서 보고한 실패는 이 방법의 적용 범위를 해석하는 데 중요하다.