


Soft Adaptive Policy Optimization 요약 설명
25 Nov 2025 | Paper Review Reinforcement Learning Loss Functions Mathematical Reasoning목차
이번 글에서는 Soft Adaptive Policy Optimization 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 11월 25일(Arxiv)
- Gao, Chang, Zheng, Chujie, Chen, Xiong-Hui, Dang, Kai, Liu, Shixuan, Yu, Bowen, Yang, An, Bai, Shuai, Zhou, Jingren, Lin, Junyang.
- Qwen Team, Alibaba Inc.
- 논문 링크
- Github
- Project Page
요약
- 언어 모델을 보상으로 학습할 때 응답 생성 시점과 파라미터 갱신 시점 사이에 토큰 확률이 불균일하게 변하면 학습이 불안정해질 수 있다. Soft Adaptive Policy Optimization (SAPO)은 이러한 확률 변화에 따라 갱신 강도를 매끄럽게 줄이는 방법이다. 수학적 추론 통제 실험에서 SAPO는 비슷한 학습 예산으로 유효한 학습을 더 오래 유지하고 더 높은 단일 응답 성공률을 달성한다. 비교 대상은 응답 단위로 갱신을 클리핑하는 Group Sequence Policy Optimization (GSPO)과 토큰 단위로 갱신을 클리핑하고 전문가 라우팅 결정을 재사용하는 Group Relative Policy Optimization with routing replay (GRPO-R2)다.
- Hard clipping은 advantage에 따라 정해지는 임계값을 벗어나면 파라미터 갱신에 쓰이는 미분값인 gradient를 제거한다. SAPO는 이를 sigmoid 기반 gate로 대체한다. 이 gate는 현재 정책의 토큰 확률을 응답 생성 정책의 토큰 확률로 나눈 비율에 따라 갱신 가중치를 매끄럽게 조절하며 가중치는 제한된 범위 안에 있다. Advantage는 응답 보상에서 그룹 평균을 뺀 뒤 그룹 보상의 표준편차로 정규화한 값이다. SAPO는 비율이 1일 때 클리핑하지 않은 gradient를 보존한다. 음의 advantage에는 가중치가 감소하는 속도를 조절하는 파라미터인 temperature를 더 크게 적용한다.
- 통제 실험은 Qwen3-30B-A3B-Base를 미세 조정한 cold-start checkpoint를 사용한다. 이 checkpoint는 비교할 보상 기반 학습을 시작하기 전의 초기 모델이다. 별도의 Qwen3-VL-30B-A3B 비교는 텍스트 과제와 여러 입력 모달리티를 다루는 멀티모달 과제를 대상으로 한다. 동일한 연산 예산에서 더 높은 종합 검증 성능을 보이며 이 비교에서는 통제 실험에서 관찰된 기준 모델의 학습 붕괴가 나타나지 않는다. 논문은 학습 곡선을 제시하지만 최종 점수표, 반복 실행의 불확실성 추정치, 전체 연산 사양은 제공하지 않는다.
1 Introduction
강화학습(Reinforcement Learning, RL)은 보상으로 정책을 학습하며 토큰 시퀀스를 생성하는 대규모 언어 모델(Large Language Models, LLMs)의 추론 능력을 개선한다. 그룹 기반 정책 최적화는 질의마다 여러 응답을 샘플링하고 그룹 안에서 보상을 정규화한다. 갱신에는 중요도 비율(importance ratio)을 가중치로 사용한다. 이 비율은 현재 정책의 확률을 응답을 생성한 행동 정책(behavior policy)의 확률로 나눈 값이다.
- Mixture-of-Experts (MoE) 모델은 선택된 전문가 구성요소로 연산을 라우팅하는 구조다. 토큰마다 라우팅이 달라 토큰 비율의 변동이 더 커질 수 있으며 긴 응답은 이러한 불균일성을 더 키울 수 있다.
- 클리핑 범위가 좁으면 유용한 학습 신호를 버리고, 넓으면 잡음이 큰 off-policy 갱신을 허용한다. Off-policy 갱신은 다른 정책이 생성한 응답을 사용하는 갱신이다. SAPO는 유용한 정보를 담은 토큰을 유지하면서 큰 편차를 매끄럽게 억제하려 한다.
- 서론은 비교한 모든 방법이 결국 불안정해질 수 있음을 인정한다. 실험에서 주장하는 효과는 발산하기 전까지 유효한 학습을 더 오래 유지하고 더 높은 정확도를 달성한다는 것이다.
2 Preliminaries
자기회귀 정책은 앞선 토큰을 조건으로 각 토큰을 예측하는 모델이며 응답의 우도를 토큰 확률의 곱으로 분해한다. Group Relative Policy Optimization (GRPO)은 응답 i의 모든 토큰에 동일한 그룹 정규화 advantage Âᵢ = (Rᵢ − mean(R))/std(R)를 부여한다. 이후 클리핑한 토큰 목적함수를 응답과 각 응답의 토큰에 대해 평균한다.
- 토큰 중요도 비율은 rᵢ,ₜ(θ) = πθ(yᵢ,ₜ | q, yᵢ,<ₜ)/πθold(yᵢ,ₜ | q, yᵢ,<ₜ)다. 여기서 q는 질의, θ는 현재 파라미터, θold는 행동 정책의 파라미터, Rᵢ는 응답 i의 보상이다.
- GSPO는 대신 길이로 정규화한 응답 비율 sᵢ(θ) = exp(meanₜ log rᵢ,ₜ(θ))를 클리핑한다. 이 값은 토큰 비율의 기하평균이다. 길이 정규화는 분산을 줄이고 길이가 다른 응답에 일관된 수치 척도를 제공한다.
- 2개 방법 모두 원래 목적함수와 클리핑한 목적함수에 advantage를 곱한 뒤 그중 최솟값을 사용한다. 양의 advantage는 비율이 상한 임계값을 넘으면 gradient를 잃고, 음의 advantage는 하한 임계값보다 낮아지면 gradient를 잃는다.
3 Soft Adaptive Policy Optimization
SAPO는 fᵢ,ₜ(rᵢ,ₜ(θ))Âᵢ,ₜ를 응답과 토큰에 대해 평균한 값의 기댓값을 최대화한다. 여기서 fᵢ,ₜ(x) = (4/τᵢ,ₜ)σ(τᵢ,ₜ(x − 1))이며, σ(x) = 1/(1 + e⁻ˣ)다. Temperature τᵢ,ₜ는 advantage가 양수일 때 τpos이고, 나머지 경우에는 τneg다.
- 미분하면 중요도 비율로 가중한 로그 정책 gradient에 wᵢ,ₜ = 4pᵢ,ₜ(1 − pᵢ,ₜ)가 곱해진다. 여기서 pᵢ,ₜ = σ(τᵢ,ₜ(rᵢ,ₜ − 1))다. 이 가중치는 확률 비율이 1일 때 최댓값 1을 가지며, 비율이 1에서 멀어질수록 매끄럽게 감소한다.
- 계수 4/τᵢ,ₜ 덕분에 모든 temperature에서 비율이 1일 때의 gradient가 클리핑하지 않은 gradient와 같아진다. Temperature가 클수록 상당한 gradient 가중치를 받는 범위가 좁아진다.
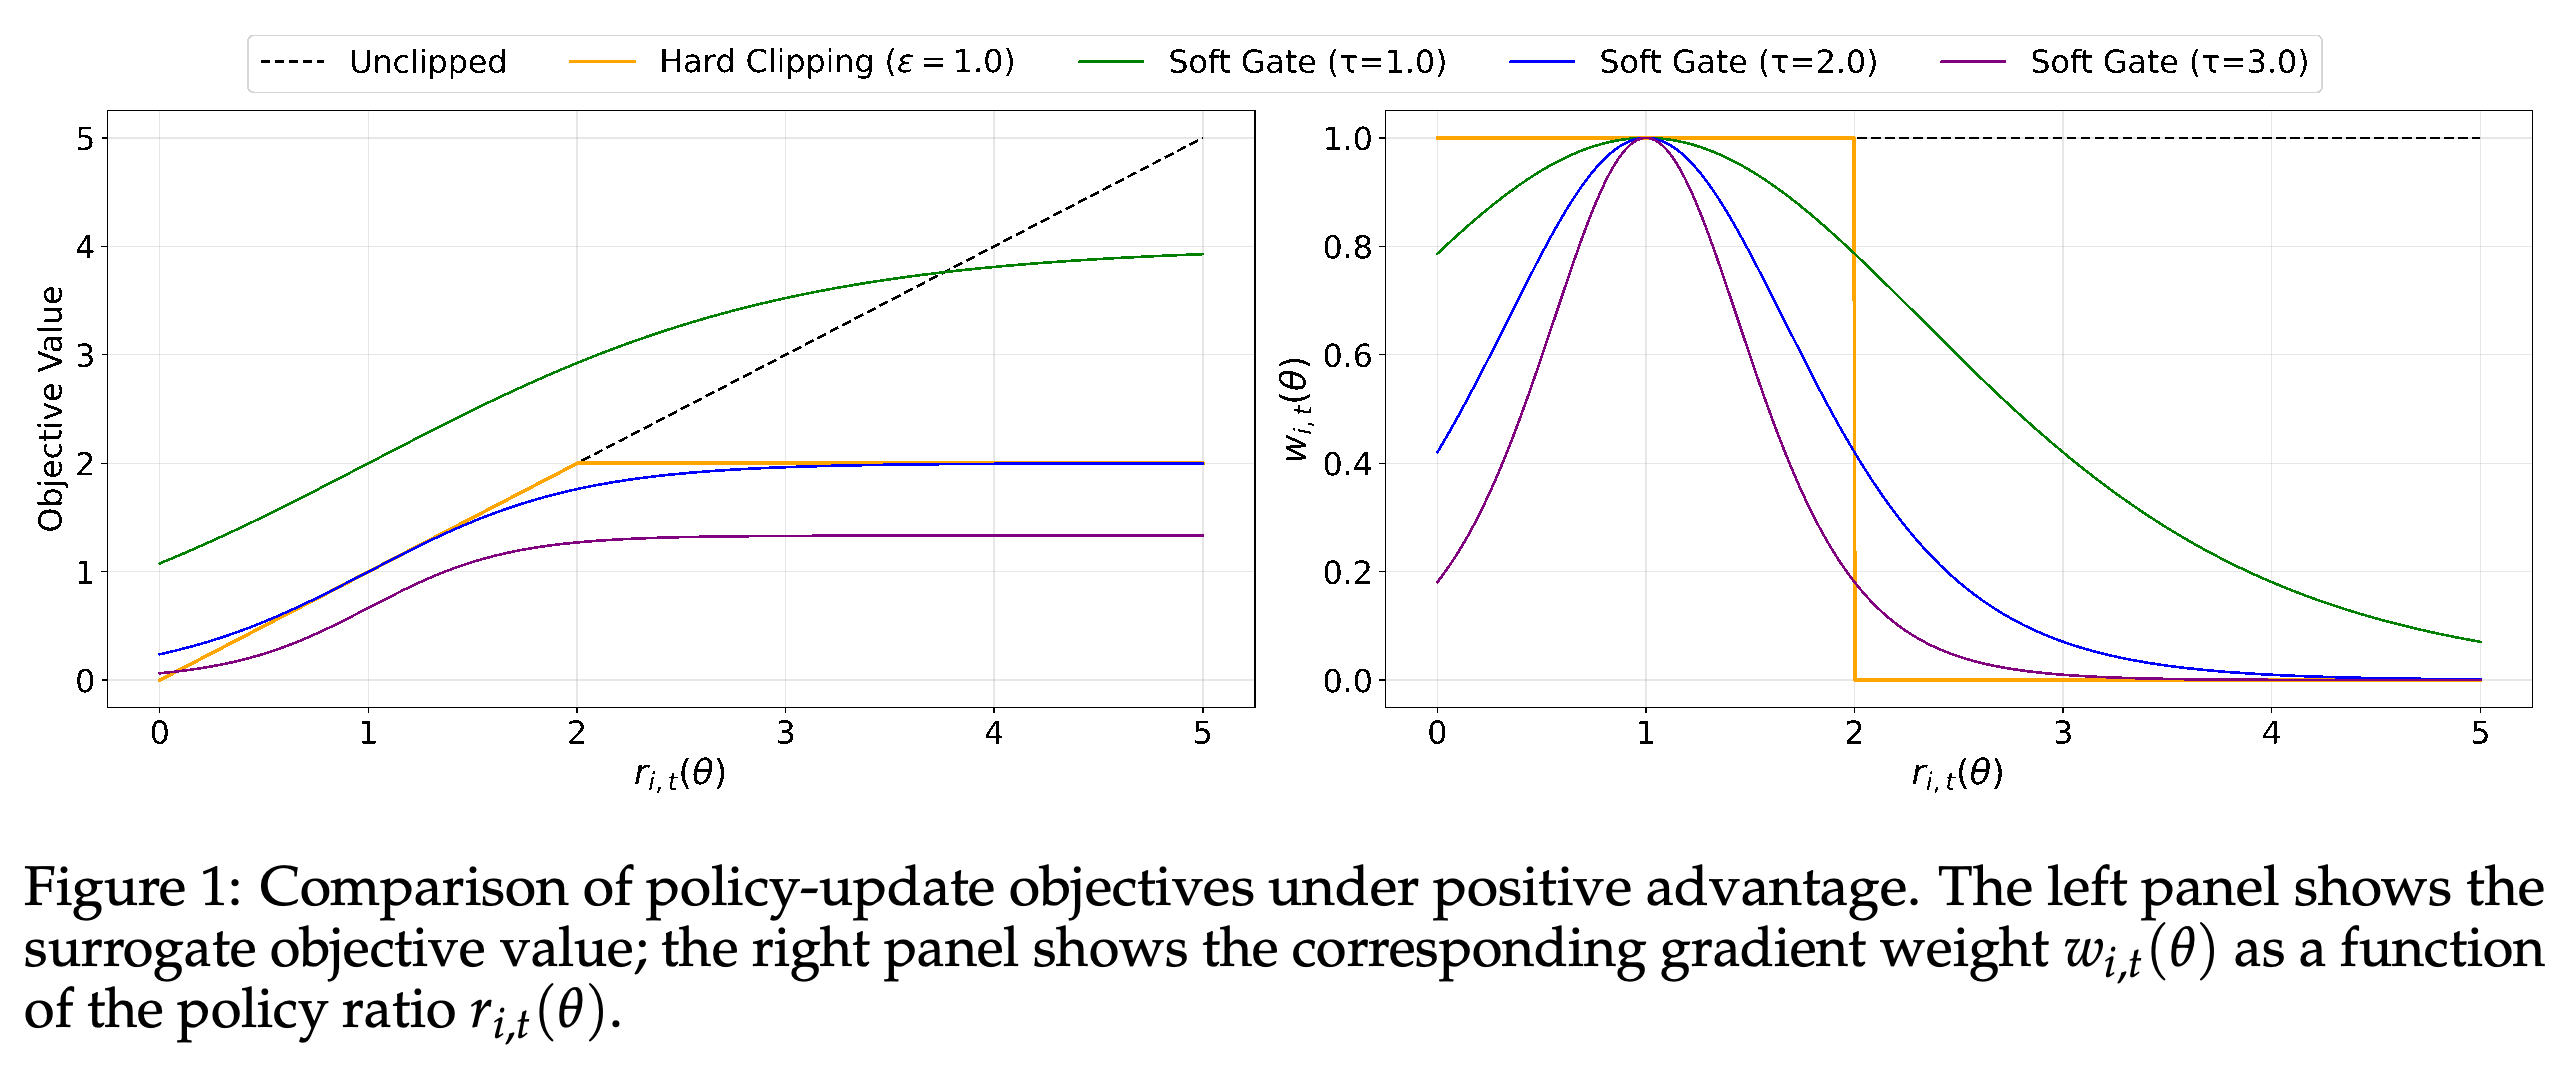
- Figure 1은 정책 변화에 상당한 갱신 가중치를 부여하는 범위인 soft trust region을 보여준다. 변화가 적당한 토큰은 gradient를 유지하고 편차가 극단적인 토큰은 점차 더 작은 가중치를 받는다.
양의 advantage에서 ε = 1.0인 hard clipping은 비율이 2를 넘으면 gradient 가중치를 갑자기 제거한다. τ = 1.0, 2.0, 3.0인 SAPO gate는 모두 비율 1에서 가중치 1을 가지며, 그 값에서 멀어질수록 매끄럽게 감소한다. Temperature가 클수록 gate의 폭이 좁아진다. 함께 제시한 목적함수 곡선은 그 결과로 나타나는 매끄러운 포화를 보여준다.
Why Different Temperatures for Positive and Negative Advantages에서는 토큰 확률로 변환되는 점수인 logit의 gradient를 통해 τneg > τpos의 근거를 설명한다. 양의 advantage는 샘플링한 토큰의 점수를 높이고 샘플링하지 않은 토큰의 점수를 낮춘다. 음의 advantage는 이 방향을 뒤집으므로 샘플링하지 않은 많은 토큰의 점수를 높인다.
- 논문은 큰 어휘 집합에 각 생성 단계와 무관한 대안 토큰이 많으므로 음의 갱신이 바람직하지 않은 토큰의 점수를 높일 수 있다고 주장한다. 특히 off-policy 응답에서 이러한 문제가 발생할 수 있다고 설명한다.
- 음의 advantage를 더 강하게 감쇠하는 목적은 탐색과 정규화에 대한 기여를 유지하면서 이러한 불안정성을 줄이는 데 있다. 통제 실험의 temperature ablation은 해당 파라미터를 바꾸는 비교를 통해 이 근거를 검증한다.
4 A Gating-Function Perspective on SAPO’s Connections to GRPO and GSPO
논문은 SAPO, GRPO, GSPO를 통합 대리 목적함수(surrogate objective)로 표현한다. 이는 샘플링한 응답을 사용해 최적화하는 함수다. 알고리즘별 함수 fᵢ,ₜ가 중요도 비율이 갱신에 미치는 영향을 결정한다. SAPO는 sigmoid 대리 함수를 사용하고 GRPO는 advantage에 따라 클리핑한 토큰 비율을, GSPO는 advantage에 따라 클리핑한 시퀀스 비율을 사용한다.
- 양의 advantage에 대해 GRPO는 min(rᵢ,ₜ, 1 + ε)를 사용하고 양수가 아닌 advantage에 대해서는 max(rᵢ,ₜ, 1 − ε)를 사용한다. 여기서 ε > 0은 클리핑 범위다.
- GSPO는 토큰들이 공유하는 시퀀스 비율에 동일한 부호별 클리핑 구조를 적용한다. 수식의 sg[·]는 미분할 때 해당 값을 고정하는 stop-gradient 연산이다.
- SAPO와 GRPO에서 각 로그 정책 gradient에는 f′ᵢ,ₜ(rᵢ,ₜ)rᵢ,ₜÂᵢ가 가중치로 곱해진다. 이 표현은 매끄럽거나 이진적인 gradient gate를 나머지 정책 gradient 항과 분리한다.
4.1 SAPO–GSPO Connection: Reduction to a Sequence-Level Soft Gate
SAPO의 정확한 토큰 gate는 \(f’_{i,t}(r)=\operatorname{sech}^{2}\!\left(\frac{\tau_i}{2}(r-1)\right)\)다. 여기서 sech는 쌍곡코사인의 역수인 쌍곡시컨트다. 논문이 제시하는 시퀀스 수준 최적화와의 연결은 (A1) 정책 변화가 작아 rᵢ,ₜ ≈ 1이고, (A2) 응답 내부의 로그 토큰 비율 분산이 낮다고 가정한다.
- (A1)에서 r − 1을 log r로 근사하면 gτ(z) = sech²(τz/2)를 얻는다. (A2)에서는 이 매끄러운 gate를 토큰에 대해 평균한 값을 응답의 평균 로그 비율인 log sᵢ에서 평가한 값으로 근사한다.
- 2차 Taylor 전개를 통해 스칼라 gate의 차이에 Dᵢ(θ) ≤ (τᵢ²/4)Varᵢ(θ)라는 상한을 얻는다. 여기서 Varᵢ는 응답 내부의 로그 비율 분산이다.
- 논문은 이어서 연속적인 gate를 사용하는 GSPO 형태의 근사 시퀀스 gradient를 제시한다. 제시한 상한은 평균 스칼라 gate의 차이를 제한하며 전체 벡터 gradient의 근사 오차에는 별도의 상한을 제공하지 않는다.
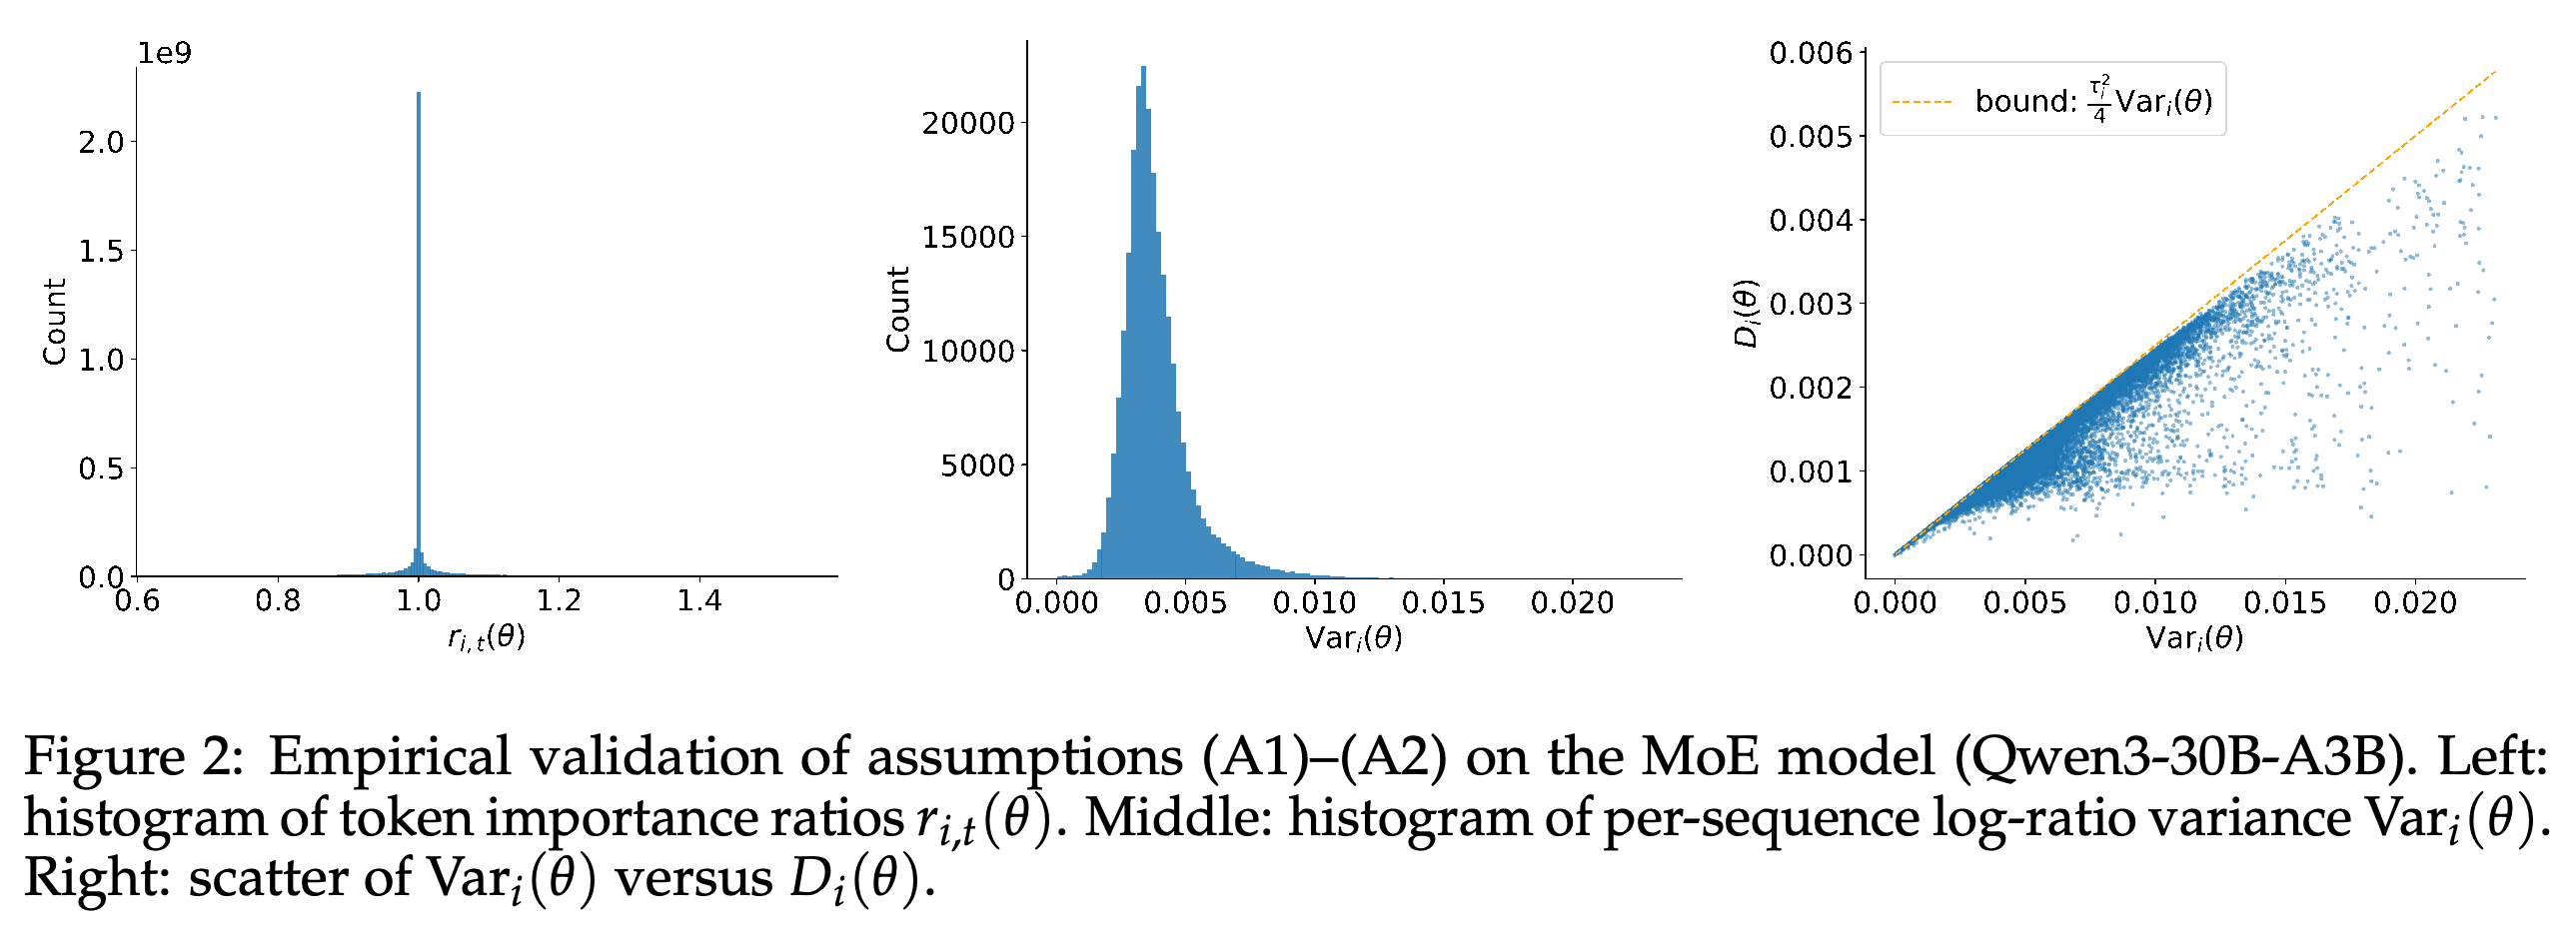
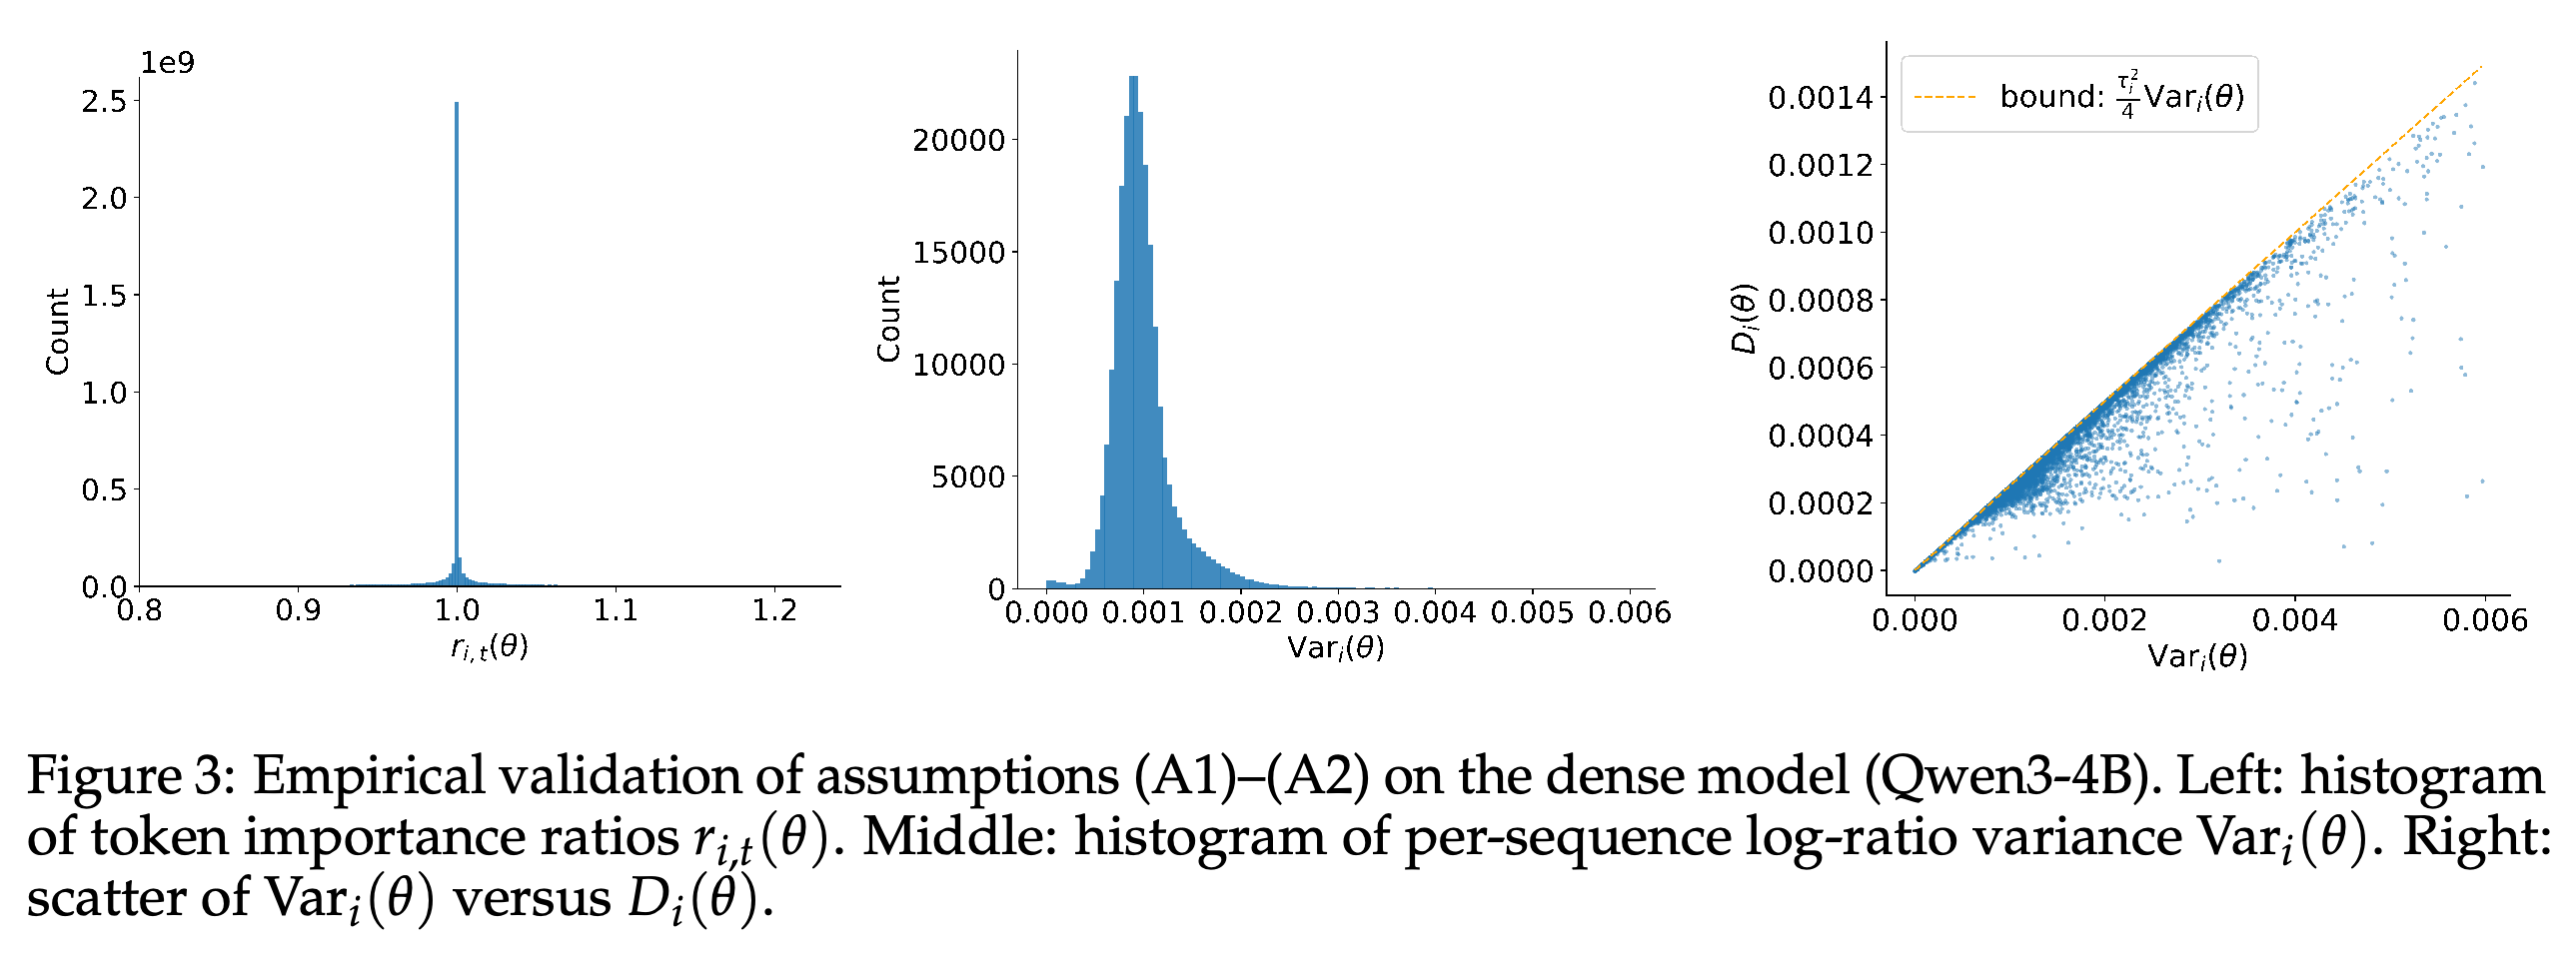
저자들은 cold-start Qwen3-30B-A3B와 Qwen3-4B checkpoint의 off-policy 미니배치에서 얻은 10⁵개를 초과하는 시퀀스와 10⁹개를 초과하는 토큰으로 (A1)과 (A2)를 검토한다. Figures 2와 3에서는 비율이 1 주변에 강하게 집중되고 로그 비율 분산은 대체로 0.02보다 낮으며 스칼라 gate의 차이는 이론적 상한을 따른다.
- MoE checkpoint인 Qwen3-30B-A3B는 희소 전문가 라우팅을 사용하지 않는 dense checkpoint Qwen3-4B보다 분산 분포가 넓다. 논문은 전문가 라우팅의 불균일성을 가능한 원인으로 제시한다.
- 이 관찰은 샘플링한 응답 대부분에서, 특히 dense 모델에서 가정이 성립함을 뒷받침한다. 모든 학습 실행의 전체 구간에서 가정이 성립함을 입증하지는 않는다.
- 불균일하거나 이상치에 해당하는 토큰이 가정을 위반해도 SAPO는 토큰별 가중치를 계속 계산한다. 시퀀스 비율과 advantage 부호에 따라 GSPO가 응답 전체를 클리핑할 수 있는 상황에서, SAPO는 극단적인 토큰을 억제하면서 응답의 다른 토큰을 보존할 수 있다.
Qwen3-30B-A3B의 토큰 비율은 1 주변에 집중되며, 대부분의 응답은 로그 비율 분산이 작다. 평균 토큰 gate와 시퀀스 gate의 차이는 그래프에 표시한 분산에 따른 상한보다 낮다. 분산 분포의 꼬리가 눈에 띄지만 이 결과는 샘플링한 MoE checkpoint에서 스칼라 근사를 뒷받침한다.
Qwen3-4B는 MoE checkpoint보다 토큰 비율과 로그 비율 분산의 분포가 더 좁다. Gate의 차이도 더 작고 그래프에 표시한 상한 아래에 있어, 이 dense checkpoint의 산포가 낮음을 뒷받침한다. 2개 그림을 비교할 때는 축 범위가 다르다는 점을 고려해야 한다.
4.2 SAPO–GRPO Connection: Smooth Token Gates vs. Hard Token Clipping
GRPO의 gradient gate는 양의 advantage를 가진 토큰에서 rᵢ,ₜ ≤ 1 + ε이면 1이고, 이 임계값을 넘으면 0이다. Advantage가 양수가 아닌 경우에는 rᵢ,ₜ ≥ 1 − ε이면 1이고, 이 임계값보다 낮으면 0이다. SAPO는 이러한 부호별 이진 gate를 비율 1을 중심으로 하는 매끄러운 가중치로 대체한다.
- 행동 정책에 가까울 때 SAPO는 변화에 반응하는 gradient를 보존한다. 편차가 커지면 클리핑에 따른 불연속성을 도입하는 대신 갱신 가중치를 연속적으로 줄인다.
- SAPO는 유한한 클리핑 임계값에서 gradient가 갑자기 사라지는 현상을 피한다. 다만 극단적인 편차에서는 가중치가 매우 작아질 수 있다. Advantage가 양수도 음수도 아니면 gate와 무관하게 advantage를 곱한 gradient도 사라진다.
4.3 Summary
3가지 방법의 주된 차이는 현재 정책과 행동 정책 사이의 확률 비율이 1에서 벗어난 토큰을 처리하는 방식에 있다. SAPO는 토큰별로 매끄럽게 감쇠하여 응답에서 유용한 정보를 담은 부분을 보존할 수 있다. GRPO와 GSPO는 각각 토큰 수준과 시퀀스 수준에서 advantage 부호에 따라 hard clipping을 적용한다.
5 Experiments
실험은 통제된 수학적 추론 학습과 텍스트 및 멀티모달 과제를 혼합한 Qwen3-VL 학습에서 최적화 동작을 평가한다. 학습 보상과 검증 성능의 변화가 주요 근거이며 별도의 temperature ablation으로 비대칭 gate 설계를 검증한다.
5.1 Controlled Experiments
통제 실험은 Qwen3-30B-A3B-Base를 수학적 추론 질의로 미세 조정한 cold-start 모델에서 시작한다. 검증에서는 수학적 추론 벤치마크인 AIME25, HMMT25, BeyondAIME에서 16개 샘플에 대한 평균 Pass@1을 보고한다. Pass@1은 개별 생성 응답의 성공률이다. 생성한 응답을 묶은 각 rollout 배치는 gradient 갱신을 위해 4개 미니배치로 나눈다.
- SAPO는 τpos = 1.0과 τneg = 1.05를 사용한다. GSPO와 GRPO-R2는 Zheng et al. (2025)의 하이퍼파라미터 설정을 사용한다. GRPO-R2는 GRPO에 routing replay를 추가하지만 SAPO는 이를 필요로 하지 않는다.
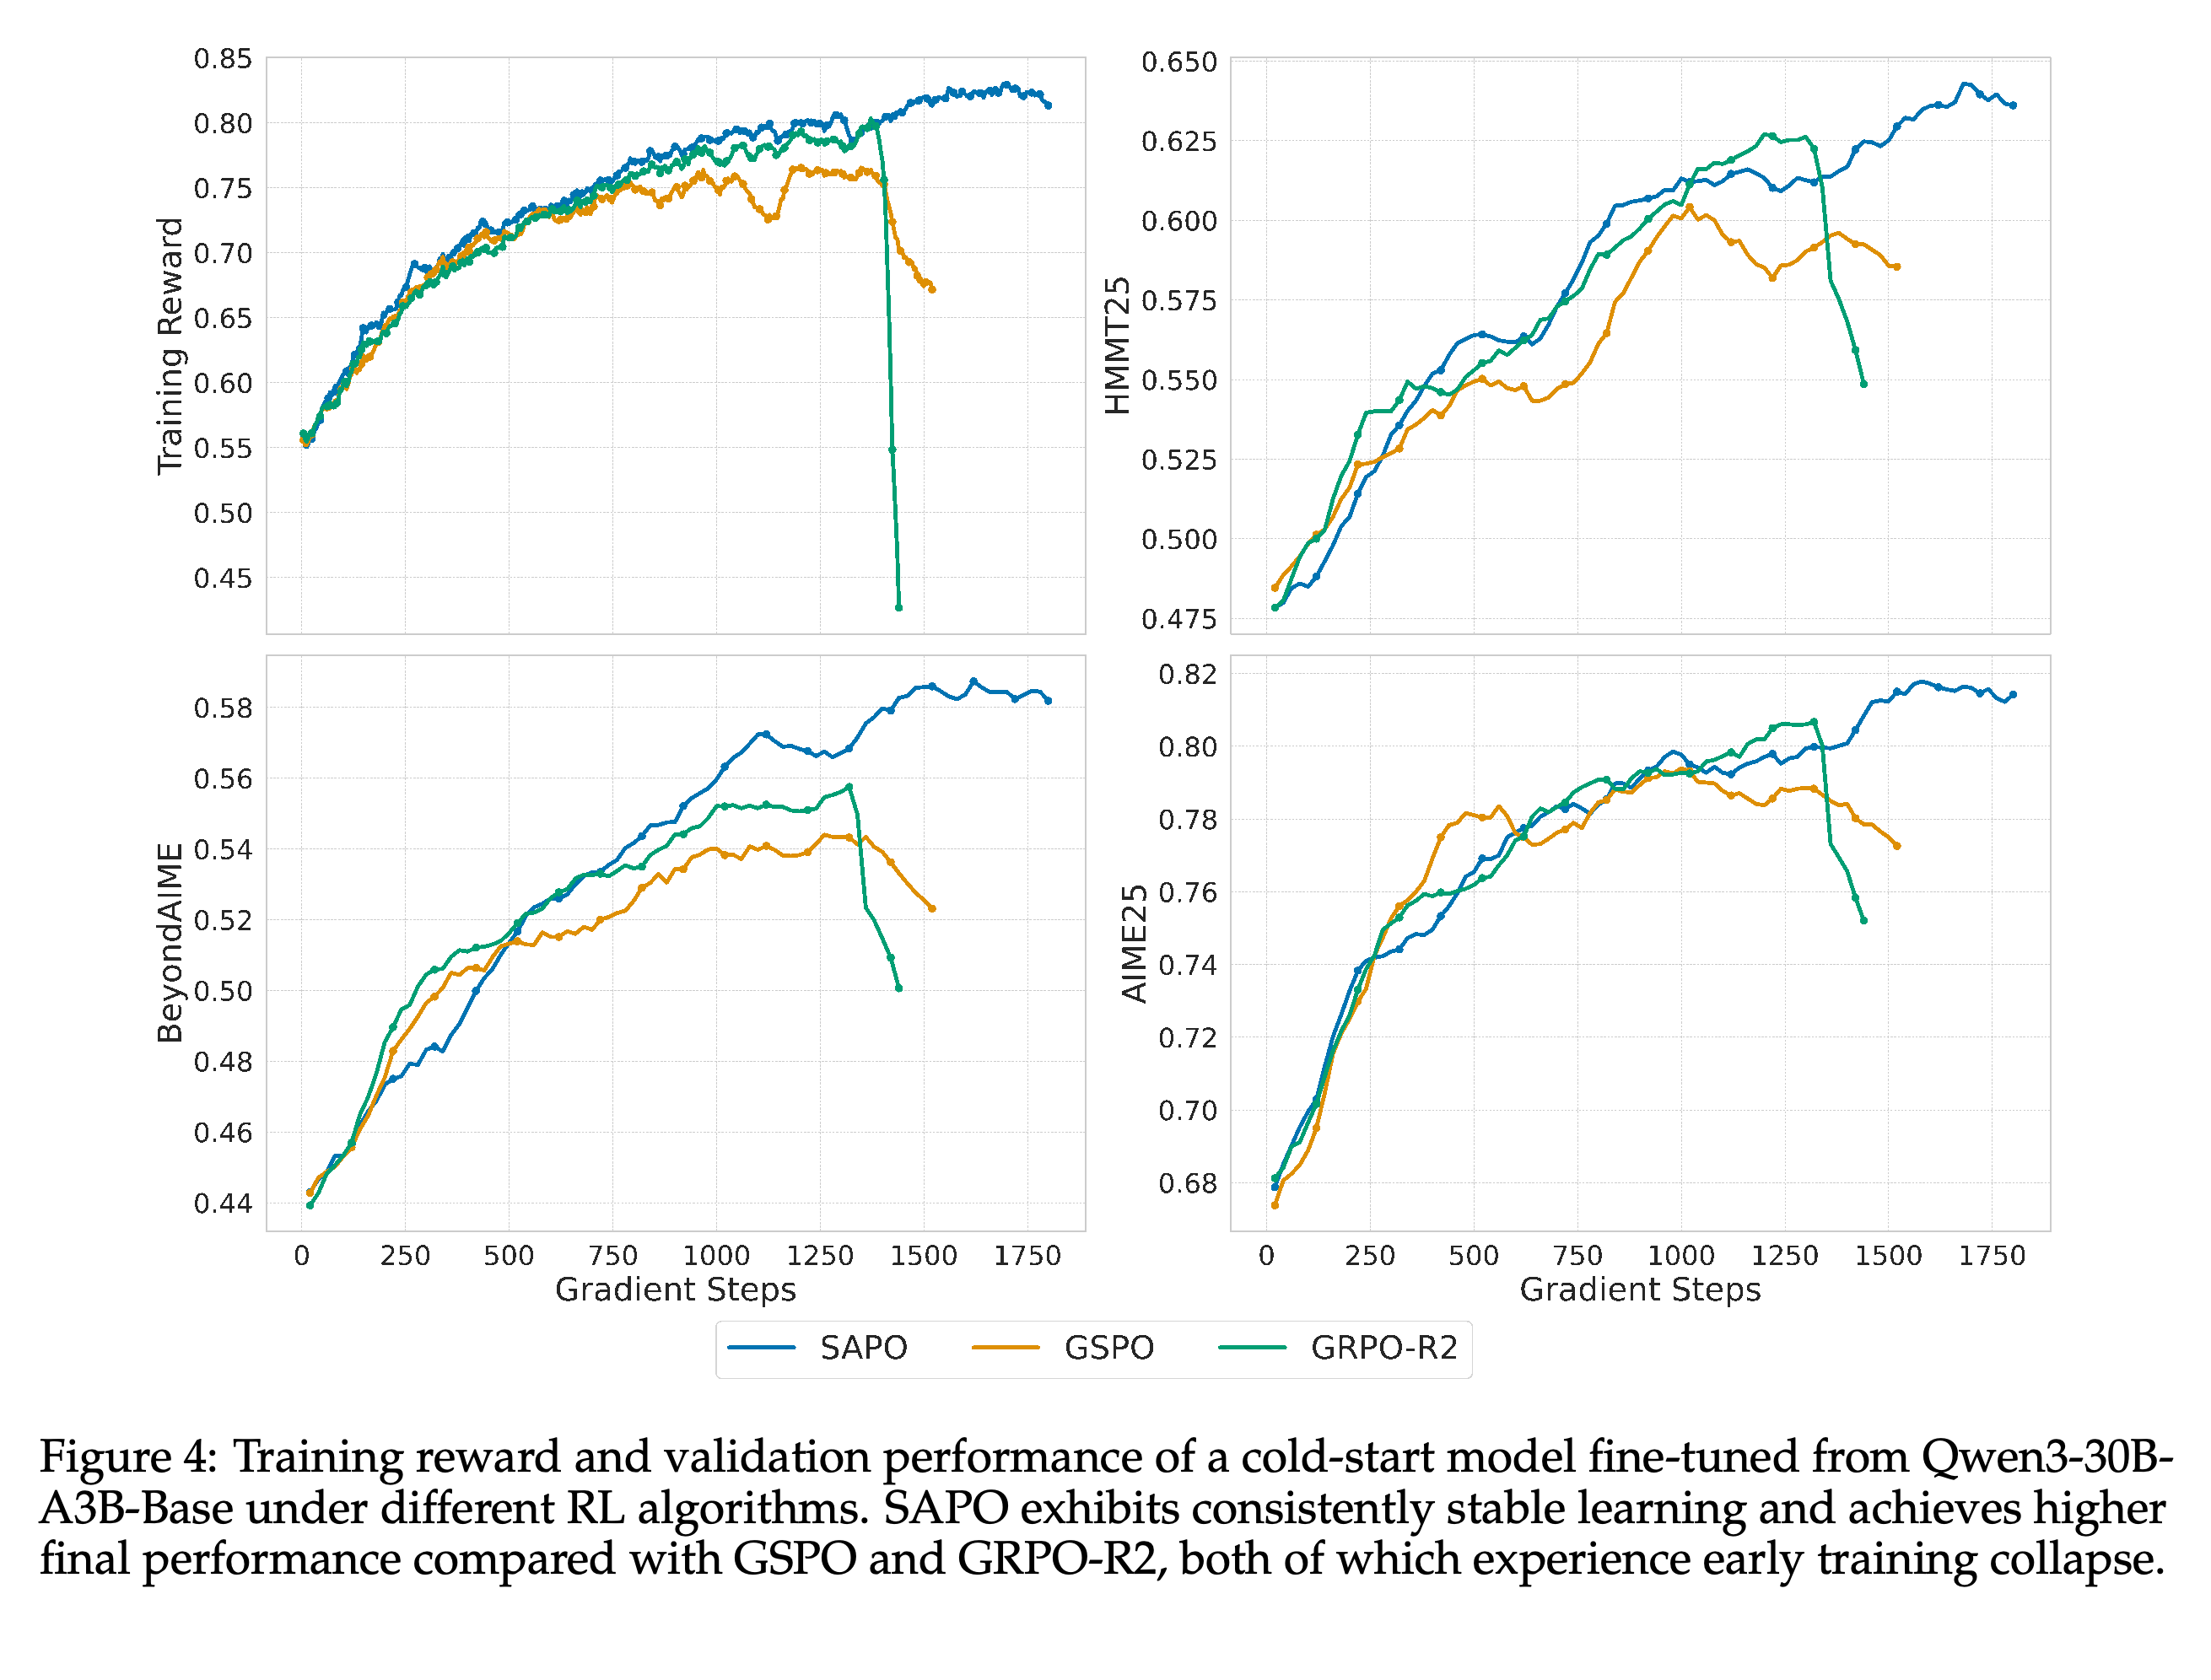
- Figure 4에서 SAPO는 기준 모델의 성능이 악화된 뒤에도 더 높은 보상과 검증 성능을 유지한다. GSPO와 GRPO-R2는 SAPO의 학습 곡선이 끝나기 전에 급격히 하락한다.
- 결과는 정확한 최종 점수표 대신 곡선으로 제시된다. 논문은 이 비교에 대해 여러 무작위 시드, 신뢰구간, 구체적인 연산량 내역을 보고하지 않는다.
4개 패널은 학습 보상과 HMMT25, BeyondAIME, AIME25의 검증 성능을 보여준다. SAPO는 GSPO와 GRPO-R2의 성능이 하락한 뒤에도 더 높은 성능을 유지한다. 이는 유효한 학습 기간이 더 길다는 근거이며 이전의 모든 단계에서 일관되게 우세하다는 의미는 아니다. 그래프는 성능 변화를 제시하지만 불확실성 구간이나 정확한 최종 값은 제공하지 않는다.
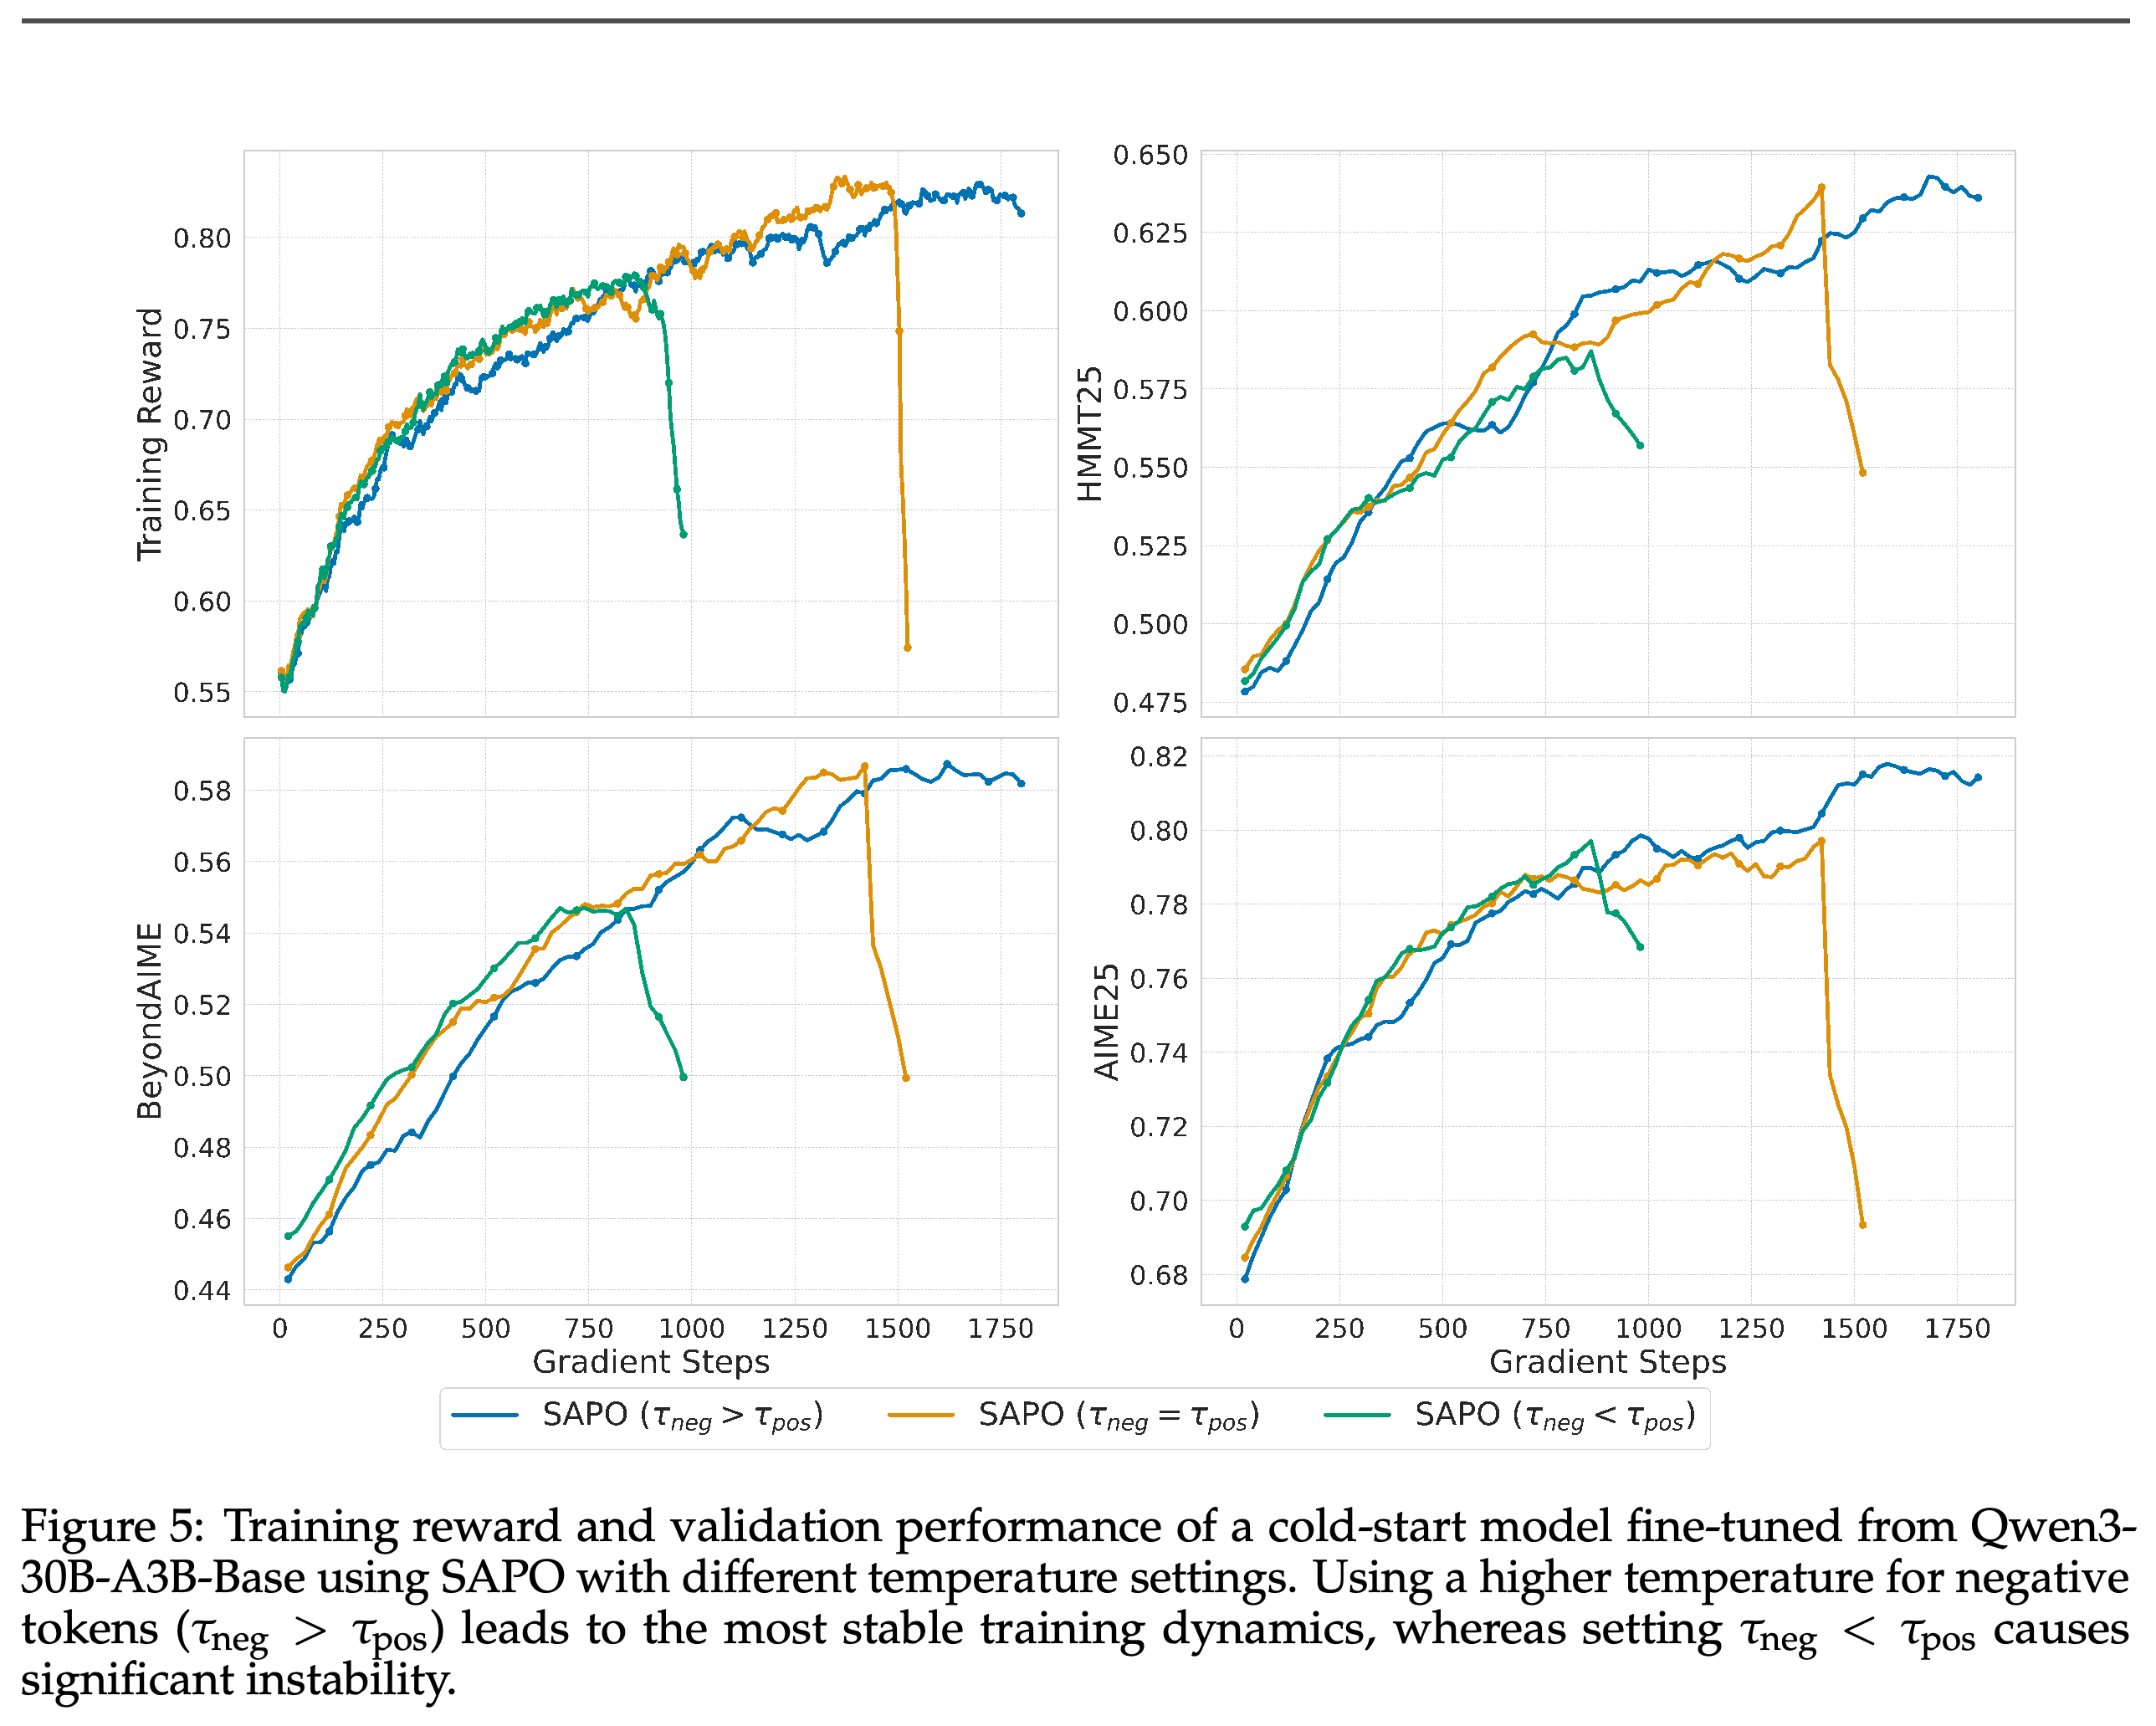
Temperature ablation은 τpos = 1.0으로 고정하고 τneg = 1.05, τneg = 1.0, τneg = 0.95를 비교한다. Figure 5에서 τneg = 1.05는 안정적인 학습을 가장 오래 유지한다. 양쪽 temperature가 같으면 더 늦게 학습이 붕괴하고 τneg = 0.95이면 더 일찍 성능이 악화된다.
- 이 비교는 실험한 설정에서 음의 advantage를 가진 갱신을 더 강하게 감쇠하는 방식을 뒷받침한다.
- 서로 가까운 음의 temperature 3개만 검토하므로, 이 근거만으로 다양한 구조, 과제, 학습 방식에 걸쳐 최적의 temperature를 정할 수는 없다.
τpos를 1.0으로 고정하면 τneg = 0.95가 먼저 악화되고 τneg = 1.0은 나중에 붕괴하며 τneg = 1.05는 표시된 구간에서 안정성을 유지한다. 같은 temperature를 사용하는 설정은 초기의 일부 곡선에서 비대칭 설정과 비슷하거나 더 높은 성능을 보인다. 그러나 이후 붕괴하는 양상은 음의 갱신을 더 강하게 감쇠할 때 안정성이 개선됨을 뒷받침한다.
5.2 Qwen3-VL Training
이 연구에서 텍스트와 멀티모달 과제로 학습하는 모델 계열인 Qwen3-VL은 수학, 코딩, 논리적 추론 학습을 결합한다. 배치 안에서 각 과제의 샘플링 비율은 고정한다. 큰 rollout 배치는 gradient 갱신을 위해 2개 미니배치로 나눈다.
- 3가지 방법의 직접 비교는 동일한 예비 cold-start Qwen3-VL-30B-A3B checkpoint에서 시작한다. AIME25는 32개 샘플의 Pass@1로, 코드 생성 벤치마크인 LiveCodeBench v6는 8개 샘플의 Pass@1로 평가한다. 논리적 추론 벤치마크인 ZebraLogic과 멀티모달 수학적 추론 벤치마크인 MathVision도 평가한다.
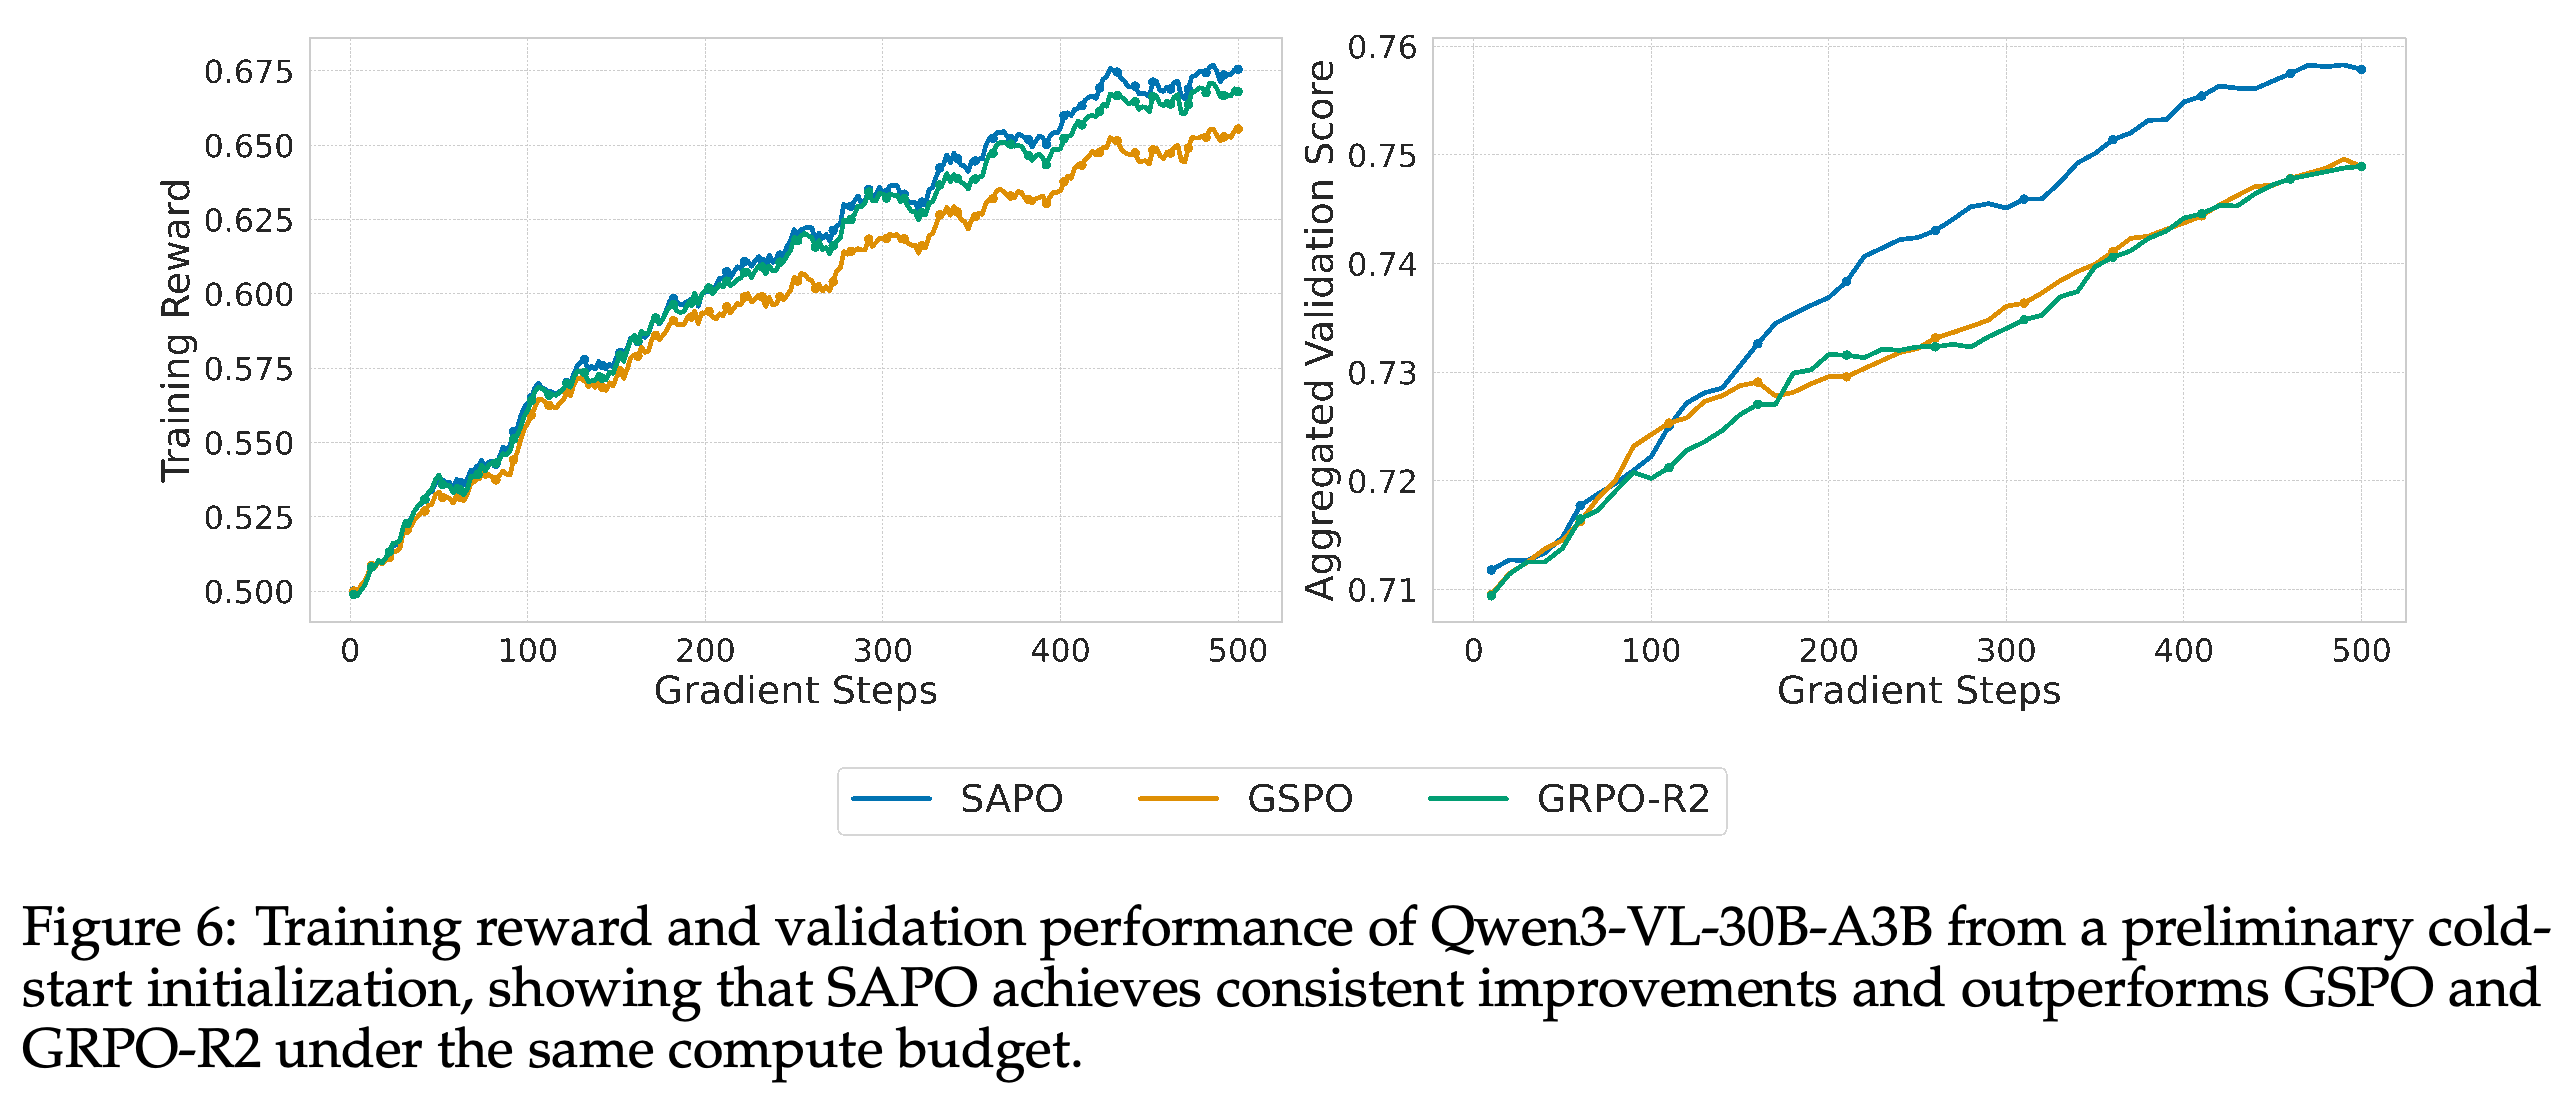
- Figure 6은 학습 보상과 4개 벤치마크의 평균 검증 점수를 보고한다. 보고된 동일 연산 예산에서 SAPO의 최종 성능은 GSPO와 GRPO-R2보다 높다.
- 논문은 SAPO가 다양한 크기의 모델과 dense 및 MoE 구조 모두를 개선한다고 서술하지만 제시한 비교 곡선은 Qwen3-VL-30B-A3B에 한정된다. 벤치마크별 점수, 정확한 과제 샘플링 비율, 구체적인 배치 크기는 제공하지 않는다.
3가지 방법 모두 표시된 500 gradient step 동안 개선되며, SAPO의 최종 종합 검증 점수가 가장 높다. 이 그래프는 보고된 동일 연산 예산에서 성능상 이점을 뒷받침하며 기준 모델의 학습 붕괴는 나타나지 않는다. 4개 벤치마크를 종합한 결과이므로 개별 과제의 개선 폭은 평가할 수 없다.
6 Conclusion
결론은 SAPO의 성능 향상 원인으로 매끄러운 토큰별 적응형 gating과 음의 advantage gradient를 더 강하게 감쇠하는 비대칭 temperature를 제시한다. 보고된 수학적 추론 비교는 안정적인 학습을 더 오래 유지한다는 점을 뒷받침한다. 이 비교와 Qwen3-VL 비교는 모두 평가한 예산 안에서 더 높은 검증 성능을 뒷받침한다.
- 제시된 결과는 향후 발산이 발생하지 않음을 입증하지 않으며 결론에서 언급한 모든 모델 크기와 구조의 개선 폭을 정량화하지도 않는다.
부록
- 제공된 9페이지 PDF에는 부록이 없다. 이론적 유도, 가정에 대한 실증 검토, temperature ablation은 본문에 포함되어 있다.
짧은 생각
통제 비교와 temperature ablation은 실험한 학습 설정에서 음의 advantage 갱신을 더 강하게 감쇠하는 매끄러운 gating을 뒷받침한다. Qwen3-VL 비교는 혼합 과제 설정에서도 근거를 제공한다. 이 설정에서 SAPO는 기준 모델의 학습 붕괴 없이 더 높은 종합 검증 성능을 달성한다. 시퀀스 일관성에 대한 논의는 근사에 기반한다. 스칼라 gate의 상한은 명시하지만 이어지는 전체 gradient의 환원에는 별도의 오차 상한이 없다. 정확한 최종 점수, 반복 실행의 변동성, 전체 학습 설정, 주장한 각 모델 규모의 비교 결과가 없어 재현성과 일반화 가능성을 판단하는 데 한계가 있다. Qwen3-VL의 종합 곡선만으로는 개별 벤치마크가 모두 개선되는지 알 수 없다.