


Robot Learning: A Tutorial 요약 설명
14 Oct 2025 | Paper Review Robotic Learning Behavioral Cloning Reinforcement Learning Vision-Language-Action Models목차
이번 글에서는 Robot Learning: A Tutorial 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 14일(Arxiv)
- Capuano, Francesco, Pascal, Caroline, Zouitine, Adil, Wolf, Thomas, Aractingi, Michel.
- University of Oxford, Hugging Face
- 논문 링크
- Github
- Project Page
요약
- Robot Learning: A Tutorial은 물리 모델링과 과제별 설계를 확장하기 어려운 상황에서 로봇이 관측을 신뢰할 수 있는 행동으로 바꾸는 방법을 살펴본다. 대표적인 결과로, 여러 명령을 함께 예측하는 action chunking을 사용했을 때 과제 성공률이 44%, 사용하지 않았을 때 1%였다는 Action Chunking with Transformers 연구를 소개한다. 튜토리얼 자체는 새로운 비교 벤치마크를 제시하지 않는다.
- 논문은 고전 제어를 Reinforcement Learning (RL), Behavioral Cloning (BC)과 연결한다. RL은 보상으로 평가하는 상호작용을 통해 행동을 학습하고 BC는 전문가의 관측-행동 시연을 재현하도록 학습한다. 실용적인 기여는 로봇 제어, 데이터셋 처리, 정책 학습, 추론을 지원하는 오픈소스 라이브러리 lerobot을 활용해 설명과 코드 예제를 순서대로 제공한다는 점이다.
- Human-in-the-Loop, Sample Efficient Robot reinforcement Learning (HIL-SERL)은 사전 시연과 학습 중 사람의 교정을 결합하는 방법이다. Luo et al. (2024)은 다양한 조작 과제에서 1–2시간 안에 99%+ 성공률을 달성했다고 보고한다. 가능한 행동의 분포를 학습하는 생성 정책은 여러 유효한 행동이 포함된 시연을 다룬다. 튜토리얼은 노이즈를 반복해서 제거하며 행동 시퀀스를 생성하는 Diffusion Policy를 50–150개 시연으로 학습할 수 있다고 설명한다. 이는 사람이 로봇을 원격으로 제어하는 teleoperation 약 15–60분에 해당한다.
- Vision-Language-Action (VLA) 모델은 시각 관측과 언어 지시로부터 로봇 행동을 생성하며 여러 과제와 서로 다른 물리적 로봇 구성인 embodiment를 다룬다. 튜토리얼은 π₀가 기록된 상호작용 시퀀스인 trajectory 10M+개로 사전 학습되고 SmolVLA가 총 20k+개 trajectory를 포함하는 커뮤니티 데이터셋 450+개로 사전 학습된다고 설명한다. Shukor et al. (2025)을 인용해 SmolVLA가 π₀보다 40%에 가까운 속도 향상을 보이고 메모리를 6배 적게 사용한다고 소개한다. 다만 비교 조건이 충분히 제시되지 않았으며 Figure 39에는 이와 상충하는 7배라는 메모리 비율이 나온다.
- 수치 근거는 개별 방법에 관한 선행 연구에서 가져온 결과다. 튜토리얼이 다루는 모든 방법을 통제된 조건에서 비교한 결과는 없다. 실용적인 제약으로는 보상 설계, 시뮬레이션 충실도, 시연 품질, 실행 오차 누적, 이질적인 로봇 데이터, 추론 지연이 있다. Foreword는 로봇공학 전반을 포괄하거나 개별 학습 방법을 깊이 다루는 것을 범위에서 제외한다.
Foreword
Foreword는 고전 로봇공학 연구의 가치를 인정하면서 현대 머신러닝이 로봇의 자율성에 기여한다고 설명한다. 로봇공학에서 학습 방법들이 어떻게 결합되는지 설명하는 것이 목적이다. 로봇공학 전반을 다루는 교과서, 통계 학습이나 딥러닝 입문서, RL과 diffusion 및 flow matching의 상세한 해설을 제공하지는 않는다. Flow matching은 단순한 분포를 데이터 분포로 연속적으로 변환하는 방법을 학습한다.
1 Introduction
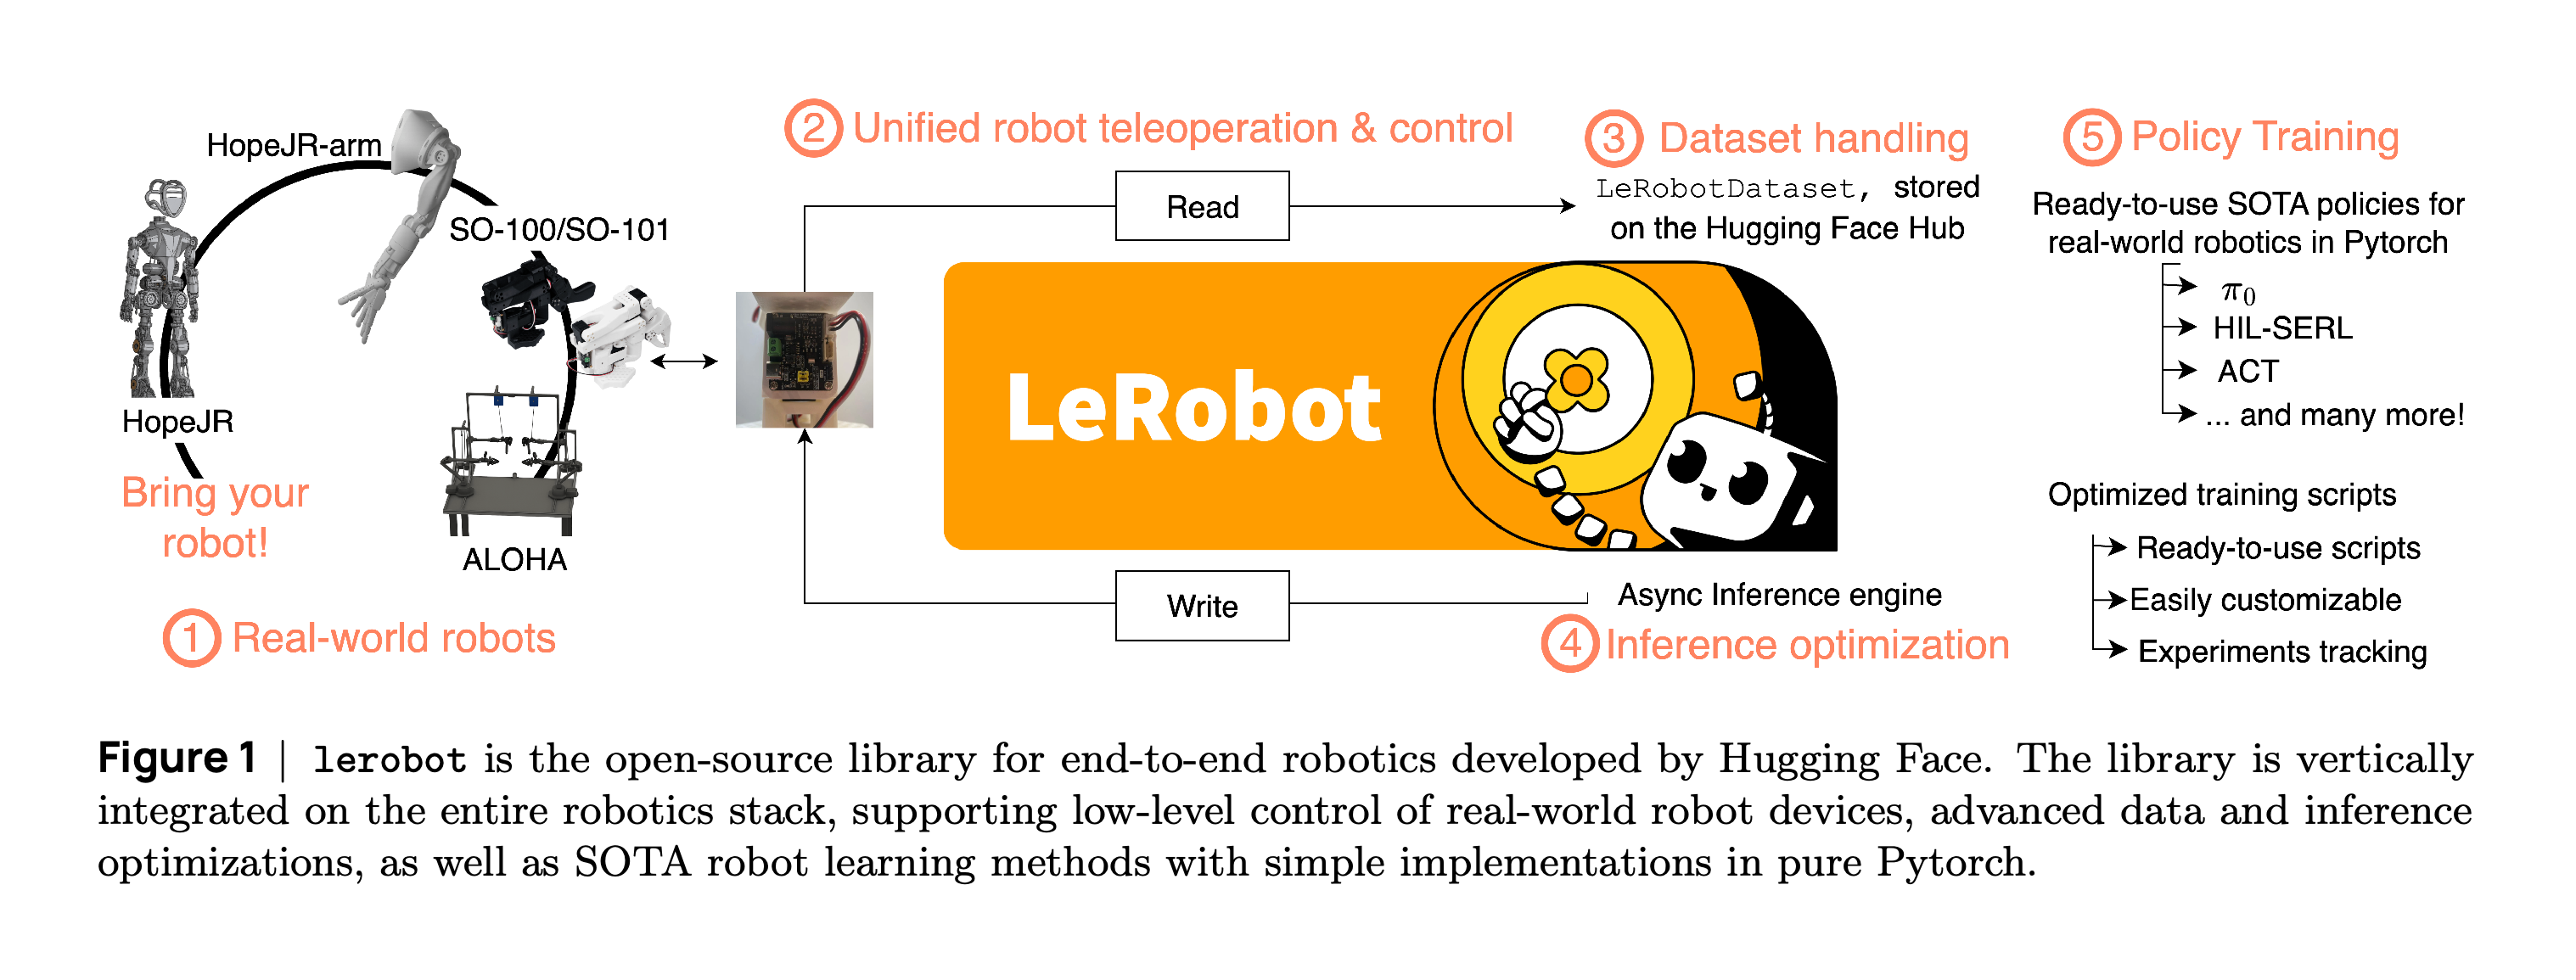
Introduction은 로봇과 환경의 상호작용을 정확히 모델링하고 인지, 계획, 제어를 통합하기 어렵다는 점에서 데이터 기반 학습의 필요성을 설명한다. Figure 1은 lerobot이 실제 로봇, teleoperation, 데이터 처리, 정책 학습, 추론 최적화를 연결하는 방식을 보여준다. 라이브러리는 https://github.com/huggingface/lerobot 에서 제공한다.
도식은 하드웨어 접근, 관측 기록, 데이터셋 처리, 정책 학습, 행동 실행을 하나의 작업 과정으로 연결한다. 로봇 시스템에서 lerobot이 지원하는 범위를 보여주며, 정책 성능을 측정하지는 않는다.
1.1 LeRobotDataset
LeRobotDataset은 동기화된 로봇 상태, 행동, 카메라 스트림, teleoperation 상태, 과제 설명을 다루는 공통 인터페이스를 제공한다. 저장 구조는 사용자에게 제공하는 인터페이스와 실제 저장 방식을 분리하며 데이터는 표 형식 데이터, 압축 비디오, 메타데이터로 구성된다. 개별 과제 시도를 기록한 여러 episode를 큰 파일에 함께 저장할 수 있으며 메타데이터가 각 episode의 경계를 식별한다.
- 1.1.1 The dataset class design에서는 data/*에 프레임 단위 Parquet 테이블을, videos/*에 MP4 비디오 스트림을 저장한다. Episode를 이어 붙이면 파일 수와 파일시스템 부담이 줄어든다.
- meta/info.json은 feature 스키마, shape, type, 프레임률, 버전, 경로 템플릿을 기록한다. meta/stats.json은 dataset.meta.stats를 통해 정규화 통계를 제공한다.
- meta/tasks.jsonl은 과제 설명을 정수 인덱스에 연결하고 meta/episodes/*는 episode 길이, 과제, 저장 위치를 기록한다.
1.2 Code Example: Batching a (Streaming) Dataset
배치 구성 예제는 LeRobotDataset 또는 StreamingLeRobotDataset으로 lerobot/svla_so101_pickplace를 불러온다. delta_timestamps를 사용해 기준 프레임으로부터 [-0.2, -0.1, 0.0]초 시점의 손목 카메라 관측을 요청한다. 사용할 수 없는 프레임에는 패딩을 적용하고 해당 항목을 식별하는 마스크를 제공한다. torch.utils.data.DataLoader는 샘플을 크기 16의 배치로 묶는다. 본문은 연결 상태에 따라 스트리밍이 초당 약 80–100회 반복을 처리한다고 보고하지만 표준화된 하드웨어 벤치마크를 제공하지 않는다.
1.3 Code Example: Collecting Data
데이터 수집 예제는 SO100Follower 로봇을 SO100Leader teleoperator와 640 × 480 전면 카메라에 연결한다. 설정은 NUM_EPISODES = 5, FPS = 30, EPISODE_TIME_SEC = 60, RESET_TIME_SEC = 10이다. 스크립트는 관측과 행동을 기록하고 episode 재기록을 지원하며 유지할 episode를 저장한다. 이후 장치 연결을 해제하고 dataset.push_to_hub()를 호출한다.
2 Classical Robotics
Classical Robotics는 학습 정책의 필요성을 설명하기 위해 모델링과 제어 개념을 정리한다. 정책은 관측으로부터 행동을 선택하는 규칙이다. 이 장은 과제와 embodiment 사이의 일반화, 수작업 모델링 의존도 감소, 늘어나는 데이터셋의 활용을 강조한다. 예제는 단순화된 설명용 사례이며 실험적 비교는 아니다.
2.1 Explicit and Implicit Models
명시적 모델은 로봇의 역학과 환경 상호작용을 직접 기술하고 암시적 모델은 센서와 행동 데이터에서 움직임 패턴을 학습한다. 논문은 이 접근들을 결합하는 방법도 다룬다. 연속된 상태 전이로 가치 추정치를 갱신하는 Temporal Difference learning은 모델로 제어를 계획하는 Model-Predictive Control을 보완할 수 있다. 학습은 인지 성능을 개선하거나 복잡한 물리 효과를 근사하는 데도 활용할 수 있다.
2.2 Different Types of Motion
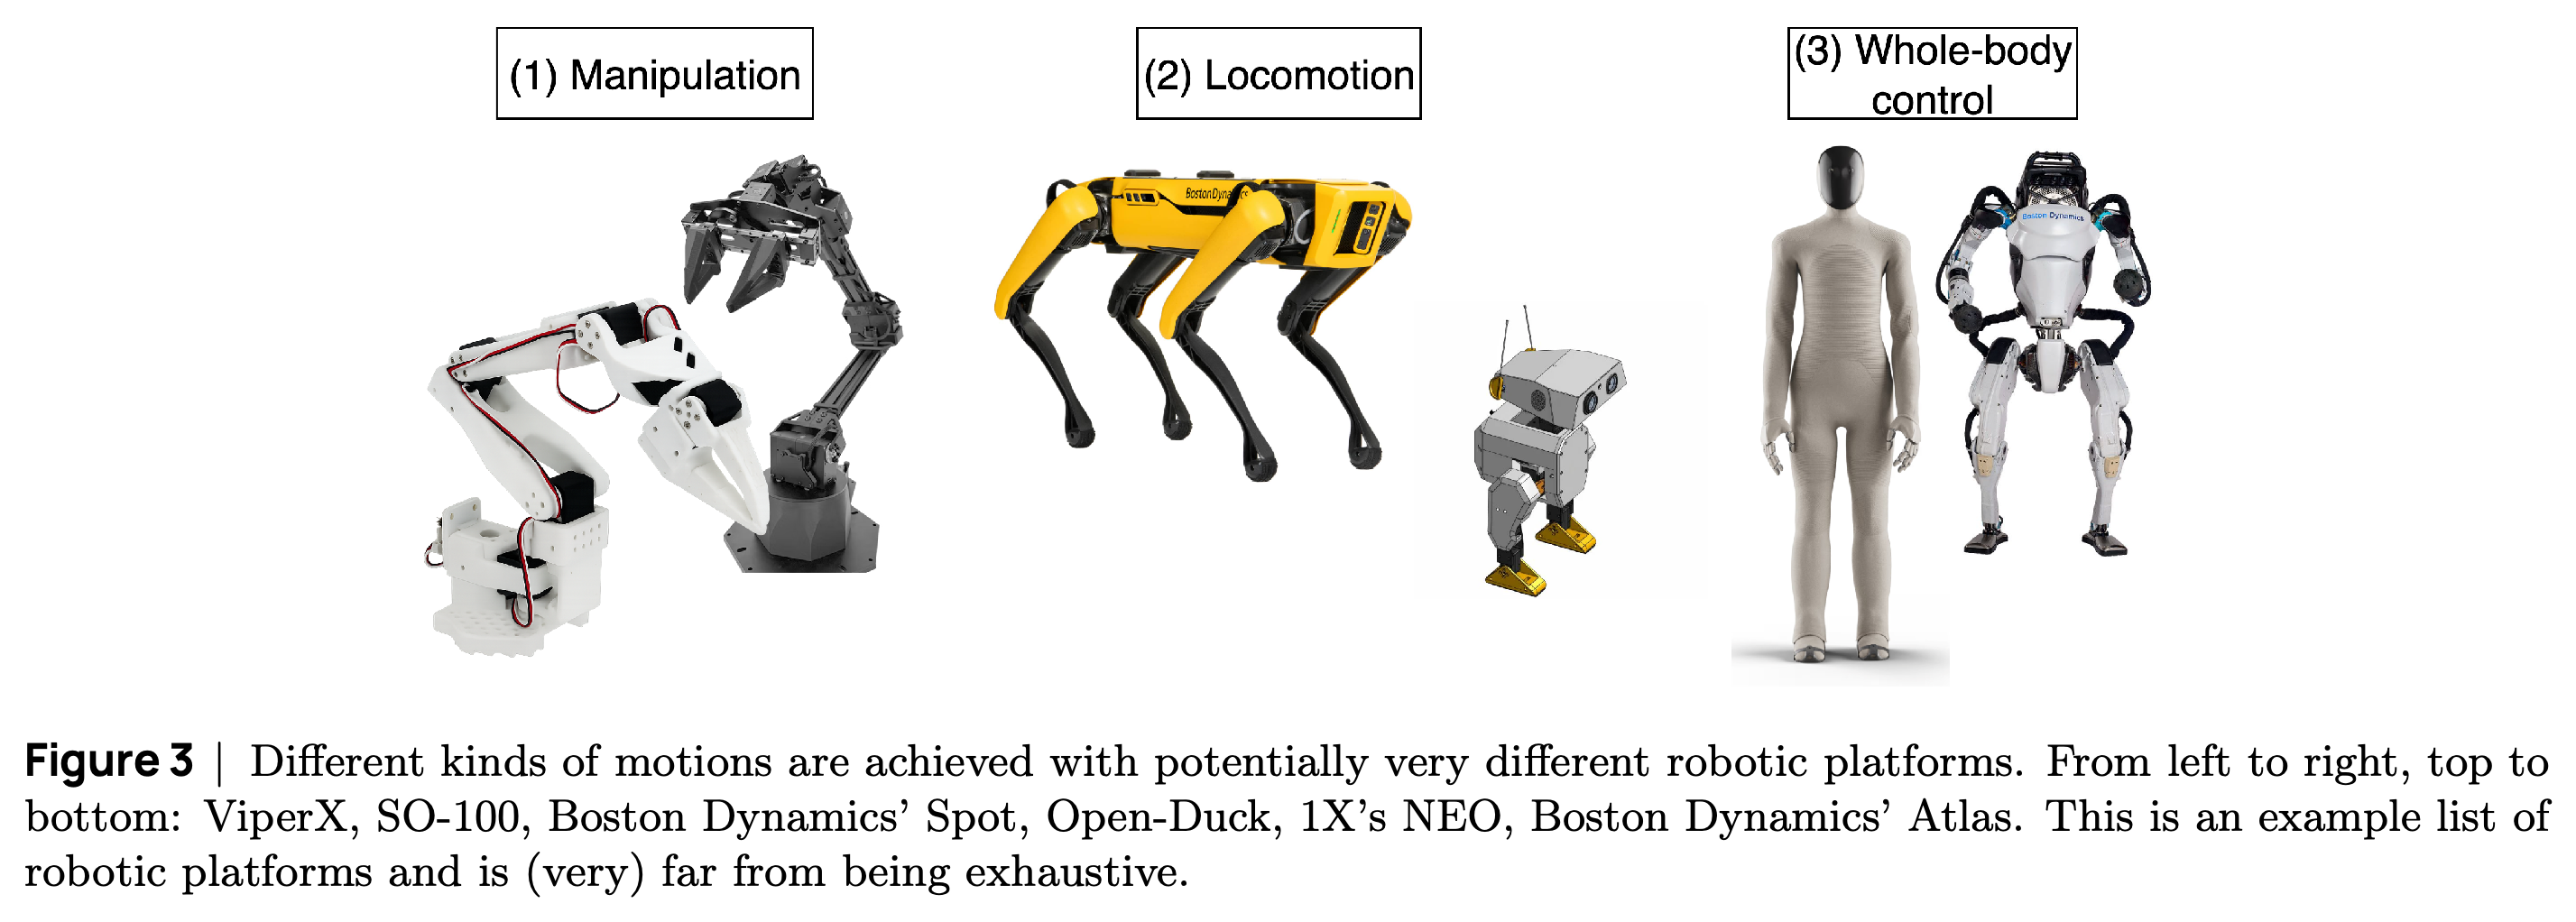
Manipulation은 물체 잡기 같은 행동으로 환경을 바꾸고, locomotion은 로봇의 위치를 바꾸며, mobile manipulation은 환경과의 상호작용에 이동을 결합한다. Figure 3은 로봇 팔, 다리형 로봇, 휴머노이드로 manipulation, locomotion, whole-body control을 설명한다. Whole-body control은 로봇 몸 전체의 움직임을 조율하는 제어다. 이동과 조작을 결합하면 일반적으로 제어 변수 수가 늘어난다.
로봇 예시는 물체를 바꾸는 행동, 환경 내 이동, 전신 행동의 조율에 서로 다른 하드웨어와 제어 요건이 필요함을 보여준다. 설명용 사례 모음이며 로봇의 능력을 정량적으로 비교하지는 않는다.
2.3 Example: Planar Manipulation
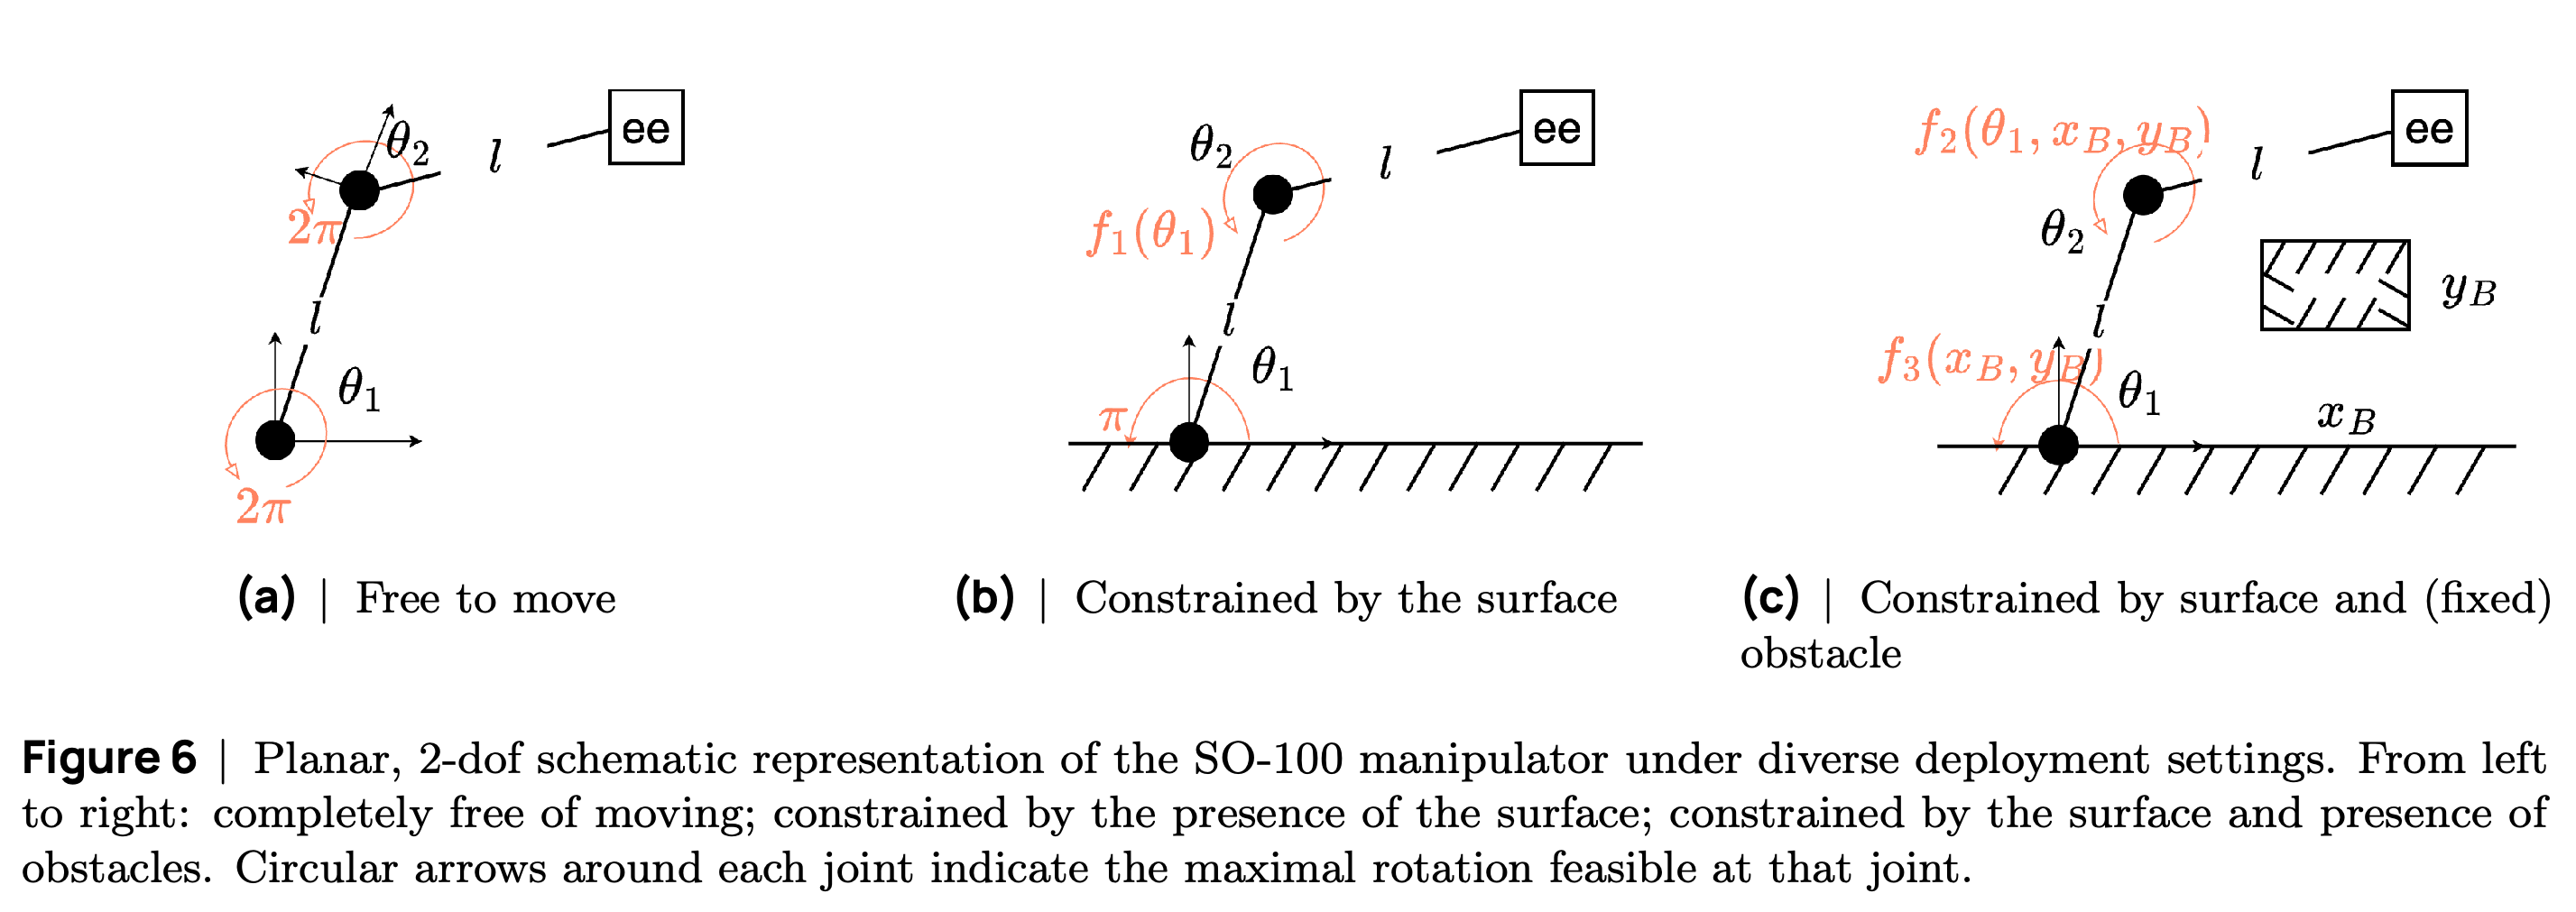
평면 조작 예제는 SO-100의 움직임을 shoulder lift와 elbow flex로 제한한다. 이에 따라 독립적으로 제어할 수 있는 운동 변수인 운동 자유도는 2개이며 그리퍼가 추가된다. 순기구학은 관절 구성을 로봇 작업 끝점의 위치와 방향인 end-effector pose로 변환하고 역기구학은 목표 pose에 해당하는 관절 구성을 찾는다. Figure 6이 보여주듯 표면과 장애물은 가능한 관절 구성을 제한한다.
- 링크 길이가 모두 l이고 관절각이 θ₁, θ₂일 때, 예제는 p(q) = [l cos(θ₁) + l cos(θ₁ + θ₂), l sin(θ₁) + l sin(θ₁ + θ₂)]ᵀ를 사용하며 목표 위치까지의 제곱 거리를 최소화한다. 이 단순화된 모델은 끝점 방향을 고려하지 않으며 처음에는 관절이 제한 없이 회전한다고 가정한다.
- 미분 역기구학은 관절 변화와 pose 변화의 관계를 나타내는 행렬인 Jacobian으로 관절 속도를 구하고 그 속도를 적분해 다음 관절 구성을 얻는다.
- 2.3.1 Adding Feedback Loops에서는 측정한 pose 오차로 속도 명령을 조정해 외란을 보상한다. 움직이는 장애물 예제는 로봇과 물체 사이의 거리를 감시할 필요성도 보여준다. 게인 조정은 시스템마다 필요하며 간헐적인 접촉은 안정성과 추종을 어렵게 만든다.
지지 표면을 추가하고 이어 장애물을 추가하면 동일한 2관절 로봇 팔에서 허용되는 관절 회전이 달라진다. 이 예시는 목표 위치에 맞는 관절 구성을 찾을 때 환경 제약을 고려해야 하는 이유를 보여준다.
2.4 Limitations of Dynamics-based Robotics
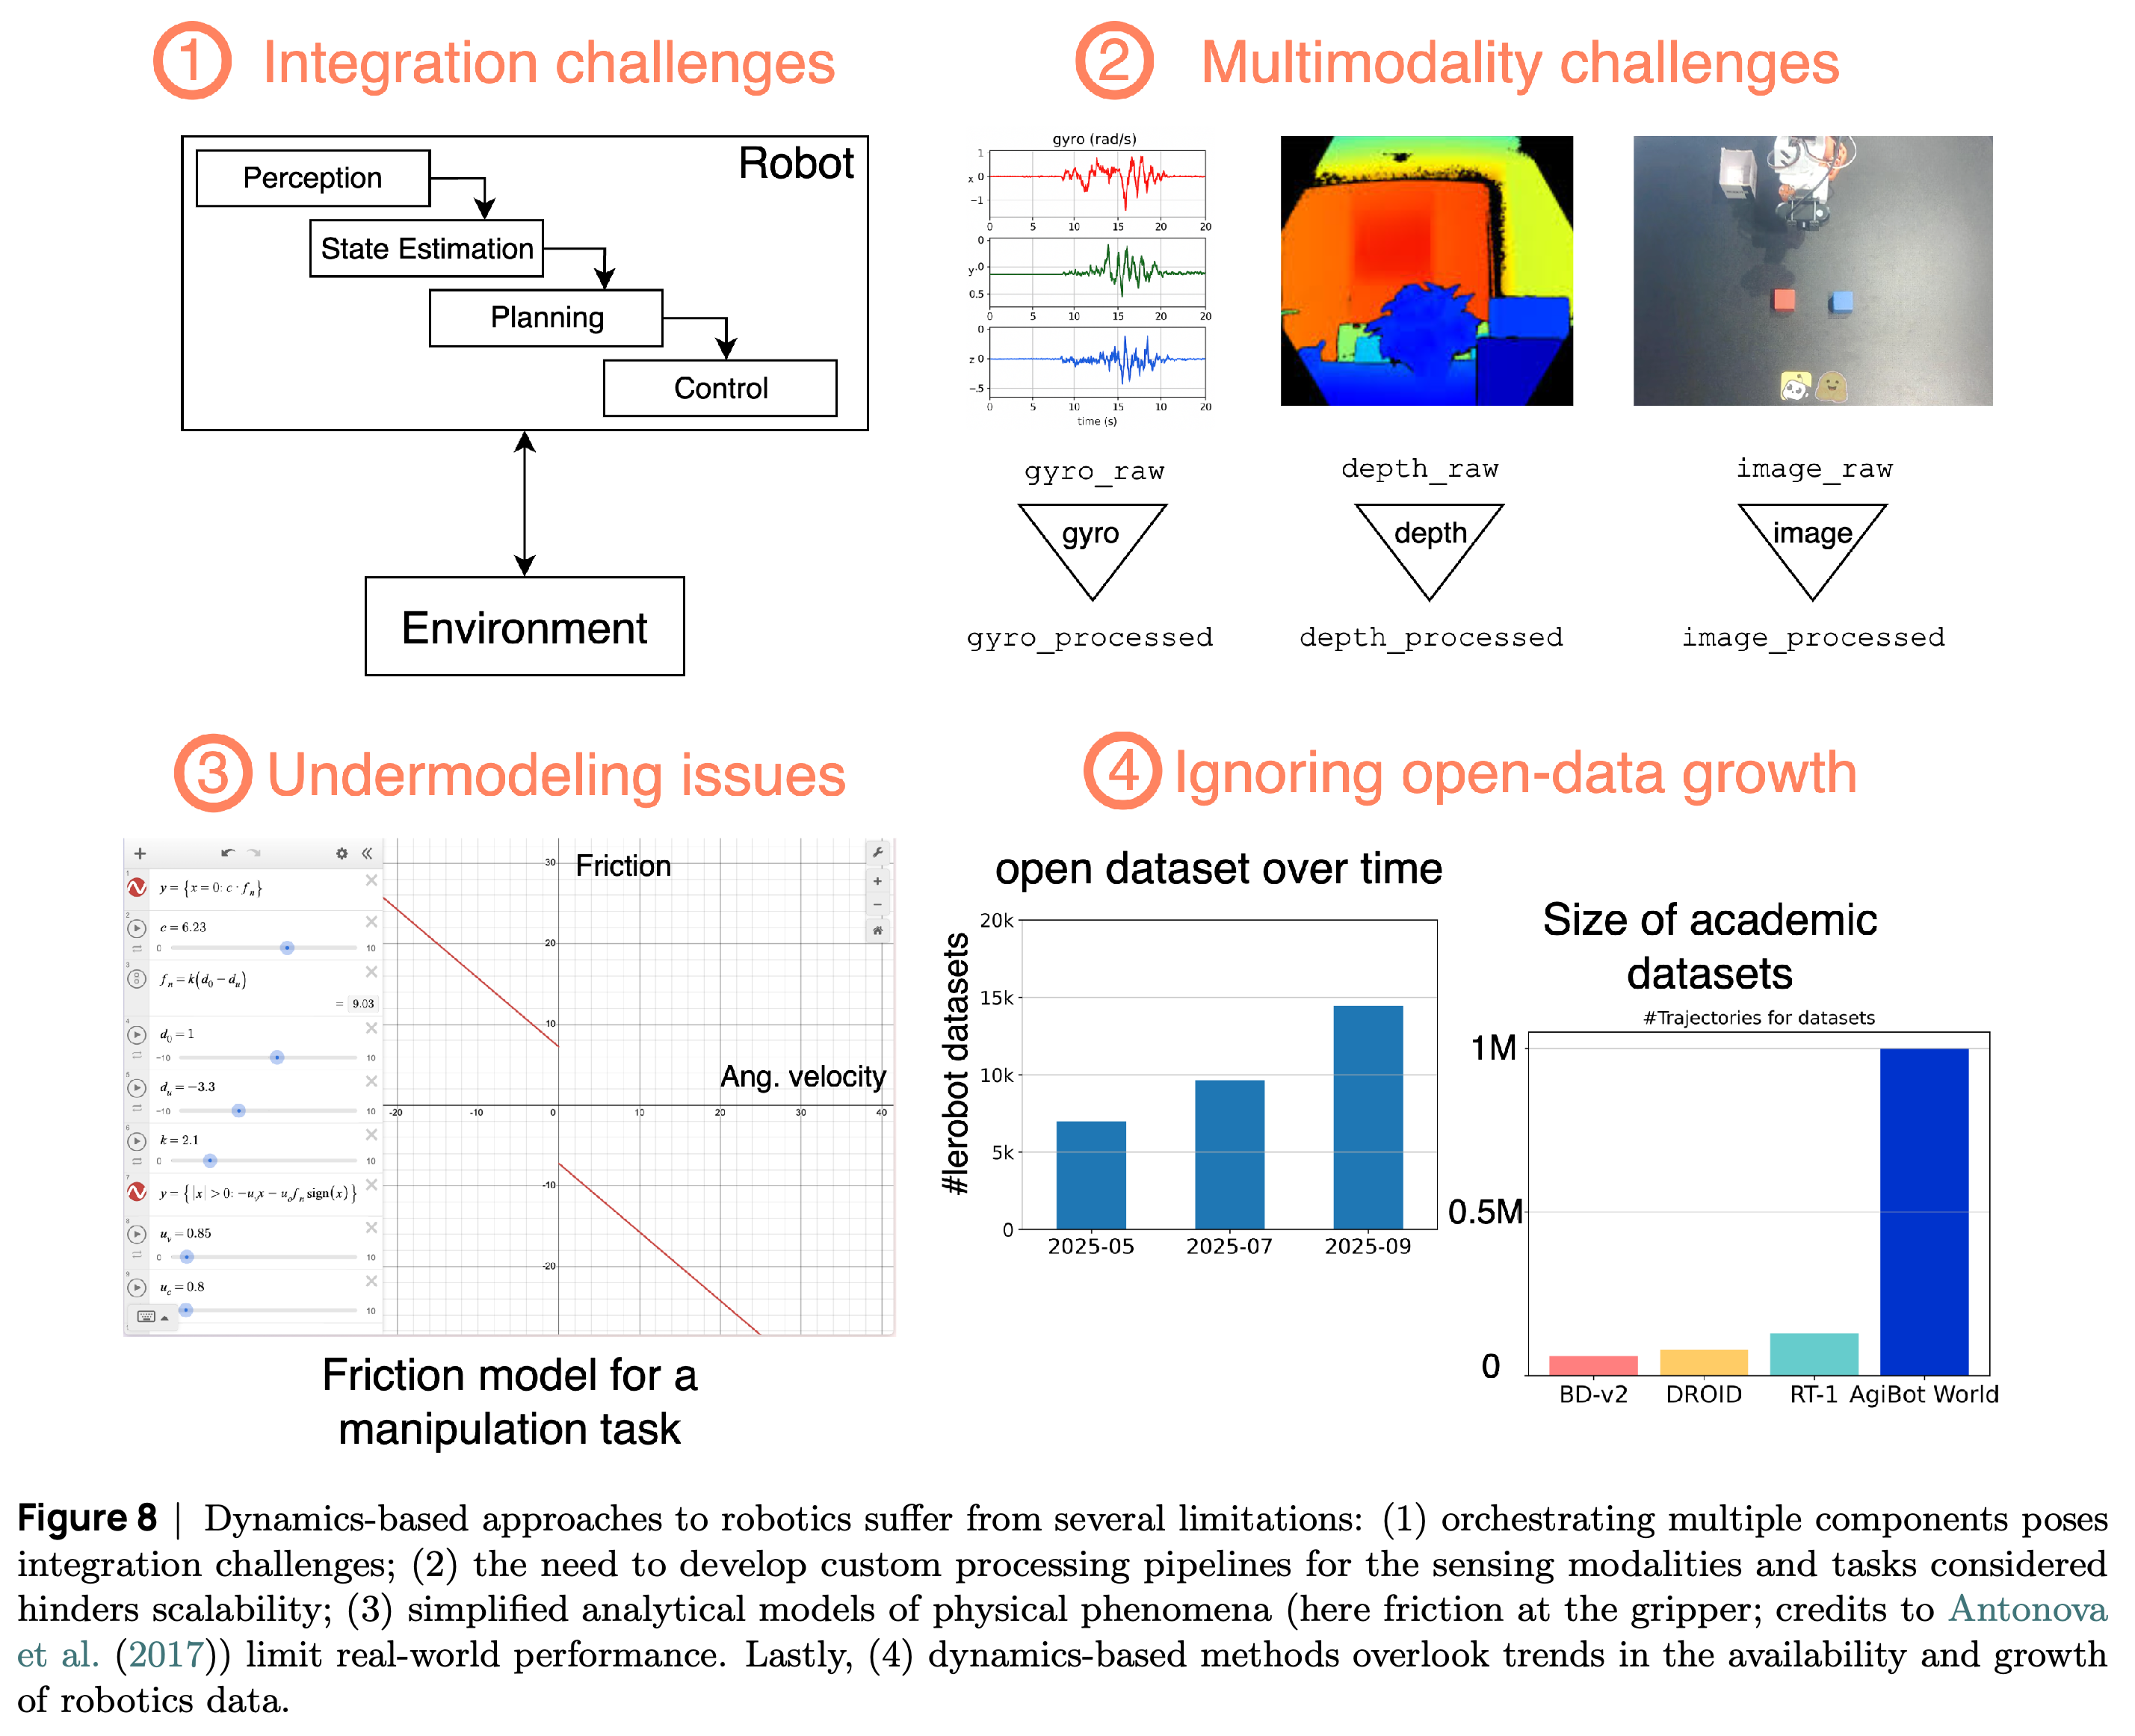
논문은 동역학 기반 파이프라인의 한계를 4가지로 정리한다. 독립적으로 설계한 모듈 간 통합, 센서 모달리티별 맞춤 처리, 부정확한 물리 근사, 늘어나는 로봇 데이터셋의 제한적인 활용이다. Figure 8은 이러한 논점을 정리한다. 본문은 인터페이스 오차 누적, 과제별 재설계, 접촉과 마찰, 힘에 따른 유연성이나 변형, 변형 가능한 물체를 모델링하기 어렵다는 점을 강조한다.
4개 패널은 이 장의 비판을 모듈 통합, 모달리티별 처리, 근사 물리 모델, 데이터 증가의 제한적인 활용으로 정리한다. 도식과 데이터셋 그래프는 학습의 필요성을 설명하지만 고전 제어기와 학습된 제어기를 통제된 조건에서 비교하지는 않는다.
3 Robot (Reinforcement) Learning
학습된 visuomotor 정책은 시각 및 로봇 상태 관측을 행동으로 변환한다. 이를 통해 인지와 제어를 통합하고 이질적인 입력에서 특징을 학습한다. 이 장은 방법을 RL과 BC로 나누며, 시연으로 학습한 generalist 정책도 여전히 기록된 trajectory를 재현하는 학습이 주를 이루므로 BC와 함께 다룬다. 모든 상황에서 우월한 접근을 제시하지는 않는다.
3.1 A (Concise) Introduction to RL
RL은 Markov Decision Process (MDP)로 상호작용을 표현한다. MDP는 상태, 행동, 전이 동역학, 보상, 초기 상태 분포, 할인율, 시간 범위를 정의하는 틀이다. 튜토리얼은 주로 이산 시간과 유한한 시간 범위의 episode를 다루며, 할인된 return의 기댓값을 최대화한다. 상태 가치 함수와 상태-행동 가치 함수는 상태 또는 상태-행동 쌍에서 얻을 미래 보상을 추정한다.
- Return은 \(G(\tau)=\sum_{t=0}^{T-1}\gamma^t r_t\)이며, \(\gamma\in[0,1)\)는 미래 보상의 상대적 가중치를 조절한다.
- Figure 13은 명시적 전이 모델 없이 학습하는 model-free 방법과 전이 모델을 사용하는 model-based 방법을 구분한다. 연속적인 로봇 제어를 다루기 위해 정책 최적화와 행동 선택 및 가치 추정을 함께 학습하는 actor-critic 접근을 사용한다.
3.2 Real-world RL for Robotics
실제 환경의 RL은 위험한 탐색, 느린 transition 수집, 반복적인 환경 초기화 문제를 겪는다. Transition은 상태, 행동, 보상, 다음 상태를 담은 개별 기록이다. 시뮬레이션은 처리량을 높이지만 시뮬레이션과 실제 동역학이 다른 reality gap을 만든다. Domain randomization은 학습 중 시뮬레이션 매개변수를 바꾸지만 매개변수와 분포를 선택하기 어렵고 충실도의 모든 한계를 해결하지는 못한다.
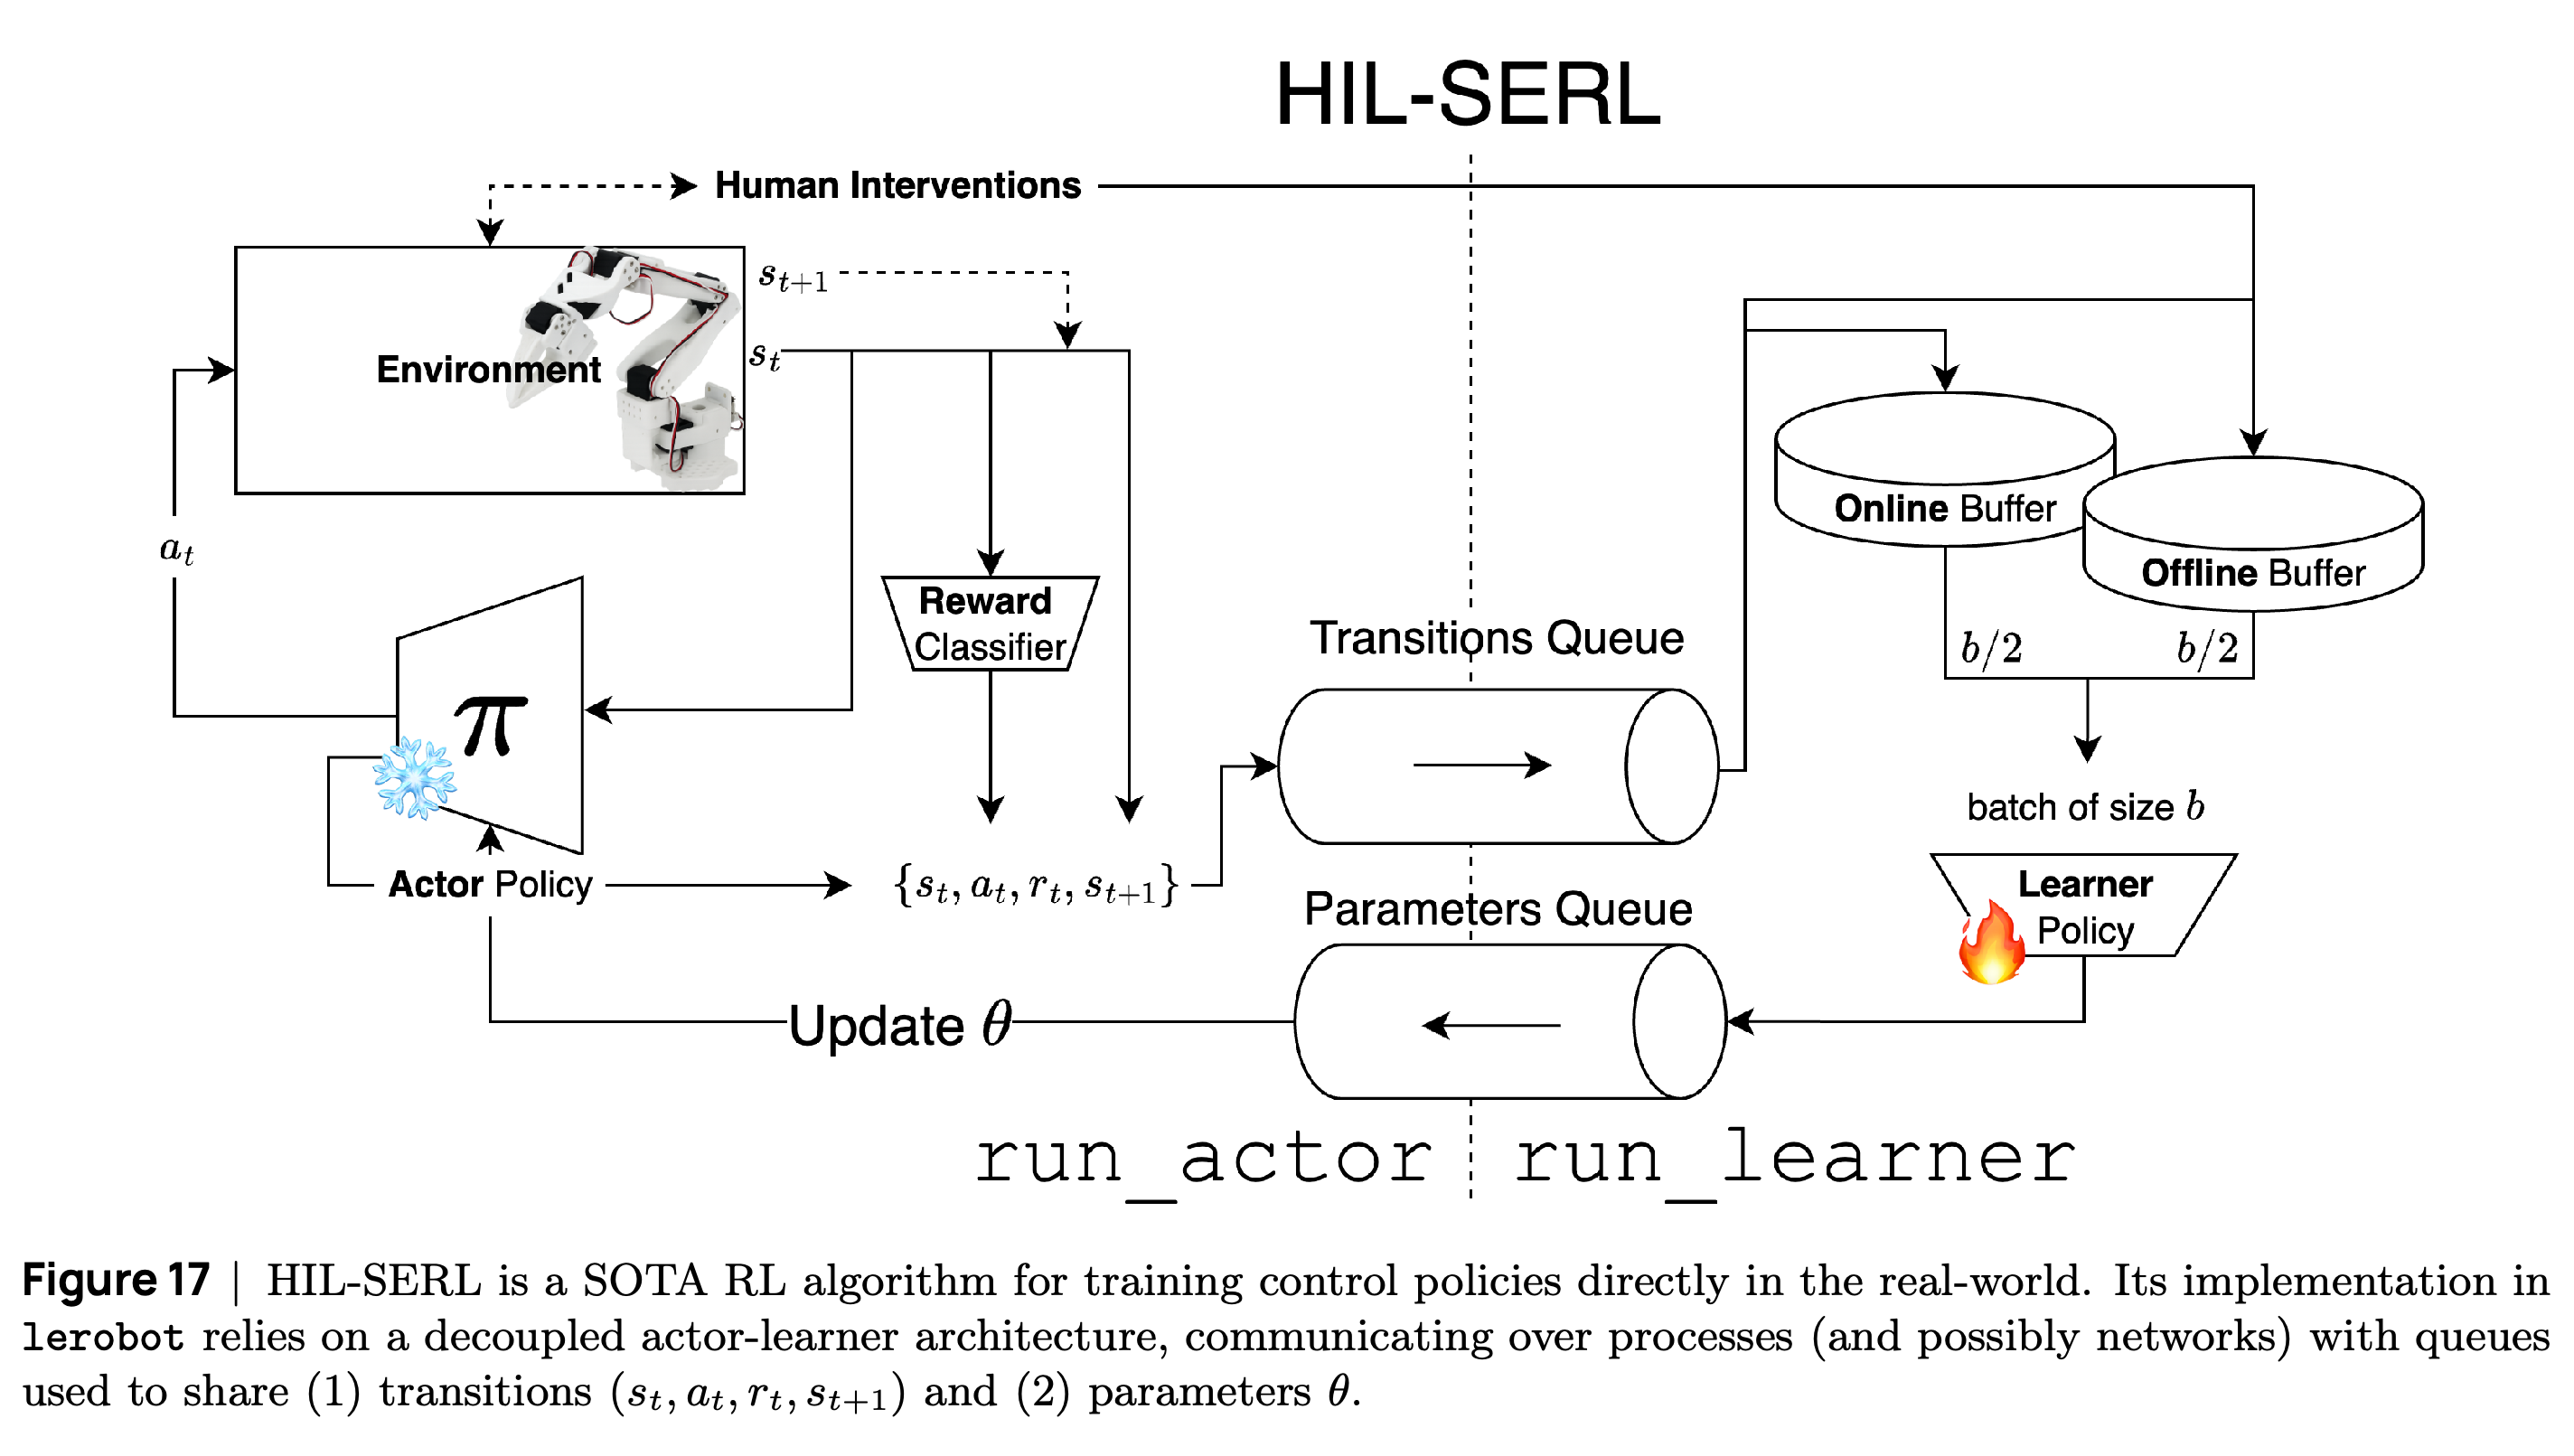
- Soft Actor-Critic (SAC)은 이전에 수집한 행동과 보상으로 학습하면서 다양한 행동을 장려하는 off-policy actor-critic 방법이다. 과거 경험을 저장하는 replay buffer를 통해 transition을 재사용한다. Reinforcement Learning with Prior Data (RLPD)는 별도 사전 학습 단계 없이 offline과 online transition을 같은 비율로 샘플링한다.
- 샘플 효율적인 로봇 RL을 위한 소프트웨어 모음인 SERL은 학습된 성공 분류기와 과제 실행 및 초기화를 위한 정방향/역방향 제어기를 추가한다. HIL-SERL은 필요한 시점에 사람이 제공한 교정을 양쪽 replay buffer에 넣어 교정 데이터의 샘플링 빈도를 높인다. 튜토리얼은 Luo et al. (2024)을 인용해 1–2시간 안에 99%+ 성공률을 달성했다고 소개한다.
- 3.2.1 Code Example: Real-world RL은 보상 분류기를 학습하고 하드웨어 상호작용을 담당하는 actor와 매개변수 갱신을 담당하는 learner를 정의한다. Figure 17처럼 transition 큐와 매개변수 큐로 이들을 연결한다. 3.2.2 Limitations of RL in Real-World Robotics: Simulators and Reward Design은 경험 수집 비용, 접촉 시뮬레이션의 어려움, 의도하지 않은 해결책을 유도할 수 있는 reward shaping을 강조한다. Reward shaping은 중간 보상 신호를 추가하는 방법이다.
Transition은 actor에서 learner로 전달되고 갱신된 정책 매개변수는 반대 방향으로 전달된다. Online 및 offline buffer에서 같은 비율로 샘플링하고 사람의 개입을 양쪽 buffer에 넣는 구조는 교정 데이터가 학습에 반복적으로 사용되는 이유를 설명한다. 하드웨어 상호작용과 최적화는 별도로 실행된다.
4 Robot (Imitation) Learning
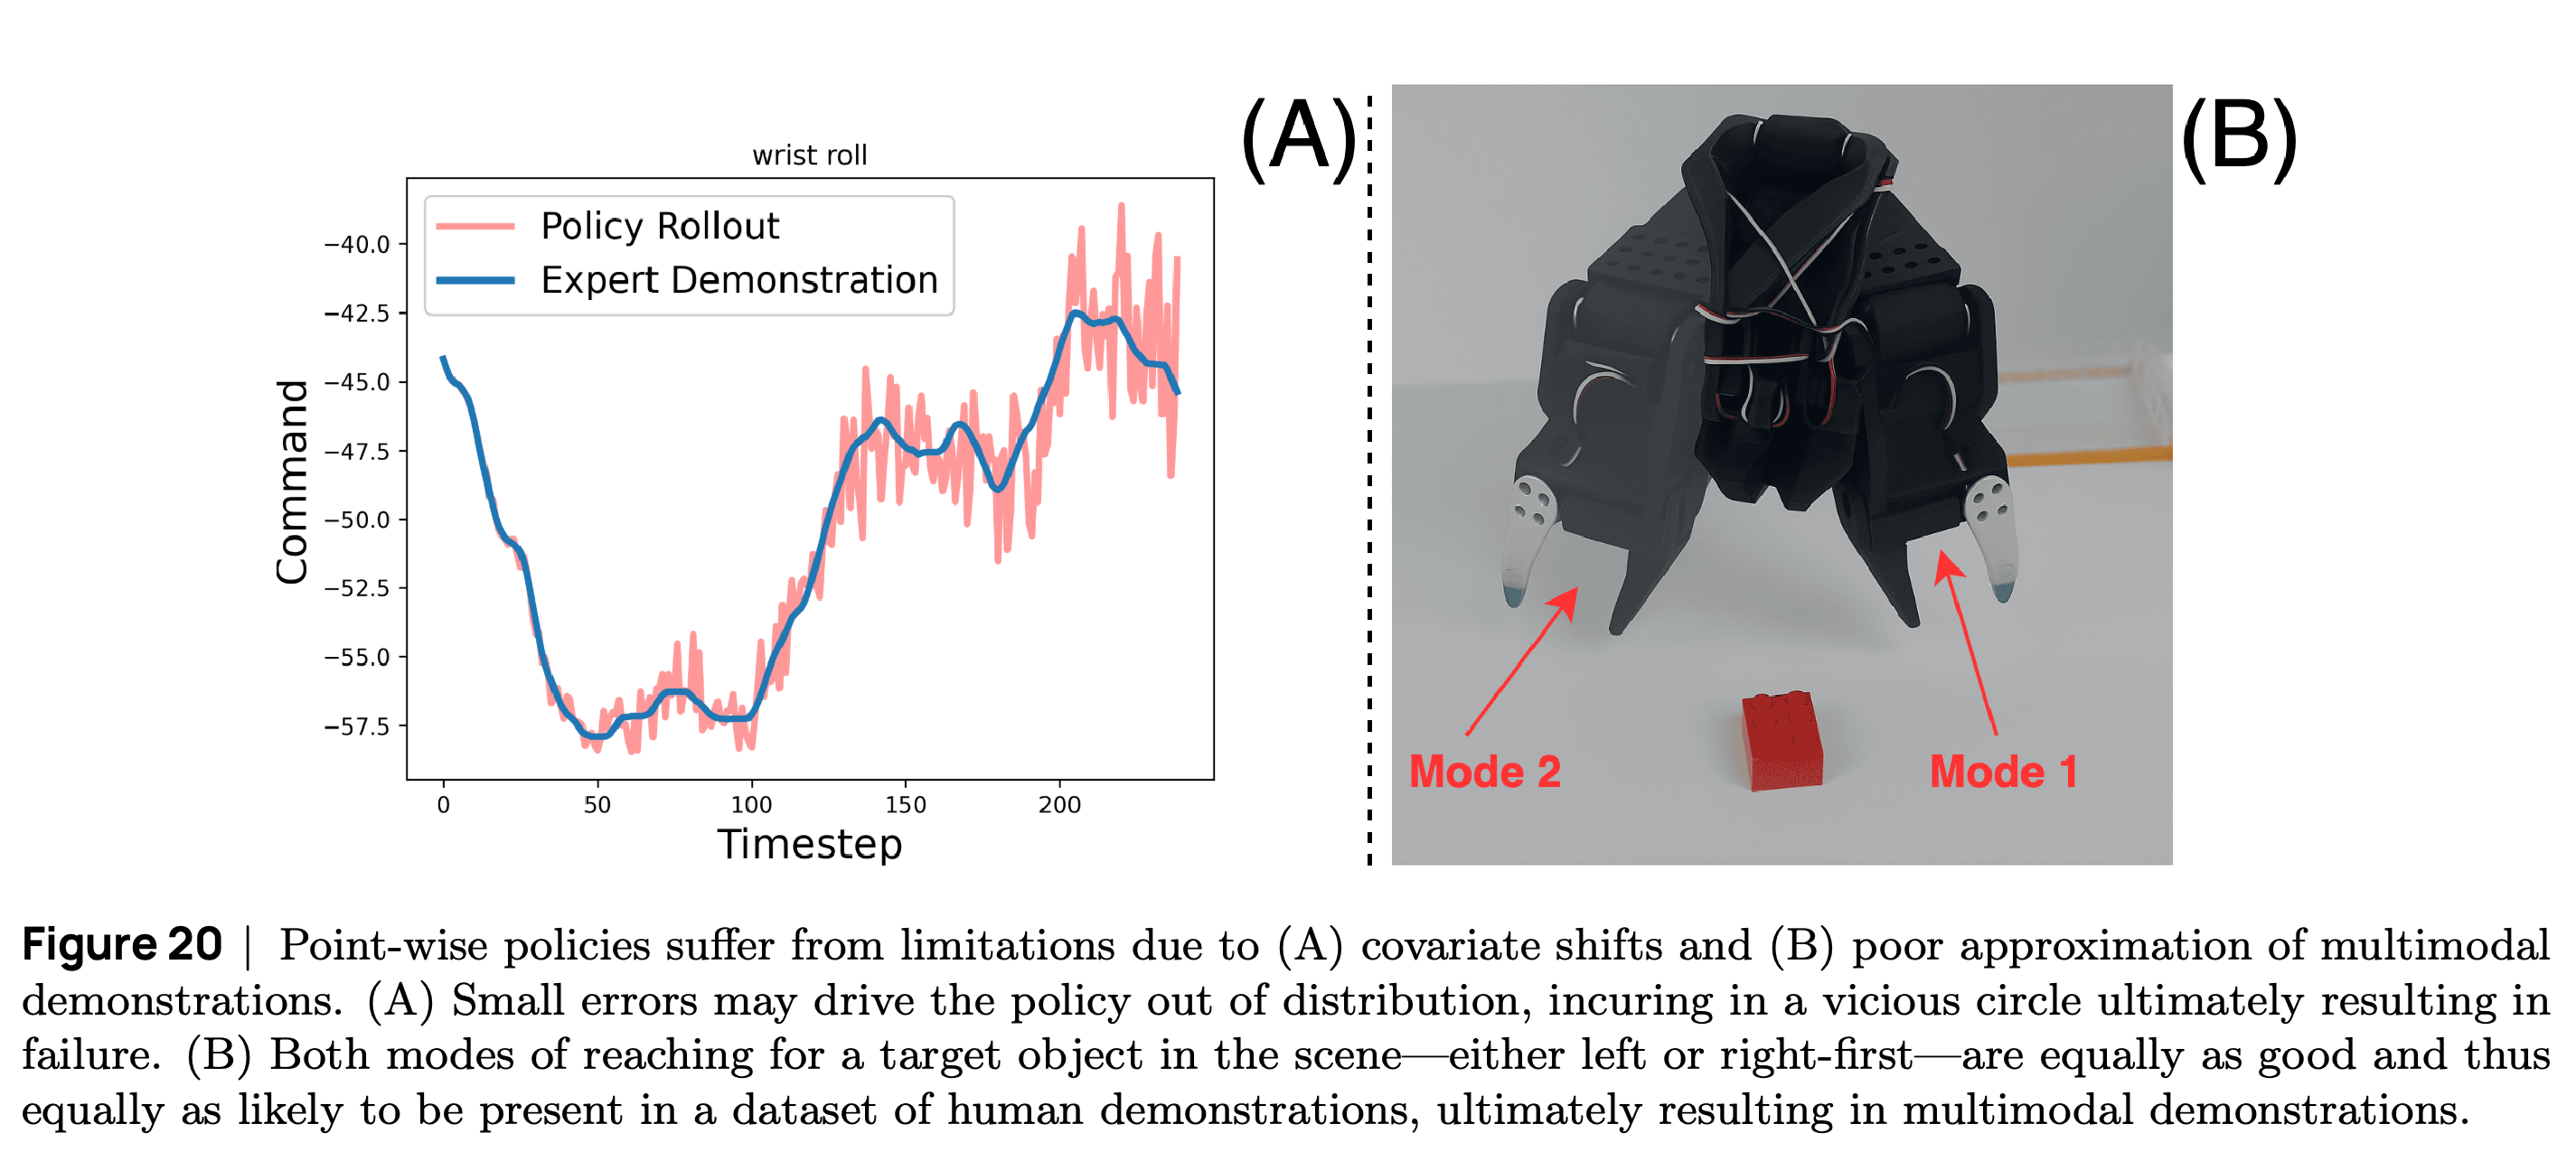
BC는 학습 중 보상이나 online 탐색 없이 offline 전문가 trajectory에서 관측을 행동으로 변환하는 방식을 학습한다. 논문은 순차적으로 의존하는 샘플, 배포 시 관측이 학습 분포에서 벗어나는 covariate shift, 비슷한 관측에 여러 유효한 행동 전략이 존재하는 다중 모드 시연을 핵심 난점으로 꼽는다. Offline 학습은 학습 중 하드웨어 탐색을 피할 수 있지만 안전한 배포를 보장하지는 않는다.
- Figures 18과 19는 lerobot/svla_so101_pickplace로 동기화된 관절 측정값, 이미지, 전문가 행동을 보여준다. Figure 18은 처음 기록한 5개 episode를 평균과 표준편차로 요약한다.
- Figure 20은 예측 오차가 누적되는 방식과, 행동 예측 1개를 출력하는 점 추정 정책이 서로 양립할 수 없는 유효한 전략을 평균낼 수 있음을 설명한다. 튜토리얼은 모방 학습이 시연 품질에 영향을 받으며 데이터에 없는 복구 행동을 갖추지 못할 수 있다는 점도 경고한다.
Trajectory 패널은 전문가 명령과 정책 실행이 서로 어긋나는 모습을 보여준다. 물체 잡기 패널은 동일한 물체에 대한 유효한 접근 방식 2가지를 보여준다. 이 패널들은 실행 오차 누적과 여러 유효한 행동 모드를 표현하기 어려운 문제를 구분한다.
4.1 A (Concise) Introduction to Generative Models
생성 모델은 시연의 분포를 학습해 정책이 여러 가능한 행동을 표현할 수 있게 한다. 이 절은 데이터에 영향을 주지만 관측되지 않은 요인을 도입하는 잠재 변수 모델을 설명한다. 이어 행동 생성 정책의 기반이 되는 diffusion과 flow matching을 다룬다.
- 4.1.1 Variational Auto-Encoders에서 variational auto-encoder (VAE)는 디코더와 근사 사후분포를 학습한다. 근사 사후분포는 관측 데이터에서 추론한 잠재 요인의 분포다. 로그 우도의 계산 가능한 하한인 Evidence Lower Bound (ELBO)는 재구성과 Kullback–Leibler divergence를 결합한다. 이 divergence는 분포 간 차이를 나타내며, 사후분포가 샘플 관측 전에 지정한 잠재 분포인 사전분포에 가까워지도록 정규화한다.
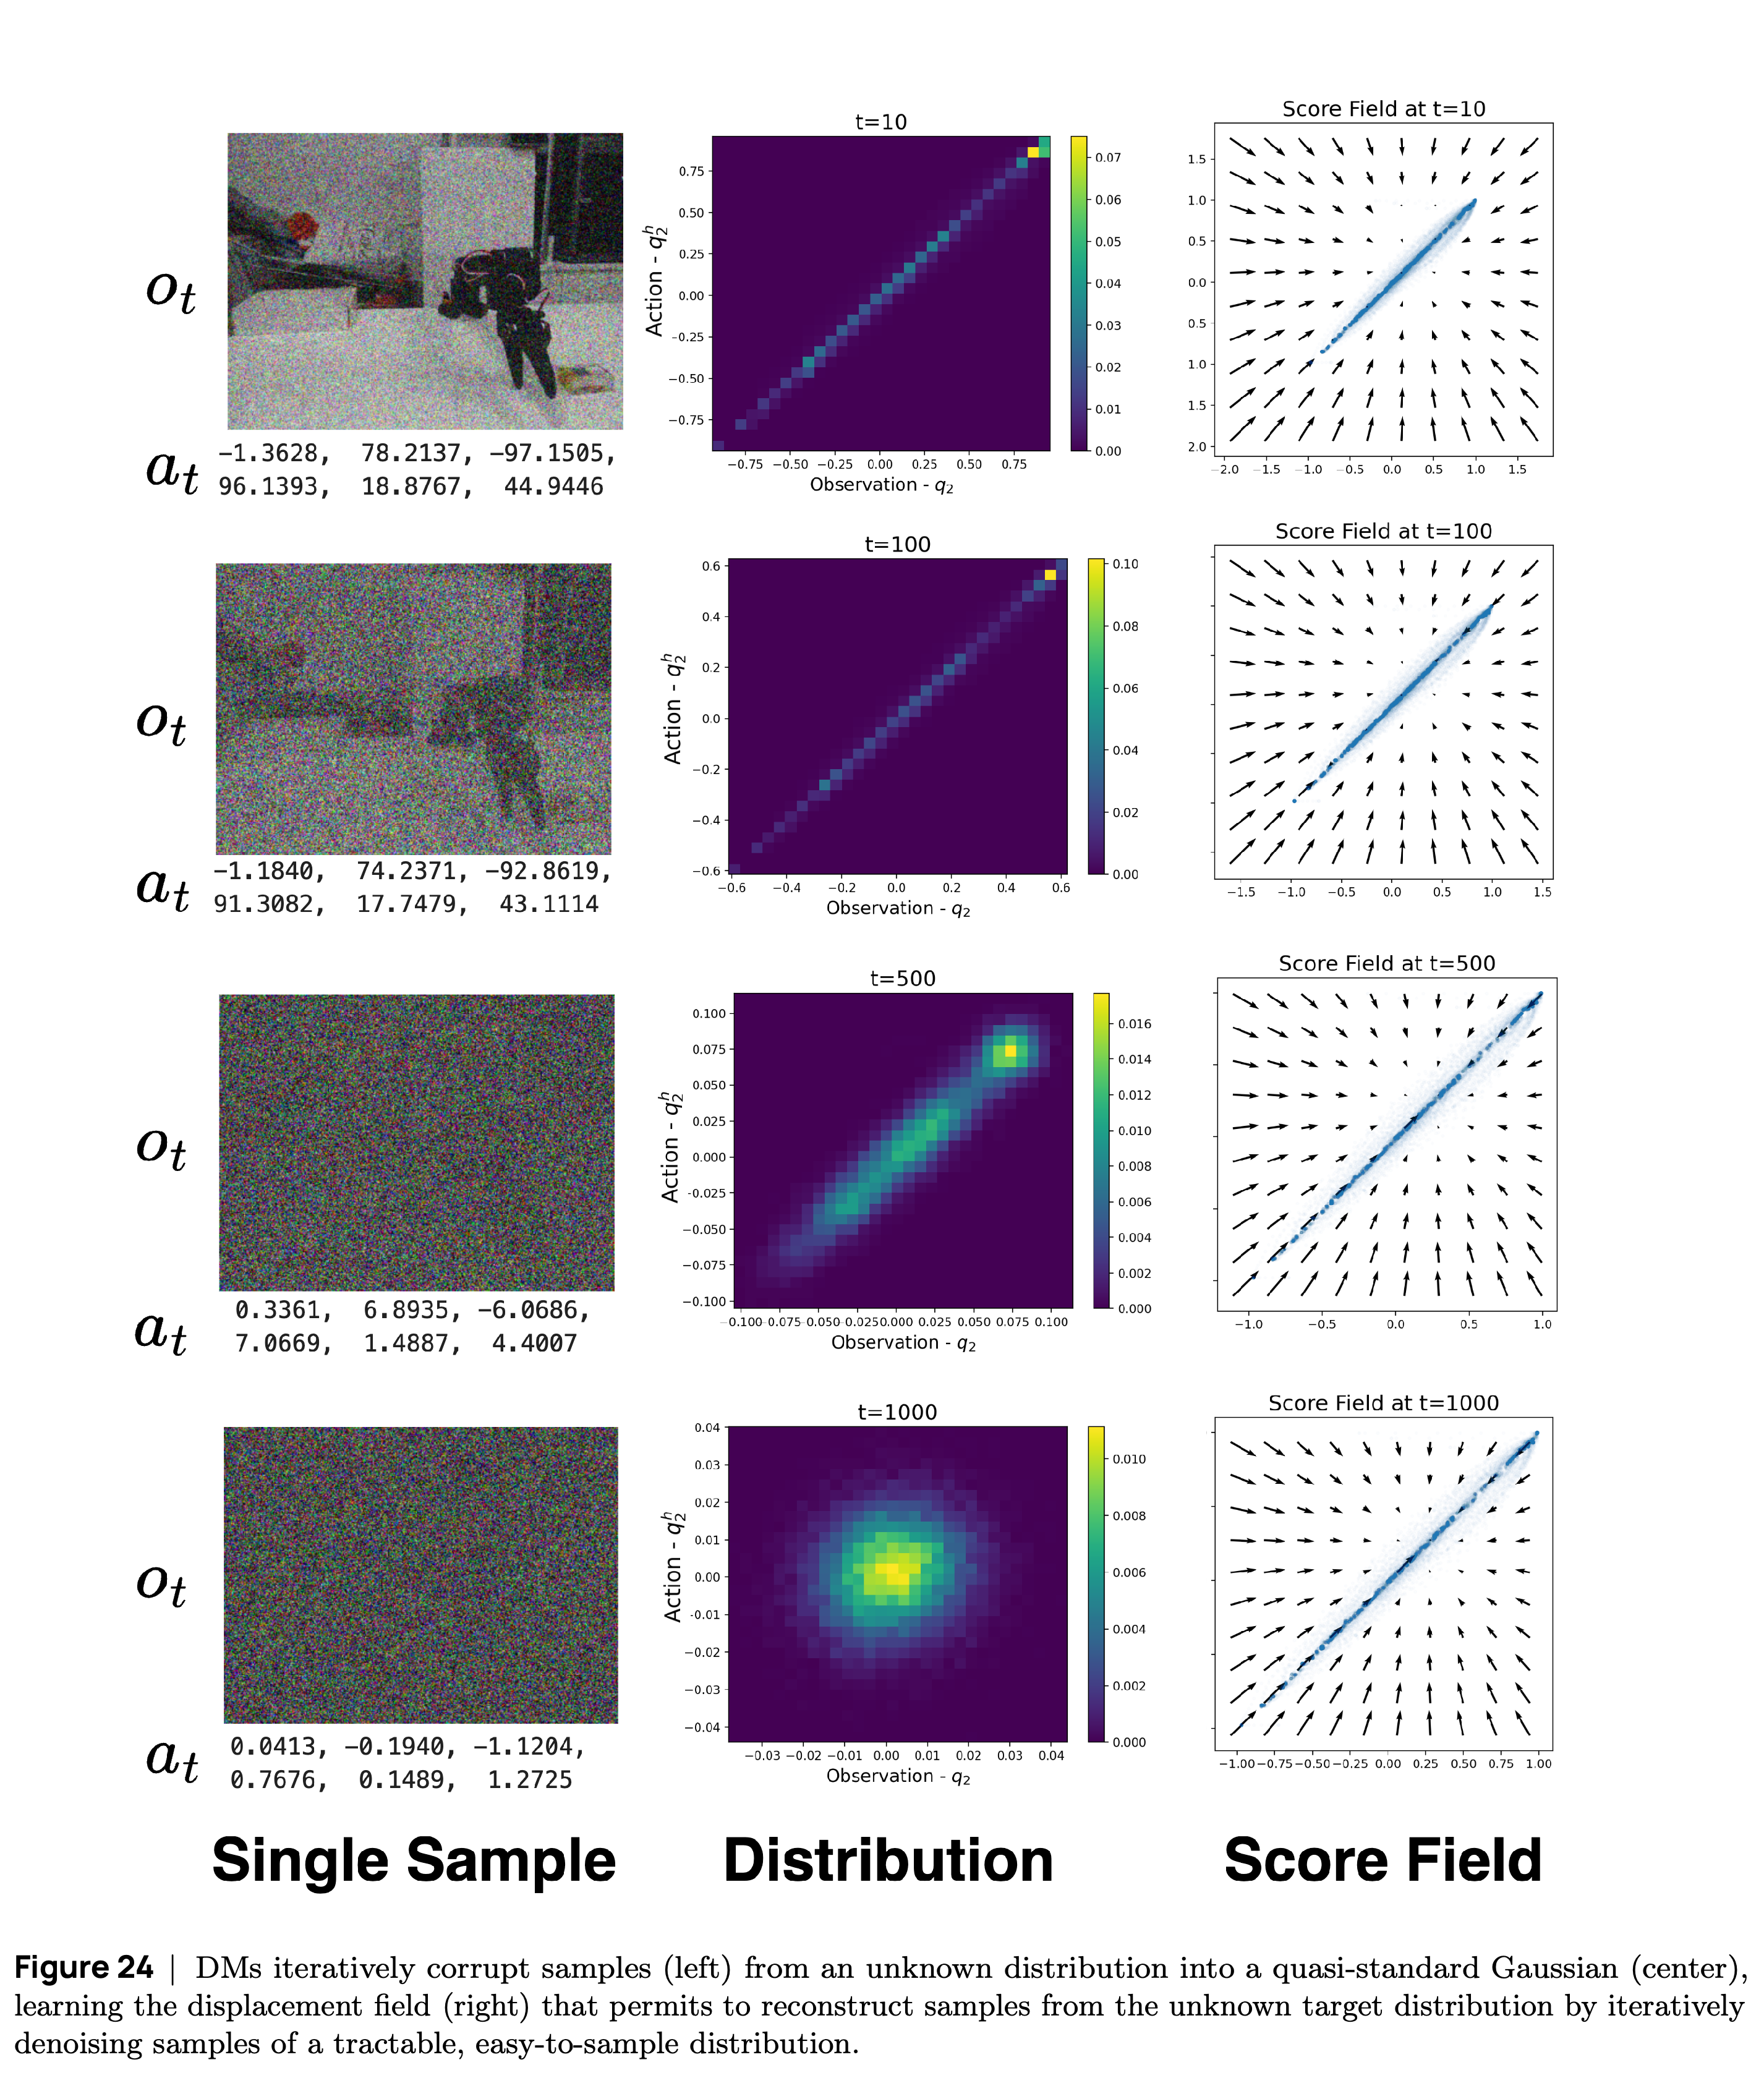
- 4.1.2 Diffusion Models에서는 학습 중 데이터에 Gaussian noise를 점진적으로 추가하고 이를 되돌리는 방법을 학습한다. Figure 24는 로봇 관측-행동 샘플로 이 과정을 보여준다. 단순화된 목적 함수는 무작위로 선택한 diffusion 단계에서 노이즈 예측기를 학습한다.
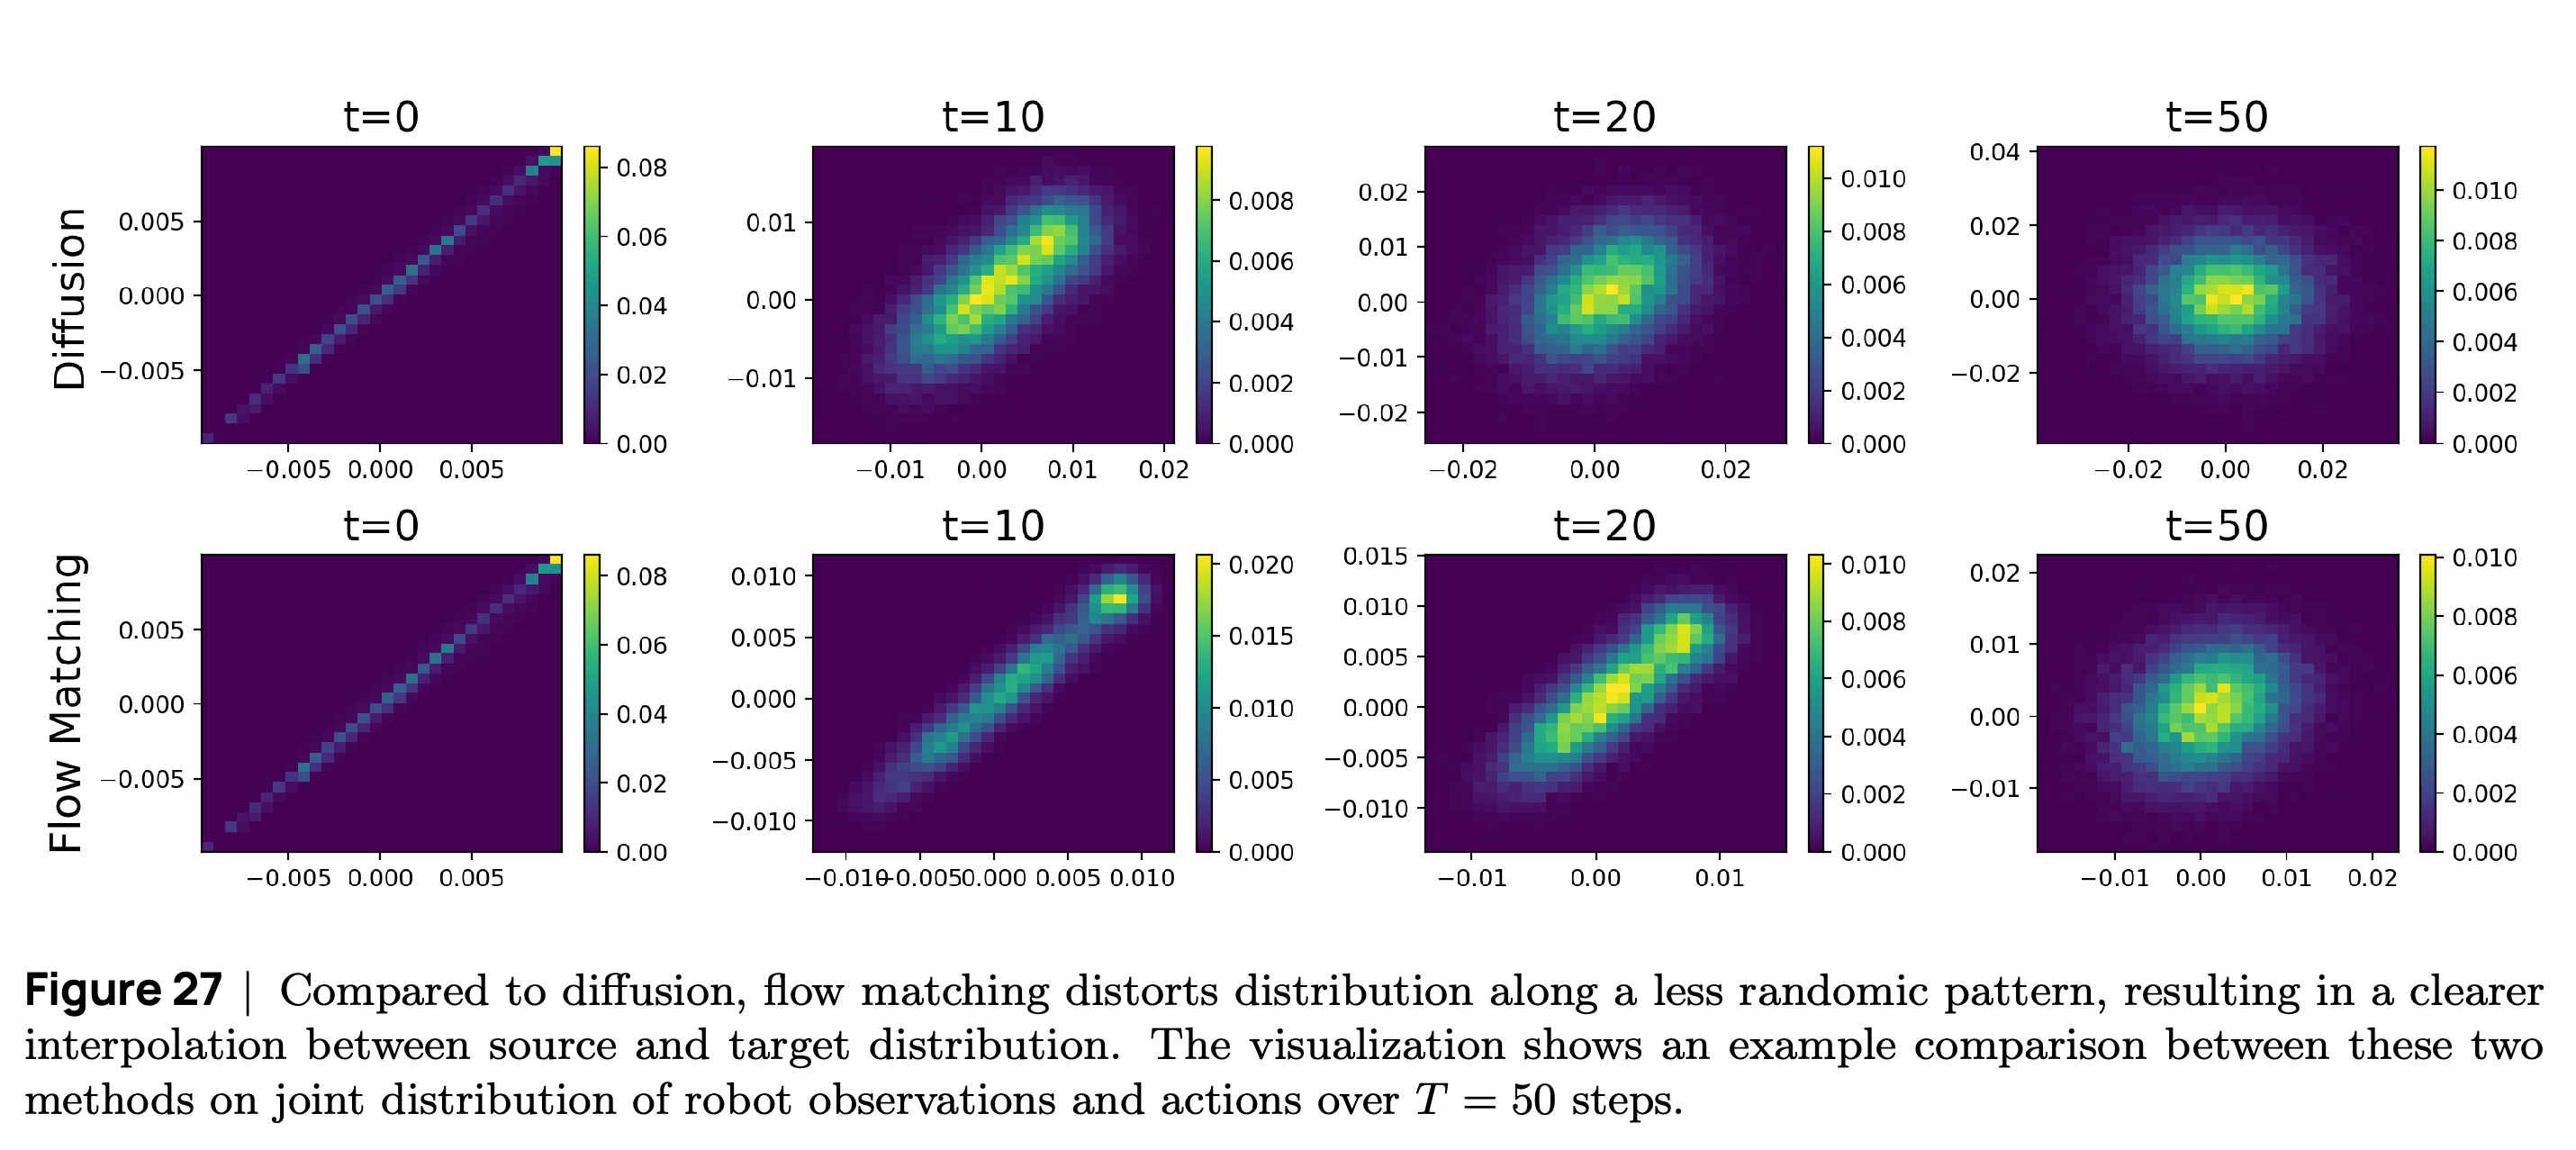
- 4.1.3 Flow Matching에서는 단순한 사전분포의 샘플을 데이터 분포로 이동시키는 벡터장을 학습한다. 벡터장은 각 샘플에 순간적인 방향과 속도를 지정하는 규칙이다. Conditional flow matching은 \(z_t=(1-t)z_0+t z_1\)과 목표 속도 \(z_1-z_0\)를 사용한다. 추론에서는 학습된 벡터장을 수치적으로 적분하며 Figure 27은 \(T=50\) 단계에 걸친 예시 분포 경로를 비교한다.
각 행은 관측과 행동에 노이즈가 점점 더해지는 과정, 그 분포의 변화, 복원과 관련된 벡터장을 보여준다. 로봇 데이터로 diffusion의 학습 문제를 설명하며 최종 제어 정확도를 보고하지는 않는다.
2개 행은 T = 50에 걸쳐 선택한 단계에서 diffusion과 flow matching의 변환을 비교한다. Flow matching 행은 중간 분포에서 구조가 더 잘 유지되는 모습을 보여주며, 더 직접적인 확률 경로에 관한 논의를 설명한다. 그림은 추론 속도나 로봇 과제 성공률을 측정하지 않는다.
4.2 Action Chunking with Transformers
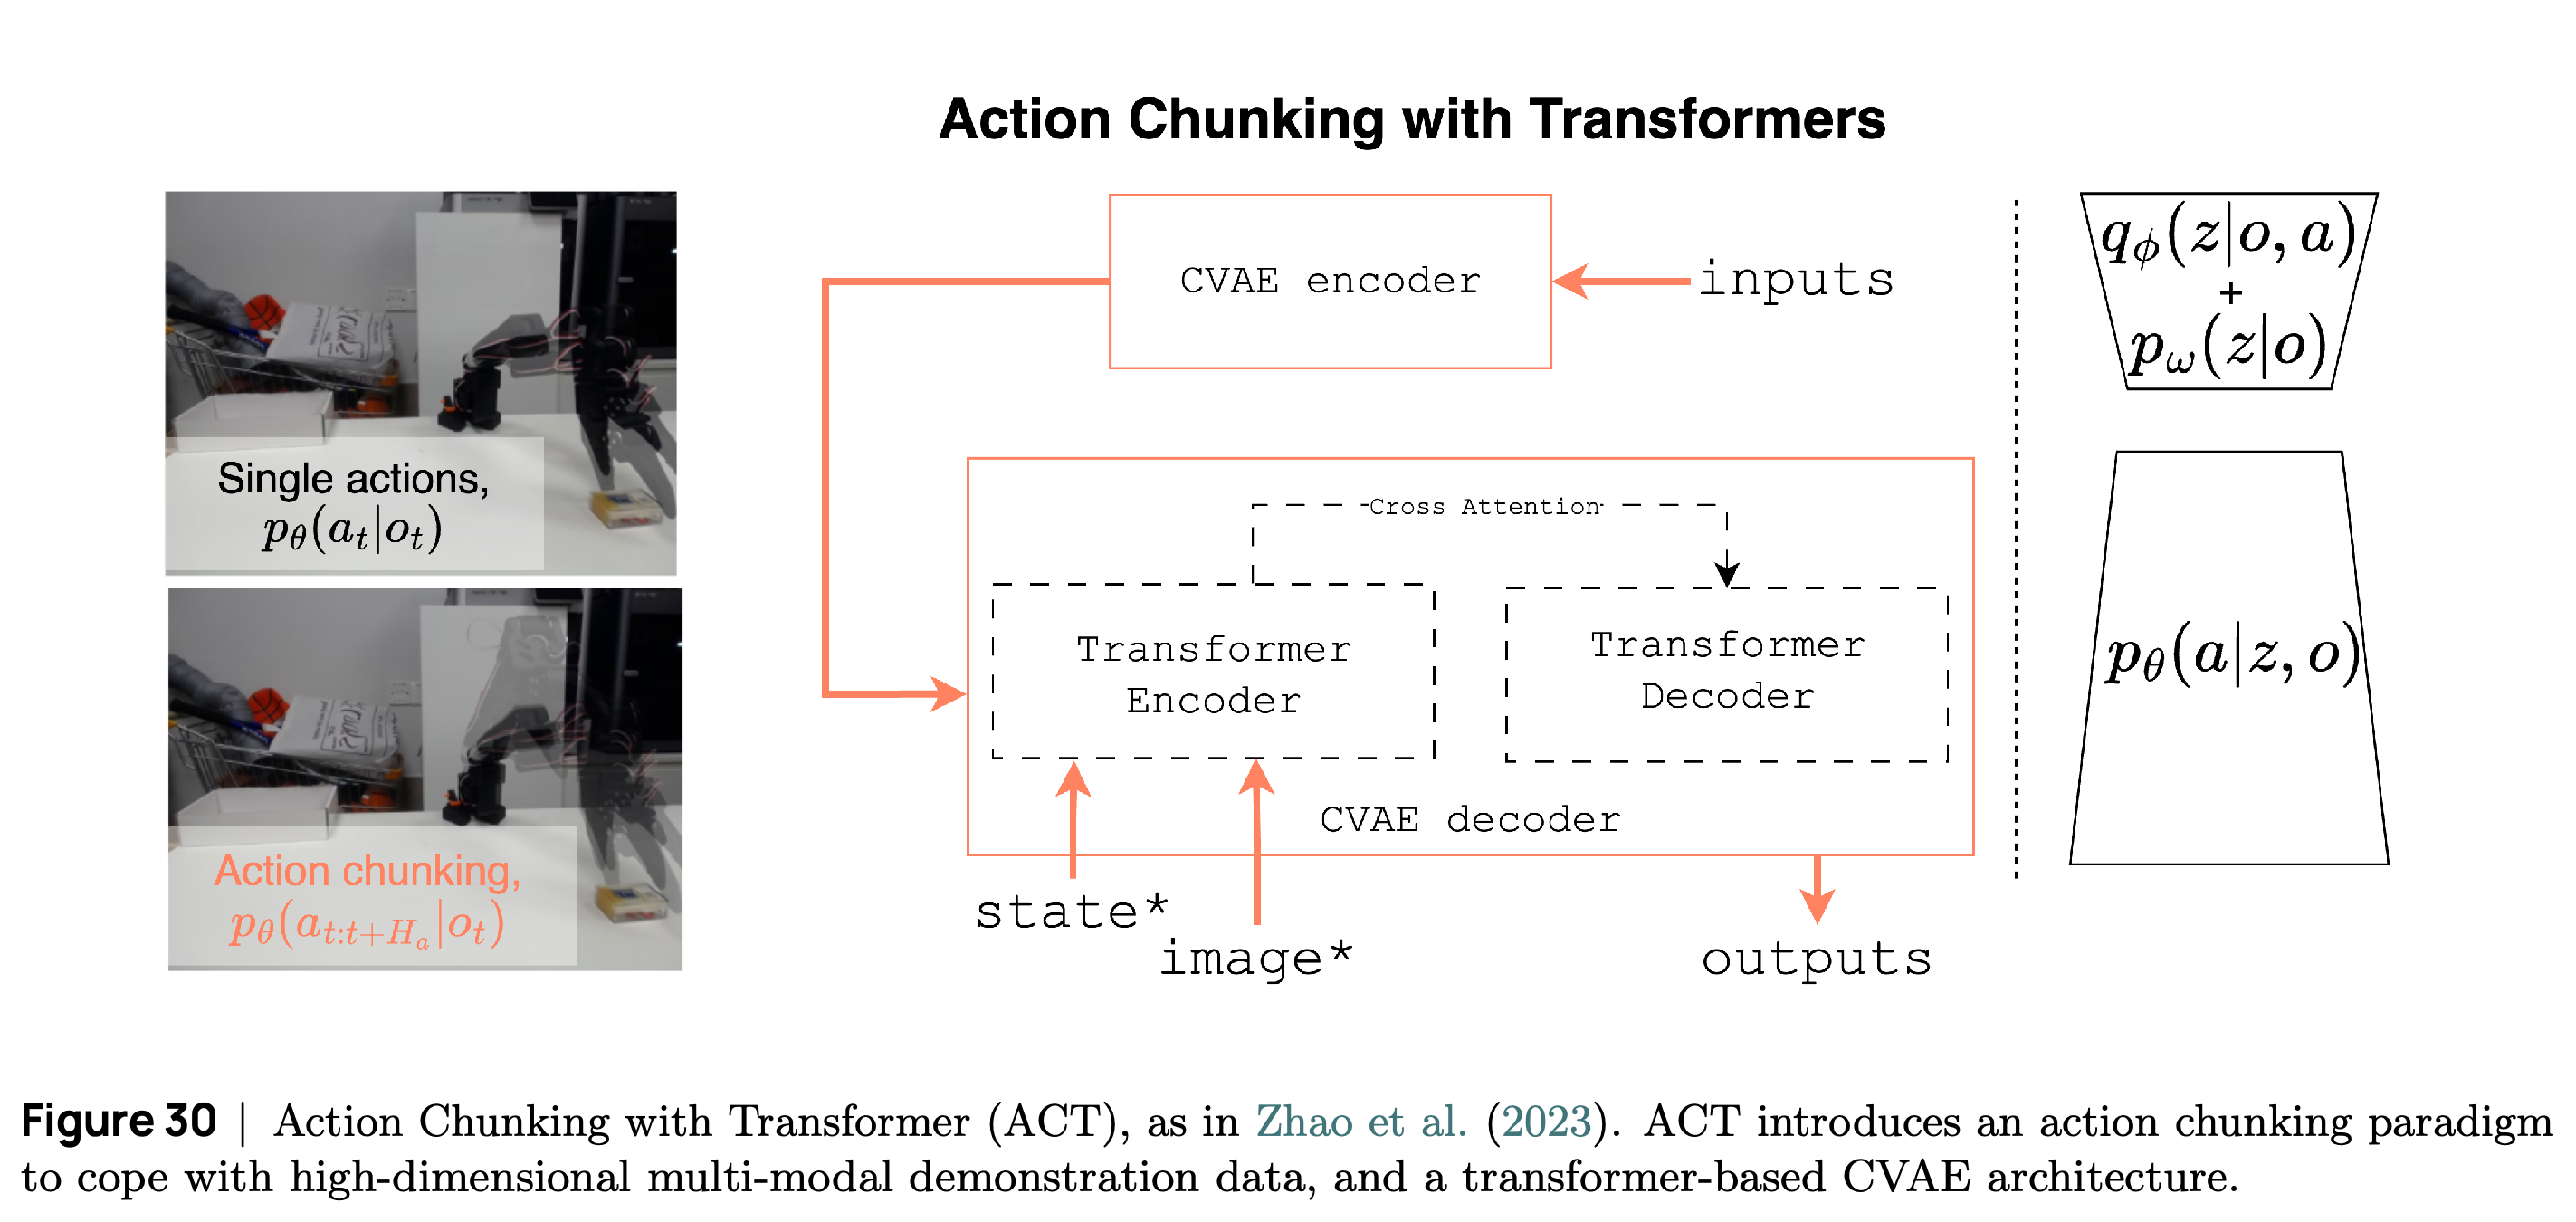
Action Chunking with Transformers (ACT)는 attention 기반 시퀀스 구조인 transformer와 관측을 조건으로 사용하는 잠재 변수 생성 모델인 Conditional VAE를 결합해 여러 미래 행동을 함께 예측한다. 튜토리얼은 Zhao et al. (2023)의 ablation에서 chunking을 사용하지 않았을 때 성공률이 1%, 사용했을 때 44%였다고 보고한다. 사람의 시연에서 변분 목적 함수를 일반적인 지도 학습으로 대체했을 때 성능 변화는 −33.3%였다. 스크립트로 생성한 시연에서는 비교한 목적 함수들의 성능이 비슷했다. 튜토리얼은 −33.3%가 상대적 변화인지 퍼센트포인트인지 명시하지 않는다.
- 인코더는 학습 중 action chunk와 로봇 상태 정보를 style 변수로 요약한다. 테스트 시에는 인코더를 제거하고 \(z=0\)을 사용한다. 디코더는 Figures 28–30이 설명하듯 이미지와 로봇 상태 관측을 입력받는다.
- 겹치는 action chunk는 예측들을 가중 결합하는 지수 이동 평균으로 합칠 수 있다. 이를 통해 새로운 관측을 반영하지 않고 행동하는 open-loop 실행을 줄일 수 있다.
- 4.2.1 Code Example: Training and Using ACT in Practice는 lerobot/svla_so101_pickplace에서 ACTConfig, ACTPolicy, 데이터셋에서 얻은 feature, 정규화, delta_timestamps를 사용한다. 제시된 학습 예제는 batch_size = 32와 training_steps = 1로 설정해 작업 과정을 보여주며, 인용된 성공률을 재현하지는 않는다. 배포 시 카메라 이름과 해상도는 학습 때와 같아야 한다.
도식은 학습 중에만 사용하는 ACT의 잠재 인코더를 관측 조건부 transformer 디코더에 연결하고 단일 행동과 행동 시퀀스를 대비한다. 인용된 chunking ablation의 기반 구조를 설명하며 성공률의 수치 비교는 주변 본문에 나온다.
4.3 Diffusion Policy
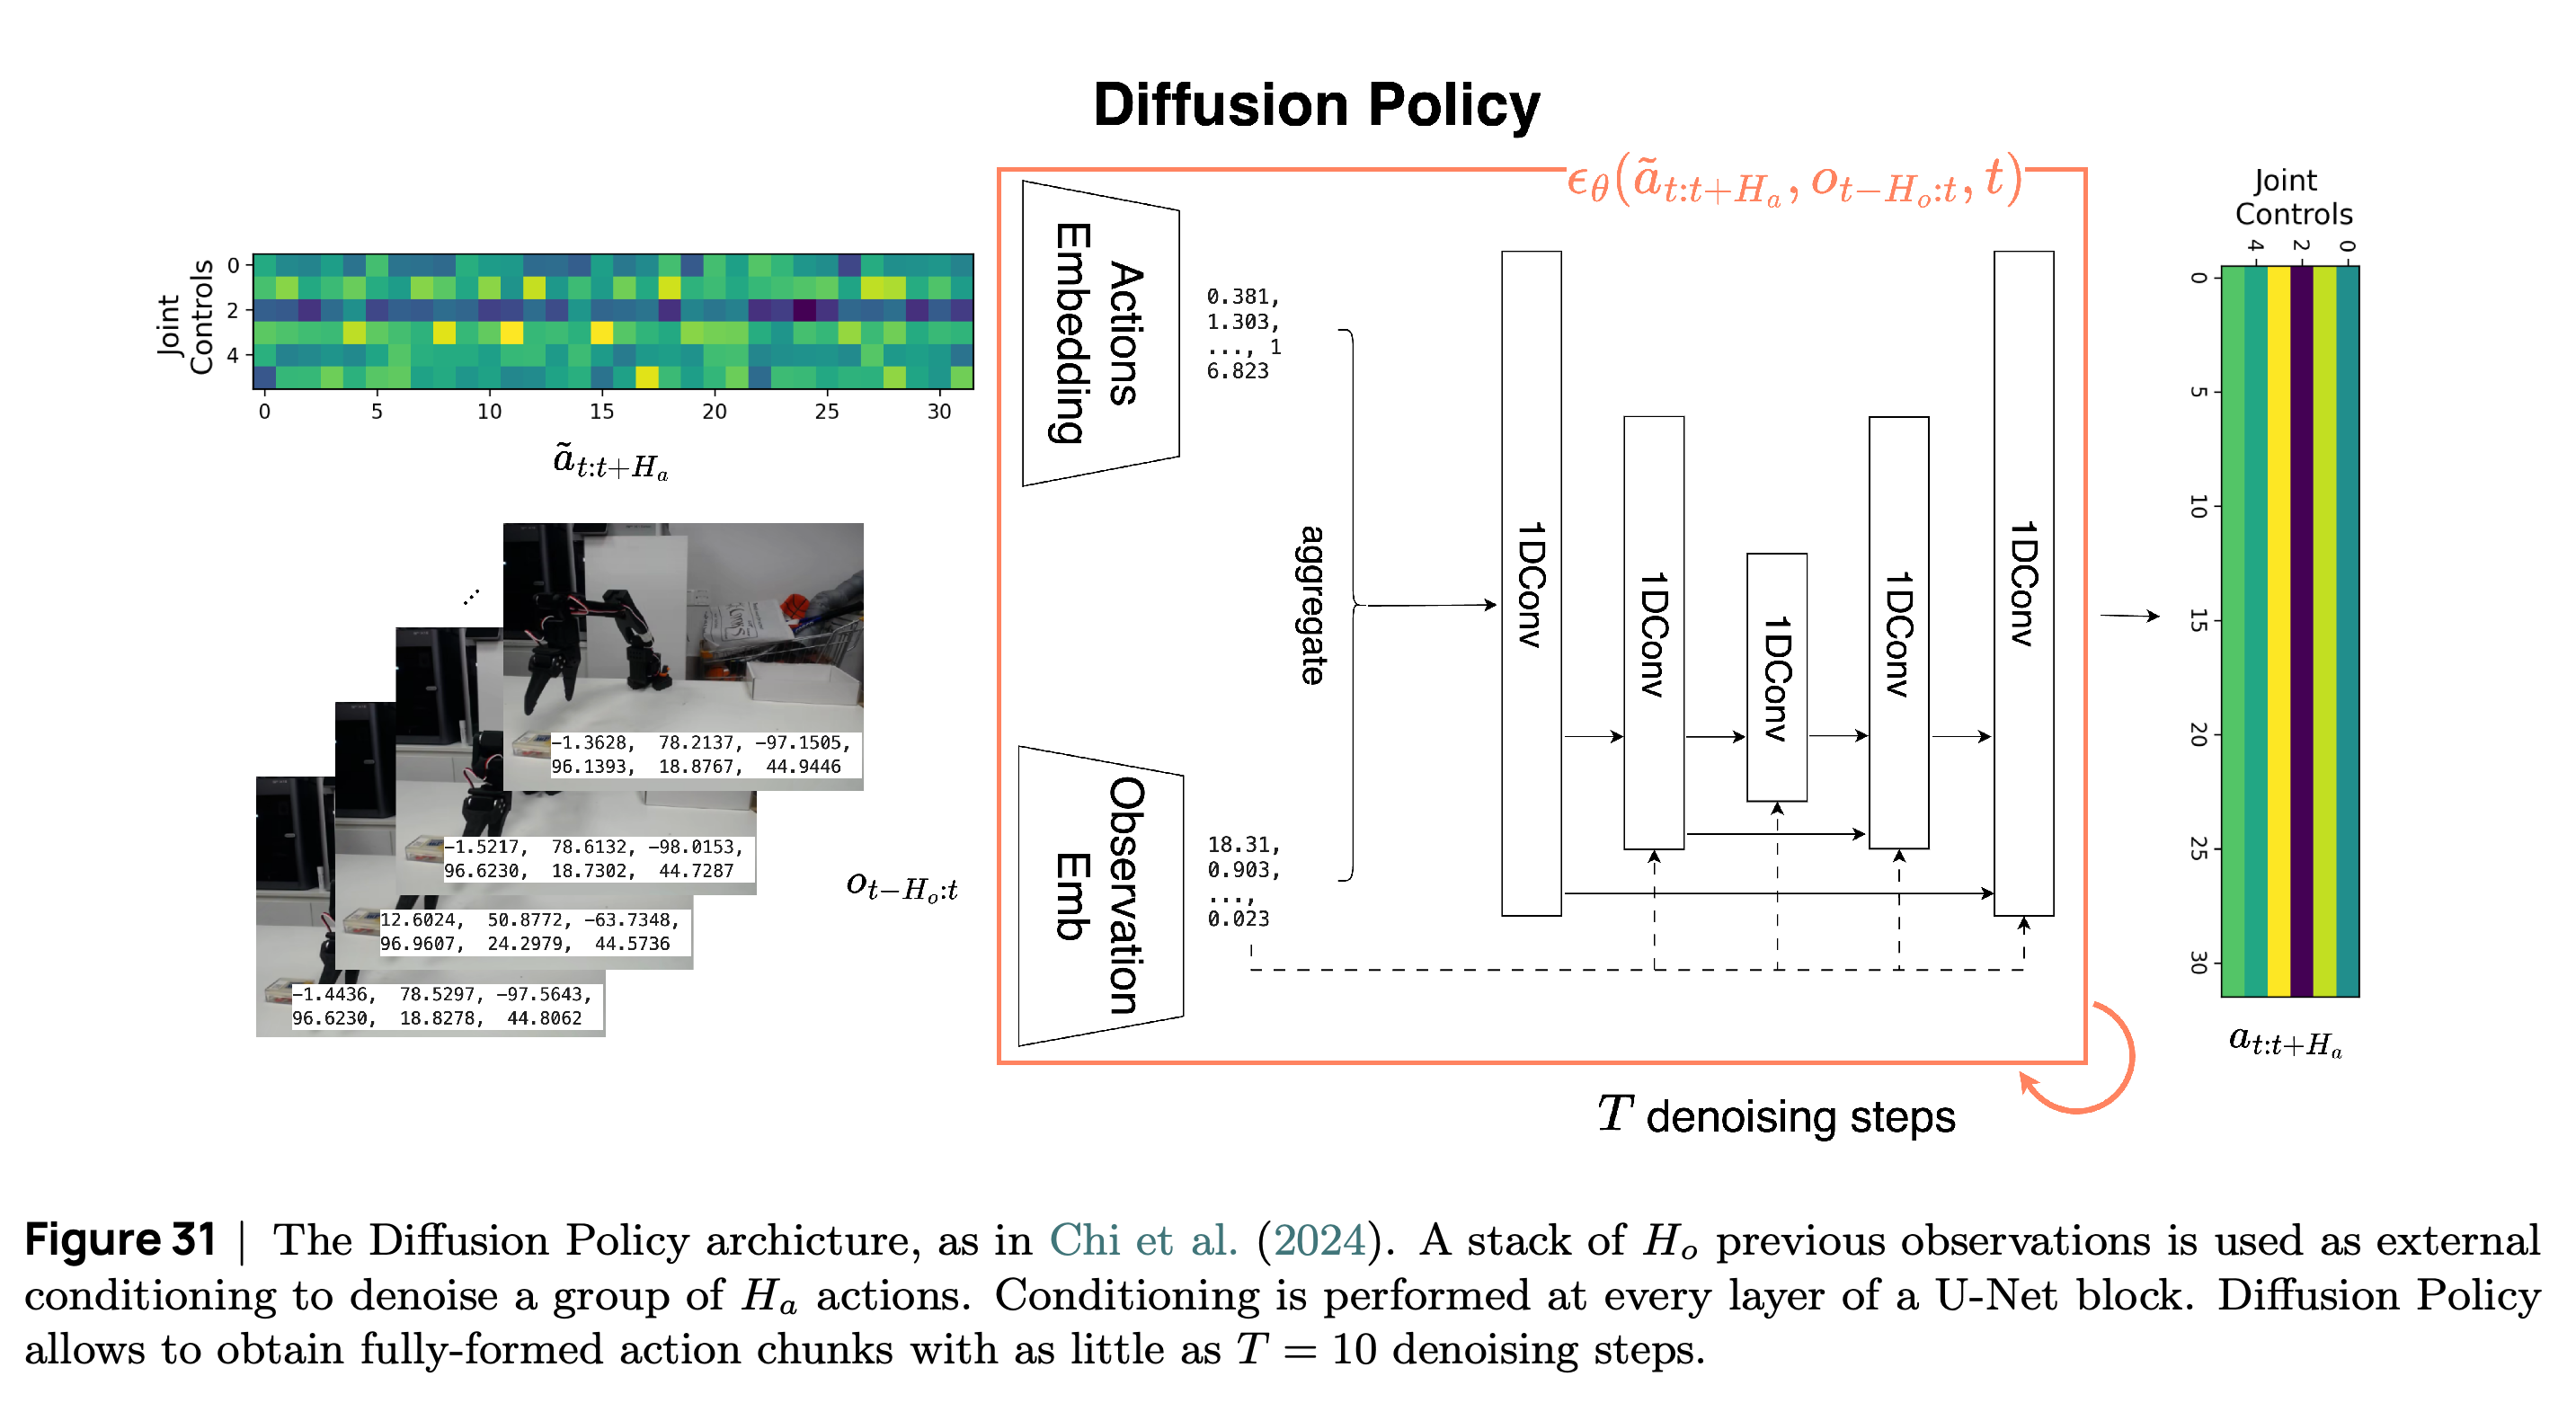
Diffusion Policy는 이미지와 로봇 상태 관측 이력을 action chunk 노이즈 예측기의 조건으로 사용하며 관측은 고정한 채 행동을 생성한다. 튜토리얼은 50–150개 시연, 약 15–60 minutes의 teleoperation으로 학습한다고 보고한다. 시각 기반 정책이 특권 정보를 사용하는 상태 기반 정책과 비슷한 성공률을 보였다는 결과는 인용된 평가에서 가져온 것이다. 특권 정보는 배포된 로봇이 사용할 수 없는 시뮬레이터 상태를 뜻한다.
- Figure 31은 대응하는 중간 계층 사이에 연결을 둔 인코더-디코더 네트워크인 convolution 기반 U-Net을 보여준다. 네트워크 전반에서 관측을 denoising의 조건으로 사용한다. Action chunk는 최소 \(T=10\) denoising 단계로 생성할 수 있다.
- Denoising Diffusion Implicit Models는 여기서 설명하는 결정론적 샘플링 방식을 제공하며 참조된 확률적 방식보다 denoising 단계가 10배 적다. Transformer 예측기는 높은 성능을 낼 수 있지만 하이퍼파라미터에 더 민감하다. 튜토리얼은 convolution 기반 예측기를 출발점으로 권장하면서 천천히 변하는 저주파 행동 성분에 편향될 수 있다고 설명한다.
- 4.3.1 Code Example: Training and Using Diffusion Policies in Practice는 관측 및 행동 구간과 함께 DiffusionConfig와 DiffusionPolicy를 사용한다. batch_size = 32와 training_steps = 1은 설명용 설정이다. 배포 예제는 체크포인트를 불러오고 전처리 및 후처리를 적용한 뒤 로봇에 행동을 전달한다.
노이즈가 섞인 행동 시퀀스와 관측 이력이 조건부 denoising 네트워크에 입력되며, 네트워크는 시퀀스를 반복해서 정제한다. 네트워크 내부의 조건부 처리는 Diffusion Policy가 관측된 이미지와 상태를 고정한 채 미래 행동을 생성하는 방식을 설명한다.
4.4 Optimized Inference
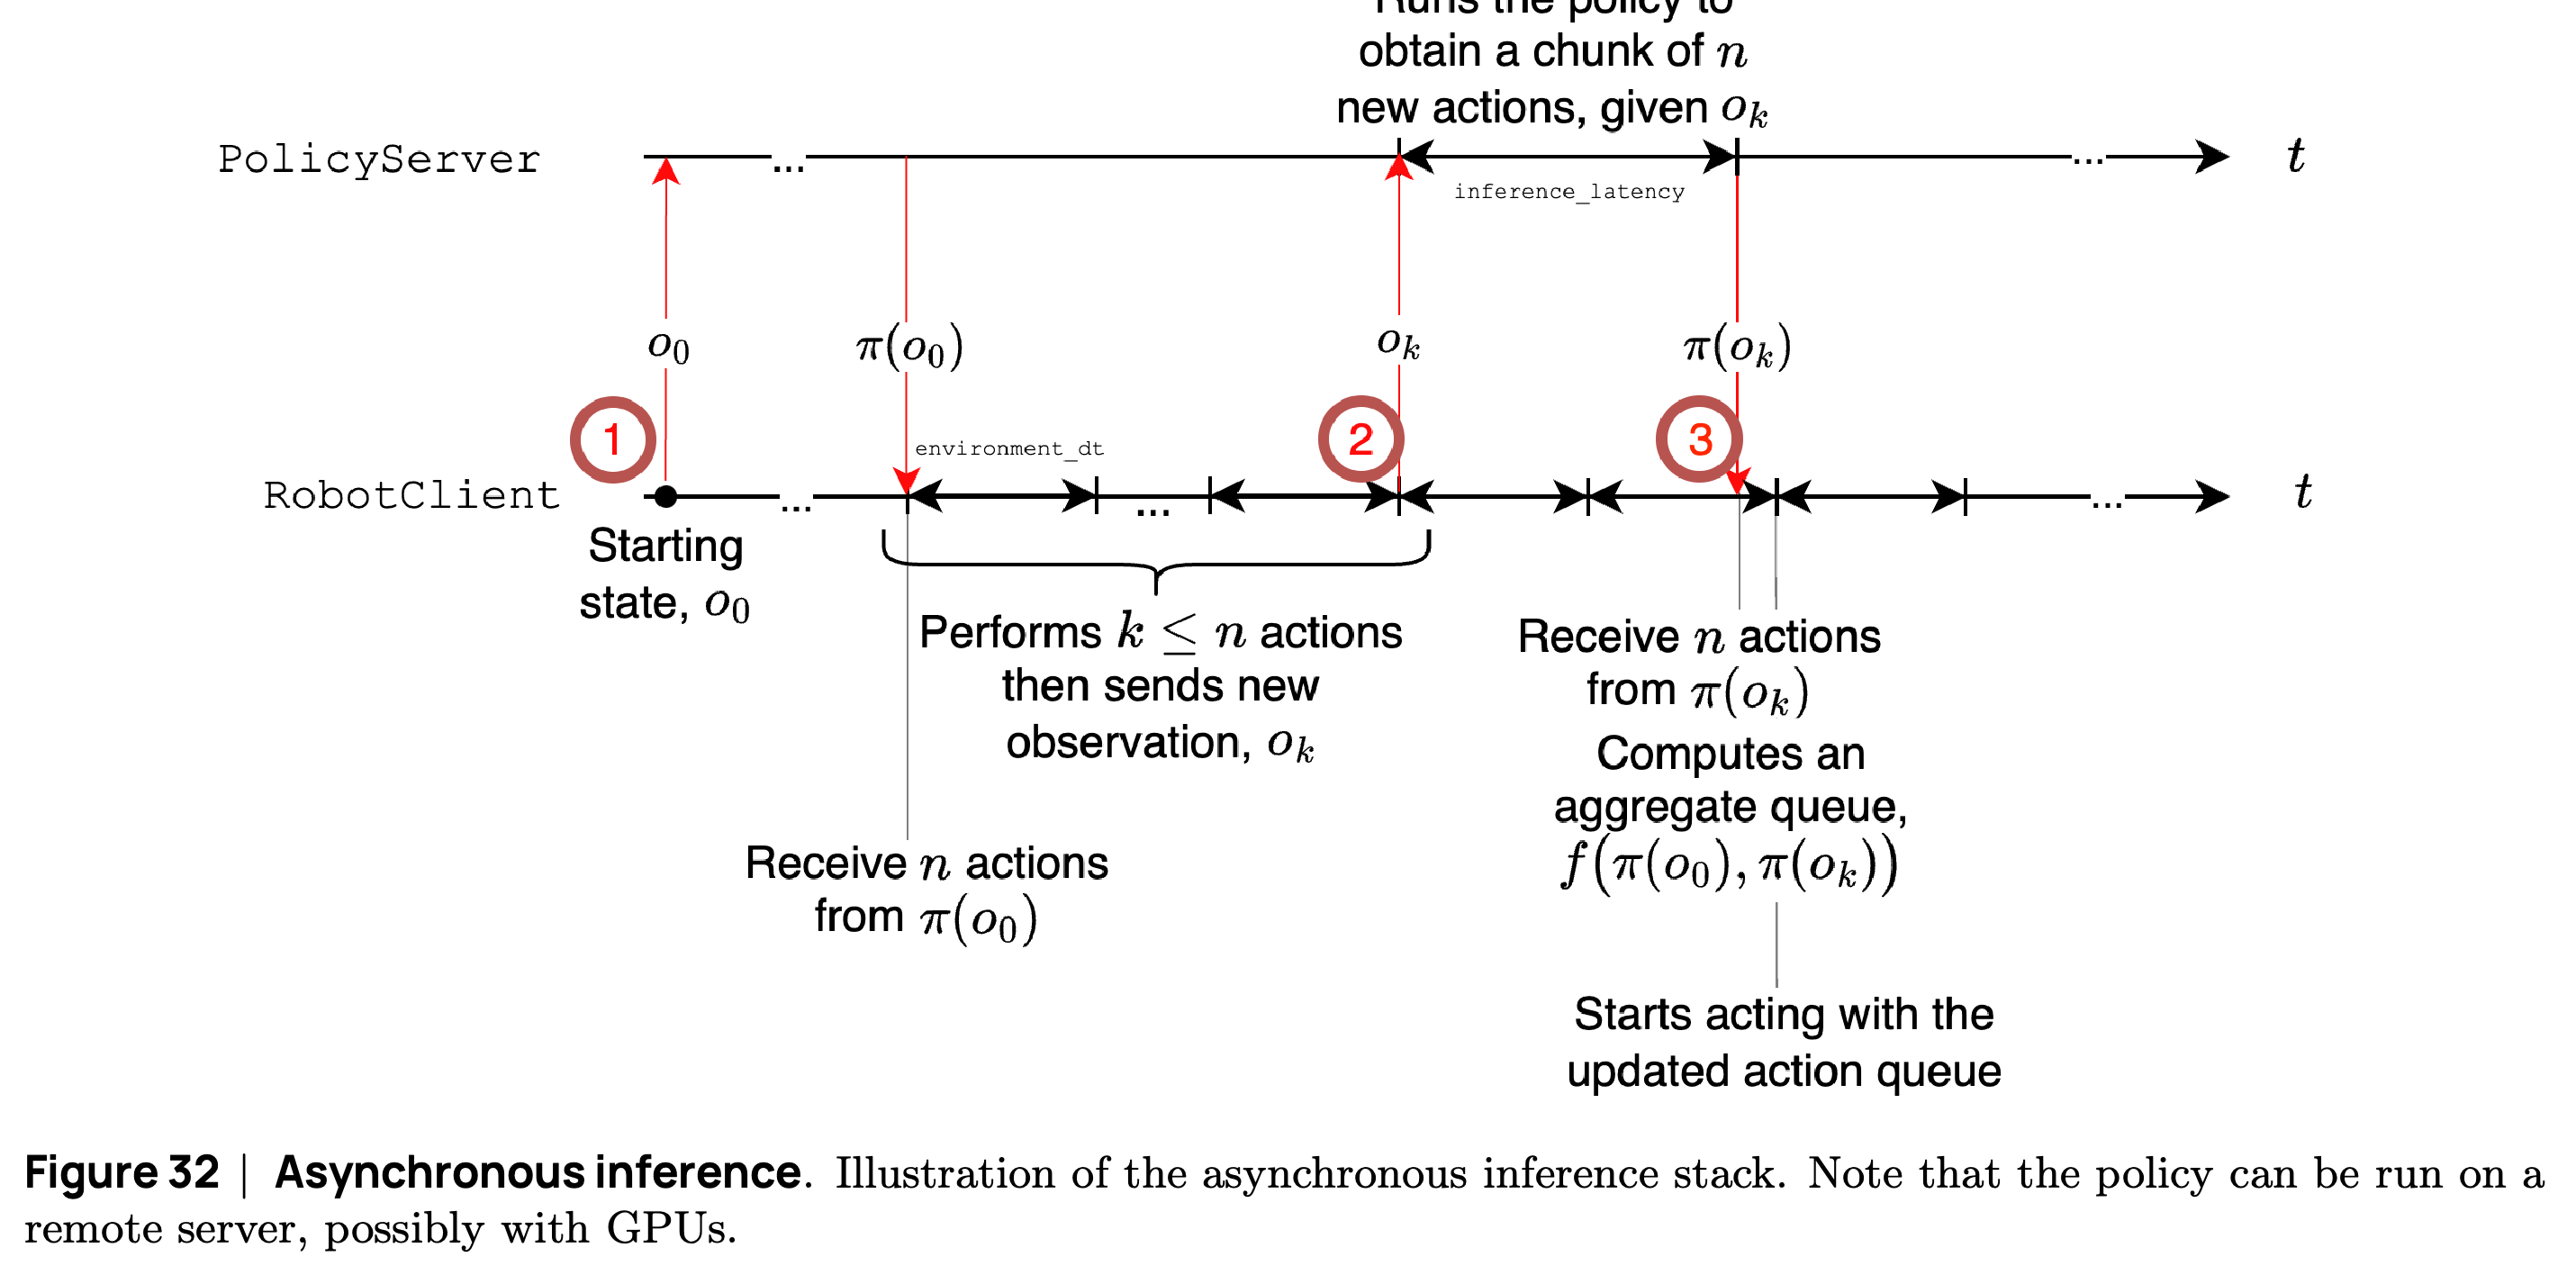
Optimized Inference는 action chunk 예측과 실행을 분리한다. PolicyServer가 대체할 chunk를 계산하는 동안 RobotClient는 큐에 있는 행동을 실행할 수 있으며 서버를 다른 기계에서 실행할 수도 있다. Figures 32와 33은 예측 빈도, 계산 비용, 행동 큐가 비는 상황 사이의 절충을 설명한다. 실행이 멈추지 않으려면 사용 가능한 행동을 모두 소진하기 전에 대체 chunk가 도착해야 한다.
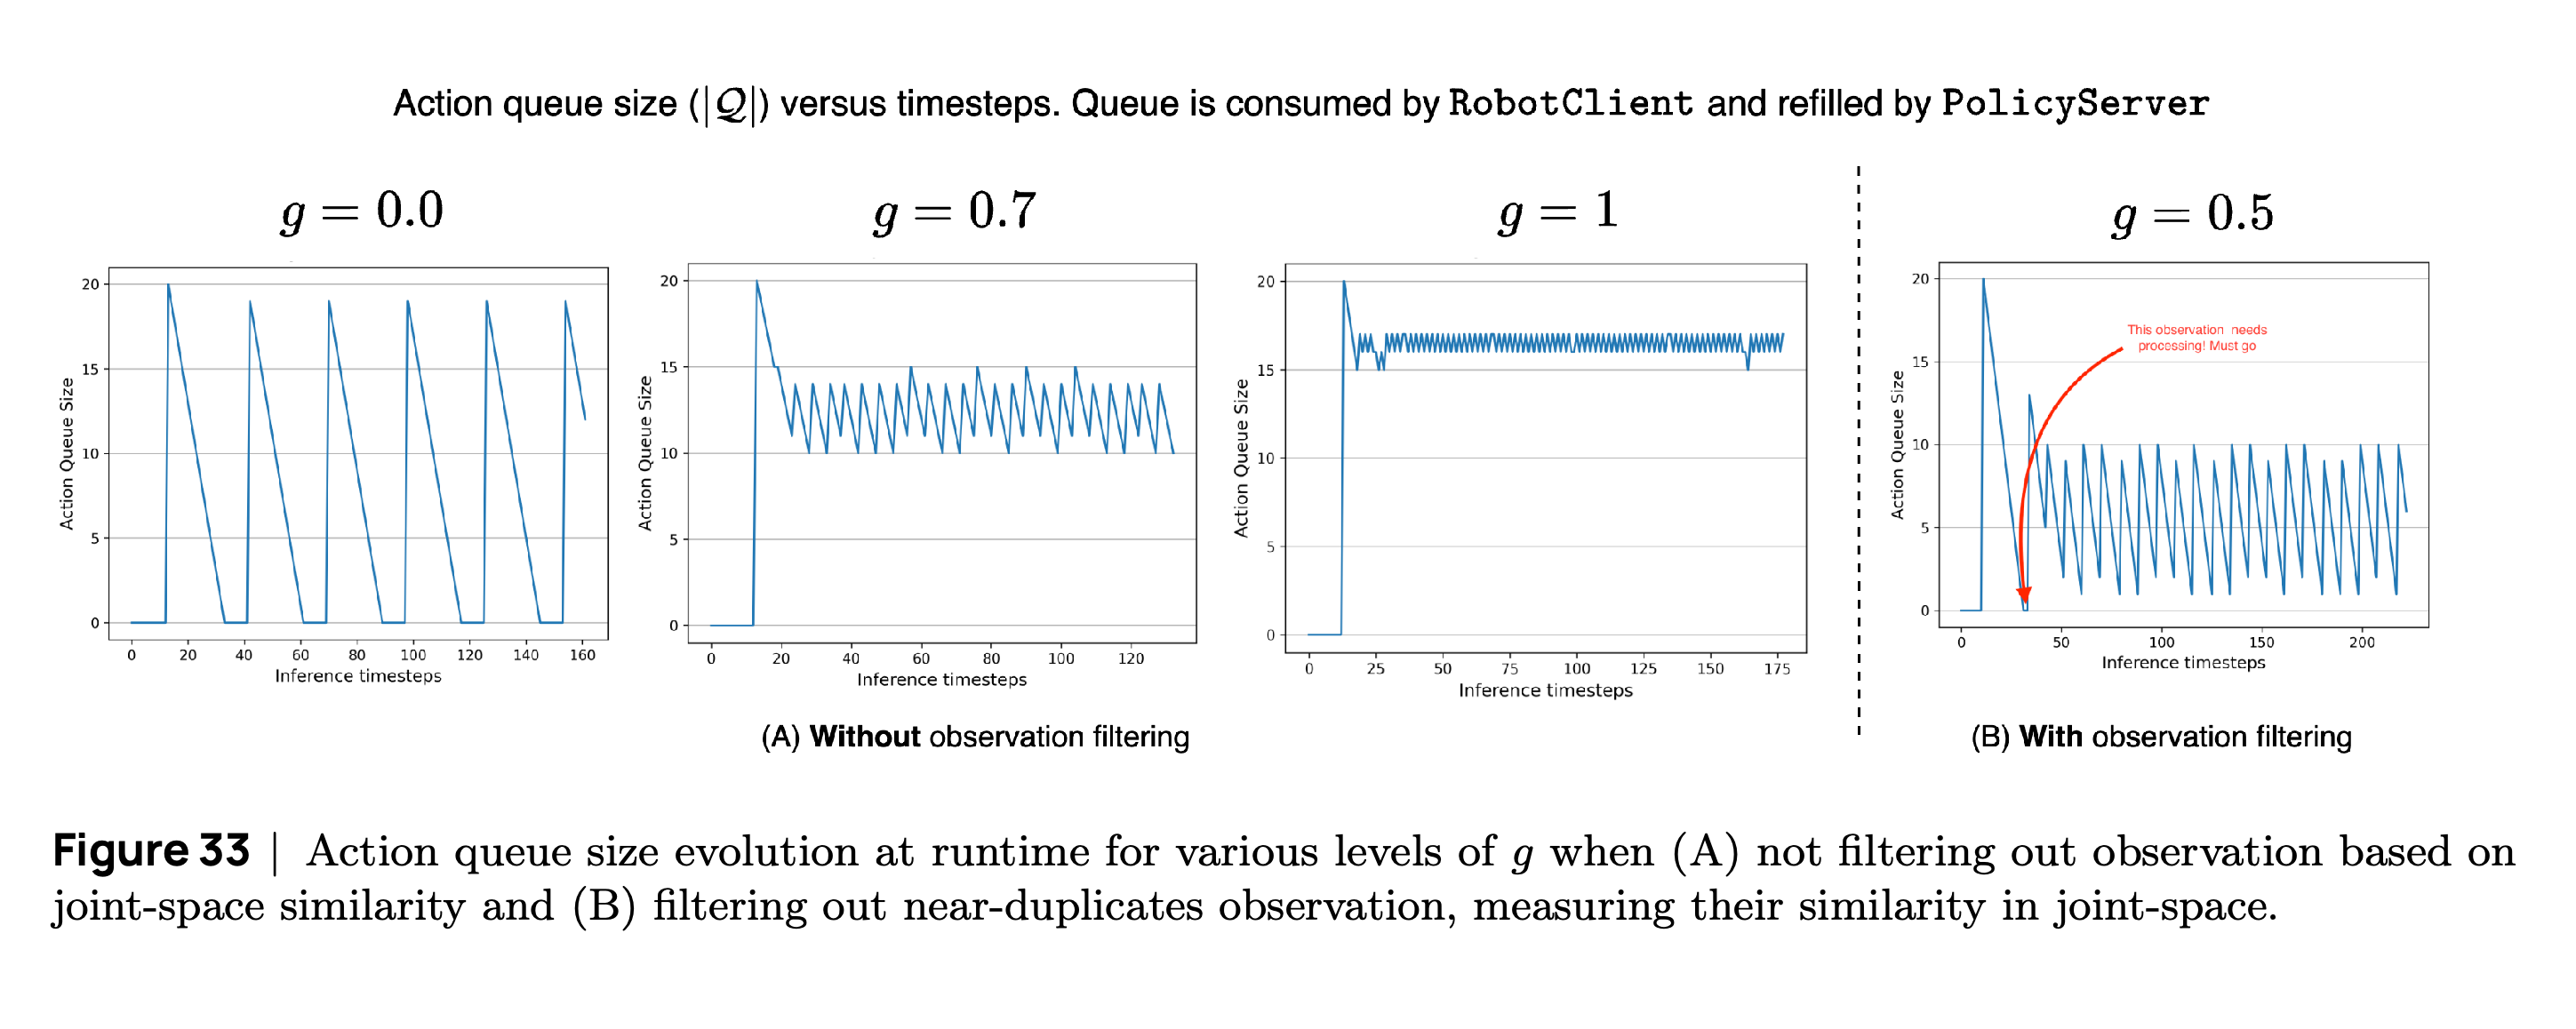
- |Aₜ|/Hₐ < g일 때 새 추론을 시작한다. Hₐ는 chunk 크기이고 \(g\in[0,1]\)는 큐 임계값이다. 거의 중복되는 관측은 관절 구성 사이의 거리인 joint-space distance로 걸러내지만 큐가 비면 최신 관측을 반드시 처리한다.
- 논문은 초당 30프레임에서 \(\Delta t=33\,\mathrm{ms}\)를 사용한다. 통신 시간이 서버 추론 지연 ℓₛ에 비해 무시할 만큼 작다고 가정하고 큐가 소진되지 않기 위한 평균 지연 조건으로 g ≥ E[ℓₛ]/(HₐΔt)를 제시한다. 지연의 기댓값을 사용하는 조건이므로, 지연이 변동할 때 큐에 항상 행동이 남아 있음을 보장하지는 않는다.
- 4.4.1 Code Example: Using Async Inference는 PolicyServerConfig와 RobotClientConfig에 policy_type=”smolvla”, pretrained_name_or_path=”fracapuano/smolvla_async”, chunk_size_threshold=0.5, actions_per_chunk=50을 설정한다. 이후 제어 루프와 함께 행동 수신 스레드를 실행한다. 카메라 사양은 정책과 일치해야 하며, actions_per_chunk는 정책이 지원하는 최대 행동 수보다 작아야 한다.
타임라인은 서버가 추론하는 동안 클라이언트가 사용 가능한 행동을 실행하고 반환된 chunk를 큐에 남은 행동과 결합하는 모습을 보여준다. 이 중첩은 현재 시퀀스가 끝나기 전에 예측을 시작하는 방식과 별도 정책 서버가 제어 루프를 지원하는 방식을 설명한다.
곡선들은 관측 필터링 없이 g = 0.0, g = 0.7, g = 1을 사용한 경우와, 필터링을 적용해 g = 0.5를 사용한 경우를 비교한다. 큐가 비었을 때의 실행 중단, 더 이른 행동 보충, 큐가 비면 유사한 관측도 강제로 처리하는 동작을 보여준다.
5 Generalist Robot Policies
Generalist Robot Policies는 개별 과제에서 여러 과제, 환경, embodiment에 걸쳐 학습한 정책으로 논의를 확장한다. 더 폭넓은 데이터로 사전 학습한 뒤 과제에 맞게 적응시키는 방식이 중심이다. 사전 학습된 인지 모델, 표현력이 높은 행동 생성 모델, 통합된 시연 데이터셋이 이를 뒷받침한다.
5.1 Preliminaries: Models and Data
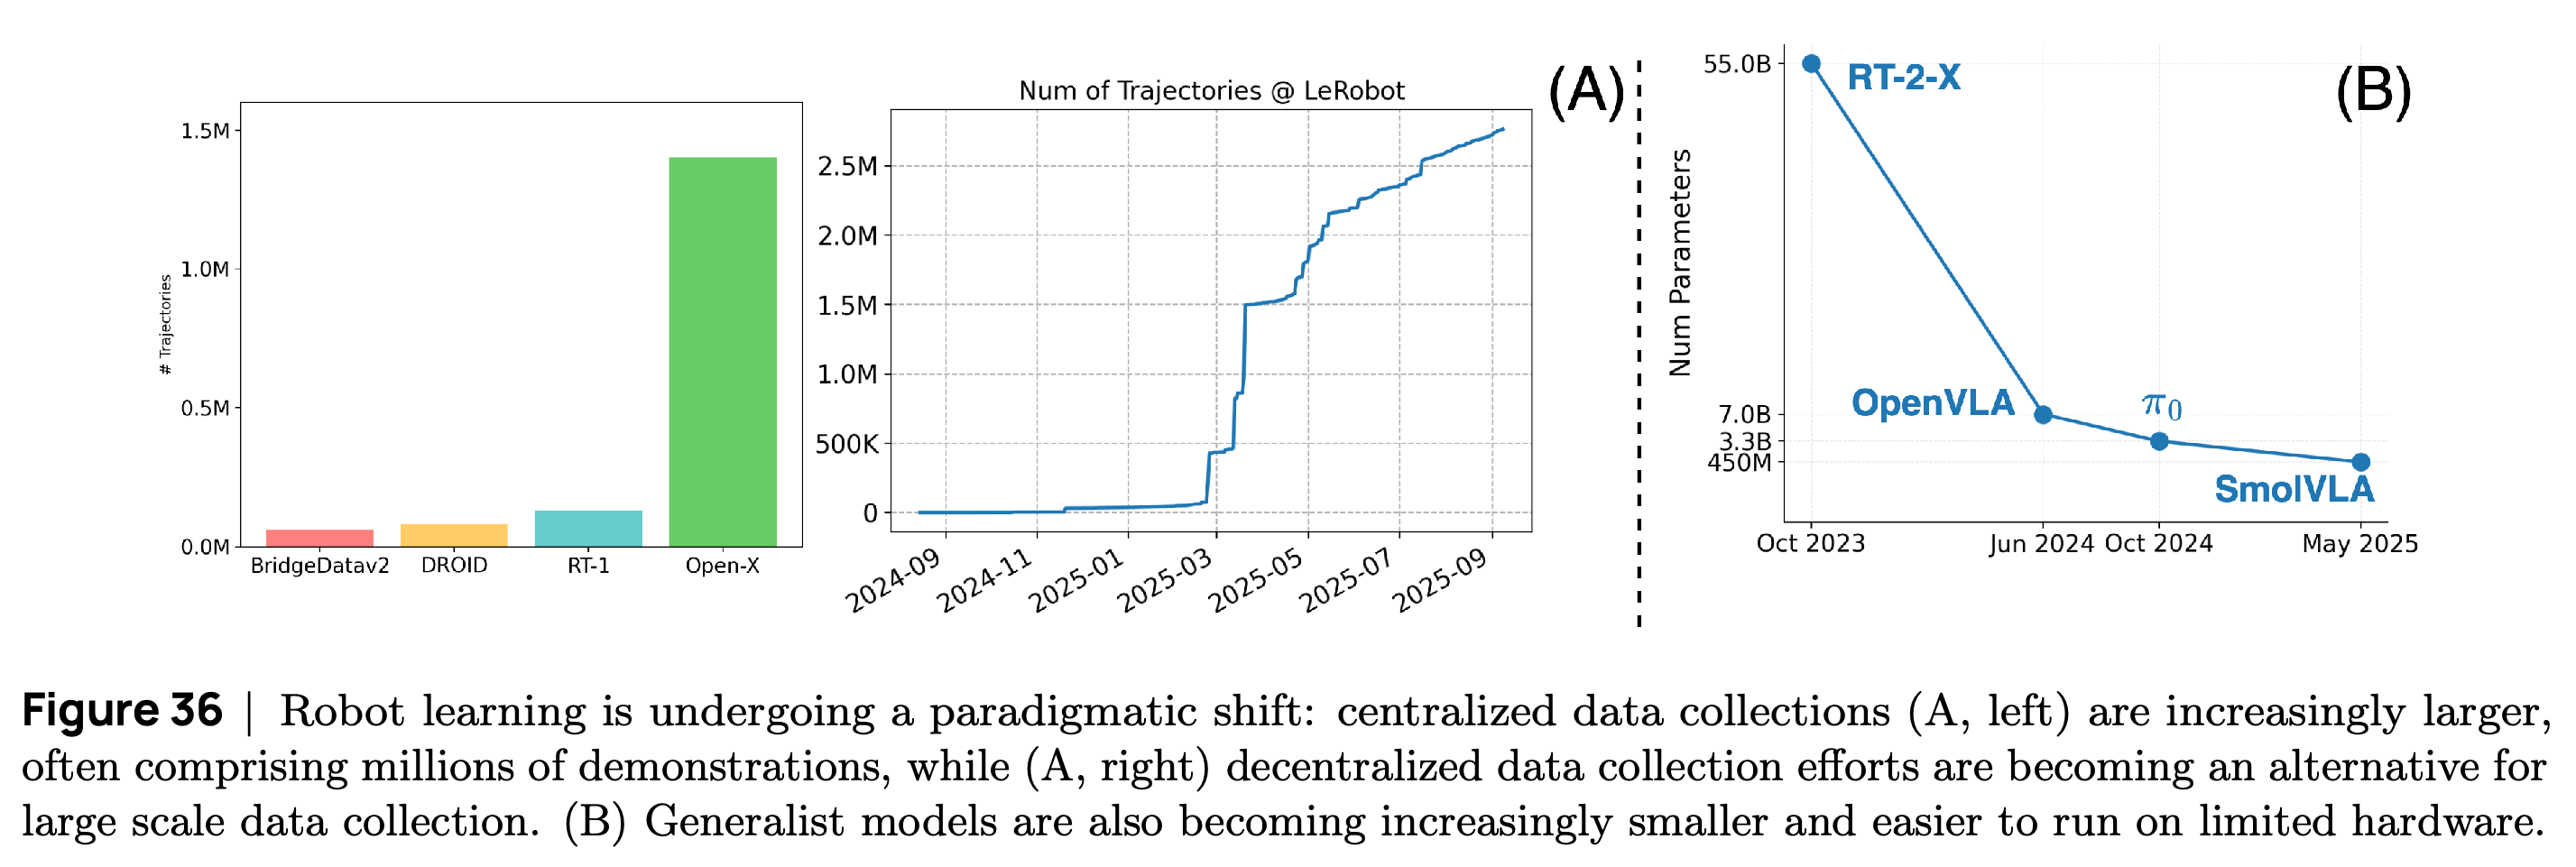
로봇 데이터는 수집 비용이 높고 하드웨어 및 작동 조건에 종속된다. 따라서 데이터를 통합할 때는 이질적인 상태와 행동 표현, 데이터 결합이 성능을 떨어뜨리는 negative transfer 가능성을 다뤄야 한다. 튜토리얼은 시연으로 학습한 잠재 변수 정책 BC-Zero에서 Robotics Transformer 1 (RT-1), RT-2, 공개 VLA 모델로 이어지는 발전을 설명한다. RT-1은 로봇 13대로 17개월 동안 수집한 trajectory 130k개로 학습했다고 소개한다. RT-2는 웹 데이터와 로봇 데이터를 결합해 시각적, 의미적 지식을 재사용한다.
- Open X-Embodiment는 로봇 embodiment 22종과 기관 21곳의 데이터셋 60개를 통합해 trajectory 1.4M개를 제공한다. 인용된 연구는 여러 embodiment로 학습한 모델이 각 단일 embodiment 데이터셋으로 학습한 전문 모델보다 높은 성능을 낼 수 있다고 보고한다.
- Distributed Robot Interaction Dataset (DROID)은 현실적인 조작 환경에서 수집한 사람의 시연 75k+개를 포함한다. OpenVLA는 Open-X trajectory 970k+개를 사용하고 가중치와 학습 방법을 공개한다. 또한 제어를 범주형으로 표현하는 이산 행동 토큰을 256개 수준으로 예측한다.
- Figure 36은 중앙 집중 및 커뮤니티 데이터 수집량의 증가와 일부 모델의 매개변수 수 감소를 대비한다. 이 사례들은 접근성에 관한 논의를 뒷받침하지만 매개변수 수가 배포 성능에 미치는 영향을 따로 측정하지는 않는다.
데이터 패널은 시간에 따른 중앙 집중 trajectory 수집과 커뮤니티 수집을 비교하고 모델 패널은 일부 모델의 매개변수 수가 감소하는 모습을 보여준다. 그림은 접근성의 역사적 변화에 관한 논의를 뒷받침하지만 동일 조건의 과제 성능이나 실행 비용을 측정하지는 않는다.
5.2 VLAs
여기서 다루는 현대 VLA는 이미지와 텍스트를 함께 처리하는 Vision-Language Model (VLM)에 연속 action chunk를 예측하는 전문 구성 요소인 action expert를 결합한다. 튜토리얼은 통합된 transformer 안에서 별도 매개변수 집합을 사용하는 구조를 Mixture of Experts로 설명한다. 시각적, 의미적 처리와 로봇 제어에 서로 다른 가중치를 할당한다. 이 설명은 π₀와 SmolVLA에 해당하며 튜토리얼의 앞부분에서 다룬 모델들은 이산 행동을 예측한다.
- 5.2.1 VLMs for VLAs는 이미지를 feature로 변환하는 사전 학습된 vision encoder와 대규모로 학습한 텍스트 모델인 large language model을 결합하는 방법을 설명한다. 이미지-텍스트 데이터로 학습한 뒤 지도 방식의 instruction fine-tuning을 수행한다.
- 제시하는 이점은 시각적, 의미적 표현을 재사용해 로봇 지시를 해석하고 물체를 인식할 수 있다는 점이다. 본문은 새로운 상황으로의 일반화를 가능성으로 제시하며 배포를 위한 효율적인 계산을 강조한다.
5.3 π₀
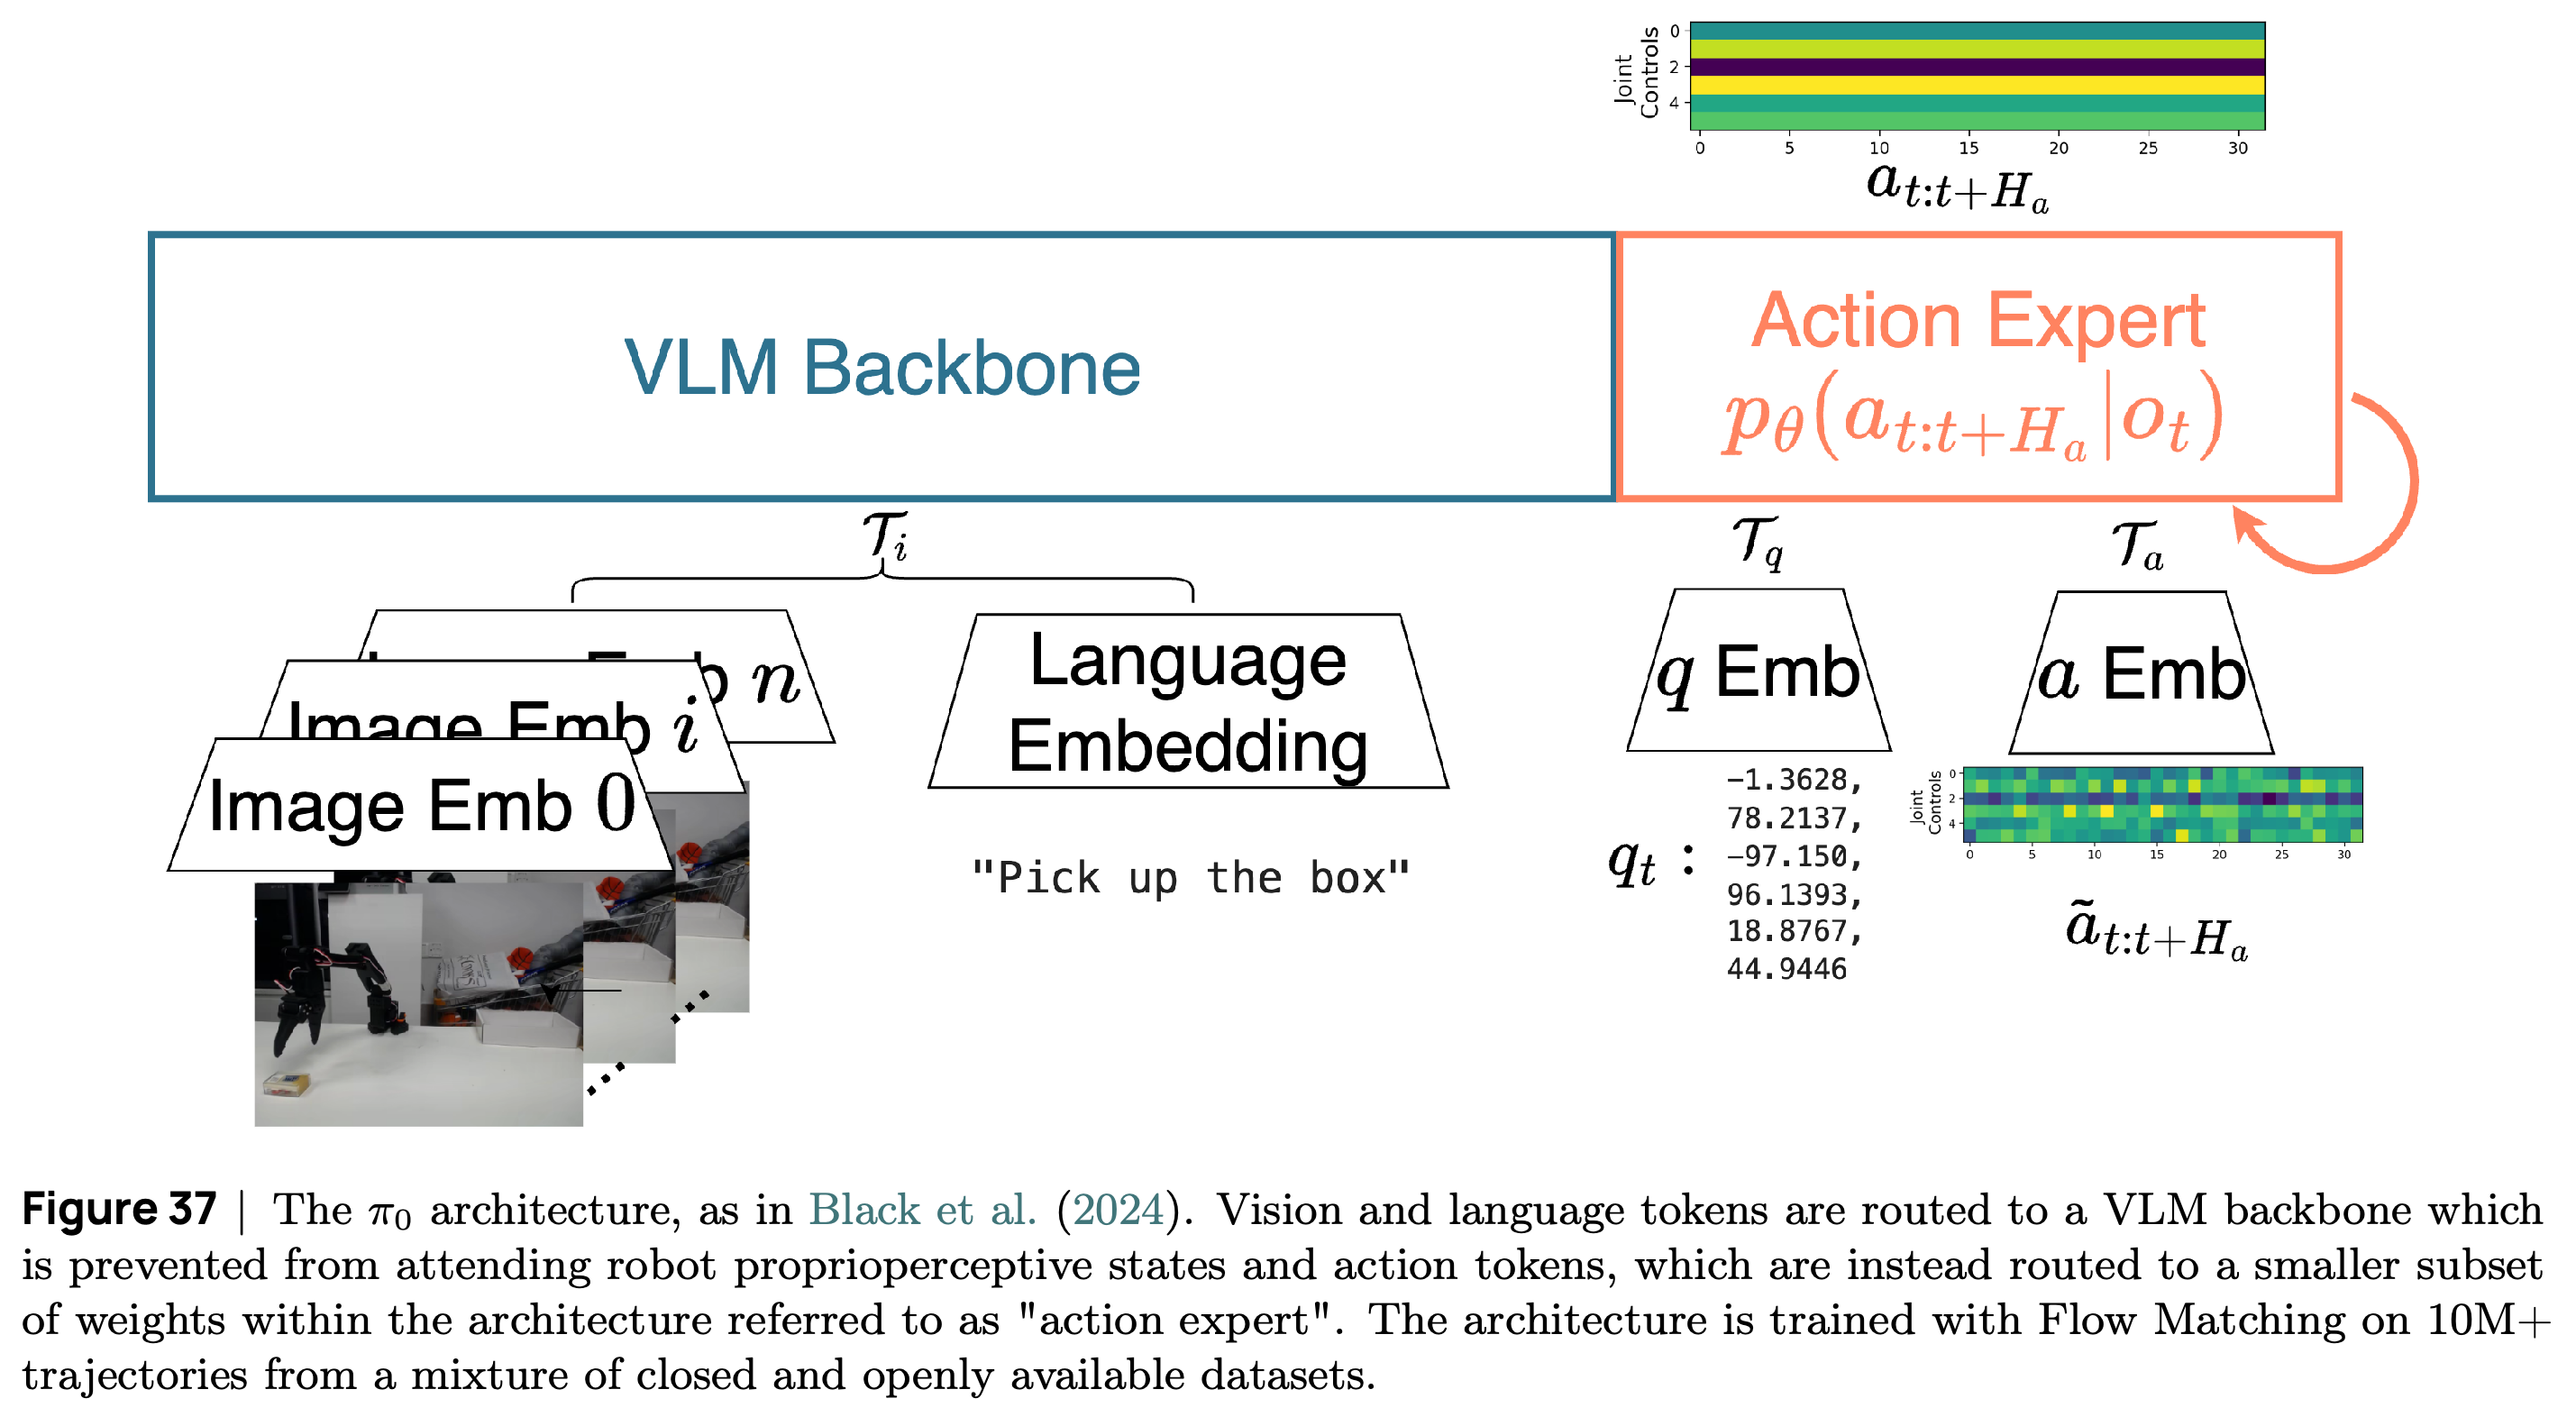
π₀는 PaliGemma vision-language backbone에 300M-parameter action expert를 결합한다. Action expert는 flow matching으로 연속 action chunk를 생성한다. Figure 37은 이미지-언어, 로봇 상태, 행동 토큰 블록을 분리해 보여준다. 각 블록 내부의 attention은 허용하고 뒤쪽 블록에 대한 접근은 차단하는 blockwise causal masking은 이미지-언어 토큰이 로봇 상태 및 행동 토큰에 attention하지 못하게 한다. 이를 통해 반복 생성 중 캐시한 attention 정보를 재사용할 수 있다.
- π 데이터셋은 trajectory 10M+개를 포함하며 약 9.1%가 공개되어 있다. 시연은 로봇 구성 7종과 과제 68개에 걸쳐 있다. 튜토리얼은 인용된 벤치마크에서 사전 학습 후 fine-tuning한 모델이 처음부터 학습한 과제별 π₀ 모델보다 일관되게 높은 성능을 보였다고 보고한다. 다만 사전 학습 데이터의 상당 부분은 공개되지 않았다.
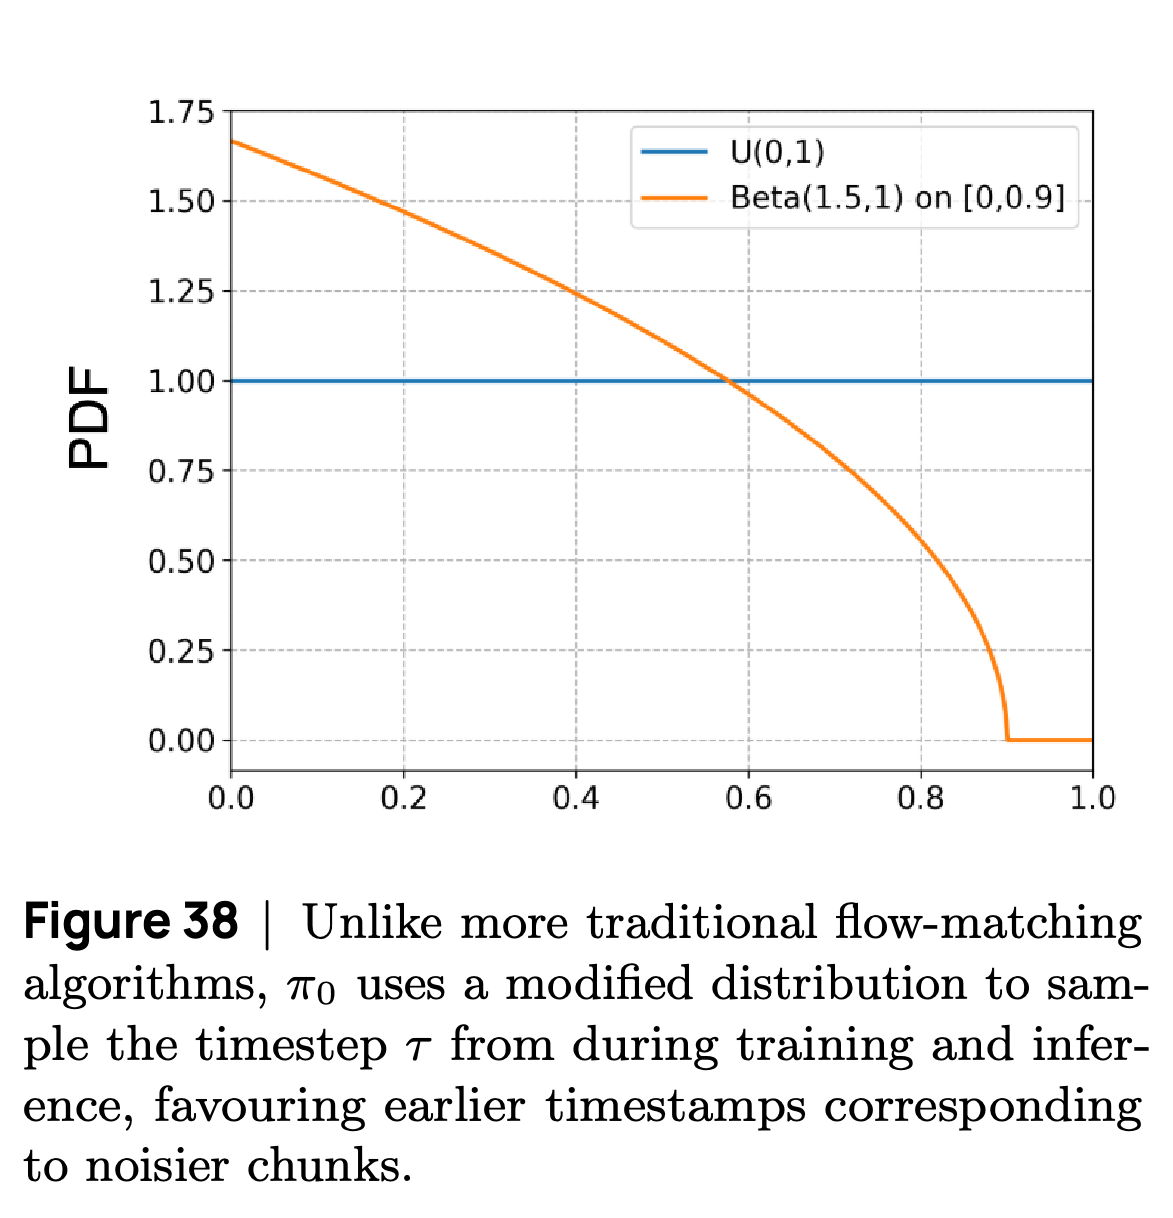
- 추론은 최소 10번의 flow 적분 단계로 수행할 수 있다. Figure 38은 노이즈가 더 많은 action chunk를 강조하기 위해 수정한 학습 시 timestep 샘플링을 보여준다. 본문은 행동 학습의 gradient가 vision-language backbone을 바꾸도록 허용하면 성능이 저하될 수 있다는 후속 근거도 인용한다.
- 5.3.1 Code Example: Using π₀는 PI0Policy로 lerobot/pi0_base를 불러오고, 과제 설명과 robot_type을 제공하며 카메라 슬롯 3개를 설정한다. 모델은 운동 변수가 적은 로봇을 0 패딩으로 처리하고 카메라 시점이 적으면 해당 슬롯을 마스킹한다. 배포 시 카메라 사양은 정책과 일치해야 한다.
이미지와 지시는 vision-language backbone에 입력되고 로봇 상태와 노이즈가 섞인 행동은 action expert에 입력된다. 이러한 분리와 attention 제한은 각 구성 요소의 전문화와 행동 정제 단계에 걸쳐 이미지-언어 attention 정보를 캐시해 재사용할 수 있는 이유를 설명한다.
밀도 그래프는 균일 샘플링과 π₀에 대해 설명한 수정 timestep 샘플링을 대비한다. 노이즈가 더 많은 action chunk를 강조하려는 의도를 보여준다. 다만 튜토리얼에 명시된 Beta(1.5,1) 분포와 감소하는 그래프 곡선은 명확하고 일관된 수학적 정의를 제공하지 않는다.
5.4 SmolVLA
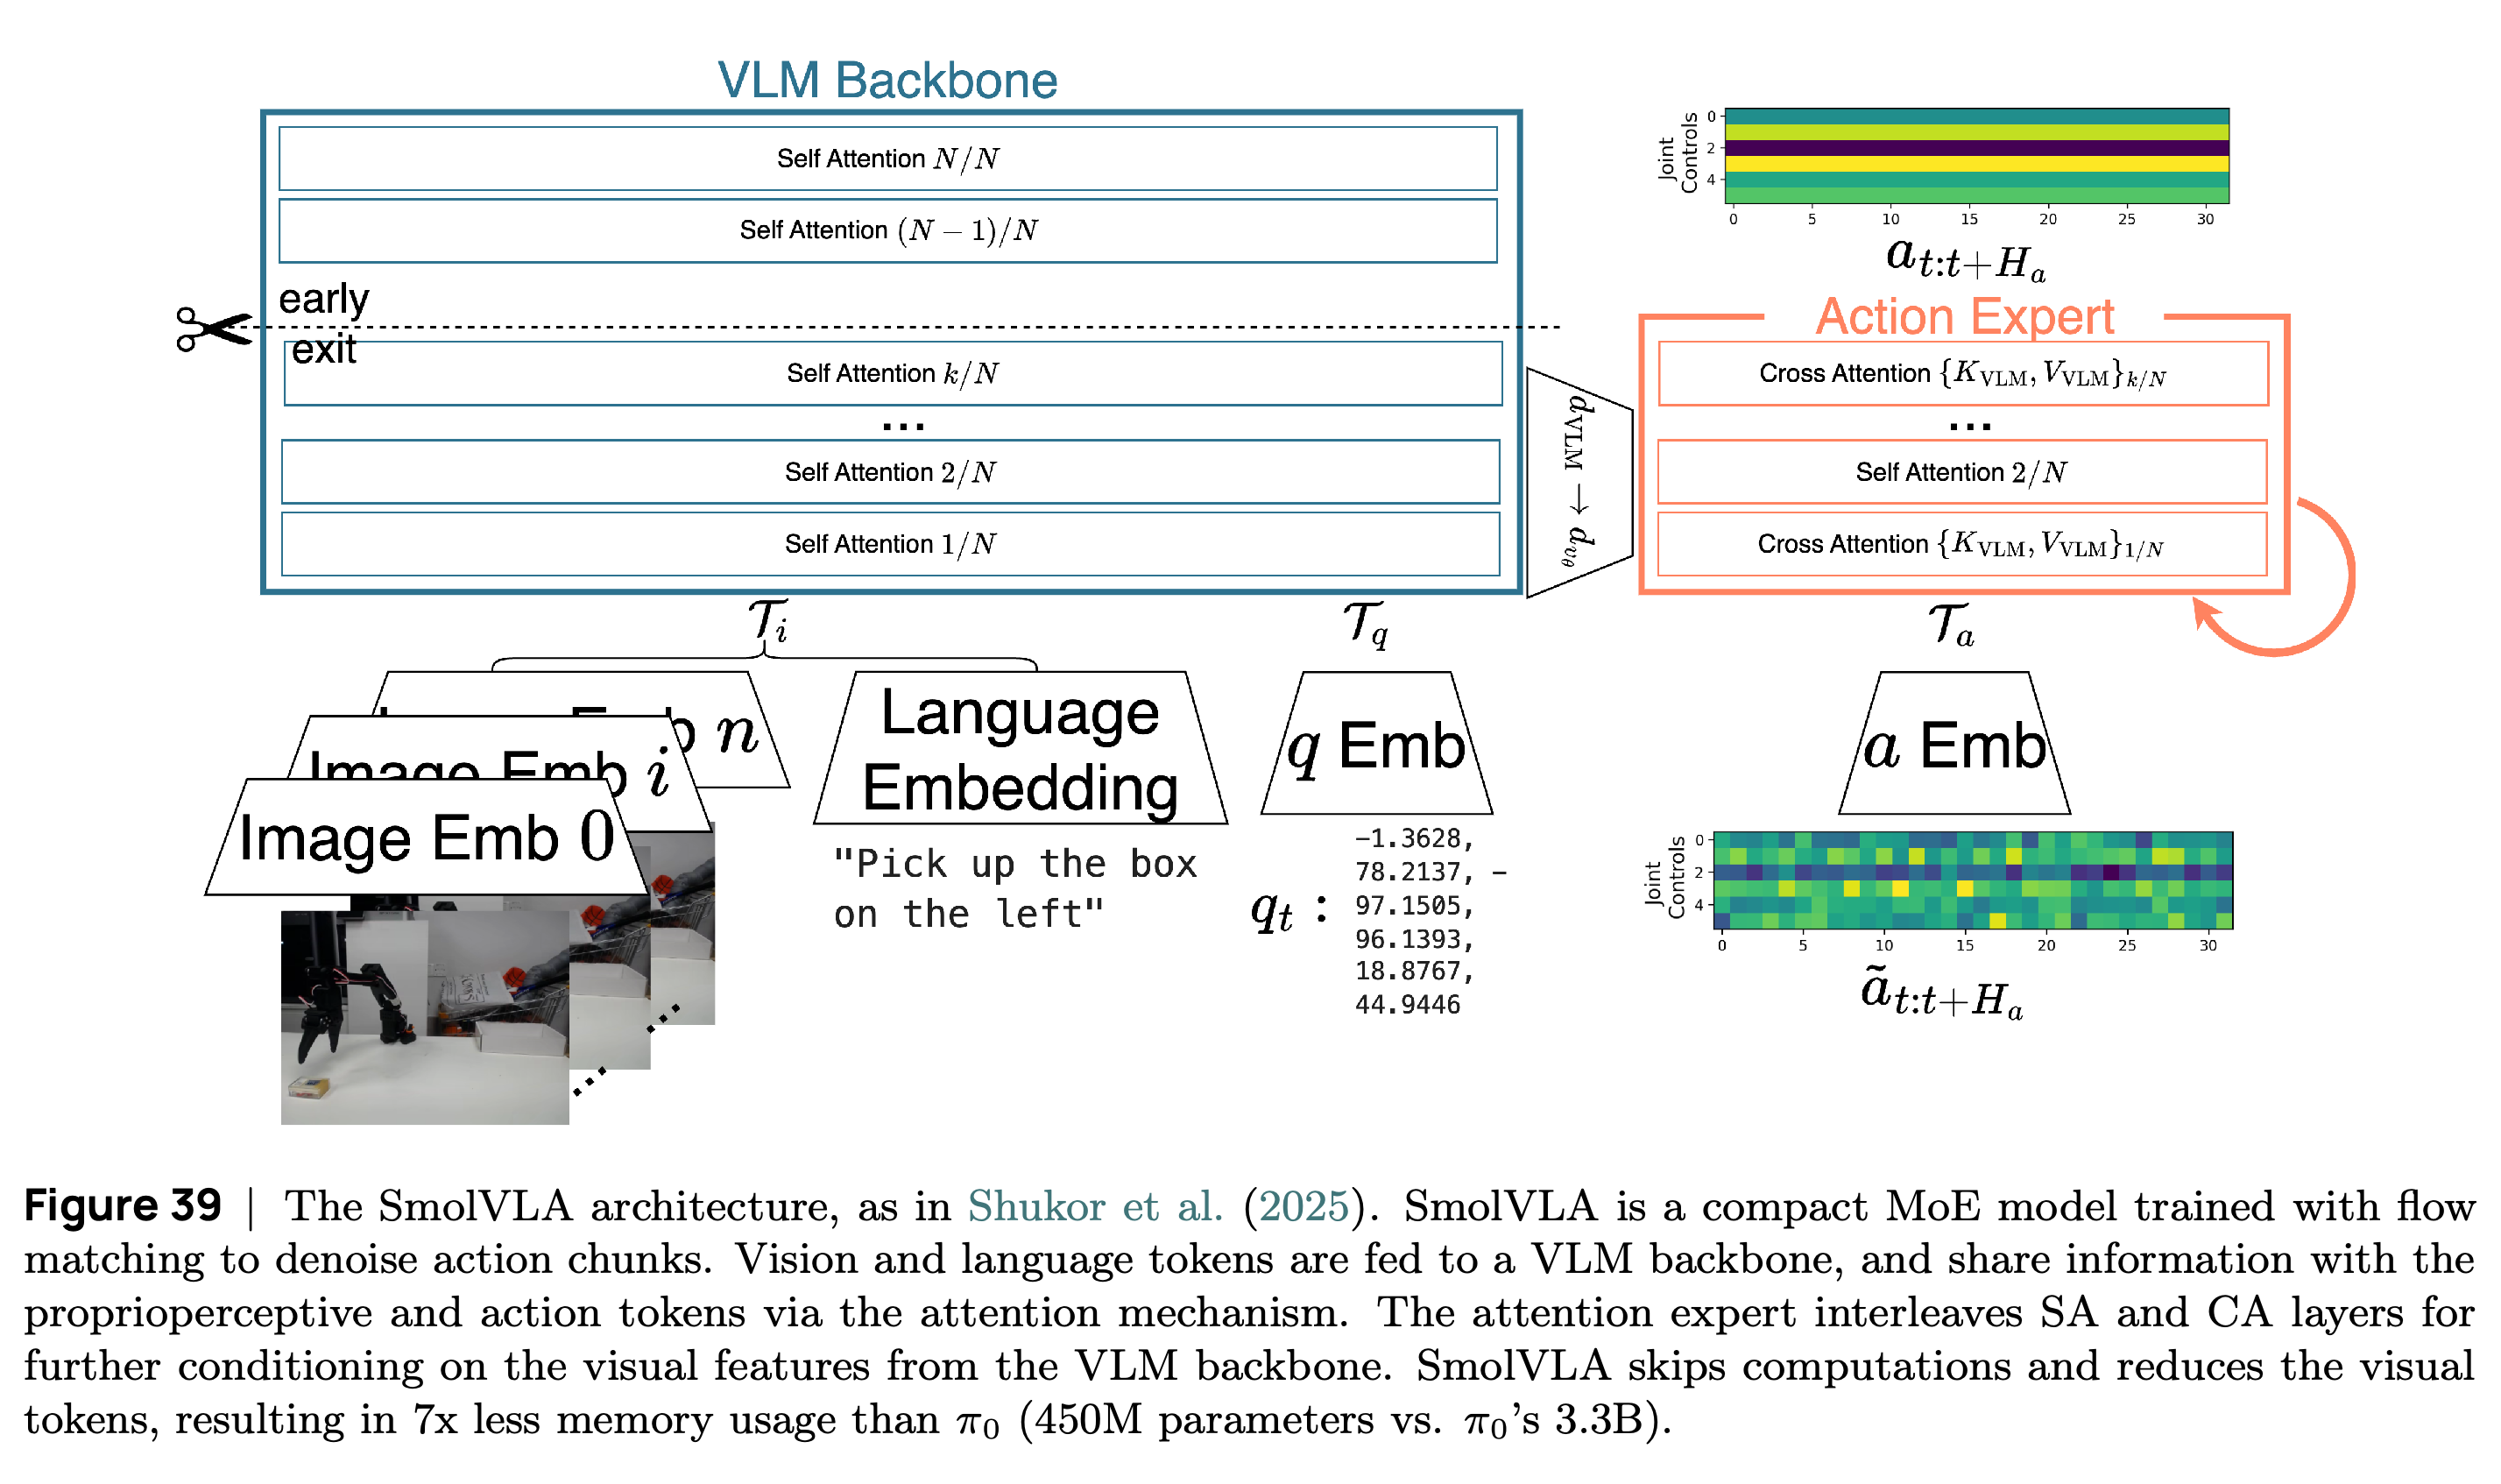
SmolVLA는 소형 SmolVLM-2 vision-language backbone과 약 100M-parameter action expert를 사용한다. 전체 매개변수는 약 450M개이며 π₀는 3.3B개다. 사전 학습에는 총 trajectory 20k+개를 포함하는 커뮤니티 데이터셋 450+개를 사용한다. 과제 설명을 다시 주석 처리하고 카메라 순서를 top/wrist/side로 표준화해 커뮤니티 데이터의 불일치를 다룬다.
- Figure 39는 행동 토큰끼리 상호작용하는 self-attention과, 행동 토큰이 시각, 언어, 로봇 상태 feature를 조회하는 cross-attention을 번갈아 사용하는 구조를 보여준다. 계산량을 줄이기 위해 시각 토큰을 프레임당 64개로 제한하고 backbone 디코더 계층의 앞쪽 절반만 사용한다. Action expert의 임베딩 차원은 backbone 차원을 기준으로 0.75 times로 설정한다.
- 추론 시 SmolVLA는 10단계에 걸쳐 flow를 적분하며 예측과 실행을 분리할 수 있다. 본문은 π₀보다 40%에 가까운 속도 향상을 보이고 메모리를 6배 적게 사용한다고 보고하지만 Figure 39의 캡션은 메모리를 7배 적게 사용한다고 설명한다. 튜토리얼은 이 비율의 차이를 해소하거나 여러 하드웨어에 일반화할 만큼 충분한 측정 정보를 제공하지 않는다.
- 5.4.1 Code Example: Using SmolVLA는 SmolVLAPolicy로 lerobot/smolvla_base를 불러오고, 로봇 feature와 과제 텍스트를 준비한다. 640 × 480 카메라 2대를 초당 30프레임으로 설정한다. 각각 20단계인 episode 5개는 배포 호출을 보여주는 예시이며 카메라 이름과 해상도는 학습 때와 같아야 한다.
Early-exit 표시와 action expert의 attention 구조는 SmolVLA에서 설명한 계산량 절감 방식을 보여준다. 캡션은 π₀보다 메모리를 7배 적게 사용한다고 보고하지만 절의 본문은 6배 적게 사용한다고 보고한다. 튜토리얼 안에서는 이 비교의 불일치가 해소되지 않는다.
6 Conclusions
Conclusions는 고전 모델링의 한계, 실제 환경의 RL, 시연 기반 생성 정책, 언어를 조건으로 사용하는 generalist 모델을 연결한다. 저자들은 공개 데이터셋, 접근하기 쉬운 하드웨어, 표준화된 구조, lerobot을 이를 가능하게 하는 기반으로 꼽는다. 이는 검토한 연구를 종합한 설명이며 개방성의 효과를 따로 측정하는 새 실험은 없다.
부록
- 제공된 PDF에는 별도 부록이 없다. References는 67페이지에서 시작해 76페이지까지 이어진다. 논문이 소개하는 실용 자료에는 https://github.com/huggingface/lerobot 과 https://github.com/fracapuano/robot-learning-tutorial 이 있다. 문서는 arXiv:2510.12403v1이며, 표제지의 날짜는 2025년 10월 15일이다.
짧은 생각
튜토리얼은 제어 개념을 데이터셋 인터페이스, 학습 루프, 배포 스케줄링과 연결하므로 로봇 학습 작업 과정을 준비하는 엔지니어에게 유용하다. 정량적 주장에는 인용된 연구의 출처를 명시해야 한다. 1단계 학습 코드 조각은 보고된 성능을 재현하지 않으며 방법 간 논의에는 공통 평가 프로토콜이 없다. SmolVLA의 상충하는 메모리 비율도 자원 계획에 사용하기 전에 원 연구를 확인해야 한다.