


Tensor Logic: The Language of AI 요약 설명
14 Oct 2025 | Paper Review Neurosymbolic AI Logic Programming Tensor Operations목차
이번 글에서는 Tensor Logic: The Language of AI 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 14일(Arxiv)
- Domingos, Pedro.
- Paul G. Allen School of Computer Science & Engineering, University of Washington
- 논문 링크
- Project Page
요약
- Tensor Logic: The Language of AI는 데이터에서 수치 표현을 학습하는 신경망 계산과 명시적인 규칙과 사실에서 결론을 도출하는 기호 추론 사이의 분리를 다룬다. 핵심 결과는 인덱스가 있는 다차원 배열에 관한 방정식인 텐서 방정식으로 이들을 함께 표현하는 구성이다. 논문은 이를 Python 기반 학습 라이브러리와 논리 프로그래밍 언어가 각각 제공하는 기능과 개념적으로 비교하며 벤치마크 비교 결과는 보고하지 않는다.
- 이 구성은 관계를 희소 Boolean 텐서로 표현한다. 이는 참과 거짓을 저장하며 대부분의 원소가 거짓인 배열이다. 사실과 규칙을 사용하는 논리 프로그래밍 언어인 Datalog의 규칙은 Einstein summation을 수행한 뒤 임계값을 적용하는 방식으로 표현한다. Einstein summation은 인덱스가 있는 텐서의 곱과 선택한 인덱스에 대한 합산을 결합하며 임계값 처리는 규칙을 뒷받침하는 사실의 개수가 양수일 때 이를 참으로 변환한다.
- 논문은 신경망, 기호 시스템, 예제 간 유사도 함수로 예측하는 kernel machine, 상호작용하는 factor로 분포를 표현하는 확률 그래프 모델을 방정식으로 구현하는 방법을 제시한다. 객체와 관계를 수치로 표현하는 임베딩 공간에서의 추론과 2가지 확장 전략도 제안한다. 근거는 수학적 구성과 구현 제안이며 학습 실행 결과, 정확도, 하드웨어 측정값, 실측 속도 향상은 보고하지 않는다.
1. Introduction
서론은 AI 프로그래밍 언어가 사전 지식, 자동 추론, 학습, 투명성, 신뢰성, 확장성을 통합해야 한다고 주장한다. 저자는 기호 AI에 사용하는 LISP와 Prolog가 학습과 확장성에 한계가 있으며 수치 학습 라이브러리인 PyTorch나 TensorFlow를 사용하는 Python은 추론과 지식 획득을 기본 기능으로 제공하지 않는다고 설명한다. Tensor logic은 이러한 기능의 수학적 기반을 통합하려는 제안이다.
2. Background
배경 절은 논리 프로그래밍과 텐서 대수의 대응 관계를 설명한다. 논리 프로그래밍은 사실, 규칙, 답을 도출하는 절차를 제공한다. 텐서 대수는 이러한 절차를 수치로 표현할 수 있는 인덱스 배열과 연산을 제공한다.
2.1 Logic Programming
Datalog 프로그램은 사실과 규칙으로 구성된다. 규칙은 공유하는 인자가 일치하도록 관계를 조인한 뒤, 결론에 해당하는 head에 없는 인자를 제거하여 결과를 투영한다. Ancestor(x,z) ← Ancestor(x,y),Parent(y,z)는 y를 기준으로 일치시키고 x와 z를 남긴다. Ancestor(Alice,Bob)과 Parent(Bob,Charlie)가 주어지면 Ancestor(Alice,Charlie)를 도출한다.
- 전방 추론은 새로운 사실이 더 이상 도출되지 않을 때까지 규칙을 반복 적용한다. 이렇게 얻은 집합을 연역적 폐쇄 또는 고정점이라고 한다. 후방 추론은 질의에서 시작하여 이를 뒷받침하는 사실이나 규칙을 재귀적으로 찾는다.
- Datalog에서는 이들 절차가 모두 건전하다. 즉, 답은 주어진 규칙과 사실에서 논리적으로 도출된다. 규칙은 세계에 관한 진술로서 선언적 의미를 가지며, 근거 조건인 body에서 head를 계산하는 과정으로서 절차적 의미도 가진다.
- 데이터에서 논리 프로그램을 학습하는 inductive logic programming (ILP)은 규칙을 유도하고 predicate invention을 수행하여 원래 데이터에 없던 관계를 발견할 수 있다.
2.2 Tensor Algebra
텐서는 원소 타입과 각 인덱스의 크기를 지정하는 shape를 가지며, rank는 인덱스의 개수다. Einstein 표기법은 행렬 곱을 \(C_{ik}=\sum_j A_{ij}B_{jk}\)로 표현하며 공유 인덱스 j에 대해 합산한다. Tucker decomposition은 더 작은 core 텐서와 core의 인덱스를 원래 차원에 대응시키는 factor 행렬로 텐서를 표현한다.
- rank-3 예시는 \(A_{ijk}=M_{ip}M’_{jq}M’‘_{kr}C_{pqr}\)이며, C는 core이고 M, M′, M″는 factor 행렬이다. 이 표현은 이후 압축, 학습, 임베딩된 관계를 연결한다.
3. Tensor Logic
Tensor logic은 텐서 방정식만을 프로그램 구성 요소로 사용한다. 이어지는 하위 절은 관계와 Boolean 텐서, 논리 규칙과 텐서 연산의 대응을 바탕으로 표현 방식, 실행 절차, 학습 방법을 정의한다.
3.1 Representation
Aunt(x,z) ← Sister(x,y),Parent(y,z)에 대응하는 방정식은 \(A_{xz}=H\left(\sum_y S_{xy}P_{yz}\right)\)다. 여기서 H(x)는 x > 0이면 1이고, 그 외에는 0이다. 곱셈은 서로 일치하는 사실을 연결하고 합산은 y를 제거한다. 계단 함수는 규칙을 뒷받침하는 일치 결과의 개수가 양수이면 Boolean 참으로 변환한다.
- 텐서 투영은 제거할 인덱스에 대해 합산한다. 텐서 조인은 공통 인덱스의 값이 일치하는 원소를 곱하면서 해당 인덱스를 유지하며 조인 뒤에 투영하면 합산이 이루어진다. 공통 인덱스가 없으면 조인은 텐서 곱이 되고, 모든 인덱스를 공유하면 원소별 곱이 된다.
- 방정식의 우변은 조인, 좌변 인덱스로의 투영, 선택적인 원소별 비선형 함수로 구성된다. 좌변에 없는 인덱스만 합산하여 제거한다. Y = step(W[i] X[i])는 내적에 임계값을 적용하지만 Y[i] = step(W[i] X[i])는 i를 유지한다.
- 원소의 기본값은 0이며, 좌변이 같은 방정식은 암묵적으로 합산한다. 소괄호는 Boolean 텐서를 나타내며 Datalog 사실을 표현할 수 있고, 대괄호는 인덱스가 있는 텐서를 나타낸다. 파일 대입은 텐서를 읽거나 쓴다. 편의를 위해 제안한 표기에는 인덱스 함수, 정규화, 대체 투영 연산자, 슬라이스, 외부 함수가 포함된다.
- X[i,j] = sig(W[i,j,k] X[i−1,k])는 가중치를 적용하는 층을 순차적으로 연결한 multilayer perceptron (MLP)을 표현한다. sig는 값을 0과 1 사이로 부드럽게 매핑하는 sigmoid 함수를 뜻한다. recursive neural network (RNN) 예시는 저장 공간을 재사용하는 가상 인덱스로 시간에 따라 상태를 갱신한다. 저자는 인용한 신경망이 일반적인 계산을 표현할 수 있다는 Turing completeness를 근거로 tensor logic도 같은 성질을 가진다고 주장한다.
3.2 Inference
전방 추론은 입력이 준비된 방정식을 차례로 실행하며 더 이상 새로운 원소를 계산할 수 없거나 중단 조건을 충족할 때까지 반복한다. 후방 추론은 방정식을 함수로 취급한다. 질의는 답에 필요한 텐서를 재귀적으로 요청하며 데이터나 방정식으로 뒷받침되지 않는 원소에는 0을 대입한다. 실행 방향은 응용에 따라 달라진다.
3.3 Learning
학습 구성은 매개변수 갱신에 사용하는 미분값인 gradient를 또 다른 tensor logic 프로그램으로 표현한다. 곱셈 방정식에서 어떤 factor가 1번 나타나면, 그 factor에 대한 미분은 나머지 factor의 곱으로 남는다. 손실 gradient에는 비선형 함수의 미분과 해당 텐서를 사용하는 방정식의 기여도 함께 반영된다. 학습에는 손실을 정의하는 방정식이 필요하며 학습 데이터로 제공하지 않은 텐서는 상수로 지정하지 않는 한 기본적으로 학습한다.
- 제곱 손실 예시는 Loss = (Y[e] − X[*e,N,j])²다. e는 예제 인덱스이고, N은 마지막 층을 지정하며 j는 유닛 인덱스다. 가상 예제 인덱스를 사용하면 저장 공간을 재사용할 수 있으며 optimizer는 외부에서 제공하거나 tensor logic으로 표현할 수 있다.
- 각 예제의 도출 과정을 따라 매개변수 갱신을 계산하는 backpropagation through structure는 예제마다 서로 다른 방정식을 사용하는 경우를 처리한다. Backpropagation through time은 recursive network에 적용하는 특수한 경우다.
- 주어진 데이터 텐서에서 Tucker decomposition을 학습하면 core와 factor 행렬을 얻는다. 여기에 임계값을 적용하여 Boolean 값으로 변환하면 새로운 predicate를 얻는다. 논문은 이 연결을 제시하지만 생성된 predicate를 평가하지 않는다.
4. Implementing AI Paradigms
별도로 명시하지 않는 한 구현은 전방 추론을 사용한다. 이 절은 기존 AI 패러다임 4가지를 텐서 방정식으로 표현하고 각 구성 요소를 표기법에 어떻게 대응시키는지 연산 과정과 함께 설명한다.
4.1 Neural Networks
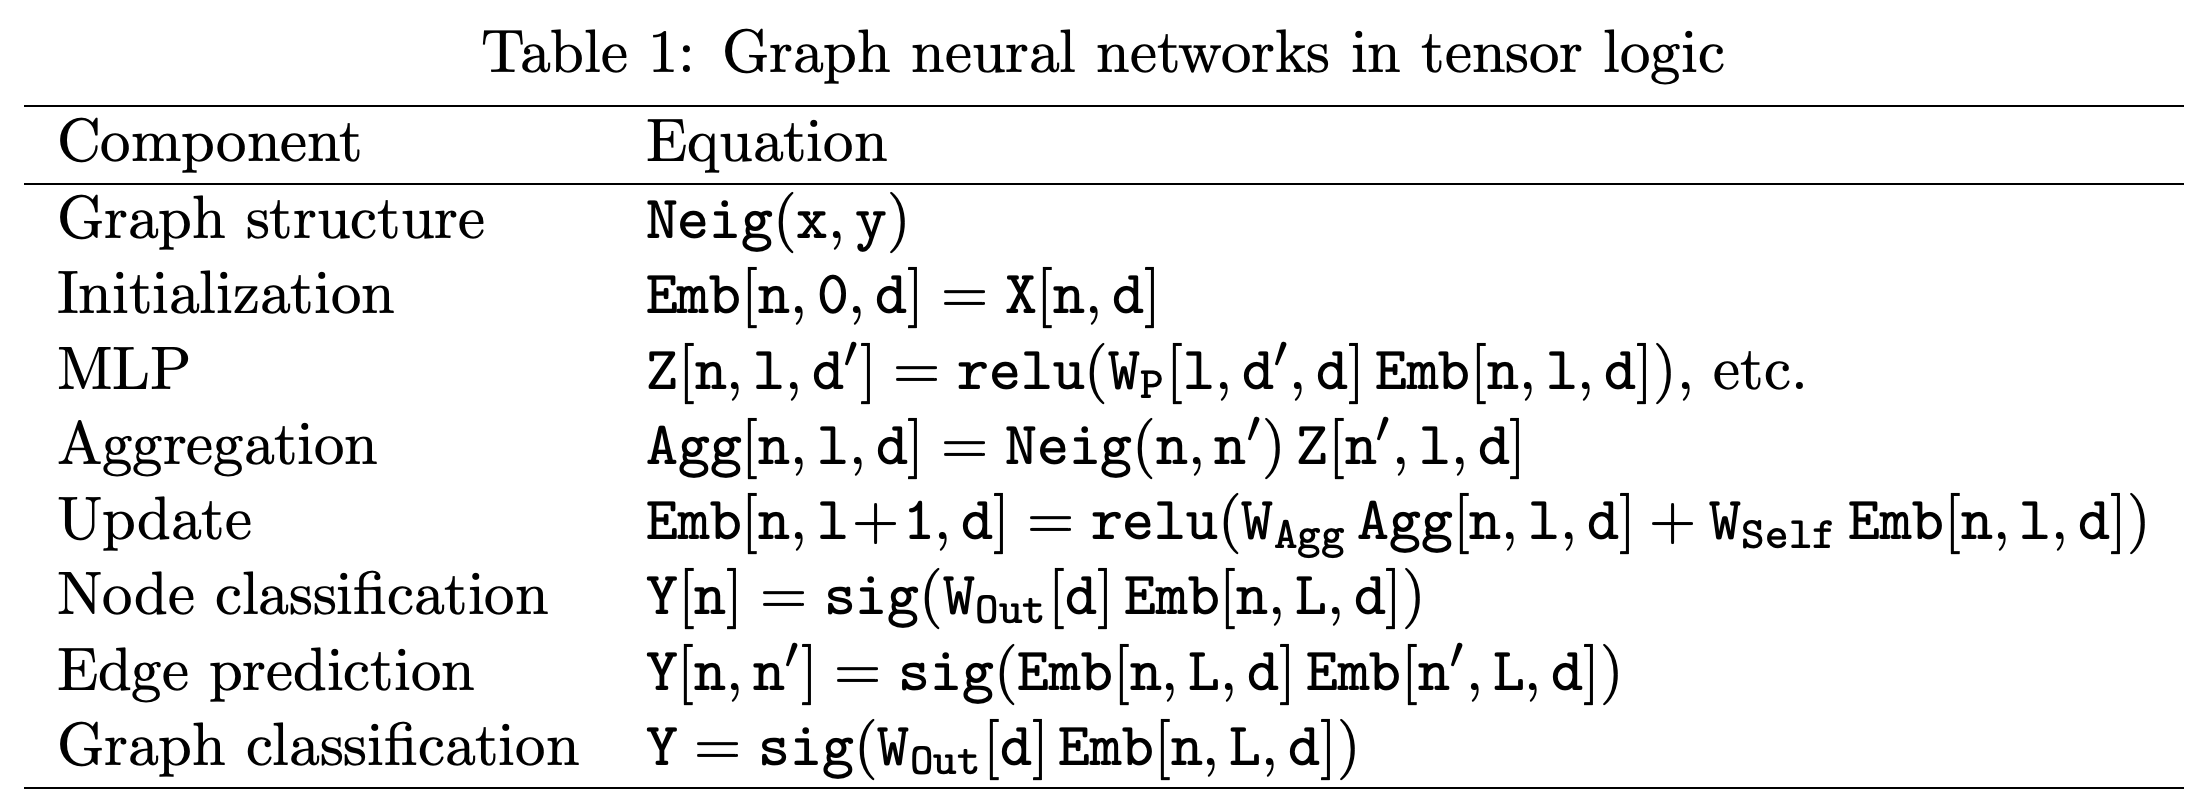
Convolution은 이미지 위치마다 공유 필터를 적용하며 pooling은 인접한 출력을 결합한다. Pooled[x/S,y/S] = Features[x,y]는 정수 나눗셈과 각 pooling 블록의 크기인 stride S를 사용하여 sum-pooling을 구현한다. max=를 사용하면 최댓값으로 집계한다. Table 1은 그래프 구조의 데이터를 처리하는 graph neural network (GNN)를 노드 변환, 이웃 집계, 임베딩 갱신으로 표현한다.
- Boolean 관계 Neig(n,n′)는 인접 노드를 선택한다. 변환된 특징과 이 관계를 조인하고 n′를 합산하여 제거하면 이웃 정보를 집계한다. 노드에 독립적인 변환 가중치를 사용하므로 노드의 이름을 바꾸어도 계산이 유지된다.
- 각 층은 이웃 노드의 정보를 결합하여 노드 표현을 갱신하는 message passing을 수행한다. 표는 node classification, edge prediction, graph classification의 최종 출력 방정식을 제시한다.
Boolean 인접 관계가 이웃을 선택하고 투영이 이웃의 변환된 특징을 합산한다. 같은 최종 임베딩으로 노드, 엣지, 그래프 출력을 모두 계산할 수 있다. 그래프 출력에서 노드 인덱스를 생략하면 노드 전체에 걸쳐 집계한다.
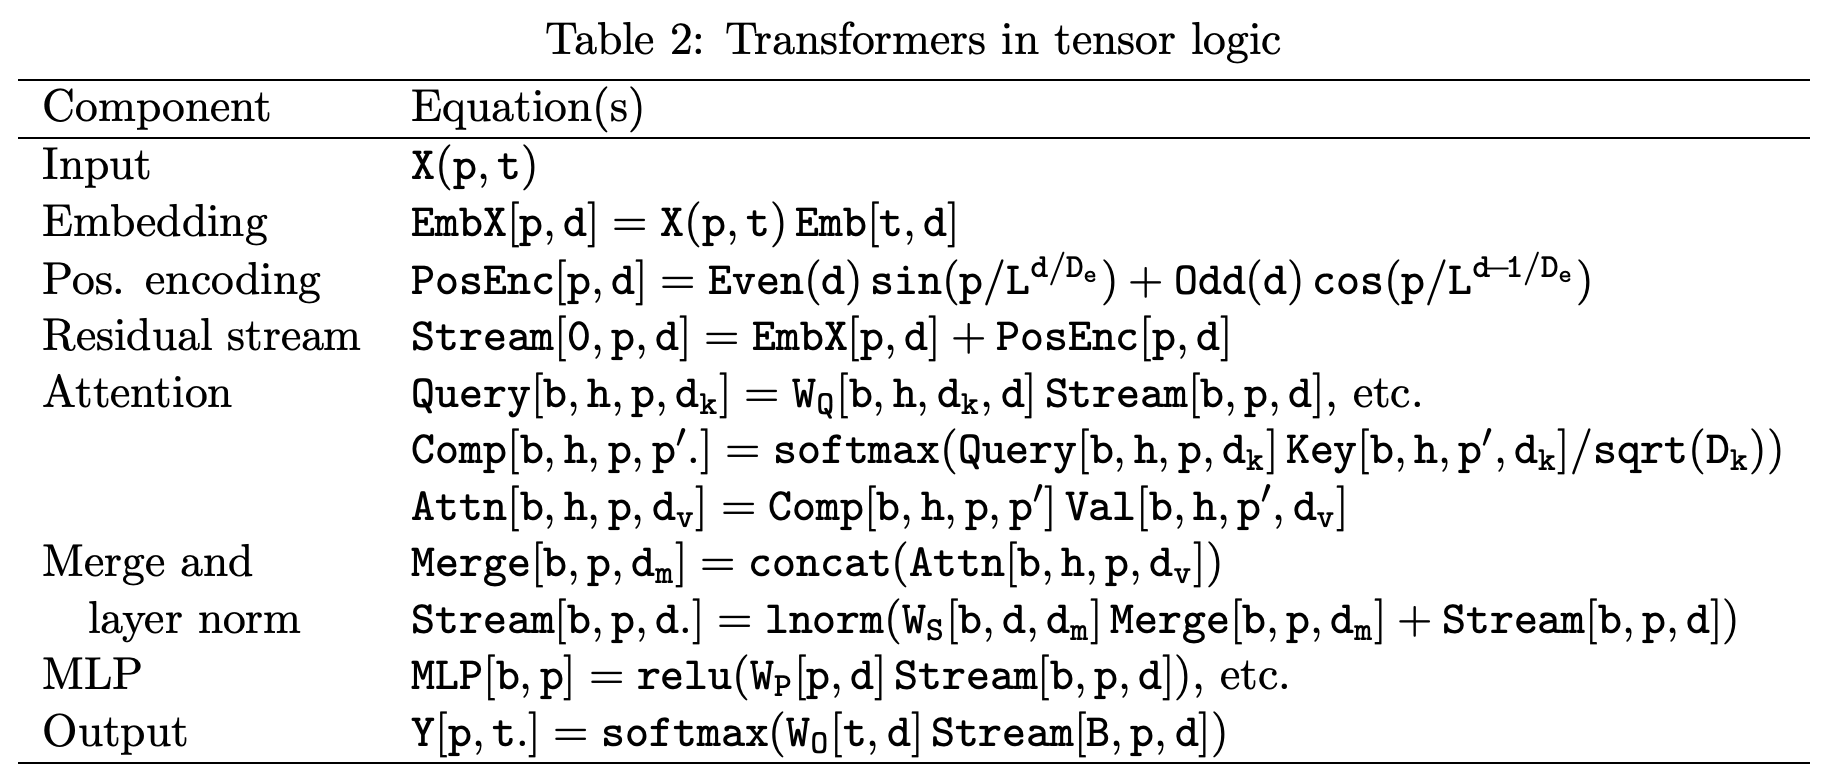
Attention은 학습된 가중치로 입력을 투영한 query와 key 벡터를 비교하여 value 벡터에 가중치를 부여한다. Table 2는 이를 attention 기반 신경망 구조인 transformer로 확장한다. 여기에는 token embedding, 시퀀스 위치를 표현하는 positional encoding, 중간 표현을 전달하는 residual stream, 여러 attention head, 정규화, 출력 토큰 확률이 포함된다. 저자는 텐서 방정식 한 다스만으로 전체 transformer를 표현한다고 설명하지만 일부 구성 요소는 “etc.”로 축약하거나 생략한다. Attention에 대해서는 Linformer(Self-Attention with Linear Complexity) 요약 설명 글을 참조하라.
- Attention 비교는 key 위치 인덱스에 대해 softmax를 적용하여 합이 1인 양의 가중치로 정규화한다. 비교값을 key 차원의 제곱근인 sqrt(D_k)로 나눈 뒤, 가중치를 적용한 value를 합산하여 해당 위치 인덱스를 제거한다.
- Block과 head 인덱스는 반복되는 attention 계산을 구성한다. Head 출력을 이어 붙이고 residual stream과 결합한 뒤, 특징 차원에 걸쳐 값을 재조정하는 layer normalization을 적용한다. 이후 MLP 처리 과정은 표에서 일부 생략한다.
Block, head, 위치, 특징 인덱스가 입력 사실에서 토큰 확률까지 이어지는 계산을 구성한다. 표는 모델 구조를 표현하는 방법을 보여주지만 “etc.” 항목과 생략된 MLP residual 처리로 인해 일부 계산은 암묵적으로 남아 있다.
4.2 Symbolic AI
모든 Datalog 프로그램은 유효한 tensor logic 프로그램이다. 따라서 표현식에 함수 항이 없는 영역에서 Datalog 방식의 추론과 계획을 지원한다. Prolog처럼 함수를 지원하려면 표현식이 일치하도록 치환을 찾는 unification이 추가로 필요하다. 논문은 이 요구 사항을 제시하지만 완전한 Prolog 구현은 제공하지 않는다.
4.3 Kernel Machines
Kernel machine은 Y[Q] = f(A[i] Y[i] K[Q,i] + B)로 표현한다. Q는 질의 예제이고, i는 예측에 기여하는 예제인 support vector를 순회한다. A는 계수, B는 bias, f는 출력 비선형 함수다. 별도 방정식은 polynomial kernel과 Gaussian kernel을 정의하며 K는 예제 간 kernel 값을 담은 Gram matrix다. 서로 연관된 출력 요소를 생성하는 structured prediction은 벡터 출력과 출력 간 상호작용 및 출력과 입력 간 상호작용을 기술하는 방정식을 사용한다.
4.4 Probabilistic Graphical Models
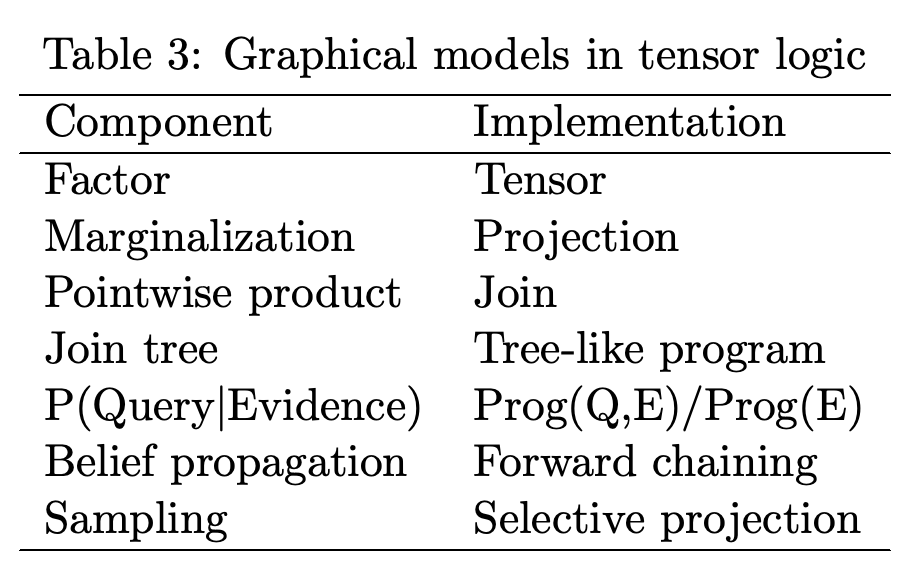
이산 확률 그래프 모델은 변수의 부분집합에 관한 함수인 음이 아닌 factor들의 정규화된 곱으로 결합 분포를 표현한다. Table 3은 factor를 텐서에, 변수를 합산하여 제거하는 주변화를 투영에, factor의 원소별 곱을 조인에 대응시킨다. 추론에 사용하는 결합된 factor의 트리인 join tree는 후방 추론으로 평가하는 트리 형태의 tensor logic 프로그램이 된다.
- Factor가 부모 변수가 주어졌을 때의 조건부 분포인 Bayesian network에서는 정규화 상수가 1이다. Evidence는 사실로 제공하며 프로그램 평가값의 비율로 evidence 확률과 조건부 확률을 구한다. Table 3은 이를 정리한다.
- 논문에서 제시한 선형 시간 추론 조건은 join tree 크기에 대해 선형이라는 뜻이다. 이 트리는 원래 모델보다 지수적으로 클 수 있으므로, 이 구성에서도 기존 추론의 복잡도가 유지된다.
- 근사 추론에서는 확률 정보를 반복 갱신하는 loopy belief propagation을 전방 추론에 대응시킨다. 무작위 표본으로 추론하는 Monte Carlo sampling은 항의 무작위 부분집합을 남기는 선택적 투영을 사용하는 후방 추론에 대응시킨다.
투영은 합산으로 변수를 제거하고 조인은 곱셈으로 factor를 결합한다. 이 대응은 확률 질의와 근사 추론을 프로그램 평가에도 연결한다. 다만 해당 표를 설명하는 본문은 join tree가 지수적으로 커질 가능성을 명시한다.
5. Reasoning in Embedding Space
길이가 1인 무작위 단위 벡터 임베딩을 사용하면 집합을 구성원 벡터의 합으로 표현한다. S[d] = V[x] Emb[x,d]에서 V는 구성원마다 0이 아닌 원소를 1개씩 갖는 multi-hot 지시 벡터다. D[A] = S[d] Emb[A,d]로 복원하면 구성원일 때는 약 1, 그 외에는 약 0을 얻는다. 논문이 제시한 표준편차는 \(\sqrt{N/D}\)이며, N은 집합의 크기이고 D는 임베딩 차원이다. 집합의 크기가 고정되어 있을 때 \(\frac{1}{2}\)을 임계값으로 사용하면 구성원 여부를 판정할 수 있으며 논문은 차원이 커질수록 오류 확률이 감소한다고 설명한다.
- 이항 관계는 인자 임베딩의 텐서 곱을 합산한 EmbR[i,j] = R(x,y) Emb[x,i] Emb[y,j]로 임베딩한다. 서로 다른 무작위 단위 벡터의 내적이 0에 가깝기 때문에 D[A,B] = EmbR[i,j] Emb[A,i] Emb[B,j]로 복원하면 R(A,B)를 근사적으로 얻는다.
- 규칙의 전제와 결론에 해당하는 관계를 각각 임베딩으로 대체한 뒤, 임베딩된 규칙에 전방 또는 후방 추론을 적용한다. 이 주장은 임베딩의 내적이 항등행렬을 근사한다는 성질에 의존한다. 오류를 줄이기 위해 주기적인 추출, 임계값 처리, 재임베딩을 제안한다.
- 인자뿐 아니라 관계 기호도 임베딩하면 데이터베이스를 (relation, argument, value) triple로 구성된 rank-3 텐서에 표현할 수 있다고 저자는 제안한다. 논문은 복원 오류나 추론이 이어질 때 누적되는 오류를 측정하지 않는다.
학습한 임베딩에서는 Sim[x,x′] = Emb[x,d] Emb[x′,d]가 객체 간 유사도를 측정한다. 이를 통해 비슷한 객체가 유사도에 따른 가중치로 다른 객체의 추론 결과를 활용할 수 있다. 저자는 방정식에 σ(x,T) = 1/(1 + e^(−x/T))를 적용하고 sigmoid의 가파른 정도를 조절하는 매개변수인 temperature T를 바꾸는 방법을 제안한다. 이 방법은 연역 추론과 비슷한 객체 사이에서 추론 결과를 전이하는 유추 추론 사이를 조절한다. 중간 텐서를 추출하여 계산 과정을 살펴볼 수도 있다.
- 논문은 T를 0으로 설정하면 유사도 Gram matrix가 사실상 항등행렬로 바뀌어 순수한 연역 추론이 된다고 주장한다. 그러나 임의의 학습된 Gram matrix가 이렇게 작동하기에 충분한 조건은 명시하지 않으며 제시한 sigmoid는 T = 0에서 극한으로 해석해야 한다.
- 저자는 충분히 낮은 temperature에서 근거 없는 출력인 hallucination이 발생하지 않으며 검색한 근거 정보를 활용하여 생성하는 retrieval-augmented generation보다 지수적으로 우수하다고도 주장한다. 언어를 다루는 신경망 모델인 large language model (LLM)과의 이러한 비교를 뒷받침하는 벤치마크 조건이나 측정 결과는 제시하지 않는다.
6. Scaling Up
첫 번째 확장 전략은 밀집 부분 텐서 연산을 graphics processing unit (GPU)에서 수행하고 희소 연산은 데이터베이스 질의 엔진에서 수행한다. 질의 엔진은 희소 텐서를 관계로 취급하여 질의 최적화를 적용한다. 두 번째 전략은 Tucker decomposition으로 희소 텐서를 밀집 표현으로 변환하고 모든 연산을 GPU에서 수행한다. 이러한 근사는 오류를 유발할 수 있으며 저자는 임베딩 차원과 계단 함수를 통한 잡음 제거로 오류를 제어하는 방법을 제안한다.
- 분해 전략은 학습 및 임베딩 공간 추론 구성과 같은 표현을 사용한다. 지수적인 효율 우위를 주장하지만 이를 뒷받침하는 작업 부하 조건, 분해 차원, 실행 시간, 메모리 측정값은 제시하지 않는다.
7. Discussion
논의 절은 추가 응용으로 과학 계산과 학습 가능한 프로그램 제어를 제안한다. Boolean 제어 텐서를 수치 값으로 완화하고 필요하면 임계값을 적용하여 다시 논리 값으로 변환한다. 도입을 위한 방안으로 Python 호환성, 라이브러리, 오픈소스 커뮤니티, 통합 개발 도구, 교육을 제안한다. 다음 단계로 NVIDIA의 GPU 프로그래밍 플랫폼인 CUDA에서의 직접 구현과 응용 연구를 제시하며 tensor-logic.org를 안내한다.
부록
- 제공된 17페이지 논문에는 부록이 없다. 논의 절 뒤에는 감사의 글과 참고문헌이 이어진다.
짧은 생각
Aunt 예시는 Boolean 규칙 평가와 텐서 연산 사이의 구체적인 대응을 보여주며, 3개 표는 이 표기법으로 기존 AI 계산을 표현하는 방법을 보여준다. 주요 미해결 문제는 압축된 표현에서 추론할 때의 오류 누적, 학습한 임베딩이 연역적으로 작동하는 조건, 실행 비용이다. 임베딩 차원과 추론 깊이를 바꾸는 실험, 텐서 및 데이터베이스 구현과의 비교를 통해 이러한 주장을 직접 검증할 수 있다.