


Mage-Flow: An Efficient Native-Resolution Foundation Model for Image Generation and Editing 요약 설명
21 Jul 2026 | Paper Review Text-to-Image Generation Instruction-Based Image Editing Diffusion Transformers Flow MatchingContents
- 요약
- 1 Introduction
- 2 Related Work
- 3 Mage-Flow Stack
- 4 Data Collection and Curation
- 5 Training
- 6 Experiments
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Mage-Flow: An Efficient Native-Resolution Foundation Model for Image Generation and Editing 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 21일(Arxiv)
- Zhang, Xinjie, Zhang, Peng, Zheng, Shicheng, Guo, Jinghao, Jia, Zhaoyang, Shen, Yifei, Guo, Xun, Luo, Yuxuan, Li, Jiahao, Xie, Wenxuan, et al.
- Microsoft Mage Team
- 논문 링크
- Project Page
요약
- Mage-Flow는 텍스트-이미지 생성과 지시 기반 편집을 위한 4B-scale 스택이다. Mage-VAE, rectified flow로 학습한 native-resolution MMDiT, packed sequence, fused CUDA kernel을 결합한다. 4-step Turbo 변형은 NVIDIA A100 1대에서 1024² 이미지를 각각 0.59 s와 1.02 s에 생성하고 편집한다고 보고한다.
1 Introduction
이 논문은 대규모 시각 생성기의 학습, 적응, 배포 비용을 다룬다. 이미지 backbone을 수백억 개 파라미터로 확장하는 대신 공유 소형 스택을 제안한다.
2 Related Work
관련 연구는 diffusion 및 MMDiT 생성기, 지시 기반 편집기, 시각 토크나이저, 선호도 기반 사후 학습, few-step distillation을 다룬다. Mage-Flow는 이해와 생성을 통합한 모델이 아니라 효율적인 전문 생성·편집기로 자리매김한다.
2.1 Image Generation Foundation Models
생성 연구는 pixel-space 및 U-Net latent diffusion에서 diffusion Transformer와 rectified-flow 모델로 이동해 왔다. Mage-Flow는 경량 VAE와 함께 설계한 4B 생성기를 사용한다.
2.2 Tokenization for Image Generation
Mage-VAE는 고해상도에서 VAE의 지연 시간과 메모리 사용량을 줄이는 것을 목표로 한다. 1-step diffusion 방식의 인코딩과 디코딩으로 16× 다운샘플링된 128-channel Transformer용 latent를 생성한다.
2.3 Post-training for Image Generation
사후 학습 단계에서는 flow-matching 생성기를 위한 온라인 negative-aware 방법인 Diffusion-NFT를 사용한다. 역량별 보상은 텍스트 렌더링, 미적 품질, 의미 충실도, 편집 충실도를 겨냥한다.
2.4 Distillation for Image Generation
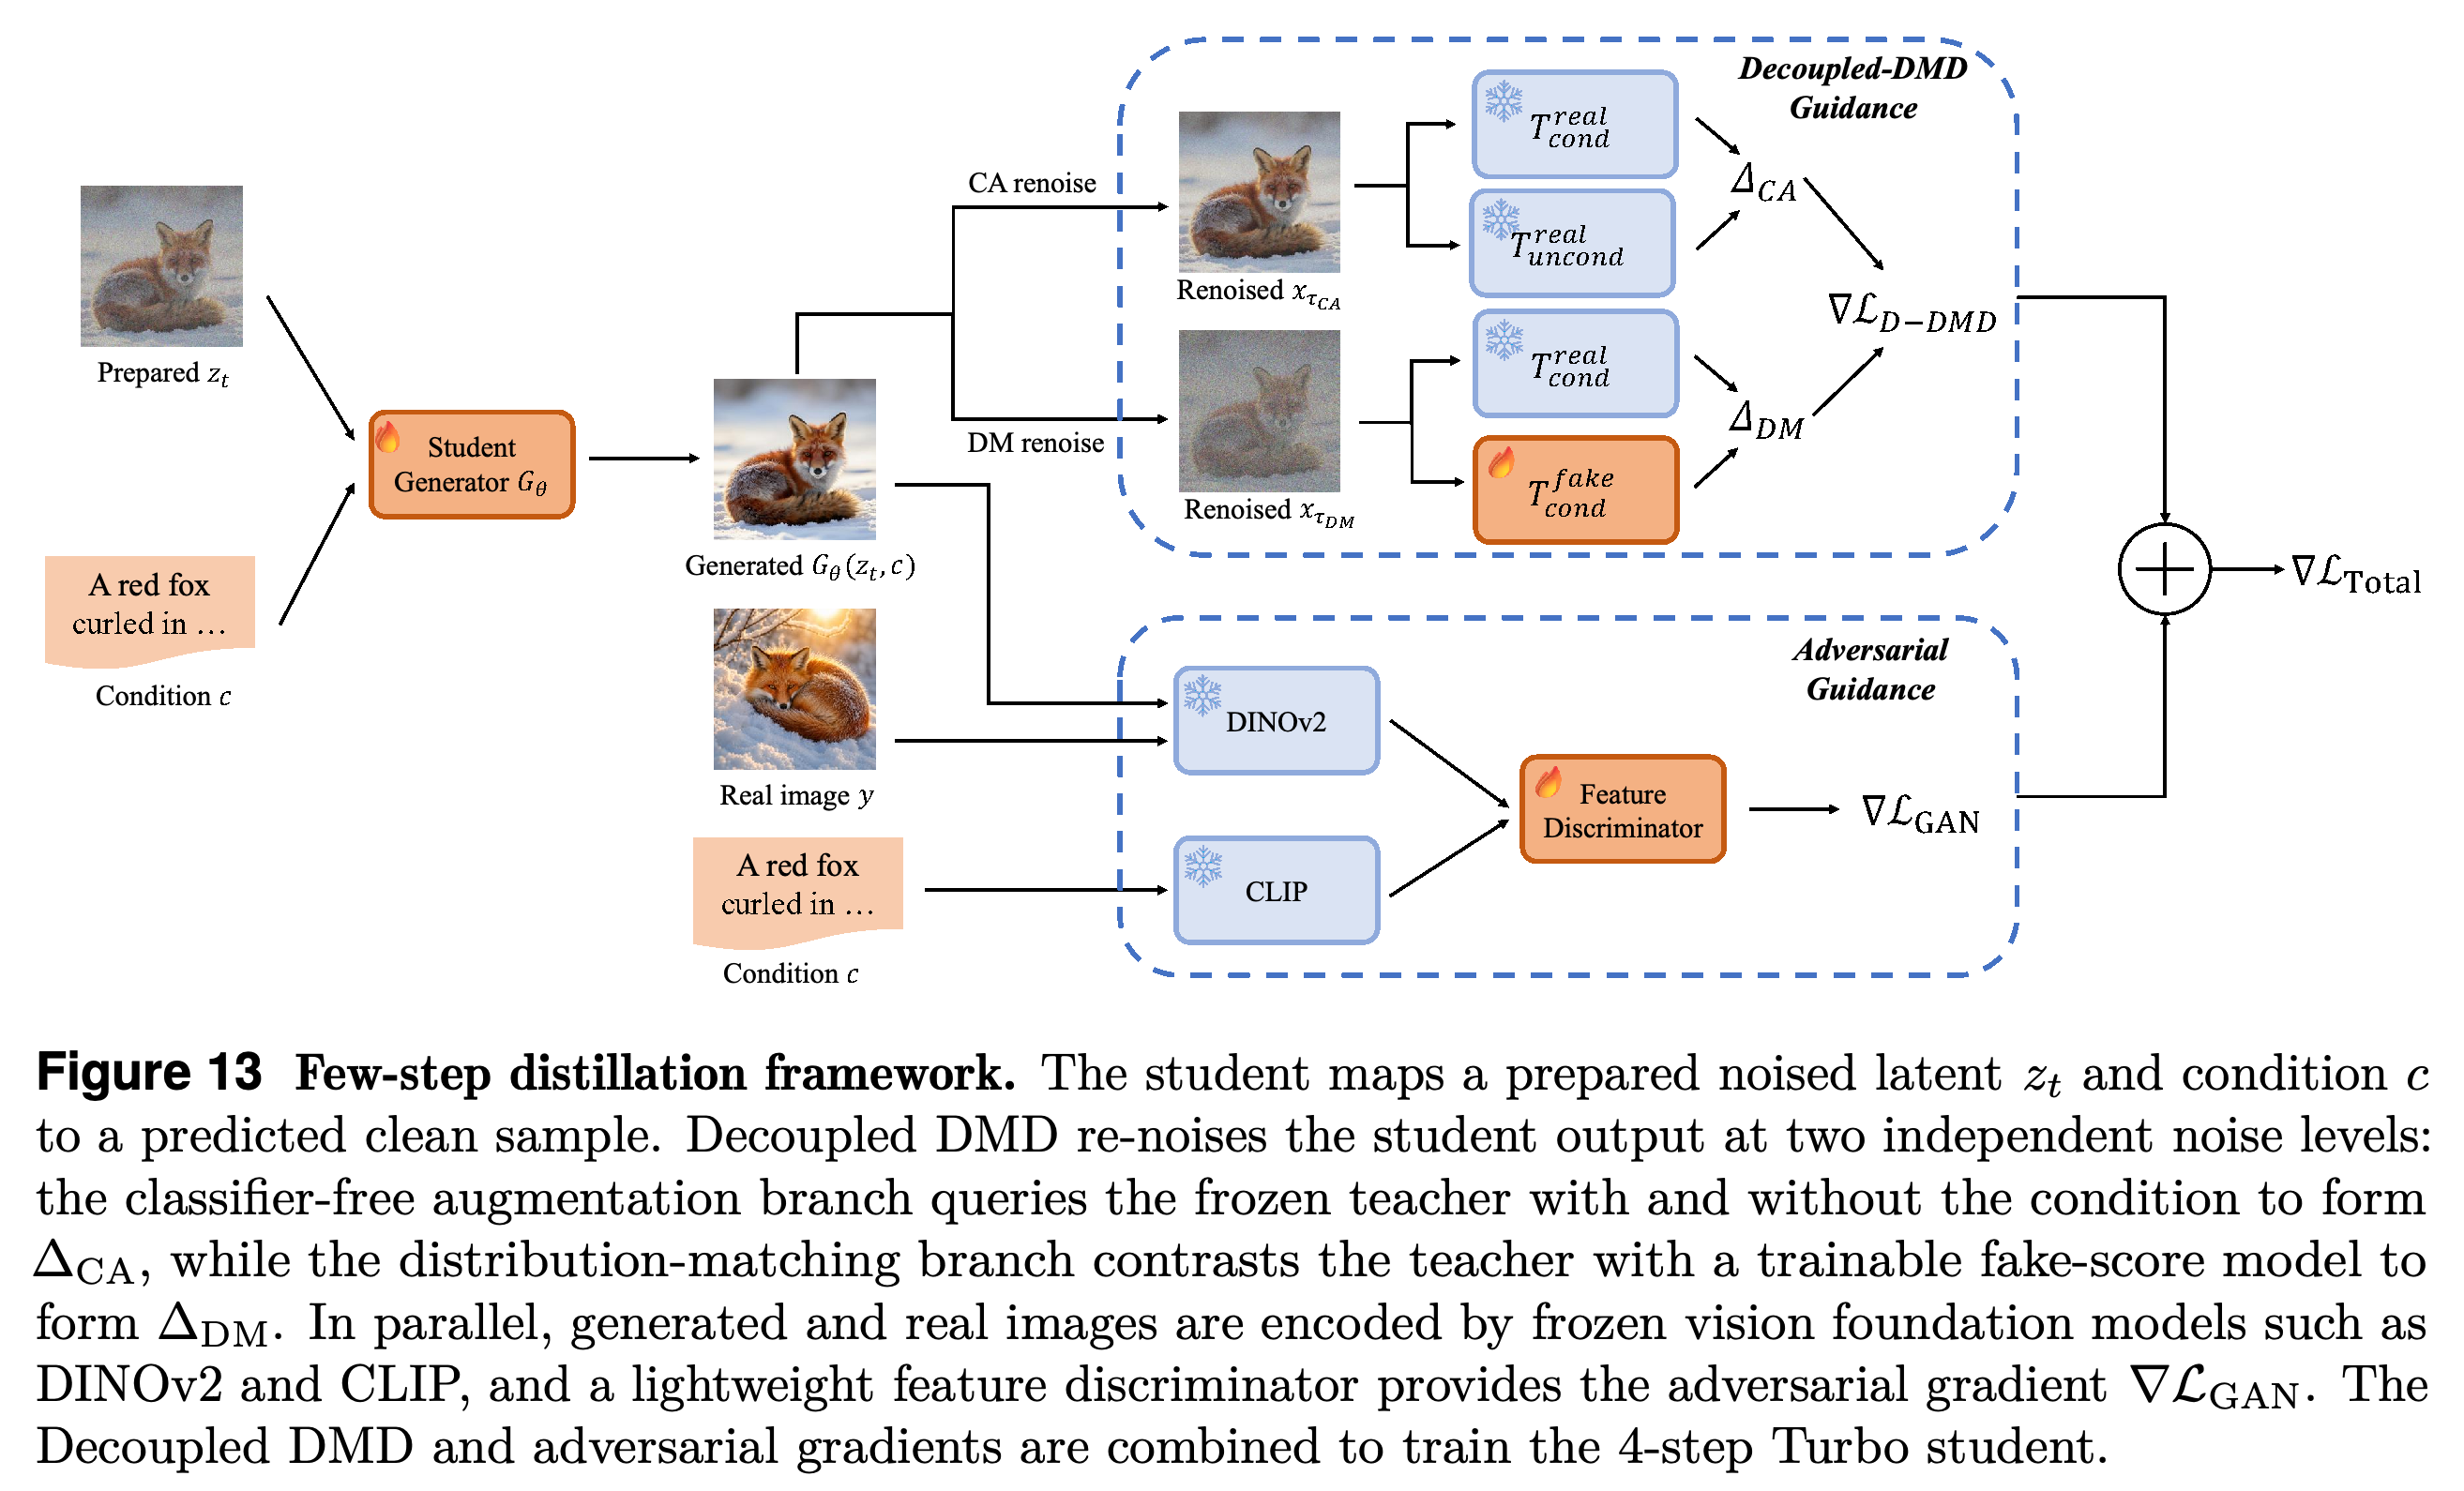
4-step 추론에는 VFM 기반 adversarial perceptual guidance를 포함한 Decoupled DMD를 적용한다. 강한 trajectory 압축에서도 multi-step teacher의 품질과 지시 이행 능력을 유지하는 것이 목표다.
3 Mage-Flow Stack
스택은 Mage-VAE, 4B Native-Resolution MMDiT, 학습 및 추론 최적화로 구성된다. Mage-VAE는 소형 latent를 제공하고 backbone은 native size 전반에서 packed text 및 image sequence를 모델링한다.
3.1 Mage-VAE: Lightweight Image Tokenizer
Mage-VAE는 고해상도 및 few-step pipeline에서 tokenizer 오버헤드를 제거하려 한다. 1-step diffusion 방식의 인코딩과 디코딩, 그리고 FLUX.2-VAE latent 분포를 향한 regularization을 사용한다.
3.1.1 Architecture
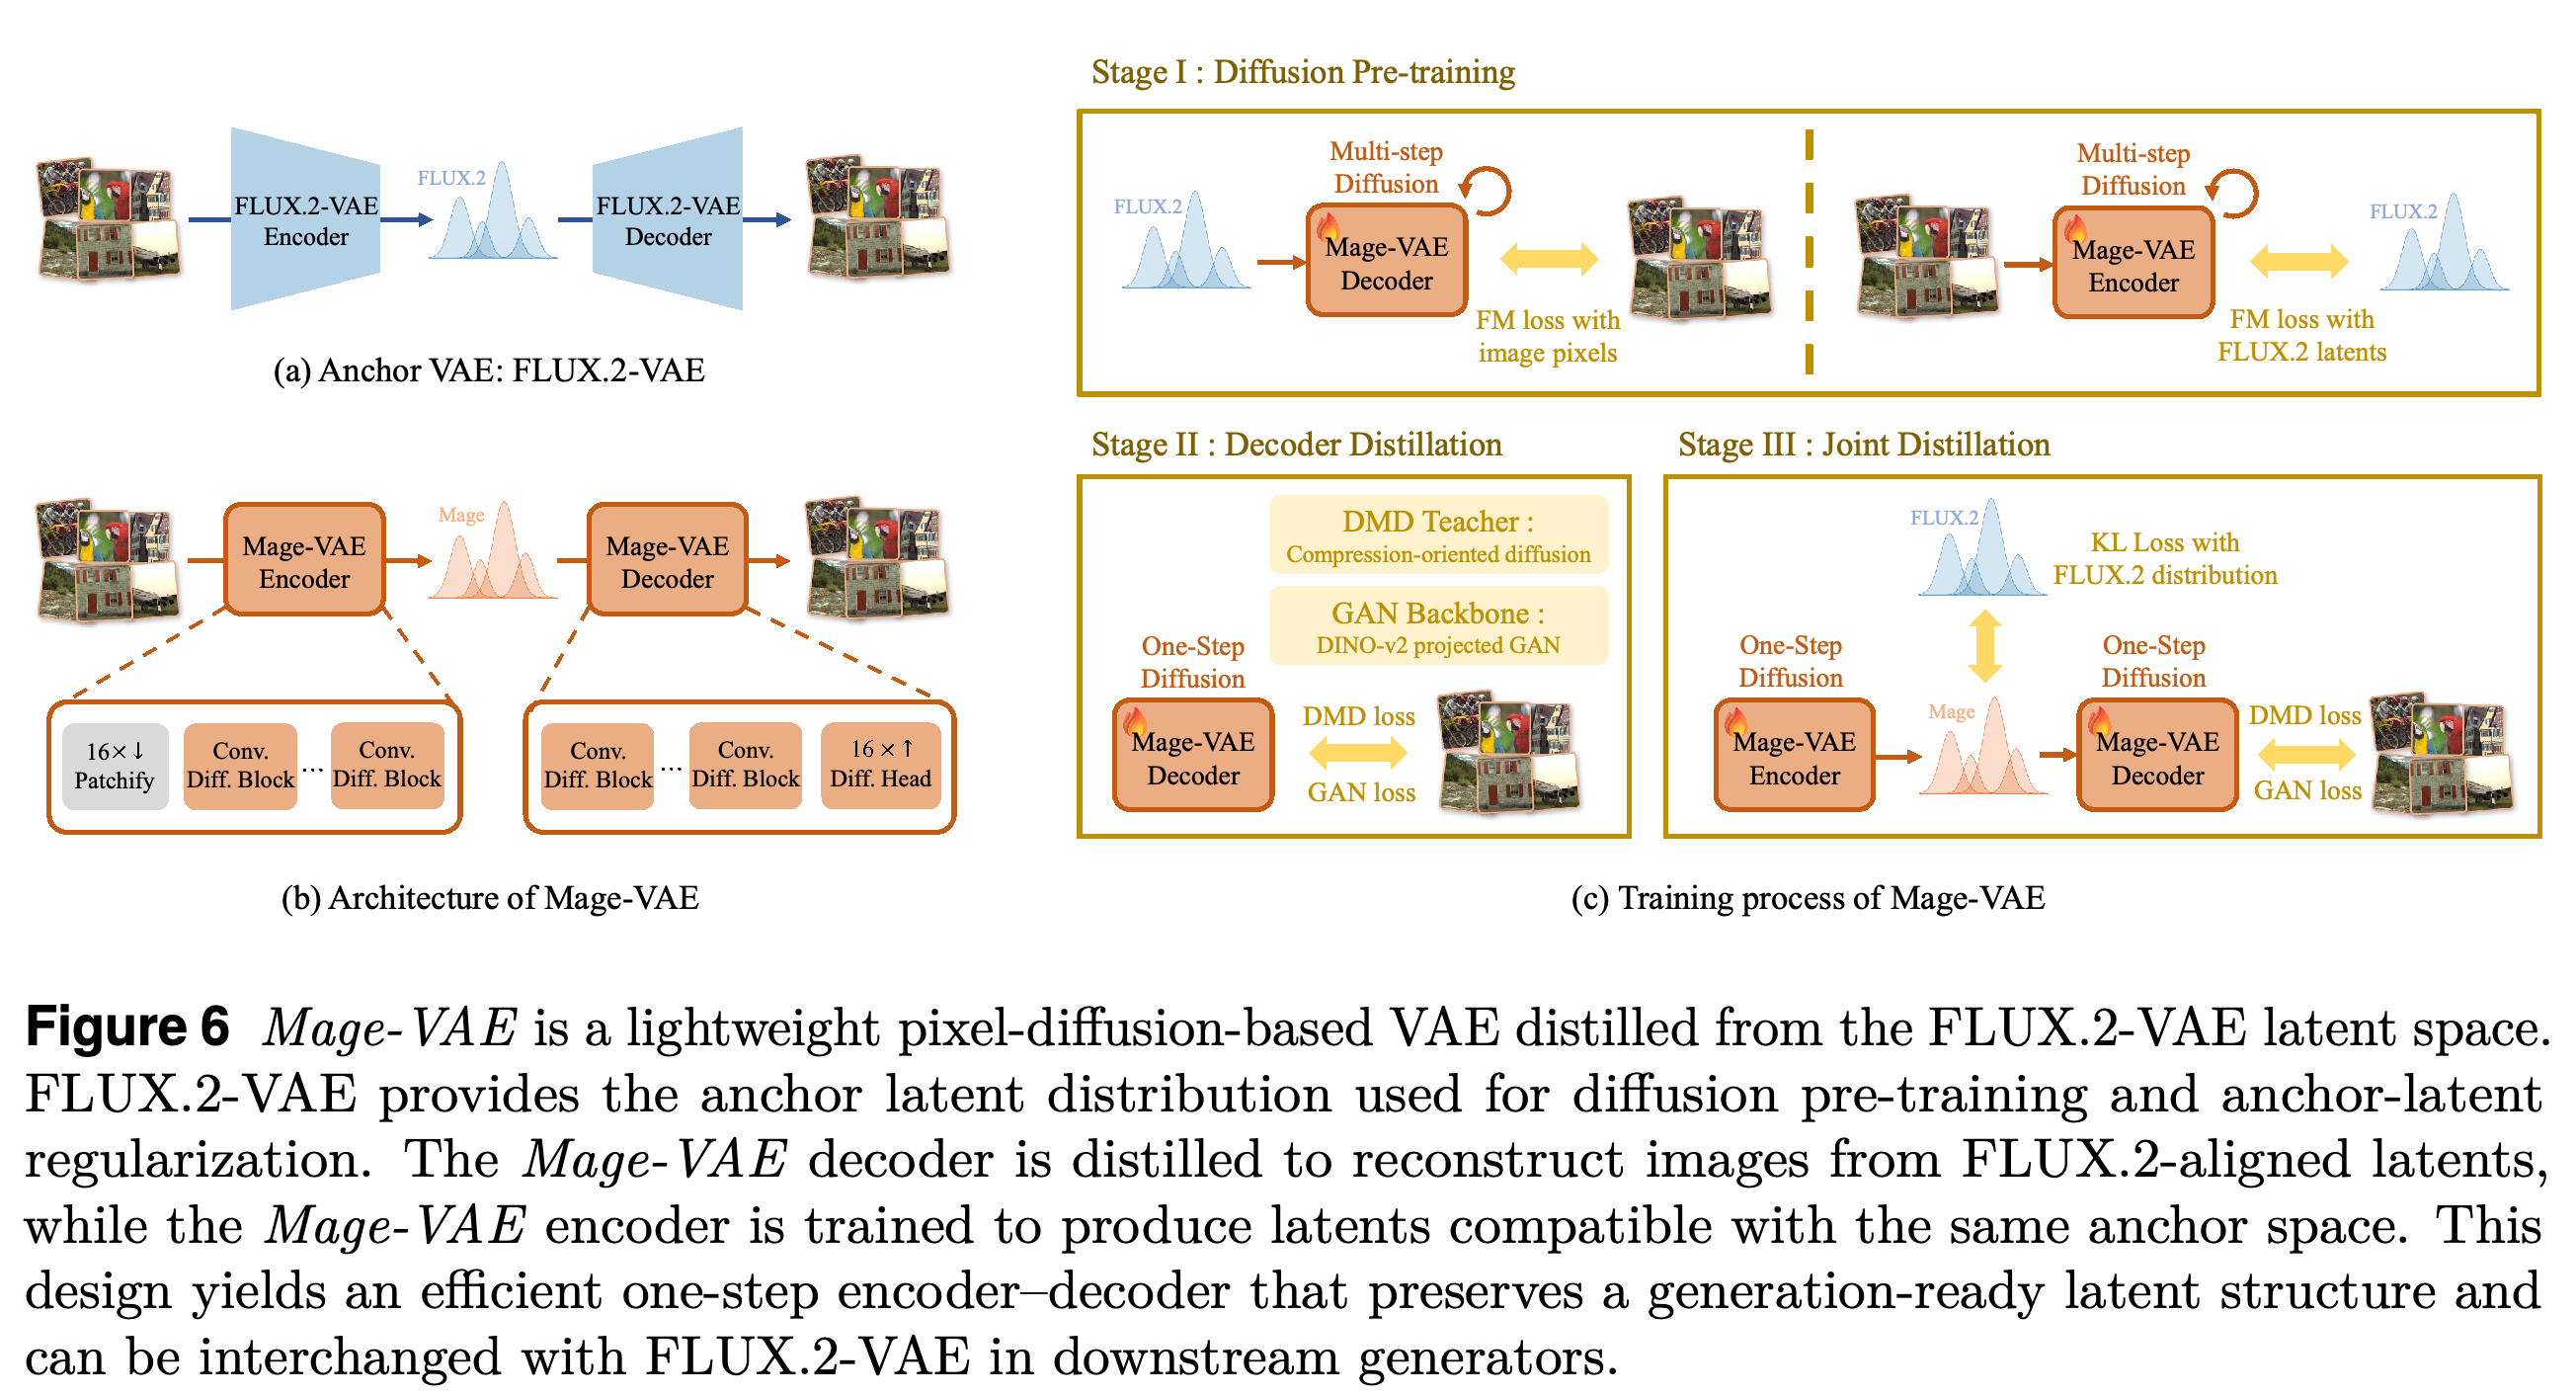
decoder는 convolutional diffusion block과 분리된 pixel diffusion head로 구성한 완전 합성곱 1-step pixel-diffusion 모델이다. encoder는 그 쌍대 구조로, patch embedding 뒤에 pixel에 조건화한 convolutional diffusion block을 둔다.
3.1.2 KL regularization with an anchor latent distribution
Mage-VAE는 표준 Gaussian prior 대신 patchify한 FLUX.2-VAE latent에 posterior를 정렬한다. FLUX.2 patchification을 내부화한 16× 다운샘플링된 128-channel latent를 직접 출력한다.
3.1.3 Training
학습은 별도의 multi-step flow-matching 사전 학습, reconstruction·DMD·projected-GAN loss를 이용한 1-step decoder distillation, 이후 anchor-latent KL regularization을 포함한 공동 최적화로 진행한다. Appendix A는 decoder를 고정한 encoder warm-up을 추가한다.
FLUX.2-VAE anchor latent, 대칭형 Mage-VAE, 3개 학습 단계를 연결해 보여준다.
3.1.4 Evaluation
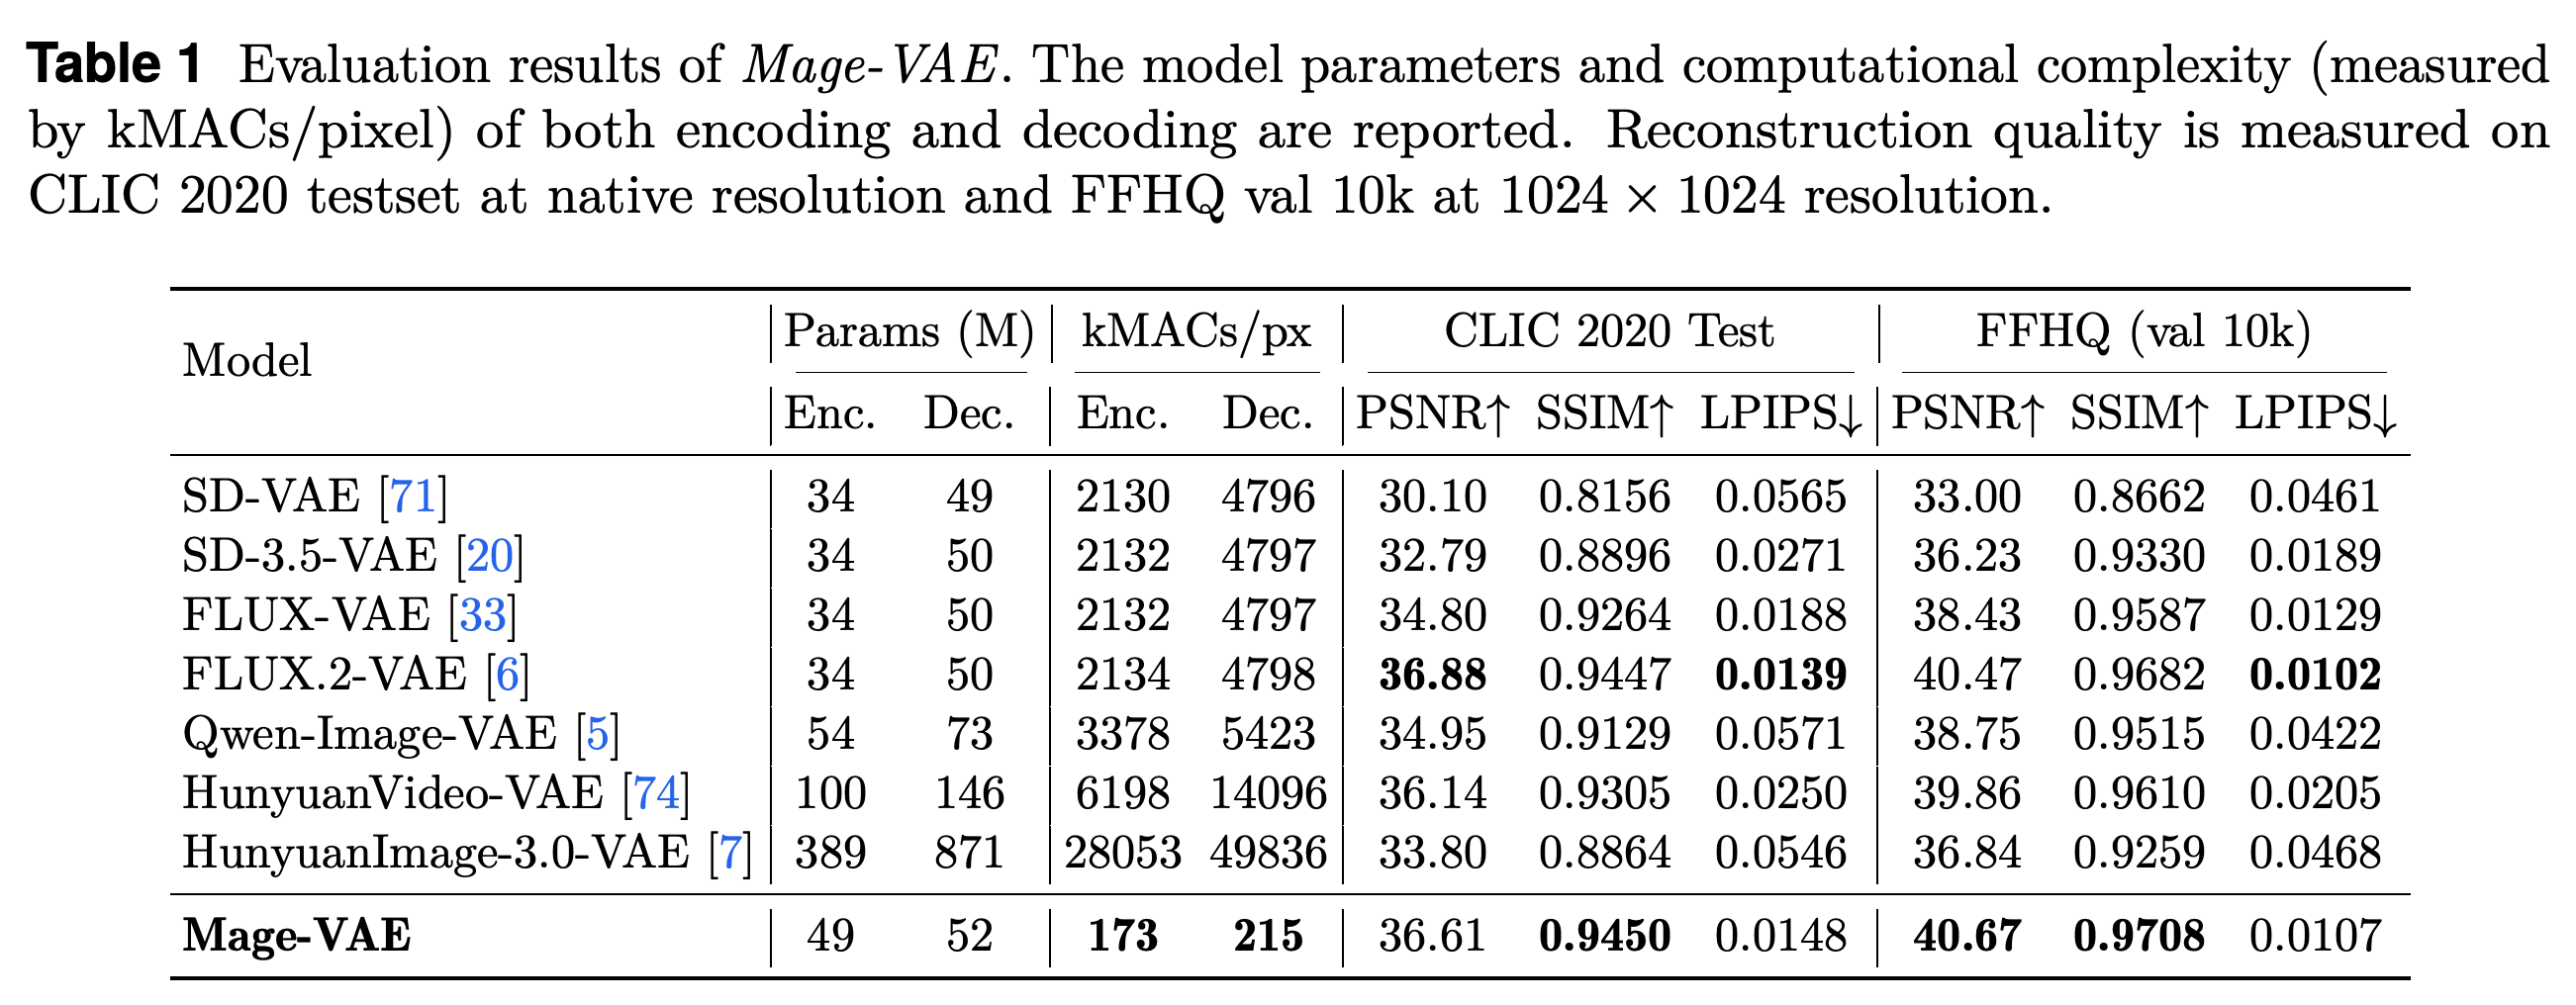
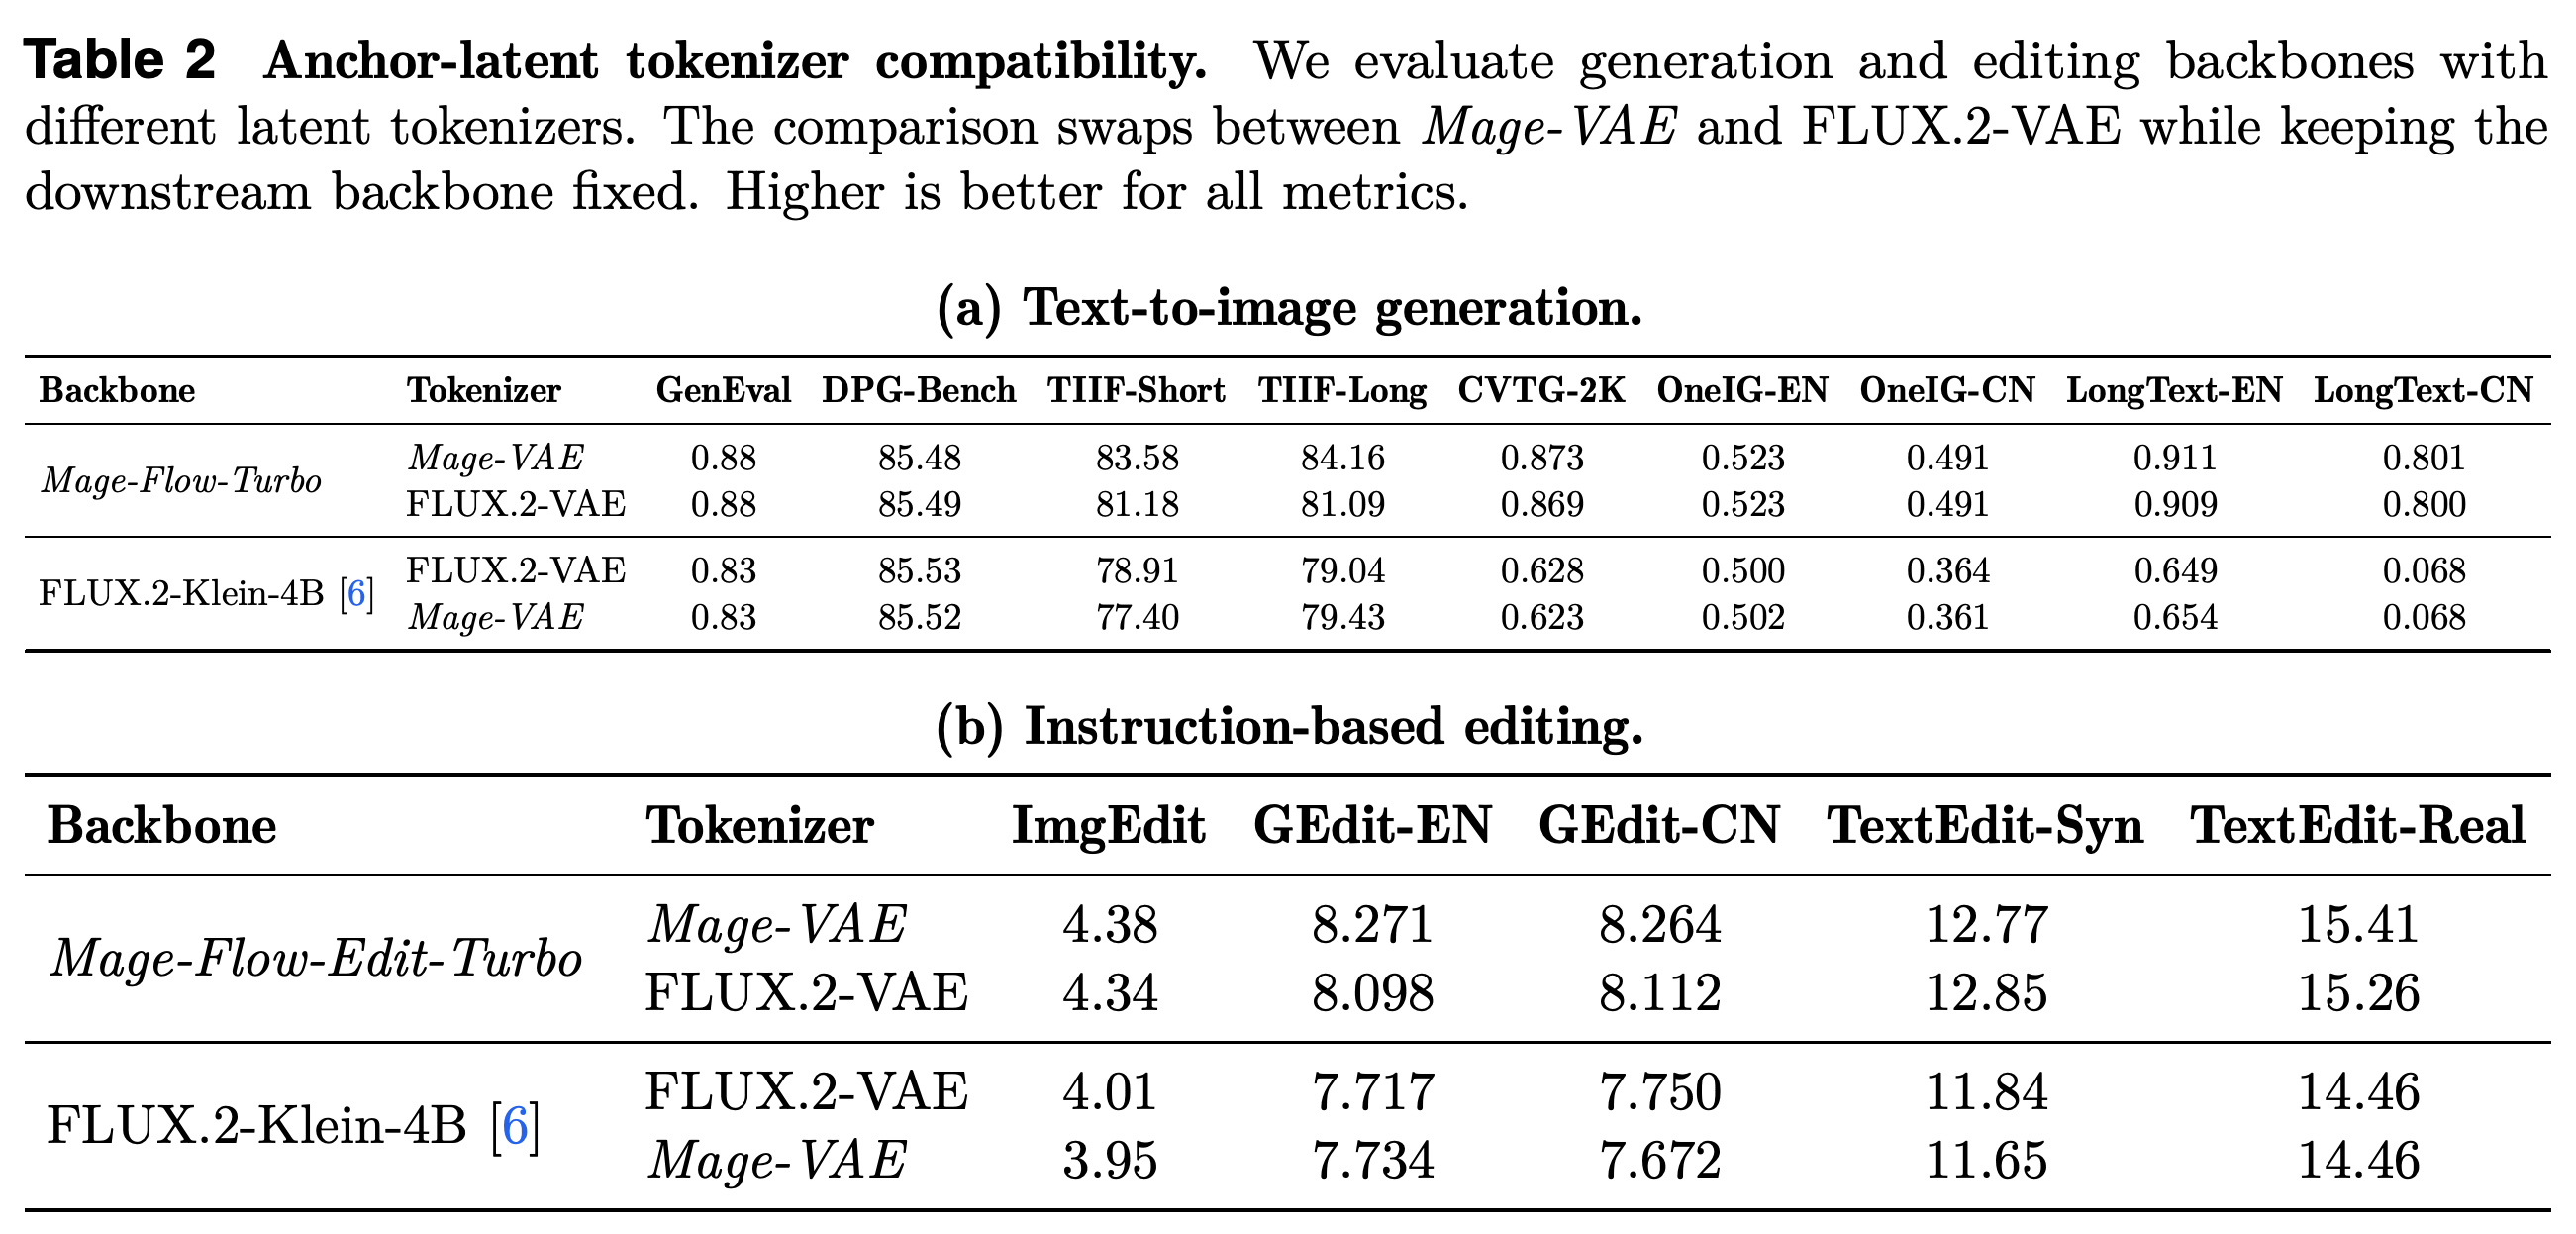
CLIC 2020과 FFHQ에서 Mage-VAE는 FLUX.2-VAE와 비슷한 reconstruction quality를 보고하면서 pixel당 encoding과 decoding kMACs는 각각 약 12.3×와 22.3× 적게 사용한다. tokenizer를 교체한 실험에서도 downstream 생성 및 편집 결과가 유사하다고 보고한다.
Mage-VAE는 FLUX.2-VAE의 2134/4798 대비 encoding/decoding에 pixel당 173/215 kMACs를 사용하면서 유사한 reconstruction metric을 보고한다.
backbone을 고정한 채 Mage-VAE와 FLUX.2-VAE를 교체하면 생성 및 편집 score가 유사하게 나온다.
3.2 Native-Resolution MMDiT
NR-MMDiT는 modality별 normalization 및 projection layer와 joint self-attention을 갖춘 4B MMDiT다. 핵심 학습 방식은 업데이트마다 단일 해상도 bucket을 쓰는 대신 native-resolution packing을 사용하는 것이다.
3.2.1 Model Architecture and Native Packing
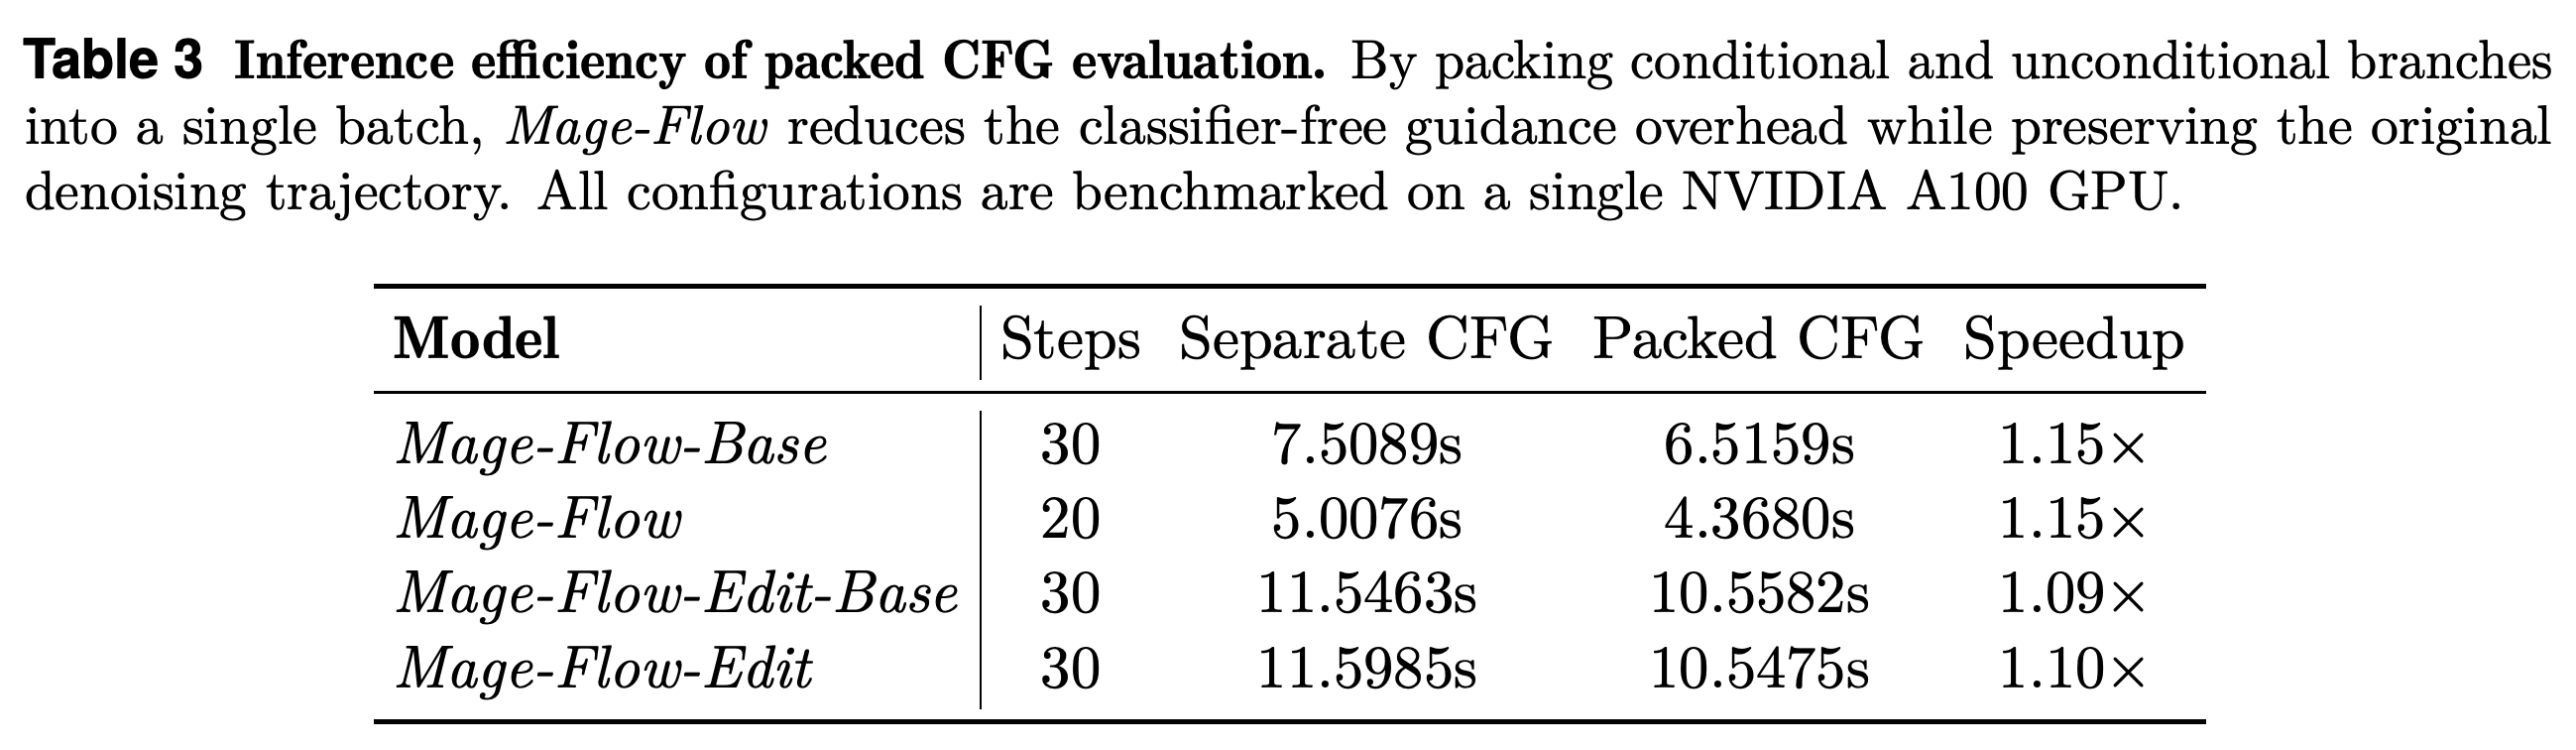
가변 길이 latent 및 prompt sequence를 고정 token budget 안에 packing한다. FlashAttention variable-length kernel과 sample별 2D RoPE가 sample 경계를 보존하며, conditional 및 unconditional CFG branch를 함께 packing하면 측정상 1.09×–1.15× 속도가 향상된다.
packed variable-length image 및 text sequence와 joint-attention MMDiT block을 나타낸다.
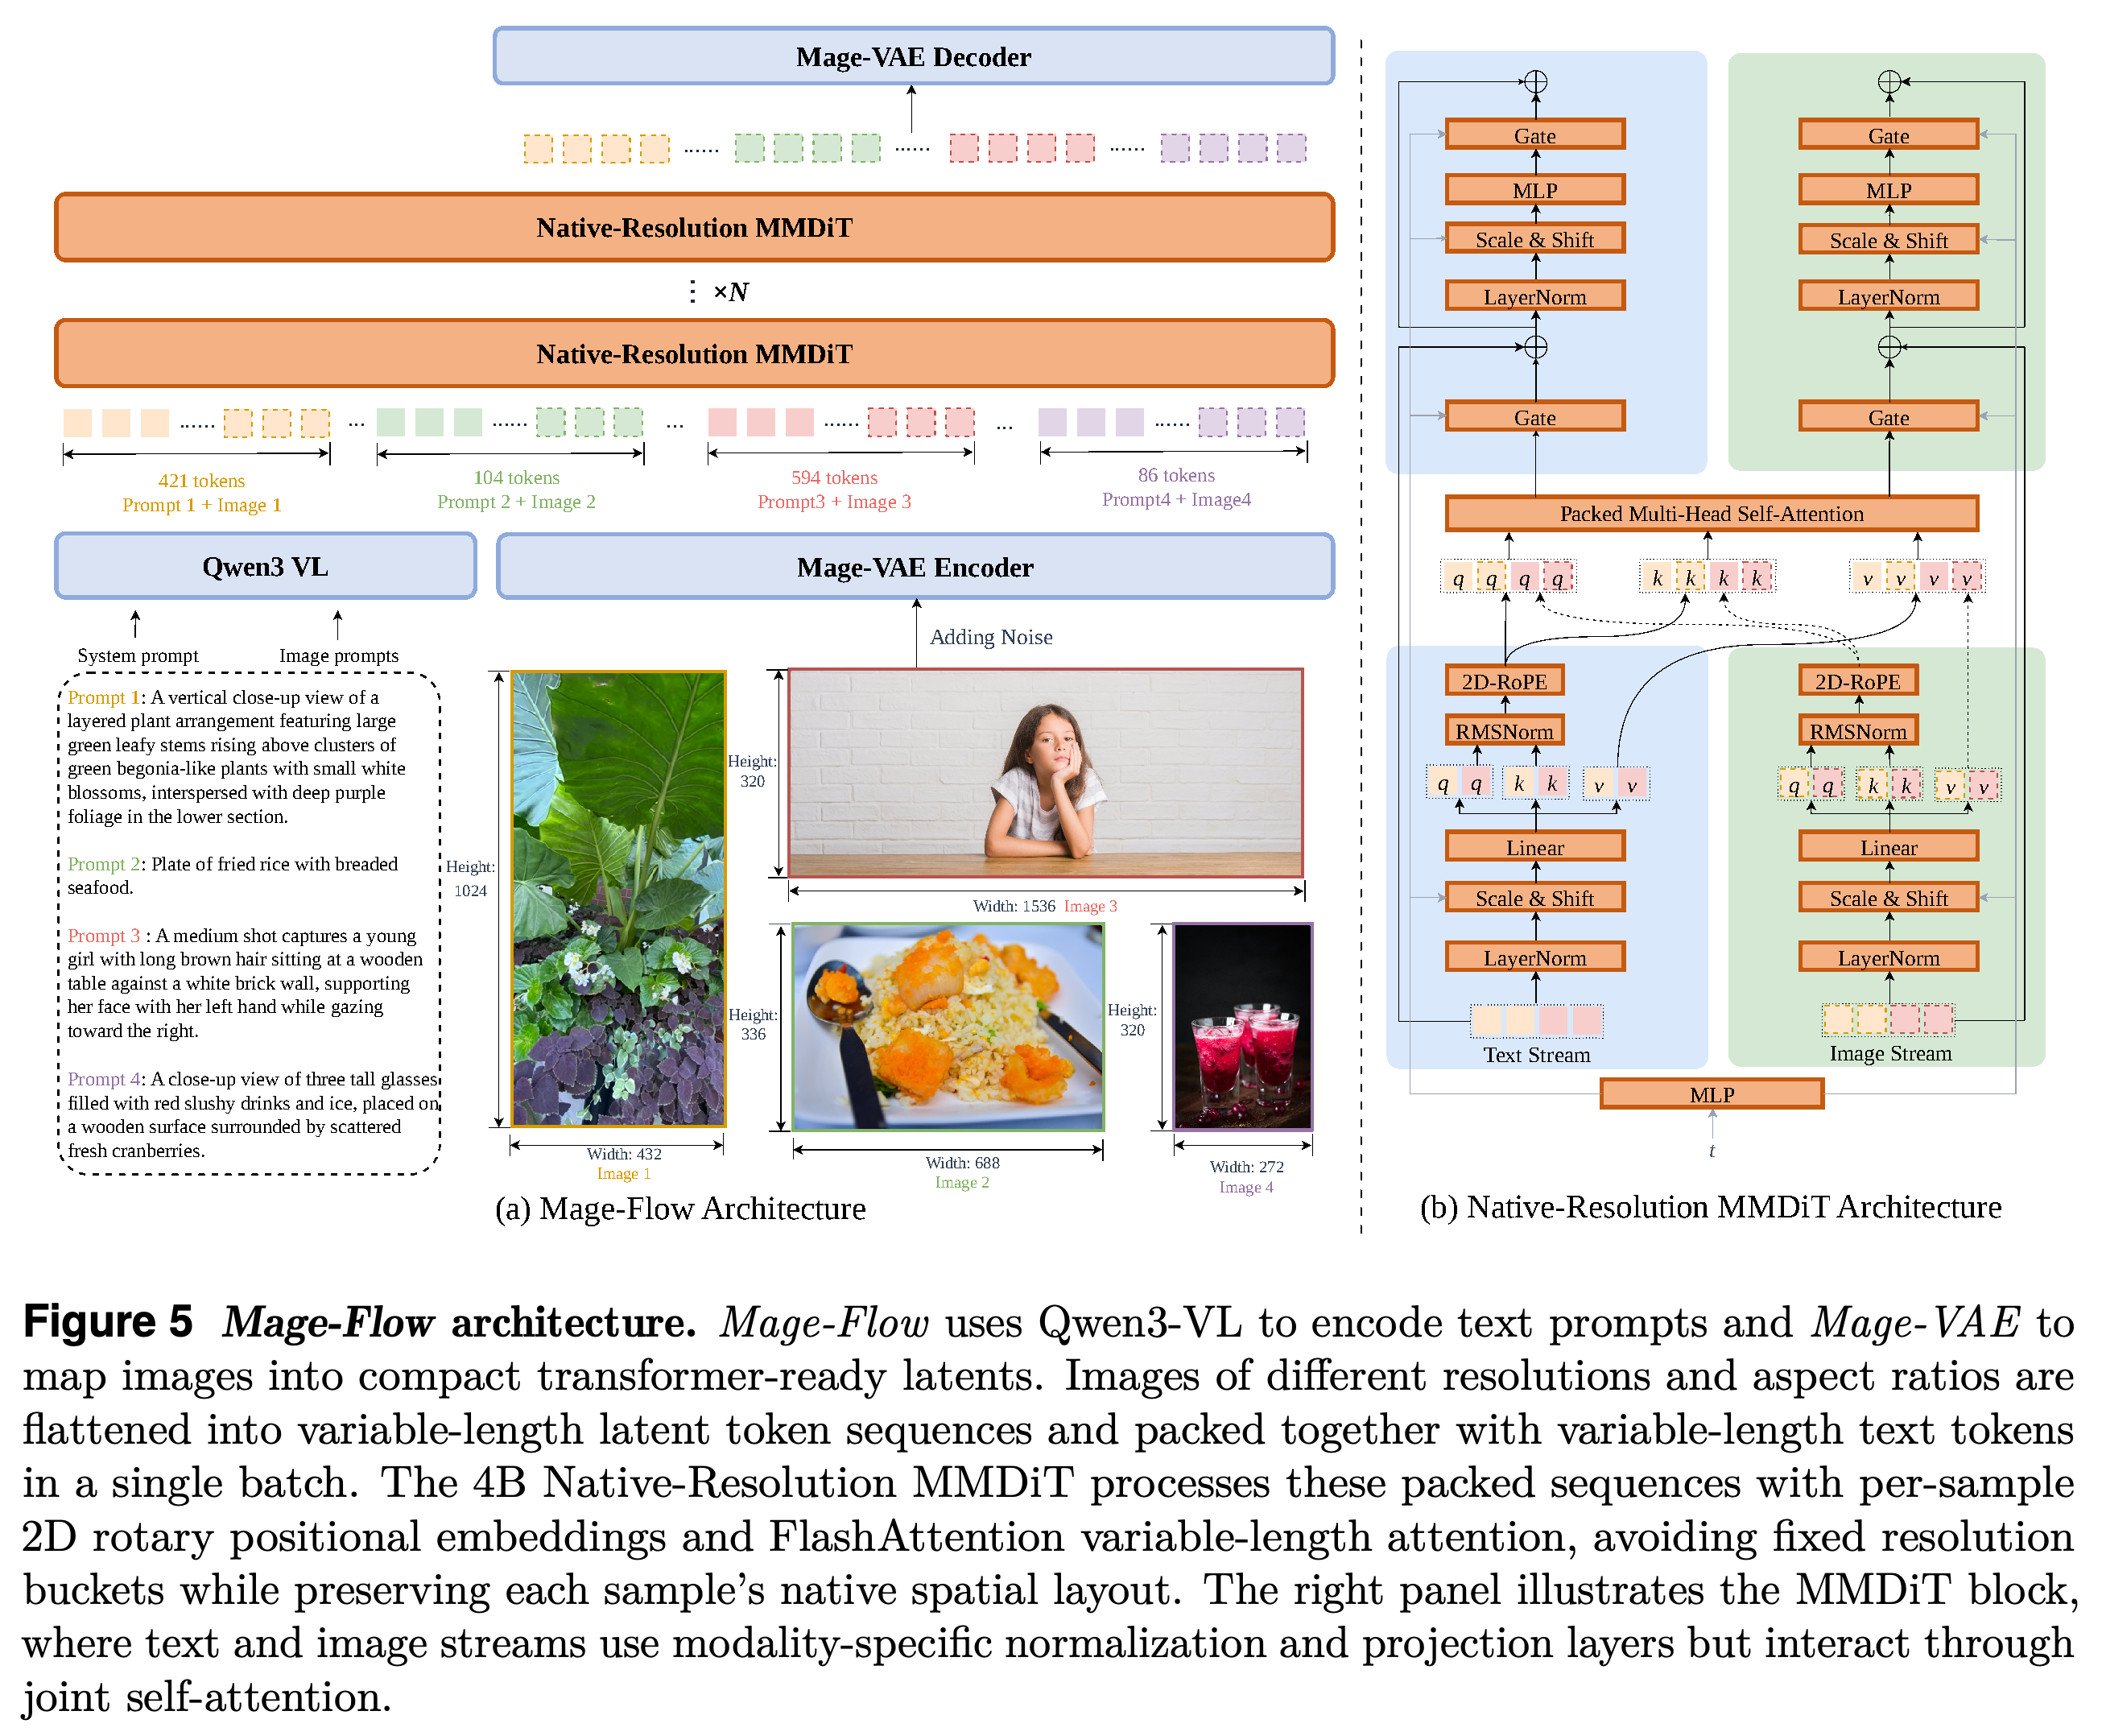
conditional 및 unconditional CFG branch를 packing하면 추론 시간이 1.09×–1.15× 줄어든다.
3.2.2 Conditioning and rectified-flow training
고정한 Qwen3-VL-4B-Instruct encoder가 conditioning을 제공하고, 모델은 Mage-VAE 공간에서 rectified flow matching으로 학습한다. 편집에서는 instruction embedding, source latent, noisy target latent를 연결하고 frame-aware 3D RoPE를 사용하며 target token에만 loss를 적용한다.
3.3 Training Infrastructure
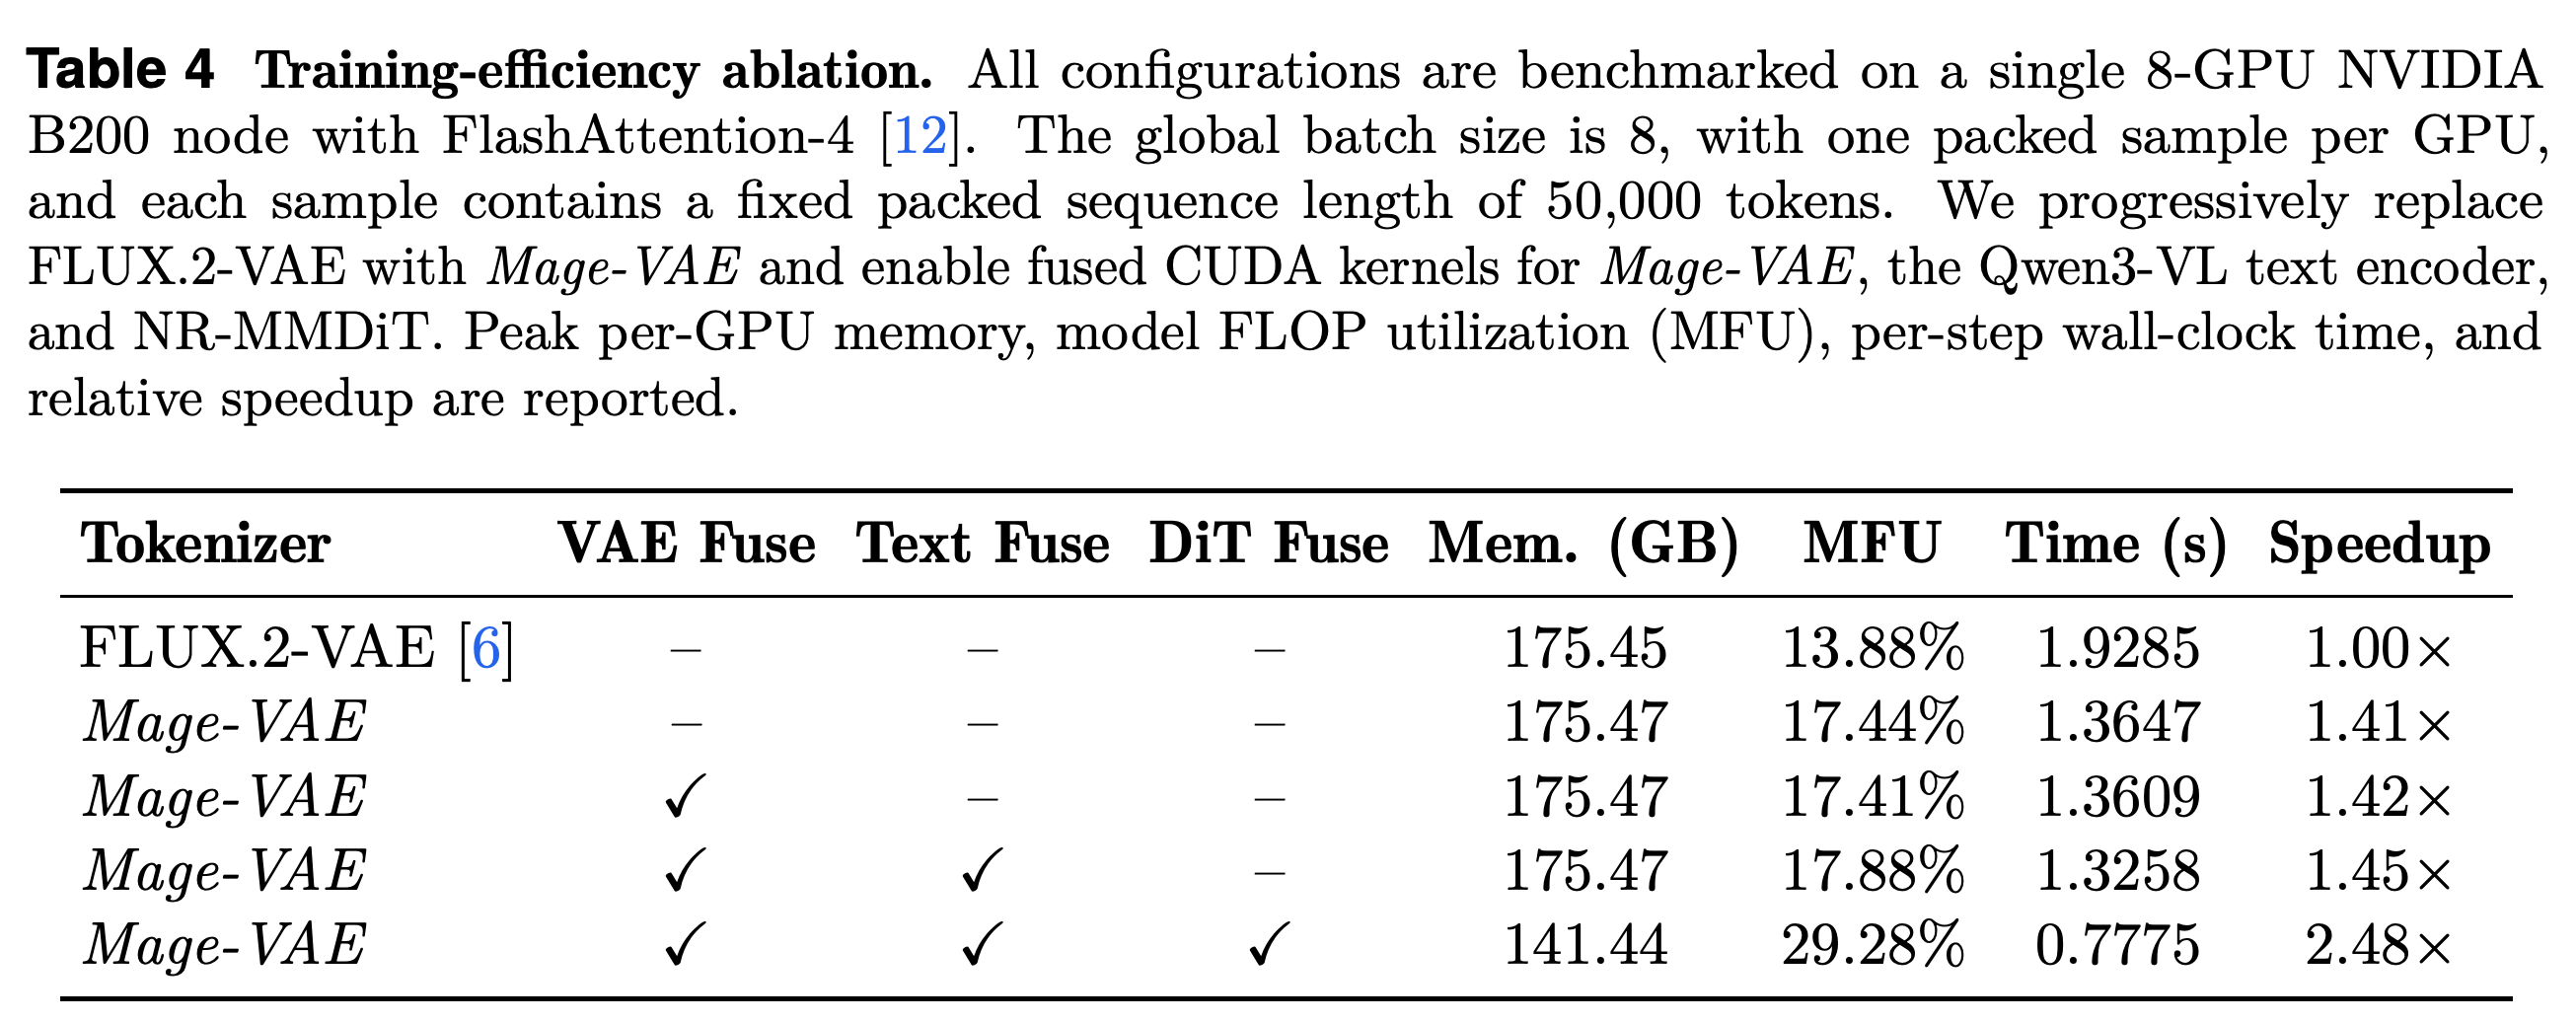
시스템은 Mage-VAE, Qwen3-VL, NR-MMDiT에서 반복되는 memory-bound operator chain을 융합한다. 8-GPU NVIDIA B200 node 1대에서 전체 구성은 MFU를 13.88%에서 29.28%로 높이고, GPU당 메모리를 175.45 GB에서 141.44 GB로 줄이며, step time을 1.9285 s에서 0.7775 s로 줄인다.
Mage-VAE와 full fusion은 step time을 0.7775 s, GPU당 memory를 141.44 GB까지 줄인다.
4 Data Collection and Curation
생성과 편집에는 각각 image-text pair 및 source-image/instruction/target-image triple을 정제하는 별도 pipeline을 사용한다. 두 pipeline 모두 품질, 안전성, 의미 정렬, 다양성, 역량 범위를 목표로 한다.
4.1 Text-to-Image Data Collection and Filtering
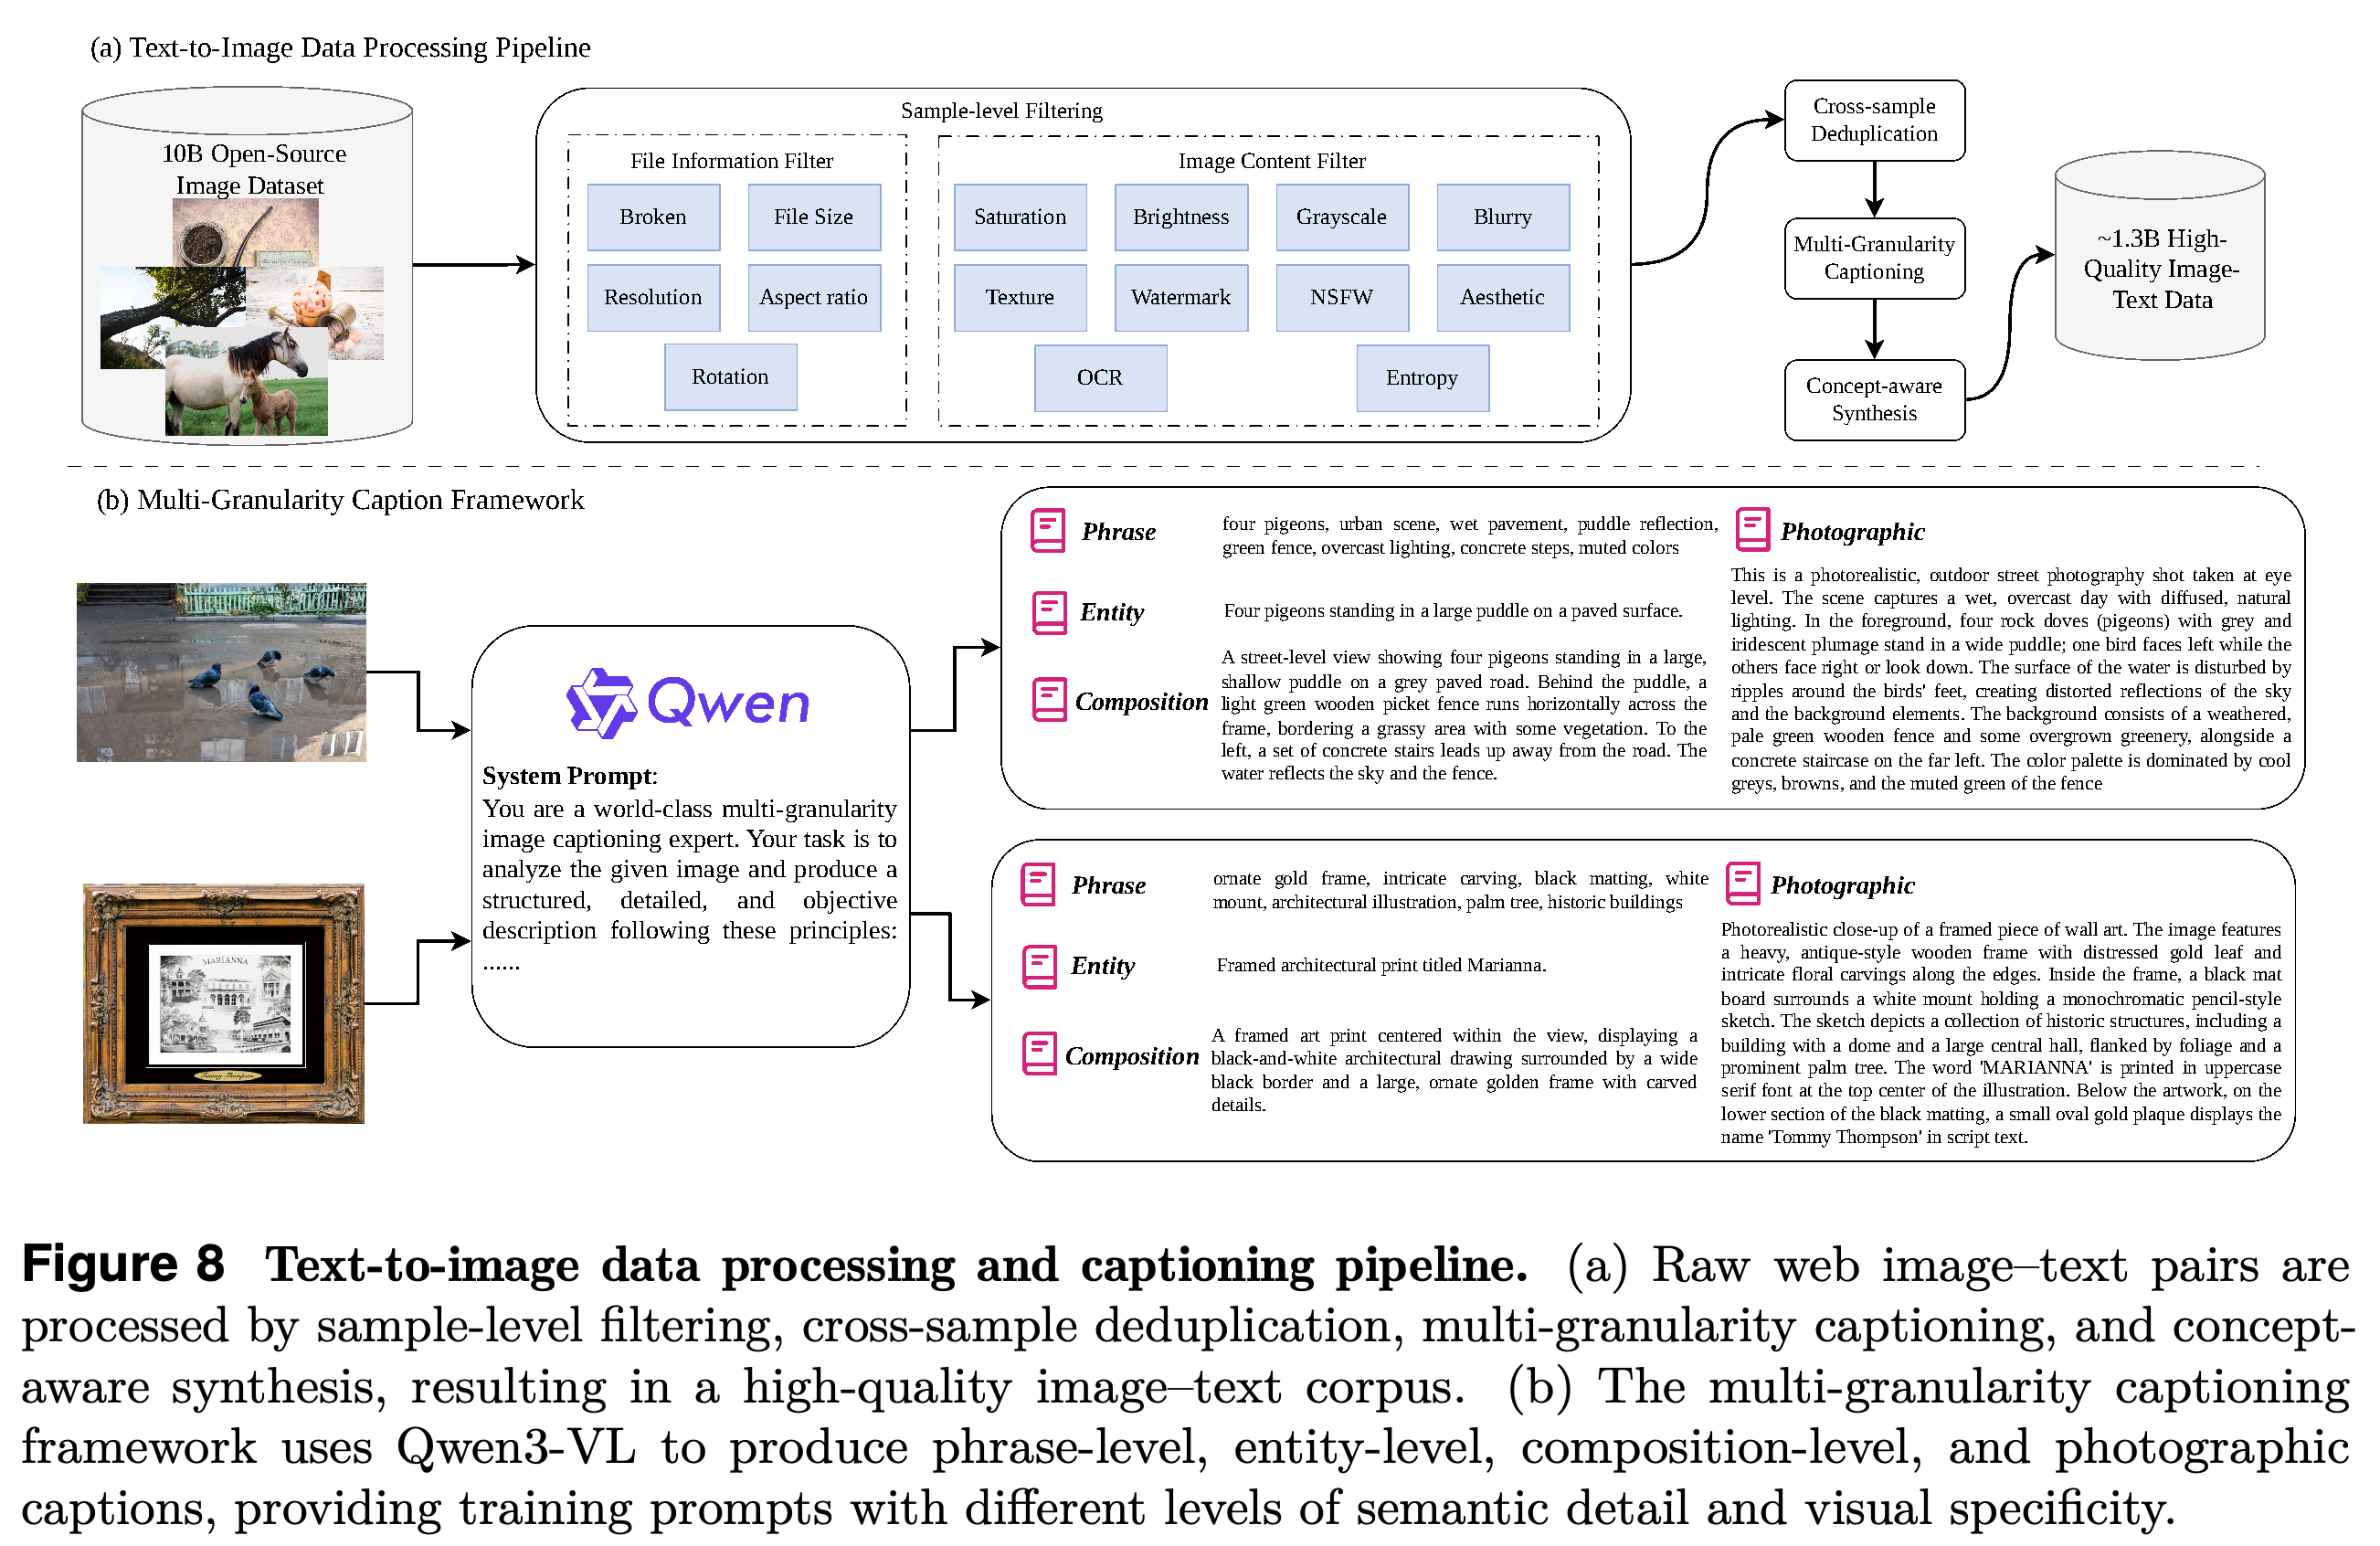
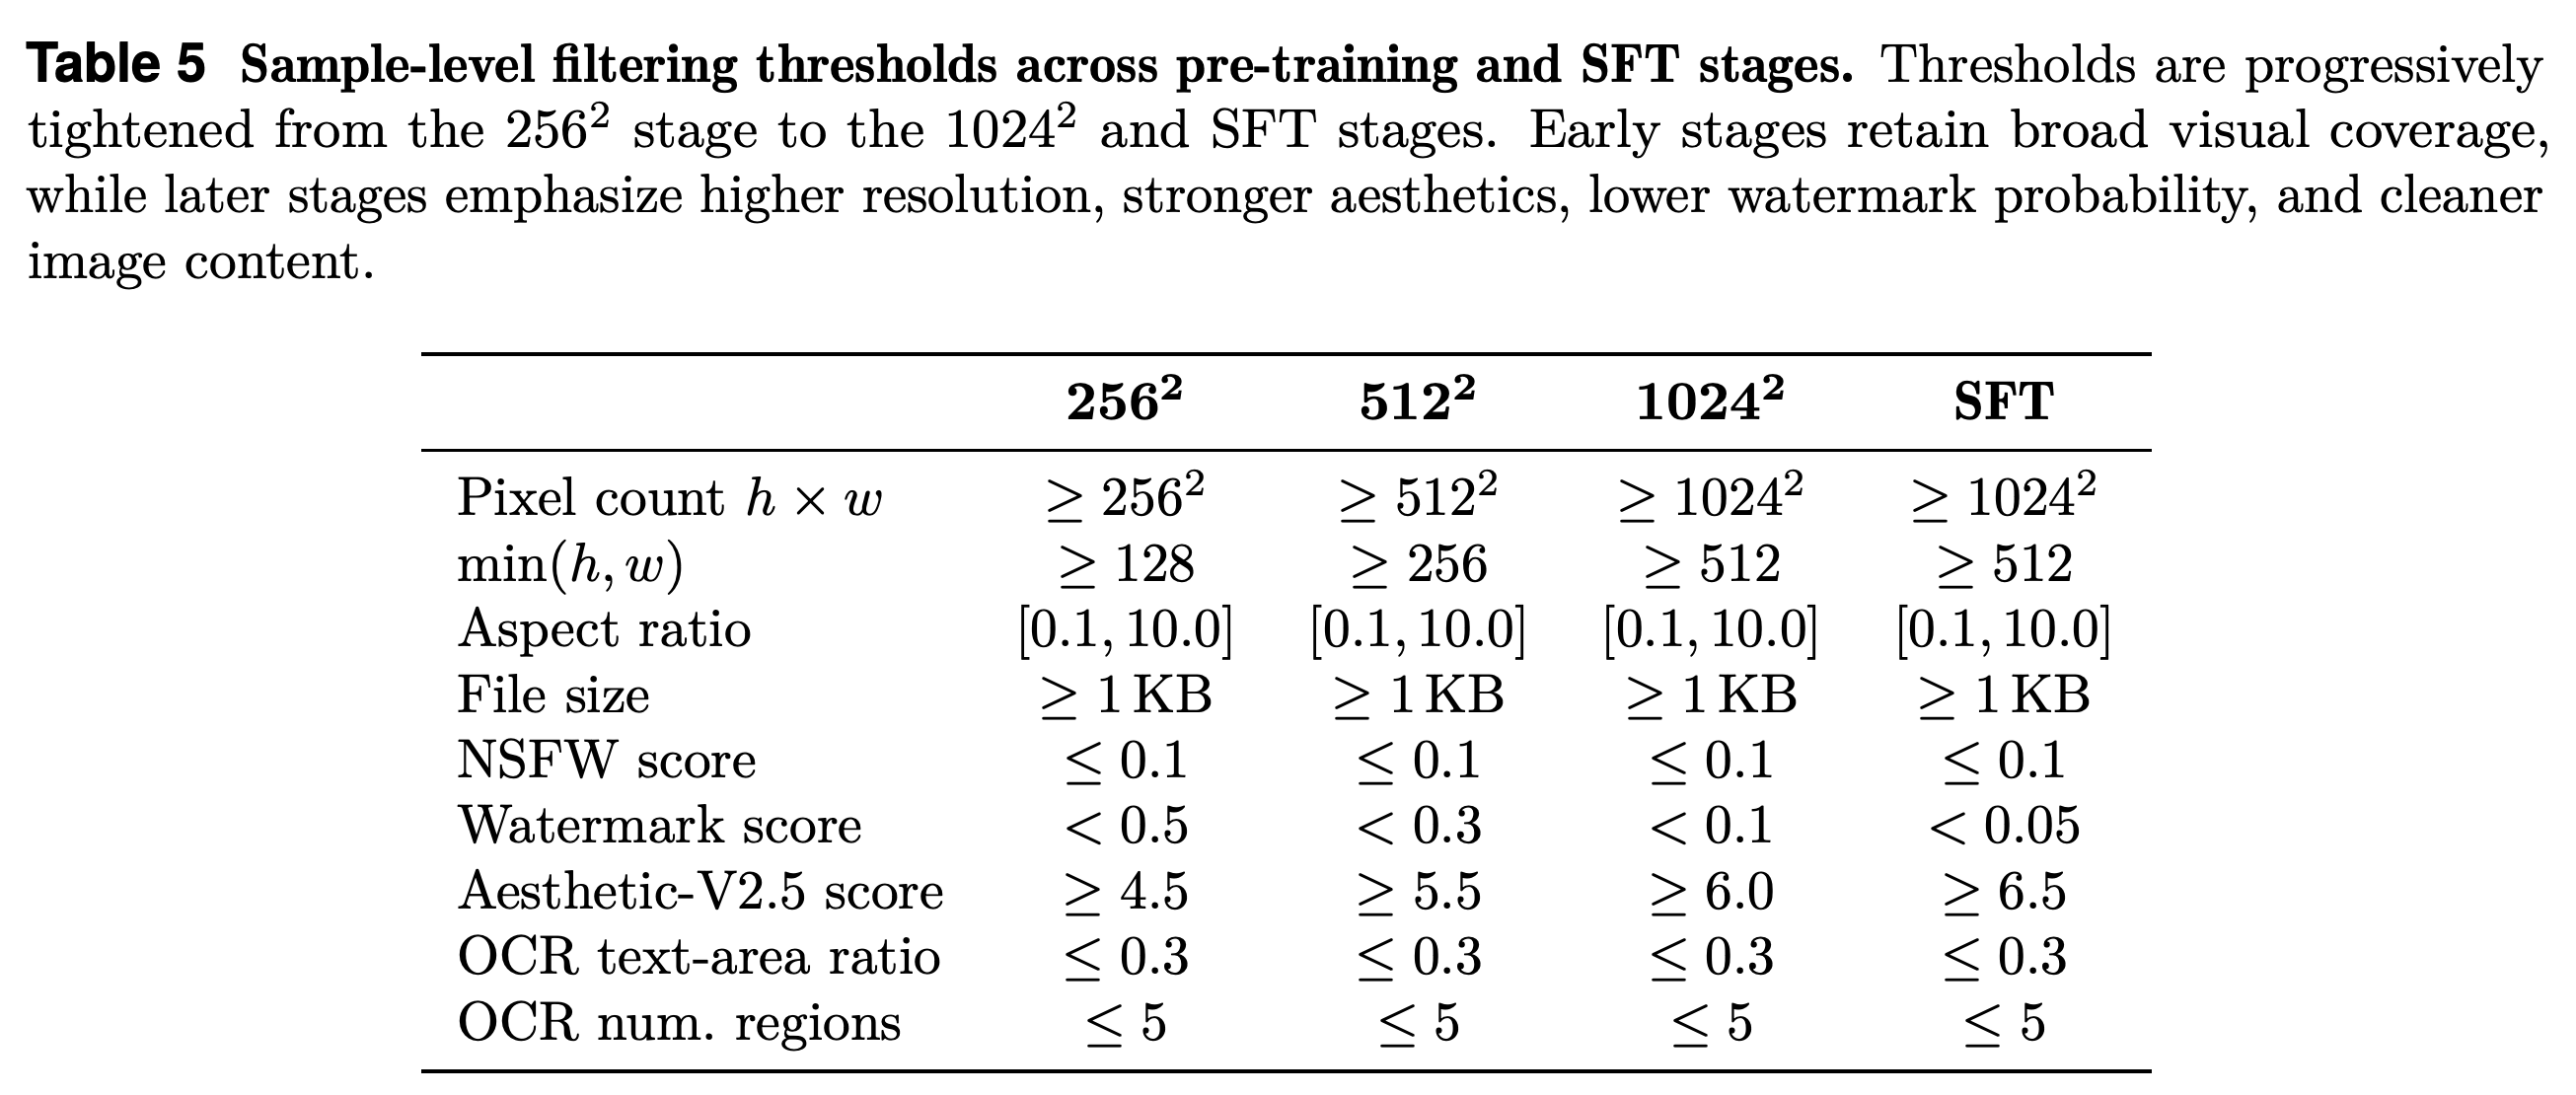
생성 pipeline은 약 10B open-source pair에서 시작하며, filtering, SSCD/FAISS deduplication, multi-granularity recaptioning, concept-aware synthesis 뒤 약 1.3B개를 남긴다. 256²부터 1024² 및 SFT 단계로 갈수록 threshold를 더 엄격하게 적용한다.
filtering, deduplication, recaptioning, synthesis, 4가지 caption granularity를 나타낸다.
후속 단계에서 pixel, aesthetic, watermark, content threshold를 더 엄격하게 적용함을 문서화한다.
4.2 Image-Editing Data Collection and Filtering
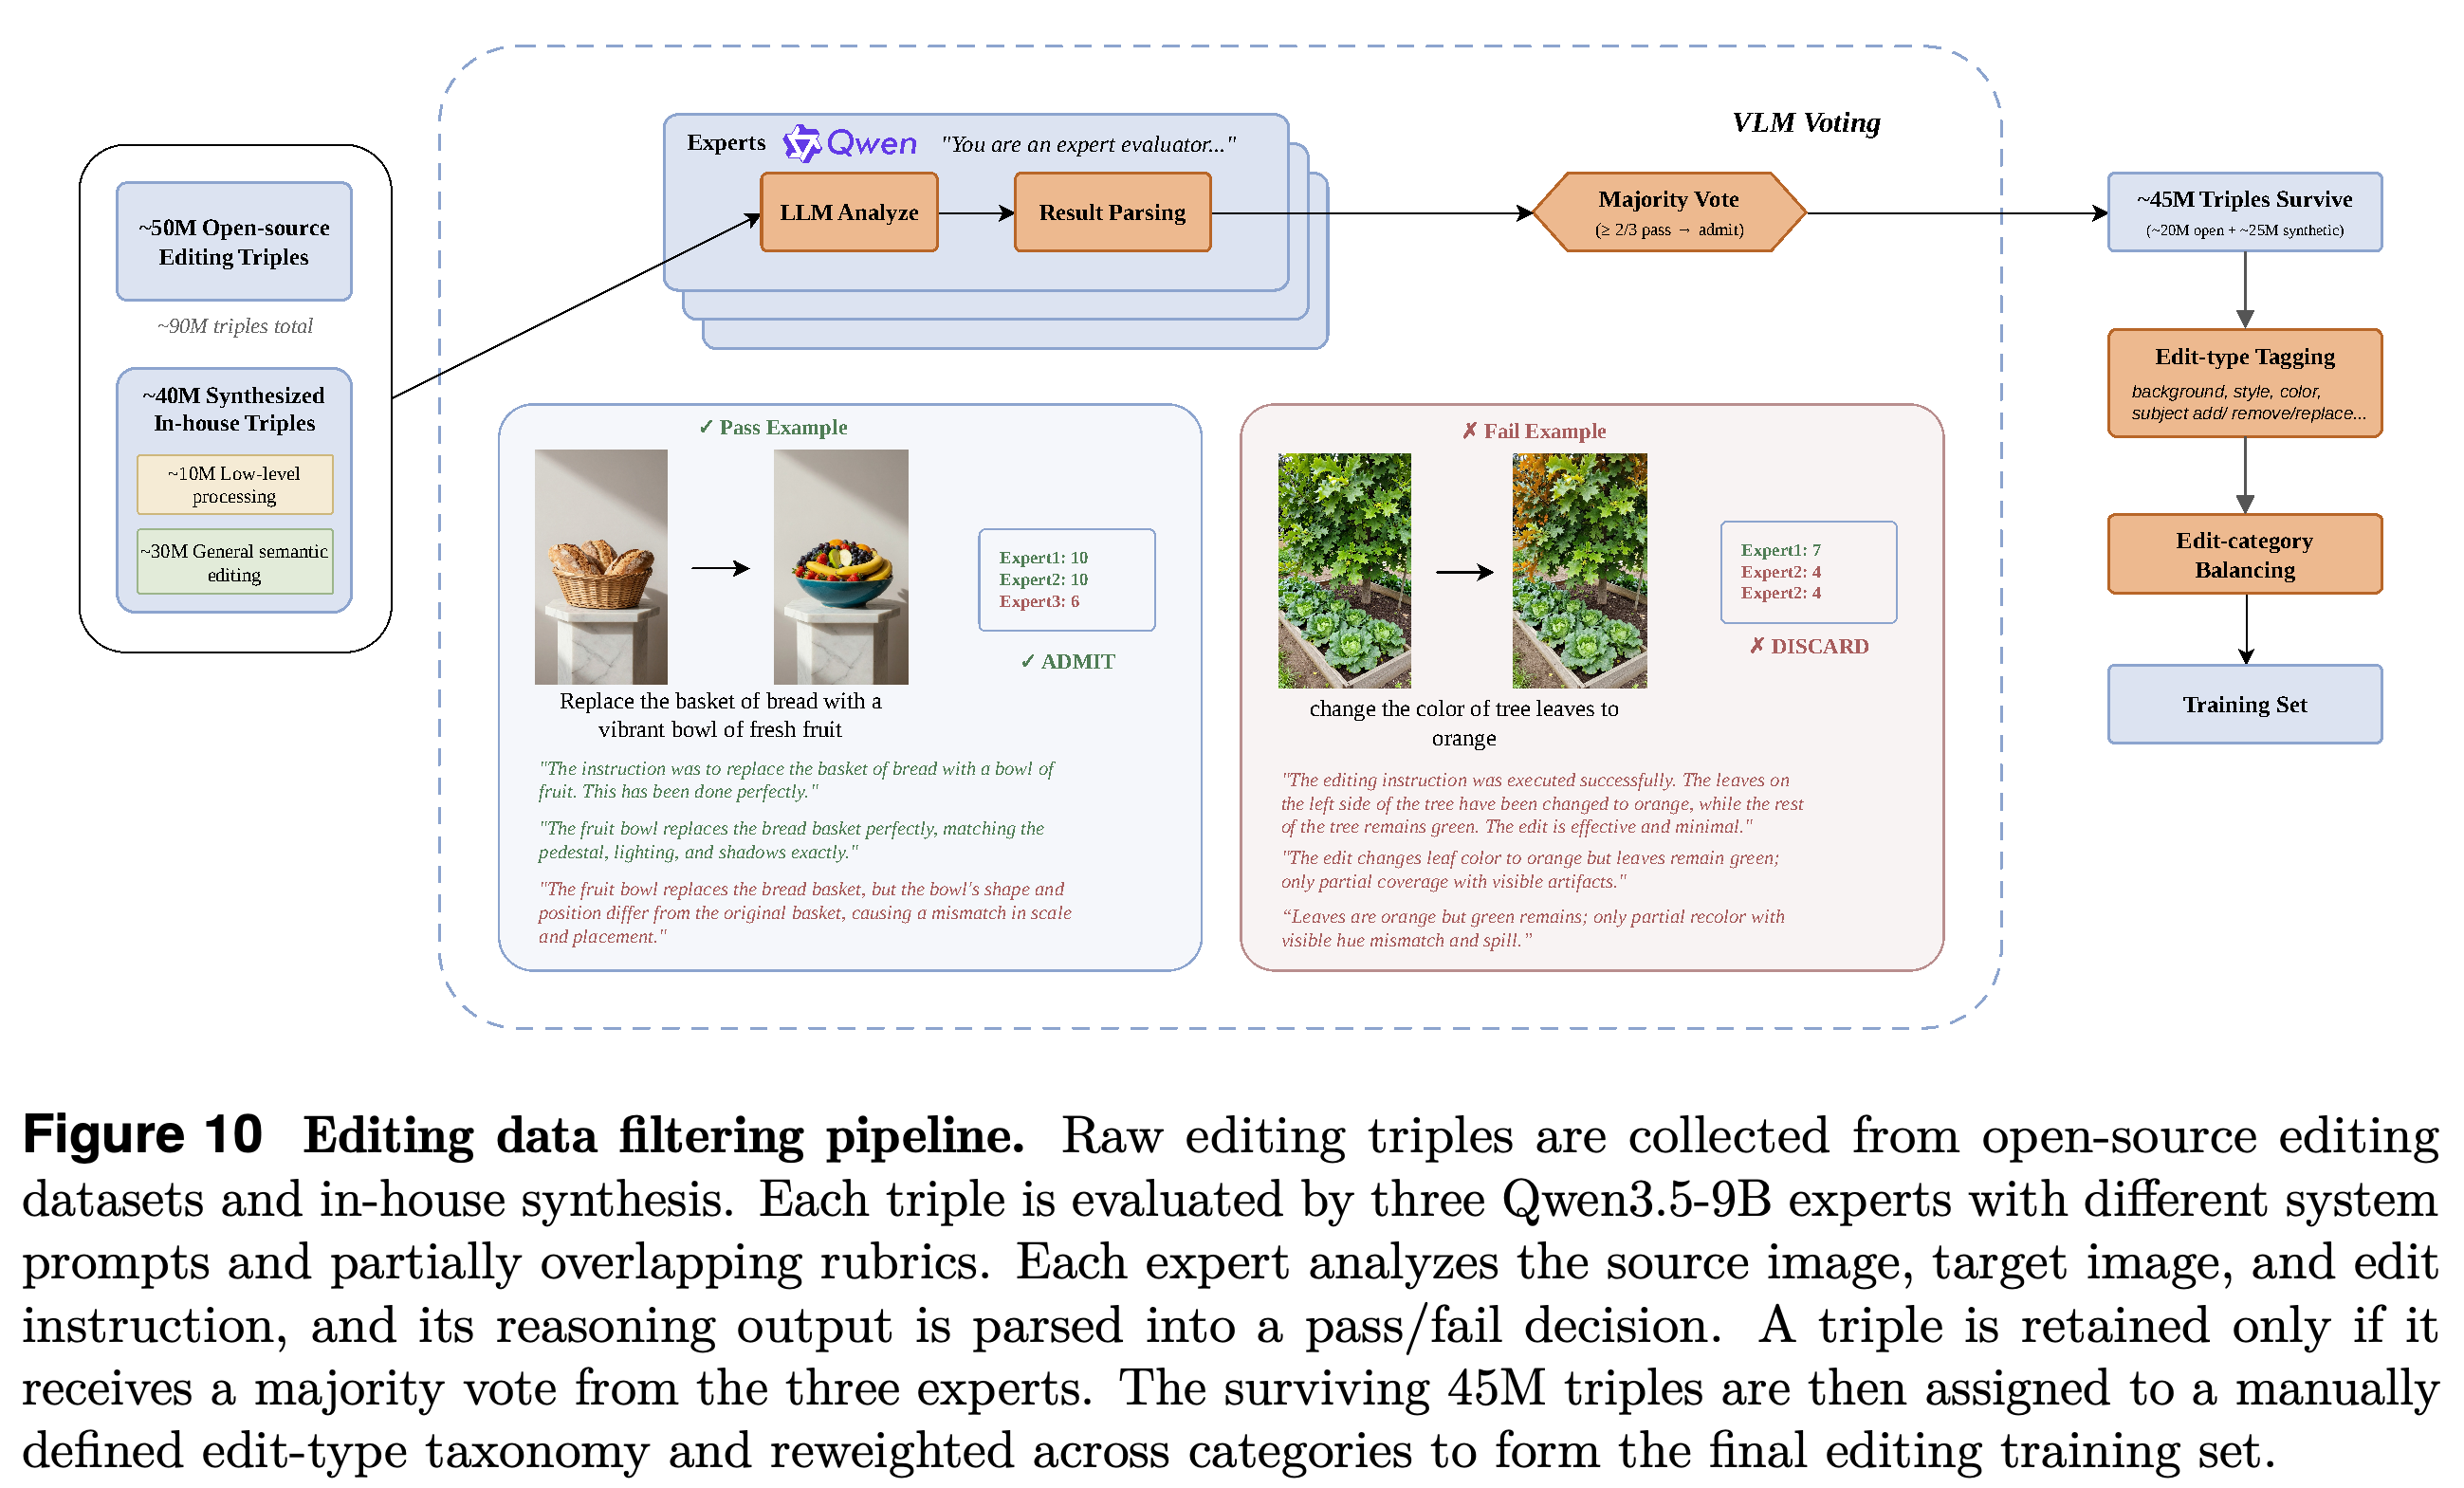
편집 corpus는 약 90M개 triple로 시작하며, 약 50M개는 open-source이고 40M개는 내부에서 합성했다. Qwen3.5-9B expert 3개가 각 triple에 투표하며, 약 45M개가 남아 수작업으로 정의한 19개 edit category taxonomy에 맞춰 균형을 맞춘다.
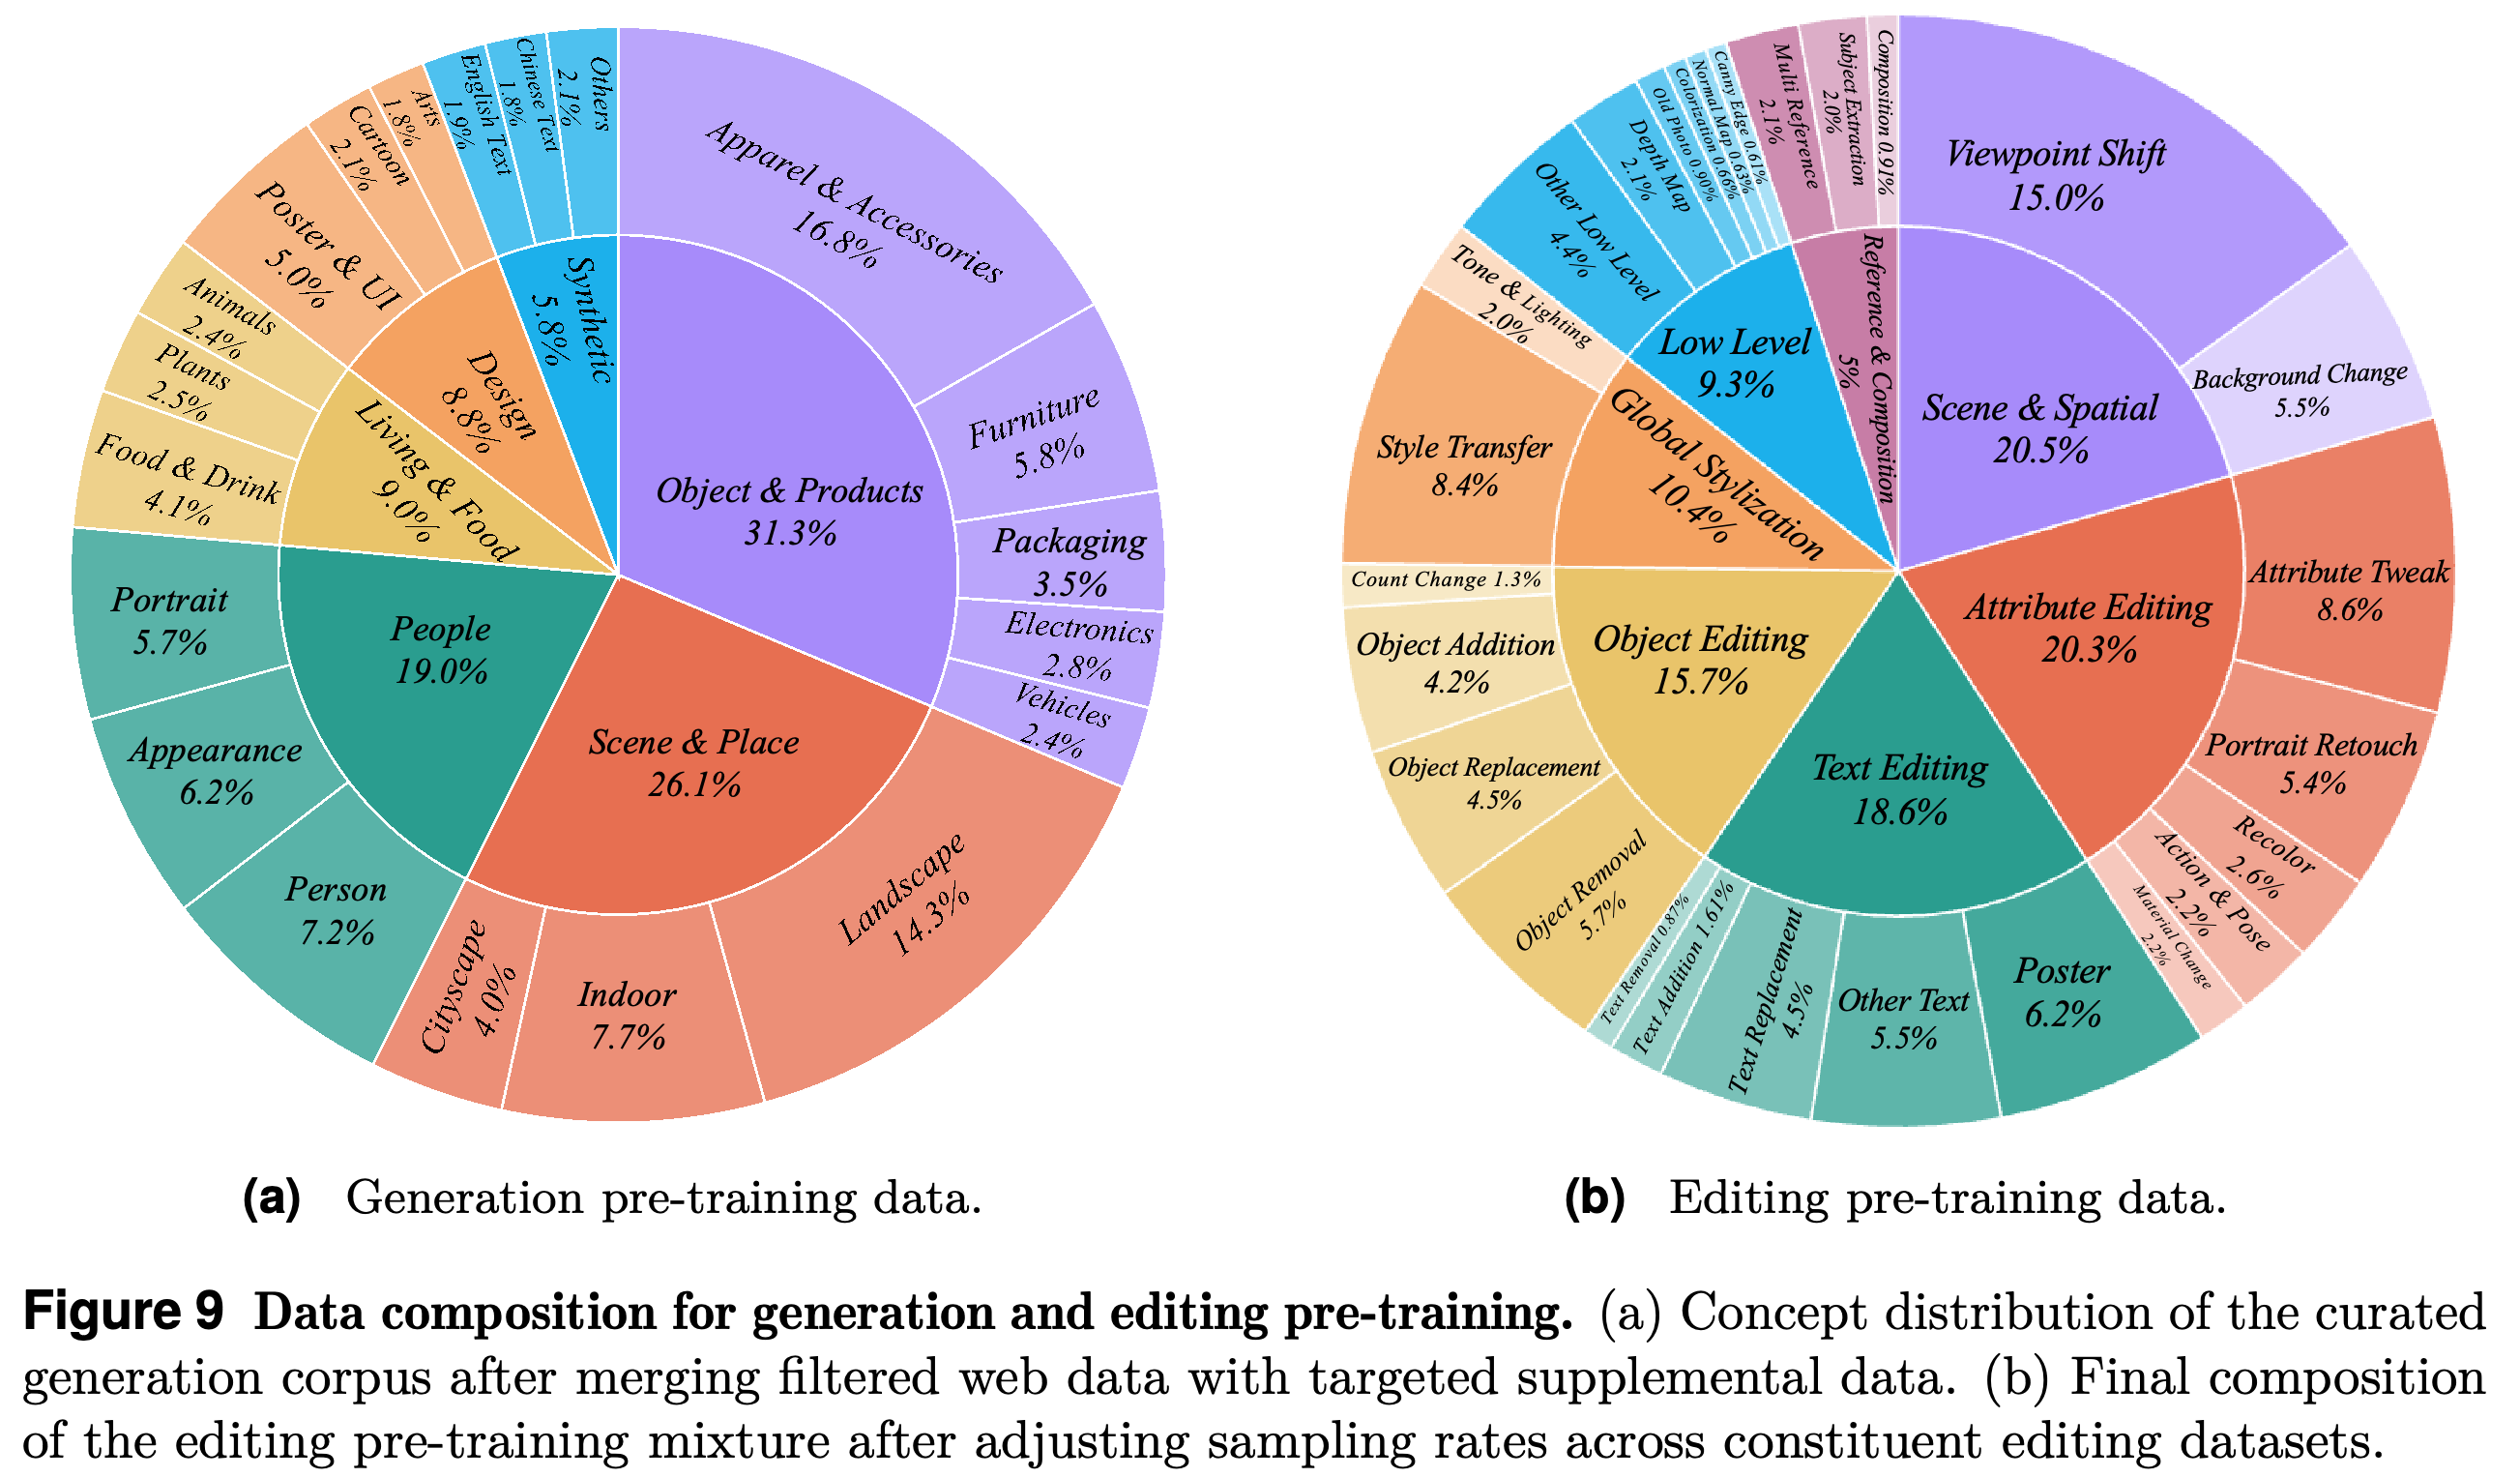
생성 및 편집 pre-training의 최종 concept mixture를 보여준다.
3개 expert의 다수결 필터링, edit tagging, category balancing을 보여준다.
5 Training
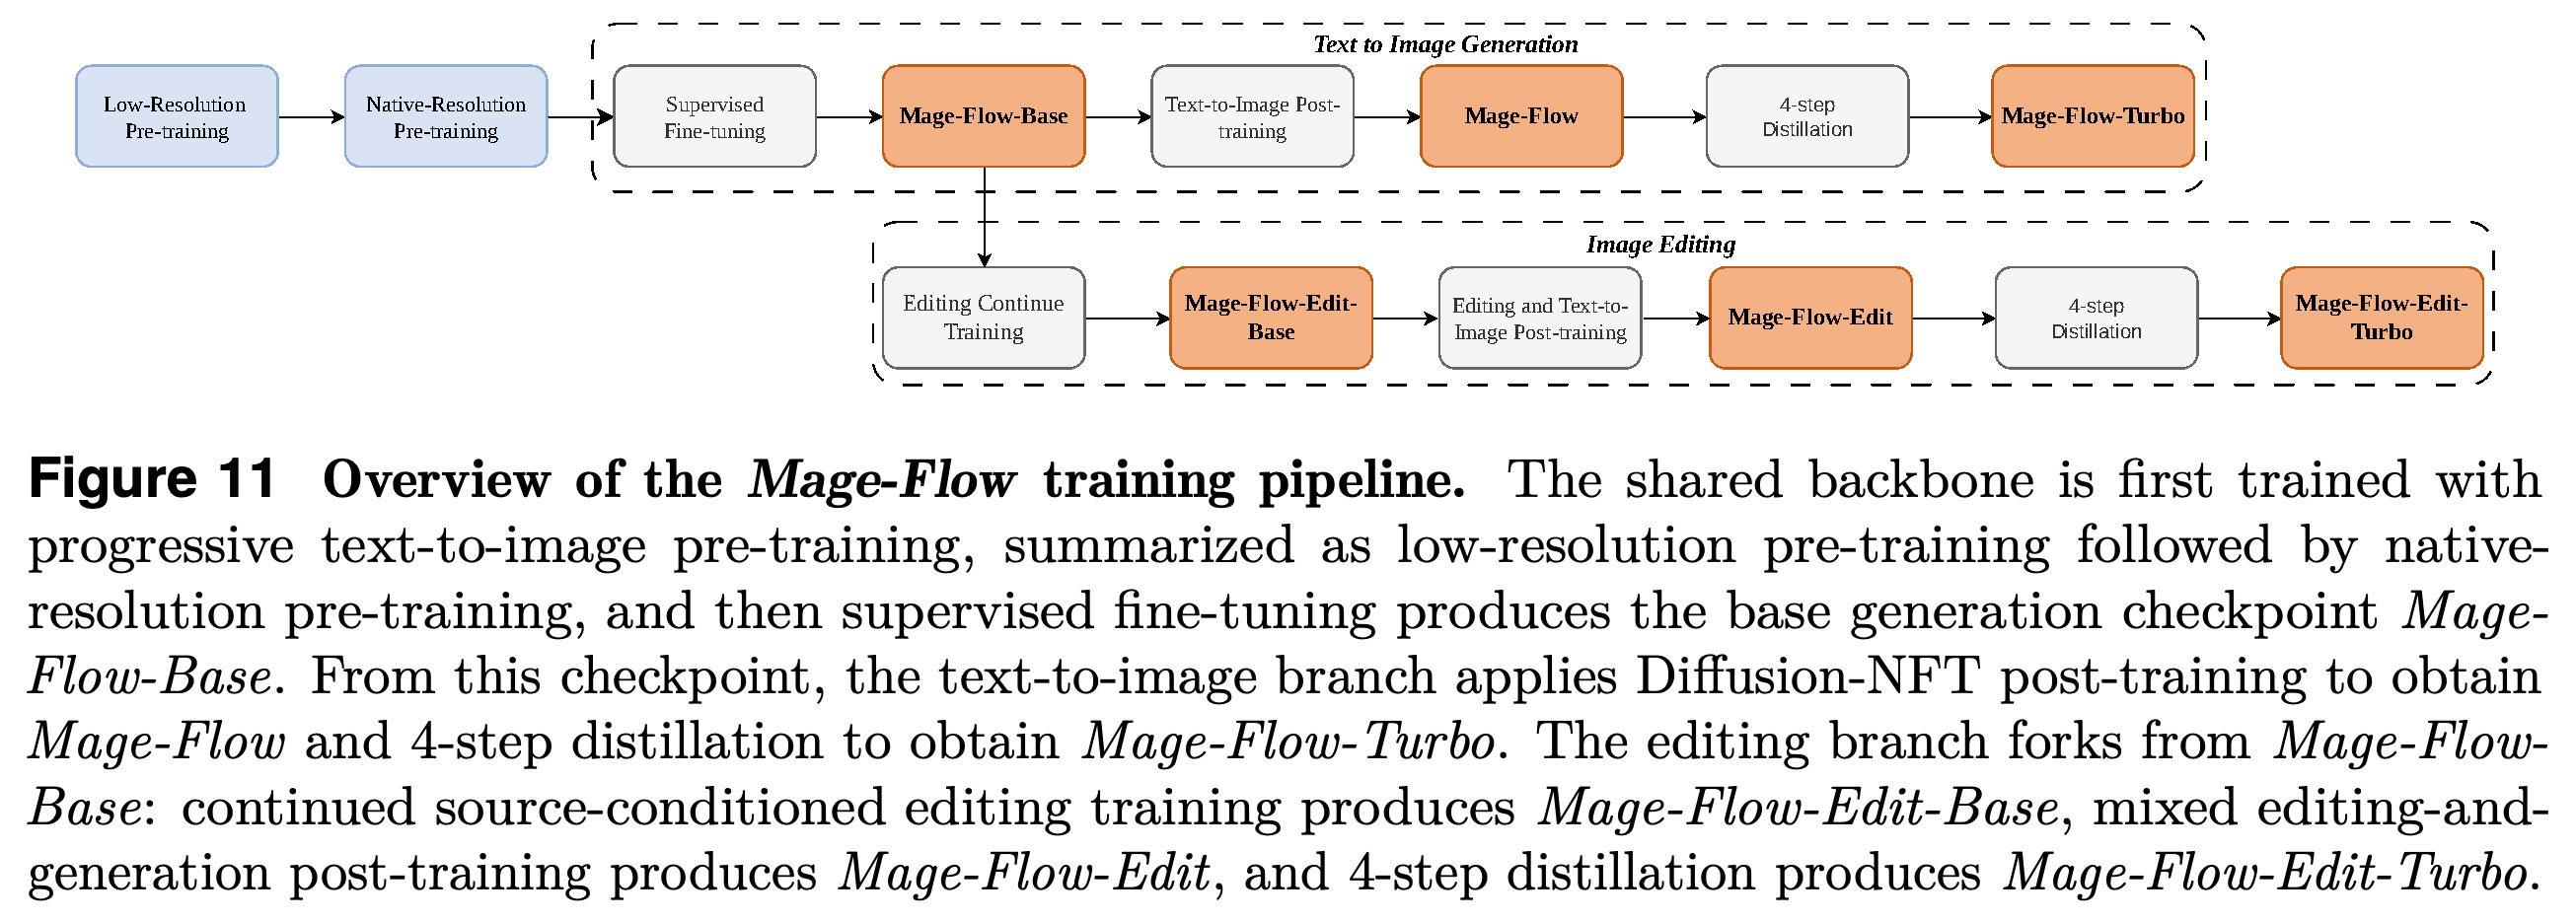
생성과 편집은 Mage-VAE latent, 4B backbone, rectified-flow 학습을 공유하고 conditioning과 data mixture만 다르다. pipeline은 Base, Diffusion-NFT-aligned, 4-step Turbo checkpoint를 생성한다.
Base checkpoint가 aligned 및 4-step Turbo 생성·편집 모델로 분기하는 과정을 보여준다.
5.1 Pre-training and Supervised Fine-tuning
생성 학습은 256 × 256에서 1.2B pair, 512-pixel native-aspect-ratio regime에서 600M개, 1024-pixel regime에서 300M개, 150M pair의 SFT 순으로 진행한다. 편집은 35M triple과 35M generation pair를 사용한 뒤 20M triple과 10M generation pair를 사용하며, multi-image 예시는 편집 데이터의 최대 0.5%다.
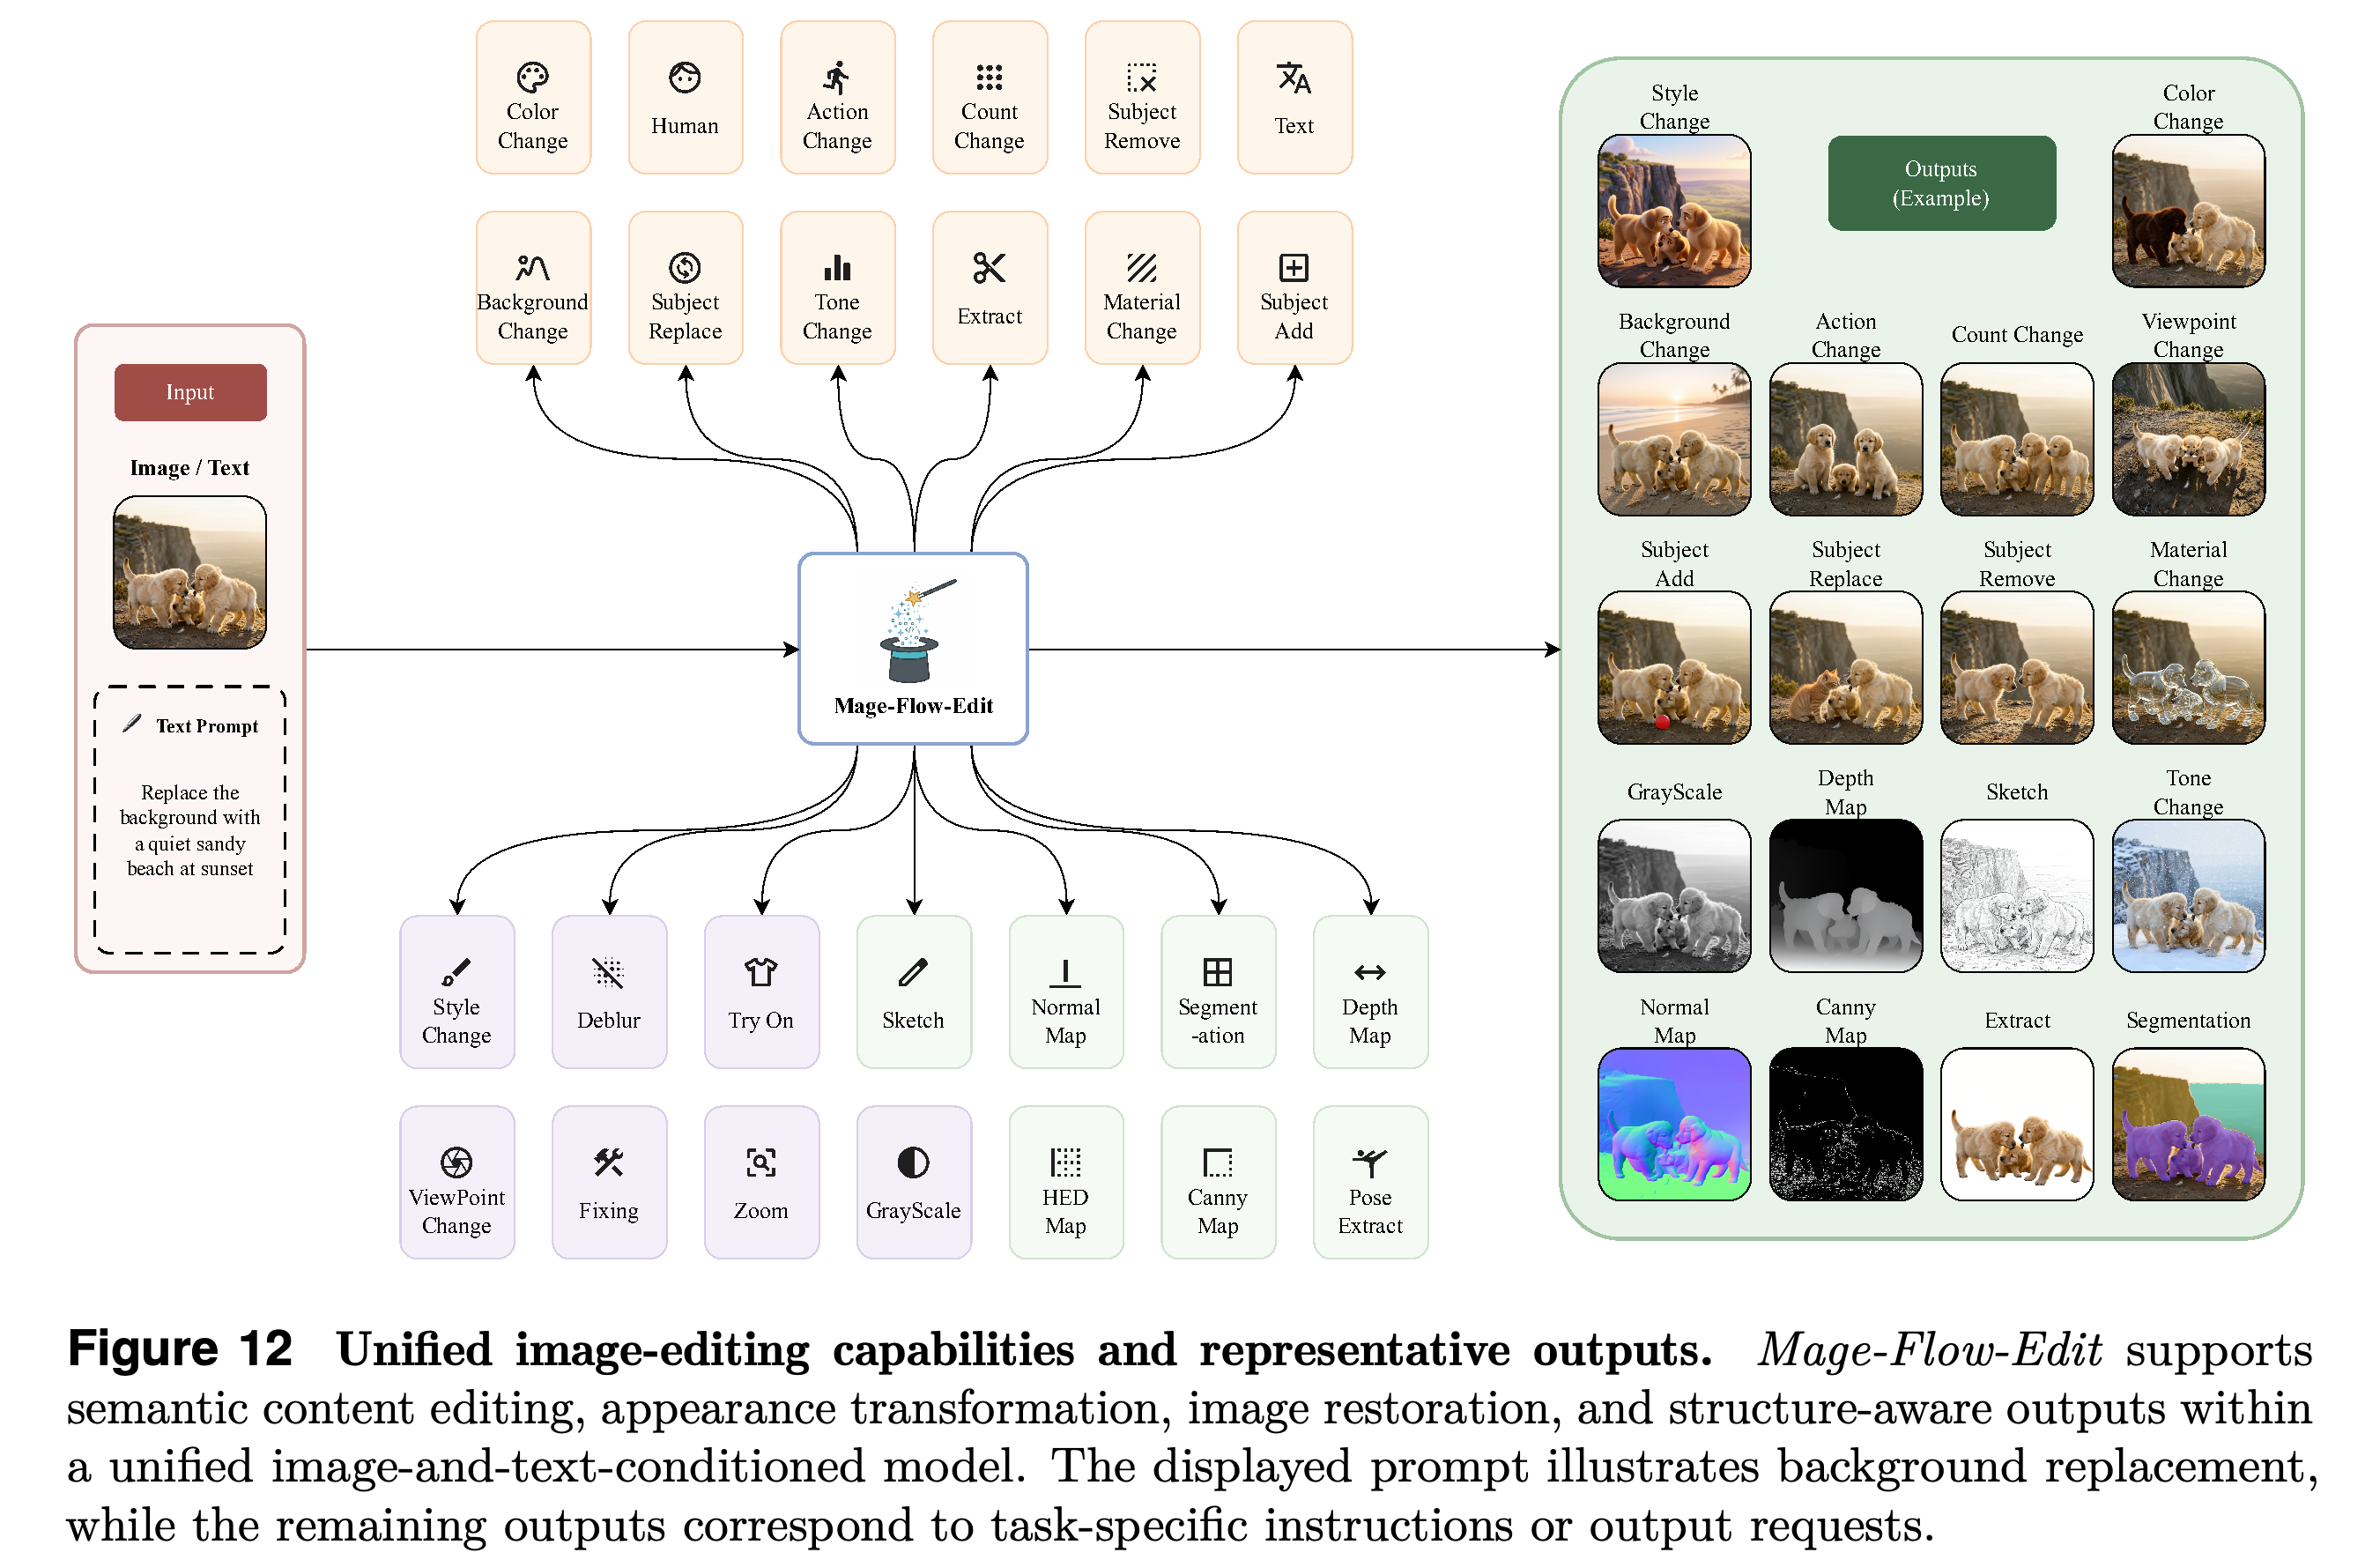
이미지와 텍스트에 조건화된 editor 1개가 semantic, appearance, restoration, structural output을 생성하는 모습을 보여준다.
5.2 Diffusion-NFT Post-training
생성 사후 학습은 텍스트 렌더링, 미적 품질, 의미 이해로 나눈 약 20K prompt를 사용한다. 편집은 4:1 비율로 편집 및 생성 update를 교차하고, RationalRewards로 약 30K editing prompt를 채점하며, 300 optimizer step을 수행한다.
5.3 Few-step Distillation
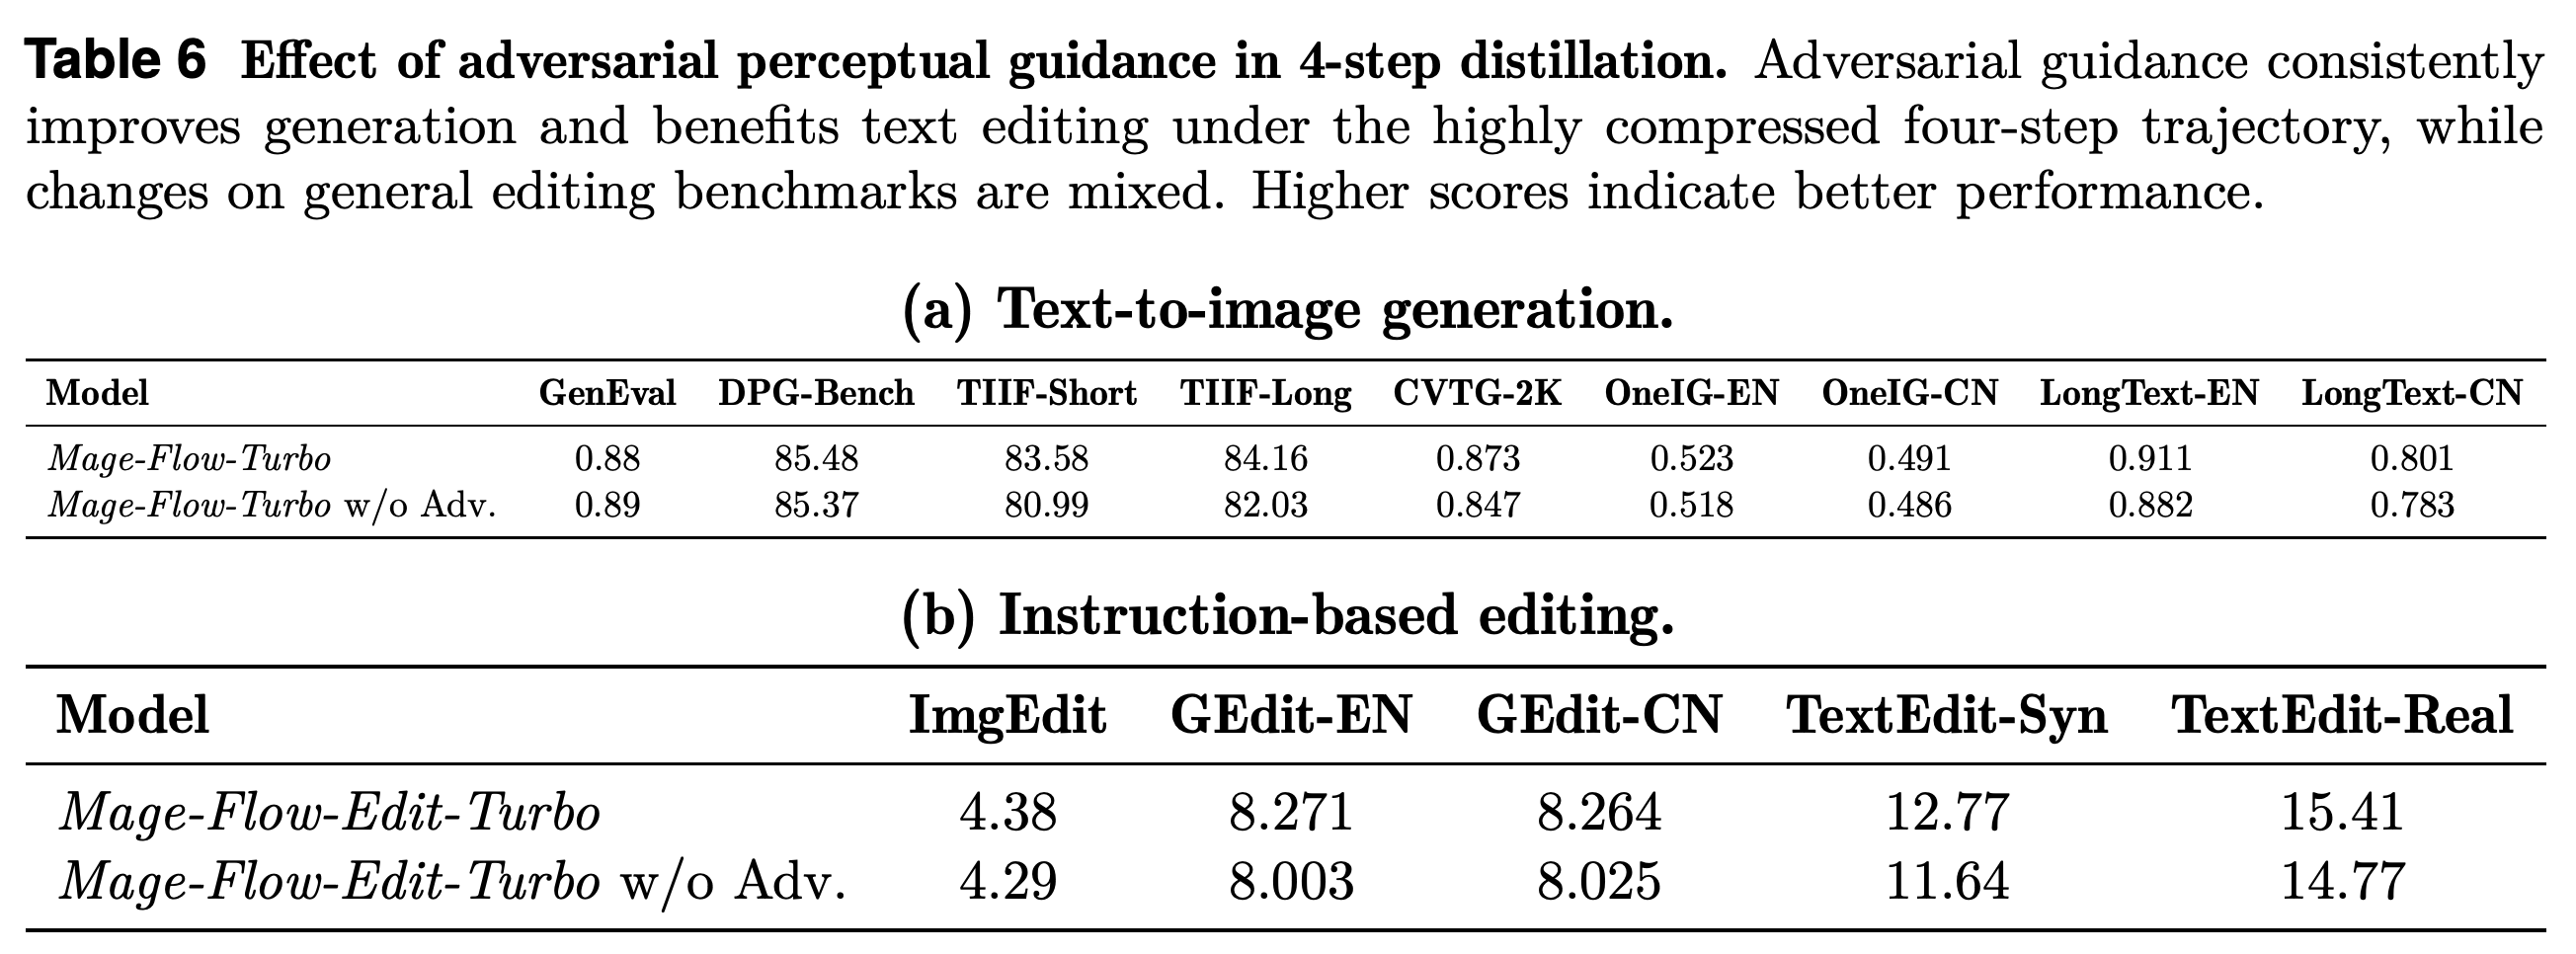
Turbo student는 고정한 aligned teacher에서 초기화하며 Decoupled DMD와 DINOv2/CLIP feature discriminator로 학습한다. 보고한 설정은 w = 7.5와 λGAN = 0.13이며, adversarial guidance는 여러 생성 및 text-editing metric을 개선하지만 general editing 효과는 혼재한다. CLIP에 대해서는 이 글을 참조하라.
Decoupled DMD의 classifier-free augmentation 및 distribution-matching gradient를 adversarial guidance와 분리해 보여준다.
adversarial guidance를 제거하면 여러 생성 및 text-editing score가 낮아지지만, general editing의 변화는 일관되지 않다.
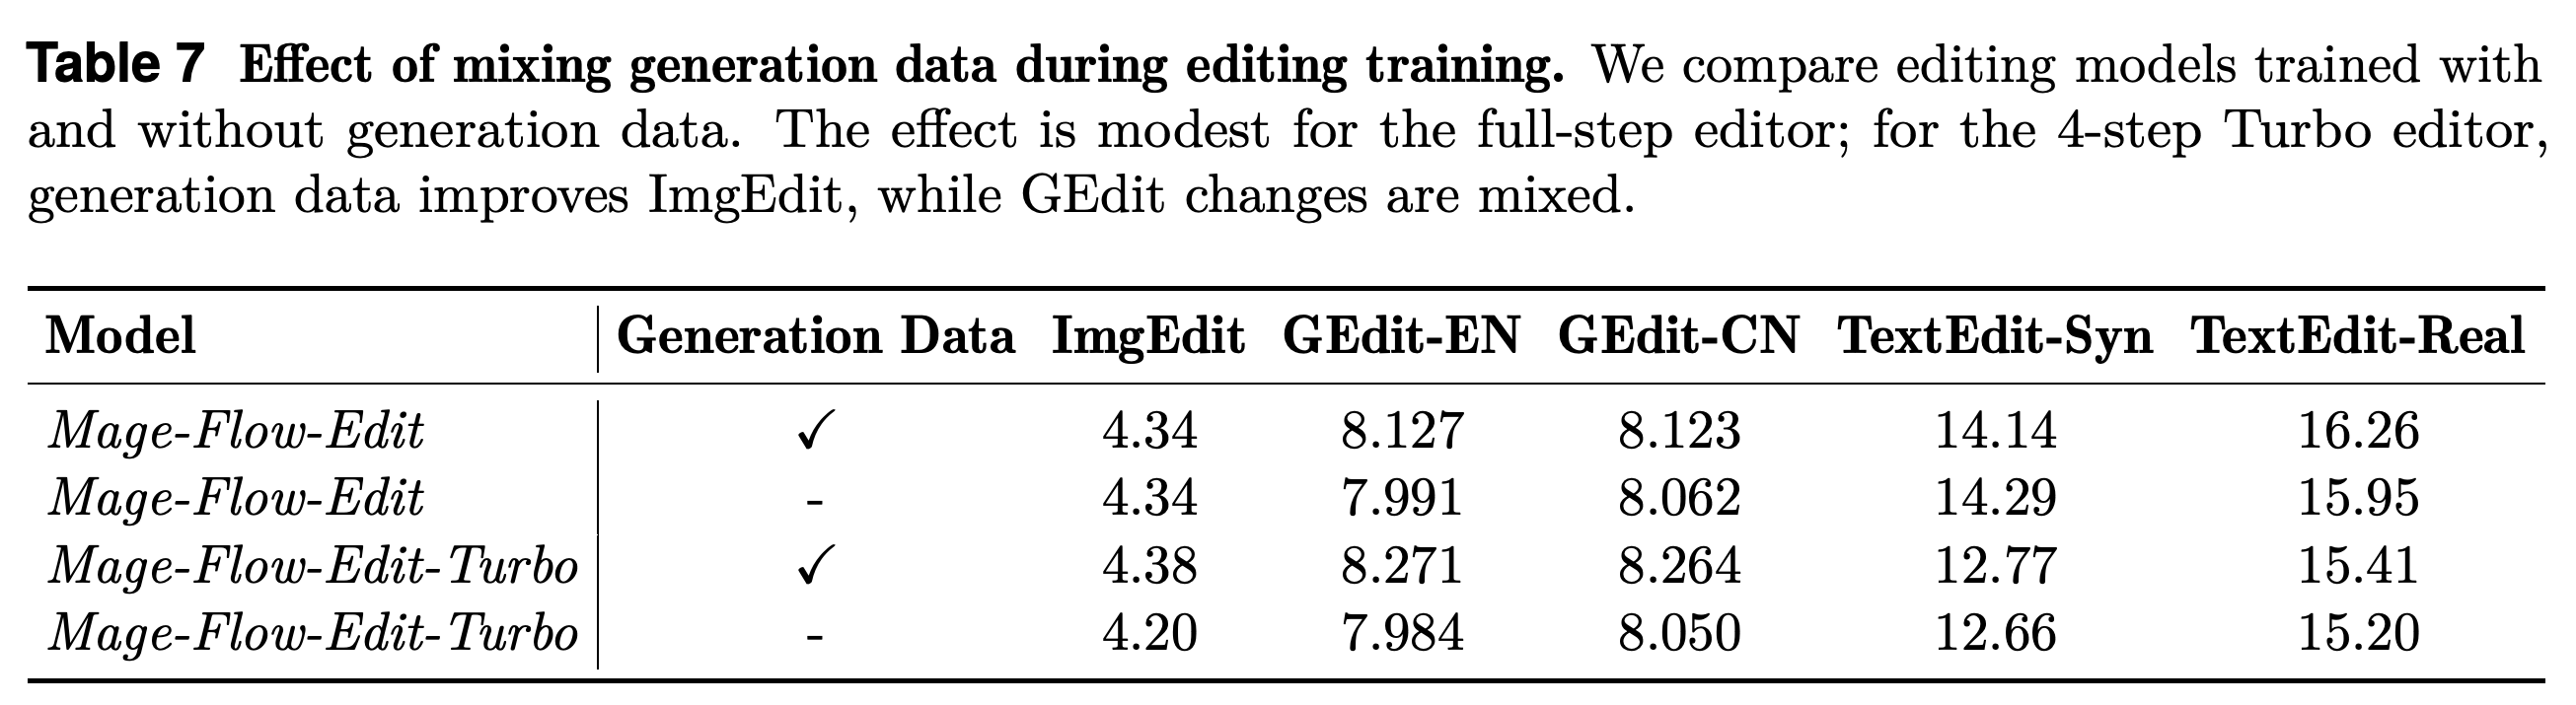
generation-data mixing은 Turbo ImgEdit를 4.20에서 4.38로 개선하지만 GEdit 변화는 혼재한다.
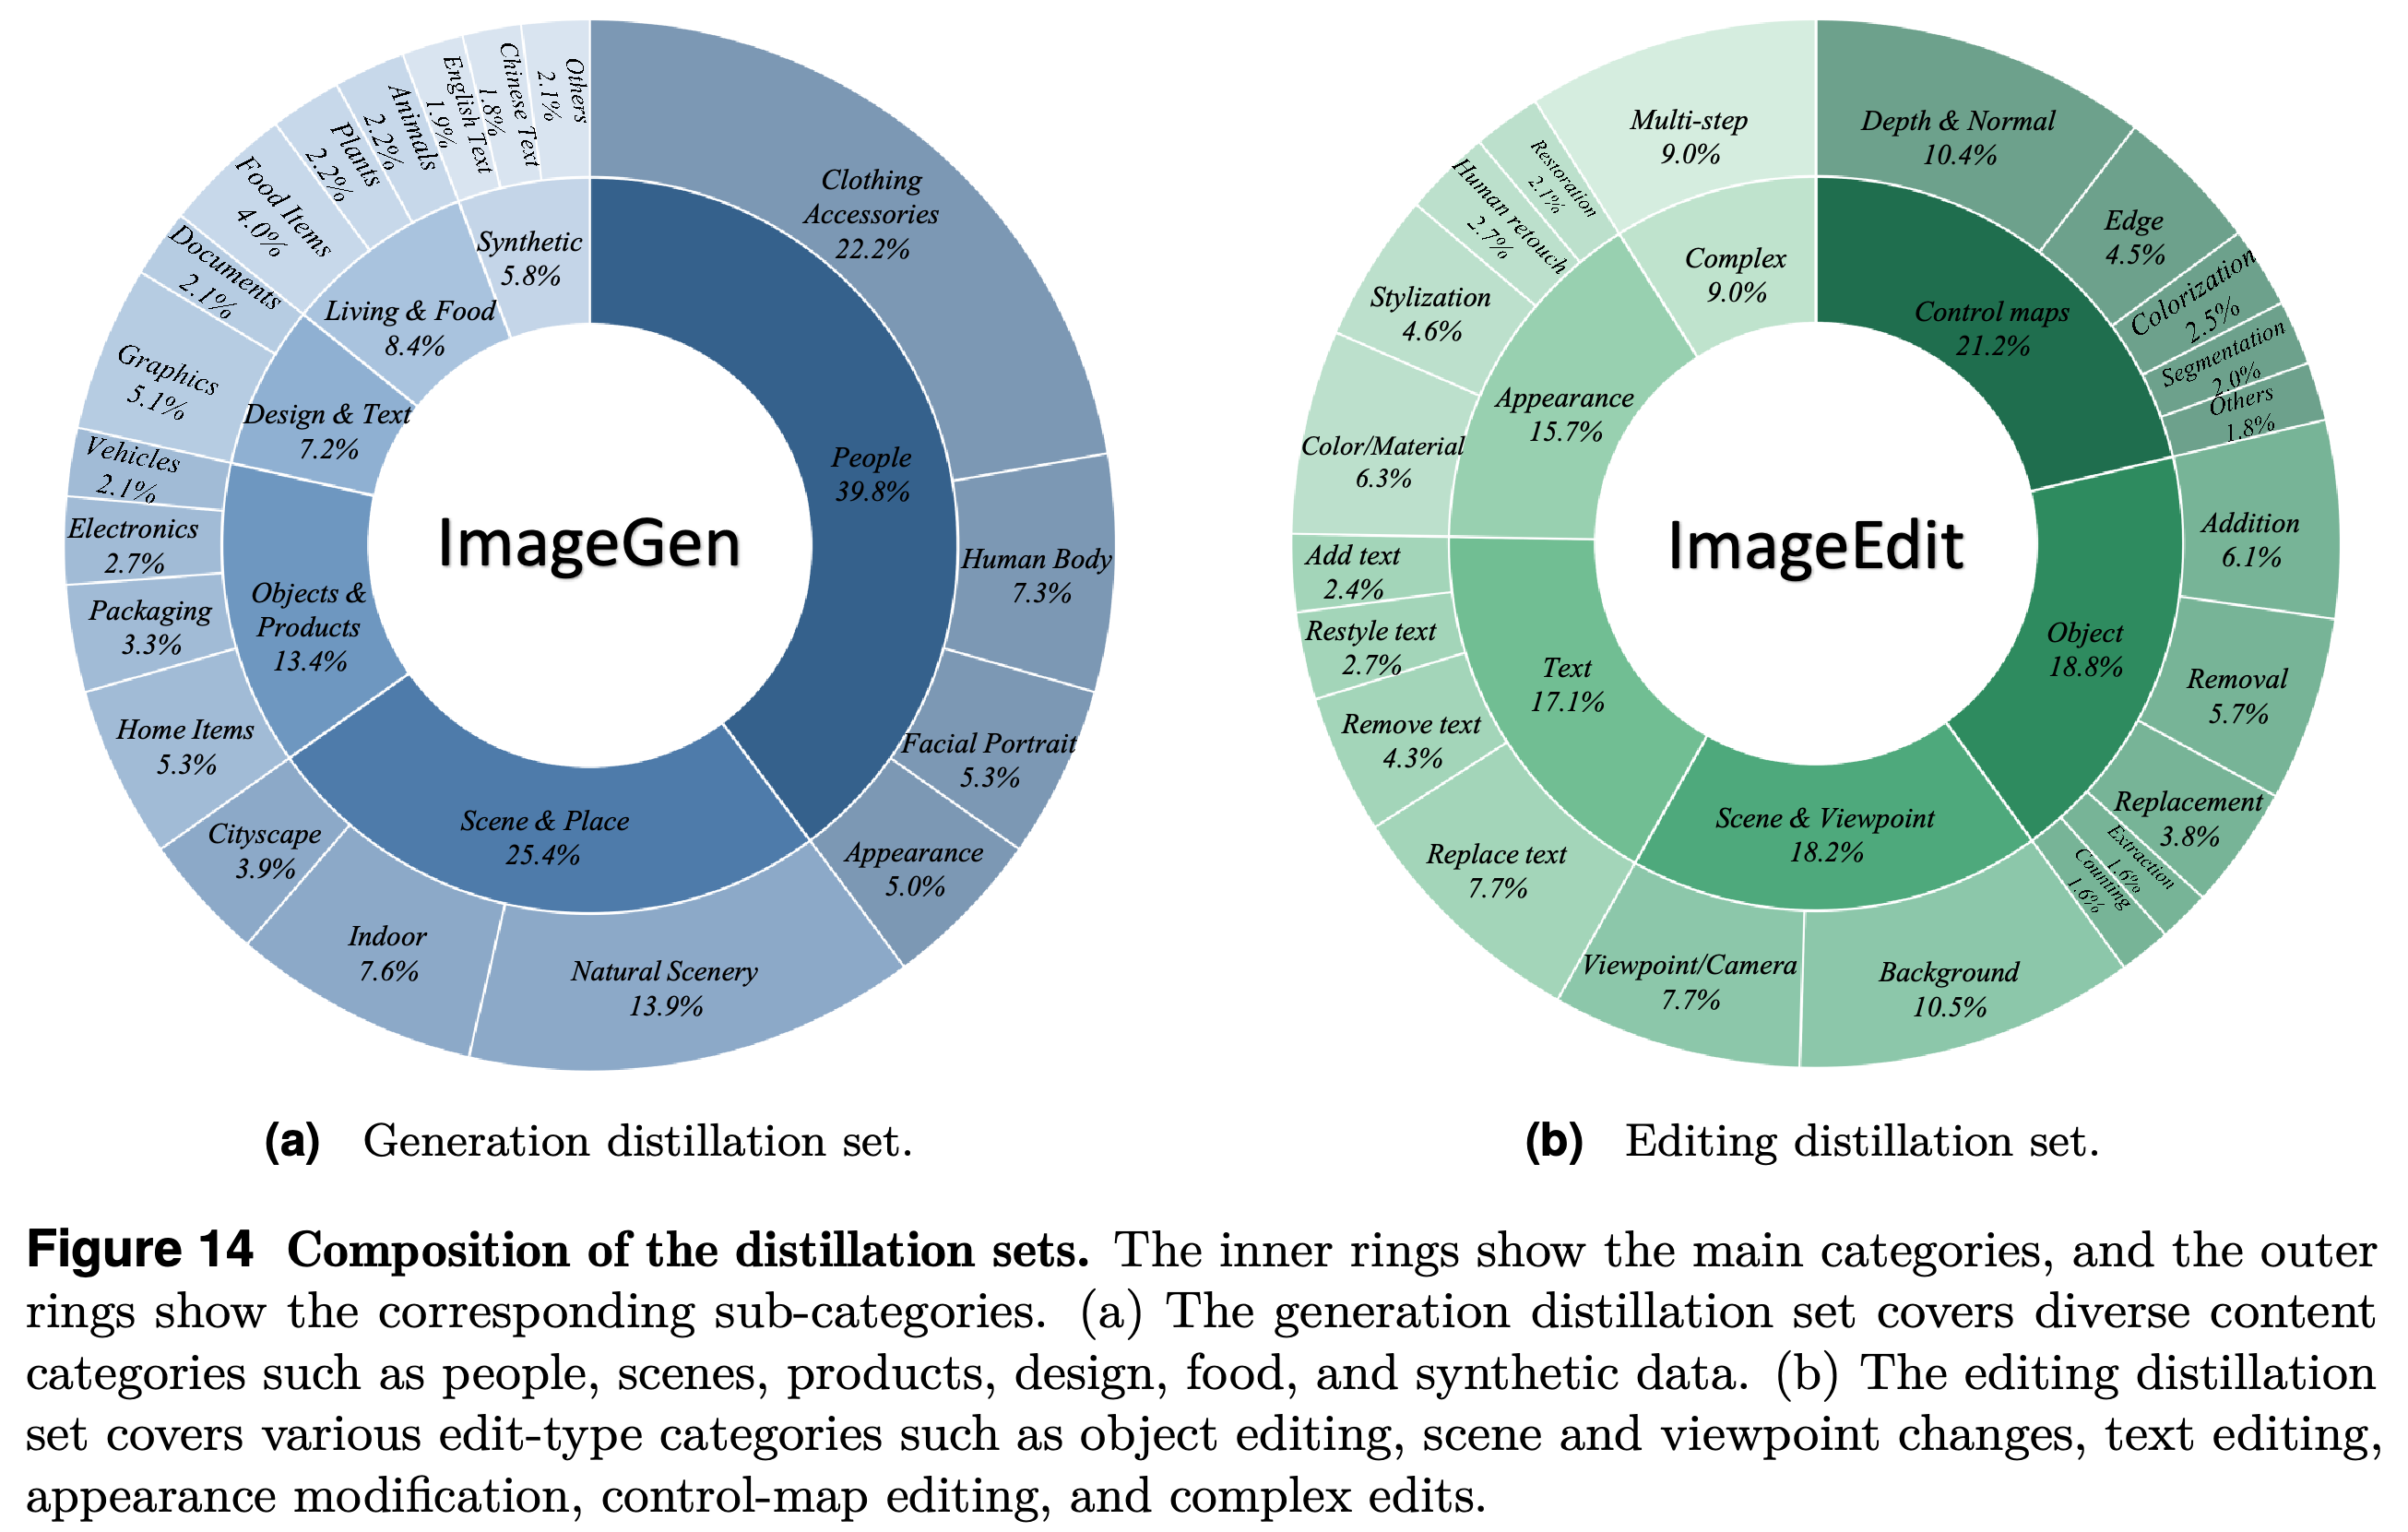
Turbo distillation에 사용한 생성 및 편집 데이터 구성을 세분화해 보여준다.
6 Experiments
실험은 8개 benchmark에서 생성을, ImgEdit-Bench, GEdit-Bench, TextEdit-Bench에서 편집을 평가한다. closed-source, unified, specialist 시스템과 함께 Base, aligned, Turbo 변형을 비교한다.
6.1 Experimental Setup
Mage-Flow-Base, Mage-Flow, Mage-Flow-Turbo는 각각 30, 20, 4 denoising step을 사용한다. Editing Base와 aligned 모델은 30 step을 사용하고 Edit-Turbo는 4 step을 사용한다. benchmark는 생성, 텍스트 렌더링, 편집 충실도, 보존성, 시각 품질을 다룬다.
6.2 Quantitative Results
결과는 보편적인 최고 성능이 아니라 품질과 효율의 trade-off를 보여준다. Mage-Flow는 20 step에서 0.90 GenEval을, Turbo는 4 step에서 0.88을 보고한다. Edit-Turbo는 4 step에서 4.38 ImgEdit, 8.271 GEdit-EN, 8.264 GEdit-CN을 보고한다.
생성 및 편집 시스템의 score와 A100 latency를 비교하며, marker 면적은 peak memory를 나타낸다.
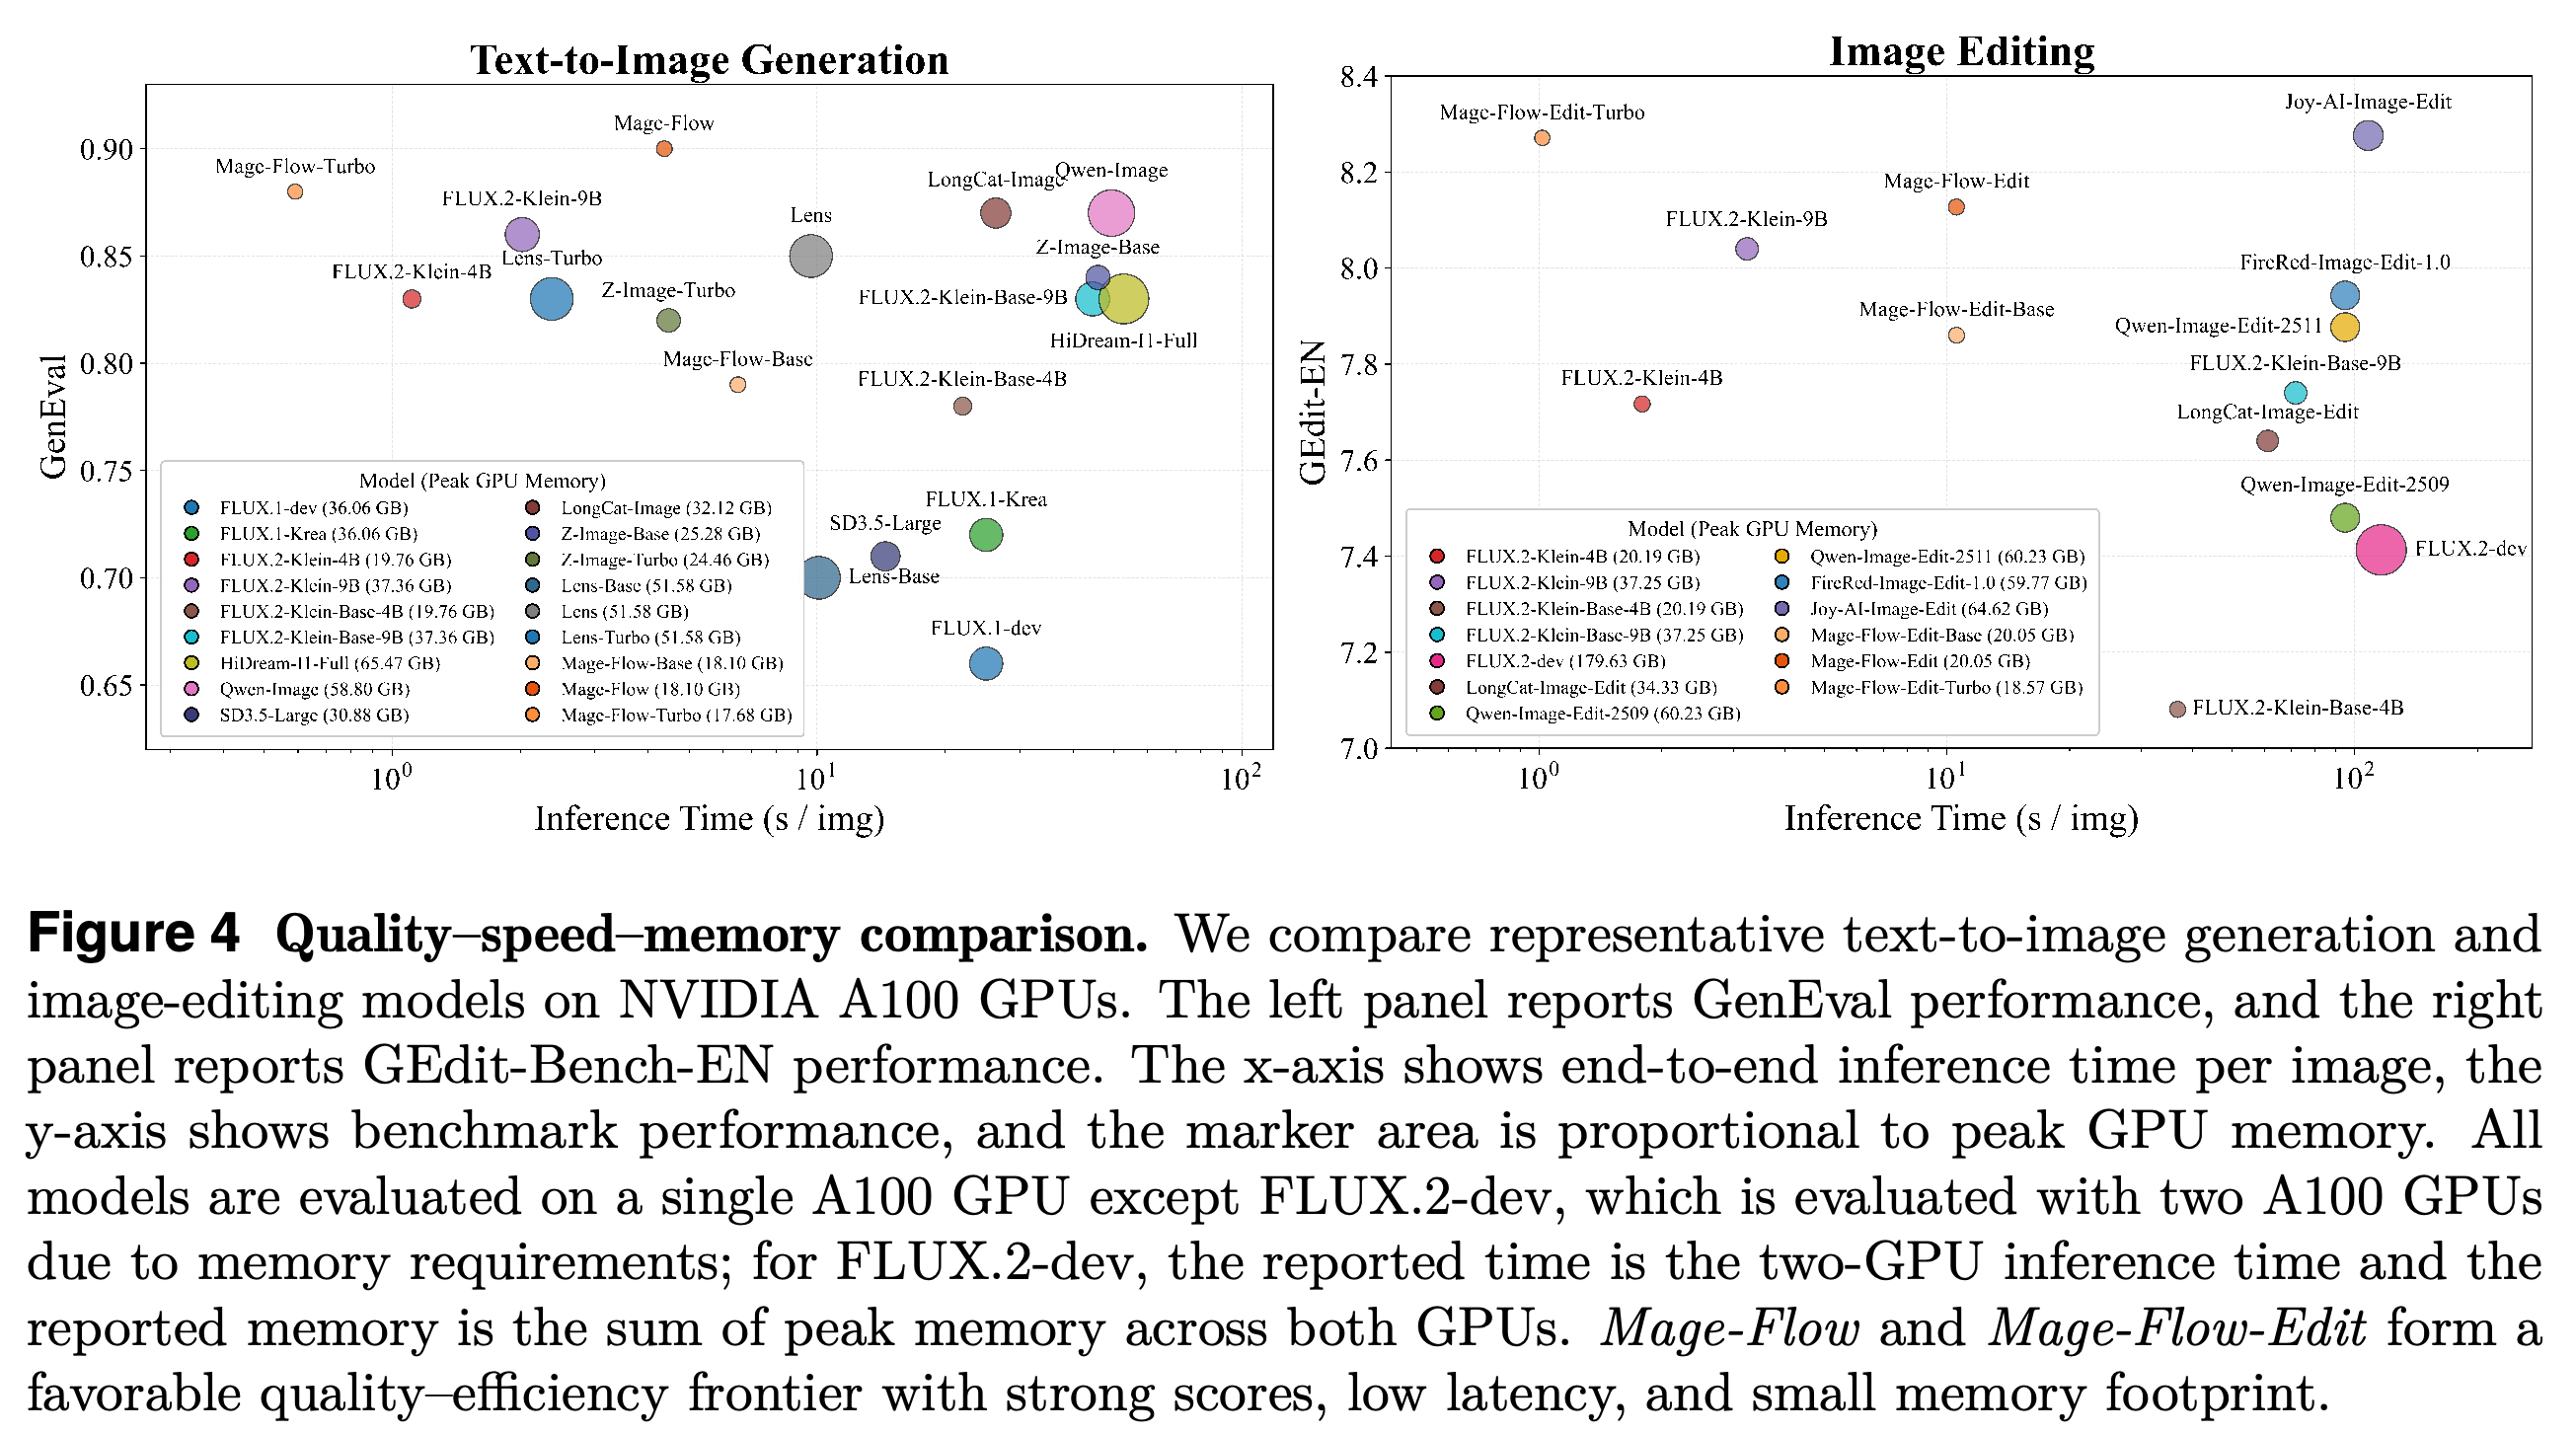
6.2.1 Text-to-image generation
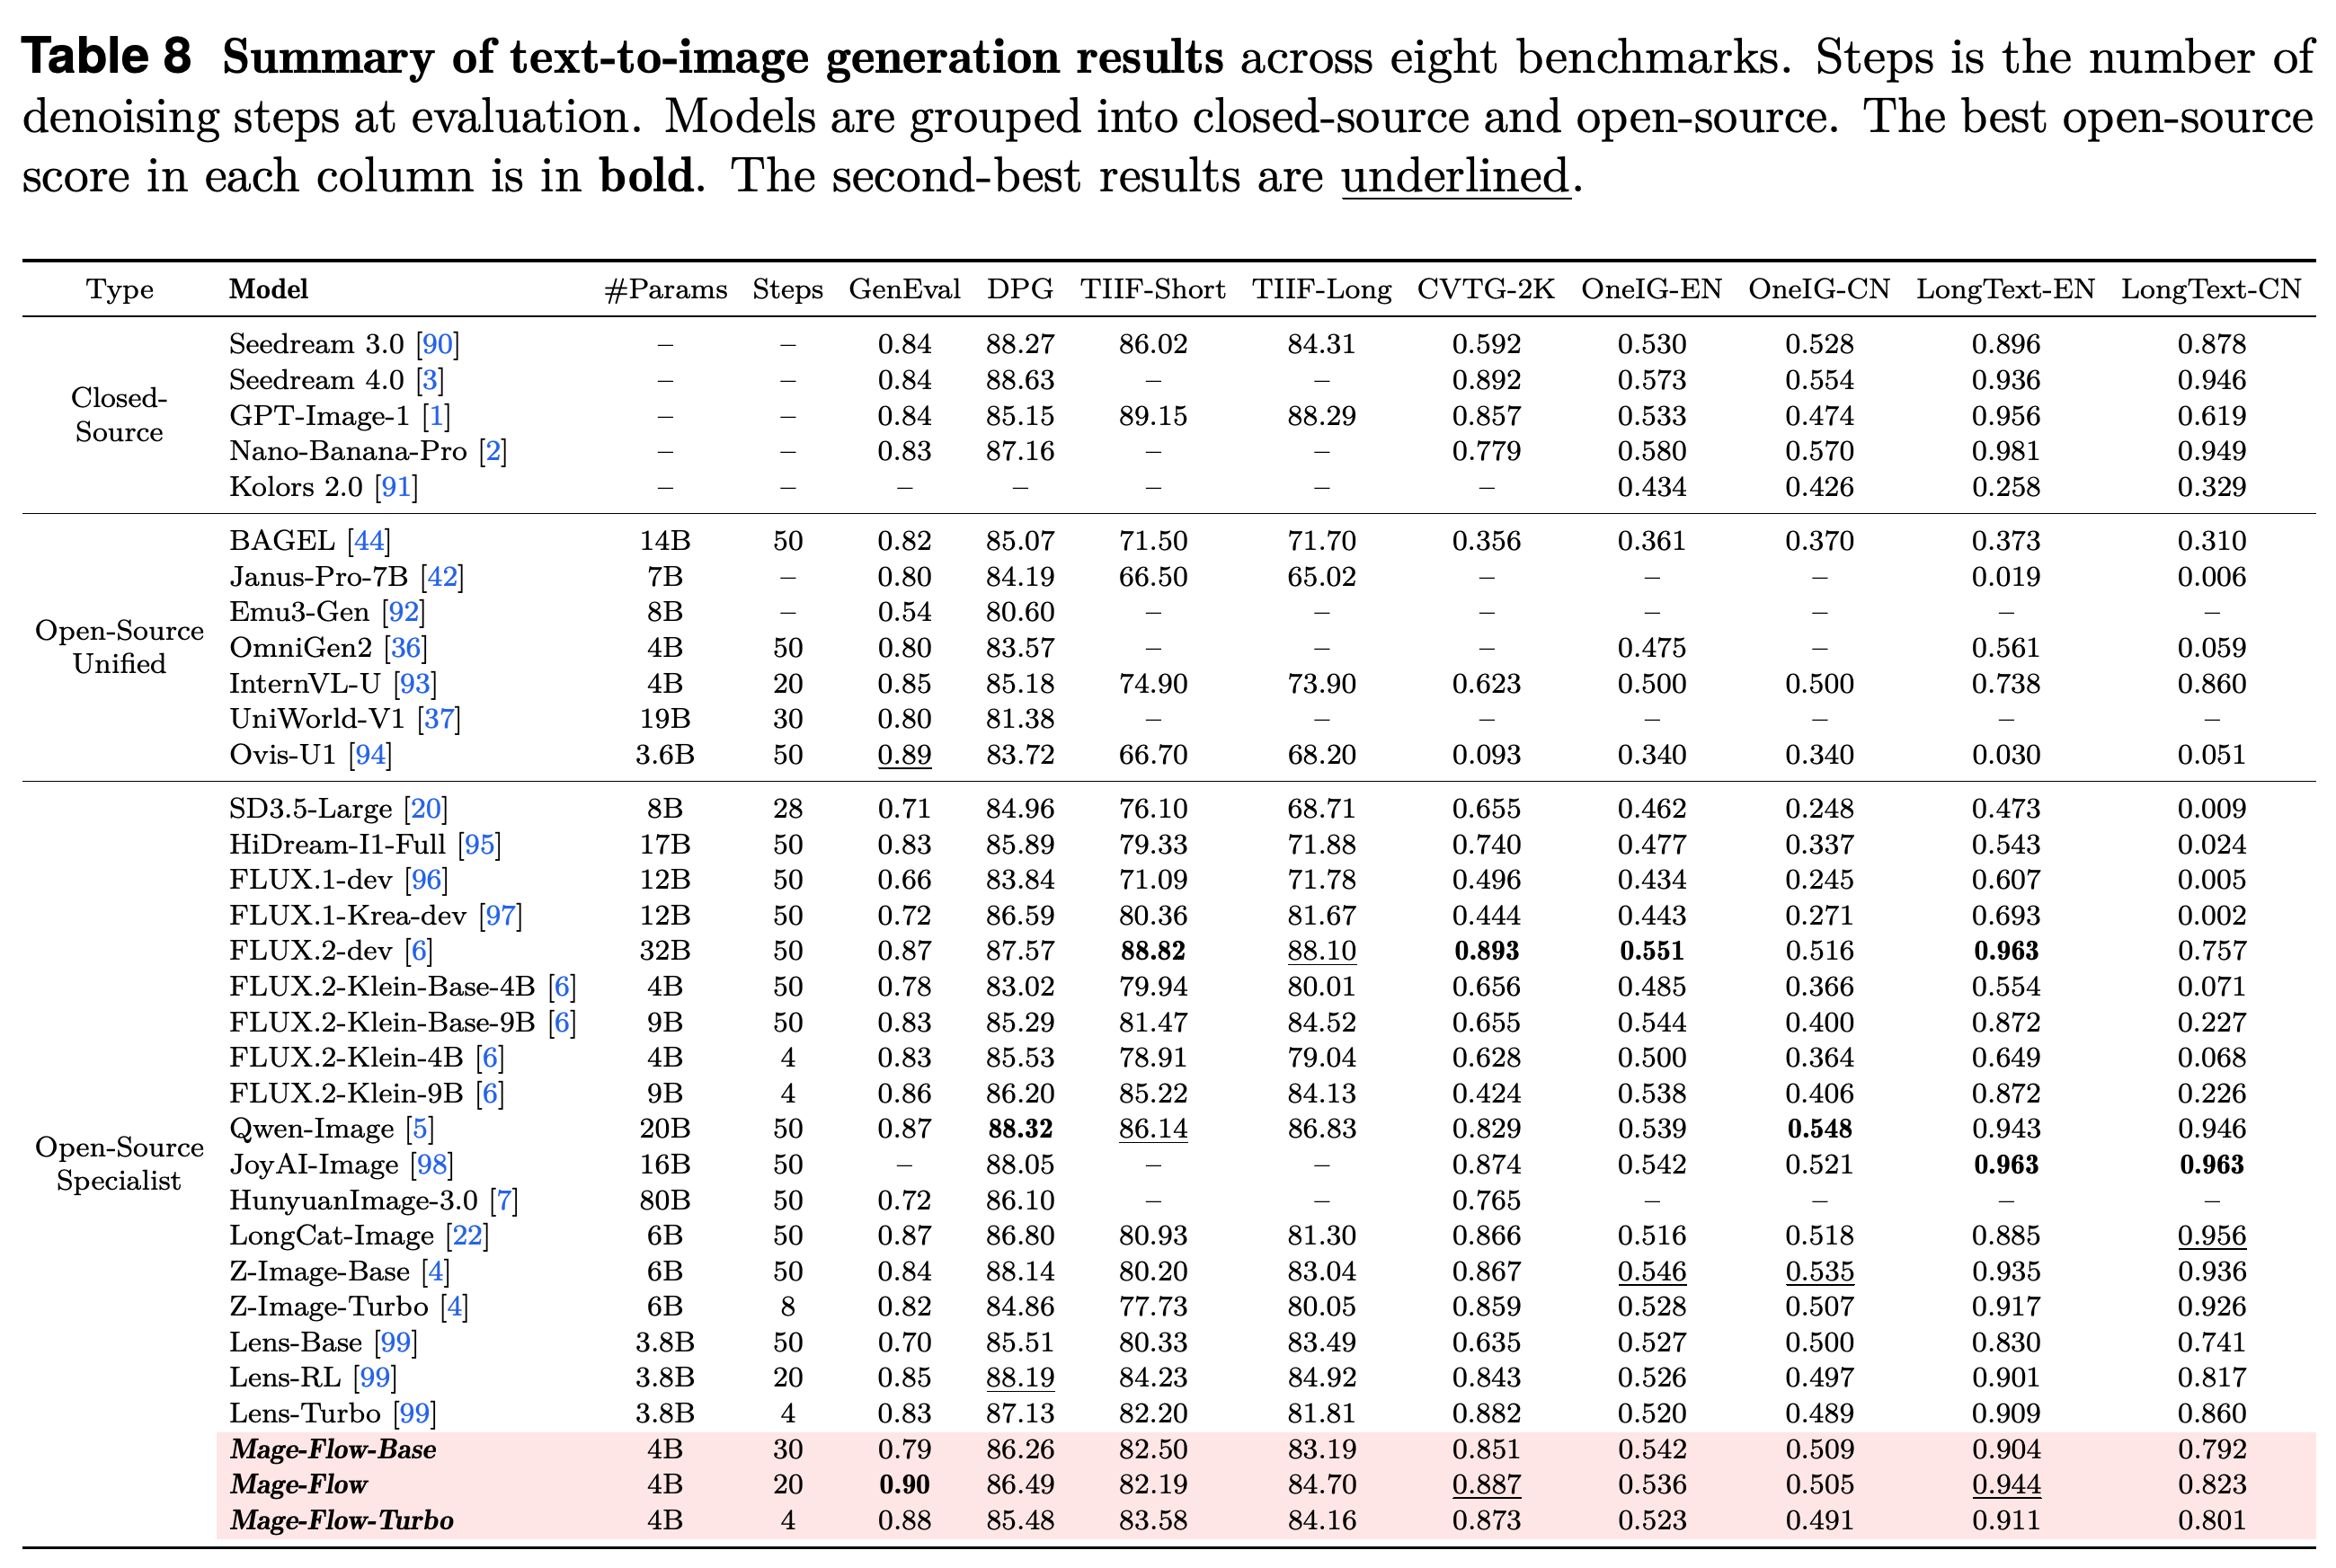
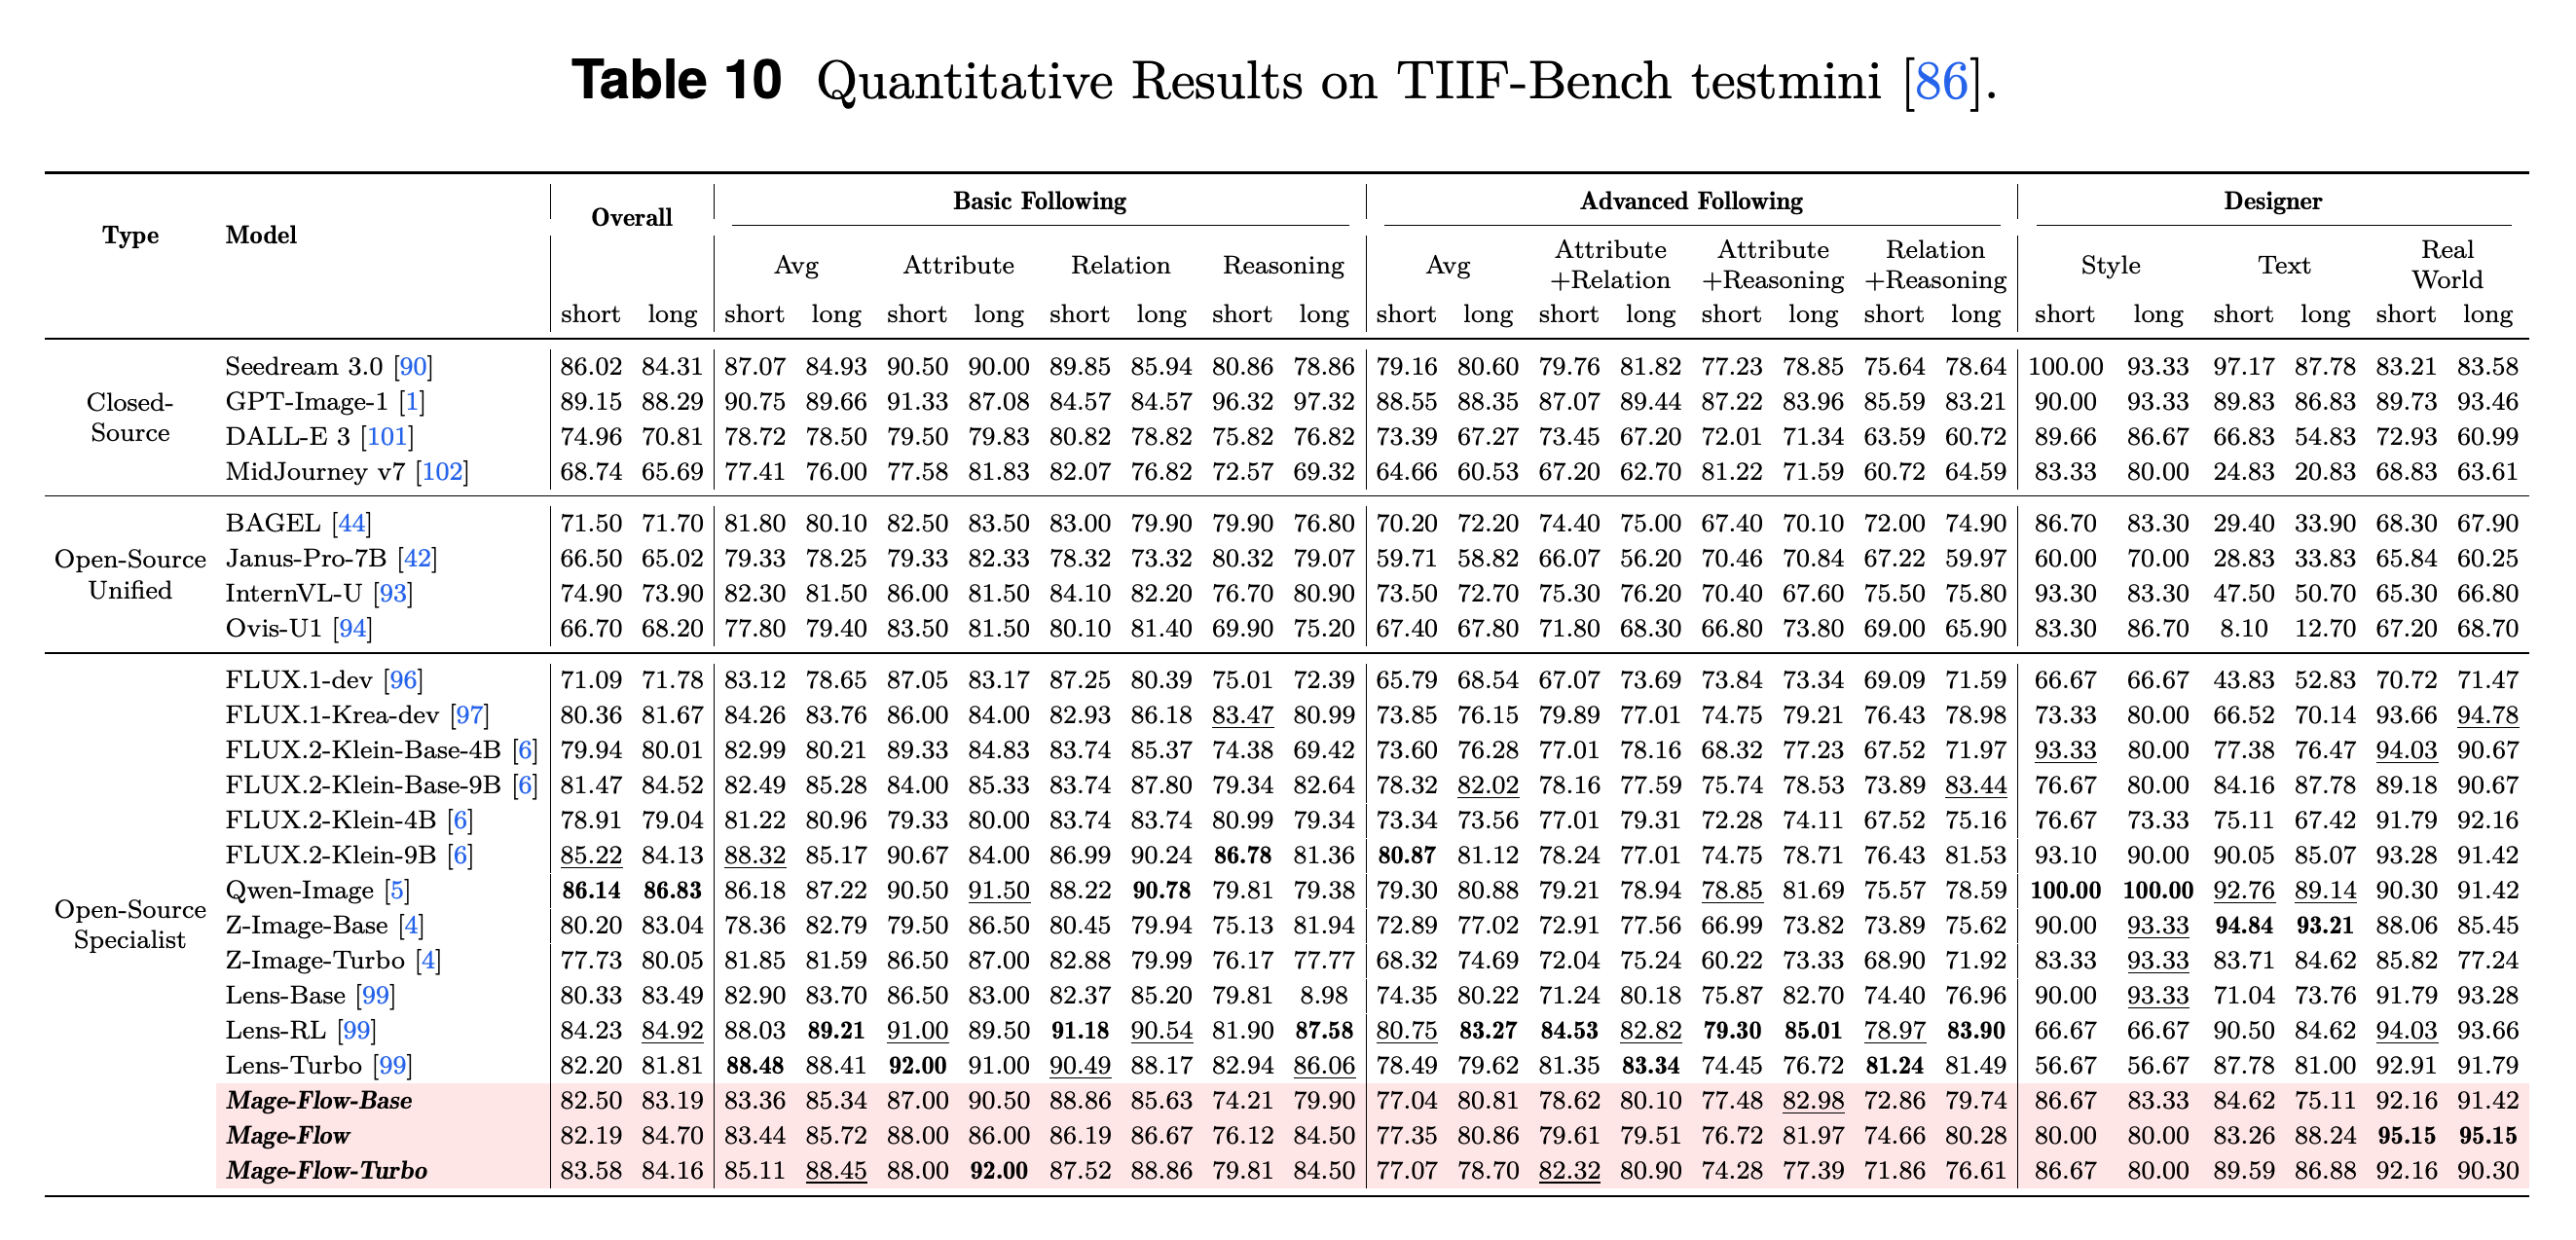
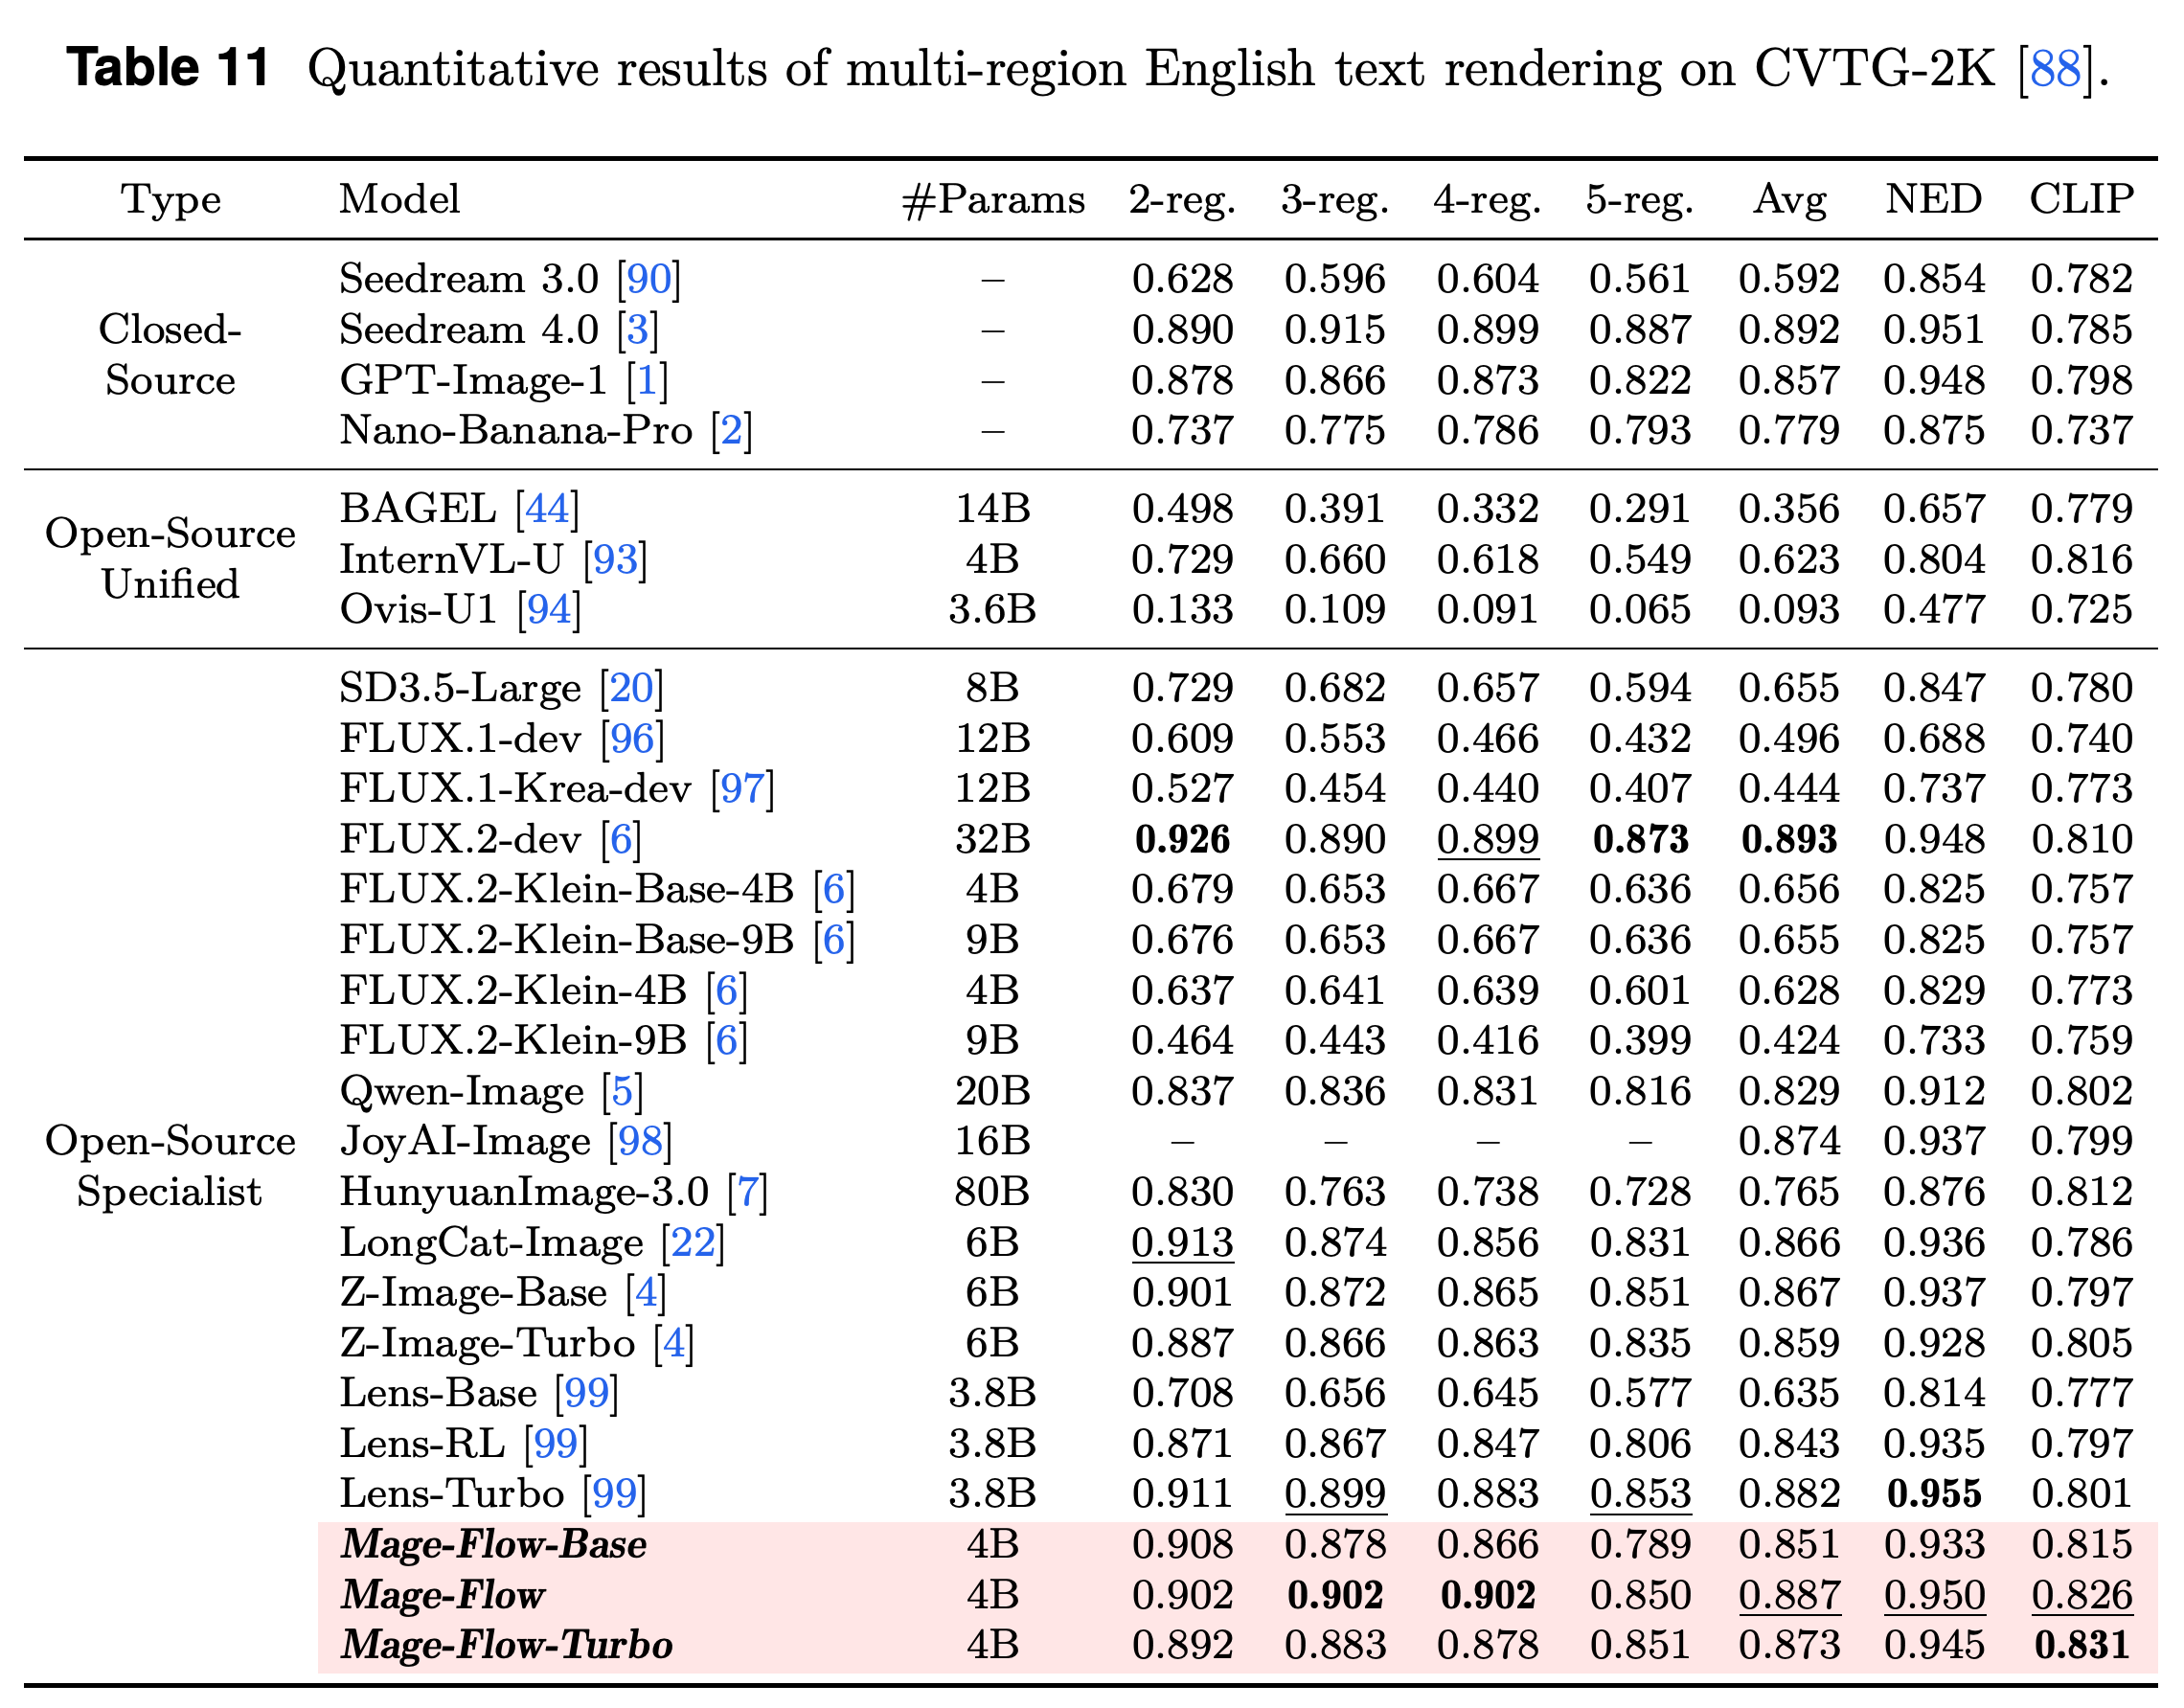
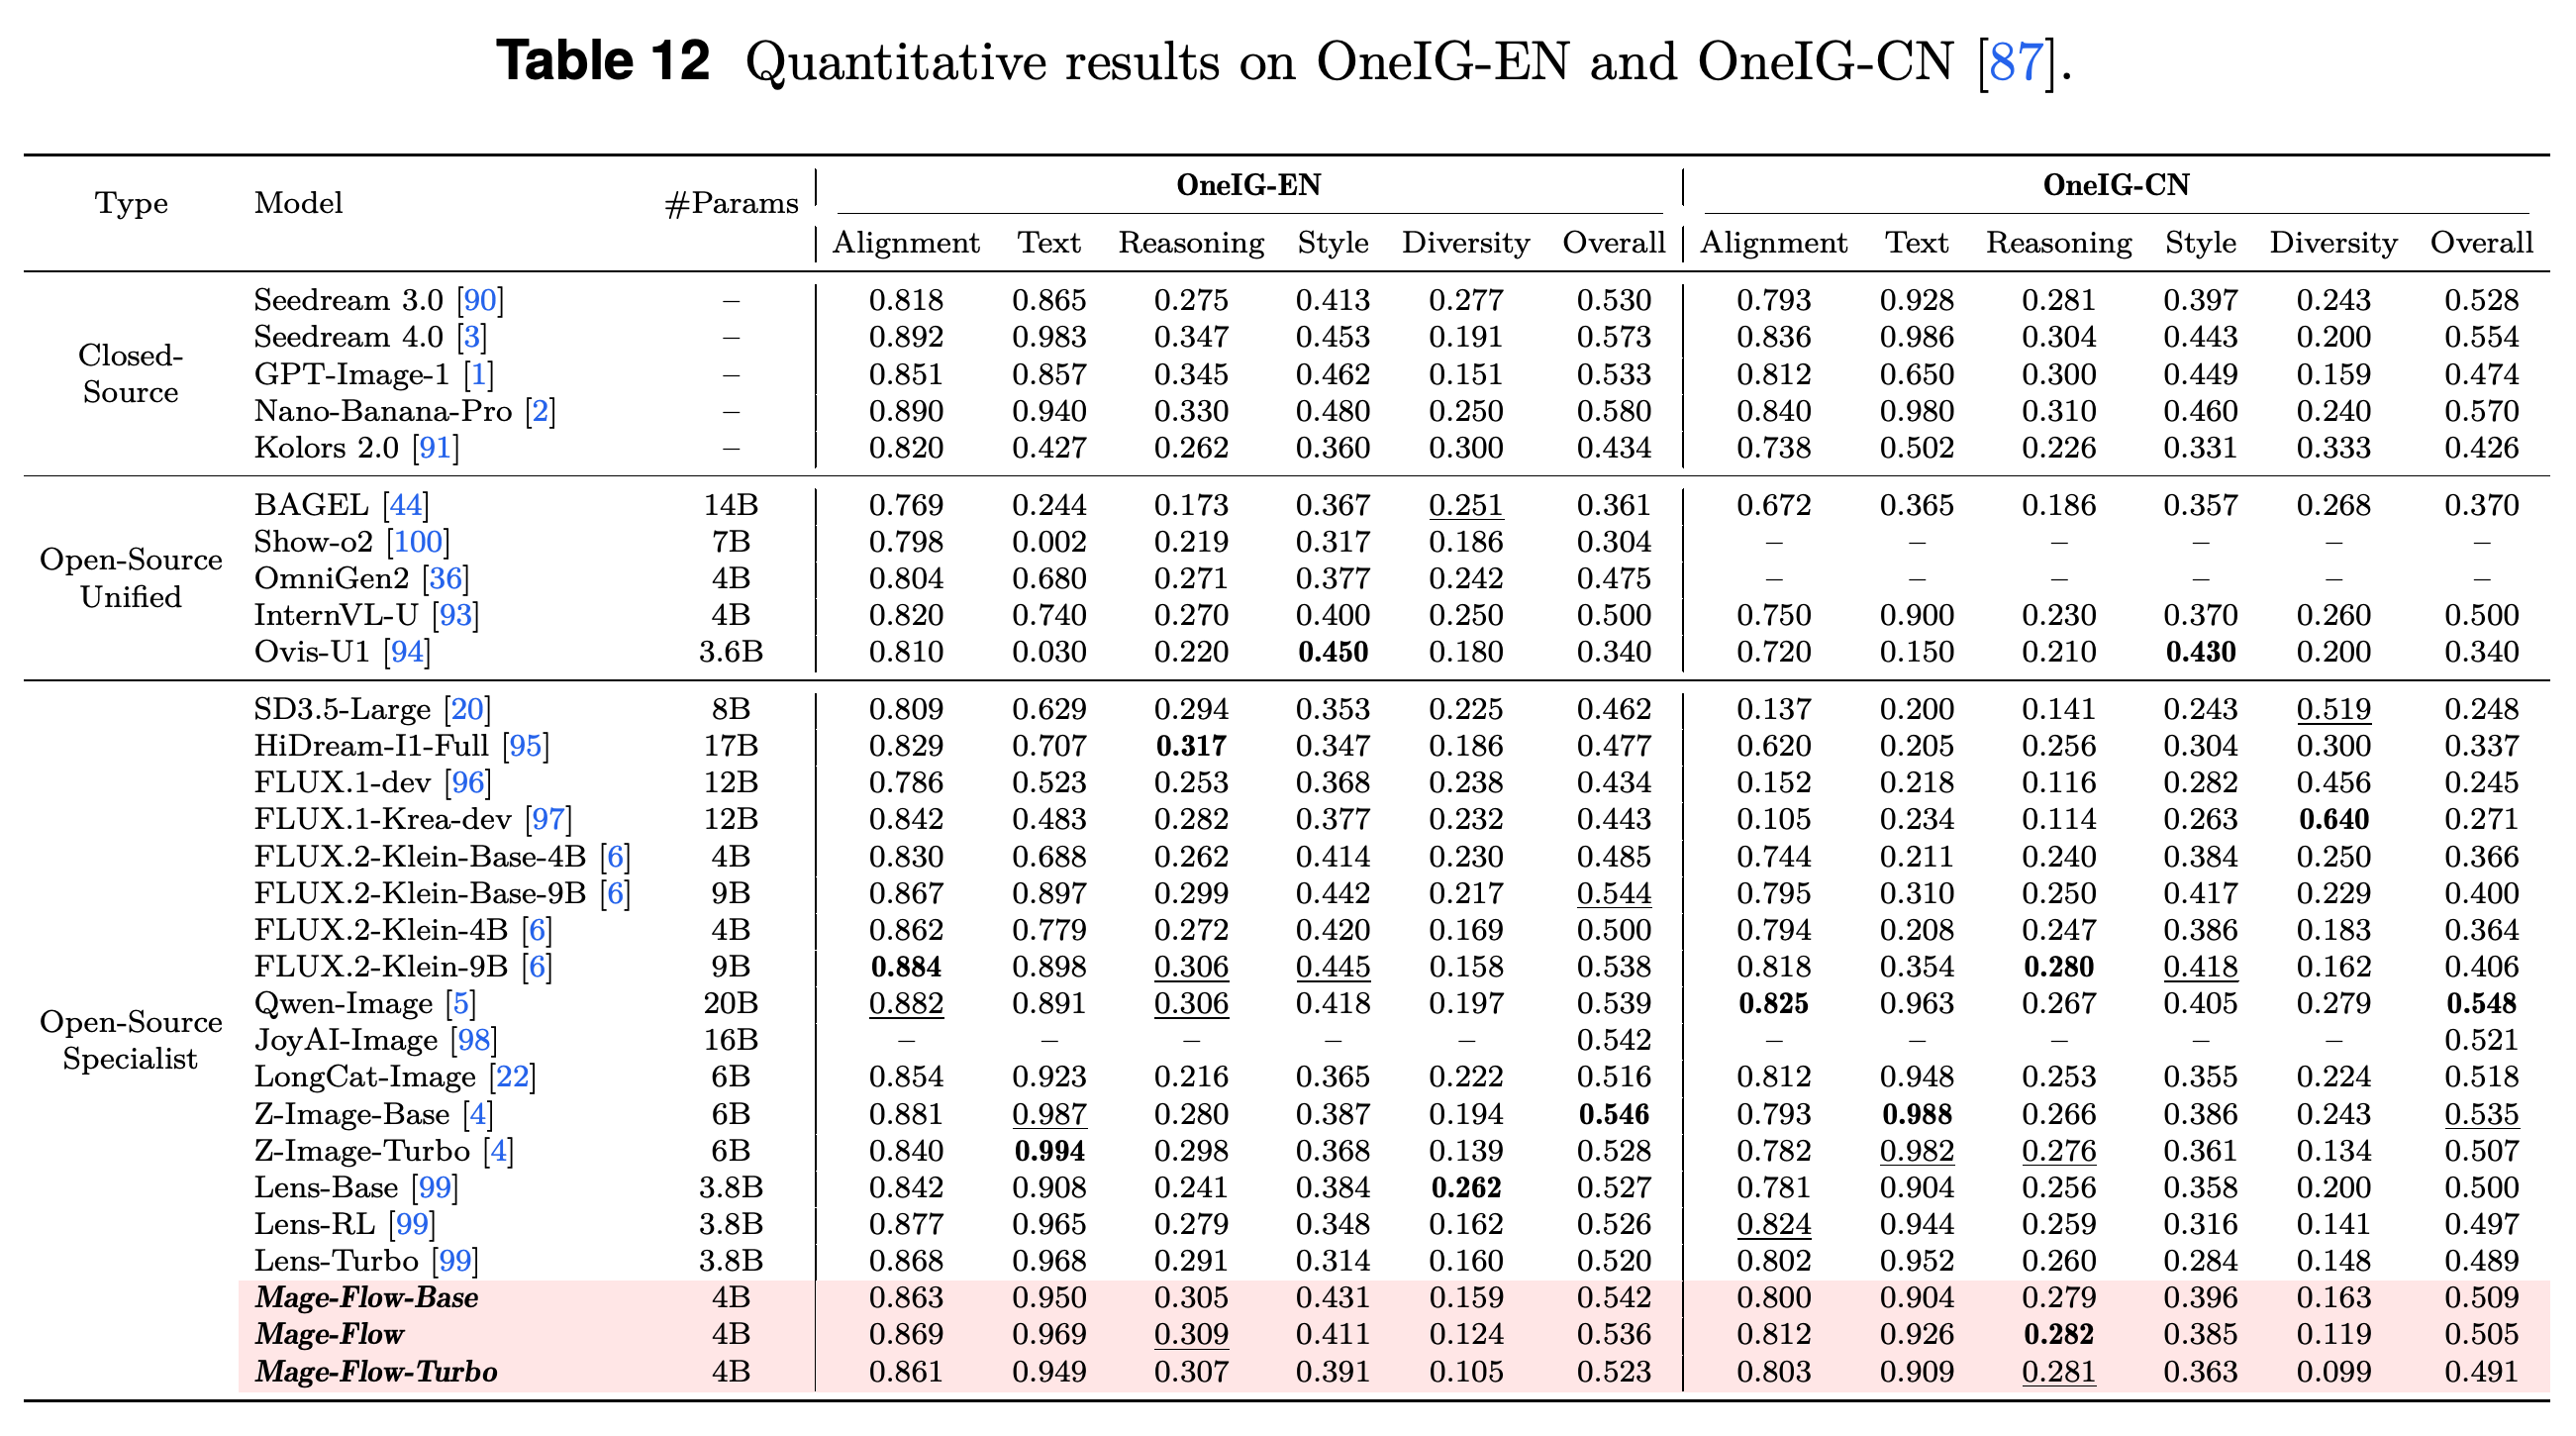
Mage-Flow의 0.90 GenEval은 Table 8에서 보고된 open-source 최고 점수다. DPG-Bench, TIIF-Bench, OneIG, LongText, CVTG-2K에서도 경쟁력 있는 결과를 보고하며, 후자에서는 Mage-Flow가 0.887, Turbo가 0.873이다.
Mage-Flow의 0.90 GenEval과 Turbo의 0.88을 포함한 8개 생성 benchmark 결과를 보고한다.
TIIF-Bench에서 short prompt와 long prompt의 instruction-following 결과를 나누어 보고한다.
Mage-Flow의 0.887 CVTG-2K 평균과 Turbo의 0.873을 보고한다.
alignment, text, reasoning, style, diversity별 영어 및 중국어 OneIG 결과를 분리한다.
6.2.2 Instruction-based image editing
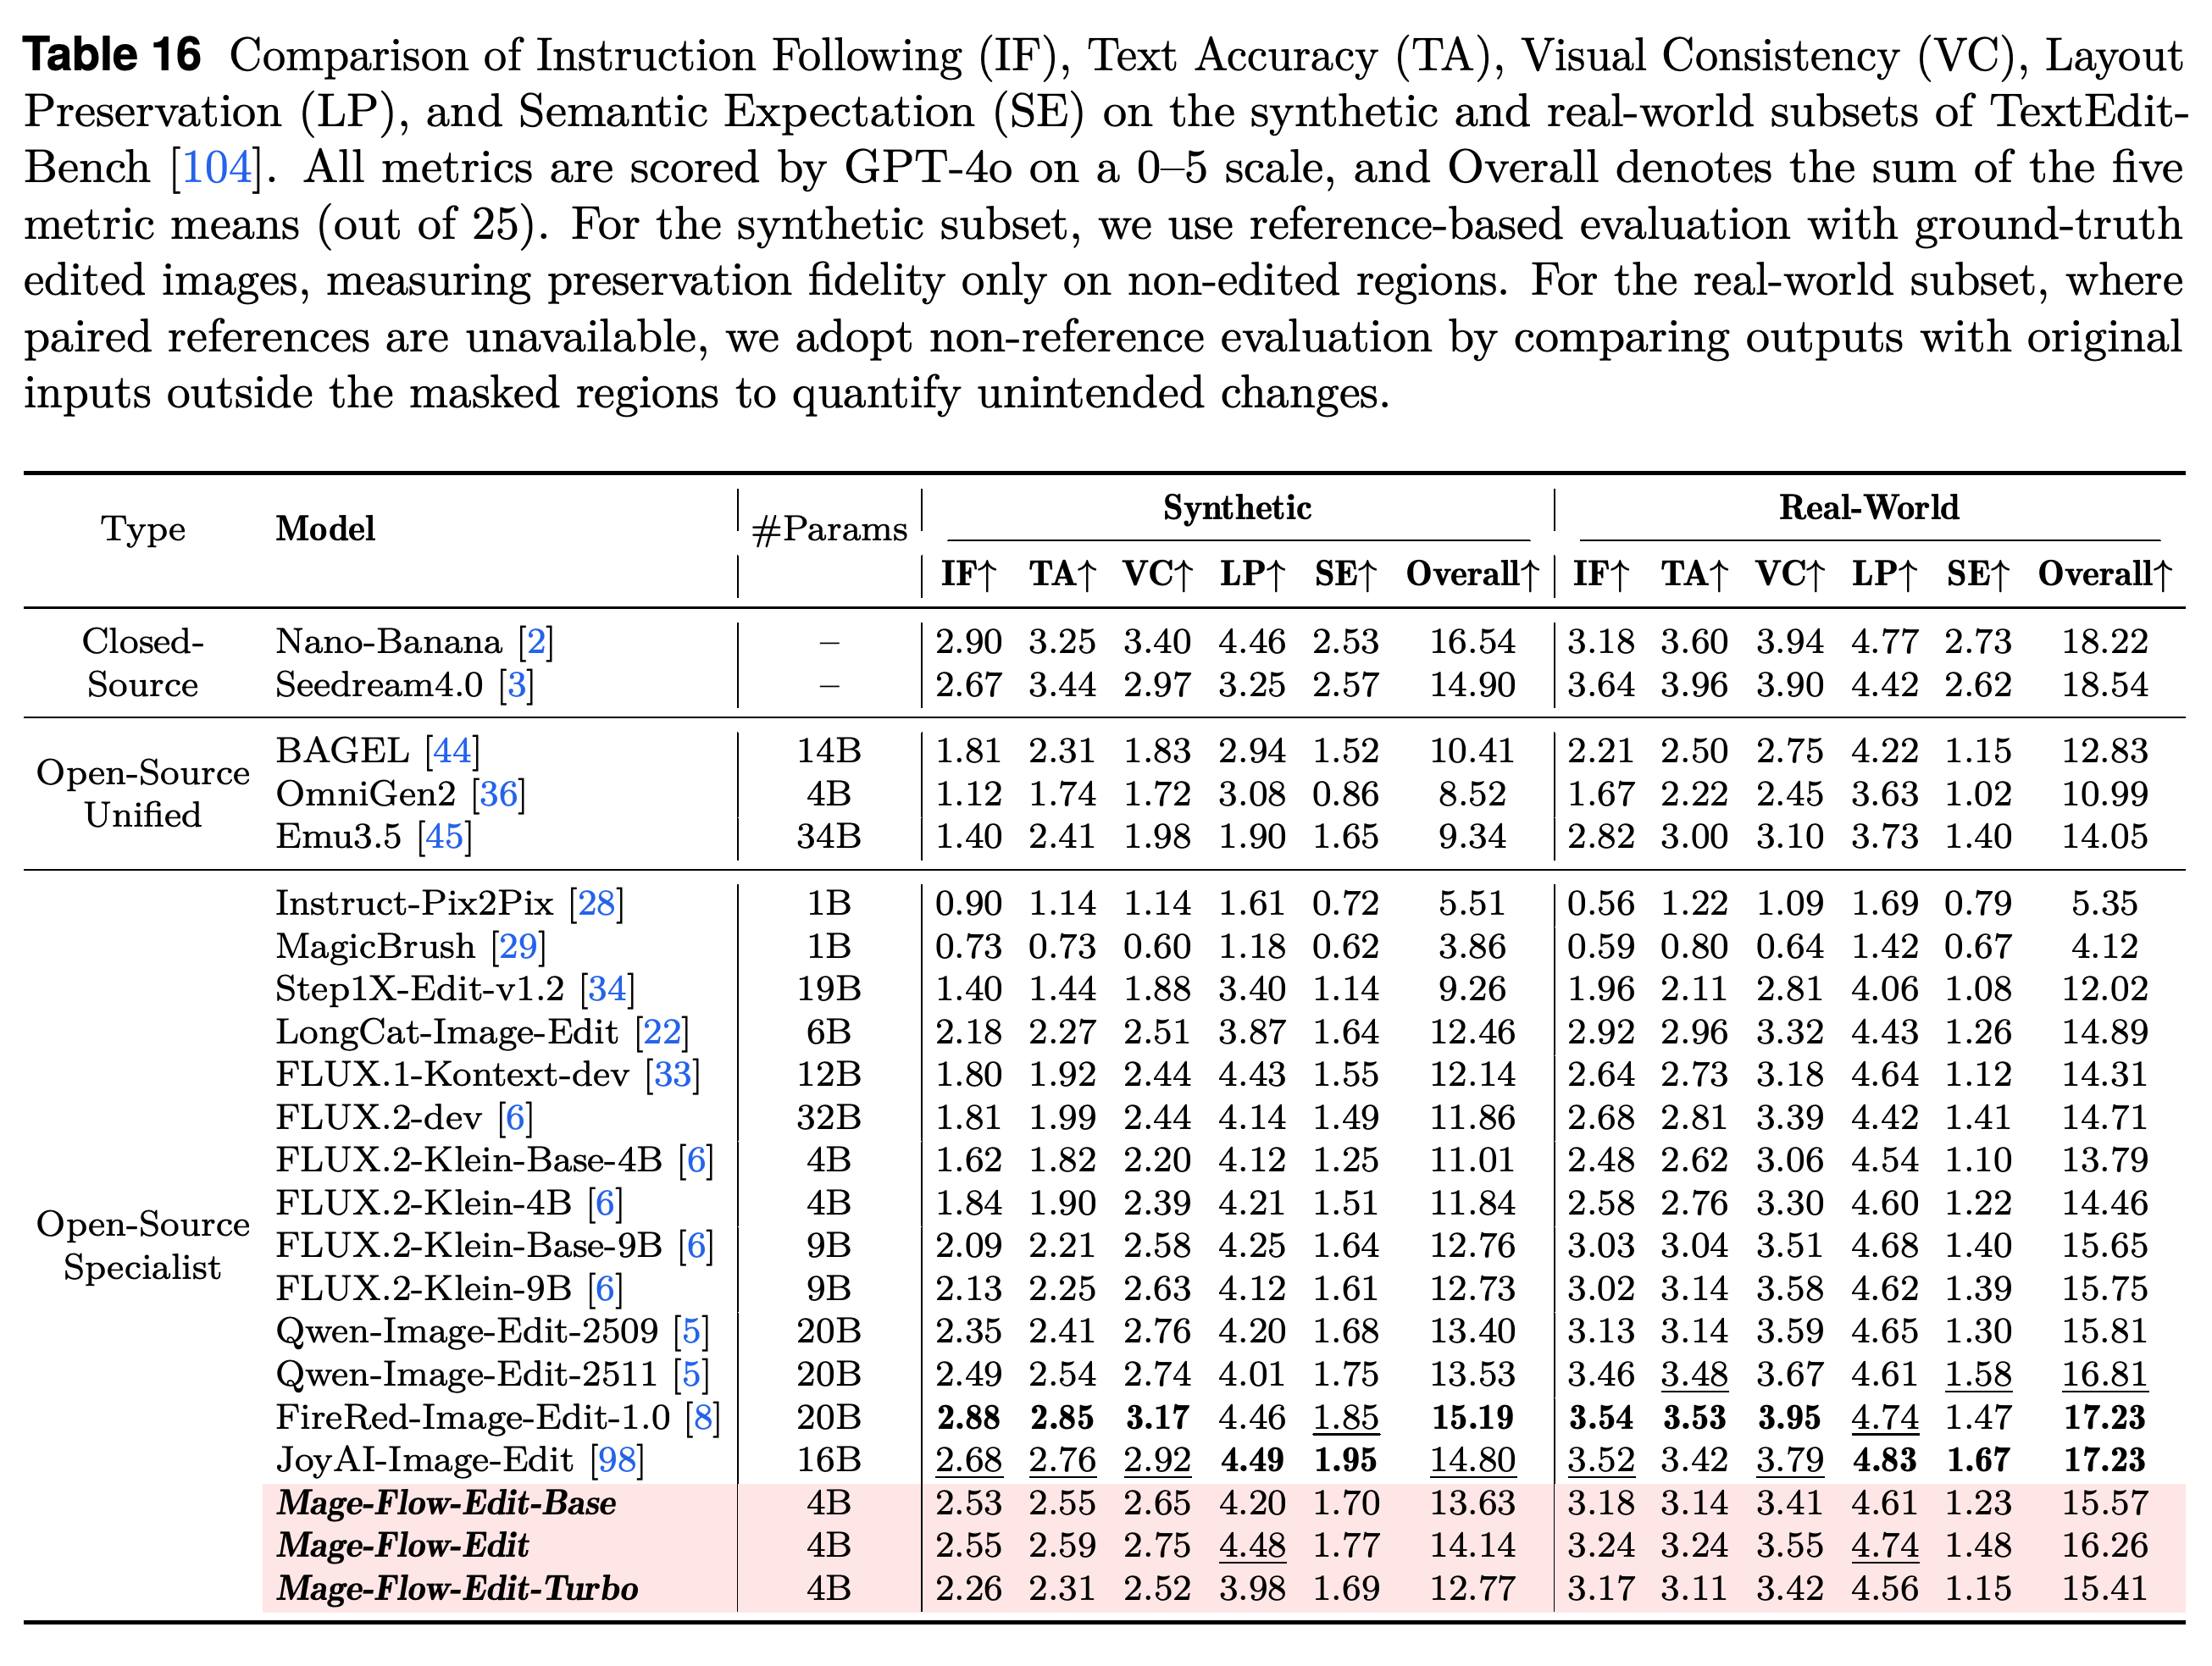
Mage-Flow-Edit는 더 큰 specialist 시스템과 경쟁력 있는 성능을 보인다. Edit-Turbo는 8.271 GEdit-EN과 8.264 GEdit-CN에 도달하며, 30-step aligned editor는 14.14 Synthetic 및 16.26 Real-World의 더 높은 TextEdit-Bench 총점을 보고한다.
ImgEdit, GEdit, TextEdit benchmark 전반의 편집 결과를 비교한다.
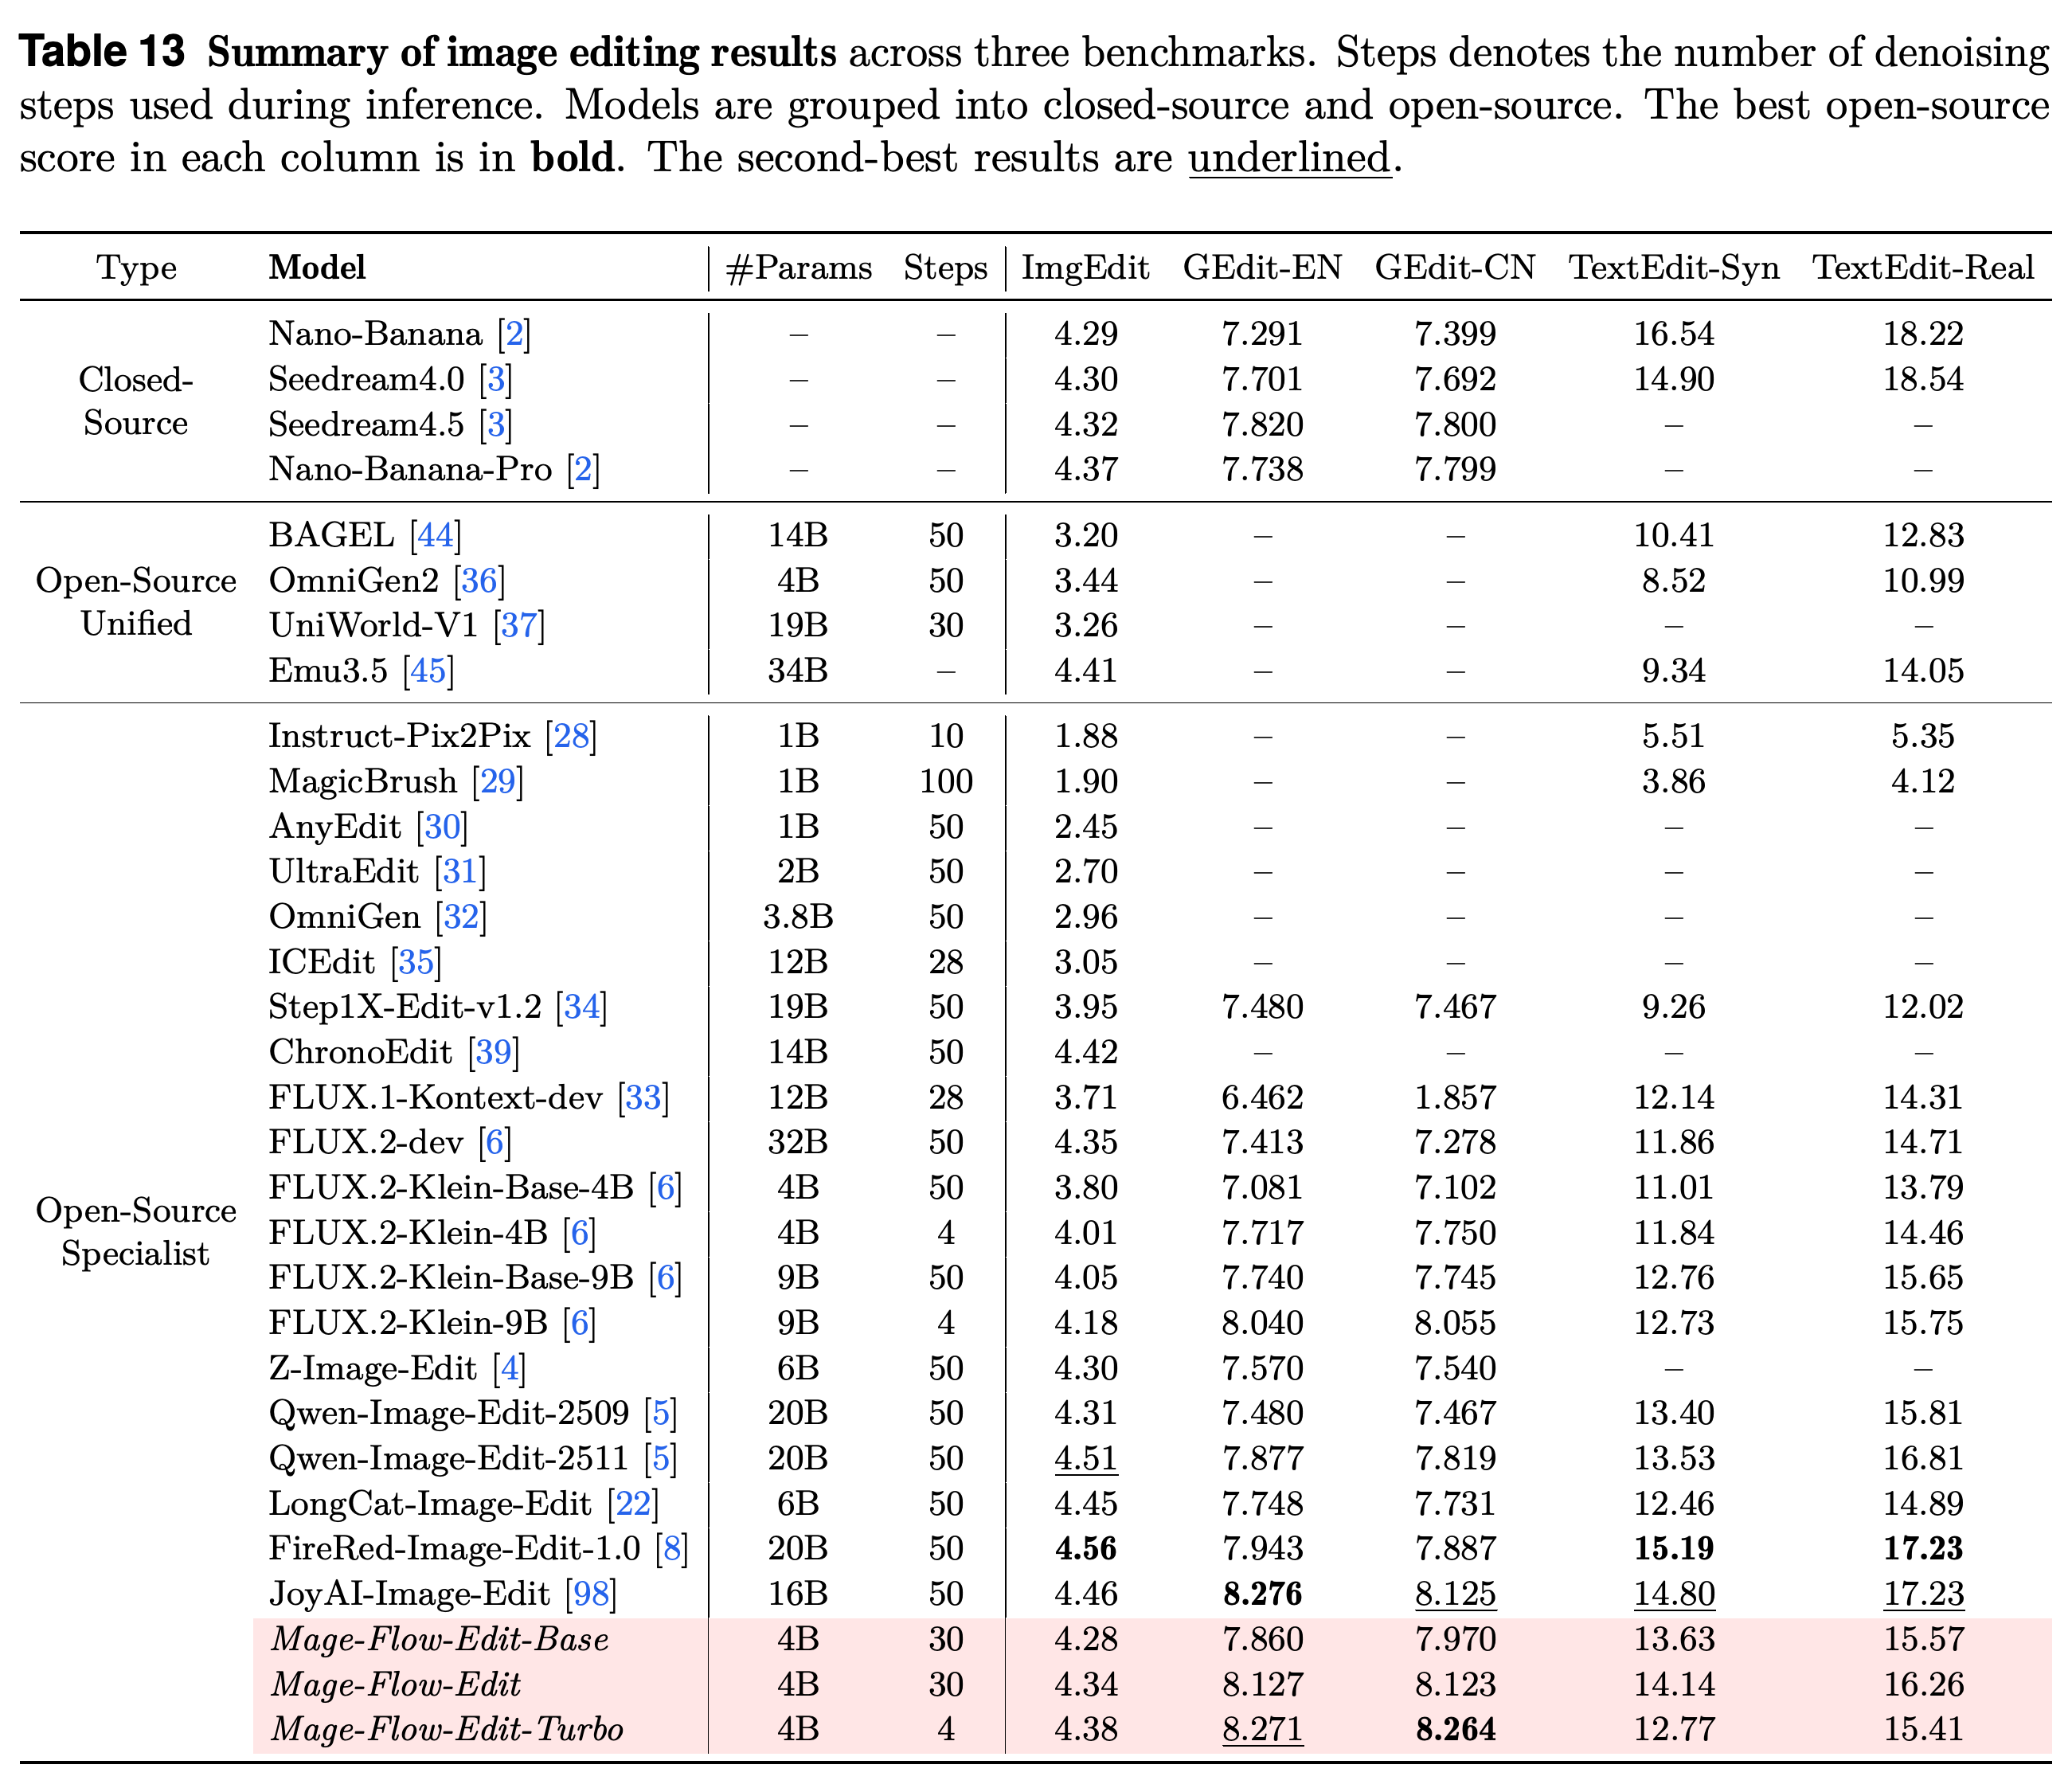
category별 ImgEdit 성능과 Edit-Turbo의 4.38 overall score를 보여준다.
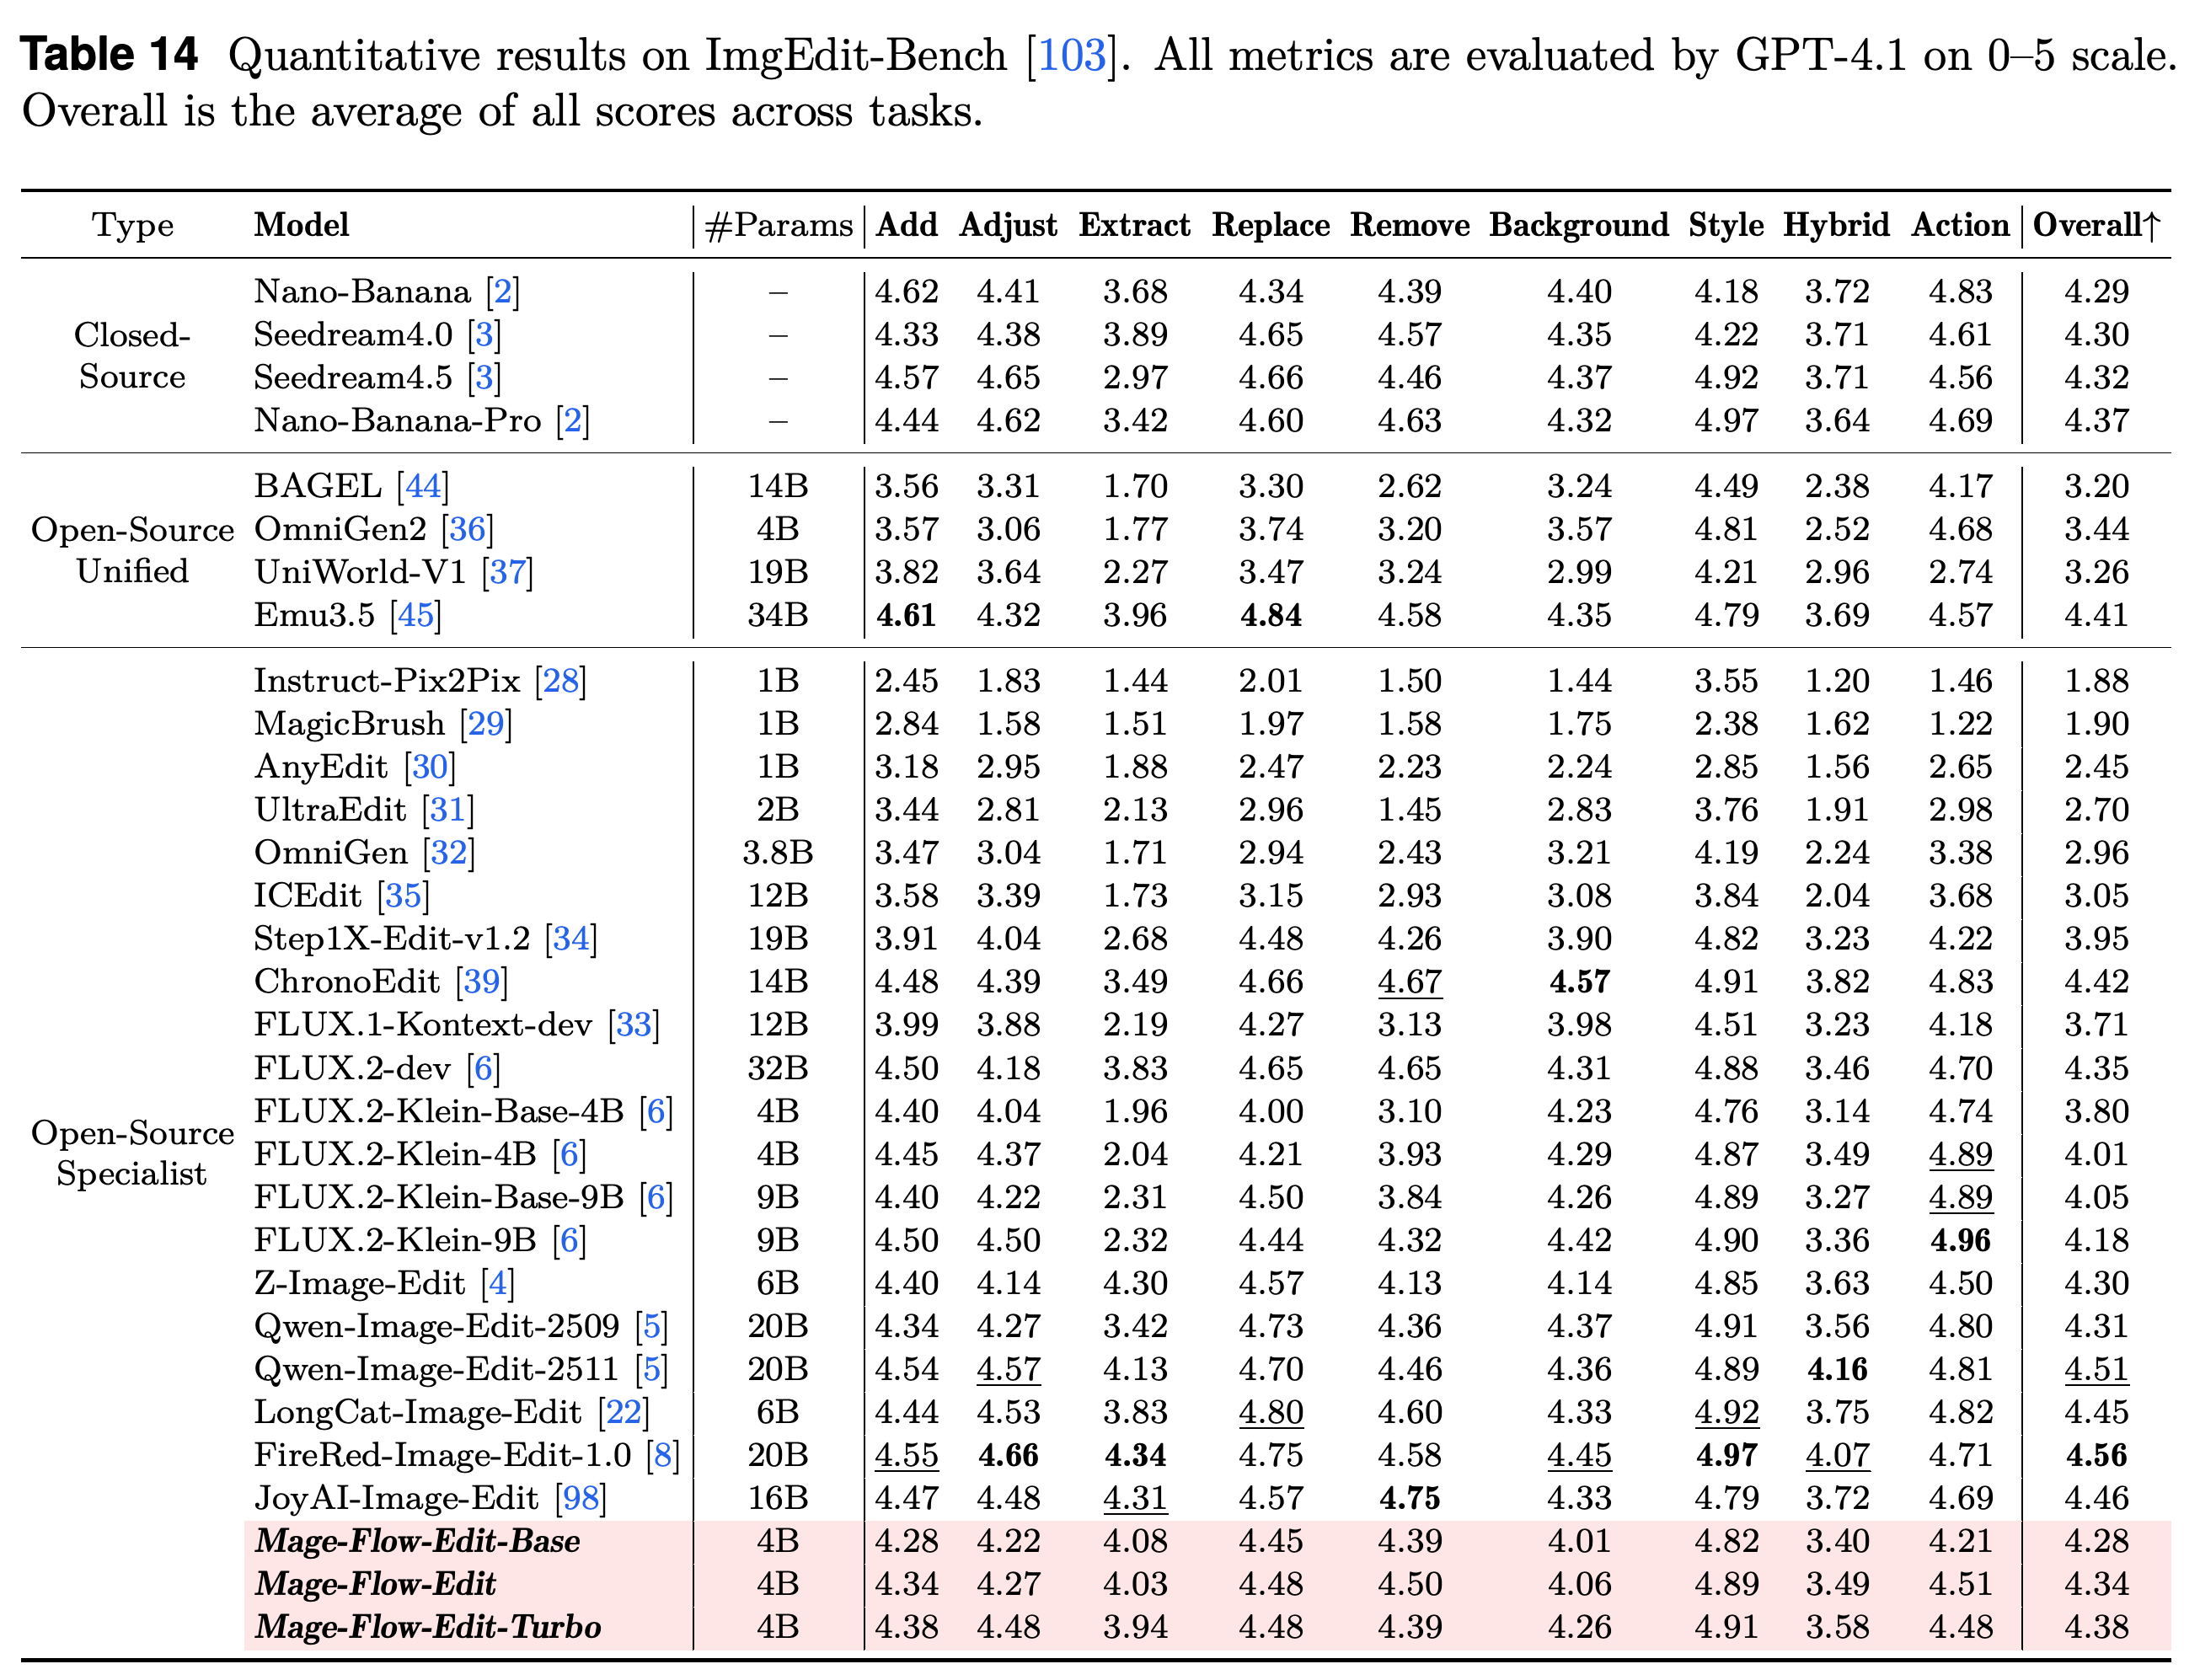
Edit-Turbo의 8.271 GEdit-EN 및 8.264 GEdit-CN score와 semantic-consistency 및 perceptual-quality component를 보여준다.
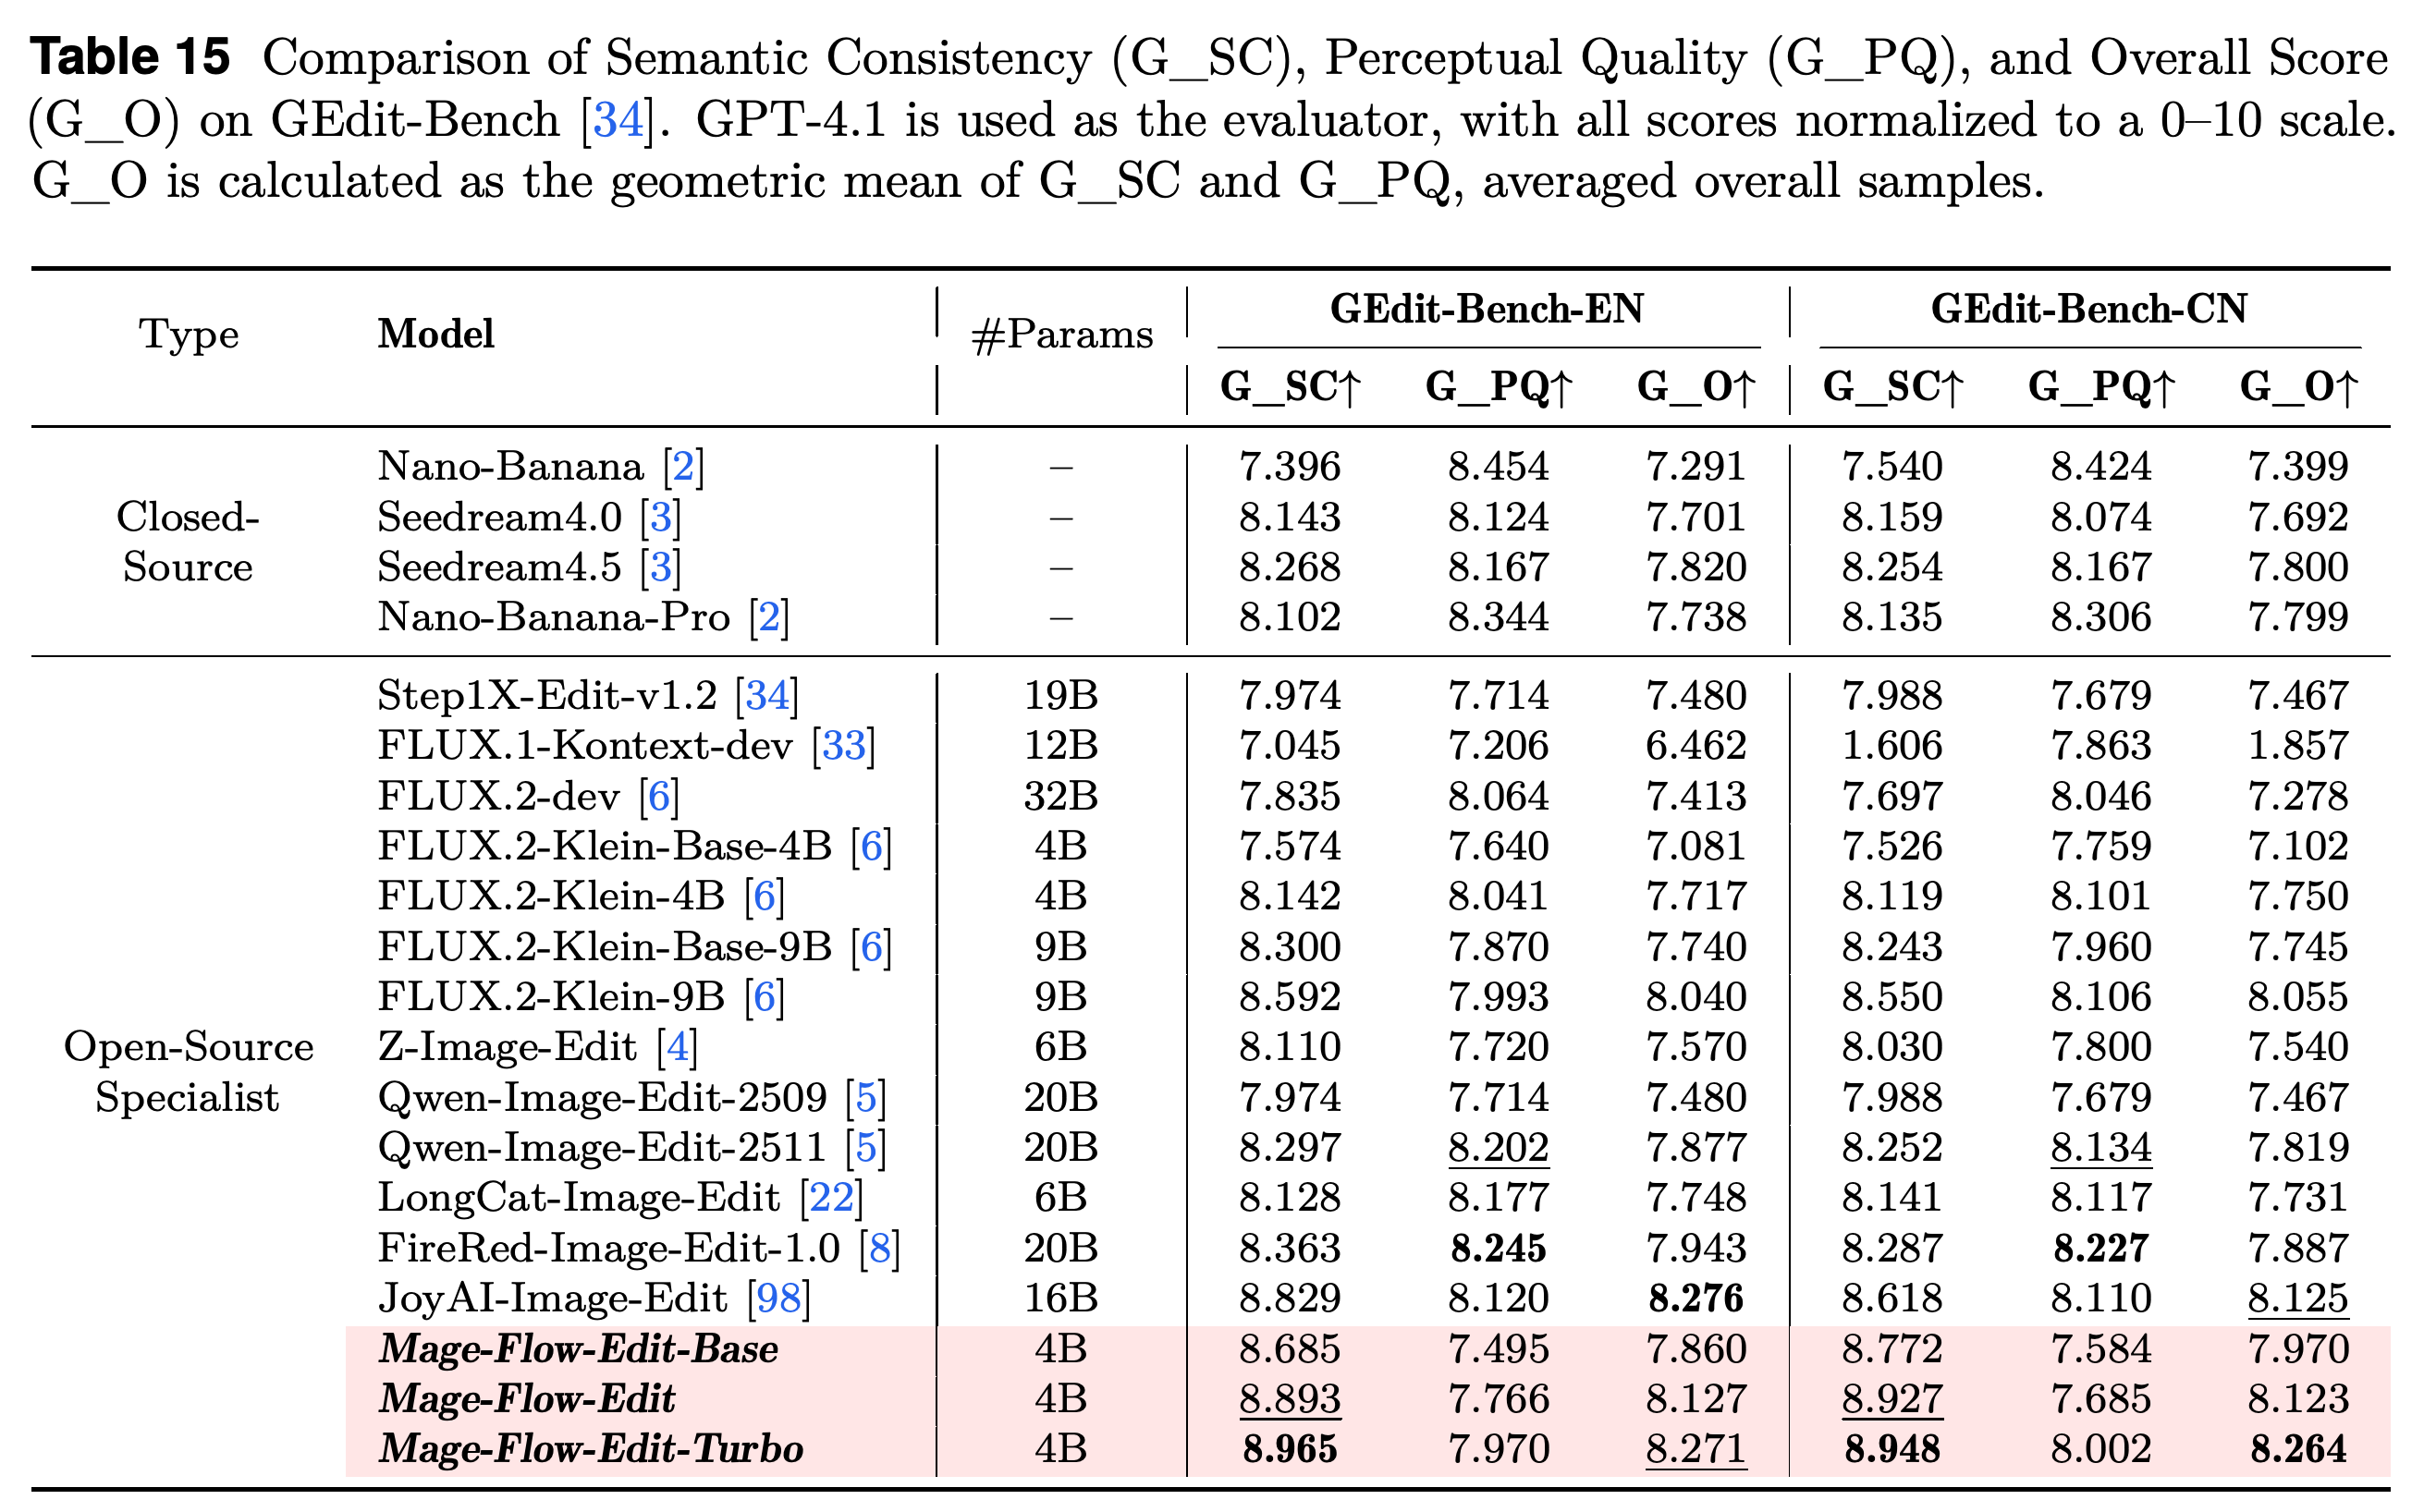
30-step aligned editor가 TextEdit total에서 Turbo보다 우수함을 보여준다.
6.3 Qualitative Results
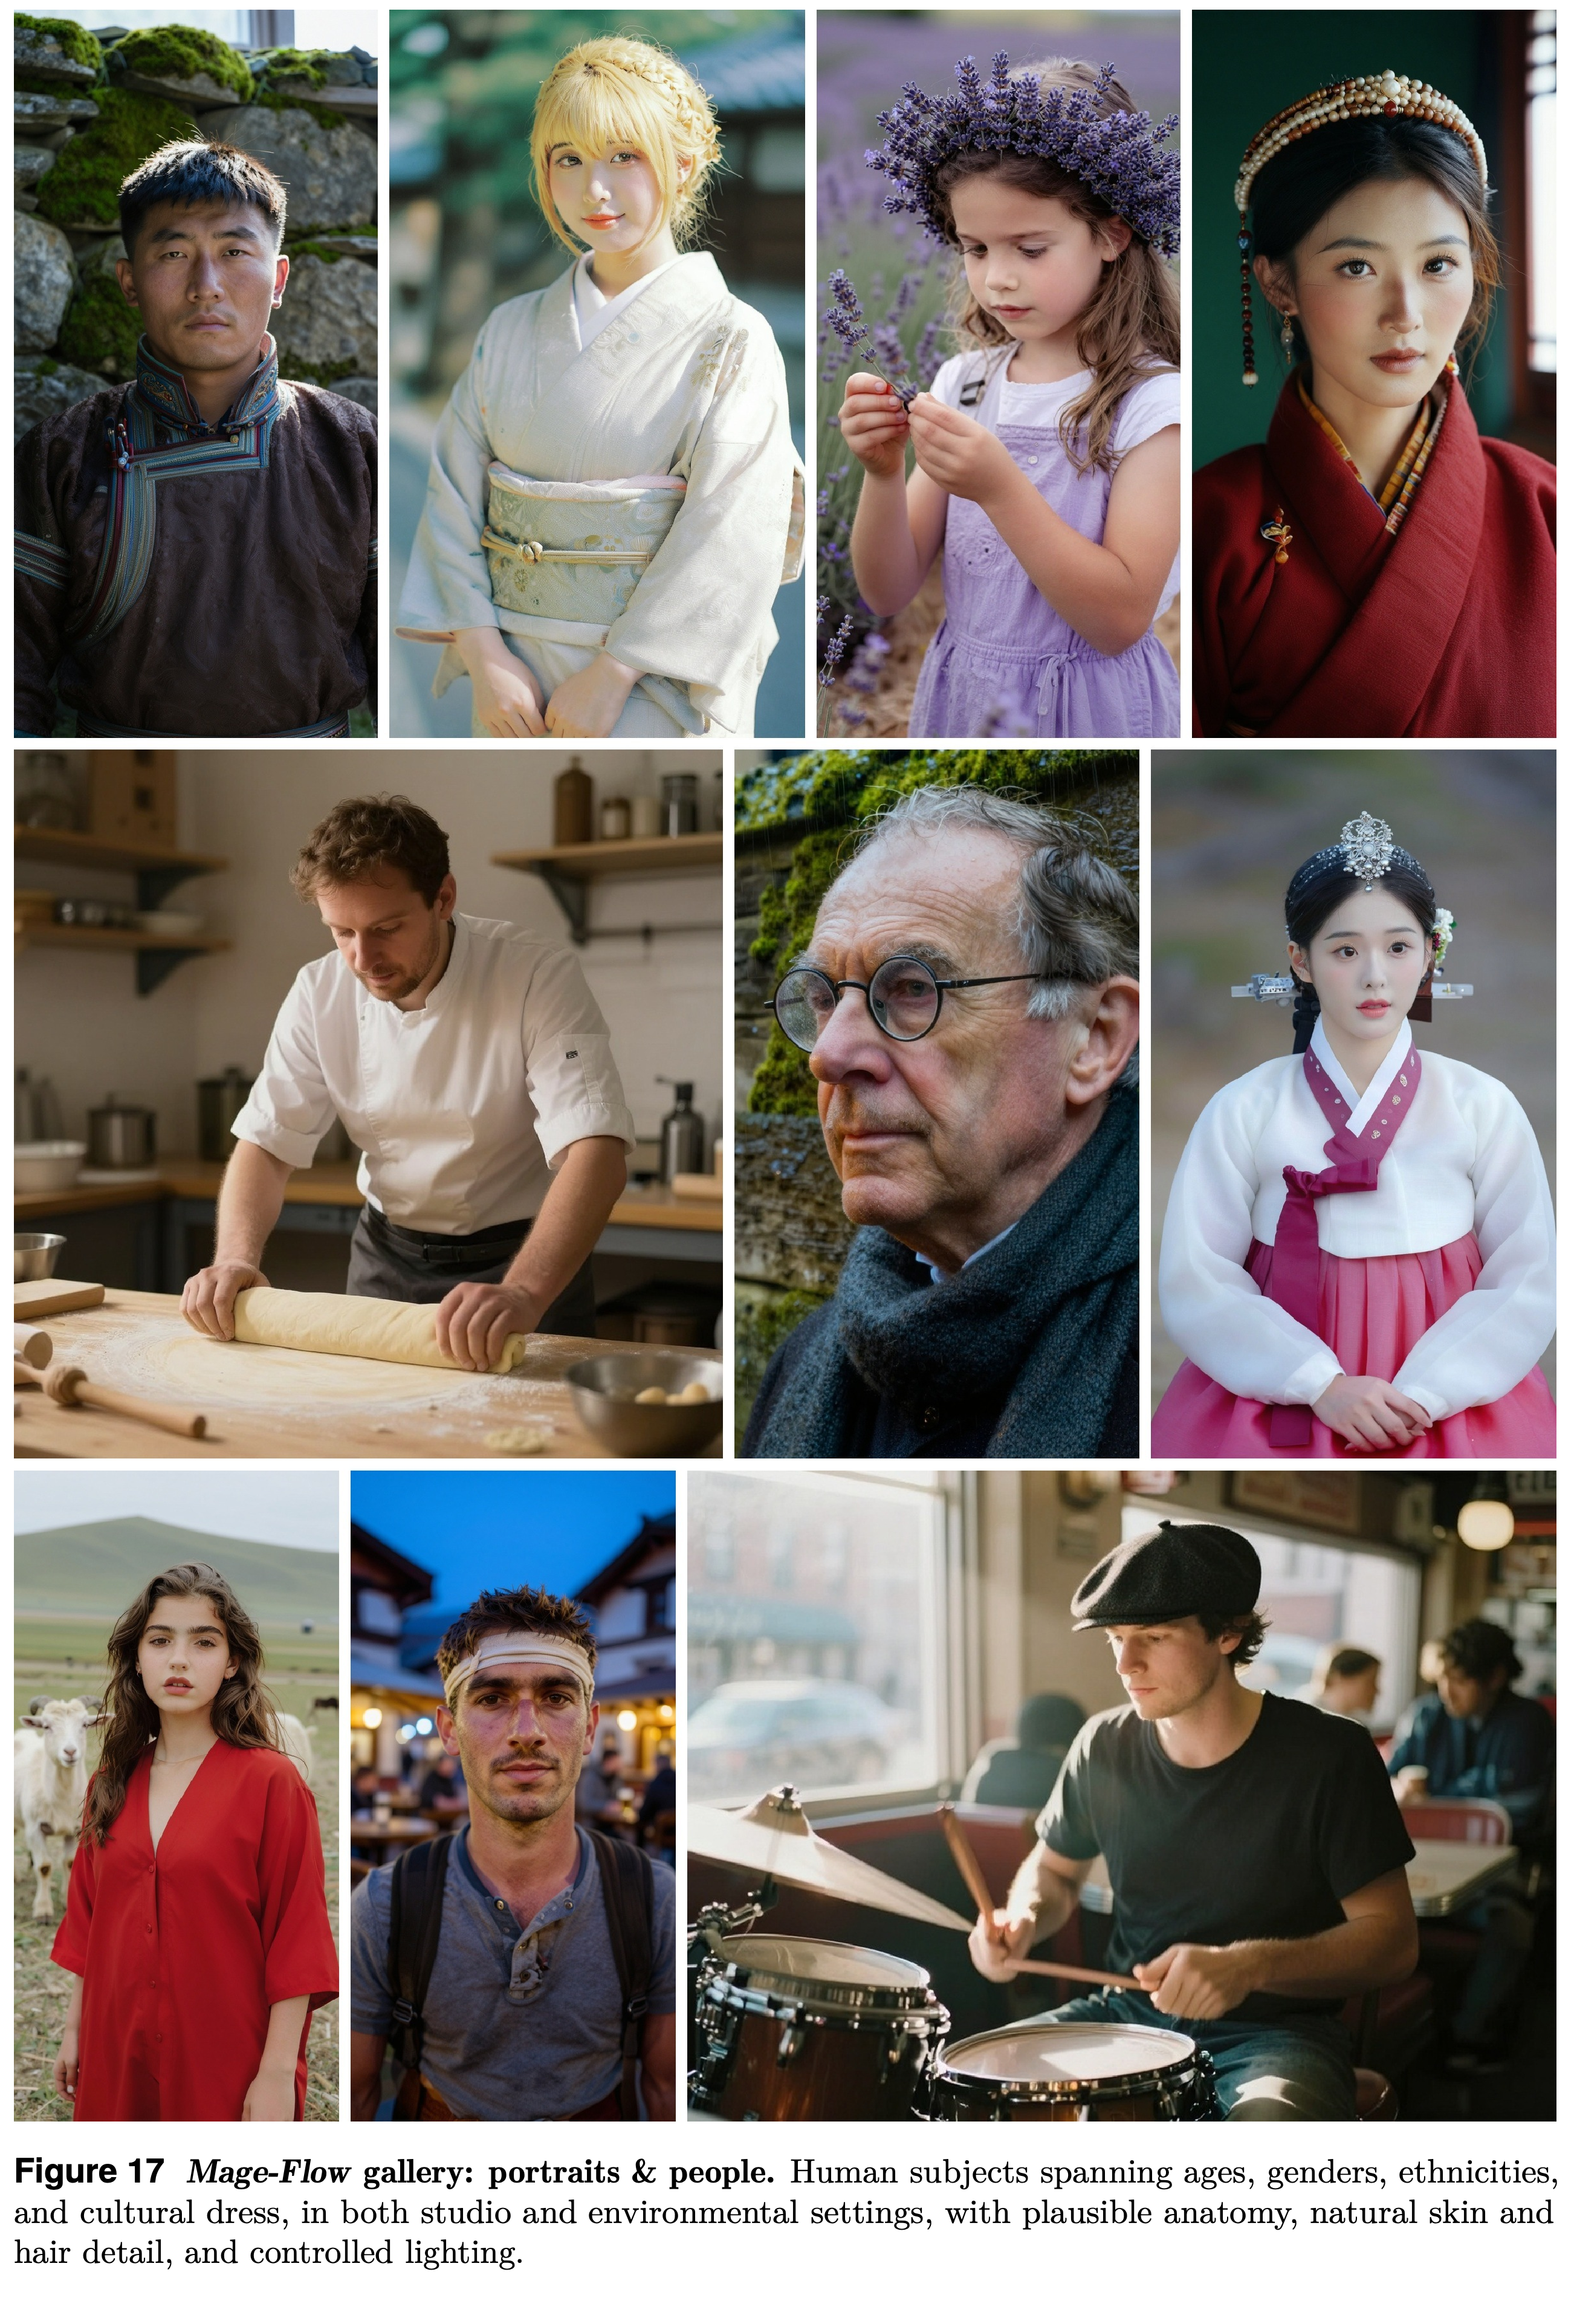
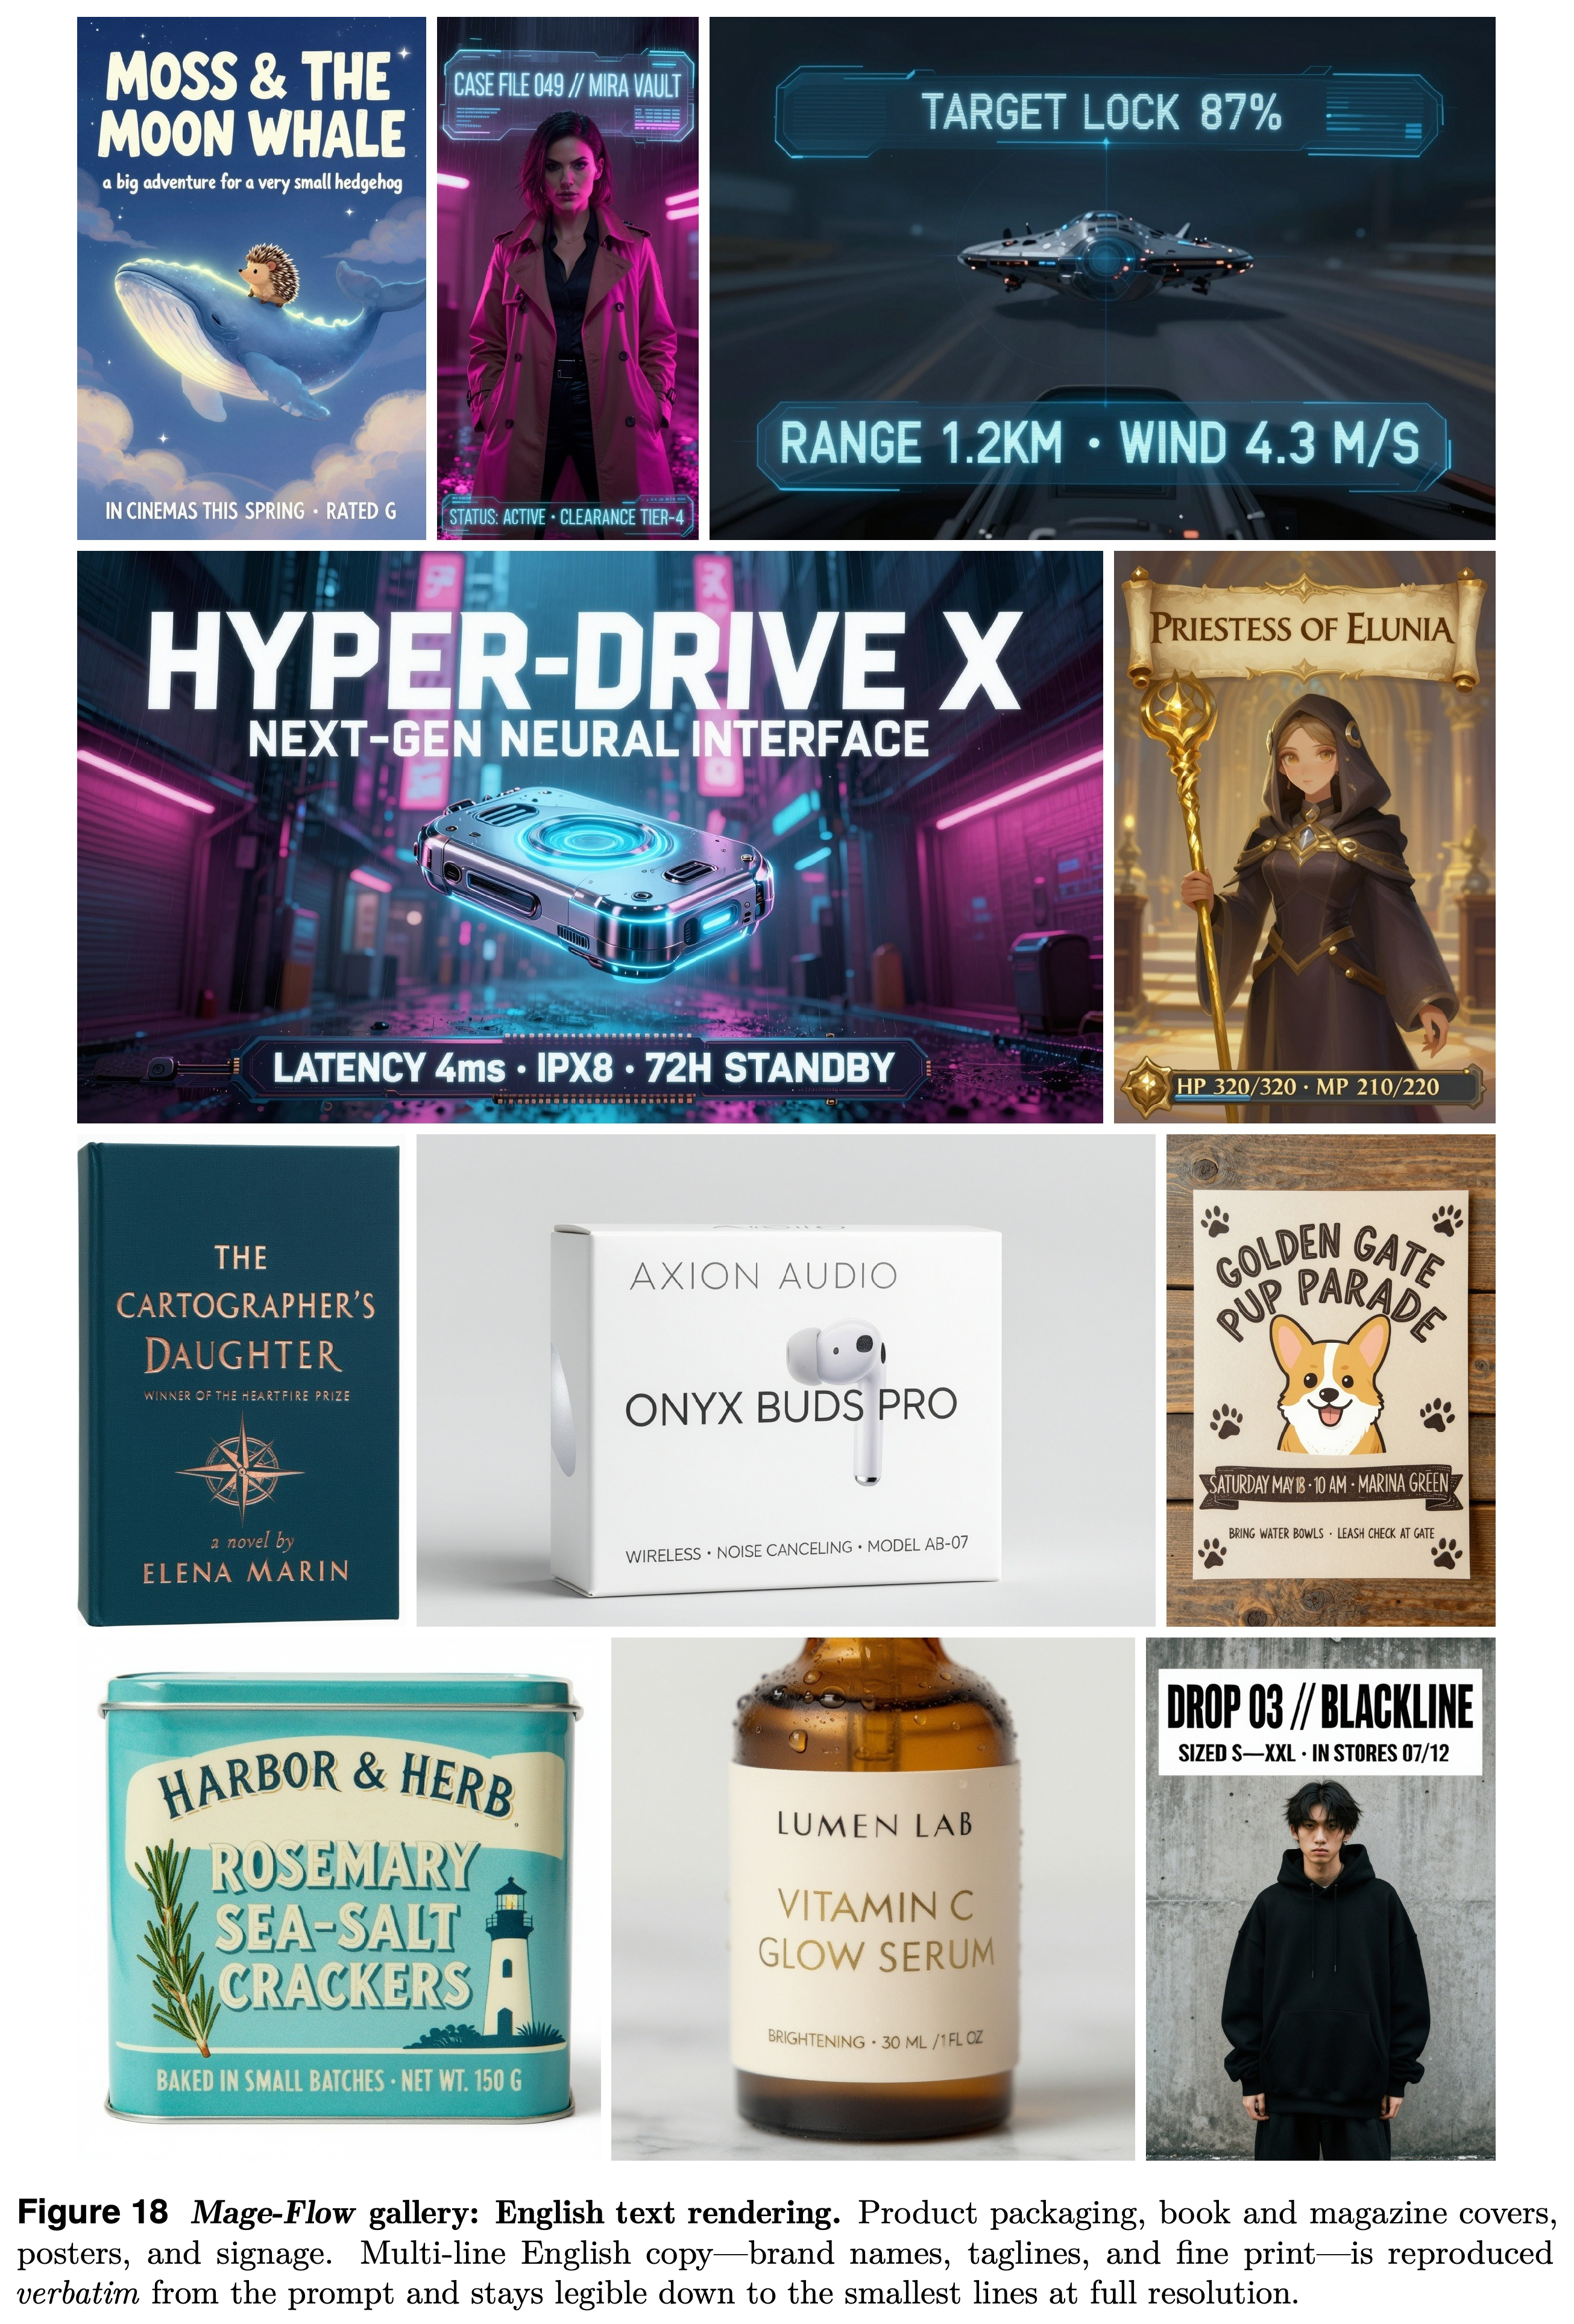
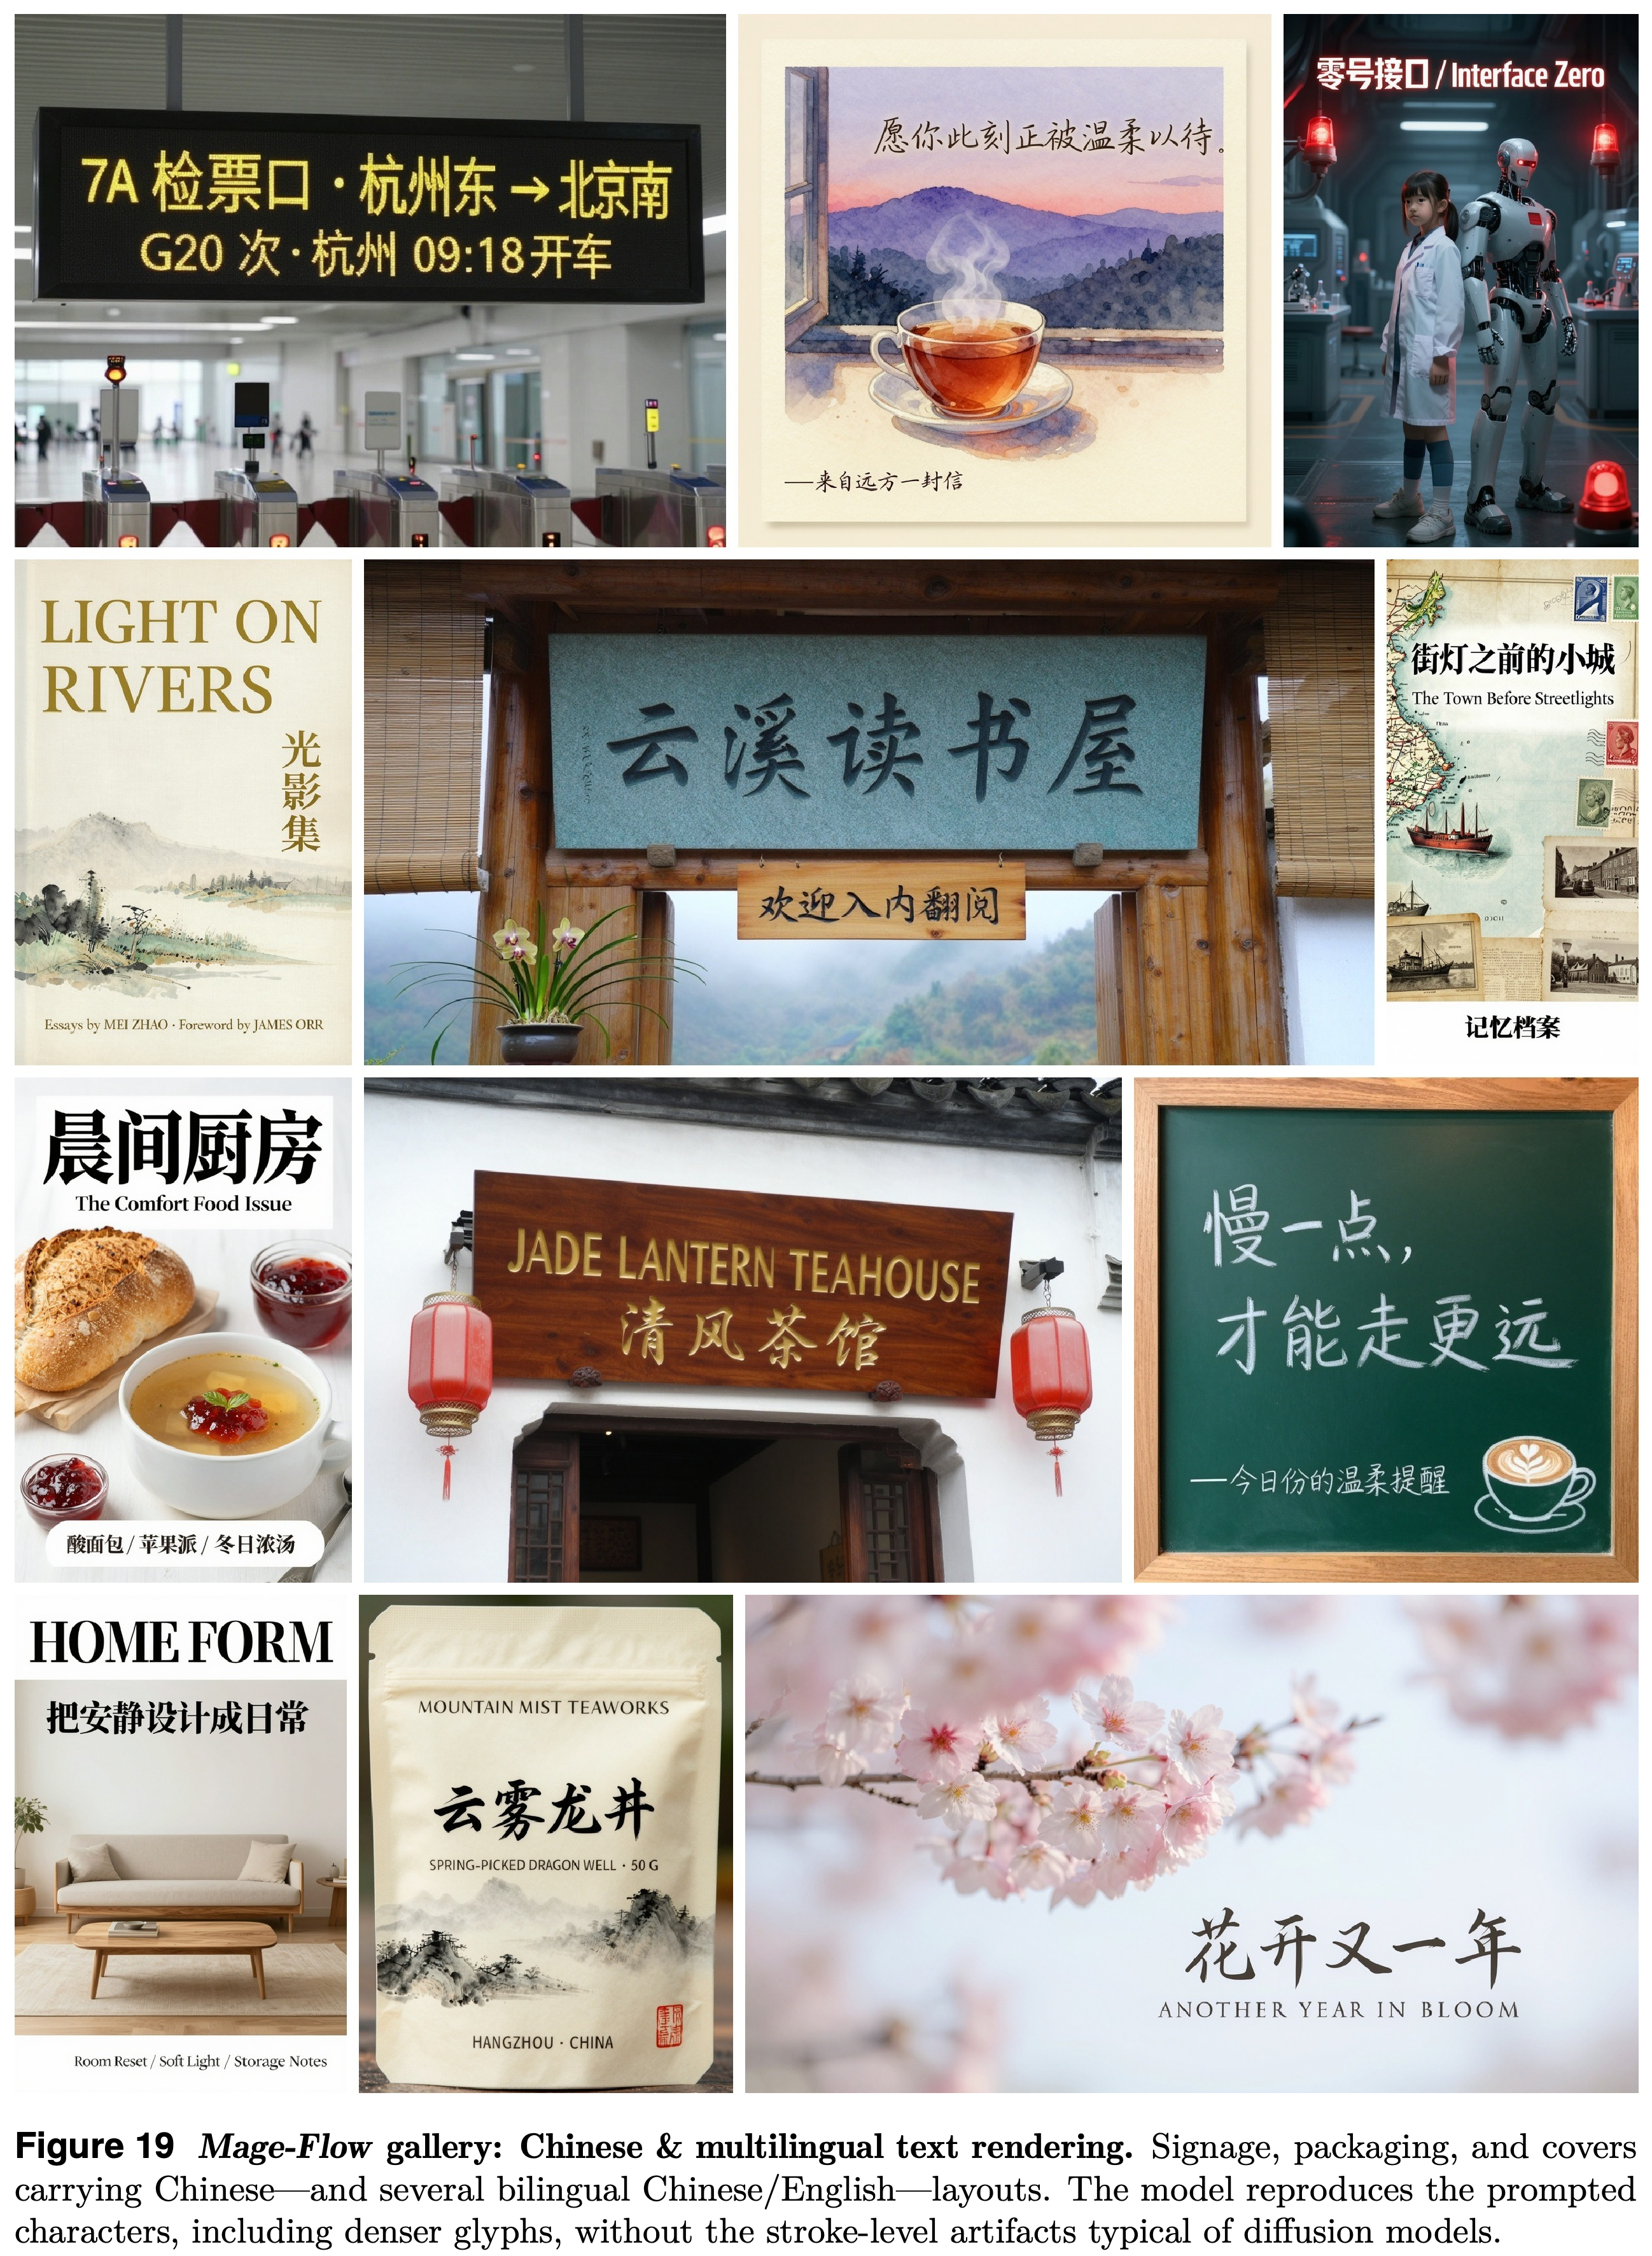
정성적 gallery는 native-resolution 생성, 영어 및 중국어 텍스트 렌더링, 다양한 source-conditioned edit를 보여준다. 이는 통제된 측정이 아니라 예시다.
6.3.1 Text-to-image visualizations
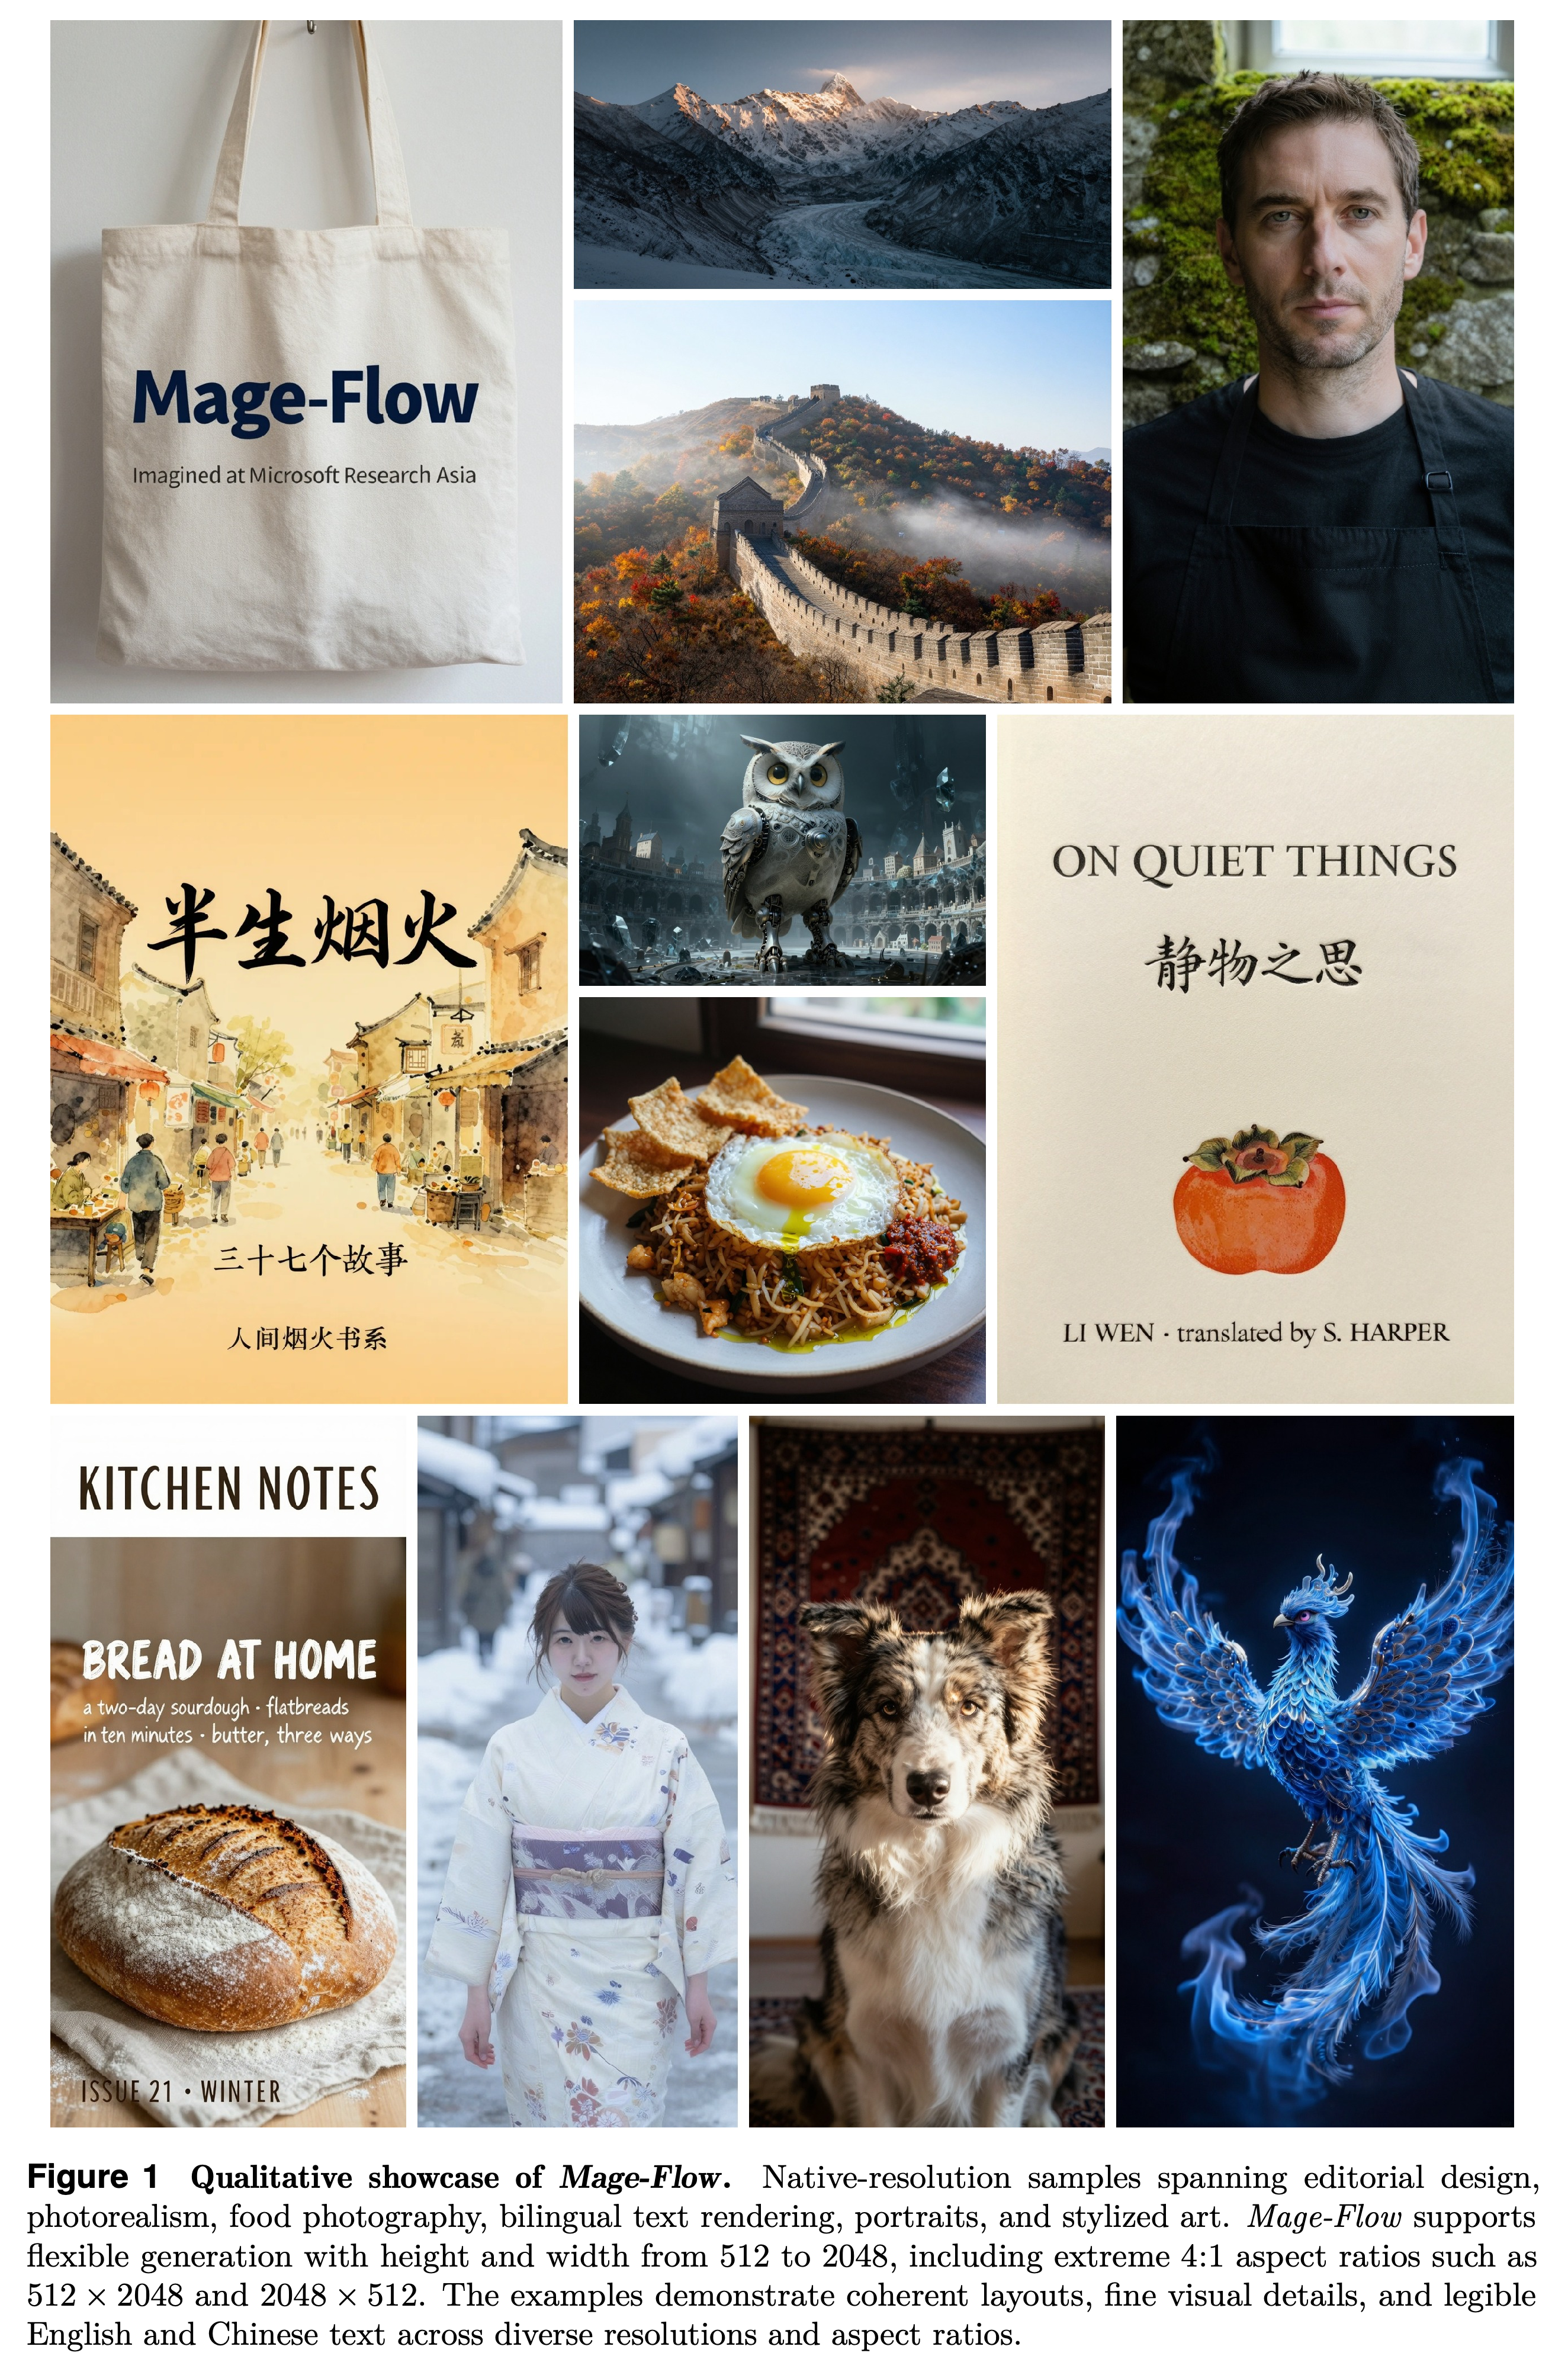
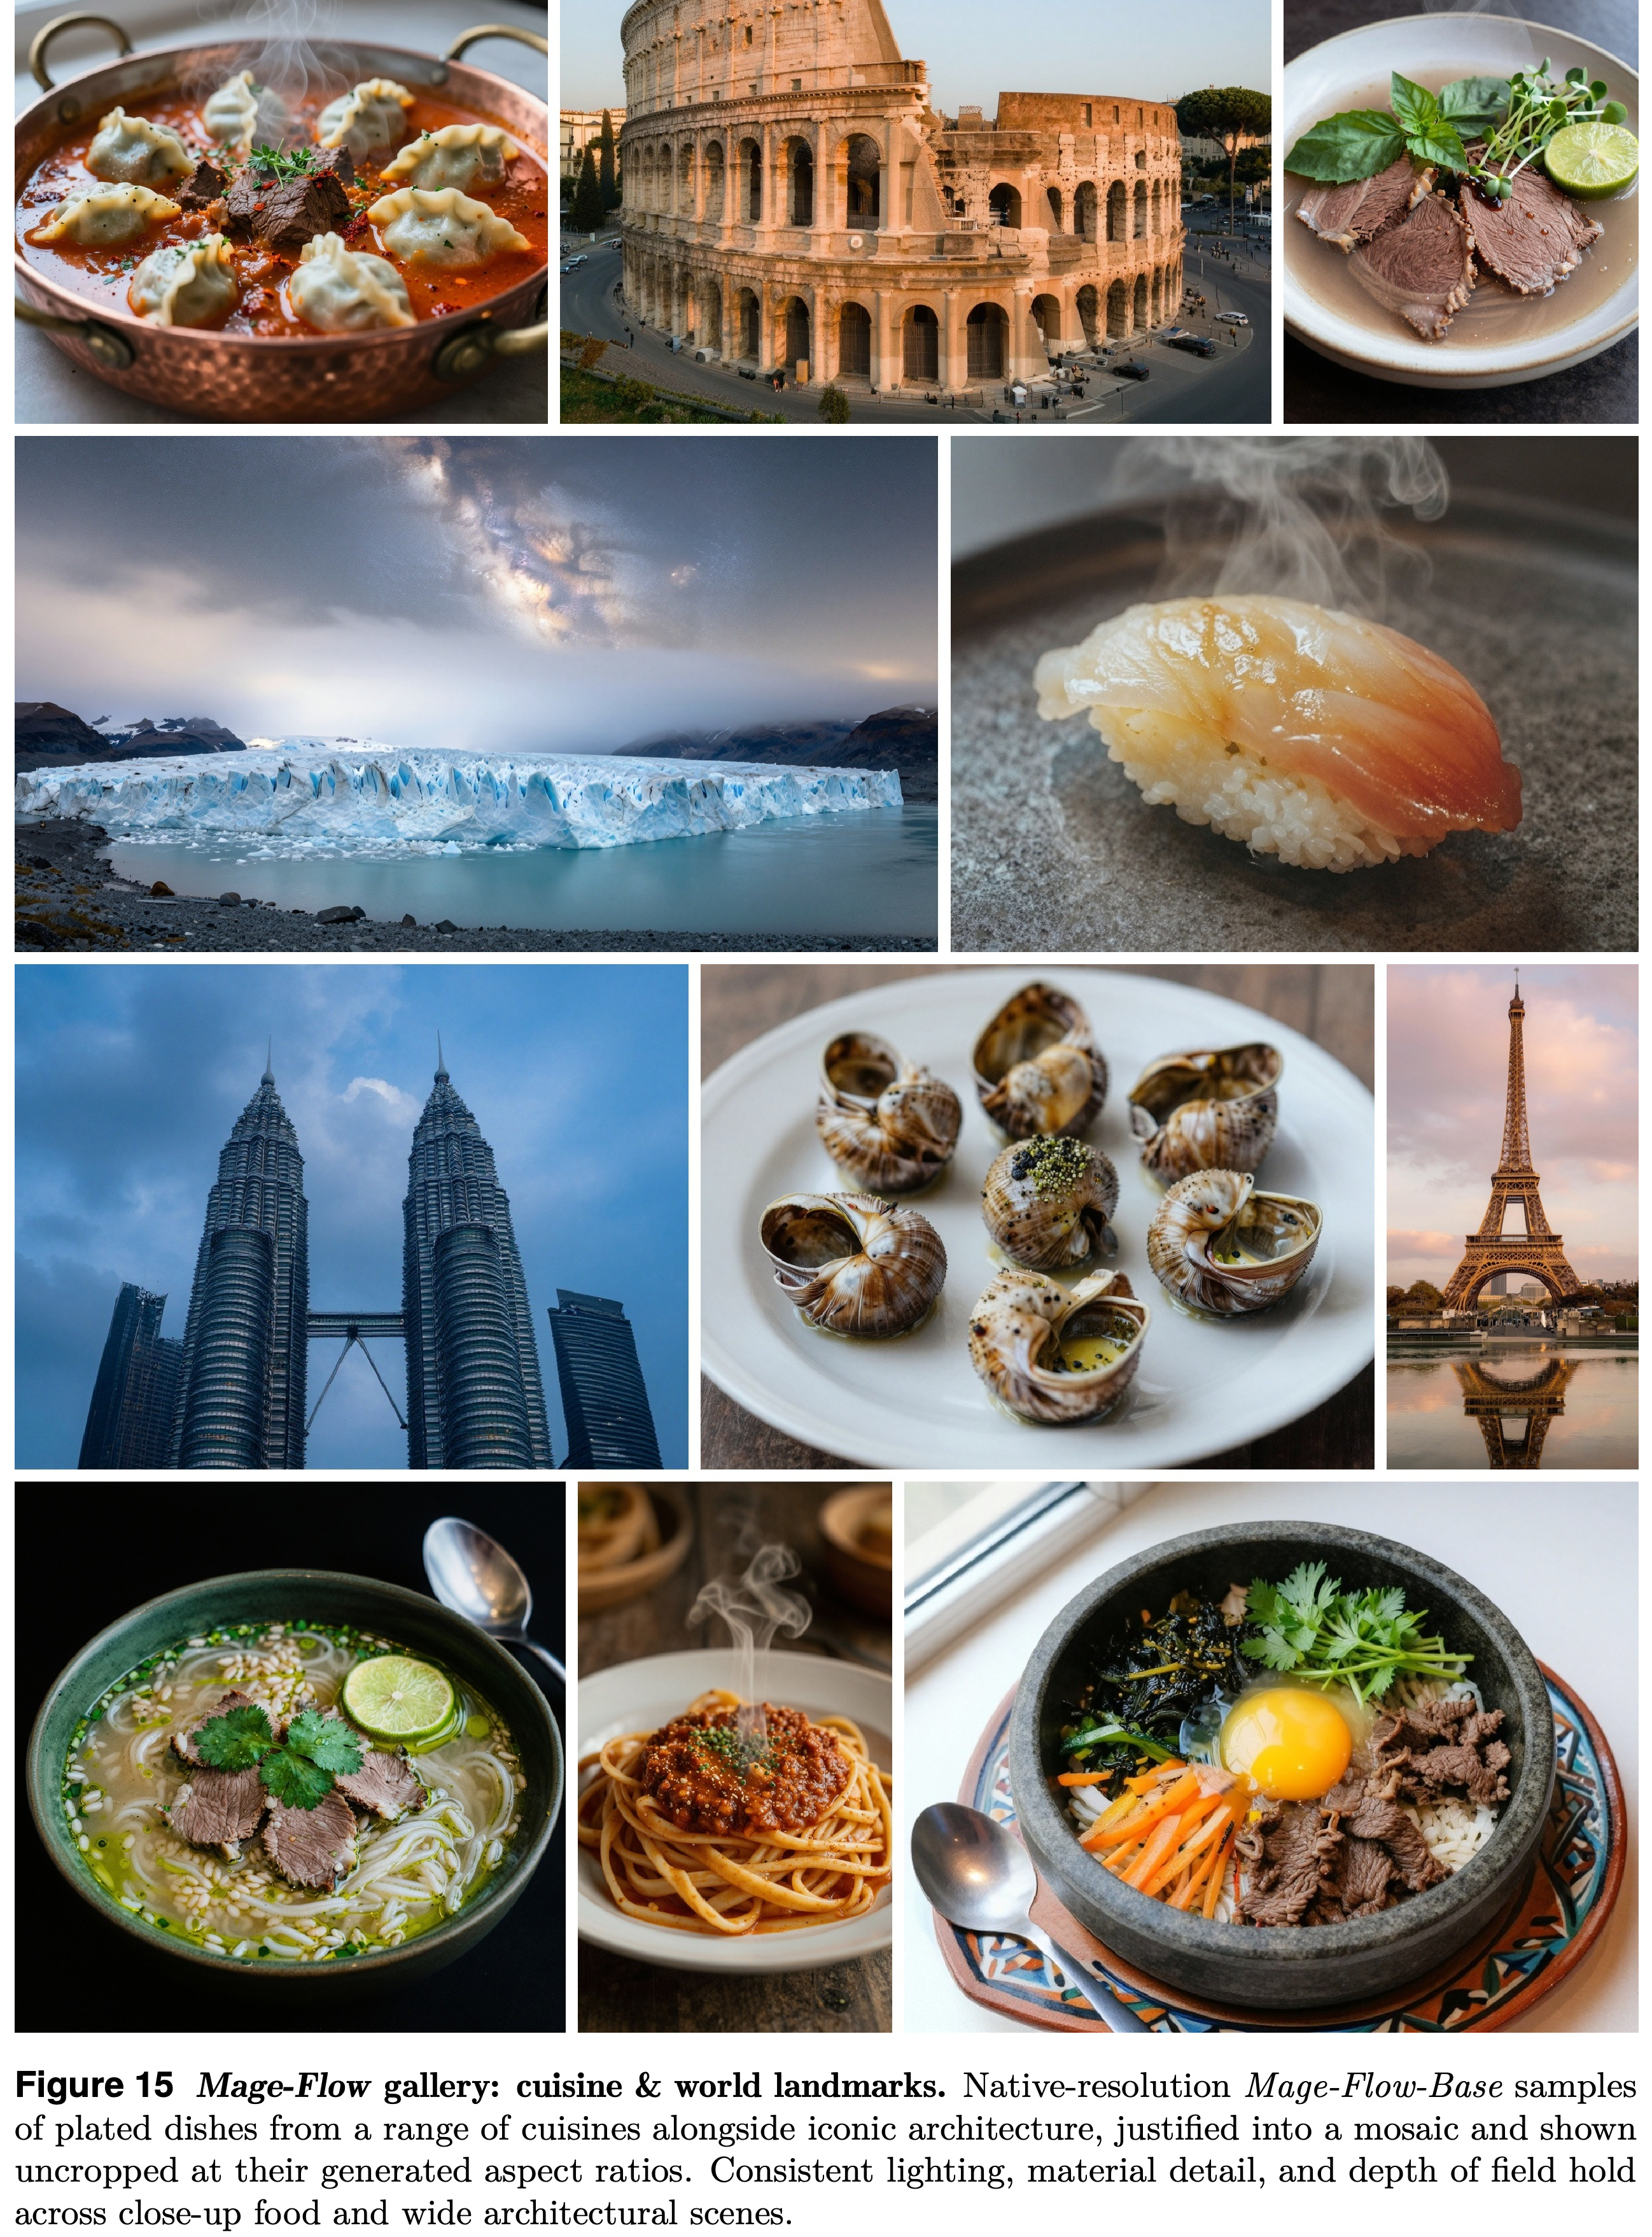
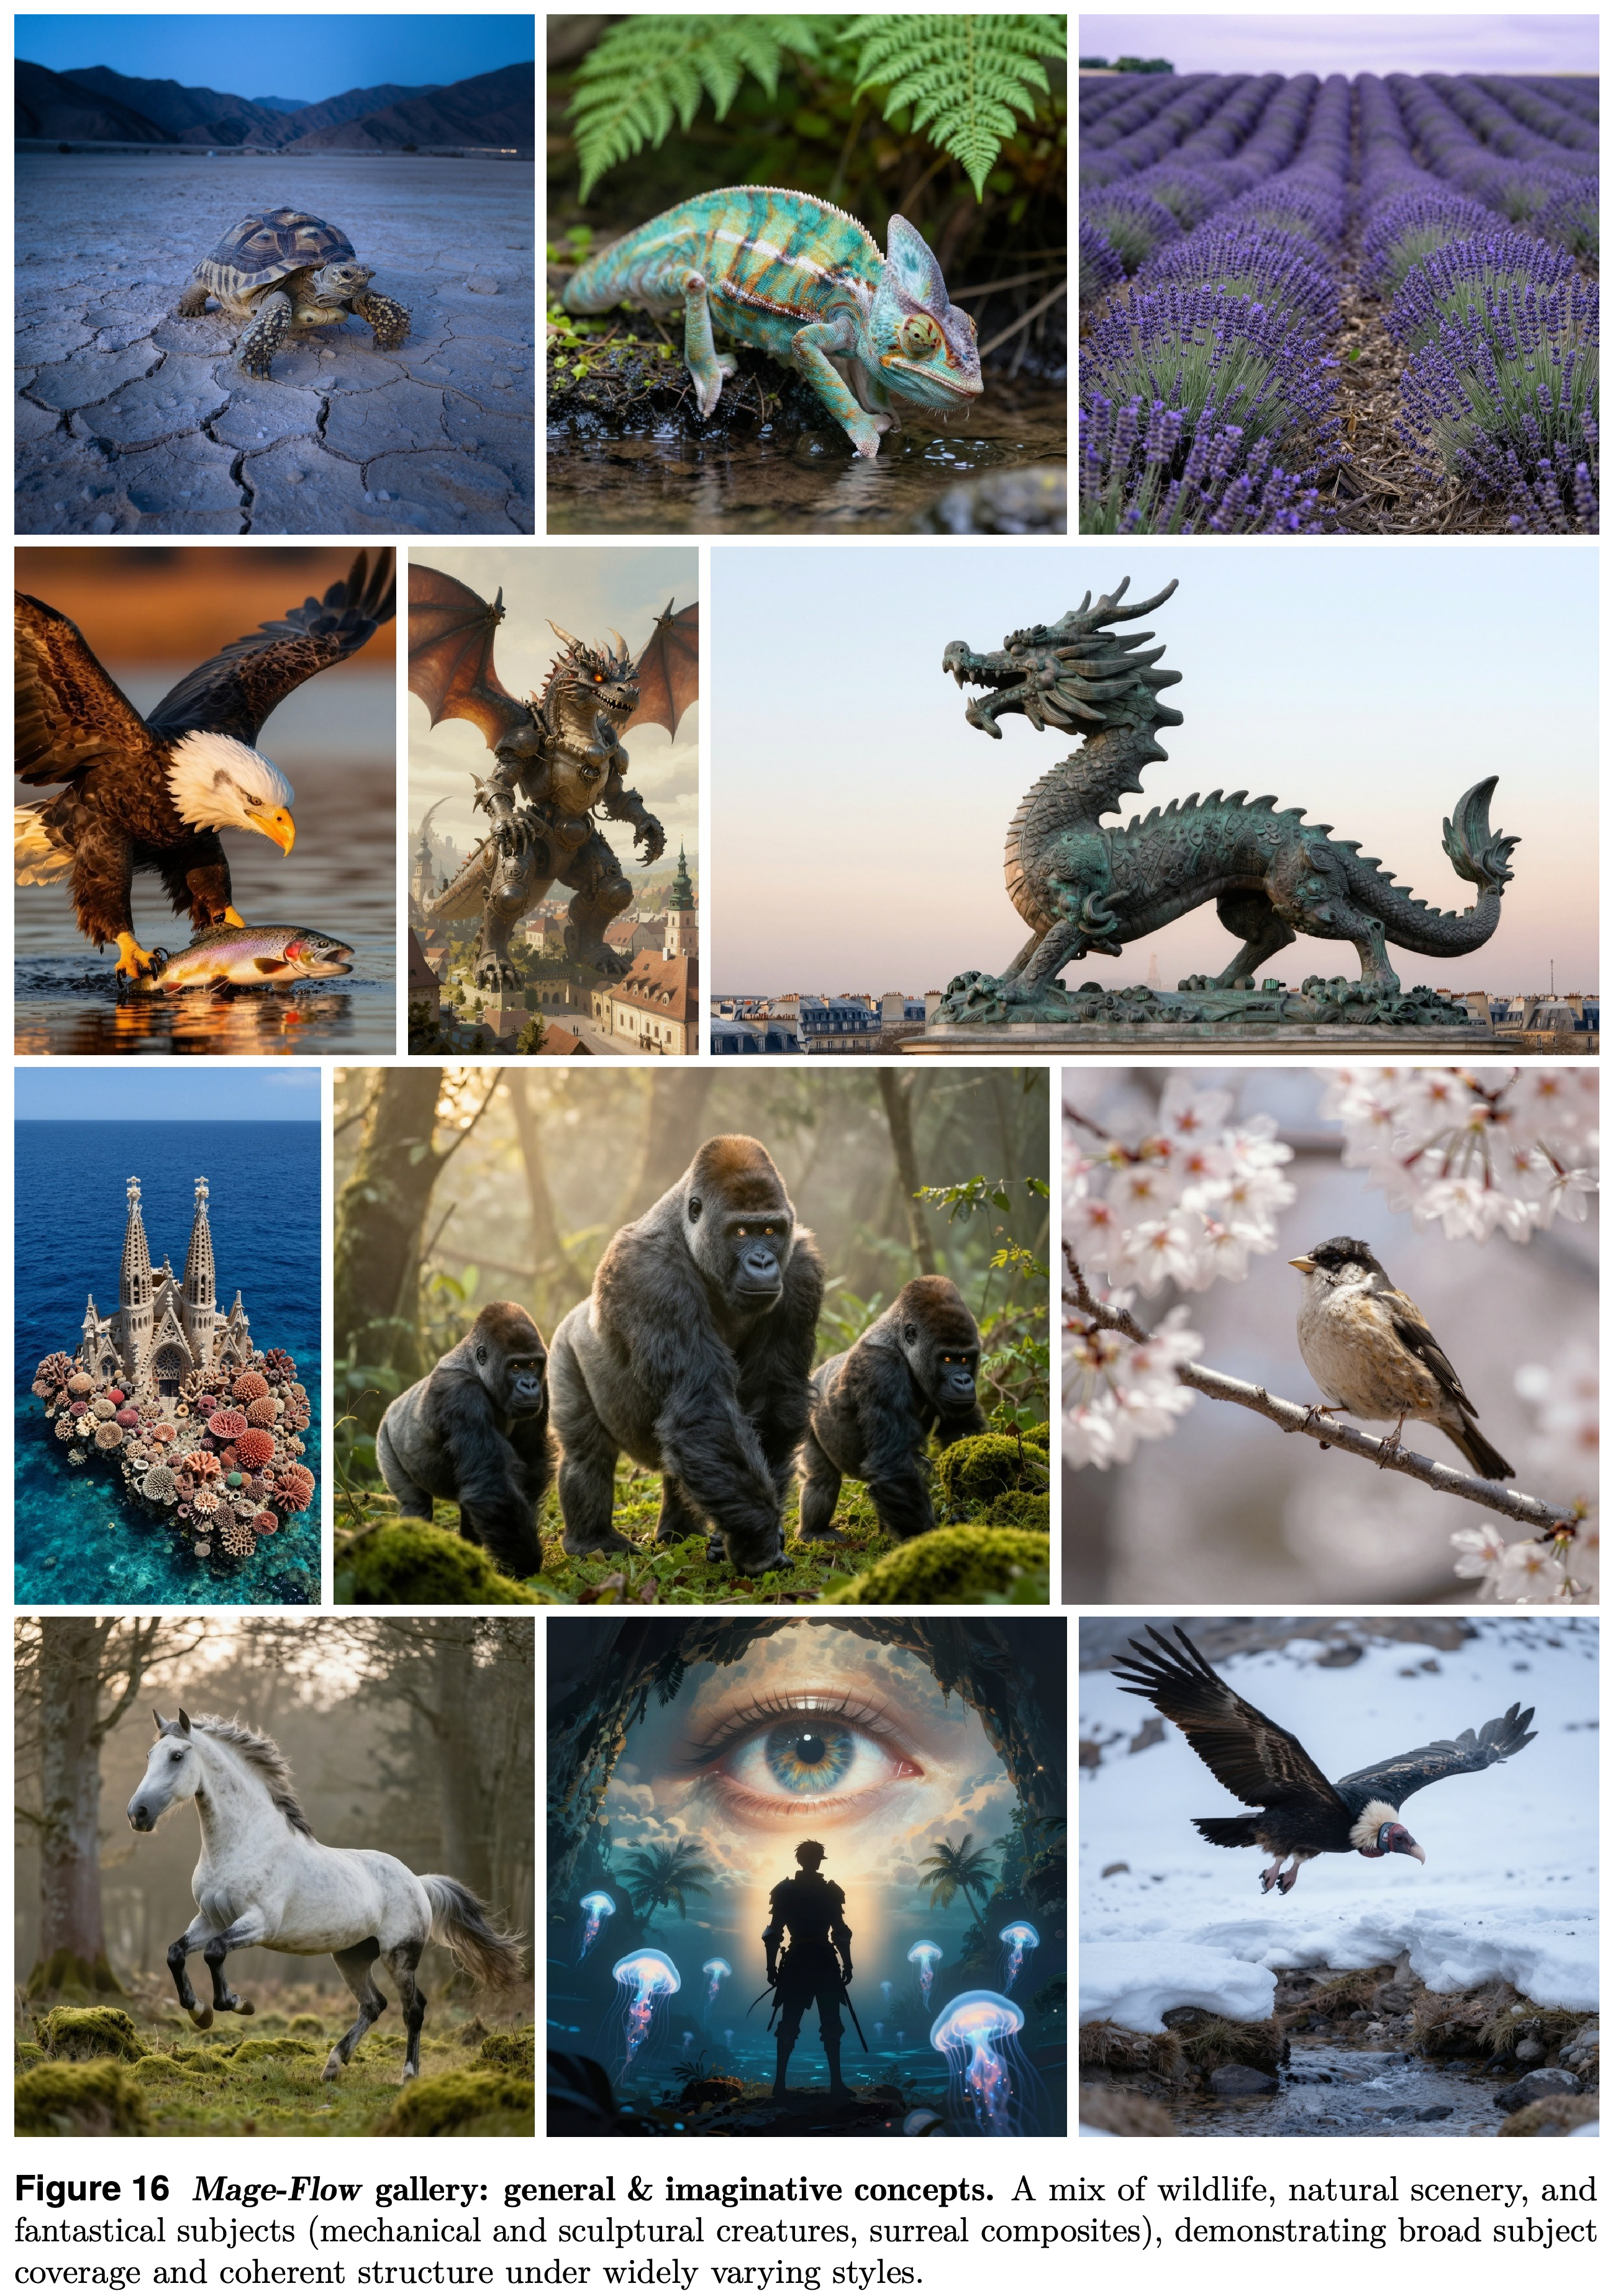
생성 gallery는 다양한 native aspect ratio에서 음식, 랜드마크, 야생동물, 상상 속 피사체, 인물, 영어 및 중국어 텍스트를 다룬다. 텍스트 중심 예시에는 포장, 포스터, 표지, 간판이 포함된다.
영어 및 중국어 텍스트를 포함해 정사각형, 세로형, 가로형, 4:1 aspect ratio로 생성한 native-resolution sample을 보여준다.
native-aspect-ratio mosaic으로 음식 및 건축물 sample을 보여준다.
야생동물, 풍경, 환상적 생물, 초현실적 합성물을 보여준다.
다양한 연령, 표현, 복장, 환경의 인물 portrait를 보여준다.
포장, 책, 포스터, 간판, 인터페이스풍 디자인에 나타난 영어 텍스트를 보여준다.
간판, 책, 포장, 포스터의 중국어 및 이중 언어 텍스트를 보여준다.
6.3.2 Instruction-based editing visualizations
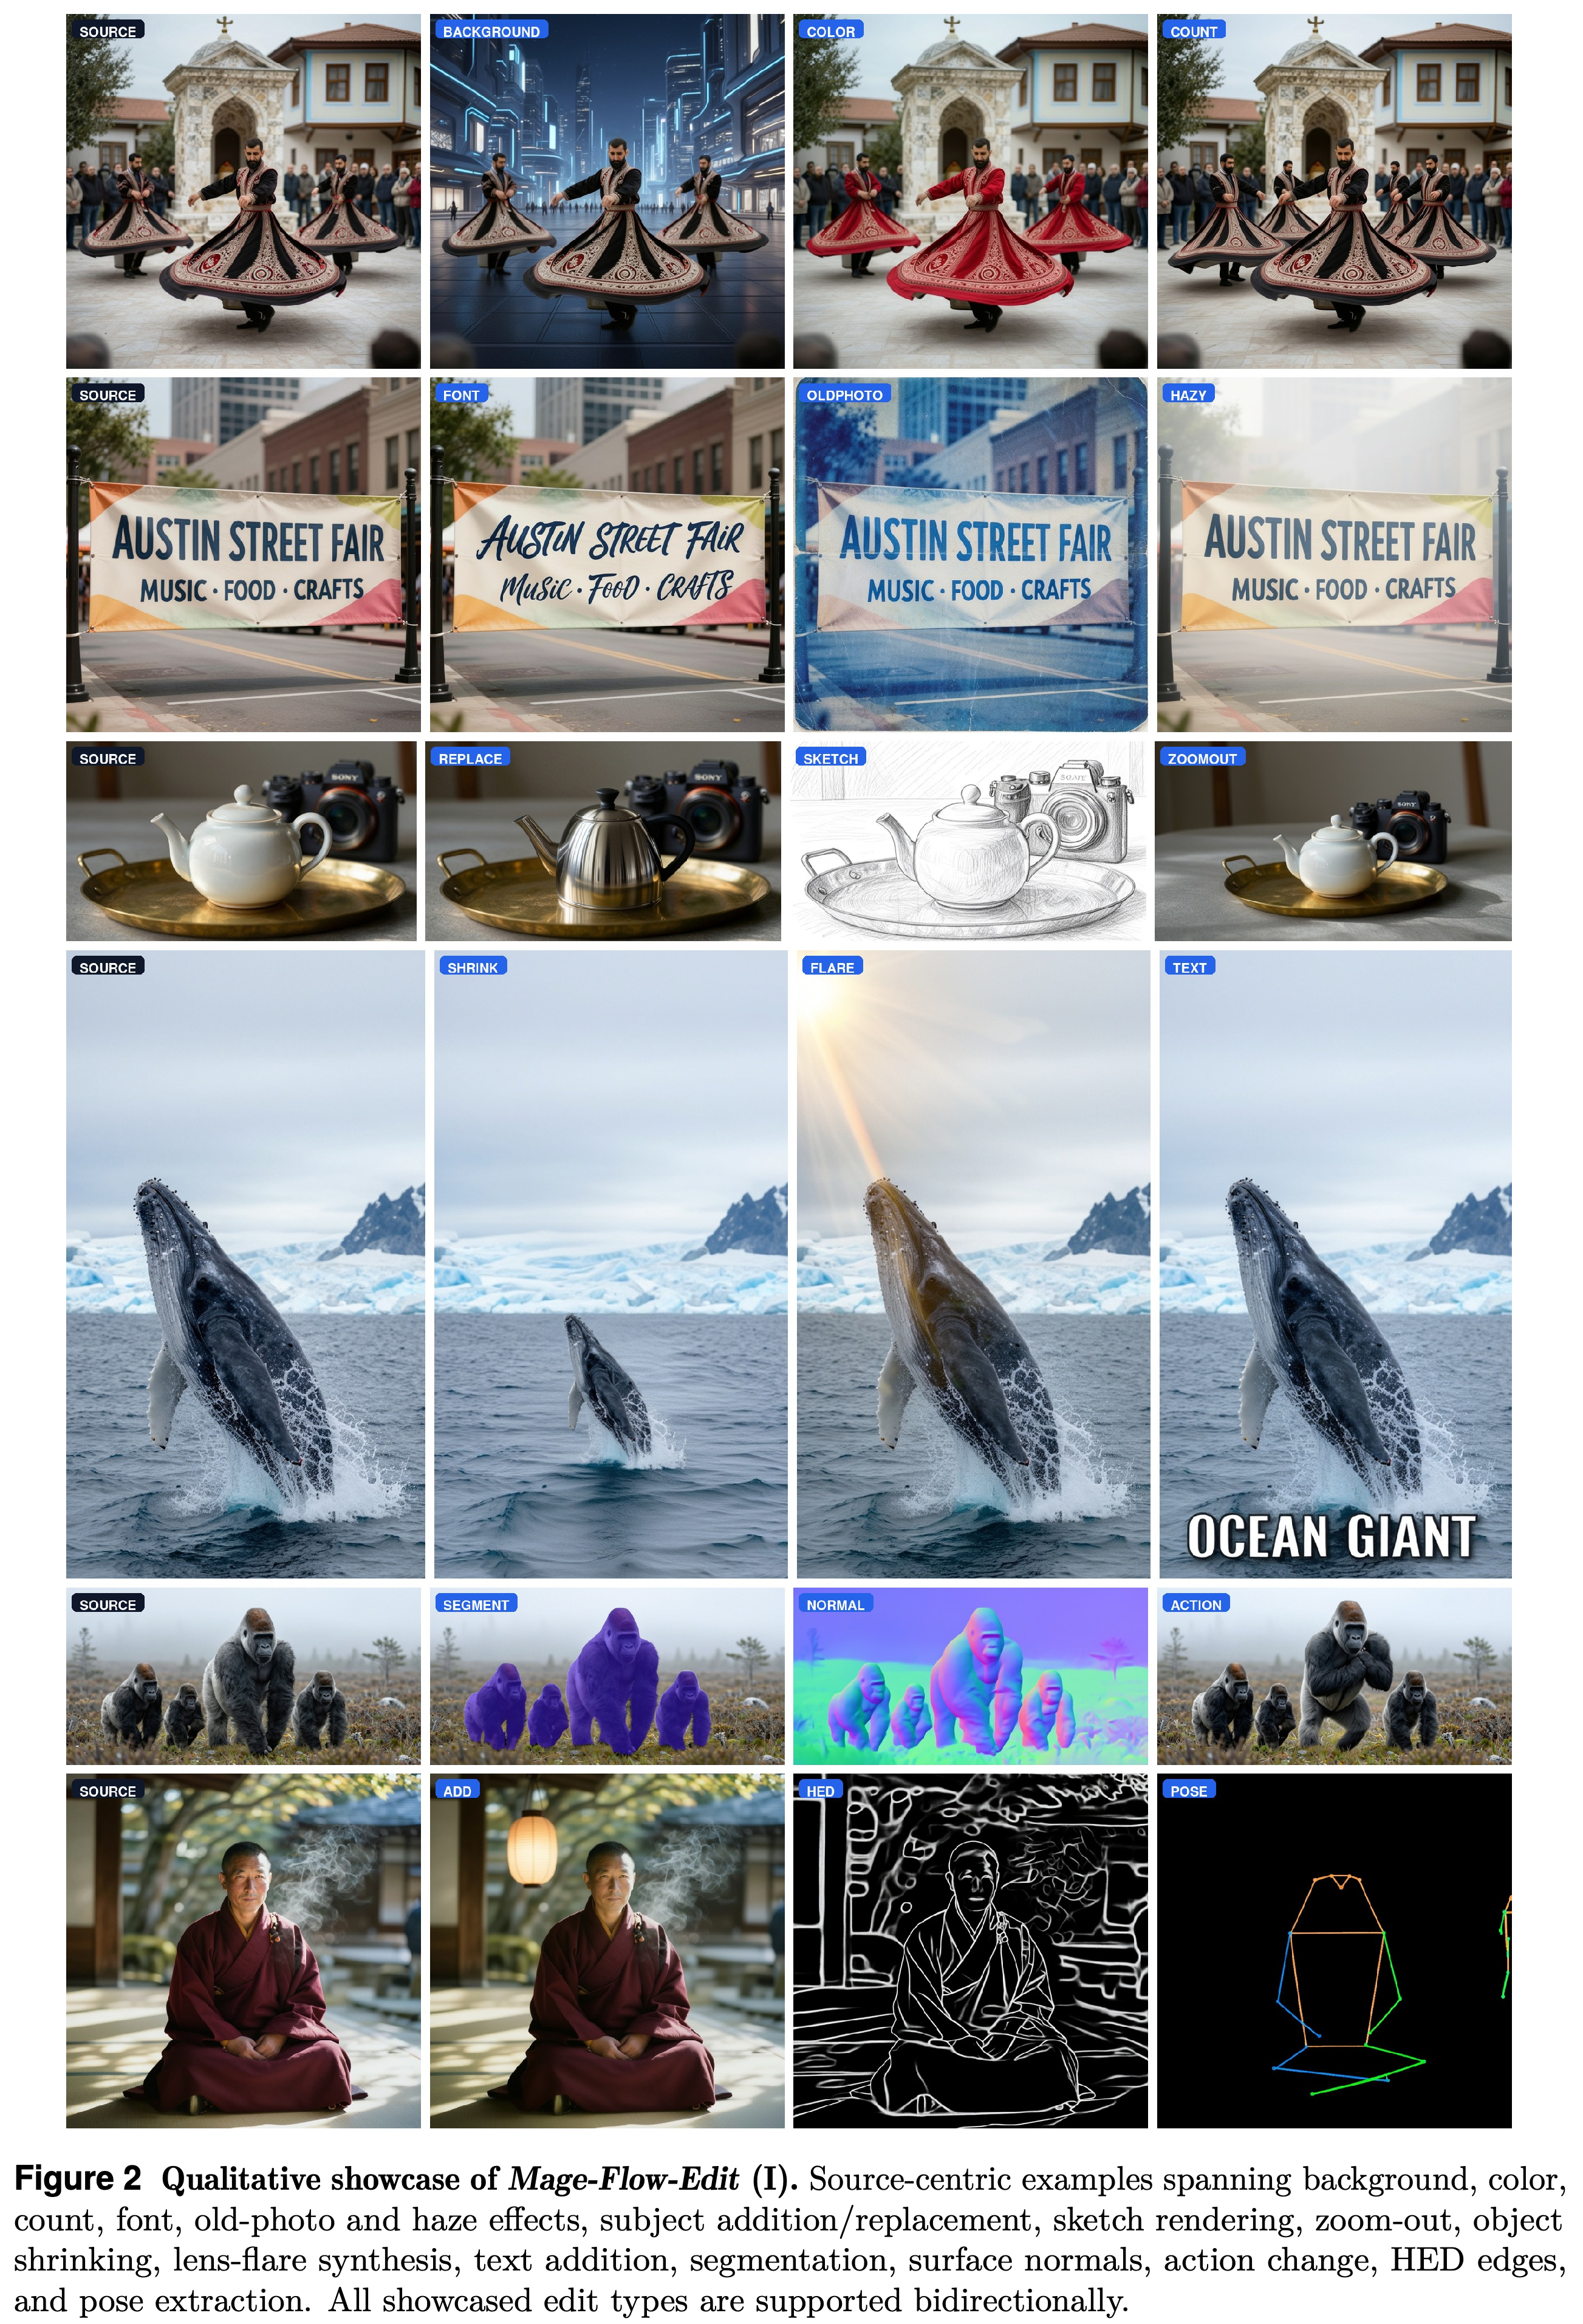
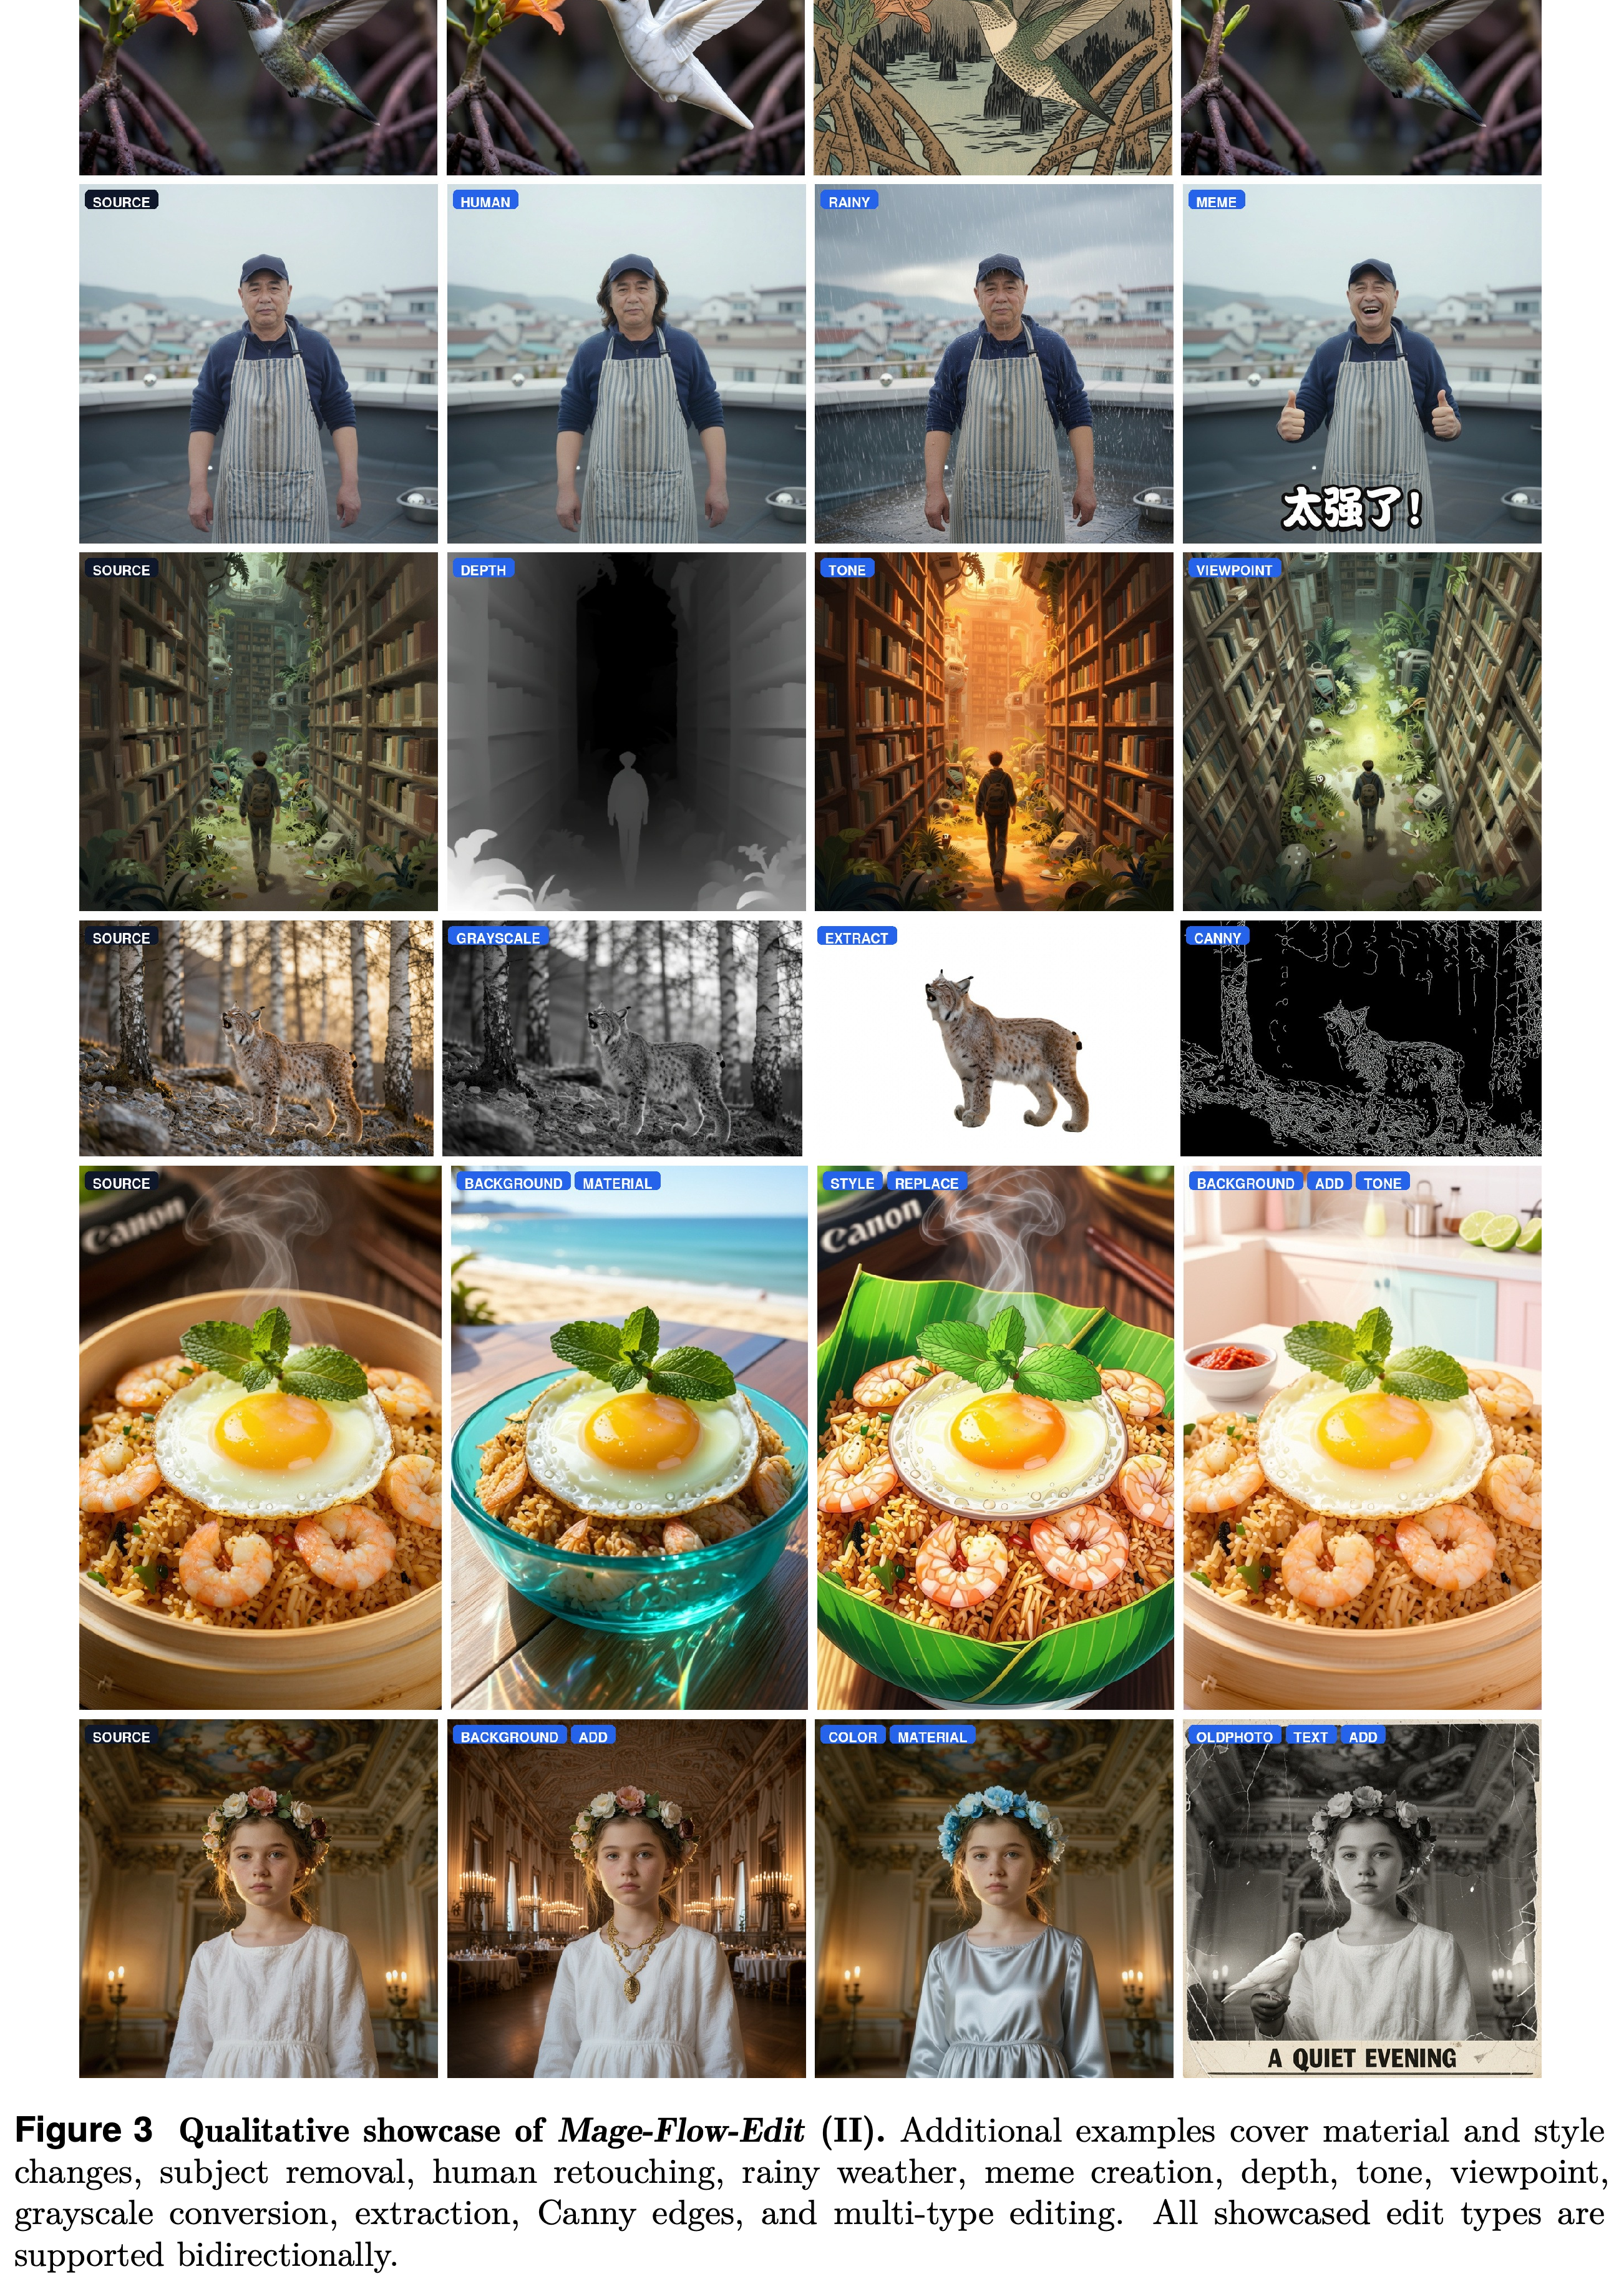
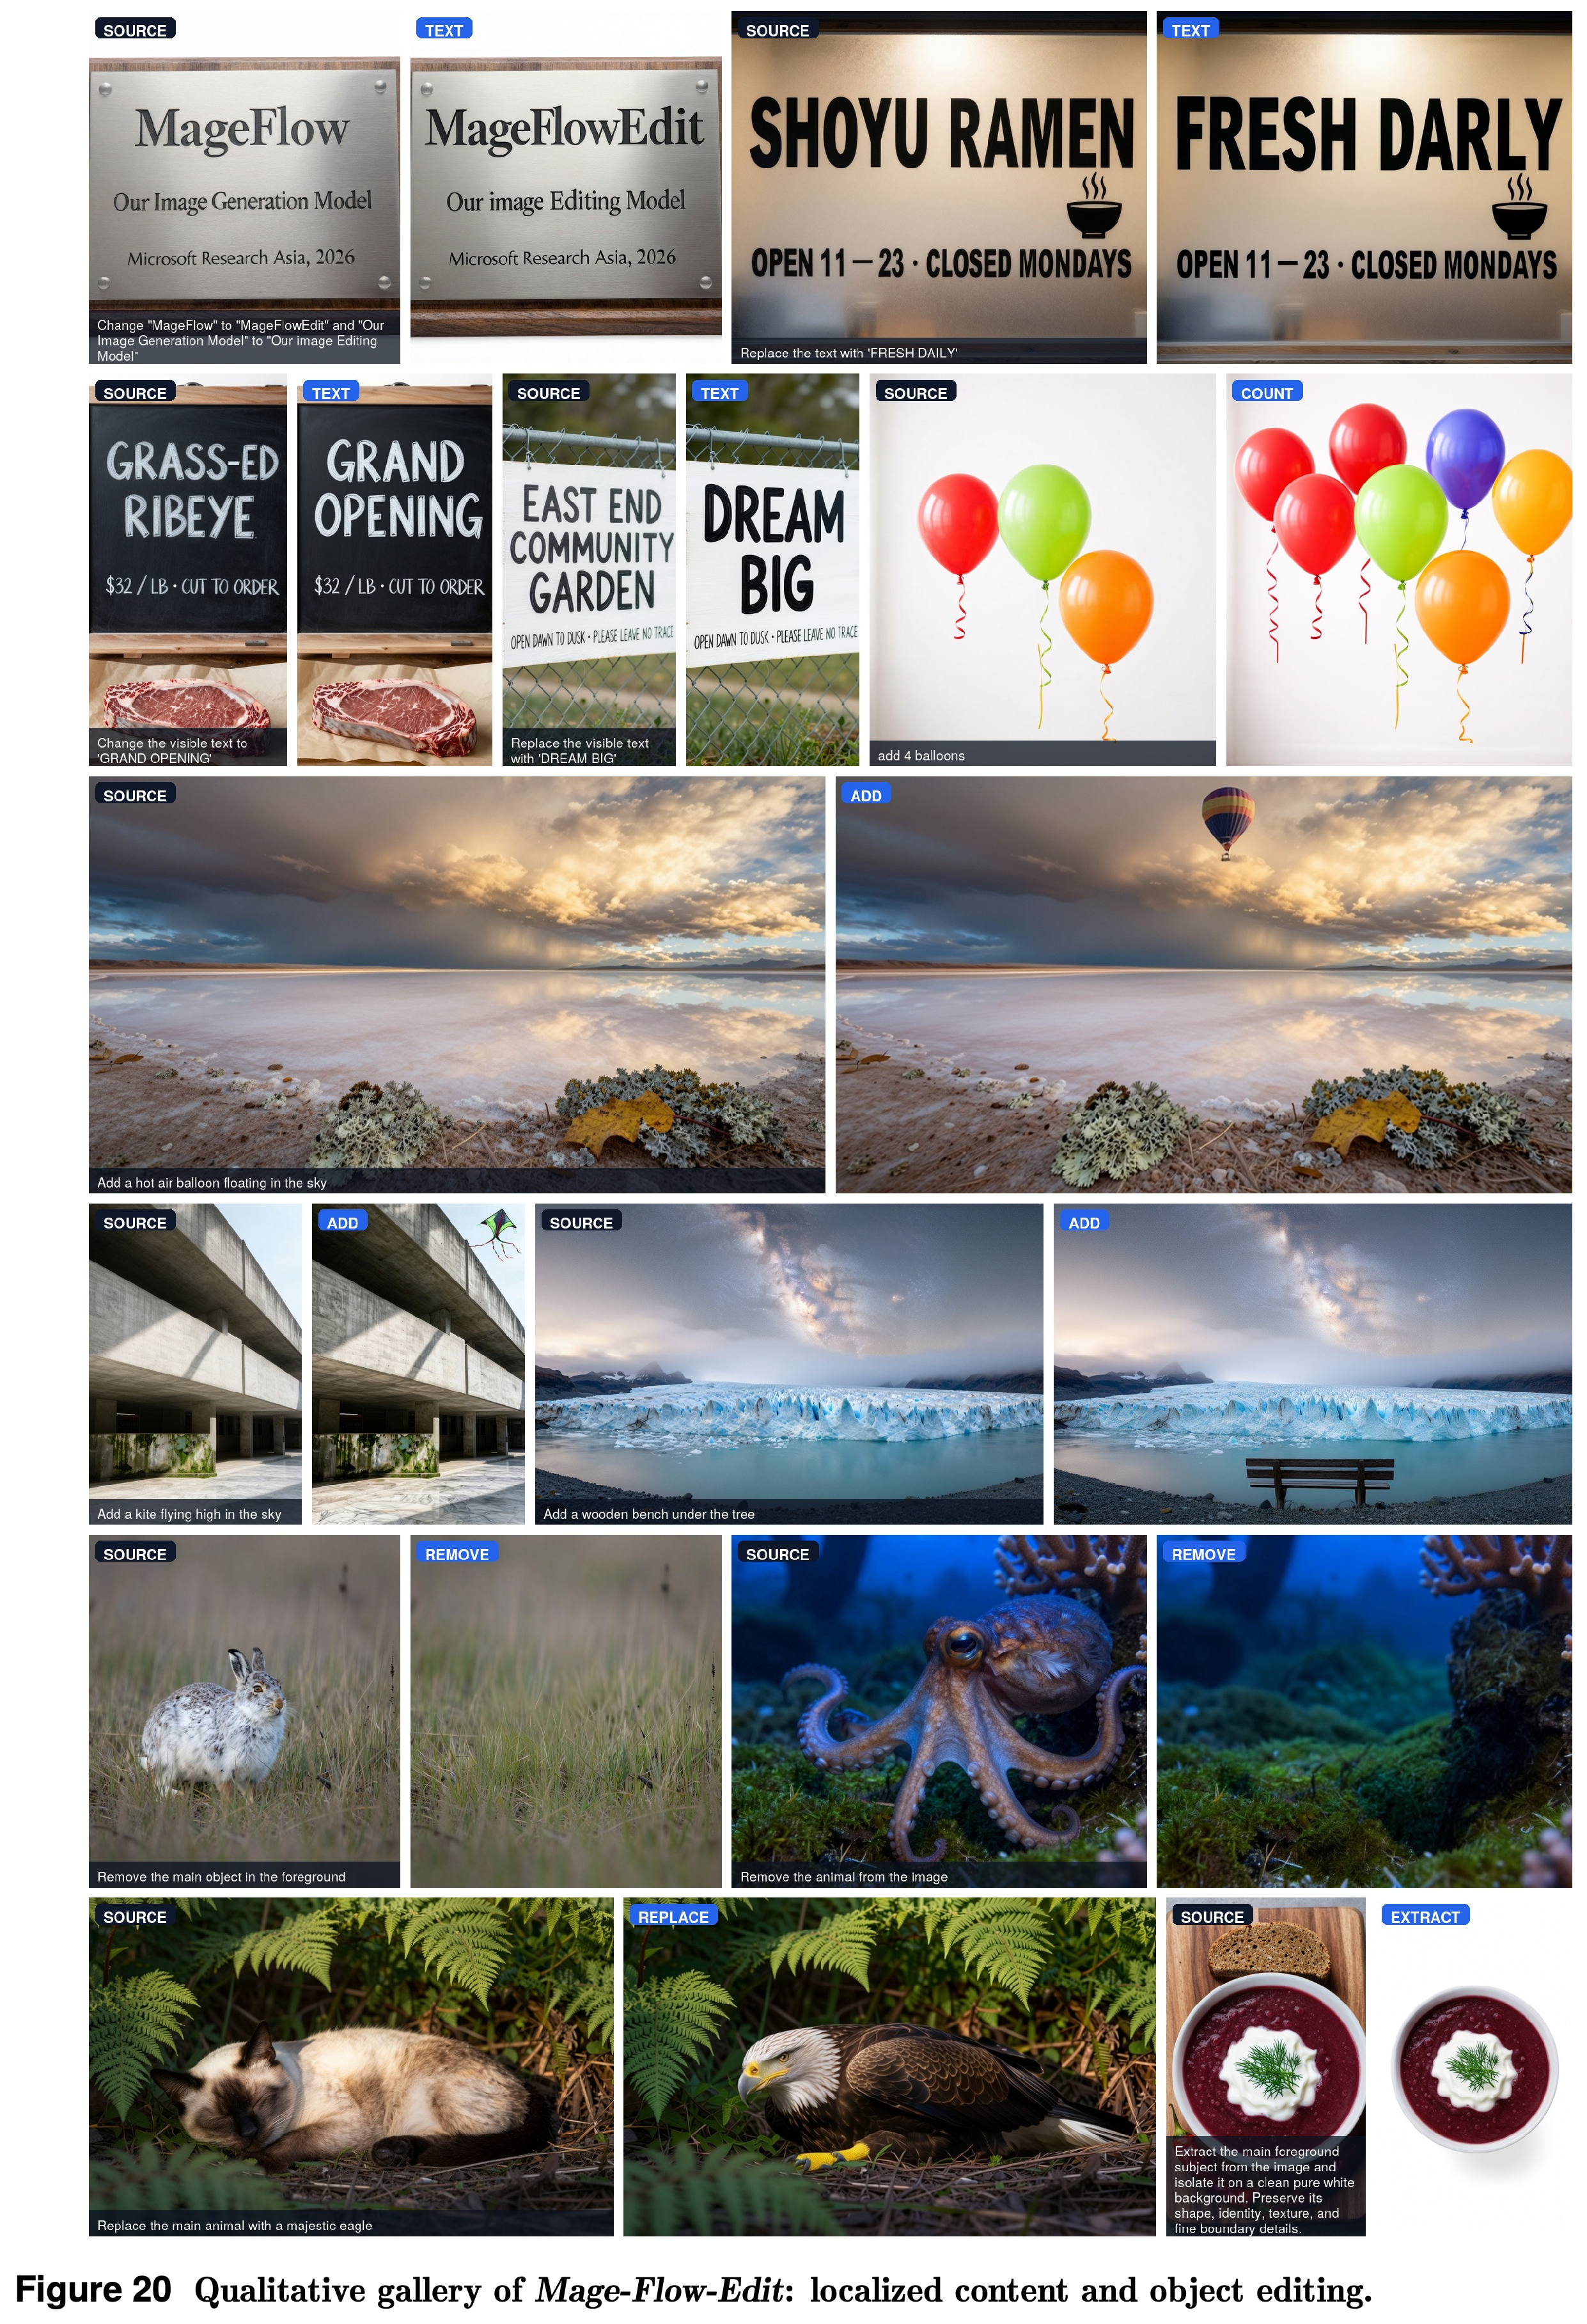
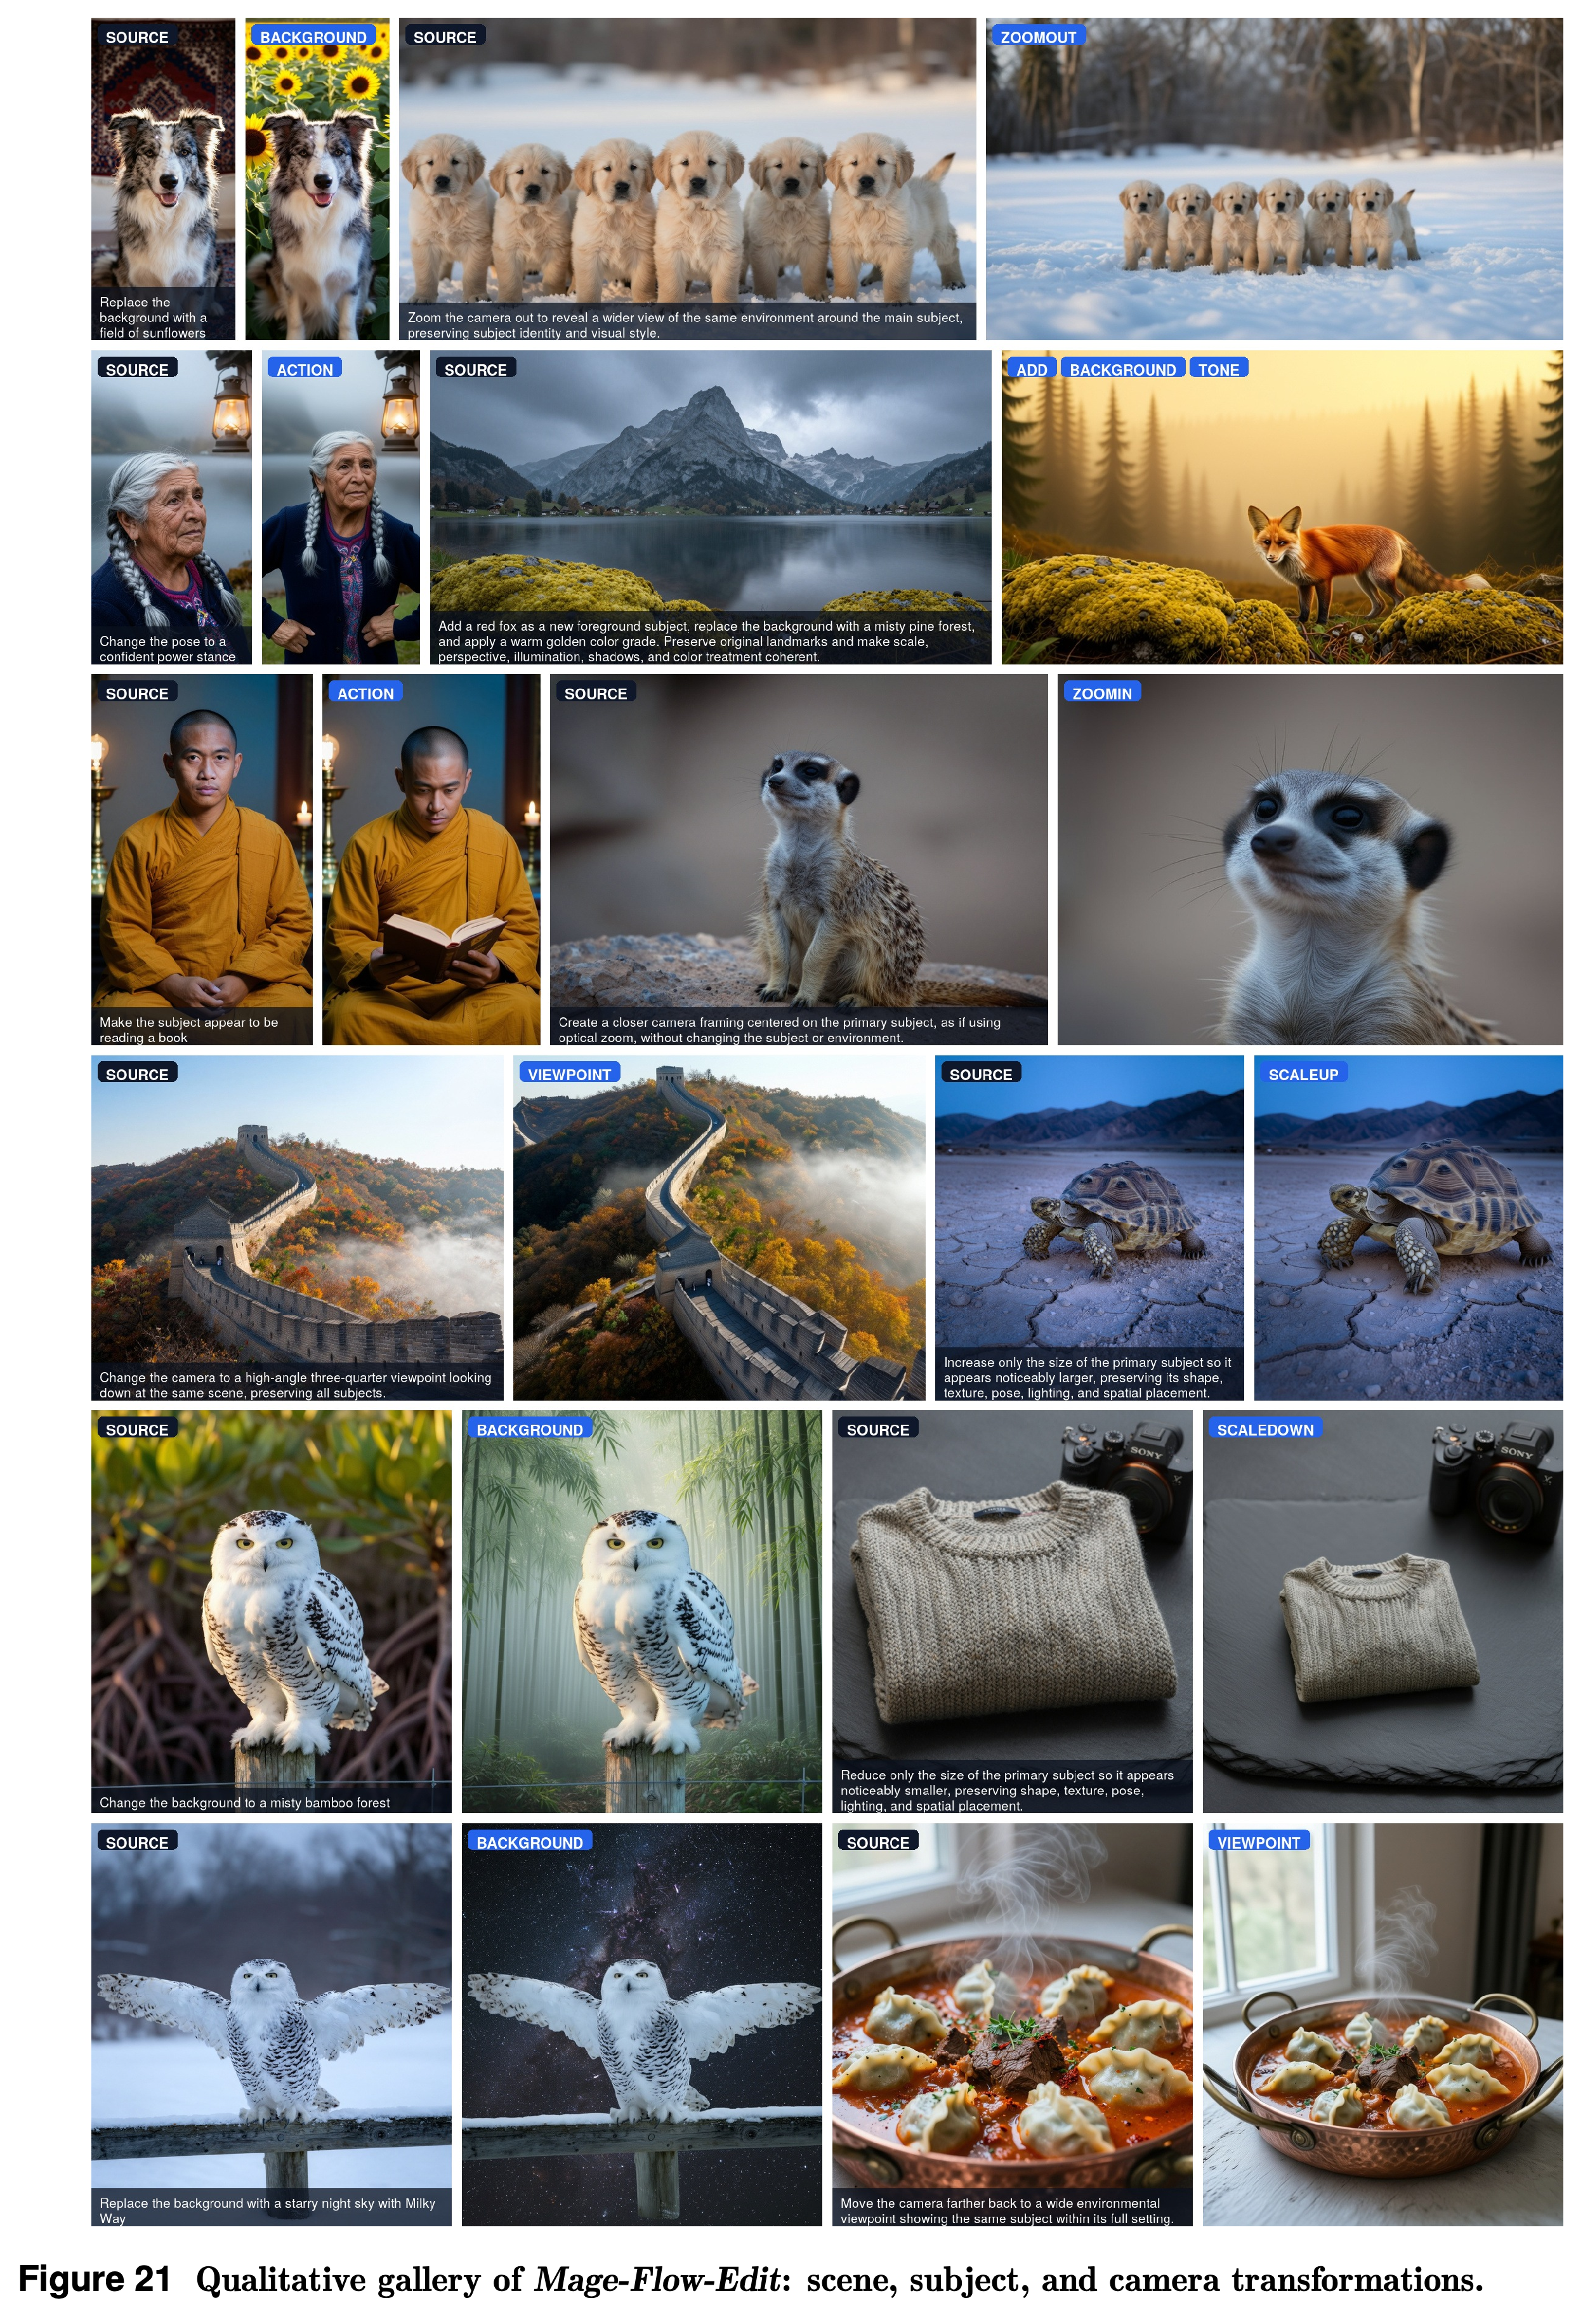
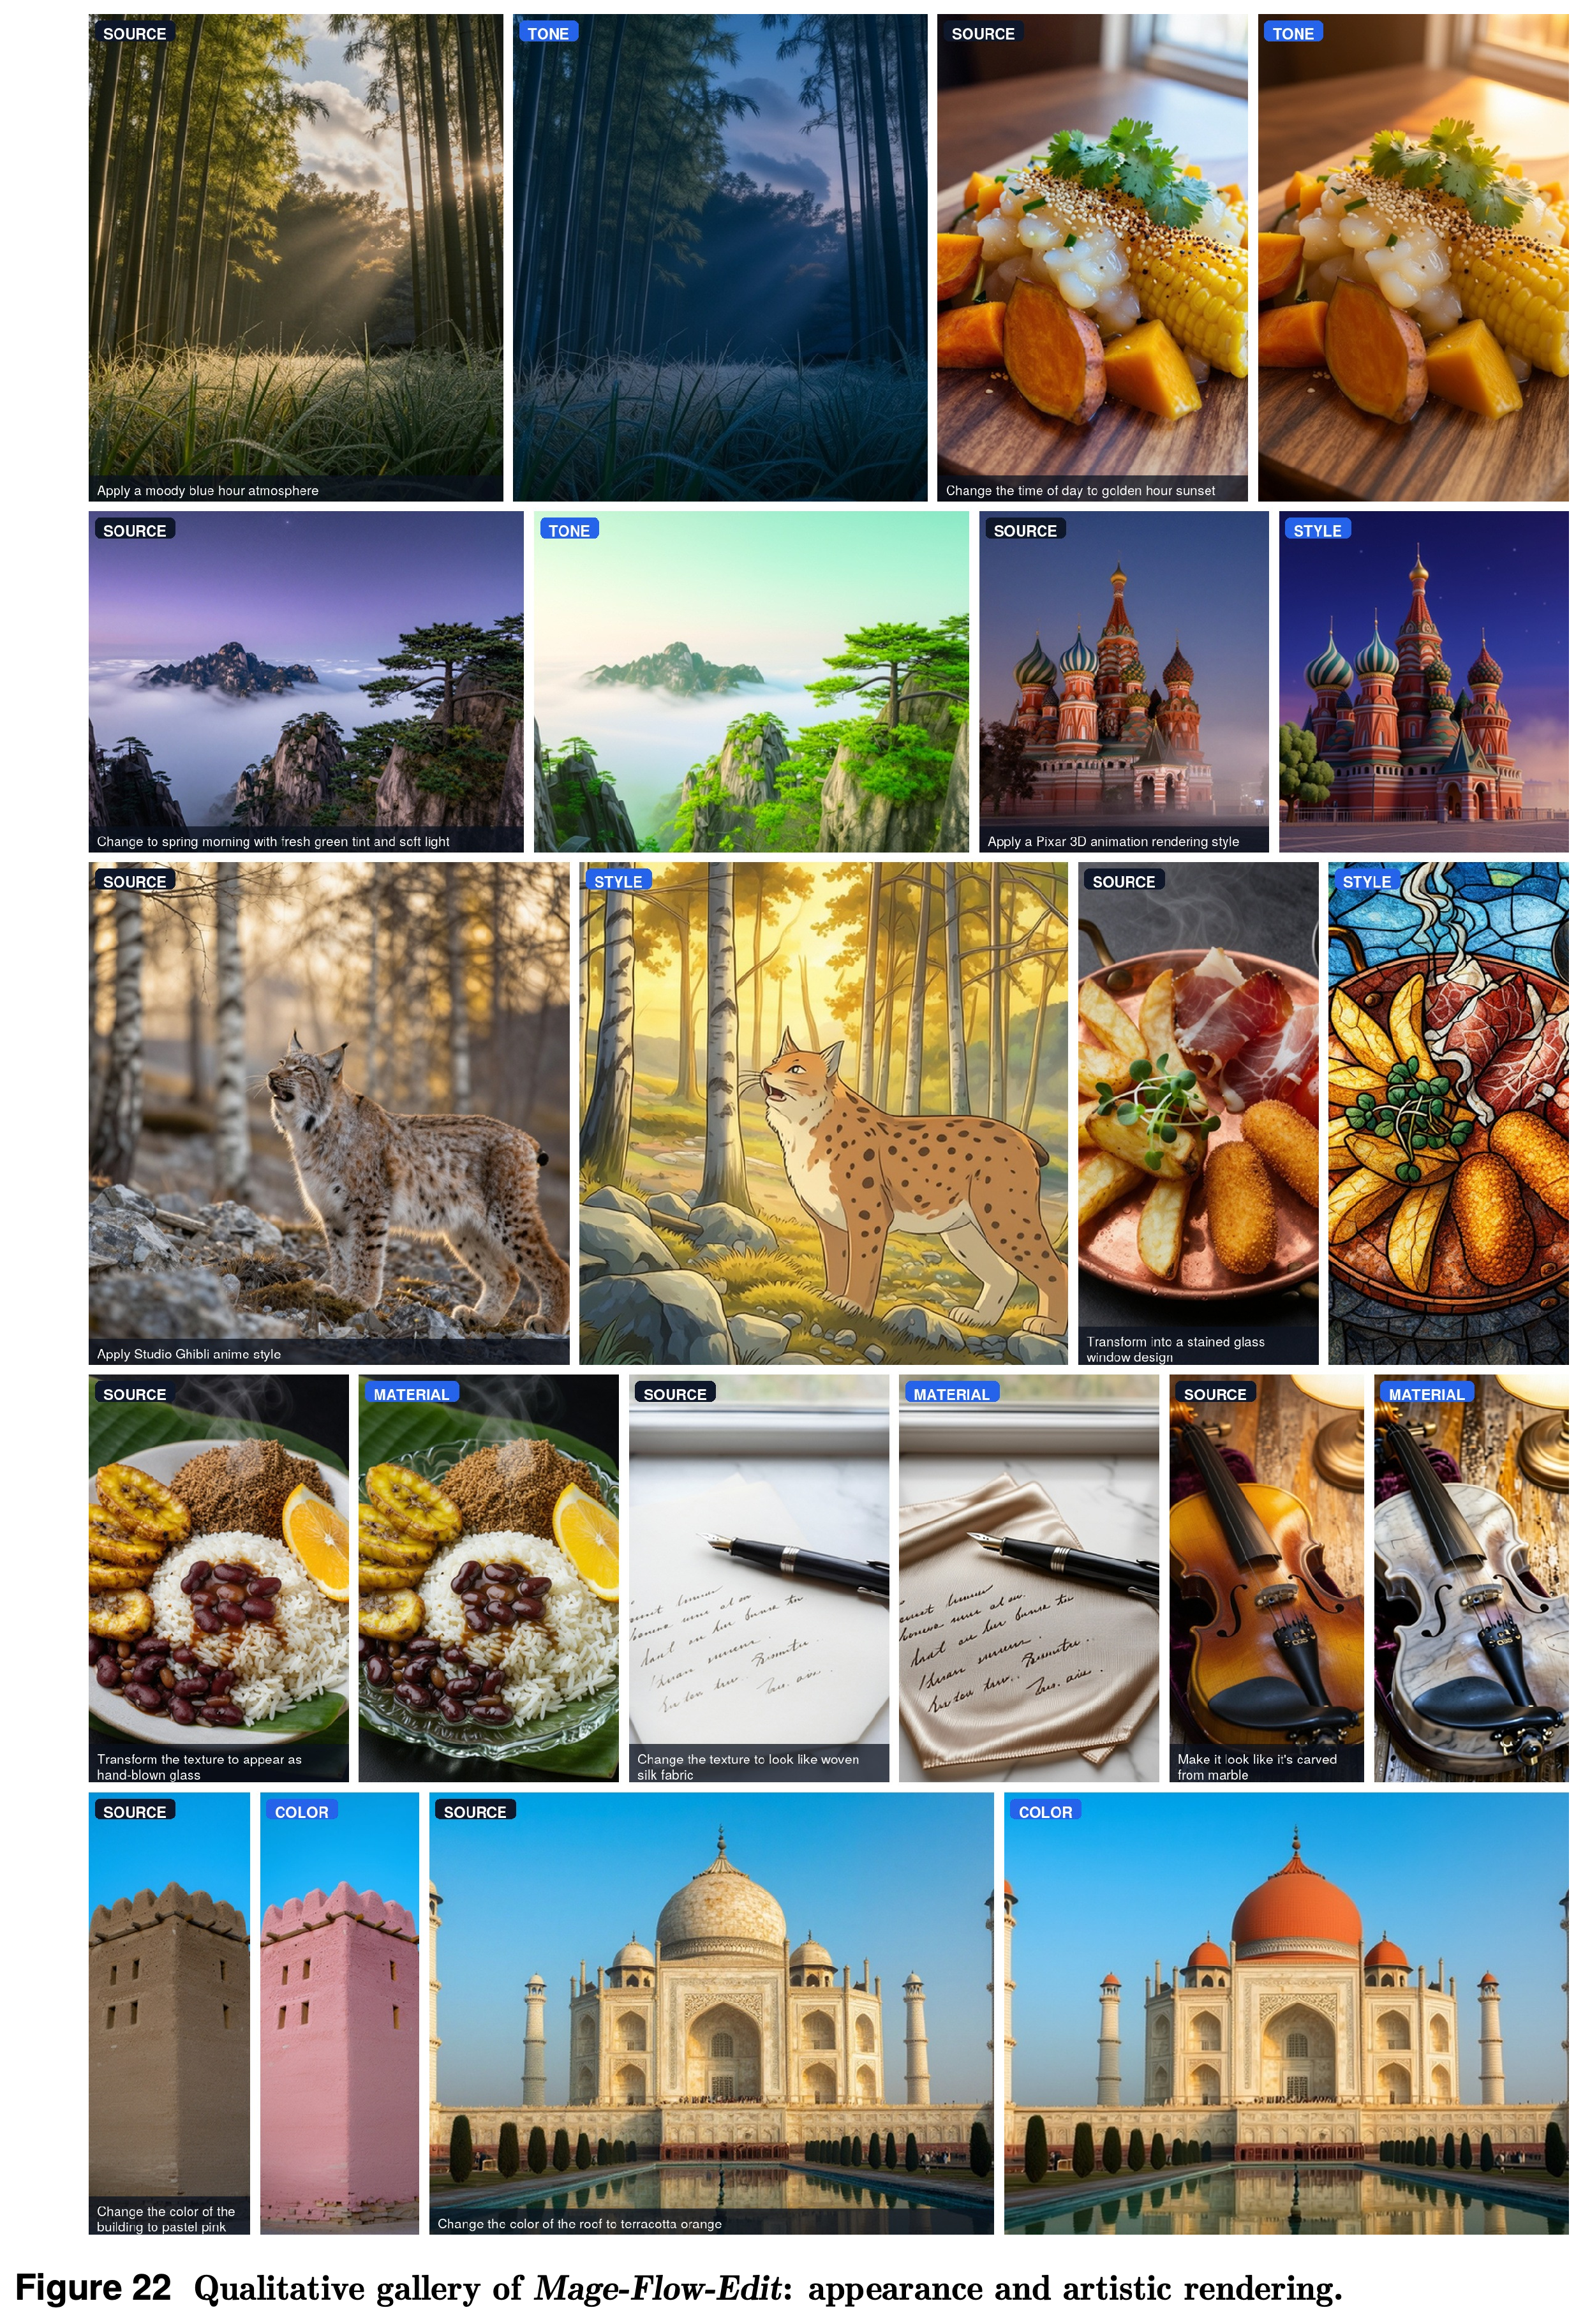
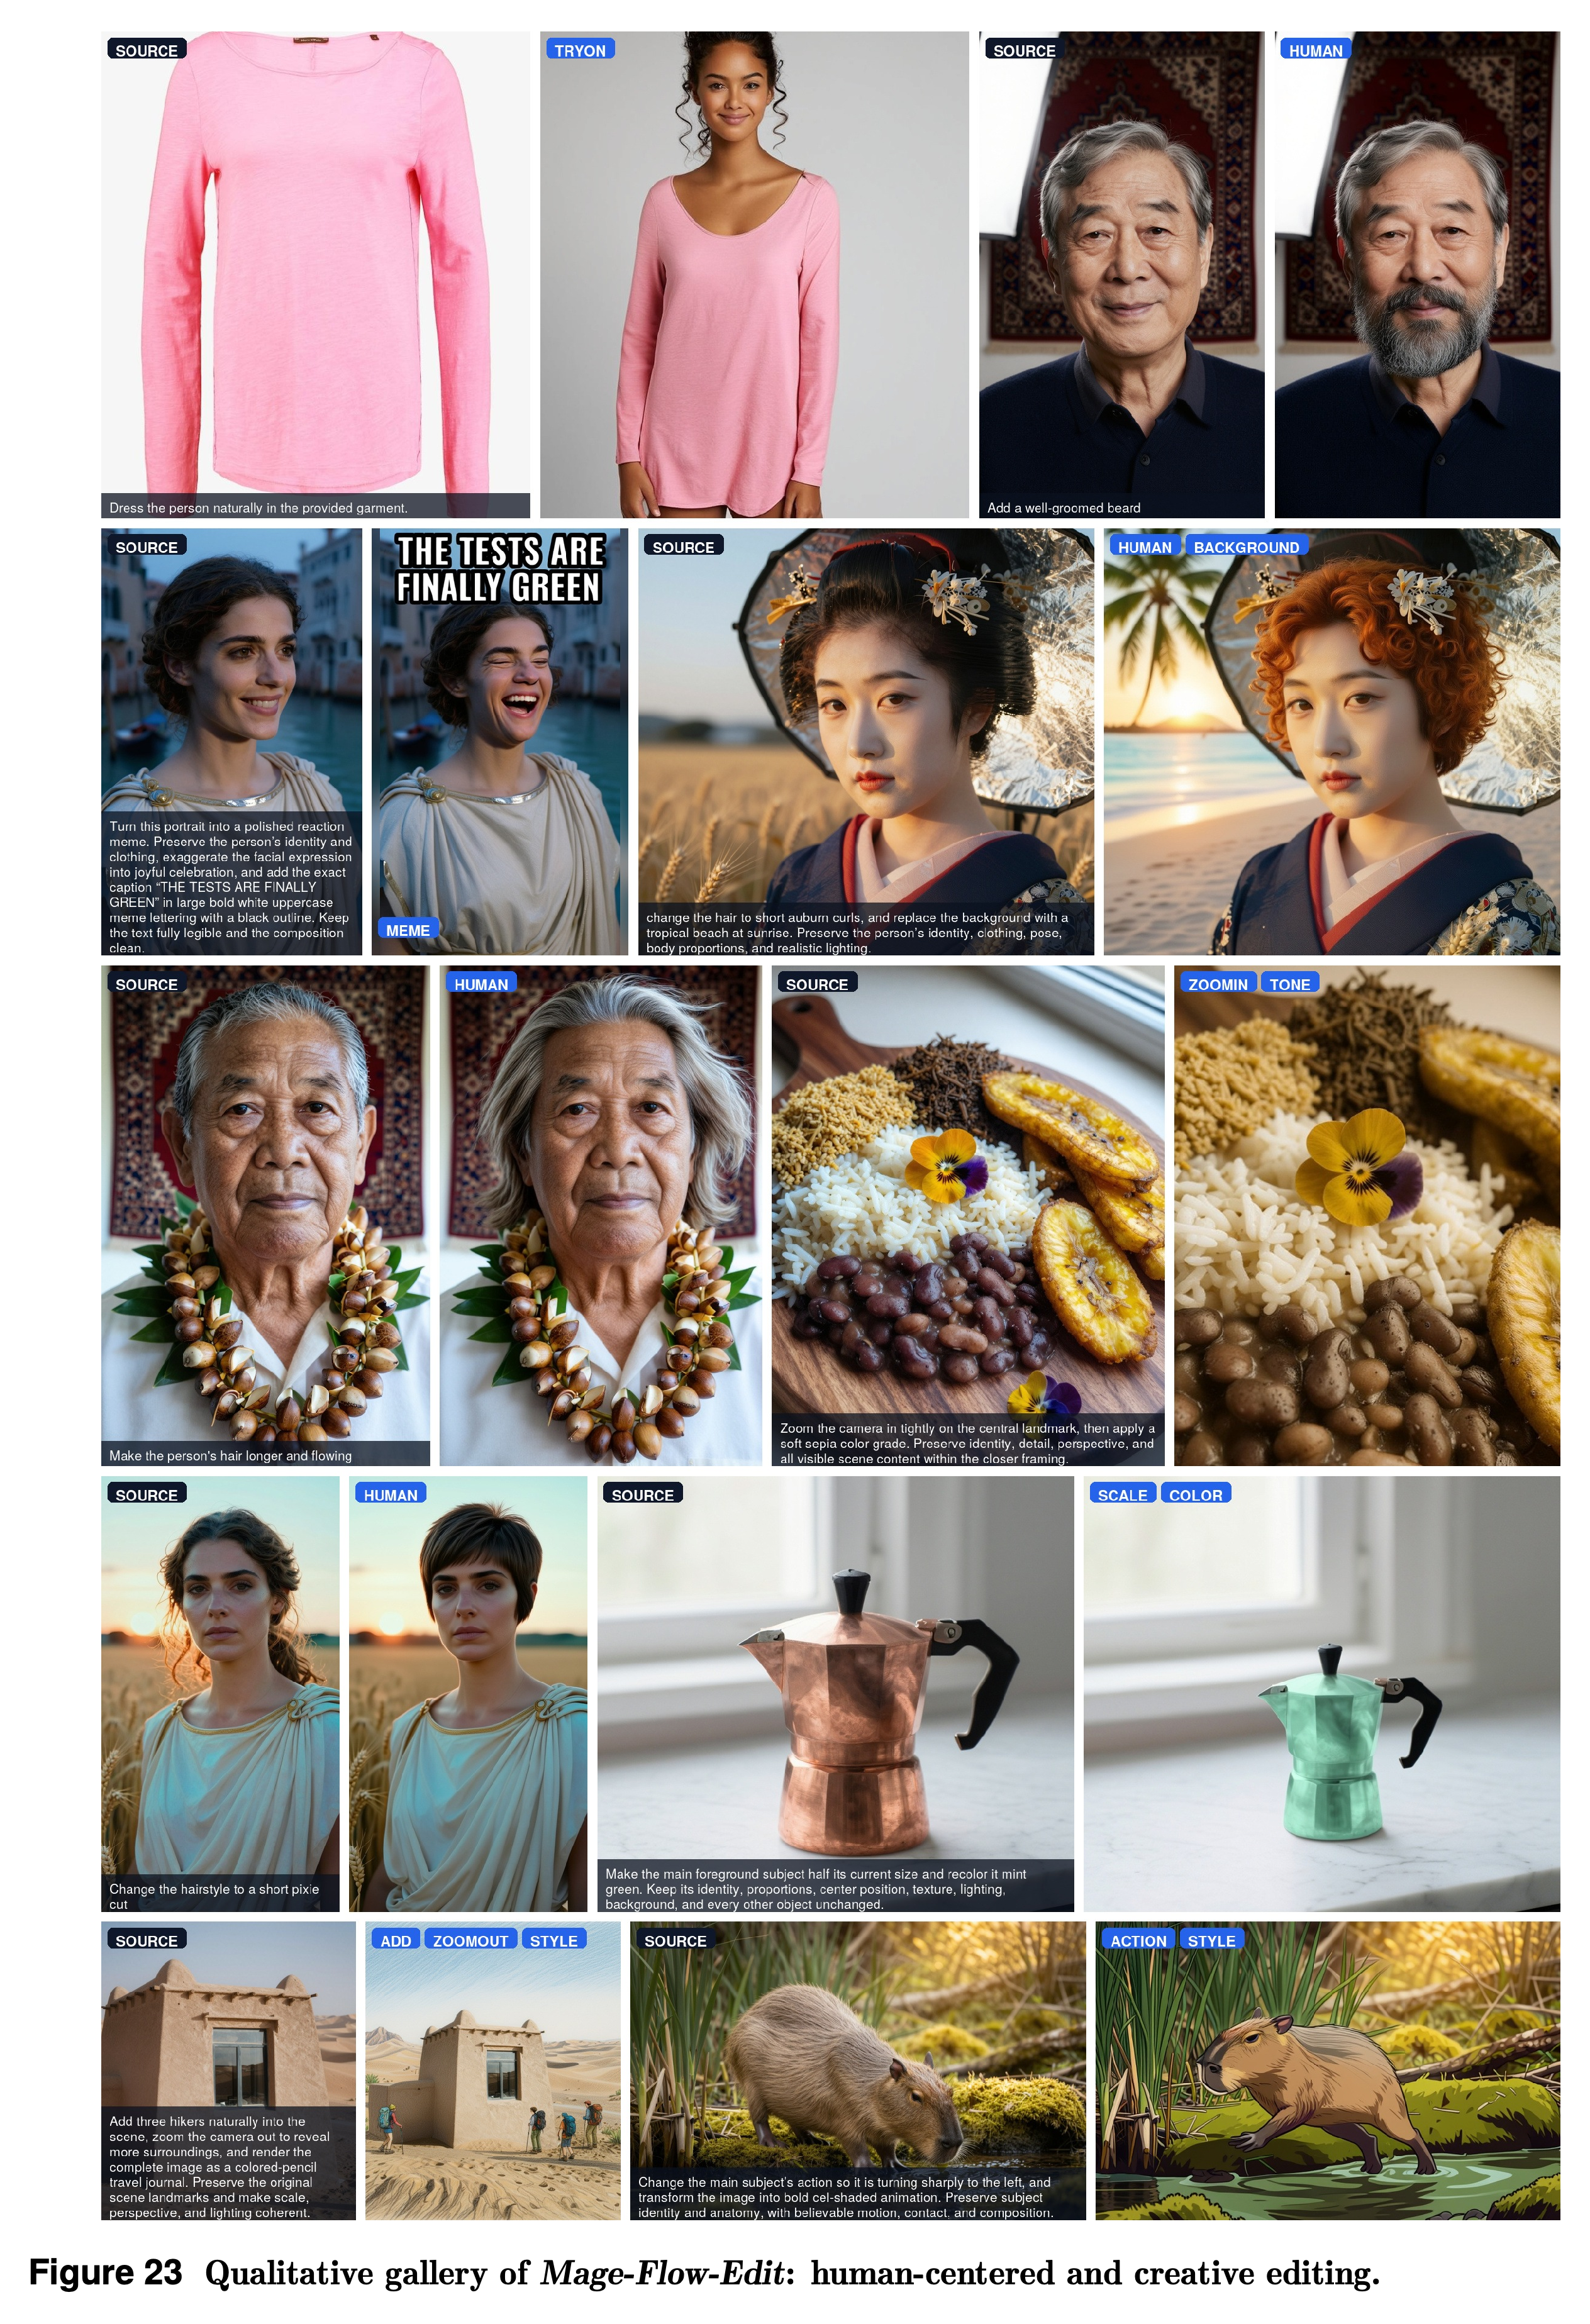
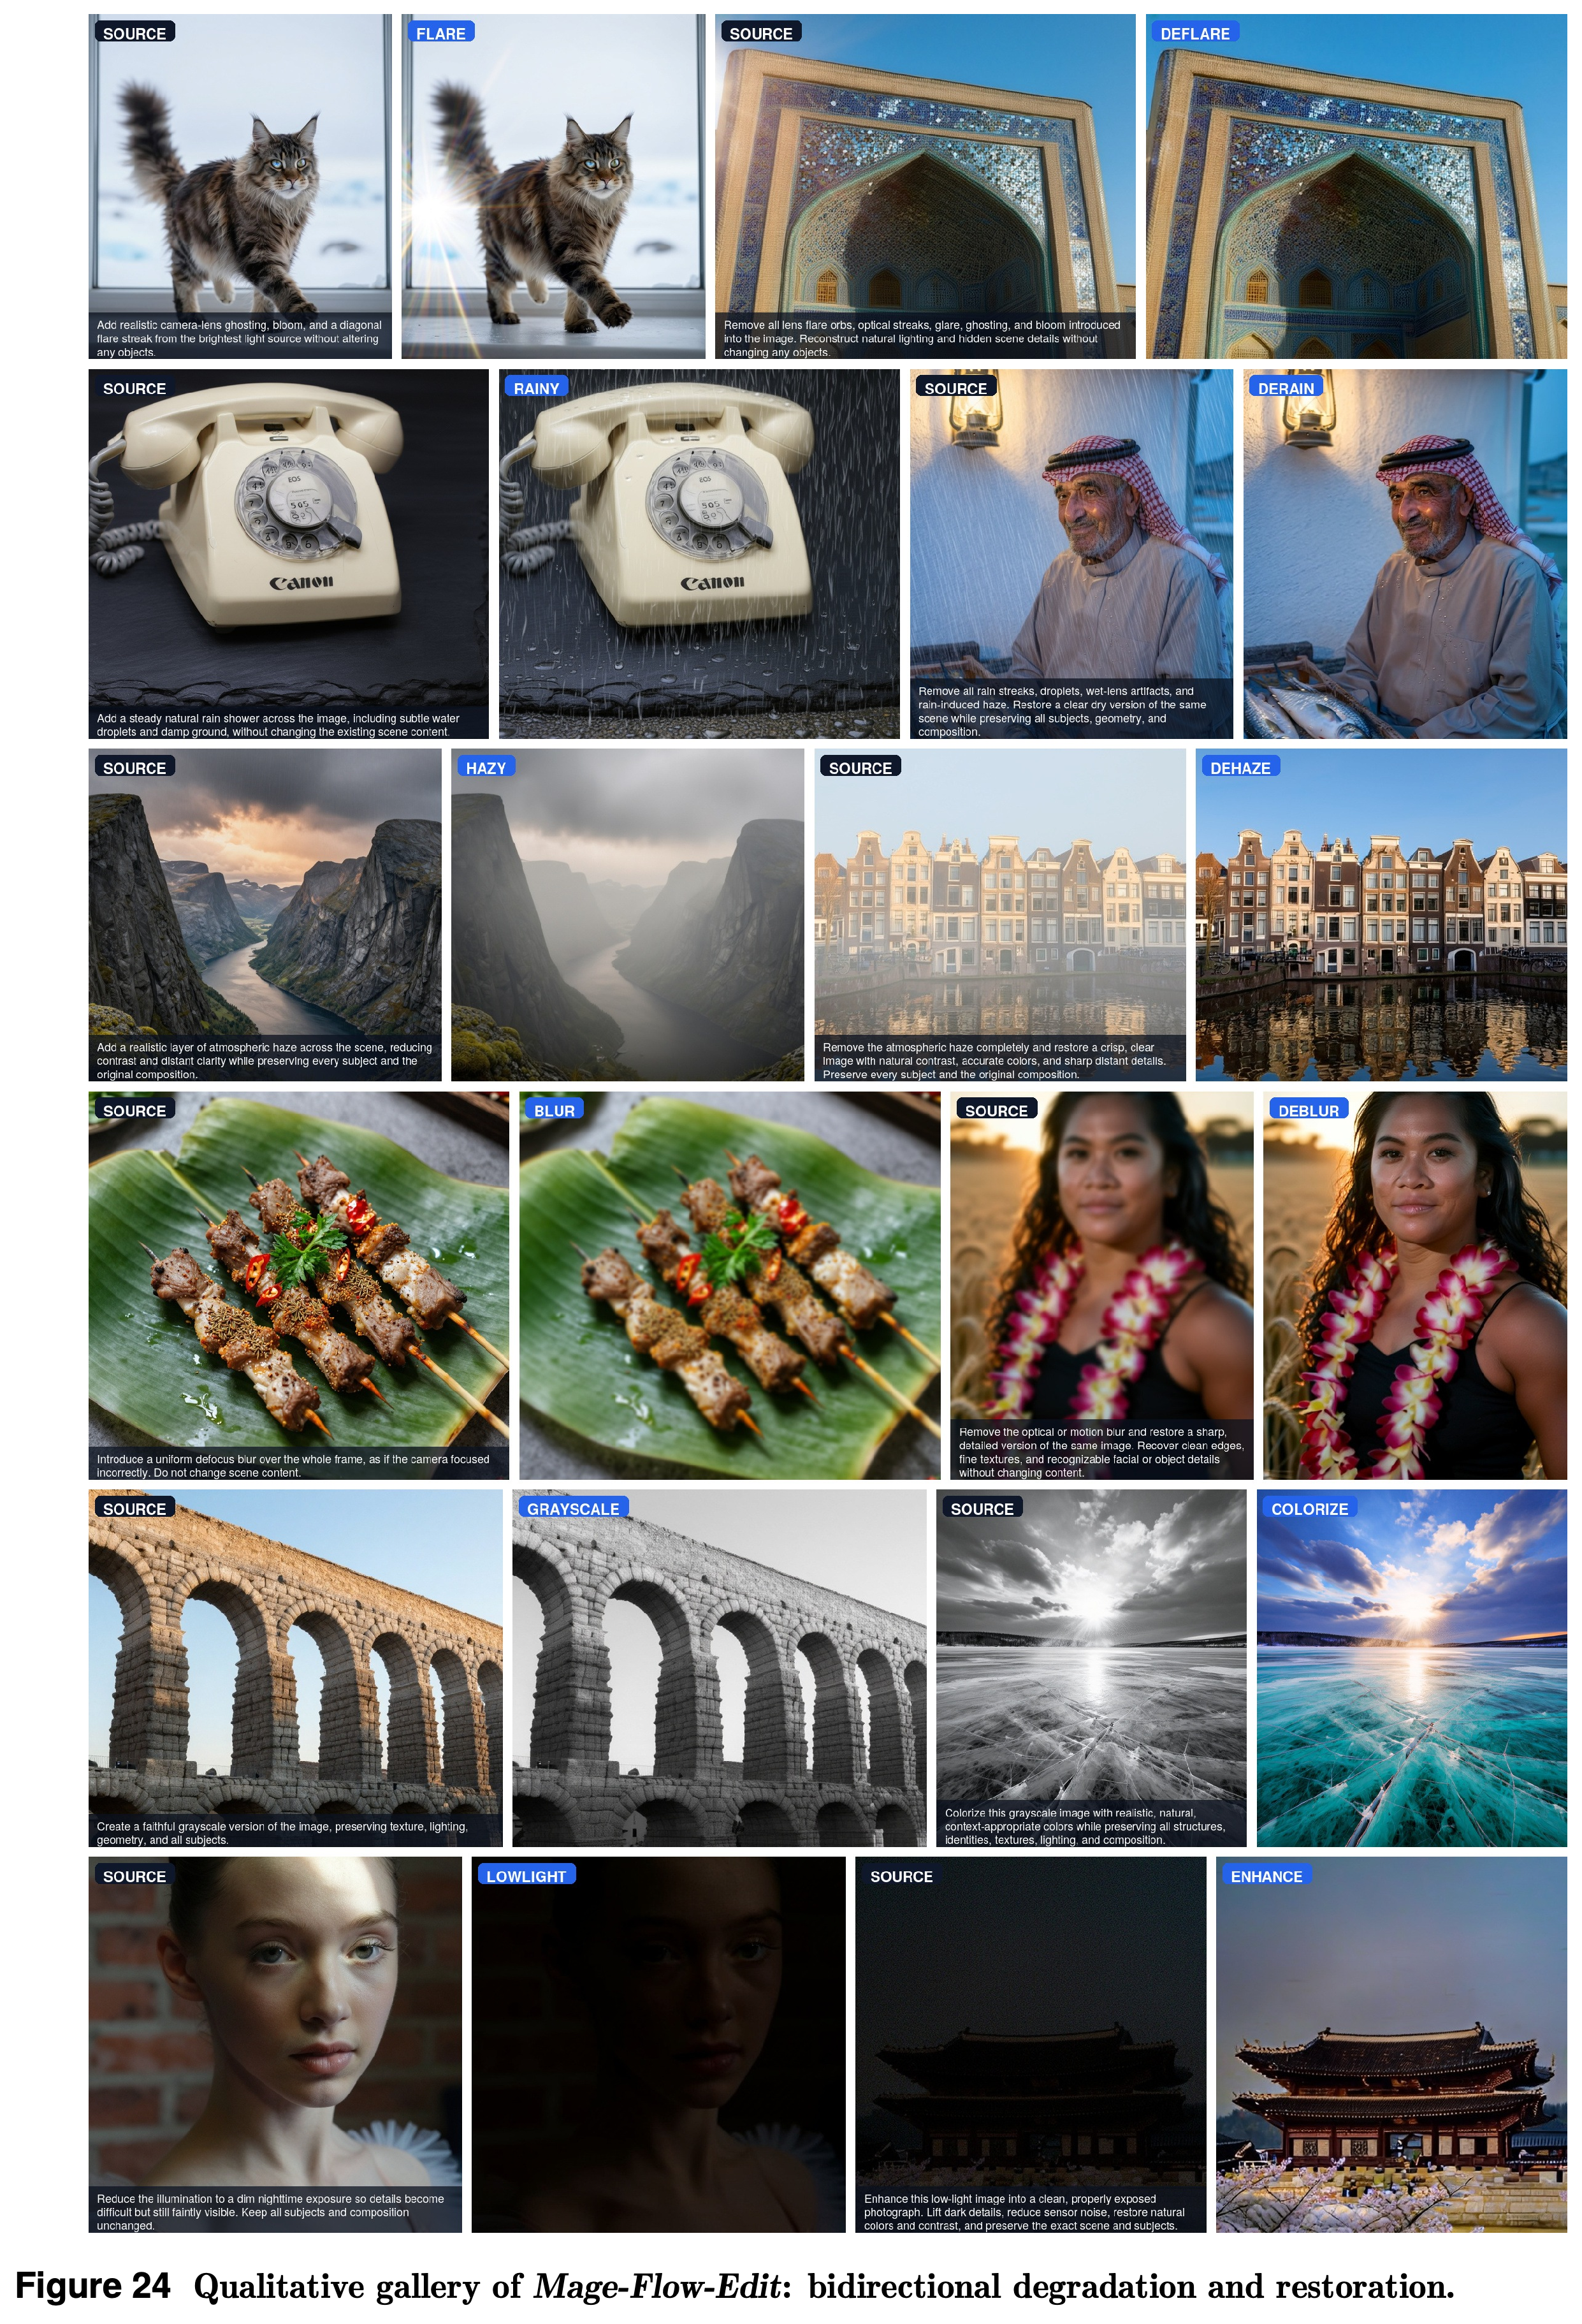
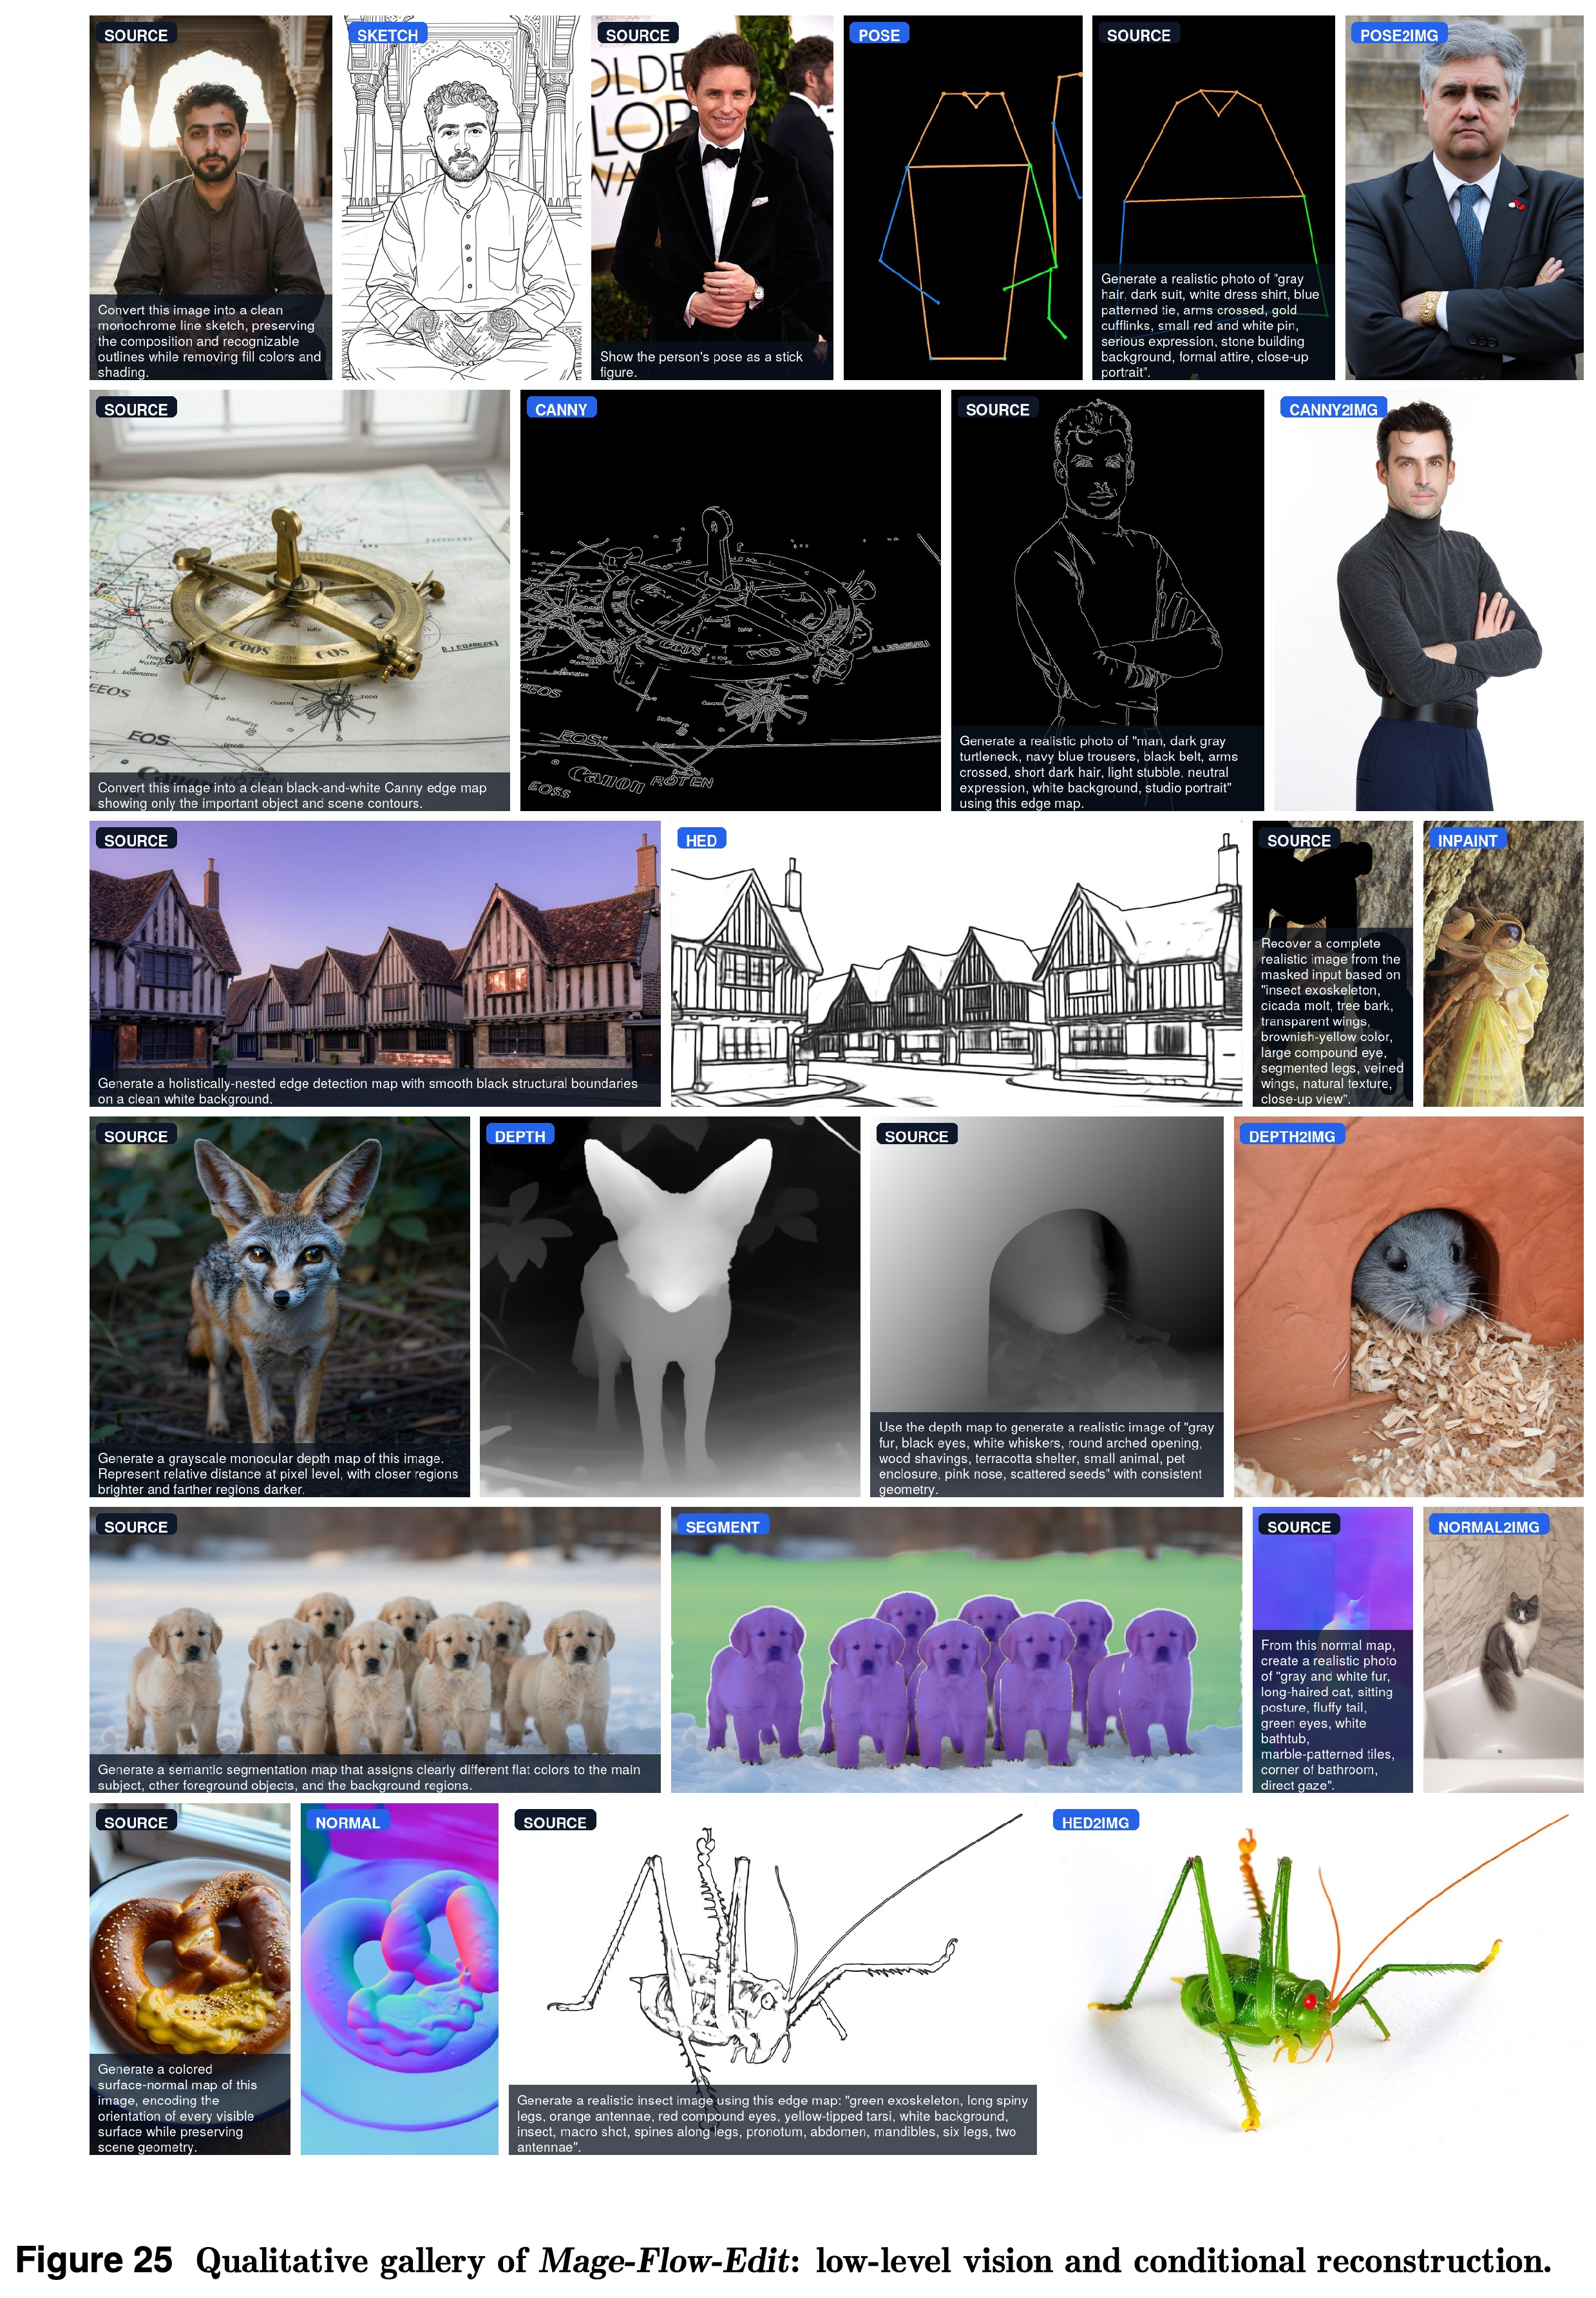
편집 gallery는 객체 및 국소 편집, 장면 및 카메라 변경, 외관 변환, 사람 중심 편집, 복원, low-level 출력, conditional reconstruction을 보여준다. 논문은 표시한 edit type을 양방향으로 지원한다고 밝힌다.
배경, 색상, 개수, 글꼴, 구조 인식 출력, 동작 편집을 위한 source-centric 편집 예시를 보여준다.
재질, 스타일, 제거, 보정, 날씨, 깊이, 색조, 시점, Canny edge로 편집 예시를 확장한다.
텍스트 변경, 개수 편집, 추가, 제거, 교체, 추출을 보여준다.
배경, 카메라, 동작, 시점, scale, 복합 장면 변환을 보여준다.
색조, 스타일, 재질, 색상 변환을 보여준다.
가상 착용, 얼굴 및 머리카락 편집, 밈, 인물 portrait, 창의적 합성 편집을 보여준다.
flare, 비, haze, blur, grayscale, low light를 포함한 양방향 열화 및 복원 연산을 보여준다.
sketch, pose, Canny, HED, depth, segmentation, normal map, conditional reconstruction을 보여준다.
7 Conclusion
결론은 tokenizer, backbone, packing, 시스템 설계를 함께 최적화한 점이 효율성의 원인이라고 본다. 향후 과제로 더 견고한 multi-image editing, 더 강한 multilingual long-text rendering, agentic visual-creation 통합을 제시한다.
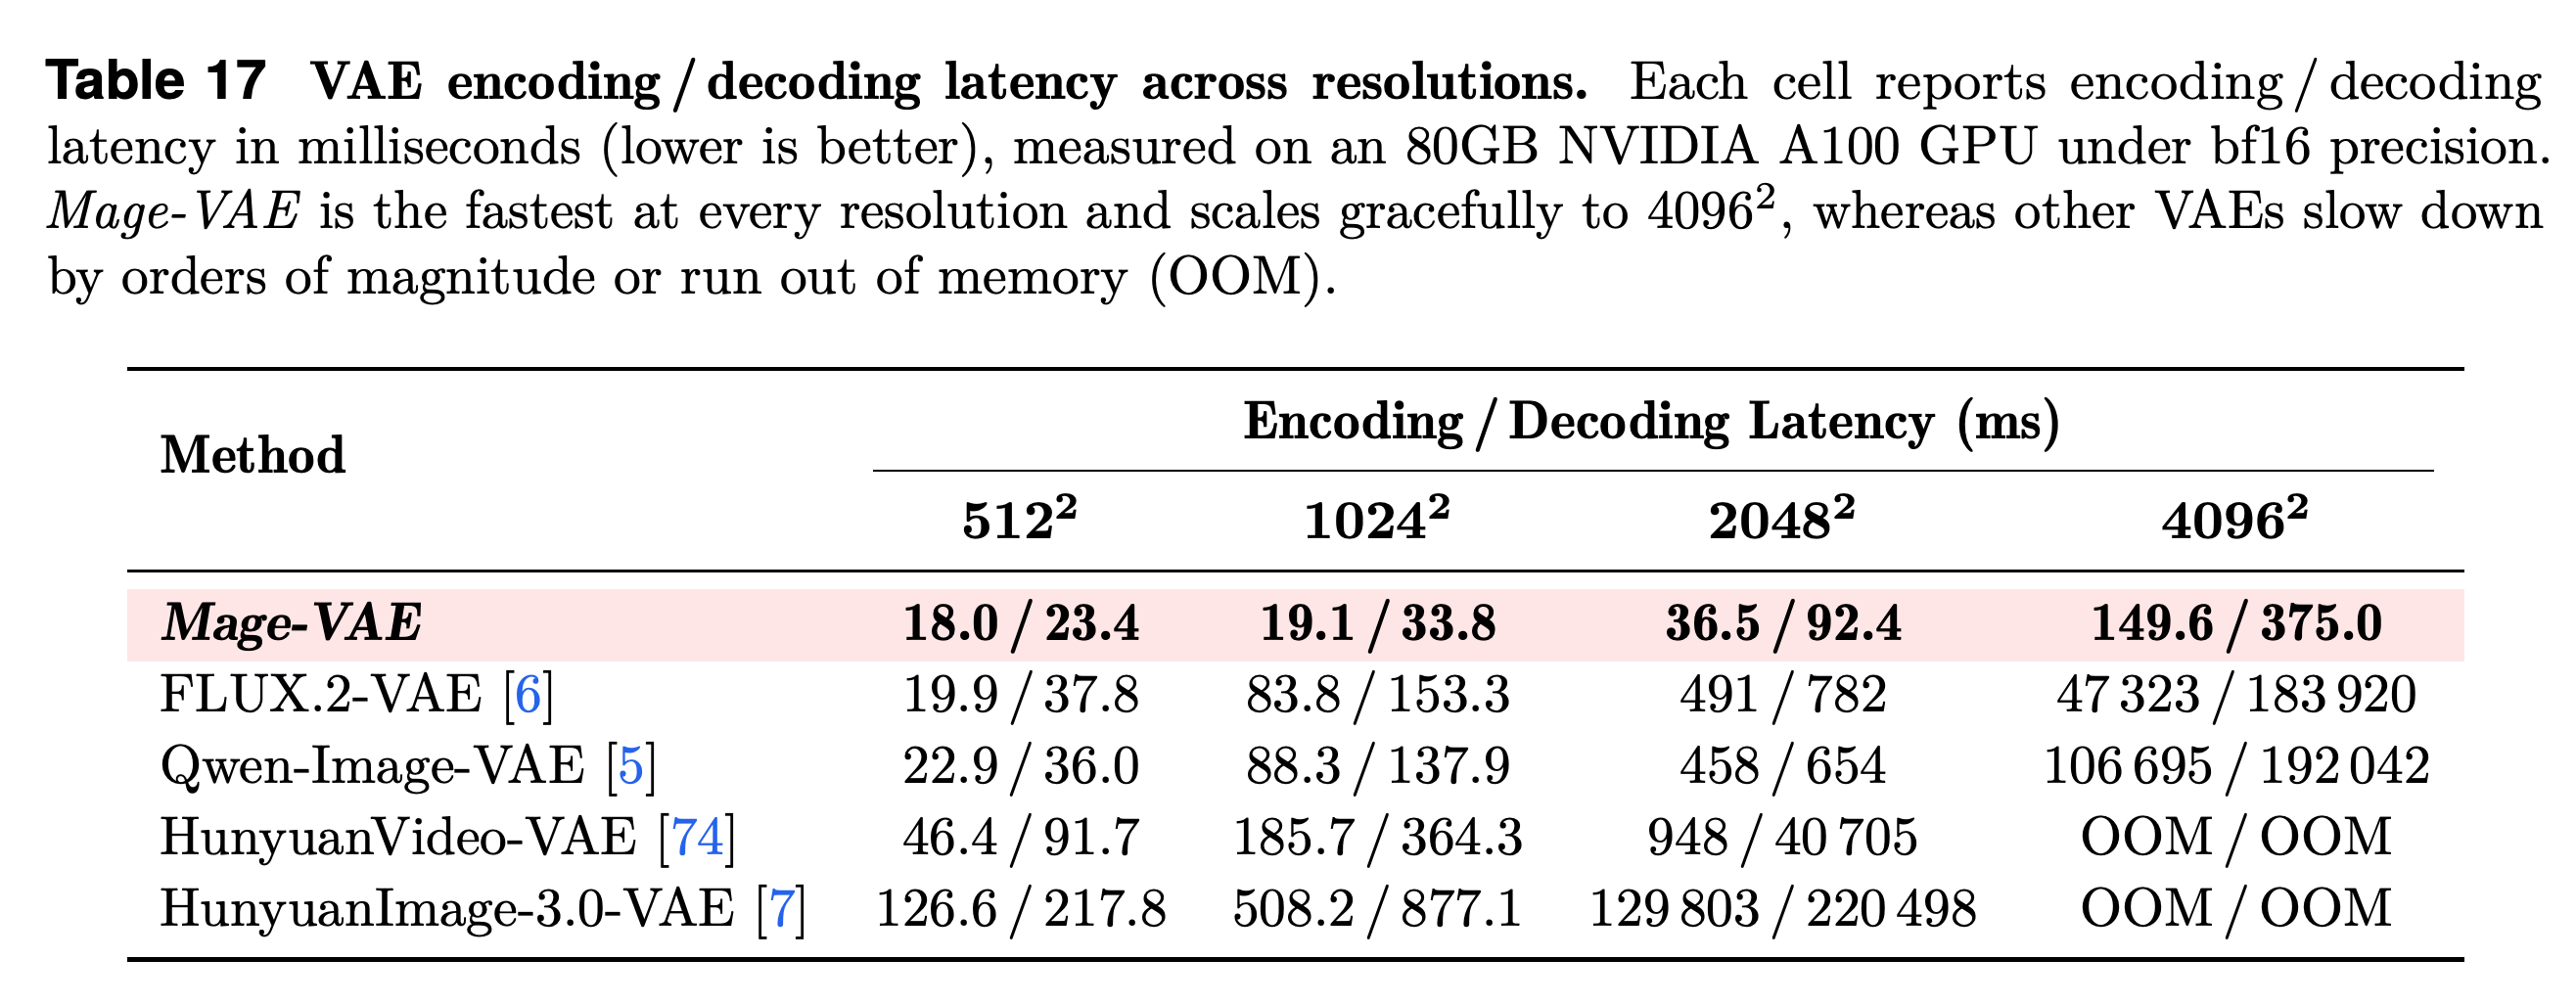
4096²에서 Mage-VAE는 80GB A100의 encoding/decoding에 149.6/375.0 ms를 보고하며, 여러 baseline은 훨씬 오래 걸리거나 OOM이 발생한다.
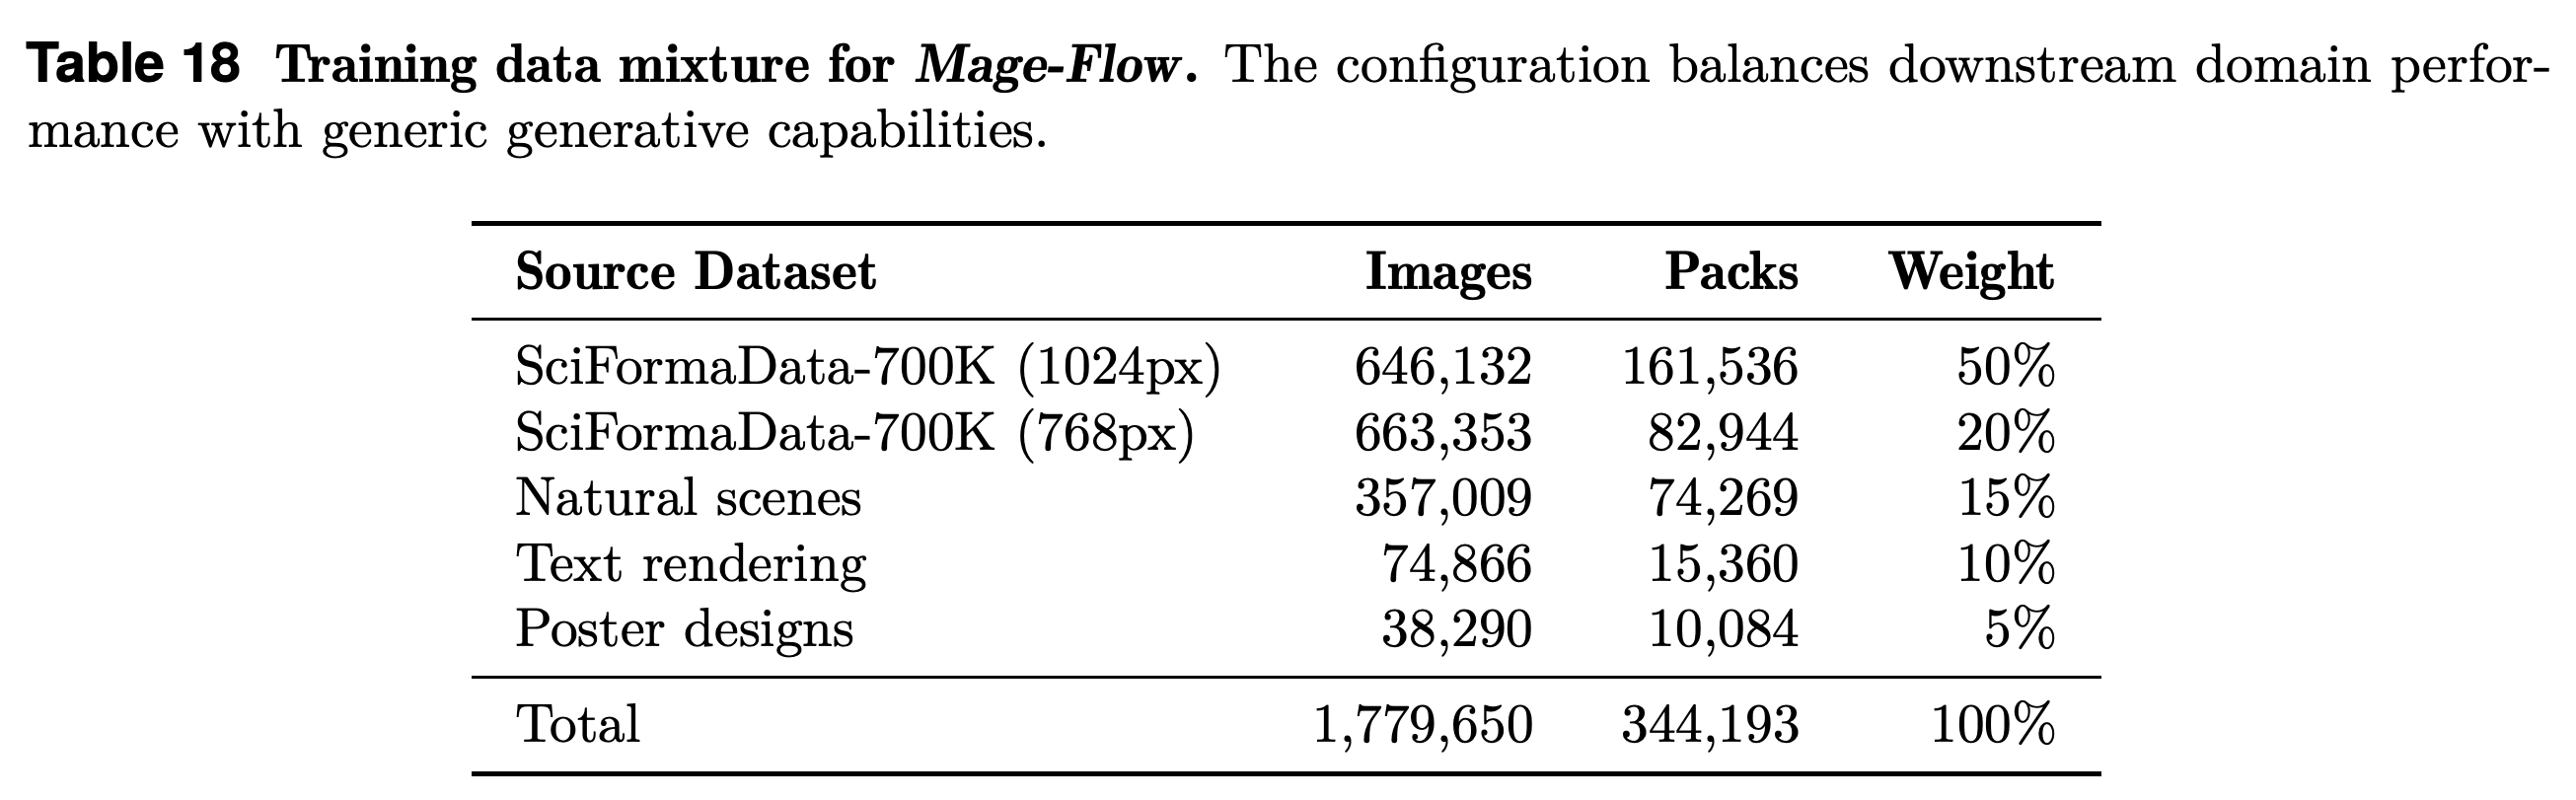
scientific-diagram mixture는 SciFormaData-700K의 2개 해상도에 weight의 70%를 할당한다.
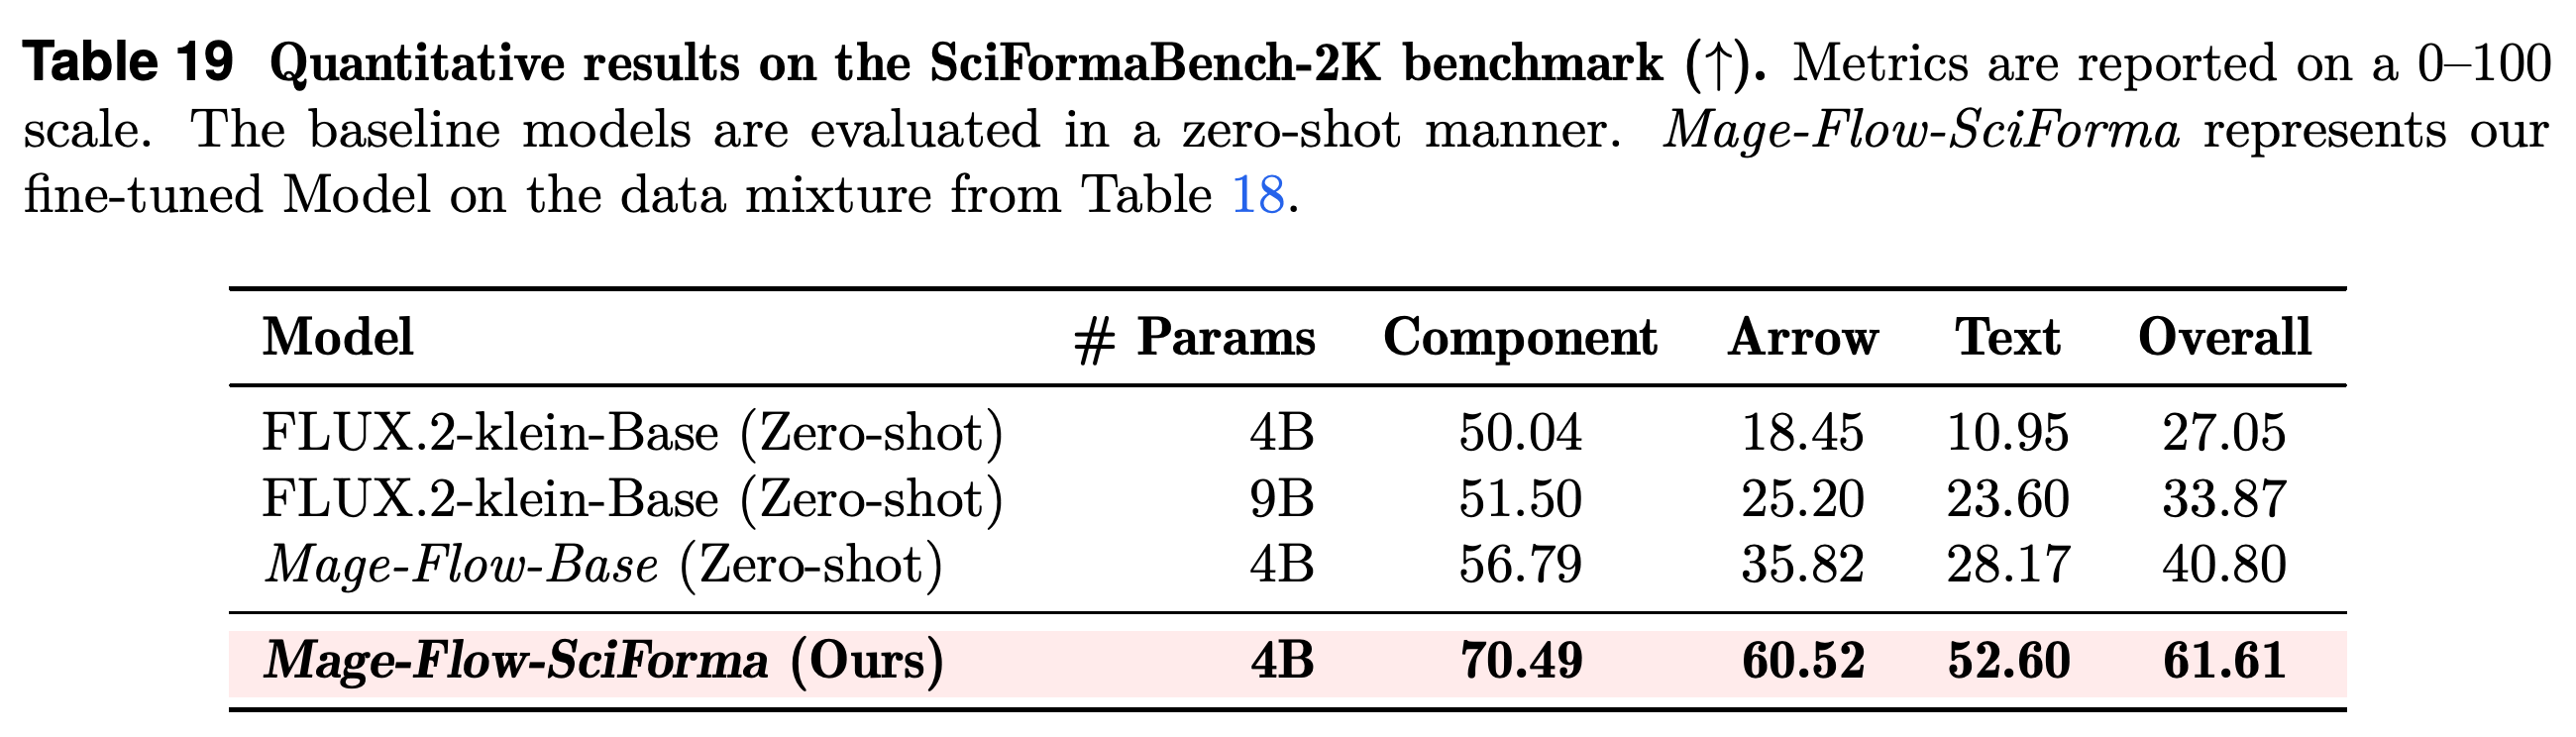
fine-tuned Mage-Flow-SciForma는 zero-shot Mage-Flow-Base의 40.80 대비 61.61 overall을 보고한다.
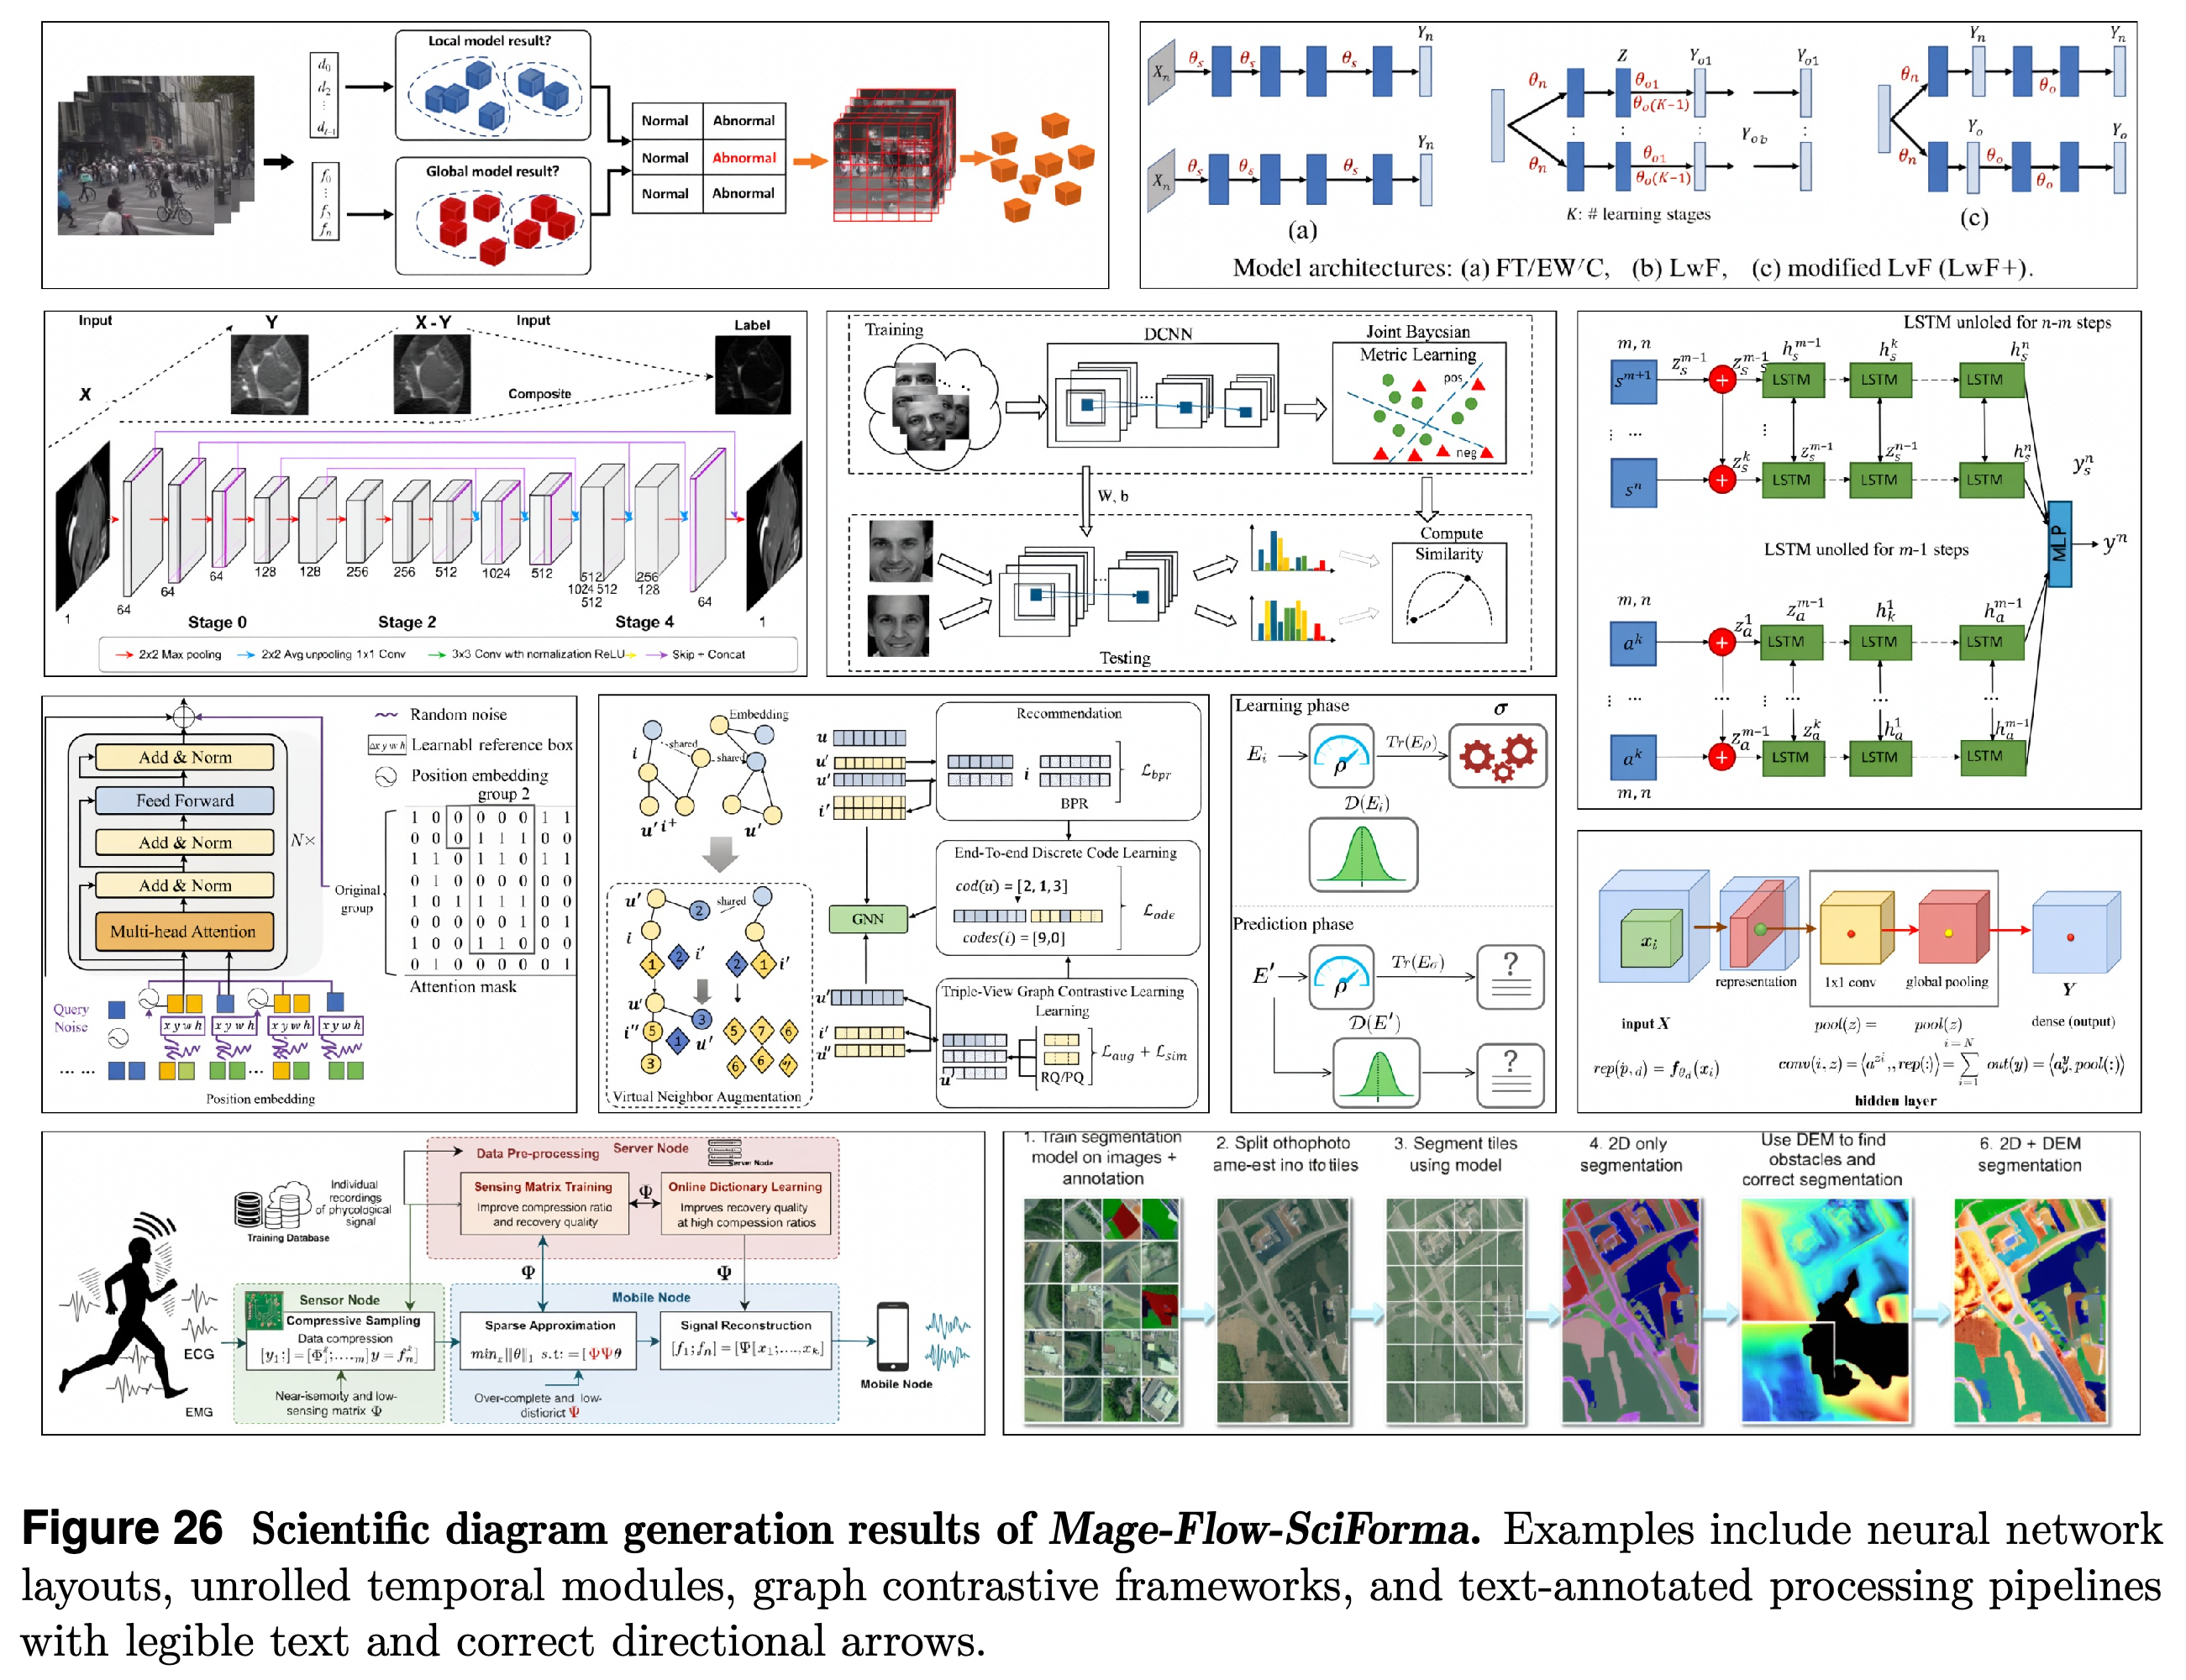
neural layout, temporal module, graph framework, pipeline이 포함된 생성 scientific diagram을 보여준다.
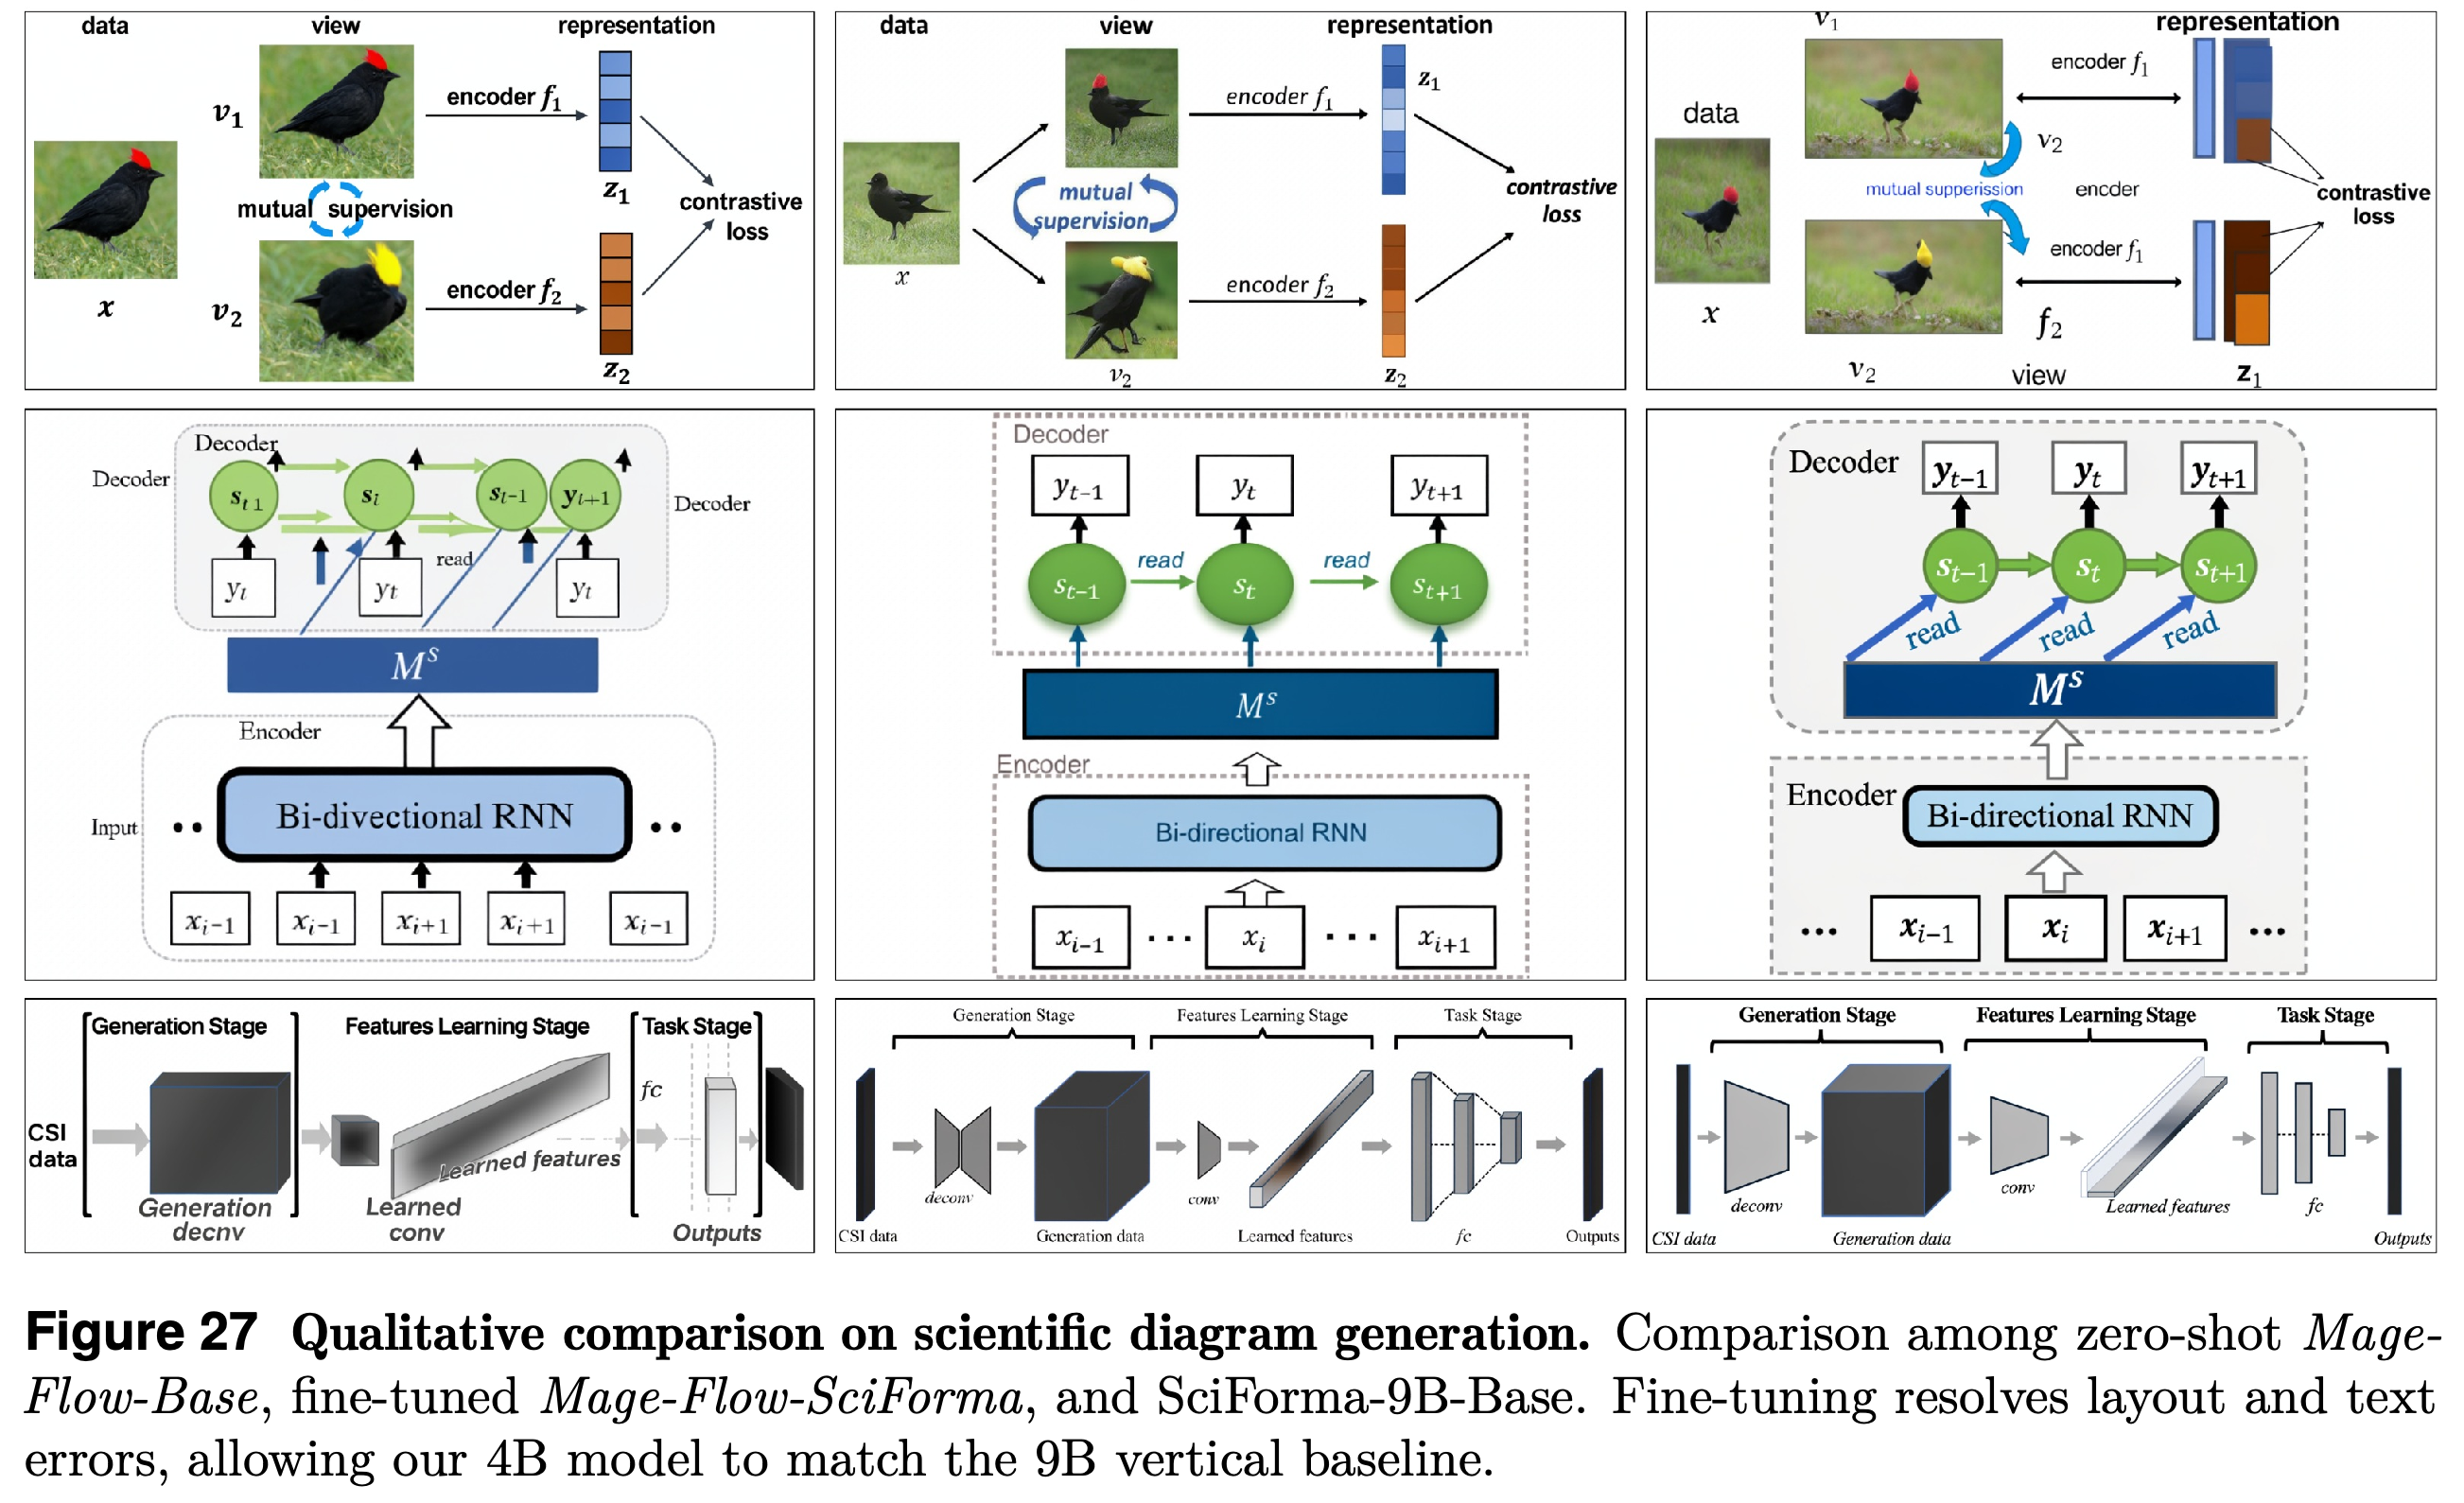
zero-shot Mage-Flow-Base, fine-tuned Mage-Flow-SciForma, SciForma-9B-Base를 비교한다.
부록
- appendix는 Mage-VAE objective와 latency, reward evaluator, recaptioning prompt, scientific-diagram fine-tuning을 명시한다. Mage-VAE는 80GB A100에서 4096² 인코딩 및 디코딩에 149.6/375.0 ms를 보고하며, fine-tuned Mage-Flow-SciForma는 SciFormaBench-2K에서 61.61 overall을 보고한다.
짧은 생각
논문은 tokenizer 비용, packed CFG, kernel fusion, data mixing, adversarial guidance에 대한 component-level ablation을 제공한다. 주요 한계는 model-based evaluator와 curated example에 의존한다는 점, 그리고 adversarial guidance 및 generation-data mixing 효과가 benchmark에 따라 달라진다는 점이다.