


AURORA-LM: Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling 요약 설명
03 Aug 2026 | Paper Review Continuous Diffusion Language Models Flow Matching Autoencoders Block-Causal ModelingContents
- 요약
- 3.2 Continuous Text Latent Construction
- 3.3 Block-Causal Modeling of Continuous Text Latents
- 3.4 Learning the Full-Width Latent Distribution
- 3.5 Latent Generation and Text Decoding
- 4.1 Further analysis
- 4.2 System-Level Comparison
- 4.3 Scaling Evaluation
- 부록
- 짧은 생각
이번 글에서는 AURORA-LM: Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 3일(Arxiv)
- Liang, Jiajun, Liao, Yucheng, Cao, Yukang, Wei, Jiazhe, Li, Ken, Tan, Wende, Zhang, Jiankun, Cui, ZY, Yang, Jingkang, Guo, Liucheng, et al.
- PRLab, Nanjing University, S-Lab, Nanyang Technological University, Imperial College London
- 논문 링크
- Github
- Project Page
요약
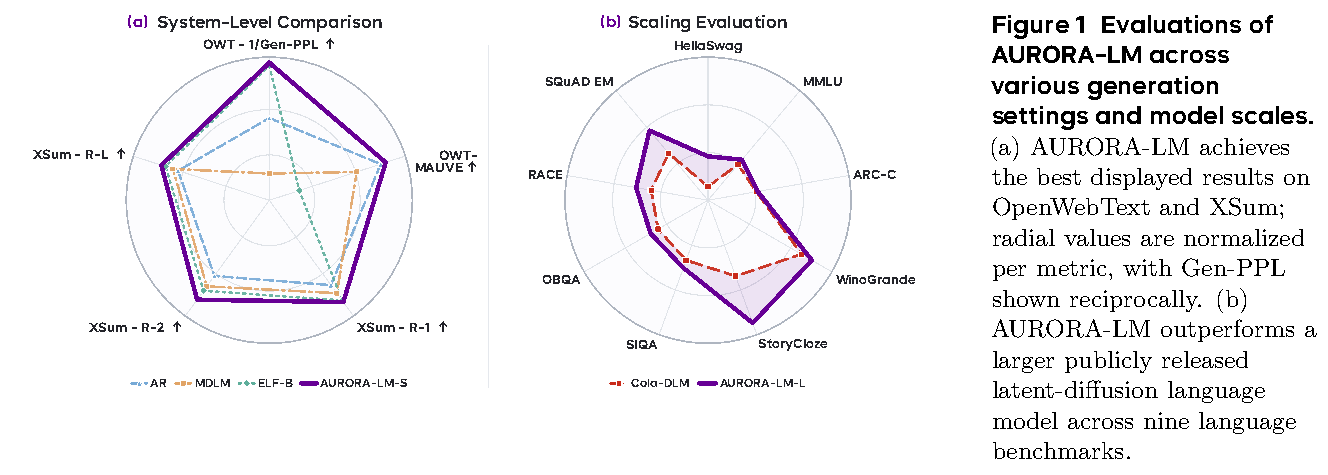
- AURORA-LM은 토큰 복호화에 충분히 풍부한 텍스트 잠재 표현을 유지하면서도, 이를 연속 생성에 적합하게 만드는 문제를 다룬다. Query-based Encoder-Decoder를 학습해 고용량의 prefix-aligned 잠재 시퀀스를 구성하고, 이 autoencoder를 고정한 뒤 block-causal flow-matching Transformer로 잠재 분포를 학습한다. 논문은 평가한 시스템 가운데 OpenWebText 자유 생성과 XSum 요약에서 가장 강한 결과를 보고하며, 명시된 공통 벤치마크 프로토콜에서 1B denoiser 파라미터로 공개된 1.8B-parameter Cola-DLM checkpoint보다 높은 9개 과제 macro average를 달성했다고 보고한다. autoencoder에 대해서는 이 글을 참조하라.
왼쪽 radar chart는 OpenWebText와 XSum 지표를 정규화하고, 보고한 축에서 AURORA-LM-S가 표시된 시스템 가운데 가장 바깥쪽에 위치함을 보여준다. 오른쪽 chart는 1B AURORA-LM-L와 Cola-DLM을 9개 benchmark에서 비교하며, AURORA-LM-L가 각 과제에서 더 높은 표시 점수를 기록했음을 나타낸다.
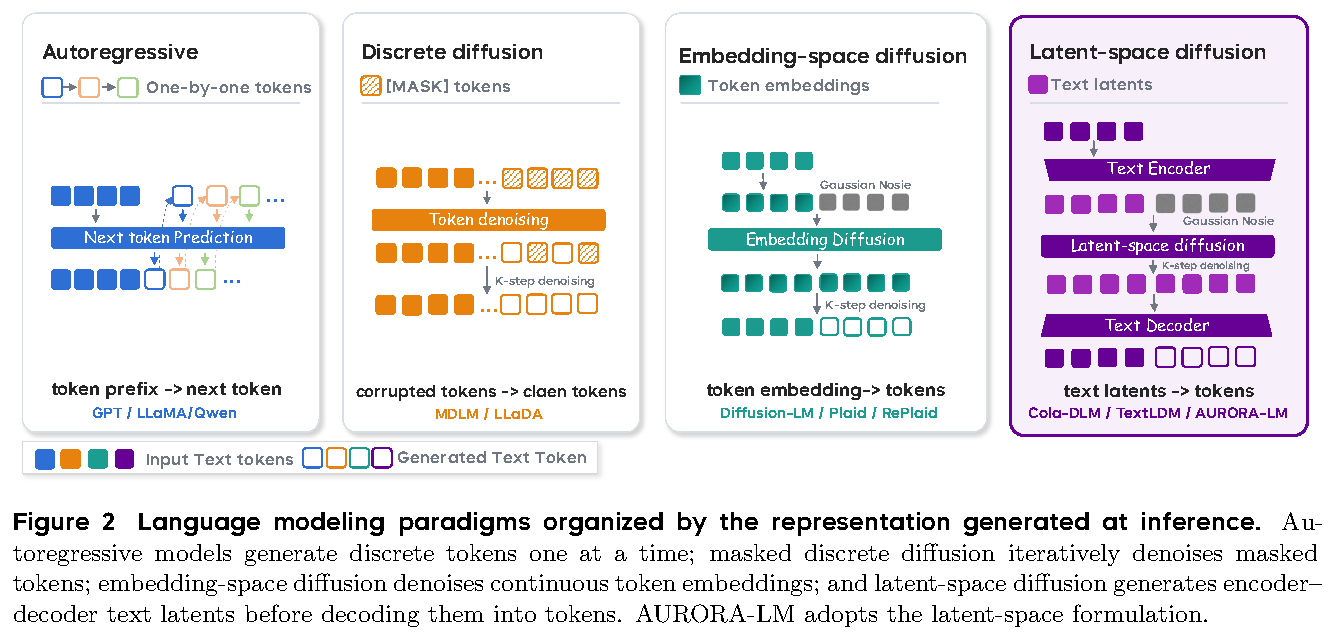
도식은 inference에서 생성하는 표현을 기준으로 언어 모델링 패러다임을 순차 discrete token, masked token, token embedding, encoder-decoder text latent로 구분한다. AURORA-LM은 token decoding 전에 continuous latent를 denoising하는 latent-space 범주에 배치된다.
3.2 Continuous Text Latent Construction
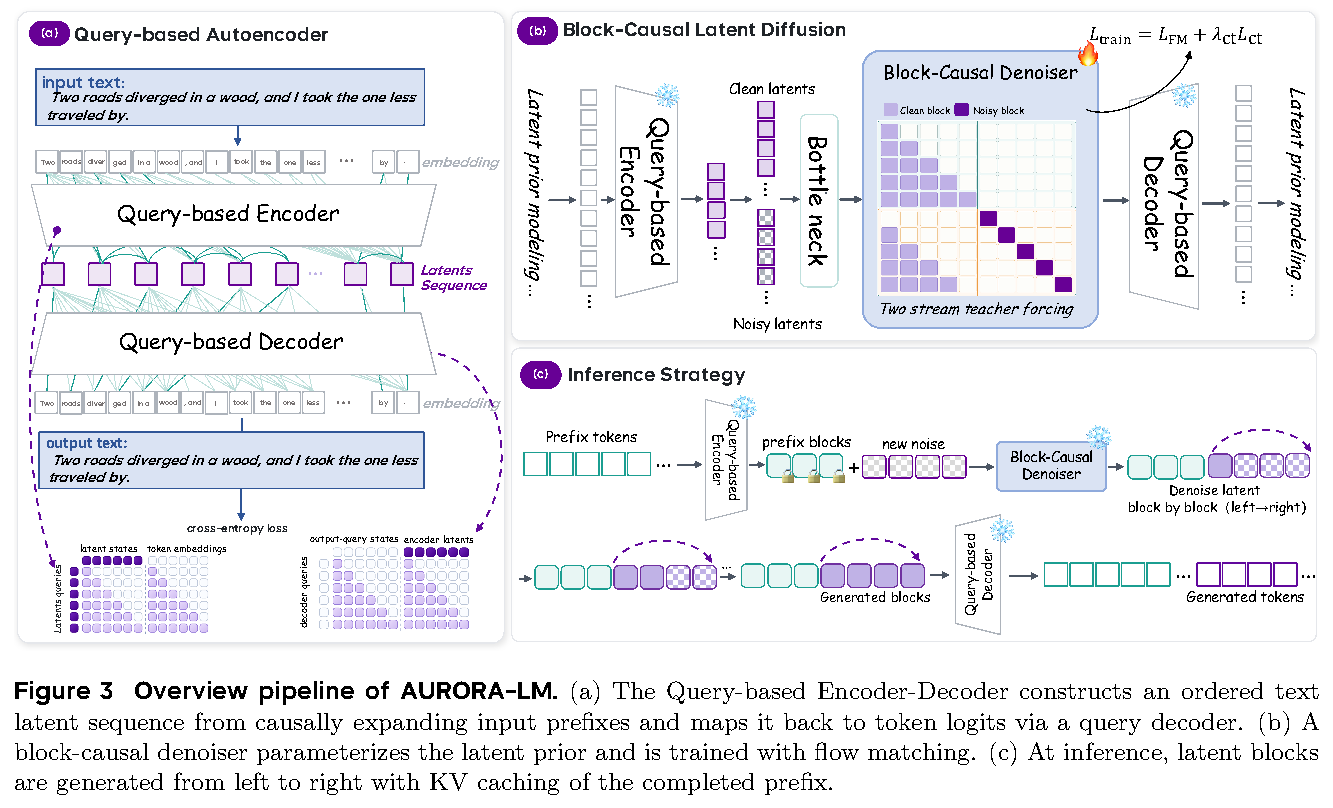
토큰 w1:L이 주어지면 encoder는 zenc ∈ R^(N×D)를 생성하며, 여기서 N = round(cL)이다. D는 잠재 위치당 채널 용량을 제어하고 c는 유지하는 시퀀스 길이를 제어한다. 인과적으로 확장되는 encoder query가 토큰 prefix를 읽고, decoder query는 대응하는 잠재 prefix만으로 각 토큰을 복원하므로, 왼쪽에서 오른쪽으로 잠재 생성을 수행하기에 적합한 순서형 표현을 얻는다. autoencoder는 토큰 수준 cross-entropy와 token-embedding 및 latent dropout으로 학습한 뒤 denoiser 학습 전에 고정한다.
3.3 Block-Causal Modeling of Continuous Text Latents
표준화한 잠재 시퀀스를 Q개 위치로 이루어진 연속 block으로 나누고 왼쪽에서 오른쪽으로 분해한다. 각 block은 완료된 이전 block들을 조건으로 생성하며, block 내부 위치들은 함께 denoising한다. Linear-interpolant flow matching은 각 clean block에 Gaussian noise를 더하고, noisy block, noise level, clean prefix로부터 clean endpoint를 예측하도록 모델을 학습한다. Two-stream attention mask는 미래 clean block이나 다른 target block의 noisy state를 노출하지 않으면서 모든 block conditional을 병렬로 학습할 수 있게 한다.
3.4 Learning the Full-Width Latent Distribution
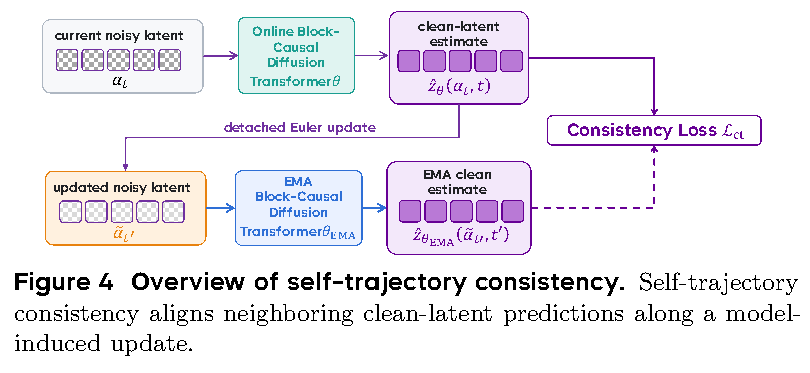
AURORA-LM은 고정된 decoder가 요구하는 D-dimensional clean target을 유지하되, noisy-latent 입력 경로에만 low-rank projection을 적용한다. 목적함수는 clean-latent flow-matching loss와 self-trajectory consistency를 결합한다. EMA teacher는 분리된 Euler update 뒤 인접한 더 낮은 noise state에서 예측하고, online model은 두 추정값이 일치하지 않을 때 페널티를 받는다. 모델은 self-conditioning도 사용하며, 학습 noise distribution을 잠재 폭에 맞춰 보정한다. 보고한 sweep에서는 더 넓은 target일수록 high-noise 배분을 늘리는 방식이 더 우수했다.
Consistency branch는 online denoiser 예측을 분리된 Euler update에 사용한 뒤, 다음의 더 낮은 noise state에서 EMA denoiser 추정값과 이를 정렬한다. Gradient는 online prediction을 통해서만 흐르므로, 이 branch는 별도로 학습하는 consistency model이 아니라 보조 regularizer다.
3.5 Latent Generation and Text Decoding
무조건 생성에서는 각 잠재 block을 Gaussian noise로 시작하고, 이전에 생성한 block들을 조건으로 t = 1에서 t = 0까지 denoising한다. Prompt-conditioned 생성에서는 prompt를 clean standardized latent prefix로 인코딩하고 continuation block만 생성한다. 생성한 latent는 고정된 query decoder가 vocabulary logits로 복호화하기 전에 표준화를 해제한다. SC-CFG는 무조건 샘플링에서 self-conditioned 추정값과 non-self-conditioned 추정값을 결합하고, classifier-free guidance는 prompt-conditioned 생성에서 conditional 추정값과 unconditional 추정값을 결합한다.
그림은 방법의 3개 단계를 연결한다. 즉, prefix 제약 query autoencoding, two-stream block-causal latent-prior 학습, KV caching을 사용한 왼쪽에서 오른쪽 block 생성이다. Bottleneck은 noisy-latent 경로에 적용하고 query decoder는 고정된 latent-to-token interface로 유지함을 보여준다.
4.1 Further analysis
통제 ablation은 최대 128 tokens 길이의 OpenWebText 시퀀스를 사용하고, 각 설계 선택을 개별적으로 변경한다. 별도 명시가 없는 한 구성마다 1,000 samples를 32-step ODE sampler로 생성하고, held-out OpenWebText를 기준으로 MAUVE를 평가한다. AURORA-LM-S는 시스템 비교에 130M-parameter denoiser를 사용하고, AURORA-LM-L는 scaling에 1.01B-parameter denoiser를 사용한다. 이 파라미터 수에는 autoencoder를 포함하지 않는다. 보고한 모든 실험은 Ascend NPU를 사용한다.
4.1.1 Latent Capacity
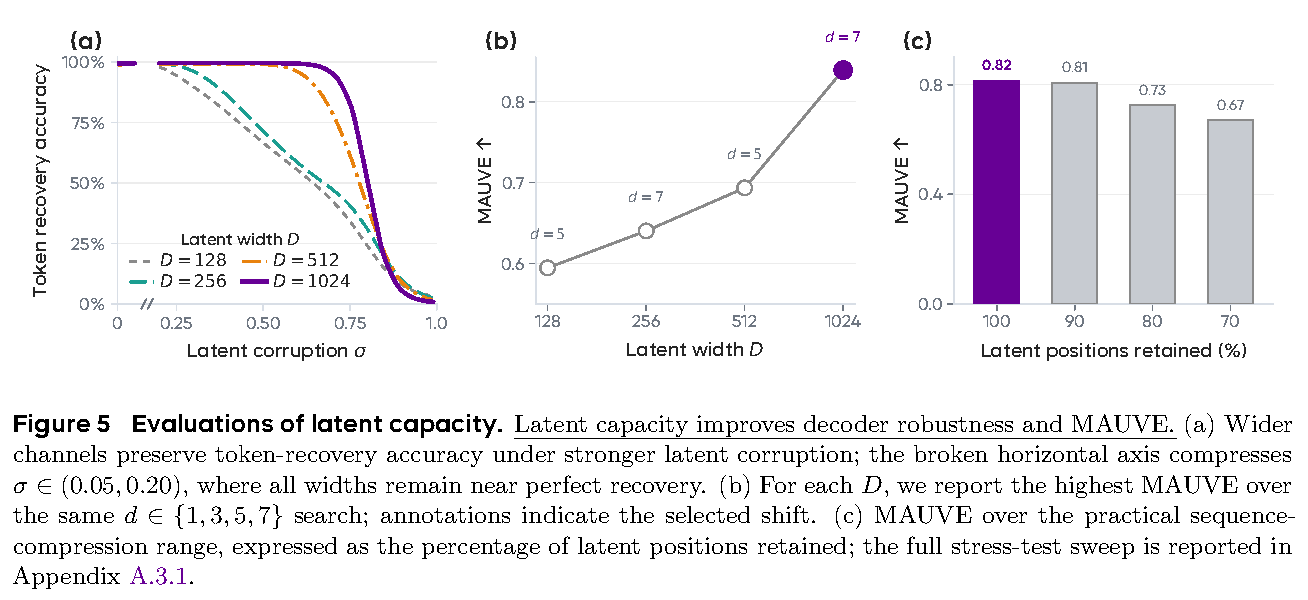
잠재 폭을 D = 128에서 1024로 늘리면 잠재 corruption 상황에서 토큰 복원의 강건성이 향상되고, 가장 우수한 보정 MAUVE가 0.594에서 0.839로 오른다. D = 1024에서 잠재 위치의 90%를 유지하면 MAUVE는 0.807이며, 압축하지 않은 경우의 0.815와 비교된다. 80%와 70% 유지에서는 각각 0.726과 0.671을 기록한다. 따라서 통제 실험의 기준 구성은 D = 1024 및 c = 1을 사용하며, c = 0.9는 효율 중심 대안으로 제시한다.
Panel (a)는 더 넓은 latent가 강한 corruption에서도 token-recovery accuracy를 보존함을 보인다. Panel (b)는 가장 우수한 보정 MAUVE가 latent width와 함께 상승함을 보이고, panel (c)는 sequence compression에 따른 품질 저하를 정량화한다. 이 결과들은 통제 실험의 기준 구성으로 D = 1024와 전체 latent retention을 선택한 근거가 된다.
4.1.2 Modeling the Full-Width Latent Distribution
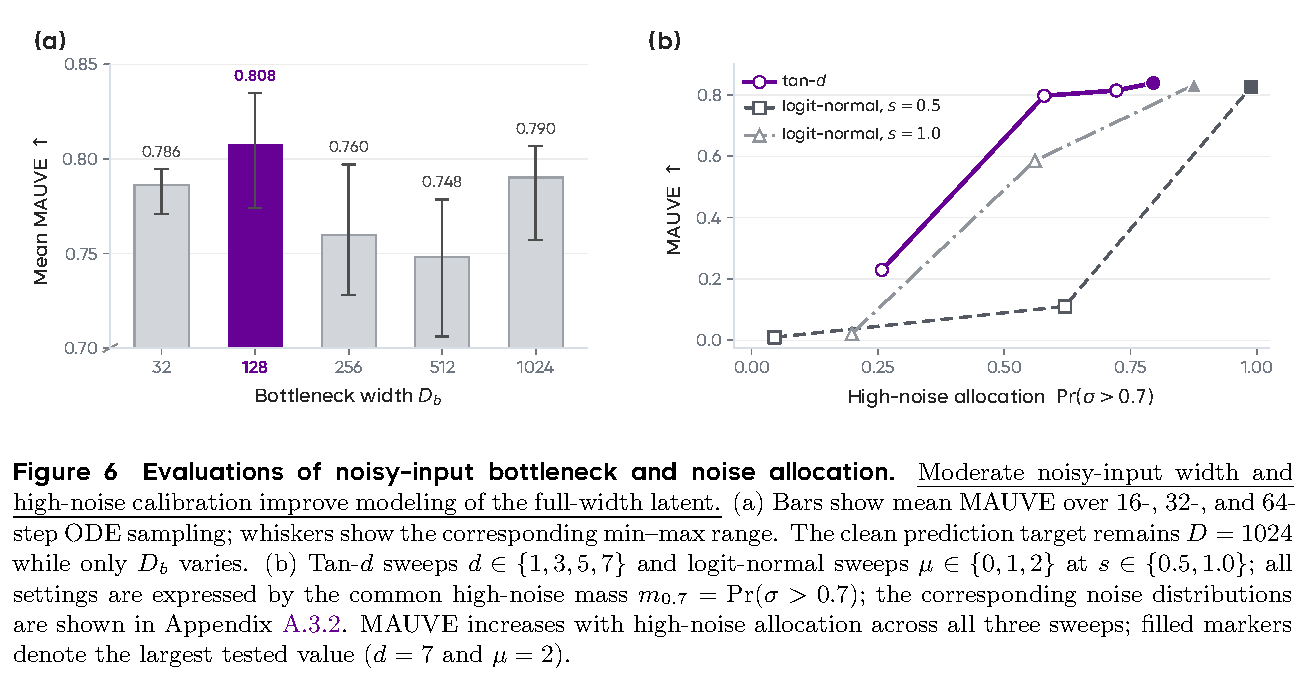
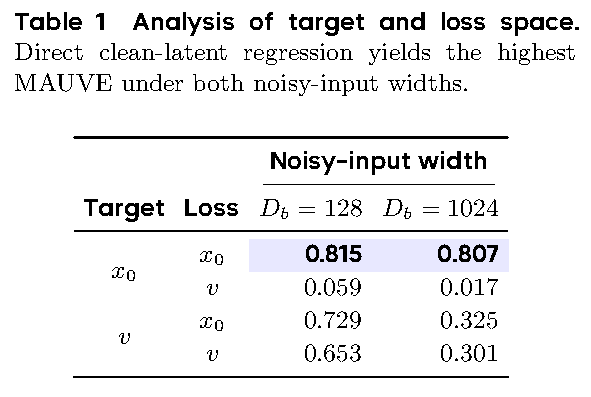
D = 1024 clean target에서 Db = 128인 noisy-input bottleneck은 16-, 32-, 64-step ODE sampling 전반에서 평균 MAUVE 0.808로 가장 좋다. 이는 Db = 32의 0.786 및 Db = 1024의 0.790과 비교된다. tan-d와 logit-normal schedule sweep 전반에서 high-noise state에 더 많은 학습 비중을 배정할수록 MAUVE가 상승하며, d = 7인 tan-d는 0.839에 도달한다. x0-space loss를 사용한 직접 x0 예측은 두 입력 폭 모두에서 가장 우수한 반면, velocity space에서 x0 예측을 평가하면 low-noise state 쪽으로 1/σ² 가중치가 부여된다.
Bottleneck sweep은 지나치게 좁은 noisy input이나 full-width noisy input이 아니라 Db = 128에서 정점을 보인다. Schedule sweep은 Pr(σ > 0.7)을 기준으로 parameterization을 묶고, 시험한 family 전반에서 high-noise allocation이 커질수록 MAUVE가 높아짐을 보인다.
표는 Db = 128과 Db = 1024에서 prediction target과 loss space를 구분한다. x0 space에서 최적화한 clean-latent x0 prediction이 두 열 모두에서 가장 우수하며, velocity space에서 평가한 x0 prediction은 특히 성능이 낮다.
4.1.3 Efficient Blockwise Generation
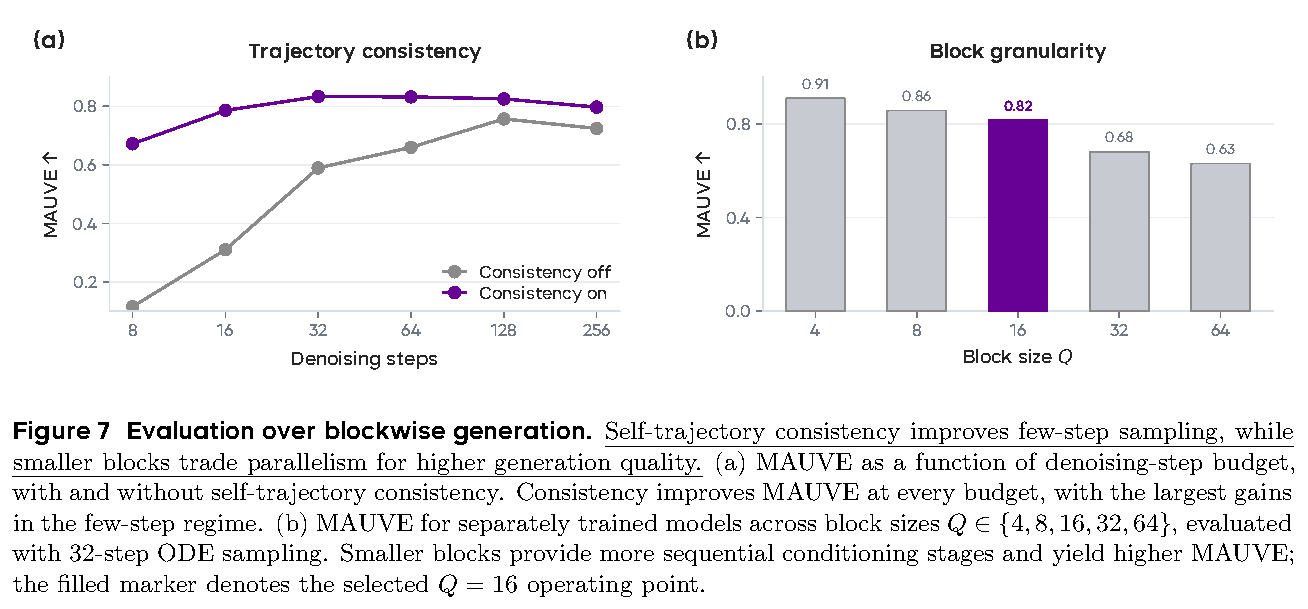
Self-trajectory consistency는 시험한 모든 sampling budget에서 MAUVE를 향상시키며, 특히 8 step에서는 0.116에서 0.672로, 16 step에서는 0.310에서 0.786으로 높인다. 더 작은 잠재 block은 품질을 개선하지만 순차 단계 수를 늘린다. Q = 4는 MAUVE 0.909에 도달하는 반면, Q = 64는 0.631에 도달한다. 선택한 Q = 16은 MAUVE 0.815를 달성하면서 Q = 4와 비교해 block-generation 단계를 32에서 8로 줄인다.
Trajectory consistency는 모든 denoising-step budget에서 MAUVE를 개선하며, 특히 8 step과 16 step에서 격차가 크다. Block-size sweep은 품질과 병렬성의 trade-off를 시각화하고 Q = 16을 선택한 절충안으로 제시한다.
4.2 System-Level Comparison
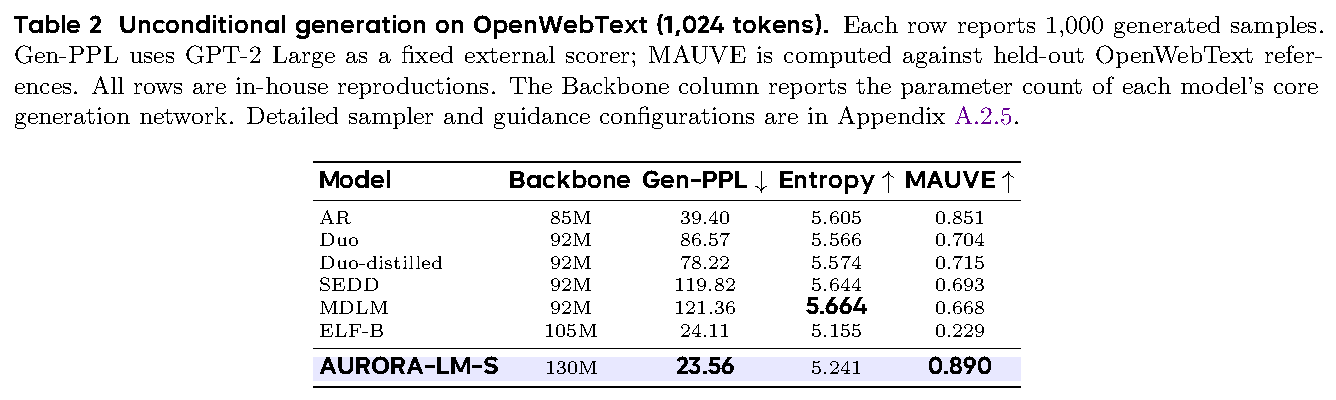
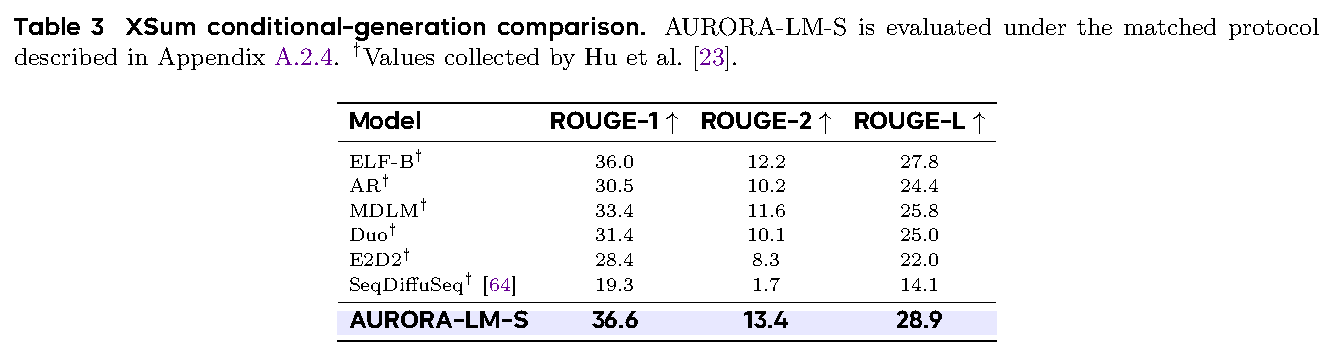
1,024-token OpenWebText 자유 생성에서 AURORA-LM-S는 64-step SDE-DPM++ sampling과 SC-CFG scale 4를 사용해 1,000개 샘플에서 Gen-PPL 23.56, entropy 5.241, MAUVE 0.890을 얻는다. 논문이 재현한 AR, Duo, Duo-distilled, SEDD, MDLM, ELF-B 비교에서 가장 낮은 Gen-PPL과 가장 높은 MAUVE를 기록한다. XSum에서는 classifier-free guidance scale 2.0을 적용한 32-step ODE sampling으로 ROUGE-1/ROUGE-2/ROUGE-L 36.6/13.4/28.9를 얻는다. 해당 표의 baseline 값은 이 논문에서 end-to-end로 재현한 결과가 아니라 Hu et al.에서 수집한 값이다.
논문의 OpenWebText evaluation harness에서 AURORA-LM-S는 나열한 시스템 가운데 가장 낮은 external-scorer Gen-PPL과 가장 높은 MAUVE를 기록한다. Entropy는 대부분의 discrete baseline보다 낮지만 ELF-B보다는 높으므로, 보고한 품질 우위가 단순히 최대 unigram diversity와 연관된 것은 아니다.
AURORA-LM-S는 XSum에서 나열한 ROUGE-1, ROUGE-2, ROUGE-L 모두 가장 높은 값을 기록하며, ELF-B 대비 절대 격차는 ROUGE-2에서 가장 크다. 표는 AURORA 외 모든 값을 Hu et al.이 수집한 것으로 표시하므로, 프로토콜의 직접적 동등성에는 한계가 있다.
4.3 Scaling Evaluation
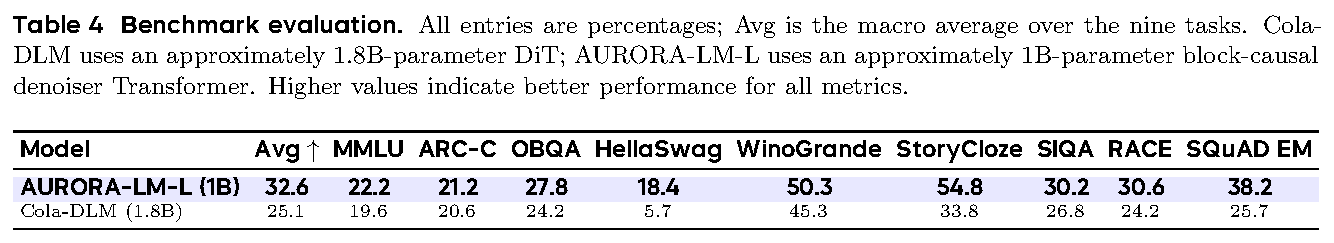
AURORA-LM-L는 294.7B-token English mixture로 590,000 denoiser updates를 수행해 학습한다. denoiser 학습 compute는 약 1,406 EFLOPs이고 전체 compute는 약 1,500 EFLOPs이다. 공통 two-shot benchmark protocol, 16 denoising steps, 최대 32 generated tokens 조건에서 1B denoiser는 MMLU, ARC-C, OBQA, HellaSwag, WinoGrande, StoryCloze, SIQA, RACE, SQuAD EM 전반의 macro average로 32.6을 얻으며, 공개된 1.8B-parameter Cola-DLM checkpoint의 25.1과 비교된다. 시스템들은 같은 과제 인스턴스, prompting, truncation, scoring pipeline을 사용하지만, 모델별 inference default를 유지했고 일치한 조건으로 학습하지는 않았다.
1B AURORA-LM-L는 표에 제시한 macro average와 모든 개별 benchmark에서 공개된 1.8B Cola-DLM checkpoint를 앞선다. 표시한 가장 큰 격차는 WinoGrande, SIQA, SQuAD EM에서 나타나지만, 여러 과제의 절대 점수는 여전히 높지 않다.
부록
- Appendix는 autoencoder masking rate px = 0.3과 pz = 0.6을 명시하고, velocity space에서 x0 예측을 평가할 때 유도되는 1/σ² 가중치를 도출하며, schedule family별 high-noise-mass 공식을 제시한다. 또한 architecture, optimization setting, inference sweep, baseline protocol, answer extraction, 통제 실험 전체 결과를 문서화한다. 정성적 OpenWebText 샘플은 외부 GPT-2 Large perplexity가 양호하지만, 비일관적인 산문과 뒷받침되지 않는 entity 또는 claim을 포함한다. 반면 제시한 2개 XSum 출력은 간결하며 reference를 밀접하게 따른다.
짧은 생각
논문은 일관된 설계 원칙을 제시한다. 즉, decoder가 활용할 수 있는 텍스트 잠재 표현을 보존하고, causal blocking, input-only bottleneck, noise calibration을 통해 diffusion 측에 tractability 개입을 적용한다. 통제 ablation은 이러한 선택을 직접 뒷받침하며, 특히 trajectory consistency가 적은 step에서 크게 개선하는 결과가 두드러진다. 다만 비교 주장은 서로 다른 parameter accounting, sampler, guidance setting, baseline provenance에 의존한다. 또한 appendix의 자유 생성 예시는 낮은 external-scorer perplexity가 사실성이나 일관성을 보장하지 않음을 보여준다.