


Two-Level Meta-Rubrics for Evaluating Open-Ended Generation: GAMUT, a Benchmark for Factual Completeness 요약 설명
21 Jul 2026 | Paper Review LLM Evaluation Factual Completeness Multimodal Learning Rubric-Based EvaluationContents
- 요약
- 1 Introduction
- 2 Related Work
- 3 A Two-Level Meta-Rubric Framework for Evaluating Open-Ended Generation
- 4 Dataset Construction
- 5 Evaluating Models on Gamut
- 6 Dataset Analysis
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Two-Level Meta-Rubrics for Evaluating Open-Ended Generation: GAMUT, a Benchmark for Factual Completeness 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 21일(Arxiv)
- Chen, Xilun, Feizollahi, Zhaleh, Goodwin, Ross, Moon, Seungwhan, Yih, Scott, Donmez, Pinar, Damavandi, Babak, Dong, Luna.
- Meta AI
- 논문 링크
- Github
요약
- Gamut(Grounded Assessment of Multimodal Factuality)은 이미지에 근거한 일상적 심층 리서치 질문의 장문 답변에서 사실적 완전성을 평가한다. 이중 수준 프레임워크는 구조화되고 근거로 뒷받침되는 메타 루브릭을 작성한 뒤, 이를 LLM 판정을 위한 이진 점검 항목으로 기계적으로 컴파일한다. 벤치마크에는 10개 도메인에서 사람이 검증한 질문 1,813개가 포함된다. 데이터는 https://huggingface.co/datasets/facebook/GAMUT 에서, 코드는 https://github.com/facebookresearch/GAMUT 에서 제공한다.
1 Introduction
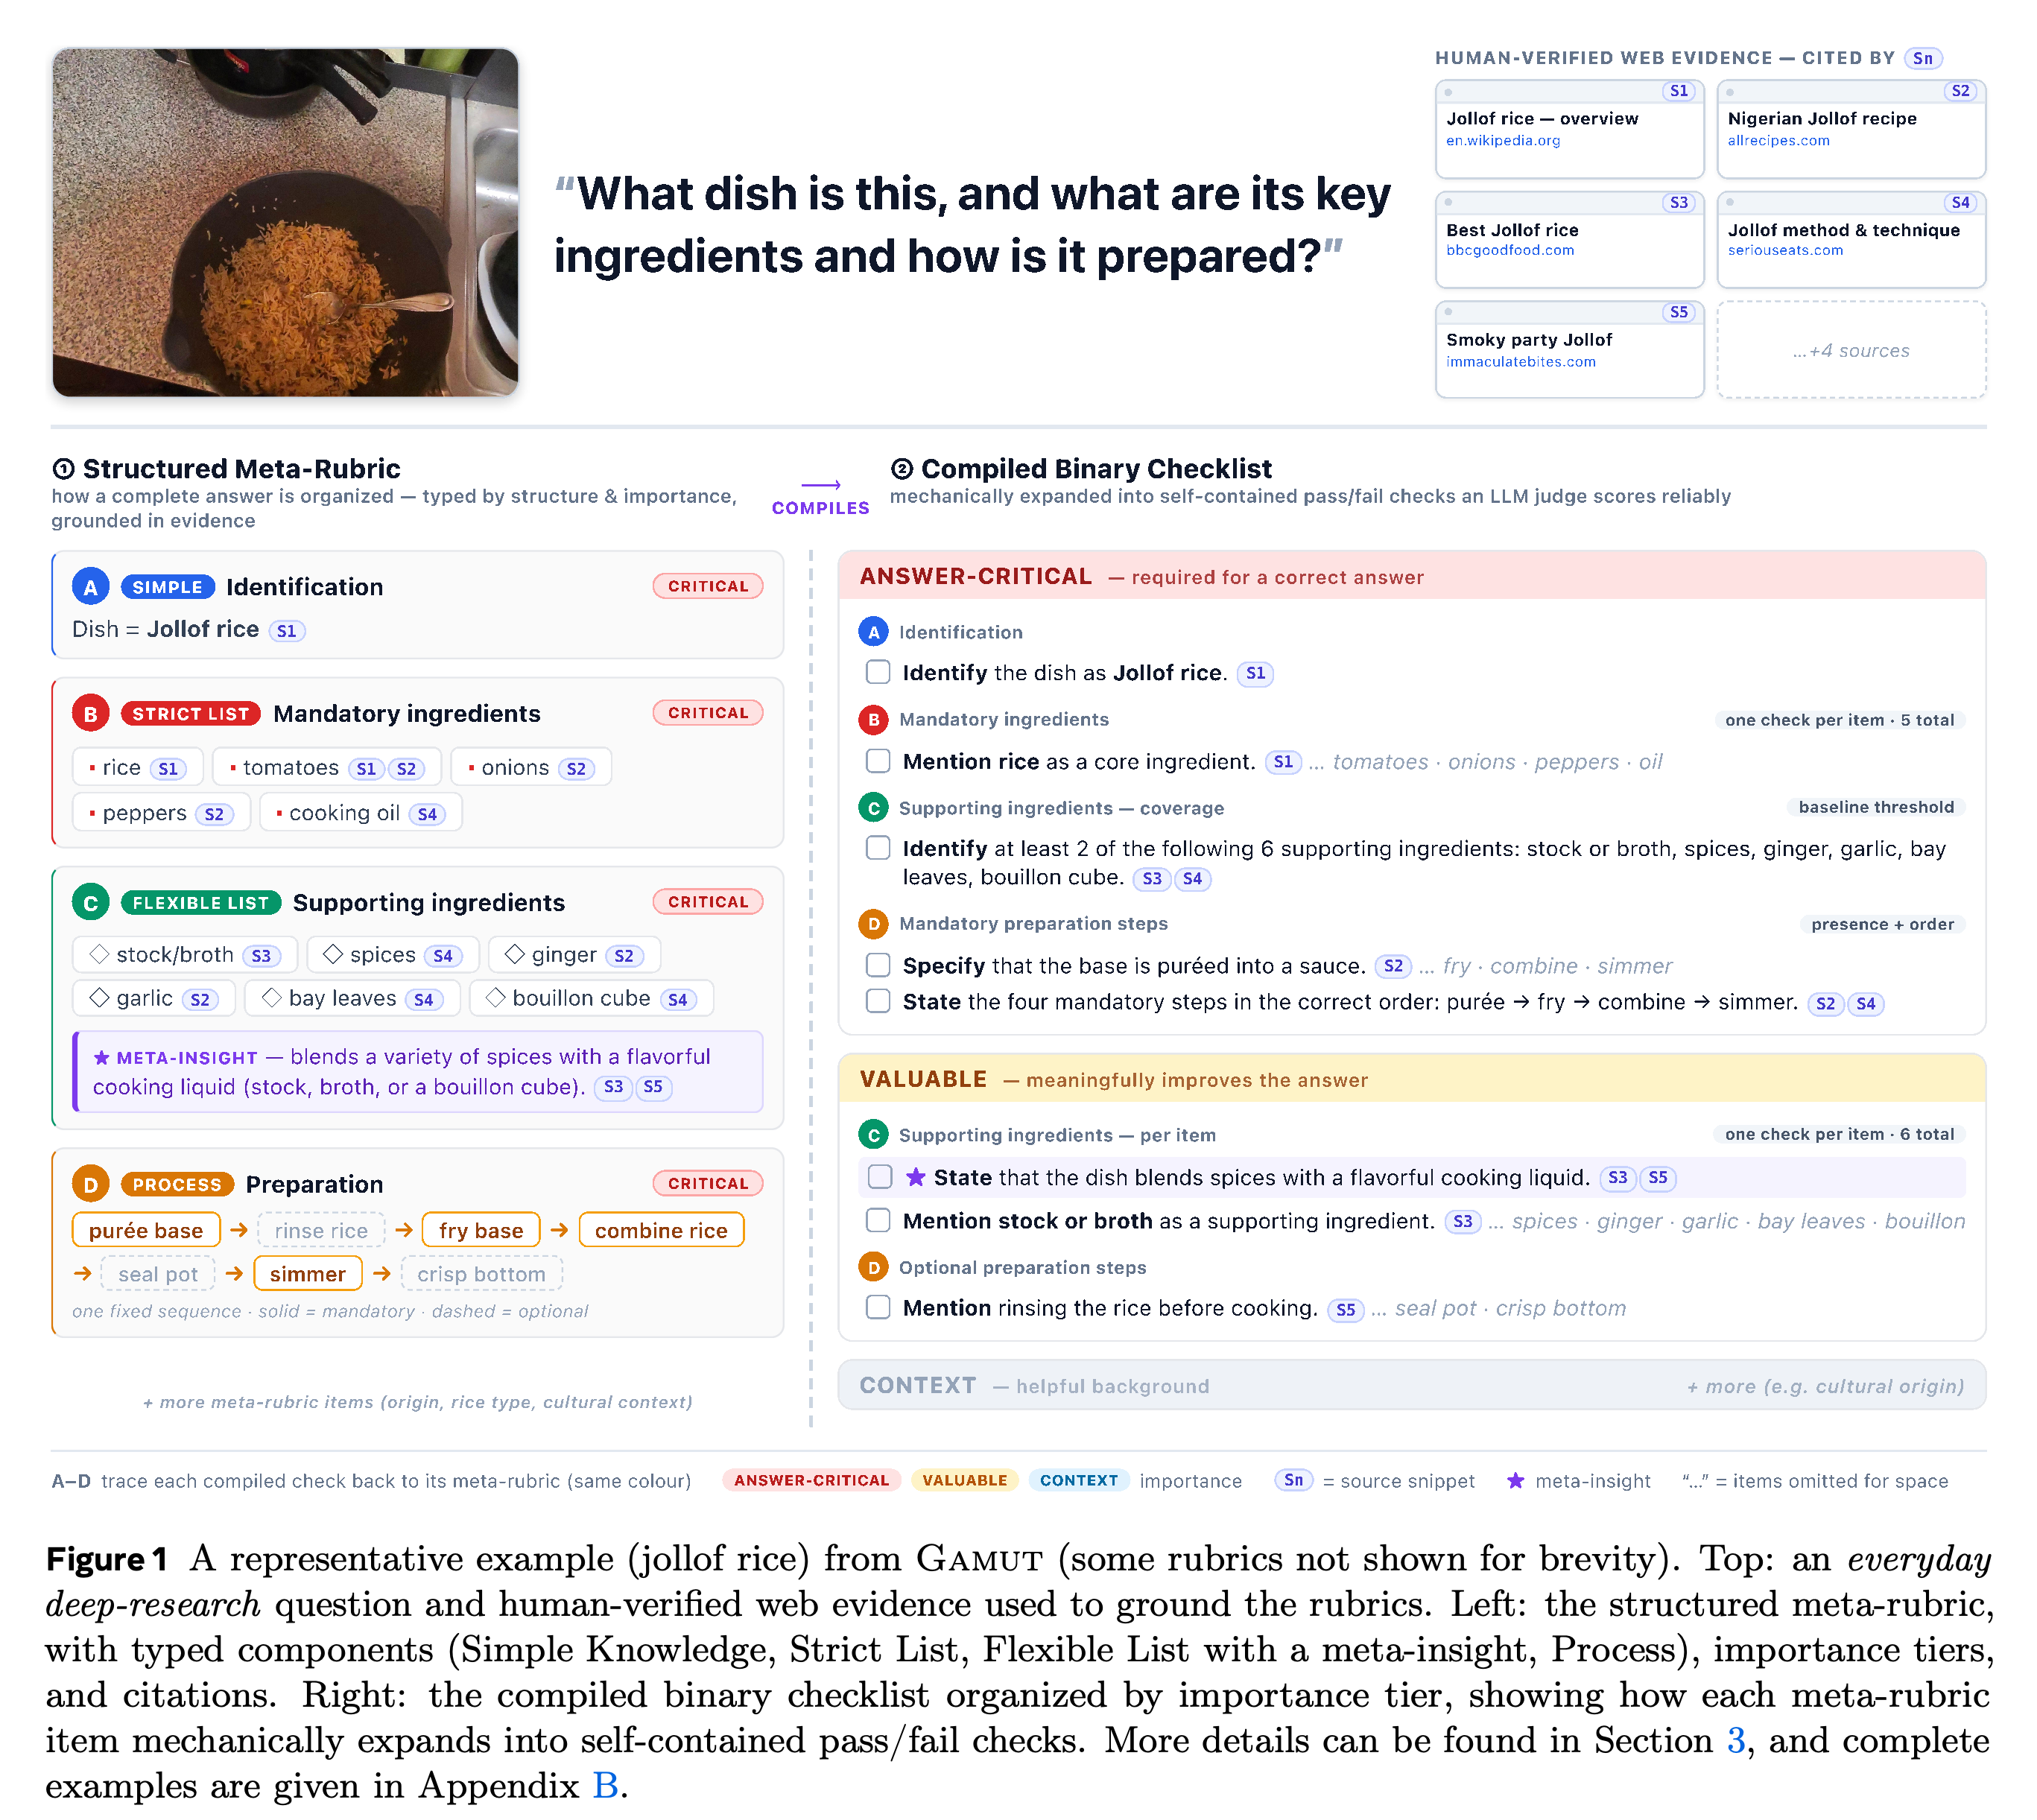
논문은 장문 사실성 평가가 정밀도를 강조해 왔고, 답변 품질을 흔히 독립적인 사실 점검의 집합으로 취급한다고 주장한다. 그러나 완전성을 평가하려면 허용 가능한 사실의 열린 집합을 얼마나 포괄하는지, 절차 순서가 올바른지, 사실별 중요도가 어떻게 다른지를 고려해야 할 수 있다. GAMUT은 신뢰할 수 있는 채점을 위해 요구사항을 컴파일하기 전에 이러한 요소를 표현한다.
jollof-rice 예시는 주석과 채점을 분리하는 방식을 보여 준다. 필수 재료는 개별 점검 항목이 되고, 유연한 재료 집합은 포괄성 임곗값과 하위 등급 점수가 되며, 조리 과정은 존재 여부와 순서 점검으로 바뀐다. 인용과 중요도 등급은 2개 수준을 연결한다.
2 Related Work
선행 연구에는 정밀도 중심의 decompose-search-verify 파이프라인, 재현율 중심의 참조 사실 평가, 루브릭 기반 LLM 판정, 멀티모달 지식 탐색 벤치마크가 포함된다. 저자들은 평면적 사실 목록이 그룹화, 포괄성 임곗값, 순서, 중요도를 인코딩하는 능력이 제한적이라는 점에서 GAMUT의 위치를 설정한다.
2.1 Long-Form Factuality Evaluation
Decompose-search-verify 방법은 응답을 원자적 주장으로 분해하고 검색된 근거와 대조한다. 재현율 방법은 참조 사실을 얼마나 포괄하는지 평가한다. GAMUT은 유효한 답변의 풀을 충분히 포괄하는지나 필수 순서를 직접 표현할 수 없는 두 방법의 공통된 평면 표현을 겨냥한다.
2.2 Rubric-Based Evaluation
루브릭 기반 LLM 평가는 총체적인 Likert식 판단에서 분산을 줄이기 위한 명시적 기준과 이진 체크리스트로 이동해 왔다. GAMUT은 루브릭 작성과 채점에 같은 표현을 쓰지 않고, 구조화된 루브릭 작성과 평면 체크리스트 채점을 분리한다는 점에서 다르다.
2.3 Multimodal Knowledge-Seeking Benchmarks
멀티모달 검색 및 에이전트형 리서치 벤치마크는 흔히 짧고 검증 가능한 답을 찾거나 생성된 보고서를 총체적으로 채점한다. GAMUT은 일상적 대상에 관한 다중 출처 조사가 필요한 개방형 이미지 기반 질문을 대상으로, 사전에 마련한 참조 사실 루브릭에 따라 완전성을 점수화한다.
3 A Two-Level Meta-Rubric Framework for Evaluating Open-Ended Generation
프레임워크는 각 질문에 구조화된 메타 루브릭을 정의하고, 고정된 컴파일 규칙을 적용해 이진 루브릭을 만든 뒤, LLM 판정자에게 각 점검 항목을 평가하게 한다. 이 분업은 포괄성, 순서, 의미적 구성을 주석 단계에 두고, 판정자는 좁고 독립적인 요구사항만 판단하게 한다. LLM 판정자에 대해서는 이 글을 참조하라.
3.1 Meta-Rubrics
각 메타 루브릭 항목은 Answer-Critical, Valuable, Context 중 1개의 중요도 등급과 Simple Knowledge, Strict List, Flexible List, Process, Relationship 중 1개의 구조를 갖는다. 목록과 절차에는 개별 사실만으로 포착할 수 없는 항목 간 종합인 메타 인사이트도 포함할 수 있다.
3.2 From Meta-Rubrics to Binary Rubrics
Simple Knowledge는 1개의 점검 항목이 되고, strict list는 필수 항목마다 1개의 점검 항목이 된다. Flexible list는 독립적인 포괄성 임곗값과 더 넓은 포괄성에 대한 하위 등급의 점수를 만들며, process는 단계 존재 여부와 순서 점검을 만든다. Relationship과 메타 인사이트는 원자적 점검 항목으로 변환한다. 이 결정론적 매핑은 임곗값과 순서 요구사항을 보존하면서 컴파일 과정을 검토 가능하게 한다.
3.3 Scoring
각 컴파일된 점검 항목에 대해 판정자는 meets, partially meets, missing, contradicts 중 하나를 반환한다. 각 등급 안에서 이 결과에는 각각 1, λ, 0, µ의 값을 부여한다. 저자들은 λ = 0.5와 µ = −2를 사용하고, wAC = 0.6, wV = 0.3, wC = 0.1의 가중치로 등급 점수를 결합하며, 없는 등급의 가중치는 재분배한다. 모순은 누락보다 더 크게 감점한다.
4 Dataset Construction
데이터셋 구축은 착용형 이미지에 근거한 일상적 심층 리서치 질문을 만들고, 이에 대한 구조화된 루브릭과 컴파일된 루브릭을 구축하는 것으로 시작한다. Frontier-LLM이 제안한 초안은 반복적인 인간 검토, 수정, 근거 점검을 거친다. 개체 또는 질문 오류 12개를 수정했고, 적절한 루브릭을 만들 수 없는 예시는 제거하여 1,813개 항목이 남았다.
4.1 Question Creation
저자들은 10개 일상 도메인에 걸친 1,938개의 CRAG-MM 이미지와 정답 개체에서 출발한다. 약 80%는 자아 중심 시점의 스마트글래스 사진이다. Gemini 3.1 Pro가 질문을 제안하고, 2명의 주석자가 독립적으로 검토하며, 3번째 주석자가 불일치를 조정한다. 자동 필터링은 유도 질문을 위한 stranger test와 다양화 단계를 적용하며, 이후 루브릭 단계의 제거 전까지 이미지-질문 쌍 1,843개를 만든다.
4.2 Rubric Creation
Gemini 3.1 Pro는 웹 출처를 조사하고, 인용을 포함한 메타 루브릭을 초안으로 작성하며, 이진 루브릭으로 컴파일한다. 이어서 뒷받침 발췌문을 감사하고 빈틈을 독립적으로 조사한다. 소규모 사내 전문가 팀은 사실적 근거와 컴파일 정확성 점검을 포함해 2차례 수정한다. 주석자들은 인용된 발췌문도 검토하여 뒷받침되지 않는 근거를 제거하고 누락된 근거를 추가한다.
5 Evaluating Models on Gamut
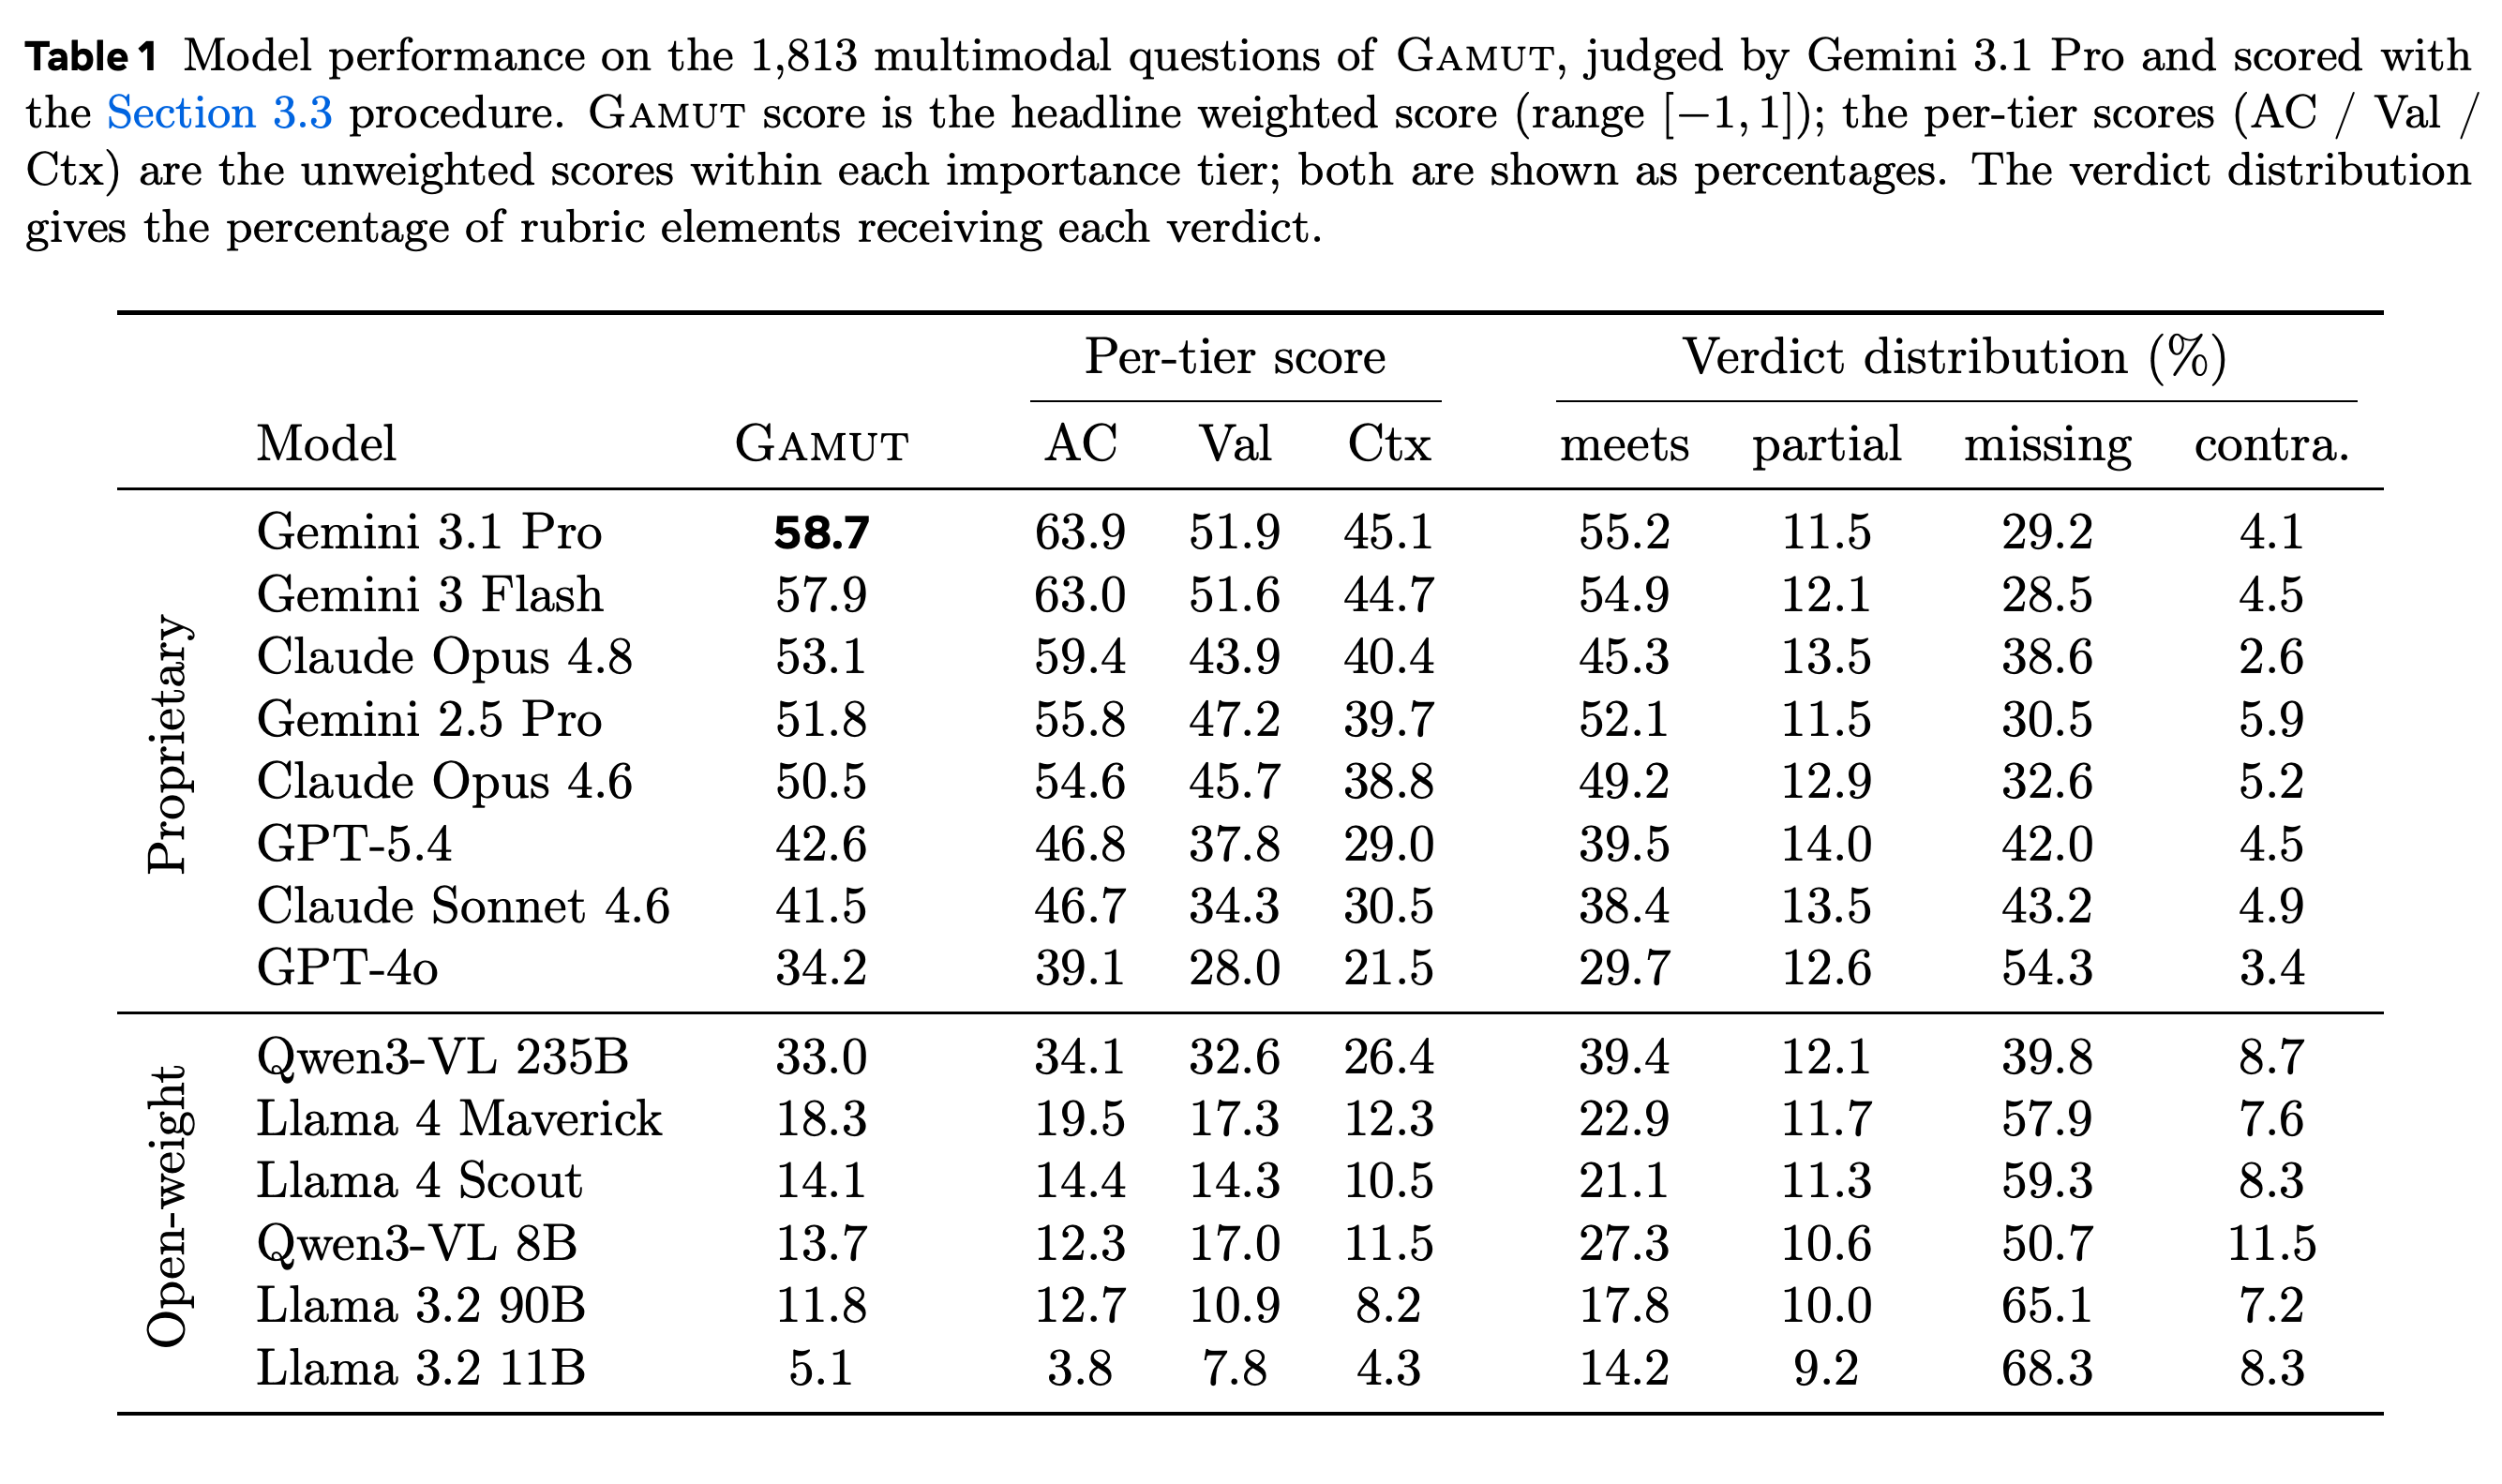
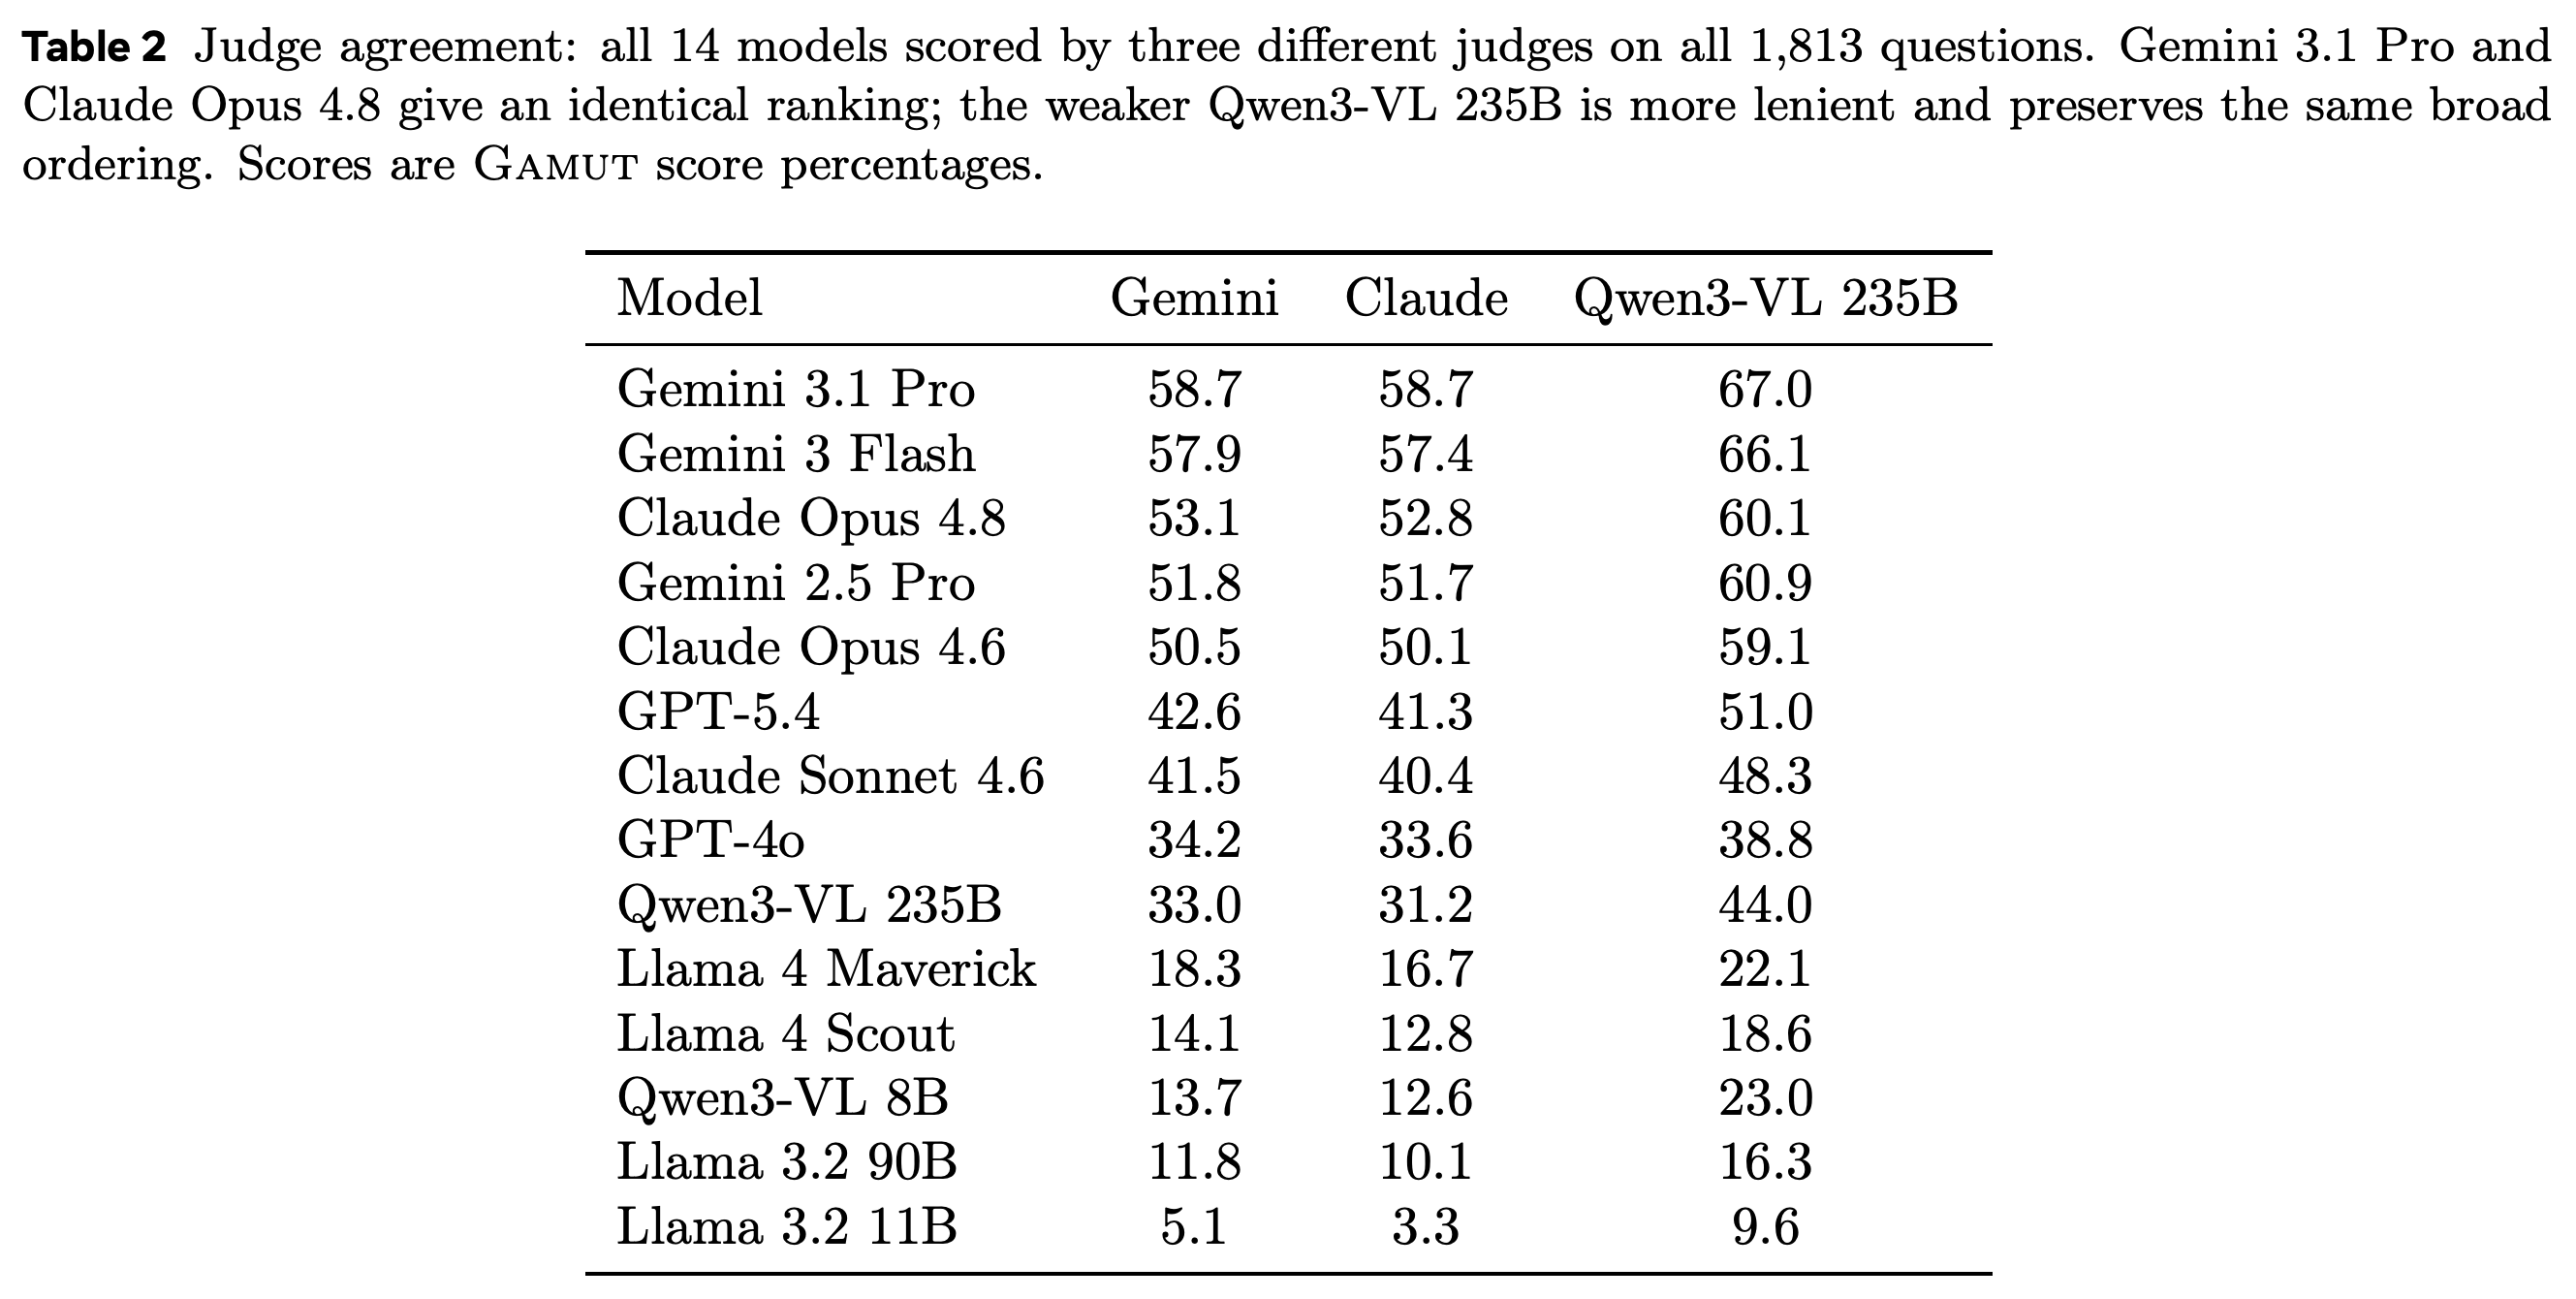
독점 모델과 open-weight 모델 14개가 각 이미지-질문 쌍에 자유 형식으로 답변하며, Gemini 3.1 Pro가 고정된 채점 절차로 컴파일된 점검 항목을 채점한다. Claude Opus 4.8과 Qwen3-VL 235B는 주 판정자에 대한 의존성을 평가하기 위해 전체 데이터셋을 추가로 판정한다.
5.1 Main Results
Gemini 3.1 Pro는 보고된 멀티모달 Gamut 점수 중 가장 높은 58.7%를 기록했고, 루브릭 요소의 55.2%를 충족했다. Gemini 3 Flash는 57.9%, Claude Opus 4.8은 53.1%, 가장 강한 open-weight 모델인 Qwen3-VL 235B는 33.0%를 기록했다. 실패는 주로 요구사항 누락에서 발생했으며, 약한 시스템일수록 모순 비율이 대체로 높고 특히 2개의 Qwen3-VL 변형에서 높았다.
이 표는 평가한 14개 시스템의 난도와 성능 분별력을 함께 보여 준다. Gemini 3.1 Pro가 58.7%로 선두이지만, 판정 분포에는 missing 29.2%와 contradictory 4.1%도 포함된다. Open-weight 모델의 점수 범위는 33.0%에서 5.1%다.
판정자 비교에서 Gemini 3.1 Pro와 Claude Opus 4.8은 동일한 순위를 산출했고, 모델별 점수 차이는 최대 1.8점이다. Qwen3-VL 235B는 더 관대하지만, 인접한 시스템 사이에서만 순위가 바뀌며 전반적 순서를 유지한다.
5.2 A Text-Only Variant
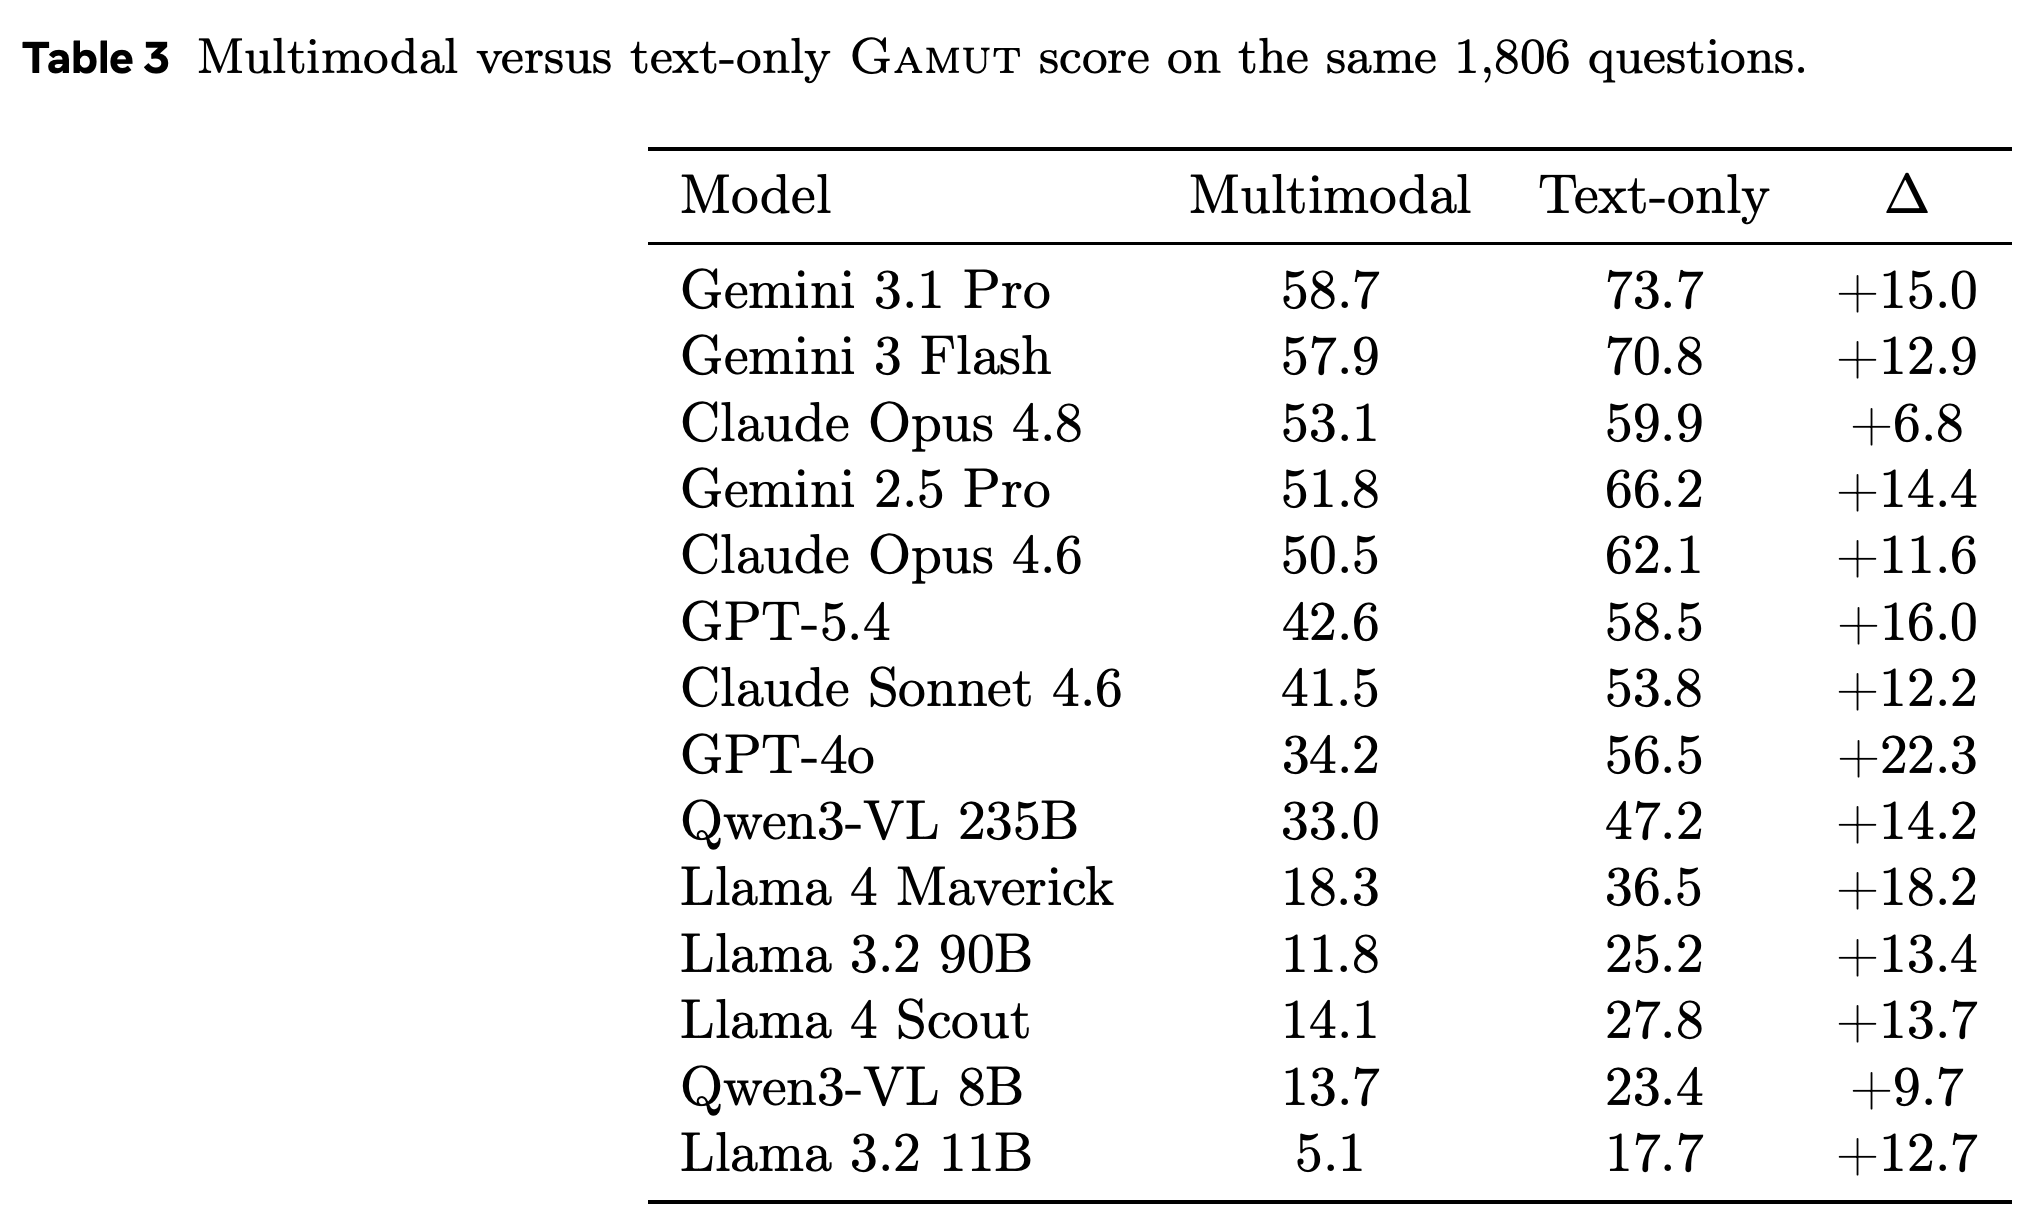
텍스트 전용 변형은 대상을 명시하고, 자명해지는 Answer-Critical 식별 점검 항목을 제거한다. 이미지 의존적인 예시 7개를 제외해 질문 1,806개가 남는다. 평가한 모든 모델의 성능이 향상했다. Gemini 3.1 Pro는 58.7%에서 73.7%로 올랐으며, 대체로 유지된 순위는 시각적 식별이 성능 격차의 주된 원인이라기보다 대부분 모델이 공통으로 부담하는 비용이라는 저자들의 해석을 뒷받침한다.
대상을 명시하면 동일한 질문 1,806개에서 모든 모델의 점수가 상승한다. Claude Opus 4.8은 6.8점, GPT-4o는 22.3점 상승한다. 전반적 순위가 유지된 점은 시각적 식별을 대체로 공통된 부담으로 해석하는 근거가 된다.
6 Dataset Analysis
분석은 질문 다양성, 루브릭 규모와 근거 기반성, 고립된 사실을 넘어서는 구조의 보급 정도를 살펴본다. 다양한 도메인 내용, 상당한 깊이의 루브릭, 널리 나타나는 구조화된 구성요소, 높은 인용 포괄성을 보고한다.
6.1 Question Diversity
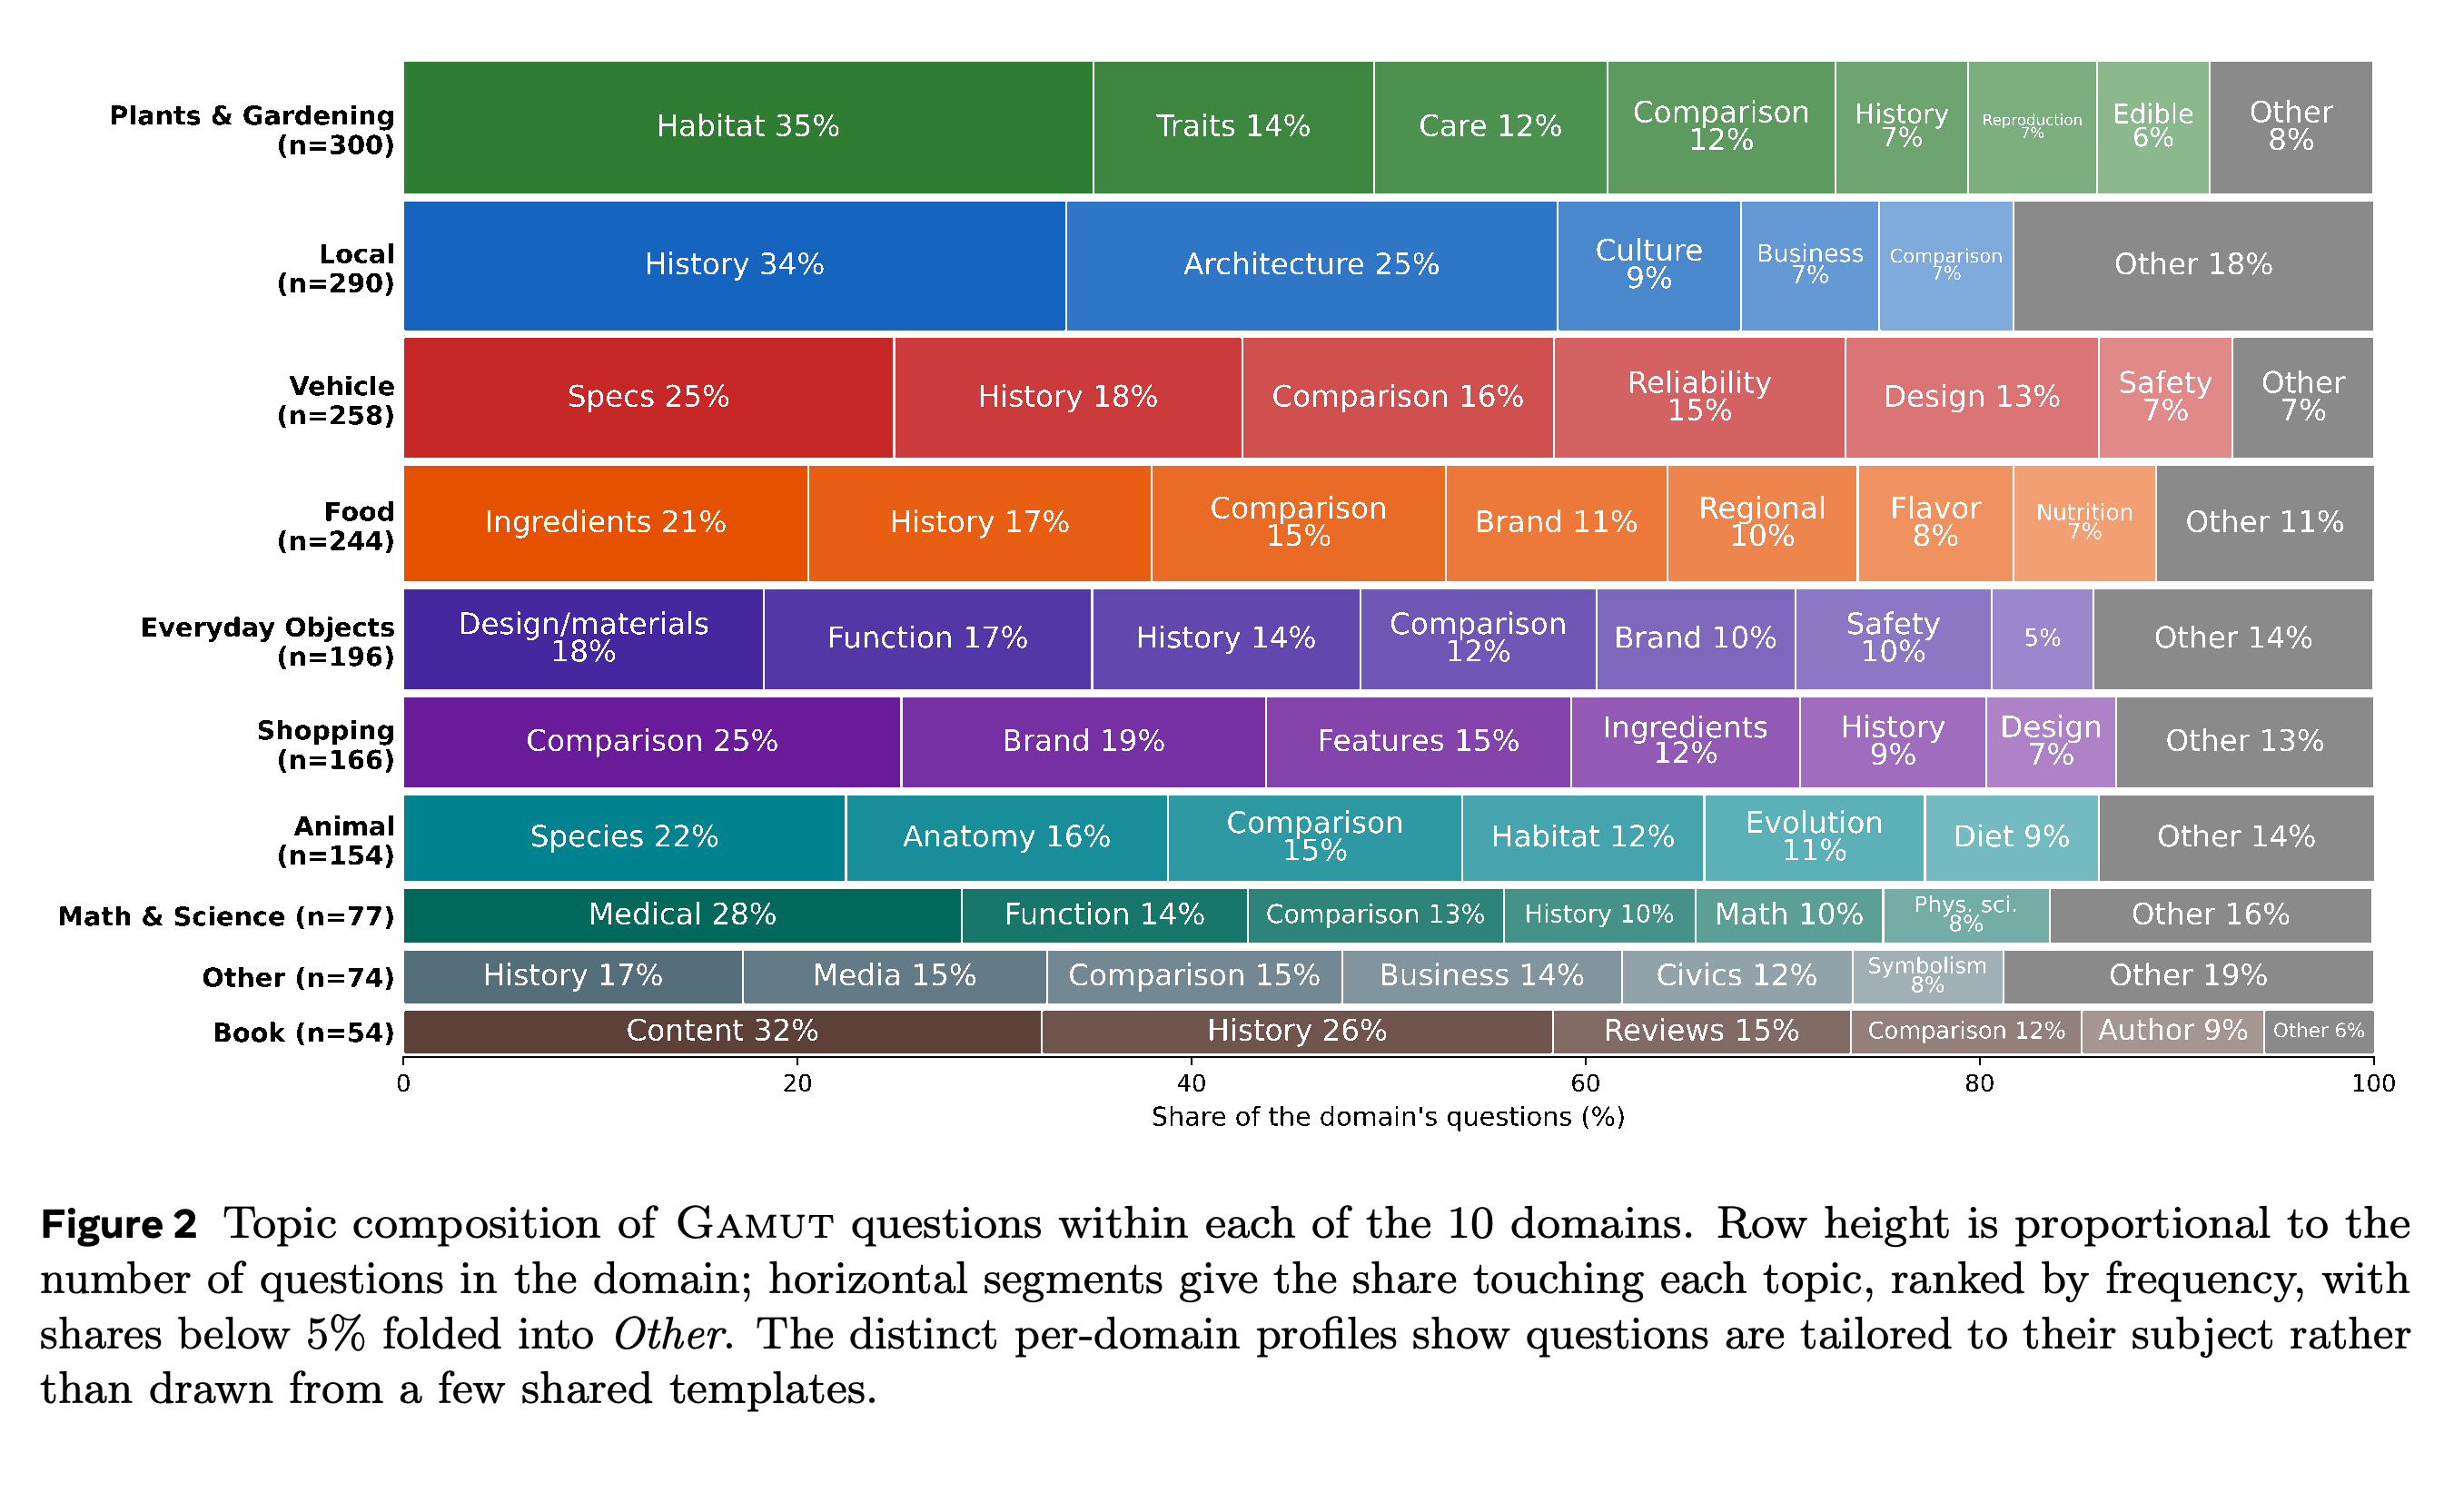
질문의 중앙 길이는 23단어이며, 가장 흔한 시작 구문 25개가 데이터셋에서 차지하는 비율은 60% 미만이다. 약 6분의 1은 표준 의문사로 시작하지 않는다. 주제 구성도 도메인마다 다르다. 식물 질문은 서식지와 관리, 지역 장소 질문은 역사와 건축, 차량 질문은 사양과 신뢰성, 음식 질문은 재료와 지역적 변이를 강조한다.
도메인별 행은 하나의 공통 질문 템플릿이 아니라 서로 다른 주제 조합을 보인다. Plants & Gardening은 서식지, Local은 역사와 건축, Vehicle은 사양, Food는 재료가 가장 큰 비중을 차지한다. 행 높이는 도메인 크기의 차이를 나타낸다.
6.2 Rubric Statistics
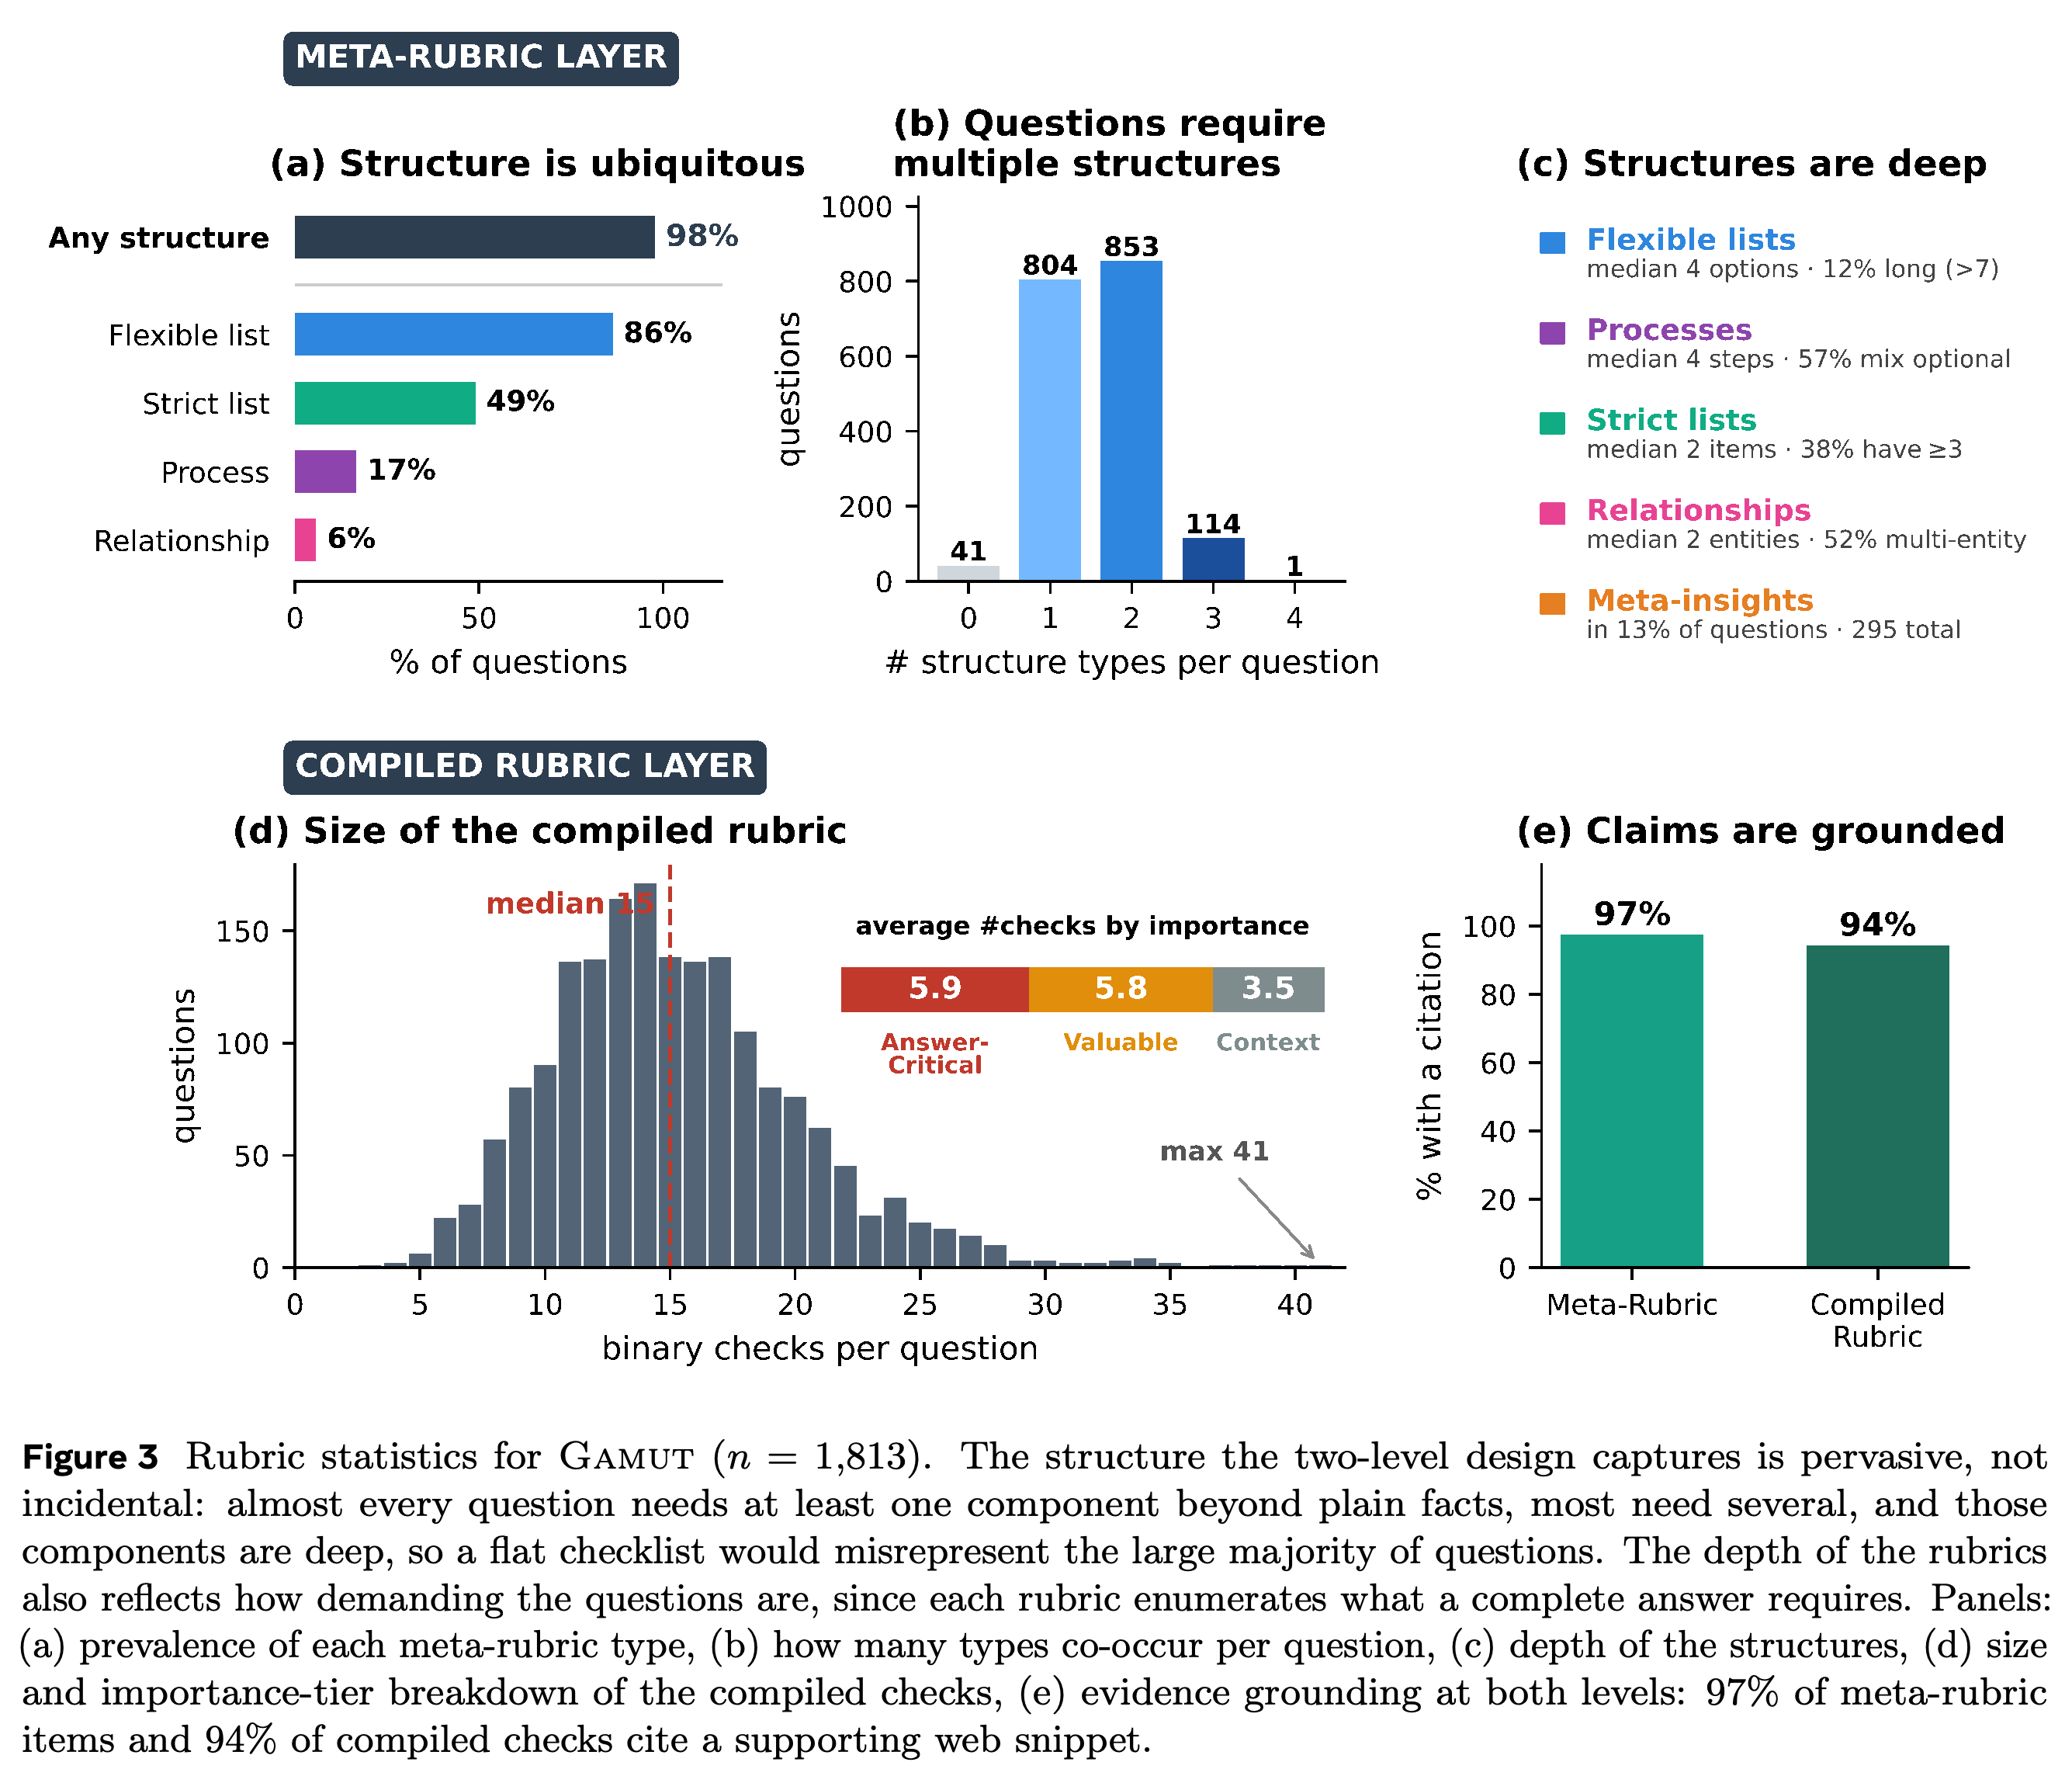
각 질문은 평균 15.2개의 컴파일된 이진 점검 항목을 가지며 중앙값은 15개다. 대략 Answer-Critical 5.9개, Valuable 5.8개, Context 3.5개로 구성된다. 루브릭은 질문마다 약 10개의 웹 발췌문을 활용하고, 전체적으로 9,400개가 넘는 서로 다른 페이지를 인용한다. 메타 루브릭 항목의 97%와 컴파일된 점검 항목의 94%에는 뒷받침 인용이 있다.
6.3 The Structure Behind the Rubrics
Simple Knowledge를 넘어서는 구조화된 구성요소가 적어도 1개 있는 질문은 98%다. Flexible list는 86%, strict list는 49%, process는 17%, relationship은 6%에서 나타난다. Flexible-list 풀과 process의 중앙 깊이는 모두 4이며, 질문의 13%에는 메타 인사이트가 포함된다. 이 수치는 독립적으로 요구되는 사실 목록이 많은 GAMUT 질문을 잘못 표현하게 된다는 저자들의 주장을 뒷받침한다.
이 그림은 메타 루브릭 설계의 정량적 근거를 제공한다. 질문의 98%에 구조화된 구성요소가 있고 flexible list가 가장 흔하며, 대부분의 질문은 1개 또는 2개의 구조 유형을 사용한다. 또한 루브릭 중앙 크기 15개 점검 항목과 메타 루브릭 항목 97%, 컴파일된 점검 항목 94%의 인용 포괄성을 보여 준다.
7 Conclusion
논문은 이중 수준 메타 루브릭이 완전한 답변을 위한 표현력 있는 표현과 이진 LLM 판정을 분리한다고 결론짓는다. Gamut은 사실적 완전성을 위한 멀티모달 우선 및 텍스트 전용 벤치마크를 제공하지만, 입증된 범위는 모든 개방형 생성 평가가 아니라 구축된 일상적 심층 리서치 환경이다. 함께 제시된 진술은 Gemini 3.1 Pro가 인간 검토 아래 데이터 구축에 사용됐고, Claude Opus 4.8이 원고 작성과 구현을 보조했다고 밝힌다.
부록
- 부록은 질문 생성, 선택, 루브릭 생성과 개선, 판정, 텍스트 전용 변환을 위한 프롬프트를 제공한다. 5가지 메타 루브릭 유형과 그 컴파일을 모두 보여 주는 완전한 jollof-rice 및 Tang sancai 예시를 포함한다. 주석 작업에서 질문 작업자는 95% 기준의 점수화된 gold job을 통과해야 했고, 루브릭 작업자는 90% 퀴즈를 통과하고 45분 교육 2회를 이수했으며, 완료한 작업의 10%를 감사받았다.
짧은 생각
프레임워크를 뒷받침하는 가장 강한 실증적 근거는 기술적 분석이다. 구조화된 구성요소는 벤치마크 질문의 98%에 나타나며, 3명의 판정자를 비교한 실험에서는 Gemini–Claude 순위가 동일했고 더 관대한 Qwen 순위도 대체로 유사했다. 중요한 한계도 남는다. 질문과 루브릭 제안은 인간 수정 전에 Gemini 3.1 Pro에서 시작됐고, 보고된 판정자 연구는 인간 판정과의 직접 일치가 아니라 순위 안정성을 측정했으며, 논문은 같은 질문에서 대응되는 평면 루브릭 기준선을 제시하지 않았다.