


HarnessOpt-Bench: Evaluating LLMs at Harness Optimization 요약 설명
06 Aug 2026 | Paper Review Harness Optimization LLM Evaluation Agent LearningContents
- 요약
- 1 Introduction
- 2 Related Work
- 3 HarnessOpt-Bench: Harness Optimization as a Task
- 4 Experimental Setup
- 5 Results
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 HarnessOpt-Bench: Evaluating LLMs at Harness Optimization 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 6일(Arxiv)
- Ursekar, Varun, Shanker, Apaar, Maurya, Yash, Yasser, Shehab, Kalmath, Vijay S., Chatrath, Veronica, Xue, Yuan.
- Scale AI
- 논문 링크
요약
- HARNESSOPT-BENCH는 코딩 하니스를 통해 작동하는 LLM이 비용이 크고 확률적인 평가 환경에서 대상 에이전트의 프롬프트, 도구, 제어 흐름, 메모리, 오케스트레이션 코드를 개선할 수 있는지 평가한다. 4개 하위 작업에서 점수가 산정된 111회 실행을 분석한 결과, 평균적으로 optimizer model 간 차이가 coding harness 간 차이보다 크며, native coding harness는 일관된 이점을 보이지 않는다. 코딩 하니스에 대해서는 이 글을 참조하라.
1 Introduction
논문은 optimizer가 고정된 대상 평가 예산 안에서 잡음이 크고 비용이 높은 에이전트 평가로부터 개선 여부를 추론해야 하므로 harness optimization이 일반적인 코드 편집보다 어렵다고 본다. 대상 모델, 환경, verifier는 고정하고, 최종 점수 산정은 검색 중 접근할 수 없는 test 분할에서 수행한다. 또한 신뢰 경계를 통해 접근 제한, 자원 계측, 후보 감사 가능성을 강제한다. verifier에 대해서는 이 글을 참조하라.
2 Related Work
관련 연구에는 프롬프트 및 텍스트 산출물 최적화, 진화적 프로그램 탐색, 코드로 정의된 에이전트 설계 탐색이 포함된다. 가장 가까운 방법은 coding agent를 end-to-end harness optimizer로 사용하지만, 보고된 결과는 seed, 예산, 탐색 공간, 평가 프로토콜에 따라 함께 달라지는 경우가 많다. HARNESSOPT-BENCH는 이러한 요인을 고정해 통제된 비교를 지원한다.
3 HarnessOpt-Bench: Harness Optimization as a Task
이 벤치마크는 harness optimization을 제약된 확률적 프로그램 최적화로 정의한다. Optimizer는 고정된 실행 가능한 seed harness를 편집하고, 자원 예산 안에서 채점된 피드백으로 후보 버전을 평가하며, hidden test 평가에 제출할 후보 1개를 지명한다.
3.1 The optimization problem
각 작업은 불변 조건 θ = (M, E, V)를 고정한다. 여기에는 후보가 사용할 수 있는 대상 모델, 각 사례의 환경, 궤적을 [0, 1] 점수로 매핑하는 verifier가 포함된다. Optimizer는 실행 가능한 harness H는 수정할 수 있지만 θ는 수정할 수 없다. 개발 피드백은 입력, 사례별 결과, trace를 공개하고, validation은 집계 점수를 공개하며, test 피드백은 후보를 지명할 때까지 제공되지 않는다. 벤치마크는 정규화된 향상도 g = (Eθ(H+) − Eθ(H0)) / (1 − Eθ(H0))를 보고한다.
3.2 The HarnessOpt-Bench suite
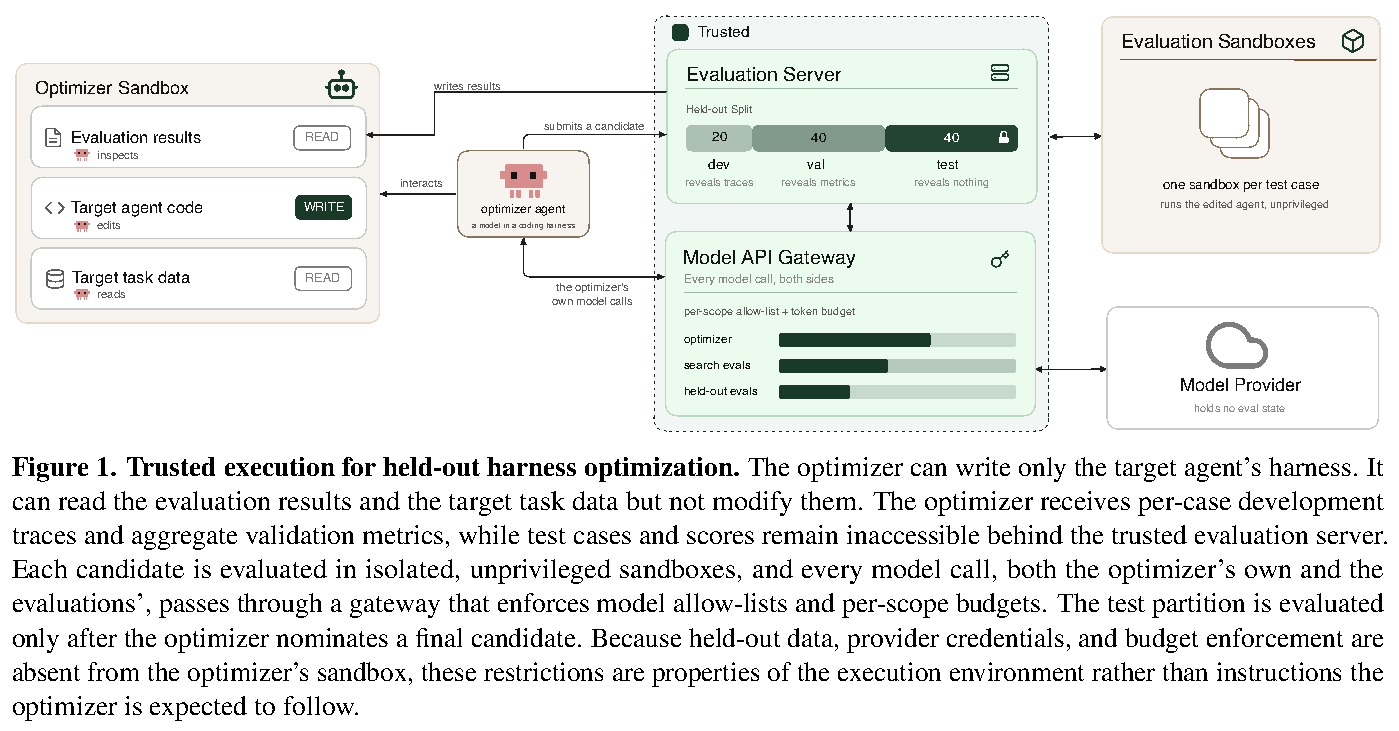
이 스위트는 OfficeQA, BrowseComp-Plus, Terminal-Bench, GAIA로 구성되며, 각각 의도적으로 튜닝하지 않은 Python seed harness를 제공한다. 3개 seed는 유능하지만 단순한 반면, GAIA는 작동하지 않는 stub에서 시작한다. Seed와 지명된 후보의 test 점수는 K=3 라운드에 걸쳐 통합한다. 격리된 sandbox와 신뢰할 수 있는 gateway는 후보 버전을 보존하고 대상 에이전트 접근 및 자원 제어를 강제한다.
이 도식은 held-out 프로토콜을 실제 실행 구조로 보여 준다. Optimizer는 대상 에이전트 코드만 수정할 수 있고 허용된 작업 데이터와 피드백을 살필 수 있지만, 평가 서버는 test 데이터와 예산 집행을 유지한다. 격리된 rollout sandbox와 gateway를 거치는 model call은 평가 상태를 바꾸거나 자원 제어를 우회할 기회를 줄인다.
4 Experimental Setup
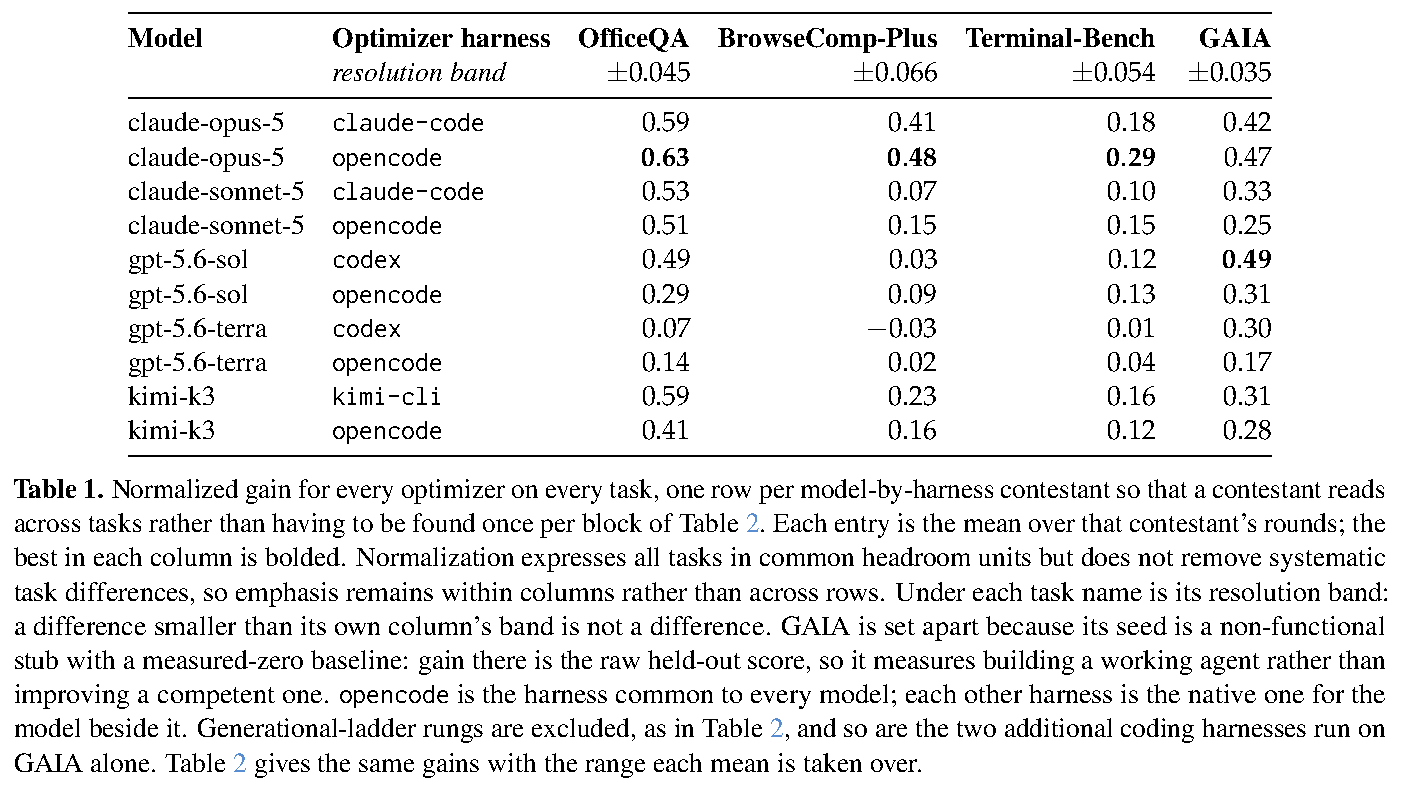
claude-opus-5, claude-sonnet-5, gpt-5.6-sol, gpt-5.6-terra, kimi-k3의 5개 optimizer model을 공통 opencode harness와 각 모델의 native harness에서 평가해 10개 핵심 구성을 만든다. Held-out 점수는 test case마다 3회 시도의 평균이며, 핵심 구성은 2회 실행한다. 작업별 resolution band는 반복 평가 변동을 나타낸다. LSS-λ는 3개 유능한 seed 작업의 균형 잡힌 shared-harness grid를 사용해 작업 보정 model effect를 추정한다.
5 Results
결과는 각 작업의 고정된 seed 대비 정규화된 향상도로 표현하며, 작업별 resolution band로 측정된 반복성 범위에서 구분되지 않는 차이를 표시한다. 분석은 optimizer model을 비교하고, release 수준의 진전을 평가하며, 탐색 행동을 살피고, shared harness와 native optimizer harness를 대조한다.
이 표는 4개 작업 전체에서 각 model–harness 구성의 평균 정규화된 향상도와 작업별 resolution band를 제시한다. 상당한 작업 의존성을 보여 주며, 측정된 seed 점수가 0인 GAIA에서는 향상도가 남은 headroom의 비율이 아니라 raw held-out 점수와 같다는 점을 구분한다.
5.1 Distinguishing frontier models
작업과 harness를 고정하고 optimizer model을 바꾸면 향상도가 평균 0.142 변하며, 작업과 model을 고정하고 harness를 바꾸면 0.079 변한다. 따라서 model 대비는 약 1.8× 더 크다. Shared-harness competent-seed 범위에서 claude-opus-5는 tier 1의 LSS-λ +0.228을 기록했고, claude-sonnet-5, kimi-k3, gpt-5.6-sol은 구분되지 않는 tier 2를 형성했으며, gpt-5.6-terra는 tier 3의 −0.174를 기록했다.
5.2 Tracking model progress
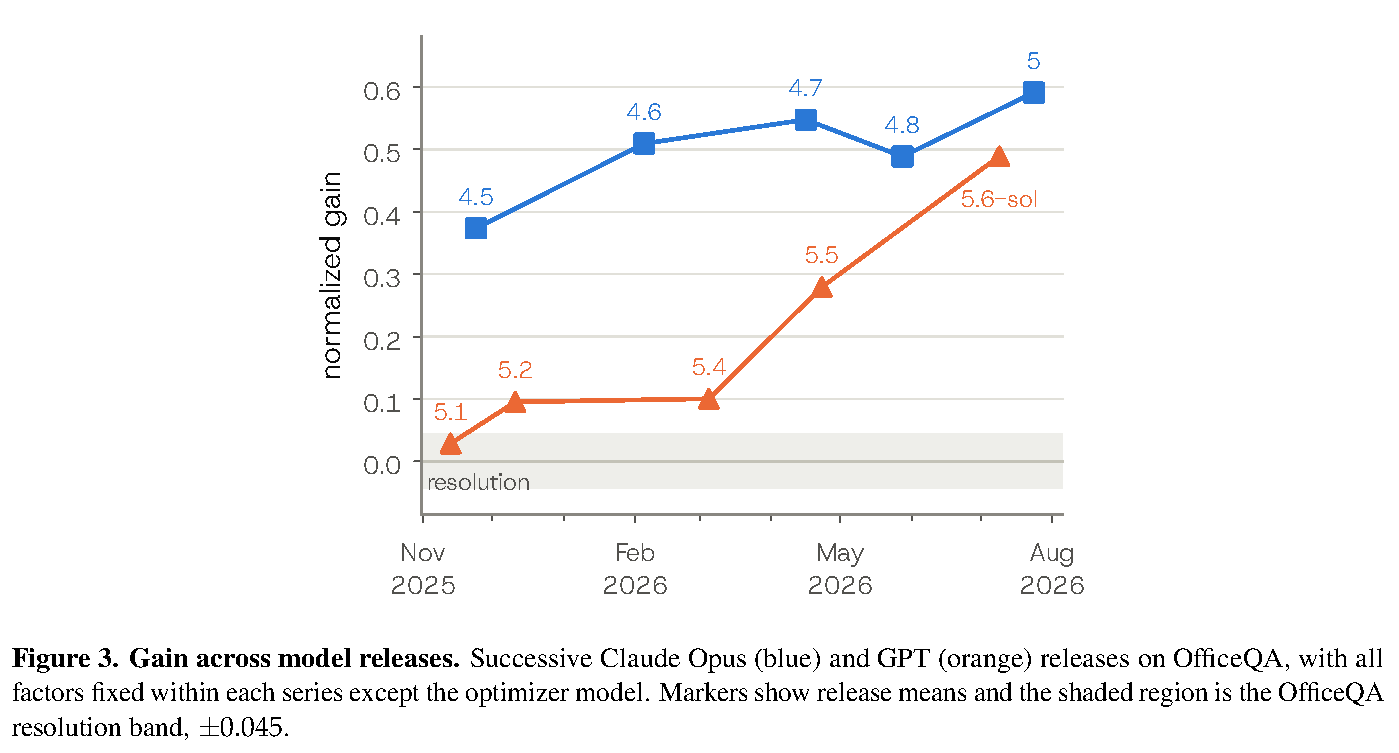
OfficeQA에서 5개 GPT release의 정규화된 향상도는 +0.03에서 +0.49까지 단조롭게 증가했고, 연속한 4개 변화 중 3개가 ±0.045 resolution band를 넘었다. 5개 Claude Opus release는 +0.37에서 +0.59 범위였으며, 계열은 단조롭지 않았지만 최초와 최종 release의 차이는 이 band를 넘었다.
각 release 계열에서 대상 모델, seed, 예산, coding harness를 고정한 이 그래프는 벤치마크가 model progress를 구분할 수 있는지 검증한다. GPT 향상도는 표시된 release 전체에서 꾸준히 증가하지만, Claude Opus 향상도는 최초부터 최종까지는 증가했음에도 변동한다.
5.3 Where current optimizers fall short
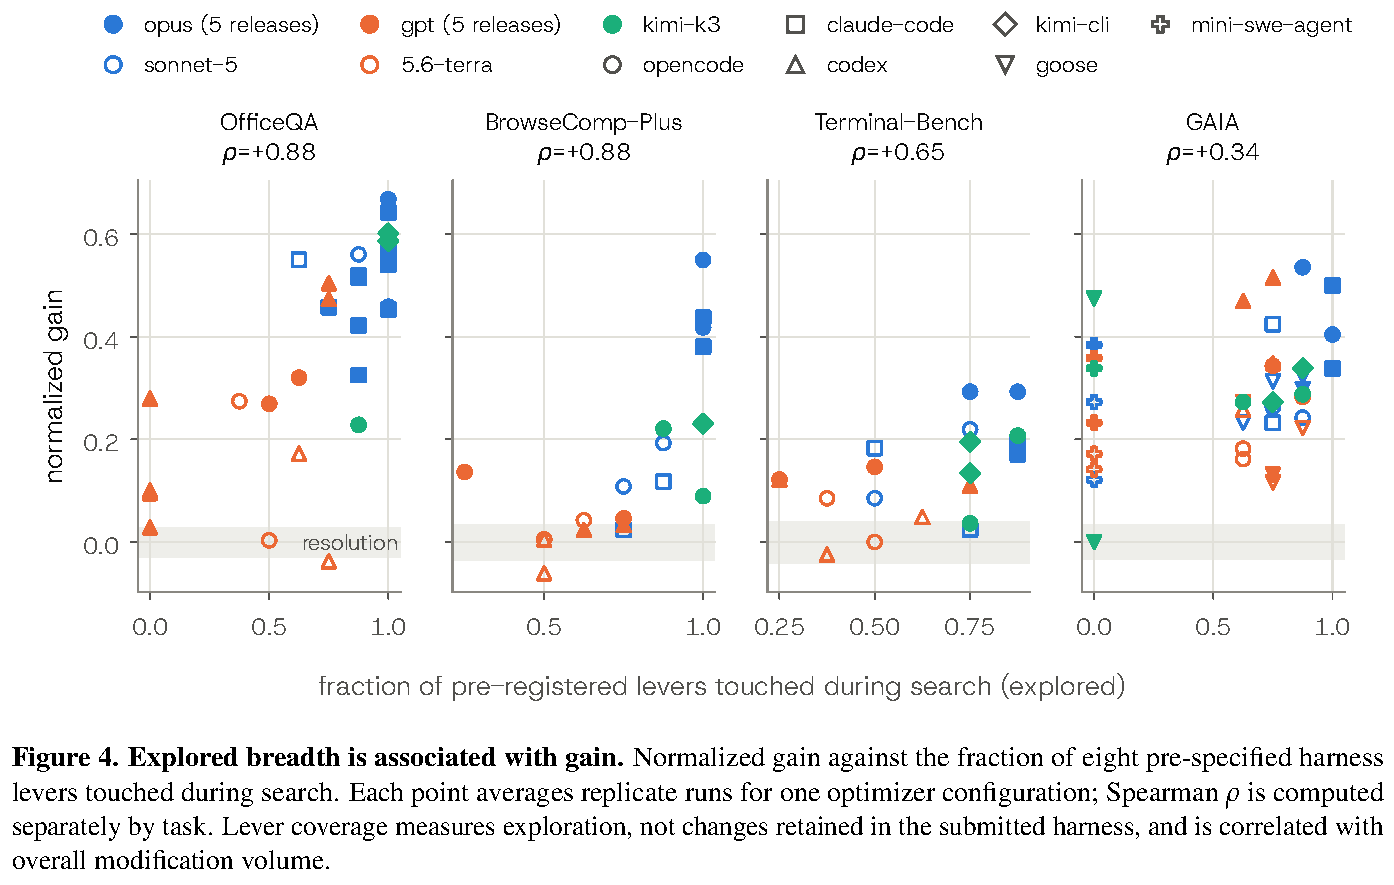
탐색 중 사전 등록된 8개 harness lever 가운데 더 큰 비율을 건드린 경우는 모든 작업에서 더 높은 향상도와 양의 연관을 보였으며, Spearman ρ는 +0.34에서 +0.88이었다. Lever 범위는 수정량 및 탐색 노력과 상관되어 있으므로 이는 기술적 분석이다. 상세 trace는 111개 점수 산정 cell 중 7개가 16회만 요청했으며, trace-reading 비중은 향상도와 음의 연관을 보였다(−0.31에서 −0.64). 보고된 실행에서는 평가 호출 상한보다 case-pass allowance가 탐색을 제한했고, 관측 가능한 최고 validation 점수는 대체로 제출 후보의 held-out 점수보다 높았다.
각 패널은 탐색 중 건드린 사전 지정 harness lever의 비율과 정규화된 향상도의 관계를 나타낸다. 작업 내 양의 Spearman 상관은 더 넓은 탐색과 높은 향상도의 연관을 뒷받침하지만, lever 적용 범위가 전체 수정량과 상관되므로 인과관계를 입증하지는 않는다.
5.4 The effect of the optimizer’s own harness
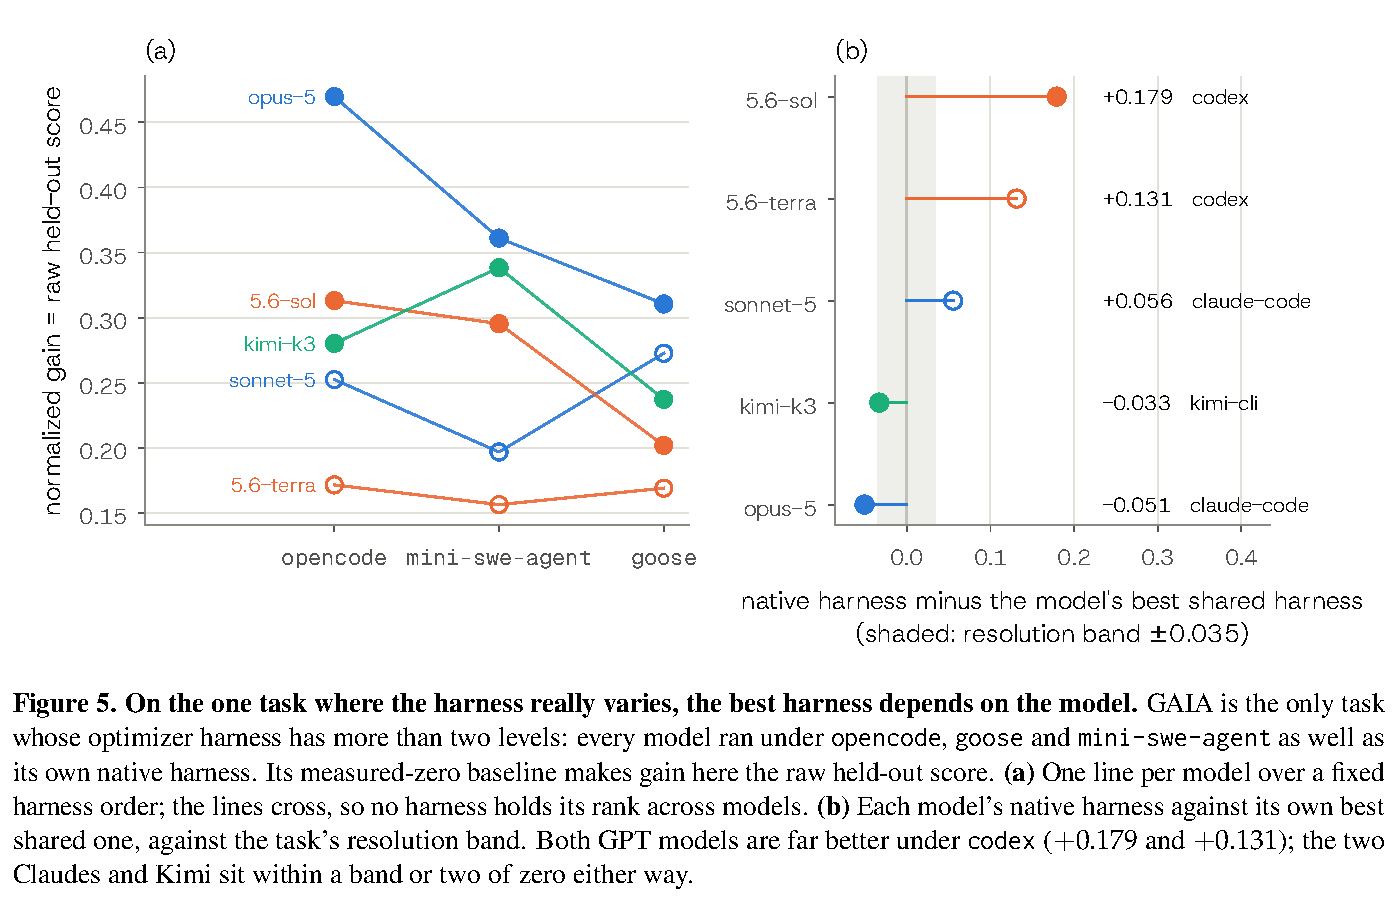
20개 쌍의 model–task 비교에서 opencode는 11회 이기고 native harness는 9회 이겼으므로 native tooling이 일관되게 우수하지는 않다. 효과는 이질적이다. GAIA에서 codex는 gpt-5.6-sol에 대해 최선의 shared harness보다 +0.179, gpt-5.6-terra에 대해 +0.131 높았지만, Claude와 Kimi의 native-harness 차이는 대략 1개 또는 2개 resolution band 안에 있다.
교차하는 선은 GAIA에서 optimizer-harness 순위가 optimizer model에 따라 달라짐을 보여 준다. Native-versus-best-shared 비교는 native harness의 일반적 이점이 아니라 2개 GPT model에서 codex가 크게 앞선다는 점을 분리해 보여 준다.
6 Conclusion
저자들은 harness optimization을 model capability로 평가할 수 있다고 결론짓지만, 향상도는 작업마다 고르지 않고 완전한 세밀 순위를 뒷받침하지 못하는 경우가 많다고 말한다. 한계로는 안정적인 개발 및 validation evaluator의 악용 가능성, seed 성숙도 의존성, Python 전용 후보, 작업당 1개로 고정된 대상 모델, runtime·architecture·target model 간 전이 미검증이 있다. 윤리 성명은 자동화된 에이전트 개선에서 발생하는 이중 용도 위험을 지적하고, 범위가 제한된 무해한 작업, 고정된 모델 allow-list, 계량 실행, 감사 가능한 버전 관리를 보호 장치로 제시한다.
부록
- Appendix A는 구성별 향상도, 관측된 반복 범위, 탐색한 lever 적용 범위, 대상 token 사용량을 보고한다. Appendix B는 작업 분할, 고정된 대상 모델, seed baseline, off-the-shelf harness 점수를 명시한다. 이후 appendix는 model effect, 보조 그림, immutable manifest, Git-versioned 후보, lockfile, 격리 sandbox, trace 기반 process metric을 다루는 재현성 세부 사항을 제공한다.
짧은 생각
이 벤치마크의 핵심 기여는 optimizer의 자기 보고나 공개된 validation 점수에 의존하지 않고 주장된 harness 개선을 감사 가능하게 만드는 강제된 held-out 평가 경계다. 이 결과는 seed, 작업, 대상 모델, 상한 없는 optimizer inference의 평가된 조합에 적용되며, 에이전트 개선 능력의 포괄적 순위를 구성하지는 않는다.