


Code as Worlds: Agentic Discovery of Executable World Representations for Physical Reasoning 요약 설명
27 Aug 2026 | Paper Review Physical Reasoning Executable World Representations Agentic Discovery Vision-Language ModelsContents
- 요약
- 2 In Search of Physical World Representations
- 3 Code as Worlds: Executable World Representations
- 4 Agentic Discovery of World Representations
- 5 Application: Learning Quantitative Physical Reasoning
- 부록
- 짧은 생각
이번 글에서는 Code as Worlds: Agentic Discovery of Executable World Representations for Physical Reasoning 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 27일(Arxiv), MirroS Technical Report
- Wang, Hanyang, Cai, Yimo, Chen, Weiliang, Chi, Jiawei, Sun, Haowen, Dai, Qiyu, Hung, Yi-Hsin, Guo, Xingzhuo, Ren, Jinshan, Yao, Runmao, et al.
- MirroS, Tsinghua University, Peking University, Nanyang Technological University
- 논문 링크
- Github
- Project Page
요약
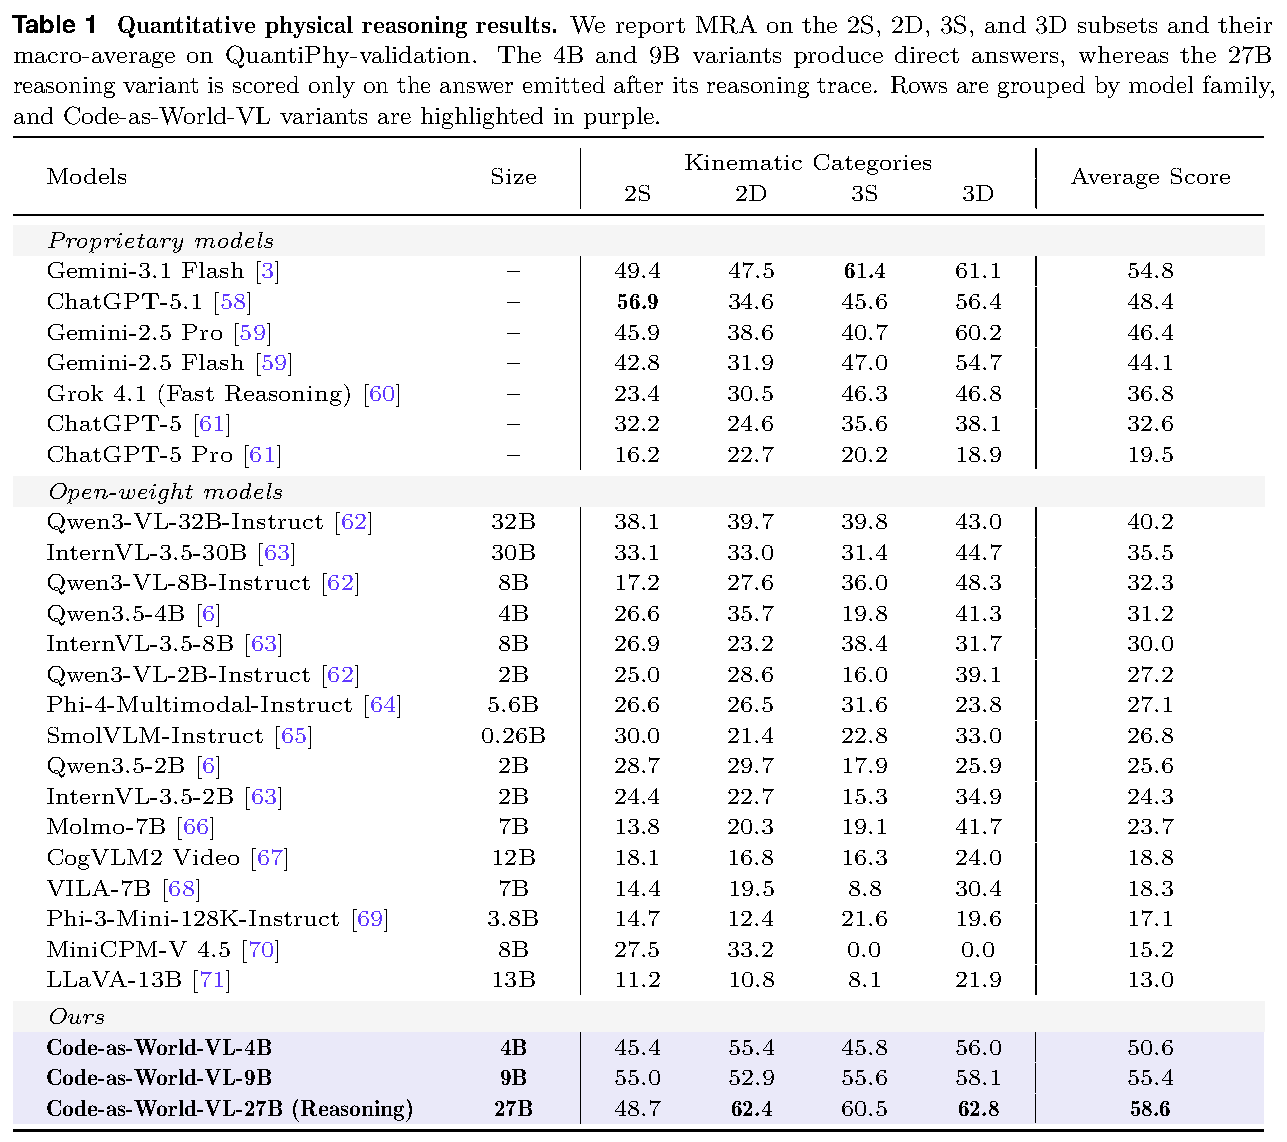
- Code-as-World는 물리 장면을 픽셀, 잠재 특징, 언어만으로 표현하지 않고 실행 가능한 코드로 표현하여 객체, 상태, 파라미터, 동역학, 개입을 명시한다. 반복적인 시뮬레이션·검증 에이전트가 텍스트나 비디오에서 이 표현을 구성하고, 검증된 world를 vision-language model의 정량적 물리 추론을 위한 확장 가능한 supervision으로 활용한다. QuantiPhy-validation에서 Code-as-World-VL-27B (Reasoning)는 58.6 macro MRA를 보고했으며, 통제된 4B와 9B direct-answer variant는 각각 50.6과 55.4를 보고했다. vision-language model에 대해서는 이 글을 참조하라. vision-language model에 대해서는 이 글을 참조하라.
제안 인터페이스를 소개한다. 코드는 구성, 변화, 외관을 지정하며, 논문은 이것이 물리 질문, 제어 가능한 비디오 생성, embodied-action planning을 지원한다고 제시한다.
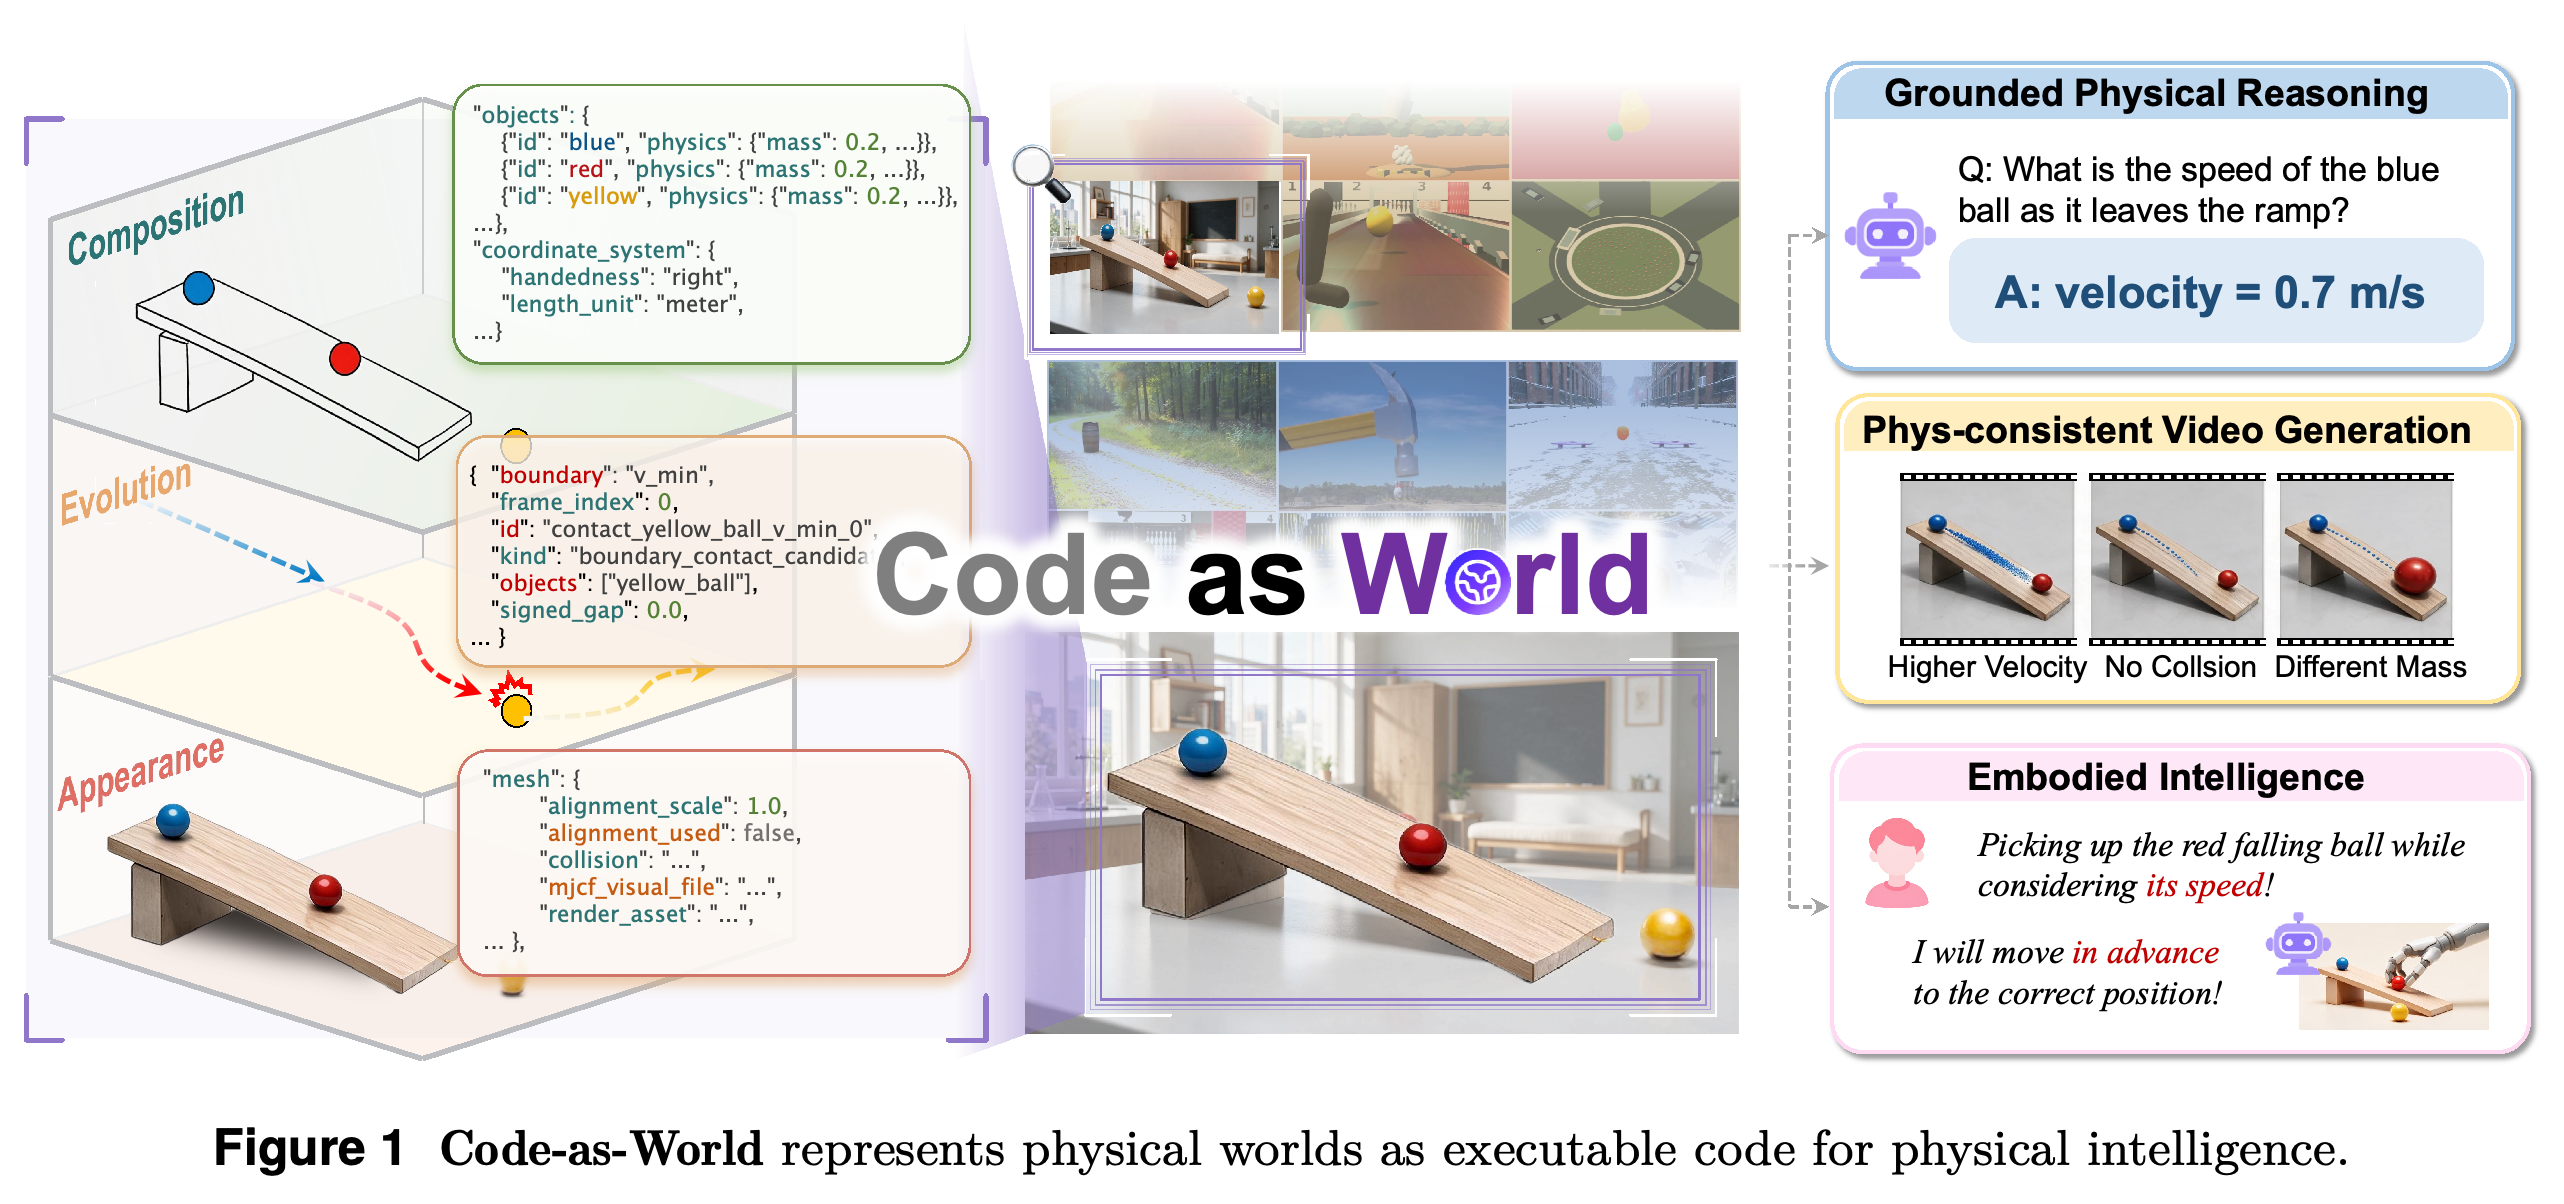
2 In Search of Physical World Representations
논문은 픽셀 예측이 물리적 원인을 식별하지 못해도 시각적으로 그럴듯한 미래를 만들 수 있고, 3D reconstruction은 인과적 동역학을 분리하지 못한 채 기하 구조를 보존할 수 있다고 주장한다. 언어는 간결하고 조합적이지만 궤적, 접촉, 물리 파라미터처럼 연속적인 양을 정확히 표현하기에는 부정확하다. 제안 표현은 의미적 추상화, 구조, 시간적 메커니즘을 결합하는 것을 목표로 한다. reconstruction에 대해서는 이 글을 참조하라.
3 Code as Worlds: Executable World Representations
실행 가능한 world representation(EWR)은 p = (C, E, A) ∈ Pexec로 정의한다. C는 객체, 기하 구조, 크기, 질량, 마찰, 중력, 고정 지지대 등 물리적 구성을 지정하고, E는 초기 상태, 시간적 변화, 사건, 지속 시간을 지정하며, A는 카메라, 재질, 조명, 배경, 해상도, 렌더링 설정을 지정한다. 구현은 검사와 편집이 가능한 이 표현을 시뮬레이션 엔진에 연결하며, 픽셀 수준의 복제보다 물리적 동등성을 우선시한다.
픽셀·비디오, 3D, 언어 표현을 실행 가능한 코드와 대비한다. 그림은 Code-as-World가 시각적 세부 정보, 기하 구조, 간결한 의미에 명시적인 연속 물리 메커니즘을 추가한다고 설명한다.
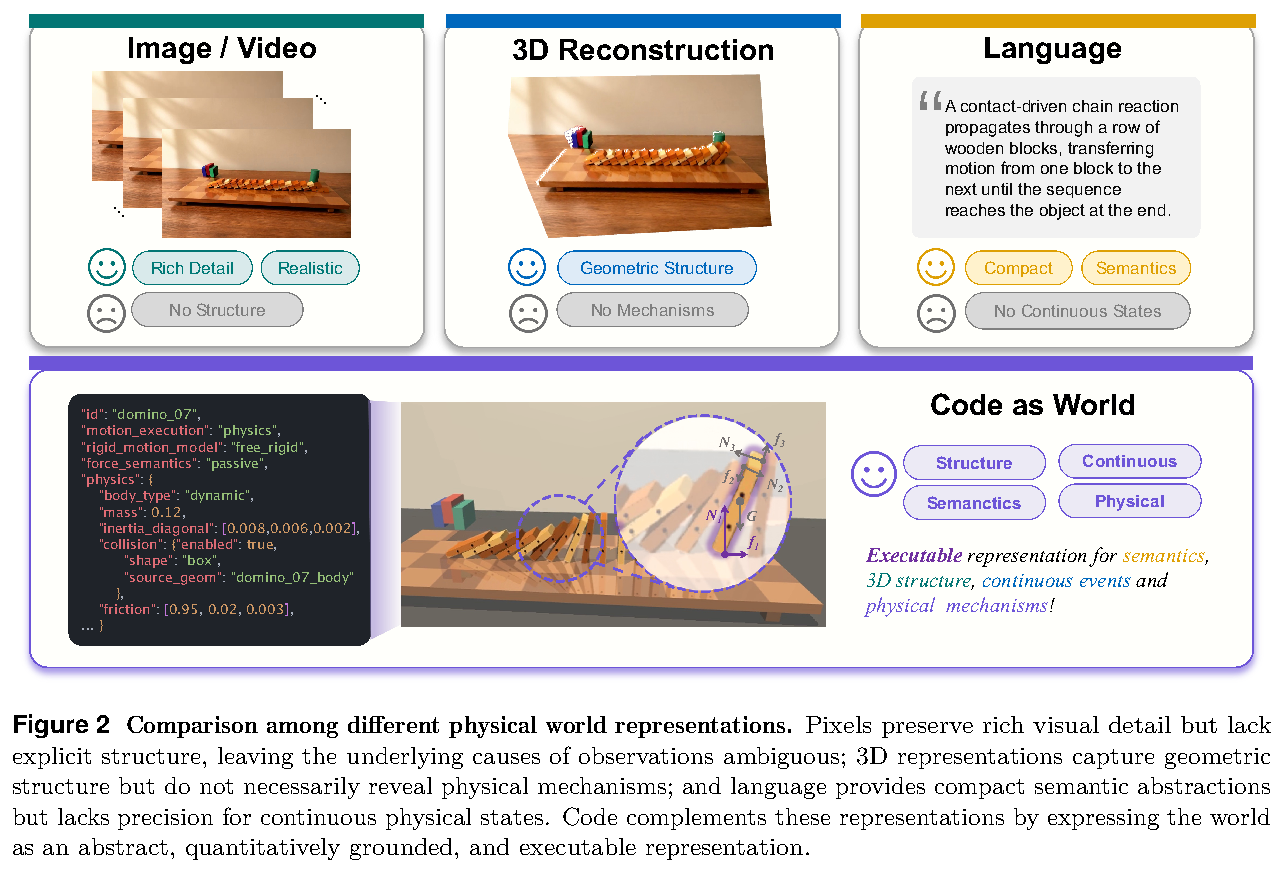
4 Agentic Discovery of World Representations
World 구성은 한 번에 예측하는 문제가 아니라 실행 가능한 가설에 대한 abductive search로 정식화한다. 모달리티별 증거가 주어지면 에이전트는 EWR을 제안하고, 시뮬레이터가 실행할 수 있는 파라미터를 구성하며, 궤적을 실행하고, 예측 관측을 렌더링하고, 불일치를 검증한다. 이어서 수용되거나 반복 예산이 소진될 때까지 관련 world 구성 요소를 수정한다.
4.1 Evidence Construction
텍스트 입력에서는 시스템이 개체, 공간 관계, 사건, 의도한 결과를 추출한 뒤, 명시되지 않은 기하 구조, 파라미터, 카메라 설정을 사전 지식과 기본값으로 채운다. 실제 비디오에서는 depth map, instance mask, track, 카메라 기하, 생성한 object mesh를 사용해 객체의 크기, 위치, 동역학을 제약한다. 후보 world는 렌더링 결과를 원본 비디오와 검증한 뒤에만 유지한다.
4.2 Agentic Discovery Loop
각 round에서 에이전트는 증거 η와 구조화된 feedback Δ를 바탕으로 p를 갱신하고, 이를 시뮬레이터 파라미터 θ로 컴파일하며, 상태, 접촉, 충돌, 결과를 포함하는 상태 궤적 τ를 실행한다. 비디오에서는 선택한 frame에서 렌더링한 RGB, 투영 depth, mask, image-plane track을 비교해 검증하고, 텍스트에서는 의미적·물리적 제약을 주로 검증한다. 절차는 K iteration 안에 acceptance condition을 만족하지 못한 가설을 기각한다.
텍스트와 비디오 입력에 공통으로 적용하는 discovery loop를 보인다. 언어의 의미 증거 또는 비디오의 RGB, depth, instance, track 증거가 EWR을 제약하며, EWR은 제안, 인스턴스화, 실행, 렌더링, 비교, 개선 단계를 거친다.
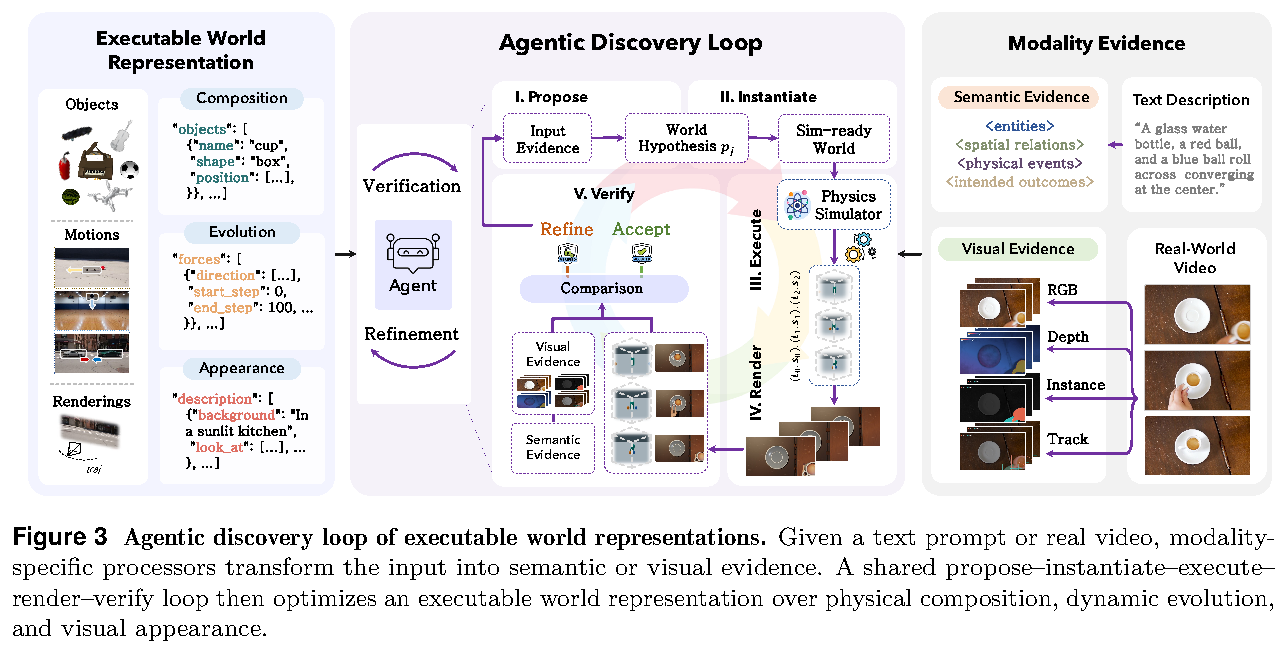
4.3 Evaluation
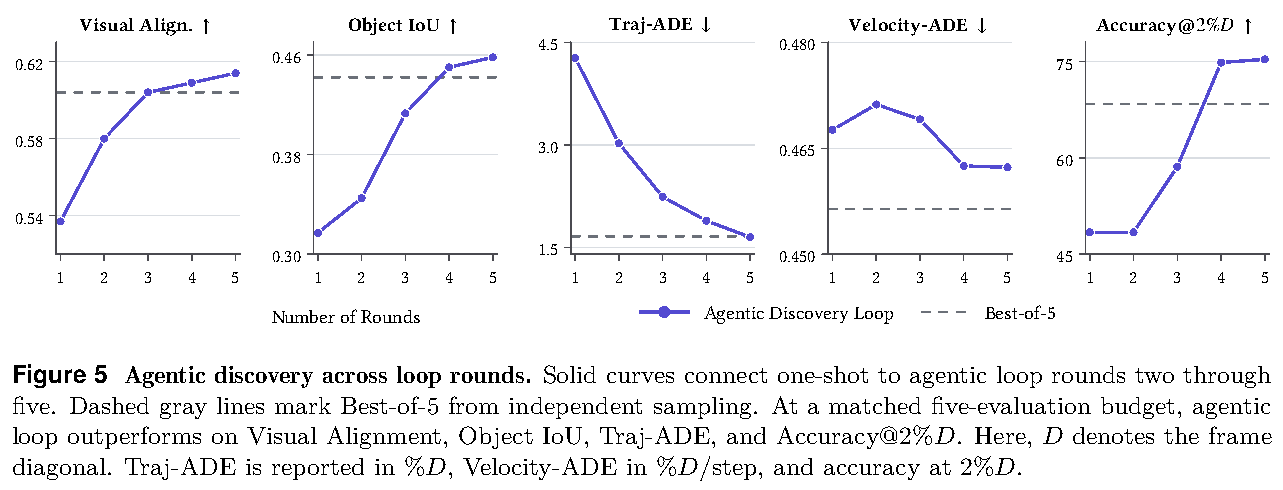
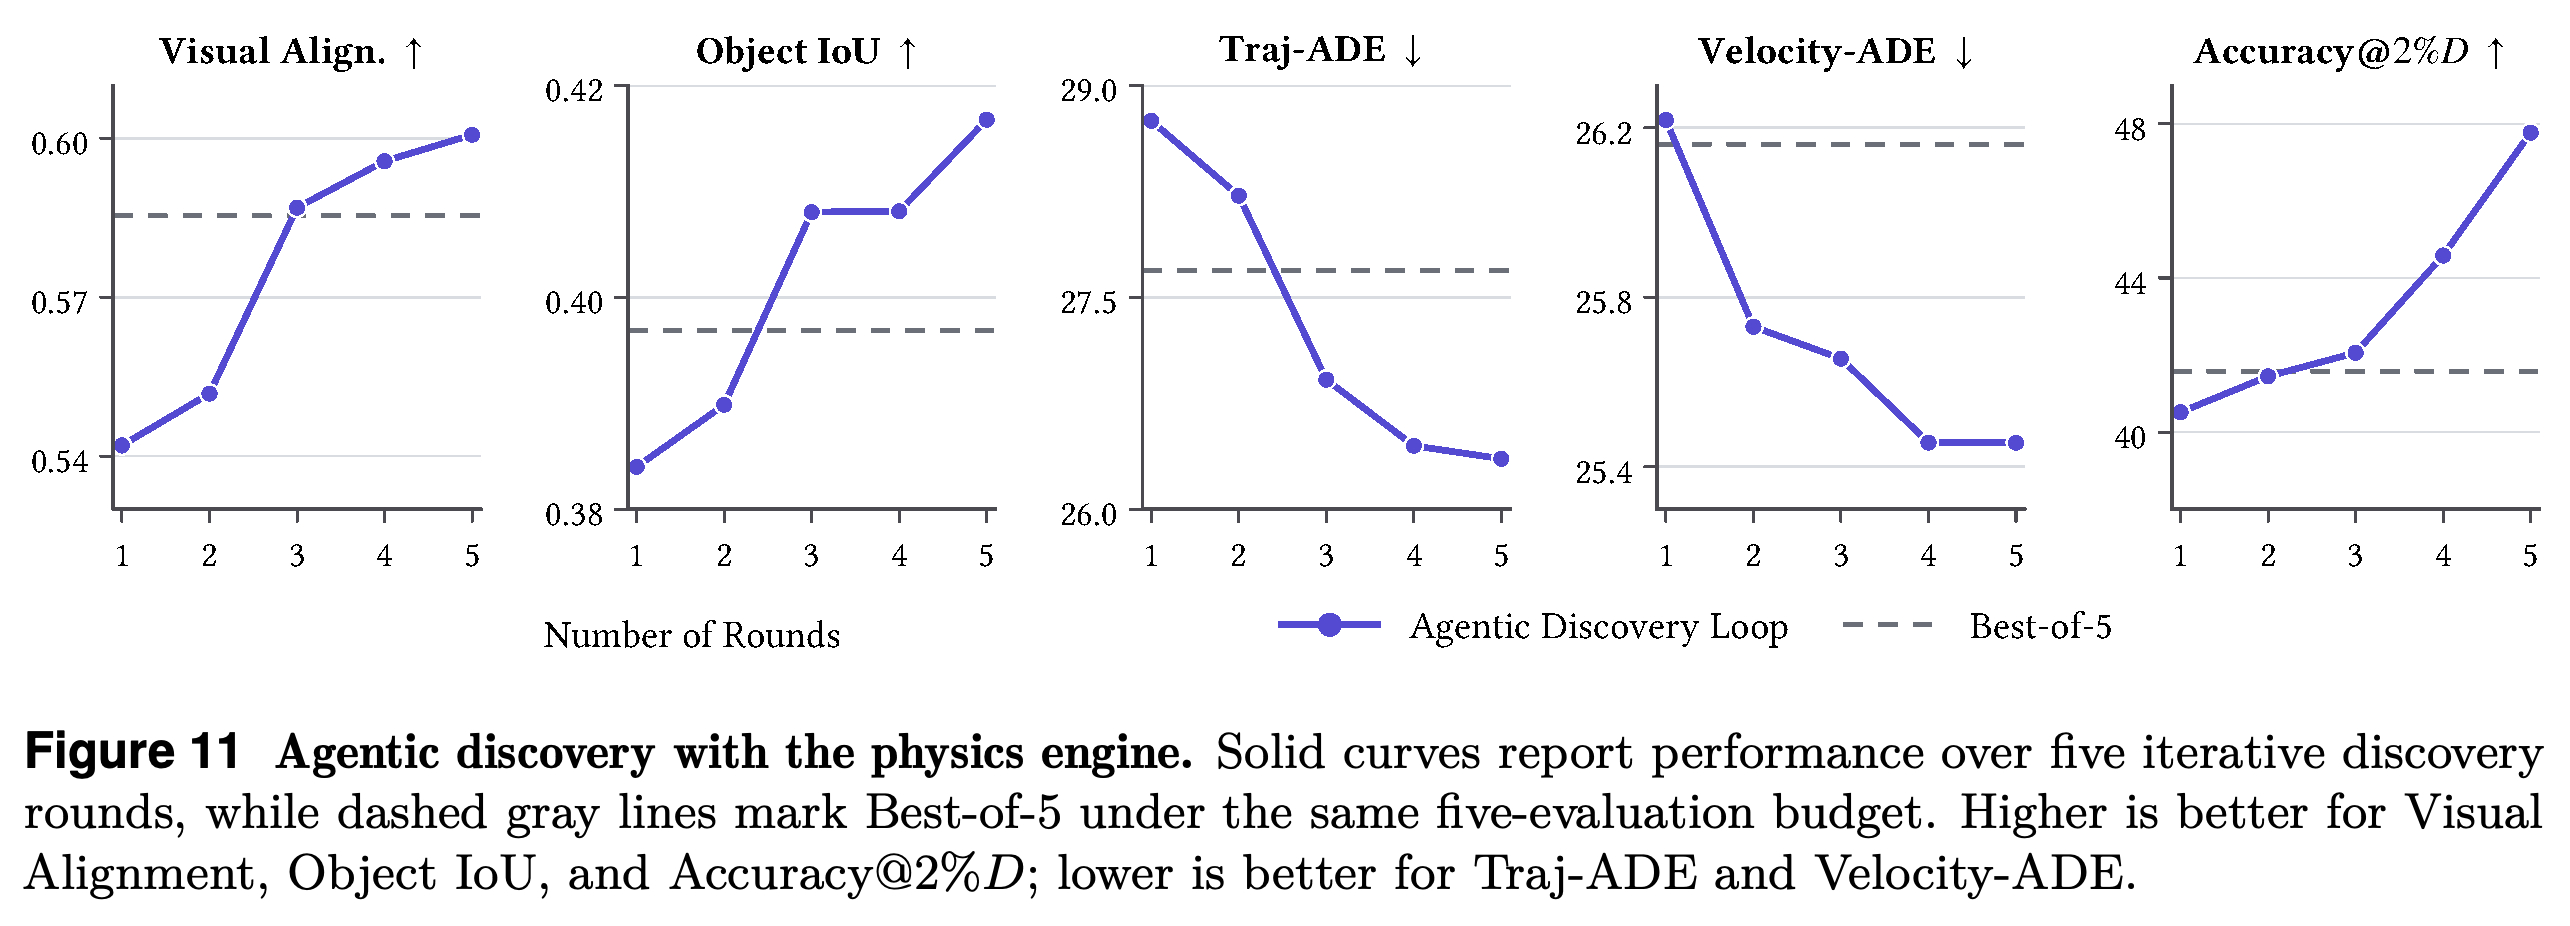
비디오 기반 reconstruction에서 저자들은 WISA-80K에서 뚜렷한 rigid-body motion을 보이는 영상을 선별하고, 큰 카메라 움직임, 불충분한 객체 움직임, 심한 편집, 불완전한 사건이 있는 영상을 제외한 뒤 나머지를 수작업으로 검토한다. Visual Alignment, Object IoU, Traj-ADE, Velocity-ADE, Accuracy@2%D를 사용하여 최대 K = 5 round를 평가했다. 동일한 5회 평가 예산에서 주 실험은 Visual Alignment, Object IoU, Traj-ADE, Accuracy@2%D에서 Best-of-5를 능가한다. Appendix는 physics engine을 사용했을 때 5번째 round가 5개 지표 모두에서 대응하는 Best-of-5 baseline을 능가한다고 보고한다.
World 구성 뒤의 편집 가능성을 보인다. bowling 방향이나 카메라 관점을 바꾸면 simulator rollout과 이에 정렬된 realistic-video rendering도 달라진다.
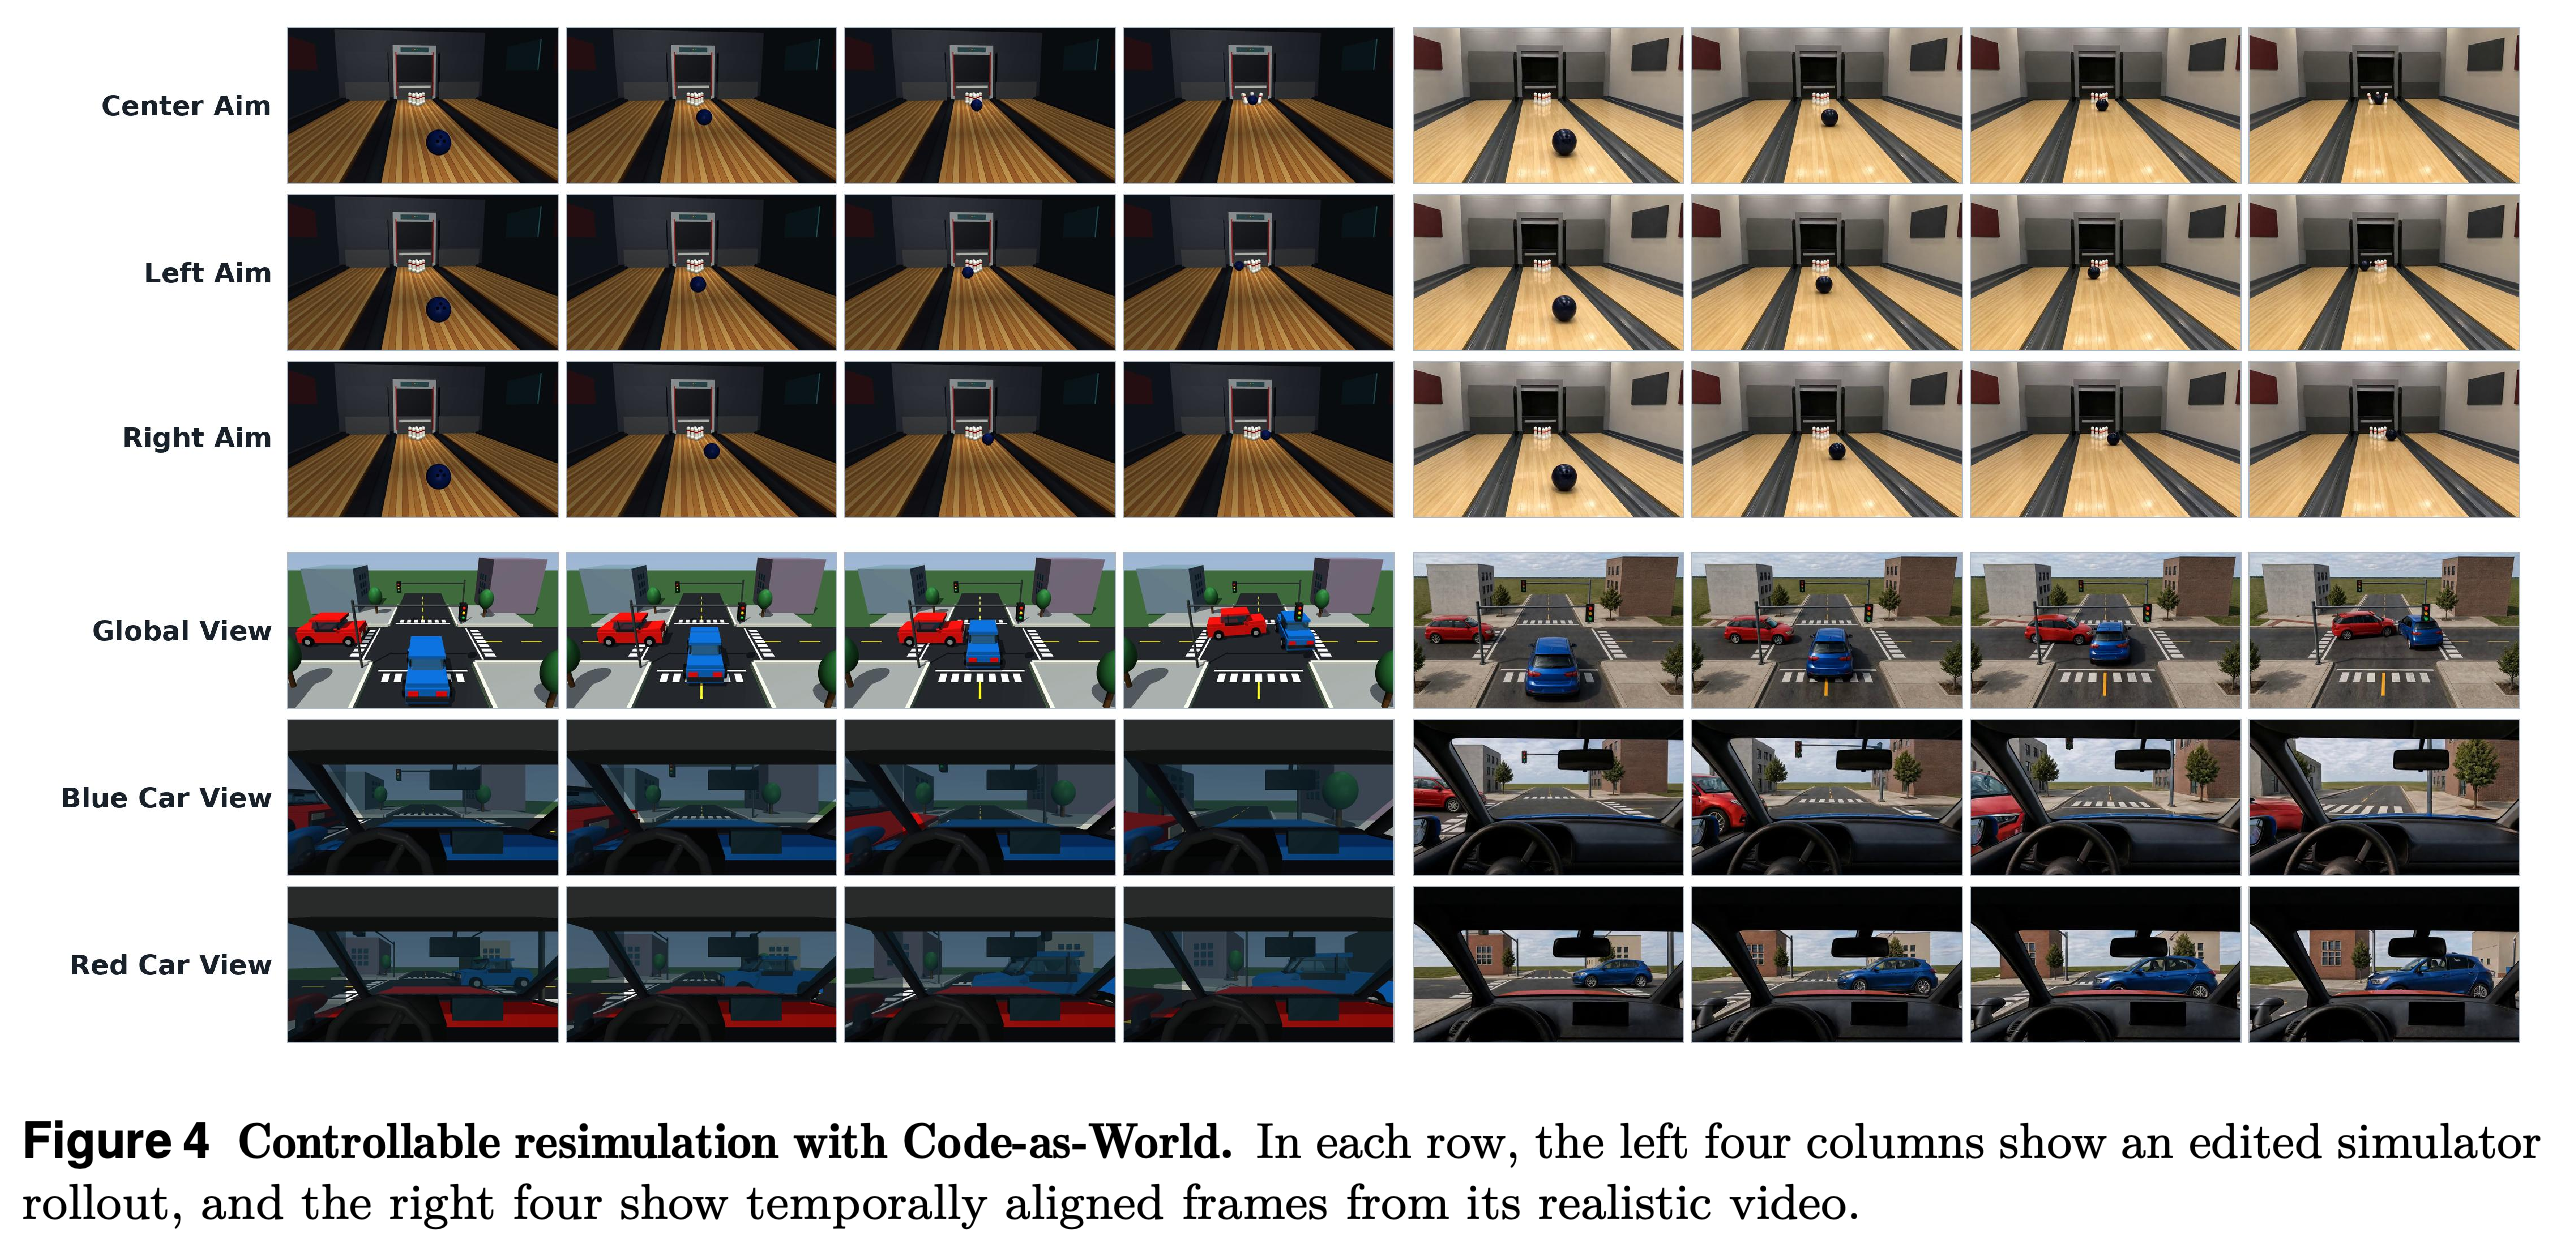
One-shot generation과 5회 반복 round에 걸친 reconstruction metric을 나타낸다. 동일한 5회 평가 예산에서 마지막 반복 결과는 Visual Alignment, Object IoU, Traj-ADE, Accuracy@2%D에서 Best-of-5 reference를 능가하지만, Velocity-ADE에서는 능가하지 못한다.
4.4 Limitations
이 방법은 simulator coverage의 제약을 받는다. 지형, 접촉 기하, 재질 특성, 기타 잠재 조건에서 관측되지 않은 작은 차이도 rigid-body motion을 바꿀 수 있다. 따라서 실제 과정이 simulator의 모델링 범위를 벗어나면, 이 loop는 기계적으로 올바른 설명을 제공하지 못한 채 국소적으로 그럴듯하고 시각적으로 정렬된 EWR에 수렴할 수 있다.
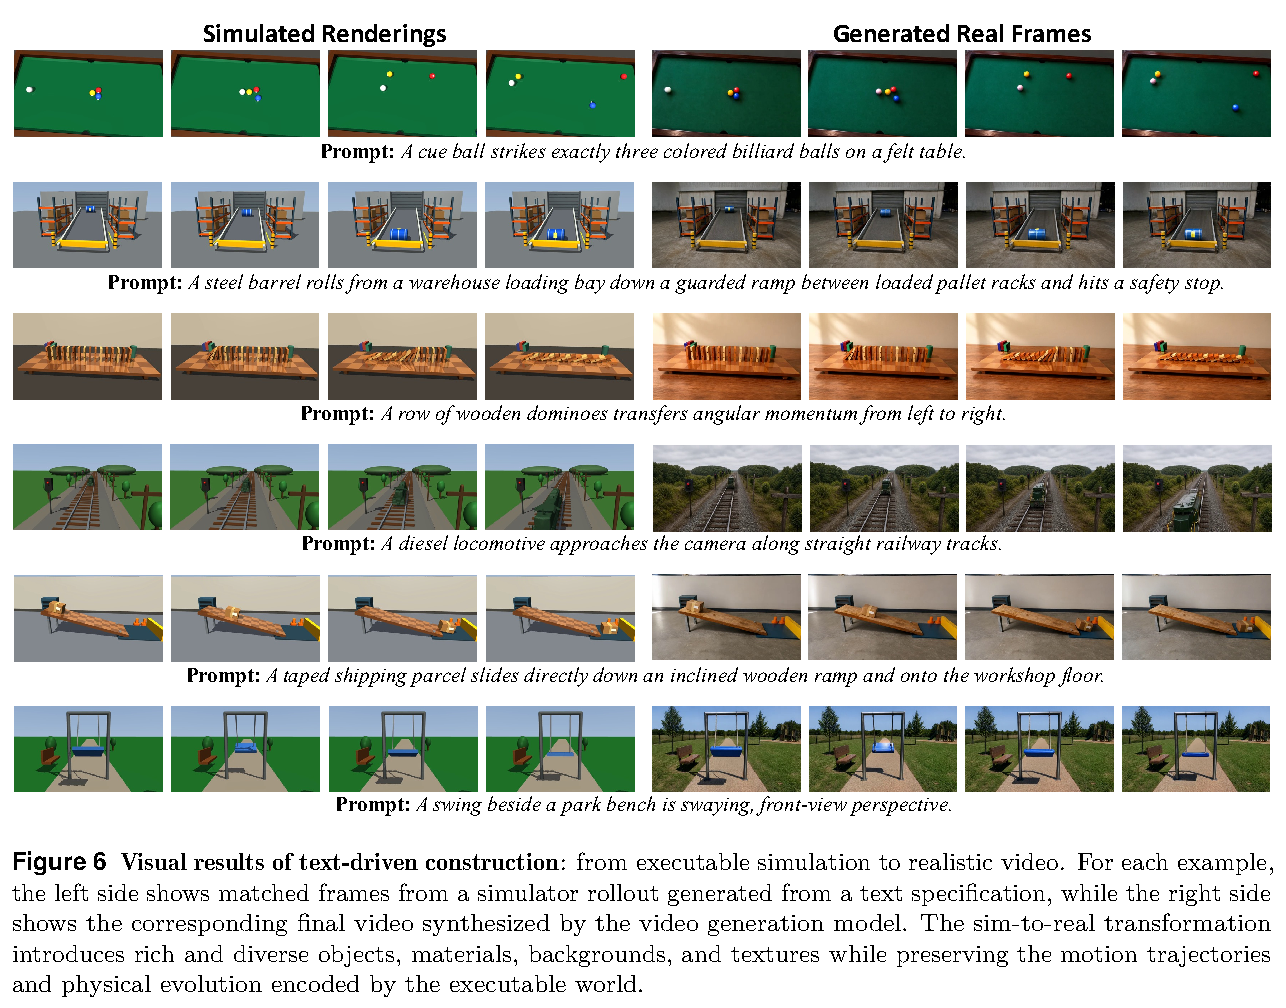
Prompt에서 생성한 simulation rollout을 더 현실적인 비디오로 변환하는 text-to-world 예시를 제공한다. 논문은 인코딩된 궤적과 물리적 변화가 보존된다고 주장한다.
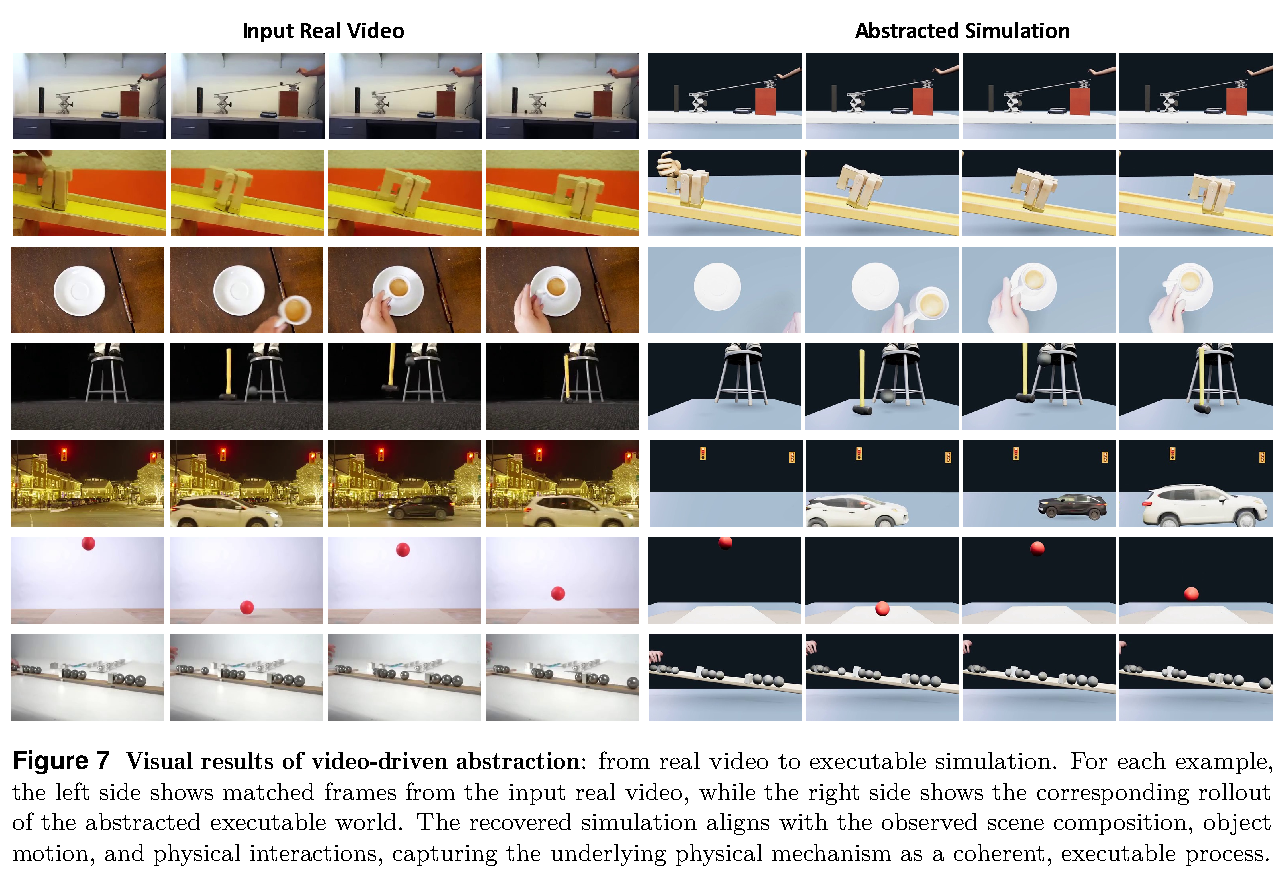
실제 비디오에서 simulation으로 이어지는 예시를 제공한다. 추상화된 simulation은 전체 photorealistic appearance가 아니라 선택한 장면의 대략적인 구성, 움직임, 상호작용을 재현한다.
5 Application: Learning Quantitative Physical Reasoning
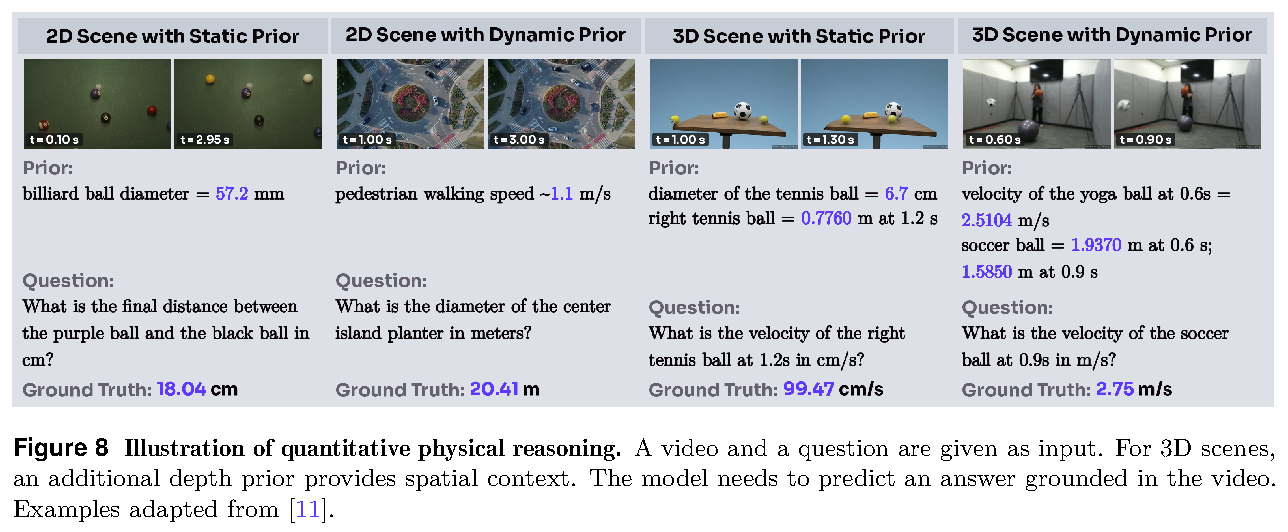
Downstream task는 단안 비디오와 질문으로부터 크기, 변위, 속도, 가속도를 포괄하는 scalar physical quantity를 예측한다. World-space question은 알려진 기준량 ρ를 제공하며, QuantiPhy를 따라 target은 γ = ρ/ρpix와 y = γypix를 사용해 pixel-space measurement에서 calibration한다. 논문은 image-space supervision 뒤에 executable-world supervision을 적용하여 4B와 9B direct-answer variant를 학습하고, 별도로 27B reasoning variant를 학습한다.
QuantiPhy의 4가지 설정을 보여 준다. 각 설정은 2D 또는 depth-aware 3D 장면과, 요청한 world-space measurement를 calibration하는 데 사용하는 static 또는 dynamic prior를 결합한다.
5.2 Image-Space Measurement Grounding
Image-space supervision은 RefCOCO, RefCOCO+, RefCOCOg, RefCLEF, GOT-10K의 bounding box, mask, track에서 도출한다. 객체 크기와 위치는 box 또는 mask에서 얻고, motion은 tracked center를 사용하여 d = ct2 − ct1, vt = (ct+1 − ct−1)/(2Δt), at = (ct+1 − 2ct + ct−1)/Δt²로 계산한다. Dpix에 대한 supervised fine-tuning은 metric calibration 이전에 localization, measurement, tracking 능력을 구축한다.
5.3 World-Space Physical Calibration from Verified Executable Worlds
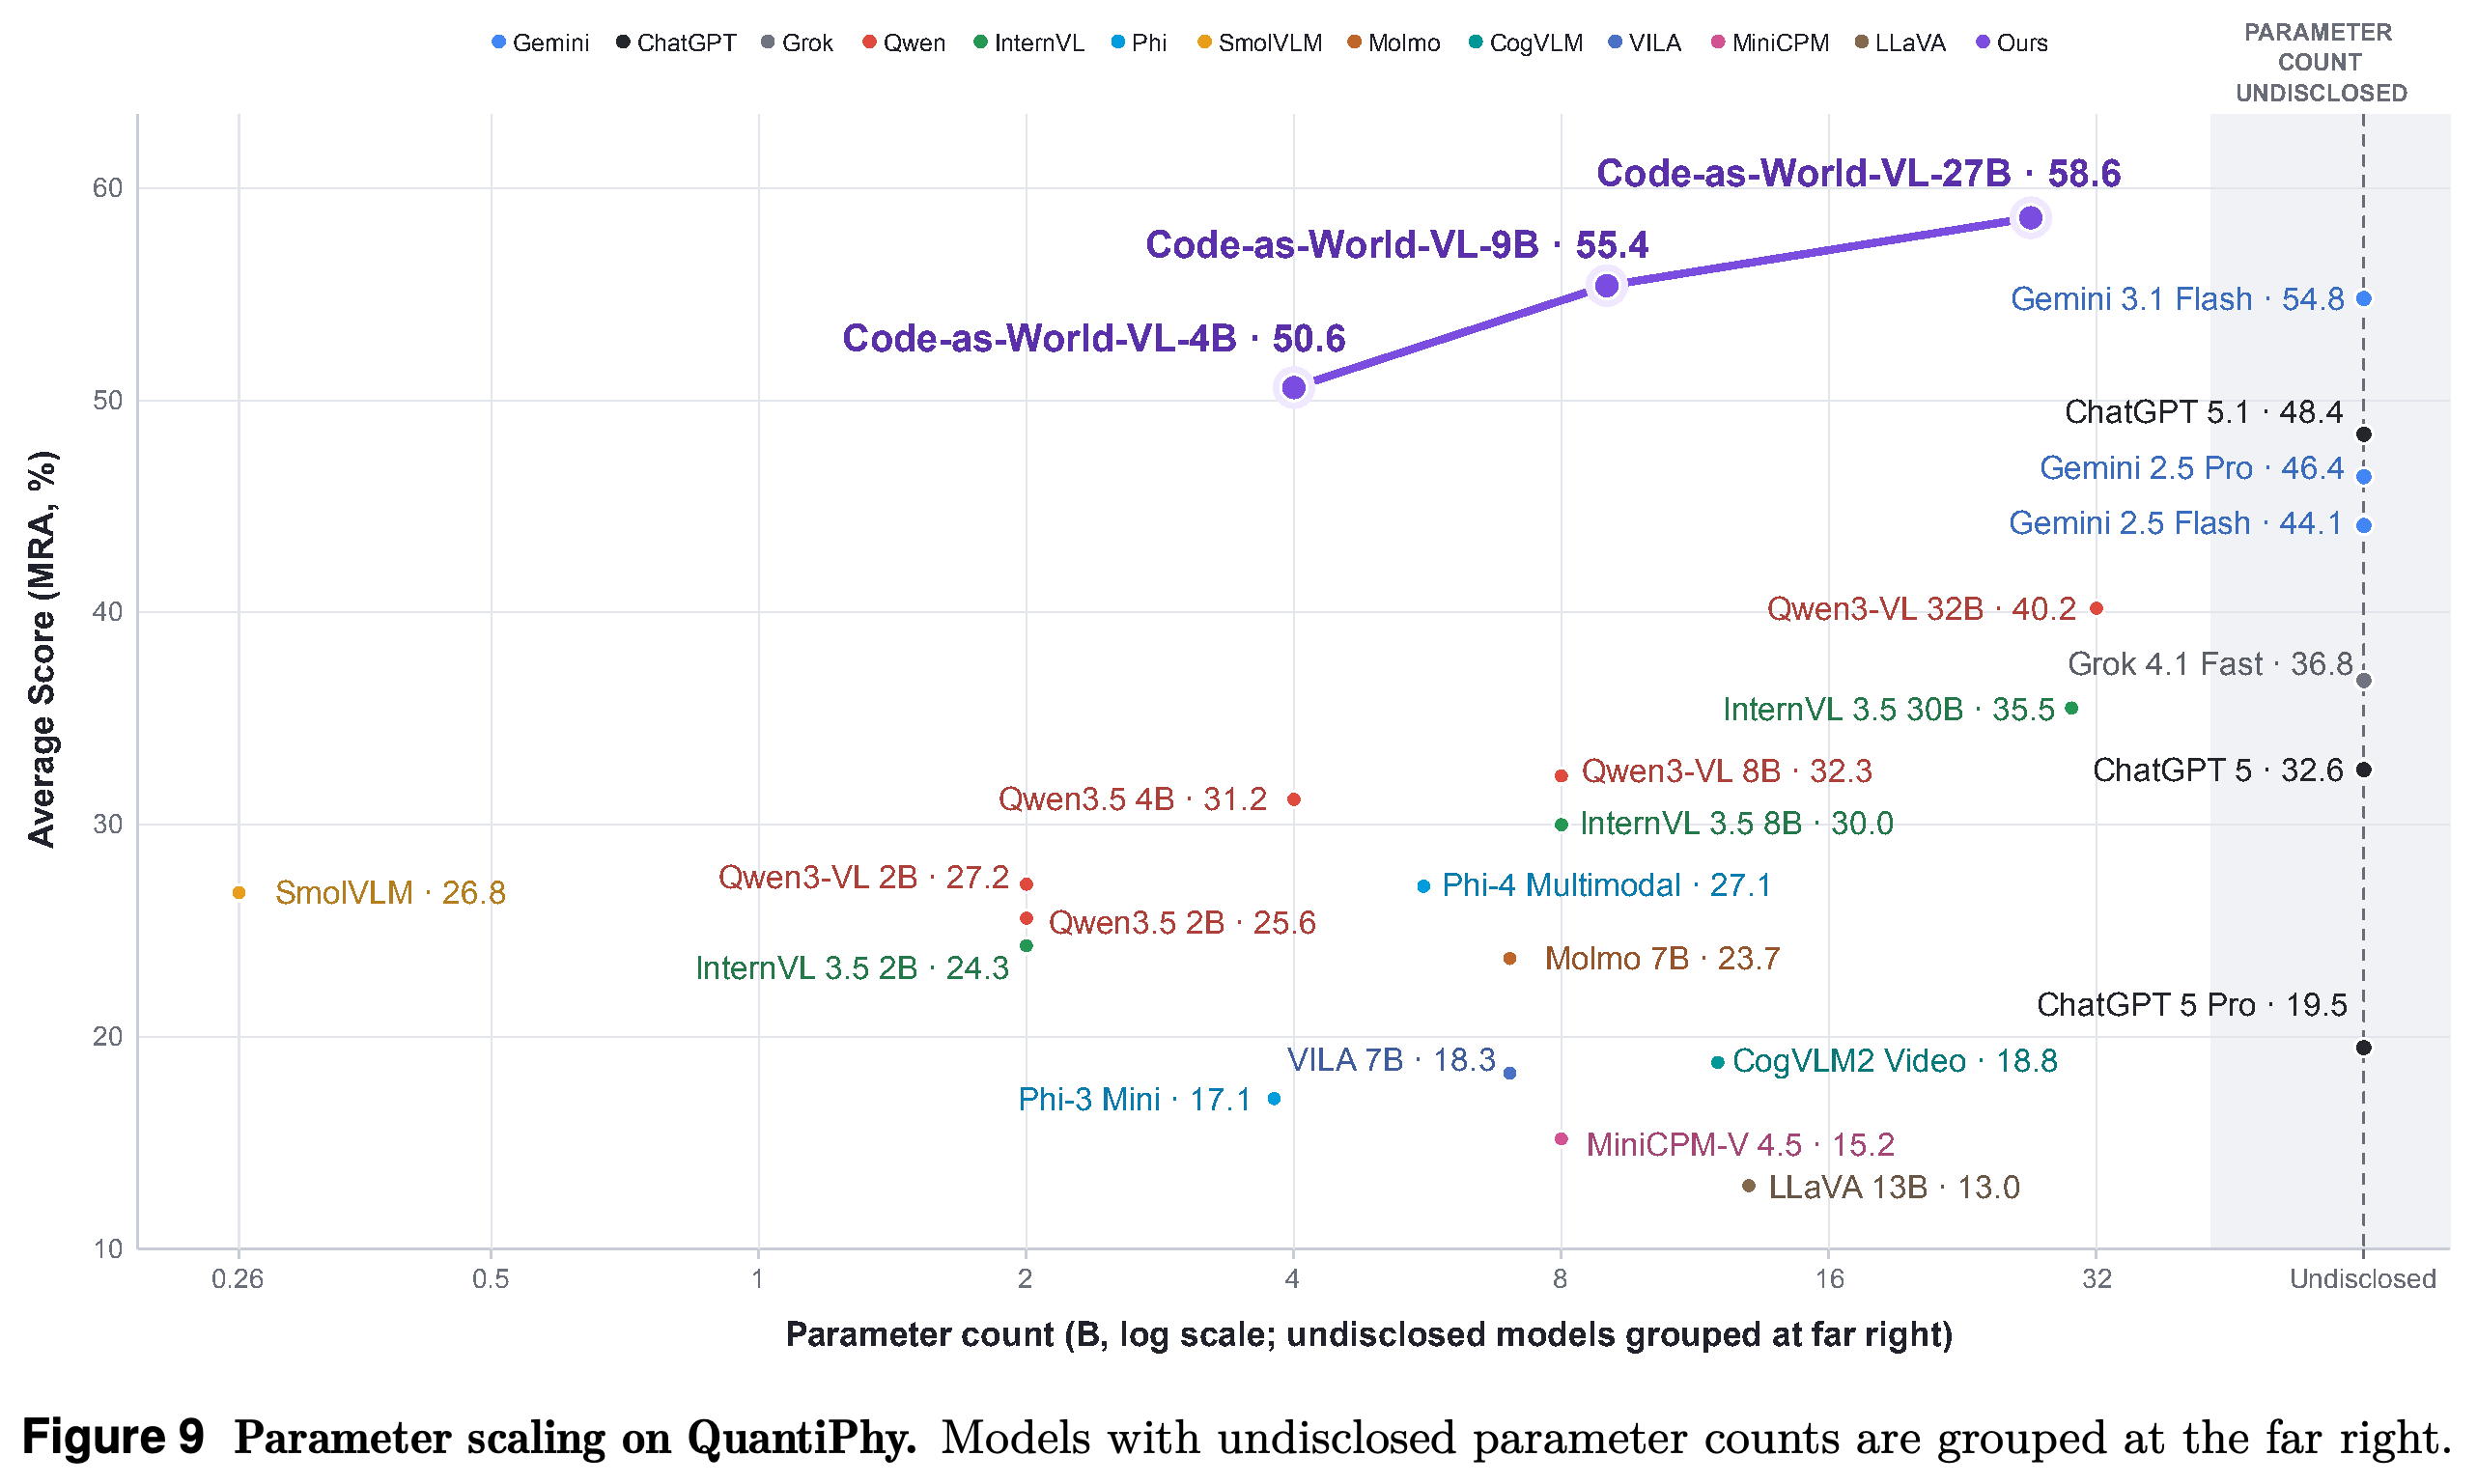
검증된 EWR은 동기화된 비디오와 정확한 장면 기하, 카메라 설정, timestamp, physical-state trajectory를 제공하므로 Dtext와 Dvideo에서 world-space VQA label을 생성할 수 있다. 2번째 단계는 수치, 단위, 형식 reward를 갖는 GRPO를 사용한다. 텍스트 기반 world는 정확한 simulator label을 제공하는 반면, 비디오 기반 world는 실제 시각 및 motion distribution에 더 잘 부합한다. QuantiPhy-validation에서 9B direct-answer model은 Qwen3-VL-32B-Instruct의 40.2 및 Gemini-3.1 Flash의 54.8과 비교해 55.4 average MRA를 보고했다. 27B reasoning model은 58.6을 기록했지만, 규모와 응답 protocol이 direct-answer 비교와 다르다.
QuantiPhy-validation MRA를 2S, 2D, 3S, 3D category별로 보고한다. Code-as-World-VL-4B, 9B, 27B (Reasoning)는 각각 50.6, 55.4, 58.6 average MRA를 기록했으며, 27B 결과는 reasoning trace 뒤에 출력한 answer로 평가한다.
QuantiPhy average MRA를 model parameter count에 대해 나타낸다. Code-as-World 계열은 4B의 50.6에서 9B의 55.4, 27B reasoning model의 58.6으로 상승하며, 크기를 공개하지 않은 model은 별도 그룹으로 표시한다.
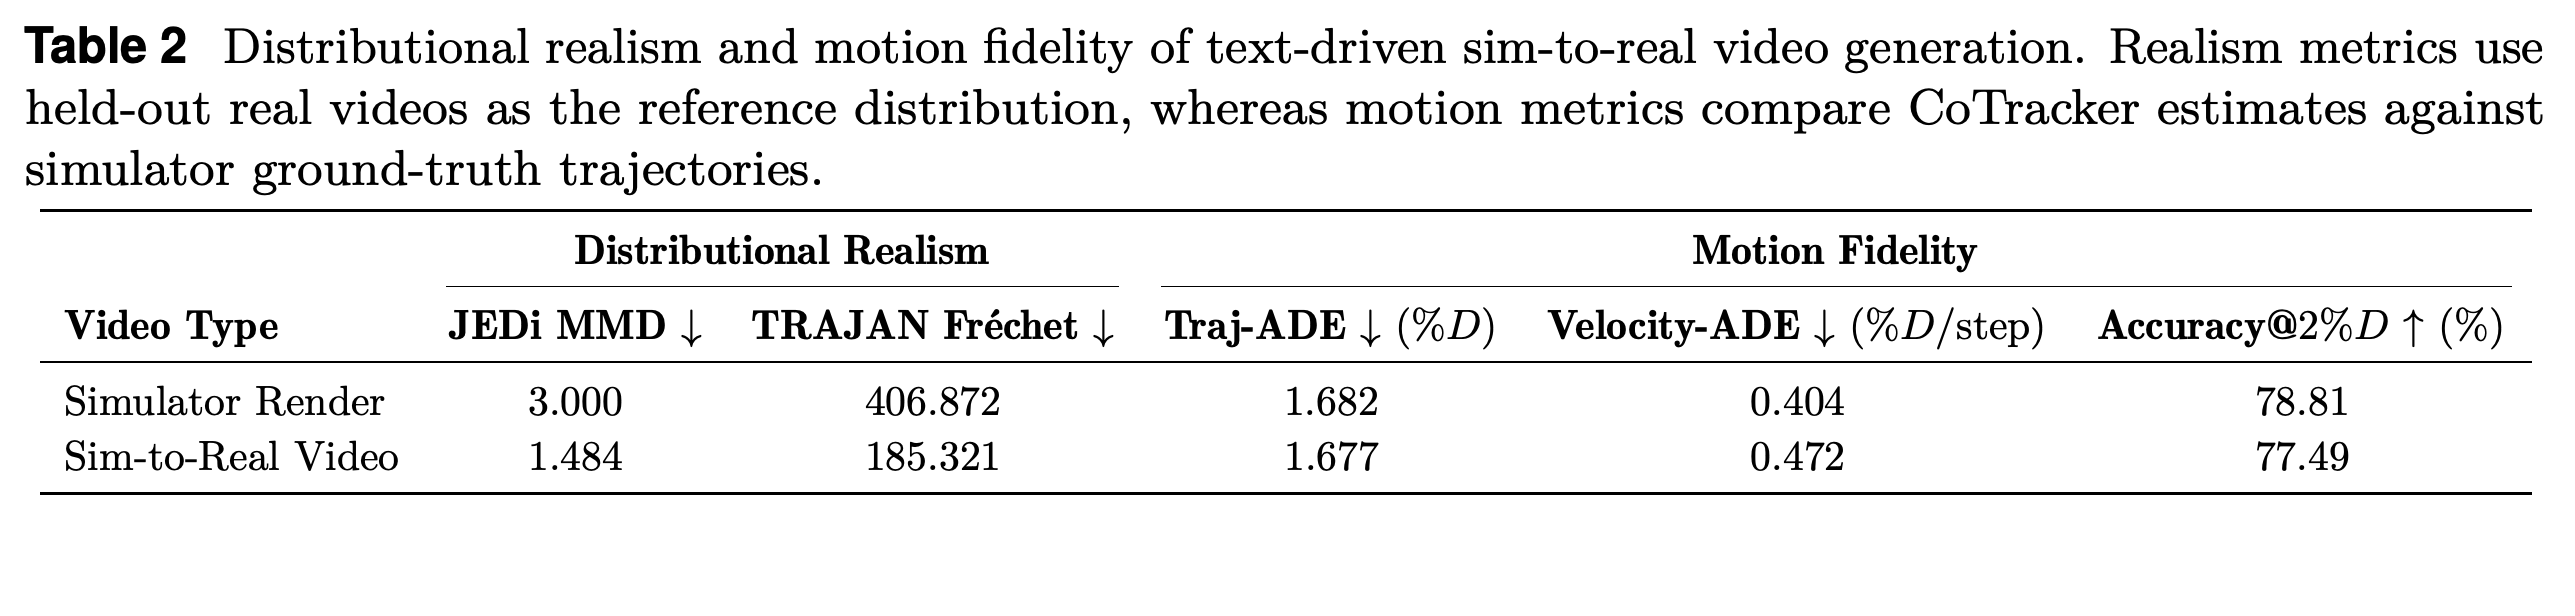
Simulator render와 sim-to-real video를 비교한다. Sim-to-real은 JEDi MMD를 3.000에서 1.484로, TRAJAN Fréchet를 406.872에서 185.321로 개선한다. 반면 Traj-ADE는 1.682에서 1.677 %D로 변하고, Velocity-ADE는 0.404에서 0.472 %D/step로 악화되며, Accuracy@2%D는 78.81%에서 77.49%로 하락한다.
Animation engine 대신 physics engine을 사용한 반복 discovery를 보인다. 5개 round에 걸쳐 Visual Alignment, Object IoU, Accuracy@2%D는 증가하고 Traj-ADE와 Velocity-ADE는 감소하며, 최종 결과는 5개 지표 모두에서 대응하는 Best-of-5를 능가한다.
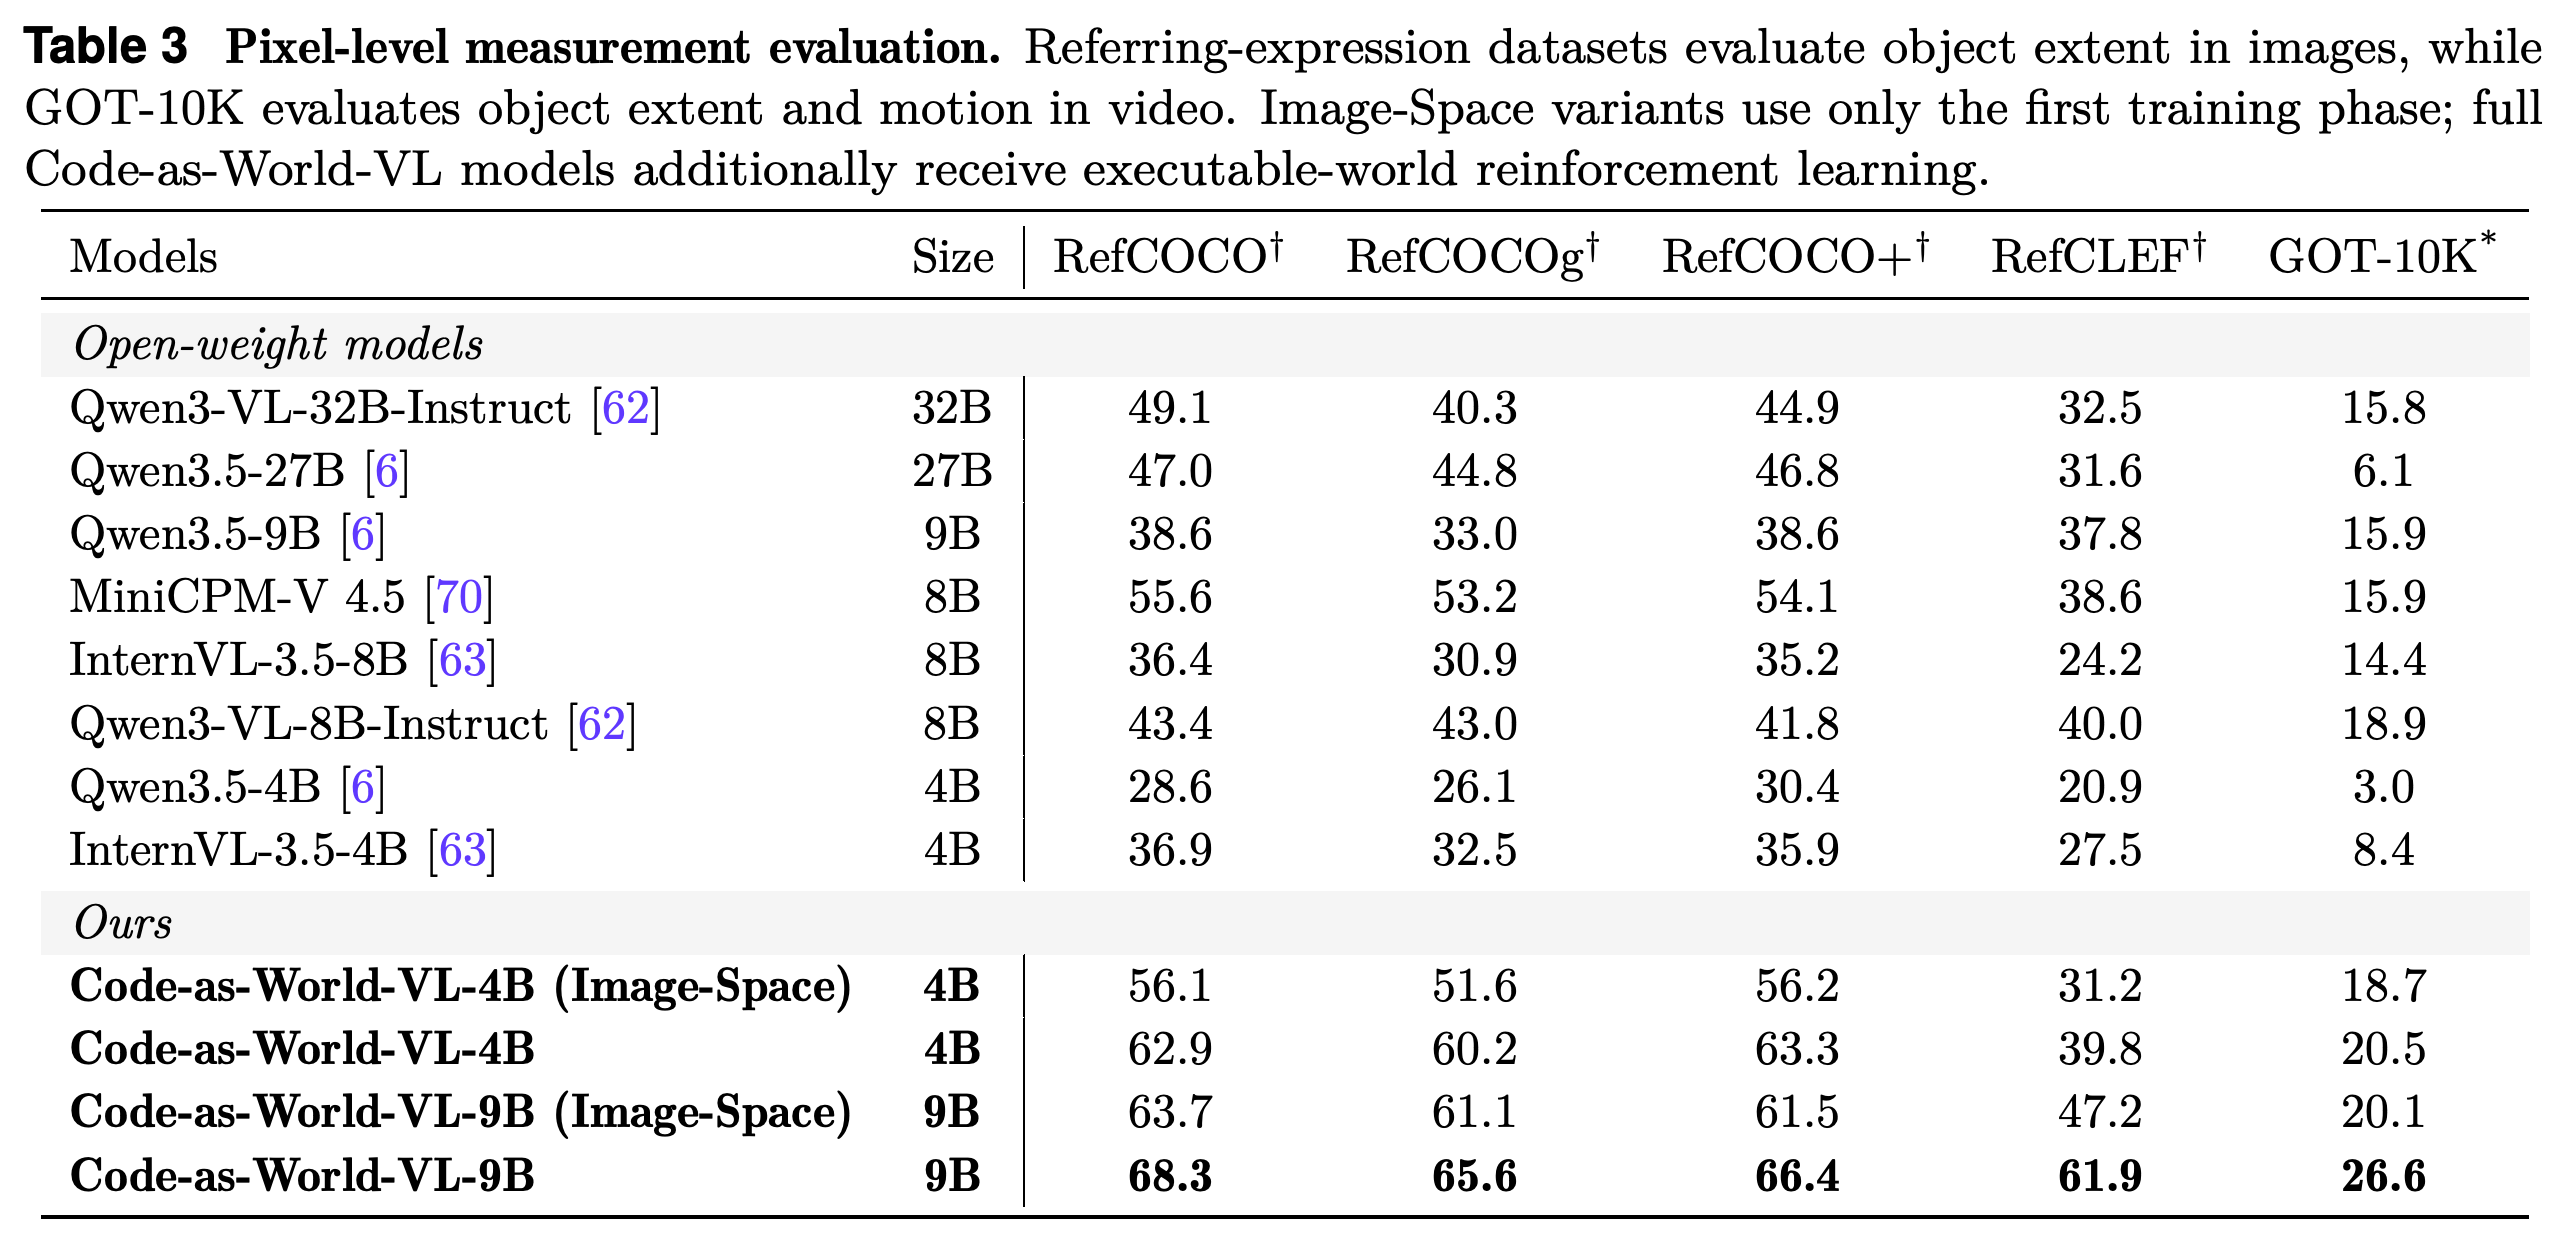
4개 referring-expression dataset과 GOT-10K에서 pixel-level MRA를 보고한다. Executable-world reinforcement learning을 추가하면 제시된 모든 benchmark에서 두 크기 모두 개선된다. 예를 들어 9B model은 RefCOCO에서 63.7에서 68.3으로, GOT-10K에서 20.1에서 26.6으로 상승한다.
Grounding, 길이, 속도, 가속도 예측을 정성적으로 비교한다. 선택한 예시에서 Code-as-World-VL output은 표시된 target box와 numerical ground truth에 다른 비교 output보다 더 가깝다.
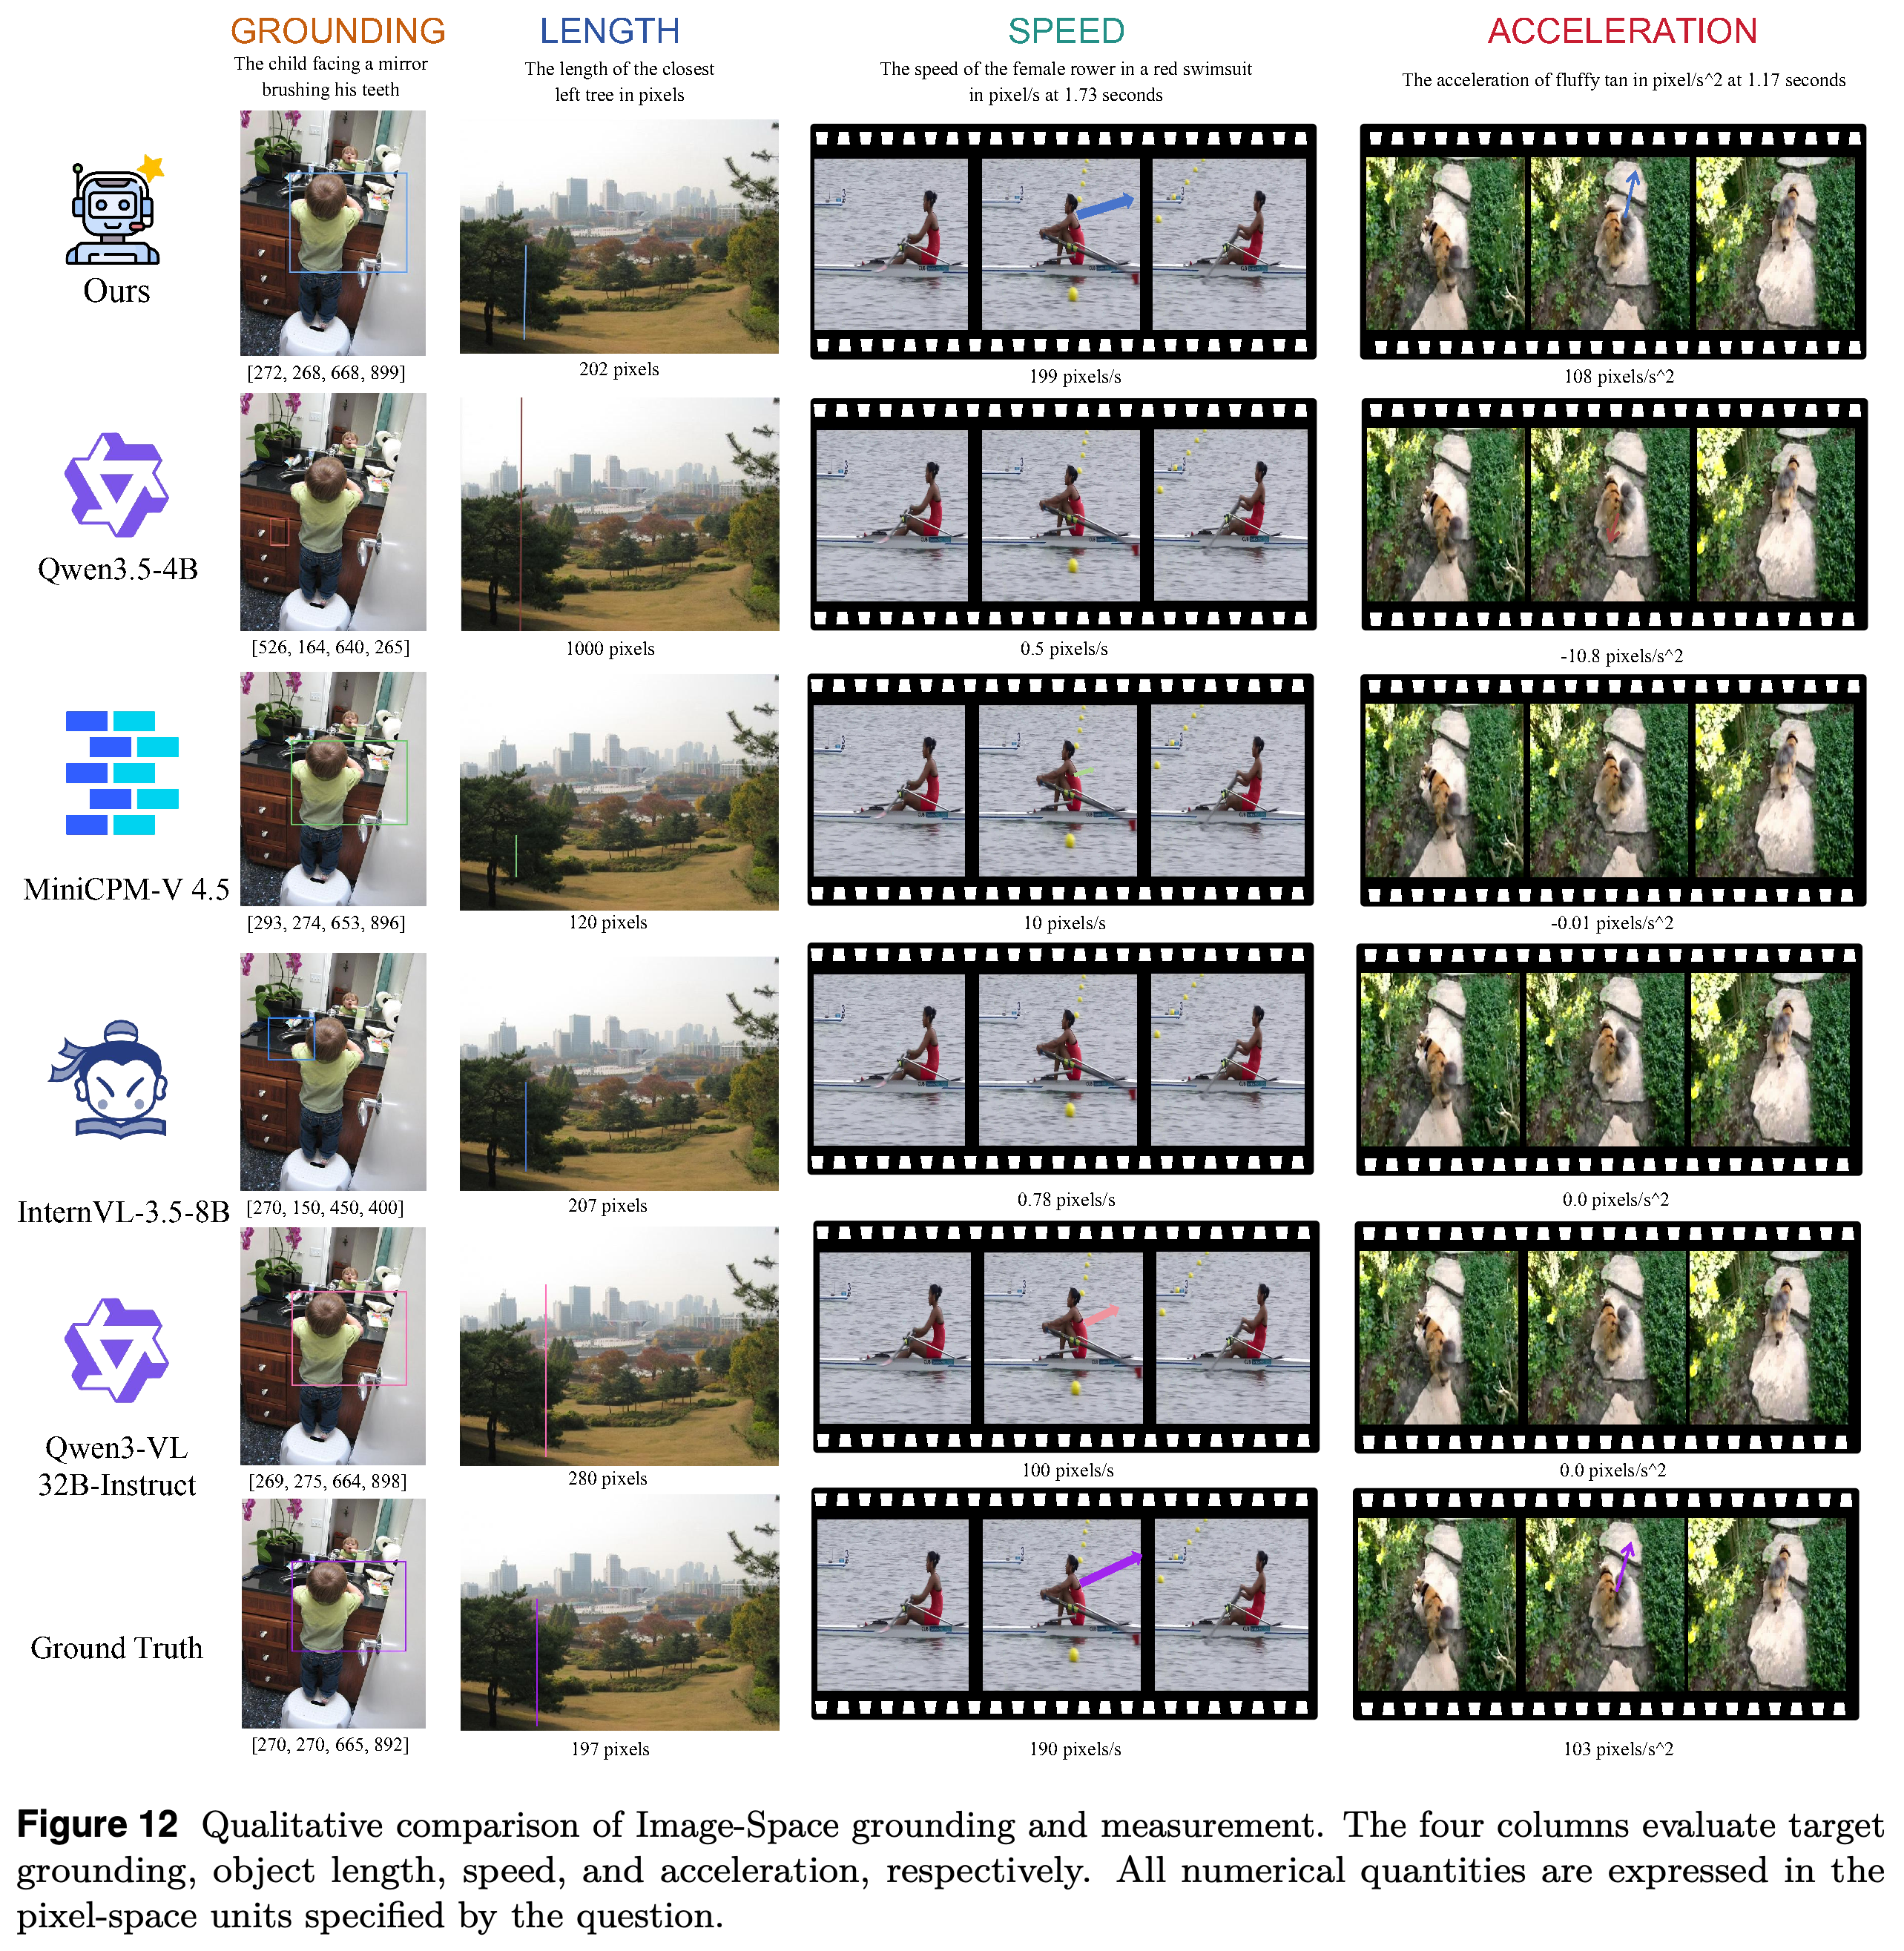
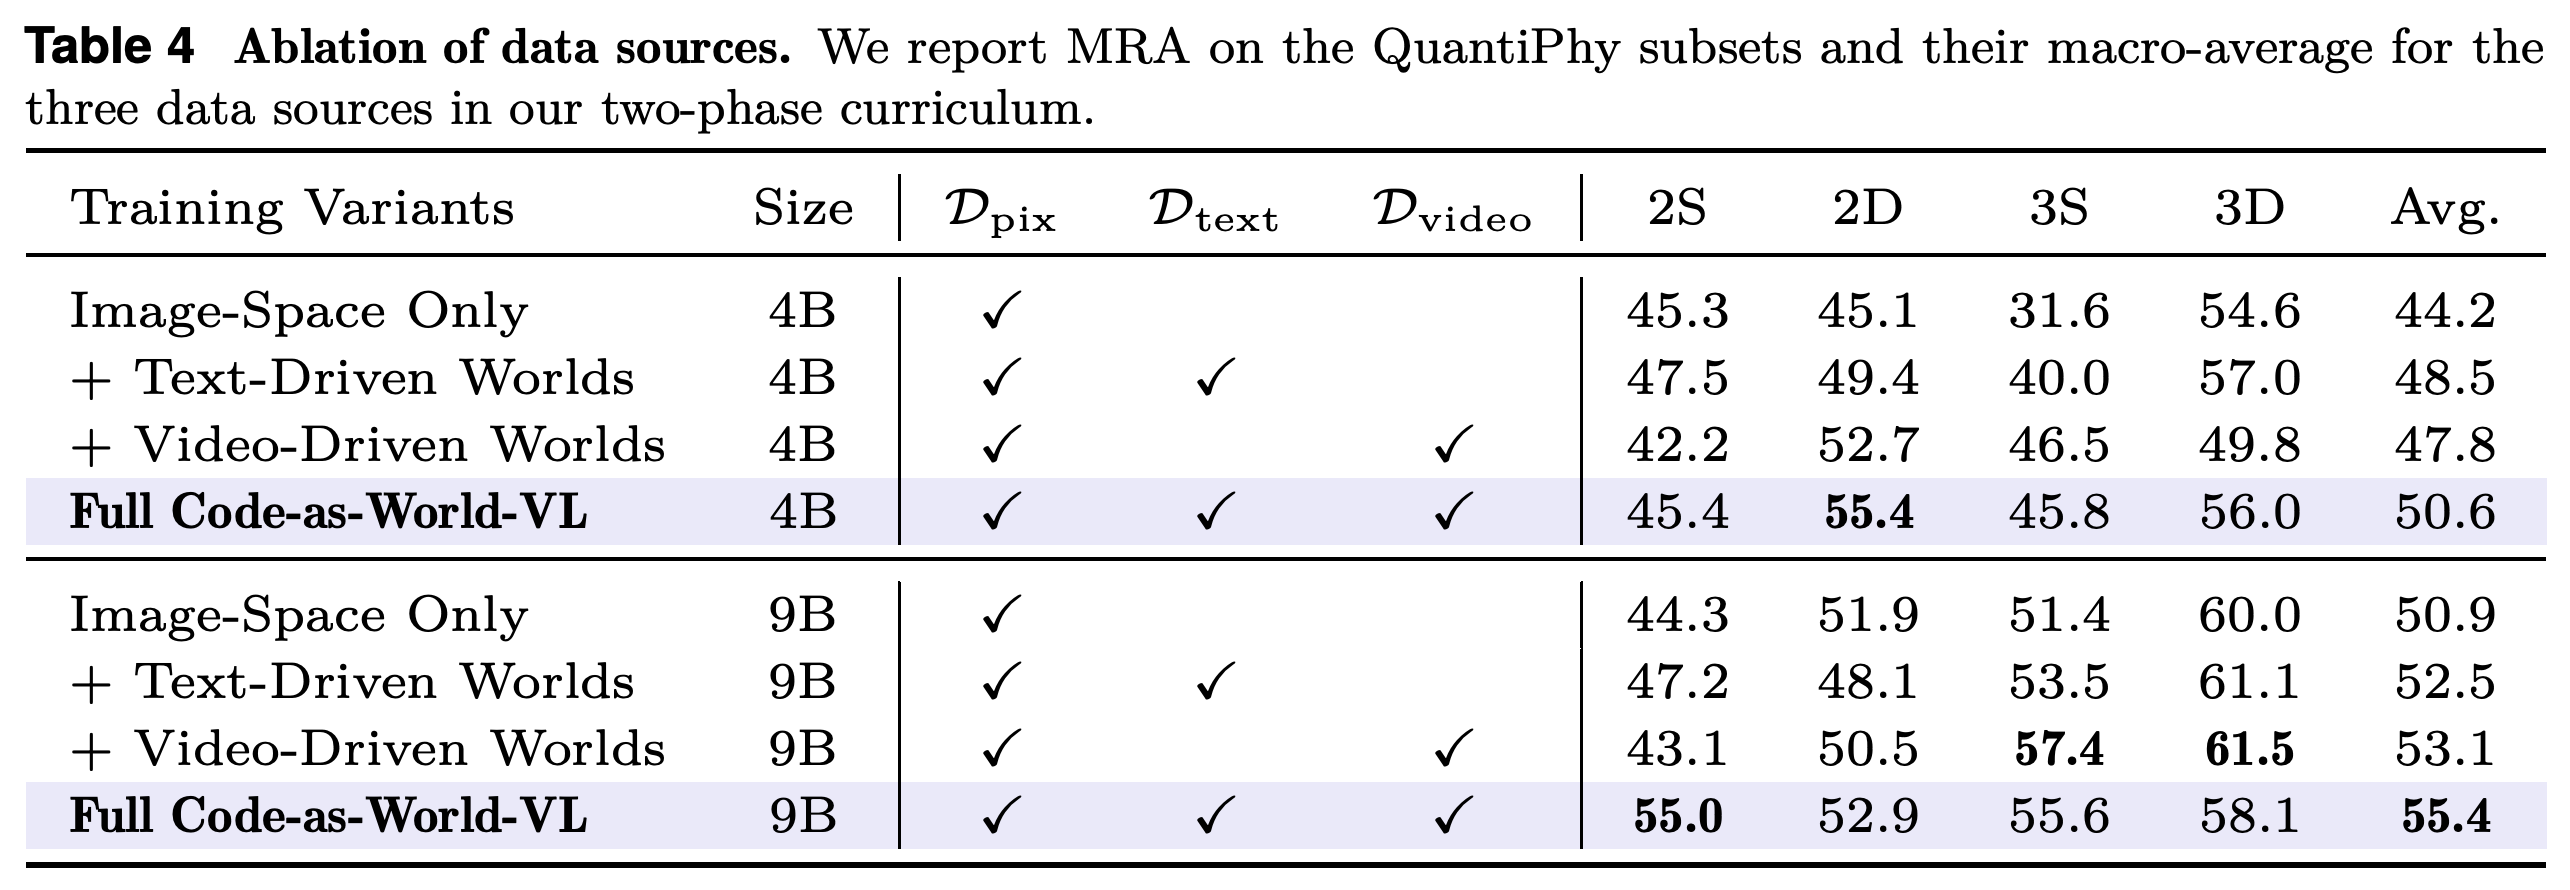
Image-space data Dpix와 text- 및 video-driven world data Dtext, Dvideo의 기여를 분리한다. 각 world-data source는 image-space-only training보다 제시된 average를 개선하며, 두 source를 모두 사용하면 표에서 가장 높은 average를 얻는다. 4B는 50.6이고 9B는 55.4이다.
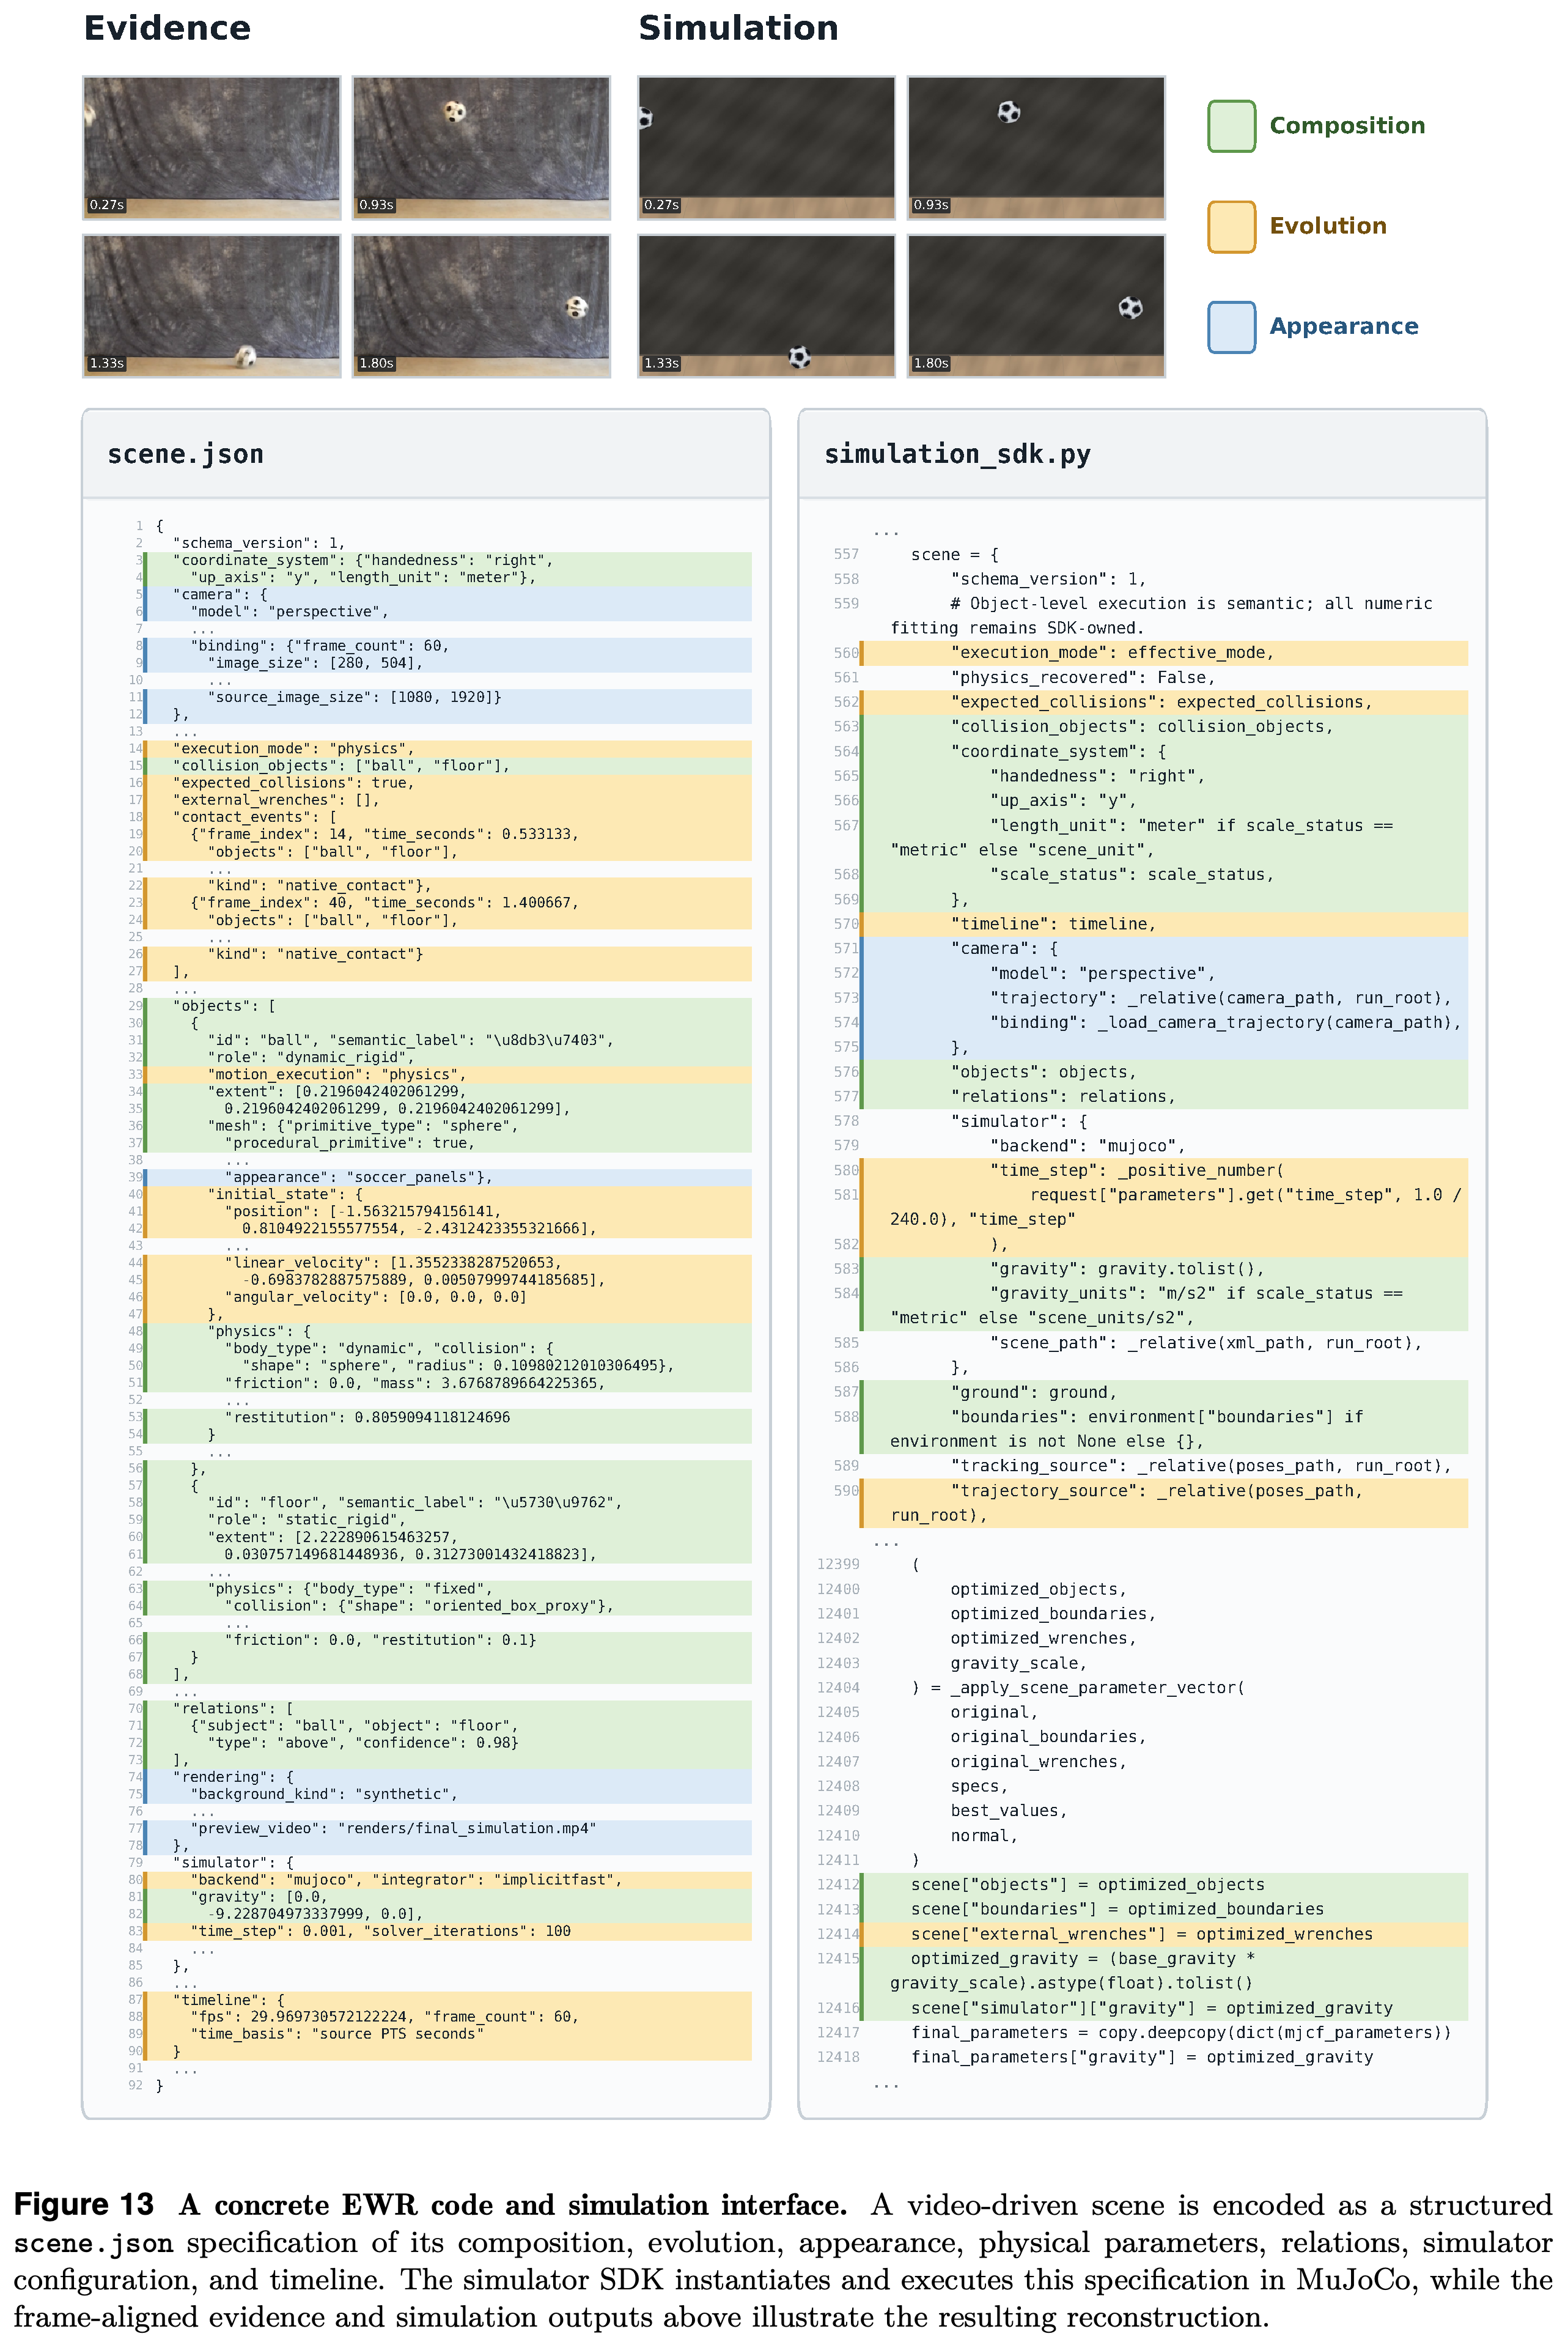
Video-driven soccer-ball reconstruction과 scene.json 및 simulation_sdk.py 일부를 보여 준다. 색상 표시는 구조화된 field와 SDK operation을 구성, 변화, 외관에 연결하며, 구현은 MuJoCo에서 장면을 실행한다.
부록
- Appendix는 73,335개의 Image-Space question-answer pair와 1,585개의 text-driven 및 988개의 video-driven VQA sample로 구성된 executable-world dataset을 명시한다. 또한 MuJoCo 기반 animation 및 physics engine, QuantiPhy의 159 validation pair, MRA evaluation, reasoning-model setting, realism 및 motion metric, data-source ablation을 상세히 설명한다. Ablation table은 Dpix, Dtext, Dvideo를 결합했을 때 제시된 QuantiPhy average가 가장 높으며, 4B는 50.6이고 9B는 55.4임을 보인다.
짧은 생각
핵심 기여는 simulation data 생성에만 있지 않다. 실행 가능한 표현을 통해 물리 가정을 검사하고, 편집하고, 검증할 수 있게 만든다. 보고된 증거는 제약된 rigid-body reconstruction과 QuantiPhy calibration의 성능 향상을 뒷받침한다. 다만 물리 지능에 관한 더 넓은 주장은 simulator fidelity, 더 광범위한 물리 영역의 coverage, 카메라 움직임에 대한 robustness, 검증된 출력뿐 아니라 discovery loop 자체를 학습하는지 여부에 달려 있다.