


ThinkAct: Vision-Language-Action Reasoning via Reinforced Visual Latent Planning 요약 설명
22 Jul 2025 | Paper Review Vision-Language-Action Models Latent Reasoning Reinforcement Learning이번 글에서는 ThinkAct: Vision-Language-Action Reasoning via Reinforced Visual Latent Planning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 7월 22일(Arxiv)
- Huang, Chi-Pin, Wu, Yueh-Hua, Chen, Min-Hung, Wang, Yu-Chiang Frank, Yang, Fu-En.
- NVIDIA, National Taiwan University
- 논문 링크
- Project Page
요약
- ThinkAct는 시각 관찰과 언어 지시를 행동으로 변환하는 vision-language-action(VLA) 모델이 여러 단계로 이루어진 로봇 과제를 실행 전에 계획하도록 하는 방법을 다룬다. 표준 LIBERO 시뮬레이션 조작 평가에서 전체 성공률 84.4%를 달성한다. 비교 대상인 diffusion Transformer 기반 행동 기준 모델 DiT-Policy는 76.8%, 행동 예측 전에 시각적 하위 목표를 예측하는 CoT-VLA는 83.9%를 기록한다.
- 시각 입력도 처리하는 언어 모델인 multimodal large language model(MLLM)이 보상 신호로 모델을 최적화하는 강화학습(RL)을 통해 계획을 학습한다. 보상은 로봇의 파지 도구인 gripper의 예측 이동 궤적을 시연 궤적과 비교해 계산한다. 이후 계획 의도를 압축한 학습 표현인 visual plan latent를 별도의 행동 모델에 조건으로 제공한다. 행동 모델은 시연된 행동을 재현하는 모방학습으로 훈련한다.
- LIBERO 과제당 시연 10개를 사용하는 Figure 5에서 ThinkAct의 평균 성공률은 39.1%다. 멀티모달 에이전트 모델인 Magma는 34.7%, 로봇 시연으로 학습한 OpenVLA는 14.0%다. 개별 학습 신호를 제거하는 보상 제거 실험은 목표 보상과 궤적 보상이 모두 기여함을 뒷받침한다. 자기 수정의 근거는 선별된 실행 사례다. 부록에서는 A100 그래픽 처리 장치(GPU)에서 실행 시간이 OpenVLA보다 17% 길다고 보고한다. 저자들은 관찰된 물체나 물체 사이의 관계를 잘못 기술하는 시각적, 공간적 환각이 사전학습 모델에서 이어진다는 한계도 인정한다.
1. Introduction
서론은 변화하는 환경에서 멀티모달 입력을 해석하는 능력과 긴 과제의 행동을 계획하는 능력 사이에 격차가 있다고 지적한다. 입력에서 행동으로 직접 연결하는 학습에는 명시적 계획이 빠지는 경우가 많다. 중간 추론 단계를 텍스트로 표현하는 chain-of-thought(CoT)를 지도학습하려면 비용을 들여 추론 과정을 정제해야 하며, 특정 장면이나 추론 패턴에 과적합할 수 있다.
- ThinkAct는 시각적 궤적 보상과 압축된 계획 표현을 통해 상위 수준의 추론을 하위 수준의 제어와 연결한다.
- 프로젝트 페이지는 https://jasper0314-huang.github.io/thinkact-vla/ 이다.
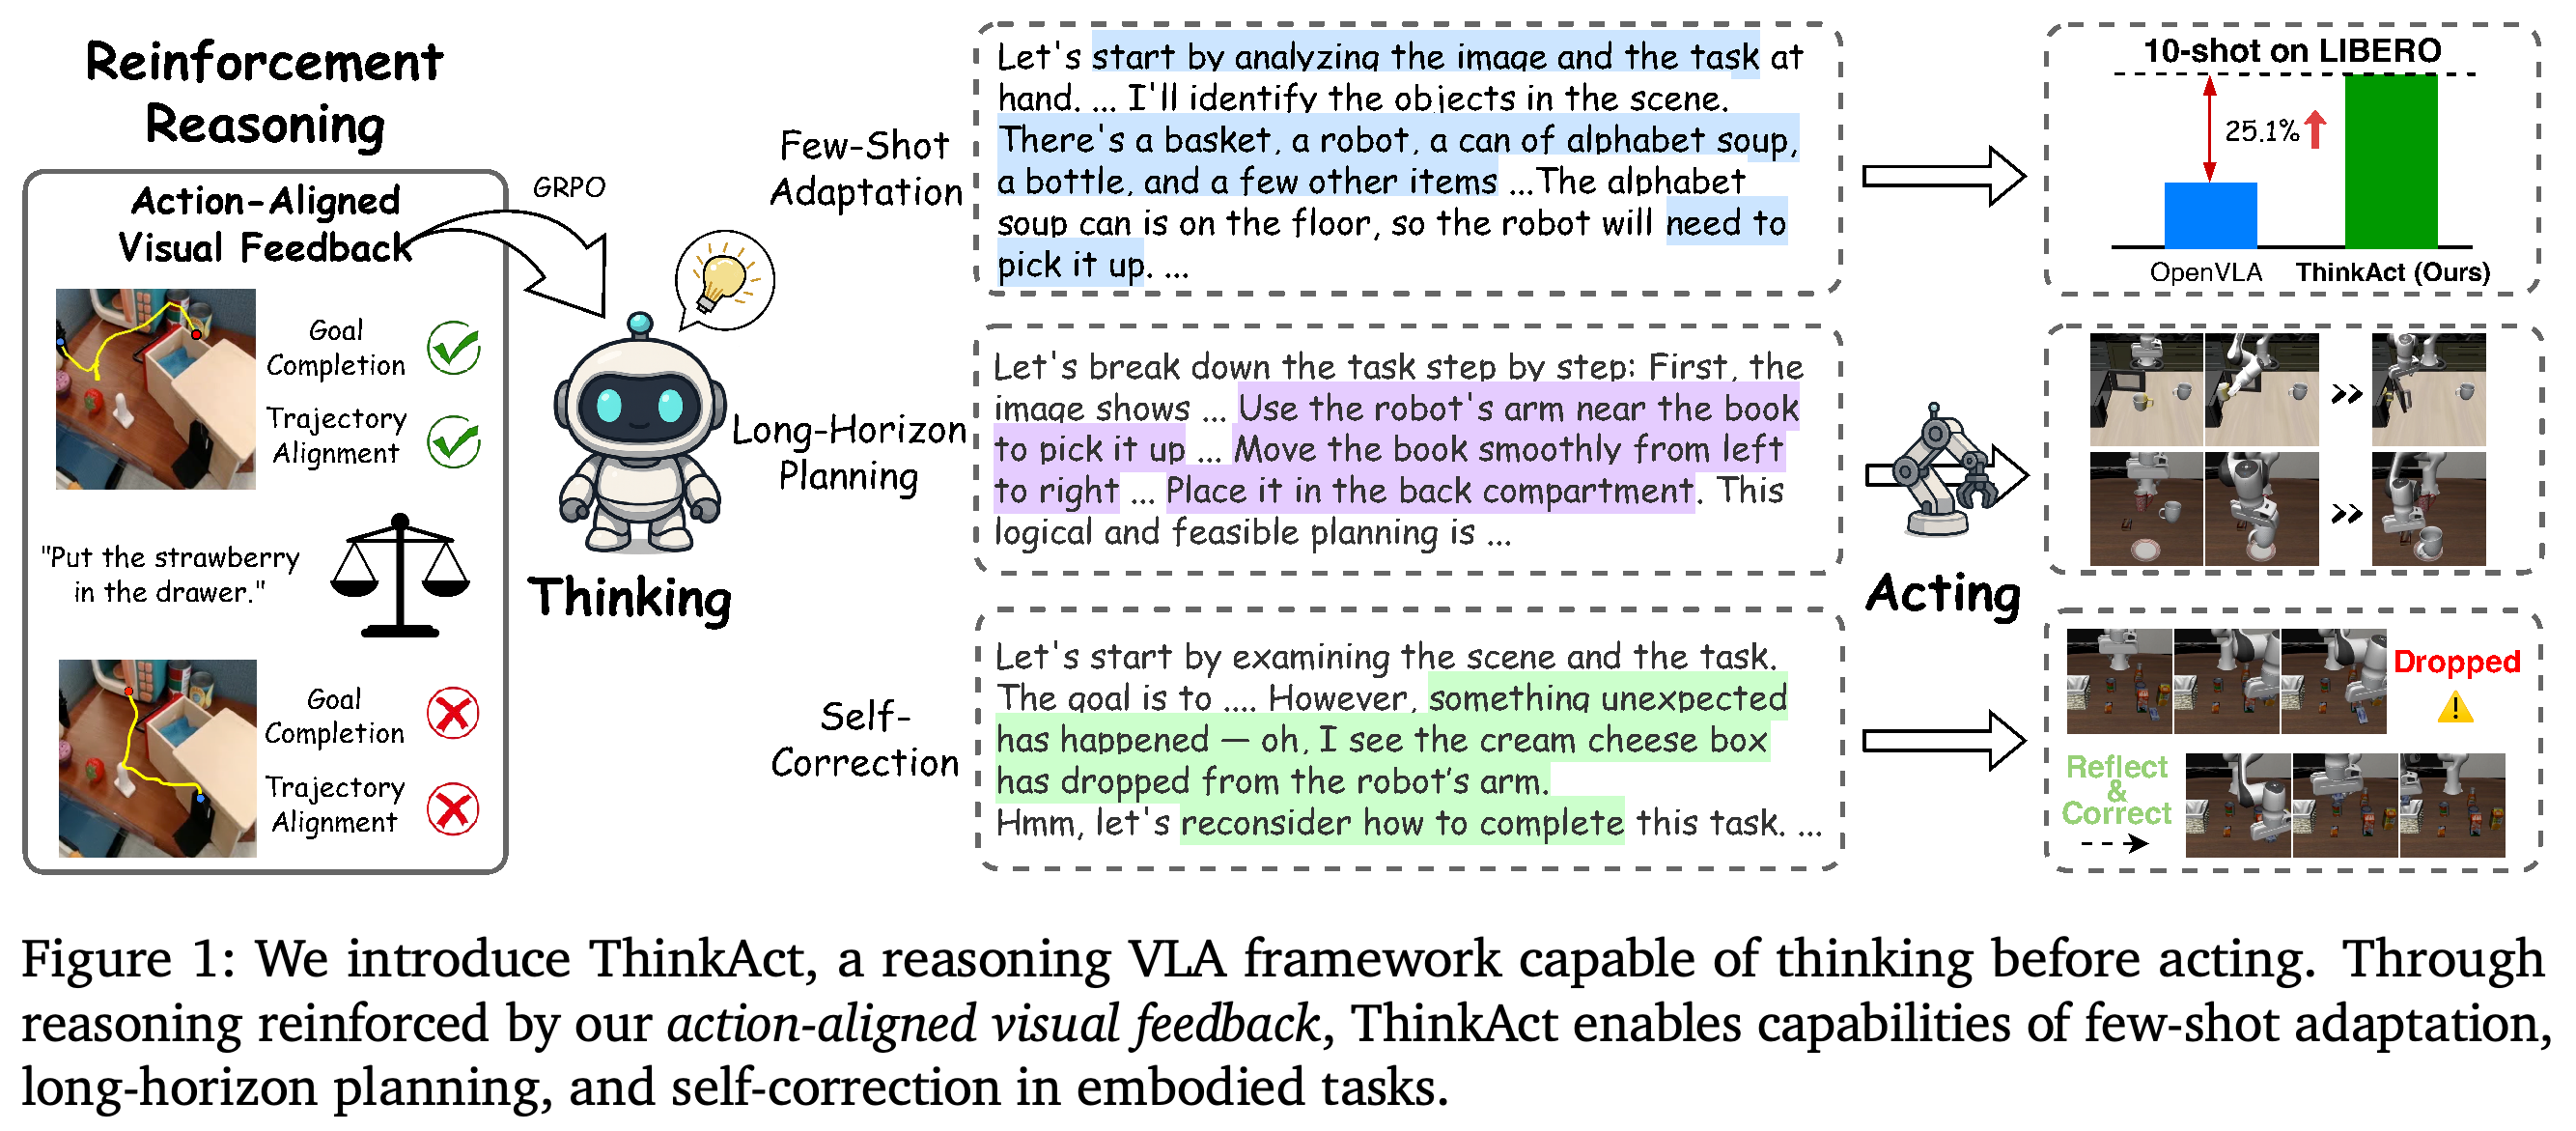
이 도식은 시연 기반 시각 피드백을 제한된 시연을 통한 적응, 다단계 계획, 물체를 떨어뜨린 뒤의 복구와 연결한다. 이후 정량 실험과 선별된 실행 사례에서 이러한 능력을 살펴본다.
2. Related Works
관련 연구에서는 시각적 행동 이해와 실행을 학습하는 모델과 중간 추론을 도입하는 방법을 구분한다. ThinkAct는 행동과 관련된 시각 피드백으로 추론을 학습하고, 계획 표현을 행동 정책에 전달하여 이 방향들을 결합한다. 행동 정책은 실행할 행동을 선택하는 모델이다.
2.1. Vision-Language-Action Models
공간상의 점을 예측하는 RoboPoint와 시각적 궤적으로 학습한 LLARVA는 공간 정보를 활용해 행동 이해를 개선한다. 조작 실패를 감지하는 AHA는 합성된 실패 사례로 학습한다. OpenVLA는 로봇 시연으로 행동 실행을 학습하며, TraceVLA와 HAMSTER는 시각적 이동 경로를 활용한다. 저자들은 복잡한 지시와 익숙하지 않은 상황에 필요한 명시적 계획이 여전히 부족하다고 지적한다.
2.2. Reasoning in Vision-Language-(Action) Models
신체를 가진 에이전트의 추론 방법인 ECoT는 제공된 목표 출력에 맞춰 모델을 학습하는 supervised fine-tuning(SFT)으로 중간 하위 목표를 학습시킨다. 행동 데이터 없이 추론을 학습하는 RAD는 사람의 영상에서 추론 데이터를 정제한 뒤 로봇 행동과 연결한다. CoT-VLA는 행동을 예측하기 전에 시각적 하위 목표 프레임을 생성한다.
- 논문은 정제된 추론 주석과 과제별 영상 생성이 규모 확장을 제약한다고 지적한다.
- 기존 추론 RL 방법은 주로 질의응답의 정답 여부에 보상을 부여한다. ThinkAct는 시각적 궤적 피드백을 추가하여 추론을 실행 가능한 계획과 연결한다.
3. Method
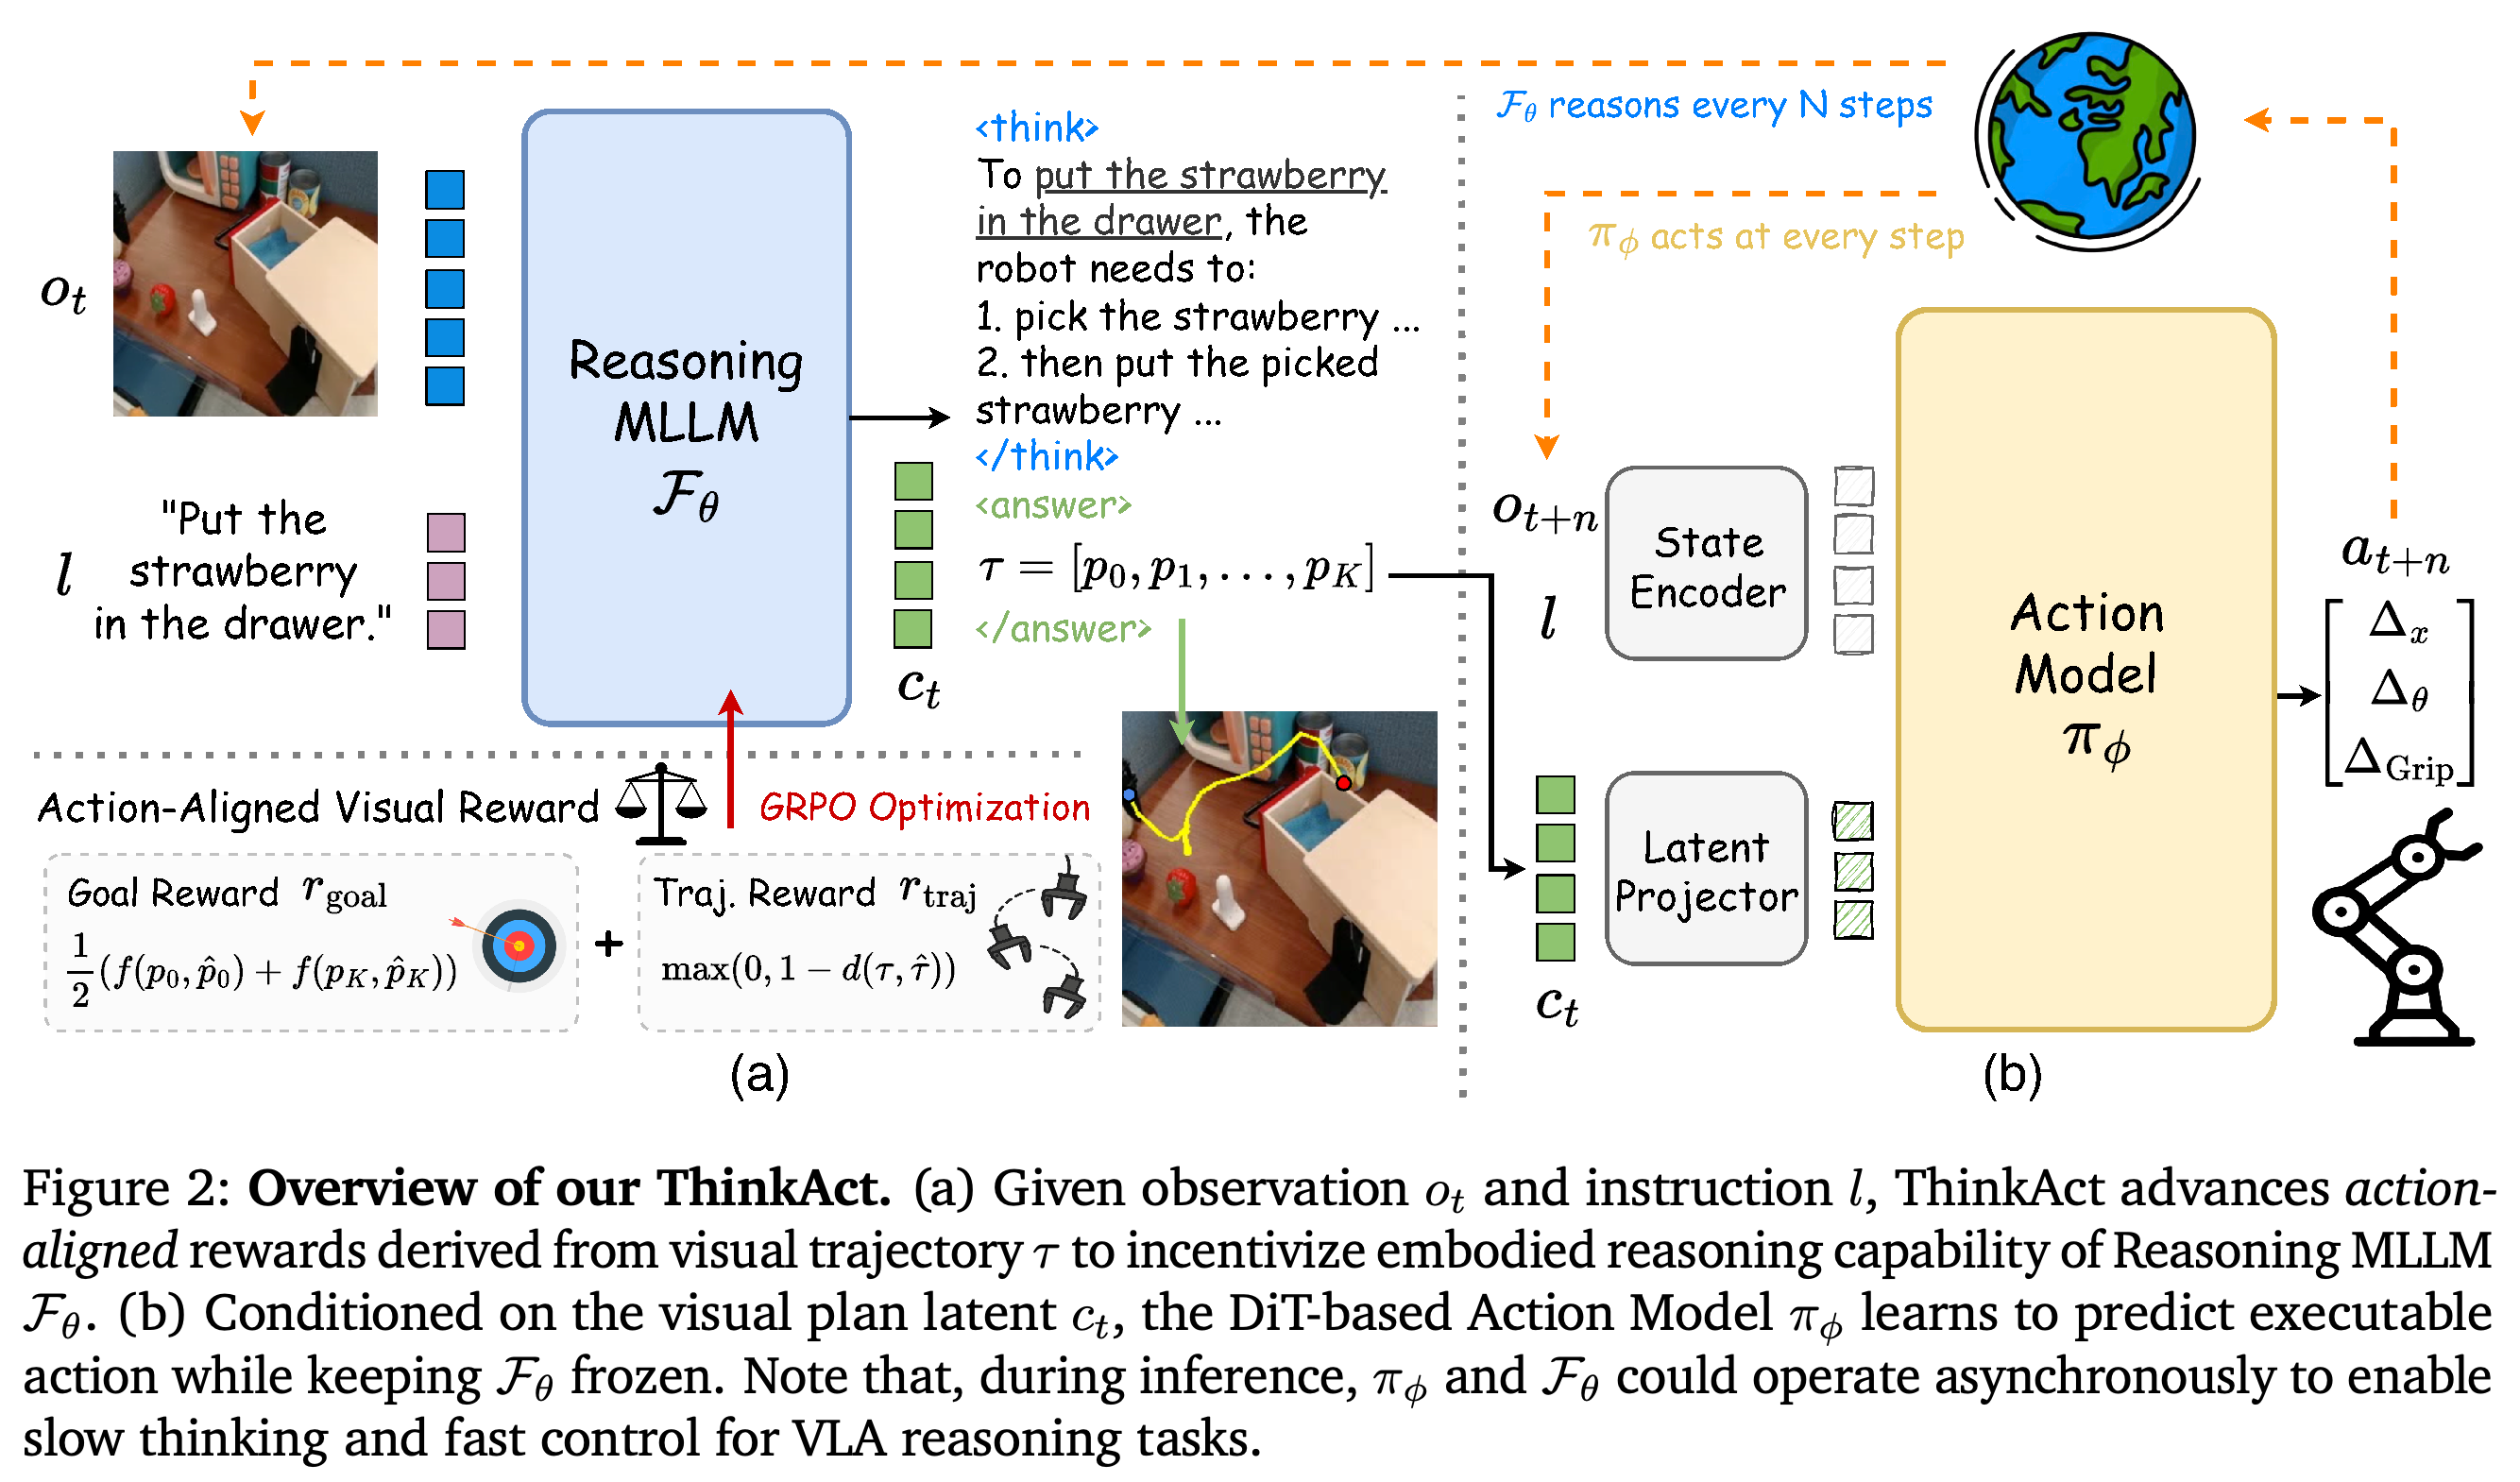
ThinkAct는 별도로 학습하는 2개 구성 요소를 사용한다. 추론 MLLM은 visual plan latent를 생성하고, 행동 모델은 이 latent를 현재 관찰 및 지시와 함께 사용한다. 계획은 제어보다 낮은 빈도로 갱신할 수 있다.
3.1. Problem Formulation
시점 t에서 모델은 시각 관찰 o_t와 지시 l을 받아 행동 a_t를 예측한다. 에이전트의 신체 구성에 따라 행동은 텍스트 명령이거나, 병진 이동, 회전, gripper 제어를 포함하는 7자유도 제어 벡터다.
- 추론 모델 F_θ는 관찰과 지시에서 latent c_t를 생성하며, 행동 모델 π_φ는 이를 사용해 이후 환경과의 상호작용 N회를 유도한다.
궤적 보상으로 추론 모델을 학습하며, 추론 모델의 latent 출력은 별도의 projector를 거쳐 제어기에 전달된다. 학습 경로가 분리되어 있어 제어기를 적응시키는 동안 계획기를 고정할 수 있다. 실행 루프에서는 제어보다 낮은 빈도로 계획을 수행할 수 있다.
3.2. Reinforced Visual Latent Planning for Embodied Reasoning
Reward Shaping from Action-Aligned Visual Feedback에서는 계획기가 추론과 정규화된 2차원 gripper 점의 궤적을 생성한다. 목표 보상은 예측한 시작 및 끝 위치를 검출기로 추출한 시연 위치와 비교한다. 수식은 r_goal = 1/2(f(p_1, p̂_1) + f(p_K, p̂_K))이며, 여기서 f(p, p′) = max(0, 1 − ‖p − p′‖₂²)다.
- 이 보상은 시연의 시작점 및 끝점과 얼마나 일치하는지 측정하며, 시뮬레이터에서 실행이 성공했는지를 직접 측정하지는 않는다.
- Visual plan latent는 궤적 점으로 디코딩되며, 제어기에 조건으로 제공하는 표현으로도 사용된다.
궤적 보상은 r_traj = max(0, 1 − d(τ, τ̂))이며, 궤적 시퀀스를 정렬해 거리를 계산하는 dynamic time warping으로 d를 구한다. 결합 보상은 r = 0.9r_visual + 0.1r_format이며, r_visual = 0.5r_goal + 0.5r_traj이고 r_format은 출력 형식의 정확성을 측정한다.
- Reinforced Fine-Tuning for Eliciting Visual Latent Planning에서는 샘플링한 응답 그룹 안에서 보상을 비교하는 RL 방법인 Group Relative Policy Optimization(GRPO)으로 추론 모델을 학습한다.
- 목적함수는 그룹 내에서 표준화한 보상과 Kullback–Leibler divergence 페널티를 사용한다. 이 페널티는 분포 차이를 측정하여 원래 모델에서 과도하게 벗어나지 않도록 규제한다. 추가 질의응답 데이터는 정답 보상을 제공한다.
3.3. Reasoning-Enhanced Action Adaptation
Latent projector는 행동 모델의 입력 공간으로 변환하는 학습 모듈이며, 고정된 추론 모델을 행동 정책과 연결한다. 관찰과 지시를 표현하는 state encoder, projector, 행동 모델은 주석이 달린 행동 시연으로 학습하며, 추론 모델은 고정한다.
- Latent 계획 1개로 상호작용 N회를 유도하여 계획과 제어를 비동기적으로 수행할 수 있다. 계획기는 주기적으로 추론하고 행동 모델은 매 단계 갱신한다.
3.4. Learning Strategy and Inference
먼저 지도학습용 궤적 및 질의응답 데이터로 추론 모델을 초기화하고, 로봇 시연 모음인 Open X-Embodiment(OXE)로 행동 모델을 독립적으로 사전학습한다. 이후 GRPO로 시각 보상을 사용해 추론 모델을 학습한다. 마지막으로 행동 적응 단계에서 고정된 계획기의 출력을 사용하여 제어기와 연결 모듈을 학습한다.
- 추론 시에는 관찰과 지시로 visual plan latent를 생성하고, 이를 조건으로 실행 가능한 행동 시퀀스를 생성한다.
4. Experiment
실험은 로봇 실행과 embodied reasoning을 평가한다. Embodied reasoning은 에이전트가 속한 환경의 과제와 관찰에 관한 추론이다. 조작 성공률과 질의응답 성능을 측정한 뒤, 보상 제거, 제한된 시연을 통한 적응, 선별된 실패 복구 사례를 살펴본다.
4.1. Experimental Setup
Implementation Details에서는 계획기를 매개변수 규모가 7B인 멀티모달 모델 Qwen2.5-VL 7B로 초기화한다. 제어기는 432M-parameter diffusion Transformer(DiT)를 사용하며, 반복적인 잡음 제거로 행동을 생성한다. SFT는 분산 학습 설정인 DeepSpeed ZeRO-3에서 20K회 반복, 배치 크기 32, 학습률 1e−5로 수행한다. GRPO는 6K회 반복, 배치 크기 64, 학습률 1e−6을 사용하며, 입력당 샘플링하는 응답 수인 rollout size는 5다.
- 이미지 인코더 DINOv2와 텍스트 인코더 CLIP은 1024차원 상태 임베딩을 생성한다. 쿼리 기반 latent projector인 Q-Former는 쿼리 32개를 사용한다. CLIP에 대해서는 CLIP 논문 리뷰(Learning Transferable Visual Models From Natural Language Supervision) 글을 참조하라.
- 행동 적응은 OXE 샘플 100K개로 120K회 반복하며, 배치 크기는 256, 학습률은 2e−5다. LIBERO에서는 배치 크기 128로 75K회 추가 미세조정한다.
- 모든 실험은 메모리가 80 GB인 NVIDIA A100 GPU 16개를 사용한다.
Training Datasets and Evaluation Benchmarks에서는 초기 학습을 위해 OXE 궤적을 로봇 시각 질의응답 데이터셋 RoboVQA, 1인칭 계획 데이터셋 EgoPlan-IT, 추론 주석이 포함된 영상 추론 데이터셋 Video-R1-CoT와 결합한다. RL에는 Something-Something v2의 사람 조작 영상, EgoPlan-IT/Val 학습 및 검증 데이터, Reflect 실패 데이터, 일반 영상 지시 데이터셋 LLaVA-Video-178K도 사용한다.
- 시각적 장면 변화가 포함된 시뮬레이션 벤치마크 SimplerEnv와 LIBERO는 조작 성공률을 측정한다.
- EgoPlan-Bench2는 객관식 정답률로 1인칭 다단계 계획을 측정한다. RoboVQA는 텍스트 중복도 점수인 BLEU를 사용하고, OpenEQA는 언어 모델 기반 답변 채점으로 환경 이해를 측정한다.
4.2. Quantitative Evaluation
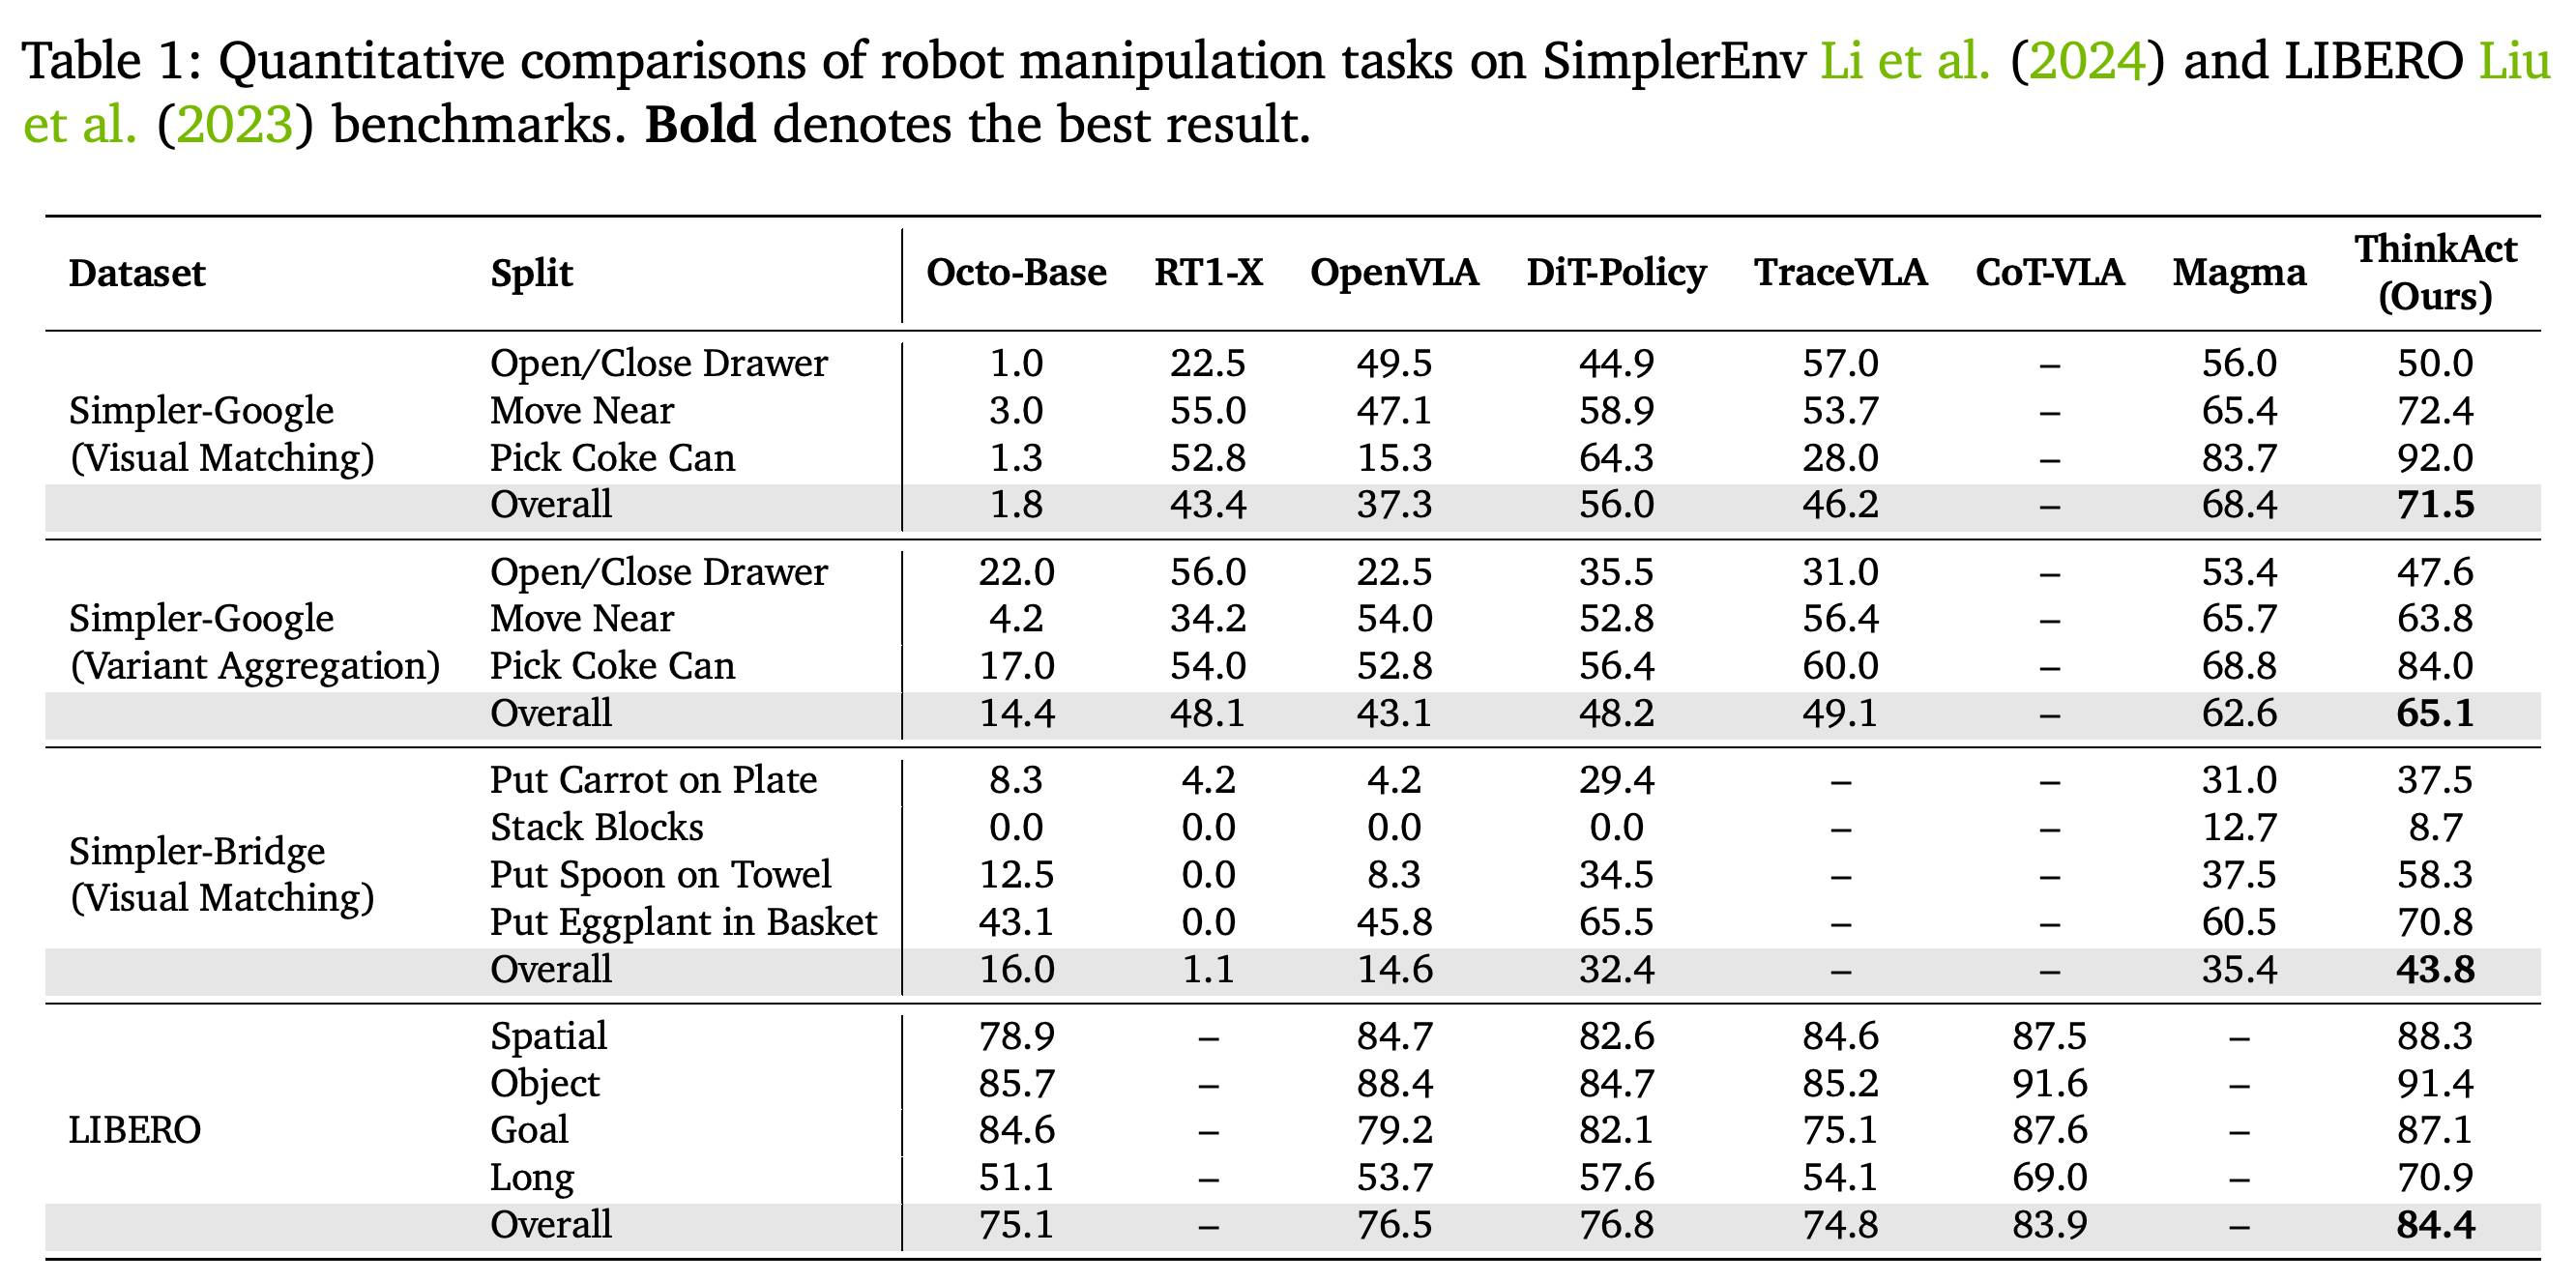
Robot Manipulation에서 ThinkAct는 Simpler-Google Visual Matching, Simpler-Google Variant Aggregation, Simpler-Bridge Visual Matching에서 각각 전체 성공률 71.5%, 65.1%, 43.8%를 달성한다. 이 설정들은 시각적 장면 조건에 따른 성능을 평가한다. 대응하는 DiT-Policy 결과는 56.0%, 48.2%, 32.4%이며, 절대 향상 폭은 각각 15.5, 16.9, 11.4%포인트다.
- LIBERO에서 ThinkAct의 전체 성공률은 84.4%이며, DiT-Policy는 76.8%, OpenVLA는 76.5%, CoT-VLA는 83.9%다.
- 전체 성능의 우위가 모든 하위 과제에 적용되지는 않는다. LIBERO-Object와 LIBERO-Goal에서는 CoT-VLA가, Simpler-Bridge Stack Blocks에서는 Magma가 더 높은 점수를 기록한다.
ThinkAct는 보고된 4개 조작 설정의 전체 성능에서 앞서며, LIBERO에서 84.4%, Simpler-Google Visual Matching에서 71.5%를 기록한다. 다만 개별 행에서는 LIBERO-Object와 LIBERO-Goal에서 CoT-VLA가, Simpler-Bridge Stack Blocks에서 Magma가 앞선다.
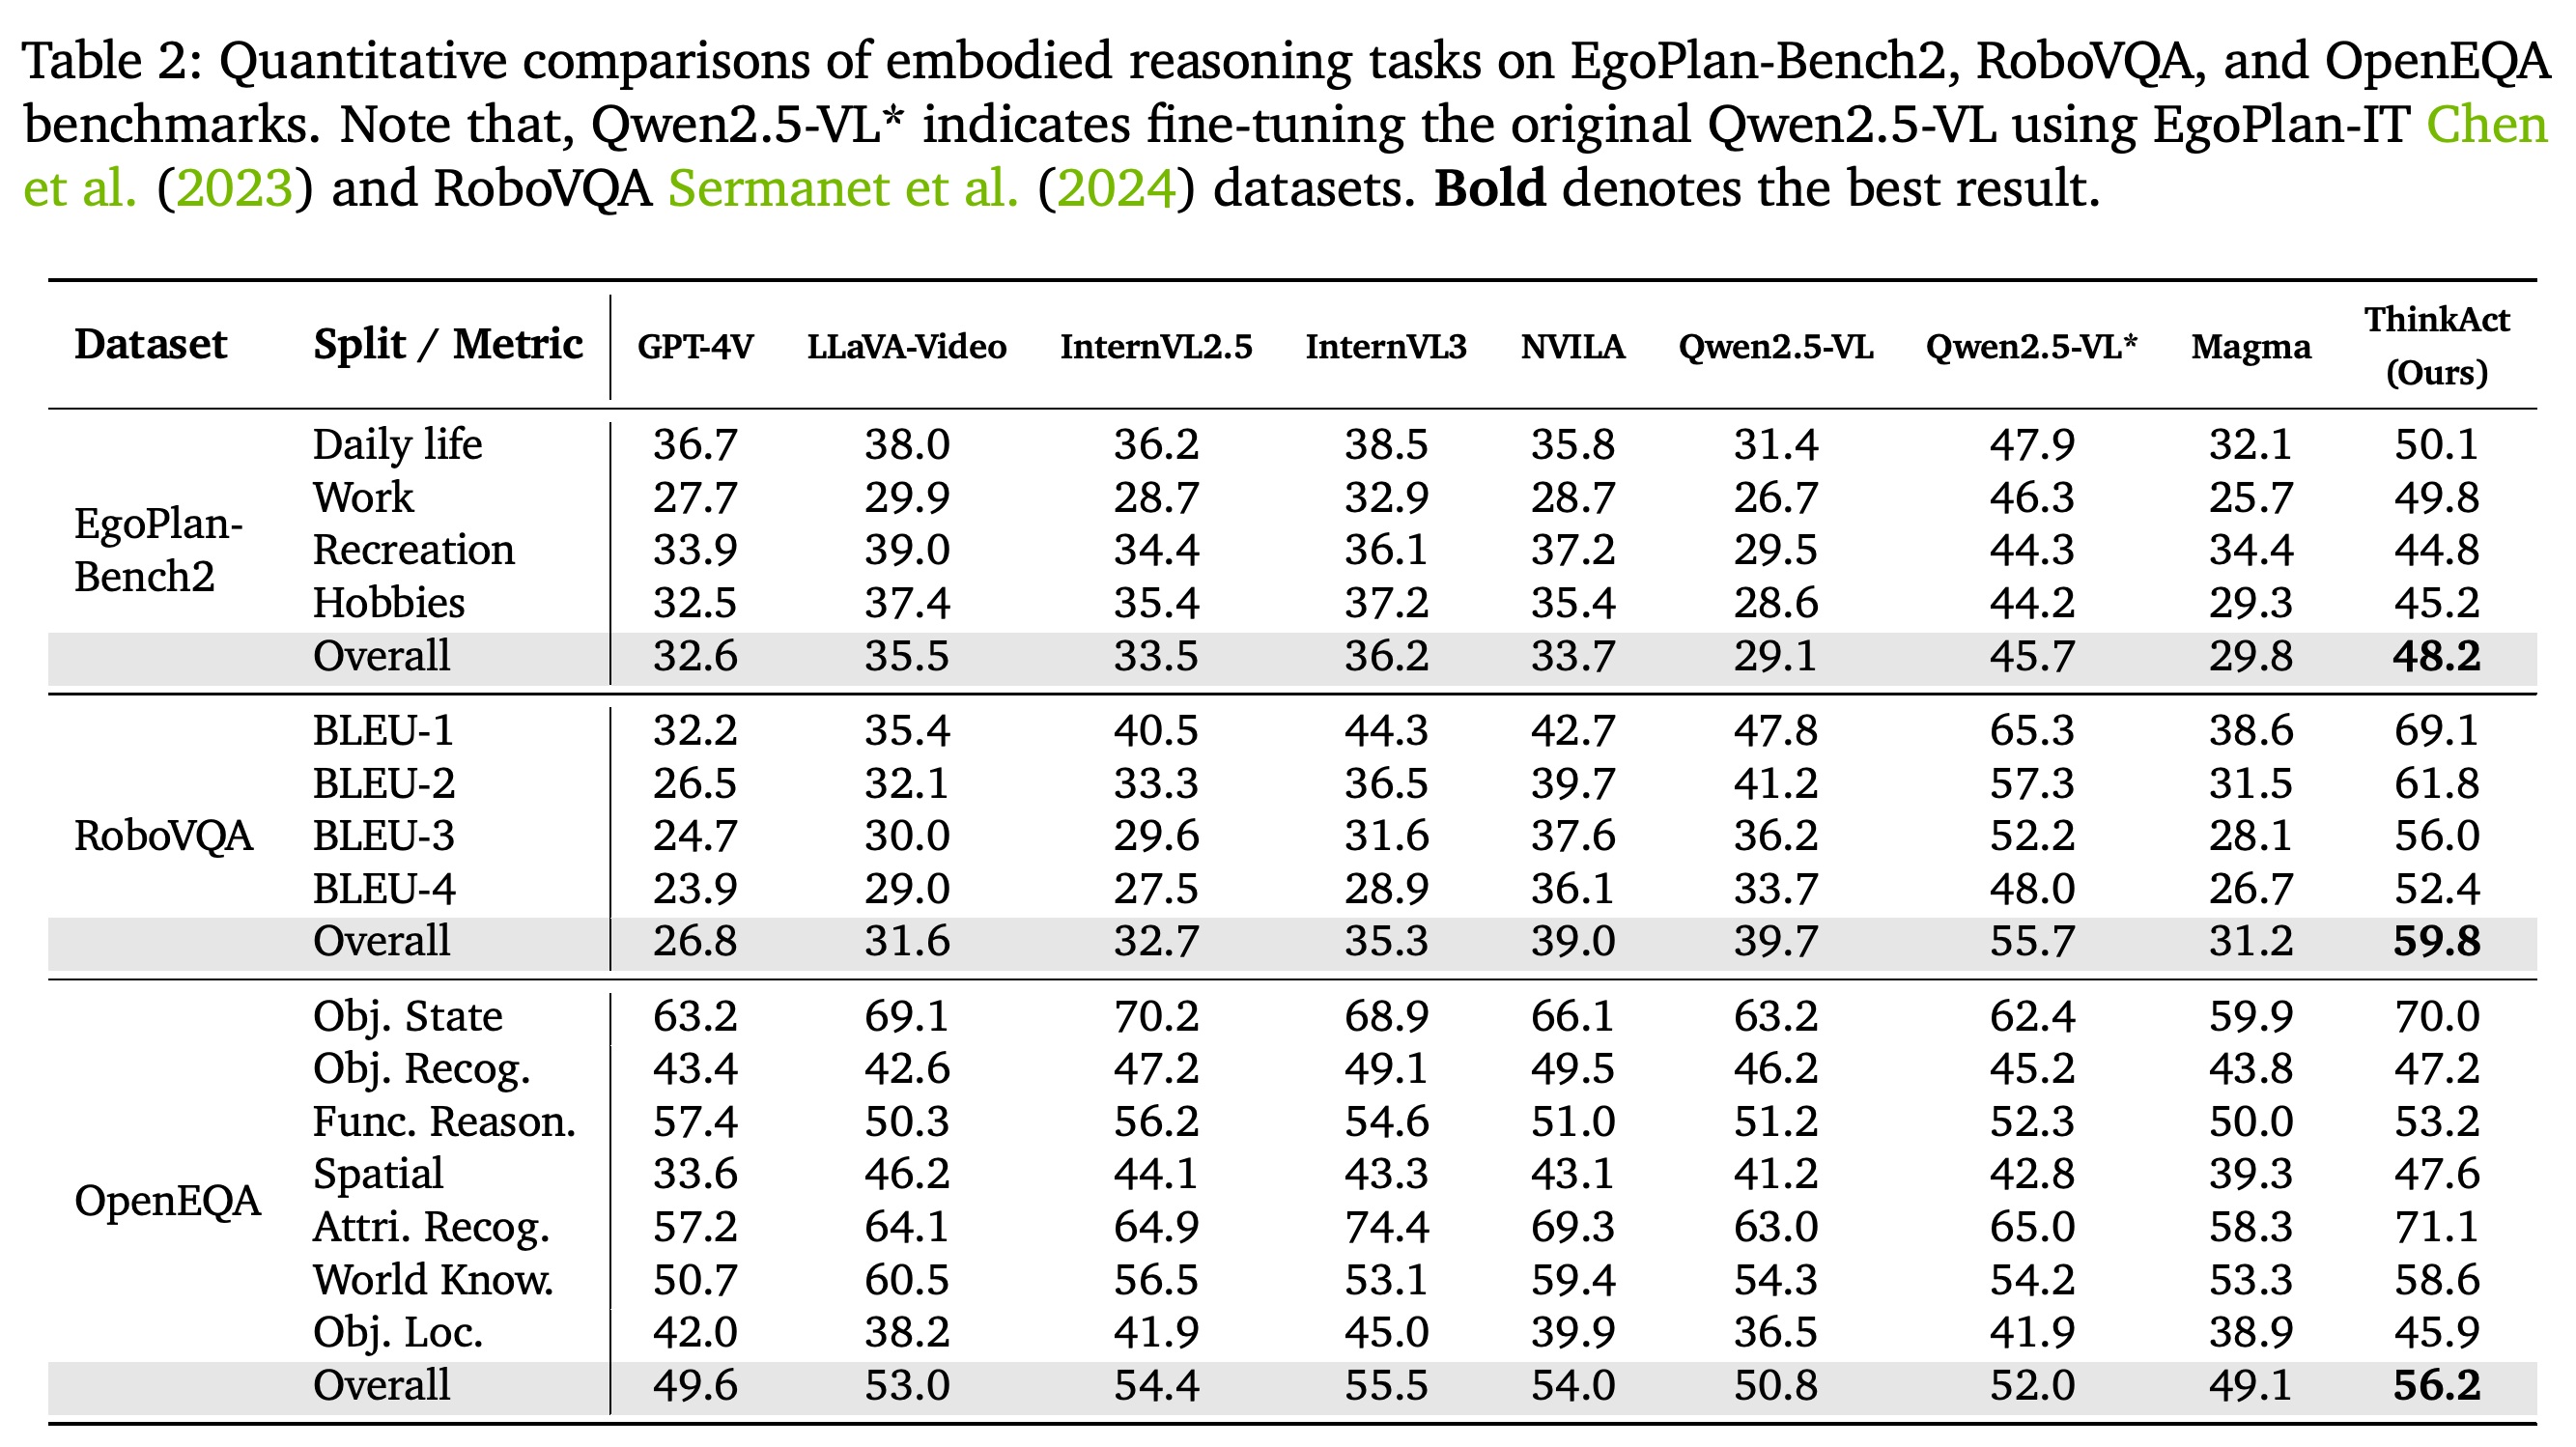
Embodied Reasoning에서 ThinkAct는 EgoPlan-Bench2에서 48.2%, RoboVQA에서 전체 BLEU 59.8을 기록한다. EgoPlan-IT와 RoboVQA로 미세조정한 기준 모델 Qwen2.5-VL*의 결과는 각각 45.7%, 55.7이다. OpenEQA에서 ThinkAct의 전체 점수는 56.2이며, 표에 제시된 비교 모델 중 전체 점수가 가장 높은 InternVL3는 55.5다.
- ThinkAct는 표에 제시된 EgoPlan-Bench2의 4개 도메인과 RoboVQA의 4개 BLEU 차수 모두에서 가장 높은 점수를 기록한다.
- OpenEQA 결과는 범주별로 차이가 있다. 기능 추론, 물체 인식, 세계 지식 등의 범주에서는 다른 모델이 앞선다.
Qwen2.5-VL*와의 비교는 계획 및 로봇 질의응답 데이터로 이미 미세조정한 기반 모델에 비해서도 성능이 향상됨을 보여준다. ThinkAct는 3개 전체 지표 모두에서 앞선다. 다만 OpenEQA에서 InternVL3 대비 차이는 0.7점이며, 모든 범주에서 앞서지는 않는다.
4.3. Qualitative Results
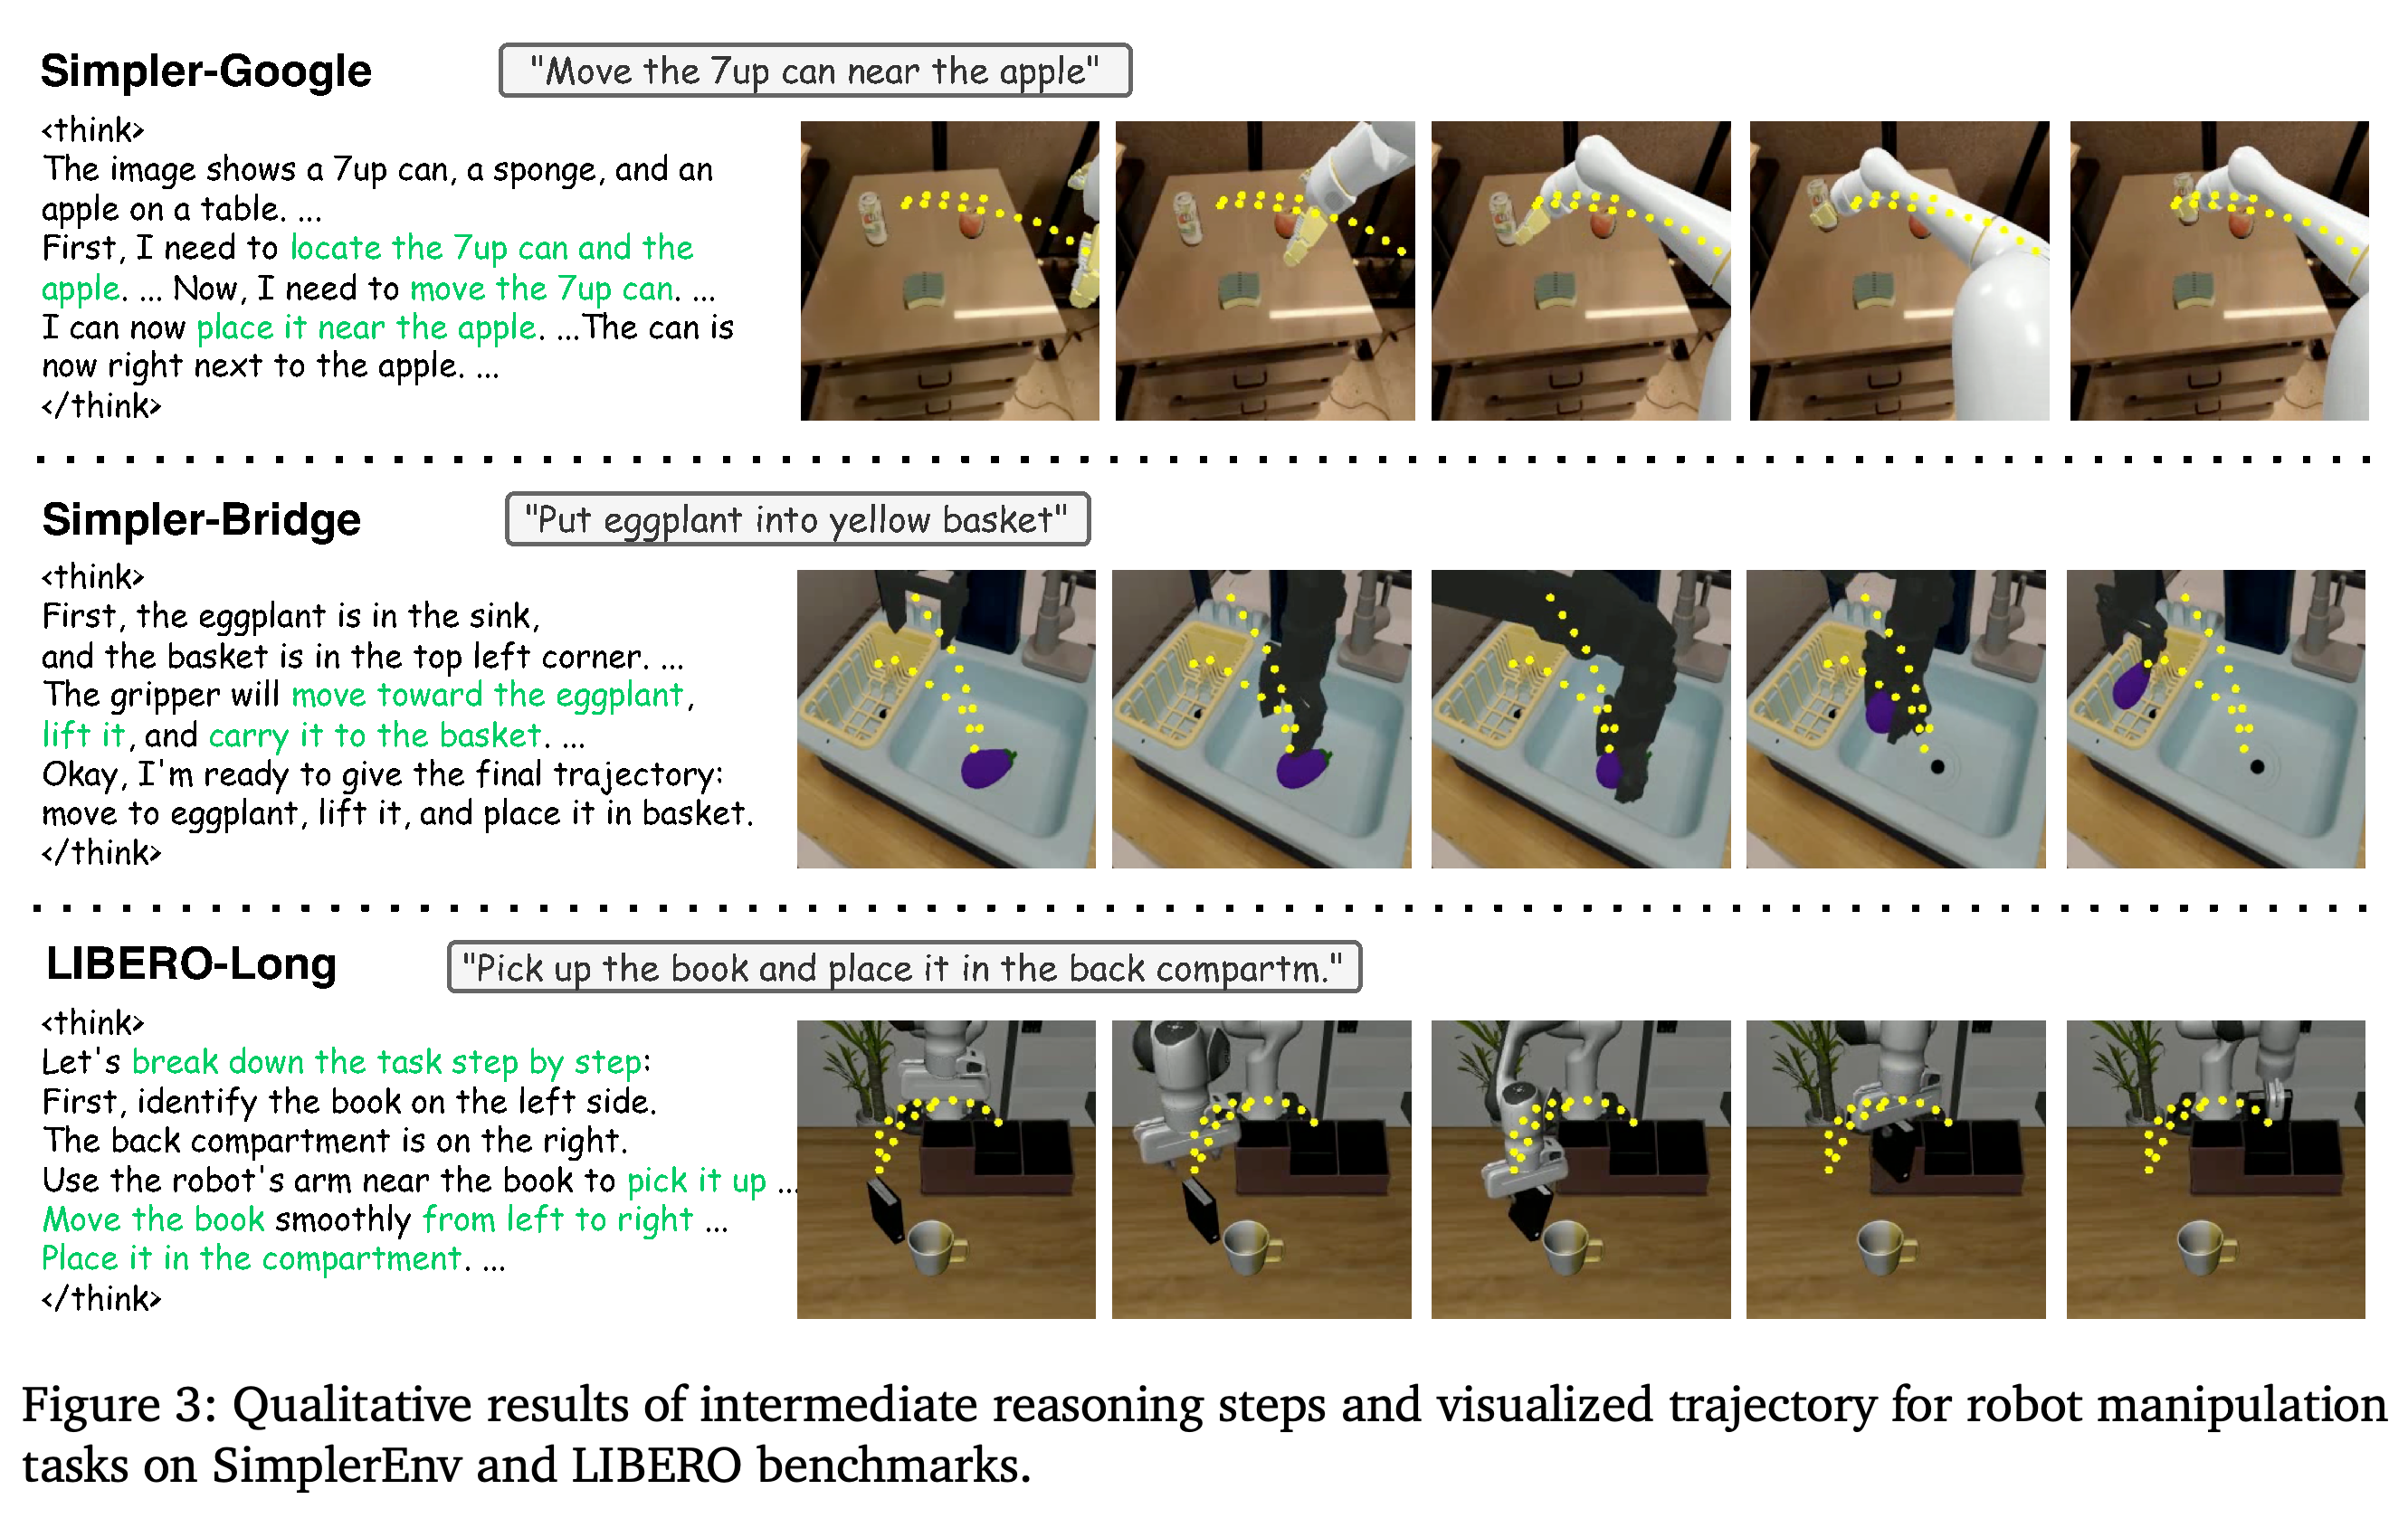
조작 사례는 텍스트 하위 목표, 이미지 공간에서 계획한 궤적, 실행 프레임을 함께 제시한다. LIBERO-Long의 책 과제에서는 책 잡기, 왼쪽에서 오른쪽으로 옮기기, 뒤쪽 칸에 놓기로 계획을 나눈다.
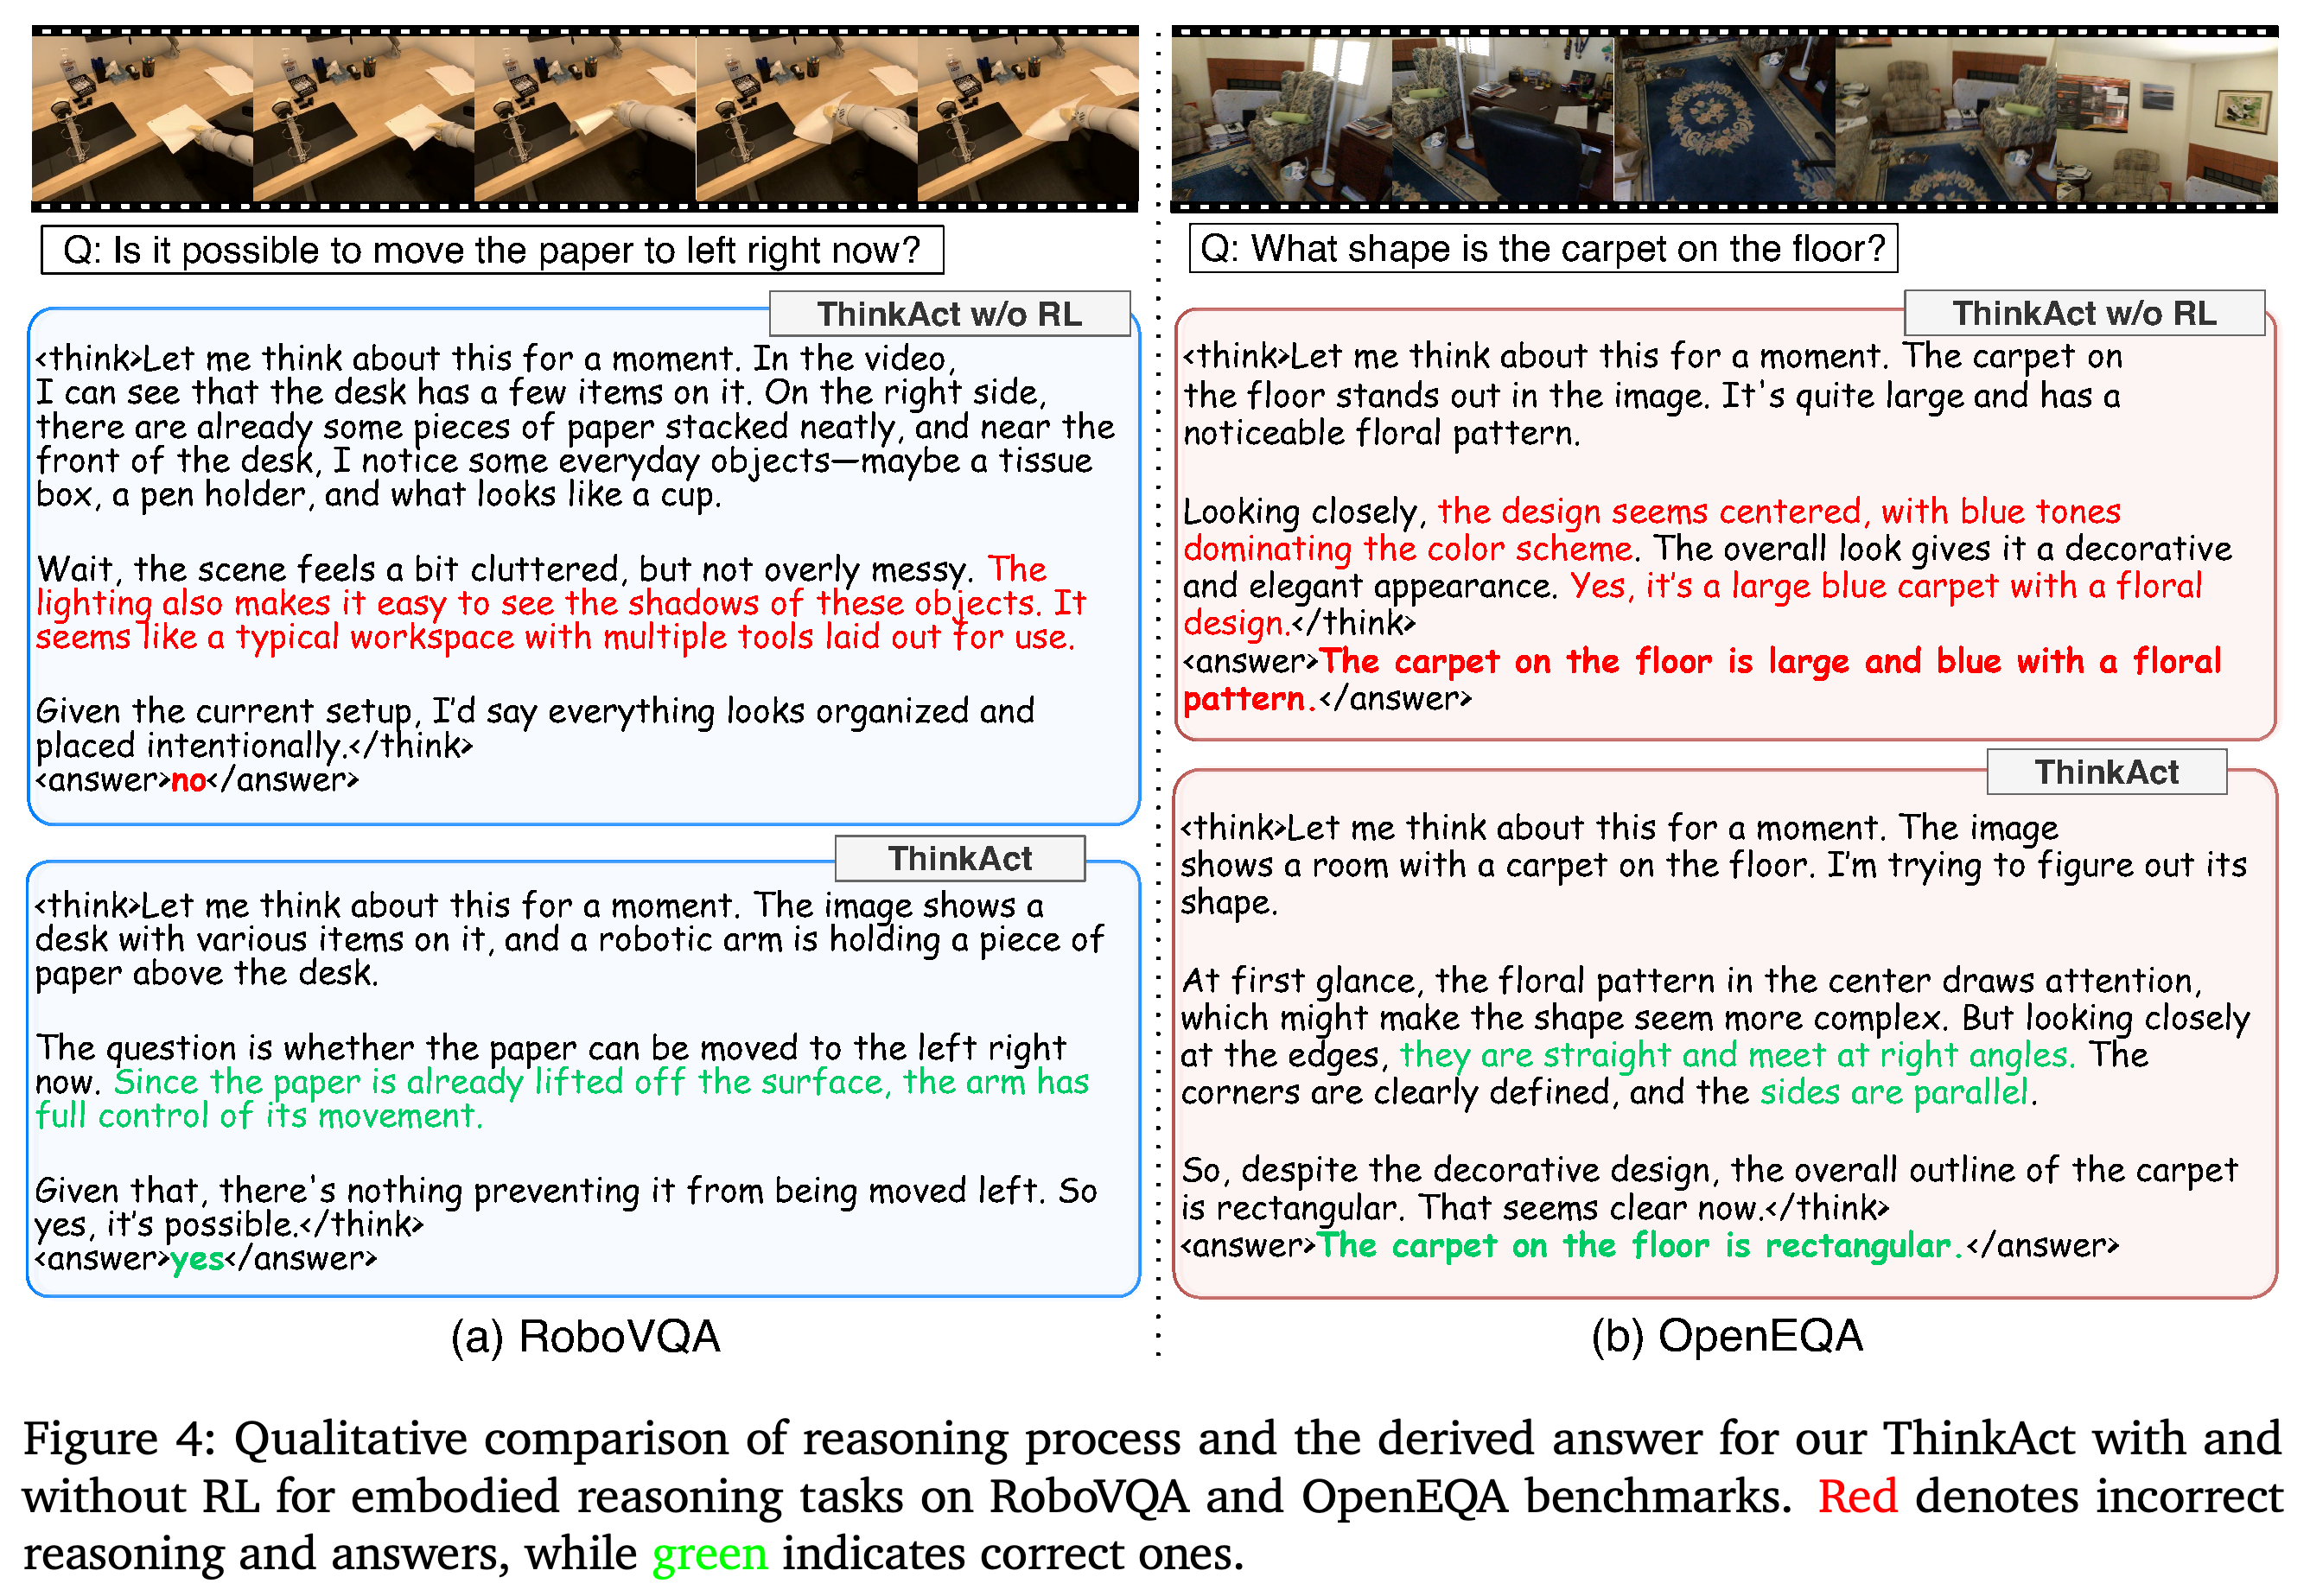
- RL 전후 비교에서 RoboVQA 답변은 들어 올린 종이를 왼쪽으로 옮길 수 있음을 인식하도록 바뀐다. OpenEQA 답변은 카펫의 외관에 관한 설명에서 직사각형 모양에 관한 설명으로 바뀐다.
- 이 선별 사례들은 계획과 질문 해석을 보여주지만, 생성한 추론이 얼마나 자주 정확한지는 정량화하지 않는다.
발췌한 추론은 캔, 가지, 책 조작을 공간적 단계로 나누며, 노란 궤적은 실행 프레임 위에 표시된다. 이 시퀀스는 계획한 움직임과 실행 사이의 대응을 보여주지만, 전체 벤치마크에서 그 대응을 측정하지는 않는다.
RL 이후 모델은 종이가 이미 들어 올려져 있다는 관찰을 활용해 종이 이동 질문에 답하고, 카펫의 윤곽을 활용해 카펫 질문에 답한다. 이 2개 사례는 질문과 관련된 시각적 근거를 선택하는 능력의 개선을 보여준다.
4.4. Ablation Study
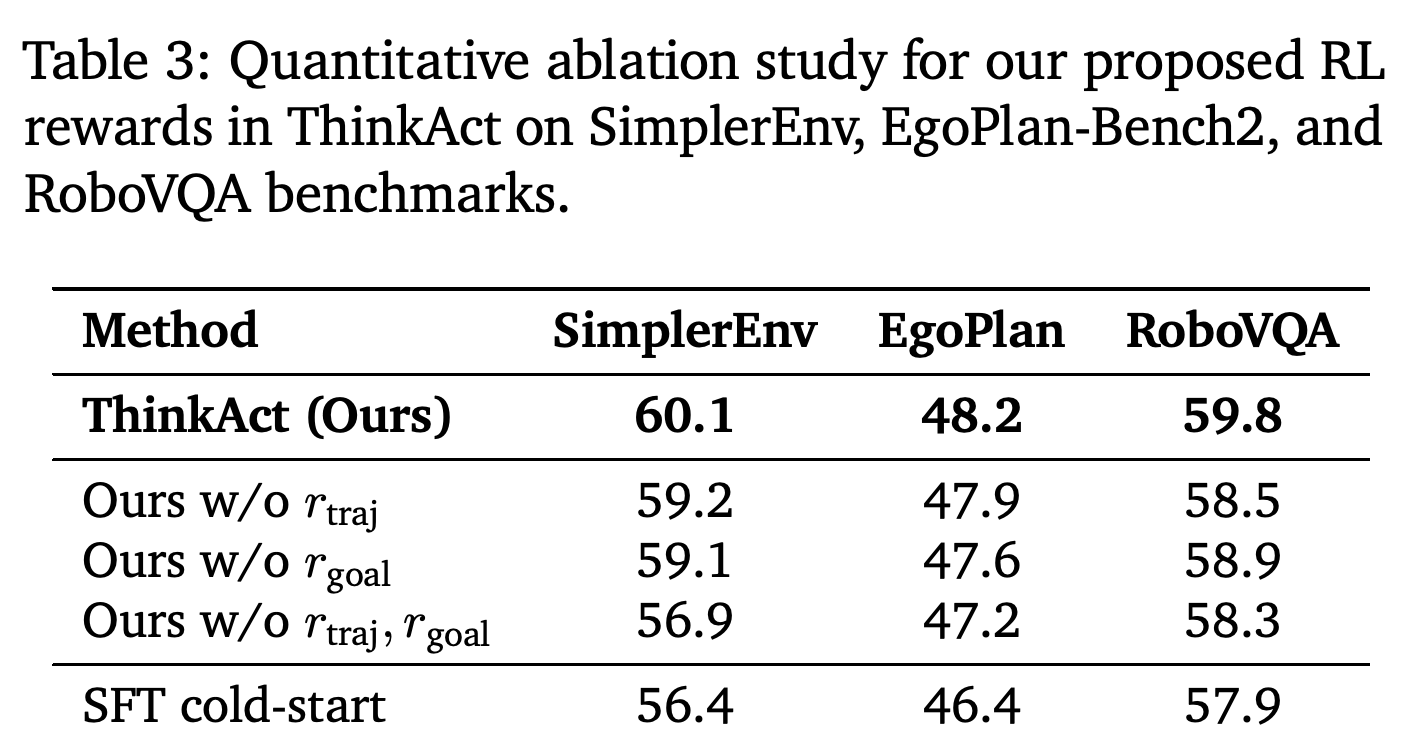
전체 모델은 SimplerEnv에서 60.1, EgoPlan-Bench2에서 48.2, RoboVQA에서 59.8을 기록한다. 궤적 보상을 제거하면 각각 59.2, 47.9, 58.5이며, 목표 보상을 제거하면 59.1, 47.6, 58.9다.
- 시각 보상을 모두 제거한 결과는 56.9, 47.2, 58.3이며, SFT 초기 모델의 결과는 56.4, 46.4, 57.9다.
- 목표 보상과 궤적 보상은 모두 질의응답 보상만 사용하는 설정보다 보고된 점수를 높인다. 표에는 불확실성 추정치가 없다.
시각 보상 중 어느 하나를 제거해도 보고된 3개 점수가 모두 낮아진다. 모두 제거하면 결과가 SFT 초기 모델에 가까워진다. 이는 질의응답 보상과 함께 사용하는 시각 피드백의 기여를 뒷받침한다. 불확실성 추정치는 제시하지 않는다.
4.5. Analysis of ThinkAct
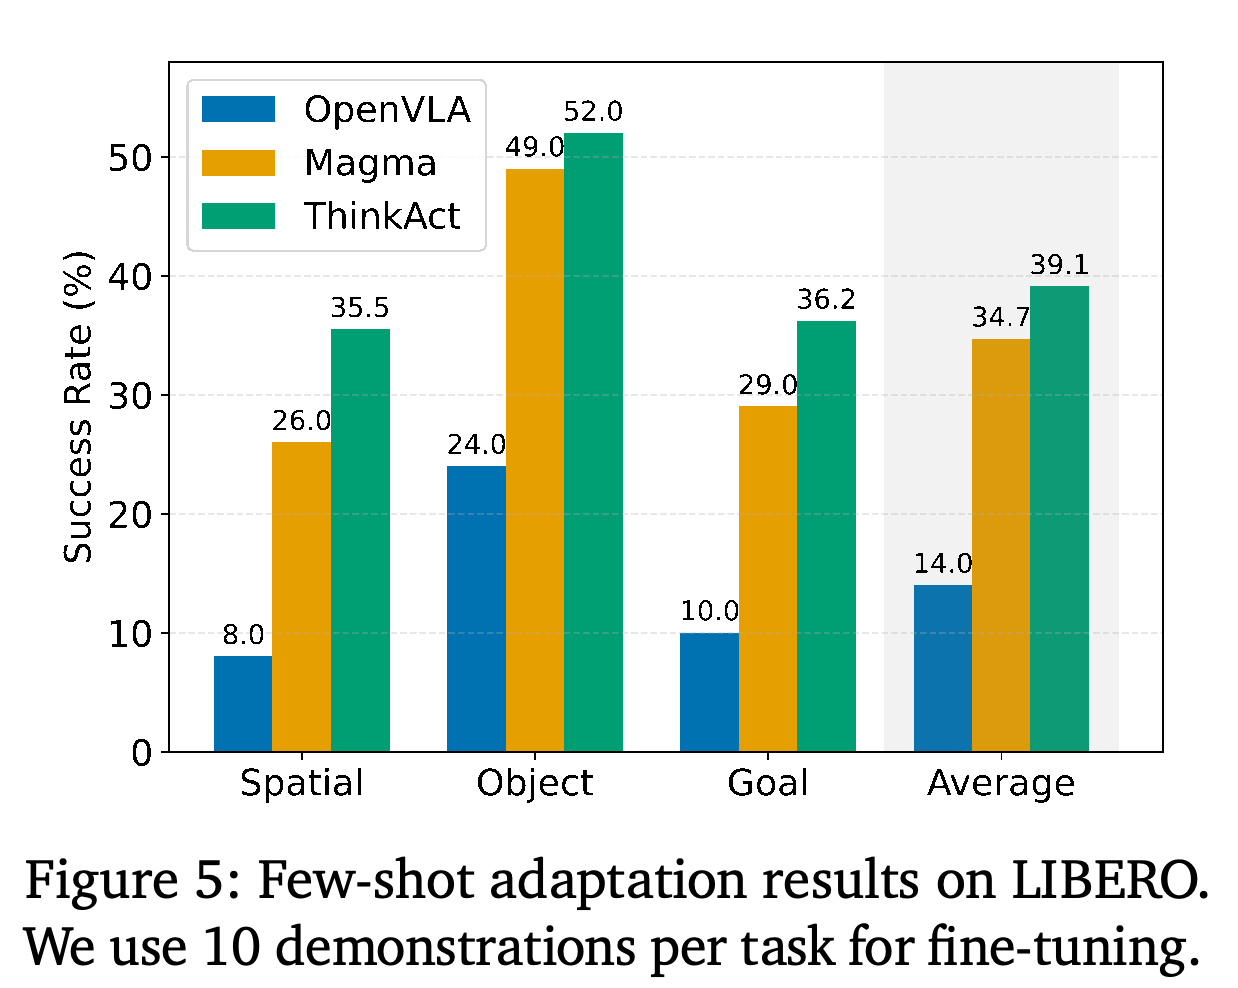
소수의 시연으로 적응하는 Reasoning Enhance Few-Shot Adaptation에서는 과제당 시연 10개로 제어기를 미세조정하고 100회 시행으로 평가한다. LIBERO-Spatial과 LIBERO-Object는 보지 못한 환경을, LIBERO-Goal은 새로운 기술을 평가한다. ThinkAct는 각각 35.5%, 52.0%, 36.2%를 달성하며, Magma는 26.0%, 49.0%, 29.0%를 기록한다.
- Figure 5에 보고된 평균은 ThinkAct 39.1%, Magma 34.7%, OpenVLA 14.0%다. ThinkAct의 평균은 표시된 3개 평가군 점수의 산술평균인 약 41.2%와 일치하지 않는다. 그래프의 Goal 값으로 계산한 Magma 대비 향상 폭도 7.2%포인트이지만, 본문에는 7.3%로 기재되어 있다.
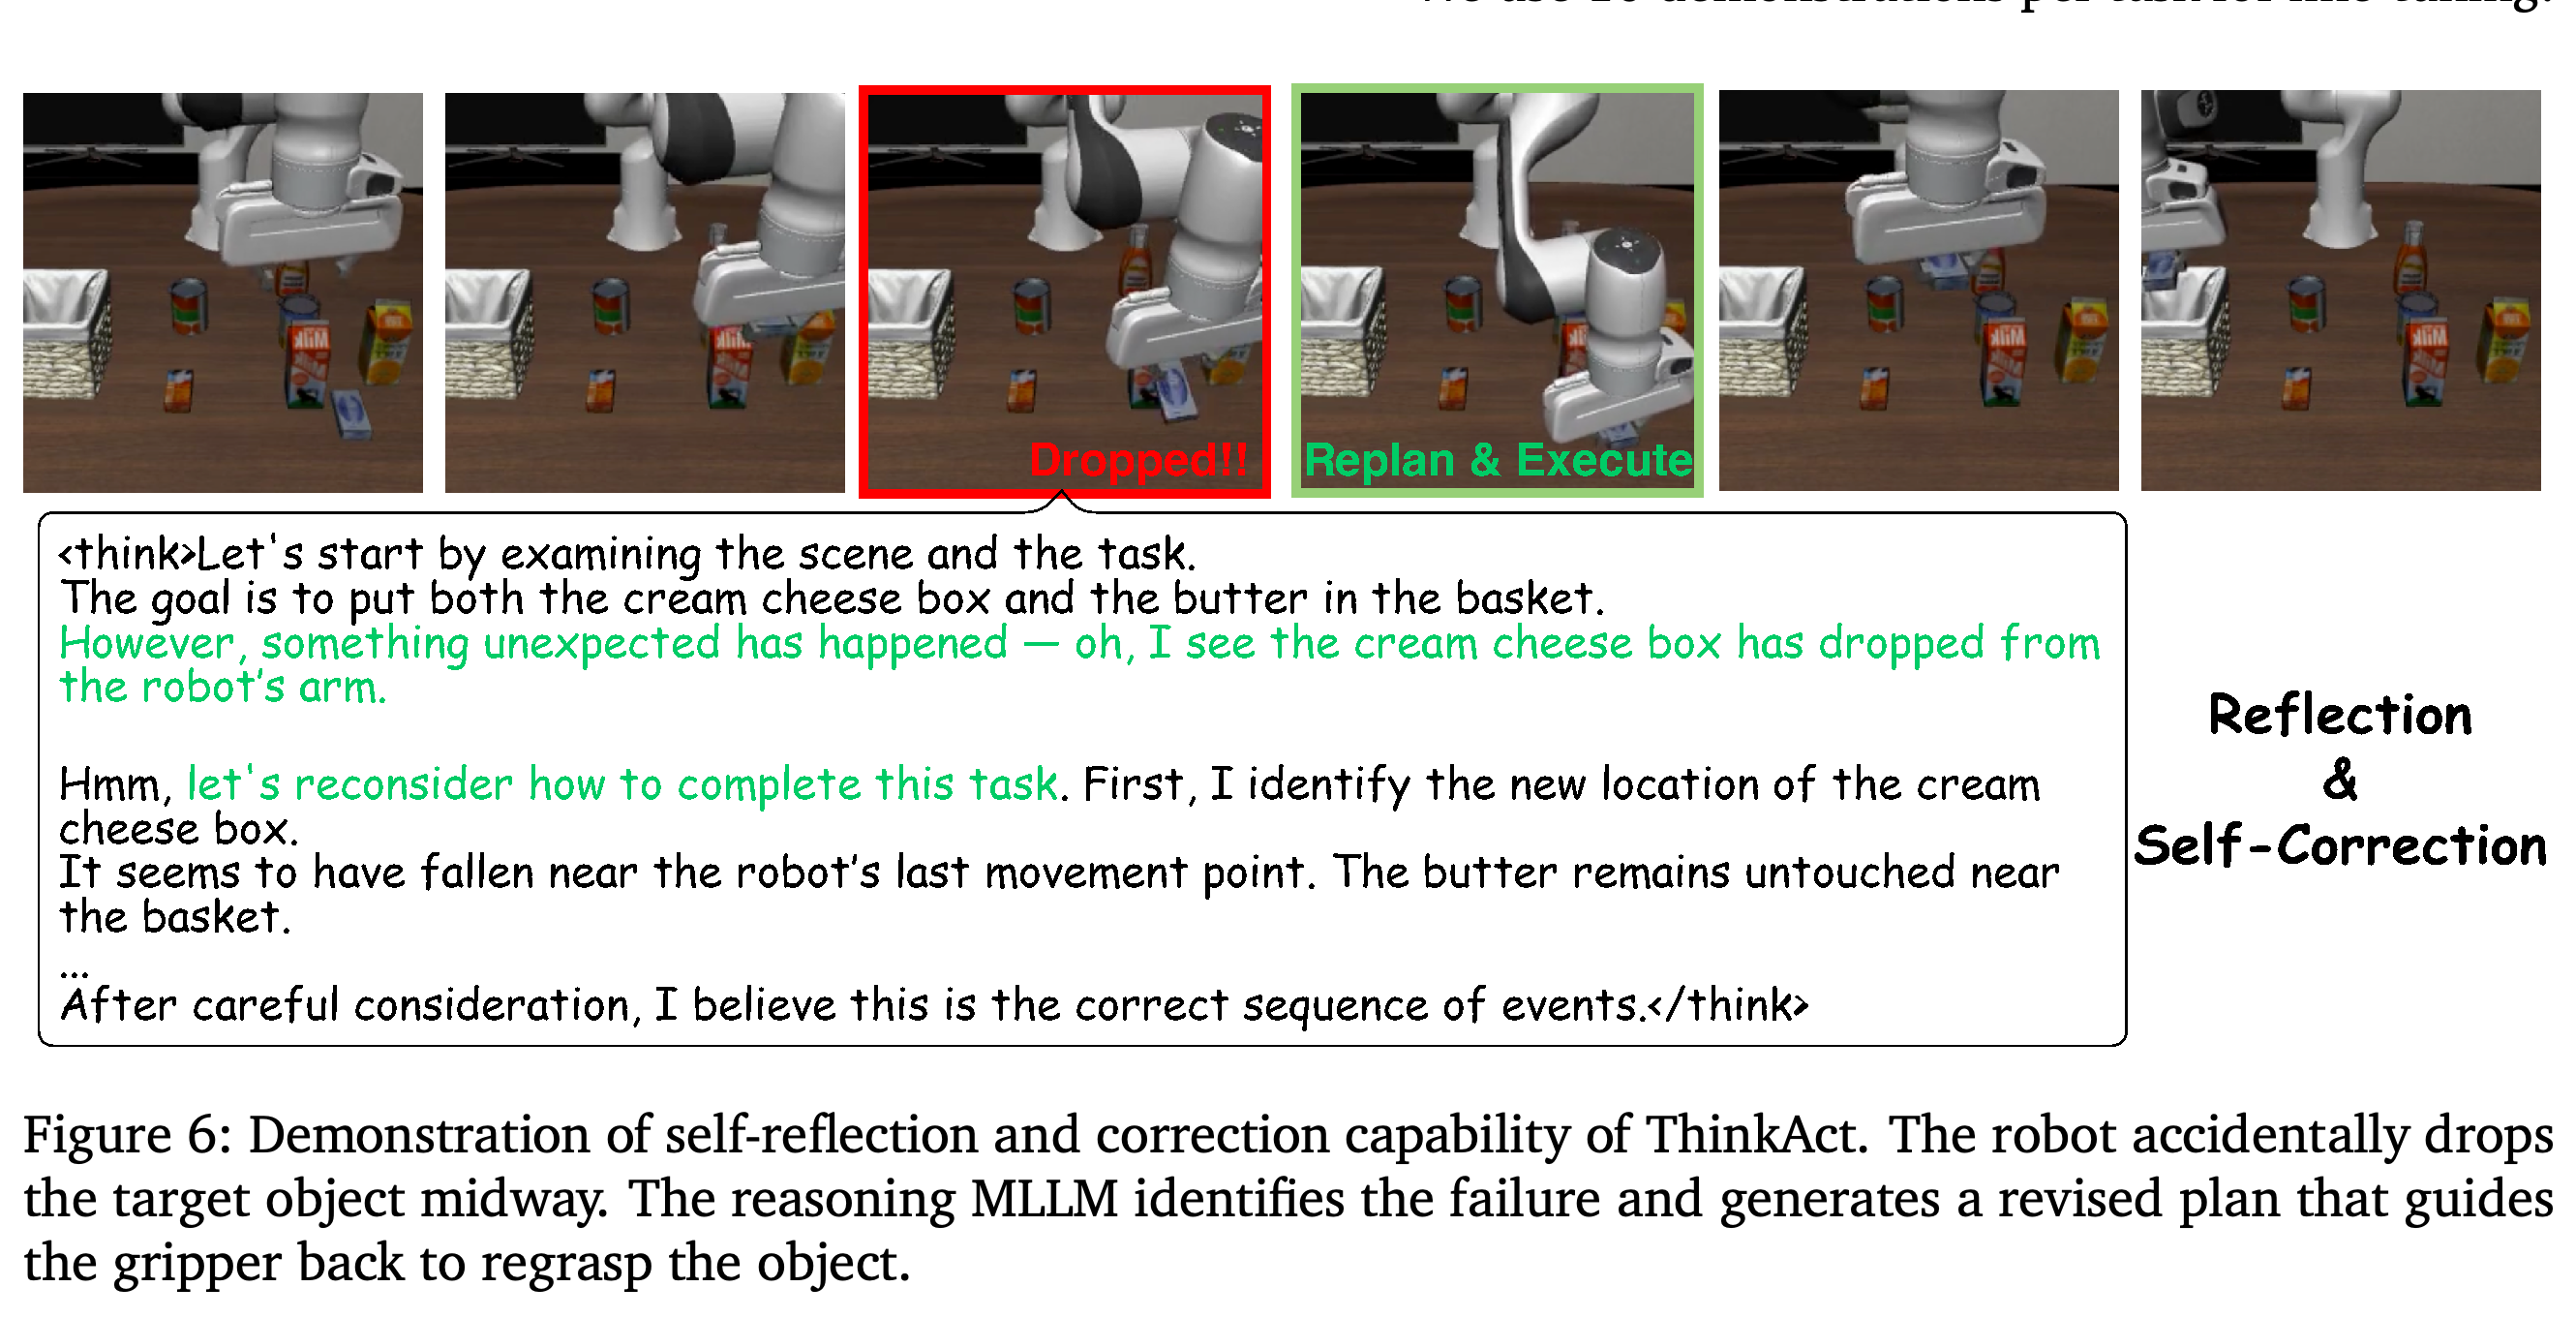
- Reasoning Elicit Self-Correction에서는 계획기에 이미지 1개 대신 짧은 영상 구간을 입력한다. 제시된 로봇은 떨어진 상자를 감지하고 계획을 수정한 뒤, 상자를 다시 잡아 과제를 완료한다.
- 이 복구 사례는 시간적 맥락을 추가로 사용한다. 해당 절에는 전체 복구 성공률이 보고되어 있지 않다.
과제당 시연 10개를 사용했을 때 ThinkAct는 그래프에 표시된 3개 LIBERO 평가군 모두에서 OpenVLA와 Magma를 앞선다. 차트는 평균을 ThinkAct 39.1%, Magma 34.7%, OpenVLA 14.0%로 보고하지만, ThinkAct에 표시된 평가군별 점수의 산술평균은 약 41.2%다.
이 시퀀스는 크림치즈 상자를 떨어뜨린 뒤 계획을 다시 세우고 실행을 재개하는 과정을 보여준다. 본문에서 설명한 짧은 영상 입력을 사용하는 복구 사례 1개를 제시하며, 논문은 전체 복구 성공률을 제공하지 않는다.
5. Conclusion
결론에서는 시각 보상으로 학습한 계획과 latent를 조건으로 사용하는 행동 적응을 결합하여 ThinkAct의 조작 및 추론 결과를 얻었다고 설명한다. 벤치마크 비교는 전체 과제 성능의 개선을 뒷받침하며, 실행 사례는 다단계 분해와 실패 복구를 보여준다.
Limitations
저자들은 사전학습된 MLLM이 물체 속성과 공간 관계에 관한 환각을 생성하여, 후속 실행에 영향을 주는 잘못된 계획을 만들 수 있다고 인정한다. 시각 관찰과의 일치도를 높이는 학습과 환각 억제를 향후 과제로 제시한다.
Broader Impacts
논문은 보조 로봇, 가정 자동화, 산업 시스템을 잠재적 응용 분야로 제시한다. 또한 모호한 지시, 시각적 추론의 환각, 생성된 추론에 대한 과신이 특히 안전이 중요한 환경에서 의도하지 않은 행동을 일으킬 수 있다고 지적한다.
부록
- A. Additional Experimental Setup과 A.1. Implementation Details에서는 GRPO 규제 가중치 β를 1e−2, 최대 응답 길이를 1024, temperature를 1.0으로 명시한다. 누적 확률 p = 0.99에 해당하는 유력 출력 집합에서 샘플링하는 top-p sampling도 사용한다. 계획기는 영상 프레임을 최대 16개 사용한다. 최대 해상도는 영상 데이터에서 128 × 28 × 28 pixels, 이미지 데이터에서 256 × 28 × 28 pixels로 기재하며, 궤적 점 K = 8개를 생성한다. 추가 질의응답 보상은 객관식 답변에 정확도를, 자유 형식 답변에 텍스트 중복도 지표인 ROUGE-1/2/L 점수의 평균을 사용한다.
- Reasoning-Enhanced Action Adaptation에서는 제어기를 학습하는 동안 계획기의 latent를 오프라인으로 캐시한다. Diffusion 제어기는 학습 시 잡음 스케줄인 DDPM noise scheduler에서 1000개 timestep을 사용하고, 추론 시 잡음 제거 절차인 DDIM sampling을 20단계 수행한다. 표준 제어기 관찰은 빨강, 초록, 파랑 채널로 구성된 224 × 224 RGB 3인칭 이미지 1장이다. 계획은 SimplerEnv에서 상호작용 N = 15회마다, LIBERO에서 N = 75회마다 갱신한다.
- A.2. Training Data Preparation과 A.2.1. Training Datasets에서는 OXE의 fractal20220817_data 및 bridge 하위 집합에서 gripper 이동 경로를 추출하고, 영상당 시작 프레임 3개를 샘플링하며, 핵심점 수를 줄이는 Ramer–Douglas–Peucker 알고리즘으로 궤적을 단순화한다고 설명한다. 사람의 궤적에는 손 검출을 사용하며, 손이 2개 나타나면 움직임이 가장 큰 손을 선택하고 카메라 안정화를 적용한다. 데이터셋에는 RoboVQA의 약 5K개 장기 과제 영상과 92K개 중기 과제 영상, 질의응답 300쌍으로 재구성한 RoboFail의 시뮬레이션 사례 100개와 실제 사례 30개, EgoPlan-IT 사례 50K개와 EgoPlan-Val 사례 5K개, Video-R1-CoT 샘플 165K개가 포함된다. LLaVA-Video-178K에는 영상 178K개, 개방형 질문 960K개, 객관식 질문 196K개가 포함된다.
- A.2.2. Training Data Construction에서는 SFT에 궤적 30K개, RoboVQA 샘플 50K개, EgoPlan-IT 샘플 50K개, Video-R1-CoT 샘플 165K개를 사용한다고 명시한다. RL에는 궤적 12.5K개, RoboVQA 샘플 10K개, EgoPlan-IT/Val 샘플 10K개, RoboFail 샘플 0.5K개, LLaVA-Video-178K 샘플 10K개를 사용한다. Table A4는 정규화된 궤적 점 8개와 별도의 추론 및 답변 태그를 포함하는 궤적 및 질의응답 프롬프트 형식을 제시한다.
- A.3. Evaluation Benchmarks에서는 SimplerEnv의 조명, 텍스처, 배경, 방해 물체, 카메라 자세 변화를 설명한다. LIBERO는 무작위 시드 3개를 사용하여 평가군당 500회 시행한다고 명시한다. EgoPlan-Bench2는 일상생활의 4개 도메인과 24개 시나리오에 걸친 객관식 질문 1,321개를 포함한다. RoboVQA 평가는 검증용 영상–텍스트 쌍 1,893개를 사용한다. OpenEQA는 180개가 넘는 실제 환경에서 사람이 작성한 질문 1,600개 초과를 포함하며, 언어 모델 기반 채점을 사용한다.
- B. Additional Experiment Results와 B.1. Qualitative Comparisons of Robot Execution Results에서는 DiT-Policy 및 OpenVLA와의 비교를 ThinkAct.mp4로 안내한다. B.2. Additional Qualitative Results는 RL을 통해 다음 행동에 관한 오답이 정답으로 바뀐 EgoPlan-Bench2 사례를 추가한다. B.3. More Self-Correction Samples는 머그잔 파지 실패와 상자 집기 실패에서 복구한 사례를 보여준다. B.4. Results of Smaller Model Size에서 ThinkAct-3B는 EgoPlan-Bench2, RoboVQA, OpenEQA에서 각각 44.0, 55.3, 48.9를 기록하며, Qwen2.5-VL-3B*는 43.0, 53.6, 44.6을 기록한다.
- B.5. Results of 5-Shot Adaptation에서는 과제당 시연 5개와 평가 시행 100회를 사용한다. ThinkAct는 LIBERO-Spatial, LIBERO-Object, LIBERO-Goal에서 각각 24.0%, 29.0%, 32.5%를 달성한다. 보고된 평균은 28.5%이며, Magma는 21.3%, OpenVLA는 8.3%다.
- B.6. Ablation Study에서 LIBERO/OpenEQA 점수는 전체 모델이 84.4/56.2, 궤적 보상 제거 시 82.1/55.9, 목표 보상 제거 시 81.7/55.6, 모두 제거 시 81.6/55.7, SFT 초기 모델이 79.1/53.3이다. N을 25, 50, 75, 100으로 설정하면 LIBERO 성공률은 각각 84.0%, 84.6%, 84.4%, 83.7%다. 저자들은 비슷한 성능을 유지하면서 계획 빈도를 줄이기 위해 75를 선택한다. B.7. Inference Speed에서는 A100 GPU로 LIBERO를 실행할 때 평균 실행 시간이 OpenVLA보다 17% 길다고 보고한다.
짧은 생각
ThinkAct를 뒷받침하는 가장 명확한 근거는 제어기 기준 모델과의 비교 및 보상 제거 실험이다. 시연 기반 시각 피드백은 질의응답 RL만 사용할 때보다 보고된 결과를 개선한다. CoT-VLA 대비 LIBERO 전체 성공률 차이는 0.5%포인트로 작으며, 비교에는 불확실성 추정치가 없다. 조작 평가는 시뮬레이션 벤치마크를 사용한다. 실제 환경 영상에서 얻은 결과만으로 물리적 환경에 배치했을 때의 신뢰성을 입증할 수는 없다. 자기 수정은 선별된 사례로 제시한다. 보고된 실행 시간 증가율 17%는 추가 계획에 드는 비용을 측정한 결과다.