


Demystifying Hidden-State Recurrence: Switchable Latent Reasoning with On-Policy Reinforcement Learning 요약 설명
11 Jun 2026 | Paper Review Latent Reasoning Reinforcement Learning Mechanistic Interpretability목차
- 요약
- 1. Introduction
- 2. Related Work
- 3. Method
- 4. Experiments
- 5. How Does Latent Work in Reasoning?
- 6. Conclusion
- Limitations
- 부록
- 짧은 생각
이번 글에서는 Demystifying Hidden-State Recurrence: Switchable Latent Reasoning with On-Policy Reinforcement Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 11일(Arxiv)
- Yang, Jiayu, Chen, Chao, Wu, Shengen, Liu, Yinhong, Fan, Yuxuan, Li, Lujundong, Lai, Songning, Qin, Chengwei, Guo, Zhijiang.
- HKUST(GZ), University of Cambridge, NTU, JoinQuant, HKUST
- 논문 링크
요약
- Switch는 <swi>와 </swi>로 명시적 추론 안에서 연속적인 hidden-state recurrence의 경계를 표시한다. 이 이산 경계는 전환 결정의 정책 확률을 제공하며, 프로빙과 개입을 수행할 위치를 명확히 지정한다.
- 학습은 엔트로피 기반 경계 주석, 명시적 추론을 잠재 추론으로 바꾸는 지도학습 커리큘럼, hidden-state recurrence를 실행하는 Switch-GRPO rollout을 결합한다. 구현된 RL 역전파는 텍스트 구간만 미분한다. 잠재 구간은 torch.no_grad()에서 실행되며, 고정된 KV cache를 통해 이후 텍스트 생성에 조건을 제공한다.
- Qwen3-8B에서 최고 성능 실행은 MATH-500에서 79.3%, GSM8K에서 89.2%를 달성하여 재구현한 recurrent-latent 기준 모델을 앞선다. 다만 Switch는 문제당 명시적 토큰을 각각 1,721개와 1,608개 사용하며, 해당 기준 모델은 약 10개를 사용한다. 따라서 이 비교만으로 동일한 추론 비용에서의 우위를 입증하지는 못한다.
- 경계 확률과 선형 프로브는 전환 관련 특징이 특정 위치에 집중되어 있음을 뒷받침하며, 개입 실험은 선별한 진단용 부분집합에서 답변이 개입에 민감함을 확인한다. 반면 잠재 상태가 문제별 정보를 담는다는 주장과 유용한 계산이 1개 진입 전이에 집중된다는 주장의 근거는 덜 명확하다. 같은 노름의 무작위 상태로 대체해도 영향이 비교적 작으며, 단계별 인과적 ablation 실험은 보고하지 않는다.
1. Introduction
Hidden-state recurrence는 디코딩한 추론 토큰 대신 이전 단계의 최종 hidden state를 다음 입력 임베딩으로 사용한다. 논문은 2가지 장애물을 지적한다. 연속적인 잠재 위치는 표준 policy-gradient 학습에 필요한 범주형 행동 확률을 제공하지 않으며, 실행 과정에는 인과적 분석을 위한 명시적 경계가 없다.
Switch는 별도의 잠재 아키텍처를 추가하는 대신 학습된 진입 토큰과 종료 토큰으로 두 장애물을 해결한다. 공개 구현은 https://github.com/LARK-AI-Lab/SWITCH 에 있으며, 공개 모델 가중치는 https://huggingface.co/LARK-Lab/SWITCH-Phase3-GRPO-LoRA-Qwen3-8B 에 있다.
2. Related Work
논문은 Coconut과 CODI가 사용하는 결정론적 hidden-state recurrence를 vocabulary-embedding mixture와 구분한다. 최근 mixture 기반 RL 방법은 Gumbel-Softmax로 샘플링을 도입한다. 반면 Switch는 recurrence를 유지하면서 이산 전환 결정을 추가하며, 외부 엔트로피 규칙을 사용하는 학습 없는 SwiReasoning과도 다르다.
- Vocabulary-mixture 방법은 주요 비교에서 제외한다. 따라서 결과만으로 RL로 학습한 잠재 추론 모델 전반에 대한 우위를 입증하지는 못한다.
- Pause 계열 토큰과 적응형 명시적 추론도 압축이나 계산량 배분 기능을 제공하지만, 동일한 recurrent latent representation을 사용하지는 않는다.
3. Method
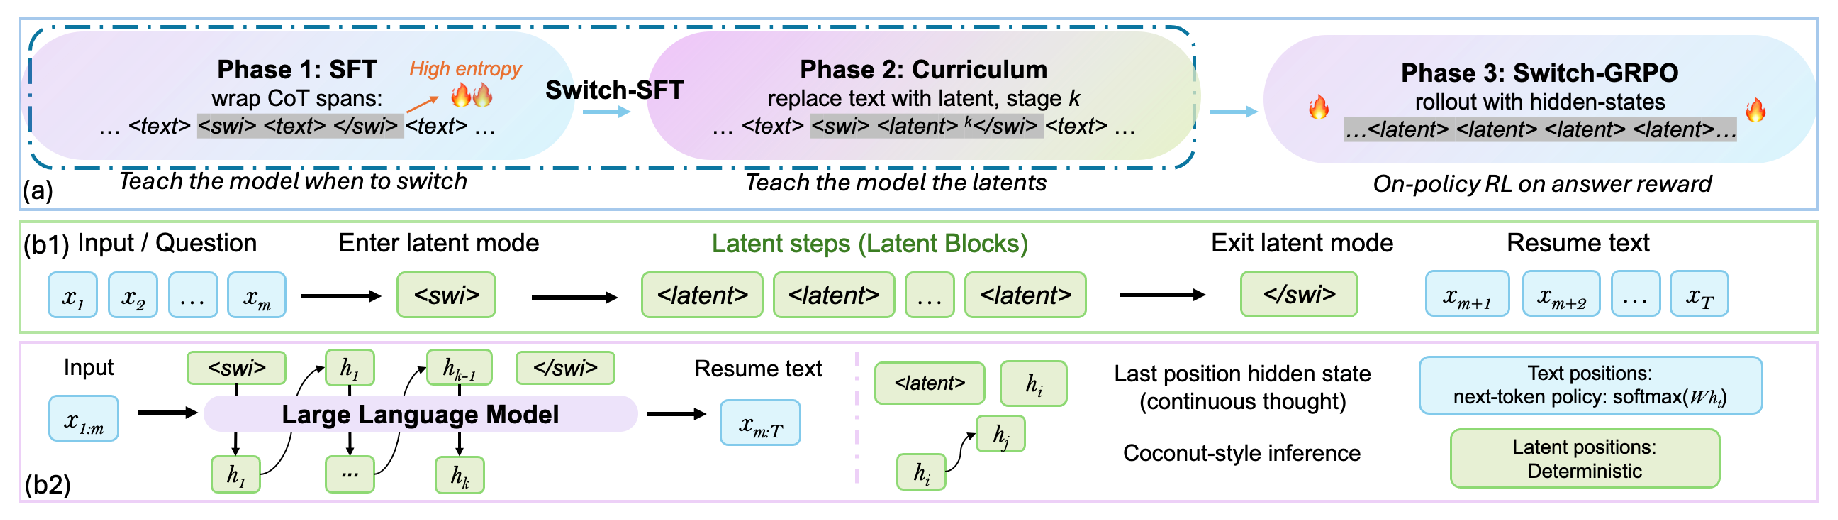
3개 학습 단계는 같은 경계 인터페이스를 공유한다. Phase 1은 선택한 명시적 CoT 구간에 경계를 표시하도록 학습한다. Phase 2는 해당 구간의 내용을 잠재 위치로 점진적으로 대체한다. Phase 3은 hidden-state injection을 포함한 궤적에 Switch-GRPO를 적용한다. 앞의 2개 단계를 합쳐 Switch-SFT라고 부른다.
도식은 3개 학습 단계를 실제 디코더와 연결한다. 정책 확률을 갖는 샘플링된 텍스트 및 경계 토큰과, 결정론적 hidden-state injection인 recurrent latent input을 구분한다.
3.1. Switchable Latent Reasoning
어휘에 <swi>, </swi>, <latent>를 추가한다. 텍스트 위치에는 일반 토큰 임베딩을 사용하고, 잠재 위치에는 직전 단계의 최종 레이어 hidden state를 입력한다. 구체적으로 x_t ≠ <latent>이면 ẽ_t = E[x_t]이고, x_t = <latent>이면 ẽ_t = h_{t−1}이다.
- 각 recurrent latent 단계에는 별도의 모델 forward pass가 필요하다. 디코딩한 토큰을 생략해도 해당 계산 비용이 사라지지는 않는다.
- 추론 시 디코더는 최소 잠재 체류 길이 (K_{\min})을 충족해야 종료를 허용한다. 이 제약이 없으면 학습된 모델은 hidden forward pass를 1회 수행한 뒤 종료하는 경향이 있다.
3.2. Switch-SFT: Curriculum Study
Phase 1은 SwiReasoning의 주석 절차를 따른다. 수학 CoT에서 Shannon entropy가 높은 연속 구간을 <swi>/</swi>로 감싼 뒤, 응답에만 적용하는 next-token cross-entropy로 학습한다. Phase 2는 잠재 위치의 라벨을 마스킹하되 경계와 주변 텍스트의 지도 신호는 유지한다.
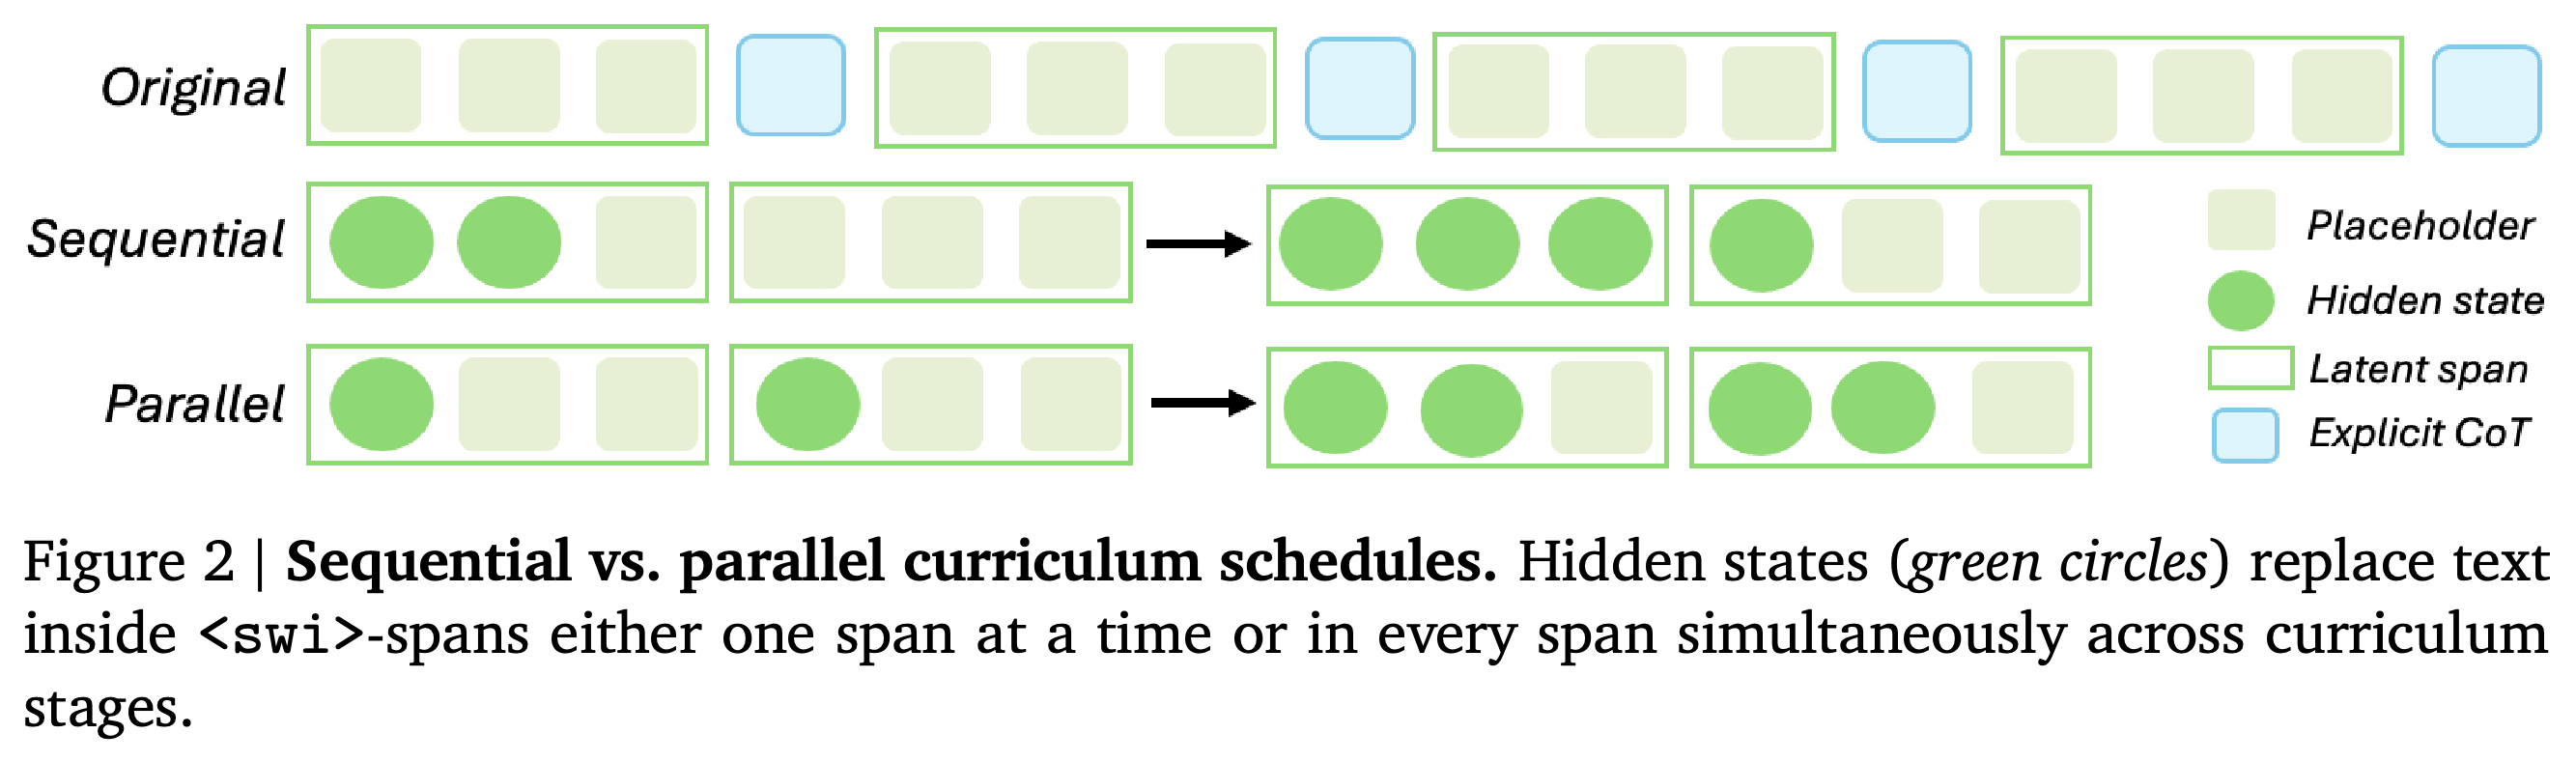
| 기본 병렬 커리큘럼은 표시한 모든 구간을 동시에 바꾸며, c=2와 K_max=8을 설정해 (n_m^{(k)}=c\cdot\min(k, | S_m | ,K_{\max}))를 사용한다. 대안인 순차 커리큘럼은 왼쪽부터 오른쪽으로 구간을 변환한다. 저자들은 병렬 대체가 더 잘 작동한다고 보고하지만, 부록에는 두 방식의 직접적인 수치 비교가 없다. |
- 저자들은 병렬 대체가 효과 없는 잠재 블록을 명시적 텍스트로 보완하기 어렵게 만든다고 해석한다. 이 설명을 별도로 검증하지는 않는다.
- 구현 세부 사항에는 구간당 최대 16개 잠재 위치, 샘플당 48개 위치 제한, 커리큘럼 평활화 확률 0.1, 각 단계의 3 epochs 학습을 명시한다.
순차 대체는 가장 왼쪽 구간부터 바꾸며, 병렬 대체는 각 단계에서 표시한 모든 구간에 잠재 계산을 도입한다. 그림은 일정의 차이를 설명하지만 성능의 정량적 비교는 제공하지 않는다.
3.3. Switch-GRPO: Latent Exploring
Switch-GRPO는 rollout에서 텍스트만 실행하는 방식으로 대체하지 않고 recurrent latent decoder를 실행한다. 잠재 주입은 샘플링한 행동이 아니라 결정론적 연산이므로, 궤적 우도는 <swi>, </swi>, 명시적 후속 토큰을 포함한 이산 텍스트 위치의 확률 곱으로 분해된다. 잠재 위치에는 직접적인 policy-gradient 항을 적용하지 않는다.
- Appendix B는 rollout의 고정된 입력 임베딩 시퀀스를 조건으로 하는 gradient pass를 명시한다. 이 과정은 그룹 상대 advantage, PPO 방식의 clipped surrogate, 이전 정책을 기준으로 하는 KL 페널티를 사용한다.
- 구현된 구간별 역전파는 latent recurrence를 통해 역전파하지 않는다. 다만 공유 모델 파라미터는 텍스트 구간에서 계속 업데이트되므로, 잠재 실행에 사용하는 모든 파라미터를 고정하는 것과는 다르다.
보상은 정답 여부, 태그 형식, 잠재 사용 여부, 선택적으로 적용하는 정답 조건부 길이 단축 보너스를 결합한다. Section 3.3은 잠재 사용 보상을 {0, 1}로 설명하지만, Appendix B는 r_use = r_corr · 1_wf · 1_used로 정의한다. 이 정의에서는 형식이 올바르고 잠재 블록을 사용했지만 오답인 응답에 −1을 부여한다.
- 길이 단축 보너스 항은 정답 여부와 잠재 사용 여부를 조건으로 적용하며, T_lo=800과 T_hi=2000을 사용한다. 압축 설정에서는 이 항의 가중치를 0.1로 지정한다.
- PDF는 나머지 보상 항의 수치 가중치를 제시하지 않는다.
4. Experiments
실험은 벤치마크 정확도, RL 이후의 변화, 정확도와 명시적 토큰 길이 사이의 운영 곡선을 살펴본다. 주요 비교에는 최고 성능의 end-to-end 실행을 사용한다. 체크포인트 궤적, 효율 분석, 메커니즘 실험에는 상세 로그가 있는 대표 실행을 사용한다.
4.1. Experimental Setup
주요 비교의 모든 방법은 동일한 OpenR1-Math 코퍼스와 논문에서 동일하다고 명시한 디코딩 설정을 사용해 Qwen3-8B에서 재구현한다. MATH-500과 GSM8K로 평가하며, 비교 대상에는 직접 답변, text-CoT SFT, iCoT, Pause Tokens, Coconut, CODI, CoLaR가 포함된다.
- 학습은 각각 95GB 메모리를 갖춘 8×NVIDIA H20 GPU가 있는 1개 노드에서 PyTorch DDP로 수행한다.
- Switch-GRPO는 질문당 G=5 rollouts, clip threshold 0.2, KL coefficient 10^−3, learning rate 10^−6, rollout당 3 inner epochs를 사용한다.
- Appendix A는 주요 rollout 설정에 temperature 0.5와 K_min=4를, 압축 설정에 temperature 0.7과 K_min=2를 명시한다. 그러나 Table 8은 길이 단축 보너스 체크포인트에도 K_min=4를 기재한다. 최대 생성 길이는 설정에 따라 2048, 4096, 6000으로 달라진다.
4.2. Main Results
최고 성능 Switch-GRPO 실행은 MATH-500 정확도 79.3%로 CoLaR의 53.6%보다 25.7포인트 높으며, GSM8K에서는 CoLaR의 78.5% 대비 89.2%를 달성한다. Text-CoT SFT는 각각 80.6%와 88.6%를 달성한다. Switch는 MATH-500에서 이보다 조금 낮고 GSM8K에서 조금 높다.
- Switch-GRPO는 MATH-500에서 명시적 토큰을 평균 1,721개, GSM8K에서 1,608개 사용한다. Text-CoT는 각각 2,079개와 1,819개를 사용한다.
- CoLaR는 명시적 토큰을 평균 11.8개와 10.6개만 사용한다. 압축된 recurrent-latent 기준 모델보다 정확도가 높은 대신 명시적 추론을 훨씬 더 많이 사용한다.
- 보고한 토큰 지표에는 latent forward pass가 포함되지 않는다. 총계산량이나 실제 실행 시간을 맞춘 비교도 제공하지 않는다.
Switch-GRPO는 선택한 recurrent-latent 기준 모델보다 정확도가 높지만, 명시적 토큰 수는 약 2차수 더 많다. Text-CoT SFT와 비교하면 MATH-500 정확도는 낮고 GSM8K 정확도는 조금 높으며, 명시적 응답은 다소 짧다.
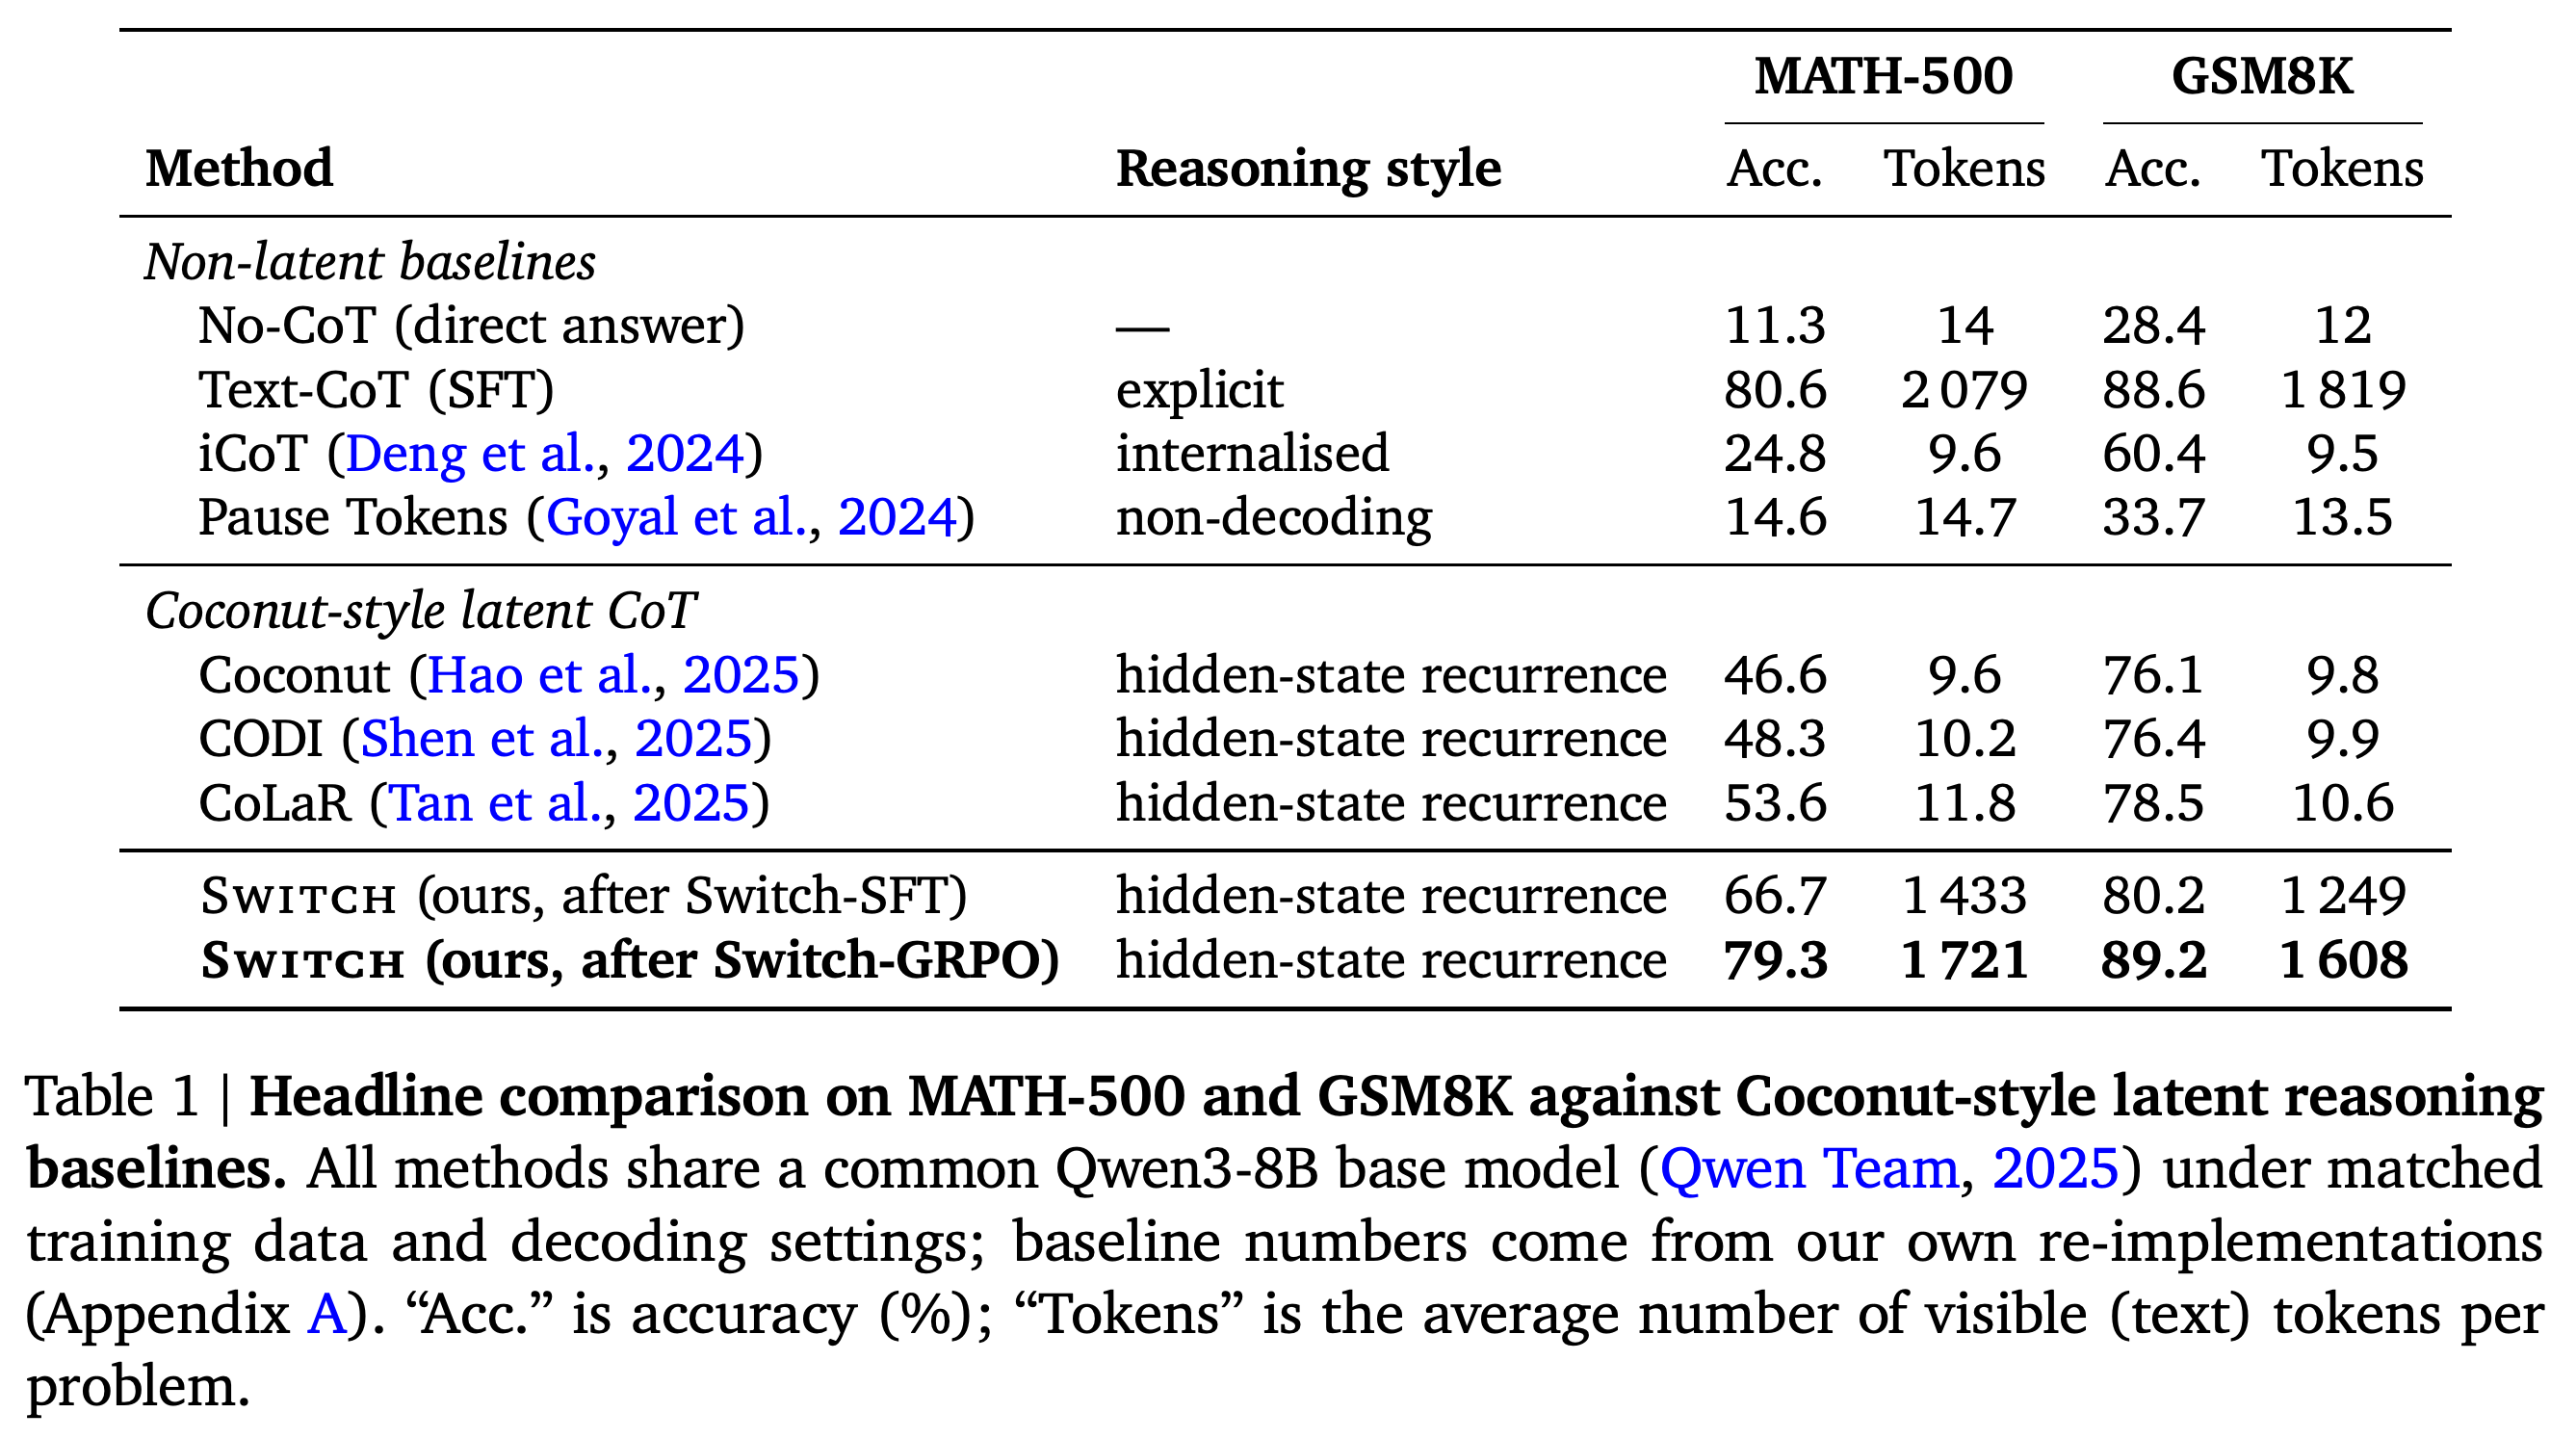
Table 2는 K_min=4의 greedy decoding에서 RL 이후 잠재 사용 조건부 정확도가 66.7%에서 79.3%로 높아지고 전환율은 81%에서 58%로 낮아졌다고 보고한다. 이는 전환율이 절반으로 줄어든 것이 아니라 23퍼센트포인트 감소한 것이다. 잠재 사용 여부가 달라지므로 조건부 정확도는 서로 다른 문제 집합을 대상으로 한다.
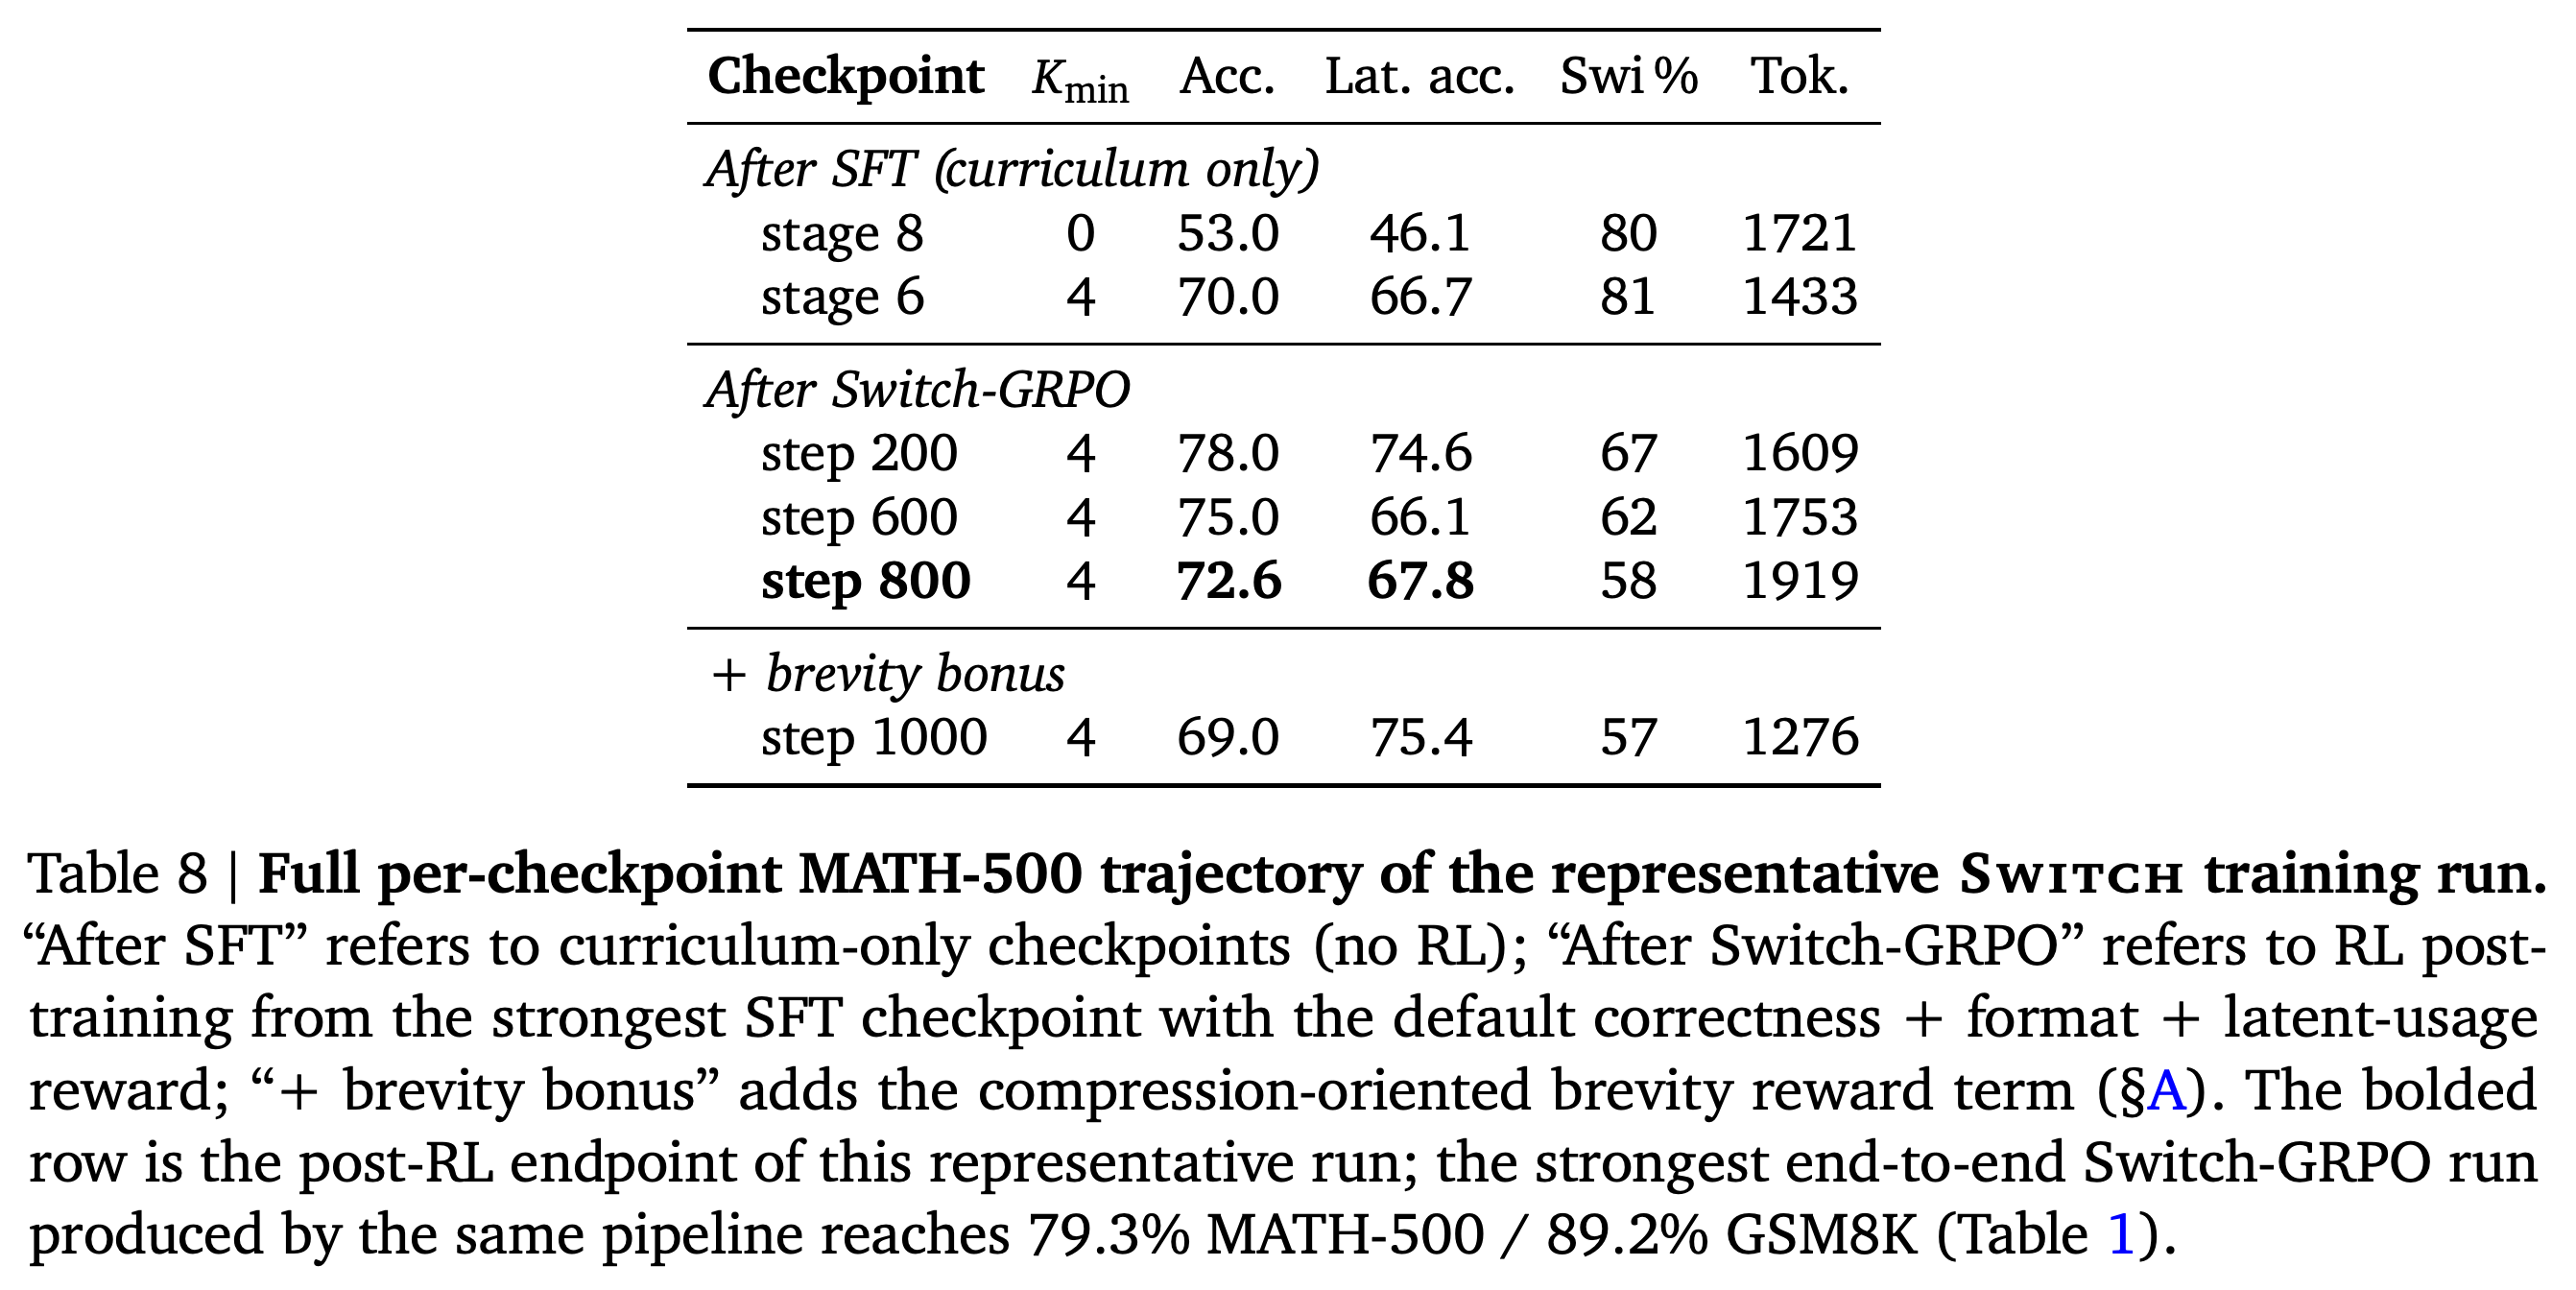
- Appendix Table 8은 대표 실행의 step-800 전체 정확도를 72.6%, 잠재 사용 조건부 정확도를 67.8%, 평균 길이를 1,919토큰으로 제시한다. 이 값들은 Table 2의 잠재 정확도 79.3% 및 1,777토큰과 일치하지 않는다.
- PDF는 대표 실행과 주요 결과를 낸 최고 성능 실행을 구분하지만, 이 구분이 Table 2에서 명시한 동일 조건의 전후 비교와 어떻게 부합하는지는 설명하지 않는다.
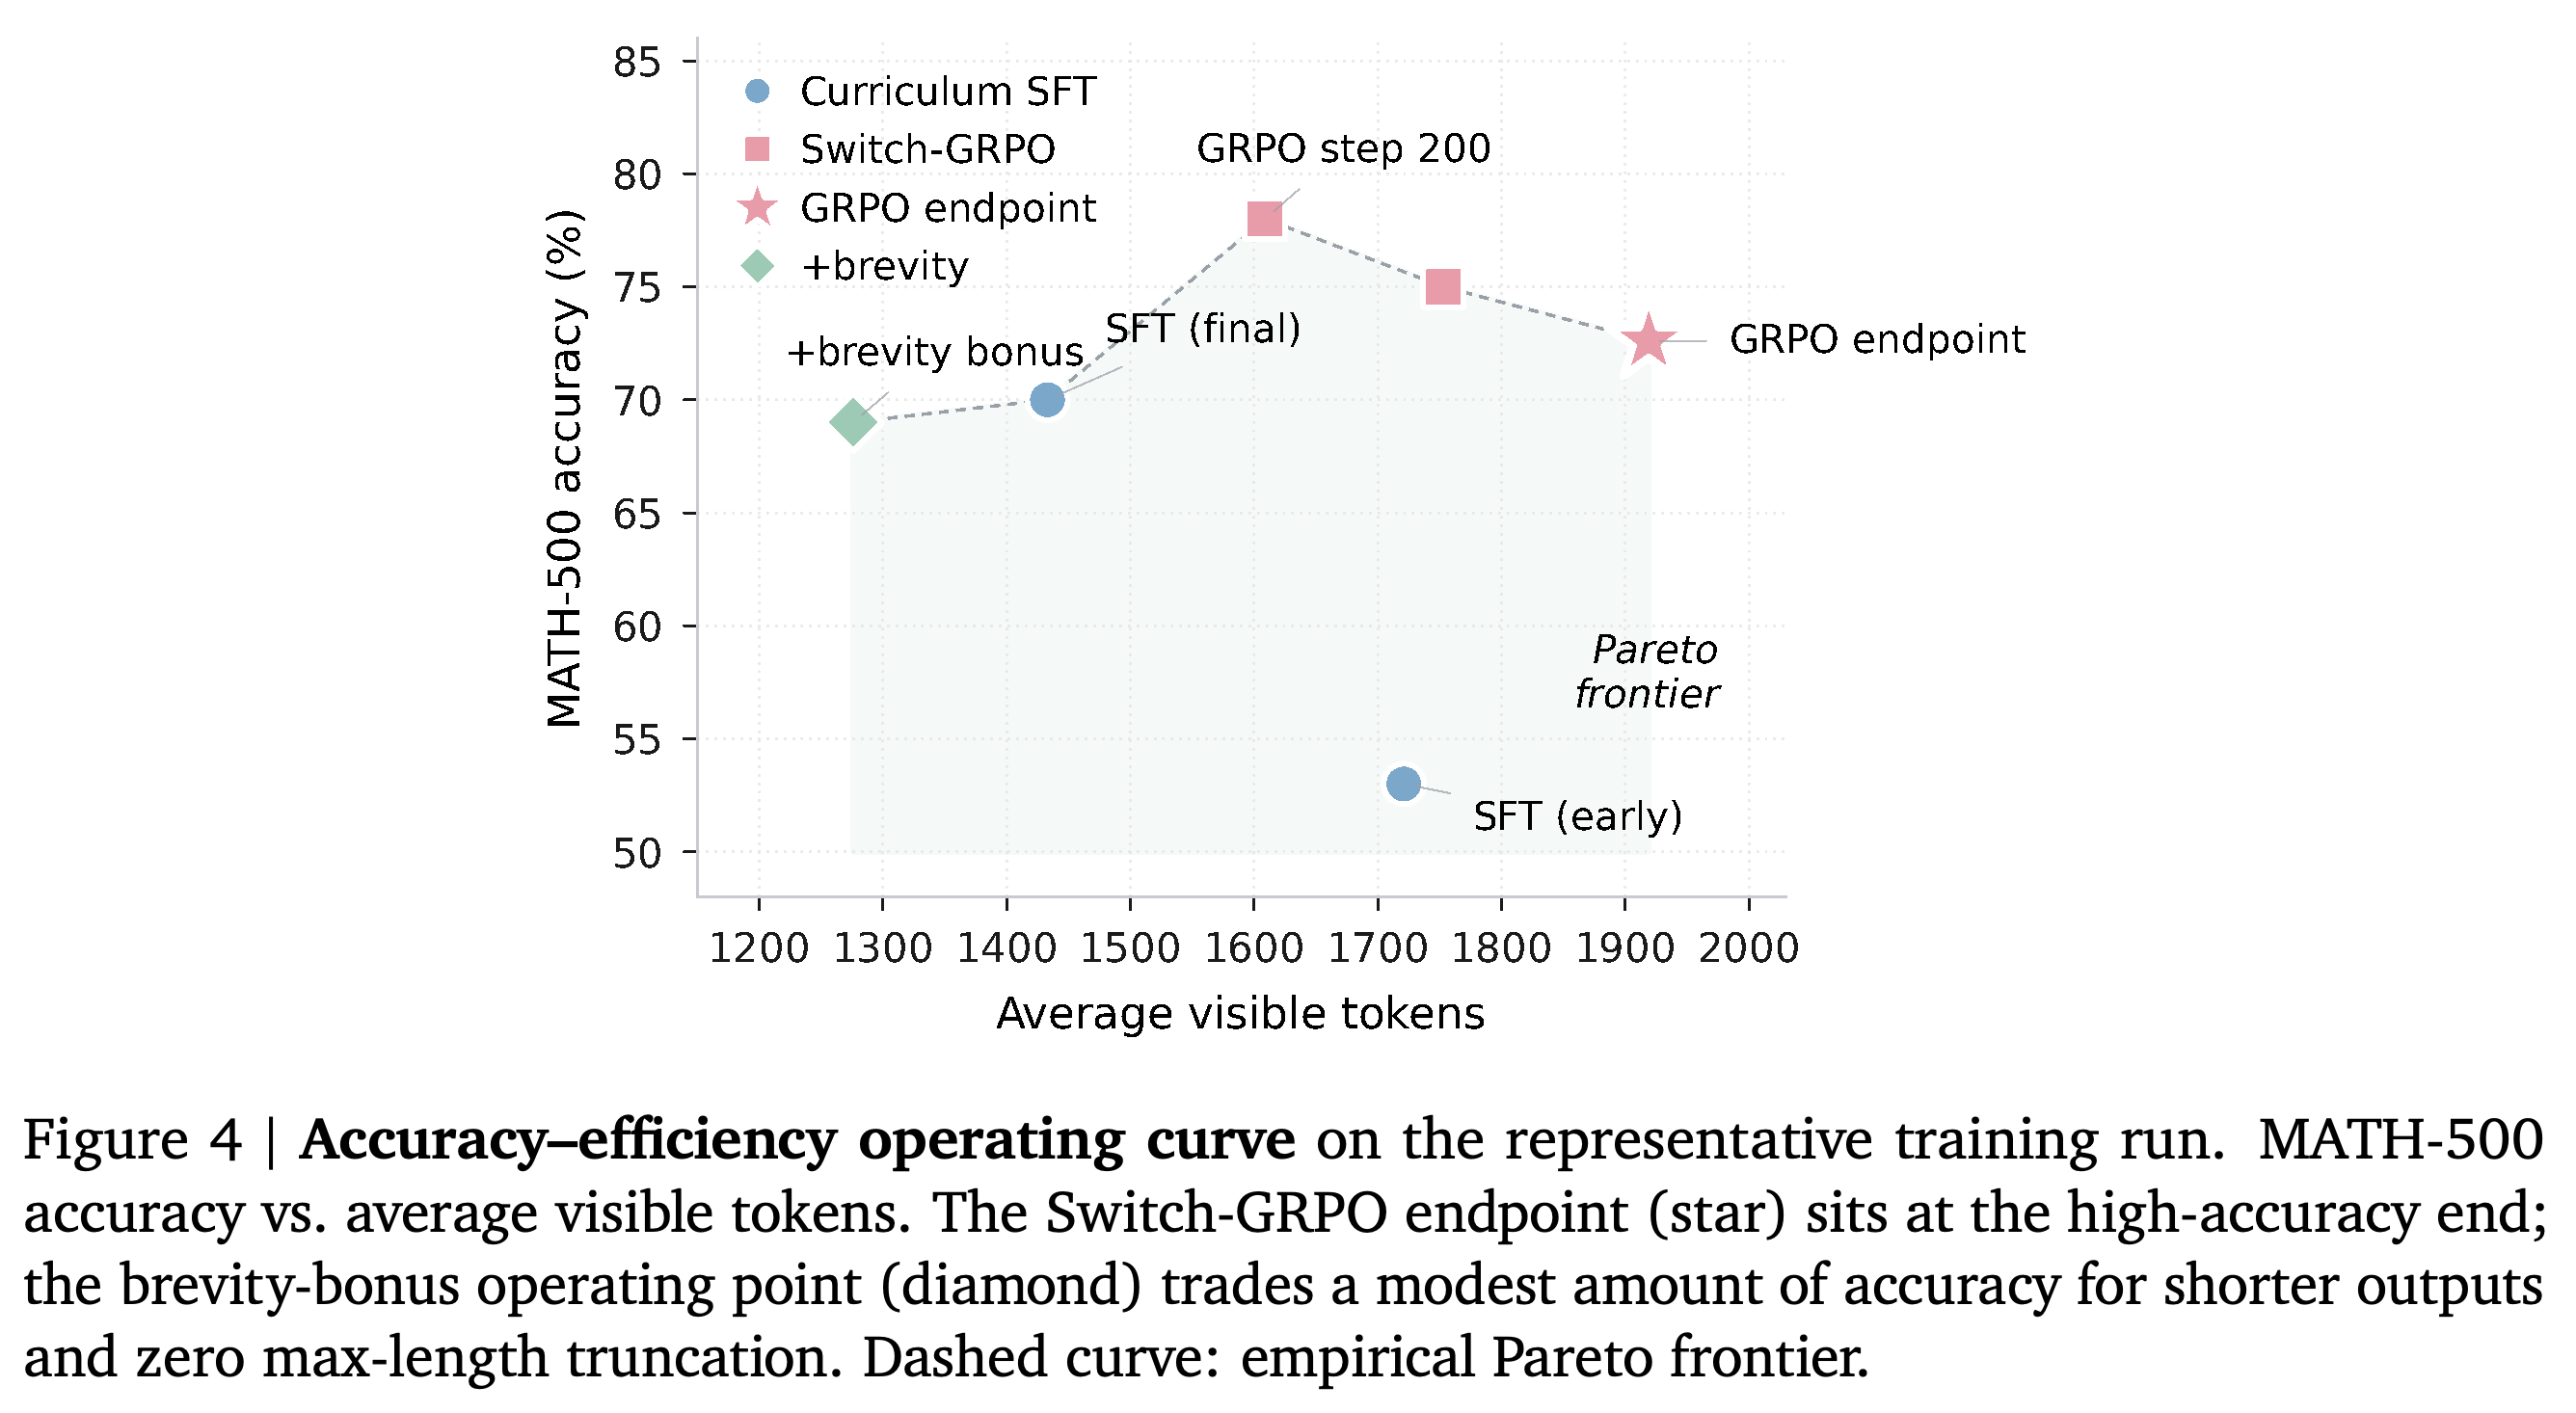
- Table 8의 step 200 전체 정확도는 78.0%로 step-800 종료점보다 높다. RL은 대표 SFT 체크포인트보다 성능을 높이지만, 이후 최적화 과정에서 정확도가 단조롭게 증가하지는 않는다.
대표 실행의 step-800 종료점은 전체 정확도 72.6%와 잠재 사용 조건부 정확도 67.8%를 달성하며, Table 2가 보고한 잠재 정확도 79.3%와 다르다. Step 200의 전체 정확도는 78.0%이며, 길이 단축 보너스 운영점은 명시적 토큰 1,276개에서 69.0%를 달성한다. 여기에 기재된 K_min=4는 Appendix A의 압축 설정인 2와 다르다.
초기 학습 궤적에서는 RL이 진행되면서 전환율, 잠재 블록 수, 출력 길이가 줄어든다. Figure 3의 시작값과 종료값은 전환율 69%→53%, 문제당 블록 수 1.53→0.89, 출력 길이 2,839→1,702토큰이다. 평균 보상도 +0.08에서 +0.01로 감소하므로, 이 그래프만으로 정답률이 개선된다고 판단할 수는 없다.
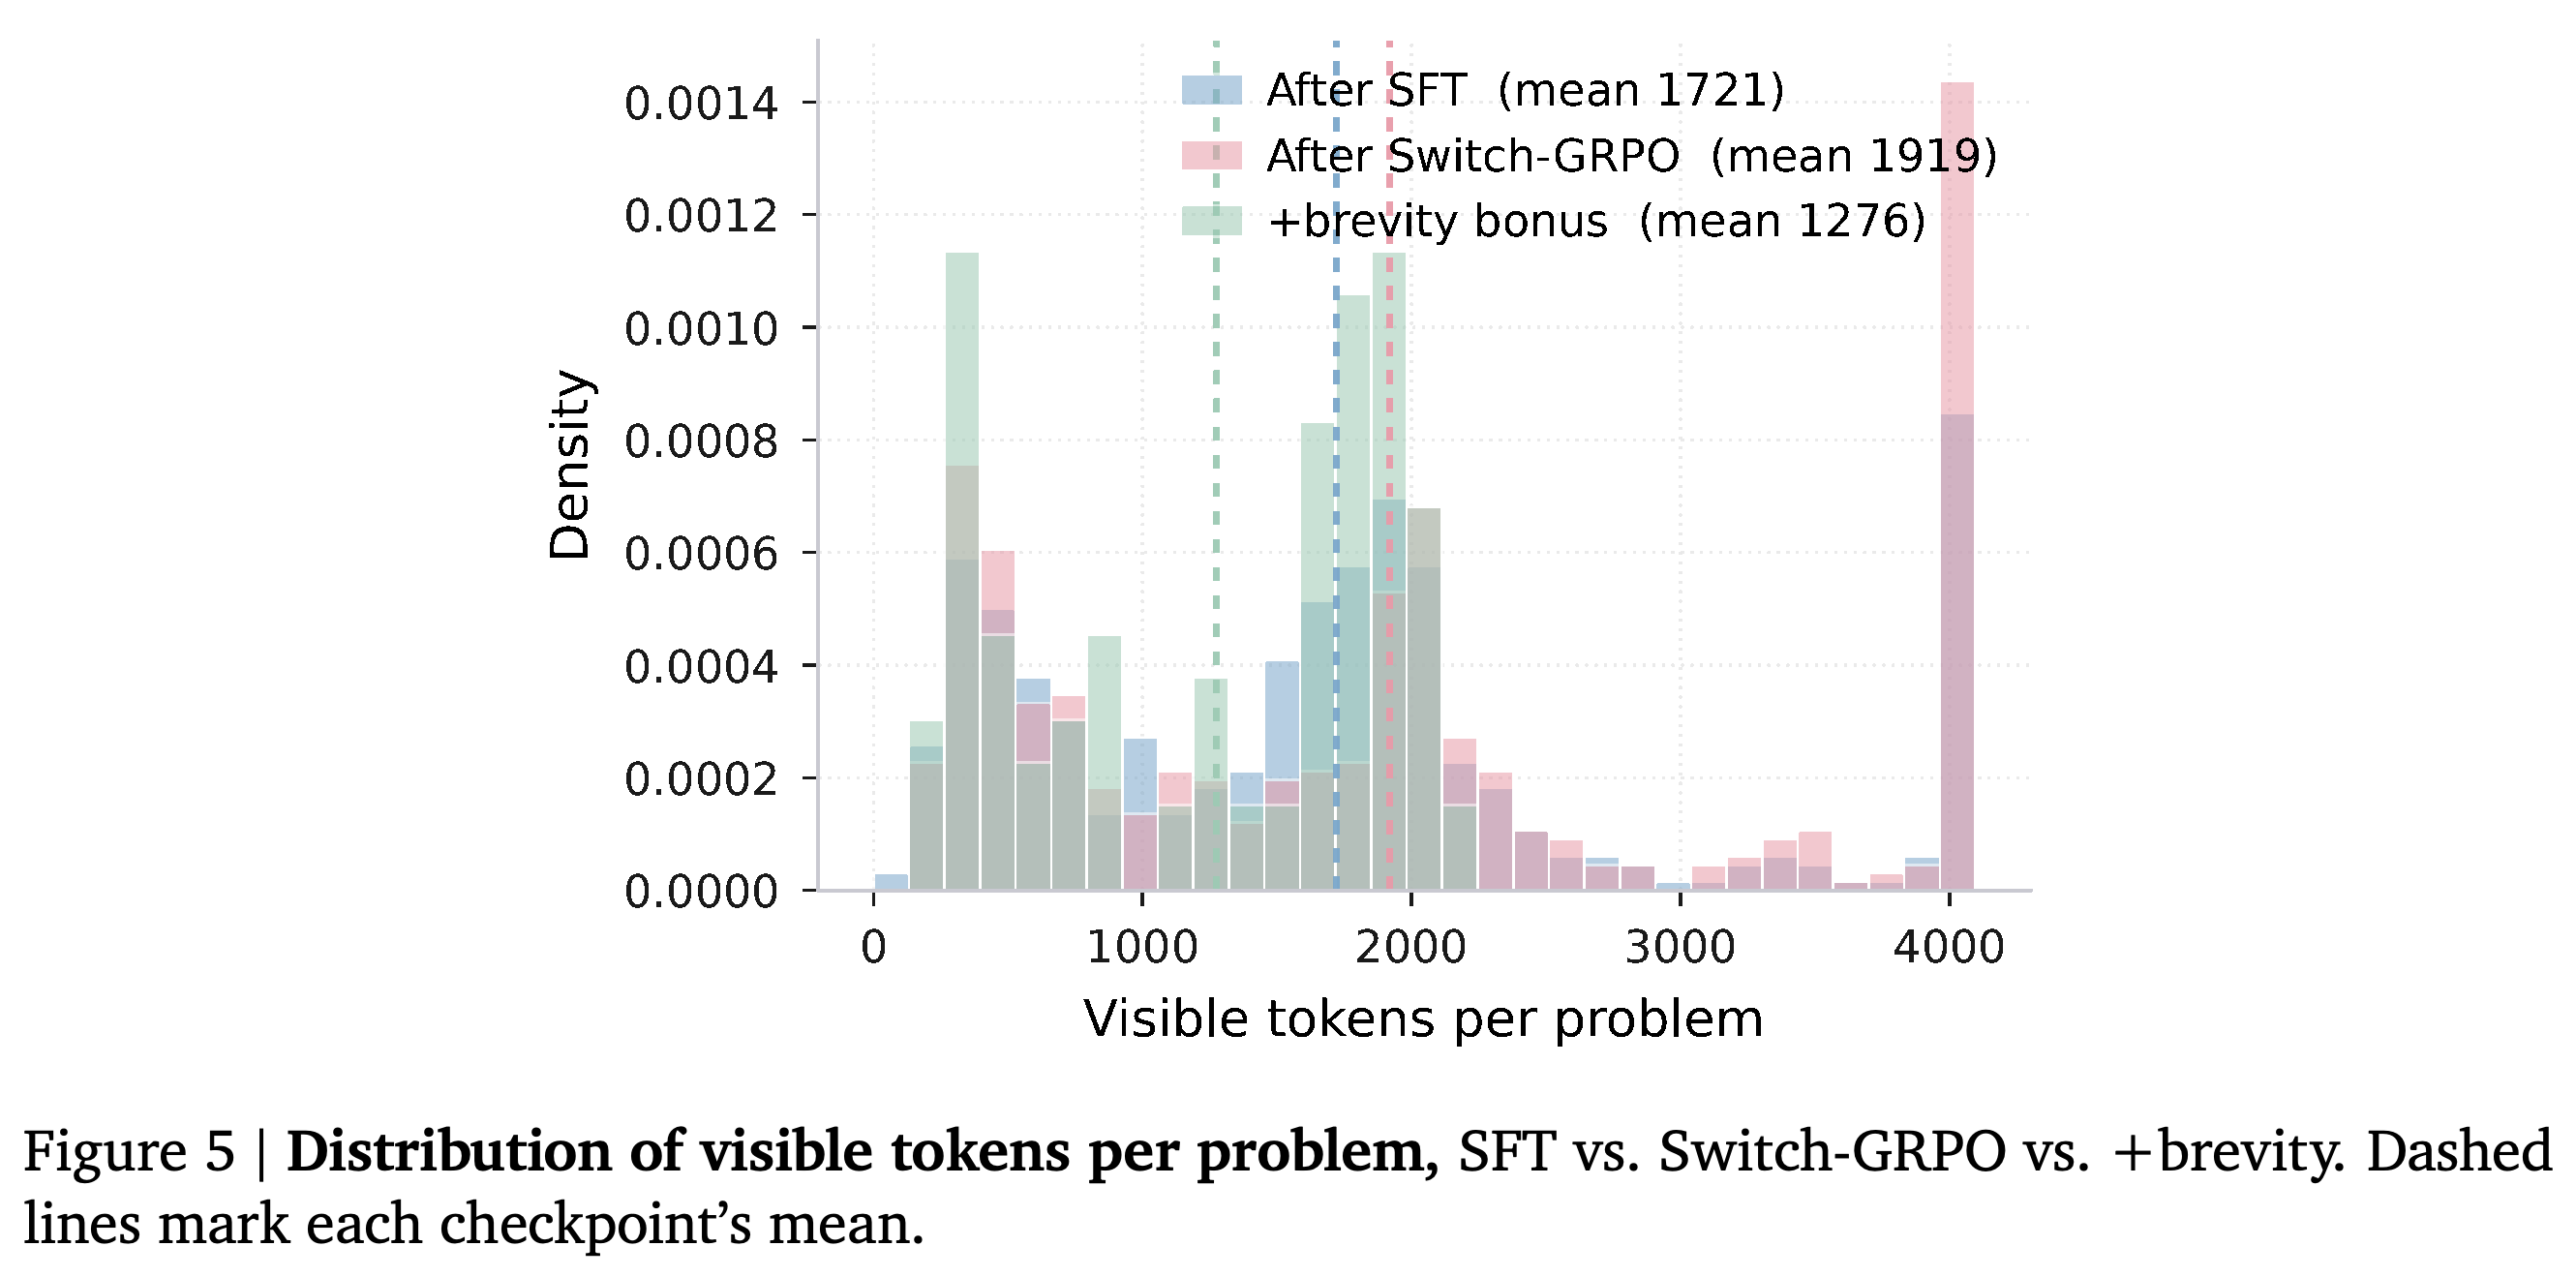
대표 실행에서 길이 단축 보너스를 적용한 운영점은 MATH-500 정확도를 72.6%에서 69.0%로, 평균 명시적 토큰 길이를 1,919토큰에서 1,276토큰으로 바꾼다. 잘림 비율은 18.4%에서 0%로 감소한다. 히스토그램은 평균만 줄어든 것이 아니라 응답 분포가 더 짧은 쪽으로 이동했음을 보여준다.
- 이는 명시적 토큰을 약 33% 줄이는 대신 정확도가 3.6포인트 낮아진 결과다.
- Appendix A는 압축 설정에서 rollout temperature와 최소 체류 길이도 바꾼다. 따라서 보상만 바꾸는 ablation 실험으로 기술되어 있지 않으며, Table 8의 체류 설정도 이 설명과 여전히 일치하지 않는다.
- Figure 4는 점선을 경험적 Pareto frontier라고 표시하지만, step 200은 step-800 종료점보다 정확도가 높으면서 토큰 수도 적다.
길이 단축 보너스 운영점은 종료점보다 응답이 짧지만 정확도도 낮다. Step 200 역시 종료점보다 정확도가 높고 토큰 수가 적으므로, 점선은 표시된 체크포인트 전체에서 엄밀한 비지배 frontier가 아니다.
길이 단축 보너스 분포는 더 짧은 출력 쪽으로 이동하며 긴 응답 쪽 꼬리를 줄인다. 그림의 평균은 SFT 1,721, 표준 RL 1,919, 길이 단축 보너스 1,276이다. 이 SFT 분포는 Table 8의 stage-6 평균 1,433이 아니라 출력이 더 긴 커리큘럼 체크포인트에 해당한다.
5. How Does Latent Work in Reasoning?
메커니즘 분석은 <swi>가 특정 위치에서 학습된 전환 결정인지, 잠재 실행이 답변에 영향을 주는지, 블록 안에서 유용한 계산이 어디서 일어나는지를 살펴본다. Teacher forcing, logistic probe, activation intervention, 정성적 logit-lens 분석으로 커리큘럼 SFT와 RL 이후 체크포인트를 비교한다. logistic probe에 대해서는 이 글을 참조하라.
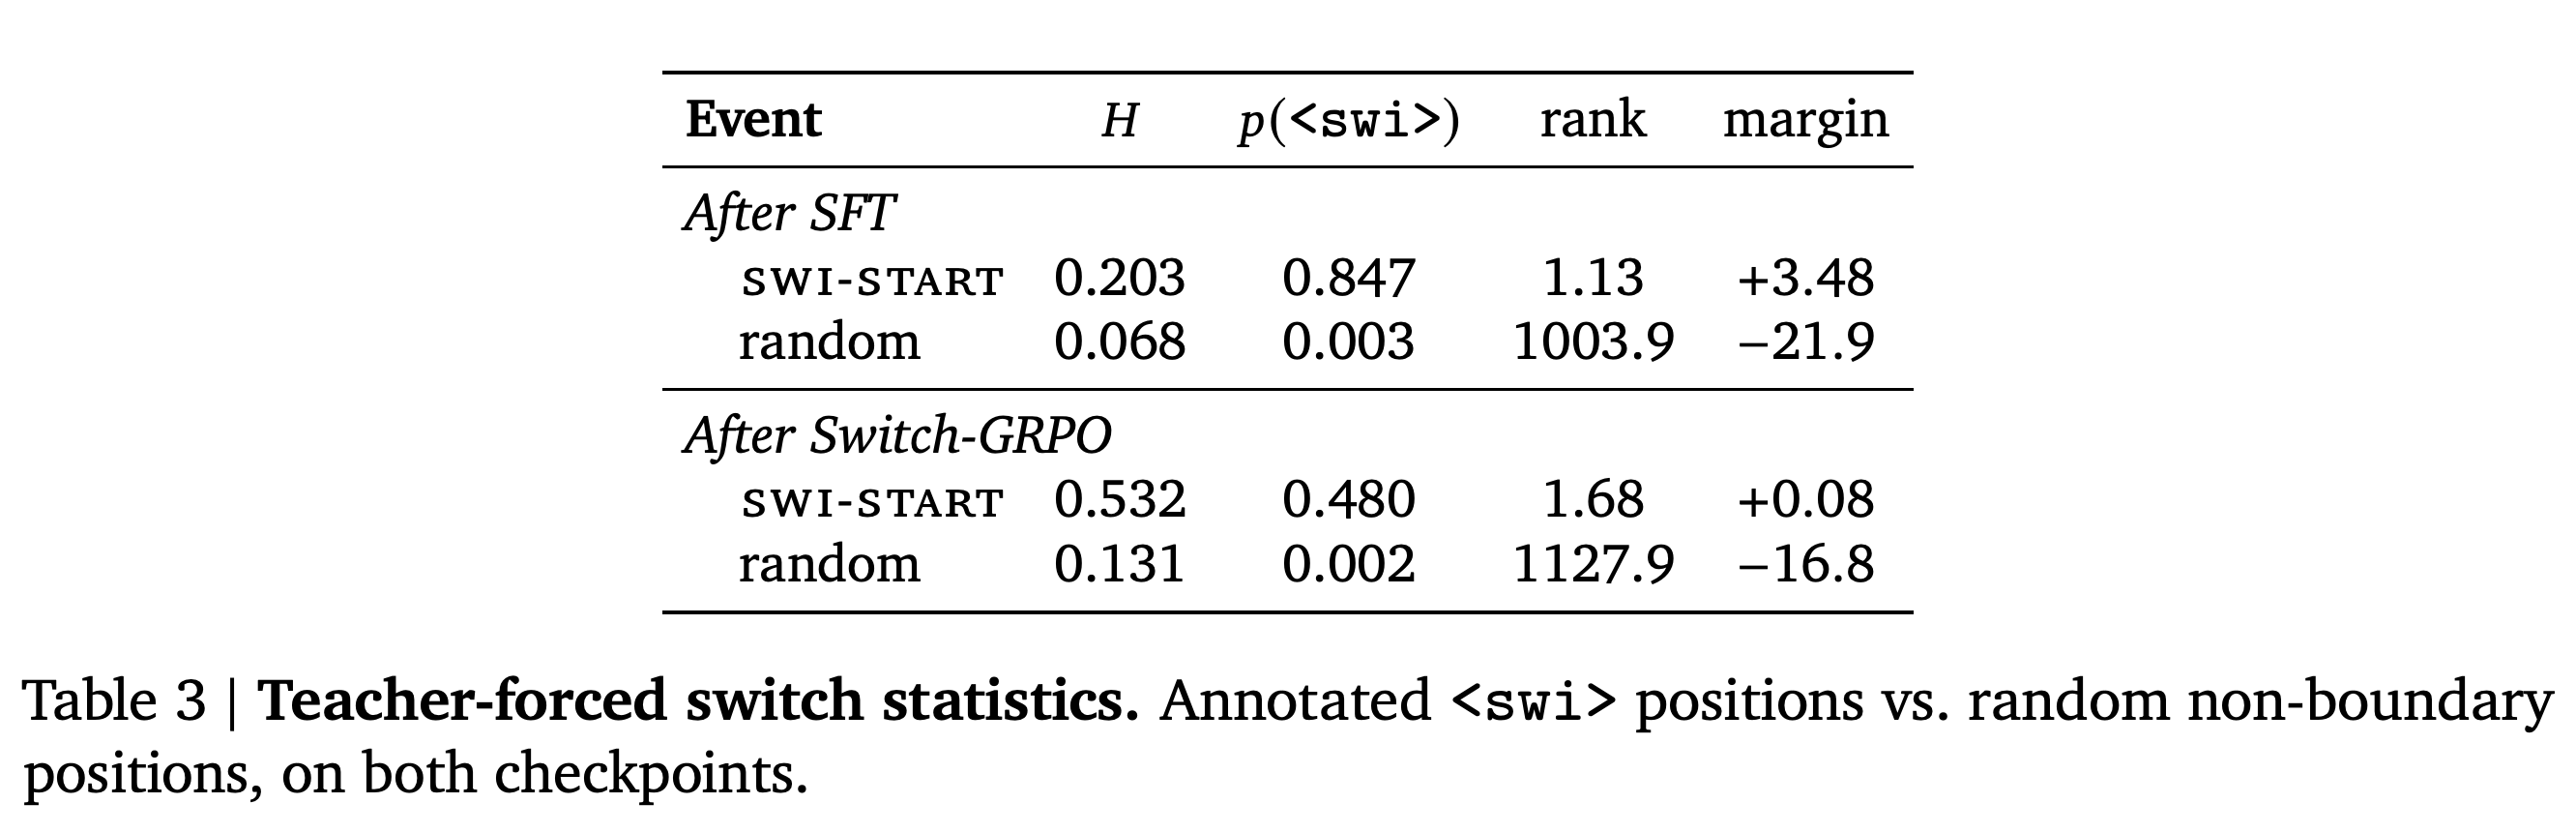
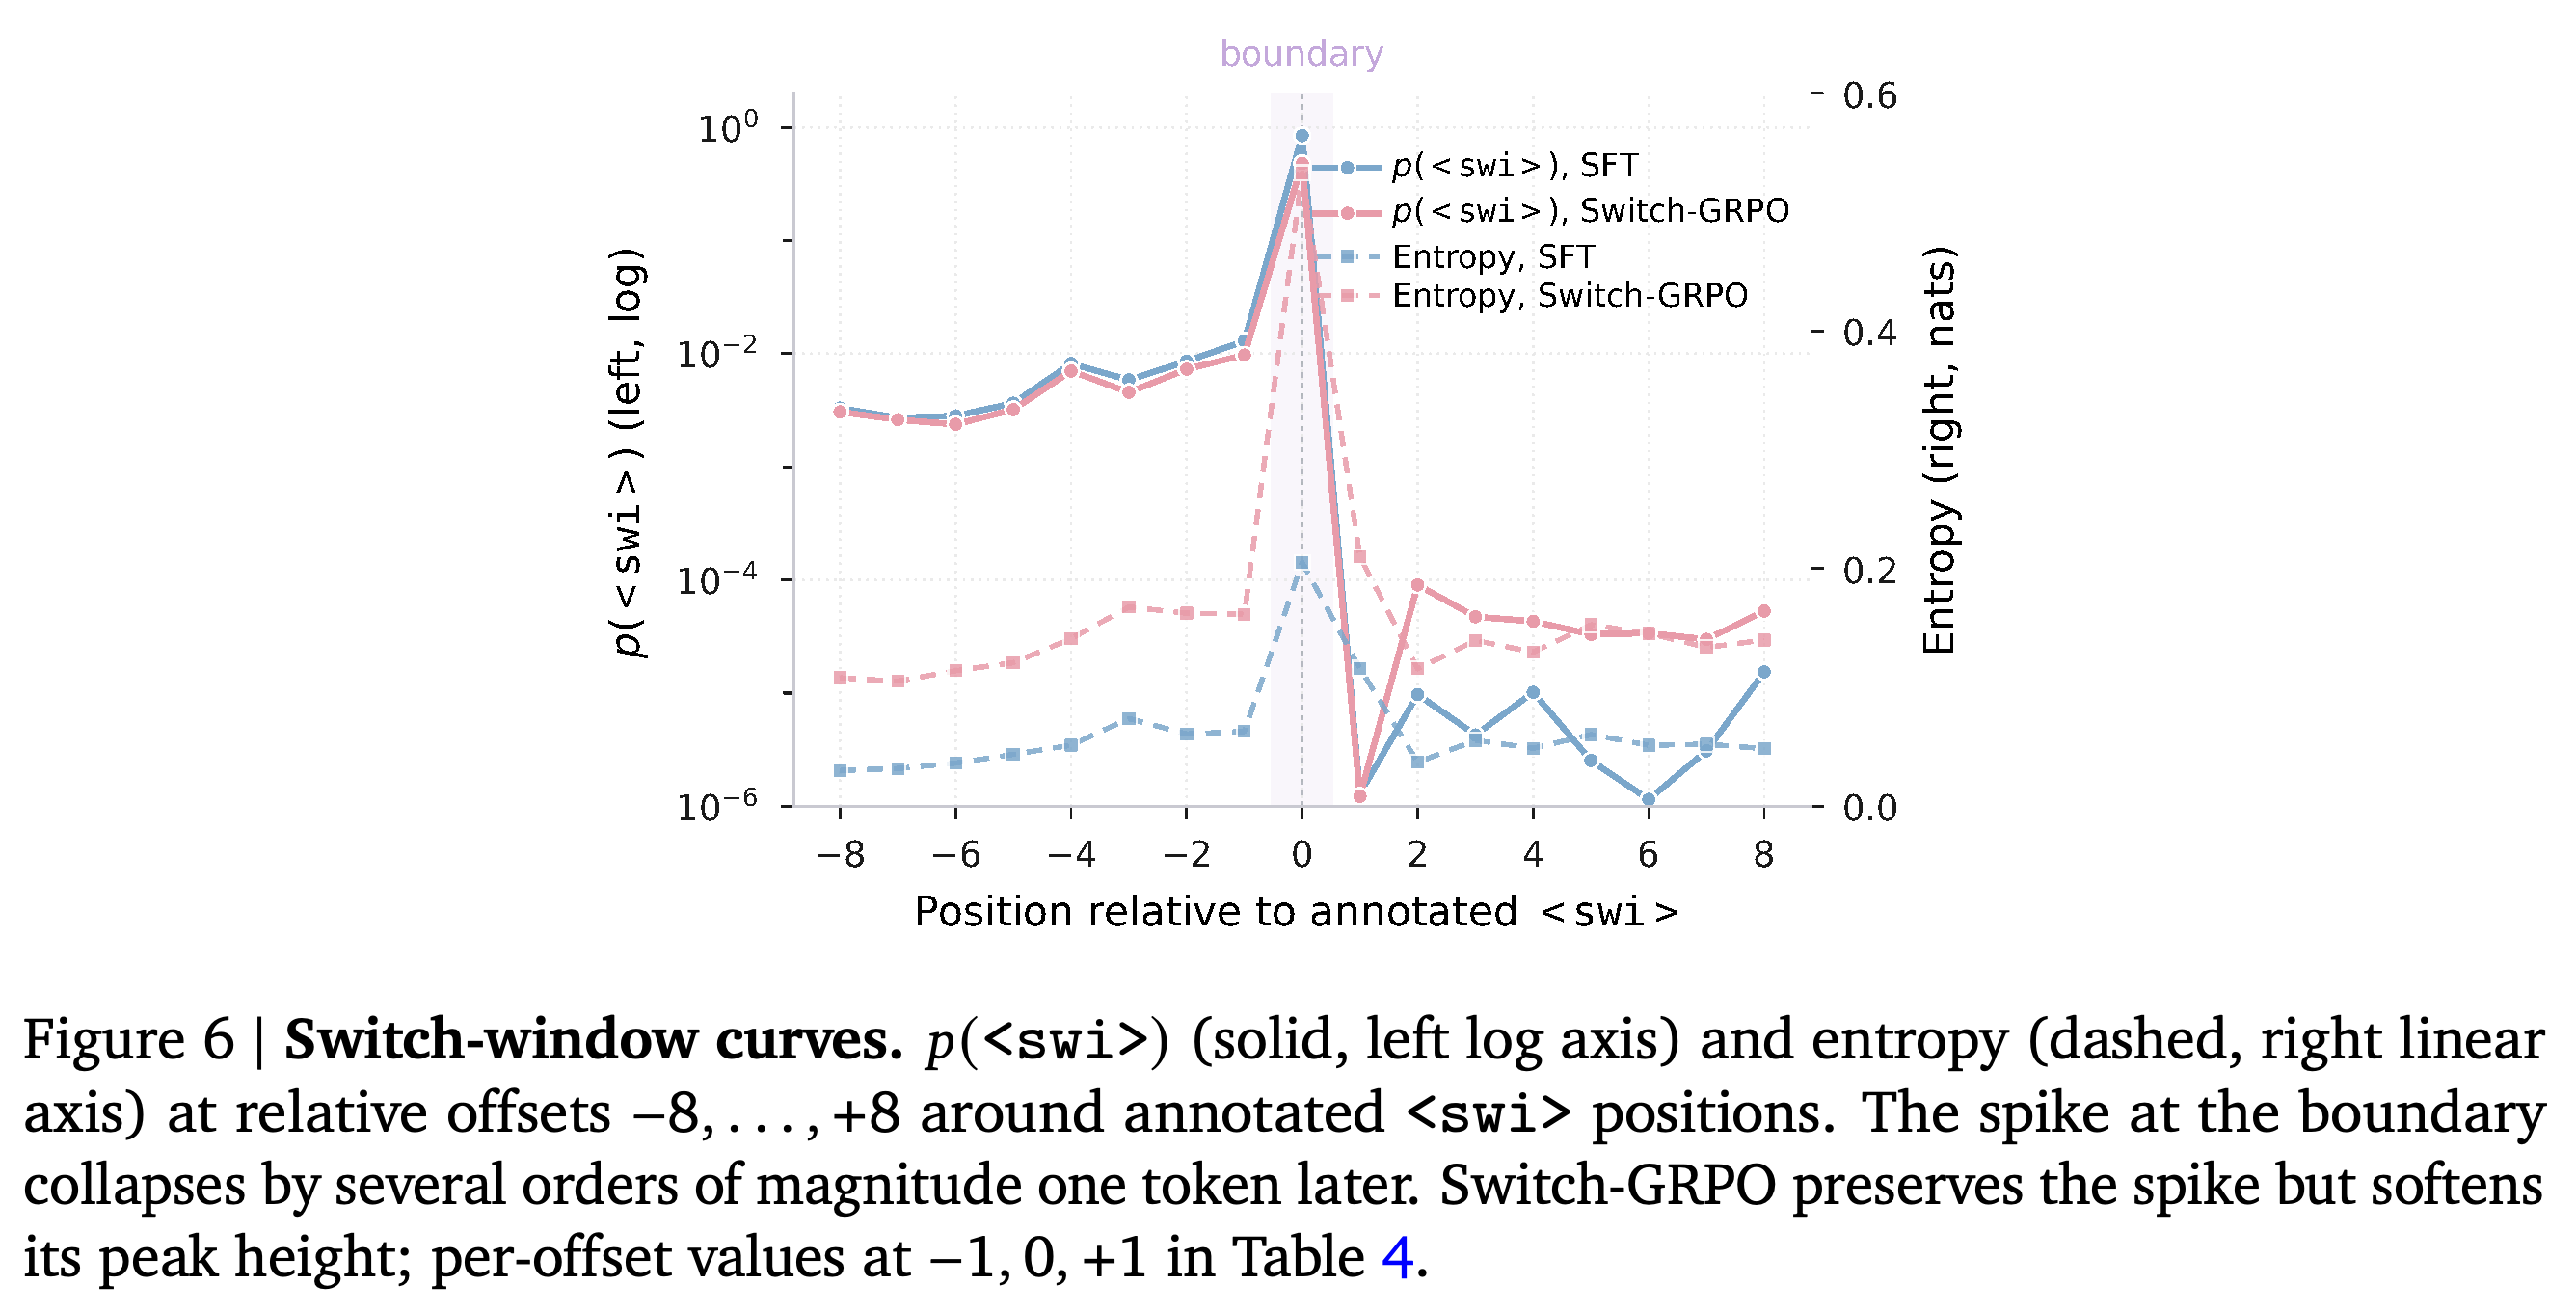
주석 경계에서 p(<swi>)는 SFT 이후 0.847, RL 이후 0.480이며, 무작위 비경계 위치에서는 각각 0.003과 0.002이다. 평균 순위는 경계에서 1.13과 1.68, 대조 위치에서 1003.9와 1127.9로, 강한 위치 선택성을 뒷받침한다.
- 표의 확률 비율은 약 282배와 240배이며, 주변 본문에서 주장하는 약 4차수의 차이는 아니다.
- RL은 경계 확신도를 낮추고 경계 엔트로피를 0.203에서 0.532로 높인다. 측정한 정책은 여전히 선택적이지만 주석 경계에서의 확신은 더 낮다.
경계 위치와 무작위 대조 위치는 전환 확률과 순위에서 뚜렷하게 구분된다. RL 이후 경계는 SFT 경계보다 확신도가 낮고 엔트로피가 높지만 선택성은 유지된다. 확률 비율은 수백 배이며, 본문에서 말하는 4차수의 차이는 아니다.
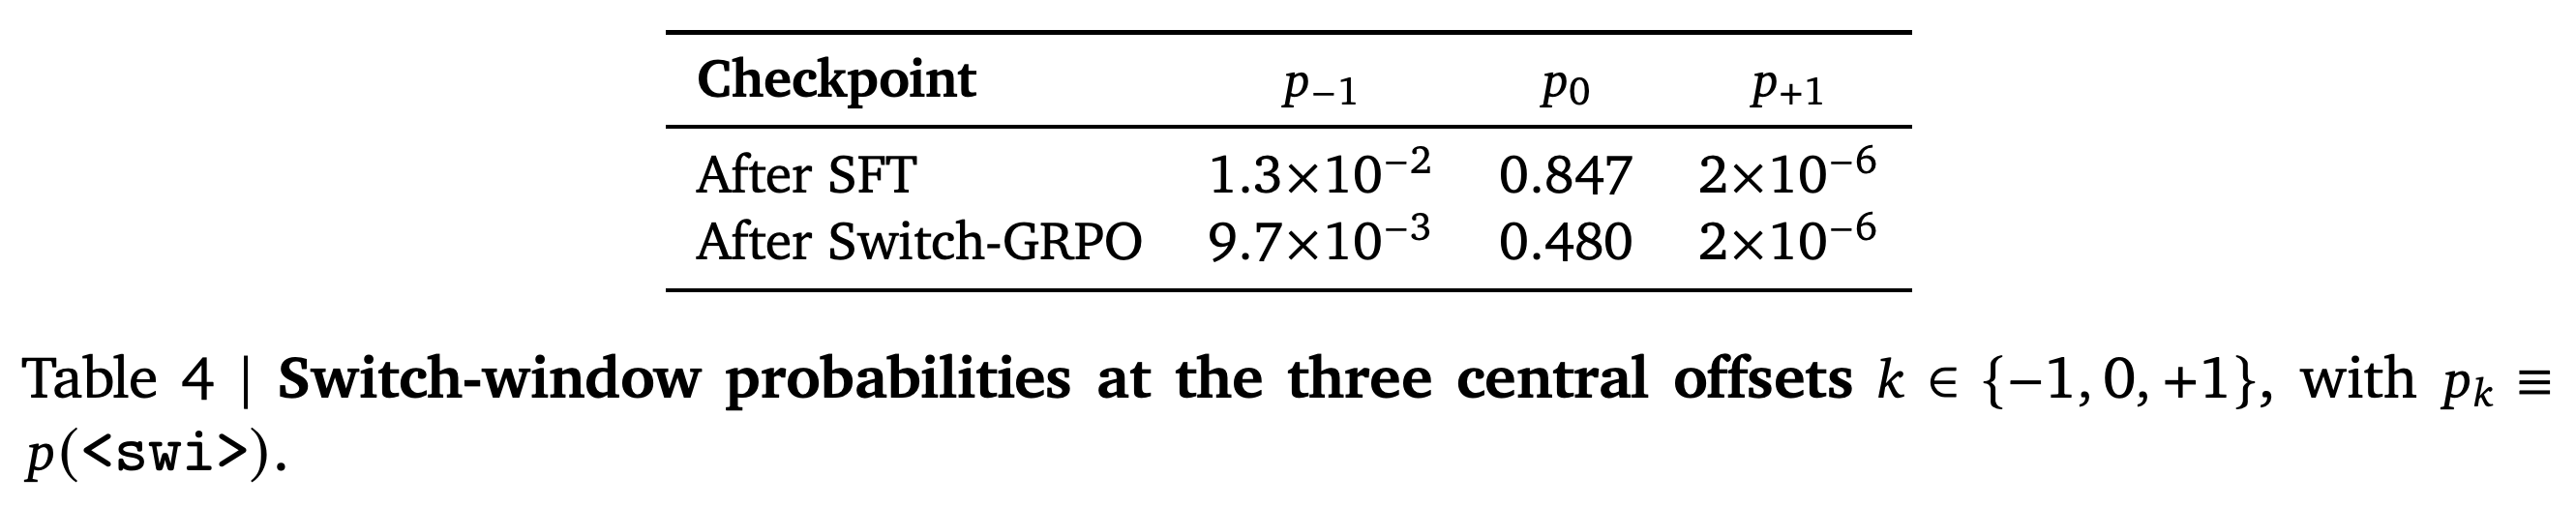
오프셋 −8부터 +8까지 살펴보면 전환 확률은 주석 경계에서 최고점에 도달한 뒤 즉시 급락한다. 오프셋 +1에서는 두 체크포인트 모두 2×10^−6이며, 오프셋 −1에서는 SFT 이후 1.3×10^−2, RL 이후 9.7×10^−3이다.
- 좁은 최고점이 유지된다는 결과는 RL 이후 확신도가 낮아져도 경계 위치의 국소성이 유지됨을 뒷받침한다.
- 이 teacher-forced 측정은 주석 위치 주변을 구별하는 능력을 보여주지만, 자유 생성에서 전환 위치가 최적임을 입증하지는 않는다.
중앙 오프셋은 좁은 전환 최고점을 정량화한다. 확률은 오프셋 0에서 높고, 바로 다음 위치에서는 두 체크포인트 모두 2×10^−6으로 떨어진다. RL은 최고점을 낮추지만 위치의 국소성을 없애지는 않는다.
로그 확률 축은 경계 직후의 급락을 보여주며, 엔트로피 축은 RL 이후 경계에서 높아진 불확실성을 보여준다. 곡선은 teacher forcing으로 입력한 주석 prefix에서 정책의 확신도가 낮아져도 특정 위치에 뚜렷하게 집중됨을 뒷받침한다.
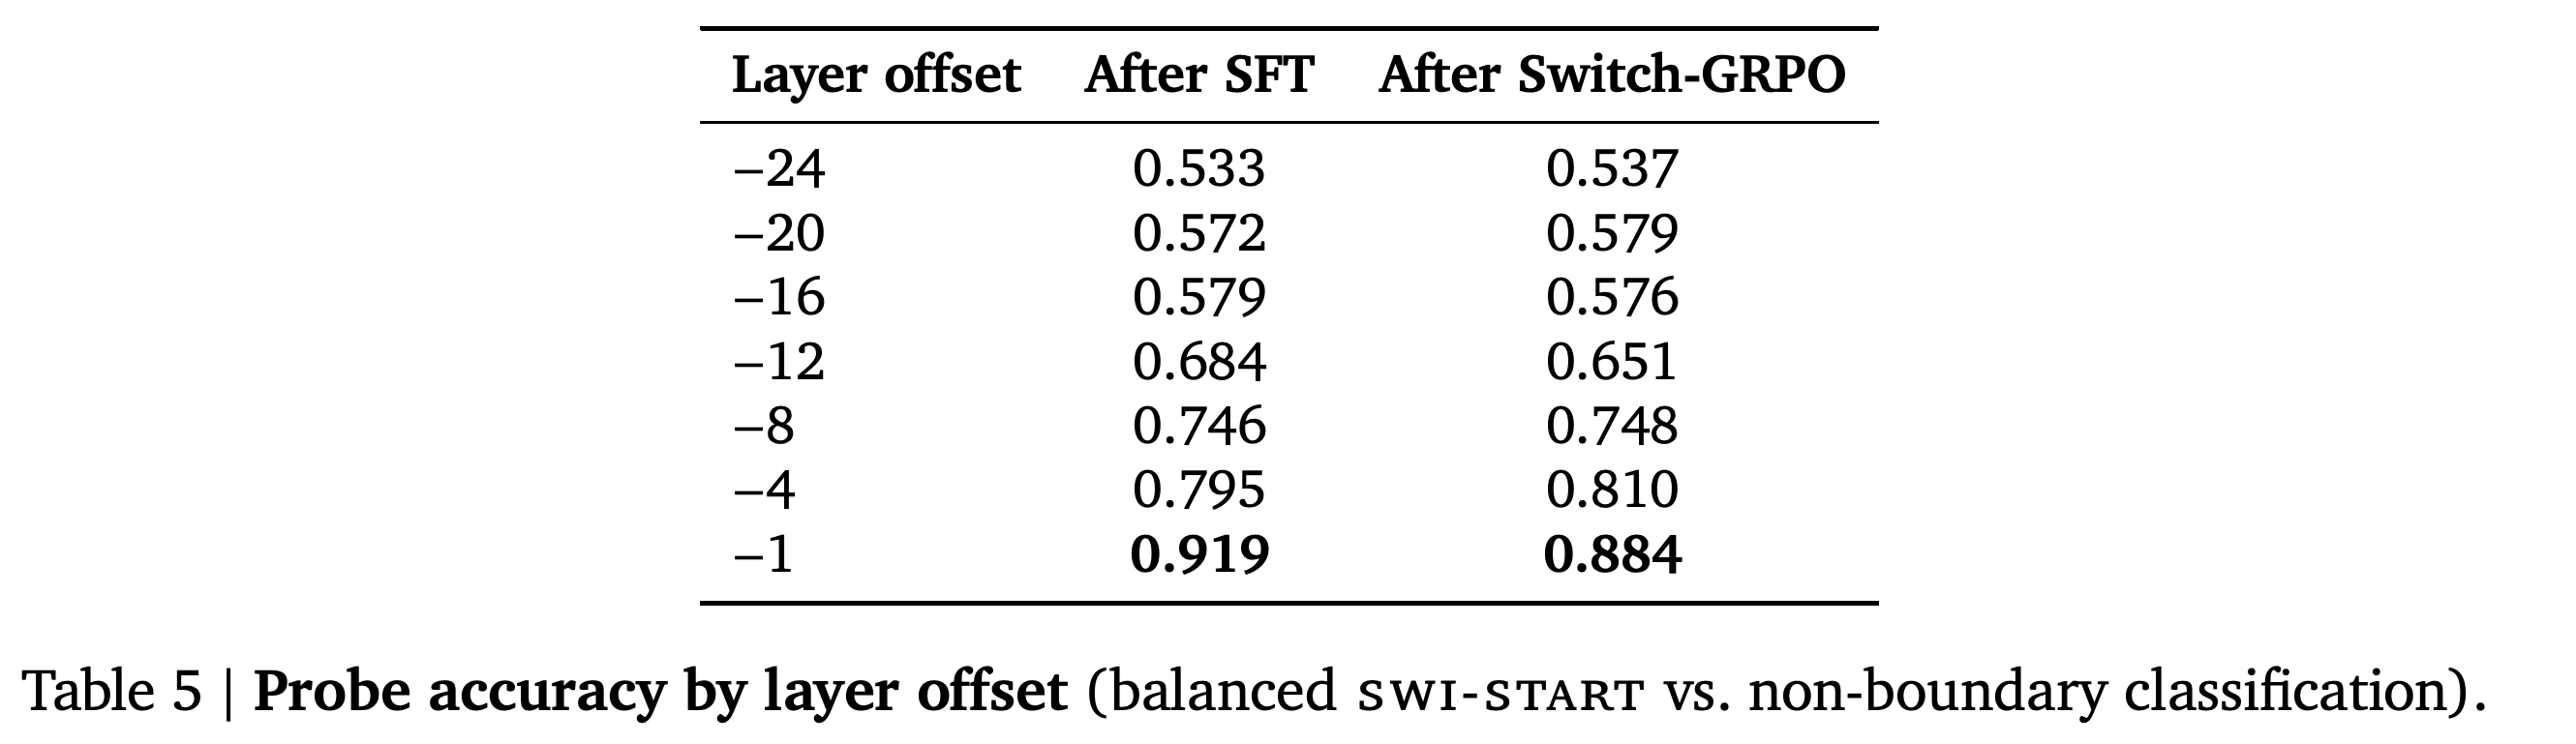
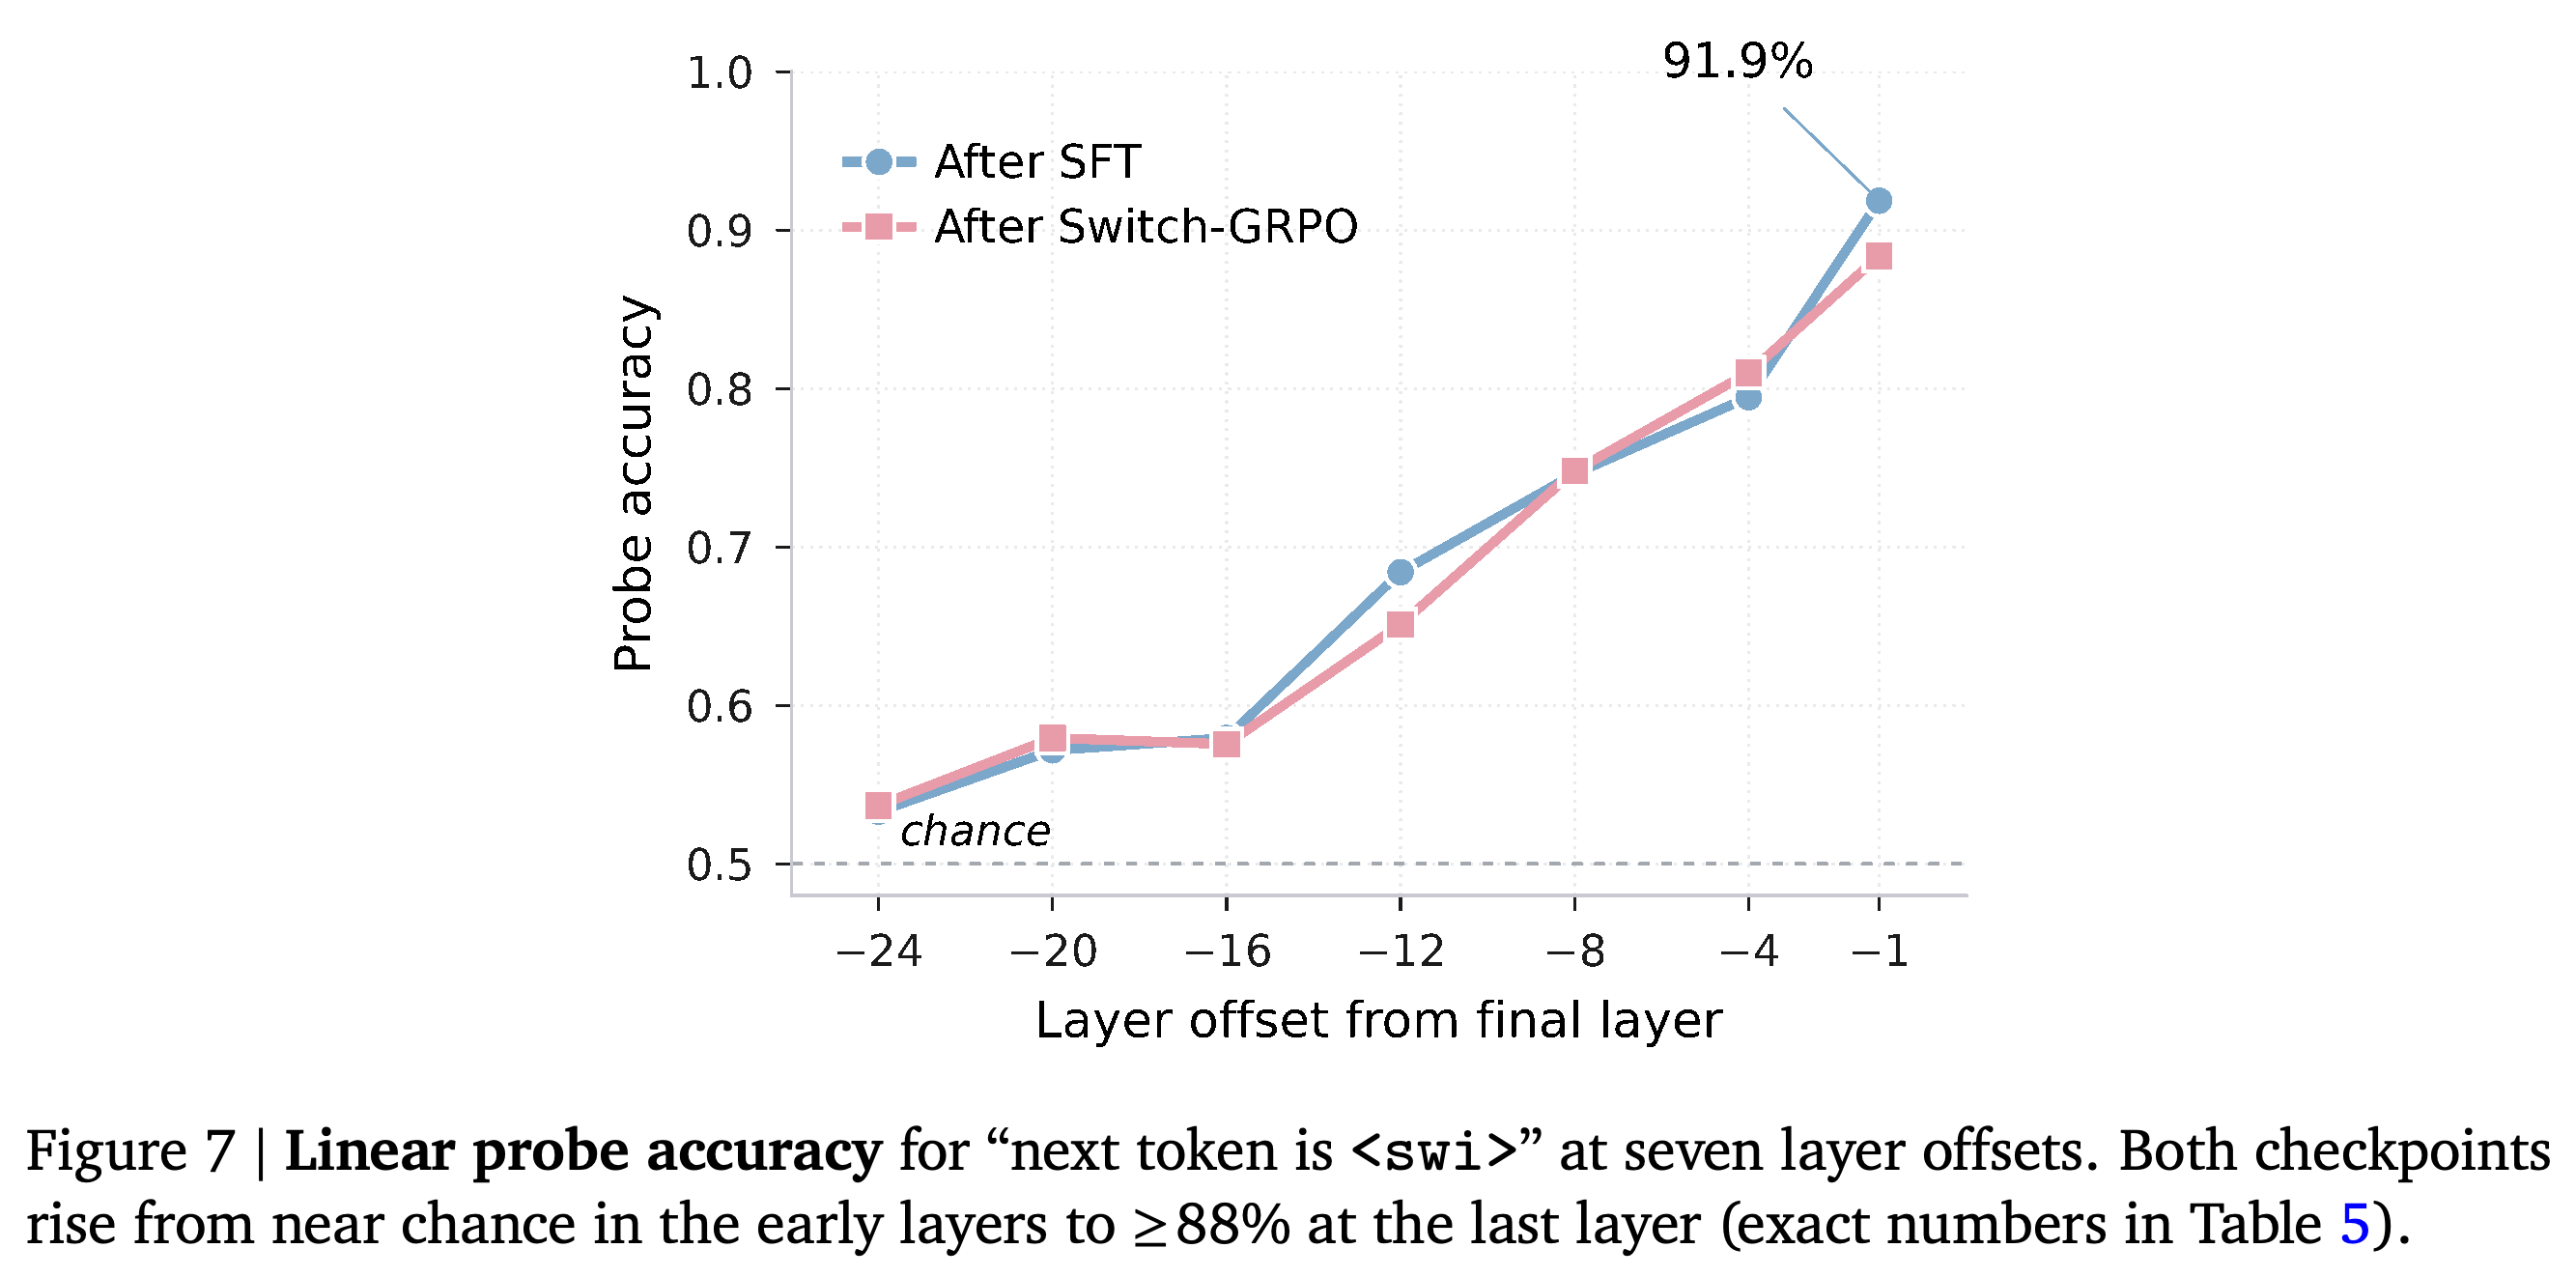
균형 잡힌 logistic probe는 깊은 레이어일수록 ‘다음 토큰이 <swi>다’라는 라벨을 더 잘 복원한다. 정확도는 레이어 오프셋 −24에서 약 53%이며, 오프셋 −1에서는 SFT 이후 91.9%, RL 이후 88.4%로 높아진다.
- 프로브는 C=1.0인 ℓ2 정규화와 1회의 80:20 학습/테스트 분할을 사용한다.
- 선형 디코딩이 가능하다는 결과는 전환 관련 특징이 인코딩되어 있음을 보여준다. 하지만 해당 특징이 전환을 인과적으로 제어한다는 사실을 독립적으로 입증하지는 않는다.
프로브 정확도는 두 체크포인트 모두 깊이에 따라 높아져 SFT 이후 0.919, RL 이후 0.884에 도달한다. 이는 후반 activation에서 전환 관련 라벨을 복원할 수 있음을 보여주지만, 특정 특징의 인과적 필요성을 입증하지는 않는다.
두 곡선 모두 앞쪽 레이어의 우연 수준에서 최종 레이어의 높은 분류 성능으로 상승한다. 깊이에 따른 양상이 유사하다는 결과는 RL이 최종 레이어 프로브 정확도를 낮추면서도 복원 가능한 전환 관련 표현을 유지함을 보여준다.
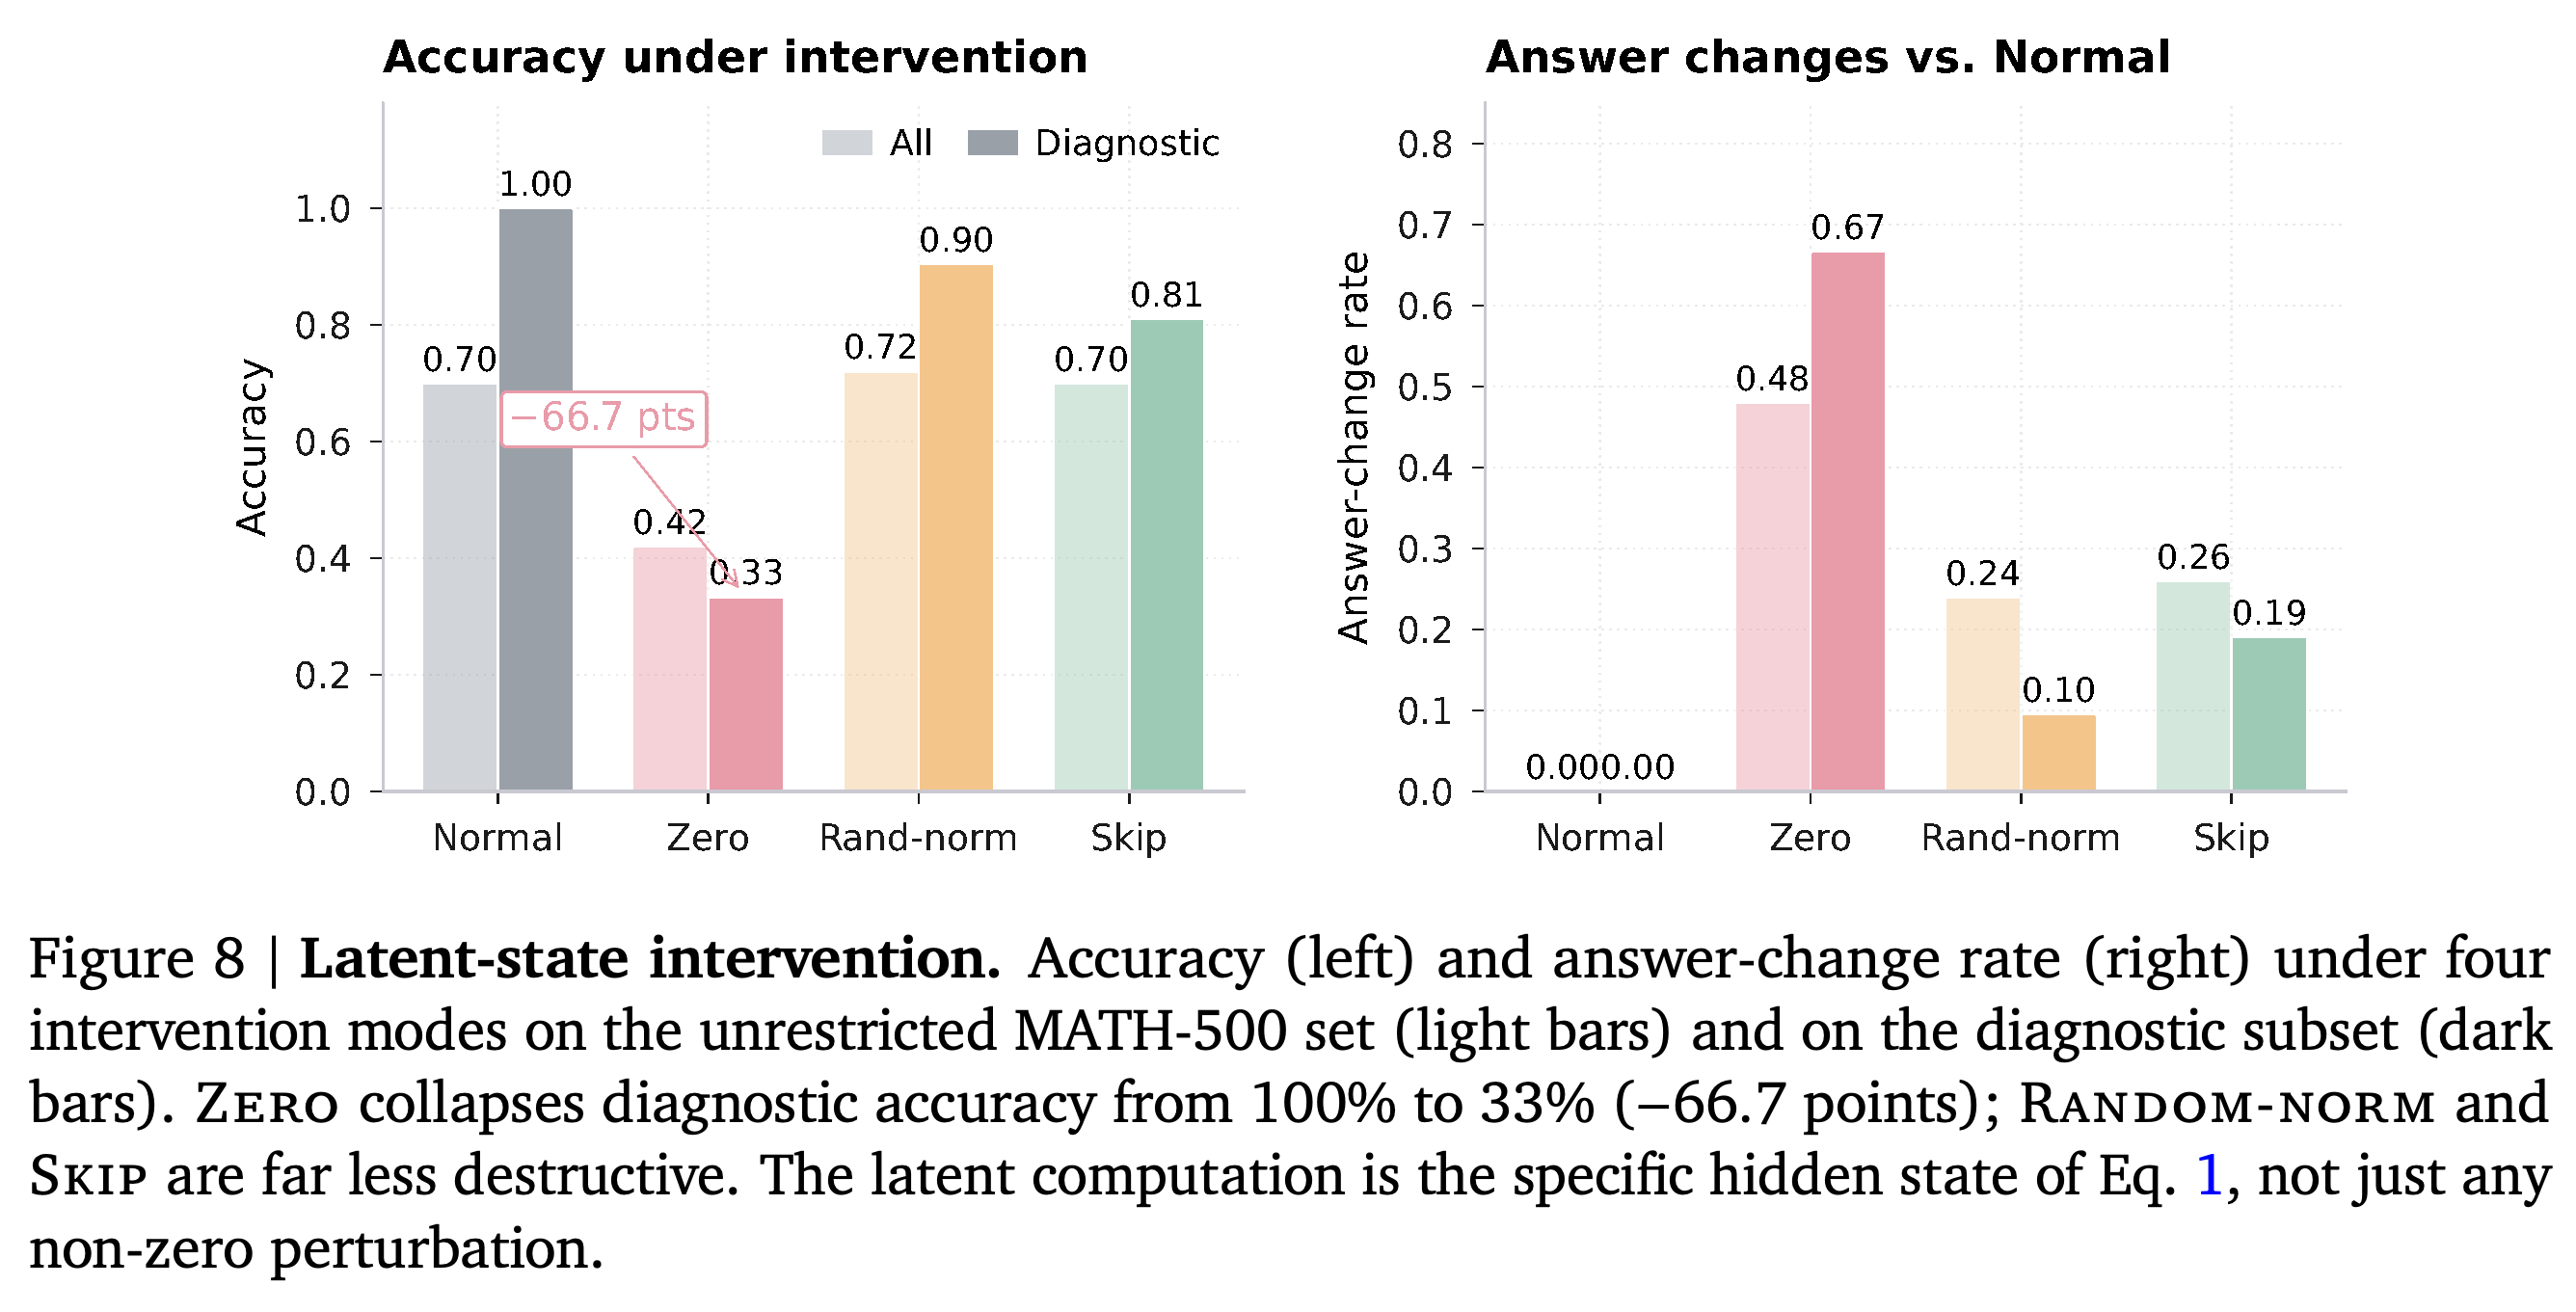
개입 실험은 정상 실행, 주입 상태의 영벡터 대체, 같은 노름의 무작위 상태 대체, 잠재 실행 건너뛰기를 비교한다. 정상 생성이 정답을 내면서 잠재 블록을 사용한 문제에서는 정확도가 100%에서 각각 33.3%, 90.5%, 81.0%로 낮아진다.
- 제한 없는 전체 평가에서 정확도는 70%, 42%, 72%, 70%이다. 따라서 건너뛰기는 선별한 진단용 부분집합의 정확도를 낮추지만, 이 실험의 전체 정확도에는 손실을 주지 않는다.
- 진단용 부분집합은 정상 모드에서 정답을 낸 사례를 기준으로 선택한다. 결과는 해당 사례의 민감도를 보여줄 뿐, 전체 문제에서 잠재 실행이 이롭다는 사실을 입증하지는 않는다.
- 영벡터 대체는 같은 노름의 대체보다 훨씬 큰 영향을 준다. 이 개입들만으로는 상태 노름, 분포 교란, 문제별 의미 정보의 영향을 충분히 분리하지 못한다.
영벡터 대체는 전체 정확도와 진단용 정확도를 모두 크게 낮춘다. 반면 건너뛰기는 전체 정확도를 유지하지만 정상 실행에서 성공한 부분집합의 정확도를 낮춘다. 같은 노름의 무작위 대체는 영향이 훨씬 작으므로, 이 실험만으로 원래 주입 상태의 의미 정보를 구체적으로 식별하는 데는 한계가 있다.
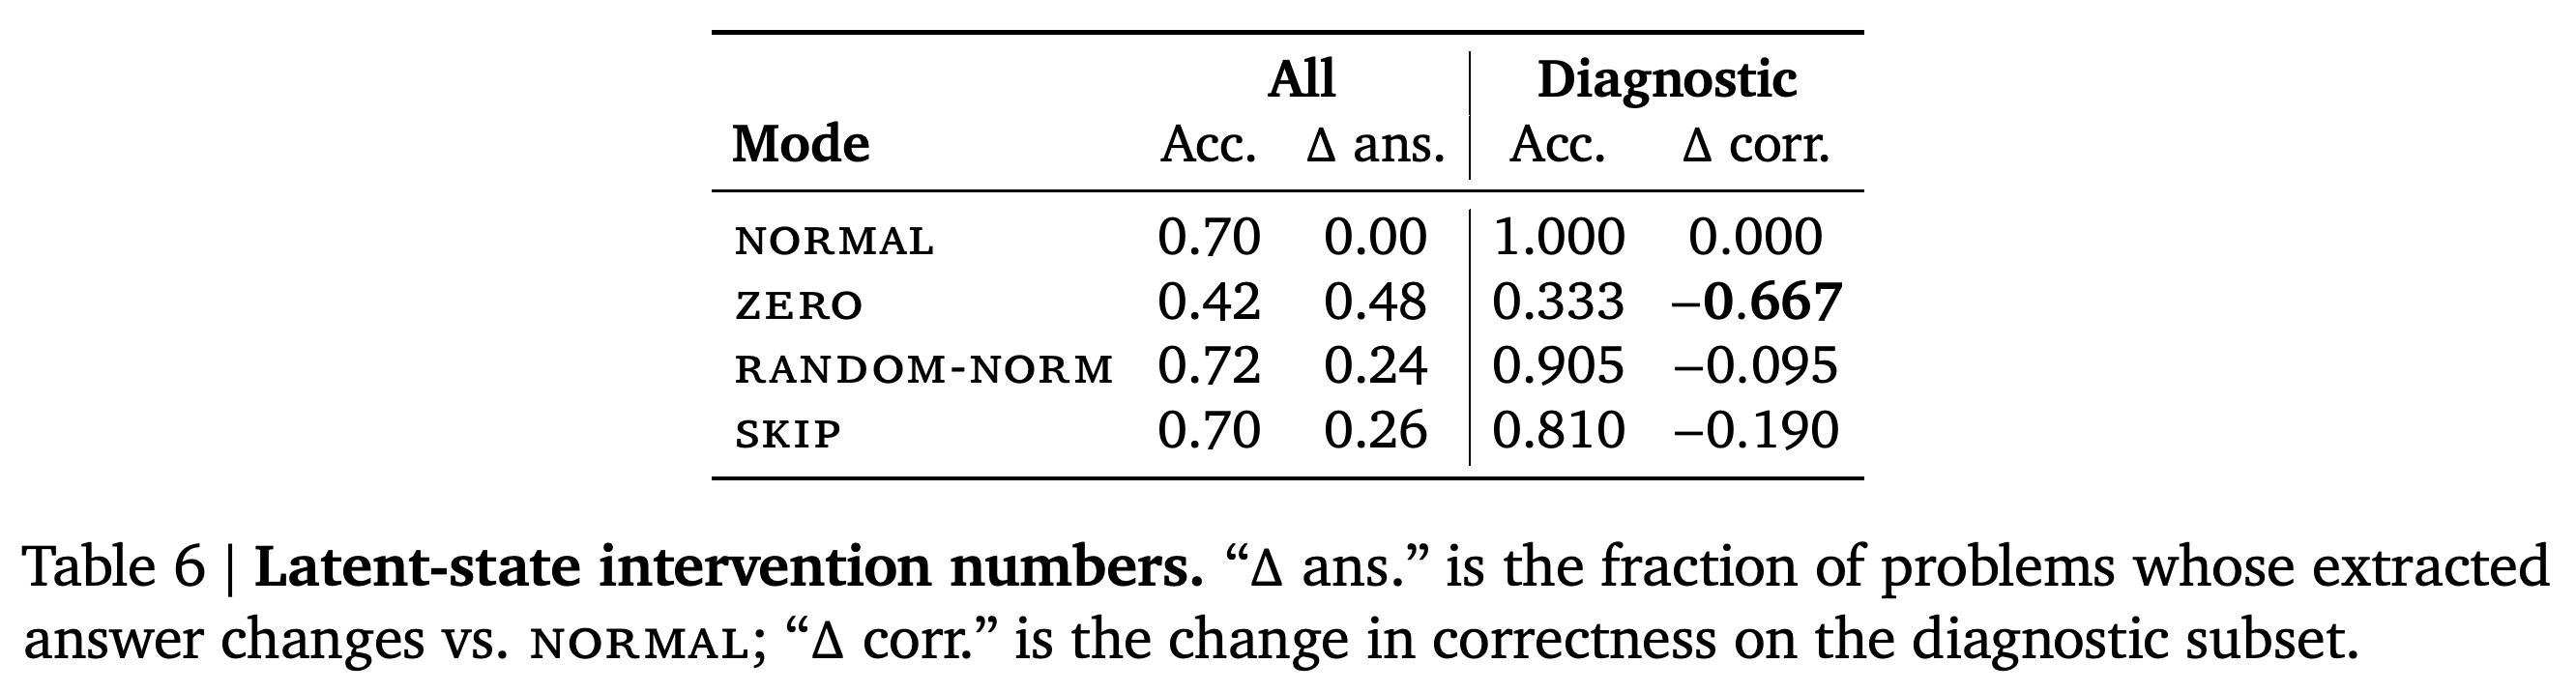
나란히 배치한 패널은 전체 평가와 선별된 부분집합에서의 효과 차이를 보여준다. 영벡터 대체가 가장 큰 교란을 일으킨다. 건너뛰기에서 전체 정확도가 변하지 않는다는 결과는 진단용 부분집합의 손실을 벤치마크 전체에서 잠재 실행이 주는 이점으로 해석해서는 안 됨을 보여준다.
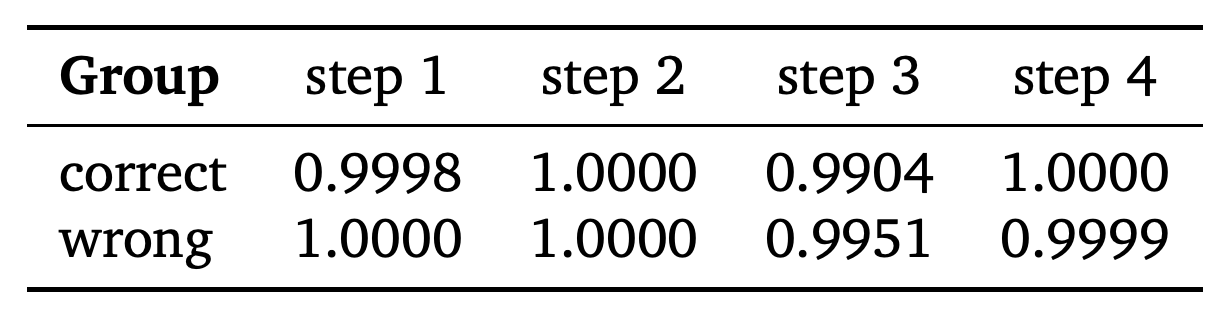
Logit lens는 각 잠재 단계에서 </swi>를 최상위 토큰으로 출력하며, 첫 단계에서는 문제와 관련된 대안 토큰의 분포가 더 넓게 퍼진다. 정답 궤적과 오답 궤적 모두 단계 1–4에서 종료 확률이 약 1로 유지된다. 이는 외부에서 최소 체류 길이를 강제해야 하는 이유를 설명한다.
- 저자들은 이 관찰을 유용한 계산이 진입 전이에 집중된다는 의미로 해석한다.
- 종료 준비도는 출력 분포의 특성이지 내부 계산의 가치를 직접 측정한 값은 아니다. 이후 전이가 기능적으로 무시할 만하다고 입증하려면 단계별 인과적 ablation 실험이 필요하다.
- 정성적 logit-lens 어휘를 잠재 추론을 충실하게 디코딩한 기록으로 간주해서는 안 된다.
정답 rollout과 오답 rollout 모두 첫 잠재 단계부터 종료 확률이 거의 1이다. 이는 강제된 최소 체류 길이에 의존하는 이유를 설명하지만, 이후 hidden transition이 유용한 계산을 전혀 하지 않는다는 사실을 입증하지는 않는다.
6. Conclusion
Switch는 hidden-state recurrence를 실행하는 추론 모델을 학습하고 분석하기 위한 이산 인터페이스를 제공한다. 최고 성능 실행은 선택한 recurrent-latent 기준 모델보다 높은 정확도를 달성하며, 경계 측정과 개입은 실행의 일부 특성을 실증적으로 분석할 수 있게 한다.
- 이 근거만으로 recurrent latent state를 통해 완전히 미분 가능한 RL, 동일 비용에서의 우위, 잠재 추론의 완전한 복원을 입증하지는 못한다.
Limitations
평가는 Qwen3-8B와 2개 수학 벤치마크로 제한된다. 저자들은 RL에서 잠재 구간을 미분하지 않으며, 해당 표현은 주로 지도학습 커리큘럼을 통해 형성된다고 인정한다. 이 단서는 recurrent latent computation을 통해 gradient가 전파된다는 초록의 주장과 충돌한다.
- Vocabulary-mixture 시스템과 규모 및 데이터를 맞춘 직접 비교는 하지 않는다.
- 저자들은 logit-lens 분석을 잠재 추론의 충실한 복원이 아니라 정성적 분석으로 설명한다.
- 메커니즘 효과 크기의 견고성을 평가할 수 있는 여러 seed의 불확실성이나 충분한 통계 세부 사항을 보고하지 않는다.
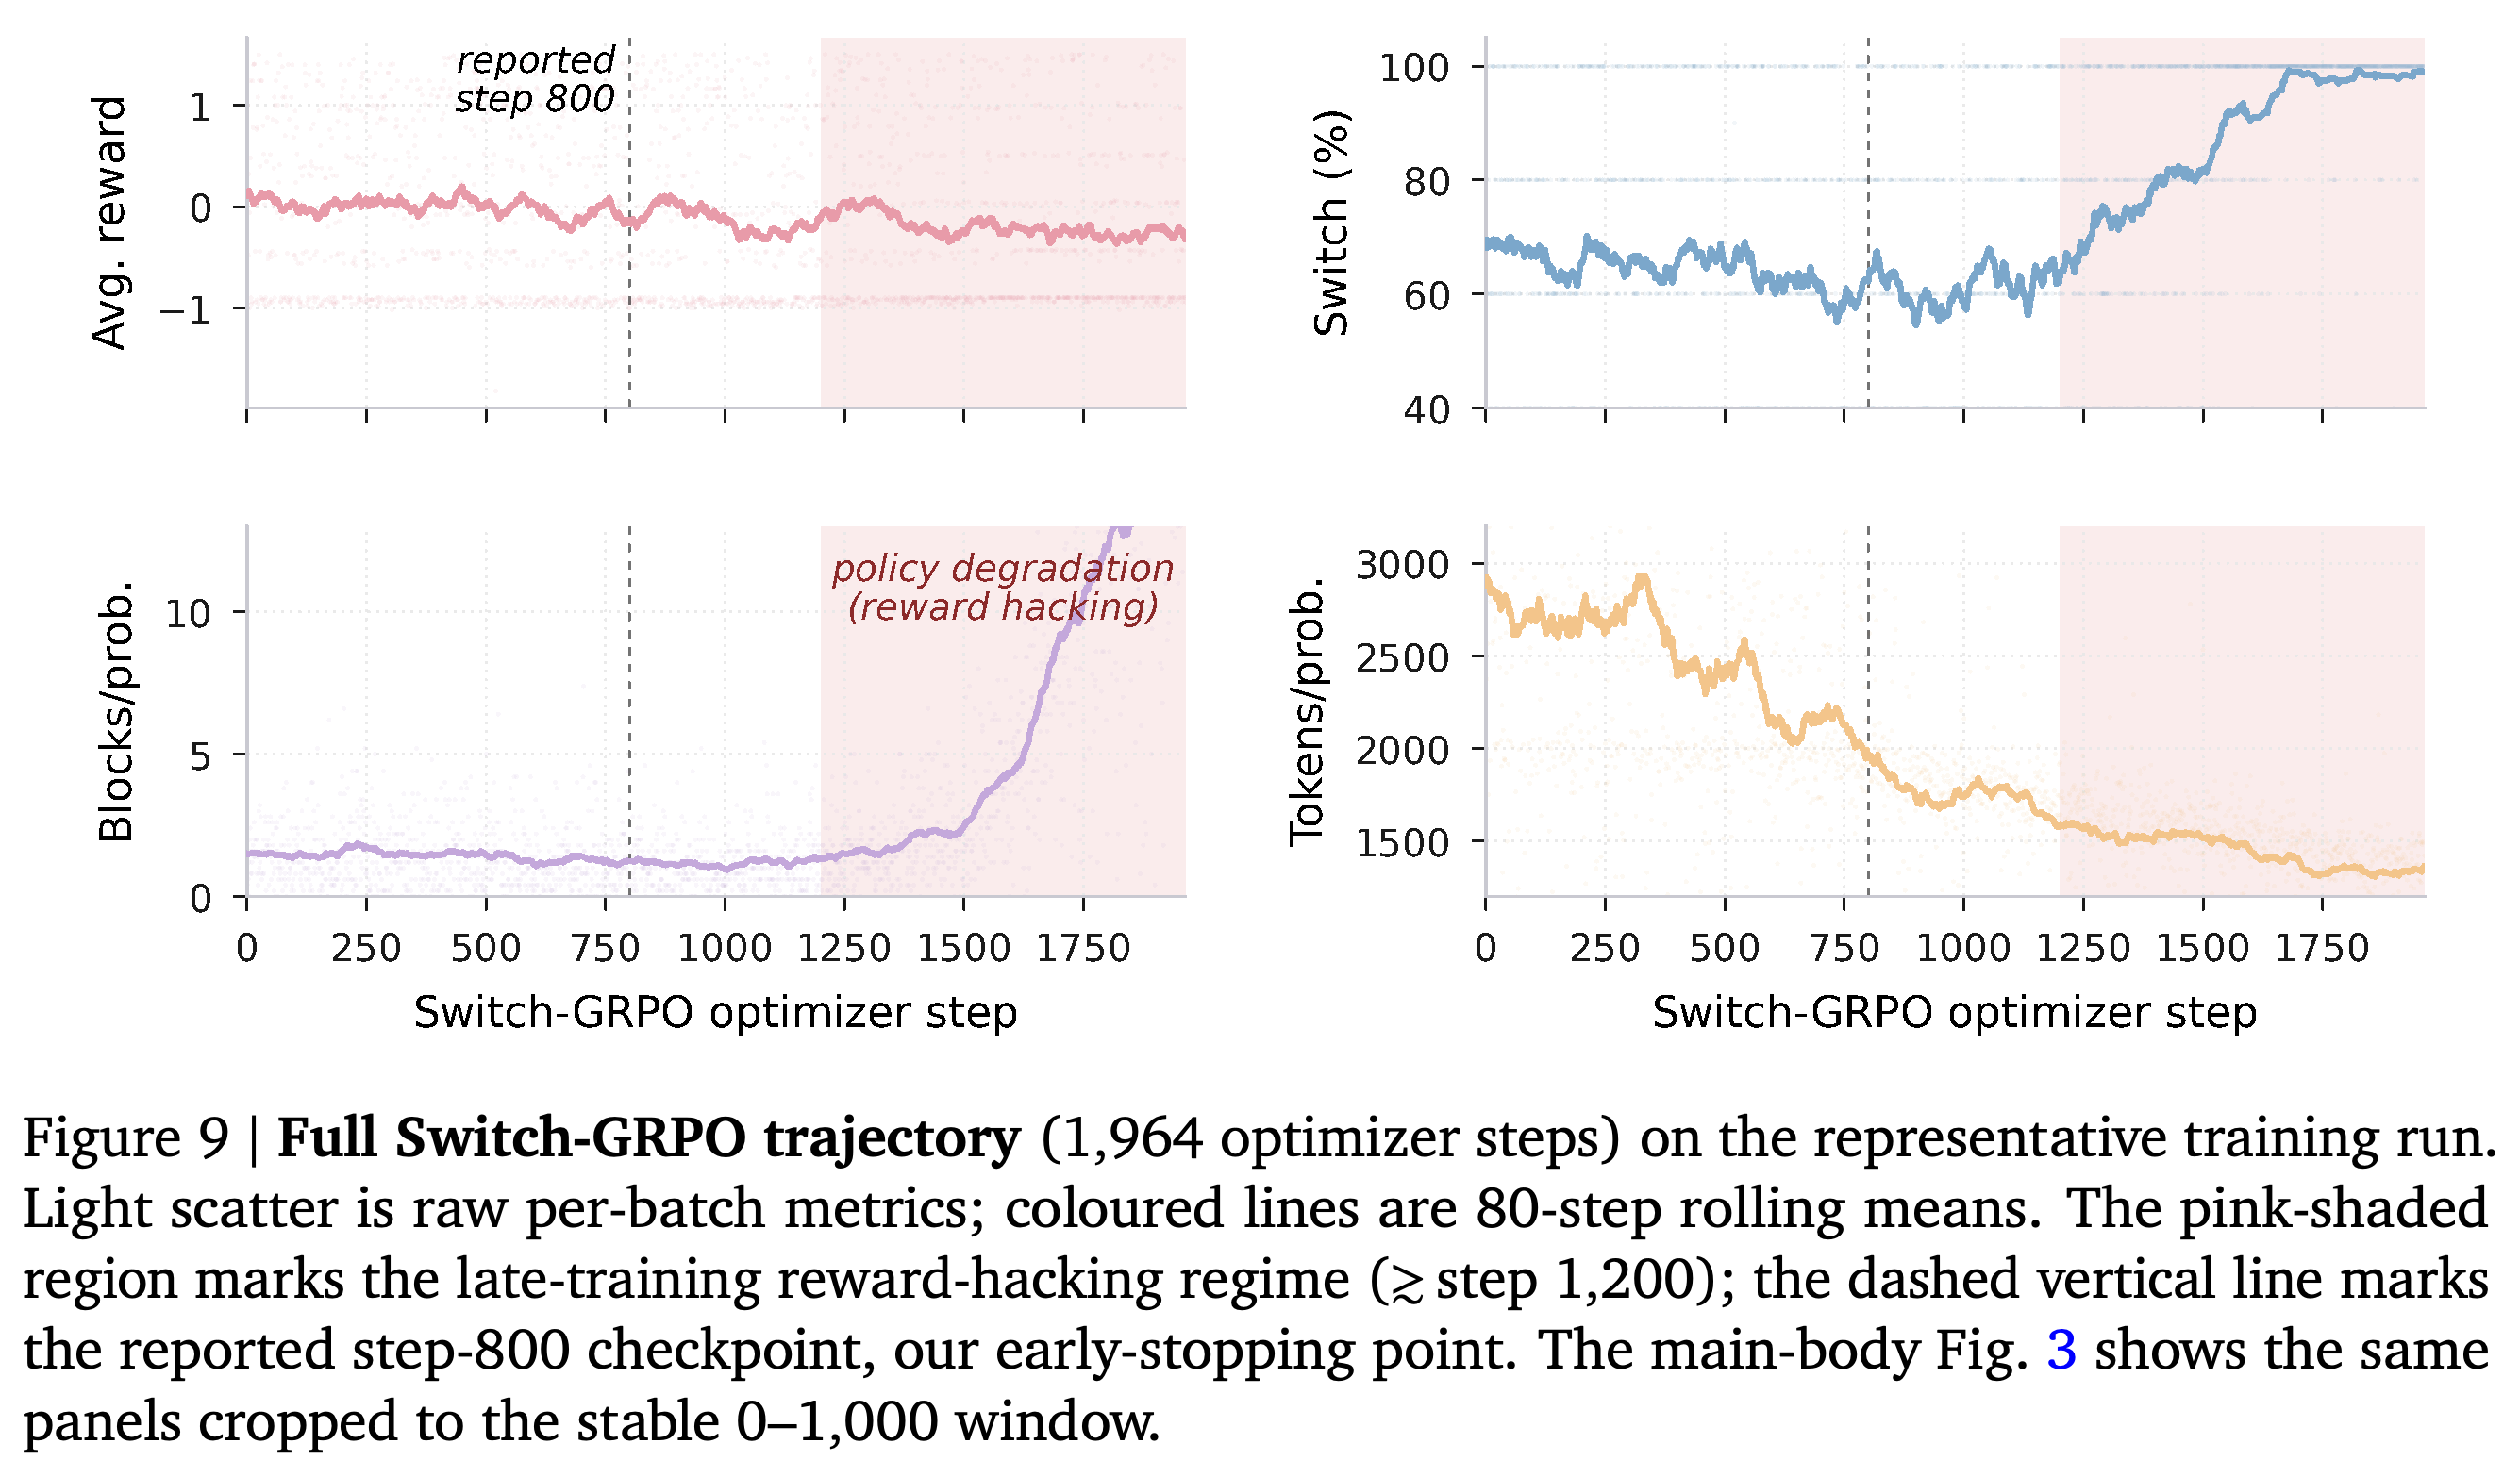
전체 1,964-step 학습 기록에는 약 step 1,200부터 시작되는 후기 구간이 나타나며, 저자들은 이를 reward hacking이라고 부른다. 이 구간에서 전환율은 100%에 가까워지고 잠재 블록은 문제당 약 13개로 늘어나지만 보상은 감소한다. Figure 9는 이 성능 저하 구간을 피해야 함을 뒷받침한다. 다만 Table 8에서 step 800은 대표 궤적의 최고 정확도 체크포인트가 아니다.
- 보고한 운영점은 보상을 수렴할 때까지 최적화한 결과가 아니라, 정책 행동을 관찰하고 체크포인트를 선택한 결과다.
- 명시적 토큰 수에는 잠재 계산량이 빠져 있다. 주요 결과, 조건부 지표, 대표 실행 지표 사이의 미해결 차이도 성능 향상의 원인을 특정하기 어렵게 한다.
확장된 궤적은 본문에서 잘라 제시한 그래프에 없는 행동을 보여준다. 후기 전환율은 100%에 가까워지고 잠재 사용 횟수는 급증하지만 보상은 악화된다. 이는 성능 저하 구간을 피해야 함을 뒷받침하지만, step 800이 평가 정확도가 가장 높은 체크포인트임을 입증하지는 않는다.
부록
- A. Implementation Details: 특수 토큰 ID는 <swi>가 151669, </swi>가 151670, <latent>가 151671이다. Phase 1은 q, k, v, o, gate, up, down projection에 LoRA rank 32와 α=64를 적용하고, 크기를 조정한 임베딩과 LM head도 학습한다. 보고한 cross-entropy는 0.098에 도달한다. 구간별 역전파는 텍스트에 gradient를 적용하고 잠재 구간은 torch.no_grad()에서 처리하여, 최대 activation memory를 텍스트 구간 1개 수준으로 줄인다. 메모리 부족을 처리할 때는 실패하지 않은 rollout을 보존해 그룹 advantage 계산에 사용한다.
- B. Switch-GRPO Loss, in Full: 정답 보상과 형식 보상은 ±1 값을 갖는다. 사용 항은 정답 보상에 올바른 형식 여부와 사용 여부의 지시자를 곱한다. 길이 단축 보너스는 0과 1 사이로 clip하며 정답 여부와 사용 여부를 조건으로 적용한다. 그룹 상대 advantage에는 ε=10^−8을 사용한다. 텍스트에만 적용하는 clipped objective는 ε_c=0.2와 β=10^−3을 사용하며, 이전 정책을 importance ratio의 기준과 KL 기준으로 모두 사용한다.
- C. Per-Checkpoint Trajectory of Switch: 대표 실행은 K_min=4에서 커리큘럼 stage 6 이후 전체 정확도 70.0%, RL step 200에서 78.0%, step 800에서 72.6%를 달성한다. 부록은 이 궤적을 주요 결과인 79.3%/89.2%를 낸 최고 성능 실행과 구분하며, 학습 후기의 정책 성능 저하를 기록한다.
- D. Algorithm Boxes: Algorithm 1인 CoconutSwiModel forward는 streaming KV cache를 전달하면서 텍스트 실행과 잠재 실행을 구분한다. Algorithm 2인 One Switch-GRPO step은 hidden-state-injection rollout을 수행하고 그룹 상대 advantage를 계산한 뒤, 텍스트 구간에만 구간별 역전파를 적용한다.
- E. Visible-Token CDF: Figure 10은 경험적 길이 분포로 본문의 히스토그램을 보완한다. 길이 단축 보너스 변형은 응답을 더 짧은 명시적 토큰 길이 쪽으로 이동시킨다. 반면 표준 RL 변형은 SFT 대비 중앙값을 그림에 표시된 69토큰만큼 늘린다.
- F. Mechanistic Analysis: Additional Details: 프로브는 균형 잡힌 양성·음성 샘플, C=1.0, 1회의 80:20 분할을 사용한다. Teacher-forced 비교는 체크포인트마다 같은 MATH-500 문제를 사용한다. 개입 실험은 K_min=4의 greedy decoding을 사용하며, 잠재 블록을 포함한 정상 모드 정답 응답에서 진단용 부분집합을 선택한다.
- G. Per-Subject and Per-Difficulty Visualisation: 보고한 과목별 정확도는 Algebra 88.7%, Prealgebra 80.5%, Number Theory 79.0%, Precalculus 67.9%, Counting & Probability 60.5%, Intermediate Algebra 56.7%, Geometry 53.7%이다. 난이도 level 1–5의 정확도는 각각 93.0%, 90.0%, 83.8%, 64.1%, 53.7%이다. Section G는 이를 주요 결과 체크포인트의 성능이라고 설명하지만, Table 9의 캡션은 대표 실행이라고 명시한다. Figure 11의 잠재 분기와 텍스트 분기는 무작위로 배정한 그룹이 아니라 모델이 선택한 그룹이다.
- H. Generation Trace Analysis: 정답 응답은 전환이 없을 때 명시적 토큰을 평균 959개, 전환이 있을 때 1,197개 사용한다. 오답 응답은 각각 1,729개와 1,805개를 사용한다. 전환한 정답 응답은 평균 1.86개 블록과 7.43개 잠재 단계를 사용하며, 전환한 오답 응답은 1.40개 블록과 5.60개 단계를 사용한다. 오답 궤적의 전환 결정은 확신도가 더 낮다. 엔트로피는 정답의 0.608 대비 0.717이며, p(<swi>)는 정답의 0.763 대비 0.669이다.
- I. Ablations: 저자들은 K_min을 {0, 2, 4, 8, 16}으로 바꾸며 실험한다. 최소 체류 제약을 제거하면 잠재 블록이 1회의 forward pass로 실행되며, 보고한 커리큘럼 SFT 정확도는 53.0%이다. 부록은 K_min=4를 선호하지만 전체 실험의 수치 표를 제공하지 않는다. Table 8은 K_min=0과 K_min=4의 SFT 행 사이에서 커리큘럼 단계도 바꾸므로, 두 행은 체류 길이의 영향만 분리하지 못한다.
- J. Full Related Work: 확장된 관련 연구 검토는 선행 연구를 잠재 표현, 하이브리드 전환, RL 최적화, 내부 상태 해석으로 분류한다. Switch는 Coconut 방식의 recurrence를 유지하면서 학습 가능한 이산 제어 인터페이스를 추가하는 방법으로 설명한다.
- J.1. Latent Chain-of-Thought Reasoning: Coconut은 점진적 recurrence 커리큘럼을 사용하고, CODI는 self-distillation으로 학생과 교사 상태를 정렬하며, CoLaR는 latent head를 추가한다. Vocabulary-mixture 접근은 대신 토큰 임베딩을 결합하고, 최근 RL 변형은 샘플링 메커니즘을 추가한다. 이 방법들을 제외했으므로 입증한 실증적 우위의 범위는 제한된다. 이 검토는 초기 소규모 recurrence 실험, pause 및 filler token, implicit-CoT 내재화, multimodal latent representation도 다룬다.
- J.2. Switchable / Hybrid Reasoning: SwiReasoning은 외부 엔트로피 규칙에 따라 고정된 모델을 전환한다. 반면 Switch는 경계 토큰 확률을 학습하고 지도학습으로 잠재 실행을 도입한다. 적응형 명시적 추론 방법은 디코딩한 추론을 recurrent hidden state로 대체하지 않고 추가 계산을 배분한다. 여기서 RL이 잠재 동역학과 체류 길이를 end-to-end로 최적화한다는 주장은 텍스트에만 gradient를 적용하는 구현과 강제된 최소 체류 길이를 고려해 제한적으로 해석해야 한다.
- J.3. Reinforcement Learning for Reasoning and Latents: Vocabulary-mixture RL 접근은 잠재 행동을 샘플링할 수 있게 만든다. 반면 Switch-GRPO는 likelihood ratio를 샘플링한 텍스트 결정으로 제한하고 결정론적 recurrent execution을 유지한다. 이는 RL과 호환되는 궤적 인터페이스를 제공하는 것이지, 연속 잠재 위치에 직접적인 policy-gradient 항을 제공하는 것은 아니다.
- J.4. Interpretability of Internal Reasoning States: 논문은 logit-lens 분석, 선형 프로브, 인과적 activation intervention을 결합한다. 이 도구들은 상호 보완적인 특성을 검증하지만, 정성적 어휘 분석과 선형으로 복원 가능한 특징만으로 전체 잠재 계산을 설명하지는 못한다.
- K. Extended Discussion: 저자들은 계산 가능한 정책 밀도가 모든 결정론적 계산 단계가 아니라 샘플링한 결정 지점에서 필요하다고 주장한다. 또한 경계 확률 감소와 개입 효과를 전환 선택의 개선 및 의미 있는 잠재 계산으로 해석한다. 하지만 전환율이 절반으로 줄고 잠재 사용 조건부 정확도가 거의 곱절이 된다는 논의의 주장은 Table 2의 81%→58%와 66.7%→79.3%로 뒷받침되지 않는다. 같은 노름의 대체 실험도 잠재 내용의 문제별 특이성을 명확히 밝히지 못한다.
짧은 생각
가장 명확한 기여는 경계 인터페이스다. 이 인터페이스는 recurrent execution을 제어할 수 있게 하고, 이산 행동 RL과 호환되게 하며, 실행을 측정하기 쉽게 만든다. 동일한 기반 모델에서의 재구현과 학습 후기 성능 저하의 공개는 평가의 정보 가치를 높인다. 다만 추론 비용의 차이는 해결하지 못한다.
실증적 주장과 메커니즘 주장에는 더 일관된 지표 정리가 필요하다. 체크포인트와 디코딩 표의 불일치 해소, 총계산량을 맞춘 비교, 반복 실행, 단계별 개입이 있다면 전환 선택 및 명시적 추론의 개선과 문제별 잠재 계산의 효과를 구분하는 데 도움이 된다.