


Qwen3-Omni Technical Report 요약 설명
22 Sep 2025 | Paper Review Unified Multimodal Models Speech Generation Mixture-of-Experts목차
이번 글에서는 Qwen3-Omni Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 22일(Arxiv)
- Xu, Jin, Guo, Zhifang, Hu, Hangrui, Chu, Yunfei, Wang, Xiong, He, Jinzheng, Wang, Yuxuan, Shi, Xian, He, Ting, Zhu, Xinfa, et al.
- 논문 링크
- Github
요약
- Qwen3-Omni는 개별 입력 유형에 특화된 모델의 능력을 약화시키지 않으면서 텍스트, 이미지, 오디오, 비디오 처리를 하나의 모델에 통합하는 문제를 다룬다. 모델 크기, 학습 일정, 공통 모달리티 데이터셋, 학습 연산량을 맞춘 Qwen 기본 모델 간 통제 비교에서는 오디오와 시청각 처리 능력을 추가하면서 텍스트와 시각 성능을 전반적으로 유지했다. 다만 일부 개별 벤치마크 점수는 하락했다.
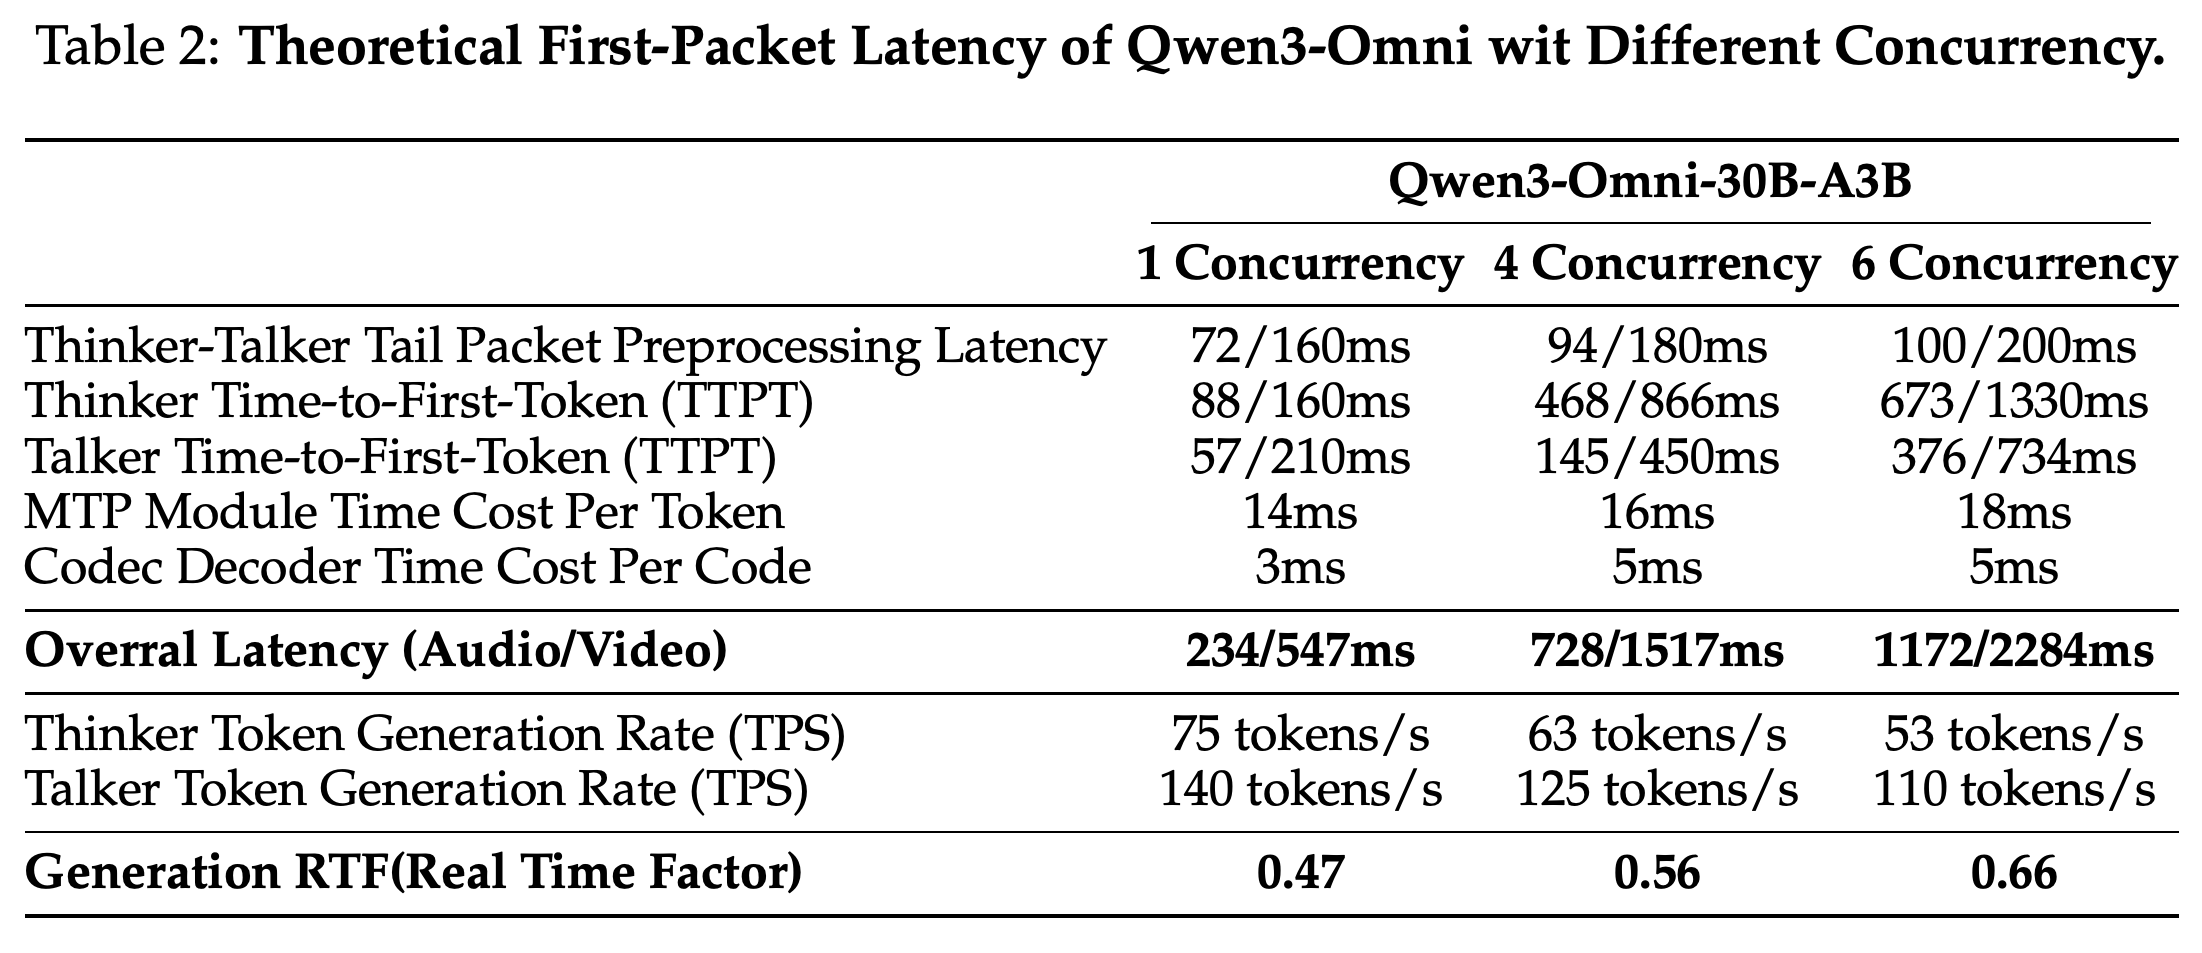
- 모델은 입력을 해석하고 텍스트를 생성하는 Thinker와 음성을 생성하는 Talker를 분리한다. 각 모듈은 전문가 구성 요소를 선택적으로 활성화하는 Mixture-of-Experts (MoE) 아키텍처를 사용한다. 오디오 인코더인 Audio Transformer (AuT)와 음성 생성 모듈은 12.5 Hz로 작동한다. 코드북은 각 오디오 프레임을 표현하는 이산 코드의 집합이다. 여러 코드북을 사용해 음향 정보를 표현하고 현재와 이전 문맥만 사용하는 경량 인과적 합성곱 신경망으로 파형을 스트리밍한다. 이전 문맥 없이 최초 음성 패킷을 생성하는 데 걸리는 이론적 콜드 스타트 지연 시간은 동시 요청 1개에서 오디오 234 ms, 비디오 547 ms로 보고된다.
- 보고서는 오디오 및 시청각 벤치마크 36개 중 32개에서 오픈소스 최고 성능을, 22개에서 전체 최고 성능을 달성했다고 주장한다. 텍스트 119개 언어, 음성 입력 19개 언어, 음성 출력 10개 언어를 지원한다. 지시에 응답하도록 학습한 Instruct는 대체로 전사와 음악 인식에서 더 좋은 성능을 보인다. 입력에 대해 명시적으로 추론하는 Thinking은 여러 추론 평가에서 성능을 높인다. 긴 비디오에서 낮은 성능을 보이고, 모델 규모를 포괄적으로 비교하지 않았으며 음성 평가가 주로 텍스트 조건부 생성에 집중되어 있다는 점은 이러한 결론의 적용 범위를 제한한다.
1 Introduction
서론은 언어를 처리하고 생성하는 대규모 언어 모델(LLM)을 중심으로 구축한 통합 시스템에서 모달리티 간 성능 상충이 장애가 된다고 지적한다. 특화된 능력을 유지하면서 시청각 추론과 상호작용을 학습하기 위해 사전학습 초기부터 단일 모달리티 데이터와 모달리티 간 데이터를 혼합할 것을 제안한다. Qwen2.5-Omni 대비 주요 변경점은 MoE 기반 Thinker와 Talker, 새로운 오디오 인코더, 더 풍부한 음성 표현, 프레임 단위 파형 생성, 낮아진 오디오 토큰 빈도다.
2 Architecture
아키텍처는 오디오 및 시각 인코더, Thinker–Talker 인터페이스, 스트리밍 음성 디코더를 결합한다. 음향 세부 정보를 여러 이산 코드북으로 표현하므로 최종 파형 생성기에 경량 합성곱 신경망을 사용할 수 있다.
2.1 Overview
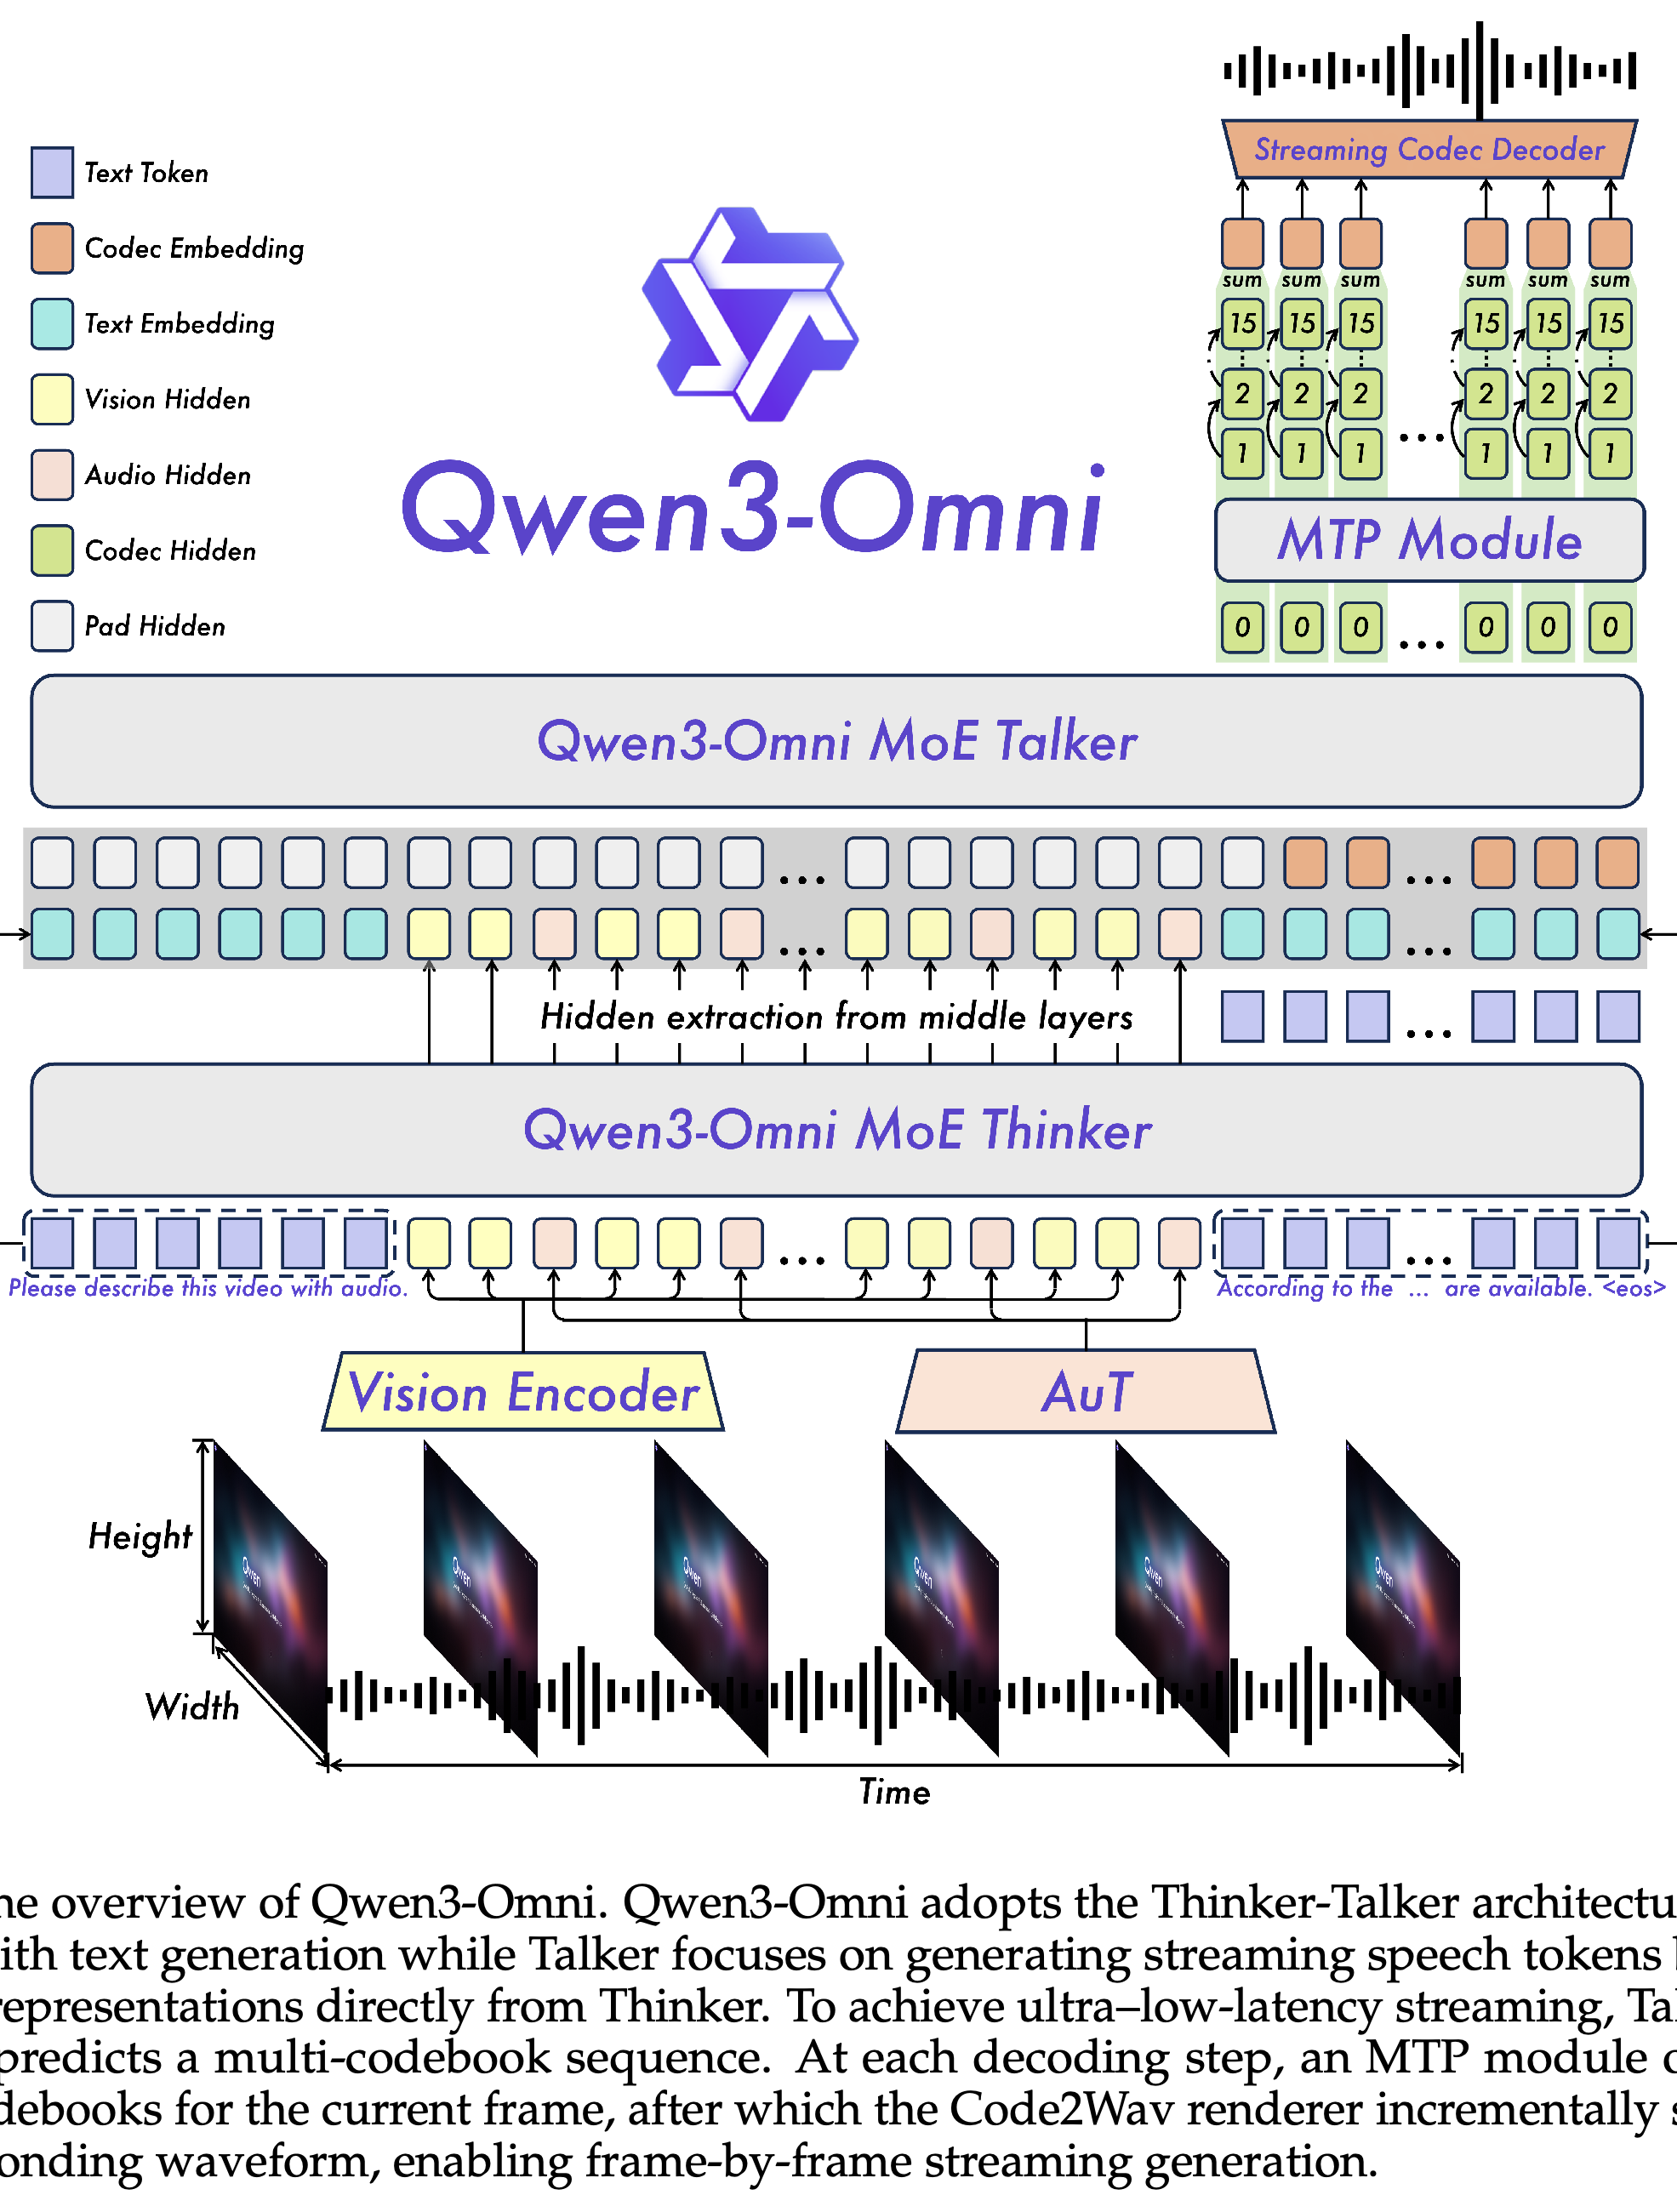
Thinker는 텍스트 응답을 생성하고 Talker는 Thinker에서 받은 오디오 및 시각 특징과 이산 텍스트 토큰, 대화 이력을 입력으로 사용한다. Talker는 더 이상 Thinker의 고수준 텍스트 표현을 사용하지 않는다. 따라서 텍스트 응답 스타일과 음성 스타일에 별도의 시스템 프롬프트를 적용하고 생성한 텍스트를 외부에서 처리한 뒤 음성을 합성할 수 있다. Talker는 각 프레임의 첫 번째 코드북을 예측하고 multi-token prediction (MTP) 모듈은 나머지 코드북을 예측한다. 파형 생성기인 Code2Wav는 이 코드들을 오디오 샘플로 변환한다.
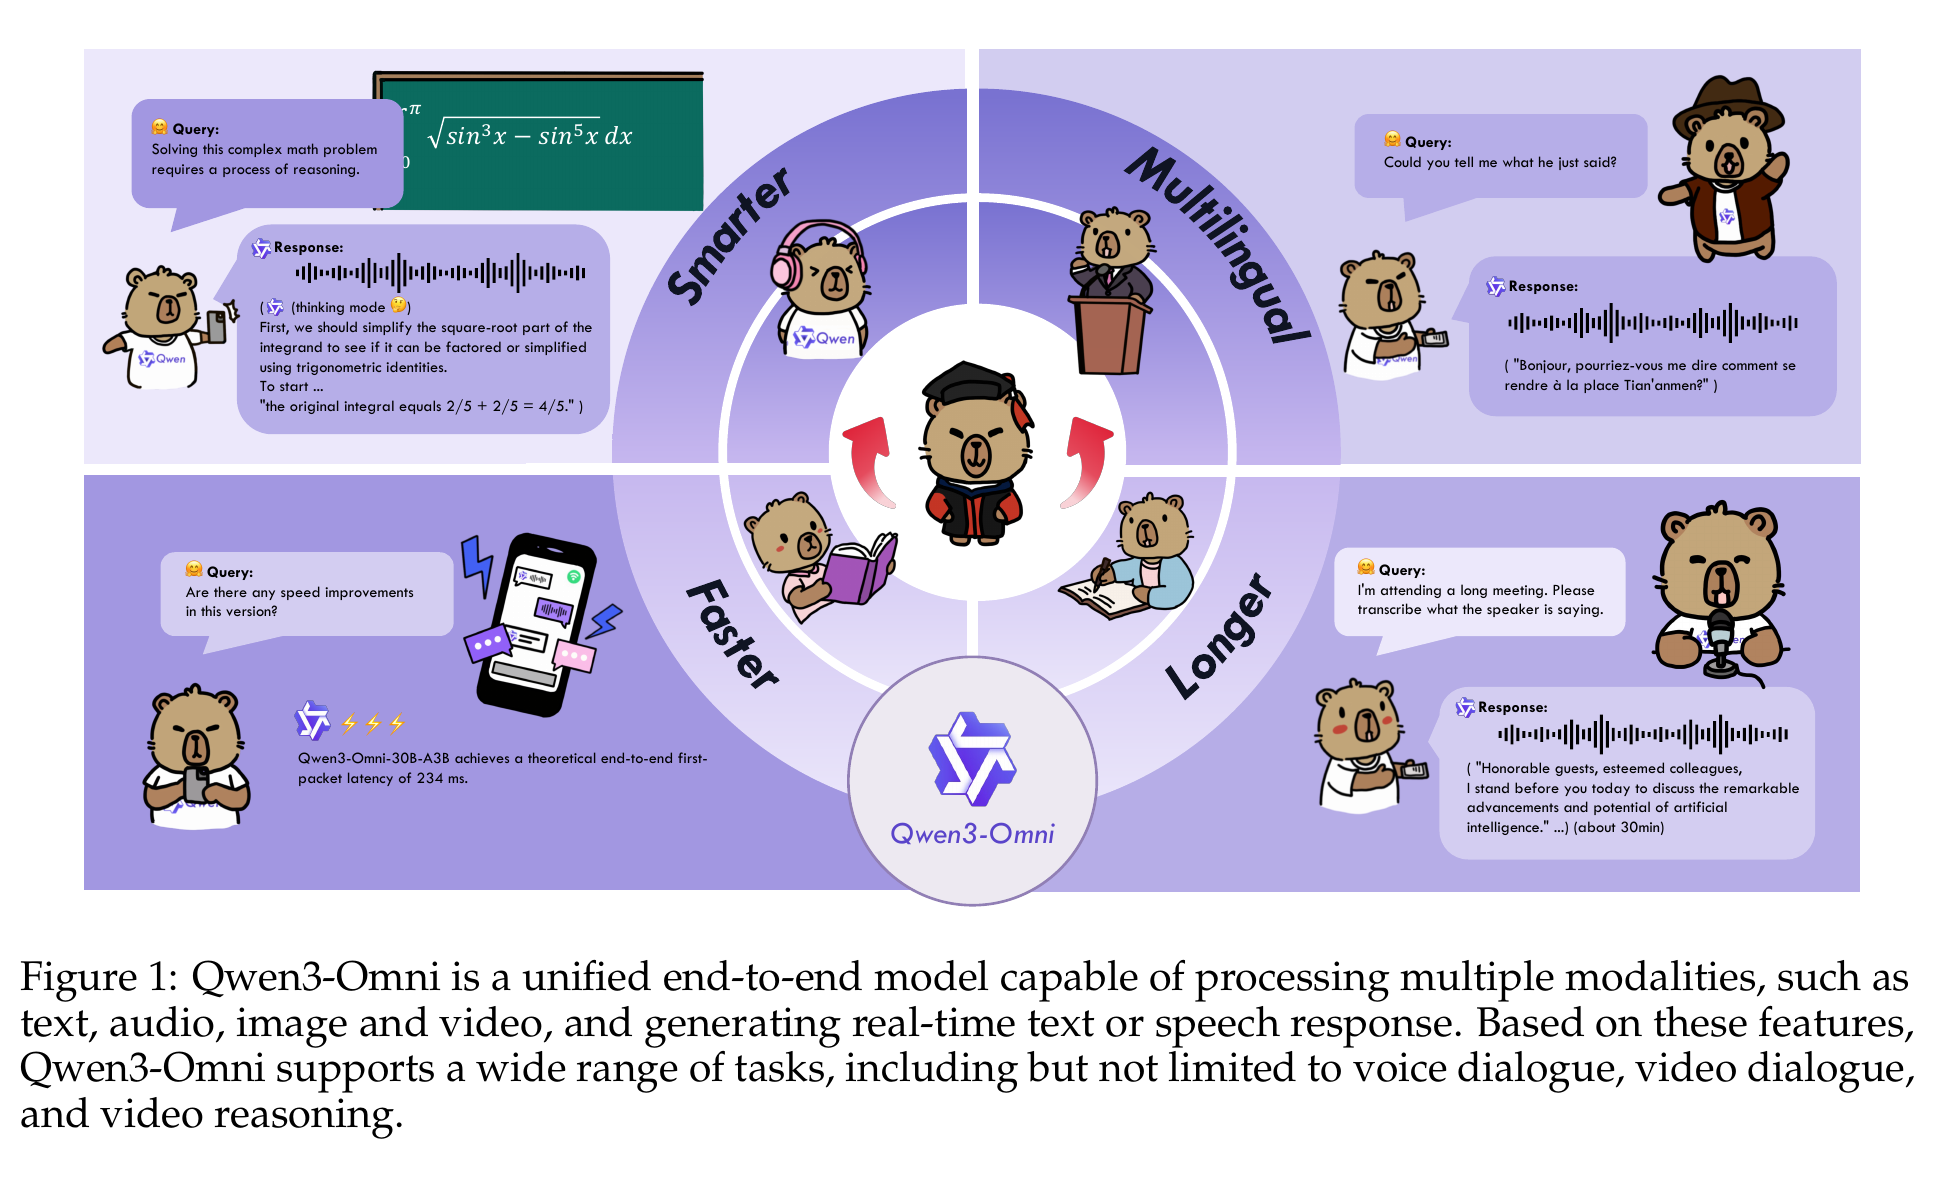
예시는 추론, 다국어 상호작용, 응답 속도, 긴 오디오 처리를 중심으로 모델이 목표로 하는 능력을 보여준다. 모델의 활용 사례를 설명하며 정량적 근거는 벤치마크 표에서 제공한다.
도식은 인식 인코더에서 Thinker를 거쳐 Talker로 이어지는 구조를 보여주며, 음성 생성이 멀티모달 특징과 텍스트를 어떻게 사용하는지 설명한다. 코드북 예측과 스트리밍 디코더 경로는 1개 프레임을 생성한 뒤 파형 생성을 시작할 수 있는 이유를 보여준다.
2.2 Audio Transformer (AuT)
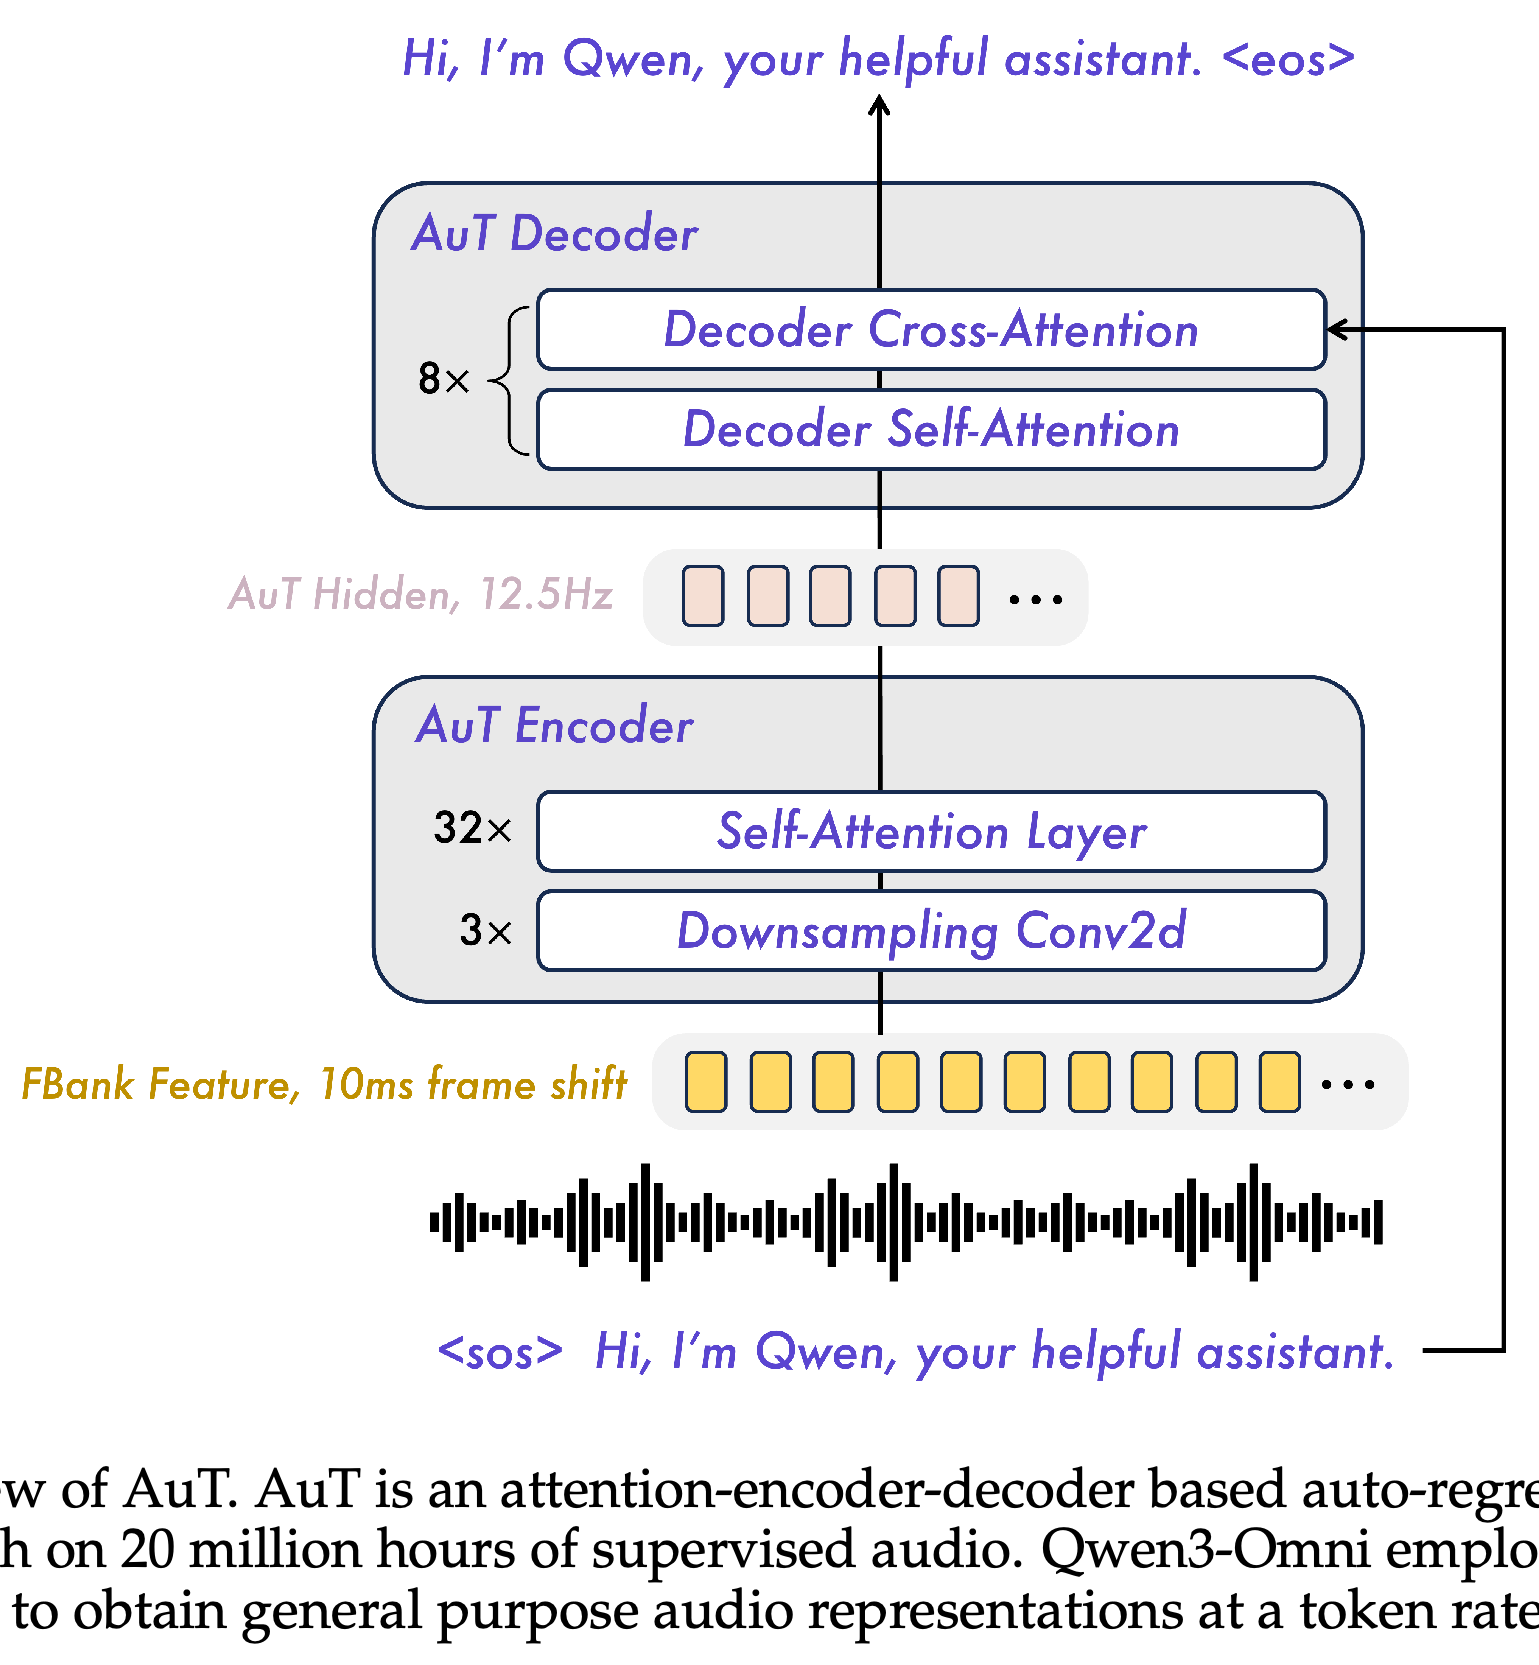
AuT는 지도학습용 오디오 20 million hours로 처음부터 학습한 어텐션 기반 인코더–디코더다. 학습 데이터는 중국어 및 영어 의사 레이블 ASR 80%, 기타 언어 ASR 10%, 오디오 이해 10%로 구성된다. 자동 음성 인식(ASR)은 음성을 텍스트로 전사하는 작업이며 의사 레이블은 자동으로 생성한 학습 레이블을 뜻한다. 합성곱 다운샘플링으로 입력 특징의 빈도를 8배 줄여 12.5 Hz로 만든다. 동적 어텐션 윈도우는 1–8 seconds 범위를 사용해 스트리밍 연산과 오프라인 이해 사이의 균형을 맞춘다. 본문은 인코더를 약 0.6B-parameter 규모로 설명하지만 Table 1은 파라미터 수를 650M으로 기재한다.
다운샘플링 합성곱 블록 3개 뒤에 인코더 어텐션 층 32개가 이어지며, 12.5 Hz 오디오 표현을 생성한다. 8개 층으로 구성된 디코더는 AuT 학습에 사용하고 Qwen3-Omni는 오디오 입력에 인코더를 사용한다.
2.3 Perceivation
텍스트에는 자주 등장하는 바이트 시퀀스를 병합하는 토크나이저인 byte-level byte-pair encoding을 사용하며 일반 토큰 수는 151,643개다. 오디오는 16 kHz로 리샘플링한 뒤 25 ms 윈도우와 10 ms 이동 간격으로 시간–주파수 표현인 128채널 mel-spectrogram으로 변환한다. 인코딩된 각 프레임은 약 80 ms를 나타낸다. 시각 인코더는 Qwen3-VL에서 가져오고 시각 언어 인코더인 SigLIP2-So400m으로 초기화한다. 본문에 따르면 파라미터 수는 약 543 million이며, 비디오 프레임은 동적 빈도로 샘플링한다.
- 절대 시간과 공간 좌표를 결합하는 위치 인코딩인 Time-aligned Multimodal Rotary Position Embedding (TM-RoPE)은 시간, 높이, 너비에 각각 24, 20, 20개의 회전 각도를 교차 배치한다.
- 오디오 위치는 80 ms마다 증가하며 비디오 위치는 같은 시간 해상도에서 실제 타임스탬프를 따른다. 이를 통해 시청각 특징을 고정된 2-second 청크로 묶는 대신 직접 정렬한다.
- 텍스트는 3개 차원에서 위치 식별자를 공유한다. 이미지는 일정한 시간 식별자와 공간상의 행 및 열 위치를 사용한다. 이후 각 모달리티는 앞선 모달리티의 최대 위치 식별자에 1을 더한 위치에서 시작한다.
2.4 Speech Generation
Talker는 이전 텍스트 토큰, 멀티모달 표현, 현재 스트리밍되는 응답을 조건으로 음성을 생성해 음향 스타일이 대화에 맞춰지도록 한다. Talker는 음향 세부 정보의 잔차를 차례로 표현하는 이산 코드인 residual vector quantization (RVQ) 토큰을 사용한다. 백본은 맨 처음 코드북을 예측하고 MTP는 나머지 코드북을 예측한다. 앞서 소개한 합성곱 파형 생성기인 인과적 ConvNet은 더 큰 미래 문맥 블록을 기다리지 않고 오디오를 복원한다.
2.5 Designs for Streaming and Concurrency
스트리밍은 비동기 청크 프리필, 이전 문맥만 사용하는 음성 디코딩, 배치 처리를 지원하는 경량 MTP 및 파형 모듈을 결합한다. 비동기 청크 프리필은 출력 생성 전에 Thinker와 Talker의 입력 문맥 처리 단계를 겹쳐 실행하는 방식이다. 모델 서빙 프레임워크인 vLLM과 음성 모듈용 torch.compile, CUDA Graph 가속을 사용한 Table 2에서는 동시 요청 1, 4, 6개에서 이론적 오디오/비디오 최초 패킷 지연 시간을 각각 234/547 ms, 728/1517 ms, 1172/2284 ms로 보고한다. 동시 요청이 늘면 시작 지연 시간이 증가하지만 보고된 생성 속도는 실시간보다 빠르다.
- Table 1은 30B-A3B Thinker, 3B-A0.3B Talker, 80M MTP 모듈, 200M 파형 디코더를 기재한다. 모델 식별자는 전체 파라미터 수와 활성 파라미터 수를 구분한다.
- 생성 real-time factor (RTF)는 처리 시간을 생성한 오디오 길이로 나눈 값이다. 3개 동시 요청 수준에서 각각 0.47, 0.56, 0.66이며, 모두 1 미만이다.
- RTF는 Thinker와 Talker의 토큰당 생성 시간에 MTP 및 디코더 처리 시간을 더한 뒤, 1개 프레임이 나타내는 오디오 길이인 80 ms로 나누어 계산한다. 보고서는 이 표에 사용한 추론 하드웨어를 밝히지 않는다.
구성 요소별 내역은 큰 Thinker와 더 작은 Talker, 경량 음성 모듈을 구분한다. 시각 인코더는 스트리밍을 지원하지 않는다고 표시하고 나머지 구성 요소는 스트리밍 지원을 기재한다. 오디오/비디오 최초 패킷 지연 시간은 234/547 ms로 제시한다.
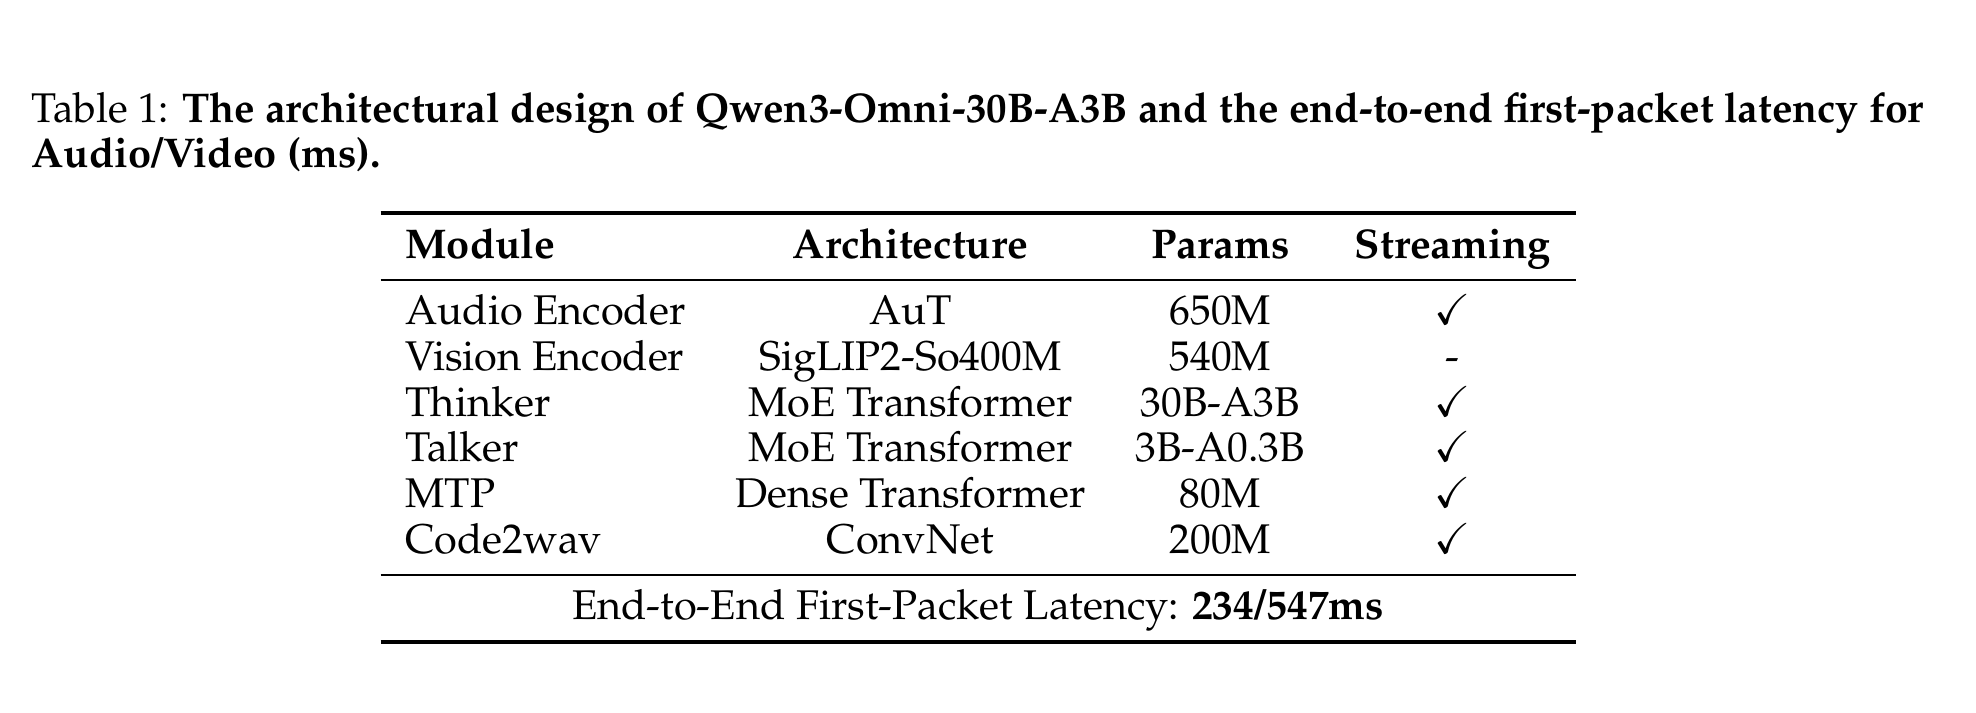
시작 지연 시간은 동시 요청 1개에서 234/547 ms이며, 6개에서는 1172/2284 ms로 증가한다. real-time factor는 1 미만을 유지한다. 표는 응답 시작 비용과 지속적인 음성 생성 속도를 구분한다.
3 Pretraining
사전학습은 다양한 자연어 프롬프트와 함께 텍스트, 이미지–텍스트, 비디오–텍스트, 오디오–텍스트, 비디오–오디오, 비디오–오디오–텍스트 데이터를 혼합한다. Encoder Alignment Stage (S1)는 언어 모델을 고정한 상태에서 인코더 출력을 언어 모델에 연결하는 어댑터를 먼저 학습한 뒤 인코더를 학습한다. General Stage (S2)는 모든 파라미터의 고정을 해제한다. Long Context Stage (S3)는 최대 시퀀스 길이를 8,192에서 32,768로 늘리고 긴 오디오 및 비디오의 비중을 높인다.
- S2는 약 2 trillion tokens로 설명된다. 모달리티별로 보고된 토큰 수는 텍스트 0.57 trillion, 오디오 0.77 trillion, 이미지 0.82 trillion, 비디오 0.05 trillion, 비디오–오디오 0.05 trillion이다. 이 값들의 합은 2.26 trillion이다.
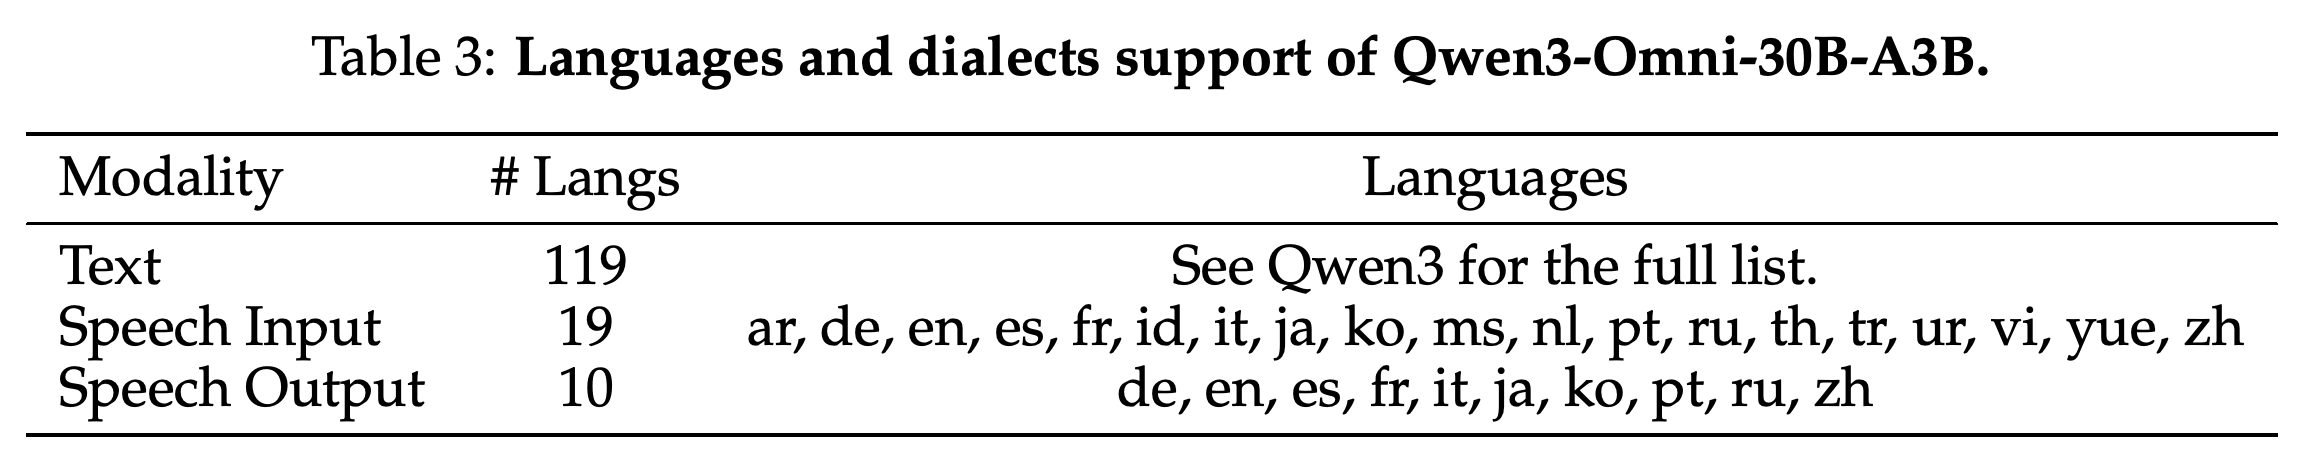
- 음성 입력은 ar, de, en, es, fr, id, it, ja, ko, ms, nl, pt, ru, th, tr, ur, vi, yue, zh를 지원한다. 음성 출력은 de, en, es, fr, it, ja, ko, pt, ru, zh를 지원한다.
- 저자들은 고정된 언어 모델에 맞춰 인코더와 어댑터를 함께 학습하면 인코더의 인식 능력이 약화될 수 있다는 위험을 근거로 어댑터를 먼저 정렬한다.
지원 언어 범위는 텍스트 상호작용, 음성 이해, 음성 생성 사이에서 크게 다르다. 한국어는 음성 입력과 출력 목록에 모두 포함되지만 음성 출력은 10개 언어만 지원한다.
4 Post-training
후학습은 Thinker와 Talker에 별도의 파이프라인을 사용한다. 소리를 글로 설명하는 오디오 캡셔닝을 위해 추가로 미세조정한 모델도 포함한다. 텍스트 전용 대화와 멀티모달 대화 데이터에는 보고서가 인용한 대화 형식인 ChatML을 적용한다.
4.1 Thinker
Thinker는 목표 응답으로 학습하는 supervised fine-tuning (SFT), 더 큰 교사 모델의 행동을 이전하는 strong-to-weak distillation, 보상으로 멀티모달 응답을 최적화하는 강화학습 방법인 Group Sequence Policy Optimization (GSPO)을 거친다. 증류는 먼저 교사가 생성한 응답을 사용한다. 이후 학생이 생성한 시퀀스에서 분포 간 불일치를 측정하는 Kullback–Leibler divergence를 최소화해 학생의 출력 분포를 Qwen3-32B 또는 Qwen3-235B-A22B와 정렬한다.
- 검증 가능한 과제는 정답 여부와 지시 준수에 대해 규칙 기반 보상을 사용한다.
- 사전에 정의된 객관적 지표가 없는 과제는 언어 모델을 자동 평가자로 사용한다. 일반 과제에는 Qwen3를, 시각 정보에 근거한 과제에는 Qwen2.5-VL을 사용하며 적용 가능한 경우 참조 답안을 제공한다.
4.2 Talker
Talker 학습은 4단계로 구성된다. 문맥이 포함된 수억 개의 음성 예시로 음성 생성을 학습하고 더 높은 품질의 데이터로 긴 문맥 학습과 지속 사전학습을 수행한 뒤, 다국어 선호도 최적화와 화자별 미세조정을 진행한다. 선호하는 음성과 선호하지 않는 음성의 쌍으로 학습하는 Direct Preference Optimization (DPO)은 다국어 일반화와 안정성을 목표로 한다. 마지막 단계는 특정 목소리에 적응하도록 학습하고 자연스러움, 표현력, 제어 가능성을 개선한다.
4.3 Captioner
Qwen3-Omni-30B-A3B-Captioner는 상세한 오디오 설명으로 구성된 대규모 데이터셋으로 Qwen3-Omni-30B-A3B를 미세조정한 모델이다. 저자들은 캡션이 상세하며 근거 없는 내용을 생성하는 환각이 적다고 설명한다. 다만 환각을 정량적으로 평가하지 않고 정성적 예시 3개를 제시한다.
5 Evaluation
평가는 Qwen3-Omni-30B-A3B-Instruct, Qwen3-Omni-30B-A3B-Thinking과 내부 개발 모델인 Qwen3-Omni-Flash-Instruct, Qwen3-Omni-Flash-Thinking을 다룬다. 결과는 여러 모달리티의 입력에 텍스트로 응답하는 X→Text와 음성을 생성하는 X→Speech로 나뉜다. Flash에는 방언 지원 등 추가 기능이 포함되므로, 공개된 30B-A3B 모델의 점수와 구분해야 한다.
5.1.1 Performance of Text→Text
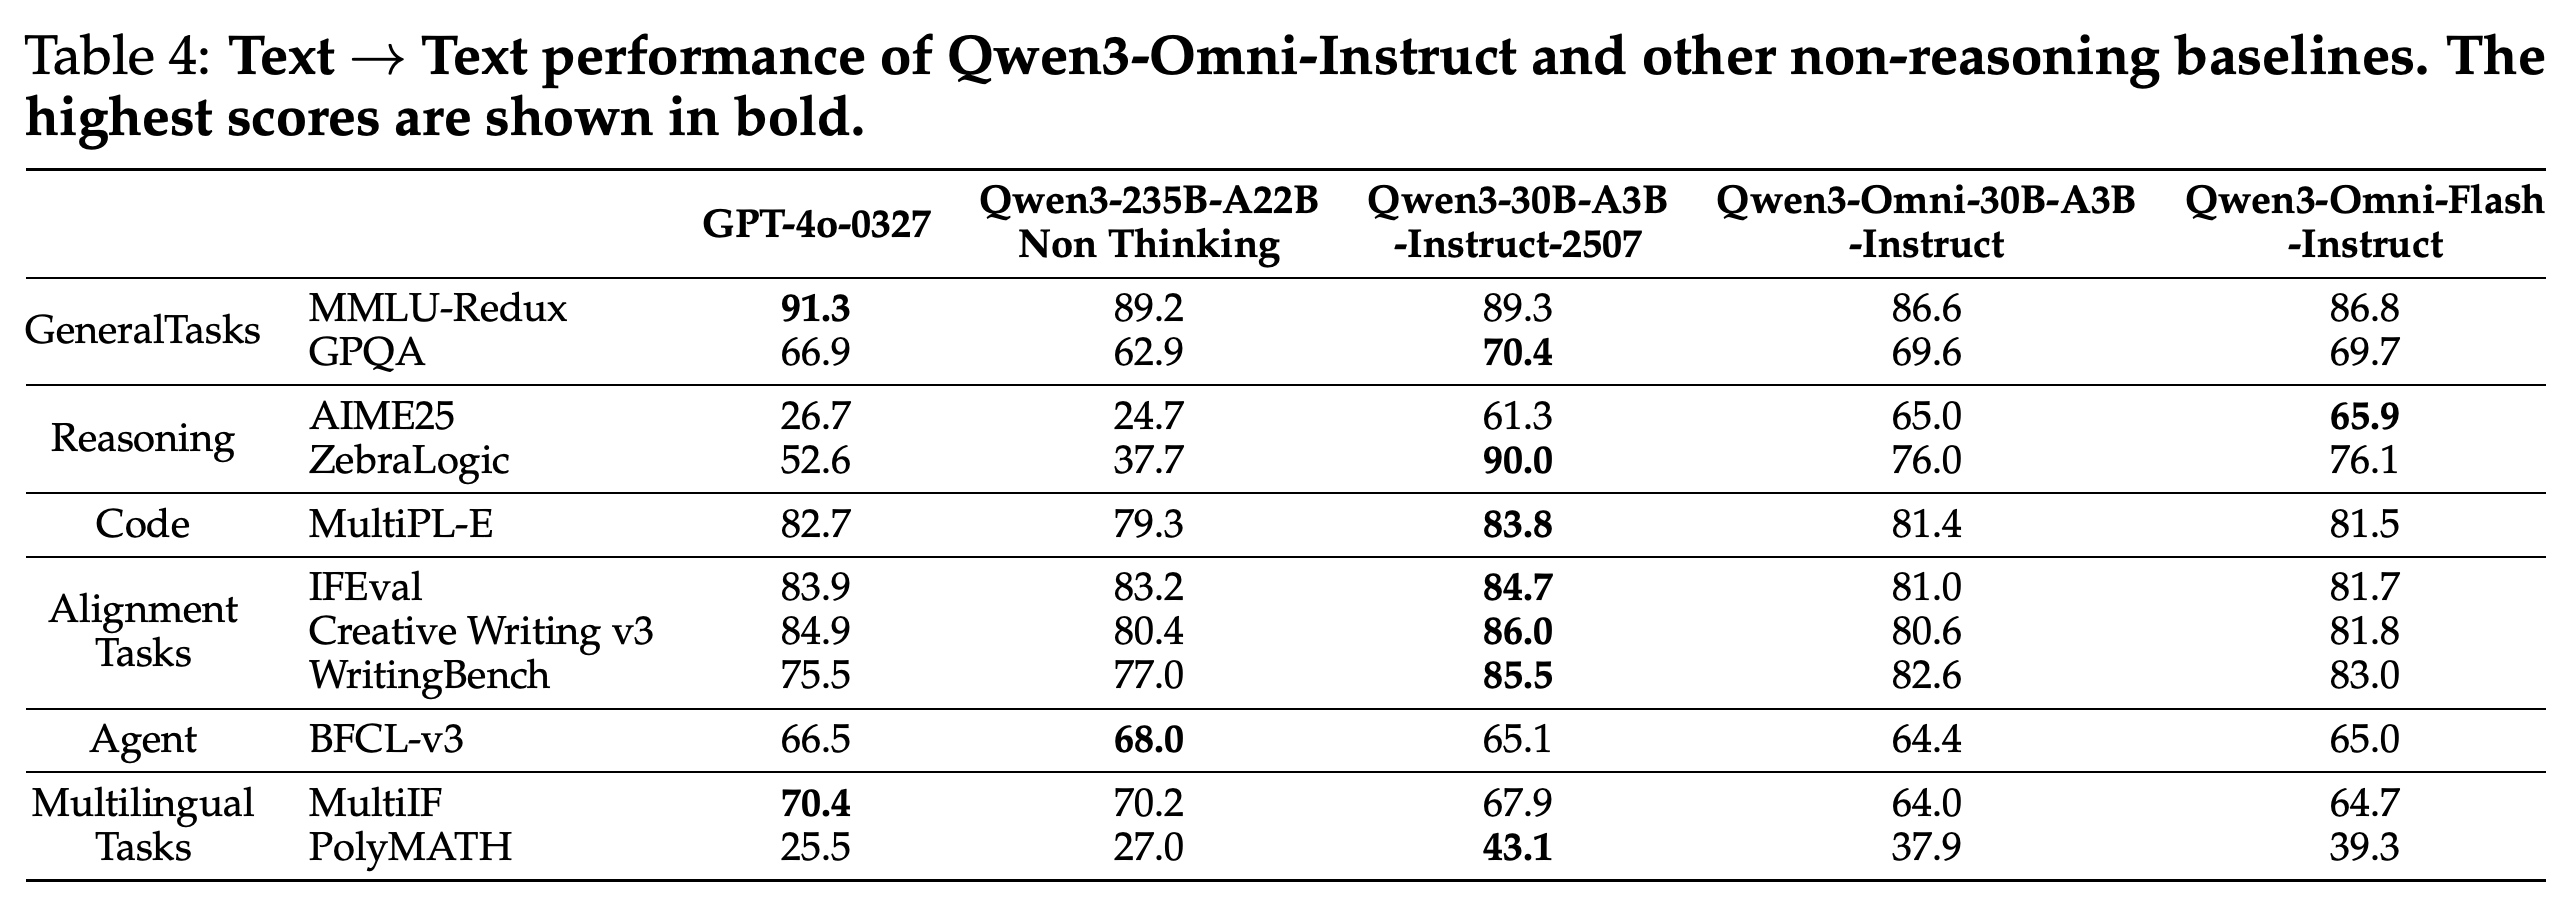
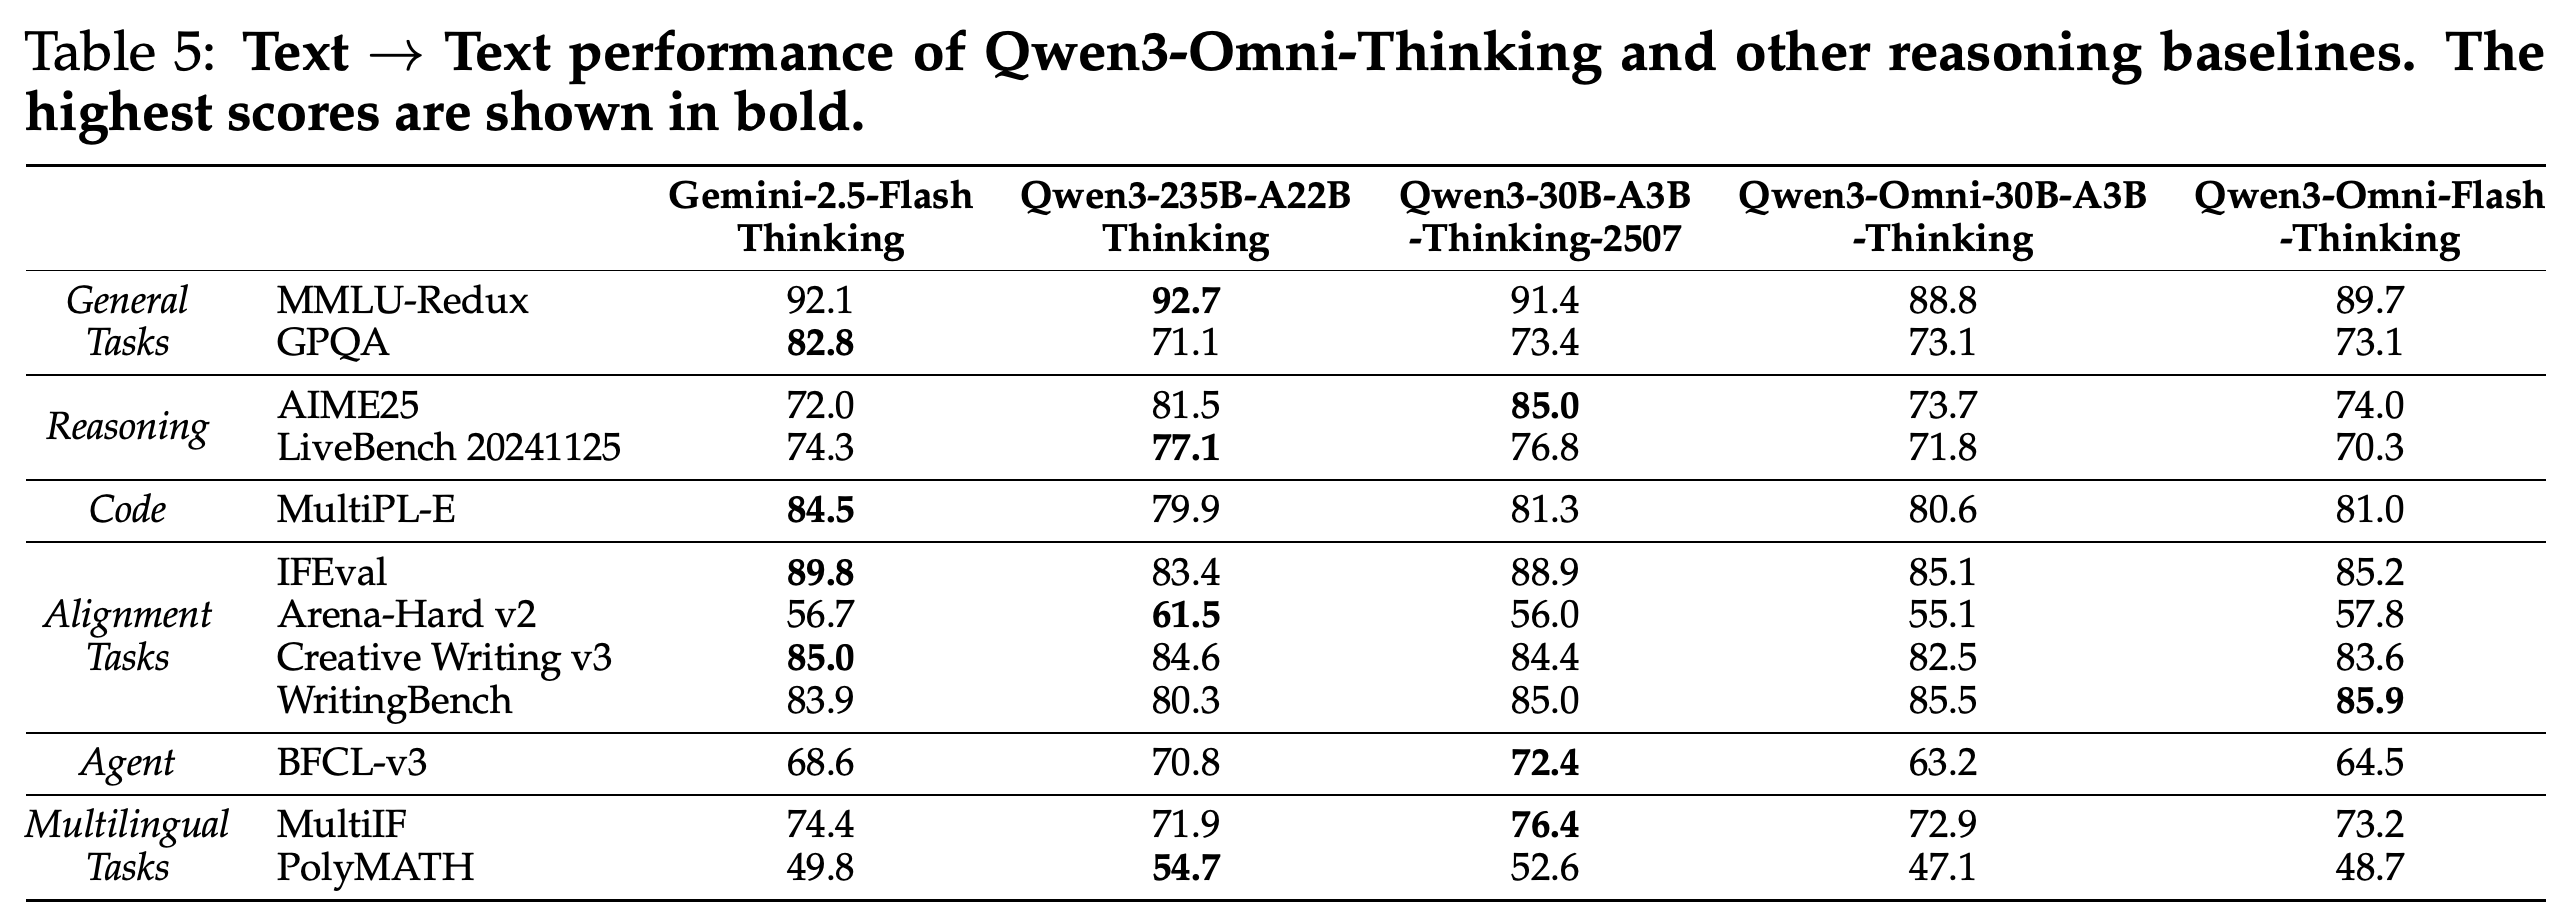
X→Text 평가는 일반 지식, 추론, 코딩, 지시 준수, 함수 호출, 다국어 과제, 오디오 인식, 시각 이해, 시청각 추론을 다룬다. 텍스트 과제에서 Instruct는 대학원 수준 질문인 GPQA, 경시대회 수학인 AIME25, 논리 추론인 ZebraLogic, 글쓰기 품질을 평가하는 WritingBench, 다국어 수학인 PolyMATH에서 GPT-4o-0327보다 높은 점수를 얻는다. 다만 같은 크기의 텍스트 전용 Qwen 모델과 비교하면 결과가 엇갈린다. Thinking은 여러 평가에서 Omni-Instruct보다 높은 점수를 얻지만 공통 평가 대부분에서 같은 크기의 텍스트 전용 Thinking 모델보다 낮은 점수를 얻는다.
- AIME25에서 Omni-Instruct는 65.0, Qwen3-30B-A3B-Instruct-2507은 61.3을 기록한다. ZebraLogic에서는 각각 76.0과 90.0으로 순위가 뒤바뀐다.
- Omni-Thinking은 AIME25에서 73.7을 기록해 Qwen3-30B-A3B-Thinking-2507의 85.0보다 낮다. 함수 호출 평가인 BFCL-v3에서도 63.2로 72.4보다 낮다.
- WritingBench에서는 Omni-Thinking이 85.5로 같은 크기의 텍스트 전용 Thinking 모델의 85.0보다 높다. 표의 결과는 모든 과제에서 동등한 성능을 보인다는 주장을 뒷받침하지 않는다.
Omni-Instruct는 AIME25에서 같은 크기의 텍스트 전용 모델보다 높지만 ZebraLogic과 여러 지시 준수 및 다국어 평가에서는 낮다. 이러한 결과는 본문의 텍스트 능력 동등성 주장이 모든 과제에 적용되지는 않음을 보여준다.
Omni-Thinking은 여러 공통 과제에서 Omni-Instruct보다 높지만 AIME25와 함수 호출 점수는 같은 크기의 텍스트 전용 Thinking 모델보다 낮다. WritingBench에서는 Omni-Thinking이 해당 비교 모델보다 높은 점수를 기록한다.
5.1.2 Performance of Audio→Text
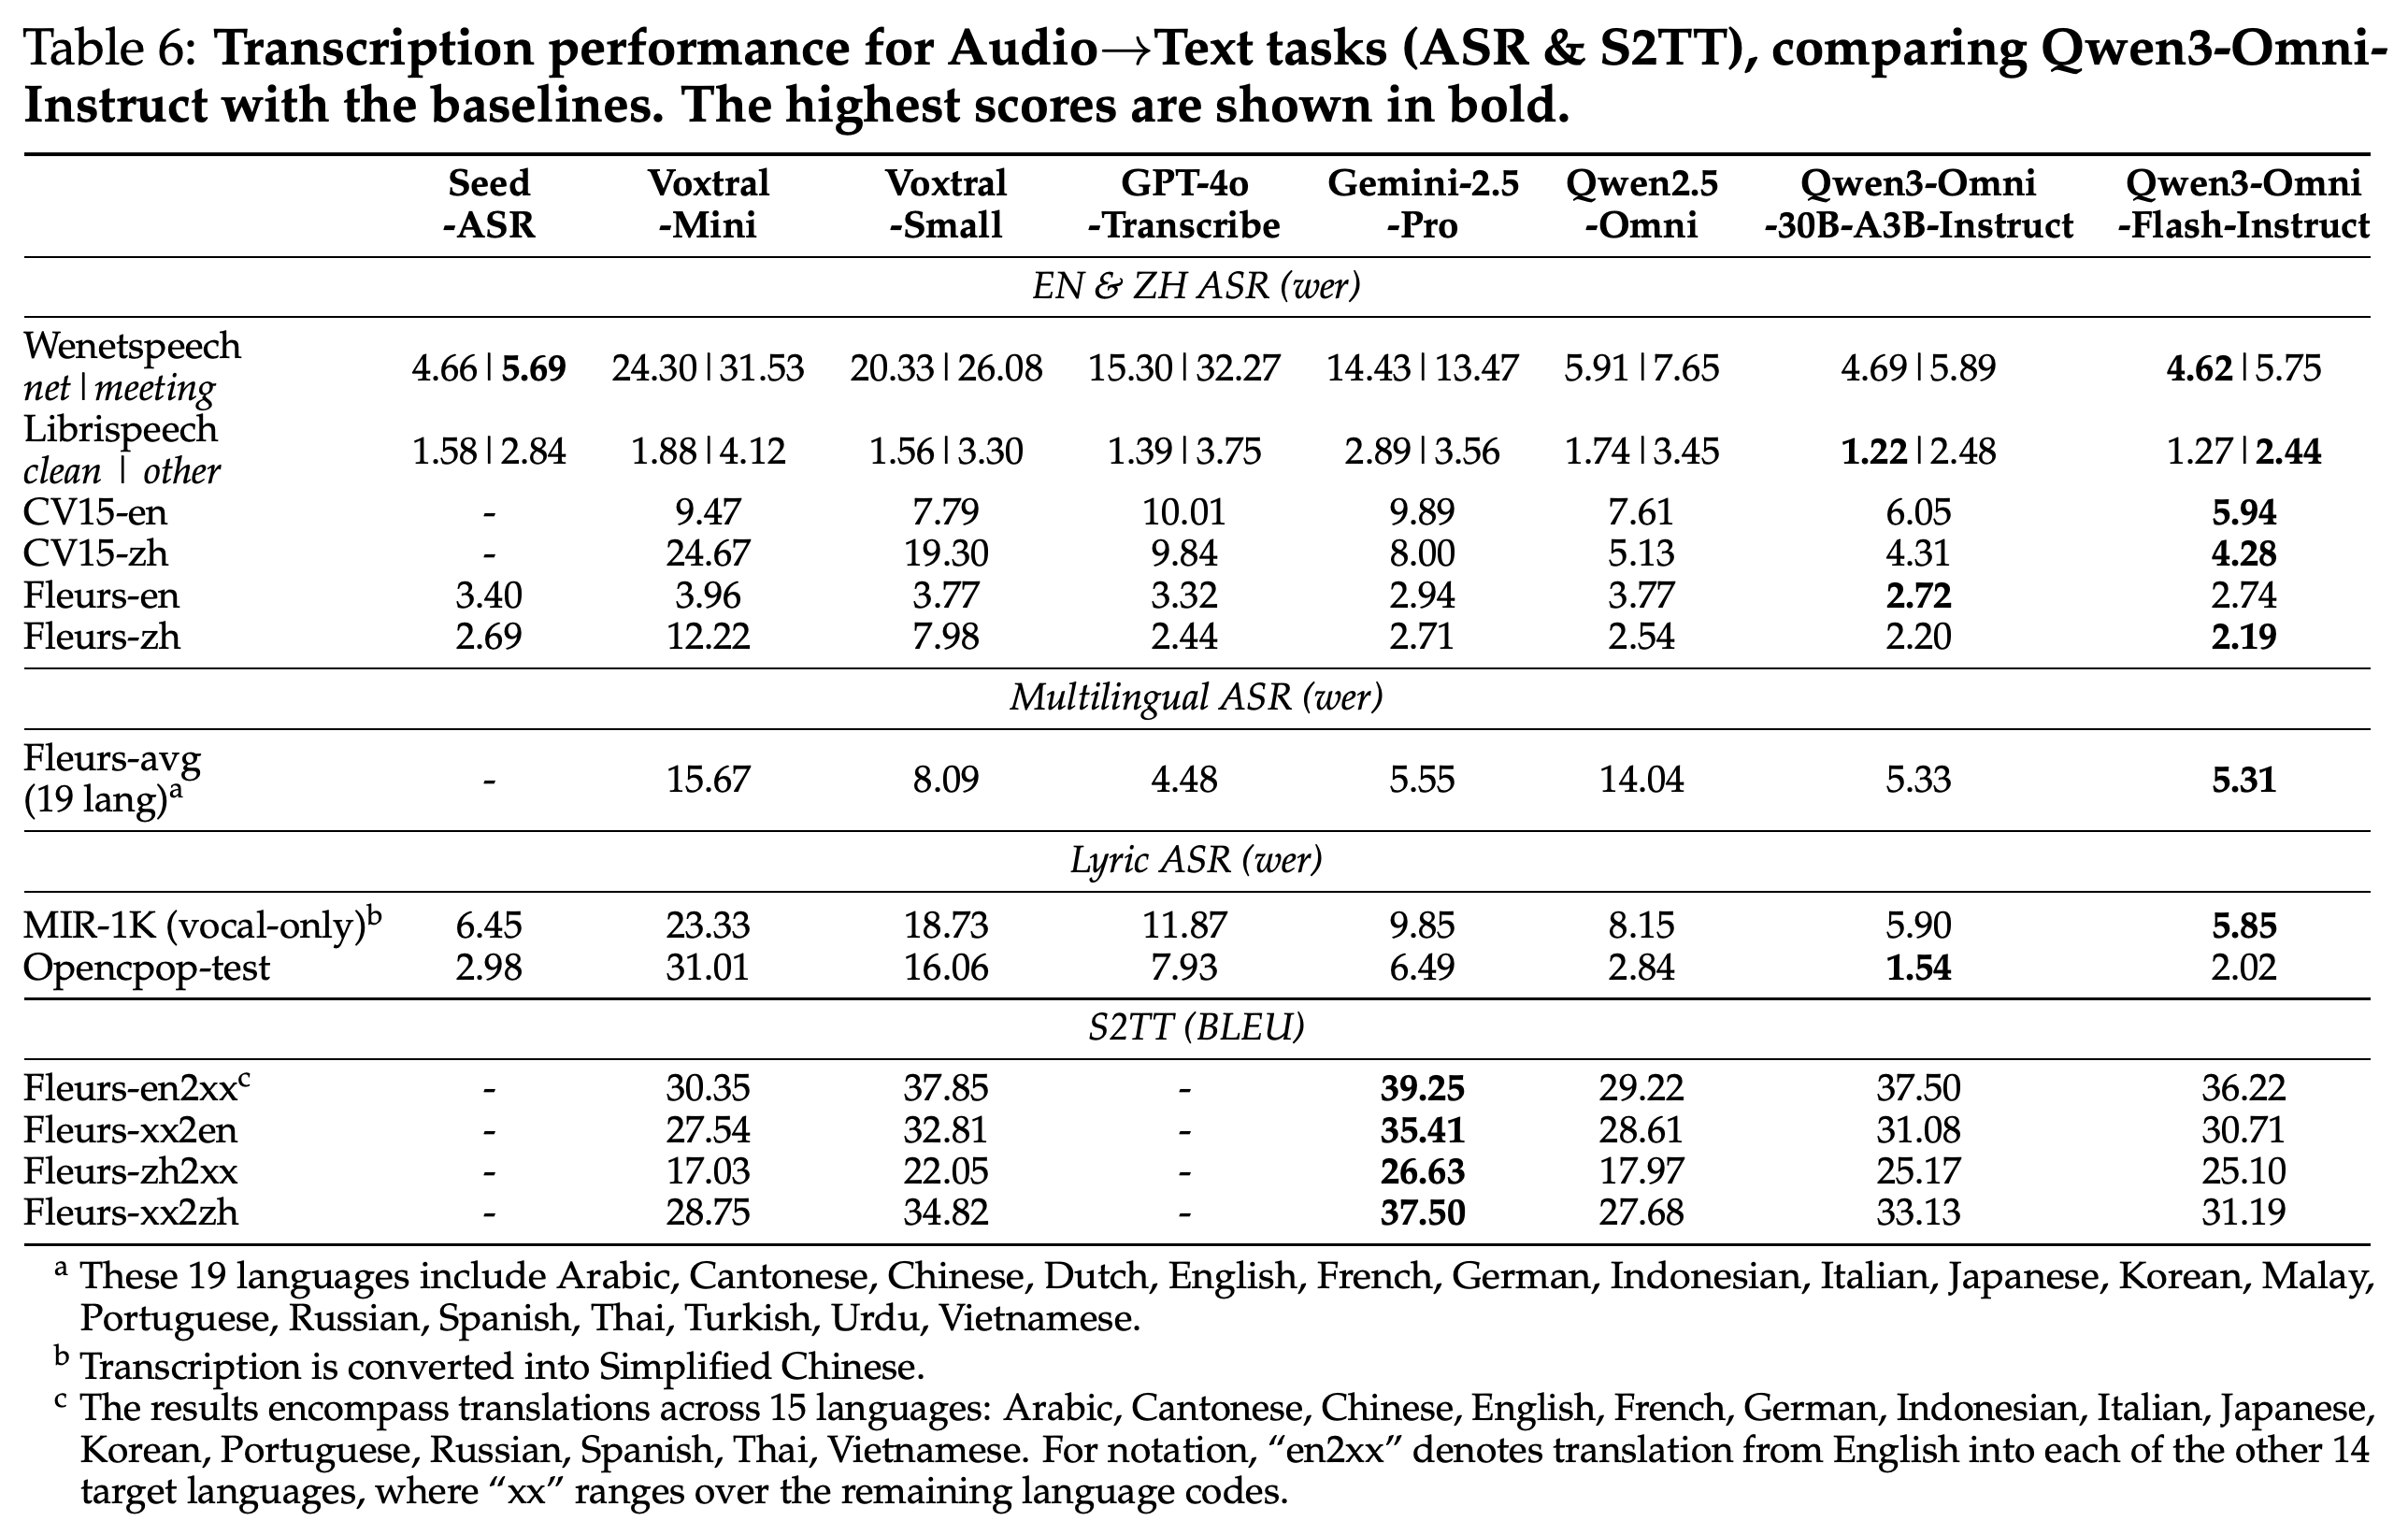
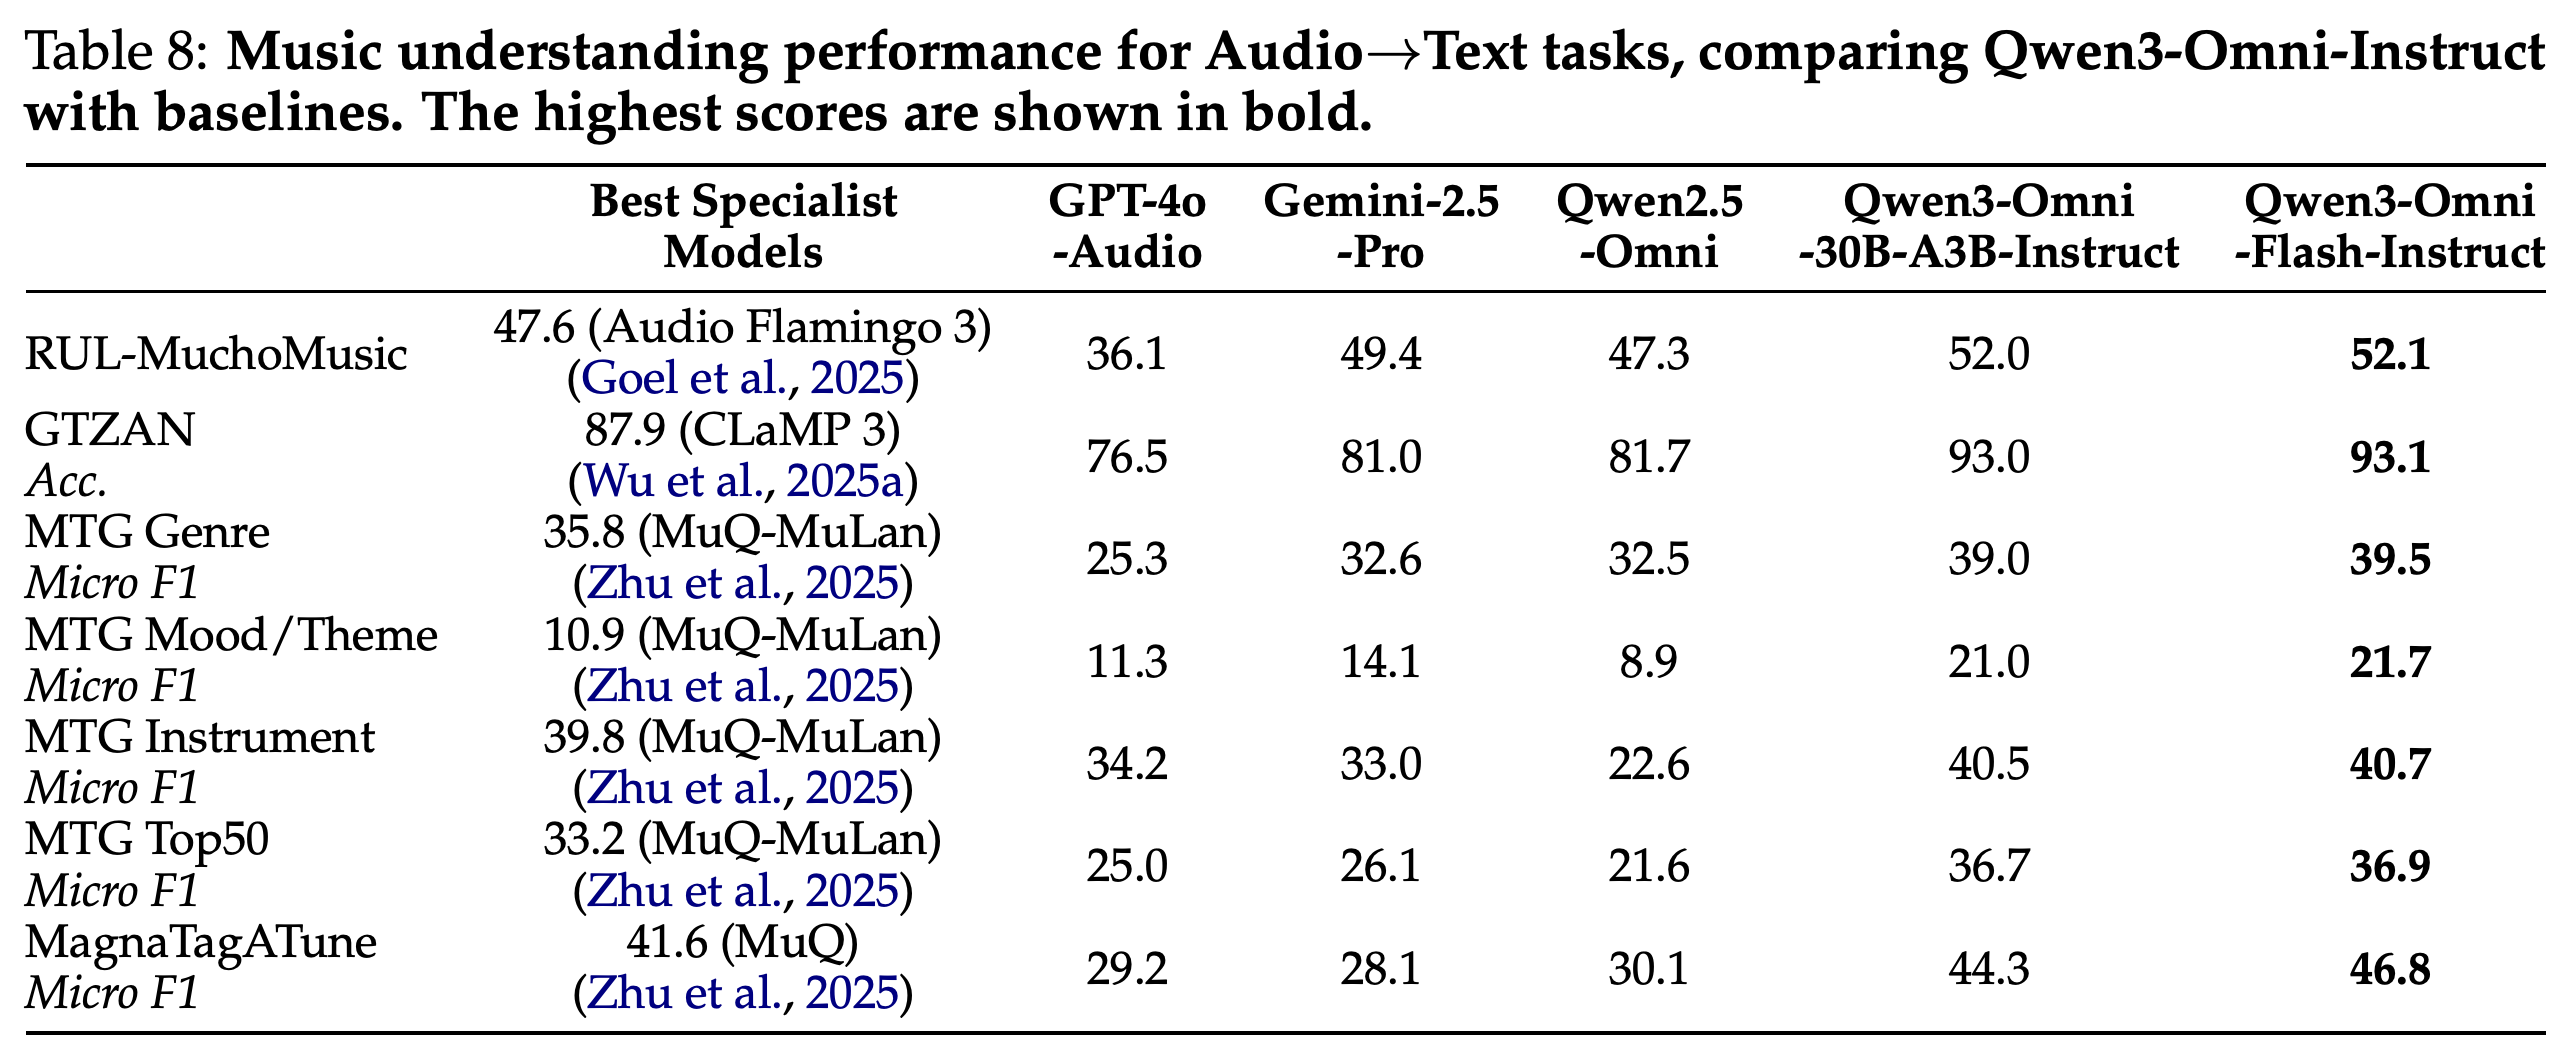
Audio→Text 평가는 전사, 음성 입력을 텍스트 출력으로 번역하는 speech-to-text translation (S2TT), 음성 상호작용, 오디오 추론, 음악 이해를 다룬다. Instruct는 영어, 중국어, 가사 전사에서 낮은 word error rate (WER)를 기록한다. WER는 전사 오류를 측정하며 낮을수록 좋다. 다만 19개 언어 Fleurs 평균에서는 GPT-4o-Transcribe가, 표에 제시된 번역 방향에서는 Gemini-2.5-Pro가 앞선다. 음악 평가에서는 Instruct가 보고된 범용 및 전문 모델 기준선보다 좋은 결과를 보인다.
- Librispeech clean/other WER는 Omni-Instruct가 1.22/2.48로 GPT-4o-Transcribe의 1.39/3.75보다 낮다. 노래 전사 평가인 Opencpop-test에서는 WER가 1.54로 Qwen2.5-Omni의 2.84보다 낮다.
- 19개 언어 Fleurs 평균 WER는 5.33으로 GPT-4o-Transcribe의 4.48보다 높다. 번역에는 참조 텍스트와의 중복을 측정하는 BLEU를 사용한다. 영어 음성을 다른 평가 언어로 번역하는 Fleurs-en2xx에서는 37.50으로 Gemini-2.5-Pro의 39.25보다 낮다.
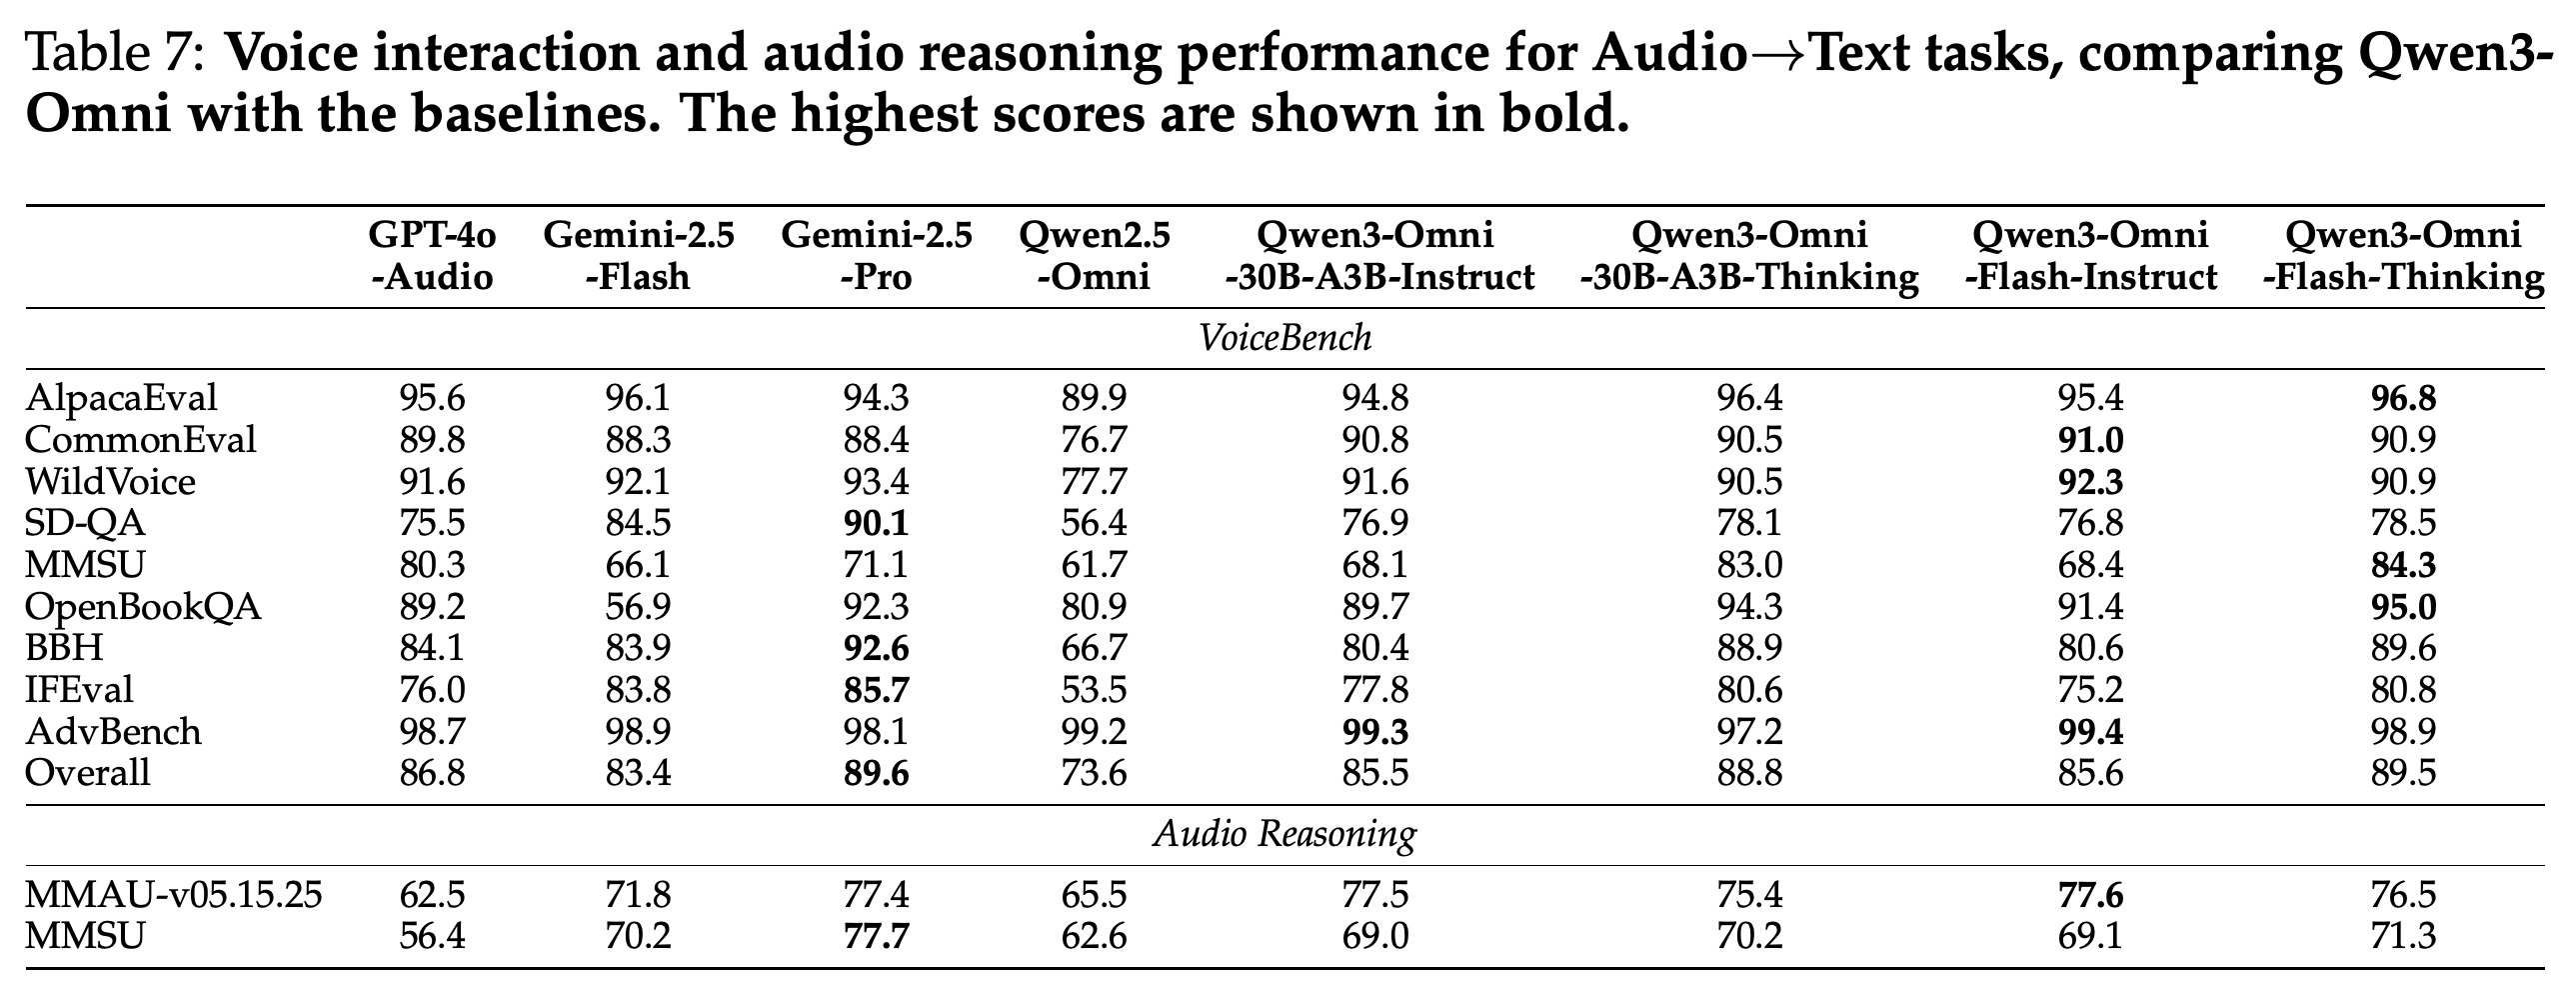
- Table 7에서 음성 비서 평가 모음인 VoiceBench의 종합 점수는 30B-A3B-Thinking이 88.8, Flash-Thinking이 89.5이며, Gemini-2.5-Pro는 89.6이다. 주변 본문은 이 구분 없이 Thinking의 점수를 89.5로 기재한다.
- Omni-Instruct는 다중 과제 오디오 이해 및 추론 벤치마크인 MMAU-v05.15.25에서 77.5로 Gemini-2.5-Pro의 77.4보다 높다. 그러나 별도의 음성 언어 추론 항목인 MMSU에서는 69.0으로 77.7보다 낮다. 음악 평가에서는 음악 이해 벤치마크인 RUL-MuchoMusic에서 52.0, 장르 분류 데이터셋인 GTZAN에서 정확도 93.0을 기록한다. 생성된 레이블에는 보정된 순위 점수가 없으므로, 다중 레이블 음악 평가는 정밀도와 재현율을 종합하는 micro F1을 사용한다.
영어, 중국어, 가사 전사에서는 높은 성능을 보이지만 다국어 전사와 번역에서는 순위가 낮다. 표는 전사에 낮을수록 좋은 WER를, 번역에 높을수록 좋은 BLEU를 사용한다. Seed-ASR도 Wenetspeech의 모든 하위 집합에서 30B-A3B-Instruct보다 좋은 성능을 보인다.
표는 30B-A3B-Thinking의 VoiceBench 종합 점수 88.8과 Flash-Thinking의 89.5를 구분한다. 별도의 오디오 추론 항목에서는 Instruct가 MMAU에서 Gemini-2.5-Pro보다 조금 앞서지만 MMSU에서는 뒤처진다.
Instruct 모델들은 모두 RUL-MuchoMusic, GTZAN, 다중 레이블 데이터셋을 포함한 모든 음악 평가에서 표에 제시된 기준선보다 높다. 전문 모델과의 비교에는 보정된 점수가 필요한 순위 지표 대신 정확도 또는 micro F1을 사용한다.
5.1.3 Performance of Vision → Text
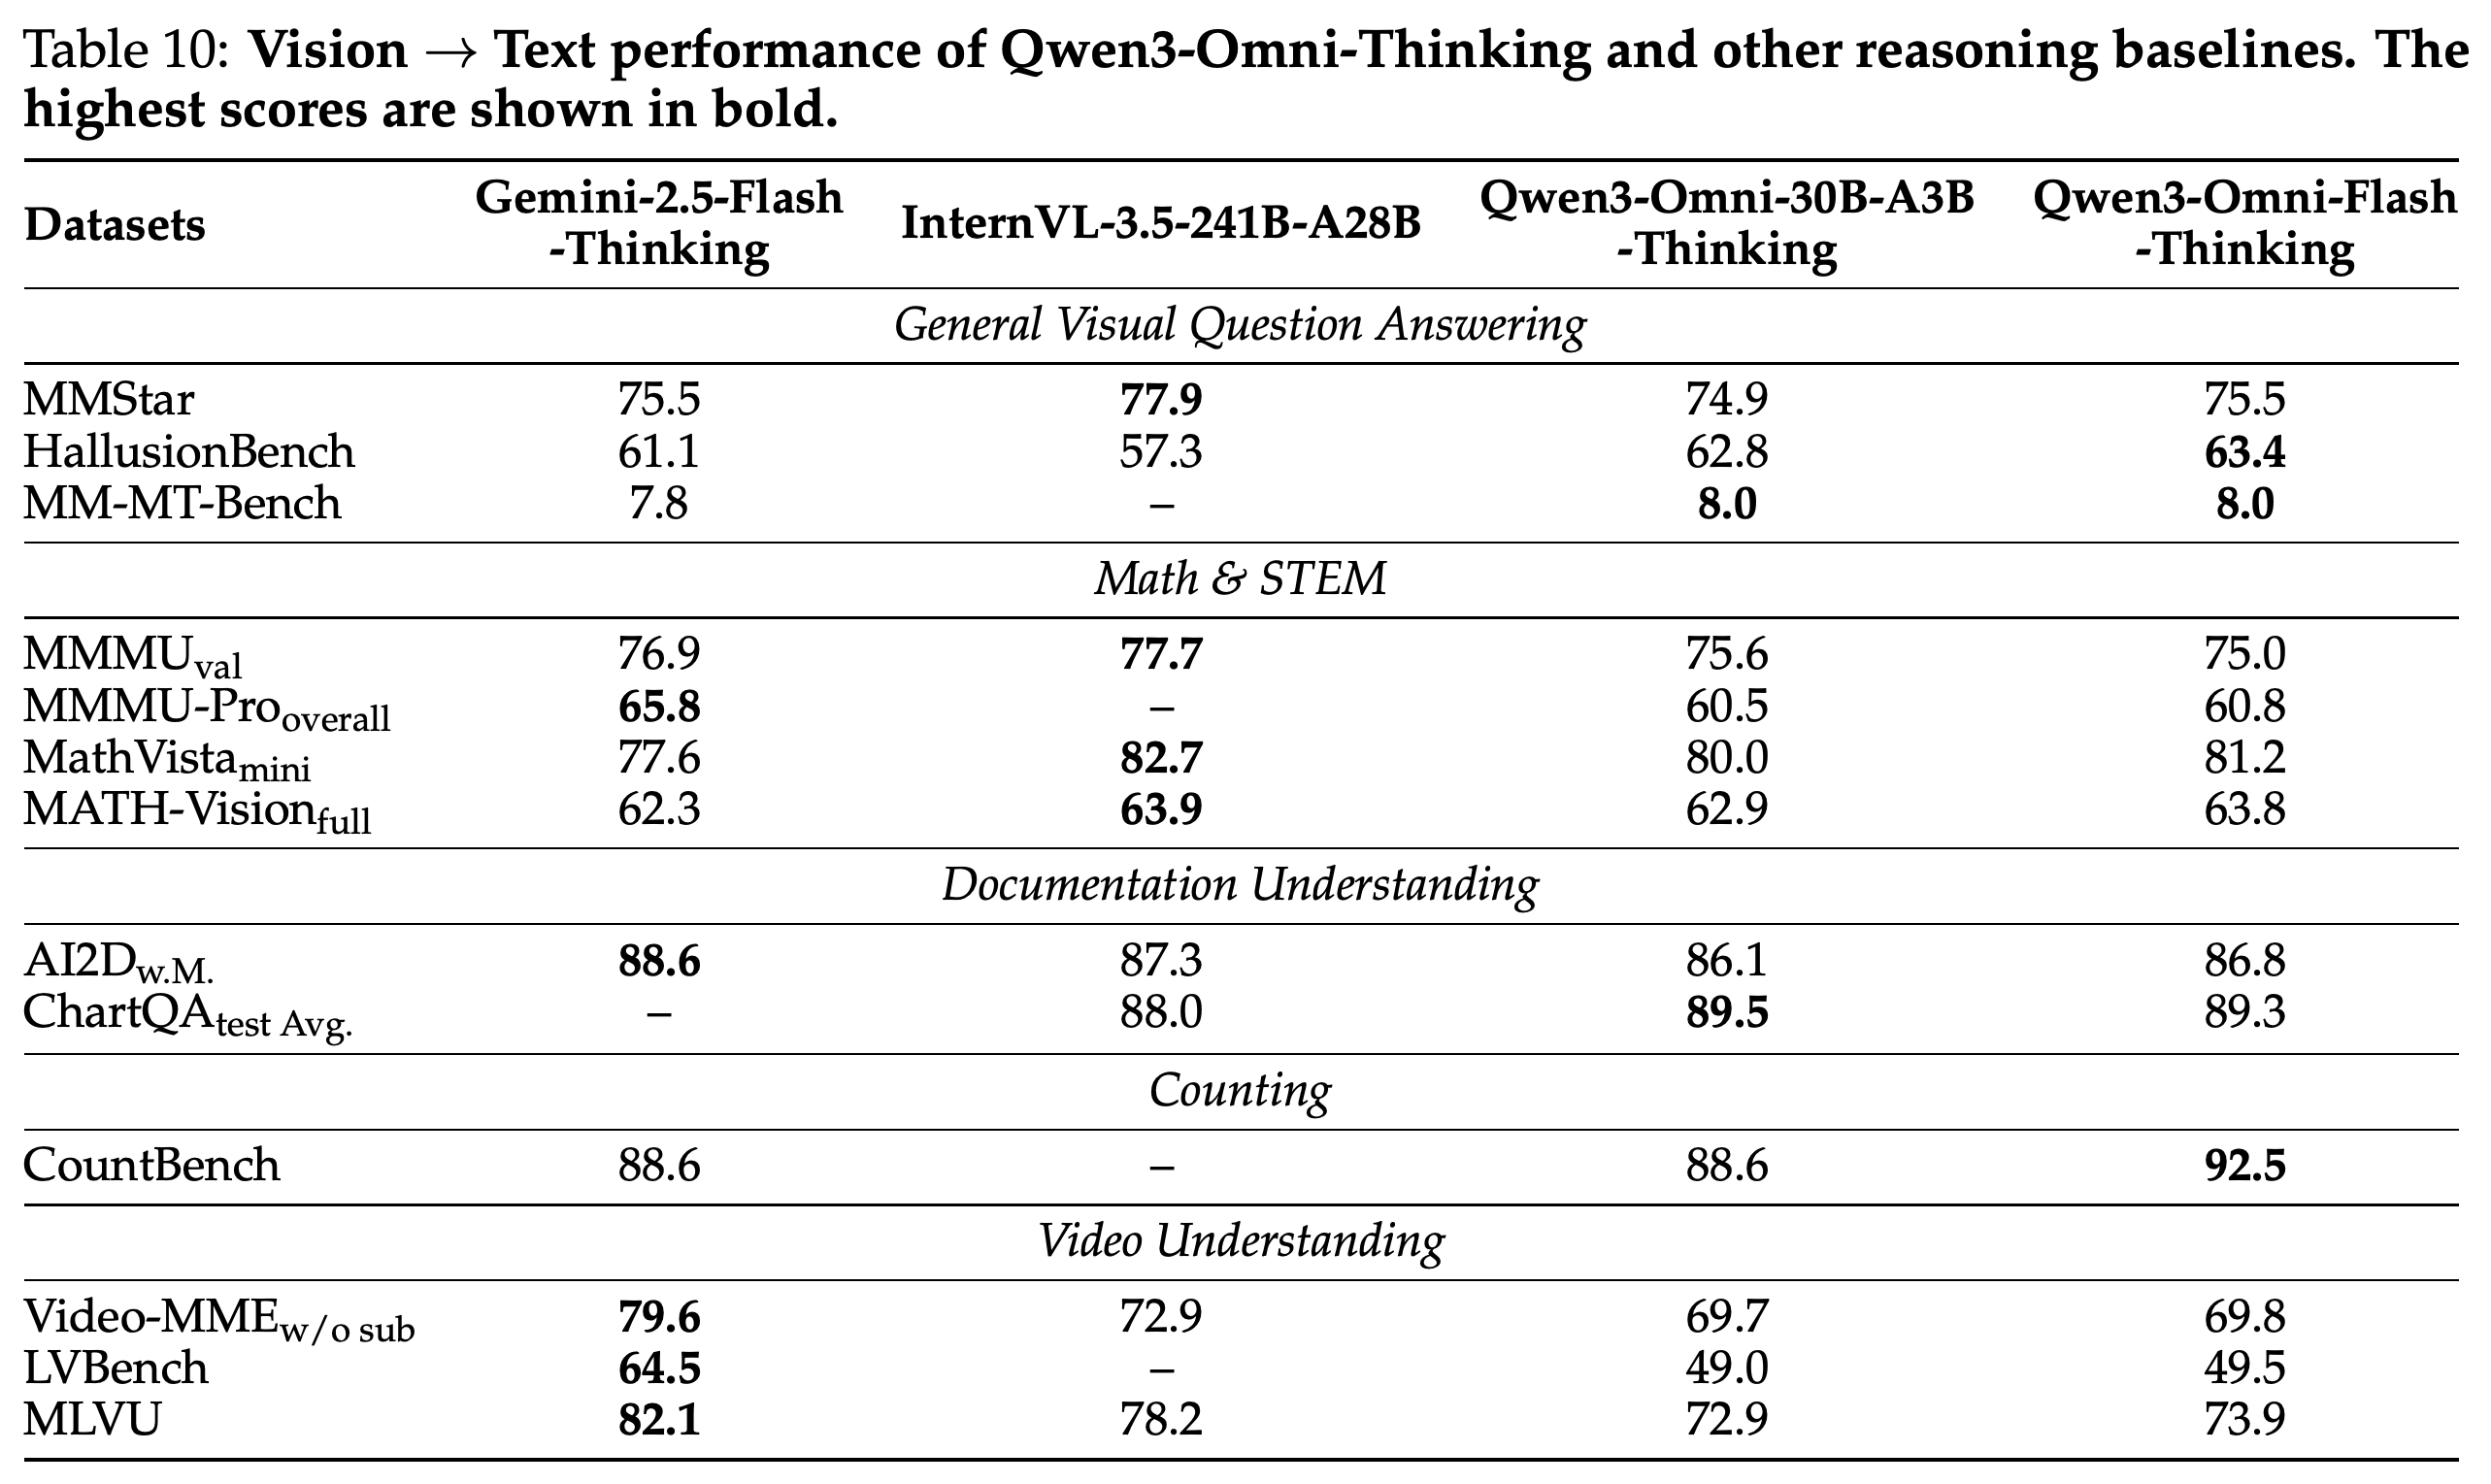
Instruct는 시각 수학 평가 2개인 MathVista mini와 MATH-Vision full에서 각각 75.9와 56.3을 기록한다. Qwen2.5-VL-72B의 점수는 74.8과 38.1이다. Thinking은 이 점수를 80.0과 62.9로 높이지만 긴 비디오에서는 Gemini-2.5-Flash-Thinking보다 낮은 성능을 보인다. 저자들은 제한된 문맥 길이와 학습 범위 밖의 위치를 처리하는 위치 외삽 능력의 한계를 아키텍처의 제약으로 지적한다.
- Omni-Thinking은 비디오 이해 벤치마크 3개인 자막 없는 Video-MME, LVBench, MLVU에서 각각 69.7, 49.0, 72.9를 기록한다. Gemini-2.5-Flash-Thinking은 각각 79.6, 64.5, 82.1을 기록한다.
- Thinking은 시각적 환각과 착시를 평가하는 HallusionBench 점수도 59.7에서 62.8로 높인다. 차트 질의응답인 ChartQA의 테스트 평균은 86.8에서 89.5로 높인다. 비디오 점수는 표에 제시된 3개 벤치마크 모두에서 Instruct보다 낮다.
Omni-Instruct는 시각 수학과 일부 환각 및 비디오 이해 테스트에서 비교 모델 대비 가장 좋은 결과를 보인다. 표에 제시된 문서 이해와 개수 세기 항목에서는 Qwen2.5-VL-72B보다 낮다.
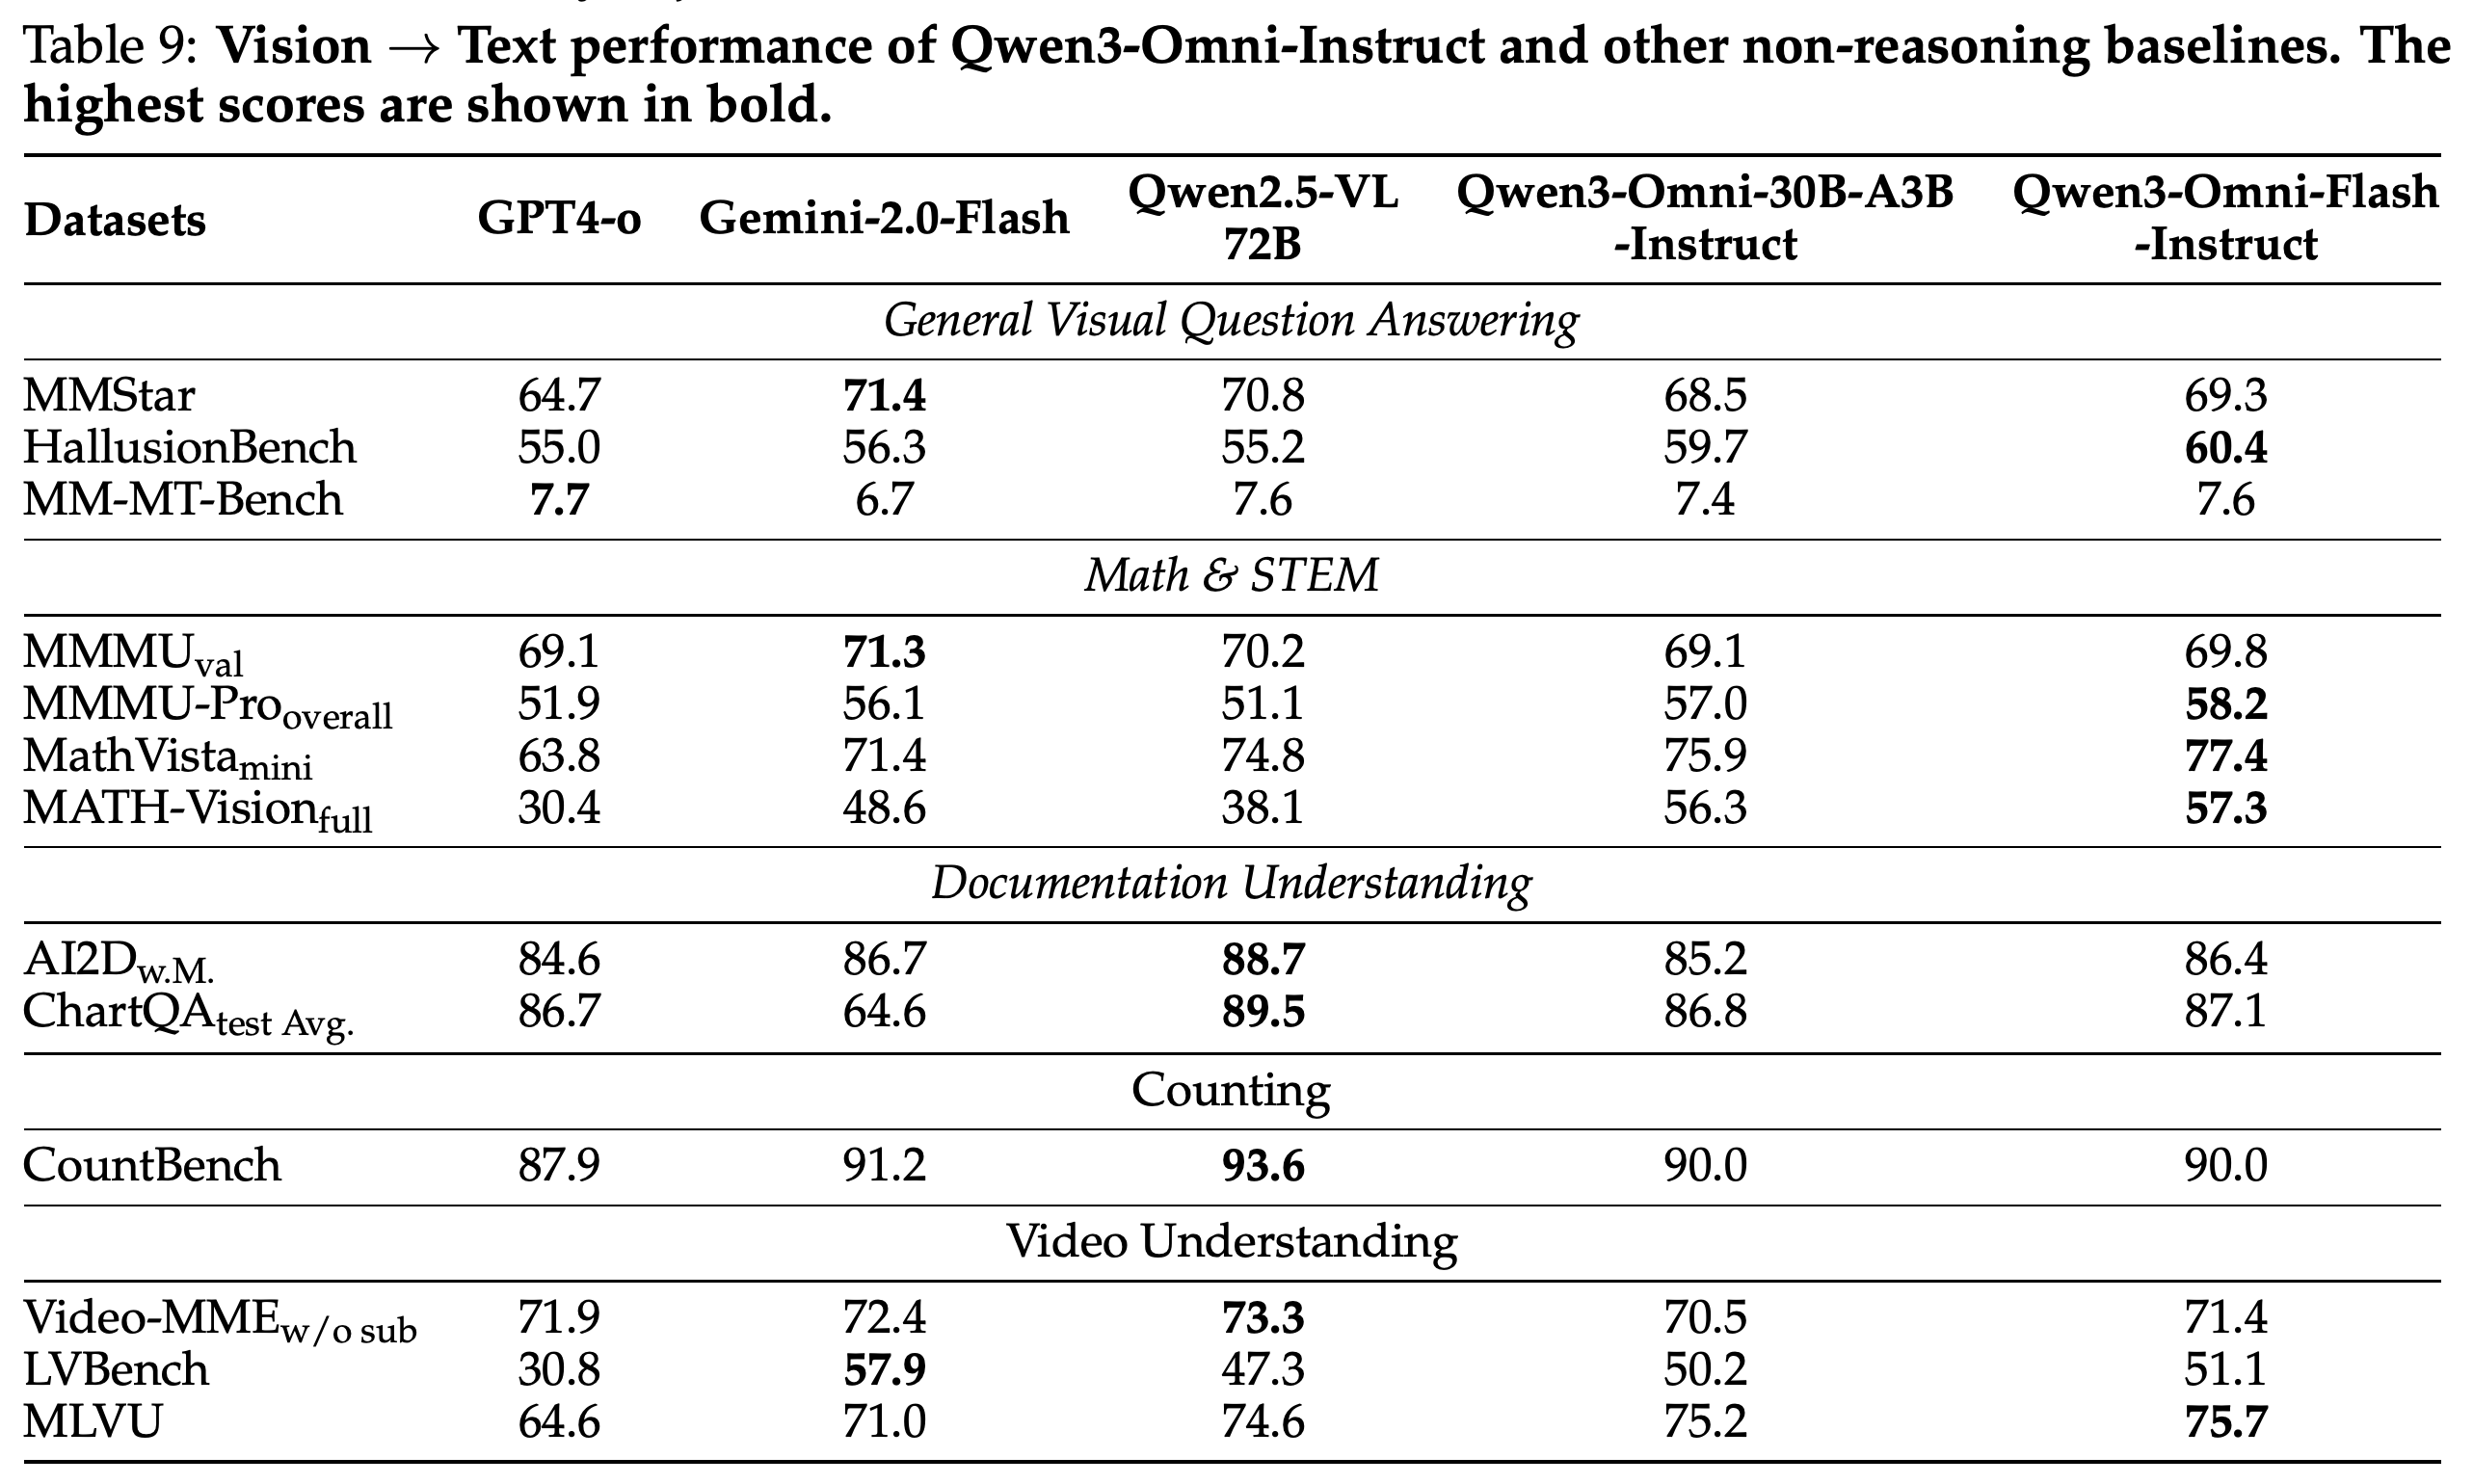
Thinking은 MathVista mini의 80.0을 포함해 경쟁력 있는 이미지 추론 점수를 보인다. 그러나 표에 제시된 비디오 평가 3개 모두에서는 Gemini-2.5-Flash-Thinking보다 낮다. 이러한 결과는 보고서가 밝힌 긴 비디오 처리의 한계를 뒷받침한다.
5.1.4 Performance of AudioVisual Video→Text
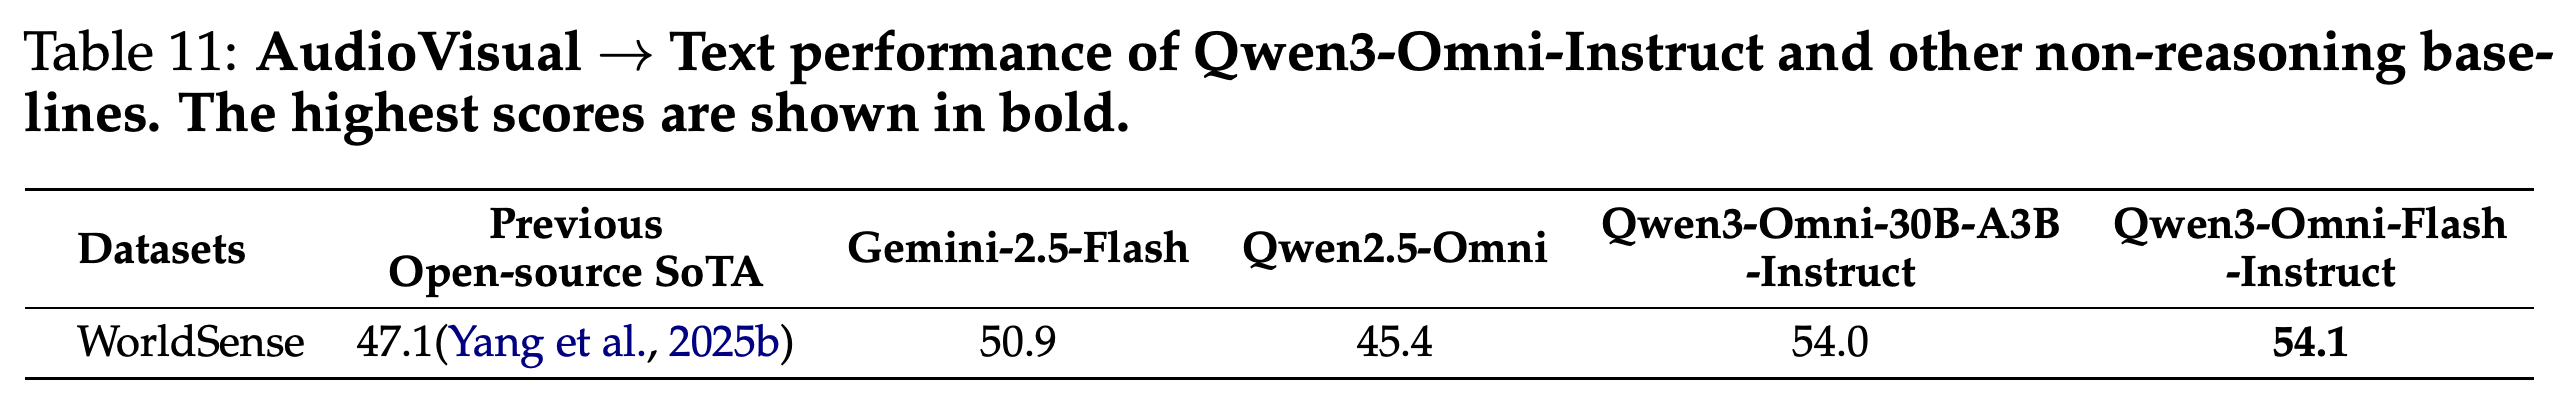
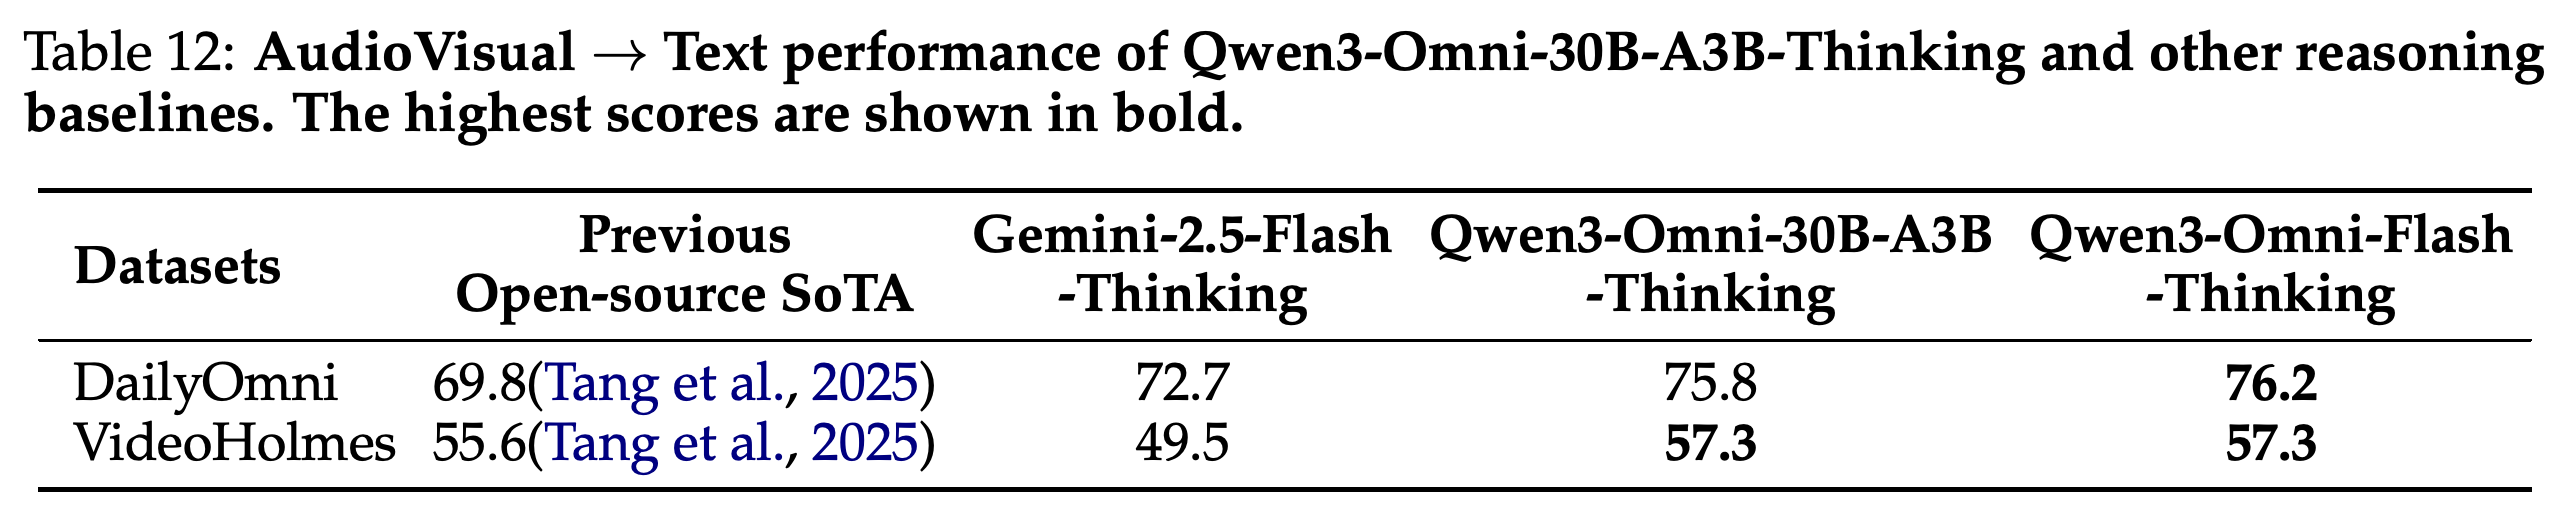
시청각 평가는 모델이 청각 신호와 시각 신호를 결합할 수 있는지 검증한다. Omni-Instruct는 시청각 이해 벤치마크인 WorldSense에서 54.0을 기록해 Gemini-2.5-Flash의 50.9와 Qwen2.5-Omni의 45.4보다 높다. Omni-Thinking은 시청각 추론 벤치마크 2개인 DailyOmni와 VideoHolmes에서 각각 75.8과 57.3을 기록한다. 이는 Gemini-2.5-Flash-Thinking의 72.7과 49.5, 표에 제시된 기존 오픈소스 결과인 69.8과 55.6보다 높다.
WorldSense 점수는 Qwen2.5-Omni의 45.4에서 Omni-Instruct의 54.0으로 상승하며 Gemini-2.5-Flash의 50.9보다 높다. 이 벤치마크는 청각과 시각을 함께 이해하는 능력의 향상을 뒷받침한다.
공개된 Thinking 모델은 DailyOmni와 VideoHolmes에서 표에 제시된 기존 오픈소스 결과와 Gemini-2.5-Flash-Thinking보다 높다. Flash-Thinking은 DailyOmni에서 조금 높은 점수를 얻고 VideoHolmes에서는 같은 점수를 기록한다.
5.2.1 Evaluation of Zero-Shot Speech Generation
저자들은 더 폭넓은 멀티모달 음성 생성을 평가할 적절한 방법이 부족하다고 보고하므로, X→Speech 평가는 주로 텍스트 조건부 합성을 검증한다. 해당 테스트를 위한 화자별 학습 없이 목표 목소리를 생성하는 SEED zero-shot 테스트에서 Qwen3-Omni-30B-A3B의 중국어/영어 내용 일관성 WER는 1.07/1.39다. 영어는 표에 제시된 시스템 중 가장 좋지만 중국어는 CosyVoice3가 0.71로 앞선다. 평가 도입부는 화자 유사성도 언급하지만 Table 13은 내용 일관성만 보고한다.
5.2.2 Evaluation of Multilingual Speech Generation
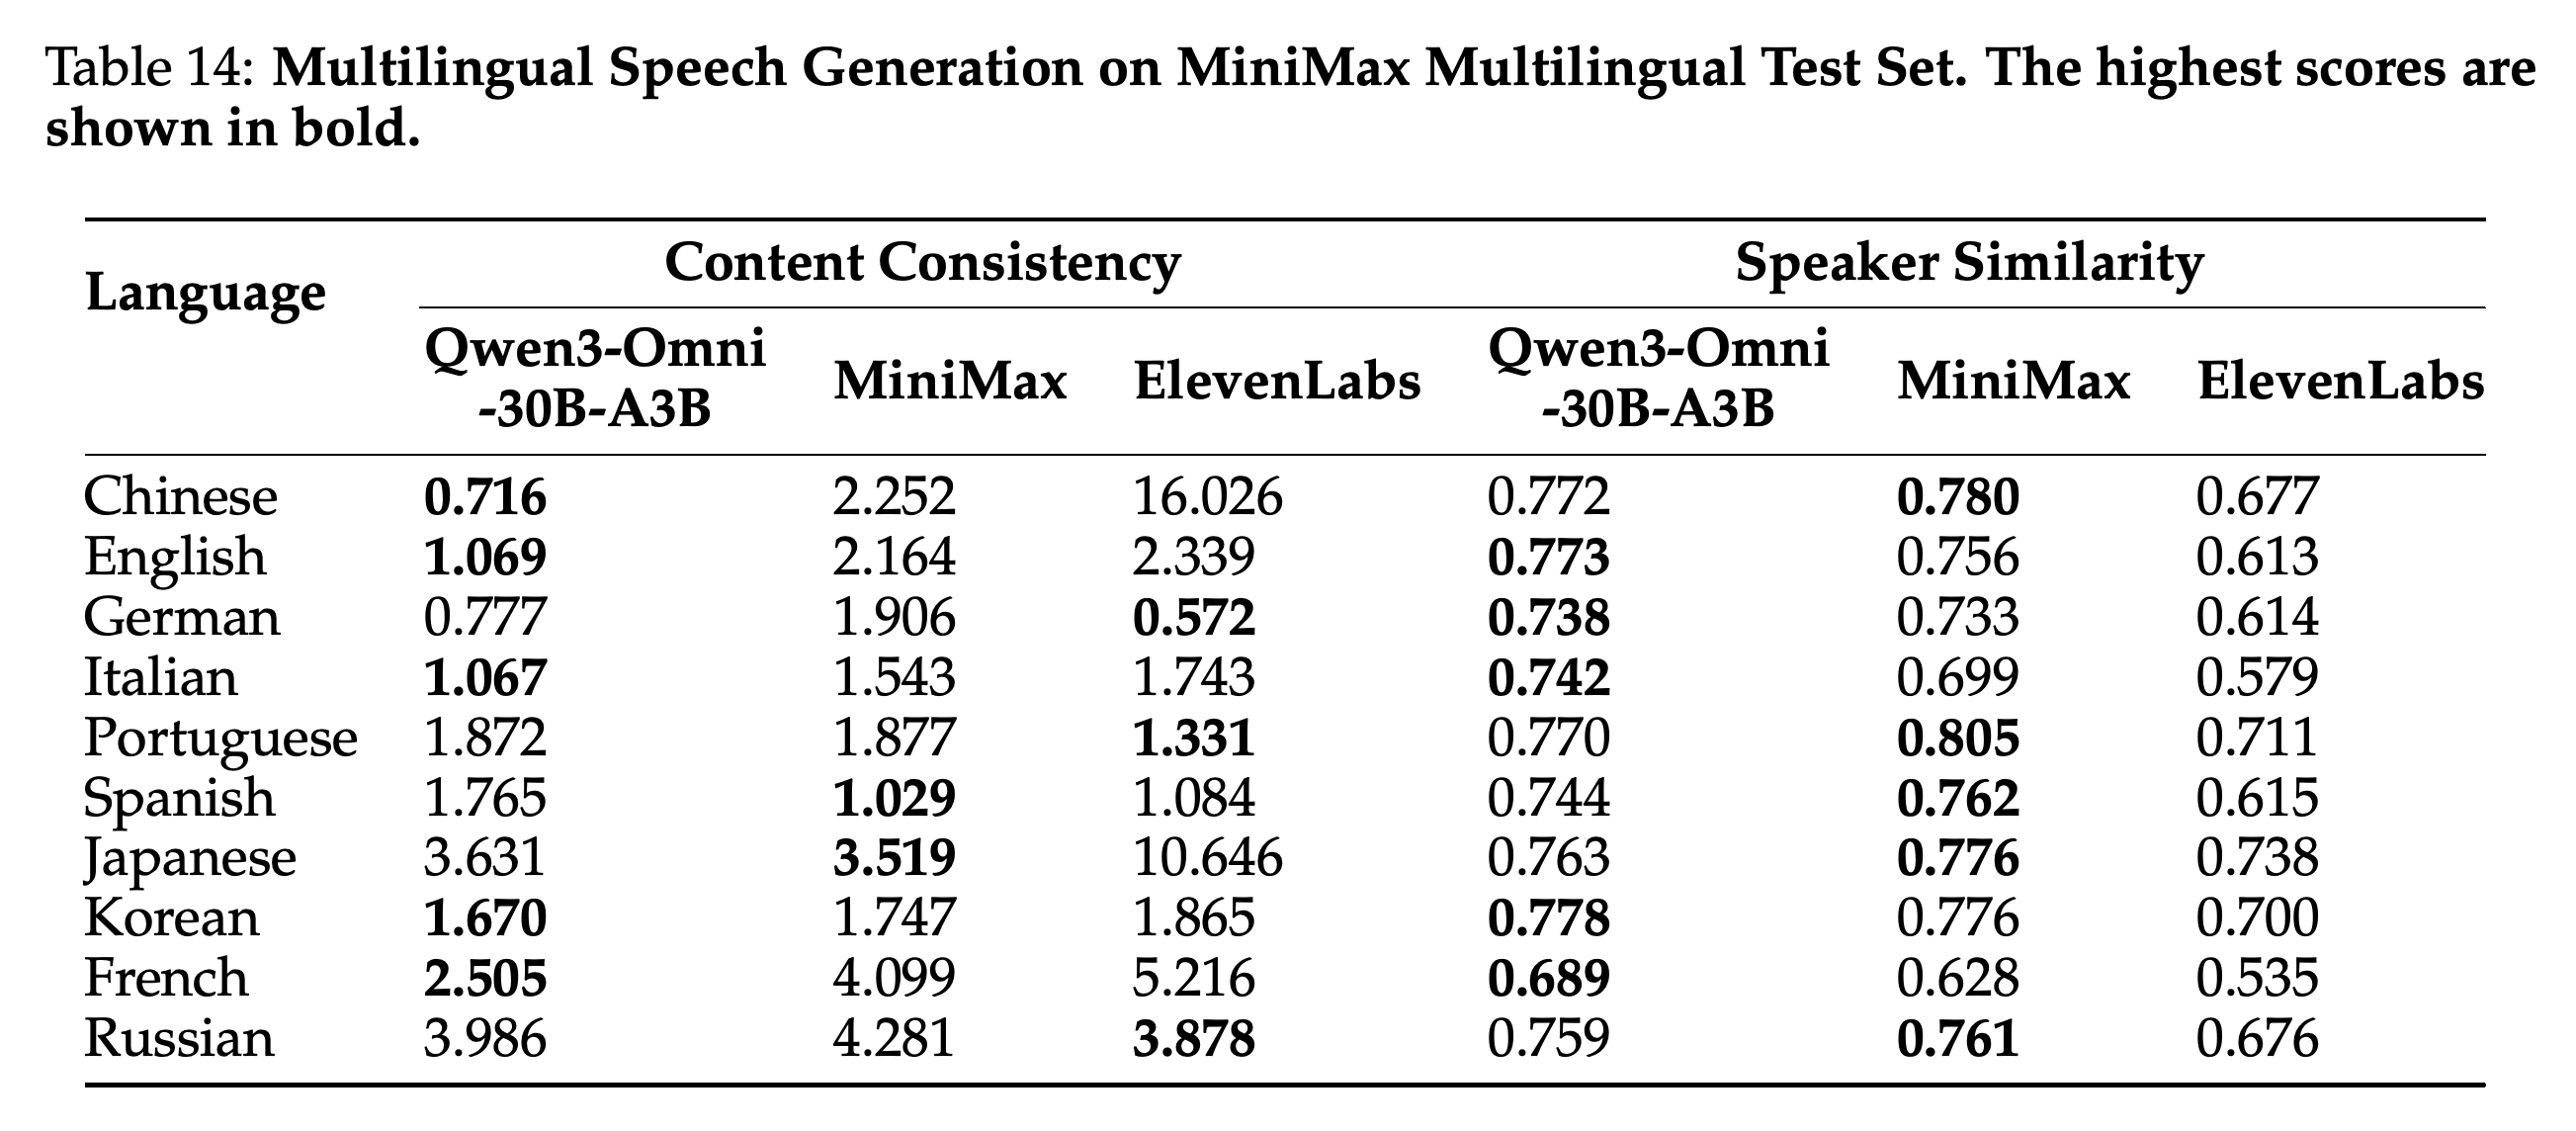
MiniMax 다국어 테스트는 출력 언어 10개 전체에서 내용 일관성과 화자 유사성을 평가한다. 화자 유사성은 합성 음성이 목표 목소리와 얼마나 비슷한지를 나타낸다. Qwen3-Omni는 중국어, 영어, 이탈리아어, 한국어, 프랑스어에서 내용 일관성이 가장 좋다. 화자 유사성은 영어, 독일어, 이탈리아어, 한국어, 프랑스어에서 가장 높다. 나머지 언어에서는 순위가 엇갈린다.
- 영어 내용 일관성 WER는 1.069로 MiniMax의 2.164와 ElevenLabs의 2.339보다 낮다. 화자 유사성은 0.773으로 각각 0.756과 0.613보다 높다.
- 한국어 WER는 1.670으로 각각 1.747과 1.865보다 낮다. 화자 유사성은 0.778로 각각 0.776과 0.700보다 높다.
- 스페인어 WER는 1.765로 MiniMax의 1.029보다 높으며 성능이 언어에 따라 달라진다는 점을 보여준다.
내용 일관성과 목소리 유사성은 언어별로 최고 성능 모델이 다르다. Qwen3-Omni는 영어, 이탈리아어, 한국어, 프랑스어에서 모든 지표가 앞서며, MiniMax는 스페인어와 일본어에서 모든 지표가 앞선다.
5.2.3 Evaluation of Cross-Lingual Speech Generation
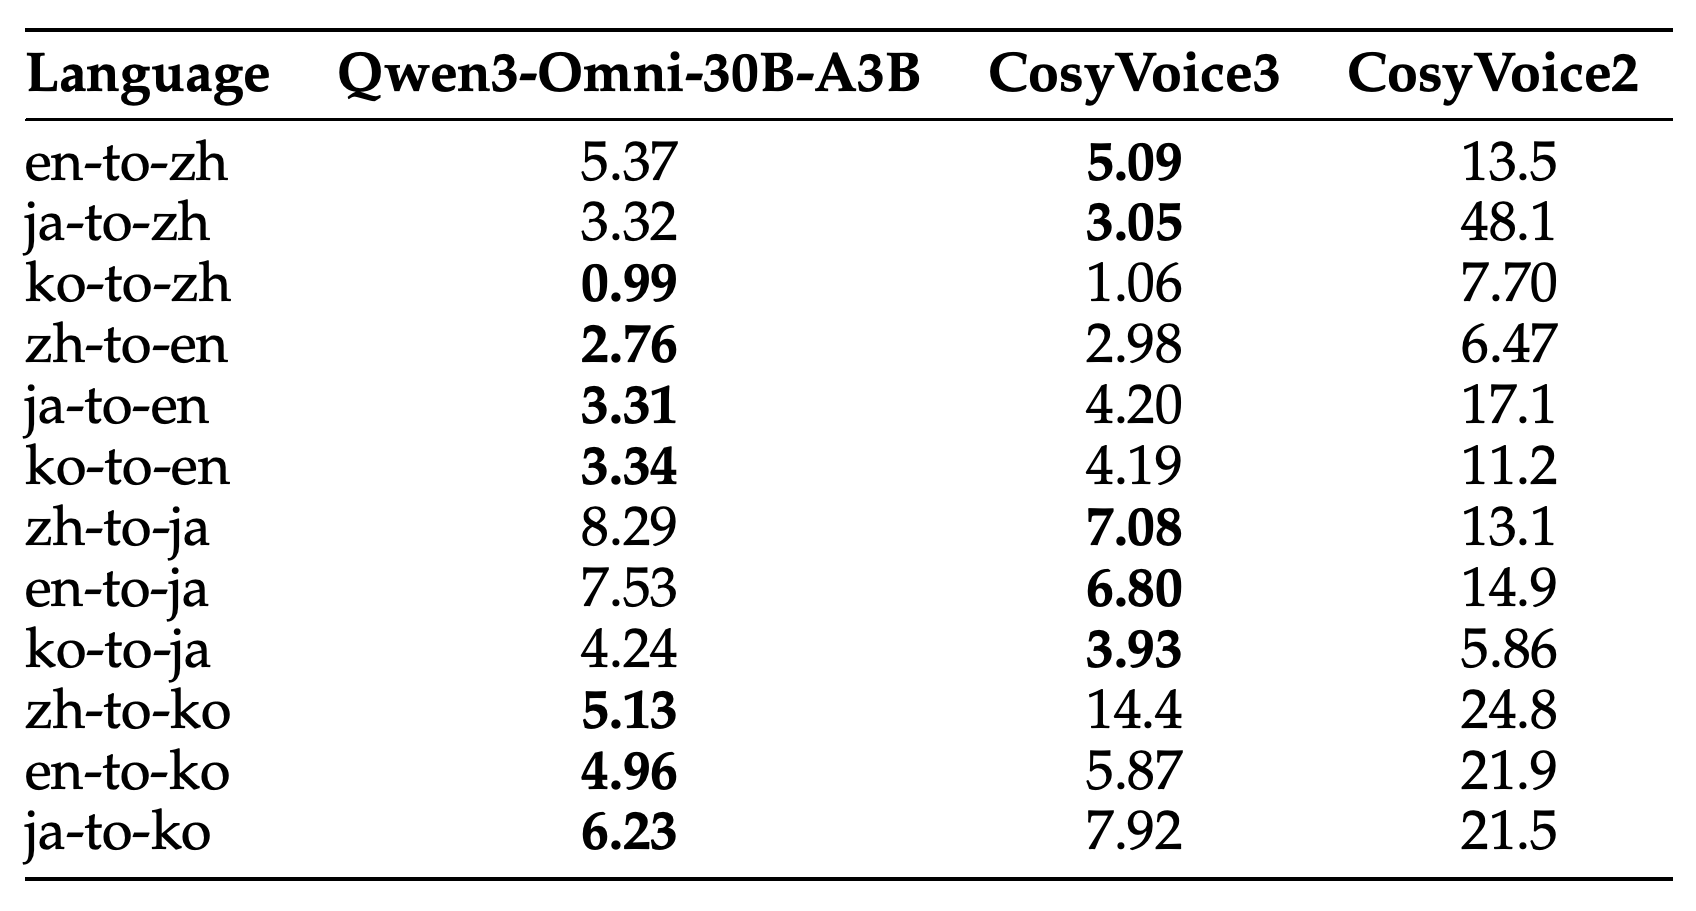
참조 목소리를 유지하면서 다른 언어의 음성을 생성하는 언어 간 음성 복제는 CosyVoice3 cross-lingual 테스트셋으로 평가한다. Qwen3-Omni는 표에 제시된 영어 및 한국어 출력 방향 모두에서 CosyVoice3보다 내용 일관성이 좋지만 일본어 출력 방향 모두에서는 점수가 나쁘다. 일본어 비교에는 서로 다른 전처리를 사용한다. CosyVoice3는 문자를 발음을 나타내는 가나로 변환하고 Qwen3-Omni는 텍스트 정규화를 사용하지 않는다.
- zh-to-en은 2.76으로 CosyVoice3의 2.98보다 낮다. zh-to-ko는 5.13으로 14.4보다 낮다.
- zh-to-ja는 8.29로 7.08보다 높고, en-to-ja는 7.53으로 6.80보다 높으며 ko-to-ja는 4.24로 3.93보다 높다.
Qwen3-Omni는 표에 제시된 영어 및 한국어 출력 방향 모두에서 앞서며, CosyVoice3는 일본어 출력 방향 모두에서 앞선다. 보고된 전처리 차이는 일본어 출력 결과의 비교 가능성을 제한한다.
6 Evaluating Non-Degradation Across Modalities
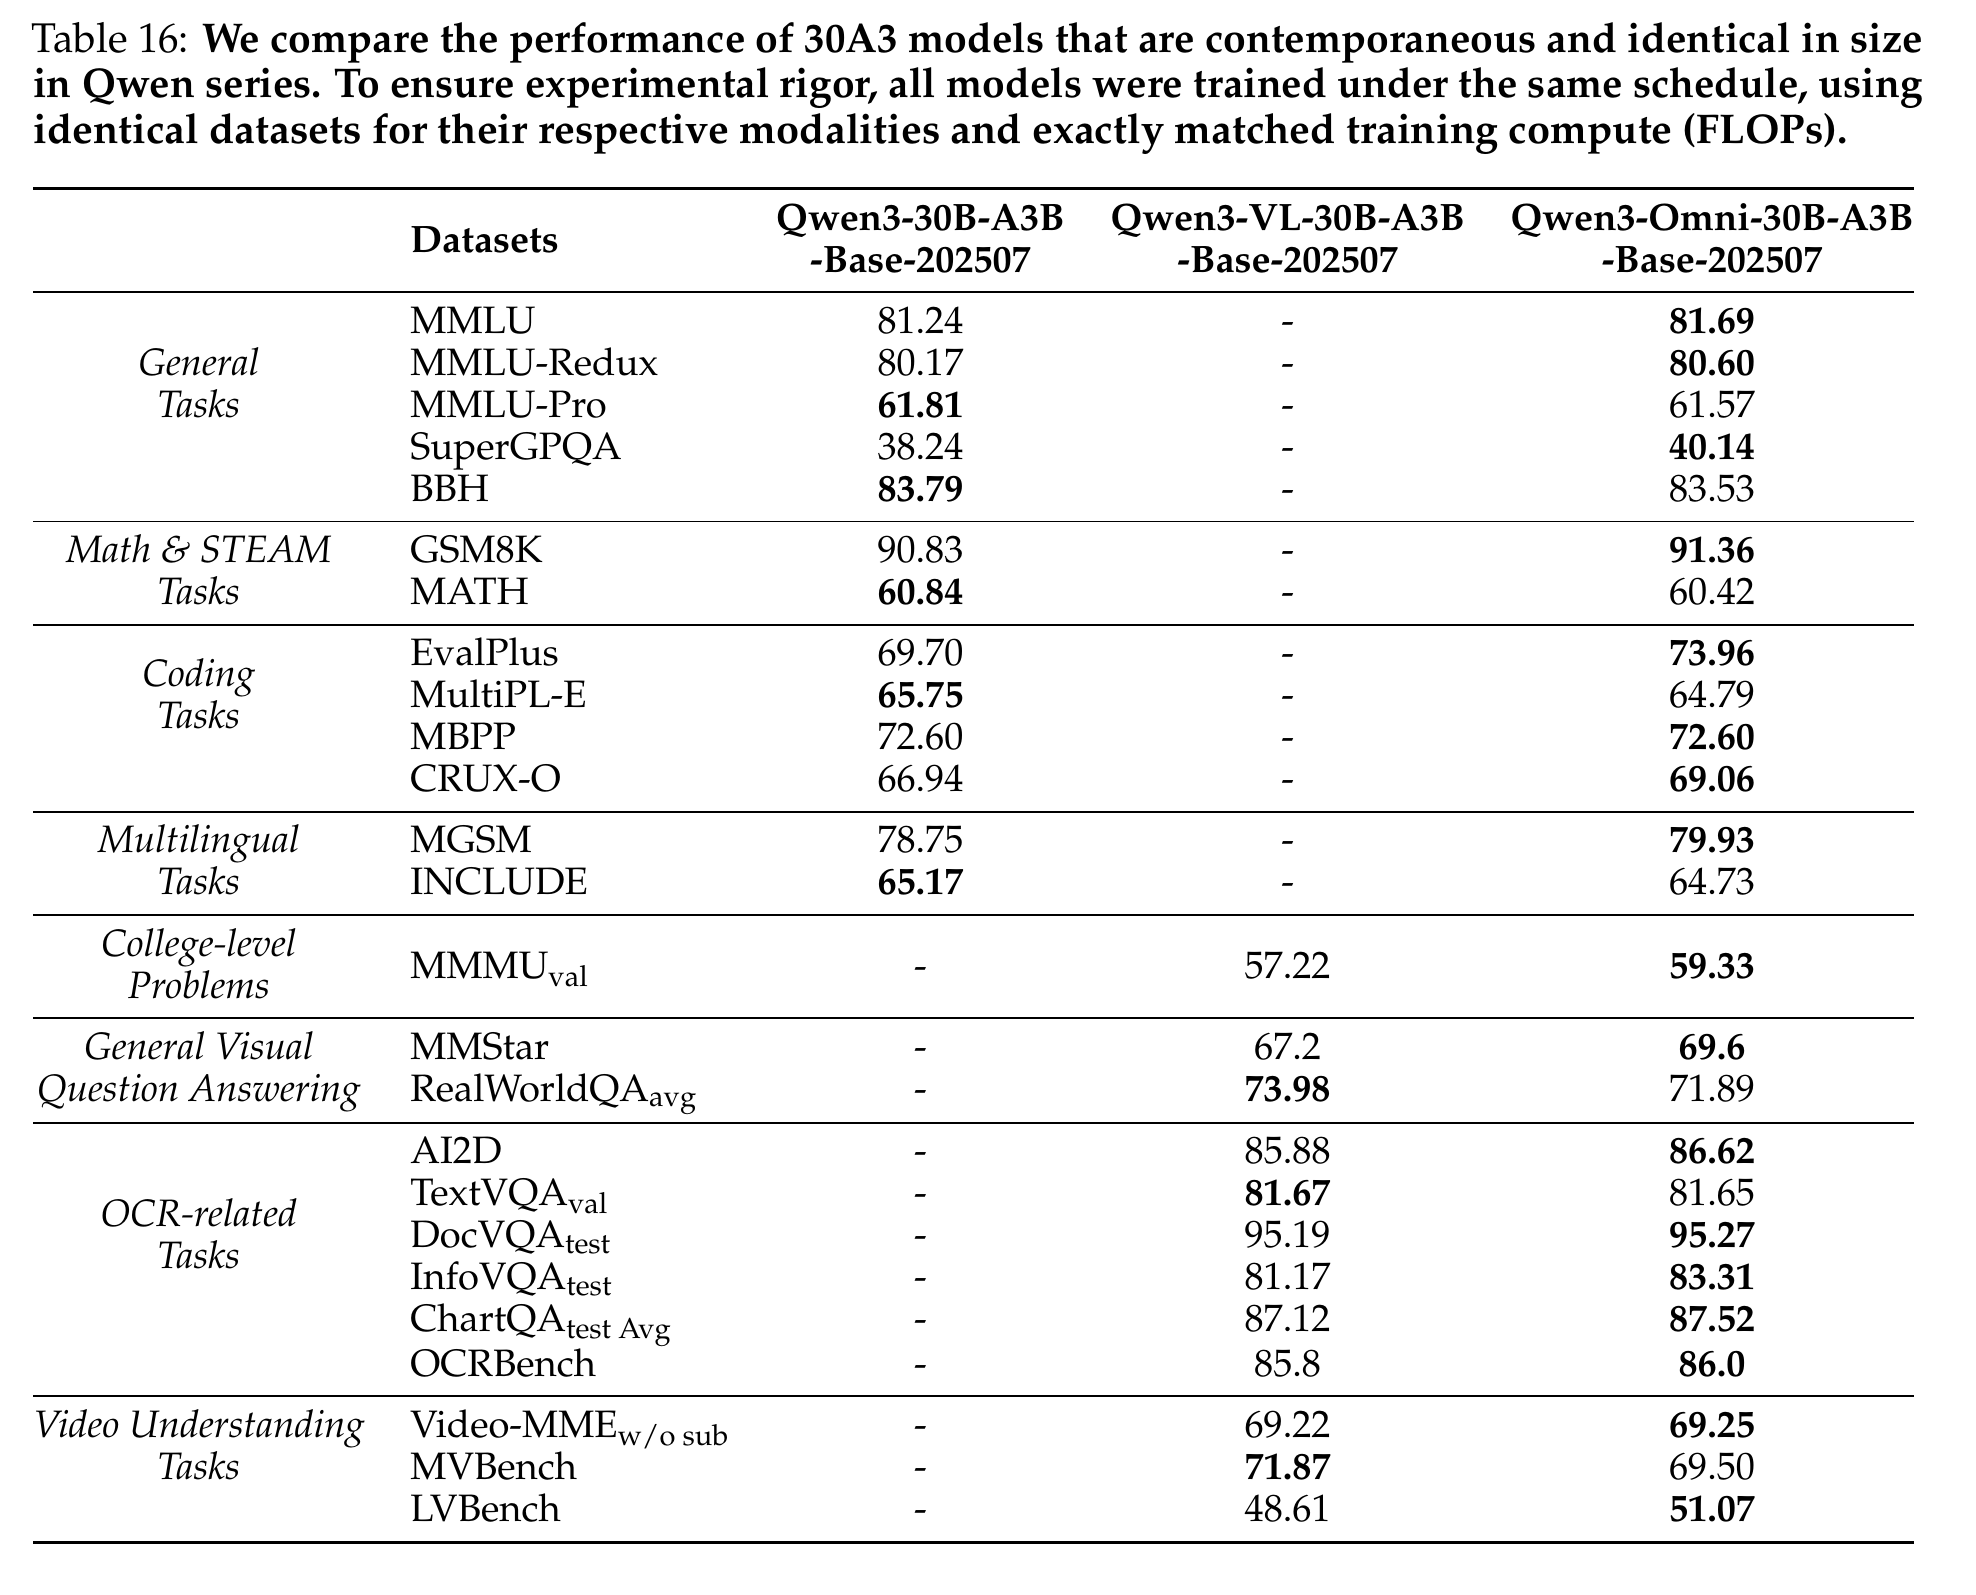
성능 저하 여부를 검증하는 통제 연구는 Qwen3-30B-A3B-Base-202507, Qwen3-VL-30B-A3B-Base-202507, Qwen3-Omni-30B-A3B-Base-202507을 비교한다. 보고서는 파라미터 규모, 학습 일정, 공통 모달리티 데이터셋, 배치 크기, 모달리티별 유효 에포크, 학습 연산량을 맞췄다고 설명한다. Omni는 추가 오디오 및 시청각 데이터를 사용한다는 점에서 차이가 있다. Table 16은 전반적인 능력 유지와 여러 시각 성능 향상을 뒷받침하지만 개별 텍스트, 이미지, 비디오 과제의 성능 하락도 기록한다.
- 텍스트 기준선과 비교하면 Omni는 일반 지식 벤치마크인 MMLU에서 81.69로 81.24보다 높고, 코드 생성 평가인 EvalPlus에서 73.96으로 69.70보다 높다. 그러나 수학 문제 평가인 MATH에서는 60.42로 60.84보다 낮고, 다국어 코드 생성 평가인 MultiPL-E에서는 64.79로 65.75보다 낮다.
- 시각 언어 기준선과 비교하면 Omni는 여러 분야의 시각 질문을 다루는 MMMU validation에서 59.33으로 57.22보다 높다. 인포그래픽 질의응답인 InfoVQA test에서는 83.31로 81.17보다 높고, LVBench에서는 51.07로 48.61보다 높다.
- 실세계 시각 질의응답인 RealWorldQA 평균은 73.98에서 71.89로 하락하고 비디오 이해 평가인 MVBench는 71.87에서 69.50으로 하락한다. 모델 규모를 포괄적으로 비교하거나 불확실성 추정치를 제시하지 않았으므로, 이 연구는 모든 조건에서 성능 저하가 없거나 통계적으로 성능이 유지된다는 점을 입증하지 않는다.
학습 조건을 맞춘 기본 모델 연구는 MMMU validation의 57.22 대비 59.33, InfoVQA test의 81.17 대비 83.31과 같은 향상과 MVBench의 71.87 대비 69.50과 같은 하락을 함께 기록한다. 과제별로 엇갈리는 결과는 평가한 규모에서 전반적인 능력 유지를 뒷받침하지만 모든 능력이 그대로 유지된다는 점을 입증하지는 않는다.
7 Conclusion
결론은 통합 멀티모달 학습과 프레임 단위 음성 스트리밍을 보고서의 주요 기여로 제시한다. 향후 과제로 다중 화자 ASR, 비디오의 텍스트를 읽는 광학 문자 인식(OCR), 시청각 proactive learning, 에이전트 워크플로와 함수 호출 개선을 제시한다. 초록은 Qwen3-Omni-30B-A3B, Qwen3-Omni-30B-A3B-Thinking, Qwen3-Omni-30B-A3B-Captioner가 Apache 2.0 라이선스로 공개되었다고 명시한다.
- 논문은 https://github.com/QwenLM/Qwen3-Omni, https://huggingface.co/spaces/Qwen/Qwen3-Omni-Demo, https://modelscope.cn/studios/Qwen/Qwen3-Omni-Demo를 제시한다.
- 결론의 “20개가 넘는 언어에서 대화형 음성 지원”이라는 표현은 Table 3에 명시된 음성 입력 19개 언어, 음성 출력 10개 언어와 일치하지 않는다.
8 Authors
보고서의 저자는 Qwen Team이며, Core Contributors와 Contributors를 별도로 나열한다. Contributors 목록은 알파벳순이라고 명시한다. Core Contributors 목록은 Jin Xu, Zhifang Guo, Hangrui Hu, Yunfei Chu로 시작하고 Jingren Zhou, Junyang Lin으로 끝난다. 기관 소속이나 학회 및 학술지 발표처는 명시하지 않는다.
부록
- 9.1 More Evaluation on Speech and Music Understanding은 Thinking이 Instruct보다 전사와 음악 평가에서 낮은 성능을 보인다고 보고한다. Librispeech clean/other WER는 1.22/2.48에서 2.22/4.38로 상승하고 19개 언어 Fleurs 평균은 5.33에서 8.63으로 상승하며 RUL-MuchoMusic은 52.0에서 48.3으로 하락한다. 저자들은 추론이 이러한 과제에서 환각을 늘릴 수 있다고 제안하지만 그 메커니즘을 직접 정량화하지는 않는다. 번역 결과가 모두 나빠지는 것은 아니다. Fleurs-xx2zh는 33.13에서 34.51 BLEU로 향상된다.
- 9.2 Qualitative Results from Qwen3-Omni-30B-A3B-Captioner는 Analysis of Expressive Speech, Analysis of Complex Scene Sound Effect, Analysis of Mixed Speech, Audio, and Music이라는 예시 3개를 제공한다. 생성된 설명은 대화, 발화 방식, 음향 질감, 시간에 따른 사건을 포함한다. 복잡한 장면의 캡션은 25-second 사운드스케이프에서 약 9, 15, 19 seconds에 발생하는 사건을 설명한다. 이러한 출력은 폭넓은 묘사 능력을 보여주지만 추론한 배경과 관계도 포함하며 참조 캡션이나 정량적 정확도 평가는 제공하지 않는다.
짧은 생각
Table 16의 통제된 기본 모델 비교와 Tables 11–12의 시청각 결과는 평가한 규모에서 유용한 멀티모달 통합을 뒷받침한다. 배포를 평가할 때는 이론적 시작 지연 시간과 지속적인 생성 속도를 구분하고 목표 과제에서 Instruct와 Thinking을 비교해야 한다. 추론은 일부 평가를 개선하지만 전사와 음악 인식은 약화시키기 때문이다. 성능 저하가 없다는 주장은 보고된 조건에서 전반적인 능력을 유지한다는 범위에서 뒷받침된다. 다만 과제별 성능 하락이 있고 모델 규모를 포괄적으로 비교하지 않았다는 제약이 있다.