


Orion: A Unified Visual Agent for Multimodal Perception, Advanced Visual Reasoning and Execution 요약 설명
18 Nov 2025 | Paper Review Tool Use Agent Planning Vision-Language Models목차
이번 글에서는 Orion: A Unified Visual Agent for Multimodal Perception, Advanced Visual Reasoning and Execution 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 11월 18일(Arxiv)
- Reddy, N Dinesh, Snyder, Dylan, Kiragu, Lona, Mohin, Mirajul, Amin, Shahrear Bin, Pillai, Sudeep.
- VLM Run Research
- 논문 링크
- Project Page
요약
- Orion은 모델이 여러 실행 단계를 거쳐 시각 콘텐츠를 찾고, 변환하고 생성해야 하는 시각 작업을 다룬다. 논문에서 이중맹검 방식이라고 명시한 사람 평가에서는 출력물을 제시할 때 모델 이름을 숨긴다. 46개 시각 과제에서 Orion의 종합 점수는 9.2/10이며, ChatGPT (GPT-5)는 6.6, Gemini 2.5 Pro는 6.4, Claude Sonnet 4.5는 5.7이다.
- 이 시스템은 언어를 처리하고 생성하는 대규모 언어 모델(LLM), 전문 시각 도구, 시각 콘텐츠와 언어를 함께 추론하는 비전 언어 모델(VLM)을 결합한다. Plan-Execute-Reflect 루프는 도구 실행 순서를 계획하고 작업을 실행하고 중간 결과를 확인한 뒤 필요에 따라 재시도하거나 수정한다. 논문의 기여는 시스템 아키텍처에 있으며 새로운 학습 절차는 설명하지 않는다.
- 표준 벤치마크 결과는 엇갈린다. 시각 콘텐츠가 뒷받침하지 않는 응답인 환각을 평가하는 것으로 소개된 HallusionBench에서 Orion은 69.7을 기록하며 비교 모델은 53.6–55.9를 기록한다. 반면 긴 문서 벤치마크인 MMLongBench-Doc에서는 Orion이 33.3, 비교 모델이 38.3–48.1을 기록한다. 모델 구성을 명시하지 않고, 개별 설계 선택의 효과를 검증하는 구성요소 제거 실험과 불확실성 및 비용 측정도 없어 결과를 재현하거나 성능 향상의 원인을 판단하기 어렵다.
1. Introduction
서론은 시각 입력에 실제 작업을 수행하는 시각 에이전트의 필요성을 제시한다. Orion은 자연어를 통한 과제 분해와 전문 도구를 결합한다. 도구는 객체를 식별하고 위치를 찾는 객체 탐지, 픽셀 수준에서 콘텐츠 영역을 구분하는 분할, 시각 입력에서 텍스트를 추출하는 광학 문자 인식(OCR), 이미지, 비디오, 문서, 오디오, 텍스트 전반의 콘텐츠 생성을 지원한다.
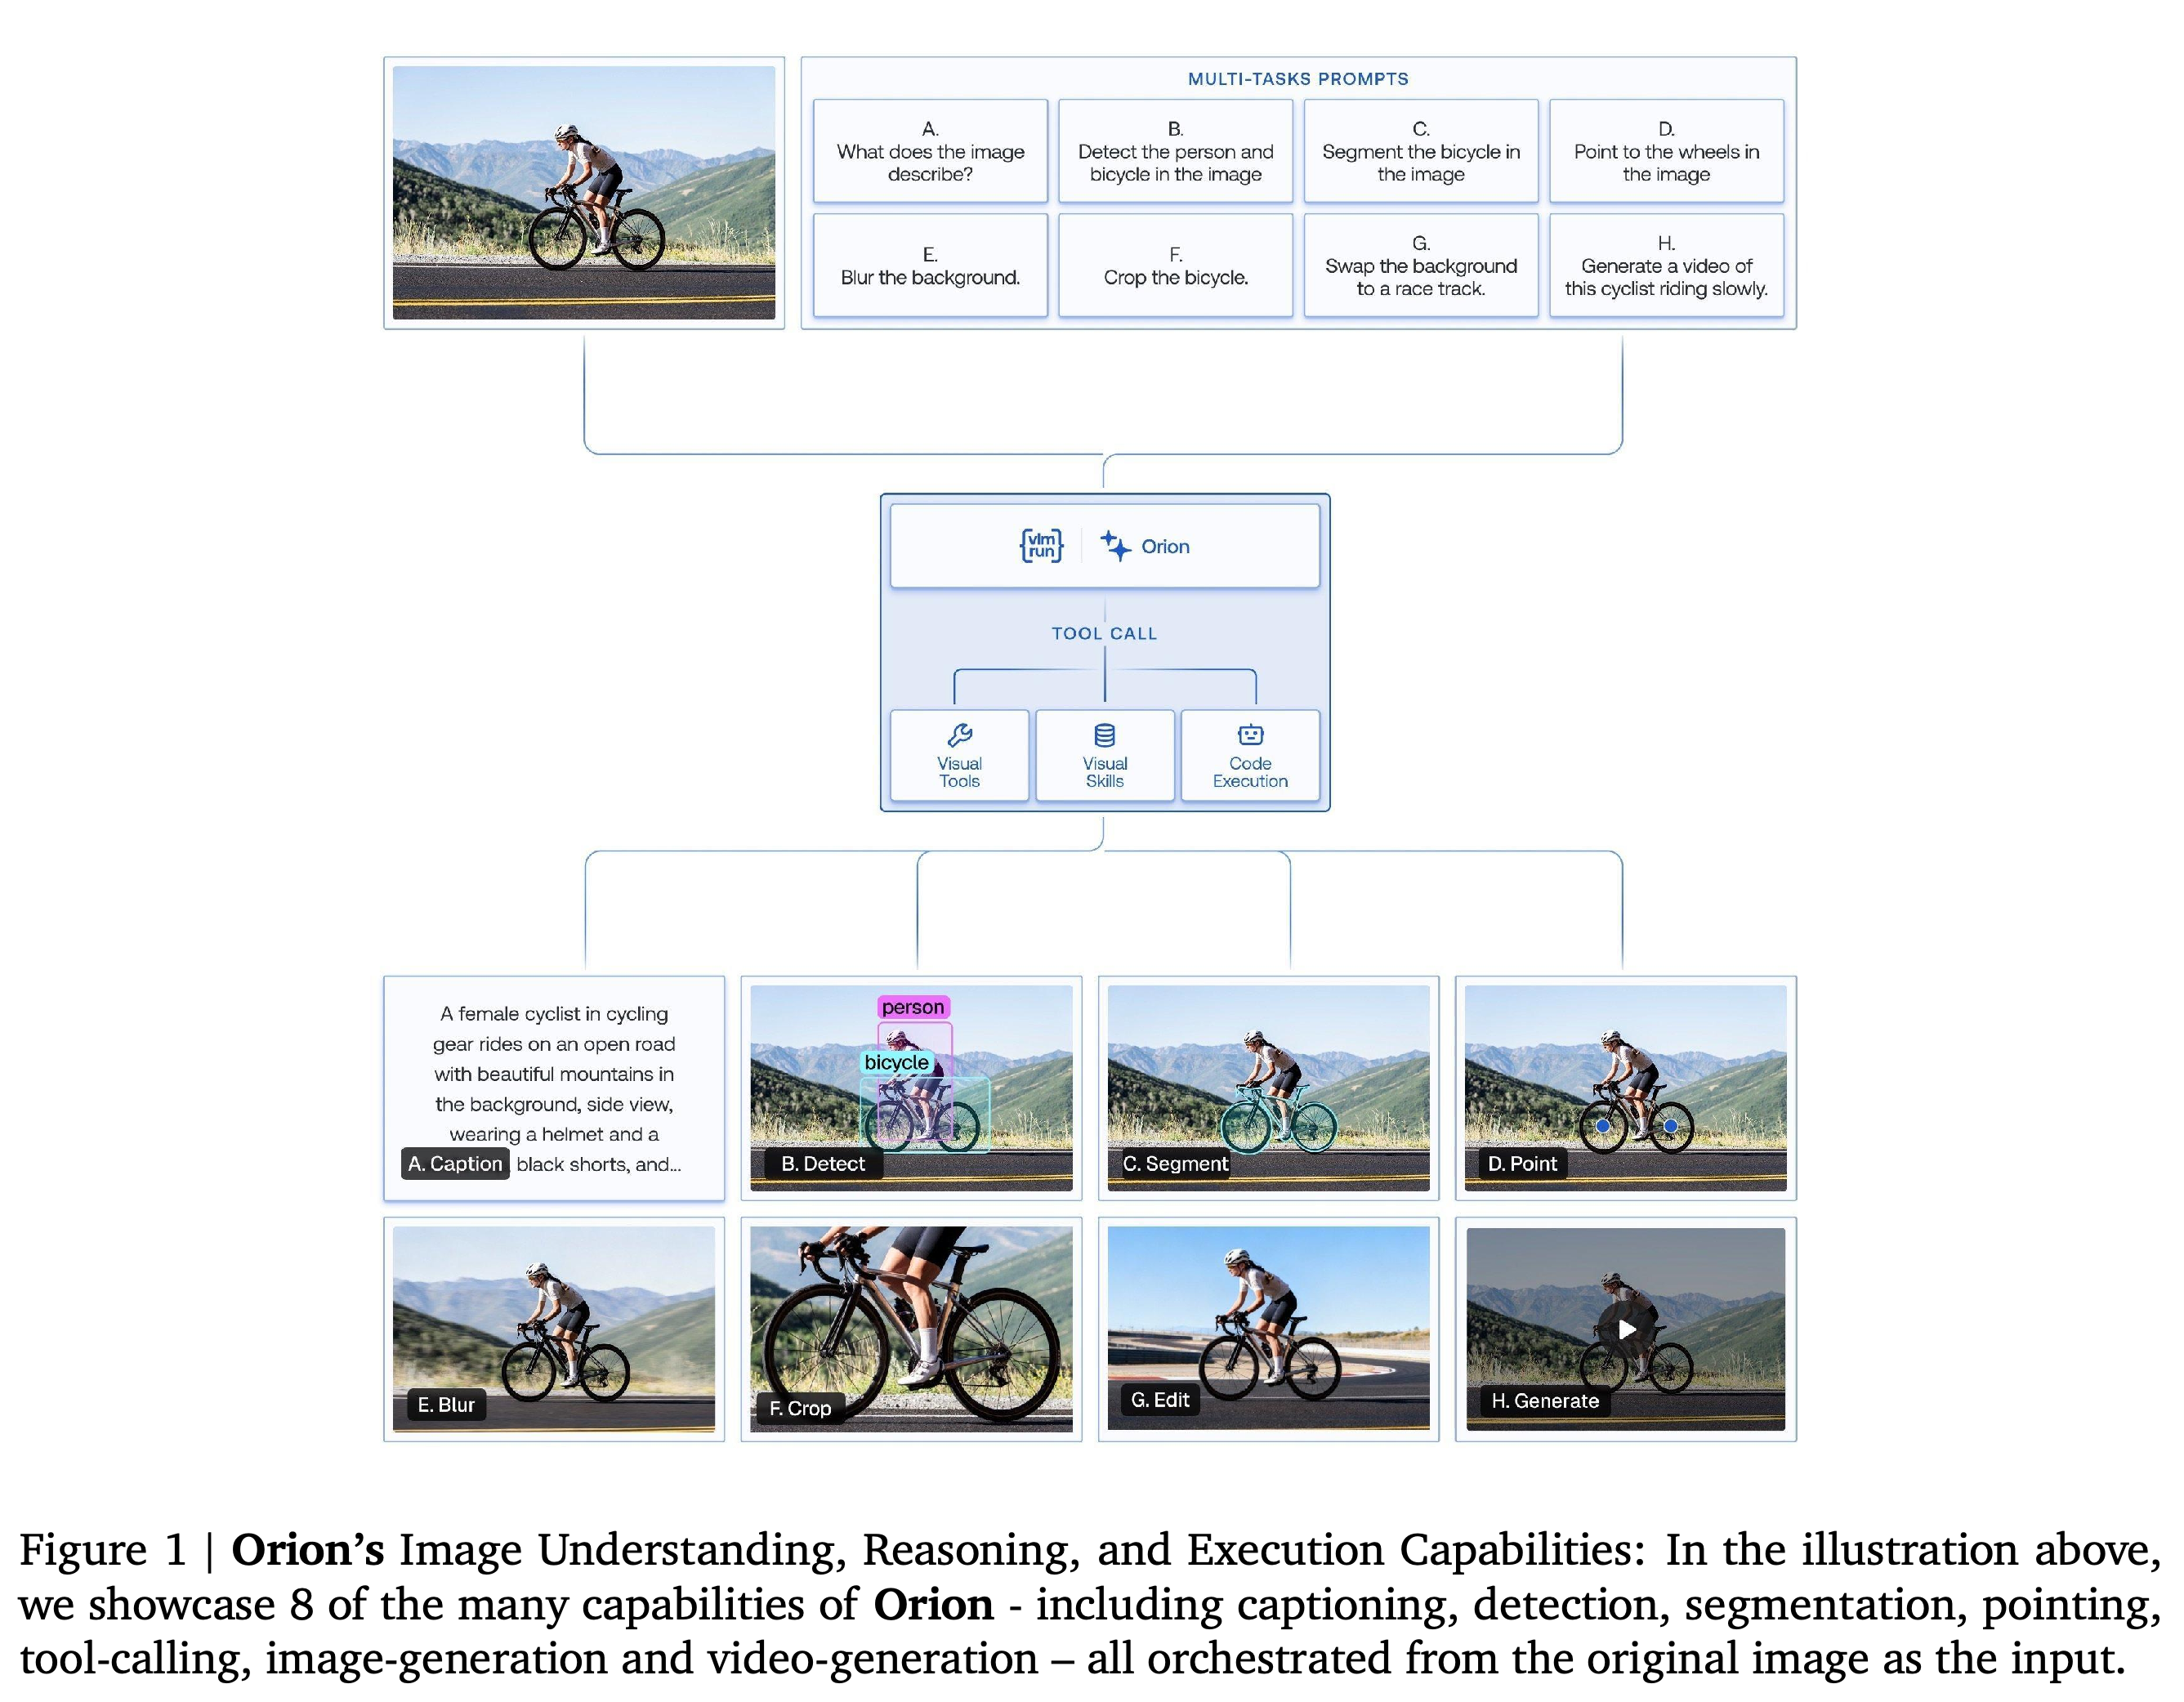
- Figure 1은 자전거를 타는 사람의 이미지에서 만든 8개 출력을 보여준다. 출력은 캡셔닝, 탐지, 분할, 포인팅, 블러 처리, 자르기, 편집, 비디오 생성이다.
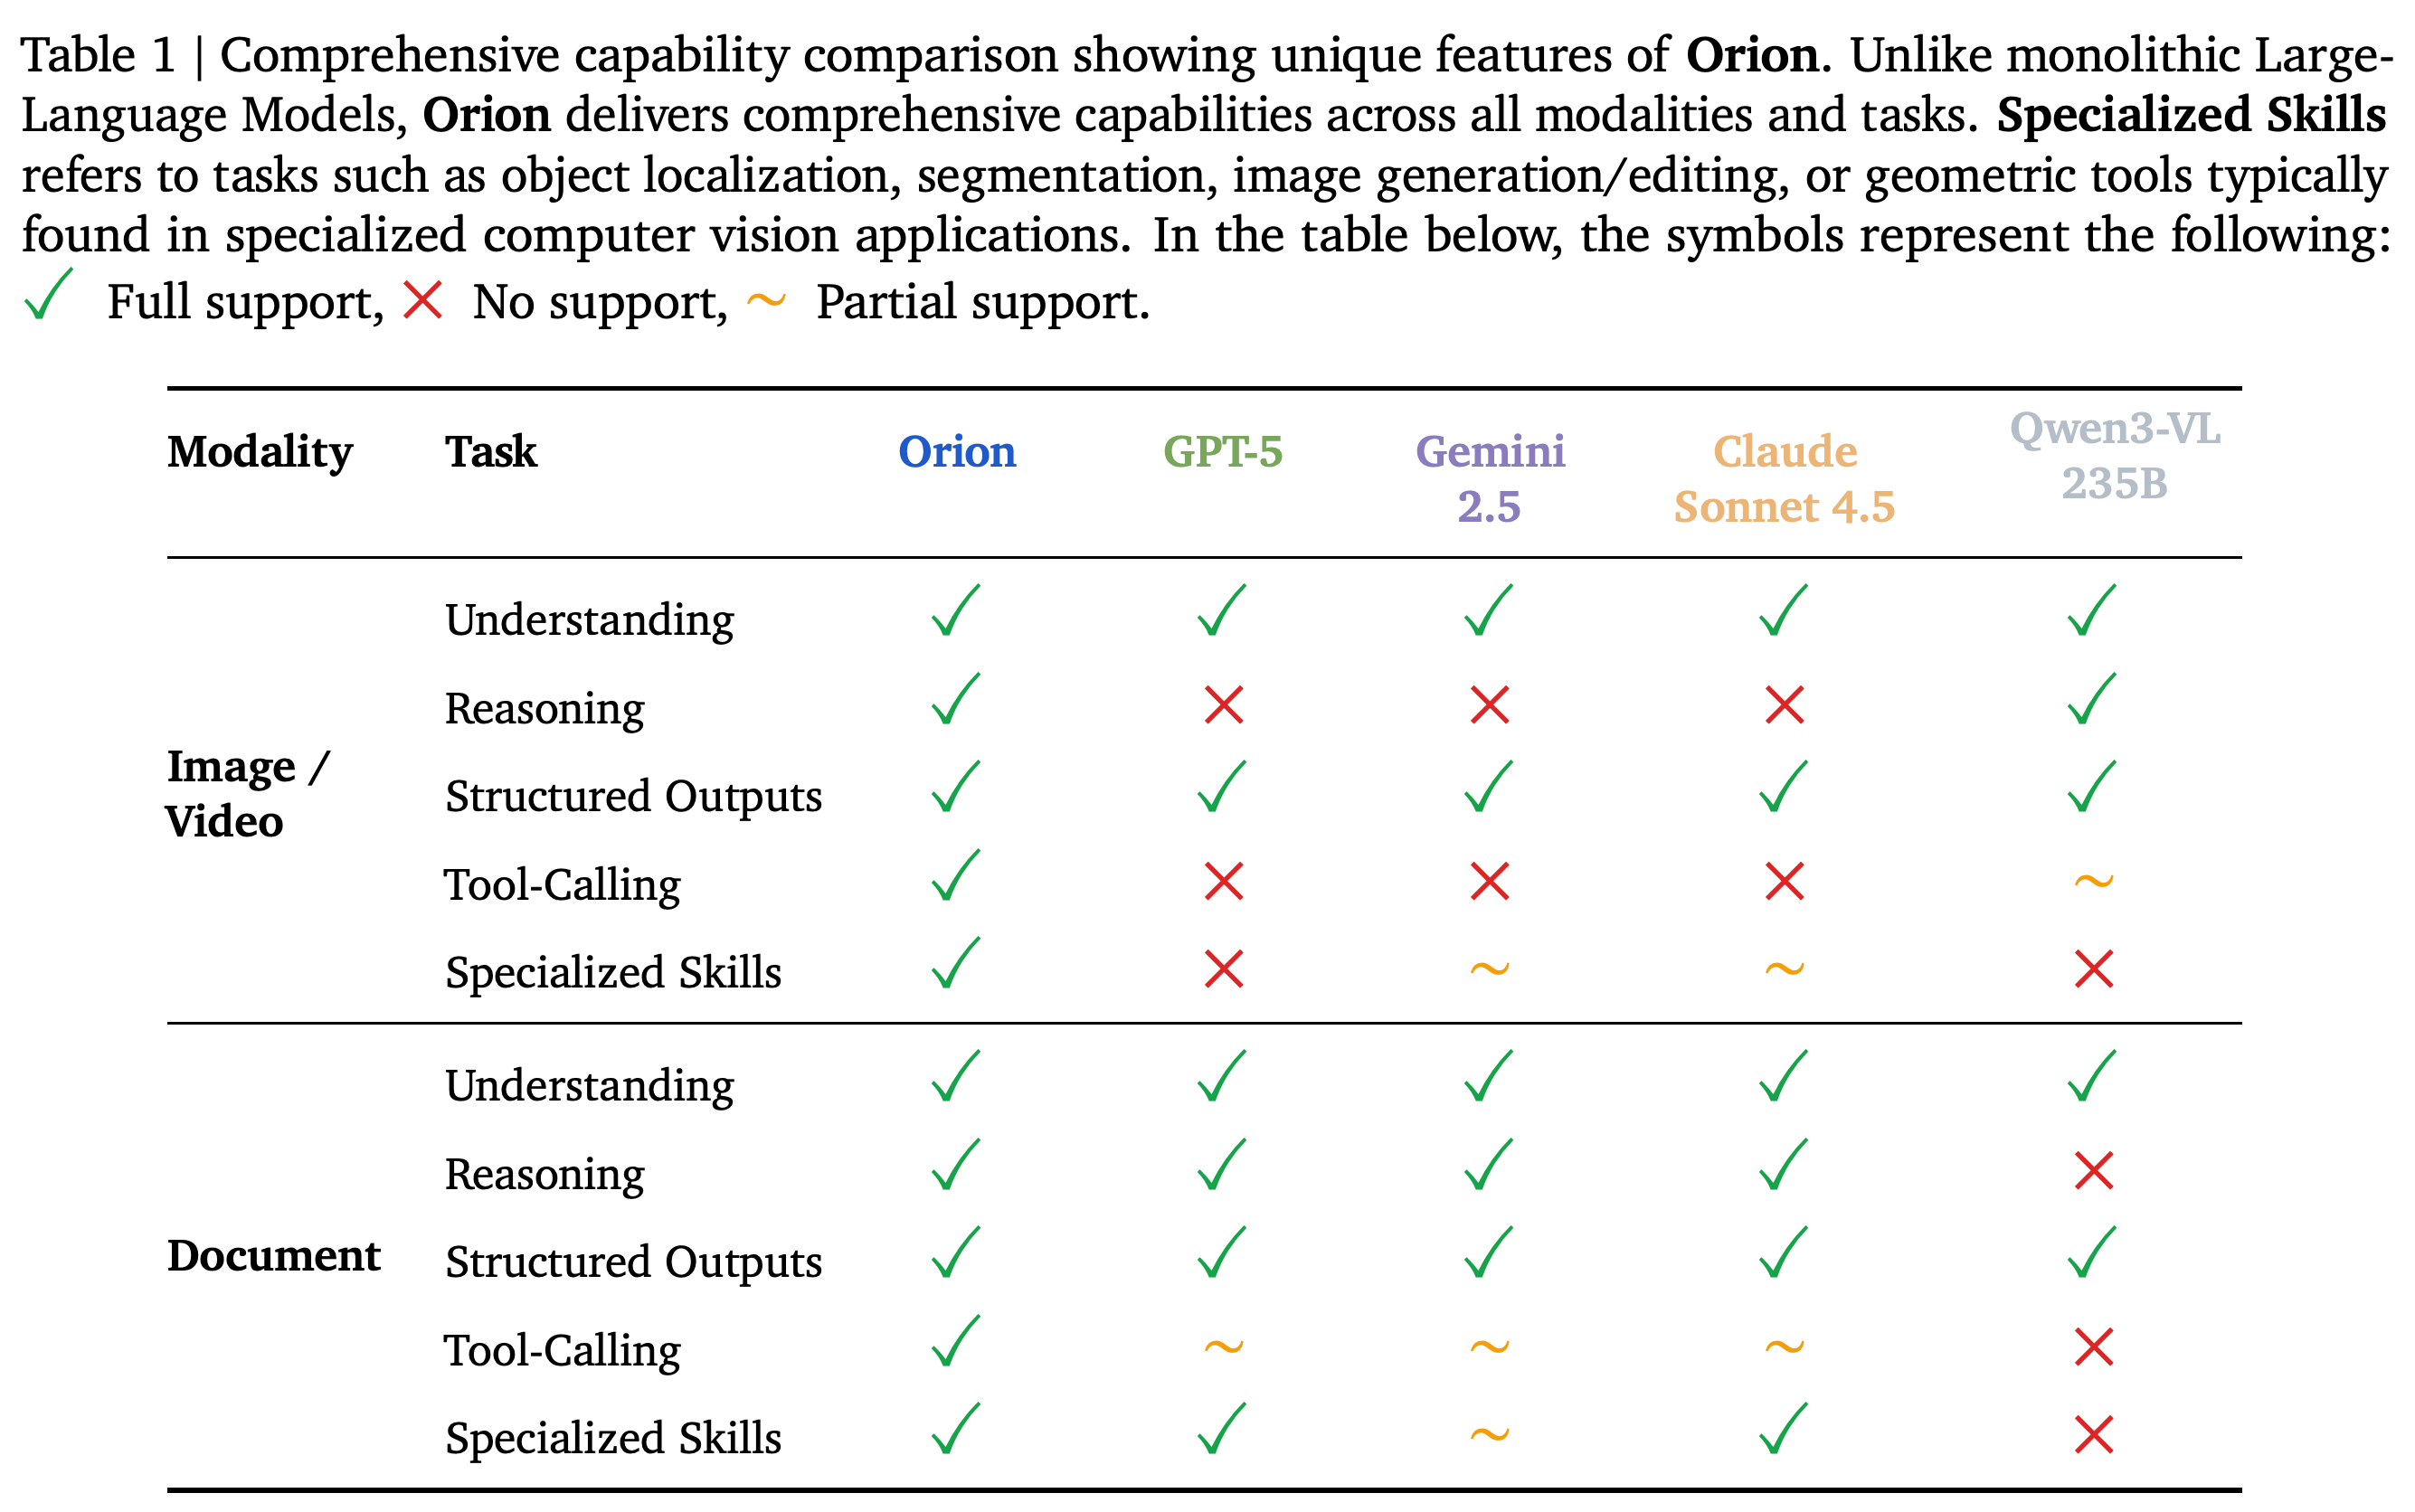
- Table 1은 저자들이 GPT-5, Gemini 2.5, Claude Sonnet 4.5, Qwen3-VL 235B와 기능 지원 여부를 범주별로 비교한 표다. 지원 표시는 측정한 과제 점수가 아니라 정성적 주장이다.
- 서론은 전반적인 우수성을 주장하지만 뒤의 벤치마크 표에는 Orion이 비교 모델보다 낮은 점수를 받은 과제가 여럿 있다.
8개 요청이 자전거를 타는 사람의 이미지 1장을 공유하고 설명, 공간 주석, 변환 결과, 생성 콘텐츠를 만든다. 이 그림은 서로 다른 작업에서 입력을 재사용하는 모습을 보여주지만 정확도나 작업 성공률은 측정하지 않는다.
저자들은 표에 제시한 모든 이미지/비디오 및 문서 기능을 Orion이 완전히 지원한다고 표시한다. 범주별 표시에는 구체적인 점수 산정 절차가 없어, 저자들이 주장하는 기능 목록으로 해석해야 한다.
2. System Overview
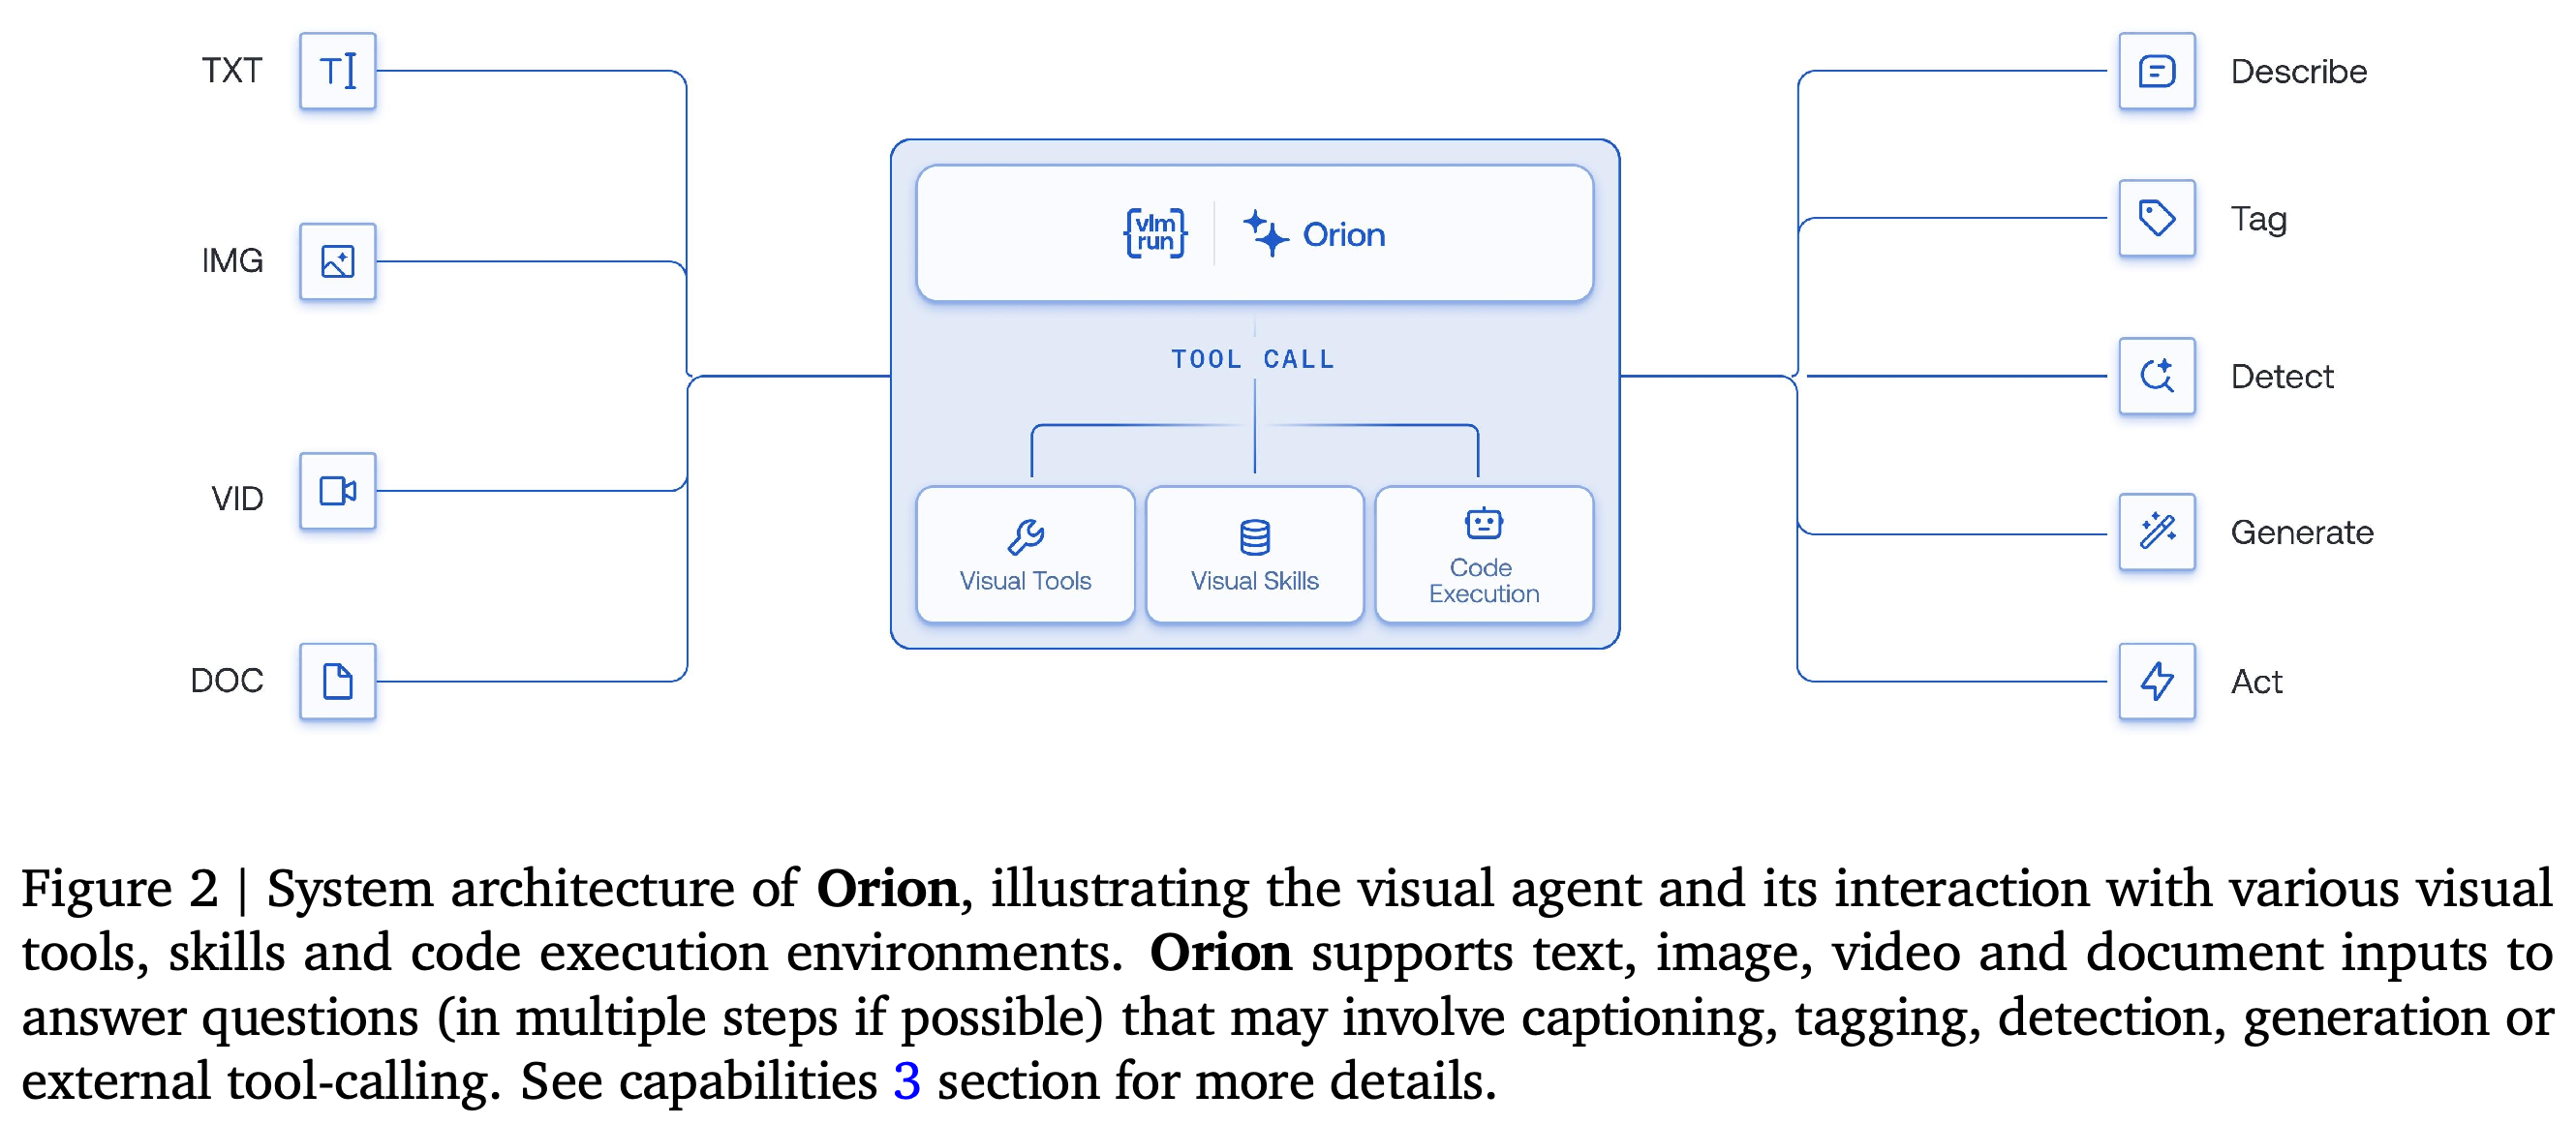
시스템 개요는 서로 다른 데이터 형식으로 구성된 멀티모달 입력을 시각 도구, 재사용 가능한 스킬, 실행 환경과 연결하고 조율하는 오케스트레이션 프레임워크를 설명한다. 컨트롤러 아키텍처, 라우팅 및 검증 기능, 개발자 인터페이스, 향후 확장 계획을 다룬다.
2.1. System Architecture
2.1.1. Unified Orchestration with Planning, Execution and Reflection은 추론과 행동을 번갈아 수행하는 ReAct 방식의 컨트롤러를 Plan-Execute-Reflect 구조로 설명한다. 계획기는 도구 순서와 의존 관계를 정하고 실행 엔진은 의존 관계가 허용하는 범위에서 작업을 순차 또는 병렬로 실행한다. 검증기는 출력을 확인한 뒤 재시도, 수정, 과제 완료 여부를 결정한다.
- 2.1.2. Multi-Modal Tool Execution은 도구를 이미지, 문서, 비디오, 혼합 모달리티 범주로 나눈다. 표준화된 입출력 인터페이스를 통해 1개 도구의 결과를 다른 도구의 입력으로 사용할 수 있다.
- 이미지 도구는 탐지, 신원 확인을 위한 얼굴 인식, 분할, 이미지에 관한 질문에 답하는 시각 질의응답을 지원한다. 문서 도구는 OCR, 레이아웃 분석, 표, 양식, 키워드 검색을 지원한다.
- 비디오 도구는 캡셔닝, 장면 경계 탐지, 프레임 간 객체 추적, 활동을 분류하는 행동 인식을 지원한다. 혼합 모달리티 도구는 데이터 형식 간 검색, 선택한 콘텐츠를 가리는 삭제 또는 가림 처리, 영역 단위 추출을 지원한다.
- 2.1.3. Multi-Modal Context and Session Management는 현재 지시와 관련된 문맥을 선택적으로 검색한다. 논문은 이 기능이 25턴을 넘는 대화를 지원한다고 설명하지만 문맥 관리만을 평가한 실험은 보고하지 않는다.
- 2.1.4. Reflection with Visual Judges는 조건부 점검 시점에 시각 도구 출력을 평가하는 VLM-as-a-Judge 모델을 사용해 구조적, 의미적 요구사항을 확인한다. 이 점검의 효과를 분리해 검증한 구성요소 제거 실험은 없다.
텍스트, 이미지, 비디오, 문서 입력이 시각 도구, 스킬, 코드 실행과 연결된 에이전트로 모인다. 도식은 조율 대상인 구성요소를 보여주며, 함께 제시된 본문은 계획과 검증을 설명한다.
2.2. Key System Features
Orion은 1개 대화 안에서 여러 입력 모달리티를 지원하고 어려운 과제를 더 강력한 모델이나 전문 도구로 동적으로 라우팅하며 우선 사용할 자원을 이용할 수 없을 때 대체 수단을 제공한다. 채팅 모드는 https://chat.vlm.run 에서 탐색적 상호작용을 지원한다. 프로그램에서 접근할 수 있는 애플리케이션 프로그래밍 인터페이스(API)는 예상 타입과 필수 데이터 구조를 정의한 스키마에 맞춰 검증한 구조화 출력을 지원하며 성찰 단계는 중간 결과와 최종 결과를 확인한다.
2.3. Key API Features
API는 업로드한 파일 식별자나 직접 URL을 통해 멀티모달 콘텐츠를 받으며 응답을 생성하는 대로 점진적으로 전달하는 스트리밍을 지원한다. 논문은 OpenAI 호환 Chat Completions와 미리 정의한 스키마로 검증하는 구조화 출력도 설명한다. 문서는 https://docs.vlm.run/agents/introduction 에서 제공한다.
- VLMRun 예제는 https://agent.vlm.run/v1 을 사용하고 logo.jpg와 racing.mp4를 업로드한 뒤 model=”vlmrun-orion-1:auto”로 client.agent.completions.create를 호출한다.
- OpenAI 클라이언트 예제는 https://agent.vlm.run/v1/openai 와 client.chat.completions.create를 사용한다. 본문은 스트리밍에 stream=True를 지정한다.
- 구조화 출력 예제는 caption: str과 tags: list[str]를 갖는 ImageCaption을 정의하고 {“type”: “json_schema”, “schema”: ImageCaption.model_json_schema()}를 전달한 뒤 ImageCaption.model_validate_json(content)로 반환된 콘텐츠를 검증한다. 여기서 JSON은 응답에 사용하는 구조화 데이터 형식이다. 코드 예제는 연동 방법을 보여주지만 테스트 결과는 보고하지 않는다.
2.4. Extensions and Future Work
확장 계획에는 외부 도구나 사용자 정의 도구, 맞춤형 컴퓨터 비전 모듈의 자동 생성과 실행, 기반 모델을 교체할 수 있는 핫스왑 아키텍처가 포함된다. 논문은 이러한 맞춤화 기능을 향후 과제로 제시하지만 앞의 도식에는 이미 도구 호출과 코드 실행이 포함되어 있다.
3. Capabilities
기능 절은 이미지, 문서, 비디오 작업과 구조화 출력을 정리한다. 예제는 출력 형식과 도구 조합을 보여주지만 소개한 각 기능의 정확도 추정치는 제공하지 않는다.
3.1. Image Understanding, Reasoning and Tool-Use
Orion의 이미지 기능은 설명, 공간 분석, 텍스트 추출, 인터페이스 파싱, 이미지 조작을 포괄한다. Figures 3–11은 이러한 기능을 보여주며, 위치 파악을 후속 변환이나 질의응답과 결합하는 작업도 포함한다.
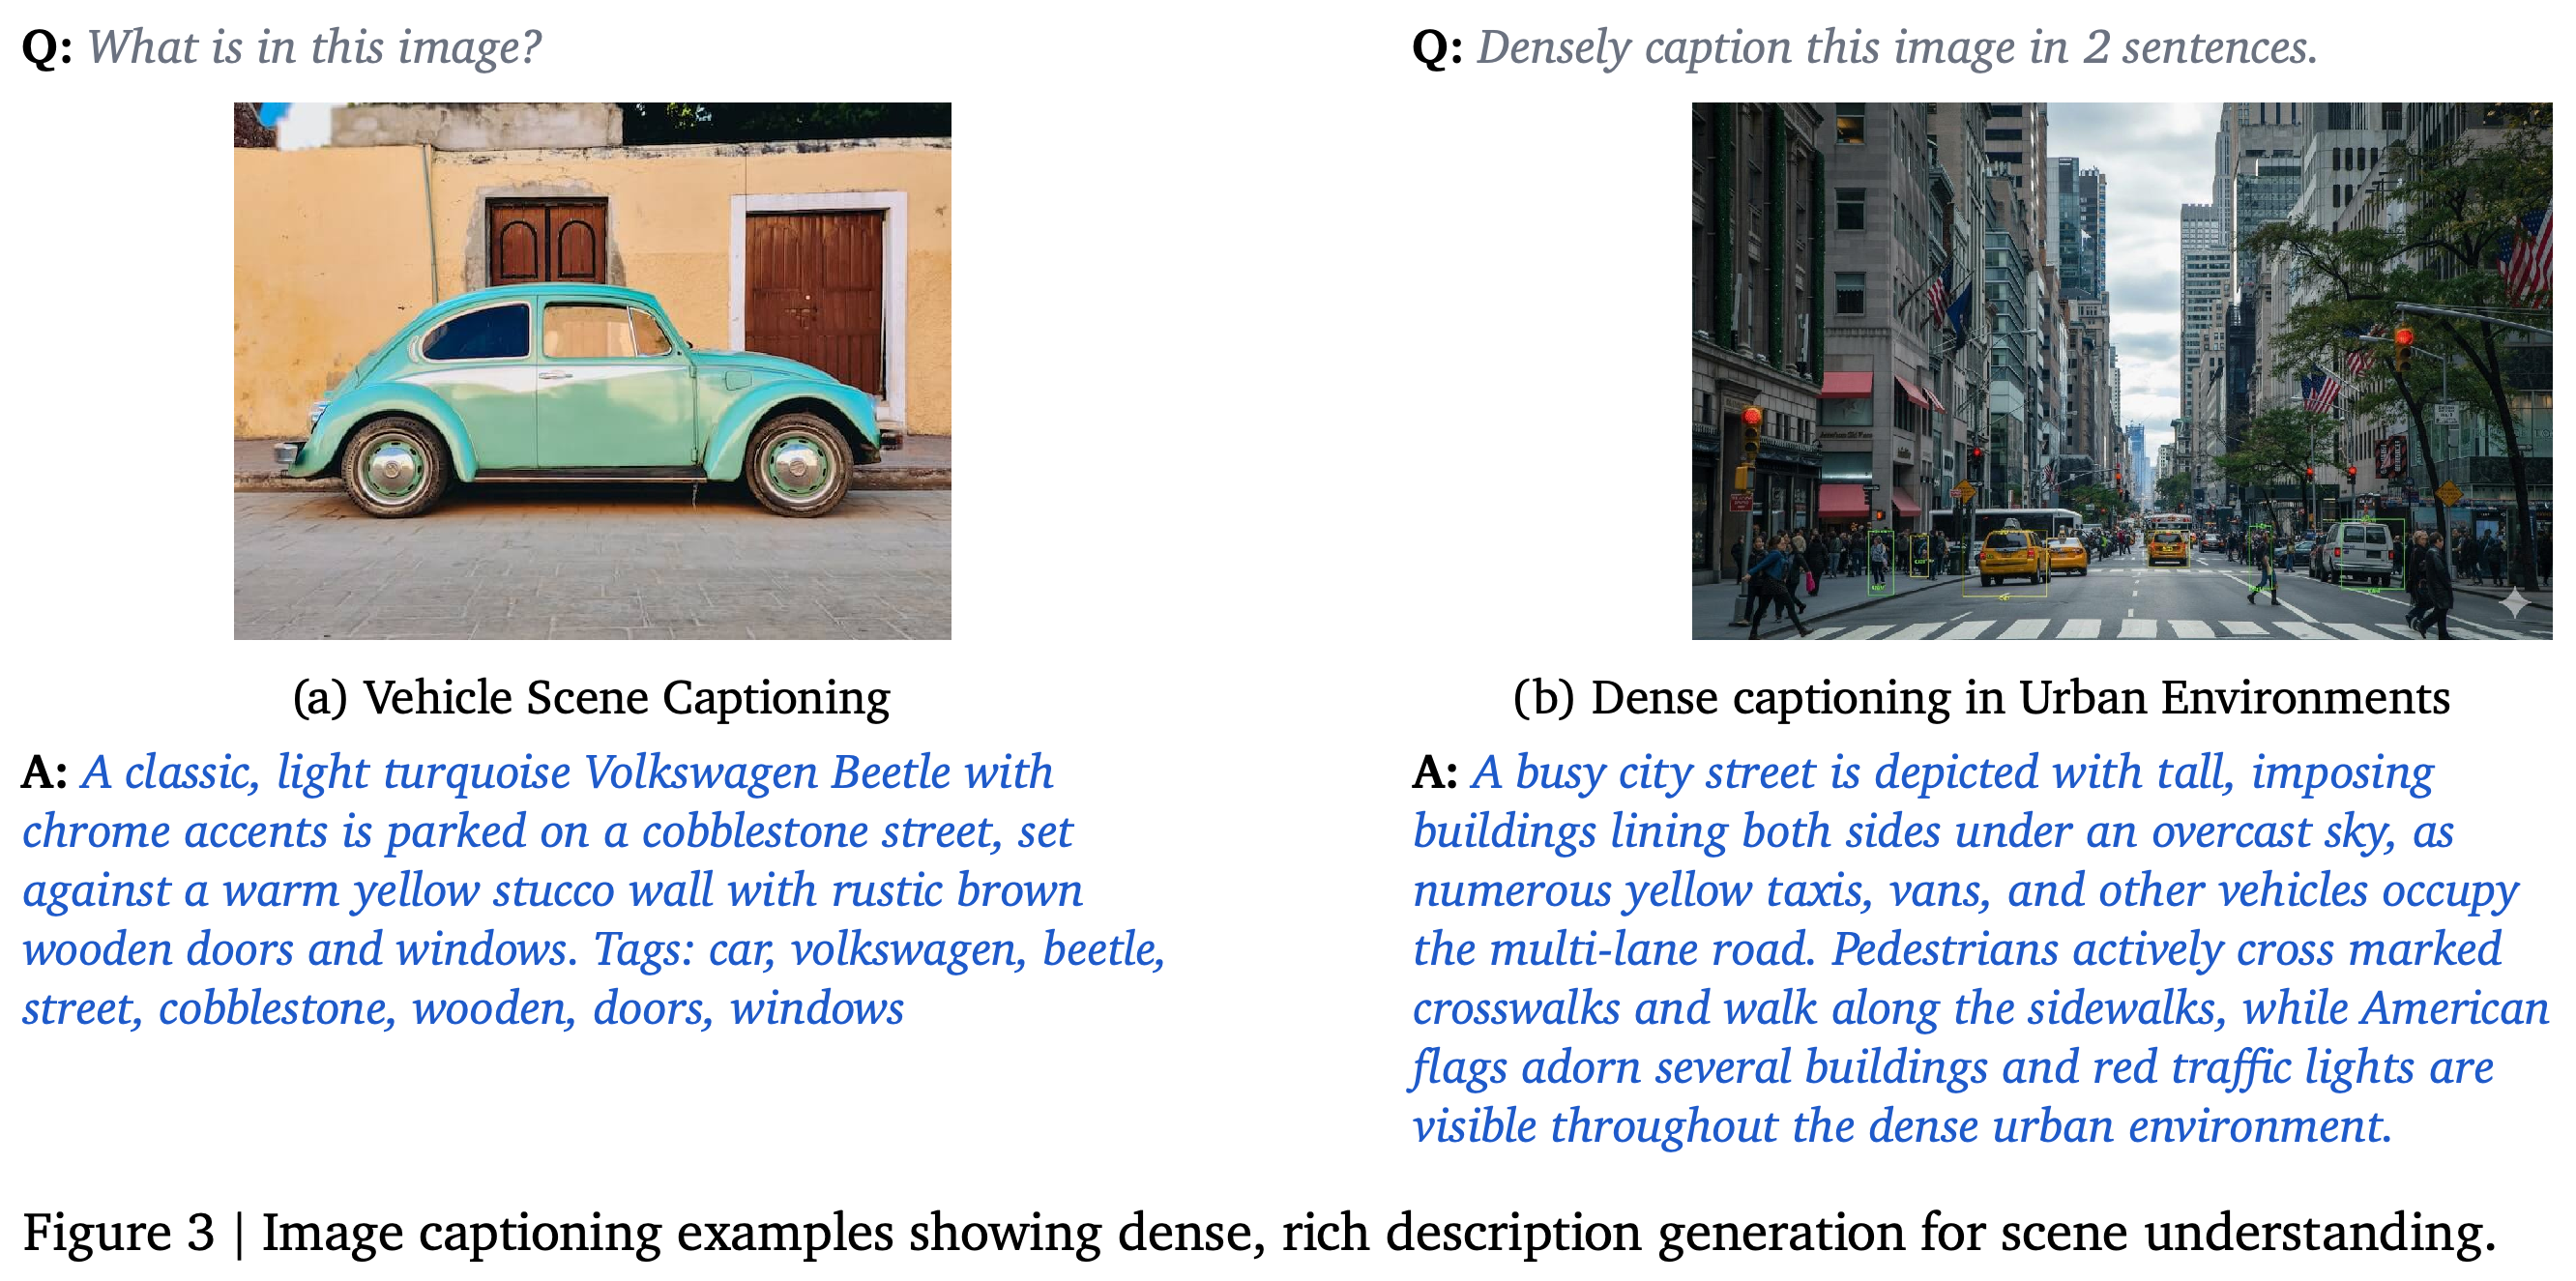
- 3.1.1. Image Captioning은 장면 설명, 특정 영역의 주석, 이미지 콘텐츠를 나타내는 의미 태그를 생성한다. Figure 3은 차량 설명과 도시 장면의 상세 캡션을 보여준다.
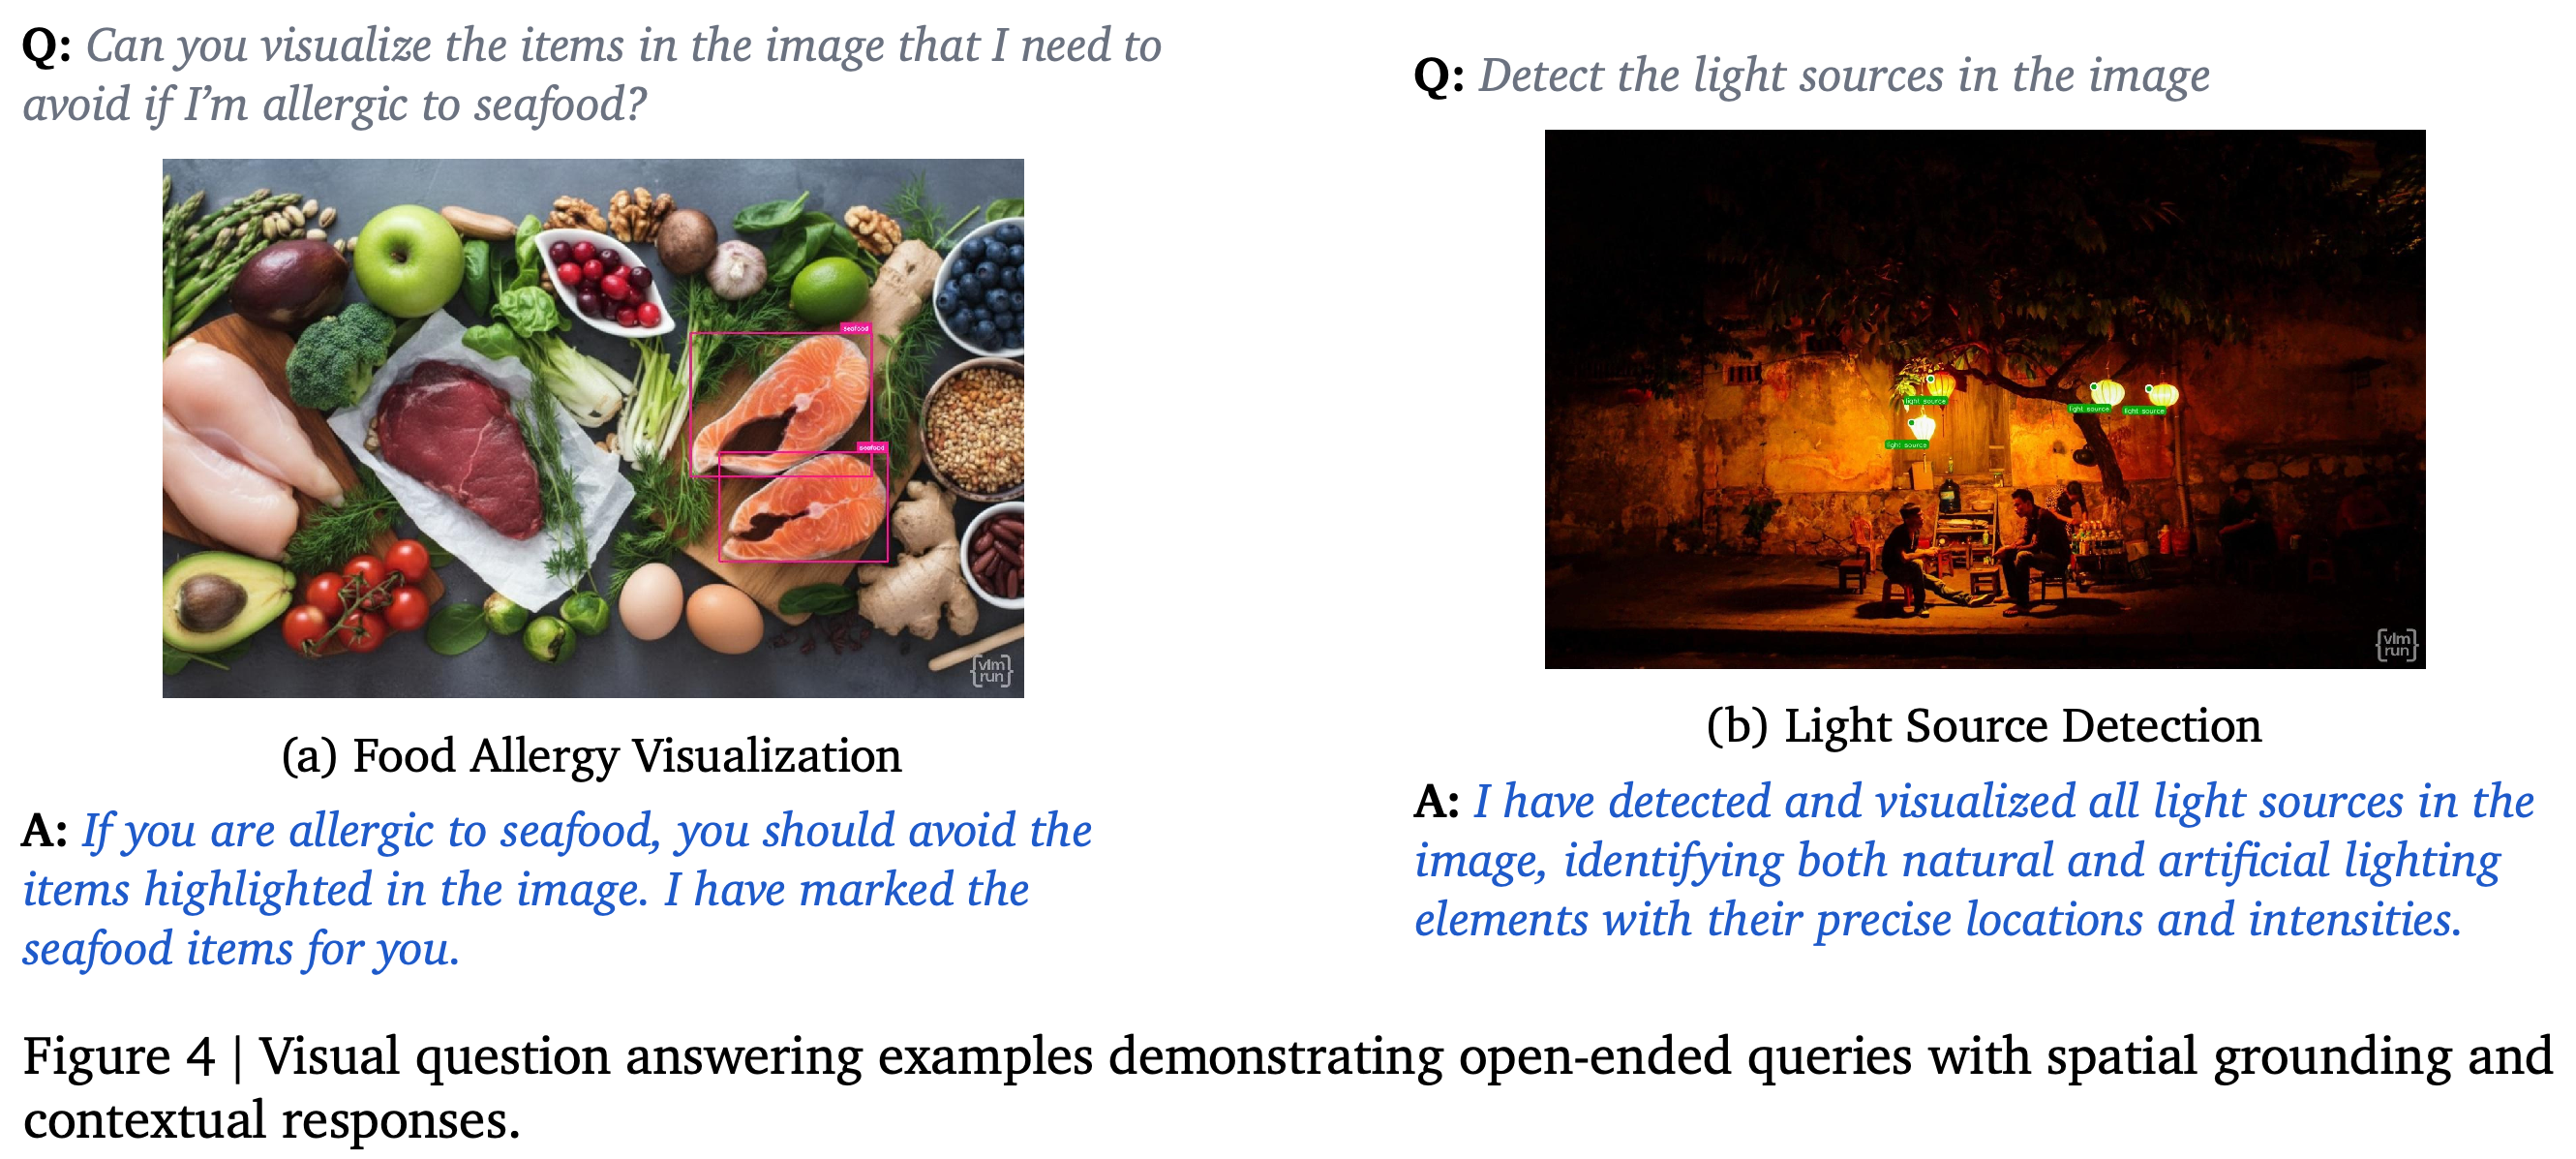
- 3.1.2. Visual Question Answering (VQA) with Grounding은 답변을 뒷받침하는 이미지 영역과 연결한다. Figure 4는 자연어 요청에 따라 해산물과 광원을 표시한다.
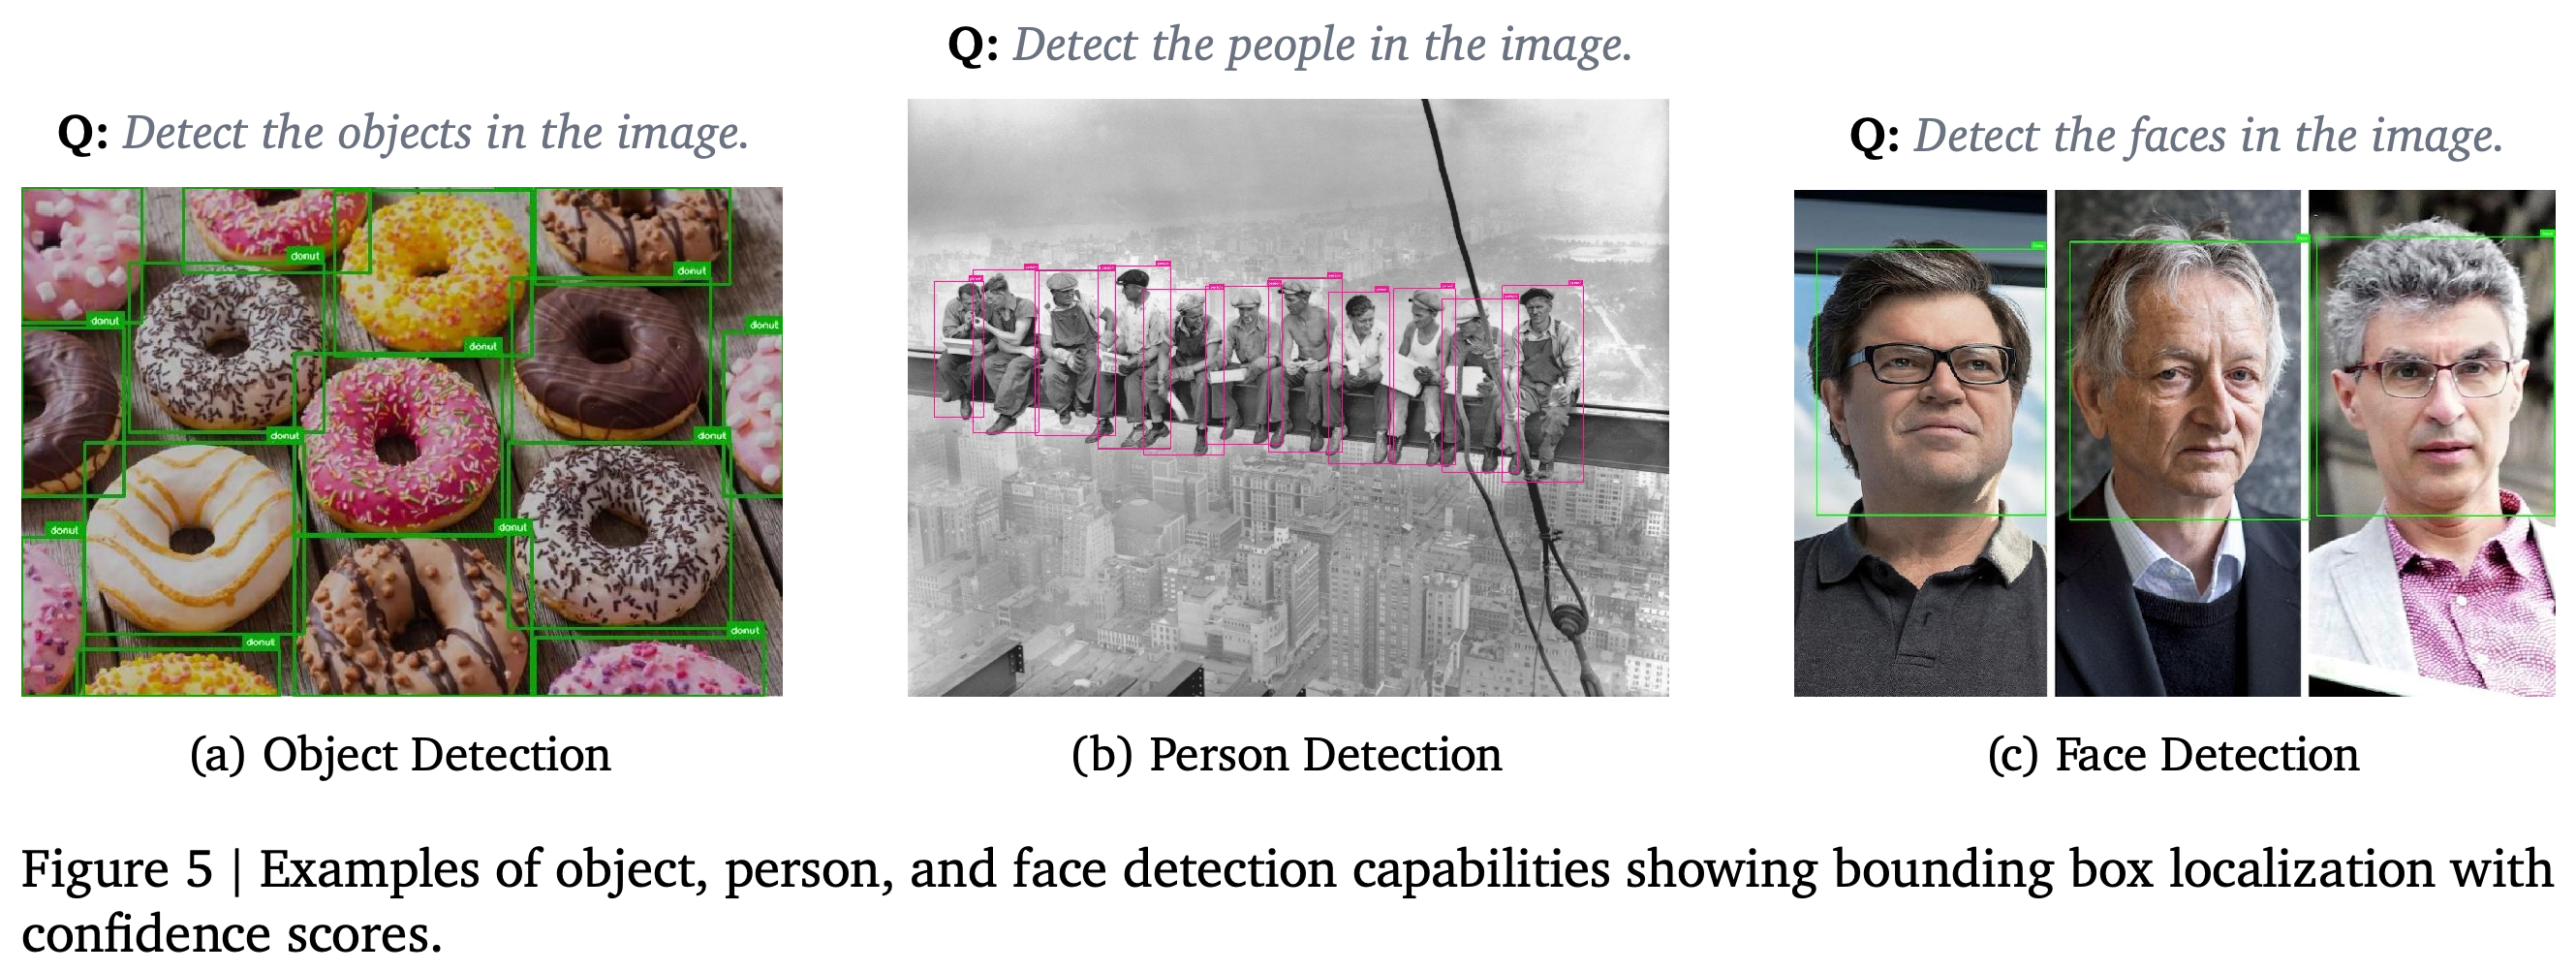
- 3.1.3. Object, Person, and Face Detection은 클래스 라벨, 신뢰도 점수, 정규화된 xywh 경계 상자를 반환한다. xywh는 이미지 크기를 기준으로 가로 및 세로 위치, 너비, 높이를 나타낸다. Figure 5는 객체, 사람, 얼굴의 경계 상자를 보여준다.
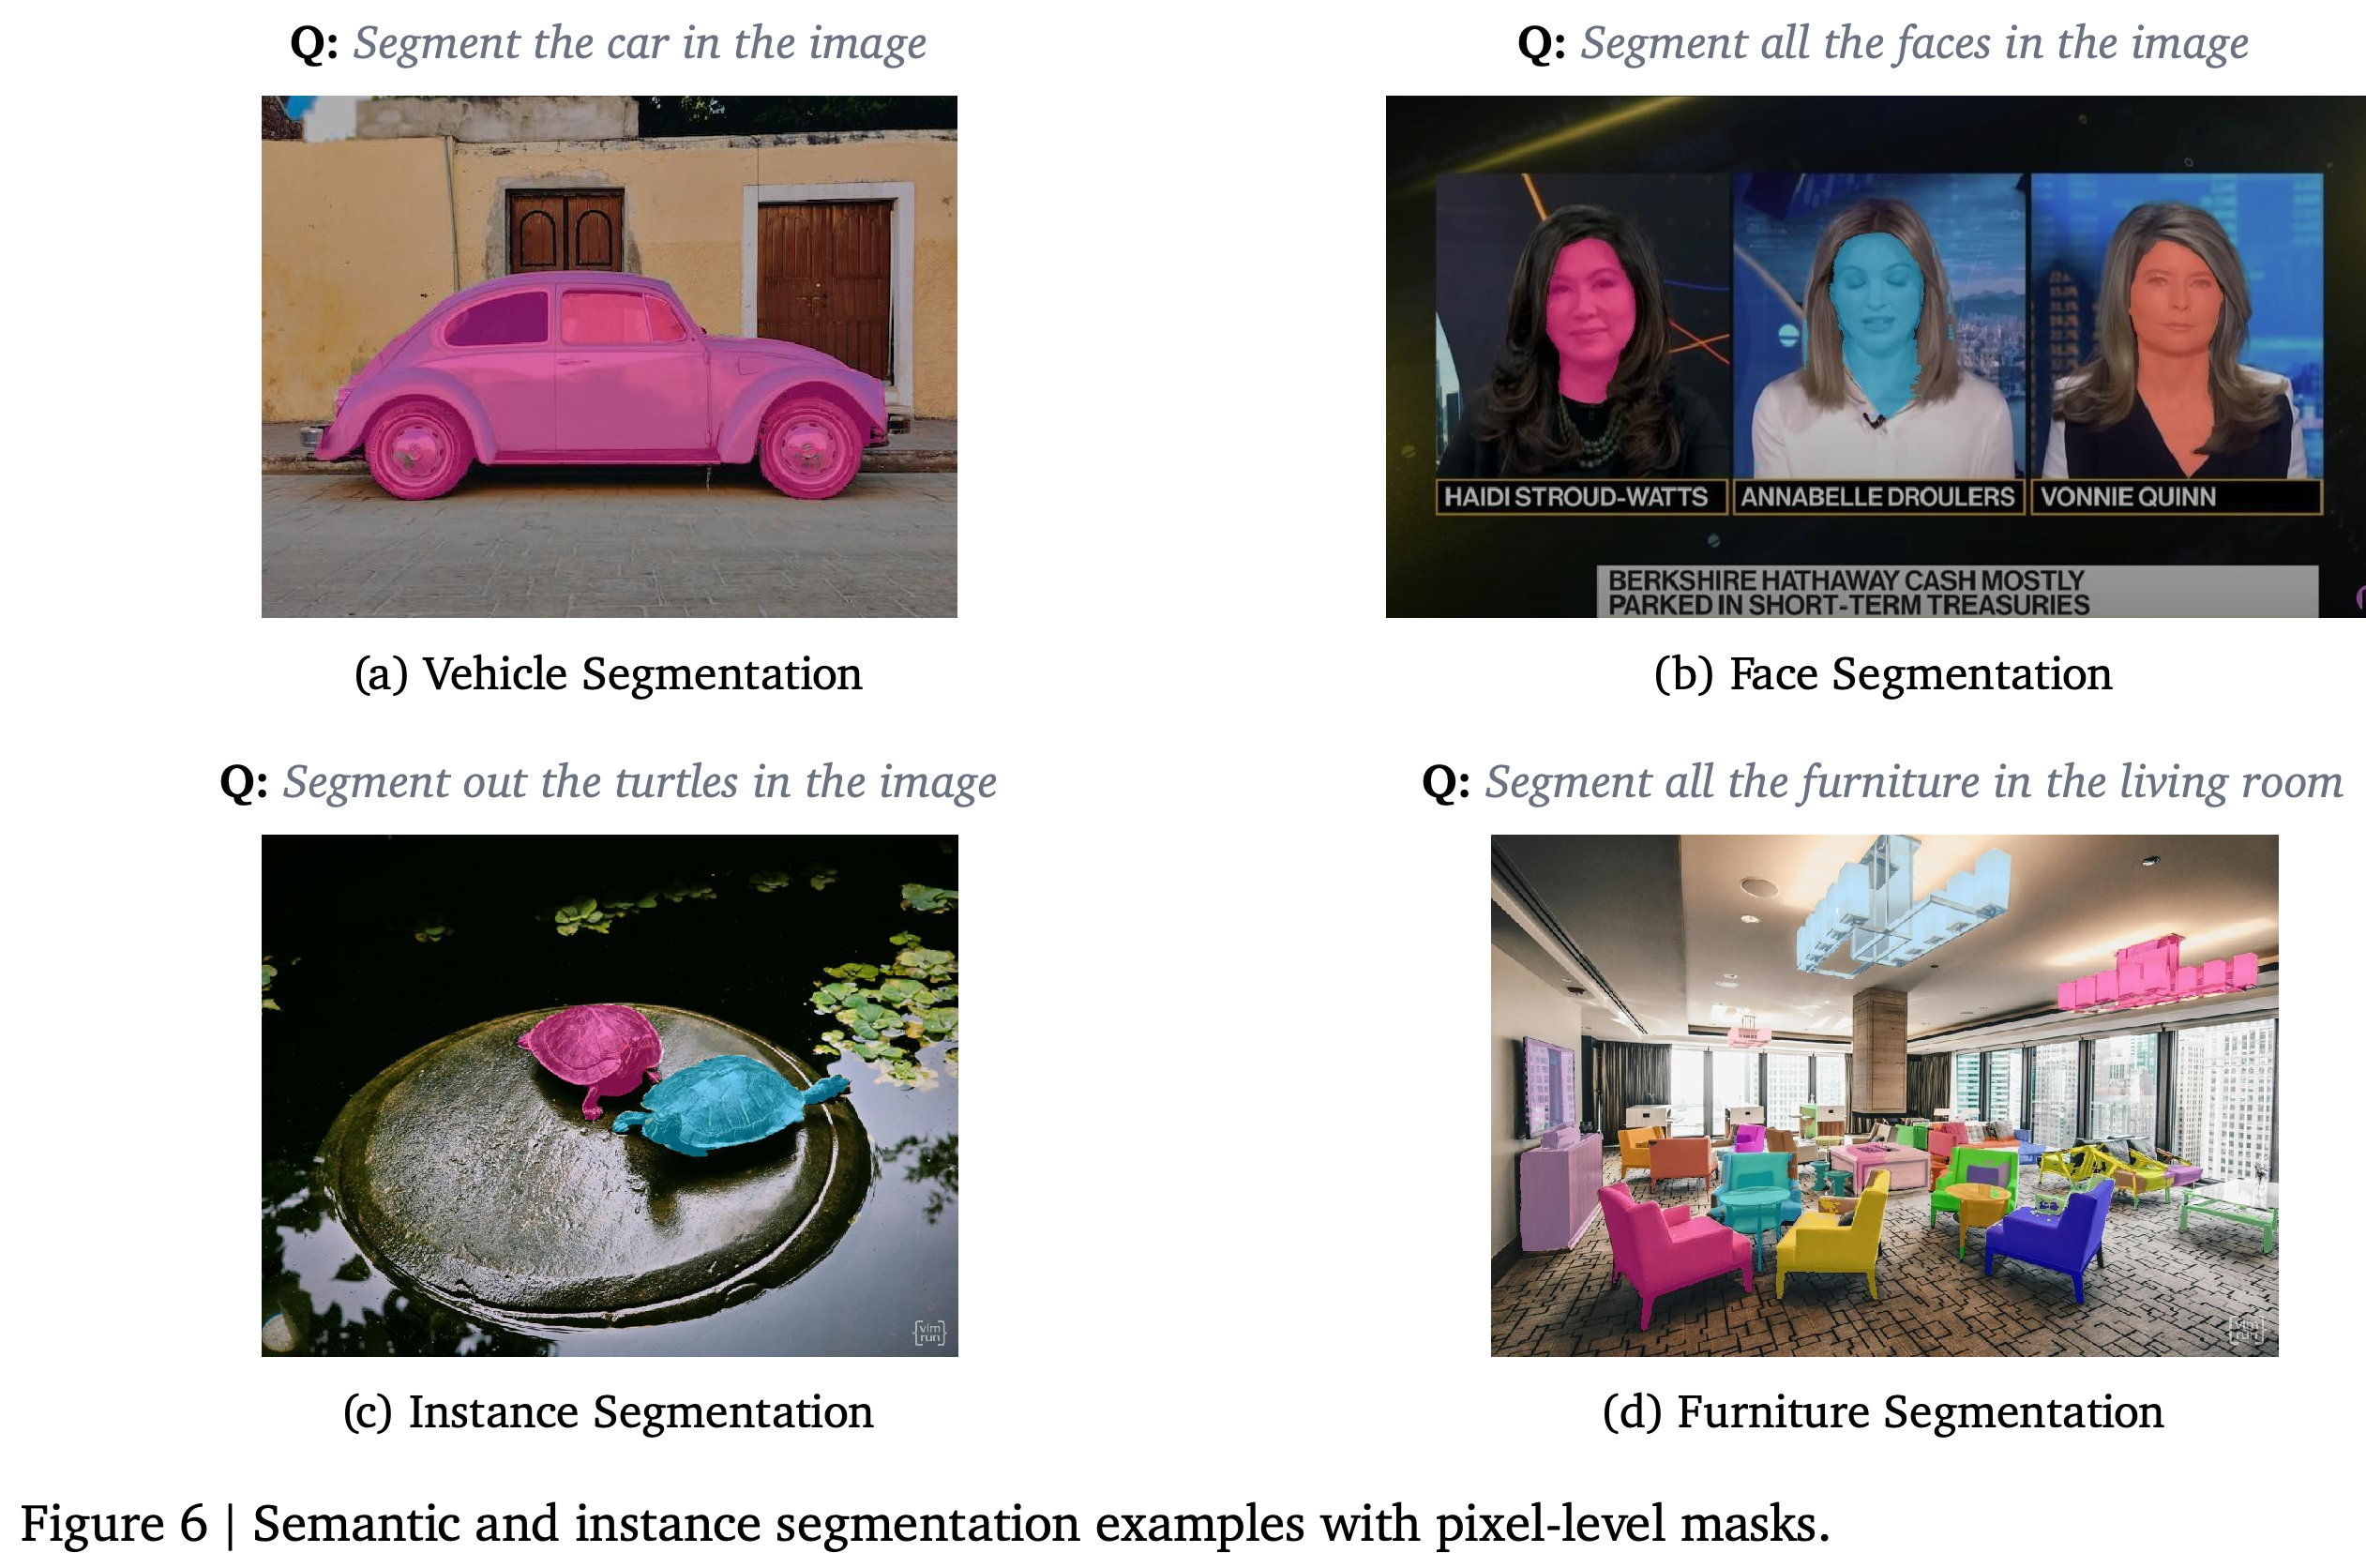
- 3.1.4. Image Segmentation은 장면의 픽셀을 분류하는 의미 분할과 개별 객체의 영역을 구분하는 인스턴스 분할을 지원한다. 마스크는 입력과 같은 크기의 uint8 이미지이며 부호 없는 8비트 정수 값으로 고유 라벨(0, 1, 2, ..)을 사용한다. Figure 6은 차량, 얼굴, 거북이, 가구의 예를 보여준다.
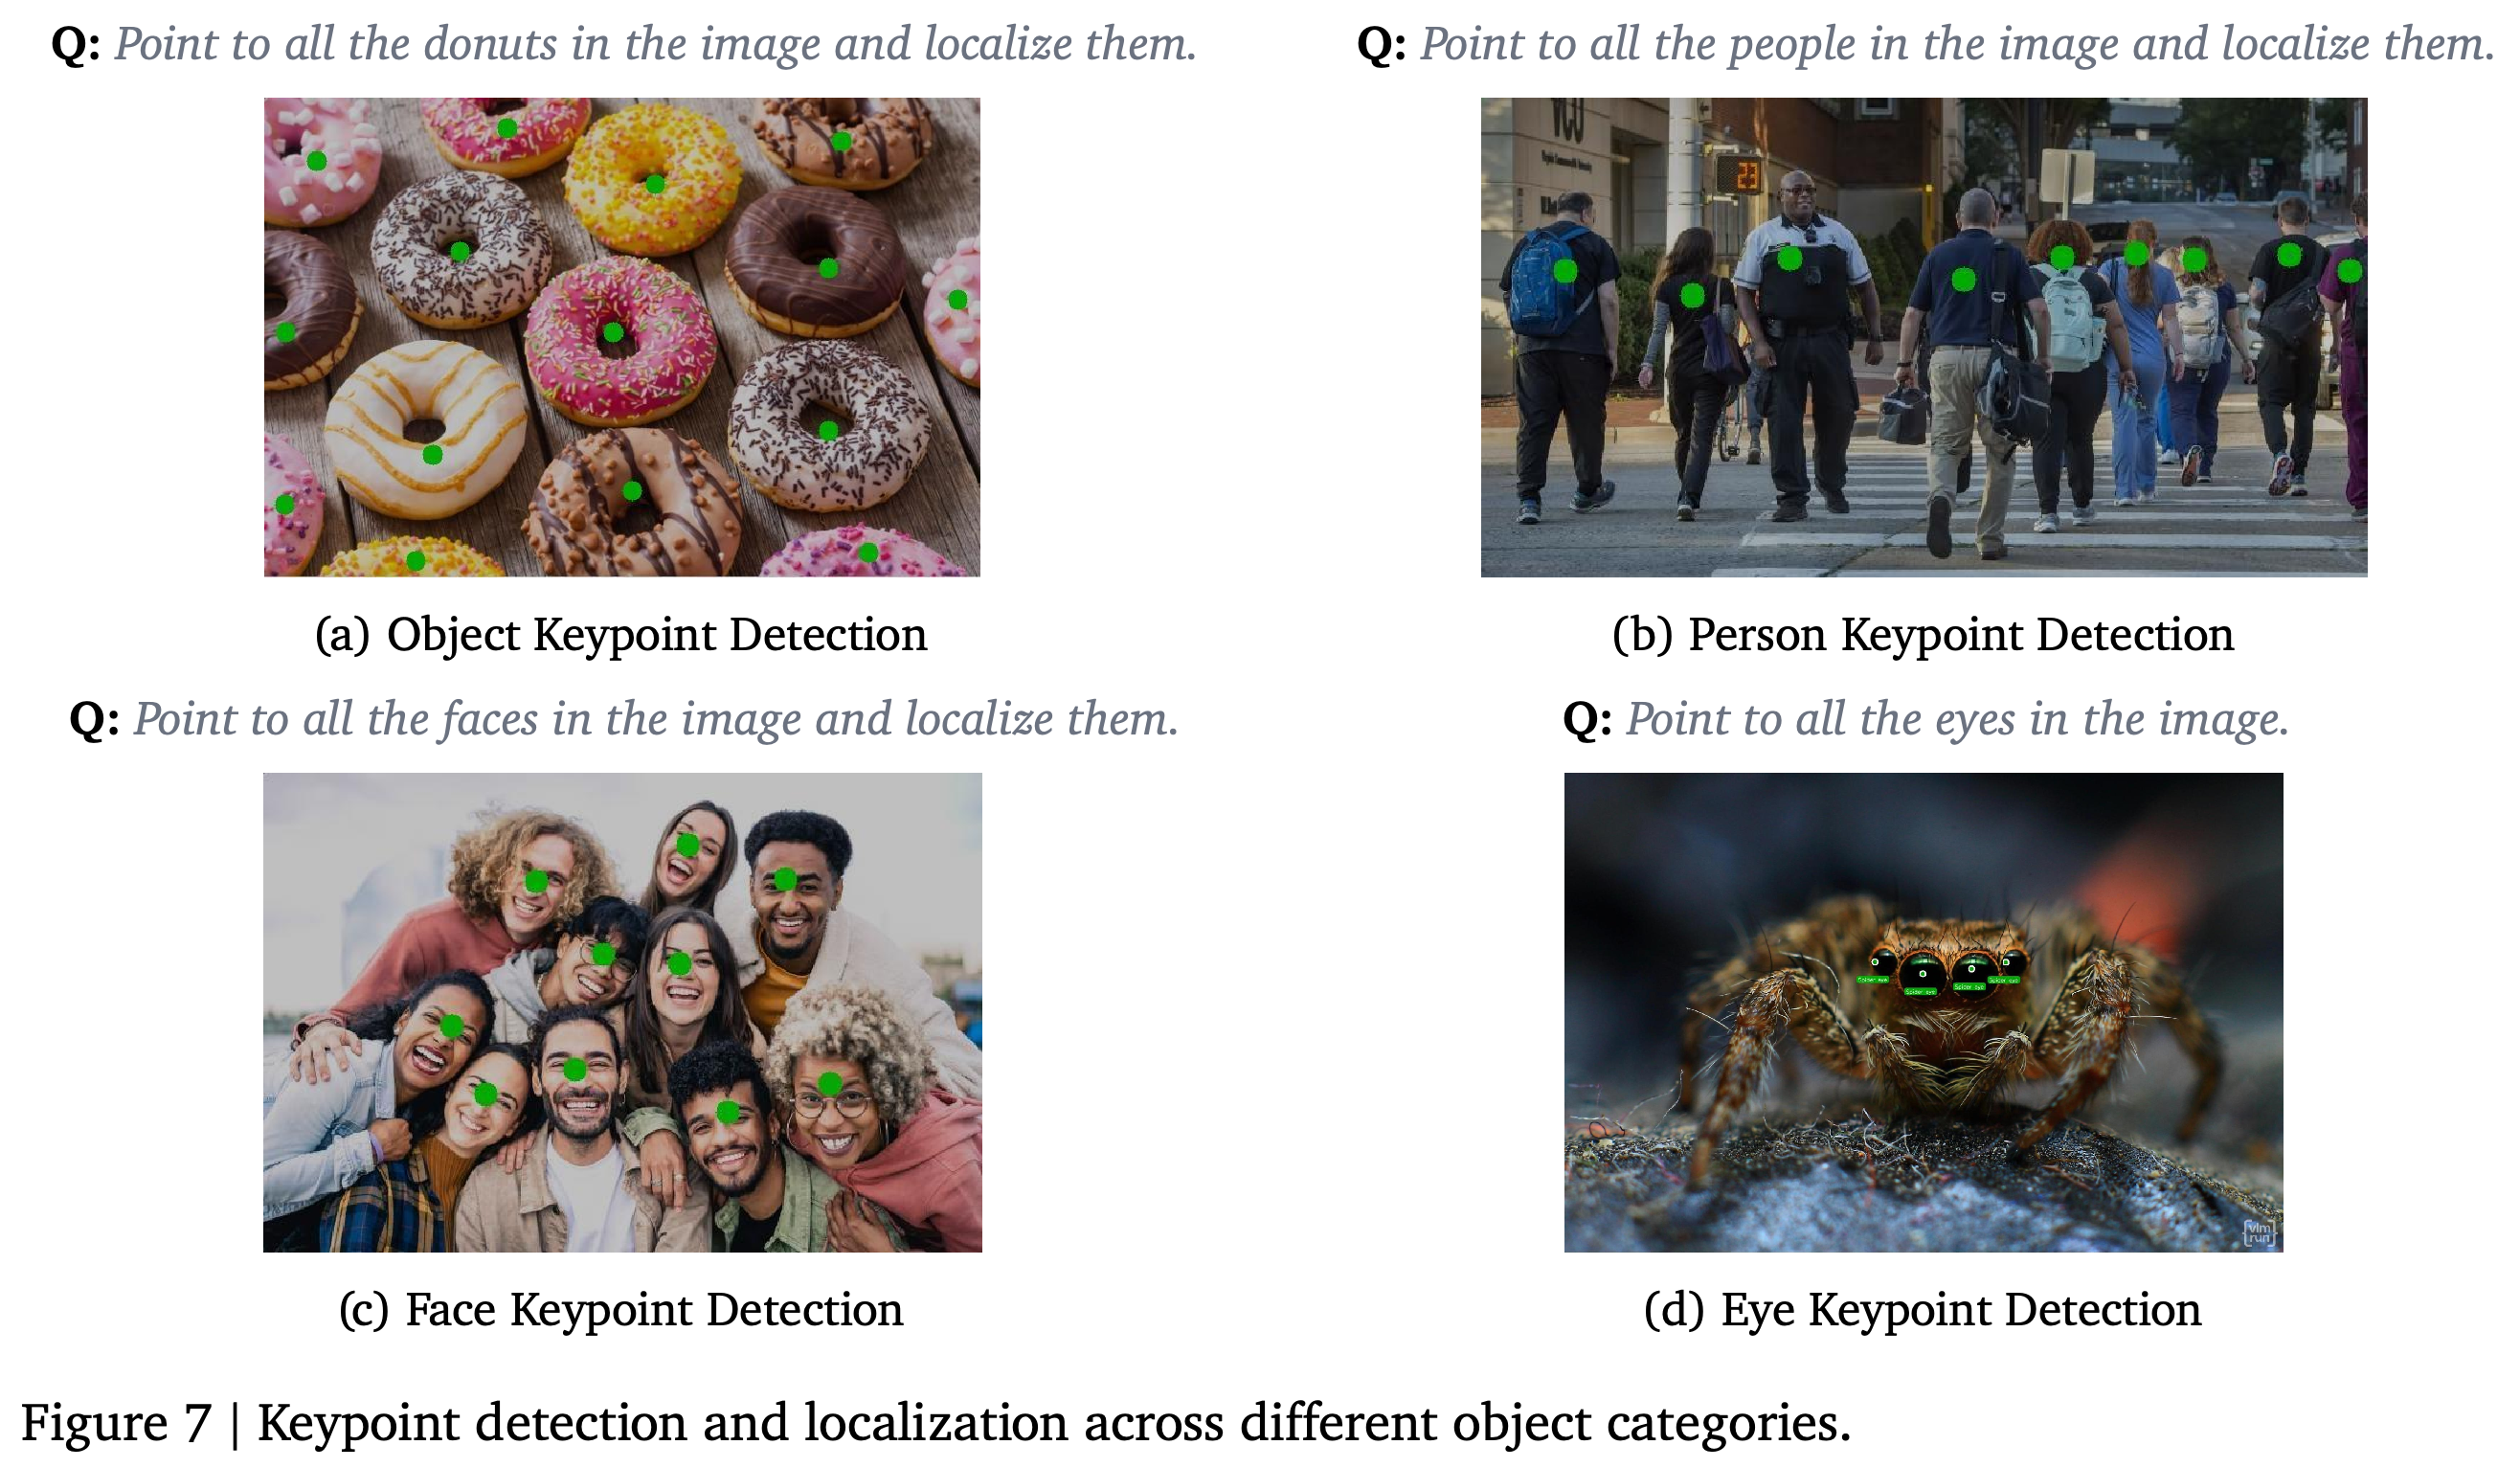
- 3.1.5. Spatial Localization and Pointing은 정규화된 xy 키포인트, 즉 2차원 점 위치를 반환한다. 이를 개수 세기, 분류, 시각적으로 두드러진 콘텐츠를 찾는 현저성 탐지, 공간 추론에 사용한다. Figure 7은 도넛, 사람, 얼굴, 눈에 표시한 점을 보여준다.
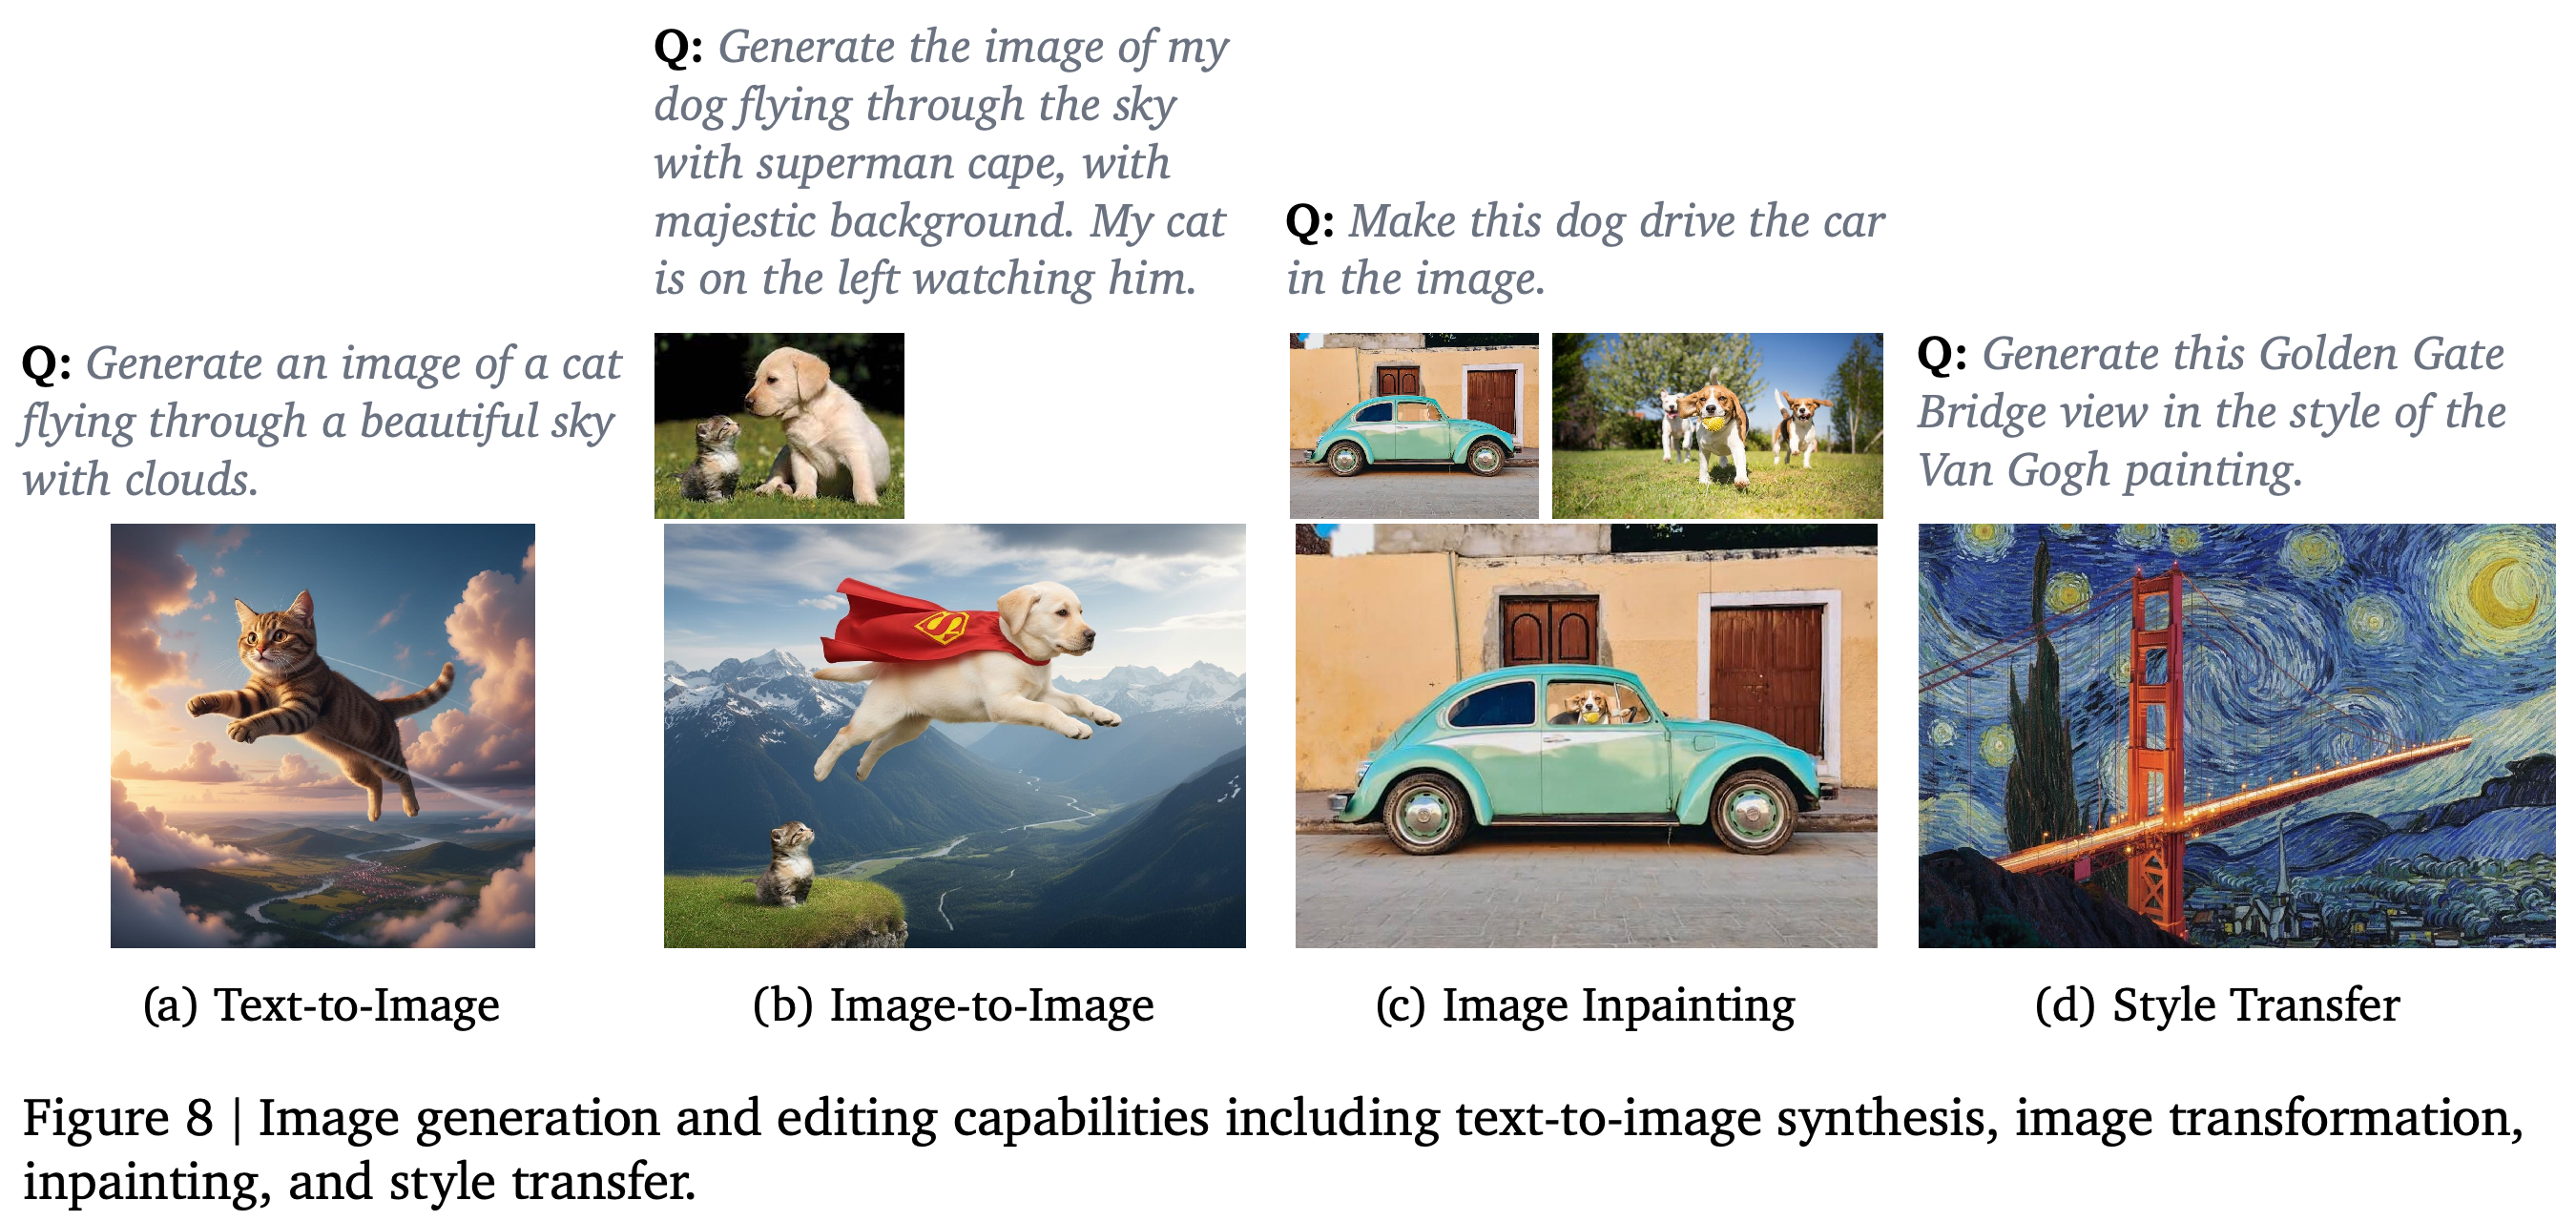
- 3.1.6. Image Generation and Editing은 텍스트 기반 이미지 생성, 참조 이미지 기반 편집, 지정한 영역을 대체하는 인페인팅, 콘텐츠 구조를 유지하면서 시각적 스타일을 바꾸는 스타일 전이를 포함한다. Figure 8은 4개 기능을 모두 보여준다. 본문은 여러 참조 입력이나 이전 도구의 출력도 사용할 수 있다고 설명한다.
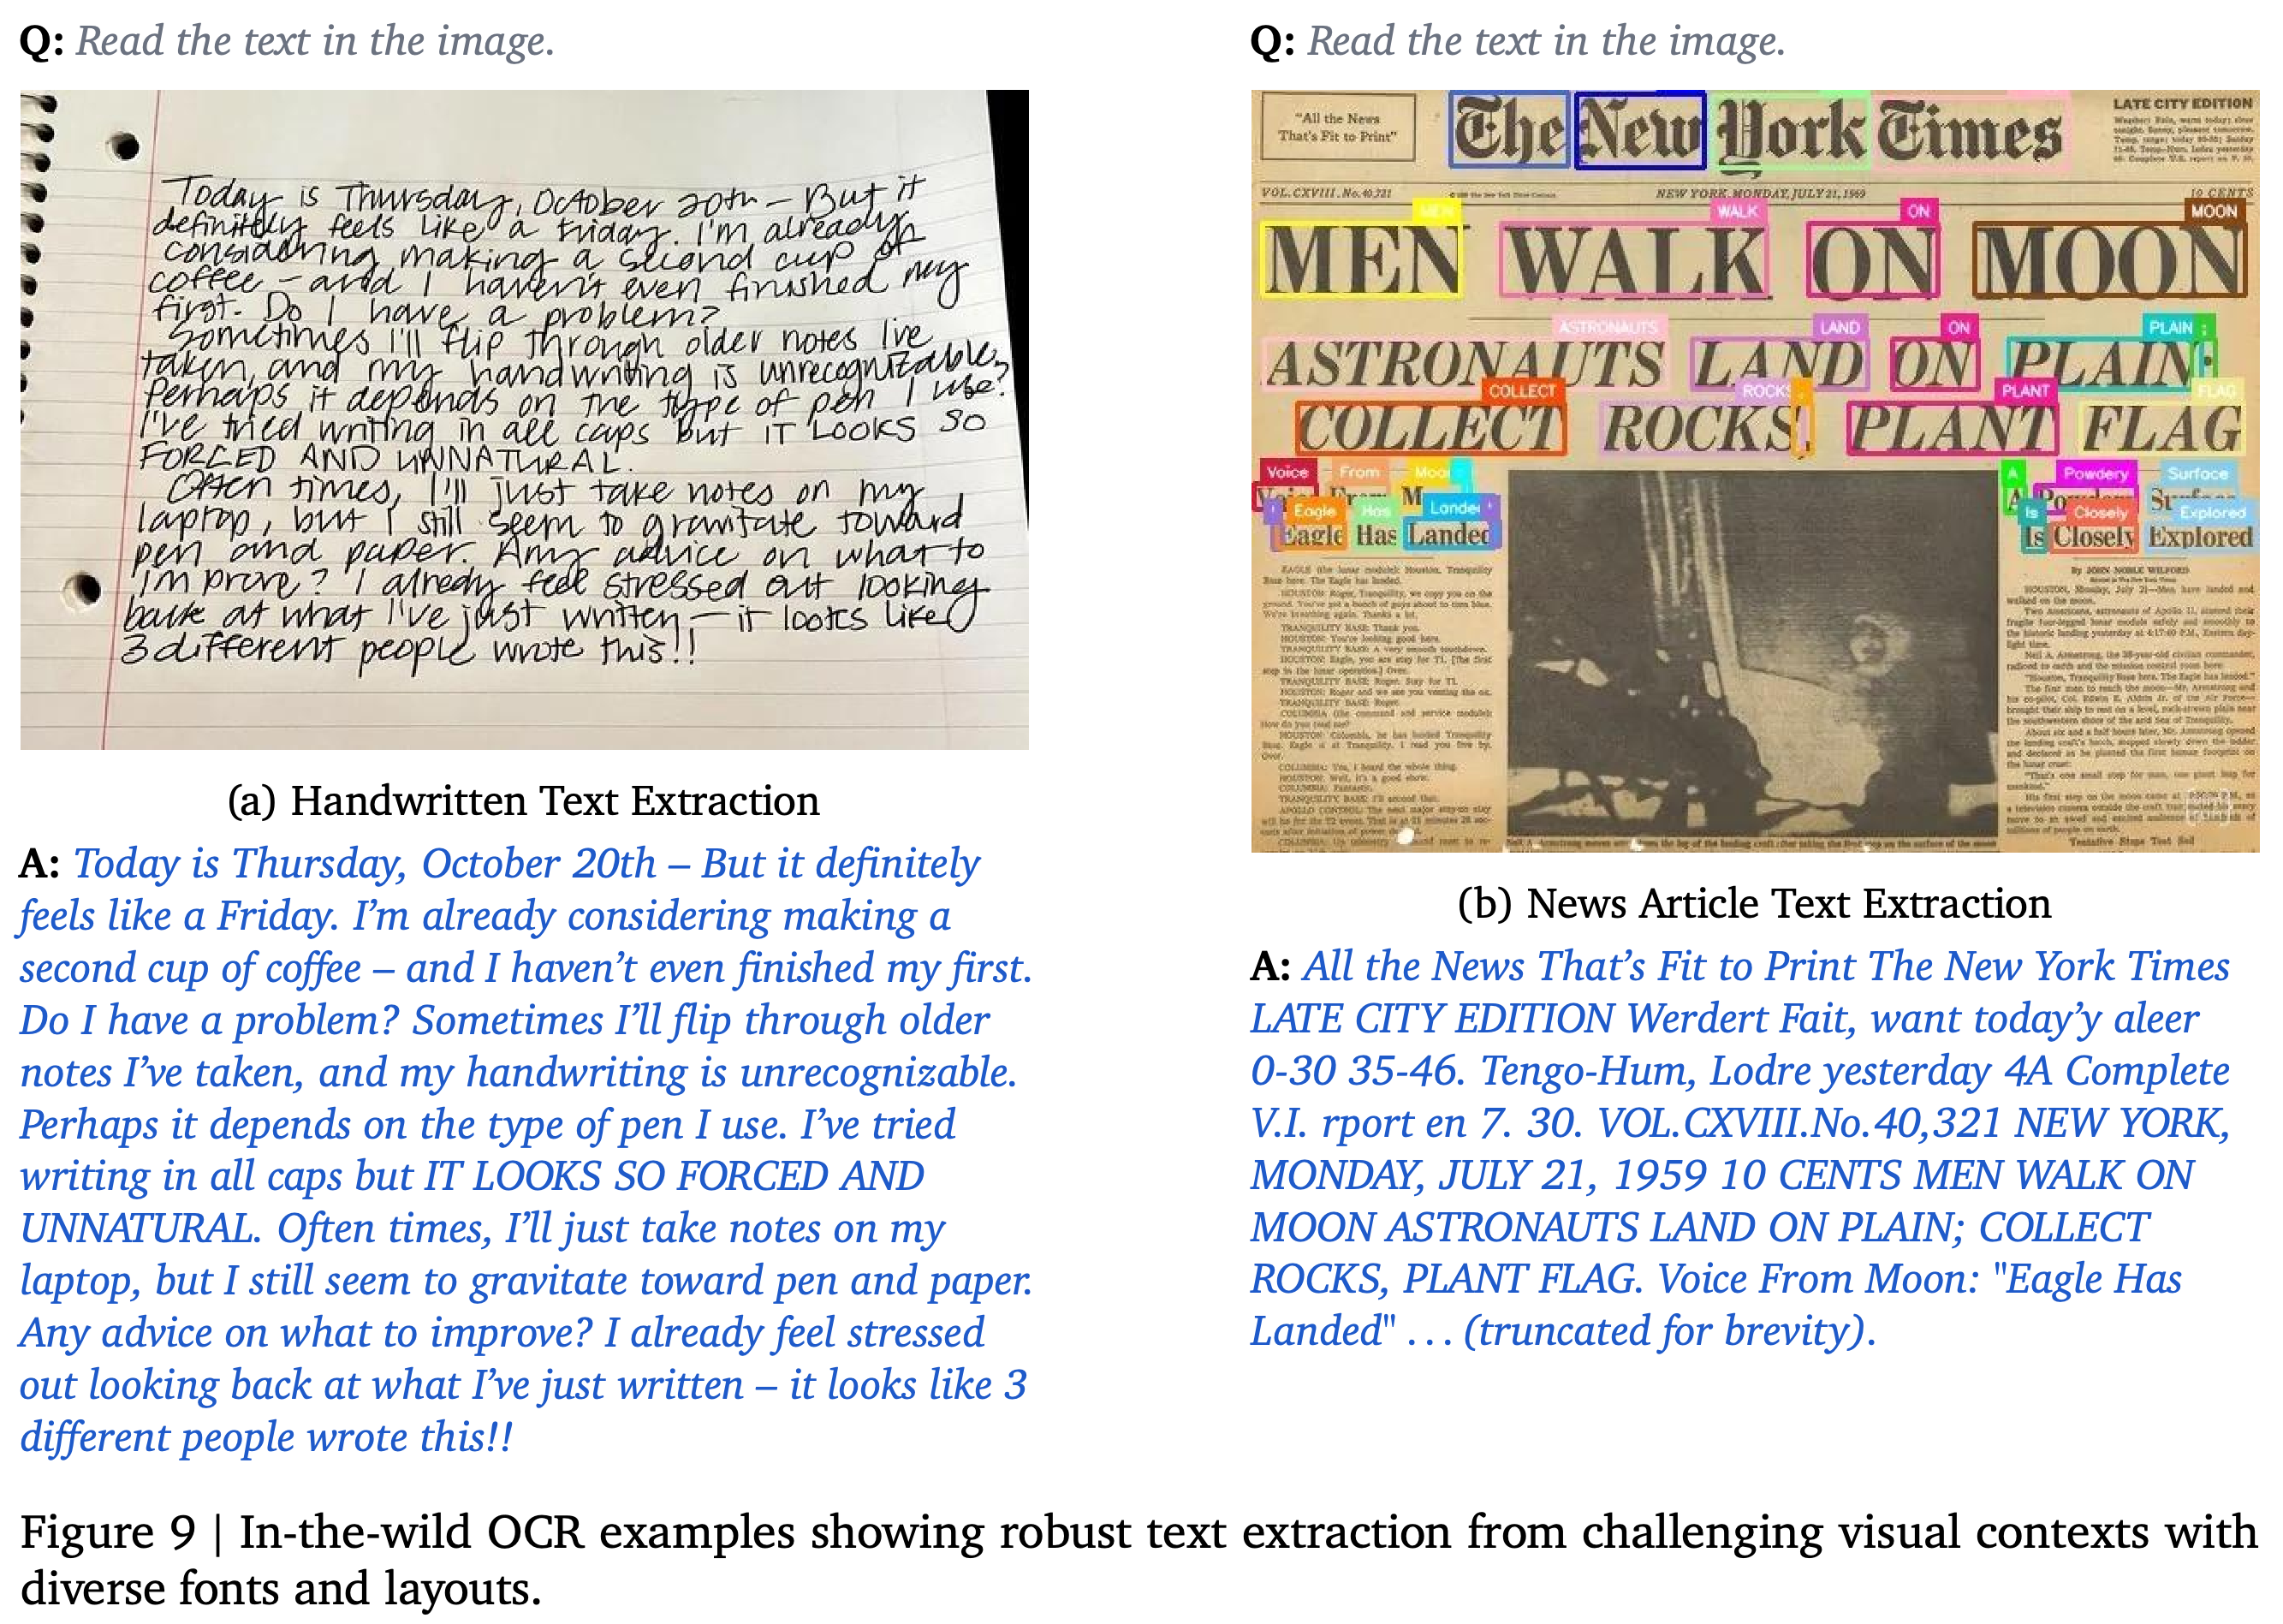
- 3.1.7. Image OCR은 추출한 텍스트, 경계 상자, 단어별 신뢰도 점수를 반환한다. Figure 9에는 손글씨와 신문 예제가 있지만 신문 전사에는 이미지의 JULY 21, 1969를 JULY 21, 1959로 옮긴 오류 등이 있다.
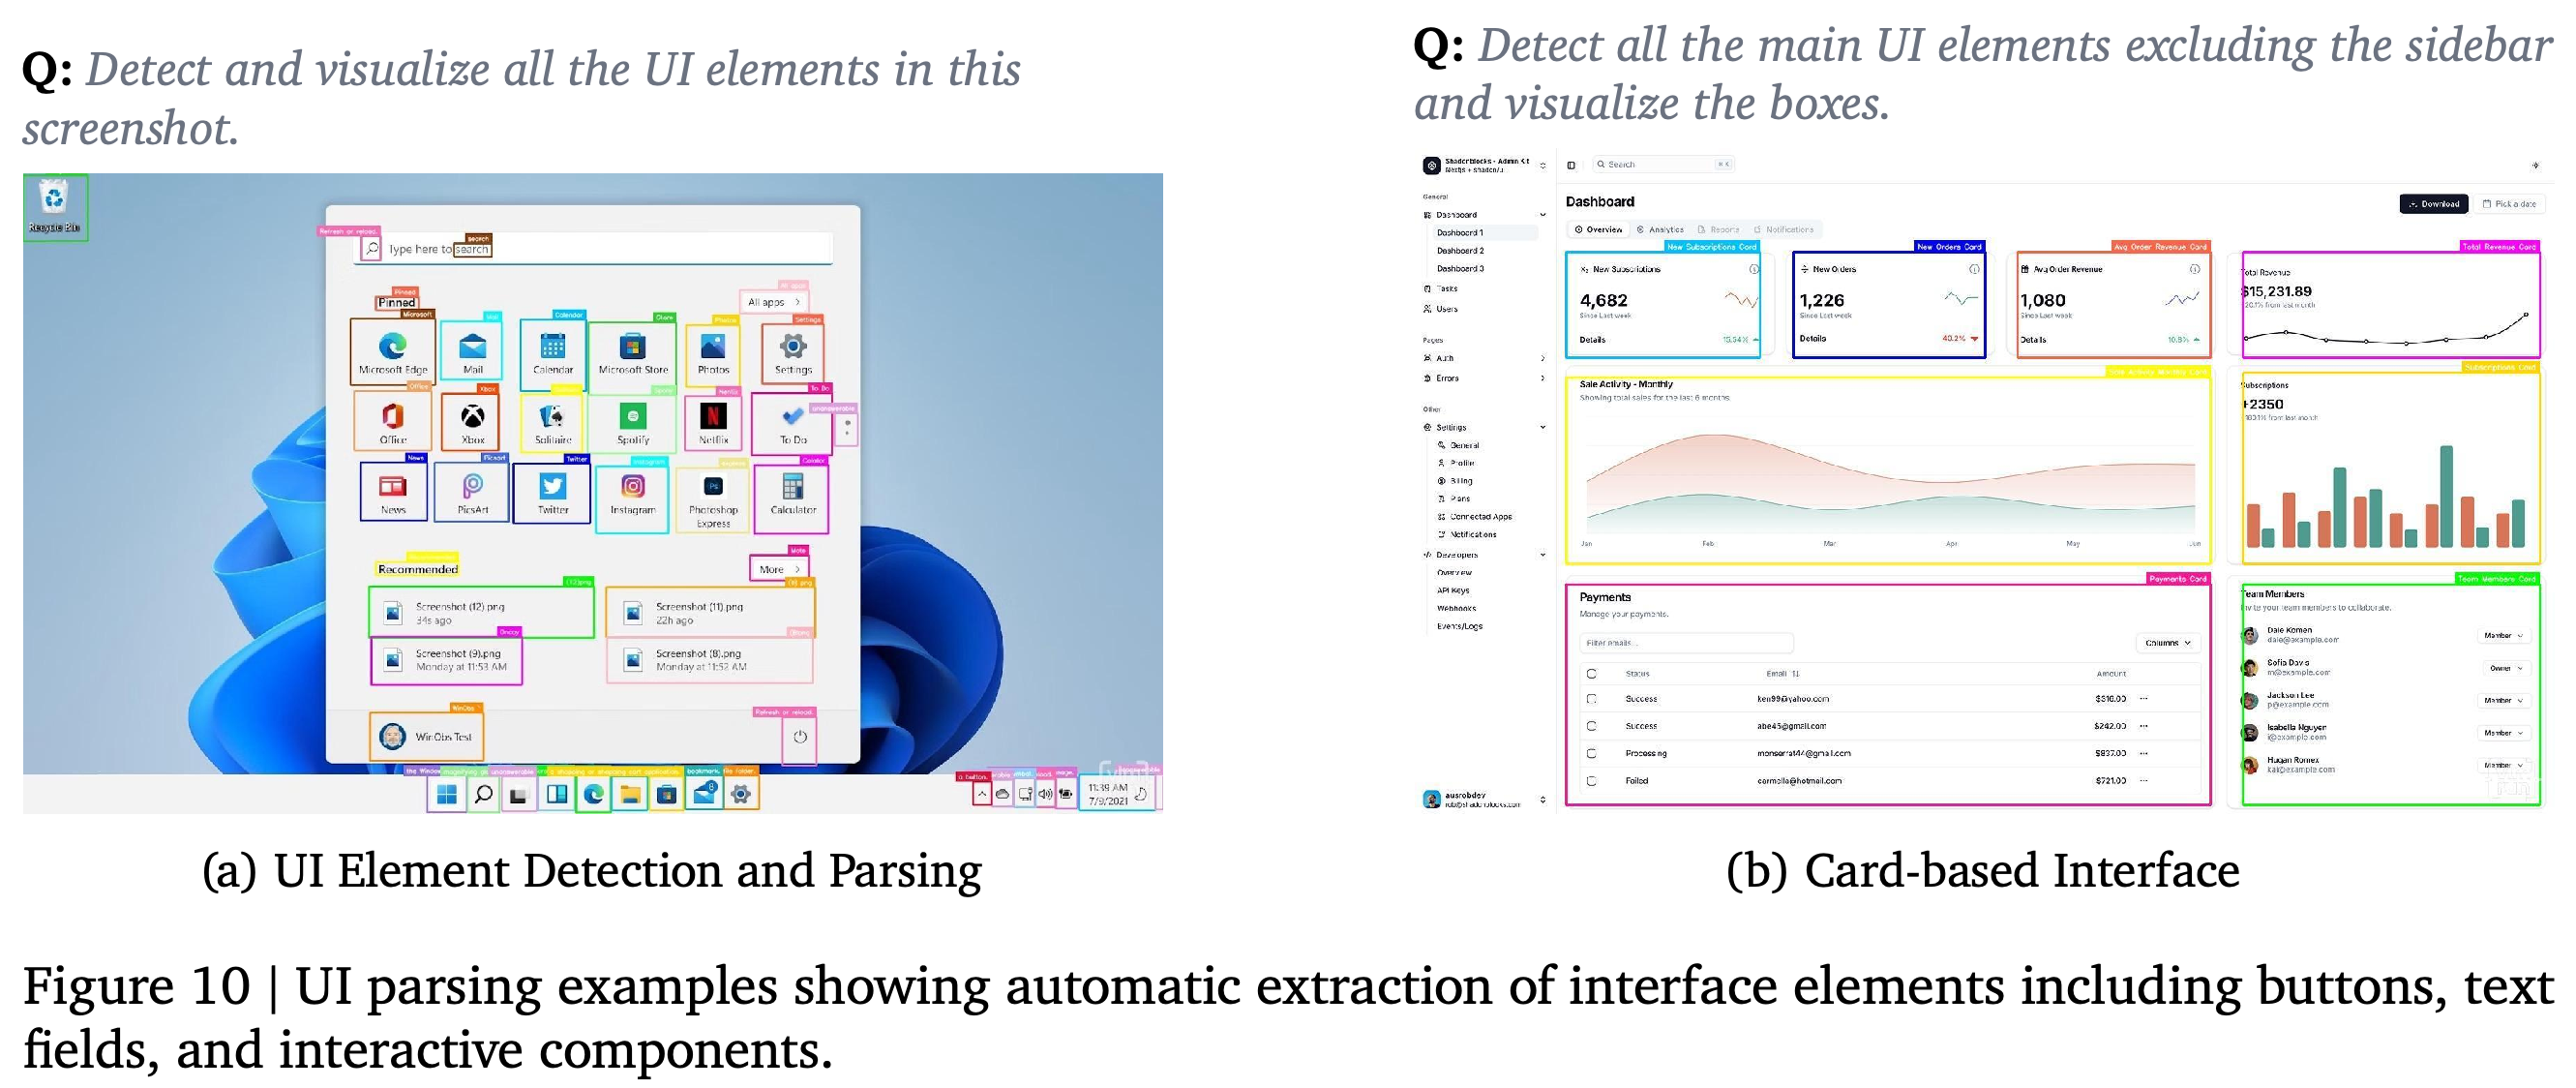
- 3.1.8. UI Parsing은 버튼, 입력란, 링크, 아이콘 등의 사용자 인터페이스(UI) 요소를 정규화된 xywh 상자와 함께 추출한다. Figure 10은 데스크톱 인터페이스와 사이드바를 제외하도록 요청한 대시보드 예제를 보여준다.
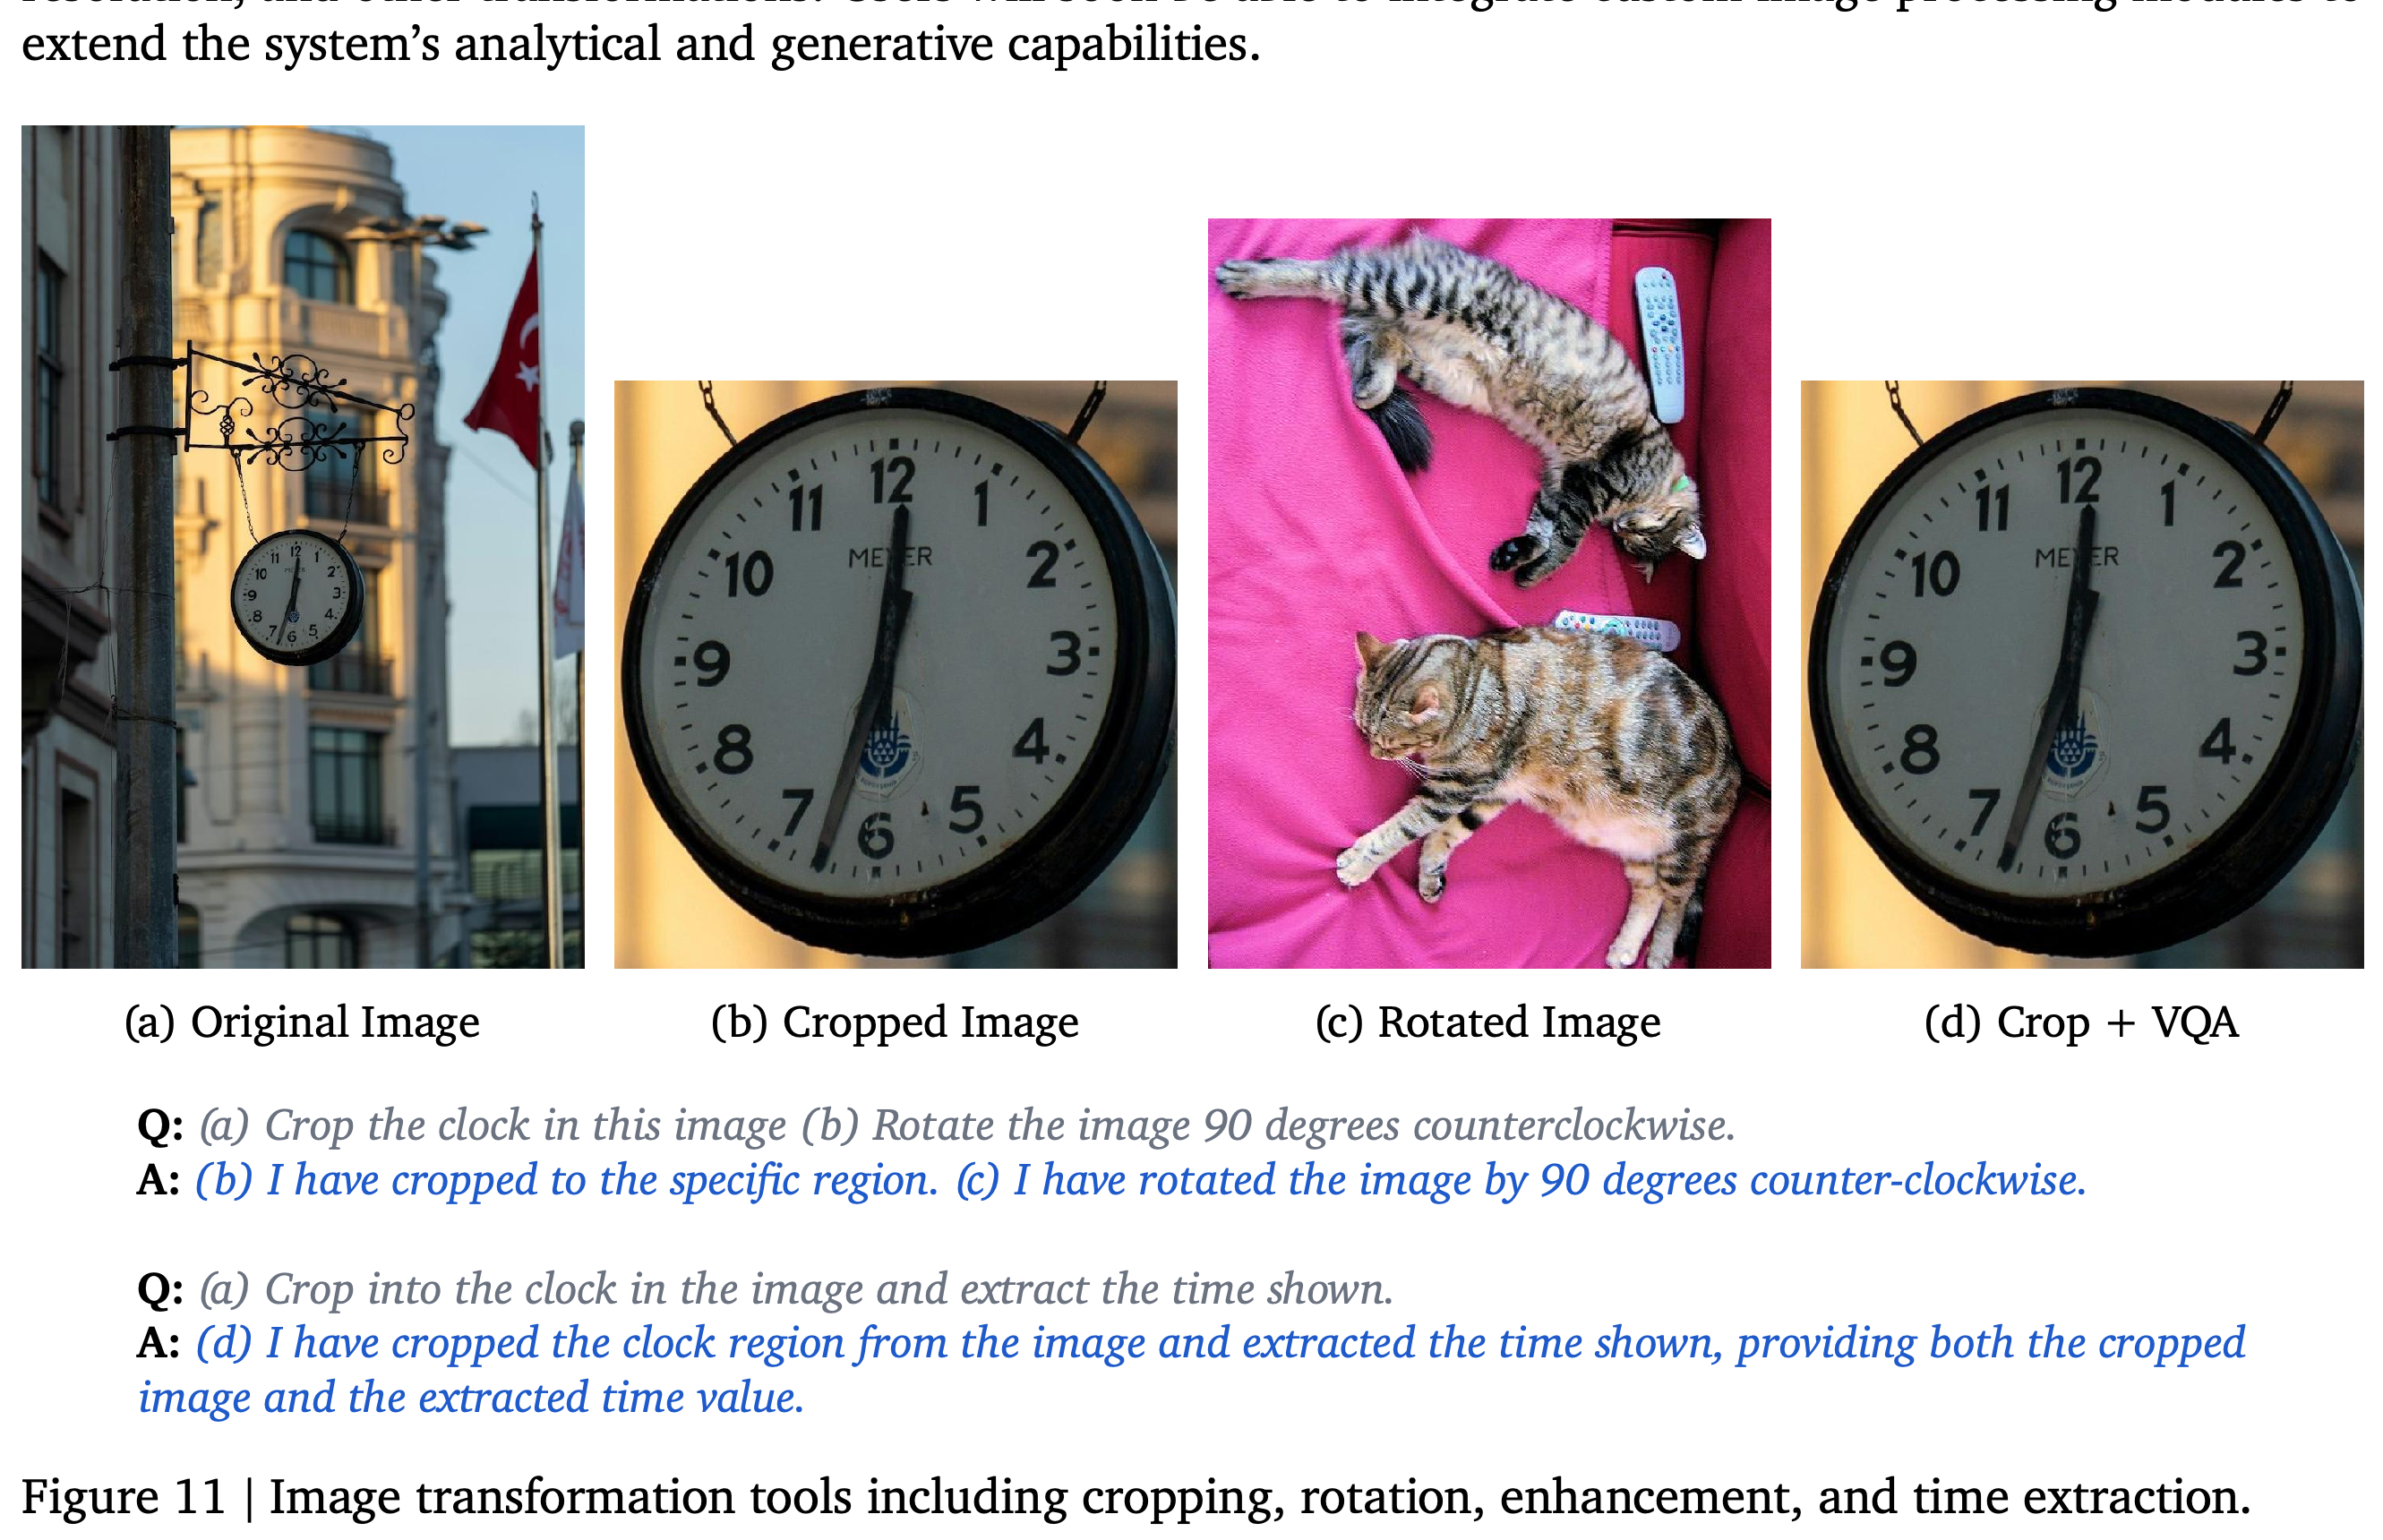
- 3.1.9. Image Tools는 자르기, 회전, 블러 처리, 이미지 해상도를 높이는 초해상화를 포함한다. Figure 11은 자르기, 반시계 방향 90도 회전, 이미지를 자른 뒤 VQA로 시계를 읽는 작업을 보여준다. 맞춤형 이미지 처리 모듈은 향후 제공할 기능으로 설명한다.
차량 예제는 설명과 태그를 결합하고 거리 예제는 2문장 캡션 요청을 따른다. 설명의 상세도와 출력 형식이 달라질 수 있음을 보여주지만 캡션 품질을 측정해 비교하지는 않는다.
출력은 자연어 요청을 표시된 해산물 영역 및 광원과 연결한다. 답변을 이미지의 특정 위치와 연결하는 모습을 보여주지만 모든 대상을 빠짐없이 탐지했는지나 특정 응용 분야에서 신뢰할 수 있는지는 입증하지 않는다.
경계 상자가 서로 다른 장면에서 도넛, 사람, 얼굴의 위치를 표시한다. 위치 출력의 형태를 보여주지만 탐지가 얼마나 자주 정확한지나 놓친 객체가 얼마나 많은지는 보고하지 않는다.
색상 마스크가 선택한 객체의 영역을 구분하고 인스턴스를 나눈다. 예제에는 거북이 2마리와 여러 가구가 포함된다. 마스크는 경계 상자보다 세밀하게 객체 영역을 나타낸다.
점 주석은 객체, 사람, 얼굴, 눈의 위치를 표시한다. 개수 세기와 작은 시각적 특징에 관한 질의에 사용하는 키포인트 인터페이스를 보여준다.
예제는 텍스트만 사용한 생성, 참조 이미지 사용, 편집을 위한 여러 참조 사용, 요청한 예술적 스타일 적용을 보여준다. 생성 방식을 시연하지만 기반 생성 모델을 밝히거나 참조 콘텐츠의 보존 정도를 측정하지는 않는다.
손글씨와 신문에 추출한 텍스트를 함께 제시하며 신문에는 단어 위치도 표시한다. 표시된 전사에는 연도 불일치 등 눈으로 확인할 수 있는 오류가 있어, 안정적으로 추출한다는 캡션의 주장을 제한한다.
경계 상자가 데스크톱 제어 요소와 대시보드 구성요소를 표시하며 대시보드 요청은 사이드바를 제외한다. 지시에 따른 인터페이스 위치 파악을 보여주지만 상호작용이나 자동 테스트의 성공을 입증하지는 않는다.
시계 부분을 잘라 후속 질의응답에 해당 영역을 집중적으로 볼 수 있는 입력을 제공하며 별도 예제는 이미지 회전을 보여준다. 표시된 응답은 시간을 추출했다고 주장하지만 구체적으로 추출한 시간 값은 보여주지 않는다.
3.2. Document Understanding, Reasoning and Tool-Use
문서 작업은 스캔 문서와 디지털 문서를 대상으로 레이아웃 분석, OCR, 필드 추출, 선택적 페이지 검색, 편집을 결합한다. Figures 12와 13은 문서 구조의 위치 파악과 인쇄 또는 손글씨 필드 추출을 보여준다.
- 3.2.1. Document Layout Understanding은 읽기 순서와 공간 관계를 유지하면서 문단, 제목, 표, 각주 등의 요소를 식별한다. 위치는 정규화된 xywh 상자로 나타낸다.
- 3.2.2. Document OCR은 인쇄 및 손글씨 콘텐츠, 구조화된 양식, 표를 지원한다. 양식 OCR은 위치를 파악한 필드와 값을 연결하며 체크박스, 서명, 여러 페이지 분석, 페이지 간 필드 추적을 포함한다.
- 3.2.3. Document Tools는 전체 파일을 메모리에 올리지 않고 100+페이지 문서에서 관련 페이지를 검색하며 원본 문서 내 편집이나 콘텐츠 삭제 또는 가림 처리를 지원한다. 논문은 이 문서 크기 조건에서 메모리 사용량이나 실행 시간을 측정한 결과를 보고하지 않는다.
레이아웃이 서로 다른 문서 4개에 구조 및 텍스트 영역 주석을 표시한다. 다양한 페이지에서 위치를 파악하는 예를 보여주지만 읽기 순서의 보존은 정량적 확인 없이 주장한다.
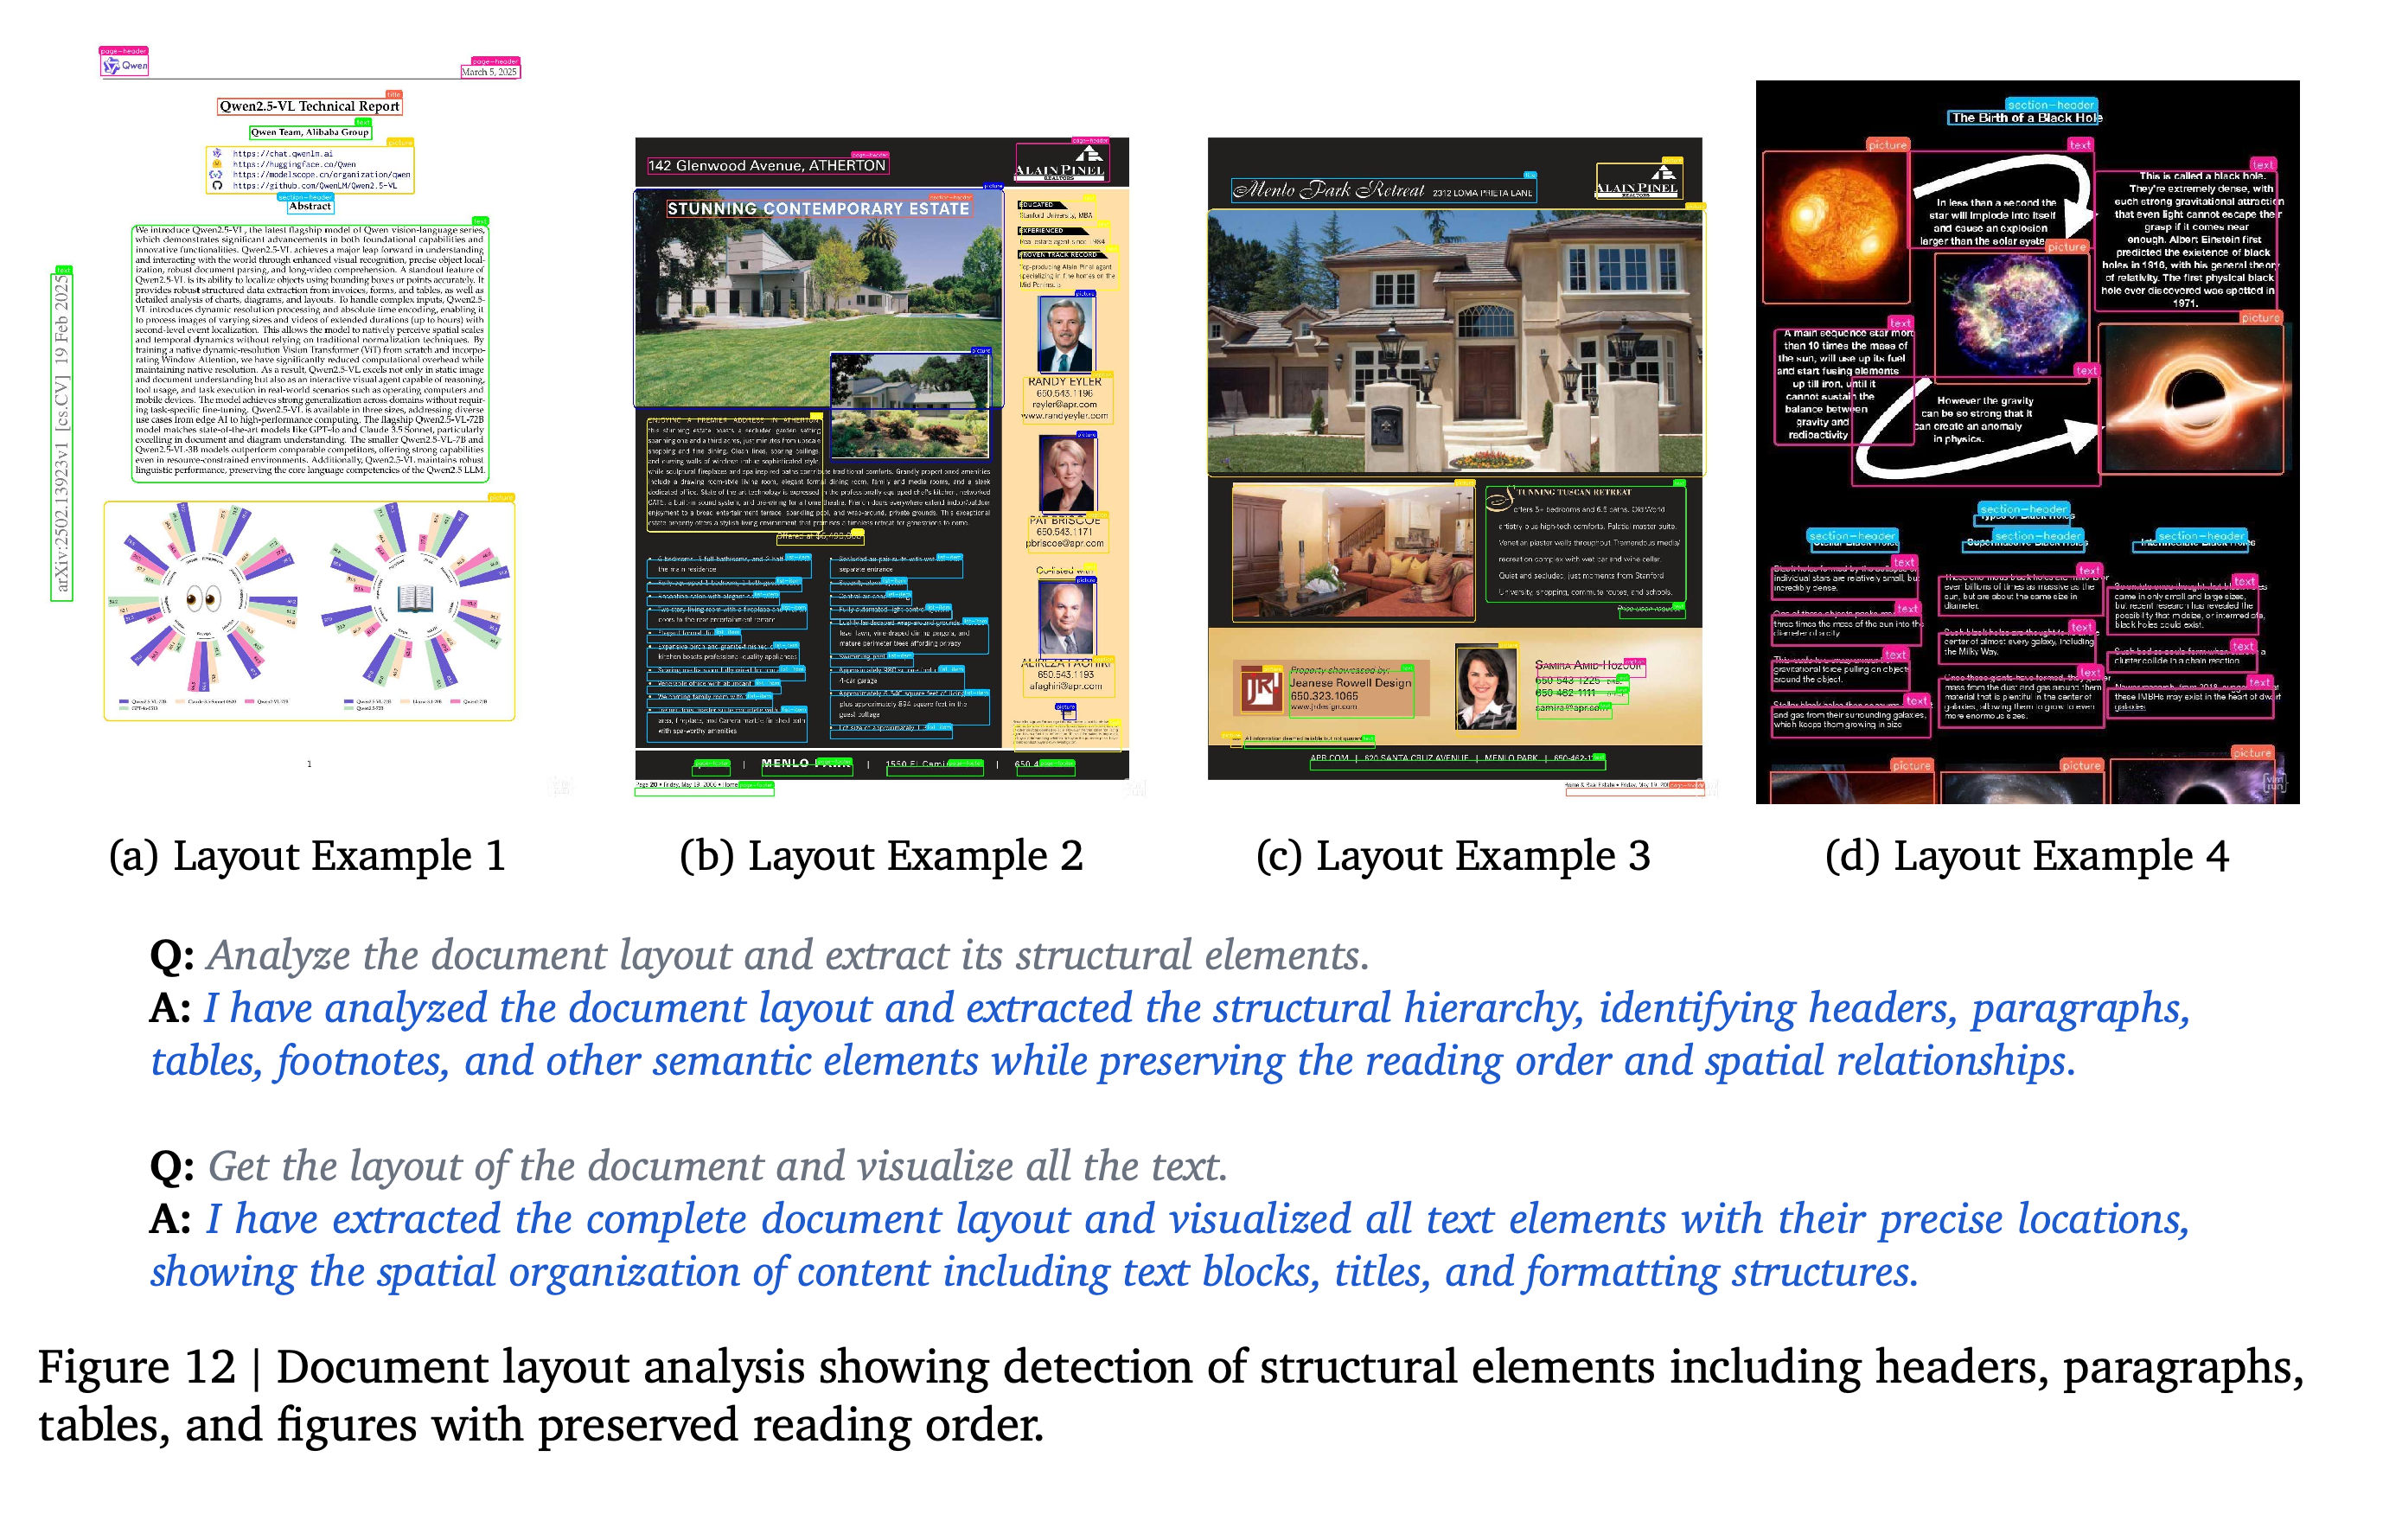
영수증과 손글씨 의뢰서에 필드 위치 주석을 표시한다. 추출한 텍스트는 필드와 값을 연결할 수 있도록 공간 정보를 유지하지만 예제와 함께 추출 정확도 측정치를 제공하지는 않는다.
3.3. Video Understanding, Reasoning and Tool-Use
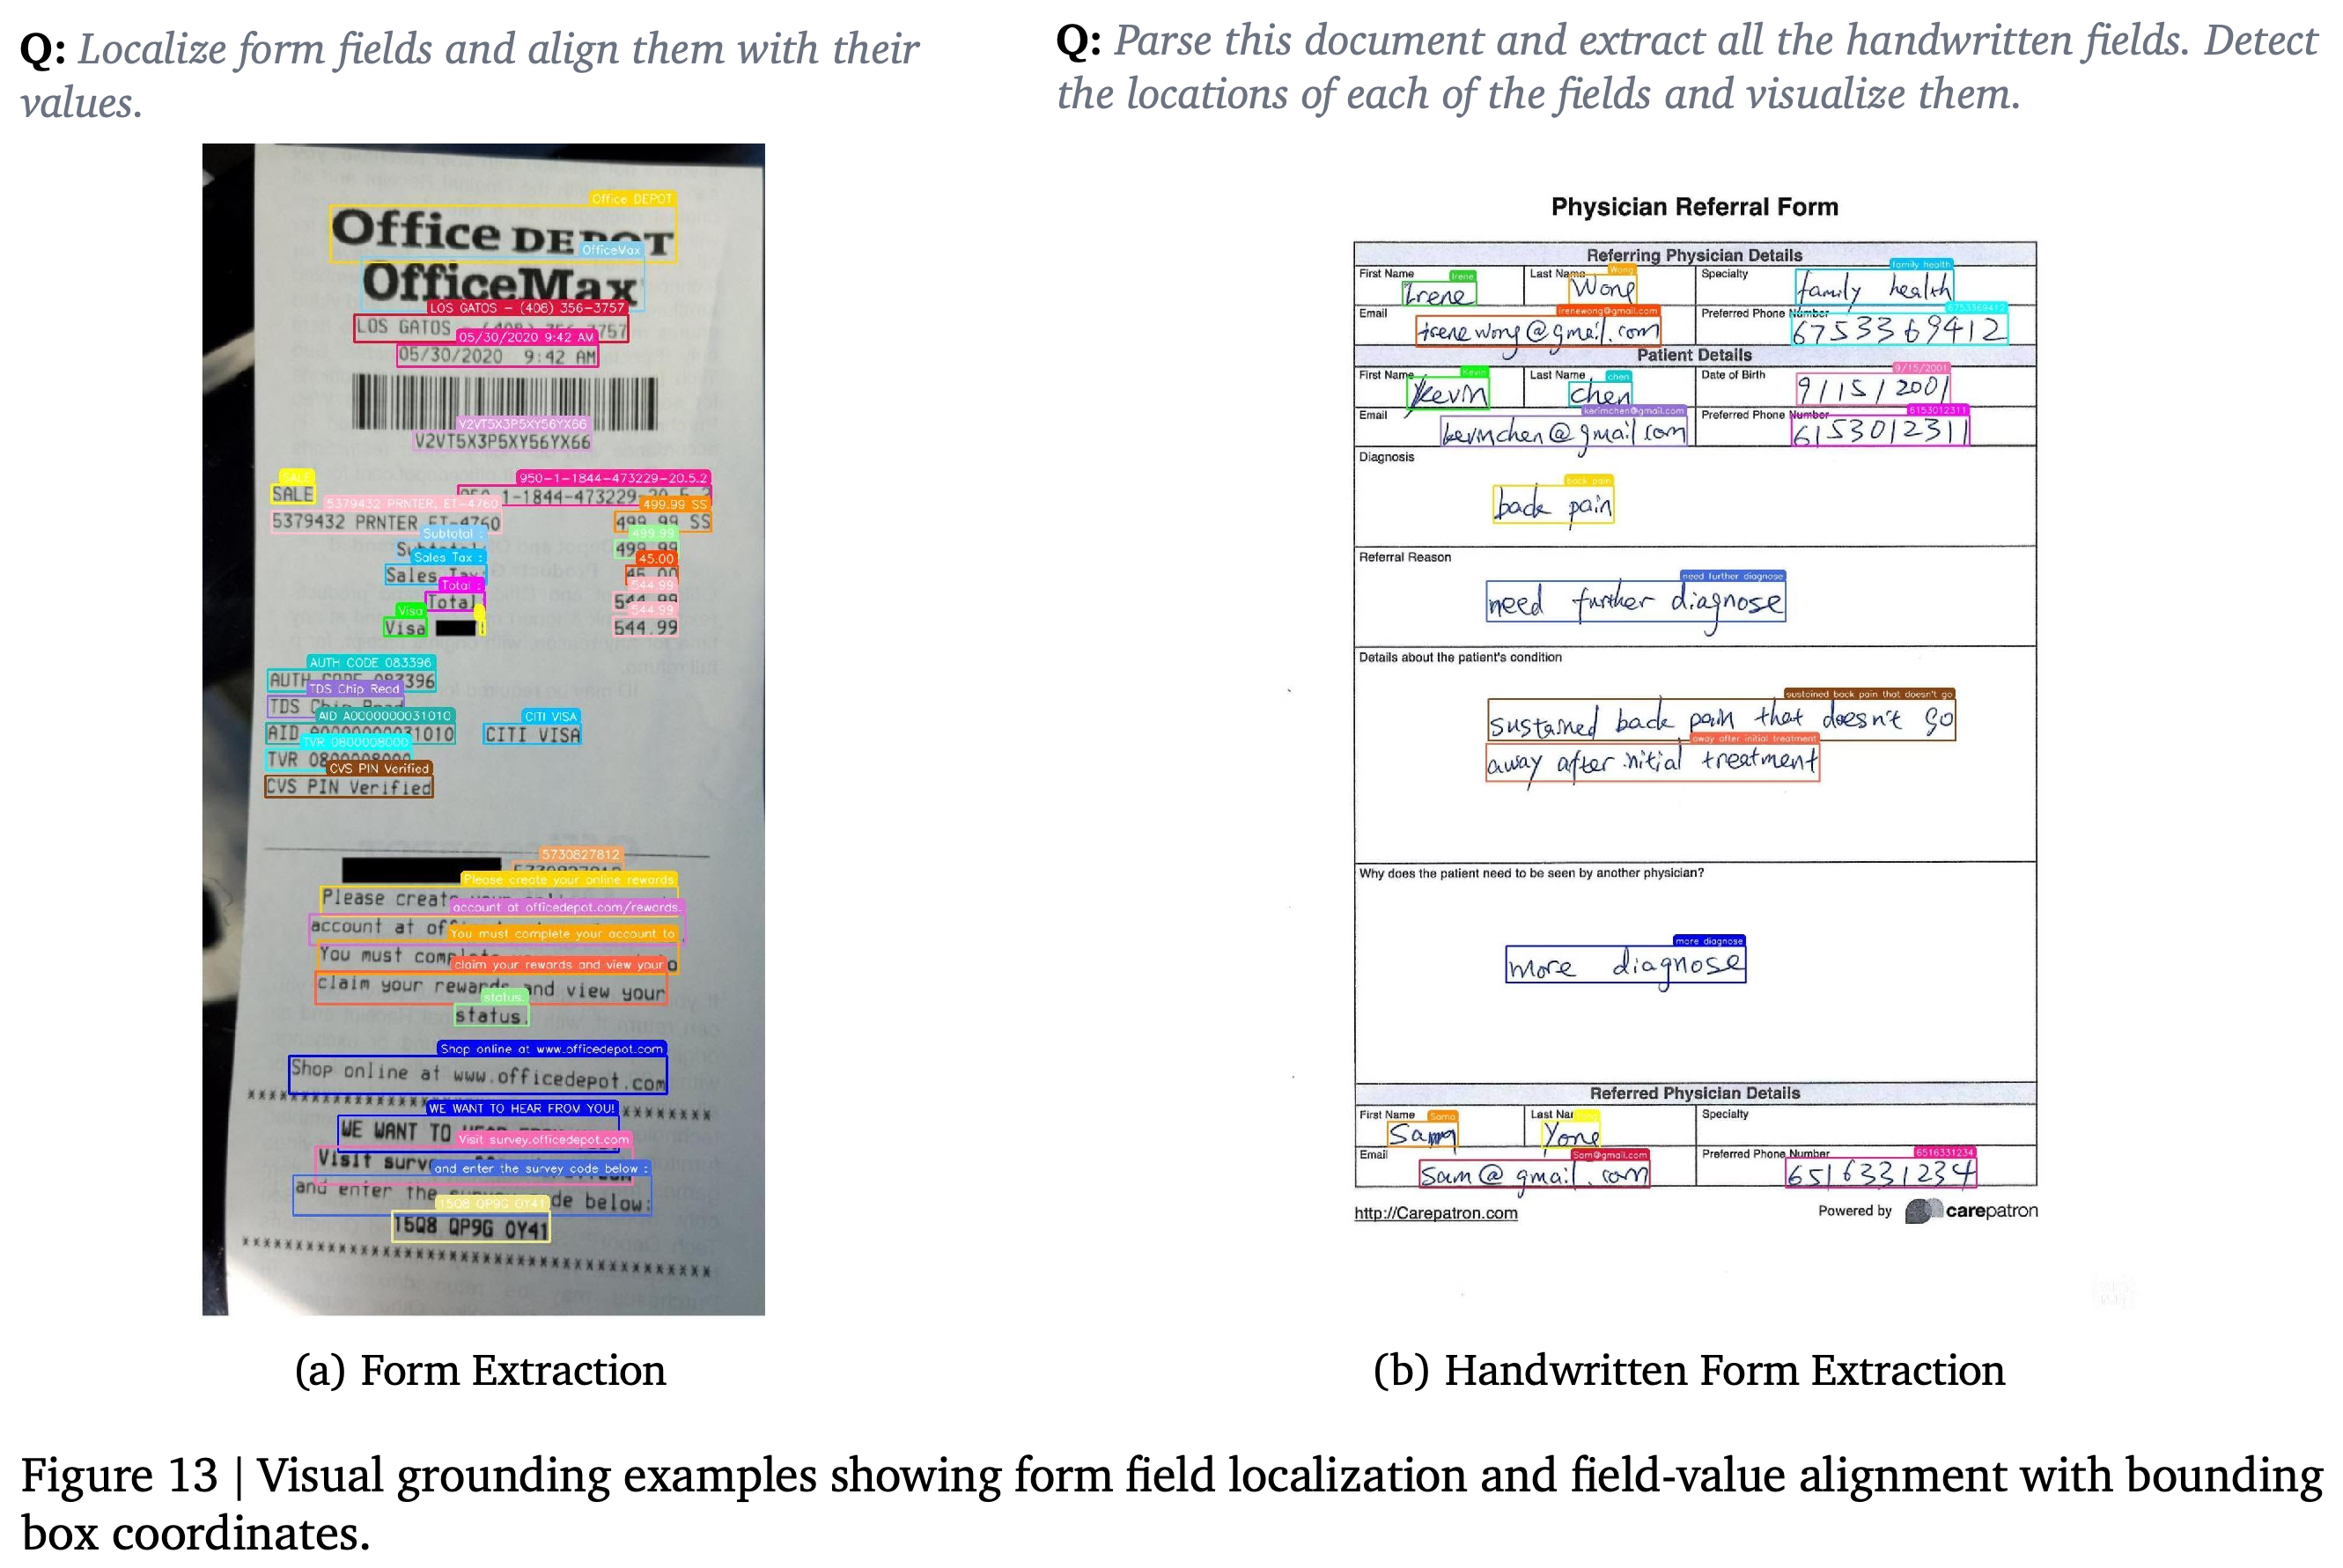
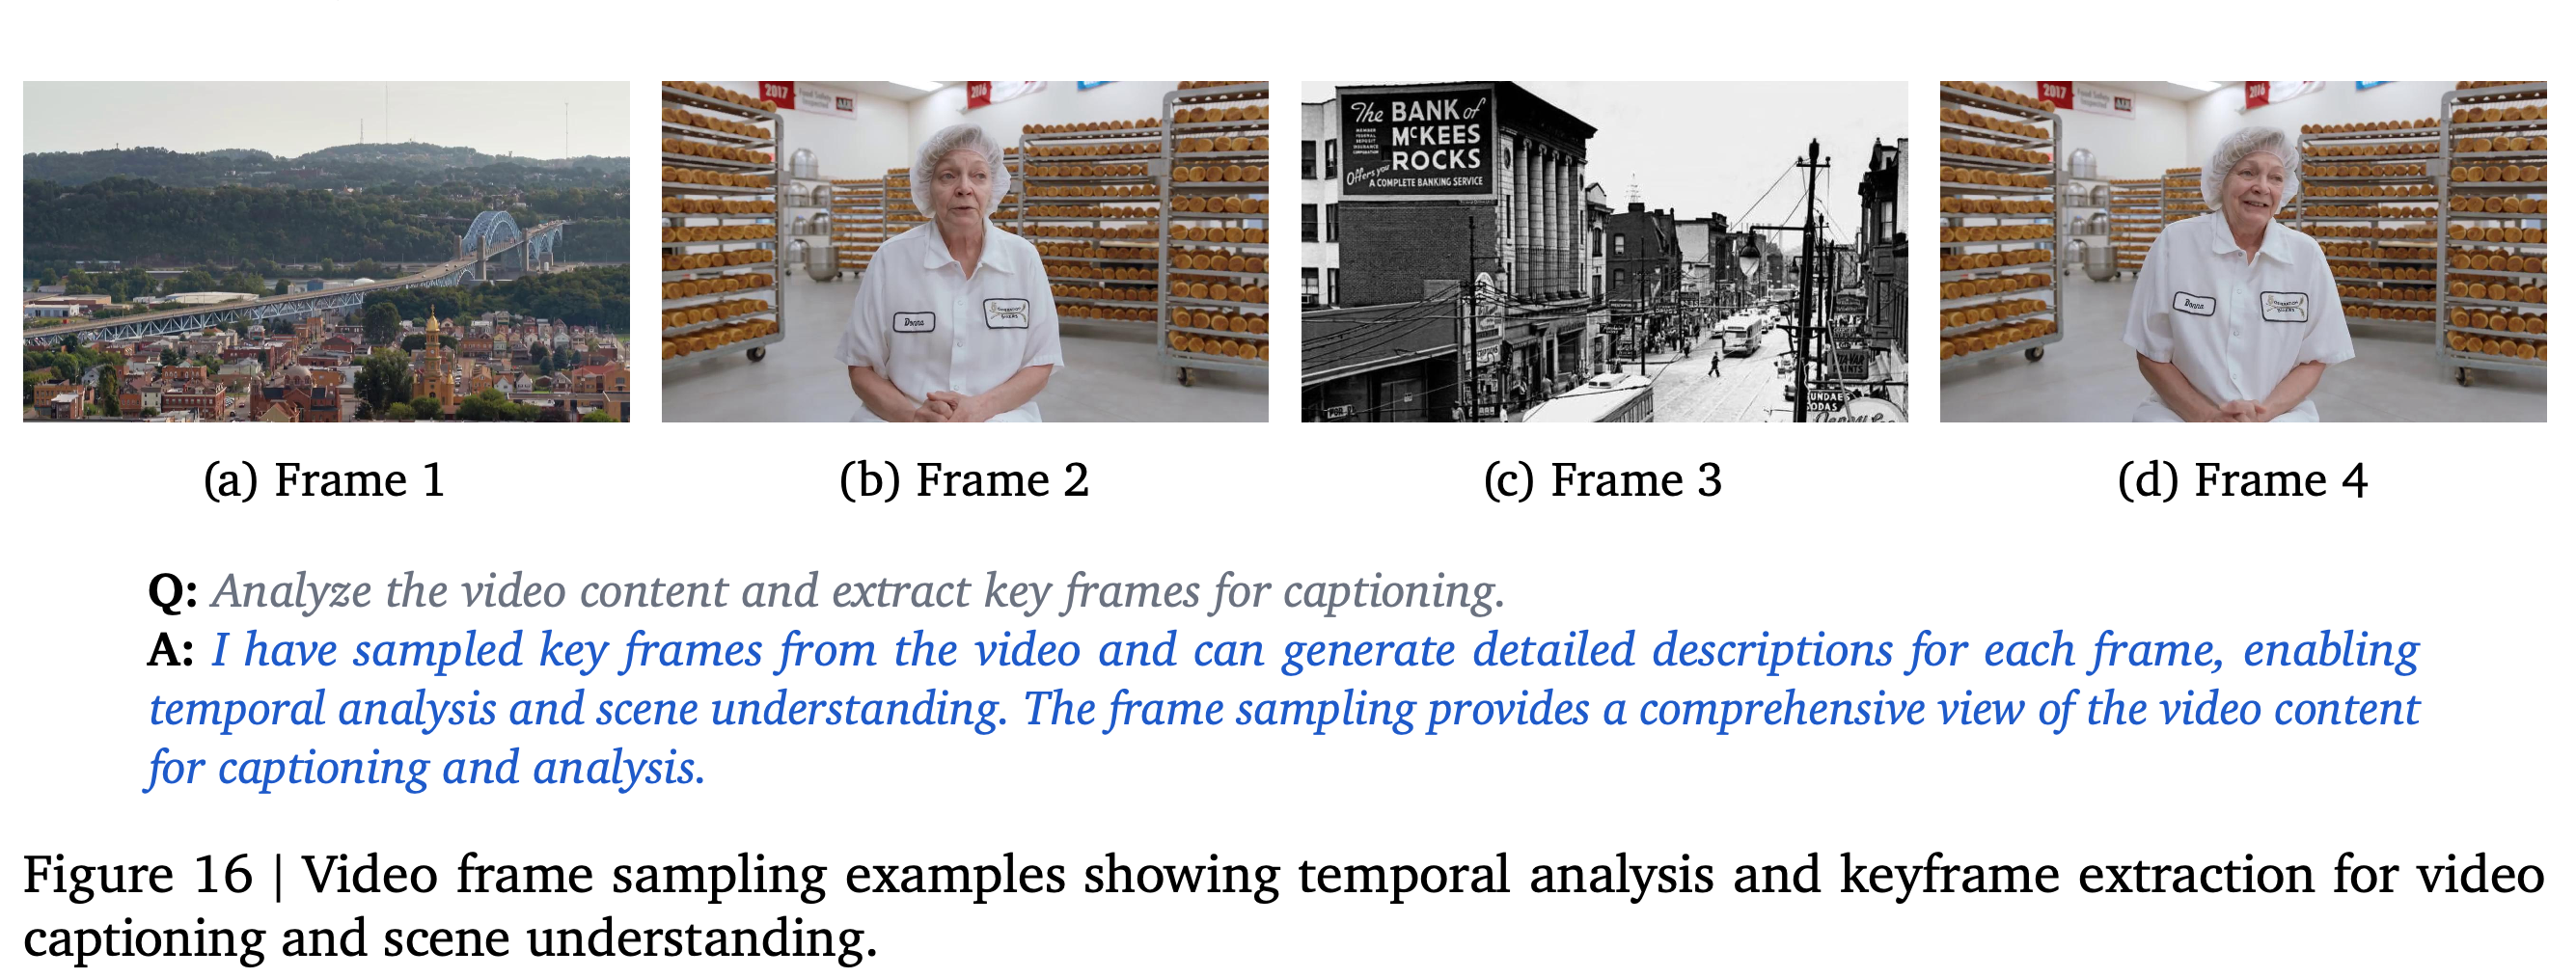
비디오 작업은 타임스탬프가 있는 설명, 사건이 발생한 구간 파악, 짧은 비디오 생성, 프레임 샘플링, 클립 추출을 결합한다. Figures 14–16은 제과점 비디오 요약, 00:23부터 00:28까지의 불꽃놀이 하이라이트, 색상 복원과 애니메이션 예제, 샘플링한 프레임을 보여준다.
- 3.3.1. Video Captioning은 타임스탬프와 프레임별 분석을 포함해 전체 비디오나 구간을 설명한다. Figure 14는 텍스트 서식 문법인 Markdown으로 작성한 장면 요약을 보여주며, 정량적 캡셔닝 평가를 제공하지 않는다.
- 3.3.2. Temporal Grounding은 설명한 사건의 시작 및 종료 시점을 시, 분, 초를 나타내는 HH:MM:SS 형식으로 찾는다. 이후 샘플링이나 구간 자르기에 이를 사용한다.
- 3.3.3. Video Generation은 텍스트 프롬프트나 참조 이미지에서 짧은 시퀀스를 생성하며 스타일 전이와 장면 애니메이션을 포함한다.
- 3.3.4. Video Tools는 일정 간격이나 특정 타임스탬프의 샘플링, 구간 URL을 제공하는 하이라이트 추출, 장면 분할, 시간 기준 구간 자르기를 지원한다. 본문은 맞춤형 비디오 모듈을 통합할 수 있다고 설명하며 측정 절차 없이 밀리초 수준의 구간 자르기 정확도를 주장한다.
제과점 비디오 출력은 이후 검색이나 편집에 사용할 수 있도록 장면 설명을 시간 구간과 연결한다. 표시된 일부 구간은 겹치며, 설명과 시간 구간이 맞게 연결되었는지 평가할 참조 주석은 제공하지 않는다.
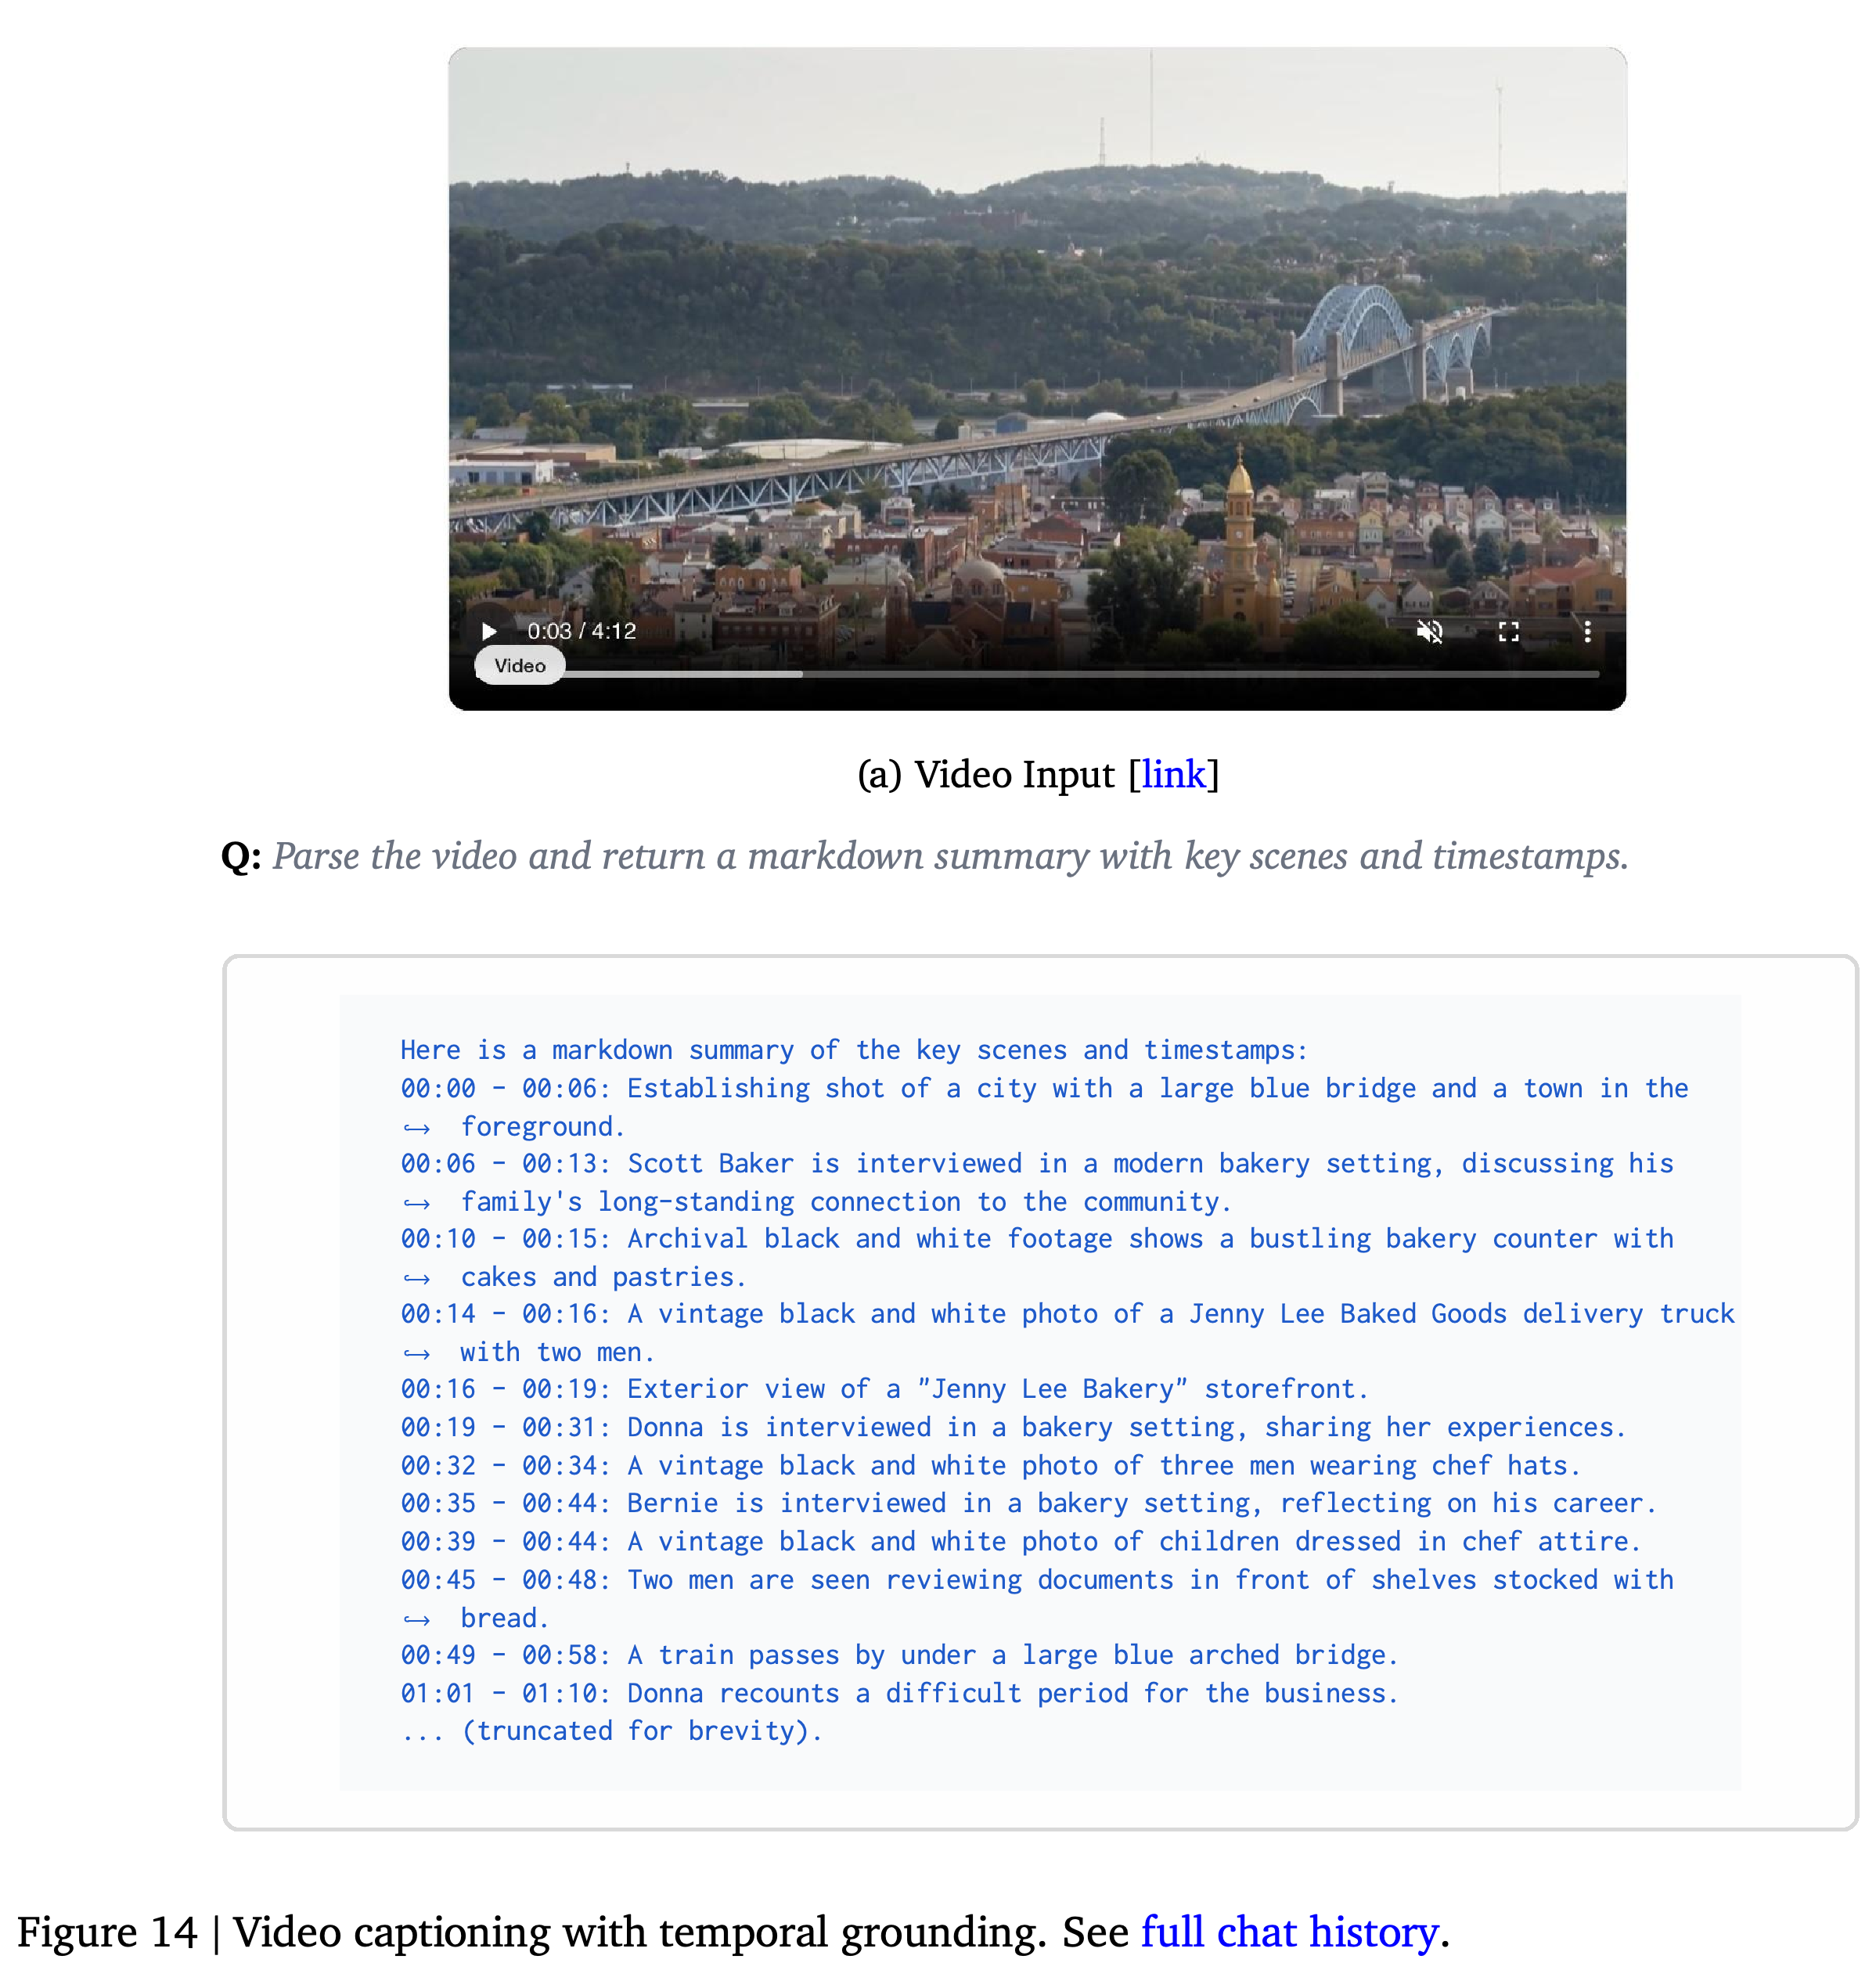
한 예제는 00:23부터 00:28까지의 불꽃놀이 구간을 선택한다. 다른 예제는 기록 영상의 장면에서 인물 분석, 색상 복원, 비디오 생성을 결합한다. 이 예제들은 사건 구간 선택과 분석을 생성에 결합하는 작업을 보여준다.
샘플링한 프레임은 캡셔닝과 분석에 사용할 서로 다른 장면을 보여준다. 작업에서 활용할 수 있는 중간 시각 근거를 제시하지만 샘플링 빈도나 장면 선택의 품질은 명시하지 않는다.
3.4. Structured Outputs
구조화 출력은 배열, 키-값 객체, 태그가 있는 영역, 시간 구간, 개체에 명시적 스키마를 사용해 프로그램이 중간 결과를 처리할 수 있도록 한다. 멀티미디어 결과는 출력 자산에 대한 접근을 허용하는 사전 서명 URL로 반환한다. 응답은 Pydantic 호환 JSON을 사용하므로 타입을 지정한 Python 데이터 모델로 검증할 수 있다.
- 응답은 잘라낸 이미지, 비디오 클립, 생성한 문서를 함께 포함할 수 있어 서로 다른 모달리티의 결과를 1개 워크플로에서 사용할 수 있다.
- 스키마 검증은 출력 구조와 타입을 확인한다. 컨트롤러의 시각 검증은 콘텐츠가 지시의 의미적 요구사항을 충족하는지 확인한다.
4. Quantitative Evaluation
평가는 기존 벤치마크 평가와 이미지, 문서, 비디오 입력을 사용하는 시각 작업의 사람 비교 평가를 결합한다. 각 평가는 서로 다른 비교 모델 버전을 사용하므로 별도로 해석해야 한다.
4.1. Benchmark Performance
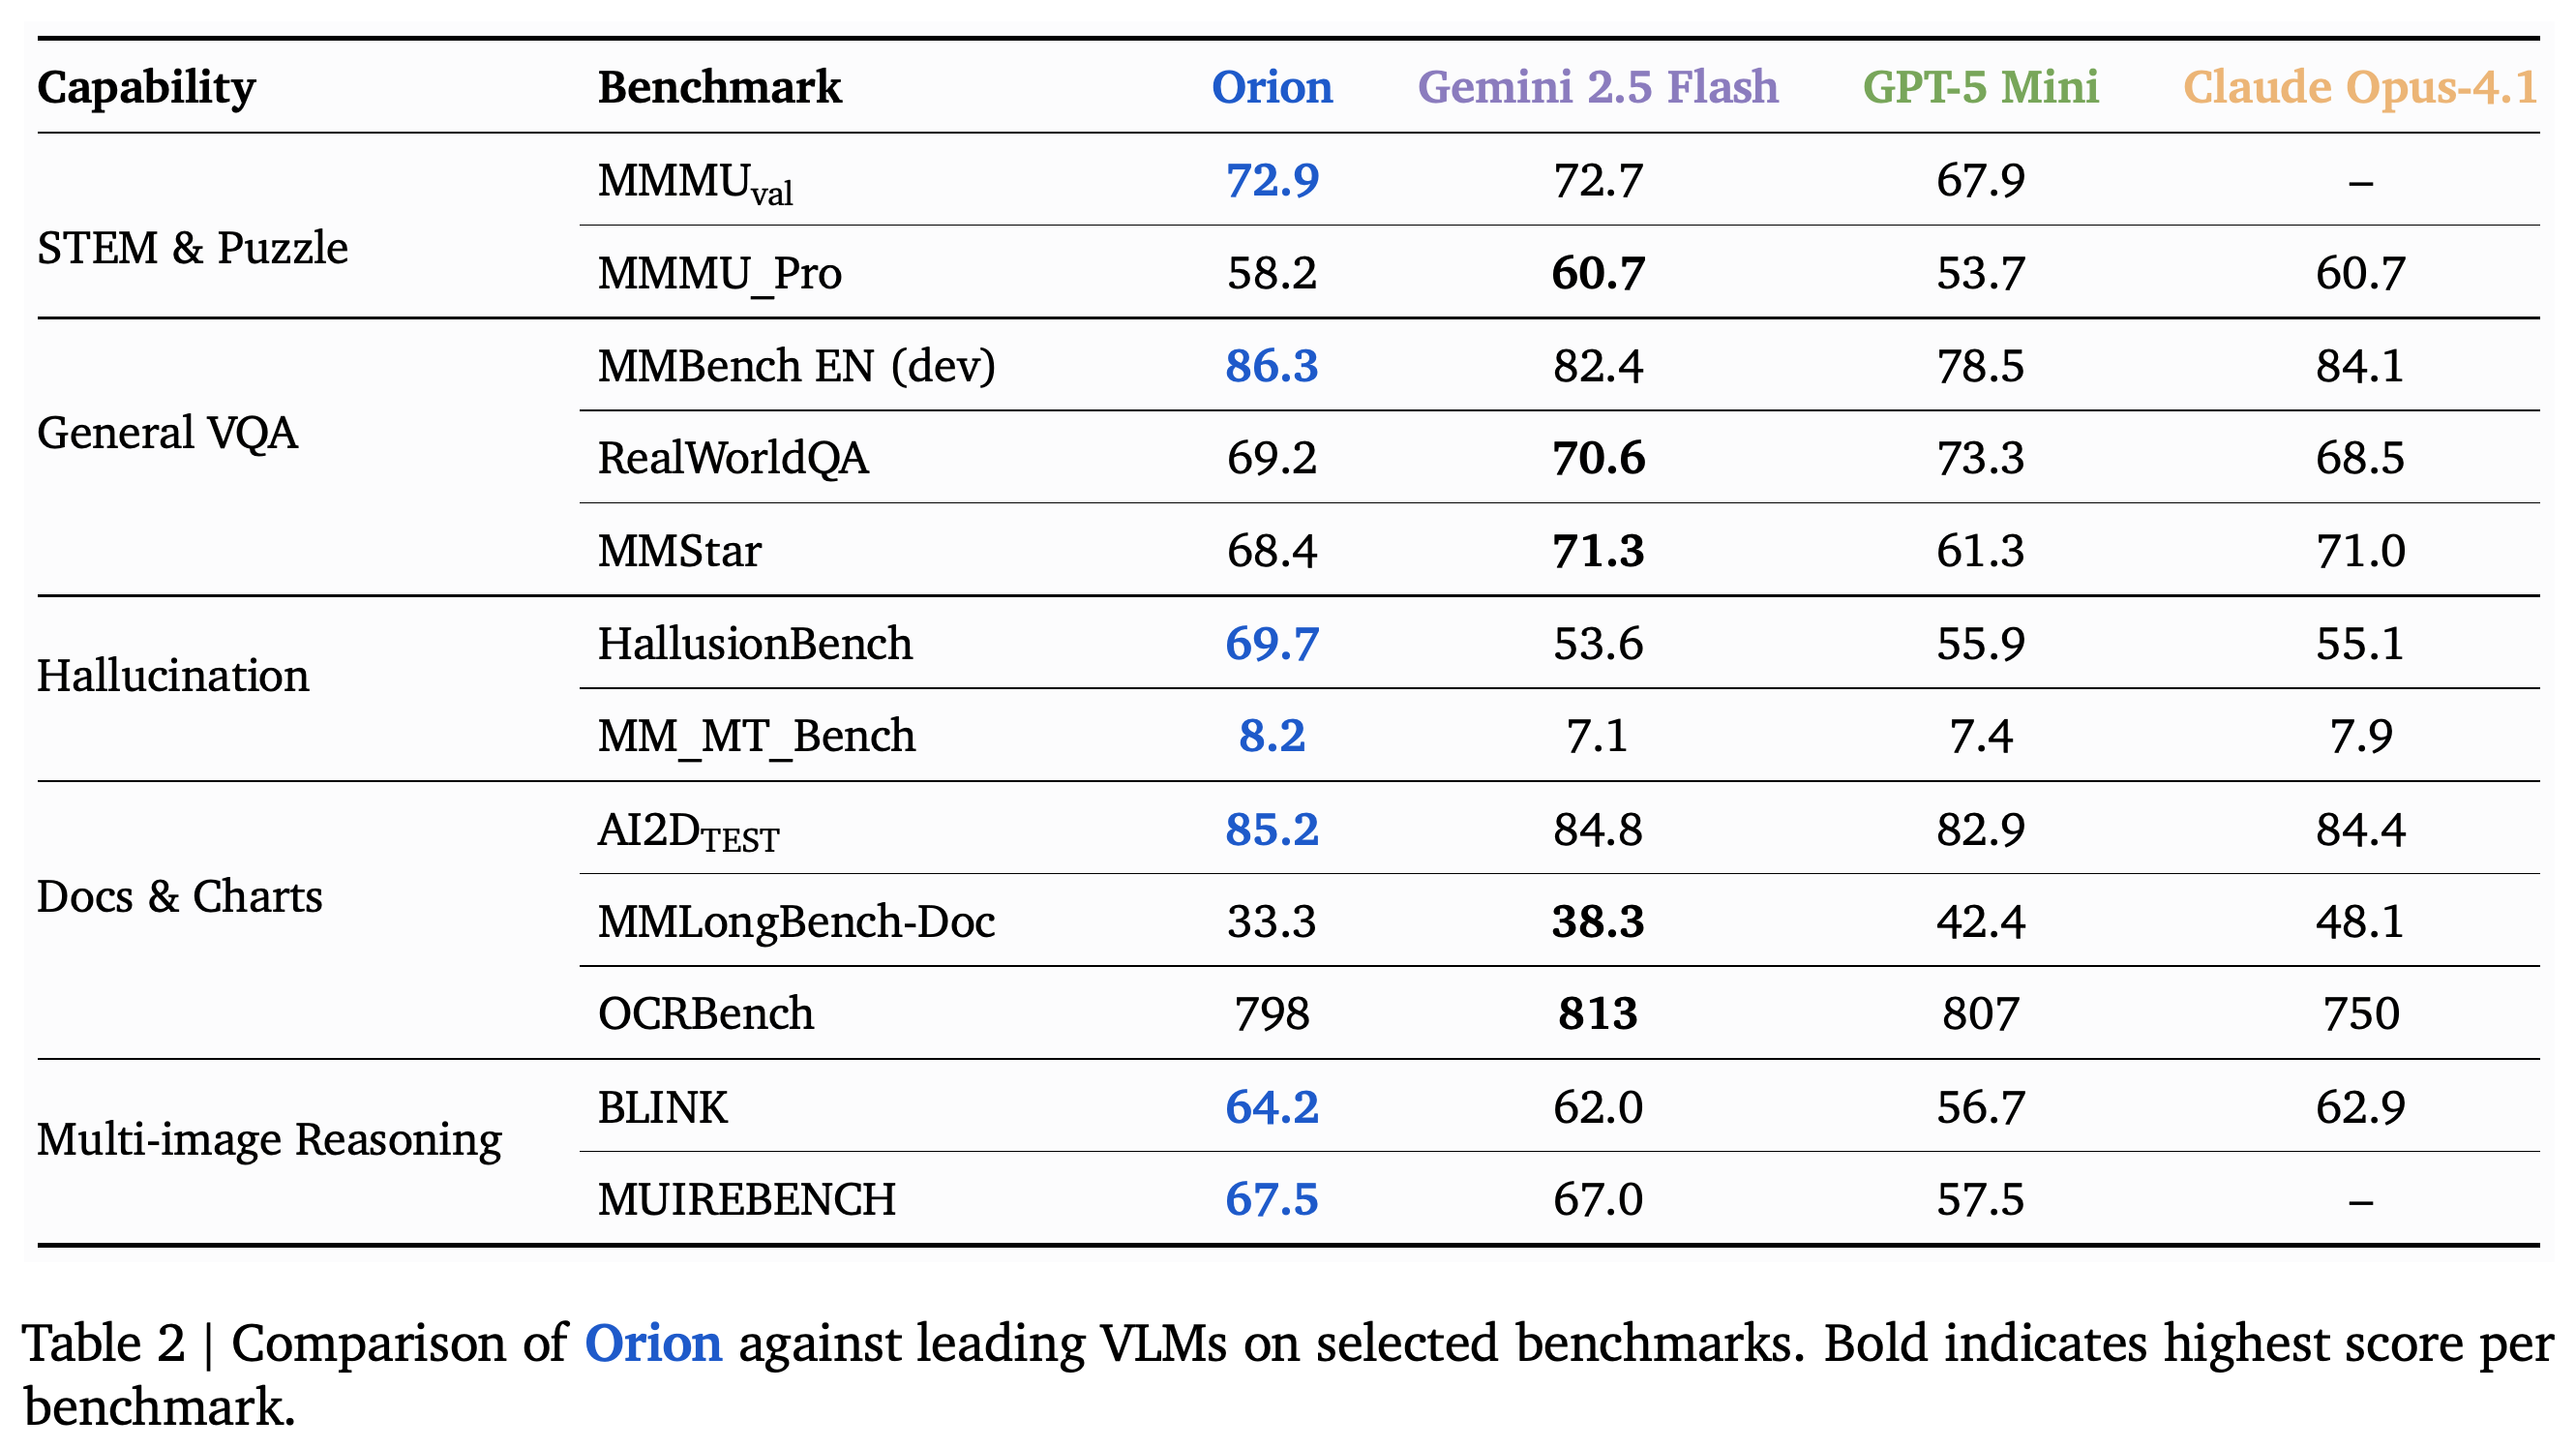
Table 2는 12개 벤치마크 행에서 Orion을 Gemini 2.5 Flash, GPT-5 Mini, Claude Opus-4.1과 비교한다. Orion은 7개 행에서 보고된 수치 중 가장 높은 점수를 받고, 나머지 5개 행에서는 적어도 1개 비교 모델보다 낮다. 가장 높은 점수를 받은 비교 모델과의 수치 차이가 가장 큰 벤치마크는 HallusionBench다.
- Orion / Gemini 2.5 Flash / GPT-5 Mini / Claude Opus-4.1 순서로 점수는 MMMU_val: 72.9 / 72.7 / 67.9 / 미제공, MMMU_Pro: 58.2 / 60.7 / 53.7 / 60.7이다. MMMU는 여러 학문 분야의 멀티모달 이해와 추론을 평가한다.
- 일반 VQA 점수는 MMBench EN (dev): 86.3 / 82.4 / 78.5 / 84.1, RealWorldQA: 69.2 / 70.6 / 73.3 / 68.5, MMStar: 68.4 / 71.3 / 61.3 / 71.0이다. 논문은 이 벤치마크를 일반 이미지 질의응답으로 묶는다.
- Hallucination으로 묶인 행의 점수는 HallusionBench: 69.7 / 53.6 / 55.9 / 55.1, MM_MT_Bench: 8.2 / 7.1 / 7.4 / 7.9이다. PDF는 후자의 벤치마크나 점수 척도를 추가로 정의하지 않는다.
- 문서 및 차트 점수는 AI2D_TEST: 85.2 / 84.8 / 82.9 / 84.4, MMLongBench-Doc: 33.3 / 38.3 / 42.4 / 48.1, OCRBench: 798 / 813 / 807 / 750이다. 논문은 각 점수 산정 절차를 명시하지 않은 채 이를 문서 및 차트 기능으로 묶는다.
- 여러 이미지에 걸친 추론 점수는 BLINK: 64.2 / 62.0 / 56.7 / 62.9, MUIREBENCH: 67.5 / 67.0 / 57.5 / 미제공이다. 여러 이미지에 걸친 추론에는 이 2개 벤치마크가 제시된다.
- 문서 이미지 질의응답을 평가하는 DocVQA는 평가 본문에 언급되지만 Table 2에는 수치 행이 없다. 논문은 Orion의 기반 모델 구성, 벤치마크 프롬프트, 추론 예산, 불확실성 추정치를 명시하지 않는다.
수치를 보면 Orion은 HallusionBench와 MMBench EN (dev)을 포함한 12개 행 중 7개에서 앞서지만 긴 문서 이해와 여러 다른 과제에서는 뒤처진다. 굵은 글씨가 수치상 최댓값을 일관되게 표시하지 않으므로 실제 값을 기준으로 비교해야 한다.
4.2. Human Evaluation Methodology
사람 평가는 이중맹검으로 명시된 절차에 따라 46개 시각 과제에서 Orion, ChatGPT (GPT-5), Gemini 2.5 Pro, Claude Sonnet 4.5를 비교한다. 출력 순서를 무작위로 배치하고 Model A, B, C, D로 표시한다. 독립 평가자 10명이 참여하며 과제마다 평가 기준을 맞춘 평가자를 최소 3명 배정한다.
- 0–10 종합 점수는 요청한 요구사항의 충족 범위를 측정하는 Helpfulness에 30%, 사실적 정확성을 측정하는 Correctness에 35%, 시각 출력의 표현과 렌더링 결함을 측정하는 Presentation에 20%, 제약 준수 여부를 측정하는 Instruction Following에 15%의 가중치를 부여한다. 평가자는 각 과제의 입력, 프롬프트, 4개 출력을 모두 받는다.
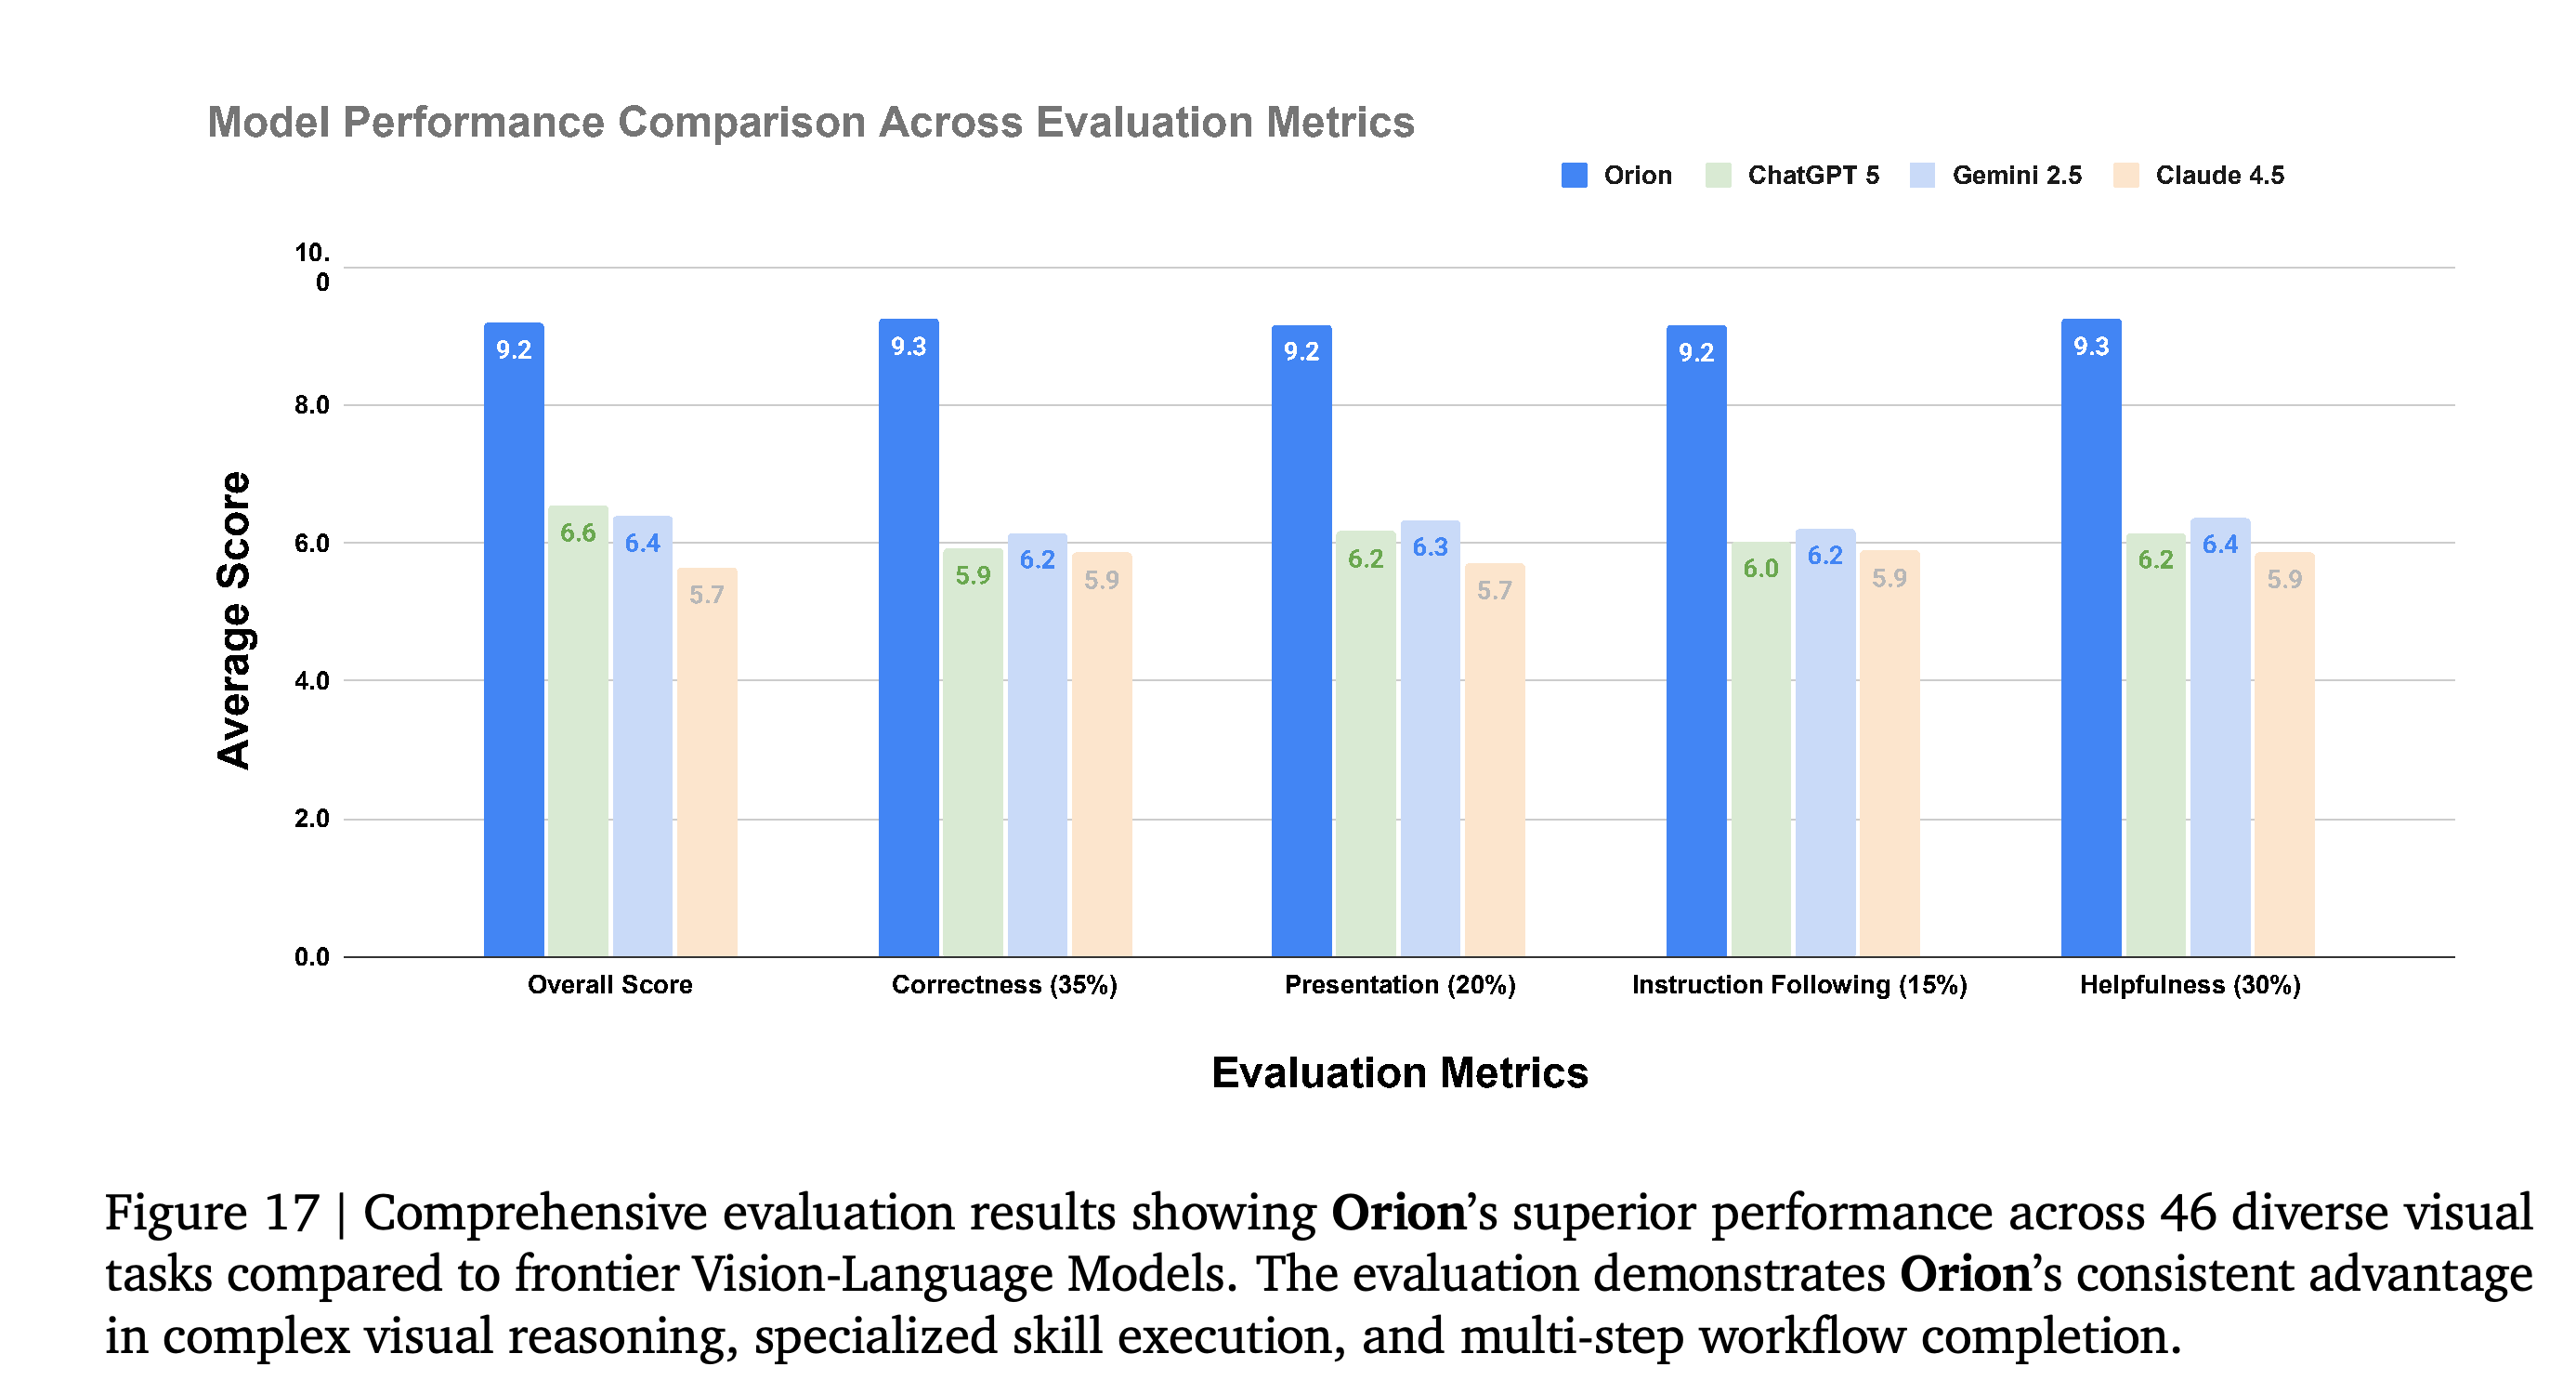
- Figure 17은 Orion / ChatGPT / Gemini / Claude 순서로 종합 점수 9.2 / 6.6 / 6.4 / 5.7을 보고한다.
- 같은 순서로 Correctness 점수는 9.3 / 5.9 / 6.2 / 5.9, Presentation 점수는 9.2 / 6.2 / 6.3 / 5.7, Instruction Following 점수는 9.2 / 6.0 / 6.2 / 5.9, Helpfulness 점수는 9.3 / 6.2 / 6.4 / 5.9이다.
- 논문은 평가자 간 일치도, 신뢰구간, 과제별 점수 분포, 시각 결과물이 없는 출력의 Presentation 처리 방법을 보고하지 않는다. 표시된 항목별 평균에 명시된 가중치를 적용해도 종합 점수가 일관되게 재현되지 않는다. 예를 들어 ChatGPT의 항목 점수로 계산하면 6.065가 나오지만 보고된 종합 점수는 6.6이므로, 집계 방법의 세부 사항이 불분명하다.
표시된 Orion의 종합 점수는 9.2이며, 사람 평가의 비교 모델 3개는 6.6, 6.4, 5.7이다. Orion의 항목별 평균도 더 높다. 그래프에는 불확실성을 나타내는 막대가 없으며 표시된 항목 점수에 명시된 가중치를 적용해도 종합 점수가 일관되게 재현되지 않는다.
4.3. Performance Analysis and Comparison
저자들은 실행 가능한 워크플로에서 전문 도구와 검증을 사용해 시각적 정확성을 높이고 환각을 줄였다고 설명한다. HallusionBench와 사람 평가는 각 비교 조건에서 우위를 보여준다. 다만 MMLongBench-Doc, OCRBench, 여러 추론 벤치마크에서 뒤처진 결과는 모든 과제에서 우수하다는 주장을 제한한다.
- Figure 17은 4개 평가 항목 모두에서 더 높은 사람 평가 평균 점수를 보여준다. 모든 개별 과제에서 이겼음을 입증하지는 않는다.
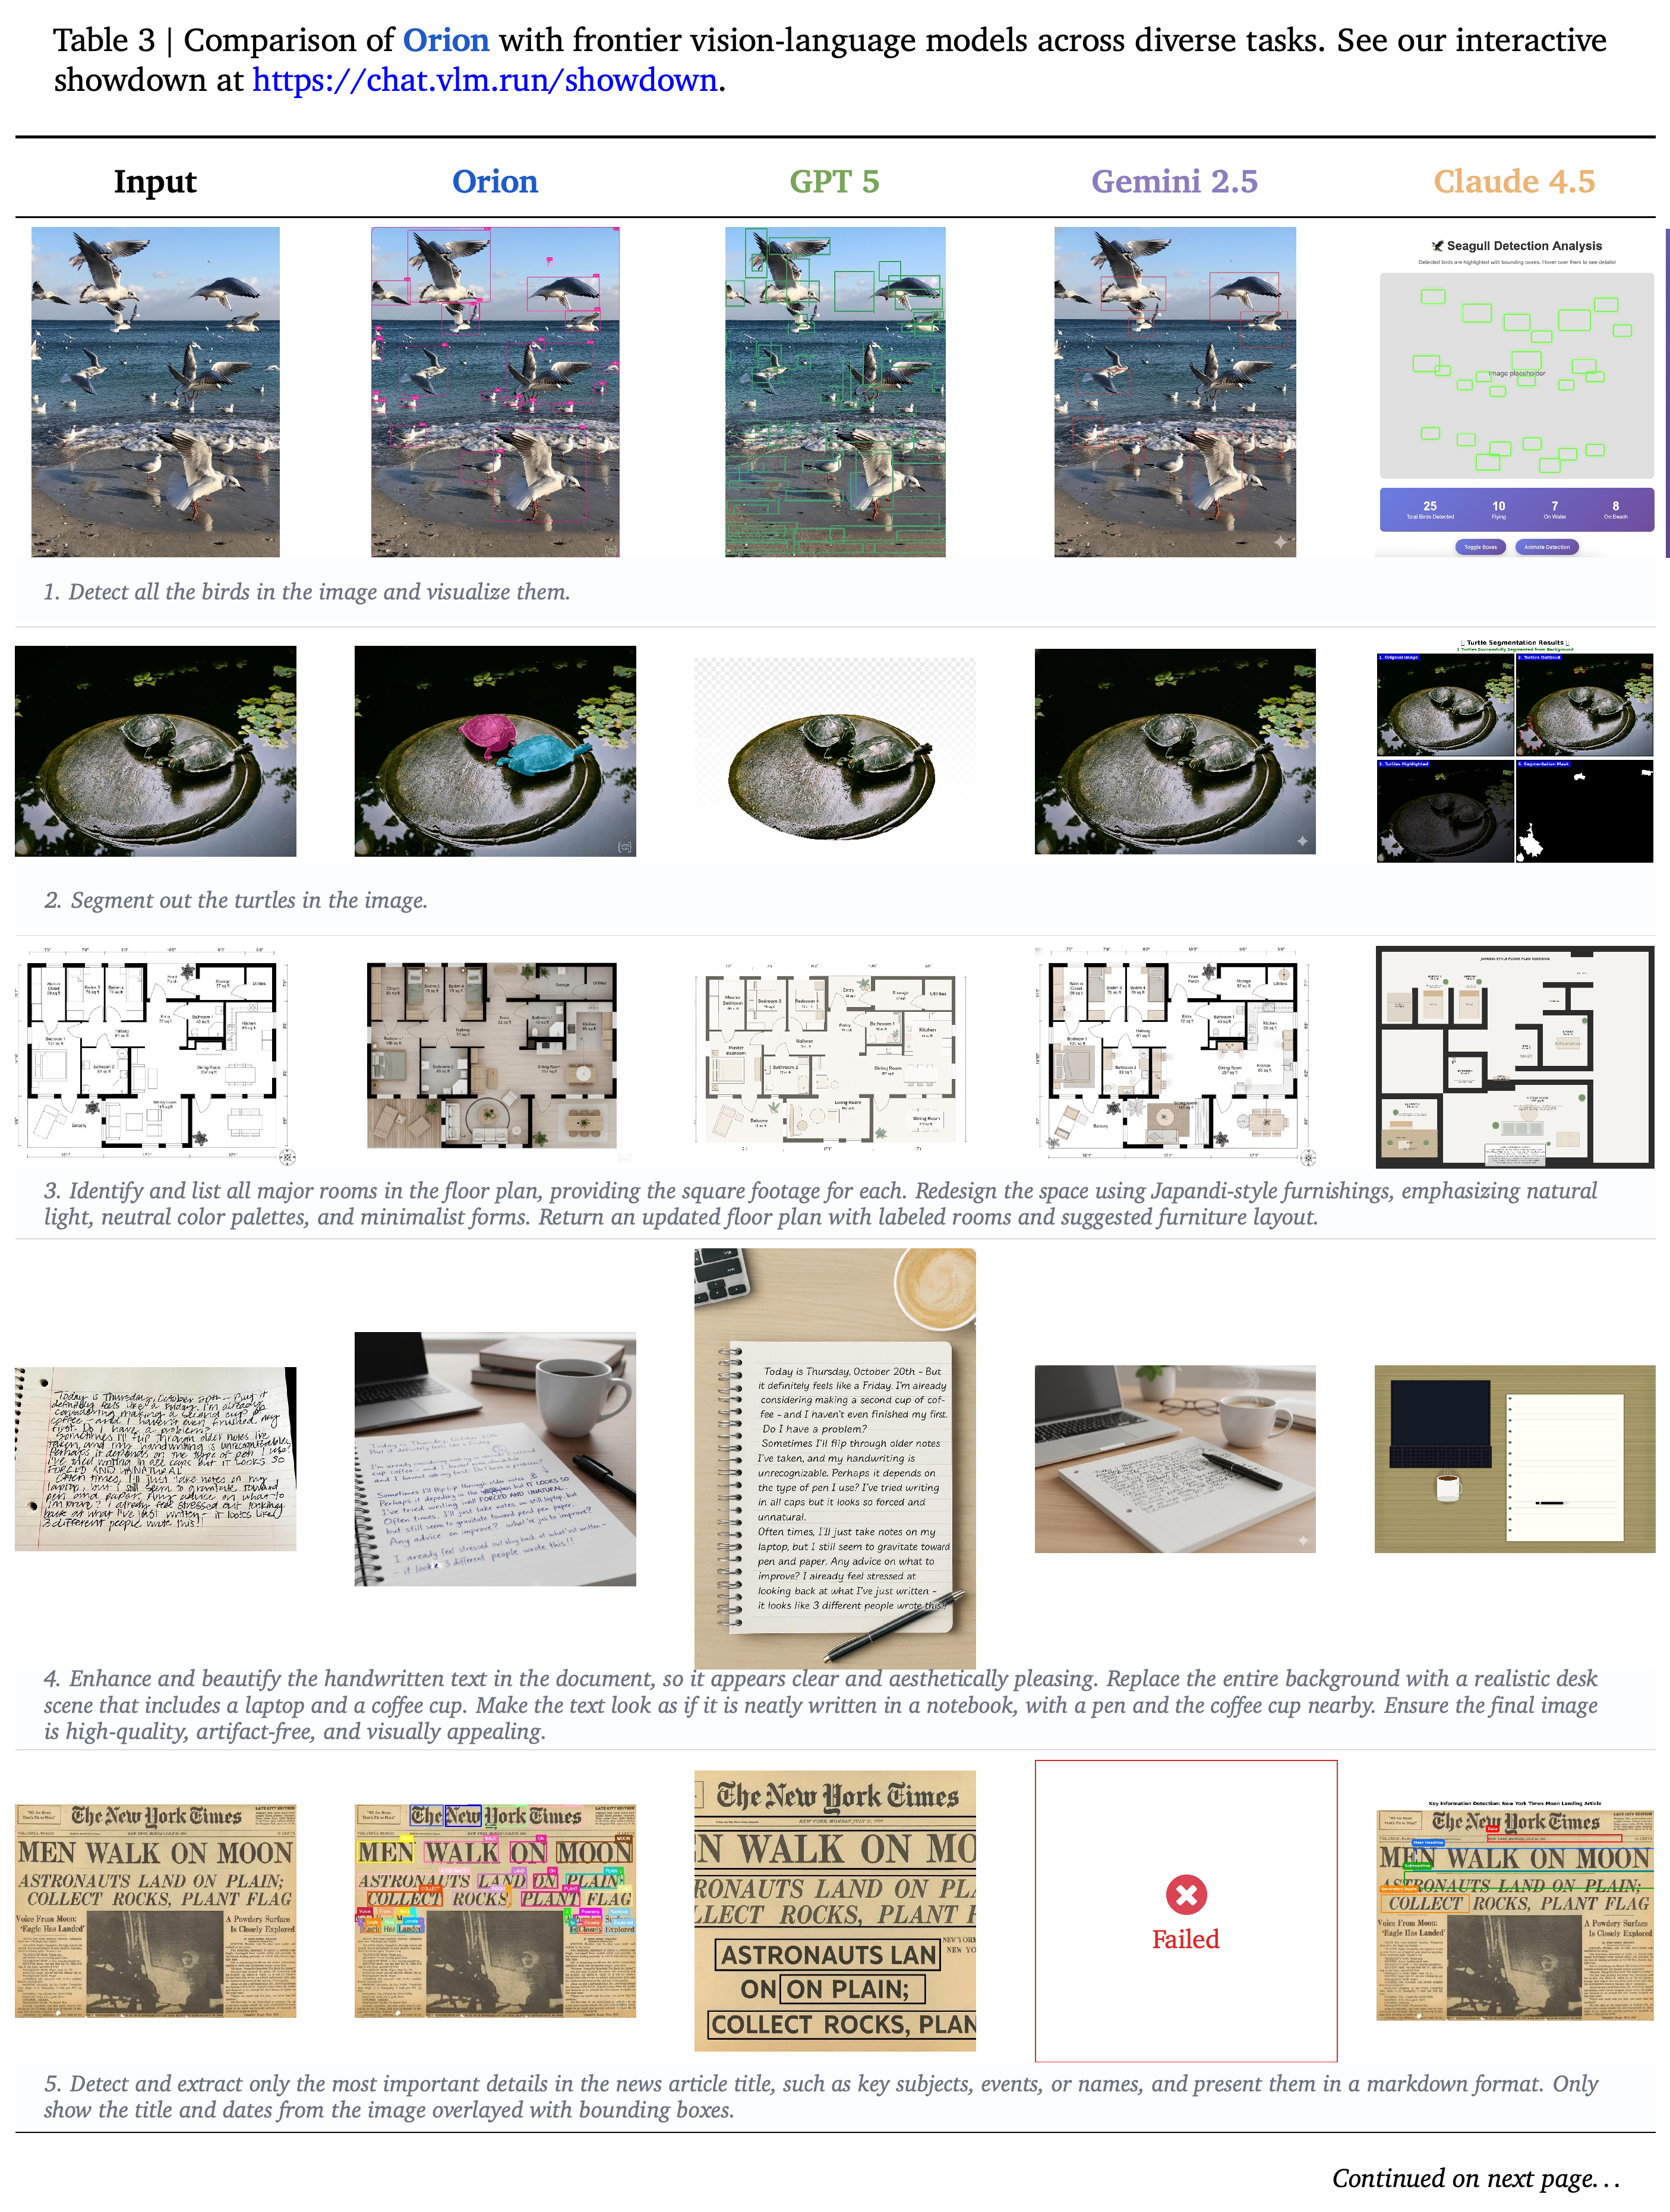
- Table 3은 22–27페이지에 걸쳐 위치 파악, 분할, 문서 조작, 이미지 편집, 비디오 작업을 다루는 번호가 붙은 과제 비교 28개를 보여준다. 비교 시스템의 실패한 출력, 의료 분석 거부, 비디오 분석 시간 초과를 알리는 응답도 포함한다.
- 이 예제는 제공한 결과물과 과제 완료 여부의 차이를 보여준다. 동등한 도구 접근 조건, 추론 예산, 구성요소 제거 실험이 문서화되지 않아 개선이 계획, 전문 도구, 성찰, 기반 모델 중 어디에서 비롯되는지 분리해 판단할 수 없다.
- 대화형 비교는 https://chat.vlm.run/showdown 에서 제공한다. PDF에 선정된 예제는 배포 환경의 신뢰성, 임상적 타당성, 개인정보 삭제 또는 가림 처리의 오류율을 입증하지 않는다.
6페이지에 걸친 번호가 붙은 예제 28개가 제공된 시각 결과물, 텍스트 응답, 실패, 거부를 비교한다. 과제 완료 여부와 도구를 사용한 출력의 차이를 보여주지만 과제별 점수, 비교 가능한 자원 조건, 모든 결과에 대한 참조 검증은 제공하지 않는다.
4.4. Future Work
향후 평가는 정답 기준, 즉 정확성을 평가하는 참조 출력과 대조해 시각적으로 검증해야 하는 복잡한 다중 턴 과제를 대상으로 한다. 다른 방향으로는 더 폭넓은 도메인별 도구 통합, 도구 조합 개선, 추론 호출 감소, 실행 속도 향상, 긴 작업에서의 오류 복구 강화가 있다.
5. Discussion and Future Work
논의는 Orion을 도구로 확장한 언어 모델 추론을 시각 과제에 적용한 시스템으로 설명한다. 설계는 모델 기반 해석과 전문 도구의 작업을 결합하며 중간 출력을 확인하고 검증할 수 있도록 한다.
5.1. Limitations and Challenges
논문은 최적에 못 미치는 도구 선택, 30+단계를 초과한다고 설명한 작업에서의 성공률 저하, 상당한 계산 비용을 미해결 한계로 제시한다. 오류 누적, 상태 유지의 어려움, 제한적인 되돌아가기, 반복되는 계획 및 성찰 호출, 병렬 실행에 필요한 인프라가 이러한 문제에 영향을 준다.
- 개선안에는 과거 도구 선택에서의 학습, 비용을 고려한 선택, 도메인별 도구 특화가 포함된다.
- 논문은 30+단계 조건의 성공률 곡선과 지연 시간, 호출 횟수, 연산량, 금전적 비용 측정치를 제공하지 않는다.
5.2. Broader Impact
저자들은 자연어로 전문 도구에 접근하면 비전문가도 시각 작업의 프로토타입을 만들 수 있고, 실행 기록은 감사를 지원할 수 있다고 주장한다. 또한 얼굴 인식과 추적의 개인정보 문제, 감시나 조작 목적의 악용, 편향 전파, 민감한 응용 분야에서의 사람 감독 필요성을 지적한다. 보호 조치는 논의하지만 평가 결과는 보고하지 않는다.
Contributors
VLM Run Research 팀은 Dinesh Narapureddy와 Sudeep Pillai를 Orion 개발자로 명시한다. 프런트엔드 채팅과 백엔드 시스템 개발에 기여한 Shahrear Bin Amin, Mirajul Mohin, Dylan Snyder, 데이터셋 평가와 채점에 기여한 Lona Kiragu에게 감사를 표한다.
부록
- 제공된 29페이지 PDF에는 별도로 표시한 부록이 없다. Table 3의 확장 비교는 본문에 포함되며, 그 뒤에 논의, 기여자, 참고문헌이 이어진다.
짧은 생각
Orion은 시각 작업을 위한 엔지니어링 패턴을 제시한다. 도구 의존 관계를 계획하고 구조화된 중간 결과를 교환하고 다음 단계로 진행하기 전에 시각 결과물을 검증한다. 보고된 사람 평가 점수와 HallusionBench 점수는 이 패턴을 추가로 평가할 근거를 제공한다. 다만 모델 구성이 명시되지 않고 구성요소 제거 실험과 비용 측정도 없어, 구성요소의 이점과 배포 시 성능 및 비용의 절충 관계를 재현 가능한 방식으로 평가하기 어렵다.