


VideoAuto-R1: Video Auto Reasoning via Thinking Once, Answering Twice 요약 설명
08 Jan 2026 | Paper Review Video Question Answering Adaptive Computation Reinforcement Learning목차
이번 글에서는 VideoAuto-R1: Video Auto Reasoning via Thinking Once, Answering Twice 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 8일(Arxiv)
- Liu, Shuming, Zhuge, Mingchen, Zhao, Changsheng, Chen, Jun, Wu, Lemeng, Liu, Zechun, Zhu, Chenchen, Cai, Zhipeng, Zhou, Chong, Liu, Haozhe, et al.
- Meta AI, King Abdullah University of Science and Technology (KAUST), Princeton University
- 논문 링크
- Github
- Project Page
요약
- VideoAuto-R1: Video Auto Reasoning via Thinking Once, Answering Twice는 명시적인 chain-of-thought(CoT)가 비디오 이해에 도움이 되는 조건을 살펴본다. RL로 학습한 비디오 모델 3개를 재평가한 결과, 지각 중심 벤치마크에서는 직접 답변이 CoT와 비슷하거나 더 나은 경우가 많았지만, VideoMMMU에서는 추론이 일관되게 도움이 되었다.
- 이 방법은 answer → think → answer로 이어지는 단일 시퀀스를 학습한다. 두 답변 모두에 검증 가능한 보상을 주되, 검토 후 답변에 더 큰 가중치를 부여하고 답변을 유보한 뒤 정답을 맞히면 추가 보상을 준다. 추론 시에는 초기 답변의 길이 정규화 토큰 신뢰도가 임계값을 충족하면 조기 종료하고, 그렇지 않으면 추론을 이어간다.
- Qwen2.5-VL-7B 기반 VideoAuto-R1은 VideoMMMU에서 58.6%를 달성하고, 평균 응답 길이를 추론을 사용하는 표준 RL의 149토큰에서 44토큰으로 줄인다. 효과는 과제에 따라 다르다. 검토 후 답변 단계는 보고된 grounding 결과를 개선하지 못하며, 일부 비디오 QA 점수는 해당 기반 모델보다 낮다.
1 Introduction
서론은 기호 추론과 비디오 지각을 구분한다. 관련 시각 정보를 정확히 추출하고 나면, 많은 질문에는 추가적인 추론이 거의 필요하지 않다. 무조건 긴 추론 과정을 생성하면 디코딩 비용이 늘어나고, 답변을 개선하기보다 오류를 유발할 수 있다.
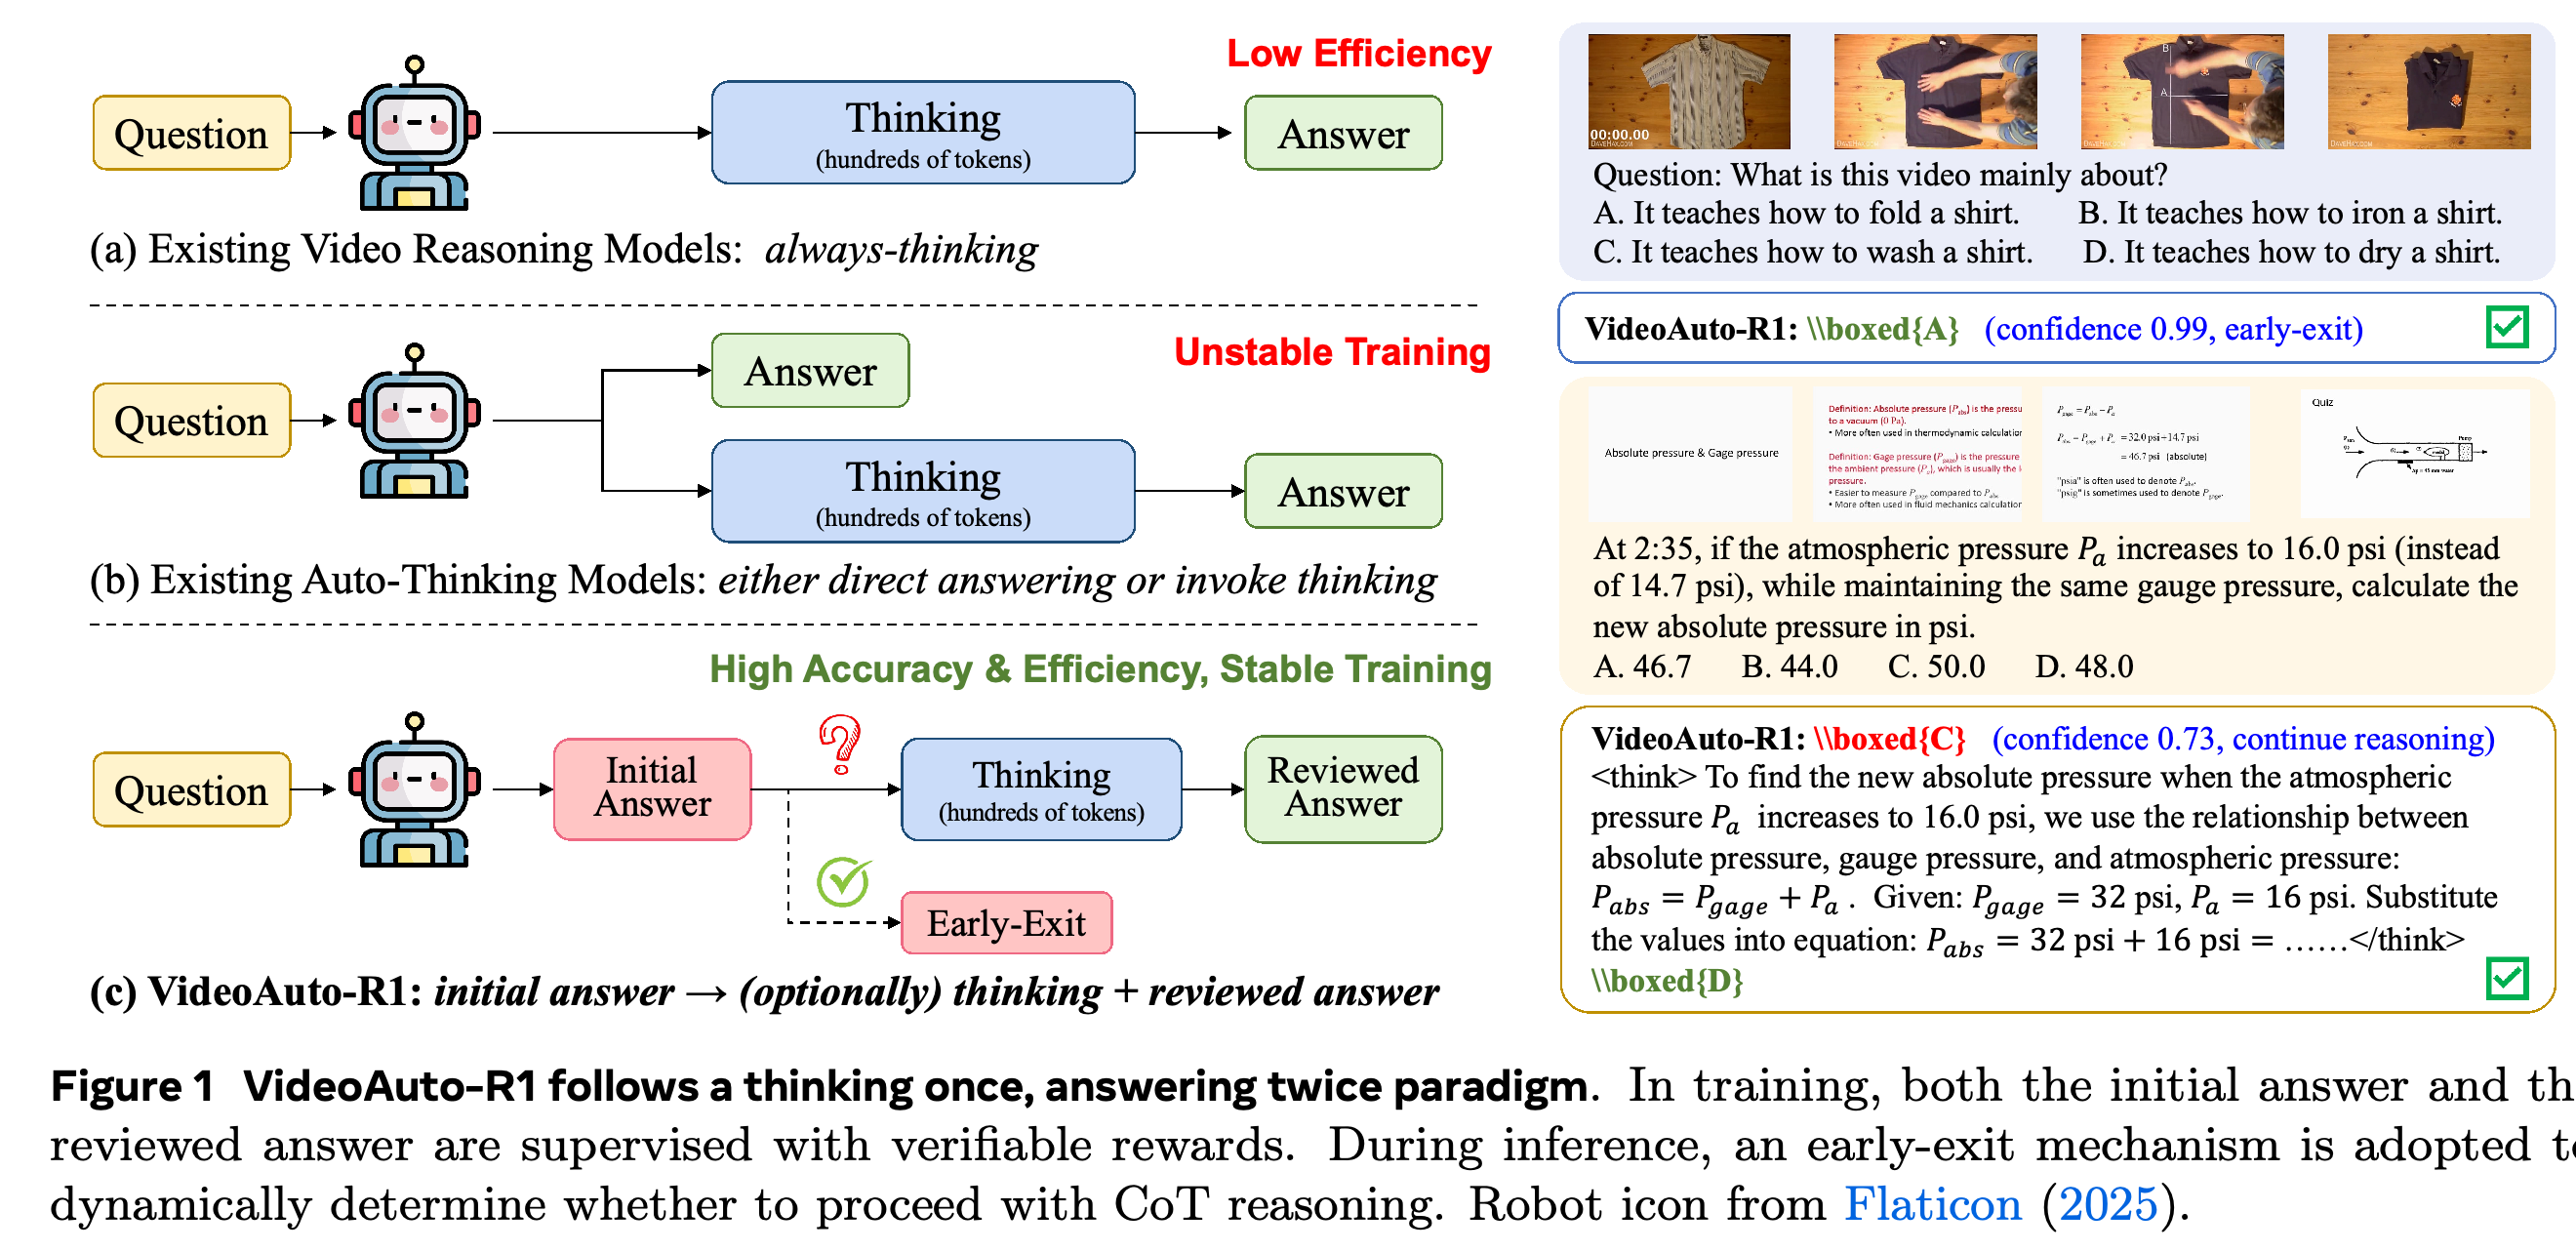
- 제안 방법은 초기 답변과 검토 후 답변을 생성하도록 학습하는 과정과 실제 추론 시 추론을 계속할지 결정하는 과정을 분리한다.
- Figure 1은 이 설계를 항상 추론하는 모델 및 학습된 이진 모드 전환 방식과 비교한다. 프로젝트와 데모는 https://ivul-kaust.github.io/projects/videoauto-r1 에서 확인할 수 있다.
예제는 신뢰도 0.99에서 종료하는 셔츠 접기 질문과 신뢰도 0.73에서 추론을 계속해 C를 D로 바꾸는 압력 계산 문제를 대비한다. 동일한 출력 형식으로 즉시 답변과 추론을 통한 답변 수정을 모두 지원할 수 있음을 보여준다.
2 Related Work
관련 연구에서는 CoT 추론, 비디오 추론 모델, 적응형 추론을 다룬다. VideoAuto-R1은 별도의 think/no-think 결정을 지도하는 대신, 학습 중에 직접 답변과 추론 후 답변을 모두 최적화한다.
2.1 Chain-of-Thought Reasoning
CoT 프롬프팅과 강화학습은 수학, 과학, 코딩, 시각 추론 성능을 개선해 왔다. 논문은 주로 지각이 필요한 과제에서 과도한 추론이 발생한다는 근거도 인용한다. 이를 바탕으로 추론의 이점이 일반적인 비디오 이해에도 적용되는지 검증한다.
2.2 Video Reasoning Models
기존 비디오 추론 방법은 R1 방식의 학습을 QA, temporal grounding, 객체 관계, 긴 비디오의 서사 이해로 확장한다. “thinking with frames”를 사용하는 방법은 선택한 시각 정보를 다시 살펴본다. 반면 VideoAuto-R1은 초기 답변 이후에도 언어 기반 추론을 계속해야 하는지 연구한다.
2.3 Auto-Thinking
기존 자동 추론 방법은 대체로 SFT나 RL로 전환 정책을 학습하며, think/no-think 데이터의 균형이 필요할 수 있다. VideoAuto-R1은 샘플별 모드 레이블, 전용 전환 토큰이나 헤드, cold-start CoT SFT를 사용하지 않는다. 테스트 시 초기 답변의 신뢰도로 추론 여부를 선택한다.
- 저자들은 반드시 추론해야 하는 비디오 예제가 부족해 지도학습 기반 모드 선택이 불안정해진다고 주장한다. 재현한 학습 기반 기준선은 실험한 설정에서 이 우려를 뒷받침하지만, 가능한 모든 학습 기반 라우팅 방식에 적용되는 근거는 아니다.
3 Preliminaries
배경 절에서는 GRPO 학습을 소개하고 기존 비디오 추론 모델의 직접 답변과 CoT 추론을 비교한다. 이 비교는 무조건 추론하기보다 선택적으로 추론해야 할 필요성을 보여준다.
3.1 Training Framework
Group Relative Policy Optimization(GRPO)은 후보 출력을 샘플링하고 검증 가능한 보상을 계산한 뒤, 학습된 critic 없이 그룹 내 상대적 advantage로 정규화한다. 클리핑된 중요도 비율 목적함수로 정책을 갱신하며, 참조 정책에 대한 KL 페널티를 적용한다.
- 상대적 advantage는 (A_i = \frac{r_i-\mu}{\sigma+\varepsilon})이며, μ와 σ는 샘플링한 그룹 내 보상의 평균과 표준편차다.
- 표준 보상은 과제 정답 여부와 출력 형식의 준수 여부를 결합한다. 과제에는 QA, temporal grounding, grounding QA가 포함된다.
학습 코퍼스는 기호 추론을 지원하기 위해 비디오 QA 및 grounding 예제와 텍스트·이미지 기반 수학 또는 과학 문제를 결합한다. 필터링 후 약 83K개 샘플이 남는다. RL은 cold-start CoT SFT 단계 없이 instruction tuning을 거친 backbone에서 바로 시작한다.
- Video-R1-CoT로 SFT를 수행하면 Qwen2.5-VL 기준선보다 성능이 떨어지고, 후속 RL을 시작하기에도 더 불리한 체크포인트가 된다. 이는 해당 cold-start 단계를 생략하는 선택을 뒷받침한다.
3.2 Analysis of Existing Video Reasoning Models
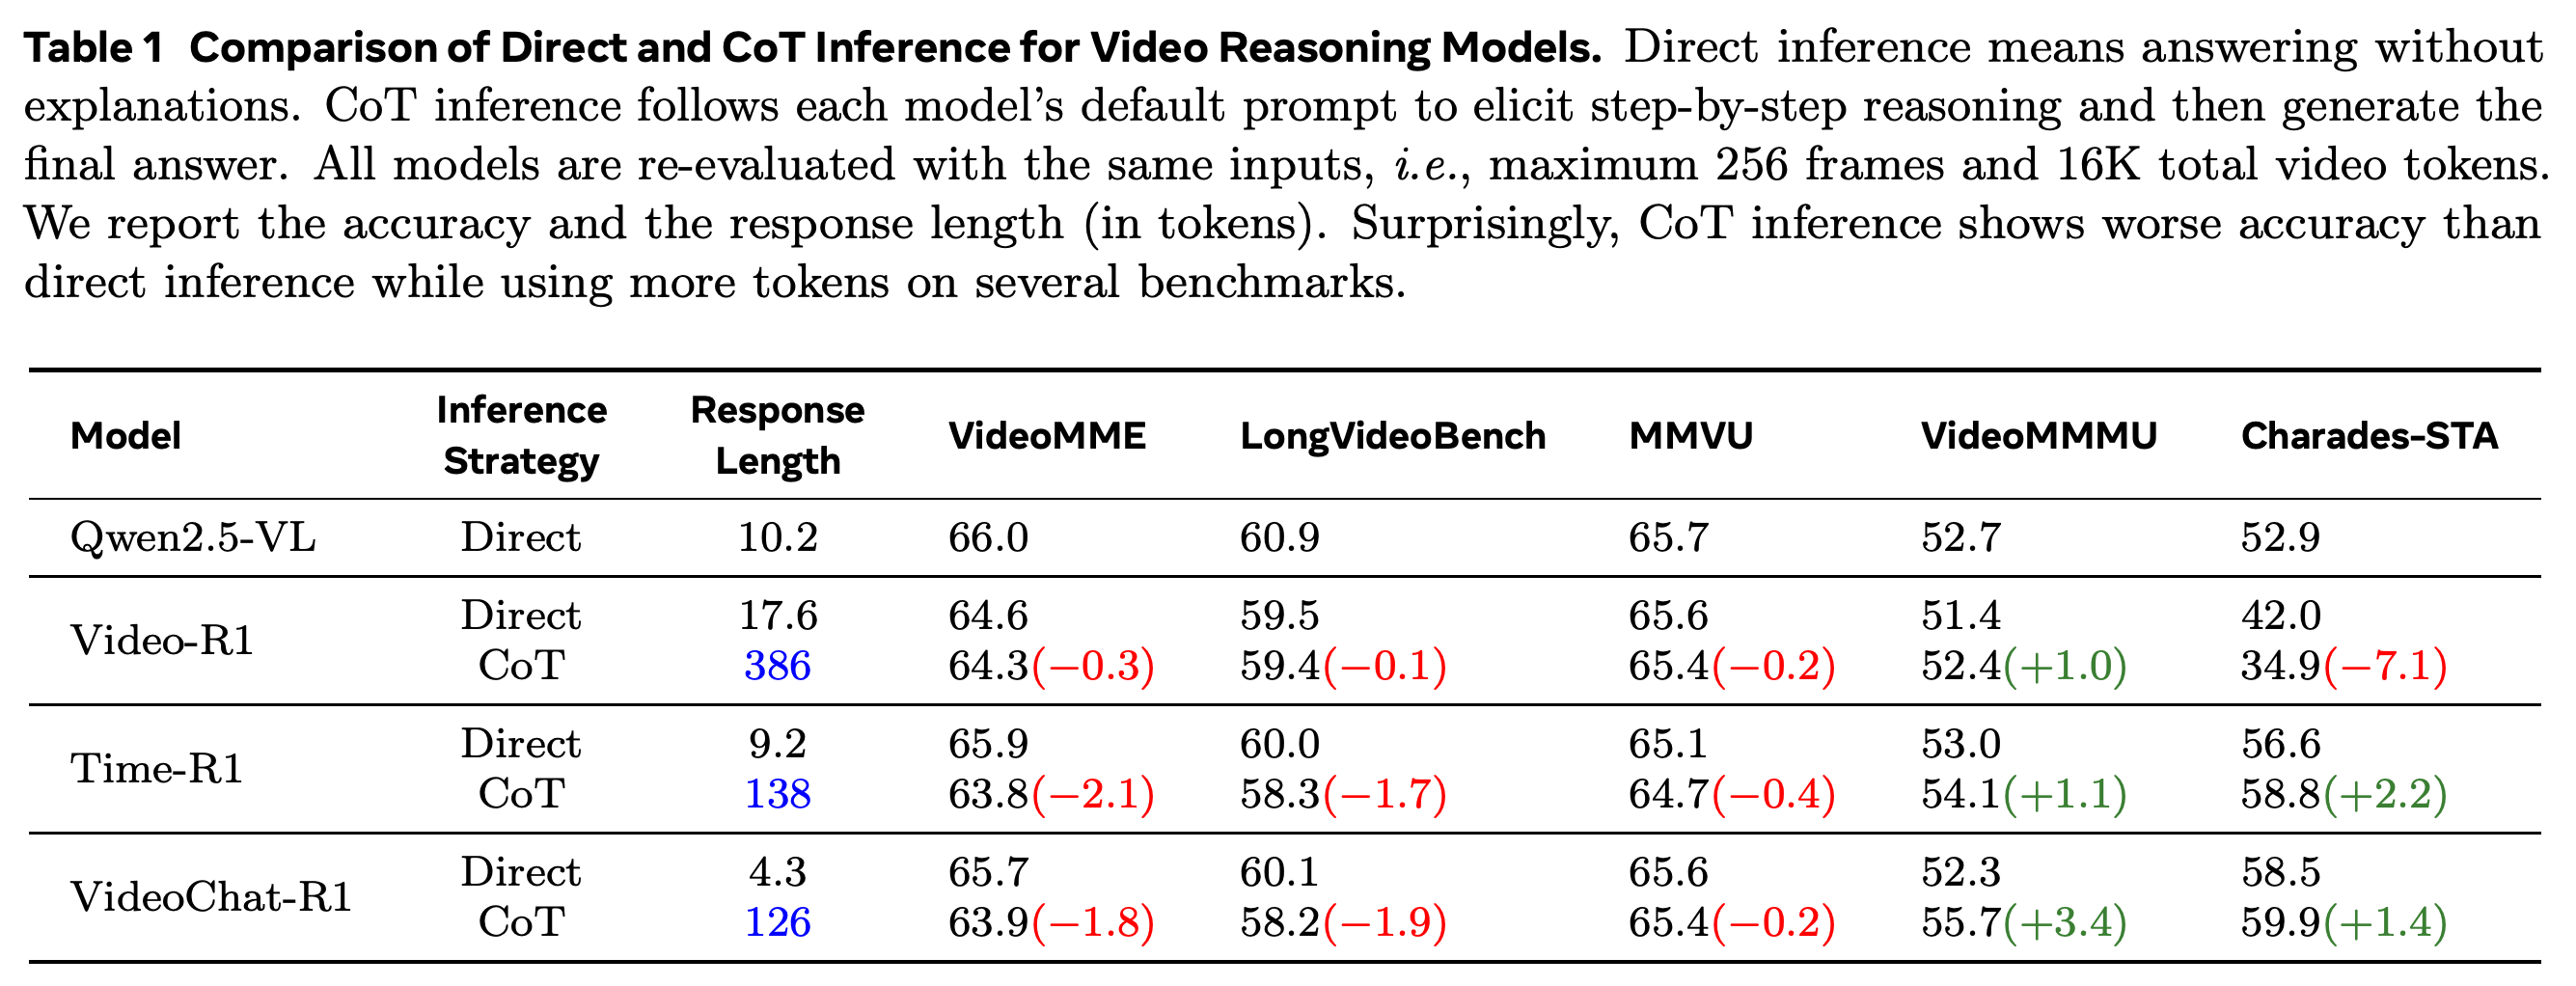
Table 1은 최대 256프레임과 총 16K 비디오 토큰이라는 동일한 입력 조건에서 Video-R1, Time-R1, VideoChat-R1을 재평가한다. 직접 답변은 VideoMME, LongVideoBench, MMVU에서 경쟁력 있는 성능을 보이면서 훨씬 적은 토큰을 생성한다.
- VideoChat-R1에서는 CoT가 VideoMME 정확도를 65.7에서 63.9로, LongVideoBench 정확도를 60.1에서 58.2로 낮추고, 평균 응답 길이는 4.3토큰에서 126토큰으로 늘린다.
- 모델 3개 모두 CoT를 사용하면 VideoMMMU에서 각각 +1.0, +1.1, +3.4점 개선된다. Grounding 결과는 덜 일관된다. CoT는 Charades-STA에서 Time-R1과 VideoChat-R1을 개선하지만, Video-R1은 42.0에서 34.9로 낮춘다.
- 정성 분석은 잡음이 적은 기호 입력과 여러 단계의 과학적 추론이 필요한 경우에 추론이 유용함을 보여준다. 지각 중심 과제의 추론 과정은 관찰 내용을 반복하거나 실제로 없는 세부 사항을 생성할 수 있다.
동일한 비디오 입력을 사용하므로, 모델 내에서 추론 전략을 비교할 수 있다. CoT는 VideoMMMU에는 일관되게 도움이 되지만, 여러 지각 벤치마크 점수를 낮추고 응답을 크게 늘린다. Grounding 결과는 모델마다 다르다.
4 VideoAuto-R1
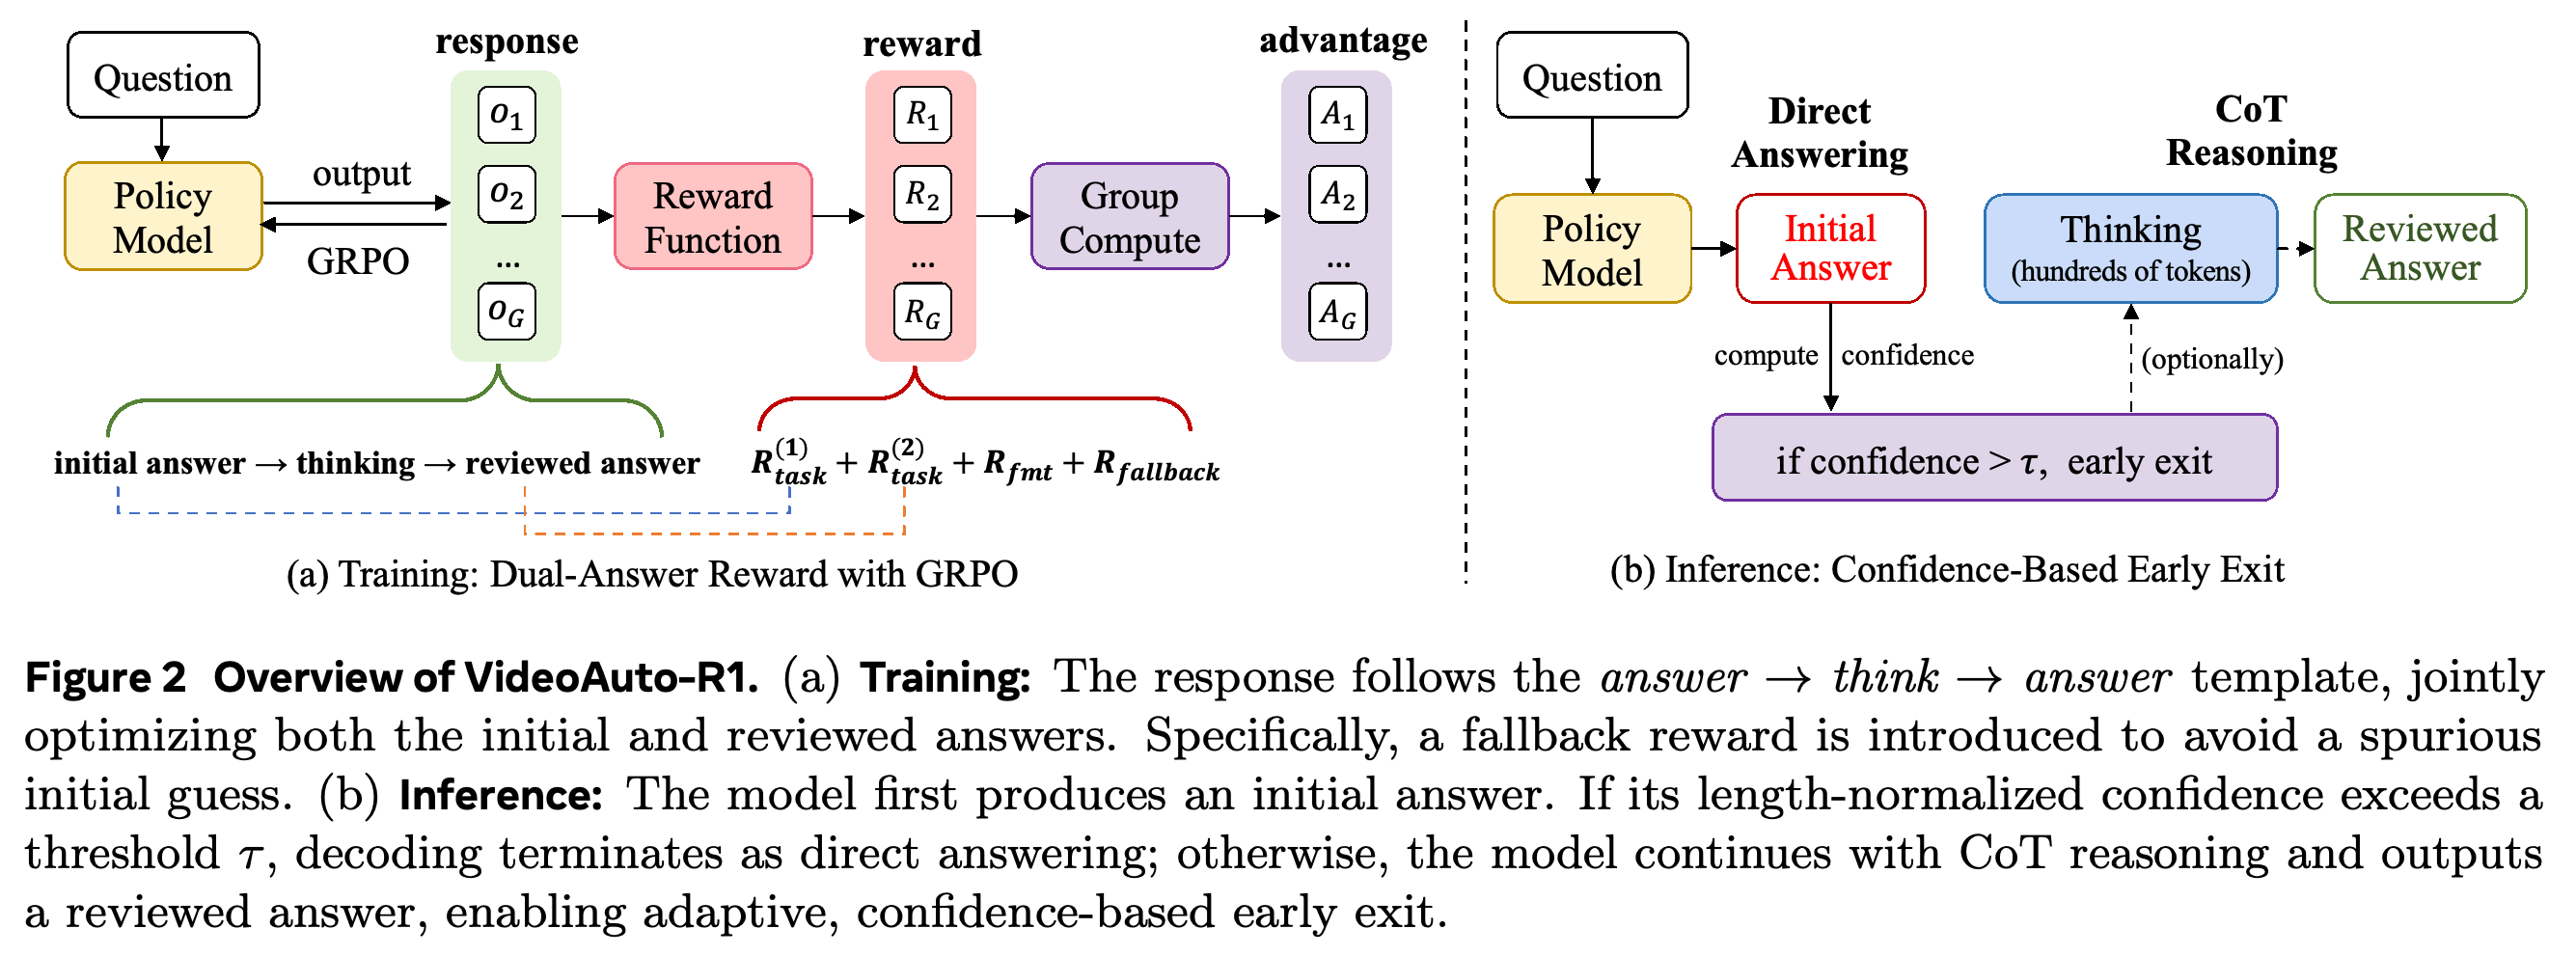
VideoAuto-R1은 초기 답변, 추론 과정, 검토 후 답변을 포함한 1개 시퀀스를 학습한다. Figure 2는 이중 답변 GRPO 학습과 신뢰도 기반 추론 결정을 구분해 보여준다.
학습 과정에서는 샘플링한 각 응답의 두 답변에 보상을 준 뒤 그룹 내 상대적 advantage를 계산한다. 추론 과정에서는 별도로 학습한 이진 라우팅 정책을 호출하지 않고, 초기 답변 이후에 종료 여부를 결정한다.
4.1 Thinking Once, Answering Twice
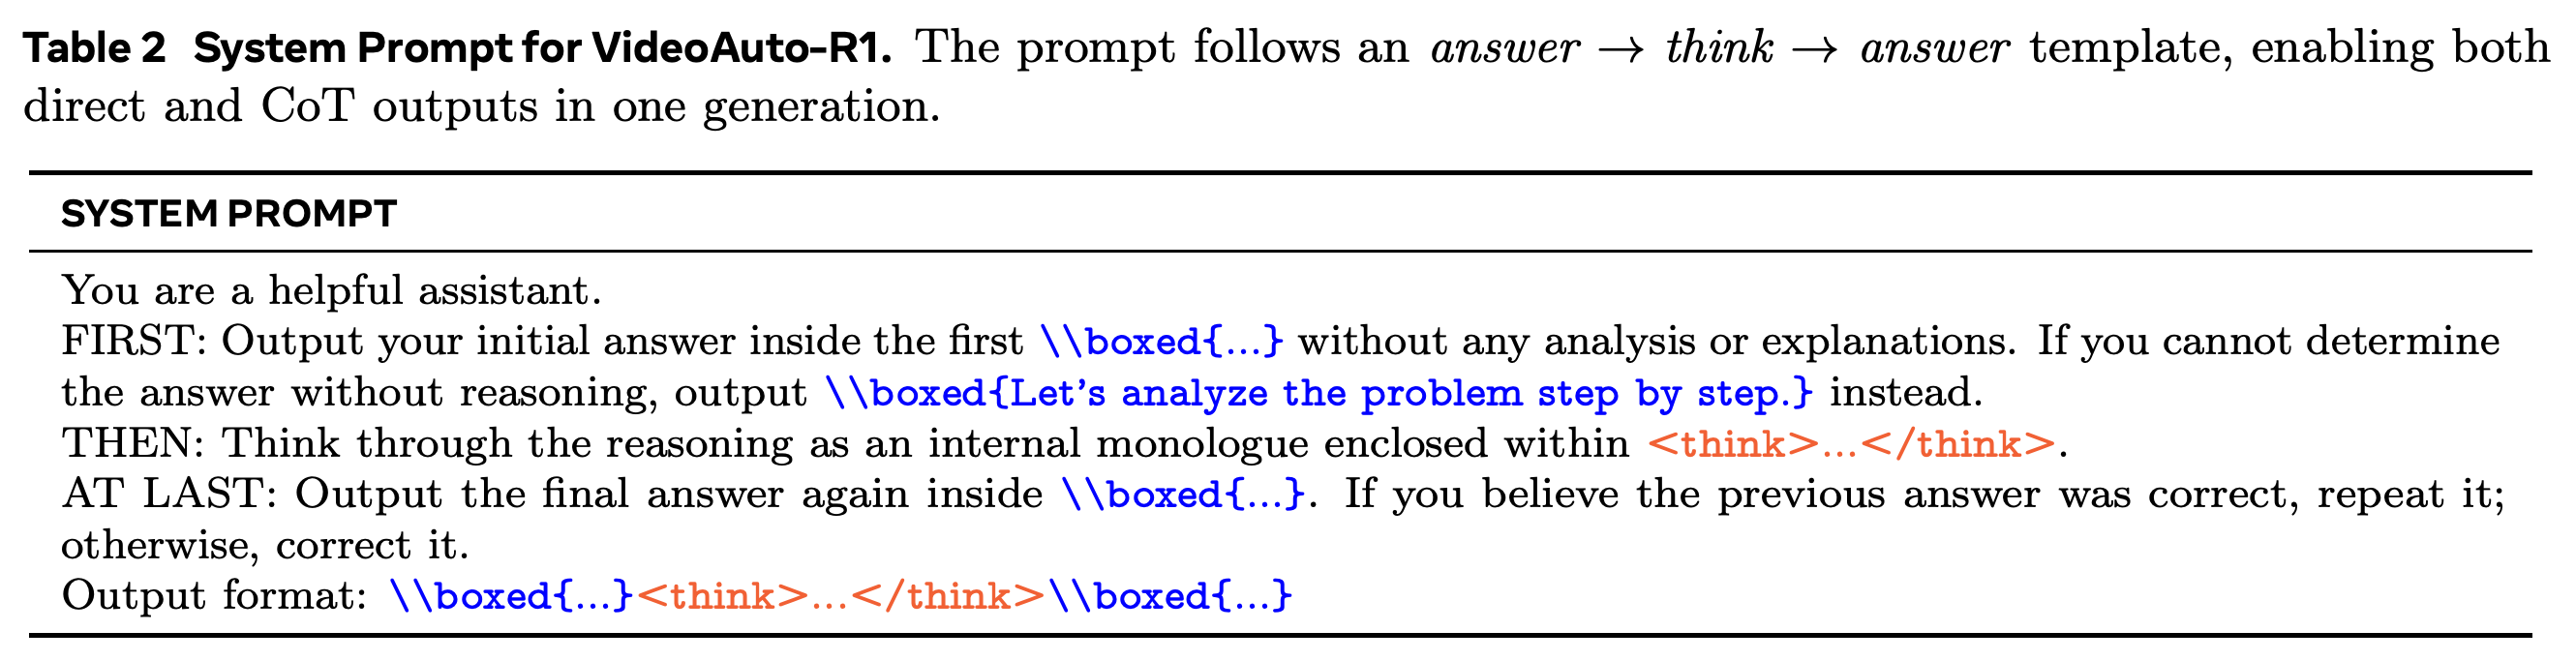
각 학습 응답은 엄격한 형식인 \\boxed{a1}<think>r</think>\\boxed{a2}를 따른다. 정확히 2개의 boxed answer와 그 사이의 1개 추론 블록으로 구성하며, 추가 텍스트는 허용하지 않는다. Table 2는 cold-start SFT 없이 이 시퀀스를 생성하게 하는 프롬프트를 제시한다.
- 즉시 답변하기 어려우면 첫 번째 박스에 지정된 fallback 문구인 “Let’s analyze the problem step by step.”을 넣을 수 있다. 추론 규칙은 이 문구를 답변으로 수용하지 않고 반드시 생성을 계속하도록 한다.
- 이 설계는 RL로 학습하는 추론 방법과 실제 추론 시 결정하는 추론 수행 여부를 분리한다. 사용자는 첫 번째 또는 두 번째 답변을 무조건 선택할 수도 있다.
프롬프트는 출력 구조와 순서를 지정하고 첫 번째 박스에 fallback을 허용한다. 학습된 전환 구성요소를 추가하지 않고 단일 생성 과정에서 두 답변 단계를 모두 유도한다.
4.2 Training: Dual-Answer Reward with GRPO
이중 답변 보상은 R = w1 R_task^(1)(a1) + w2 R_task^(2)(a2) + λ R_fmt + α R_fallback이며, w2 > w1 ≥ 0과 λ, α ≥ 0을 만족한다. 검토 후 답변에 더 큰 가중치를 주므로 wrong → correct 결과가 correct → wrong 결과보다 높은 보상을 받는다. 다만 이 보상이 정답을 오답으로 바꾸는 수정을 막지는 못한다.
- R_fallback은 초기 답변이 지정된 fallback이고 검토 후 답변이 정답일 때 주는 이진 보너스다. 잘못된 초기 추측이 아니라, 답변을 유보한 뒤 정답을 맞히는 행동에 보상한다.
- 형식 보상은 answer → think → answer 구조를 강제한다. 학습 중에는 검토 후 답변의 과제 보상이 대체로 초기 답변의 과제 보상보다 높다.
4.3 Inference: Confidence-Based Early Exit
초기 답변의 신뢰도는 s(a1) = (1/L) Σ_ℓ log pθ(tℓ | t<ℓ, q)이며, 박스 안의 토큰에 대해 계산한다. s(a1) ≥ log τ이면 모델이 종료하고, 그렇지 않으면 추론 과정과 검토 후 답변을 계속 생성한다.
- Fallback 답변에는 신뢰도 −∞를 부여해 조기 종료가 발생하지 않도록 한다.
- 이 길이 정규화 로그 확률은 답변이 정답일 확률로 보정된 값이 아니다. 초기 답변은 보통 10토큰 미만이므로 점수 계산에 필요한 작업량은 제한적이다.
5 Experiments
실험은 비디오 지각, 비디오 추론, temporal grounding, grounding QA, 이미지 추론에서 정확도, 출력 길이, 추론 활성화율을 평가한다. 학습 전략, 적응형 라우팅, 신뢰도 임계값, 보상, 데이터 선별, 프레임 수, cold-start SFT도 분석한다.
5.1 Experiment Details
Backbone은 Qwen2.5-VL-7B-Instruct와 Qwen3-VL-8B-Instruct다. 학습에는 최대 4,096 비디오 토큰과 256프레임을 사용한다. 시각 인코더는 고정하고 projector와 LLM을 32개의 H100 GPU에서 약 35시간 동안 1 epoch 학습한다.
- AdamW의 학습률은 1×10⁻⁶, weight decay는 0.01, 최대 gradient norm은 1.0이다. Warm-up 없이 일정한 학습률을 사용한다. 전역 배치 크기는 256이고 KL 계수 β는 0.01이다.
- 보상 계수는 w1 = 0.9, w2 = 1.1, λ_fmt = 1, α = 0.3이다. GRPO는 temperature 1.0에서 프롬프트당 16개 rollout을 사용한다.
- 테스트에는 lmms-eval, temperature 0의 greedy decoding, 4,096토큰 응답 제한을 사용한다. τ = 0.97은 소규모 held-out 검증 부분집합에서 조정한 값이다.
비디오 QA 평가는 자막 없는 VideoMME, MVBench, LongVideoBench, MMVU multi-choice, VideoMMMU, MVP-mini를 포함한다. MVP는 시각적으로 비슷하지만 정답이 반대인 비디오 모두에 정답을 맞혀야 하는 pairwise accuracy를 보고한다.
- Charades-STA와 ActivityNet은 IoU 임계값별 recall과 평균 IoU로 temporal grounding을 측정하며, NExT-GQA는 grounding QA를 측정한다.
- Qwen2.5-VL 테스트는 16K 비디오 토큰과 {64, 128, 256}프레임을 허용한다. Qwen3-VL은 128K 토큰과 {64, 256, 2048}프레임을 허용한다. 주요 결과는 고정된 단일 프레임 설정이 아니라 이 설정들 중 가장 높은 성능을 보고한다.
- 이미지 평가에는 MathVista, MathVision, MathVerse, MMMU, MMMU-Pro, MM-Vet을 사용한다.
5.2 Main Results
Table 3에서 Qwen2.5-VL 기반 VideoAuto-R1은 VideoMME 67.3, MVBench 71.0, LongVideoBench 60.5, MMVU 69.7, VideoMMMU 58.6, MVP 39.4를 기록한다. 추론 벤치마크의 향상 폭은 대부분의 지각 벤치마크보다 크지만, LongVideoBench는 기반 모델의 60.9에서 60.5로 낮아진다.
- Qwen3-VL 버전은 VideoMMMU 65.0, MVP 43.0을 달성하며, 기반 모델의 점수는 각각 61.0과 40.5다. VideoMME와 LongVideoBench 점수는 71.7과 67.4로, 기준선의 72.5와 67.6보다 낮다.
- Backbone 2개의 평균 응답 길이는 각각 44토큰과 52토큰이다. Qwen2.5-VL에서는 MVBench 샘플의 25%, VideoMMMU 샘플의 51%에서 추론이 활성화된다.
- 결과는 선택적 디코딩으로 추론 벤치마크 정확도를 높일 수 있음을 뒷받침하지만, 모든 벤치마크에서 일관되게 우수하다는 뜻은 아니다. Table 3의 MMVU 추론 활성화율은 28%인 반면, Tables 7–8에서는 39%로 보고한다.
Backbone 모두 짧은 평균 응답을 생성하면서 추론 벤치마크 성능을 개선한다. LongVideoBench는 어느 기반 모델과 비교해도 개선되지 않으며, Qwen3-VL 버전은 VideoMME에서도 기준선보다 낮다. 여기서 Qwen2.5-VL의 MMVU 활성화율은 28%로, Tables 7–8의 39%와 일치하지 않는다.
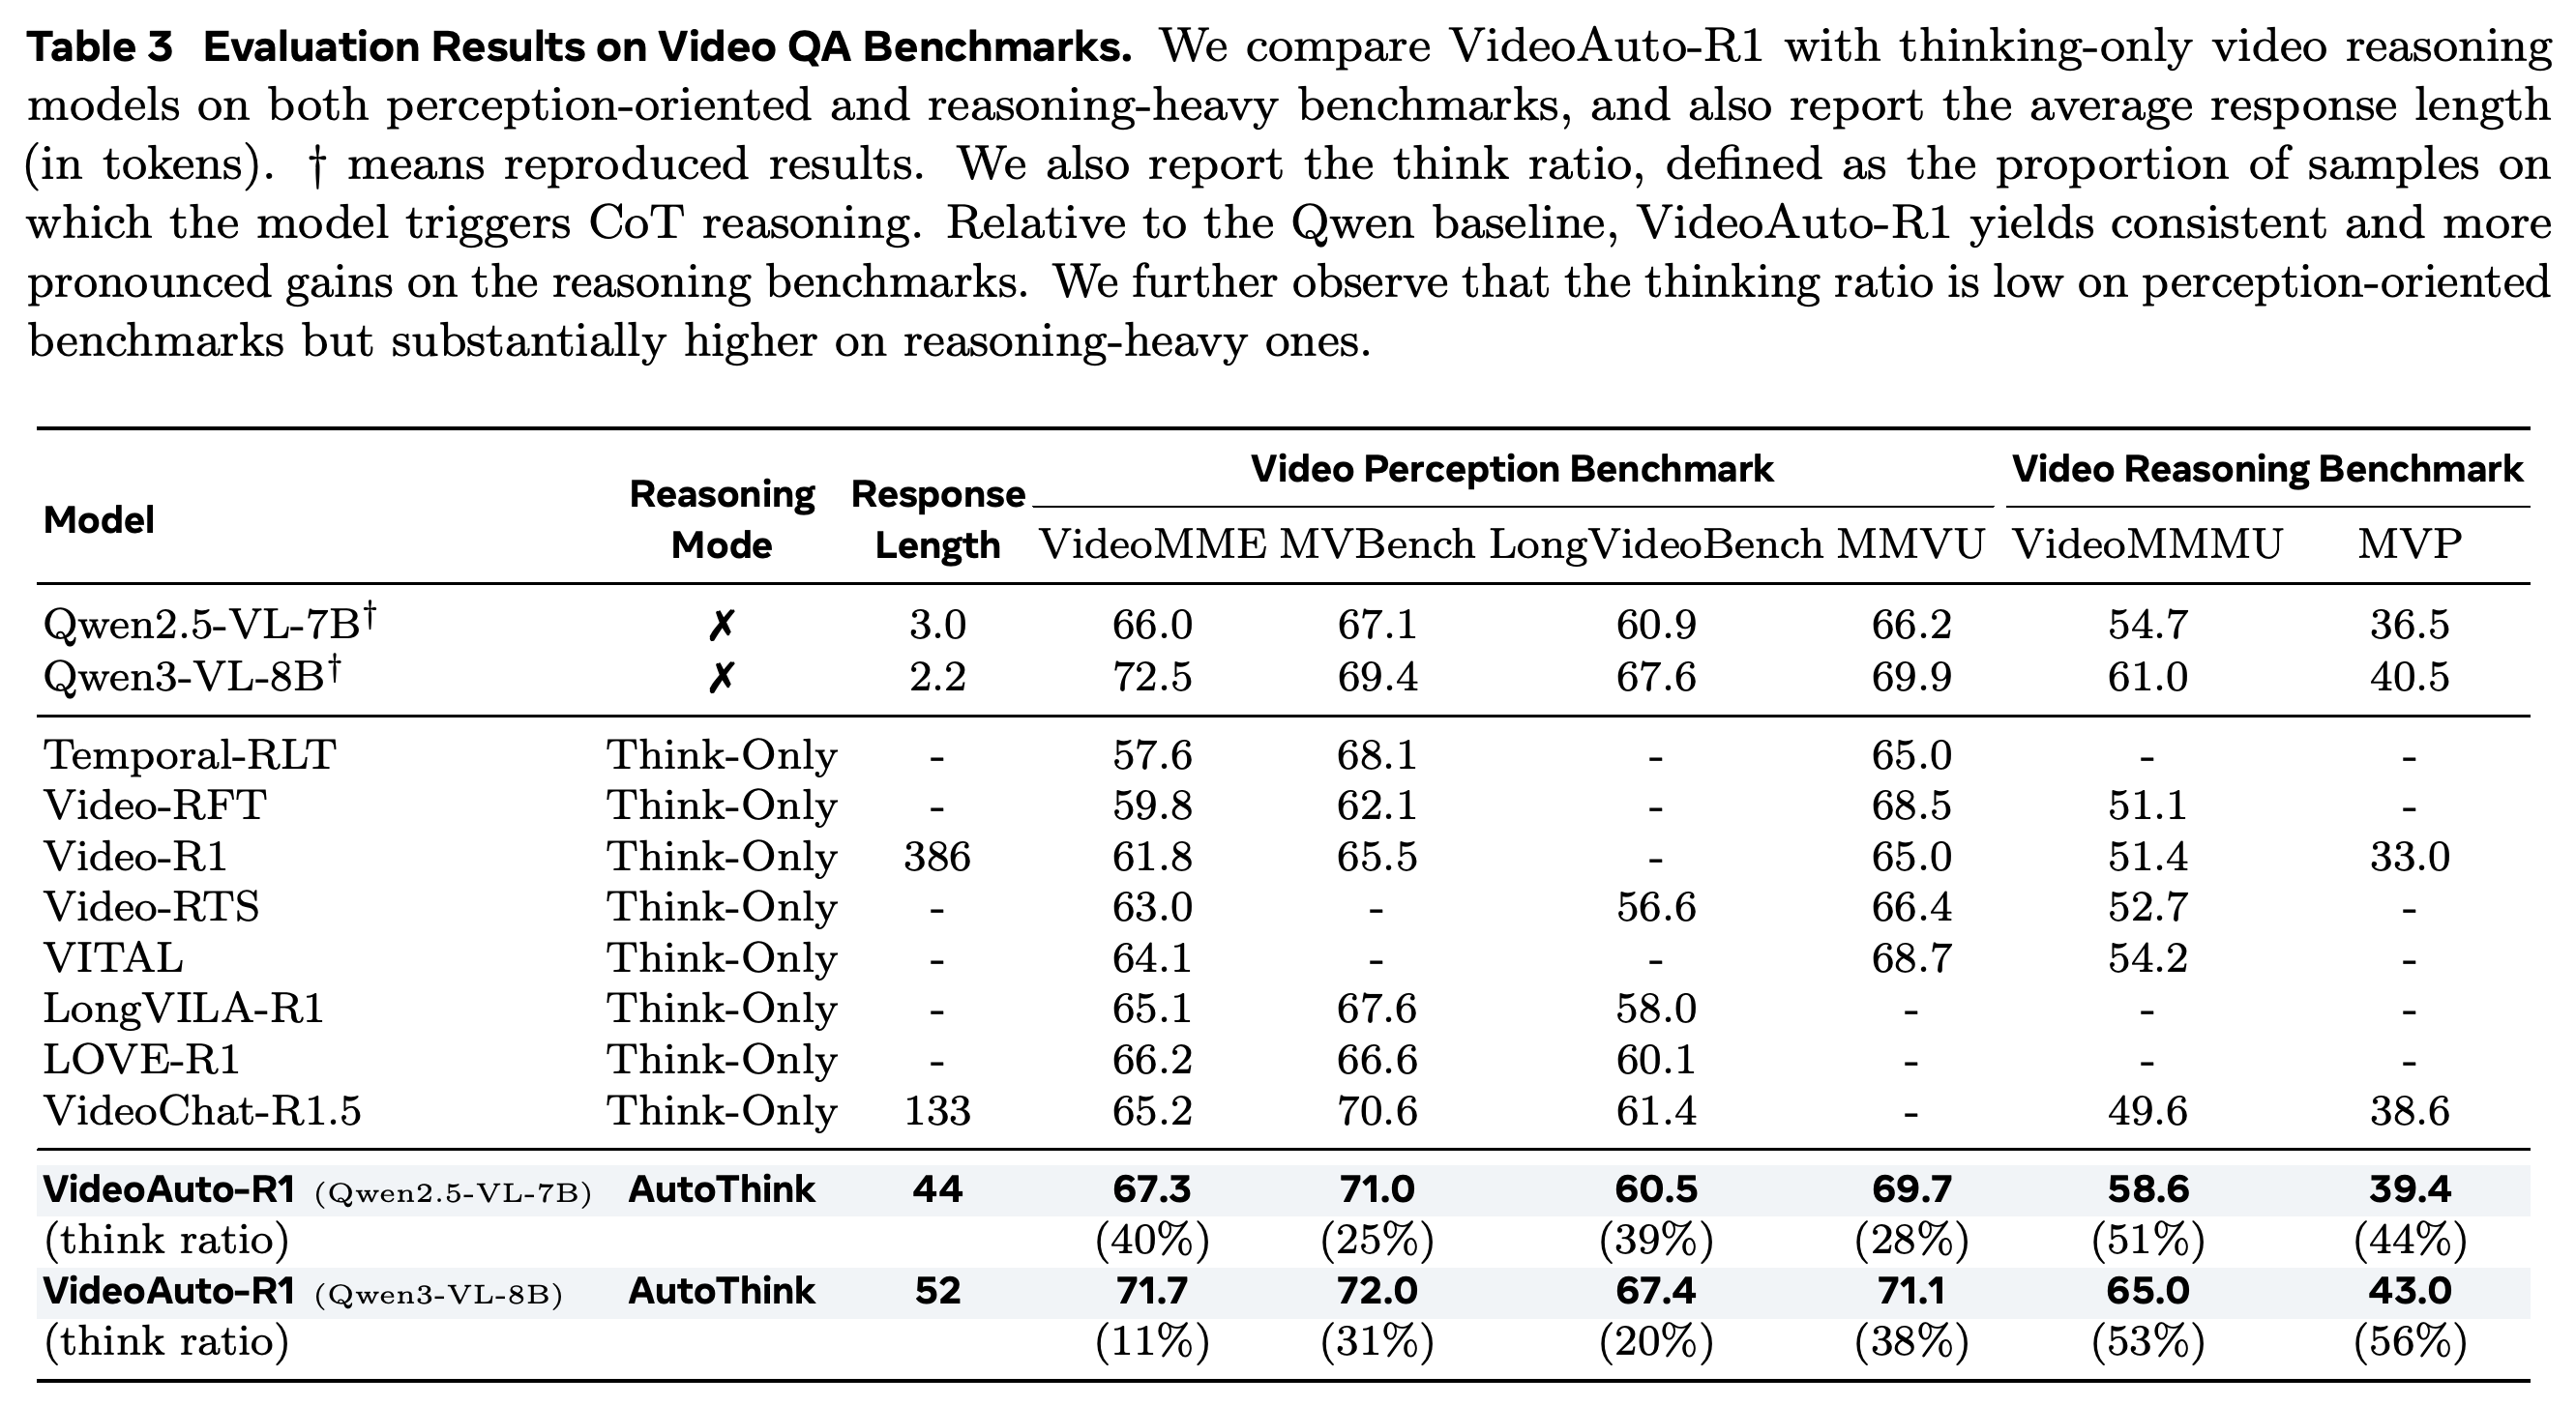
Table 4는 Qwen2.5-VL 기준선 대비 grounding 개선을 보여준다. Charades-STA mIoU는 52.9에서 60.0으로, ActivityNet은 26.9에서 47.6으로, NExT-GQA 정확도는 53.3에서 80.6으로 오른다. 검토 후 답변이 보고된 위치 추정 결과를 개선하지 못하므로, grounding 평가는 기본적으로 초기 답변을 사용한다.
- Qwen3-VL 기반 VideoAuto-R1은 Charades-STA에서 mIoU 63.7, ActivityNet에서 51.9, NExT-GQA에서 정확도 81.1과 mIoU 44.2를 달성한다.
- 기존 모델과의 비교 결과는 지표에 따라 다르다. Qwen2.5-VL 버전의 ActivityNet mIoU 47.6은 Time-R1의 52.1보다 낮고, NExT-GQA mIoU 36.7은 VITAL의 43.0보다 낮다.
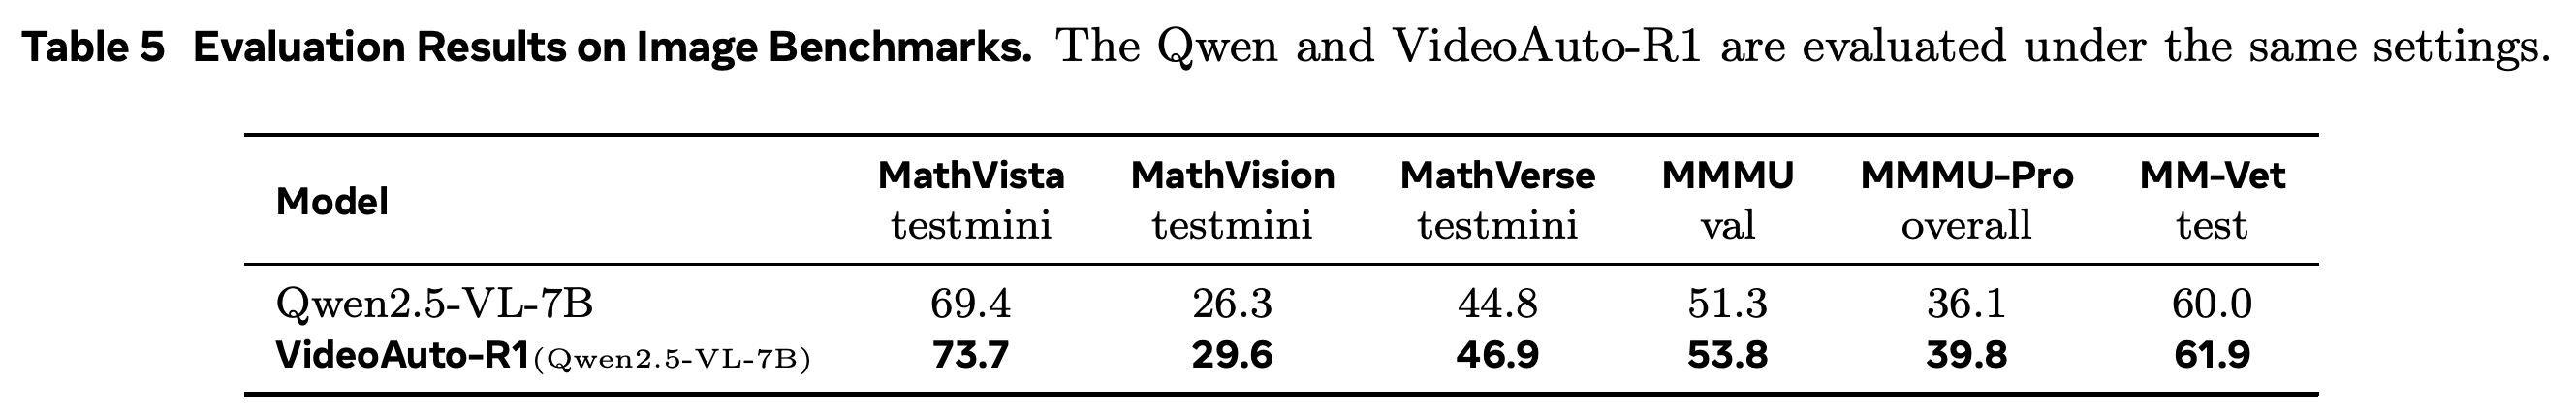
Table 5는 동일한 설정에서 평가한 이미지 벤치마크 6개 모두에서 Qwen2.5-VL 대비 개선을 보여준다. MathVista는 69.4에서 73.7로, MathVision은 26.3에서 29.6으로, MathVerse는 44.8에서 46.9로, MMMU는 51.3에서 53.8로, MMMU-Pro는 36.1에서 39.8로, MM-Vet은 60.0에서 61.9로 오른다.
- 학습 코퍼스에 이미지 추론 데이터가 포함되어 있으므로, 이 결과는 학습에 없던 모달리티로의 전이가 아니라 비디오 외 과제에도 적용할 수 있음을 보여준다.
동일한 평가 설정에서 이미지 벤치마크 6개의 점수가 모두 오른다. 학습에 이미지 추론 예제가 포함되어 있으므로, 이 결과는 멀티모달 적용 가능성을 뒷받침하지만 학습하지 않은 모달리티로의 전이 효과를 분리하지는 못한다.
5.3 Analyses and Ablations
Table 6은 동일한 학습 데이터에서 SFT, 추론 없는 RL, 추론을 사용하는 표준 RL, VideoAuto-R1을 비교한다. VideoAuto-R1은 VideoMMMU에서 58.6을 기록해 추론을 사용하는 RL의 56.4보다 높으며, 평균 응답 길이는 149토큰에서 44토큰으로 줄인다.
- 추론을 사용하는 RL과 비교하면 VideoAuto-R1은 VideoMME를 66.1에서 67.3으로, MMVU를 67.5에서 69.7로, Charades-STA를 59.8에서 60.0으로 개선한다.
- 이 통제된 비교는 이중 답변 학습과 적응형 추론을 함께 평가한다. 정확도 향상이나 전체 토큰 감소를 조기 종료만의 효과로 볼 수는 없다.
동일한 학습 데이터에서 VideoAuto-R1은 추론을 사용하는 표준 RL보다 기재된 점수를 높이고, 응답 길이를 149토큰에서 44토큰으로 줄인다. 이 비교는 조기 종료만이 아니라 전체 학습·추론 방법을 평가한다.
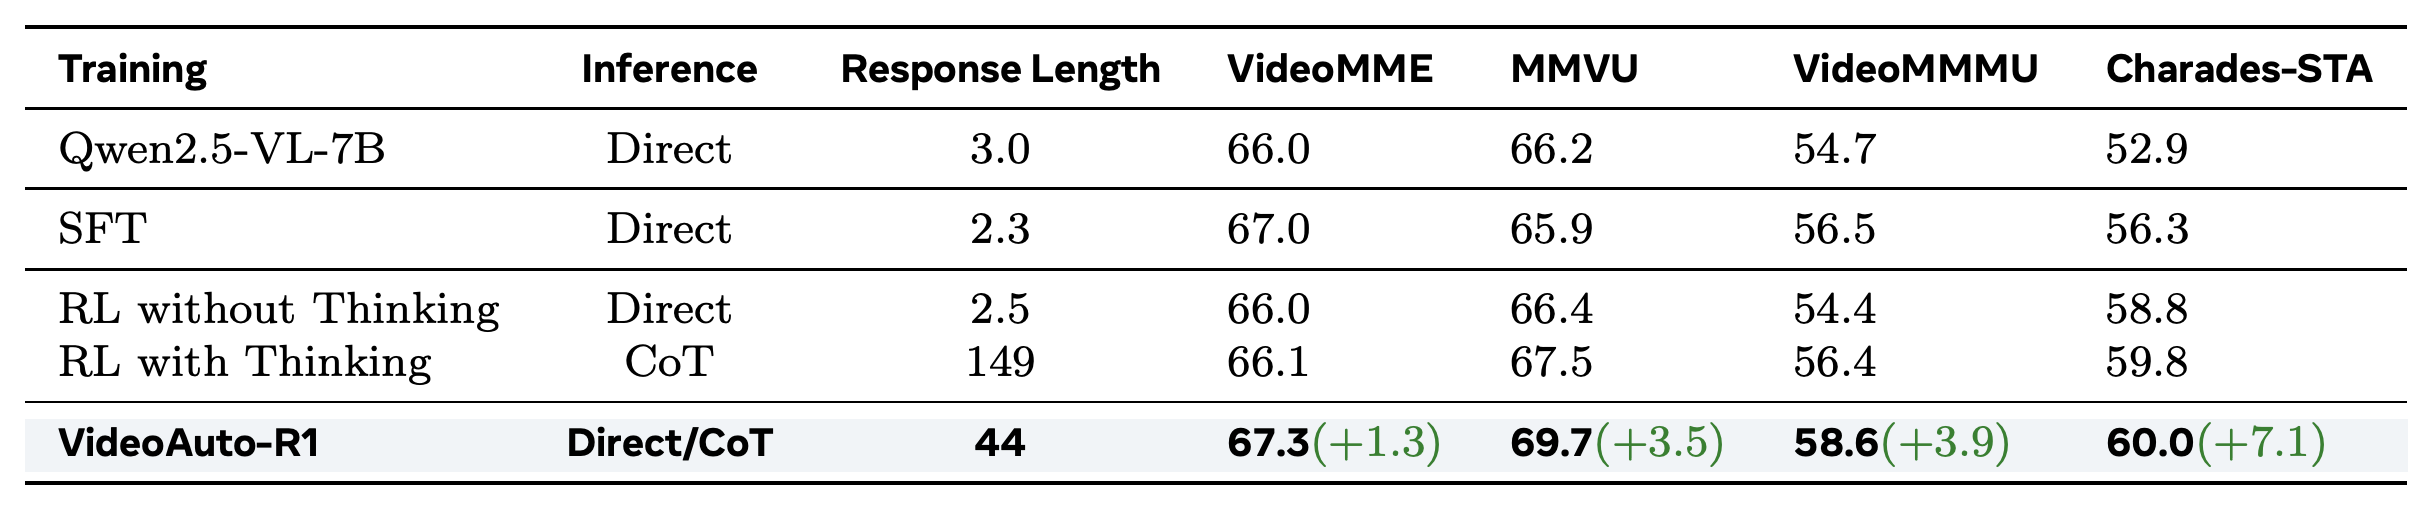
Table 7은 추론 시 신뢰도 라우팅을 AdaptThink에서 착안한 학습 기반 기준선과 비교한다. 기준선은 8개 rollout으로 예제에 레이블을 부여하고, 학습 중 think/no-think 비율을 약 1:1로 유지한다. 그런데도 자동 모드에서는 평가 샘플의 14%에서만 추론을 활성화한다.
- 학습 기반 자동 모드는 VideoMMMU 55.7, MVP 36.8을 기록하며, VideoAuto-R1은 각각 58.6과 39.4를 기록한다.
- VideoAuto-R1에서 항상 첫 번째 답변을 사용하면 평균 8토큰, 항상 검토 후 답변을 사용하면 91토큰, 적응형 추론을 사용하면 44토큰이 필요하다.
- 적응형 추론은 검토 후 답변의 정확도를 거의 유지한다. VideoMMMU는 항상 추론하는 경우의 58.7에 비해 58.6이며, MVP는 39.8에 비해 39.4다. 동일 모델 내에서 수행한 이 비교는 Table 6보다 추론 규칙의 효과를 더 직접적으로 분리한다.
Table 8은 초기 답변 신뢰도와 추론의 이점 사이의 관계를 살펴본다. 초기 답변의 평균 확률은 MVBench 0.948, MMVU 0.933, VideoMMMU 0.874이며, 해당 추론 활성화율은 각각 25%, 39%, 51%다.
- 검토 후 답변은 초기 답변보다 정확도를 각각 +0.1, +0.4, +4.0점 높인다.
- 초기 답변은 오답이지만 검토 후 답변은 정답인 사례에 대한 라우팅 recall은 MVBench와 MMVU 모두 100%이고, VideoMMMU는 94%다.
- 높은 recall은 이 평가에서 라우팅이 수정 가능한 사례 대부분을 포착함을 보여준다. 다만 표는 라우팅 precision이나 종합적인 신뢰도 보정 분석을 보고하지 않는다.
VideoMMMU는 MVBench나 MMVU보다 초기 신뢰도가 낮고, 추론 활성화율이 높으며, 검토 후 답변의 개선 폭도 크다. 초기 답변은 오답이고 후속 답변은 정답인 사례에서 높은 recall은 라우팅이 유용한 추론 지속 사례 대부분을 포착함을 보여준다. 다만 라우팅 precision이나 신뢰도가 잘 보정되었음을 입증하지는 않는다.
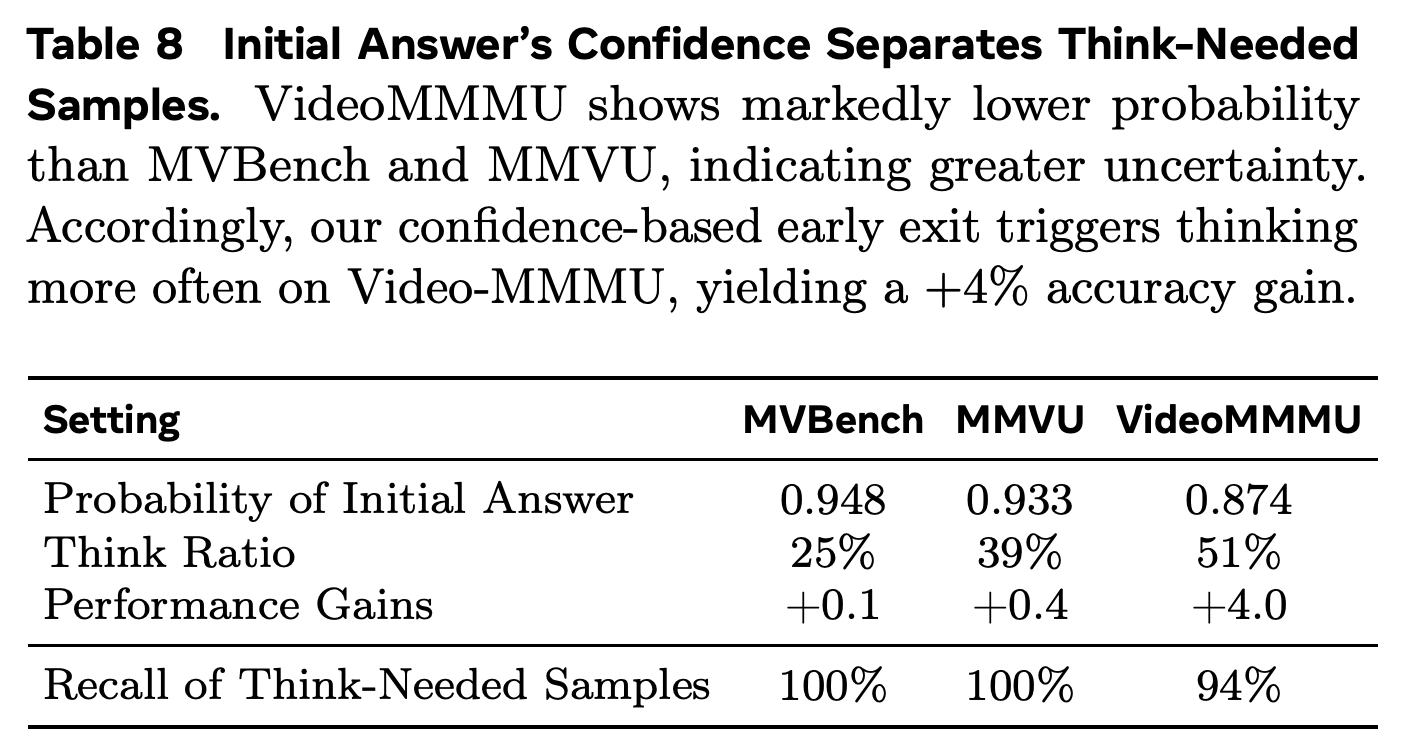
Table 9는 답변 가중치와 fallback 보너스를 분석한다. 가중치가 0.9:1.1일 때 fallback 보상을 추가하면 VideoMMMU는 56.4에서 58.6으로, MVP는 37.2에서 39.4로, Charades-STA는 59.1에서 60.0으로 오른다.
- 비대칭 가중치만으로는 1:1보다 일관되게 나아지지 않는다. Fallback 없이 0.9:1.1을 적용하면 VideoMME는 66.1에서 66.0으로, MVP는 38.3에서 37.2로 낮아진다.
- 보고된 최상의 설정은 검토 후 답변에 약간 더 큰 가중치를 주면서 fallback 보너스를 함께 사용하는 방식이다. 가중치 비대칭을 더 크게 해도 결과가 일관되게 개선되지는 않는다.
Fallback 보너스는 실험한 비대칭 가중치 설정 모두를 개선한다. Fallback 없이 비대칭 가중치만 사용하면 결과가 엇갈린다. 따라서 보고된 최상의 설정은 비대칭 가중치만이 아니라 결합된 보상 설계를 뒷받침한다.
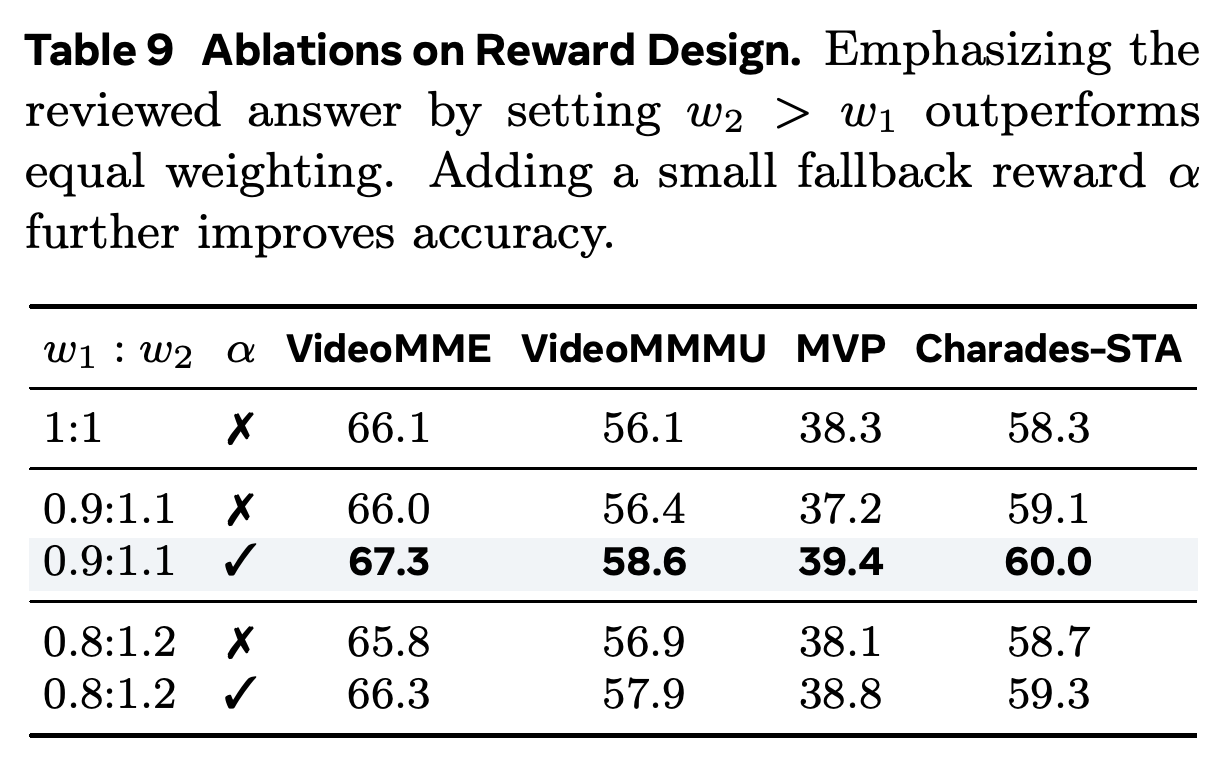
Figure 3은 조기 종료 임계값을 바꾸며 정확도와 계산량 사이의 절충 관계를 보여준다. τ를 0.86에서 0.98로 높이면 VideoMMMU 정확도는 57.5%에서 58.7%로, 추론 활성화율은 29%에서 55%로 오른다.
- MVP 정확도는 39.16%에서 39.37%로 오르는 동안 활성화율은 20%에서 51%로 오른다. 추가 추론에 비해 정확도 향상은 작다.
- VideoMME는 제시된 임계값 범위에서 활성화율이 증가해도 정확도 67.3%를 유지한다. 논문은 공통 기본값으로 τ = 0.97을 사용한다.
임계값을 높이면 추론 활성화율은 일관되게 증가한다. 정확도는 VideoMMMU에서 개선되고, MVP에서는 조금만 변하며, VideoMME에서는 그대로다. 추가 디코딩의 효과가 과제에 따라 다름을 보여준다.
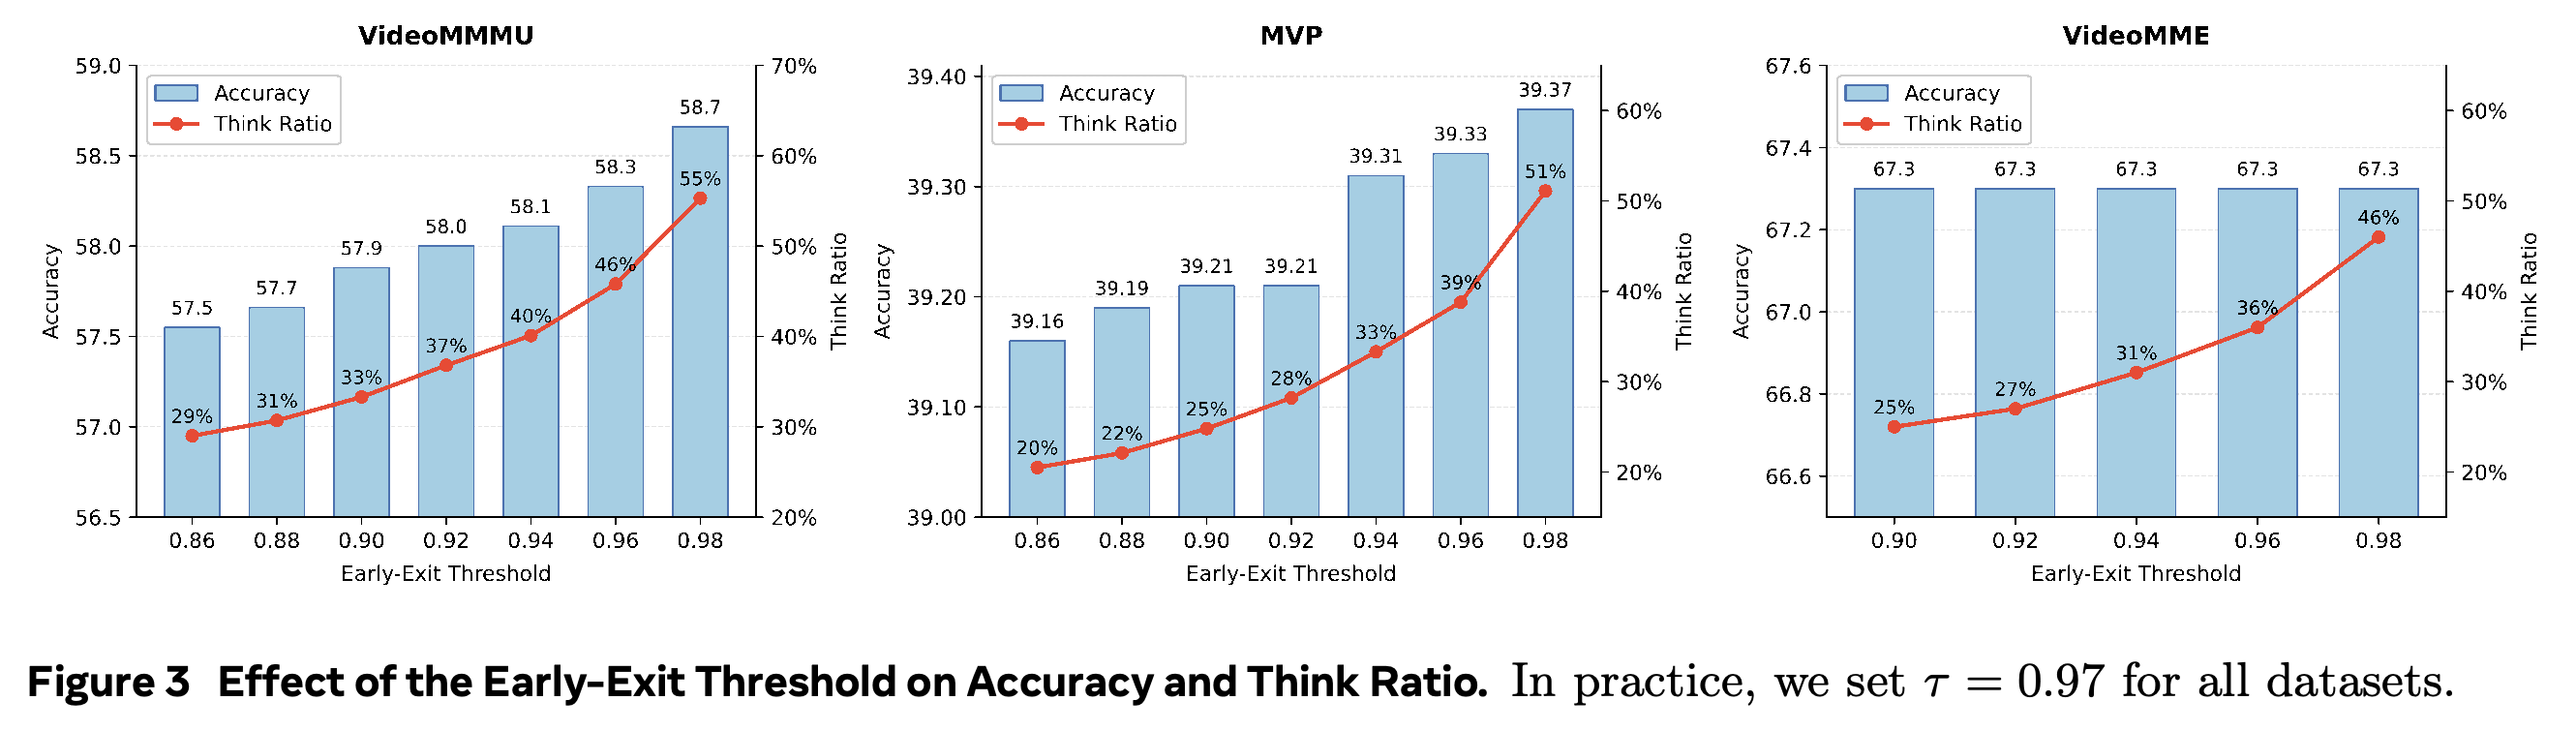
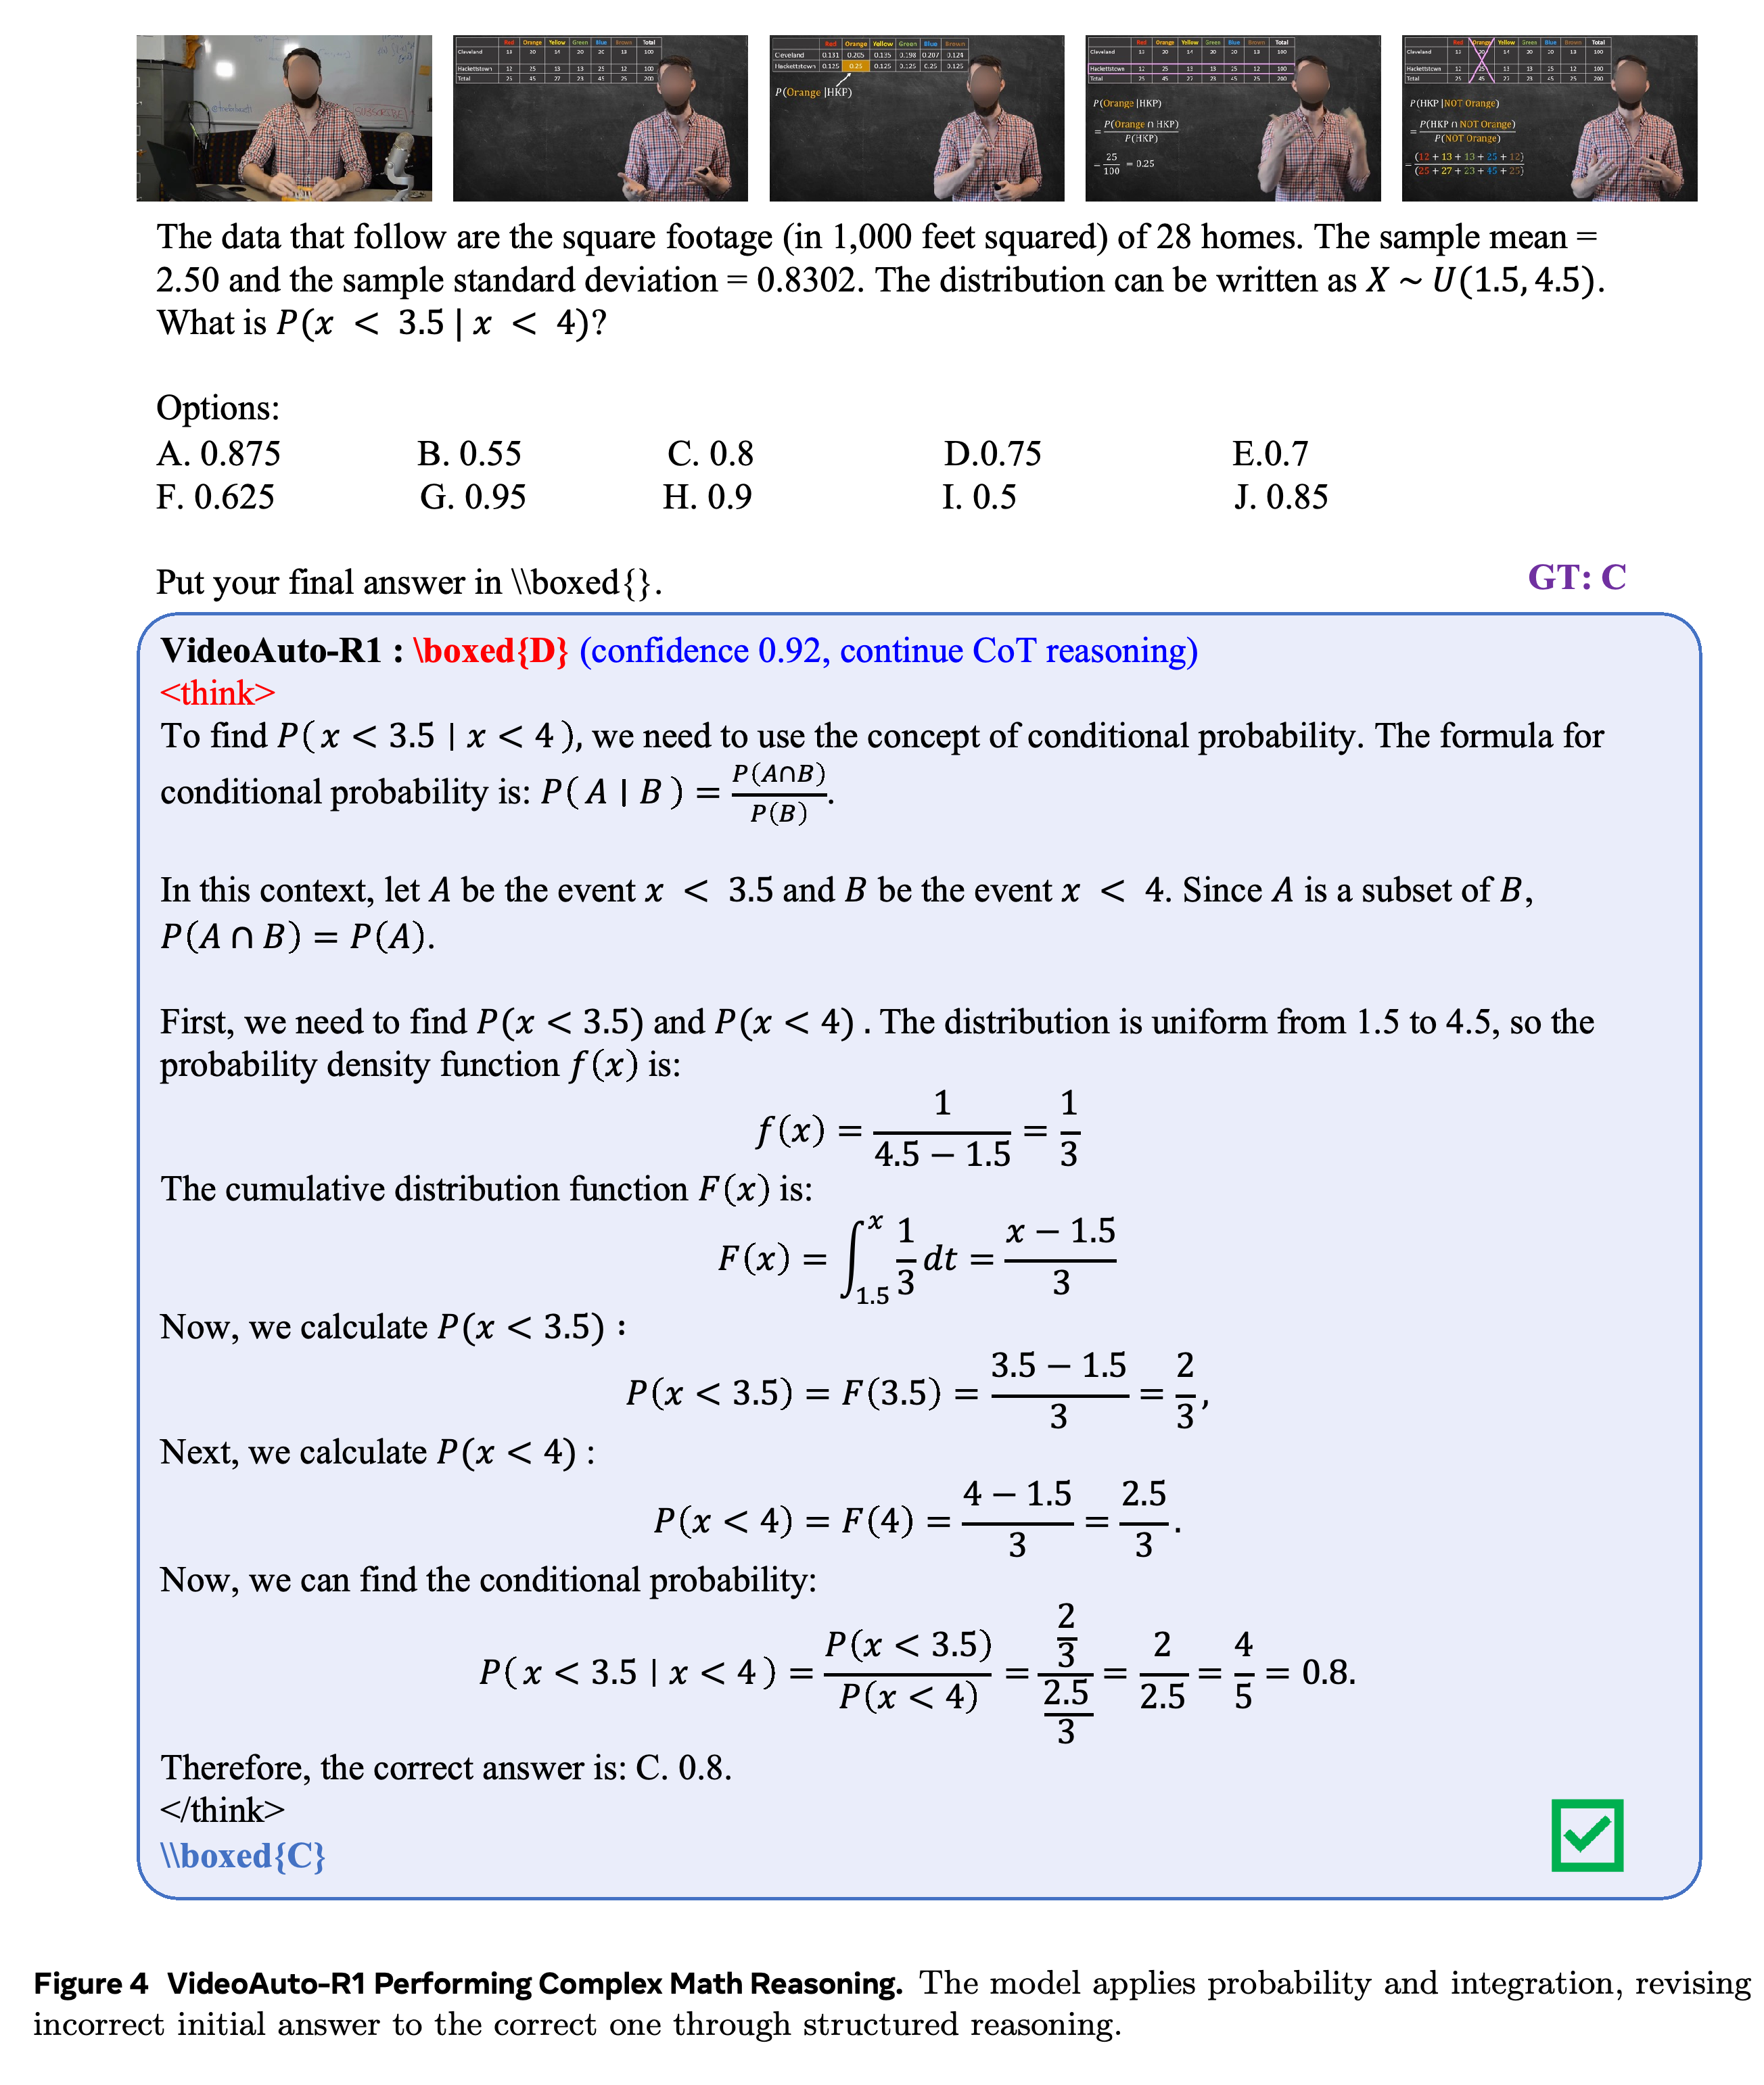
Figure 4는 균등분포 (X\sim U(1.5,4.5))가 등장하는 문제에서 추론으로 답변을 수정한 사례를 보여준다. 신뢰도 0.92의 초기 답변 D는 P(x < 3.5 | x < 4) = 0.8을 계산한 뒤 C로 수정된다.
- 이 예제는 기호 문제에서 성공적으로 답변을 수정한 사례다. 다만 추론이 얼마나 자주 답변을 바로잡는지, 생성된 추론 과정이 일반적으로 실제 답변 도출 과정을 충실히 반영하는지는 입증하지 않는다.
신뢰도 0.92에서는 초기 선택지 D를 수용하지 않는다. 이어지는 추론은 균등분포의 조건부 확률을 0.8로 계산하고, 답변을 정답 선택지 C로 수정한다.
6 Conclusion
결론은 이중 답변 학습과 신뢰도 기반 조기 종료를 무조건적인 비디오 CoT의 대안으로 제시한다. 실험은 추론 벤치마크 정확도를 유지하면서 출력 생성을 줄일 수 있음을 뒷받침한다. 반면 검토 후 답변 단계가 grounding에 주는 추가 이점은 작다.
부록
- A Training Data: 필터링한 데이터셋은 텍스트 6.4K개, 이미지 27.5K개, 비디오 49.4K개 예제로 구성된다. 출처는 DAPO-Math, ViRL, ThinkLite-Hard, Video-R1, TVBench, STI-Bench, MMR-VBench, Charades-STA, ActivityNet, Time-R1, NExT-GQA다. 저자들은 평가용 테스트 샘플을 수작업으로 제외했다고 밝힌다.
- A Training Data: 필터링 과정은 정답의 유효성을 확인하고, Qwen2.5-VL-7B-Instruct로 예제당 8개 응답을 생성한 뒤, Qwen3-30B-A3B-Instruct로 정답 여부를 판정한다. QA 샘플은 응답 8개가 모두 정답이거나 모두 오답이면 제거하지만, temporal grounding 샘플은 유지한다. CoT를 사용하는 RL에서는 멀티모달 코퍼스를 필터링하면 VideoMMMU가 55.4에서 56.4로 개선되고, 기재된 데이터 규모는 138K에서 83K로 줄어든다. 텍스트만으로 학습하면 비디오 과제 성능이 낮으며, 모든 모달리티를 섞은 구성이 전반적으로 가장 좋은 성능을 보인다.
- B Reward Designs: QA 보상은 이진값이며, 수학 답변에는 math-verify를 사용하고 나머지는 정규화한 문자열을 비교한다. Temporal grounding은 예측 구간과 참조 구간의 조합에서 최대 temporal IoU를 사용하며, 파싱할 수 없는 예측에는 보상 0을 준다. Grounding QA는 답변 정답 여부와 temporal IoU를 합산하고, 엄격한 정규식 검사로 출력 형식을 강제한다. 이진 QA 보상에서 가중치 0.9와 1.1, fallback 계수 0.3을 사용하면 형식 항을 제외한 과제 보상과 fallback 보상의 합은 correct → wrong에서 0.9, wrong → correct에서 1.1, fallback → correct에서 1.4, 두 답변 모두 정답일 때 2다.
- C Prompt Template: 추론 없는 RL 기준선은 boxed answer만 생성한다. 추론을 사용하는 RL 기준선은 <think>…</think> 추론 과정 뒤에 boxed answer를 생성한다. 이 템플릿은 기준선의 학습 전략과 VideoAuto-R1의 answer → think → answer 형식을 구분한다.
- D Training Curve: Backbone 모두 초기 답변과 검토 후 답변의 과제 보상이 학습 초기에 빠르게 오르고, 이후에는 더 완만하게 개선된다. 수렴 후에도 검토 후 답변의 보상이 더 높으며, 제시된 곡선에서는 Qwen3-VL의 격차가 더 크다. 이 관찰만으로는 보상 비대칭이나 모델 용량의 인과적 효과를 다른 backbone 차이와 분리할 수 없다.
- E Inference Strategy: Algorithm 1은 첫 번째 <think> 시작 태그가 나올 때까지 greedy decoding을 수행하고, 앞서 생성된 boxed answer를 추출해 평균 토큰 로그 확률을 평가한다. 구현에서는 fallback에 −1e6 점수를 부여한다. 점수가 log τ 이상이면 초기 답변을 수용하고, 그렇지 않으면 기존 prefix에서 디코딩을 재개한다.
- F Additional Experiments: F.1 Performance with Different Frames에서는 프레임을 늘리는 것이 대체로 VideoMMMU보다 VideoMME와 LongVideoBench에 더 큰 도움이 된다고 보고한다. Qwen2.5-VL 기반 VideoAuto-R1에서 VideoMME는 64프레임의 64.6에서 256프레임의 67.3으로 오르지만, VideoMMMU는 58.7에서 56.7로 낮아진다. Table 15의 최고 VideoMMMU 점수 58.7은 Table 3에 보고된 58.6과 약간 다르다.
- F.2 Analysis on Temporal Grounding Benchmarks: Qwen2.5-VL 기반 VideoAuto-R1은 첫 번째 답변, 두 번째 답변, 적응형 추론을 사용했을 때 기재된 ActivityNet과 NExT-GQA 결과가 동일하다. 저자들은 시각 정보에서 직접 위치를 찾는 과제에서는 텍스트 추론의 이점이 작고, grounding 전용 추론 SFT를 생략한 탓에 예측을 개선하기 어렵다고 가정한다. 이는 제안된 설명이며, 별도로 검증한 작동 원리는 아니다.
- F.3 Analysis of the Impact of Cold-Start SFT: Video-R1-CoT로 SFT를 수행하면 VideoMME는 66.0에서 60.1로, MVBench는 67.1에서 64.0으로, VideoMMMU는 54.7에서 53.8로 낮아진다. 해당 체크포인트에서 후속 RL을 수행해도 기반 모델에서 바로 시작한 추론 사용 RL보다 성능이 낮다. 이는 이 특정 cold-start 데이터셋을 생략할 근거이지, CoT SFT 전반을 배제할 근거는 아니다.
- G Limitations: 초기 답변 신뢰도는 학습 중 명시적으로 보정하거나 최적화하지 않는다. 언어만 사용하는 CoT는 시각 입력을 다시 확인해 지각 오류나 시간 경계 오류를 수정할 수 없다. 저자들은 벤치마크 범위가 제한적이고 반드시 추론해야 하는 비디오 데이터가 부족하다는 점도 지적한다. 따라서 장기적, 인과적, 구성적, 반사실적 비디오 추론에 대한 결론은 제한된다.
- H Qualitative Examples: 부록은 지각 과제에서 CoT가 환각으로 실패하는 사례와 CoT 답변이 정답과 일치하는 과학 QA 사례, 달라지지 않는 grounding 예측, 높은 신뢰도에서의 조기 종료, 낮은 신뢰도에서의 추론 지속을 대비한다. Grounding 예제에서는 주석과 다른 구간을 반복해 예측한다. 이는 초기 답변과 검토 후 답변이 일치하더라도 위치 추정이 정확하다는 뜻은 아님을 보여준다. Belbin-role 예제는 초기 정답을 수정하는 사례가 아니라, 처음부터 맞았던 답변을 확인하는 사례다.
짧은 생각
가장 명확한 기여는 이중 답변 학습과 실제 추론 시 추론량 배분을 분리한 점이다. Table 7은 라우팅 규칙에 대한 직접적인 근거를 제공한다. 적응형 디코딩은 VideoMMMU에서 항상 추론하는 방식에 가까운 정확도를 유지하면서 평균 출력 길이를 91토큰에서 44토큰으로 줄인다.
효율성 결과는 응답 생성량의 감소이지, 측정된 3.3× end-to-end 속도 향상이 아니다. 전체 방법을 비교한 결과는 출력 149토큰 대 44토큰이며, 비디오 인코딩 비용은 여전히 남는다. 라우팅 precision과 신뢰도 보정 분석의 부재, 프레임 설정별 최댓값 보고, 일치하지 않는 활성화율, 벤치마크별로 엇갈리는 개선 결과 때문에 보편적으로 우수하다고 주장하기는 어렵다.