


OLMoTrace: Tracing Language Model Outputs Back to Trillions of Training Tokens 요약 설명
09 Apr 2025 | Paper Review Data Attribution Language Models Information Retrieval목차
이번 글에서는 OLMoTrace: Tracing Language Model Outputs Back to Trillions of Training Tokens 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 9일(Arxiv)
- Liu, Jiacheng, Blanton, Taylor, Elazar, Yanai, Min, Sewon, Chen, YenSung, Chheda-Kothary, Arnavi, Tran, Huy, Bischoff, Byron, Marsh, Eric, Schmitz, Michael, et al.
- Allen Institute for AI, University of Washington, UC Berkeley, Stanford University
- 논문 링크
- Github
- Project Page
요약
- OLMoTrace는 언어 모델이 생성한 응답과 전체 학습 코퍼스에서 정확히 일치하는 구절을 찾는 문제를 다룬다. 평균 응답 토큰 수가 458인 내부 대화 98개를 대상으로, multi-trillion-token 규모의 코퍼스에서 일치 구간 탐색과 문서 검색에 평균 4.46초가 걸렸다. 이는 논문에 제시된 배포 환경에서 측정한 실행 시간이며, 다른 추적 시스템과 비교한 측정 결과는 없다.
- 이 시스템은 trillion-token 규모의 코퍼스를 검색하는 텍스트 검색 엔진인 infini-gram에 최대 일치 구간을 찾는 병렬 알고리즘을 추가한다. 최대 일치 구간은 단어와 문장 경계 조건을 만족하며 정확히 일치하는 구절 가운데, 다른 유효한 일치 구간에 포함되지 않는 구간이다. 시스템은 길고 드문 구절을 선택하고, 해당 구절이 포함된 학습 문서를 검색한 뒤, 주제 관련성에 따라 문서 순위를 정한다.
- 언어 모델을 평가자로 사용했을 때 최종 설정의 문서 관련성 점수는 0–3 척도에서 첫 번째 표시 문서가 1.82, 상위 5개 문서가 평균 1.50이었다. 사례 연구는 사실의 출처 확인, 창작 표현의 재사용, 수학 계산의 일치를 보여준다. 다만 어휘가 일치한다는 사실만으로 인과적 영향이나 사실을 뒷받침하는 근거가 확인되지는 않는다.
1 Introduction
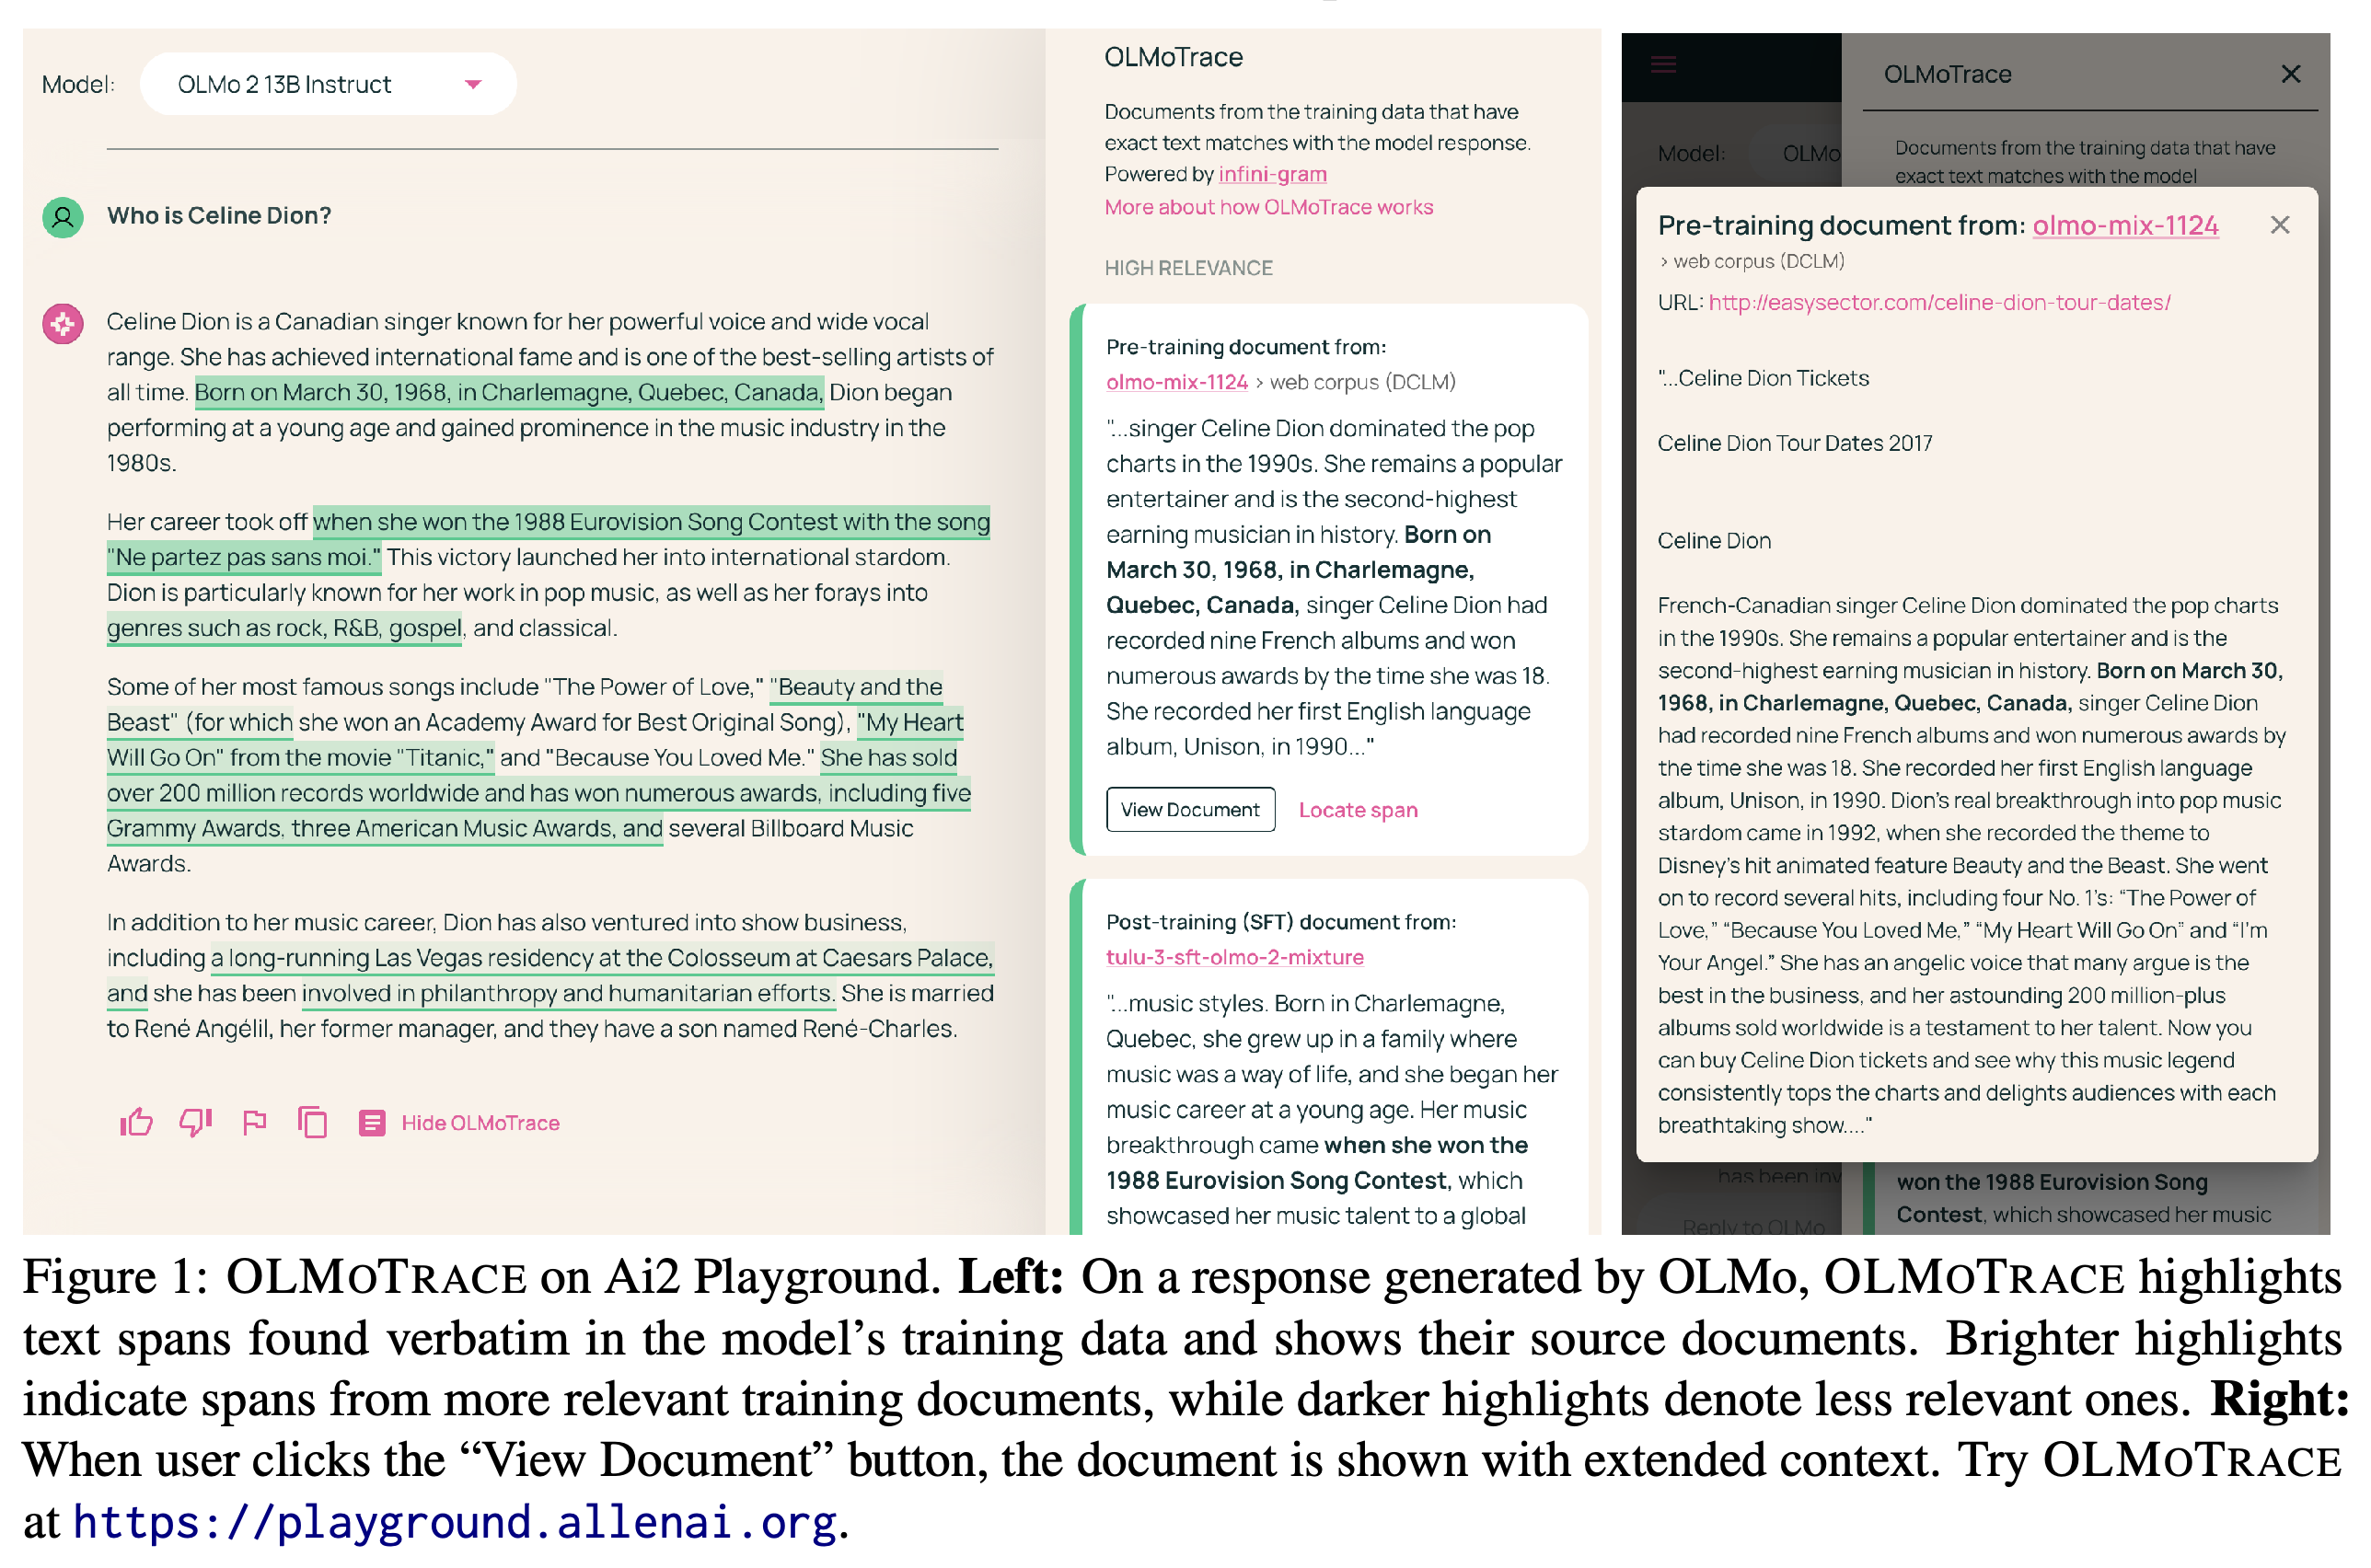
OLMoTrace는 응답을 생성한 뒤 학습 데이터와 겹치는 부분을 살펴볼 수 있게 한다. 기존의 모델 행동 추적 방법을 수조 토큰으로 구성된 전체 학습 코퍼스에 적용하기에는 계산 비용이 크다는 문제가 출발점이다. 토큰은 색인과 일치 구간 탐색에 사용하는 텍스트 단위다.
- 배포된 시스템은 OLMo-2-32B-Instruct를 포함해 논문에서 다루는 대표적인 공개 언어 모델인 OLMo 모델 3개를 지원한다. 초기 학습과 후속 학습 단계를 포괄하는 pre-training, mid-training, post-training 데이터를 검색한다.
- 다른 모델에 이 시스템을 적용하려면 해당 모델의 전체 학습 데이터에 접근할 수 있어야 한다. 인터페이스는 https://playground.allenai.org 에서 사용할 수 있으며, 핵심 구현은 https://github.com/allenai/infinigram-api 에 Apache 2.0 라이선스로 공개되어 있다.
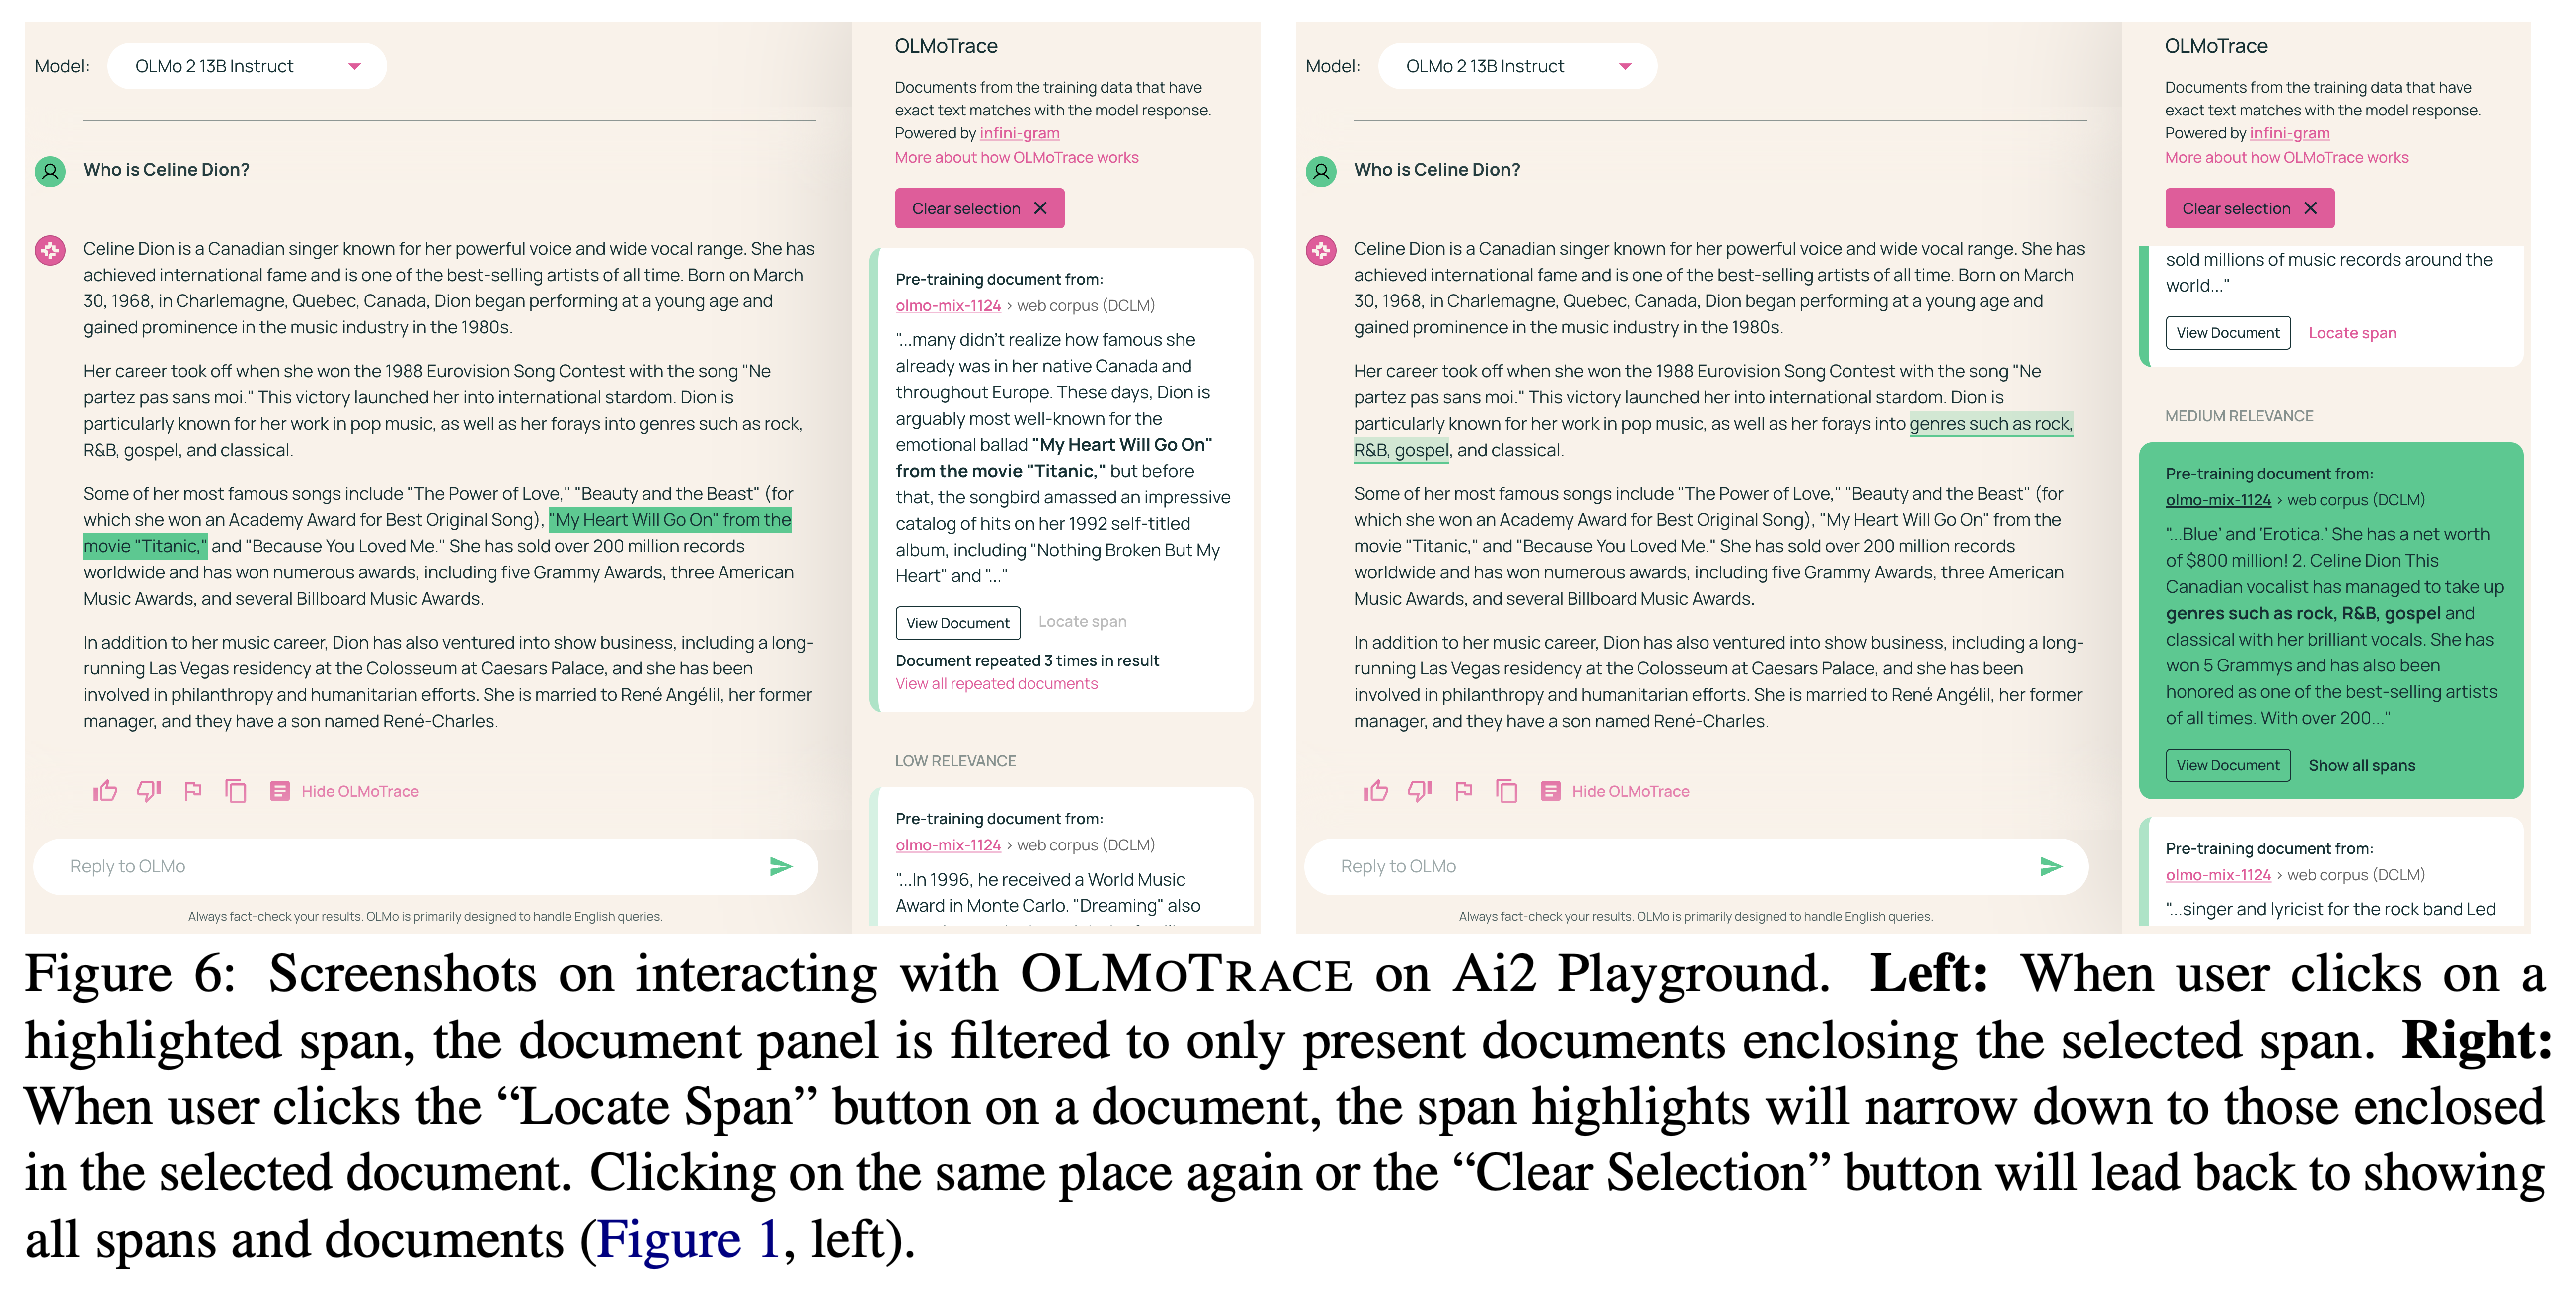
Celine Dion 사례는 응답에서 강조된 구절을 학습 문서 카드와 확장된 문서 보기에 연결한다. 관련성 색상은 주제 관련성 순위를 나타내며, 인과적 영향에 대한 확신도를 나타내지는 않는다.
2 System Description
인터페이스는 응답에서 일치하는 구절을 강조하고 검색된 학습 문서를 표시하며, 색의 채도로 주제 관련성을 나타낸다. 구절을 선택하면 일치하는 문서를 살펴볼 수 있고, 문서를 선택하면 그 문서와 일치하는 구절을 찾을 수 있다. 문서 카드에는 80토큰 분량의 발췌문이 표시되며, 500토큰으로 확장한 문맥도 확인할 수 있다.
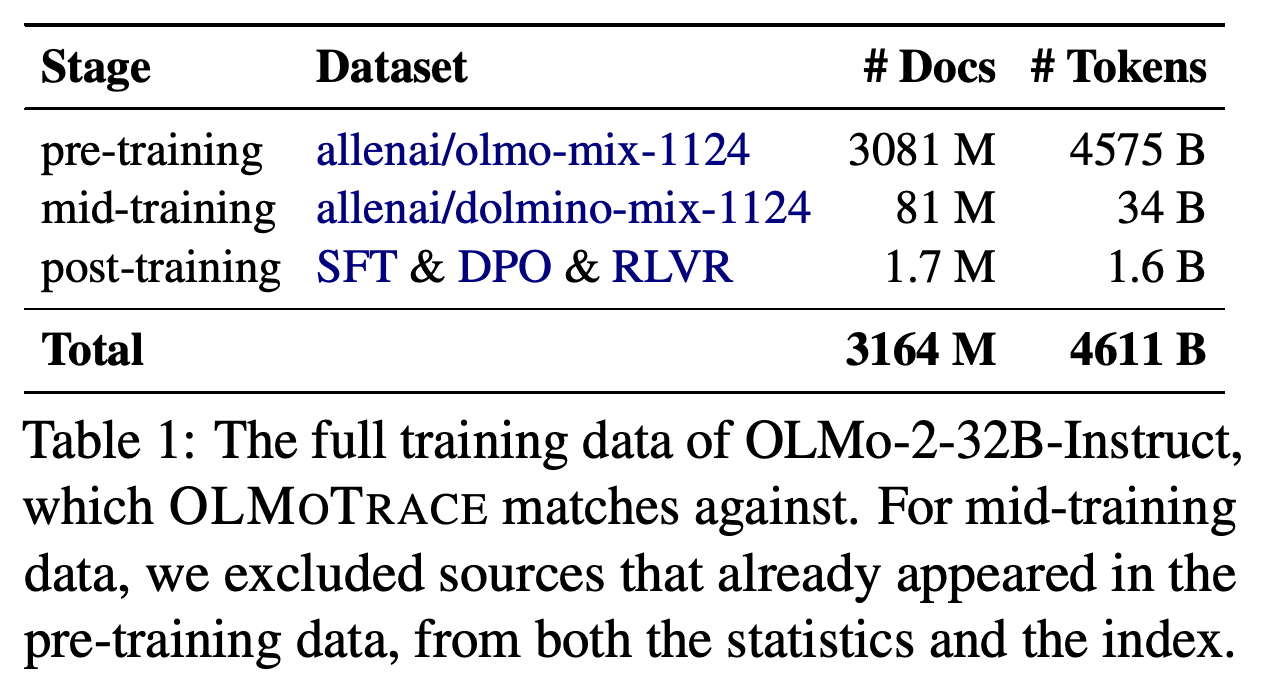
- Table 1에 따르면 OLMo-2-32B-Instruct의 검색 대상은 Llama-2 토크나이저로 집계했을 때 문서 3164 M개와 4611 B토큰이다. 이 토크나이저는 색인에 사용하는 텍스트를 토큰으로 변환한다. pre-training에 이미 포함된 mid-training 출처는 보고된 mid-training 통계와 색인에서 모두 제외한다.
- 지원하는 모델 3개는 pre-training과 mid-training 데이터를 공유하며, post-training 데이터는 조금씩 다르다.
색인은 모든 학습 단계를 포괄한다. pre-training은 문서 3081 M개와 4575 B토큰, mid-training은 81 M과 34 B, post-training은 1.7 M과 1.6 B를 차지한다. 보고된 합계는 문서 3164 M개와 4611 B토큰으로, 검색 가능한 코퍼스의 규모와 pre-training의 높은 비중을 보여준다.
3 The Inference Pipeline
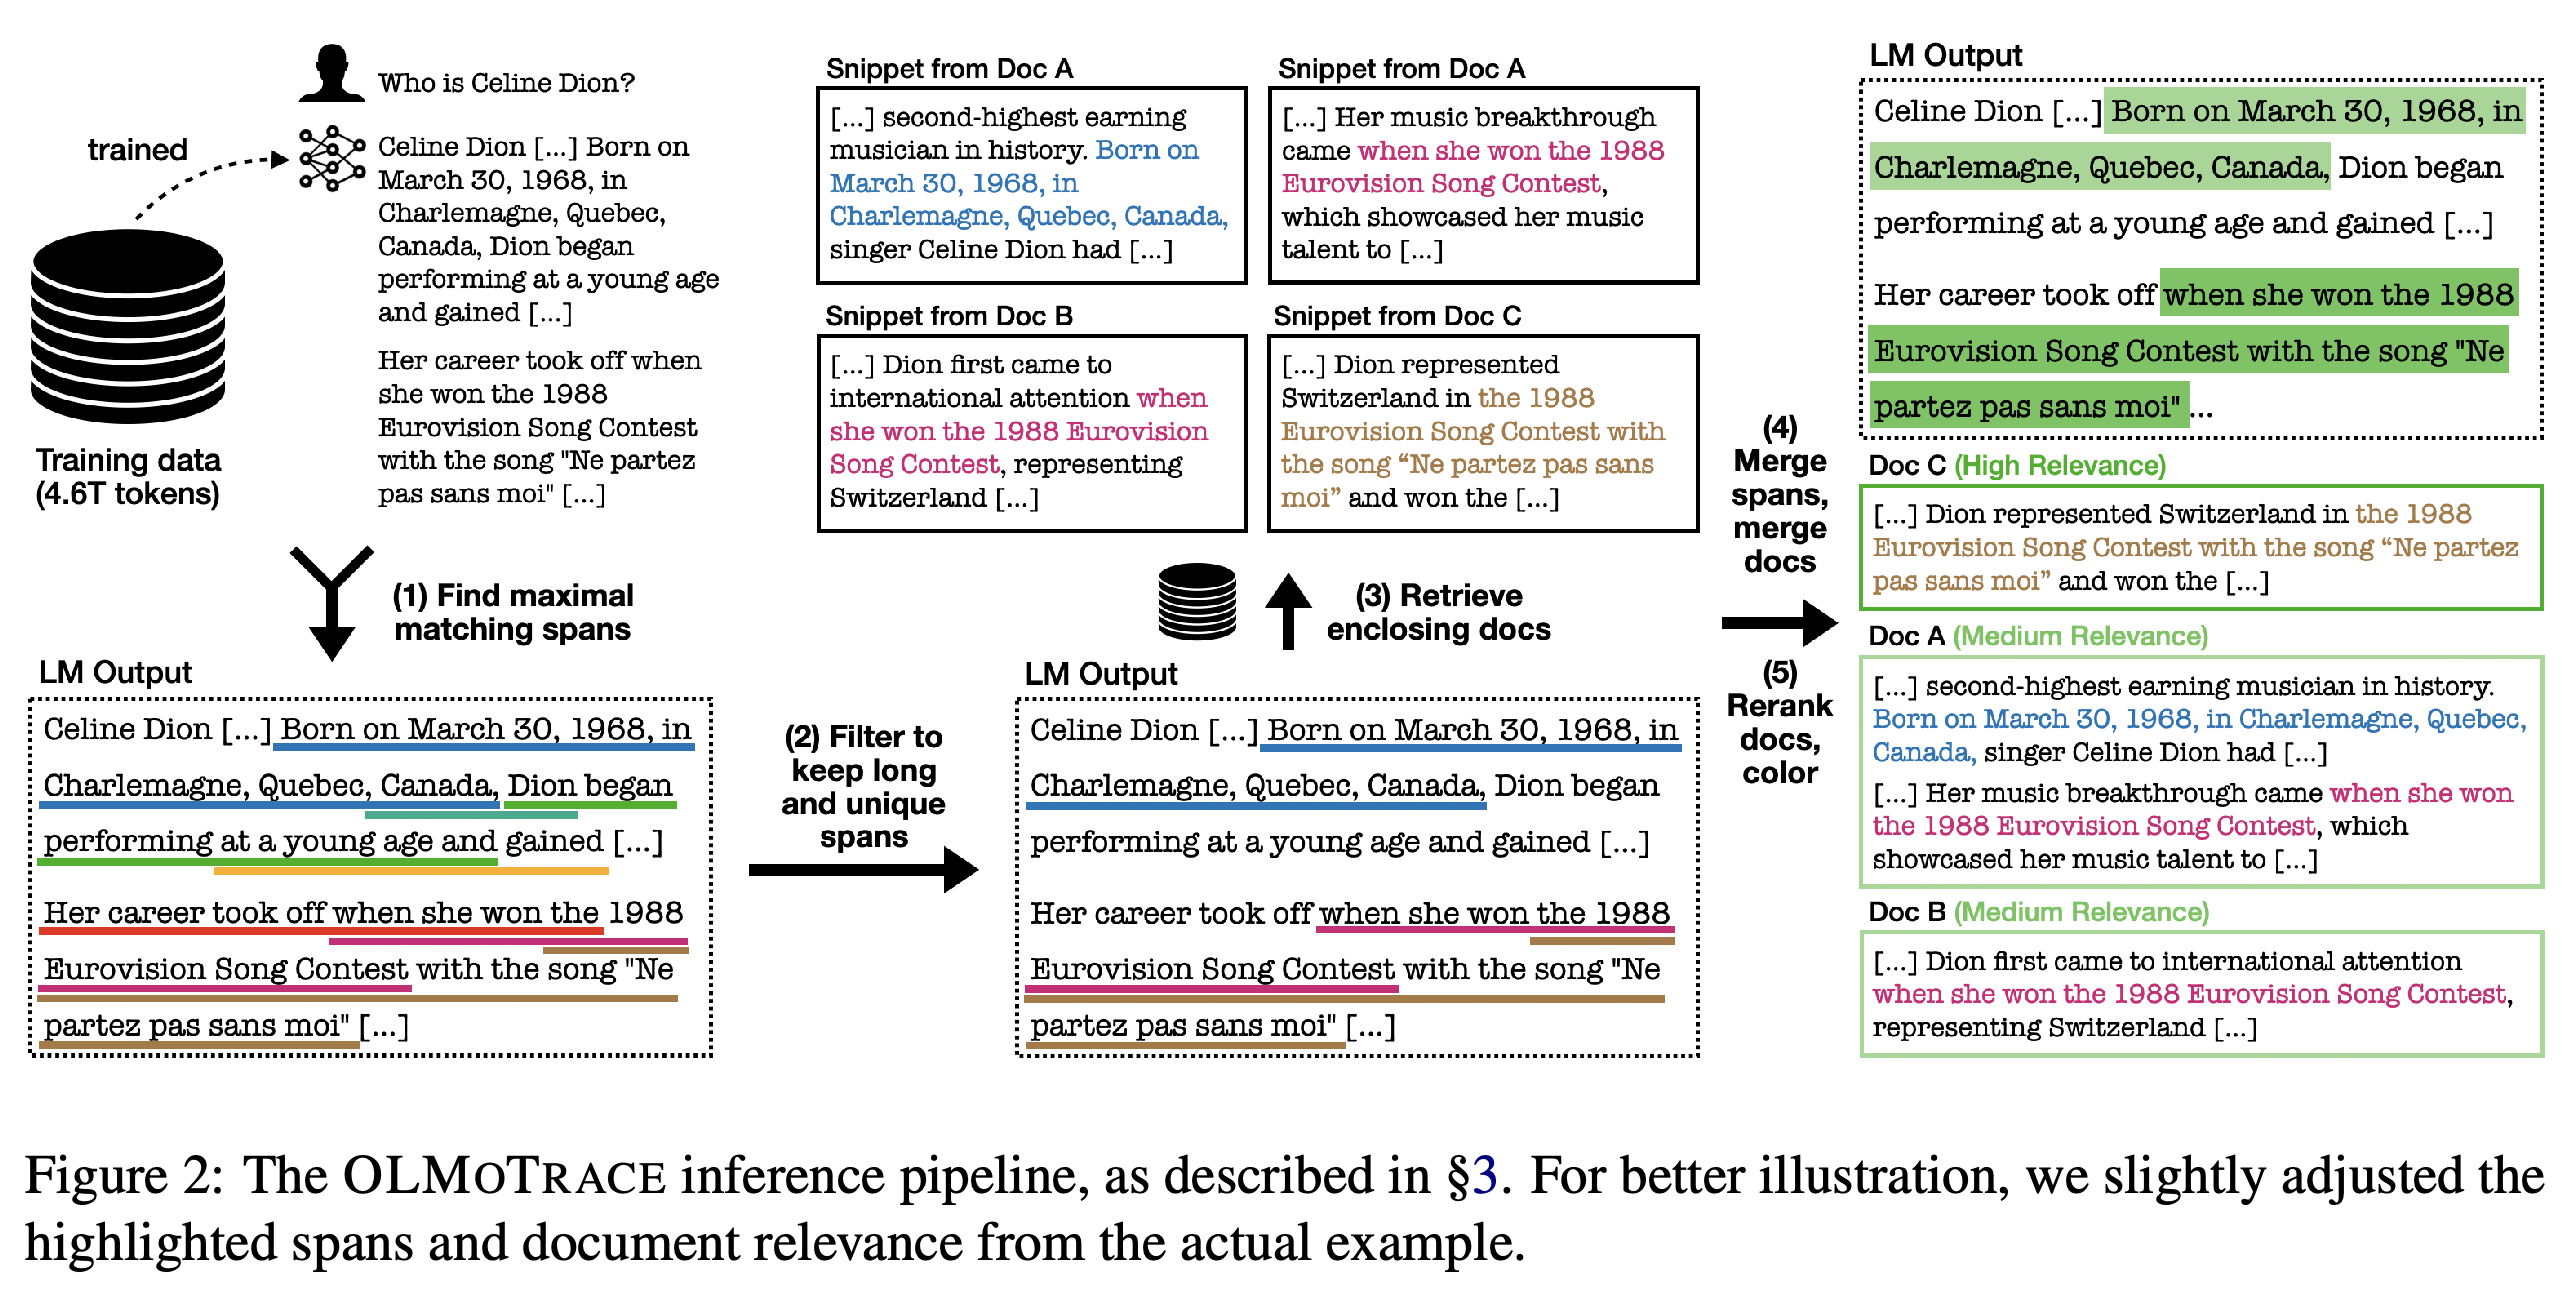
파이프라인은 먼저 Llama-2 토크나이저로 응답을 토큰화하고 최대 일치 구간을 찾는다. 각 구간은 학습 코퍼스에 존재하고, 완전한 단어의 경계에서 시작하고 끝나야 한다. 마침표나 줄바꿈은 구간 끝에만 포함할 수 있으며, 같은 조건을 만족하는 다른 구간에 포함되지 않아야 한다.
- 그다음 구간별 유니그램 확률이 작은 순서로 K = ⌈0.05 × L⌉개의 구간을 남긴다. L은 토큰 단위 응답 길이다. 구간의 유니그램 확률은 전체 학습 코퍼스에서 추정한 개별 토큰 확률을 곱한 값이다.
- 이 선택 방식은 드문 토큰을 포함한 긴 구절을 선호한다. 토큰 확률은 캐시에 저장한다. 저자들은 길이만으로 순위를 정하면 검색된 문서의 관련성이 낮아졌다고 보고한다.
남겨진 각 구간에 대해 해당 구간을 포함한 문서 발췌문을 최대 10개 검색한다. 일치하는 문서가 더 많으면 10개를 무작위로 추출한다. 응답에서 겹치는 구간과 같은 문서에 속한 발췌문을 병합한 뒤, 사용자 프롬프트와 응답을 이어 붙인 쿼리로 어휘 기반 검색 점수인 BM25를 계산해 문서 순위를 다시 정한다.
- 검색된 문서 집합을 BM25 코퍼스로 사용한다. 문서에는 높음, 중간, 낮음의 관련성 레이블을 부여한다. 강조된 구간은 자신을 포함하는 문서 가운데 가장 높은 관련성 등급을 따른다.
- 구간 필터링과 구간별 검색 개수 제한 때문에 표시되는 문서는 정확히 일치하는 전체 문서 중 선택된 일부다.
이 도식은 정확한 일치 구간 탐색, 구간 선택, 문서 검색, 병합, 관련성 순위 결정을 구분한다. 강조 표시와 관련성 등급은 설명을 위해 조정되었으므로, 이 예시는 파이프라인을 설명하는 개략도다.
3.1 Fast Span Computation
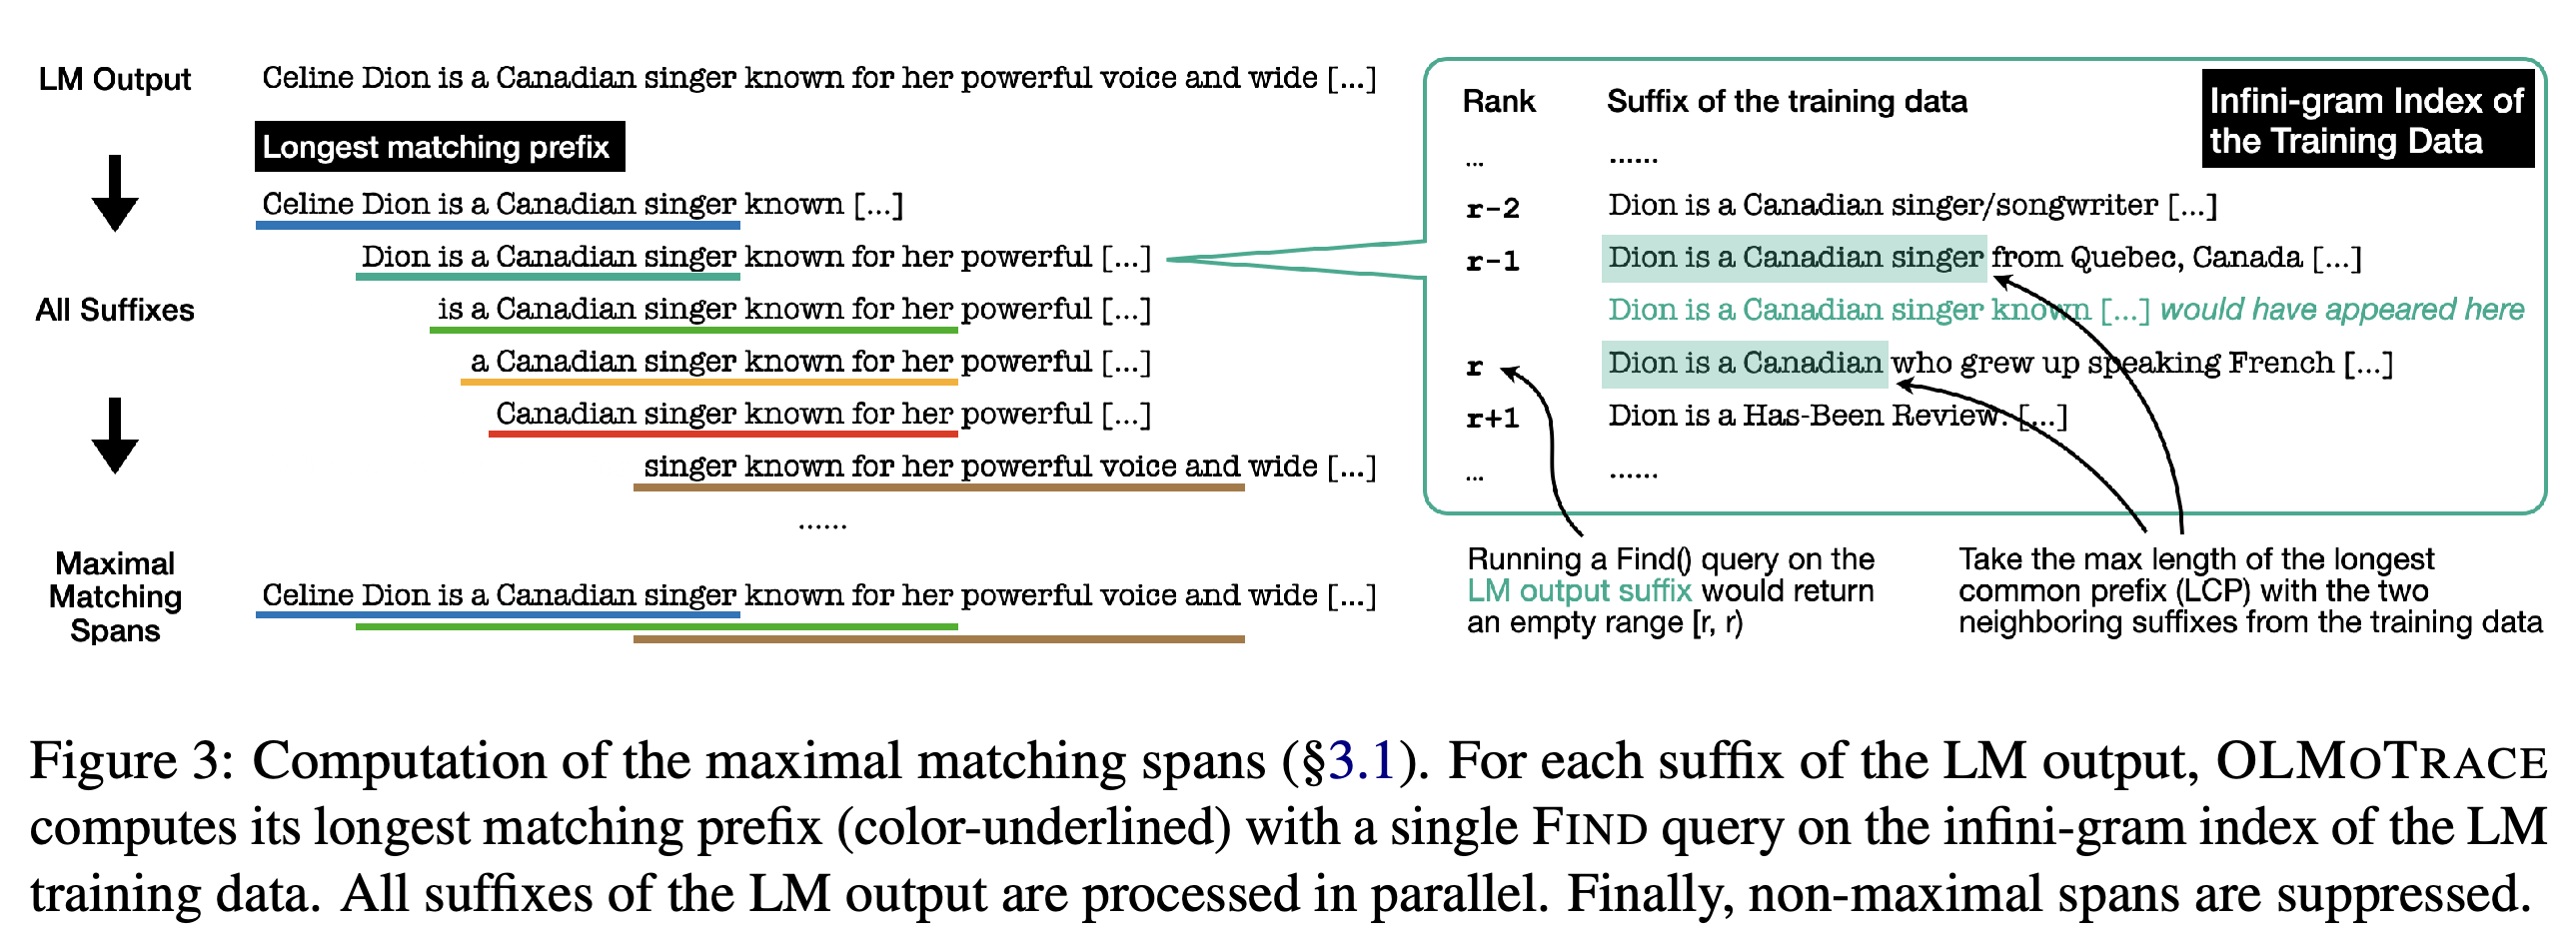
빠른 구간 계산에는 코퍼스의 모든 접미사를 사전순으로 정렬한 색인인 접미사 배열을 사용한다. 이 색인은 메모리에 적재하지 않고 솔리드 스테이트 드라이브에 저장한다. 접미사는 특정 시작 위치부터 끝까지의 텍스트다. 각 응답 접미사에 대해 infini-gram FIND 쿼리로 코퍼스 텍스트와 처음부터 일치하는 가장 긴 접두사를 찾는다. 전체 접미사가 코퍼스에 없으면 삽입 위치의 양옆에 있는 코퍼스 접미사만 확인하면 된다.
- 응답 접미사에 대한 쿼리는 병렬로 실행한다. 이후 순회에서는 지금까지 확인한 모든 끝 위치보다 더 뒤에서 끝나는 구간만 남겨 최대 구간이 아닌 구간을 제거한다.
- 논문은 시간 복잡도를 \(O(L\log N)\), 완전 병렬화 시 지연 시간을 \(O(\log N)\)으로 제시한다. N은 코퍼스의 토큰 수다. 실제 처리량은 디스크 입출력에 제한된다.
- 색인을 나눈 각 샤드는 최대 500 B토큰으로 제한한다. 샤드별 쿼리를 병렬로 실행하고, 두 번째 FIND 쿼리로 선택된 최장 접두사의 출현 위치를 찾는다. 이때 캐시된 디스크 읽기 결과를 활용한다.
코퍼스에 없는 응답 접미사는 색인에 있는 코퍼스 접미사 2개 사이에 위치하므로, 인접한 접미사를 확인해 최장 공통 접두사를 구할 수 있다. 응답 접미사를 병렬로 처리하고 다른 구간에 포함된 구간을 제거하는 방식이 알고리즘의 효율성을 설명한다.
3.2 Benchmarking Inference Latency
지연 시간 벤치마크는 가상 CPU 64개, 주기억장치 256 GB, 솔리드 스테이트 드라이브 저장 공간 40 TB를 갖춘 Google Cloud Platform의 CPU 전용 노드에서 수행했다. 내부 Ai2 Playground 사용 중 수집한 대화 98개에서 응답 길이는 평균 458토큰이었으며, 파이프라인에서 1–3에 해당하는 단계는 쿼리당 평균 4.46초가 걸렸다.
- 측정 대상은 최대 일치 구간 계산, 구간 필터링, 문서 발췌문 검색이다. 벤치마크는 나머지 병합, 순위 재조정, 인터페이스 렌더링 단계의 시간을 별도로 제시하지 않는다.
- 평가는 이 내부 표본의 평균을 보고하며, 지연 시간 분포, 통제된 조건의 경쟁 시스템 기준선, 동시 부하 벤치마크는 제공하지 않는다.
4 Analyses
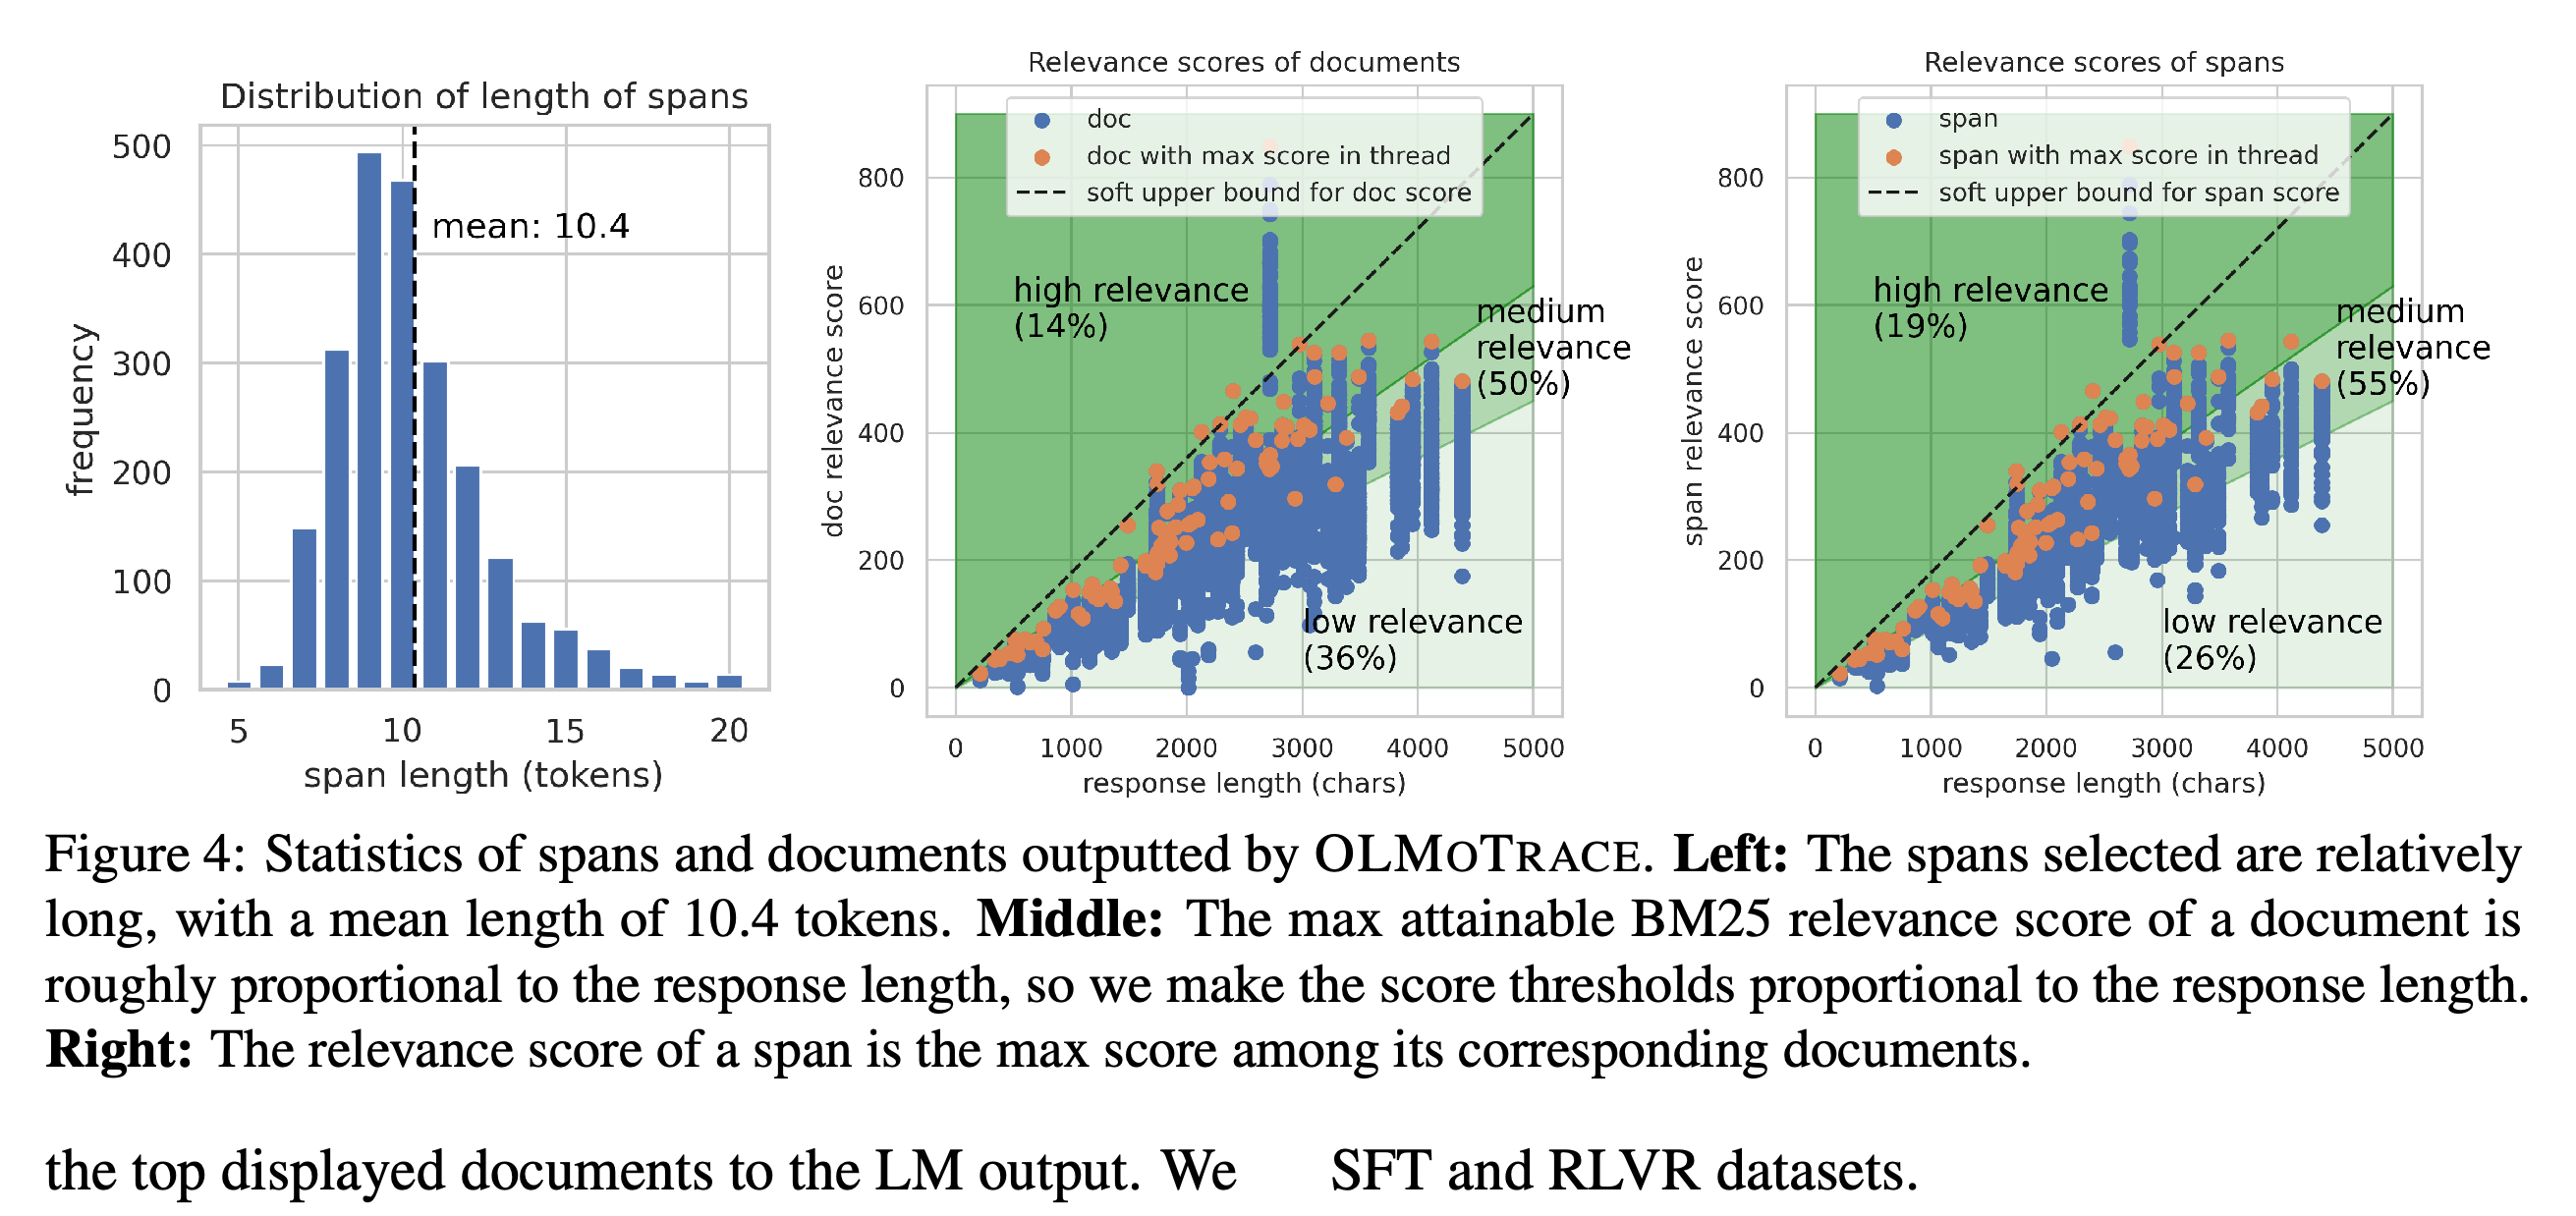
같은 대화 98개에서 병합 전 선택된 구간의 평균 길이는 10.4토큰, 중앙값은 10이었다. BM25 점수는 응답 문자 수에 0.18 times를 적용한 값을 경험적인 대략적 상한으로 삼아 정규화한다. 정규화 점수가 ≥ 0.7이면 높은 관련성, 0.5와 0.7 사이면 중간 관련성, < 0.5이면 낮은 관련성으로 분류한다.
- 이 임계값을 적용하면 검색 문서의 14%, 구간의 19%가 높은 관련성 레이블을 받는다.
- 검색된 문서는 대부분 pre-training에서 나오며, 그 비율은 96.7%다. mid-training은 0.9%, post-training은 2.4%다. 전체 검색 문서 중 예시 응답으로 학습하는 supervised fine-tuning은 0.9%, 선호도 기반 post-training인 direct preference optimization은 1.5%를 차지한다. 검증 가능한 보상으로 post-training을 수행하는 reinforcement learning with verifiable rewards에서 나온 문서는 없다.
- 저자들은 이 비율이 대화 주제에 따라 달라진다고 강조한다. 수학 응답에서는 post-training 문서가 더 많이 검색될 수 있다.
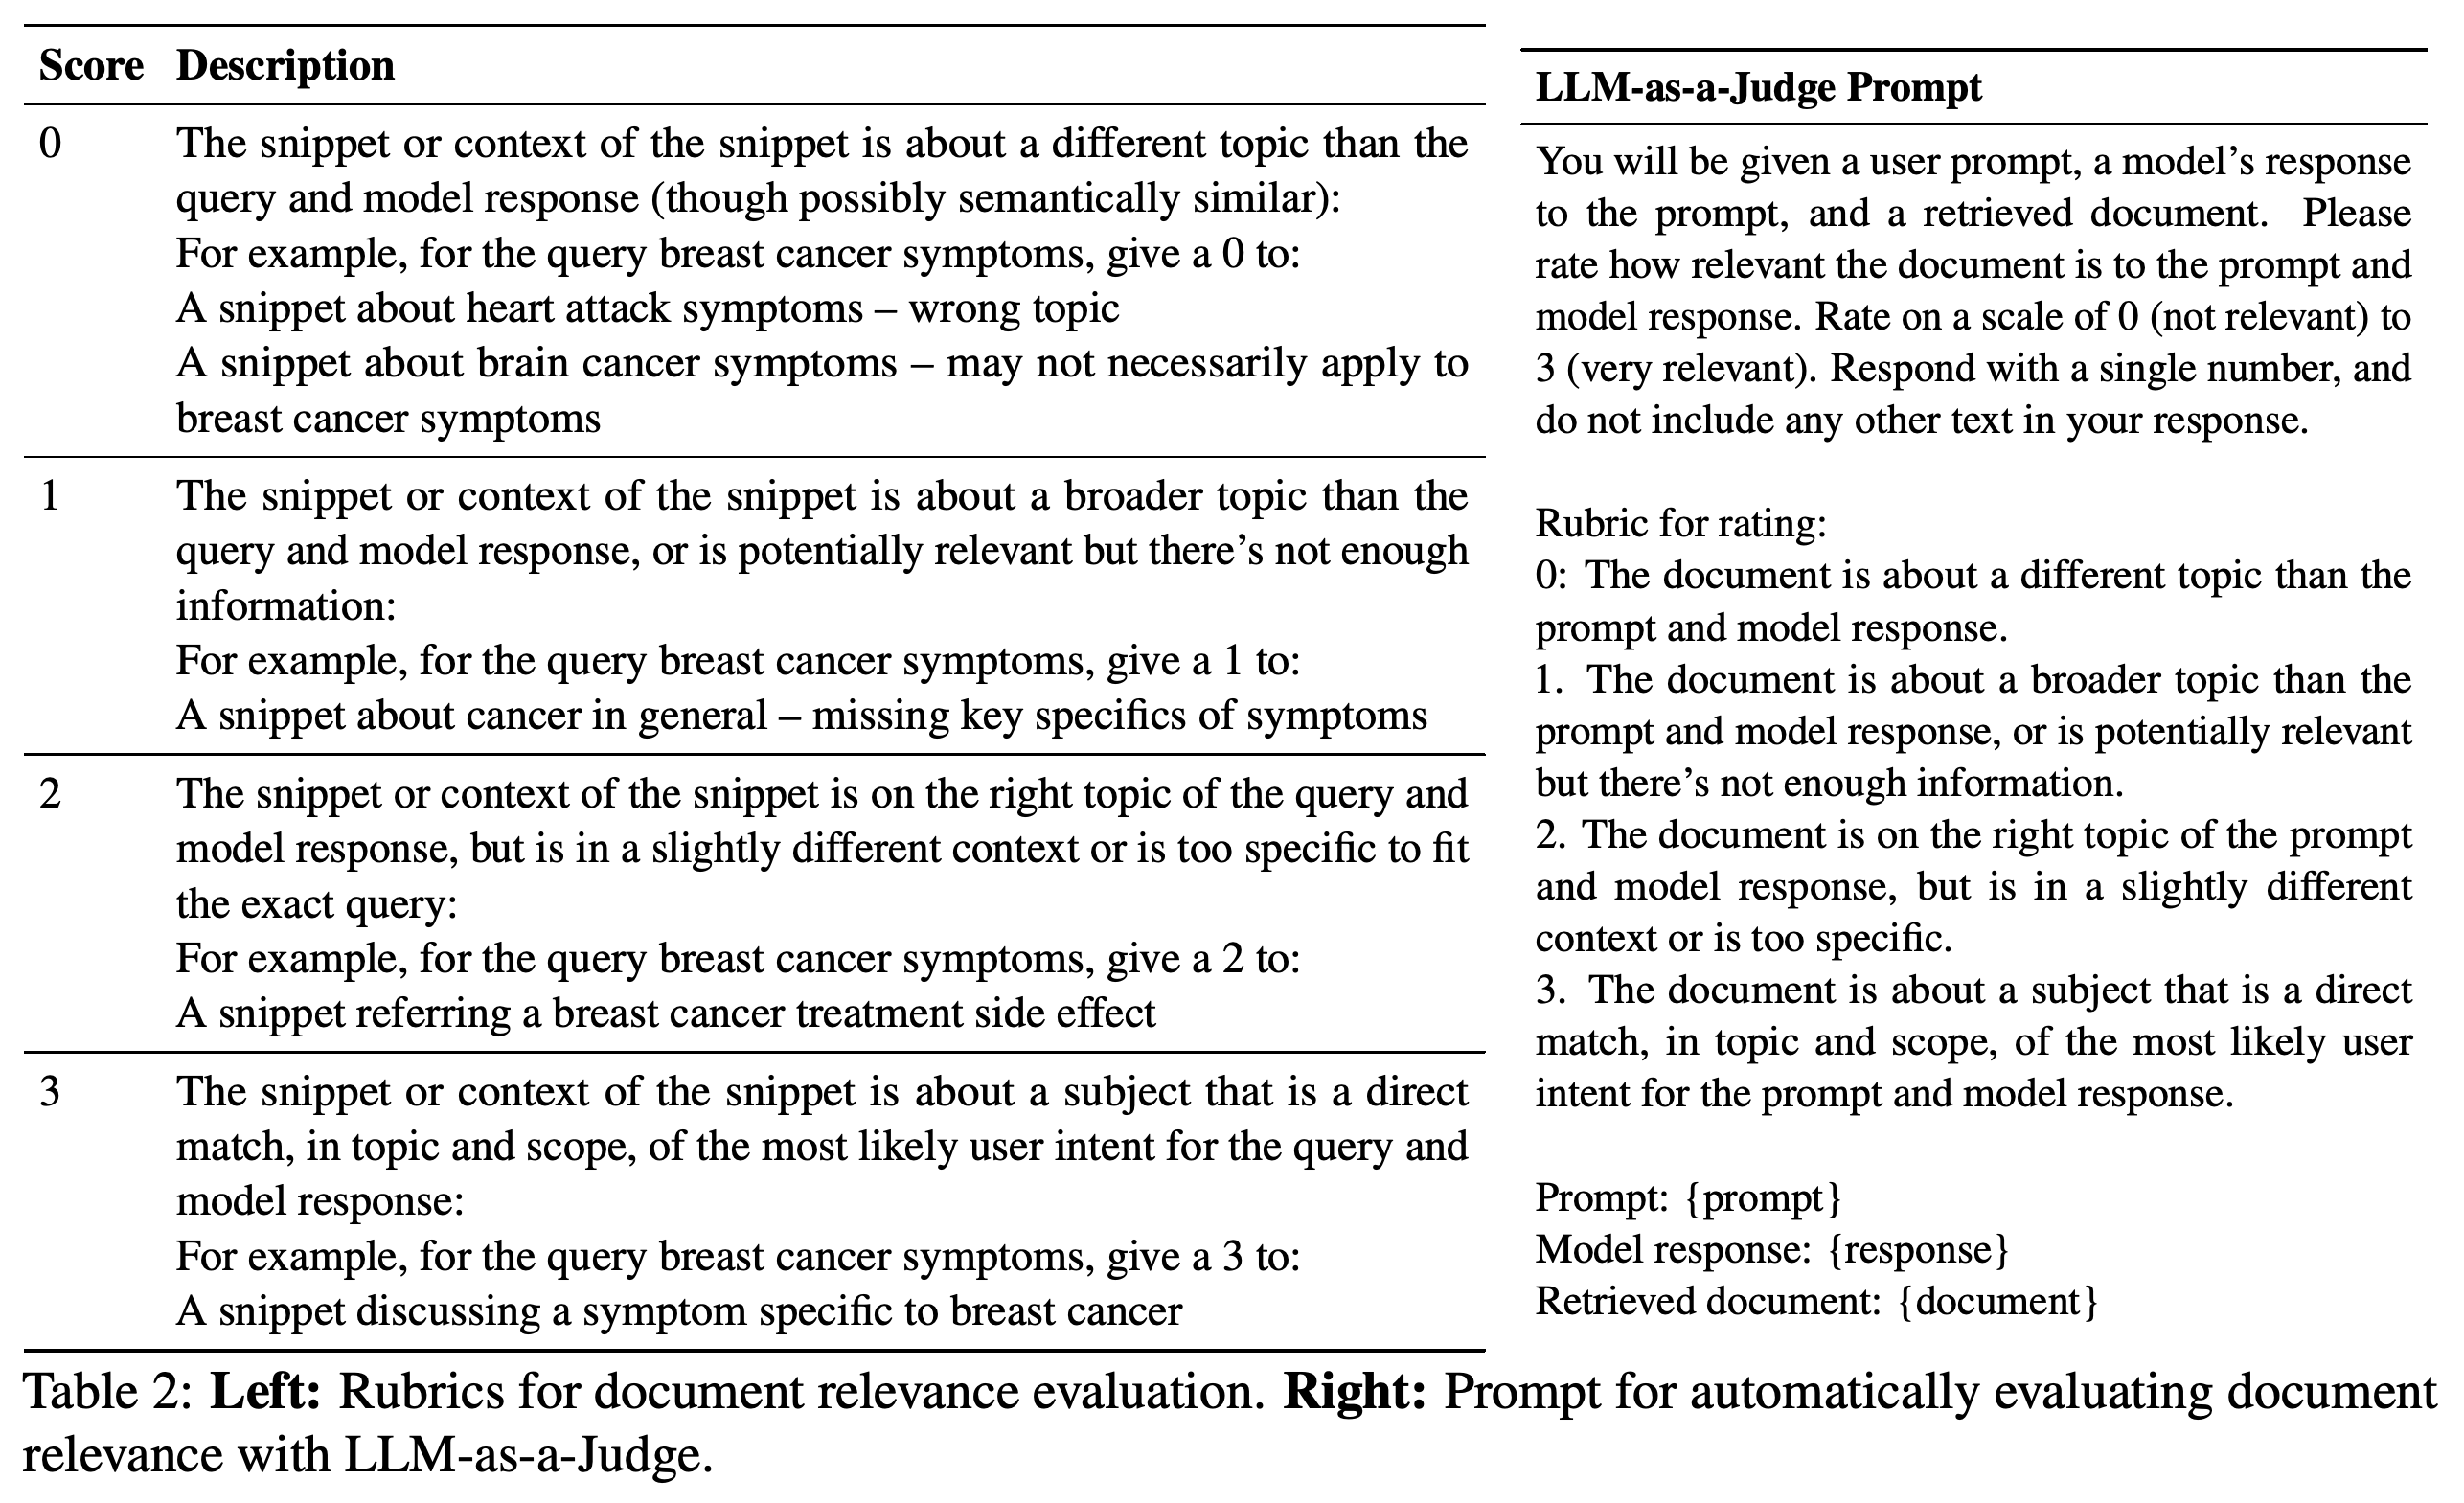
초기 시스템 설정에서 인간 전문가가 상위 5개 문서를 0–3의 주제 관련성 척도로 평가했을 때, 첫 번째 문서는 평균 1.90, 상위 5개 문서는 평균 1.43을 받았다. 대규모 언어 모델로 평가하는 LLM-as-a-Judge에 gpt-4o를 사용한 결과, 인간 평가와의 Spearman 순위 상관계수는 0.73이었고 같은 설정의 점수는 각각 1.73과 1.28이었다. 이 상관계수는 순위 간 일치도를 측정한다.
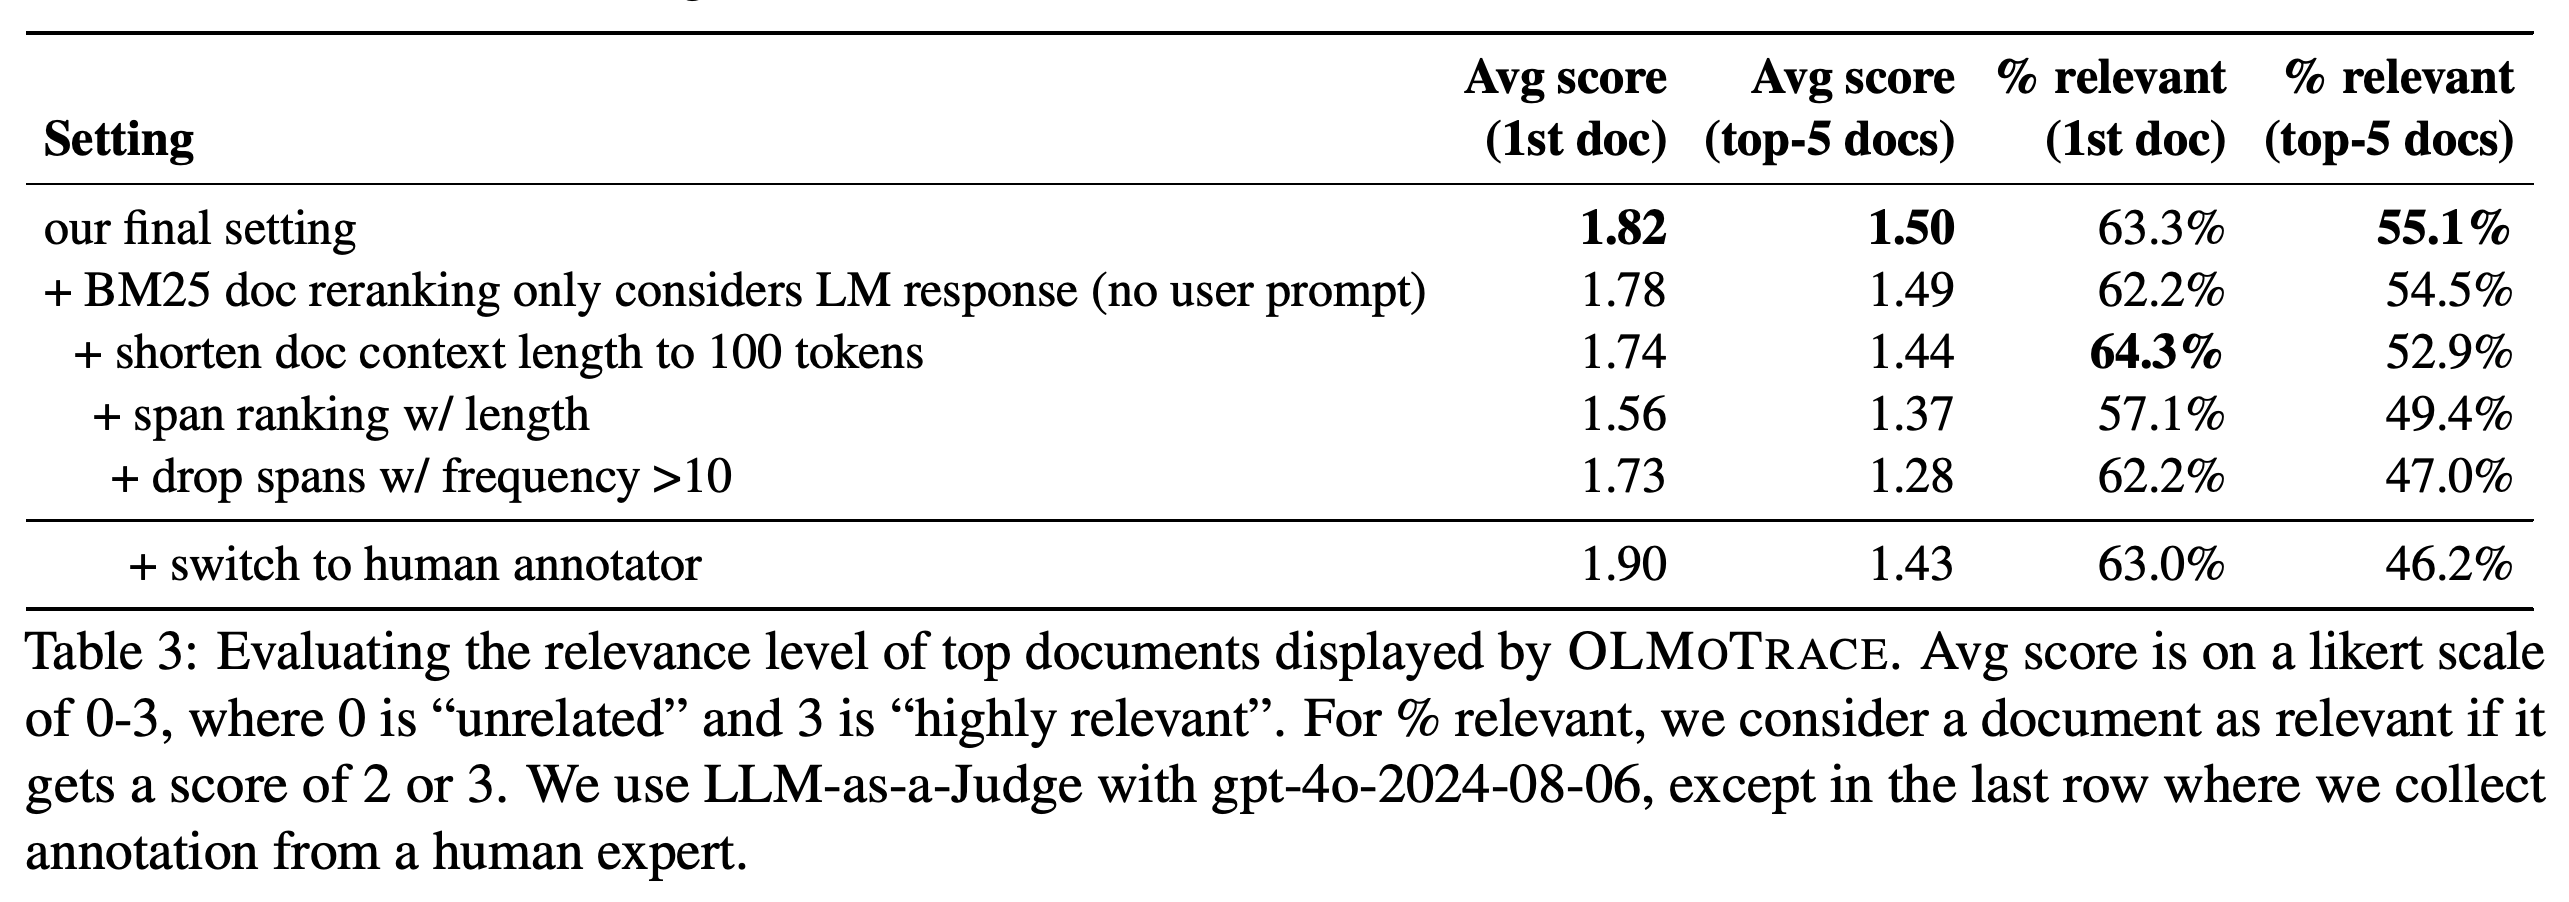
- 모델 평가를 참고해 설정을 조정한 결과, 최종 설정에서 첫 번째 문서는 1.82, 상위 5개 문서는 1.50을 받았다. 2점 또는 3점을 받은 비율은 각각 63.3%와 55.1%였다.
- Table 2는 관련 없는 자료부터 주제와 범위가 직접 일치하는 자료까지 평가 기준을 정의한다. Table 3은 각 요인을 독립적으로 비교한 결과가 아니라 설정을 순차적으로 변경한 결과를 제시한다. 인간 전문가는 최종 설정을 별도로 평가하지 않았다.
- 이 평가는 프롬프트와 응답에 대한 주제 적합성을 측정한다. 인과적 기여나 응답의 진위를 측정하지는 않는다.
히스토그램에서 선택된 구간은 10토큰 부근에 모여 있으며, 평균은 10.4다. 점수 그래프는 응답 길이에 따라 관련성 임계값을 설정한 이유를 보여준다. 높은 관련성 레이블은 문서의 14%, 구간의 19%에 부여되며, 이 레이블은 BM25 점수로 결정된다.
5 Case Studies
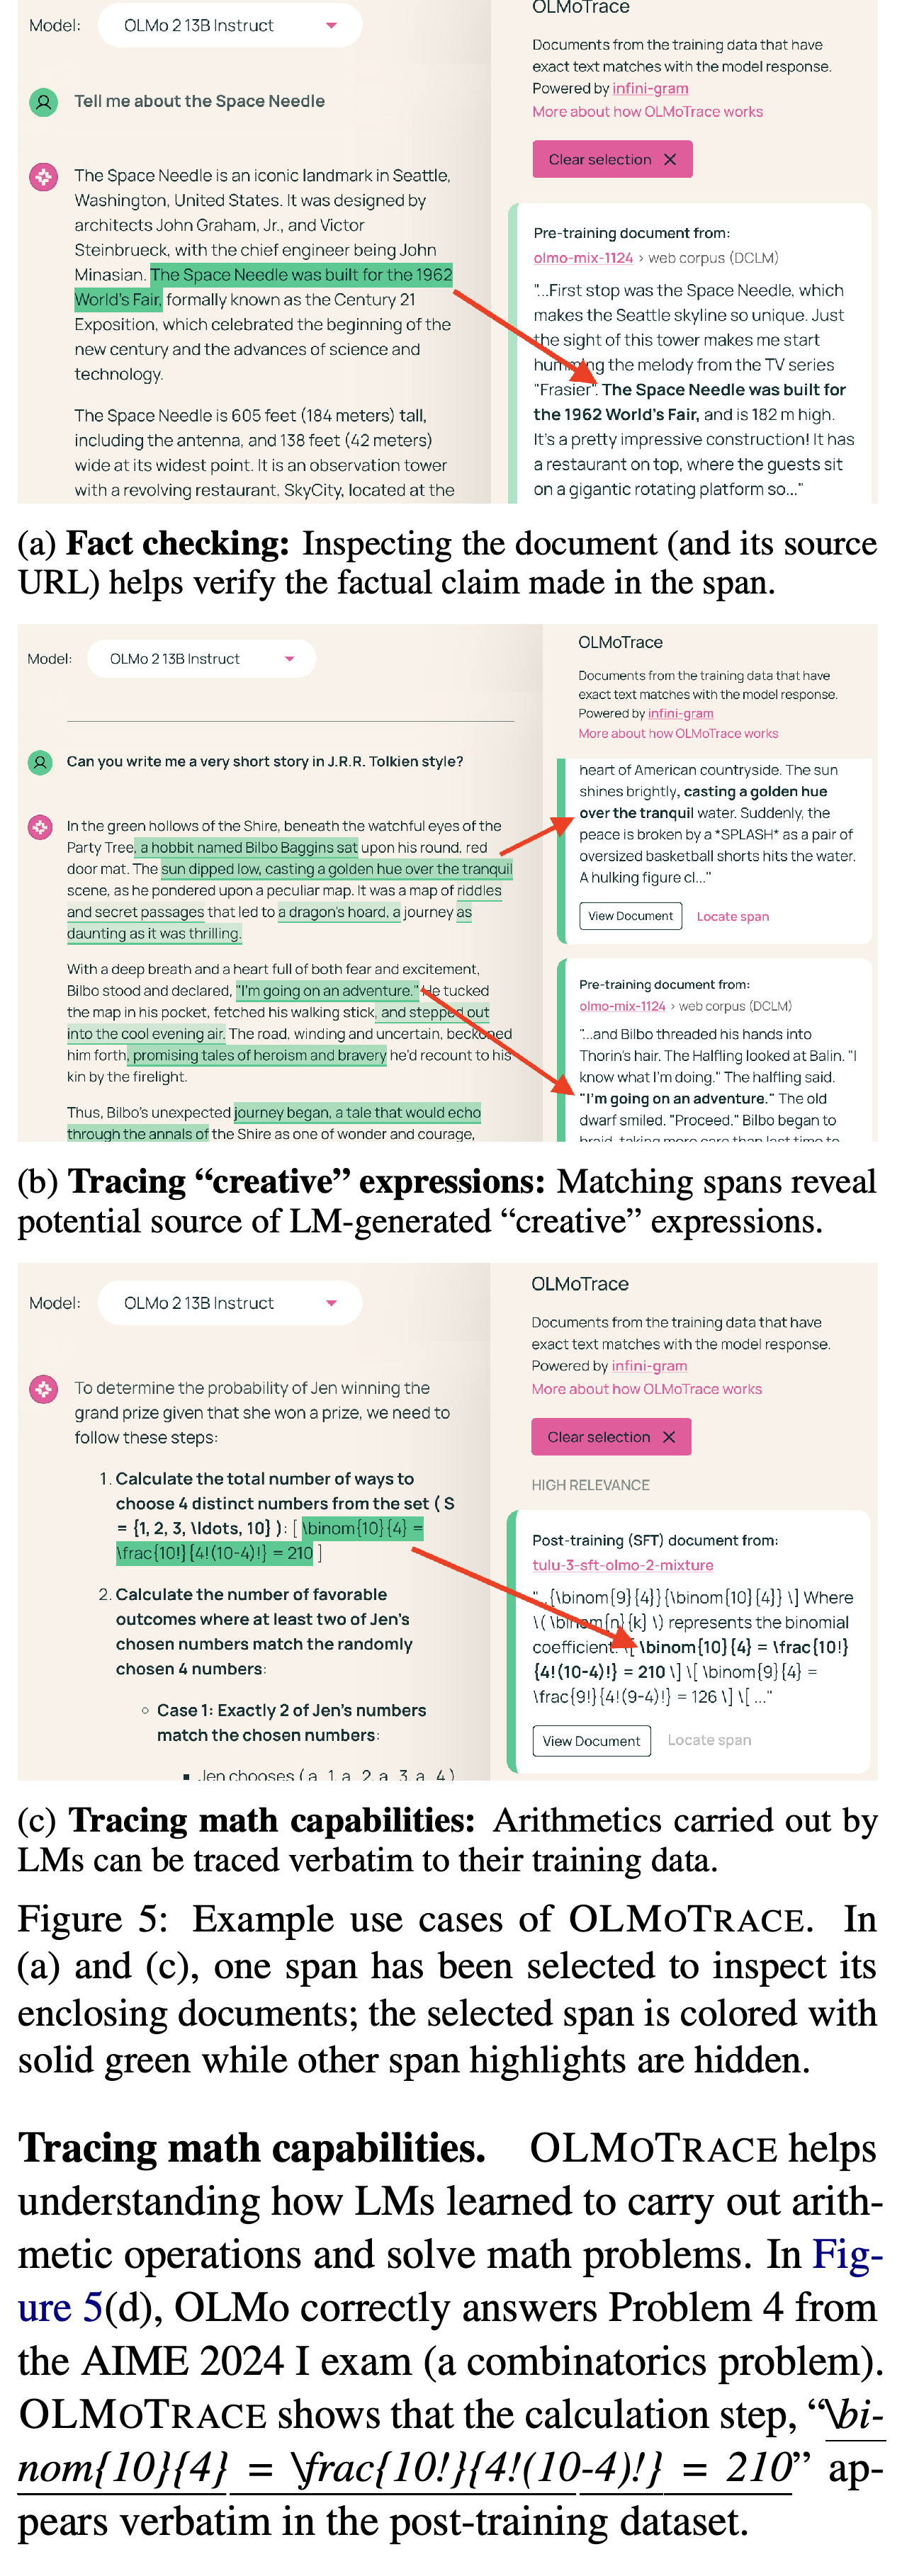
사례 연구 3건은 정확히 일치하는 구절을 살펴보며 무엇을 확인할 수 있는지 보여준다. 학습 문서에는 Space Needle이 1962 World Fair를 위해 건설되었다는 진술이 반복된다. Tolkien 스타일의 이야기에는 Hobbit 팬픽과 같은 “I’m going on an adventure”라는 표현이 등장한다. 조합론 시험 문제인 AIME 2024 I Problem 4의 풀이에는 post-training 데이터에도 존재하는 계산이 포함된다.
- 일치하는 수학 계산은 \(\binom{10}{4} = \frac{10!}{4!(10-4)!} = 210\)이다. 이는 해당 계산 문자열이 학습 데이터에 존재함을 보여주지만, 모델이 더 넓은 범위의 문제 해결 능력을 어떻게 습득했는지는 입증하지 않는다.
- 사실을 확인하려면 문서 문맥과 출처의 신뢰성을 살펴봐야 한다. 스크린샷은 개별 활용 사례를 보여주며, 사실 확인 정확도가 향상되었는지를 측정한 결과는 아니다.
- Figure 6은 개별 일치 항목을 살펴보는 방법을 보여준다. 강조된 구절을 선택하면 문서 패널이 필터링되고, “Locate Span”을 선택하면 해당 문서에 있는 구절만 응답에 강조된다. 다시 클릭하거나 “Clear Selection”을 사용하면 전체 보기가 복원된다.
3개 패널은 사실의 출처 확인, 생성된 소설과 학습 텍스트의 중복, post-training 데이터와 공유하는 수학 계산을 보여준다. 이 사례들은 직접 살펴볼 수 있는 중복의 예시를 제공하며, 인과적 기여나 사실 확인 성능을 측정하지는 않는다.
함께 제시된 스크린샷은 양방향 탐색을 보여준다. 응답 구절을 선택하면 표시되는 문서가 좁혀지고, 문서를 선택하면 응답에서 강조되는 구절이 좁혀진다. 이 상호작용을 통해 여러 중복이 포함된 응답에서 개별 일치 항목을 살펴볼 수 있다.
평가 기준은 관련 없는 자료, 주제가 더 넓거나 관련 정보가 부족한 자료, 주제는 맞지만 문맥이 다른 자료, 주제와 범위가 직접 일치하는 자료를 구분한다. 대응하는 모델 평가 프롬프트는 사용자 프롬프트와 응답에 대한 관련성을 측정하며, 사실적 정확성을 평가하지는 않는다.
최종 설정에서 첫 번째 문서와 상위 5개 문서의 평균 관련성 점수는 각각 1.82와 1.50이며, 관련성이 있다고 평가된 비율은 63.3%와 55.1%다. 각 행은 설정 변경을 차례로 되돌리므로 행 간 차이는 순차적 비교에 해당한다. 인간 평가 행은 초기 설정을 대상으로 한다.
6 Related Work
검색한 문서를 조건으로 응답을 생성하는 검색 증강 생성은 생성 이후 문서를 검색하는 OLMoTrace와 다르다. 웹 검색은 변화하는 웹 색인을 검색하지만, OLMoTrace는 모델의 학습 코퍼스를 검색한다.
- 영향 함수는 기울기 정보로 영향력 있는 학습 예시를 식별한다. 다만 논문은 trillion-token 규모에서 그 계산 비용을 감당하기 어렵다고 설명한다. OLMoTrace는 정확한 어휘 일치를 기준으로 예시를 검색한다.
- 논문에서 인용한 다른 접근법은 pre-training 문서나 제공된 문맥을 인용하도록 모델을 학습한다. OLMoTrace는 모델 학습을 변경하거나 생성 과정에 개입할 필요가 없다.
Limitations
정확한 어휘 일치를 모델 응답의 인과적 설명, 뒷받침하는 근거, 인용 출처로 해석하면 안 된다. 시스템의 일치 기준상 표현이 그대로 겹치지 않는 의미적 관계는 추적 범위에 포함되지 않는다.
- 내부 적대적 테스트에서는 뉴스 기사와 노래 가사가 노출되었지만, 저자들은 저작권이 있는 책을 발견하지 못했다. 저자들은 삭제 요청 절차를 제공하며, 전체 색인을 다시 구축하지 않고 문서를 제거할 수 있게 한다.
- 저자들은 테스트에서 개인 식별 정보를 발견하지 못했으며, 지정한 텍스트 패턴을 찾아 개인 식별 정보가 포함된 문서를 차단하는 정규 표현식 필터를 구현했다. 유해성 완화에는 기존 Ai2 Playground의 프롬프트 검토 기능을 사용하며, 추가 필터링은 보고하지 않았다.
Author Contributions
논문은 Jiacheng Liu와 Taylor Blanton을 핵심 기여자로 명시하고, 연구, 엔지니어링, 디자인, 사용자 경험, 프로젝트 관리, 법무, 커뮤니케이션, 자문 역할을 별도로 기재한다.
부록
- A More Screenshots of OLMoTrace는 구절에서 일치 문서를 찾고 문서에서 일치 구절을 찾는 인터페이스 시연을 추가한다. 강조된 구절을 클릭하면 문서 패널이 필터링되며, “Locate Span”을 선택하면 선택한 문서에서 발견된 구절만 강조된다. 다시 클릭하거나 “Clear Selection”을 사용하면 전체 보기가 복원된다.
- B Production System Setup은 가상 머신당 초당 최대 80,000회의 읽기 입출력 연산을 지원하는 pd-balanced 저장 장치, N2 가상 머신 복제본 2개, 공유 디스크 마운트, 별도의 처리 워커를 설명한다. 추가 읽기가 디스크 처리량 병목을 악화시키므로, 요청 전에 데이터를 미리 읽는 프리페칭은 비활성화하고 문서 검색은 배치로 처리한다. 샤드가 12개일 때 디스크 분석은 응답 토큰당 읽기 횟수를 40 × 2 × 12 = 960회로, 100토큰 처리 시간을 약 1.2초로 추정한다. 이는 추가로 측정한 벤치마크가 아니라 분석적 추정치다.
- C More Details on Document Relevance Evaluation은 0–3 평가 척도와 gpt-4o-2024-08-06 평가자를 명시한다. Table 3은 출현 횟수가 10회를 넘는 구간을 유지하고, 유니그램 확률로 구간 순위를 정하고, 문서 문맥을 100토큰에서 500토큰으로 늘리고, BM25 쿼리에 사용자 프롬프트를 포함하는 순차적 변경을 제시한다. 같은 모델 평가자에서 최종 상위 5개 문서의 관련성 점수는 초기 설정의 1.28에서 1.50으로, 첫 번째 문서의 점수는 1.73에서 1.82로 상승한다.
짧은 생각
OLMoTrace는 구체적인 색인 알고리즘을 바탕으로 4.6-trillion-token 규모에서 학습 데이터와 정확히 겹치는 부분을 대화형으로 살펴볼 수 있게 한다. 일치 구간 탐색과 문서 검색에 걸린 시간은 측정 결과 평균 4.46초였다. 내부 대화 98개의 표본과 평가자를 참고한 설정 조정 때문에, 평가한 환경을 넘어 관련성을 일반화하는 데는 한계가 있다. 정확한 일치는 데이터가 겹친다는 증거이며, 인과적 설명을 제공하지는 않는다.