


Self-Steering Language Models 요약 설명
09 Apr 2025 | Paper Review Constrained Generation Probabilistic Programming Test-Time Scaling목차
이번 글에서는 Self-Steering Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 9일(Arxiv), COLM 2025
- Grand, Gabriel, Tenenbaum, Joshua B., Mansinghka, Vikash K., Lew, Alexander K., Andreas, Jacob.
- Massachusetts Institute of Technology, Yale University
- 논문 링크
요약
- 언어 모델은 문자 수, 단어 위치, 예산 같은 정확한 제약을 지키면서 유창한 텍스트를 생성하는 데 어려움을 겪는다. 제약 텍스트 생성 벤치마크인 COLLIE의 문장 과제에서 DISCIPL(Distributional Constraints by Inference Programming with Language Models)은 GPT-4o-generated 프로그램과 실행 모델인 Llama-3.2-1B를 사용한다. 독립적으로 생성한 후보에 가중치를 부여하는 importance sampling을 적용하면 후보 32개 예산에서 선택한 답변이 제약을 충족할 기대 확률인 Pass@1이 0.84에 이른다. Llama 직접 샘플링은 0.07, 단계별 자연어 추론을 사용한 GPT-4o는 0.46, o1은 0.96을 기록한다.
- DISCIPL에서는 Planner 모델이 과제별 추론 프로그램을 작성한다. 이 프로그램은 Follower 모델의 생성과 채점을 조율하는 실행 절차다. 파인튜닝은 필요하지 않으며, 확률 모델과 추론 절차를 코드로 표현하는 Python 확률적 프로그래밍 프레임워크인 LLAMPPL을 사용한다.
- Sequential Monte Carlo(SMC)는 점수가 낮은 부분 생성 결과를 유망한 결과의 복사본으로 반복해서 교체하며, importance sampling(IS)보다 coherency를 높인다. Coherency는 이 논문에서 사용하는 유창성 지표다. 1B Follower를 사용한 SMC는 문장, 문단, PUZZLES에서 각각 후보 32개, 8개, 16개 예산으로 Pass@1 0.76, 0.69, 0.42를 기록한다. PUZZLES는 제약 글쓰기 과제 4개로 구성한 자체 데이터셋이다. 같은 영역에서 직접 샘플링은 0.07, 0.38, 0.08을 기록한다.
- 생성된 프로그램에는 버그가 있을 수 있으며, SMC와 IS는 직접 생성보다 제약 충족률이 높지만 유창성 점수는 낮다. o1은 3개 영역 모두에서 종합 제약 충족률이 더 높다. 문장 영역 비용 분석에서는 논문의 가격과 프롬프트 캐싱 가정에 따라 과제 100개당 DISCIPL-SMC 비용이 $4.2606, o1 비용이 $4.7457로 산정된다. DISCIPL 비용의 대부분은 긴 Planner 프롬프트에서 발생한다.
1 Introduction
서론은 언어 모델이 문제의 구조를 설명하는 능력과 정확하게 수를 세거나 제약에 맞춰 생성하는 능력 사이의 차이를 지적한다. Chain-of-thought(CoT)는 추론을 연속된 자연어 단계로 표현하는 방식이지만 비용이 크고 신뢰하기 어려울 수 있다. 외부에서 설계한 탐색 절차에는 과제별 구현 작업이 필요하다. DISCIPL은 생성, 검증, 탐색 절차의 명세를 모델이 생성한 프로그램에 맡긴다.
2 Related Work
이 논문은 추론 시점 탐색, 병렬 생성, 자동 시스템 개선, 제약 디코딩, SMC, 확률적 프로그래밍을 연결한다. 핵심 기여는 사람이 과제별 채점 함수나 고정된 탐색 절차를 지정하는 대신, 언어 모델이 개별 생성 토큰과 그 확률을 제어하는 실행 가능한 추론 절차를 생성하도록 한 데 있다.
- 기존 SMC 접근법도 언어 모델의 생성을 유도하지만, 생성과 채점 방식을 새로운 과제에 맞추려면 구현이나 학습이 필요하다. DISCIPL에서는 Planner가 이 방식을 작성한다.
- Python은 병렬 생성용 특수 마크업보다 일반적인 연산을 폭넓게 지원하지만, 이러한 유연성 때문에 프로그램 오류도 발생할 수 있다.
3 DISCIPL
DISCIPL은 추론 설계와 실행을 분리한다. Planner가 추론 프로그램을 작성하면, 범용 추론 엔진이 Follower와 지정된 샘플링 예산을 사용해 프로그램을 실행한다.
3.1 General Framework
모델 2개는 모두 앞선 문맥을 조건으로 텍스트를 생성하는 조건부 생성을 효율적으로 지원해야 한다. Follower는 조건부 확률도 효율적으로 계산해야 한다. 생성된 프로그램은 Follower를 비동기로 호출해 여러 요청을 동시에 진행하면서 텍스트를 샘플링하거나 우도를 계산할 수 있다. 추론 엔진은 답변이나 런타임 오류를 반환한다.
- Algorithm 1은 과제를 Planner에 제시하고, 생성된 프로그램을 실행한 뒤 실행에 성공하면 결과를 반환한다.
- 런타임 오류가 발생하면 Planner는 오류와 실패한 실행 기록인 traceback을 받아 재시도 한도 내에서 수정을 시도한다. 이 피드백은 실행에는 성공하지만 논리적으로 잘못된 프로그램을 자동으로 탐지하지는 못한다.
3.2 Our Instantiation: Language Model Probabilistic Programs
LLAMPPL 프로그램은 부분 생성 결과를 반복해서 확장하고, 과제에 따른 갱신값을 점수에 곱한다. 갱신값 0은 필수 제약 위반을 나타낼 수 있다. 다른 갱신값은 기호 규칙, 모델의 판단, Follower 확률을 통해 선호를 표현할 수 있다. observe()로 필수 단어를 강제로 삽입할 때도 해당 문맥에서 그 단어가 나올 확률을 점수에 반영한다.
- 추론 엔진이 샘플링하려는 확률 분포인 목표 분포는 각 프로그램 실행에 점수 갱신값의 곱을 가중치로 부여한다.
- 프로그램은 후보를 생성하고 채점하는 방법을 지정한다. 이 방법이 과제를 올바르게 구현하는지는 생성된 코드에 달려 있다.
실험에서는 추론 방법 3개를 비교한다. IS는 완성된 후보를 독립적으로 생성하고 누적 가중치에 따라 출력을 샘플링한다. SMC는 여기에 생성 중인 부분 후보의 재샘플링을 추가한다. Rejection sampling(RS)은 완성된 후보를 생성한 뒤 제약 충족 여부를 확인한다. 예산이 무한히 증가할 때, 프로그램이 정의한 목표 분포가 잘 정의되어 있으면 IS는 그 분포로 수렴한다. SMC도 논문에 명시된 비교적 약한 기술적 조건 아래에서 그 분포로 수렴한다.
- SMC는 후보 생성 결과와 실행 상태로 구성된 입자를 유지하고, 유망한 부분 출력에 연산을 재배분한다.
- 이 수렴 설명은 프로그램이 정의한 분포에 관한 것이다. 프로그램이 과제를 올바르게 표현한다는 근거가 되거나 유한한 예산에서 성공을 보장하지는 않는다.
3.3 Common Patterns
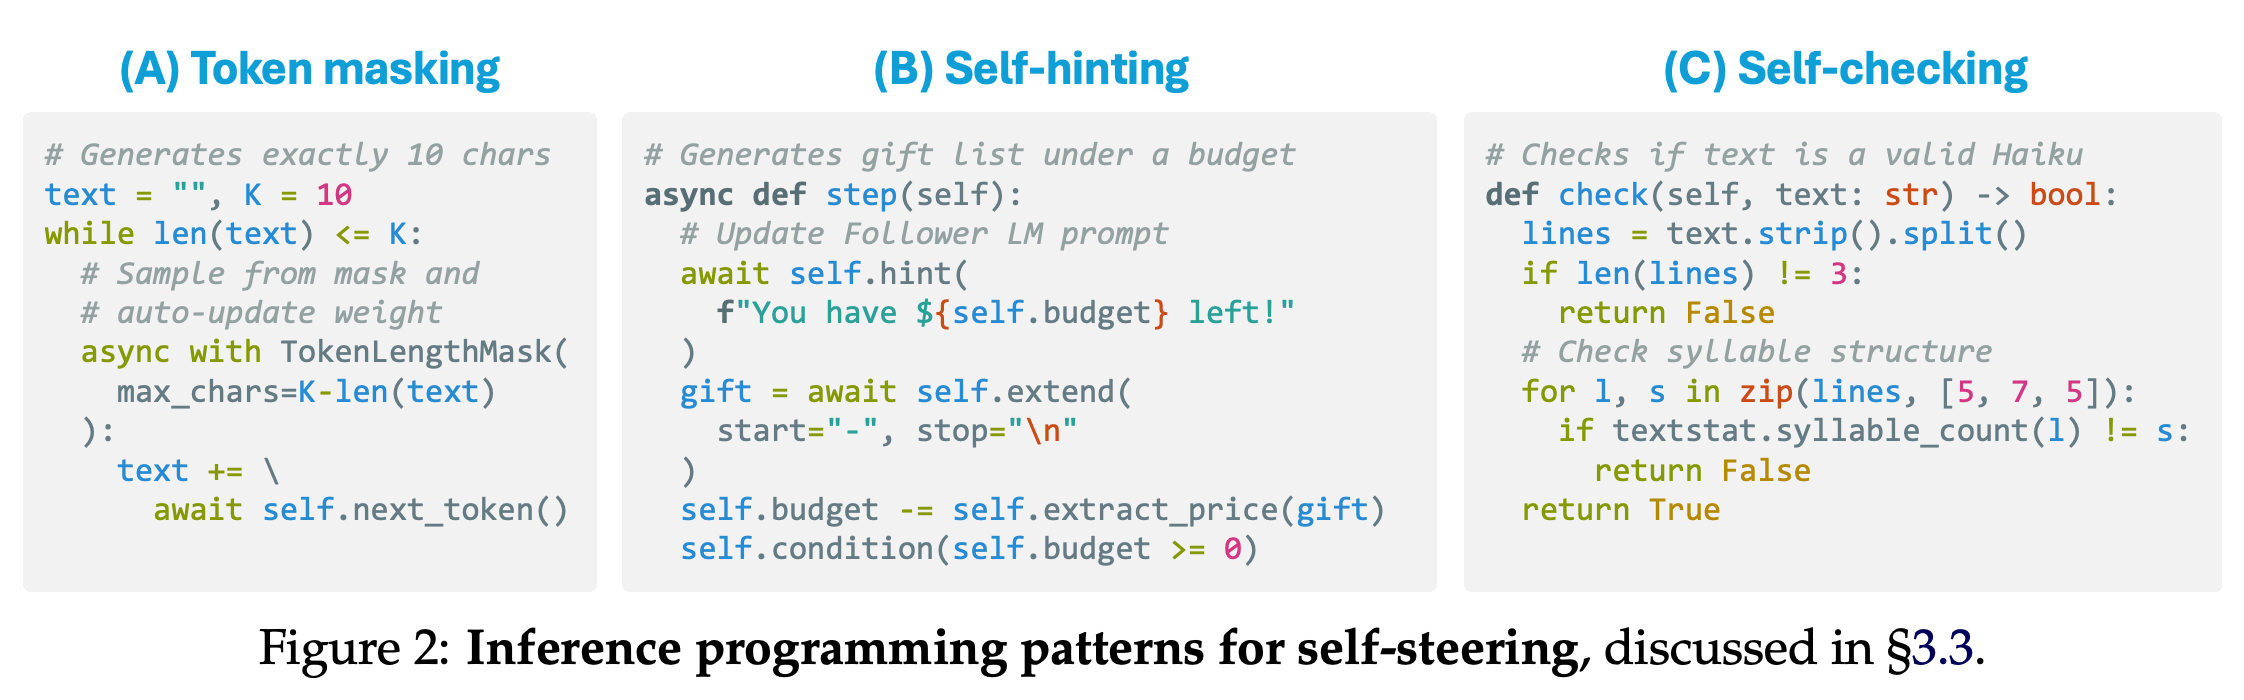
Planner는 단어, 시의 한 행, 다음 제약까지의 구간처럼 확장과 채점을 수행할 단계의 크기를 정한다. Proposal 프롬프트와 prior 프롬프트를 분리하면 생성은 과제 지시를 따르고 확률 기반 채점은 유창한 텍스트를 선호하도록 할 수 있다. Proposal은 후보를 생성하고, prior는 채점에 사용할 기준 확률을 제공한다.
- 토큰 마스크는 생성할 수 있는 토큰을 제한한다. Importance weight는 편향된 샘플링을 보정하기 위해 곱하는 가중치로, 토큰 제한으로 발생한 분포 왜곡을 보정한다.
- Self-hinting은 hint()를 통해 남은 예산처럼 계산된 상태를 Follower의 문맥에 삽입한다.
- Self-checking은 생성된 check() 메서드로 완성된 출력을 검증하며, 필요하면 외부 라이브러리를 사용한다.
예시는 상호 보완적인 제어 방식 3개를 구분한다. 토큰 선택을 제한하고, 생성 중 계산된 상태를 제공하며, 완성된 출력을 검증한다. 이 인터페이스는 생성 과정에서 제약을 충족시키는 방식과 생성 후 검증을 모두 지원한다.
4 Experiments
실험은 Planner의 예제에서 제외한 과제 유형에 대해 생성된 프로그램을 평가한다. 추론 예산과 Follower 모델을 바꾸면서 제약 충족률과 coherency를 측정한다. DISCIPL을 직접 생성, 디코딩 중 여러 후속 후보를 유지하는 stochastic beam search, CoT 프롬프팅, o1, 전문가 참조 구현을 제공하는 조건과 비교한다.
4.1 Domains
COLLIE-v1은 형식 문법으로 구성한 텍스트 제약을 제공하며, 평가에서는 문장과 문단 과제를 사용한다. PUZZLES는 정형시, 제약이 있는 연구비 신청 초록, 금전 예산을 지켜야 하는 재료 목록, 여러 날에 걸친 여행 일정으로 구성된다.
- COLLIE 평가에서는 Wikipedia 코퍼스의 사례를 사용해 과제 유형 13개 중 9개를 다룬다.
- 모델의 토큰 경계 때문에 세밀한 제약을 처리하기 어렵고 문자 수준 분포를 복원하는 비용도 커서 단어 수준 과제는 제외한다.
4.2 Evaluation Metrics
제약 충족률은 기대 Pass@1으로 측정한다. 추론 가중치가 있으면 이를 사용하고, 베이스라인에는 균등 가중치를 사용한다. 이 지표는 여러 후보에서 정답을 선택할 수 있는 완벽한 외부 검사기인 oracle verifier에 접근한다고 가정하지 않고, 선택한 답변이 유효할 확률을 평가한다.
- Coherency는 채점된 예시 없이 지시만 제공하는 zero-shot 평가 프롬프트를 사용해 GPT-4o-mini가 1부터 10까지 점수를 매긴다.
- Coherency 평가에는 제약을 위반한 생성 결과도 포함하므로, 제약을 자주 위반하는 방법도 높은 유창성 점수를 받을 수 있다.
4.3 Experiment Setup
Planner는 gpt-4o-2024-08-06이며, 기본 Follower는 Llama-3.2-1B-Instruct다. Planner에는 README.md 형식의 튜토리얼과 사람이 작성한 예제 프로그램을 제공하되, 목표 과제 유형의 예제는 제외한다. PUZZLES 프롬프트에는 COLLIE 예제도 추가한다.
- Follower-only 베이스라인은 temperature=1.0으로 독립적인 완성 결과 N개를 샘플링한다. N은 추론 예산이며, stochastic beam search는 N을 빔 크기로 사용한다.
- Planner-only 베이스라인에는 GPT-4o 직접 생성, GPT-4o CoT, gpt-4o-mini-2024-07-18이 포함된다.
- o1-2024-12-17 베이스라인은 max_tokens=25000을 사용하며 비용 때문에 과제 사례마다 1회만 질의한다. 따라서 연산량을 맞춘 비교 대상이 아니라 성능 참조점이다. DISCIPL*는 Planner에 목표 과제의 참조 구현을 제공한다.
5 Results and Analysis
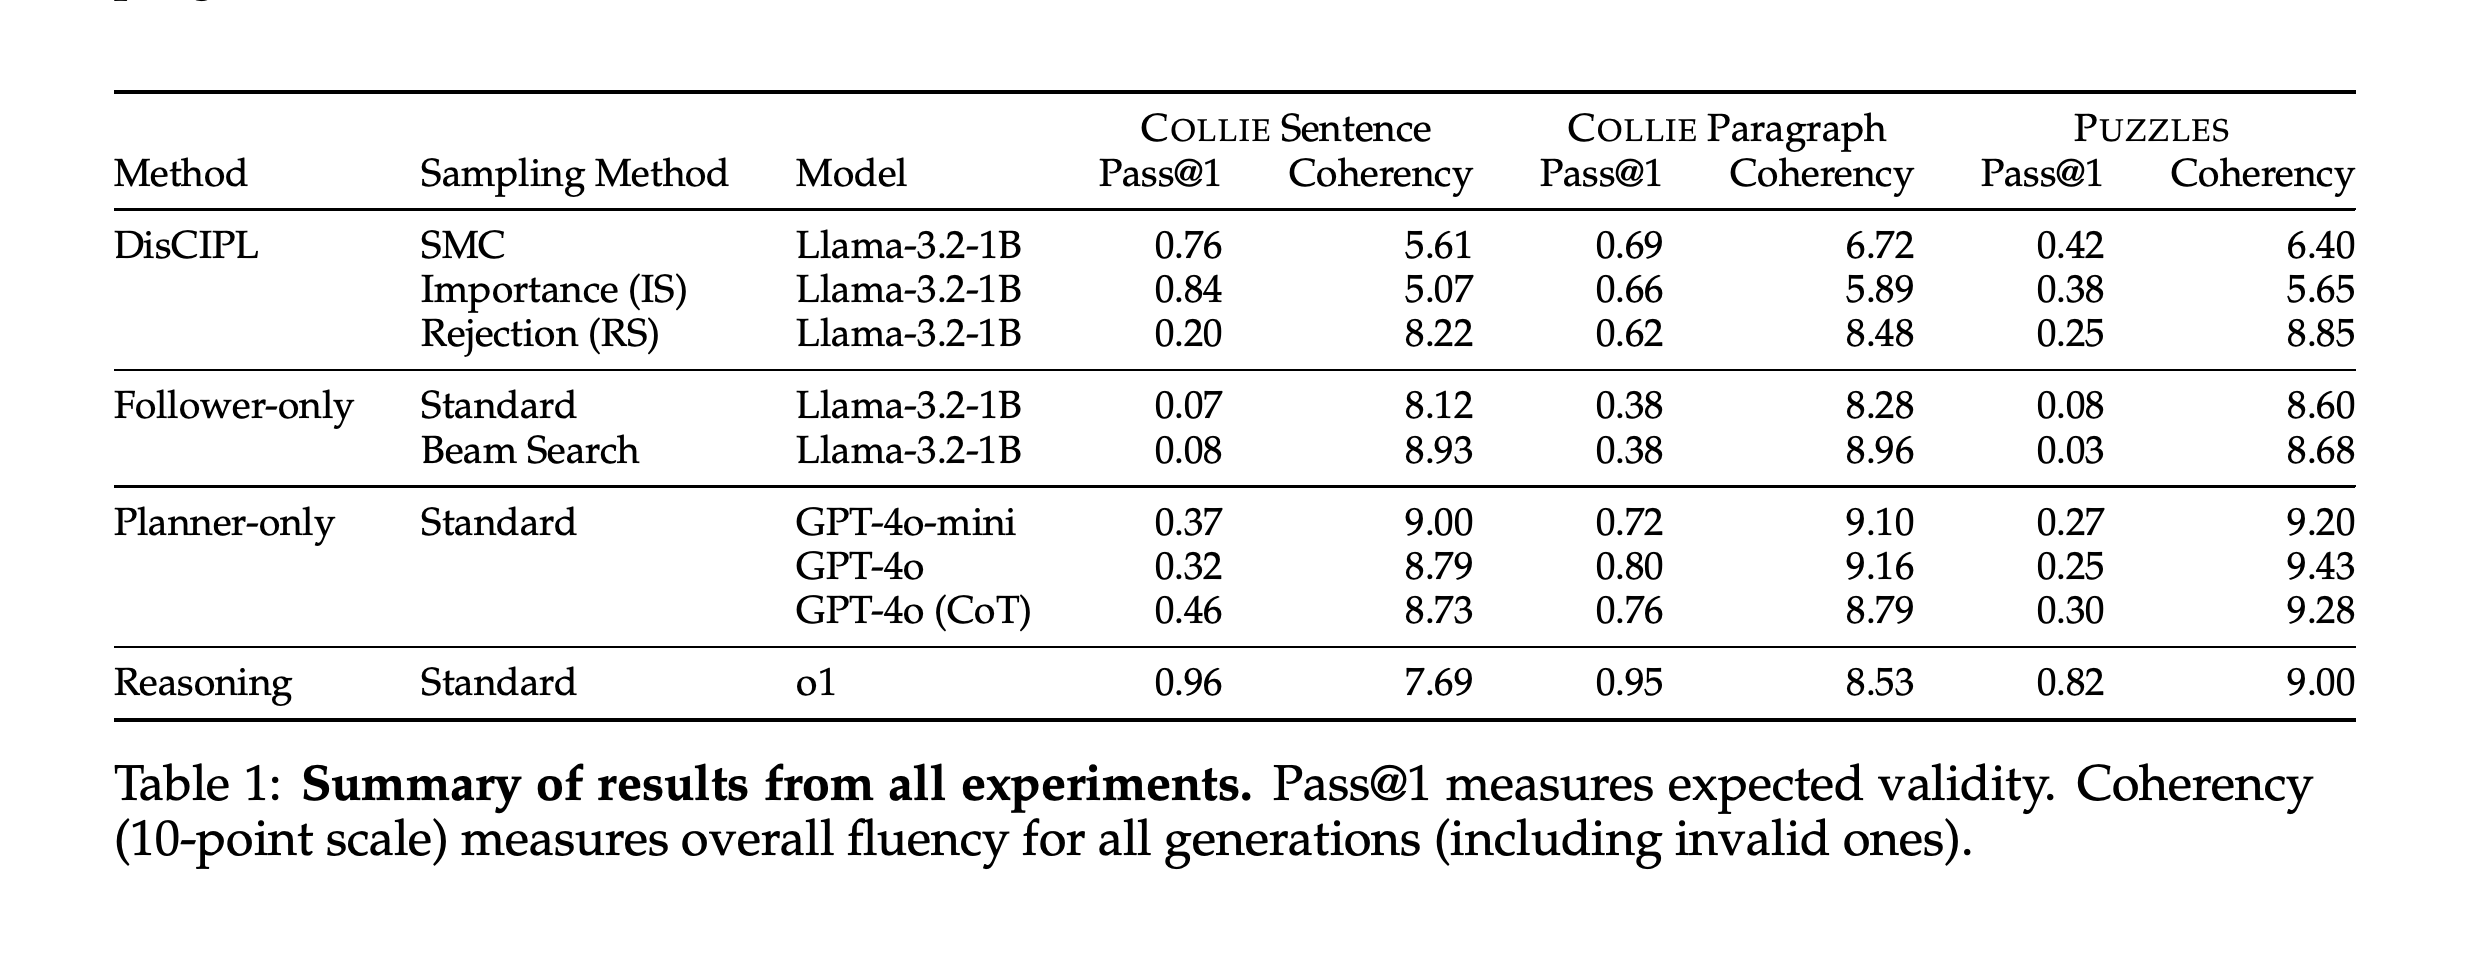
Table 1은 3개 영역의 종합 제약 충족률과 coherency를 제시한다. SMC와 IS는 1B Follower의 직접 생성보다 제약 충족률을 크게 높이지만 coherency 점수는 낮다. Planner의 직접 생성과 비교한 성능은 영역에 따라 달라진다.
5.1 Validity
N=32인 COLLIE 문장 과제에서 DISCIPL-IS는 Pass@1 0.84, DISCIPL-SMC는 0.76을 기록한다. Follower 직접 샘플링은 0.07, 빔 탐색은 0.08, GPT-4o는 0.32, GPT-4o CoT는 0.46, o1은 0.96이다. 이 결과는 해당 영역에서 Planner가 작성한 절차를 실행하는 방식이 Planner에 직접 답변을 요청하는 방식보다 나을 수 있음을 보여준다.
- 생성된 check() 메서드는 대체로 정답 검증기와 높은 일치도를 보이지만, 검사만으로는 충분하지 않다. DISCIPL-RS의 문장 Pass@1은 0.20에 그친다.
- 문장 과제에서 전문가 참조 구현을 사용하면 SMC는 0.90, IS는 0.91에 도달한다. 자동 생성 프로그램과는 측정 가능한 격차가 남아 있다.
N=32에서 SMC와 IS는 문장 제약 충족률에서 Follower와 Planner의 직접 생성을 크게 앞서지만, 종합 성능은 o1이 더 높다. 과제별 곡선은 입자를 추가해도 정확도가 항상 개선되지는 않음을 보여준다. 특히 생성된 채점 전략이 필수 단어의 점수를 낮출 때 이러한 현상이 나타난다.
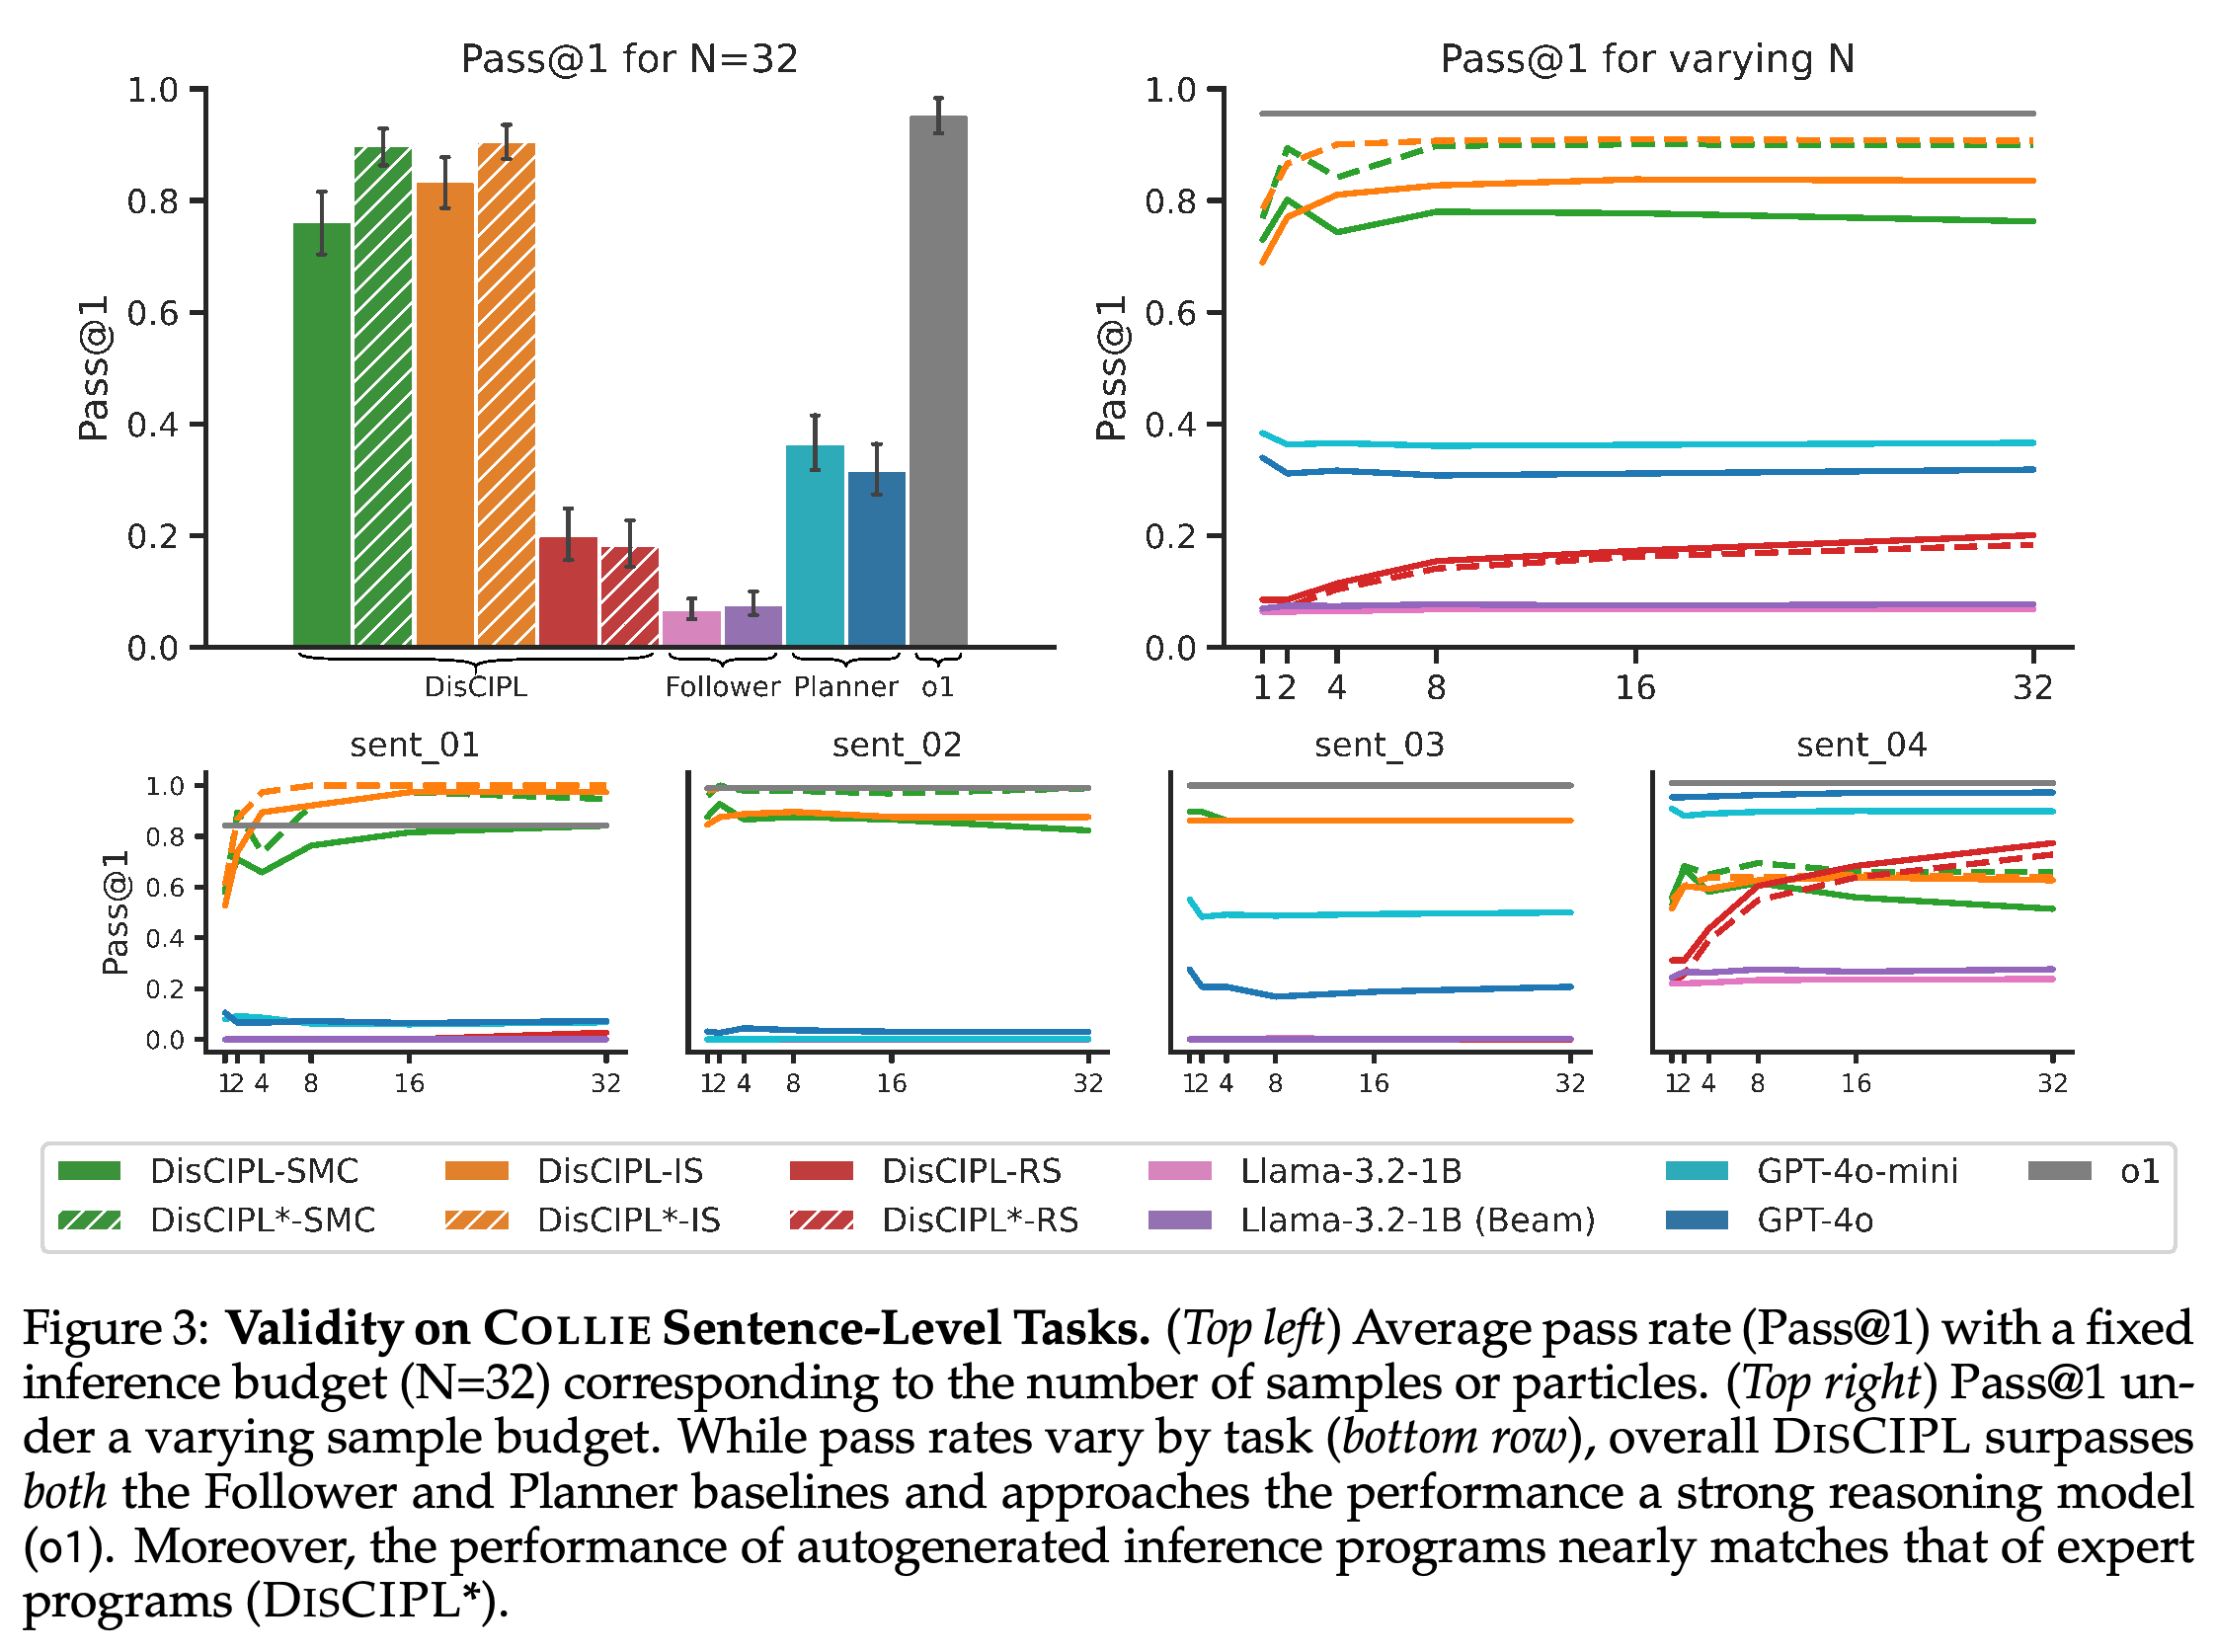
N=8인 COLLIE 문단 과제에서 SMC는 Pass@1을 Follower의 0.38에서 0.69로 높인다. GPT-4o는 0.80, o1은 0.95를 기록한다. N=16인 PUZZLES에서 SMC는 0.42, Follower는 0.08, GPT-4o는 0.25, GPT-4o CoT는 0.30, o1은 0.82를 기록한다.
- PUZZLES 성능은 과제에 따라 달라진다. SMC는 grant_proposal에서 0.20, ingredients_list에서 0.50, square_poem에서 0.70, trip_itinerary에서 0.30을 기록한다.
- PUZZLES에서 전문가 참조 구현을 사용한 SMC 점수는 0.70이다. 이는 생성된 추론 프로그램을 개선할 여지가 크다는 점을 보여준다.
나란히 제시된 열은 SMC와 IS가 1B Follower보다 제약 충족률을 높이는 동시에 유창성 점수를 낮춘다는 점을 보여준다. 이 방법들은 문장과 PUZZLES에서 GPT-4o 직접 생성을 앞서고 문단에서는 뒤처진다. 3개 영역 모두에서 종합 제약 충족률은 o1보다 낮다.
5.2 Coherency
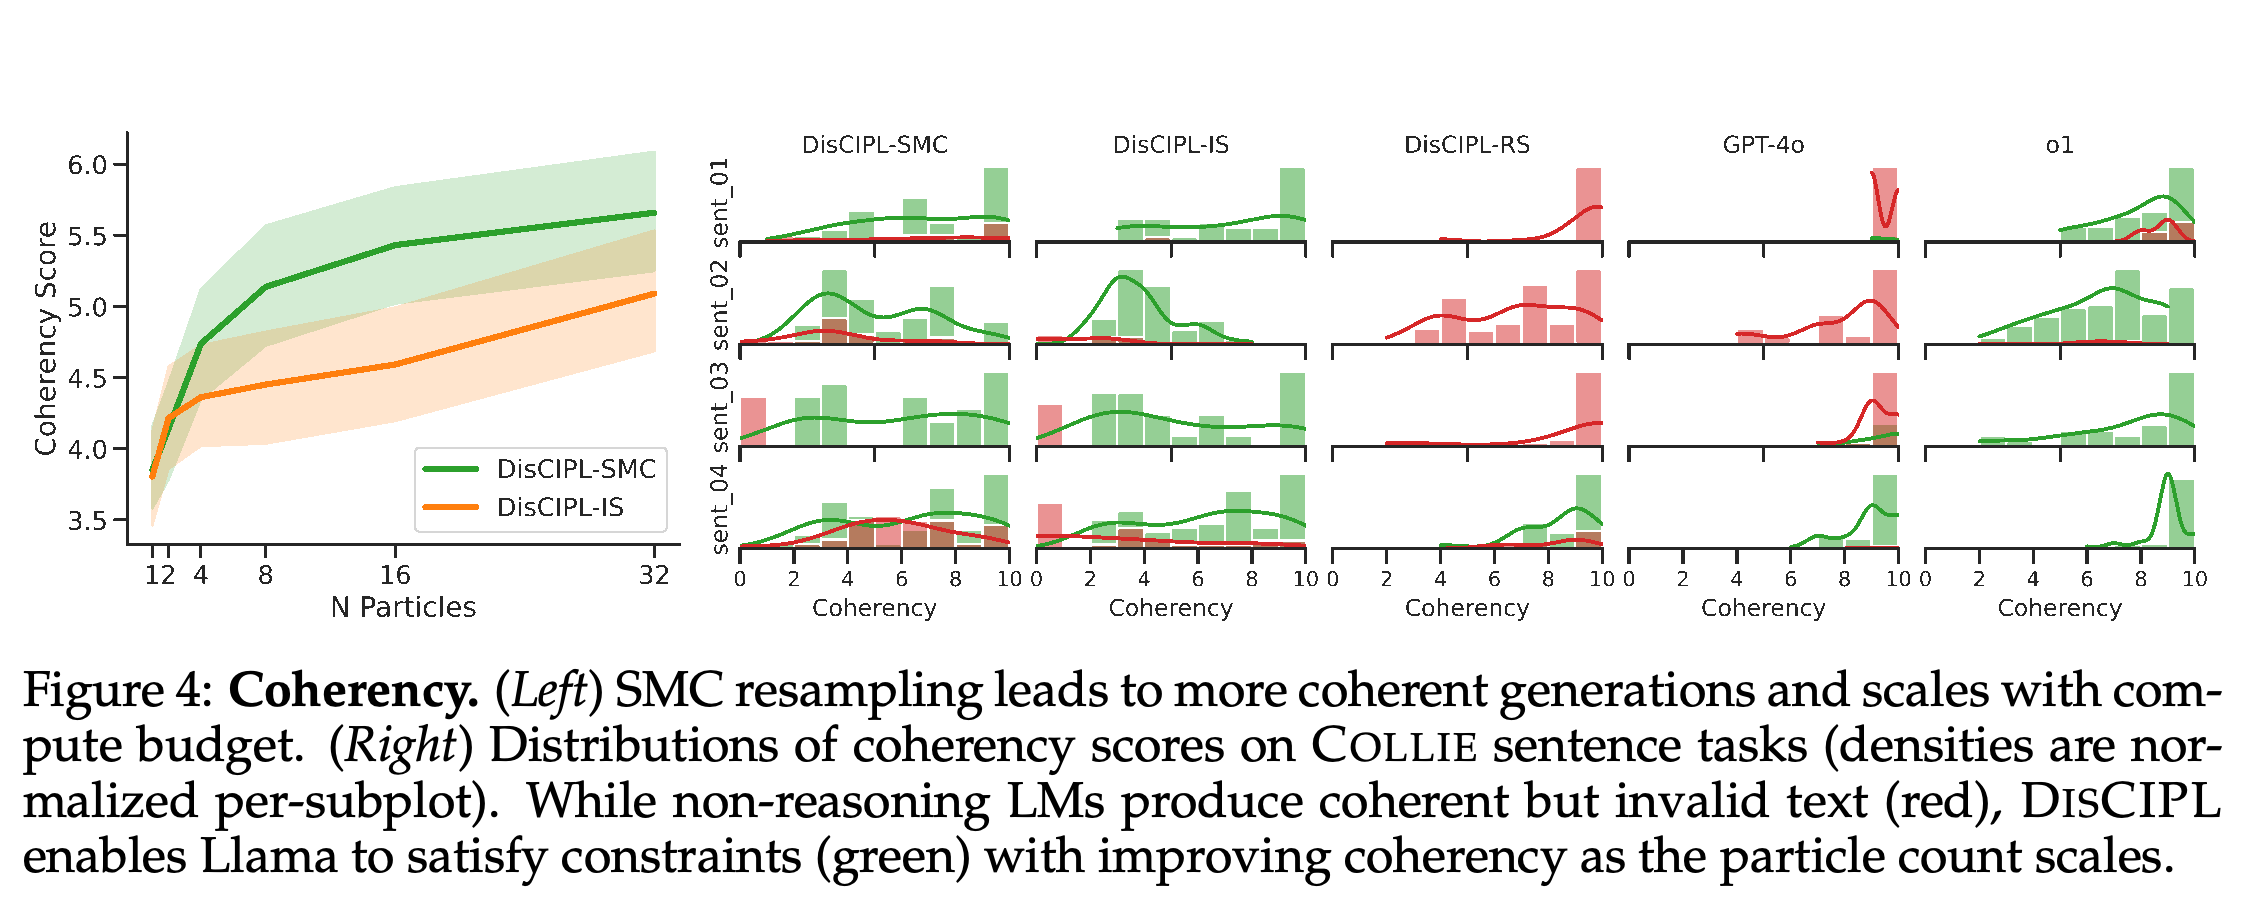
SMC는 평가한 모든 영역에서 IS보다 종합 coherency가 높다. 문장에서는 5.61 대 5.07, 문단에서는 6.72 대 5.89, PUZZLES에서는 6.40 대 5.65다. Figure 4에서는 입자 수가 늘수록 문장 coherency가 개선된다. 이는 중간 재샘플링이 어색한 부분 생성 결과를 제거한다는 설명과 부합한다.
- 같은 영역에서 Follower 직접 생성은 제약 충족률이 훨씬 낮지만, coherency 점수는 8.12, 8.28, 8.60을 기록한다.
- sent_04에서는 N > 8일 때 SMC Pass@1이 감소한다. 저자들은 단어 수준 재샘플링이 prior 확률이 낮은 필수 단어를 제거하기 때문이라고 설명한다. 이는 단계 분해가 과제와 잘 맞지 않으면 예산을 늘려도 제약 충족률이 나빠질 수 있음을 보여준다.
입자 예산 곡선은 연산량이 늘어날 때 SMC가 IS보다 높은 문장 coherency를 달성함을 보여준다. 제약 충족 여부에 따라 점수 분포를 나누면 유창성만으로 평가하기 어려운 이유가 드러난다. 여러 베이스라인이 유창하지만 제약을 위반하는 텍스트를 생성한다.
혼동 행렬은 생성된 check() 메서드가 독립적인 정답 검증기와 대체로 일치하지만 일부 불일치가 남아 있음을 보여준다. 런타임 오류로 발생한 null 출력은 별도 실패 범주이므로, 검증기 간 일치가 생성 성공을 입증하지는 않는다.
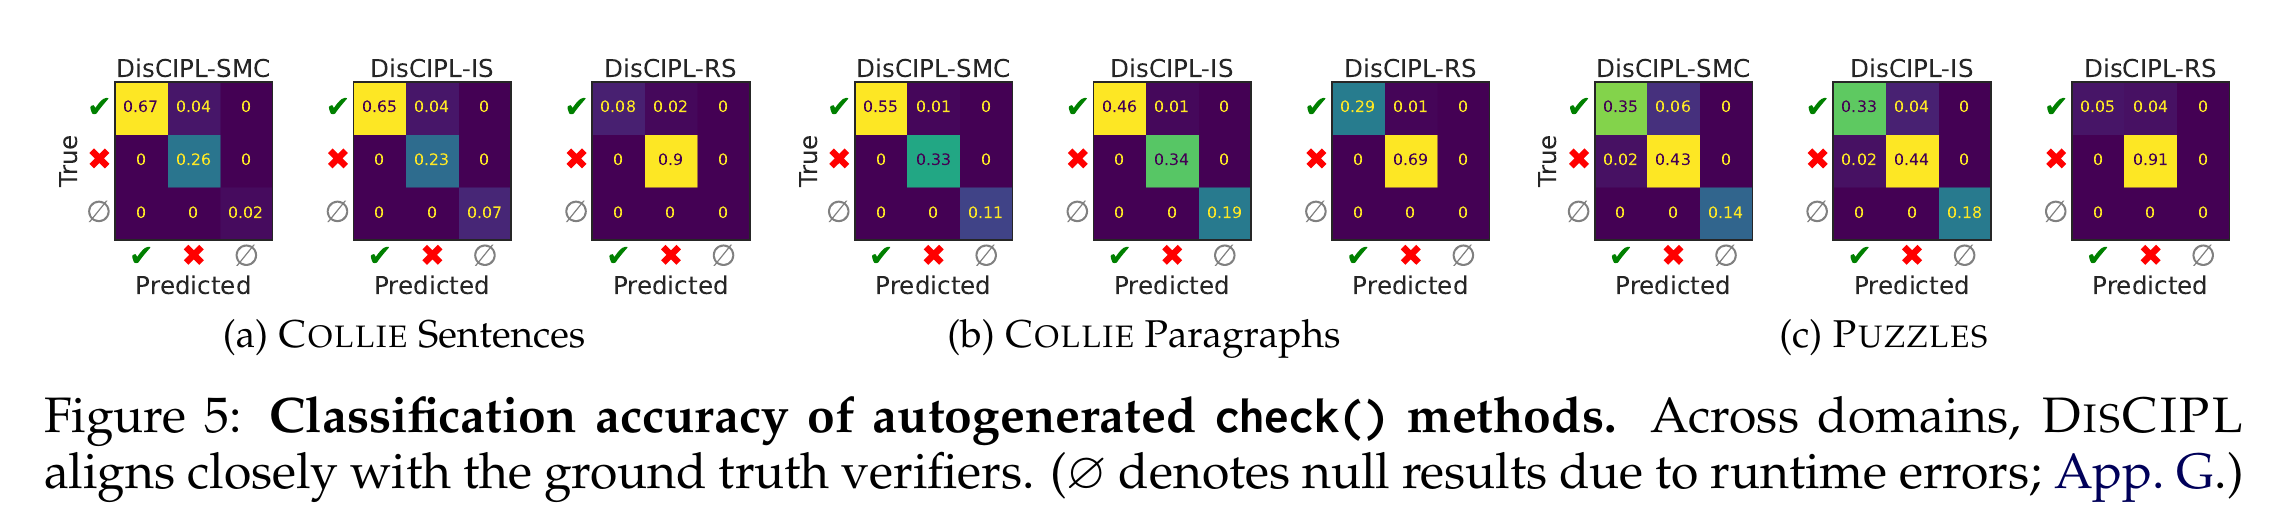
5.3 Scaling the Follower Model
Planner를 고정하면 문장 SMC Pass@1은 Llama-3.2-1B의 0.76에서 Llama-3.2-3B의 0.83, Llama-3.1-8B의 0.85로 높아진다. 문단 점수는 0.69에서 0.74, 0.75로 높아진다. 개선 정도는 추론 방법과 과제에 따라 달라진다.
- 모델 크기 비교에서 8B는 Llama-3.2 대신 Llama-3.1을 사용하므로, 차이를 파라미터 수만으로 설명하기는 어렵다.
- Qwen3-1.7B는 문장 SMC Pass@1을 0.83으로 높인다. 이는 1B Llama Follower보다 0.07 높은 값이다. 논문은 이 모델 계열 간 문단 성능에는 유의한 차이가 없다고 보고한다.
- 모든 설정에서 coherency가 단조롭게 증가하지는 않는다. Llama 크기 3개에 따른 문장 SMC coherency는 5.61, 6.36, 6.07이다.
Planner를 고정해도 더 강한 Follower를 사용하면 제약 충족률이 개선될 수 있지만, 경향은 영역과 추론 방법에 따라 달라진다. 8B 비교에서는 Llama-3.2 대신 Llama-3.1을 사용하므로 차이를 파라미터 수만으로 설명하기는 어렵다. Qwen3의 문장 성능 우위는 비슷한 수준의 문단 성능 향상으로 이어지지 않는다.
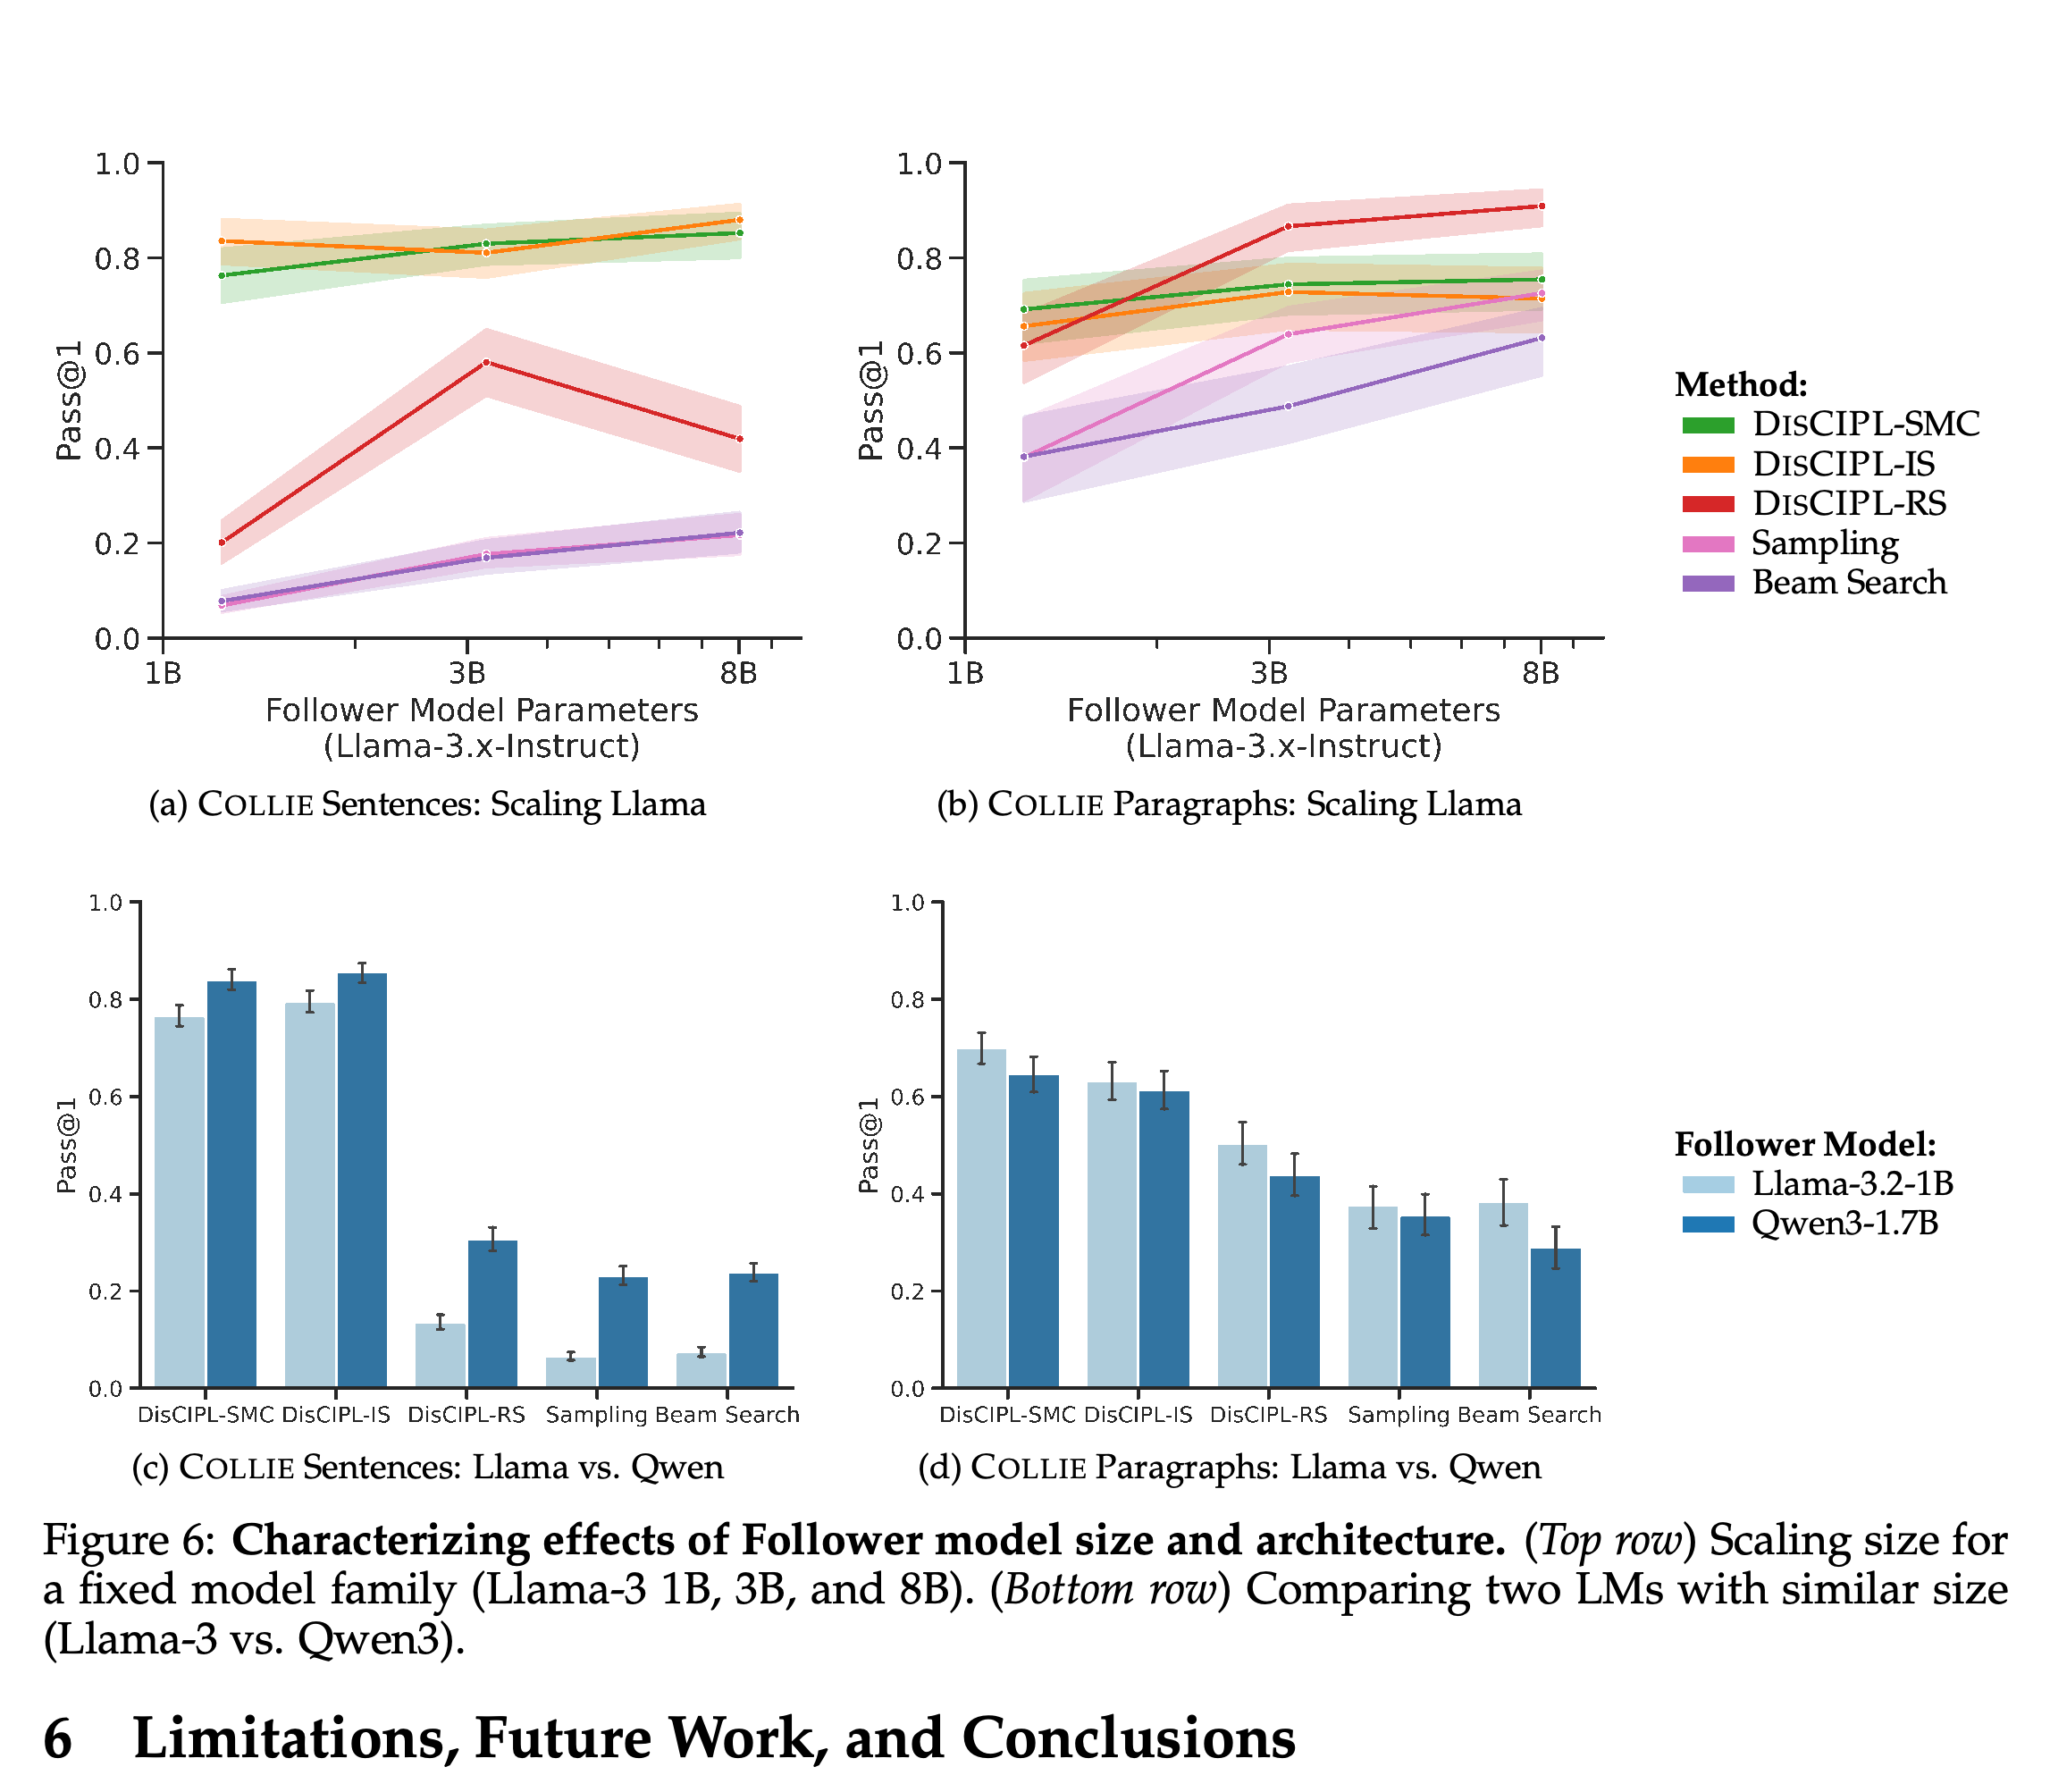
6 Limitations, Future Work, and Conclusions
실험으로 확인한 범위는 큰 Planner와 작은 Follower를 사용하는 제약 텍스트 생성이다. 수학 추론, 필수 조건 대신 선호를 표현하는 소프트 제약, 앞선 결정을 다시 검토하는 역추적 탐색, 반복 편집, 같은 모델로 Planner와 Follower 역할을 수행하는 방식은 실험으로 확립한 결과가 아니라 확장 방향으로 제안한다.
- 평가한 영역에서는 모델이 생성한 프로그램이 병렬 추론을 조율하고 작은 모델의 제약 충족률을 크게 높인다.
- 더 넓은 범위의 적용 가능성은 아직 검증하지 않았다. 보고된 프로그램 실패와 제약 충족률, coherency 간 상충 관계도 현재 결과의 한계다.
Author Contributions
Gabriel Grand는 연구 구상, 논지 구성, 소프트웨어 설계와 구현, 실험, 분석, 그림 제작, 집필을 주도했다. Joshua B. Tenenbaum과 Vikash K. Mansinghka는 선임 연구자로서 멘토링과 논지 구성에 기여했다. Alexander K. Lew는 여기에 연구 구상, 수학적 정식화, 분석, 그림 제작, 집필을 더했으며, Jacob Andreas는 멘토링과 논지 구성 외에도 연구 구상, 분석, 집필에 기여했다.
부록
- A SMC Visualization은 정확히 18단어로 구성하고 “Glasgow”, “in”, “and”를 각각 4, 8, 11번째 위치에 배치해야 하는 문장에서 N=16인 입자의 진행 과정을 추적한다. Figure 1의 단어별 단순 예시와 달리, 처음 3단계는 다음 필수 단어까지의 구간을 생성하고 마지막 단계는 문장을 완성한다. 재샘플링은 제약 아래에서 확률이 높은 후보를 선호한다.
- B COLLIE Dataset and Results는 과제 정의와 상세한 문장, 문단 결과를 제공한다. 문장 과제 유형 4개의 사례 수는 38, 98, 29, 94개이며, 문단 과제 유형 5개의 사례 수는 9, 94, 93, 18, 89개다. 종합 지표는 사례가 많은 과제 집단이 결과를 좌우하지 않도록 각 텍스트 수준 내에서 제약 유형에 같은 가중치를 부여한다.
- C Puzzles Dataset and Results는 4가지 과제 유형 각각에서 방법별로 10회 실행한 결과를 보고한다. 조건에는 8줄로 이루어지고 줄마다 정확히 8단어를 사용하는 시, 지정 용어를 피하는 75–100단어 연구비 신청 초록, 총비용이 $18.00 미만인 최대 7개 재료 목록, 매일 최소 4가지 활동과 최소 9시간의 자유 시간을 포함한 3일 Singapore 여행 일정이 있다. Tables 5와 6은 유효한 출력 예시와 과제별 결과를 제공한다.
- D Weighted Pass@1은 전체 샘플 가중치 중 유효한 출력에 할당된 비율로 지표를 정의한다. 식은 Weighted Pass@1 = sum of weights of passing samples / sum of weights of all samples이다. 비정규화 가중치는 로그 가중치에 지수 함수를 적용해 구하며, null 출력에는 가중치 0을 부여한다. 모든 가중치에 같은 양수를 곱해도 지표는 변하지 않으며, 모든 샘플의 가중치가 같으면 일반 Pass@1과 같아진다.
- E Coherency Score는 비용과 추론 시간을 줄이기 위해 기존 평가의 GPT-4 대신 gpt-4o-mini-2024-07-18을 평가자로 지정한다. 프롬프트는 최대 3문장으로 분석하고 마지막에 1부터 10 사이의 점수를 제시하도록 요청한다. 논문은 사람의 평가와 비교한 결과를 보고하지 않는다.
- F Planner-Only Chain-of-Thought와 F.1 Chain-of-Thought Prompt는 단계별 추론 베이스라인을 설명하며, 최종 답변은 <answer></answer> 태그로 감싼다. F.2 Error Examples에는 GPT-4o가 82자라고 주장하면서 90자를 반환하는 F.2.1 Character Counting과, 명시적인 위치 계획을 세웠는데도 필수 단어가 8, 11번째 위치를 벗어나는 F.2.2 Word Positioning이 포함된다.
- G DISCIPL Error Analysis에 따르면 traceback 피드백은 초기 런타임 오류의 약 절반을 수정하지만, 3회 시도 후에도 COLLIE에서는 2–6%, PUZZLES에서는 18%의 오류가 남는다. 흔한 원인은 가능한 다음 토큰을 모두 제외하는 토큰 마스크와 잘못된 종료 로직에 따른 시간 초과다. Listings 1과 2는 목표 길이에 도달한 뒤 문장 부호가 추가되는 사례와 대소문자 정규화 버그 때문에 대문자가 포함된 목표 단어가 일치하지 않는 사례를 보여준다.
- H Inference Methods는 SMC를 정식화하고 실행을 T=1000단계로 제한한다. step() 내부 반복문에는 별도의 실제 경과 시간 제한을 적용한다. I Implementation Details는 언어 모델 서빙 시스템인 vLLM 백엔드를 사용하며, 베이스라인의 max_tokens를 문장 32, 문단 128, PUZZLES 512로 설정한다. DISCIPL은 Planner가 선택한 토큰 한도와 R=3 재시도를 사용한다. 각 영역의 시간 제한은 120s, 240s, 360s이며, 최대 예산은 각각 N=32, N=8, N=16이다.
- J Compute Cost Analysis와 Key Takeaways는 COLLIE 문장 과제를 분석한다. Table 7의 과제 100개당 비용은 Follower-only $0.0004, GPT-4o $0.0709, GPT-4o CoT $0.3612, o1 $4.7457, N=32인 DISCIPL-SMC $4.2606이다. DISCIPL 프로그램은 o1 추론 기록보다 중간 토큰을 40.1% 적게 사용하며 생성 비용은 80.2% 낮다. 다만 Planner 프롬프팅이 대부분의 비용을 차지해 전체 시스템의 비용 우위는 크지 않다. 이 설정에서 Follower 생성은 DISCIPL 추정 비용의 <0.1%를 차지한다.
- Column Descriptions:에서는 답변 생성, 추론 또는 프로그램 생성, 과제 프롬프팅, 캐시 적용 여부에 따른 Planner 프롬프팅을 구분한다. Token Counts and API Pricing Details는 2025-05-31 기준 가격을 사용하며, 로컬 Follower 연산 비용은 보수적인 상한으로 Together API 가격을 적용해 추정한다. Average Token Counts and Standard Deviations per Task는 DISCIPL 프로그램 토큰을 456.9 (69.4), o1 추론 토큰을 764.8 (1018.3)으로 보고한다. 저자들은 Planner 프롬프트 토큰의 95.6%가 캐시되었다고 보고한다. 이는 이전에 처리한 프롬프트 내용을 할인된 가격으로 재사용했다는 뜻이다. 생성 전에 프롬프트 토큰을 처리하는 prefill 중 과제 간에 동일한 정적 프롬프트 부분을 처리하는 비용이 DISCIPL 비용의 72%를 차지한다. 이 오버헤드를 줄이는 방안은 제안했지만 실증하지 않았다.
- K Prompts and Code Links는 버전을 명시한 재현 자료를 제공한다. K.1 Planner System Prompt는 https://github.com/gabegrand/self-steering/blob/v1.0.0/disciple/prompts/planner_system_prompt.md 링크를 제공한다. K.2 Example Models는 COLLIE Example Models를 https://github.com/gabegrand/self-steering/blob/v1.0.0/evaluations/collie_eval/models.py 에, PUZZLES Example Models를 https://github.com/gabegrand/self-steering/blob/v1.0.0/evaluations/puzzle/models.py 에 제시한다. 본문의 leave-one-out 평가에서는 목표 과제의 예제를 제외한다.
짧은 생각
이 논문의 기여는 과제별 추론 절차를 생성하는 실행 가능한 인터페이스다. 문장 결과는 직접 생성과 rejection sampling보다 상당한 우위를 보인다. 반면 자동 생성 프로그램과 전문가 참조 PUZZLES 프로그램 사이의 격차는 프로그램 품질이 실용적인 한계임을 보여준다.
공학적으로 평가할 때는 제약 충족률, 유창성, 총비용을 함께 고려해야 한다. 작은 Follower에서 보고된 제약 준수 성능 향상은 크지만, coherency 점수가 낮고 프롬프트 처리에 비용이 집중되므로 적합한 시스템은 응용 분야의 요구에 따라 달라진다.