


Self-Improving Language Models with Bidirectional Evolutionary Search 요약 설명
27 May 2026 | Paper Review Evolutionary Search Reinforcement Learning With Verifiable Rewards Test-Time Scaling목차
- 요약
- 1 Introduction
- 2 Preliminaries
- 3 BES: Bidirectional Evolutionary Search
- 4 Theoretical Motivations
- 5 Experiments
- 6 Related Work
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Self-Improving Language Models with Bidirectional Evolutionary Search 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 27일(Arxiv), Preprint
- Xu, Guowei, Qi, Zhenting, Su, Huangyuan, Ye, Weirui, Lakkaraju, Himabindu, Kakade, Sham M., Du, Yilun.
- Harvard University, MIT
- 논문 링크
- Github
- Project Page
요약
- Self-Improving Language Models with Bidirectional Evolutionary Search는 post-training과 추론을 위한 샘플링 프레임워크 BES를 제안한다. 순방향 경로 확장 및 재조합과 역방향 목표 분해를 결합한다. 검증 가능한 하위 목표를 활용해 드문 해답을 찾기 어렵고 최종 피드백이 희소한 문제를 다룬다.
- BES는 논리 추론 post-training을 개선한다. MuSiQue 정확도는 Llama-3.2-3B-Instruct에서 4.0%에서 7.0%로, Llama-3.1-8B-Instruct에서 6.6%에서 10.4%로 높아진다. GPT-5 프로그램 탐색 벤치마크 3개에서는 평가한 오픈소스 프레임워크 중 가장 높은 평균 목적함숫값을 달성한다. 다만 Heilbronn 최고 결과는 보고된 정밀도에서 OpenEvolve 및 GEPA와 같다.
- 이론 분석은 경로의 자기정보량 증가로 재조합의 동기를 설명하고, 하위 목표 증거 수집의 샘플 복잡도로 역방향 검증의 동기를 설명한다. 그러나 비전형적인 후보가 더 나은 해답이라는 점이나 상호 보완적인 증거를 항상 성공적으로 재조합할 수 있다는 점은 입증하지 않는다. 평가에는 과제별 검증 휴리스틱, 작은 post-training 모델, 논리 추론에서 서로 다른 생성 호출 예산, 벤치마크당 추론 실행 3회라는 한계가 있다.
1 Introduction
이 논문은 모델의 능력 한계에 가까운 영역에서 샘플링하는 문제를 다룬다. 이 영역에서는 올바른 경로가 너무 드물어 일반적인 rollout만으로 유용한 학습 데이터나 신뢰할 만한 추론 답변을 얻기 어려울 수 있다. Best-of-N 샘플링과 트리 탐색은 주로 순차적 확장으로 후보를 구성한다. 이진 보상이나 세분화되지 않은 최종 보상은 완전한 해답을 찾기 전까지 탐색에 충분한 지침을 제공하지 못한다.
- BES는 후보 구성과 진행 상황 평가를 분리한다. 순방향 진화는 서로 다른 경로의 조각을 결합하고, 역방향 탐색은 중간 목표를 명시한다.
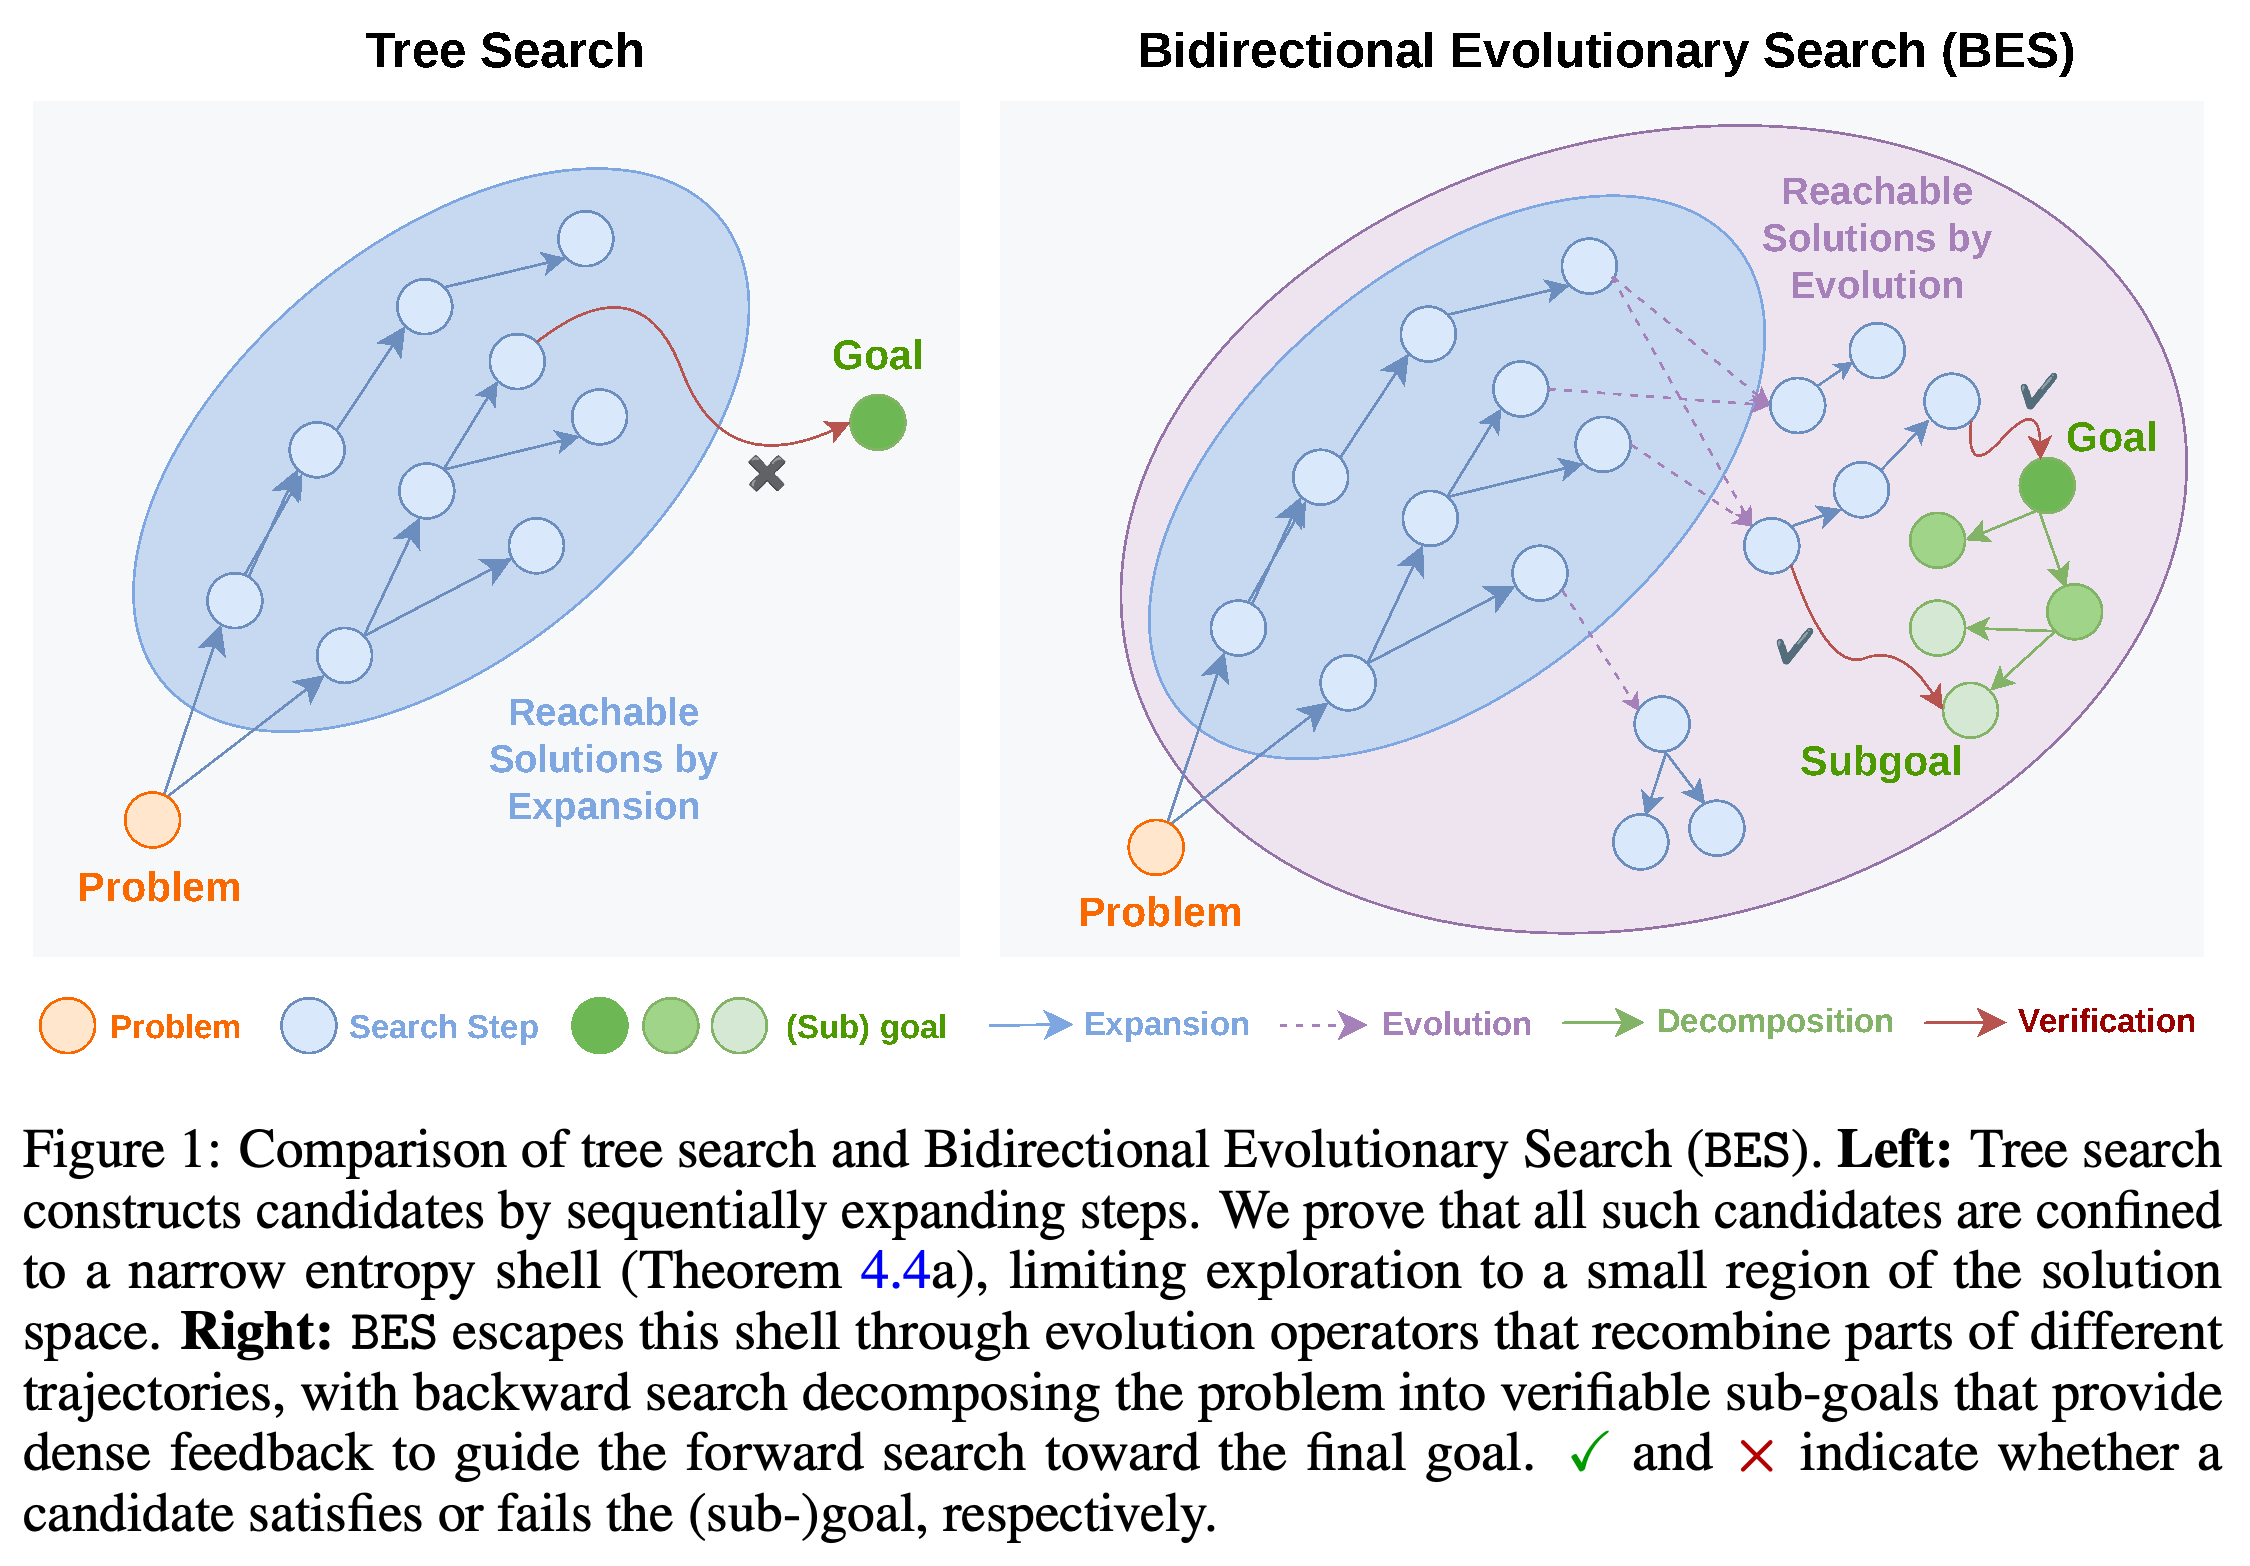
- Figure 1은 일반적인 확장과 재조합을 활용한 탐색의 차이를 보여 준다. 도달 가능한 영역은 개념적 표현이며, 해답 공간의 탐색 범위를 측정한 결과가 아니다.
- 코드와 학습된 모델은 https://github.com/Embodied-Minds-Lab/BES 에서 제공한다.
도식은 제안한 메커니즘 2개를 구분한다. 진화는 순방향 경로들의 조각을 연결하고, 목표 분해는 중간 검증 대상을 제공한다. 표시된 영역은 엔트로피 껍질에 관한 이론적 동기를 표현하며, 도달 가능한 해답을 실증적으로 측정한 결과가 아니다.
2 Preliminaries
과제는 문제 설명 x와 검증기 V(x, y) ∈ [0, 1]로 구성된다. 정책 πθ로 후보를 생성하고, 과제 명세와 자원 예산 안에서 유효한 최종 응답의 검증 점수를 최대화하는 것이 목표다.
- Best-of-N은 같은 정책에서 독립적인 경로를 샘플링하고 가장 높은 점수를 받은 경로를 반환한다. 정책이 매우 낮은 확률을 부여한 해답은 놓칠 수 있다.
- 트리 탐색은 beam search, best-first search, Monte Carlo Tree Search를 통해 유망한 접두 경로에 연산을 집중한다. 다만 각 최종 응답은 하나의 연속된 확장 과정으로 구성한다.
3 BES: Bidirectional Evolutionary Search
BES는 부분 경로의 후보 집합을 유지하면서 순방향 후보 생성과 역방향 목표 세분화를 번갈아 수행한다. 새 후보에는 재귀적인 하위 목표 점수를 부여한다. 목표 트리가 세분화되면 기존 후보도 다시 평가하므로, 이후 선택에는 갱신된 피드백을 사용한다.
- 일반 알고리즘은 여러 순방향 단계를 수행한 뒤 역방향 분해를 수행한다. 실험 구현에서는 과제에 맞게 이 일정을 조정한다.
- 진화는 후보가 하나의 끊김 없는 rollout 계보만 따르도록 제한하지 않고, 여러 부모의 기여를 받도록 허용한다.
3.1 Forward Search: Expanding the Reachable Solution Space
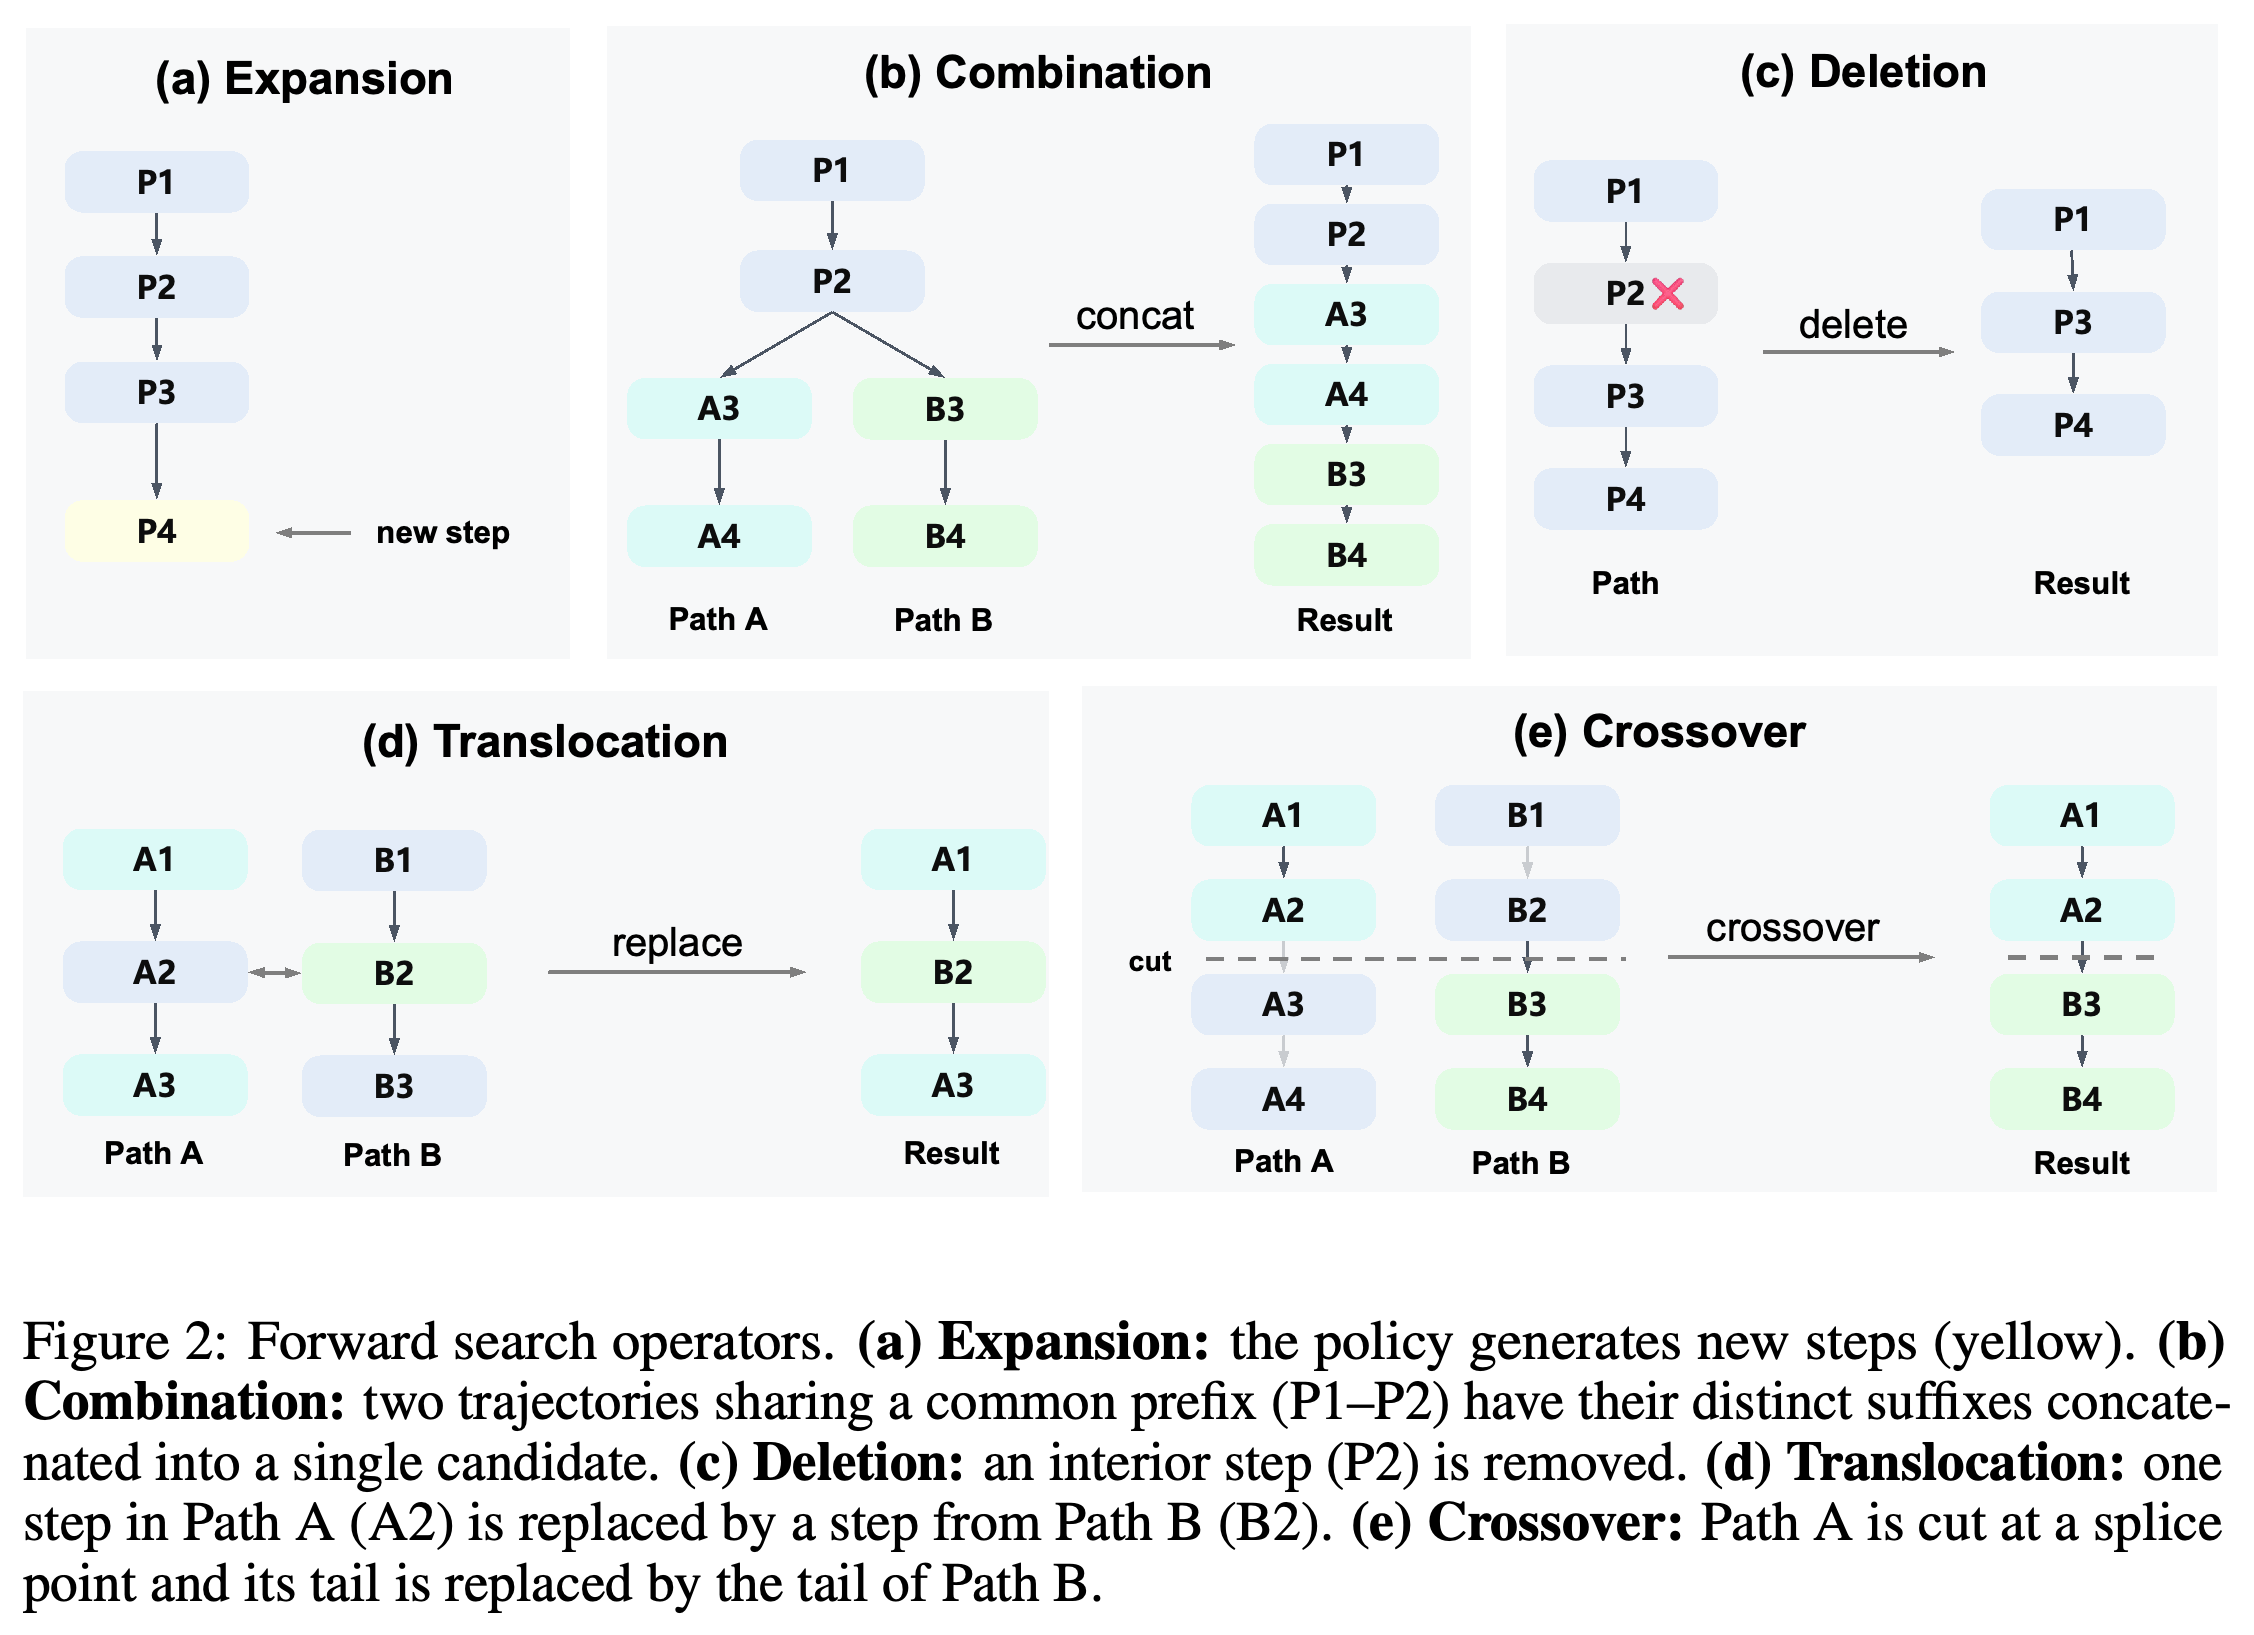
순방향 탐색은 확장과 진화 연산자 4개를 사용한다. combination은 공통 접두 경로 뒤의 서로 다른 접미 경로를 이어 붙이고, deletion은 중간 단계 1개를 제거한다. translocation은 한 단계를 다른 경로에서 가져온 단계로 교체하고, crossover는 한 경로의 접두부에 다른 경로의 후반부를 연결한다. 확장은 {1, …, Kmax}에서 K를 균등하게 샘플링한 뒤 정책이 생성한 단계를 최대 K개 추가한다.
- 단일 부모 선택에는 역방향 점수에 대한 Boltzmann 분포를 사용하며, 아직 자식을 생성하지 않은 노드에는 λ = 0.1을 더한다.
- 부모 2개를 선택할 때는 개별 점수가 가장 높은 후보 2개를 단순히 고르지 않는다. 공동 하위 목표 충족 범위를 사용해 상호 보완적인 부모를 선호한다.
- 선택 temperature는 예산 소진에 따라 선형으로 감소한다. 직접 편집이 품질을 높이거나 일관성을 유지한다는 보장은 없다. 실행 가능한 프로그램 실험에서는 대신 LLM 프롬프트로 연산자를 구현한다.
각 패널은 편집 단위를 명확히 보여 준다. combination은 양쪽 접미 경로를 유지하고, deletion은 경로 1개를 줄이며, translocation은 단계 1개를 교체하고, crossover는 후반부를 대체한다. 이 연산들은 정책에 새 단계를 추가하도록 요청하는 데 그치지 않고 기존 경로를 수정한다.
3.2 Backward Search: Better Verification through Goal Decomposition
역방향 탐색은 루트 과제를 더 세밀한 목표로 재귀적으로 분해하고 각 목표에 로컬 검증기를 부여한다. 현재 후보 중 어느 것도 완전히 충족하지 못한 리프를 선택해 추가로 분해한 뒤, 세분화된 트리로 모든 순방향 후보를 평가한다.
- 내부 목표에서는 Eq. (5)가 α를 사용해 해당 목표의 검증 점수와 자식들의 평균 재귀 점수를 혼합한다. 리프는 로컬 검증기를 직접 사용하며, 완전히 충족된 목표는 추가 계산 없이 1을 반환한다.
- Eq. (6)은 각 로컬 검증기 출력을 부모 2개의 출력 중 최댓값으로 대체해 부모 조합의 점수를 계산한다. 이는 부모들이 함께 충족하는 목표의 범위를 측정한다.
- 검증기는 규칙 기반 검사, 실행 가능한 테스트, 임베딩 유사도, LLM 판단으로 구현할 수 있다. 검증기의 정확성에 따라 촘촘한 피드백이 실제 진전을 반영하는지가 결정된다.
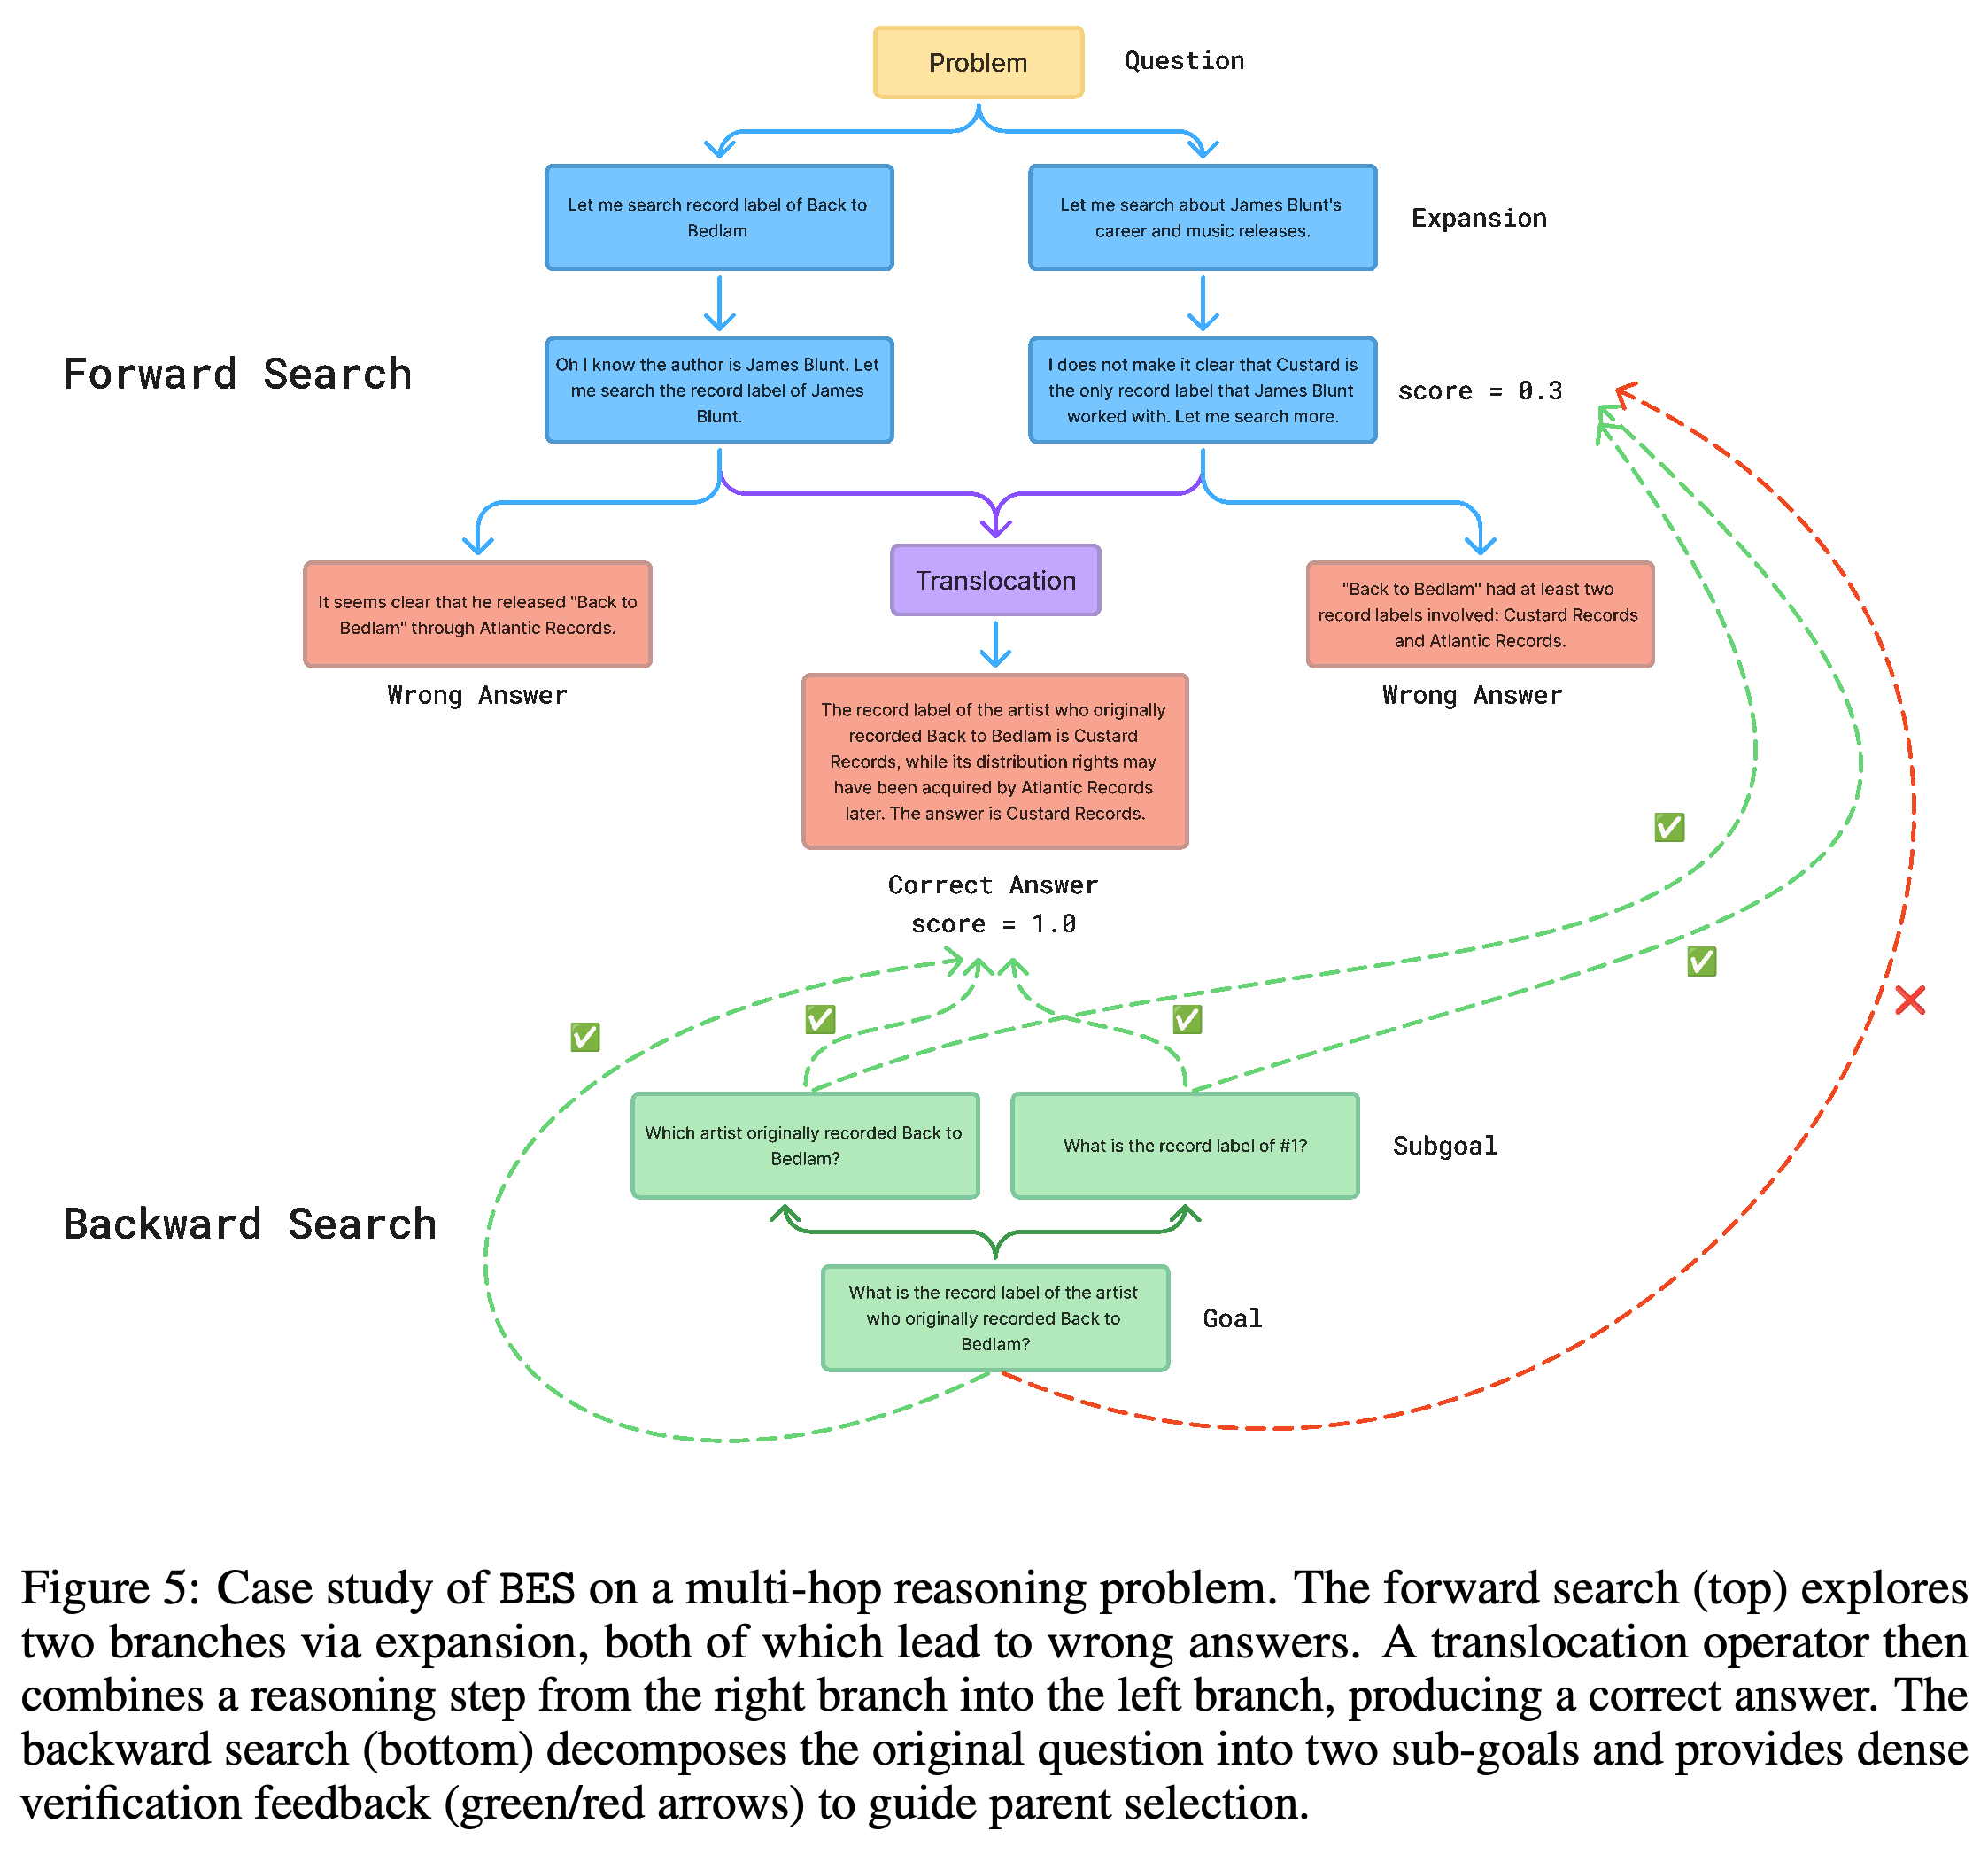
MuSiQue 사례는 “Back to Bedlam을 처음 녹음한 아티스트의 음반사는 어디인가?”라는 질문을 다룬다. 역방향 탐색은 아티스트 식별과 음반사 식별을 분리한다. translocation은 실패한 분기 2개의 추론을 결합해 데이터셋의 정답인 Custard Records를 생성한다.
- 예시의 부분 후보는 0.3점을 받고, 성공적으로 재조합된 후보는 1.0점을 받는다.
- 이 탐색 기록은 경로 간 재사용을 보여 준다. 그러나 전체 성공률을 보여 주거나, 계속 확장했더라도 이 문제를 풀 수 없었다는 점을 입증하지는 않는다.
확장 분기 2개는 데이터셋의 올바른 음반사를 반환하지 못하지만, translocation으로 옮긴 추론 단계는 Custard Records라는 답을 뒷받침한다. 점수 0.3과 1.0은 완전한 성공에 앞서 부분 피드백이 제공됨을 보여 준다. 이 기록은 설명용 사례이며 재조합 성공률의 추정치가 아니다.
3.3 Using BES for Post-Training and Inference
Post-training에서는 BES가 샘플 생성 단계를 대체하고 선택한 경로를 기존 학습 알고리즘에 제공한다. 추론에서는 고정된 예산 안에서 탐색한 뒤 원래 검증기 점수가 가장 높은 최종 후보를 반환한다.
- 실험에서는 논리 추론에 MaxRL, multi-hop 추론에 GRPO, 실행 가능한 프로그램 탐색에 ShinkaEvolve를 사용하고 그 위에 BES를 적용한다.
- BES는 탐색과 샘플링을 담당하는 구성 요소이며, 독립적인 파라미터 갱신 규칙은 아니다.
4 Theoretical Motivations
이론 분석은 질문 2개를 다룬다. 재조합이 일반적인 정책 샘플링으로는 나오기 어려운 경로에 도달하는지, 중간 검증이 유용한 부분 증거를 수집하는 데 필요한 샘플 수를 줄이는지 살펴본다. 분석은 전체 실험 시스템을 직접 모델링하지 않고 이상화한 경로 분포와 하위 목표 사건을 사용한다.
4.1 Theoretical Motivation for Evolution Operators
Theorem 4.4는 단계별 자기정보량이 유계이고, 미래 조건부 엔트로피에 미치는 영향이 합산 가능한 속도로 감소하며, 블록의 총상관이 적어도 γT라고 가정한다. 분석은 정책 rollout의 자기정보량이 경로 엔트로피 HT 주변에 집중된다는 점을 보인다. 또한 각 주변분포에서 블록을 독립적으로 재조합하면 원래 정책 분포에서 계산한 기대 자기정보량이 적어도 γT만큼 증가한다는 점을 보인다.
- 전형 집합은 Aϵ^(T) = {y : |−log P(y) − HT| ≤ ϵT}이며, 그 크기는 최대 exp(HT + ϵT)다. ϵ < γ일 때, 재조합 후보에도 유한한 자기정보량 상한이 성립한다면 제시된 확률 경계에 따라 이 집합 밖에 양의 확률 질량이 존재한다.
- Appendix C는 자기정보량 증가를 총상관과 DKL(Q∥P)의 합으로 유도한다. 재조합이 P의 지지집합 밖에 있는 후보를 생성하면 원래 정책 분포에서의 자기정보량은 무한대가 되므로, 증명에서 사용하는 상한 LT는 정당화되지 않는다.
- 자기정보량이 증가한다고 검증 점수가 높아지는 것은 아니다. Y ∼ P에 대한 집중 결과도 적응적으로 선택되는 모든 트리 탐색 출력이 같은 영역에 갇힌다는 점을 입증하지는 않는다.
4.2 Theoretical Motivation for Bidirectional Search
Theorem 4.5는 최종 성공과 리프 하위 목표 m개의 증거 수집을 비교한다. 각 하위 목표의 충족 사건이 서로 독립이고 그 확률이 pi이며, 후보도 독립적으로 샘플링된다고 가정한다. 이때 최종 결과만 평가하는 탐색은 상수 수준의 성공 확률을 얻는 데 Ω(1/∏i pi)개의 후보가 필요하다. 반면 모든 하위 목표에 대해 이를 충족하는 후보를 적어도 1개씩 수집하는 데는 확률 1 − δ 이상을 위해 O(pmin⁻¹ log(m/δ))개의 후보가 필요하다.
- pi = p일 때 제시된 비율은 Ω(p⁻(m−1)/log(m/δ))다. 고정된 p < 1에서는 하위 목표 수에 따라 지수적으로 증가한다.
- 역방향 탐색의 경계는 후보 집합 전체의 목표 충족 범위에 관한 것이다. 완전한 해답을 생성하려면 부분 경로들이 서로 호환되고 재조합도 성공해야 하지만, 이 경계는 그 조건을 정량화하지 않는다.
- 실제 multi-hop 목표는 서로 의존할 수 있다. 실험 검증기는 목표들이 독립적으로 충족된다고 가정하지 않고 순차적으로 검사한다.
5 Experiments
평가는 LLM의 논리 추론, 에이전트의 multi-hop 검색 추론, 기하 최적화 문제 3개를 위한 실행 가능한 프로그램 탐색을 다룬다. Post-training 실험은 기존 알고리즘의 개선이 제한적이거나 성능이 저하되는 설정을 대상으로 한다. 추론 실험은 공통 GPT-5 API 비용 상한 아래에서 목적함숫값을 비교한다.
5.1 Bidirectional Evolutionary Search for Post-Training
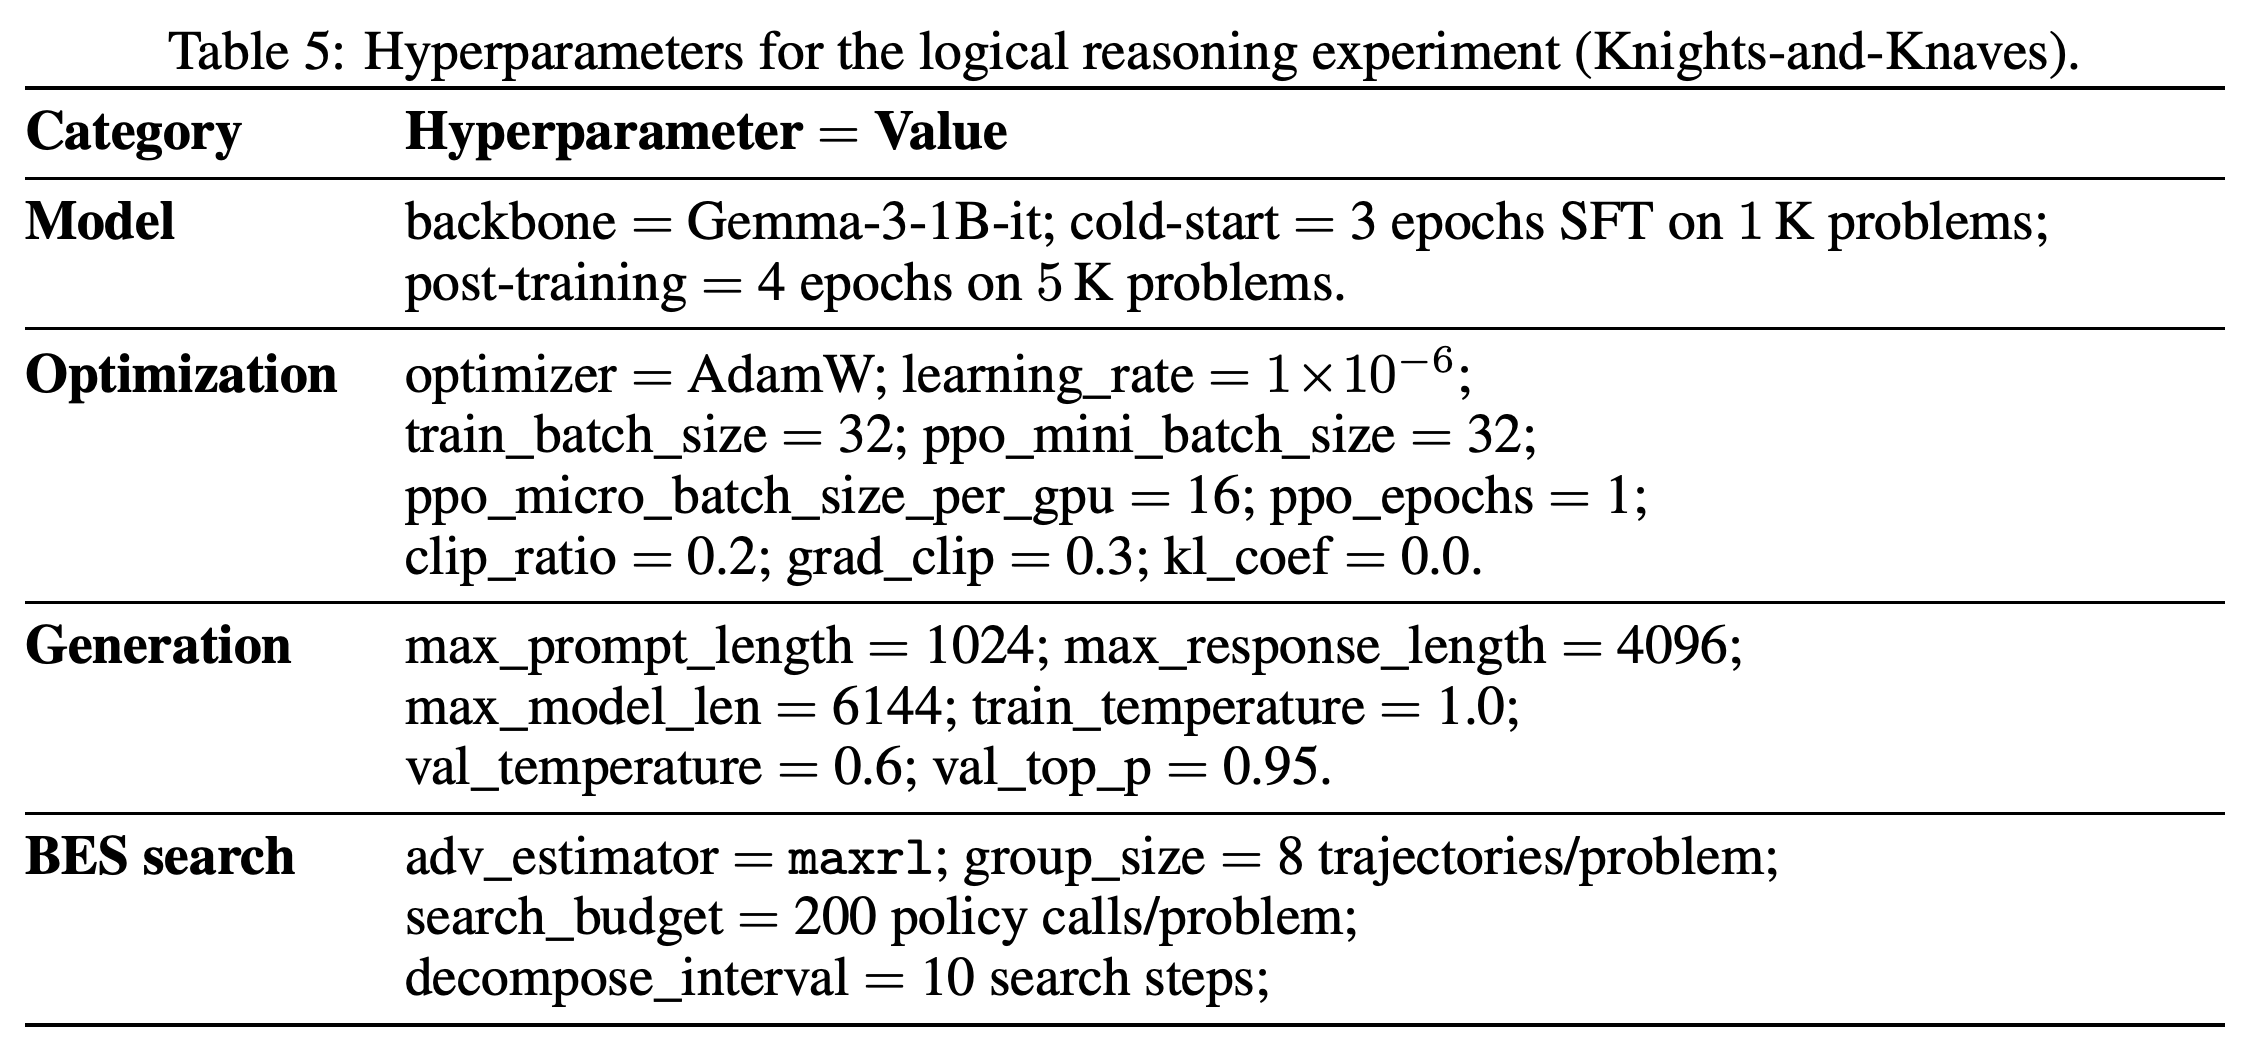
5.1.1 Logical Reasoning은 Gemma-3-1B-it으로 Knights-and-Knaves를 푼다. 모든 방법은 문제 1,000개로 3 epochs의 SFT를 수행한 뒤, 문제 5,000개로 4 epochs의 post-training을 수행한다. 검증 세트에는 등장인물이 2–10명인 문제 1,287개가 포함된다.
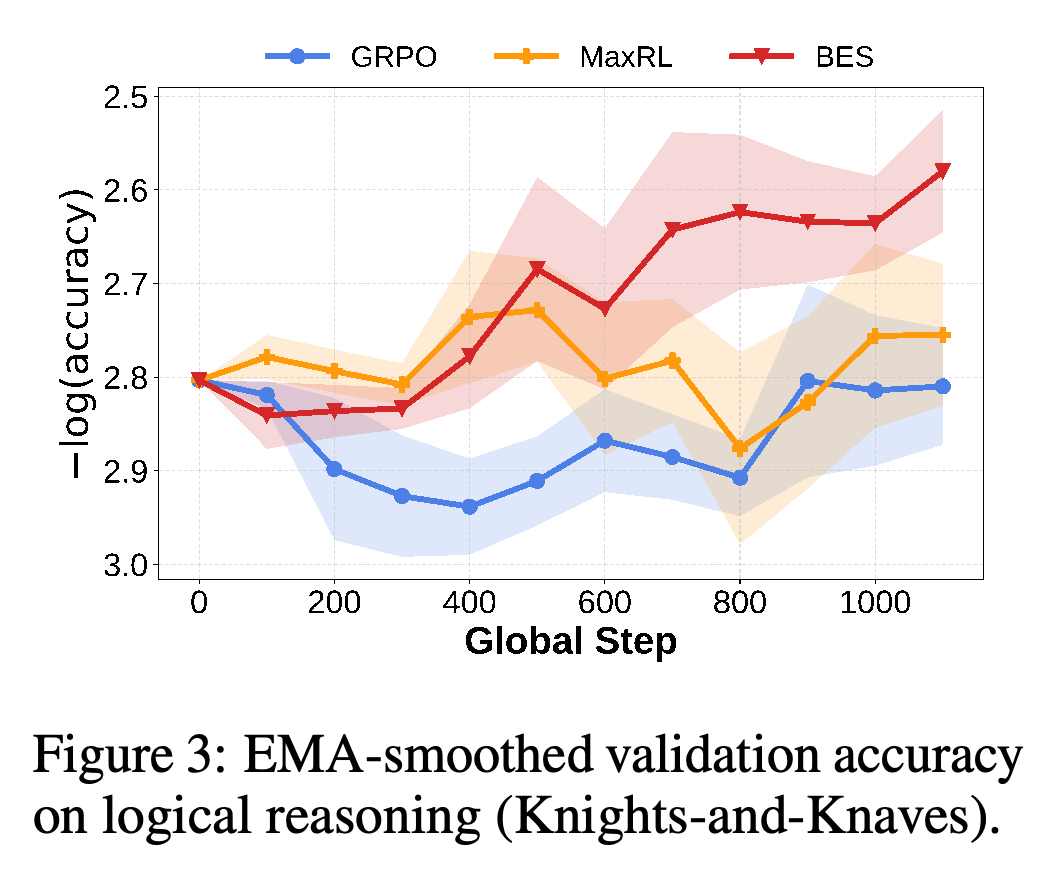
- BES는 MaxRL에 샘플을 제공하며, 독립적인 rollout을 사용하는 GRPO 및 MaxRL과 비교한다. Figure 3에서 BES의 검증 성능 개선이 가장 크다. GRPO는 초기 성능에 가까운 수준으로 끝나고 MaxRL은 소폭 개선된다.
- 각 BES 탐색은 정책 호출 200회를 허용하고 서로 다른 최종 경로 8개를 목표로 한다. 부족한 자리는 일반적인 rollout으로 채운다. 기준 방법은 독립적인 경로 8개를 생성하므로, 이 비교는 같은 생성 호출 비용에서 탐색 구조의 효과만 분리하지 못한다.
- Gemma-3-1B-it은 자유로운 목표 분해를 안정적으로 구성하지 못한다. 따라서 역방향 탐색은 미리 정의한 검증 전략 트리를 사용하고 모델에 트리 순회 일정을 정하도록 요청한다.
BES의 검증 성능 개선이 가장 크지만, 성능은 단조롭게 좋아지지 않고 변동한다. GRPO는 시작 수준에 가깝게 끝나며 MaxRL은 소폭 개선된다. 세로축은 −log(accuracy)로, 값이 작을수록 정확도가 높다. 그림은 정확한 최종 정확도를 표로 제시하지 않으며, 음영 영역의 정의도 제공하지 않는다.
이 설정은 고정된 경로 8개의 학습 그룹과 문제당 정책 호출 200회의 BES 예산을 결합한다. 독립적인 경로 8개를 생성하는 기준 방법과의 비교를 해석할 때 이 차이가 중요하다.
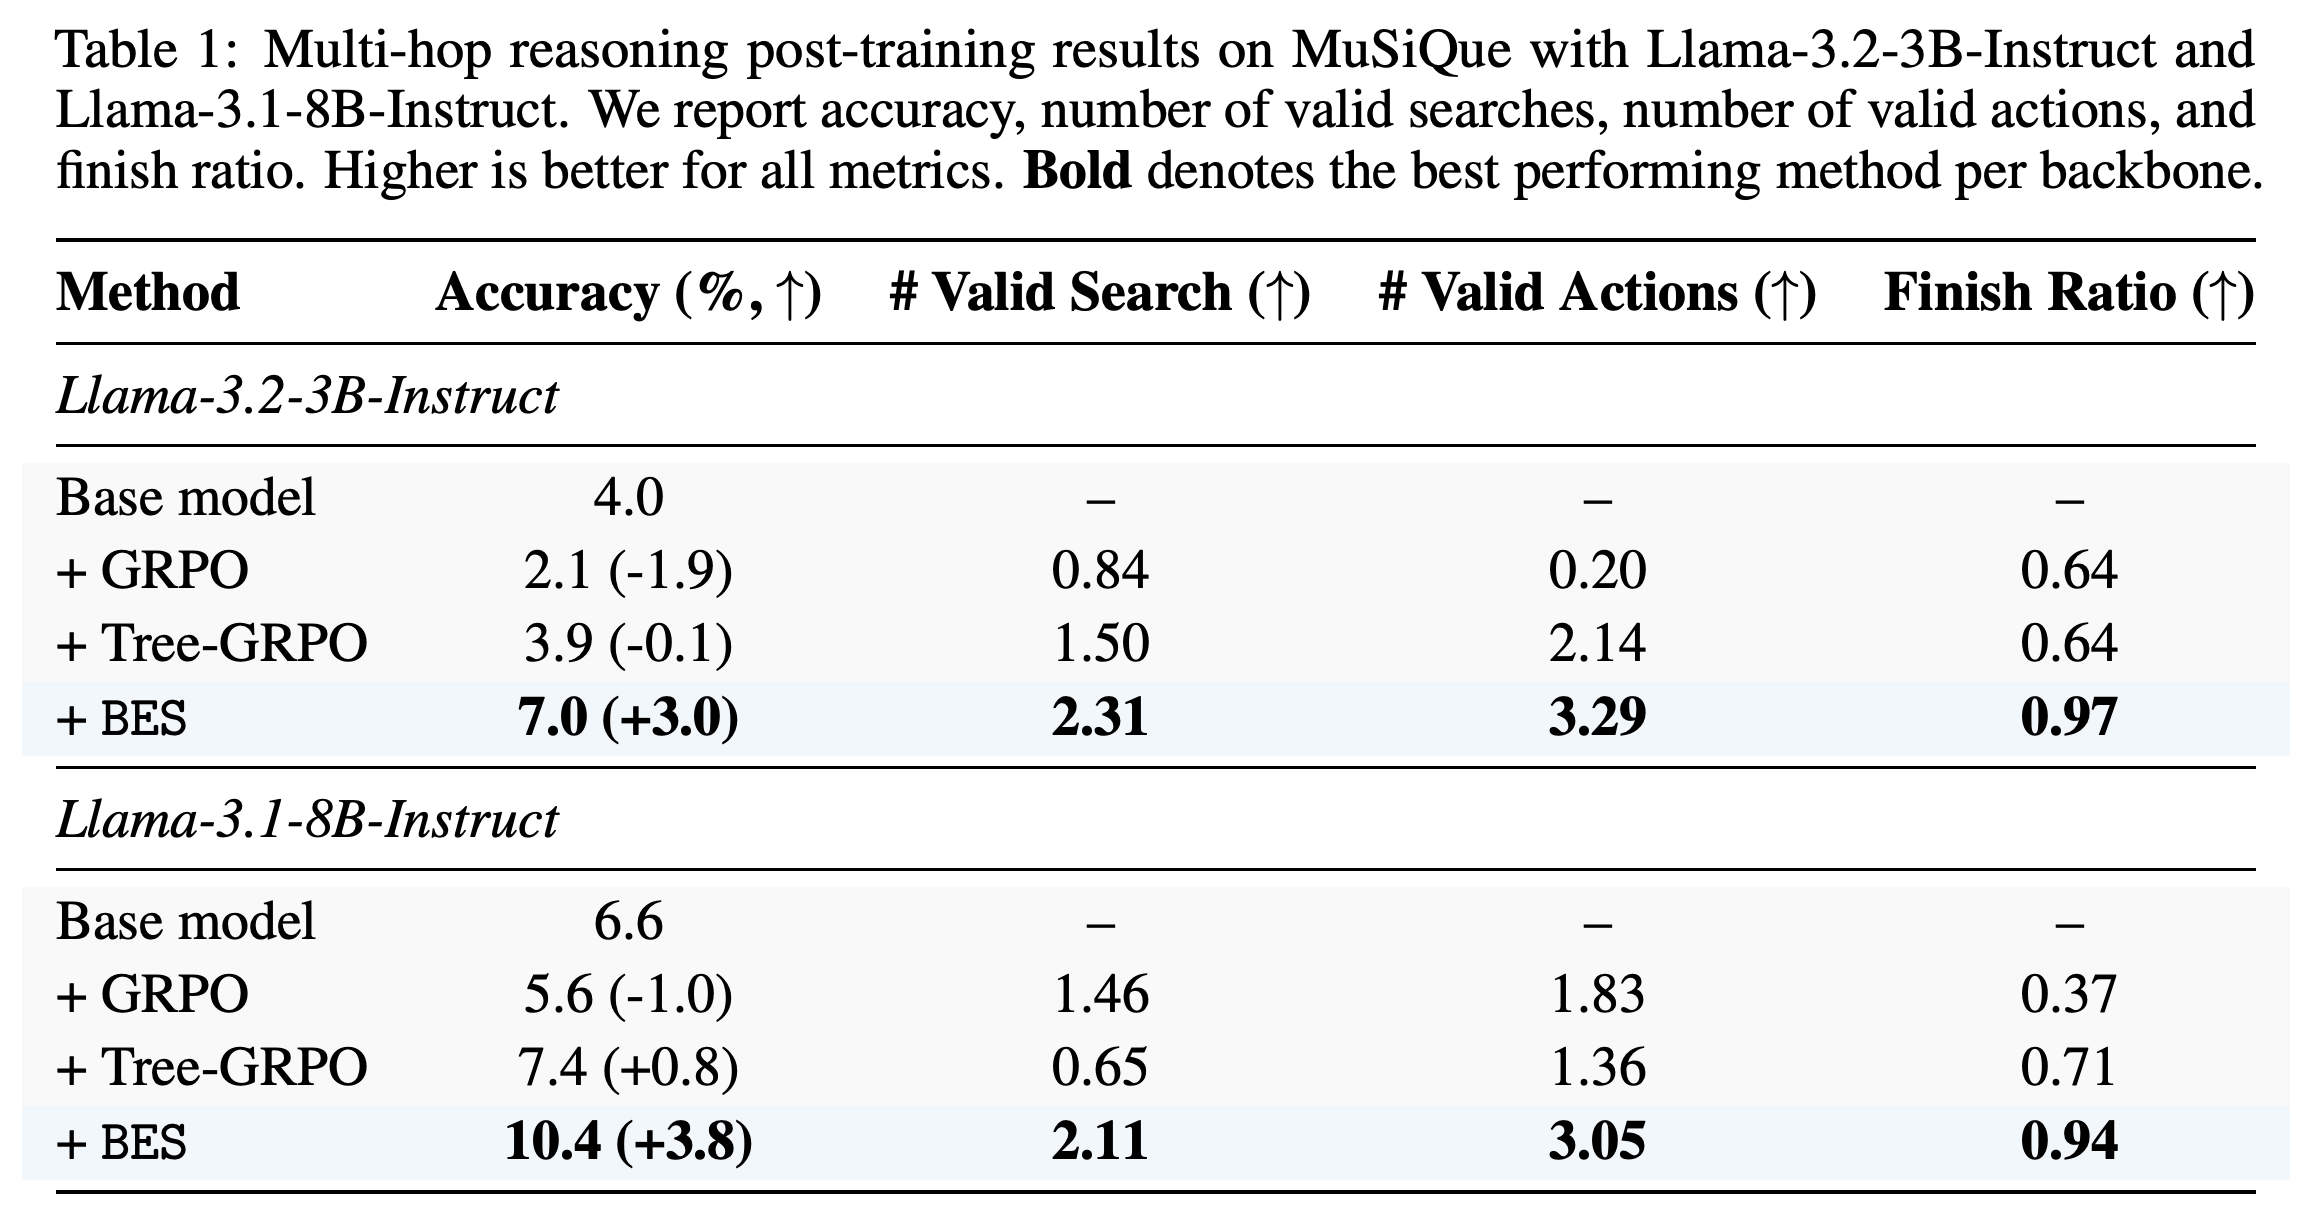
5.1.2 Multi-Hop Reasoning은 MuSiQue의 답변 가능한 3–4-hop 학습 부분집합과 공식 검증 세트 전체를 사용한다. Llama-3.2-3B-Instruct와 Llama-3.1-8B-Instruct를 오프라인 Wikipedia 검색기와 함께 2 epochs 동안 post-training한다. 논문은 epochs를 추가하면 학습 붕괴가 발생한다고 보고한다.
- 3B 모델에서 base, GRPO, Tree-GRPO, BES의 정확도는 각각 4.0%, 2.1%, 3.9%, 7.0%다. 8B 모델에서는 각각 6.6%, 5.6%, 7.4%, 10.4%다.
- BES의 종료 비율은 0.97과 0.94이며, Tree-GRPO는 0.64와 0.71이다. BES는 유효 검색 수 2.31과 2.11, 유효 행동 수 3.29와 3.05도 기록한다.
- 저자들은 GRPO의 성능 저하를 검색을 생략하는 reward hacking 때문이라고 설명한다. 보고된 검색 수는 이 해석과 부합하지만, 인과 메커니즘을 독립적으로 입증하지는 않는다.
BES는 base 모델 2개 모두와 post-training 기준 방법 2개 모두보다 정확도를 높인다. 더 높은 종료 비율과 유효 행동 수는 검색 에이전트가 실행을 더 완전하게 수행했음을 나타낸다. 다만 이 지표만으로 저자들이 제시한 GRPO의 reward hacking 설명을 입증하지는 못한다.
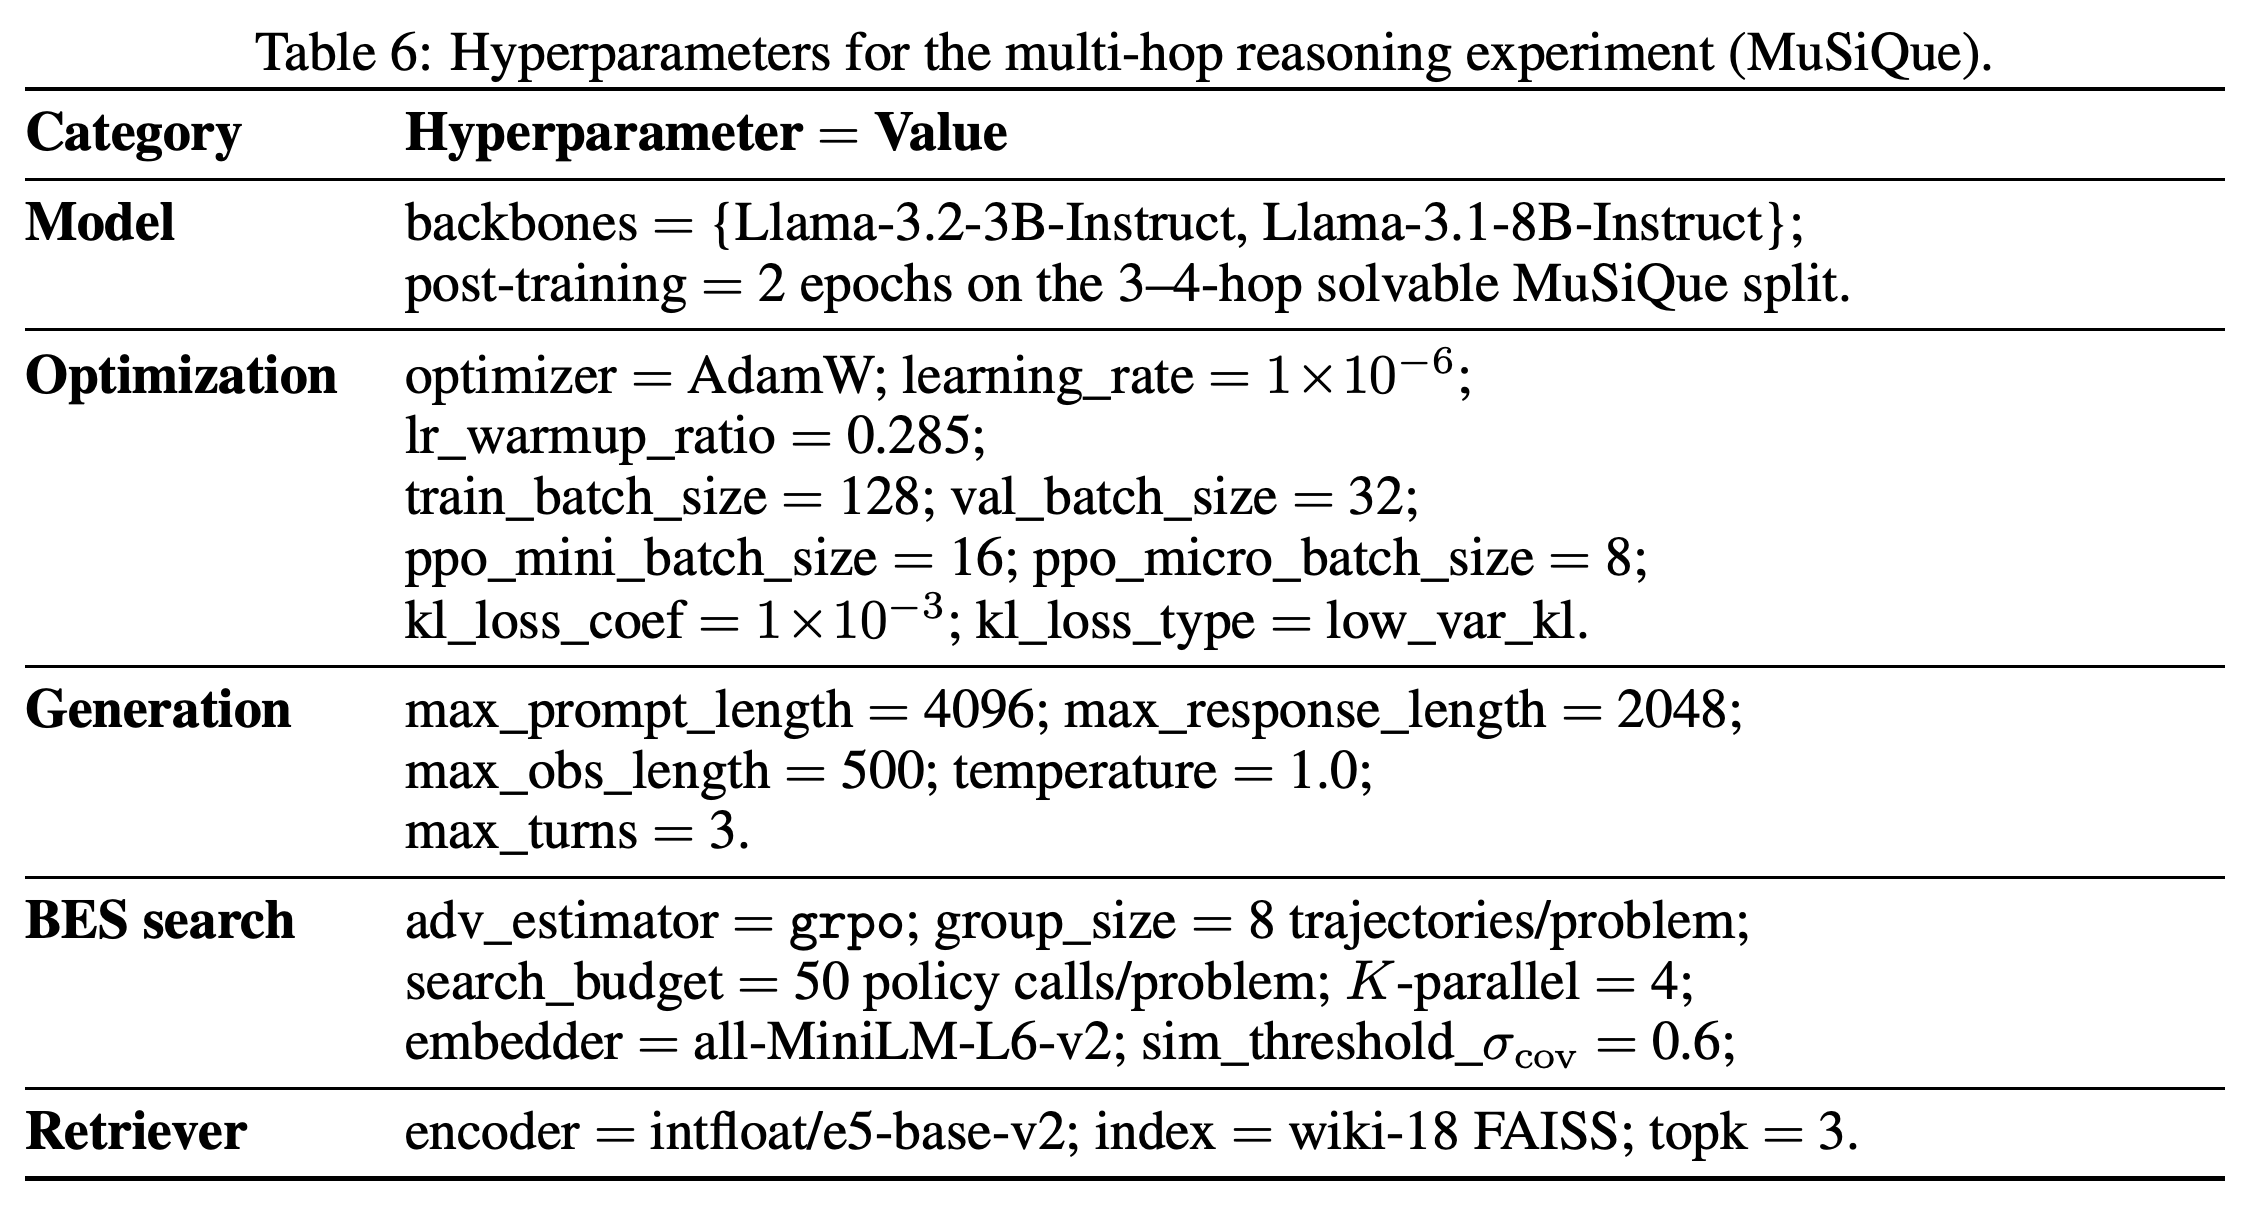
설정은 탐색 예산 50회 호출, 4방향 병렬 실행, 에이전트 최대 3턴, 하위 질문 충족 여부를 판단하는 임베딩 임계값 0.6을 명시한다. 촘촘한 검증은 단계별 LLM 판정이 아니라 쿼리 유사도 휴리스틱으로 구현한다.
5.2 Bidirectional Evolutionary Search for Inference
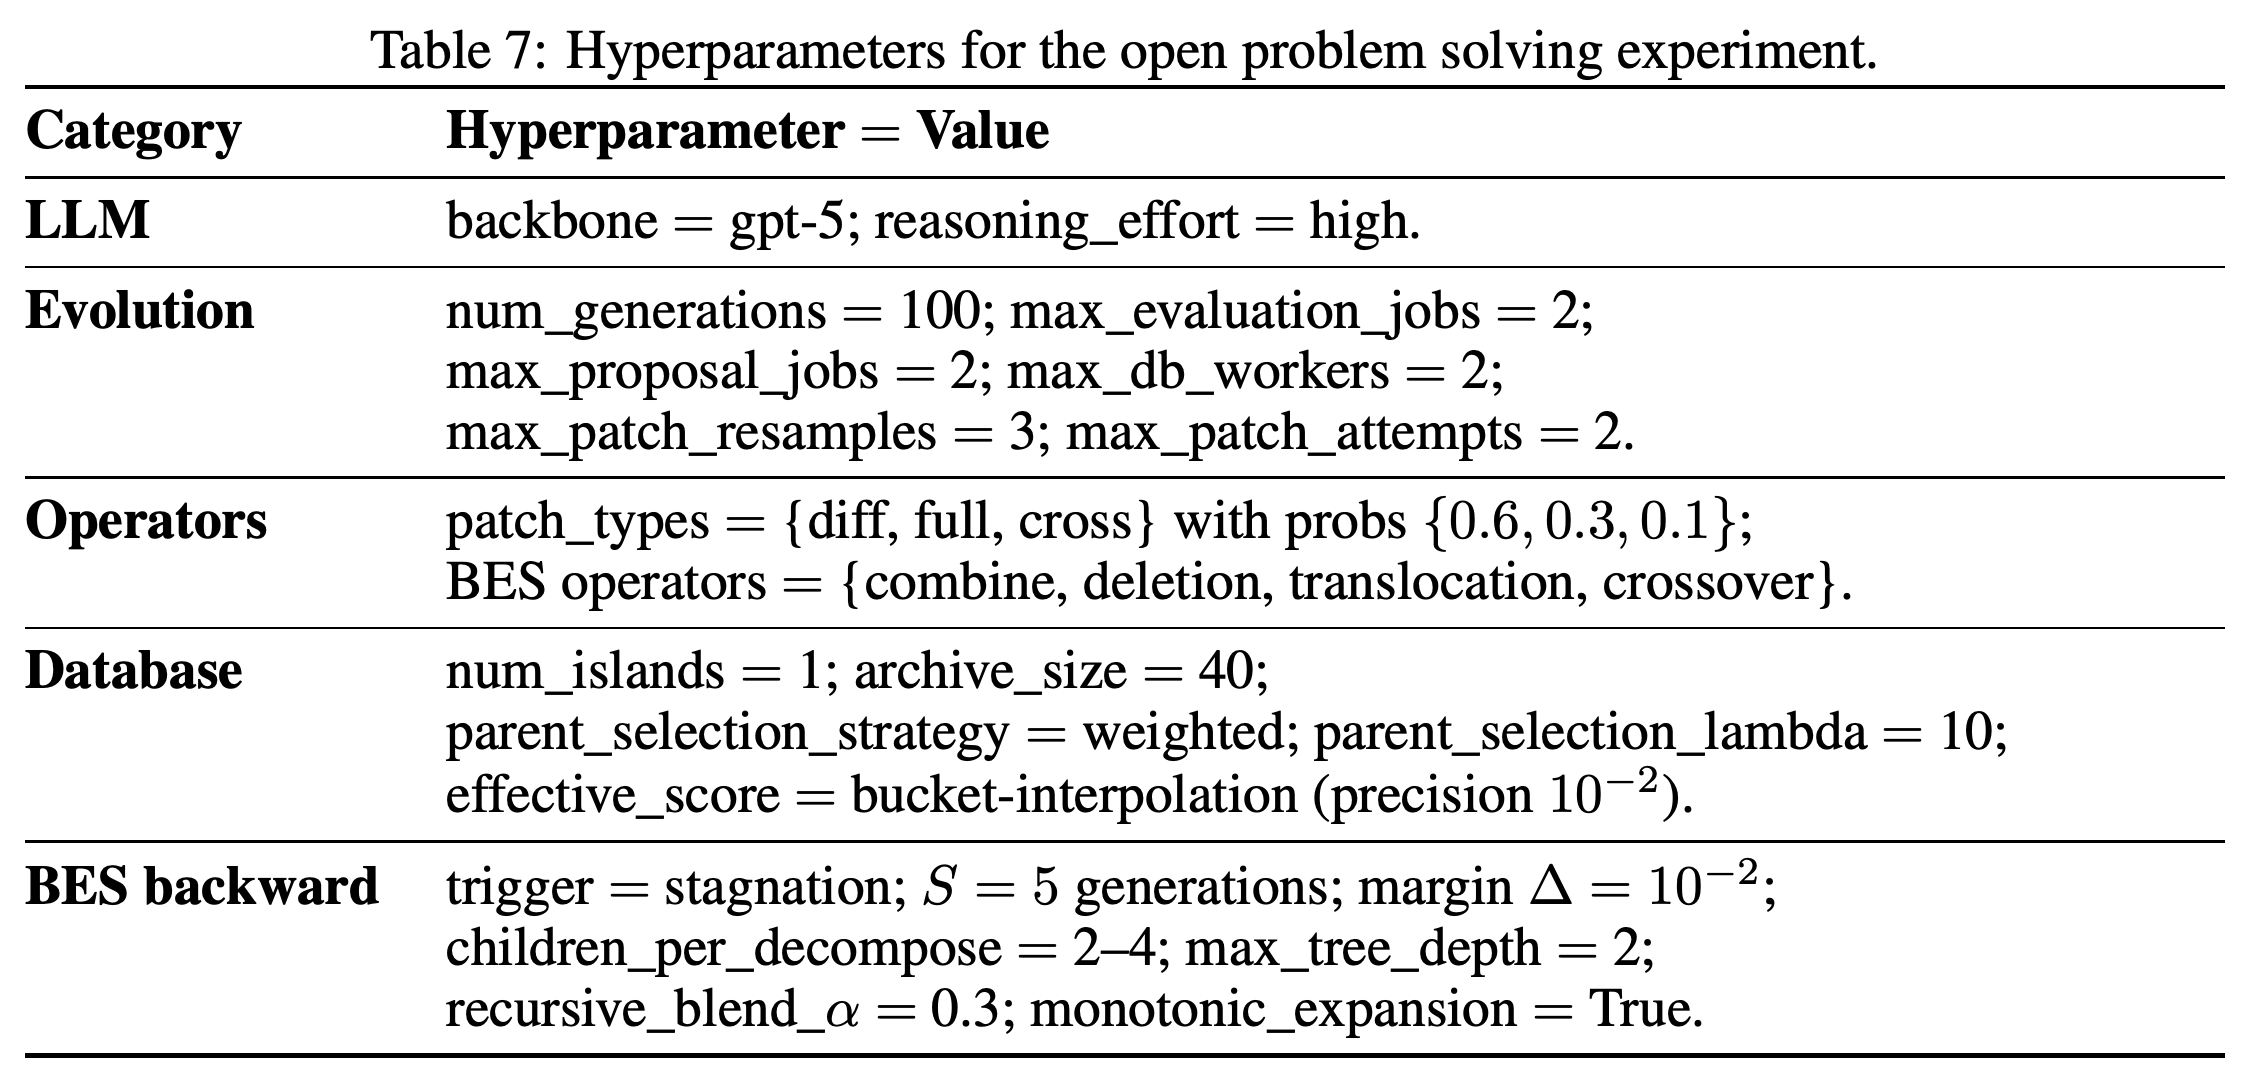
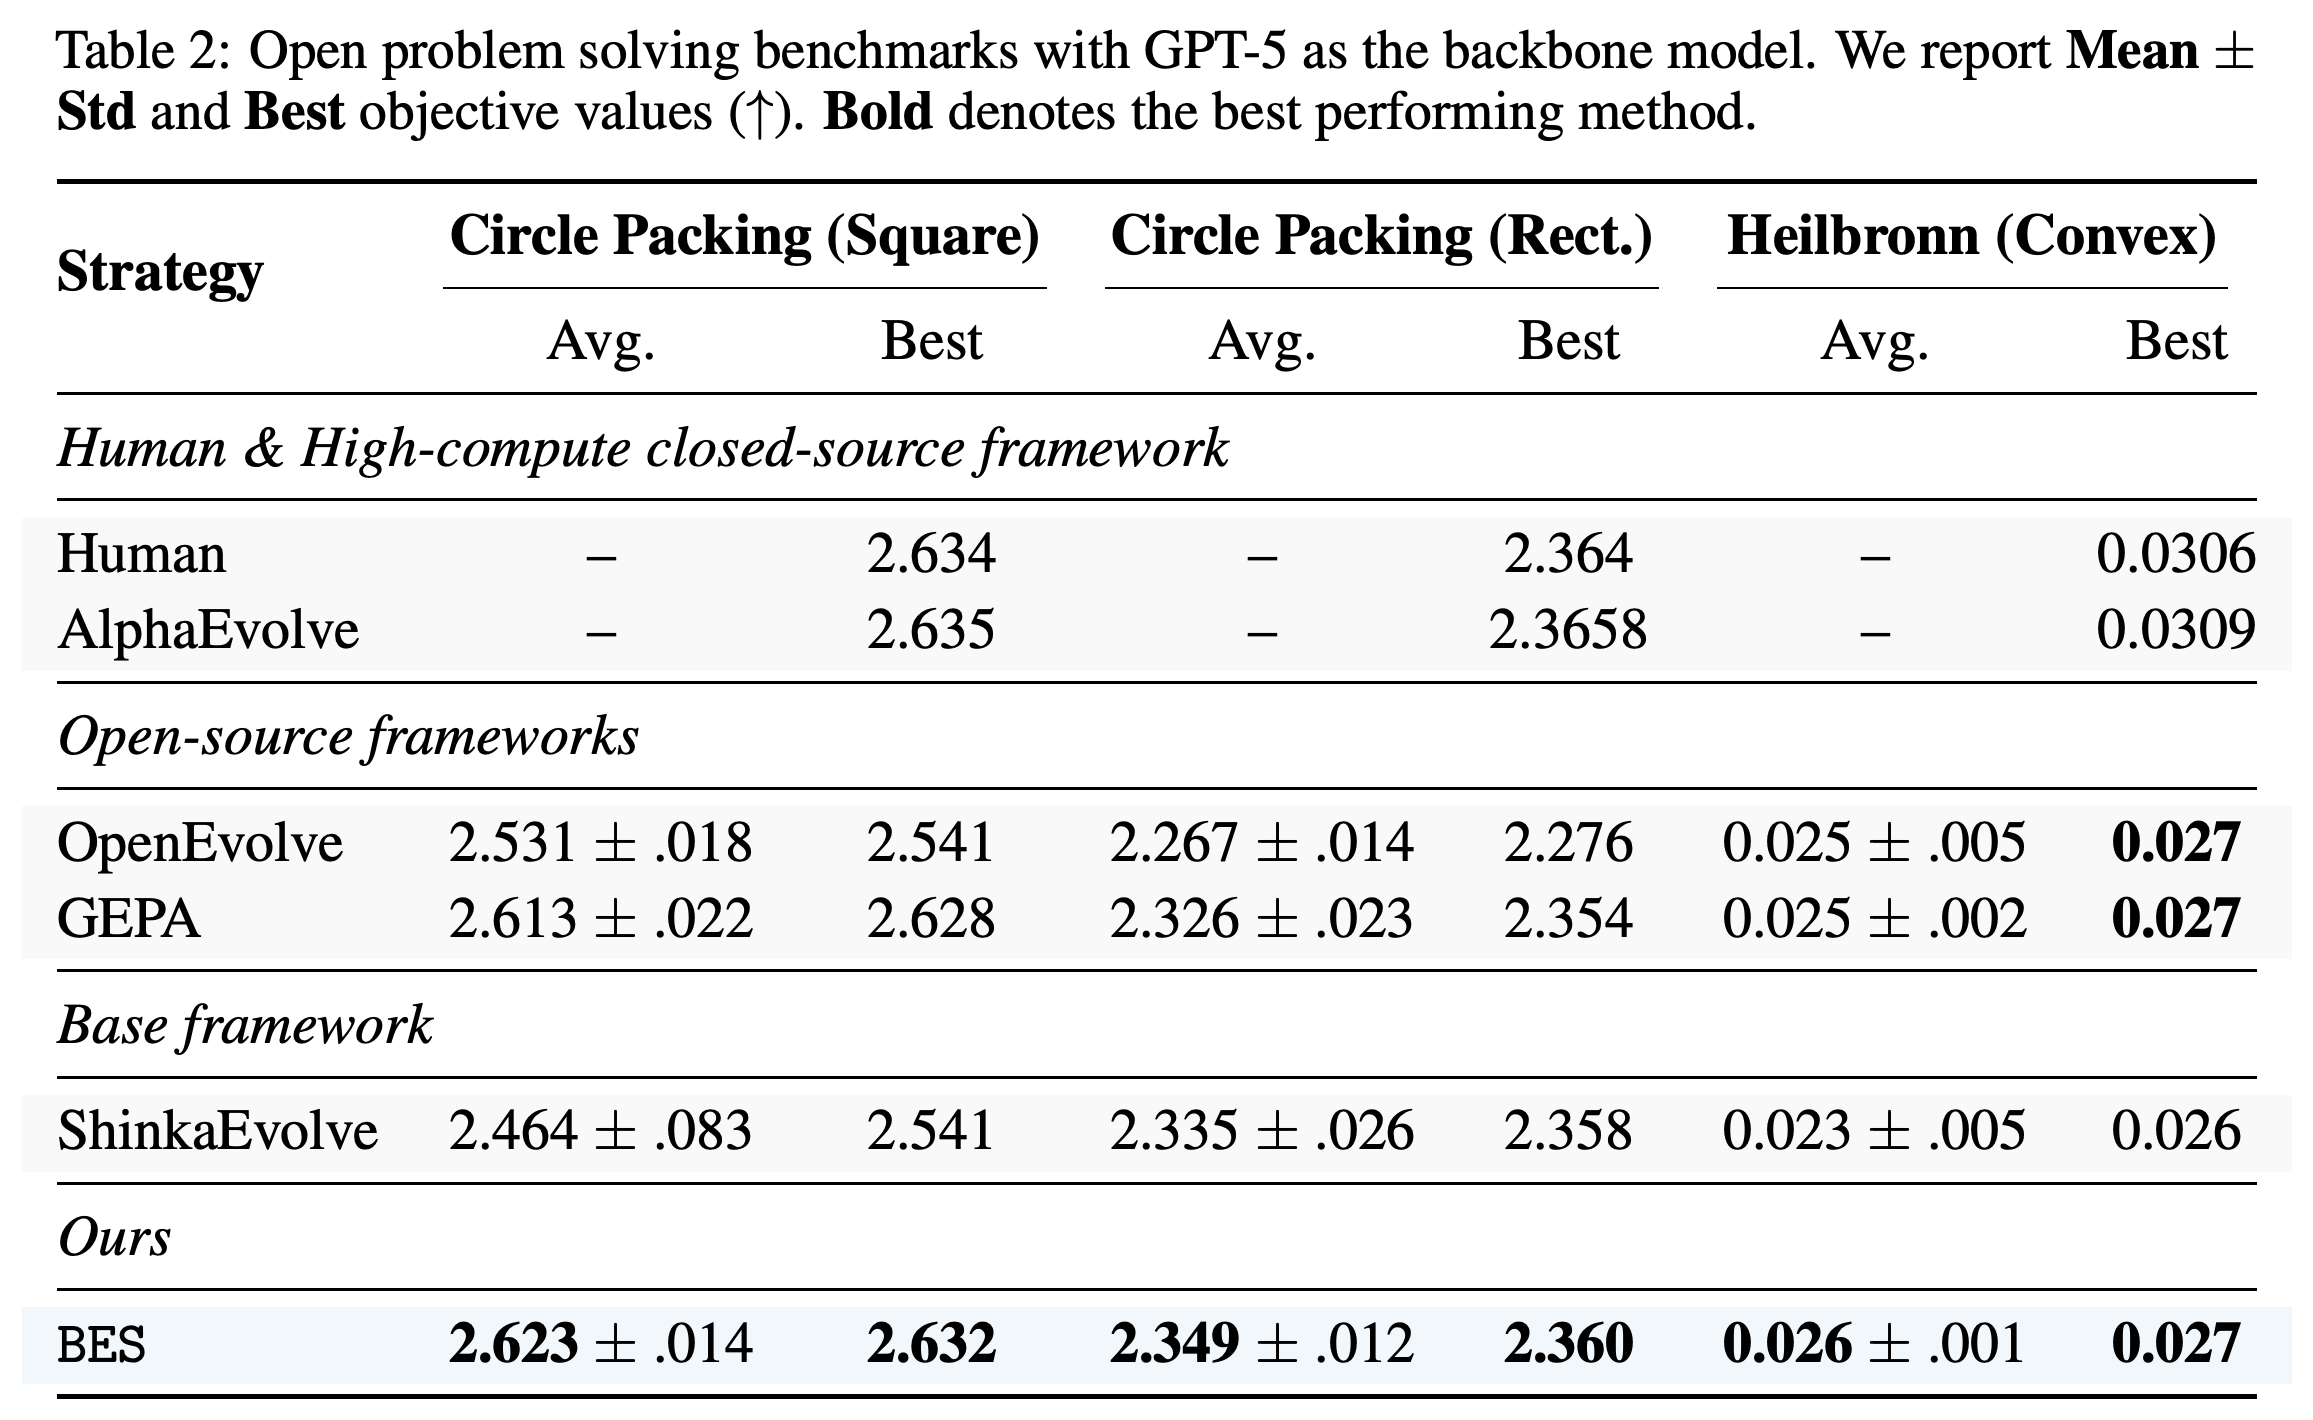
추론 실험은 ShinkaEvolve의 실행 가능한 Python 프로그램 아카이브에 BES를 추가하고, reasoning_effort = high로 설정한 gpt-5를 사용한다. 각 실행의 API 비용 상한은 $50이다. 벤치마크당 3회 실행의 평균, 표준편차, 최댓값을 보고한다. 기준 결과는 논문에서 일치한다고 명시한 설정의 SkyDiscover 결과를 가져온다.
- Appendix D는 정사각형 원 패킹을 n = 26으로 명시하며, 목적함수는 공통 최대 반지름이 아니라 반지름의 합이다. Heilbronn은 n = 13개의 점을 사용한다. Appendix G는 삼각형 넓이의 최솟값을 구하고 볼록껍질 넓이로 정규화한다고 설명하며, 이는 Appendix D의 단위 정사각형 설명과 다르다.
- 직사각형 명세도 일관되지 않다. Appendix D는 종횡비가 고정된 용기를 설명하지만, Appendix G는 둘레가 4인 직사각형 안에 n = 21개의 원을 배치하고 종횡비도 최적화한다고 설명한다.
- 목적함숫값이 적어도 10⁻²만큼 개선되지 않은 채 5세대가 지나면 역방향 세분화를 수행한다. 정밀도 10⁻²의 원래 목적함수 버킷이 버킷 간 순위를 결정하고, 같은 버킷 안에서는 역방향 점수를 사용한다. 따라서 같은 버킷에 속하는 서로 다른 원래 점수의 순서를 모두 보존하지는 않는다.
역방향 트리의 최대 깊이는 2이며, 성능이 정체되면 확장한다. 버킷 보간 점수는 원래 목적함수의 버킷 순서를 보존하면서 같은 버킷 안에서는 역방향 점수로 후보 순위를 정한다. 원래 목적함수의 모든 후보 간 순서를 보존하지는 않는다.
BES가 보고한 평균 ± 표준편차와 최댓값은 정사각형 패킹에서 2.623 ± .014와 2.632, 직사각형 패킹에서 2.349 ± .012와 2.360, Heilbronn에서 0.026 ± .001과 0.027이다. Table 2에서 평가한 오픈소스 프레임워크 중 가장 높은 평균이며, 보고된 표준편차도 나열된 모든 오픈소스 기준 방법보다 낮다.
- 경쟁 방법 중 정사각형 평균이 가장 높은 것은 GEPA의 2.613 ± .022이며, 직사각형 평균이 가장 높은 것은 ShinkaEvolve의 2.335 ± .026이다.
- BES의 패킹 최고값은 과제 2개 모두에서 오픈소스 최고값보다 높다. 다만 Heilbronn 최고값 0.027은 보고된 정밀도에서 OpenEvolve 및 GEPA와 같다.
- BES의 최고값은 모두 표에 제시된 인간 및 AlphaEvolve 참고값보다 낮다. AlphaEvolve는 훨씬 많은 연산을 사용하므로, 해당 참고 행은 예산을 맞춘 비교가 아니다.
BES는 각 과제에서 오픈소스 방법 중 가장 높은 평균 목적함숫값과 가장 낮은 보고 표준편차를 보인다. 패킹 최고값은 오픈소스 대안보다 높지만, Heilbronn 최고값은 기준 방법 2개와 0.027로 같다. 인간과 AlphaEvolve의 참고값은 여전히 더 높다.
5.3 Ablation Study
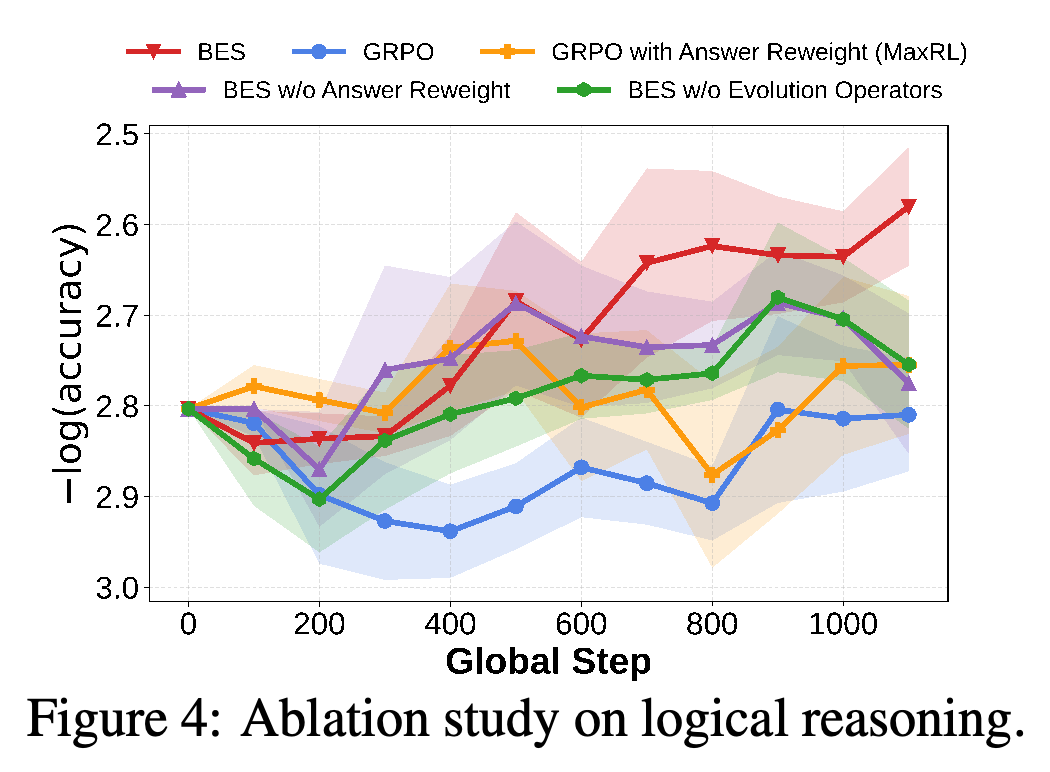
Knights-and-Knaves 제거 실험은 전체 방법에서 MaxRL 답변 재가중이나 진화 연산자를 제거한다. Figure 4에서 축소된 변형들은 모두 전체 BES보다 최종 성능이 낮다. 이는 이 설정에서 답변 재가중과 경로 진화가 기여한다는 점을 뒷받침한다.
- 보고된 제거 실험은 역방향 분해를 별도로 제거하거나 combination, deletion, translocation, crossover를 개별적으로 분리하지 않는다.
- 따라서 모든 탐색 구성 요소가 독립적으로 필요하다는 점을 입증하지는 않는다.
이 학습 설정에서는 답변 재가중이나 진화를 제거하면 전체 BES보다 최종 성능이 낮아진다. 역방향 분해나 개별 진화 연산자를 직접 제거한 곡선은 없으므로, 각 탐색 구성 요소의 독립적인 기여를 입증하지는 않는다.
5.4 Cost Analysis
Llama-3.2-3B-Instruct의 MuSiQue post-training에서 단계별 실제 실행 시간 중앙값은 GRPO가 64 s, Tree-GRPO가 240 s, BES가 309 s다. BES는 Tree-GRPO보다 시간이 30% 미만으로 늘어나면서 정확도를 3.9%에서 7.0%로 높인다.
- GRPO의 짧은 실행 시간에는 유효 검색 수 0.84와 정확도 2.1%가 동반된다. 반면 BES의 유효 검색 수는 2.31이다. 따라서 실행 시간 비교에는 검색 행동의 양이 서로 다른 에이전트들이 포함된다.
- 측정값은 단계별 중앙값이며, 정확도와 총 연산량의 관계를 다룬 완전한 스케일링 연구는 아니다.
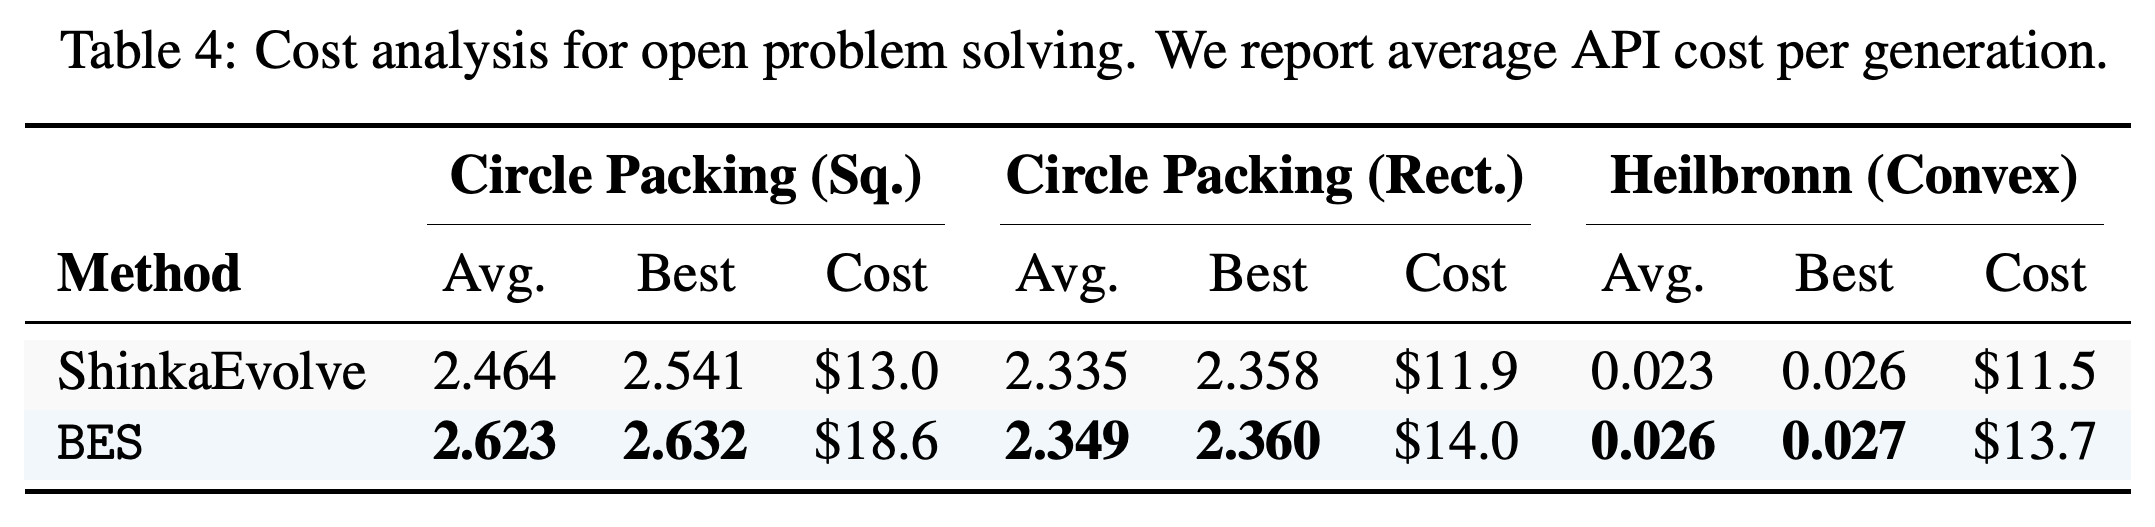
Table 4는 정사각형 패킹, 직사각형 패킹, Heilbronn의 API 비용을 BES에서 각각 $18.6, $14.0, $13.7, ShinkaEvolve에서 각각 $13.0, $11.9, $11.5로 보고한다. BES는 3개 비교 모두에서 평균 목적함숫값이 더 높지만, 보고된 API 지출도 더 크다.
- 캡션은 이 값을 생성당 평균 API 비용으로 표기하지만, Appendix D는 별도로 API 비용 상한을 $50 per run(실행당)으로 설정한다. 논문은 이 보고 단위들이 어떻게 연결되는지 설명하지 않는다.
- 이 결과는 실제 지출이 같은 비교가 아니라 품질과 비용 사이의 상충 관계를 보여 준다.
BES는 과제 3개 모두에서 평균 목적함숫값과 보고 비용이 더 높으며, 절대 비용 증가가 가장 큰 과제는 정사각형 패킹이다. 캡션의 생성당 비용 표기가 별도로 설명한 실행당 API 상한 $50와 어떻게 연결되는지는 설명하지 않는다.
6 Related Work
관련 연구는 BES를 자기 학습과 출력 개선, 탐색으로 생성한 post-training 데이터, 추론 시점의 추론 탐색, 진화적 프로그램 탐색, 고전적인 휴리스틱 및 유전 탐색과 연결한다. BES는 상호 보완적인 부모의 재조합과 명시적으로 세분화되는 검증 가능한 목표 트리를 결합한다.
- STaR, Self-Refine, Reflexion, Voyager는 필터링한 출력, 수정, 성찰, 축적한 기술을 통한 개선의 사례다.
- Tree-GRPO, TreeRL, ReST-MCTS*와 관련 방법은 탐색으로 생성한 학습 데이터를 활용하는 근거가 된다. AlphaEvolve와 ShinkaEvolve는 프로그램 진화 측면에서 가장 가까운 관련 연구다.
- 고전적인 연결점으로는 A*와 양방향 탐색의 휴리스틱 지침, branch-and-bound의 가지치기, 유전 탐색과 differential evolution의 집단 기반 최적화가 있다.
7 Conclusion
논문은 순방향 진화와 역방향 검증이 post-training과 추론을 위해 탐색으로 생성한 샘플을 개선한다고 결론짓는다. 실험은 평가한 객관적 보상 기반 과제에서의 개선을 뒷받침한다. 이론은 더 넓은 탐색과 더 효율적인 부분 증거 수집을 조건부로 설명한다.
부록
- A Pseudo Code와 B Formal Definitions of Evolution Operators는 후보 집합 갱신, Boltzmann 부모 선택, 재귀적 점수 계산, 무작위로 선택한 미해결 리프의 주기적 분해를 명시한다. 일반 알고리즘은 완전히 검증된 최종 후보를 찾으면 반환하고, 그렇지 않으면 예산 소진 시 가장 좋은 최종 후보를 반환한다. Post-training 구현은 추가로 경로 그룹을 수집한다.
- C Theoretical Motivations는 C.1 Theoretical Motivation for Evolution Operators를 C.1.1 Discussion of Assumptions, C.1.2 Shell Confinement of Expansion, C.1.3 Shell Escape via Evolution에서 상세히 설명한다. rollout 자기정보량에는 martingale 집중을, 독립적으로 이어 붙인 블록에는 KL 항등식을 사용한다. C.2 Theoretical Motivation for Bidirectional Search는 누락된 하위 목표 증거에 union bound를 적용한다.
- D Detailed Experimental Setup은 D.1 Logical Reasoning으로 시작하며, 이 설정은 학습용 H200 GPU 2개와 보조 분해 서버를 사용한다. 문단 단위 연산자의 확률은 expansion이 0.70, combination이 0.10, deletion이 0.05, translocation과 crossover가 각각 0.075다. temperature는 2.0에서 1.0으로 감소하고, 분해 일정은 10단계마다 결정하며, α = 0.3이다. Table 5는 AdamW와 learning_rate = 1×10⁻⁶, train_batch_size = 32, group_size = 8, search_budget = 200 policy calls/problem을 명시한다. 전략 리프는 논리적 증명 검증 대신 구문적인 추론 표지 검사를 사용한다.
- D.2 Multi-Hop Reasoning은 학습용 H200 GPU 2개, 2018 Wikipedia dump를 대상으로 하는 E5 + FAISS 검색기, Llama-3.1-8B-Instruct 분해 서버를 사용한다. 연산자는 reasoning/search/information으로 이루어진 완전한 묶음을 편집한다. 논리 추론과 같은 확률 혼합을 사용하며, temperature는 1.5에서 0.3으로 감소하고, α = 0.7, 50 policy calls/problem, K-parallel = 4로 설정한다. 앞선 하위 목표들이 충족되었다는 조건 아래, 검색 쿼리와 하위 질문의 코사인 유사도가 all-MiniLM-L6-v2 공간에서 0.6 이상이면 해당 하위 질문이 충족되었다고 간주한다. 이는 사실적 답변의 완성이 아니라 쿼리의 의미적 정합성을 측정한다.
- D.3 Open Problem Solving은 단일 CPU 노드에서 실행하며 API로 LLM에 접근한다. Table 7은 num_generations = 100, archive_size = 40, num_islands = 1, 평가 및 제안 작업의 최대 동시 실행 수 2, 목표 트리 최대 깊이 2, recursive_blend_α = 0.3을 명시한다. 생성된 리프 검증기는 부분 진전 점수를 반환하는 Python 표현식이다. 목적함수 버킷 보간은 역방향 피드백 때문에 프로그램이 더 높은 원래 목적함수 버킷보다 위로 올라가지 못하게 한다.
- E Case Study는 본문 리뷰에서 다룬 Back to Bedlam 탐색 기록을 제시한다. 실패한 분기 2개가 상호 보완적인 추론을 제공하고, translocation으로 Custard Records를 얻는다. 이 사례는 0이 아닌 중간 피드백과 경로 간 재사용을 보여 주지만, 전체 성공률에 관한 증거는 제공하지 않는다.
- F Prompts for Open Problem Solving Tasks에는 F.1 Backward Search: Goal Tree Decomposition과 F.2 Forward Evolution Operations가 포함되며, Combination, Deletion, Crossover, Translocation 프롬프트를 제시한다. 정사각형 분해 프롬프트는 sum_of_radii > 2.636을 목표로 한다. 우수 후보들이 공유하는 참고 특성과 달성하고자 하는 구조적 특성을 요청하고, 각 특성에 단일 표현식 verify_code를 부여한다. Combination은 호환 가능한 메커니즘을 추가하고, crossover는 구현을 결합하며, translocation은 메커니즘 1개를 가져온다. 프로그램 수준의 deletion은 형식적 연산자처럼 중간 단계 1개만 삭제하는 것이 아니라, 성능을 제한하는 구성 요소를 제거한 뒤 전략을 크게 다시 작성하도록 요청한다.
- G Identified Programs for Open Problem Solving Tasks는 발견한 최상의 구현을 요약한다. G.1 Circle Packing (Square)는 반지름 투영, active-set LP, simulated annealing, SLSQP를 결합한다. G.2 Circle Packing (Rectangle)은 결정론적 multi-start 배치 뒤에 고정 종횡비와 자유 종횡비의 SLSQP 단계를 수행한다. G.3 Heilbronn (Convex)는 파라미터 8개를 갖는 C3-symmetric 13점 구성과 Coordinate Pattern Search를 사용한다. 삼각형 286개를 모두 평가하고 볼록껍질 넓이로 정규화한다.
- H Potential Limitations and Broader Impacts는 객관적 보상에 대한 의존성, 약한 모델의 분해 능력 한계, 최대 8B 파라미터 모델로 제한된 post-training 실험을 인정한다. 저자들은 추론과 해석 가능성 측면의 잠재적 이점을 제시하면서, 더 강한 탐색이 유해한 과제에 활용할 수 있는 능력도 높일 수 있다고 지적한다. 논문은 환경 비용 절감이나 후속 오용을 측정하지 않는다.
짧은 생각
BES는 상호 보완적인 부분 진전을 실제 탐색에 활용한다. 부모 조합 선택은 부모들이 함께 충족하는 목표 범위에 보상을 주며, MuSiQue 결과는 답변 정확도와 에이전트 실행 완료 측면의 개선을 보여 준다. 검증기의 타당성은 여전히 핵심 한계다. 구문적인 추론 표지와 의미적으로 정합한 쿼리는 탐색을 안내할 수 있지만, 하위 문제를 올바르게 해결했다는 점을 보증하지는 않는다.
이론은 BES의 일반적인 보장이 아니라 동기를 제공한다. 유한한 어휘가 있다고 해서 모든 토큰의 자기정보량에 대해 부록이 주장한 상한 L = log |V|가 성립하는 것은 아니다. 또한 추가적인 지지집합 조건이 없으면 재조합은 서로 호환되지 않거나 확률이 0인 블록 조합을 만들 수 있다. rollout 집중 결과도 적응적인 접두 경로 선택을 직접 다루지 않는다. 호출 수를 맞춘 논리 추론 비교, 역방향 탐색의 직접적인 제거 실험, 더 많은 추론 실행은 제안한 메커니즘의 효과를 추가 샘플링 효과 및 실행 간 변동과 구분하는 데 도움이 된다.