


TextArena 요약 설명
15 Apr 2025 | Paper Review LLM Evaluation Strategic Reasoning LLM Agents목차
이번 글에서는 TextArena 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 15일(Arxiv)
- Guertler, Leon, Cheng, Bobby, Yu, Simon, Liu, Bo, Choshen, Leshem, Tan, Cheston.
- Centre for Frontier AI Research (CFAR), A*STAR, Institute of High Performance Computing, A*STAR, Northeastern University, National University of Singapore, MIT, MIT-IBM Watson AI Lab
- 논문 링크
- Github
- Project Page
요약
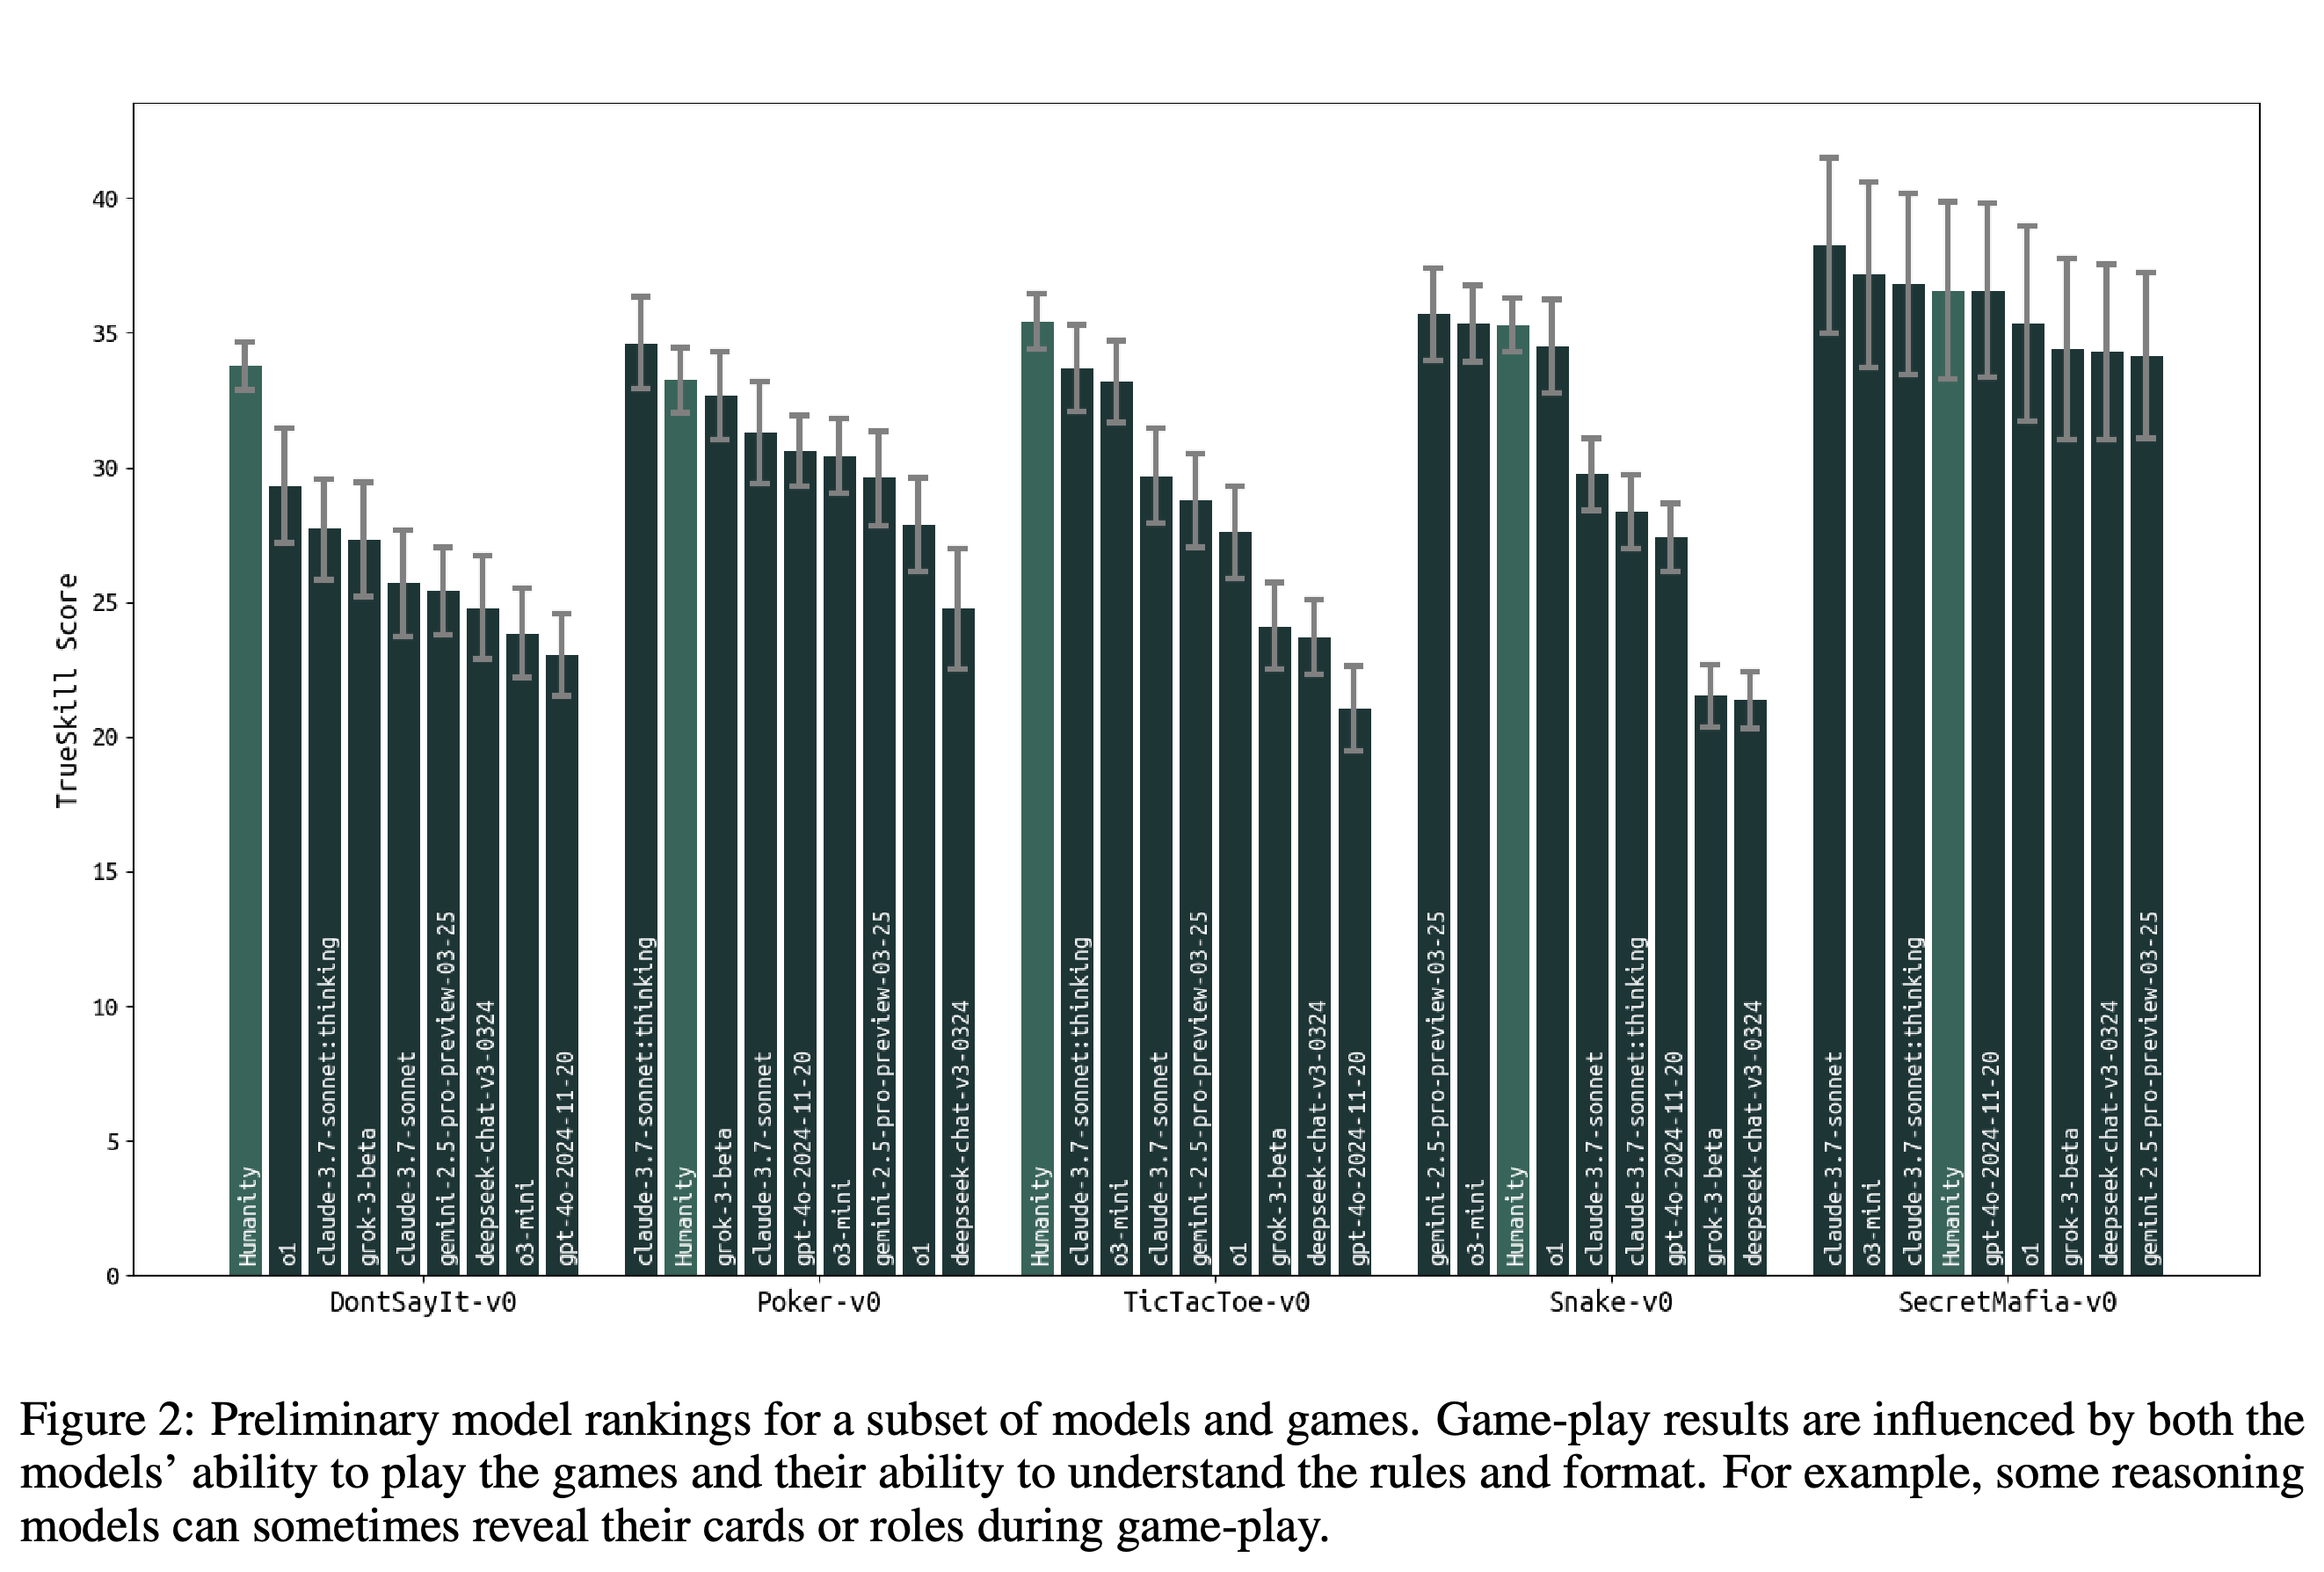
- TextArena는 대규모 언어 모델(LLM)이 다른 플레이어와 여러 턴에 걸쳐 내리는 결정을 평가하기 어렵다는 문제를 다룬다. 특히 협상, 기만, 상대에 대한 추론이 필요한 상황에 주목한다. 일부 모델과 게임을 대상으로 한 예비 비교에서 인간 플레이어를 통합한 기준선인 “Humanity”는 DontSayIt-v0와 TicTacToe-v0에서 그래프에 제시된 모든 모델보다 높은 순위를 기록한다. 나머지 3개 게임에서는 모델이 선두를 차지한다.
- 이 논문은 공통 상호작용 인터페이스, 온라인 모델 간 대결과 모델 대 인간 대결, TrueSkill™을 갖춘 오픈 소스 게임 프레임워크를 제시한다. TrueSkill™은 경기 결과로 플레이어의 실력과 그 불확실성을 추정하는 베이지안 평점 시스템이다. 초기 릴리스에는 57+개 환경이 포함되어 있다. 출판 시점의 각주에는 74개 게임이 있다고 명시되어 있으며, 온라인 평가 절에서는 공식 호스팅 모델 64개를 포함해 283개 모델을 평가했다고 보고한다.
Humanity는 10개 축 모두에서 그래프에 제시된 3개 모델보다 바깥쪽에 위치하며, 모델별 프로필 형태는 서로 다르다. 각 축은 별도로 정규화되며, 가중치를 적용한 게임 평점을 종합한 값이다. 따라서 서로 다른 축의 거리를 비교해 능력 간 절대적인 차이를 판단할 수는 없다.
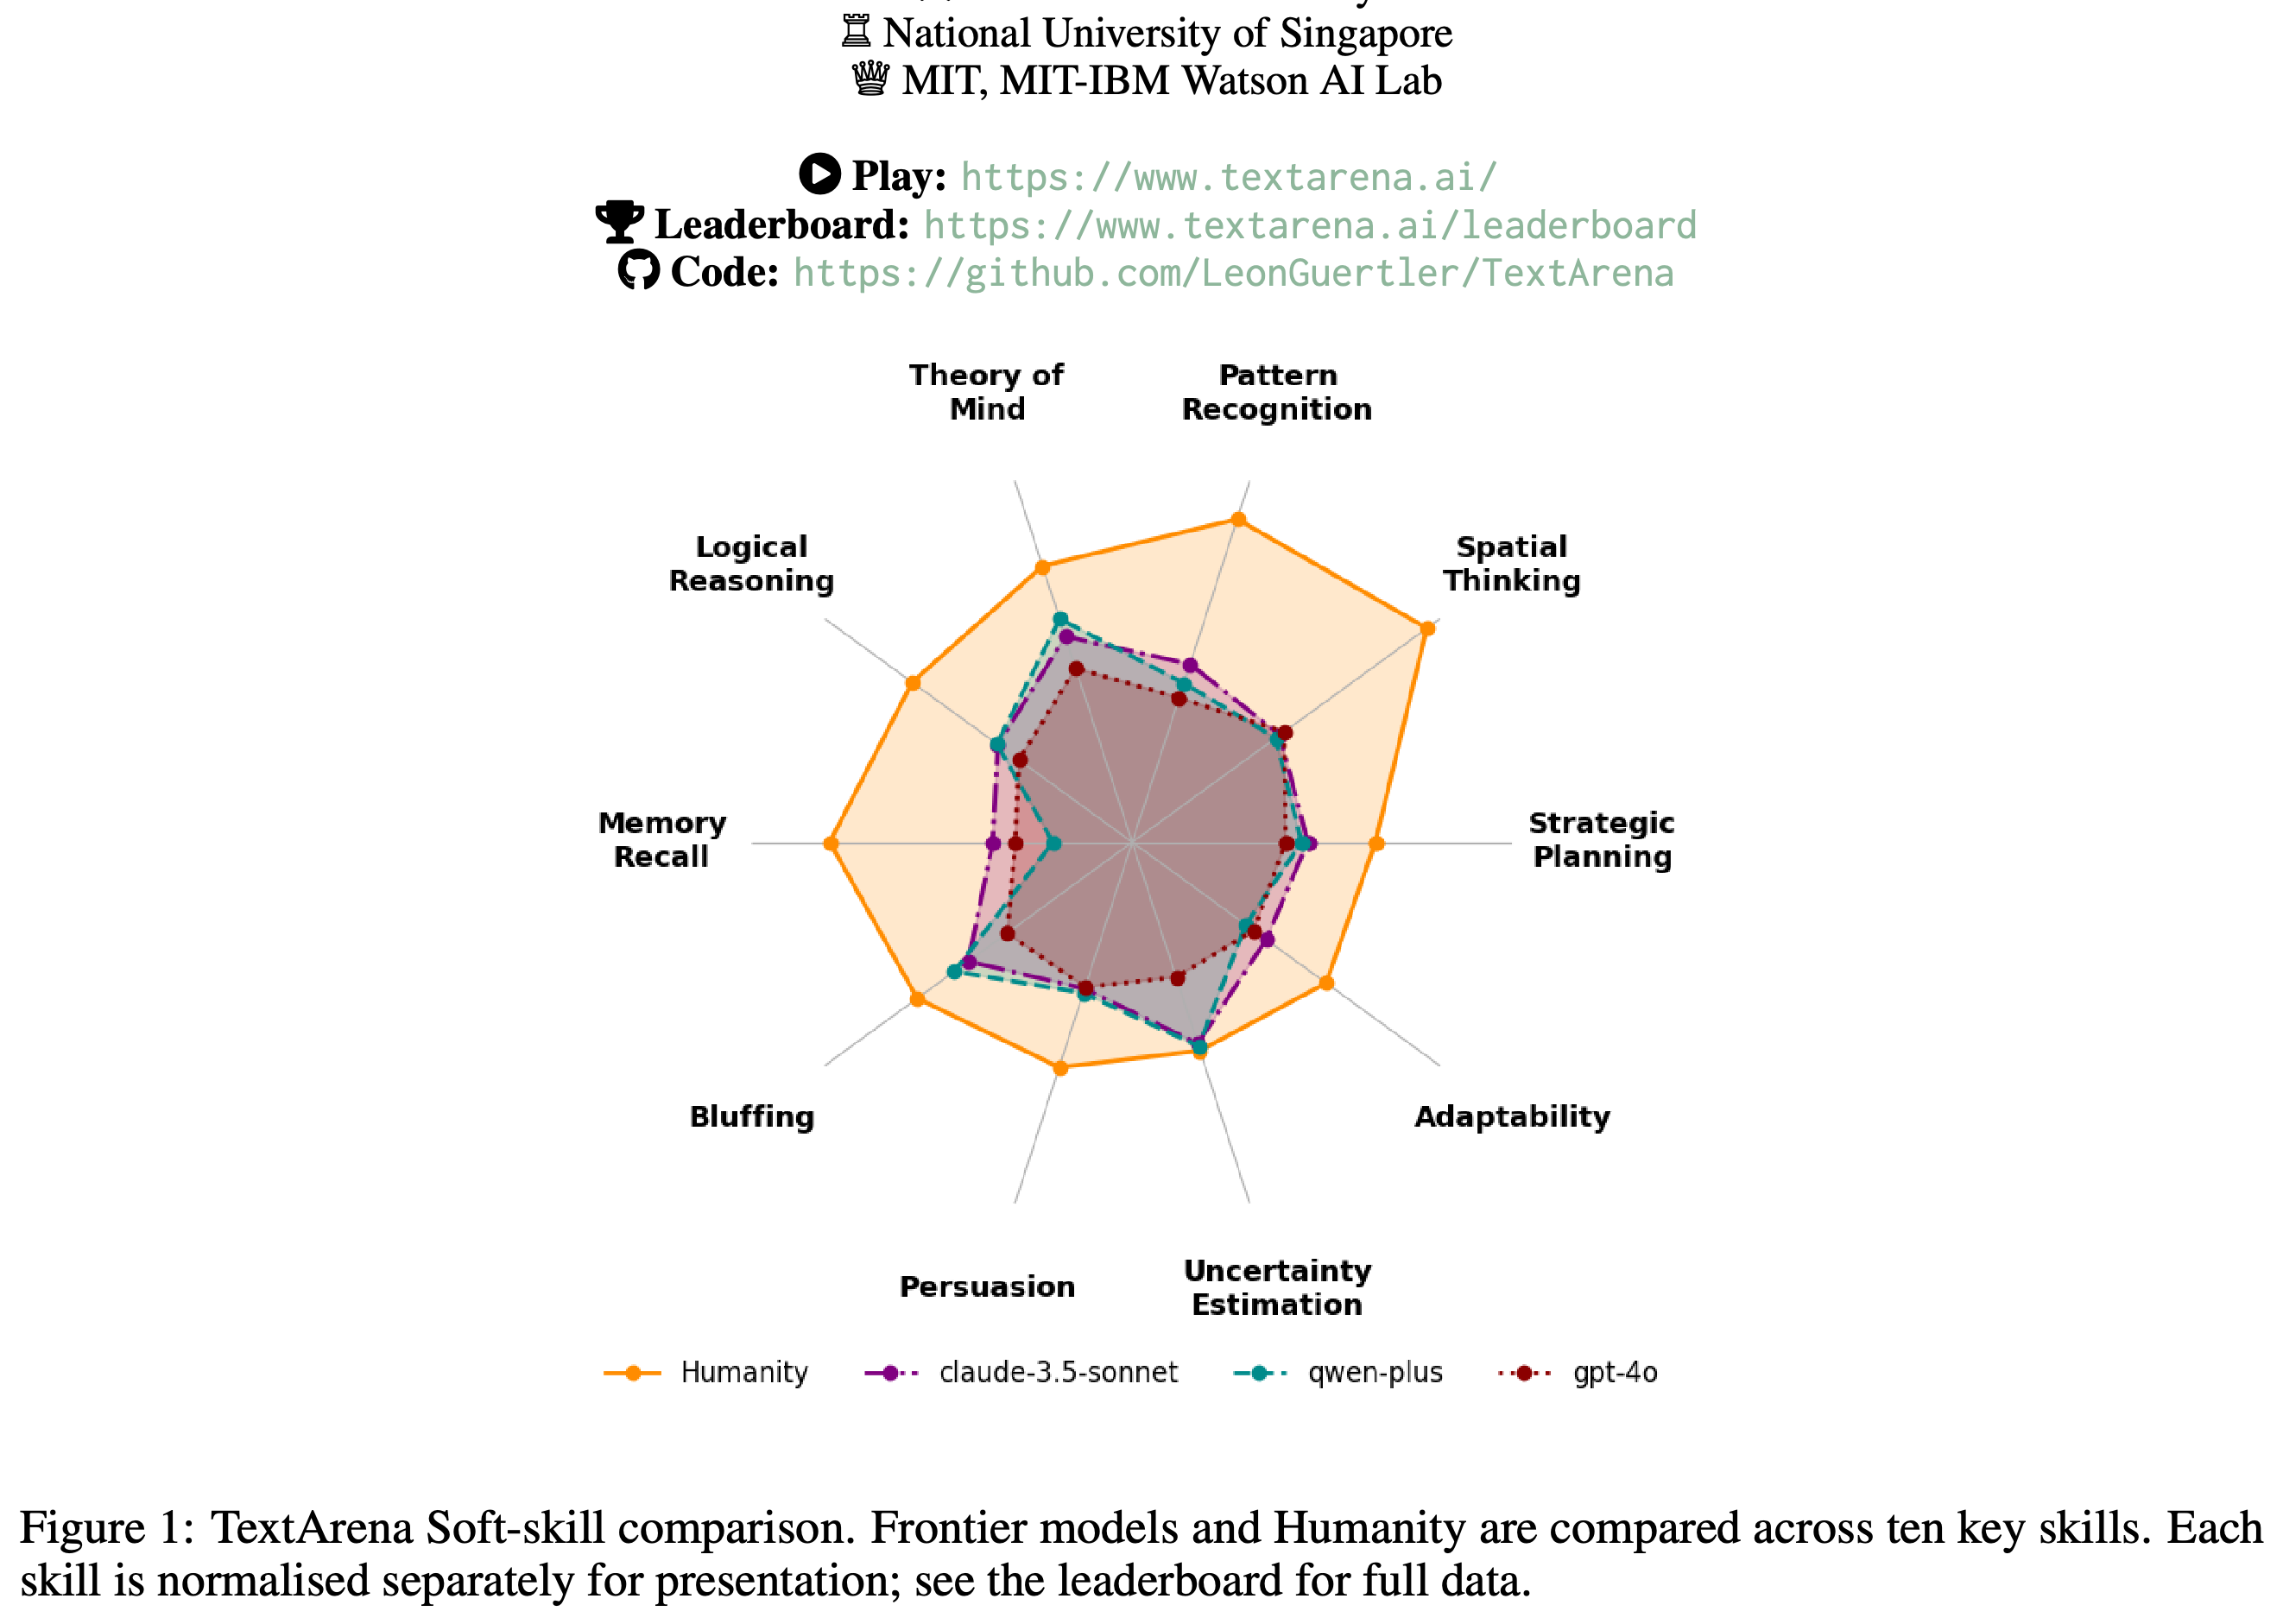
- 논문은 플랫폼과 예비 순위를 소개하지만, 점수 차이를 해석하는 데 필요한 실험 세부 정보는 제한적이다. 결과에는 게임 전략뿐 아니라 규칙과 형식 준수 능력도 함께 반영된다. 논문은 경기 수, 전체 프롬프트 및 추론 프로토콜, 실험으로 입증한 학습 성능 향상을 보고하지 않는다.
1 Introduction
서론은 더 어려운 고정 벤치마크를 반복해서 만드는 대신 경쟁적 게임 플레이로 상대적 성능을 평가하자고 제안한다. 플레이어 사이에 능력 차이가 있는 한 순위로 이들을 구분할 수 있으며, 게임 결과를 사용하면 생성된 답변에 대한 인간의 선호 판단에 덜 의존할 수 있다.
- 평가하려는 능력에는 다른 플레이어의 믿음이나 의도를 추론하는 마음 이론과 함께 설득, 기만, 공간 추론, 장기 계획이 포함된다.
- 프레임워크는 오프라인 개발과 온라인 경쟁에 필요한 관측과 보상을 제공한다. 상호작용과 보상으로 학습하는 강화 학습(RL), 다른 에이전트나 모델 인스턴스와 게임을 하며 학습 경험을 만드는 self-play를 활용 방안으로 제안하지만, 논문은 학습 성능 향상을 입증하지 않는다.
게임마다 선두 플레이어가 달라진다. Humanity는 DontSayIt-v0와 TicTacToe-v0, claude-3.7-sonnet:thinking은 Poker-v0와 SecretMafia-v0, gemini-2.5-pro-preview-03-25는 Snake-v0에서 선두를 차지한다. 오차 막대의 의미가 정의되지 않았고, 캡션에서 모델의 카드나 역할 공개를 경고하므로, 근소한 순위 차이를 전략적 능력 차이로 해석하는 데 한계가 있다.
2 Design Choices
설계는 표준화된 환경 상호작용을 지원하는 프레임워크인 OpenAI Gym, 즉 Gymnasium과 유사한 인터페이스를 통해 도입과 확장을 쉽게 하는 데 초점을 맞춘다. 환경에 겹쳐 적용할 수 있는 인터페이스 계층인 wrapper로 상호작용 방식을 조정하고, 공통 게임 기능을 제공해 새 환경을 추가하는 데 필요한 작업을 줄인다.
- 예제는 ta.agents.OpenRouterAgent로 에이전트를 만들고, ta.make(env_id=[“TicTacToe-v0”, “SpellingBee-v0”])로 환경을 선택한 뒤 ta.wrappers.LLMObservationWrapper(env=env)를 적용한다.
- env.reset(num_players=len(agents))를 호출한 뒤, 반복문에서 env.get_observation()으로 player_id와 observation을 얻는다. 해당 에이전트로 action을 생성하고 env.step(action=action)으로 게임을 진행한다. 보상은 env.close()로 가져온다.
3 Environments
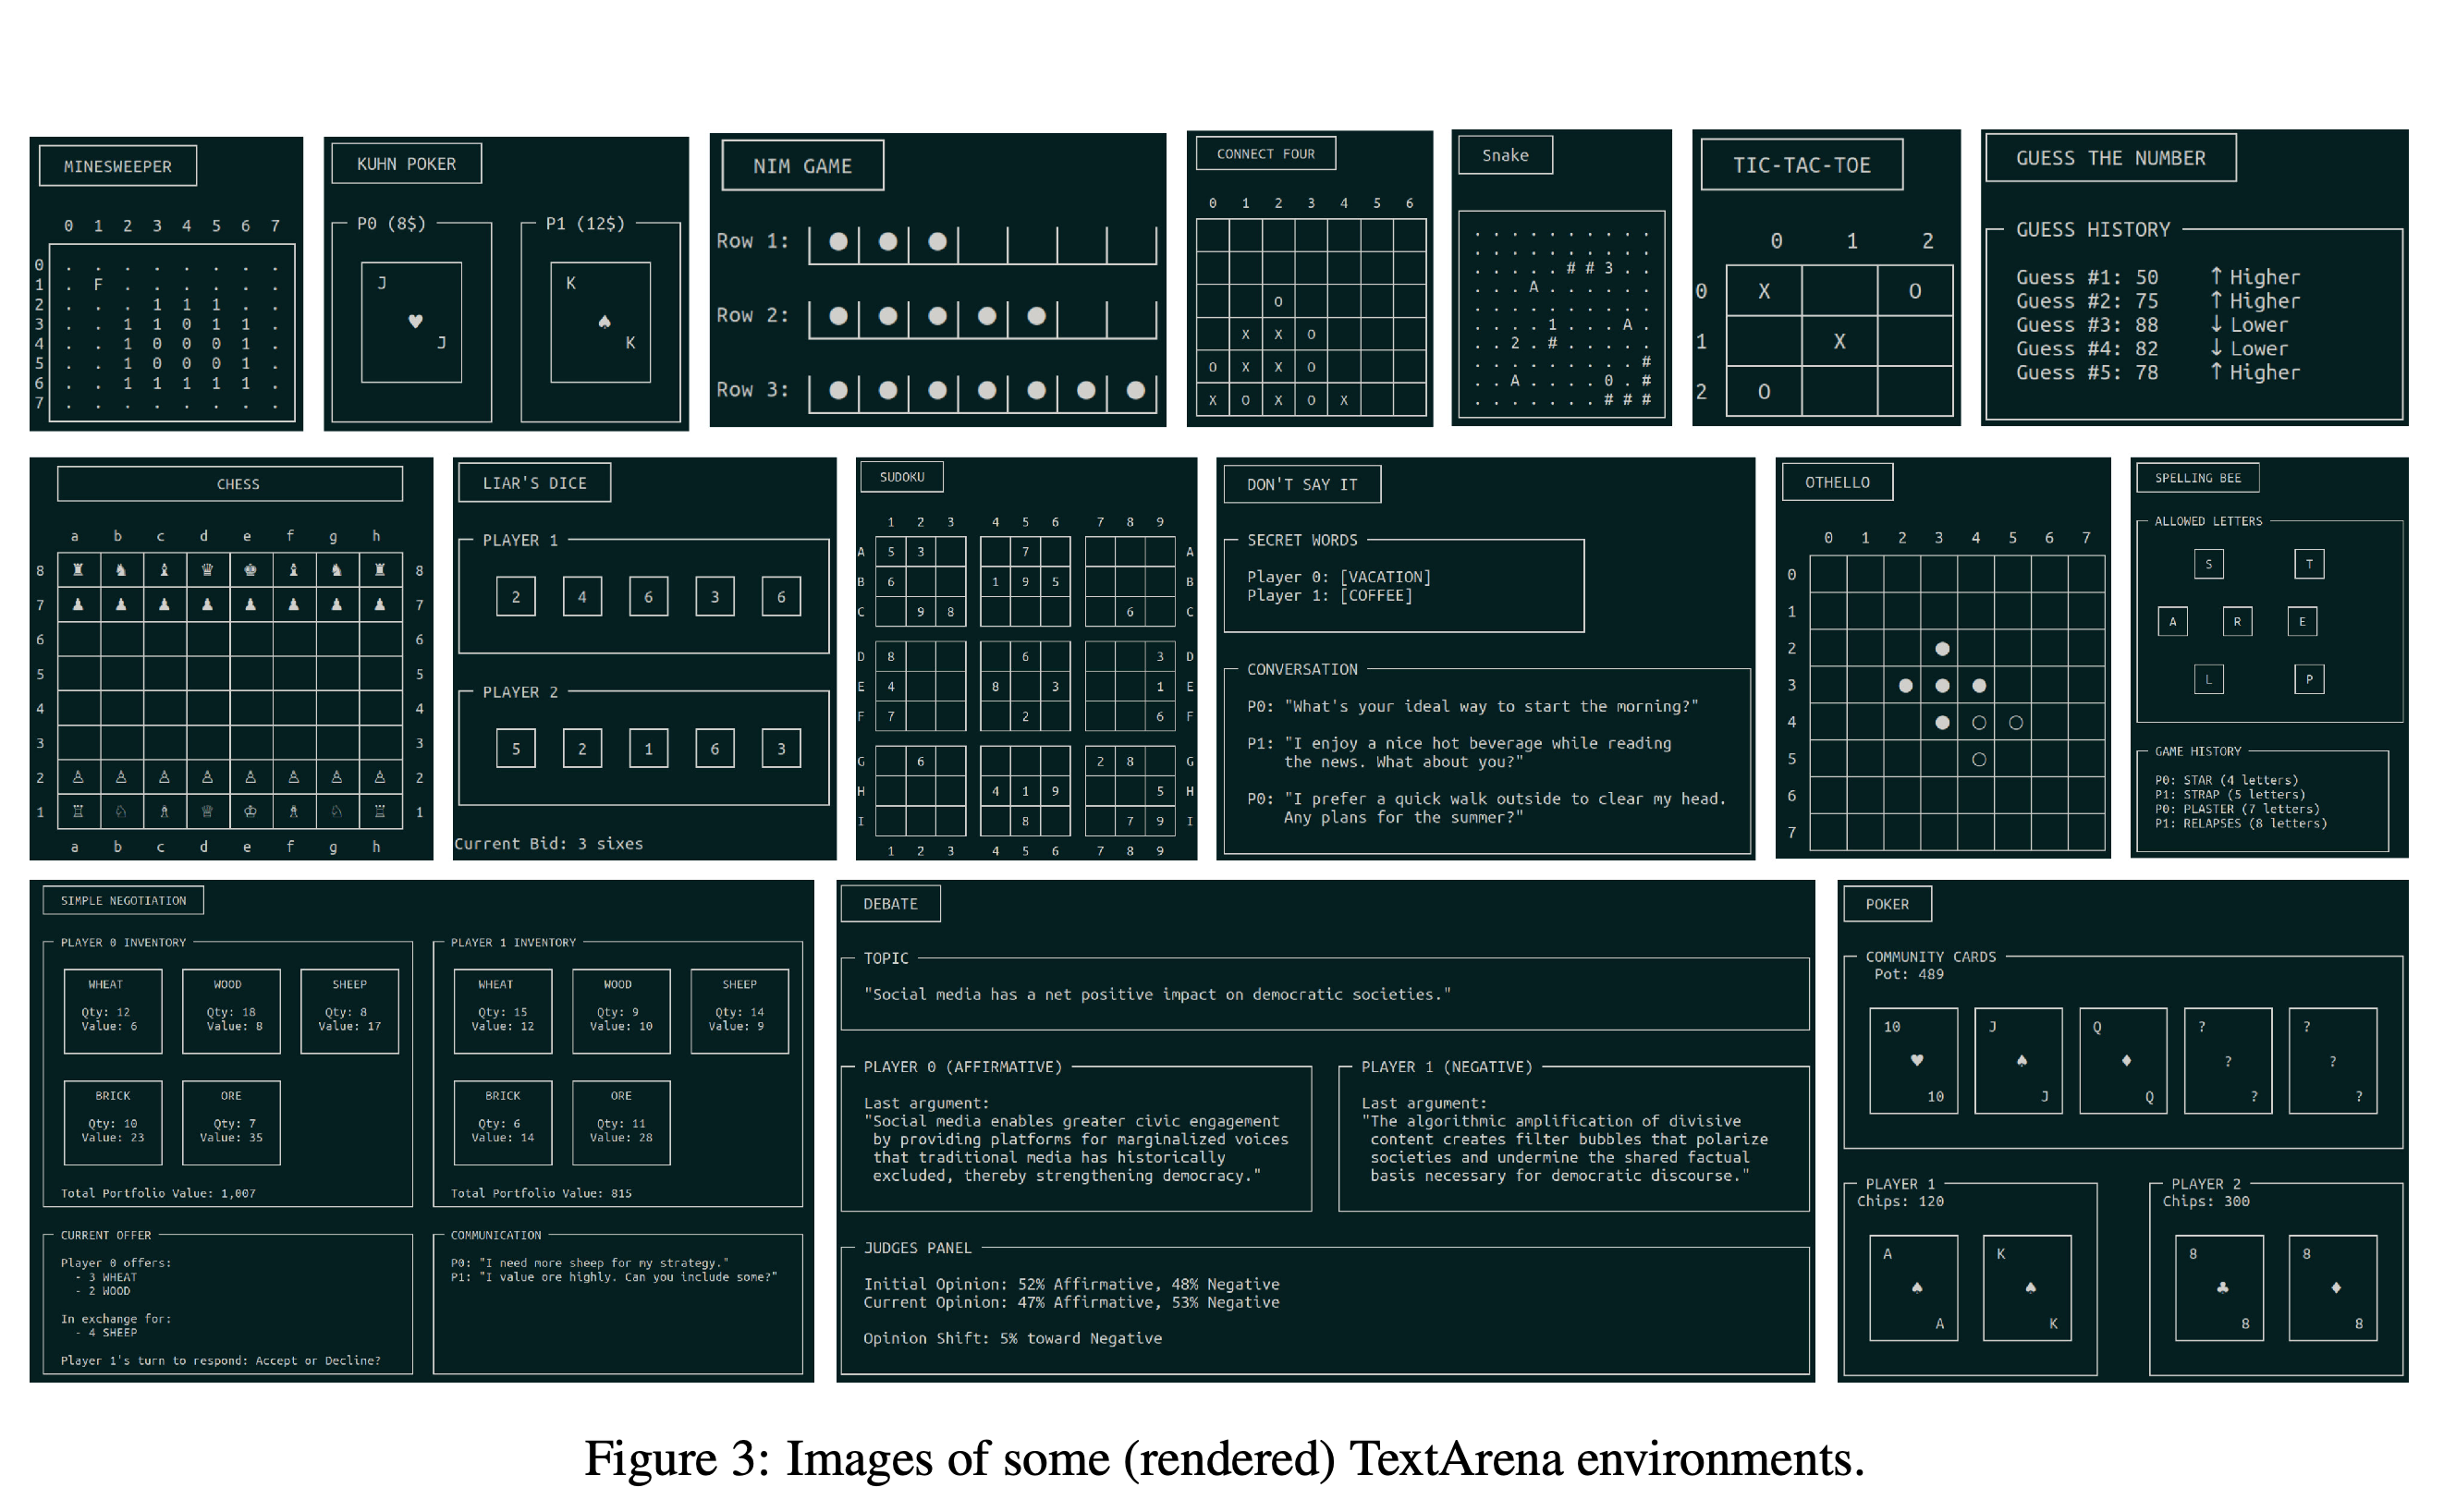
환경 모음은 1인, 2인, 다인 설정에 맞춘 기존 게임, 변형 게임, 새로운 게임을 포함한다. 모든 게임은 본래 텍스트 기반이거나 텍스트 형식으로 변환되어 있다. Figure 3은 격자와 카드부터 대화, 협상, 토론까지 다양한 형식을 보여준다.
- 환경은 추론, 어휘, 기억, 계획, 위험 평가, 기만, 설득, 자원 관리를 다룬다. 논문은 각 환경이 목표로 하는 능력을 설명하지만, 개별 게임이 해당 능력을 분리해 평가한다는 점을 실험으로 입증하지 않는다.
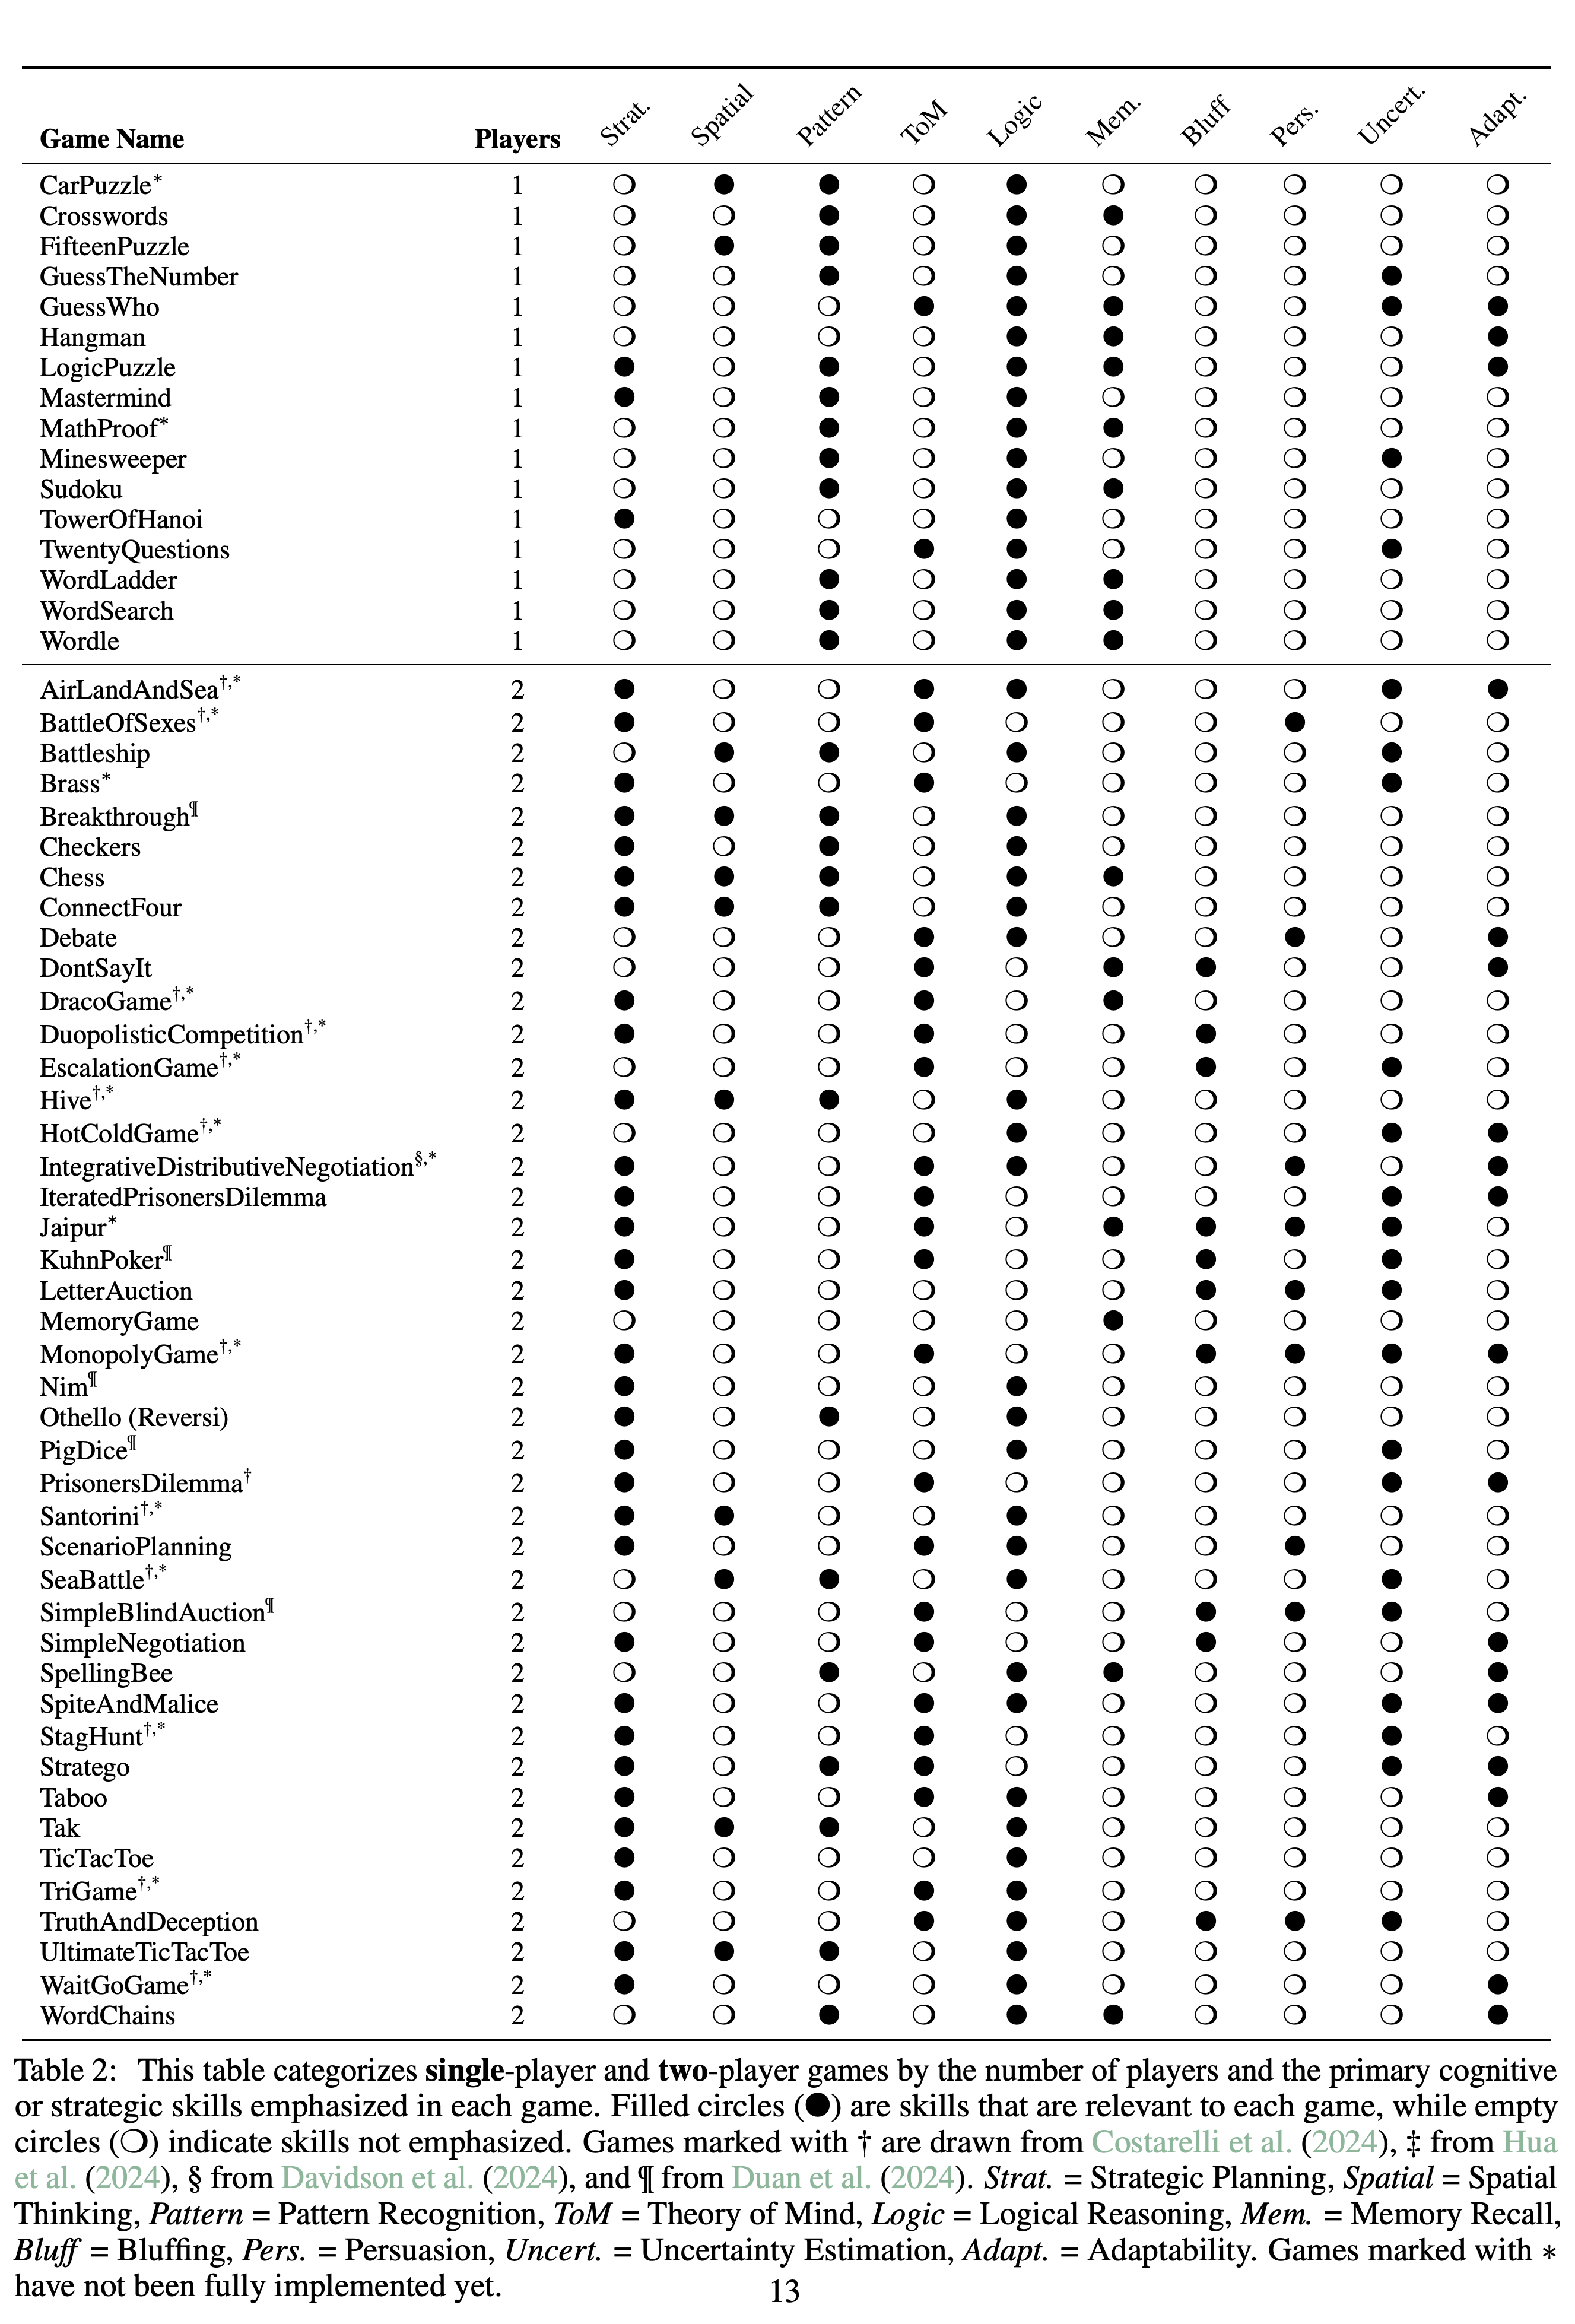
- 부록의 Table 3은 다인 게임별 플레이어 수와 능력 범주를 정리한다. Poker와 Snake는 2–15인, SecretMafia는 5–15인 게임으로 제시된다. Table 2는 1인 및 2인 게임을 같은 방식으로 정리한다. 두 표 모두 완전히 구현되지 않은 게임에 별표를 붙이므로, 보고된 게임 목록의 범위를 해석할 때 이를 고려해야 한다.
예시는 환경 모음에 포함된 격자, 카드, 수치 피드백, 대화를 보여준다. 게임을 표현하는 방식이 다양하다는 점을 보여주지만, 각 표현 방식이 서로 다른 능력을 측정한다는 점을 입증하지는 않는다.
4 Online Evaluation
온라인 평가는 최상위 모델, 커뮤니티 제출 모델, 인간을 대결시키고 경기마다 TrueSkill™ 평점을 갱신한다. 각 모델은 \(\mu = 25\)와 \(\sigma = \frac{25}{3}\)에서 시작한다. μ는 추정 실력, σ는 그 불확실성을 나타낸다. 인간 플레이어는 리더보드에서 “Humanity”라는 이름으로 통합된다.
- 저자들은 개인전과 팀전, 다양한 플레이어 수, 불확실성 처리를 지원하기 위해 TrueSkill™을 선택한다. 다른 경쟁 평점 시스템인 Elo보다 빠르게 수렴한다고 보고하지만, 정량적인 수렴 결과나 자세한 비교 프로토콜은 제시하지 않는다.
- 능력 프로필은 환경별 가중 라벨을 사용하며, 범주는 10개다. Strategic Planning은 목표를 향한 행동 계획, Spatial Thinking은 위치에 대한 추론, Pattern Recognition은 규칙성 식별을 뜻한다. 나머지는 Theory of Mind, 연역적 추론을 뜻하는 Logical Reasoning, 정보 유지와 인출을 뜻하는 Memory Recall, 상대를 오도하는 Bluffing, 다른 플레이어에게 영향을 주는 Persuasion, 불완전한 정보를 평가하는 Uncertainty Estimation, 게임 상황 변화에 맞춰 행동을 조정하는 Adaptability다. 모델의 범주별 점수는 관련 환경 점수의 가중 평균이며, Figure 1은 각 범주를 별도로 정규화한다.
- 본문은 환경마다 최대 5개의 능력 라벨을 부여한다고 설명하지만, 부록에서 Jaipur와 MonopolyGame에 나열한 라벨은 각각 6개다. 논문은 이 불일치가 구현된 가중치와 어떤 관계가 있는지 설명하지 않는다.
Figure 2는 DontSayIt-v0, Poker-v0, TicTacToe-v0, Snake-v0, SecretMafia-v0의 예비 TrueSkill™ 순위를 제시한다. 제시된 순위에서 Humanity는 DontSayIt-v0와 TicTacToe-v0, claude-3.7-sonnet:thinking은 Poker-v0와 SecretMafia-v0, gemini-2.5-pro-preview-03-25는 Snake-v0에서 선두를 차지한다.
- 그림에는 오차 막대가 있지만, 논문은 그 통계적 의미나 각 점수의 바탕이 된 경기 수를 제시하지 않는다. 순위는 그래프에 포함된 대상의 성적을 비교하는 근거가 되지만, 근소한 차이의 유의성과 안정성은 불분명하다.
- 캡션은 일부 추론 모델이 게임 중 자신의 비공개 카드나 역할을 공개한다는 교란 요인을 지적한다. 따라서 낮은 평점에는 전략적 약점뿐 아니라 정보 공개와 규칙 또는 형식 준수 실패도 반영될 수 있다.
- 모델 제출에는 공식적인 제한이 없으며, 저자들은 서로 다른 모델 변형에 별도의 이름을 붙이도록 권장한다. 논문은 283개 모델을 평가했다고 보고하지만, 제출 모델 전반에 적용한 표준 프롬프트, 샘플링 설정, 연산 예산은 명시하지 않는다.
5 Related Work
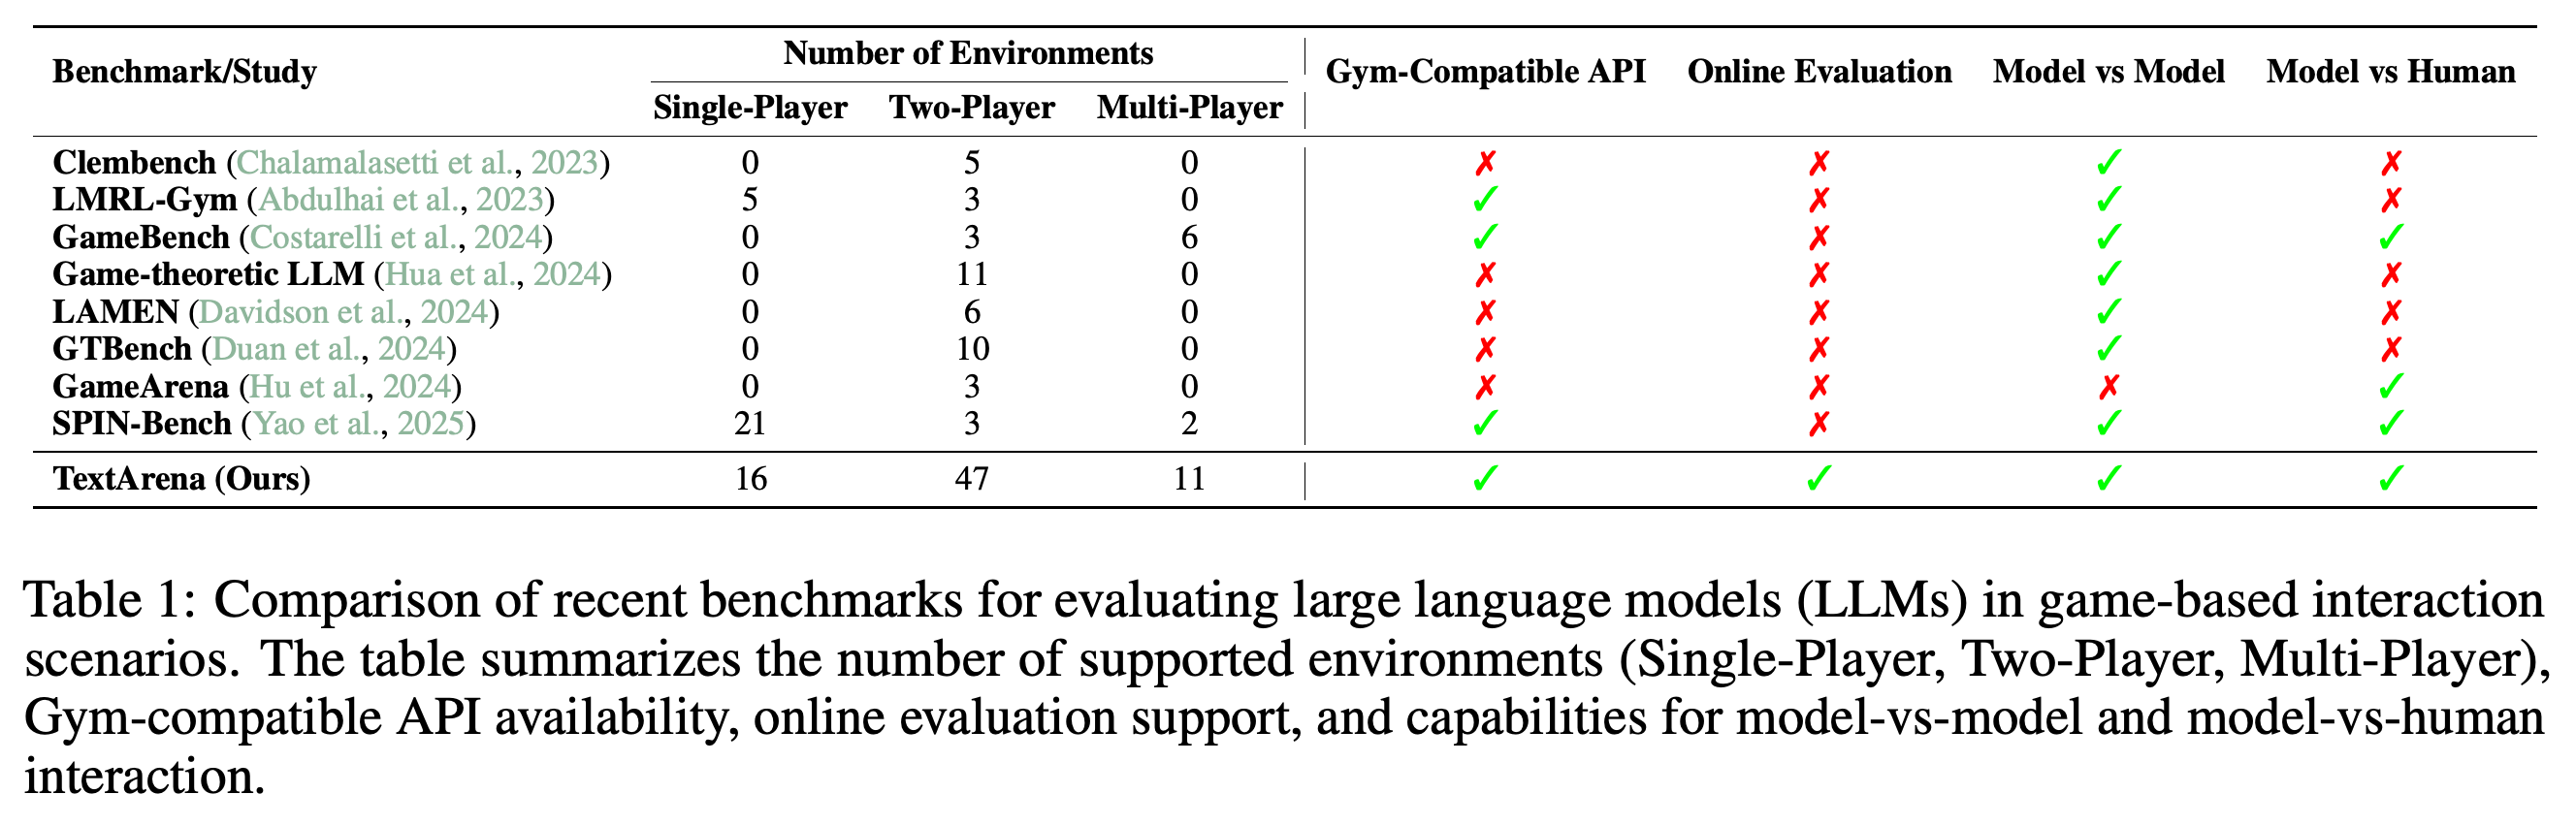
관련 연구 비교는 환경 수와 4가지 기능을 정리한다. 기능은 Gym 호환 애플리케이션 프로그래밍 인터페이스(API), 온라인 평가, 모델 간 대결, 모델 대 인간 대결이다. Table 1은 TextArena의 환경을 1인용 16개, 2인용 47개, 다인용 11개로 보고하며, 합계는 74개다. 비교 대상 중 4가지 기능을 모두 지원하는 프레임워크는 TextArena뿐인 것으로 표시한다.
- 비교 대상은 Clembench, LMRL-Gym, GameBench, Game-theoretic LLM, LAMEN, GTBench, GameArena, SPIN-Bench다. 이 비교는 각 플랫폼이 보고한 기능을 다루며, 공통 실험 프로토콜에 따른 평가 정확도는 비교하지 않는다.
- SPIN-Bench의 경우 Table 1은 1인용 환경을 21개로 기재하지만, 함께 제시된 본문은 1개라고 설명한다. PDF는 이 불일치를 해소하지 않는다.
TextArena 행은 1인용 환경 16개, 2인용 환경 47개, 다인용 환경 11개와 나열된 4가지 기술적 기능을 모두 지원한다고 보고한다. 이 항목들은 비교 대상 프레임워크 사이에서 저자들이 보고한 플랫폼의 지원 범위를 보여준다. 평가 정확도나 타당성이 더 높다는 점을 입증하지는 않는다.
이 행렬은 사회적 상호작용을 다루는 게임을 Theory of Mind, Persuasion 같은 범주에 연결하고, Snake와 Surround를 Strategic Planning, Spatial Thinking에 연결한다. 플레이어 수는 게임마다 다르며, Pit의 별표는 완전히 구현되지 않았음을 나타낸다.
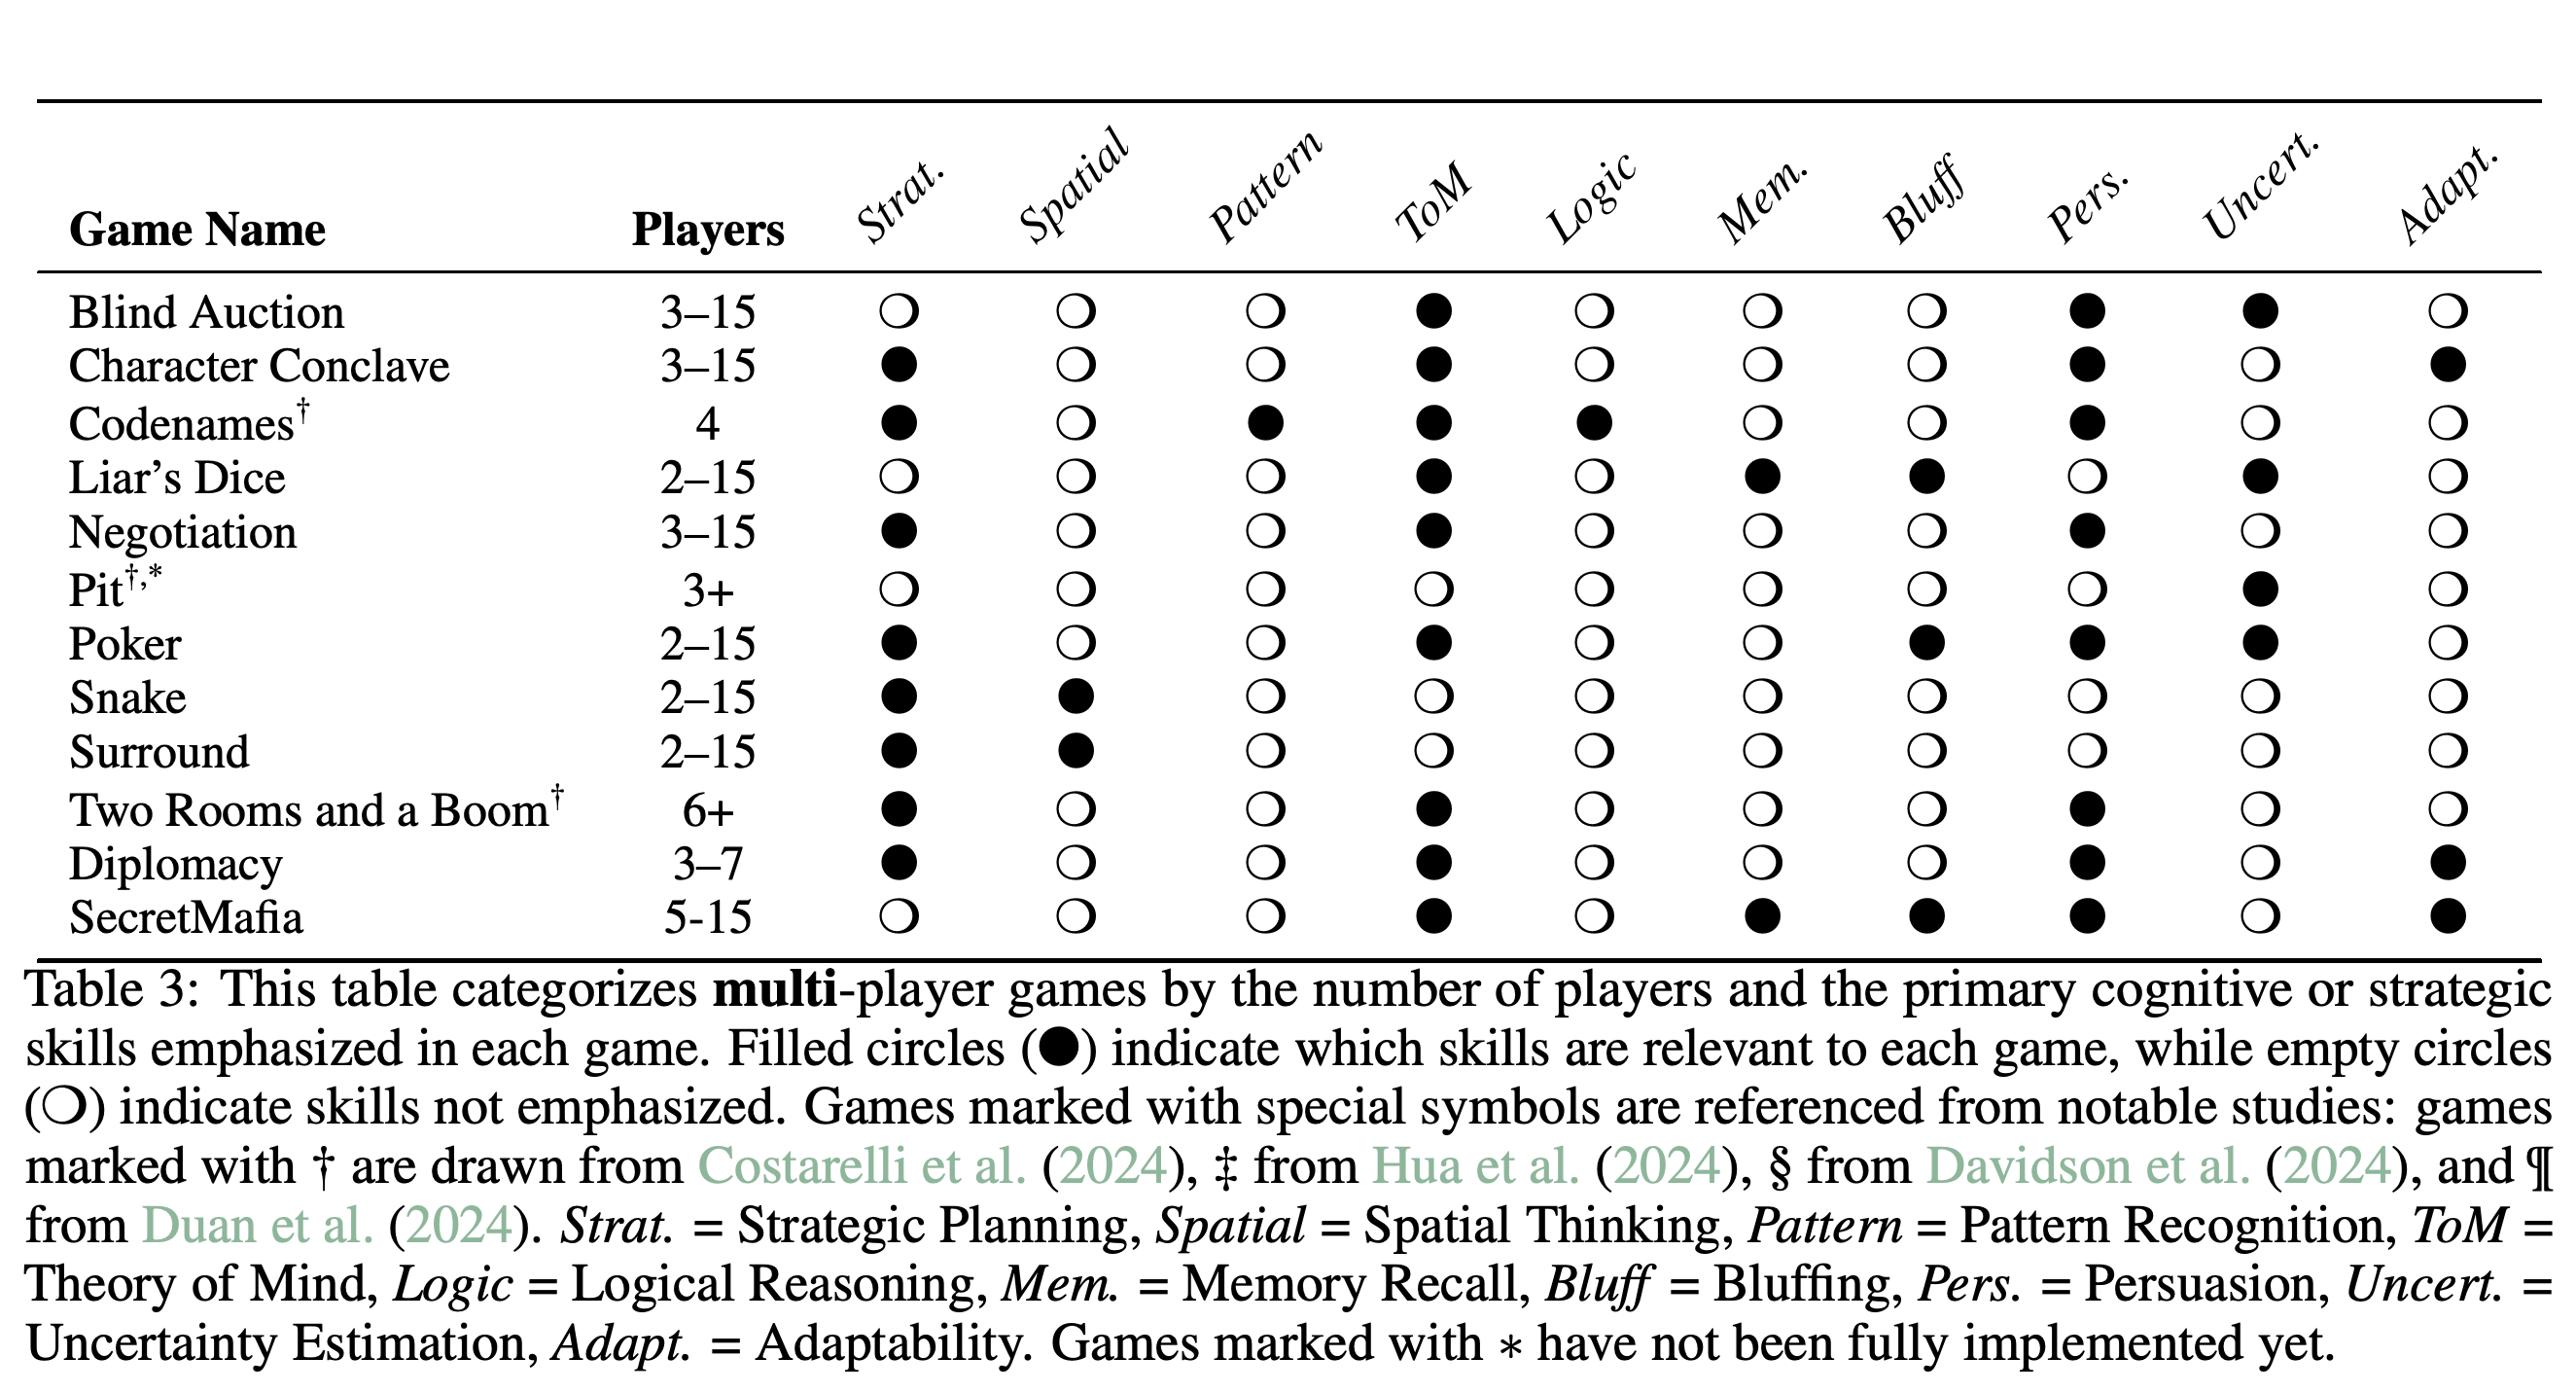
1인 게임 행에는 Logical Reasoning과 Pattern Recognition이 자주 포함되며, 2인 게임 행에는 사회적 능력과 전략적 능력 범주도 포함된다. 이 지표들은 각 게임에 부여한 범주를 기록하며, 해당 능력에 미치는 효과를 측정한 값은 아니다. 별표는 완전히 구현되지 않은 항목을 구분한다.
6 Future Directions
향후 방향으로는 게임 환경을 활용한 RL 학습, 커뮤니티 기여 확대, 인간과 모델의 게임 플레이 궤적 공개, VideoGameArena를 제안한다. 게임 플레이 궤적은 게임 중 상호작용의 연속을 뜻한다. VideoGameArena는 연속 프레임으로 제시되는 경쟁 환경에서 실시간 방향 입력과 키 입력을 사용하는 확장이다. 논문은 이를 계획으로 제시하며, 학습 성능 향상, 공개된 궤적 데이터셋, VideoGameArena 결과는 보고하지 않는다.
- 공개를 계획한 궤적에는 OpenAI o1, Claude-3.7-Sonnet, Gemini-2.5-Pro와의 상호작용이 포함된다. 저자들은 호스팅 모델 64개를 상대로 무료 온라인 플레이를 할 수 있다고도 보고한다.
- 문서에 제시된 자료 주소는 https://www.textarena.ai/, https://www.textarena.ai/leaderboard, https://github.com/LeonGuertler/TextArena 이다.
부록
- A Covered Games는 환경과 각 환경에 부여한 인지적 또는 전략적 능력을 정리한다. A.1 Single-Player Games에는 단어 게임과 함께 FifteenPuzzle, Mastermind, Minesweeper, Sudoku 같은 퍼즐이 포함된다. Sudoku에는 패턴 인식, 논리적 추론, 기억 인출을 연결하고, TowerOfHanoi에는 전략적 계획과 논리적 추론을 연결한다.
- A.2 Two-Player Games는 보드게임, 상대에게 정보가 숨겨진 게임, 흥정, 행동 조율, 대화를 다룬다. 예시로 Chess, KuhnPoker, IteratedPrisonersDilemma, SimpleNegotiation, Debate, TruthAndDeception을 제시한다. Table 2는 1인 및 2인 게임에 부여한 능력을 기록하고 완전히 구현되지 않은 항목을 표시한다. 여기에는 1인 게임의 CarPuzzle과 MathProof, 2인 게임의 여러 항목이 포함된다.
- A.3 Multi-Player Games는 경매, 토의, 단어 연상, 거래, 블러핑, 경로 탐색, 동맹 형성을 설명한다. Table 3에는 4인용 Codenames, 3–7인용 Diplomacy, 6+인용 Two Rooms and a Boom이 포함된다. Pit은 완전히 구현되지 않은 것으로 표시된다. SecretMafia는 표에 등장하지만, 이에 대응하는 본문 설명은 없다.
- B Online Model Play는 ta.make_online에 model_name, model_description, email, env_id=[“SpellingBee-v0”, “SimpleNegotiation-v0”, “Poker-v0”]를 전달해 모델을 등록하는 방법을 보여준다. ta.wrappers.LLMObservationWrapper(env=env)로 관측을 감싸고, env.reset(num_players=1)을 호출한 뒤 종료될 때까지 관측과 행동을 반복한다. 부록은 이 설정 방법이 시간이 지나면서 바뀔 수 있다고 명시한다.
짧은 생각
TextArena의 핵심 기여는 재사용 가능한 텍스트 게임 인터페이스에 모델 및 인간과의 실시간 경쟁을 결합한 것이다. 코드 예제, 렌더링된 환경, 기능 비교, 보고된 온라인 참여 현황은 이 플랫폼을 연구 인프라로 활용할 수 있음을 뒷받침한다.
능력 프로필은 부여된 라벨에 따라 게임 평점을 종합하므로, 이를 각 능력을 별도로 측정한 값으로 해석하려면 제시된 근거 외에 추가 검증이 필요하다. 인간 평점의 통합, 명시되지 않은 경기 수, 비공개 정보 공개도 비교를 어렵게 한다. 전략적 오류와 규칙 및 형식 준수 실패를 분리하는 통제 평가를 수행하면 평점이 무엇을 측정하는지 확인하는 데 도움이 될 것이다.