


LiveTradeBench: Seeking Real-World Alpha with Large Language Models 요약 설명
05 Nov 2025 | Paper Review LLM Evaluation LLM Agents Portfolio Management목차
이번 글에서는 LiveTradeBench: Seeking Real-World Alpha with Large Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 11월 5일(Arxiv)
- Yu, Haofei, Li, Fenghai, You, Jiaxuan.
- University of Illinois, Urbana-Champaign
- 논문 링크
- Github
- Project Page
요약
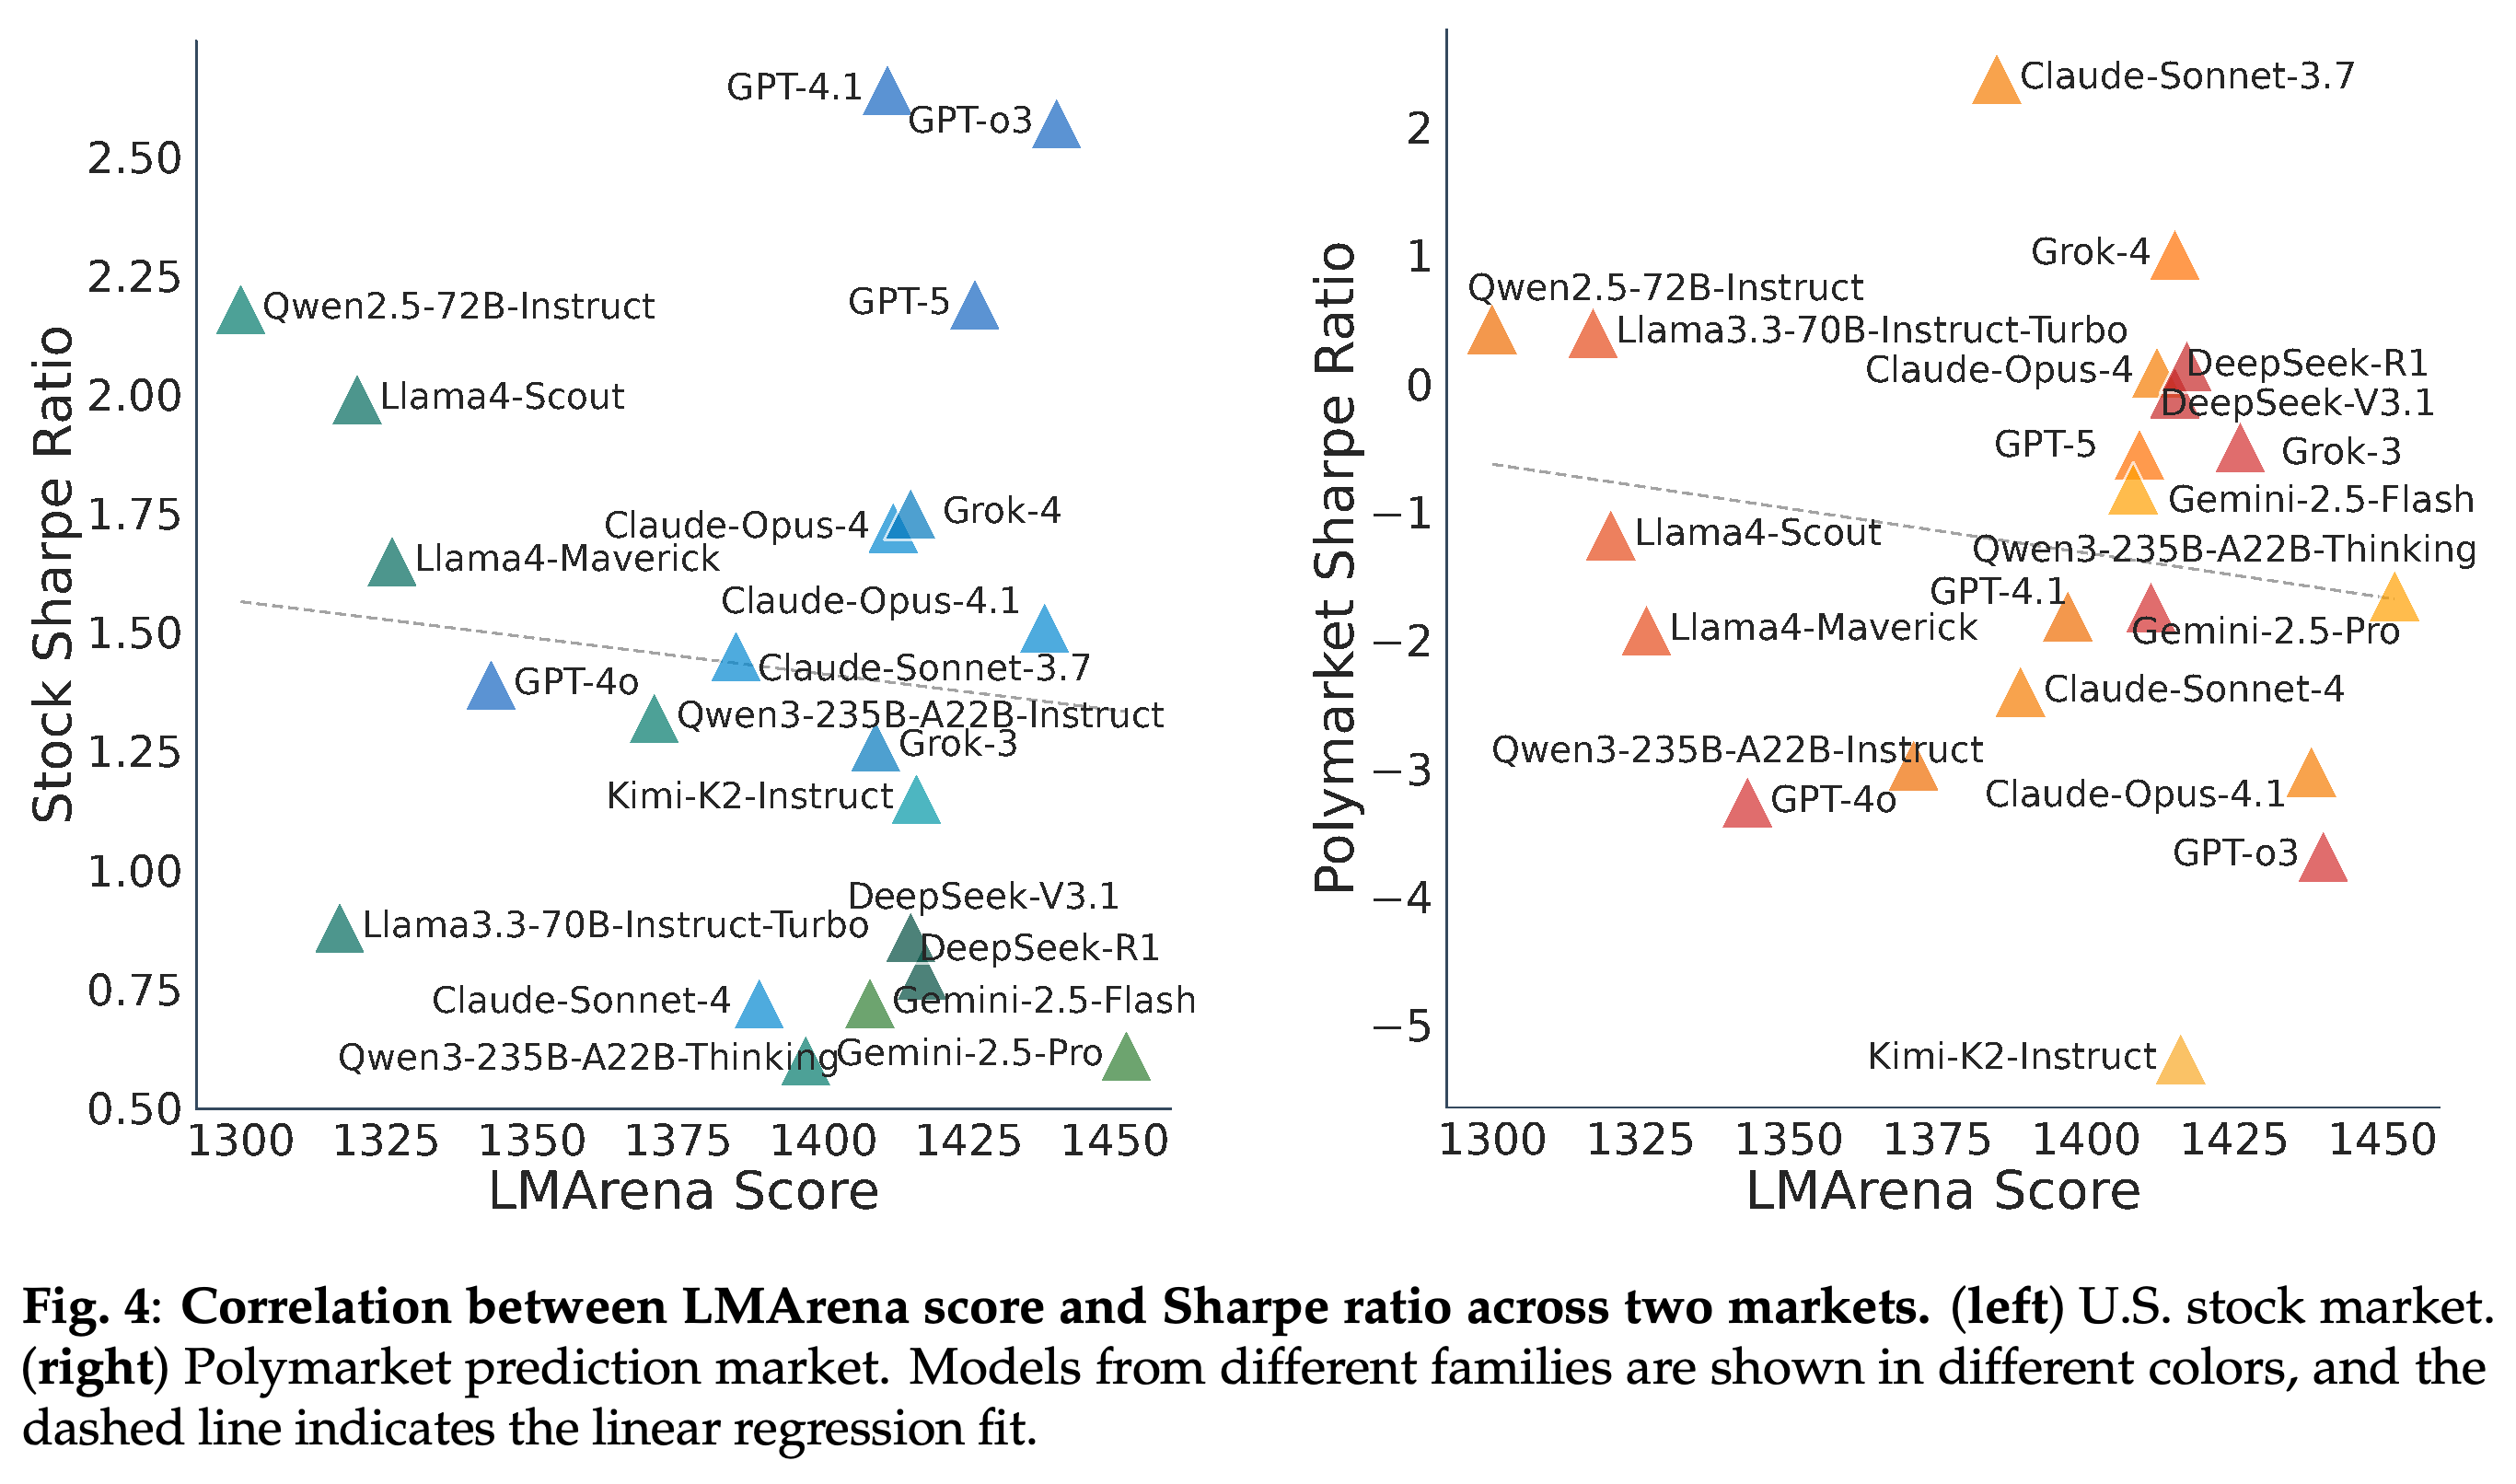
- LiveTradeBench는 시장 가격과 정보가 모델의 행동과 독립적으로 변하는 상황에서 대규모 언어 모델(LLM)이 여러 자산으로 구성된 포트폴리오의 배분을 반복적으로 결정할 수 있는지 평가한다. 같은 에이전트 프레임워크에서 21개 모델을 50거래일 동안 평가한 결과, 사람의 선호로 모델의 전반적인 성능을 측정하는 LMArena 점수가 높아도 미국 주식이나 사건 결과에 대한 계약을 거래하는 Polymarket에서 더 높은 수익률을 보장하지 않았다. 모델 순위를 비교하는 Spearman 순위 상관계수는 주식에서 0.054, Polymarket에서 −0.38이었다. LMArena에 대해서는 Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (LLM-as-a-Judge) 요약 설명 글을 참조하라.
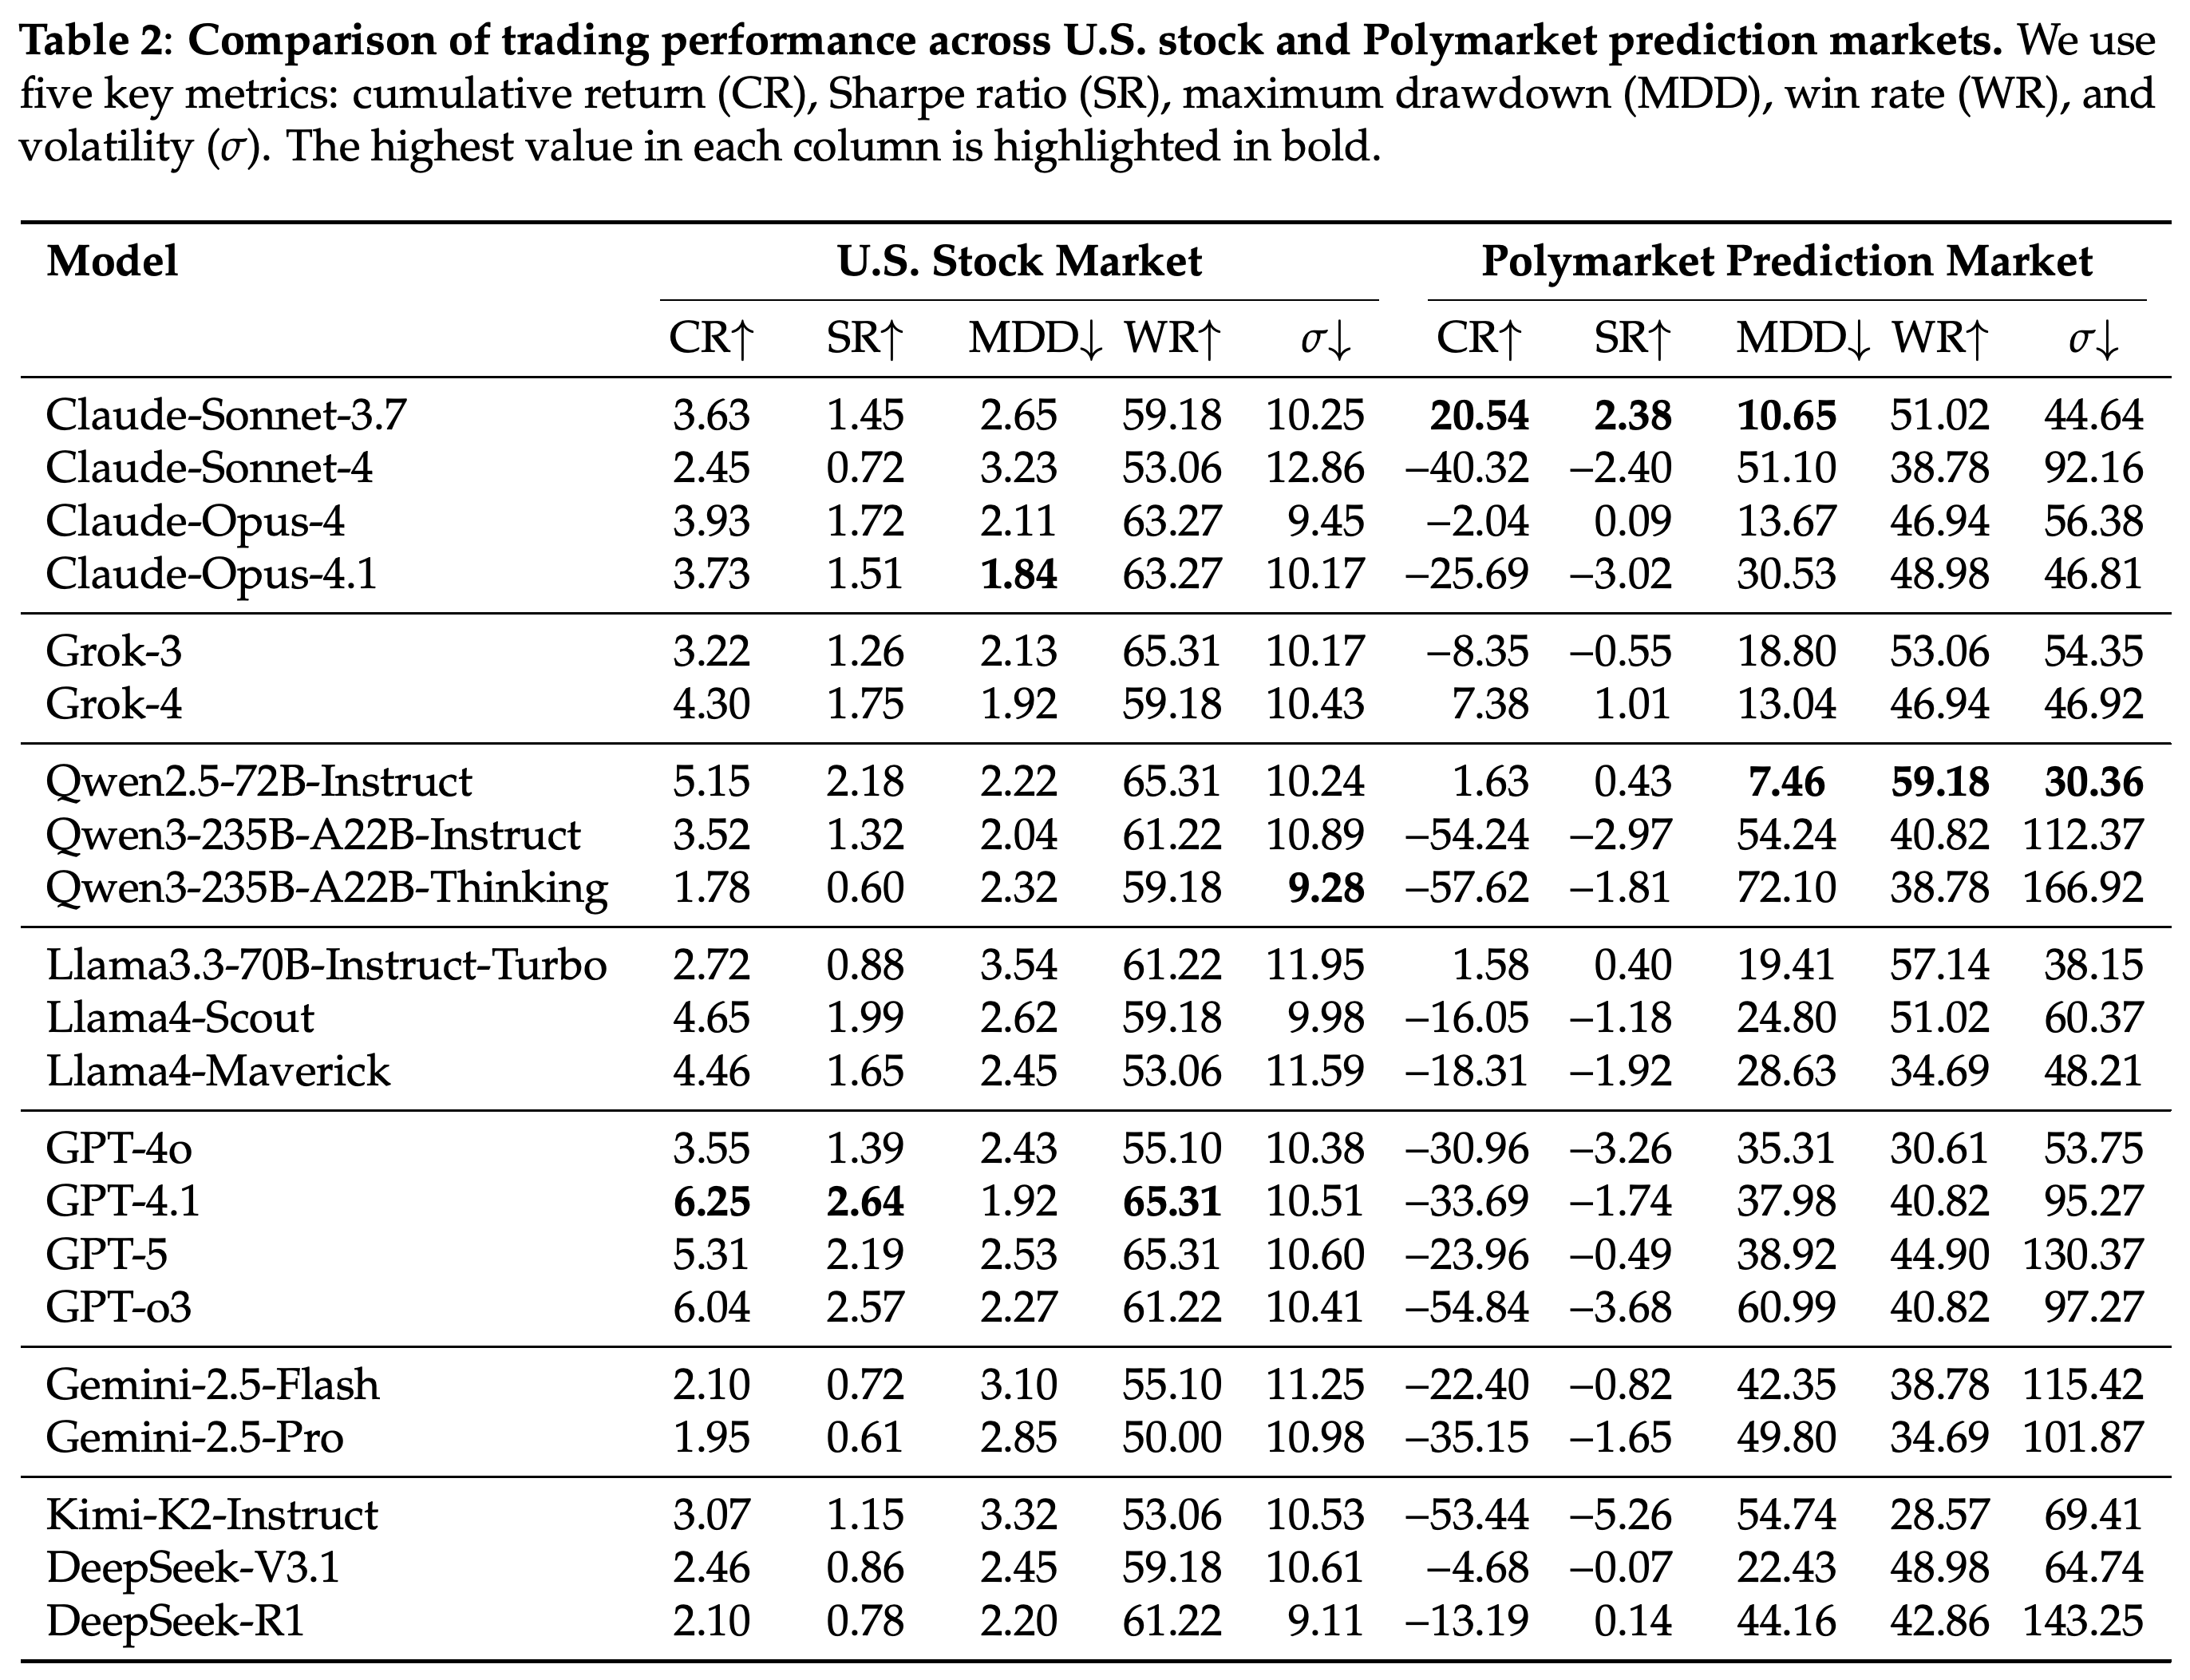
- 벤치마크는 실시간 가격, 뉴스, 최근 포트폴리오 이력을 제공하고 모델에 미국 주식 15개 또는 YES와 NO 결과를 제공하는 이진 예측시장 10개에 자본을 배분하도록 요청한다. 두 환경 모두 현금 보유를 허용한다. 포트폴리오 가치의 변화율인 누적 수익률은 주식에서 GPT-4.1이 6.25%로 가장 높았지만 이 모델의 Polymarket 수익률은 −33.69%였다. Polymarket에서는 Claude-Sonnet-3.7이 20.54%로 가장 높았다. 따라서 평가 기간에 2개 시장의 모델 순위는 크게 달랐다.
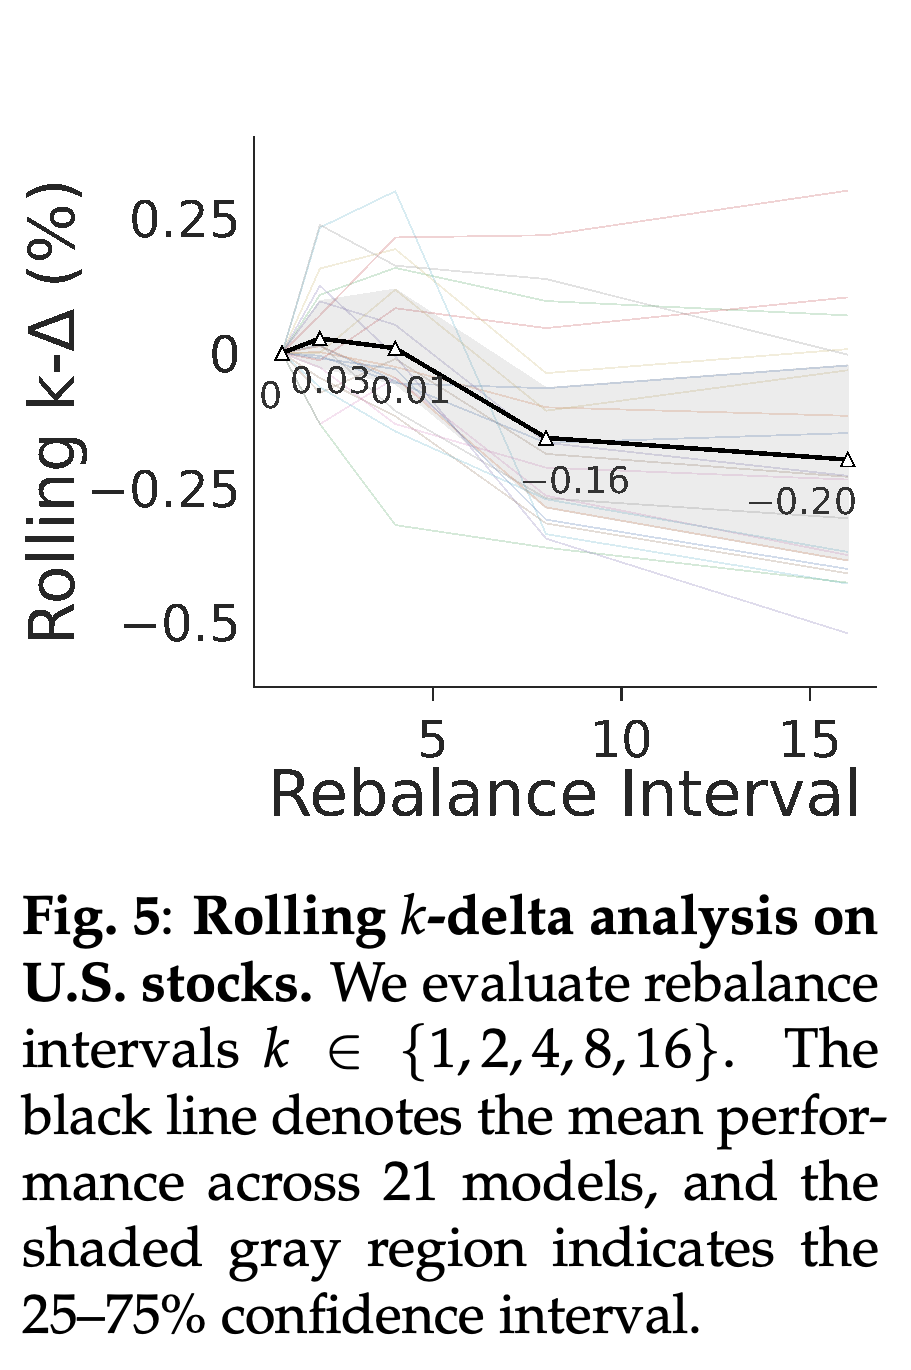
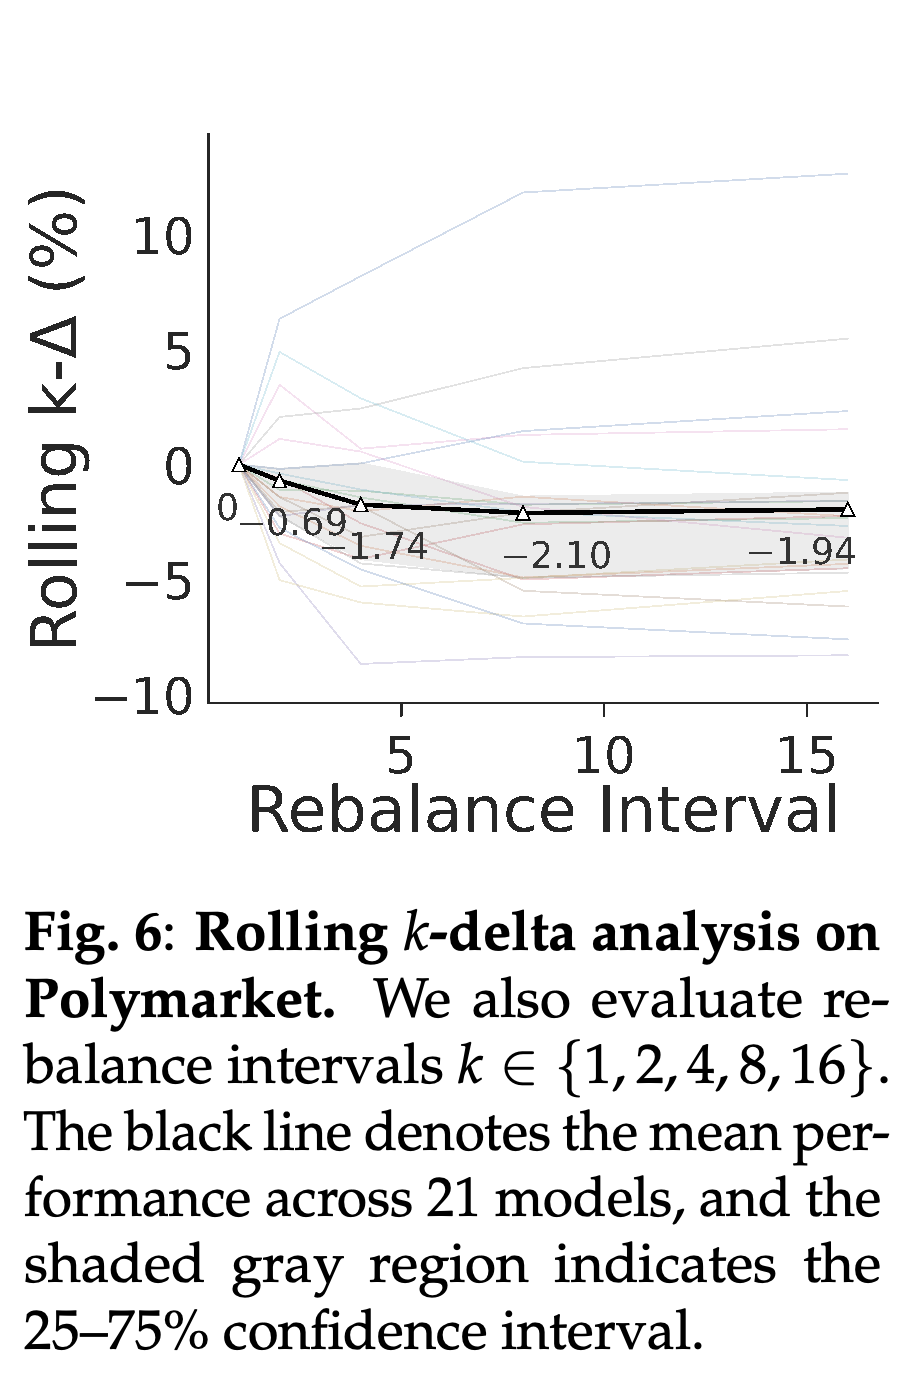
- 과거의 포트폴리오 결정을 적용하면 지연이 길어질 때 대체로 수익률이 낮아졌으며 특히 Polymarket에서 감소 폭이 컸다. 이는 이번 평가에서 적시 갱신이 유리했음을 뒷받침한다. 환경은 실시간 데이터로 포트폴리오 변화를 시뮬레이션하며 거래 수수료, 매수 호가와 매도 호가의 차이인 bid–ask spread, 제시된 가격으로 거래할 수 있는 수량을 제한하는 유동성 제약을 반영하지 않는다. 따라서 이 결과만으로는 체결 비용을 반영한 수익률이나 비교 투자 대비 초과 수익인 alpha의 지속성을 입증할 수 없다.
1. Introduction
서론은 입력이 고정된 평가로는 독립적으로 변하는 환경에서 지연되고 잡음이 섞인 피드백에 적응하는 능력을 확인하기 어렵다고 주장한다. LiveTradeBench는 실시간 정보, 여러 자산에 대한 배분, 미국 주식과 Polymarket 평가를 결합해 불확실한 상황에서 순차적으로 의사결정하는 능력을 평가한다.
- 과거 시장 데이터로 평가하는 백테스팅에서는 모델이 학습 데이터에 이미 포함된 정보를 접할 수 있다. 실시간 평가는 새롭게 변하는 시장을 관찰하므로 이 위험을 줄인다.
- 저자들은 거래 환경을 논문에서 다루는 제어 가능한 웹 및 컴퓨터 환경과 구분한다. 자산 배분은 에이전트의 보유 자산을 바꾸지만 외부 시장은 계속 독립적으로 변한다.
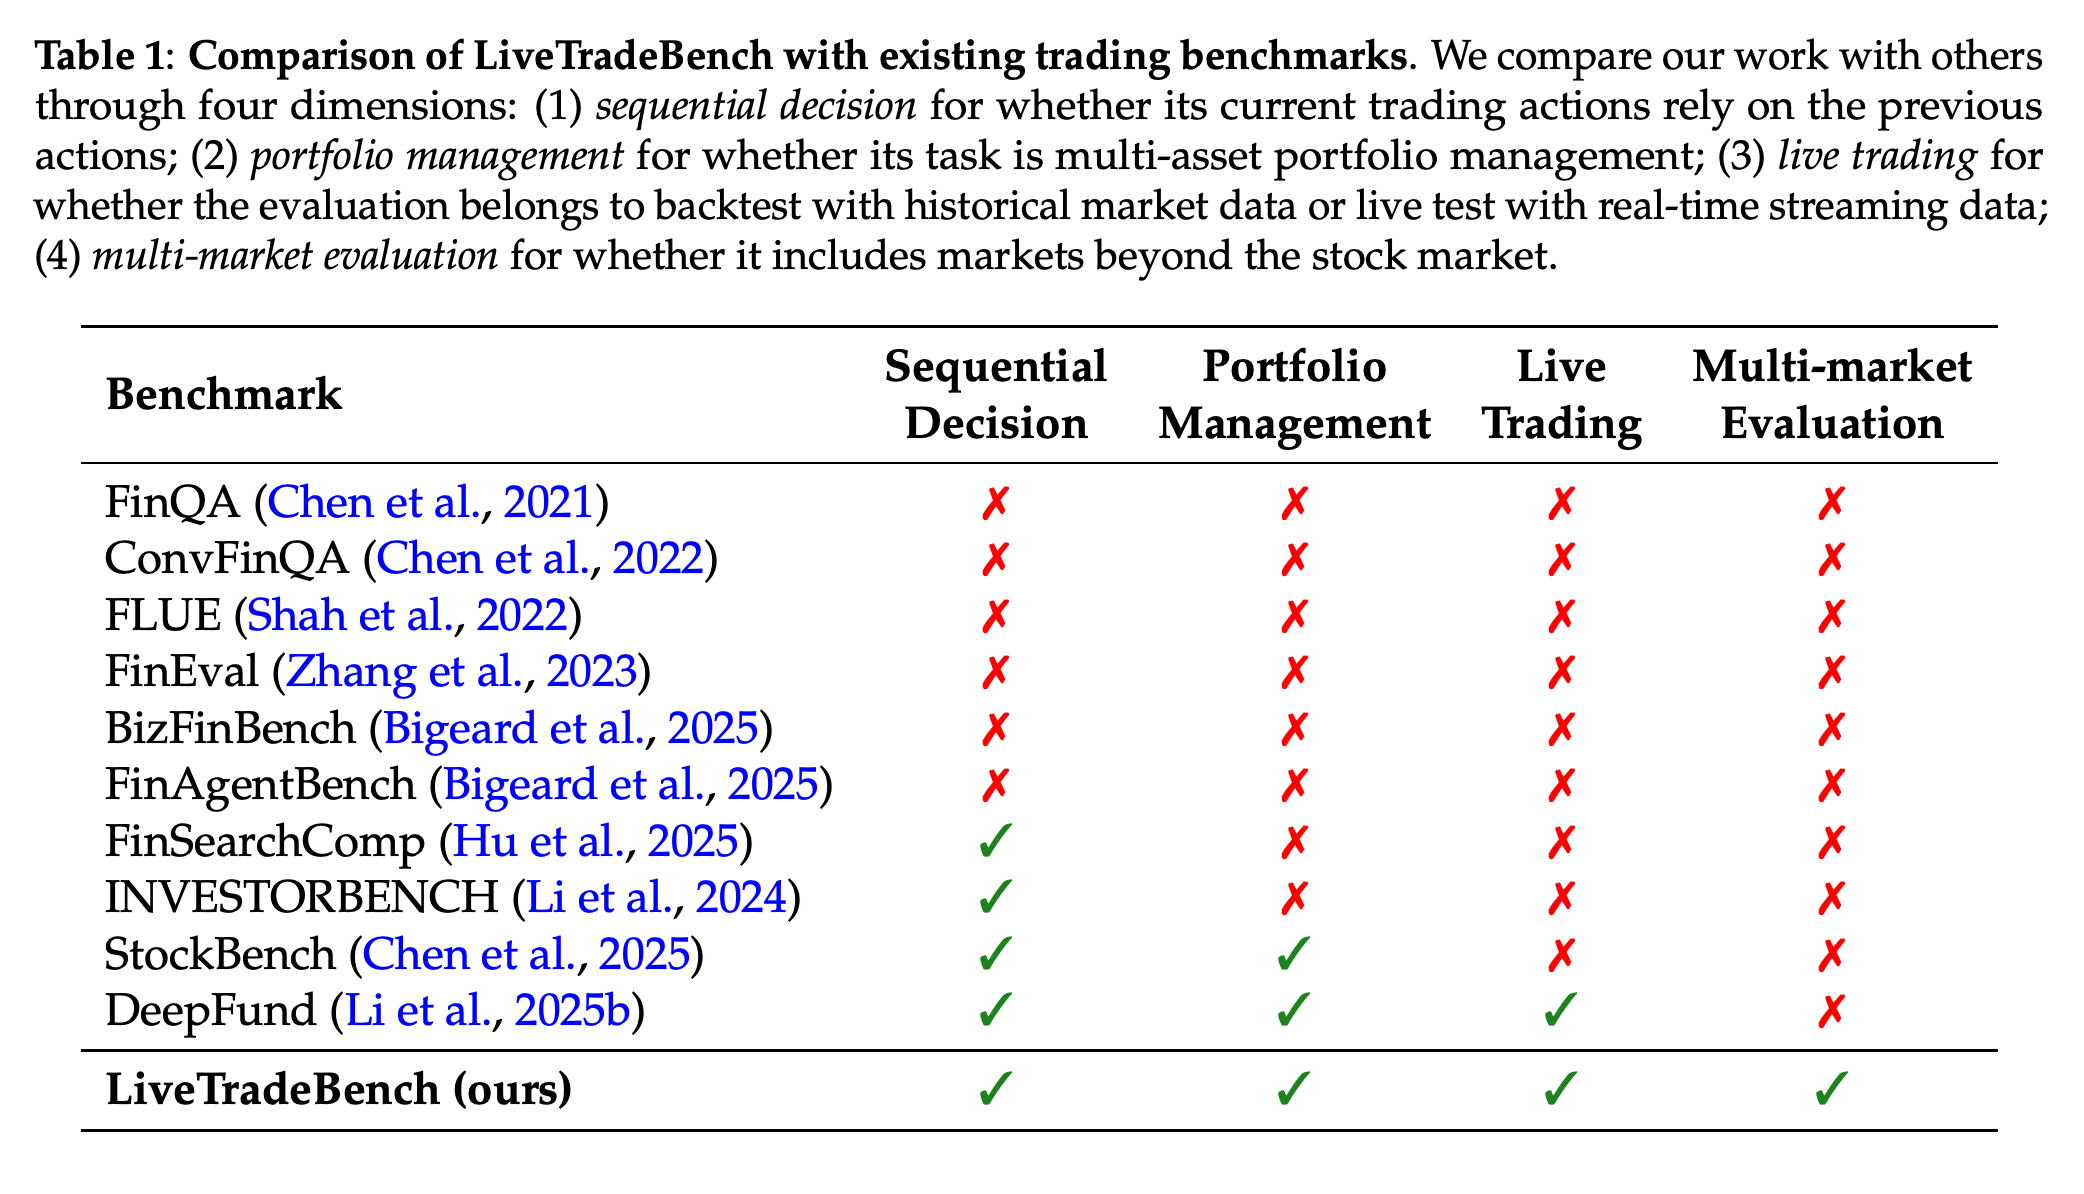
- Table 1은 순차적 의사결정, 포트폴리오 관리, 실시간 거래 데이터, 주식 이외 시장에서의 평가를 비교한다. 이 항목들은 거래 수익성이 아니라 벤치마크 설계를 설명한다.
LiveTradeBench는 제시된 설계 기준 4개를 모두 충족한다. DeepFund도 순차적 의사결정, 포트폴리오 관리, 실시간 거래를 이미 충족하므로, 이 비교에서는 여러 시장 유형에서의 평가가 LiveTradeBench의 차별점이다. 이 표는 수익률을 비교하지 않는다.
2. Related Work
관련 연구에서는 거래 평가를 과거 데이터에 대한 백테스팅, 합성 시장 시뮬레이션, 실시간 평가로 분류한다. 단일 자산에 대한 이산 행동, 예상 초과 수익 예측, 사건 확률 추정을 비교하고 포트폴리오 배분에 기반한 공통 행동 표현의 필요성을 설명한다.
- 백테스팅에는 정보 오염과 일반화 문제가 있다. 합성 시장은 행동 분석에 유용하지만 실제 시장의 변화 양상과 다를 수 있다.
- 자산에 배정한 자본 비율인 포트폴리오 가중치는 예측을 보유 자산으로 연결하면서 위험과 수익 사이의 상충 관계 및 자산 간 관계를 표현한다.
- 기존 프레임워크에는 행동에 대한 피드백으로 학습하는 강화학습과 여러 에이전트의 협업이 포함된다. 이 연구는 명시적 추론과 행동을 결합하는 공통 ReAct 프레임워크에 도구와 최근 관찰을 저장하는 기억을 함께 사용한다.
3. Building Live Trading Environment for Portfolio Management
환경은 외부에서 제공되는 시장 변화와 시뮬레이션된 포트폴리오 조정을 분리한다. 포트폴리오 과제를 정의하고 2개 시장을 선택한 뒤, 두 환경에서 공통으로 사용할 관찰과 배분 행동을 명시한다.
3.1. Definition of Portfolio Management
포트폴리오 관리는 실제 시장 상태를 완전히 관찰할 수 없는 순차적 의사결정 모델인 부분 관찰 마르코프 의사결정 과정(POMDP)으로 정식화한다. 관찰 \(\mathbf{o}_t=(\mathbf{q}_t,\mathbf{p}_t,c_t)\)는 보유 자산, 가격, 맥락 정보를 포함한다. 포트폴리오 가치는 v_t = q_t^T p_t이며, 행동은 합이 1인 목표 배분 가중치를 지정한다.
- Equation (2)는 다음 시점의 가격으로 기존 보유 자산의 가치를 계산하고 목표 가중치를 해당 가격으로 원소별 나눗셈하여 새로운 보유 수량으로 변환한다. 비용을 제외한 이 정식화에서는 리밸런싱이 포트폴리오 가치를 보존한다.
- 거래 벡터 \(\Delta\mathbf{q}_t=\mathbf{q}_{t+1}-\mathbf{q}_t\)에서 양의 변화는 BUY, 음의 변화는 SELL, 0인 변화는 HOLD에 대응한다.
- 저자들은 선택한 자산의 유동성이 충분하므로 개별 시뮬레이션 거래가 외부 가격에 미치는 영향은 미미하다고 가정한다. 세부적인 주문 체결은 모델 범위에서 제외한다.
3.2. Market Selection
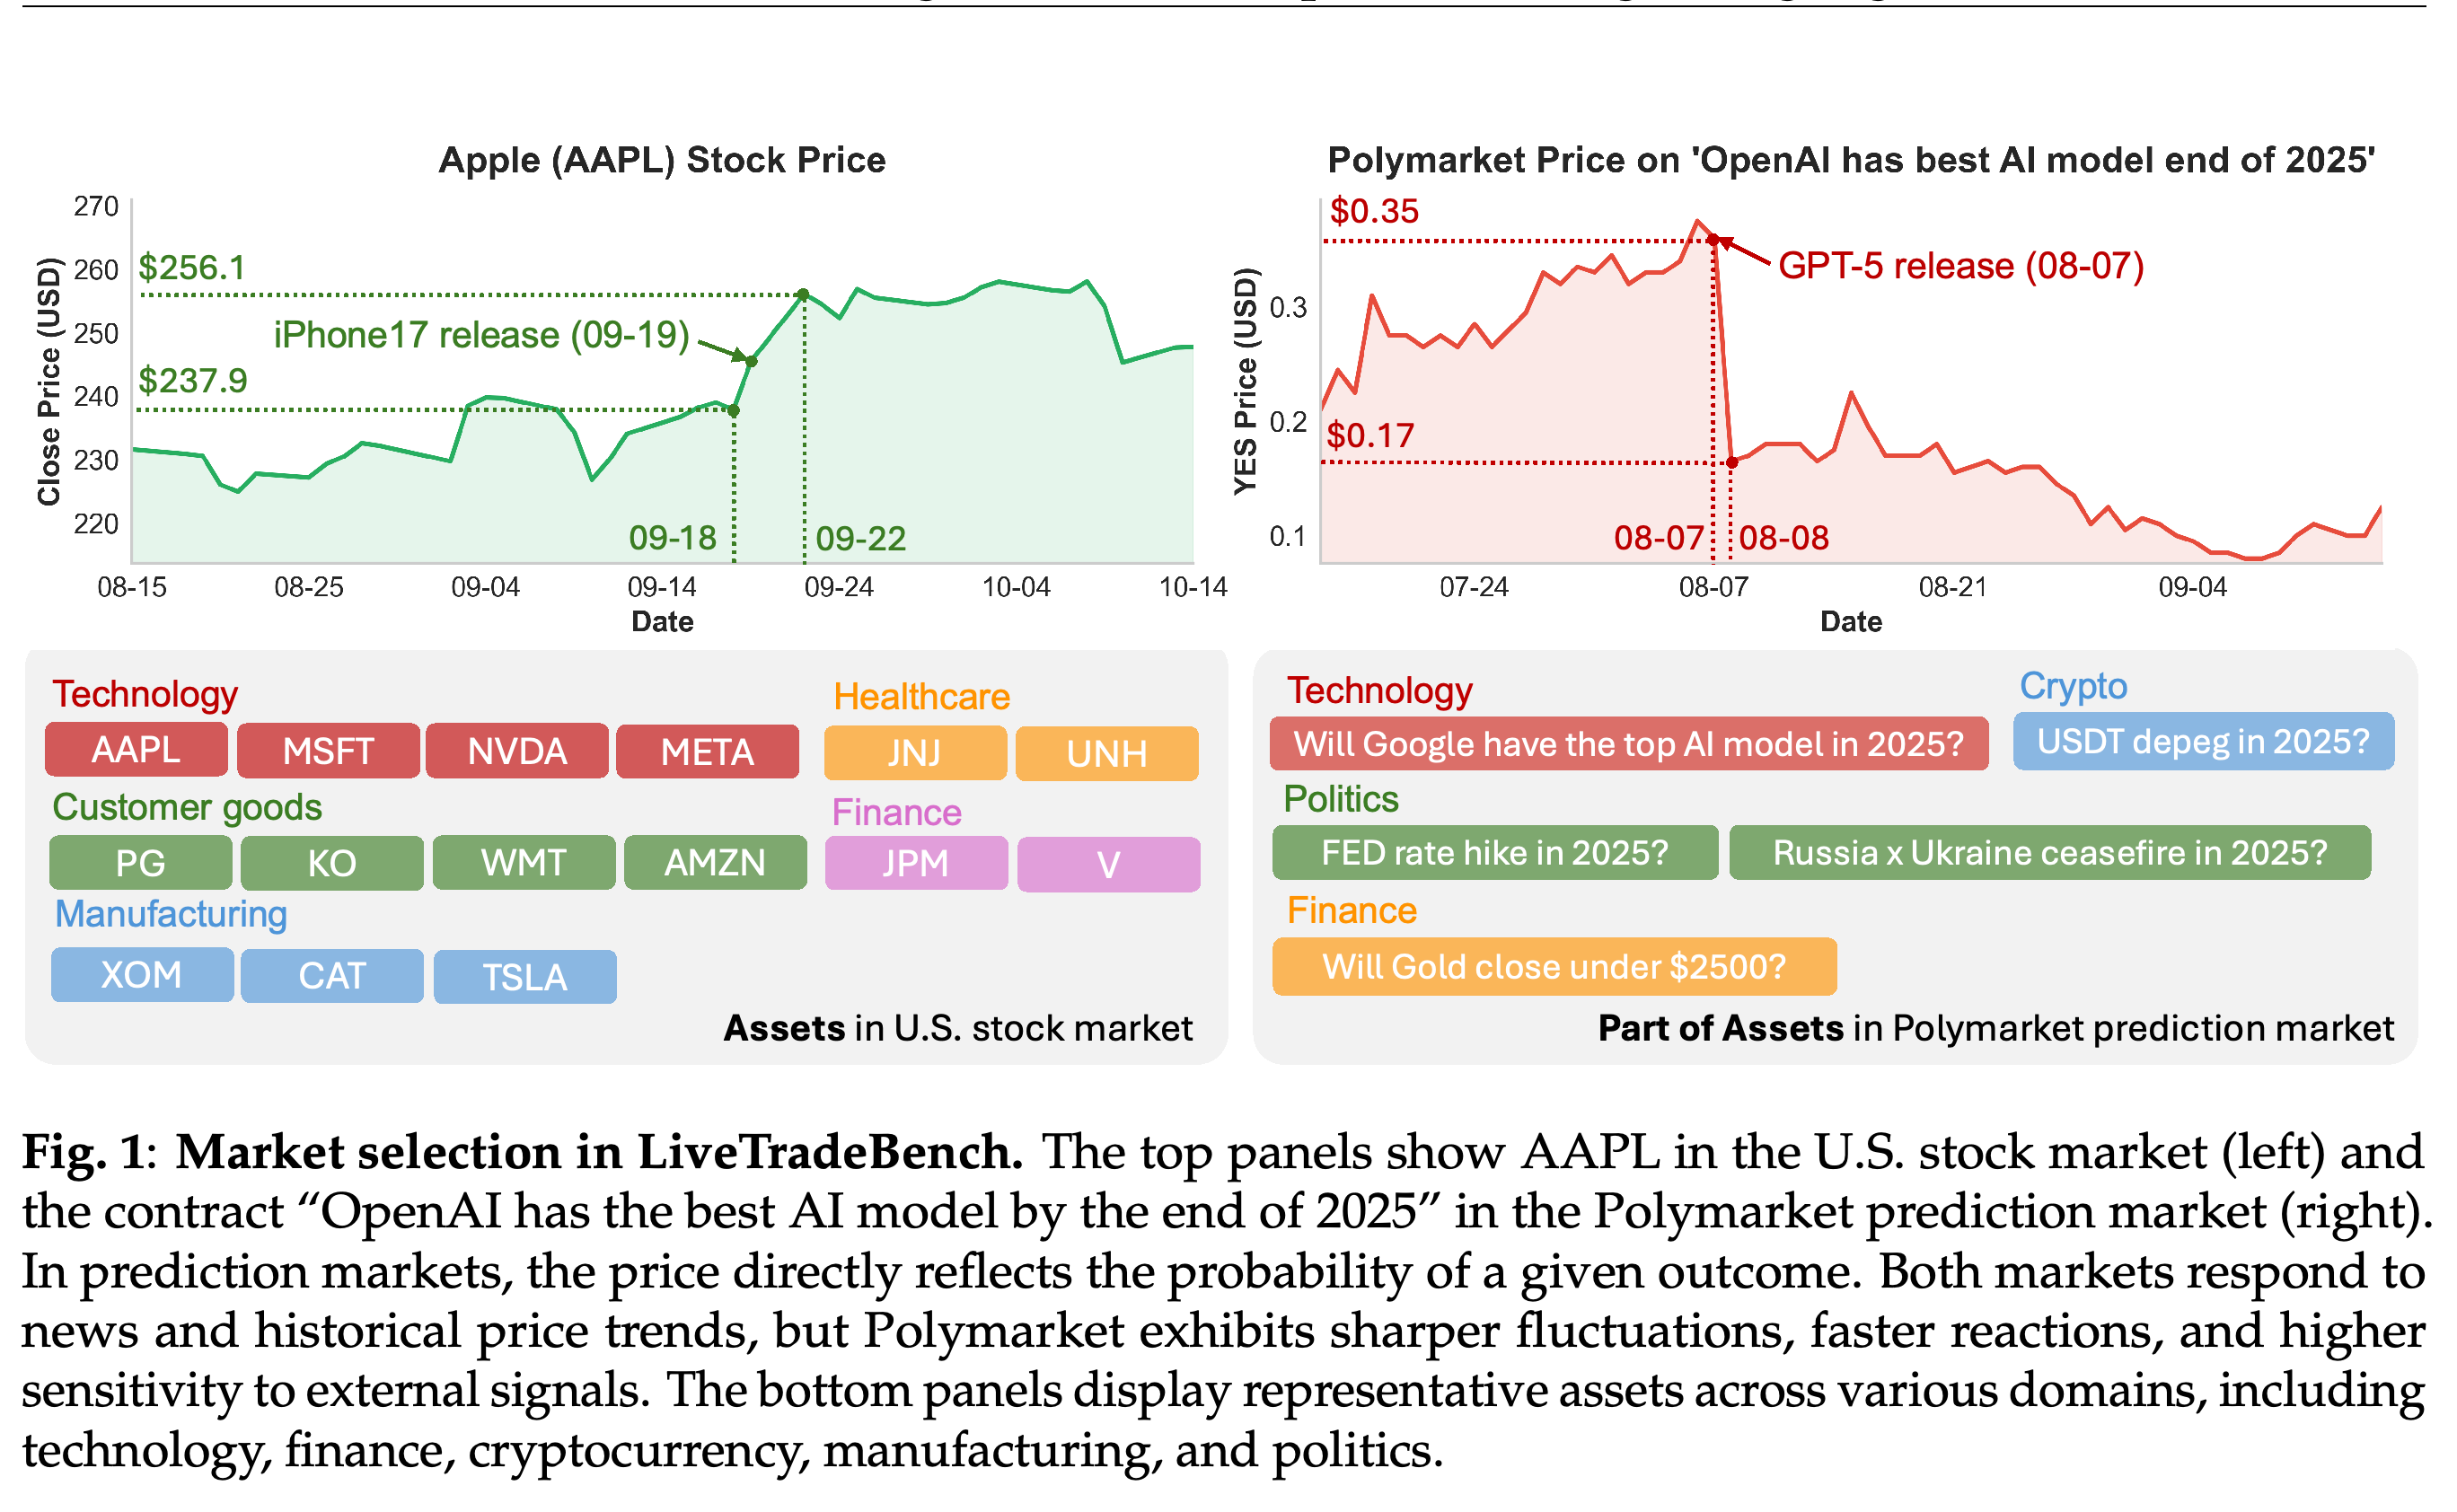
선택한 시장에서는 서로 다른 정보 흐름에서 자산 배분을 평가한다. 미국 주식은 업종 간 관계와 기업 및 거시경제 변화에 대한 노출을 제공하고 Polymarket 계약은 특정 사건에 관한 정보에 반응한다. 논문은 예측시장이 주식과 다른 반응 지연과 변화 폭을 보일 것이라는 가설을 제시한다. 이 가설은 비교의 근거이며 어느 시장에나 적용되는 보편적 특성을 입증한 것은 아니다.
- 주식 티커 15개는 AAPL, MSFT, NVDA, META, JPM, V, XOM, CAT, TSLA, PG, KO, AMZN, WMT, JNJ, UNH다. 현금의 단위 가격은 일정하며 수익률은 0이다.
- 활성 이진 Polymarket 시장 10개는 정치, 암호화폐, 기술, 금융을 다룬다. Federal Reserve의 금리 인상, Tether의 지급불능, 미국 경기 침체, 통화 연동 가치의 상실을 다루는 “USDT depeg in 2025?” 등이 포함된다.
- Figure 1은 iPhone17 출시 전후의 AAPL 가격과 GPT-5 출시 전후의 OpenAI 관련 예측 계약을 통해 두 시장을 비교한다.
예시는 AAPL 가격이 $237.9에서 $256.1로 변한 것을 iPhone17 출시와 연결하고 예측 계약 가격이 $0.35에서 $0.17로 변한 것을 GPT-5 출시와 연결한다. 선택한 시장에서 사건과 관련된 가격 패턴이 다름을 보여주지만 일반적인 인과 반응 규칙을 입증하지는 않는다.
3.3. Observation Space
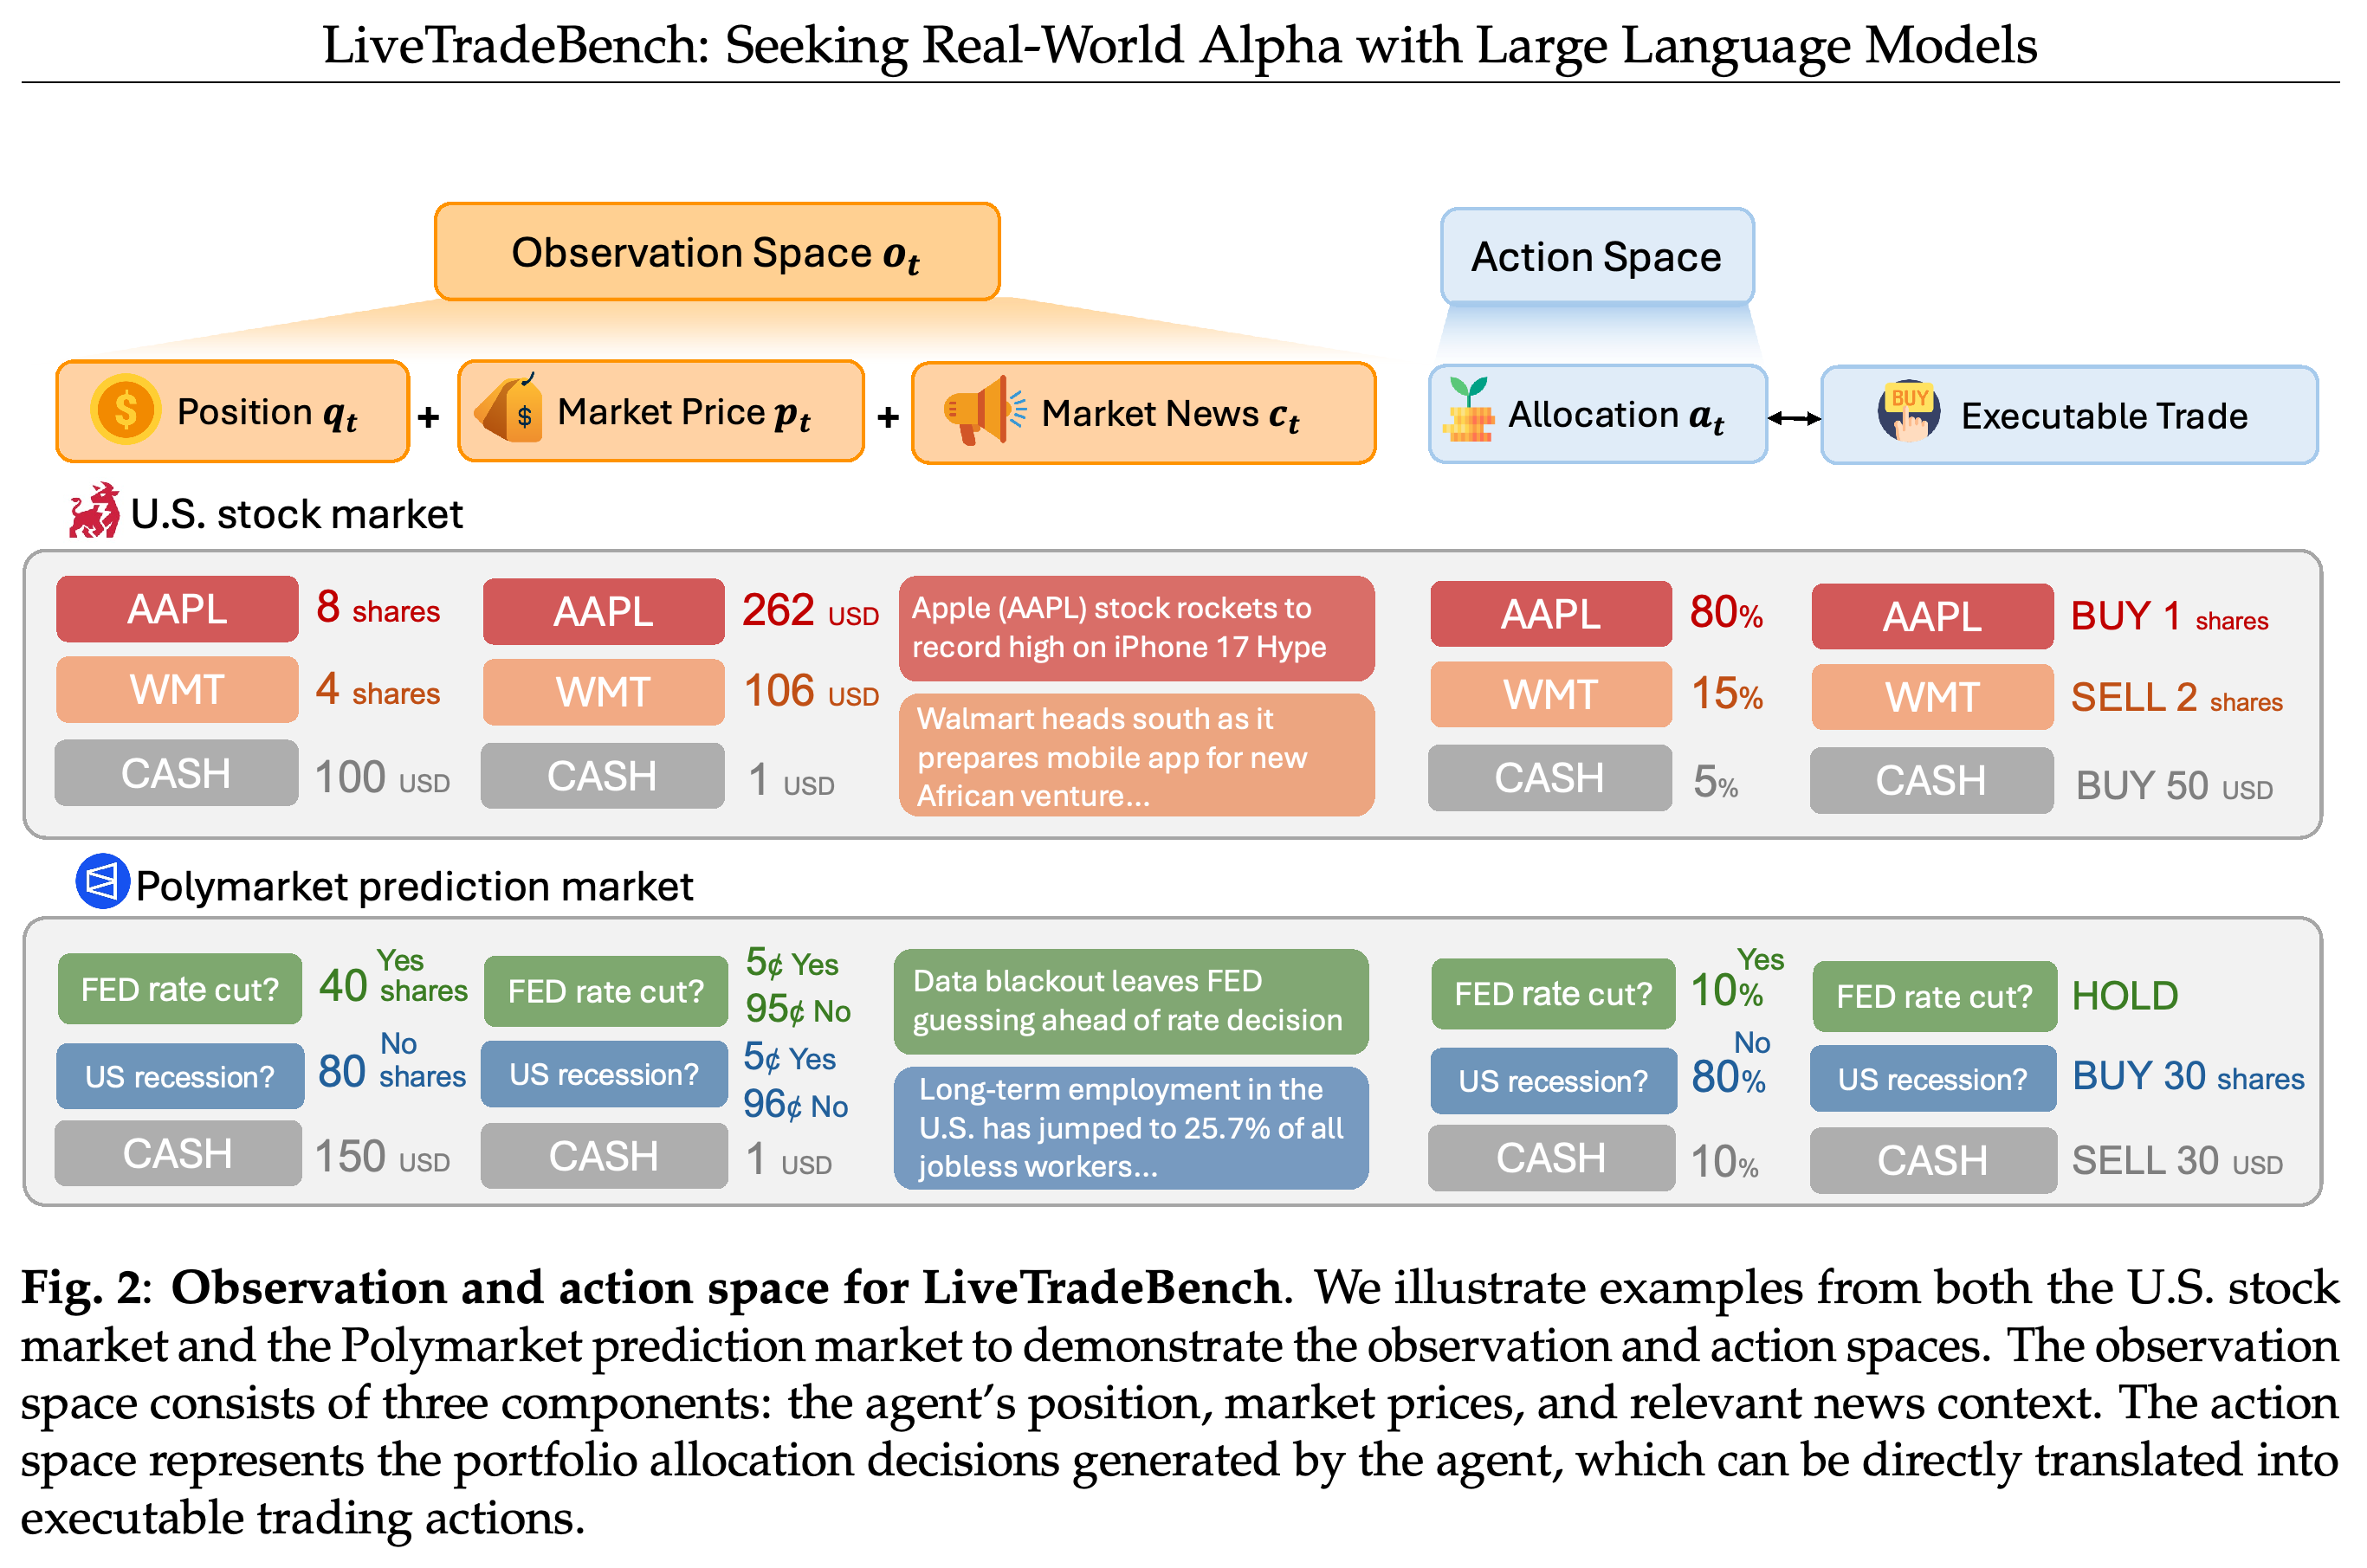
각 관찰은 현재 보유 자산, 타임스탬프가 있는 시장 가격, 텍스트 뉴스 맥락을 결합한다. 보유 수량은 연속값이며 음수가 될 수 없으므로, 기본 설정에서는 소수 단위의 보유를 허용하지만 자산 가격 하락에서 이익을 얻는 공매도 포지션은 제외한다.
- 주식 관찰에는 선택한 주식 15개의 종가가 포함되고 예측시장 관찰에는 Polymarket 시장 10개의 가격이 포함된다.
- Google News 검색에는 자산과 주제 키워드를 사용한다. 뉴스 요약을 프롬프트에 넣어 기업 관련 사건, 정책 기대, 기타 맥락 신호를 제공한다.
- Figure 2는 두 시장에서 이러한 입력이 배분 가중치와 이에 대응하는 매수, 매도, 보유 행동으로 이어지는 과정을 보여준다.
두 예시는 모두 보유 자산, 가격, 뉴스를 관찰로 사용하고 의사결정을 거래로 변환할 수 있는 포트폴리오 비율로 표현한다. 도식은 주식과 사건 결과에 공통으로 적용되는 인터페이스를 설명한다. 수치 예시는 평가된 모델 성과가 아니라 인터페이스를 보여준다.
3.4. Action Space
행동은 합이 1인 비음수 가중치의 집합인 확률 단체에 속한다. 즉, \(\sum_i a_t^{(i)}=1\)과 a_t^(i) ≥ 0을 만족한다. 주식 가중치는 각 주식에 배분한 자본을 지정하며 각 이진 예측시장에는 별도의 YES와 NO 결과 자산이 있다.
- 논문은 k개 예측시장에 대해 2k개의 결과 성분을 정의한다. 구현된 프롬프트는 CASH도 허용하며 각 질문에서 0이 아닌 결과 배분을 최대 1개만 허용한다.
- 사건에 대한 순노출은 e_t^(k) = a_{t,YES}^(k) − a_{t,NO}^(k)이며, 양의 노출은 YES를 선호함을 뜻한다.
- 이 표현은 주문 체결을 추상화하고 목표 자산 가중치에 맞추어 조정하는 포트폴리오 리밸런싱에 평가를 집중한다.
4. Designing LLM-based Agents for Portfolio Management
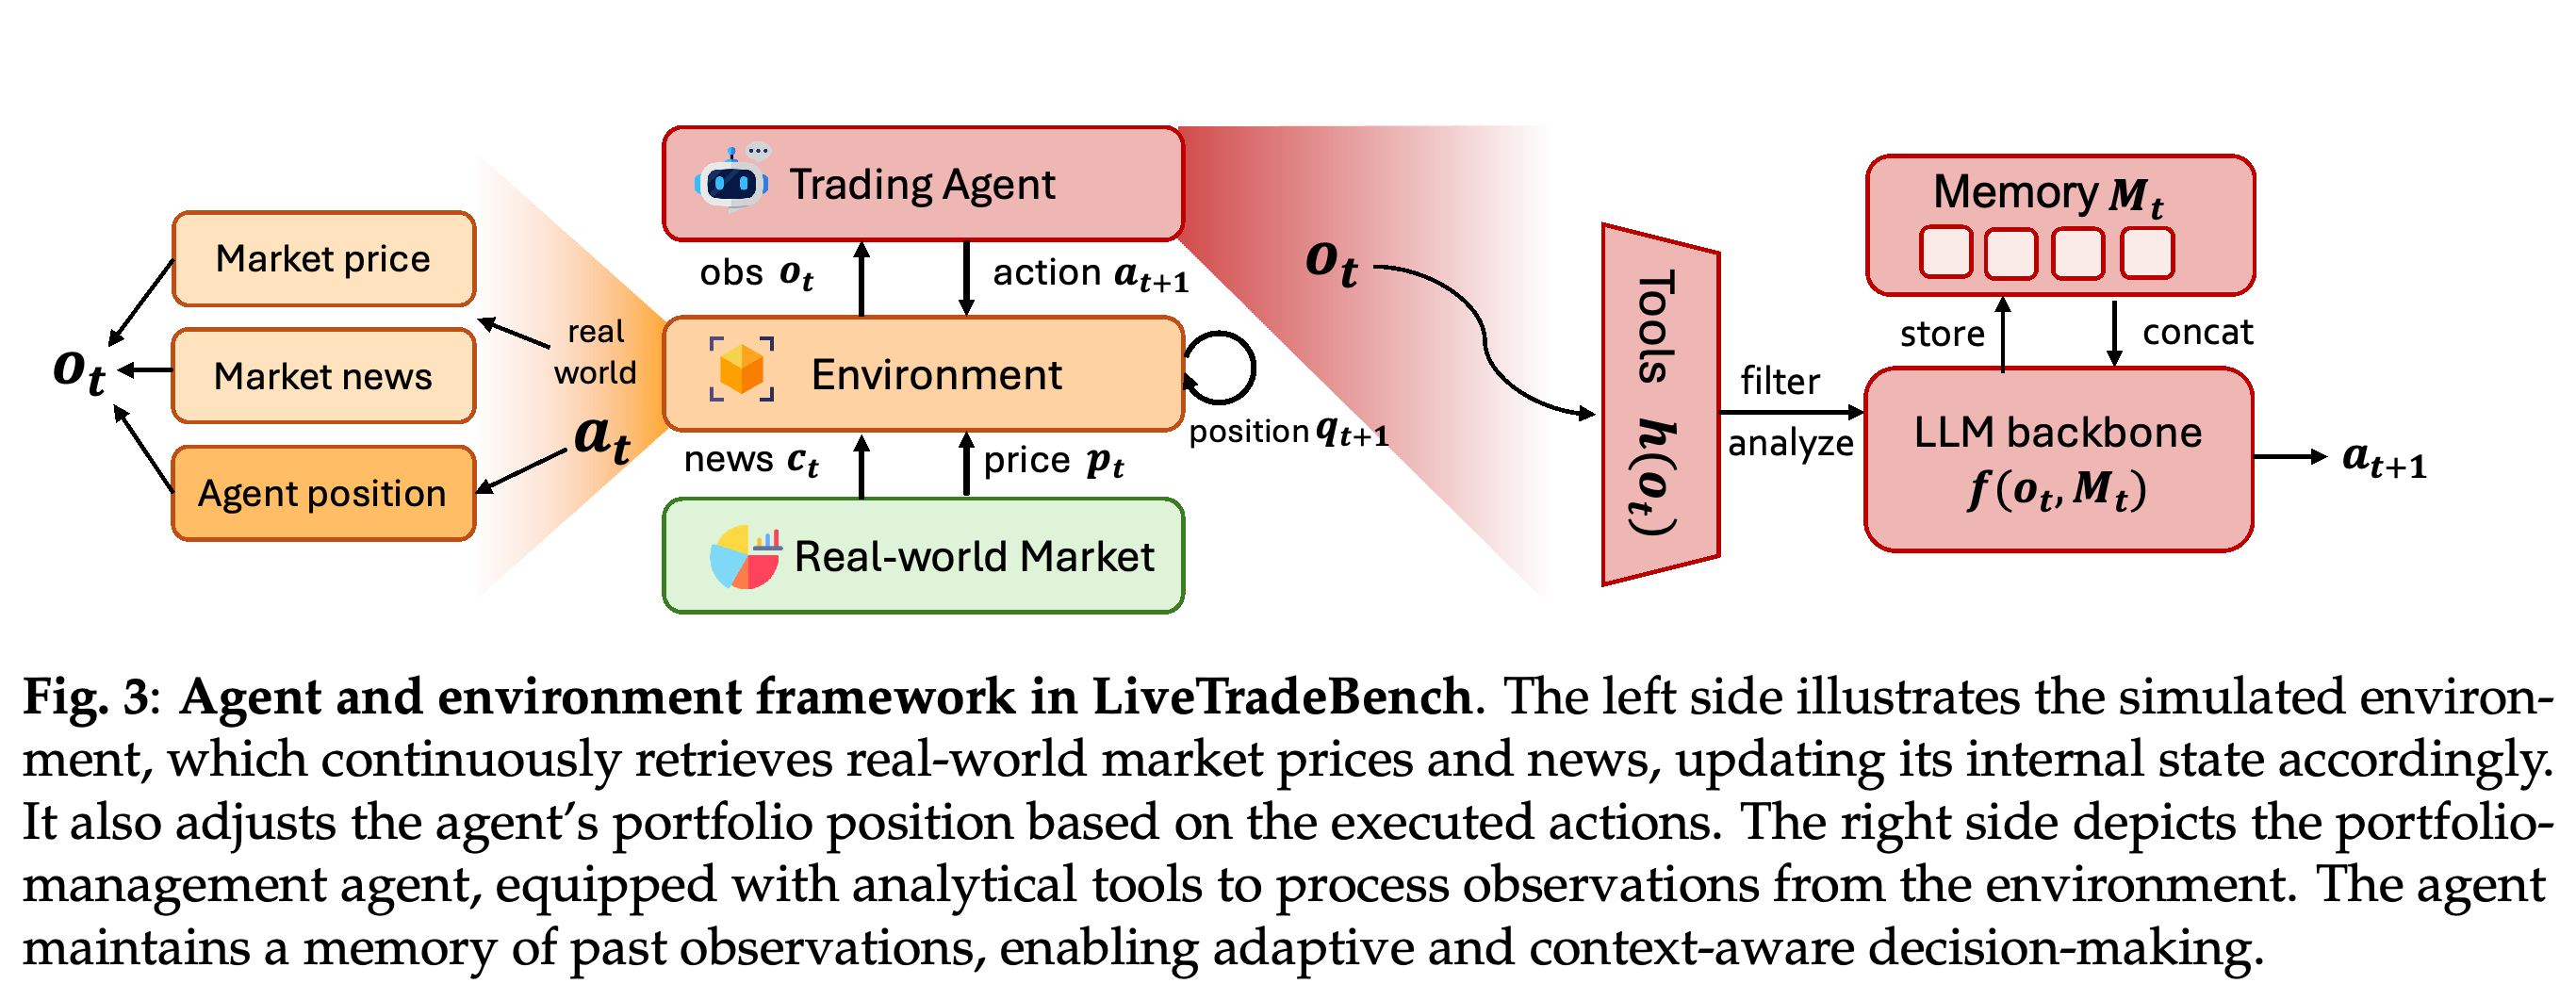
에이전트는 현재 관찰과 이전 관찰의 기억을 바탕으로 \(\mathbf{a}_t=f_{\theta}(\mathbf{o}_t,\mathbf{M}_t)\)를 통해 배분을 생성한다. 구성 요소는 정보를 수집하고 처리하는 도구, 최근의 시간적 맥락을 보존하는 기억, 배분을 반환하기 전에 수행하는 명시적 추론의 3가지다.
- 도구는 원시 관찰을 구조화된 정량 특성과 관련 텍스트 정보로 변환하며 이를 õ_t = h(o_t)로 표현한다.
- 기억은 M_t = {o_τ | t − Δ ≤ τ < t}이며, Δ는 보존하는 이력의 범위다. 과거 관찰을 이어 붙여 가격, 배분, 포트폴리오 결과에 관한 맥락을 제공한다.
- ReAct 방식의 프레임워크는 행동과 함께 검토할 수 있는 설명을 생성한다. 이 연구는 의사결정을 생성하는 기반 LLM인 기존 모델 backbone을 평가하며 새로운 학습 알고리즘을 제안하지 않는다.
실제 시장의 가격과 뉴스가 포트폴리오 포지션을 갱신하는 시뮬레이션 환경에 들어간다. 에이전트는 도구와 보존한 이력으로 관찰을 처리한 뒤 배분을 생성한다. 도식은 벤치마크에서 실시간 외부 데이터와 시뮬레이션된 포트폴리오 체결이 함께 사용되는 방식을 보여준다.
5. Evaluating LLM-based Agents under Live Test
실시간 평가는 2025년 8월 18일부터 2025년 10월 24일까지 수행했으며 논문은 이를 50거래일로 보고한다. 서로 다른 LLM backbone 21개를 평가했다. 분석에서는 금융 성과, 전반적인 모델 점수와의 관계, 의사결정 지연에 대한 민감도, 배분 설명에서 언급한 정보를 비교한다.
5.1. Backbone LLMs for Evaluation
모든 모델은 같은 에이전트 프레임워크로 관찰을 프롬프트로 변환하고 출력을 포트폴리오 가중치로 파싱한다. 평가 대상은 Claude, Grok, Qwen, Llama, GPT, Gemini, Kimi, DeepSeek 계열이며 모델 크기와 추론 방식이 서로 다르다.
- Table 2에는 Claude 모델 4개, Grok 모델 2개, Qwen 모델 3개, Llama 모델 3개, GPT 모델 4개, Gemini 모델 2개, Kimi-K2-Instruct, DeepSeek-V3.1, DeepSeek-R1이 포함된다.
- 공통 프레임워크는 프롬프트 형식과 실행 방식의 차이를 줄인다. 다만 성과 차이의 유일한 원인이 모델 자체의 추론 능력임을 분리하여 확인하지는 않는다.
- Section 5.1은 처음에 대표적인 계열이 6개라고 서술하지만 Table S1에는 계열 또는 제공업체 행이 8개 있다. 구체적인 21개 모델 목록이 평가 대상을 더 정확히 설명한다.
5.2. Trading Metrics for Evaluation
평가는 지표 5개를 보고한다. 누적 수익률(CR)은 전체 수익을 측정한다. Sharpe ratio(SR)는 무위험 비교 수익률을 초과한 평균 수익률을 수익률 변동성으로 나눈 값이다. Maximum drawdown(MDD)은 이전 포트폴리오 최고점 대비 최대 하락 폭이다. Win rate(WR)는 수익을 낸 단계의 비율이며 volatility는 수익률의 변동 정도다. CR, SR, WR은 높을수록 좋고, MDD와 volatility는 낮을수록 좋다.
- 정의에는 \(CR=\frac{v_T-v_0}{v_0}\)와 \(SR=\frac{\bar r-r_f}{\sigma}\)가 포함된다. 여기서 r_f는 무위험 수익률이고 σ는 수익률 변동성이다.
- 주식의 무위험 비교 기준은 단기 Treasury 수익률이다. Polymarket에서는 안정적인 통화 가치를 유지하도록 설계된 토큰으로 표시된 자산에 이자가 발생하지 않는다고 가정하므로 비교 수익률은 0이다.
- 도입 문단은 지표 4개를 언급하지만 상세 정의와 Table 2에는 WR도 포함된다. 제공된 정의만으로는 보고된 SR과 volatility 값에 적용한 척도나 연율화 방식을 완전히 알 수 없다.
5.3. Evaluation Results
Table 2는 시장에 따라 최상위 모델이 달라짐을 보여준다. 주식에서는 GPT-4.1이 CR 6.25%, SR 2.64로 가장 높고, Polymarket에서는 Claude-Sonnet-3.7이 CR 20.54%, SR 2.38로 가장 높다. 논문은 2개 시장의 Sharpe ratio 사이의 상관관계가 0에 가깝다고 보고한다. LMArena 점수와 누적 수익률 사이의 Spearman 상관계수는 주식에서 0.054, Polymarket에서 −0.38이다.
- GPT-4.1의 Polymarket 수익률은 −33.69%다. GPT-o3의 수익률은 주식에서 6.04%, Polymarket에서 −54.84%다. Grok-4와 Qwen2.5-72B-Instruct는 두 시장 모두에서 양의 누적 수익률을 기록한다.
- Qwen2.5-72B-Instruct는 Polymarket에서 MDD 7.46%, WR 59.18%, 보고된 volatility 30.36을 기록한다. 소폭의 양의 수익률을 내면서 예측시장 표에 제시된 모델 중 drawdown과 volatility가 가장 낮다.
- 저자들은 모델별 자산 및 현금 선호 차이를 설명한다. GPT-4o는 AAPL, MSFT, NVDA에 집중하고 GPT-5는 더 폭넓게 분산한다. Llama4-Scout는 현금 비중을 20%보다 높게 유지하고 GPT-5는 위험이 극도로 높은 상황을 제외하면 10%보다 낮게 유지한다.
- 추론 모델에 관한 논의에는 단서가 필요하다. DeepSeek-R1과 Qwen3-235B-A22B-Thinking의 Polymarket volatility는 각각 143.25와 166.92지만, GPT-o3는 97.27이다. volatility가 140을 넘는다는 본문 주장은 언급한 모델 3개 모두에 적용되지 않으며 GPT-o3의 주식 수익률은 2번째로 높다.
- Figure 4는 LMArena 점수와 SR의 관계를 그리지만 본문의 Spearman 상관계수는 누적 수익률에 관한 값이다. 그래프와 계수는 서로 다른 성과 지표를 설명한다.
주식에서는 GPT-4.1이 누적 수익률 6.25%, Sharpe ratio 2.64로 가장 높고, Polymarket에서는 Claude-Sonnet-3.7이 20.54%와 2.38로 가장 높다. GPT-4.1의 Polymarket 수익률 −33.69%는 시장 간 순위 변화를 보여준다. Qwen2.5-72B-Instruct는 Polymarket에서 양의 수익률을 내면서 표에 제시된 drawdown과 volatility가 가장 낮다.
산점도는 LMArena 점수가 비슷한 모델 사이에서도 Sharpe ratio가 크게 다름을 보여주며, 적합한 직선은 약한 하향 기울기를 보인다. 이 표본에서는 단순한 양의 관계가 보이지 않는다. 다만 그래프는 본문의 Spearman 계수에 사용한 누적 수익률이 아니라 Sharpe ratio를 나타낸다.
5.4. Analysis and Discussion
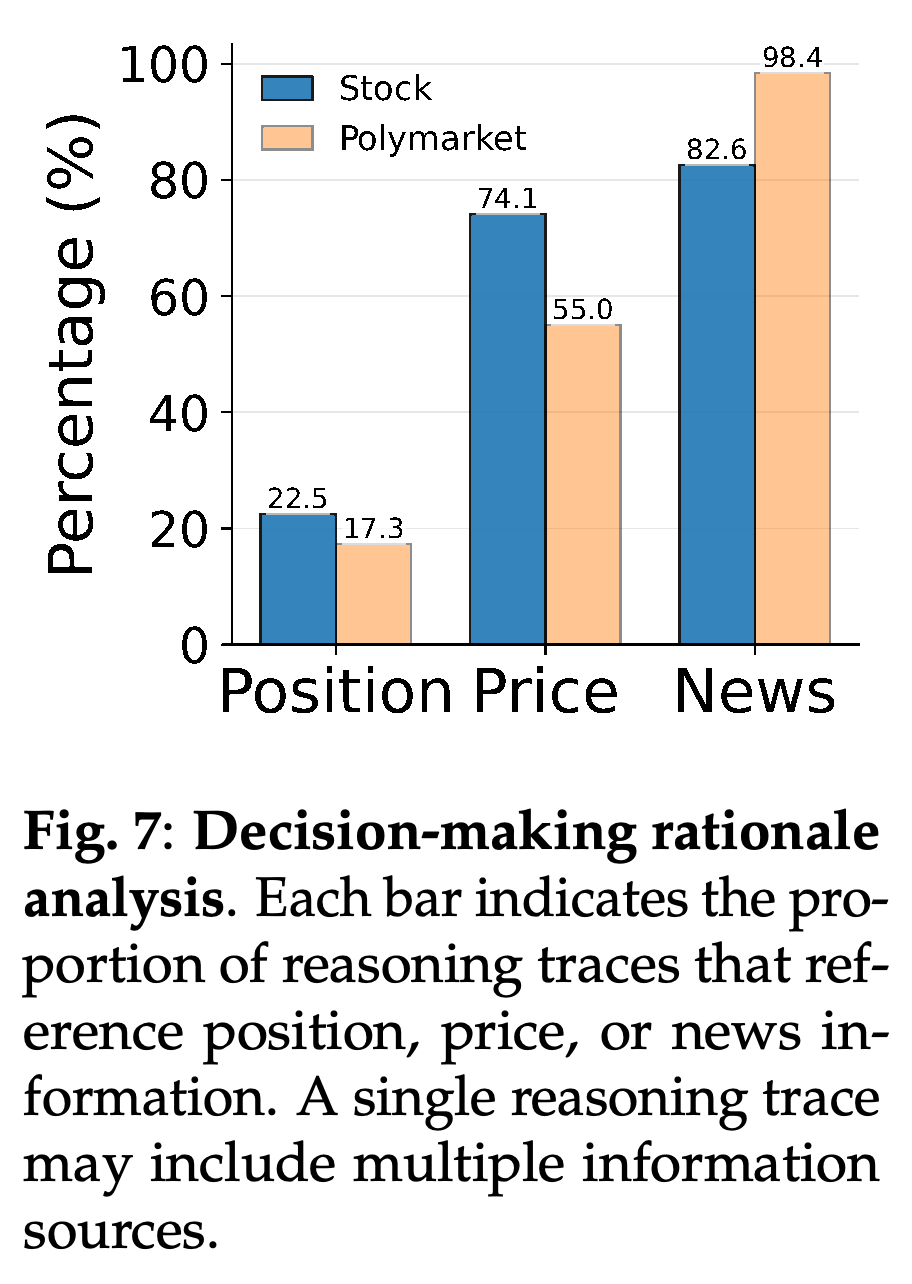
Rolling-k delta 분석은 보유 자산을 k일 전의 보유 자산으로 대체했을 때 누적 수익률이 얼마나 변하는지 측정한다. \(\Delta_k=CR^{(k)}-CR^{(0)}\)이며, \(k\in\{1,2,4,8,16\}\)이다. 별도의 분석에서는 다른 LLM을 사용해 일별 설명이 포트폴리오 포지션, 가격 이력, 뉴스를 언급하는지 표시한다.
- 주식에서 평가한 지연 간격별 평균 수익률 차이는 0, 0.03%, 0.01%, −0.16%, −0.20%다. Polymarket에서는 0, −0.69%, −1.74%, −2.10%, −1.94%이며, 이 시장이 오래된 보유 자산에 더 민감함을 보여준다.
- 보유 자산을 지연시킨 결과는 지연이 길 때 적시 갱신이 유리함을 뒷받침한다. 다만 명시적인 무작위 배분 비교나 유의성 검정을 보고하지 않으므로, 에이전트가 무작위로 행동하지 않는다는 저자들의 주장보다 제한적인 근거를 제공한다.
- 주식 설명에서는 포지션을 22.5%, 가격을 74.1%, 뉴스를 82.6%의 추론 기록에서 언급한다. Polymarket 설명에서는 각각 17.3%, 55.0%, 98.4%다. 하나의 추론 기록에서 여러 정보원을 언급할 수 있다.
- 이 주석은 각 입력에 대한 인과적 의존성이 아니라 설명에 명시한 근거를 측정한다. 논문은 주석을 부여한 모델에 대한 사람의 검증을 보고하지 않는다.
주식의 평균 수익률 차이는 짧은 지연에서 0에 가깝게 유지되며, k = 2에서는 +0.03%다. 이후 k = 16에서는 −0.20%로 낮아진다. 모델별 곡선은 영향이 서로 다름을 보여준다. 음영으로 표시한 25–75% 범위만으로는 평균에 대한 통상적인 신뢰구간이라고 볼 수 없다.
Polymarket의 평균 차이는 처음 표시한 간격 이후 −0.69%, −1.74%, −2.10%, −1.94%로 낮아진다. 주식보다 큰 손실은 이번 평가에서 오래된 보유 자산에 대한 민감도가 더 높음을 보여준다. 다만 곡선이 모든 간격에서 감소하지는 않는다.
뉴스는 주식 설명의 82.6%, Polymarket 설명의 98.4%에 등장한다. 가격 언급은 주식에서 74.1%, Polymarket에서 55.0%로 주식에서 더 흔하다. 하나의 추론 기록에 여러 라벨을 부여할 수 있으며 이 빈도는 입력의 인과적 중요도가 아니라 설명 내용을 측정한다.
6. Case Study
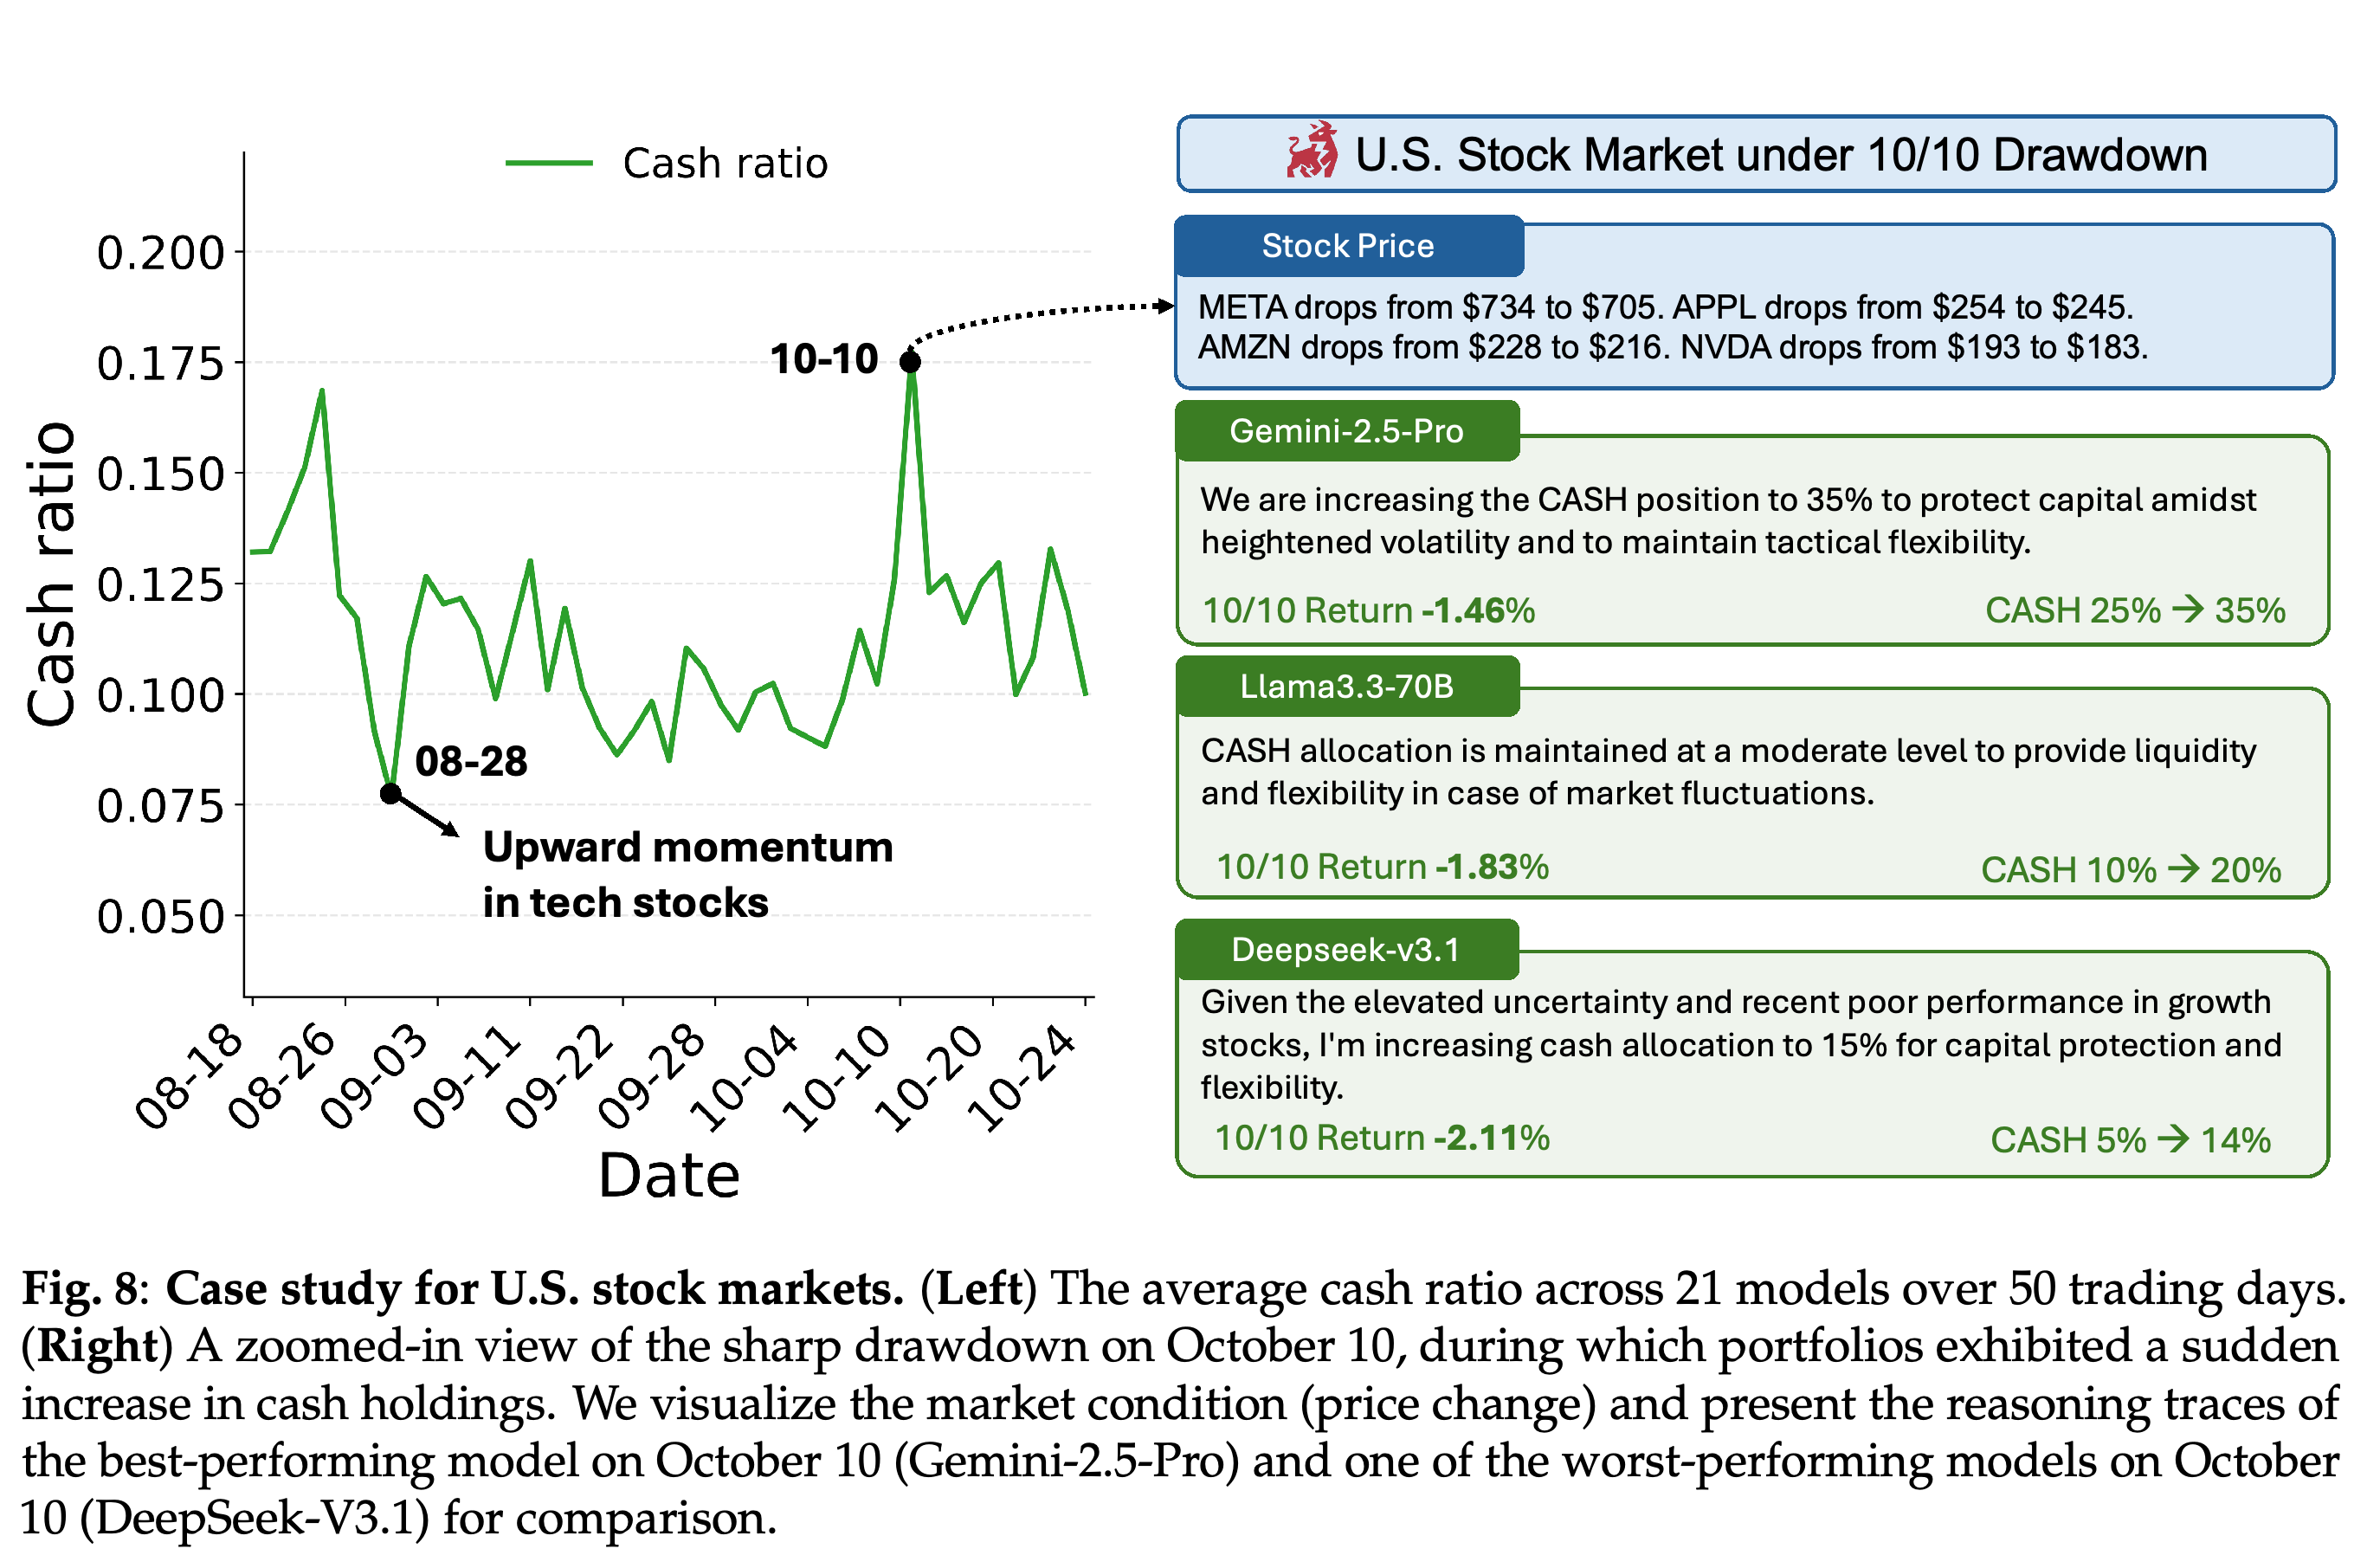
사례 연구는 주식시장의 현금 배분과 Russia–Ukraine 휴전 예측 계약에서 선택한 극단적인 상황을 살펴본다. 보유 자산의 변화를 당시 시장 상황 및 생성된 설명과 연결하여 배분 행동에 관한 정성적 근거를 제공한다.
6.1. Cash Asset Dynamics in the U.S. Stock Market
8월 28일 전후의 기술주 상승기에 21개 모델의 평균 현금 비중은 4거래일 안에 17%에서 7.5%로 낮아졌다. 10월 10일 하락장에서는 모든 에이전트가 당일 손실을 냈고, 대부분 현금 보유를 늘렸다. 이는 설명에 명시한 방어적 판단과 일치한다.
- 논문은 10월 10일 Tesla가 5% 넘게 하락하고 Amazon과 NVIDIA가 4% 넘게 하락했다고 보고한다.
- Figure 8은 Gemini-2.5-Pro의 일별 수익률 −1.46%와 현금 비중 25%에서 35%로의 증가, Llama3.3-70B의 −1.83%와 현금 비중 10%에서 20%로의 증가, DeepSeek-V3.1의 −2.11%와 현금 비중 5%에서 14%로의 증가를 비교한다.
- 논문에 따르면 Gemini-2.5-Pro의 당일 손실이 가장 작았다. 이 사례는 현금 노출과 손실의 관계를 보여주지만 해당 모델의 위험 관리가 전반적으로 우월함을 입증하지는 않는다.
평균 현금 보유는 8월 28일 기술주 상승기 전후에 줄고, 10월 10일 전후에 급증한다. 선택한 10월 10일 사례에서는 높은 현금 비중과 작은 손실이 함께 나타난다. Gemini-2.5-Pro의 손실은 1.46%이며, Llama3.3-70B는 1.83%, DeepSeek-V3.1은 2.11%다. 이 비교는 현금의 효과를 다른 포트폴리오 차이와 분리하지 않는다.
6.2. Russia–Ukraine Ceasefire Market in Polymarket Prediction Market
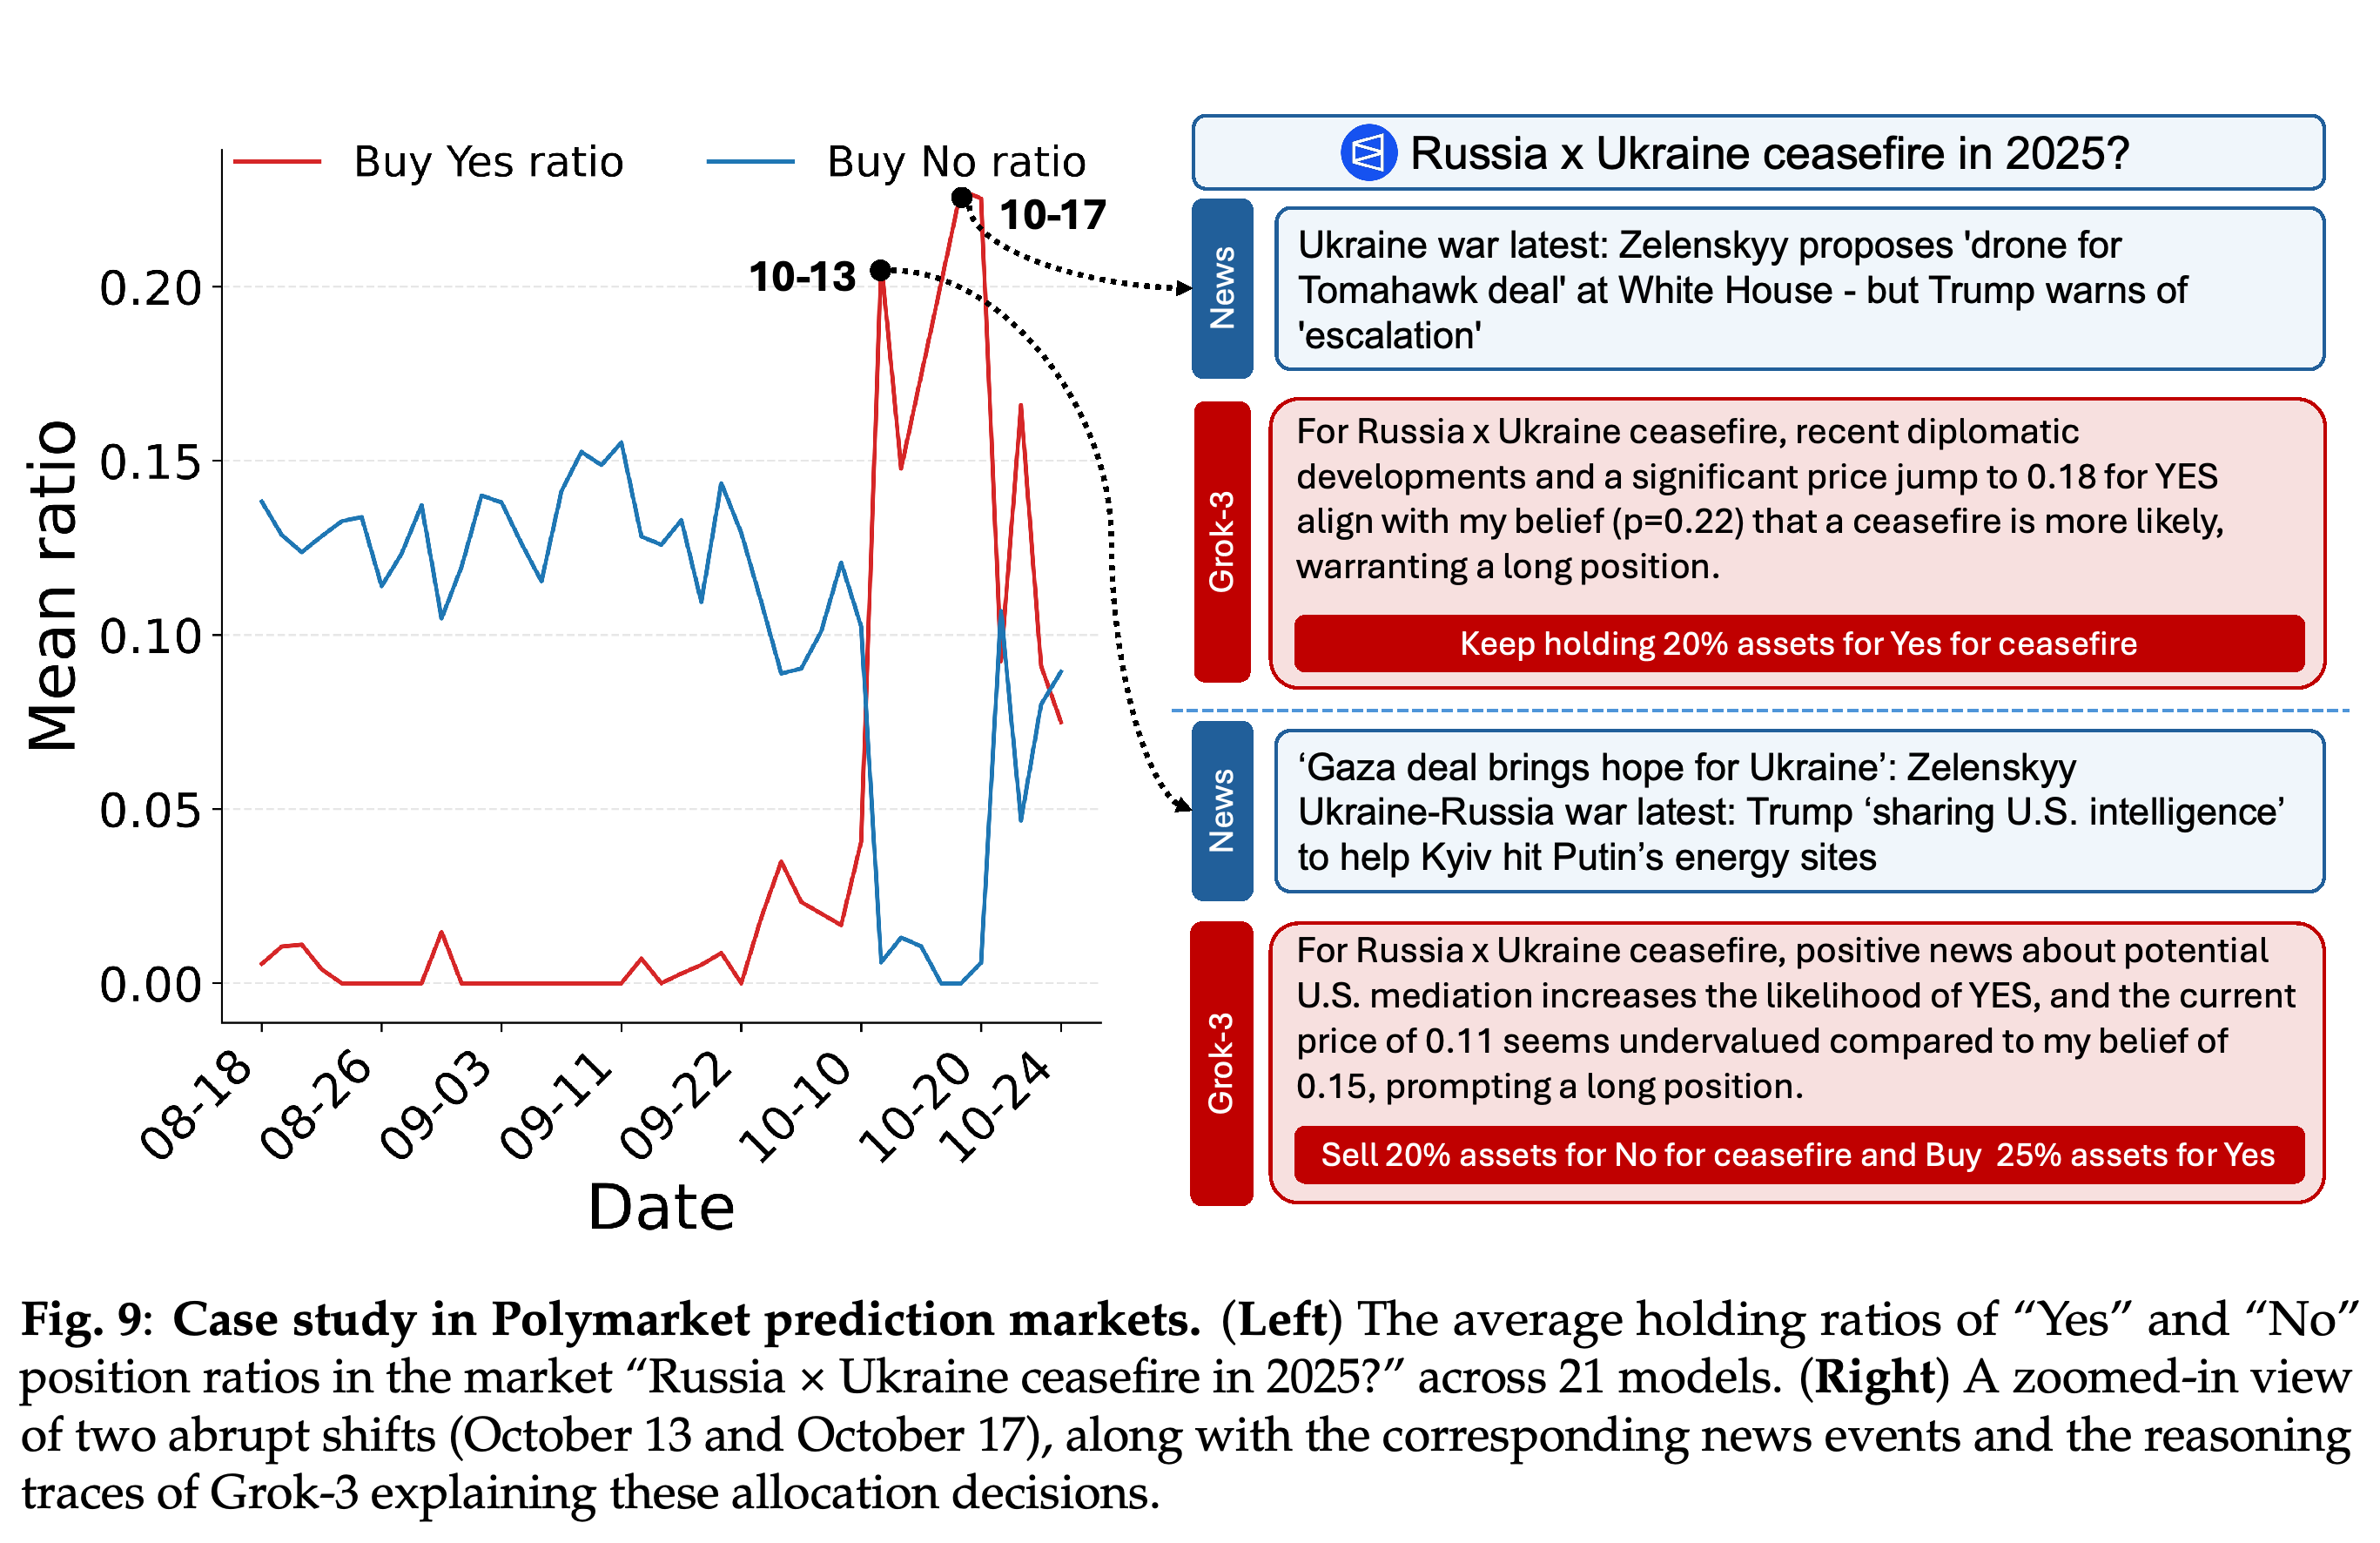
“Russia × Ukraine ceasefire in 2025?” 시장에서 에이전트는 10월 13일 낙관적인 뉴스 이후 NO에서 YES 쪽으로 배분을 전환했다. 그러나 논문은 가격 변화가 작았으며 이 반응으로 수익을 얻지 못했다고 보고한다. 10월 17일에는 Zelenskyy의 White House 방문 소식을 전후해 YES 포지션을 늘리고 유지했으며 이후 10월 18일까지 가격이 상승하면서 수익을 냈다고 보고한다.
- Grok-3가 설명에 제시한 사건 확률은 10월 13일 0.15에서 10월 17일 0.22로 높아졌다. 설명에서는 이 추정치를 각 날짜의 YES 가격인 0.11과 0.18에 비교한다.
- Figure 9는 전체 21개 모델의 평균 YES 및 NO 보유 비율과 2개 날짜에 대한 Grok-3의 설명을 함께 보여준다.
- 저자들은 첫 사례를 결정적 근거가 부족한 뉴스에 대한 과잉 반응으로, 다음 사례를 근거가 더 충분한 보유 결정으로 해석한다. 이러한 해석은 뉴스 사건의 인과 효과를 통제하여 검증한 결과가 아니라 선택한 사례에 기반한다.
평균 보유 곡선은 휴전 시장에서 10월 13일과 10월 17일 YES로 급격히 이동하는 모습을 보여준다. 함께 제시한 Grok-3의 설명은 사건 확률 0.15와 0.22를 시장 가격 0.11과 0.18에 비교한다. 이는 선택한 사례에서 설명에 명시한 믿음이 배분과 연결되는 방식을 보여준다.
7. Conclusion
결론은 LiveTradeBench를 실시간 불확실성 아래에서 지각, 추론, 적응을 연구하는 환경으로 제시한다. 실험에서는 시장 간 모델 순위의 전이성이 낮고, 전반적인 모델 점수와 거래 성과 사이의 연관성이 약했다. 또한 가격, 뉴스, 포트폴리오 이력과 연관된 배분 행동이 모델마다 달랐다.
Limitation and Future Work
저자들은 거래 비용과 시장 마찰의 누락, 제한된 관찰 및 행동 공간, 단순한 에이전트 구조라는 3가지 한계를 제시한다. 이러한 한계는 보고된 수익률의 현실성과 평가한 금융 의사결정의 범위를 제한한다.
- 거래 수수료, spread, 유동성 제약을 제외하므로 자주 리밸런싱하는 포트폴리오에서 달성 가능한 수익률을 과대평가할 수 있다. 제안한 확장에는 비용 모델과 가정한 체결 가격 및 실제 체결 가격의 차이인 slippage가 포함된다.
- 에이전트는 제한된 이력과 소수의 시장만 관찰하며 뉴스 입력은 제목과 초록으로 제한된다. 더 긴 이력, 더 완전한 텍스트 맥락, 추가 시장을 확장 방향으로 제안한다.
- 기본 ReAct 설정은 추론 깊이와 더 긴 기간에 걸쳐 의사결정을 구성하는 시간적 추상화 능력이 제한적이다. 전문 도구, 계층적 기억, 에이전트 간 협업, 강화학습은 평가로 확인한 개선점이 아니라 향후 방향으로 제안한다.
Open-source Application
공개한 Python 패키지 live-trade-bench는 데이터 수집, 환경 설정, 에이전트 구성 인터페이스를 제공하며 웹 애플리케이션은 실시간 모니터링을 지원한다. 논문은 접속 경로로 https://trade-bench.live, https://github.com/ulab-uiuc/live-trade-bench, https://pypi.org/project/live-trade-bench/를 제공한다.
부록
- S1. Data Collection과 S1.1. Market News Data는 티커 또는 시장 식별자에 연결된 실시간 가격과 맥락 정보를 설명한다. 개요에서는 맥락 정보원으로 Google News와 Reddit을 명시한다. Google News 검색 범위는 \([t-3,t-1]\)이며, 주식에는 <TICKER> stock news OR <Company Name>을, Polymarket에는 시장 질문을 검색어로 사용한다. 제목, snippet, 링크, 출처, 타임스탬프를 정규화하고 유효한 타임스탬프가 없는 항목은 제거한다.
- S1.2. Stock Price Data는 금융 데이터 클라이언트인 yfinance로 t−1에 끝나는 10일 이력을 조회하고 현재 가격과 일별 날짜, 수정 종가, 거래량을 제공한다. S1.3. Polymarket Price Data는 같은 과거 조회 범위로 공개 시장 탐색 및 가격 endpoint를 사용하고 중복된 event slug와 거의 변하지 않는 시계열을 제거하며 호가를 [0, 1] 범위의 확률로 정규화한다. 이 조회 범위는 당일 정보 누출을 줄이기 위한 것이다. 다만 Table S2의 주식 프롬프트 예시에는 의사결정 당일 날짜의 종가가 포함되어 있어, 이 예시만으로는 의사결정 시점의 정확한 정보 마감 기준을 확인할 수 없다.
- S2. Prompting Details는 동적으로 변하는 시장, 뉴스, 계좌 맥락을 시장별 고정 지시문 헤더와 결합한다. Tables S2와 S3는 주식의 맥락 및 의사결정 프롬프트를 설명한다. Tables S4와 S5는 Polymarket의 대응 프롬프트를 설명하며 질문별로 0이 아닌 YES 또는 NO 배분을 최대 1개만 허용한다. 출력에는 추론과 배분이 포함되며, CASH를 포함한 가중치의 합은 1.0이다. Polymarket 프롬프트는 모델에 비용을 고려하도록 요청하지만 평가 환경은 비용을 제외한다.
- S3. Model Details는 요청을 모델 제공업체로 전달하는 클라이언트인 LiteLLM을 사용하며 접두사가 없는 이름은 기본적으로 Together AI로 연결한다. 일반 채팅 모델에는 생성 샘플링 설정인 temperature = 0.3과 출력 길이 제한인 max_tokens = 16000을 사용한다. 구조화된 추론 모델에는 제공업체의 기본값을 유지하도록 이 매개변수를 생략하고 계좌를 갱신하기 전에 출력을 파싱하고 검증한다. S4. Frontend UI Details는 배분 이력과 모델 입력 및 출력을 제공하는 leaderboard, 주식, Polymarket, 뉴스 화면을 설명한다. 주식 계좌는 1000 USD, Polymarket 계좌는 500 USD로 시작한다.
짧은 생각
핵심 기여는 실시간 정보 환경 2개에서 순차적 의사결정을 평가하는 공통 인터페이스다. Table 2는 모델 순위가 시장에 따라 달라짐을 보여준다. 다만 지속적인 거래 능력이나 행동의 인과적 설명을 뒷받침하는 근거는 단일 50일 평가 기간, 체결 비용의 누락, 개별 정보원을 제거하는 입력 ablation 실험의 부재로 제한된다. 결과는 전반적인 모델 순위가 이 포트폴리오 벤치마크의 성능을 대신하기에 부적절하다는 결론을 뒷받침한다. 지속적인 alpha를 확인하려면 같은 비용 조건에서 비교하고 여러 시장 기간에 걸쳐 반복 평가해야 한다. Leaderboard 스크린샷에는 비교 펀드가 포함되어 있지만 Table 2는 이들과 조건을 맞춘 통계 분석을 제공하지 않는다. 오래된 보유 자산을 적용한 실험은 갱신 시점에 관한 정보를 제공한다. 선택한 뉴스 사례는 관련성이 있어 보이는 정보에 반응해도 수익을 내지 못할 수 있음을 보여준다.