


Remote Labor Index: Measuring AI Automation of Remote Work 요약 설명
30 Oct 2025 | Paper Review LLM Evaluation LLM Agents Benchmark목차
이번 글에서는 Remote Labor Index: Measuring AI Automation of Remote Work 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 30일(Arxiv)
- Mazeika, Mantas, Gatti, Alice, Menghini, Cristina, Sehwag, Udari Madhushani, Singhal, Shivam, Orlovskiy, Yury, Basart, Steven, Sharma, Manasi, Peskoff, Denis, Lau, Elaine, et al.
- Center for AI Safety, Scale AI
- 논문 링크
요약
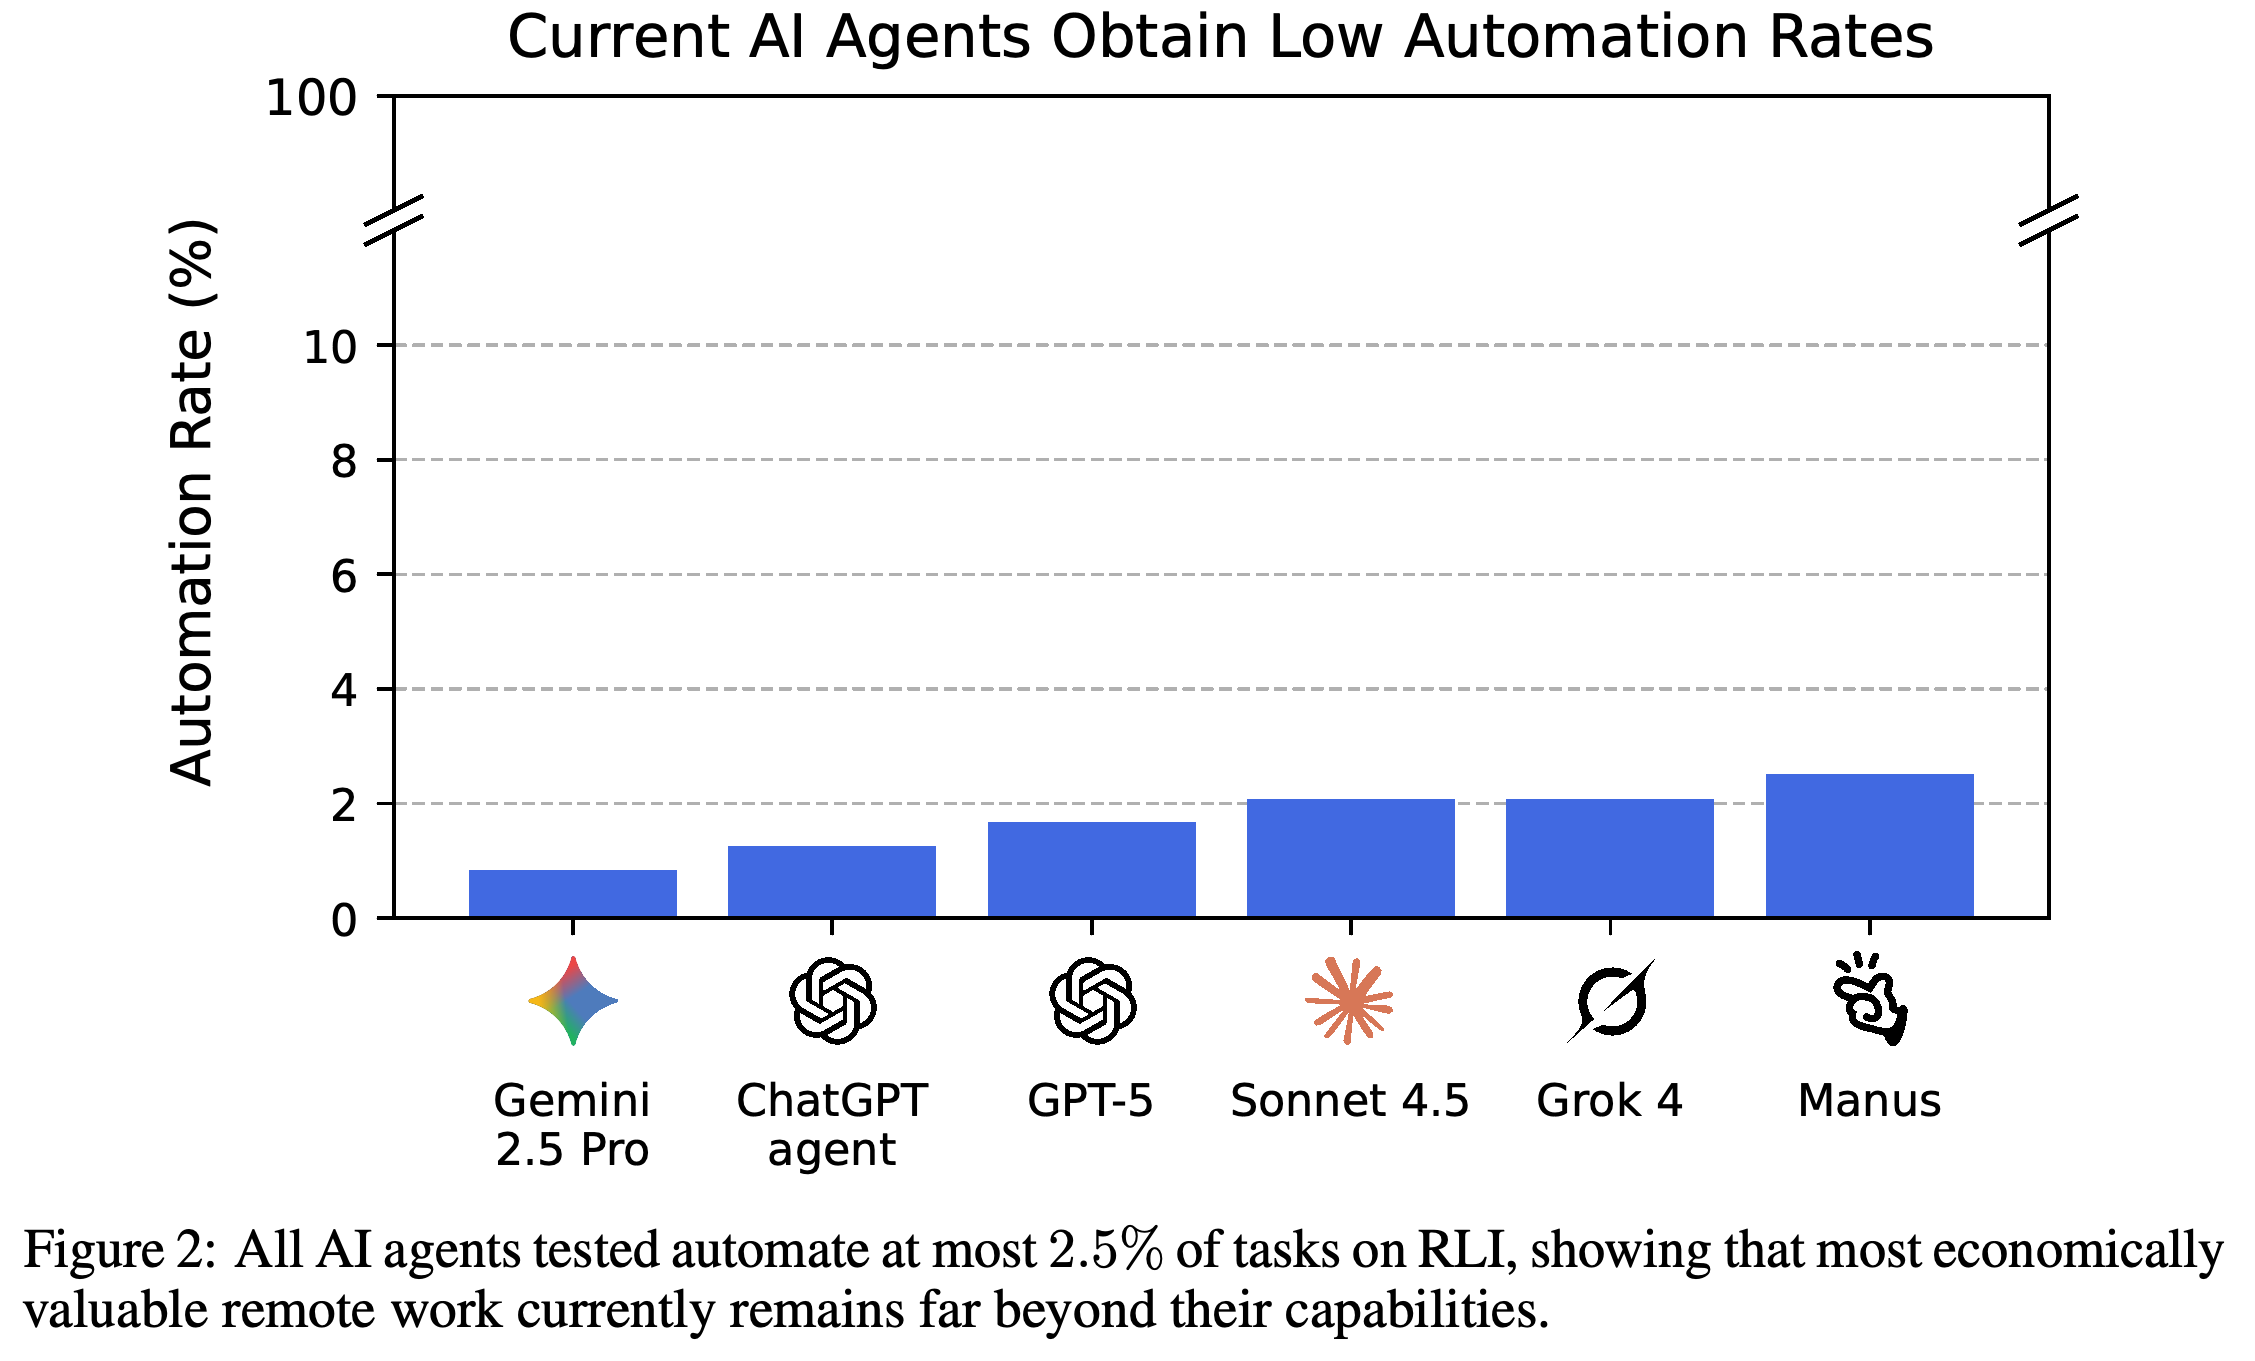
- 벤치마크에서 높은 성능을 보였다고 해서 도구를 사용해 프로젝트를 수행하는 AI 에이전트가 수용 가능한 전문 작업물을 만들 수 있다는 뜻은 아니다. 평가한 에이전트 6개 중 Manus의 자동화율이 2.5%로 가장 높았다. 이 지표는 제출한 산출물, 즉 요청한 작업물이 전문가의 기준 산출물과 동등하거나 더 나은 수준으로 프로젝트를 완수했는지를 사람이 판단해 측정한다.
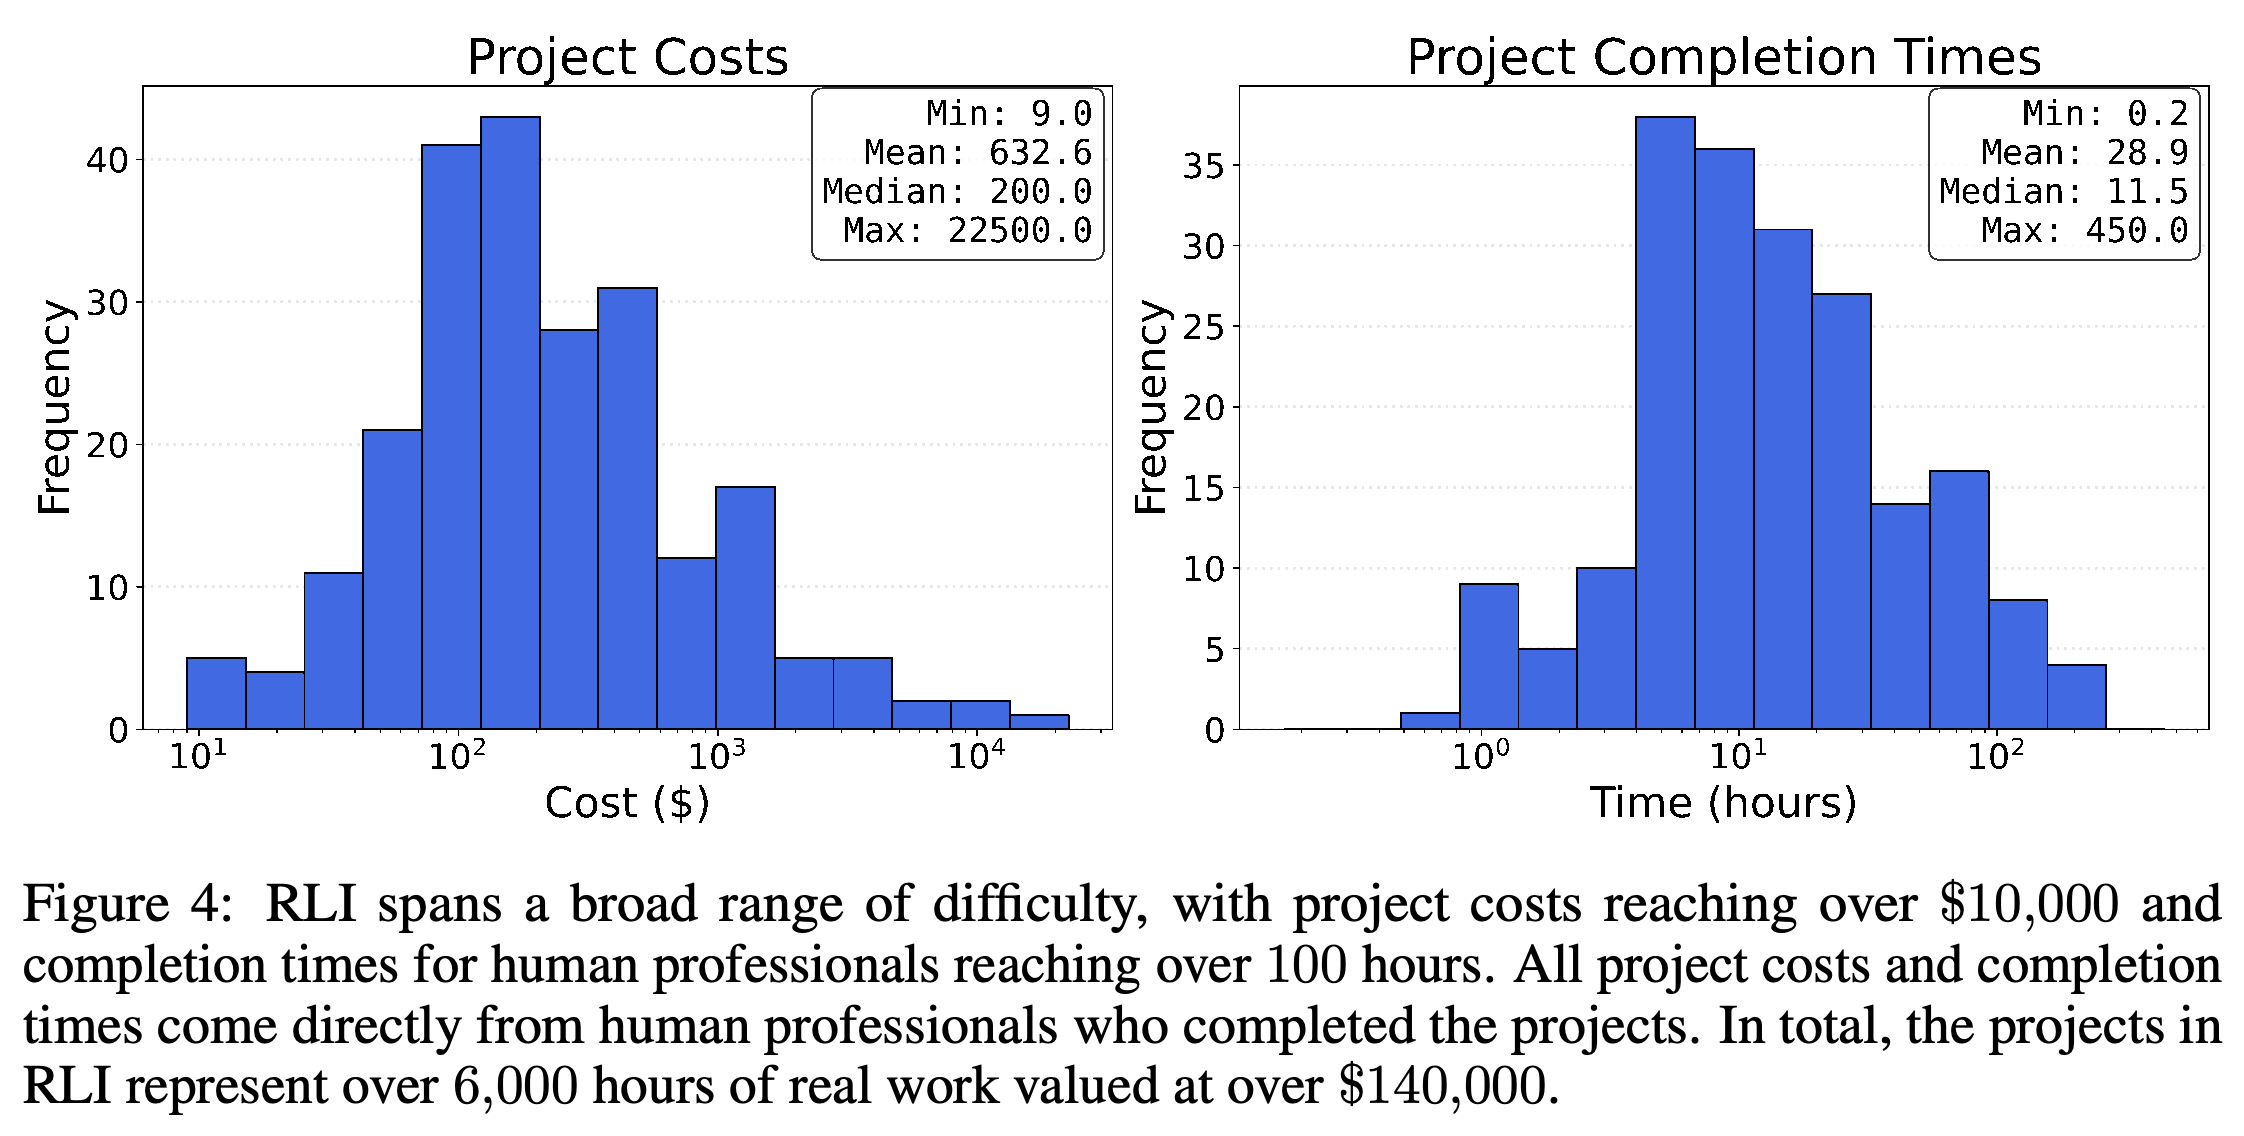
- Remote Labor Index(RLI)는 원격 프리랜서 프로젝트 전체를 평가하는 벤치마크다. 온라인 프리랜서 마켓플레이스인 Upwork의 작업 범주 23개에 걸쳐 프로젝트 240개를 포함한다. 각 프로젝트에는 작업 설명서, 입력 파일, 전문가가 만든 산출물이 있다. 확보한 자기 보고 자료에서 사람의 평균 작업 시간은 28.9시간이고, 평균 프로젝트 비용은 $632.6이다.
- 평가자는 합리적인 고객의 관점에서 산출물을 수용할 수 있는지 판단한다. 자동화율 평가에서 보고한 평가자 간 일치율, 즉 평가자들의 판단이 일치하는 비율은 94.4%다. 산출물 간 쌍별 선호를 바탕으로 추정하는 상대 점수인 Elo는 완수율이 낮아도 부분적인 진전을 구분한다. 평가한 모든 시스템의 점수는 사람 기준선인 1,000보다 낮다.
- 약 400건의 평가를 분석한 결과, 낮은 품질, 불완전한 산출물, 손상된 파일, 불일치가 반복해서 나타났다. 수용된 사례에는 오디오 작업, 이미지 기반 광고, 보고서 작성, 대화형 데이터 시각화가 있다. 저자들은 복잡한 시청각 산출물을 검증하고 수정하기 어렵다는 점을 반복적으로 나타나는 한계로 지적한다.
- RLI는 실험에 사용한 도구와 실행 조건에서 프로젝트를 자율적으로 완수하는 능력을 측정한다. 경제 전반에서 일자리가 대체되는 정도를 측정하지는 않는다. 고객과의 소통, 팀 작업을 비롯한 여러 작업 유형은 평가 범위에서 제외한다. AI가 이미 쉽게 해결하는 작업을 범주 단위로 의도적으로 제외했다는 점도 대표성을 제한한다.
1 Introduction
논문은 기존 평가로 확인하기 어려운 능력을 측정하기 위해 RLI를 제안한다. 지식, 추론, 소프트웨어 엔지니어링, 기본적인 컴퓨터 사용 벤치마크에서의 진전만으로는 경제적 가치가 있는 원격 프로젝트를 완수할 수 있는지 알기 어렵다. RLI의 평가 단위는 프로젝트 전체이며 전문가의 산출물을 성공적인 완수의 구체적인 기준으로 삼는다. 대부분의 프로젝트는 실제 프리랜서 거래에서 확보했다.
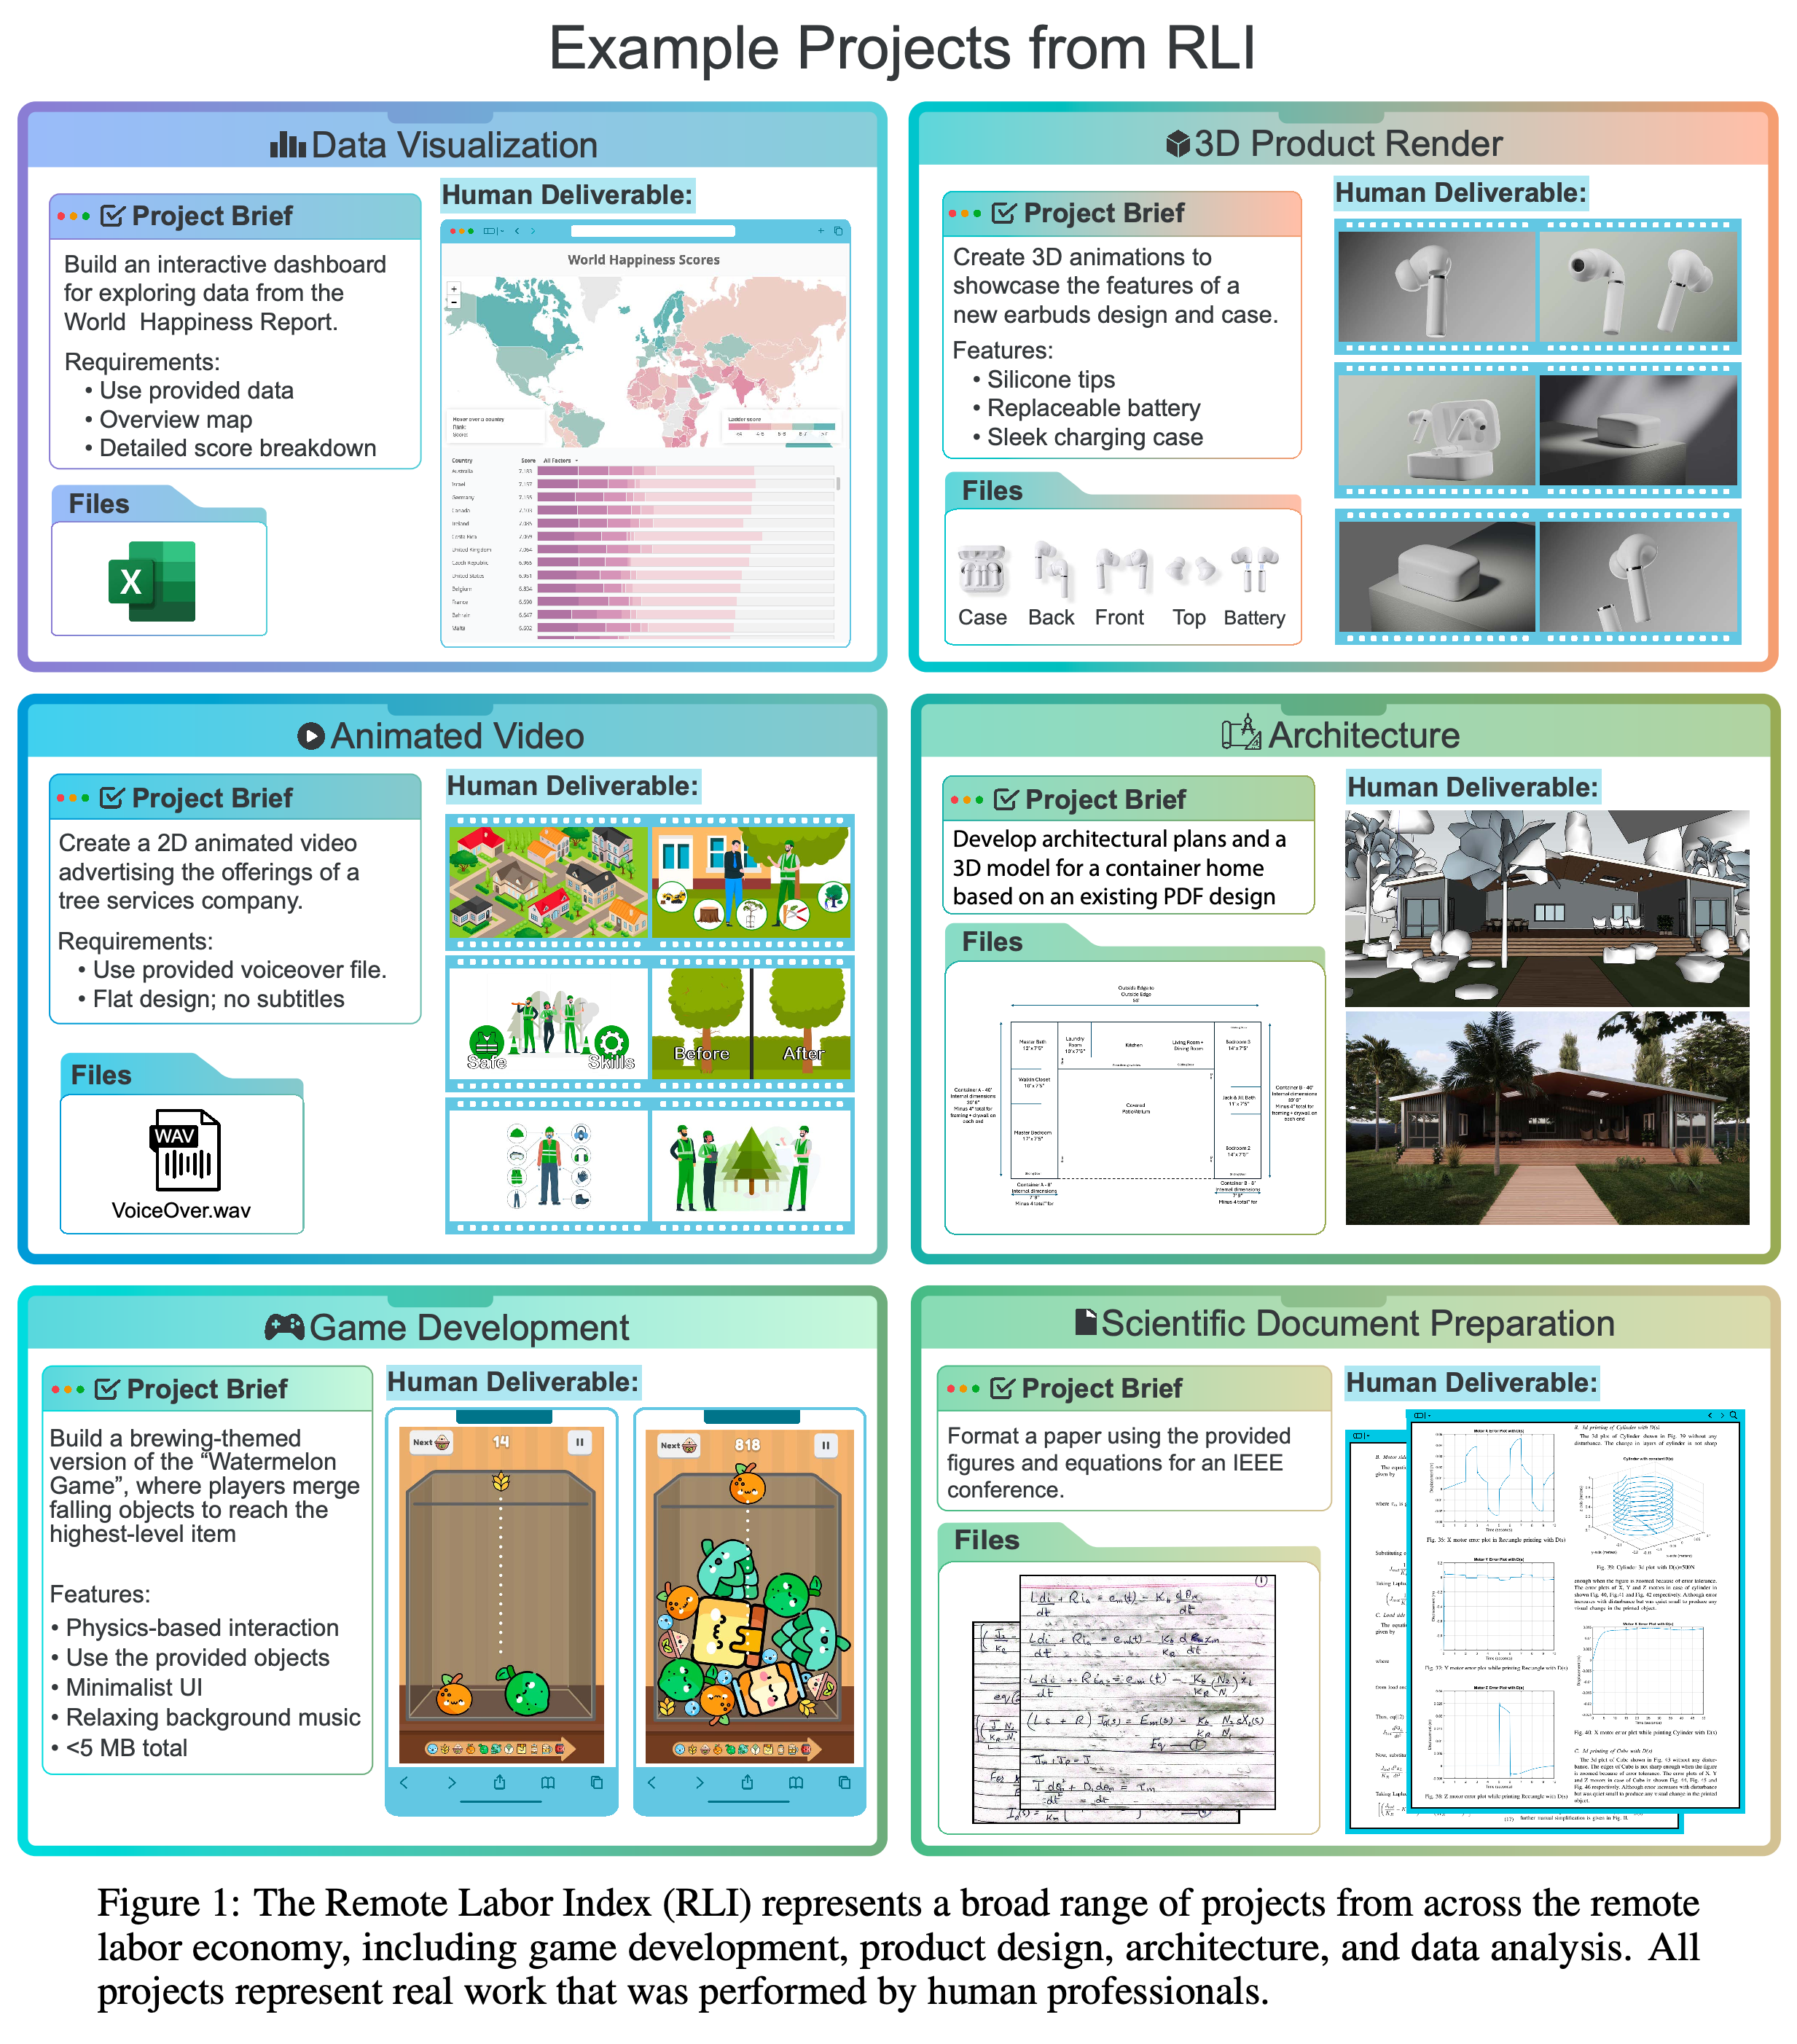
- Figure 1은 대시보드, 제품 애니메이션, 건축 모델, 게임, 과학 문서 작성 사례를 보여준다. 각 사례는 입력 자료와 산출물 요구사항이 다르다.
- Figure 2는 평가한 에이전트 6개 모두 자동화율이 2.5%를 넘지 못했다는 결과를 요약한다.
입력에는 스프레드시트, 음성 녹음, 디자인 파일 등이 있고, 출력에는 대화형 애플리케이션, 애니메이션, 건축 산출물, 서식을 갖춘 문서가 있다. 이 사례들은 프로젝트 전체의 수용 여부를 판단하기 위해 평가자가 확인해야 하는 산출물의 다양성을 보여준다.
막대 6개 모두 3% 미만이며 Manus가 2.5%로 가장 높다. 세로축을 중간에서 끊어 작은 수용률과 100% 지점을 함께 표시함으로써, 벤치마크 기준상 완전 자동화까지의 차이를 보여준다.
2 Related Work
관련 연구에서는 학술 지식 시험에서 컴퓨터, 웹사이트, 도구와의 상호작용 평가를 거쳐 분야별 전문 벤치마크로 이어진 변화를 정리한다. 여러 직업에 걸쳐 경제적 가치가 있는 작업을 평가하는 GDPval이 논문에서 논의하는 가장 가까운 비교 대상이다. 저자들은 글쓰기와 웹 검색처럼 여러 직업에 공통으로 나타나는 활동과 프리랜서 프로젝트 전체를 자율적으로 완수하는 능력을 구분한다.
- RLI는 원격 프리랜서 작업에 나타나는 여러 전문 분야를 함께 다룬다. 반면 논문에서 논의하는 인지 능력 비교는 폭넓은 교육을 받은 개인을 대상으로 한다.
- 저자들은 실제 거래에서 확보한 프로젝트와 완성된 전문가 산출물을 사용해 평가를 실제 프로젝트 수용 여부와 연결한다.
3 Remote Labor Index
RLI는 전문가에게서 확보한 원격 프리랜서 프로젝트와 사용 허가를 받은 추가 디지털 작업 사례로 구성되며, 전체 과정을 포함하는 프로젝트 240개를 담고 있다. 기존 산출물과 보고된 프로젝트 가치를 기준으로 에이전트를 평가한다.
3.1 Dataset Description
각 프로젝트는 요청한 작업을 설명하는 작업 설명서, 수행에 필요한 입력 파일, 프로젝트를 완수한 전문가 산출물로 구성된다. 프리랜서에게서 확보한 프로젝트는 해당 전문가가 작업 설명서와 입력 자료를 제공한다. 사람의 작업 비용과 완료 시간은 확보 가능한 경우 기록한다.
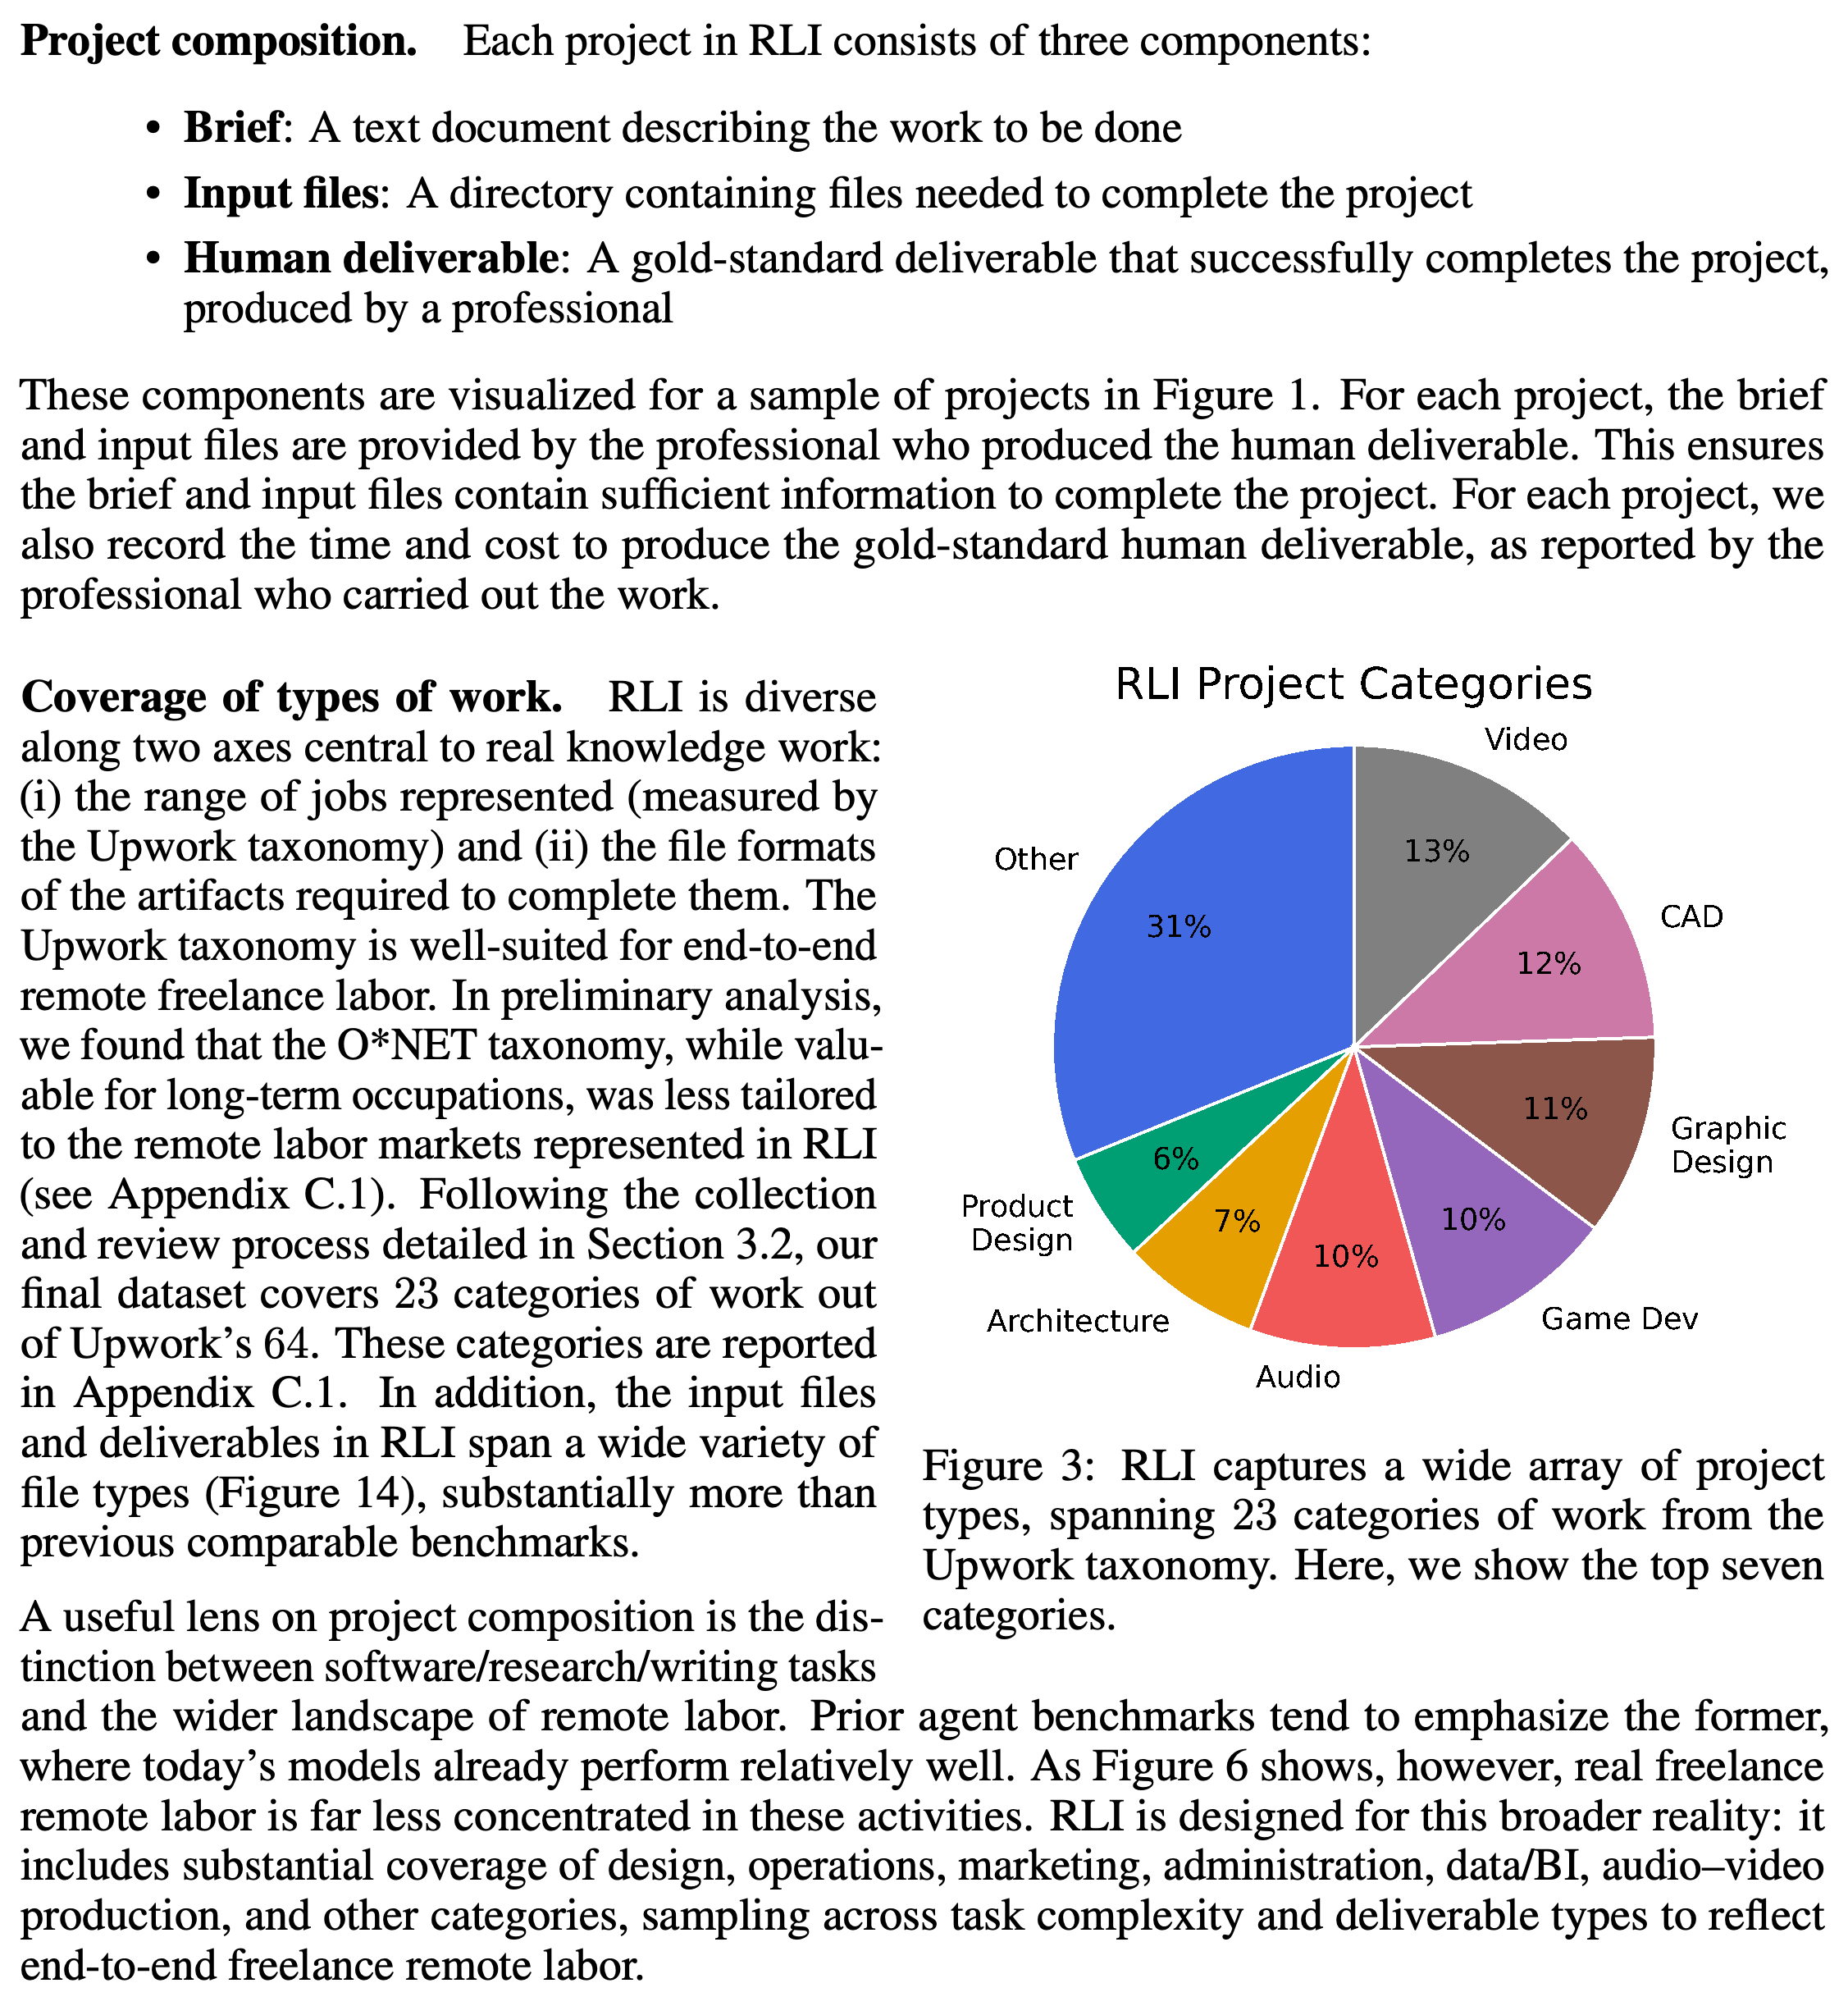
- 최종 데이터셋은 Upwork의 작업 범주 64개 중 23개를 포함한다. 디자인, 건축, 오디오 및 영상 제작, 게임을 비롯해 여러 산출물을 함께 구성해야 하는 작업을 다룬다.
- Figure 3의 비중은 Video 13%, 3D Modeling & CAD에 속하는 컴퓨터 지원 설계인 CAD 12%, Graphic Design 11%, 게임 개발인 Game Dev와 Audio 각각 10%, Architecture 7%, Product Design 6%, Other 31%다.
개별 범주 중 가장 큰 비중은 Video 13%와 CAD 12%이며, Other는 31%를 차지한다. 이 차트는 선별해 구성한 벤치마크의 작업 범주를 설명하며 시장에서 관측한 일감 빈도를 나타내지는 않는다.
확보한 자기 보고 자료에서 사람의 작업 시간은 평균 28.9시간, 중앙값 11.5시간이다. 보고된 비용은 평균 $632.6, 중앙값 $200이다. Figure 4의 비용 범위는 $9에서 $22,500이고, 작업 시간 범위는 0.2시간에서 450시간이다. 데이터셋은 총 6,000시간을 넘는 작업과 $140,000을 넘는 가치를 포함한다.
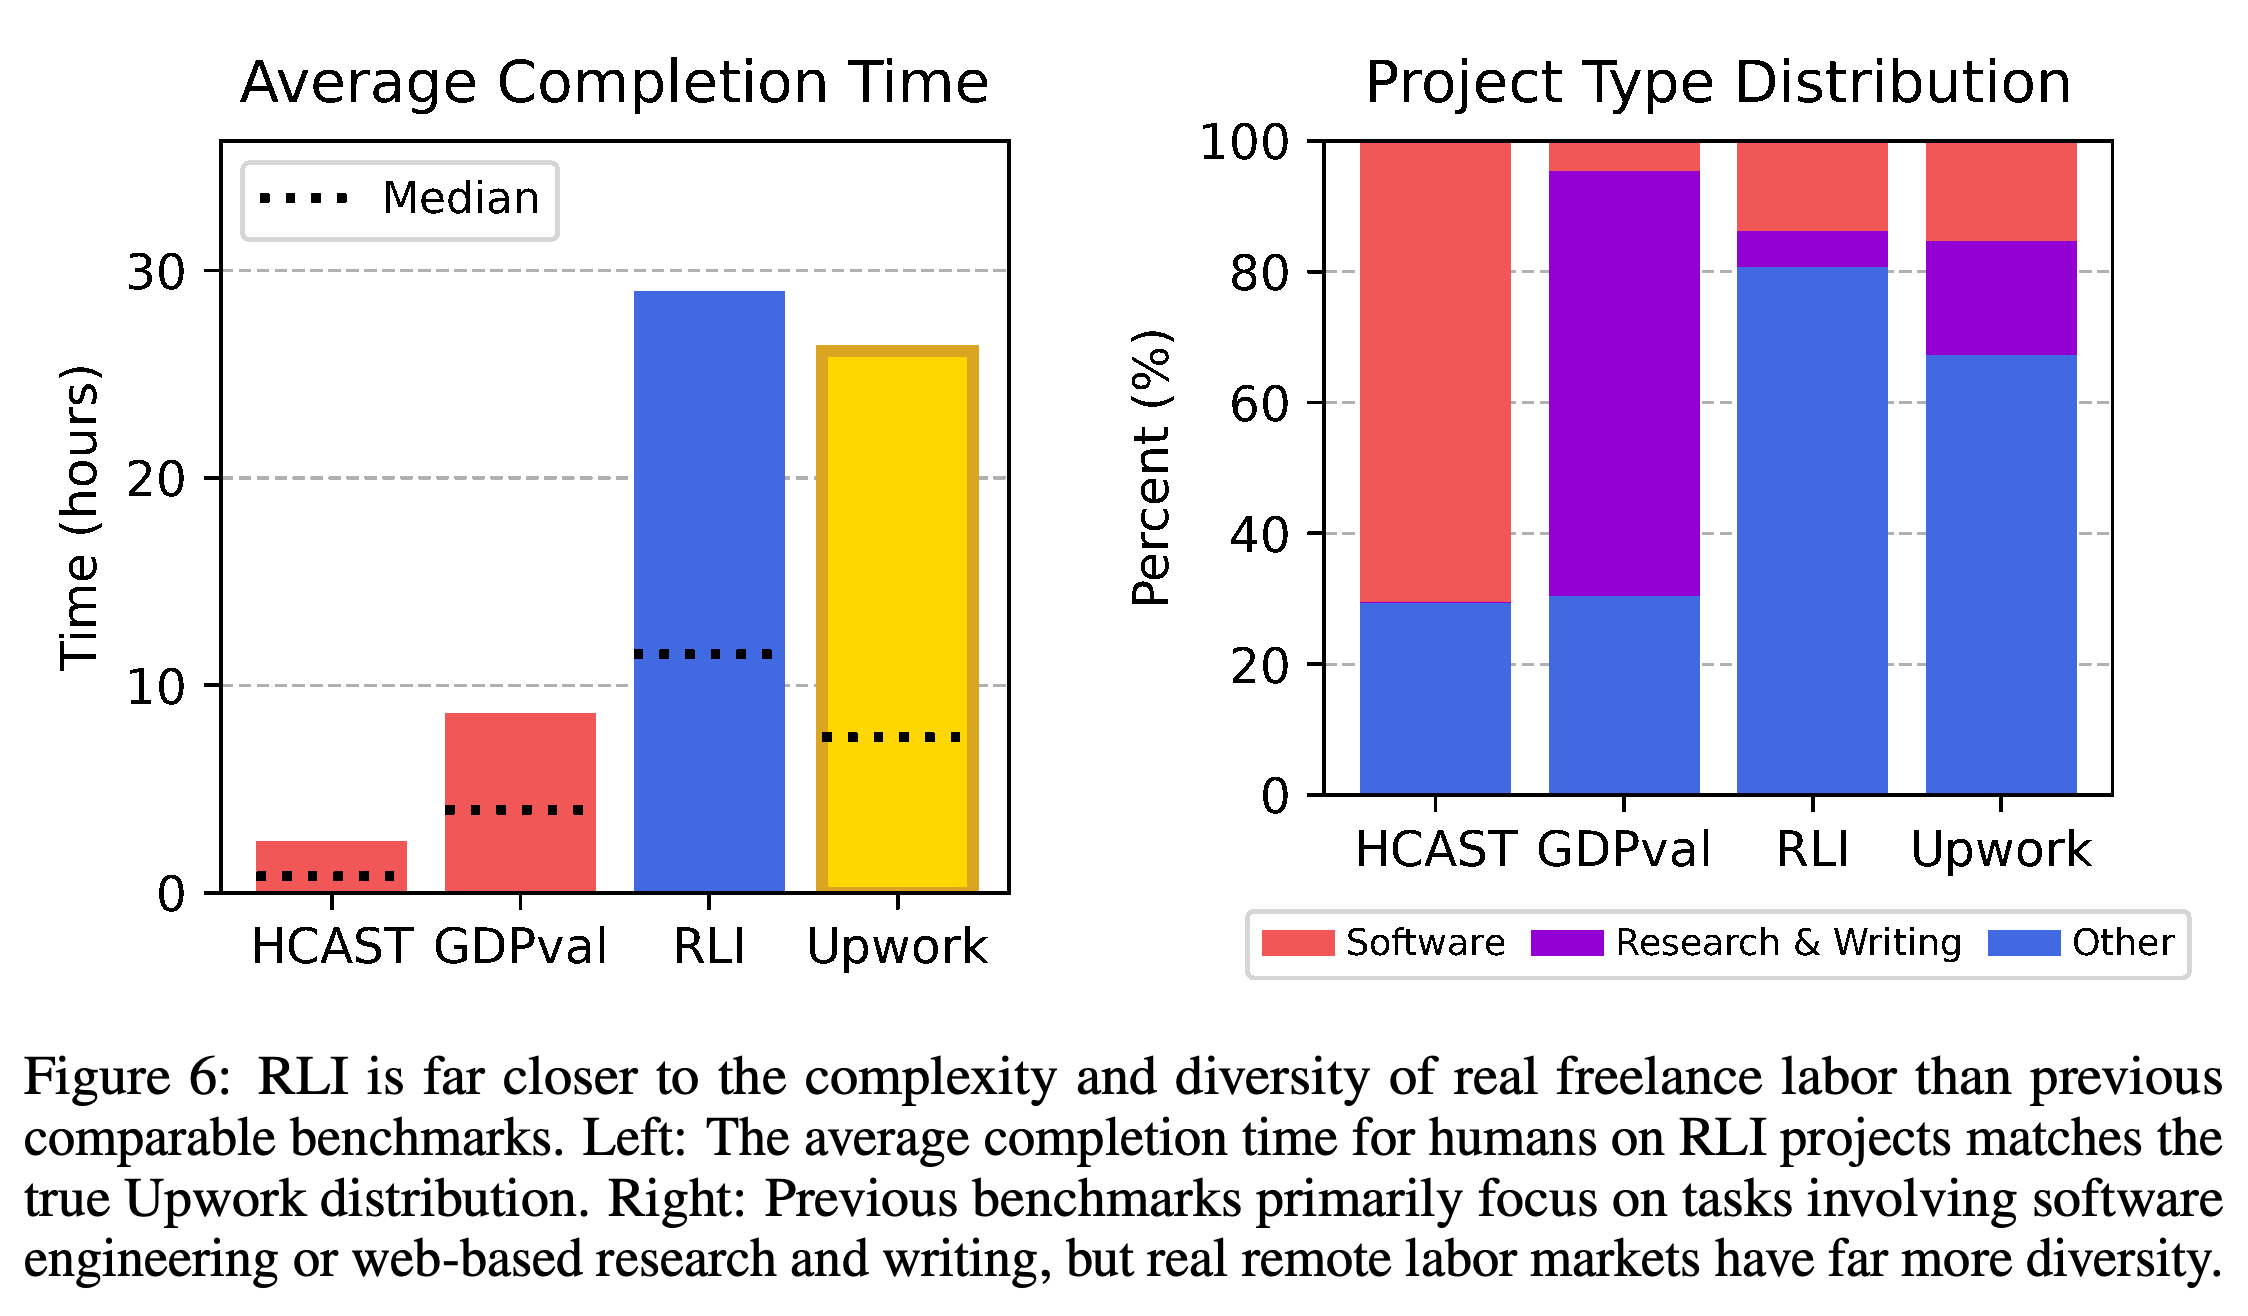
- Figure 6은 RLI를 사람의 수행 능력을 기준으로 보정한 소프트웨어 작업 벤치마크 HCAST, GDPval, Upwork 표본과 비교한다. RLI는 비교 벤치마크보다 평균 작업 시간이 길고, 소프트웨어, 조사, 글쓰기 이외의 작업 비중이 높다.
- Upwork의 프로젝트 유형 추정치는 실제 일감의 빈도를 측정하지 않고 분류 체계의 범주를 분류한다. 따라서 RLI의 프로젝트 구성이 시장과 일치한다고 주장하기에는 한계가 있다.
로그 척도의 가로축은 값의 범위가 넓고 상위 값 쪽으로 꼬리가 길게 이어지는 분포를 보여준다. 비용과 작업 시간 모두 평균이 중앙값보다 높다. 비용이 높고 시간이 오래 걸리는 프로젝트가 평균을 전형적인 보고값보다 끌어올린다는 뜻이다.
RLI는 HCAST와 GDPval보다 사람의 평균 작업 시간이 길고, 소프트웨어, 조사, 글쓰기 이외의 작업 비중이 높다. Upwork의 시간 비교에는 표본 일감을 사용하고 프로젝트 유형 추정에는 분류 체계의 범주를 사용한다. 따라서 각 패널은 서로 다른 방식으로 시장과 비교한다.
3.2 Dataset Collection
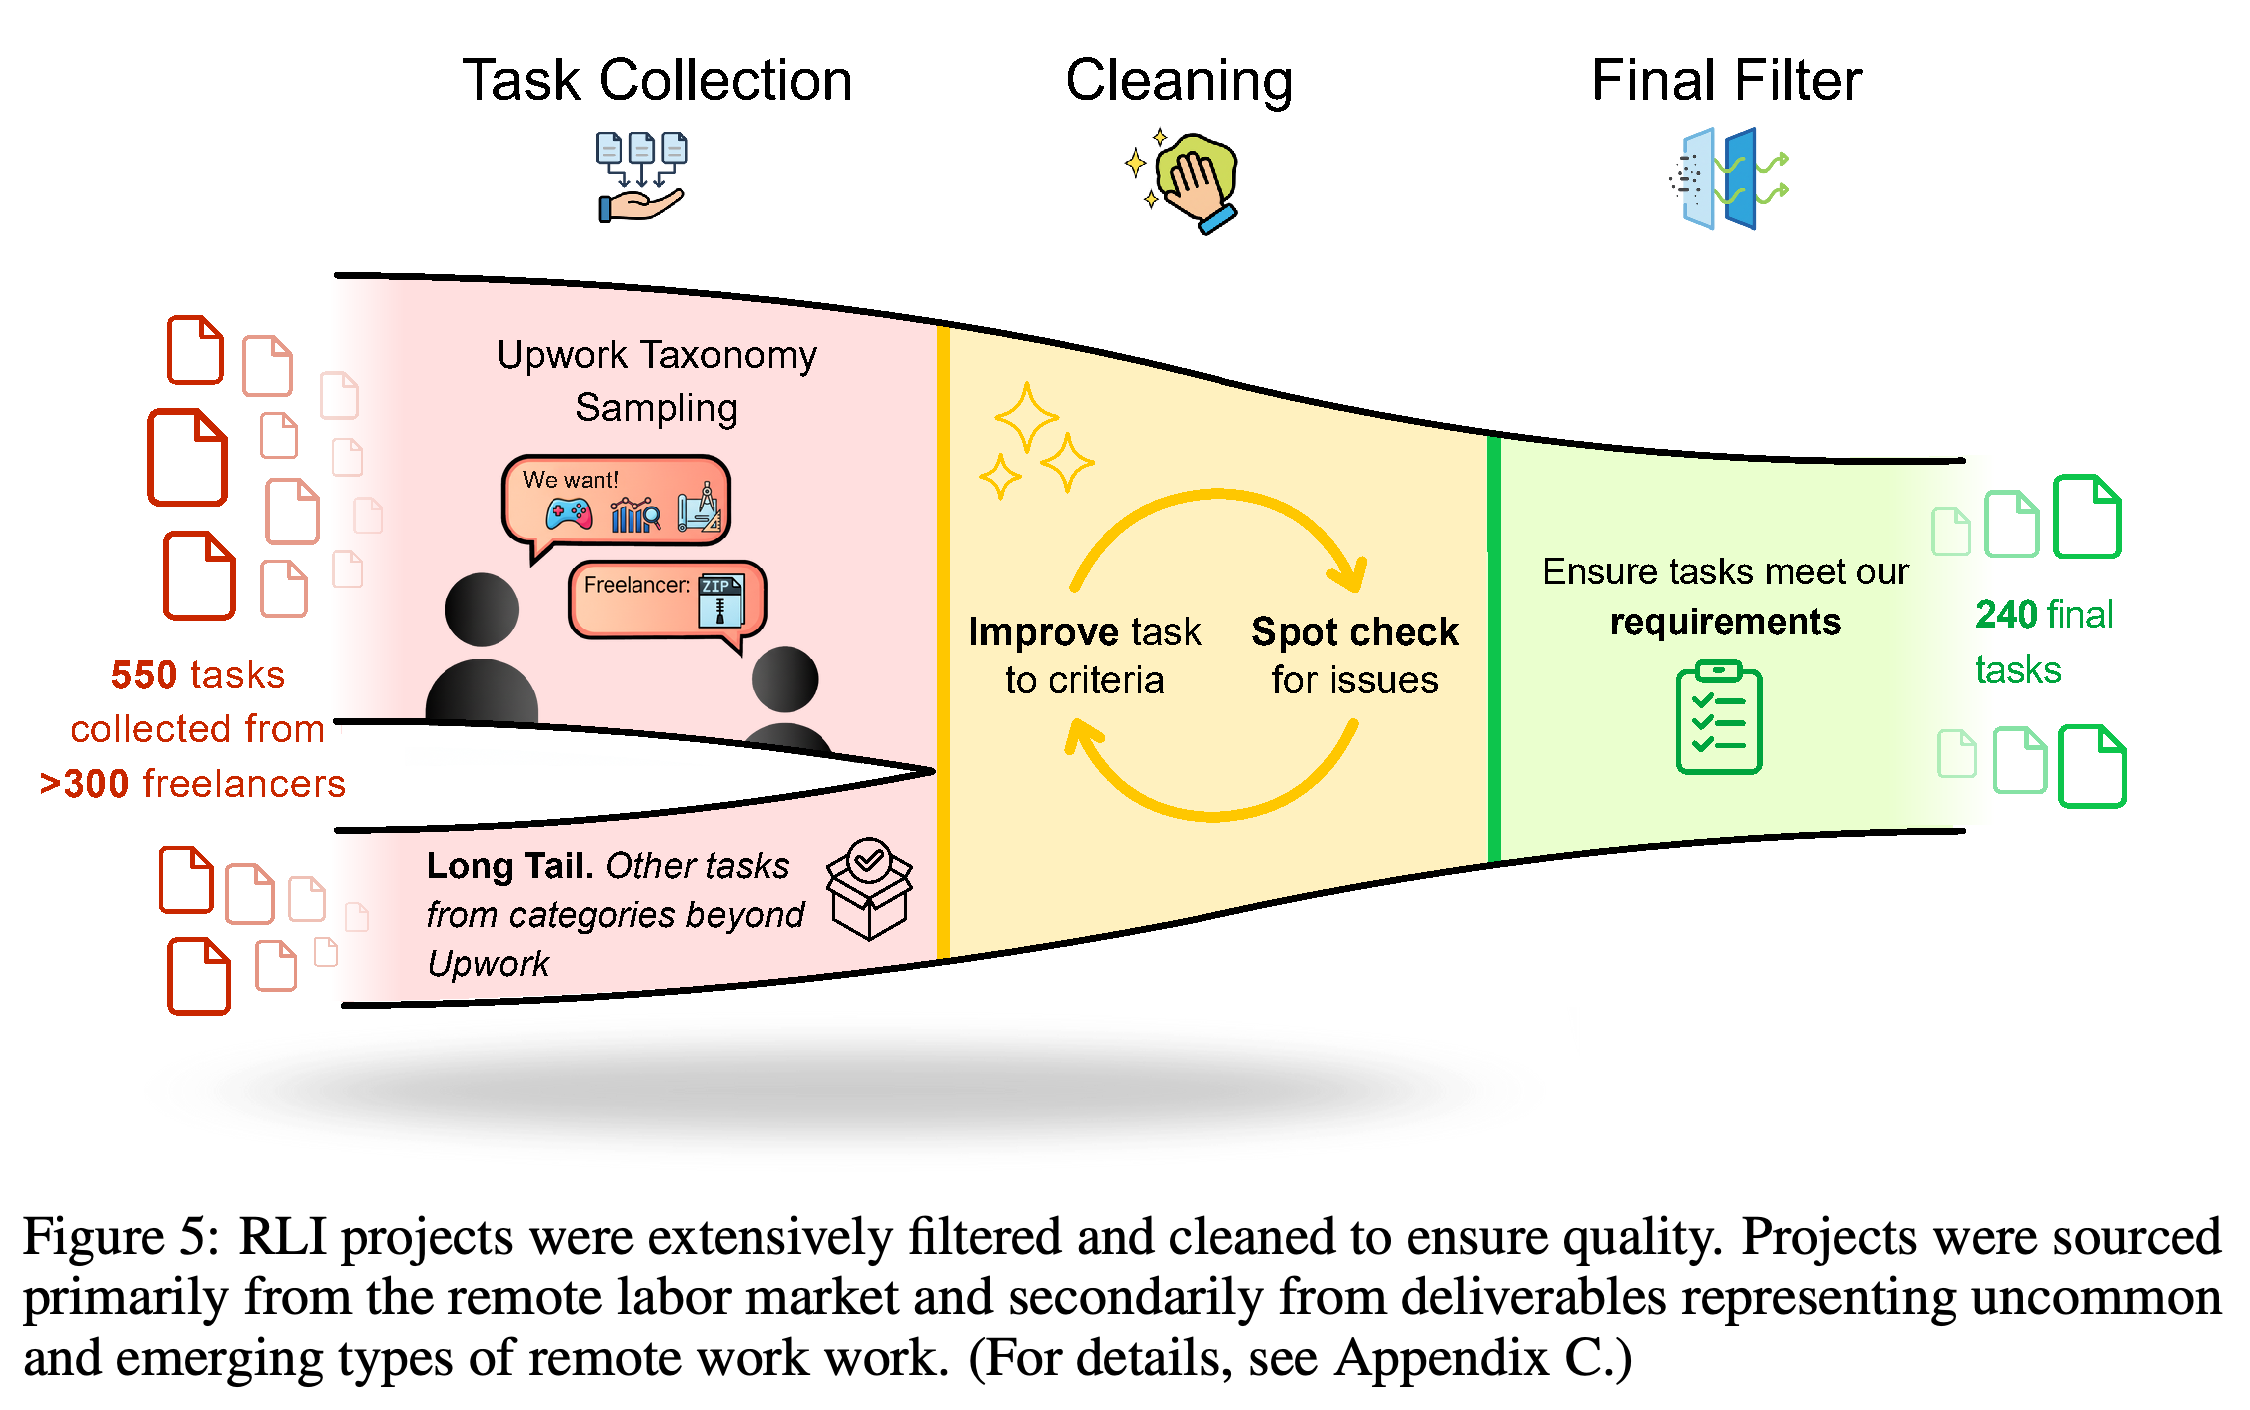
저자들은 Upwork 계정을 검증한 프리랜서 358명을 모집해 초기 프로젝트 550개를 수집했다. 기여자들의 Upwork 실적은 평균 작업 시간 2,341시간, 이전 일감 89건, 수입 $23,364였다. 기존 작업 사례에 지급한 금액은 프로젝트당 $15에서 $200이었으며 평균은 $41이었다.
- Section 3.2는 수집 가능한 범주 43개를 보고하며 프리랜서 플랫폼 프로젝트 207개, 별도 의뢰하거나 드문 유형에 해당하는 프로젝트 7개, 사용 허가를 받은 온라인 사례 33개를 확보했다고 설명한다. 합계는 247개이며 논문은 최종 프로젝트 240개와의 차이를 명시적으로 설명하지 않는다.
- 검토 과정에서는 적합성, 완전성, 파일을 화면에 표시해 확인할 수 있는지, 기준 산출물의 품질을 점검했다. 누락된 자료를 요청하고 승인된 프로젝트를 표준화한 뒤 최종적으로 필터링했다.
데이터 공개 계획은 정량 평가용 비공개 프로젝트 230개와 정성 평가용 공개 프로젝트 10개를 구분하며 오픈 소스 평가 플랫폼 코드도 포함한다. 저자들은 개인을 식별할 수 있는 정보를 익명화한다. 또한 일부 온라인 기준 산출물과 관련된 도메인을 차단해, 평가를 훼손할 수 있는 시험 자료 접근으로 인한 벤치마크 오염을 줄인다.
- 논문에 따르면 프로젝트 설명은 검색으로 찾을 수 없다. 다만 드문 유형이나 추가 출처에서 확보한 일부 전문가 산출물은 온라인에 존재한다.
- Figure 5는 정제와 적합성 검사를 통해 초기 프로젝트 550개가 최종 프로젝트 240개로 줄어드는 과정을 보여준다.
반복적인 정제와 적합성 검사를 통해 초기 프로젝트 550개가 최종 프로젝트 240개로 줄어든다. 도식은 품질 관리 과정과 최종 데이터셋을 구성하기까지 상당수 프로젝트를 걸러낸 과정을 함께 보여준다.
3.3 Metrics
자동화율은 AI 산출물이 전문가의 기준 산출물과 동등하거나 더 나은 수준으로 작업을 완수했다고 평가된 프로젝트의 비율이다. Elo는 프로젝트 완수 정도와 품질에 대한 상대적인 선호를 측정한다. 사람 기준선을 1,000으로 정규화하며 400점 차이는 승리 오즈 10:1에 해당한다.
- Dollars earned는 에이전트가 성공적으로 완수한 프로젝트에 대해 보고된 사람의 작업 가치를 합산한다. 보고된 전체 프로젝트 묶음의 최대 가치는 $143,991이다. 이는 벤치마크상의 가치 평가이며 에이전트가 실제로 지급받은 금액을 뜻하지 않는다.
- 쌍별 선호 평가에서는 AI 산출물 중 어느 하나라도 실패하면 완수에 얼마나 가까운지를 우선한다. 모두 성공하면 전반적인 품질을 우선한다.
Autoflation은 고정된 RLI 프로젝트 묶음을 수용 가능한 사람 또는 AI 방식 중 가장 저렴한 방식으로 완수할 때의 비용 절감률이며 \(1-\frac{\sum \min\left(\operatorname{cost}(H),\min_j\operatorname{cost}(AI_j)\right)}{\sum\operatorname{cost}(H)}\)로 계산한다. 여기서 cost(H)는 전문가 산출물의 비용이고, cost(AI_j)는 해당 프로젝트에서 평가한 에이전트의 비용이다. 실패한 AI 산출물에는 무한대의 비용을 부여한다.
3.4 Evaluation
에이전트에는 작업 설명서, 입력 파일, 평가 플랫폼이 지원하는 형식을 설명한 지침을 제공한다. 훈련받은 평가자는 작업 설명서와 전문가 기준 산출물을 바탕으로 산출물을 확인한다. 예비 평가에서 프로젝트별 세부 기준을 나열한 체크리스트가 전문적인 품질 문제를 놓치는 경우가 있었기 때문에, 합리적인 고객의 관점에서 전체적으로 판단한다.
- 자동화율 평가는 수용 불가, 기준 수준으로 수용 가능, 전반적인 품질이 더 우수한 수준으로 수용 가능이라는 3개 등급을 사용한다. 등급 2와 3을 성공적인 완수로 집계한다.
- 오픈 소스 웹 플랫폼은 수십 가지 형식을 표시하며 평가자가 대화형 애플리케이션과 3차원 산출물을 포함한 산출물 디렉터리를 확인할 수 있게 한다.
최종 판단은 다수결로 결정한다. 본문은 독립 평가 3회를 설명하지만 Appendix B.2는 쌍별 평가 2회를 수행하고 동률을 해소해야 할 때 3번째 평가를 추가한다고 명시한다. 자동화율 평가의 일치율은 94.4%다. Elo의 3가지 선택에 대한 일치율은 56.9%로, 무작위 선택의 33.0%와 비교된다. 서로 반대 방향의 선호가 나타날 확률은 5.9%다.
- 요청한 검토 시간 상한은 자동화율 평가 20분, Elo 평가 30분이며 평균 소요 시간은 각각 11.4분과 17.4분이다.
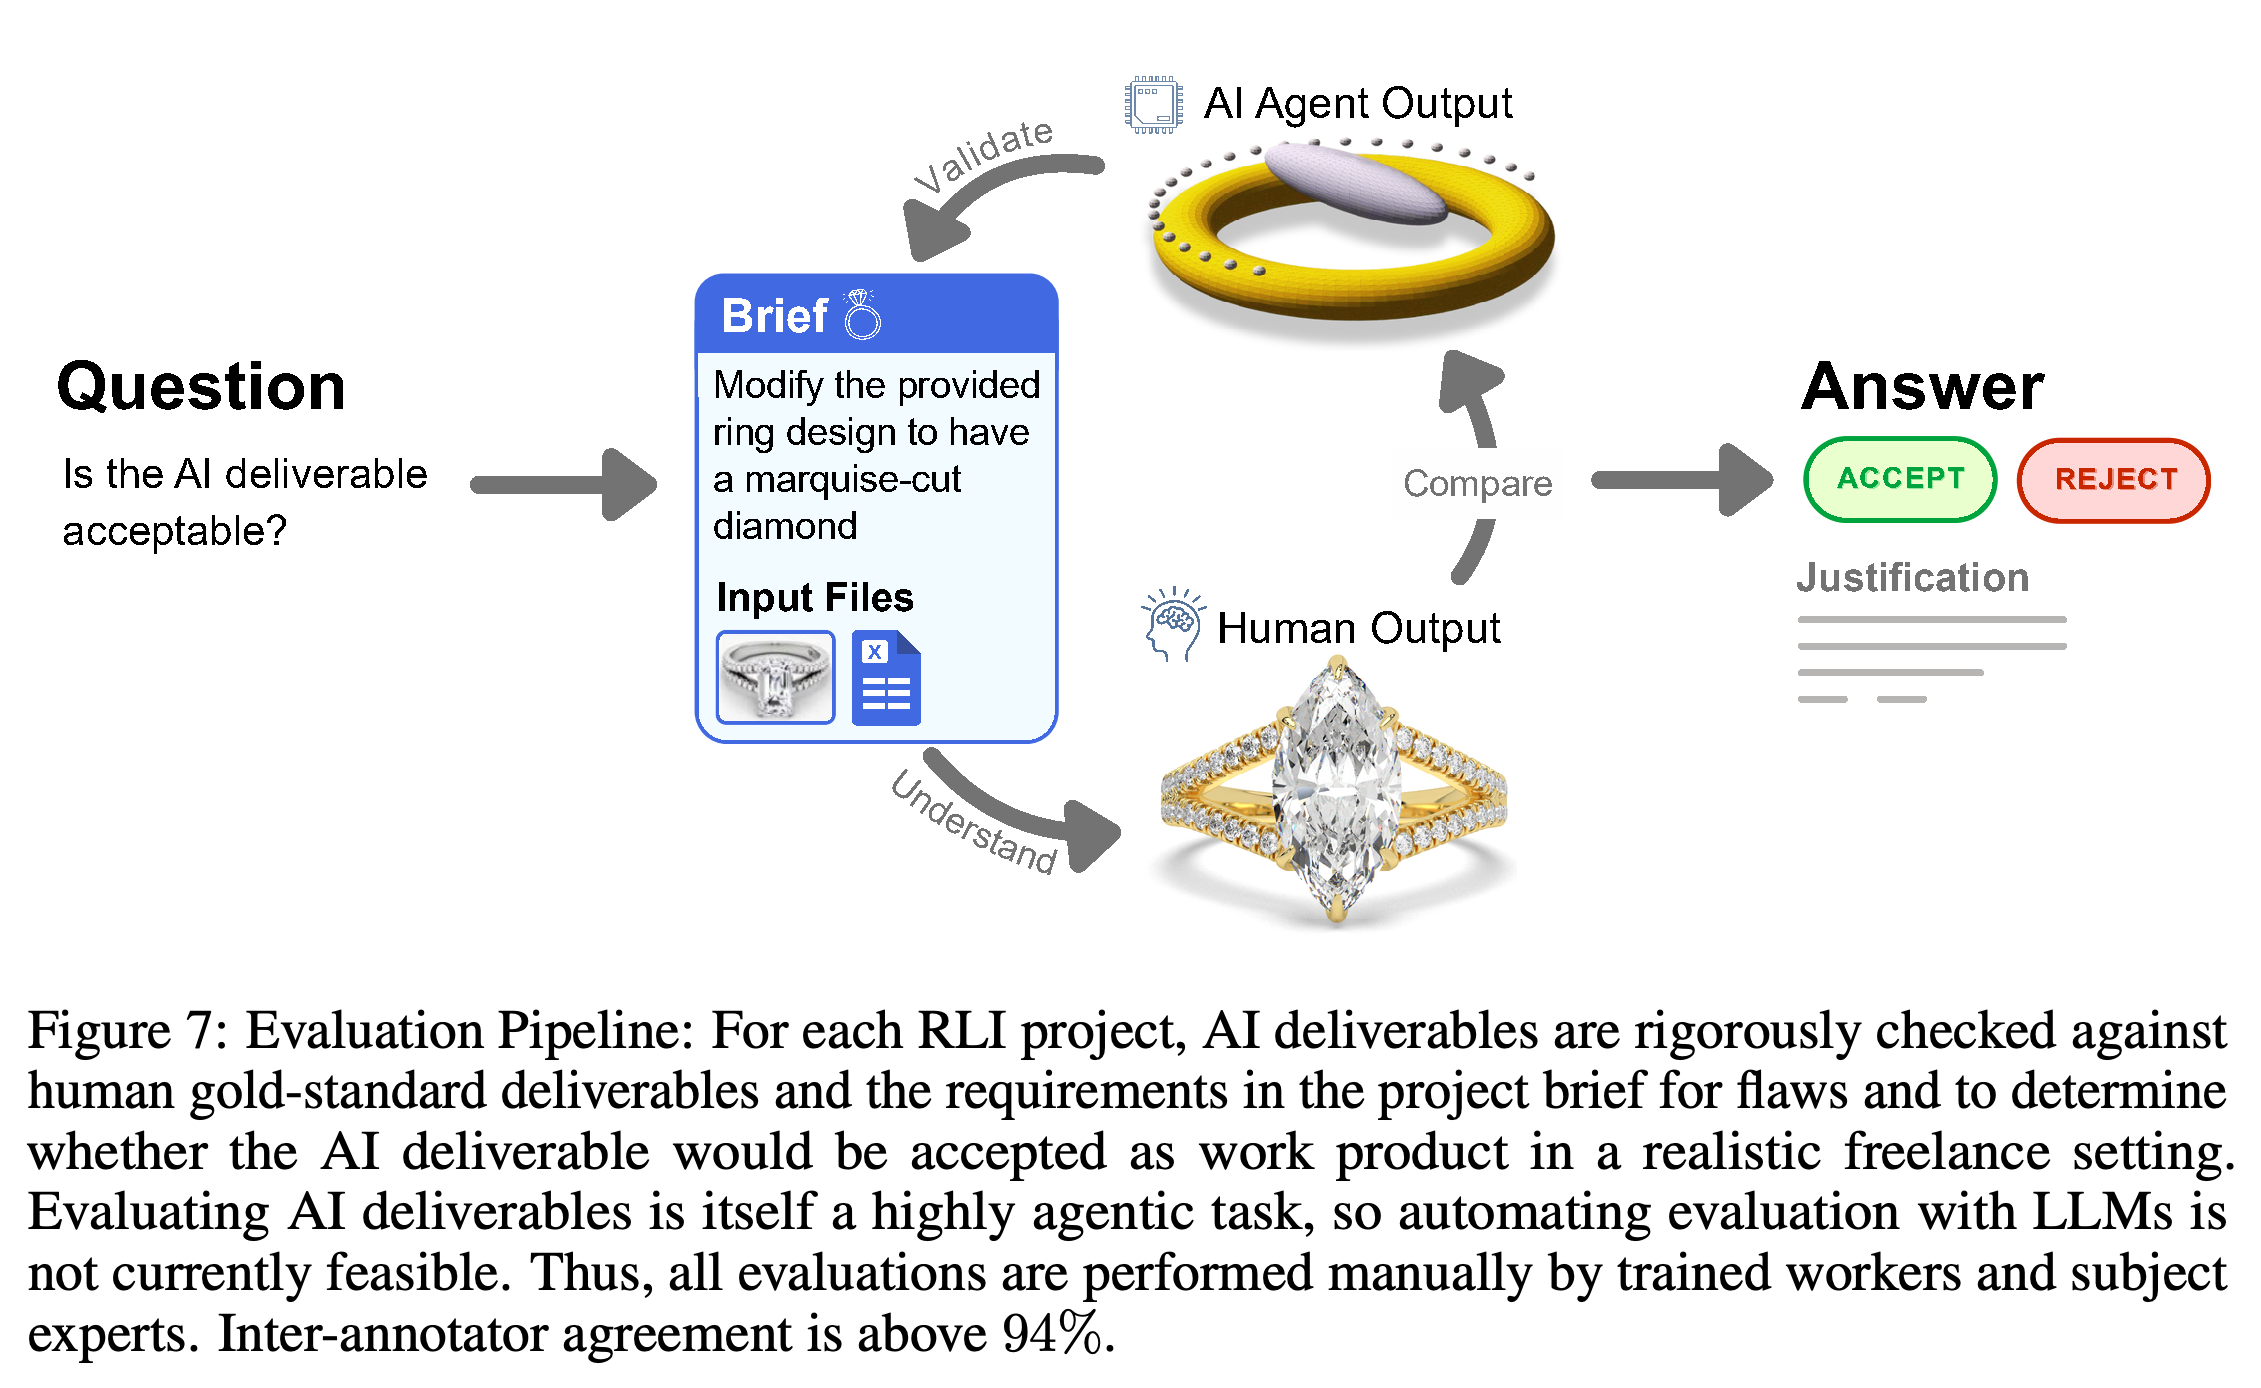
- Figure 7은 프로젝트 요구사항과 전문가 기준 산출물을 바탕으로 수용 여부를 판단하는 과정을 보여준다. 일치율은 평가자 간 판단의 일관성을 측정한다. Appendix B.5의 별도 감사는 평가 오류를 확인한다.
반지 사례는 작업 설명서를 이해하고 전문가 기준과 비교하고 AI 산출물을 검증하는 과정을 구분한다. 수용 여부는 의뢰한 디자인 요구사항을 충족하는지에 달려 있다. 뷰어에서 볼 수 있는 모델을 제출하는 것만으로는 충분하지 않다.
4 Experiments
실험은 프로젝트 완수 여부, 산출물 간 상대적인 선호, 경제적 가치 지표, 정성적인 실패 양상을 평가한다. 쌍별 선호는 자동화율에서 동일하게 실패로 분류된 산출물 사이의 차이를 구분한다.
4.1 Experimental Setup
평가한 시스템은 ChatGPT agent, GPT-5, Claude Sonnet 4.5, Grok 4, Gemini 2.5 Pro, Manus다. Scaffold는 모델을 둘러싼 실행 환경과 도구를 뜻한다. 실험에서는 통합 에이전트 기능, 그래픽 상호작용을 위한 computer-use agent(CUA) 환경, 또는 셸 작업을 위한 command-line interface(CLI)를 갖춘 OpenHands를 사용한다.
- GPT-5의 주요 결과는 CLI 조건이 CUA 조건보다 성능이 높았기 때문에 OpenHands를 사용한다. Sonnet 4.5는 컴퓨터 사용 scaffold를 사용하고 Grok 4와 Gemini 2.5 Pro는 OpenHands를 사용한다.
- 저자들은 프롬프트를 조정하고 지원 형식에 관한 지침을 제공한다. OpenHands에는 이미지, 음성, 영상 생성을 위해 gpt-image-1, openai/tts-1, veo-3.0-generate-preview도 제공한다.
- Appendix B.6은 컴퓨터 사용 세션의 기본 제한 시간을 1시간으로 명시한다. Figure 12의 평균 생성 비용은 $2.34이며, 관측한 모든 실행의 application programming interface(API) 비용, 즉 모델 서비스 호출 요금은 $30 미만이다.
4.2 Quantitative Results
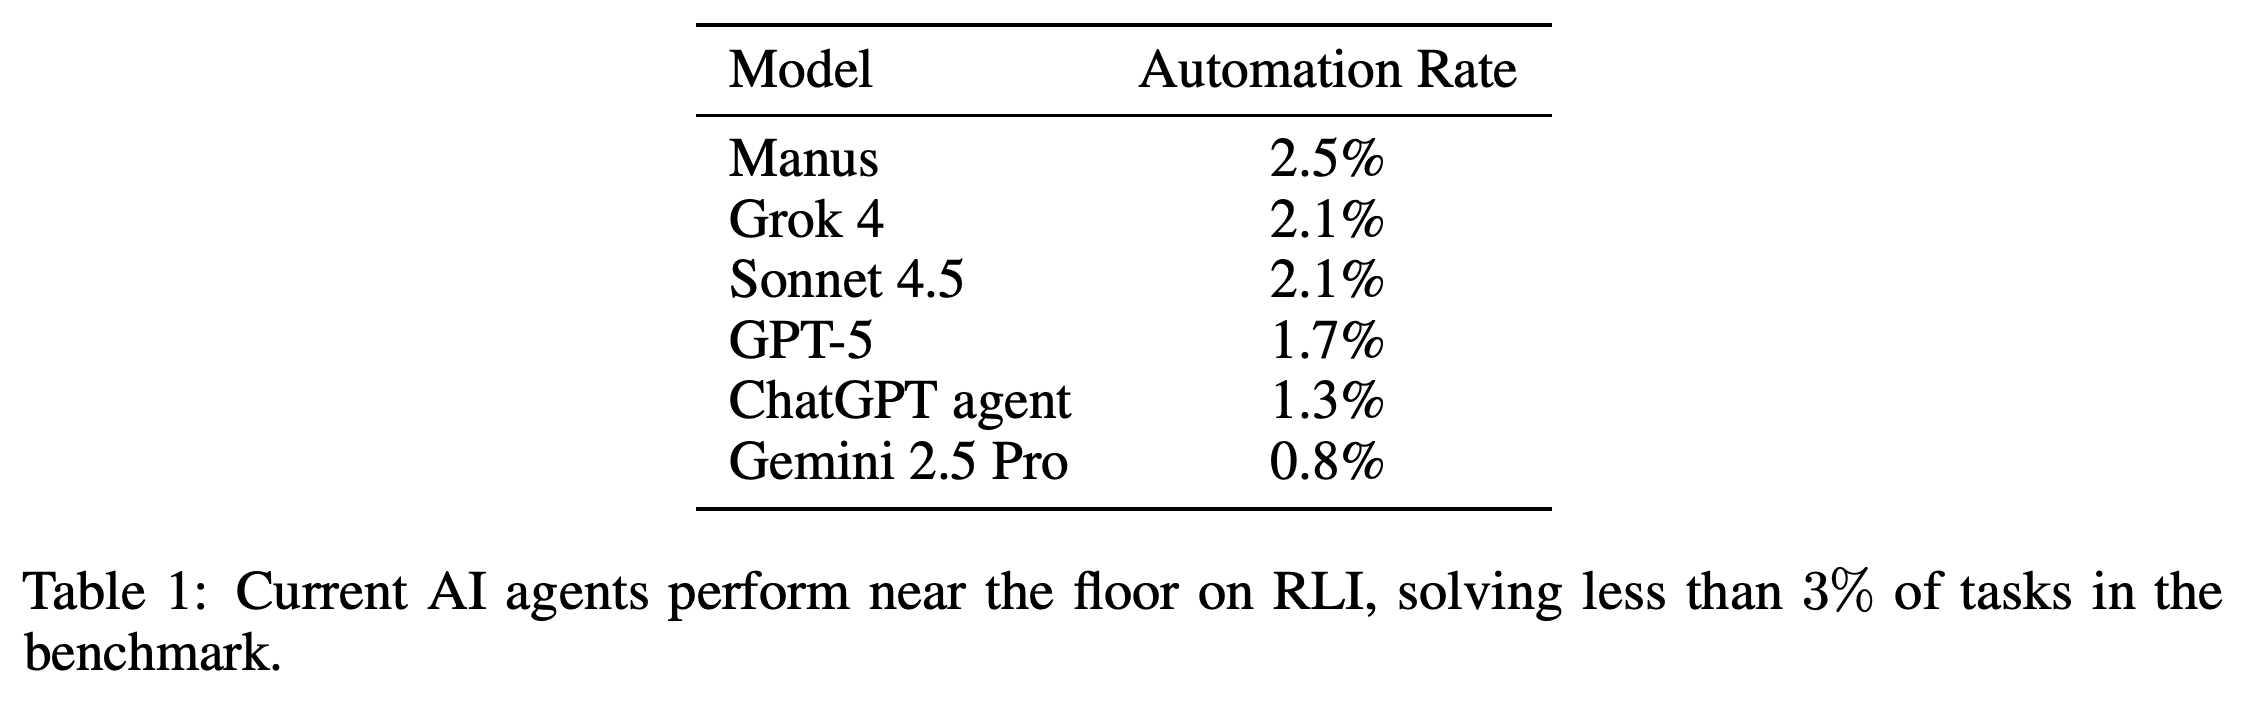
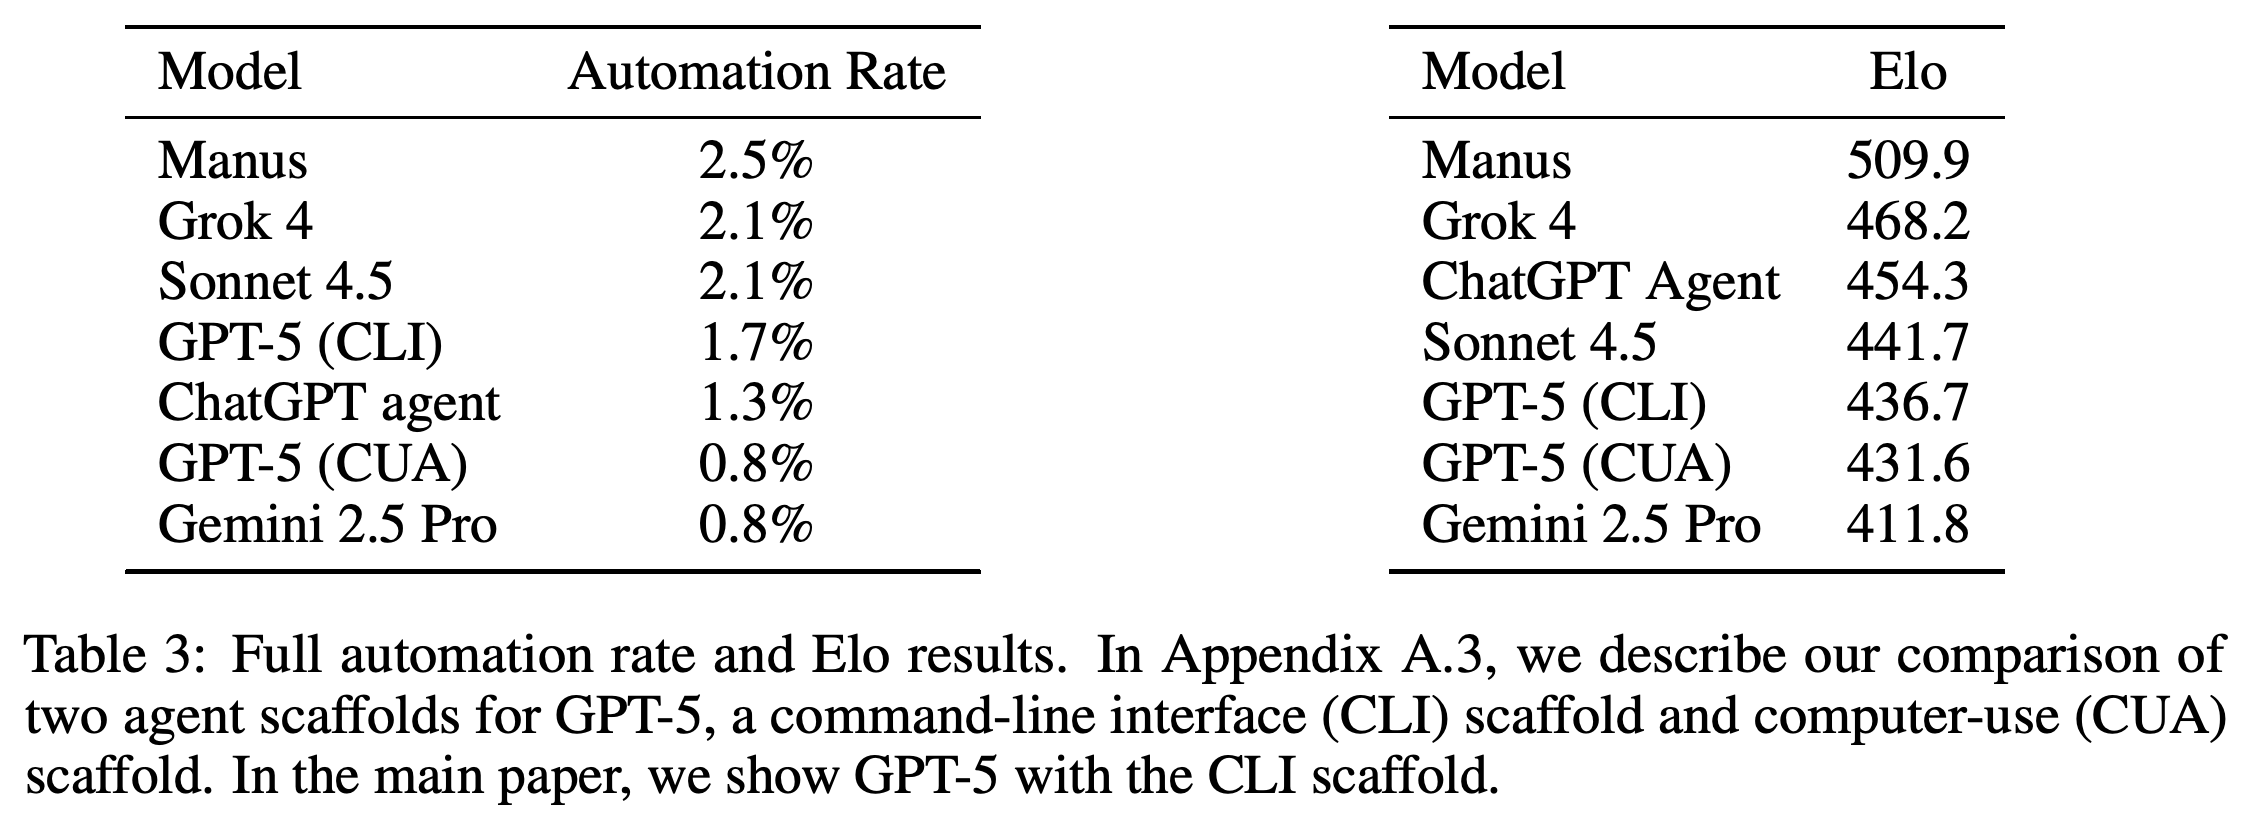
Table 1의 자동화율은 Manus 2.5%, Grok 4 2.1%, Sonnet 4.5 2.1%, GPT-5 1.7%, ChatGPT agent 1.3%, Gemini 2.5 Pro 0.8%다. 이는 평가에 사용한 구성과 전문가 기준 아래에서 프로젝트 전체가 수용된 비율이다.
- Figure 8은 상대적인 성능 차이를 보여준다. Manus는 509.9점, Grok 4는 468.2점, ChatGPT Agent는 454.3점, Sonnet 4.5는 441.7점, GPT-5 (CLI)는 436.7점, Gemini 2.5 Pro는 411.8점이며 모두 사람 기준선인 1,000보다 낮다.
- 논문은 이 순위를 능력 향상의 근거로 해석한다. 보고된 점수는 평가한 시스템을 직접 비교한 결과이며 통제된 조건에서 동일한 시스템 1개를 반복 측정한 결과는 아니다.
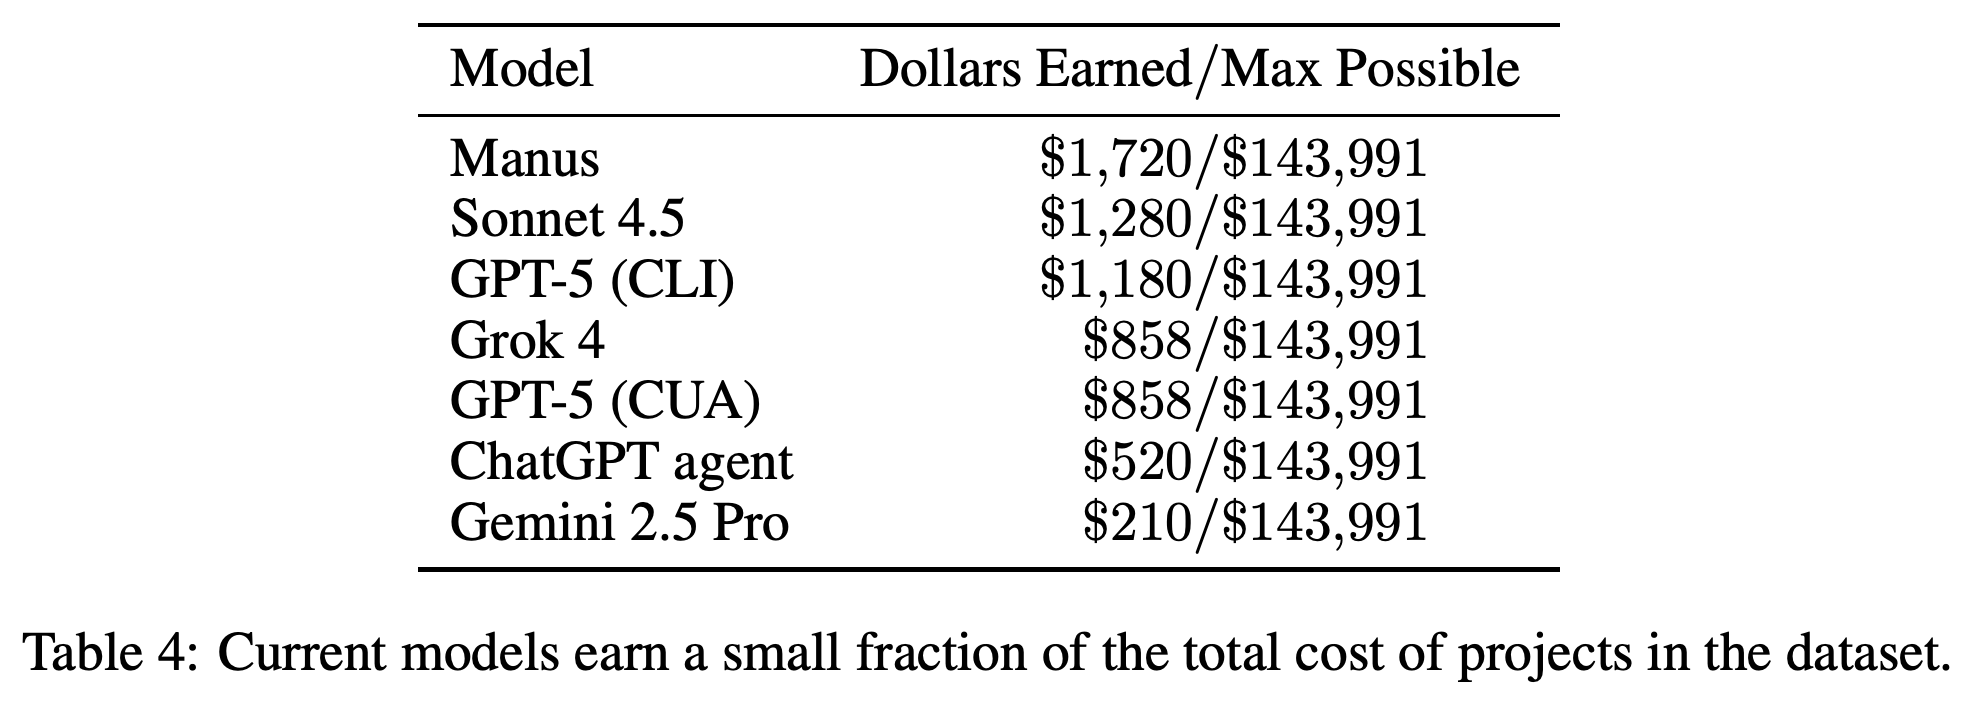
- 경제적 가치 합계도 작다. Table 4에서 Manus가 완수해 수용된 프로젝트의 가치는 $1,720이며, 최대 가치는 $143,991이다.
자동화율은 0.8%에서 2.5%이며, Grok 4와 Sonnet 4.5는 2.1%로 같다. 이 값은 전체 작업이 수용된 프로젝트를 집계하며 유용한 부분 작업의 양을 측정하지 않는다.
쌍별 선호 점수는 수용 기준을 충족한 출력이 적어도 에이전트 간 차이를 구분한다. Manus가 표시된 순위에서 가장 높지만 모든 점수와 표시된 95% 신뢰구간은 정규화한 사람 기준선 1,000보다 낮다. 가로축은 날짜가 아니라 시스템을 비교한다.
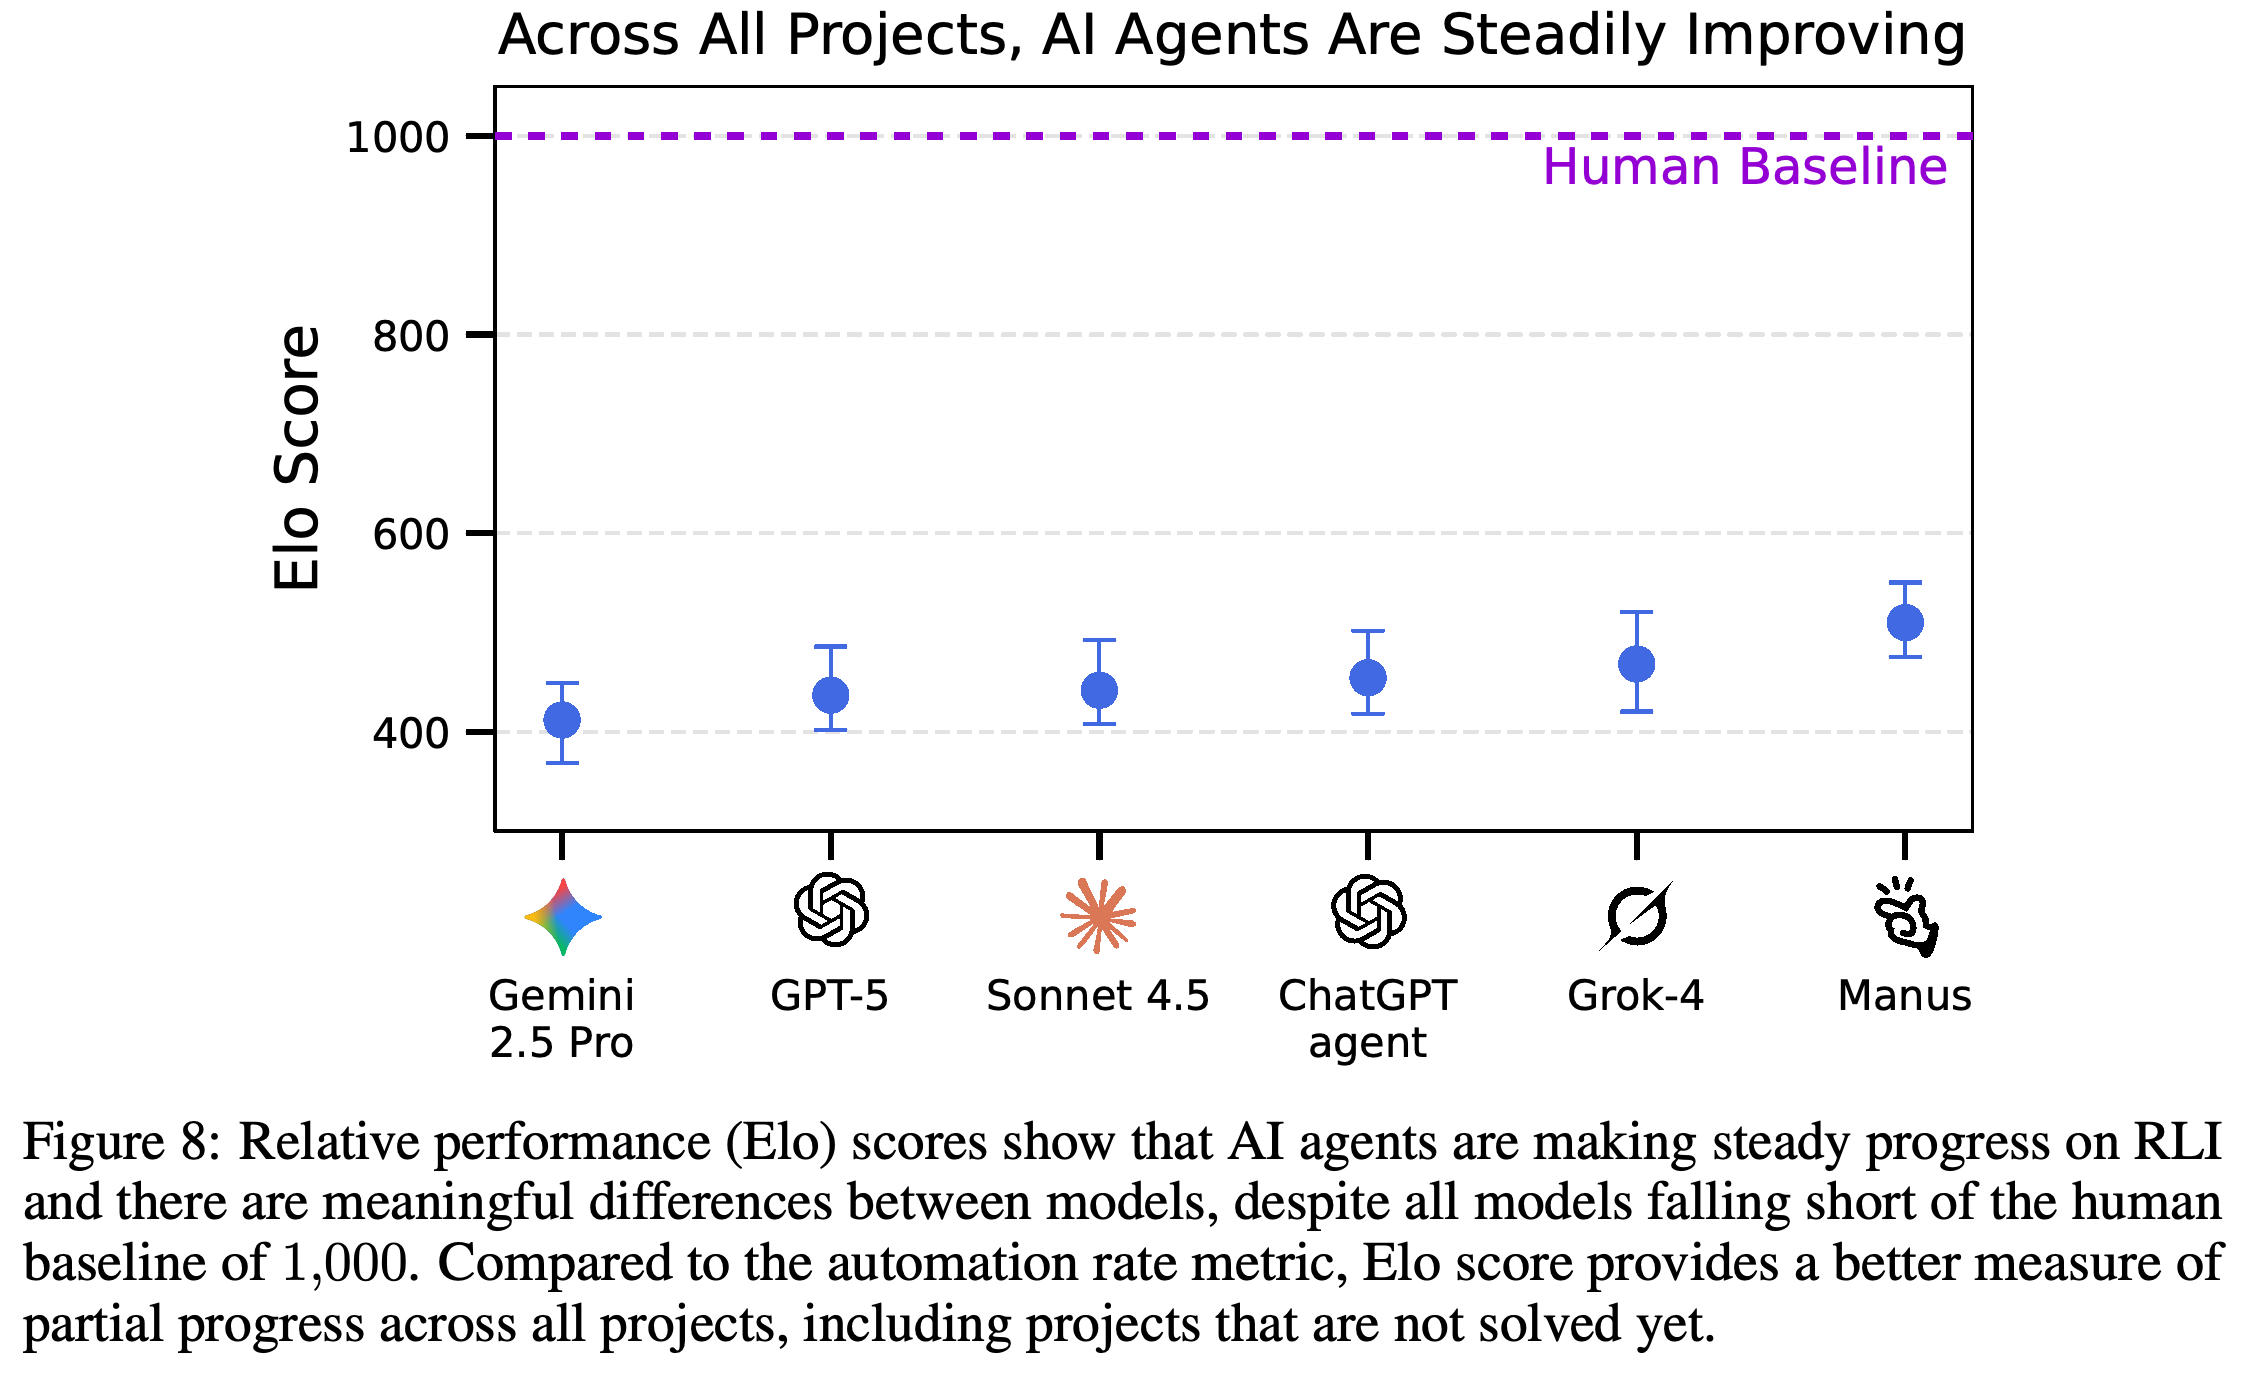
GPT-5는 CLI에서 자동화율 1.7%와 Elo 436.7을 달성하고 CUA에서는 각각 0.8%와 431.6을 달성한다. ChatGPT agent는 자동화율이 더 낮은데도 Elo에서는 Sonnet 4.5와 GPT-5보다 높다. 이는 수용된 프로젝트 수와 상대적인 선호가 시스템 순위를 다르게 매길 수 있음을 보여준다.
Manus가 완수해 수용된 프로젝트의 가치는 $1,720으로 가장 높지만 최대 가치 $143,991에는 크게 못 미친다. Grok 4와 Sonnet 4.5는 자동화율이 같아도 수용된 프로젝트의 보고된 가치가 달라 달러 기준 합계가 다르다.
4.3 Qualitative Findings
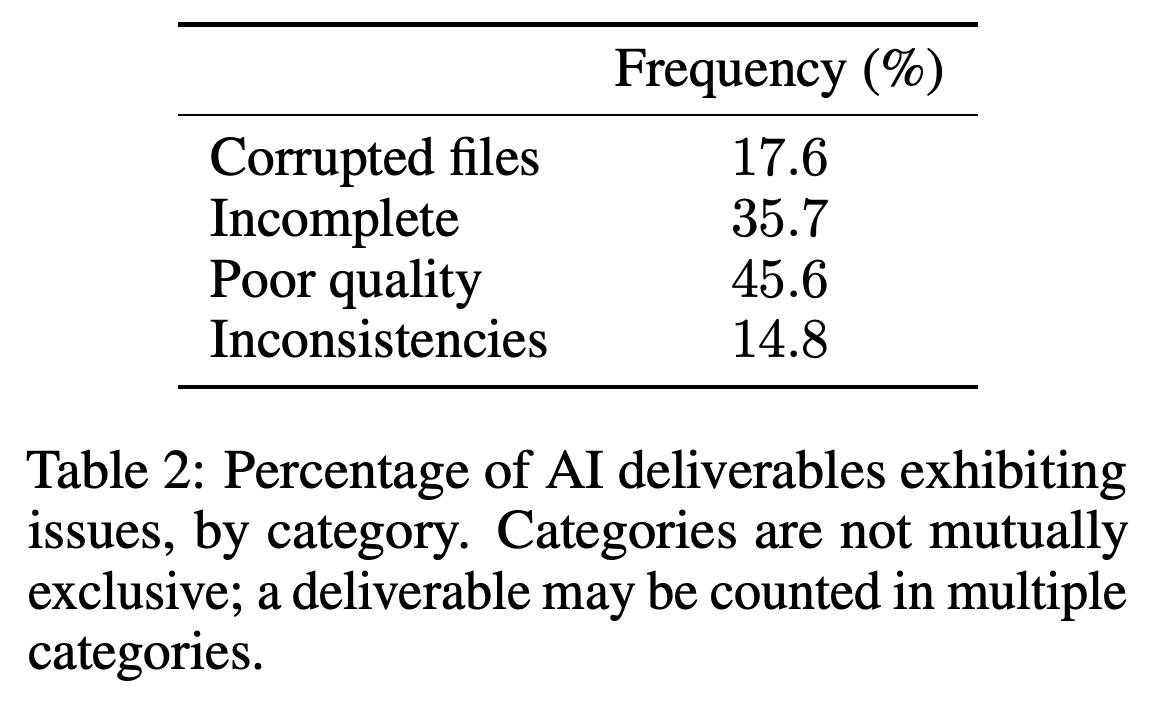
약 400건의 평가에서 평가자의 판단 근거를 군집화한 결과, 반복적으로 나타나는 실패 범주 4개가 확인됐다. Table 2에서 산출물의 17.6%는 손상된 파일, 35.7%는 불완전한 작업, 45.6%는 낮은 품질, 14.8%는 불일치로 분류된다. 같은 산출물이 여러 범주에 포함될 수 있다.
- 사례에는 비어 있거나 사용할 수 없는 파일, 누락된 에셋, 8분을 요청했지만 8초만 재생되는 영상, 부자연스러운 음성 해설, 제공한 스케치와 맞지 않는 평면도, 같은 물체를 다른 시점에서 볼 때 나타나는 시각적 차이가 있다.
- 저자들은 많은 실패가 산출물을 확인하고 수정하기 어려운 데서 비롯된다고 설명한다. 특히 검증에 대화형 시청각 검사가 필요한 경우를 지적한다. 이 설명은 인과 효과를 분리해 검증한 실험이 아니라 정성 분석에서 나온다.
낮은 품질이 45.6%로 가장 자주 나타난 문제이며 불완전한 작업이 35.7%로 그다음이다. 같은 산출물에 여러 분류가 적용될 수 있으므로, 이 비율을 더해 전체 실패율을 구할 수는 없다.
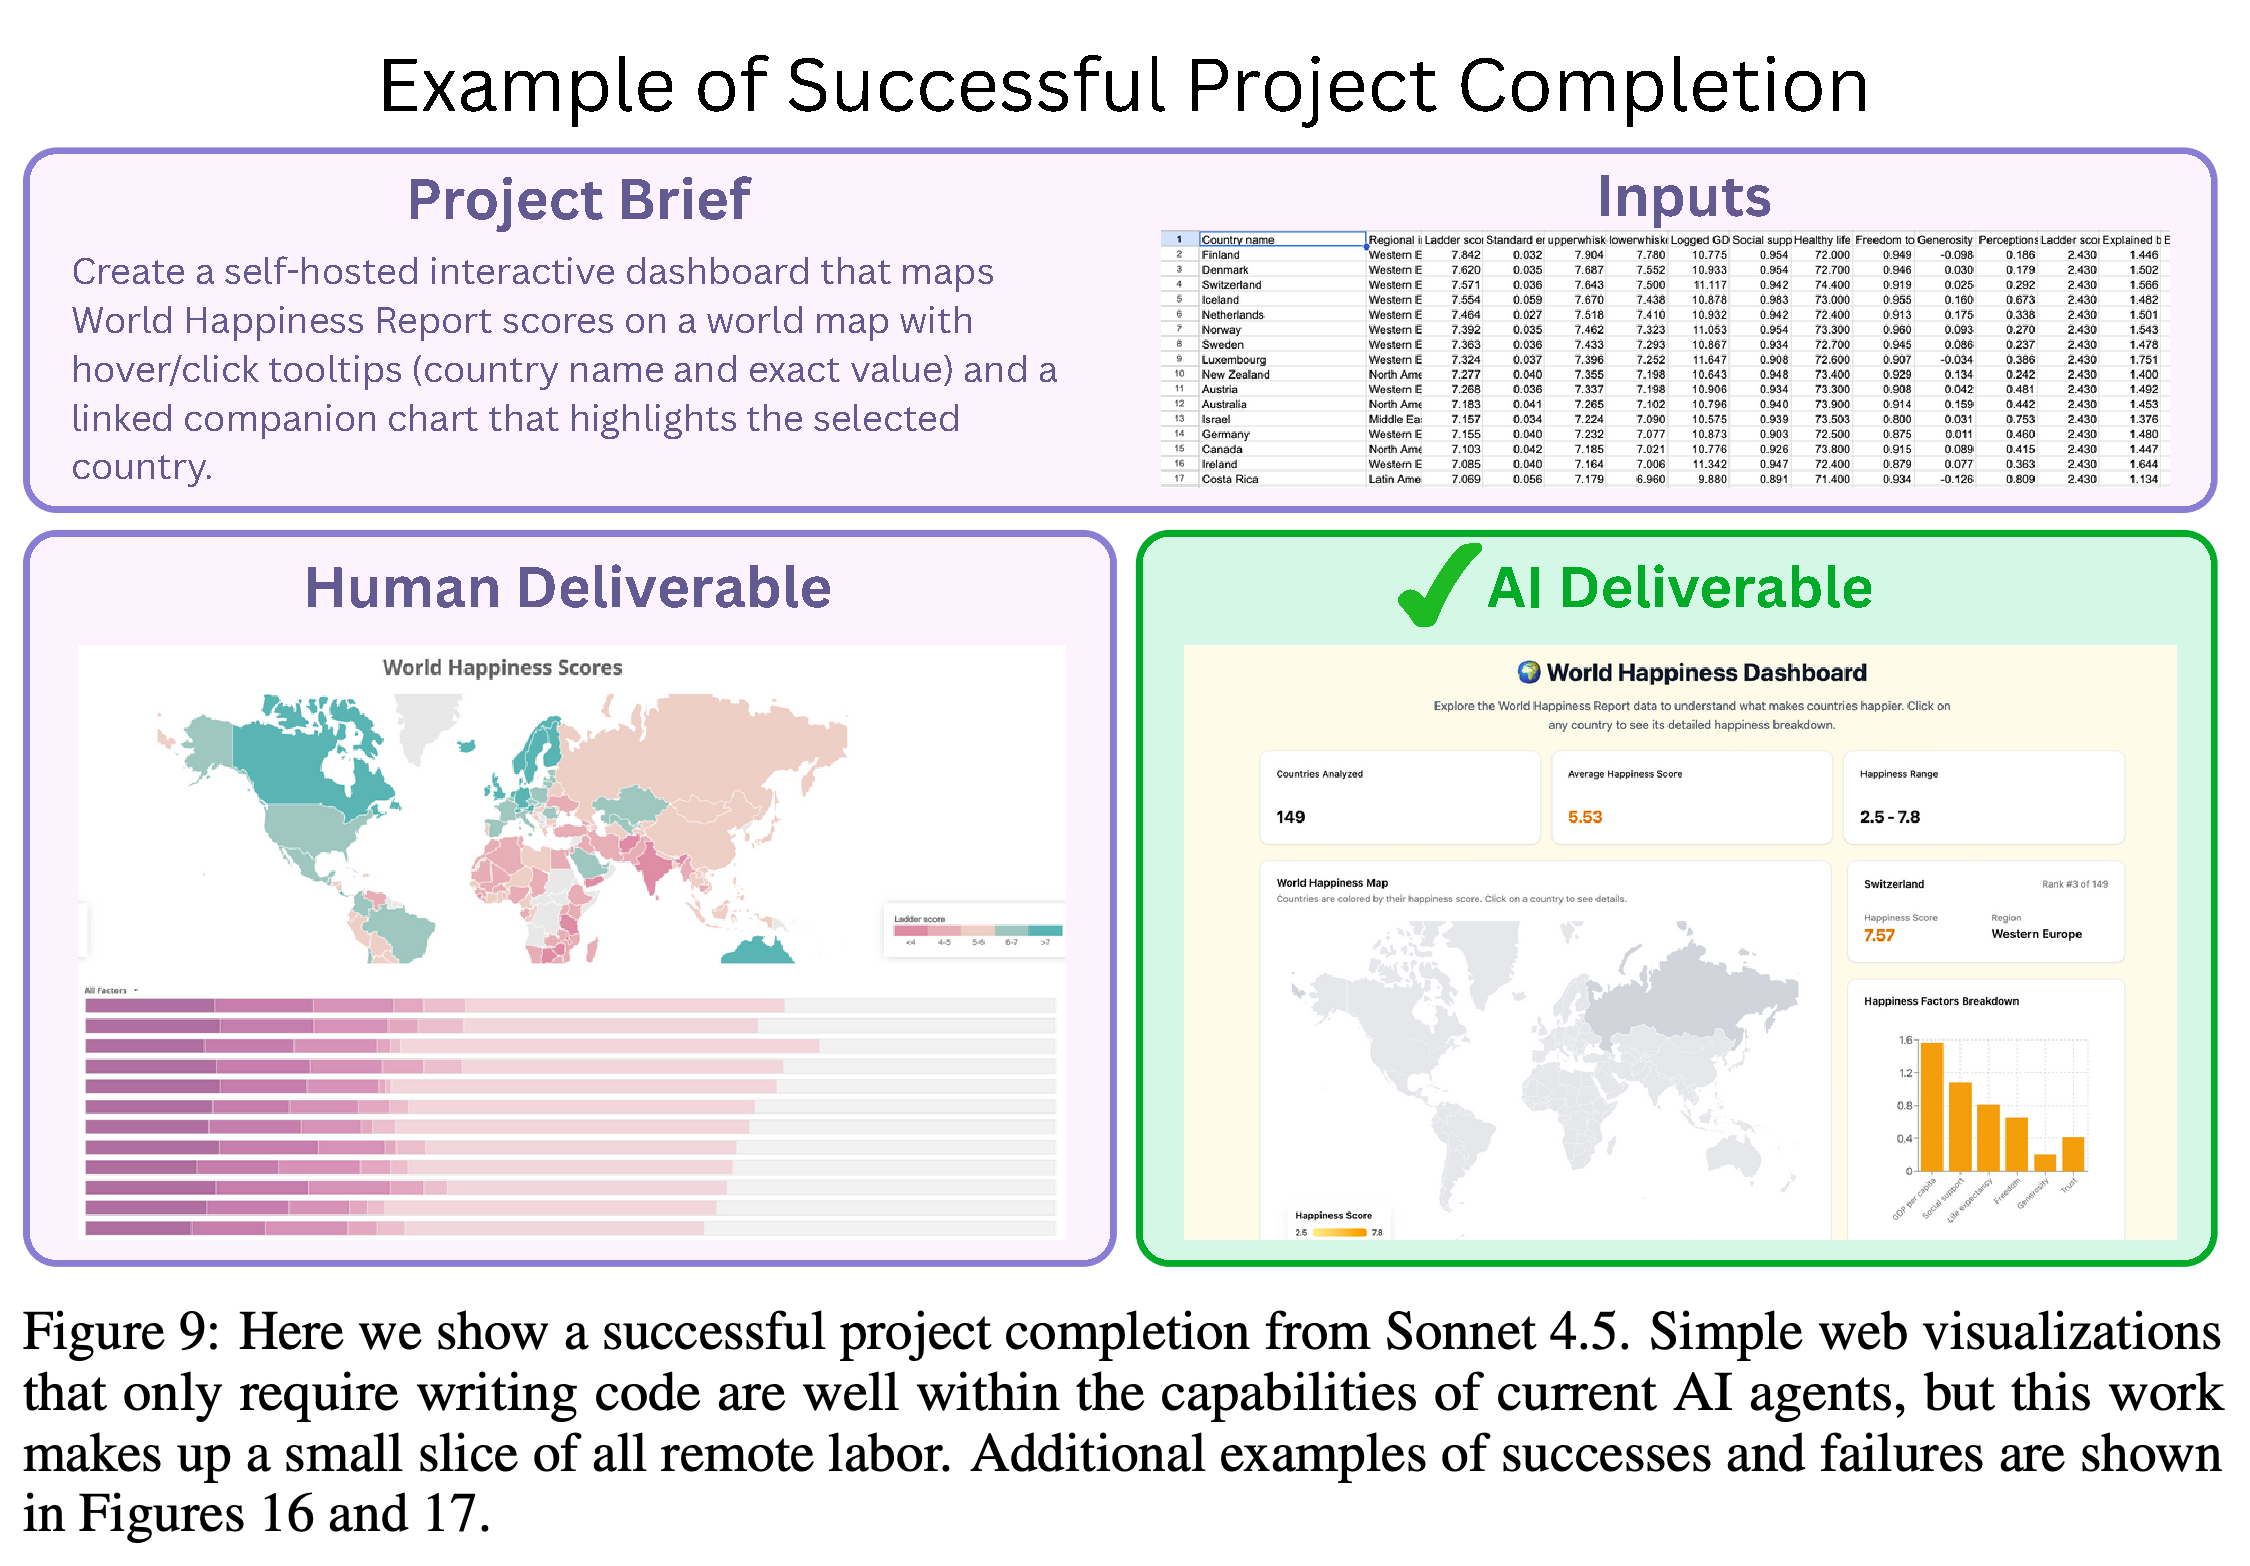
수용된 산출물에는 오디오 편집과 믹싱, 이미지 기반 광고와 로고, 보고서 작성, 데이터 수집, 대화형 시각화 코드가 있다. Figure 9는 수용된 Sonnet 4.5의 World Happiness Report 대시보드를 보여준다. Figures 16과 17은 수용된 Manus 광고와 거절된 애니메이션 및 제품 시연 프로젝트를 보여준다.
- 논문은 특정 작업 과정에서의 성공을 설명하지만 분야별 순위를 신뢰성 있게 매길 만큼 충분한 범주별 성공률은 제공하지 않는다.
- 대시보드 작업 설명서는 지도와 차트의 연동을 요구한다. 이는 프로젝트 수용 기준에 외관뿐 아니라 기능적 동작도 포함될 수 있음을 보여준다.
그림은 제공된 데이터와 대시보드 요구사항을 전문가 기준 산출물 및 수용된 Sonnet 4.5 출력 위에 배치한다. 대화형 코딩 프로젝트의 성공 사례를 보여주지만 시각화 작업 전반의 성공률을 입증하지는 않는다.
5 Discussion
논의에서는 AI가 일반적인 인지 능력을 바탕으로 새롭게 등장하는 일자리도 자동화할 수 있다고 제안한다. 보고된 실험은 기존 프로젝트를 평가하며 미래 작업에 대한 이러한 일반화를 직접 검증하지는 않는다.
- RLI는 필수적인 고객 소통, 팀 작업, 시간이 지난 뒤의 결과 평가, 웹 뷰어에 적합하지 않은 산출물을 제외한다. 자동화율이 100%여도 이러한 활동은 검증되지 않는다.
- 사람의 프로젝트 비용은 과거 금액이며 물가 상승을 반영하지 않는다. 완료 날짜를 아는 프로젝트 대부분은 이전 5년 이내에 완료됐다.
- Appendix C.2는 해당 프로젝트 중 상당수를 AI가 이미 해결할 수 있다는 이유로 Content Writing과 관련 범주를 제외한다. 이러한 범주 선택은 전체 자동화율의 해석에 영향을 준다.
6 Conclusion
논문은 디지털 프리랜서 작업 범주 23개에 걸친 프로젝트 240개를 자율적인 프로젝트 완수 능력을 측정하는 경제적 근거로 제시한다. 3% 미만의 자동화율은 RLI에서 평가한 에이전트의 산출물과 전문가 기준 산출물 사이에 수용 가능성의 큰 격차가 있음을 보여준다. 쌍별 선호 점수는 부분적인 완수 정도와 품질을 구분한다.
부록
- A Additional Results, A.1 Full Results: Table 3은 주요 구성과 함께 GPT-5 (CUA)의 자동화율 0.8%와 Elo 431.6을 제시한다. Table 4에서 수용된 프로젝트의 가치는 Manus $1,720, Sonnet 4.5 $1,280, GPT-5 (CLI) $1,180, Grok 4 $858, GPT-5 (CUA) $858, ChatGPT agent $520, Gemini 2.5 Pro $210이다. 각 결과에서 가능한 최대 가치는 $143,991이다.
- A.2 Autoflation: Figure 10은 평가한 시스템이 사용 가능해짐에 따라 고정된 프로젝트 묶음의 실질적인 비용 절감률이 어떻게 변하는지 보여준다. AI가 전문가 기준보다 낮은 비용으로 프로젝트를 수용 가능한 수준으로 완수할 때만 AI를 선택한다. 실패한 작업을 잘못 수용하는 거짓 양성이 이 지표를 왜곡할 수 있기 때문에 저자들은 성공한 산출물을 감사한다. A.3 Effect of Agent Scaffolds: GPT-5 (CLI)는 Elo 436.7과 자동화율 1.7%를 달성하고 GPT-5 (CUA)는 각각 431.6과 0.8%를 달성한다. 이는 실험에 사용한 GPT-5 설정 간의 차이를 보여준다.
- B Evaluation Details, B.1 Model Details: Manus 산출물 대부분은 2025년 6월에 생성됐고, 일부는 2025년 9월에 생성됐다. Gemini 평가에는 Gemini 2.5 Pro를 사용한다. B.2 Elo Computation: 무작위 순서와 층화 표본 추출을 사용해 각 모델 쌍을 최소 10개 프로젝트에서 비교하며 비교 프로젝트 수의 중앙값은 25개다. 이 선호 결과를 모델과 사람 간 평가 결과와 결합한다. 쌍별 선호 확률을 모델링하는 Bradley-Terry 모형을 적합해 점수를 산출한다. 프로젝트 집합을 다시 표본 추출하는 프로젝트 단위 bootstrap 표본 100개로 Figure 8의 95% 신뢰구간을 산출한다.
- B.3 Evaluation and Generation Budgets: 검토의 권장 시간 상한은 자동화율 평가에서 20분, Elo 평가에서 30분이다. Figure 11의 평균 소요 시간은 각각 11.4분과 17.4분이며 일부 검토는 이 상한을 넘는다. B.4 Evaluation Instructions: 훈련에서는 합리적인 고객의 관점, 전문가 기준 산출물에서 허용할 수 있는 오류 범위, 사소한 결함이나 중요하지 않은 누락에 대한 허용, 흔한 AI 실패를 강조한다. 무작위 부분집합에서 일치율이 최소 85%에 도달하도록 지침과 평가자들의 평가 품질을 개선했으며 최종 자동화율 평가의 일치율은 94.4%다.
- B.5 Evaluation verification: 저자들은 전문가 기준과 동등하거나 더 우수하다고 분류된 모든 사례를 수동으로 감사한다. 공동 저자들은 무작위 프로젝트 50개에서 사람과 모델의 산출물 쌍을 추가로 검토했다. 수용 가능한 AI 작업을 잘못 거절하는 거짓 음성은 발견되지 않았다. 이에 따라 보고한 거짓 음성률 상한은 95% 신뢰수준에서 ≤5.8%다. 이 표본에서 오류가 발견되지 않았다고 해서 전체 벤치마크에도 오류가 없다고 볼 수는 없다.
- B.6 Agent Setup: 통합 에이전트, 컴퓨터 사용 환경, OpenHands에는 작업 설명서, 입력 파일, 지원하는 출력 형식 명세를 제공한다. OpenHands에는 이미지, 음성, 영상 도구가 포함된다. 컴퓨터 사용 환경에는 마우스, 키보드, 스크린샷, 파일 편집, 셸 도구가 포함되며, 기본 세션 제한 시간은 1시간이다. Sonnet 4.5에는 출력 검증 지침과 1M 토큰을 넘는 맥락 관리 기능을 추가로 제공한다. 토큰은 모델의 입력 및 출력 텍스트 단위다. Figure 12의 생성 비용은 평균 $2.34, 중앙값 $0.92, 최솟값 $0.03, 최댓값 $29.51이다.
- B.7 Evaluation Platform Details: 오픈 소스 뷰어는 문서, 스프레드시트, Office 파일, 이미지, 오디오, 영상, 디자인 파일, 3개 차원을 갖춘 모델, 데이터베이스, 대화형 웹사이트, Anki 플래시카드 패키지를 지원하며 형식마다 제약이 있다. 평가자 참고사항이 있는 프로젝트는 20개 미만이다. 일부 참고사항은 전문가 기준 산출물의 추가 기능이 작업 설명서 범위를 벗어나므로 평가에서 제외해야 한다고 명시한다. Figure 13은 작업 설명서, 파일 디렉터리, 나란히 배치한 대화형 반지 모델을 보여준다.
- C Dataset Details, C.1 Categorization: Upwork 분류 체계에는 대분류 12개와 하위 범주 64개가 있으며 최종 데이터셋은 대분류 9개와 하위 범주 23개를 포함한다. 저자들은 US의 직업별 요구사항과 작업 활동을 분류하는 O*NET보다 이 체계를 선호한다. 장기적인 직무 책임이나 일반적인 활동 명칭은 프리랜서 프로젝트 전체를 분류하는 데 덜 적합하기 때문이다. Figure 14는 RLI의 파일 수와 형식 다양성을 GDPval과 비교한다.
- C.2 Filtering & Cleaning Criteria: 수집 가능한 작업은 원격으로 수행할 수 있고, 필요한 자료를 자체적으로 갖추며, 독립적으로 수행하고 즉시 평가할 수 있어야 한다. 산출물은 플랫폼에서 확인할 수 있어야 한다. 고객이나 실시간 서비스와의 필수 상호작용이 없어야 하며, 허가 없는 스크래핑과 특정 작업 범주는 제외한다. 정제 과정에서는 완전성, 익명화, 수용 가능한 전문가 기준 산출물, 입력 품질, 원래 요청에 대한 충실성, 표준화된 작업 설명서, 뷰어에서 확인 가능한지를 점검한다. 부록은 수집 가능한 범주를 45개로 보고하지만 Section 3.2는 43개로 보고한다. 제공된 버전은 이 차이를 설명하지 않는다.
- C.3 Analysis Details: 작업 시간 비교에는 공개된 GDPval 및 HCAST 자료와 프리랜서 60명의 무작위 표본에서 얻은 완료된 Upwork 일감 275건을 사용한다. 텍스트 분류에 사용하는 평가용 대규모 언어 모델(LLM)이 RLI와 GDPval 작업 설명서를 소프트웨어, 조사 및 글쓰기, 기타로 분류한다. HCAST는 수동으로 분류하며 Upwork 유형 추정치는 분류 체계의 범주명을 분류한다. 부록은 이 추정치가 일감 단위의 분포가 아니라고 명시한다. 일감 단위로 보면 소프트웨어 작업에 더 치우친 분포가 나타날 것이라고 설명한다.
- C.4 Data Collection Details: 프리랜서는 작업물을 판매할 권리가 있음을 확인한다. 식별 정보나 저작권이 있는 자료는 가리거나 대체하며 추가 사례는 구매하거나 저자의 허가를 받아 사용한다. C.5 Project cost and completion time.: 전문가는 비용을 US dollars(USD)로, 작업 시간을 시간 단위로 자기 보고하며 범위를 제시한 경우 중간값을 사용한다. 프로젝트의 95%는 비용 자료가 있고, 84%는 시간 자료가 있으며 5%는 모두 없다. 각 지표에서는 필요한 값이 없는 프로젝트를 제외한다. Figure 15는 로그 변환한 비용과 작업 시간 사이의 Pearson 상관계수를 0.785로 보고한다. 이 계수는 선형 관계의 정도를 측정한다.
- C.6 AI Deliverable Examples: Figure 16은 수용된 Manus의 Halloween 광고를 보여준다. Figure 17은 거절된 Gemini 2.5 Pro의 설명 애니메이션과 GPT-5의 이어버드 시연을 보여준다. C.7 Detailed Project Examples: Figures 18과 19는 이어버드 애니메이션과 모델, 실내 디자인과 가구 배치, Mega-Merge 웹 게임, World Happiness Index 대시보드의 상세 작업 설명서를 제시한다. 요구사항에는 이어버드 영상 5개와 모델, 욕실 디자인 대안 3개, 가구 배치 6개, 5 MB 미만의 전체 게임 파일 크기가 포함된다.
짧은 생각
전문가 기준 산출물은 프로젝트 수용 기준을 구체적으로 만든다. 평가자는 작동하는 시연만으로는 드러나지 않을 수 있는 산출물 누락, 사용할 수 없는 파일, 품질 문제를 식별할 수 있다. 관측된 이러한 실패는 에이전트 개발에서 산출물 검사와 출력 검증을 우선할 근거가 된다.
2.5%라는 결과는 실험에 사용한 구성에서 RLI 성능을 측정한 값이다. 범주 제외, 비공개 시험 데이터, 서로 다른 도구와 프롬프트, 과거 비용에 대한 자기 보고, 생성 예산을 달리하는 실험의 부재는 실제 배포 성능과 경제적 대체에 관한 폭넓은 주장을 제한한다.