


BitNet b1.58 2B4T Technical Report 요약 설명
16 Apr 2025 | Paper Review Model Compression LLM Pretraining On-Device Inference목차
이번 글에서는 BitNet b1.58 2B4T Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 16일(Arxiv)
- Ma, Shuming, Wang, Hongyu, Huang, Shaohan, Zhang, Xingxing, Hu, Ying, Song, Ting, Xia, Yan, Wei, Furu.
- Microsoft Research, University of Chinese Academy of Sciences, Tsinghua University
- 논문 링크
요약
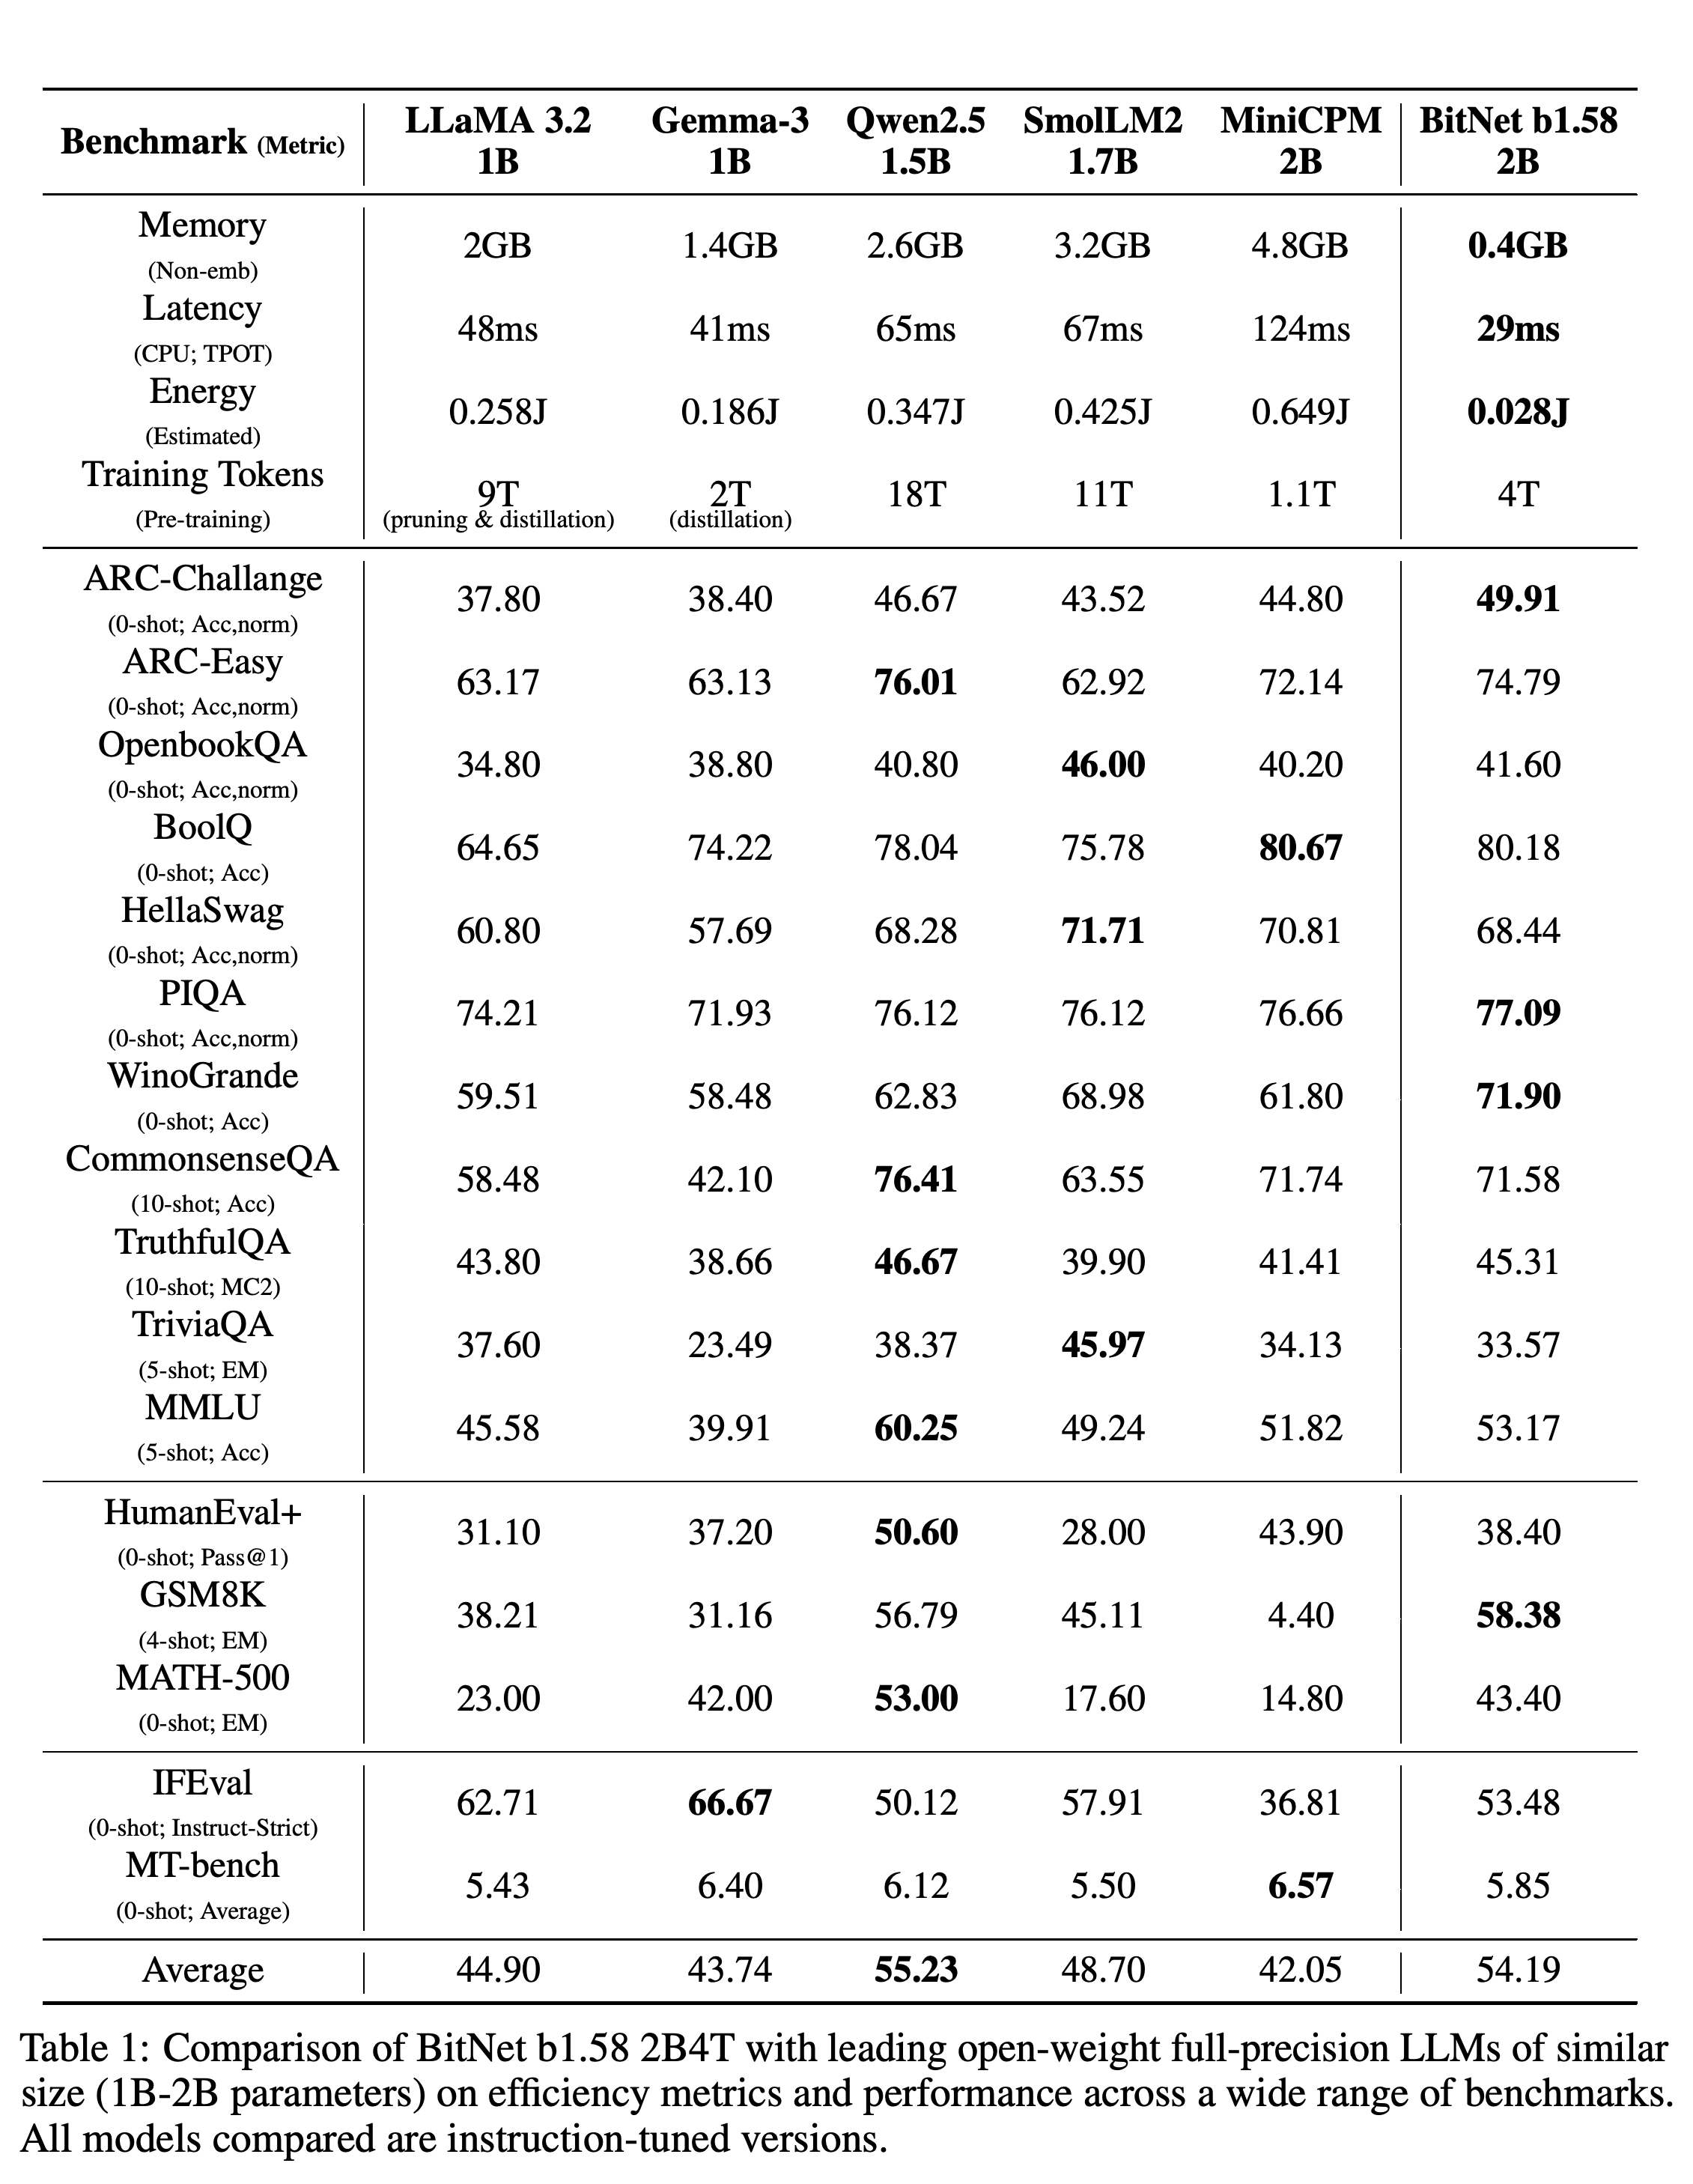
- 언어를 처리하고 생성하는 대규모 언어 모델(LLM)을 배포하려면 상당한 메모리와 에너지가 필요하며, 출력 토큰을 생성하는 데도 시간이 든다. BitNet b1.58 2B4T는 4 trillion 토큰으로 학습한 2B 매개변수 모델이다. Table 1에 보고된 평균 점수는 54.19로, 지시 학습을 거친 Qwen2.5 1.5B의 55.23에 근접한다. 임베딩을 제외한 가중치 메모리는 각각 0.4GB와 2.6GB이며, 보고된 중앙처리장치(CPU) 노트북 벤치마크에서 출력 토큰당 소요 시간은 각각 29ms와 65ms다.
- 모델은 {−1, 0, +1}로 제한한 삼진 가중치와 8비트 정수 활성화값을 사용해 처음부터 학습한다. 활성화값은 계층 사이에 전달되는 중간값이다. 학습은 텍스트와 코드 사전 학습, 지시 및 대화 예제를 활용하는 지도 미세 조정(SFT), 별도 보상 모델 없이 응답 선호도로 학습하는 Direct Preference Optimization(DPO)으로 구성된다.
- 이 모델은 실험에서 비교한 소형 모델들 사이에서 성능 대비 메모리 효율이 좋다. 평가한 4비트 Qwen2.5 변형과 다른 near-1-bit models보다 보고된 평균 점수가 높다. 0.4GB에는 학습된 토큰 표현인 임베딩이 포함되지 않는다. 에너지는 산술 연산을 바탕으로 추정했으며, 디코딩 지연 시간은 단일 CPU 구성에서 측정했다. BitNet과 비교 모델에는 서로 다른 추론 라이브러리를 사용했다.
1 Introduction
Introduction에서는 로컬에서 연산을 수행하는 엣지 기기와 짧은 응답 지연 시간이 필요한 애플리케이션에서 공개 언어 모델을 사용하는 데 배포 자원이 제약이 된다고 설명한다. 학습이 끝난 뒤 수치 정밀도를 낮추는 학습 후 양자화(PTQ)와 처음부터 양자화된 가중치를 사용하는 네이티브 저비트 학습을 구분한다.
- 논문이 제시하는 기여는 2B 매개변수와 학습 토큰 4 trillion개 규모의 native 1-bit model이 언어, 수학, 코드, 대화 평가에서 비슷한 크기의 전체 정밀도 모델에 근접한다는 점이다. 여기서 논문의 1비트라는 용어에는 1.58비트로 표현하는 삼진 가중치가 포함된다.
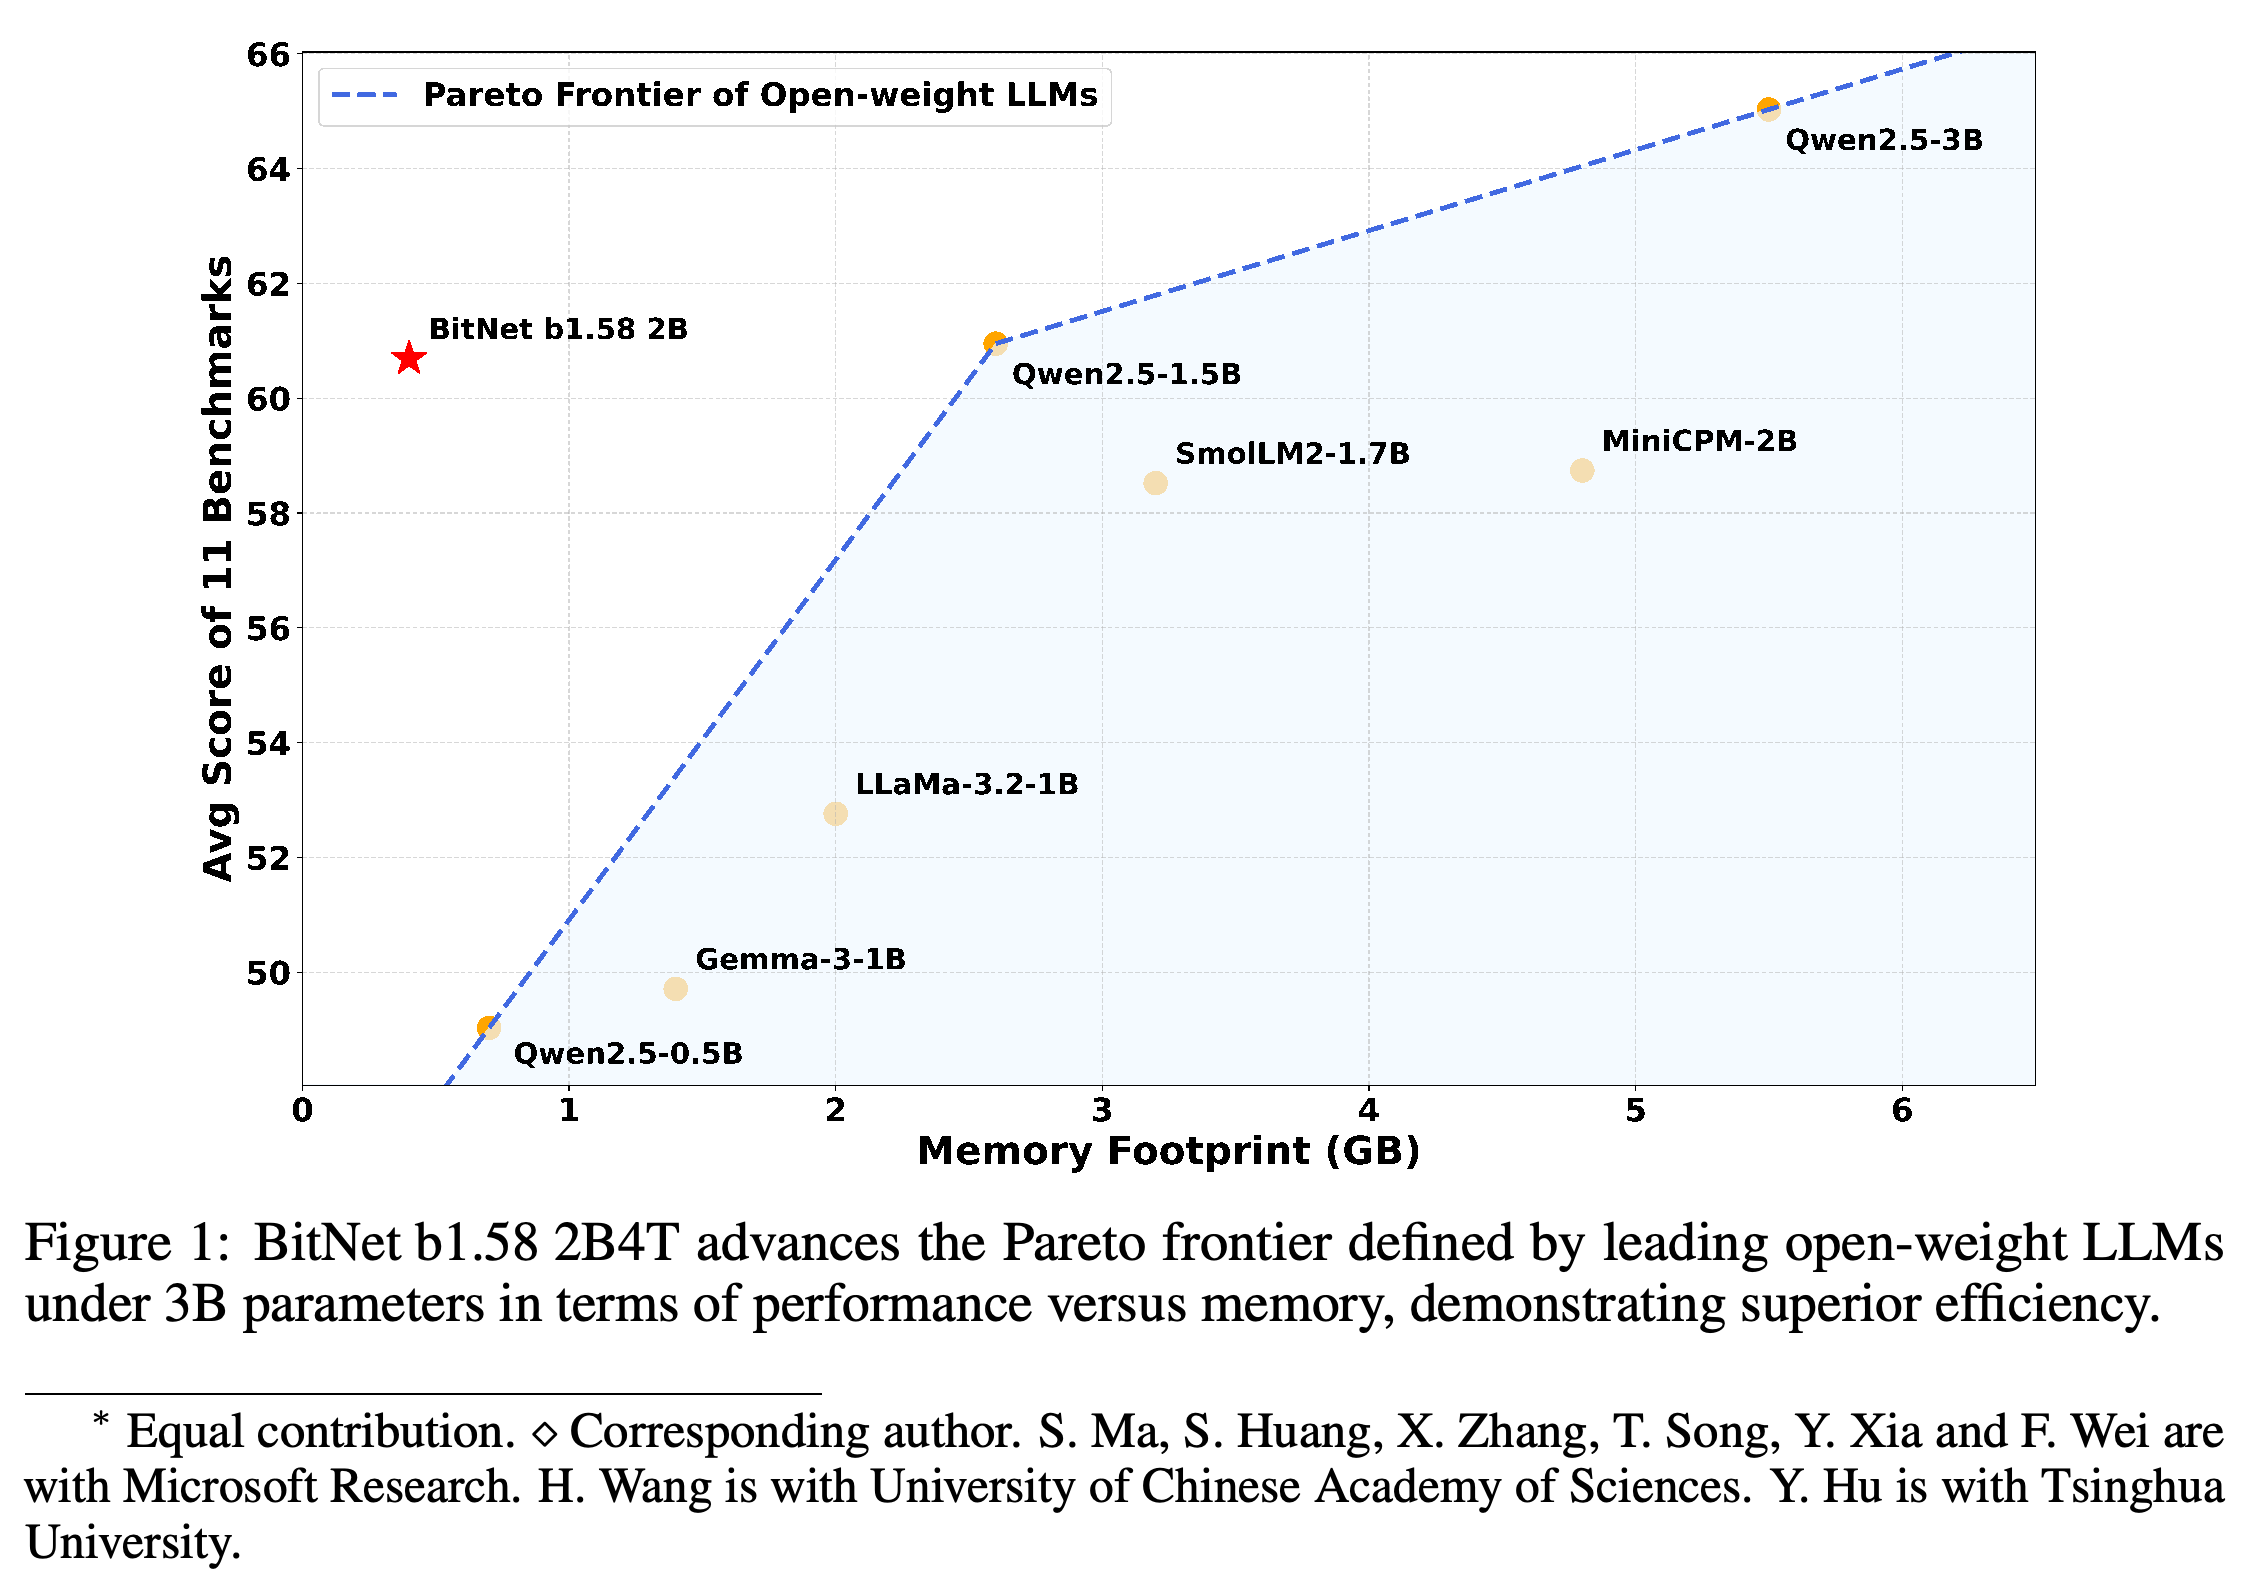
- Figure 1은 11개 벤치마크의 평균 성능과 메모리 사용량을 비교한다. 이 벤치마크 집계는 더 넓은 평가 범위를 다루는 Table 1의 집계와 다르다.
BitNet은 11개 벤치마크에서 Qwen2.5 1.5B와 거의 같은 성능 수준을 보이면서 메모리를 훨씬 적게 사용한다. 이 그래프는 성능 대비 메모리 효율이 좋다는 점을 뒷받침한다. 다만 11개 과제의 집계는 더 넓은 평가 범위를 다루는 Table 1의 보고 평균과 다르다.
2 Architecture
모델 구조는 보고서에서 표준 언어 모델 구조로 사용하는 Transformer를 기반으로 한다. torch.nn.Linear를 순전파 중 가중치를 양자화하는 맞춤형 선형 계층인 BitLinear로 교체한다. 가중치에는 절댓값 평균을 기준으로 {−1, 0, +1}에 매핑하는 absmean 양자화를 적용한다. 활성화값에는 토큰별 절댓값 최댓값을 기준으로 8비트 정수를 만드는 absmax 양자화를 적용한다. 학습 안정성을 위한 정규화 방법인 subln도 사용한다.
- 변환을 수행하는 하위 계층인 피드포워드 네트워크(FFN)에는 희소성과 연산상의 이점을 기대해 squared ReLU(ReLU²)를 사용한다. 이는 정류 선형 활성화값을 제곱하는 함수다. Rotary Position Embeddings(RoPE)로 위치 정보를 제공하며, 선형 계층과 정규화 계층에서는 편향 항을 생략한다.
- 어휘 크기가 128,256토큰인 LLaMA 3 토크나이저를 채택한다. 이 토크나이저는 바이트 단위 Byte-Pair Encoding(BPE)을 사용해 텍스트를 토큰으로 변환한다.
- 1.58비트라는 명칭은 삼진 가중치를 가리키며, 학습이나 추론에 사용하는 모든 값의 정밀도를 뜻하지는 않는다. 논문은 학습용 마스터 가중치를 16비트 부동소수점 형식인 bf16으로 별도 공개하며, 추론용으로는 패킹한 가중치를 공개한다.
3 Training
학습은 사전 학습, SFT, DPO 순서로 진행한다. 보상을 통해 동작을 최적화하는 추가 강화 학습은 이번 공개 모델의 향후 확장 방안으로 제안한다.
3.1 Pre-training
사전 학습은 4 trillion 토큰에 걸쳐 two-stage 일정으로 진행한다. 1단계에서는 비교적 높은 최대 학습률과 코사인 곡선을 따라 학습률을 부드럽게 낮추는 코사인 감쇠를 결합한다. 계획한 토큰 수의 대략 중간 지점에서 쿨다운 단계로 전환해 학습률을 급격히 낮춘 뒤, 최대 학습률이 더 낮은 코사인 일정을 이어간다.
- 3.1.1 Learning Rate Schedule에서는 1비트 학습이 더 안정적이라는 저자들의 관찰을 근거로 높은 초기 학습률을 사용했다고 설명한다. 정확한 최대 학습률은 제시하지 않는다.
- 3.1.2 Weight Decay Schedule에서는 정규화 설정인 가중치 감쇠에 코사인 일정을 적용한다. Stage 1의 최댓값은 0.1이며, 단계 2에서는 zero로 설정한다.
- 3.1.3 Pre-training Data에서는 DCLM 웹 데이터, FineWeb-EDU 교육용 페이지, 합성 수학 데이터를 비롯한 공개 텍스트와 코드를 결합한다. Stage 1에서는 일반 웹 데이터가 주를 이루며, 쿨다운 단계에서는 선별한 고품질 데이터의 비중을 높인다.
3.2 Supervised Fine-tuning (SFT)
SFT는 공개 지시 및 대화 데이터셋인 WildChat, LMSYS-Chat-1M, WizardLM Evol-Instruct, SlimOrca를 사용해 지시 수행과 대화 능력을 학습한다. 지시 학습 데이터를 구성하는 방법인 GLAN과 MathScale로 생성한 합성 예제도 추가한다. 저자들은 토큰 예측을 위한 학습 손실인 토큰 교차 엔트로피 손실을 평균내는 대신 합산할 때 수렴이 더 좋았다고 보고한다. 일반적인 전체 정밀도 미세 조정보다 비교적 높은 학습률을 사용하고, 데이터를 반복해서 학습하는 횟수인 에포크도 늘렸다.
- 3.2.1 SFT Data에서는 공개 대화 데이터와 추론 및 복잡한 지시 수행을 위한 합성 예제를 결합한다.
- 3.2.2 Chat Template에서는 SFT와 대화형 추론 중 다음 구조를 그대로 사용한다. <|begin_of_text|>System: {system_message}<|eot_id|> User: {user_message_1}<|eot_id|> Assistant: {assistant_message_1}<|eot_id|> User: {user_message_2}<|eot_id|> Assistant: {assistant_message_2}<|eot_id|>…
- 3.2.3 Optimization Details에서는 이러한 손실과 하이퍼파라미터 선택을 정성적으로 설명한다. 각 선택의 효과를 분리한 수치 비교, 정확한 SFT 학습률, 정확한 에포크 수는 제시하지 않는다.
3.3 Direct Preference Optimization (DPO)
DPO는 SFT 이후에 적용하며, 유용성과 안전성에 관한 선호도에 맞춰 응답을 조정한다. 보고된 선호도 데이터 자원 2개인 UltraFeedback과 MagPie를 사용한다. 학습률은 2 × 10⁻⁷, 학습 기간은 2에포크, beta는 0.1이다. beta는 기준 정책, 즉 기준 모델에서 벗어나는 정도를 제어하는 매개변수다.
- 3.3.1 Training Data에서는 공개 선호도 데이터 자원 2개를 결합한다.
- 3.3.2 Training Details에서는 Liger Kernel 라이브러리의 최적화된 연산 루틴을 사용한다. 저자들은 핵심 능력을 크게 잃지 않으면서 선호하는 응답 스타일을 얻었다고 정성적으로 설명한다. 다만 DPO 전후의 정량 비교나 별도의 안전성 평가는 제시하지 않는다.
4 Evaluation
평가는 언어 이해와 추론, 세계 지식, 독해, 수학, 코드 생성, 지시 수행, 대화를 다룬다. 저자들은 공개 평가 파이프라인을 사용해 지시 학습을 거친 LLaMA 3.2 1B, Gemma-3 1B, Qwen2.5 1.5B, SmolLM2 1.7B, MiniCPM 2B를 다시 평가한다. 지시 학습은 모델이 지시에 응답하도록 학습하는 과정이다.
- 언어와 추론 벤치마크는 ARC-Easy, ARC-Challenge, HellaSwag, WinoGrande, PIQA, OpenbookQA, CommonsenseQA다. 세계 지식은 TruthfulQA와 MMLU로, 독해는 TriviaQA와 BoolQ로 평가한다.
- 수학 벤치마크는 GSM8K와 MATH-500이며, 코드 생성에는 HumanEval+를 사용한다. IFEval은 지시 수행을, MT-bench는 대화를 평가한다.
- 비교한 시스템들은 매개변수 수, 사전 학습 토큰 수, 학습 절차가 서로 다르다. 이 평가는 공개된 시스템을 비교하며, 가중치 정밀도의 효과를 분리하기 위해 학습 조건을 통제하지는 않는다.
4.1 Main Results
Table 1에서 BitNet은 임베딩을 제외한 가중치 메모리 0.4GB, 출력 토큰당 CPU 소요 시간 29ms, 추정 산술 연산 에너지 0.028J를 기록한다. 전체 정밀도 기준 모델들의 값은 각각 1.4GB–4.8GB, 41ms–124ms, 0.186J–0.649J다. 보고된 평균 점수는 BitNet이 54.19, Qwen2.5 1.5B가 55.23이다.
- BitNet은 ARC-Challenge 49.91, PIQA 77.09, WinoGrande 71.90, GSM8K 58.38로 비교 모델 중 가장 높은 점수를 기록한다. 앞의 3개는 예제 0개를 제공하는 프롬프팅을 사용하며, GSM8K는 예제 4개를 제공한다.
- 예제 5개를 제공하는 MMLU에서 BitNet은 53.17, Qwen2.5는 60.25를 기록한다. 예제 0개를 제공하는 HumanEval+에서는 각각 38.40과 50.60, 예제 0개를 제공하는 MATH-500에서는 각각 43.40과 53.00을 기록한다.
- CPU 지연 시간은 13th Gen Intel Core i7-13800H가 탑재된 Surface Laptop Studio 2에서 CPU 스레드 8개를 사용해 측정한다. 토큰 128개를 생성하는 동안 토큰당 시간을 평균낸다. BitNet은 bitnet.cpp를 사용하며, 다른 모델은 별도의 추론 프레임워크인 llama.cpp를 사용한다.
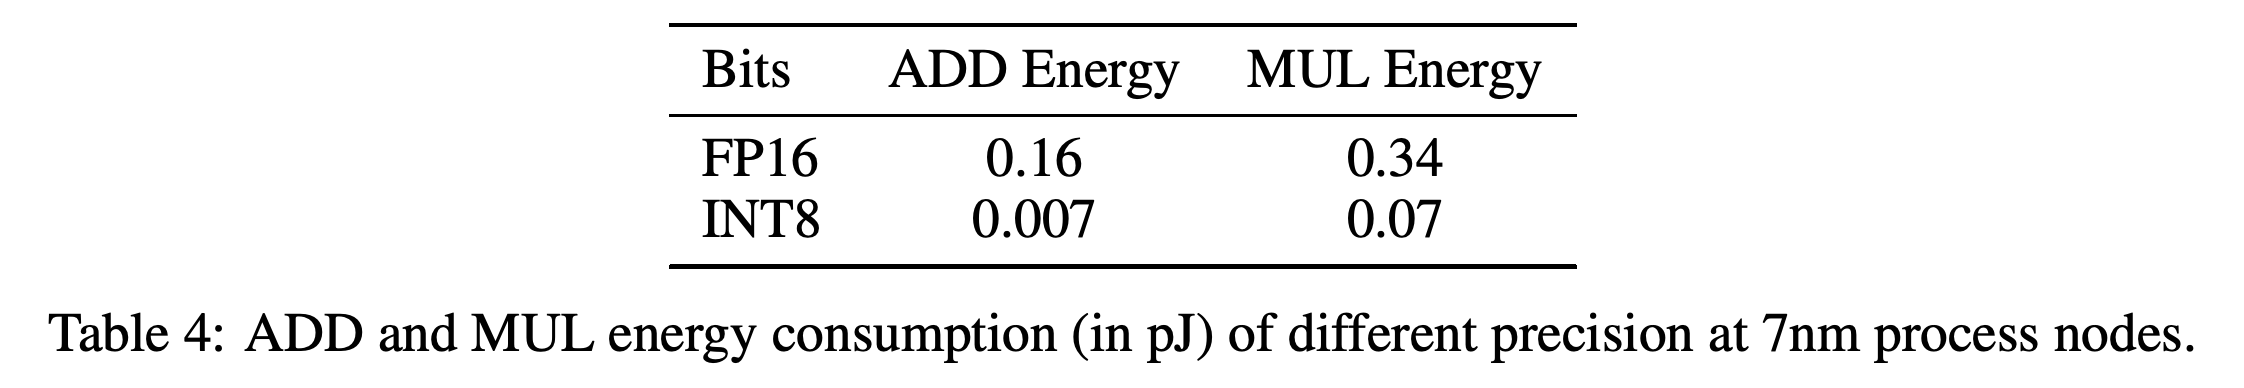
- 에너지는 시퀀스 길이 512토큰에서 행렬 곱셈의 산술 연산을 대상으로 추정한다. Table 4는 7nm 공정의 연산 비용을 제시한다. 16비트 부동소수점 형식인 FP16은 덧셈에 0.16pJ, 곱셈에 0.34pJ가 든다. 8비트 정수 형식인 INT8은 각각 0.007pJ와 0.07pJ가 든다. 이는 연산 에너지 계수이며 기기 전체의 측정값은 아니다.
나열된 시스템 중 BitNet은 보고된 임베딩 제외 메모리, 출력 토큰당 CPU 소요 시간, 추정 산술 연산 에너지가 가장 낮다. 보고된 평균 점수는 Qwen2.5 1.5B에 가깝다. 추론과 수학의 일부 과제에서 강점을 보이지만, 여러 지식, 코드, 지시 수행 지표에서는 점수가 낮다.
에너지 모델은 7nm에서 INT8의 산술 연산 비용을 FP16보다 낮게 설정한다. 덧셈은 각각 0.007pJ와 0.16pJ, 곱셈은 각각 0.07pJ와 0.34pJ다. 이 계수들은 연산 에너지 추정에 사용하며, 노트북의 전력 소비를 측정한 값은 아니다.
4.2 Comparison with Post-training Quantized Models
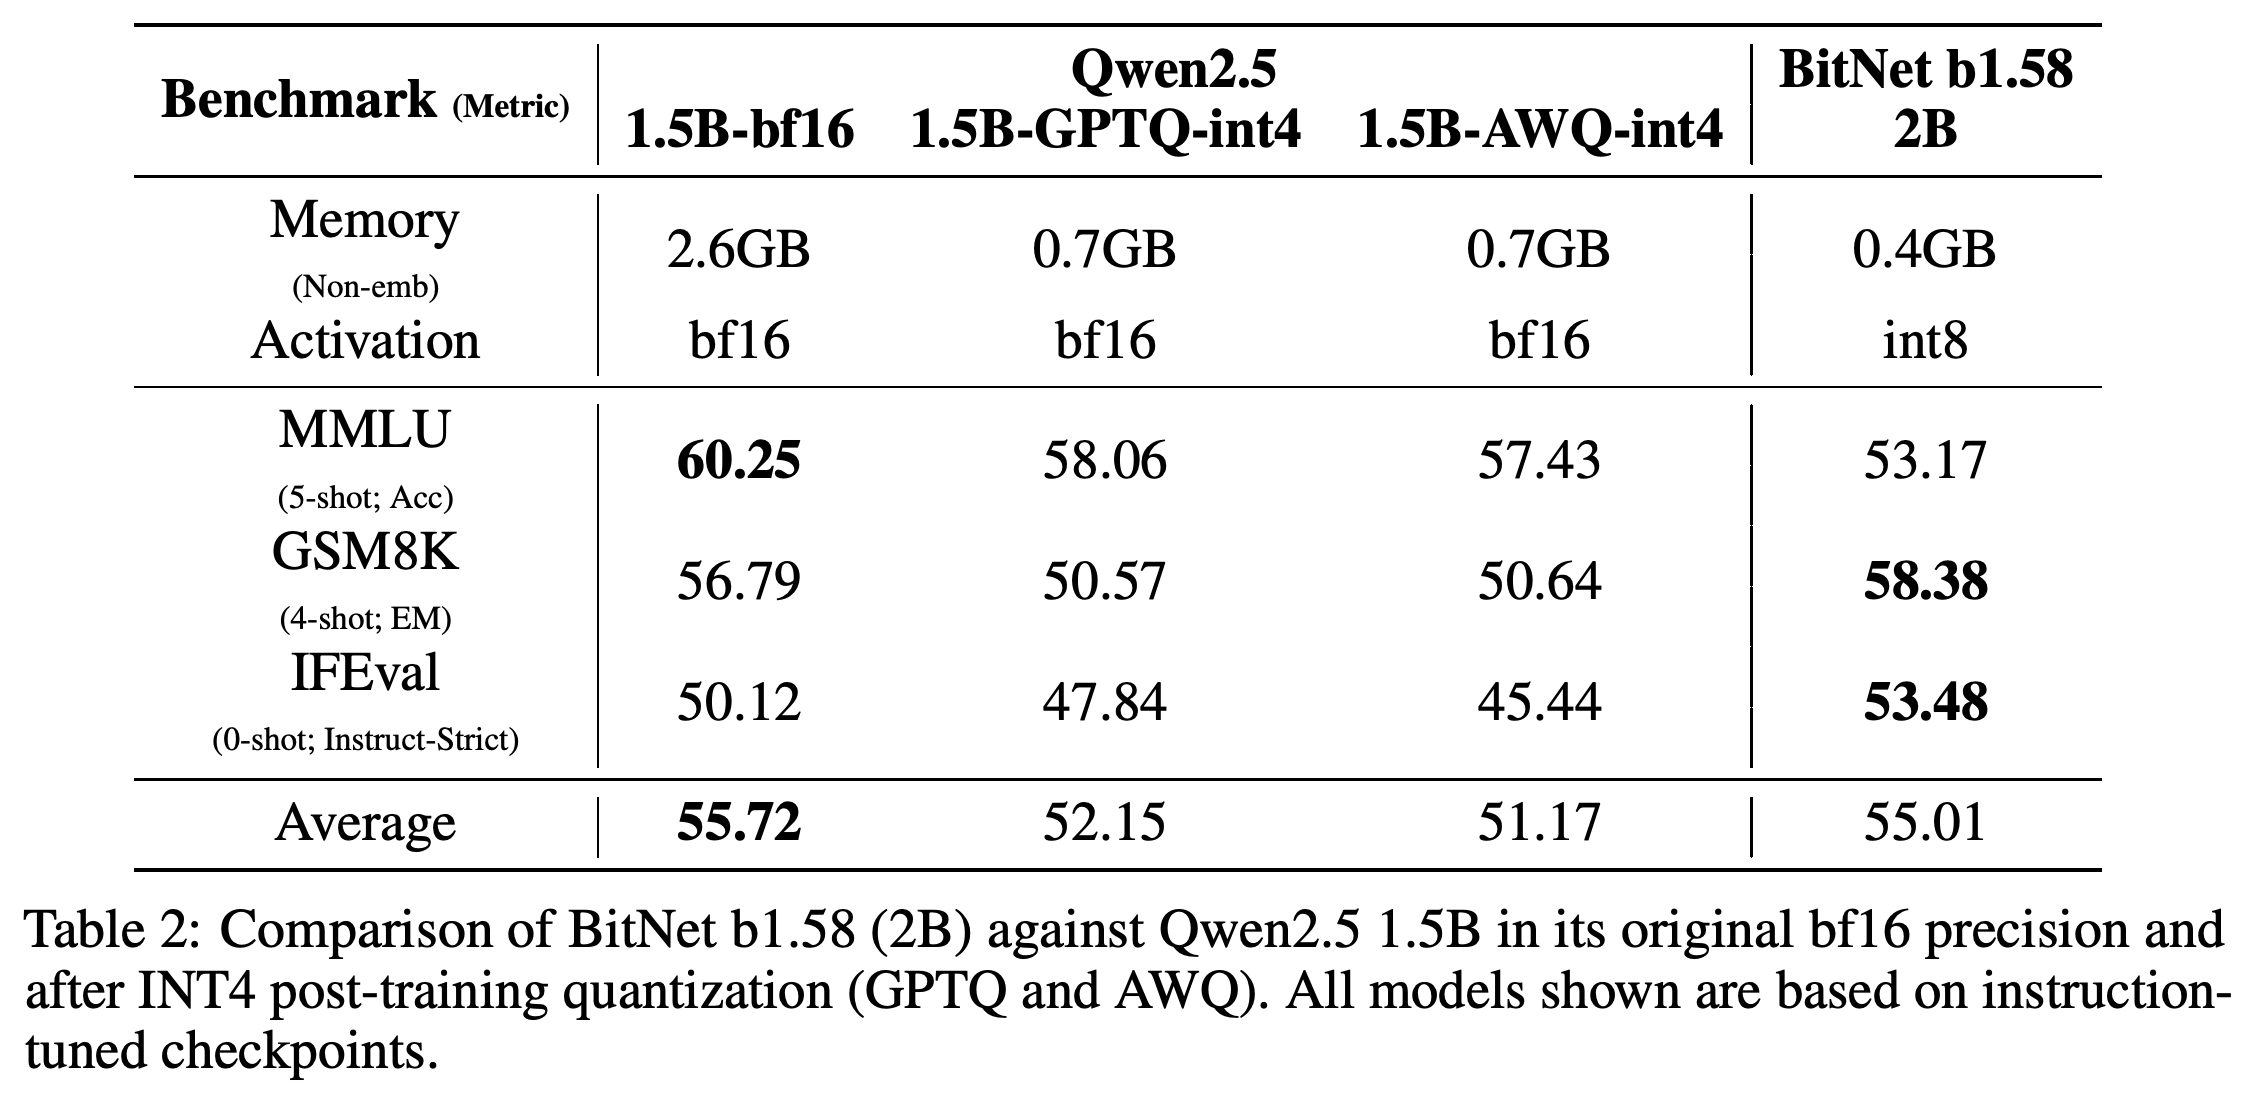
PTQ 비교에서는 Qwen2.5 1.5B의 bf16 모델과 GPTQ 또는 AWQ를 적용한 모델을 평가한다. GPTQ와 AWQ는 가중치를 4비트 정수로 양자화하는 평가 대상 방법 2개다. Table 2에서 MMLU, GSM8K, IFEval의 평균 점수는 bf16 Qwen2.5가 55.72, GPTQ가 52.15, AWQ가 51.17, BitNet이 55.01로 보고된다.
- BitNet은 임베딩을 제외한 메모리 0.4GB와 int8 활성화값을 사용한다. 4비트 Qwen2.5 변형은 모두 메모리 0.7GB와 bf16 활성화값을 사용한다.
- BitNet은 양자화한 변형 모두보다 GSM8K와 IFEval에서 높은 점수를 기록하지만, MMLU에서는 53.17로 GPTQ의 58.06과 AWQ의 57.43에 뒤처진다. 따라서 보고된 평균 점수의 우위는 평가한 과제 구성에 따라 달라진다.
BitNet은 임베딩을 제외한 메모리 0.4GB를 사용해 비교 모델의 0.7GB보다 메모리가 적게 든다. 보고된 3개 과제 평균은 55.01로, GPTQ의 52.15와 AWQ의 51.17보다 높다. 양자화한 Qwen2.5 변형 모두 MMLU 점수는 더 높으므로, 종합 점수의 우위는 과제 구성에 따라 달라진다.
4.3 Comparison with Open-weight 1-bit Models
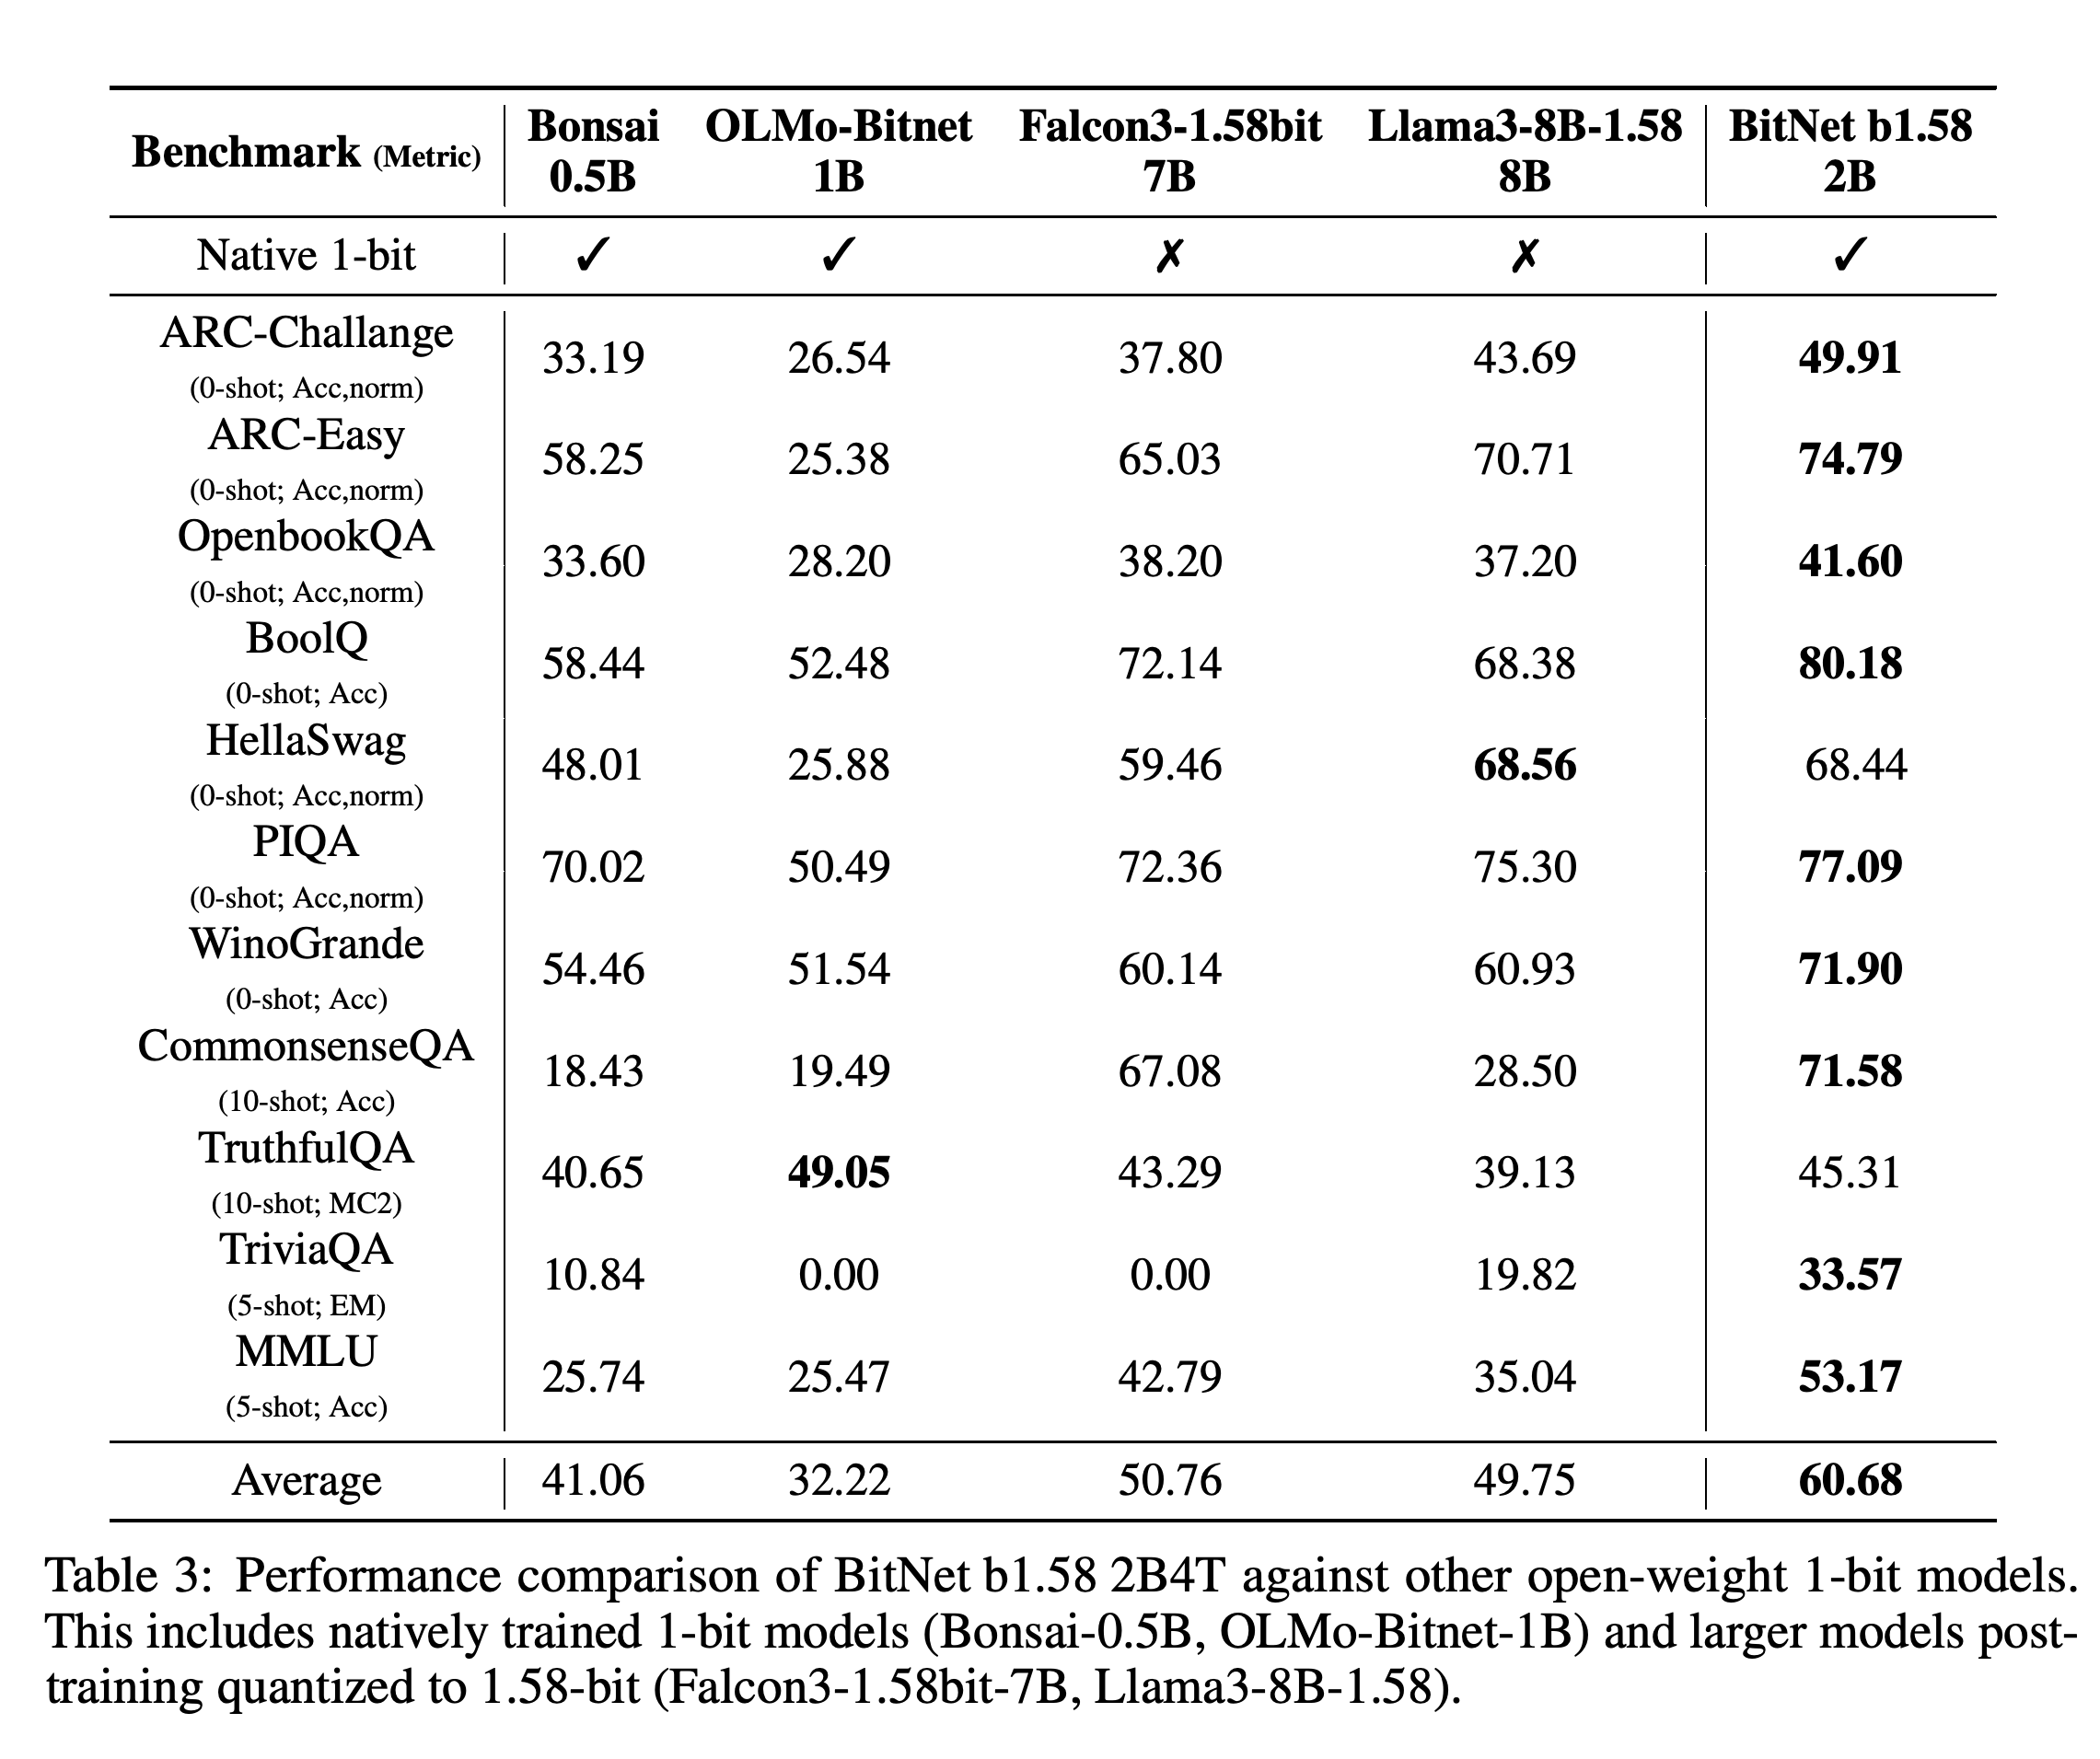
1비트에 가까운 모델 간 비교에는 네이티브 모델인 Bonsai 0.5B와 OLMo-Bitnet 1B, 학습 후 양자화한 Falcon3-1.58bit 7B와 Llama3-8B-1.58 8B가 포함된다. Table 3에 나열된 11개 벤치마크의 평균 점수는 BitNet 60.68, Bonsai 41.06, OLMo-Bitnet 32.22, Falcon3 50.76, Llama3 49.75로 보고된다.
- BitNet은 11개 과제 중 9개에서 가장 높은 점수를 기록한다. 예외는 Llama3가 BitNet의 68.44보다 높은 68.56을 기록한 HellaSwag와 OLMo-Bitnet이 BitNet의 45.31보다 높은 49.05를 기록한 TruthfulQA다.
- 이 결과는 더 큰 양자화 모델을 포함해 평가한 체크포인트들 사이에서 더 높은 성능을 보여준다. 다만 모델 크기, 데이터, 학습 방식이 달라 성능 차이 전체를 네이티브 저비트 학습만의 효과로 볼 수는 없다.
BitNet은 나열된 11개 과제 중 9개에서 앞서며, 평가한 네이티브 및 학습 후 양자화된 near-1-bit models 중 보고된 평균 점수가 가장 높다. 7B와 8B 비교 모델은 전체 점수가 더 낮지만, 이 비교는 데이터나 학습 절차를 통제하지 않는다.
5 Inference Implementation
Inference Implementation에서는 1.58비트 가중치와 8비트 활성화값을 결합한 W1.58A8을 그래픽처리장치(GPU)와 CPU에 특화된 구현으로 지원한다. 표준 라이브러리가 대체로 최적화하지 않는 이 수치 형식을 위한 연산 루틴을 제공하며, 코드는 https://aka.ms/bitnet 에 공개한다.
5.1 GPU Inference
GPU 추론에는 삼진 가중치 4개를 int8 값 1개로 패킹해 저장하는 맞춤형 CUDA 커널을 사용한다. CUDA 커널은 GPU 연산 루틴이다. 패킹한 가중치를 GPU의 주 메모리인 High Bandwidth Memory(HBM)에서 더 빠른 칩 내부 공유 메모리로 불러온 뒤, 패킹을 해제하고 8비트 활성화값으로 연산한다.
- 패킹, 저장, 로드, 패킹 해제, 연산 순서로 처리하면 가중치 전송에 필요한 대역폭을 줄이면서 맞춤형 삼진 연산을 수행할 수 있다. 보고서는 추가 구현 세부 사항으로 텐서 컴파일 프레임워크인 Ladder를 참조한다.
- 저자들은 범용 GPU의 네이티브 W1.58A8 지원이 제한적이라는 점을 제약으로 꼽는다. 이 보고서에는 GPU 지연 시간이나 처리량을 수치로 비교한 결과가 없다.
5.2 CPU Inference
CPU 추론은 BitNet 양자화 방식에 맞춘 연산 루틴을 제공하는 공식 C++ 참조 라이브러리인 bitnet.cpp를 사용한다. 저자들은 추론이 학습 절차를 기준으로 무손실이라고 설명한다. 이는 추론이 학습한 양자화 연산과 수치적으로 일치한다는 뜻이다.
- 구현은 엣지 기기, 노트북, 서버의 CPU를 대상으로 한다. 측정된 출력 토큰당 소요 시간 29ms는 평가 부록에 설명한 특정 노트북과 스레드 8개 구성에 해당한다.
6 Conclusion
Conclusion에서는 2B 매개변수의 4-trillion-token model을 통해 극단적인 가중치 양자화를 학습에 직접 통합하면서도 소형 모델로서 경쟁력 있는 성능을 유지할 수 있음을 제시한다. 공개 자료에는 모델 가중치와 GPU 및 CPU에 특화된 추론 구현이 포함된다.
7 Future Directions
Future Directions에서는 더 큰 네이티브 모델, 하드웨어 최적화, 더 긴 시퀀스, 지원 언어 확대, 멀티모달 통합, 저비트 학습에 대한 이론적 설명을 미해결 연구 과제로 제시한다. 이는 향후 확장 제안이며, 공개 모델에서 입증한 능력은 아니다.
- Scaling Laws and Larger Models에서는 7B, 13B 및 그보다 큰 매개변수 규모에서도 경쟁력 있는 성능을 유지하는지 검증할 것을 제안한다.
- Hardware Co-Design and Optimization에서는 저비트 연산과 데이터 이동에 맞춰 연산 루틴을 개선하고 하드웨어를 설계할 것을 제안한다. 제안한 향후 개선 효과는 이 보고서에서 측정하지 않는다.
- Extended Sequence Length에서는 긴 문서와 긴 추론 과정을 더 잘 지원할 것을 제안한다. Multilingual Capabilities에서는 현재 학습 데이터가 주로 영어 중심이라고 설명한다.
- Multimodal Integration에서는 텍스트와 이미지처럼 서로 다른 입력 유형을 결합할 것을 제안한다. Theoretical Understanding에서는 학습 동역학, 손실 지형, 학습된 표현을 통해 저비트 학습이 효과적인 이유를 설명하고자 한다.
부록
- A Open-weight Baselines에서는 평가한 전체 정밀도 체크포인트로 meta-llama/Llama-3.2-1B-Instruct, google/gemma-3-1b-it, Qwen/Qwen2.5-0.5B-Instruct, Qwen/Qwen2.5-1.5B-Instruct, Qwen/Qwen2.5-3B-Instruct, HuggingFaceTB/SmolLM2-1.7B-Instruct, openbmb/MiniCPM-2B-dpo-bf16을 명시한다. 양자화 및 near-1-bit baselines는 Qwen/Qwen2.5-1.5B-Instruct-GPTQ-Int4, Qwen/Qwen2.5-1.5B-Instruct-AWQ, deepgrove/Bonsai, NousResearch/OLMo-Bitnet-1B, tiiuae/Falcon3-7B-Instruct-1.58bit, HF1BitLLM/Llama3-8B-1.58-100B-tokens다.
- B Evaluation Pipeline Details에서는 HumanEval+에 evalplus, MATH-500에 수정한 math-evaluation-harness, MT-Bench에 공식 LLM Judge 코드베이스, 나머지 과제에 lm-evaluation-harness를 사용한다. 이들은 벤치마크 실행에 사용한 평가 도구다. 생성 과제에는 채팅 프롬프트를 사용하고, 다른 과제에는 도구의 기본 설정을 사용한다. CPU 지연 시간과 추정 산술 연산 에너지는 Main Results에 명시한 하드웨어 및 수치 조건을 따른다.
- 첫 페이지의 공개 링크는 패킹한 추론 가중치 https://huggingface.co/microsoft/bitnet-b1.58-2B-4T, bf16 학습용 마스터 가중치 https://huggingface.co/microsoft/bitnet-b1.58-2B-4T-bf16, GGUF 형식 파일 https://huggingface.co/microsoft/bitnet-b1.58-2B-4T-gguf 을 구분해 제공한다. GGUF 형식 파일은 bitnet.cpp용 배포 파일이다. 소스 코드는 https://github.com/microsoft/BitNet 에, 데모는 https://aka.ms/bitnet-demo 에 공개한다.
짧은 생각
배포 측면에서 가장 설득력 있는 근거는 경쟁력 있는 과제 점수, 적은 임베딩 제외 가중치 메모리, 측정된 CPU 디코딩 결과다. 실제 배포를 평가하려면 대상 하드웨어에서 전체 실행 메모리와 지연 시간을 추가로 측정해야 한다. 비교 대상에는 동일한 구조, 데이터, 토큰 수로 학습한 전체 정밀도 대응 모델이 없다. 따라서 이 비교는 공개 시스템의 성능을 보여주지만, 개별 구조나 학습 요소의 기여를 분리하지는 못한다. 학습률, 손실 합산, SFT 에포크 추가에 관한 권고에는 정량적 제거 실험과 개별 선택의 효과를 분리한 비교가 없으며, 일부 하이퍼파라미터의 정확한 값도 제시하지 않는다. 이 때문에 학습 절차를 재현하는 데 한계가 있다. 추정 산술 연산 에너지만으로 기기 전체의 에너지 절감을 입증할 수는 없다. CPU 벤치마크도 단일 구성에서만 수행해 GPU 성능과 다른 하드웨어 및 서빙 워크로드는 측정하지 않았다.