


Beyond Context Limits: Subconscious Threads for Long-Horizon Reasoning 요약 설명
22 Jul 2025 | Paper Review Context Compression Long-Context Reasoning Tool Use LLM Serving목차
이번 글에서는 Beyond Context Limits: Subconscious Threads for Long-Horizon Reasoning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 7월 22일(Arxiv)
- Luo, Hongyin, Morgan, Nathaniel, Li, Tina, Zhao, Derek, Ngo, Ai Vy, Schroeder, Philip, Yang, Lijie, Ben-Kish, Assaf, O’Brien, Jack, Glass, James.
- MIT CSAIL, Subconscious Systems Technologies, Inc., Princeton University, Tel Aviv University
- 논문 링크
- Github
- Project Page
요약
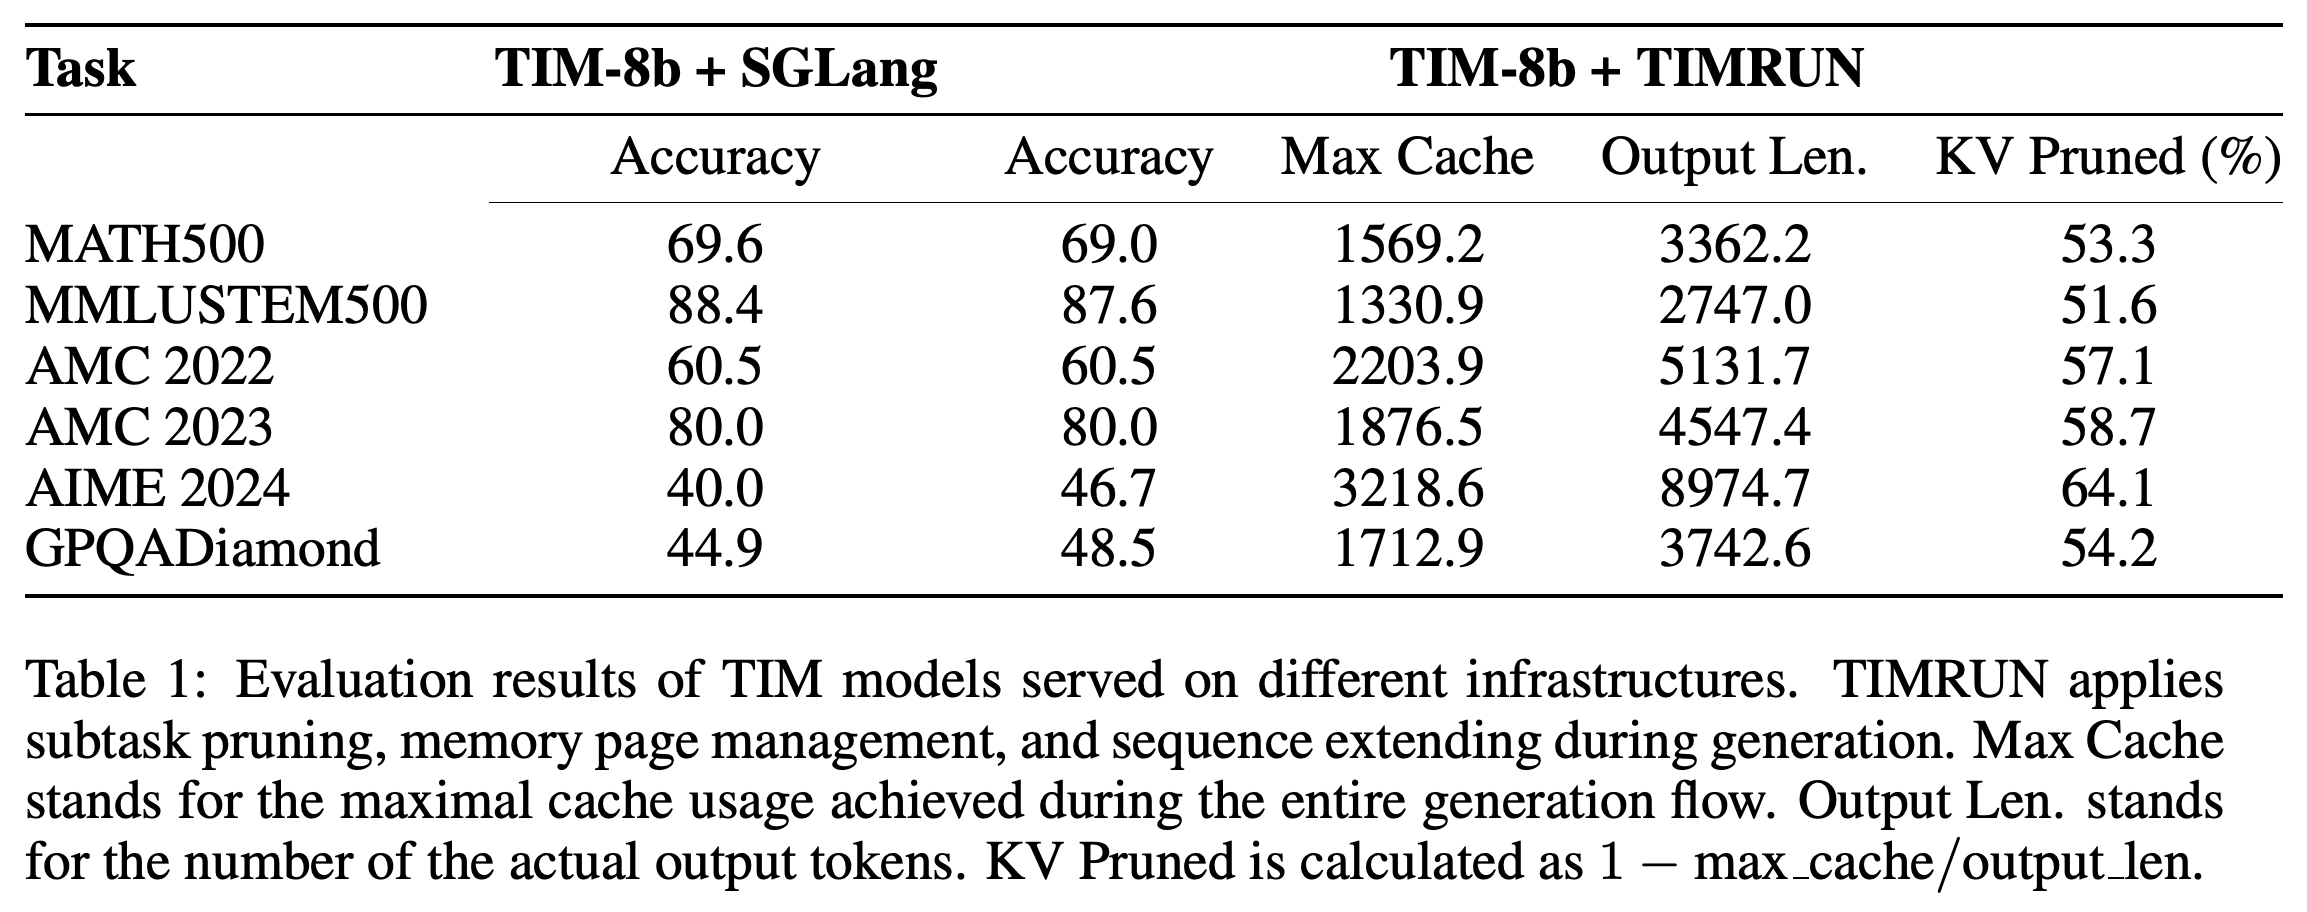
- 긴 추론 과정에서는 완료한 하위 작업과 도구 응답이 누적되어 대규모 언어 모델의 문맥 창이 소진될 수 있다. 문맥 창은 다음 예측에 사용할 수 있는 토큰 이력이다. 재귀적 작업 트리를 생성하도록 학습한 Thread Inference Model(TIM)과 추론 런타임 TIMRUN은 6개 추론 벤치마크에서 최대 캐시 문맥 길이를 전체 출력 길이보다 51.6–64.1% 짧게 유지한다. 언어 모델 서빙 시스템인 SGLang에서 가지치기 없이 실행한 동일한 TIM-8b 모델과 비교하면 정확도는 작업에 따라 오르거나 내리지만 전반적으로 유지된다.
- 각 작업은 추론, 선택적인 도구 사용, 선택적인 하위 작업, 결론을 JSON으로 기록한다. JSON은 기계가 작업 경계를 식별할 수 있게 하는 구조화된 데이터 형식이다. TIMRUN은 상위 작업의 결론을 유지하면서 완료한 하위 작업의 세부 내용을 key/value(KV) 캐시에서 제거한다. KV 캐시는 생성 과정에서 사용하는 어텐션 상태를 저장한다. 이후 토큰을 다시 인코딩하여 토큰 위치를 나타내는 위치 임베딩을 재사용한다.
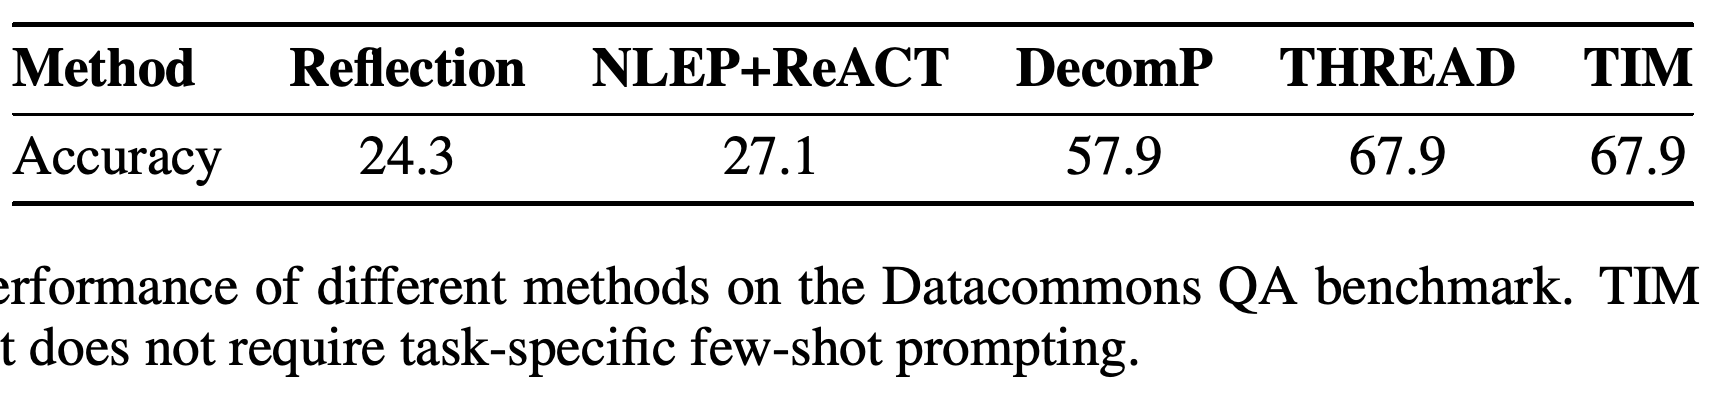
- 검색 도구로 정보를 찾아야 하는 Datacommons QA의 140개 질문에서 TIM은 기존 재귀적 작업 프레임워크 THREAD와 같은 67.9% 정확도를 달성한다. 이때 THREAD가 사용하는 4,000토큰을 초과하는 작업별 프롬프트와 예시 2개는 필요하지 않다. 런타임 실험에서는 완료한 하위 작업 목록을 임시로 보관하는 가지치기 버퍼를 적절히 설정하면 SGLang보다 높은 처리량을 보인다. 다만 이 연구는 예비 단계다. 합성 학습 응답은 도구를 실행하지 않고 생성했고, 웹 탐색 성공률은 낮으며, 실험은 무제한으로 신뢰할 수 있는 추론을 입증하지 않는다.
1 Introduction
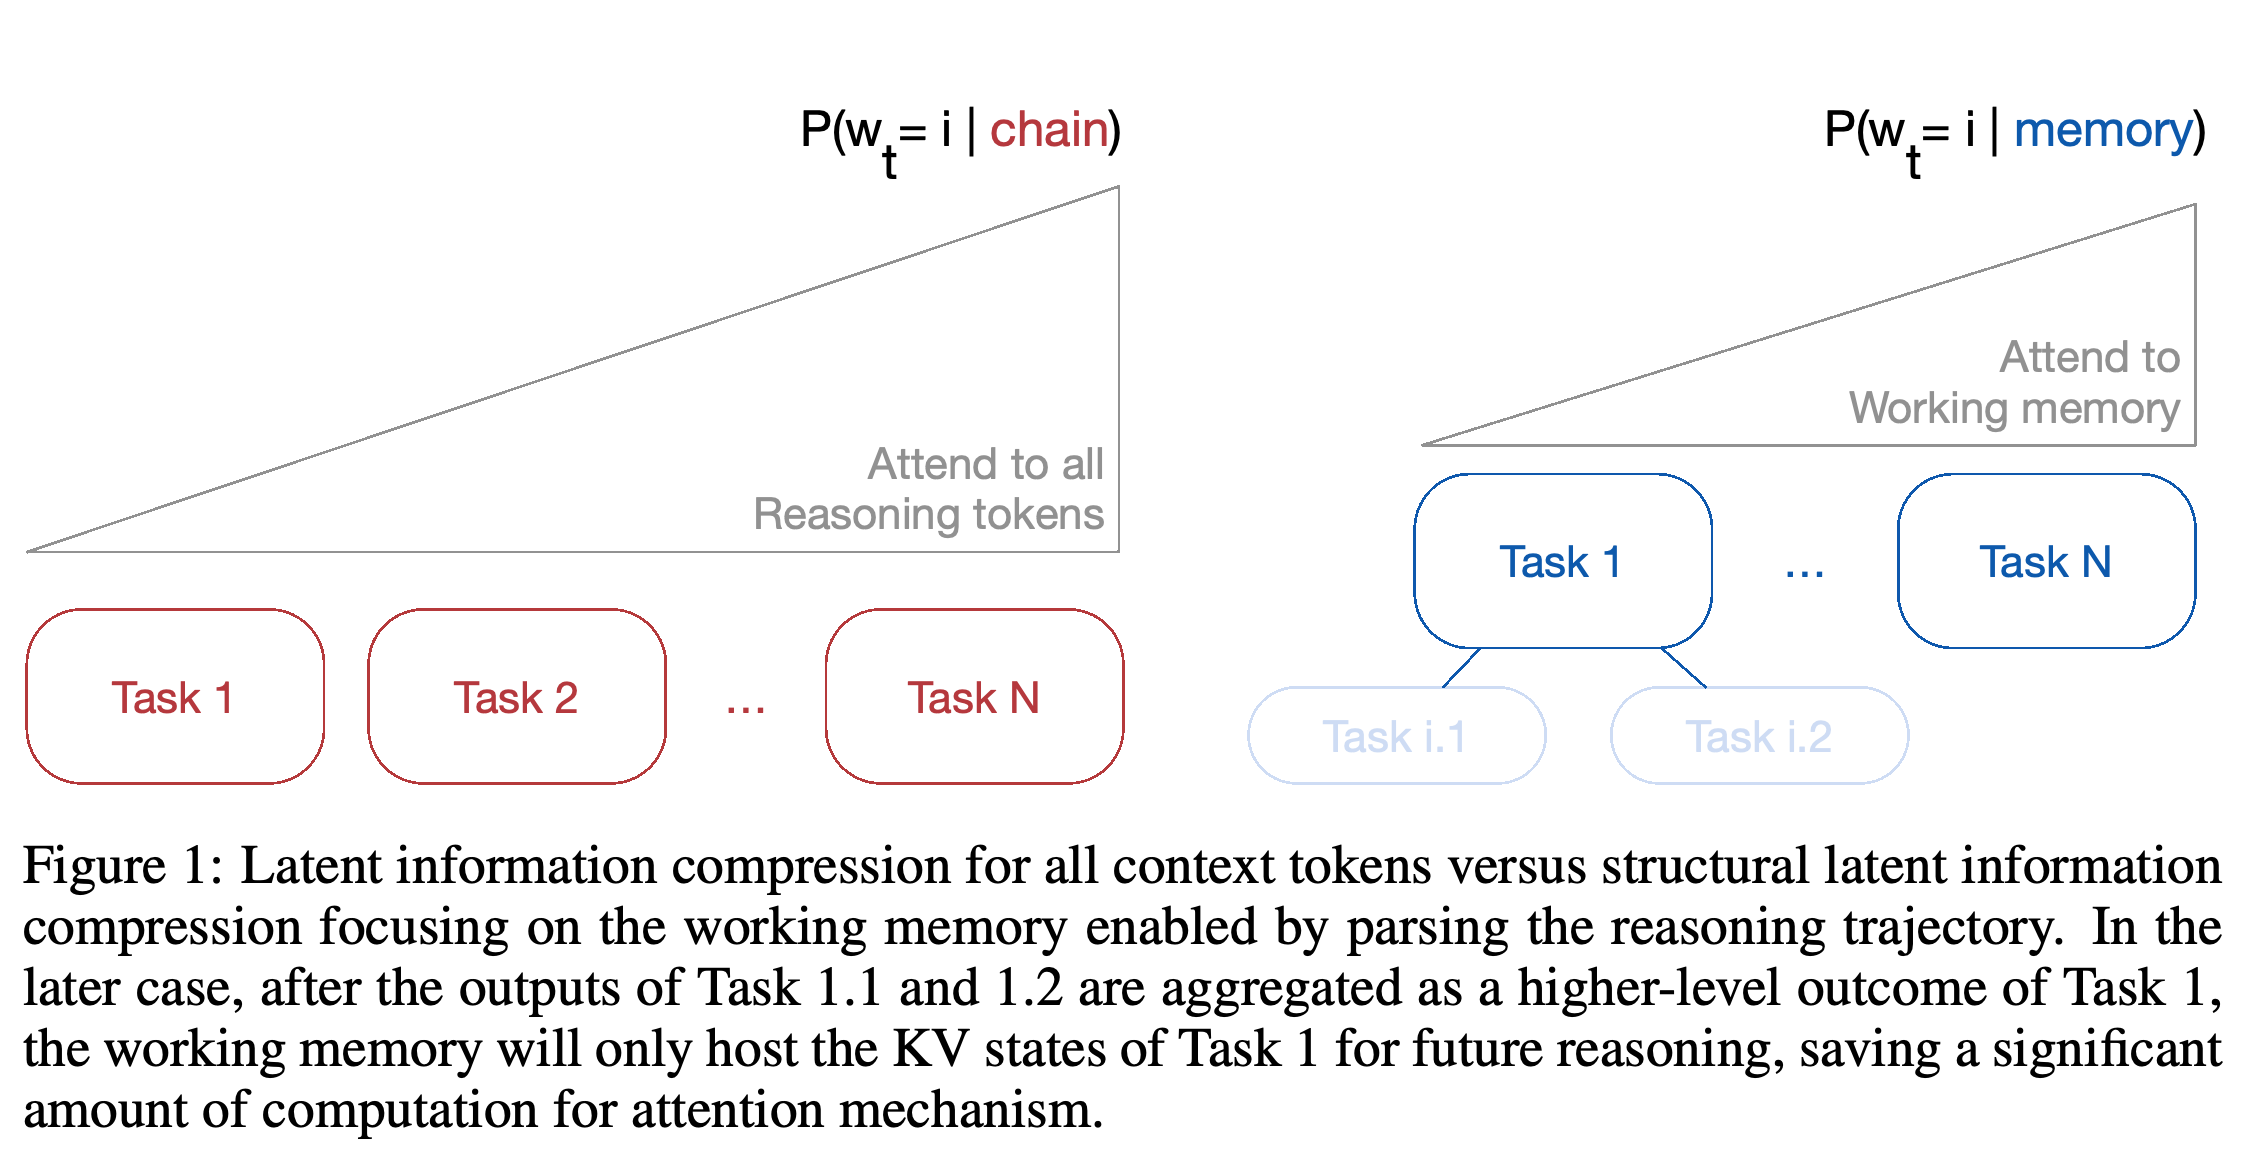
서론은 서로 연결된 2가지 병목을 지적한다. 선형으로 늘어나는 추론 이력을 유지하면 문맥과 메모리를 소모하고, 작업을 여러 모델 인스턴스에 분산하면 명시적인 조율, 문맥 관리, 도구 응답 처리가 필요하다. 제안하는 방법은 추론을 재귀적 작업 트리로 표현하고, 완료한 가지의 결과를 결론으로 종합한 뒤 해당 가지를 제거한다. 이후 작업에는 대개 앞선 하위 작업의 모든 내부 단계 대신 그 결론이 필요하다는 가정을 바탕으로 한다.
완료한 하위 작업 가지는 출력이 상위 작업의 결과로 종합된 뒤 활성 문맥에서 제거된다. 이 도식은 남겨 둔 결과만으로 이후 추론에 충분하다는 가정을 보여주며, 버린 세부 내용이 불필요한지는 검증하지 않는다.
2 THREAD Inference Model (TIM)
TIM은 사용 가능한 문맥에 어텐션을 적용하는 트랜스포머 기반 언어 모델이다. 작업을 재귀적으로 분해하고 말단 작업부터 상위 작업으로 결과를 종합하도록 학습한다. 모델은 파싱할 수 있는 추론 구조를 제공하고, TIMRUN은 이 구조를 이용해 계속 진행되는 1회의 추론 요청 안에서 메모리와 외부 도구 실행을 관리한다.
2.1 Thread-2
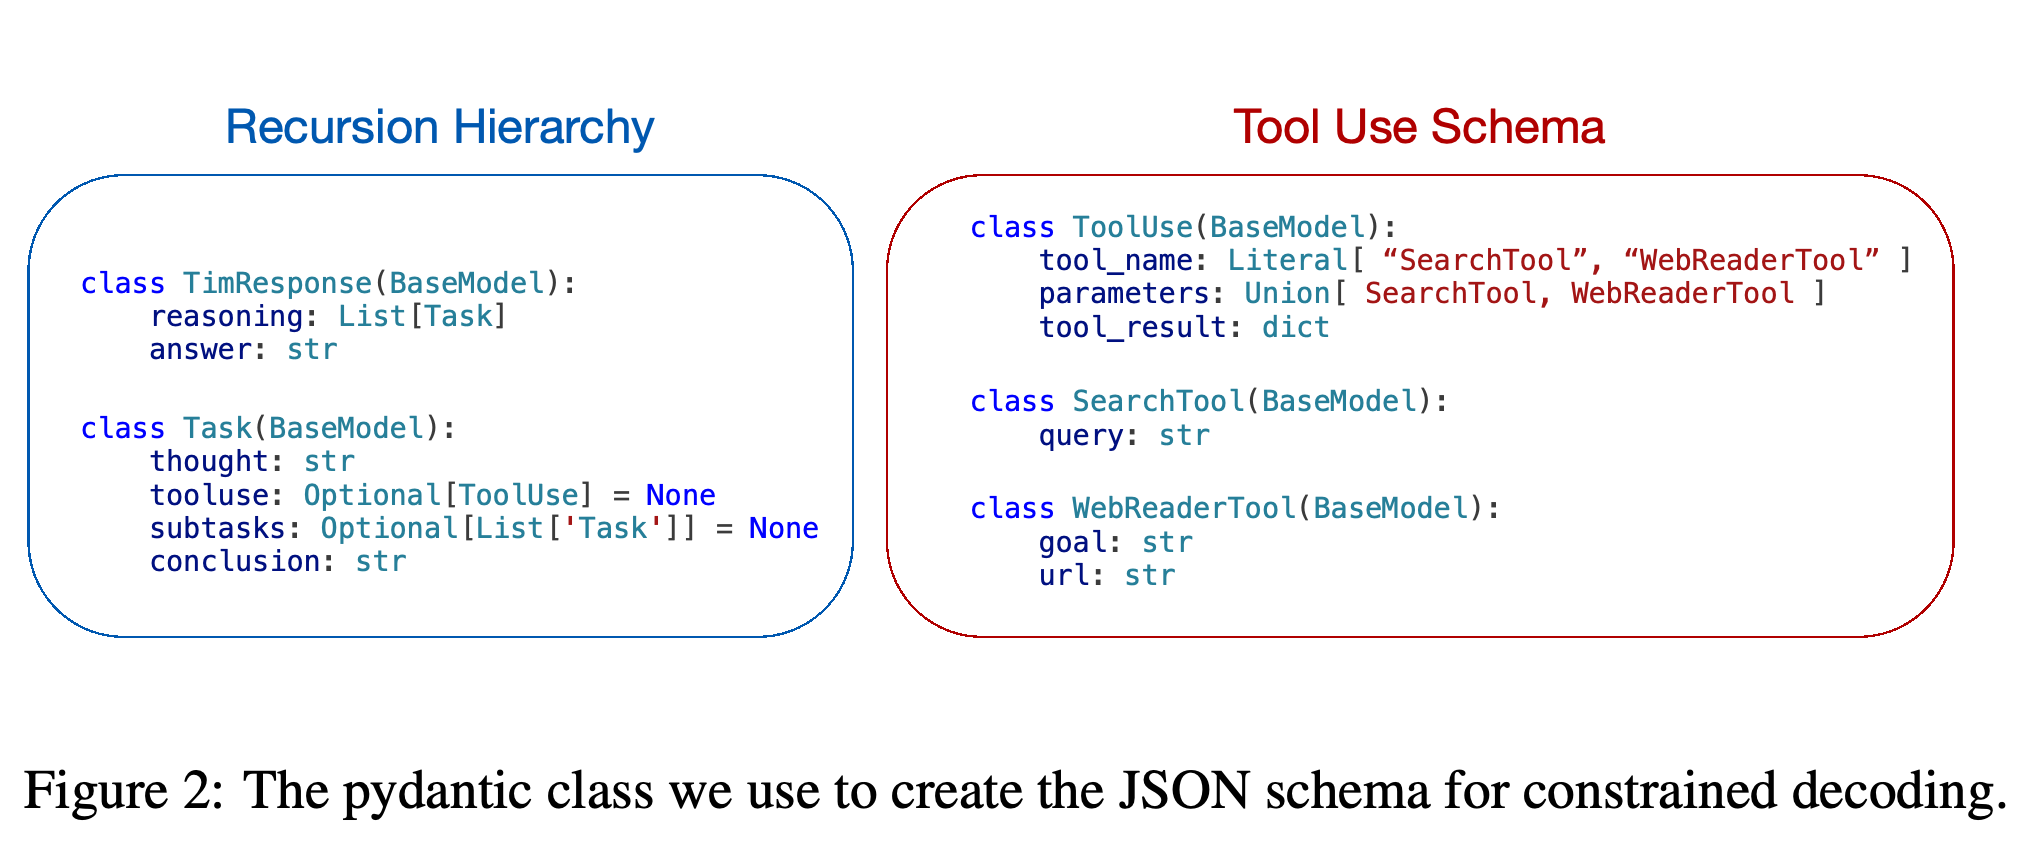
논문에서 개정한 재귀적 추론 형식인 Thread-2는 모든 작업에 같은 필드를 부여한다. thought는 진행 상황 검토와 계획을, tooluse는 선택적인 외부 호출을, subtasks는 선택적인 재귀적 작업 목록을, conclusion은 이후 추론에 필요한 결과를 담는다. 기존 Thread 프레임워크와 달리 하위 작업은 시스템 프롬프트, 사용자 입력, 아직 가지치기하지 않은 모든 작업을 담은 공유 작업 메모리에 접근한다.
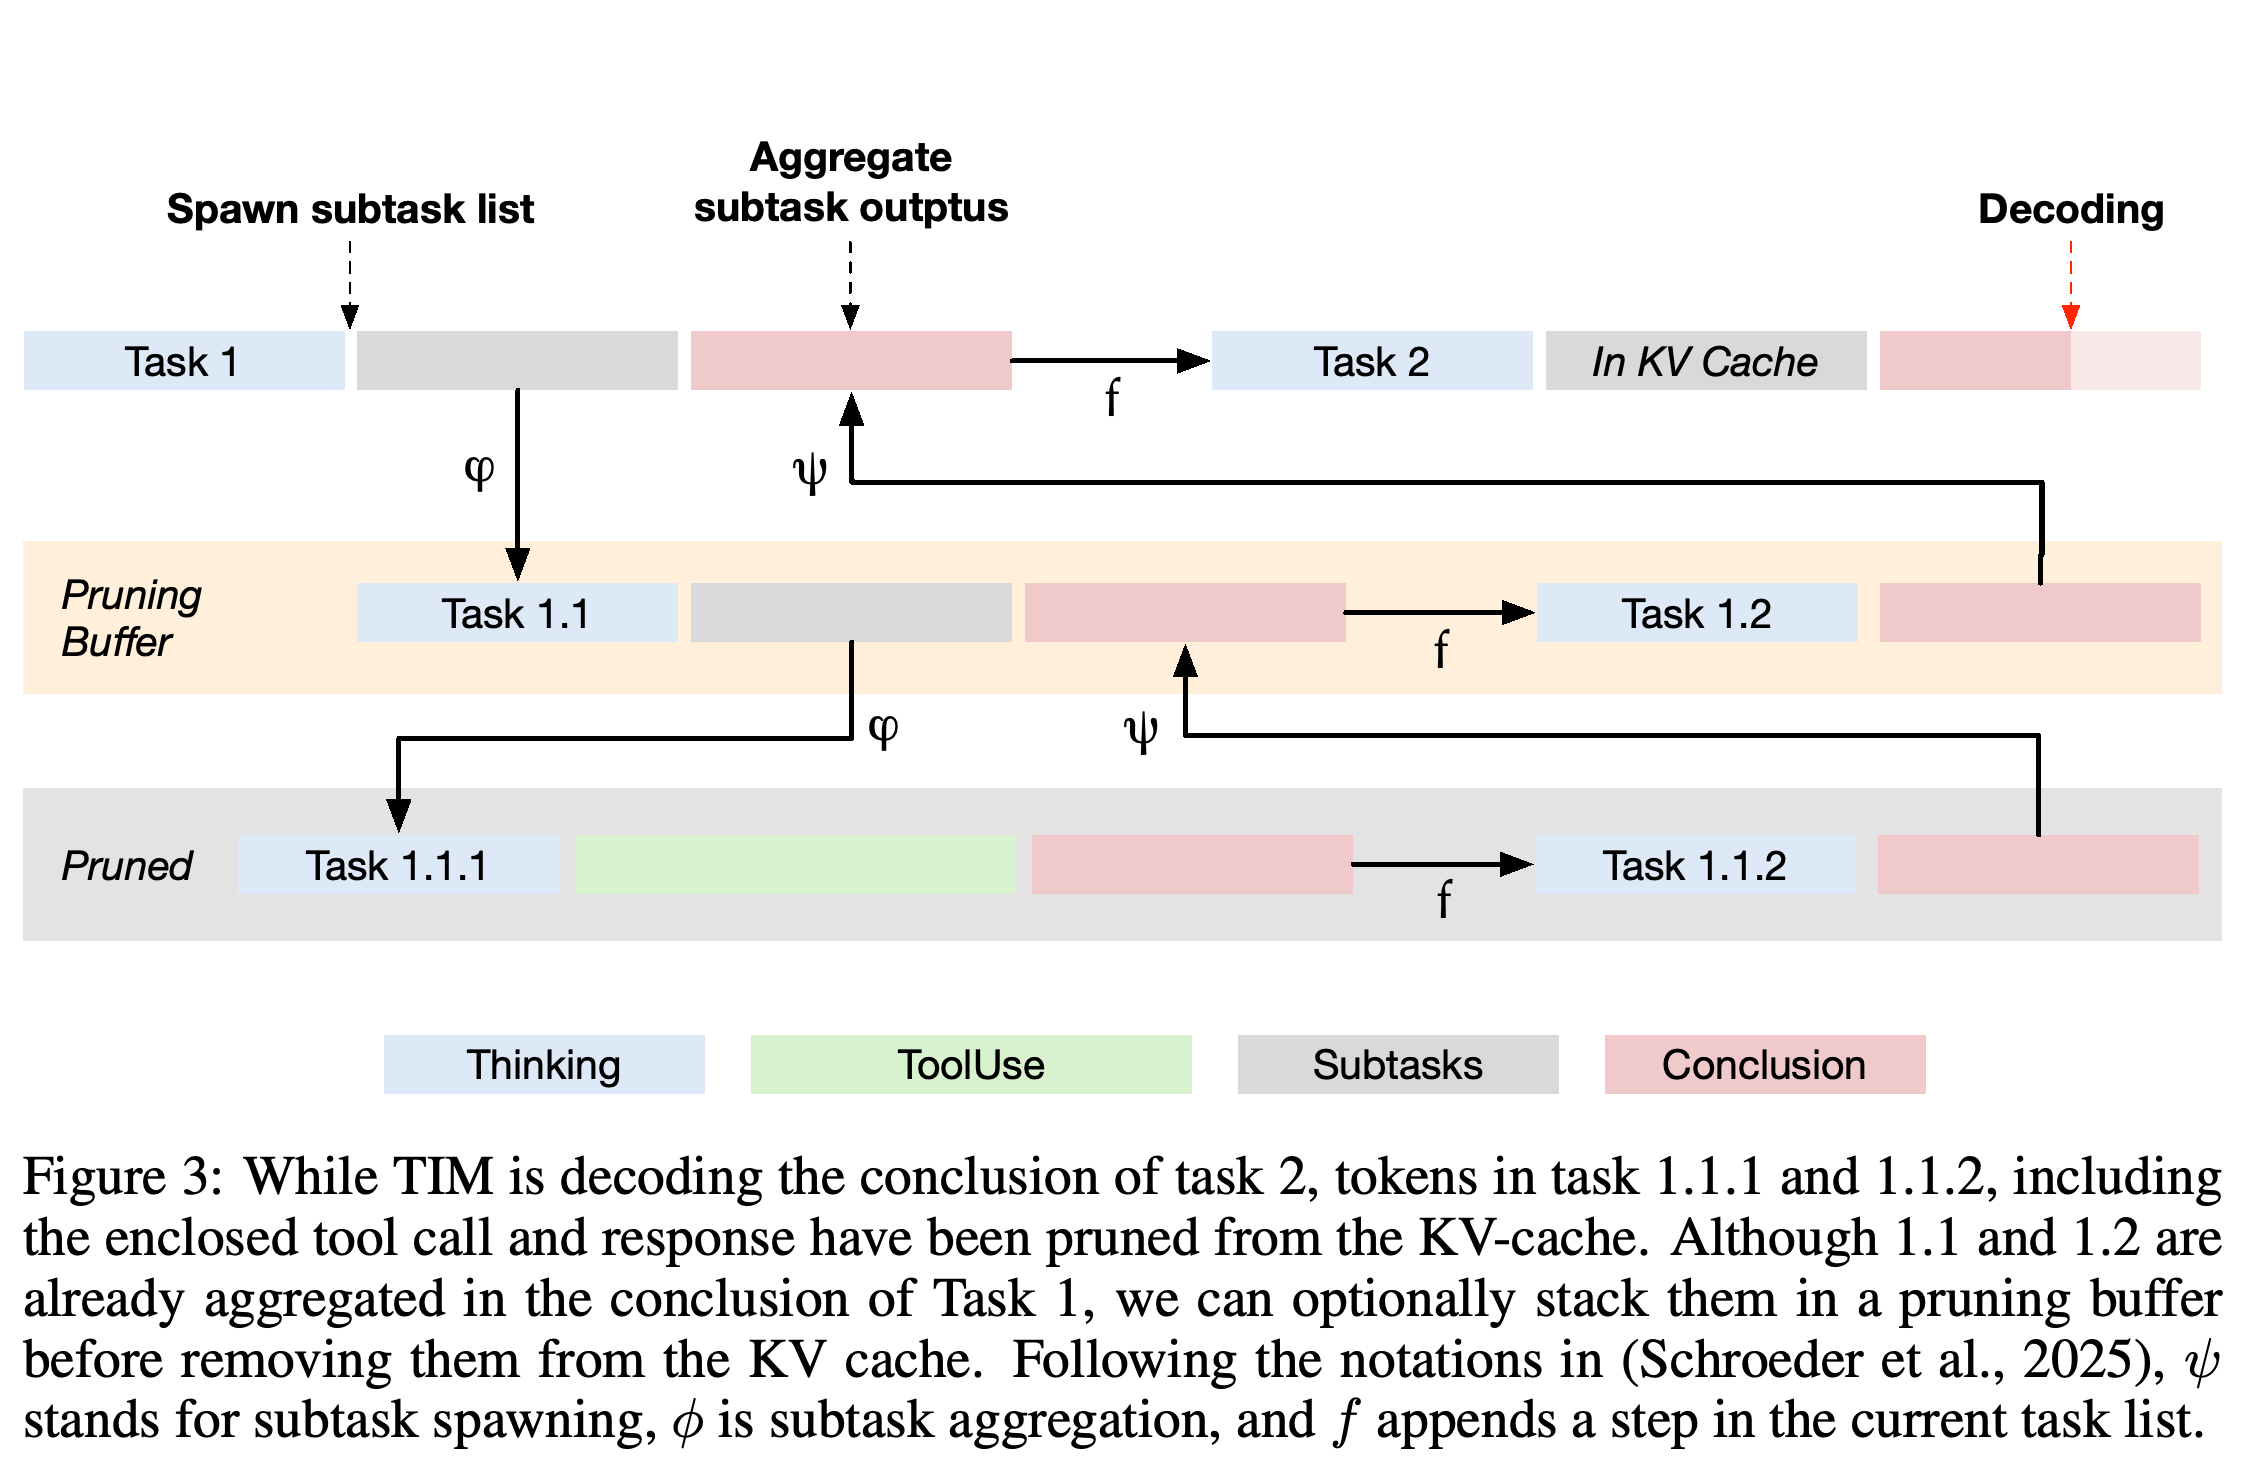
- 완료한 하위 작업 목록은 고정 크기의 가지치기 버퍼에 들어간다. 임계값을 넘으면 가장 먼저 들어온 목록을 작업 메모리에서 제거한다. 이 절에서는 임계값을 {0, 1, 2} 중에서 지정한다.
- 생성을 정해진 스키마로 제한하는 제약 디코딩을 사용해 재귀적 JSON을 생성한다. 특수 구조 토큰이나 하위 작업별 별도 모델 호출은 사용하지 않는다.
- 생성이 tool_result에 도달하면 런타임은 앞서 생성한 매개변수를 추출해 도구를 실행하고, 반환된 JSON을 진행 중인 문맥에 인코딩한다.
재귀적 Task 스키마는 가지치기에 필요한 경계를 드러내고, ToolUse는 런타임 실행에 필요한 도구 이름, 매개변수, 반환 결과를 드러낸다. 따라서 같은 파싱 방식을 서로 다른 재귀 깊이에 적용할 수 있다.
2.2 Training (Preview)
예시 응답으로 학습하는 지도 미세조정을 통해 Qwen3-8b가 Thread-2 구조를 생성하도록 한다. 질문은 openr1-math-220k의 수학 예제 20k개, 연구 질문 20k개, ToolBench의 도구 사용 질문 6k개에서 가져온다. 수학 예제에서는 도구 사용을 금지하고, 연구 예제에서는 검색과 웹페이지 읽기를 허용하며, 도구 사용 예제에는 합성한 입출력 스키마를 제공한다. 언어 모델이 추론과 모의 도구 응답을 모두 생성하며, 저자들은 이 방식 때문에 데이터 품질을 확신하기 어렵다고 명시한다.
- 이렇게 만든 합성 데이터로 모델 미세조정 프레임워크인 LlamaFactory를 사용해 Qwen3-8b를 학습한다.
- 이후 보상을 통해 학습하는 강화학습 단계에서는 남은 openR1-math-220k 질문에 GRPO 최적화 방법을 적용한다. 샘플링 중에도 JSON 제약을 유지하고, 예측 답변을 정답 주석과 비교해 보상을 부여한다.
- 저자들은 지도학습 데이터에 잡음이 있어도 이 보상 기반 단계가 미세조정한 모델의 성능을 개선한다고 보고한다. 다만 해당 학습 단계의 효과만 분리한 정량 비교는 제시하지 않는다.
3 TIMRUN, the Inference Runtime for TIM
TIMRUN은 계속 진행되는 추론 과정을 모델의 출력 스트림에 담을 때 발생하는 배포 문제를 해결한다. 캐시된 토큰을 제거하면 메모리는 확보되지만 토큰 위치가 자동으로 초기화되지는 않는다. 따라서 런타임은 그래픽 처리 장치(GPU) 메모리와 위치 임베딩을 모두 재사용해야 한다. 논문은 Qwen 2.5에 명시된 입력 한도 128k-token과 출력 한도 32k-token을 예로 들어 그 필요성을 설명한다.
3.1 Subtask Pruning
TIMRUN은 다음 예측을 계산하는 모델의 순전파 내부에서 메모리를 조작하는 대신, 어텐션 계산 전에 완료한 하위 작업의 상태를 제거한다. 캐시된 어텐션 상태를 메모리 페이지로 관리하는 paged attention을 사용하며, 요청마다 서로 다른 가지치기를 적용할 수 있도록 페이지 크기를 1로 설정한다. 배치 단위 가지치기는 GPU 프로그래밍 도구인 Triton으로 구현하고, 어텐션 엔진인 FlashInfer로 단일 토큰 페이지를 사용하는 추론을 가속한다.
- 하위 작업을 삭제한 뒤에는 변경하지 않은 앞부분을 기준으로 삭제 지점 이후에 남아 있는 토큰을 다시 인코딩한다. 이렇게 하면 해당 토큰에 더 이른 위치를 부여해 추가 생성에 사용할 위치 공간을 확보한다.
- 재인코딩에는 추가 계산이 필요하지만 대상 토큰은 병렬로 처리할 수 있다. 가지치기가 처리량을 높이는지는 이 계산과 메모리 관리 비용이 짧아진 캐시의 어텐션 계산 절감 효과와 어떤 균형을 이루는지에 달려 있다.
- 가지치기 버퍼는 완료한 하위 작업 목록을 임시로 보관하여 세부 내용을 버리기 전에 정보를 중복해서 유지한다. 추론을 계속하려면 작업을 적절히 분해하고 충분한 정보를 담은 결론을 남겨야 한다.
Task 2를 디코딩하는 동안 Task 1.1.1과 Task 1.1.2는 도구 상호작용을 포함해 이미 제거된 상태다. Task 1.1과 Task 1.2는 결과가 Task 1의 결론에 이미 종합되었어도 가지치기 버퍼에 임시로 남아 있을 수 있다.
3.2 End-to-End Multi-Hop Tool Use
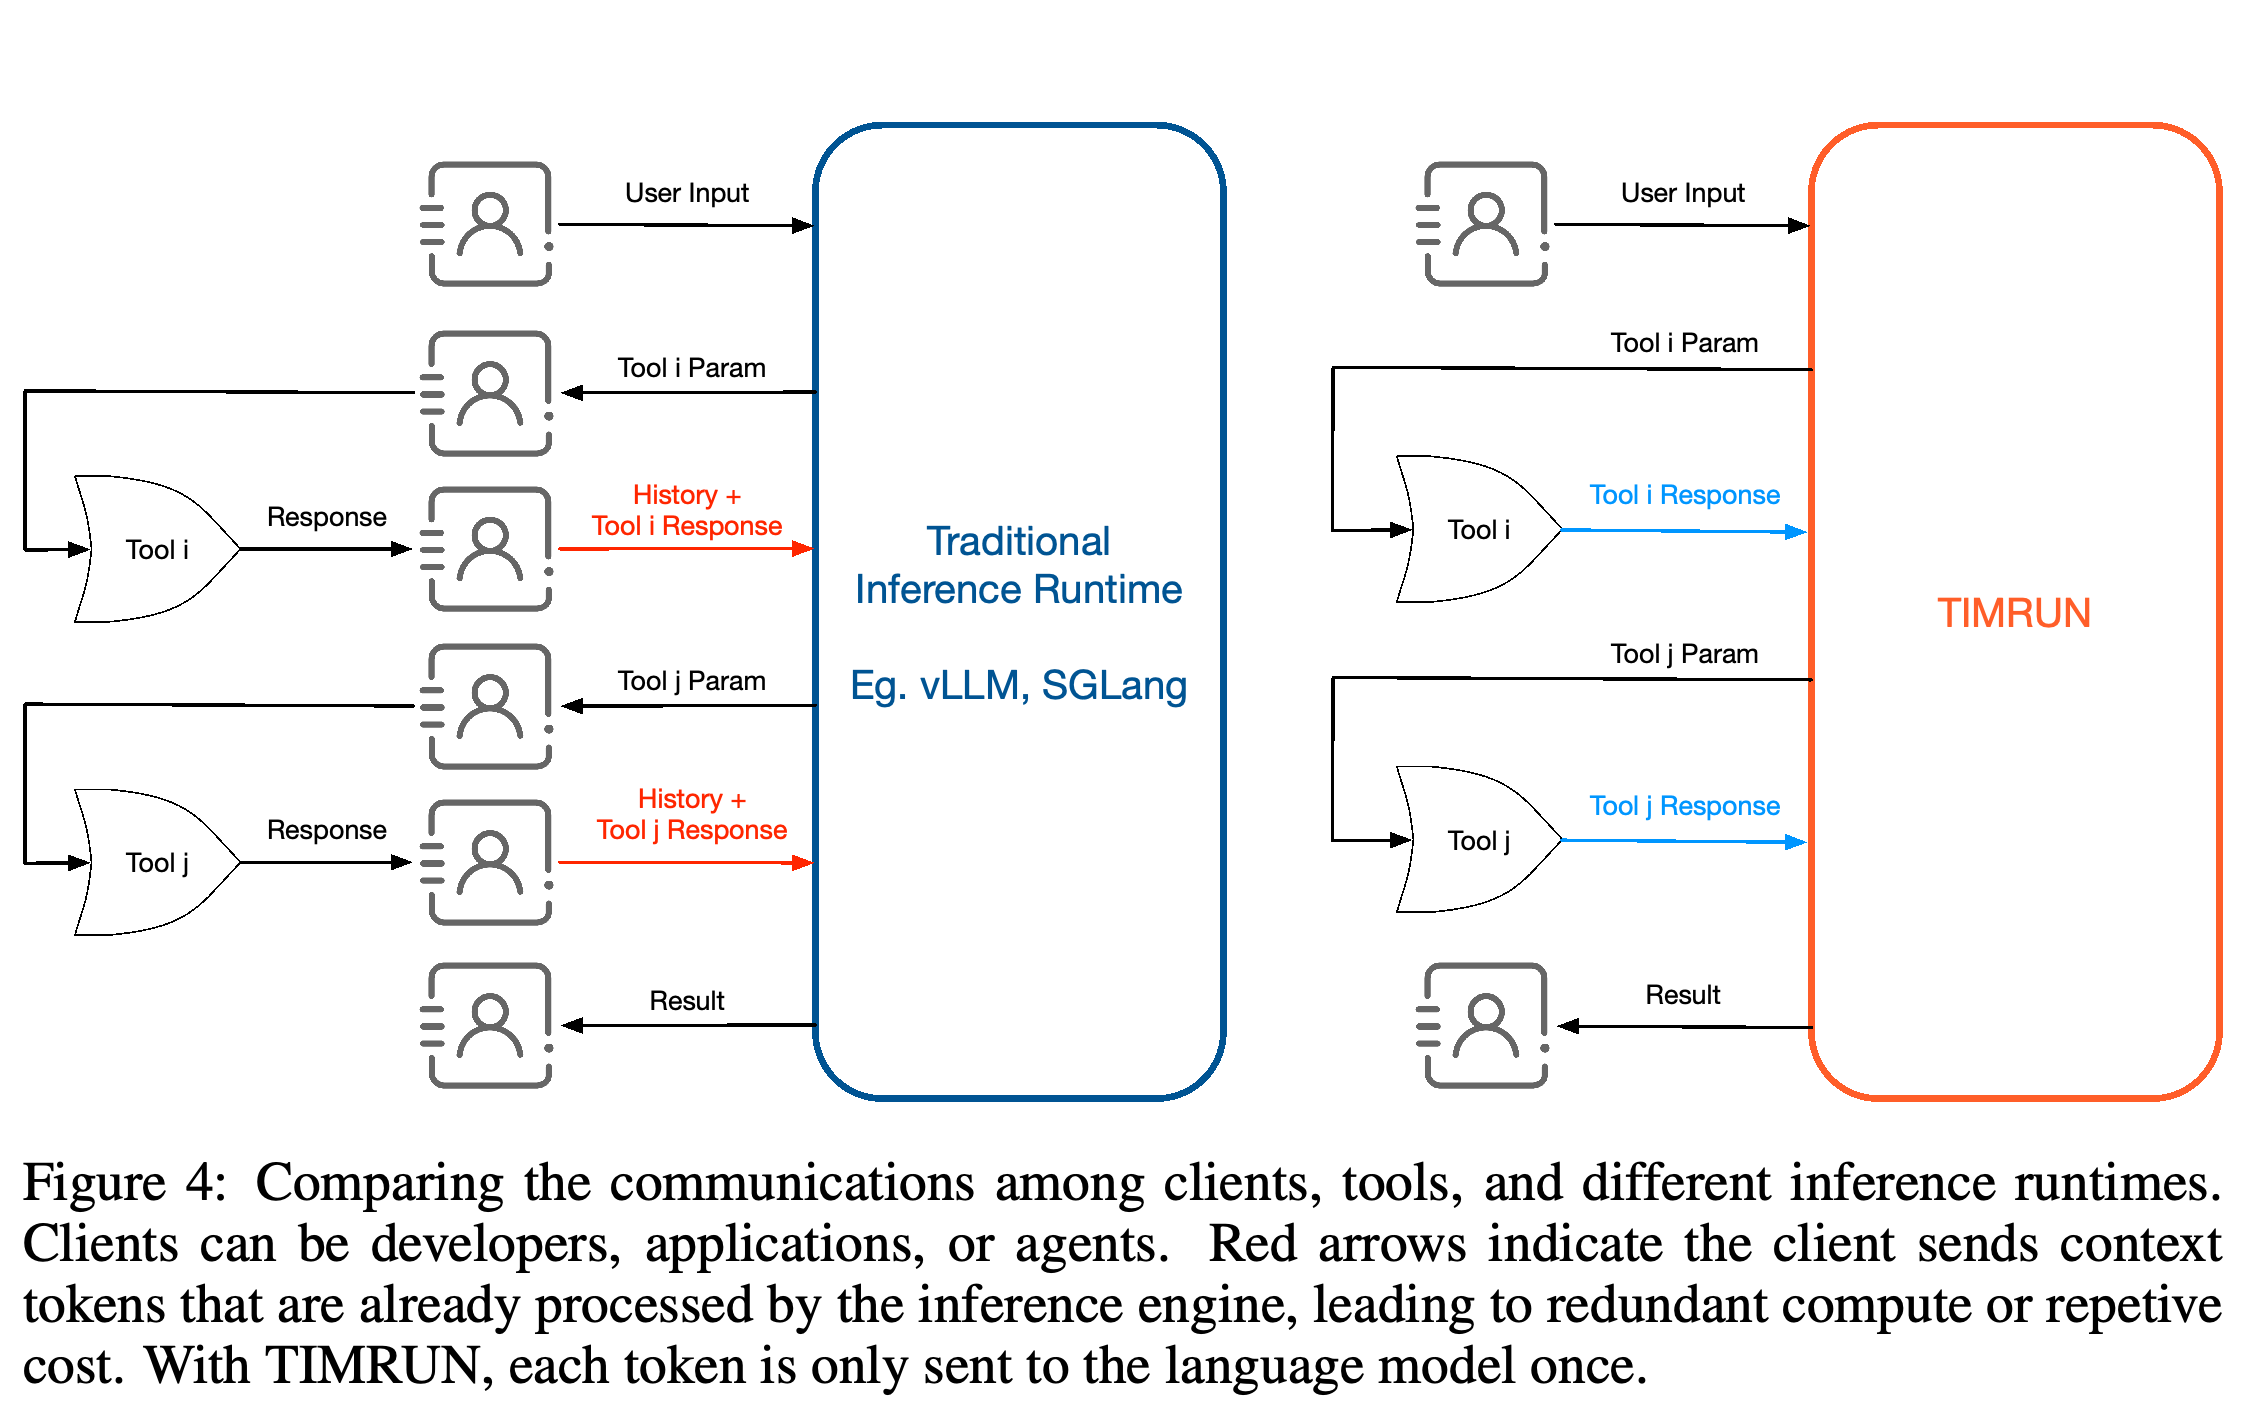
앞선 도구 호출 결과를 후속 단계에 활용하는 다중 홉 도구 사용에서는 보통 계속 늘어나는 메시지 이력을 반복해서 제출해야 한다. TIMRUN은 생성된 매개변수로 도구를 직접 실행하고 그 응답을 진행 중인 추론에 추가하여, 클라이언트에서 런타임으로 이력을 반복 전송하는 일을 줄인다.
- Prefilling은 초기 입력을 인코딩하고 어텐션 상태를 저장하는 과정이며, extending은 캐시된 앞부분을 기준으로 추가 토큰을 인코딩하는 과정이다. 접두부 캐싱으로 재계산을 피할 수 있지만, 요청을 반복 제출하면 전송과 캐시 관리에 따른 추가 비용은 여전히 발생한다.
- 논문은 각 추론 단계를 새 요청으로 제출하는 일부 작업에서 캐시된 이력에 반복 과금하면 토큰 비용이 대략 이차적으로 증가할 수 있다고 주장한다. 이는 요청 구성과 가격 정책에 따른 조건부 논의이며, 보편적인 비용 절감 효과를 측정한 결과는 아니다.
- 도구 응답을 기다리는 동안에도 같은 추론 배치의 다른 요청은 계속 처리할 수 있다.
도구 실행을 TIMRUN 내부로 옮기면 클라이언트가 도구 응답마다 이력을 다시 제출할 필요가 없어진다. 통신 경로는 제안한 전송량 감소의 원리를 설명하지만, 금전적 절감이나 종단 간 지연 시간을 정량화하지는 않는다.
4 Experiments
실험은 추론 정확도, 도구를 활용한 정보 검색, 추론 처리량을 평가한다. 가장 직접적인 정확도 비교에서는 2개 서빙 시스템 모두에서 동일한 TIM-8b 모델과 구조화된 출력을 사용한다. SGLang은 추론 이력을 유지하고, TIMRUN은 하위 작업 가지치기, 메모리 페이지 관리, 시퀀스 재인코딩을 추가한다. 연구 작업 비교에서는 프롬프트, 모델, 상호작용 방식도 달라지므로 런타임의 기여를 분리해서 보기 어렵다.
4.1 Reasoning
수학 추론이나 과학 및 기술 지식을 평가하는 MATH500, MMLU-STEM500, AMC 2022, AMC 2023, AIME 2024, GPQADiamond에서 가지치기에 따른 정확도 변화는 작업마다 다르다. SGLang과 TIMRUN의 점수는 순서대로 69.6% 대 69.0%, 88.4% 대 87.6%, 60.5% 대 60.5%, 80.0% 대 80.0%, 40.0% 대 46.7%, 44.9% 대 48.5%다.
- 보고된 KV Pruned 값은 각각 53.3%, 51.6%, 57.1%, 58.7%, 64.1%, 54.2%이며, 1 − max_cache/output_len으로 계산한다.
- AIME 2024에서 보고된 최대 캐시 길이는 3218.6토큰이고 출력 길이는 8974.7토큰이다. 따라서 활성 캐시 문맥은 전체 생성 이력보다 상당히 짧다.
- 이 지표는 최대 캐시 길이를 전체 출력 길이와 비교한다. 평균 메모리 사용량이나 전체 GPU 할당량을 측정하지는 않는다. 표에는 정확도 차이의 불확실성 추정치가 없다.
동일한 TIM-8b 모델을 사용하므로 이 표는 논문에서 가지치기 유무에 따른 서빙을 가장 직접적으로 비교한다. 6개 작업 모두에서 보고된 캐시 감소율은 50%를 넘는다. 정확도는 2개 작업에서 소폭 하락하고, 2개에서 같으며, 2개에서 상승한다.
4.2 Research
Datacommons QA에서는 TIM에 검색 도구를 제공하고, 해당 도구에 대한 별도 학습 없이 140개 질문으로 평가한다. TIM은 THREAD와 같은 67.9% 정확도를 달성하며, 표에 제시된 다른 프롬프트 기반 기준선인 Reflection, NLEP+ReACT, DecomP의 24.3%, 27.1%, 57.9%를 각각 웃돈다. TIM은 간결한 시스템 메시지와 도구 명세를 사용하지만, THREAD는 4,000토큰을 초과하는 프롬프트와 작업별 예시 2개를 사용한다.
TIM은 THREAD의 작업별 예시와 긴 프롬프트 없이 Datacommons QA에서 같은 67.9% 정확도를 달성한다. 이 표는 서로 다른 프롬프트 요구 조건에서 비슷한 정확도를 보인다는 점을 확인하지만, 실행 시간이나 토큰 비용을 직접 측정한 결과는 제공하지 않는다.
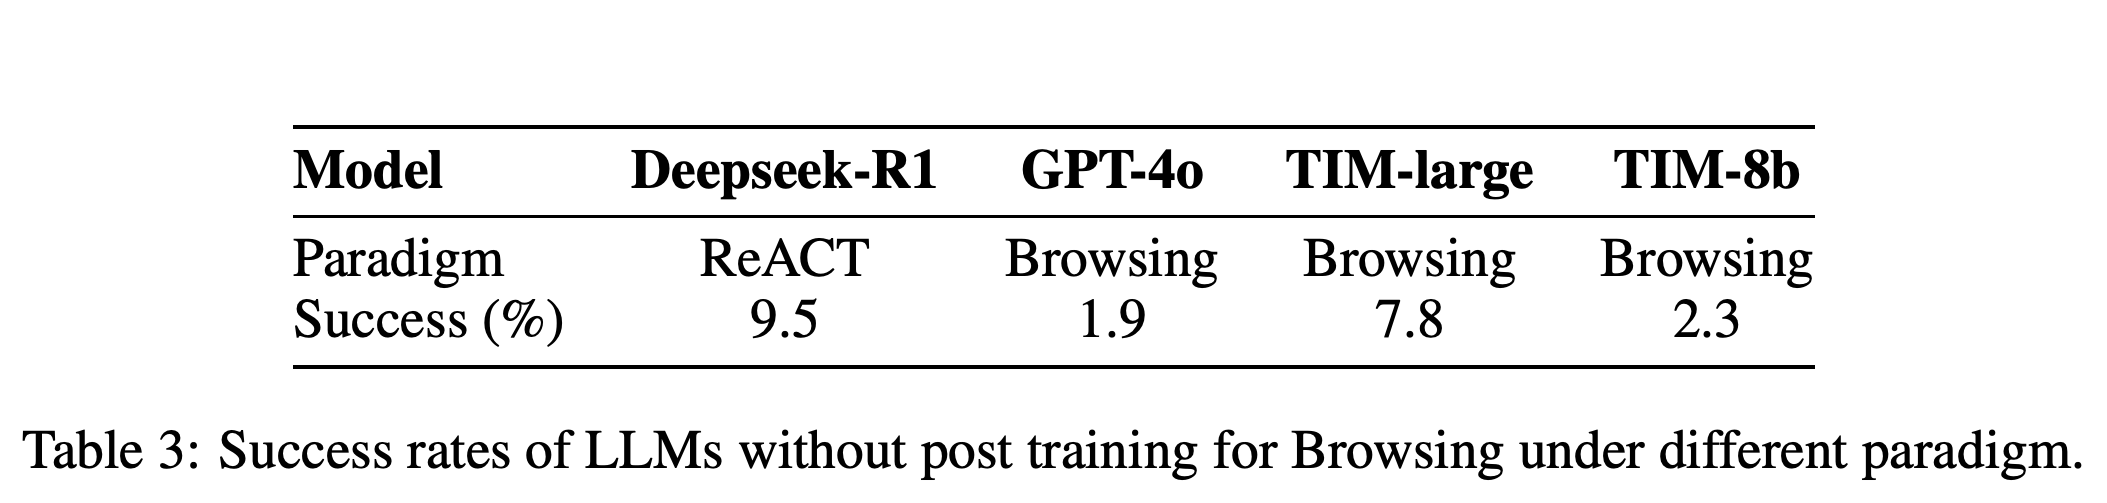
BrowseComp는 작업 분해, 정보 검색, 질문 조건에 따른 검증이 필요한 웹 연구를 평가한다. TIM-large는 GPT-4.1을 기반으로 가지치기를 포함한 재귀적 JSON 파이프라인을 구현한 시스템이며 TIMRUN에서 서빙하지 않는다. 성공률은 TIM-large가 7.8%, TIM-8b가 2.3%, 웹 탐색을 사용하는 GPT-4o가 1.9%, 추론과 도구 상호작용을 결합한 ReACT 방식을 사용하는 Deepseek-R1이 9.5%다.
- TIM-large는 프롬프트를 적용한 GPT-4.1 시스템이며, 더 큰 TIM 모델을 학습해 얻은 체크포인트가 아니다. 따라서 이 점수로 TIM 학습 효과가 모델 크기에 따라 어떻게 달라지는지 확인할 수는 없다.
- 기반 모델과 상호작용 방식이 달라 웹 탐색 성능 차이를 가지치기만의 효과로 볼 수 없다. 보고된 표에서 TIM-large는 여전히 Deepseek-R1보다 낮은 점수를 보인다.
- BrowseComp 전용 후속 학습을 하지 않았다는 점은 TIM-8b가 앞서 연구 질문과 합성 도구 사용 예제로 학습했다는 점과 구분해야 한다.
TIM-large는 웹 탐색을 사용하는 GPT-4o보다 높고 ReACT를 사용하는 Deepseek-R1보다 낮은 점수를 보이며, TIM-8b는 GPT-4o보다 0.4%p 높다. 모델과 상호작용 방식이 모두 다르므로 이 결과만으로 Thread-2나 TIMRUN의 효과를 분리할 수 없다.
4.3 Efficiency and Scalability
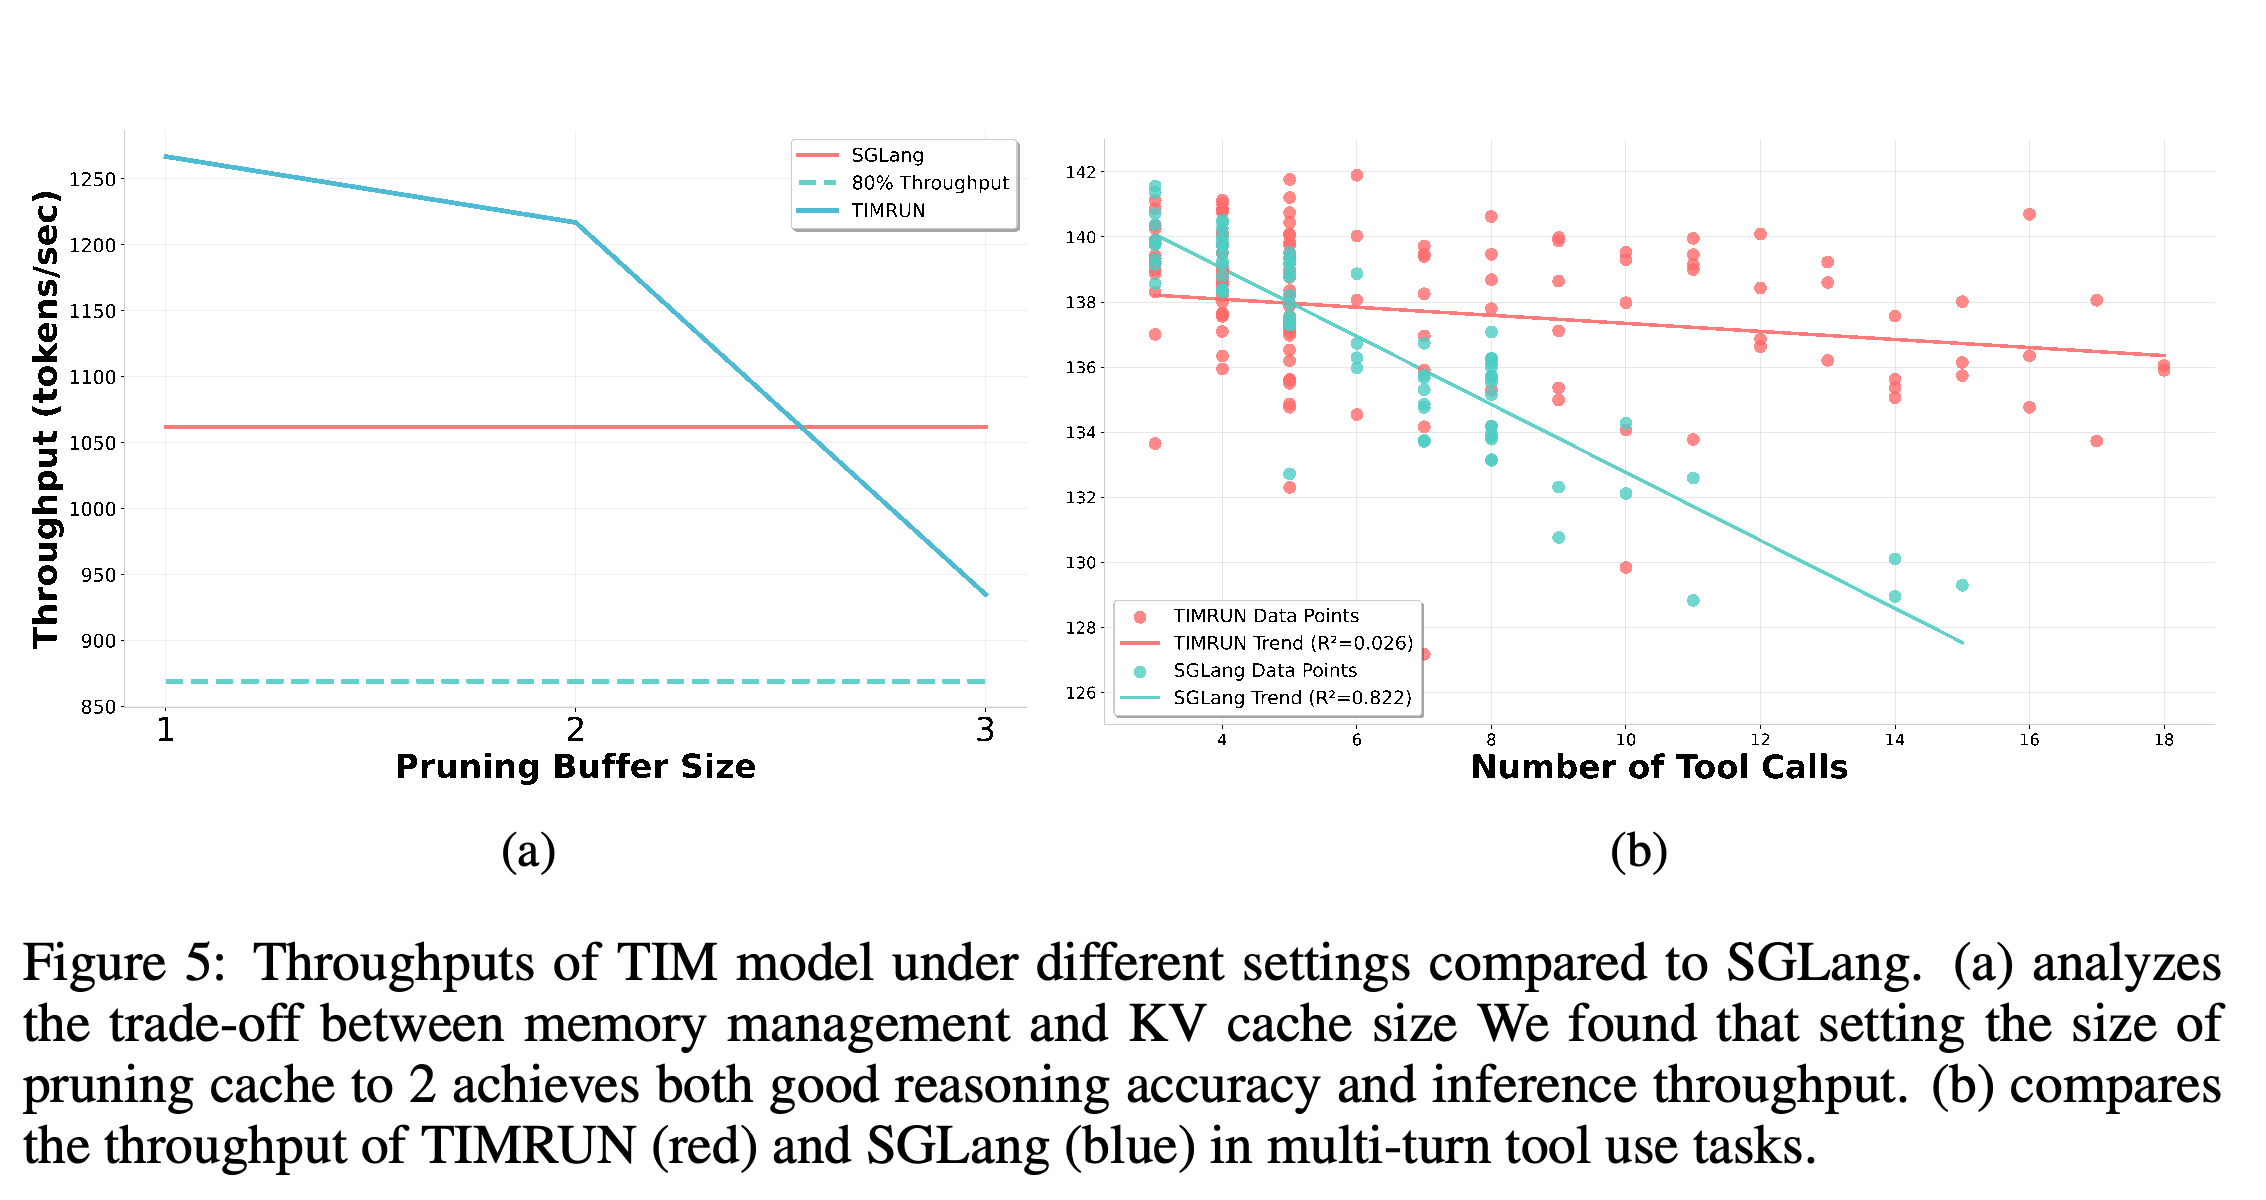
단순한 구현은 캐시 축소만으로 충분하지 않은 이유를 보여준다. 배치 크기 1에서 이 실험의 표준 어텐션 구현인 eager attention을 사용하면, Hugging Face Transformers의 처리량은 가지치기를 추가했을 때 초당 22토큰에서 18토큰으로 떨어진다. 배치 크기 30으로 실행한 AIME 2024에서는 가지치기 버퍼 크기가 1과 2일 때 TIMRUN의 처리량이 SGLang보다 높지만, 크기가 3이면 더 낮다. 저자들은 크기 2를 정확도와 처리량 사이의 유용한 절충점으로 제시한다.
- BrowseComp의 Figure 5b에서는 도구 호출이 늘어날 때 TIMRUN의 처리량 감소가 비교적 완만하고 SGLang의 감소는 더 가파르다. 본문은 1회의 추론에서 30회를 초과하는 도구 호출도 지원한다고 보고한다.
- 초록은 KV 캐시의 최대 90%를 조작하면서도 처리량을 유지한다고 주장하지만, 본문의 실험 결과에는 해당 주장에 대응하는 상세한 조건별 실험이 없다.
- 논문은 처리량 측정을 재현하는 데 필요한 GPU 하드웨어, 수치 정밀도, 전반적인 서빙 설정을 명시하지 않는다. 더 큰 배치를 수용할 수 있는지 질문을 제기하지만 이를 평가하는 실험도 제시하지 않는다.
패널 (a)는 조건에 따른 속도 향상을 보여준다. 가지치기 버퍼 크기가 1과 2이면 SGLang 기준선보다 처리량이 높지만, 크기가 3이면 그렇지 않다. 패널 (b)에서는 도구 호출이 늘어날 때 TIMRUN의 처리량 감소가 더 완만하다. 이는 누적된 하위 작업의 세부 내용과 도구 응답을 제거하는 방식에 부합한다.
5 Conclusion
결론은 시스템의 이점이 모델과 런타임의 공동 설계에서 나온다고 설명한다. TIM은 재귀적 작업 경계와 결론을 출력하고, TIMRUN은 이를 가지치기, 배치 처리, 도구 통합에 활용한다. 보고된 근거는 활성 캐시 문맥을 줄이면서 벤치마크 정확도를 대체로 유지하고, 특정 설정에서 처리량을 개선할 수 있음을 뒷받침한다. 구현은 https://github.com/subconscious-systems/TIMRUN 에서 확인할 수 있다.
부록
- 제공된 13페이지 분량의 연구 예비 보고서에는 부록이 없다. 참고문헌은 결론 뒤인 11–13페이지에 나온다.
짧은 생각
가장 분명한 기여는 생성한 작업 구조와 런타임 메모리 관리를 연결한 점이다. 완료한 가지를 식별할 수 있어 이를 단위로 캐시를 제거하고 위치를 재사용할 수 있다. Table 1은 정확도가 소폭 하락하거나 같거나 상승하면서 캐시를 상당히 줄일 수 있음을 뒷받침한다. Figure 5는 이러한 축소가 속도 향상으로 이어지는지를 구현 효율과 가지치기 버퍼 선택이 결정한다는 점을 보여준다. 사실상 무제한인 추론과 손실 없는 정보 전달이라는 주장은 입증된 근거를 넘어선다. 연구는 추론 길이를 늘려 가며 수행한 통제 평가나 가지치기로 잃는 정보를 직접 검증한 실험을 제공하지 않는다.