


Grove MoE: Towards Efficient and Superior MoE LLMs with Adjugate Experts 요약 설명
11 Aug 2025 | Paper Review Mixture-of-Experts Adaptive Computation Model Upcycling목차
이번 글에서는 Grove MoE: Towards Efficient and Superior MoE LLMs with Adjugate Experts 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 8월 11일(Arxiv)
- Wu, Haoyuan, Chen, Haoxing, Chen, Xiaodong, Zhou, Zhanchao, Chen, Tieyuan, Zhuang, Yihong, Lu, Guoshan, Huang, Zenan, Zhao, Junbo, Liu, Lin, et al.
- Inclusion AI, The Chinese University of Hong Kong, Renmin University of China, Zhejiang University, Shanghai Jiao Tong University, Westlake University
- 논문 링크
- Github
요약
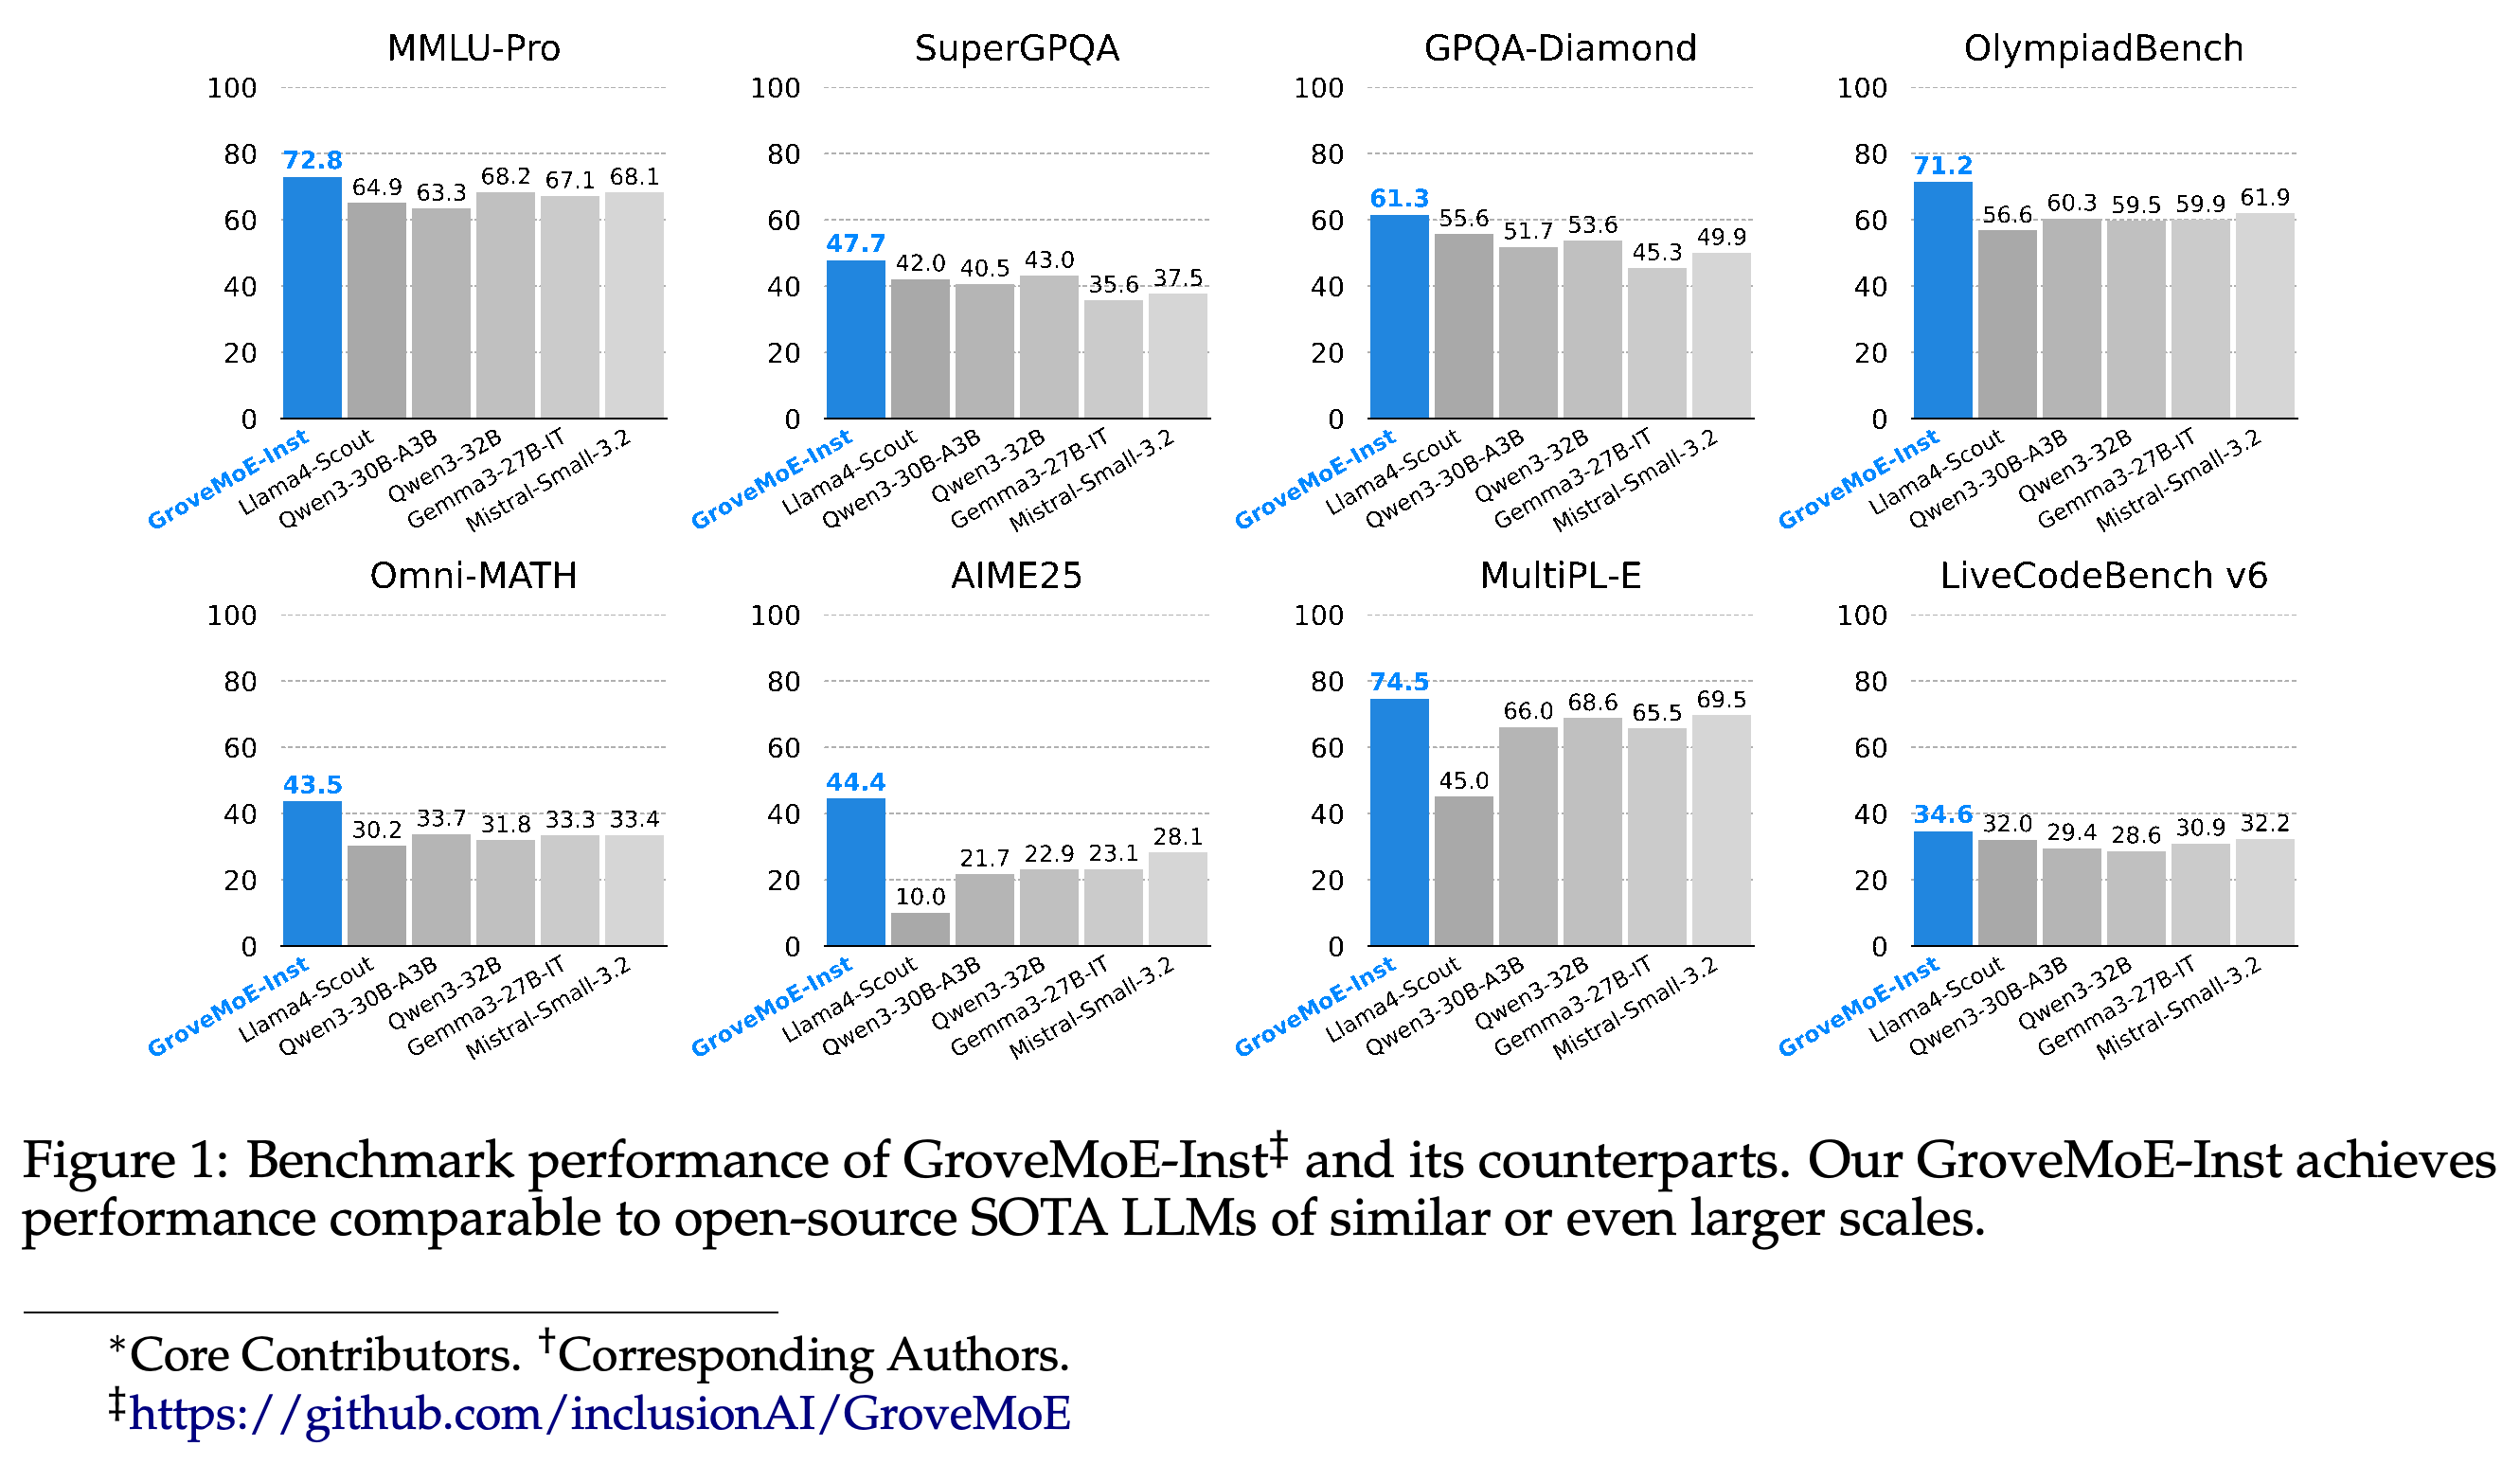
- 기존 mixture-of-experts (MoE) 대규모 언어 모델(LLM)은 일부 expert 네트워크를 선택하지만 모든 토큰에서 같은 수의 파라미터를 활성화하므로 입력에 따라 연산량을 조절하는 데 한계가 있다. GroveMoE-Inst는 총 33B 파라미터를 가지며, B는 billion을 뜻한다. 토큰마다 3.14–3.28B 파라미터를 활성화하고 Table 4에 제시된 모든 일반 능력, 정렬, 수학, 과학 지식 벤치마크에서 오픈소스 non-reasoning 기준 모델을 앞선다. 이 기준 모델들은 별도의 추론 모드 없이 평가한 모델이다.
- 이 아키텍처는 기존 expert 그룹이 공유하는 병렬 네트워크인 adjugate expert를 추가하고 해당 그룹이 선택될 때 이 네트워크를 한 번만 계산한다. 사전 학습 가중치를 재사용해 모델을 확장하는 upcycling으로 Qwen3-30B-A3B-Base를 확장하고 특정 능력을 강화하는 추가 학습인 mid-training을 400B 토큰으로 수행해 GroveMoE-Base를 만든다. 이어 프롬프트와 응답 예시로 학습하는 supervised fine-tuning (SFT)을 수행해 GroveMoE-Inst를 얻는다.
- 50B 토큰을 사용한 아키텍처 실험에서 선택된 그룹 구성은 8개 벤치마크 평균 70.54를 기록하며 확장 없이 추가 학습한 모델은 69.59를 기록한다. 이후 2개 기반 모델에 같은 후속 학습 전략을 적용했을 때 GroveMoE에서 파생된 모델의 평균 점수는 2.27 높았다고 보고한다. 추론 프레임워크인 SGLang으로 구현한 모델은 Qwen3-30B-A3B보다 약 30% 느리므로, 활성화 파라미터 수만으로 더 빠른 서빙을 입증할 수는 없다.
8개 벤치마크 패널에서 GroveMoE-Inst는 표시된 지시 학습 기준 모델보다 높은 점수를 보이며 특히 AIME25와 Omni-MATH에서 차이가 크다. 이 그림은 일부 벤치마크 점수를 요약하며 실행 시간 측정값은 포함하지 않는다.
1 Introduction
기존 MoE 모델은 크기가 같은 expert 중 고정된 수를 선택해 토큰을 라우팅하므로, 토큰의 복잡도에 따라 연산량을 조절하는 데 한계가 있다. Grove MoE는 expert를 서로 겹치지 않는 그룹으로 나누고 각 그룹이 병렬 adjugate expert를 공유하도록 한다. 기존 라우팅 방식을 유지하면서 활성화되는 공유 네트워크 수를 달리할 수 있다. 논문은 GroveMoE-Base와 GroveMoE-Inst를 소개하며 프로젝트 URL은 https://github.com/inclusionAI/GroveMoE 이다.
2 Related Works
이 설계는 고성능 코어와 에너지 효율적인 코어를 결합하는 프로세서 아키텍처인 big.LITTLE에서 착안했다. 기존 동적 MoE 방식은 blank 또는 constant expert, 가변적인 수의 expert를 선택하는 top-any gating, 라우팅 점수가 양수인 expert를 활성화하는 ReMoE 등을 사용한다. 논문은 활성화 수의 제한과 기존 라우팅 방식과의 호환성을 실용적인 과제로 제시한다. Grove MoE는 사전 학습된 MoE 체크포인트를 재사용하면서 활성화되는 공유 그룹 수를 바꾸는 방식으로 기존 upcycling 연구를 확장한다.
3 Architecture
이 아키텍처는 기존 expert 집합과 각 토큰에 대해 expert 점수를 계산하는 router를 유지하고 그룹마다 adjugate expert를 1개 추가한다. 별도의 라우팅 편향으로 expert 부하를 조절한다. 그룹별 공유 연산, 부하 균형, 사전 학습 가중치를 이용한 초기화를 결합해 모델 용량을 확장한다.
3.1 Traditional MoE Layer
토큰 표현 x에 대해 router R은 점수 ρ = R(x)를 계산하고 expert E_i는 e_i = E_i(x)를 계산한다. 점수가 가장 높은 k개 expert를 선택하는 Top-k routing은 출력 y = ∑_{i∈arg topk(ρ)} ρ_i e_i를 만든다. expert 크기가 같고 k가 고정되어 있으면 활성화되는 expert 파라미터 수는 일정하다.
3.2 Grove MoE with Adjugate Experts
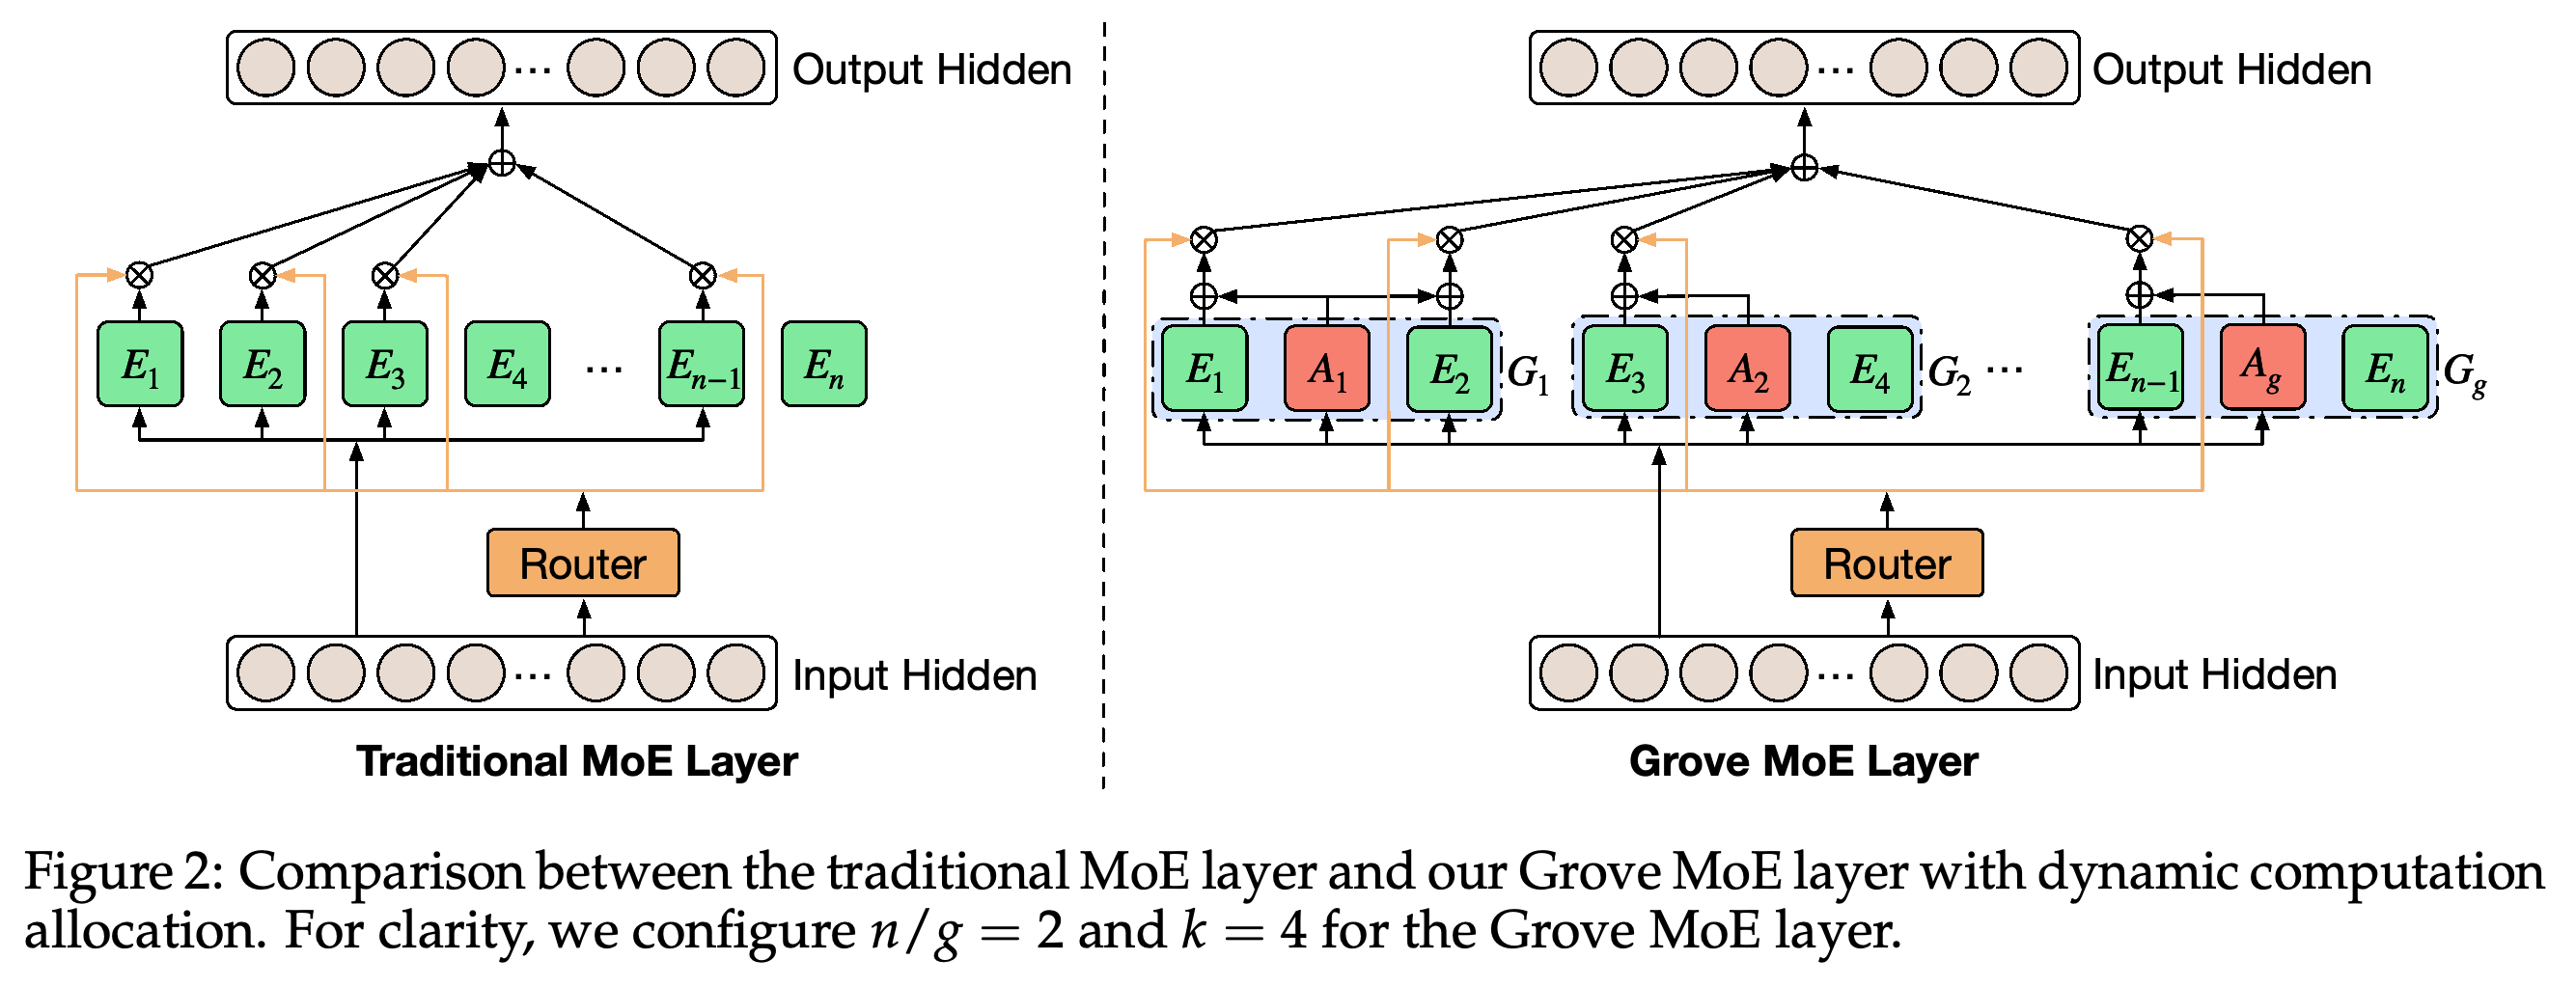
기존 n개 expert를 서로 겹치지 않는 g개 그룹으로 나눈다. g는 n의 약수이며 각 그룹은 n/g개 expert를 포함하고 그룹 인덱스는 j = ⌊(i−1)/(n/g)⌋ + 1이다. 수정된 expert 출력은 ē_i = E_i(x) + λA_j(x)이며, A_j는 해당 그룹의 adjugate expert이고 λ는 그 기여도를 조절한다. 레이어는 기존 라우팅 가중치로 이 출력들을 합산한다. 선택된 expert 2개가 같은 그룹에 속하면 공유 기여분은 (ρ_r + ρ_s)λA_j(x)가 되므로 A_j를 한 번만 계산한다.
- 논문은 λ ≤ g/n으로 제한한다. n = 128이고 g = 64이면 λ ≤ 0.5가 된다.
- 논문에 따르면 활성화되는 adjugate expert 수는 ⌈k/(n/g)⌉부터 k까지다. 동적 연산량은 선택된 서로 다른 그룹 수에 따라 달라진다. 이 절에서는 그 수가 토큰 난이도를 직접 나타낸다는 점을 입증하지 않는다.
- Figure 2는 n/g = 2와 k = 4인 경우를 통해 선택된 expert가 그룹 단위 연산을 재사용하는 방식을 보여준다.
그룹당 기존 expert가 2개이고 선택된 expert가 4개인 구성에서, 같은 그룹에 속한 선택된 expert 2개가 adjugate 네트워크 1개를 재사용하는 방식을 보여준다. Router는 기존 expert를 선택하며 선택된 expert가 속한 그룹에 따라 실행할 추가 네트워크가 결정된다.
3.3 Experts Loading Balance
Auxiliary-loss-free load balancing은 학습 손실에 별도의 균형 목적함수를 추가하지 않고 라우팅을 조절하는 방식이다. expert별 편향 b를 선택 과정에 도입한다. 현재 할당 분포 F와 균등한 목표 분포 Q = [1/n, …, 1/n]에 대해 b ← b − α(F−Q)/√[(1/n)∑_{i=1}^{n}(F_i−Q_i)²]로 갱신하며 불균형의 제곱평균제곱근으로 정규화한다. 선택에는 각 점수를 독립적으로 0과 1 사이로 변환하는 Sigmoid 점수에 b를 더한 값을 사용한다. 합산에는 합이 1이 되도록 정규화한 Softmax 가중치를 사용하며 이 방식으로 α = 0.001을 고정할 수 있다.
- 선택된 각 expert에는 할당 확률 1/k를 부여하고 선택되지 않은 expert에는 0을 부여한다.
- Equation (9)는 합산하는 expert 출력을 e_i로 표기하지만 Equation (6)은 ē_i를 사용한다. 이 표기만으로는 Equation (9)에 adjugate 기여분이 포함되는지 명확하지 않다.
3.4 Reuse of Pre-Trained Weights
기존 expert, attention 레이어, normalization 레이어는 사전 학습 모델에서 복사한다. 새로 삽입한 adjugate 네트워크의 출력 투영인 down-projection 블록은 0으로 초기화하고 나머지 가중치는 표준편차 0.006인 정규분포로 초기화한다. down-projection을 0으로 설정하면 복사한 모델 구성요소를 유지하면서 추가 분기의 초기 출력을 억제할 수 있다.
4 Mid-Training
Mid-training은 사전 학습 아키텍처를 확장하면서 추론과 코드 생성 능력을 강화하는 것을 목표로 한다. 먼저 50B 토큰으로 그룹 크기와 출력 배율을 탐색한 뒤, 선택한 GroveMoE-Base 구성을 400B 토큰으로 학습한다.
4.1 Mid-Training Data
코퍼스 규모는 약 400B 토큰이며, 웹 콘텐츠, 책, 학술 논문, 소셜 미디어, 백과사전, 수학, 프로그래밍 코드가 포함된다. 논문은 텍스트와 비텍스트 자료를 설명하지만 자료별 혼합 비율이나 상세한 코퍼스 구축 절차는 제시하지 않는다.
4.2 Evaluation Benchmarks
기반 모델 평가는 일반 지식, 과학 지식, 추론, 수학, 코딩을 다루는 13개 벤치마크로 구성된다. Shot 수는 프롬프트에 제공하는 예시 수를 뜻하며 chain-of-thought (CoT) 설정은 중간 추론을 유도한다.
- 일반 과제에서는 다중 과제 언어 이해 벤치마크인 MMLU에 5-shot 평가를 적용하고 더 어려운 MMLU-Pro에는 5-shot CoT를 적용한다. 중국어 다중 과제 언어 이해를 평가하는 CMMLU, 대학원 수준 지식을 평가하는 SuperGPQA, 중국어 다분야 평가인 C-Eval에는 5-shot 프롬프트를 사용한다. 어려운 Big-Bench 과제로 구성된 BBH에는 3-shot CoT를 사용한다.
- 수학과 과학 과제에서는 수학 문장제를 다루는 GSM8K와 수학 문제 풀이를 평가하는 MATH에 4-shot CoT를 사용한다. 대학원 수준 과학 질문을 다루는 GPQA-Diamond에는 5-shot 프롬프트를 사용한다.
- 코딩 과제에서는 코드 생성 평가인 HumanEval+와 MBPP+, 다국어 코드 생성 평가인 MultiPL-E에 0-shot 프롬프트를 사용한다. 코드 출력 추론을 평가하는 CRUX-O에는 1-shot CoT를 사용한다. MultiPL-E는 Python, C++, Java, PHP, TypeScript, C#, Bash, JavaScript를 포함한다.
4.3 Architecture Exploration
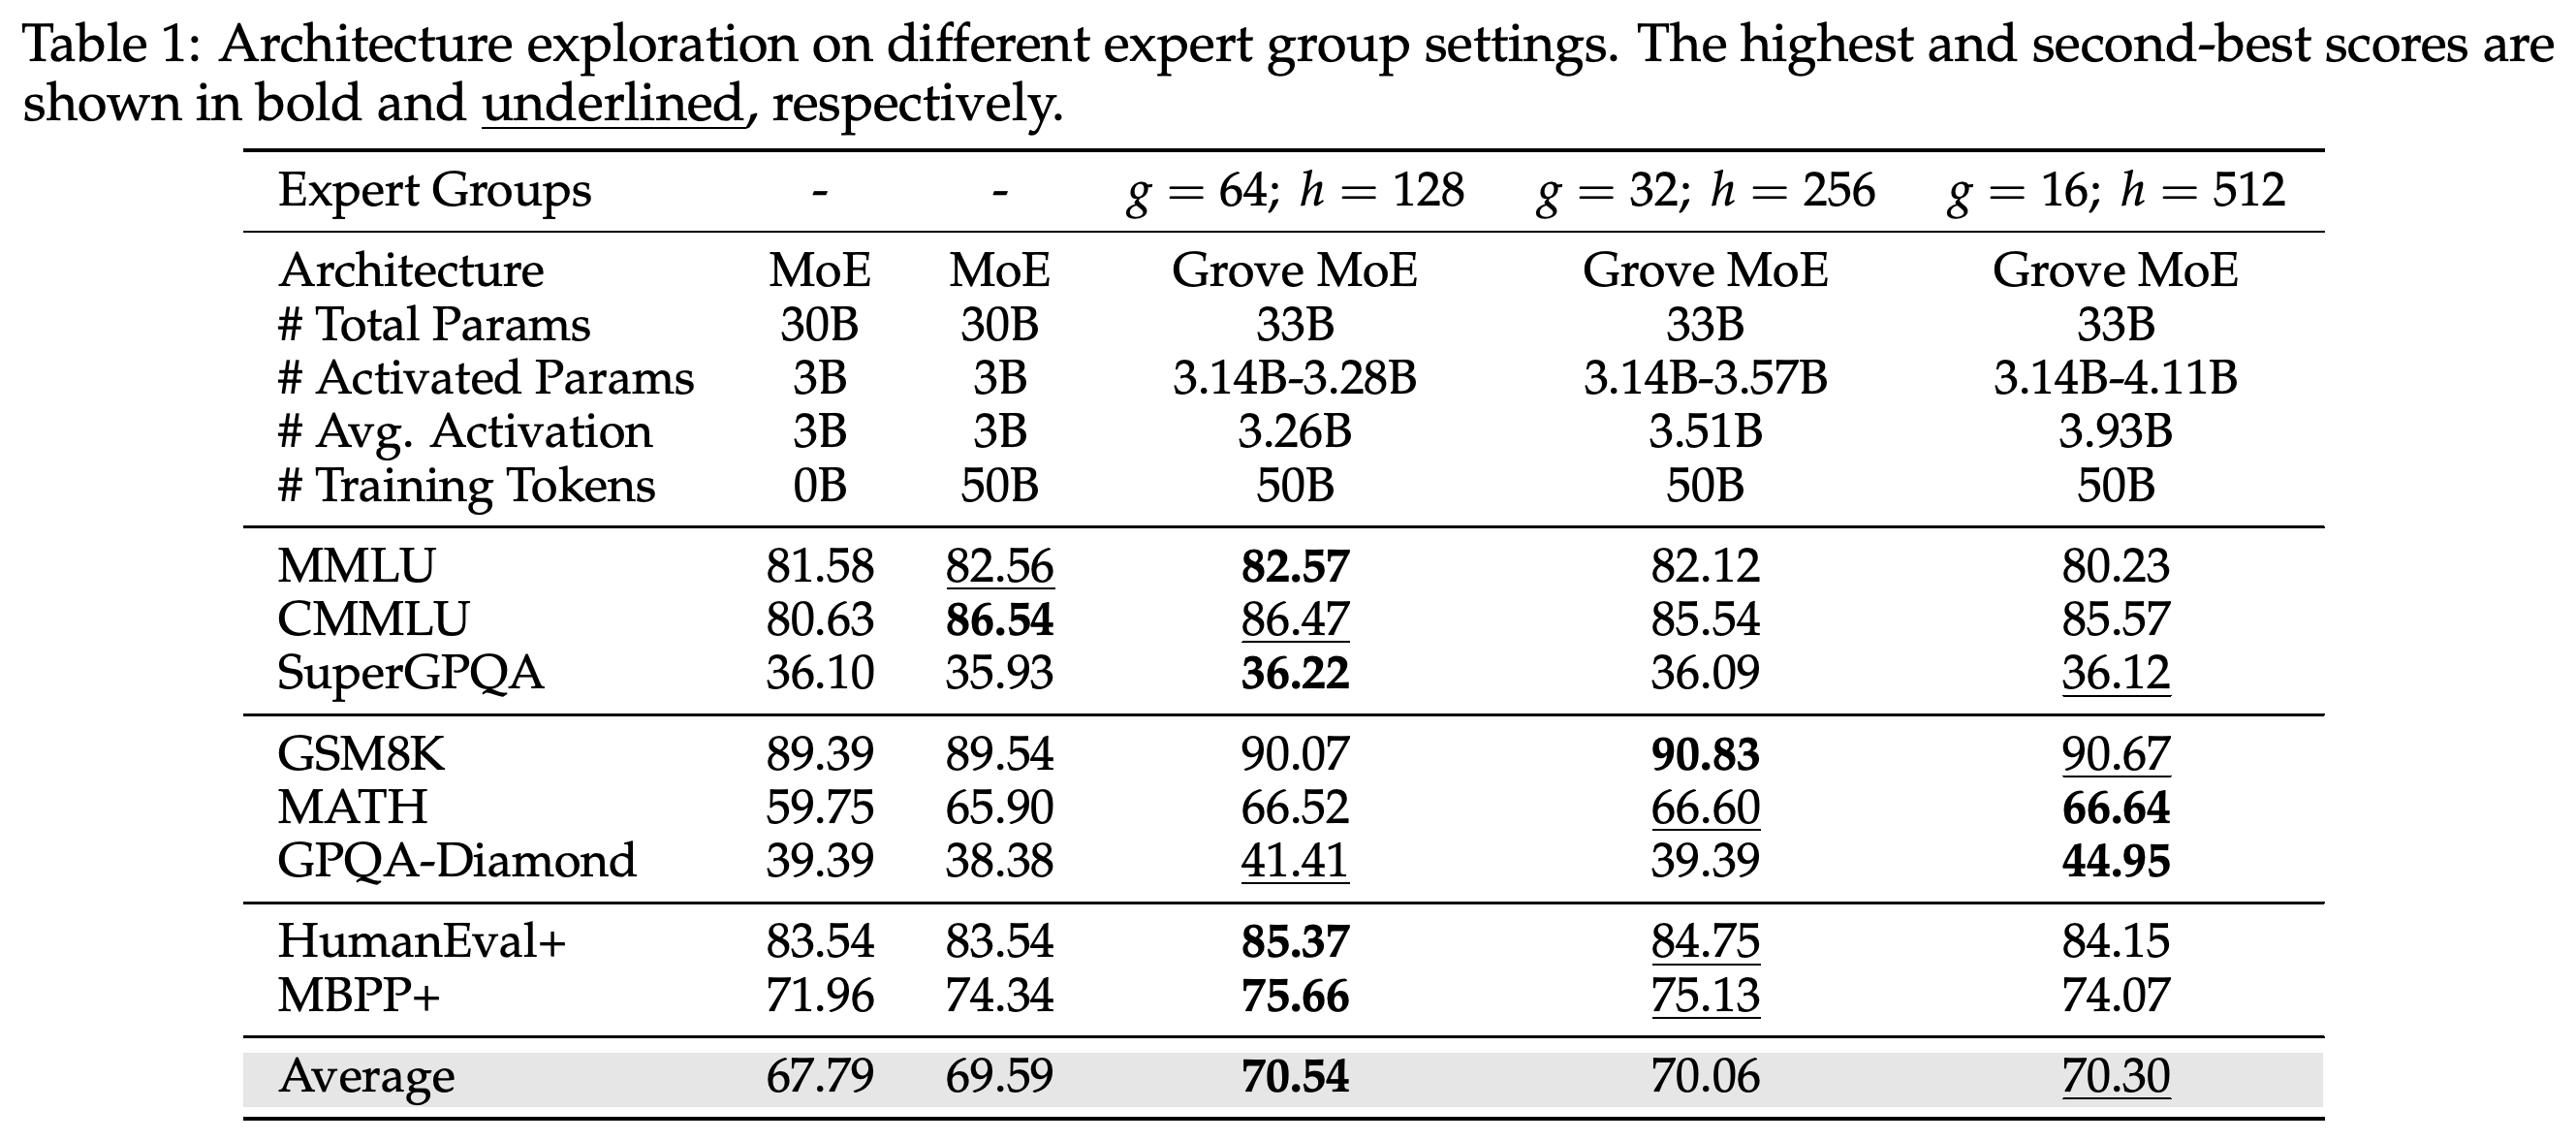
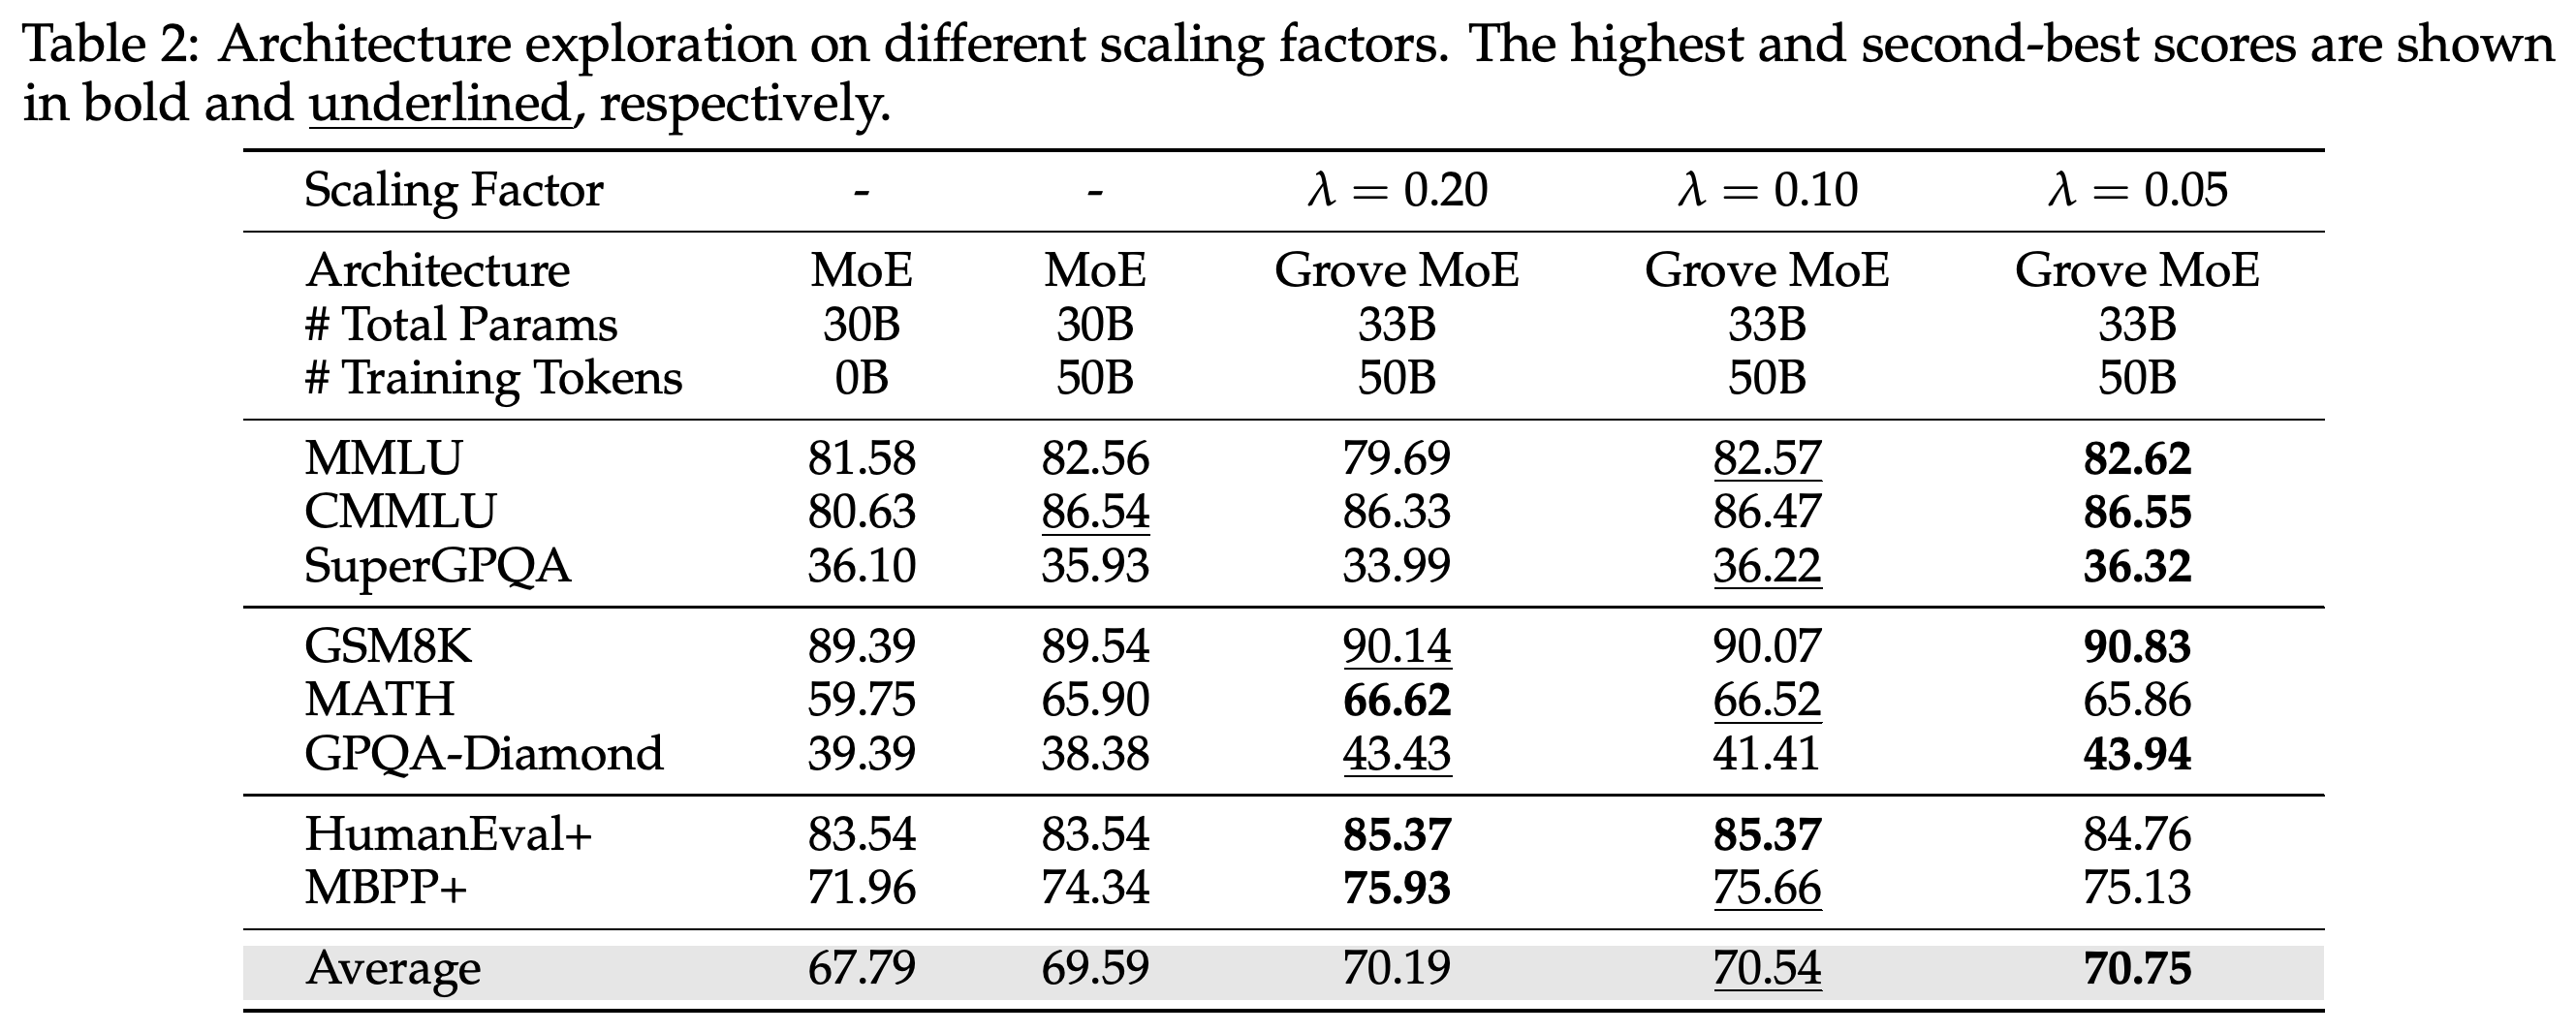
아키텍처 탐색에는 50B 토큰을 사용한다. 확장한 33B-parameter 모델을 upcycling 없이 같은 토큰 수로 추가 학습한 Qwen3-30B-A3B-Base와 비교한다. Table 1은 g = 64, h = 128; g = 32, h = 256; g = 16, h = 512를 비교한다. h는 adjugate 네트워크의 중간 차원이며 각 구성의 평균 점수는 70.54, 70.06, 70.30이고 추가 학습 기준 모델은 69.59다. Table 2는 λ = 0.20, 0.10, 0.05를 비교하며 평균 점수는 각각 70.19, 70.54, 70.75다.
- g = 64 구성은 평균 3.26B 파라미터를 활성화하면서 8개 벤치마크 평균에서 가장 높은 점수를 기록한다. g = 16은 GPQA-Diamond에서 44.95를 기록하지만 평균 3.93B 파라미터를 활성화한다.
- λ = 0.05는 전체 평균이 가장 높으며 λ = 0.20은 실험한 배율 중 MATH와 MBPP+ 점수가 가장 높다.
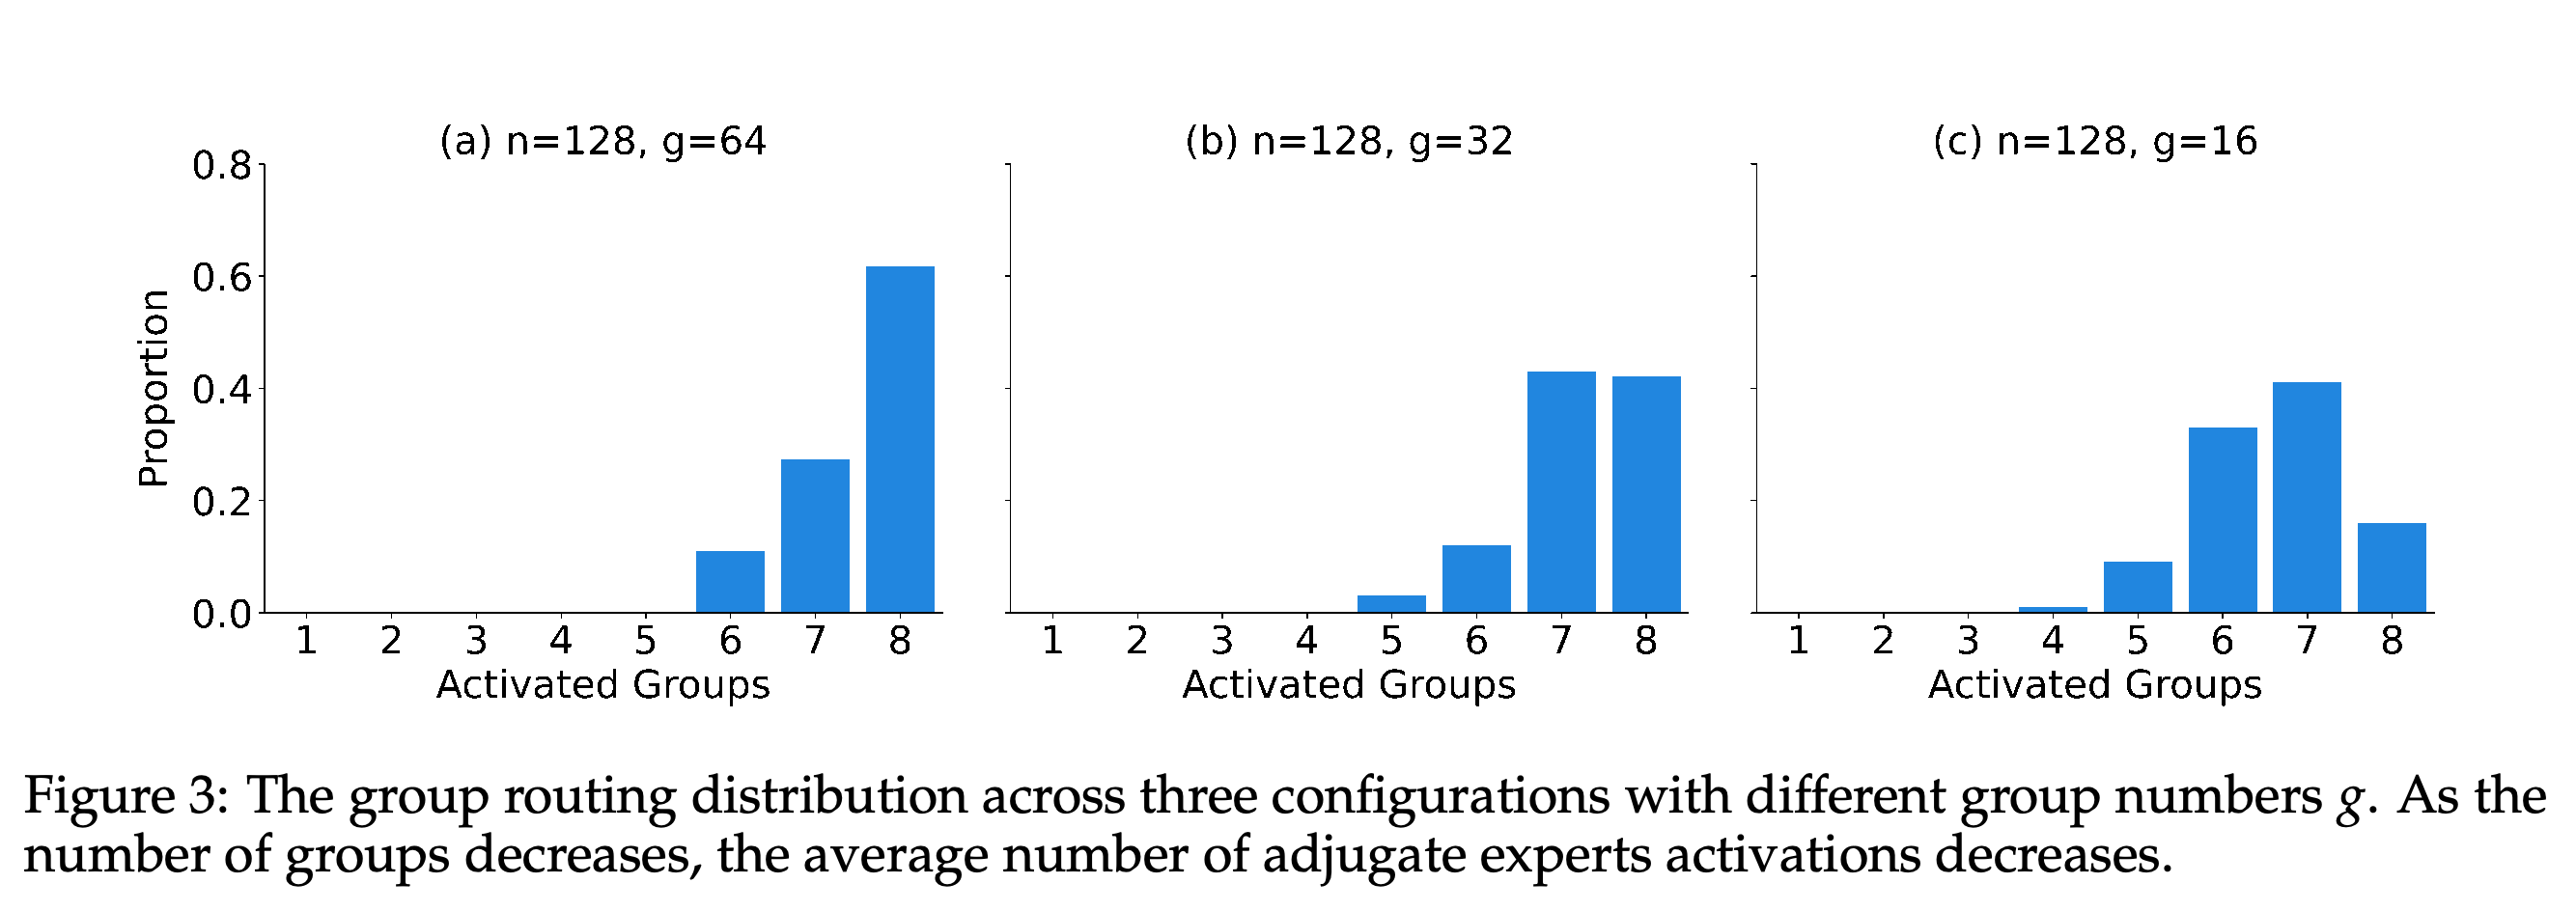
- Figure 3은 n = 128에서 샘플링한 1 million 토큰을 분석한다. 그룹 수가 적으면 활성화되는 adjugate 네트워크 수는 줄지만 adjugate 네트워크의 폭이 넓어져 전체 평균 활성화 파라미터 수는 3.26B, 3.51B, 3.93B로 증가한다. 논문은 g = 64와 g = 16에서 각각 약 5%와 20%의 연산 절감 효과를 보고하지만 기준 연산량을 명시하거나 이에 해당하는 실행 시간 측정값을 제시하지 않는다.
확장한 구성 모두 50B-token continued-training baseline보다 8개 과제 평균이 높다. g = 64, h = 128 구성은 평균 70.54로 기준 모델의 69.59보다 높으며 확장한 모델 중 평균 활성화 파라미터 수가 3.26B로 가장 적다.
실험한 배율 중 가장 작은 λ = 0.05가 평균 70.75로 가장 높지만 과제별 최적값은 다르다. λ = 0.20은 MATH와 MBPP+에서 가장 높은 점수를 기록하므로, 공유 분기의 기여도를 높인다고 성능이 일관되게 개선되지는 않는다.
샘플링한 1 million 토큰과 기존 expert 128개를 대상으로 분석하면, 그룹 수가 줄수록 활성화되는 그룹 수가 적은 쪽으로 분포가 이동한다. 이는 adjugate 연산의 재사용이 늘어남을 보여준다. 다만 Table 1에서 보듯 adjugate 네트워크의 폭이 넓어지면 전체 활성화 파라미터 수는 여전히 증가할 수 있다.
4.4 Hyper-Parameters
GroveMoE-Base는 g = 64, h = 128, λ = 0.05를 사용한다. 학습에는 가중치 감쇠를 분리한 옵티마이저인 AdamW를 사용하며 β₁ = 0.9, β₂ = 0.95, 가중치 감쇠 0.1, gradient clipping 1.0을 적용한다. 최대 시퀀스 길이는 8192 토큰, 배치 크기는 16 million 토큰이며 총 400 billion 토큰으로 학습한다. Cosine 스케줄로 학습률을 1 × 10⁻⁴에서 5 × 10⁻⁵로 낮춘다.
4.5 Mid-Training Evaluation
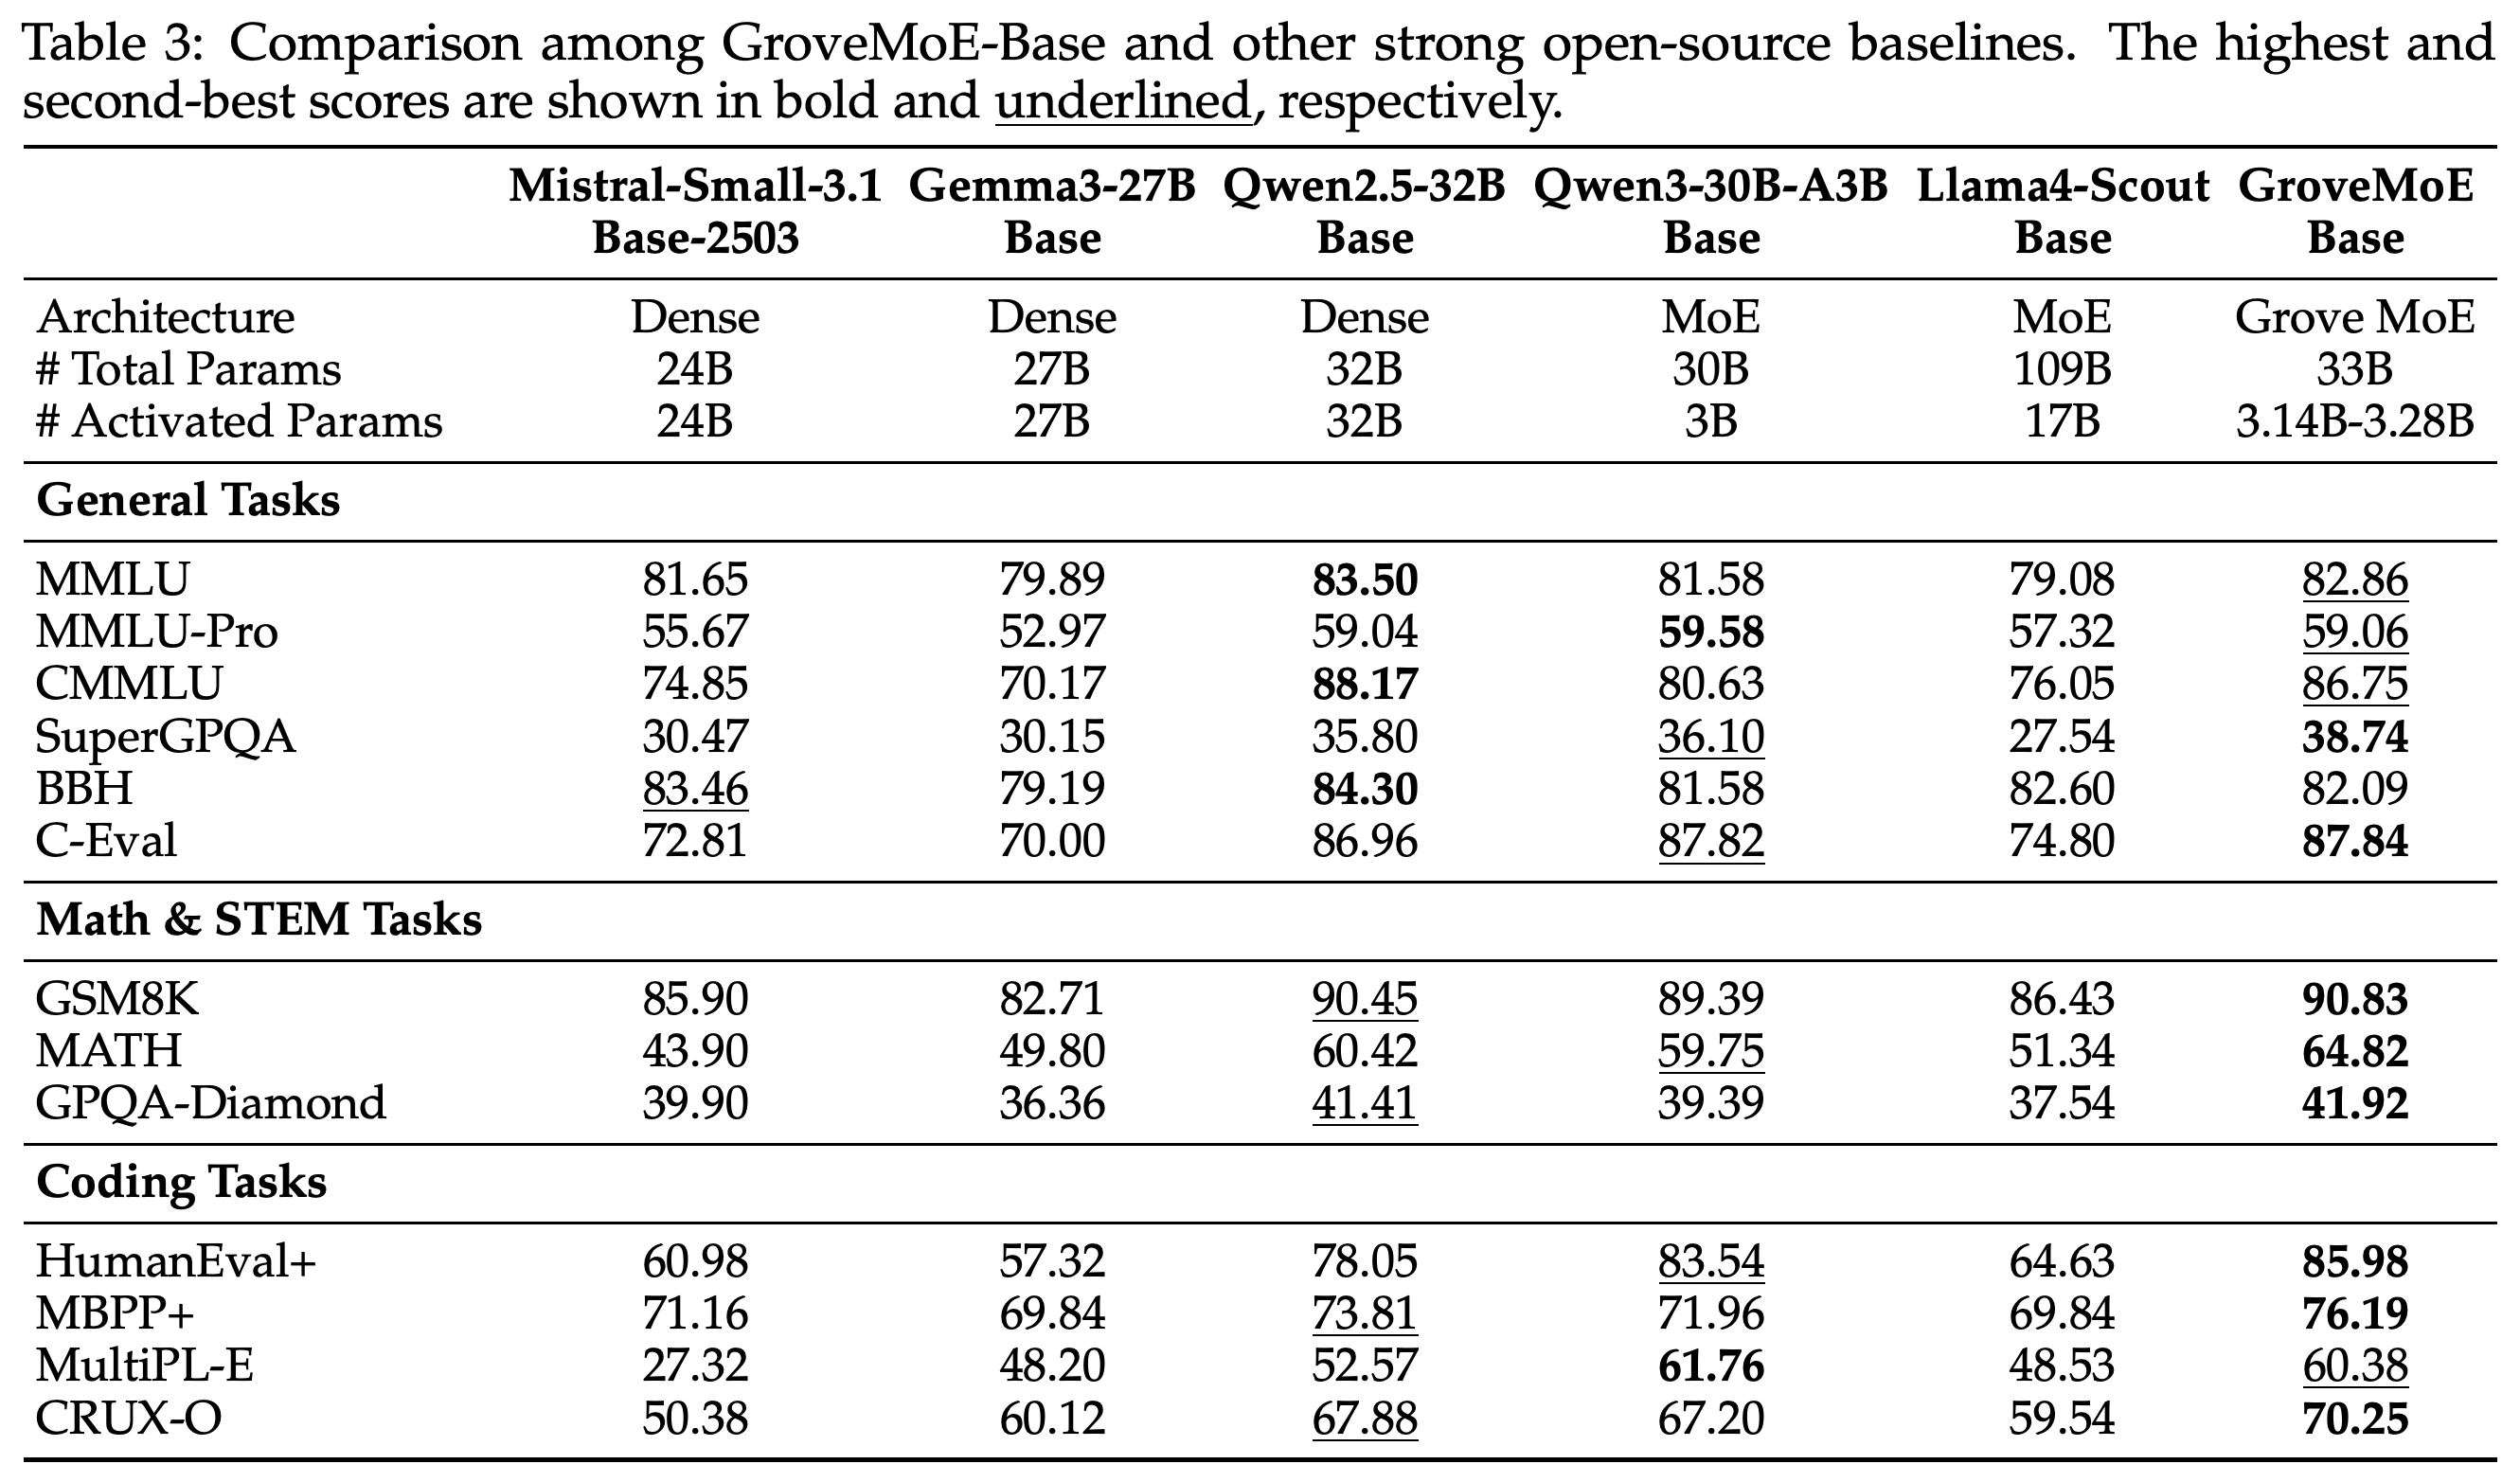
Table 3은 같은 평가 파이프라인에서 GroveMoE-Base와 오픈소스 기반 모델 5개를 비교한다. 원본 Qwen3-30B-A3B-Base 체크포인트와 비교하면 GroveMoE-Base는 MATH가 59.75에서 64.82로, HumanEval+가 83.54에서 85.98로, MBPP+가 71.96에서 76.19로 높아진다. 반면 MMLU-Pro는 59.58에서 59.06으로, MultiPL-E는 61.76에서 60.38로 낮아진다. GroveMoE-Base는 제시된 수학과 과학 벤치마크 3개 모두와 코딩 벤치마크 4개 중 3개에서 가장 높은 점수를 기록하지만 모든 일반 지식 과제에서 선두를 차지하지는 않는다.
- 이 모델은 3.14–3.28B 파라미터를 활성화한다. 토큰마다 모든 파라미터를 활성화하는 제시된 dense 기준 모델은 24B–32B를, Llama4-Scout-Base는 17B를 활성화한다.
- 원본 체크포인트와의 비교에는 아키텍처 확장과 400B 토큰의 추가 학습 효과가 모두 포함된다. 50B 토큰 실험은 확장 없이 추가 학습한 모델과 비교하므로 조건을 더 잘 통제한다.
GroveMoE-Base는 3.14–3.28B 파라미터를 활성화하면서 수학과 과학 과제 3개 모두와 코딩 과제 4개 중 3개에서 가장 높은 점수를 기록한다. 일반 과제에서는 결과가 엇갈리며, MMLU-Pro와 MultiPL-E에서는 Qwen3-30B-A3B-Base가 더 높은 점수를 유지한다.
5 Post-Training
후속 학습은 선별한 지시와 응답 데이터로 GroveMoE-Base를 GroveMoE-Inst로 변환한다. 평가는 일반 능력, 지시와 선호에 대한 정렬, 수학과 과학 지식, 코딩, 지정된 함수의 호출을 생성하는 function calling을 다룬다.
5.1 Supervised Fine-Tuning
SFT는 사람이 주석을 단 자료와 오픈소스 자료에서 추출한 1–2 million 예시로 시작하고 합성 데이터 생성으로 이를 확장한다. 새로운 지시 프롬프트를 생성하는 Magpie 방식과 원본 자료에서 착안해 지시를 합성하는 OSS-Instruct를 활용해 프롬프트를 만든다. 후보 응답을 생성하고 선별하는 rejection sampling에는 여러 LLM을 사용한다. 규칙 기반 필터로 추론 비중이 높은 예시를 검사한 뒤, LLM 평가자가 모든 데이터 유형에 걸쳐 상세한 품질과 관련성 기준을 적용한다.
- 논문은 확장 후 최종 데이터셋 크기, 전체 필터링 기준, 각 데이터 출처의 기여도를 명시하지 않는다.
5.2 Evaluation Benchmarks
후속 학습 평가에는 일반 과제 8개, 정렬 과제 2개, 수학과 과학 과제 7개, 코딩과 에이전트 과제 6개가 포함된다. 지시 이행 평가인 IFEval은 프롬프트 수준과 지시 수준의 엄격한 정확도 평균을 보고한다. Arena-Hard는 사람의 선호에 대한 정렬을, DROP은 문단에 대한 이산적 추론을, AGIEval은 사람을 대상으로 설계된 시험 과제에서 기반 모델의 능력을 평가한다.
- MATH-500은 수학 문제 풀이를 평가하고 Omni-MATH는 올림피아드 수준의 수학을 다루며, AIME24와 AIME25는 수학 경시대회 문제를 사용한다. AIME 점수는 질문당 16개 샘플의 평균이고, GPQA-Diamond 점수는 질의당 8개 샘플의 평균이다. OlympiadBench는 올림피아드 수준의 과학 문제를 평가한다.
- 코드 생성 평가인 LiveCodeBench는 2024.10–2025.02를 포함하는 v5와 2025.02–2025.05를 포함하는 v6를 사용한다. Berkeley Function Calling Leaderboard 평가인 BFCL v3 (Live)는 모든 모델을 프롬프트 형식으로 평가한다.
- Non-reasoning 모델 평가의 최대 출력 길이는 16K다.
5.3 Hyper-Parameters
후속 학습에는 AdamW를 사용하며 β₁ = 0.9, β₂ = 0.95, 가중치 감쇠 0.1, gradient clipping 1.0을 적용한다. Cosine 학습률 스케줄로 학습률을 5 × 10⁻⁶에서 최솟값 1 × 10⁻⁶까지 낮춘다.
5.4 Post-Training Evaluation
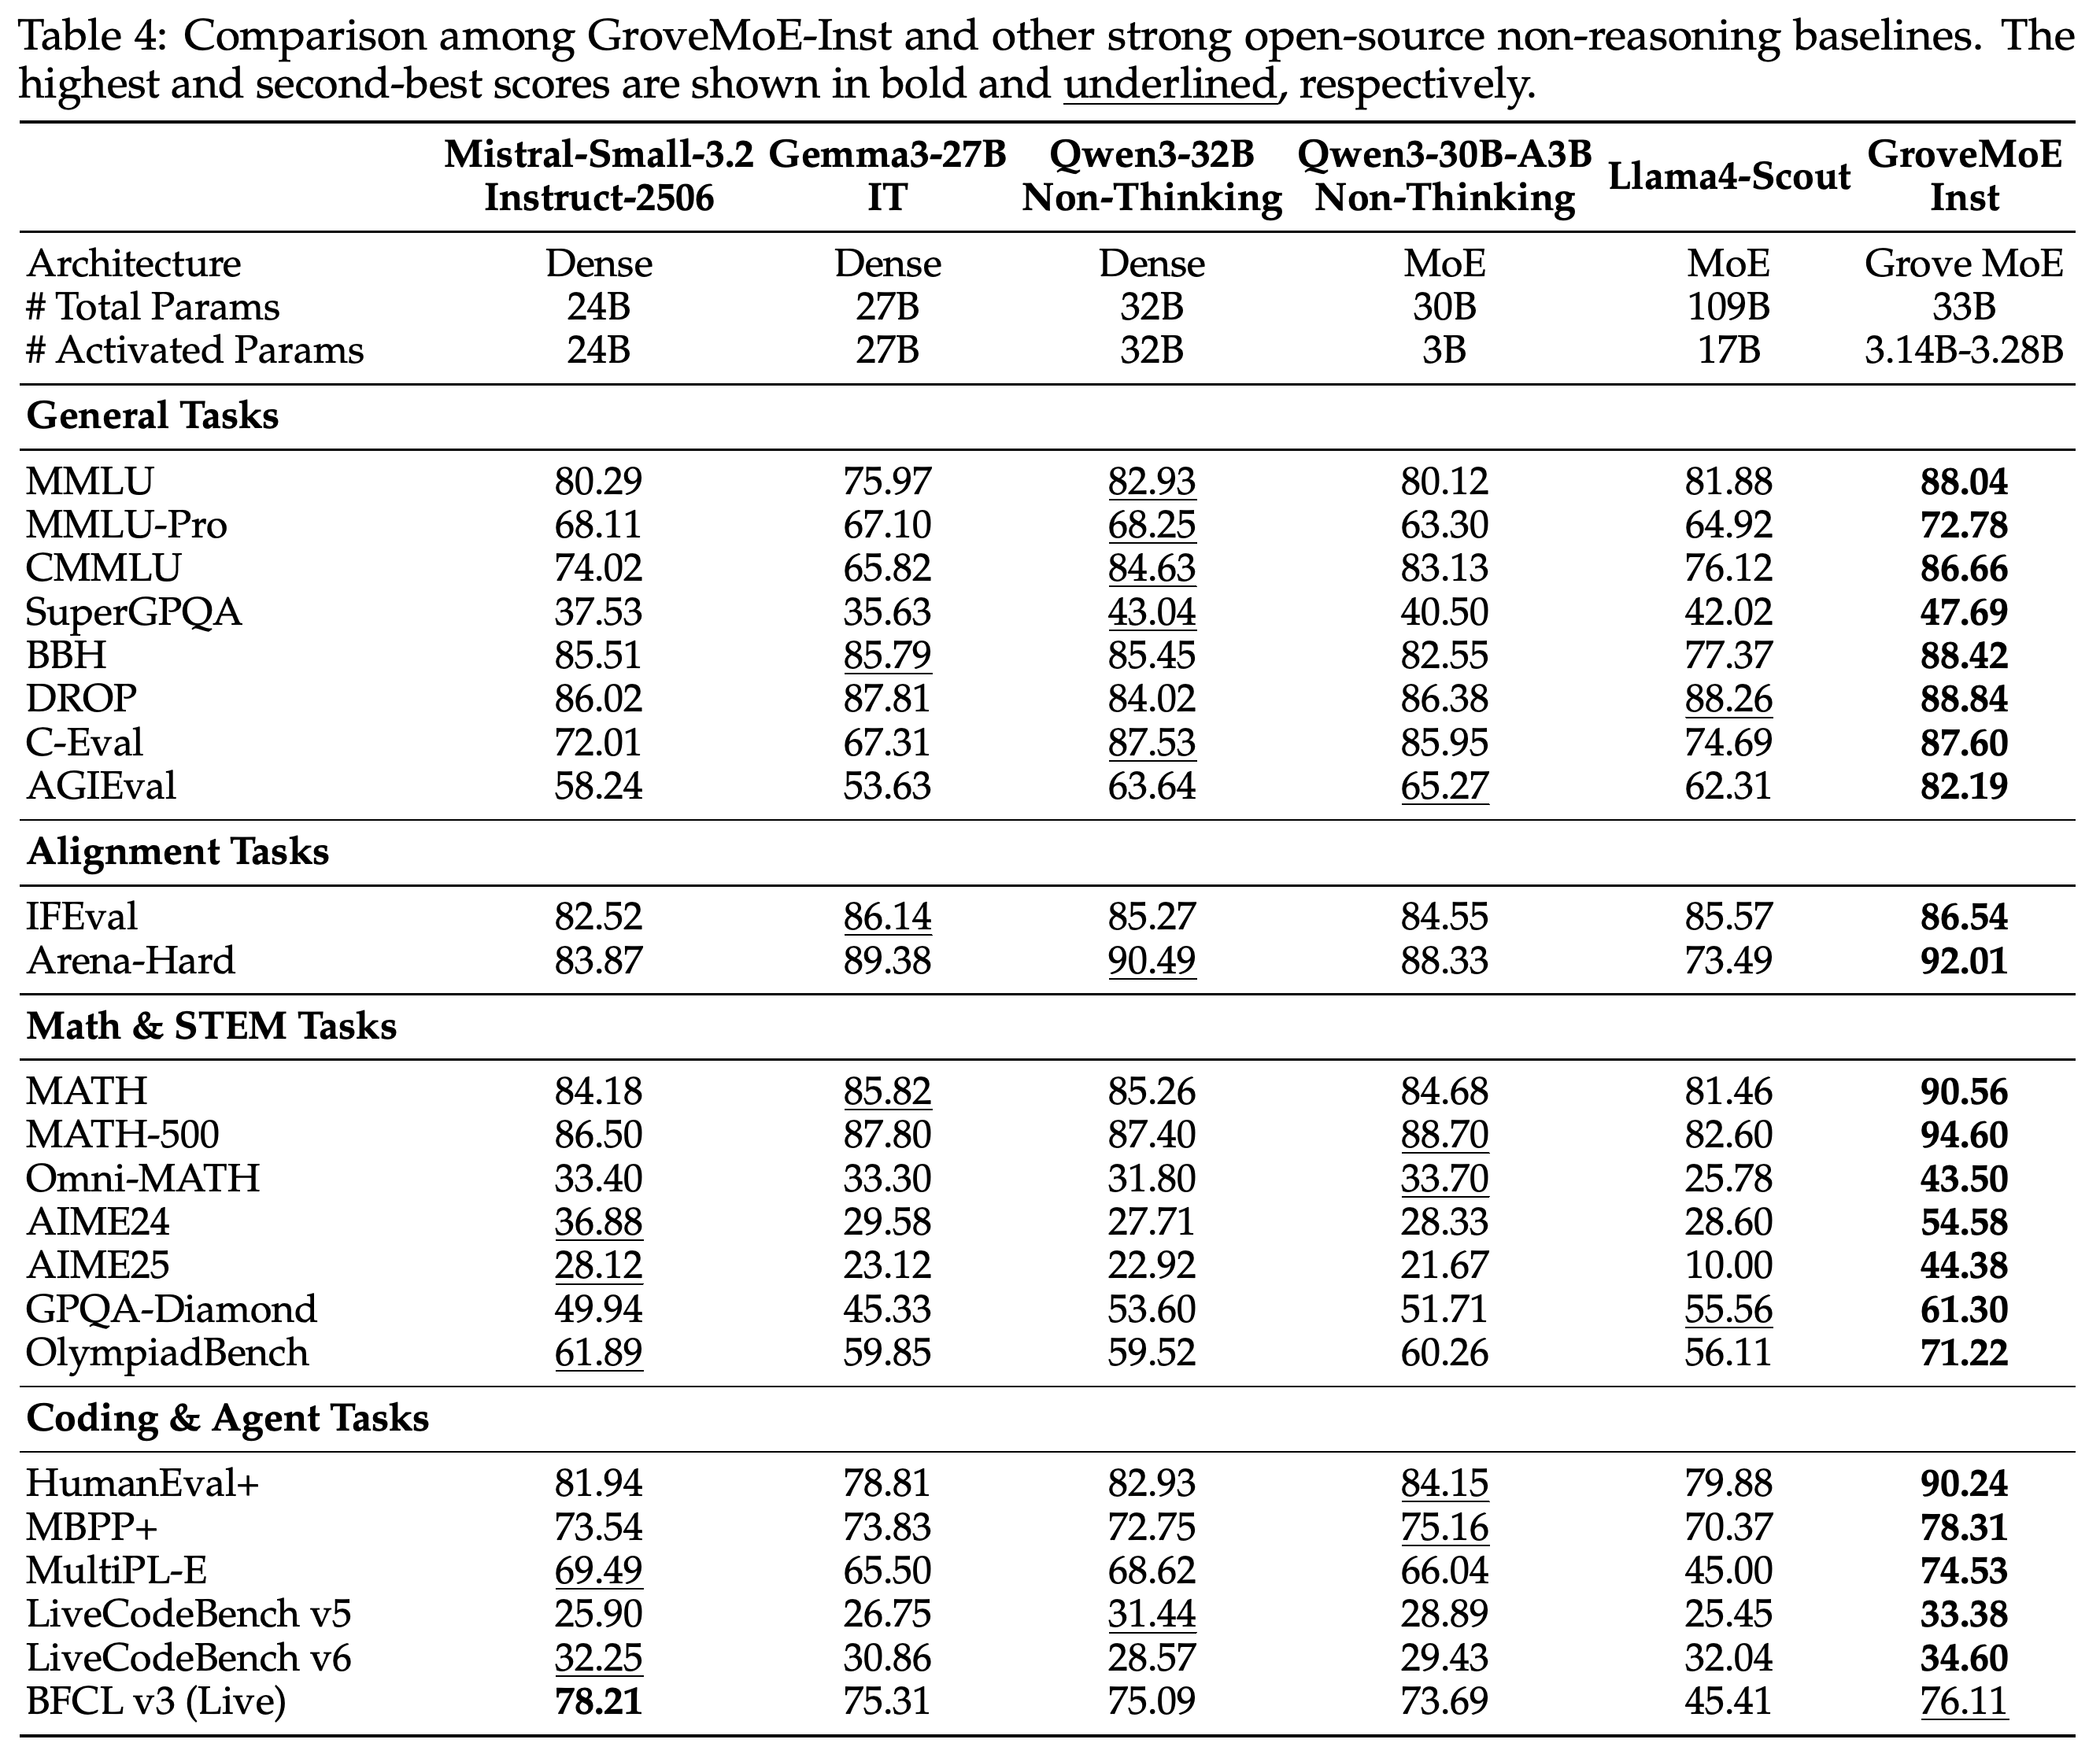
Table 4는 GroveMoE-Inst를 Mistral-Small-3.2-Instruct-2506, Gemma3-27B-IT, Qwen3-32B Non-Thinking, Qwen3-30B-A3B Non-Thinking, Llama4-Scout와 비교한다. GroveMoE-Inst는 제시된 모든 일반 능력, 정렬, 수학, 과학 과제에서 가장 높은 점수를 기록하며 MMLU-Pro는 72.78, AIME25는 44.38, GPQA-Diamond는 61.30이다. 코딩과 에이전트 과제도 6개 중 5개에서 가장 높은 점수를 기록하지만 BFCL v3 (Live) 점수는 76.11로 Mistral의 78.21보다 낮다.
- 경쟁 모델의 최고 점수는 MMLU-Pro에서 68.25, AIME25에서 28.12, GPQA-Diamond에서 55.56이다.
- 이 결과는 논문의 평가 조건에서 제시된 non-reasoning 기준 모델에 적용된다. 추론 모드 모델은 이 비교에 포함되지 않는다.
GroveMoE-Inst는 지정된 non-reasoning 기준 모델과 비교한 벤치마크 23개 중 22개에서 가장 높은 점수를 기록한다. 예외인 BFCL v3 (Live)에서 GroveMoE-Inst는 76.11, Mistral-Small-3.2-Instruct-2506은 78.21을 기록한다.
5.5 Effectiveness of GroveMoE-Base
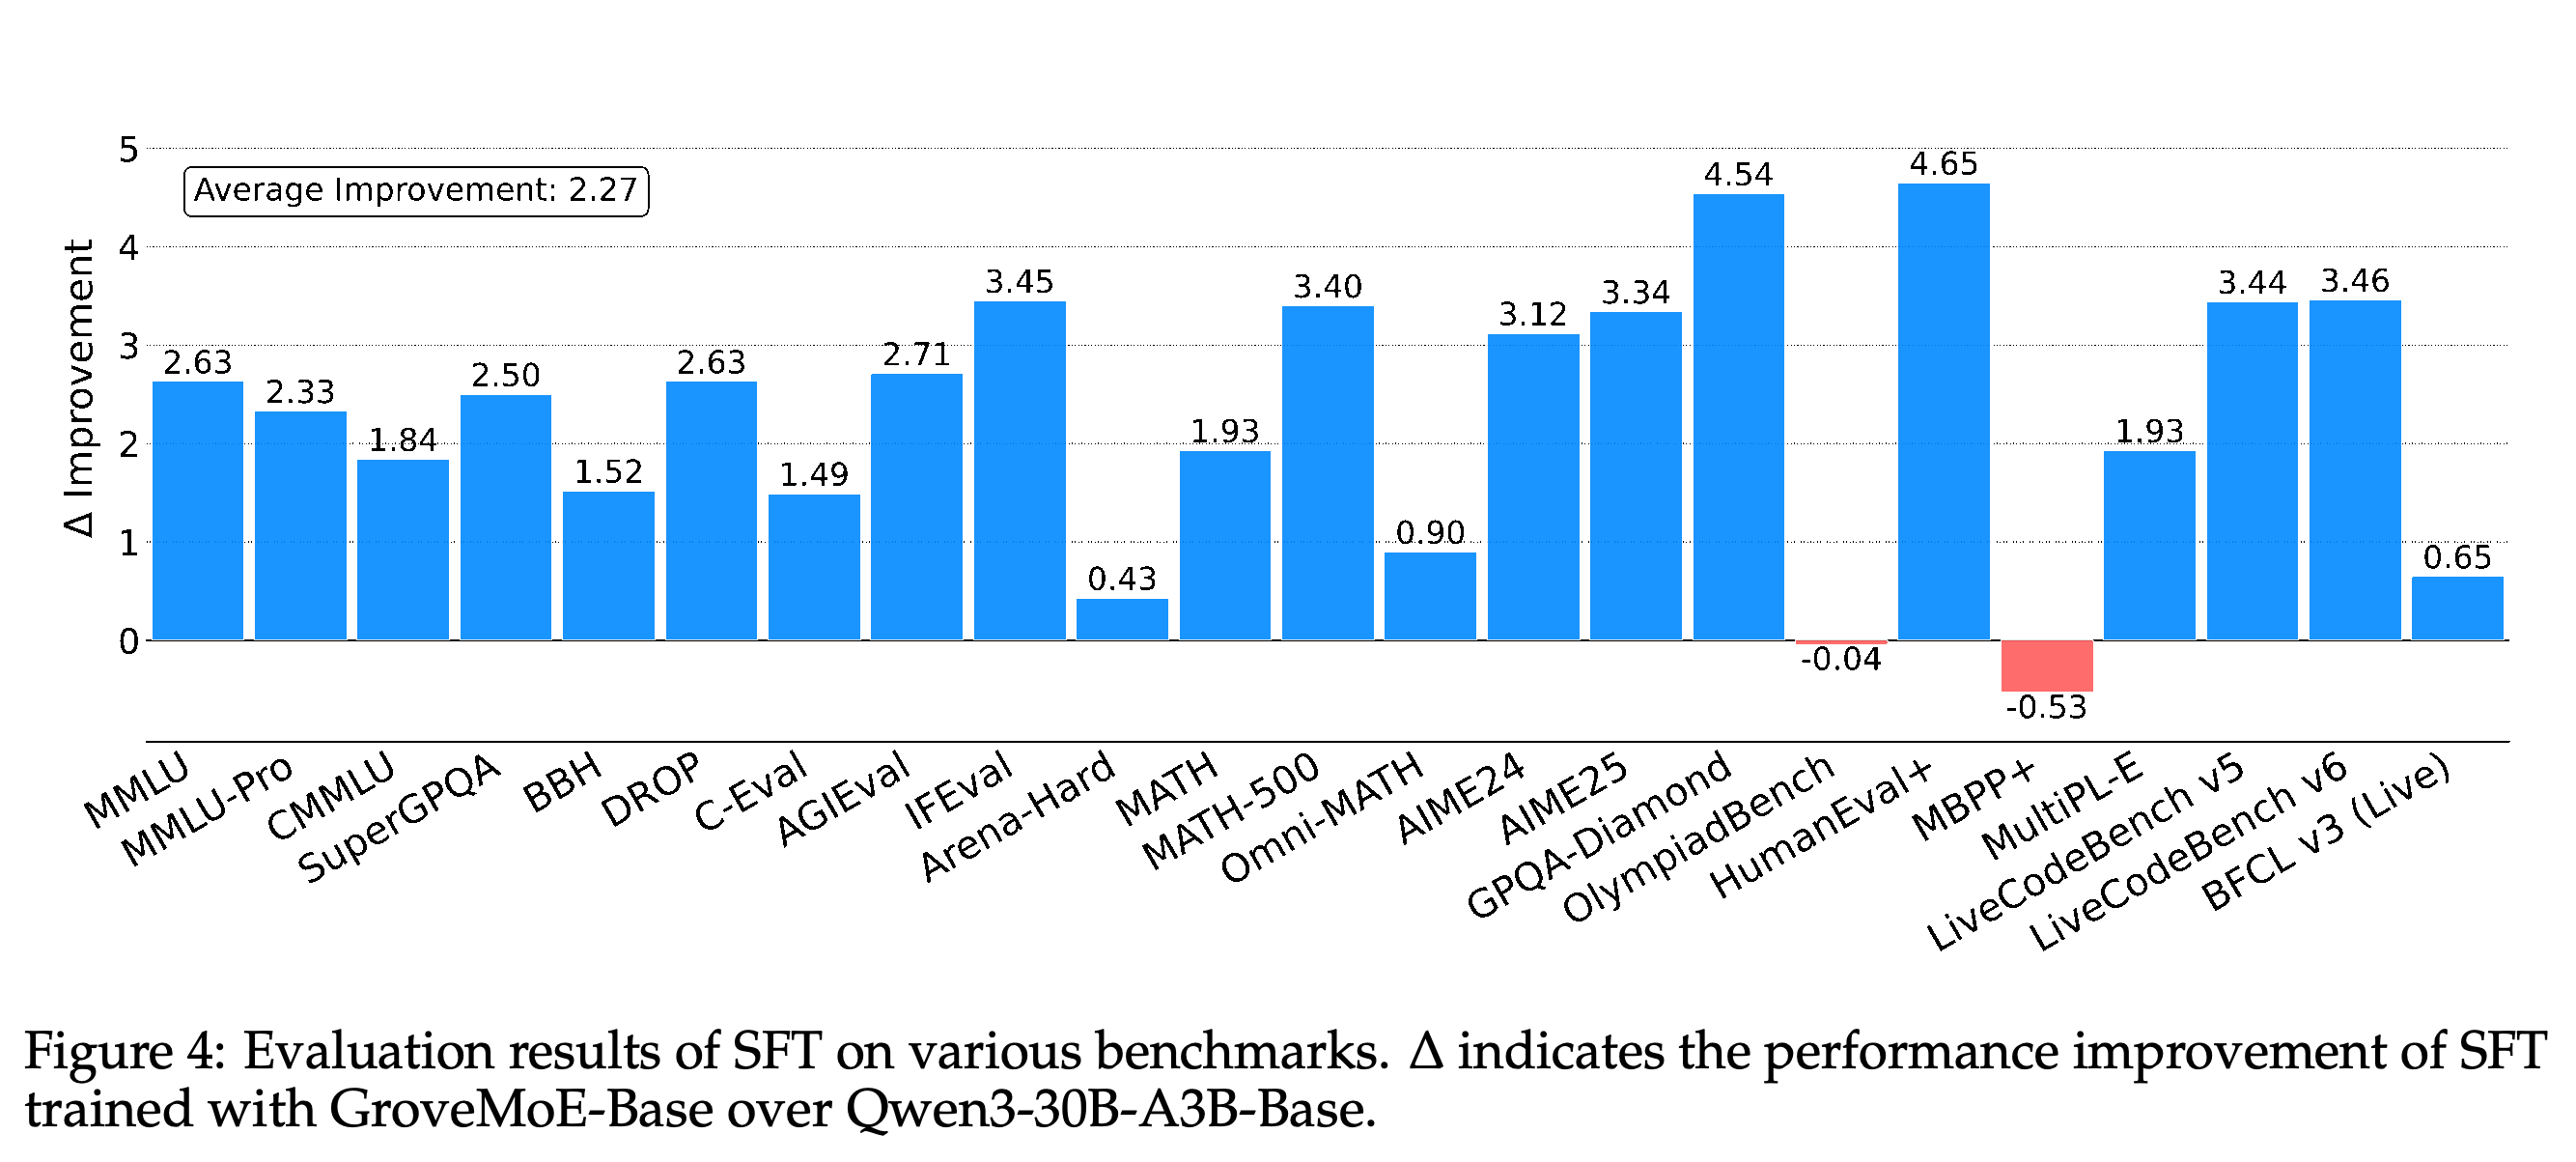
저자들은 기반 모델이 instruction tuning에 얼마나 적합한지 비교하기 위해 GroveMoE-Base와 Qwen3-30B-A3B-Base에 같은 후속 학습 전략을 적용한다. Figure 4는 GroveMoE 기반 파생 모델의 평균 점수가 2.27 높다고 보고한다. HumanEval+는 4.65, GPQA-Diamond는 4.54, LiveCodeBench v6는 3.46 높다. 예외는 −0.04인 OlympiadBench와 −0.53인 MBPP+다.
- 후속 학습 전략을 맞추면 출발점인 2개 체크포인트의 비교 조건을 더 잘 통제할 수 있지만 아키텍처와 이전 mid-training 이력은 여전히 다르다.
같은 후속 학습 전략을 적용하면 GroveMoE 기반 파생 모델은 23개 과제 중 21개에서 점수가 높으며 보고된 평균 차이는 2.27이다. OlympiadBench와 MBPP+의 음수 막대는 예외인 2개 과제를 나타낸다.
5.6 Deployment of GroveMoE-Inst
SGLang 구현은 Qwen3-30B-A3B보다 약 30% 느리며, 이는 논문이 제시한 활성화 파라미터 수의 이론적 최대 증가율 10%를 웃돈다. 저자들은 각 Grove MoE 레이어에서 일반 expert 연산 루틴인 fused-moe 커널을 별도로 2회 호출하는 데서 추가 비용이 발생한다고 설명한다. 향후 과제로 통합 커널을 제안하지만 이에 따른 지연 시간 개선은 측정하지 않는다. 이 절에는 속도 비교에 사용한 하드웨어나 작업 부하의 세부 정보도 없다.
6 Conclusion
Grove MoE는 그룹이 공유하는 adjugate expert를 추가해 사전 학습된 MoE 모델을 확장한다. 선택된 여러 expert가 같은 그룹에 속하면 adjugate 연산을 재사용한다. 그 결과인 GroveMoE-Base와 GroveMoE-Inst는 33B 파라미터를 가지며 토큰마다 3.14–3.28B를 활성화하고 제시된 모델들과의 벤치마크 비교에서 경쟁력 있는 결과를 보인다. 이 결과는 활성화 파라미터의 증가를 작게 유지하면서 모델 용량을 확장할 수 있음을 뒷받침한다. 다만 배포 측정에서는 실행 시간 비용이 아직 해결되지 않았음을 보여준다.
Limitations
저자들은 mid-training 코퍼스에 긴 중간 추론을 포함하는 long-CoT 데이터가 부족하다는 점을 한계로 제시한다. 이는 Qwen3-30B-A3B-2507 같은 모델에 비해 고급 추론 능력을 제한한다. 모델 개선에는 rejection sampling을 사용하며 보상 피드백으로 최적화하는 reinforcement learning (RL)은 사용하지 않는다. RL을 추가했을 때 기대되는 이점은 이 논문에서 검증하지 않는다.
부록
- 제공된 13페이지 논문에는 부록이 없다. 참고문헌은 10페이지에서 시작해 13페이지까지 이어진다.
짧은 생각
아키텍처를 뒷받침하는 가장 강한 근거는 확장 없이 추가 학습한 모델과 비교한 50B 토큰 실험이다. 그룹별 adjugate expert는 활성화 파라미터 수를 원본 모델 수준에 가깝게 유지하면서 보고된 평균 점수를 높인다. 약 30%의 추론 속도 저하는 커널 통합을 평가하기 전까지 실용적인 효율성 주장을 제한한다. 라우팅 히스토그램은 활성화되는 그룹 수가 달라짐을 보여주지만 논문은 토큰 난이도가 그 활성화를 예측하는지 직접 검증하지 않는다.