


Looped World Models 요약 설명
16 Jun 2026 | Paper Review World Models Looped Transformers Deferred Decoding Adaptive Computation목차
- 요약
- 1 Introduction
- 2 Related WORK
- 3 Looped World Model
- 4 Results
- 5 Conclusions
- 6 BROADER IMPACTS
- 부록
- 짧은 생각
이번 글에서는 Looped World Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 16일(Arxiv)
- Lu, Hongyuan Adam, Wei, Z. L. Victor, Zhang, Qun, Zeng, Jinrui, Cao, Bowen, Meng, Lingwei, Li, Mocheng, Wang, Zezhong, Yin, Haonan, Xue, Naifu, et al.
- FaceMind Research Asia
- 논문 링크
요약
- Looped World Models (LoopWM; arXiv:2606.18208)는 파라미터를 공유하는 transformer 블록을 반복 적용하는 행동 조건부 잠재 동역학을 제안한다. 내부 루프는 각 전이 추정치를 정교화하고, 외부 루프는 환경 스텝에 따라 잠재 상태를 전파한다.
- 이 구조는 스펙트럼 제약을 적용한 선형 상태 유지, 확률적 학습 깊이, 적응형 조기 종료, 지연 디코딩을 결합한다. 지연 디코딩은 잠재 공간에서 행동 시퀀스를 처리하고, 마지막 스텝에서만 관측, 보상, 지속 여부를 예측한다.
- ScienceWorld에서 5개 행동 이후를 예측할 때, 약 1B-parameter 모델은 exact match 68.4%를 보고한다. claude-opus-4-6-max는 47.2%를 기록한다. AlfWorld에서 LoopWM은 보고된 BLEU-4 점수 중 가장 높은 71.6%를 얻지만, exact match, Token F1, Entity에서는 최고 점수를 얻지 못한다.
- 보고된 결과는 짧은 예측 구간에서 경쟁력 있는 성능을 뒷받침하지만, 조건을 맞춘 ablation 실험으로 루프, 스펙트럼 제약, 지연 디코딩의 기여를 분리하지는 못한다. 최대 100× 파라미터 효율과 큰 FLOPs 절감이라는 주장에는 통제된 측정 결과가 없다. 선형 상태 유지 행렬의 수축성만으로 전체 비선형 동역학의 안정성을 입증할 수도 없다.
1 Introduction
서론은 2가지 어려움을 제시한다. 상상 궤적을 따라 예측 오차가 누적되고, 기존 신경망의 깊이를 늘리면 파라미터 수와 배포 비용이 증가한다. LoopWM은 깊이 방향으로 전이 정교화 연산자를 재사용하며, 반복적인 잠재 연산을 파라미터 수와 독립적인 확장 축으로 제안한다.
- 논문은 내부 루프의 정교화와 물리적 시간을 구분한다. transformer를 반복 적용하는 과정은 연속된 환경 스텝을 시뮬레이션하는 것이 아니라, 단일 전이 추정치를 정교화한다.
- 파라미터 공유는 저장할 파라미터 수를 줄이지만, 반복 횟수가 늘면 추가 연산이 필요하다. 추론 비용 절감은 전이의 난도, 유효한 최소 깊이, 조기 종료에 드는 추가 비용에 따라 달라진다.
2 Related WORK
관련 연구에서는 잠재 세계 모델, 깊이 방향으로 파라미터를 공유하는 recurrent-depth transformer, 입력에 따라 달라지는 연산을 연결한다. LoopWM은 행동 조건부 환경 예측을 위해 이 아이디어들을 결합한다. 파라미터 공유와 적응형 종료에는 각각 기존 연구의 선례가 있다.
2.1 World Models for Reinforcement Learning and Embodied Ai
논문은 World Models, PlaNet, Dreamer, MuZero를 통해 잠재 세계 모델의 발전을 살펴본다. 이어 IRIS, TransDreamer, DIAMOND, Genie를 포함한 transformer, diffusion, 비디오 생성 접근법을 논의한다. 예측 오차의 누적을 지속적인 한계로 지적하고, 재계획, 자기 수정, 물리 지식 기반 모델링 등 완화 전략을 검토한다.
- 이 방법들은 관련 설계 선택지를 보여준다. 보고된 실험은 학습 및 평가 조건을 맞춘 상태에서 LoopWM과 이들 방법의 동역학 백본을 비교하지 않는다.
2.2 Looped and Recurrent-Depth Transformer Architectures
Universal Transformer와 ALBERT는 깊이 방향의 가중치 공유에 대한 선례를 제공한다. 이후 recurrent-depth 모델들은 잠재 공간의 반복 연산과 테스트 시점의 깊이 확장을 연구한다. 논문은 이론적 계산 표현력, 적응형 루프 횟수, 가변 깊이 학습, mixture-of-recursions 설계도 검토한다.
- LoopWM은 prelude–recurrent–coda 구성과 Parcae의 음수 대각 상태 유지 파라미터화를 활용한다. 인용된 언어 모델의 결과는 이러한 적용의 동기가 되지만, LoopWM의 세계 모델 효율을 입증하지는 않는다.
2.3 Adaptive Computation and Early Exit
Adaptive Computation Time, 중간 층 조기 종료, 확률적 루프 깊이 학습, 은닉 상태 수렴 기준은 전이마다 연산량을 달리하는 설계의 근거가 된다. 논문은 예측하기 쉬운 전이가 복잡한 사건보다 적은 정교화 반복을 필요로 한다고 주장하지만, 사건별 루프 횟수나 정확도–연산량 곡선은 보고하지 않는다.
3 Looped World Model
LoopWM은 행동 조건부 잠재 예측, 공유 연산을 통한 반복 정교화, 적응형 깊이를 결합한다. 방법 절에서는 여러 스텝에 걸친 잠재 상태 변화와 마지막 관측 예측을 분리하는 지연 디코딩도 소개한다.
3.1 Overall Architecture
구조는 4개 모듈인 Observation Encoder Eϕ., Action Embedder Aψ., Looped Dynamics Core Lθ., Prediction Heads Dξ.로 구성된다. 환경 스텝 k에서 관측 및 행동 임베딩이 동역학 코어의 조건으로 주어지고, 경량 예측 헤드가 다음 관측 또는 잠재 타깃, 보상, 지속 여부 플래그를 출력한다.
- Observation Encoder Eϕ.는 convolutional 또는 vision-transformer 인코더로 ek = Eϕ(ok)를 계산한다. Action Embedder Aψ.는 같은 d차원 잠재 공간에서 uk = Aψ(ak)를 계산한다.
- Looped Dynamics Core Lθ.는 공유 블록을 T회 반복해 이전 잠재 상태, 관측 임베딩, 행동 임베딩을 결합한다.
- Prediction Heads Dξ.는 결과 상태를 디코딩한다. 상상 롤아웃에서는 실제 관측 인코딩을 건너뛰며, 관측 주입을 생략하거나 모델의 예측으로 대체한다.
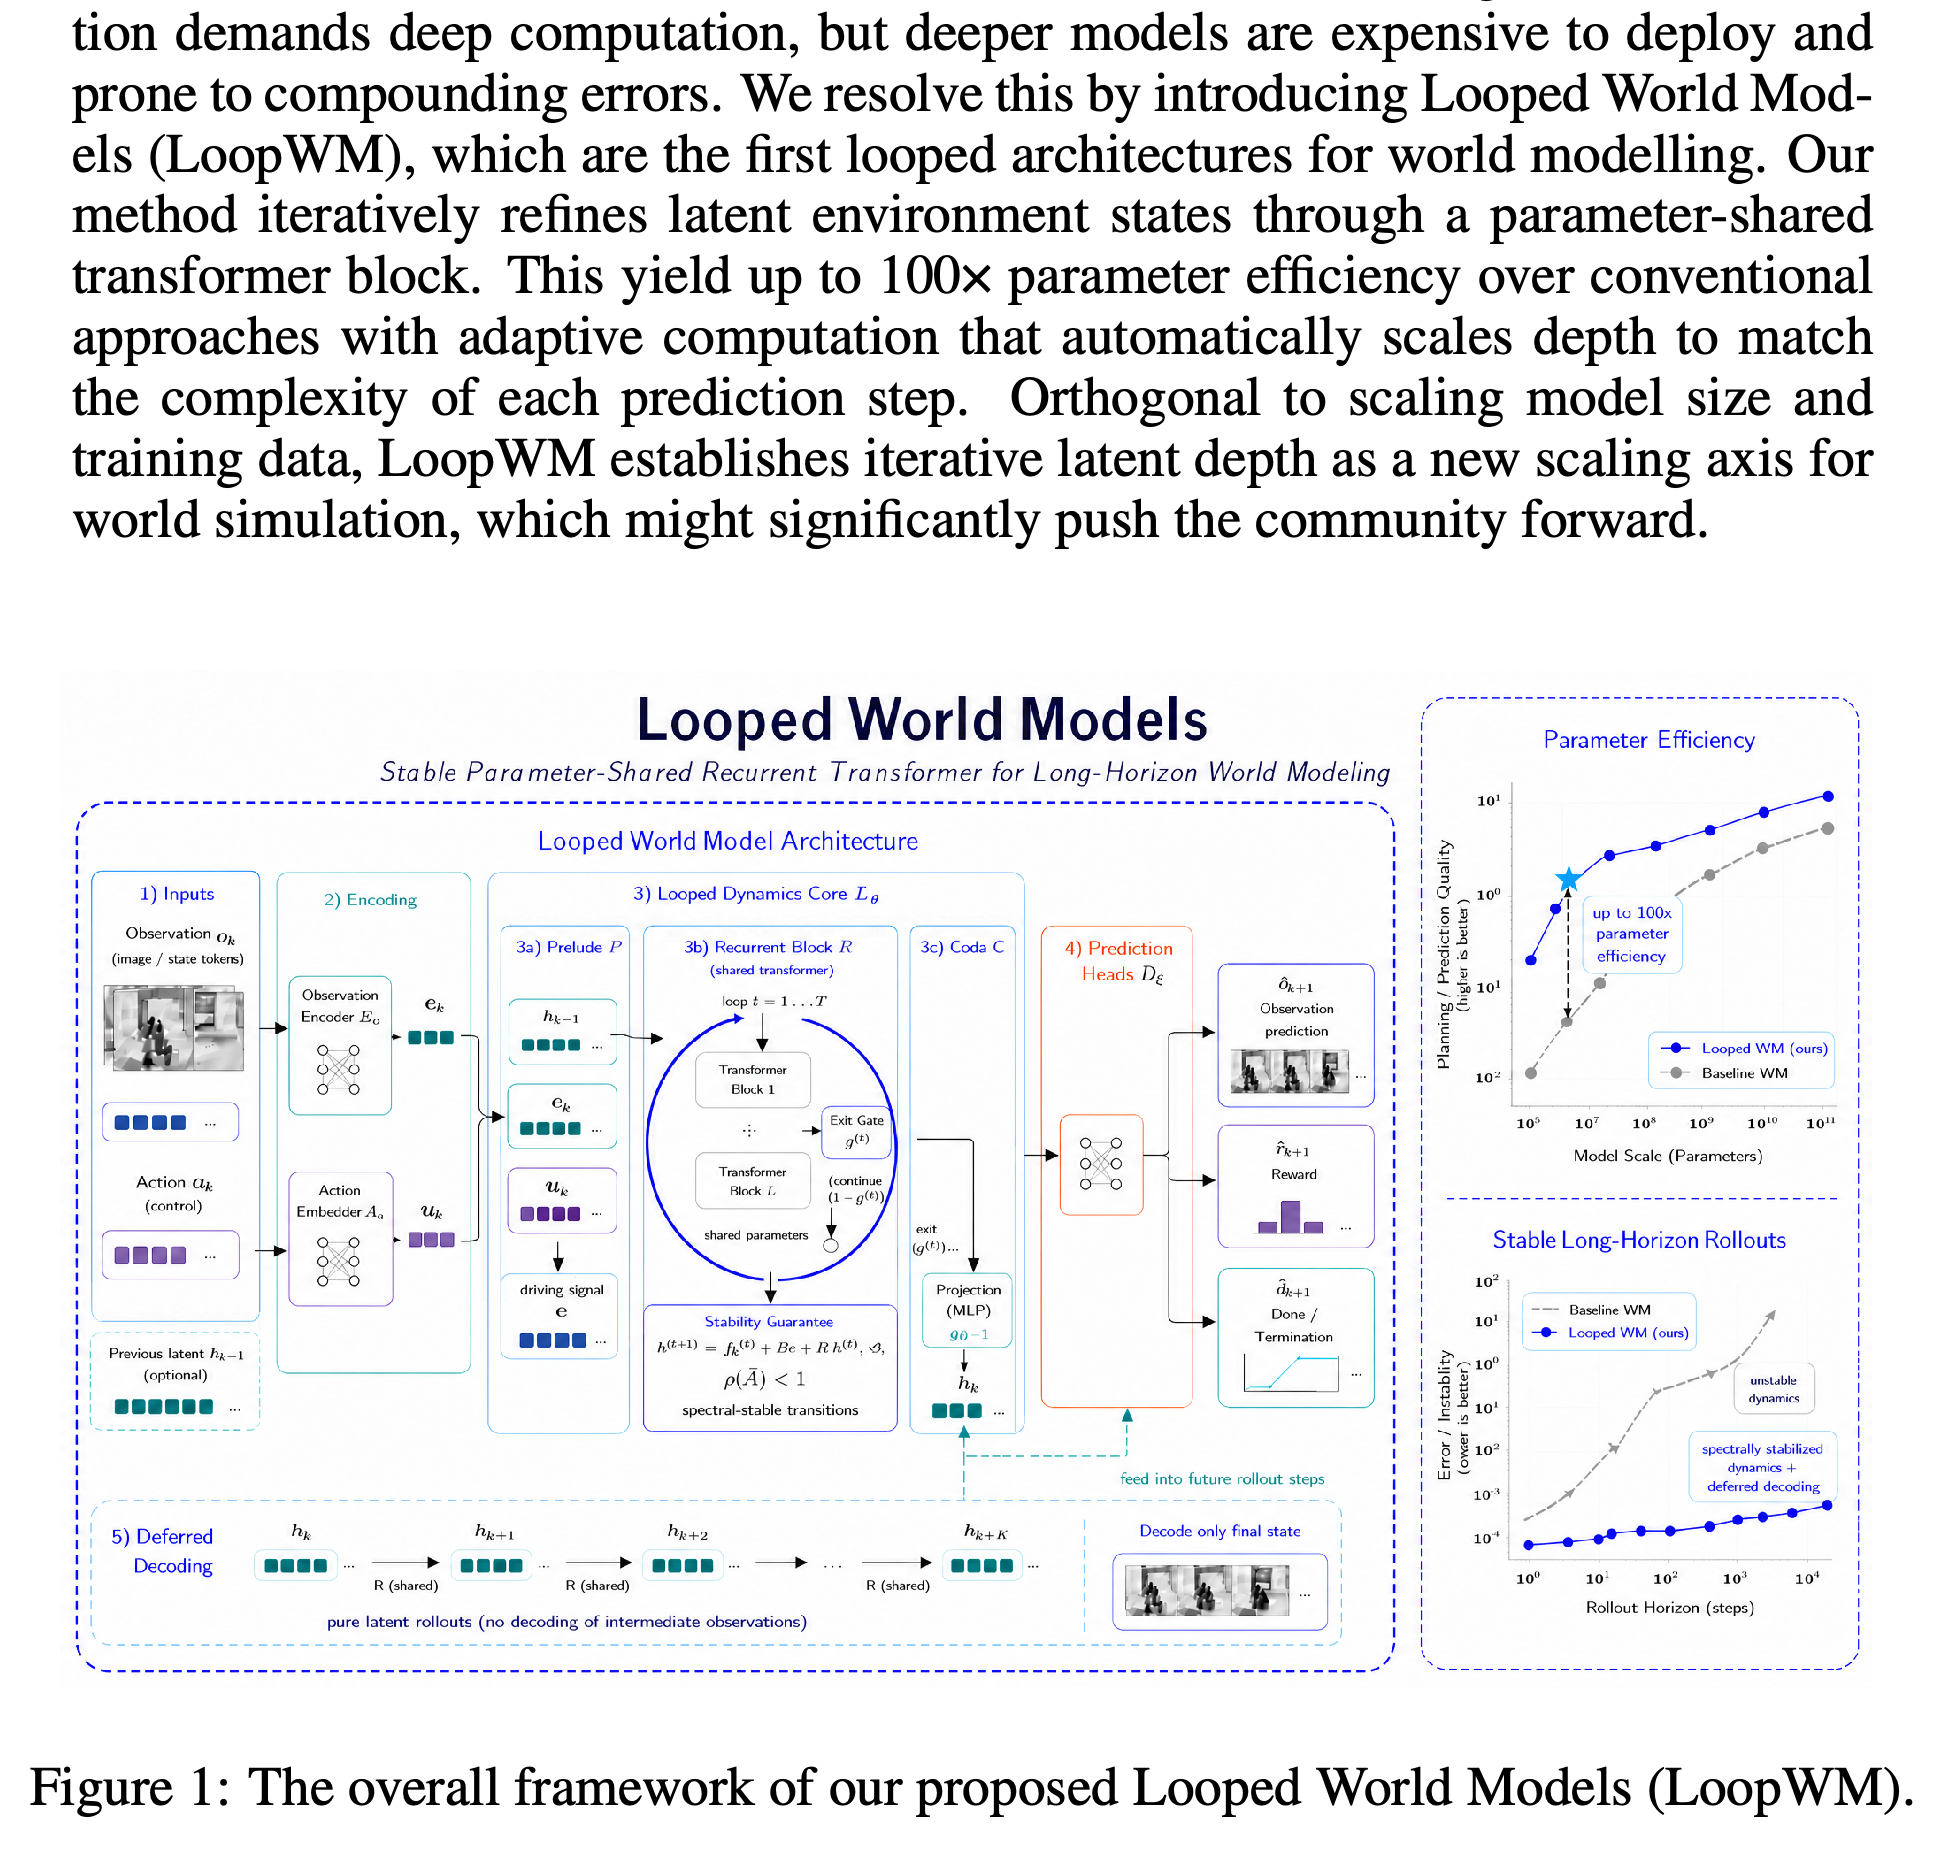
- Figure 1은 이러한 데이터 흐름, 공유 순환 블록과 종료 게이트, 마지막 상태에서만 수행하는 디코딩을 보여준다. 효율 및 롤아웃 오차 그래프는 실험 절차를 명시하지 않은 채 제안된 이점을 예시한다.
도식은 관측 및 행동 인코딩, prelude–recurrent–coda 동역학 코어, 예측 헤드, 마지막 상태 디코딩을 구분한다. 순환 블록과 종료 게이트는 파라미터 재사용과 적응형 연산이 이루어지는 위치를 보여준다. 옆의 파라미터 효율 및 롤아웃 오차 그래프에는 측정 절차가 없으므로, 제안된 이점을 설명하는 예시로 읽어야 한다.
3.2 Looped Dynamics Core with Spectral Stability
코어는 Prelude P., Recurrent Block R., Coda C.를 사용하며, 순환 갱신식은 h^(t+1) = Āh^(t) + B̄e + R̄(h^(t), e)이다. Spectral Stability Constraint.는 A := diag(−exp(a))와 Ā = exp(Δ·A)로 파라미터화한다. 학습 가능한 Δ가 양수이므로 Ā의 모든 대각 원소는 (0, 1)에 속한다.
- Prelude P.는 이전 상태, 관측 임베딩, 행동 임베딩을 이어 붙인 입력을 처리한다. 층 정규화는 조건 신호의 크기를 제어한다.
- Recurrent Block R.는 T회 반복하는 동안 transformer 파라미터를 공유한다. 초기 상태는 Gaussian 분포에서 샘플링하거나 이전 환경 스텝에서 가져온다.
- Spectral Stability Constraint.는 선형 상태 유지 성분이 구조적으로 수축성을 갖게 한다. 원고는 전체 갱신의 수축성이나 유계성을 입증할 만큼 비선형 transformer 항의 범위를 충분히 제한하지 않는다.
- Coda C.는 학습된 투영으로 마지막 순환 상태를 변환한 뒤, 파라미터를 공유하지 않는 transformer 층을 적용한다.
- Cross-Timestep State Propagation.은 마지막 상태를 다음 전이로 전달해 내부 정교화 루프와 외부 시간 루프를 구성한다. 선형 스펙트럼 제약만으로는 어느 루프도 전체적으로 안정적이라고 보장할 수 없다.
3.3 TRAINING OBJECTIVE
Variable-Depth Training.은 마이크로배치 안에서 시퀀스마다 T ∼ Poisson(µrec)를 독립적으로 샘플링하며, 평균 µrec는 학습 가능하다. World Model Loss.는 관측, 보상, 지속 여부 예측 손실을 결합한다. 순환 반복을 통한 역전파는 µbwd = ⌈µrec/2⌉ 스텝으로 절단한다.
- 관측 손실은 관측 공간에 따라 달라진다. 연속 상태에는 MSE, 이산 토큰에는 cross-entropy 등을 사용하며, λr과 λc는 보상 항과 지속 여부 항의 가중치다.
- Entropy-Regularised Adaptive Depth.는 종료 확률의 이진 엔트로피 합의 기댓값에 −α를 곱한 항을 더해, 게이트가 결정론적 동작으로 고착되는 것을 억제한다.
- 논문은 시퀀스별 깊이 샘플링 덕분에 손실 급증이 줄었다고 설명하지만, 이 주장을 뒷받침할 학습 곡선이나 통제된 비교는 제공하지 않는다.
3.4 Adaptive Early Exit for INFERENCE
적응형 추론은 학습된 sigmoid 게이트 g^(t) = σ(wg⊤h^(t) + bg)를 사용하며, 확률이 임계값 τ를 넘으면 종료한다. 추론 최대 깊이 Tmax는 학습 평균 µrec보다 클 수 있어 테스트 시점에 추가 정교화가 가능하다.
- 100개 층으로 구성된 기준 모델과 4층 순환 블록의 한 차례 반복을 비교한 예시에서는 해당 스텝의 순환 층 적용 횟수가 약 25× 줄어든다. 다른 모듈은 제외한 계산이며, 측정된 종단 간 속도 향상이 아니다.
- 전체 연산량을 최대 2 orders of magnitude만큼 절감할 수 있다는 주장은 전이의 단순성과 깊이 배분에 달려 있다. 원고는 측정된 지연 시간, FLOPs, 종료 깊이 분포, 깊이에 따른 품질 변화 실험을 보고하지 않는다.
3.5 DEFERRED DECODING: Action-Conditioned Latent Rollout
지연 디코딩은 처음 인코딩한 상태에 K개의 행동 조건부 잠재 전이를 적용하고, 마지막 상태에서 Dξ를 정확히 1회 호출한다. 표준 기준 모델과 달리 중간 관측, 보상, 지속 여부를 출력하지 않는다. 행동마다 T회 정교화한다면, 중첩 롤아웃은 파라미터를 공유하는 transformer를 K × T회 적용한다.
- 3.5.1 MOTIVATION: 중간 디코딩을 생략하면 디코더 연산이 줄고, 전이마다 상세한 관측을 복원해야 한다는 요구도 없어진다.
- 3.5.2 FORMULATION: Standard per-step decoding (baseline).은 행동 스텝마다 동역학과 예측 헤드를 적용한다. Deferred decoding.은 마지막 상태를 디코딩하기 전까지 잠재 동역학만 적용한다. Interaction between inner and outer loops.에서는 외부 스텝마다 행동을 주입하고, 각 스텝 안에서 공유 연산으로 정교화한다.
- 3.5.3 TRAINING OBJECTIVE FOR DEFERRED DECODING: Terminal prediction loss.는 최종 관측, 보상 rK−1, 지속 여부 cK−1에 감독 신호를 제공한다. Latent trajectory regularizer.는 투영된 중간 상태를 동결된 인코더의 stop-gradient 임베딩에 맞추고, 누적 상태 변위가 K·Cmax를 넘으면 페널티를 부과한다.
- 3.5.4 CURRICULUM OVER DEFERRAL HORIZON K: 학습은 K = 1에서 시작하고 K(step) = min(Kmax, 1 + ⌊step/Δ⌋)에 따라 구간을 늘린다. Δ는 증가 간격이다. 중간 일관성 손실에는 1/(K−1)이 포함되므로, 제시된 식을 K = 1에 적용하려면 별도 규칙이 필요하지만 논문은 이를 명시하지 않는다.
- 3.5.5 INFERENCE MODES: Planning mode.는 마지막 예측으로 후보 시퀀스를 평가하며, 디코더 FLOPs를 약 (K−1)×cost(Dξ)만큼 절감한다. Monitoring mode.는 경량 투영 gω로 중간 요약을 생성하고, 진단이 필요할 때 전체 디코딩을 사용할 수 있다.
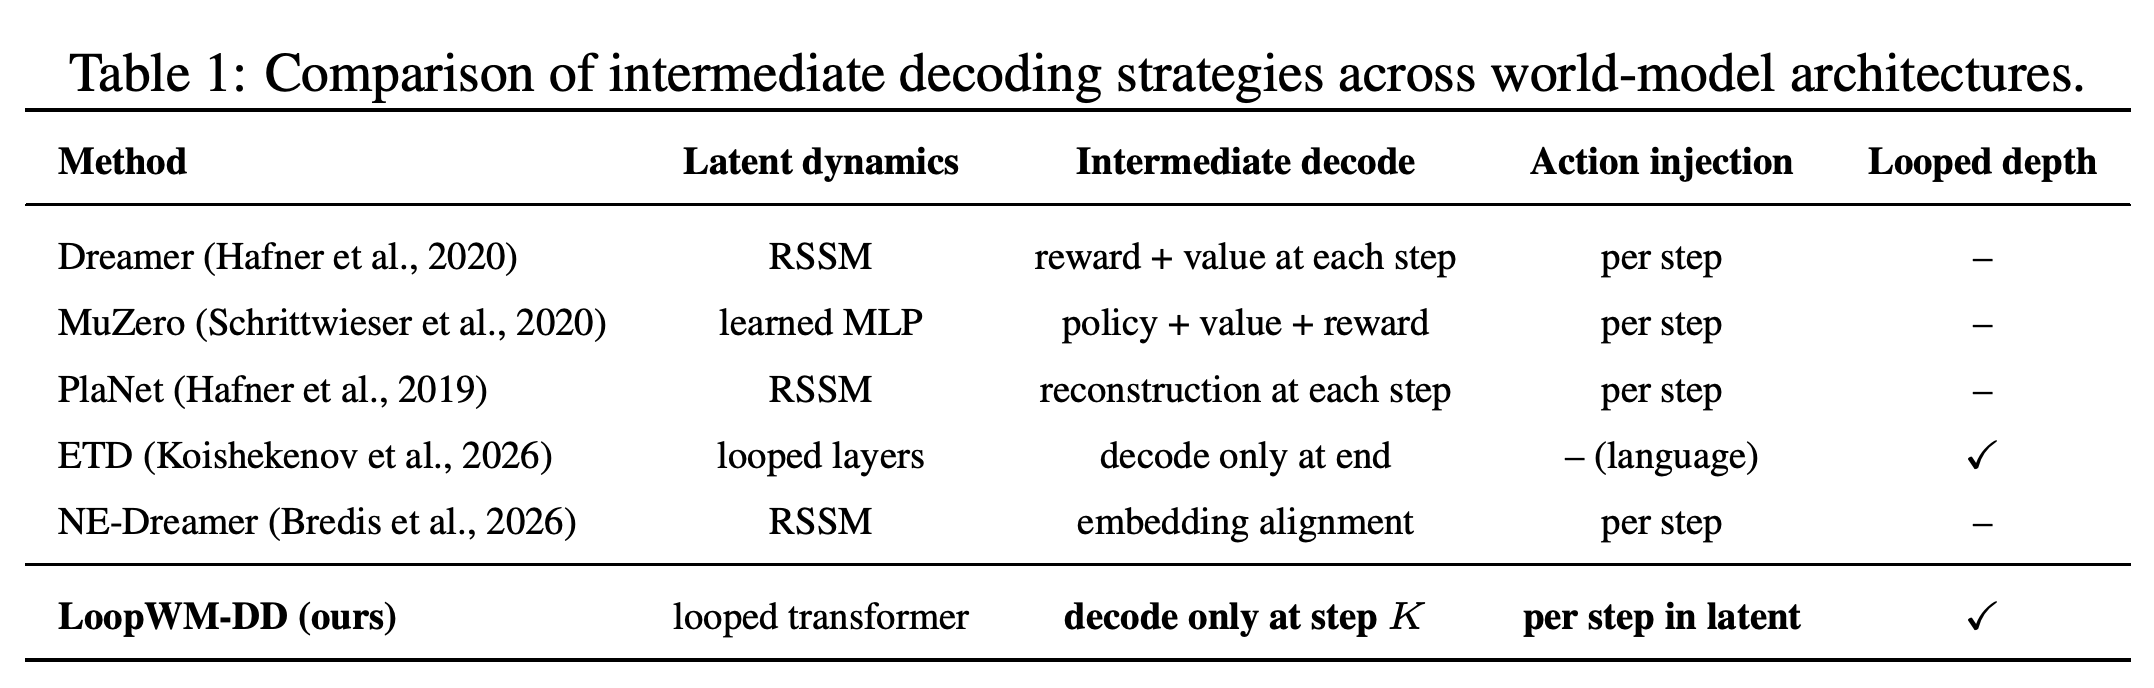
- 3.5.6 RELATIONSHIP TO PRIOR WORK: Table 1은 LoopWM-DD를 RSSM 기반 모델, MuZero, 언어 중심 encode-think-decode 방법과 구분한다. 마지막 상태의 예측만으로는 중간 보상이나 종료 확인이 필요한 계획 목적에 해당 정보를 직접 제공할 수 없다.
비교 표는 루프 깊이, 스텝별 잠재 행동 주입, 스텝 K에서만 수행하는 디코딩의 결합을 LoopWM-DD의 특징으로 제시한다. 관측 복원은 생략하더라도 중간 스텝에서 보상, 가치, 정책을 예측하는 방법들과 이 설계를 구분한다.
4 Results
주요 평가는 ScienceWorld와 AlfWorld에서 연속된 5개 행동 이후의 최종 환경 출력을 예측한다. 약 1B-parameter LoopWM과 기준 모델인 claude-opus-4-6-max, qwen-3.5-flash, gemini-3-flash-preview-thinking의 EM, Token F1, BLEU-4, Entity 점수를 보고한다.
- 원고는 데이터셋 분할, 평가 샘플 수, 기준 모델 프롬프트, 학습 데이터 구성, optimizer 설정, 실제 루프 깊이 설정, 불확실성 추정치를 명시하지 않는다.
- 이 결과는 환경 예측 점수이며, 정책 성공률, 강화학습 누적 보상, 연속적인 물리 시뮬레이션의 정량적 검증 결과가 아니다.
4.1 Main Results on ScienceWorld
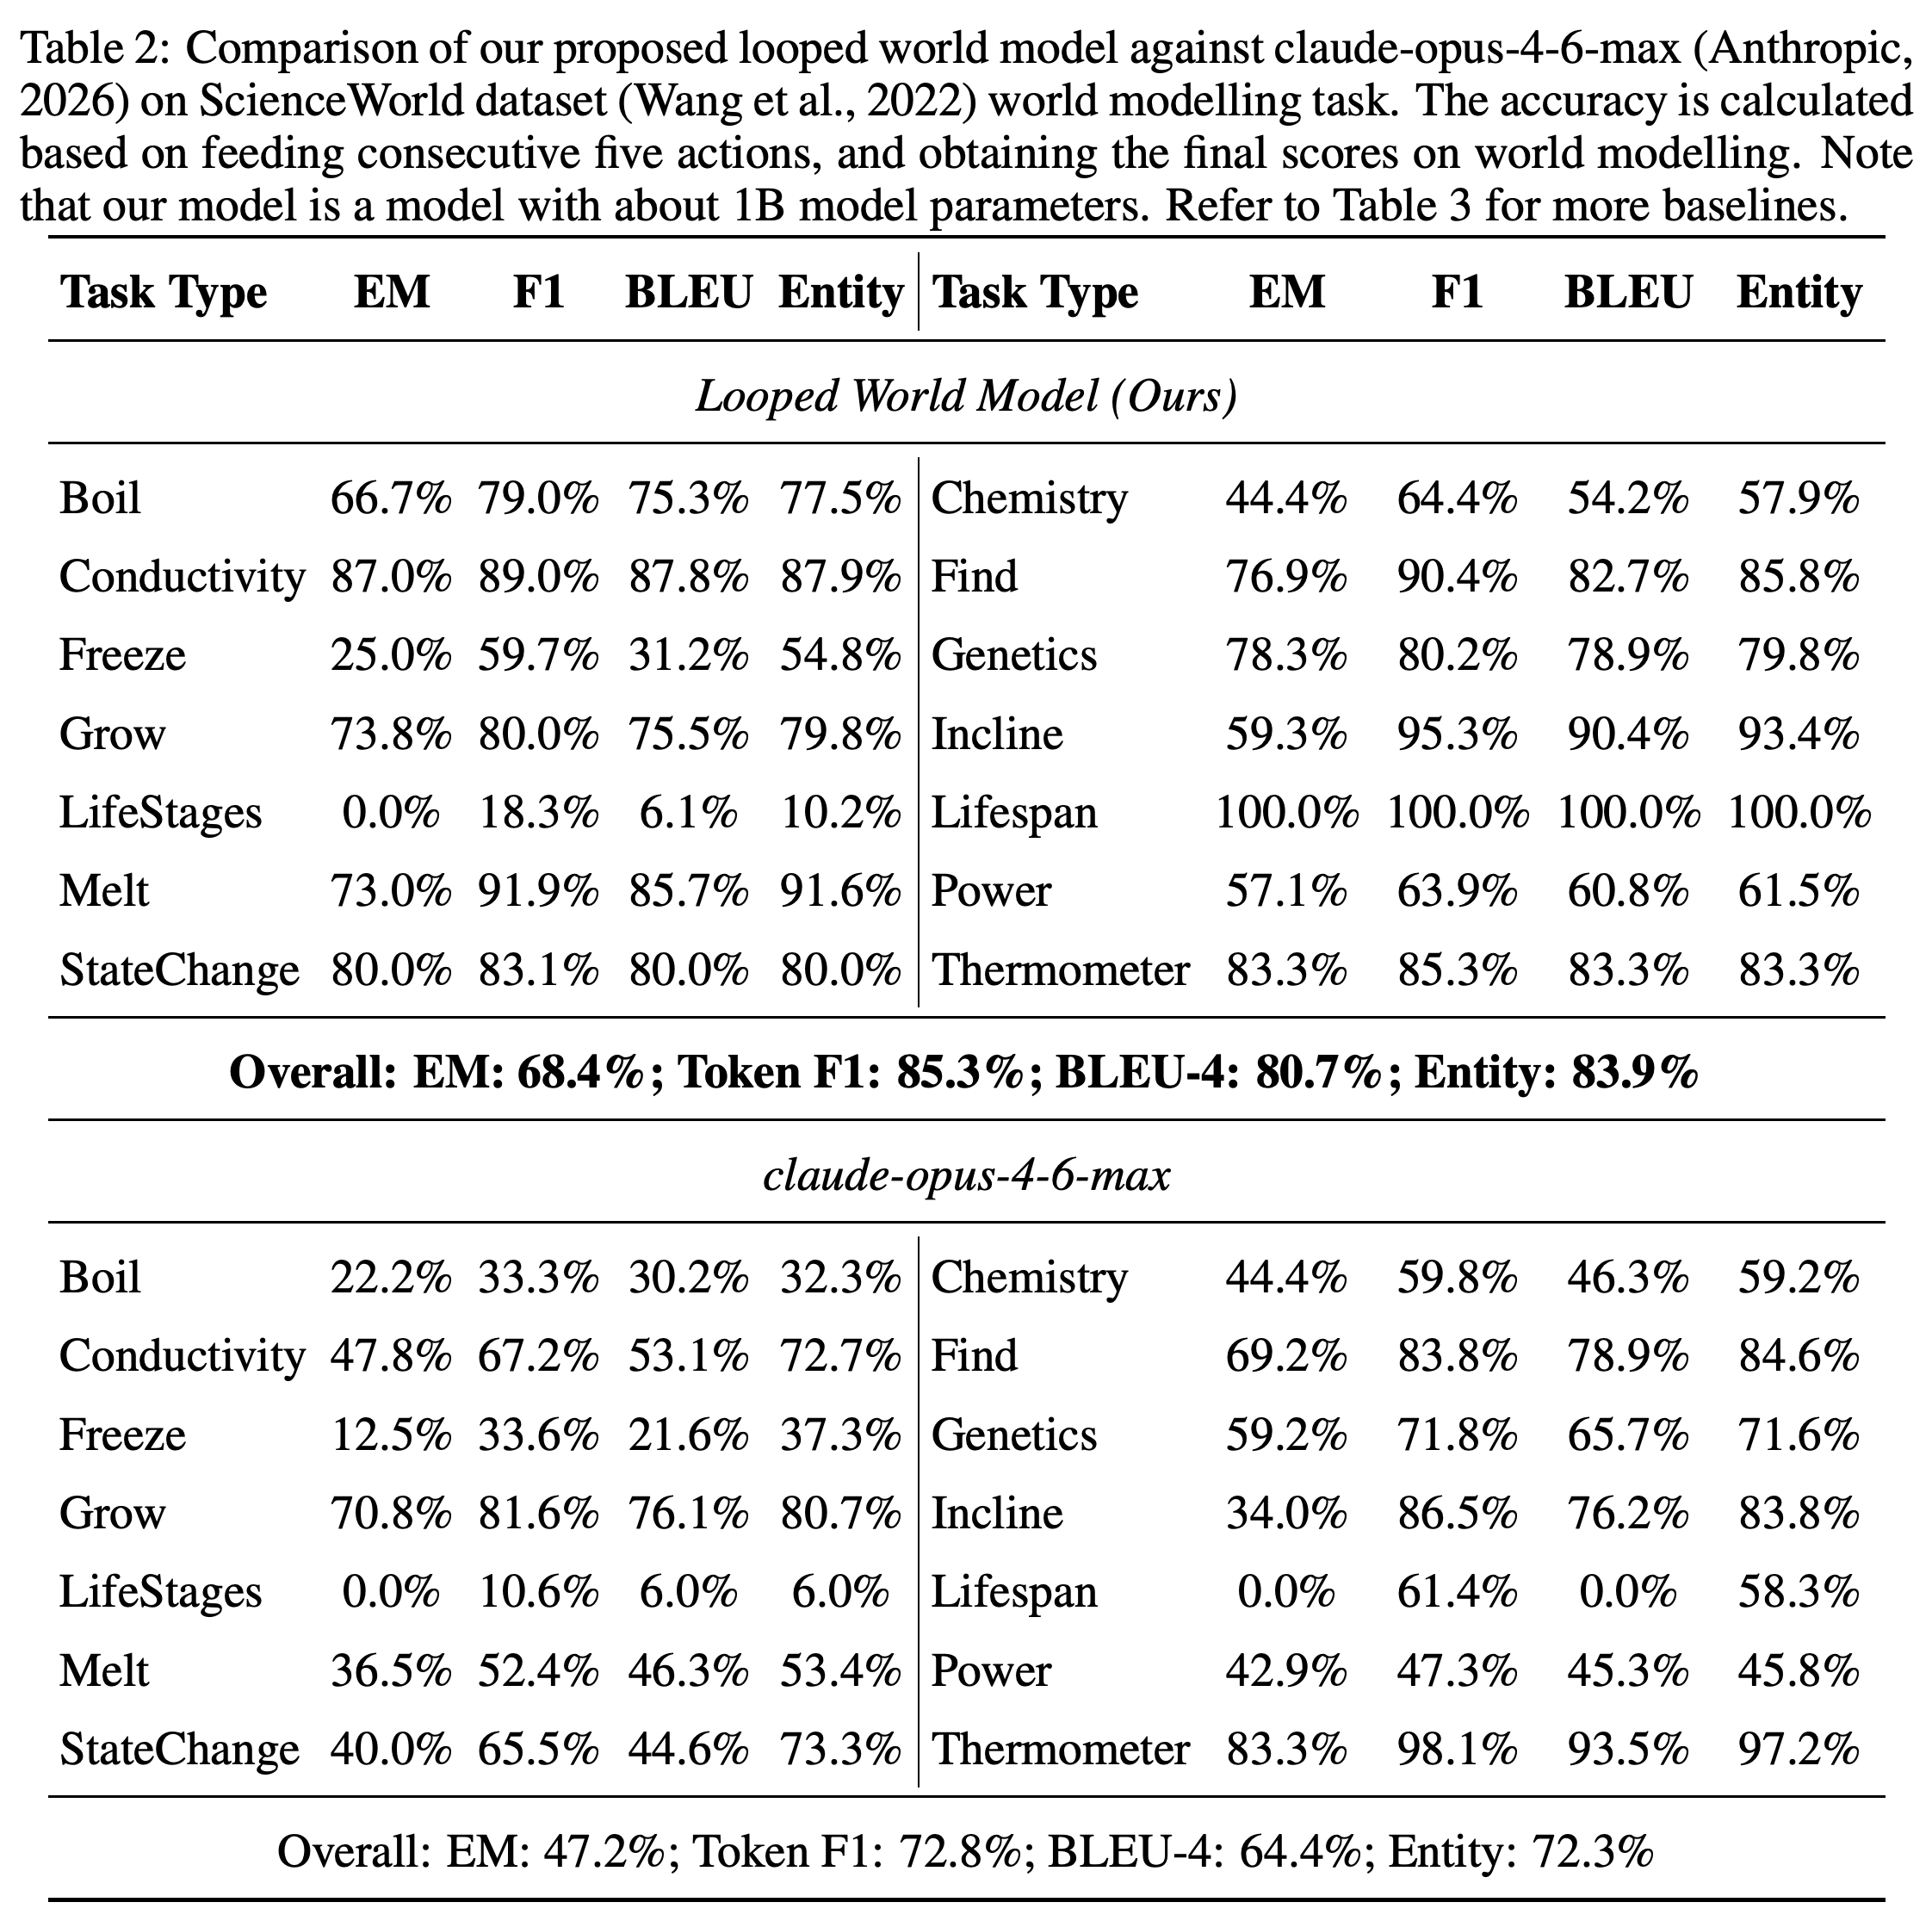
Tables 2와 3은 LoopWM의 ScienceWorld 전체 점수를 EM 68.4%, Token F1 85.3%, BLEU-4 80.7%, Entity 83.9%로 보고한다. claude-opus-4-6-max는 각각 47.2%, 72.8%, 64.4%, 72.3%를 얻는다. EM 차이는 21.2 percentage points이며, 상대적 개선율 21.2%가 아니다.
- LoopWM의 Lifespan EM은 Claude 기준 모델의 0.0%에서 100.0%로 높아지지만, LifeStages는 EM 0.0%, F1 18.3%에 머문다. 전체 점수가 우수하다고 해서 모든 과제와 지표에서 우위가 있는 것은 아니다.
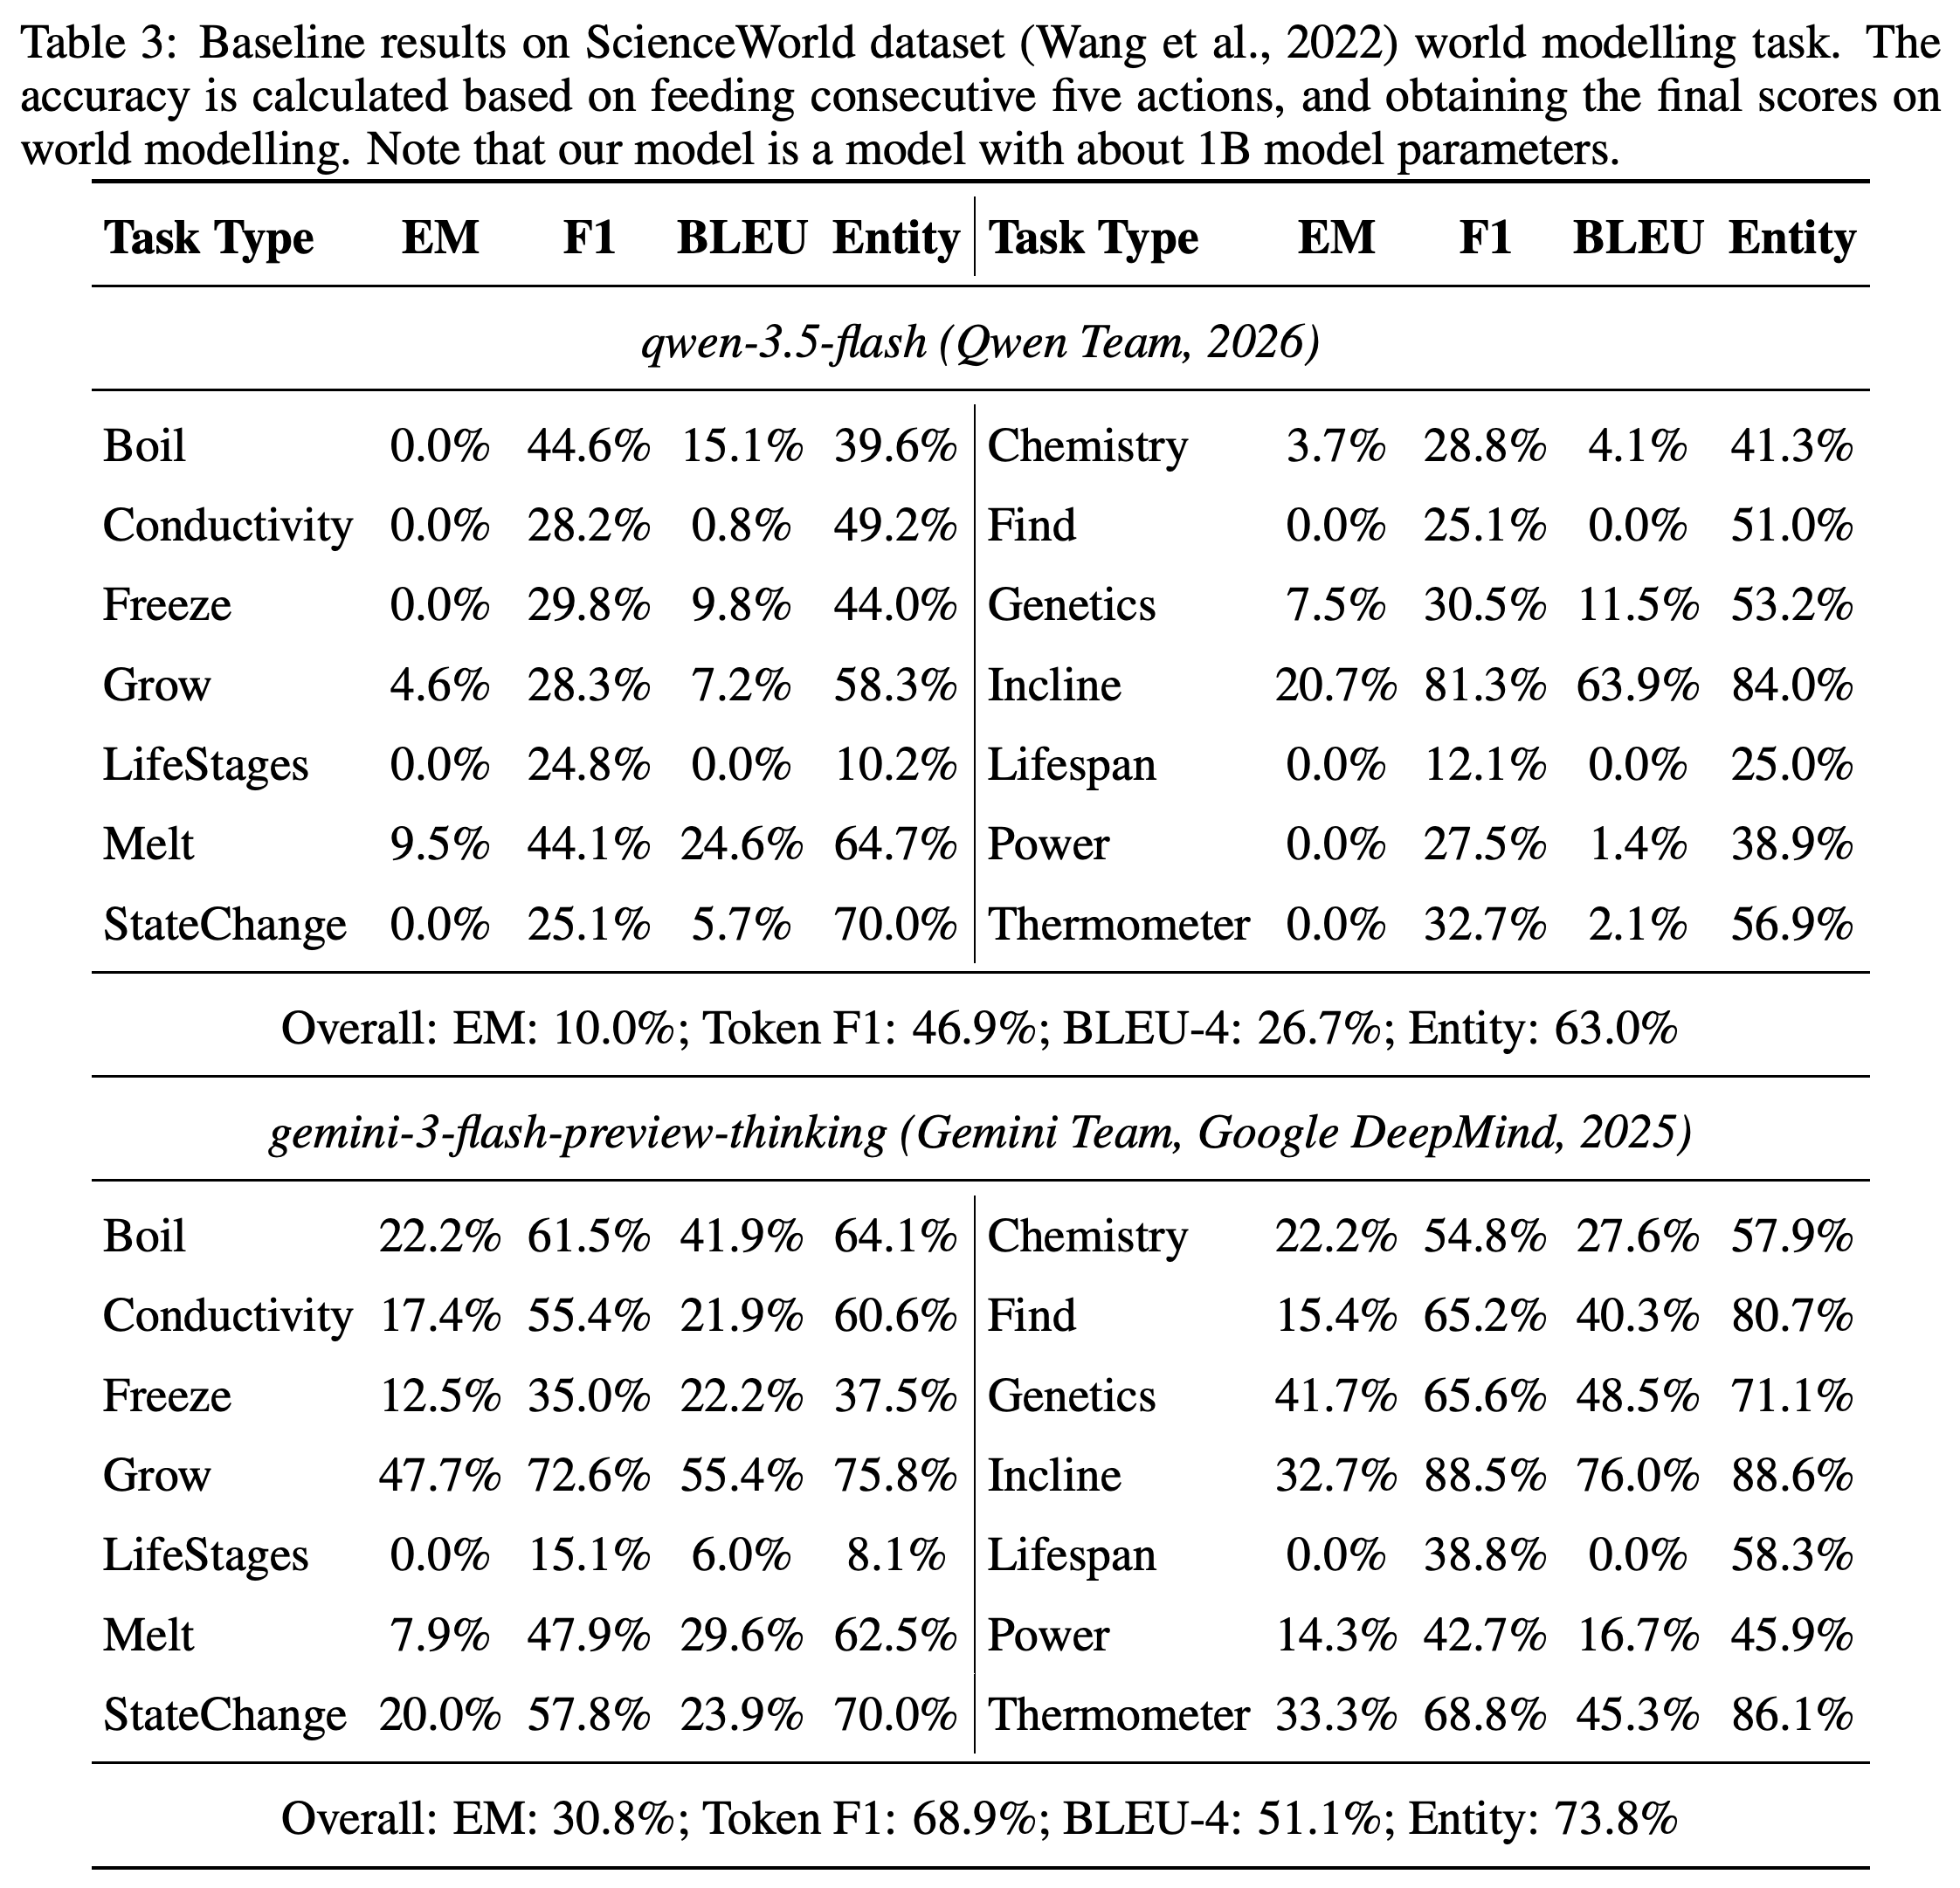
- Table 3에서 qwen-3.5-flash는 EM 10.0%, gemini-3-flash-preview-thinking은 EM 30.8%를 보고한다. 이는 보고된 과제별 비교이며, 구조적 우위를 통제된 조건에서 검증한 결과가 아니다.
- 논문의 모델 크기 비교에서 100×를 넘는다는 주장은 비공개 기준 모델의 공개되지 않은 파라미터 수에 의존한다. LoopWM의 크기가 약 1B라는 사실만으로 그 비율을 입증할 수 없다.
LoopWM은 5개 행동 이후 ScienceWorld의 전체 집계 지표 4개 모두에서 claude-opus-4-6-max를 앞서며, EM은 21.2 percentage points 높다. 과제별 결과는 크게 다르다. Lifespan은 EM 100.0%에 도달하지만 LifeStages는 0.0%에 머물고, 일부 과제의 중첩 기반 점수나 Entity 점수는 Claude가 더 높다.
추가 ScienceWorld 기준 모델의 전체 EM은 qwen-3.5-flash가 10.0%, gemini-3-flash-preview-thinking이 30.8%로, LoopWM의 68.4%보다 낮다. 표는 기준 모델의 파라미터 수나 동일하게 맞춘 학습 조건을 제공하지 않으므로, 파라미터 효율 비율을 입증하지 못한다.
4.2 Main Results on AlfWorld
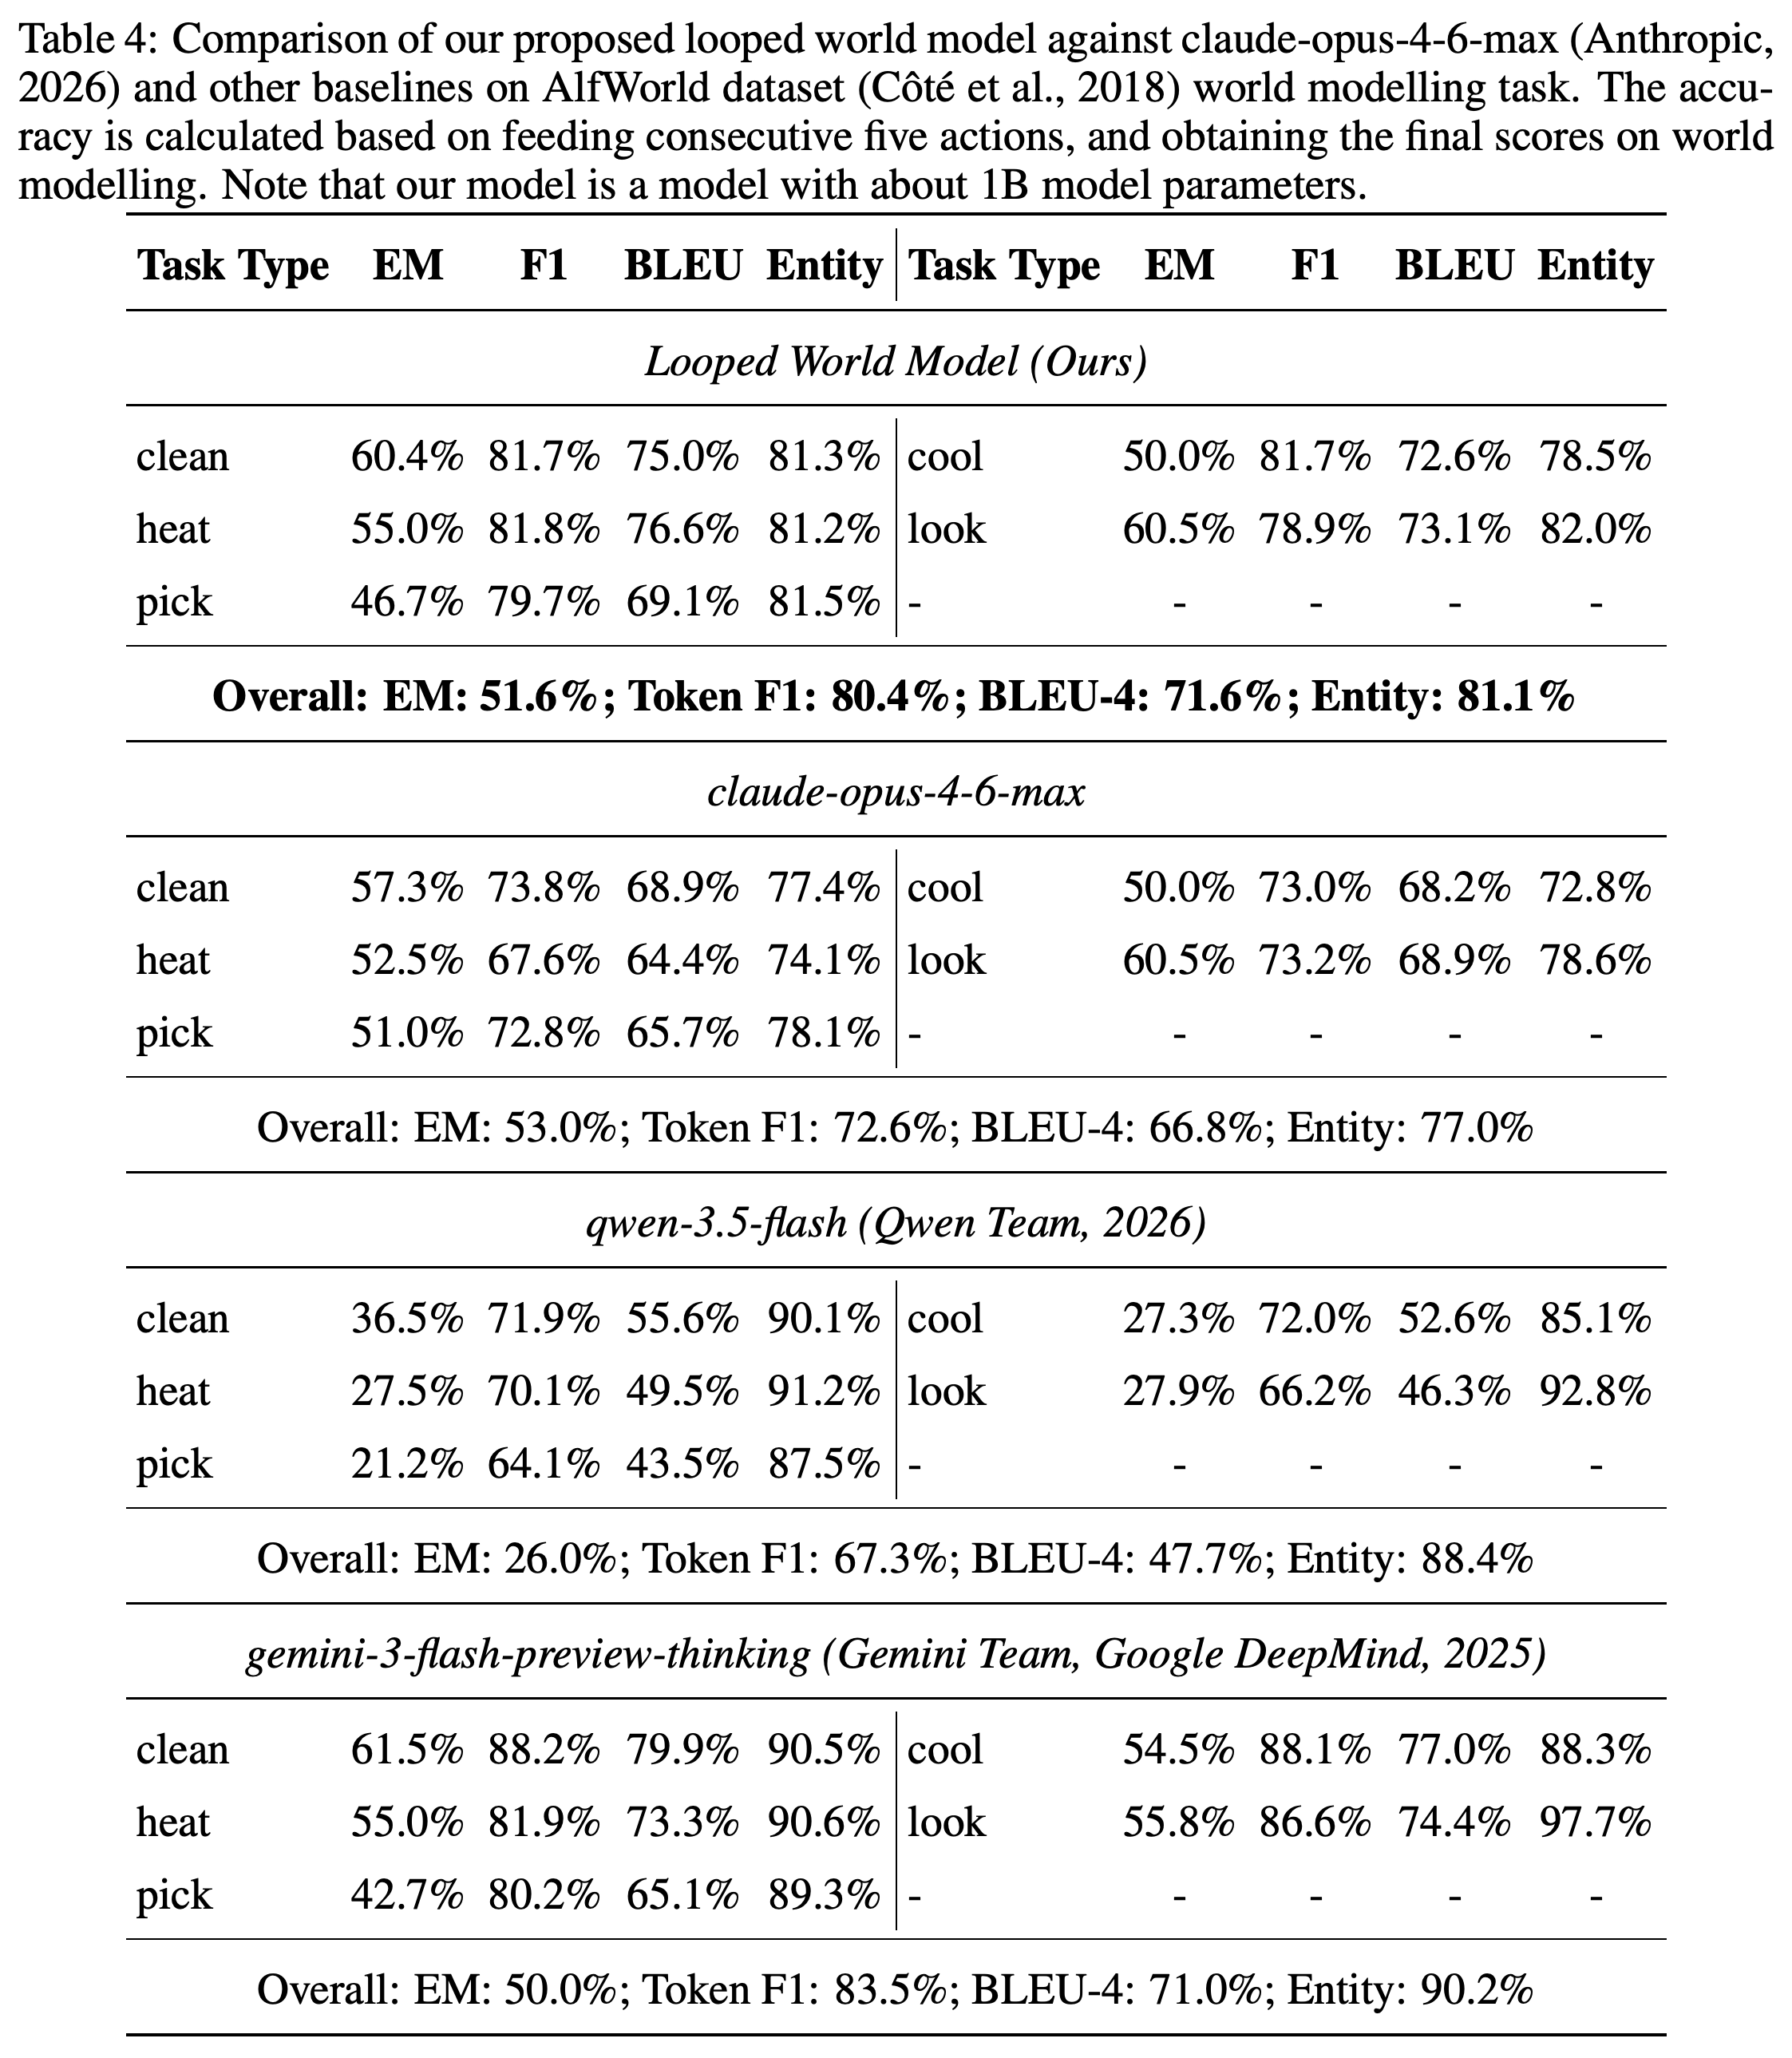
Table 4는 LoopWM의 AlfWorld 점수를 EM 51.6%, Token F1 80.4%, BLEU-4 71.6%, Entity 81.1%로 보고한다. EM은 53.0%를 기록한 claude-opus-4-6-max에 이어 2위이고, Token F1은 83.5%를 기록한 gemini-3-flash-preview-thinking에 이어 2위다. BLEU-4에서는 1위다.
- Entity 점수는 qwen-3.5-flash의 88.4%와 gemini-3-flash-preview-thinking의 90.2%보다 낮지만, Claude의 77.0%보다는 높다.
- 따라서 LoopWM은 전체 집계 지표 중 1개에서 앞서며, 기준 모델들을 모든 지표에서 능가하지는 않는다. 논문은 Entity 예측을 개선 대상으로 지목한다.
LoopWM의 전체 BLEU-4는 71.6%로 가장 높지만, EM은 Claude가 앞서고 Token F1과 Entity는 Gemini가 앞선다. LoopWM의 Entity 점수 81.1%는 Qwen의 88.4%와 Gemini의 90.2%보다 낮아, 우위 주장은 특정 지표로 한정된다.
4.3 Deep Analysis on DEFERRED DECODING
지연 디코딩 분석은 ScienceWorld의 Step 1부터 Step 5까지 예측 결과를 Gemini 및 Qwen 대비 상대적 개선율과 절대 점수 표로 보고한다. Table 27에서 LoopWM의 EM은 67.2%에서 68.6% 사이에 있다. Token F1은 Step 1의 78.0%에서 Step 3의 87.5%로 상승한 뒤 Step 5에서 85.3%로 내려간다.
- Table 5는 Gemini 대비 상대적 EM 개선율을 +73.2%, +54.5%, +103.6%, +82.9%, +113.8%로 보고한다. 개선율은 단조롭게 변하지 않으며, 행동 구간이 길어질수록 절대 정확도가 일관되게 높아진다는 것을 보여주지 않는다.
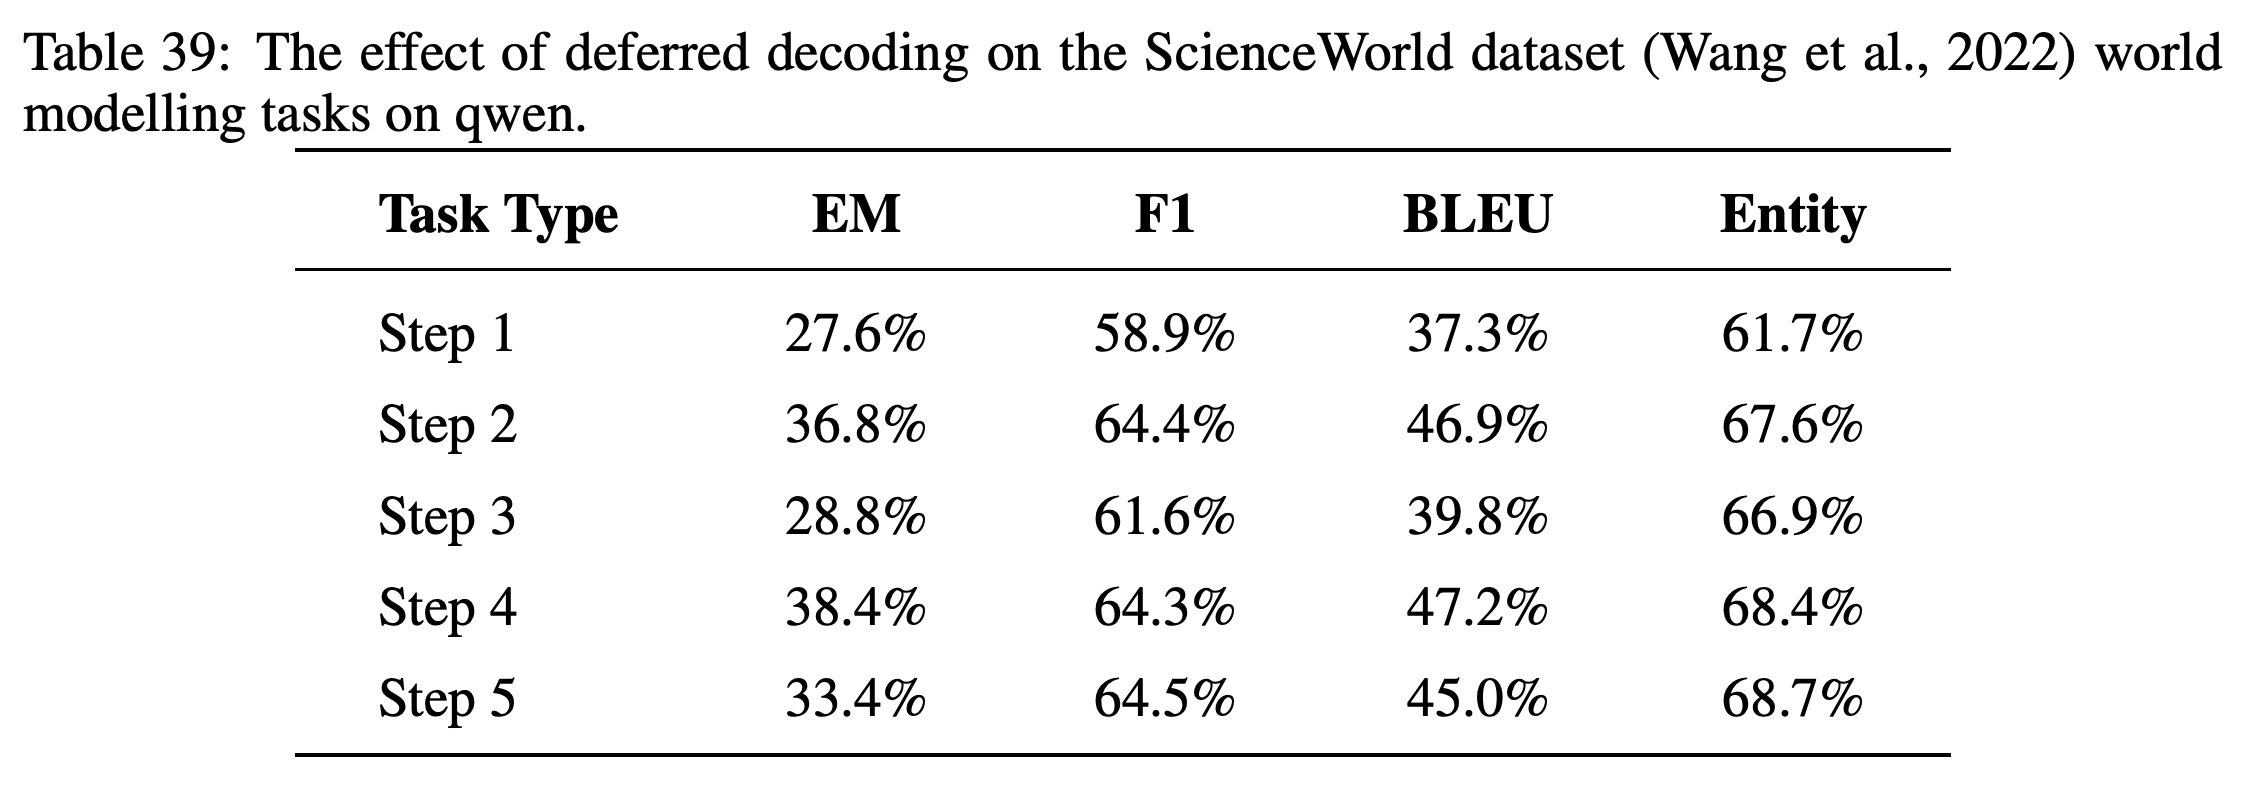
- Tables 33과 39는 Step 5 EM을 Gemini 32.0%, Qwen 33.4%로 보고하지만, Table 3에서는 각각 30.8%, 10.0%다. 본문 표와 구간별 표는 과제별 기준 모델 점수도 다르므로, 집계 방식만으로 모든 불일치를 설명할 수 없다. 원고는 평가 차이를 설명하지 않는다.
- Table 16은 Qwen 대비 전체 상대적 개선율을 제공하고, Tables 6–15와 17–26은 과제별 상대적 개선율을 제공한다. Tables 28–32, 34–38, 40–44는 LoopWM, Gemini, Qwen의 과제별 절대 점수를 제공한다. 일부 과제와 지표에서는 개선율이 음수이며, 기준 점수가 작으면 상대적 개선율이 크게 나타날 수 있다.
- 지연 디코딩을 적용한 LoopWM과 적용하지 않은 LoopWM을 동일 조건에서 비교한 결과는 없다. 따라서 이 표들은 중간 디코딩 생략의 효과를 분리하지 못한다. 외부 행동 구간 K를 바꾸는 것만으로 내부 루프 깊이 T에 따른 확장을 입증할 수도 없다.
LoopWM의 전체 EM은 5개 구간에서 거의 변하지 않는다. Token F1과 Entity는 Step 3에서 가장 높고, BLEU는 Step 4에서 가장 높다. 이 결과는 행동 구간이 길어질수록 성능이 단조롭게 개선된다는 것을 입증하지 않는다.
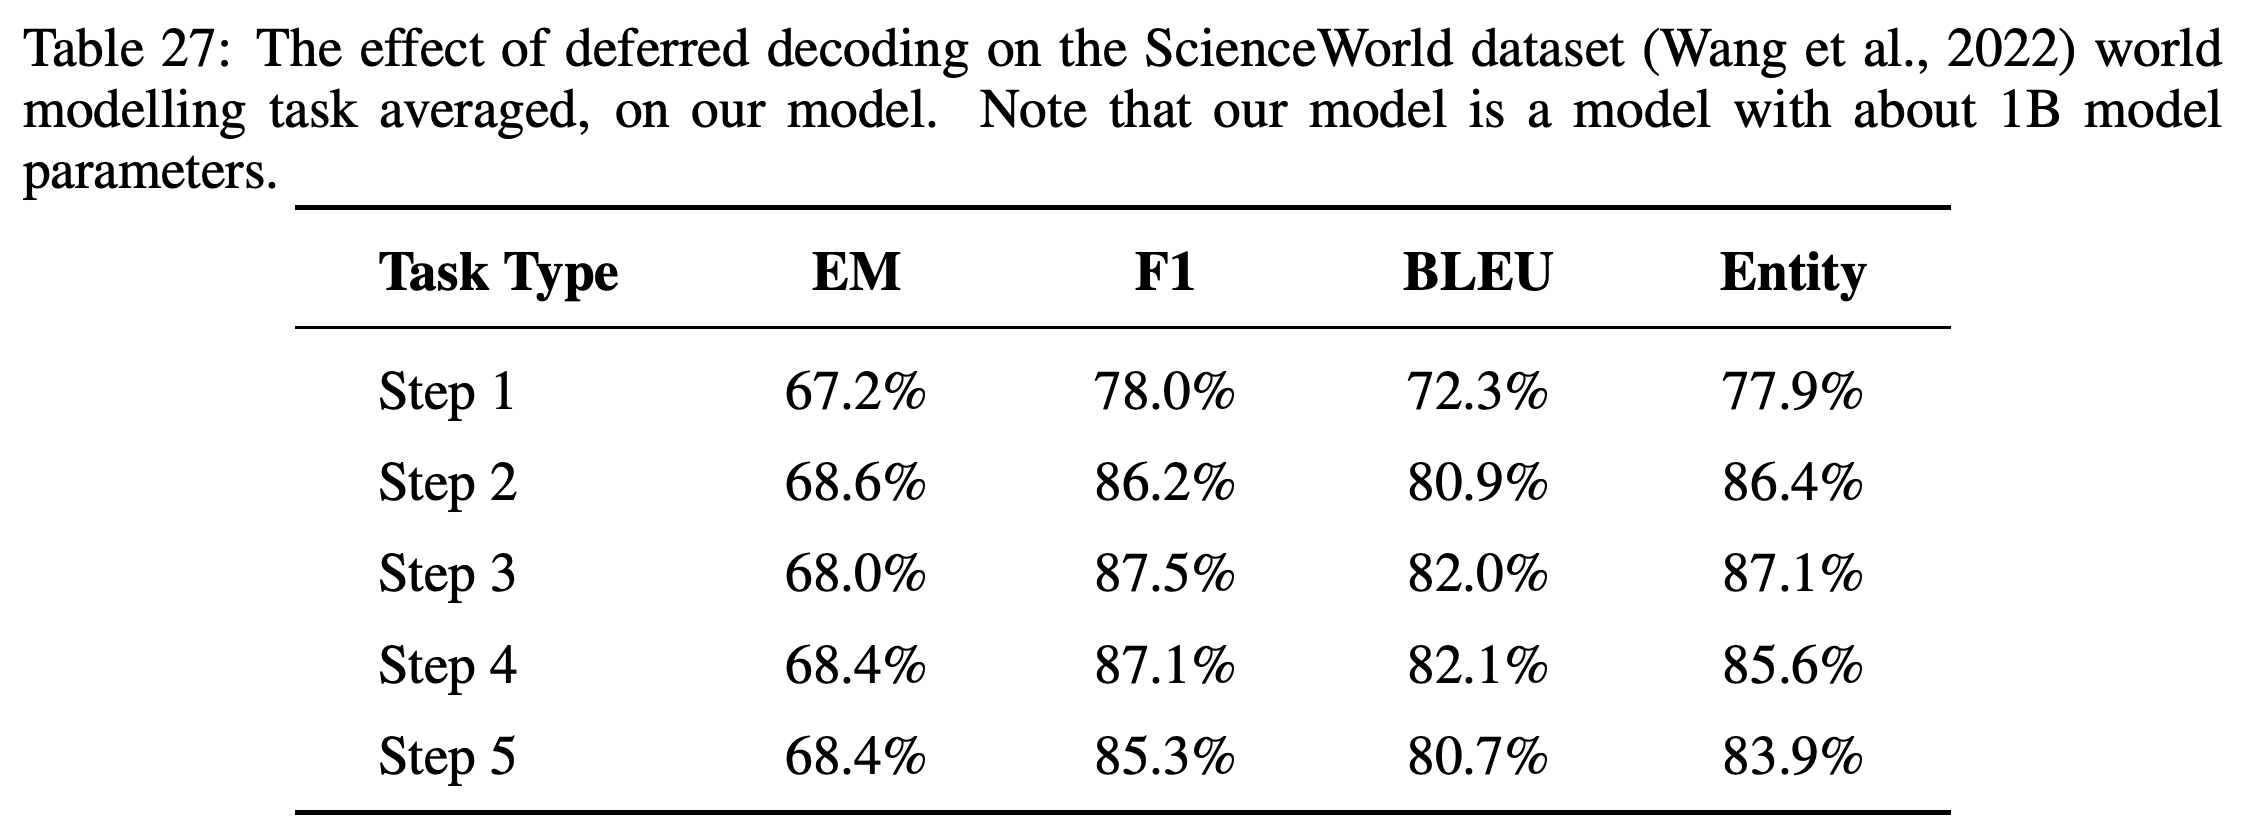
Qwen의 Step 5 EM은 구간별 분석에서 33.4%지만, 주요 ScienceWorld 기준 모델 표에서는 10.0%다. 과제별 점수도 다르므로, 이 전체 점수들을 서로 대체해 사용할 수 없으며 집계 방식만 바꿔서 차이를 해소할 수도 없다.
5 Conclusions
결론은 반복적인 잠재 연산 깊이를 소형 세계 모델의 확장 축으로 제시하고, 효율과 안정성이 파라미터 공유, 스펙트럼 제약, 적응형 깊이에서 비롯된다고 설명한다. 보고된 예측 결과는 임의 길이 구간에서의 안정성, 측정된 100× 파라미터 효율, 깊이 확장 법칙이라는 더 강한 주장을 입증하지 않는다.
6 BROADER IMPACTS
6 BROADER IMPACTS 절은 사회적 영향보다 선택적 정보 공개, 세계 모델 구조 간 위치, 확장, 최적화를 논의한다. 연속적인 시각 환경에서도 학습을 시험했다고 밝히지만, 해당 환경의 정량적 평가는 제공하지 않는다.
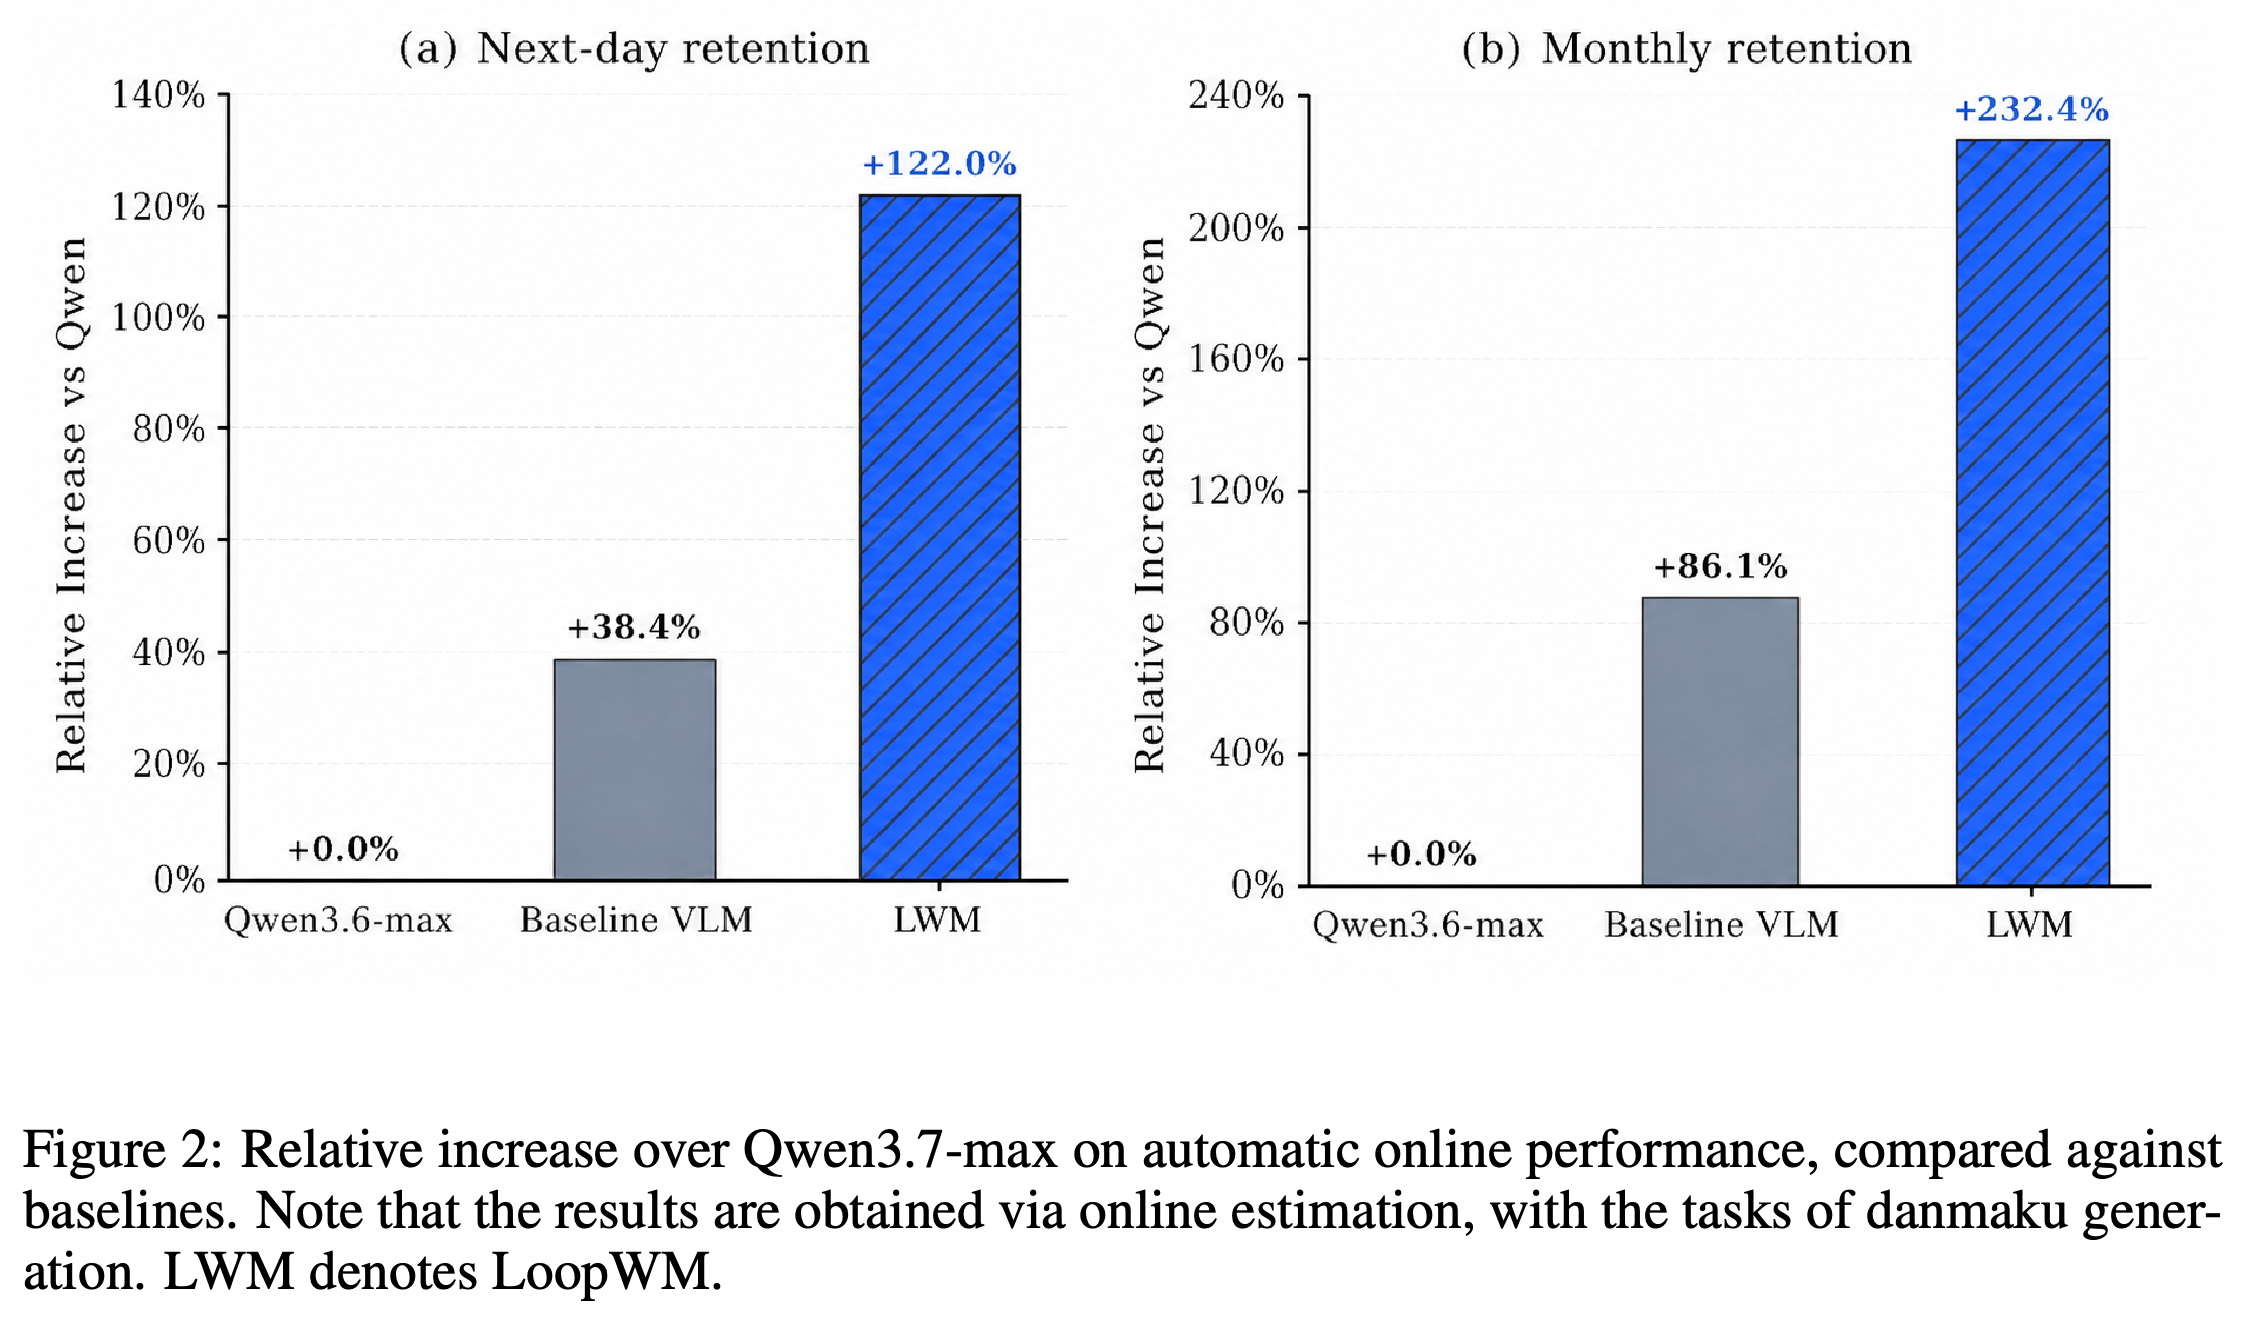
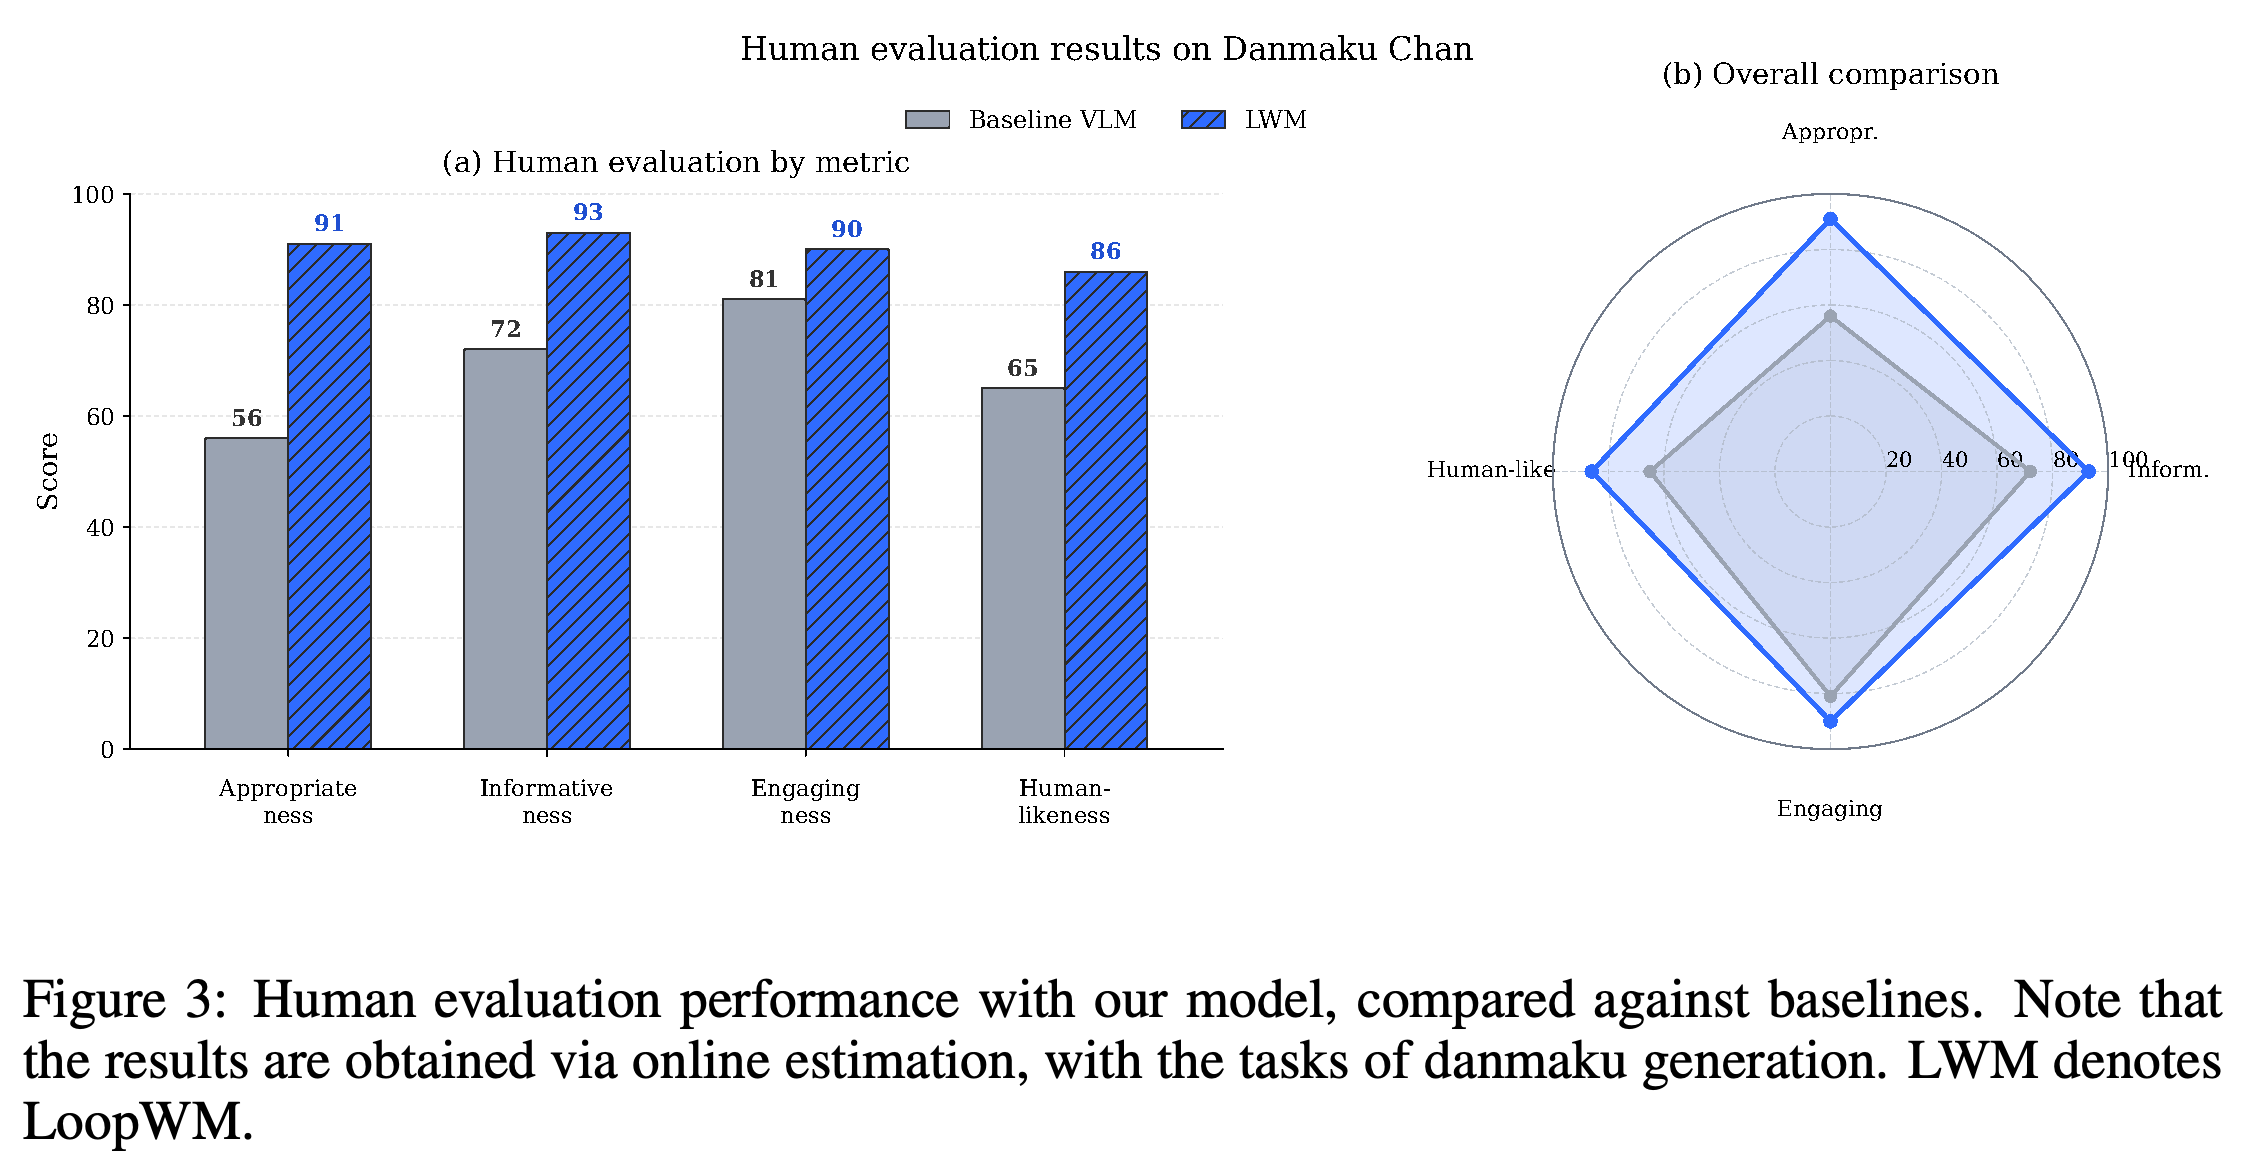
- Figures 2와 3은 주요 환경 예측 평가와 별개로 danmaku 생성 결과를 제시한다. 온라인 사용자 유지율 추정치와 사람의 평가는 Baseline VLM보다 LWM에 유리하다.
- Figure 2는 LWM의 다음 날 유지율 증가를 +122.0%, 월간 유지율 증가를 +232.4%로 보고한다. Baseline VLM은 각각 +38.4%, +86.1%다. 캡션에는 Qwen3.7-max가 쓰여 있지만 축에는 Qwen3.6-max가 쓰여 있다.
- Figure 3은 적절성, 정보성, 흥미도, 인간 유사성에서 LWM 점수를 각각 91, 93, 90, 86으로 보고한다. Baseline VLM은 각각 56, 72, 81, 65다.
- 어느 그림도 샘플 수, 불확실성, 충분한 평가 절차를 제공하지 않아, 이 응용 결과를 루프 동역학이나 지연 디코딩의 효과로 특정하기 어렵다.
온라인 danmaku 비교는 LWM의 다음 날 유지율 증가를 +122.0%, 월간 유지율 증가를 +232.4%로 보고하며, Baseline VLM의 +38.4%, +86.1%보다 높다. 축에는 기준 모델이 Qwen3.6-max로 표시되어 있지만, 원문 캡션에는 Qwen3.7-max로 표시되어 있다. 코호트 크기, 배정 절차, 불확실성은 공개하지 않는다.
막대그래프와 레이더 차트에서 LWM은 표시된 4개 차원 모두 더 높은 점수를 얻는다. 적절성은 91 대 56, 정보성은 93 대 72, 흥미도는 90 대 81, 인간 유사성은 86 대 65다. 평가자 수, 평가 절차, 불확실성이 없어, 이 차트는 세계 모델 구조의 통제된 검증이 아니라 응용 결과를 기술한 근거다.
부록
- PDF에는 명시적인 제목이 붙은 부록이 없다. 추가 ScienceWorld 표와 danmaku 그림은 REFERENCES 앞에 있으며, 위에서 관련 본문 절에 맞춰 설명했다.
짧은 생각
핵심 설계는 공유 연산을 통한 전이 정교화와 행동 조건부 잠재 롤아웃을 결합하고, 마지막 상태에서 디코딩한다. 다만 조건을 맞춘 고정 깊이 기준 모델과 비지연 디코딩 기준 모델, 측정된 연산량과 성능의 절충 관계, 재현에 충분한 학습 세부 정보가 없어 각 구성 요소를 평가하기 어렵다. 선형 스펙트럼 구성은 명확하지만, 전체 갱신에는 비선형 transformer 연산과 시간적 조건이 포함된다. 전체 시스템의 안정성을 입증하려면 Ā의 스펙트럼 외에도 추가 가정이나 상한이 필요하다. 조건을 통제한 루프 깊이 변화 실험, 디코더 ablation 실험, 더 긴 행동 구간, 중간 보상 및 종료 처리 검증을 수행하면 논문이 주장하는 효율과 계획 능력을 직접 평가할 수 있다.