


Towards a Neural Debugger for Python 요약 설명
10 Mar 2026 | Paper Review Neural Debugging Program State World Models목차
- 요약
- 1 Introduction
- 2 Related work
- 3 Python program execution traces
- 4 Neural debugger
- 5 Experimental results
- 6 Limitations and future work
- 7 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Towards a Neural Debugger for Python 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 10일(Arxiv)
- Beck, Maximilian, Gehring, Jonas, Kossen, Jannik, Synnaeve, Gabriel.
- Johannes Kepler University Linz, Institute for Machine Learning, Meta FAIR CodeGen Team
- 논문 링크
요약
- Towards a Neural Debugger for Python은 실행 추적 언어 모델을 순차적 해석에서 행동 조건부 디버깅으로 확장한다. 모델은 step_into, step_over, step_return, breakpoint, inv_step_call 같은 명령에 따라 미래 프로그램 상태나 가능한 이전 프로그램 상태를 예측한다.
- 이 방법은 Python 실행 추적에서 호출 스택 상태 트리를 재구성하고, 디버거 궤적을 샘플링한 뒤 구조화된 언어 모델 형식으로 직렬화한다. 실험에서는 32 B 파라미터 Code World Model(CWM)을 50 B 디버거 토큰으로 미세 조정하고, 1.8 B-parameter models를 50 B 또는 150 B 토큰으로 사전 학습한다.
- CruxEval에서 탐욕적 디코딩을 사용했을 때, 미세 조정한 모델은 입력 pass@1 66.5를 달성한다. 출력 pass@1은 step_return에서 77.9, breakpoint에서 83.2를 달성한다. 실행 추적만으로 150 B 토큰을 학습한 1.8 B model은 각각 53.6, 48.0, 57.7을 달성한다. 변수 값과 긴 예측 구간은 여전히 어렵다. 이 실험은 버그 위치 탐지나 프로그램 수정 성능이 개선된다는 근거를 제시하지 않는다.
1 Introduction
실행 추적 학습은 언어 모델이 런타임 동작을 학습하도록 하지만, 순차적 신경 인터프리터는 개발자가 디버거로 프로그램을 탐색하는 방식을 직접 재현하지 않는다. 이 논문은 디버거 명령을 실행 예측의 조건으로 사용하여, 모델이 중간 상태를 건너뛰고 선택된 실행 관측을 예측하도록 한다.
- 저자들은 코딩 에이전트에 실행 피드백을 제공할 수 있는 학습된 환경으로 신경 디버거를 제안한다. 에이전트와의 통합, 외부 상호작용 시뮬레이션, 일부만 명세된 프로그램에 대한 적용은 연구 동기이며, 평가한 응용 사례는 아니다.
- 근사적 역방향 실행은 미리 기록한 정방향 실행 없이도 가능한 이전 상태나 입력을 예측한다. 이는 기존 실행 이력을 거슬러 올라가는 역방향 디버깅과 다르다.
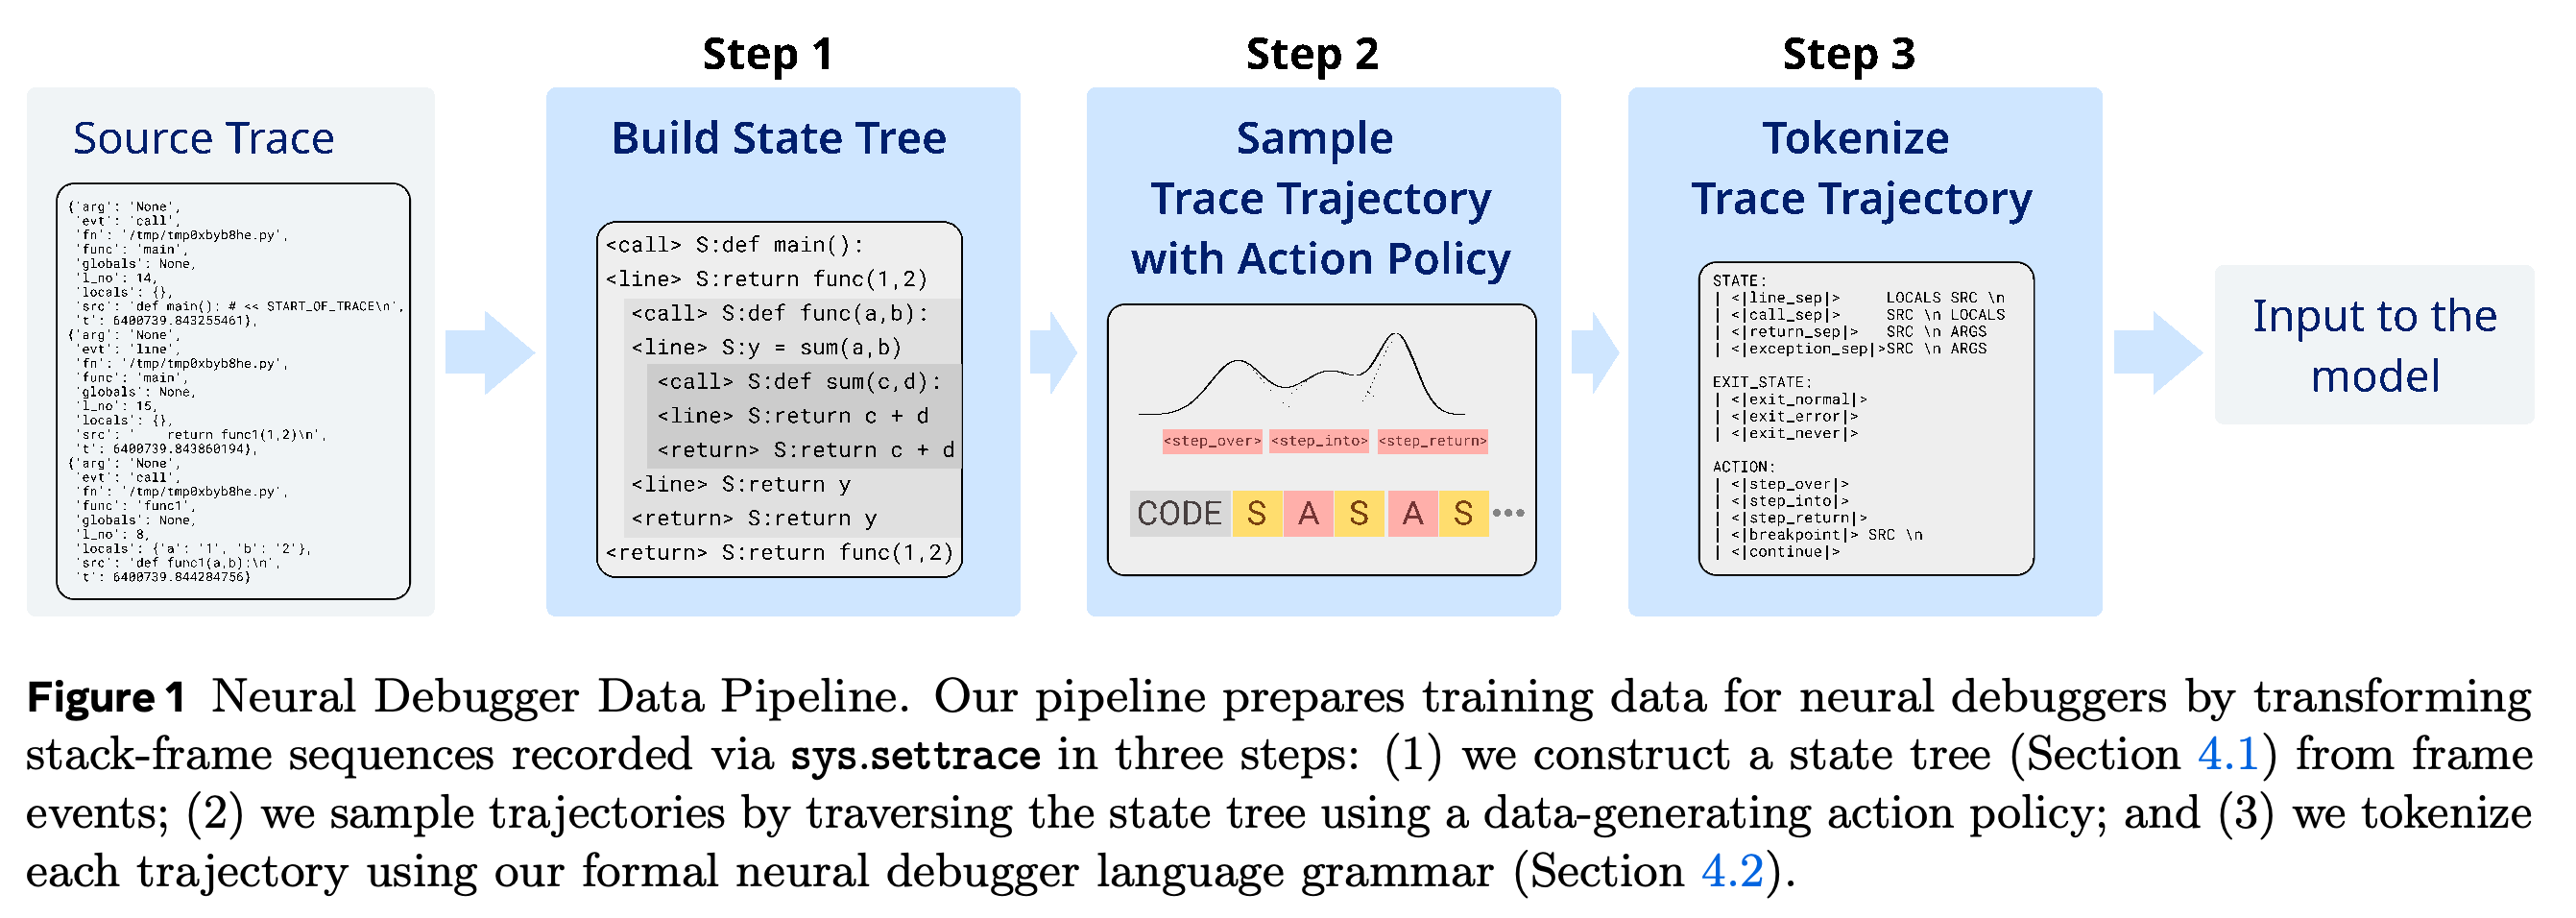
- Figure 1은 상태 트리 재구성, 행동 조건부 궤적 샘플링, 궤적 토큰화로 이루어진 3단계 데이터 파이프라인을 소개한다.
상태 트리를 재구성하면 런타임 데이터 수집과 디버거에 특화된 지도 학습을 분리할 수 있다. 행동 시퀀스마다 별도의 실제 디버거 세션을 수집하는 대신, 기존 실행에서 여러 행동 조건부 궤적을 샘플링할 수 있다.
2 Related work
관련 연구에는 학습된 인터프리터, scratchpad tracing, dynamic scratchpads, 런타임 오류 예측, 대규모 실행 추적 학습이 있다. 가장 가까운 선행 모델은 32 B-parameter model인 CWM이다. CWM의 추적 형식은 실행된 소스 코드 행을 행동으로, 변수 관측을 상태로 취급한다.
- CWM은 추적 생성 중에 수동으로 제어할 수 있지만, 기존 형식은 미래 코드 행으로의 점프, 역방향 실행, 입력 추론, 종료 예측을 직접 지원하지 않는다.
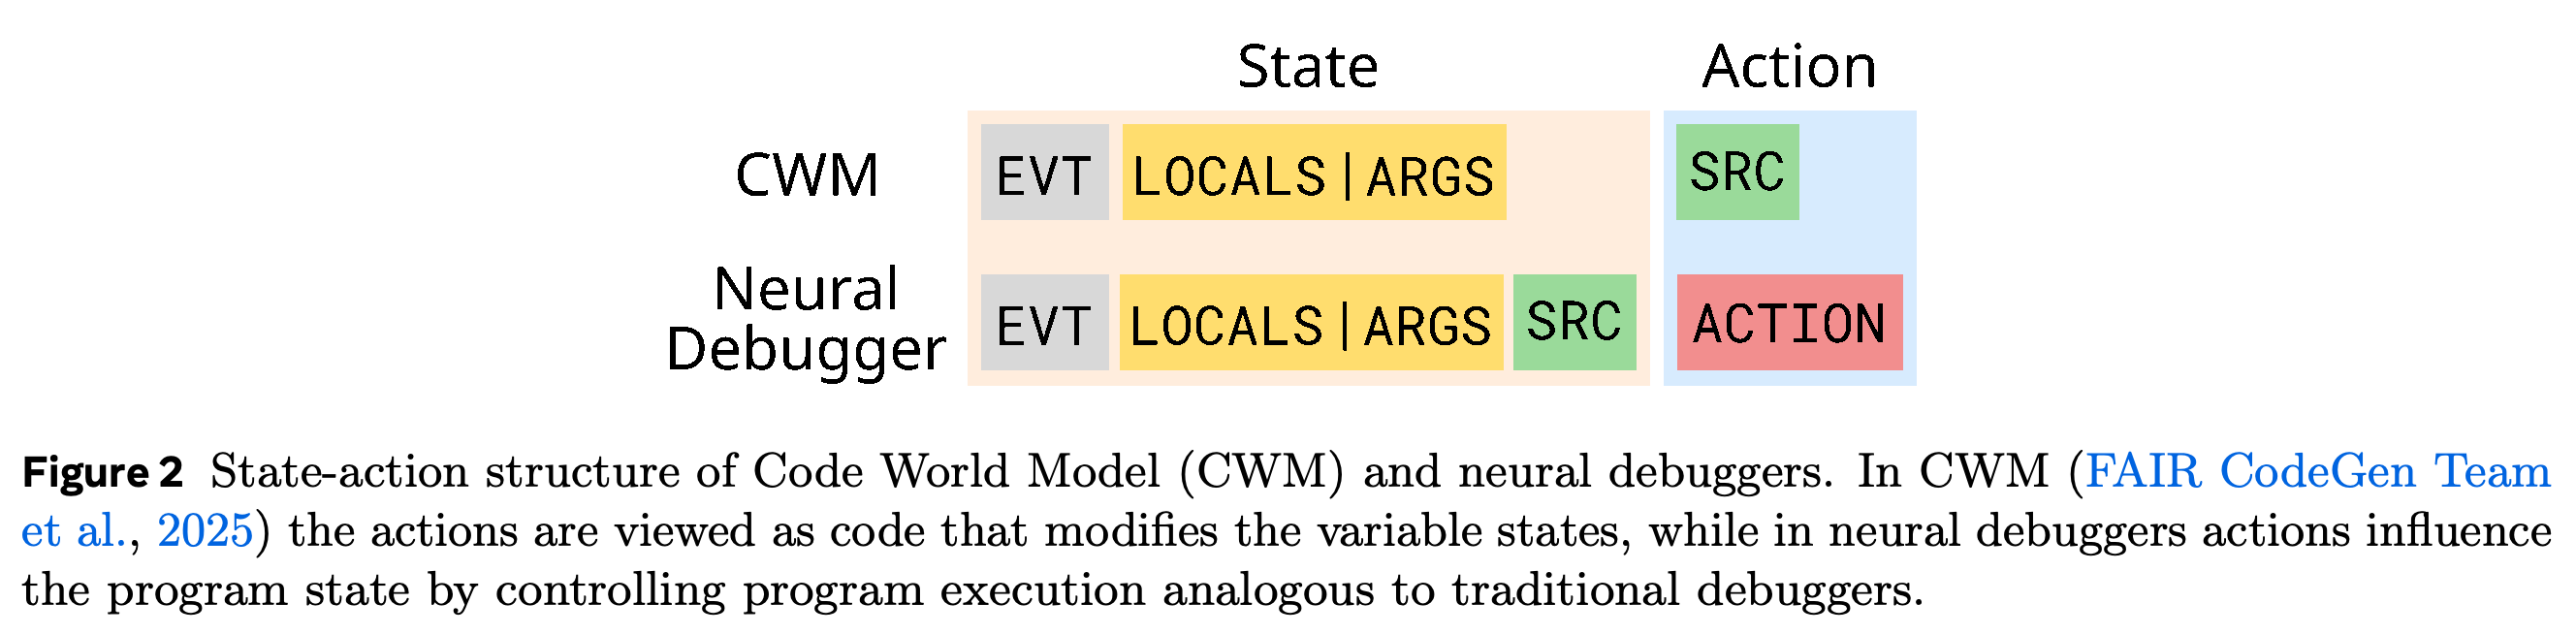
- Figure 2는 표현 방식의 변화를 보여준다. 신경 디버거는 SRC를 상태에 포함하고, 별도의 ACTION 필드로 디버거를 제어한다.
SRC를 상태에 포함하면 실행 위치가 관측의 일부가 된다. 별도의 디버거 ACTION은 예측할 전이를 요청하며, 소스 코드 행을 행동으로 사용하는 CWM 표현을 대체한다.
3 Python program execution traces
데이터셋은 스택 프레임 수준에서 Python 실행을 기록한다. sys.settrace(tracefunc)로 등록한 사용자 정의 tracefunc(frame,event,arg)는 함수와 저장소 단위 테스트를 실행하면서 지역 변수, 소스 코드 행, 런타임 이벤트 유형, 이벤트별 반환값 또는 예외 인자를 수집한다.
- Python은 코드 블록을 코드 객체로 컴파일하고 스택 프레임을 통해 실행한다. 호출과 반환 이벤트는 중첩 구조를 재구성하는 데 필요한 정보를 제공한다.
- 추적 인터페이스 문서는 https://docs.python.org/3/library/sys.html#sys.settrace 에서 확인할 수 있다.
4 Neural debugger
신경 디버거는 기호로 표현된 디버거 상호작용을 받아 프로그램 실행을 예측하는 언어 모델이다. 이 방법은 환경 정식화, 구조화된 상태–행동 언어, 궤적 생성 파이프라인을 결합한다. 유용한 디버깅 행동을 선택하는 정책이 아니라 상태 전이 결과를 학습한다.
4.1 Formulating the debugger as an MDP
디버거를 튜플 (S, A, P, R, s0)로 이루어진 MDP로 정식화한다. S는 프로그램 상태 공간이고, A는 디버거 행동을 포함하며, s0는 가능한 디버거 진입점을 나타낸다. 논문은 전이를 P: S × A → S로 정의하지만, 학습 과제가 행동 선택이 아니라 상태 예측이므로 보상 함수는 사용하지 않는다.
- 일반적인 프로그램 상태는 EVT, SRC와 함께 LOCALS 또는 ARGS를 포함하며, 런타임 이벤트, 소스 코드 행, 지역 변수 값 또는 이벤트별 인자를 나타낸다. 역방향 문법에는 값 딕셔너리가 없는 합성 inv_line_call 이벤트도 포함된다.
- 정방향 명령은 step_into, step_over, step_return, breakpoint SRC, continue이며, 일반적인 디버거 인터페이스를 참고한 명령이다.
- 함수 호출에 속한 상태는 해당 함수를 호출한 행 이벤트 노드의 자식이 된다. 이 상태 트리는 실행 순서를 유지하면서 트리 깊이가 호출 스택 깊이에 대응하도록 한다.
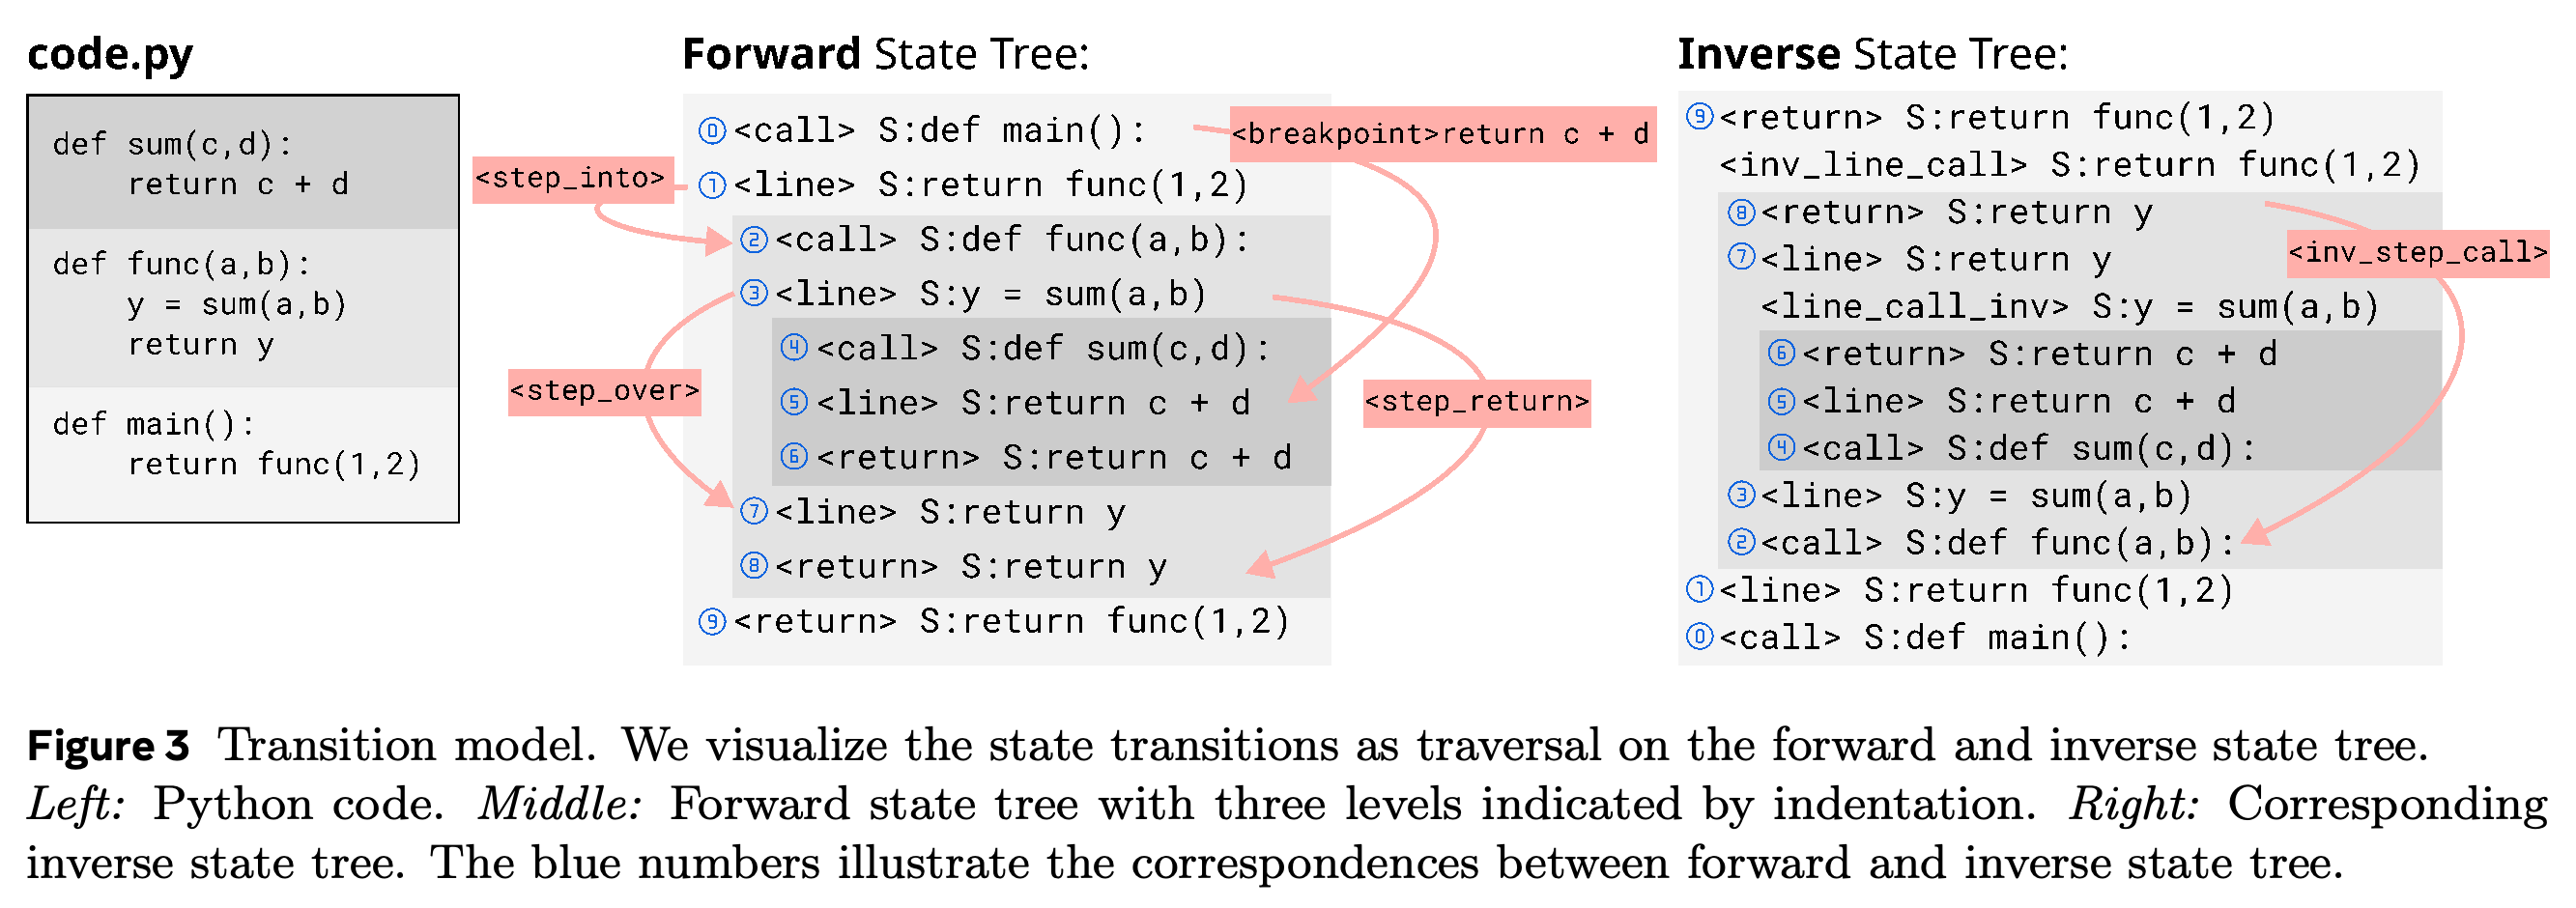
전이는 재구성한 상태 트리를 탐색하는 명시적 규칙이며, Figure 3에 제시한다. 이 규칙은 중첩 호출에 진입하는 동작과 호출을 건너뛰는 동작을 구분하고, 반환 이벤트에 도달하는 동작과 지정한 소스 코드 행에서 멈추는 동작을 구분한다.
- step_into는 다음 기록 상태로 이동하며, 필요한 경우 더 깊은 수준으로 진입한다. 이 명령만 사용하면 원래 실행 추적을 복원한다.
- step_over는 호출된 함수 내부로 내려가지 않고 현재 수준의 다음 노드로 이동하거나, 해당 수준의 끝에서 상위 수준으로 이동한다.
- step_return은 현재 수준의 반환 이벤트 노드에 도달한다. breakpoint SRC는 수준에 관계없이 이후 처음 나타나는 SRC에 도달하며, 해당 행에 끝내 도달하지 않으면 종료 코드를 생성한다.
- continue는 종료 코드를 예측한다. 정상 종료는 normal, 오류나 처리되지 않은 예외는 error, 무한 루프는 never로 나타낸다.
역방향 프로그램 실행 예측은 유일하게 결정되는 역연산이 아니라 가능한 이전 상태를 모델링한다. 정렬이나 덧셈 같은 연산은 여러 입력을 같은 출력으로 대응시킬 수 있으므로, 기록된 이전 상태와 일치하는지만으로 정확성을 온전히 판단할 수는 없다.
- 파이프라인은 상태 순서를 뒤집고, 함수를 호출하는 행 노드를 inv_line_call 노드로 복제하여 역방향 상태 트리를 구성한다. 이를 통해 역방향 탐색에서도 함수 호출에 진입하거나 이를 건너뛸 수 있다.
- 역방향 breakpoint 행동은 비활성화한다. inv_step_call은 step_return을 대체하며 함수 입력 인자를 직접 예측한다.
- 모델은 고정된 실행 이력을 탐색하는 역방향 디버거와 달리, 이전 상태의 조건부 분포에서 샘플링하도록 설계된다.
중첩 예시는 탐색 규칙을 구체적으로 보여준다. step_into는 호출된 함수에 진입하고, step_over는 해당 하위 트리를 건너뛰며, step_return은 현재 함수의 반환 이벤트를 목표로 한다. 역방향 트리는 호출 관련 노드를 추가하여 역방향 탐색에서도 진입과 건너뛰기를 선택할 수 있도록 한다.
4.2 Formal language for neural debuggers
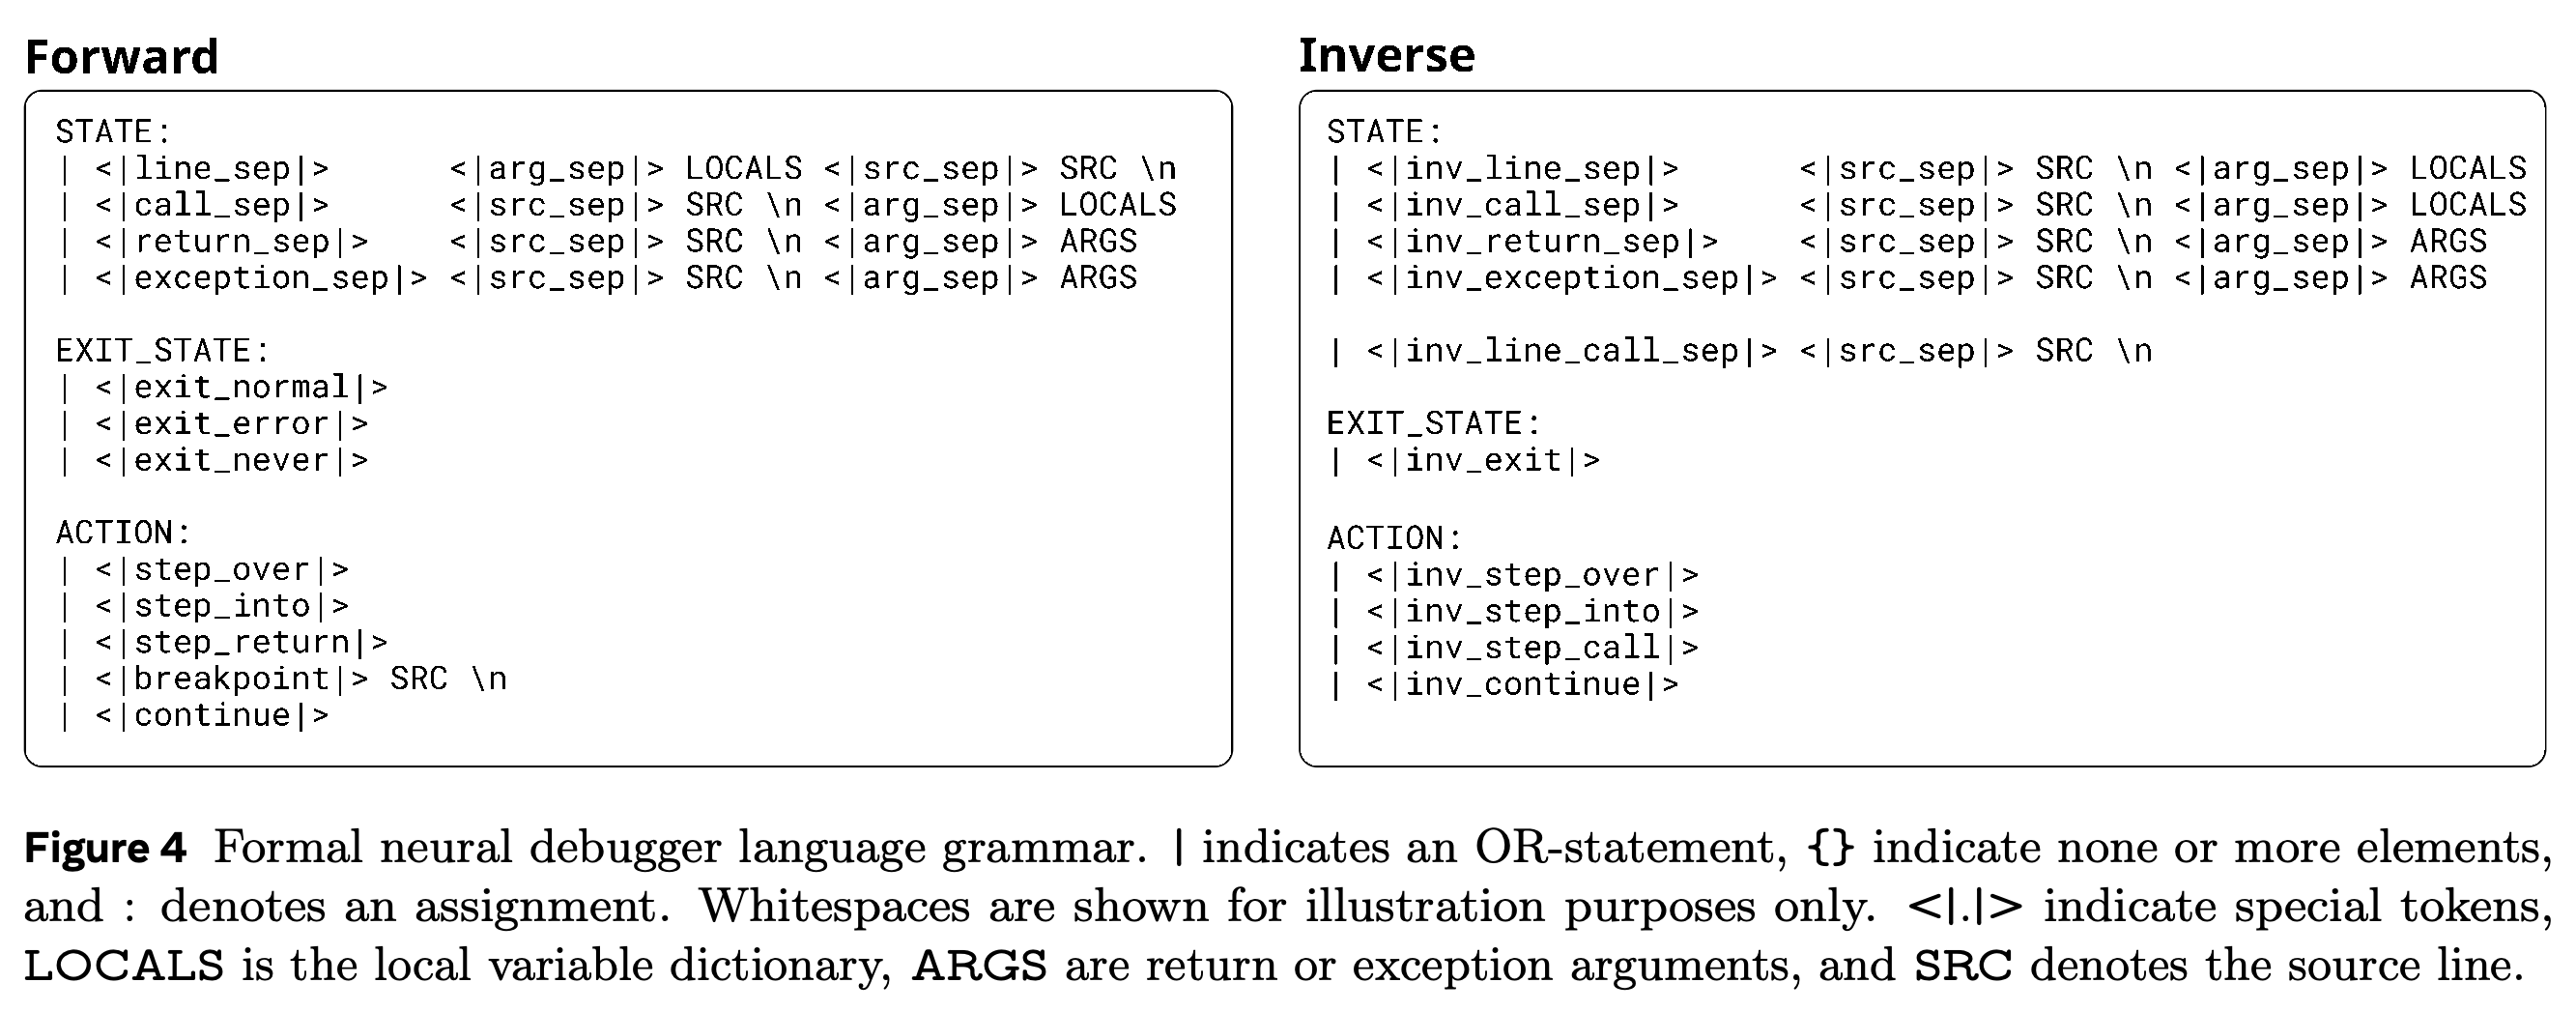
신경 디버거의 추적은 소스 코드 문맥 뒤에 상태–행동 쌍과 종료 상태가 이어지는 구조이며, 특수 토큰으로 각 구성 요소를 구분한다. Figure 4는 정방향과 역방향 이벤트 및 행동 토큰을 별도로 정의한 문법을 보여준다. 이 문법은 CWM 표현을 확장하여 디버거 제어를 인코딩한다.
- <|frame_sep|>, <|action_sep|>, <|src_sep|>, <|arg_sep|> 같은 토큰은 구조화된 관측과 명령을 구분한다.
- 역방향 문법은 <|inv_line_call_sep|>와 <|inv_step_call|>을 포함하고, 정방향 문법은 SRC가 뒤따르는 <|breakpoint|>를 포함한다.
이벤트와 행동을 구분하는 토큰을 통해 일반적인 자기회귀 언어 모델이 디버거 명령과 그 결과를 표현할 수 있다. 이벤트 스키마는 구성 요소별 평가에서 제외되는 항목도 설명한다. 반환 이벤트는 LOCALS 대신 ARGS를 포함하고, 합성 역방향 호출 행 이벤트는 SRC만 포함한다.
LOCALS는 JSON으로 직렬화하고, 임의의 Python 객체는 __repr__()로 텍스트로 변환한다. 일반적인 행 전이는 변경된 변수만 표시하며, 생략한 미변경 항목은 “..”:”..”로 나타낸다.
- 정방향 궤적은 스코프가 바뀐 뒤 모든 지역 변수를 제공한다. 저자들은 이를 호출, 반환 또는 breakpoint 이벤트 이후라고 설명한다. 다만 문법상 반환 이벤트 상태 자체에는 ARGS가 포함된다.
- 역방향 추적은 호출 이벤트에서 완전한 LOCALS 딕셔너리를 제공하여 모든 함수 입력 변수를 예측할 수 있도록 한다.
- 변경분만 기록하는 형식은 반복을 줄이지만, 크거나 복잡한 객체의 텍스트 표현은 여전히 궤적 길이에서 큰 비중을 차지할 수 있다.
4.3 Debugger trace data pipeline and dataset
데이터 생성용 행동 정책은 범주형 행동 분포의 확률적 혼합을 사용한다. 충분한 길이를 유지하면서 다양한 명령을 포함하는 궤적을 생성한다. 목적은 전문가의 디버깅 행동을 모방하는 것이 아니라 행동 조건부 전이를 학습하는 것이다.
- 데이터 파이프라인은 기록된 각 추적과 방문한 소스 코드 블록을 정방향 또는 역방향 상태 트리로 변환하고, 디버거 궤적을 샘플링한 뒤 형식 문법에 따라 토큰화한다.
- 저장소 추적에서는 샘플링한 함수 호출을 진입점으로 삼아 궤적을 해당 함수의 스코프로 제한한다.
- 행동과 진입점을 무작위로 샘플링하면 같은 실행 데이터로 반복 학습할 때 다양한 궤적을 얻을 수 있다.
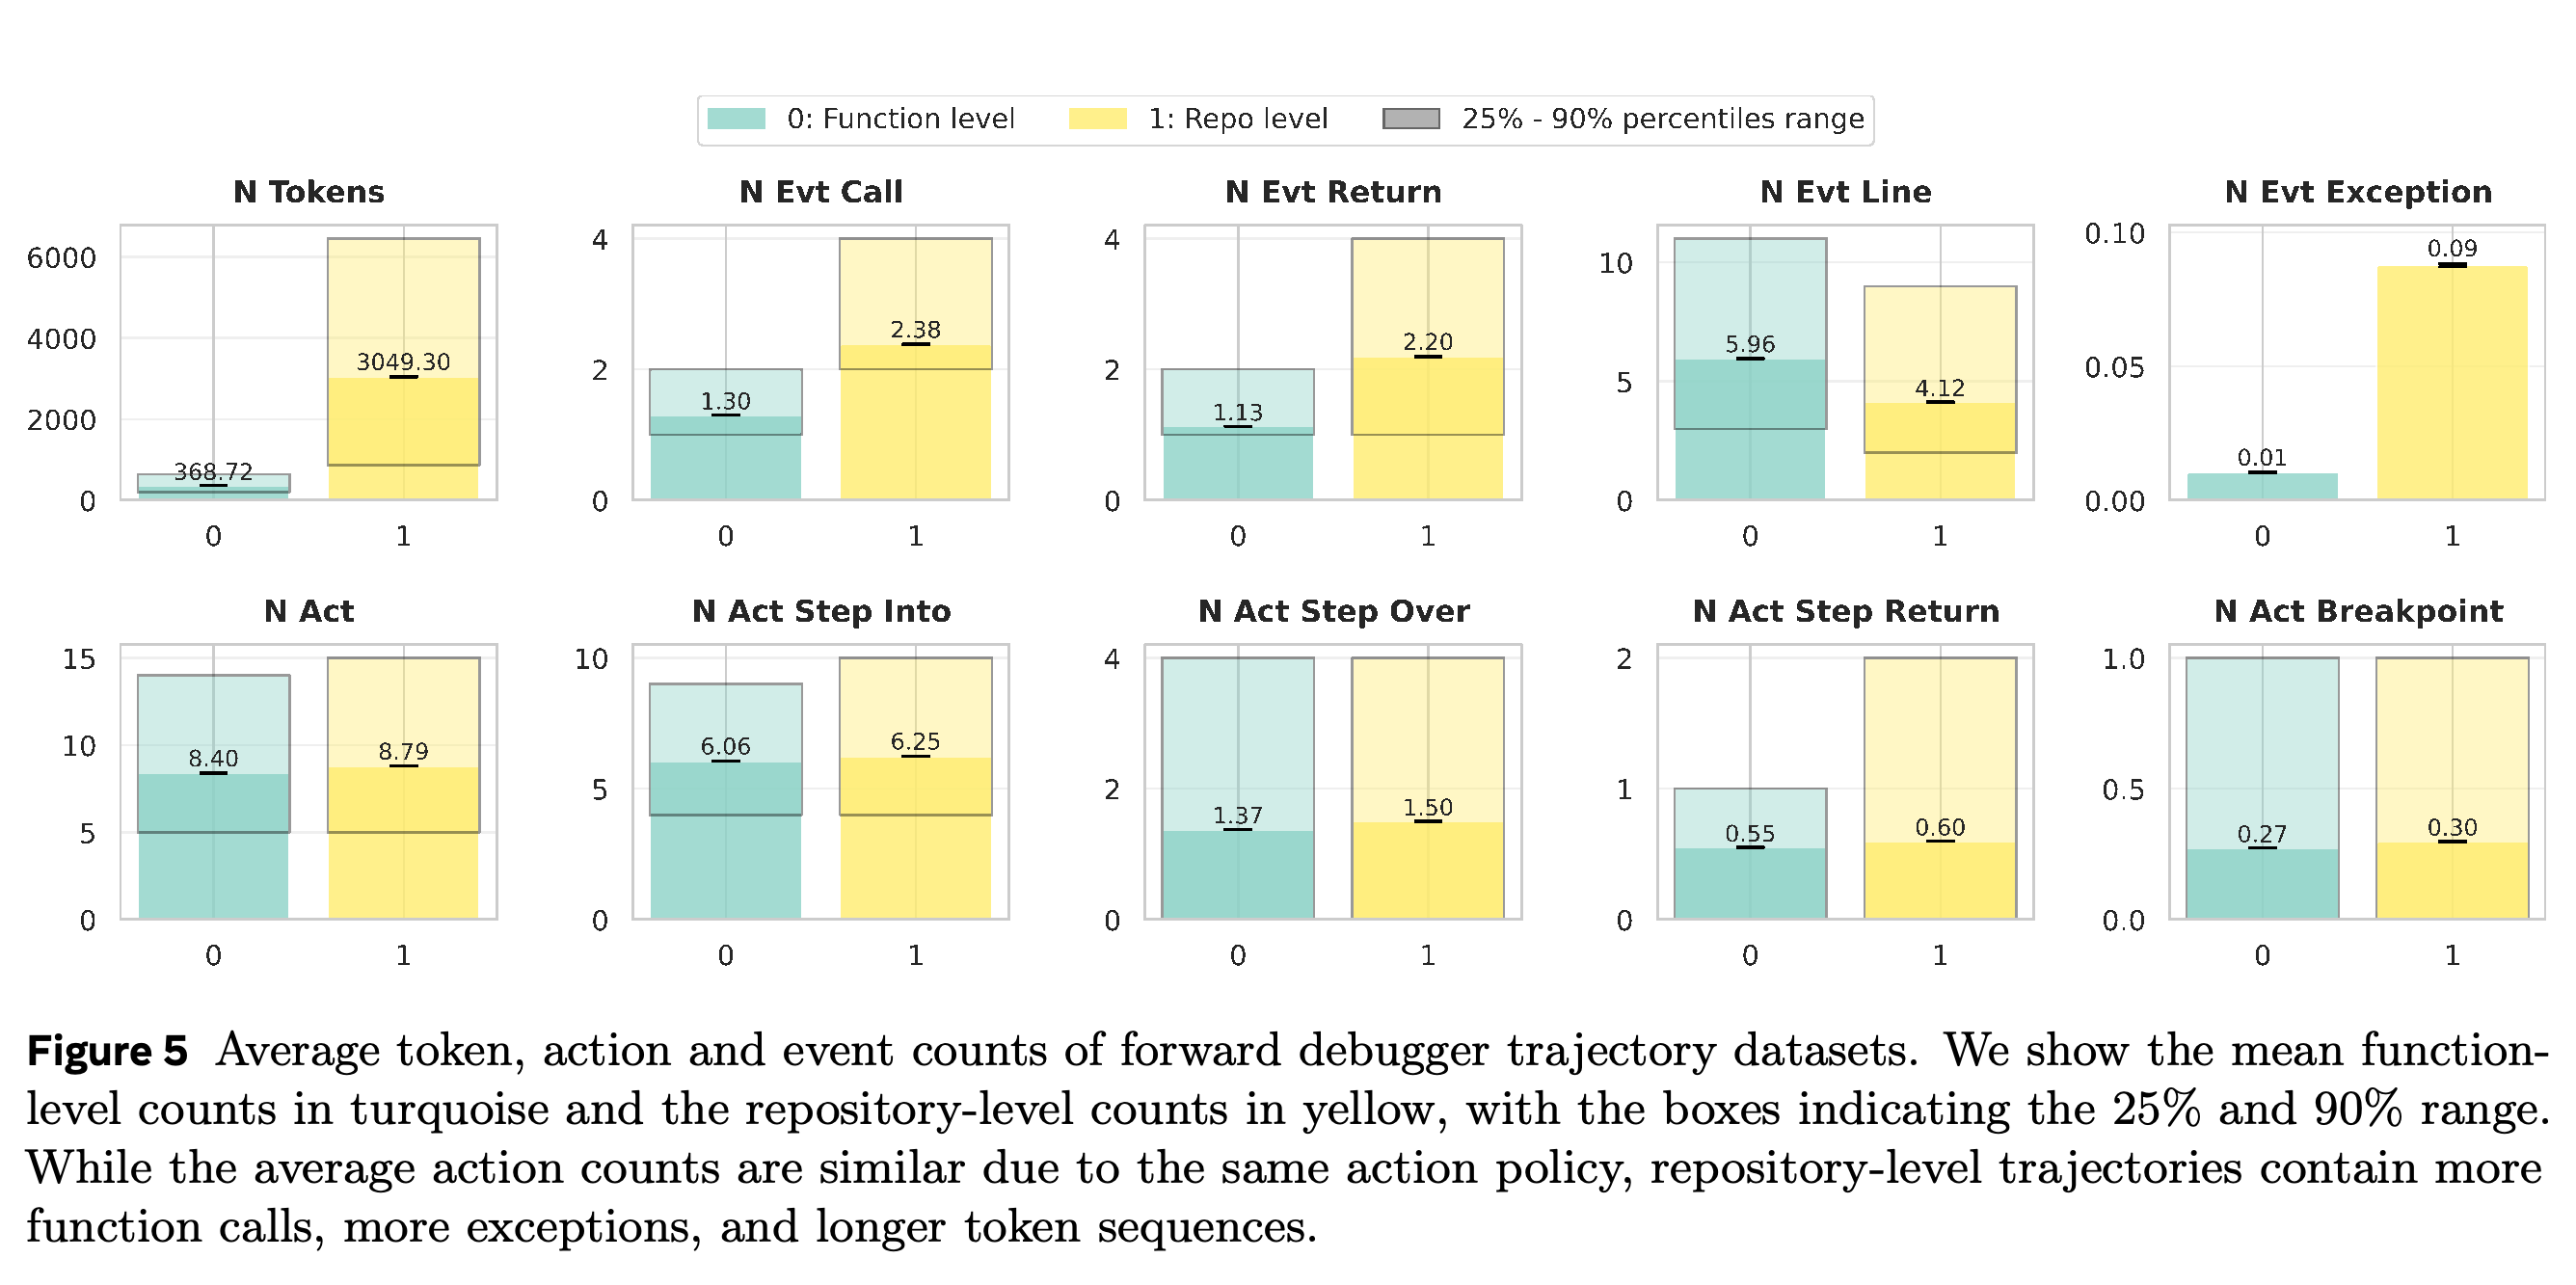
CWM 실행 데이터에 파이프라인을 적용하면 저장소 수준에서 약 15 B, 함수 수준에서 약 100 B의 디버거 궤적 토큰을 얻는다. 각 총량은 정방향과 역방향을 모두 포함한다. Figure 5는 행동 수가 비슷해도 저장소 궤적의 토큰 수가 훨씬 크다는 점을 보여준다.
- 정방향 궤적의 평균 길이는 함수 수준 데이터에서 368.72 토큰, 저장소 수준 데이터에서 3049.30 토큰이며, 평균 행동 수는 각각 8.40과 8.79다.
- 저장소 궤적에는 호출, 반환, 예외 이벤트가 더 많다. 저자들은 토큰 수가 큰 주된 이유로 더 큰 지역 변수 딕셔너리와 더 많은 임의의 Python 객체를 든다. Appendix A.1은 더 큰 코드 문맥도 원인으로 제시한다.
함수 수준과 저장소 수준 궤적의 평균 행동 수는 각각 8.40과 8.79지만, 평균 토큰 수는 368.72와 3049.30 토큰이다. 저장소 궤적은 더 큰 관측과 더 많은 호출 관련 이벤트를 포함하므로, 탐색 길이가 비슷해도 문맥 처리 비용은 크게 다르다.
5 Experimental results
학습에서는 함수 수준과 저장소 수준 실행 추적을 같은 비율로 사용하고 정방향과 역방향을 모두 포함한다. 32 B CWM model은 디버거 데이터만으로 50 B 토큰을 미세 조정하고, 1.8 B 디코더 전용 Transformer는 50 B 또는 150 B 토큰을 사전 학습한다.
- 미세 조정은 선형 warmup 후 일정한 학습률을 사용하고, 사전 학습은 선형 warmup 후 cosine decay를 사용한다.
- 작은 모델은 디버거 추적만으로 학습하거나, DCLM 웹 데이터와 GitHub 코드를 사용해 trace:web:code를 4:3:1 및 4:6:2 비율로 혼합하여 학습한다.
- 평가는 전체 다음 상태 정확도, 상태 구성 요소별 정확도, CruxEval 입력·출력 예측, 예측 구간 길이에 따른 성능 변화를 살펴본다.
5.1 Finetuning and pre-training neural debuggers
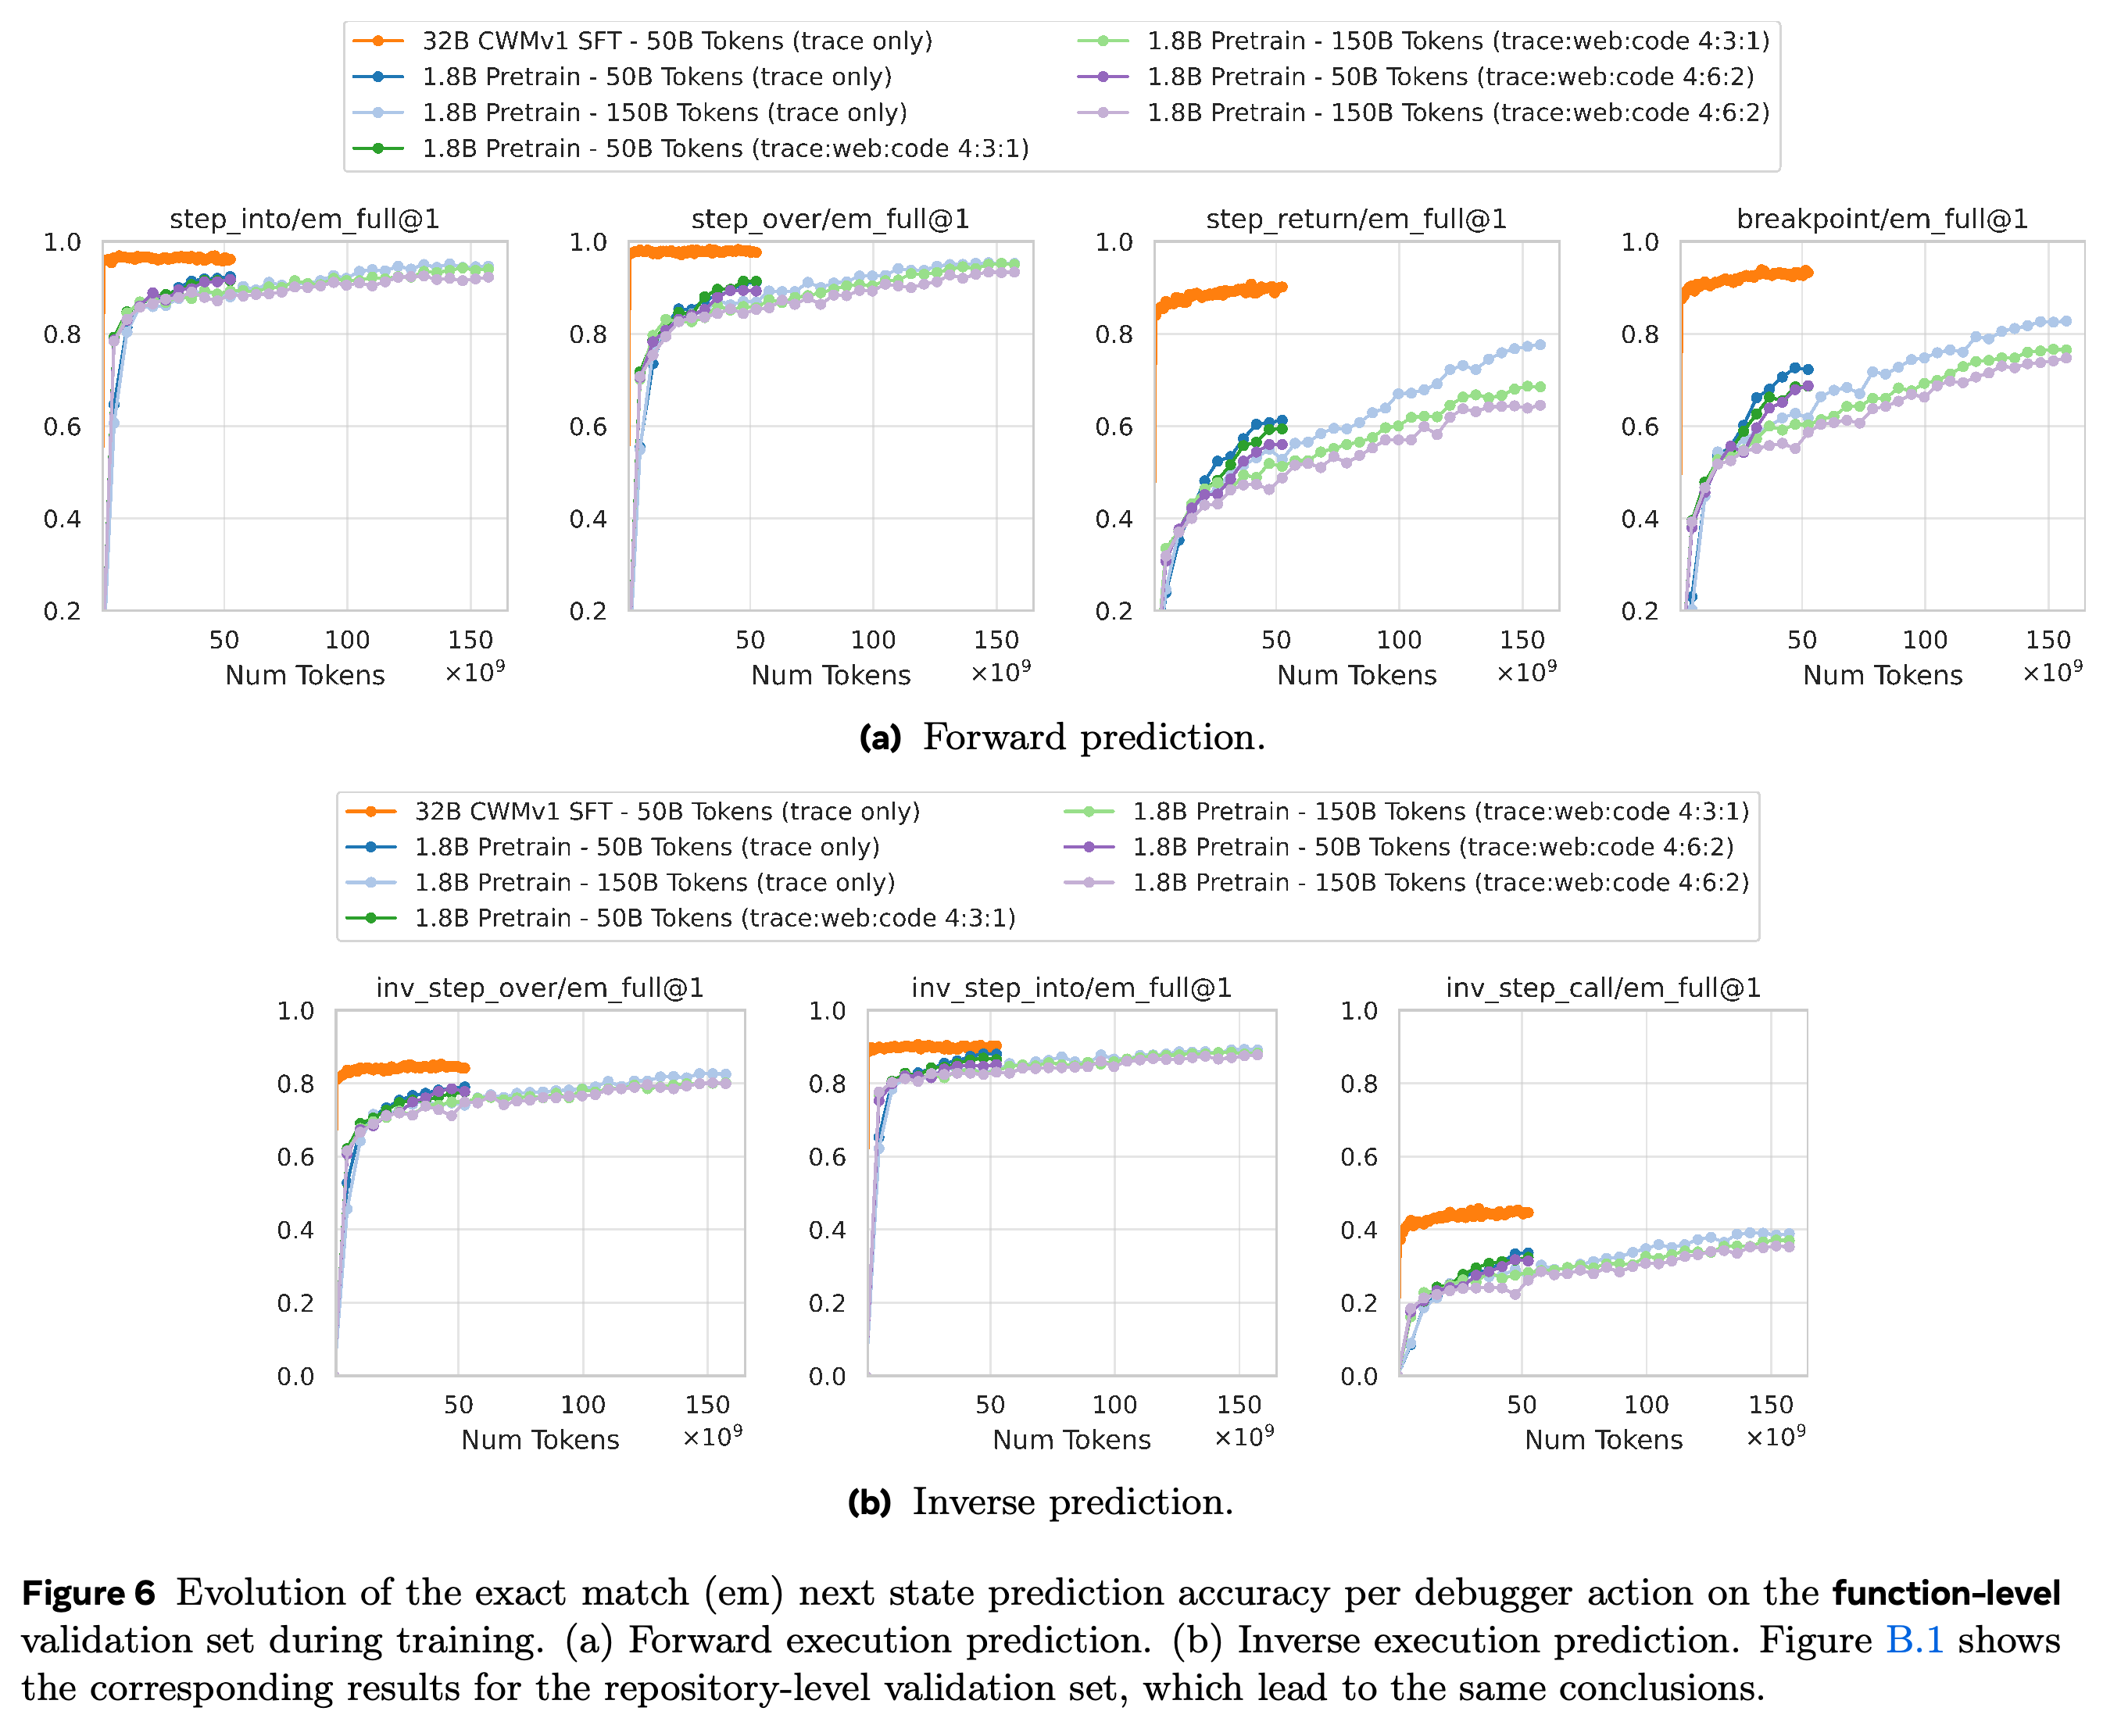
저자들은 디버거 행동마다 검증 궤적 800개를 샘플링하고 해당 행동 직후에서 잘라 예측 프롬프트를 만든다. Figure 6은 함수 수준 데이터에서 탐욕적 디코딩으로 측정한 전체 다음 상태의 정확 일치 정확도를 보고한다. 저장소 수준 결과는 부록에 별도로 제시한다.
- step 행동은 jump 행동보다 쉽다. step_into와 step_over는 더 일찍 성능이 정체되고, step_return과 breakpoint보다 높은 정확도를 달성한다. jump 행동은 더 많은 중간 실행 상태를 건너뛰며 샘플링 데이터에서 빈도도 낮다.
- CWM은 디버거 형식에 빠르게 적응한다. 저자들은 이를 이전 학습에서 실행 추적을 접했기 때문이라고 설명한다.
- 50 B 학습 토큰에서 보고된 큰 모델과 작은 모델의 차이는 step 행동에서 약 5%포인트, jump 행동에서 15%포인트를 넘는다. 작은 모델을 150 B 토큰으로 학습하면 격차가 줄지만, 이 비교에는 이전 학습 이력의 차이도 있다.
역방향 실행도 학습할 수 있다. 역방향 정확 일치 정확도는 학습에 따라 개선되지만 대체로 정방향 정확도보다 낮다. inv_step_call은 유효한 입력이 여러 개일 수 있어 절대적인 정확 일치 점수에 한계가 있다. 실제 실행으로 확인하는 입력 예측 평가가 이를 보완한다.
- 작은 모델도 신경 디버거를 학습할 수 있다. 1.8 B 모델 결과는 디버거 전이를 처음부터 학습할 수 있음을 보여주지만, jump 행동은 여전히 step 행동보다 어렵다.
- 혼합 코퍼스 실험은 웹·코드 학습 데이터에 디버거 추적을 포함할 수 있음을 뒷받침한다. 후속 프로그램 수정 성능의 이점은 측정하지 않는다.
step 행동 곡선은 jump 행동 곡선보다 빠르게 상승하고 포화된다. 더 긴 학습은 특히 작은 모델의 jump 행동에 도움이 된다. 낮은 inv_step_call 정확 일치 값은 기록된 입력과의 일치율이며, 실행상 유효한 모든 입력 예측의 비율은 아니다.
5.2 Next program state prediction by state component
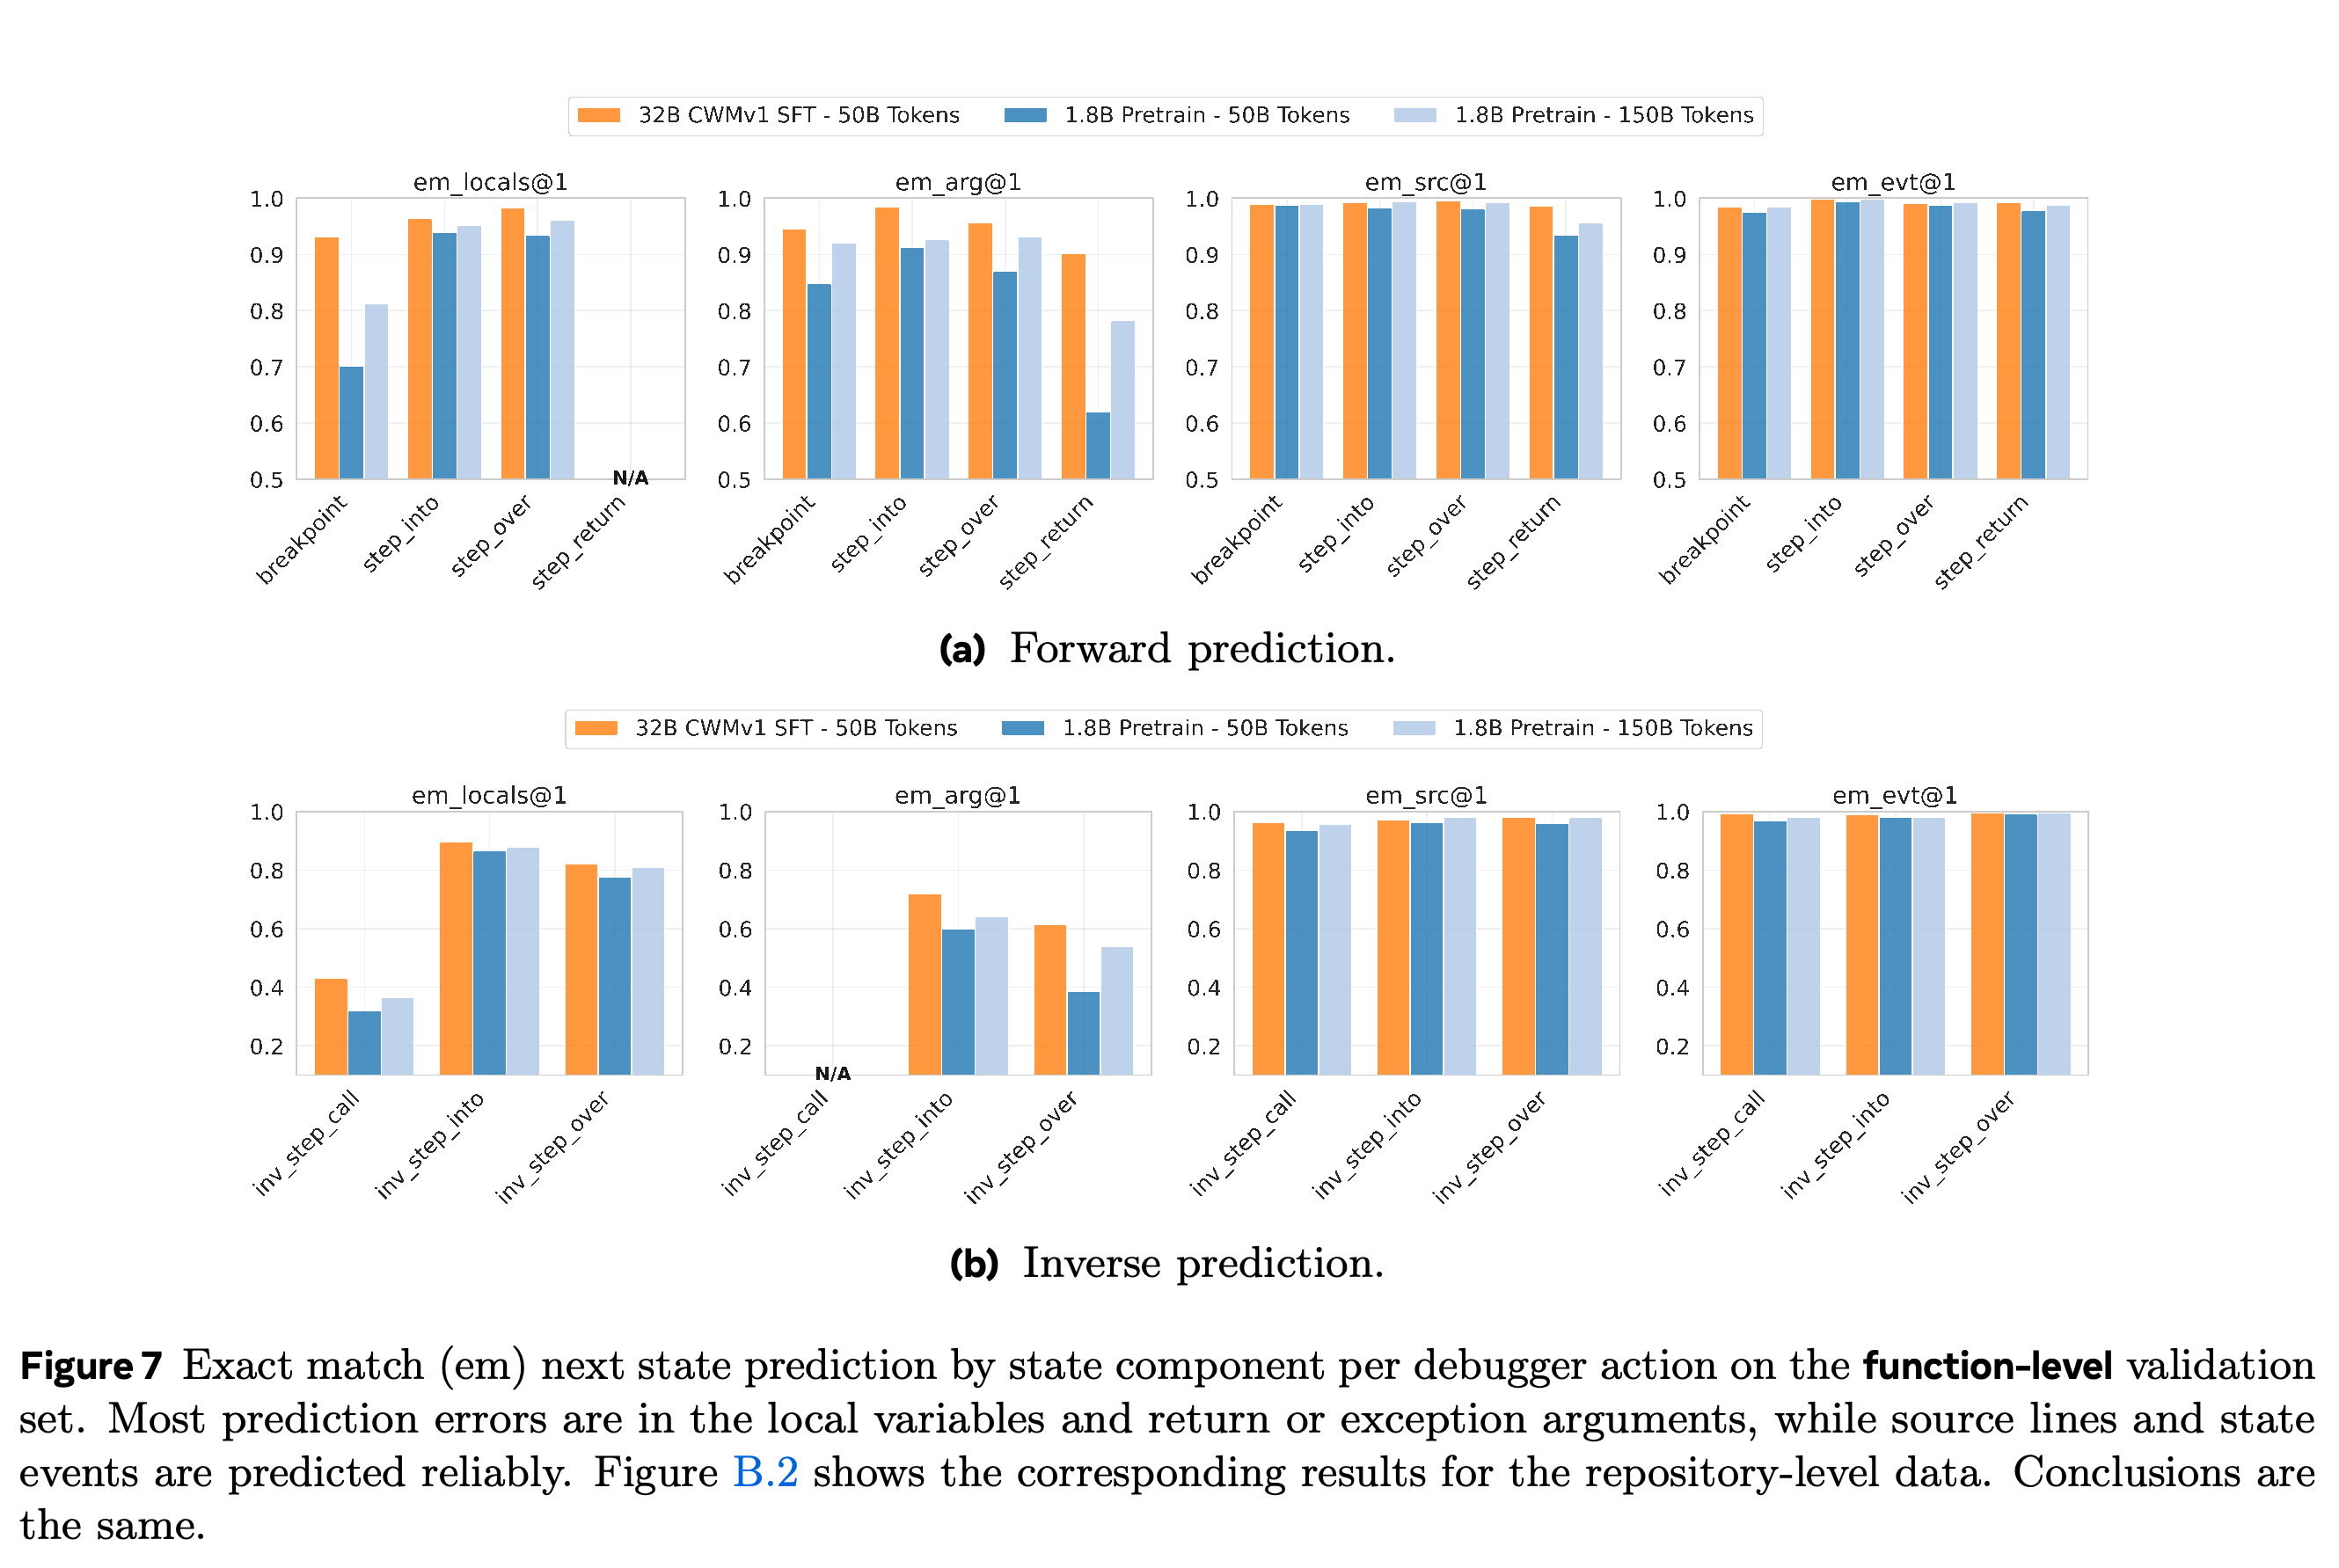
소스 코드 행과 상태 이벤트는 안정적으로 예측하지만 지역 변수에는 오류가 있다. Figure 7은 디버거 추적만으로 학습한 모델의 정확 일치 정확도를 LOCALS, ARGS, SRC, EVT로 나누어 보여준다. 남아 있는 오류와 큰 모델·작은 모델 간 격차는 대부분 소스 코드 행이나 이벤트 예측보다 지역 변수 값과 반환 또는 예외 인자에서 발생한다.
- 1.8 B models의 step_return 소스 코드 행 정확도는 함수 수준 데이터에서 약 5%포인트, 저장소 수준 데이터에서 10%포인트 하락한다고 보고한다. 저자들은 저장소 코드에 더 복잡한 조건 분기가 있기 때문이라고 추정한다.
- N/A는 특정 목표 이벤트에 해당 상태 구성 요소가 없다는 뜻이며, 예측 실패를 의미하지 않는다.
- inv_step_call의 지역 변수 딕셔너리 정확 일치는 기록된 입력과의 일치 여부를 측정하며, 다른 유효한 이전 상태는 고려하지 않는다.
SRC와 EVT 정확도는 대부분의 행동에서 높게 유지되지만, LOCALS와 ARGS는 오류와 모델 크기 간 격차가 더 크다. 이 분석은 값 예측이 남아 있는 주요 난점임을 보여준다. 역방향 입력의 모호성도 inv_step_call의 지역 변수 딕셔너리 정확 일치를 낮춘다.
5.3 Input and output prediction on CruxEval
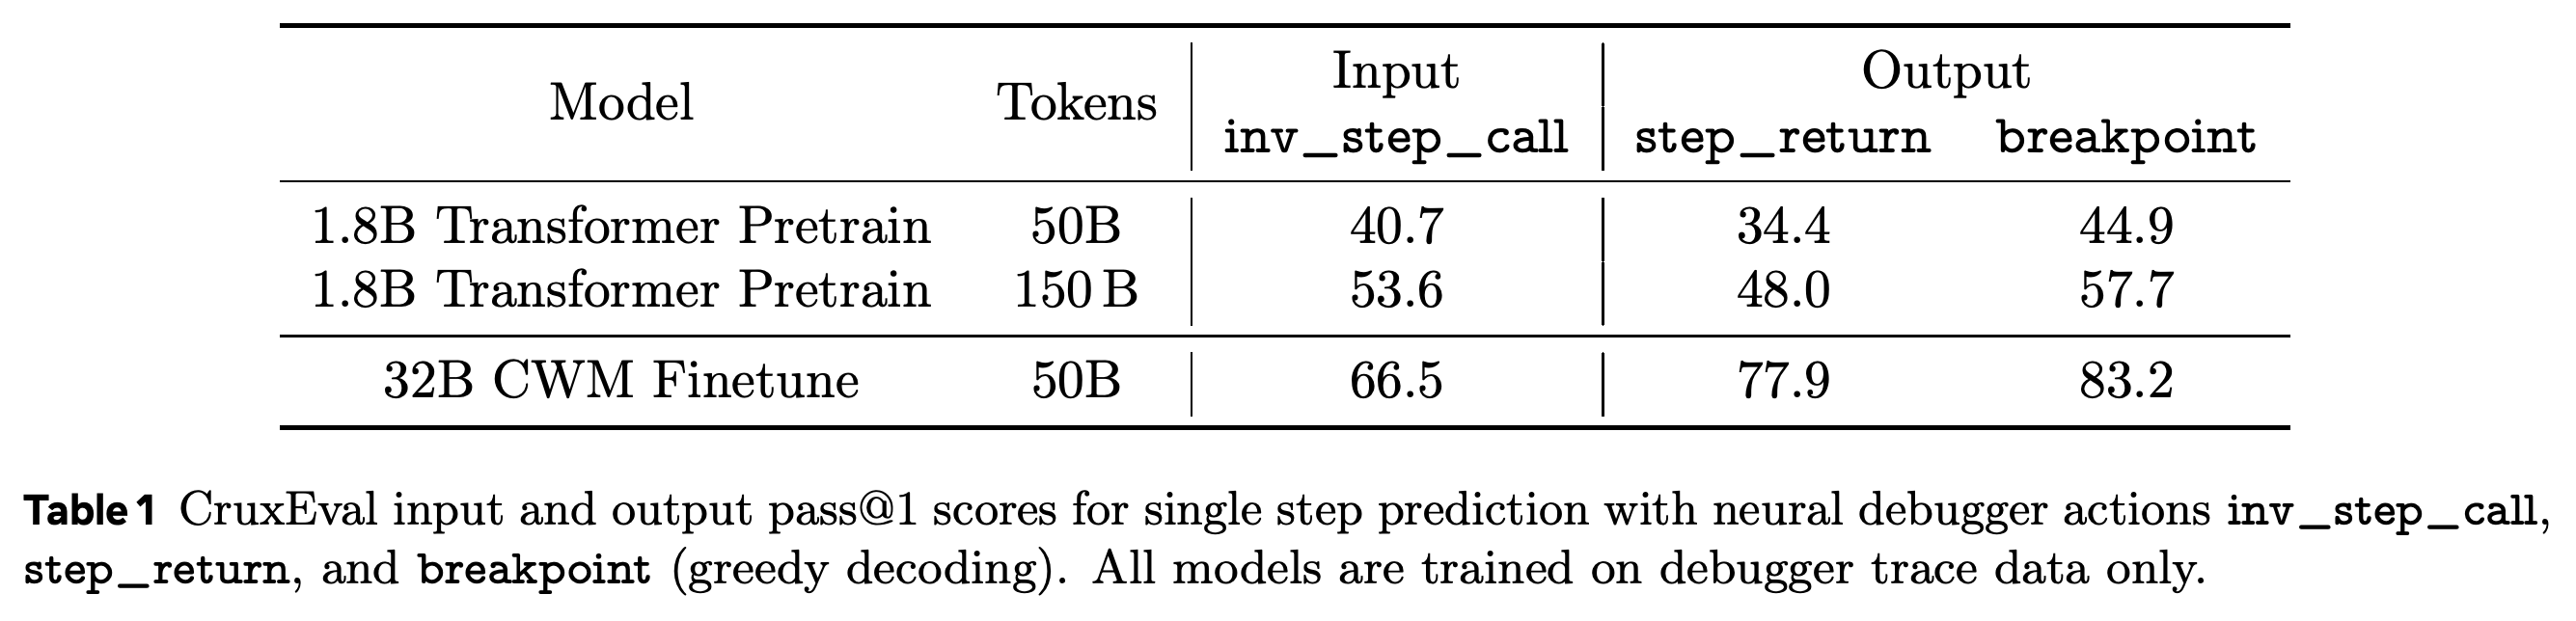
CruxEval 과제를 디버거 점프로 표현한다. inv_step_call은 입력을 예측하고, step_return과 breakpoint는 출력을 예측한다. Table 1은 탐욕적 디코딩과 실행 기반 pass@1을 사용한다. 예측 입력이 기준 입력 자체와 일치해야 하는 것은 아니며, assert f(predicted_input) == reference_output을 만족하는지 확인한다.
- 실행 추적만으로 50 B 토큰을 학습한 1.8 B model은 입력에서 40.7, step_return 출력에서 34.4, breakpoint 출력에서 44.9를 기록한다.
- 150 B 토큰으로 학습했을 때 해당 점수는 53.6, 48.0, 57.7이며, 미세 조정한 32 B CWM은 66.5, 77.9, 83.2를 기록한다.
- 신경 디버거는 출력 예측에서 높은 성능을 보인다. 77.9 step_return 점수는 인용된 기본 CWM의 추적 단계 예측 결과 58.1보다 19.8%포인트 높다.
breakpoint는 step_return보다 성능이 높다. 저자들은 breakpoint 프롬프트가 반환문의 소스 코드 행을 명시적으로 제공하기 때문이라고 설명한다. 이는 목표 실행 위치를 식별할 필요를 줄이므로, 2가지 출력 점수는 서로 다른 조건 정보를 반영한다.
- step_return의 목표 상태는 반환 이벤트와 그 인자를 포함한다. breakpoint의 목표 상태는 지정한 반환문 행의 지역 변수 딕셔너리를 포함한다.
- 부록은 2가지 출력 프롬프트와 역방향 입력 프롬프트의 구체적인 예시를 제공한다.
미세 조정한 32 B model은 입력 예측에서 66.5를 기록하고, 출력 예측에서는 행동에 따라 77.9 또는 83.2를 기록한다. 일관된 breakpoint의 우위는 반환문 행을 명시하는 프롬프트와 함께 해석해야 한다. 입력 pass@1은 실행했을 때 요구된 출력을 생성하면 다른 입력도 정답으로 인정한다.
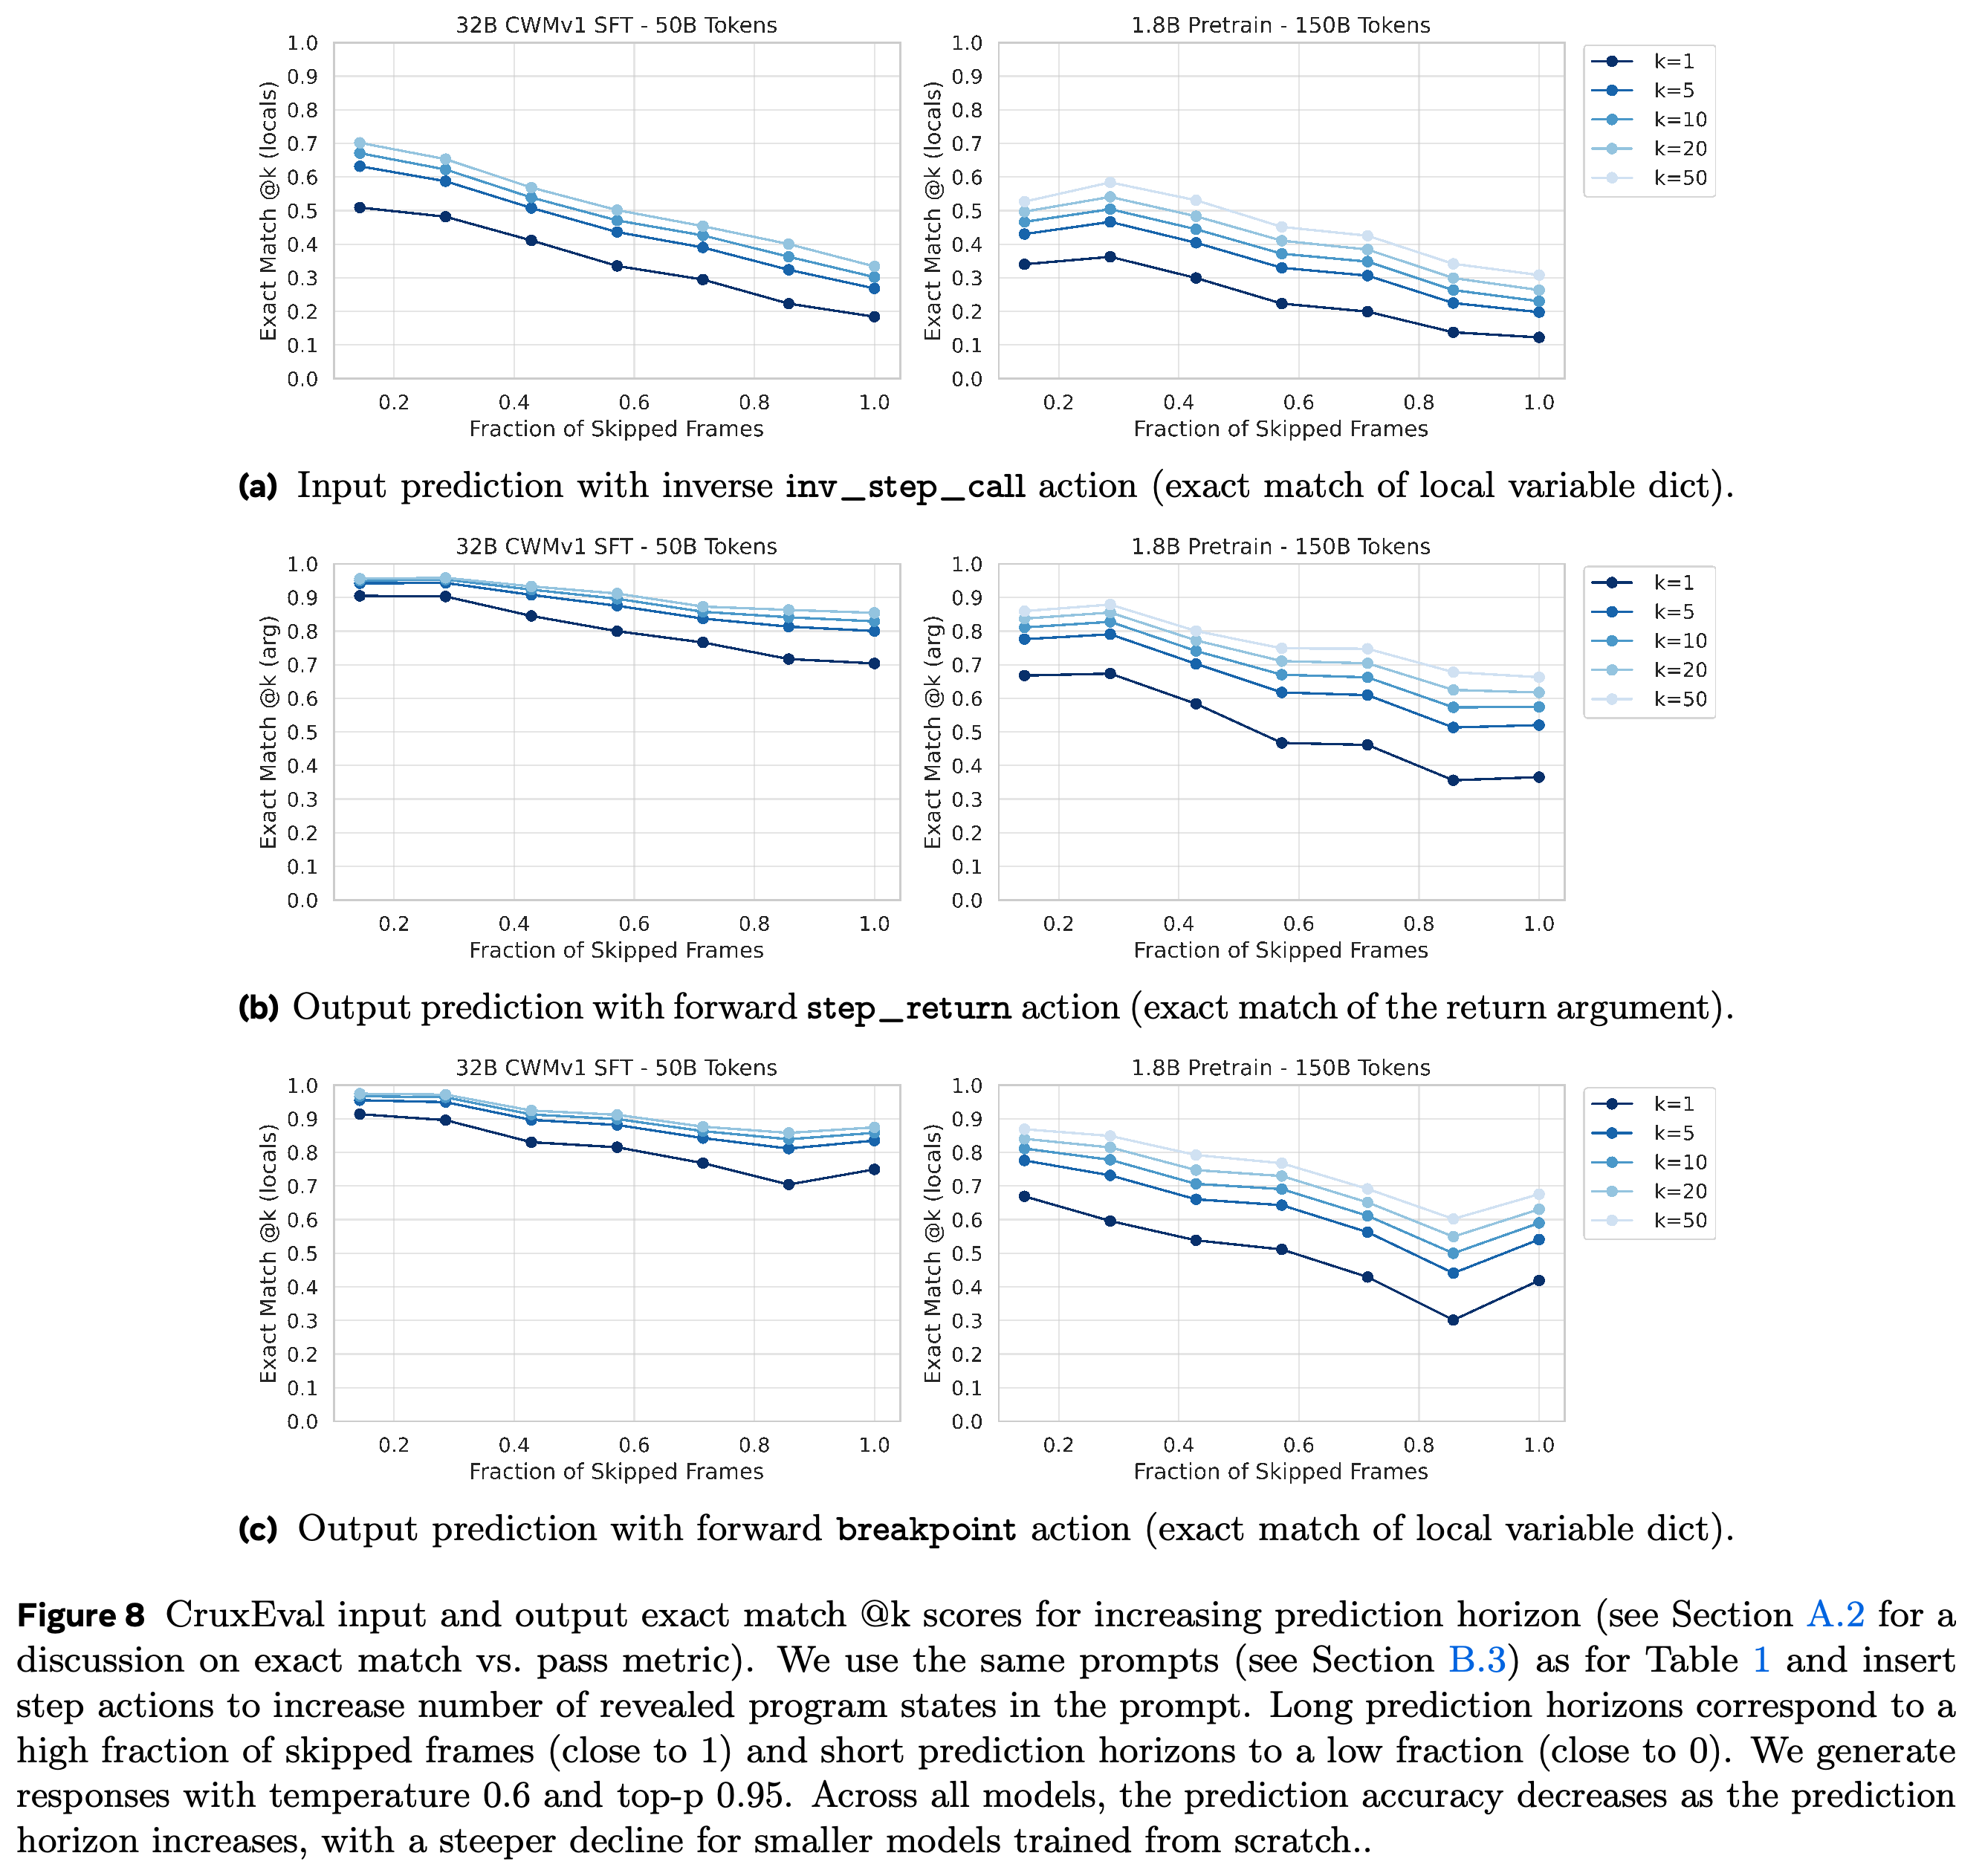
예측 구간이 길어질수록 예측 정확도가 낮아진다. Figure 8은 마지막 점프 전에 건너뛰는 중간 프레임의 비율을 바꾸고, temperature 0.6과 top-p 0.95에서 k = 1, 5, 10, 20, 50에 대한 exact match @k를 보고한다. 곡선은 전반적인 하락을 보이지만 모든 패널에서 엄격하게 단조 감소하지는 않는다.
- 건너뛴 프레임 비율이 0에 가까우면 짧은 전이를 뜻하고, 1에 가까우면 함수 전체에 걸친 예측을 뜻한다.
- 정확도는 대체로 예측 구간이 길수록 낮아지며, 1.8 B model에서 하락 폭이 더 크다. 샘플링 횟수를 늘리면 성능 저하를 일부 줄일 수 있다.
- 입력과 breakpoint 곡선은 기준 지역 변수 딕셔너리와의 정확 일치를 측정하고, step_return 곡선은 반환 인자의 정확 일치를 측정한다. Table 1과 달리 이 평가는 확률적 디코딩을 사용한다. 앙상블, 불확실성에 따른 재샘플링, 적응적 점프 선택은 제안한 확장 방향이며 시험한 방법은 아니다.
건너뛴 프레임 비율이 커지면 대체로 정확도가 낮아지며, 특히 작은 모델에서 하락이 크다. 샘플을 추가하면 정확도를 일부 회복한다. 모든 패널에서 엄격하게 단조 감소하는 것은 아니다. 입력과 breakpoint 패널은 지역 변수 딕셔너리의 정확 일치를 평가하며, 확률적 디코딩을 사용한다는 점에서도 Table 1의 탐욕적 디코딩·실행 확인 점수와 다르다.
6 Limitations and future work
실험으로 검증한 후속 응용은 입력·출력 예측이며 자동 수정은 아니다. 신경 디버거를 활용한 에이전트 기반 프로그램 수정, 추론, 도구 사용은 향후 과제로 남아 있다. 여기에는 생성한 코드의 자체 디버깅과 실제 디버깅 도구 제어가 포함된다.
- 데이터 생성을 확대하고 개선할 필요가 있다. 이 연구는 Python과 무작위 행동 정책을 다루며, 저자들은 다른 언어와 구문 인식 또는 목표 지향 궤적 샘플링을 제안한다.
- 역방향 디버깅을 개선할 필요가 있다. 모호한 역방향 상태를 다루려면 가능한 값 집합을 더 잘 모델링하고 여러 유효한 이전 상태를 고려하여 평가해야 한다.
- Python 객체 표현을 개선할 필요가 있다. __repr__() 기반 직렬화는 매우 크거나 복잡한 구조, 특히 저장소 수준 추적에서 사용하기 어려워진다.
7 Conclusion
이 논문은 행동 조건부 실행 모델링 인터페이스와 추적을 궤적으로 변환하는 파이프라인을 제안하고, 미세 조정한 큰 모델과 처음부터 학습한 작은 모델이 디버거 전이를 학습할 수 있음을 보여준다. 중간 상태와 CruxEval 결과는 실행 예측 능력을 뒷받침한다. 이 모델을 코딩 에이전트의 월드 모델로 사용하는 것은 아직 검증하지 않은 확장 방향이다.
부록
- A Extended neural debugger와 A.1 Extended debugger trace dataset은 궤적 길이 히스토그램과 행동 정책 혼합을 제공한다. Table A.1은 2개 정책을 각각 확률 0.5로 선택한다. 표시된 첫 번째 행은 step_into, step_over, step_return, breakpoint, continue의 확률을 0.35, 0.1, 0.2, 0.1, 0.05로 설정하고, 두 번째 행은 step_into와 step_over에 각각 0.5를 설정한다. 표시된 첫 번째 행의 합은 0.8이며 균등하지 않다. 함께 제시된 본문은 균등 샘플링이라고 설명하므로, 명세의 불일치가 해결되지 않은 채 남아 있다.
- A.2 Evaluating Inverse Execution Prediction은 기준 입력과 일치하는 것과 실행했을 때 요구된 출력을 내는 입력을 생성하는 것을 구분한다. Table A.2가 보고하는 입력 exact_match@1과 pass@1은 1.8 B/50 B 토큰 모델에서 14.3과 40.7, 1.8 B/150 B 토큰 모델에서 17.7과 53.6, 미세 조정한 CWM에서 23.1과 66.5다. 이 차이는 단일 기준 입력에 대한 정확 일치가 실행상 유효한 입력 예측 성능을 과소평가한다는 점을 보여준다. 저자들은 더 폭넓은 디버거 능력을 평가하기 위해 전용 실행 기반 평가를 제안한다.
- B Extended experiments와 B.1 Training recipe는 weight decay 0.1을 적용한 AdamW와 1.8 B models용 Llama-2 아키텍처를 명시한다. 두 학습 방식 모두 750 warmup 단계를 사용한다. 사전 학습의 학습률은 최대 1 × 10⁻³에서 0까지 감소하고, 미세 조정의 학습률은 최대 1 × 10⁻⁵에 도달한 뒤 일정하게 유지된다. 모든 실험은 시퀀스 길이 16 384와 배치 크기 1 M 토큰 또는 64개 시퀀스를 사용한다.
- B.2 Extended next state prediction results는 저장소 수준 검증 데이터에서 본문의 행동별·구성 요소별 분석을 반복하며, 정성적으로 비슷한 결론을 제시한다. B.3 CruxEval input and output prediction prompts in neural debugger format은 step_return이 반환 인자를, breakpoint가 반환문 행의 지역 변수를, inv_step_call이 함수 인자를 예측하는 방식을 보여준다. C Neural debugger trace example은 count(“berry”, “r”)를 정방향으로 따라가 출력 2를 얻는 과정과 역방향 궤적을 보여주며, n=2를 만드는 s와 t의 조합이 무한히 많다는 점을 설명한다.
짧은 생각
핵심 기여는 실행 모델 인터페이스다. 모든 중간 행을 예측하도록 하는 대신, 디버거 행동으로 모델이 예측해야 할 전이를 선택한다. 상태 트리 구성은 이 전이를 정확하게 정의한다. 구성 요소별 결과는 제어 흐름 위치를 예측하는 것이 해당 위치에서 관측되는 값을 예측하는 것보다 쉽다는 점을 보여준다.
실제 실행으로 확인하는 CruxEval 평가와 역방향 정확 일치·pass@1 간 격차는 유용한 조건부 실행 모델링을 가장 명확하게 뒷받침한다. 다만 실용적인 디버깅 가치는 아직 불확실하다. 프로그램 수정과 버그 위치 탐지를 평가하지 않았고, breakpoint 프롬프트는 추가적인 목표 위치 정보를 제공하며, 긴 구간의 값 예측에는 여전히 오류가 많기 때문이다.