


Dynamic Large Concept Models: Latent Reasoning in an Adaptive Semantic Space 요약 설명
31 Dec 2025 | Paper Review Latent Reasoning Adaptive Computation Scaling Laws목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 Methodology
- 4 Implementation Details
- 5 Data
- 6 Scaling Laws for DLCM
- 7 Experiments
- 8 Ablation Studies
- 9 Conclusion
- Contributions
- 부록
- 짧은 생각
이번 글에서는 Dynamic Large Concept Models: Latent Reasoning in an Adaptive Semantic Space 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 31일(Arxiv)
- Qu, Xingwei, Wang, Shaowen, Huang, Zihao, Hua, Kai, Yin, Fan, Zhu, Rui-Jie, Zhou, Jundong, Min, Qiyang, Wang, Zihao, Li, Yizhi, et al.
- ByteDance Seed, University of Manchester, Mila - Quebec AI Institute, Tsinghua University, M-A-P
- 논문 링크
요약
- Dynamic Large Concept Models: Latent Reasoning in an Adaptive Semantic Space는 가변 길이 토큰 구간을 잠재 개념으로 압축하는 계층적 다음 토큰 예측 아키텍처를 제안한다. 경량 토큰 인코더와 디코더 사이에 폭이 넓은 개념 수준 Transformer를 배치하여, 비용이 큰 연산을 더 짧은 시퀀스에서 수행한다.
- DLCM은 표현 기반 경계 탐지, 전역 정규화를 적용한 압축, 압축을 고려한 스케일링 법칙, 폭이 다른 모듈을 위한 decoupled µP를 결합한다. 실용 구성은 R = 4를 사용한다. 주 실험에서는 2.3B-parameter DLCM과 1.3B-parameter 기준 모델을 1T 토큰으로 학습하며, 파라미터 수를 맞춘 비교가 아니라 추론 FLOPs가 비슷한 비교라고 설명한다.
- 논문은 12개 zero-shot 벤치마크에서 평균 정확도 43.92% 대 41.23%와 +2.69% 향상을 보고한다. 그러나 Table 2에 표시된 행을 가중치 없이 산술평균하면 약 42.24% 대 41.23%가 나온다. DLCM은 8개 과제에서 점수가 높아지고 BoolQ, RACE, MMLU, CMMLU에서는 낮아진다. 결과는 과제에 따라 성능 향상이 다름을 뒷받침하지만, 집계값의 불일치로 인해 대표 성과로 제시한 향상 폭에 대한 확신은 제한된다.
1 Introduction
출발점은 정보 밀도가 균일하지 않다는 문제다. 표준 언어 모델은 예측하기 쉬운 구간과 어려운 의미 전환 구간에 동일한 깊이의 연산을 적용한다. DLCM은 토큰과 미리 정의한 문장 사이의 중간 단위를 도입한다. 여기서 개념은 언어학적 단위나 사람이 해석할 수 있는 단위임을 보장하지 않으며, 모델이 처리하는 가변 길이 잠재 구간으로 정의된다.
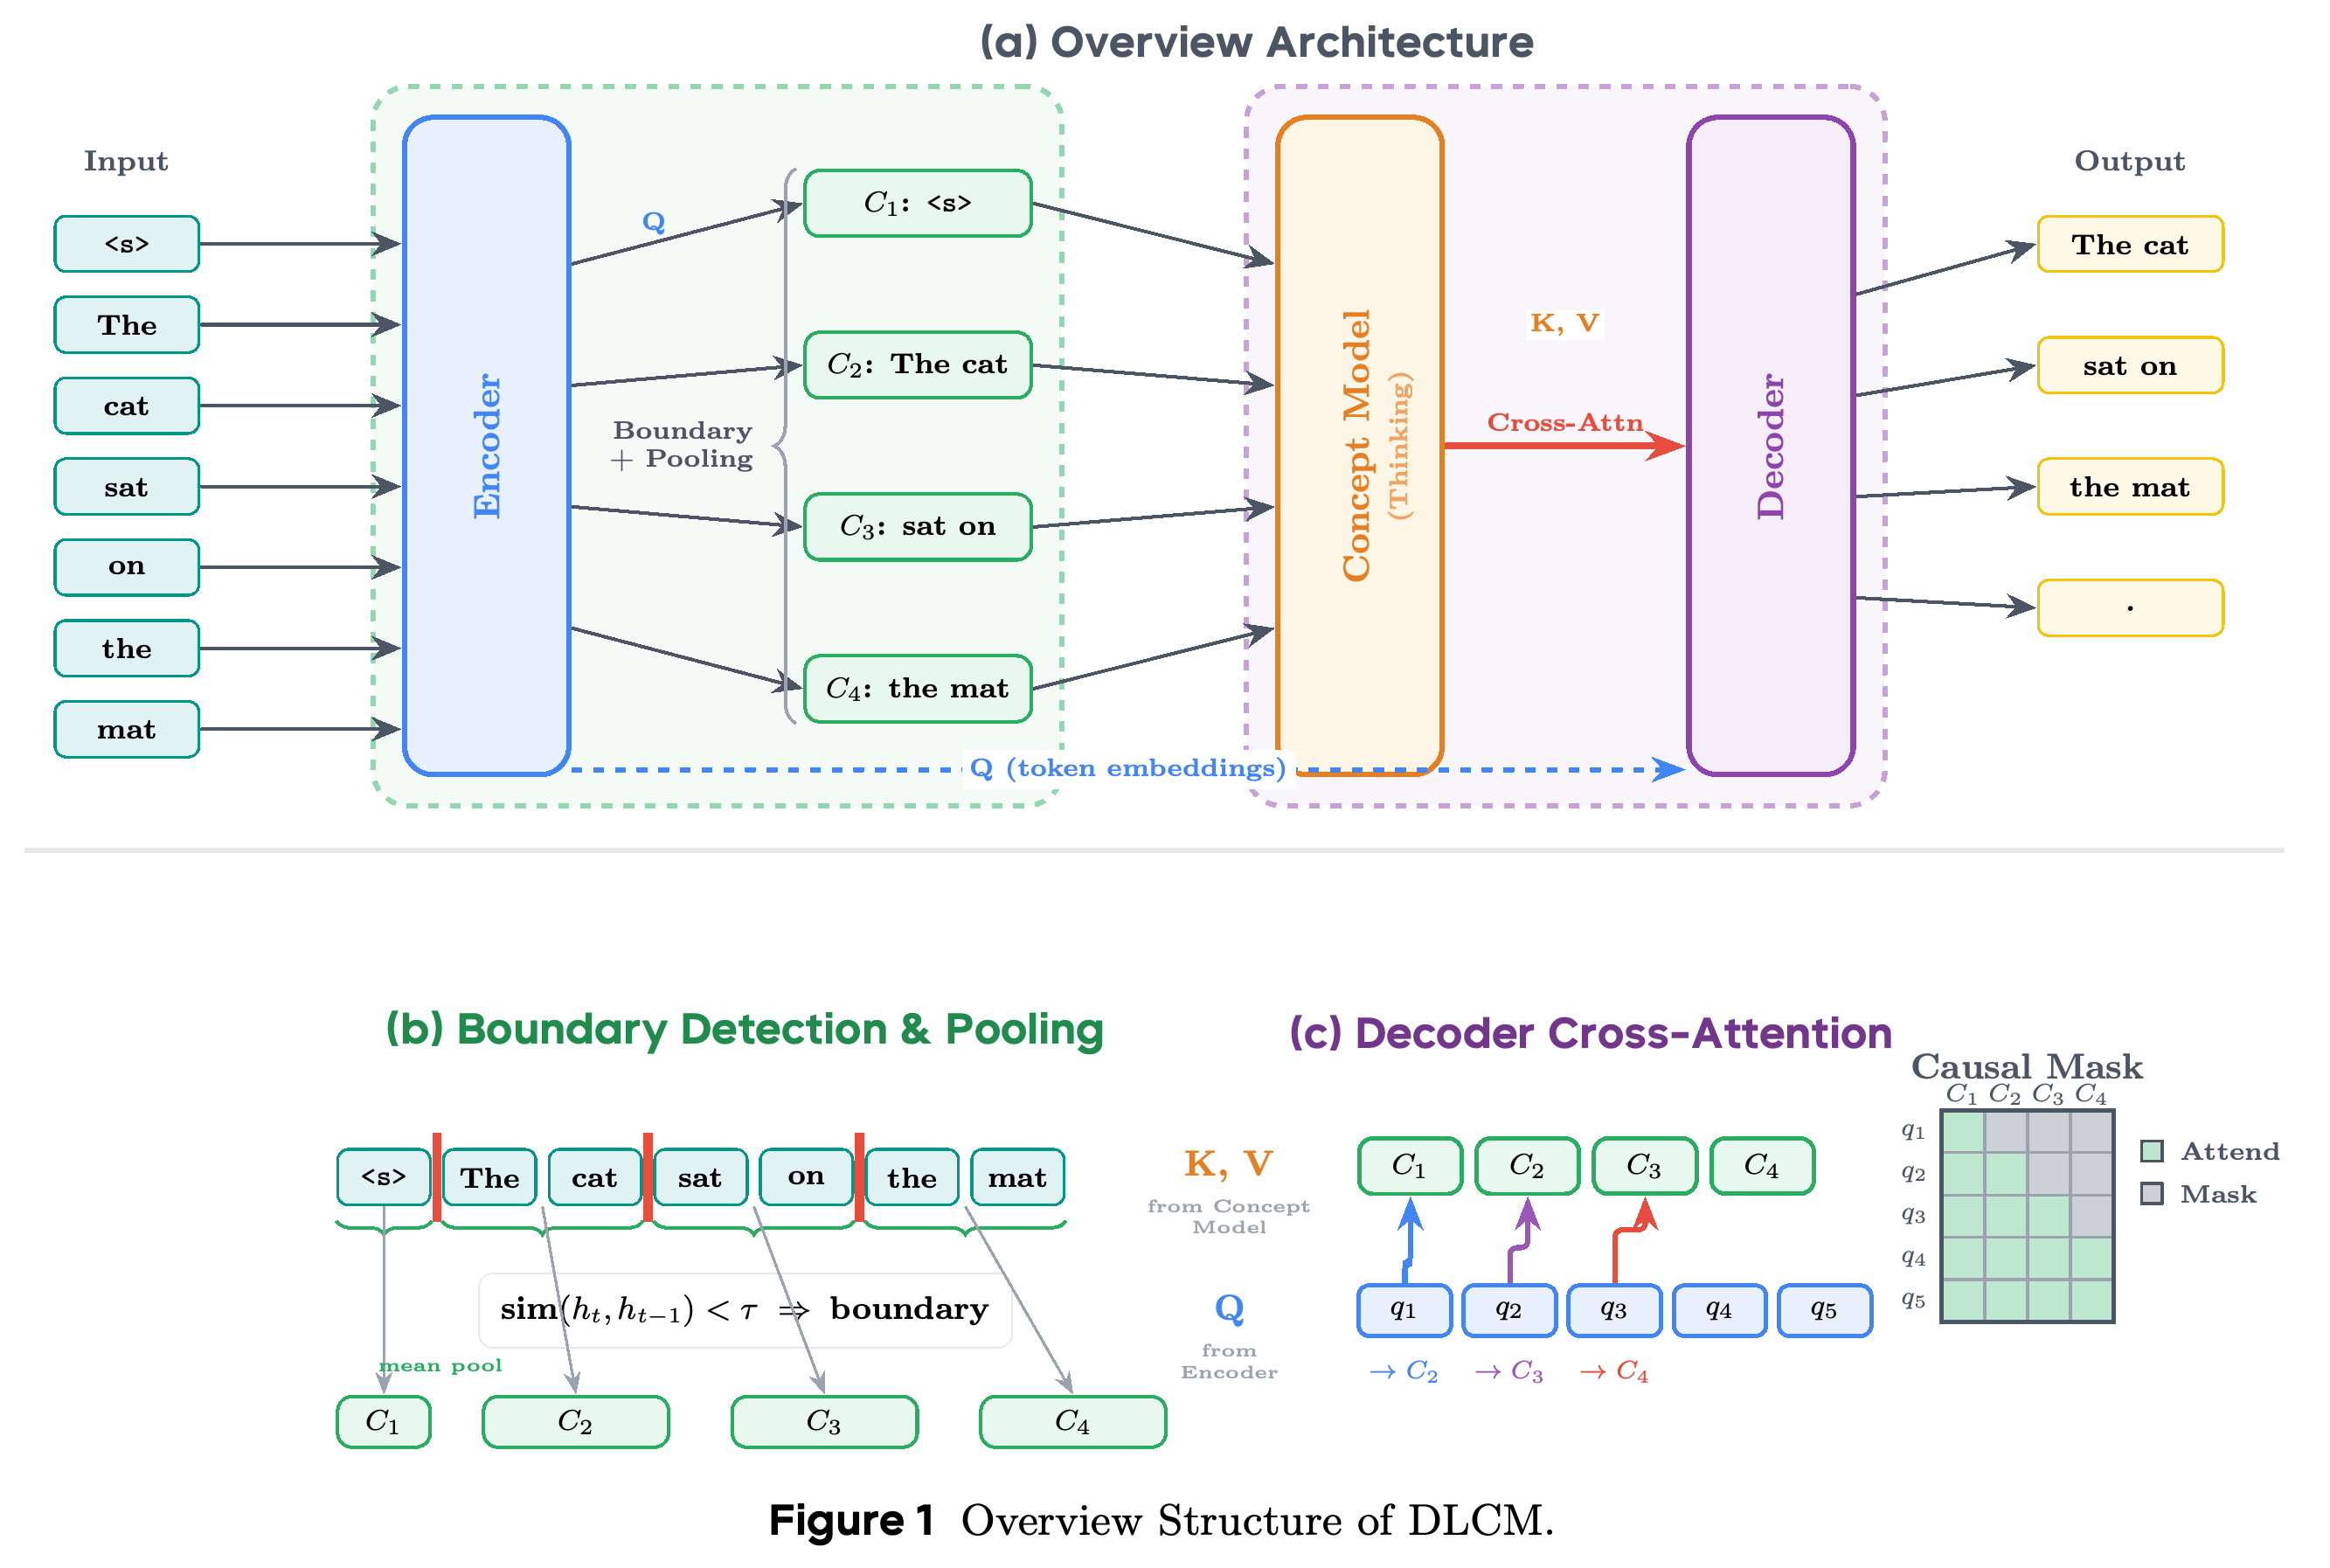
- Figure 1에 나타낸 4단계 파이프라인은 인코딩, 동적 분할과 풀링, 개념 수준 추론, 토큰 수준 디코딩으로 구성된다.
- 서론은 연산 재분배를 통해 FLOPs를 최대 34% 줄이고 벤치마크 정확도를 높인다고 주장한다. 아키텍처 자체의 연산 절감과 주 실험은 구분해야 한다. 주 실험은 전체 파라미터 수를 늘리면서 추론 FLOPs를 맞췄다고 설명한다.
도식은 토큰 수준 경로와 압축된 개념 백본을 분리한다. 예시에서는 '<s>', 'The cat', 'sat on', 'the mat'을 개념으로 풀링하여 개별 토큰과 완전한 문장 사이의 세분성을 보여준다.
2 Related Work
관련 연구에서는 DLCM을 연속 잠재 추론, 개념 수준 언어 모델링, 적응형 연산을 결합한 연구로 설명한다. 고정된 문장 임베딩을 사용하거나 바이트 수준 모델링에 집중하는 대신, 표현 기반 분할과 토큰 수준 자기회귀 예측을 결합한다는 점을 차별점으로 제시한다.
2.1 From Latent Reasoning to Concept-Level Language Modeling
COCONUT은 중간 토큰을 생성하지 않고 추론 단계 사이에 은닉 상태를 전달한다. 반면 Large Concept Models는 가중치를 고정한 모듈이 생성하고 디코딩하는 문장 임베딩을 처리한다. DLCM은 고정된 문장 단위라는 사전 가정과 별도로 사전학습한 인코더–디코더가 필요하다는 조건을 학습 가능한 토큰 모듈과 가변 길이 잠재 구간으로 대체한다.
- 관련 연구 논의에서는 연속 잠재 추론이 해석 가능성을 낮추고 정밀한 기호 조작을 어렵게 한다고 설명한다. 이는 선행 연구에 관한 관찰이며, DLCM을 직접 평가한 결과는 아니다.
- SONAR, 200+개 언어 생성, 약 10× 시퀀스 단축에 관한 주장은 기존 Large Concept Models를 설명한 것이며, DLCM에서 입증한 능력은 아니다.
2.2 Dynamic Compute Allocation in Language Models
Universal Transformers는 반복과 중단을 통해 깊이를 조절하고, Mixture of Experts는 토큰을 일부 파라미터로 라우팅한다. H-NET은 경계를 학습하고 압축한 청크를 계층적으로 처리하므로 아키텍처상 가장 가까운 선행 연구다. DLCM은 이 원리를 토큰 수준 다음 토큰 예측에 적용한다.
3 Methodology
방법론은 토큰 표현, 구간 형성, 개념 처리, 토큰 예측 복원을 분리한다. Section 3.3은 논문 전반의 end-to-end 학습 주장에 조건을 붙인다. 서로 경쟁하는 최적화 목표를 피하기 위해 이산 분할 결정을 언어 모델링 손실과 의도적으로 분리한다.
3.1 Overview
파이프라인의 형식적 표현은 (H=E(x),\quad C=\Phi(H),\quad Z=M(C),\quad \hat y=D(\Psi(H,Z)))이다. E는 토큰을 인코딩하고, Φ는 토큰을 분할하고 풀링하며, M은 개념 시퀀스를 처리한다. Ψ는 개념을 조건으로 한 토큰 특징을 디코더 D에 전달한다.
3.2 Encoding
표준 causal Transformer 인코더는 입력 시퀀스를 폭이 dtoken인 문맥적 토큰 표현으로 변환한다. 이 표현은 경계 탐지와 토큰 수준 디코딩에 모두 쓰이며, 압축된 백본을 우회하여 국소 정보를 직접 전달하는 경로를 유지한다.
3.3 Dynamic Segmentation
동적 분할은 인접한 투영 표현으로 경계 확률을 추정한 뒤, 연속된 각 구간을 평균 풀링하고 폭이 더 넓은 개념 공간으로 투영한다. Global Parser는 각 시퀀스에 동일한 압축률을 강제하지 않고 분산 배치 전체의 경계 비율을 정규화한다.
- 3.3.1 Boundary Detection에서는 qt = Wqht와 kt = Wkht를 사용하며, pt = (1 − cos(qt−1, kt))/2이고 p1 = 1이다. 학습 시에는 온도 α로 확률을 더 뚜렷하게 조정한 뒤 Bernoulli 경계를 샘플링하고, 추론 시에는 bt = [pt ≥ 0.5]를 사용한다.
- 3.3.2 Concept Formation via Pooling에서는 craw_k = (1/|Sk|) Σt∈Sk ht와 ck = Wup craw_k를 사용한다. 각 구간은 토큰 길이와 관계없이 1개 개념을 만든다.
- 3.3.3 Adaptive Compression via Global Load Balancing에서는 기대 경계 비율 Gglobal과 실제 경계 비율 Fglobal을 AllReduce로 동기화한다. Equation 10은 Laux = R/(R − 1) [(R − 1) Fglobal Gglobal + (1 − Fglobal)(1 − Gglobal)] − 1로 정의한다. 이는 국소적인 변동을 허용하면서 전역 경계 비율을 1/R로 유지하려는 목적이다.
3.4 Concept-Level Reasoning
핵심 연산 모듈은 더 짧은 개념 시퀀스를 처리하는 Lconcept개 층의 표준 causal Transformer다. 압축으로 이 모듈이 처리할 시퀀스 길이가 줄어들어 폭이 넓고 용량이 큰 백본을 사용할 수 있다. 이 연산을 고수준 추론으로 해석하는 것은 논문이 제시한 아키텍처 가설이며, 별도 지도학습으로 확보한 능력은 아니다.
3.5 Token-Level Decoding
토큰 수준 디코딩은 경량 개념 평활화 모듈을 적용한 뒤, 인코더 토큰 특징에서 처리된 개념으로 cross-attention을 수행한다. 별도 투영으로 dtoken과 dconcept의 차원을 맞추고, attention 출력을 다시 토큰 폭으로 투영하면서 인코더의 잔차 연결을 더한다.
- 3.5.1 Concept Smoothing에서는 Z̃ = S(Z)로 인접 개념을 통합하여 hard pooling에서 생기는 왜곡을 줄인다. 이 절은 평활화 모듈의 아키텍처를 명시하지 않는다.
- 3.5.2 Causal Cross-Attention에서 제시한 마스크는 토큰 t가 j(t) = Σi=1…t bi까지의 개념에만 접근하도록 제한한다. Equation 14는 Ψ(H, Z) = Softmax(QK⊤/√dhead + M)VWO + H로 정의한다.
- 수식은 토큰이 현재 구간을 풀링한 표현에 접근할 때, 같은 구간의 뒤쪽 토큰 정보를 어떻게 제외하는지 명시적으로 설명하지 않는다. 인과적 마스킹은 명시되어 있지만, 구간 완성 시점이나 정렬 규칙은 추가 설명이 필요하다.
3.6 Training Objective
학습은 출력 토큰의 cross-entropy와 압축 부하 균형을 결합한 L = LCE + λLaux를 최소화한다. 전체 손실에는 두 목표가 모두 포함되지만, Section 3.3에서 설명한 대로 이산 분할 결정은 언어 모델링 손실과 분리된다.
4 Implementation Details
구현은 FlashAttention의 packed Variable Length 학습을 사용하여 전역 압축 통계가 다양한 토큰을 포괄하도록 한다. attention query와 key에는 RMSNorm을 적용한다. 이는 통계적 특성이 다른 토큰 수준 표현과 개념 수준 표현 사이의 상호작용을 안정화하기 위한 조치다.
4.1 Efficient Cross-Attention via Concept Replication
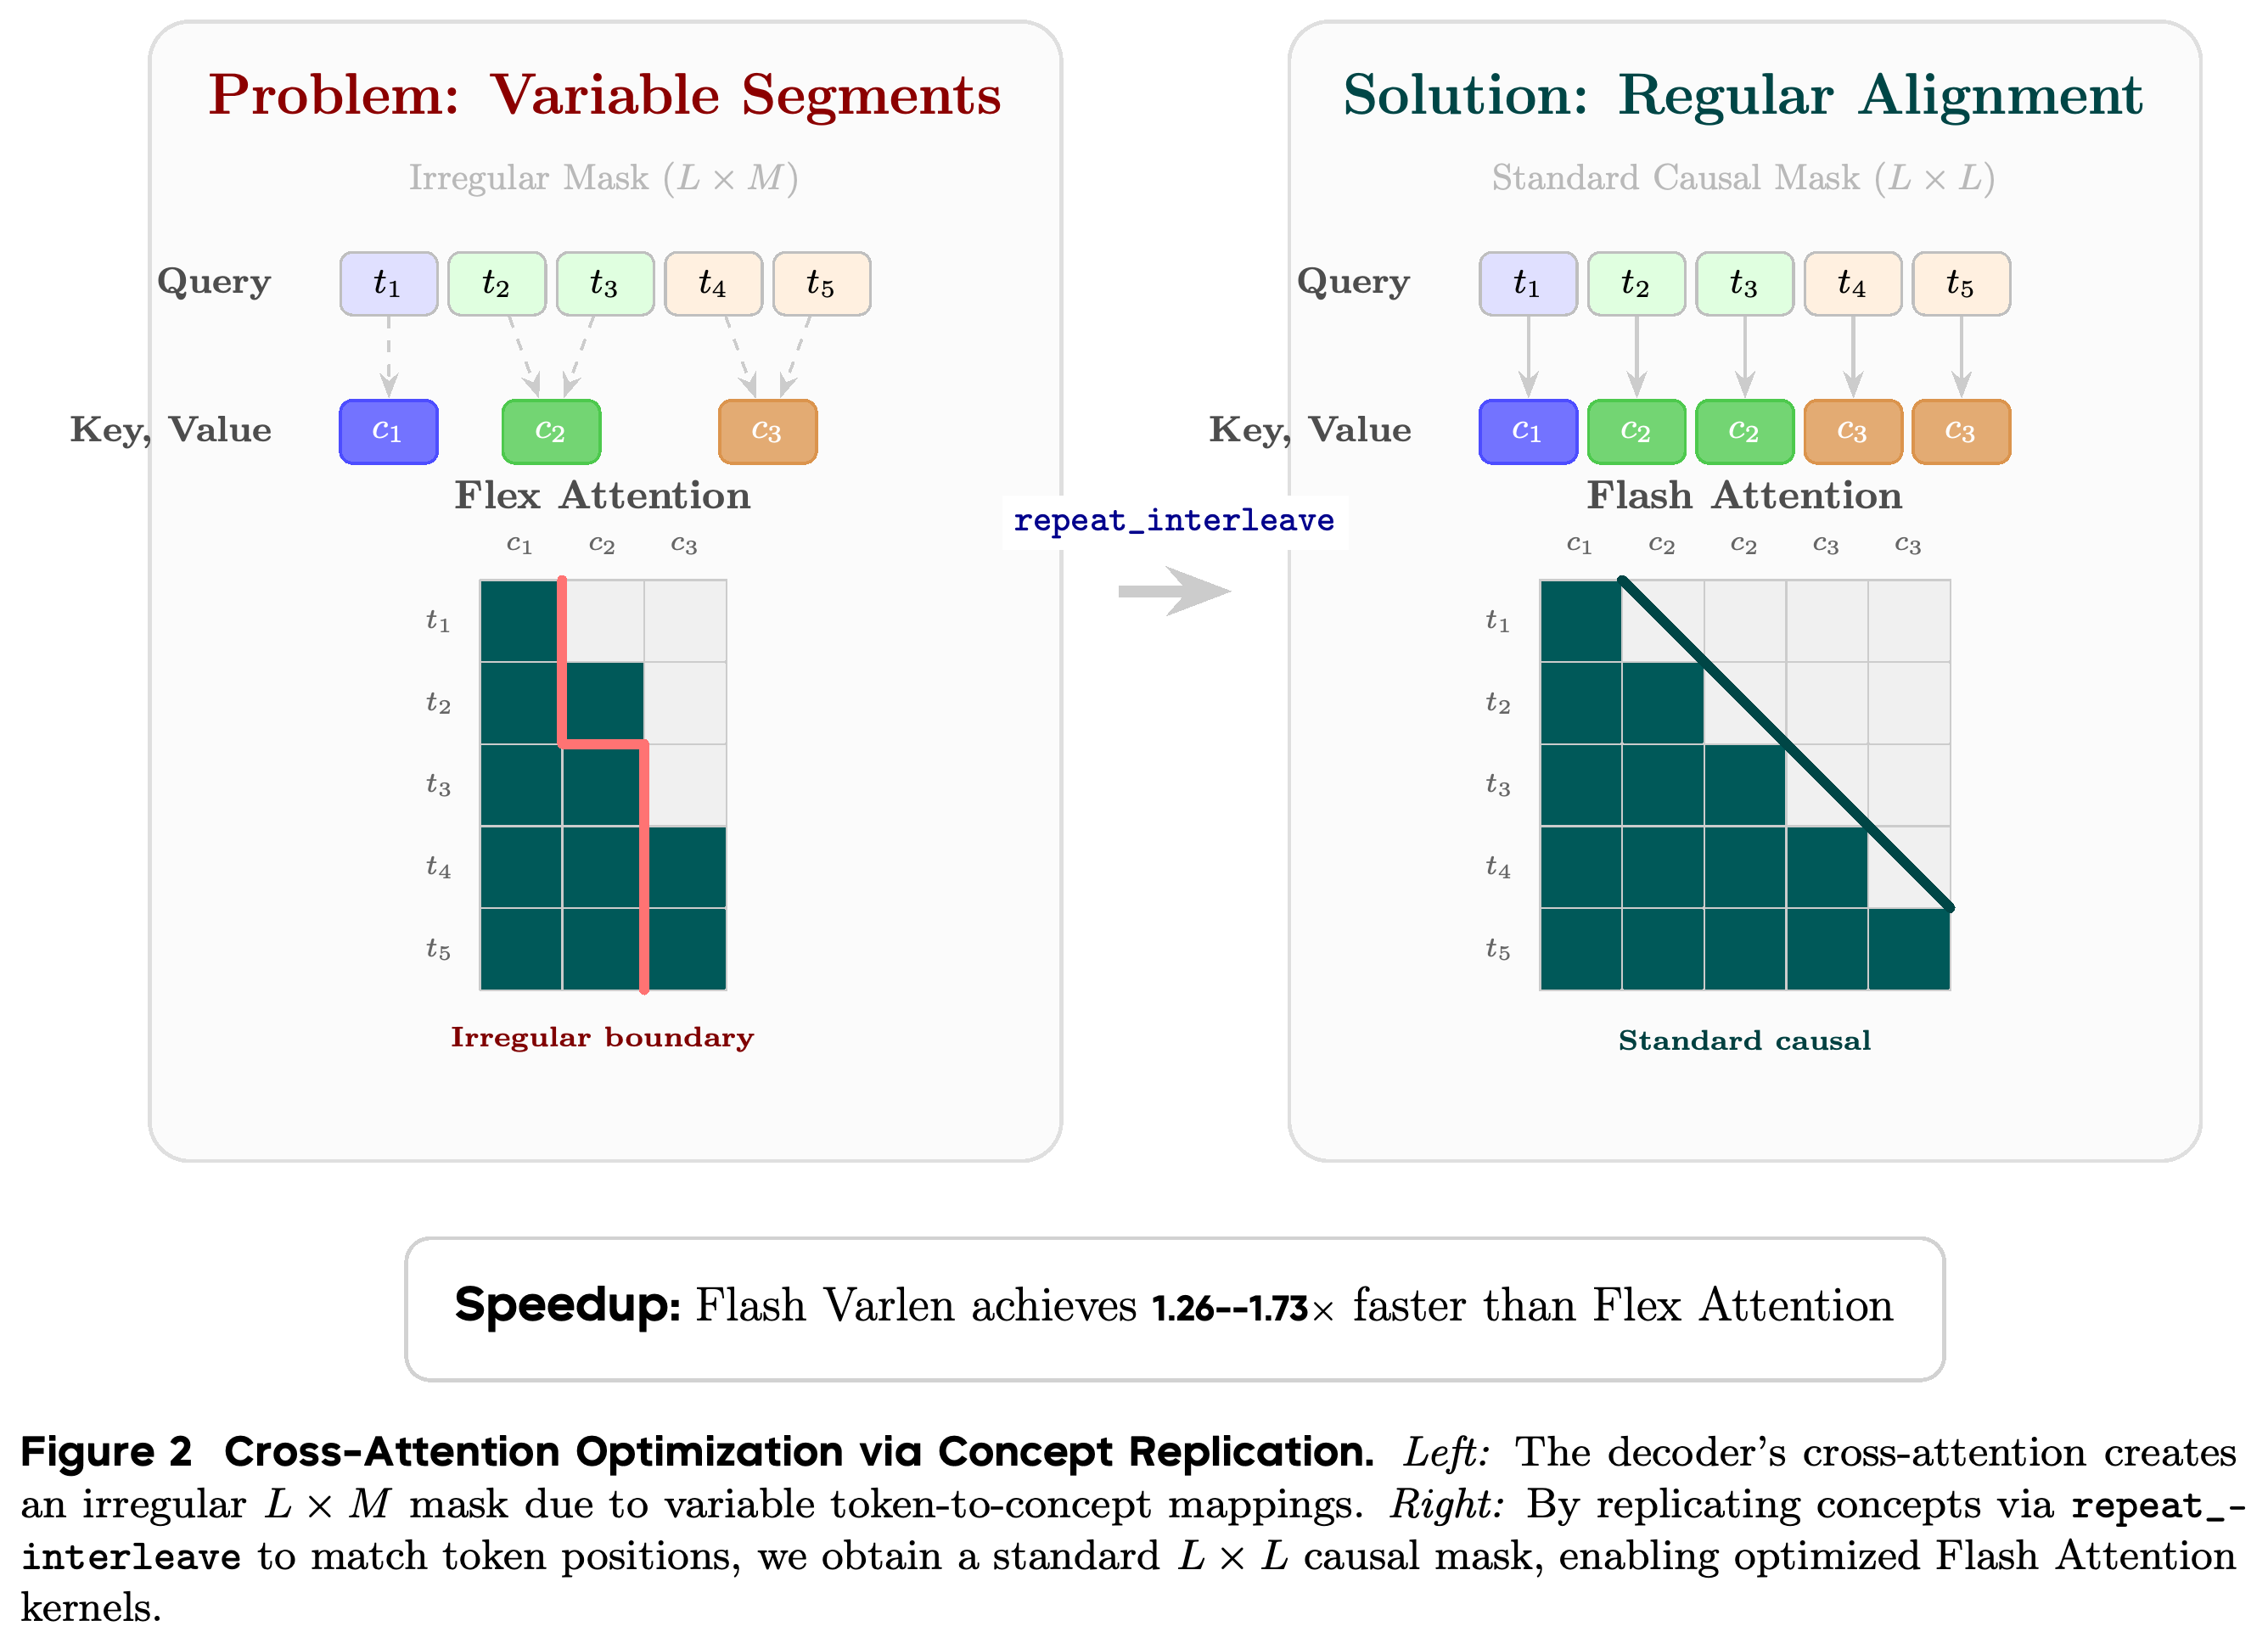
개념 복제는 불규칙한 토큰-개념 attention 배치를 토큰에 정렬된 key/value 시퀀스로 바꾼다. 구현에서는 repeat_interleave(K, segment_lengths)와 repeat_interleave(V, segment_lengths)를 사용한다. 이를 통해 Flex Attention의 불규칙한 마스크 대신 표준 causal mask를 사용하는 Flash Attention Varlen을 적용한다.
- Figure 2는 L × M 배치를 각 구간 안에서 key/value 벡터가 동일한 L × L 배치로 변환하는 과정을 보여준다.
- 복제는 key/value 저장량을 늘리는 대신 더 규칙적인 커널 배치를 만든다. 반복된 key는 softmax에서 중복 횟수에 영향을 주므로, 추가 설명 없이 복제 전 개념 수준 attention 가중치를 그대로 보존한다고 가정해서는 안 된다.
예시는 3개 개념 key/value 위치를 토큰에 정렬된 5개 위치로 확장한다. 이를 통해 규칙적인 삼각 마스크와 최적화된 Flash Attention 커널을 사용할 수 있지만, key/value 저장량은 중복된다. 도식은 이렇게 얻은 softmax 가중치가 복제하지 않은 개념 attention과 동등함을 입증하지 않는다.
4.2 Performance Benchmarks
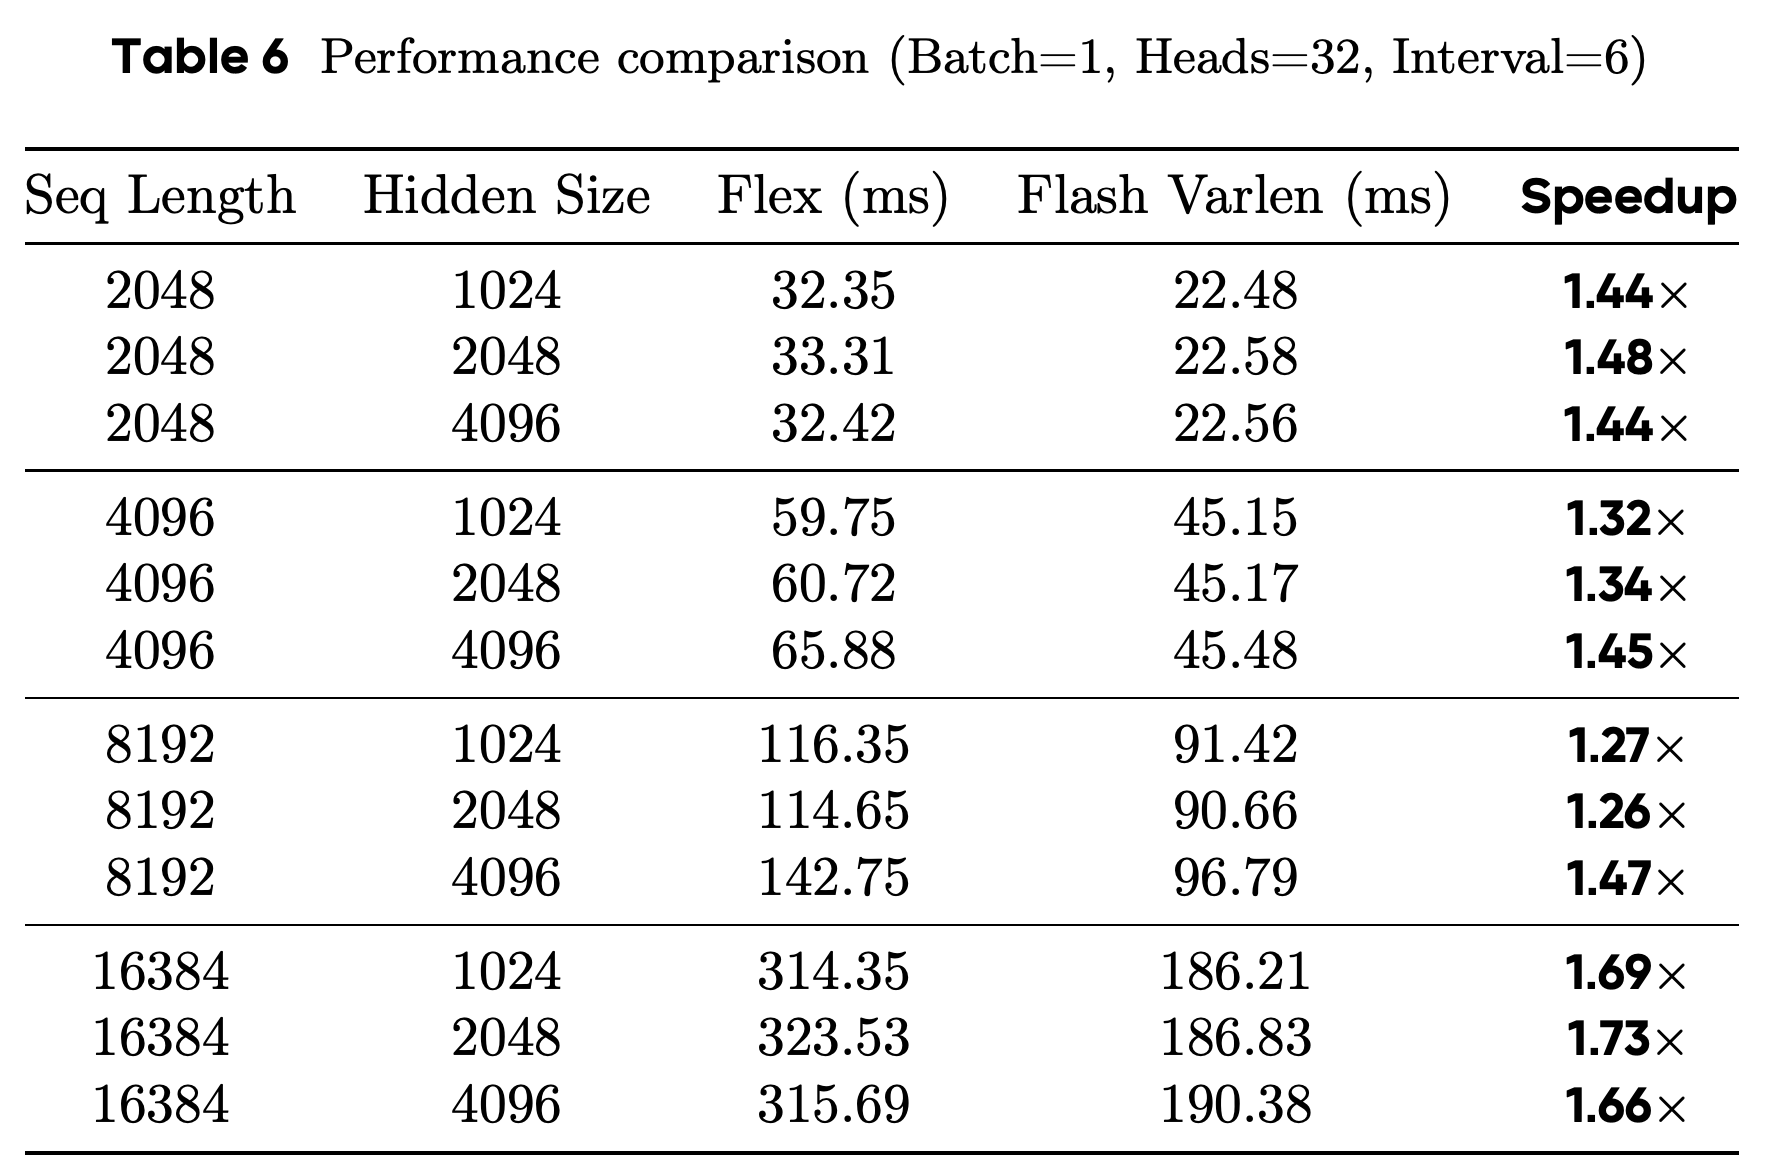
독립적인 커널 벤치마크는 시퀀스 길이 2048, 4096, 8192, 16384와 은닉 크기 1024, 2048, 4096을 시험한다. Table 6은 Batch=1, Heads=32, Interval=6을 명시한다. 이는 프로파일링 구성이며, 실제 DLCM 모듈 차원과 반드시 같지는 않다.
- 측정한 12개 구성 모두에서 Flash Attention Varlen이 더 빠르며, 속도 향상은 1.26×에서 1.73× 사이다.
- 이 측정은 커널 실행에 관한 것이며, end-to-end 자기회귀 생성 지연 시간, 서빙 처리량, 메모리 사용량을 측정한 것은 아니다.
Batch=1, Heads=32, Interval=6에서 최대 속도 향상은 시퀀스 길이 16384, 은닉 크기 2048일 때 나타난다. Flex는 323.53 ms, Flash Varlen은 186.83 ms로 1.73× 빠르다. 이 독립적인 커널 시간 측정은 DLCM 전체의 생성 지연 시간이나 메모리 비용을 정량화하지 않는다.
4.3 Key Observations and Analysis
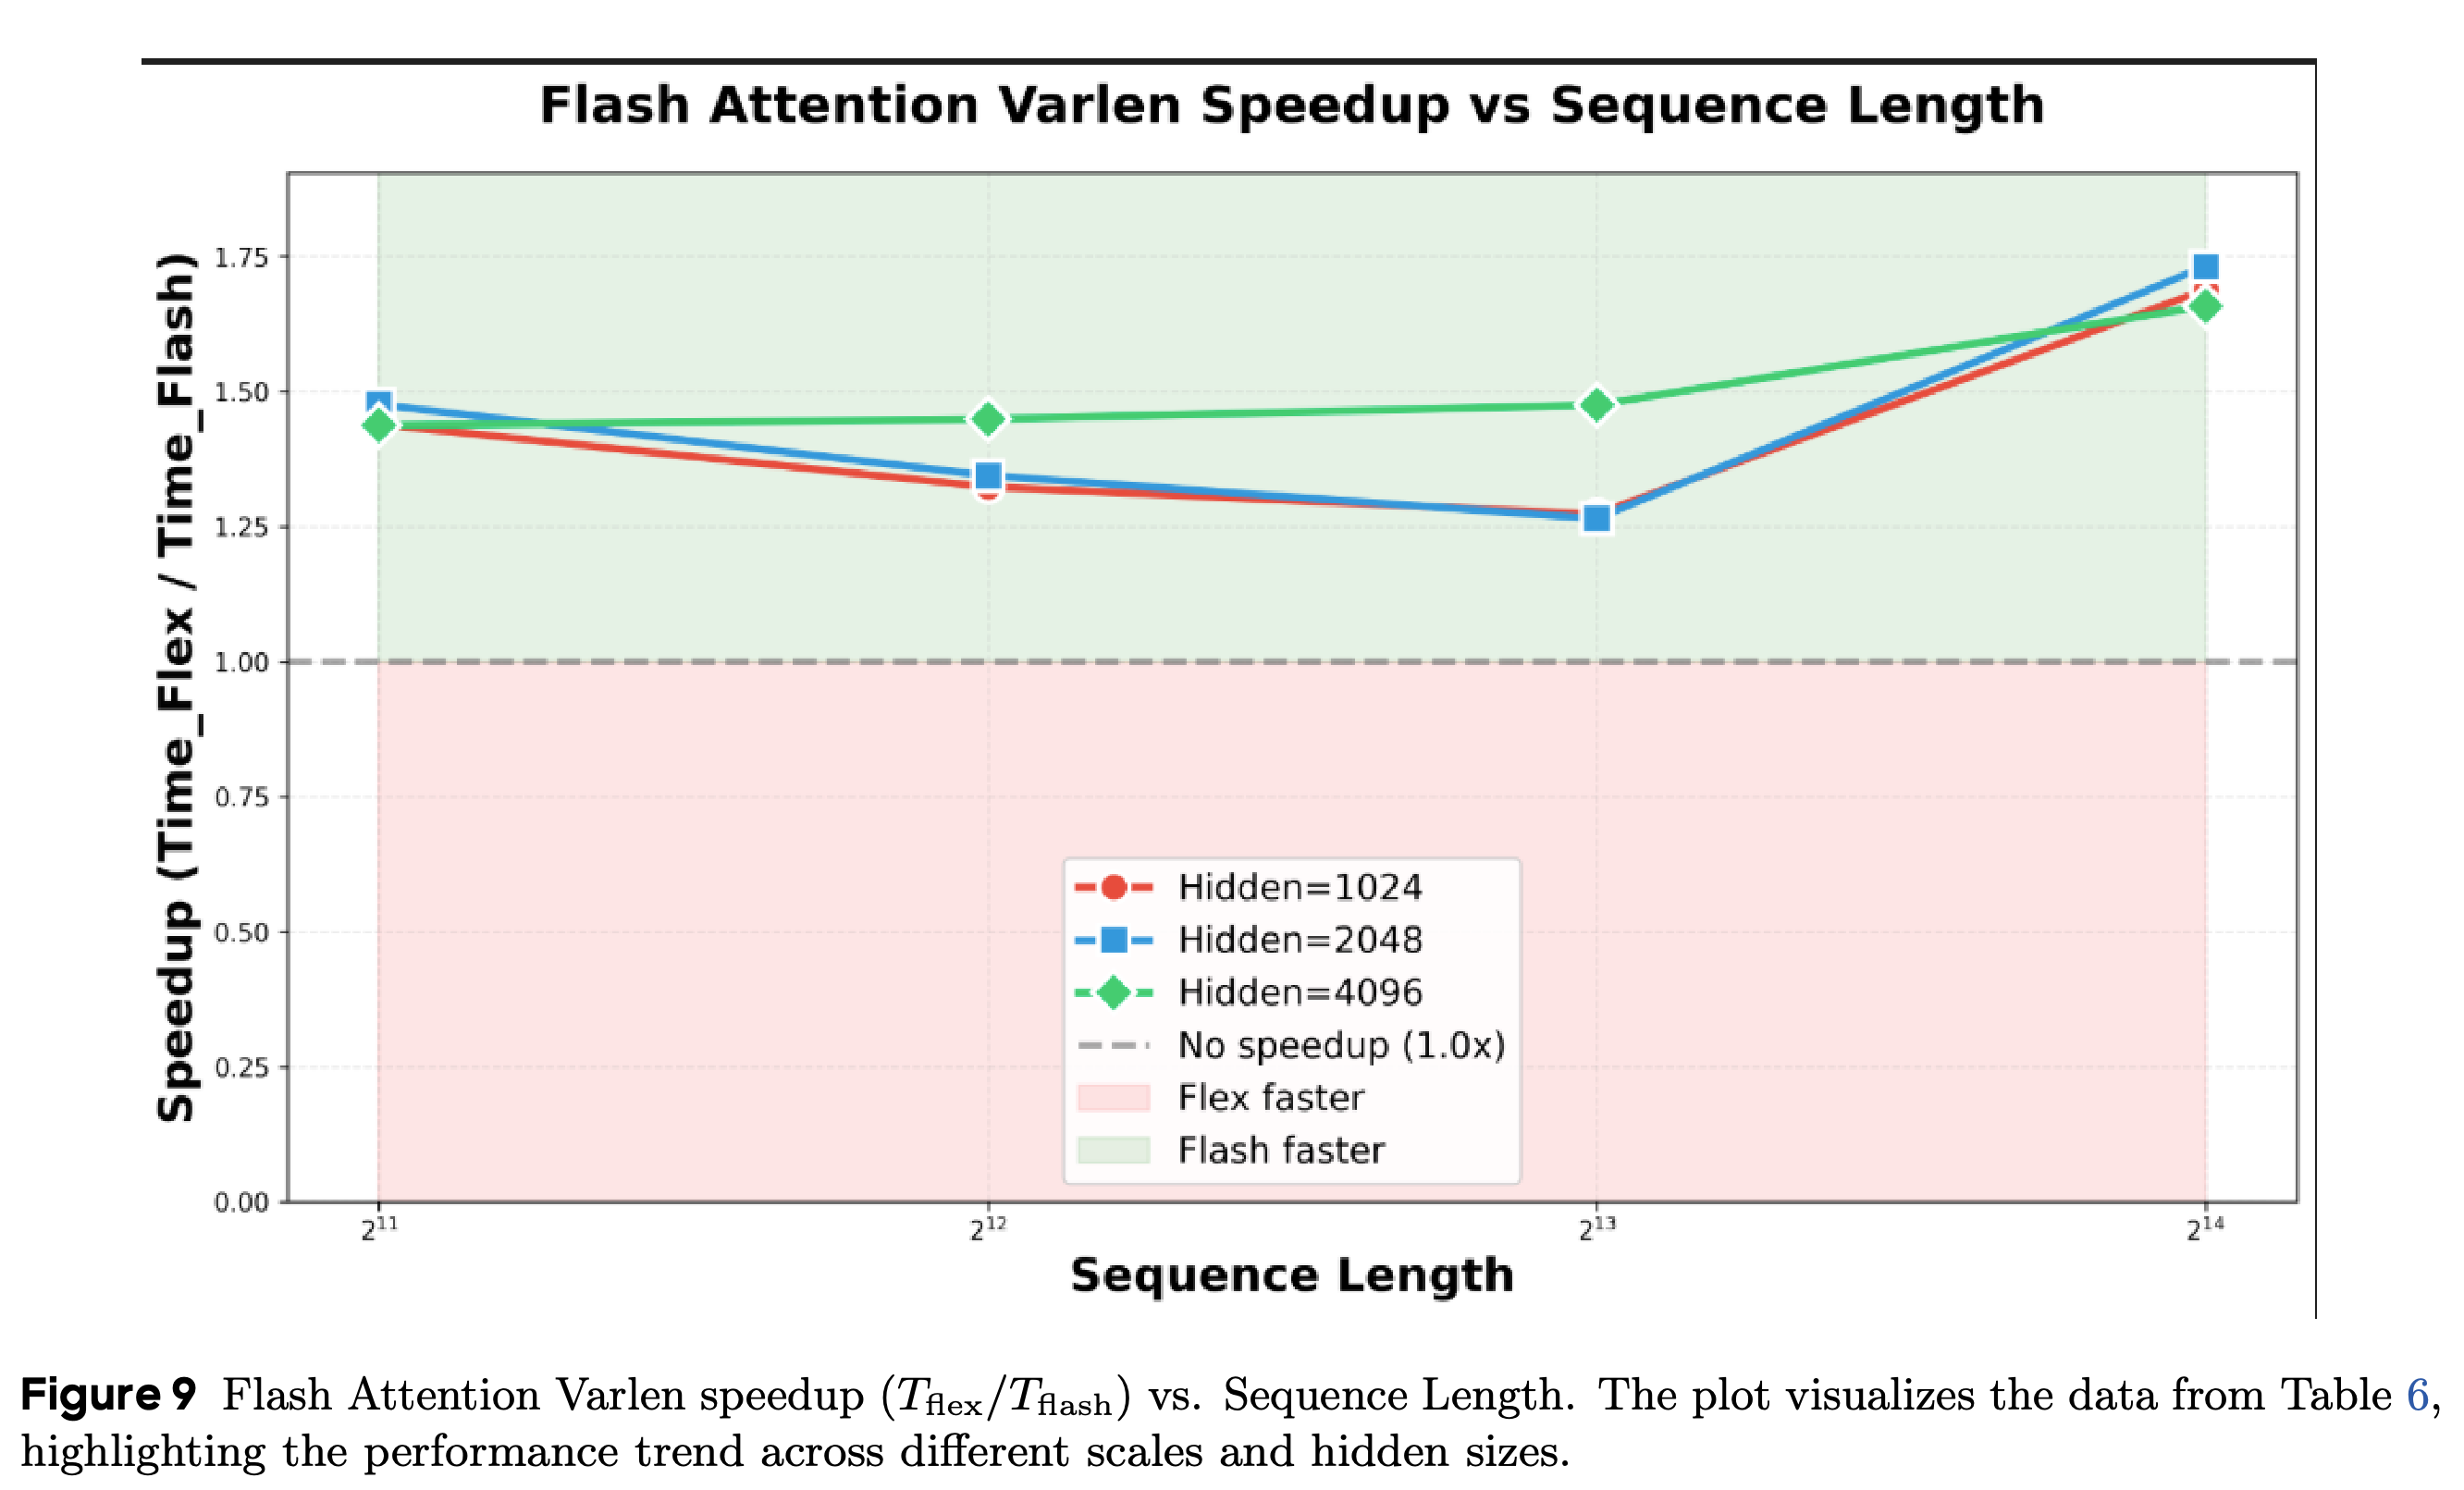
Flash Attention Varlen은 16384 토큰에서 측정상 가장 큰 이점을 보인다. 은닉 크기 1024, 2048, 4096에서 각각 1.69×, 1.73×, 1.66× 빠르다. Figure 9와 Table 6에서는 중간 길이의 속도 향상이 단조롭지 않다. 따라서 결과는 속도 향상이 계속 증가한다기보다 긴 시퀀스에서 큰 이점이 있음을 뒷받침한다.
- 은닉 크기 2048에서는 속도 향상이 2048 토큰의 1.48×에서 4096 토큰의 1.34×, 8192 토큰의 1.26×로 낮아진 뒤 16384 토큰에서 1.73×에 도달한다.
- 저자들은 규칙적인 메모리 접근과 동적 마스크 오버헤드 감소가 이점의 원인이라고 설명하지만, 시간 측정에서는 각 효과를 따로 측정하지 않는다.
- 폭이 달라도 거의 같은 양상을 보인다는 주장은 근사적인 설명이다. 8192 토큰에서 은닉 크기 4096은 1.47×를 기록하지만, 더 작은 폭에서는 1.27×와 1.26×를 기록한다.
모든 곡선은 속도 향상이 없는 기준선 위에 있다. 폭 1024와 2048의 곡선은 8192 토큰까지 낮아진 뒤 16384에서 급격히 높아진다. 이는 측정한 이점이 시퀀스 길이에 따라 단조롭게 변하지 않음을 보여준다.
5 Data
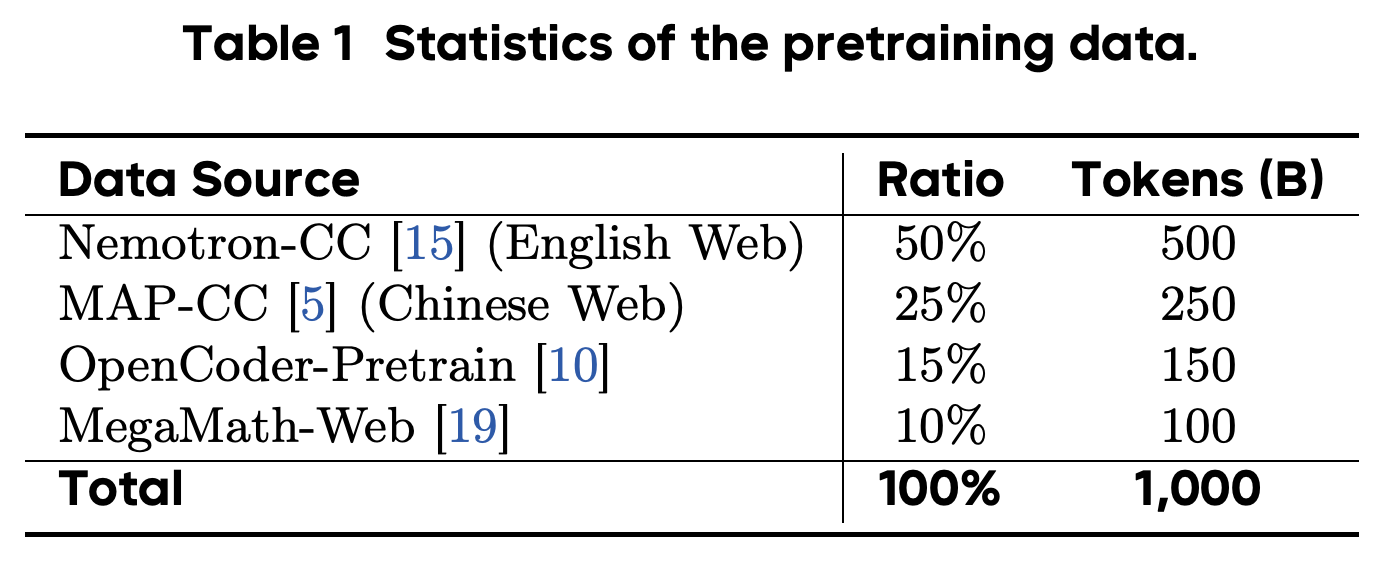
코퍼스는 오픈소스 영어·중국어 웹 텍스트, 코드, 수학 자료에서 얻은 1,000B 토큰으로 구성되며 DeepSeek-v3 tokenizer로 토큰화한다. Table 1은 Nemotron-CC에 50%/500B, MAP-CC에 25%/250B, OpenCoder-Pretrain에 15%/150B, MegaMath-Web에 10%/100B를 배정한다.
- 저자들은 강도 높은 필터링 없이 다양한 도메인을 사용하여 폭넓은 언어를 포괄하고, 분할 과정이 서로 다른 정보 밀도를 접하도록 한다.
- 데이터 절에서는 코퍼스 전체가 오픈소스라고 설명하지만, Section 7.1에서는 자체 소유 데이터셋이라고 부른다. 논문은 이 설명의 차이를 해소하지 않는다.
1,000B 토큰 혼합은 학습 토큰의 75%를 영어·중국어 웹 텍스트에, 25%를 코드와 수학에 배정한다. 이 자료들은 콘텐츠 적응형 분할을 학습하고 평가할 때 접할 수 있는 도메인을 정한다.
6 Scaling Laws for DLCM
스케일링 연구는 압축 조건에서 이질적인 모듈을 최적화하고 아키텍처 자원을 배분하는 문제를 다룬다. 구성요소별 µP 스케일링을 도입한 뒤, 토큰 파라미터, 개념 파라미터, 학습 데이터, 압축률을 분리한 손실 모델을 피팅한다.
6.1 Decoupled µP for Heterogeneous Architectures
Decoupled µP는 독립적인 폭 배수 stoken = dtoken/dbase와 sconcept = dconcept/dbase를 정의한다. 은닉 가중치의 초기화 분산, 은닉층 학습률, AdamW ϵ는 해당 모듈 폭에 반비례하여 조정한다. 임베딩은 고정된 초기화 분산과 학습률을 유지하고, 출력 logits는 stoken으로 나눈다.
- 6.1.1 Formulation of µP에서는 ηE,D = ηbase_token/stoken과 ηM = ηbase_concept/sconcept를 사용하여 토큰 모듈과 개념 모듈의 폭을 독립적으로 늘릴 수 있게 한다. bias와 임베딩은 고정 학습률 ηbase_others를 사용한다.
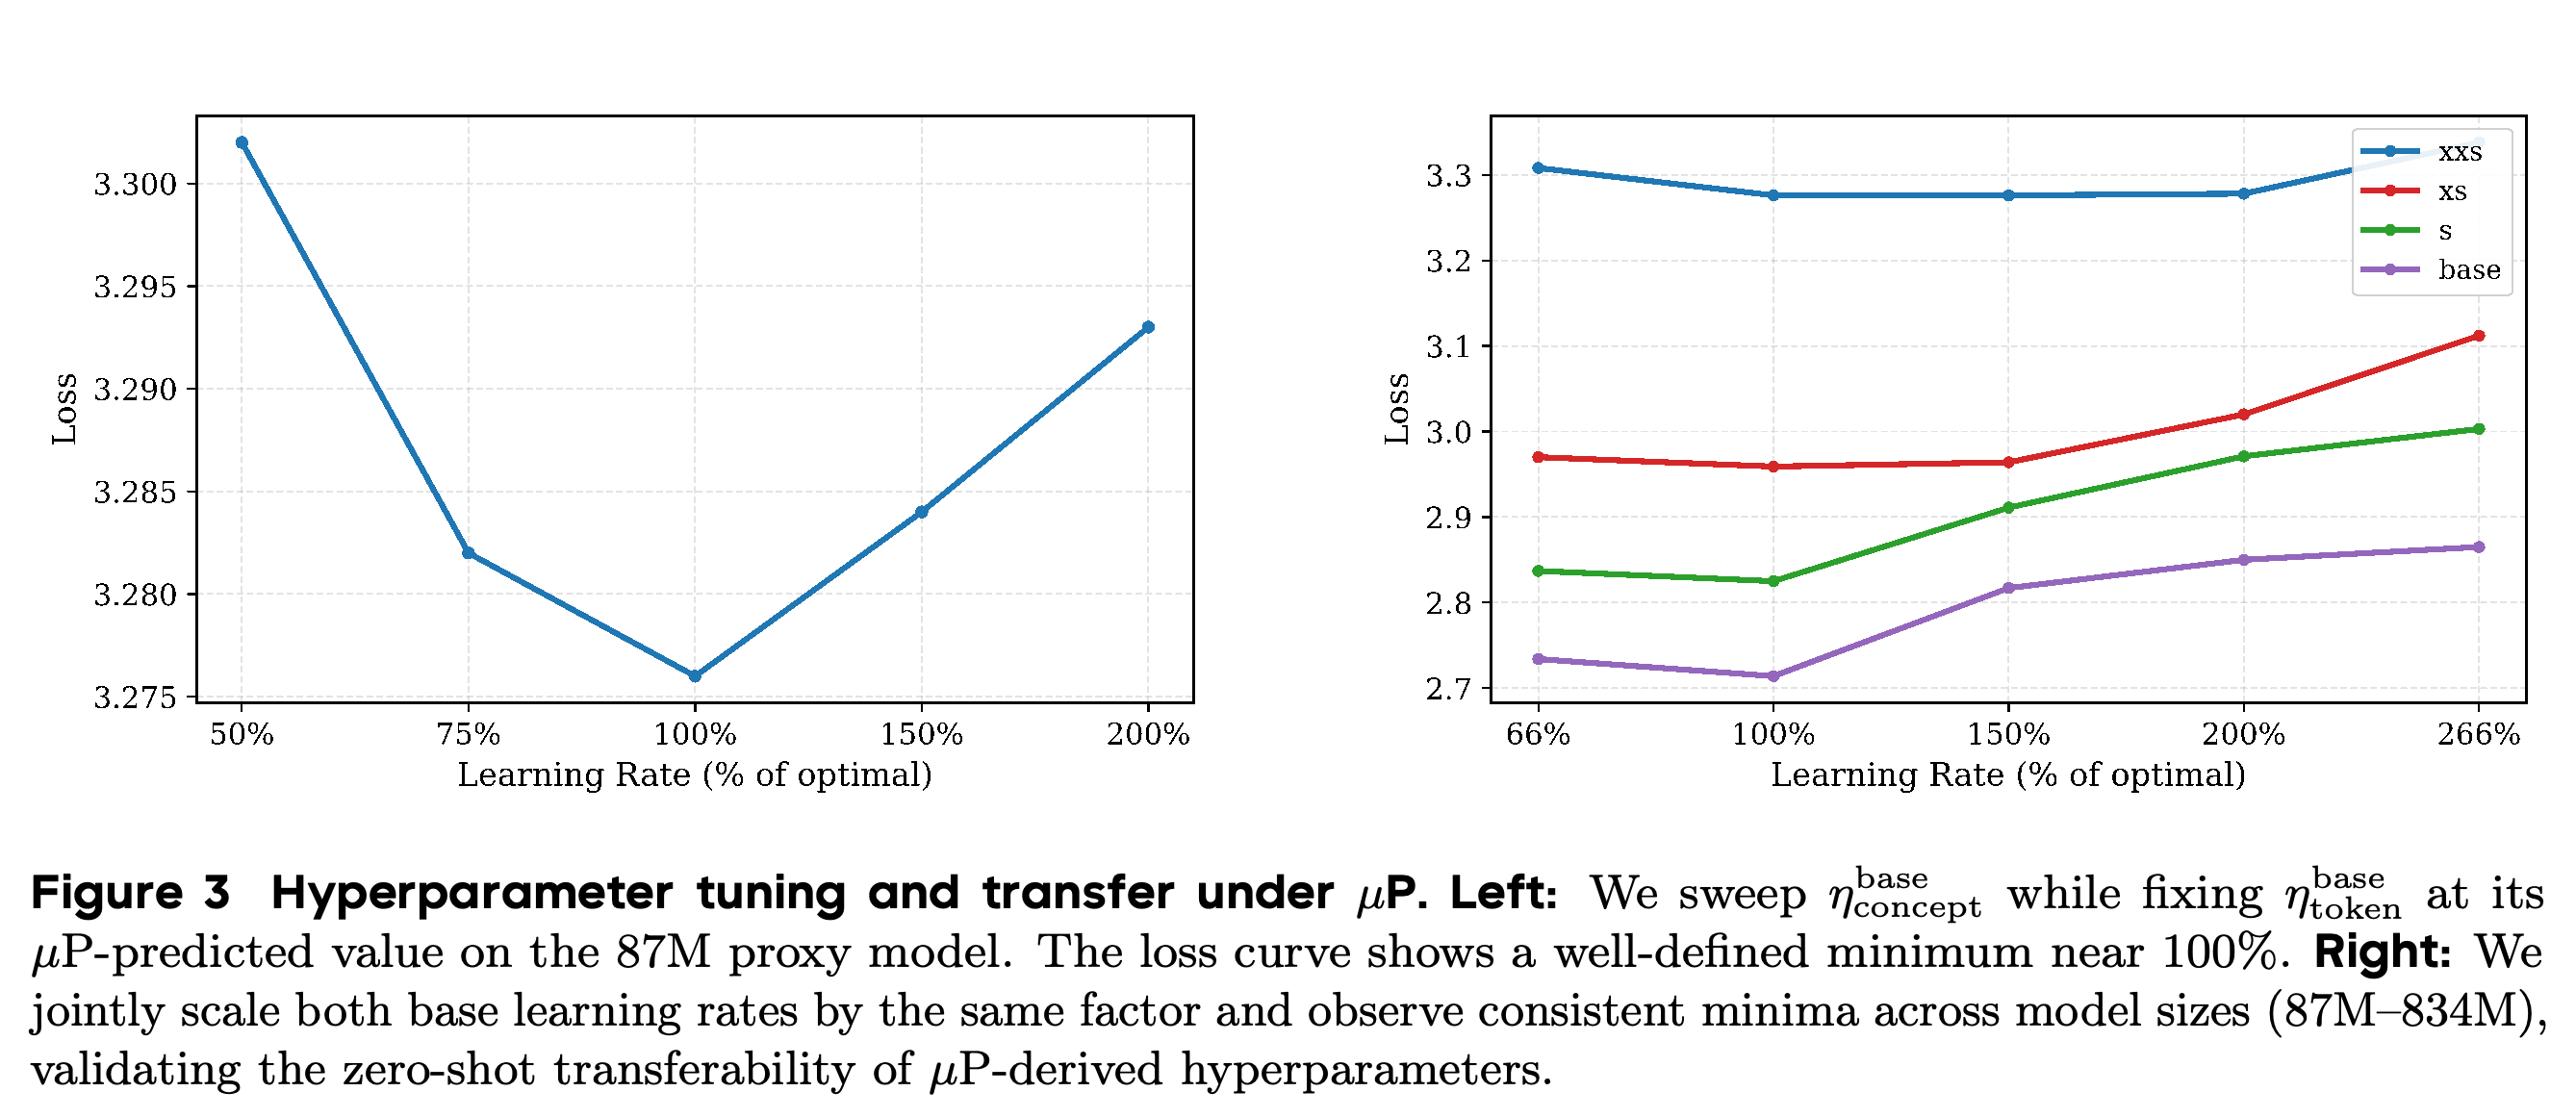
- 6.1.2 Hyperparameter Tuning and Verification에서는 87M 프록시 모델의 좌표 하강법에 배수 {0.5, 0.75, 1.5, 2.0}를 사용한다. 선택한 토큰·개념 기본 학습률은 거의 같지만, 폭 스케일링 이후 실제 학습률은 달라진다.
- Yang 등의 방법을 따라, 이전한 기본 학습률을 함께 변화시켜 274M, 468M, 834M 파라미터에서 전이를 확인한다. Figure 3은 예측한 설정 근처에 최솟값이 있음을 보여준다. 이는 시험한 모델 폭 사이의 전이를 뒷받침하지만, 모든 압축 조건에서 전이가 성립함을 입증하지는 않는다.
프록시 모델 탐색에서는 선택한 개념 학습률 근처에 최솟값이 있고, 더 큰 모델의 탐색에서도 전이한 설정 근처에 최솟값이 유지된다. 곡선은 시험한 87M–834M 범위에서 폭에 따라 조정한 학습률의 전이를 뒷받침하며, 가장 작은 모델에서는 비교적 평탄한 구간이 나타난다.
6.2 Scaling Law Formulation
스케일링 격자는 P ∈ {30%, 50%, 70%}와 R ∈ {2, 4, 8}을 변화시키며, 학습 예산은 200B 토큰, 모델 규모는 274M, 468M, 833M으로 명시한다. Equation 22는 토큰 용량, 압축에 의존하는 개념 용량, 데이터 항을 분리하여 Chinchilla 프레임워크를 확장한다. δ1, δ2, γ는 전역적으로 공유한다.
- 6.2.2 Mathematical Formulation은 L(N, D, R, P) = E0 + Atoken/[N(1 − P) + ttoken]^δ1 + Aconcept R^γ/[NP + tconcept]^δ2 + Adata/[D + tdata]^α로 정의한다. P는 개념층 파라미터 비중이고 E0는 더 줄일 수 없는 손실의 하한이다. 구성에 따라 달라질 수 있는 항은 규모와 무관한 오프셋 항뿐이다.
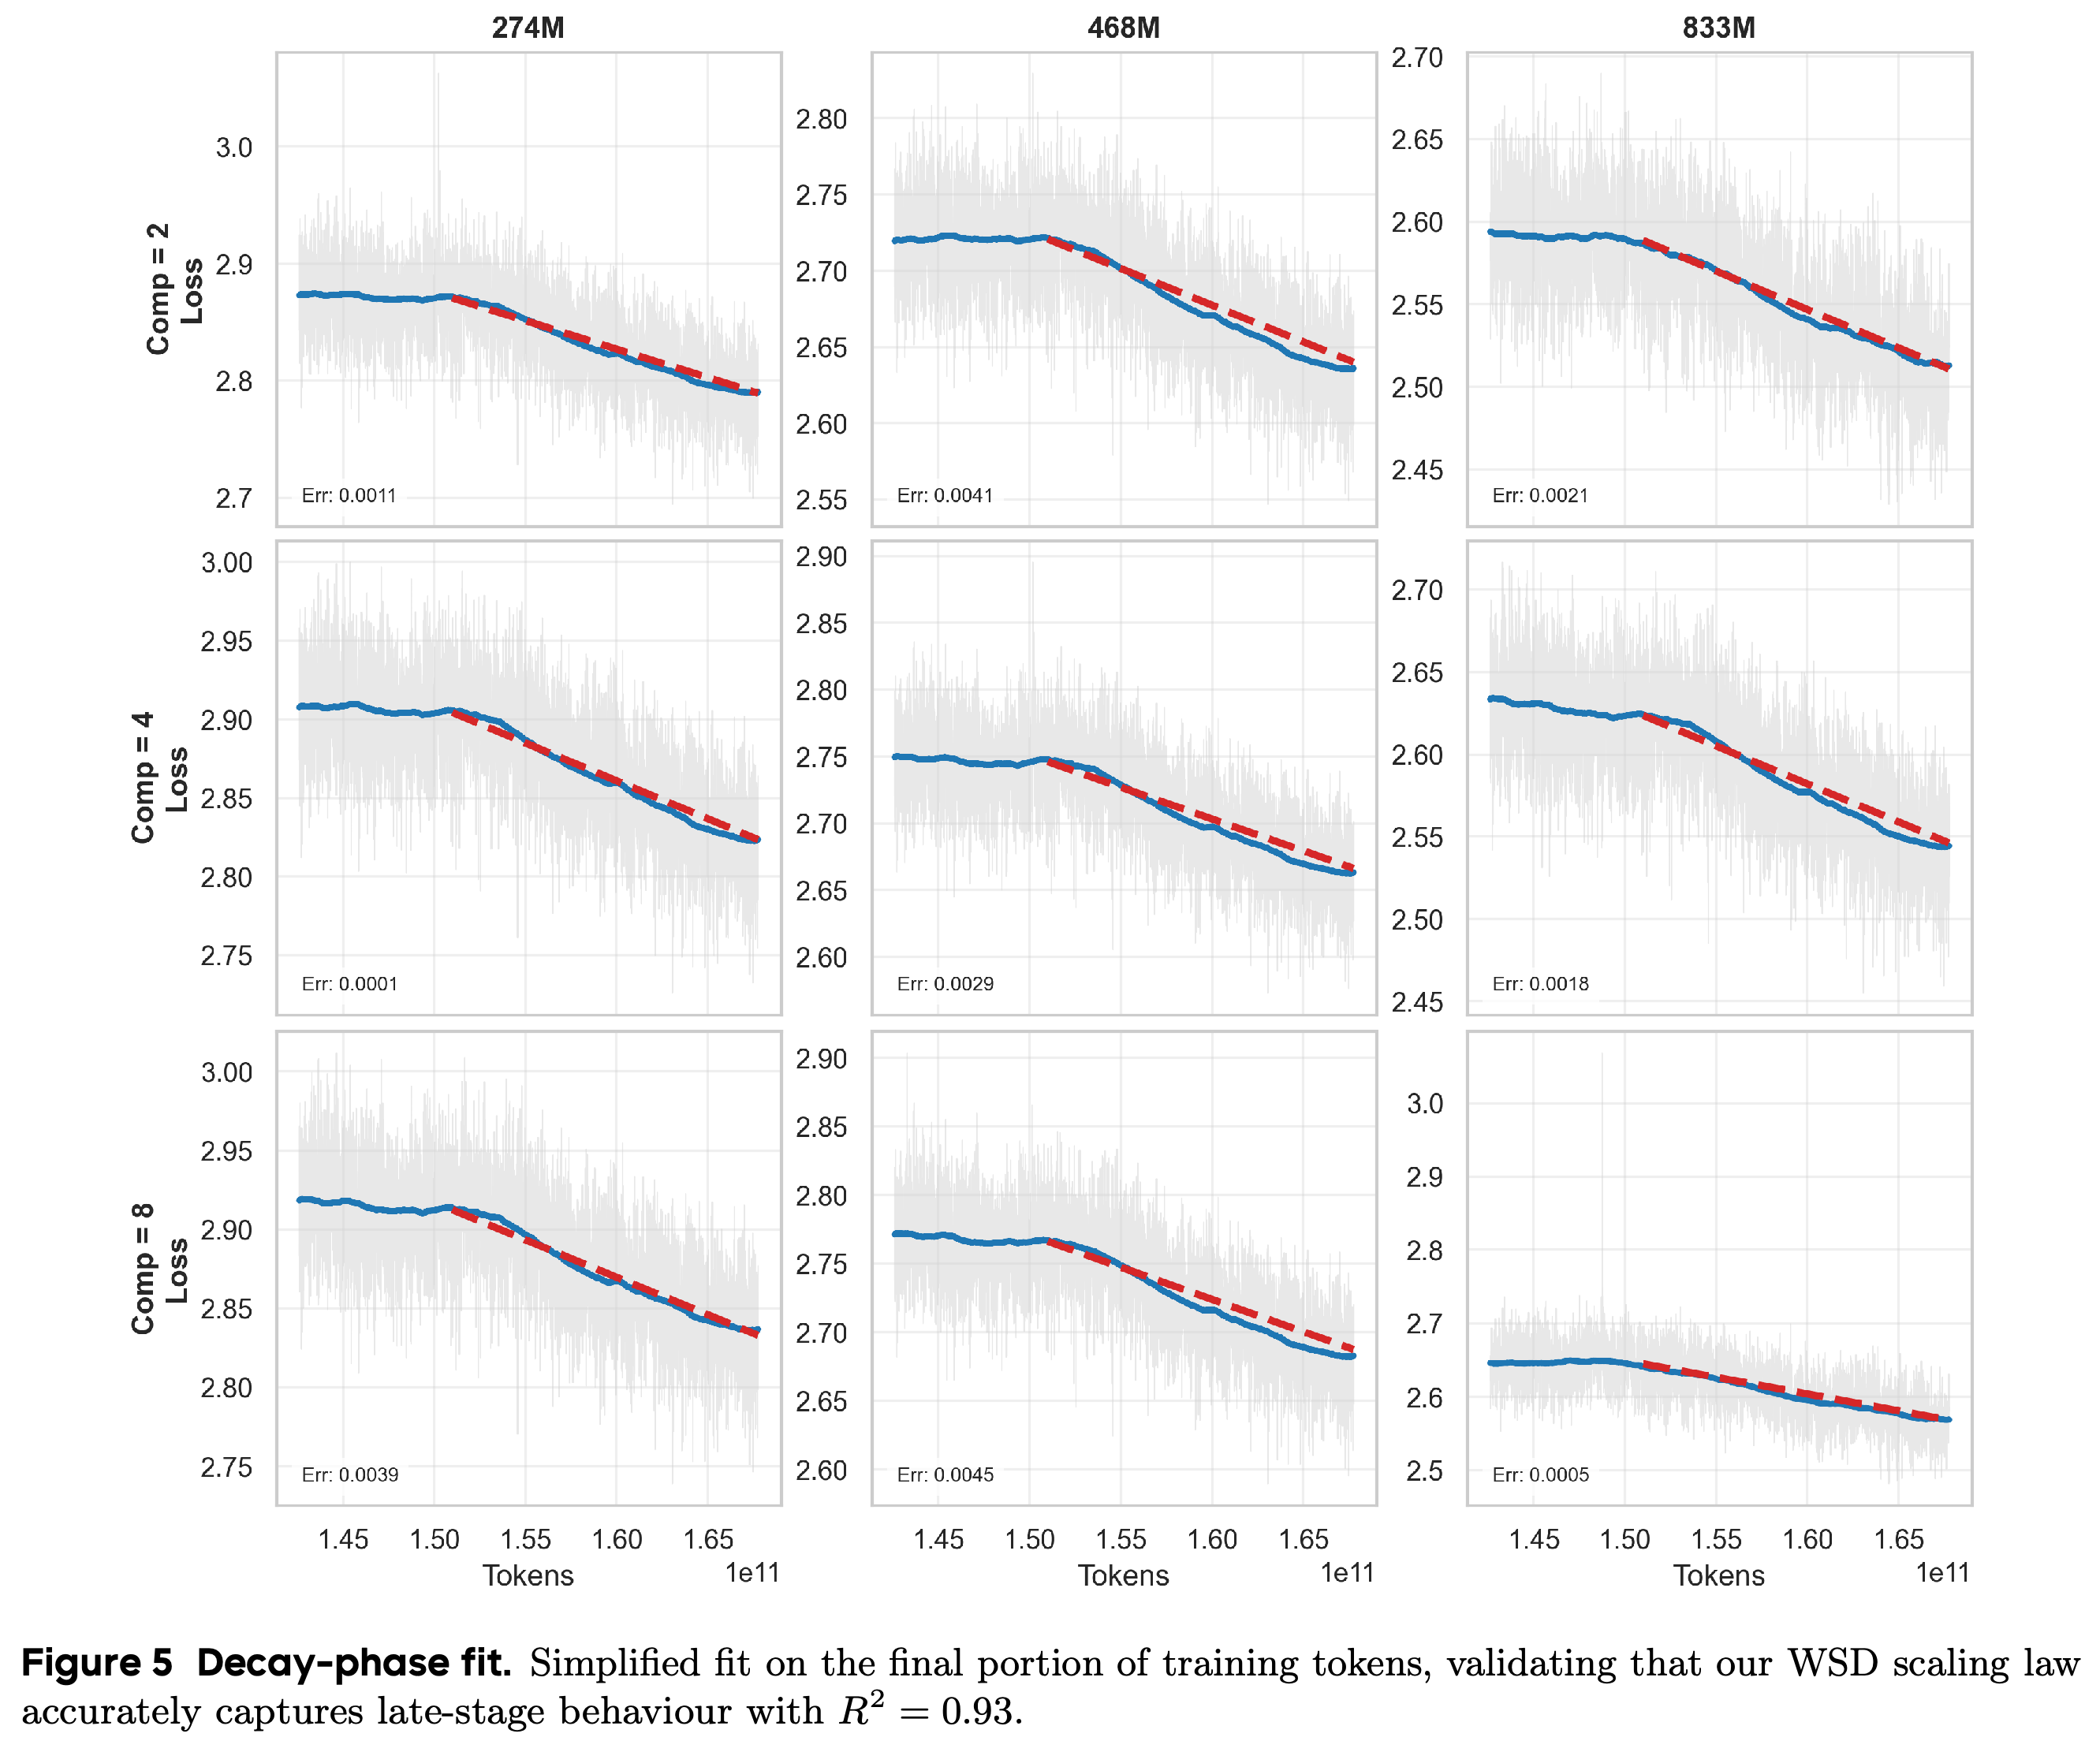
- 6.2.3 Decay-Phase Power Law에서는 WSD 프로토콜을 Weight-Sharing-and-Decay라고 부르며, 90%–99% 토큰 구간에서 Δdecay = k Lstable^a R^b N^c를 피팅한다. 로그 선형 회귀는 R² = 0.93을 얻는다.
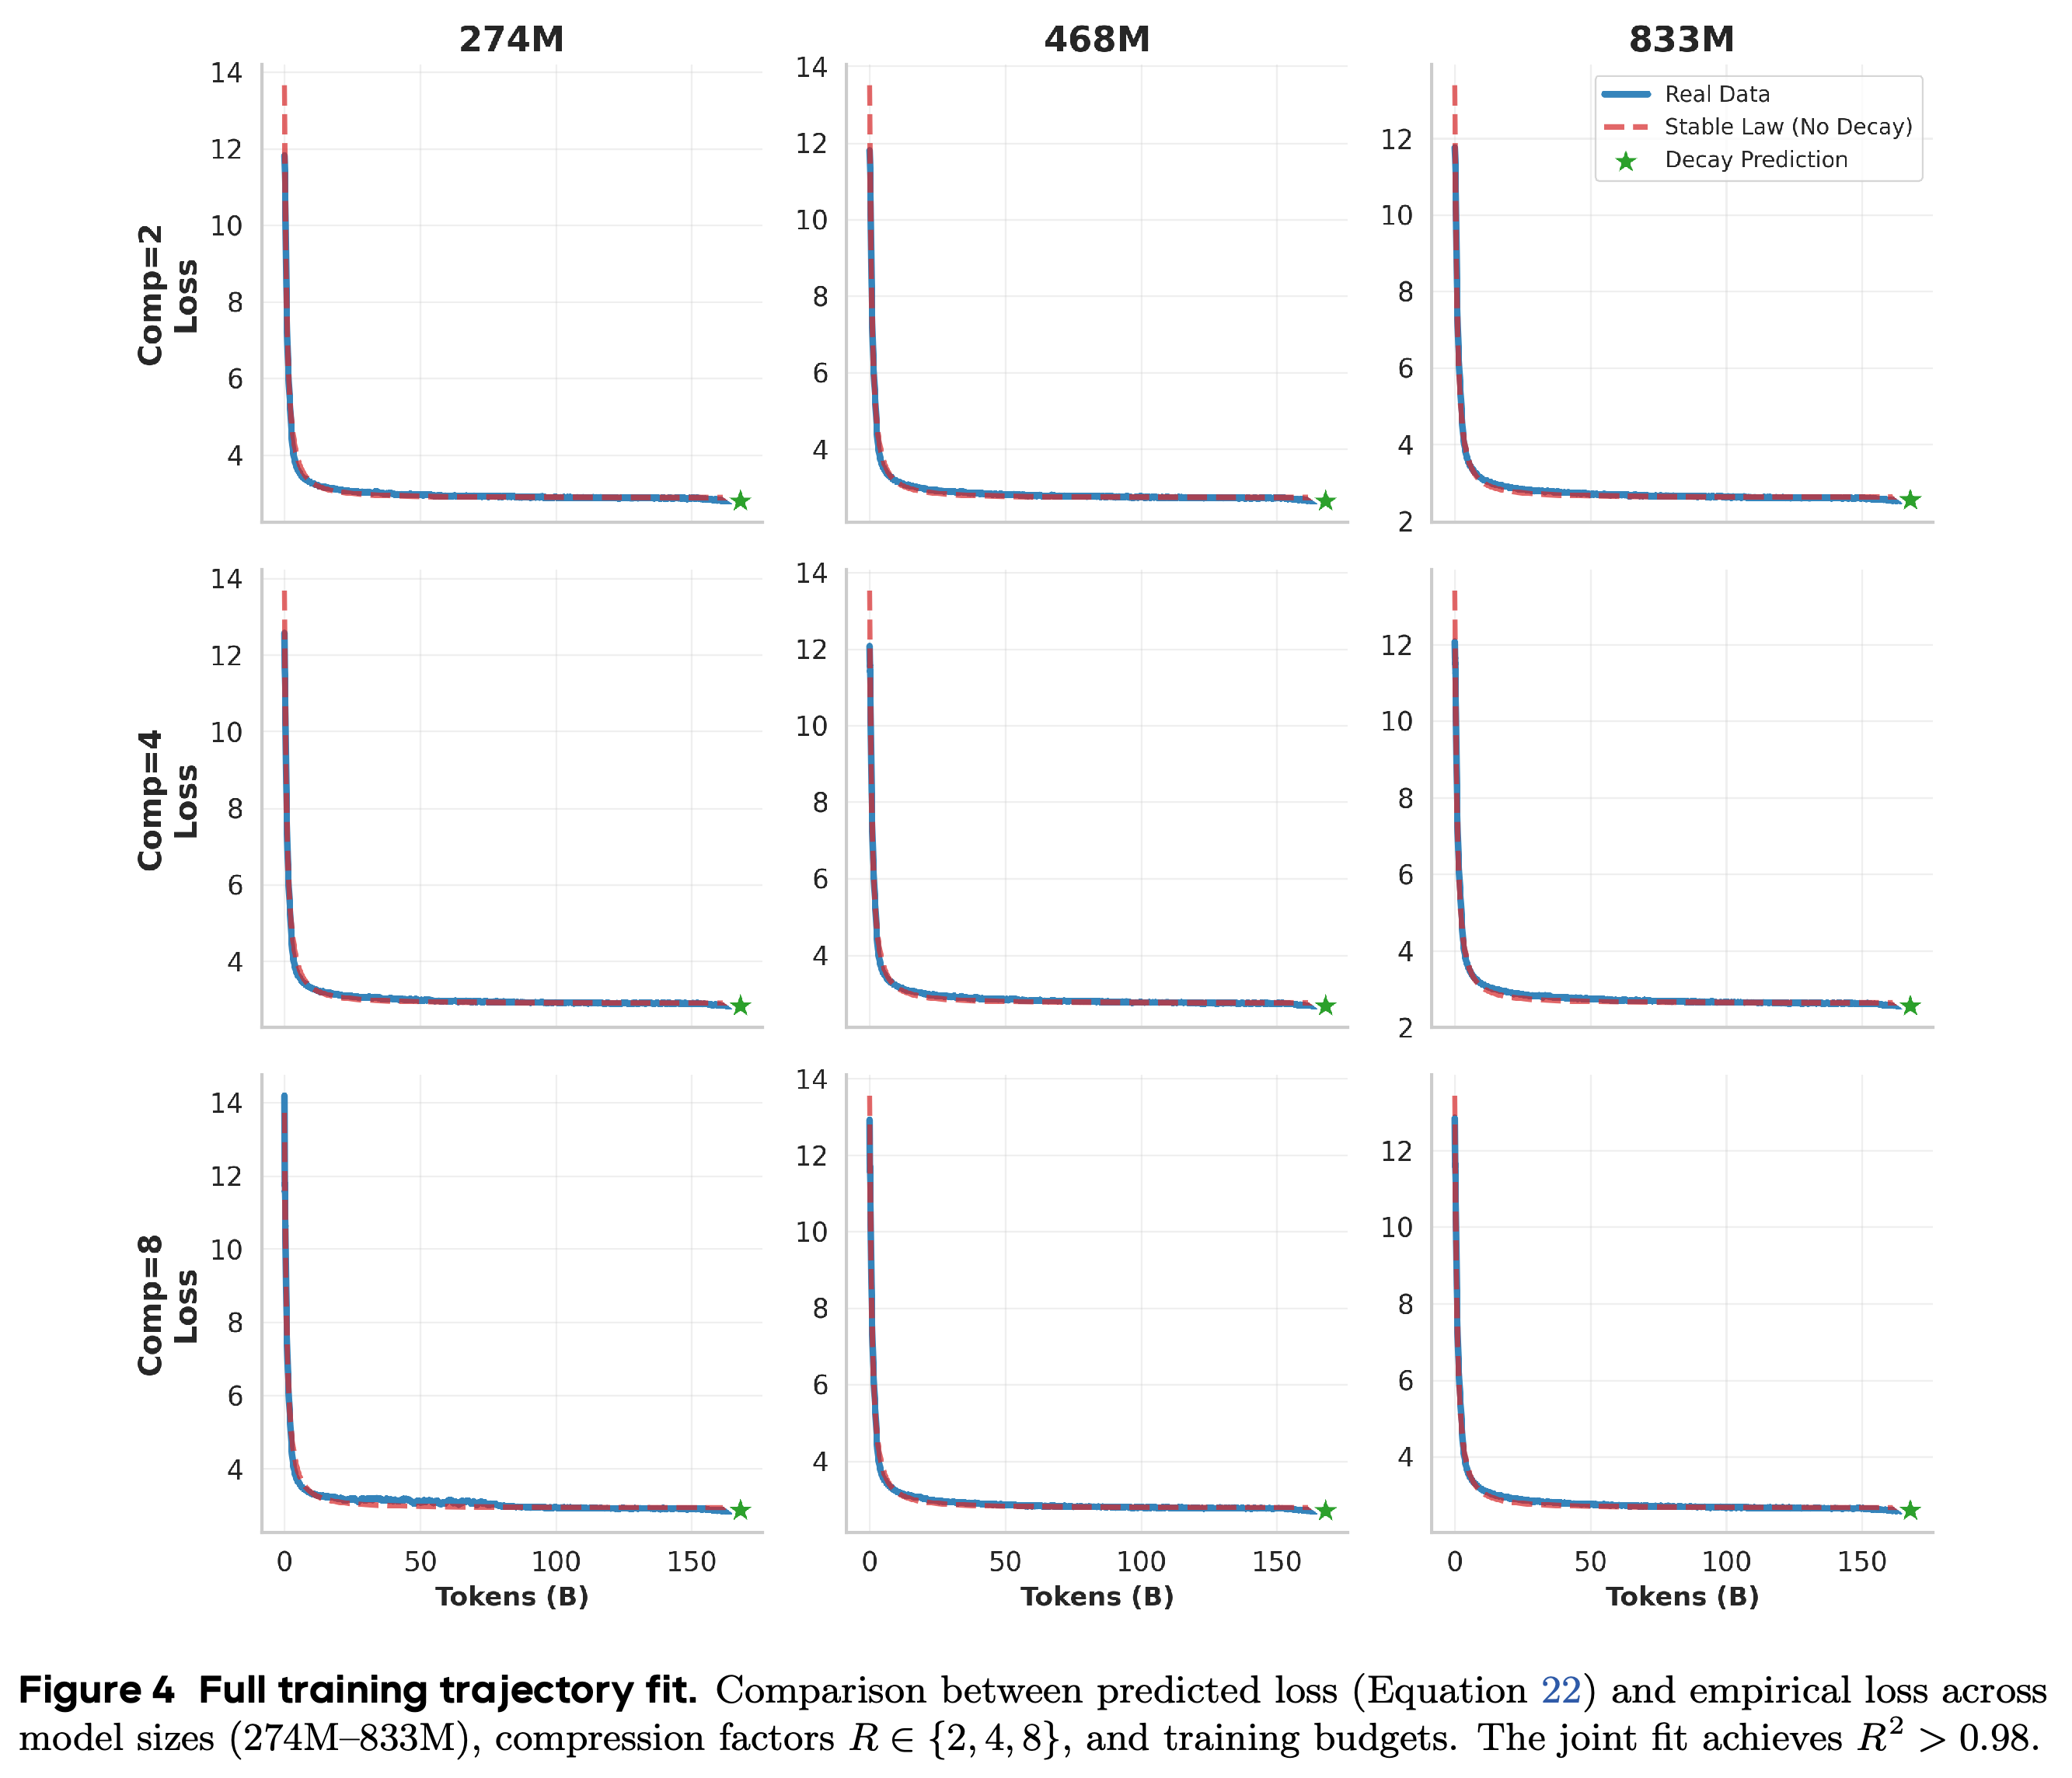
- Figure 4와 Figure 5는 예측 궤적과 실측 궤적을 비교하며, 전체 궤적 피팅에 R² > 0.98, 학습 후반 감쇠에 R² = 0.93을 보고한다.
패널은 모델 규모와 압축 배수를 3개씩 비교한다. 예측한 안정 구간 궤적은 실측 손실을 가깝게 따라가며, 감쇠 예측은 별도 표식으로 나타낸다. 보고한 R² > 0.98은 궤적 피팅에 관한 수치이며, 다운스트림 정확도나 독립적으로 입증한 1T-token 외삽에 관한 수치는 아니다.
패널은 학습 후반의 손실 감소를 따로 보여주며, 모델 규모와 압축 배수별로 잡음이 있는 관측, 평활화한 궤적, 감쇠 예측을 비교한다. 이들의 일치는 감쇠 구간을 별도로 모델링하는 접근을 뒷받침하며, 보고한 값은 R² = 0.93이다.
6.3 Optimal Configuration Analysis
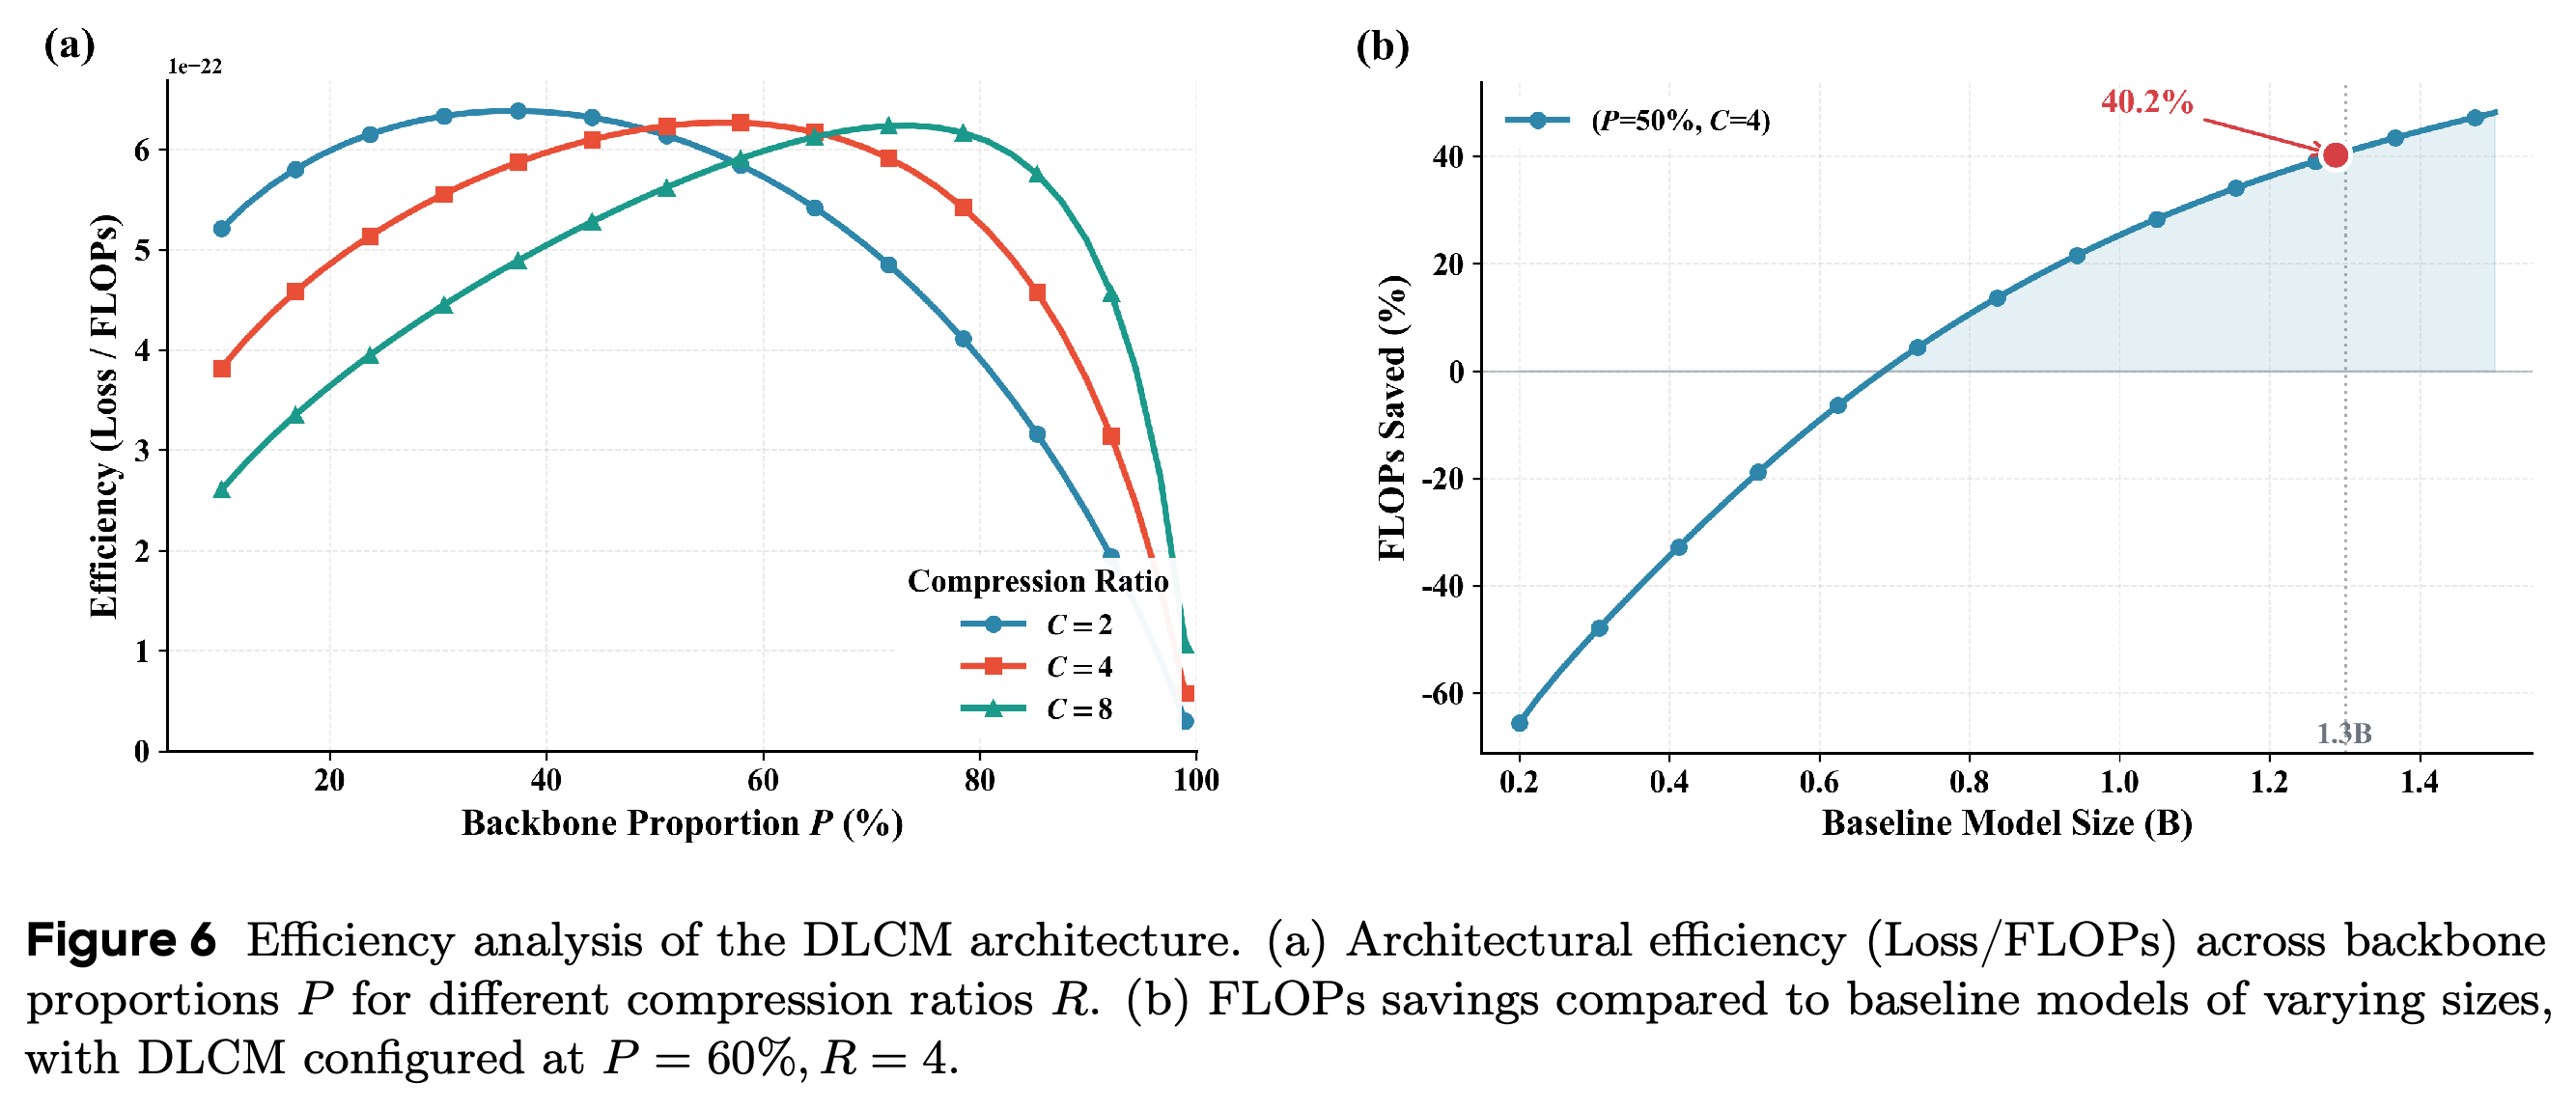
Figure 6(a)는 압축률 R이 커질수록 그래프에서 효율이 가장 높은 지점이 더 큰 개념 백본 비중 P로 이동함을 보여준다. 저자들은 Appendix A의 정성적 예시를 근거로, 분할의 세분성, 학습 안정성, 연산 효율 사이의 실용적인 절충값으로 R = 4를 선택한다.
- 부록은 분할 양상을 보여주지만 R = 4가 최적임을 정량적으로 입증하지는 않는다.
- Figure 6(b)의 구성 표기는 서로 다르다. 캡션은 P = 60%, R = 4라고 쓰지만 범례는 P = 50%, C = 4라고 쓴다. 또한 1.3B baseline에서 표시한 40.2% 절감은 서론의 최대 34%와 다르며, 두 수치의 관계는 설명하지 않는다.
패널 (a)는 압축률이 커질수록 그래프에서 효율이 가장 높은 지점이 더 큰 백본 비중으로 이동함을 보여준다. 패널 (b)는 1.3B baseline에서 FLOPs 40.2% 절감을 표시한다. 그러나 범례는 P = 50%, 캡션은 P = 60%로 명시하여 구성이 불분명하다.
6.4 Scaling Law Validation and Verification
추정기는 전체 학습 궤적과 학습 후반 감쇠를 결합하고, 수렴에 가까운 관측에 비중을 둔다. Section 6.4는 100B 토큰 궤적에 피팅하고 1T-token 한계값을 기준으로 검증했다고 보고한다. 피팅 오차는 0.05 미만이며, 유효 연산 배수는 약 1.4로 제시한다. 비교 기준으로 명시한 배수는 1.34다.
- 이 조건은 Section 6.2.1의 200B 토큰 격자와 다르다. 피팅, 학습, 외삽 예산 사이의 관계는 충분히 설명하지 않는다.
- Figure 4와 Figure 5의 궤적은 1T 토큰 미만까지만 나타낸다. 따라서 그래프상 일치만으로 주장한 1T 토큰 외삽 정확도를 검증할 수는 없다.
7 Experiments
실험은 1T-token 다운스트림 비교와 별도의 100B 토큰 위치별 손실 분석으로 구성된다. 전자는 더 큰 압축 백본의 과제 정확도를 평가하고, 후자는 구간 내 여러 위치의 예측 손실을 살펴본다.
7.1 Main Results
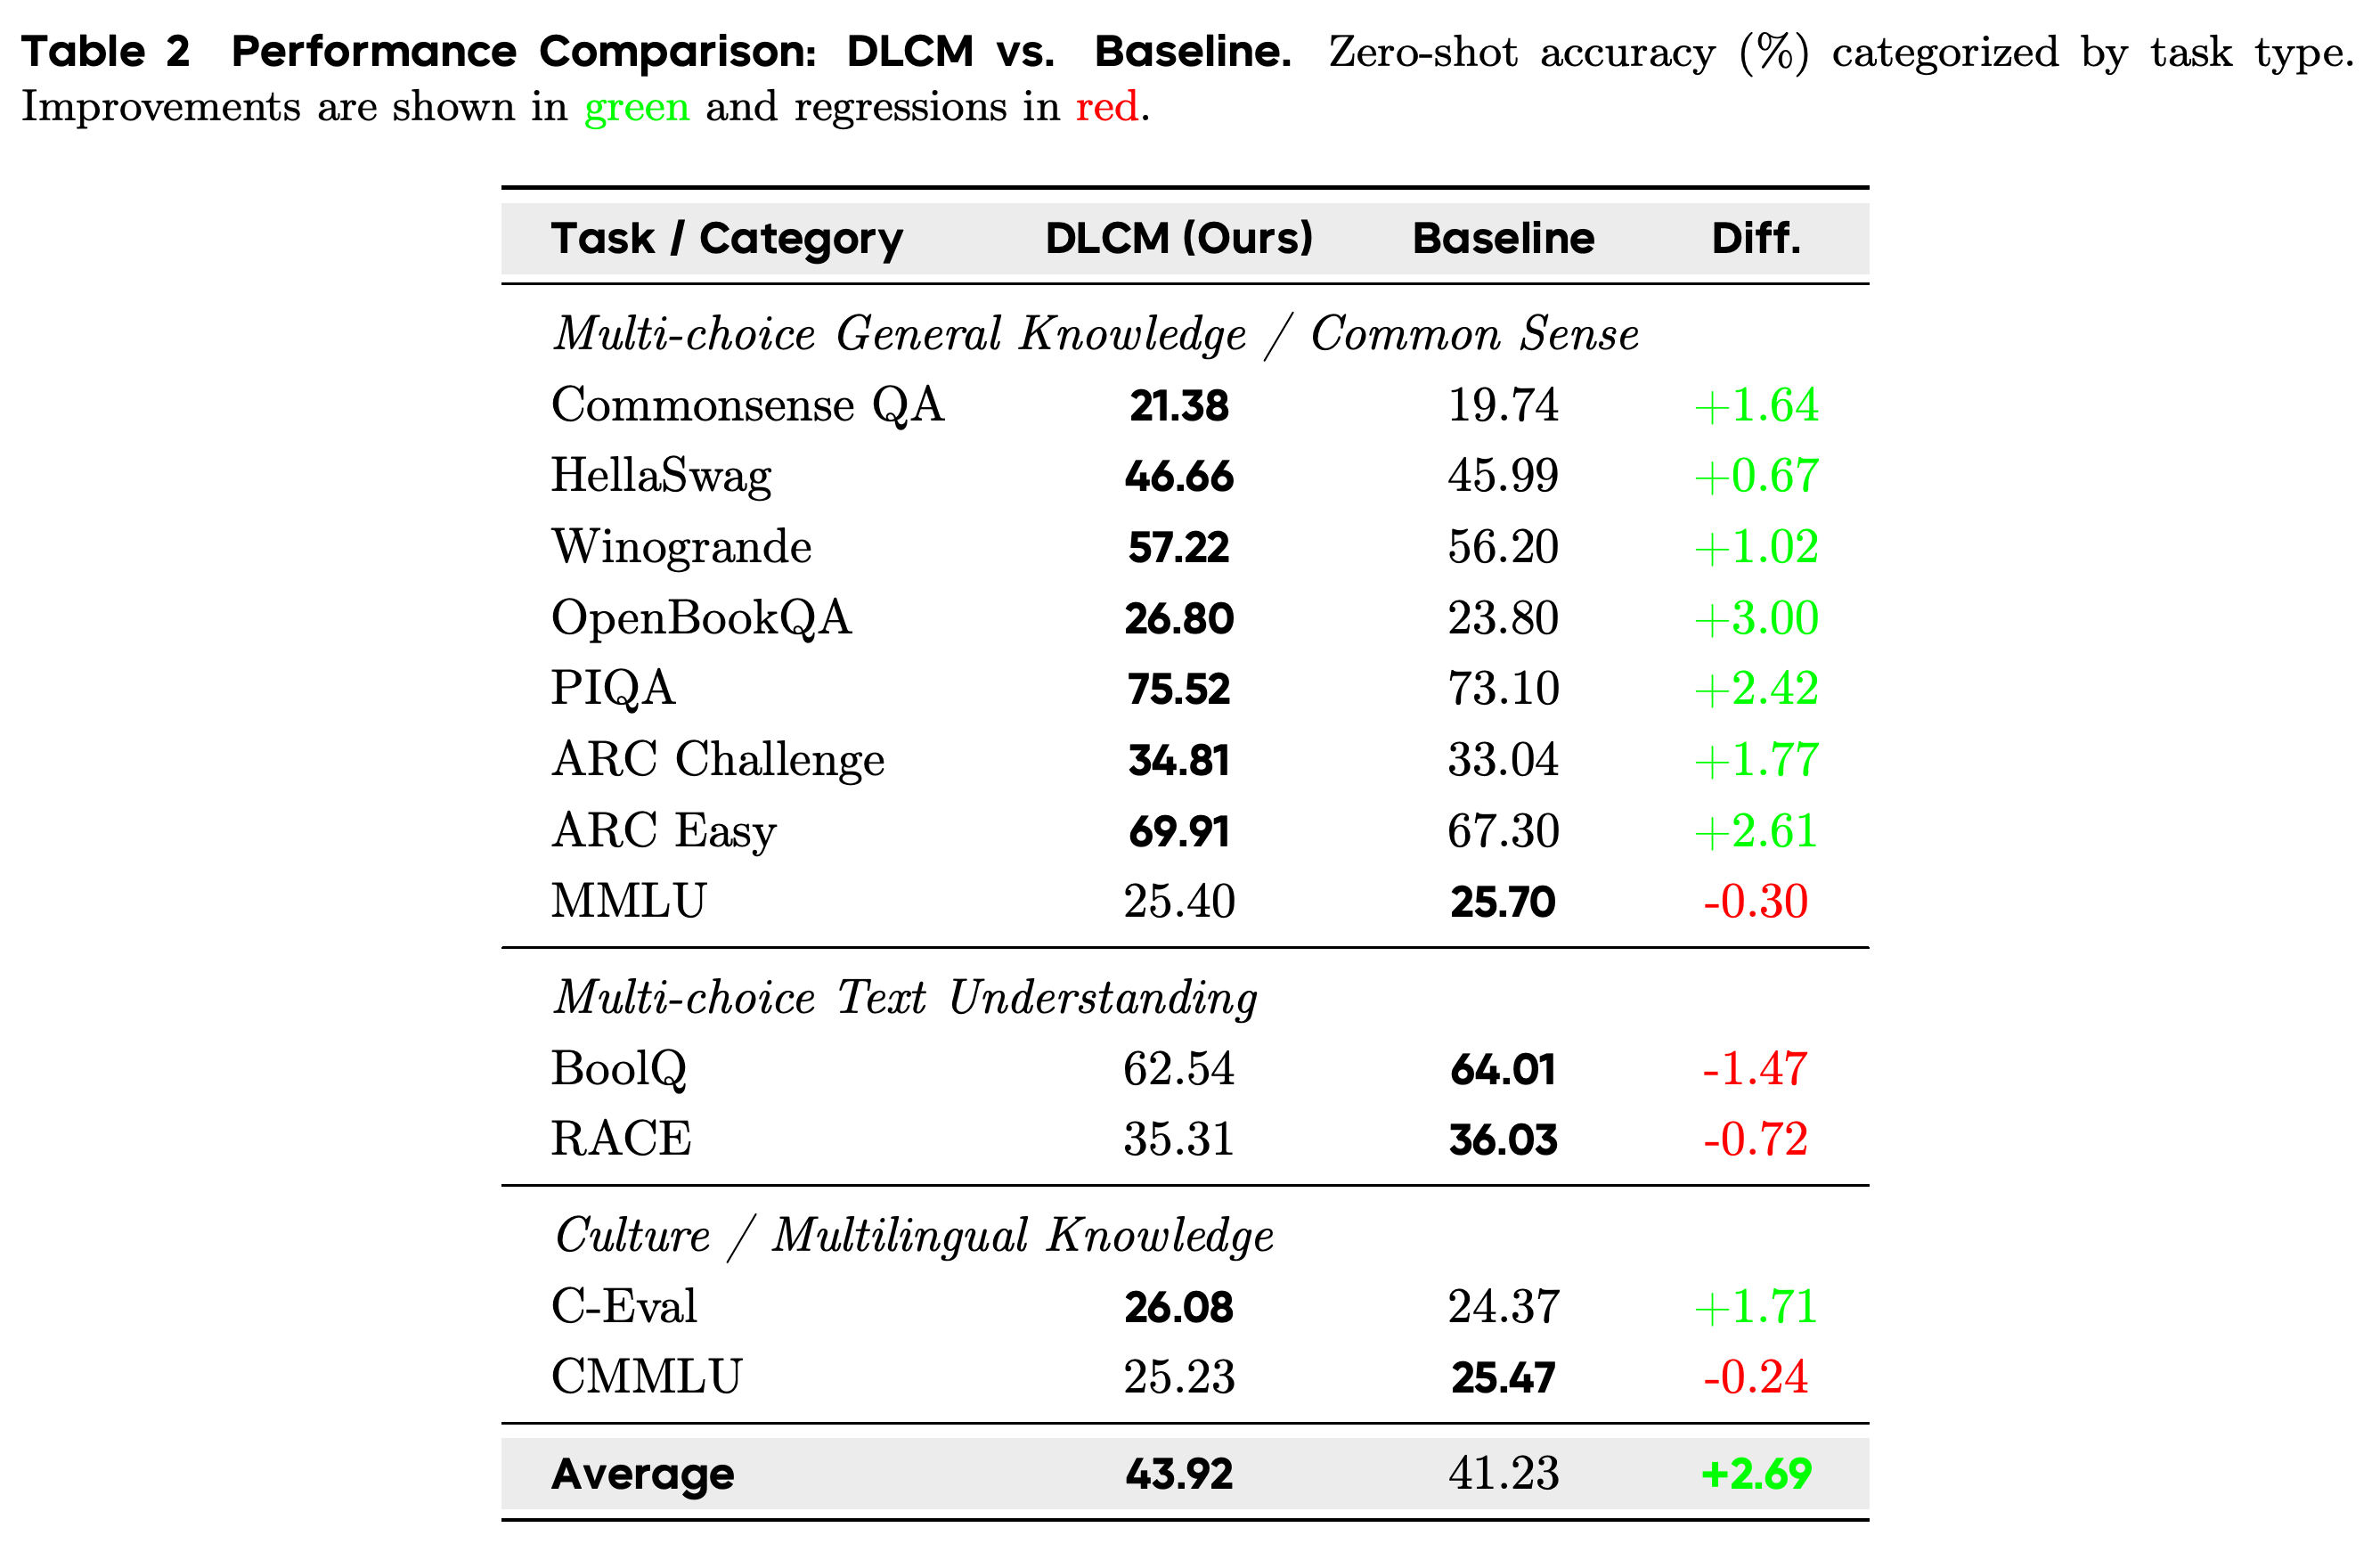
Table 2는 Commonsense QA (+1.64), HellaSwag (+0.67), Winogrande (+1.02), OpenBookQA (+3.00), PIQA (+2.42), ARC Challenge (+1.77), ARC Easy (+2.61), C-Eval (+1.71)의 향상을 보고한다. 단위는 모두 정확도 퍼센트포인트다. MMLU (−0.30), BoolQ (−1.47), RACE (−0.72), CMMLU (−0.24)에서는 성능이 낮아져, 이점이 균일하지 않고 과제에 따라 다름을 보여준다.
- 보고한 집계값은 43.92% 대 41.23%, 즉 +2.69%다. 표시된 12개 행을 가중치 없이 산술평균하면 약 42.24% 대 41.23%로, 차이는 약 1.01 %p다. 논문은 다른 집계 규칙을 제시하지 않는다.
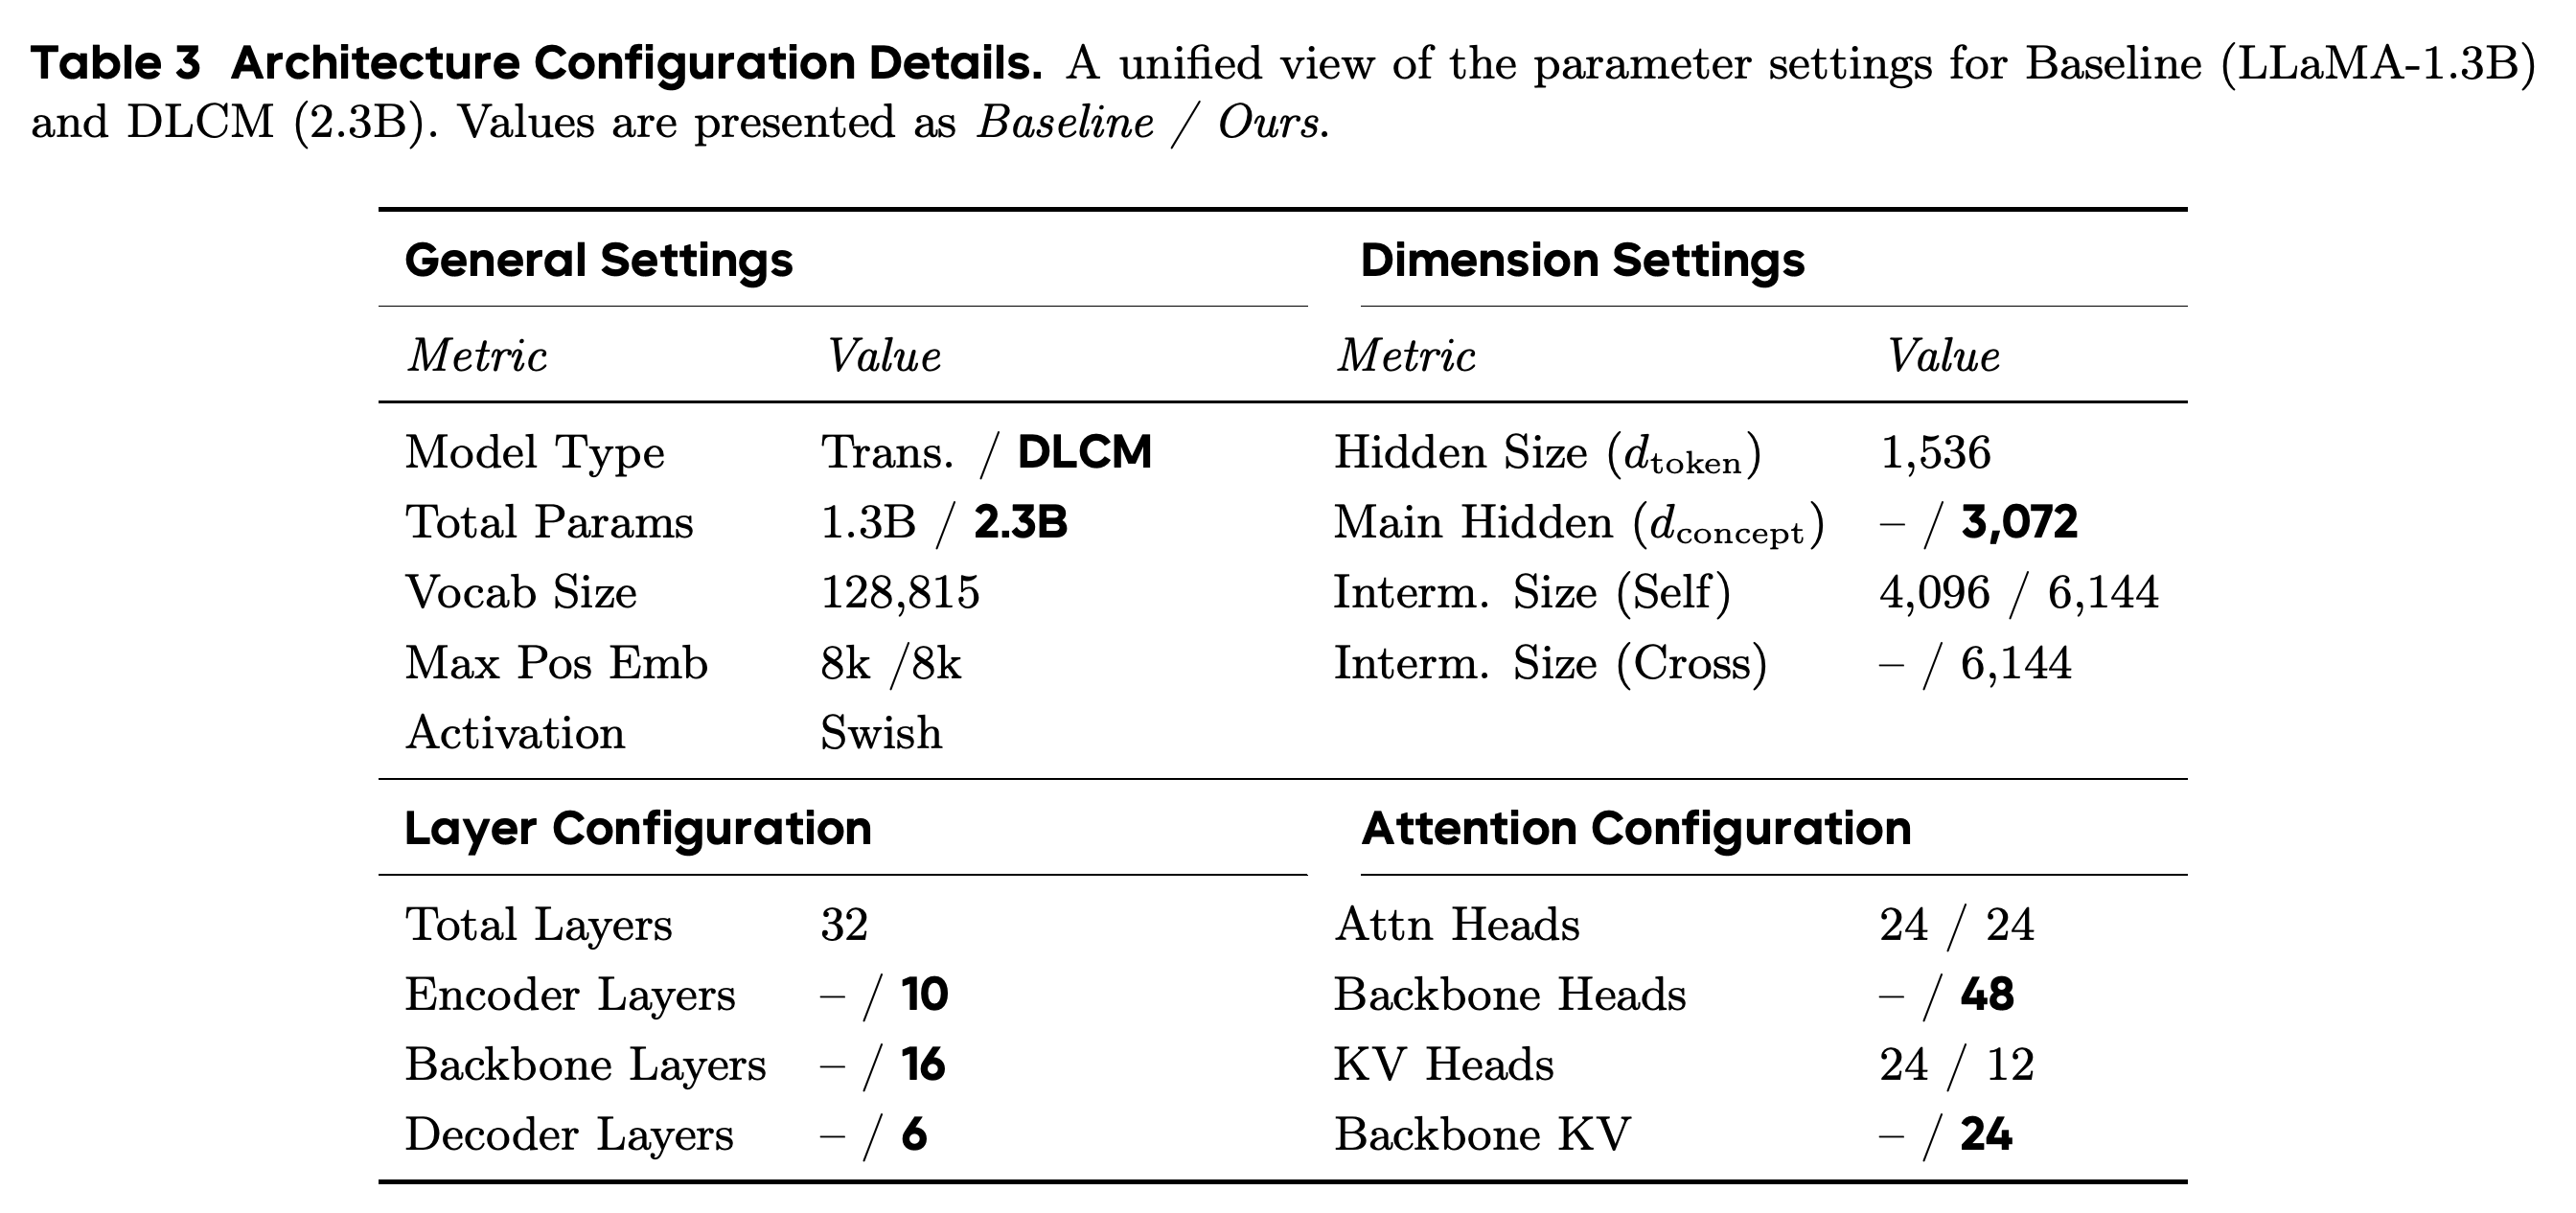
- Section 7.1은 처음에 기준 모델의 파라미터 수를 맞췄다고 설명하지만, 뒤의 논의와 Table 3은 파라미터 수를 2.3B 대 1.3B로 명시한다. 의도한 비교는 추론 FLOPs가 비슷한 비교로 설명되며, 추가 파라미터는 압축된 개념 백본에 집중된다.
- Table 3은 dtoken = 1,536, dconcept = 3,072, 어휘 크기 128,815, 최대 위치 8k, 전체 32개 층을 명시한다. DLCM은 인코더 10개 층, 백본 16개 층, 디코더 6개 층으로 배분하며, 토큰 attention head는 24개, 백본 head는 48개다.
- 2개 모델은 모두 1T 토큰으로 처음부터 학습한다. 논문은 전역 배치 크기, 학습률, 시퀀스 길이가 LLaMA 논문을 따른다고 하지만 이 절에서 수치를 제시하지 않으며, 과제별 차이의 불확실성도 보고하지 않는다. 추론, 어휘 충실도, 사실 회상에 관한 설명은 개별 원인을 분리해 확인한 실험 결과가 아니라 가설이다.
과제별 행에서는 8개가 향상되고 4개가 하락한다. OpenBookQA의 양의 차이가 가장 크고 BoolQ의 음의 차이가 가장 크다. 보고한 DLCM 평균 43.92%는 표시된 행의 가중치 없는 산술평균인 약 42.24%와 다르므로, 명시한 집계값 +2.69%는 이 계산으로 재현되지 않는다.
구성표는 주 실험의 모델들이 파라미터 수를 맞추지 않았음을 확인해 준다. DLCM은 2.3B 파라미터이고 기준 모델은 1.3B다. DLCM의 폭 3,072, 16개 층 개념 백본은 10개 층 인코더와 6개 층 디코더 사이에 놓여, 추가 용량이 압축 처리 단계에 집중되어 있음을 보여준다.
7.2 Analysis: Compute Allocation in Concept-Based Models
손실 분석은 1.3B-parameter 백본 아키텍처와 동일한 100B 토큰 학습 부분집합을 공유한다고 설명한 개념 모델과 기준 모델을 비교한다. 무작위로 선택한 검증 샘플 600개의 손실을 개념 내 상대 위치에 맞춰 정렬하고, Figure 7에 처음 20개 위치를 표시한다.
- 저자들은 초반과 후반 위치 근처에서 손실이 낮아지고, 개념 내부에서는 성능이 혼재하거나 낮아지는 U자형 향상 양상으로 설명한다.
- 막대그래프를 보면 주장한 경계 범위에는 예외가 있다. 위치 2와 18에서는 성능이 낮아지고 위치 14에서는 높아지며, 일부 내부 위치의 차이는 0에 가깝다. 증거는 위치별 효과가 균일하지 않음을 보여줄 뿐, 경계 전반에서 일관되게 우세함을 입증하지 않는다.
- 개념 시작점에서 측정한 위치만으로는 끝 경계까지의 거리를 알 수 없다. 위치별 표본 수나 불확실성이 없으므로, 이 그래프는 인과적인 연산 배분이나 전역적 일관성 향상보다 예측 손실의 절충을 더 직접적으로 뒷받침한다.
8 Ablation Studies
제거 실험은 경계 학습의 안정성, 압축 정규화의 범위, 도메인별 분할을 살펴본다. 결과는 압축을 제어할 수 있고 구간 길이가 달라진다는 증거를 제공하지만, 경계가 최적의 의미 단위에 해당함을 독립적으로 입증하지는 않는다.
8.1 Analysis: End-to-End Discrete Boundary Learning vs. Decoupled Segmentation
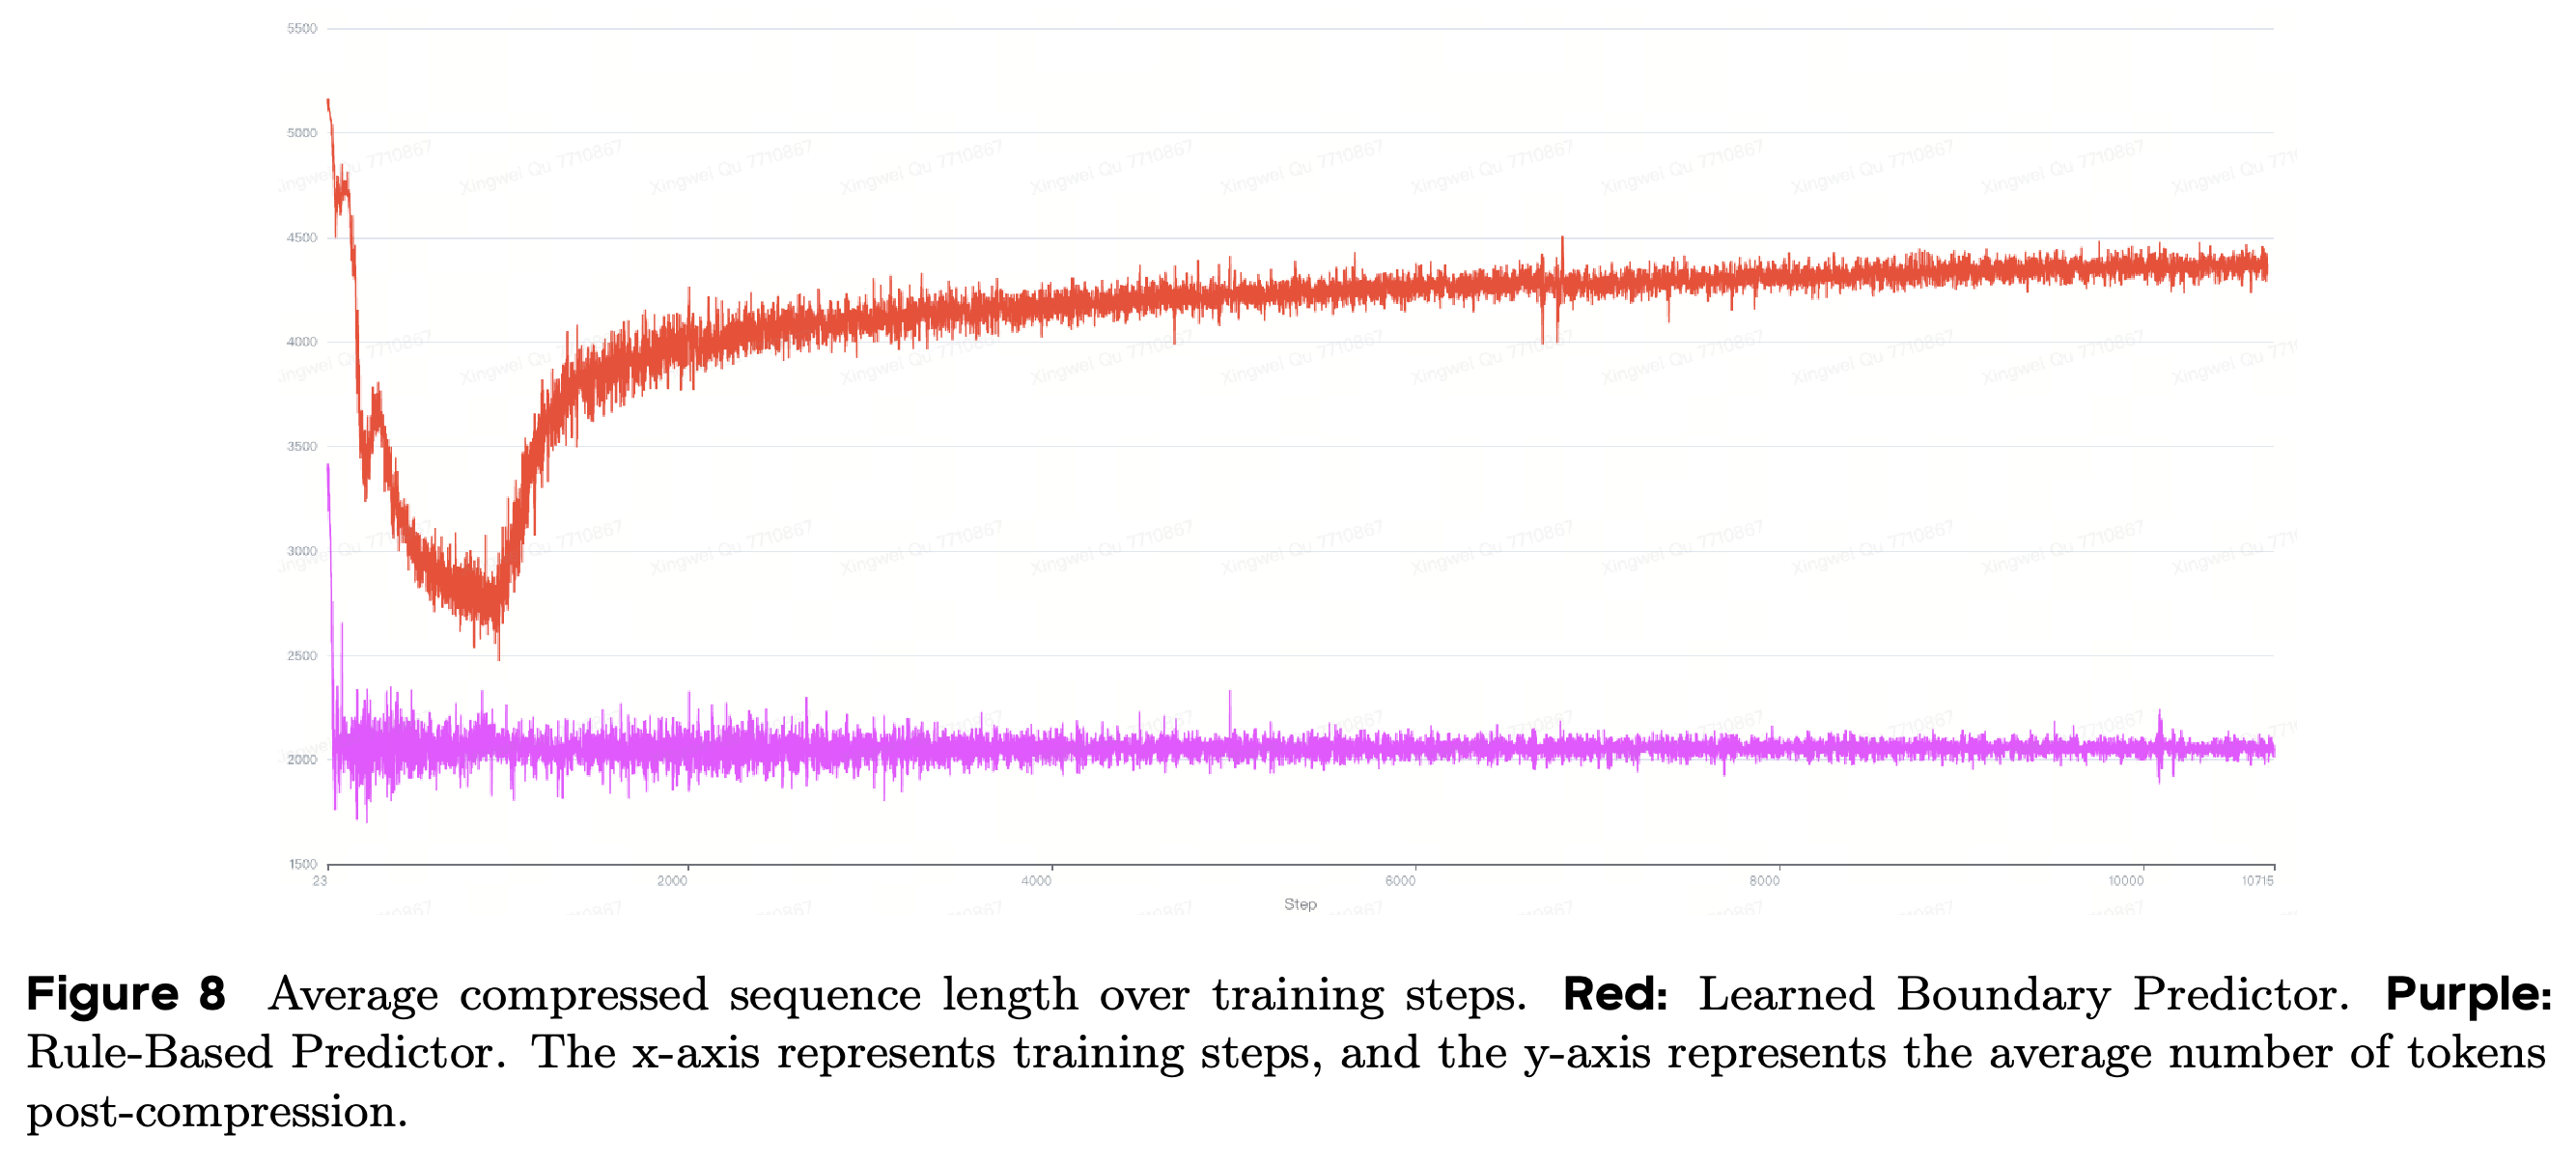
입력 길이 L = 8192에서 Figure 8은 학습된 경계 예측기와 학습된 표현에 적용하는 코사인 유사도 규칙을 비교한다. 학습된 예측기는 처음에 약 2000개 위치로 압축하지만 점차 약 4300개로 늘어나 1.9× 압축에 이른다. 언어 모델링 손실과 분리된 규칙은 약 2000개 위치, 즉 4× 압축 근처를 유지한다.
- 저자들은 cross-entropy 기울기가 정보 보존을 선호하고 보조 압축 기울기를 압도하여 드리프트가 발생한다고 설명한다. Equation 24는 이 설명을 수식으로 나타내지만, Figure 8이 측정하는 것은 기울기 크기가 아니라 압축된 길이다.
- 규칙 기반 제거 실험에서는 pt = (1 − cos(ht, ht+1))/2가 τ를 넘을 때 경계를 삽입한다. 이는 인덱스, 투영 세부사항, 임계값 설명에서 Section 3.3.1과 다르다. 논문은 두 표현의 관계를 충분히 명시하지 않는다.
초기 감소 이후 학습된 예측기의 압축 시퀀스 길이는 늘어나지만, 규칙 기반 예측기는 2000개 위치 근처를 유지한다. 이는 8192개 위치 입력에서 압축 드리프트와 안정성의 차이를 보여준다. 다만 그 원인으로 제시한 기울기 경쟁을 직접 측정하지는 않는다.
8.2 Global Regularization via Gradient Accumulation
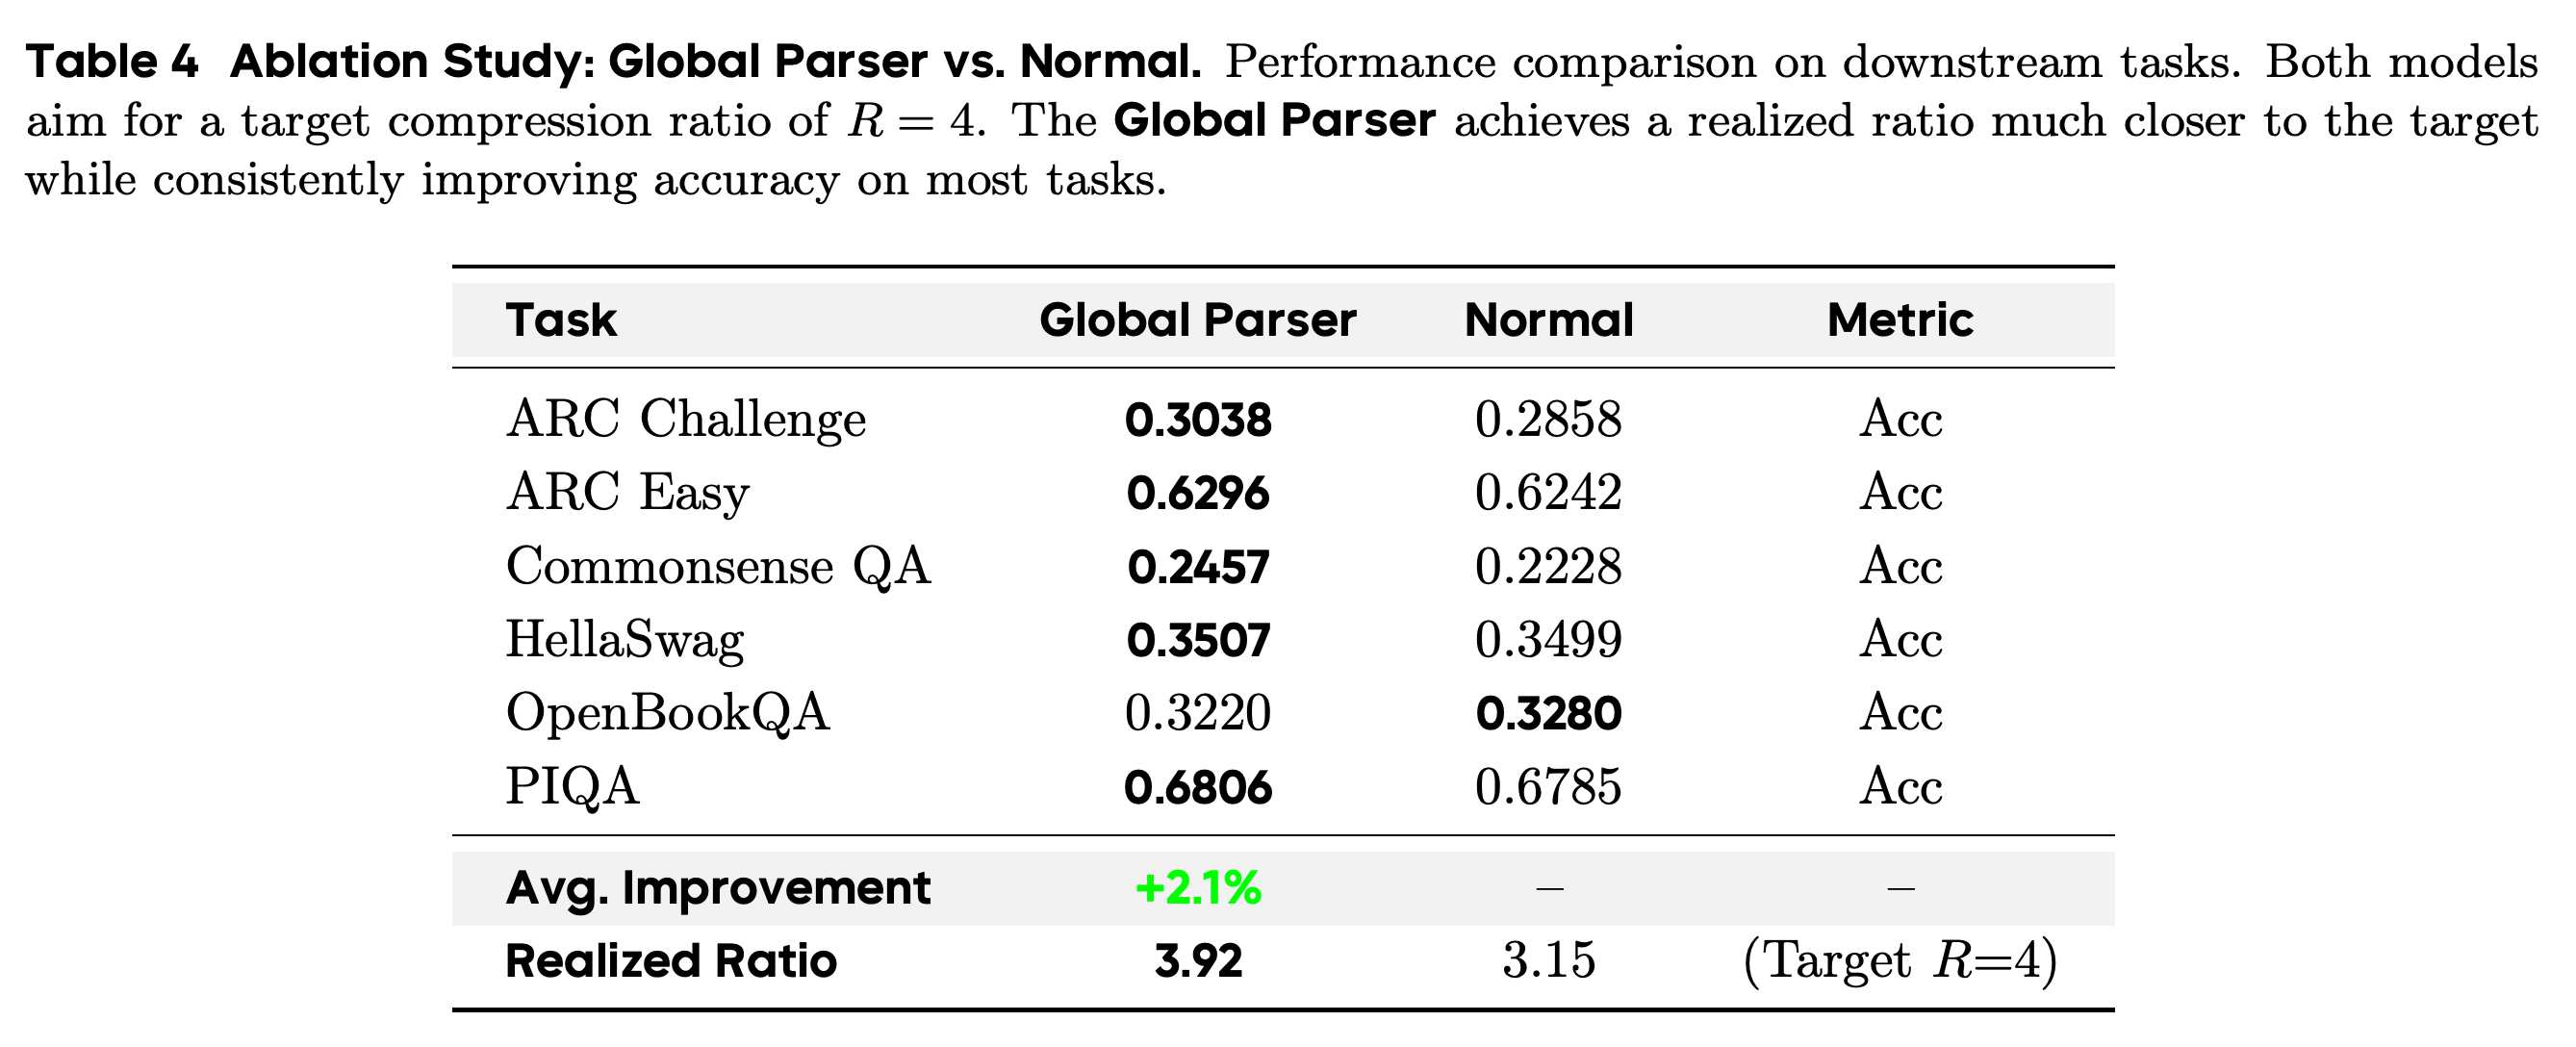
전역 정규화는 각 시퀀스를 따로 제약하지 않고 K개 마이크로배치의 경계 통계를 집계한다. Table 4는 1T 토큰으로 학습한 2개 2.3B-parameter 모델을 비교한다. 표에 명시한 목표 R = 4에 대해 실제 압축률은 Global Parser가 3.92, Normal이 3.15라고 보고한다.
- Global Parser는 나열된 6개 과제 중 5개에서 성능을 높인다. ARC Challenge는 0.3038 대 0.2858, ARC Easy는 0.6296 대 0.6242, Commonsense QA는 0.2457 대 0.2228, HellaSwag는 0.3507 대 0.3499, PIQA는 0.6806 대 0.6785다. OpenBookQA는 0.3280에서 0.3220으로 낮아진다.
- 실험 설정 문장은 R = 2를 명시하지만, 뒤의 논의와 Table 4는 R = 4를 명시한다. 따라서 원문의 실험 압축 목표가 일치하지 않는다.
- Table 4는 집계 방식을 정의하지 않은 채 평균 +2.1% 향상을 보고한다. 표시된 점수의 절대 정확도 차이를 가중치 없이 산술평균하면 약 +0.72 %p이므로, +2.1%를 검증된 퍼센트포인트 향상으로 제시해서는 안 된다.
Global Parser는 6개 과제 중 5개의 점수를 높이고, 표의 목표 R = 4에 더 가까운 압축률을 얻는다. 압축률은 3.92 대 3.15다. 평균 향상 +2.1%의 집계 규칙은 정의하지 않으며, 실험 설정 본문은 이와 달리 R = 2를 명시한다.
8.3 Content-Adaptive Compression Benefits
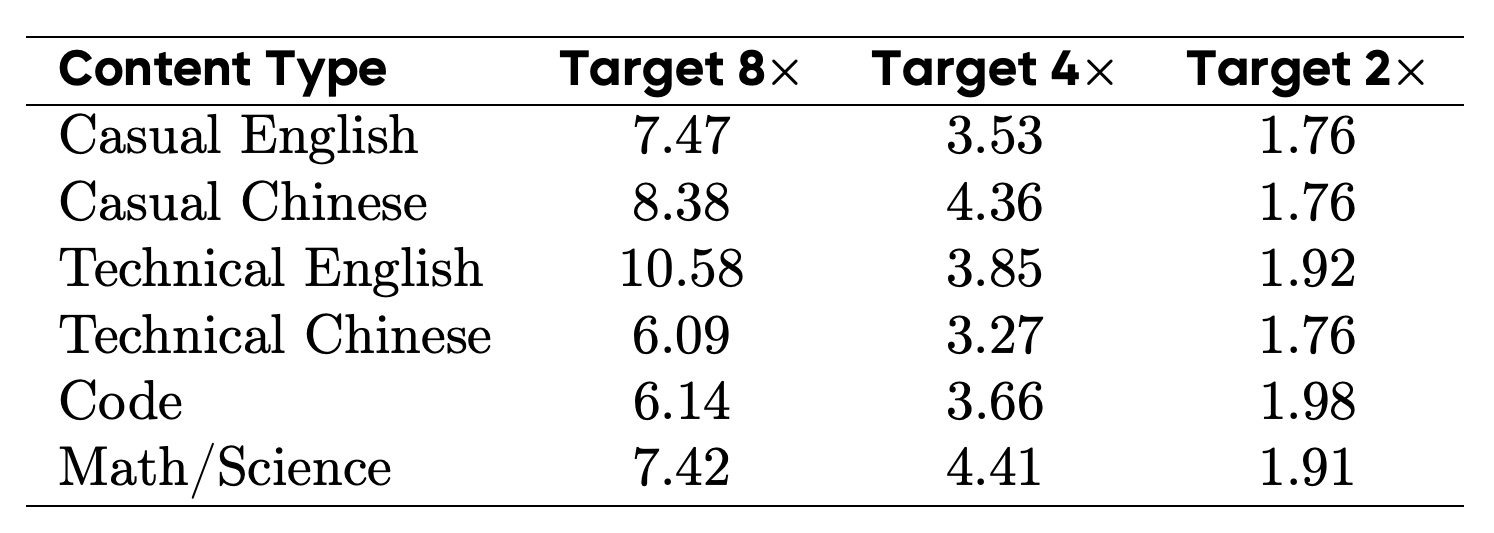
Table 5는 같은 목표에서도 콘텐츠 유형에 따라 실제 개념당 토큰 수가 달라짐을 보여준다. 목표 8×에서 Technical English는 개념당 10.58 토큰, Technical Chinese는 6.09, Code는 6.14에 이른다. 목표 4×에서는 6개 도메인의 평균이 3.27에서 4.41 사이다.
- 목표 8×/4×/2×에서 Casual English는 7.47/3.53/1.76, Casual Chinese는 8.38/4.36/1.76, Technical English는 10.58/3.85/1.92, Technical Chinese는 6.09/3.27/1.76, Code는 6.14/3.66/1.98, Math/Science는 7.42/4.41/1.91을 기록한다.
- 도메인별 차이는 고정된 시퀀스별 압축이 아니라 유연한 세분성을 보여준다. 이 표는 정보 밀도, 정보 보존, 분할 최적성을 직접 측정하지 않는다.
공통 목표에서도 실제 구간 길이는 도메인에 따라 달라진다. 특히 8×에서 Technical English는 개념당 10.58 토큰, Technical Chinese는 6.09에 이른다. 이는 유연한 세분성을 뒷받침하지만 의미적 최적성이나 정보 보존을 입증하지는 않는다.
9 Conclusion
결론은 적응형 세분성, 압축을 고려한 아키텍처 자원 배분, 이질적인 모듈 최적화를 DLCM의 주요 기여로 제시한다. 실험은 보고한 제거 실험에서의 안정적인 압축, 시험한 폭 범위 내의 하이퍼파라미터 전이, 과제에 따라 혼재된 다운스트림 정확도 향상을 뒷받침한다. 보편적인 추론 향상이나 end-to-end 서빙 효율을 입증하지는 않는다.
Contributions
Contributions 절은 주도 저자, 개인별 역할, 핵심 기여자, 기타 기여자, 교신 저자를 구분한다. 이 내용은 프로젝트 기여를 기록하며 추가 실험 증거를 제공하지는 않는다.
Leading Authors
주도 저자는 Xingwei Qu, Shaowen Wang, Zihao Huang, Ge Zhang이다.
Leading Author Contributions
Xingwei Qu는 핵심 제거 실험과 대부분의 엔지니어링 구현, Shaowen Wang은 MuP 구현과 하이퍼파라미터 튜닝, Zihao Huang은 잡음 기반 경계 예측 기법을 담당했다고 명시한다. Ge Zhang은 최초 아이디어, 데모 프로토타입, 핵심 Global Parser 기법을 담당했다고 명시한다.
Core Contributors
Kai Hua는 오픈소스 학습 데이터 구축, Fan Yin은 SGLang 구현과 최적화, Rui-Jie Zhu는 버그 해결과 인코더를 DLCM으로 대체하자는 제안에 기여했다고 명시한다. Jundong Zhou와 Qiyang Min은 프로젝트 개발과 구현에 기여했다.
Other Contributors
기타 기여자는 Zihao Wang, Yizhi Li, Tianyu Zhang, He Xing, Zheng Zhang, Yuxuan Song, Tianyu Zheng, Zhiyuan Zeng이다.
Corresponding Authors
Contributions 절은 Chenghua Lin, Ge Zhang, Wenhao Huang을 교신 저자로 명시한다. 제목 페이지에는 별도로 교신 연락처 xingwei.qu@bytedance.com과 zhangge.eli@bytedance.com을 기재한다.
부록
- A Appendix: Segmentation Examples at Different Compression Ratios는 A.1 Casual English Text, A.2 Python Code, A.3 Mathematical Text를 제시한다. 원문의 표기는 각각 원본 토큰 수를 90, 87, 95로 명시하며, Compression 8×/4×/2×에서 구간 수를 각각 11/35/56, 12/29/58, 13/32/61로 명시한다.
- 예시는 커피 관련 산문, SimpleTextDataset 코드, Euler 공식 e^ix = cos(x) + i sin(x)에 관한 설명이 점차 더 세밀하게 분할되는 모습을 보여준다. 경계가 축약형, 식별자, 수식을 나누기도 하며, 여러 예시에서 원문 일부가 빠져 있다. 명시된 구간 수는 눈에 보이는 구분자로 나눈 구간 수와 일관되게 맞지 않으므로, 검증된 개수가 아니라 원문 표기로 유지해야 한다.
짧은 생각
DLCM은 토큰 수준 입출력 인터페이스를 유지하면서 비용이 큰 연산을 압축된 잠재 시퀀스에 배정하는 구체적인 아키텍처를 제시한다. 압축 안정성 제거 실험, 도메인에 따라 달라지는 구간 길이, µP 전이 실험은 개념을 의미나 추론 단위로 해석하는 주장보다 이 설계 자체를 더 직접적으로 뒷받침한다. 대표 벤치마크 향상 수치는 집계 불일치를 해소해야 한다. 주 결과는 파라미터 수를 맞춘 비교가 아니라, 파라미터 수가 더 크고 추론 FLOPs가 비슷한 비교로 설명해야 한다. 재현성을 확보하려면 압축 목표와 스케일링 예산을 일관되게 제시하고, 인과적인 구간 정렬을 명시하며, 복제가 attention 가중치에 미치는 영향을 설명해야 한다. end-to-end 지연 시간과 메모리 측정도 필요하다. BoolQ와 RACE의 성능 하락은 제안한 세분성 절충과 부합하지만, 실험은 토큰 충실도 손실을 원인으로 분리해 확인하지 않는다.