


Train Long, Think Short: Curriculum Learning for Efficient Reasoning 요약 설명
12 Aug 2025 | Paper Review Curriculum Learning Length-Controlled Generation Reinforcement Learning With Verifiable Rewards이번 글에서는 Train Long, Think Short: Curriculum Learning for Efficient Reasoning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 8월 12일(Arxiv)
- Hammoud, Hasan Abed Al Kader, Alhamoud, Kumail, Hammoud, Abed, Bou-Zeid, Elie, Ghassemi, Marzyeh, Ghanem, Bernard.
- King Abdullah University of Science and Technology (KAUST), Saudi Arabia, Massachusetts Institute of Technology (MIT), Cambridge, MA, USA, Princeton University, Princeton, NJ, USA
- 논문 링크
- Github
요약
- 이 논문은 대규모 언어 모델이 수학 문제를 풀 때 정답 정확도를 유지하면서 생성 텍스트의 단위인 토큰 사용량을 줄이는 방법을 연구한다. 초등학교 수준의 산술 데이터셋 GSM8K로 학습한 QWEN-2.5-7B에서 목표 길이를 256토큰에서 87토큰으로 점차 줄이면 정확도가 86.20%에 도달한다. 목표를 87토큰으로 고정한 학습의 정확도는 82.71%이며, 평균 토큰 사용량은 거의 같다.
- 이 방법은 학습 제약을 점차 강화하는 커리큘럼 학습과, 같은 질문에 대한 후보 응답들의 보상을 정규화하는 Group Relative Policy Optimization (GRPO)을 결합한다. 보상에는 자동으로 검증한 정답 여부, 현재 목표 토큰 수와의 근접도, 추론과 최종 답변을 구분하는 구조 태그를 반영한다.
- 개별 설계 요소를 바꾸어 비교하는 ablation 실험은 보상 함수의 형태와 토큰 예산의 변화 경로가 정확도와 길이의 절충 관계에 영향을 준다는 점을 보여준다. 목표 길이에서 보상이 최대가 되는 삼각형 보상은 135토큰에서 평균 정확도 57.9%를 기록했다고 보고한다. 목표 이하의 모든 길이에 최대 보상을 주는 flat-band 보상은 94토큰에서 55.0%를 기록한다. 실험 근거는 모델 1개와 수학 벤치마크에 한정되며, 보고된 출력 길이는 명목상 목표인 87토큰을 자주 초과한다.
1 Introduction
서론은 주석이 달린 예시로 학습하는 지도 미세조정과, 보상 피드백으로 생성 응답을 최적화하는 강화학습을 구분한다. Chain-of-thought는 답변 전에 생성하는 중간 추론 단계를 뜻한다. 제안한 커리큘럼은 초기에 긴 추론을 허용한 뒤 이를 압축하도록 유도한다.
- 이 논문의 기여는 학습 목표 길이를 변화시키는 데 있다. 저자들은 초기에 긴 응답을 허용하면 모델이 풀이 전략을 탐색한 뒤 이를 간결하게 표현하는 방법을 학습할 수 있다고 제안한다.
- 구현에는 논문에 명시된 학습 소프트웨어 torchtune을 사용한다. 코드와 체크포인트는 https://github.com/hammoudhasan/curriculum_grpo 에서 제공한다.
2 Related Work
관련 연구는 추론 시 연산량을 늘리는 test-time scaling과 추론 길이를 제어하는 방법을 다룬다. 예시로는 샘플링한 추론 경로 중 가장 일관된 답을 선택하는 self-consistency, 효용이 낮은 토큰을 억제하는 TokenSkip, 간결한 중간 초안을 작성하도록 요청하는 Chain of Draft가 있다.
- Thinkless는 문제 난도에 따라 짧은 추론 경로와 긴 추론 경로 중 하나를 선택하고 ConciseRL은 학습된 간결성 점수를 강화학습 보상에 반영한다.
- Length Controlled Policy Optimization (LCPO)은 모델이 프롬프트에 지정된 사용자의 길이 예산을 따르도록 학습한다. 이 논문은 학습 목표 길이를 줄이는 과정이 짧은 응답을 생성하도록 설계한 모델에 어떤 영향을 주는지 연구한다.
- 저자들은 학습한 모델이 추론 시 예산을 알려주지 않아도 평균적으로 목표 대비 약 5% 이내의 길이를 유지한다고 설명한다. 이후 측정에서는 여러 벤치마크의 출력 길이가 이 범위를 초과하므로, 이 설명만으로 엄격한 상한을 전반적으로 준수한다고 볼 수는 없다.
3 Methodology
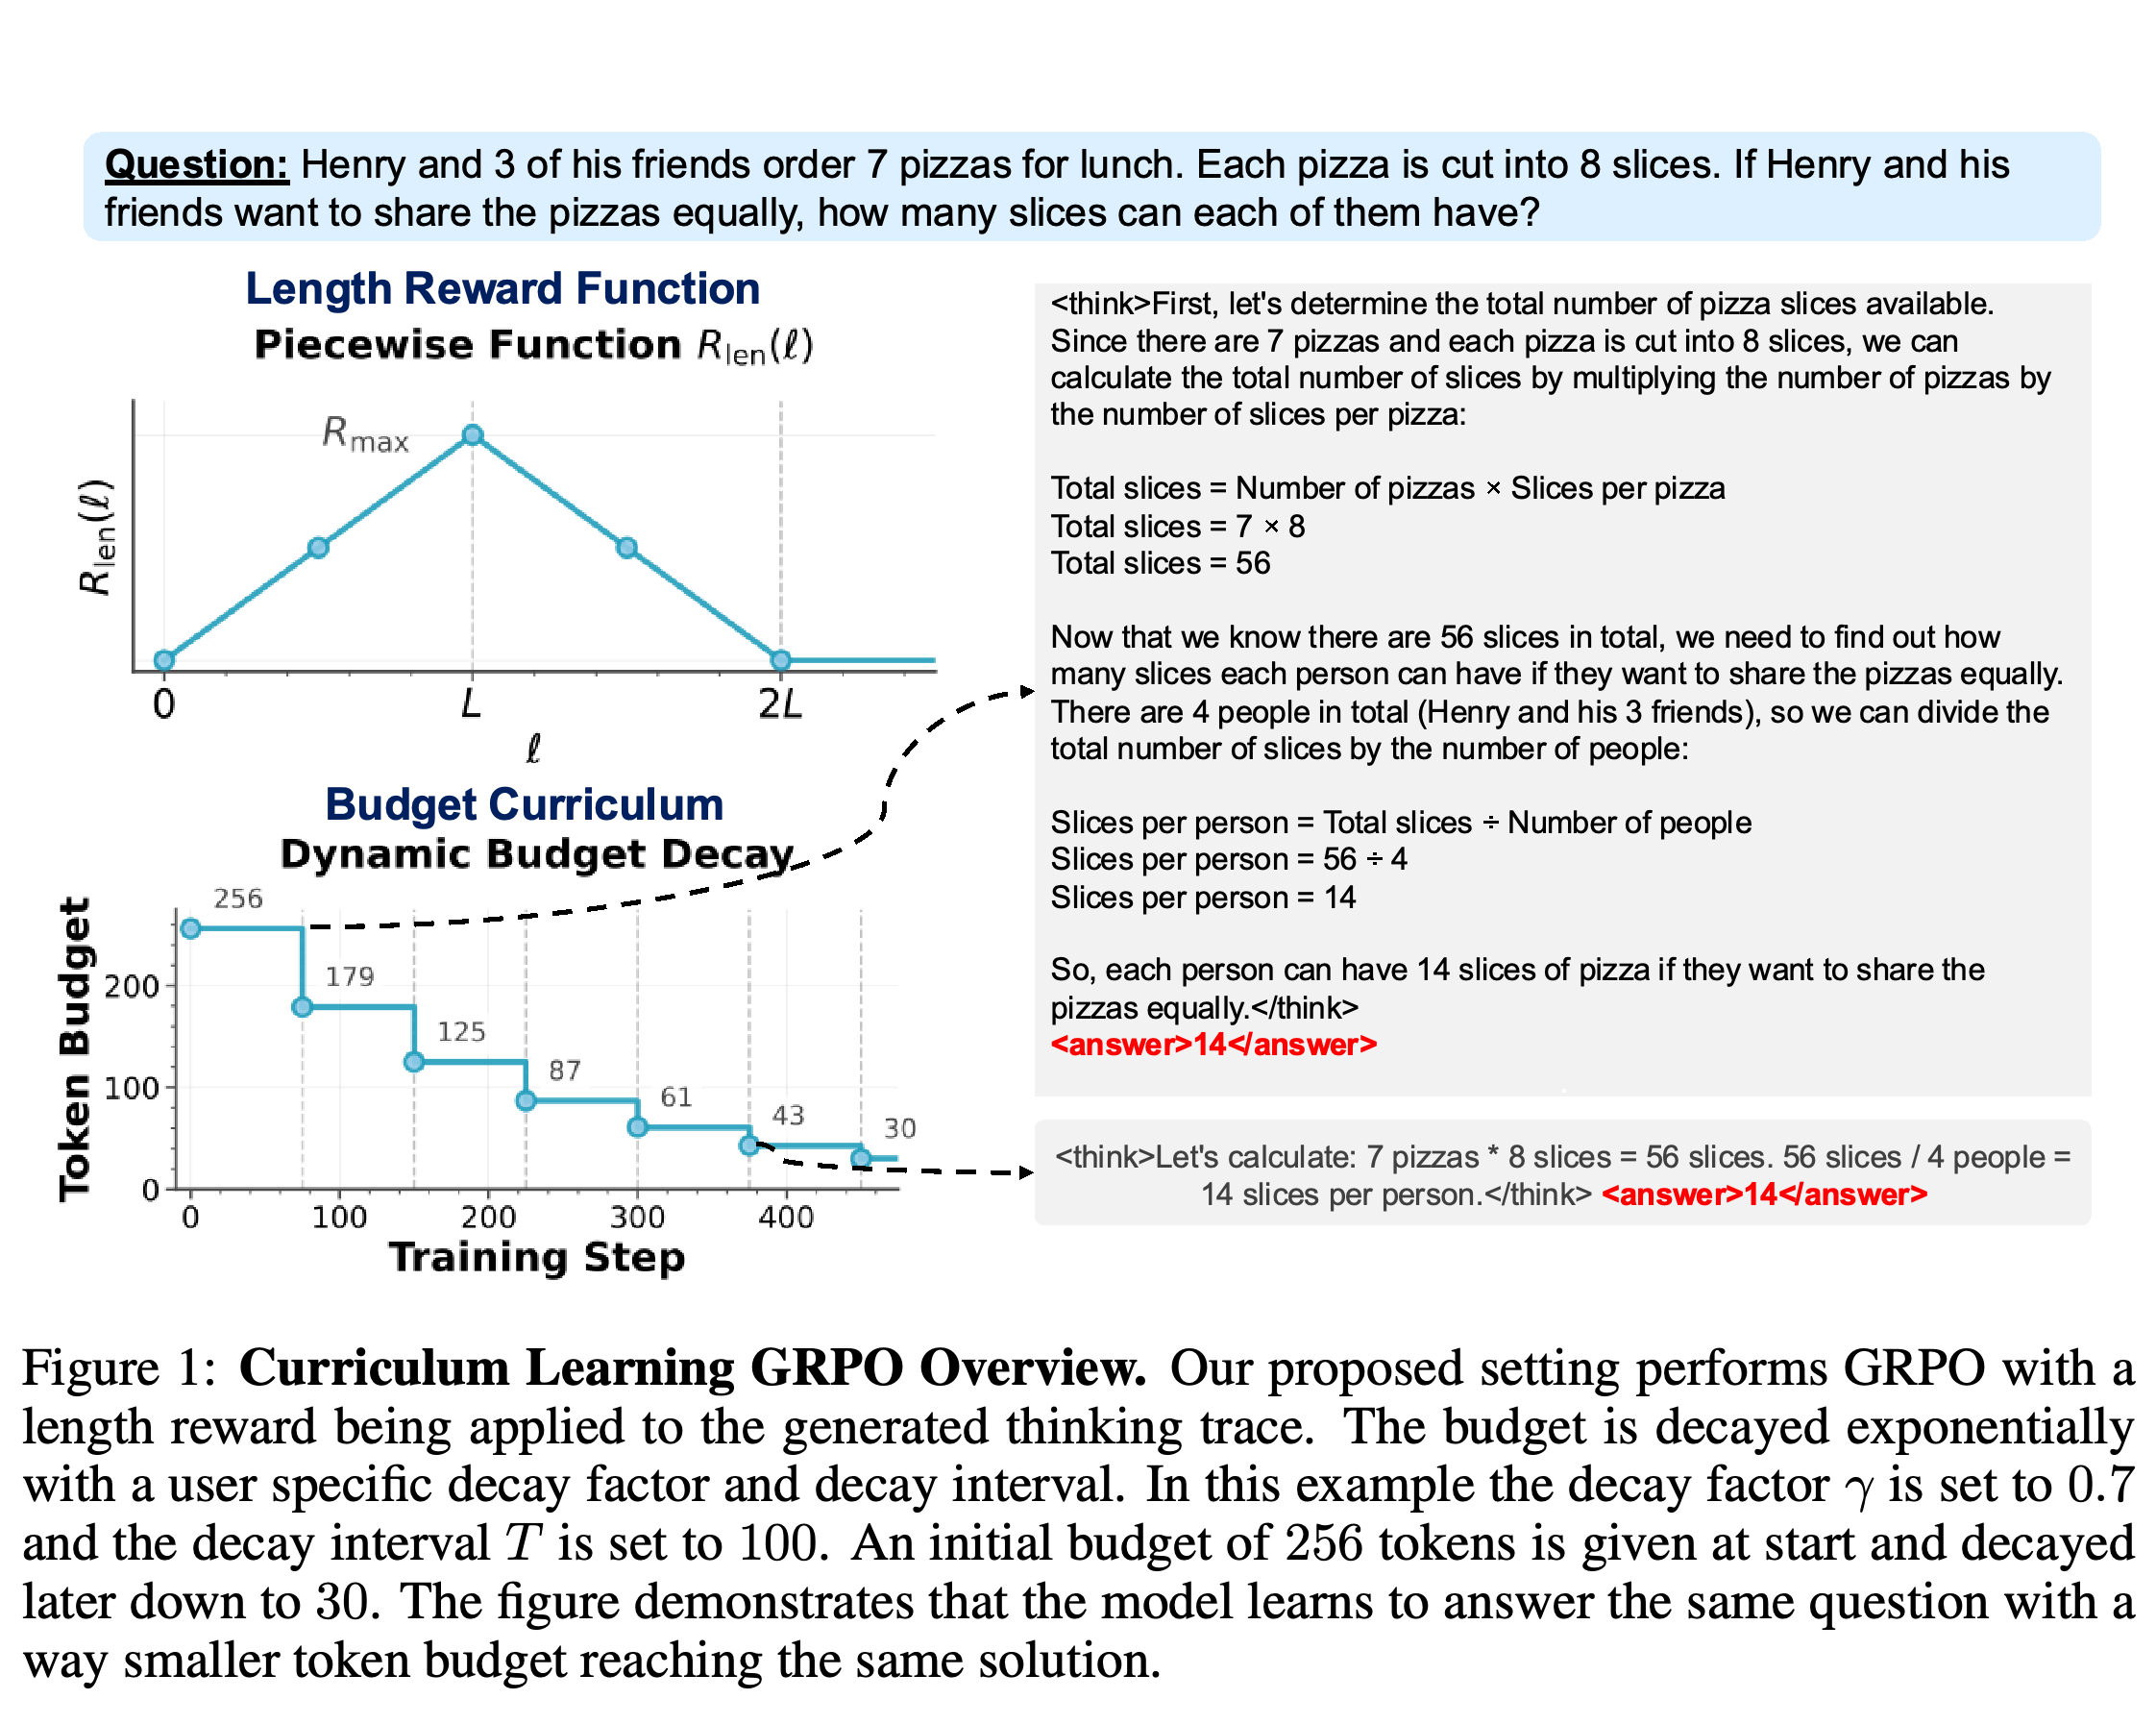
제안 방법은 GRPO에 3가지 보상 요소를 추가한다. 최종 답변에서 검증한 정답 여부, 현재 커리큘럼 목표 길이의 준수 정도, 추론과 답변 형식의 유효성이다. Figure 1은 같은 답을 유지하면서 장황한 풀이를 짧은 풀이로 바꾸는 과정을 보여준다.
이 그림은 현재 목표에서 최대가 되는 삼각형 보상과 단계적인 예산 감소를 함께 보여준다. 피자 예시는 답 14를 유지하면서 표시된 풀이를 줄인다. 예시 스케줄은 γ = 0.7과 T = 100을 사용해 256토큰에서 30토큰으로 줄이지만 주요 실험의 최종 목표는 87이다.
3.1 GRPO Preliminaries
각 프롬프트에 대해 이전 정책은 G개의 응답으로 이루어진 그룹을 생성하며 각 응답에는 스칼라 보상을 부여한다. 이전 정책은 업데이트 전에 응답을 샘플링하는 데 사용하는 모델의 확률 분포다. GRPO는 그룹 내 상대적 advantage \(A_i=\frac{r_i-\mu}{\sigma}\)를 계산한다. 이는 응답의 보상을 그룹과 비교해 정규화한 값이며 μ와 σ는 각각 그룹 보상의 평균과 안정화된 표준편차다.
- 목적 함수는 업데이트된 정책과 이전 정책의 확률 비율을 사용한다. 이 비율을 ε로 제어하는 범위 안에서 클리핑해 업데이트에 대한 기여를 제한한다.
- 참조 정책에서 벗어난 정도를 측정하는 Kullback–Leibler divergence 페널티에는 β를 가중치로 적용한다. 이 페널티는 클리핑을 적용한 보상 기반 목적 함수에 규제 항으로 작용한다.
3.2 Prompt Structure
학습 프롬프트는 추론을 <think></think> 안에, 최종 답변을 <answer></answer> 안에 작성하도록 요청하며 정확히 {token_budget}토큰을 사용하라고 명시한다. 관련 보상은 생성 길이를 목표에 가깝게 유도하지만 보고된 측정 결과를 보면 이 요청이 정확한 출력 길이를 보장하지는 않는다.
3.3 Reward Decomposition and Weighting
총보상은 r_i = λ_c r_i^correct + λ_ℓ R_len(ℓ_i) + λ_f R_fmt(a_i)이며, 정답 여부, 길이, 형식에 음이 아닌 가중치를 적용한다. 자동 검증기 math-verify는 answer 태그에서 추출한 답을 검사한다. 정답 보상은 이진 통과 지표 c_i를 사용하는 R_cor c_i다.
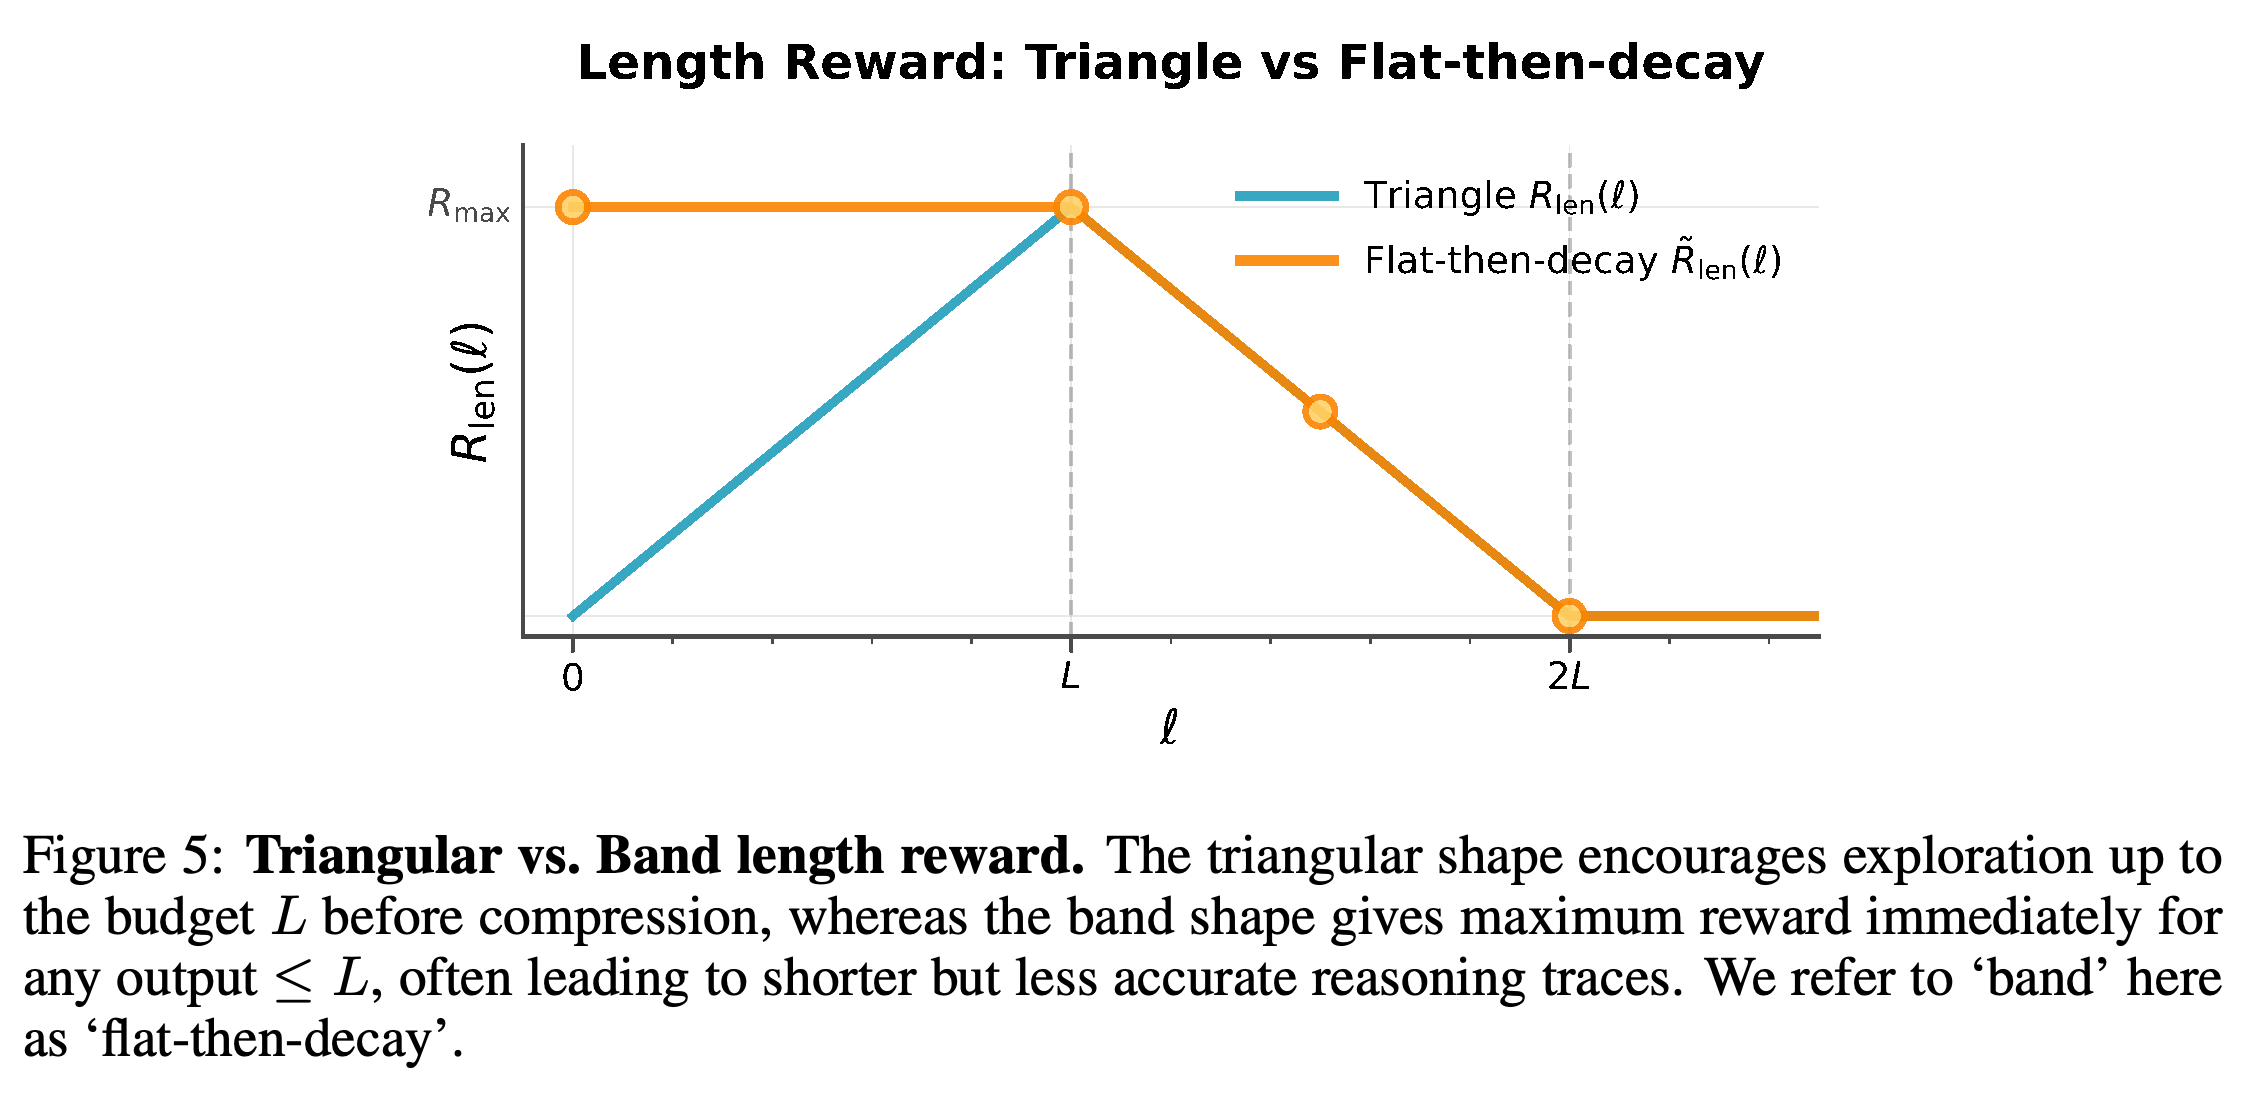
- 삼각형 길이 보상은 길이 0에서 보상 0으로 시작해 목표 L에서 R_max까지 선형으로 증가한다. 이후 2L에서 0이 되도록 선형으로 감소하며 2L을 넘으면 0을 유지한다. 이 보상은 목표 길이와의 일치를 유도하며 길이를 최소화하도록 유도하지는 않는다.
- 형식 보상은 올바른 형식을 갖추고 서로 겹치지 않는 추론 구간과 답변 구간에 각각 양의 보상을 더한다.
- 부분 정답 점수는 선택적 확장 기능으로 설명한다. PDF에는 실험에서 이를 사용했는지 확인할 근거가 없다.
3.4 Curriculum Token Budget
커리큘럼의 토큰 예산은 B(t) = max(1, B_0 γ^{⌊t/T⌋})로 설정한다. B_0는 초기 토큰 예산, γ ∈ (0,1)은 감소 계수, T는 예산 업데이트 간격이다. 길이 보상의 목표 L을 B(t)로 설정해 학습 중 길이에 대한 제약을 점차 강화한다.
4 Experiments
실험은 최종 목표 길이가 같을 때 커리큘럼 학습이 정확도와 길이의 절충 관계를 개선하는지, 쉬운 학습 데이터와 어려운 학습 데이터 모두에서 개선이 유지되는지 살펴본다. 추가로 4가지 질문을 통해 정답 보상과 길이 보상의 가중치, 감소 지점 수, 삼각형 보상과 flat-band 보상, 지수 스케줄과 선형 스케줄을 비교한다.
4.1 Setup
모든 실험은 QWEN-2.5-7B와 GRPO 그룹 크기 G = 8을 사용한다. 비교 대상은 변경하지 않은 기본 모델, 87토큰을 목표로 하는 고정 예산 GRPO, 목표를 256토큰에서 87토큰으로 줄이는 커리큘럼 GRPO다.
- 별도의 학습 조건에서 GSM8K의 초등학교 수준 문제 7,473개 전체 또는 MATH 데이터셋에서 가져온 대회 수준의 MATH500 문제 500개를 사용한다. 주요 체크포인트 그래프는 600 steps까지의 학습을 보여준다.
- 평가는 과제 시범 예시를 제공하지 않는 zero-shot prompting으로 GSM8K, SVAMP, GSM+, MATH500, College Math에서 수행한다. 논문은 SVAMP를 변형된 문장제 문제, GSM+를 적대적으로 변형한 GSM8K 문제, College Math를 대학 수준 수학으로 설명한다.
- 실험 설정은 MATH500을 학습 데이터와 평가 데이터로 모두 명시하지만 서로 겹치지 않는 분할은 설명하지 않는다. 따라서 보고된 결과만으로 학습에서 보지 못한 MATH500 문제에 대한 성능을 확인할 수는 없다.
4.2 Curriculum Learning Vs. Fixed Budget
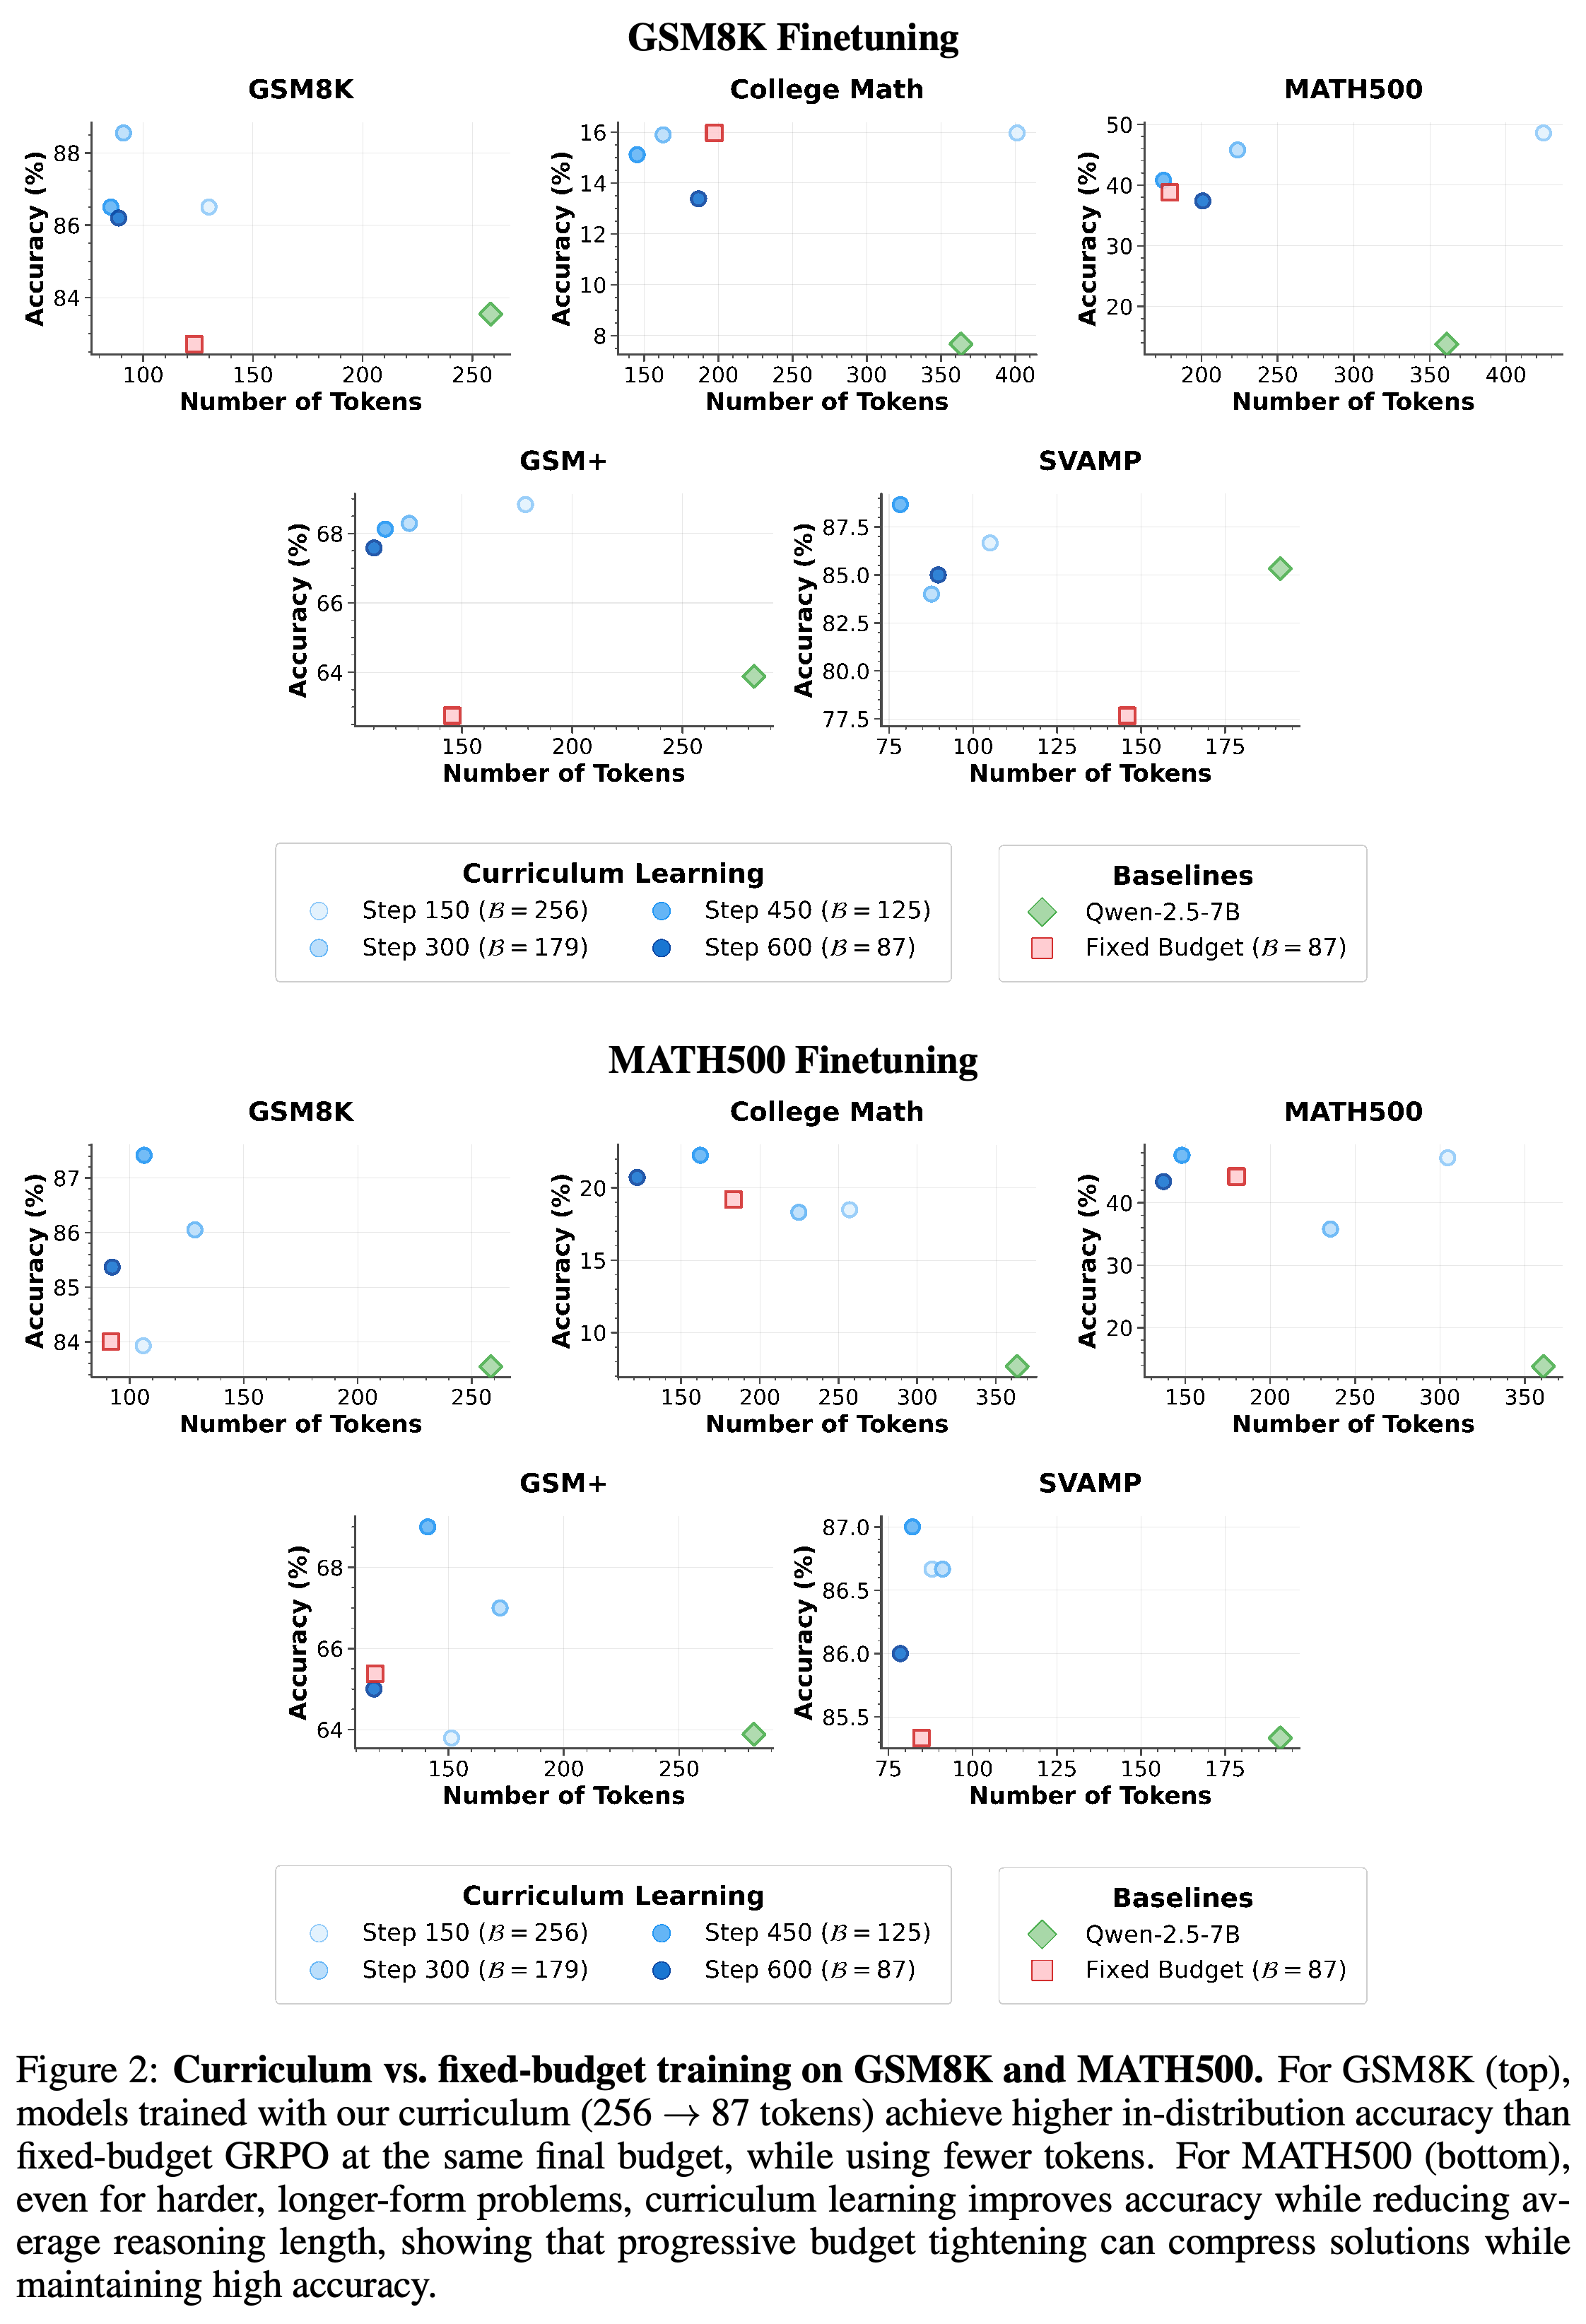
GSM8K-trained 모델에서는 커리큘럼 학습이 GSM8K 정확도를 82.71%에서 86.20%로 높인다. Section 4.2는 평균 토큰 사용량을 커리큘럼 학습에서 88.8, 고정 예산 학습에서 87.0으로 보고한다. 기본 모델은 258.4토큰을 사용해 정확도 83.55%를 기록한다.
- 학습 분포와 다른 벤치마크를 사용하는 out-of-distribution 평가에서 본문은 SVAMP 정확도가 77.67%에서 85.00%로, GSM+ 정확도가 62.75%에서 67.58%로 증가했다고 보고한다.
- MATH500-trained 모델에 대해 본문은 정확도가 38.80%에서 43.40%로 증가하고 평균 추론 길이는 179.3에서 137.1토큰으로 감소했다고 보고한다. Figure 2의 MATH500 고정 예산 표식은 명시된 38.80%와 일치하지 않는 것으로 보인다.
- Figure 2는 모든 벤치마크에서의 우위를 뒷받침하지 않는다. GSM8K 학습 후 College Math에서, MATH500 학습 후 GSM+에서 최종 커리큘럼 지점의 정확도가 고정 예산 지점보다 낮다.
각 패널은 GSM8K-trained 모델과 MATH500-trained 모델을 여러 벤치마크에서 평가해 평균 토큰 수와 정확도의 관계를 표시한다. 최종 커리큘럼 지점은 기본 모델보다 출력이 크게 줄었지만 일부 패널에서는 정확도가 고정 예산 학습보다 낮다. 하단 패널의 MATH500 고정 예산 표식도 Section 4.2의 수치 비교와 일치하지 않는 것으로 보인다.
4.3 Reward Weight Ablations: Correctness Vs. Length
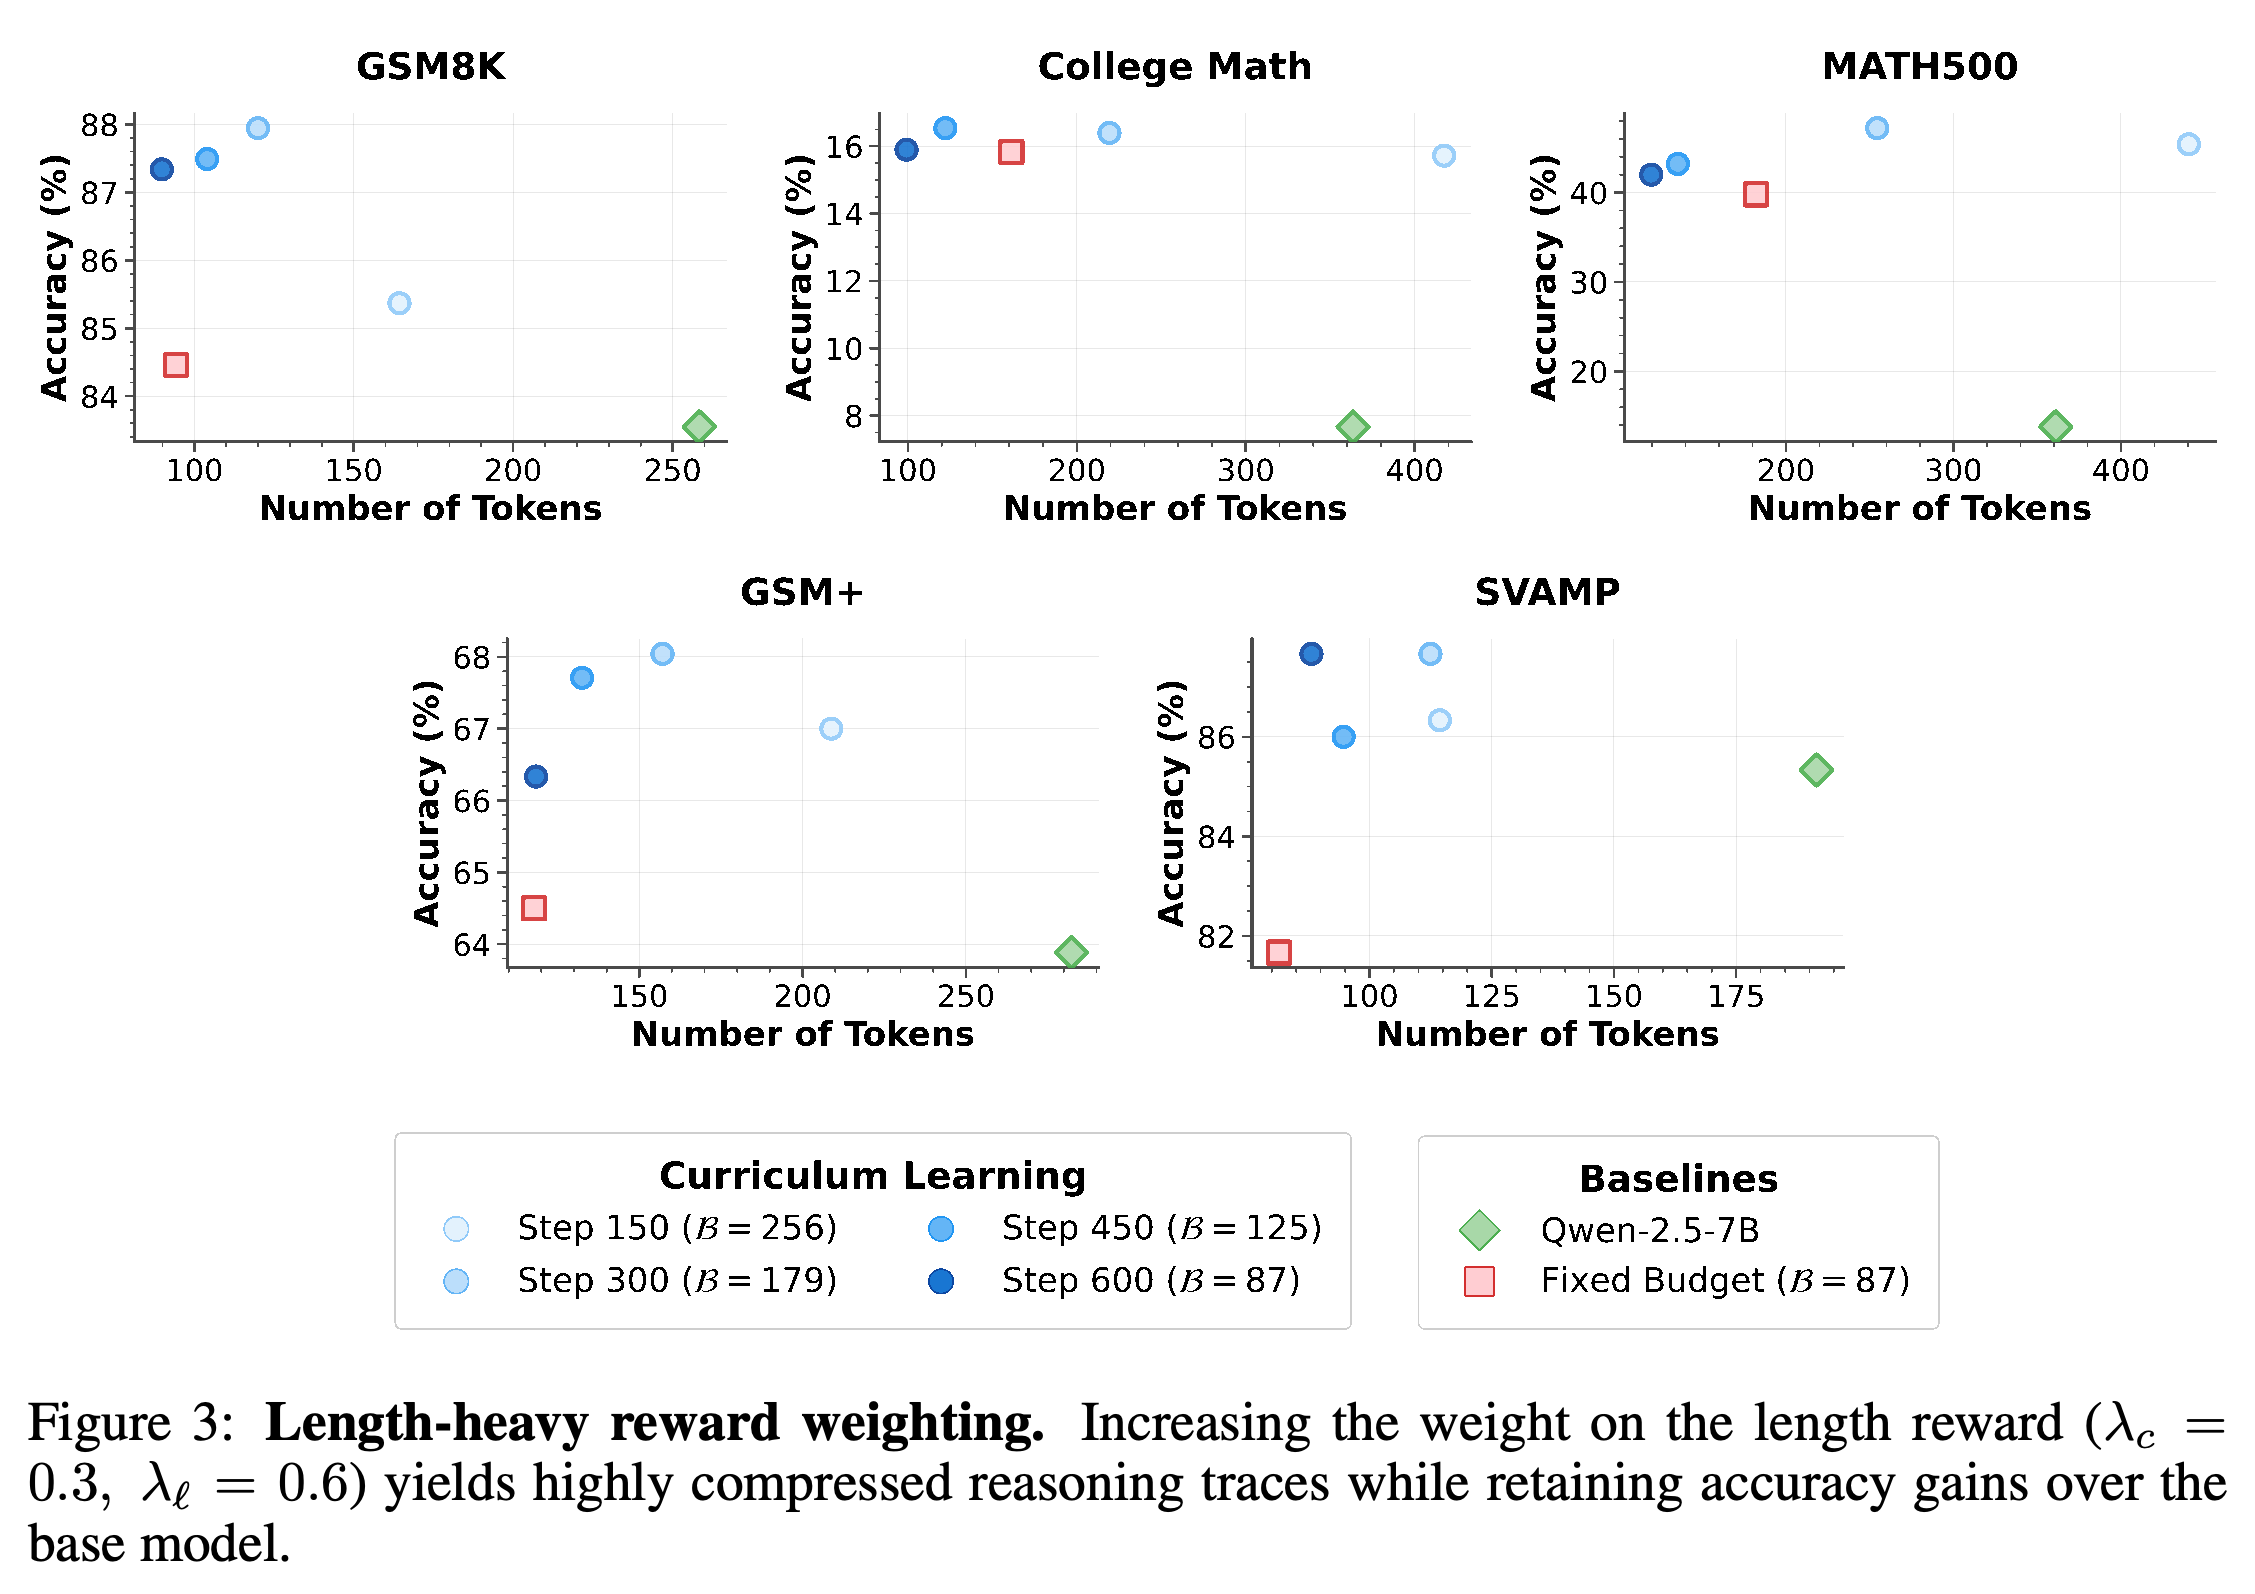
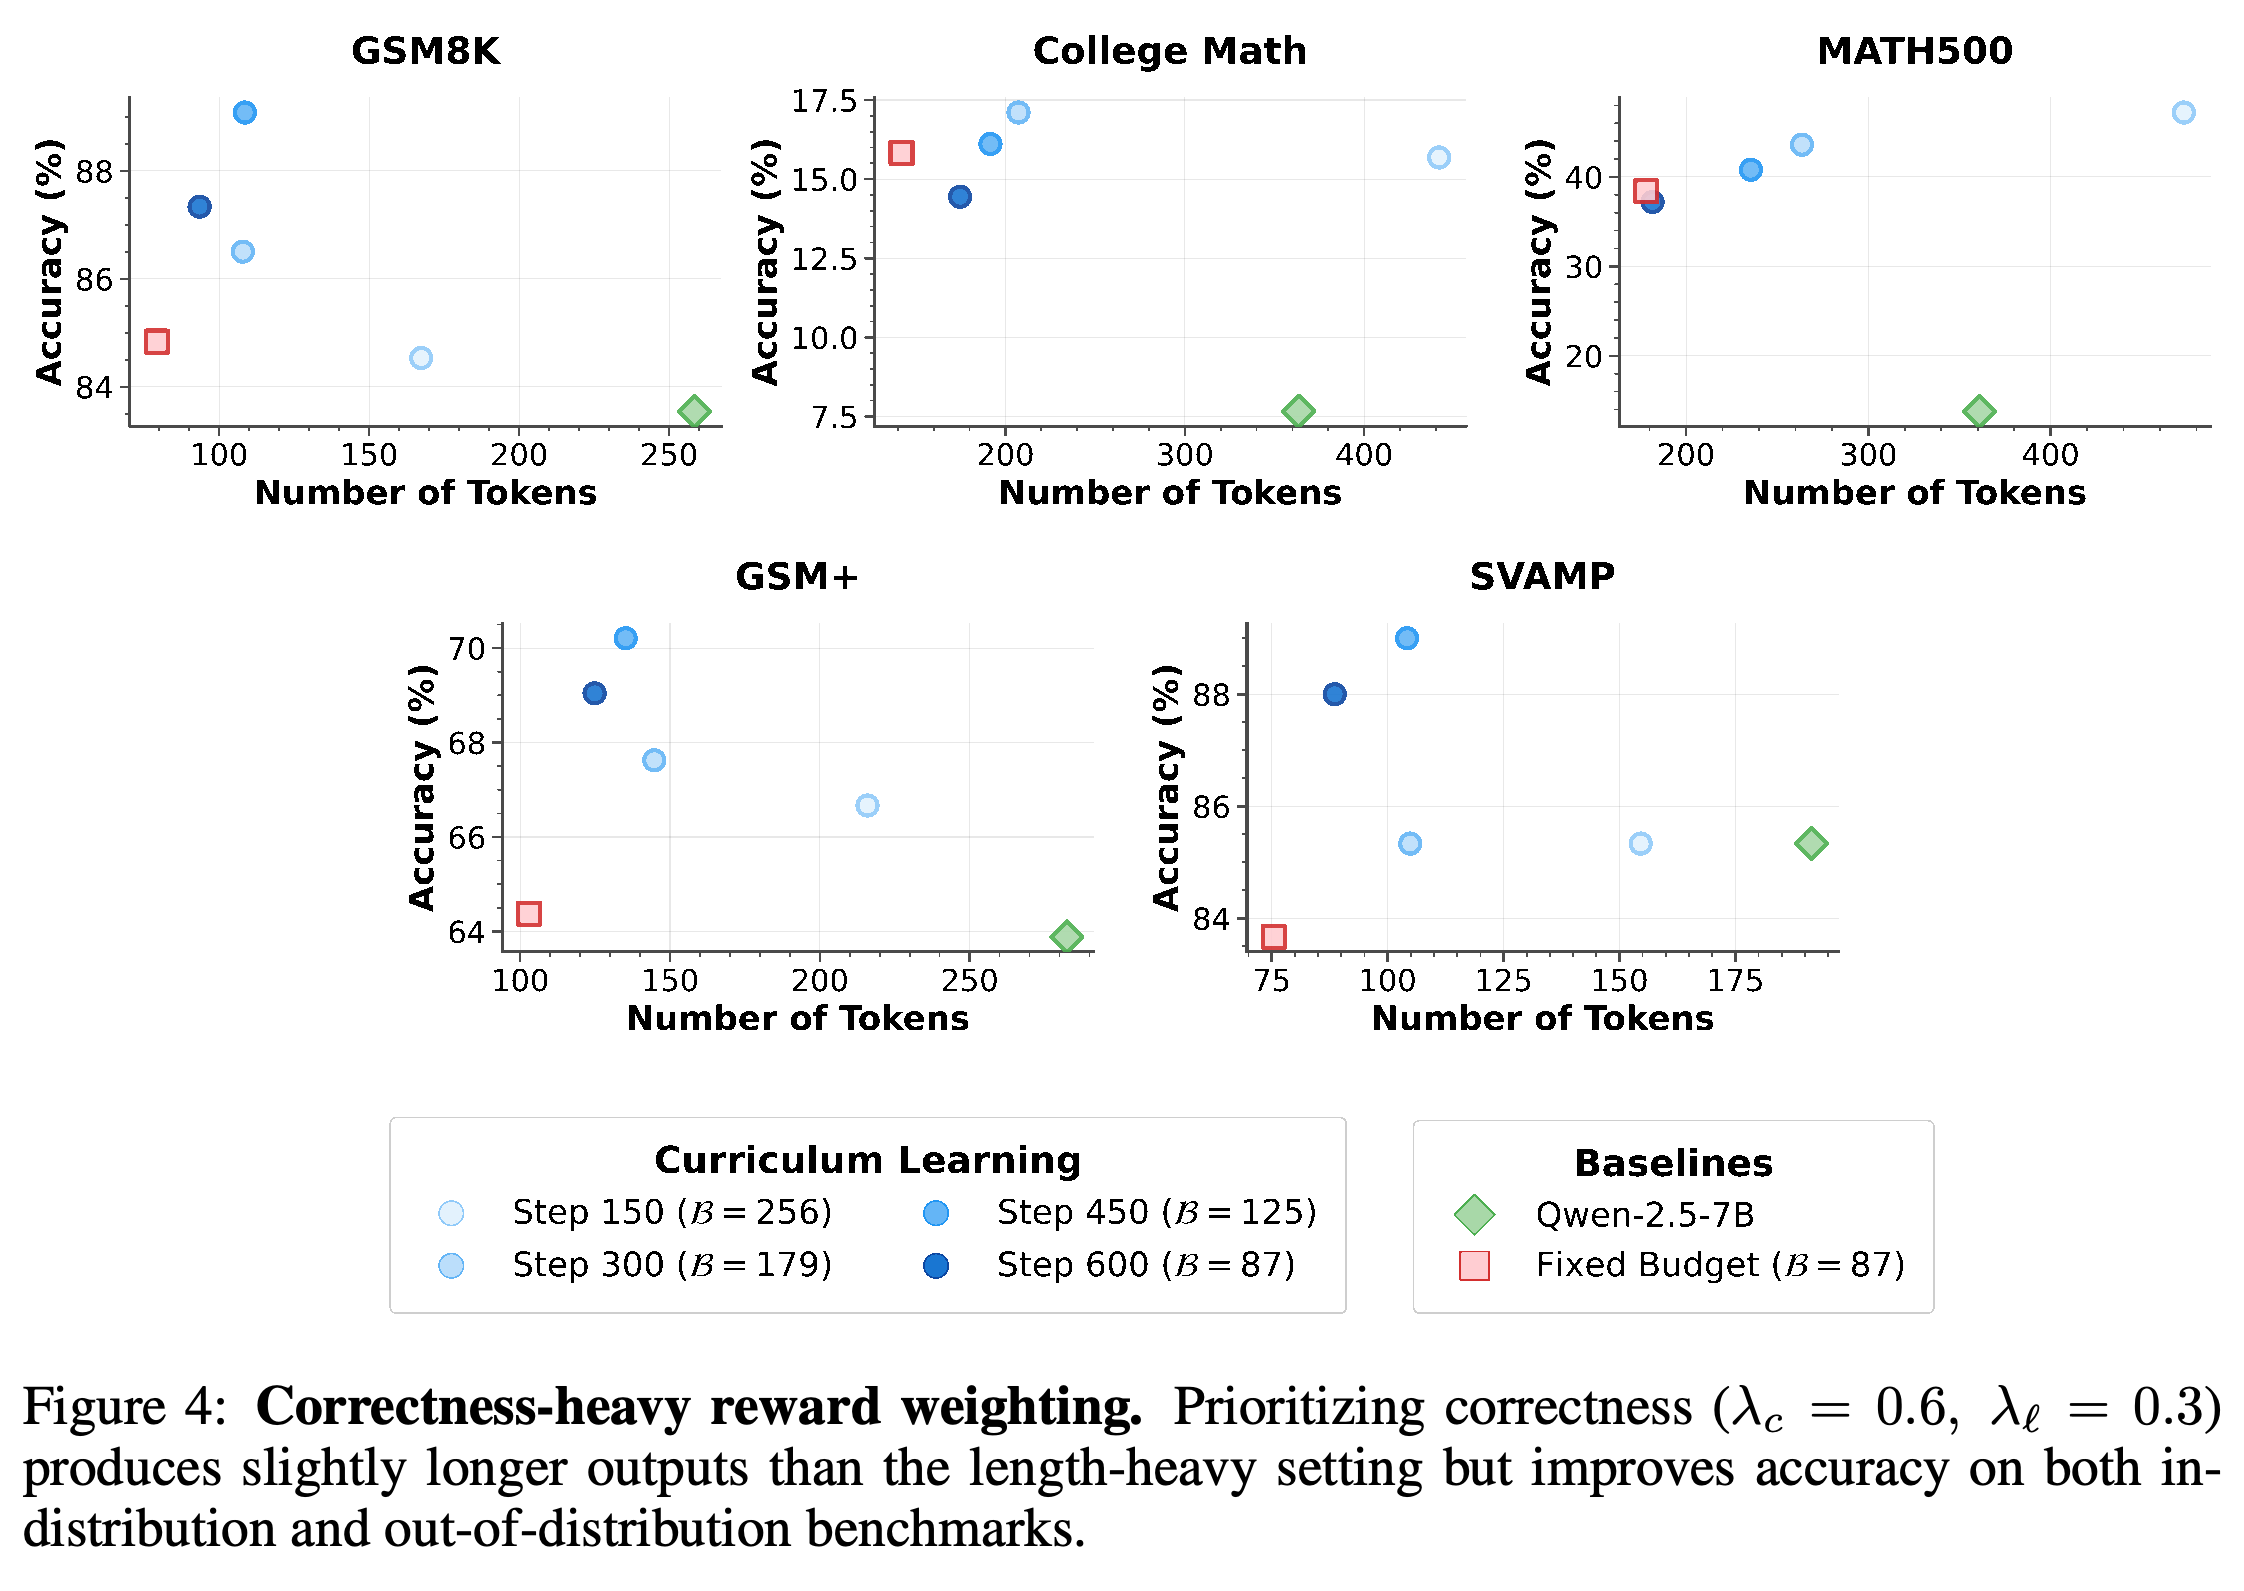
이 ablation 실험은 길이 중심 가중치 λ_c = 0.3, λ_ℓ = 0.6과 정답 중심 가중치 λ_c = 0.6, λ_ℓ = 0.3을 비교한다. Section 4.3은 최종 GSM8K 정확도를 길이 중심 학습에서 92.3토큰에 85.37%, 정답 중심 학습에서 93.5토큰에 87.34%로 보고한다.
- 본문 수치에 따르면 정답 여부에 더 큰 가중치를 부여할 때 정확도는 1.97%p 높아지고 평균 토큰 사용량은 1.2토큰 늘어난다.
- 본문은 정답 중심 학습이 SVAMP와 GSM+에서 1–2 points의 개선을 보였다고 보고한다. Figure 3의 최종 GSM8K 지점은 약 87.3%로 보여, 명시된 길이 중심 결과인 85.37%와 충돌한다. 이 수치를 비교하려면 불일치를 해소해야 한다.
길이 중심 조건은 λ_c = 0.3과 λ_ℓ = 0.6을 사용한다. 후반 체크포인트는 대체로 초기 체크포인트보다 토큰을 적게 사용한다. 그래프의 최종 GSM8K 정확도는 약 87.3%로 보여, Section 4.3에서 이 조건에 대해 명시한 85.37%보다 높다.
정답 중심 조건은 λ_c = 0.6과 λ_ℓ = 0.3을 사용한다. 출력이 짧아지는 동안 정확도는 체크포인트마다 달라지며, 최종 커리큘럼 지점은 College Math와 MATH500에서 고정 예산 학습보다 정확도가 낮다.
4.4 Effect of Curriculum Schedule
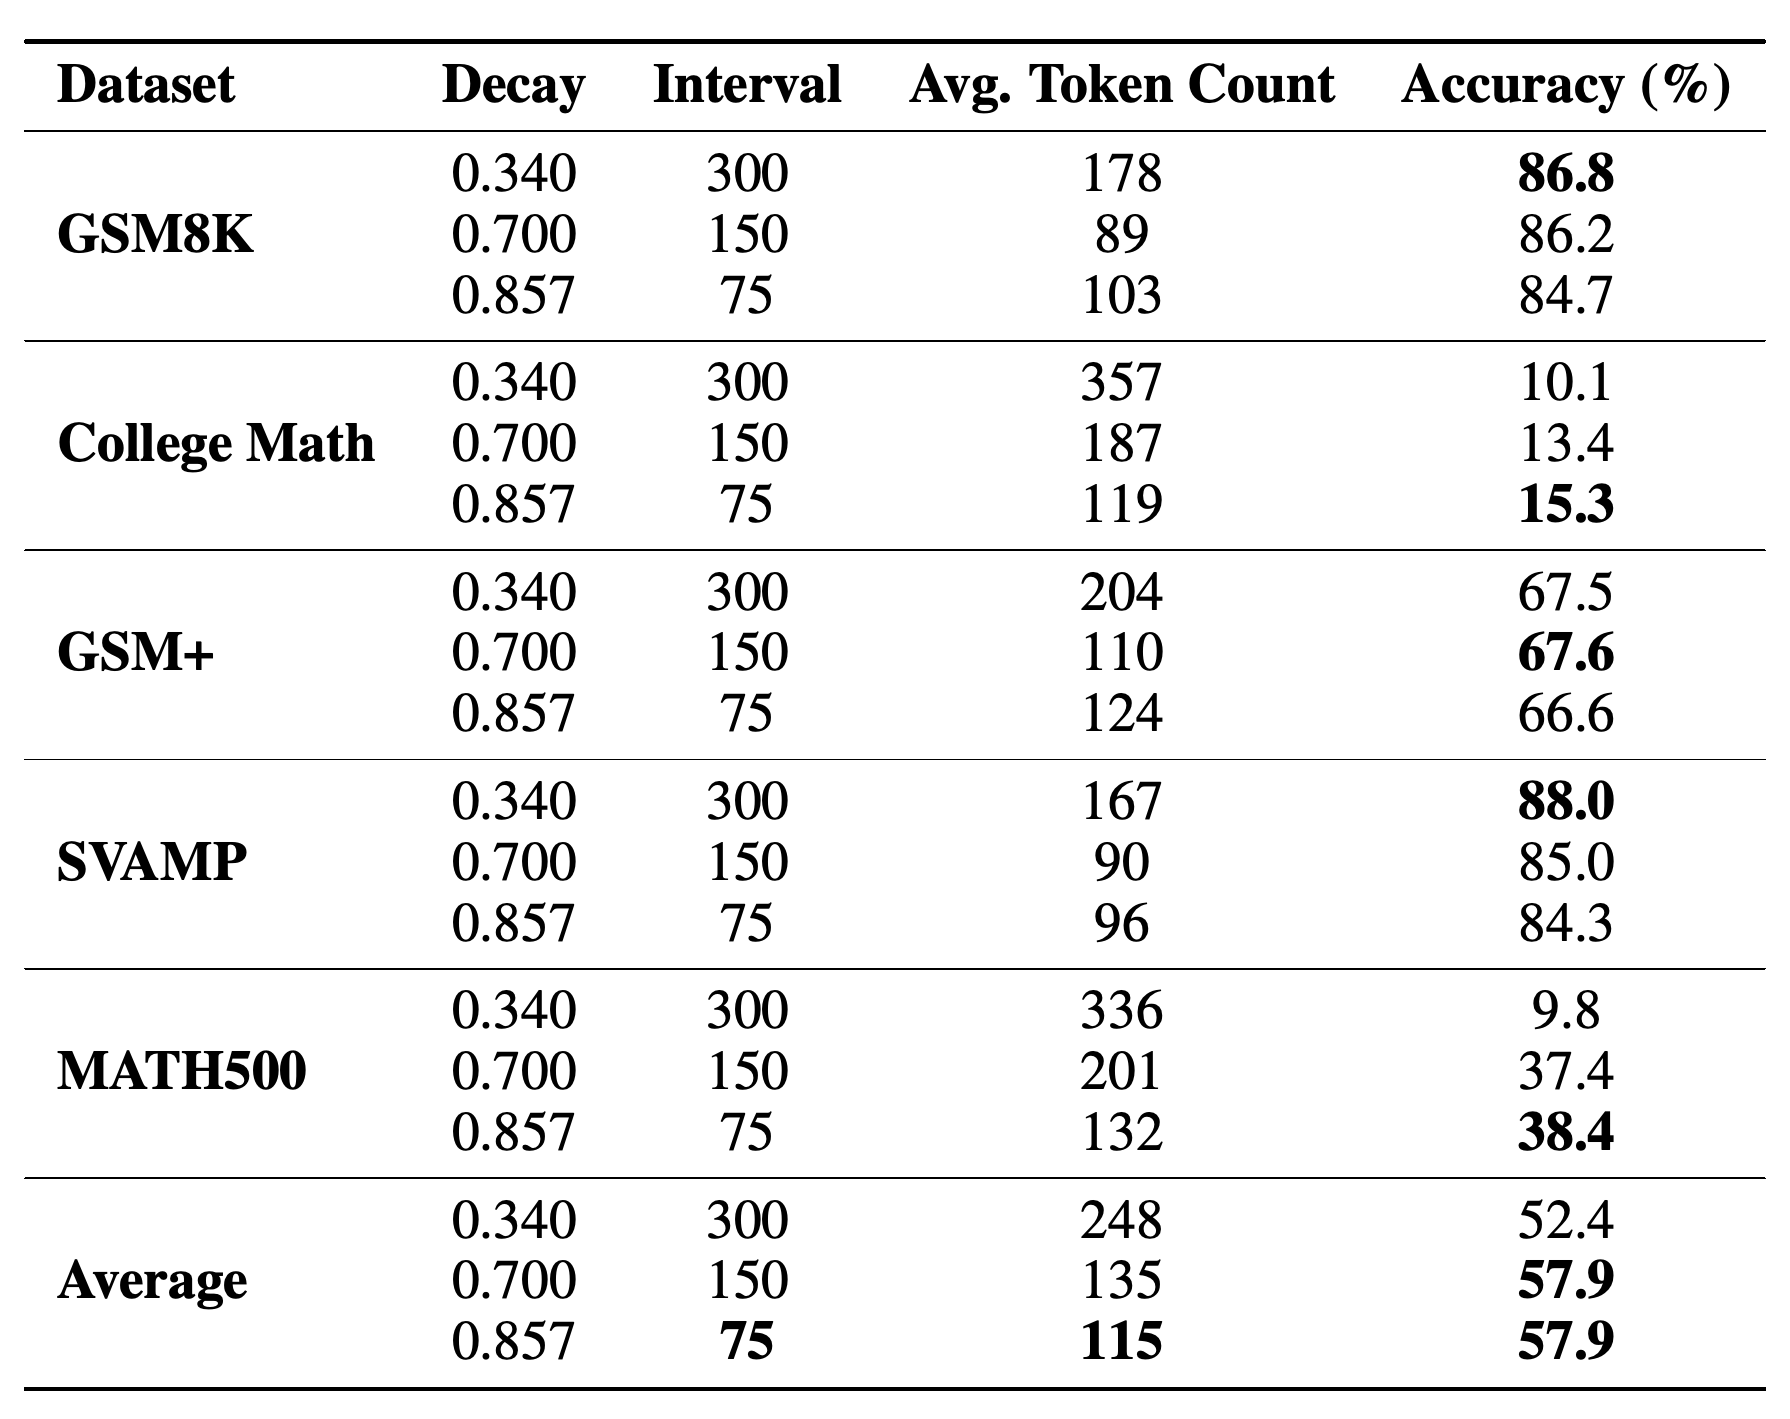
스케줄 ablation 실험은 초기 목표 S_0 = 256과 최종 목표 S_f = 87을 고정하고 감소 지점 수 n을 바꾼다. 스케줄은 다음 식으로 정의한다: \(I=\frac{T}{n+1},\qquad S_k=S_0d^k,\qquad d=\left(\frac{S_f}{S_0}\right)^{1/n}\). 여기서 T는 Section 3.4의 업데이트 간격이 아니라 전체 학습 스텝 수를 뜻한다.
- T = 600일 때 n = 1이면 d ≈ 0.340, 간격은 300이다. n = 3이면 d ≈ 0.700, 간격은 150이다. n = 7이면 d ≈ 0.857, 간격은 75다. 각 스케줄은 같은 최종 목표에 도달하지만 도달하는 스텝은 다르다.
- Table 1은 간격 150과 75에서 평균 정확도를 모두 57.9%로 보고하며 평균 토큰 수는 각각 135토큰과 115토큰이다. 간격 300에서는 248토큰에 52.4%를 기록한다.
- 후반에 1번만 감소시키는 스케줄은 GSM8K에서 86.8%, SVAMP에서 88.0%를 기록하지만 MATH500에서는 9.8%에 그친다. 이 비교는 스케줄에 따른 민감도를 보여주지만 제안한 탐색 후 압축 메커니즘을 직접 측정하지는 않는다.
간격 150과 75에서 보고된 평균 정확도는 모두 57.9%이며, 평균 길이는 135토큰과 115토큰이다. 간격 300 조건은 GSM8K와 SVAMP에서 가장 높은 성능을 보이지만 평균 248토큰을 사용하며 평균 정확도는 52.4%다. 이 조건의 MATH500 정확도는 9.8%다.
4.5 Effect of Length Reward Function
대안인 flat-band 보상은 L 이하의 모든 출력에 최대 길이 보상을 주고, 이후 2L에서 0이 되도록 선형으로 감소한다. 이 방식은 목표 길이 이하에서 토큰을 더 사용하도록 유도하는 삼각형 보상의 증가 구간을 제거한다.
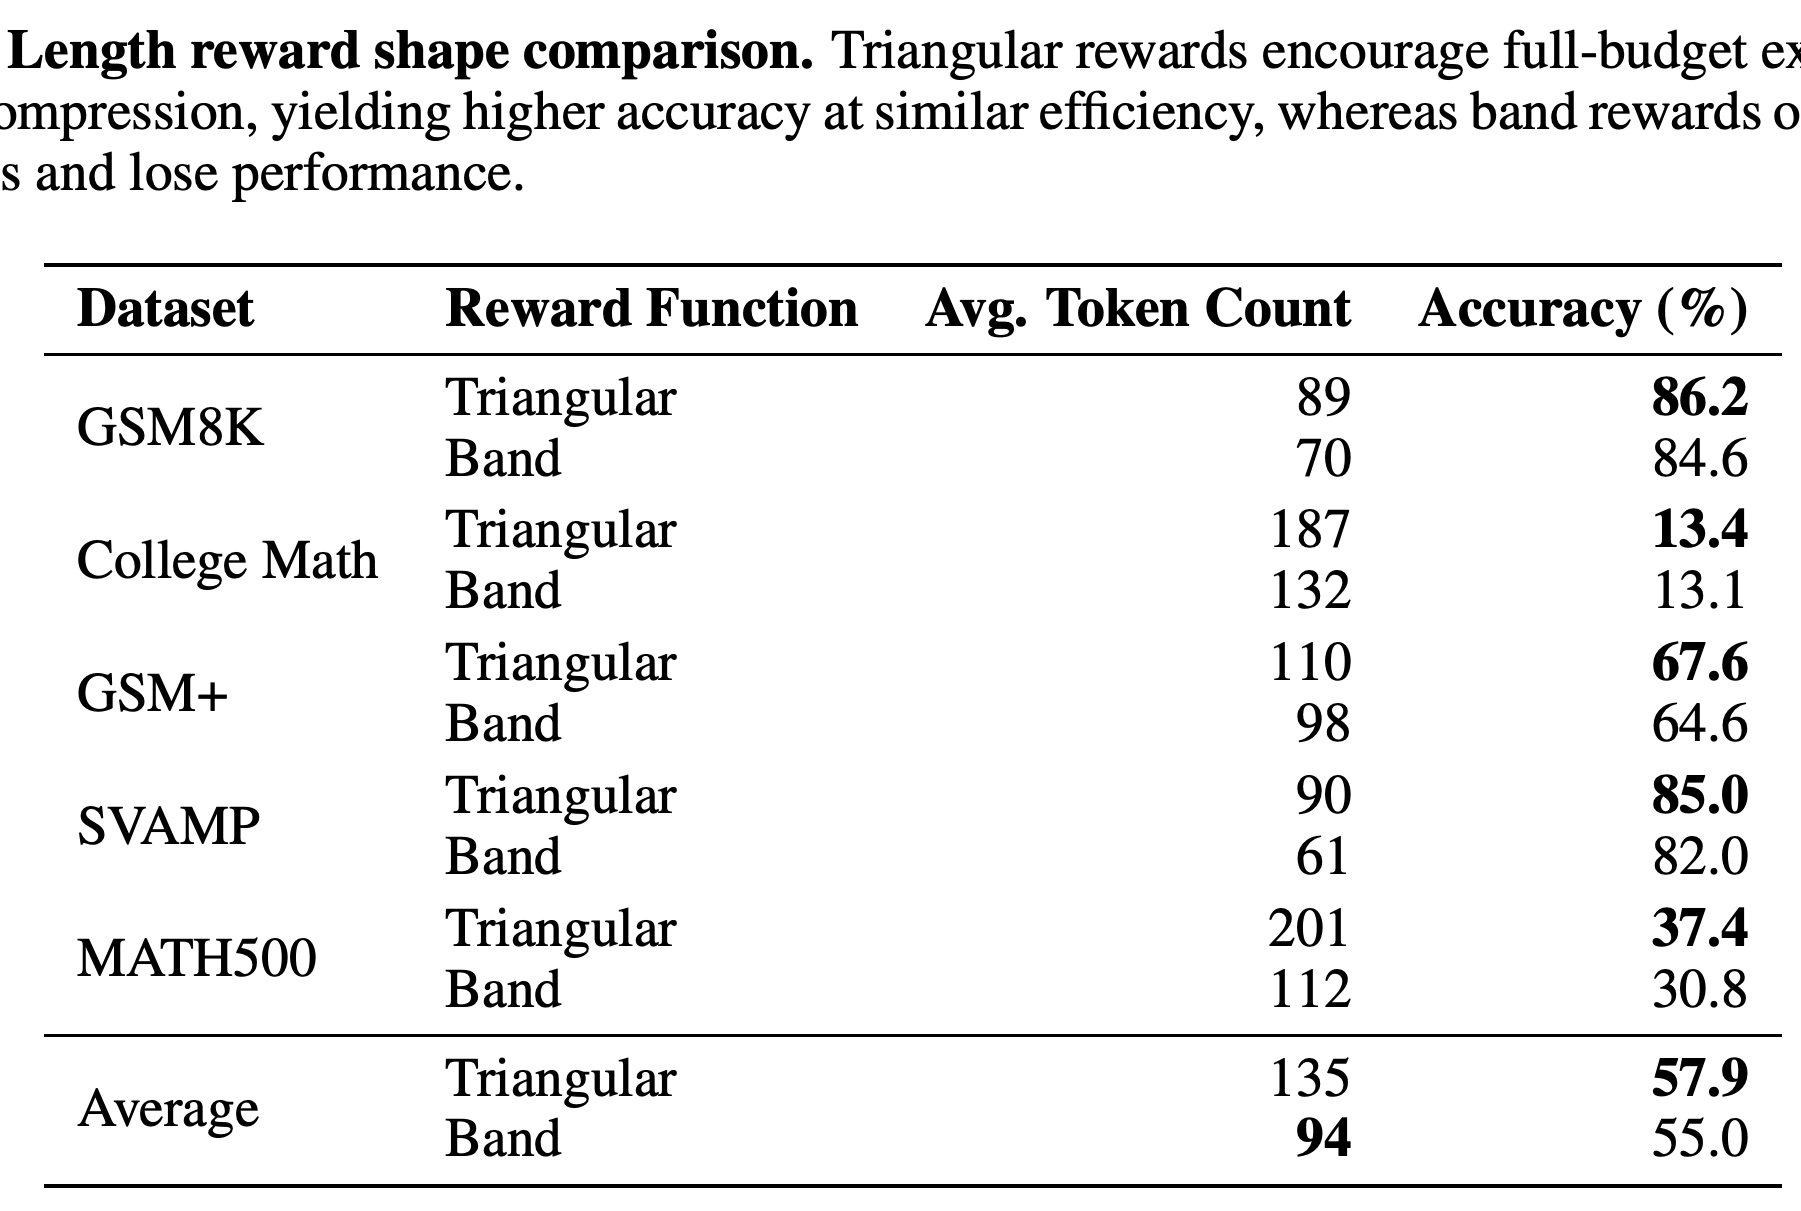
- Table 2는 band 보상에서 평균 94토큰과 정확도 55.0%를, 삼각형 보상에서 135토큰과 57.9%를 보고한다.
- 삼각형 보상은 나열된 모든 벤치마크에서 정확도가 더 높다. 가장 큰 차이는 MATH500에서 나타나며, 삼각형 보상은 201토큰에 37.4%, band 보상은 112토큰에 30.8%를 기록한다.
- 이 결과는 삼각형 보상에서 출력이 더 길고 정확도도 더 높다는 점을 보여준다. 저자들이 제시한 압축 전 탐색이라는 해석에 부합하지만 추론 전략을 발견하거나 유지하는 과정을 직접 측정하지는 않는다.
보상 곡선은 L 이하에서 다르다. 삼각형 곡선은 목표를 향해 증가하고 flat-then-decay 곡선은 이 범위 전체에 최대 보상을 준다. 두 곡선 모두 2L에서 0이 되도록 감소하므로, 목표 이하에서 추론 토큰을 더 사용하도록 하는 유인의 영향을 분리해 비교한다.
Band 보상은 5개 벤치마크 모두에서 출력을 줄이고 정확도를 낮춘다. 보고된 평균은 삼각형 보상의 135토큰과 정확도 57.9%에서 band 보상의 94토큰과 55.0%로 변한다. MATH500 정확도는 6.6%p 낮아진다.
4.6 Effect of Decay Schedule Shape
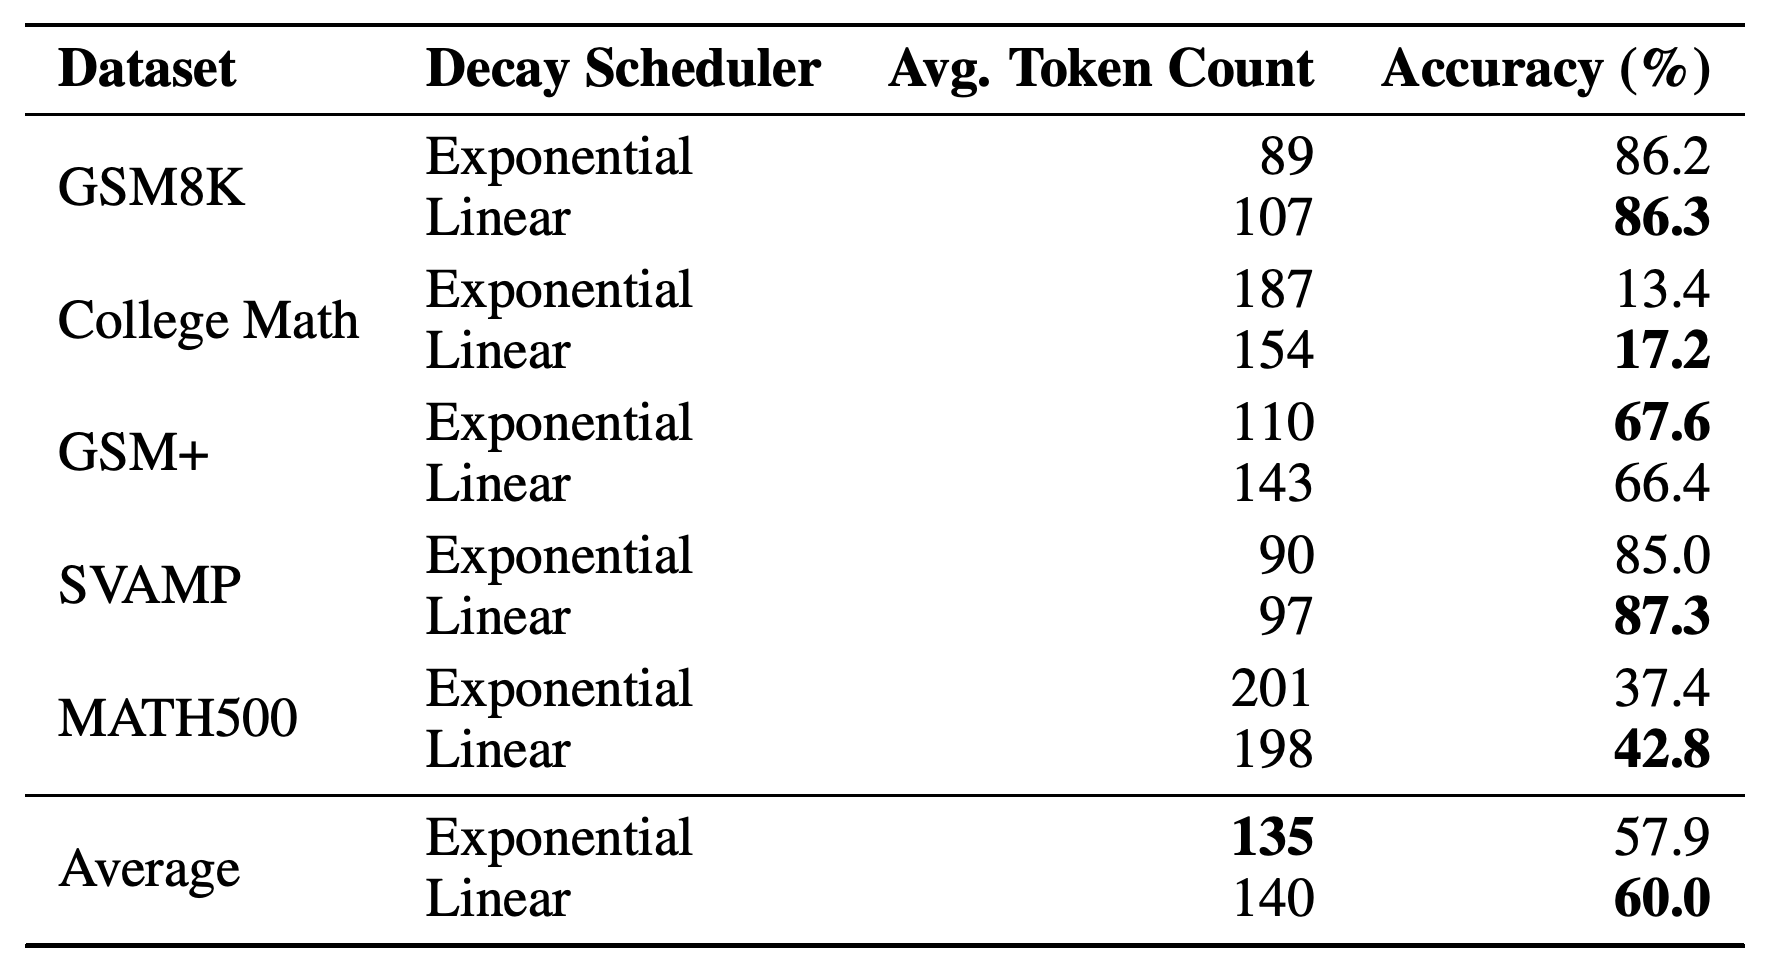
선형 스케줄은 같은 학습 기간에 대략 같은 크기의 감소를 3번 적용해 목표를 256에서 87로 줄인다. 지수 스케줄은 초기에 더 크게 줄이며 두 스케줄 모두 같은 최종 목표에 도달한다.
- Table 3은 지수 감소에서 선형 감소로 바꾸면 평균 정확도가 57.9%에서 60.0%로 증가하고 평균 토큰 수는 135토큰에서 140토큰으로 늘어난다고 보고한다.
- 선형 감소는 MATH500 정확도를 37.4%에서 42.8%로, College Math 정확도를 13.4%에서 17.2%로 높인다. 해당 데이터셋의 출력은 조금 더 짧아지며, 각각 201토큰 대비 198토큰, 187토큰 대비 154토큰이다.
- 효과는 벤치마크마다 다르다. GSM+ 정확도는 67.6%에서 66.4%로 감소하고 토큰 수는 110토큰에서 143토큰으로 늘어난다.
두 스케줄 모두 256에서 시작해 87에 도달하며 150, 300, 450스텝에서 목표를 줄인다. 선형 스케줄은 지수 스케줄보다 중간 목표를 크게 유지한다. 이를 통해 초기와 최종 목표가 같은 서로 다른 학습 경로를 비교한다.
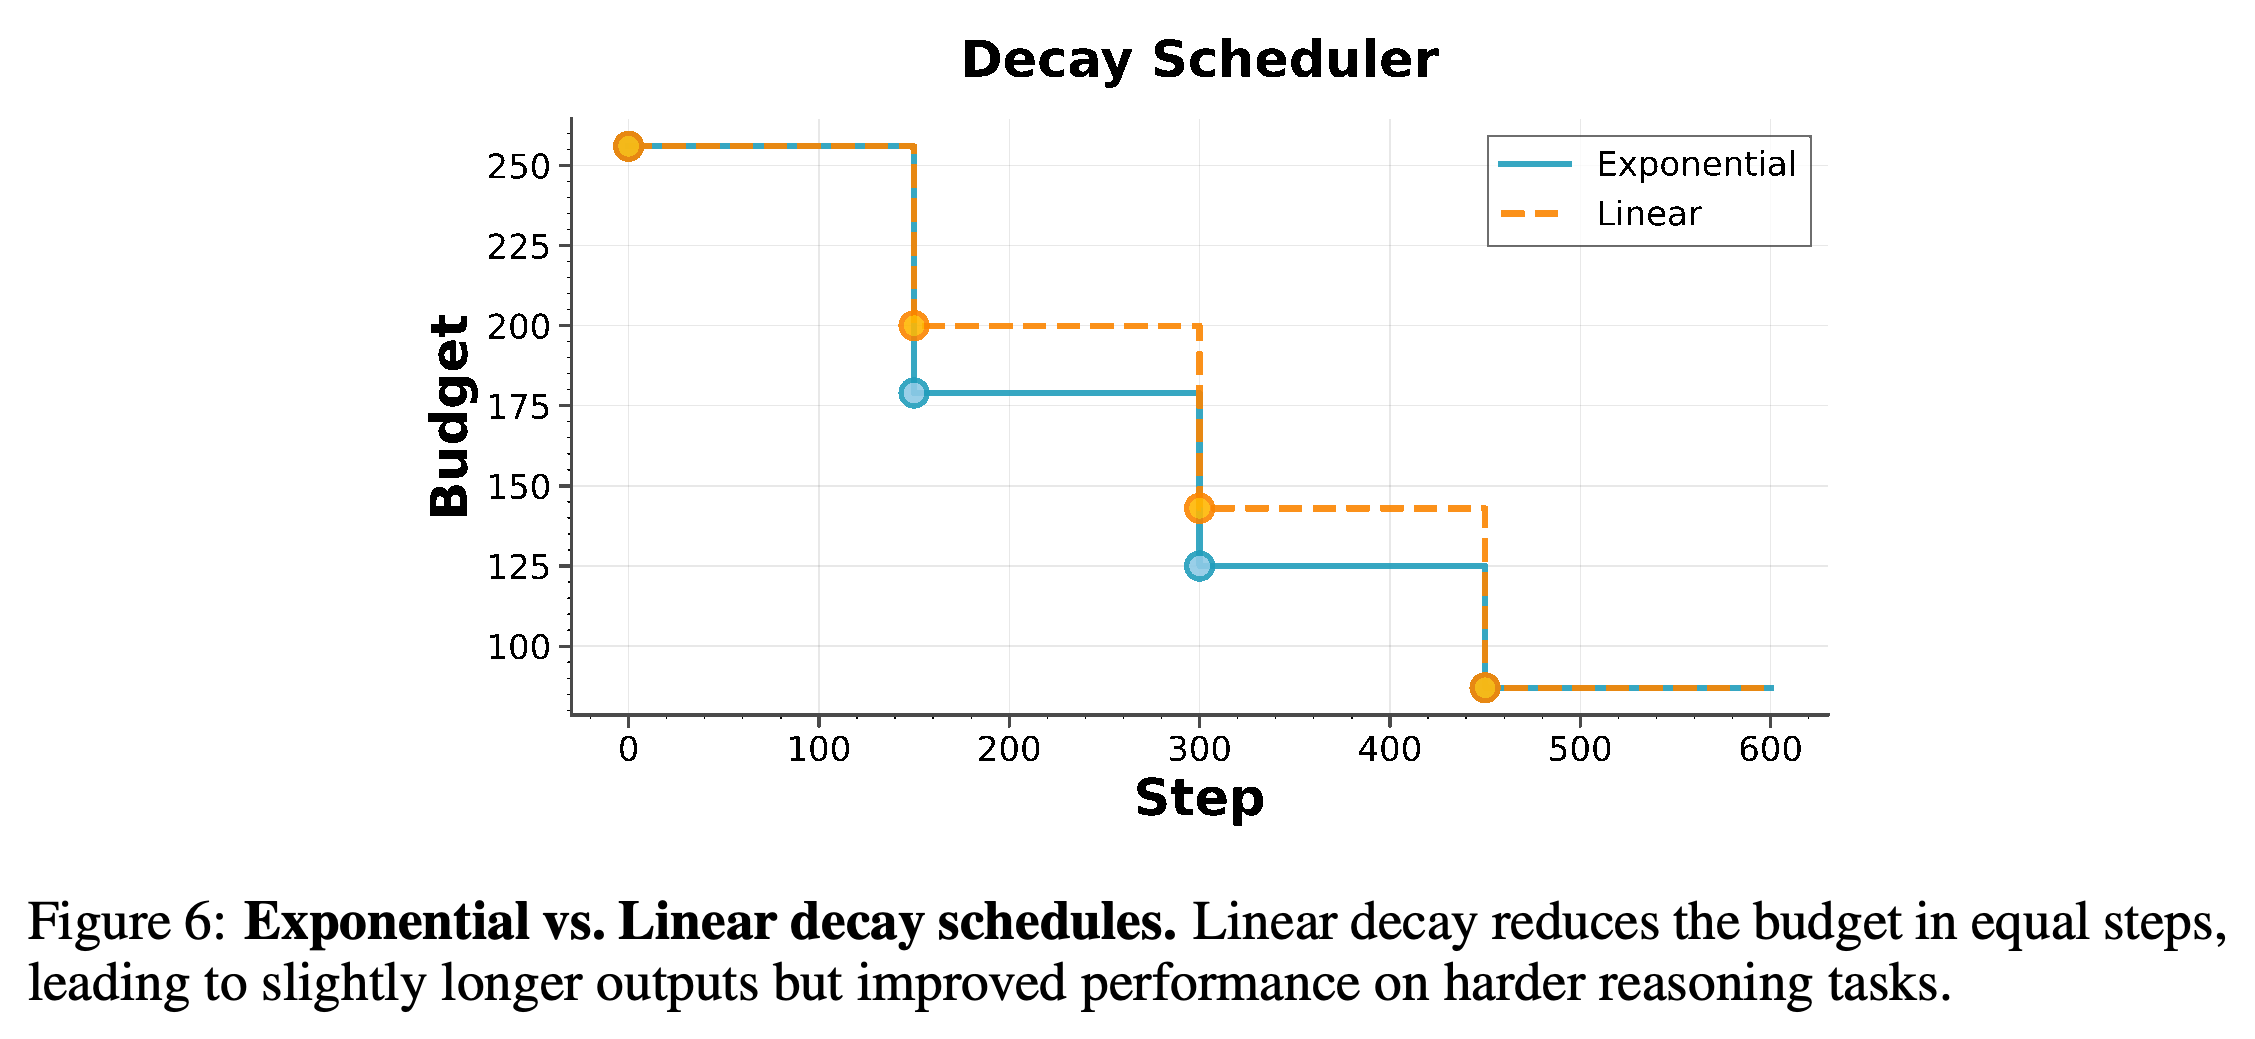
선형 감소는 평균 토큰 수를 5토큰 늘리면서 보고된 평균 정확도를 57.9%에서 60.0%로 높인다. 개선 폭은 MATH500과 College Math에서 가장 크며, 이들 데이터셋에서는 출력 길이도 줄어든다. GSM+에서는 정확도가 낮아지고 토큰 사용량이 늘어난다.
5 Limitations
저자들은 모델이 활용할 수 있는 텍스트의 양인 context window가 짧다는 점과 학습 목표 길이가 최대 256토큰이라는 점을 긴 추론이 필요한 문제에 대한 한계로 지적한다. 모든 실험은 QWEN-2.5-7B를 사용하므로, 더 작거나 큰 모델과 개방형 생성 과제에서의 동작은 검증하지 않았다.
- PDF는 불확실성 추정치나 서로 다른 난수 시드로 반복 실행한 결과를 보고하지 않으므로, 작은 차이가 얼마나 안정적인지 평가할 수 없다.
- MATH500-trained 모델 비교의 평균 길이 137.1토큰과 MATH500 ablation 실험의 201토큰은 목표인 87토큰을 초과한다. 이 목표는 학습을 유도하는 기준으로 작동하며 보고된 결과는 추론 시 엄격한 상한을 입증하지 않는다.
6 Conclusion
결론은 토큰 목표를 점차 줄이는 방식을 정확도를 유지하거나 높이면서 더 짧은 수학 추론을 생성하도록 학습하는 방법으로 제시한다. 실험은 검증한 모델과 데이터셋에서 성능이 예산의 변화 경로와 보상 설계에 영향을 받는다는 점을 뒷받침한다. 더 넓은 범위에서의 일반화와 제안한 탐색 후 압축 메커니즘은 아직 검증되지 않았다.
부록
- 제공된 14페이지 PDF에는 부록이 없으며 References로 끝난다. 추가 부록 실험이나 구현 세부 사항은 제공하지 않는다.
짧은 생각
Table 1은 가장 명확한 실무적 교훈을 보여준다. 초기와 최종 학습 목표가 같아도 정확도와 출력 길이는 달라질 수 있다. 이 방법으로 예산을 제어하려면 재현 과정에서 학습 데이터와 평가 데이터의 분리를 확인하고 본문 수치와 그래프 지점의 불일치를 해소하며 출력 길이 분포를 측정해야 한다.