DuPO: Enabling Reliable LLM Self-Verification via Dual Preference Optimization 요약 설명
20 Aug 2025 | Paper Review Dual Learning Self-Supervised Learning Reward Design Test-Time Scaling목차
이번 글에서는 DuPO: Enabling Reliable LLM Self-Verification via Dual Preference Optimization 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 8월 20일(Arxiv)
- She, Shuaijie, Bao, Yu, Lu, Yu, Xu, Lu, Li, Tao, Zhu, Wenhao, Huang, Shujian, Cheng, Shanbo, Lu, Lu, Wang, Yuxuan.
- ByteDance Seed, Nanjing University
- 논문 링크
요약
- 번역이나 수학 추론 등의 과제에서 텍스트를 생성하는 대규모 언어 모델(LLM)을 개선하려면 보통 외부 피드백이나 정답 레이블이 필요하다. 논문의 평가 방식에서 DuPO는 원래 Qwen3-4B의 수학 경시대회 벤치마크 3개 평균 정확도를 77.2%에서 83.6%로 높여 6.4%포인트 향상을 보인다.
- DuPO는 Dual Learning-based Preference Optimization의 약자로, 출력과 나머지 입력을 이용해 숨겨진 입력 요소를 복원하는 상보적 과제로 출력에 점수를 부여한다. 순방향 과제와 역방향 과제가 서로 지도 신호를 제공하는 dual learning에서 전체 입력 복원을 이러한 조건부 복원으로 대체해 적용 범위를 넓힌다.
- Seed-X-7B-Instruct는 756개 번역 방향에서 신경망 기반 번역 평가 지표인 COMET 점수가 2.13점 오른다. 생성한 후보 중 복원 점수로 출력을 선택하는 학습 없는 재순위화는 역방향 과제를 추가로 샘플링해 Qwen3-4B의 수학 벤치마크 2개 평균 정확도를 68.4%에서 77.7%로 높인다. 실험은 번역과 수학 추론을 다루며, 입력 요소 선택에는 추가 연산이 필요하고 일부 수학 결과는 주요 결과 표와 구성 요소 제거 실험에서 다르게 나타난다.
1 Introduction
서론은 외부 지도 신호를 모델 개선의 병목으로 지적한다. 사람의 선호 신호로 학습하는 Reinforcement Learning from Human Feedback(RLHF)에는 비용이 크고 일관되지 않을 수 있는 주석이 필요하다. 확정적인 정답과 대조해 보상을 검증하는 Reinforcement Learning with Verifiable Rewards(RLVR)도 정답이 필요하다.
- 번역에는 유효한 출력이 여러 개 있을 수 있으므로, 참조 번역 1개가 모든 고품질 응답을 대표하지는 않는다.
- 기존 역방향 과제의 지도 방식에는 어려움이 2개 있다. 출력만으로 입력을 유일하게 식별하지 못할 수 있고, 모델의 순방향 과제 수행 능력과 역방향 과제 수행 능력이 다를 수 있다.
- DuPO는 알려진 입력 요소를 역방향 과제에 제공하고 선택한 미지의 요소만 복원하며 양방향에 모델 1개를 사용한다.
2 Related Work
관련 연구에서는 피드백 점수로 출력 생성을 개선하는 선호 최적화와 dual learning을 연결한다. 사람의 선호, 모델의 판단, 외부에서 검증할 수 있는 정답, 대응 과제 사이의 일관성에서 얻는 지도 신호를 비교한다.
2.1 Preference Optimization for LLMs
논문은 사람의 선호에 따른 보상, 언어 모델이 출력을 평가하는 LLM-as-a-Judge, 검증 가능한 정답에 따른 보상을 비교한다. 사람의 주석에는 비용과 의견 불일치가 따르고, 모델의 판단은 평가 모델의 능력에 좌우되며 응답 제시 순서나 문체에 따른 편향을 반영할 수 있다. 정답 기반 보상에는 확정적인 참조 결과가 필요하다.
- DuPO는 별도의 선호 주석이나 제공된 최종 정답 대신 복원 일관성에서 피드백을 얻는다.
- 다만 구현에는 여전히 과제별 복원 검사를 사용한다.
2.2 Dual Learning
Dual learning은 번역 후 출력을 원래 언어로 다시 번역하는 역번역처럼, 대응 과제들이 서로 지도 신호를 제공하도록 한다. 논문은 모달리티 간 확장, 지식 추론, 강화학습에 관한 연구와 언어 모델 번역을 위한 Trans-Zero, DualReflect를 검토한다.
- 순환 일관성은 역방향 과제를 적용했을 때 허용 오차 안에서 원래 입력을 복원한다는 뜻이다.
- DuPO는 전체 복원을 선택한 입력 요소의 조건부 복원으로 대체한다. 이를 통해 정답만으로 원래 질문을 유일하게 식별할 수 없는 수학 문제도 다룬다.
3 Dual Learning-based Preference Optimization
DuPO는 과제와 그에 상보적인 과제 사이의 관계를 이용해 자기지도 보상을 만든다. 이 보상은 입력 복원에서 얻는 피드백이다. 복원 일관성을 정식화하고 전체 역변환이 실패하는 경우를 규명하며 부분 복원 보상으로 출력 생성을 최적화한다. 자기지도에 대해서는 Self-Supervised Learning(자기지도 학습 설명) 글을 참조하라.
3.1 Task Duality
Definition 1은 원래 순방향 매핑인 primal task와 역방향 매핑인 dual task를 정의하고 도메인별 복원 거리가 음이 아닌 허용 오차 이내여야 한다고 명시한다. Equation (1)의 r(y) ∝ exp(−λ · d(x, T_d(y)))는 역방향 복원 결과가 원래 입력에 가까울수록 출력에 더 큰 보상을 부여한다.
- 양의 매개변수 λ는 복원 오차에 대한 보상의 민감도를 조절한다.
- 유용한 피드백을 얻으려면 출력에 충분한 정보가 있어야 하고, 역방향 과제가 입력을 신뢰할 만하게 복원해야 한다.
3.2 Challenges in Dual Learning-based Optimization
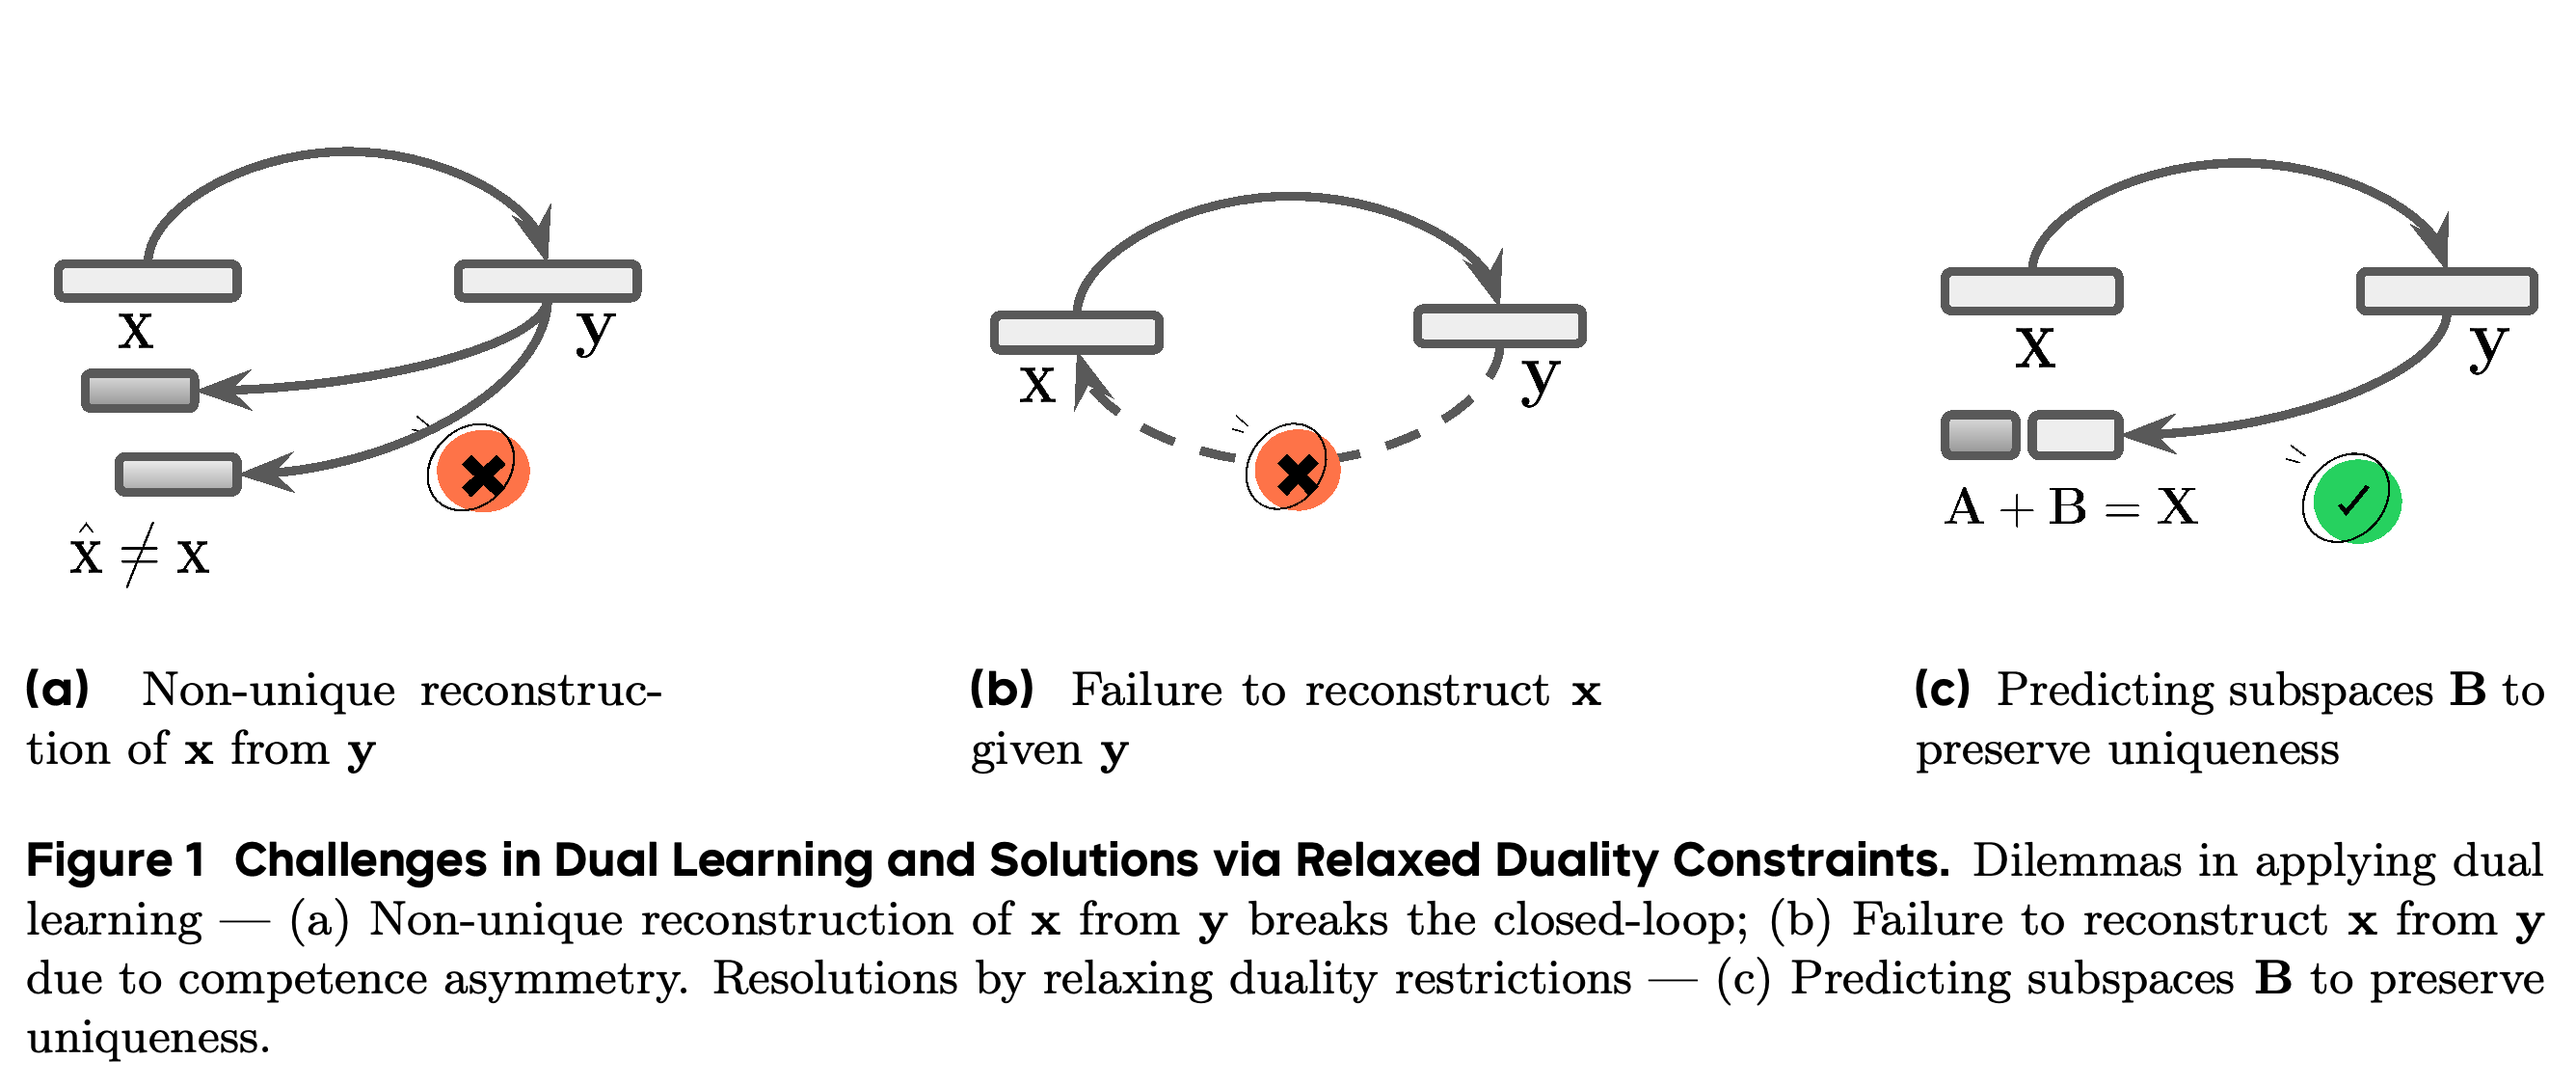
여러 입력이 같은 출력을 만들면 전체 역변환은 실패한다. 정답 8만으로는 공의 개수를 세는 질문과 정답이 같은 다른 질문을 구분할 수 없다. 역변환이 가능하더라도 순방향과 역방향의 수행 능력이 다른 양방향 능력 비대칭 때문에, 올바른 출력이 복원 오차로 불이익을 받을 수 있다.
- 번역 예시는 독일어 번역이 올바르더라도 “quick” 대신 “fast”를 복원하면 불일치가 생길 수 있음을 보여준다.
- Figure 1은 복원의 모호성과 역방향 과제의 실패를 구분하고 더 작은 입력 요소를 복원하는 해결책을 보여준다.
처음 2개 패널은 입력 복원의 모호성과 역방향 과제 수행 능력의 부족을 구분한다. 3번째 패널은 알려진 정보로 선택한 입력 요소의 복원 범위를 제한하는 방법을 보여주며, 부분 복원을 피드백 수단으로 사용하는 근거를 제시한다.
3.3 Generalized Duality Framework via Complementary Task
Definition 2는 입력을 알려진 요소와 미지의 요소로 나누고, 출력과 알려진 맥락에서 미지의 요소를 복원하는 상보적 dual task를 정의한다. 대응 과제는 부분 복원 오차의 상한을 만족해야 하며, Equation (2)는 보상을 r(y) ∝ exp(−λ · d(x_u, T_cd(y, x_k)))로 정의한다.
- 수 2개의 합을 구하는 예시에서 순방향 과제는 C = A + B를 계산한다. C와 A가 주어지면 상보적 과제는 B′ = C − A를 복원하고 B′가 B와 일치하는지 확인한다.
- 알려진 맥락은 복원 범위를 제한하고 복원 가능한 미지의 요소를 선택하면 역방향 과제의 난도가 낮아진다.
- 논문은 코드 생성과 대화에 적용하는 방안도 제안하지만 평가는 수학과 번역에서 수행한다.
3.4 Preference Optimization
Equation (3)의 J(θ) = E_{y∼π_θ(y|x)}[r(y)]는 모델의 출력 정책에 따른 기대 복원 보상을 최대화한다. 출력 정책은 생성할 출력의 조건부 분포다. 실험에서는 강화학습 최적화 알고리즘인 Group Relative Policy Optimization(GRPO)으로 이 보상을 이용해 모델을 학습한다.
- 논문은 번역에서 자동 번역 평가 지표인 BLEU를 복원 척도로 설명한다. 수학에서는 숨겨진 수치와 일치하는지에 따라 이진 보상을 부여한다.
- 이 프레임워크는 다른 강화학습 최적화 알고리즘도 사용할 수 있지만 보고된 실험에서는 GRPO를 사용한다.
4 Experiment
실험은 다국어 번역과 수학 추론을 평가한다. 학습한 모델, 추가 모델 아키텍처, base model의 직접 학습, 추론 시 재순위화를 비교한다. 또한 입력 요소 선택을 통제된 조건에서 제거하는 실험으로 해당 과정의 기여를 평가한다.
4.1 Experiment Setup
번역 학습에는 Seed-X-7B-Instruct를 사용하며 28개 언어에서 언어별 프롬프트 1,000개와 다국어 번역 데이터셋인 Flores-200 개발 세트의 병렬 데이터 항목 7,000개를 사용한다. 평가에서는 Flores 테스트 세트의 756개 번역 방향마다 예시 50개를 샘플링해 총 37,800개를 평가하고 BLEU, COMET, 학습 기반 텍스트 생성 평가 지표인 BLEURT를 보고한다.
- Seed-X-Challenge의 사람 평가는 중국어나 영어에서 7개 언어로 번역하는 14개 방향을 다룬다. 전문가가 정확성, 유창성, 관용적 표현의 적절성을 0–4점 척도로 평가한다.
- 수학 실험은 DeepSeek-R1-Distill-Qwen-1.5B, DeepSeek-R1-Distill-Qwen-7B, Qwen3-4B, OpenReasoning-Nemotron-7B를 수학 경시대회 벤치마크인 AMC23, AIME24, AIME25에서 평가한다.
- 수학 문제마다 출력의 무작위성을 조절하는 샘플링 설정인 temperature 0.8에서 응답 32개를 샘플링한다. 최대 추론 예산은 32,000토큰이며 샘플링한 응답의 평균 정확도인 Avg@32를 보고한다.
- 인용된 벤치마크 자료는 https://huggingface.co/datasets/openlanguagedata/flores_plus 및 https://github.com/ByteDance-Seed/Seed-X-7B/tree/main/challenge_set 에서 확인할 수 있다.
4.2.1 DuPO Boosts LLM’s Performance on Various Tasks
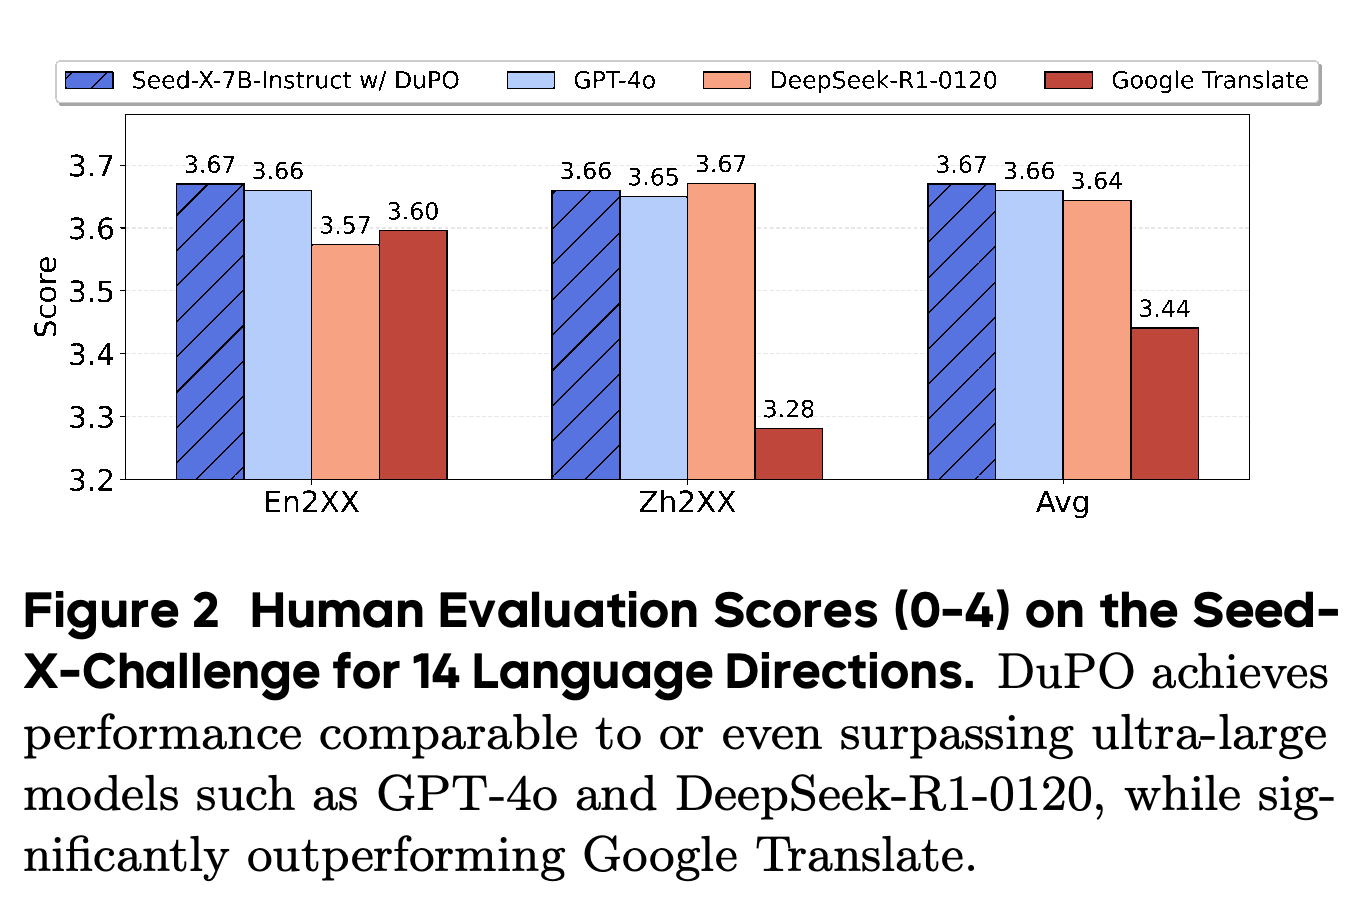
4.2 Main Results의 Table 1에서 Seed-X-7B-Instruct는 BLEU가 28.76에서 30.31로, COMET이 86.96에서 89.09로, BLEURT가 72.62에서 74.57로 오른다. Figure 2의 평균 사람 평가 점수는 3.67이며, GPT-4o는 3.65, DeepSeek-R1-0120은 3.64, Google Translate는 3.44다. 이러한 점수 비교에는 불확실성 추정치가 제공되지 않는다.
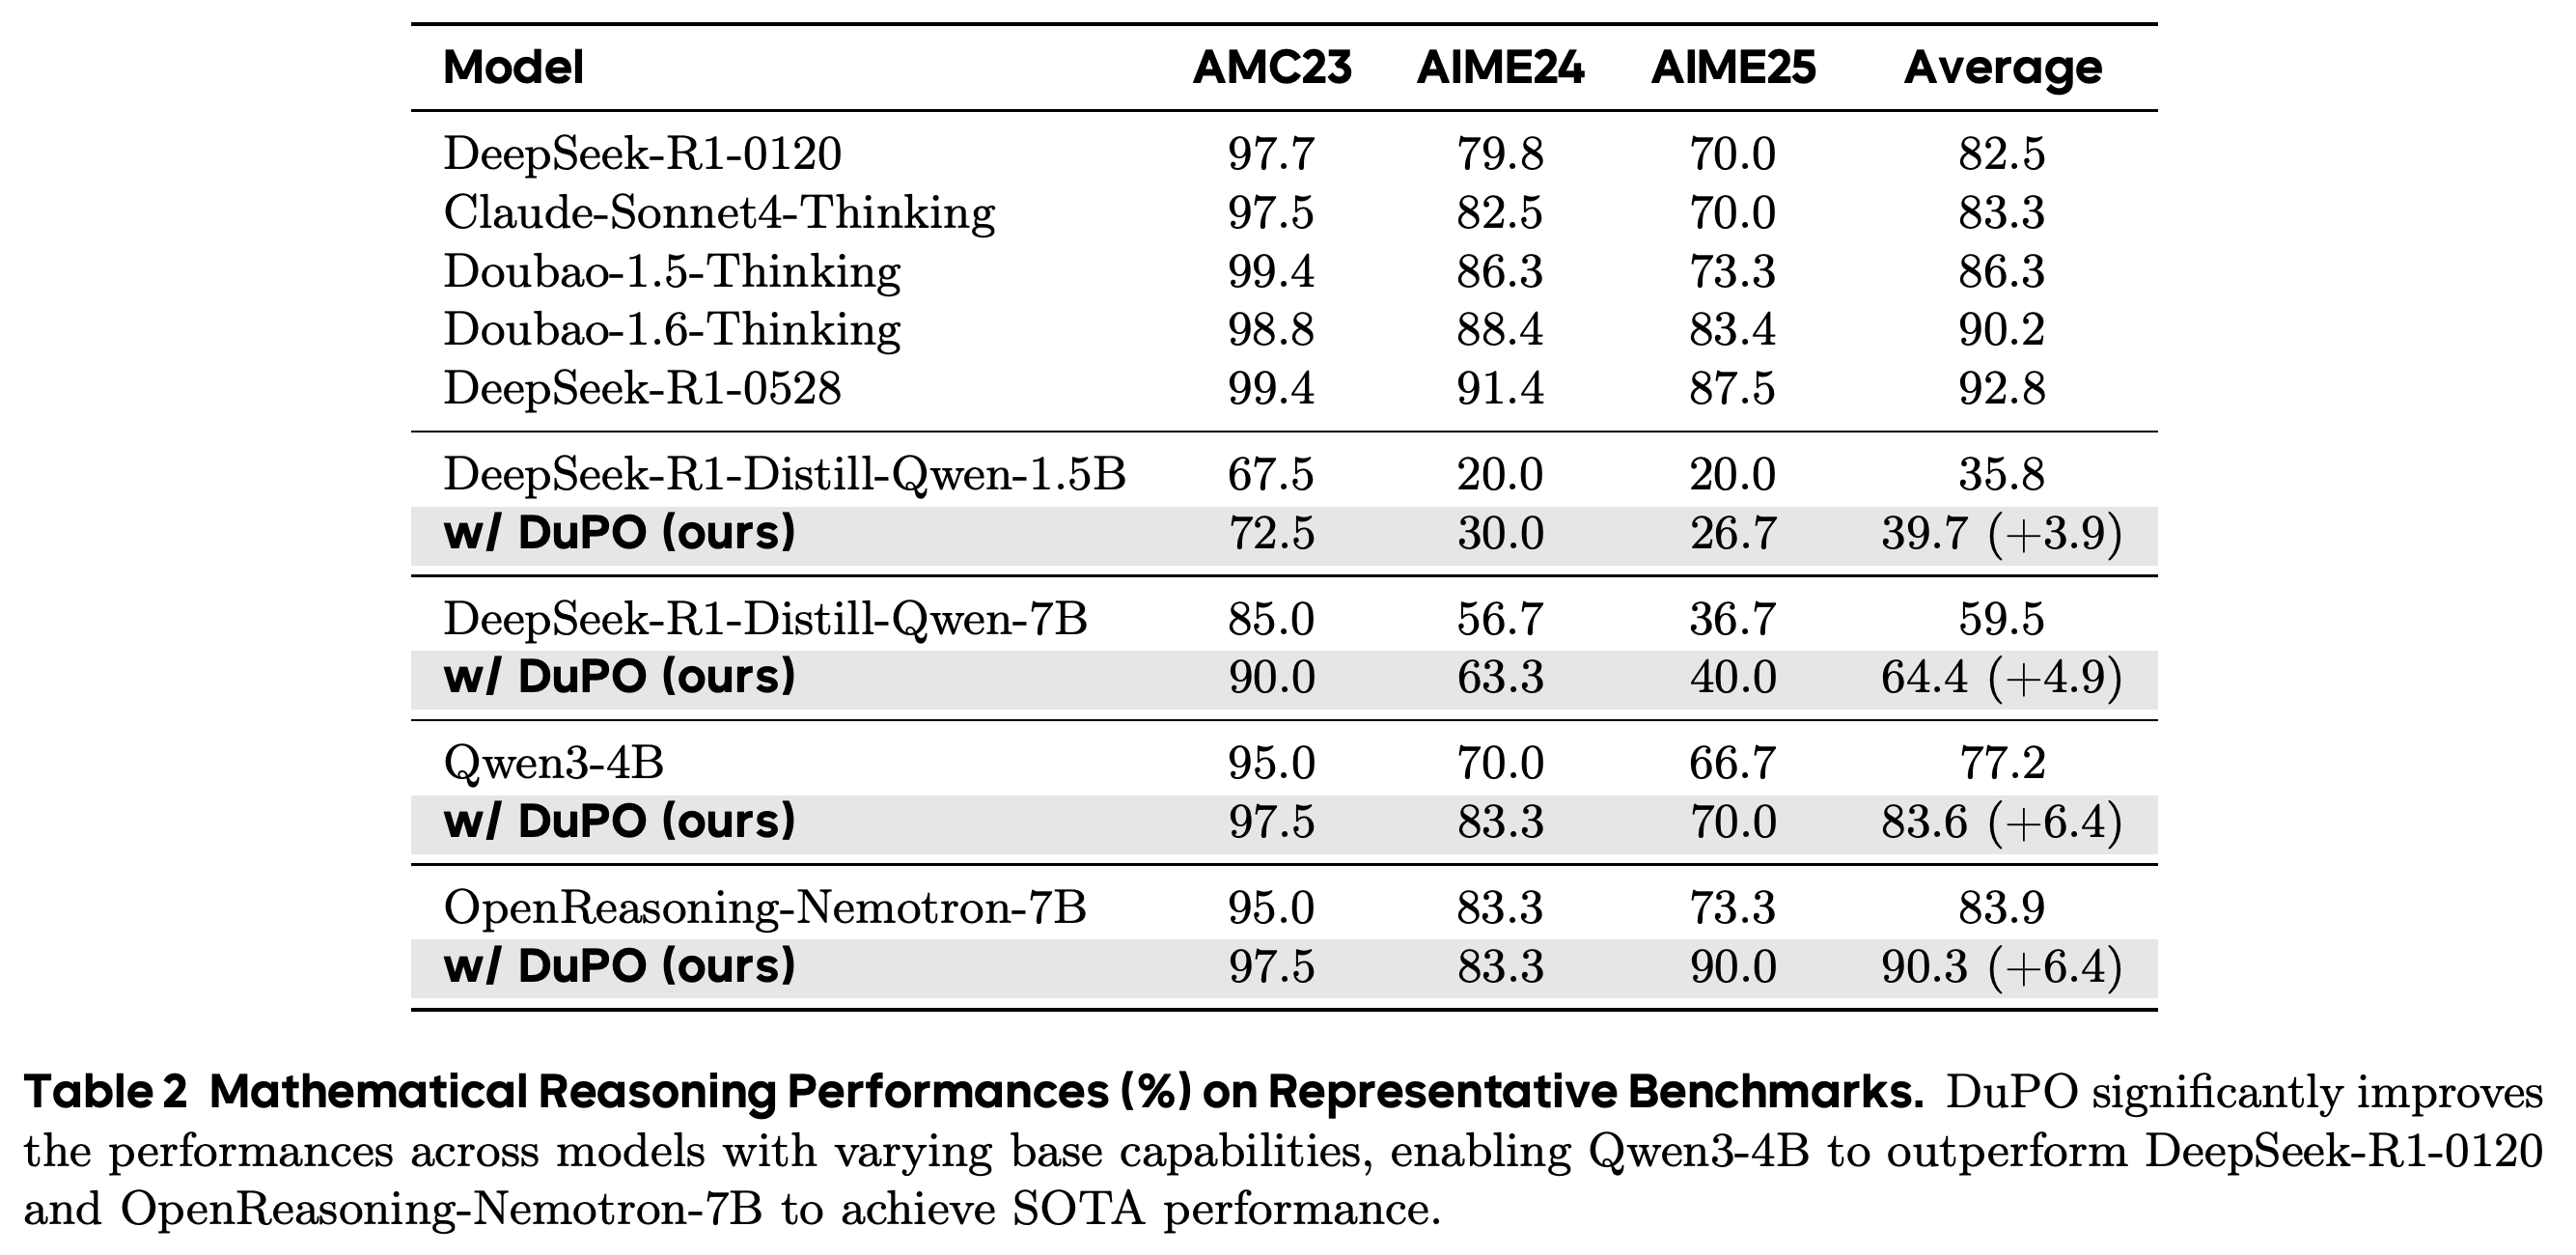
- Table 2에서 Qwen3-4B의 평균 수학 정확도는 77.2%에서 83.6%로, OpenReasoning-Nemotron-7B는 83.9%에서 90.3%로 올라 모두 6.4%포인트 향상된다.
- DeepSeek-R1-Distill-Qwen-7B는 59.5%에서 64.4%로 오르고, 1.5B 모델의 보고된 평균은 35.8%에서 39.7%로 오른다.
- 1.5B DuPO 행에는 72.5%, 30.0%, 26.7%가 기재되어 있다. 산술평균은 명시된 39.7%가 아닌 약 43.1%이므로, 보고된 평균 향상은 해당 행의 수치와 맞지 않는다.
- DuPO를 적용한 OpenReasoning-Nemotron-7B는 90.3%로, 표에 기재된 DeepSeek-R1-0528의 92.8%보다 낮다. 이 표는 자체 기준 모델 대비 향상을 뒷받침한다.
DuPO를 적용한 Seed-X-7B-Instruct는 BLEU가 1.55, COMET이 2.13, BLEURT가 1.95 오른다. 보고된 지표 평균은 64.66으로 DeepSeek-R1-0528의 64.80에 가깝다. 표는 불확실성 추정치를 제공하지 않는다.
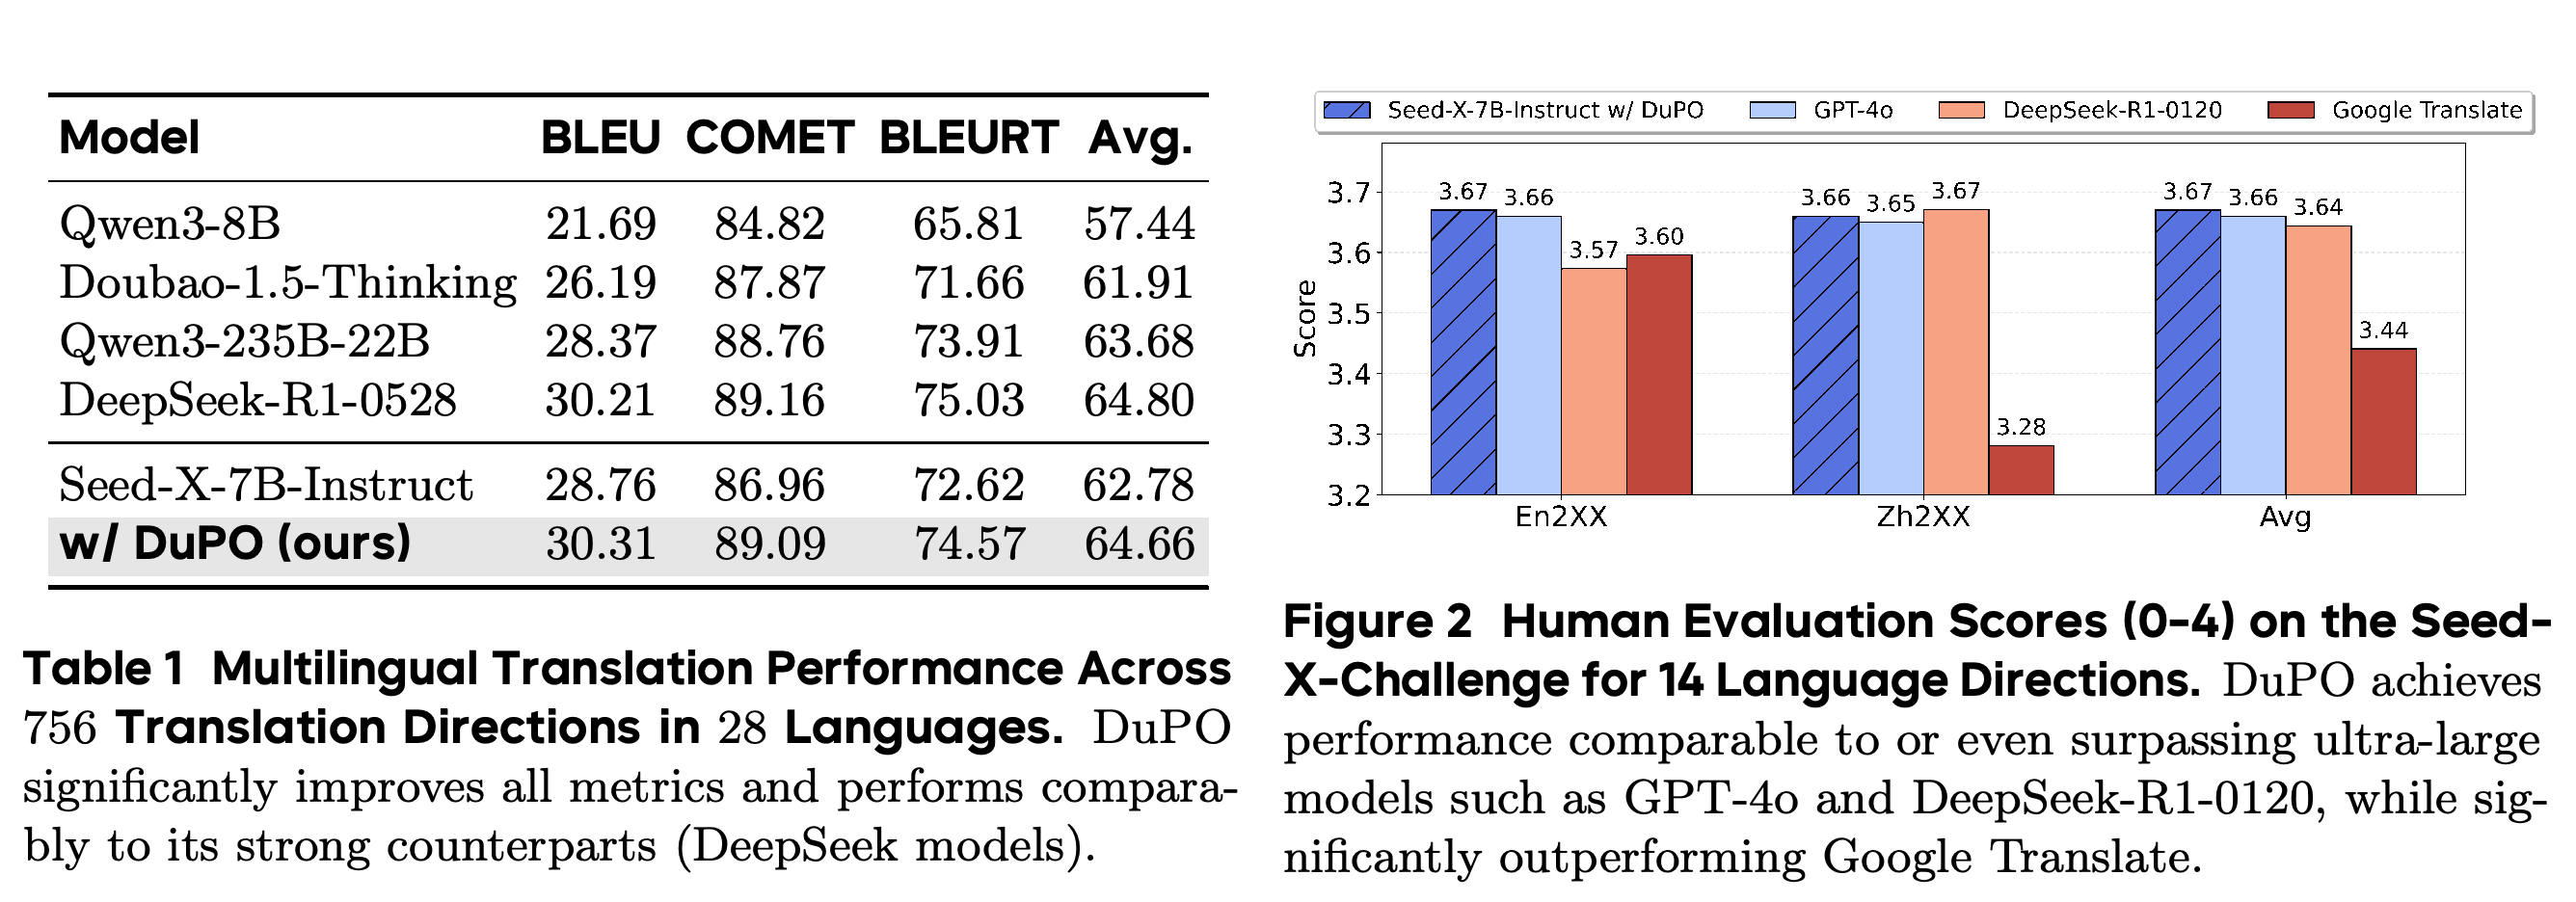
0–4점 사람 평가 척도에서 DuPO의 평균 3.67은 GPT-4o의 3.65, DeepSeek-R1-0120의 3.64에 가깝고 Google Translate의 3.44보다 높다. 영어와 중국어를 원문으로 사용하는 그룹에서 DuPO 점수는 비슷하지만 그림은 시스템 비교를 위한 불확실성 구간을 제공하지 않는다.
표는 각 모델의 초기 성능 대비 향상을 보고한다. Qwen3-4B는 77.2%에서 83.6%로, OpenReasoning-Nemotron-7B는 83.9%에서 90.3%로 오른다. 1.5B DuPO 행에 명시된 평균 39.7%는 기재된 벤치마크 점수의 평균인 약 43.1%와 맞지 않는다.
4.2.2 DuPO Scales to Various Backbones Effectively
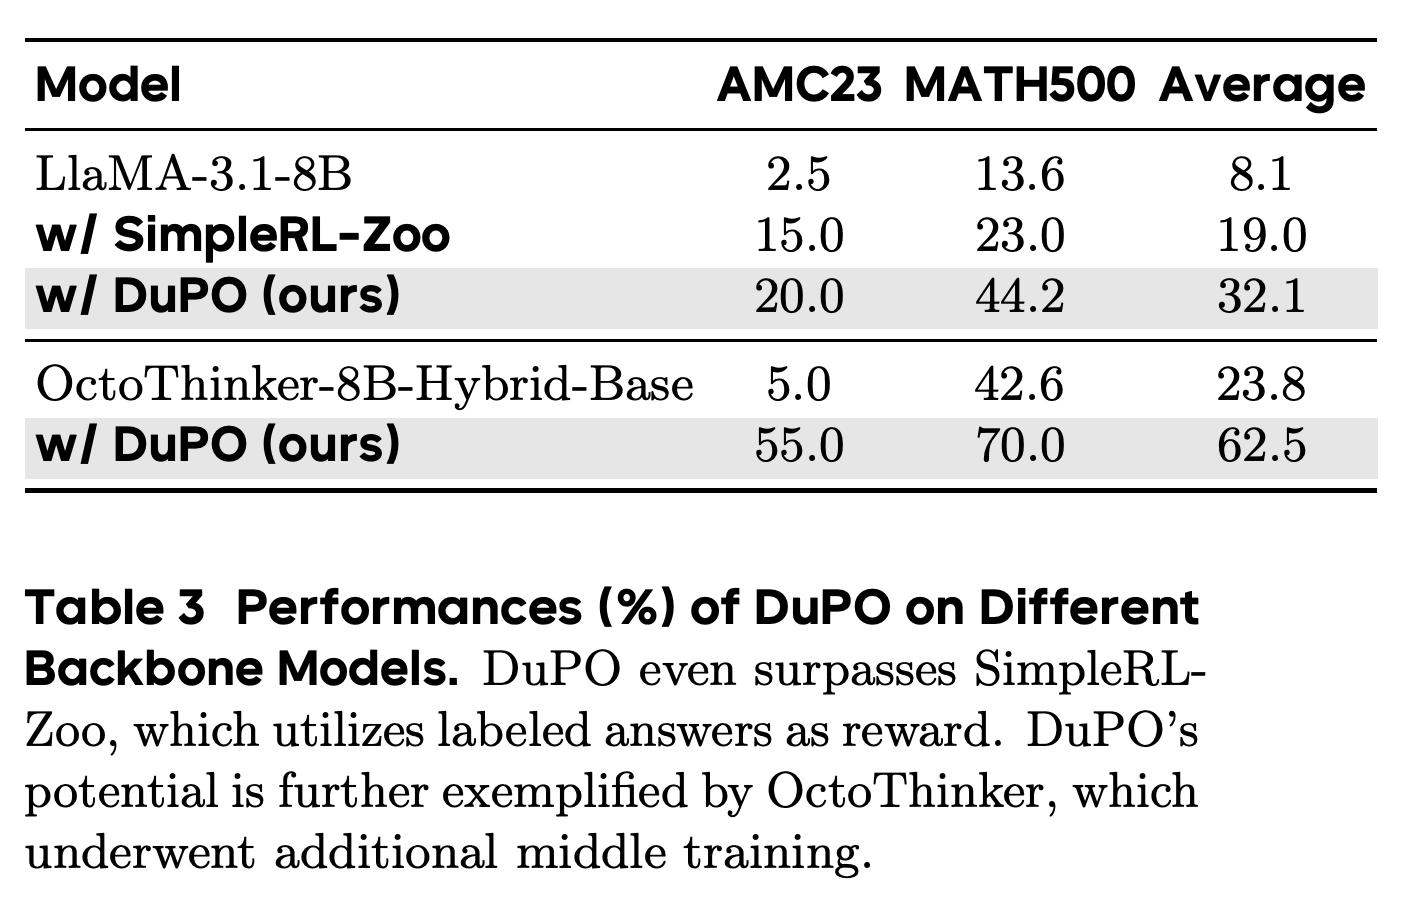
아키텍처 비교는 LlaMA-3.1-8B와 OctoThinker-8B-Hybrid-Base를 AMC23과 수학 문제 해결 벤치마크인 MATH500에서 평가한다. 논문은 모델들을 동일한 학습 데이터와 설정으로 미세조정했다고 명시한다.
- LlaMA-3.1-8B의 평균 정확도는 8.1%에서 32.1%로 오른다. 정답을 지도 신호로 사용하는 강화학습 기준 방법인 SimpleRL-Zoo는 19.0%다.
- OctoThinker-8B-Hybrid-Base는 23.8%에서 62.5%로 오르며, AMC23은 5.0%에서 55.0%로, MATH500은 42.6%에서 70.0%로 오른다.
- 이 결과는 LlaMA 계열에서도 효과를 뒷받침한다. 다만 OctoThinker의 출발 조건에는 기존 수학 학습이 포함된다.
DuPO는 LlaMA-3.1-8B의 평균을 8.1%에서 32.1%로 높여 SimpleRL-Zoo의 19.0%를 넘고, OctoThinker-8B-Hybrid-Base의 평균을 23.8%에서 62.5%로 높인다. OctoThinker의 출발 조건에는 기존 수학 학습이 포함된다.
4.2.3 DuPO Incentivizes Reasoning Capability on Base Model
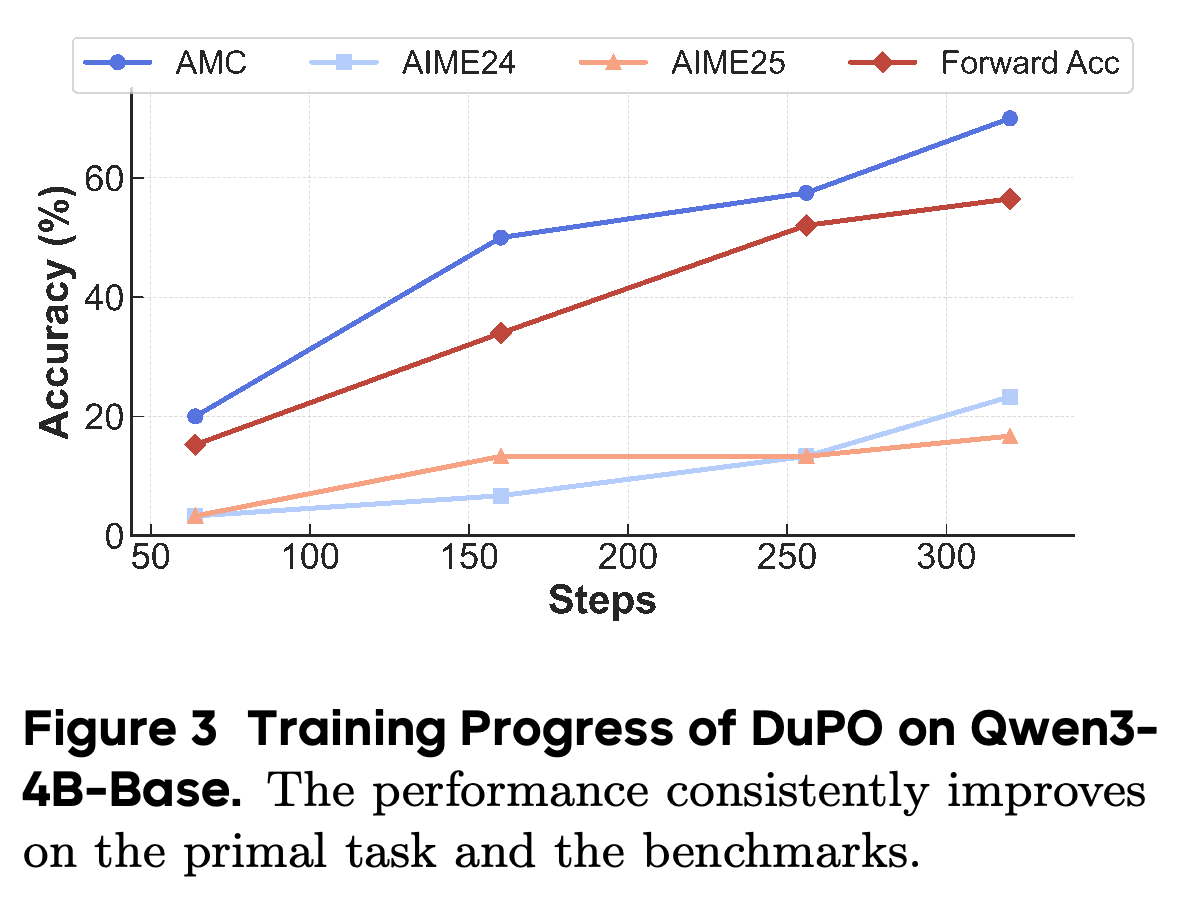
DuPO는 예시 응답으로 학습하는 사전 supervised fine-tuning(SFT) 단계 없이 Qwen3-4B-Base에 직접 적용된다. Figure 3은 순방향 과제의 학습 정확도와 학습에서 보지 못한 AMC23, AIME24, AIME25 문제의 성능을 추적한다.
- 순방향 정확도는 15.2%에서 56.5%로 오르고, AMC23 정확도는 20%에서 70%로 오른다.
- 그래프의 체크포인트에서 AIME24와 AIME25 성능도 향상된다.
- 그림은 학습 과정 1개를 보고하며 반복 실행 간 변동성은 제시하지 않는다.
체크포인트는 Qwen3-4B-Base를 직접 학습하는 동안 학습 과제의 정확도와 학습에서 보지 못한 수학 벤치마크의 성능이 향상됨을 보여준다. 본문은 사전 supervised fine-tuning 단계 없이 순방향 정확도가 15.2%에서 56.5%로, AMC23이 20%에서 70%로 올랐다고 보고한다.
4.2.4 DuPO Scales Reasoning during Inference without Training
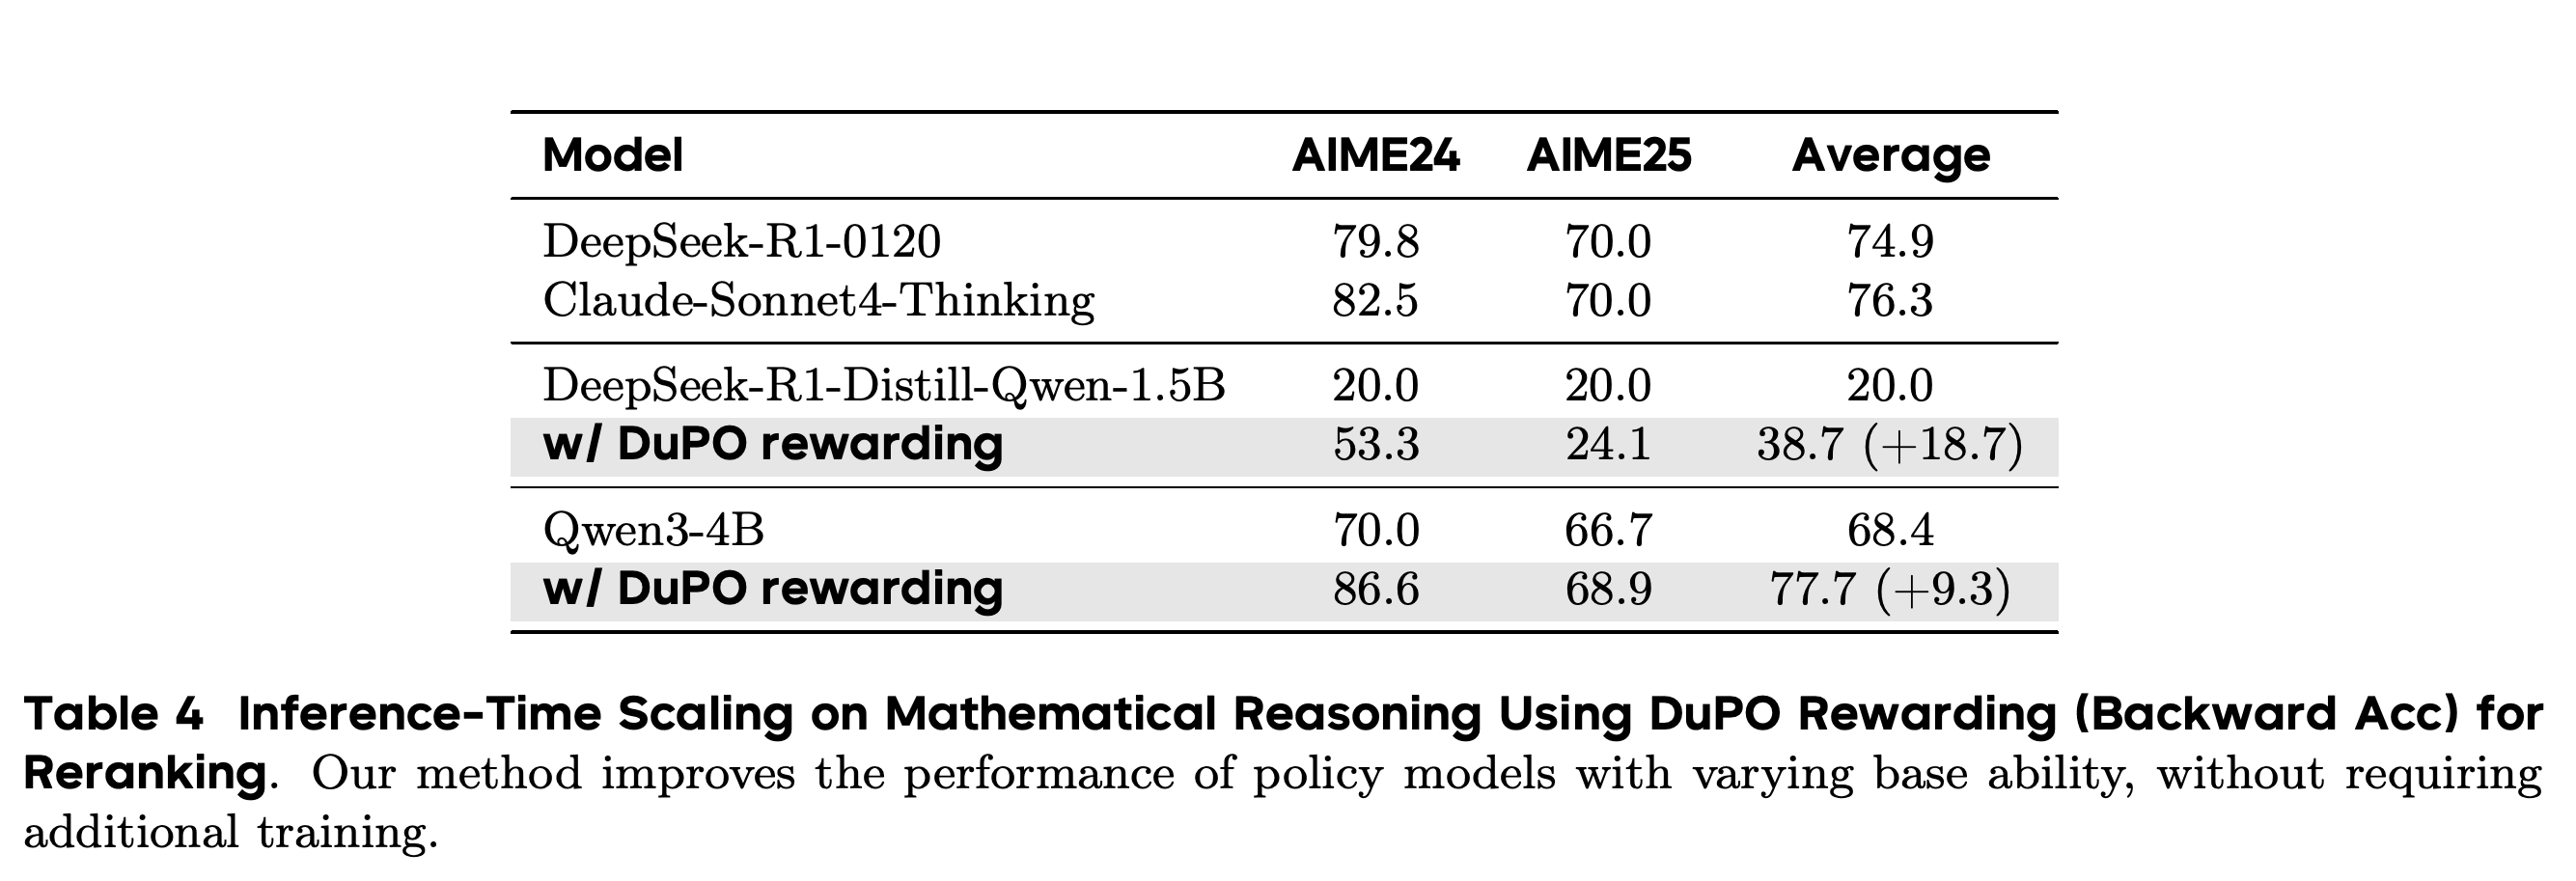
추론 시 DuPO는 후보 추론 경로를 생성하고 각 최종 정답을 조건으로 자동 구성한 상보적 질문을 사용한다. 이후 숨겨진 값의 복원 성공 비율인 역방향 정확도가 가장 높은 경로를 선택한다. 각 dual question은 추가 매개변수 학습 없이 이 점수를 추정하기 위해 K = 8회의 샘플링을 거친다.
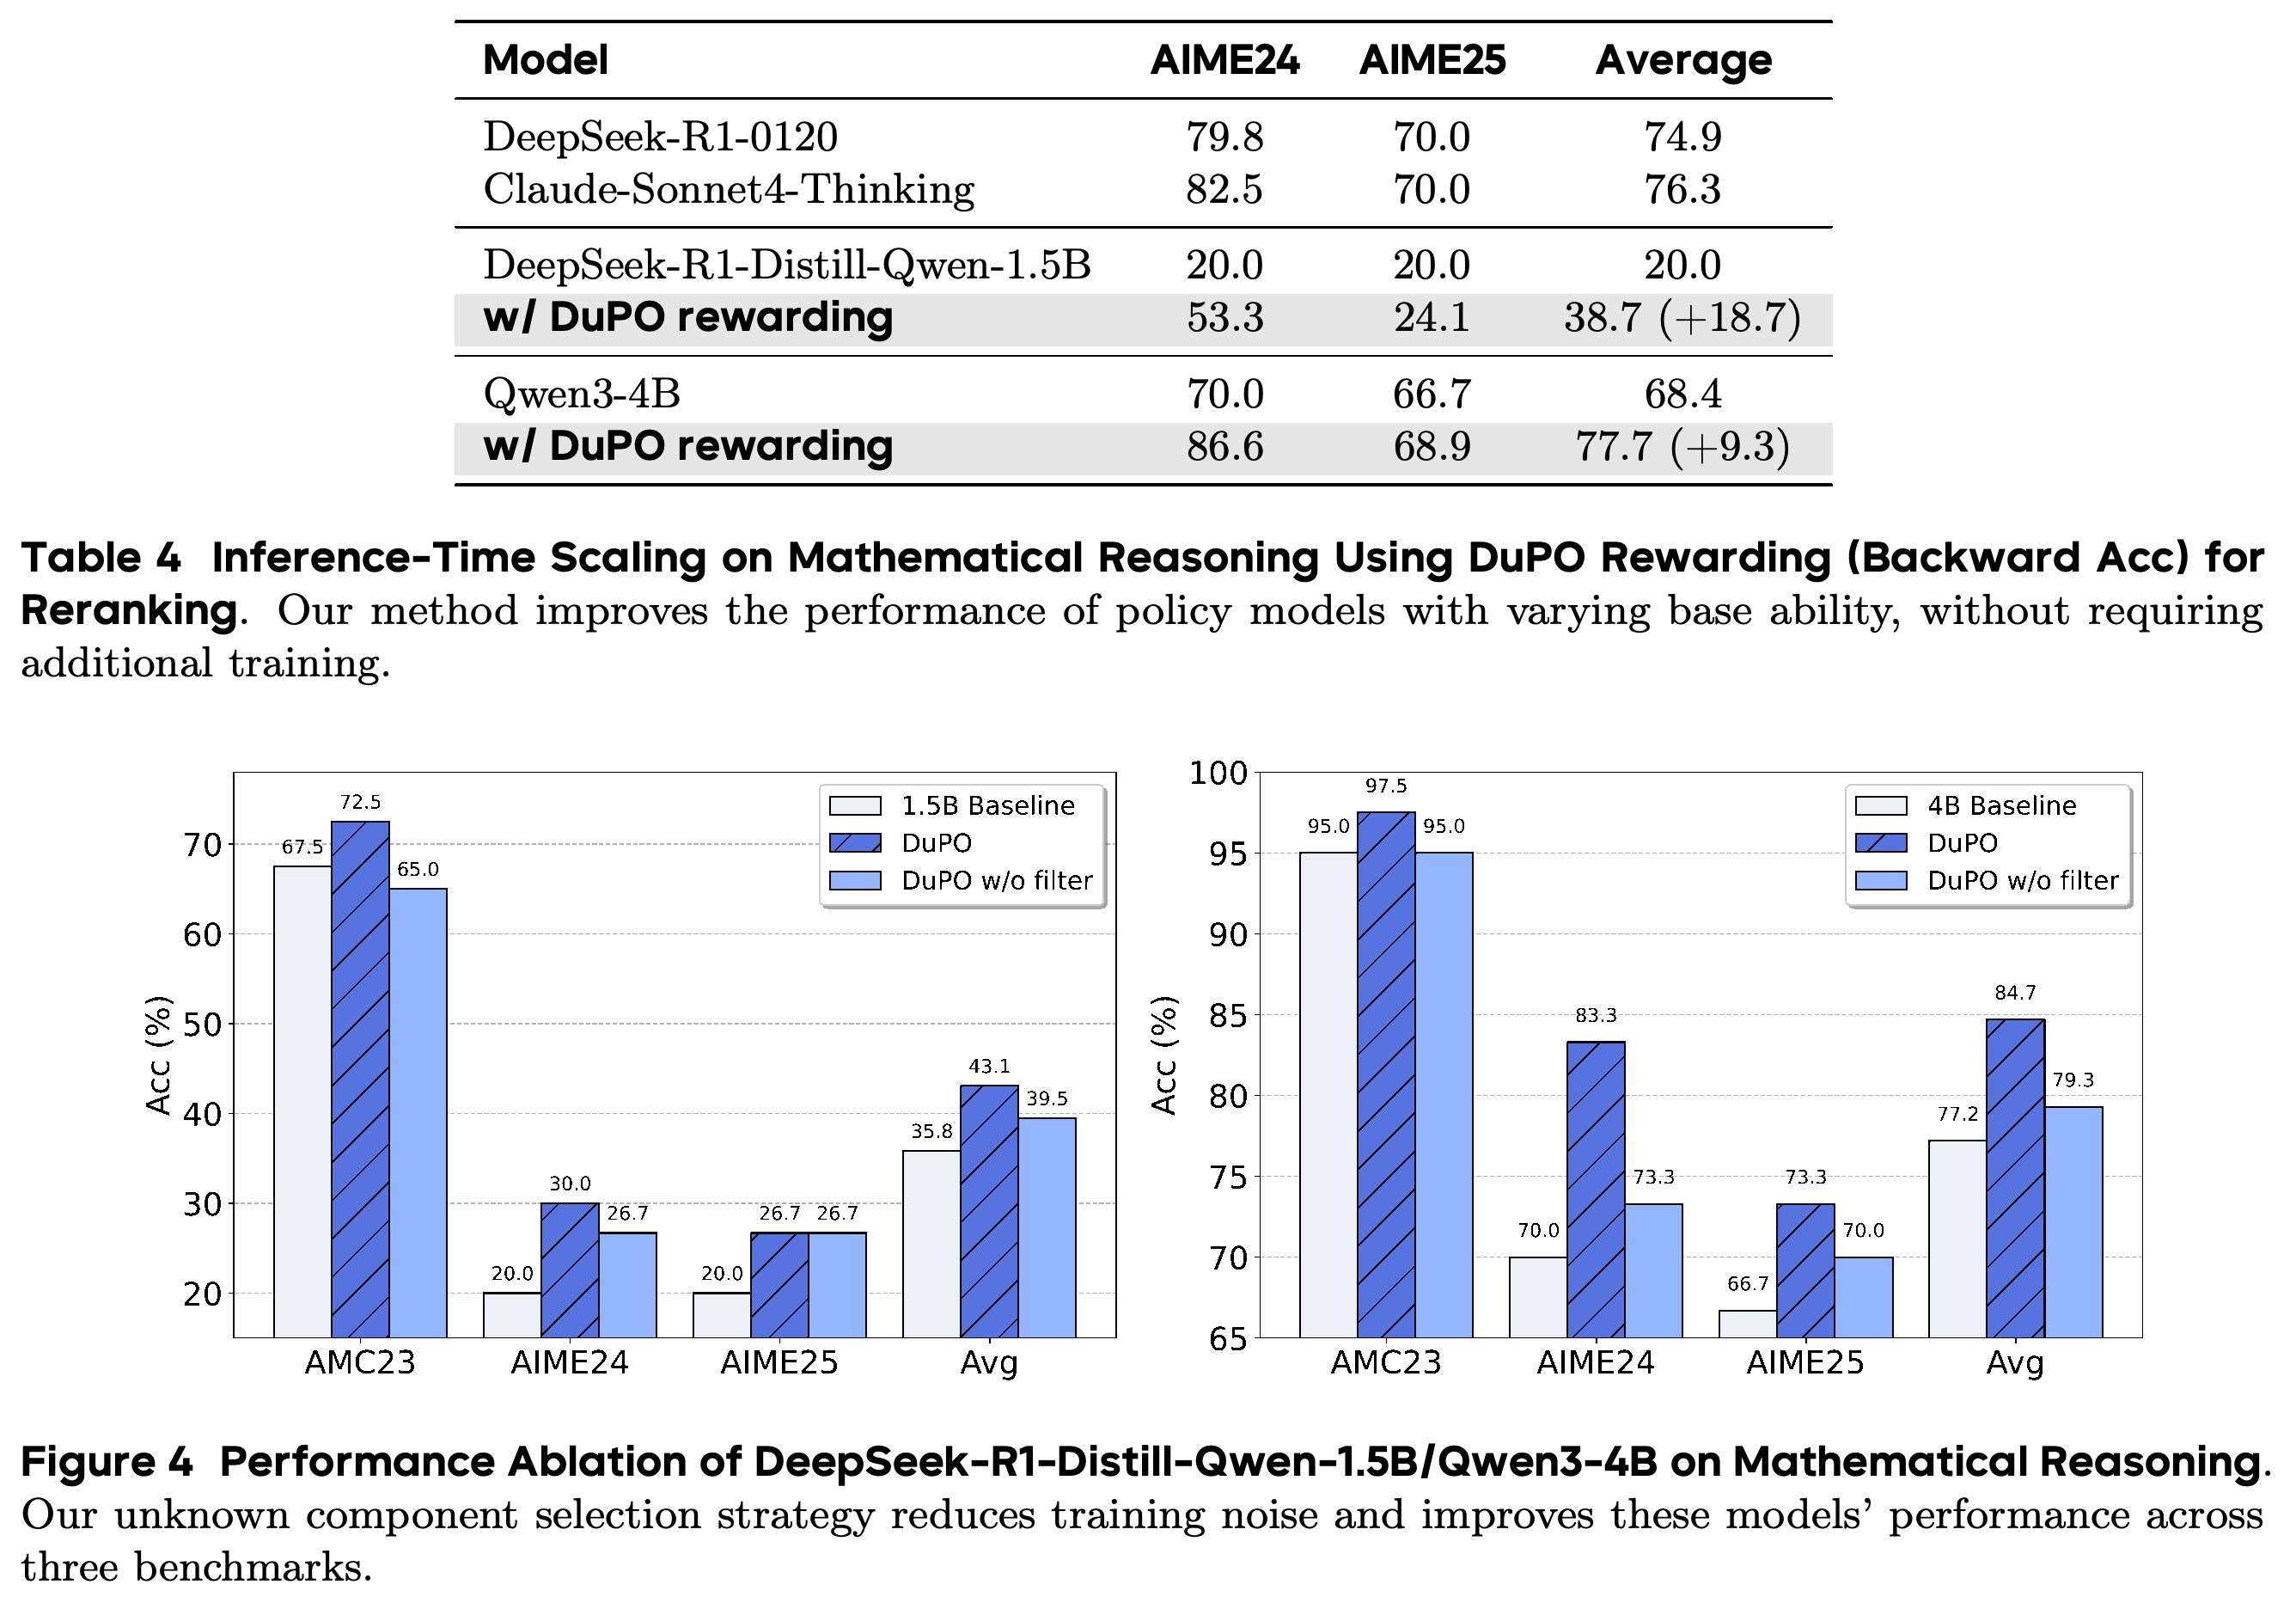
- Table 4에서 Qwen3-4B의 AIME24와 AIME25 평균 정확도는 68.4%에서 77.7%로 올라 9.3%포인트 향상된다.
- DeepSeek-R1-Distill-Qwen-1.5B는 20.0%에서 38.7%로 올라 18.7%포인트 향상된다.
- Qwen3-4B의 재순위화 후 평균은 표에 기재된 DeepSeek-R1-0120의 74.9%와 Claude-Sonnet4-Thinking의 76.3%보다 높다.
- 이 향상에는 추가 후보 생성과 역방향 과제 연산이 필요하다. Table 4는 전체 추론 예산을 맞춰 시스템을 비교하지 않는다.
역방향 정확도로 재순위화하면 매개변수 갱신 없이 Qwen3-4B의 벤치마크 2개 평균이 9.3%포인트, 1.5B 모델의 평균이 18.7%포인트 오른다. Qwen3-4B의 평균 77.7%는 표에 기재된 더 큰 모델들의 평균보다 높지만 전체 추론 비용을 맞추거나 정량화하지는 않는다.
4.3 Effects of Task Duality
구성 요소 제거 실험은 명시된 실험 설정을 동일하게 유지하면서 미지의 입력 요소 선택을 제거한다. Figure 4에서 필터링을 적용한 경우와 적용하지 않은 경우의 평균 정확도는 1.5B 모델에서 43.1%와 39.5%, Qwen3-4B에서 84.7%와 79.3%다.
- 논문은 필터링으로 얻은 향상을 3.6%포인트와 5.4%포인트로 보고한다.
- 필터링 후 평균은 Table 2의 39.7%, 83.6%와 다르다. Qwen3-4B의 AIME25 점수도 Figure 4에서는 73.3%, Table 2에서는 70.0%다.
- 이 비교는 해당 구성 요소 제거 실험 안에서 필터링의 효과를 뒷받침한다. 다만 차이에 대한 설명이 없어, 이 결과와 Table 2를 하나의 일관된 측정 결과로 합칠 수 없다.
필터링을 제거하면 표시된 평균이 1.5B 모델에서 43.1%에서 39.5%로, Qwen3-4B에서 84.7%에서 79.3%로 낮아진다. 그림 안의 비교는 입력 요소 선택의 효과를 뒷받침하지만 Table 2와 다른 이유는 설명되지 않는다.
5 Conclusion
결론은 일반화된 쌍대성을 핵심 기여로 제시한다. 선택한 입력 요소를 복원해 강화학습과 추론 시 재순위화에 피드백을 제공한다. 실험은 번역과 수학에서 성능 향상을 뒷받침하지만 자율적이거나 비용 효율적인 최적화라는 더 넓은 주장을 입증하지는 않는다.
6 Limitations
저자들은 미지의 수학 입력 요소를 선택하는 데 드는 연산 비용, 훨씬 더 큰 모델을 학습했을 때의 효과에 관한 근거 부족, 개방형 또는 창의적 지시 수행 과제에 대한 미검증을 한계로 지적한다. 이러한 한계는 실험으로 확인된 DuPO의 적용 범위와 확장성을 제한한다.
부록
- A Construction of Dual Question in Math Reasoning에서는 아래첨자, 부등식 제약, 흔히 쓰이는 지수의 밑, 함수 인수에 쓰인 수를 제외하고 수치 후보를 식별한다. 조건을 충족하는 수를 각각 Variable_{str} 형태의 식별자로 대체하며 str은 무작위로 생성한 소문자 문자열이다. 이후 정답을 조건으로 역방향 질문을 구성한다. 필터링에서는 샘플링한 후보 풀의 답 중 정확히 1개만 성공적인 복원을 가능하게 해야 한다. 이 조건이 전역적인 수학적 유일성을 증명하지는 않는다.
- B Math RL Dataset Preparation은 공개 데이터셋의 프롬프트 1,815,942개에서 시작해 중복 제거 후 primal question 318,649개를 얻고 dual question 1,059,671개를 생성한다. Qwen2.5-7B-Instruct가 primal question마다 후보 정답 32개를 제공해 샘플링과 필터링을 수행한다. 이후 Qwen3-4B로 질문마다 후보 8개를 사용하는 추가 단계를 거친다. 최종적으로 남은 학습 세트의 크기는 명시되지 않는다.
- C Experiment Details는 학습 batch size를 512, mini batch size를 32, 샘플링 temperature를 1.0으로 명시한다. 프롬프트마다 모델 응답을 샘플링하는 rollout은 16개이며 학습률은 1e-6, 기울기 크기를 제한하는 gradient clipping은 1.0이다. 최대 입력 길이는 2,048토큰이며 최대 출력 길이는 번역에서 4,096토큰, 수학에서 30,000토큰이다. 수학 학습의 출력 한도는 평가 시 추론 예산인 32,000토큰과 다르다.
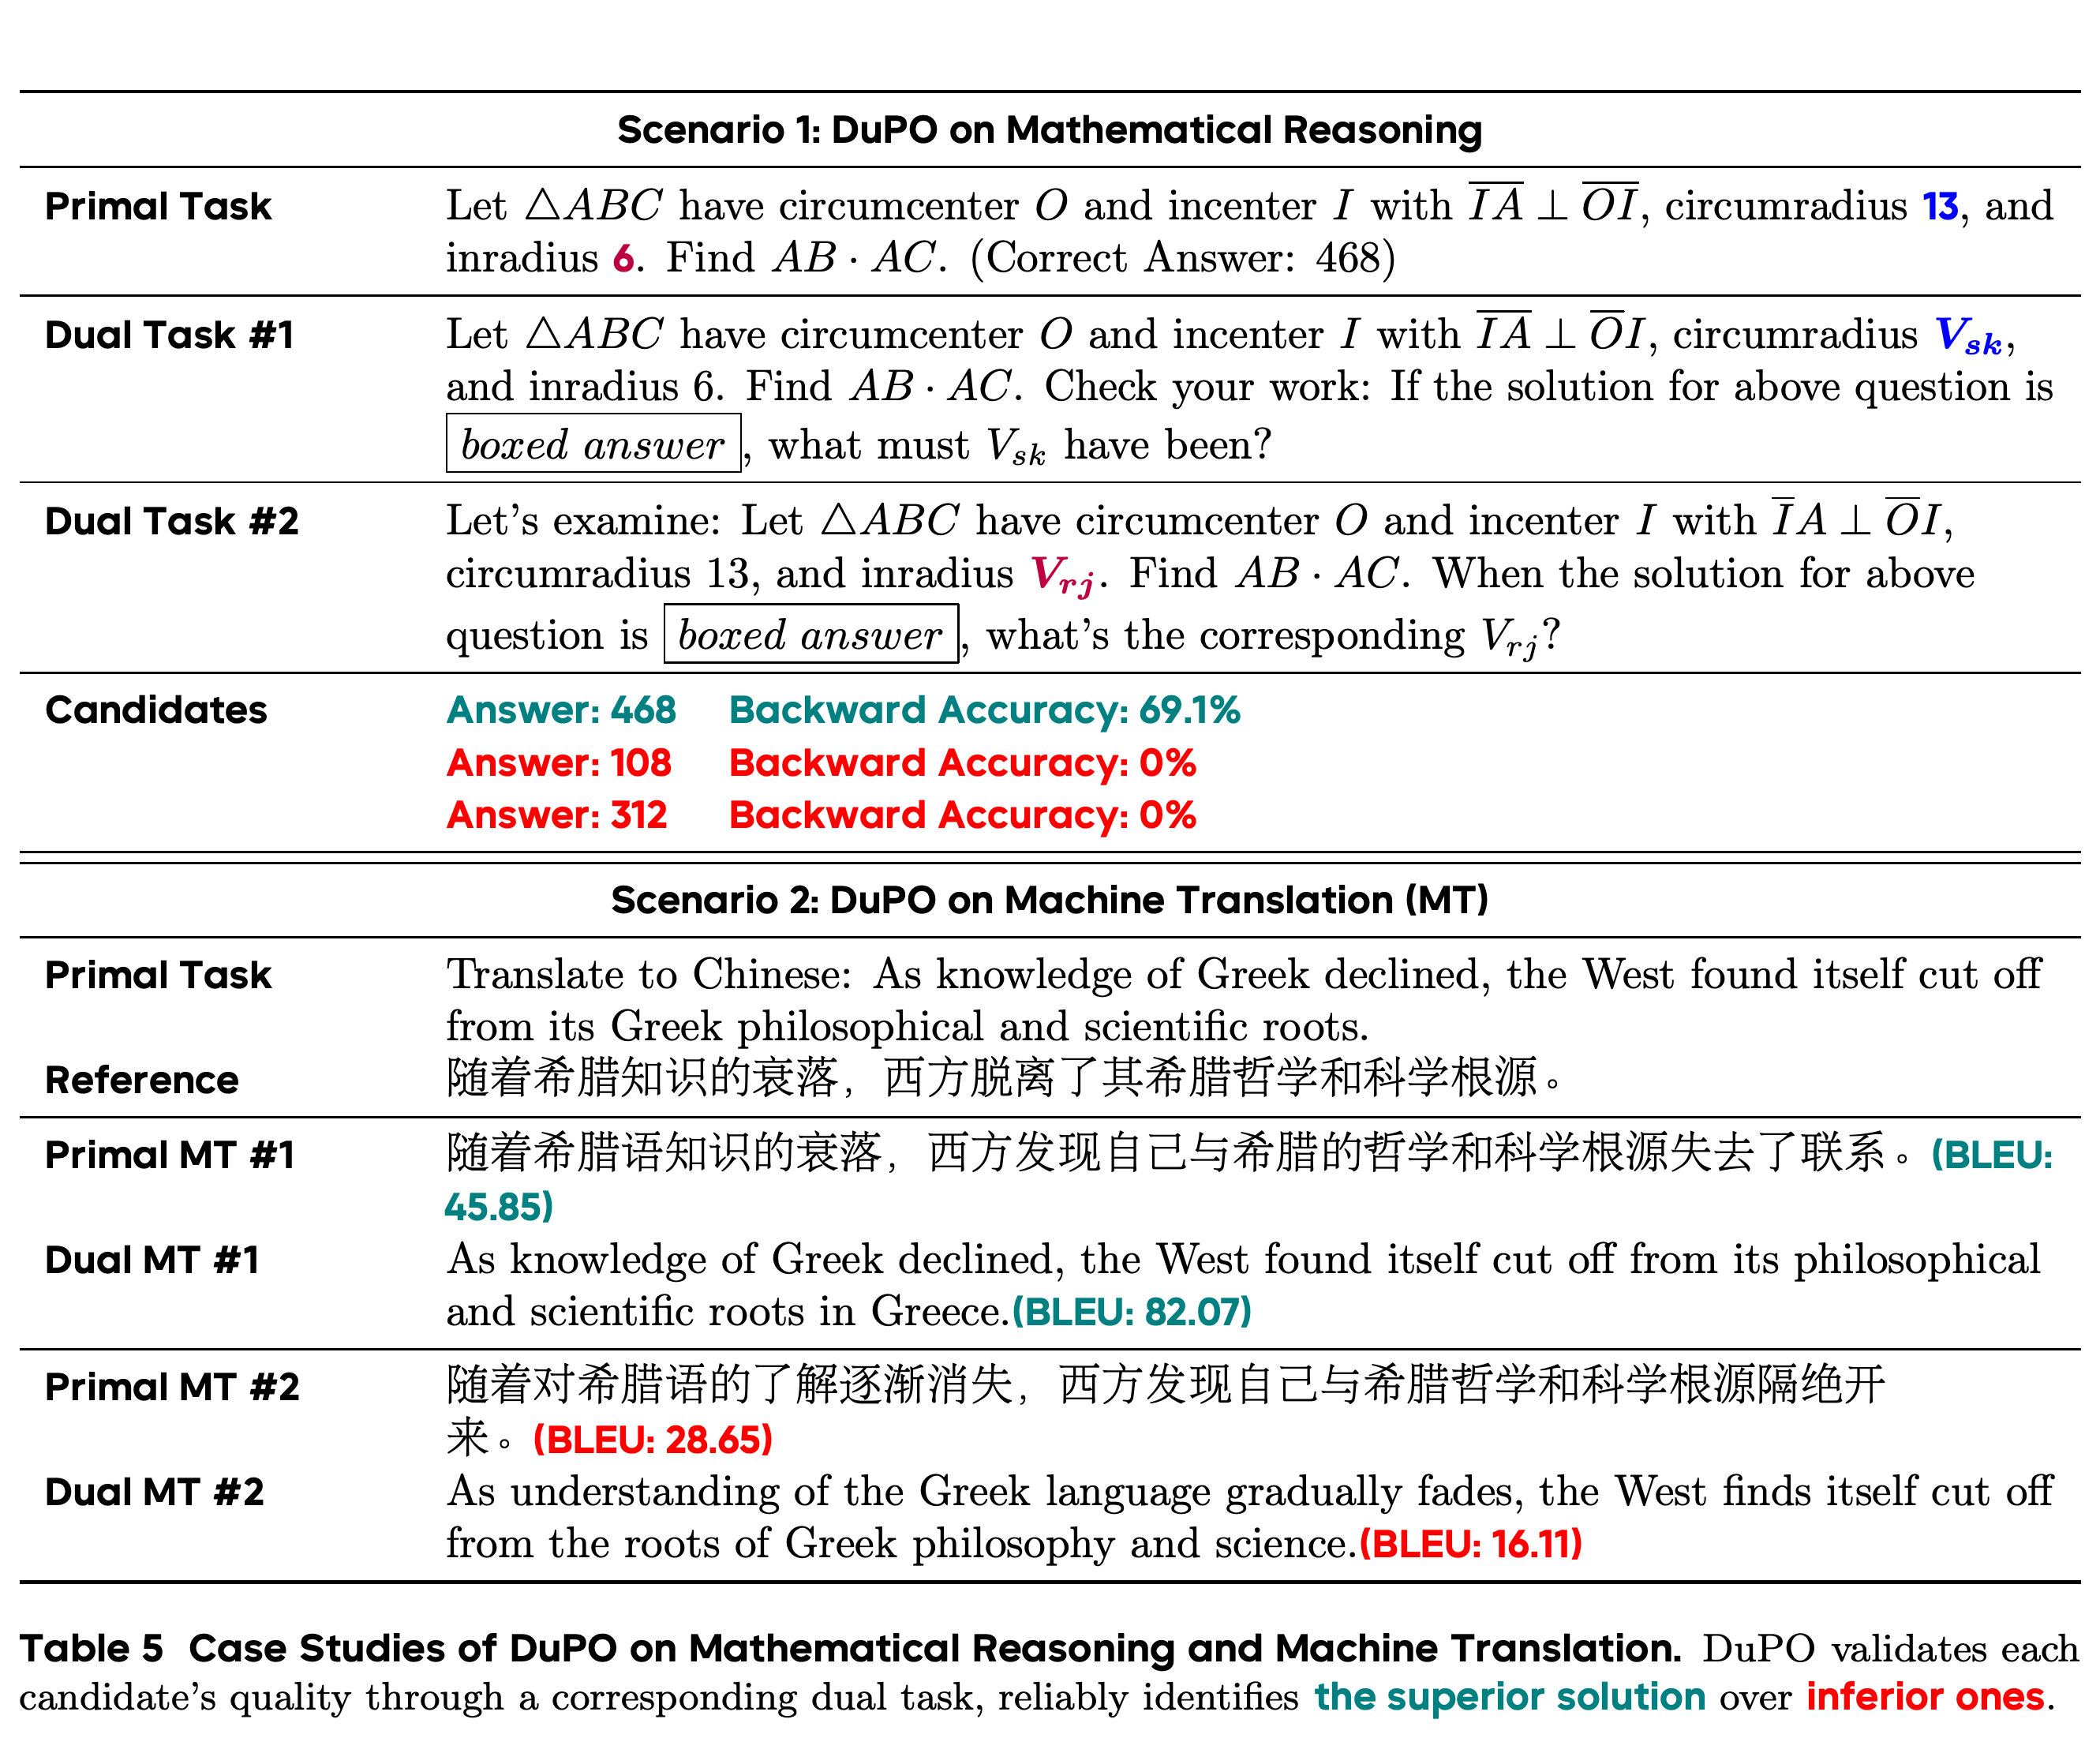
- D Case Study는 Table 5로 복원 점수 계산을 보여준다. 삼각형의 꼭짓점을 지나는 원의 반지름인 외접반지름이 13이고, 내접원의 반지름인 내접반지름이 6인 기하 문제에서 후보 정답 468은 역방향 정확도 69.1%를 받으며 108과 312는 0%를 받는다. 번역 후보의 순방향/역방향 BLEU 점수는 45.85/82.07과 28.65/16.11이다. 선택된 예시는 복원 점수와 후보 품질의 일치를 보여주지만 전체 평가 분포에서 신뢰성을 측정하지는 않는다.
짧은 생각
DuPO는 숨겨진 입력 요소를 검증 가능한 보상 목표로 사용하는 구체적인 방법을 제시하며 필터링과 아키텍처 비교는 학습에서의 유용성을 뒷받침한다. 실제 활용을 평가하려면 후보 생성, dual question 필터링, 역방향 과제 샘플링 비용을 고려하고 일관되지 않은 수학 결과를 해명해야 한다. 근거는 수학과 번역에서 복원 피드백의 효과를 뒷받침하지만 임의의 과제 전반에서 신뢰성은 입증되지 않았다.
기하 예시에서 후보 468은 복원 점수 69.1%를 받고, 후보 108과 312는 0을 받는다. 번역 예시에서도 역방향 BLEU를 이용하면 순방향 BLEU가 높은 후보를 다른 후보보다 높게 평가한다. 이는 선택된 사례에서 평가가 일치함을 보여준다.