


Quantization Meets dLLMs: A Systematic Study of Post-training Quantization for Diffusion LLMs 요약 설명
20 Aug 2025 | Paper Review Post-Training Quantization Diffusion Language Models Model Compression목차
이번 글에서는 Quantization Meets dLLMs: A Systematic Study of Post-training Quantization for Diffusion LLMs 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 8월 20일(Arxiv), Technical Report
- Lin, Haokun, Xu, Haobo, Wu, Yichen, Guo, Ziyu, Zhang, Renrui, Lu, Zhichao, Wei, Ying, Zhang, Qingfu, Sun, Zhenan.
- NLPR & MAIS, Institute of Automation, CAS, Tsinghua University, City University of Hong Kong, Harvard University, The Chinese University of Hong Kong, Zhejiang University
- 논문 링크
요약
- 확산 대규모 언어 모델(dLLMs)은 양방향 문맥을 활용해 손상된 토큰을 반복적으로 복원하며 텍스트를 생성한다. 이러한 모델에는 과제 성능을 유지하는 압축 방법이 필요하다. 학습된 모델 가중치를 양자화하는 GPTQ를 사용해 가중치를 4-bit, 중간 활성값을 16-bit로 설정하면, LLaDA-8B-Instruct의 6개 일반 과제 평균 정확도는 전체 정밀도 기준인 65.7%에서 66.0%로 높아진다고 보고된다. 이때 논문이 보고한 수학과 코드 성능 저하율은 각각 0.6%와 6.4%다.
- 이 연구는 재학습 없이 학습된 모델 텐서를 낮은 정밀도로 변환하는 학습 후 양자화(post-training quantization, PTQ)를 LLaDA-8B-Base, LLaDA-8B-Instruct, Dream-7B-Base에 적용한다. 권장 설정은 4-bit 가중치 전용 양자화와 가중치 및 중간값의 정밀도를 함께 낮추는 8-bit 가중치-활성값 양자화다. 4-bit 가중치-활성값 양자화에서는 큰 활성값을 여러 좌표로 분산하는 회전 방법이 스케일링으로 양자화 난도를 재분배하는 SmoothQuant보다 성능을 더 잘 유지한다.
- 수학과 코드 생성은 일반 질의응답보다 정밀도를 크게 낮추는 양자화에 민감하다. 지시를 따르도록 미세조정한 LLaDA는 대체로 기본 모델보다 성능을 더 잘 유지한다. 이러한 결과는 과제 수행 품질에 관한 것이다. 최적화된 저비트 추론 커널은 향후 과제로 남아 있고, Dream-7B의 가중치-활성값 실험은 수행하지 않았으며 수치 불일치 때문에 세밀한 비교에도 한계가 있다.
1 Introduction
Quantization Meets dLLMs: A Systematic Study of Post-training Quantization for Diffusion LLMs는 토큰을 순차적으로 생성하는 자기회귀 언어 모델용 압축 기법을 확산 언어 모델에도 적용할 수 있는지 조사한다. 서론은 텐서의 수치 범위를 좌우할 만큼 큰 중간값인 활성값 이상치를 장애 요인으로 제시하고 비트 폭, 방법, 과제 범주, 모델 유형을 중심으로 평가를 구성한다.
- 기존 가속 연구는 저장된 어텐션 상태를 재사용하는 key-value cache에 초점을 맞춘다. 양자화는 텐서 정밀도를 다루므로 이를 보완하는 접근법으로 제시된다.
- 이 논문은 새로운 양자화기를 제안하는 대신 기존 양자화 방법을 적용한다. 코드 URL은 https://github.com/FelixMessi/QDLM이다.
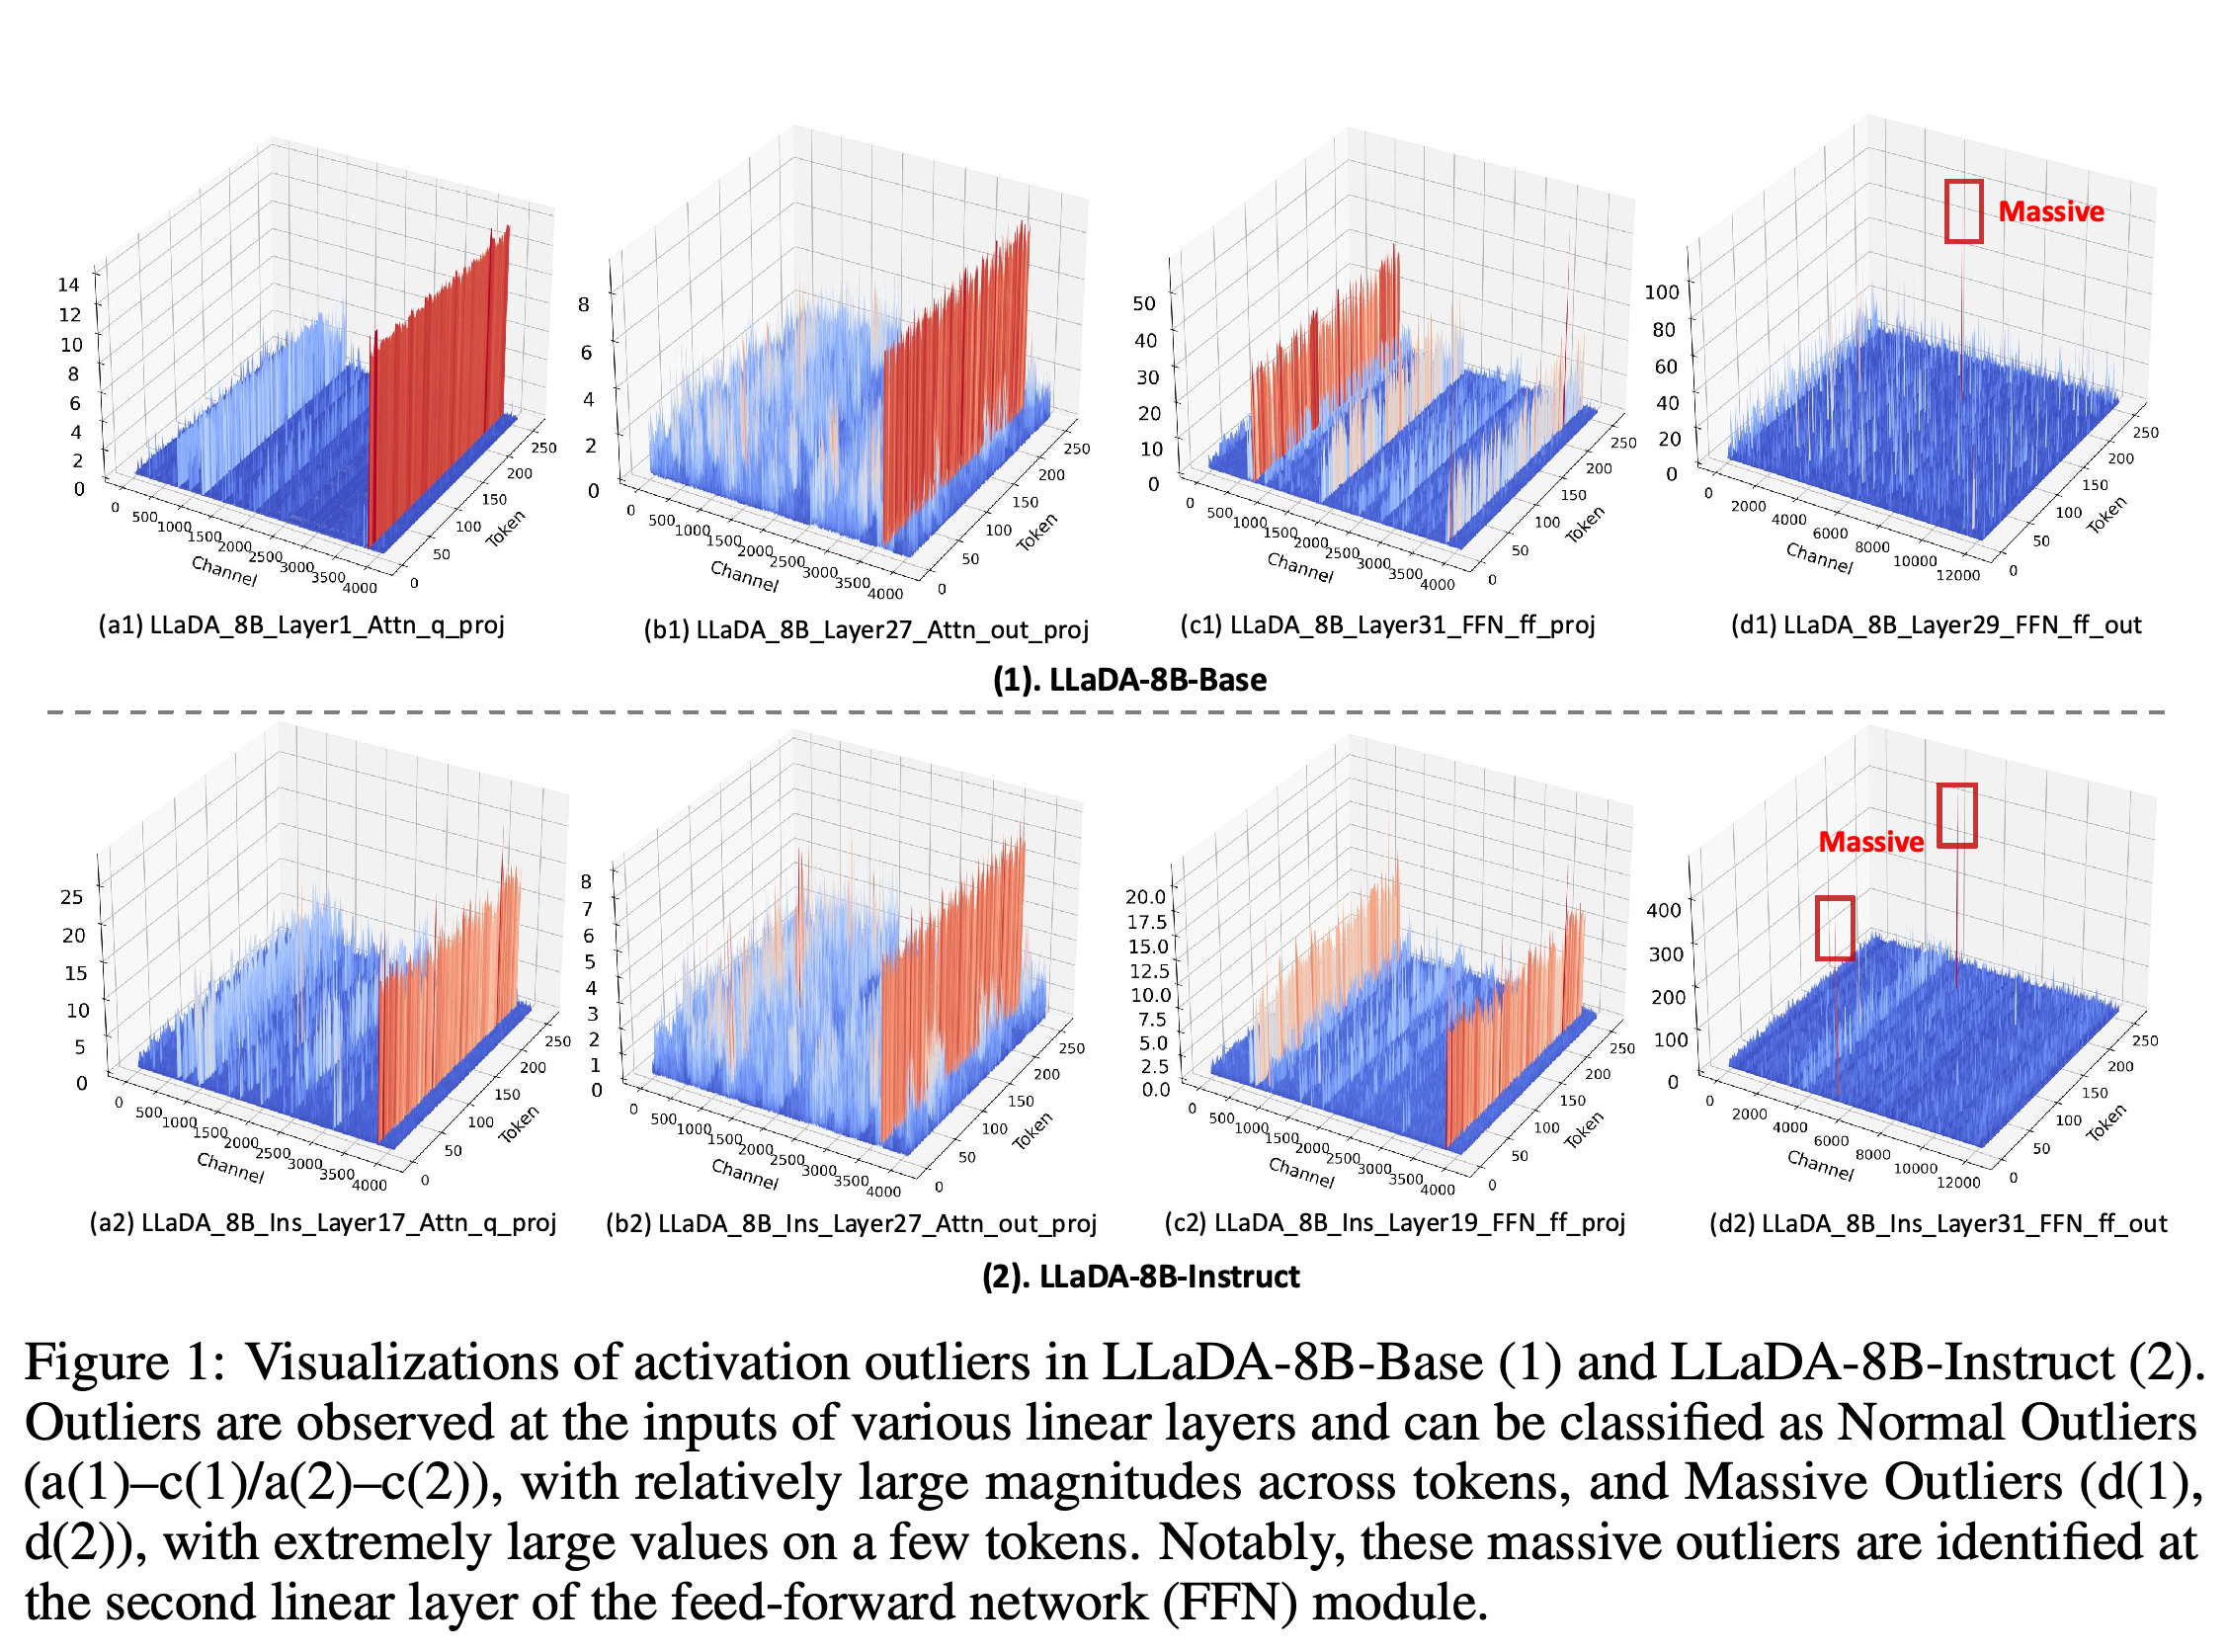
어텐션과 FFN 입력에서 채널 전체에 걸쳐 나타나는 높은 값의 분포는 FFN output-projection 입력의 고립된 높은 피크와 다르다. LLaDA 변형 모두에서 이 패턴들이 나타나므로 저비트 활성값 양자화 전에 이상치 처리 방식을 살펴볼 필요가 있다. 다만 이 분포 스냅샷은 확산 단계에 따른 변화를 측정하지 않는다.
2 Related Work
관련 연구는 확산 기반 언어 생성과 신경망 양자화를 연결한다. 순차적 생성용 압축 방법이 반복적 텍스트 생성에서도 품질을 유지하는지 검증할 필요성을 제시한다.
2.1 Diffusion Language Model
Masked Diffusion Models(MDMs)는 손상 과정에서 토큰을 점진적으로 [MASK]로 바꾸고, 생성 과정에서 빠진 내용을 예측한다. LLaDA-8B는 토큰 양쪽의 문맥을 참조하는 어텐션 기반 신경망인 양방향 Transformer를 마스크 복원기로 사용한다. Dream은 사전학습된 자기회귀 모델로 초기화한다.
- 이 절은 양자화를 확산 추론의 캐싱 전략을 보완하는 방법으로 제시한다. 양자화된 캐시와의 통합을 제안하지만 실험으로 평가하지는 않는다.
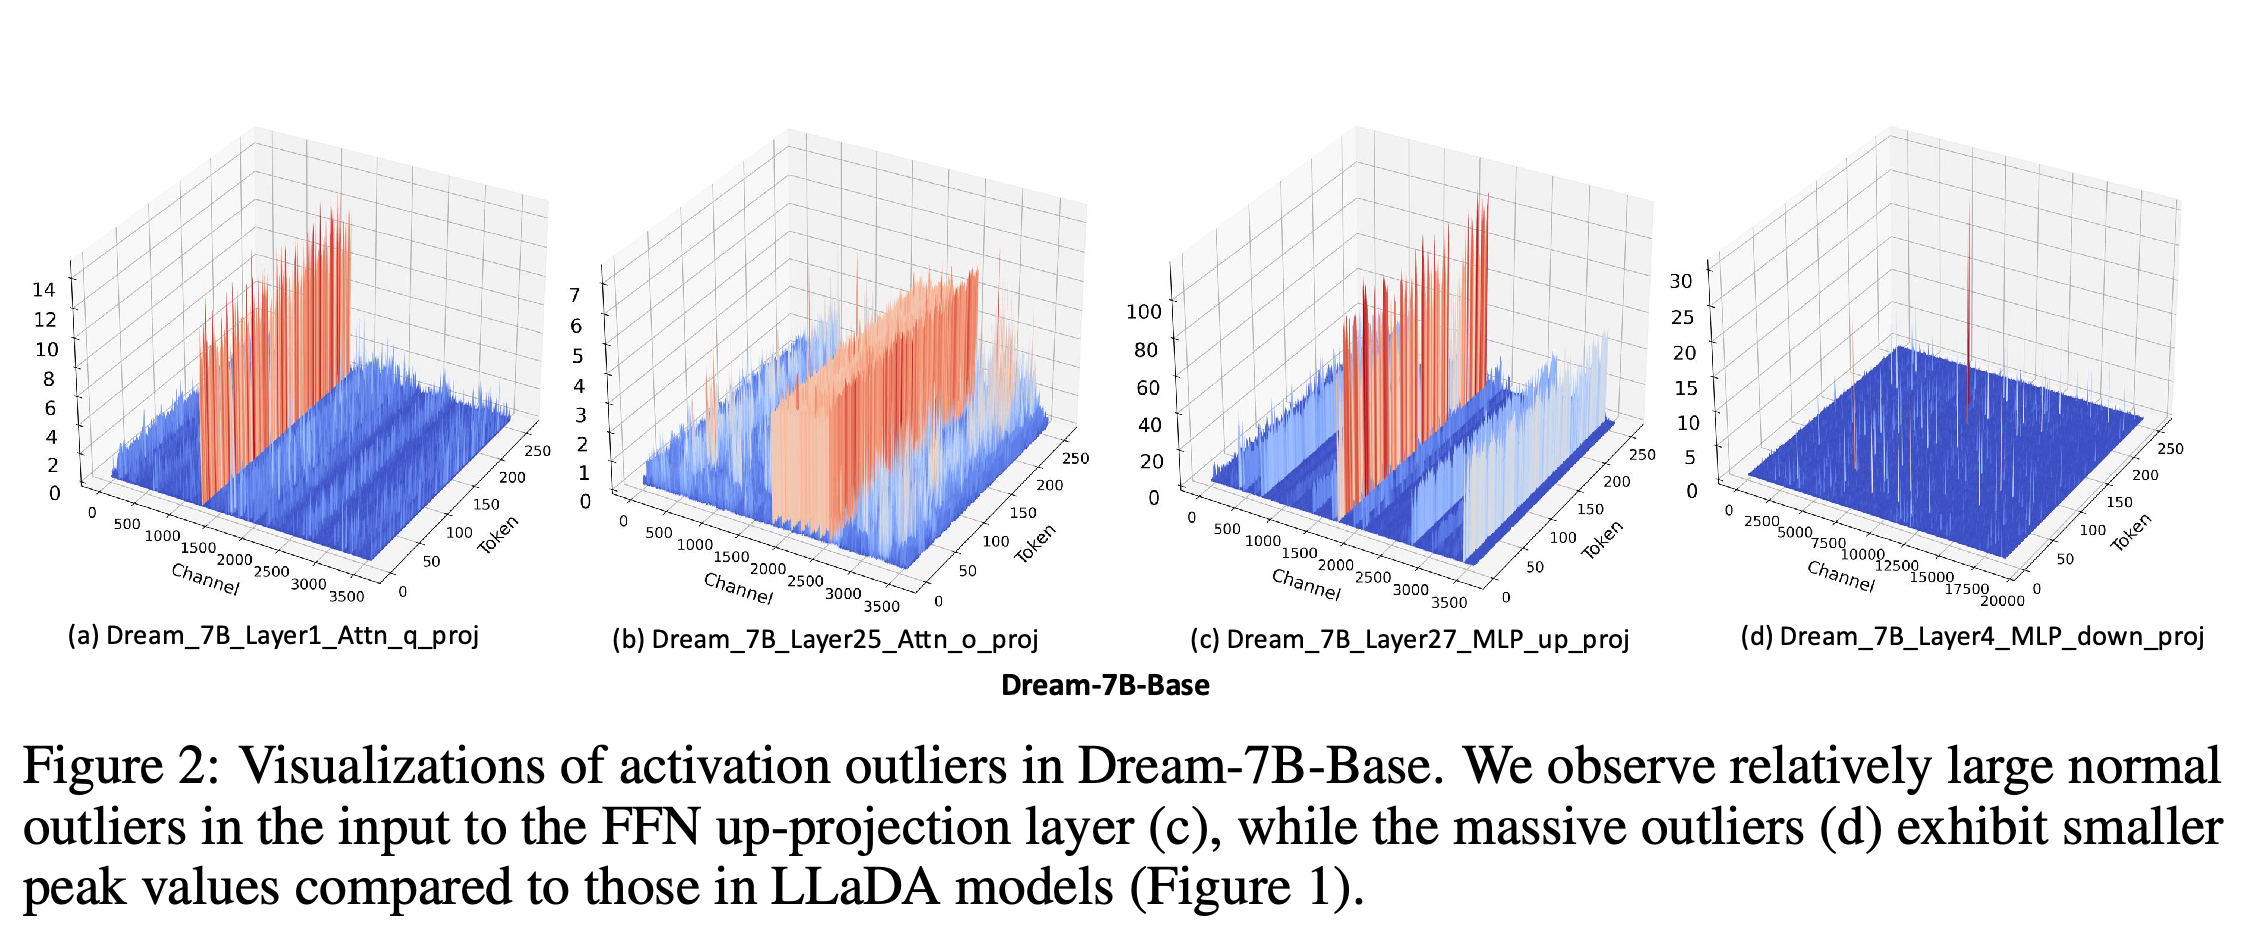
Dream에서도 채널 전반의 높은 값과 집중된 피크가 나타나므로 관측된 이상치 현상이 LLaDA에만 한정되지 않는다. 그림의 FFN up-projection 입력에는 강한 일반 이상치가 나타나며, 제시된 초대형 피크는 LLaDA 사례보다 작다.
2.2 Network Quantization
PTQ는 학습 후에 양자화를 적용하고 양자화 인지 학습(quantization-aware training)은 최적화 과정에 양자화 효과를 반영한다. 가중치 전용 방법은 가중치 행렬을 압축한다. GPTQ는 가중치 양자화 알고리즘인 Optimal Brain Quantization을 언어 모델로 확장한다. 활성값을 고려하는 가중치 양자화 방법인 AWQ는 활성값 통계와 재매개변수화를 활용해 가중치 압축을 조정한다.
- 가중치-활성값 양자화에서 SmoothQuant는 스케일링으로 활성값의 양자화 난도를 가중치로 옮긴다. QuaRot은 큰 값을 여러 좌표로 분산하는 구조적 변환인 Hadamard 기반 회전을 사용한다. DuQuant는 이상치를 고려한 회전과 활성값 좌표의 순서를 바꾸는 채널 순열을 결합한다.
- 비균일 양자화 방법인 SqueezeLLM과 클리핑 임곗값 및 스케일 계수를 함께 최적화하는 OmniQuant는 배경 설명에 포함되지만 실험 비교 방법으로 사용되지는 않는다.
3 Preliminary and Observation
예비 분석은 활성값 분포를 살펴보기 전에 마스크 복원과 균일 양자화를 소개한다. 실증 분석에서는 기존 언어 모델의 양자화를 방해하는 이상치 패턴이 평가 대상 확산 모델에도 나타나는지 확인한다.
3.1 Masked Diffusion Model
이 절은 관측 영역을 유지하는 이진 마스크와 가우시안 잡음을 예측하는 신경망을 설명한다. 가우시안 잡음은 손상 과정에서 추가되는 정규분포 잡음이다. 학습 목적함수는 L_MDM = E_{x,m,ε,t}[||ε − ε_θ(x_t,m,t)||²]로 제시된다. 여기서 x_t는 단계 t의 잡음이 섞인 입력이고, m은 마스크, ε은 가우시안 잡음, ε_θ는 잡음 예측기다.
- 이 가우시안 잡음 정식화는 Section 2.1의 이산적인 [MASK] 치환 설명과 다르다. 논문은 각 정식화의 관계를 설명하지 않으며 이 목적함수가 평가한 체크포인트의 학습 손실인지도 확인하지 않는다.
3.2 Quantization
균일 b-bit 양자화는 X_q = clamp(⌊X/s⌉ + z, 0, 2^b − 1)을 사용해 부동소수점 텐서 X를 정수값으로 변환한다. 이때 \(s=\frac{\max(\mathbf{X})-\min(\mathbf{X})}{2^b-1}\)이고 z = −⌊min(X)/s⌉다. clamp는 값을 허용 구간으로 제한하고 ⌊·⌉는 가장 가까운 정수로 반올림하는 연산을 뜻한다. s는 양자화 간격이고 z는 정수 오프셋인 0 point(영점)다. 이상치는 값의 범위를 넓히므로 비트 폭이 고정되어 있으면 양자화 간격도 커진다.
3.3 Outliers in dLLMs
양자화 설정에 사용할 대표 입력으로 WikiText-2 보정 배치를 무작위로 추출하고 각 모델에 1회 통과시켜 계층 입력을 시각화한다. 저자들은 여러 토큰에서 특정 채널값이 높게 나타나는 일반 이상치와 더 적은 토큰 위치에 훨씬 큰 값이 집중되는 초대형 이상치를 구분한다. LLaDA와 Dream에서는 이러한 이상치가 모두 나타난다.
- LLaDA에서는 각 토큰 표현을 변환하는 Transformer 구성 요소인 feed-forward network(FFN)의 2번째 선형 계층 입력에 초대형 이상치가 나타난다.
- 저자들은 초대형 이상치가 기존 언어 모델보다 더 많은 토큰에 걸쳐 나타난다고 보고한다. 이를 저정밀도에서 극단값을 잘라내는 전역 클리핑이나 스케일링의 효과가 줄어드는 현상과 연결한다. 다만 이 연구는 해당 설명을 인과관계를 분리해 확인하는 절제 실험으로 검증하지 않는다.
- Figure 2에서는 표현의 차원을 확장하는 Dream의 FFN up-projection 입력에 강한 일반 이상치가 나타난다. 초대형 이상치의 피크는 제시된 LLaDA 사례보다 작다.
4 Quantizing Diffusion LLM
실험 절은 4개 연구 질문(RQs)을 다룬다. RQ1은 권장 비트 폭을, RQ2는 양자화 방법의 비교를, RQ3는 과제별 민감도를, RQ4는 모델 유형의 비교를 다룬다. 성능은 각 모델의 전체 정밀도 기준과 비교해 평가한다.
4.1 Experimental Setup
평가 모델은 LLaDA-8B-Base, LLaDA-8B-Instruct, Dream-7B-Base다. GPTQ와 AWQ는 128개 값으로 구성된 그룹 안에서 양자화 매개변수를 공유하는 그룹별 가중치 양자화를 사용한다. SmoothQuant, QuaRot, DuQuant는 LLaDA의 가중치-활성값 양자화에 적용하며 보정 샘플은 128개를 사용한다. 보정 데이터는 대체로 WikiText-2에서 가져오고 AWQ에는 Pile 데이터를 사용한다.
- 일반 벤치마크에는 다중 과제 언어 이해를 평가하는 MMLU, 질의응답의 쉬운 하위 집합과 어려운 하위 집합인 ARC-E와 ARC-C, 문장 완성을 평가하는 Hellaswag, 대명사 지시 대상 판별을 평가하는 WinoGrande, 물리적 상식을 평가하는 PIQA가 포함된다. 수학에는 수학 문장제 벤치마크인 GSM8K와 수학 문제 해결 벤치마크인 Math를 사용한다. 코드에는 프로그램 생성 벤치마크인 HumanEval과 MBPP를 사용한다.
- 질의응답과 수학은 정확도로 평가한다. 코드는 생성한 프로그램 1개의 성공 여부를 나타내는 Pass@1로 평가한다. 전체 정밀도 대비 보고된 성능 저하율은 무시할 수준(<1%), 중간 수준(1–4%), 큰 수준(>4%)으로 구분한다. 이 저하율은 점수의 퍼센트포인트 차이와 구별된다.
- W4A16은 4-bit 가중치와 16-bit 활성값을, W3A16은 3-bit 가중치와 16-bit 활성값을 뜻한다. W8A8과 W4A4는 가중치와 활성값을 각각 8-bit와 4-bit로 양자화한다. 접미사 g128은 그룹 크기 128을 뜻한다.
- 본문은 가중치에 채널별 양자화를, 활성값에 토큰별 양자화를 적용한다고 명시한다. 이는 채널이나 토큰마다 양자화 매개변수를 따로 설정하는 방식이다. 반면 Appendix A는 SmoothQuant에 텐서별 가중치 양자화와 채널별 활성값 양자화를 적용한다고 설명한다. 이 설정 불일치는 해소되지 않는다.
4.2 Ideal Quantization Bit Precision (RQ1)
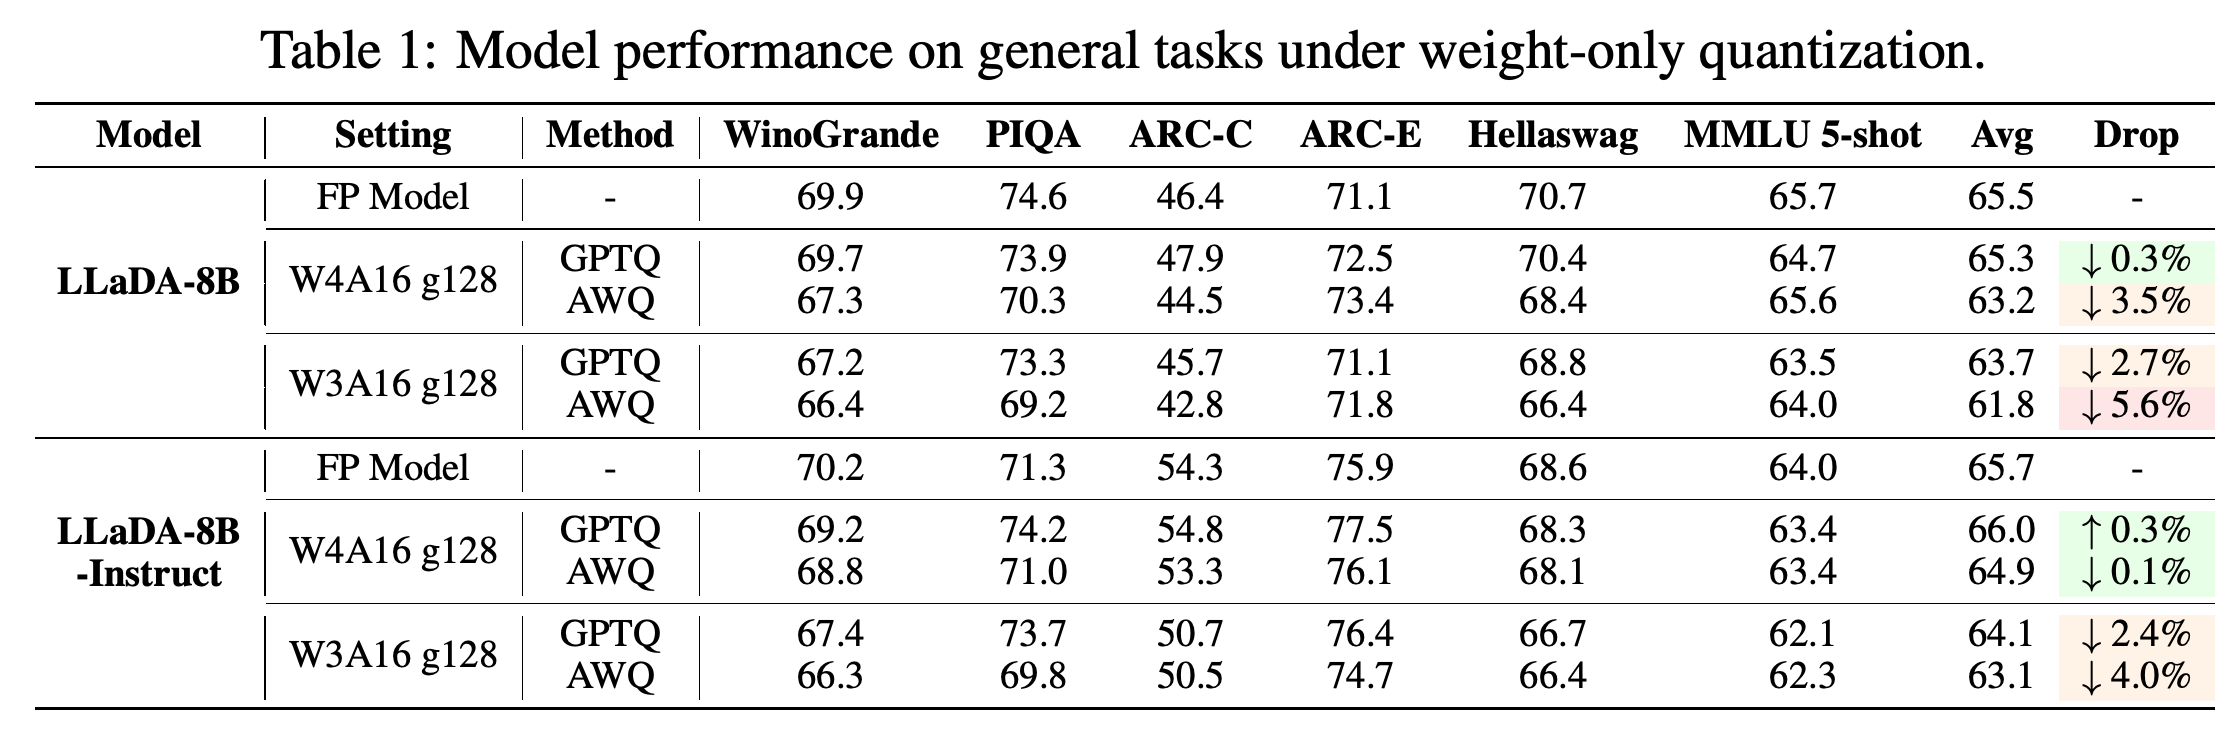
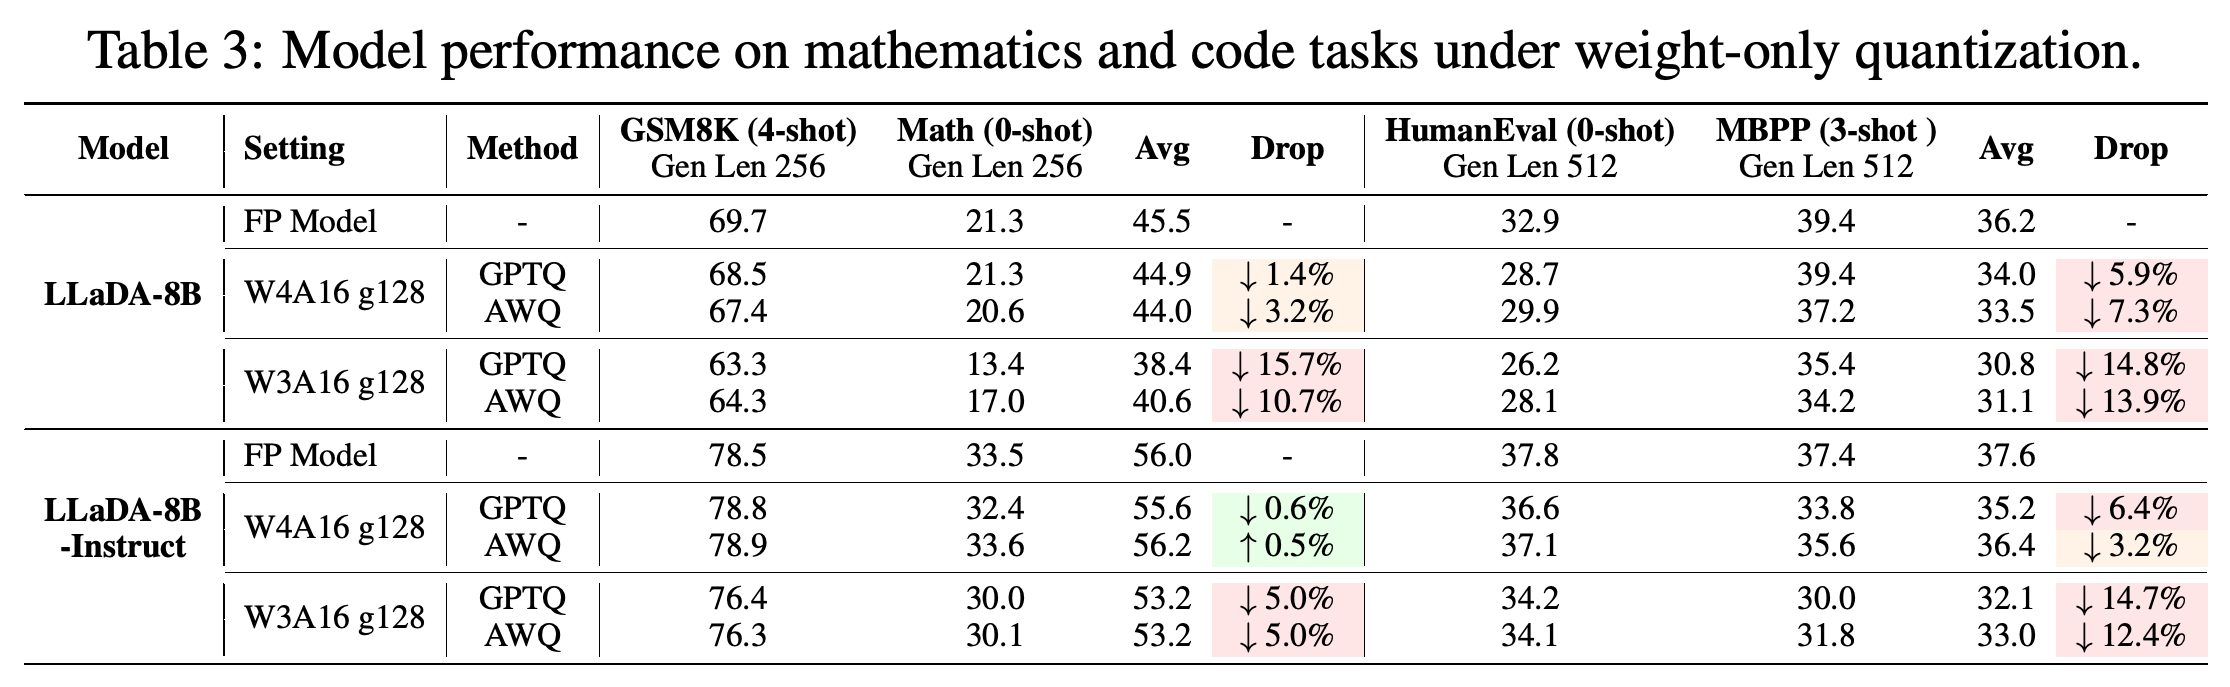
저자들은 일반 과제와 수학 성능이 대체로 3-bit보다 잘 유지된다는 이유로 4-bit 가중치 전용 양자화를 권장한다. LLaDA-8B-Instruct의 W4A16 GPTQ는 일반 과제 평균이 전체 정밀도의 65.7에서 66.0으로, 수학 평균이 56.0에서 55.6으로 바뀐다고 보고된다. 다만 코드 평균은 37.6에서 35.2로 떨어진다.
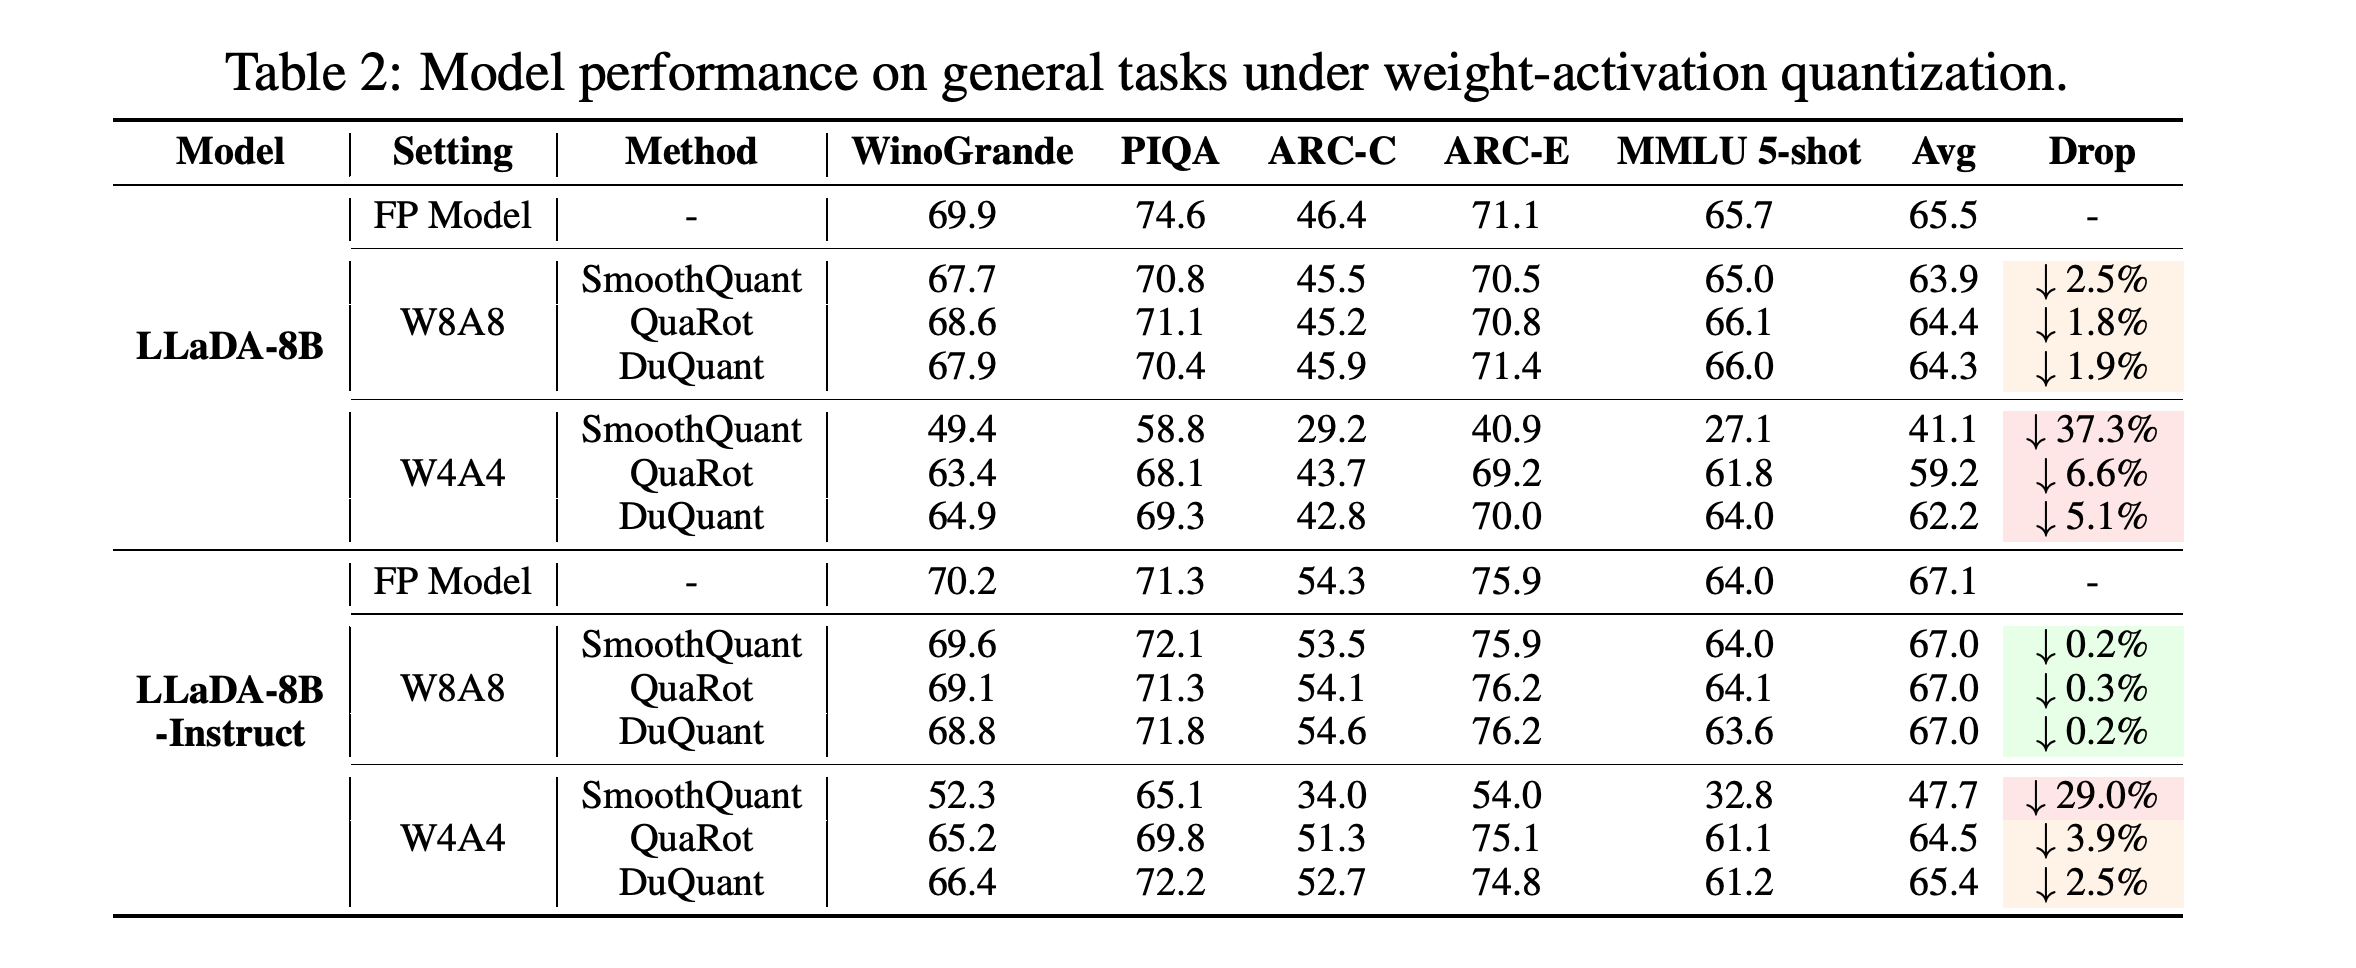
- W8A8은 대체로 W4A4보다 성능 손실이 작다. LLaDA-8B-Instruct에서는 3개 W8A8 방법 모두 일반 과제 평균이 67.0으로 보고되며, Table 2의 기준값은 67.1이다. 반면 W4A4 평균은 SmoothQuant가 47.7, QuaRot이 64.5, DuQuant가 65.4다.
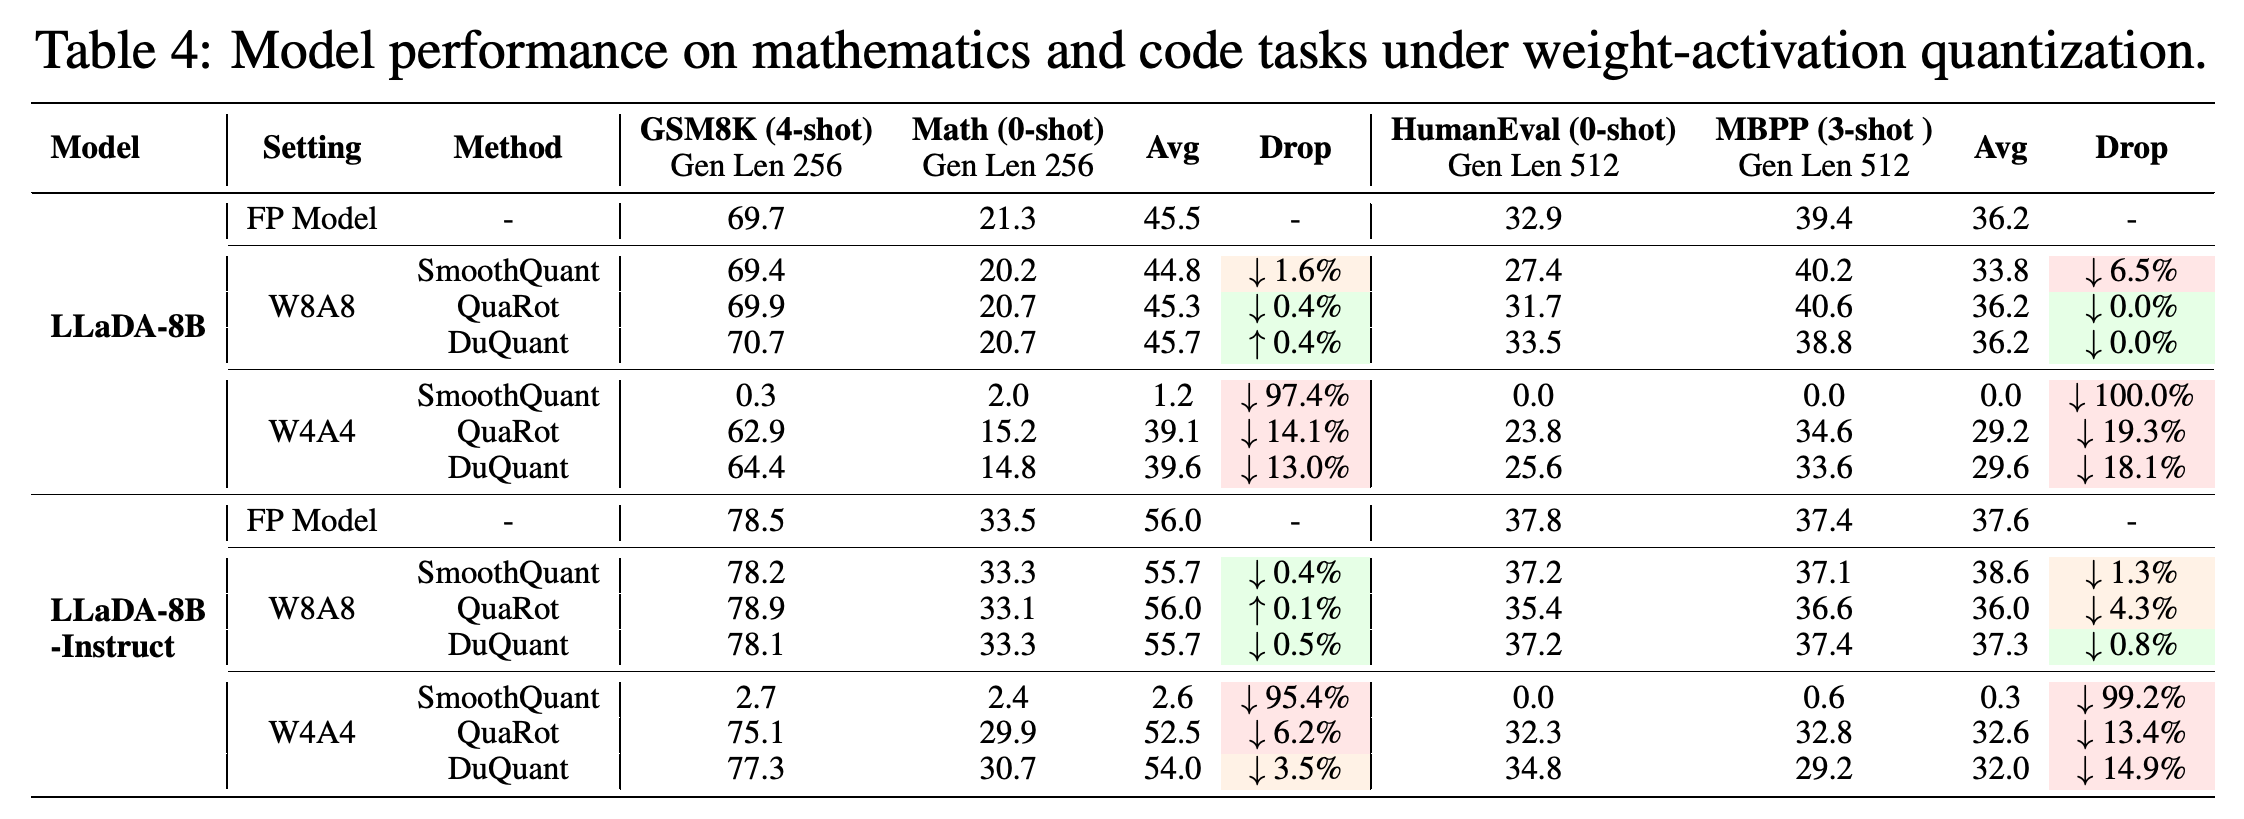
- W4A4에서 SmoothQuant의 LLaDA-8B 수학 평균은 45.5에서 1.2로, 코드 평균은 36.2에서 0.0으로 떨어진다. 회전 방법은 훨씬 높은 점수를 유지하지만 이 과제들에서 여전히 큰 손실을 보인다.
- W8A8이 거의 손실이 없다는 설명에는 과제별 조건을 덧붙여야 한다. Table 4는 기본 모델의 SmoothQuant에서 코드 성능 저하율을 6.5%로, 지시 미세조정 모델의 QuaRot에서는 4.3%로 보고한다.
4.3 Optimal Quantization Methods (RQ2)
GPTQ는 시험한 가중치 전용 정밀도 설정 모두에서 LLaDA 변형 각각의 일반 과제 평균이 AWQ보다 높으며 Dream의 해당 평균에서도 앞선다. 다른 과제에서는 순위가 달라진다. W4A16에서 LLaDA-8B-Instruct의 수학 평균은 AWQ가 56.2, GPTQ가 55.6이며, 코드 평균은 각각 36.4와 35.2다.
- 저자들은 활성값 이상치가 덜 두드러지면 AWQ가 활성값을 기반으로 중요한 가중치 상위 1%를 선택하는 효과가 약해질 수 있다고 추측한다. 이 메커니즘은 직접 검증하지 않는다. GPTQ와 AWQ는 보정 데이터셋과 시퀀스 길이도 서로 다르다.
- 가중치-활성값 양자화에서 회전 방법의 이점은 W4A4에서 가장 크다. 기본 모델의 일반 과제 성능 저하율은 DuQuant가 5.1%, QuaRot이 6.6%로 보고되며, 지시 미세조정 모델에서는 각각 2.5%와 3.9%다.
- 전반적으로 DuQuant를 권장하지만 표에는 예외가 있다. 지시 미세조정 모델의 W4A4 코드 평균은 QuaRot이 32.6, DuQuant가 32.0이다. 기본 모델의 W8A8 일반 과제 평균은 각각 64.4와 64.3이다. 회전 방법이 항상 SmoothQuant보다 우수하다는 주장에도 W8A8에서는 예외가 있다.
W4A16과 W3A16에서 LLaDA 변형 모두 GPTQ의 일반 과제 평균이 AWQ보다 높게 보고된다. 지시 미세조정 모델의 W4A16 GPTQ 평균 66.0은 전체 정밀도의 65.7 baseline을 조금 웃돈다. 다만 AWQ의 Drop 항목은 표시된 평균과 맞지 않는다.
보고된 지시 미세조정 모델 평균은 W8A8에서 전체 정밀도에 가깝게 유지되지만 W4A4에서는 회전 방법과 SmoothQuant 사이에 차이가 나타난다. 모델 변형 모두에서 DuQuant의 W4A4 일반 과제 손실이 QuaRot보다 작게 보고된다. 다만 기본 모델 QuaRot의 평균 59.2와 저하율 6.6%는 표시된 세부 점수 및 기준값과 맞지 않는다.
4.4 Influence of Task Categories on Quantization (RQ3)
정밀도를 크게 낮추는 양자화는 대체로 일반 질의응답보다 수학과 코드에서 더 큰 손실을 일으킨다. 기본 모델의 W3A16 GPTQ에 대해 Table 1은 일반 과제 성능 저하율을 2.7%로 보고한다. Table 3은 수학 성능 저하율을 15.7%, 코드 성능 저하율을 14.8%로 보고한다.
- 저자들은 다단계 추론에서 오류가 누적되고 장거리 의존 관계나 코드 구문이 손상되어 이러한 민감도가 나타날 수 있다고 설명한다. 중간 표현과 오류 전파를 직접 측정하지 않으므로 이 설명들은 가설로 남는다.
- 보고된 HumanEval 표준편차는 약 3%이므로 방법 간 작은 차이를 해석하기 어렵다. 논문은 결과표 전반에 불확실성 추정치를 제공하지 않는다.
- 본문은 4-bit 가중치 전용 양자화의 코드 손실이 5%를 넘는다고 서술하지만 지시 미세조정 모델의 AWQ 손실은 3.2%로 보고된다. 전체적인 과제 경향만으로 모든 설정이 이 서술을 따른다고 볼 수는 없다.
수학과 코드 결과를 보면 4-bit 가중치 전용 양자화의 긍정적인 일반 과제 결과를 모든 과제로 확대하기 어렵다. 기본 모델의 W4A16 GPTQ는 수학 성능을 거의 유지하지만 코드에서는 5.9% 손실이 보고된다. W3A16에서는 손실이 더 크며, 지시 미세조정 모델의 W4A16 수학 및 코드 평균은 AWQ가 GPTQ보다 높다.
W4A4 SmoothQuant에서는 수학과 코드 성능이 거의 사라진다. QuaRot과 DuQuant는 훨씬 높은 점수를 유지하지만 손실은 남는다. 지시 미세조정 모델의 W4A4 코드 성능은 QuaRot이 DuQuant보다 높다. W8A8 SmoothQuant의 지시 미세조정 모델 코드 평균은 세부 점수와 맞지 않는다.
4.5 Impact of Model Types (RQ4)
지시 미세조정된 LLaDA는 대체로 기본 모델보다 성능 저하가 작으며 특히 정밀도를 크게 낮췄을 때 이러한 경향이 두드러진다. W4A4 DuQuant의 수학 성능 저하율은 LLaDA-8B-Instruct가 3.5%, LLaDA-8B가 13.0%로 보고된다. 일반 과제 성능 저하율은 각각 2.5%와 5.1%다.
- 이 경향에도 예외가 있다. W4A16 GPTQ의 코드 성능 저하율은 지시 미세조정 모델이 6.4%, 기본 모델이 5.9%로 보고된다. 결과는 이 모델들 사이의 경향을 보여주지만 지시 미세조정이 민감도를 바꾸는 이유는 밝히지 않는다.
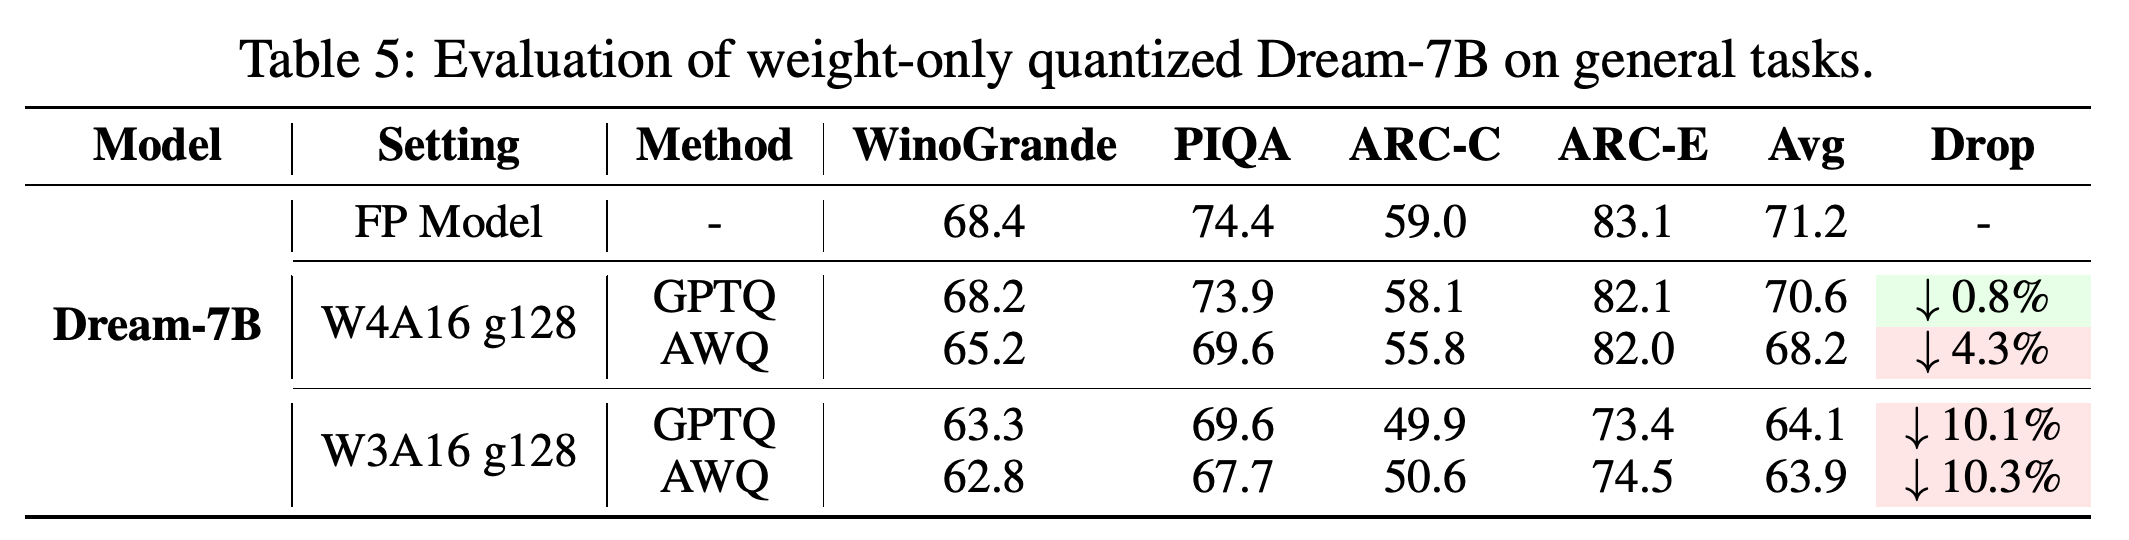
- Dream-7B의 4개 일반 과제 평균은 W4A16 GPTQ에서 71.2에서 70.6으로 떨어지며, 보고된 저하율은 0.8%다. AWQ에서는 평균이 68.2로 떨어지고 저하율은 4.3%다. W3A16에서 보고된 저하율은 각각 10.1%와 10.3%다.
- Dream 결과는 시험한 일반 과제에서 4-bit GPTQ를 선호할 근거를 제공한다. 자원 제약 때문에 Dream의 가중치-활성값 양자화는 평가하지 않았으므로, 해당 권장 설정의 실험적 근거는 LLaDA에서 나온다.
5 Limitation and Future Work
이 연구는 다운스트림 과제 품질에 초점을 맞추고, 저정밀도 연산을 구현하는 최적화된 저비트 추론 커널은 향후 과제로 남긴다. 따라서 실제로 배포한 확산 추론 시스템에서 지연 시간, 처리량, 장치 메모리가 얼마나 개선되는지는 측정해 입증하지 않는다.
- 향후 확장 계획에는 더 다양한 모델, 모델 크기, 과제를 평가하고 양자화와 생성 단계 수의 상호작용을 분석하며 생성된 토큰을 골라 다시 마스킹하고 수정하는 remasking 전략을 비교하는 작업이 포함된다.
Dream에서 시험한 4개 일반 과제의 W4A16 GPTQ 평균은 70.6이며, 전체 정밀도 평균은 71.2다. W3A16 방법 모두 보고된 성능 저하율 지표로 약 10%의 손실을 보인다. 이는 이 모델에서 4-bit를 선호할 근거가 되지만 여기서는 수학, 코드, 가중치-활성값 양자화의 성능을 시험하지 않는다.
6 Conclusion
결론은 활성값 이상치를 저비트 양자화의 장애 요인으로 지목하고 전반적인 실험 성능을 근거로 GPTQ와 DuQuant를 권장한다. 결과는 가중치 전용 양자화와 가중치-활성값 양자화에 필요한 정밀도가 다르며, 품질 손실이 과제와 모델 변형에 따라 달라진다는 점을 뒷받침한다.
부록
- A Additional Implementation Details에서 GPTQ는 시퀀스 길이 2048인 WikiText-2 samples를 128개 사용하고 0이 아닌 오프셋을 허용하는 비대칭 양자화와 그룹 크기 128을 적용한다. 구현에는 https://github.com/AutoGPTQ/AutoGPTQ를 사용한다. AWQ는 시퀀스 길이 512인 PileVal 샘플 128개, 비대칭 양자화, 그룹 크기 128을 사용하며 구현에는 https://github.com/mit-han-lab/llm-awq를 사용한다.
- SmoothQuant는 \(\alpha=0.5\)와 s_j = max(|X_j|)^α/max(|W_j|)^(1−α)를 사용하며 보정 데이터로 시퀀스 길이 2048인 WikiText-2 샘플 128개를 사용한다. QuaRot은 관련성을 결정하는 어텐션 입력인 query 상태를 16-bit 정밀도로 유지하고 양자화 범위의 중심을 0으로 두는 대칭 활성값 양자화를 사용한다. DuQuant는 SmoothQuant와 같은 보정 설정 및 α를 사용하며 활성값과 가중치 클리핑 비율은 각각 0.9와 0.8, 회전 단계는 256, 블록 크기는 128이다.
- 평가에는 https://github.com/EleutherAI/lm-evaluation-harness를 사용한다. MMLU를 제외한 일반 과제는 시범 예시가 없는 0-shot 평가와 추정을 위해 반복 추출하는 Monte Carlo 샘플 128개를 사용한다. MMLU는 시범 예시 5개를 제공하는 5-shot 평가와 샘플 1개를 사용한다. LLaDA의 일반 과제 확산 단계 수, 블록 크기, 생성 길이는 모두 1024다. 생성 조건을 조절하는 classifier-free guidance(CFG) scale과 샘플링을 조절하는 temperature는 모두 0.0이며, low confidence remasking을 사용한다. Dream은 새 토큰을 최대 128개 생성하며 CFG scale 1.0, temperature 0.0, top-p 임곗값 0.95를 사용한다. 논문은 이 임곗값을 생성된 토큰을 유지할 확률로 설명한다.
- Table A1은 LLaDA의 수학 및 코드 설정을 few-shot 예시 수, 생성 길이, 확산 단계 수, 블록 크기 순으로 제시한다. GSM8K는 4, 256, 256, 32를, Math는 0, 256, 256, 64를, HumanEval은 0, 512, 512, 32를, MBPP는 3, 512, 512, 32를 사용한다. B More Visualizations는 LLaDA-8B-Base의 Figure B1과 LLaDA-8B-Instruct의 Figure B2를 추가한다. 이 그림들은 채널 전반에 나타나는 이상치와 FFN output-projection 입력에 집중된 초대형 피크의 추가 사례를 보여준다.
짧은 생각
이 체크포인트들에서는 W4A16 GPTQ를 초기 시험 설정으로 고려할 만하다. 일반 과제 평균을 받아들이기 전에 수학과 코드를 별도로 검증해야 한다. W4A4 SmoothQuant의 실패는 높은 정밀도에서 유지되던 성능도 활성값 정밀도를 크게 낮추면 급격히 저하될 수 있음을 보여준다. 배포 결정을 내리려면 추가 근거가 필요하다. 최적화된 커널, 측정된 시스템 효율, Dream의 가중치-활성값 결과가 없기 때문이다. 순전파 1회로 수행한 이상치 분석도 반복적 디코딩 전 과정에서 일어나는 변화를 설명하지 못한다. 여러 표 항목을 확인해야 한다. Table 1은 지시 미세조정 모델의 W4A16 AWQ 기준 평균과 양자화 후 평균이 65.7과 64.9인데도 저하율을 0.1%로 보고한다. Table 4는 지시 미세조정 모델의 W8A8 SmoothQuant 코드 세부 점수가 37.2와 37.1인데도 평균을 38.6으로 제시한다. Table 2에서 기본 모델의 W4A4 QuaRot 평균 59.2는 표시된 5개 과제 점수와 맞지 않는다. 보고된 저하율 6.6%도 표시된 기준값 및 평균과 맞지 않는다. 이러한 불일치는 작은 성능 향상과 방법 간 세밀한 순위에 대한 신뢰를 제한한다.