


rStar2-Agent: Agentic Reasoning Technical Report 요약 설명
28 Aug 2025 | Paper Review Agentic Reinforcement Learning Mathematical Reasoning Tool Use목차
이번 글에서는 rStar2-Agent: Agentic Reasoning Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 8월 28일(Arxiv)
- Shang, Ning, Liu, Yifei, Zhu, Yi, Zhang, Li Lyna, Xu, Weijiang, Guan, Xinyu, Zhang, Buze, Dong, Bingcheng, Zhou, Xudong, Zhang, Bowen, et al.
- Microsoft Research
- 논문 링크
- Github
요약
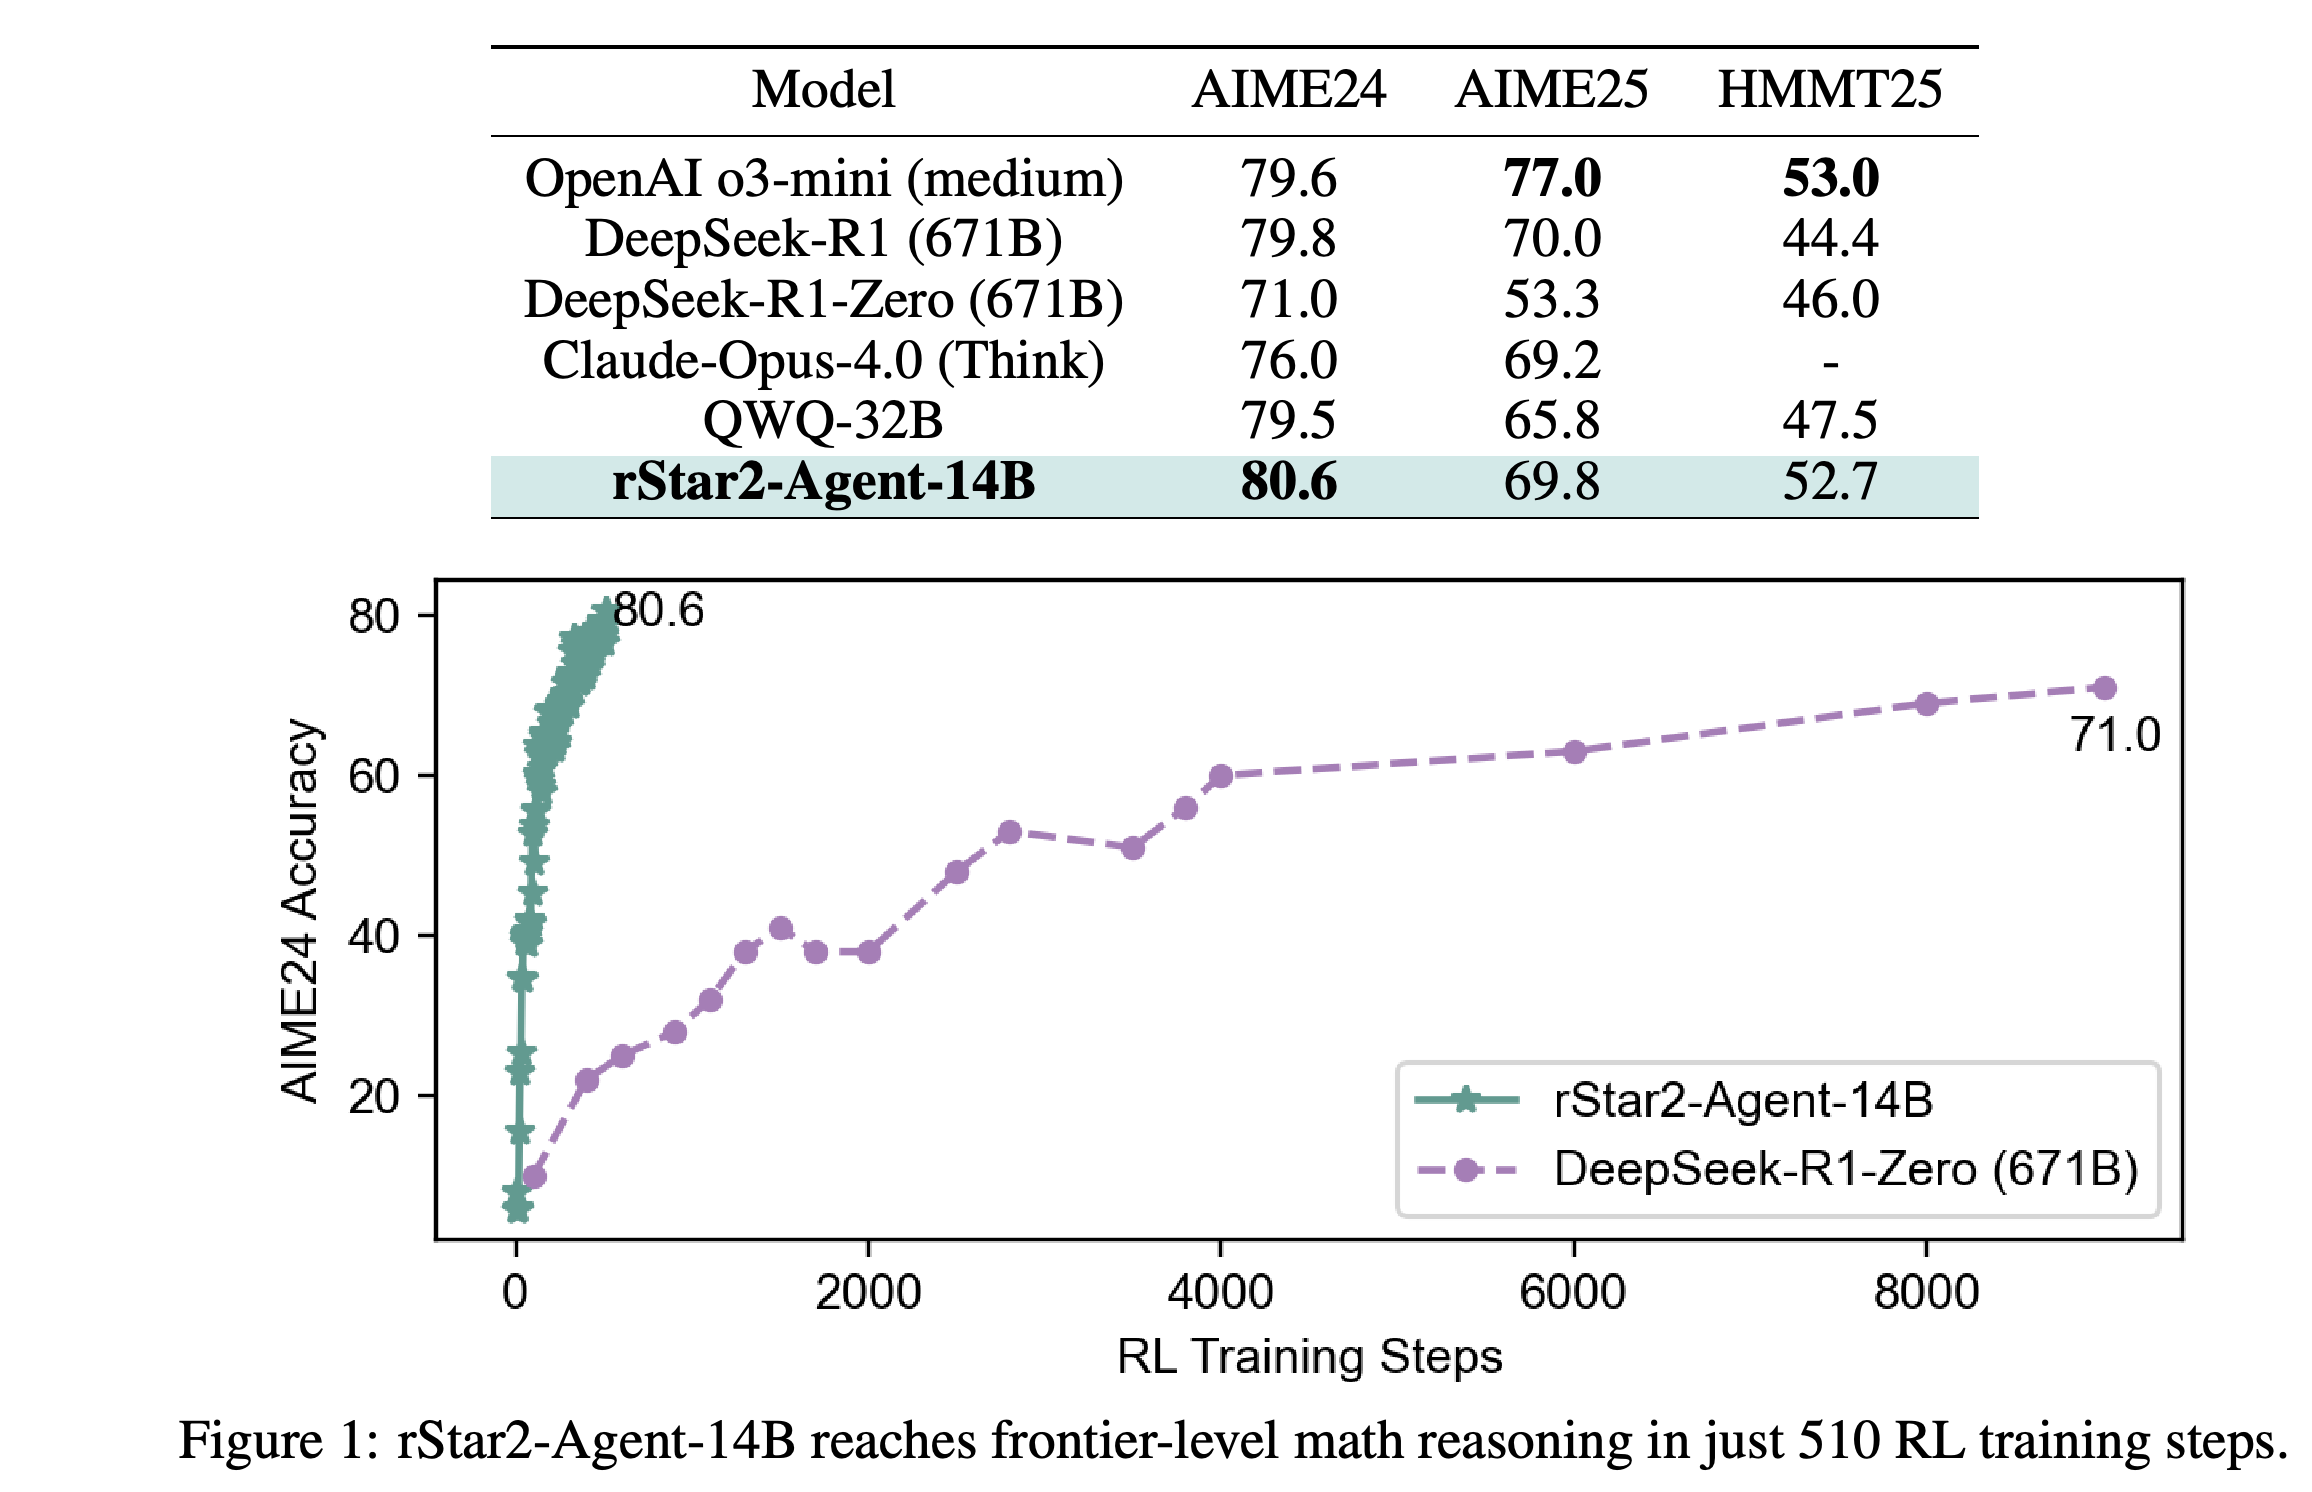
- rStar2-Agent는 Python 실행 피드백으로 중간 추론을 검증하고 수정하면서 어려운 수학 문제를 풀도록 언어 모델을 학습하는 방법을 다룬다. 보고서의 벤치마크 비교에서 14B 파라미터 모델은 경시 수학 벤치마크 AIME24에서 평균 pass@1 80.6%를 기록하며 DeepSeek-R1 (671B)의 79.8%보다 높다. 이 지표는 문제마다 생성한 16개 샘플에 대해 단일 응답의 정답률을 평균한 값이다. AIME25에서는 각각 69.8%와 70.0%를 기록한다.
- 핵심 방법은 Group Relative Policy Optimization with Resampling on Correct (GRPO-RoC)다. 응답 그룹 내 상대적인 보상으로 학습하며 모델을 업데이트하기 전에 추론과 도구 상호작용을 포함한 전체 궤적을 다시 샘플링한다. 정답을 낸 궤적은 도구 오류와 형식 위반이 적을수록 선택 확률이 높아지고, 오답을 낸 궤적은 품질에 따른 필터링 없이 샘플링한다. 이러한 에이전트 강화학습은 도구 상호작용으로 모델을 학습하되, 보상은 최종 답의 정답 여부만으로 결정한다.
- 학습은 시범 데이터로 지시 이행과 도구 호출 형식을 익히는 비추론 supervised fine-tuning (SFT)으로 시작한다. 이후 정답 보상으로 학습하는 reinforcement learning (RL)을 3단계로 수행한다. 보고된 학습에는 선별한 수학 문제 42K개를 사용하며 최대 응답 길이는 8K→12K→12K 토큰이다. 토큰은 모델이 처리하는 텍스트 단위다. 64개의 AMD MI300X GPU에서 1주 이내에 510 RL 스텝을 수행한다.
- 실험에서는 경쟁력 있는 수학 정확도와 여러 비교 모델보다 짧은 응답을 보인다. 과학 질의응답 벤치마크 GPQA-Diamond에서도 점수가 42.1%에서 60.9%로 높아진다. 지시 이행과 대화 행동을 측정하는 일반 도구 사용 및 정렬 점수는 SFT 체크포인트보다 소폭 낮아진다. 보고된 14B 실험에서는 선택한 510-step 체크포인트 이후에도 RL을 계속하면 정책과 보상이 붕괴한다.
1 Introduction
서론은 검증을 모델 자체의 성찰에 전적으로 맡기면 Chain-of-Thought (CoT)를 늘려도 미묘한 오류를 발견하지 못할 수 있다고 설명한다. CoT는 모델이 생성하는 중간 추론 단계의 연속이다. 에이전트 RL에서는 모델이 Python 인터프리터와 상호작용하고 실행 결과로 중간 판단을 확인한 뒤 접근 방식을 수정한다. 실용적인 과제는 도구 실행 실패, 중간 오류가 있어도 정답 궤적에 보상을 주는 최종 답 중심의 보상, 비용이 크고 작업량이 불균등한 다중 턴 생성이다.
- 제안한 접근법은 궤적 재샘플링, 격리된 실행 서비스, 단계별 학습을 결합한다.
- Figure 1은 모델 크기와 학습 방식에 따른 정확도를 학습 스텝에 맞춰 비교한다. 이 곡선만으로 동일한 연산량에서의 비교가 성립하지는 않는다.
개요는 벤치마크 점수와 AIME24 학습 곡선을 함께 제시한다. rStar2-Agent-14B는 510 RL 스텝에서 80.6에 도달하며 표시된 DeepSeek-R1-Zero (671B) 곡선은 훨씬 많은 스텝 이후 71.0에서 끝난다. 모델 크기와 학습 방식이 달라 통제된 연산량 비교로 볼 수 없다.
2 Agentic Reinforcement Learning Methodology
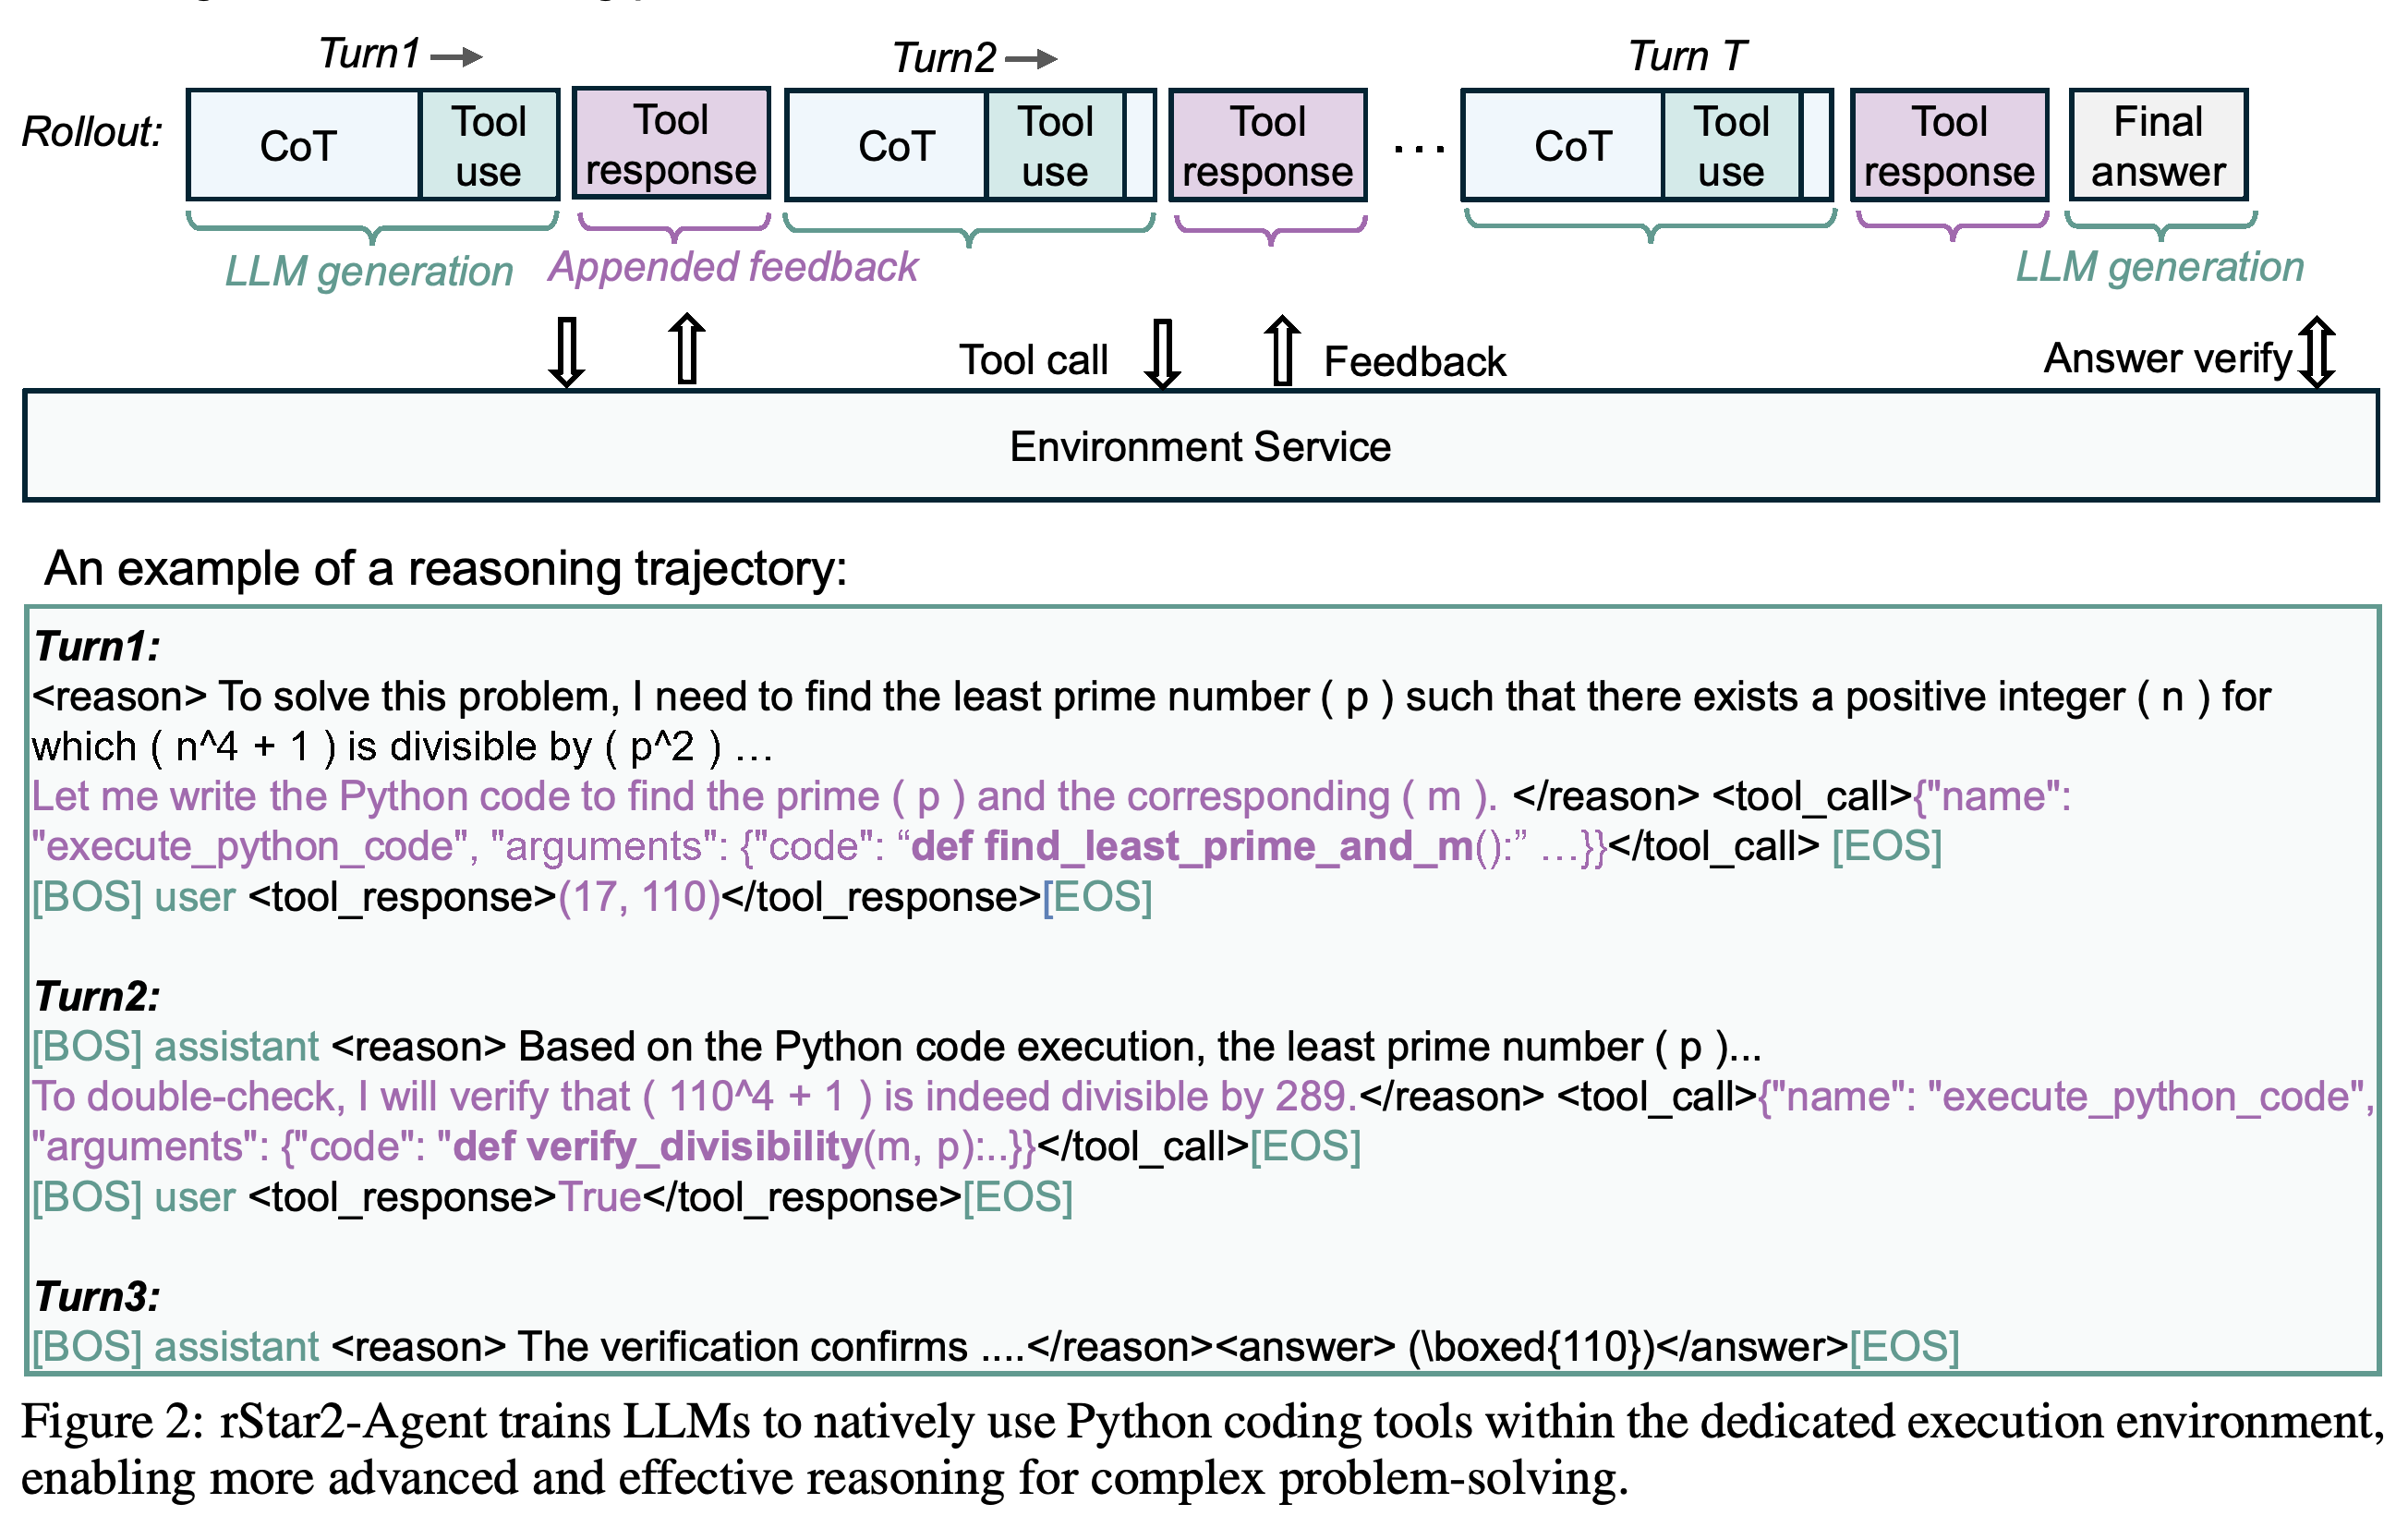
이 방법론에서 rollout은 추론과 도구 상호작용을 포함한 전체 생성 궤적이며 모델의 턴과 실행 피드백이 번갈아 나타난다. 모델은 추론하고 Python을 호출하고 반환된 결과를 확인하며 최종 답을 낼 때까지 이 과정을 이어갈 수 있다. Figure 2는 계산 후 별도의 검증 호출을 수행하고 답을 제출하는 과정을 보여준다.
실행 피드백은 모델의 다음 턴에 포함된다. 예제에서는 (17, 110)을 구한 뒤 별도의 Python 호출로 나누어떨어지는지 확인하고 110을 반환한다. 이는 제출 전에 중간 계산을 검증하는 과정을 보여준다.
2.1 Smarter Reasoning in a Code Environment
Python 환경에는 수치 계산용 Numpy, 과학 분석용 Scipy, 기호 수학용 SymPy가 포함된다. 각 assistant 턴은 end-of-sequence 토큰으로 끝난다. 도구 호출이 있으면 서비스가 이를 실행하고 user 역할로 피드백을 추가한 뒤 생성을 재개한다. 코드 호출이 없는 턴에서는 rollout을 종료하며 설정한 최대 턴 수에 도달해도 상호작용을 중단한다.
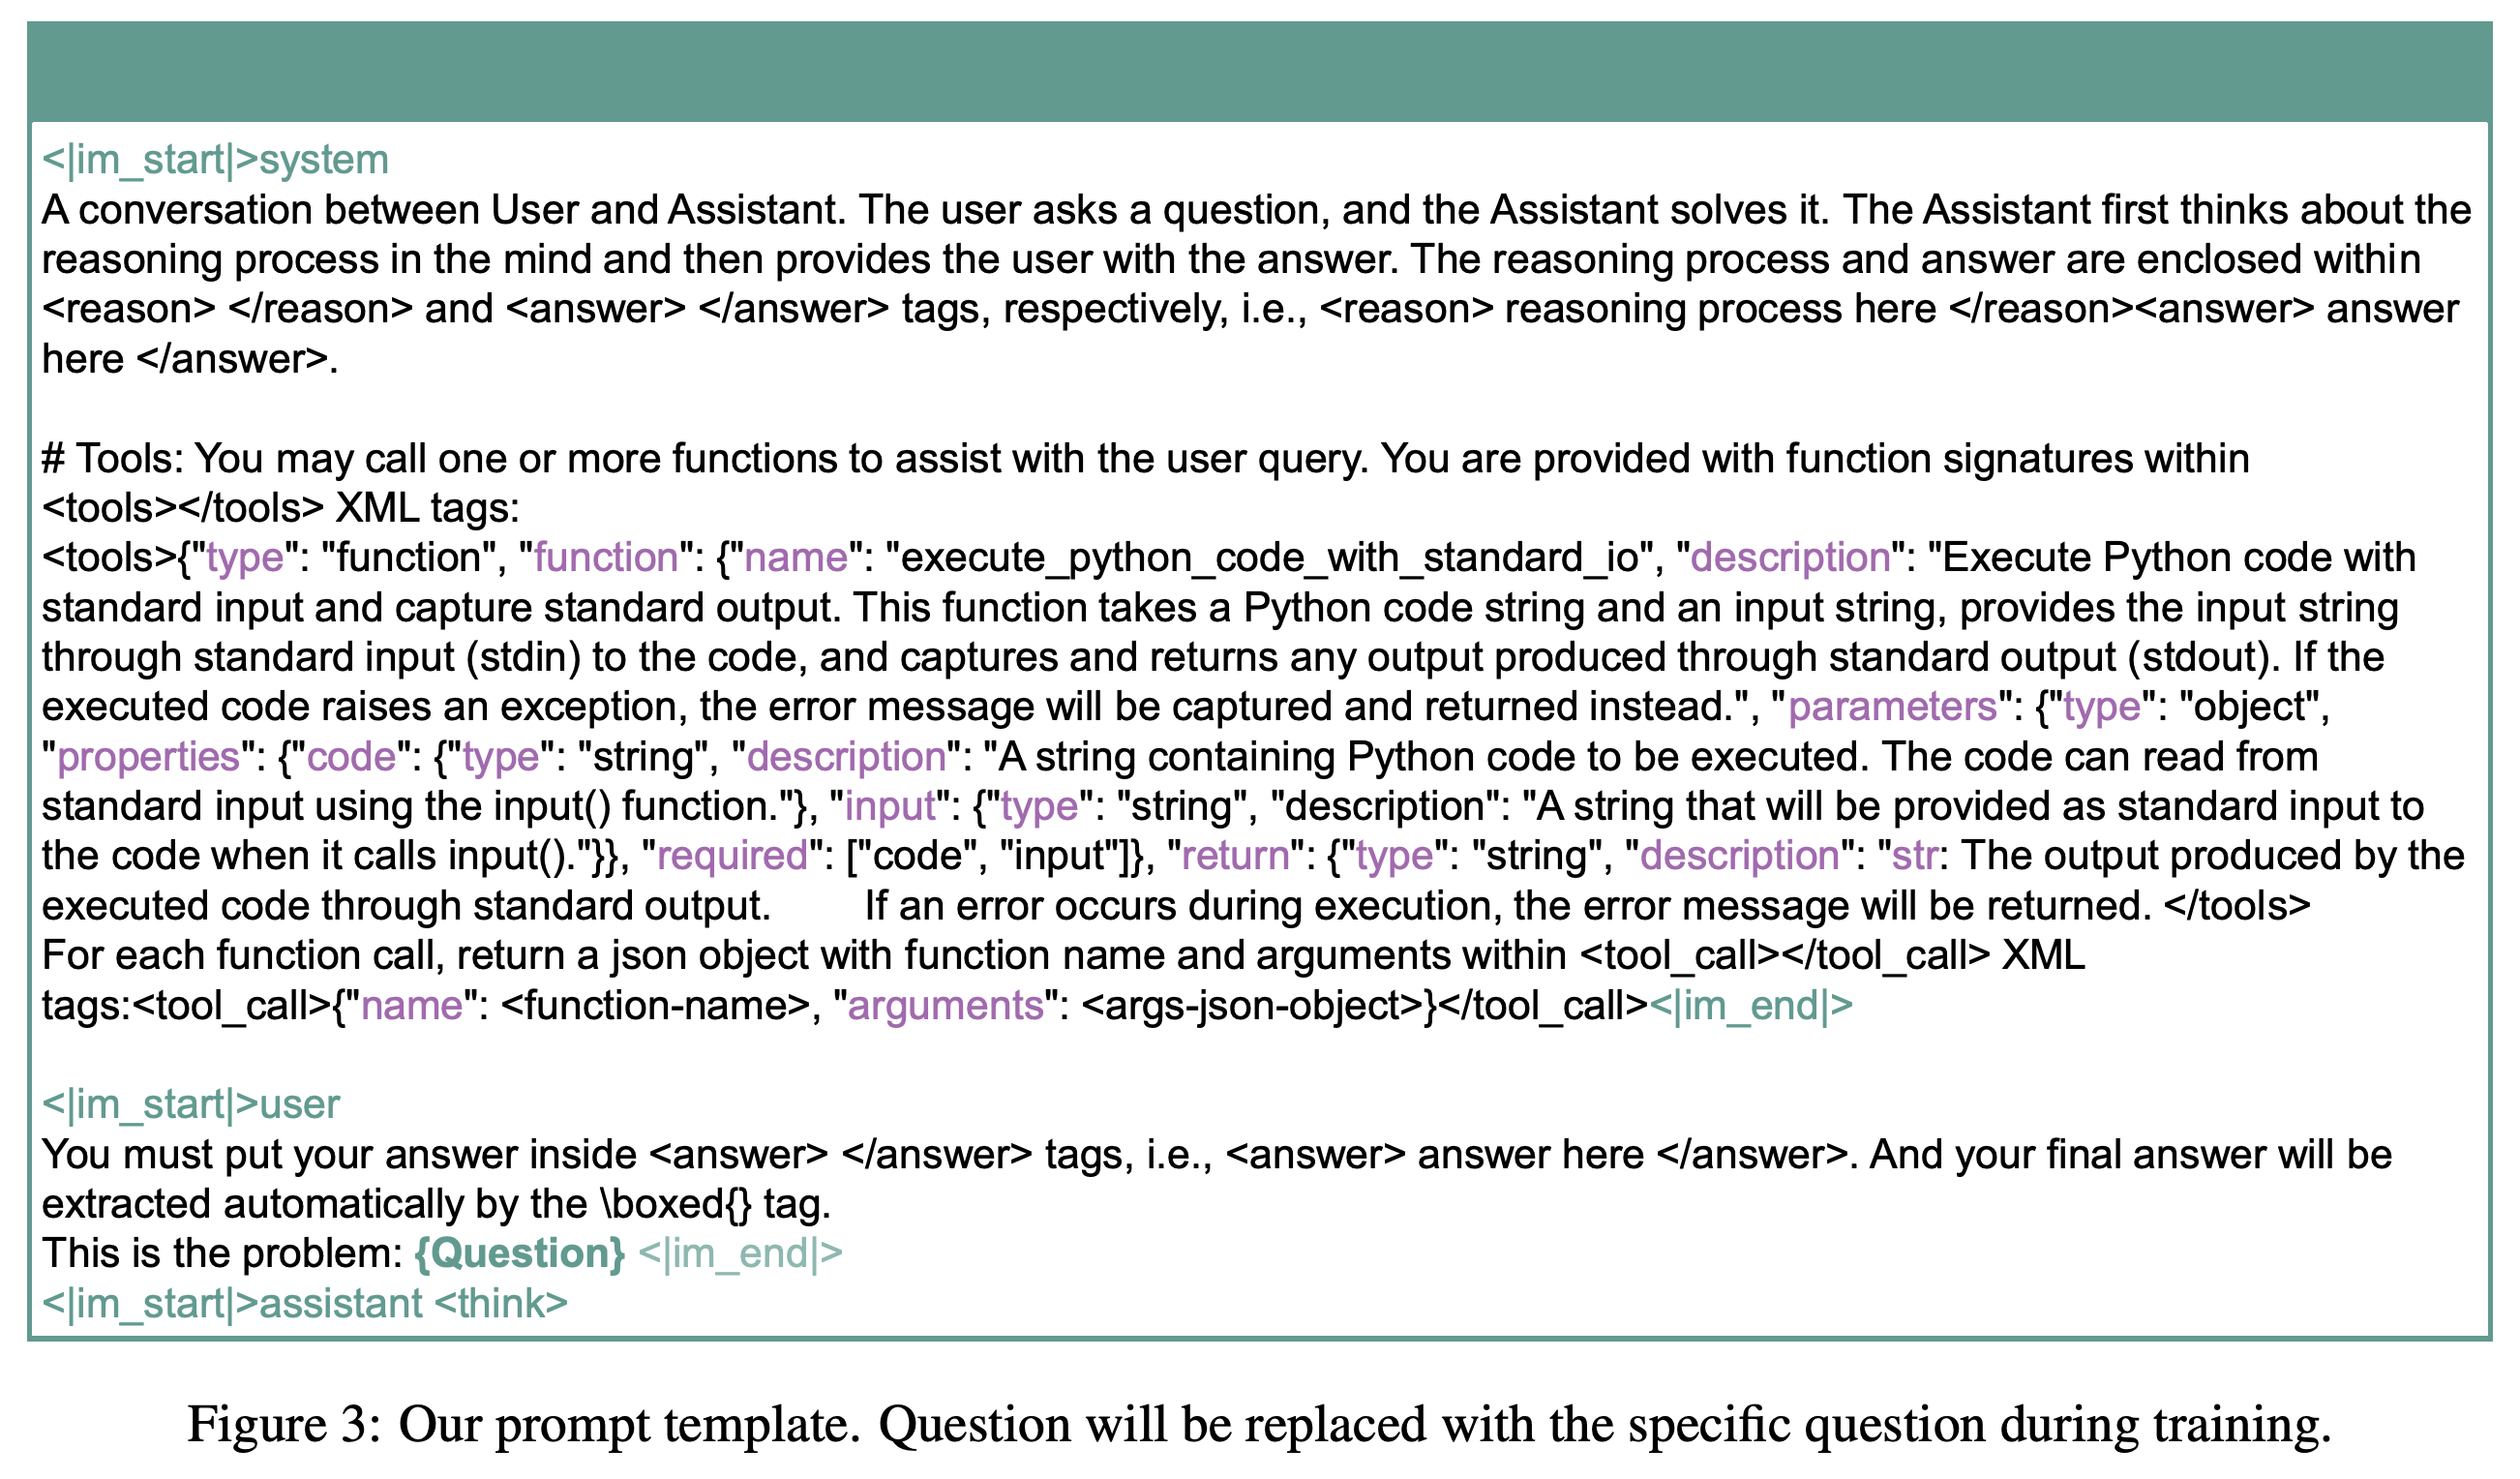
- 호출에는 구조화된 데이터 형식인 JSON을 사용하며 <tool_call> 태그 안에 execute_python_code_with_standard_io 함수와 code 및 input을 포함한 인수를 넣는다. 피드백은 <tool_response> 태그 안에 표시한다.
- 서비스는 표준 출력, 표준 출력이 없을 때의 대화형 Python 환경 IPython 결과, traceback을 포함한 실행 오류, 또는 시간 초과를 반환한다. 호출 형식이 잘못된 경우에도 피드백을 제공한다.
- 프롬프트는 <reason> 블록과 1개의 <answer> 블록을 지정하며 답을 추출할 수 있도록 최종 숫자 결과를 \boxed{} 안에 넣게 한다. Figure 3은 이 인터페이스를 제시한다.
실험 프롬프트는 Python 함수 인터페이스와 추론, 도구 호출, 최종 답을 위한 태그를 정의한다. 학습 시스템은 이 규칙으로 요청을 파싱하고 숫자 답을 추출한다.
2.2 End-to-End Agentic Reinforcement Learning
2.2.1 Preliminary: GRPO에서는 같은 질문에 대한 응답 그룹 안에서 보상을 정규화해 정책을 업데이트하는 Group Relative Policy Optimization (GRPO)을 소개한다. 정책은 모델이 응답을 생성하는 확률 분포다. 추출한 최종 답이 규칙 기반 정답 검사기 math_verify에서 기준 답과 일치하면 궤적에 보상 1을 주고, 그렇지 않으면 0을 준다. 구현에서는 기준 정책에서 벗어나는 정도를 제한하는 Kullback–Leibler (KL) divergence 페널티와 다음 토큰 예측의 불확실성을 높이는 entropy loss를 제거한다. 또한 새 정책과 이전 정책의 확률 비율을 비대칭으로 클리핑하는 Clip-Higher를 사용하며 하한과 상한 임계값은 0.2와 0.28이다.
- 그룹 상대 advantage는 A_i,t = (r_i − mean({r_1, …, r_G}))/std({r_1, …, r_G})다. 이는 해당 질문에서 샘플링한 다른 궤적에 비해 각 궤적의 보상이 어느 정도인지를 측정한다.
- 이러한 변경은 명시적인 엔트로피 유인이 일으키는 불안정성을 피하면서 도구를 활용하는 추론을 탐색하도록 설계한다.
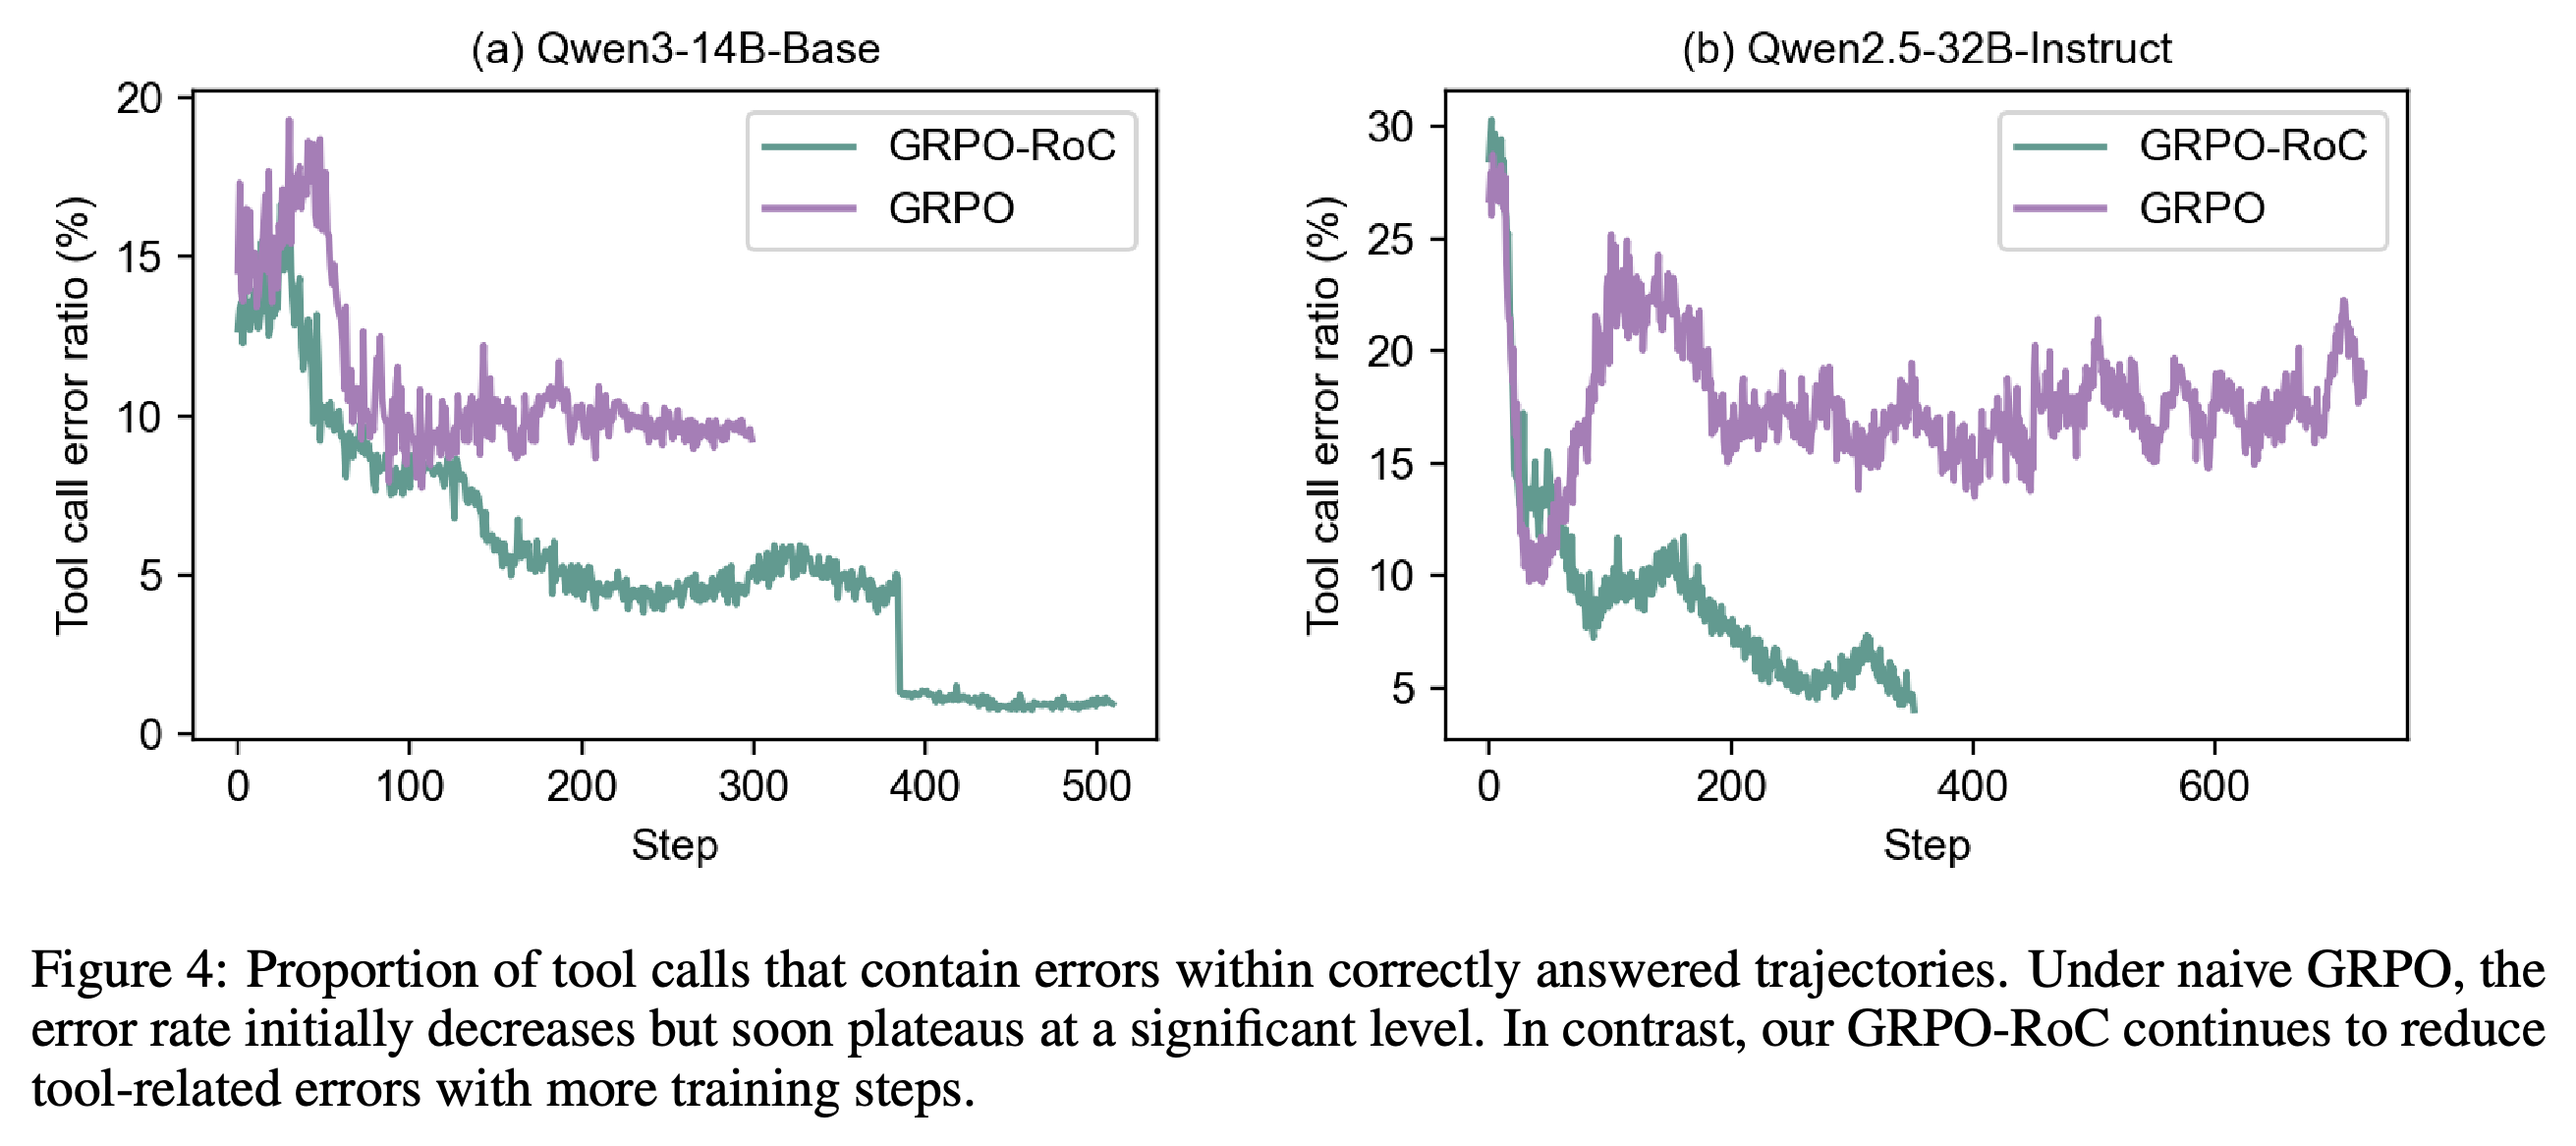
2.2.2 Challenges in Agentic Reinforcement Learning에서는 최종 답의 정답 여부와 중간 실행 품질 사이의 불일치를 지적한다. 잘못된 도구 호출이 있어도 양의 보상을 받을 수 있어, 오류를 고치는 데 토큰을 쓰는 행동이 강화된다. Figure 4에서 일반 GRPO는 정답 궤적 내 도구 오류 비율이 Qwen3-14B에서 약 10%, Qwen2.5-32B에서 약 15%에 머무르지만 GRPO-RoC는 이 비율을 계속 낮춘다.
두 패널은 정답을 낸 궤적 안에서 도구 호출 오류를 측정한다. 일반 GRPO는 초기에 개선된 뒤에도 상당한 오류율을 유지하지만 GRPO-RoC는 오류를 계속 줄인다. 이는 최종 답의 정답 여부만으로는 오류 없는 중간 실행을 보장할 수 없음을 보여준다.
2.2.3 GRPO-RoC: Group Relative Policy Optimization with Resampling on Correct는 이진 정답 보상을 유지하면서 업데이트에 사용할 궤적을 바꾼다. 질문마다 2G개 궤적을 생성하고 G개를 선택한다. 오답 궤적은 원래 분포에 따라 다운샘플링하고 정답 궤적은 도구 오류와 형식 점수가 낮을수록 우선 선택한다. 선택한 그룹으로 advantage를 다시 계산하며 목적함수는 해당 그룹에서 생성한 토큰에 대해 평균한다.
- 도구 점수 p_err는 도구 호출이 없는 궤적에서 0.5이며, 호출이 있으면 전체 호출 중 오류가 발생한 호출의 비율이다. 이 기본값은 도구를 회피하는 행동보다 오류 없이 도구를 사용해 정답을 내는 행동을 선호하게 한다.
- 형식 점수 p_format은 <answer> 태그가 없으면 1이며, 태그가 있으면 min(1, (number of <answer> tags − 1)/number of turns)이다. 따라서 답변 블록이 여러 개이면 선택 우선순위가 낮아진다.
- 결합 점수는 p_total = p_err + p_format이다. 논문은 정답 궤적의 선택 확률이 이 점수에 반비례한다고 설명하지만 제시한 규칙에는 점수가 0일 때의 처리 방식이 명시되어 있지 않다.
3 Large-Scale Agentic RL Infrastructure
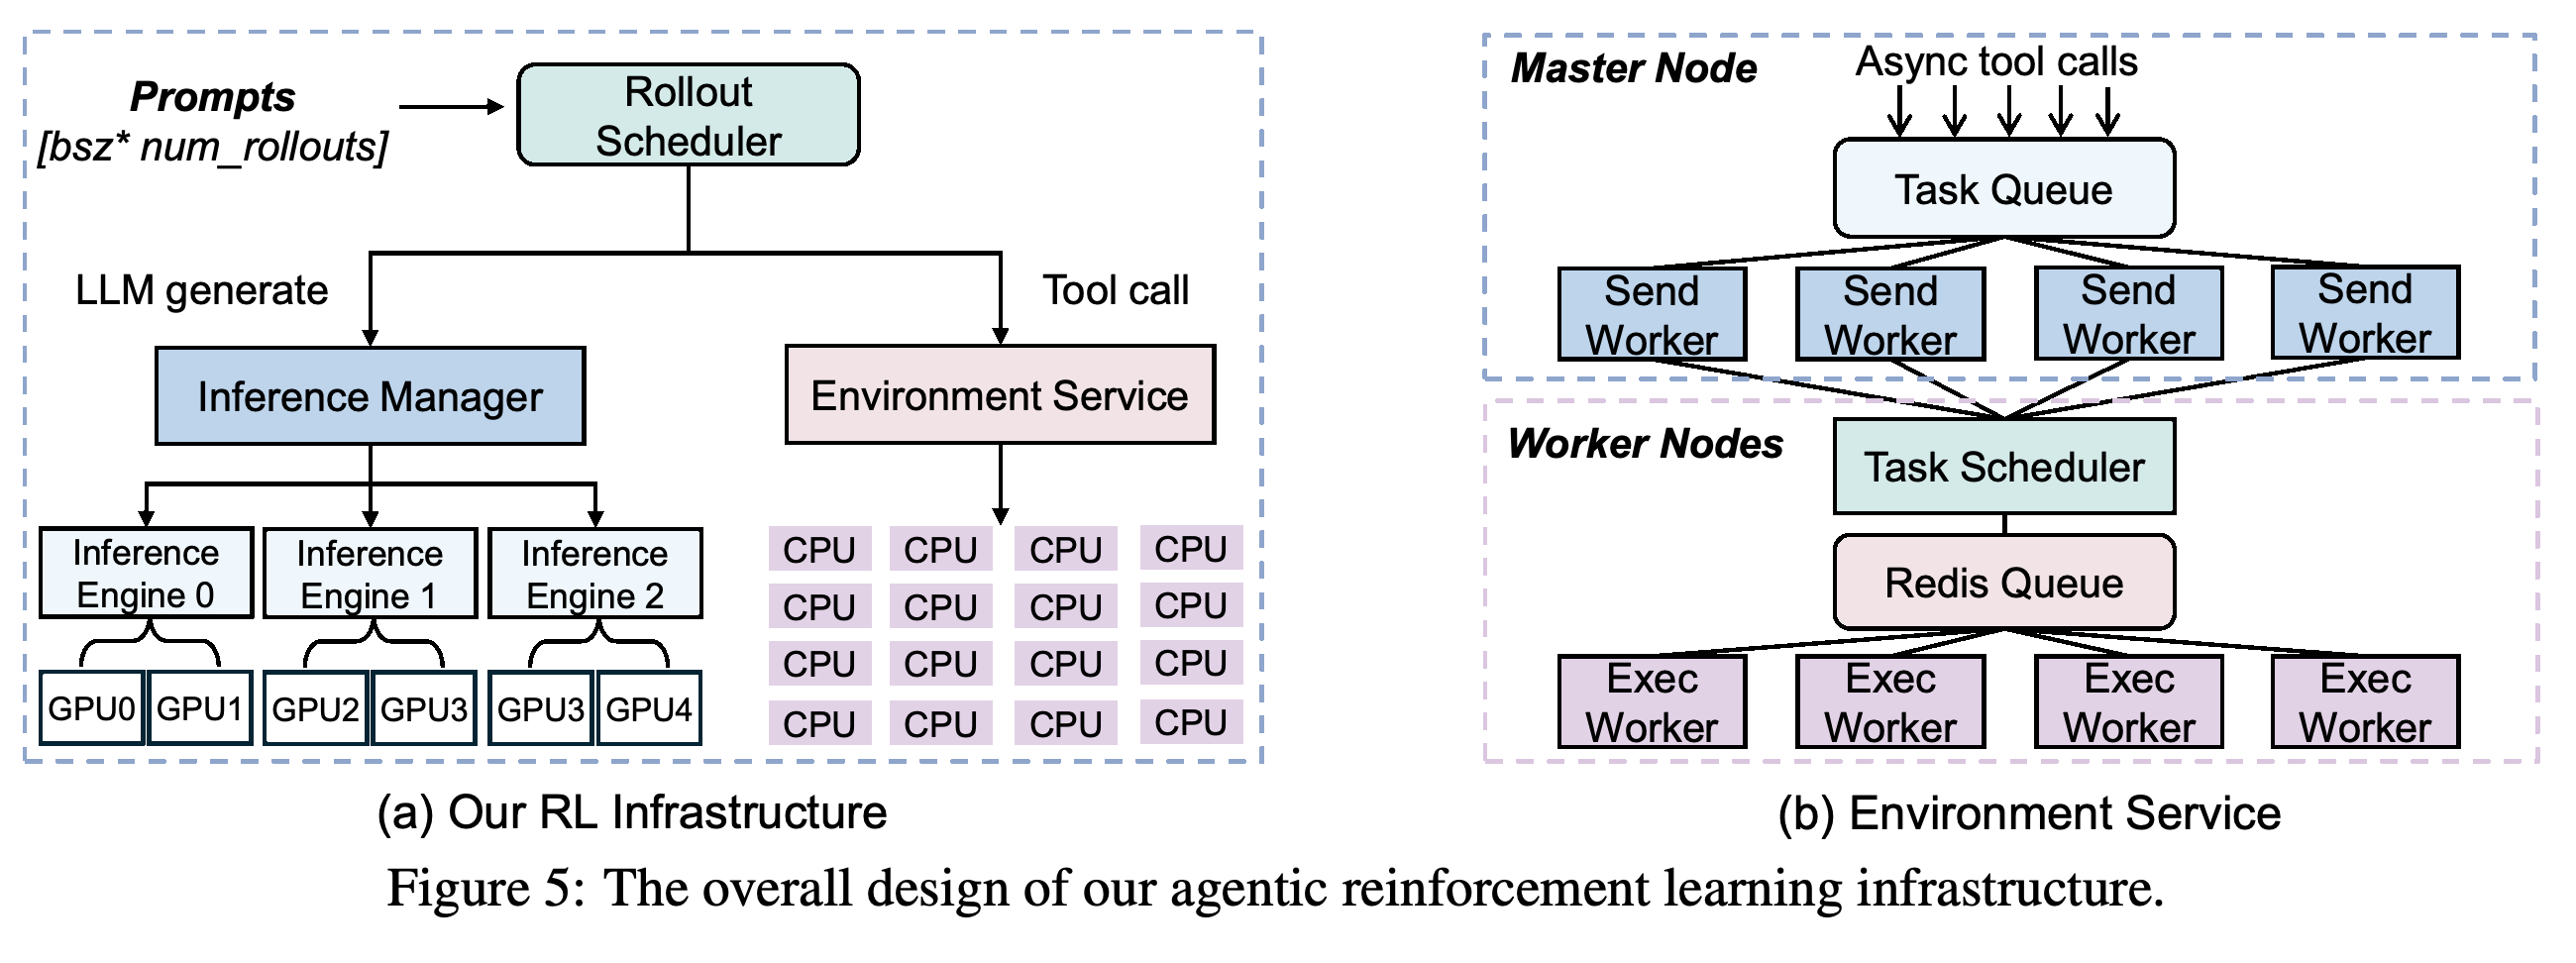
인프라는 보고서의 RL 학습 프레임워크인 VERL v0.2와 추론 엔진인 SGLang을 기반으로 한다. 생성한 프로그램을 다수 로컬에서 실행하면 자원이 과부하되거나 학습이 멈출 수 있으므로, 모델 생성과 CPU 실행을 분리한다. 전용 실행 서비스는 동시 도구 호출을 처리하고 동적 rollout 스케줄러는 불균등한 생성 길이와 반복적인 동기화 문제를 처리한다.
이 아키텍처는 GPU 추론 엔진과 CPU 실행 worker를 분리한다. 큐와 스케줄러는 환경 서비스를 통해 비동기 호출을 전달한다. 이를 통해 클러스터의 CPU 자원을 활용하면서 주요 생성 프로세스 밖에서 실행을 처리한다.
3.1 Reliable High-Throughput Code Environment
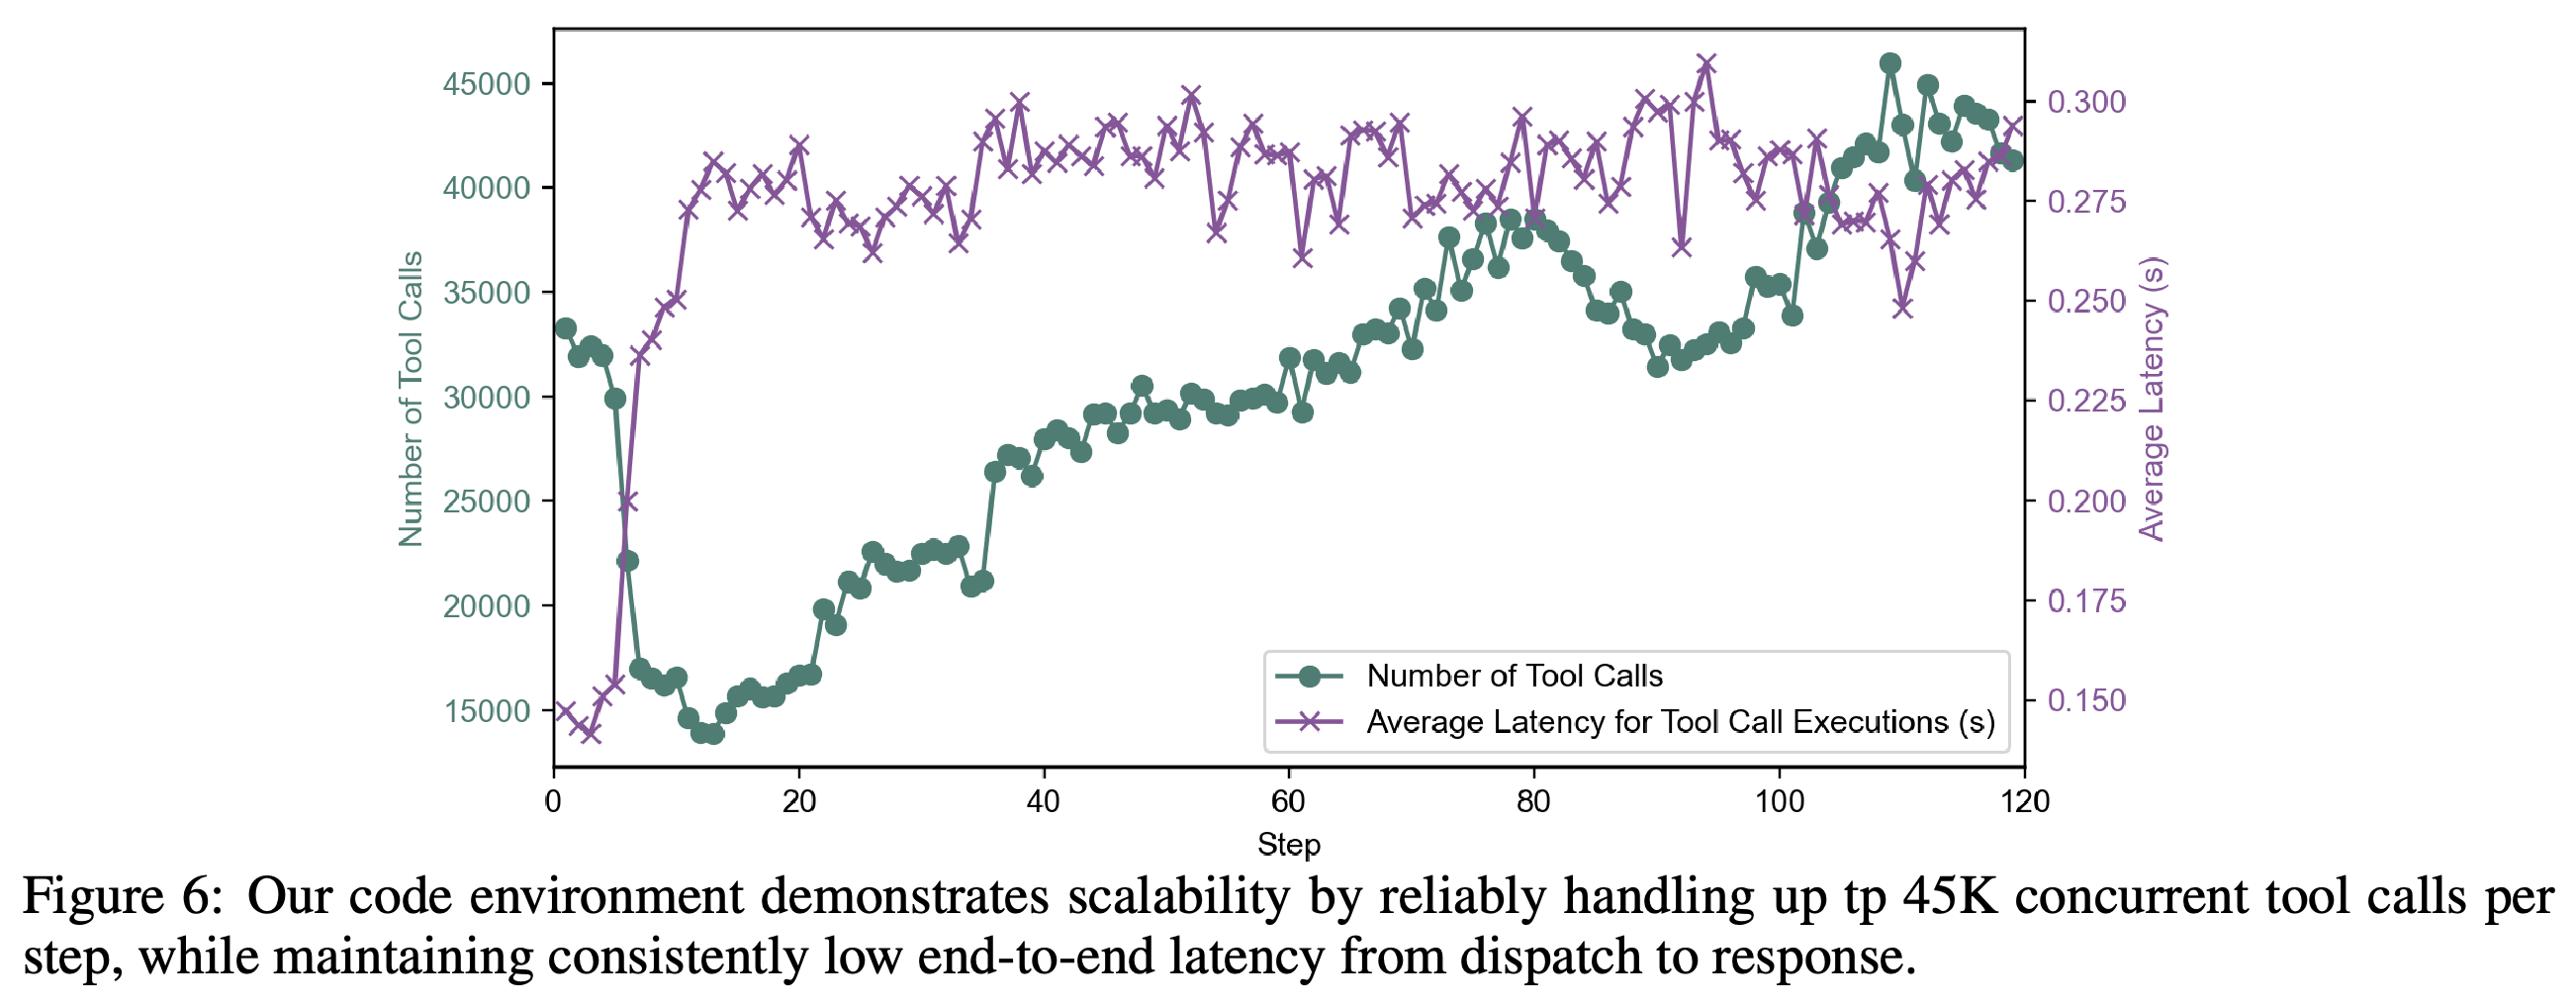
실행 서비스는 64-GPU 클러스터의 CPU 코어를 사용하며 master 노드에 중앙 큐와 32개의 전송 worker를 둔다. 전송 worker는 최대 64개 호출을 배치로 묶고, 배치가 차거나 제한 시간이 지나면 전송한다. 나머지 각 worker 노드에는 작업 스케줄러와 1024개의 실행 worker가 있다. Figure 6은 학습 스텝당 최대 45K개 도구 호출과 호출당 약 0.3초의 평균 종단 간 지연 시간을 보고한다. 이 시간에는 스케줄링과 실행이 포함된다.
- 복잡한 추출 답의 규칙 기반 검증이 생성을 막을 만큼 느려질 수 있어, 정답 검증도 이 서비스로 넘긴다.
- 10페이지 본문에는 ‘45 calls per step’이라는 불일치 표현이 있다. Figure 6과 주변 설명은 45K 규모를 뒷받침한다.
- 보고서는 아키텍처와 지연 시간 추이를 제공하지만 스케줄러의 속도 향상 수치나 동일한 하드웨어를 사용한 인프라 ablation은 제공하지 않는다.
도구 호출 수는 스텝당 약 45K개에 도달하며 전송부터 응답까지의 평균 지연 시간은 약 0.3초를 유지한다. 이 추이는 표시된 구간에서 실행 서비스의 확장성을 뒷받침하지만 기준 서비스 대비 속도 향상을 측정하지는 않는다.
3.2 Load-Balanced Rollout Scheduler
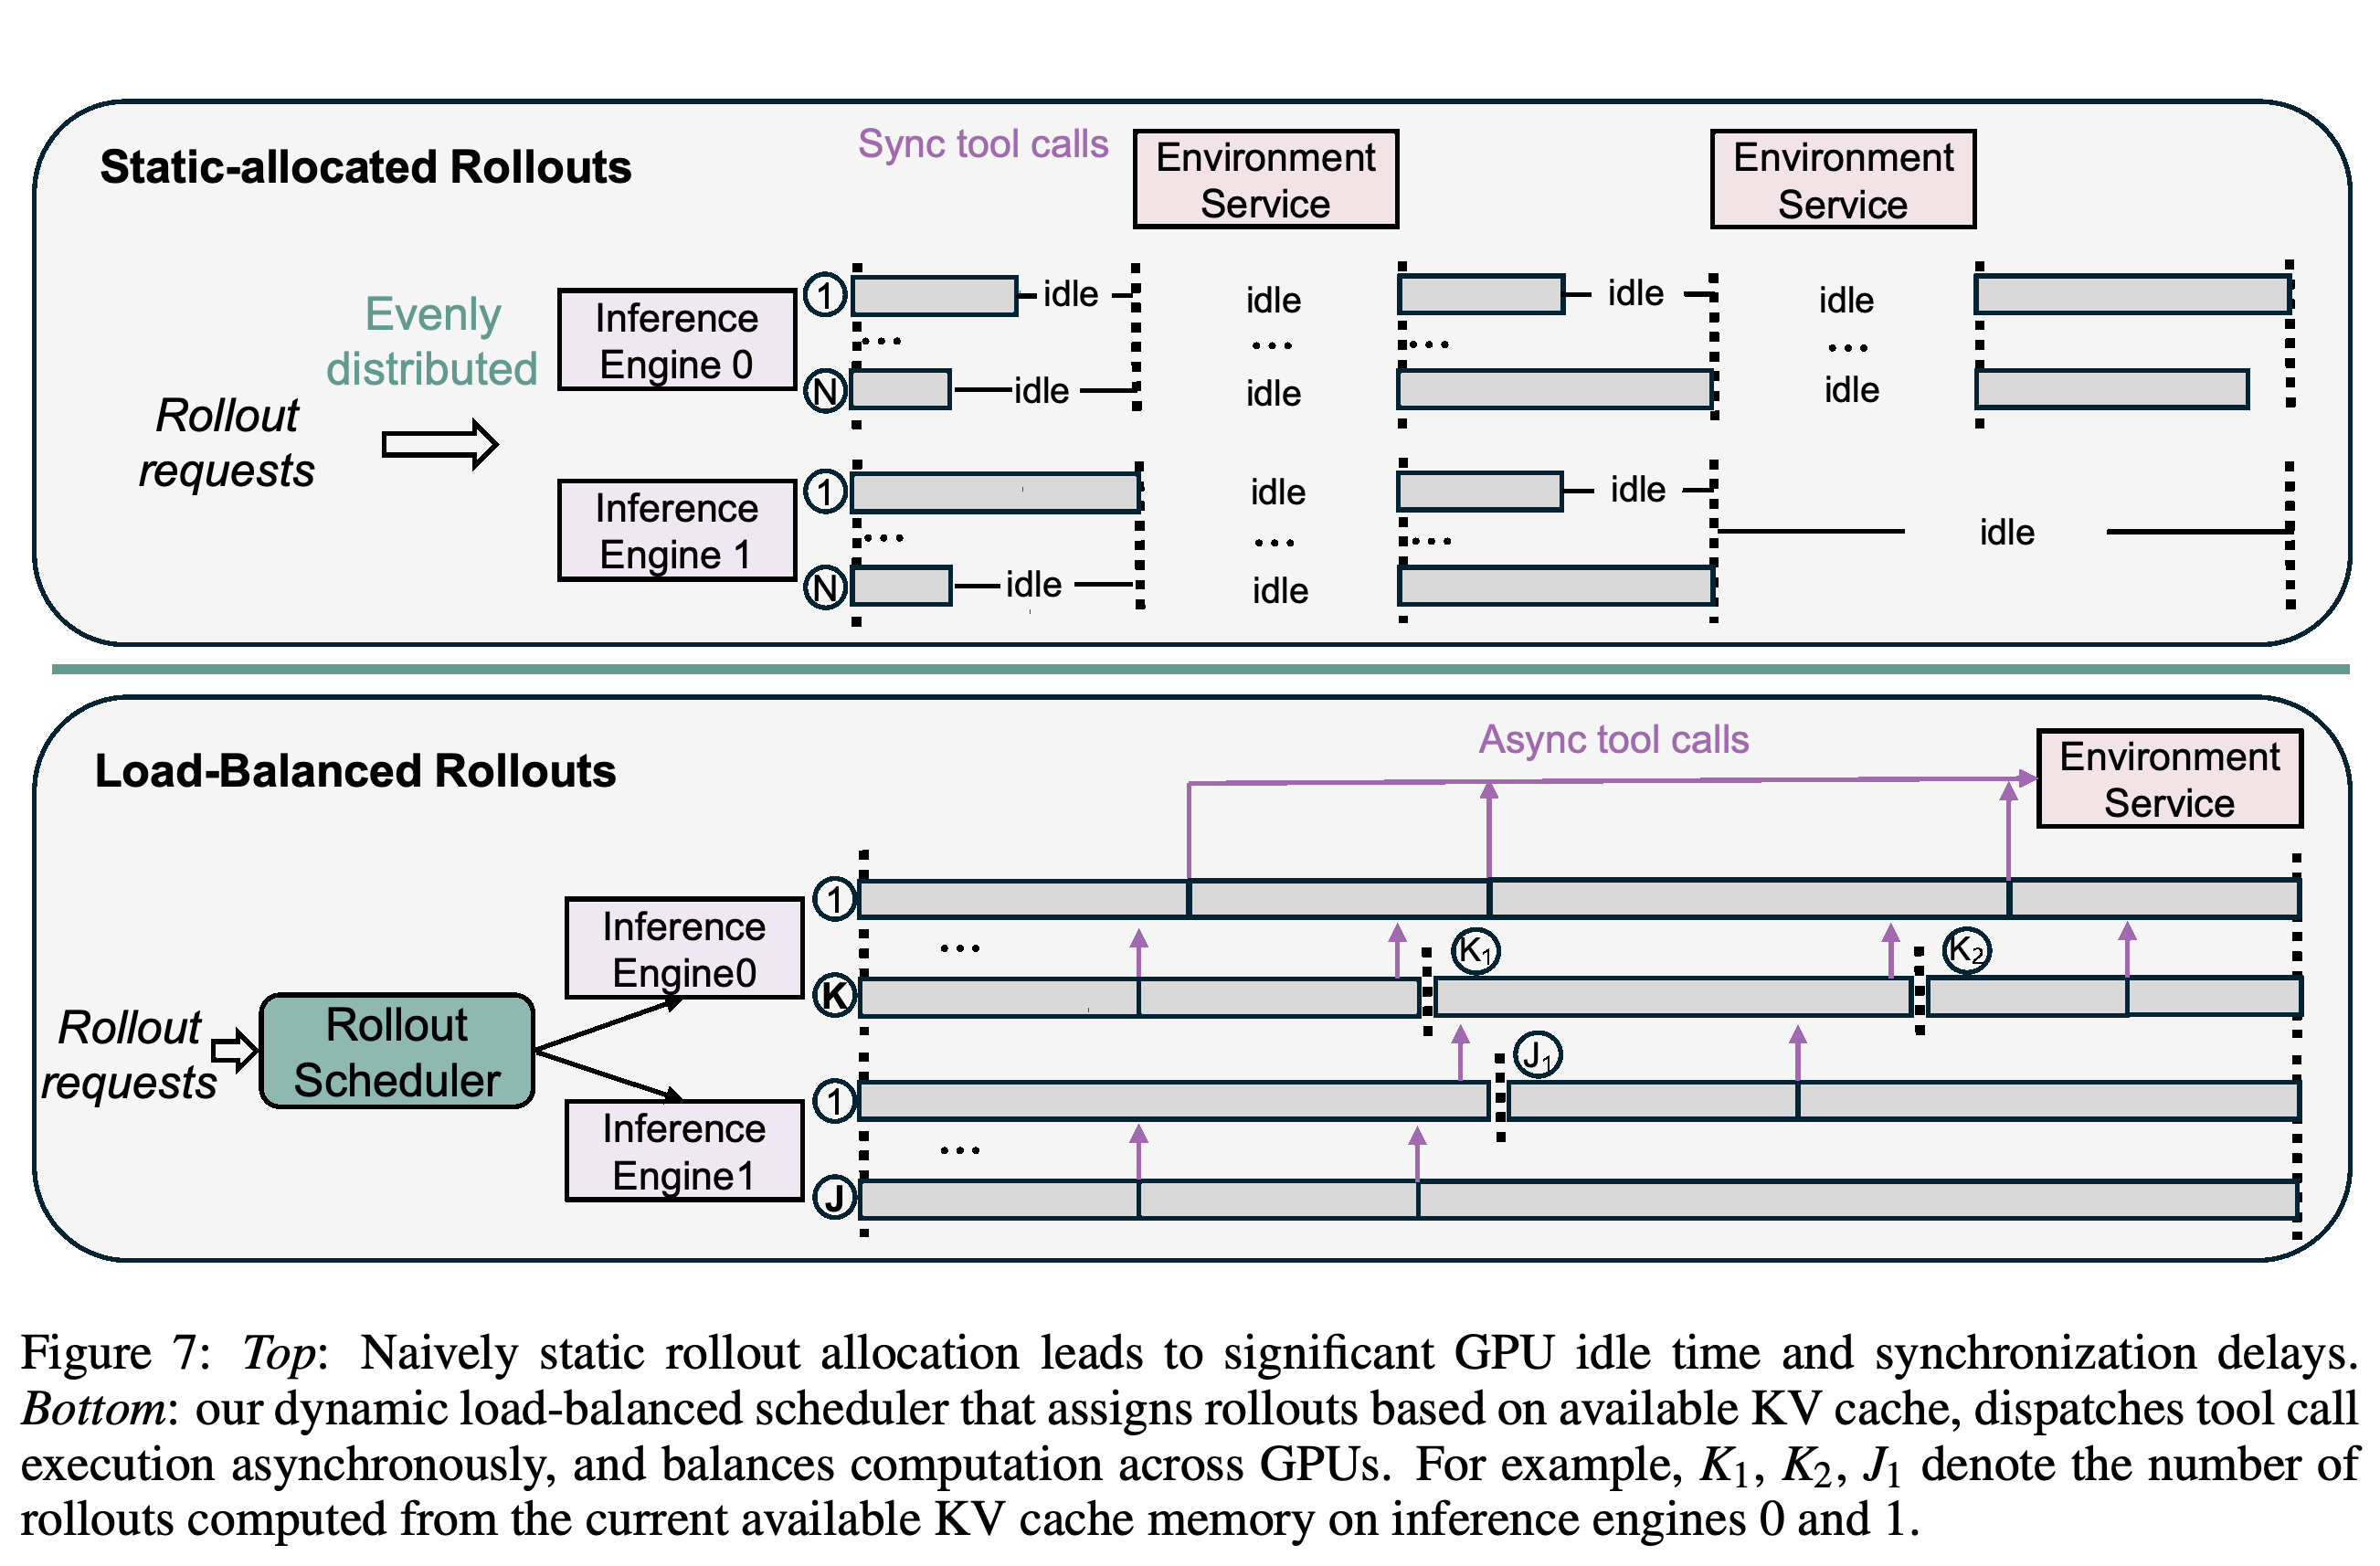
정적 할당은 턴 수와 길이가 다른 궤적을 각 GPU에 같은 개수로 배정한다. 이 때문에 짧은 요청이 긴 요청의 완료를 기다리는 동안 유휴 시간이 발생한다. 생성 중 사용하는 attention 상태를 저장하는 key–value (KV) cache가 넘치면 SGLang이 미완료 요청을 제거했다가 나중에 다시 계산할 수도 있다. 제안한 스케줄러는 사용 가능한 캐시 용량과 최대 rollout 길이로 안전한 동시 처리량을 추정하고 도구 호출을 비동기로 전송하며 용량이 확보되면 새 요청을 배정한다.
- Figure 7은 타임라인으로 작동 방식을 설명하며 스케줄러가 처리량을 얼마나 높이는지는 수치로 제시하지 않는다.
위쪽 타임라인은 고정된 요청 배정과 동기화된 도구 호출 때문에 생기는 유휴 구간을 보여준다. 아래쪽 타임라인은 비동기 실행과 캐시 용량 확보에 따른 재배정을 보여준다. 이 도식은 스케줄링 방식을 설명하지만 처리량 비교 수치는 제공하지 않는다.
4 Training Recipe
주요 학습 방식은 Qwen3-14B-Base에서 시작해 비추론 SFT를 수행한 뒤 GRPO-RoC를 3단계로 적용한다. 초기 응답이 짧아 8K 학습 길이 제한을 사용할 수 있으며 이후 단계에서는 제한을 늘리고 더 어려운 문제에 집중한다. 평균 응답 길이는 단계가 진행되면서 늘어난다. 응답이 간결하다는 근거는 다른 학습 방법 및 평가 모델과의 비교에서 나온다.
4.1 Non-Reasoning Cold Start for Instruction Following
Cold-start 데이터셋에는 함수 호출 예제 165K개가 있다. ToolACE-11K, APIGen-MT-5K, Glaive-function-calling-v2-101k에서 가져온 117K개와 JSON 함수 호출로 변환한 Magicoder 예제 48K개로 구성된다. 또한 o4-mini로 응답을 다시 작성한 Tulu3 지시 이행 예제 30K개와, o4-mini로 대화 프롬프트를 다시 작성한 LLaMA-Nemontron post-training 데이터셋의 대화 예제 27K개가 포함된다. 이 단계는 추론 중심의 시범 데이터셋 없이 상호작용 인터페이스를 학습한다.
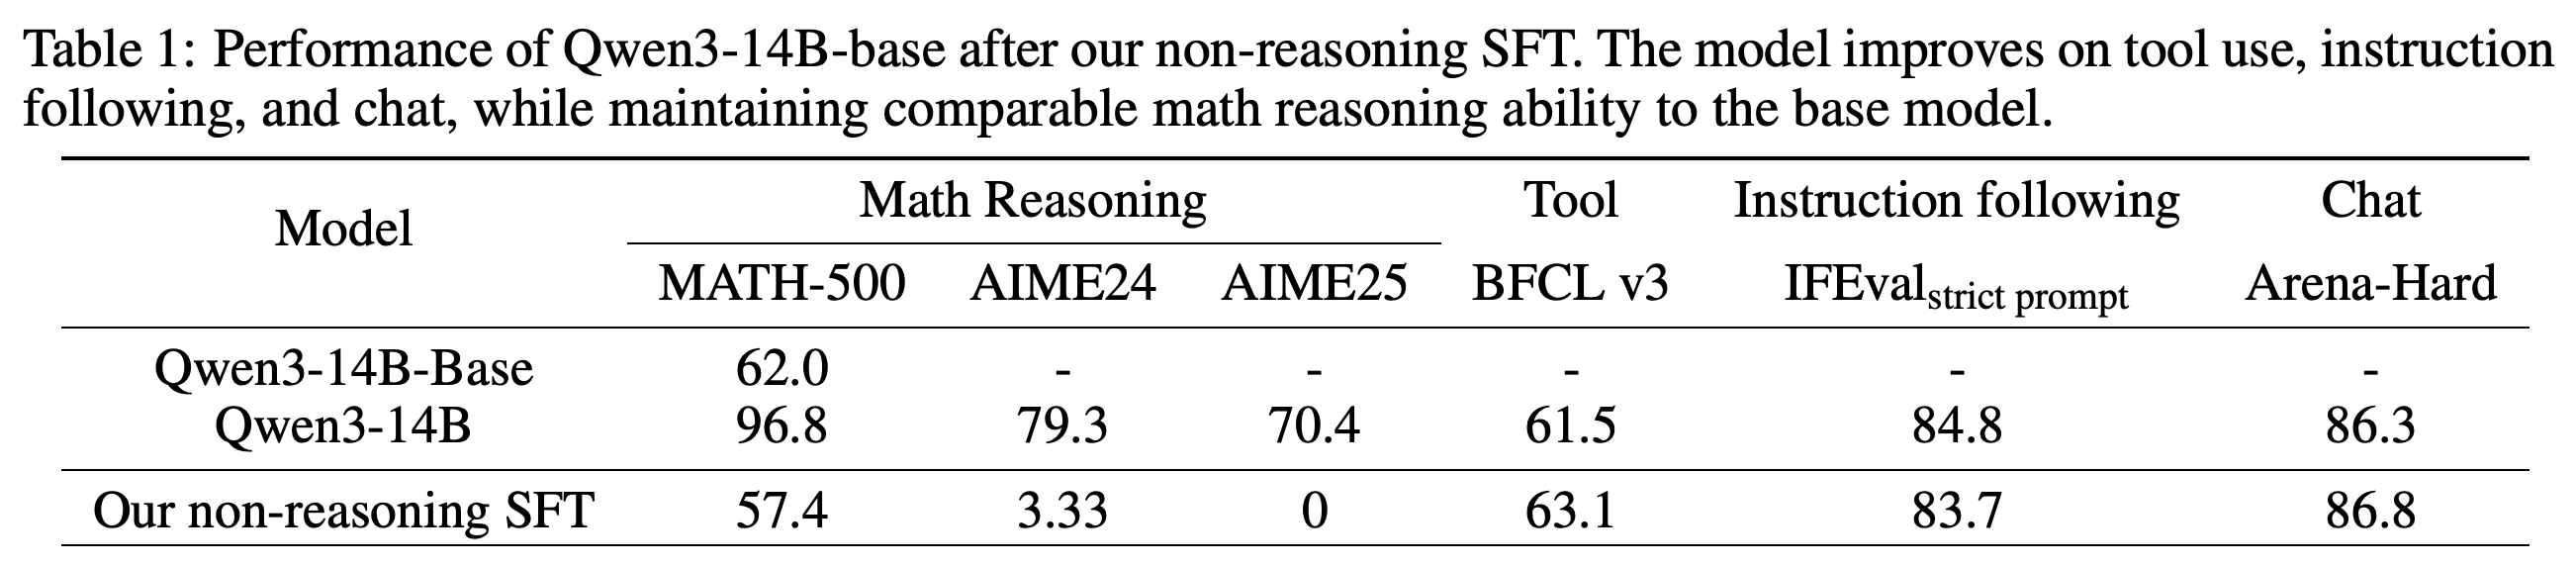
- Table 1은 도구 사용 벤치마크 Berkeley Function-Calling Leaderboard인 BFCL v3에서 63.1, 지시 이행 벤치마크 IFEval에서 83.7, 보고서의 대화 및 정렬 벤치마크 Arena-Hard에서 86.8을 보고한다.
- 이 단계 이후에도 수학 성능은 낮다. 수학 벤치마크 MATH-500은 57.4로 base 모델의 62.0보다 낮으며 AIME24와 AIME25는 각각 3.33과 0이다. 이 결과는 초기 수학 성능 향상보다 도구 상호작용을 준비하는 단계라는 해석을 뒷받침한다.
Cold-start 체크포인트의 도구 사용, 지시 이행, 대화 점수는 공식 Qwen3-14B와 비슷하거나 높지만 수학 점수는 훨씬 낮다. MATH-500 점수 57.4도 base 모델의 62.0보다 낮아, 이 단계가 상호작용 인터페이스를 준비한다는 해석을 뒷받침한다.
4.2 RL Data Curation
RL 데이터 선별에서는 기호적 동치 검사가 잘못된 보상을 줄 수 있어, 정확한 정수 답이 붙은 어려운 문제로 학습을 제한한다. 후보 데이터는 오픈소스 RL 학습 시스템 DAPO의 정수 답 문제 17K개, OpenMathReasoning을 통해 수집한 Art of Problem Solving 포럼 문제 93K개, 수학과 프로그래밍이 필요한 Project Euler 문제 937개로 구성된다. 정제 후에는 문제와 정답으로 이루어진 42K개 쌍이 남는다.
- OpenMathReasoning에서는 Qwen3-32B가 문제마다 16개 응답을 생성한다. 정수 답이 원래 라벨과 최소 2번 일치해야 문제를 유지한다. 검증할 수 없는 답, 복잡한 답 형식, 오답은 제거한다.
- 검증기의 시간 초과를 피하려고 6.5e27330467처럼 답이 지나치게 큰 Project Euler 문제를 제거한다. 정수 답만 선택하므로 학습 범위는 쉽게 검증할 수 있는 수치 답으로 좁아진다.
4.3 Multi-Stage RL Training
RL은 학습률 1e-6과 프롬프트 512개로 구성된 배치를 사용한다. 프롬프트마다 32개 궤적을 생성하고 Resample on Correct (RoC)로 16개를 선택한다. Stage 1은 문제 42K개와 응답 길이 제한 8K로 300 steps 동안 학습한다. Stage 2는 제한을 12K로 늘리고 누적 385스텝에서 끝난다. Stage 3은 12K 제한을 유지하면서 더 어려운 문제 17.3K개로 125스텝을 추가 학습해 총 510 steps에 도달한다.
- Stage 1의 평균 학습 응답 길이는 약 1K에서 4K 토큰으로 늘어난다. 보상과 평가 점수가 정체되고 잘린 응답 비율이 약 10%에서 안정되면 Stage 2에서 길이 제한을 늘리며, 평균 길이는 약 6K로 높아진다.
- Stage 3에서는 최신 정책으로 원래 문제마다 8개 궤적을 생성하고 8개가 모두 정답인 문제를 제거한다. Optimizer 상태를 초기화하고 기준 모델을 최신 정책으로 갱신한다. 이후 평균 학습 응답 길이는 약 8K 토큰으로 늘어난다.
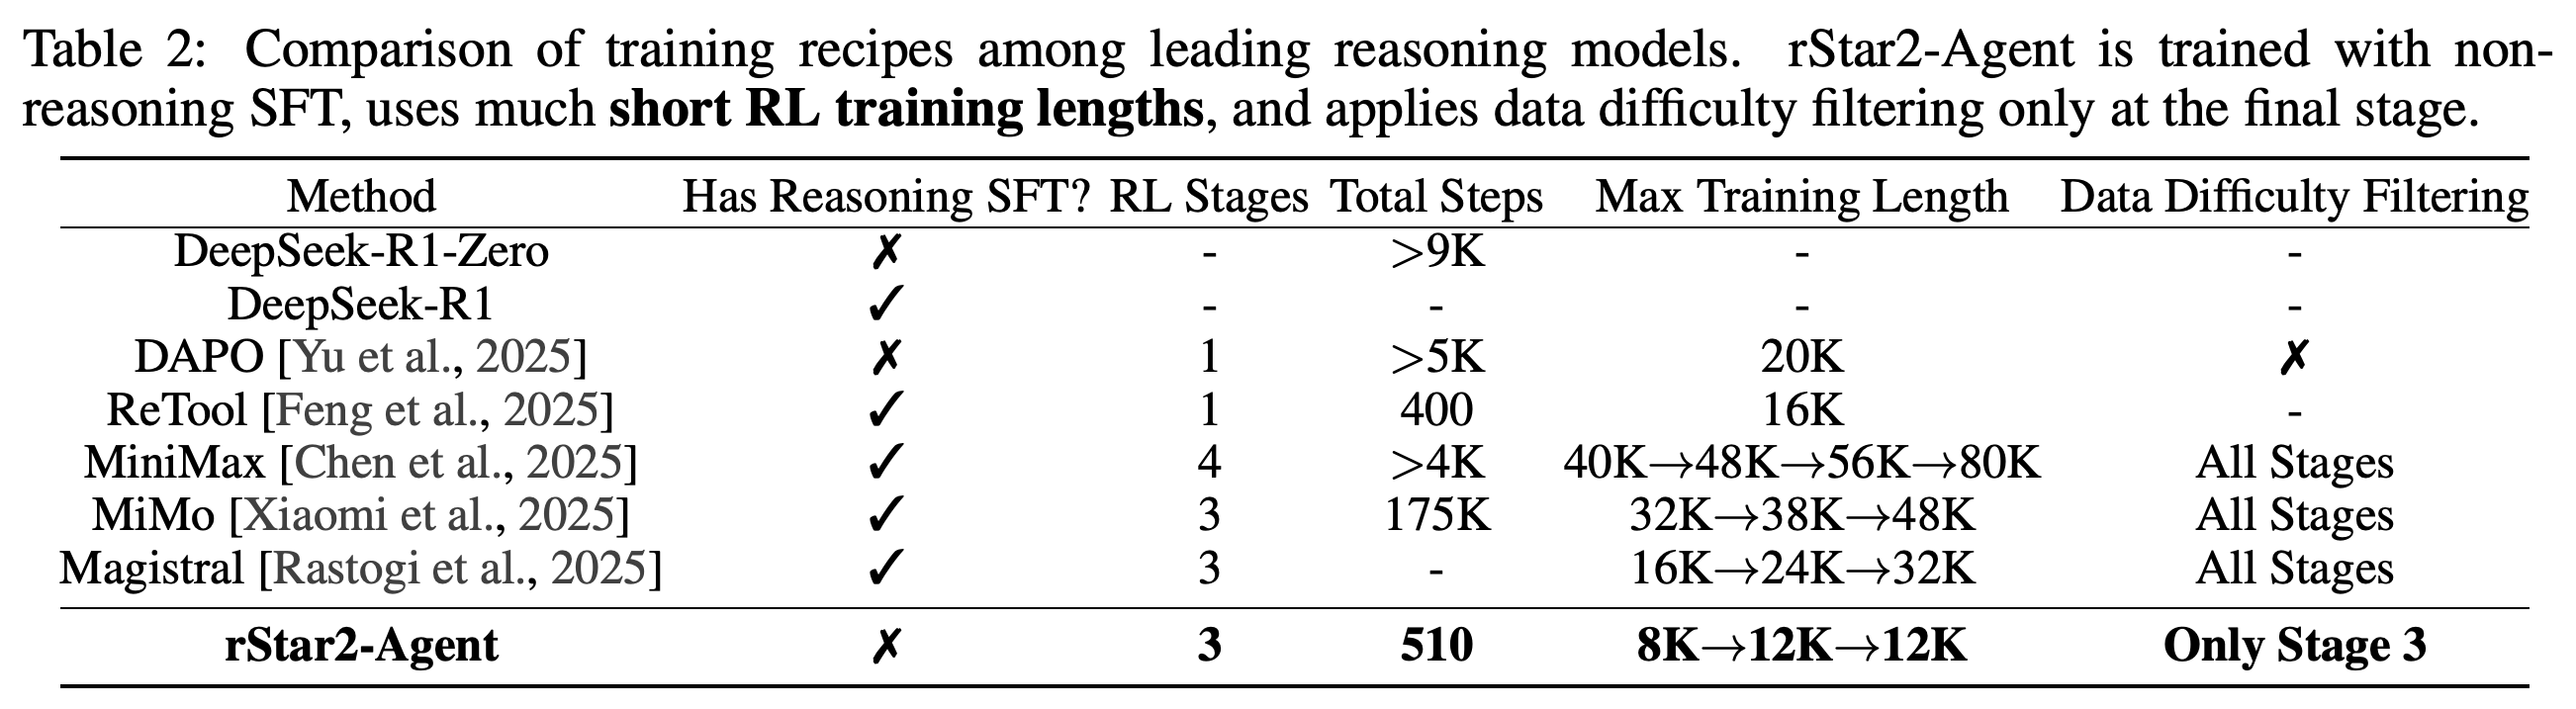
- Table 2는 보고된 학습 방식의 추론 SFT, 학습 스텝, 길이 제한을 비교한다. 이 수치들은 샘플링과 학습 설정이 다른 방식 사이의 총 연산량을 동일한 기준으로 맞추지 않는다.
이 비교는 rStar2-Agent의 3개 단계, 510 steps, 8K→12K→12K 길이 제한을 더 긴 학습 일정이나 길이 제한을 사용하는 기존 방식과 나란히 제시한다. 이러한 학습 방식의 차이만으로 동일한 기준의 연산량 우위가 입증되지는 않는다.
4.3.1 Unsuccessful Attempts And Lessons에서는 길이 제한으로 잘린 궤적을 학습에서 제거하는 overlong filtering이 해당 실험에서 과도하게 긴 응답의 비율을 높였다고 보고한다. 저자들은 대신 잘린 궤적을 실패 학습 신호로 유지한다. n개 토큰으로 이루어진 시퀀스의 반복을 확인하는 n-gram 반복 탐지로 정답 궤적의 가중치를 낮추는 방식도 응답 길이와 추론 점수에 악영향을 주었다. 저자들은 비슷한 검증 호출이 바람직하지 않은 반복으로 잘못 판별되기도 했다고 추정한다.
- 보고서는 이러한 실패를 자체 학습 과정에서 얻은 경험으로 제시하며 대안 방법이 모든 상황에서 효과가 없다고 주장하지 않는다.
5 Experiments
실험은 수학 성능, 과학 추론으로의 전이, 일반 도구 사용과 정렬, RoC의 기여를 평가한다. 주요 모델은 제안한 cold start를 적용한 Qwen3-14B-Base다. 추가 실험에서는 Qwen2.5-32B-Instruct를 사용해 32B 규모의 선행 연구와 비교한다. 자원 제약 때문에 이 모델은 처음 2개 RL 단계만 학습한다.
5.1 Setup
SFT는 학습률 5e-6, 배치 크기 128, warm-up 4%, cosine decay로 3 epoch 수행한다. Qwen2.5-32B-Instruct에는 추가 SFT를 적용하지 않는다. RL은 weight decay를 분리한 optimizer인 AdamW를 사용하며 고정 학습률 1e-6, 20 rollout 스텝의 선형 warm-up, 샘플링 무작위성을 조절하는 temperature 1.0을 적용한다. 최대 상호작용 횟수는 처음 2개 단계에서 T=10, 마지막 단계에서 T=15다. 모든 실험은 64개의 AMD MI300X GPU를 사용한다.
- 보고된 데이터 오염 제거 절차는 경시 수학 벤치마크와 8개 토큰 시퀀스인 8-grams를 공유하는 학습 문제를 제거한다.
- 수학과 GPQA-Diamond 평가에서는 temperature 0.6으로 최대 30K 토큰과 30턴을 허용한다. 질문마다 16 times 샘플링해 평균 pass@1을 추정한다. 이 점수는 best-of-16이나 다수결 정확도가 아니다.
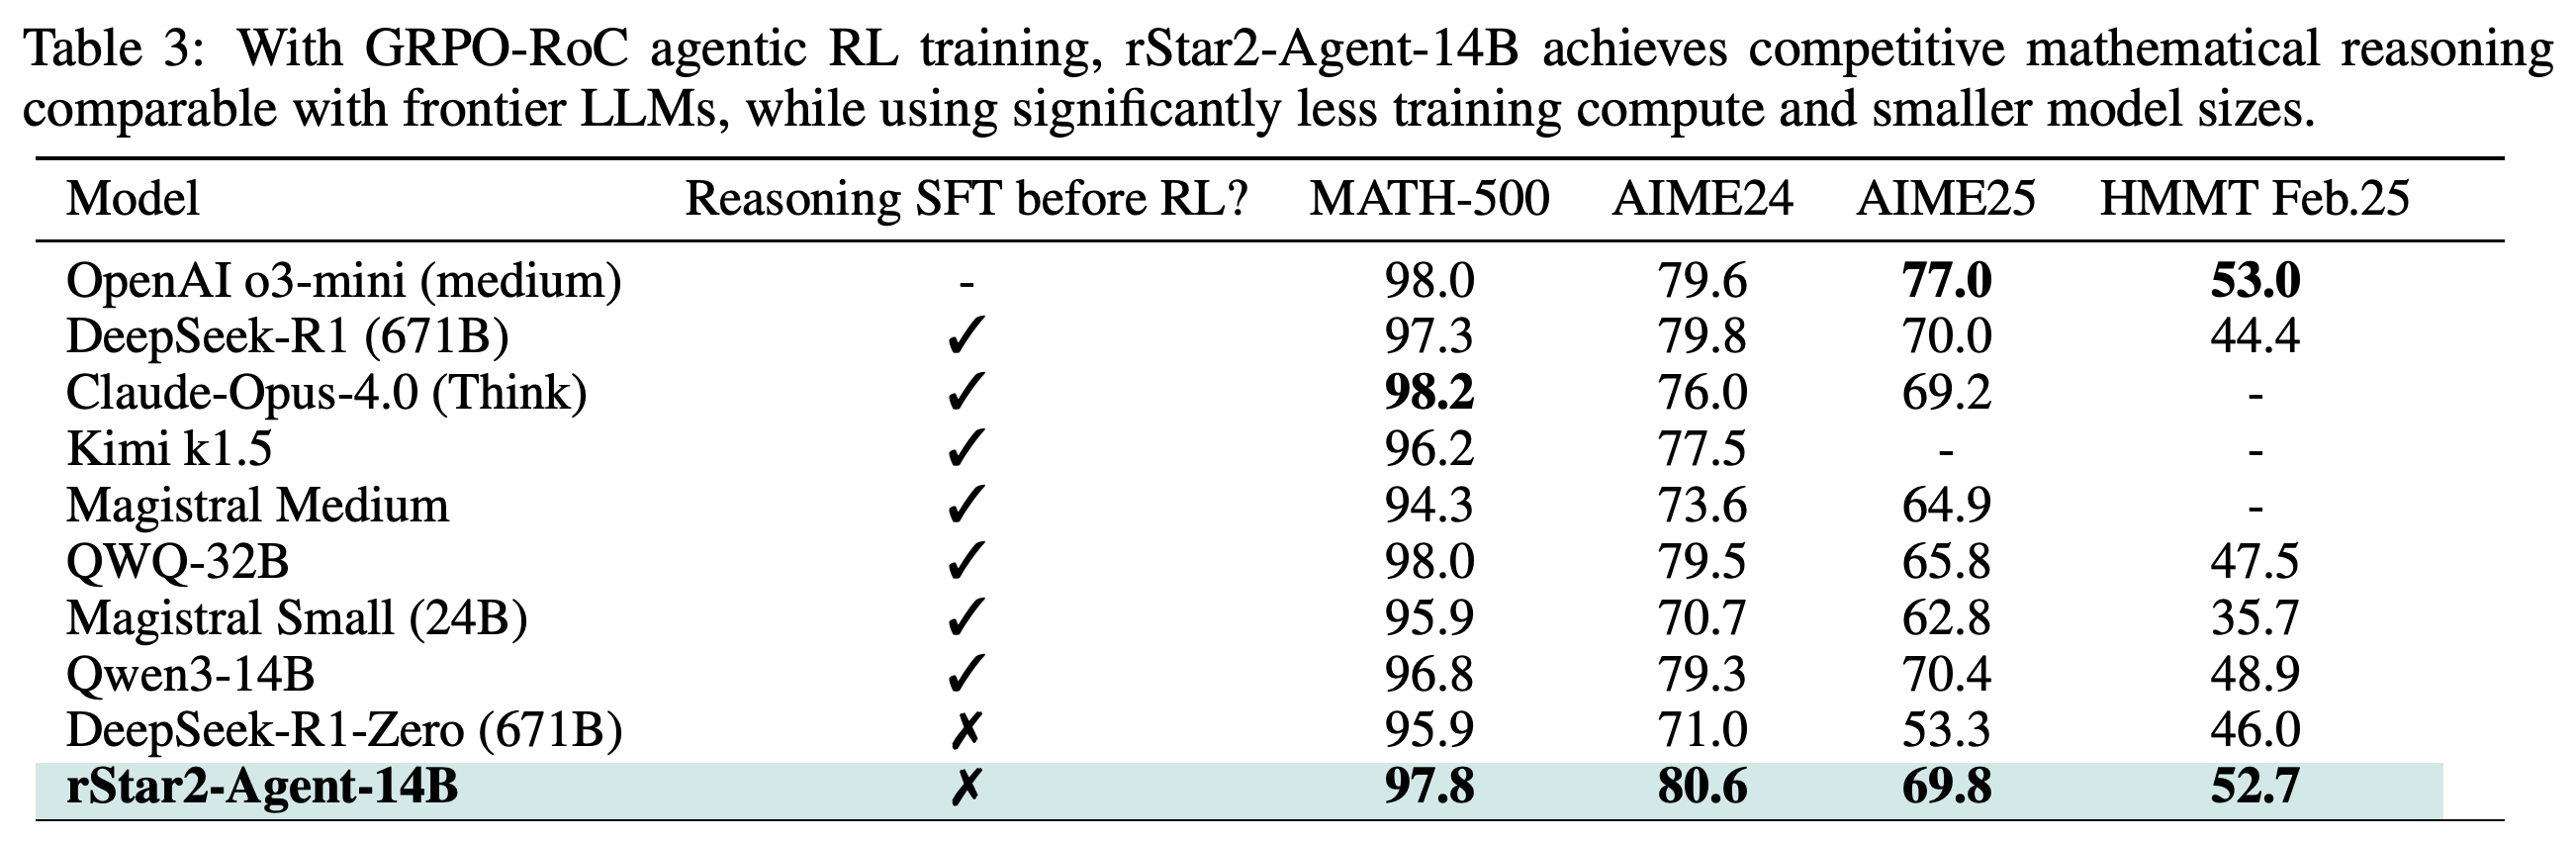
- BFCL v3, IFEval, Arena-Hard는 temperature 0에서 기본 프롬프트를 사용한다. Table 3은 나열된 모든 모델이 동일한 추론 예산이나 학습 연산량을 사용했다고 입증하지 않는다.
rStar2-Agent-14B는 AIME24에서 80.6으로 나열된 모델 중 가장 높으며 MATH-500과 HMMT Feb.25에서도 DeepSeek-R1보다 높다. AIME25 점수 69.8은 DeepSeek-R1의 70.0과 o3-mini의 77.0보다 낮으므로, 비교 결과는 벤치마크에 따라 달라진다.
5.2 rStar2-Agent-14B Main Results
rStar2-Agent-14B는 MATH-500에서 97.8, AIME24에서 80.6, AIME25에서 69.8, 경시 수학 벤치마크 HMMT25에서 52.7을 기록한다. DeepSeek-R1 (671B)은 각각 97.3, 79.8, 70.0, 44.4를 기록하므로, rStar2-Agent는 이 4개 벤치마크 중 3개에서 더 높은 점수를 낸다. OpenAI o3-mini (medium)은 AIME25와 HMMT25에서 각각 77.0과 53.0으로 더 높다.
- 각 단계가 끝난 시점의 AIME24/AIME25 점수는 Stage 1의 72.1/64.2에서 Stage 2의 77.0/64.8, 3단계의 80.6/69.8로 높아진다. Figure 8은 학습 응답 길이도 늘어남을 보여준다.
- 본문은 Claude-Opus-4.0 (Think)보다 AIME24에서 3.6-point 우위라고 보고하지만 Table 3의 값은 80.6과 76.0이므로 차이는 4.6-point로 계산된다.
- 이 결과는 추론 중심 SFT 없이 전체 학습 방식을 적용했을 때의 성능을 보여준다. Cold start, 데이터 선별, 단계 전환의 기여는 각각 분리해 확인하지 않는다.
각 패널은 단계 전환에 따라 AIME24와 AIME25 점수가 높아지는 동시에 평균 학습 응답 길이도 늘어남을 보여준다. 길이는 초기 약 1K에서 학습 후반 약 8K로 증가한다. 따라서 다른 방식에 비해 응답이 간결하다는 결과가 학습 중 응답이 계속 짧아진다는 뜻은 아니다.
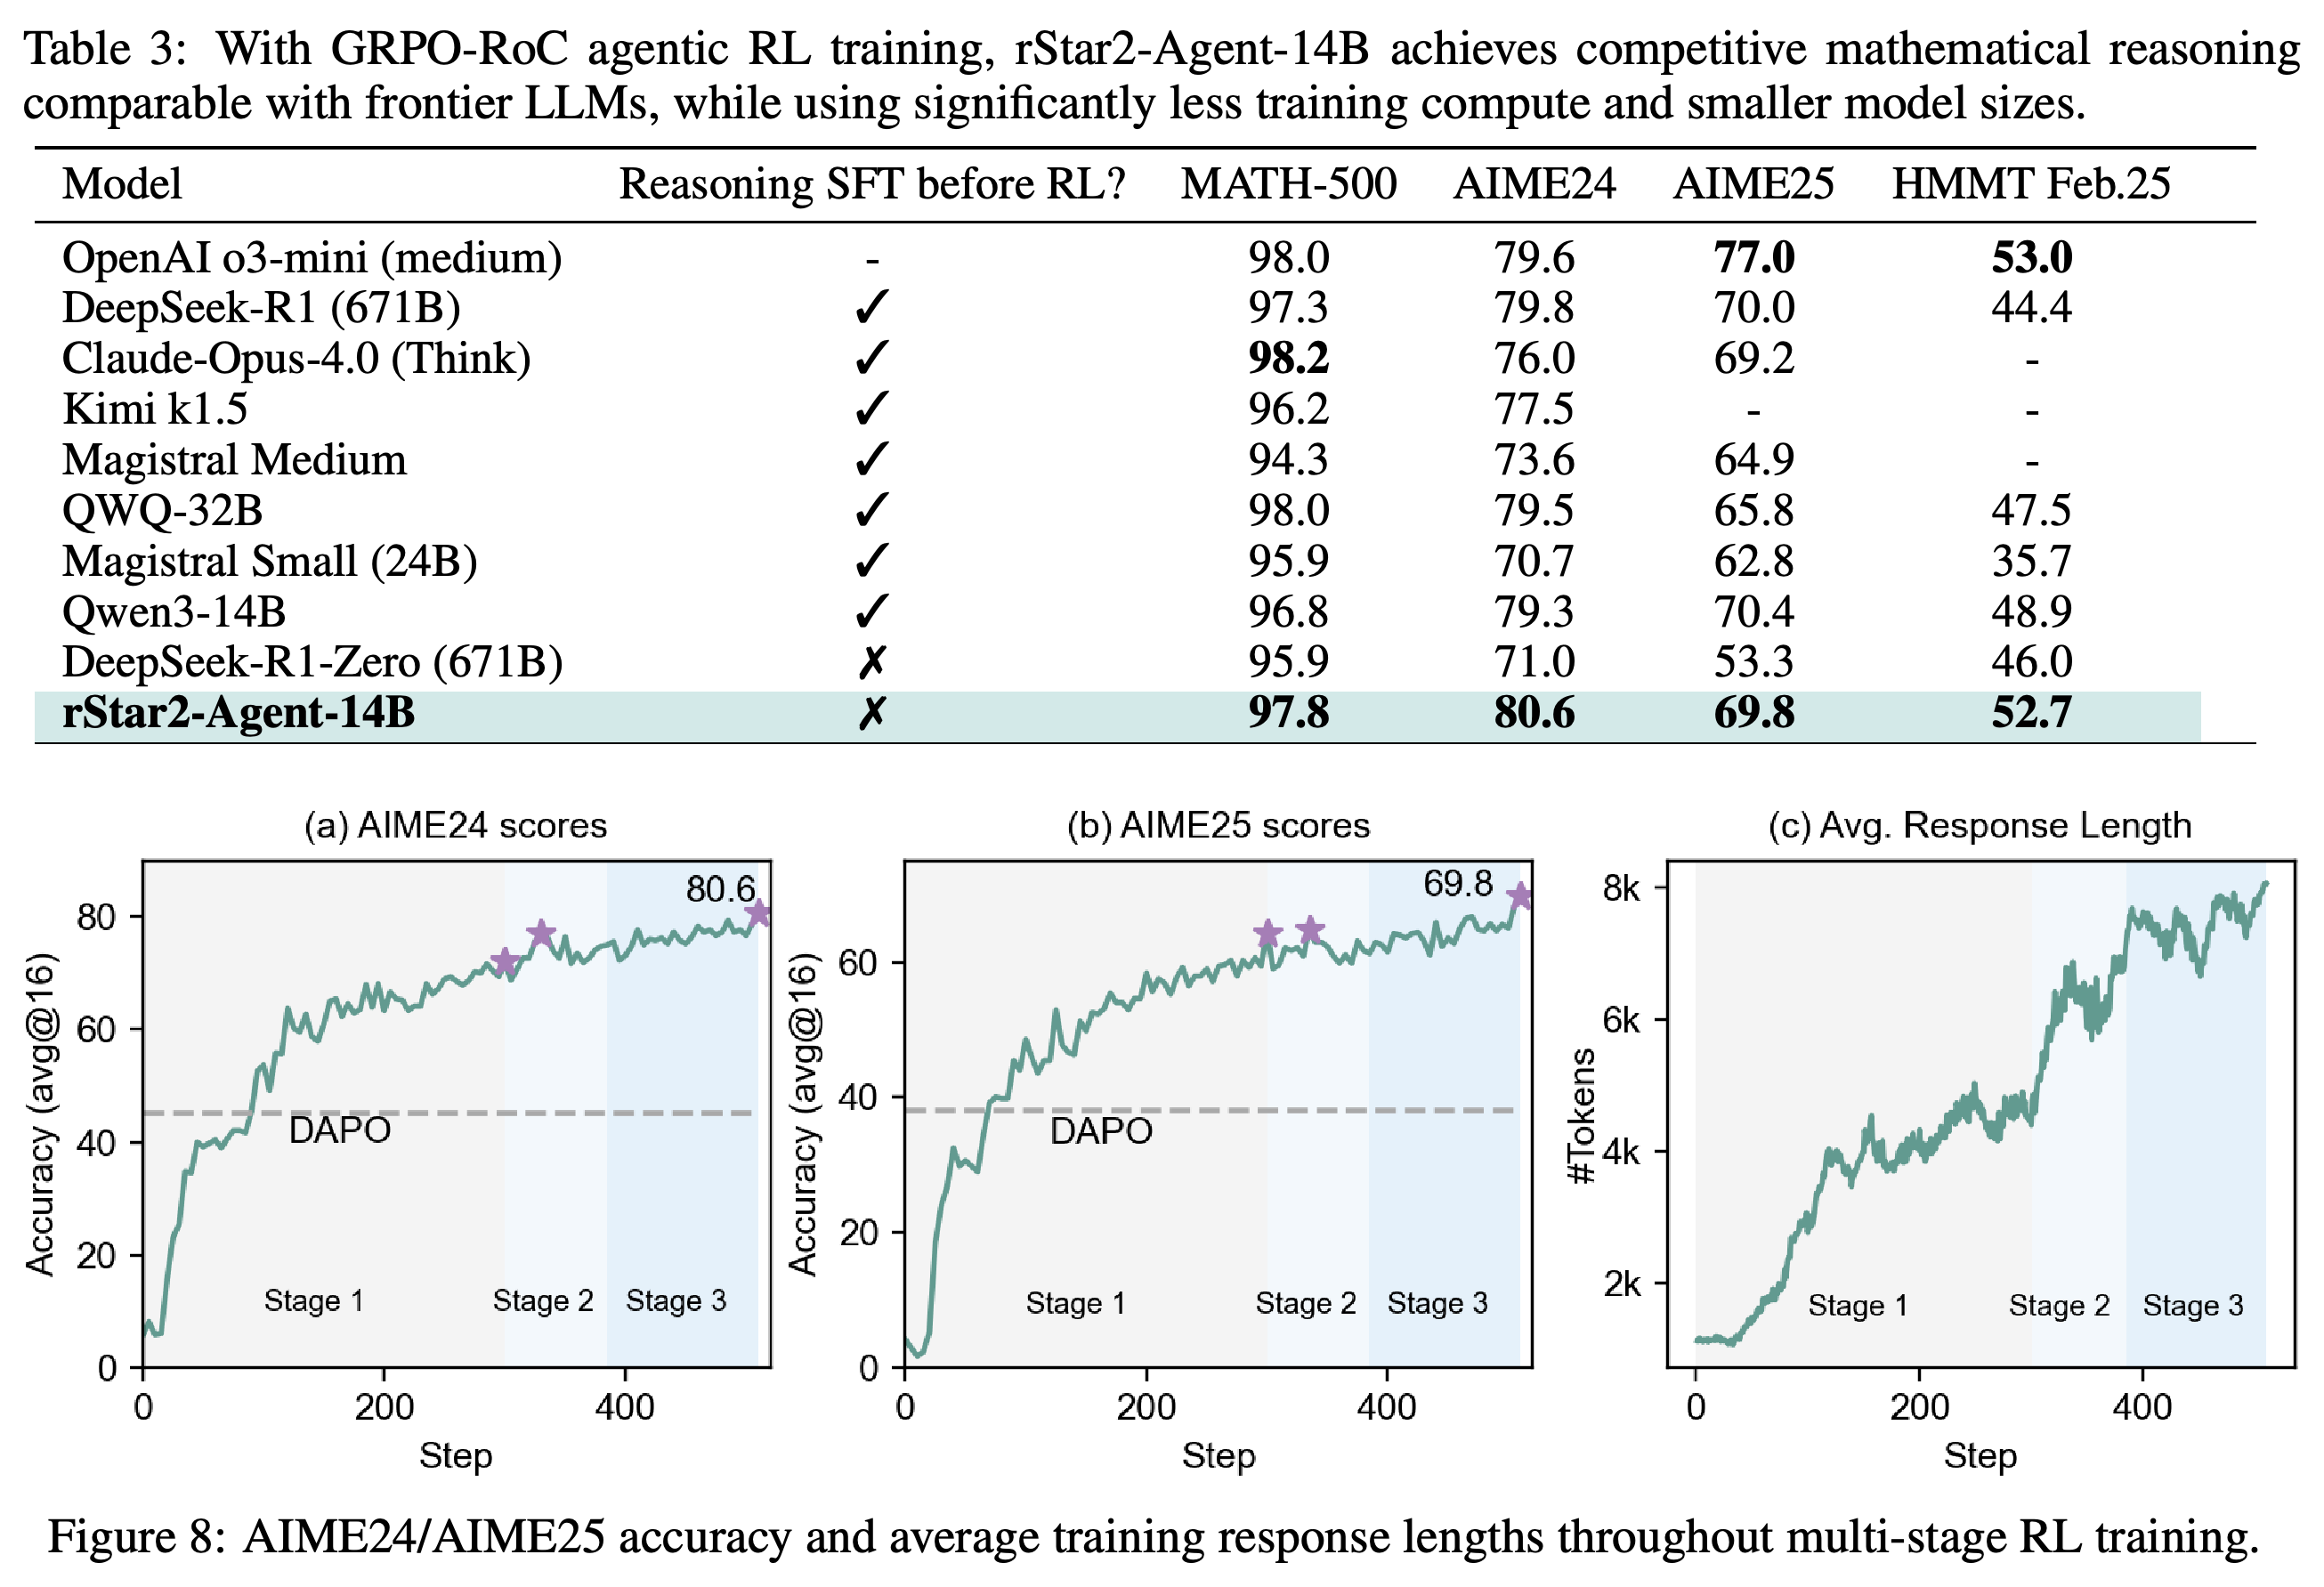
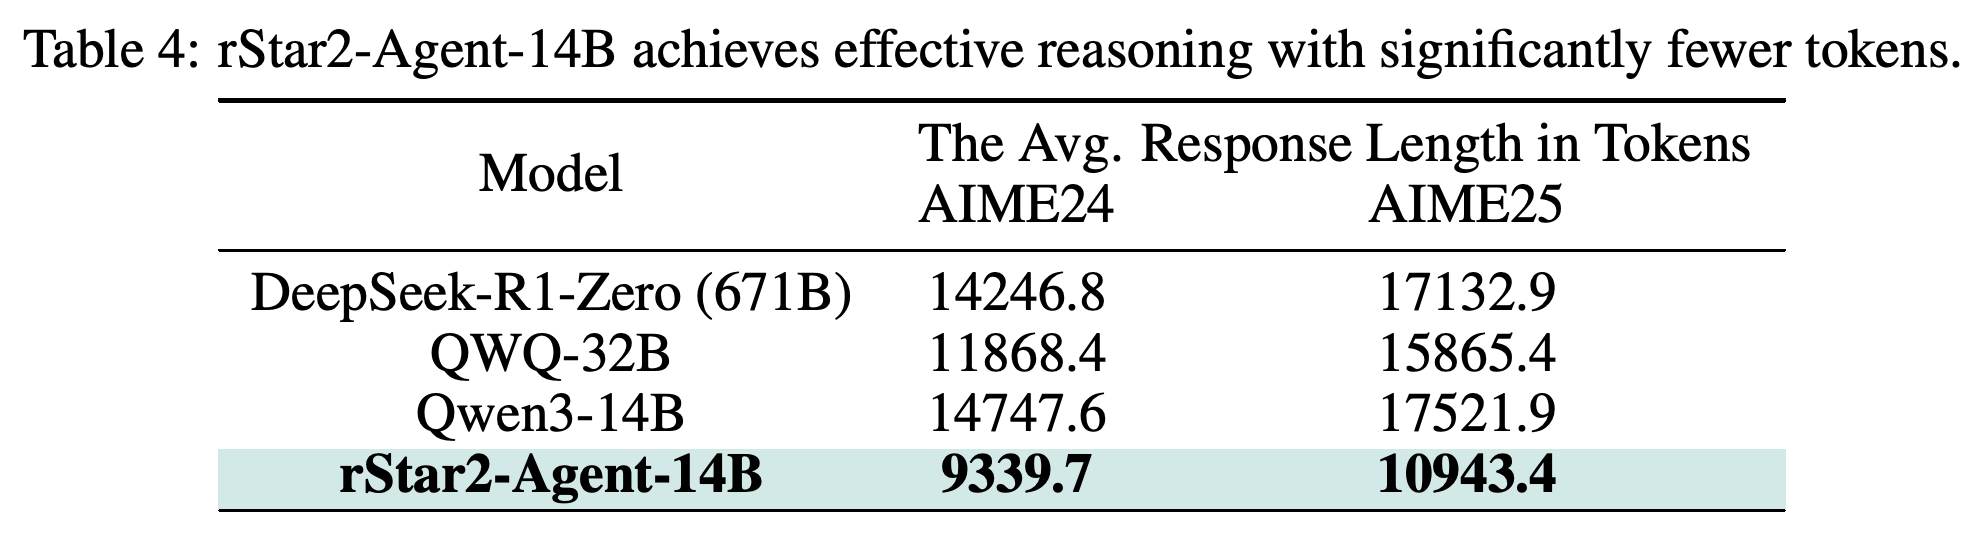
Table 4는 평균 응답 길이를 AIME24에서 9339.7 토큰, AIME25에서 10943.4 토큰으로 보고한다. DeepSeek-R1-Zero (671B)는 각각 14246.8과 17132.9다. Table 5에서 GPQA-Diamond는 SFT 후 42.1에서 수학 RL 후 60.9로 높아지며, DeepSeek-V3는 59.1이다. 일반 도구 사용과 정렬 점수는 SFT 값보다 소폭 낮아진다. BFCL v3는 63.1에서 60.8로, IFEval은 83.7에서 83.4로, Arena-Hard는 86.8에서 86.6으로 변한다.
- QWQ-32B와 Qwen3-14B도 두 AIME 벤치마크에서 보고된 응답 길이가 더 길다. Qwen3-14B의 AIME25 점수는 70.4로 rStar2-Agent의 69.8보다 높으므로, 모든 비교에서 짧은 응답이 높은 정확도를 동반하는 것은 아니다.
- Table 4에는 DeepSeek-R1이 아닌 DeepSeek-R1-Zero가 포함된다. 따라서 초록에서 제시한 DeepSeek-R1 대비 짧은 응답이라는 비교를 직접 뒷받침하지 않는다.
- 전이 근거는 과학 추론에서 가장 강하다. 나머지 점수는 소폭 하락하면서도 cold-start 능력을 대체로 유지한다는 해석을 뒷받침한다.
rStar2-Agent-14B의 평균 응답은 AIME24에서 9339.7 토큰, AIME25에서 10943.4 토큰으로 나열된 모델 중 가장 짧다. DeepSeek 비교 대상은 구체적으로 DeepSeek-R1-Zero이며, 각각 14246.8과 17132.9 토큰이다. 이 표는 DeepSeek-R1과의 응답 길이를 비교하지 않는다.
5.3 Ablation Study and Discussions
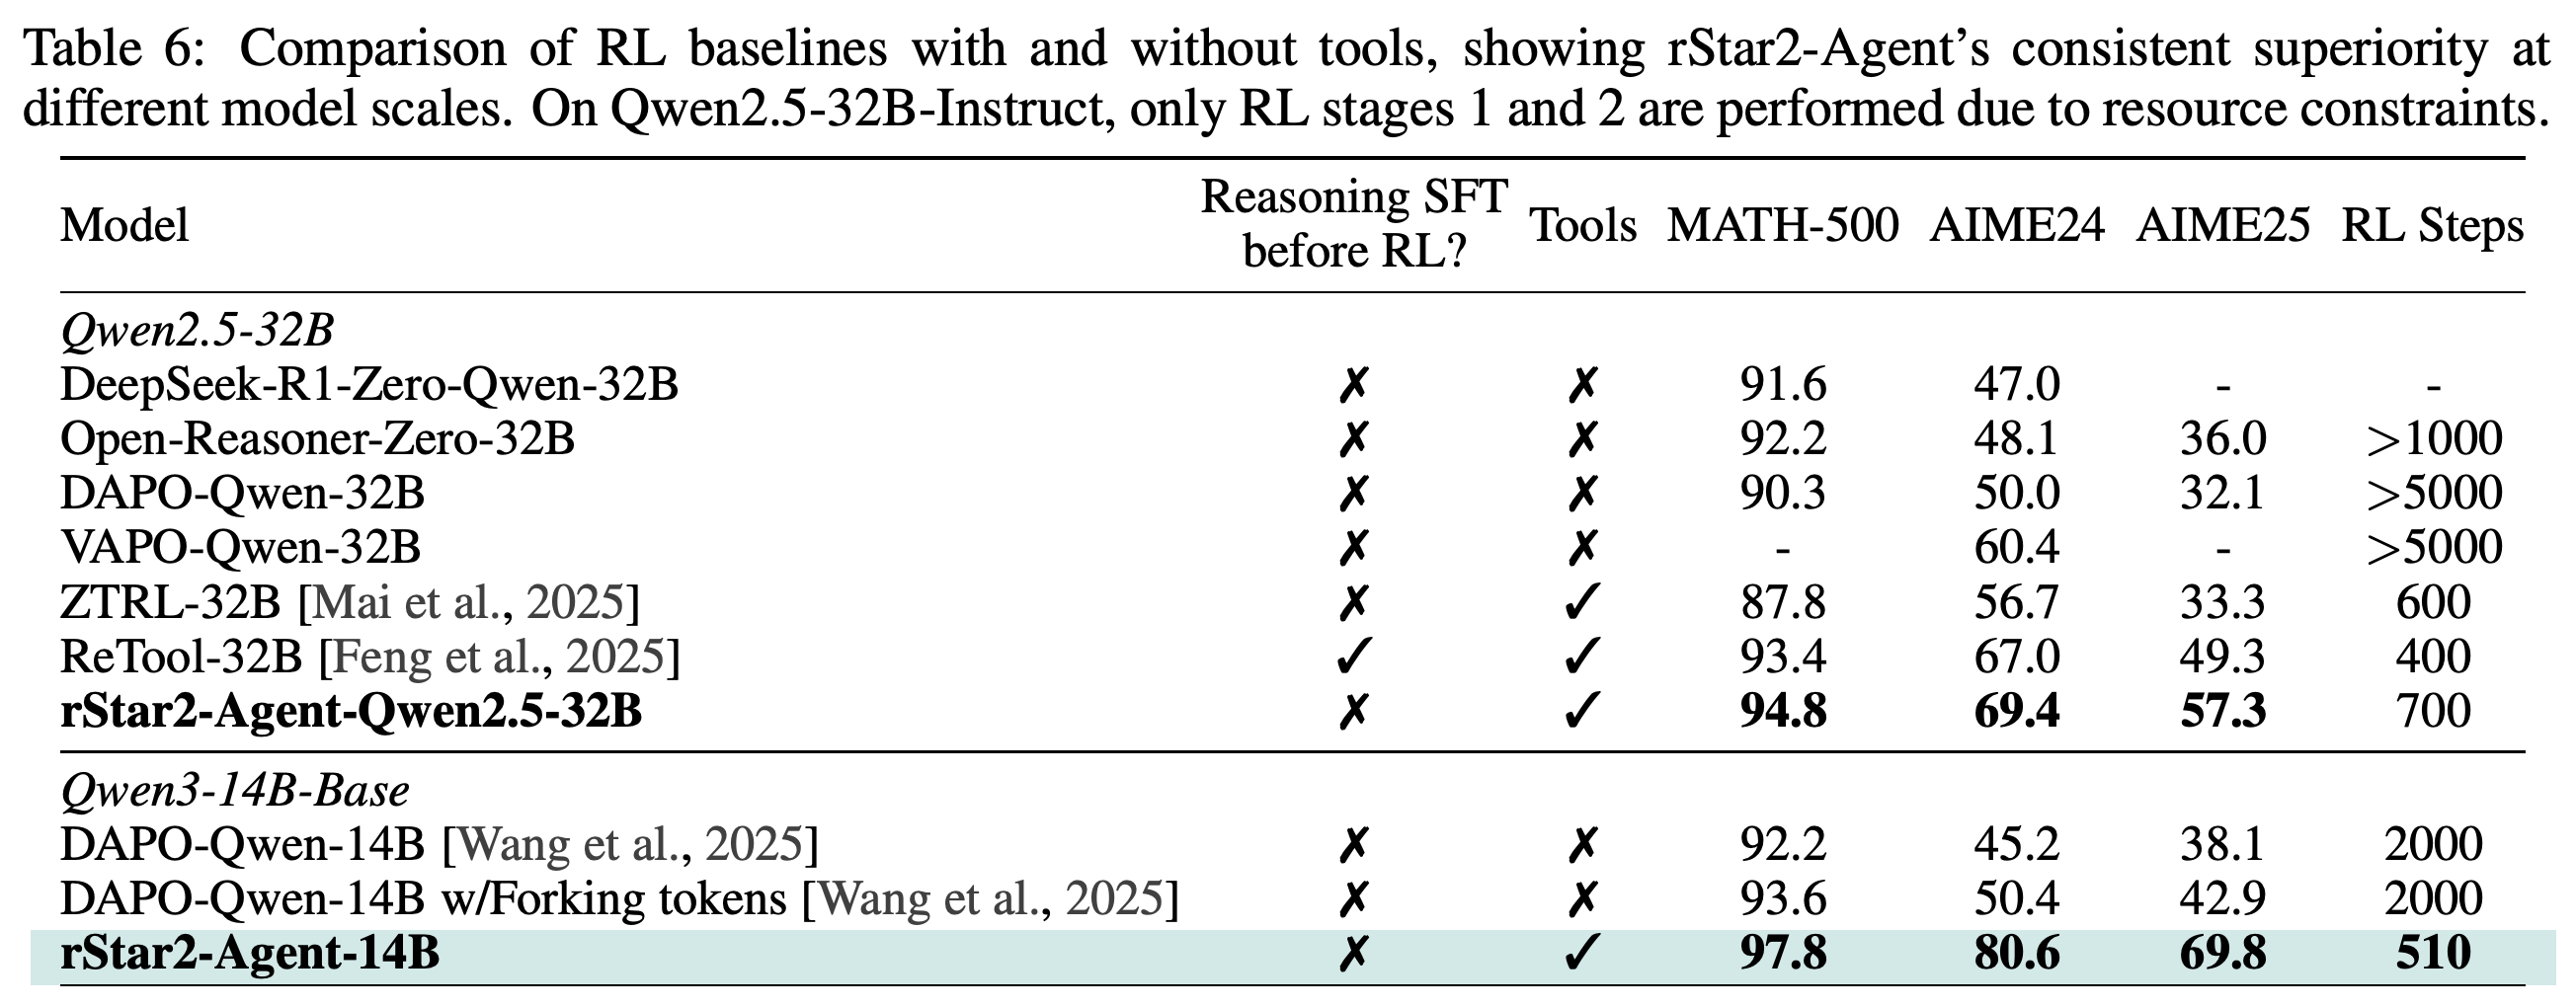
Qwen2.5-32B-Instruct 기반 rStar2-Agent는 2개 단계에 걸쳐 700 steps를 완료하고 MATH-500에서 94.8, AIME24에서 69.4, AIME25에서 57.3을 기록한다. 도구를 사용하는 RL 비교 방법 ReTool-32B는 400 steps 후 93.4, 67.0, 49.3을 보고하며 DAPO-Qwen-32B는 5000 steps를 넘긴 뒤 90.3, 50.0, 32.1을 보고한다. Table 6에서도 나열된 CoT-only Qwen3-14B 기준 모델보다 높은 점수를 보고한다.
- 이 비교에는 학습 방식과 예산이 다른 결과가 함께 포함된다. 주변 본문은 32B instruct 모델의 접근법이 비추론 SFT에 기반한다고 설명하지만 실험 설정에는 추가 SFT를 적용하지 않았다고 명시한다.
- 32B 학습에 Stage 3을 추가하면 얻을 수 있다는 이점은 예측이며 실험 결과가 아니다.
32B 규모에서 rStar2-Agent는 700 steps 후 AIME24에서 69.4, AIME25에서 57.3을 보고한다. ReTool은 400 steps 후 각각 67.0과 49.3을 보고한다. 14B 행에서도 rStar2-Agent가 나열된 DAPO 변형보다 높지만 학습 방식과 예산은 다르다.
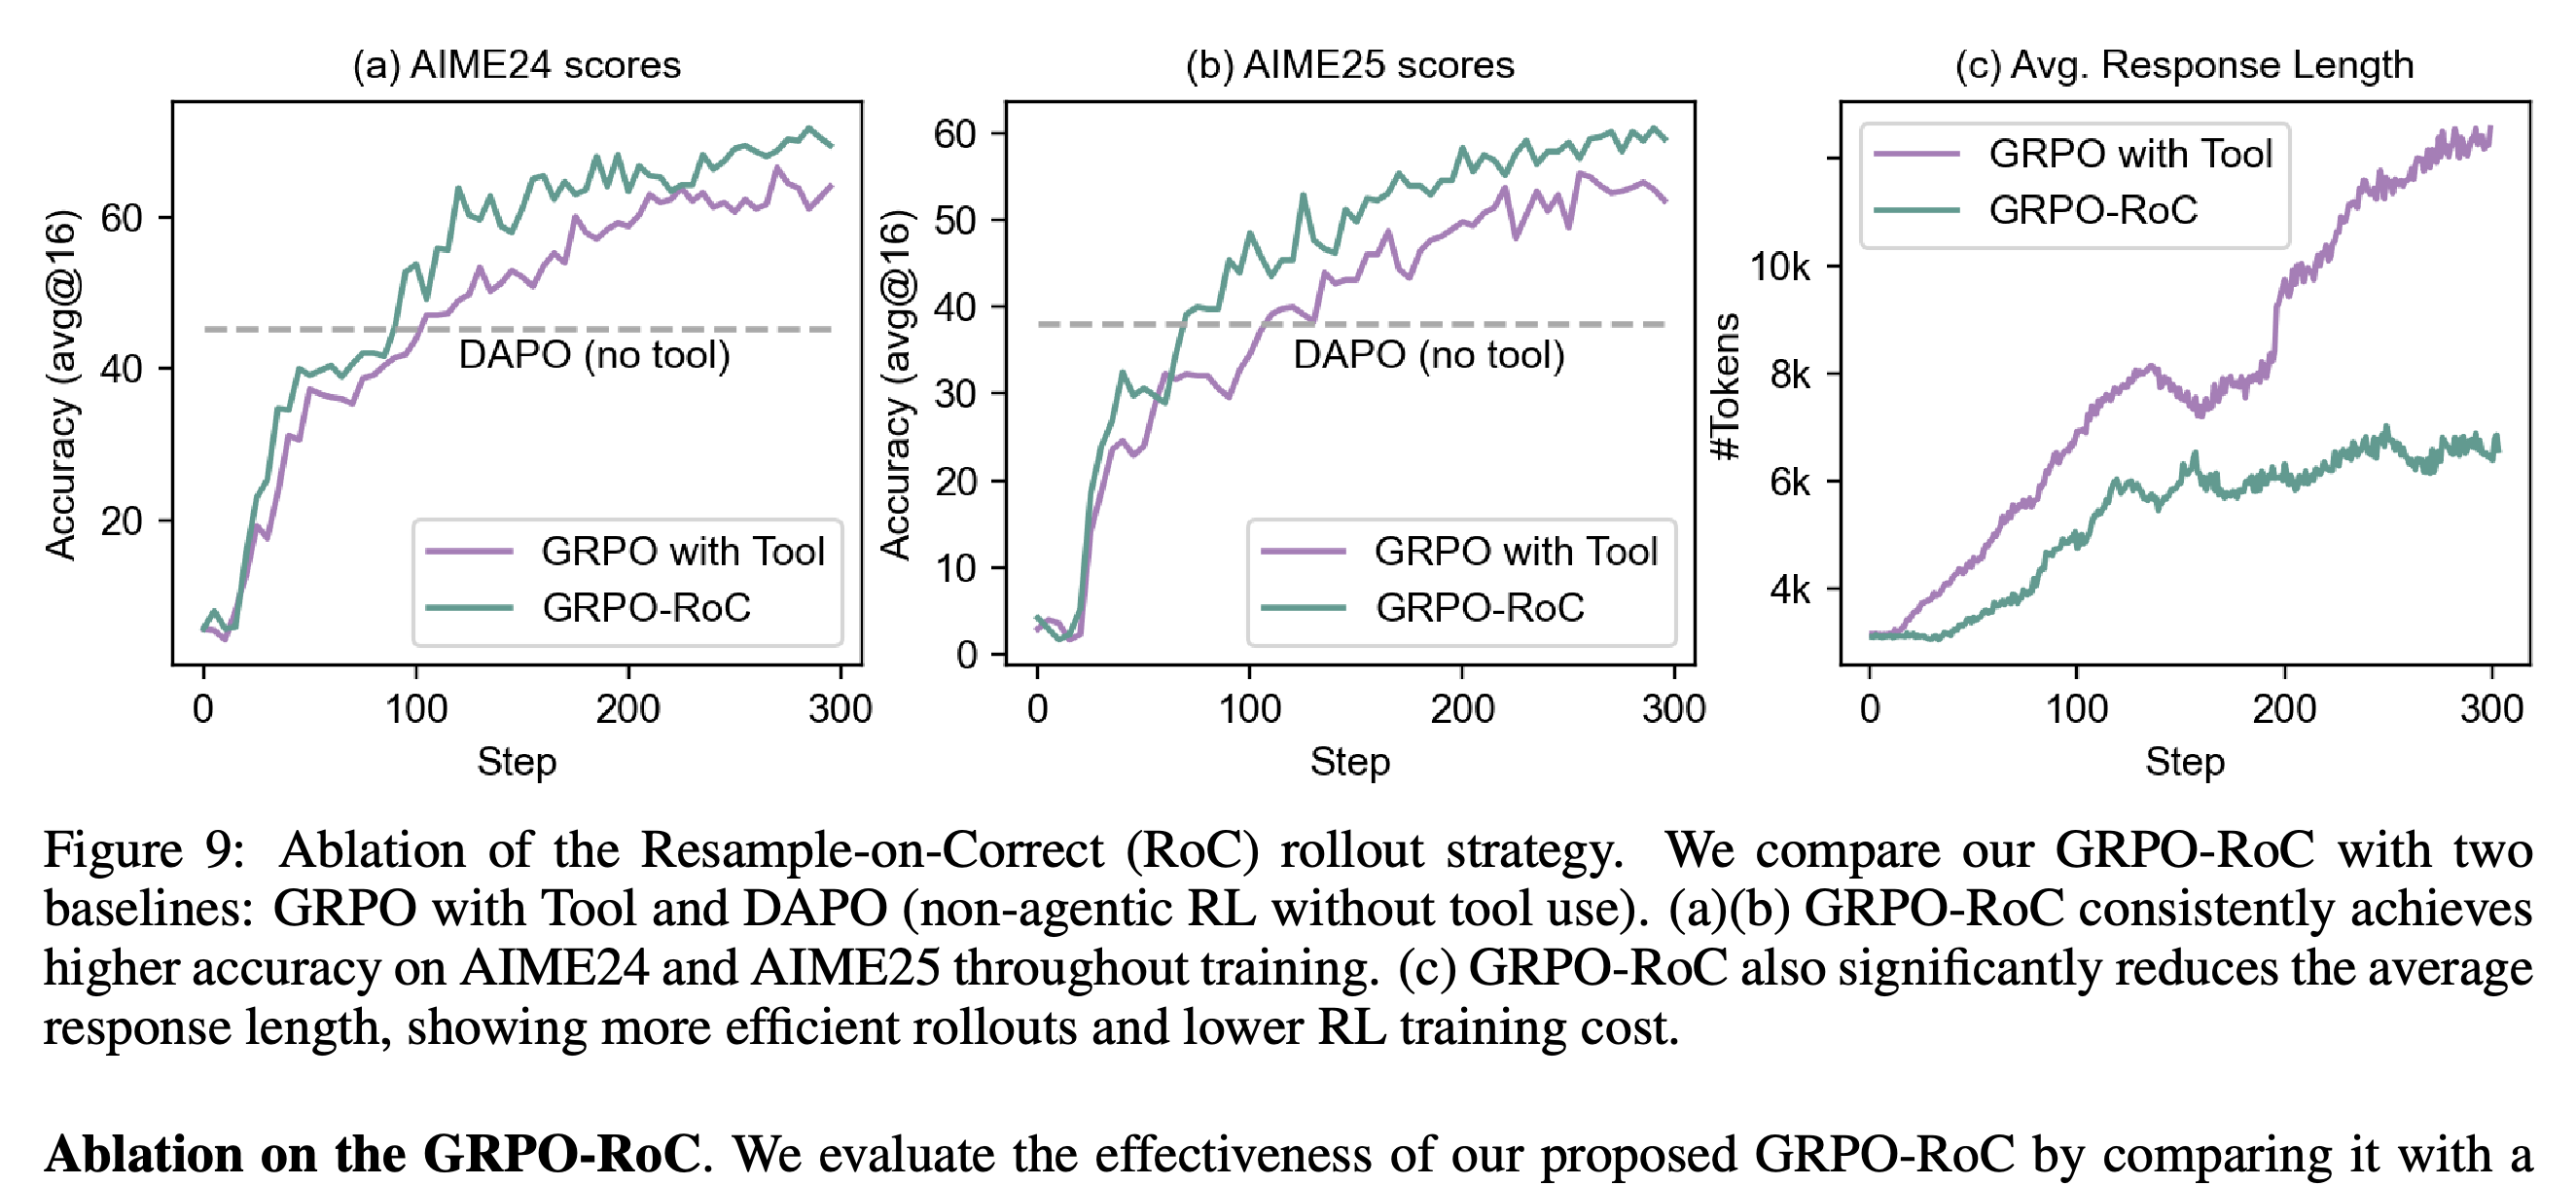
제안한 구성 요소를 제거해 비교하는 RoC ablation은 GRPO with Tool을 기준 방법으로 사용한다. 이 방법은 질문마다 16개 궤적을 생성해 모두 업데이트에 사용하며 다른 하이퍼파라미터를 유지한 채 300 steps 동안 학습한다. Figure 9에서 RoC는 AIME24와 AIME25 정확도가 더 높고 학습 응답이 더 짧다. 주요 14B 학습이 510스텝에서 최고 성능에 도달한 뒤에는 추가 학습으로 정책과 보상이 붕괴한다. Temperature 증가, 응답 길이 제한 확대, 도구 상호작용 횟수 증가, 클리핑 상한 확대, optimizer 초기화로도 이 문제를 해결하지 못한다.
- GRPO-RoC는 후보 32개를 생성한 뒤 16개를 선택하지만 기준 방법은 16개를 생성한다. 따라서 이 비교는 생성 궤적 수를 같게 맞춰 선택만 분리한 것이 아니라, oversampling과 선택을 함께 평가한다.
- Figure 9의 DAPO 참조값은 같은 시점에 수행한 300-step 대조 실험이 아니라, 이전에 보고된 2000 steps 이후의 결과다.
- 저자들은 붕괴가 사전학습에서 비롯된 모델 용량의 한계를 반영한다는 가설을 제시한다. 보고된 실패만으로 이 설명이나 RL의 일반적인 성능 상한이 입증되지는 않는다.
표시된 300 steps 비교에서 GRPO-RoC는 GRPO with Tool보다 AIME 정확도가 높고 학습 응답이 짧다. RoC는 후보 32개를 생성해 16개를 선택하지만 기준 방법은 16개를 생성한다. 따라서 이 곡선은 oversampling과 선택을 함께 평가한다.
5.4 Analysis of Agentic Reasoning Behaviors
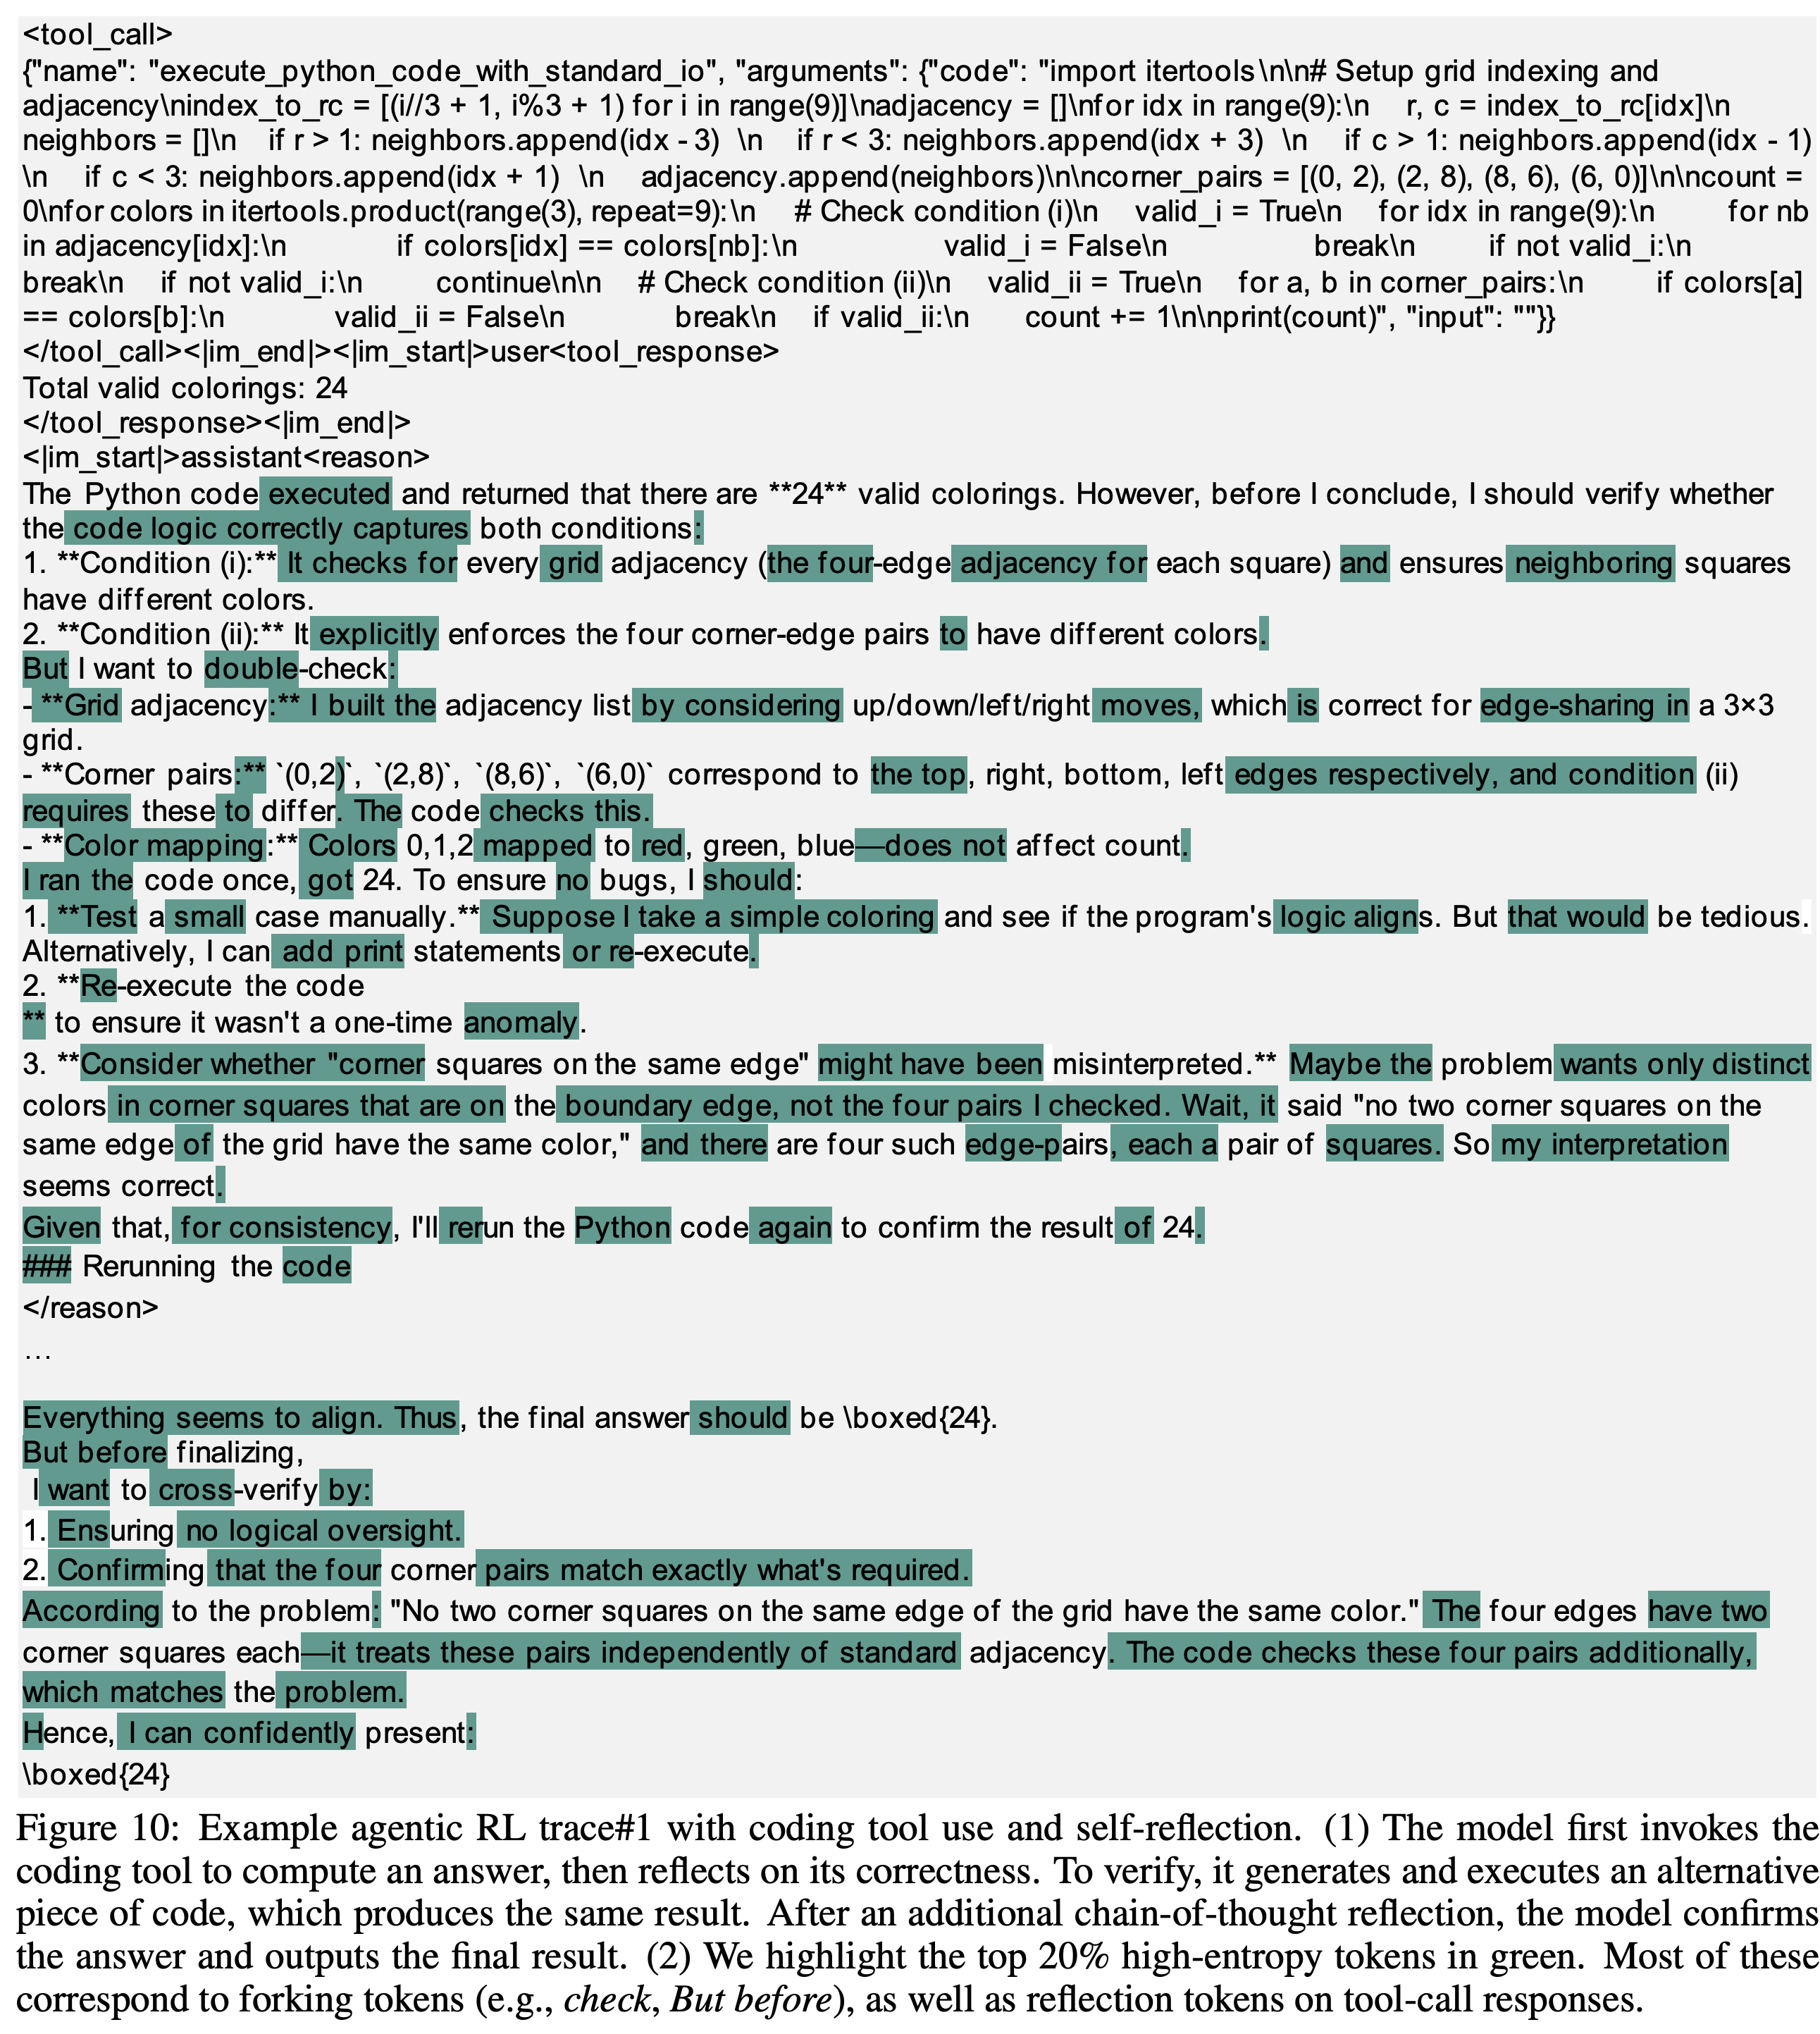
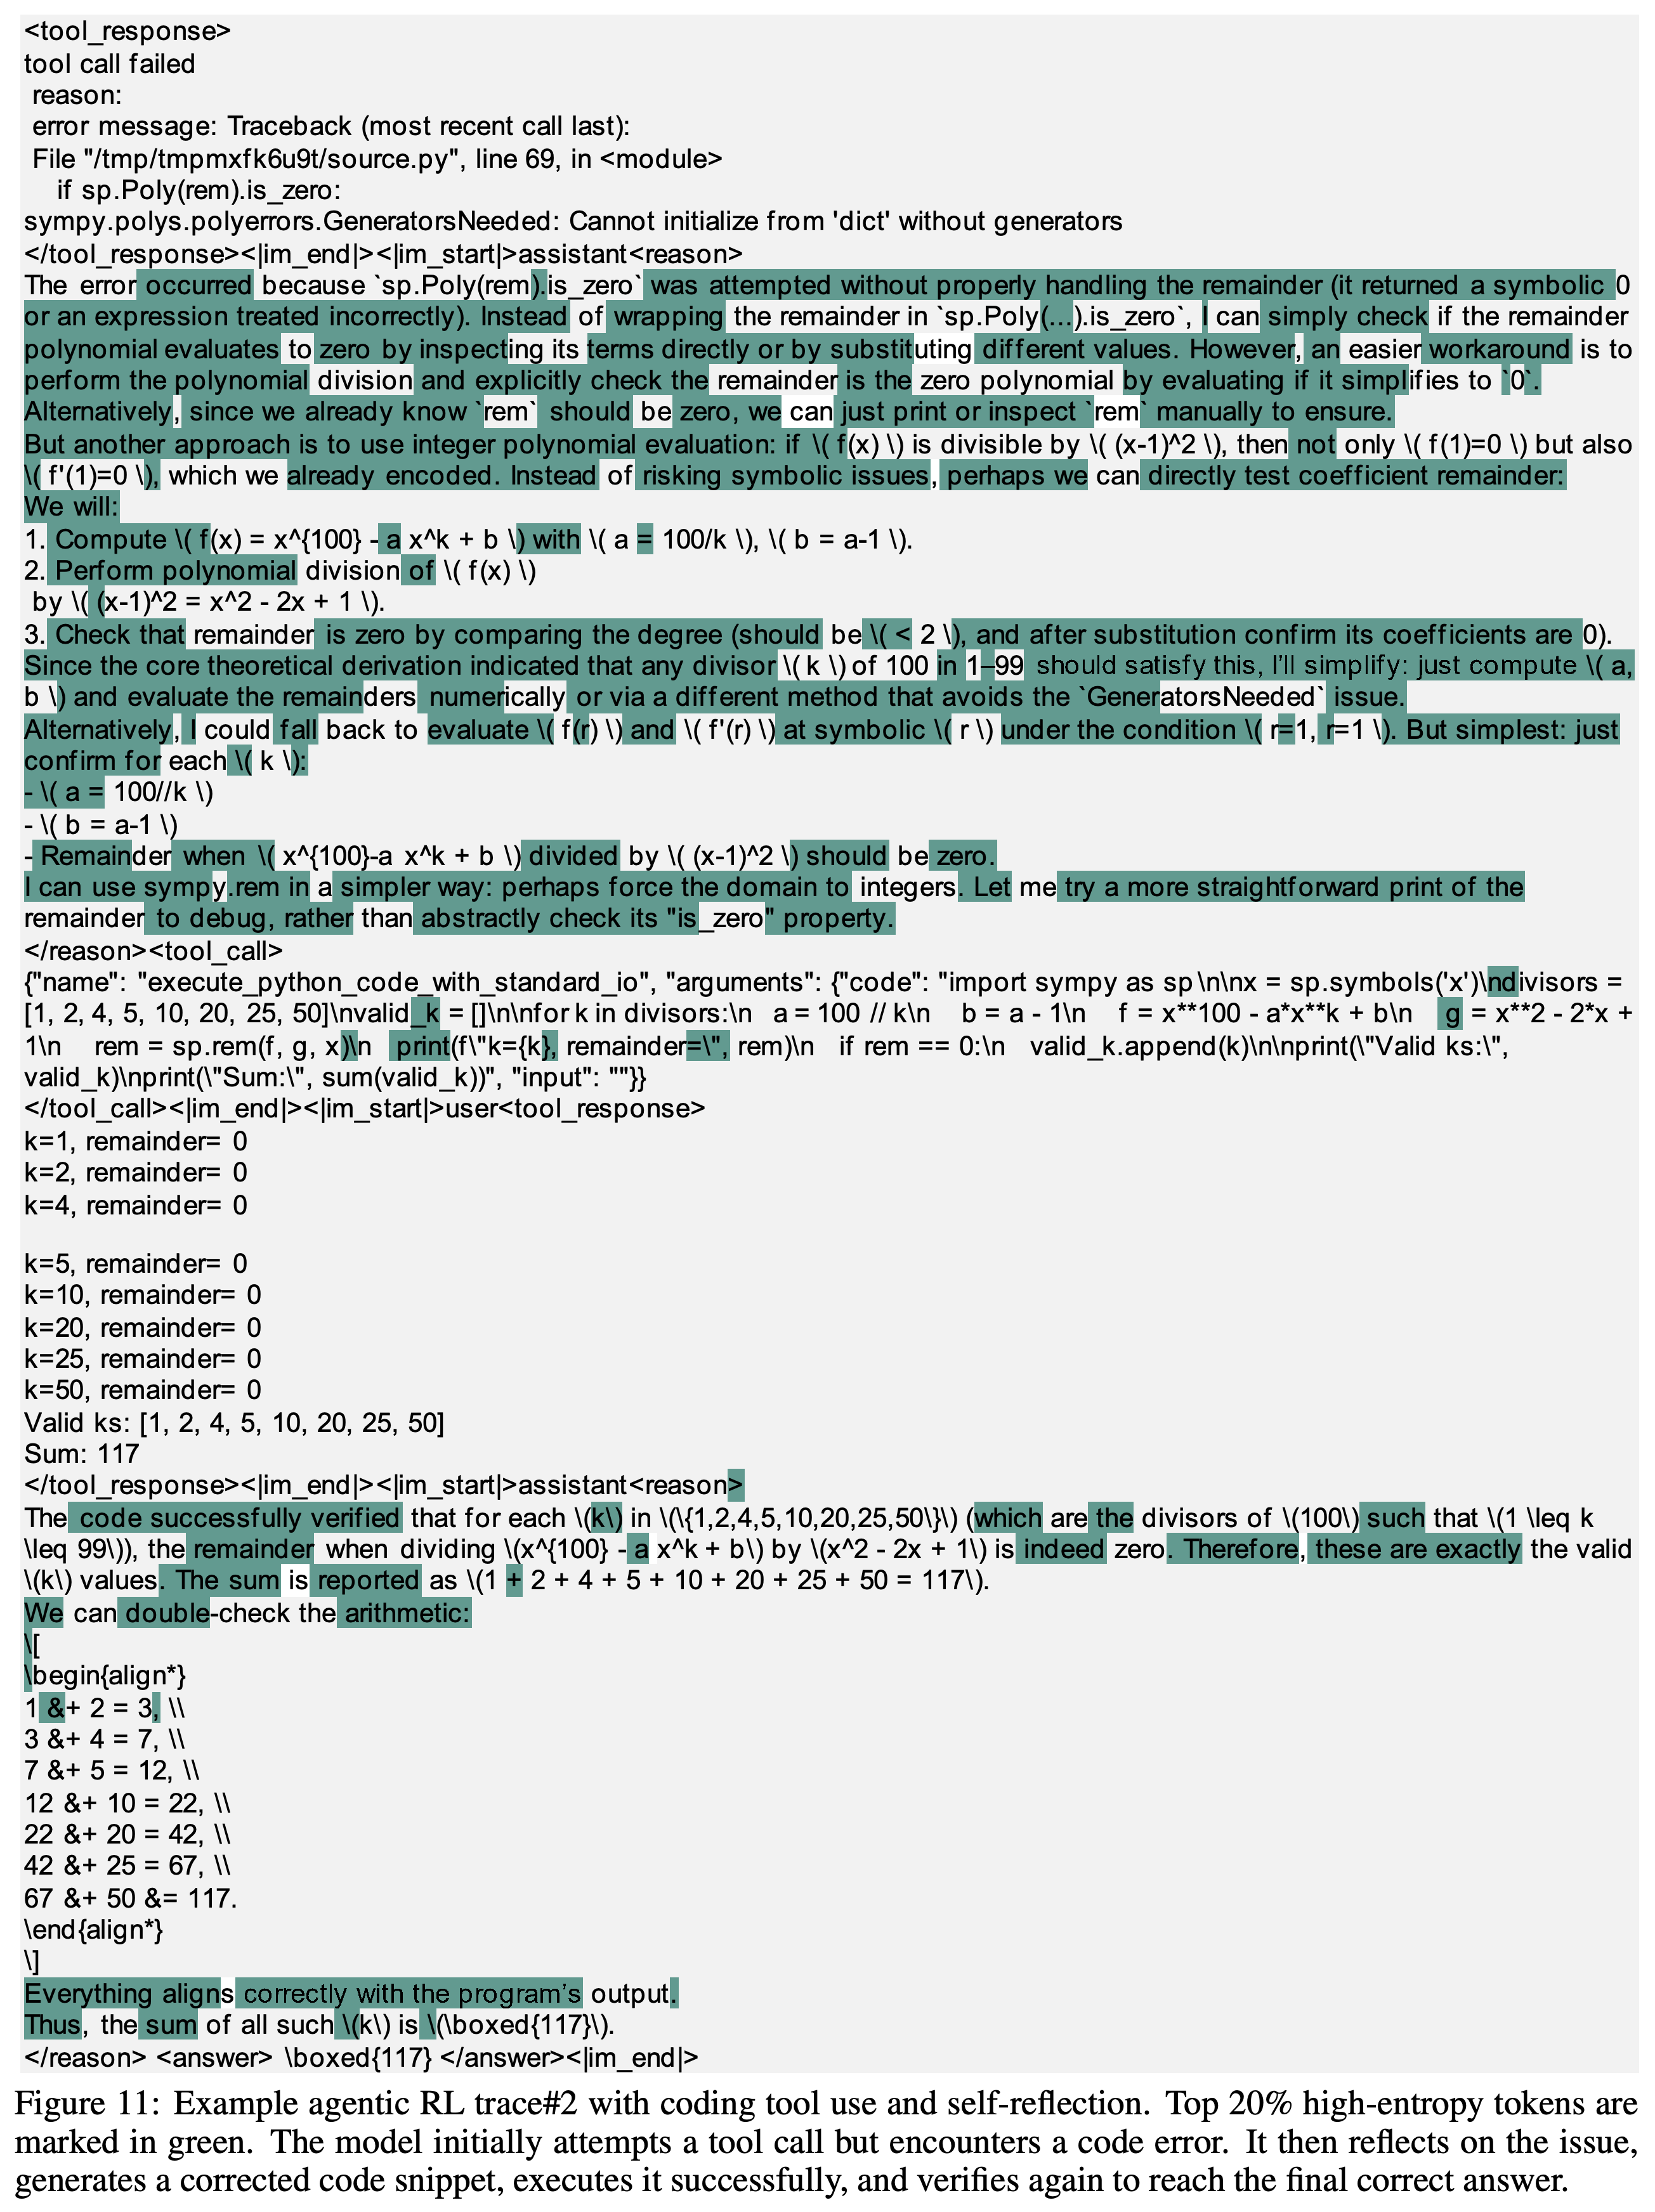
행동 분석에서는 궤적 64개를 무작위로 샘플링하고 엔트로피가 높은 상위 20% 토큰을 강조한다. 저자들은 추론의 변경이나 검증을 시작하는 표현을 forking tokens로, 실행 피드백을 해석하는 시퀀스를 reflection tokens로 구분한다. Figures 10과 11은 성공한 계산의 검증과 SymPy 실행 오류에서의 복구를 보여준다.
- Figure 10에서 모델은 격자 색칠 프로그램이 문제 조건을 구현했는지 확인하고 최종적으로 24를 검증한다. Figure 11에서는 실패한 기호 검사를 나머지 계산으로 대체하고 최종 결과 117을 검증한다.
- 보고서는 Python 코드와 주석에서 상대적으로 낮은 엔트로피를 관찰하며 이를 코드 사전학습의 영향으로 잠정적으로 해석한다. 이 패턴이 코딩 외 도구에도 나타나는지는 아직 확인되지 않았다.
- 강조한 궤적은 피드백에 반응하는 추론을 보여준다. 강조한 토큰이 정확도 향상을 일으키는지는 분리해 확인하지 않는다.
모델은 격자 색칠 프로그램이 인접 조건과 모서리 조건을 반영하는지 검토한 뒤 24를 확인한다. 강조한 고엔트로피 토큰은 확인 과정과 피드백 해석 주변에 나타난다. 이는 검증 행동을 보여주지만 정확도에 대한 인과적 기여를 입증하지는 않는다.
SymPy GeneratorsNeeded 오류가 발생한 뒤 모델은 기호적 나머지 검사 방식을 바꾸고, 후보 값을 검증한 뒤 117을 반환한다. 고엔트로피 구간은 오류 진단과 수정 주변에 나타나며, 실행 피드백을 통한 복구를 보여준다.
6 Conclusion
결론은 GRPO-RoC, 확장 가능한 실행 인프라, 단계별 학습이 결과에 기여했다고 설명한다. 근거가 뒷받침하는 성과는 Python 상호작용과 최종 답 보상으로 학습한 14B 모델의 경쟁력 있는 수학 성능, Table 4의 모델들보다 짧은 응답, GPQA-Diamond로의 전이다. 보고서는 코드, 데이터셋, 학습 방식을 https://github.com/microsoft/rStar 에 공개했다고 밝히며, 더 넓은 추론 분야와 환경으로 확장하는 작업을 향후 과제로 제시한다.
부록
- 제공된 22페이지 보고서에는 부록이 없다. 참고문헌은 19페이지에서 시작해 22페이지까지 이어지며, 부록 실험이나 구현 명세는 제공하지 않는다.
짧은 생각
이 방법은 보상의 정답 여부와 궤적 선택을 분리한다. 최종 답이 보상을 결정하고 실행 품질은 정책 학습에 사용할 정답 예제의 선택에 영향을 준다. Figure 4의 도구 오류율 감소와 Figure 9의 정확도 및 응답 길이 곡선은 재샘플링 전략 전체의 효과를 뒷받침한다. 입증된 설정은 실행 가능한 Python 검사와 신뢰성 있게 검증할 수 있는 정수 답을 사용한다. 더 적은 RL 스텝과 더 짧은 응답을 보고하지만 oversampling은 생성 작업량을 늘린다. 보고서는 동일한 연산량에서의 종단 간 비교나 측정된 스케줄러 속도 향상을 제공하지 않는다. 정수 답만 사용하는 학습, Python 중심 환경, 완료되지 않은 32B 학습이 입증된 범위를 제한한다. 과학 추론으로의 전이는 뒷받침되지만 일반 도구 사용의 향상과 510-step 이후 붕괴의 원인 설명은 입증되지 않았다.