


The Landscape of Agentic Reinforcement Learning for LLMs: A Survey 요약 설명
02 Sep 2025 | Paper Review Agentic Reinforcement Learning LLM Agents Agent Training Data목차
이번 글에서는 The Landscape of Agentic Reinforcement Learning for LLMs: A Survey 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 2일(Arxiv), Transactions on Machine Learning Research (01/2026)
- Zhang, Guibin, Geng, Hejia, Yu, Xiaohang, Yin, Zhenfei, Zhang, Zaibin, Tan, Zelin, Zhou, Heng, Li, Zhongzhi, Xue, Xiangyuan, Li, Yijiang, et al.
- University of Oxford, Shanghai AI Laboratory, National University of Singapore, University of Illinois Urbana-Champaign, Brown University, University College London, University of Science and Technology of China, Imperial College London, Dalian University of Technology, Chinese Academy of Sciences, The Chinese University of Hong Kong, University of Georgia, University of California, San Diego, University of California, Santa Barbara, University of Bristol
- 논문 링크
- Github
요약
- 언어를 생성하는 대규모 언어 모델(LLM)이 상호작용 과제를 수행하려면 앞선 결정이 이후 결과에 미치는 영향을 학습해야 한다. 이 서베이는 five hundred works가 넘는 연구를 종합한다. 여러 단계로 진행되며 상태를 부분적으로만 관측하는 환경과 단일 단계의 프롬프트–응답 환경을 비교하여, 보상으로 상호작용 의사결정 규칙을 학습하는 Agentic Reinforcement Learning(Agentic RL)을 단일 응답 최적화와 구분한다.
- 이 서베이는 문헌을 계획, 도구 사용, 메모리, 자기 개선, 추론, 지각이라는 역량과 응용 분야에 따라 분류한다. 이 분류를 학습 알고리즘, 보상 설계, 환경, 벤치마크, 오픈소스 프레임워크와 연결한다.
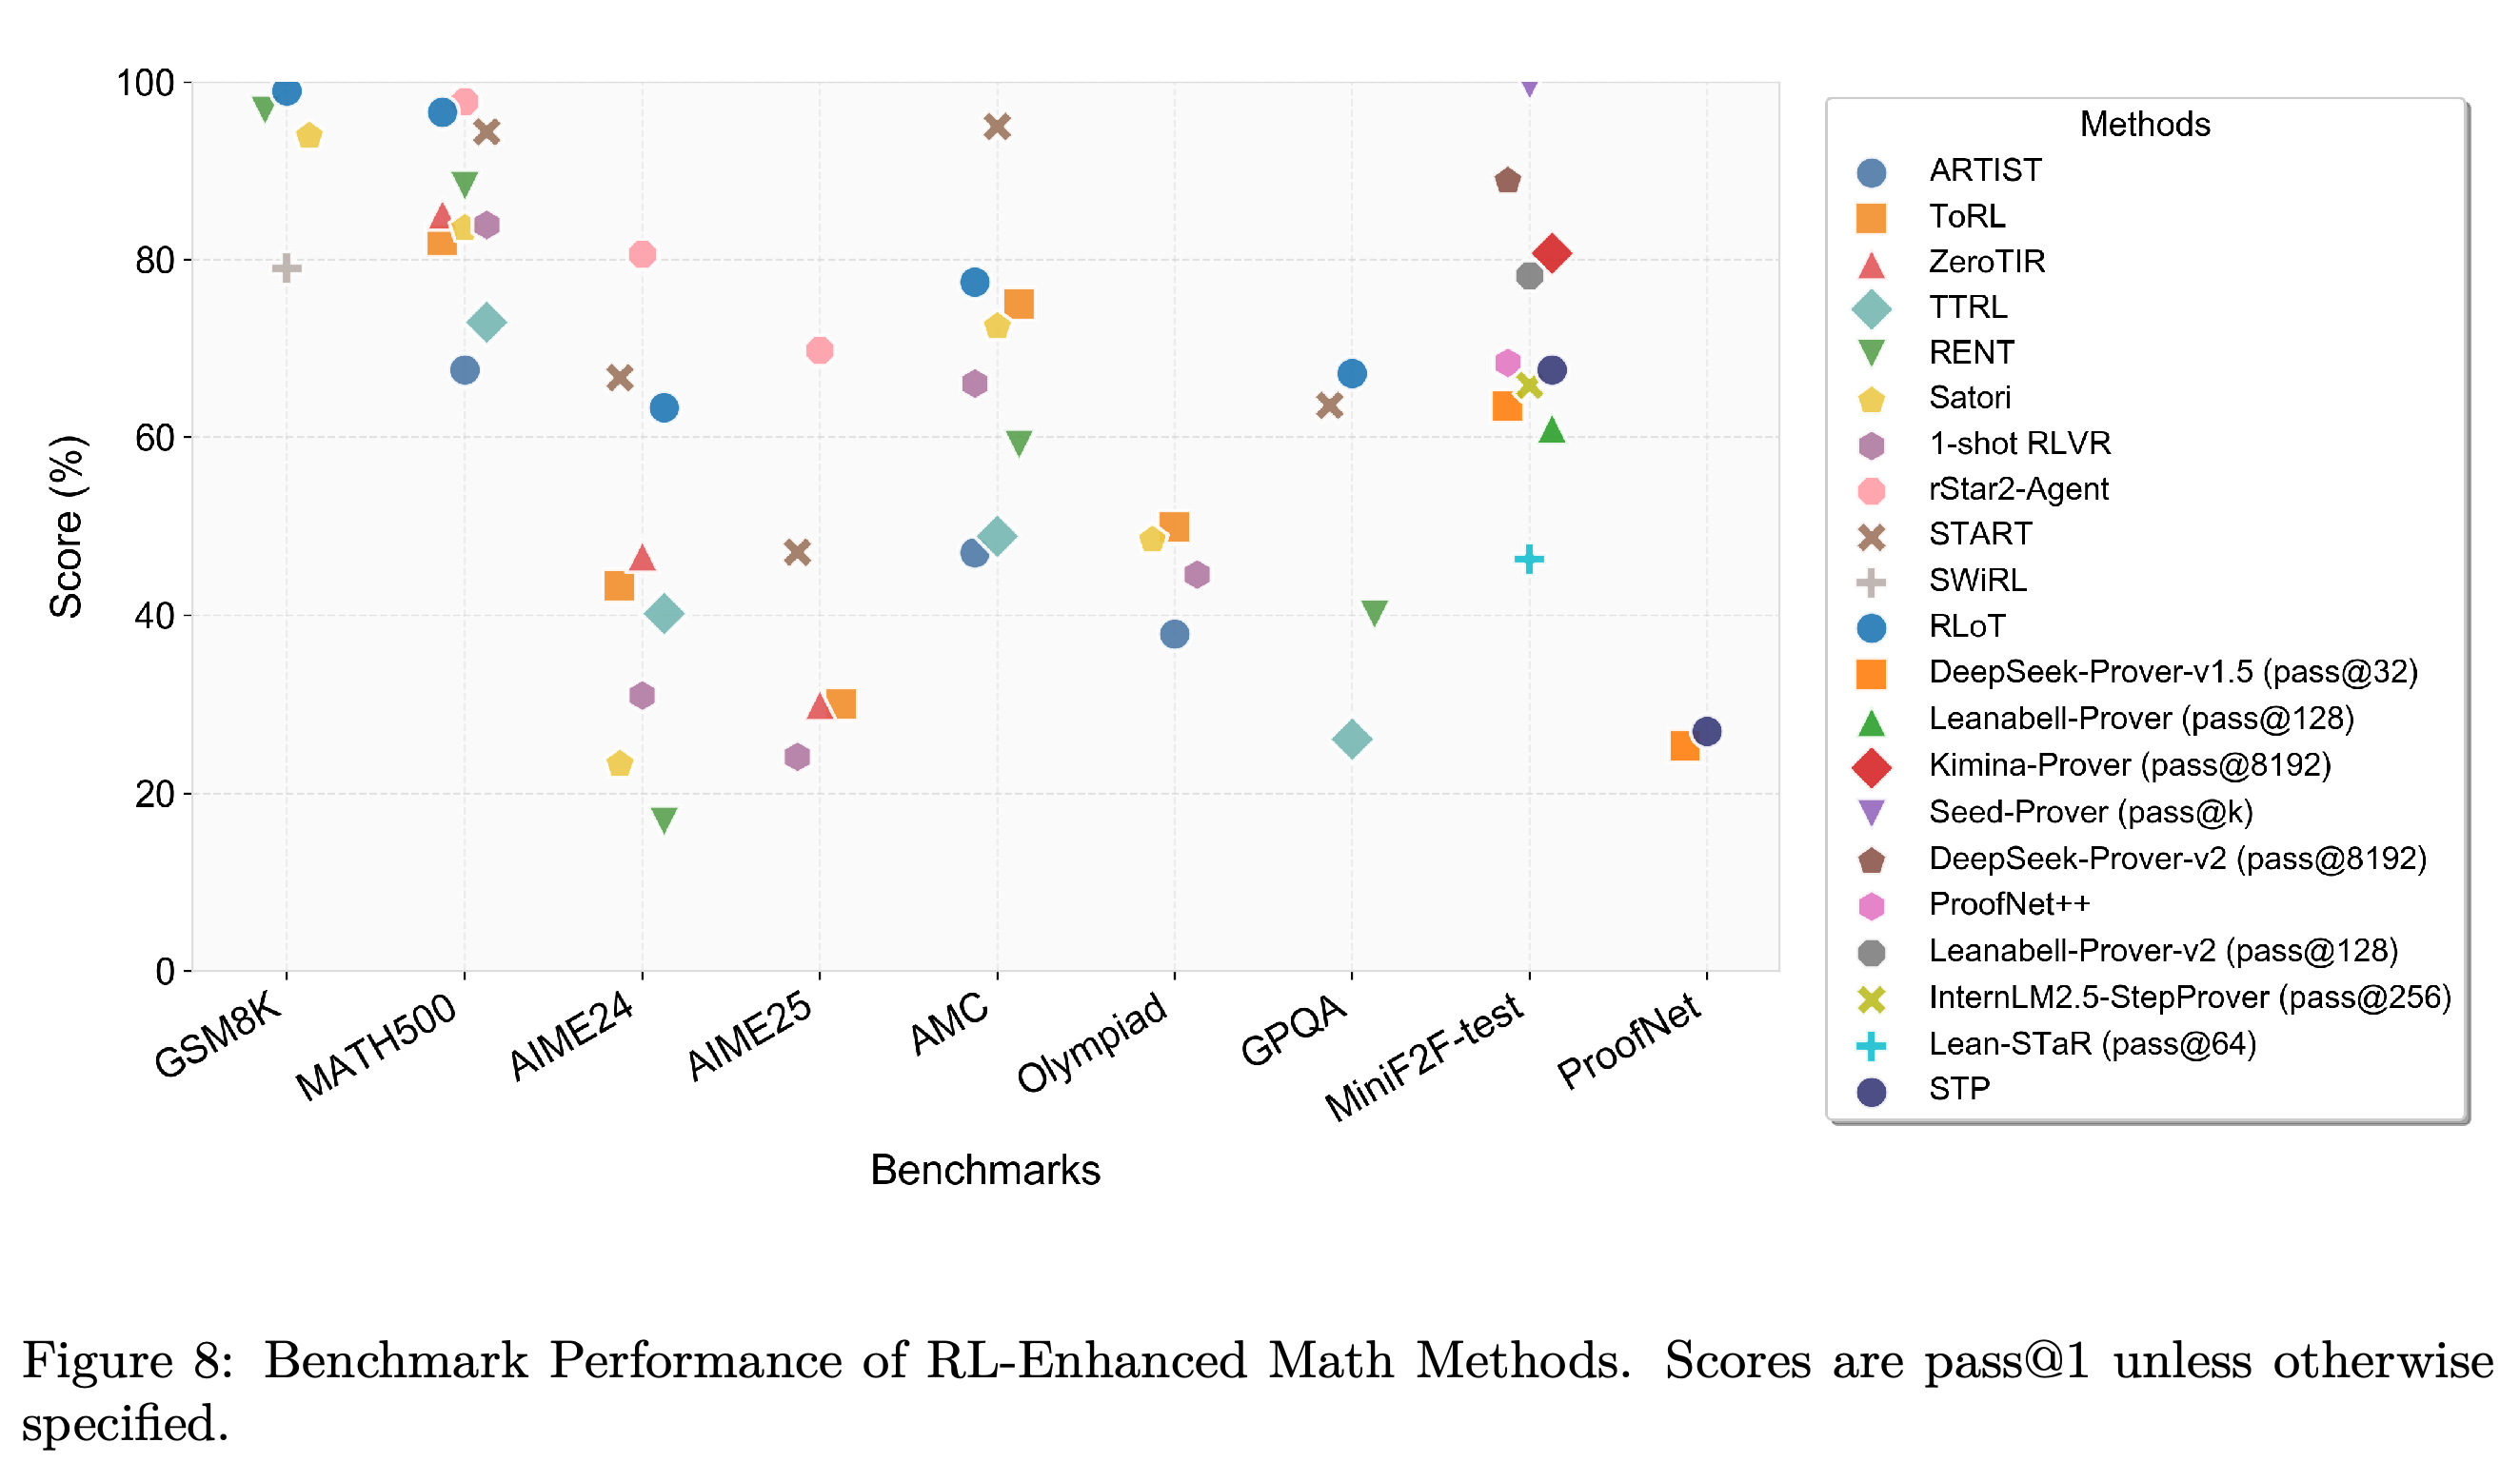
- 논문은 공통 조건의 비교 실험을 수행하지 않고 인용 연구에서 보고한 결과를 모은다. 예를 들어 rStar2-Agent는 RL 학습 510단계 후 수학 벤치마크 AIME24와 AIME25에서 평균 pass@1을 각각 80.6%와 69.8%로 보고한다. pass@1은 후보 1개를 시도했을 때의 성공률이다. 지연된 결과를 앞선 행동에 귀속하는 credit assignment, 보상의 신뢰성, 학습 비용은 여전히 해결되지 않은 문제다. RL이 추론 능력을 확장하는지, 기존의 성공적인 풀이가 나올 확률을 높이는지도 미해결 문제다.
1 Introduction
서론은 통일되지 않은 용어, 개별 역량에 국한된 연구, 일관되지 않은 평가 절차가 에이전트 학습 방법의 비교를 어렵게 한다고 지적한다. Agentic RL은 이용 가능한 정보에서 행동을 선택하는 규칙인 정책을 학습하는 방식으로 정의한다. 이 정책은 계획, 추론, 도구, 메모리, 성찰을 활용하는 순차적 의사결정 루프에서 작동한다.
- 주된 관심사는 동적 환경에서 보상을 통해 LLM 에이전트를 개선하는 것이다. 인간 가치에 대한 정렬만 다루는 연구, LLM을 사용하지 않는 전통적 RL, 정적인 언어 벤치마크에만 국한된 개선은 이 범위에 포함되지 않는다.
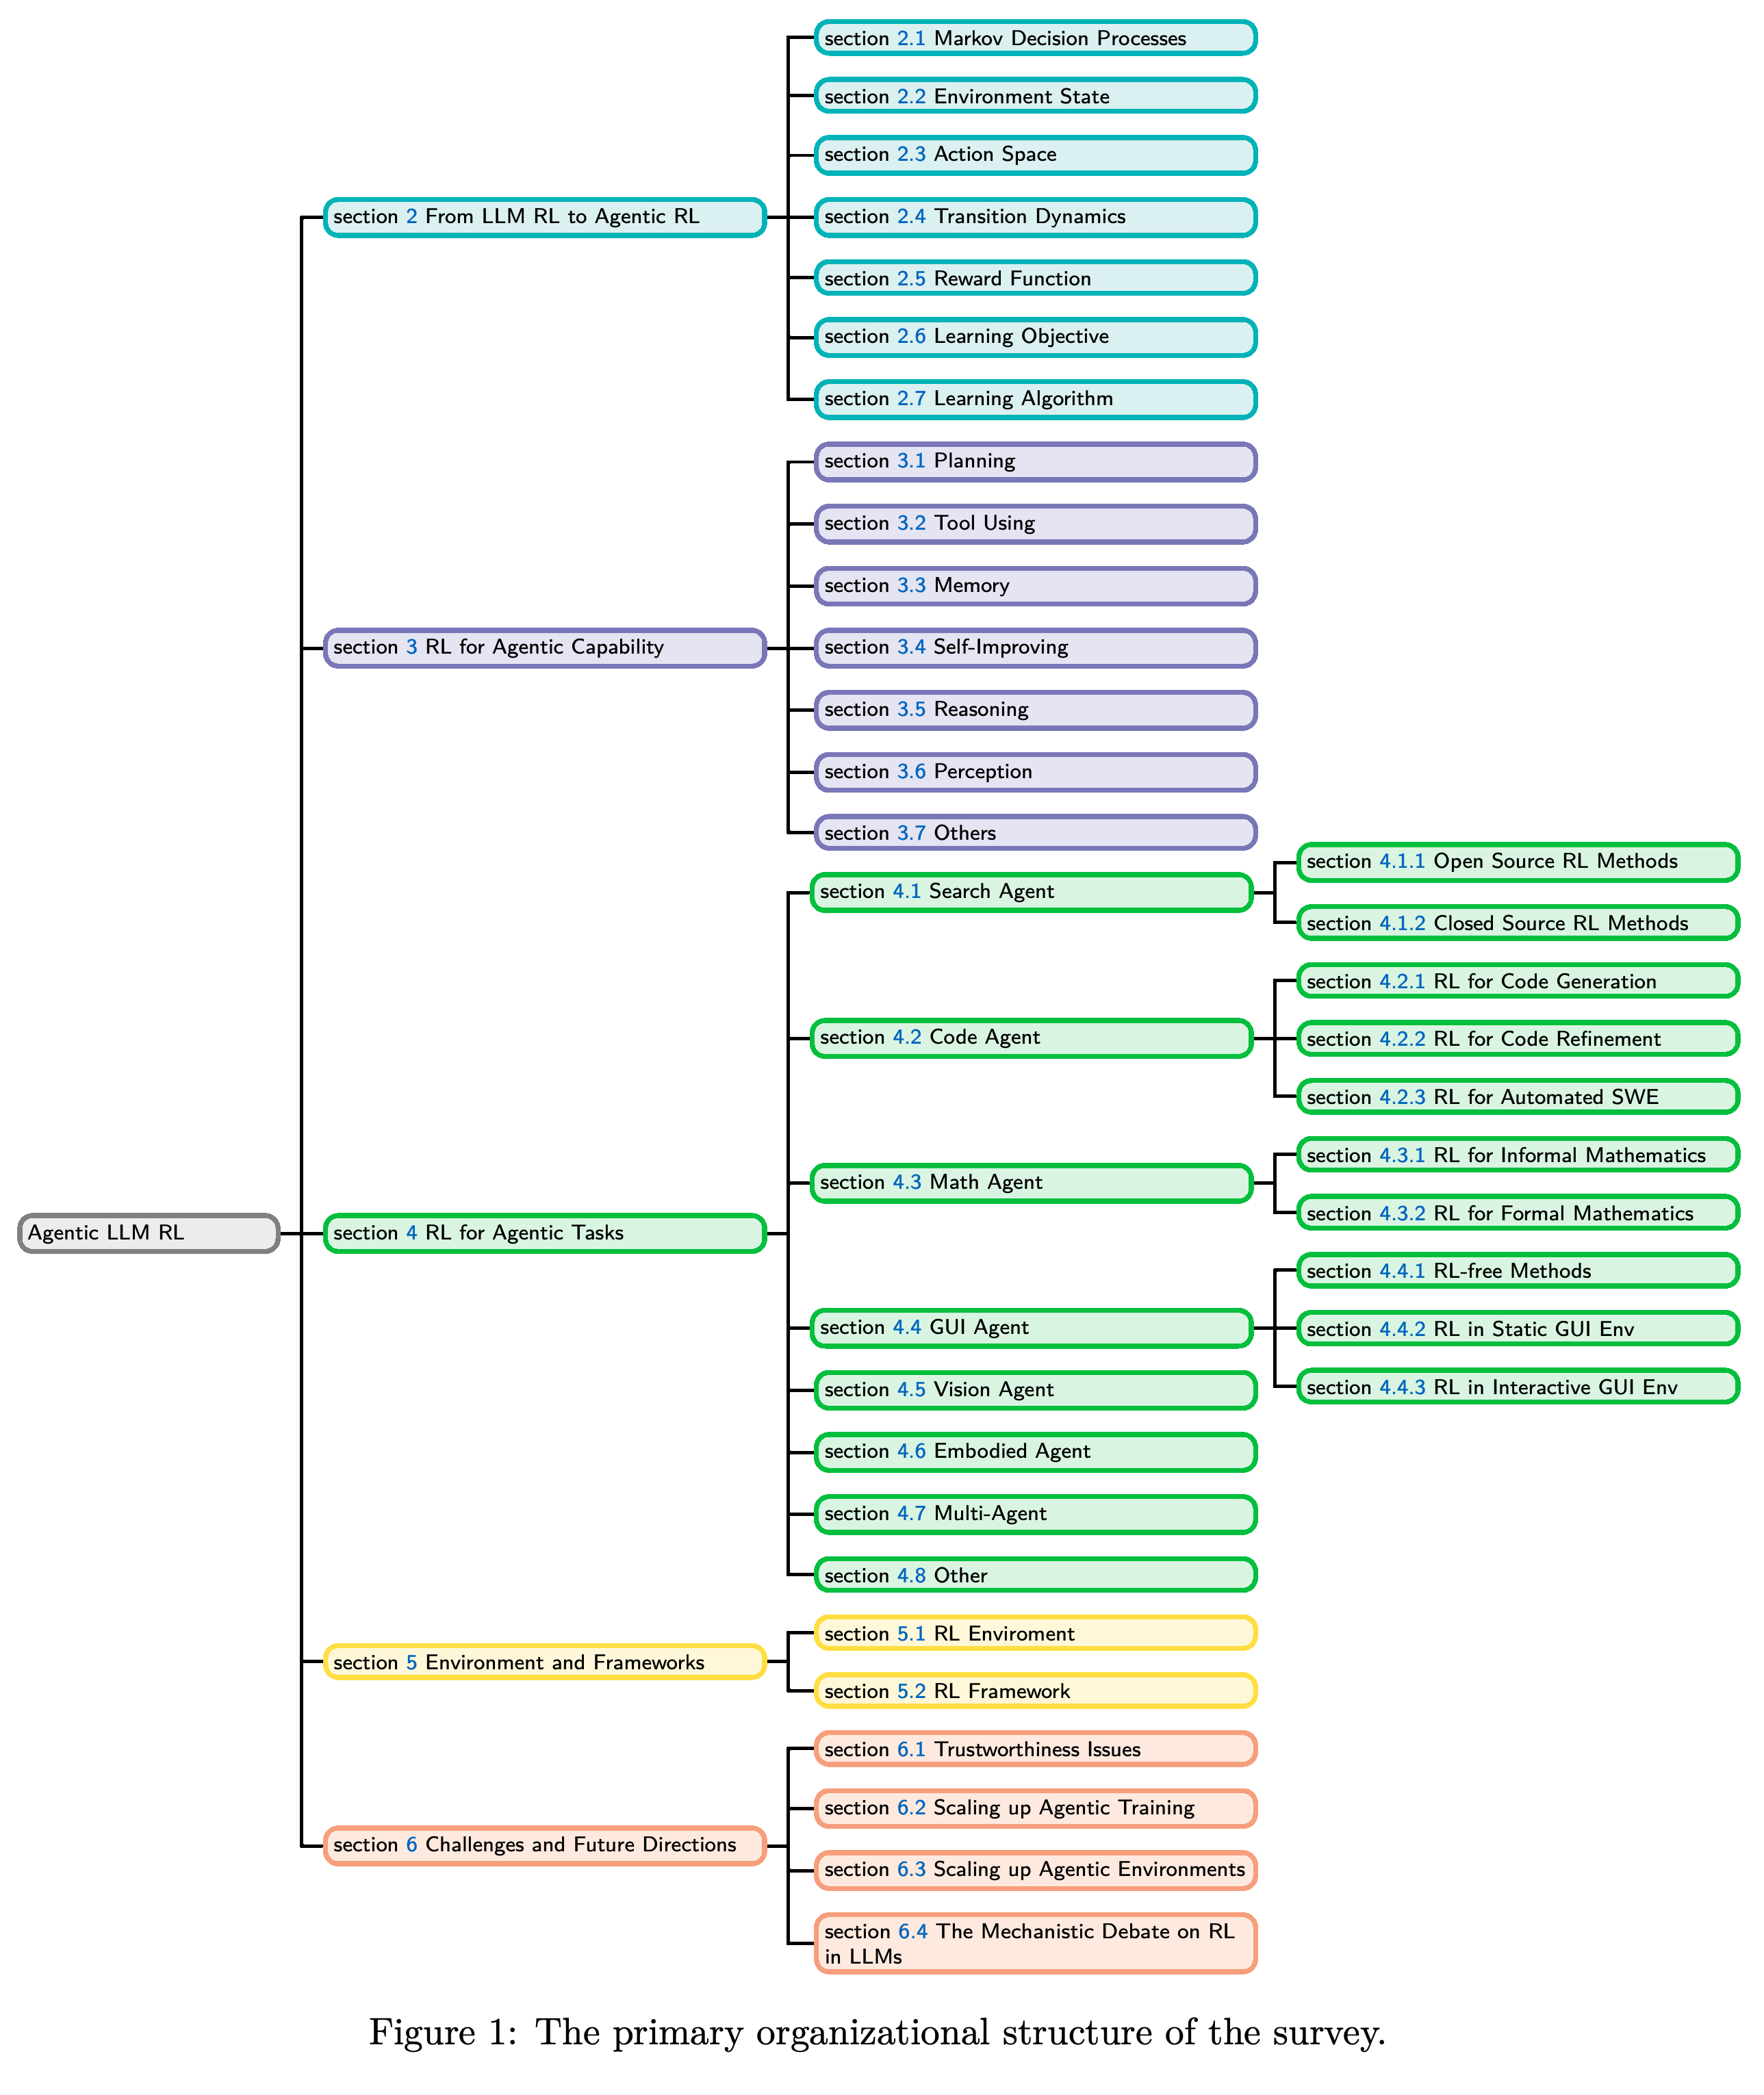
- 서베이는 형식적 기초, 역량과 과제 분류, 실용적인 인프라, 미해결 과제를 연결한다. Figure 1은 전체 구성을 보여준다.
트리는 형식적 기초, 역량 학습, 응용 분야, 인프라, 미해결 과제를 구분한다. 미해결 과제 가지는 6.4절에서 끝나지만 제공된 본문에는 6.5절과 6.6절도 포함된다.
2 Preliminary: From LLM RL to Agentic RL
기초 설명에서는 프롬프트–응답 시범 데이터로 학습하는 supervised fine-tuning(SFT)과 보상으로 모델을 최적화하는 reinforcement fine-tuning(RFT)을 비교한다. 선호 데이터나 선호에서 도출한 보상으로 최적화하는 preference-based RFT(PBRFT)를 기준으로 삼아 상호작용 과제 수행을 설명한다.
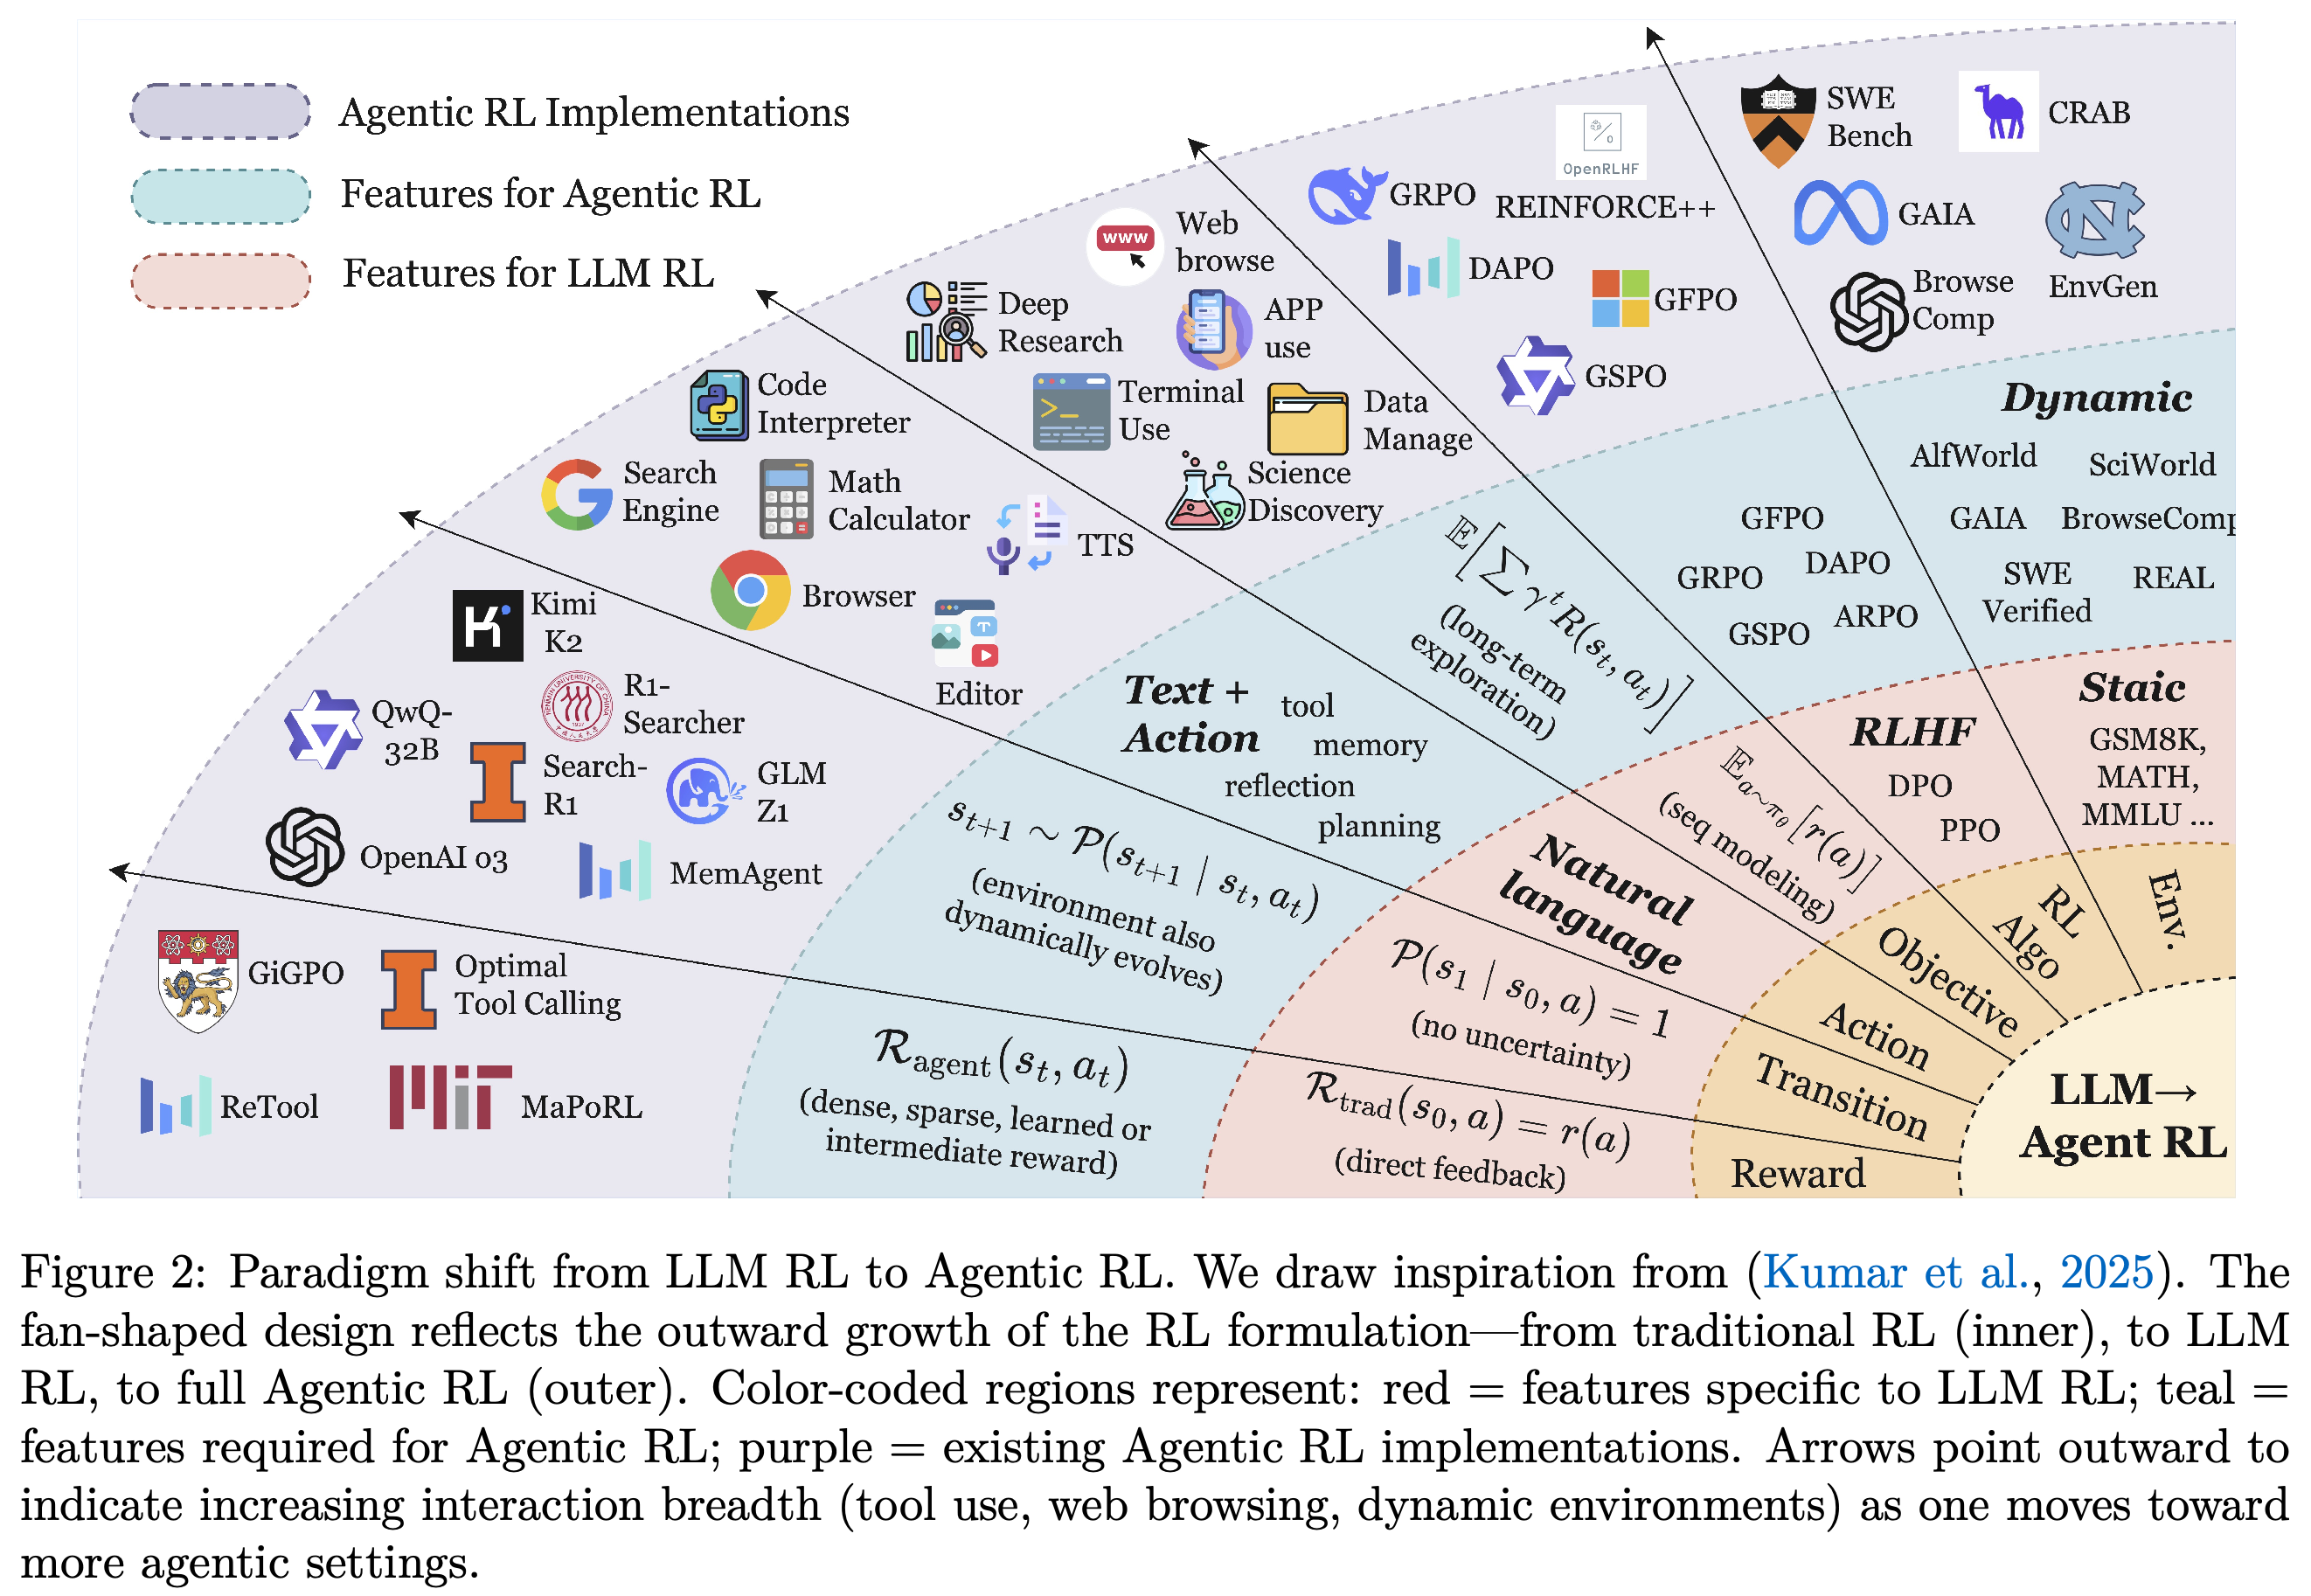
- 상태, 행동, 전이, 보상, 목표, 의사결정 단위를 비교한다. Figure 2는 텍스트 응답에서 도구를 통한 상호작용으로 확장되는 모습을 보여준다.
확장되는 부채꼴은 더 넓은 행동과 환경을 전이, 보상, 목표, 알고리즘의 변화에 연결한다. 바깥쪽 구현 예시는 분류 체계를 설명하며 비교 성능 측정치는 제공하지 않는다.
2.1 Markov Decision Processes
상태, 행동, 전이, 보상을 모델링하는 Markov decision process(MDP)가 공통의 형식적 개념을 제공한다. 논문은 PBRFT를 \(T=1\)이고 \(\gamma=1\)인 퇴화된 MDP로 모델링한다. T는 과제의 시간 범위이며 γ는 지연된 보상에 부여하는 가중치다. Agentic RL에는 관측이 실제 세계 상태의 일부만 드러내는 partially observable Markov decision process(POMDP)를 사용한다.
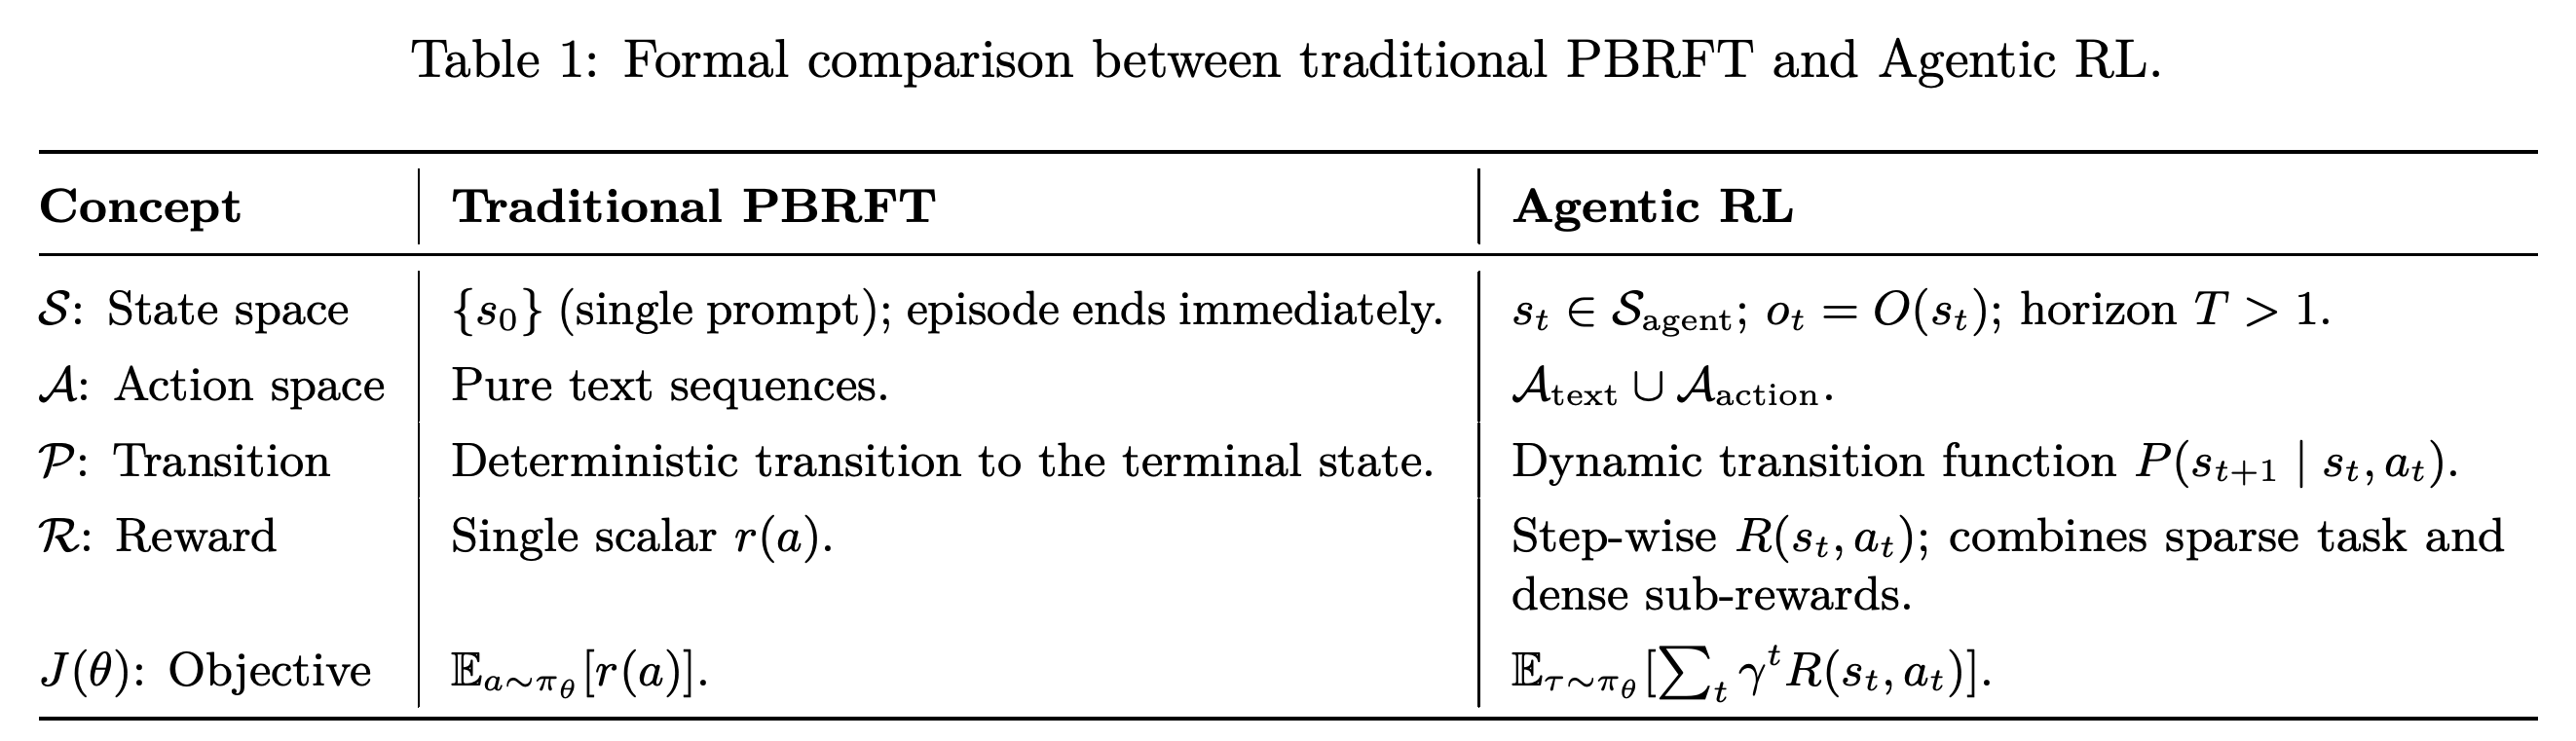
- Table 1은 단일 프롬프트와 최종 응답을 여러 상태, 텍스트와 외부 행동, 동적 전이, 누적 보상과 비교한다. 이 추상화가 서베이의 구성 기준이 된다.
각 행은 프롬프트 1개, 텍스트만 출력하는 행동, 종료 전이, 보상 1개를 여러 상태, 외부 행동, 누적 보상과 비교한다. 이 형식적 추상화는 서베이 전반에서 사용하는 기준을 제공한다.
2.2 Environment State
PBRFT는 정적인 프롬프트 1개에서 시작하고 모델이 응답을 출력하면 끝난다. Agentic RL에서는 에이전트가 여러 시간 단계에 걸쳐 관측 \(o_t=O(s_t)\)를 사용해 행동한다. O는 세계 상태 s_t를 시간 t의 관측으로 변환한다. 도구 결과, 사용자 메시지, 환경 피드백이 이후 결정에 반영된다.
2.3 Action Space
행동 공간은 언어 생성과 환경에 대한 상호작용 행동을 결합한다. A_agent = A_text ∪ A_action은 텍스트 출력과 외부 행동의 합집합이다. 외부 행동은 정보를 얻거나 상태를 변경할 수 있으며 기본 행동의 시퀀스로 구성될 수도 있다.
- 논문은 <action_start>와 <action_end>, call(“search”, “Einstein”), move(“north”)로 구조화된 행동을 예시한다. 이 예시는 정식화를 설명하며 조사한 모든 시스템에 동일한 인터페이스를 요구하지는 않는다.
2.4 Transition Dynamics
기준 정식화에서는 응답 1개를 생성한 뒤 종료 상태로 결정적으로 전이한다. Agentic RL은 변화하는 상태를 s_{t+1} ∼ P(s_{t+1} | s_t, a_t)로 모델링한다. 이는 현재 상태와 행동을 조건으로 하는 전이 분포에서 다음 상태를 뽑는다는 뜻이며 반복적인 의사소통, 정보 획득, 환경 조작을 지원한다.
2.5 Reward Function
PBRFT는 중간 피드백 없이 완성된 응답에 스칼라 점수를 부여한다. 에이전트 정식화에서는 완료 보상이나 단계별 진척 보상을 부여하고 그 외에는 0을 부여할 수 있다. 단위 테스트와 기호적 검증 등이 보상 신호를 제공한다.
- 결과 보상은 최종 성공을 평가하고 과정 보상은 중간 단계를 평가한다. 과정 보상은 credit assignment에 더 직접적인 신호를 제공하지만 유용성은 평가기나 규칙에 달려 있다.
2.6 Learning Objective
기준 방법은 응답 보상의 기댓값을 최대화한다. Agentic RL은 J_agent(θ) = E_{τ∼π_θ}[Σ_{t=0}^{T−1} γ^t R_agent(s_t,a_t)]를 최대화하며 제시된 정식화에서는 0 < γ < 1이다. 이는 매개변수 θ를 가진 정책 π_θ에서 샘플링한 상호작용 시퀀스인 궤적 τ에 걸친 할인 보상의 기댓값이다.
- 정책 경사 방법은 보상 추정치로 행동 확률을 갱신하고 가치 기반 방법은 미래 보상의 추정치를 학습한다. 서베이는 이 방법들을 탐색과 장기적인 credit assignment에 연결한다.
2.7 RL Algorithms
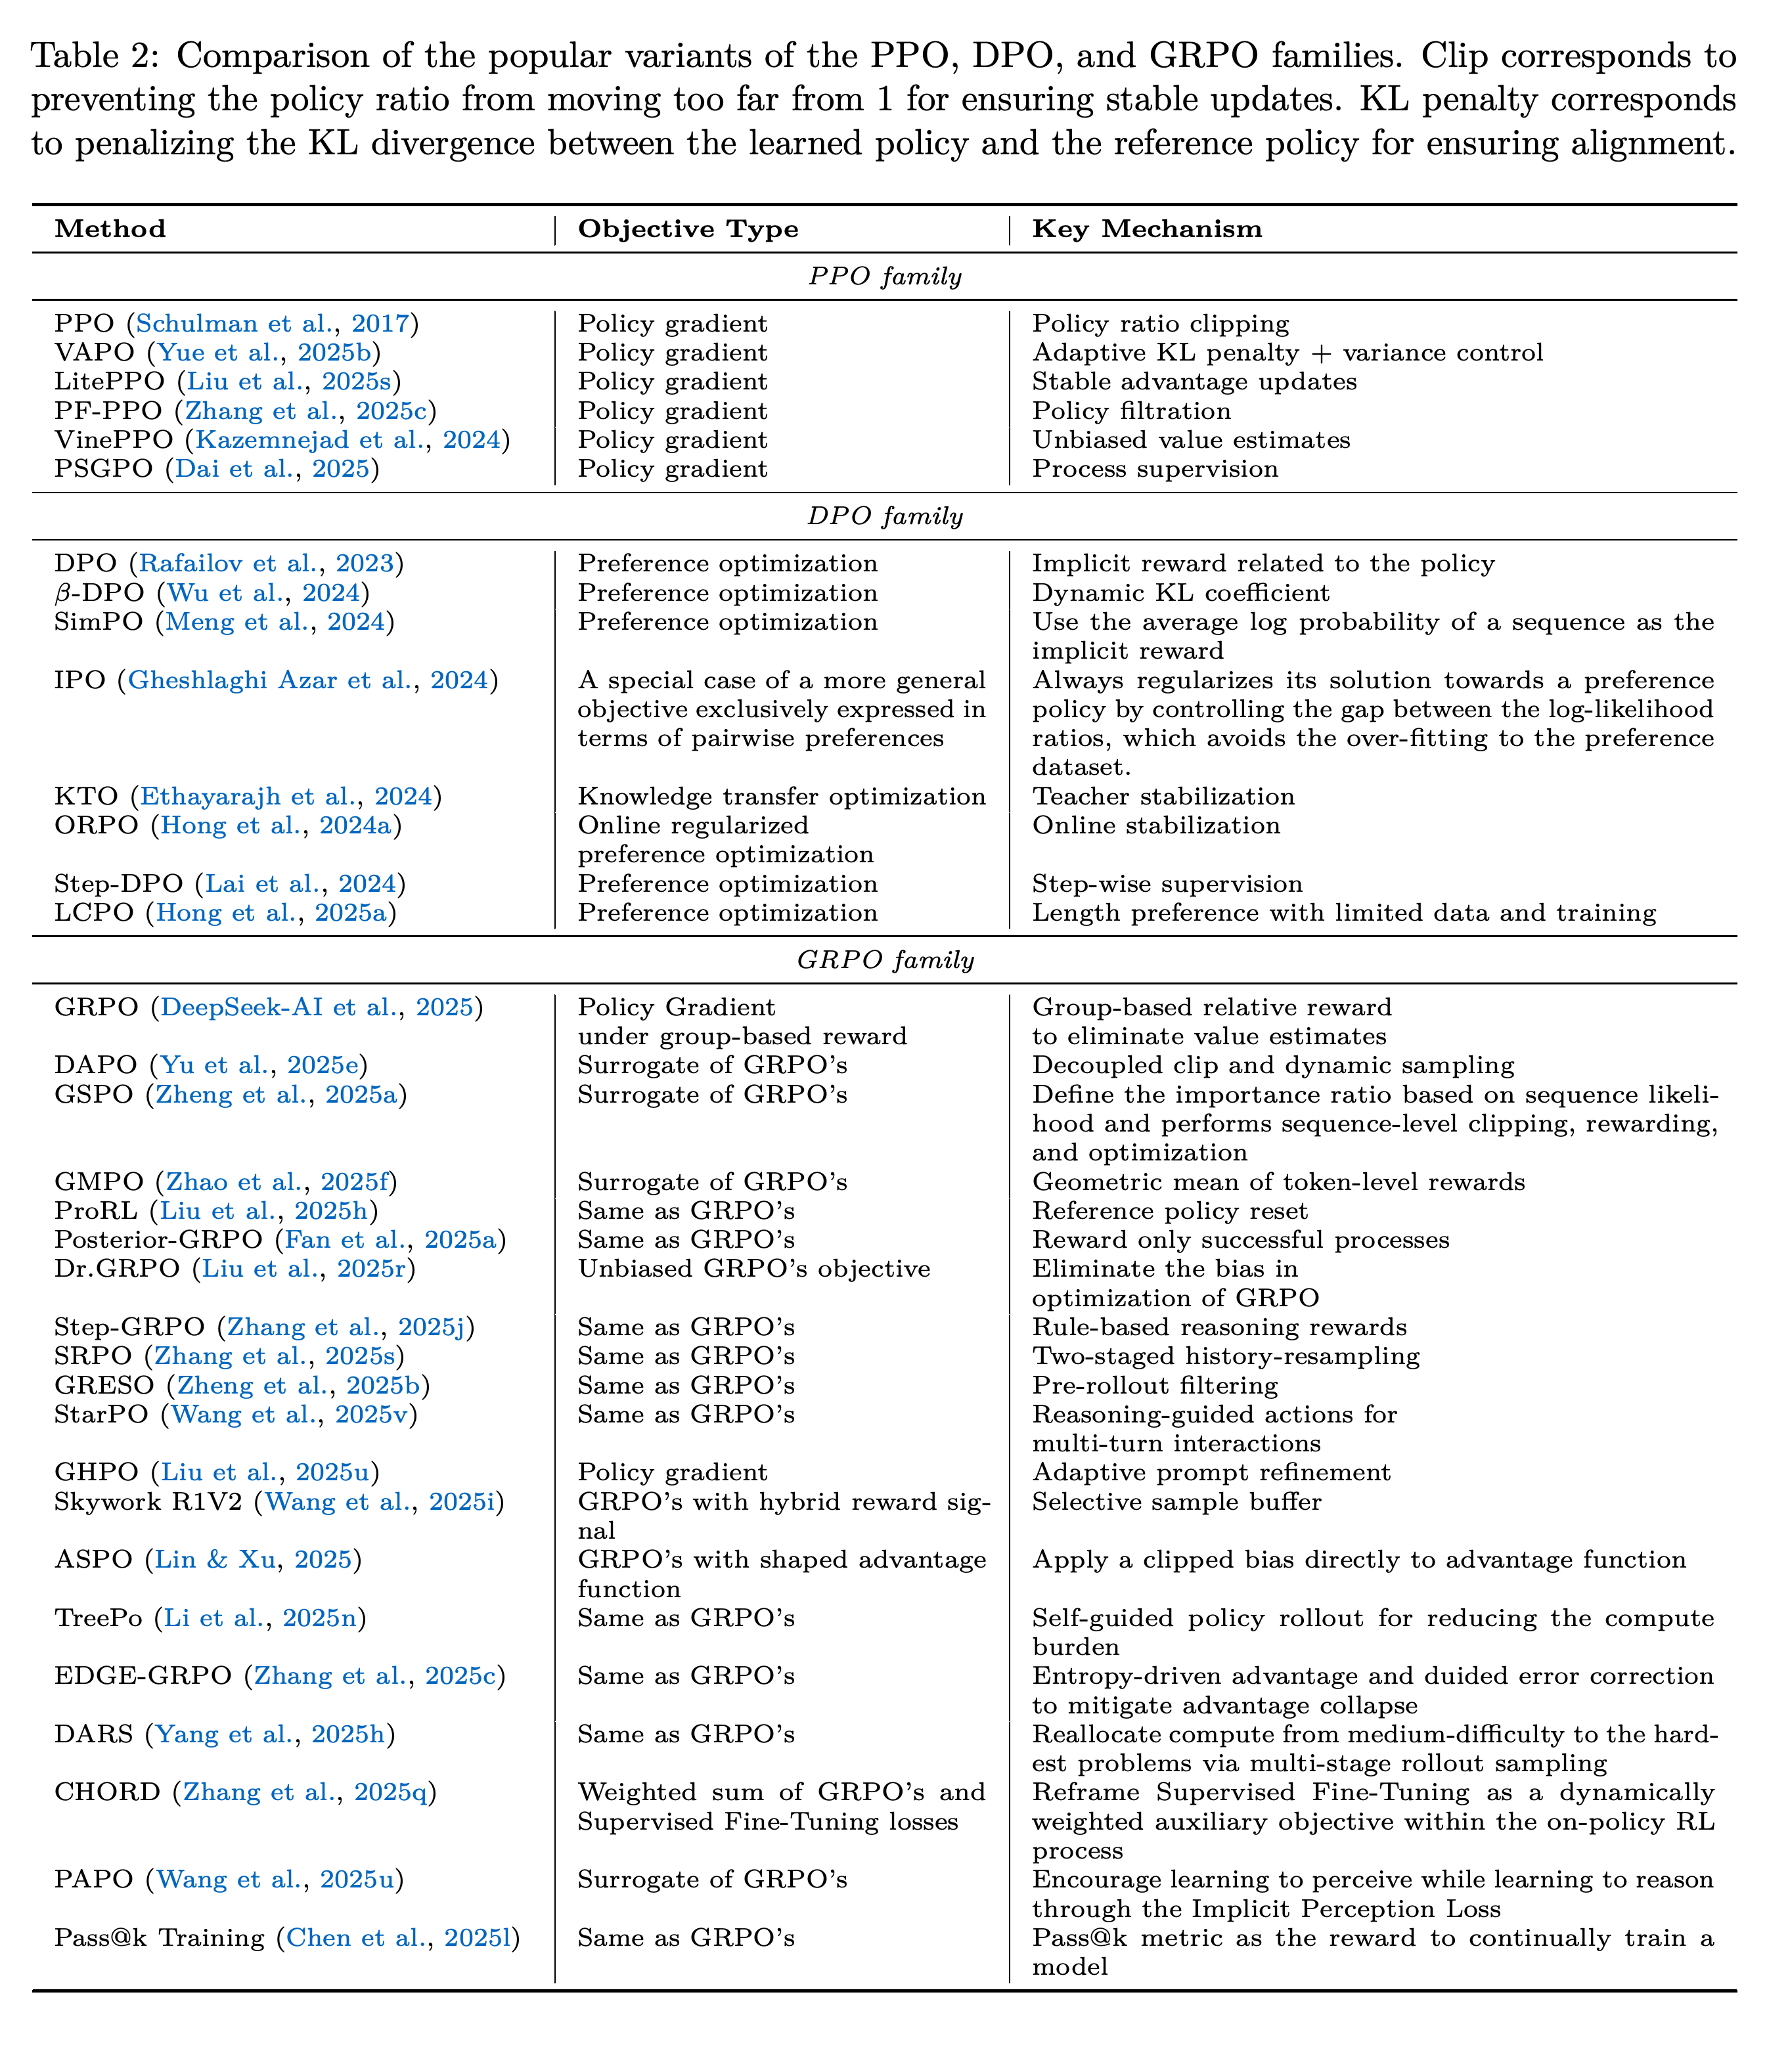
알고리즘 검토는 샘플 기반 정책 경사 추정기인 REINFORCE, 갱신 전후 행동 확률의 비율을 클리핑하는 Proximal Policy Optimization(PPO), 별도의 명시적 보상 모델 없이 선호 응답과 비선호 응답으로 학습하는 Direct Preference Optimization(DPO), 샘플링한 출력 그룹 내 상대 보상으로 행동의 질을 추정하는 Group Relative Policy Optimization(GRPO)을 다룬다. Table 2는 목표와 메커니즘에 따라 변형들을 정리한다.
- REINFORCE는 추정량의 분산이 높고 샘플 효율에 한계가 있다. PPO는 갱신을 제한하지만 일반적으로 기대 보상을 추정하는 모델인 critic의 비용이 발생한다.
- DPO는 선호 데이터의 품질과 포괄성에 의존한다. GRPO는 절대 가치를 추정하는 critic을 제거하지만 기준 대비 행동의 질을 나타내는 그룹 상대 advantage 추정치에는 잡음이나 부정확성이 있을 수 있다.
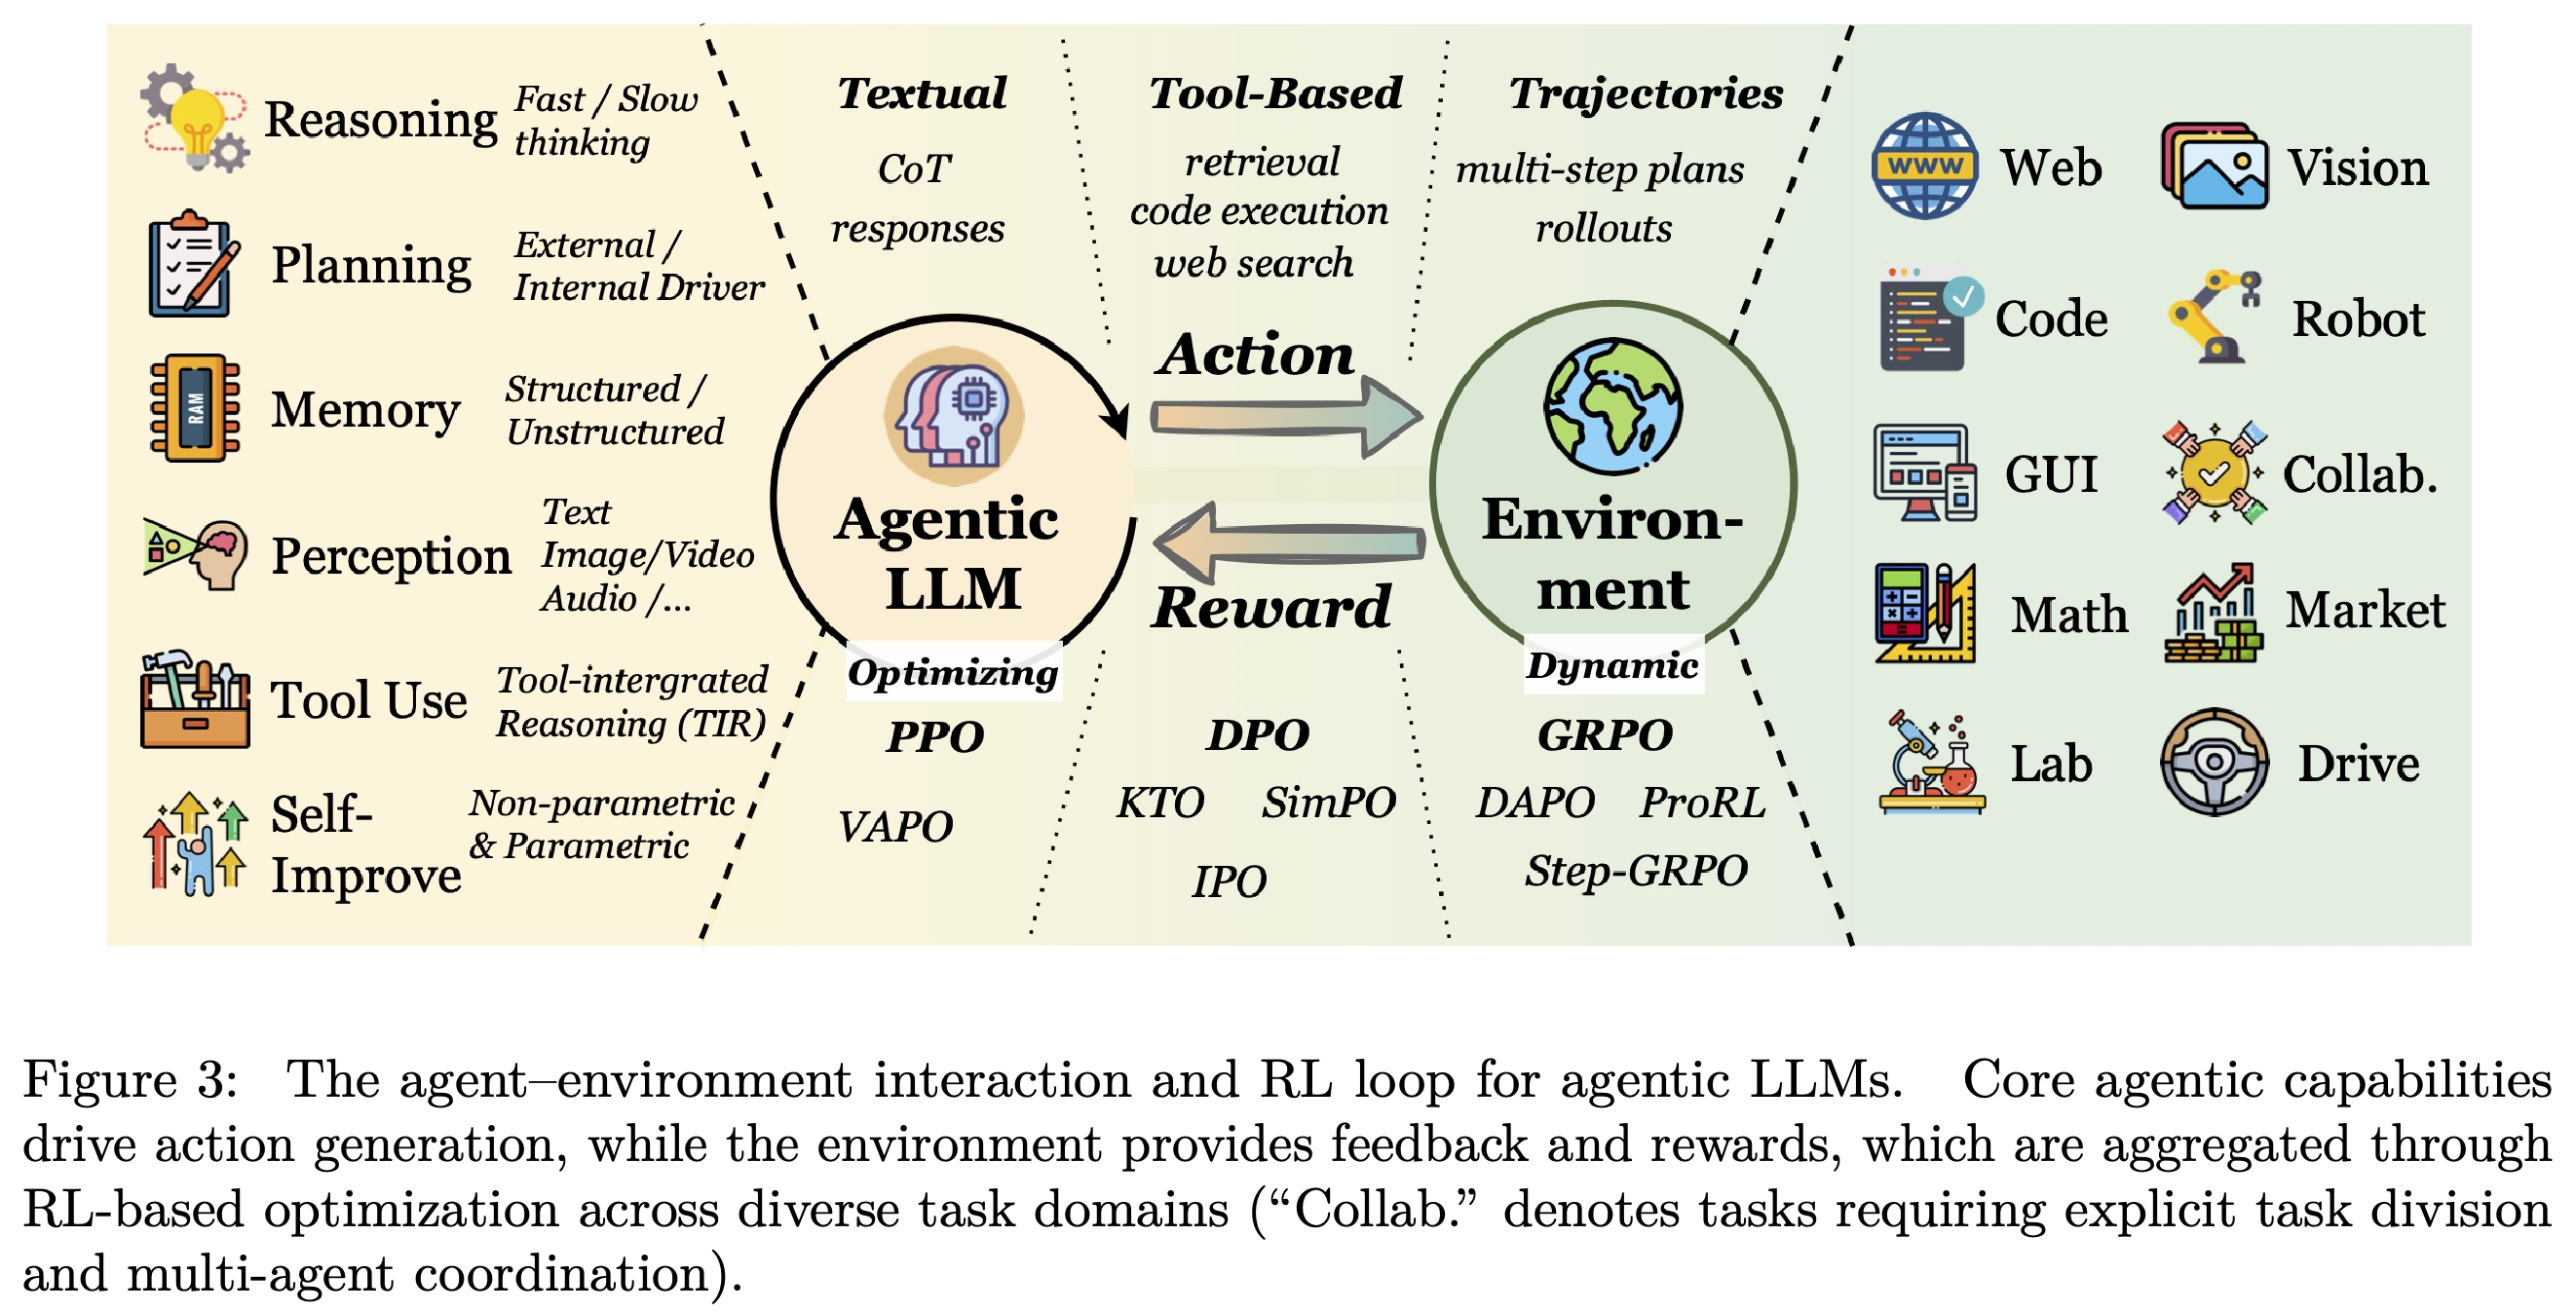
- Figure 3은 최적화 방법을 에이전트 행동과 환경 보상에 연결한다. 서베이는 4개 알고리즘의 순위를 매기는 공통 실험을 제공하지 않는다.
행동과 보상 루프는 역량 모듈을 텍스트 응답, 도구 연산, 여러 과제 분야의 다단계 궤적과 연결한다. 루프 아래의 알고리즘 이름은 최적화 선택지를 보여주며, 상대적인 적합성을 측정하지는 않는다.
목록은 PPO, DPO, GRPO 계열을 목표와 클리핑, 과정 지도, 샘플링, advantage 추정 같은 메커니즘에 따라 구분한다. 속도, 샘플 효율, 정확도를 공통 조건에서 측정한 결과는 제공하지 않는다.
3 Agentic RL: The model capability perspective
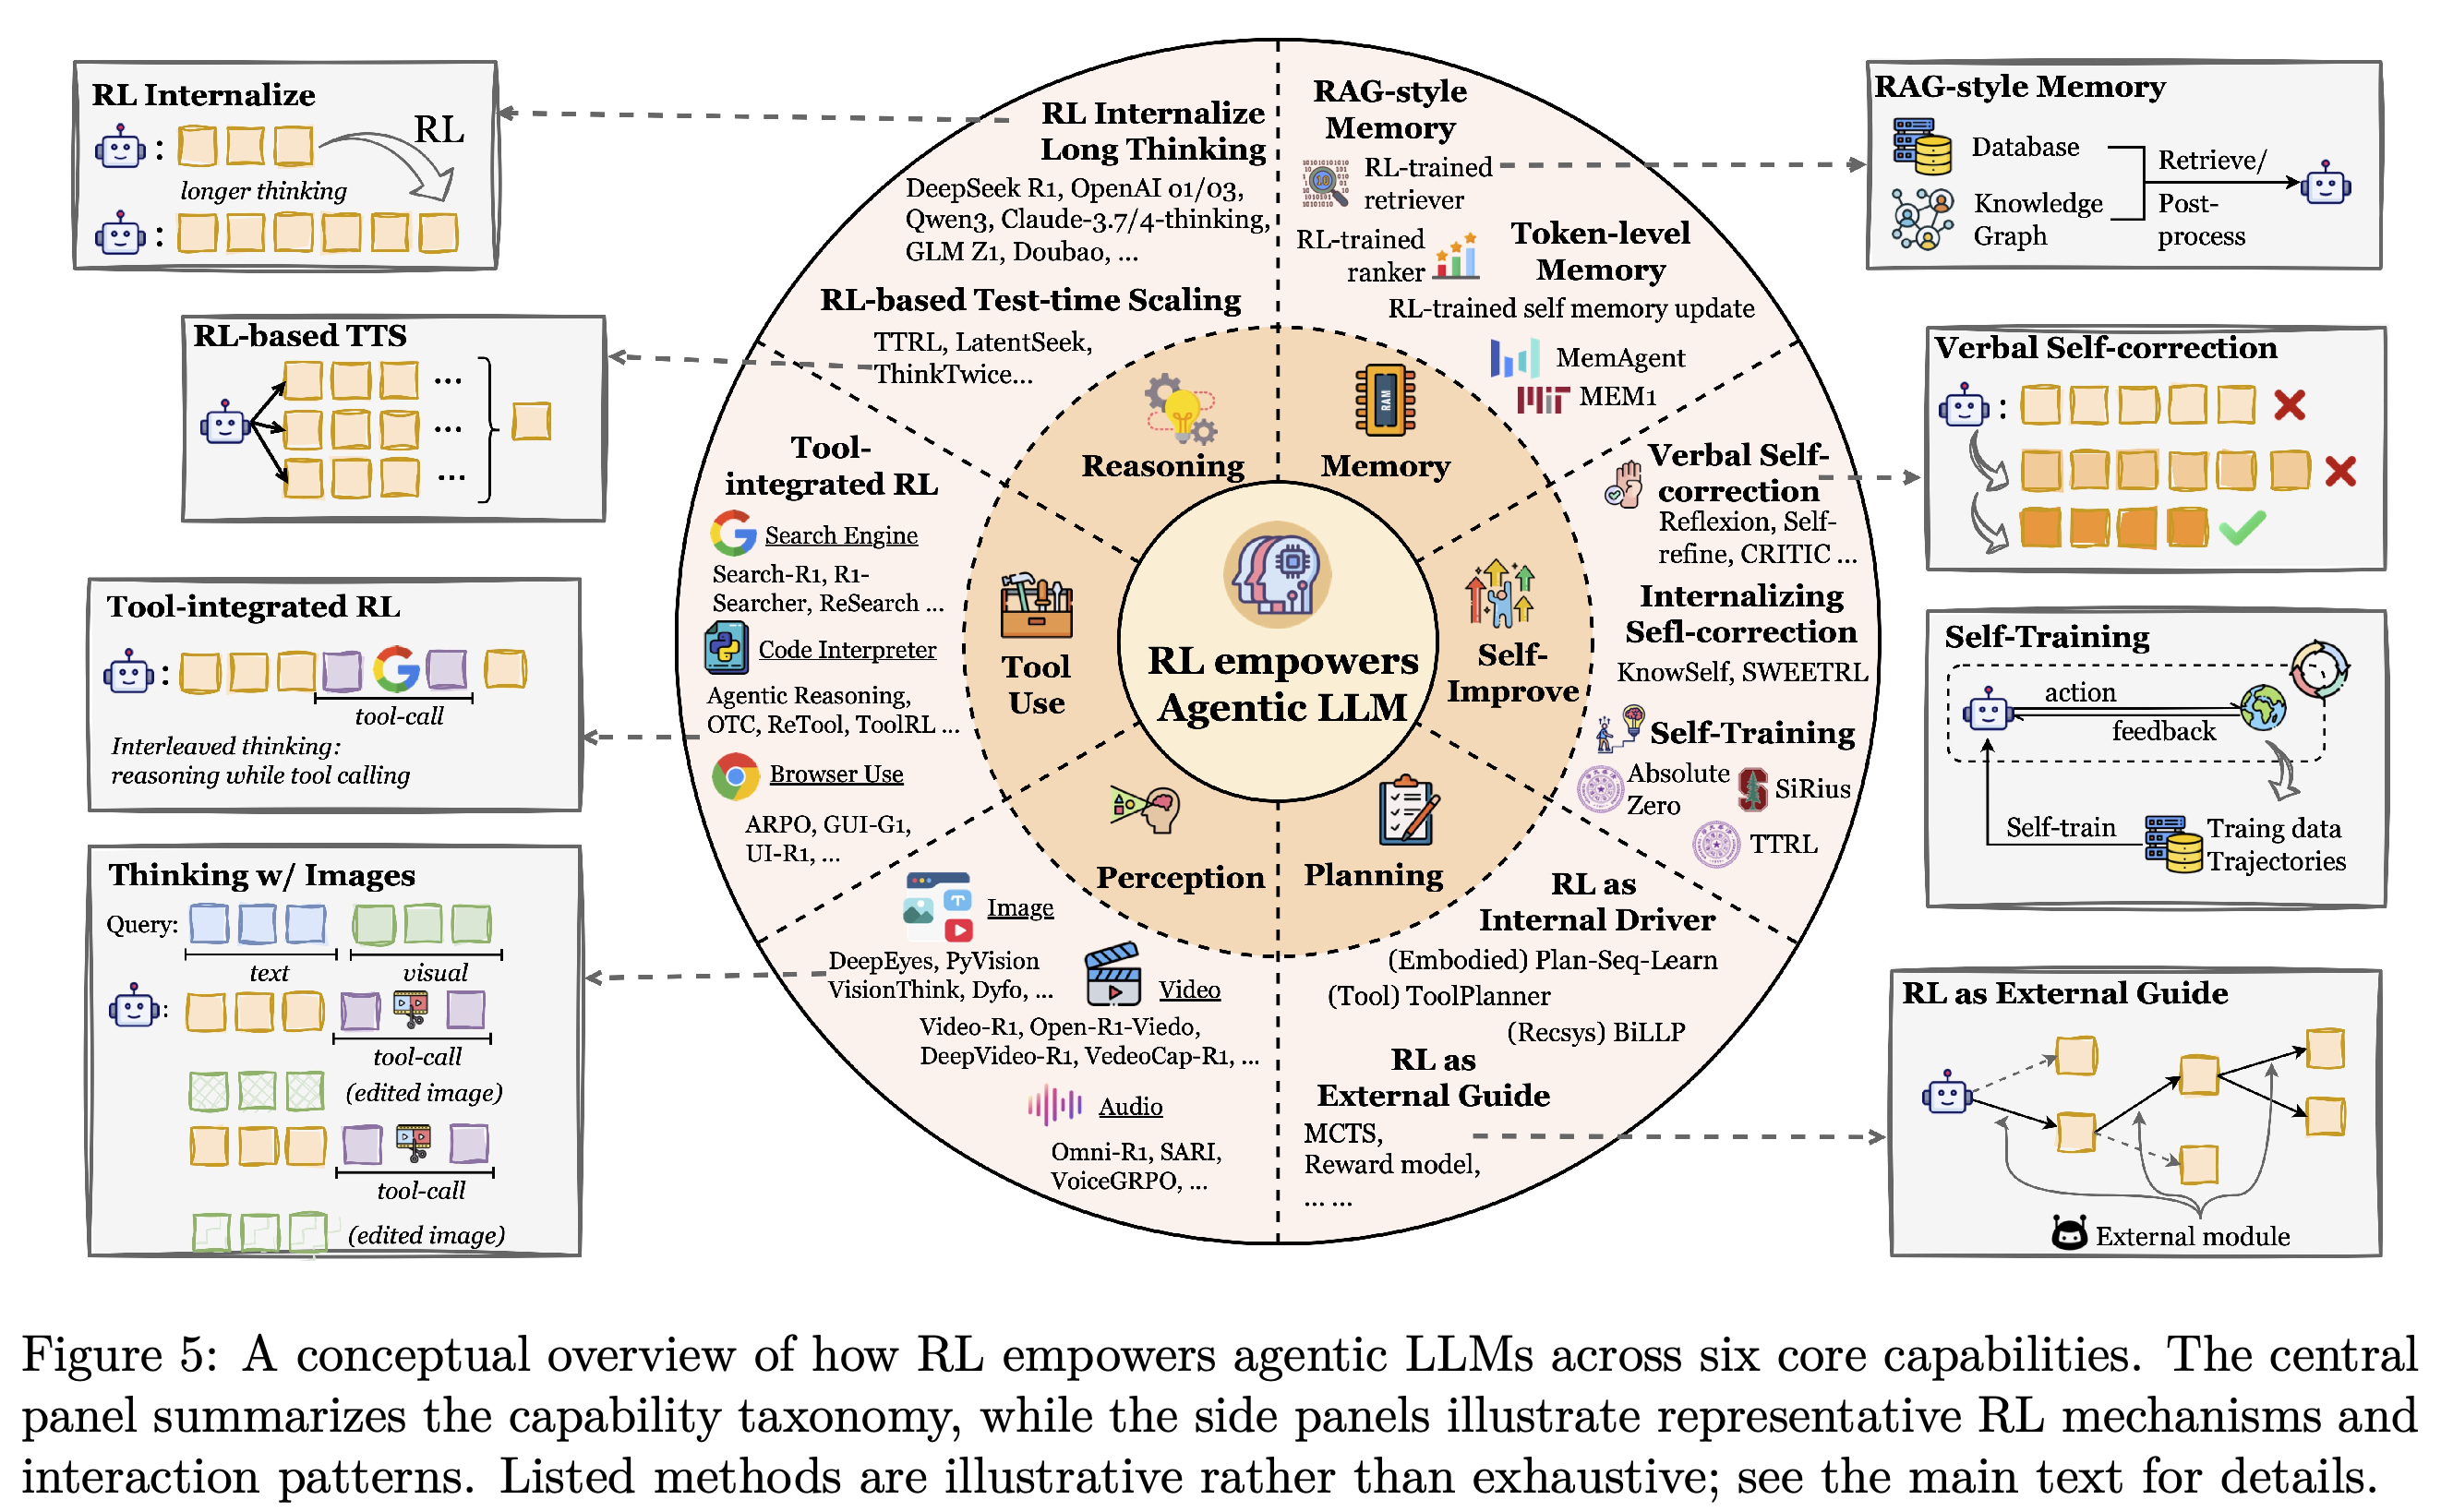
역량 분류에서는 계획, 도구 사용, 메모리, 자기 개선, 추론, 지각을 서로 의존하는 구성 요소로 보고, 피드백으로 각 요소의 행동을 최적화할 수 있다고 설명한다. Figure 5는 이 구성 요소들을 대표적인 학습 메커니즘과 상호작용 방식에 연결한다.
3.1 Planning
계획은 목표를 달성할 행동 시퀀스를 선택하는 과정이다. 논문은 RL을 외부에서 계획을 안내하는 데 사용하는 방식과 내부 계획 정책을 학습하는 데 사용하는 방식으로 구분한다. 외부 안내 방식은 제안된 계획을 평가하는 보조 가치 함수나 휴리스틱 함수를 학습하며 분기하는 행동 시퀀스를 샘플링하고 평가하는 Monte Carlo Tree Search(MCTS)를 지원하는 경우가 많다. 내부 최적화 방식은 상호작용을 통해 계획 생성 행동을 학습한다.
- 서베이는 RAP와 LATS를 외부 안내 범주에 배치한다. 내부 계획에서는 성공 궤적과 실패 궤적으로 선호를 학습하는 ETO와 행동 시퀀스를 평가하기 위해 도구 사용 보상을 활용하는 RLTR을 다룬다.
- Learning When to Plan은 숙고 비용을 다룬다. Planner-R1은 과정 수준의 보상 설계로 학습 효율을 개선하고 작은 모델로도 경쟁력 있는 계획을 수행한 사례로 인용된다.
- 2가지 접근을 통합하는 방향으로 탐색 깊이, 분기, 숙고를 제어하는 정책을 제안한다.
3.2 Tool Using
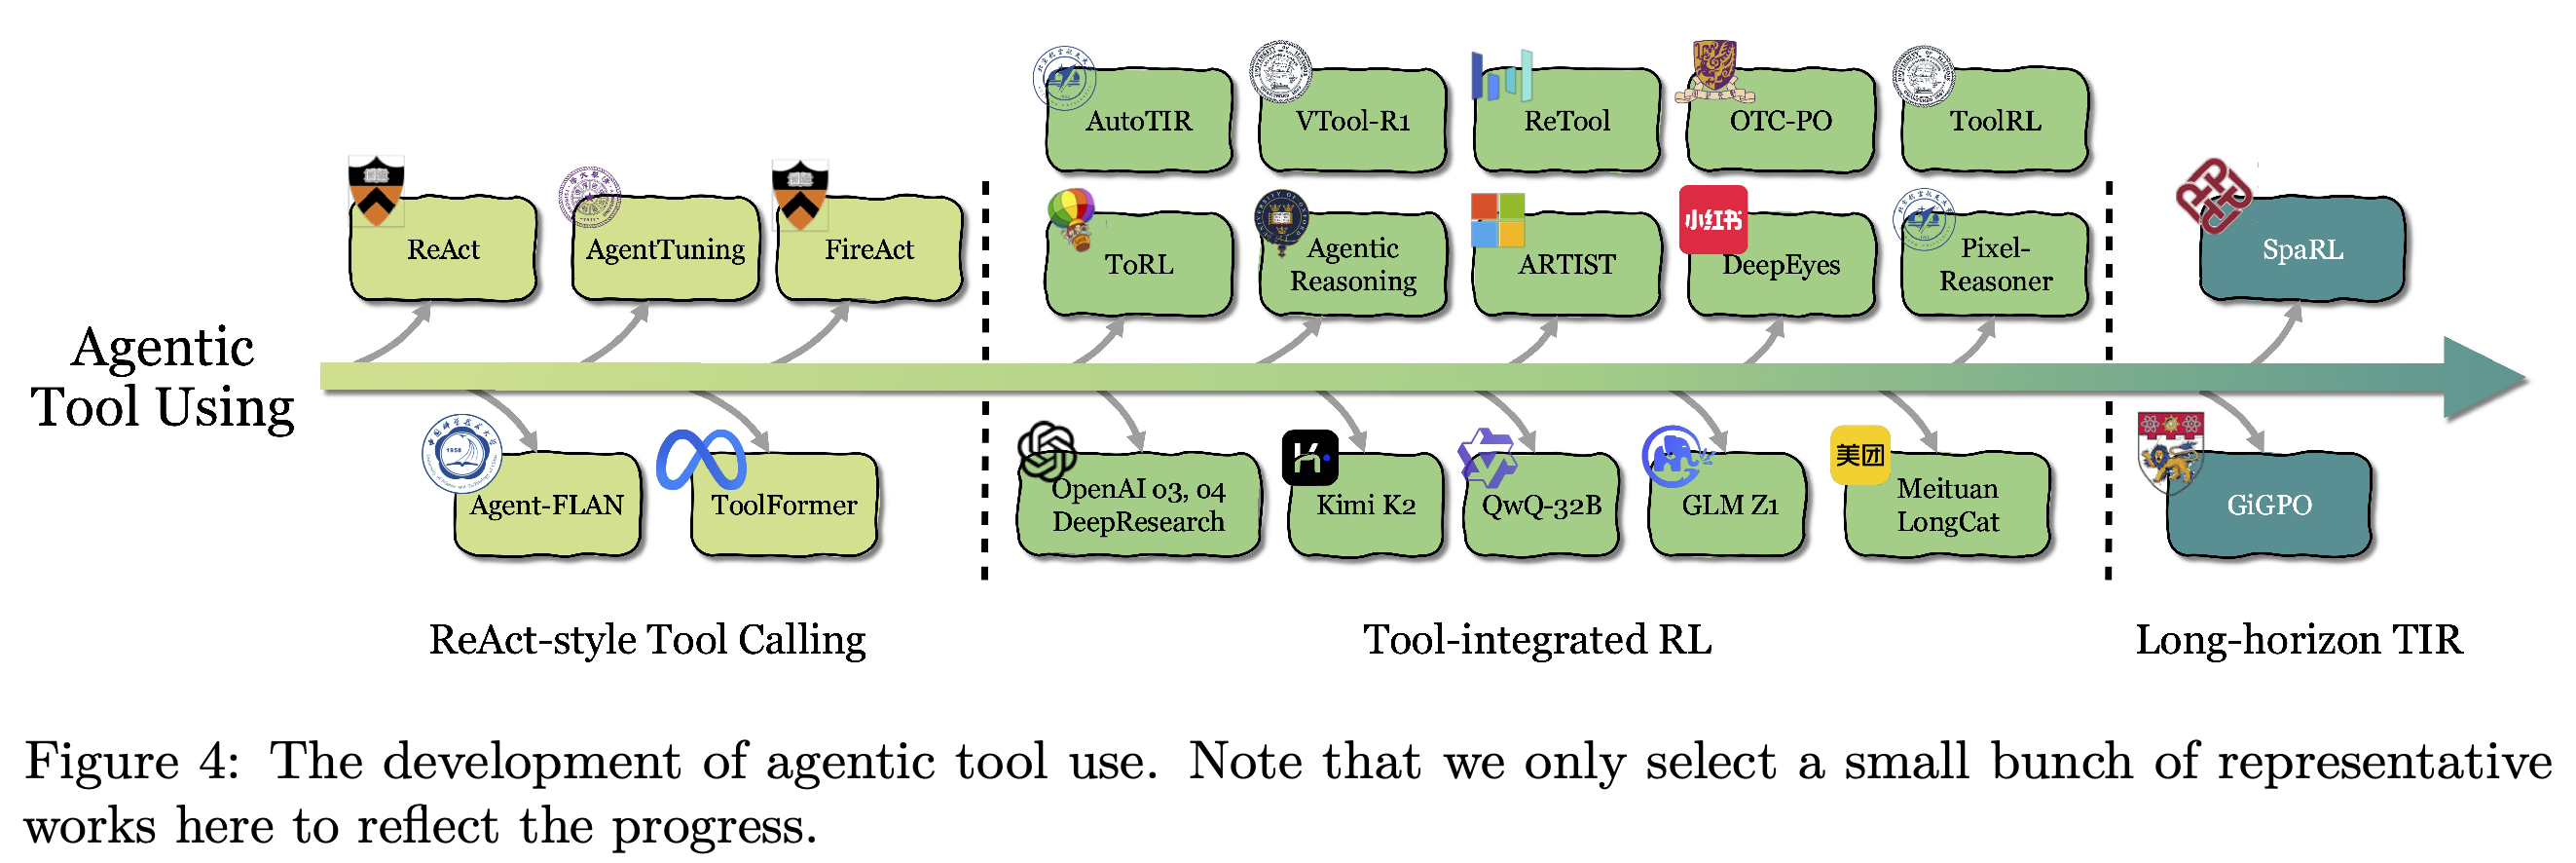
도구 사용은 Thought-Action-Observation 프롬프팅 사이클인 ReAct에서 시범 기반 학습을 거쳐 Tool-Integrated Reasoning(TIR)으로 발전한다. TIR은 자연어 추론과 코드 실행, 이미지 편집 등의 연산을 번갈아 수행한다. ToolRL, ReTool, ToRL 등의 방법은 과제 피드백으로 어떤 도구를 언제 호출할지 최적화한다.
- Figure 4는 대표적인 발전 단계를 보여주며, 모든 연구를 망라한 연대기는 아니다. ToolRL은 모방 궤적 없이 기본 모델에서 도구 사용 행동을 학습하는 방법으로 다룬다.
- 장기 TIR에서는 희소한 최종 보상만으로 개별 도구 호출의 기여를 식별하기 어렵다. GiGPO와 SPA-RL은 시간에 따른 기여를 더 세밀하게 귀속하는 초기 접근을 보여준다.
- 더 세밀한 지도 신호는 유용한 탐색을 벌점으로 억제하거나 reward hacking을 유도하지 않아야 한다. reward hacking은 의도한 목표를 달성하지 않은 채 점수 산정 방식을 악용하는 것이다.
대표 방법을 ReAct 방식의 도구 호출, 도구 통합 RL, 장기 TIR로 배치한다. 마지막 단계는 서로 의존하는 도구 호출의 긴 시퀀스에 걸친 학습을 강조한다.
3.3 Memory
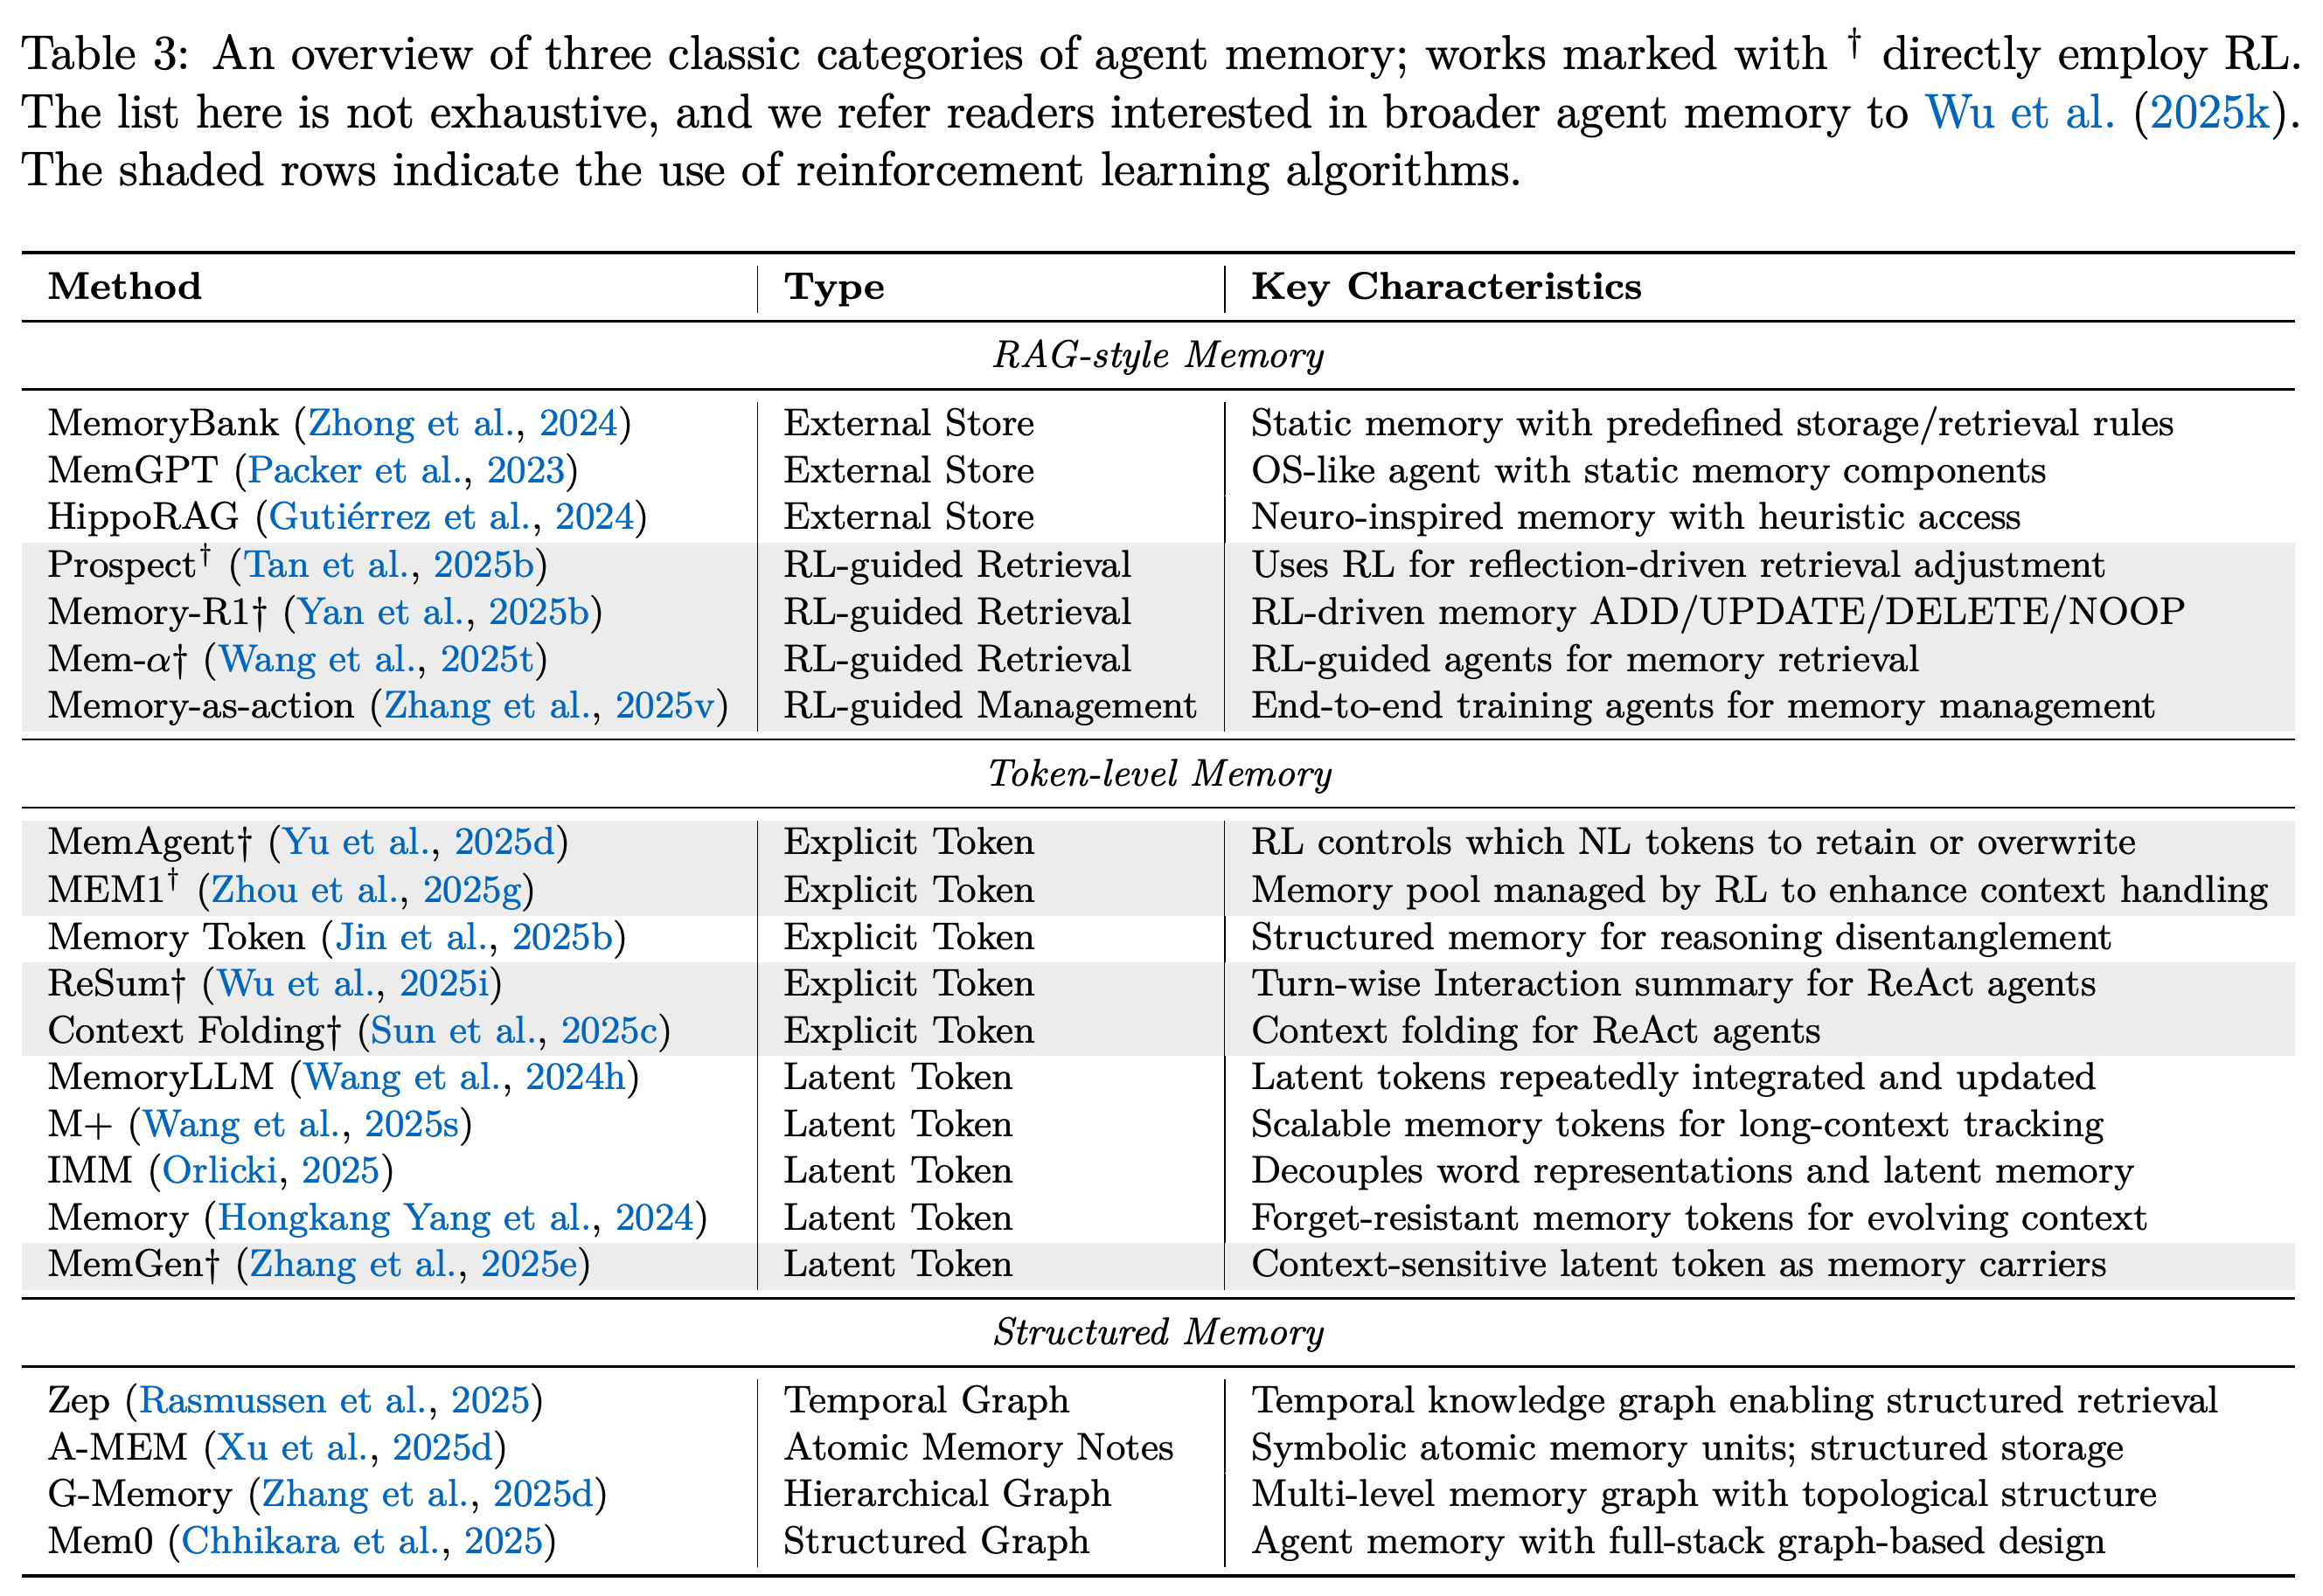
메모리 검토는 검색한 외부 정보로 응답을 생성하는 retrieval-augmented generation(RAG)을 토큰 수준 메모리 및 구조화된 메모리와 구분한다. Memory-R1은 후속 질의응답 성능을 통해 항목을 추가, 갱신, 삭제하거나 그대로 두는 ADD/UPDATE/DELETE/NOOP 연산을 학습한다. MemAgent는 어떤 자연어 메모리 토큰을 유지하거나 덮어쓸지 학습한다.
- 토큰 수준 메모리는 읽을 수 있는 텍스트나 사람이 직접 읽을 수 없는 수치 표현인 잠재 임베딩을 사용할 수 있다. MemoryLLM과 M+는 잠재 메모리 표현을 보여주며, MemGen은 RL 기반 잠재 메모리를 탐구한다. Table 3은 RL을 직접 사용하는 방법을 표시한다.
- Zep, A-MEM, G-Memory, Mem0는 관계, 시간, 계층 정보를 구성한다. 서베이는 구조화된 메모리의 구축과 수정을 제어하도록 학습하는 연구가 부족하다고 지적한다.
표는 검색 저장소, 명시적 및 잠재 토큰 메모리, 구조화된 메모리를 구분한다. RL 표시는 강화학습을 직접 사용하는 방법과 사전 정의된 절차나 휴리스틱으로 메모리 표현을 관리하는 방법을 구별한다.
3.4 Self-Improvement
자기 개선은 매개변수를 갱신하지 않는 언어적 자기 수정, 수정 능력을 내재화하는 학습, 반복적인 자기 학습으로 나뉜다. 예시는 Reflexion과 Self-Refine, 선호로 학습한 성찰 에이전트, 실행으로 검증하는 과제 생성, 성공 궤적을 공유하는 저장소를 포함한다.
- 원문의 “Absolute Zero generates tasks”는 과제를 생성하고 실행 결과로 학습하는 방식을 설명한다. SiriuS는 여러 에이전트의 경험을 공유해 학습 데이터를 만드는 집단적 bootstrapping을 보여주며, 인용된 MALT 구현은 three agents를 사용한다.
- 적응적 성찰은 제안된 연구 방향이다. 간단한 확인만으로 충분한 경우와 탐색이나 실행 기반 검증이 필요한 경우를 구분하도록 학습한다. 검토한 방법들이 무제한 자기 개선을 입증한 것은 아니다.
3.5 Reasoning
빠른 추론은 적은 중간 단계를 사용하고 느린 추론은 숙고 과정을 구조화된 추론 기록으로 생성한다. 명시적인 중간 추론 텍스트인 Chain-of-thought(CoT), 검증, 탐색으로 생성한 학습 데이터, RL이 느린 추론을 지원하지만 추론 시간이 길어지는 비용이 발생한다.
- 논문은 불필요하게 추론을 늘려 지연 시간을 높이는 overthinking과 서로 다른 환경에서 발생하는 학습 불안정을 강조한다.
- 과제 난도에 따라 추론 연산량을 바꾸는 adaptive test-time scaling을 속도와 정확도의 균형을 맞추는 방법으로 다룬다.
3.6 Perception
지각 절은 RL의 적용 범위를 시각 입력과 언어를 결합하는 vision–language 모델과 오디오 관련 과제로 확장한다. 이 절은 고정된 관측에서 답하는 방식과 입력 영역을 다시 살펴보거나 시각 도구를 호출하거나 중간 이미지를 생성하는 능동적 지각을 구분한다.
- Grounding은 추론을 특정 입력 영역에 연결한다. GRIT는 bounding-box 토큰과 추론을 번갈아 생성하며 Pixel Reasoner는 crop, erase, paint 행동을 도입한다.
- 예측 영역과 기준 영역의 교집합을 합집합으로 나눈 Intersection over Union(IoU)은 여러 방법에서 시각 보상으로 사용된다. GoT-R1과 T2I-R1 같은 생성 중심 접근은 중간 계획과 이미지 생성을 최적화한다.
- 오디오 응용에는 질의응답과 음성 합성 구성 요소 최적화가 포함된다. 음성 합성에서는 화자 유사도와 단어 수준 전사 오류의 비율인 word error rate를 사용한다.
6개 영역은 보상을 추론, 검색, 수정, 계획, 지각, 도구 사용에 연결한다. 측면 패널은 매개변수 학습, 추론 시점 탐색, 외부 제어 방식을 보여주며, 이들이 동일한 학습 절차를 따르는 것은 아니다.
3.7 Others
여러 턴에 걸쳐 일관성을 유지하려면 중간 결정과 지연된 결과를 연결하는 학습 신호가 필요하다. 서베이는 접근법을 과정 지도와 최종 보상을 결합하는 방식, 선호 비교를 개별 응답에서 다단계 구간으로 확장하는 방식으로 묶는다.
- EPO, ThinkRM, SPO, AgentPRM은 보상 모델로 중간 평가를 제공하고 RLVMR은 프로그램으로 구현한 규칙을 사용한다. 구간 수준 DPO는 대화 일부나 행동 시퀀스를 비교한다.
4 Agentic RL: The Task Perspective
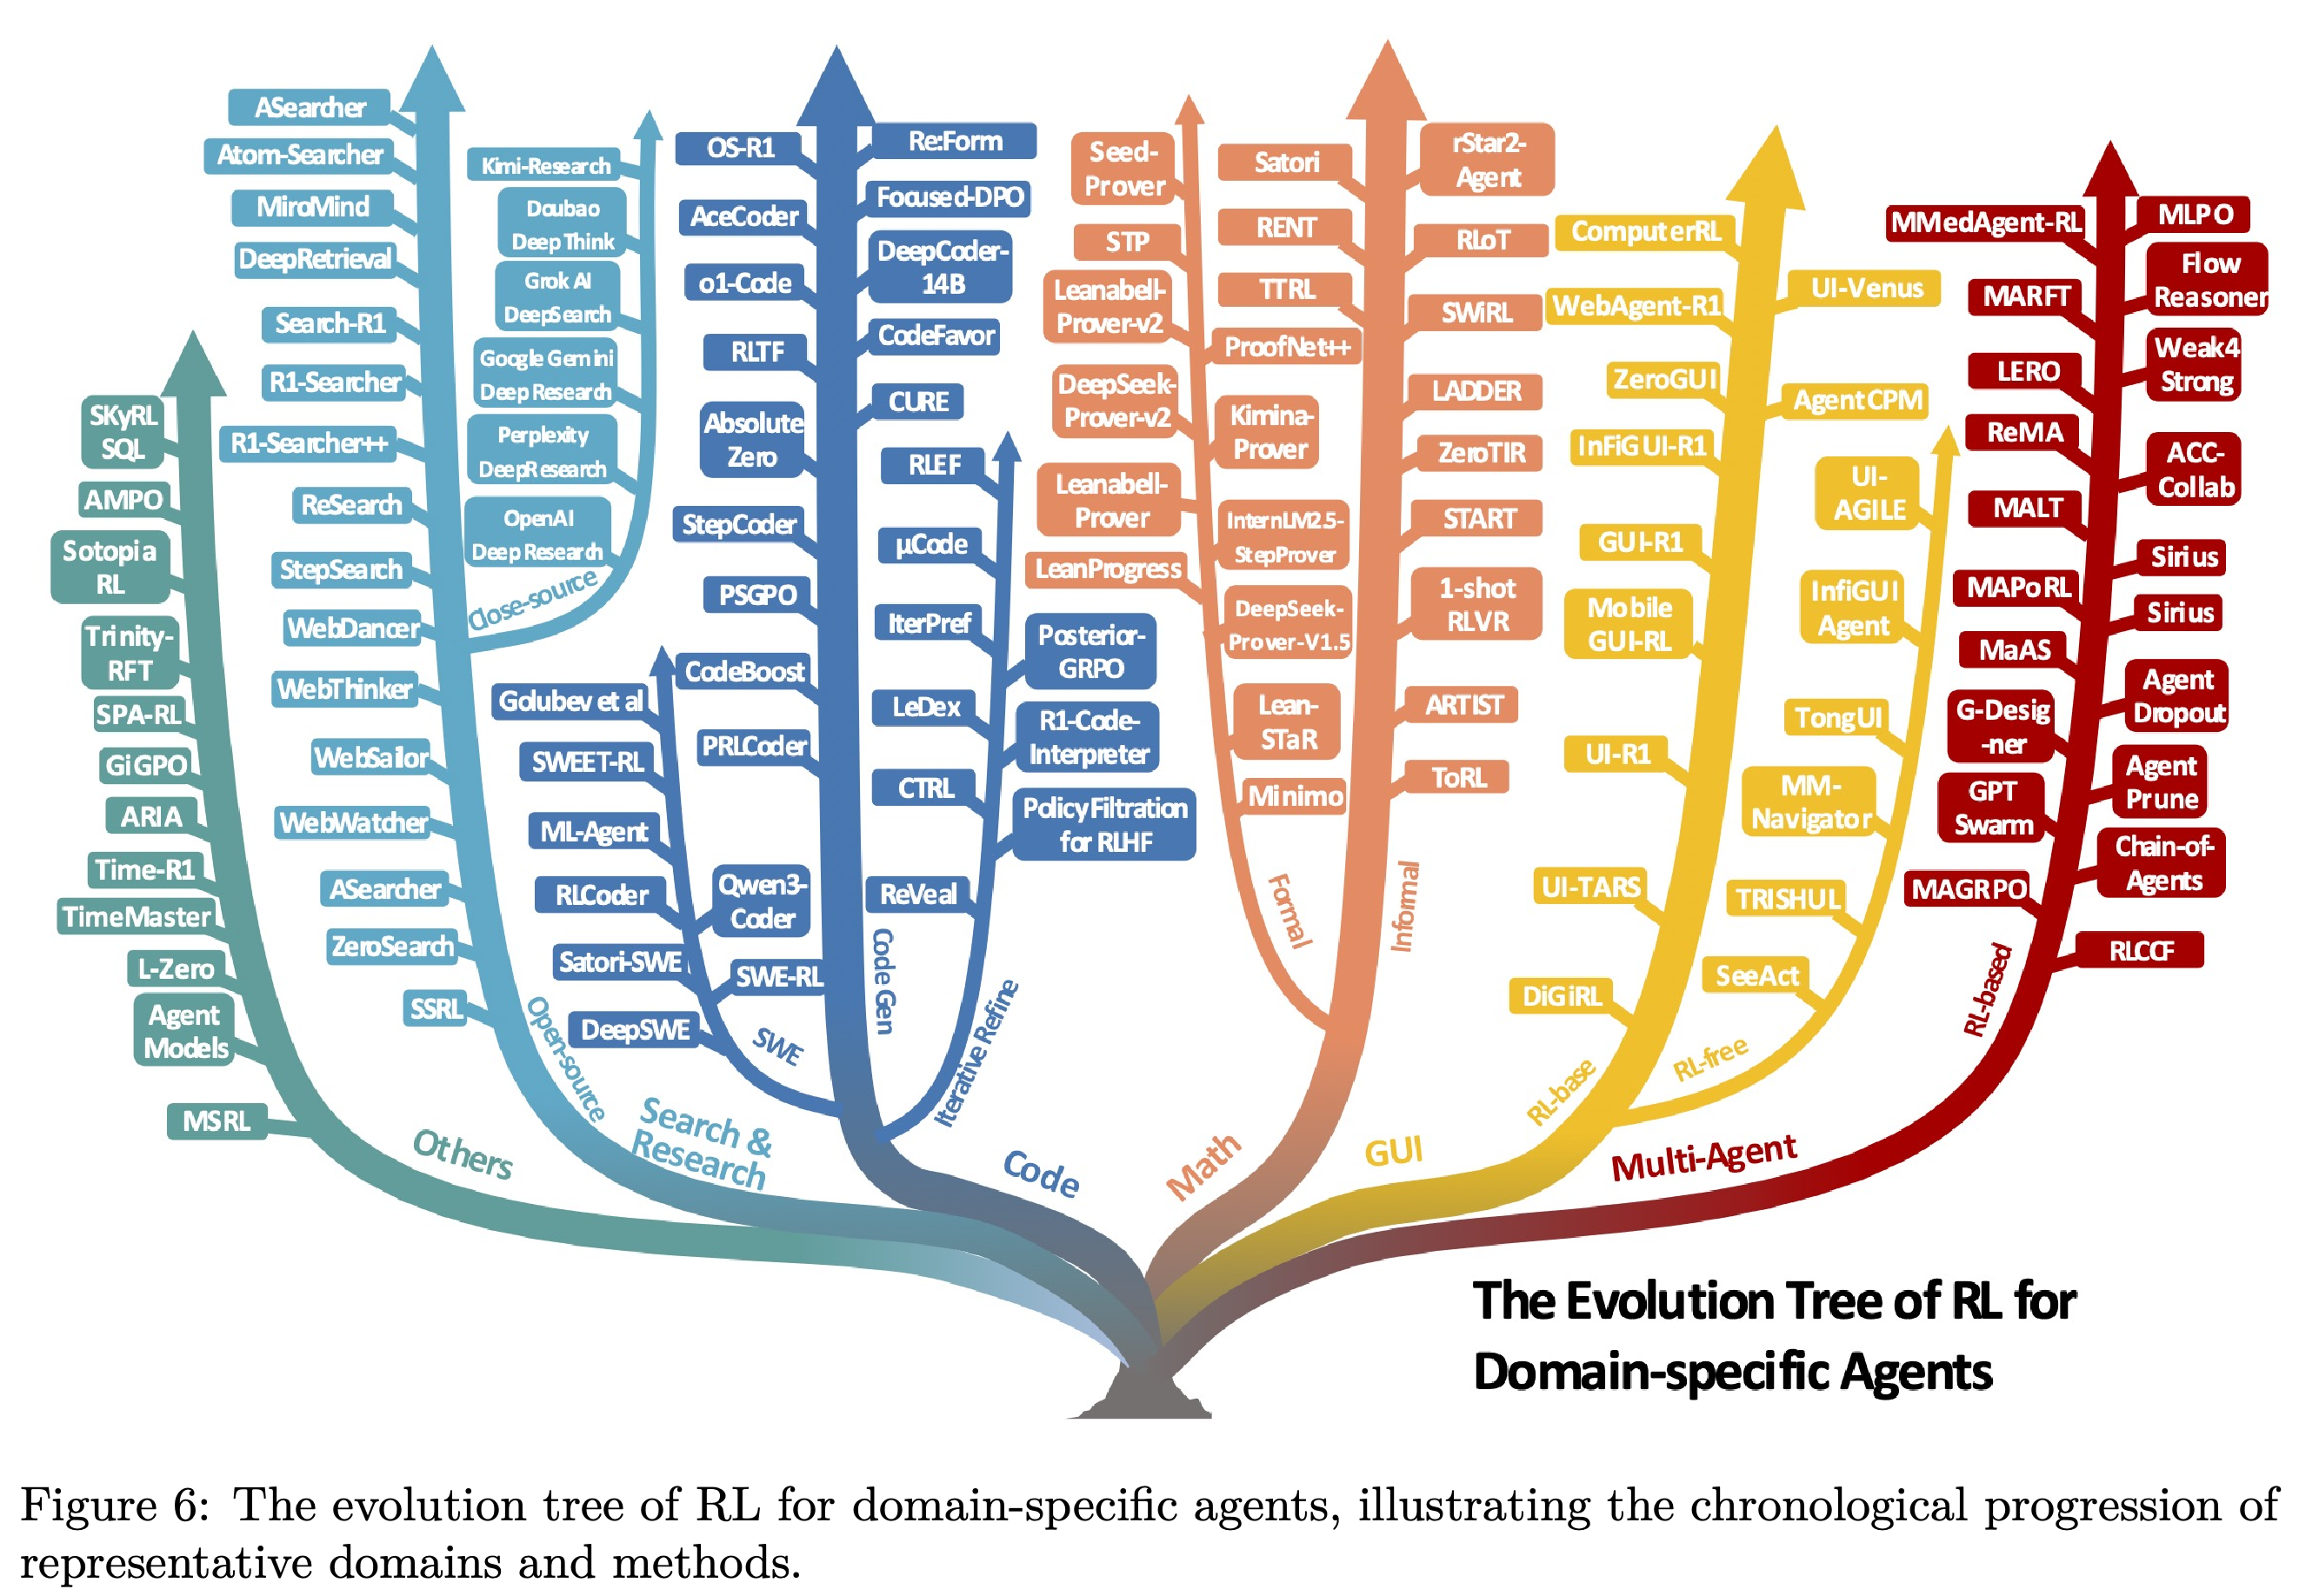
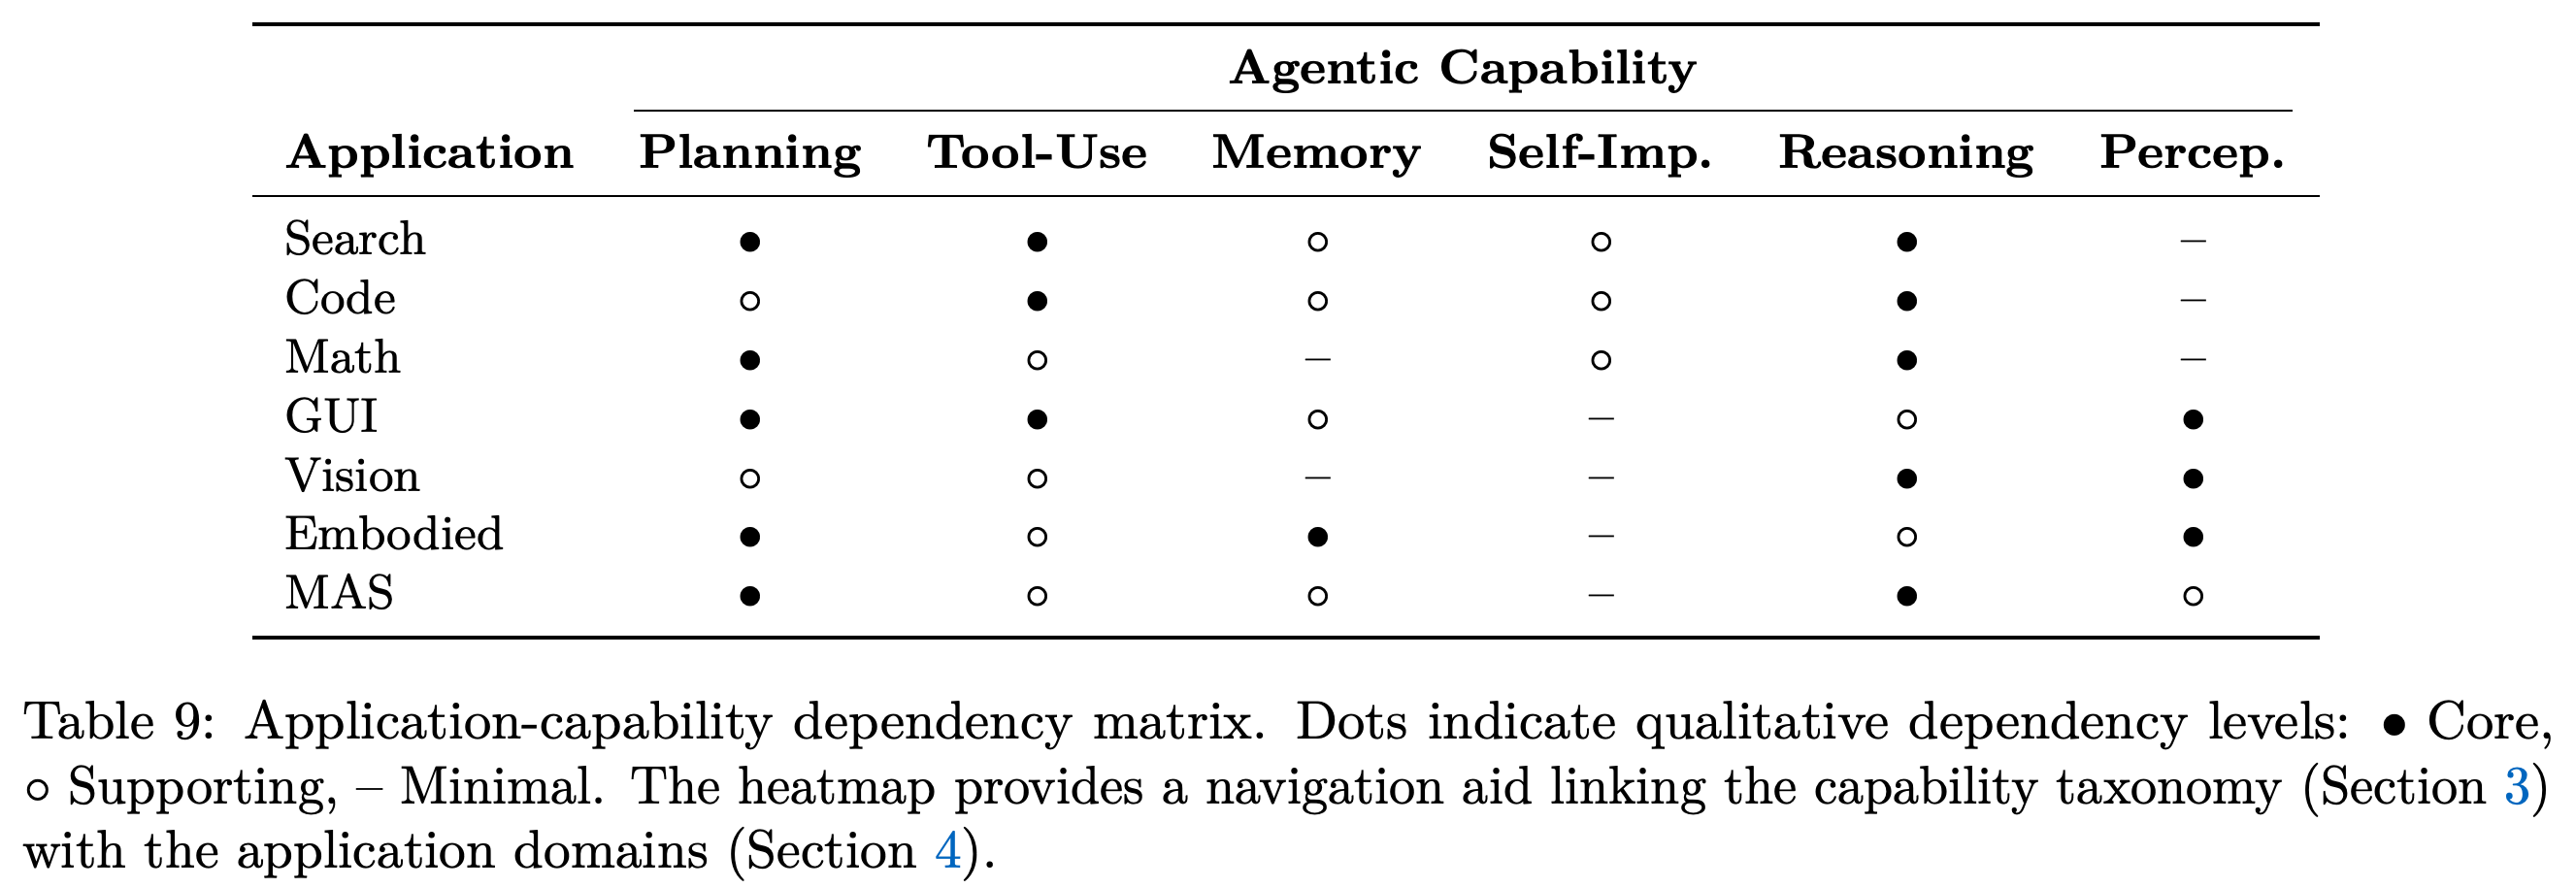
과제 분류는 검색과 연구, 코드와 소프트웨어 엔지니어링, 수학, 화면상의 행동으로 조작하는 시각적 인터페이스인 graphical user interface(GUI), 비전, 체화된 상호작용, 다중 에이전트 시스템, 기타 응용을 포함한다. Figure 6은 분야별 대표 방법을 배치하고 Table 9는 응용 분야별 역량 의존 관계를 정성적으로 보여준다.
가지는 검색, 코드, 수학, GUI 제어, 협력 등을 포함해 대표 방법을 응용과 하위 과제별로 묶는다. 시간순 구성은 성능 개선을 정량화하지 않고 문헌의 발전을 요약한다.
4.1 Search & Research Agent
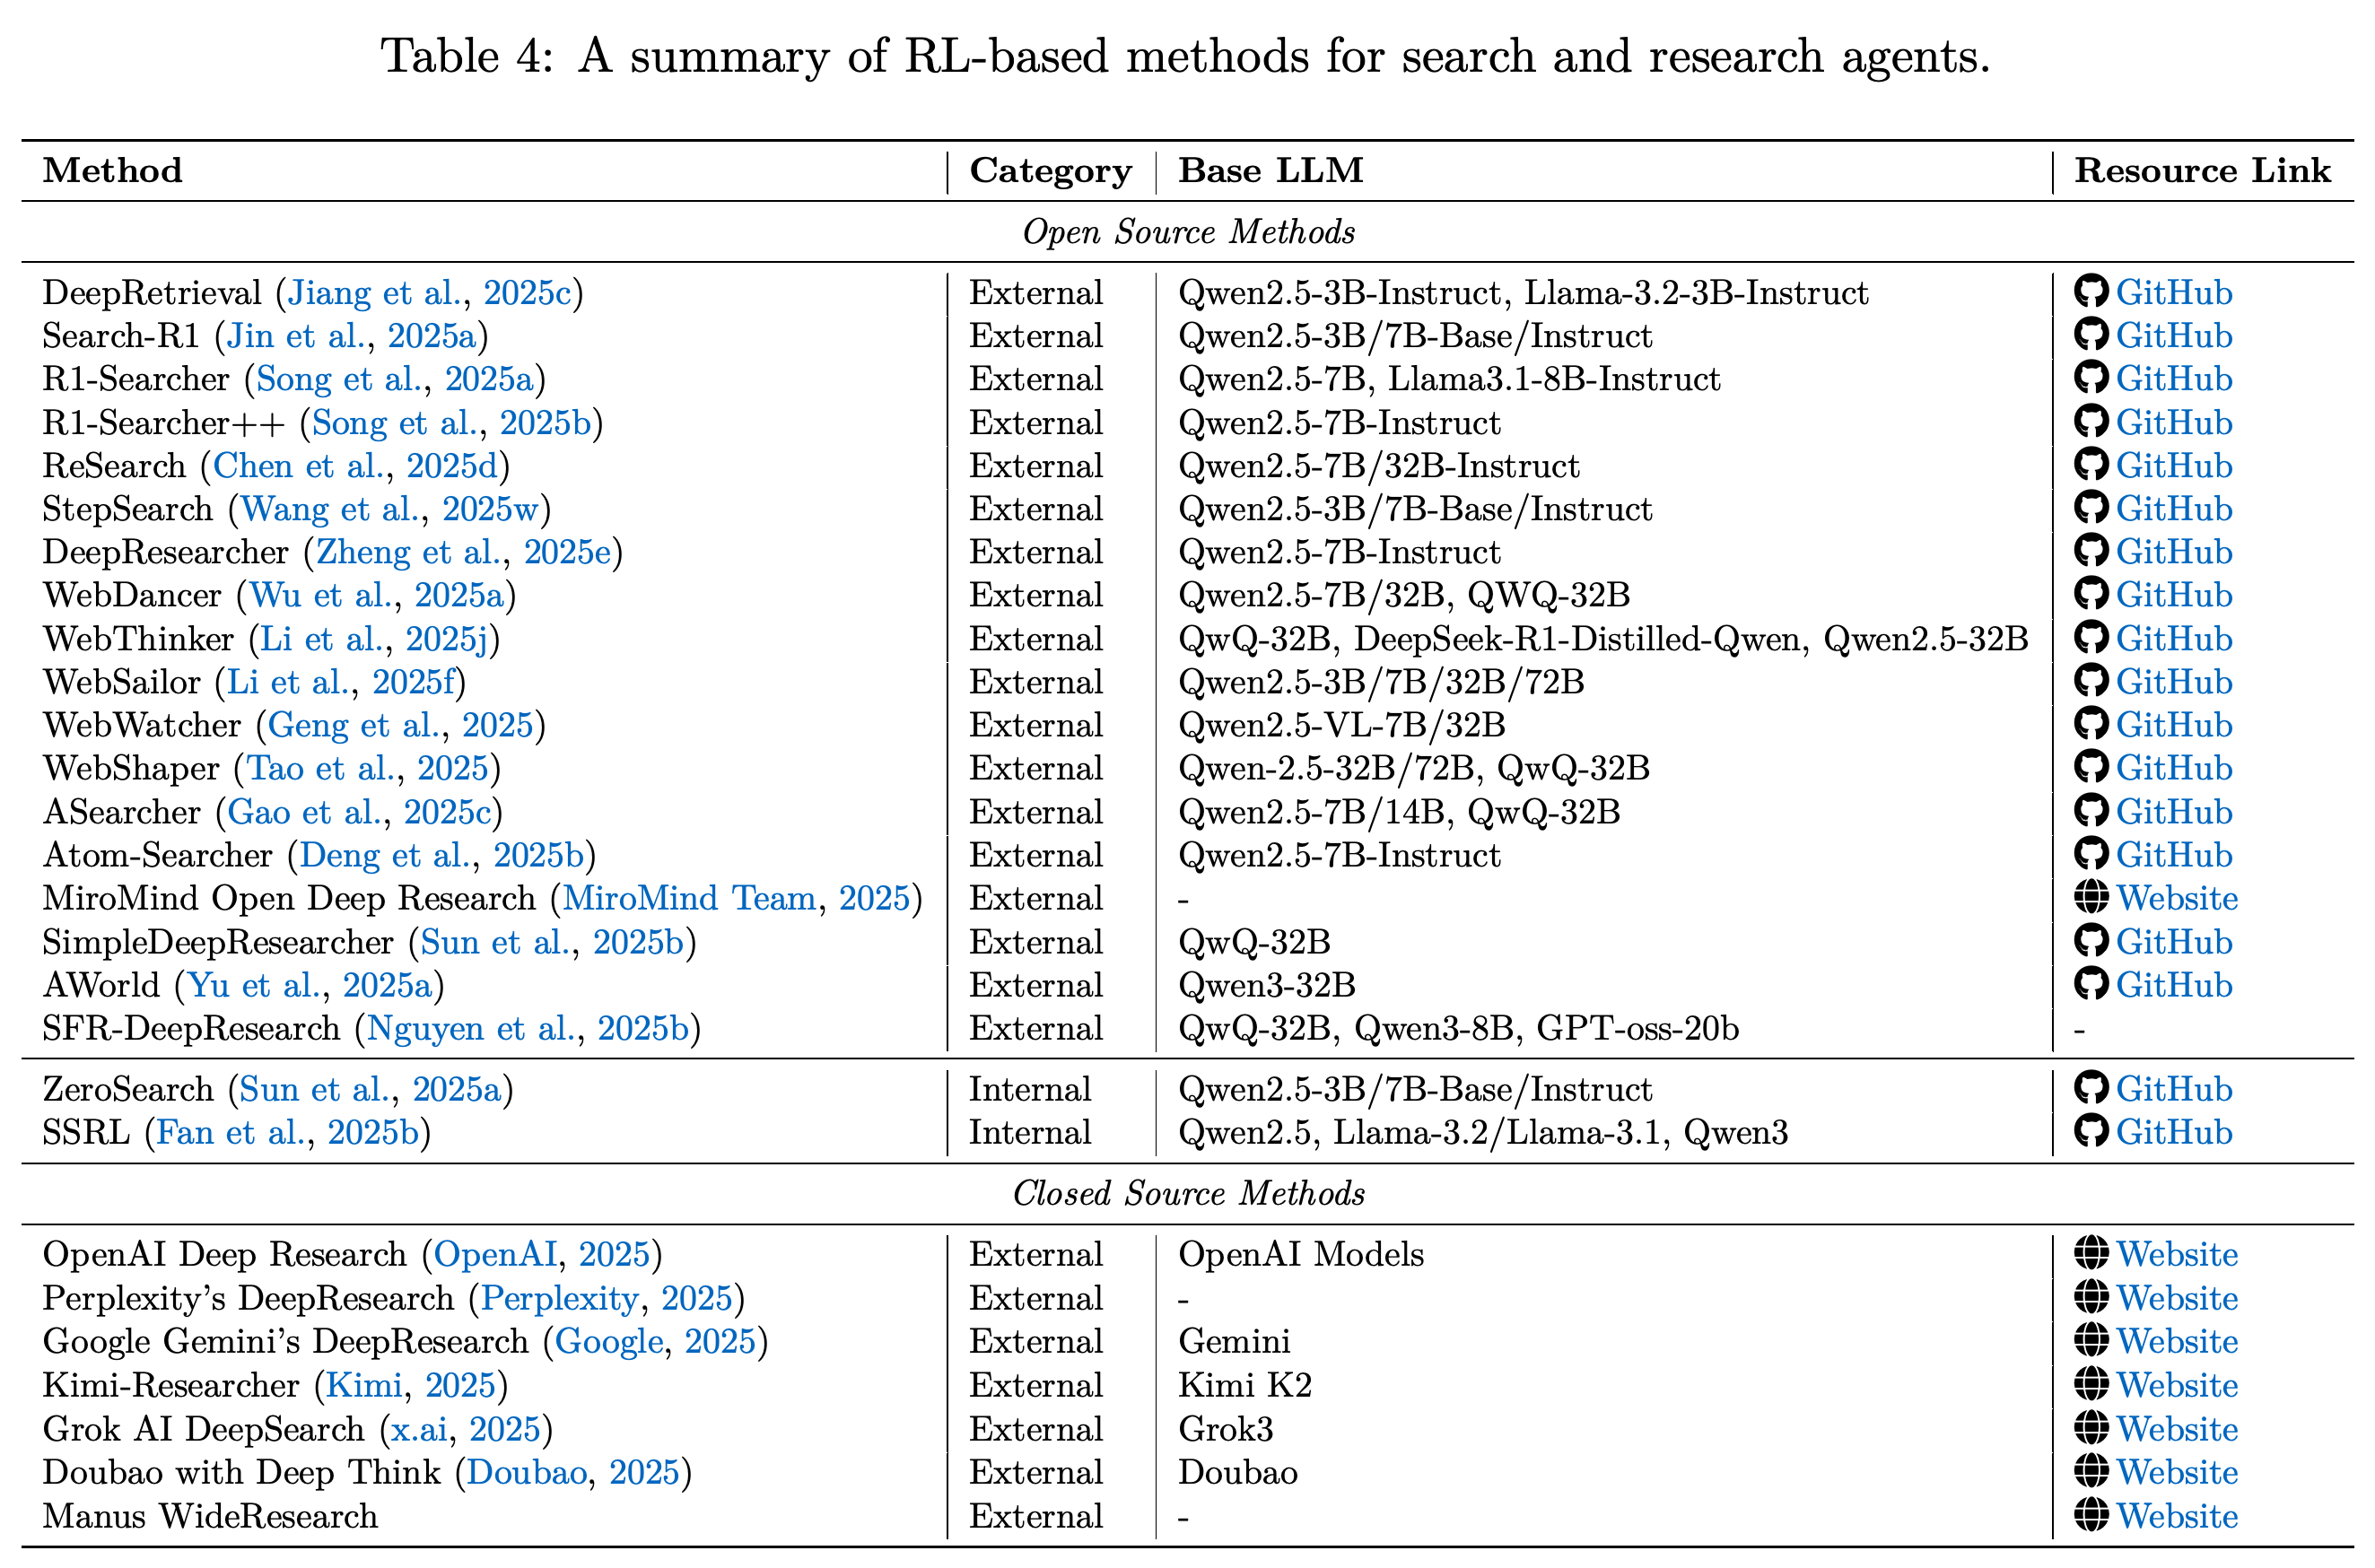
검색과 연구 에이전트는 여러 단계에 걸쳐 쿼리 생성, 검색, 추론, 종합을 최적화한다. 이 절은 실시간 검색을 사용하는 오픈소스 방법과 모의 검색 또는 내부 검색을 사용하는 방법을 구분한 뒤, 비공개 연구 시스템을 다룬다. Table 4는 대표 방법, 기본 모델, 자료를 기록한다.
- Search-R1과 DeepResearcher는 결과 보상과 retrieved-token masking을 결합한다. retrieved-token masking은 검색한 텍스트를 모델의 학습 신호에서 제외한다. StepSearch는 중간 보상을 추가한다. ASearcher는 모든 과제가 함께 끝날 필요 없이 상호작용을 수집하고 정책을 갱신하는 비동기 RL로 40+회의 도구 호출을 지원한다.
- ZeroSearch와 SSRL은 학습 중 실시간 검색 의존도를 줄여 통제하기 어려운 문서 품질과 application programming interface(API) 비용에 대응한다. API는 외부 서비스에 프로그램으로 접근하는 수단이다.
- OpenAI Deep Research는 찾기 어려운 정보를 검색하는 벤치마크 BrowseComp에서 pass@1 51.5%를 보고한다. 사례 연구는 하위 목표 계획, 웹 검색, scratchpad 메모리, 출처 간 검증을 결합한다. 서베이는 RL의 기여만 분리하는 동일 조건의 실험을 제공하지 않는다.
목록은 외부 검색과 내부 탐색, 오픈소스 방법과 비공개 방법을 구분한다. 기본 모델과 자료 열은 활용 가능한 출발점과 구현 정보가 부족한 부분을 보여준다.
4.2 Code Agent
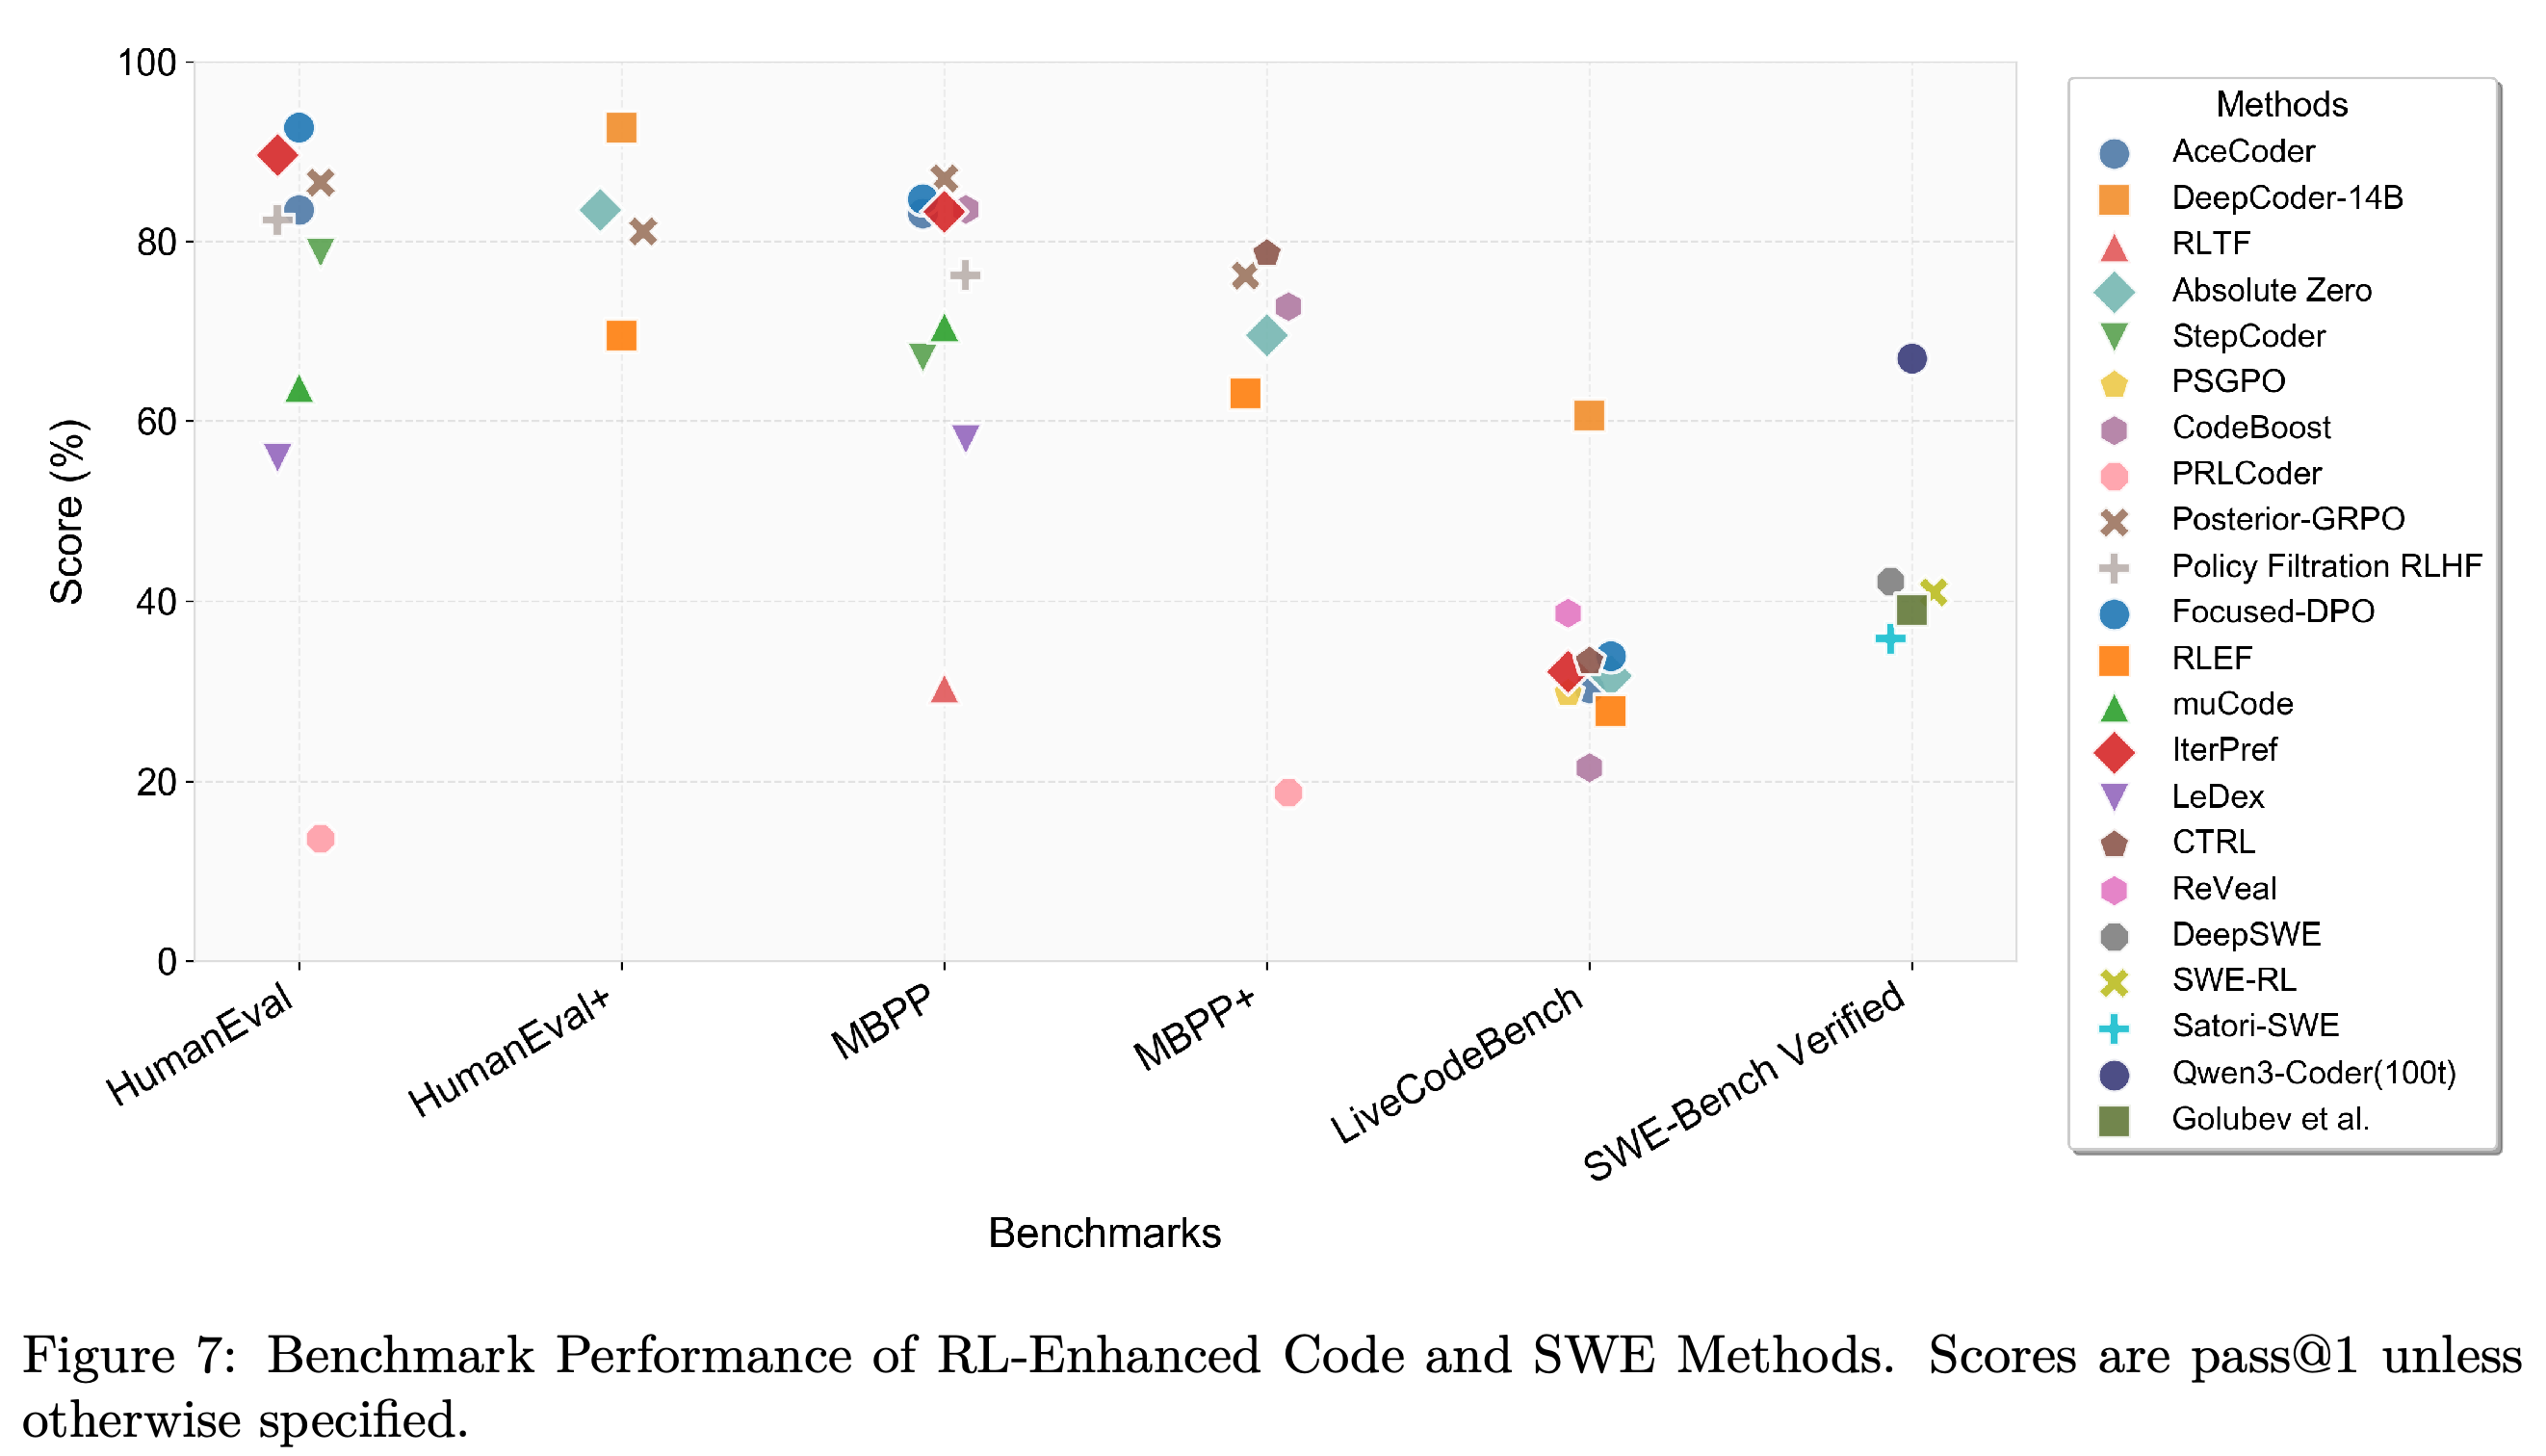
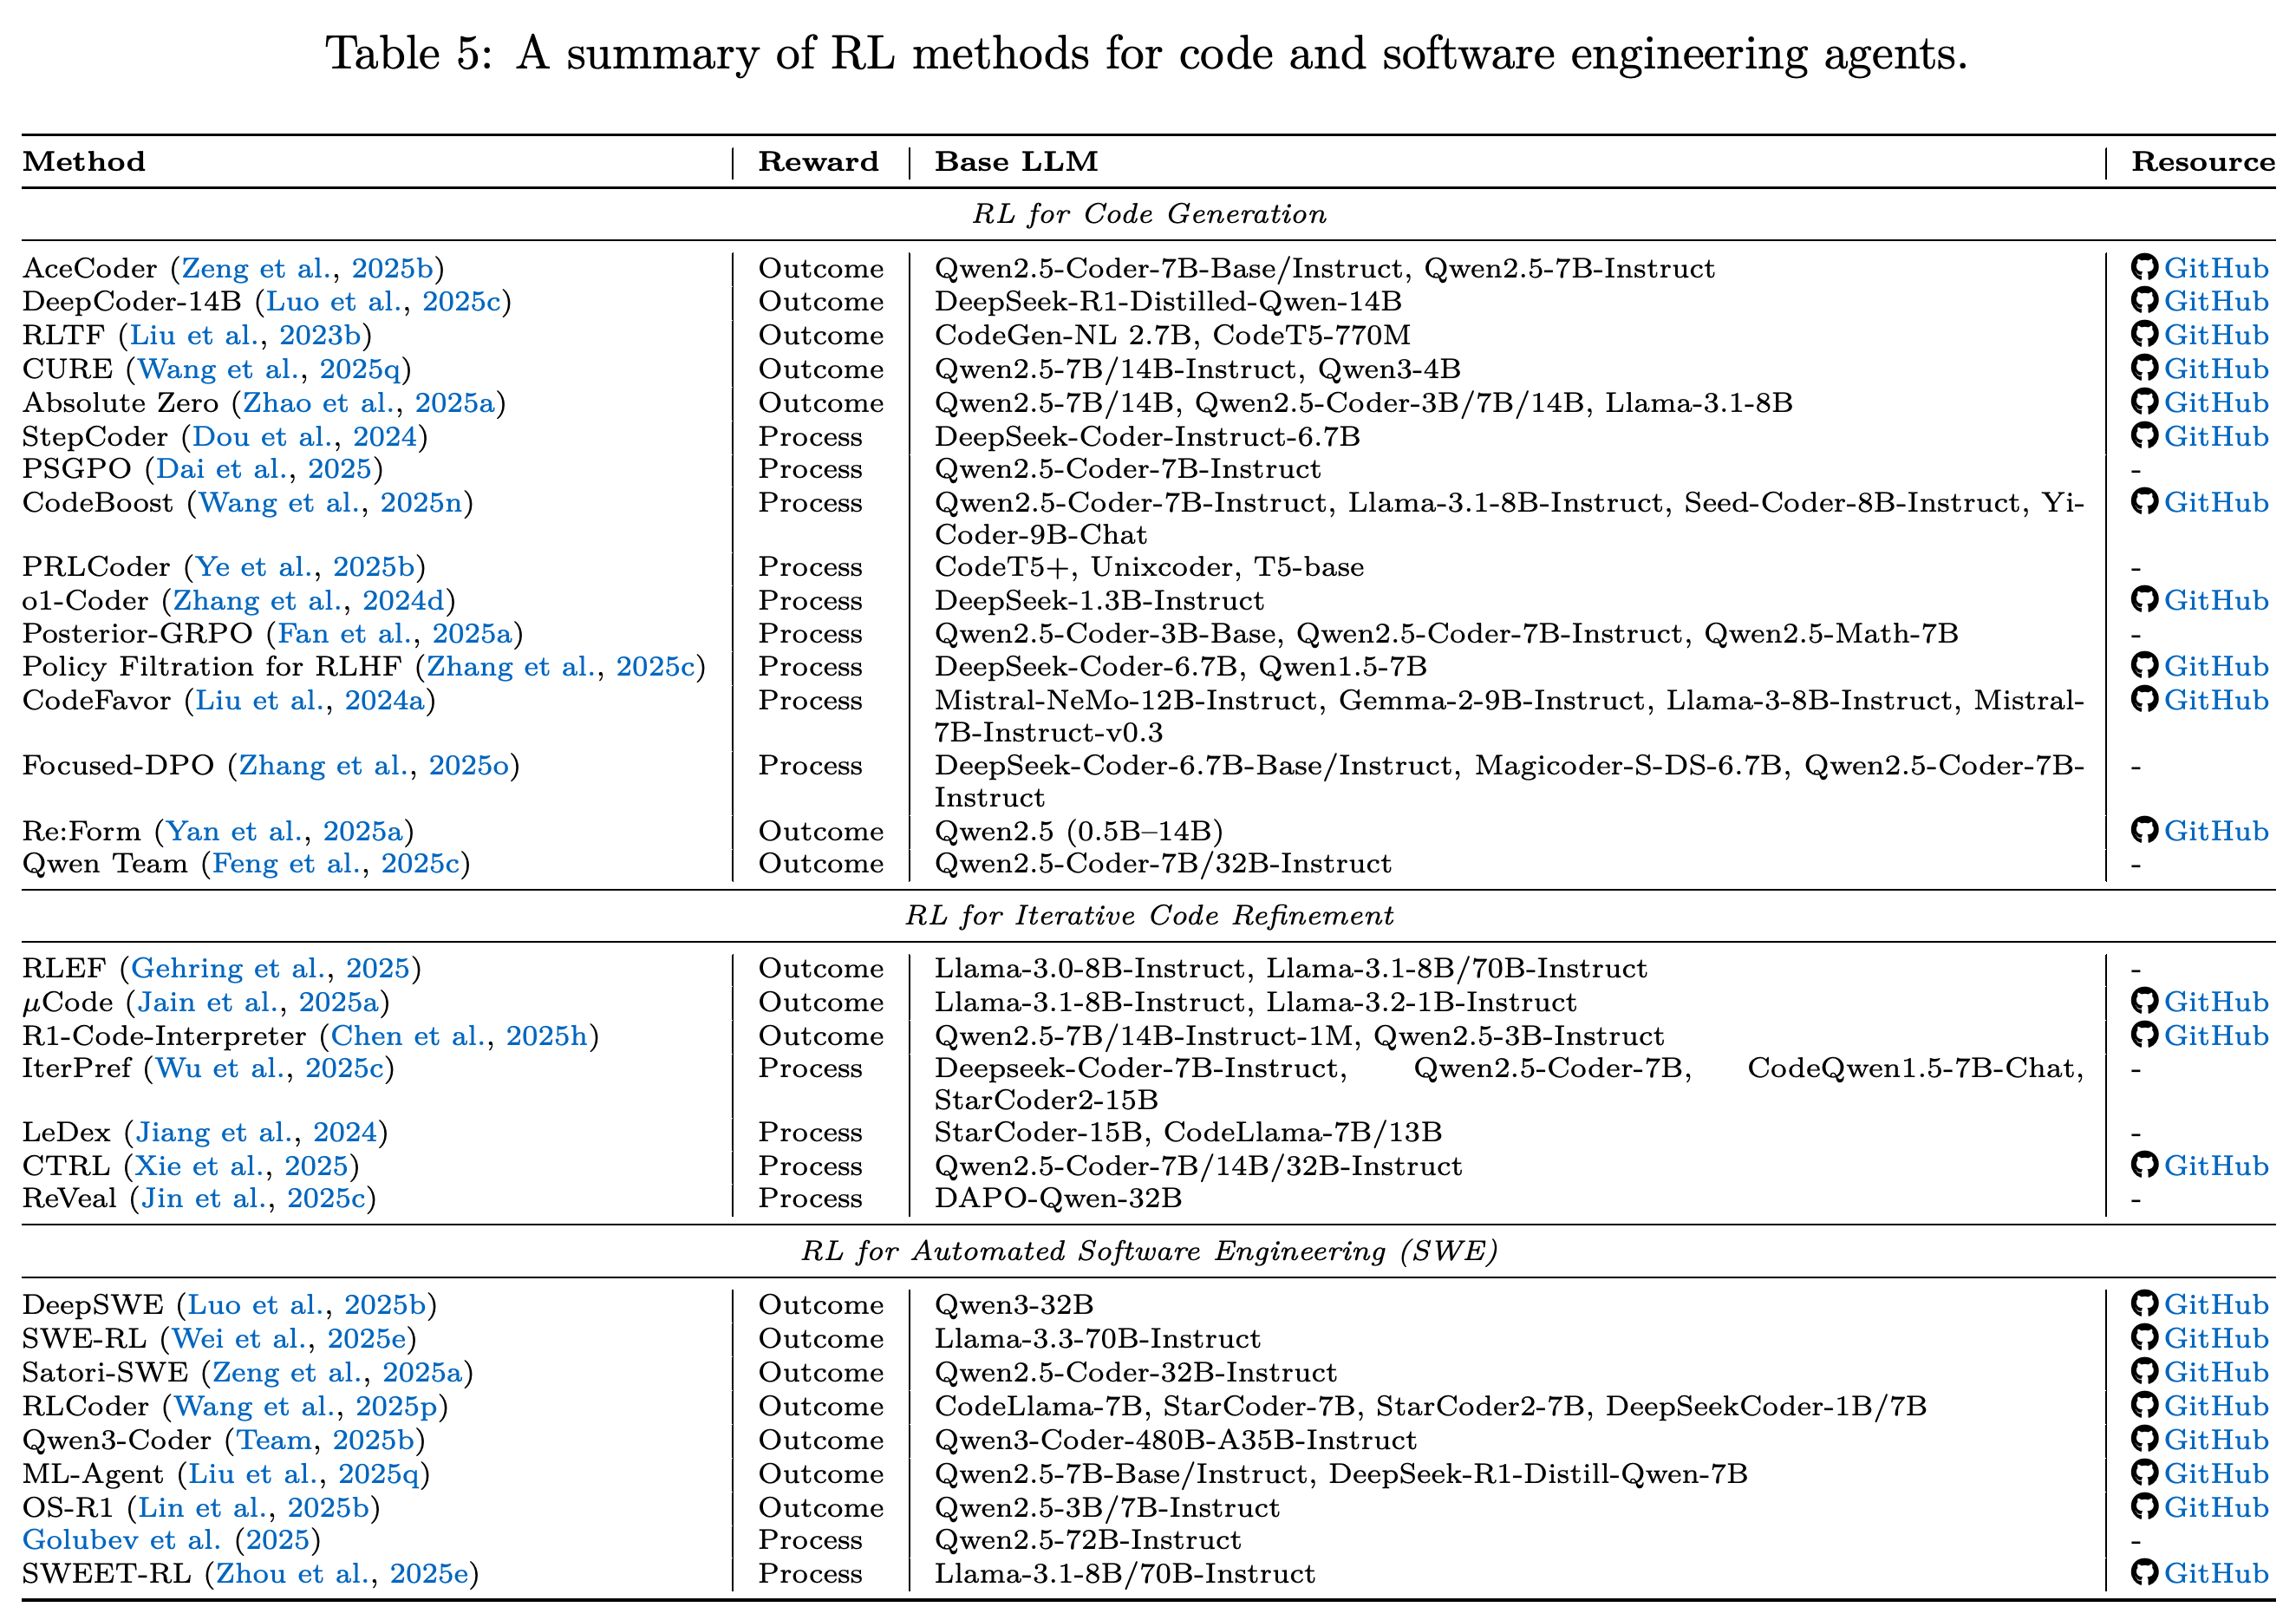
코드 에이전트는 코드 생성, 반복적 개선, 자동화된 software engineering(SWE), 실행 가능한 세계 모델로 분류한다. 컴파일, 테스트, 실행 기록이 결과와 과정에 대한 피드백을 제공한다. Figure 7은 벤치마크 점수를 모으고, Table 5는 방법, 보상 유형, 기본 모델을 기록한다.
- 생성에서는 DeepCoder-14B가 GRPO 기반 학습을 사용하고 PRLCoder는 컴파일러와 테스트 피드백으로 부분 코드에 점수를 부여한다. 서베이는 PRLCoder가 기본 모델 대비 통과율을 +10.5% 개선했다고 보고하지만 모든 방법에 공통으로 적용한 평가는 명시하지 않는다.
- 개선에서는 Reinforcement Learning from Execution Feedback인 RLEF가 실행 오류로 수정 방법을 학습하고 IterPref는 오류 영역을 겨냥하며 CTRL은 추가 추론 비용이 드는 별도 critic을 학습한다. SWE에서는 Qwen3-Coder가 병렬 환경 20,000개에서 학습하고 SWEET-RL은 ColBench에서 배포된 에이전트가 이용할 수 없는 학습 피드백인 privileged information을 사용한다.
- 전이와 보상 동역학을 프로그램으로 표현하는 Code World Models(CWMs)는 실행 가능한 시뮬레이션으로 계획을 지원한다. GIF-MCTS와 WorldCoder가 이 접근을 보여준다. 반복적인 프로그램 합성, 수정, 시뮬레이션에는 상당한 추론 비용이 들 수 있다.
보고된 점수는 HumanEval, HumanEval+, MBPP, MBPP+, LiveCodeBench, SWE-Bench Verified별로 묶인다. 별도 명시가 없으면 점수는 pass@1을 사용하지만 모델과 평가 조건이 달라 이 자료를 통제된 순위 비교로 해석할 수는 없다.
표는 생성, 반복적 개선, 자동화된 SWE를 구분하고 보상 유형과 기본 모델을 기록한다. 이러한 학습 차이는 앞선 그래프의 서로 다른 조건에서 나온 점수를 해석하는 데 도움이 된다.
4.3 Mathematical Agent
수학 에이전트는 수치 계산이나 기호 연산을 위한 코드 실행을 포함하는 자연어 기반 비형식 추론과, 기계적으로 검증 가능한 증명을 생성하는 형식 추론으로 나뉜다. 이 방식들은 결과 보상과 과정 보상을 사용한다. 형식 방법은 탐색으로 찾은 검증된 궤적으로 정책을 반복 학습하는 expert iteration도 사용한다.
- 서베이는 검증 가능한 보상을 사용하는 강화학습인 1-shot RLVR이 예제 1개로 1.2k개 예제 학습 조건에 가까운 성능을 내고, 예제 2개로 7.5k개 예제로 구성된 MATH 학습 데이터셋을 사용했을 때에 가까운 성능을 낸다고 보고한다. 이 비교는 인용 연구의 학습과 평가 조건에 해당한다.
- rStar2-Agent는 14B-parameter 모델, 고처리량 Python 실행 환경, 도구 잡음 속에서 정답 rollout을 다시 샘플링하는 GRPO 변형인 GRPO-RoC, 다단계 학습 절차를 사용한다. 510 RL steps 후 보고한 평균 pass@1은 AIME24에서 80.6%, AIME25에서 69.8%다.
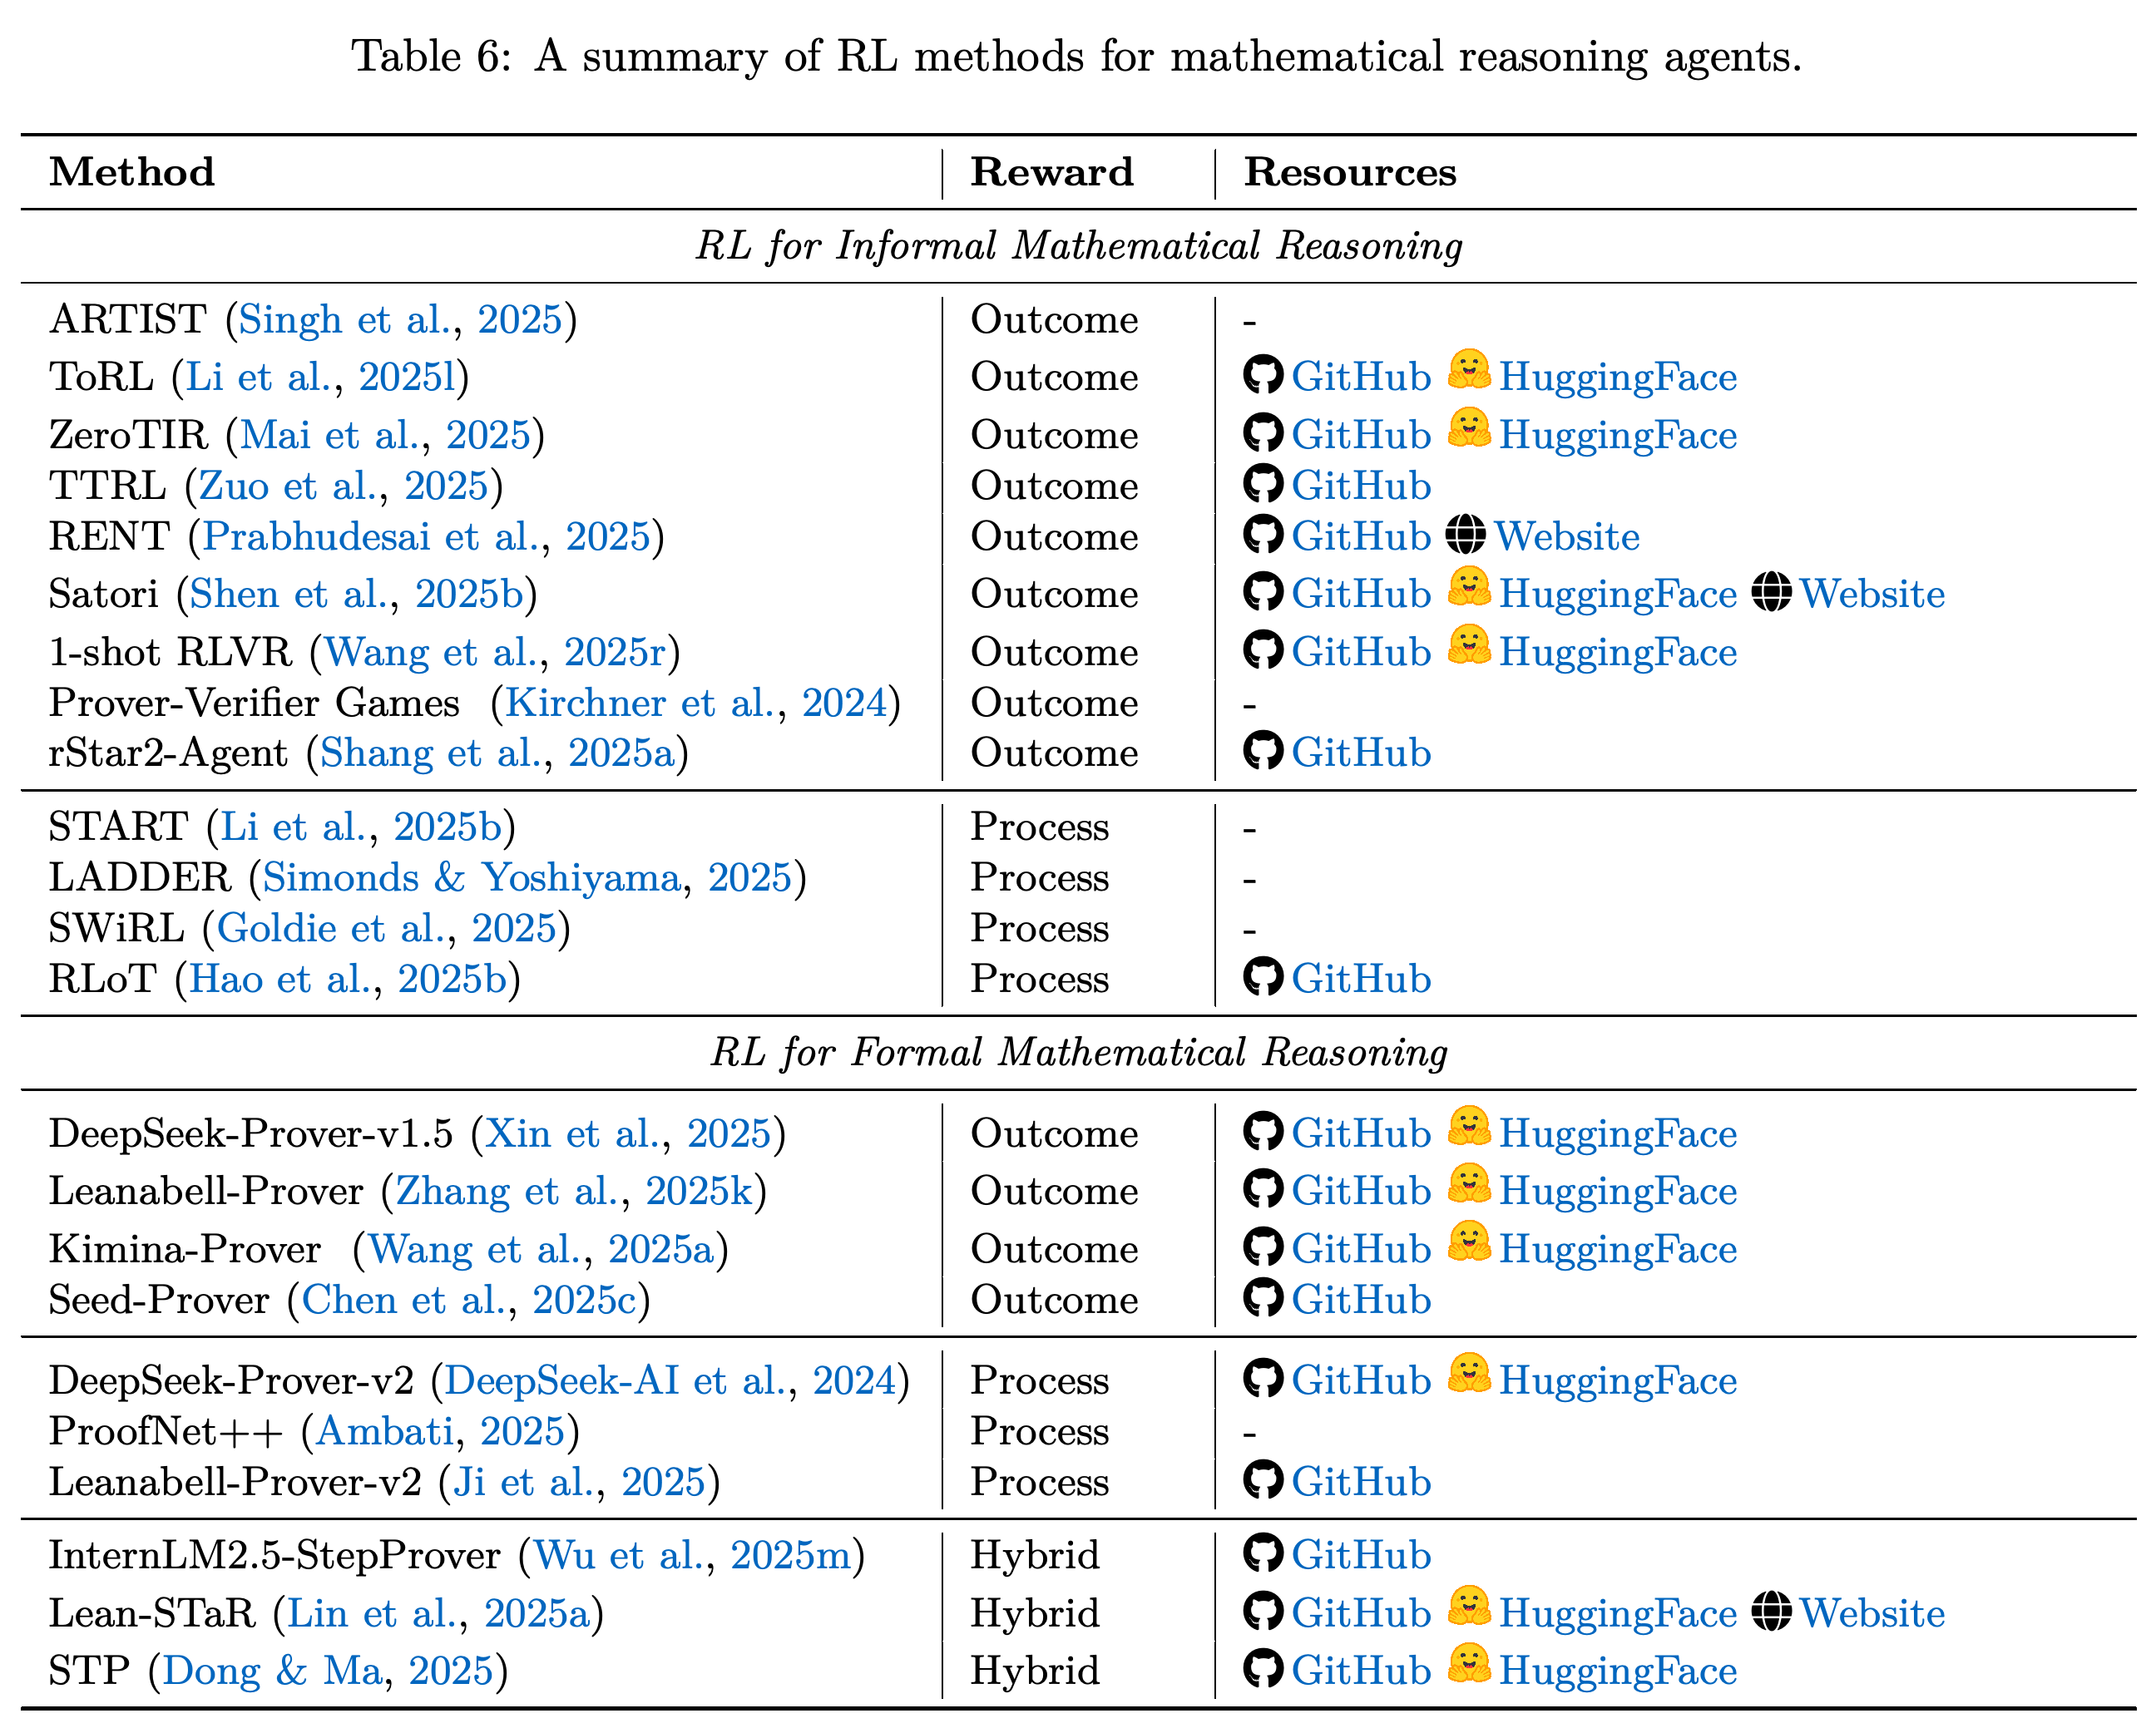
- Lean, Isabelle, Coq, HOL Light 같은 증명 보조기는 증명을 기계적으로 검증한다. DeepSeek-Prover-v2는 하위 목표 피드백을 추가한다. Kimina-Prover는 증명 목표를 구체화하는 명령 시퀀스인 tactic block을 최소 1개 요구하며 최종 증명에서 Lean 4 코드 조각을 60% 이상 재사용하도록 요구한다. Figure 8과 Table 6은 결과와 보상 방식을 요약한다.
그래프는 비형식 수학과 형식 증명 벤치마크를 함께 보여준다. 여러 형식 방법은 pass@32, pass@64, pass@128, pass@256, pass@8192를 사용한다. 후보 수의 차이는 점수에 상당한 영향을 주며 단일 시도 추론의 비교를 제한한다.
방법을 비형식 추론과 형식 추론으로 나누고 결과, 과정, 혼합 보상 방식에 따라 분류한다. 자료 항목은 구현을 살펴보는 데 도움이 되며, 보상 표시는 각 방법의 학습 피드백을 보여준다.
4.4 GUI Agent
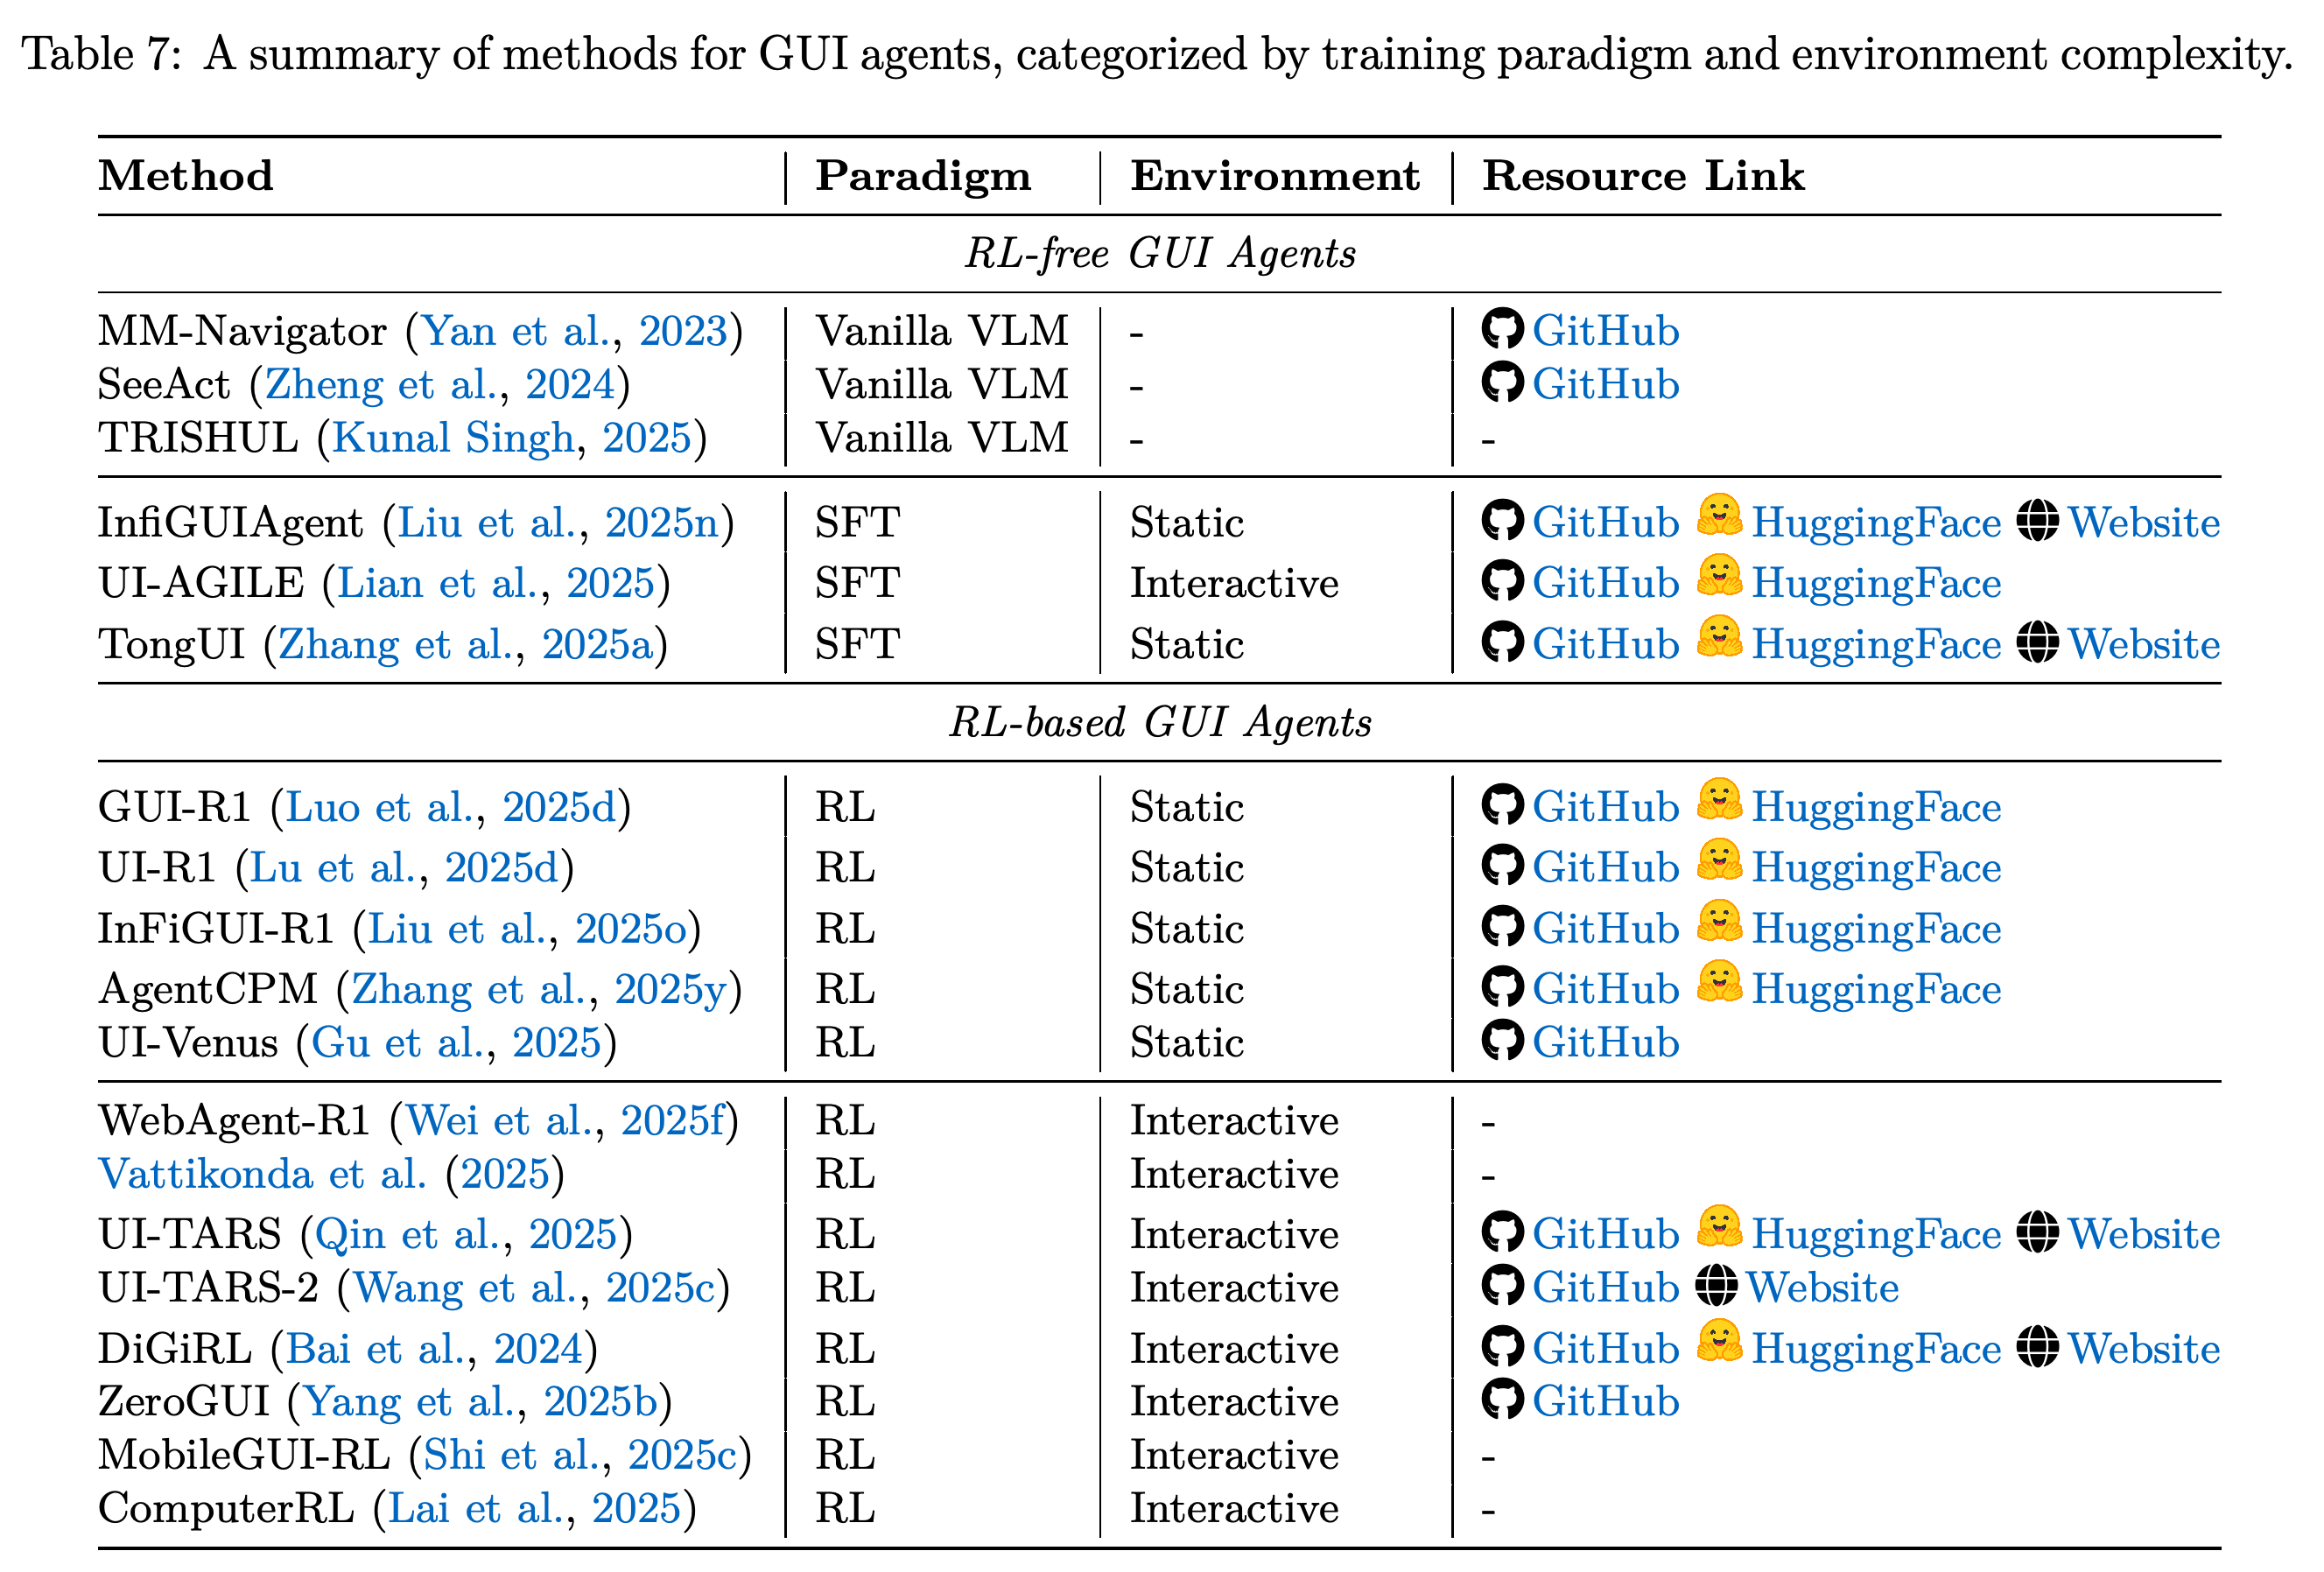
GUI 에이전트는 과제별 학습 없이 사전학습 모델을 사용하는 단계에서 화면–행동 쌍에 대한 SFT를 거쳐, 정적 데이터셋과 상호작용 환경에서 RL을 수행하는 단계로 발전한다. Table 7은 학습 패러다임과 환경 복잡도를 구분한다.
- RL-free Methods에는 MM-Navigator, SeeAct, TRISHUL이 포함된다. 시범 기반 접근은 grounding을 개선하지만 인간의 상호작용 기록에 의존한다. TongUI는 멀티모달 웹 튜토리얼에서 143K-trajectory GUI-Net을 구축한다.
- RL in Static GUI Environments는 미리 수집한 궤적과 규칙 기반 행동 평가를 사용한다. GUI-R1, UI-R1, InFiGUI-R1, AgentCPM-GUI는 형식 보상, 인자 정확도, 하위 목표 지도, 간결한 행동 인터페이스의 사례를 보여준다.
- RL in Interactive GUI Environments는 에이전트 상호작용으로 수집한 시퀀스인 온라인 rollout으로 학습한다. DiGiRL은 Android에서 오프라인 학습과 온라인 학습을 결합한다. 원문의 “ZeroGUI generates tasks”는 과제 생성과 보상 추정을 설명한다. ComputerRL은 API-GUI 행동을 비동기 학습, RL과 SFT의 교대 학습과 결합한다.
패러다임과 환경을 별도 열로 제시하여 사전학습 또는 지도학습 에이전트를 RL 시스템과 구분하고 정적 궤적을 상호작용 학습과 구분한다. 이 구분은 행동 예측 결과를 온라인 과제 수행과 연결할 때 중요하다.
4.5 Vision Agents
비전 응용은 이미지, 비디오, 3D 이해와 생성을 포함한다. 서베이는 위치 추정, 분할, 객체와 객체 간 관계를 표현하는 scene graph, 시간적 추론, 생성 품질에 대한 보상을 선별적으로 검토한다.
- 이미지 방법은 영역 중첩, precision, recall, 구조화된 출력 일치를 사용한다. 능동적 접근은 시각적 근거를 다시 살펴보거나 도구와 생성한 스케치를 사용한다.
- 비디오 방법에는 토큰별 가중 보상, keyframe 지도, DeepVideo-R1에서 사용한 GRPO의 회귀 정식화가 포함된다. 생성 방법은 시간적 일관성, 제어 가능성, 의미적 정렬을 최적화한다.
- 3D 방법에는 물리적 제약과 렌더링 이미지 평가를 사용하는 MetaSpatial의 보상, 점별 3D 지도 없이 학습하는 Scene-R1, 인간 선호나 2D 보상 신호를 사용하는 생성 접근이 포함된다.
4.6 Embodied Agents
체화된 에이전트는 물리 환경이나 모의 환경을 지각하고 그 안에서 행동한다. vision-language-action(VLA) 모델은 시각 관측, 언어 지시, 행동 예측을 결합한다. 서베이는 이동 계획을 강조하는 내비게이션과 정밀한 객체 제어가 필요한 조작을 구분한다.
- VLN-R1은 예측 경로를 기준 경로와 비교해 보상하고 RLVLA와 VLA-RL은 vision–language 평가기로 궤적 수준의 조작 피드백을 제공한다.
- 학습 시뮬레이션과 물리적 배포 사이의 차이인 simulation-to-reality gap은 여전히 한계다. 논문은 물리 실험의 비용과 유지보수 부담, 수백만 상호작용 단계가 필요하다는 점을 언급한다.
- Voyager 사례 연구는 Minecraft 탐색, 재사용 가능한 기술, 메모리, 커리큘럼 선택을 설명한다. 서베이는 각 구성 요소의 기여를 독립적으로 측정하지 않은 채 이를 RL 관점의 체화 학습 설명에 포함한다.
4.7 Multi-Agent Systems
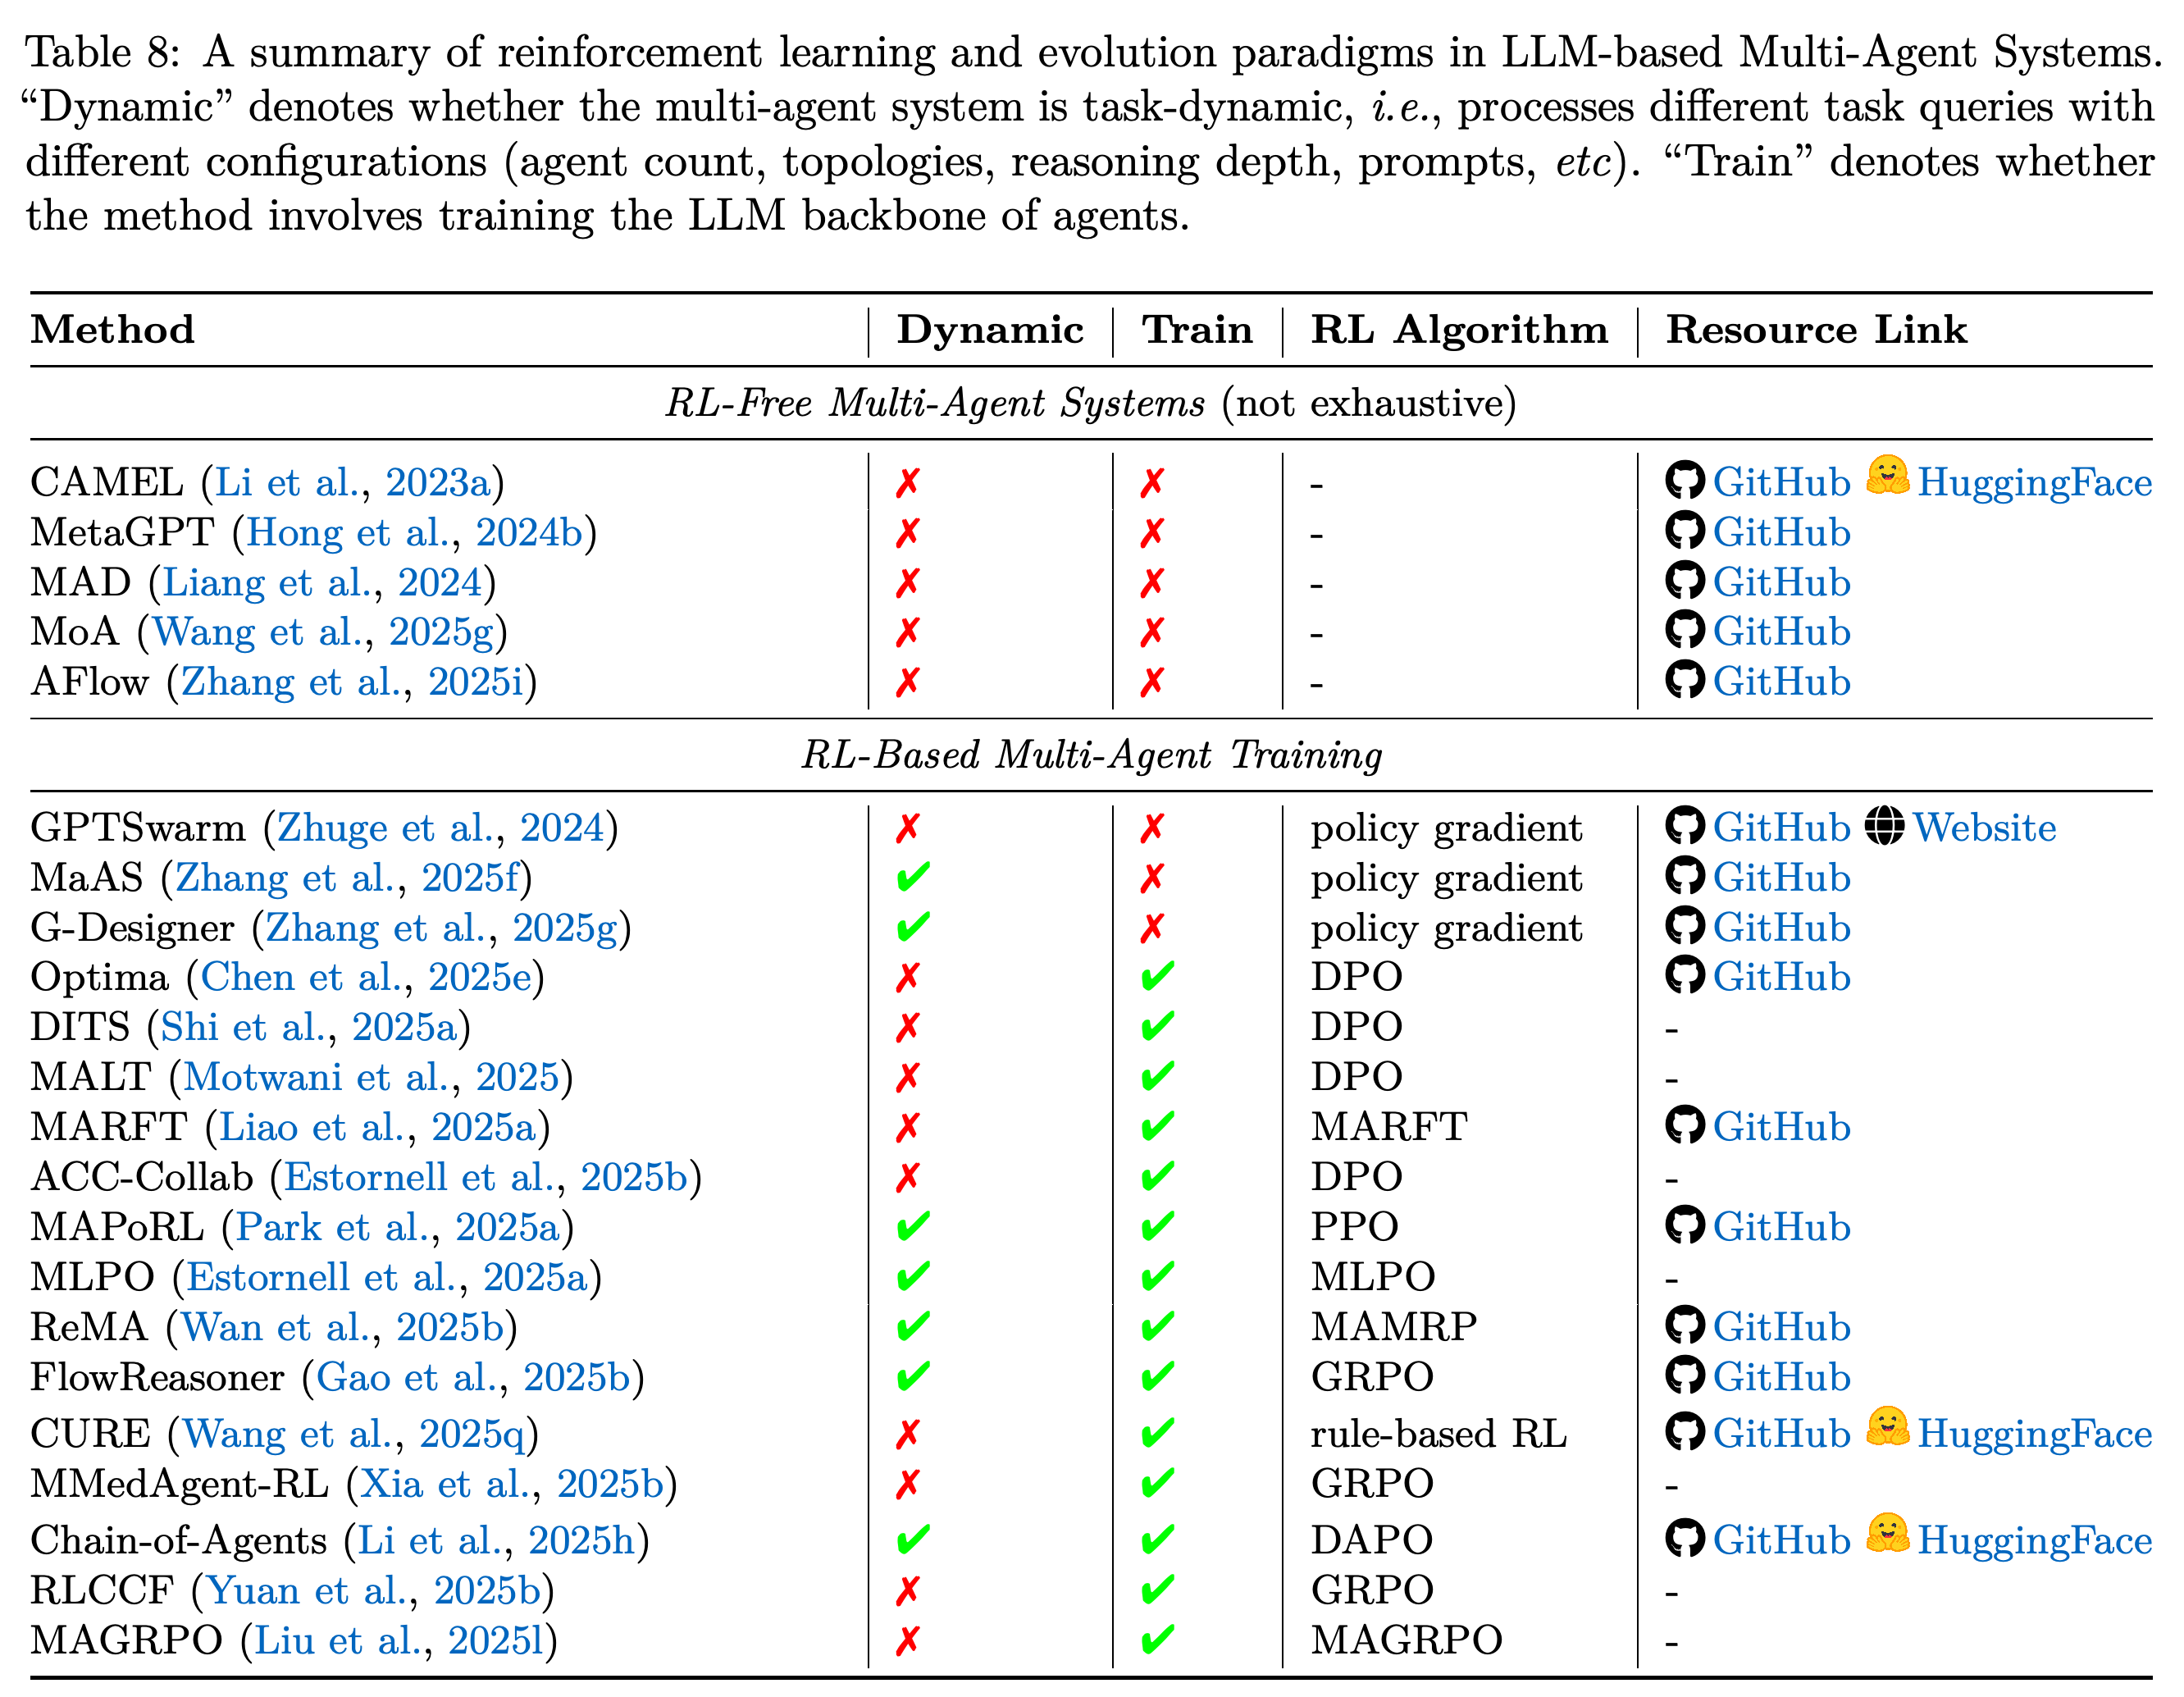
여러 에이전트가 협력적 상호작용으로 과제를 해결하는 multi-agent systems(MAS)는 학습이 외부 협력 구조, 일부 에이전트 정책, 모든 에이전트를 함께 변경하는지에 따라 분류한다. Table 8은 과제에 따른 구성 변경과 에이전트의 LLM backbone 학습을 구분한다.
- RL-Driven Optimization of Non-Parametric Coordination Modules는 에이전트 매개변수를 고정하고 의사소통이나 작업 흐름 구조를 최적화한다. GPTSwarm, MaAS, G-Designer가 그 예다. credit assignment는 연결 구조나 메시지 라우팅 수준에서 이루어진다.
- RL-Driven Optimization of Selected Agent Policies는 일부 에이전트를 갱신하며 전문화, 안정성, 샘플 비용의 균형을 맞춘다. MALT는 지도 학습과 성공 및 실패 추론 경로에서 얻은 선호를 결합한다.
- End-to-End Multi-Agent Reinforcement Learning은 협력을 공동으로 최적화한다. 에이전트마다 별도의 관측과 행동을 갖는 협력적 의사결정 모델인 decentralized POMDP를 사용하는 경우가 많다. MAGRPO, ReMA, SPIRAL은 공동 학습, 계층적 역할, 에이전트 간 상호작용으로 학습하는 self-play를 보여준다. 원문이 “both time and agents”로 표현한 시간과 에이전트 양쪽에 걸쳐 보상을 귀속하는 일은 여전히 어렵다.
Dynamic과 Train 열은 과제에 따른 구성 변경과 LLM 매개변수 갱신을 구분한다. RL 기반 그룹의 방법들이 보여주듯 backbone을 고정한 상태에서도 협력 구조를 최적화할 수 있다.
4.8 Other Tasks
기타 응용에는 텍스트 게임, 데이터베이스 질의, 차트를 코드로 변환하는 생성, 시계열, 일반 질의응답, 사회적 상호작용이 포함된다. 반복적으로 등장하는 메커니즘은 세밀한 보상 귀속, 행동 시퀀스 학습, 적응적 추론 깊이다.
- 서베이는 SkyRL-SQL-7B가 학습 예제 653개를 사용해 SQL 생성 벤치마크에서 GPT-4o와 o4-mini를 능가했다고 보고한다. SQL은 관계형 데이터베이스를 질의하는 언어다. 이 절은 차트를 코드로 변환하는 생성에서 여러 세부 수준의 보상을 사용하는 방법도 다룬다.
- Time-R1과 TimeMaster는 시간적 추론을 다루고, Sotopia-RL은 발화 수준의 다차원 보상을 사용한다. Adaptive Mode Policy Optimization은 추론 모드를 전환하며 GRPO 같은 고정 깊이 방법에 비해 정확도를 높이고 추론을 단축했다고 보고된다.
- Table 9는 과제 분야와 역량 사이의 의존 관계를 핵심, 보조, 최소로 표시한다. 이 표시는 관련 내용을 찾아보는 정성적 지침으로 사용된다.
핵심, 보조, 최소 표시는 응용을 역량 6개와 연결한다. 이 표시는 관련 내용을 찾아보는 정성적 지침이며 실험으로 측정한 중요도 점수는 아니다.
5 Enviroment and Frameworks
인프라 검토는 에이전트 학습을 관측과 보상을 반환하는 환경, 학습을 실행하고 경험을 수집하는 프레임워크와 연결한다. 과제 환경과 벤치마크를 정책 학습용 소프트웨어 시스템과 구분한다.
5.1 Environment Simulator
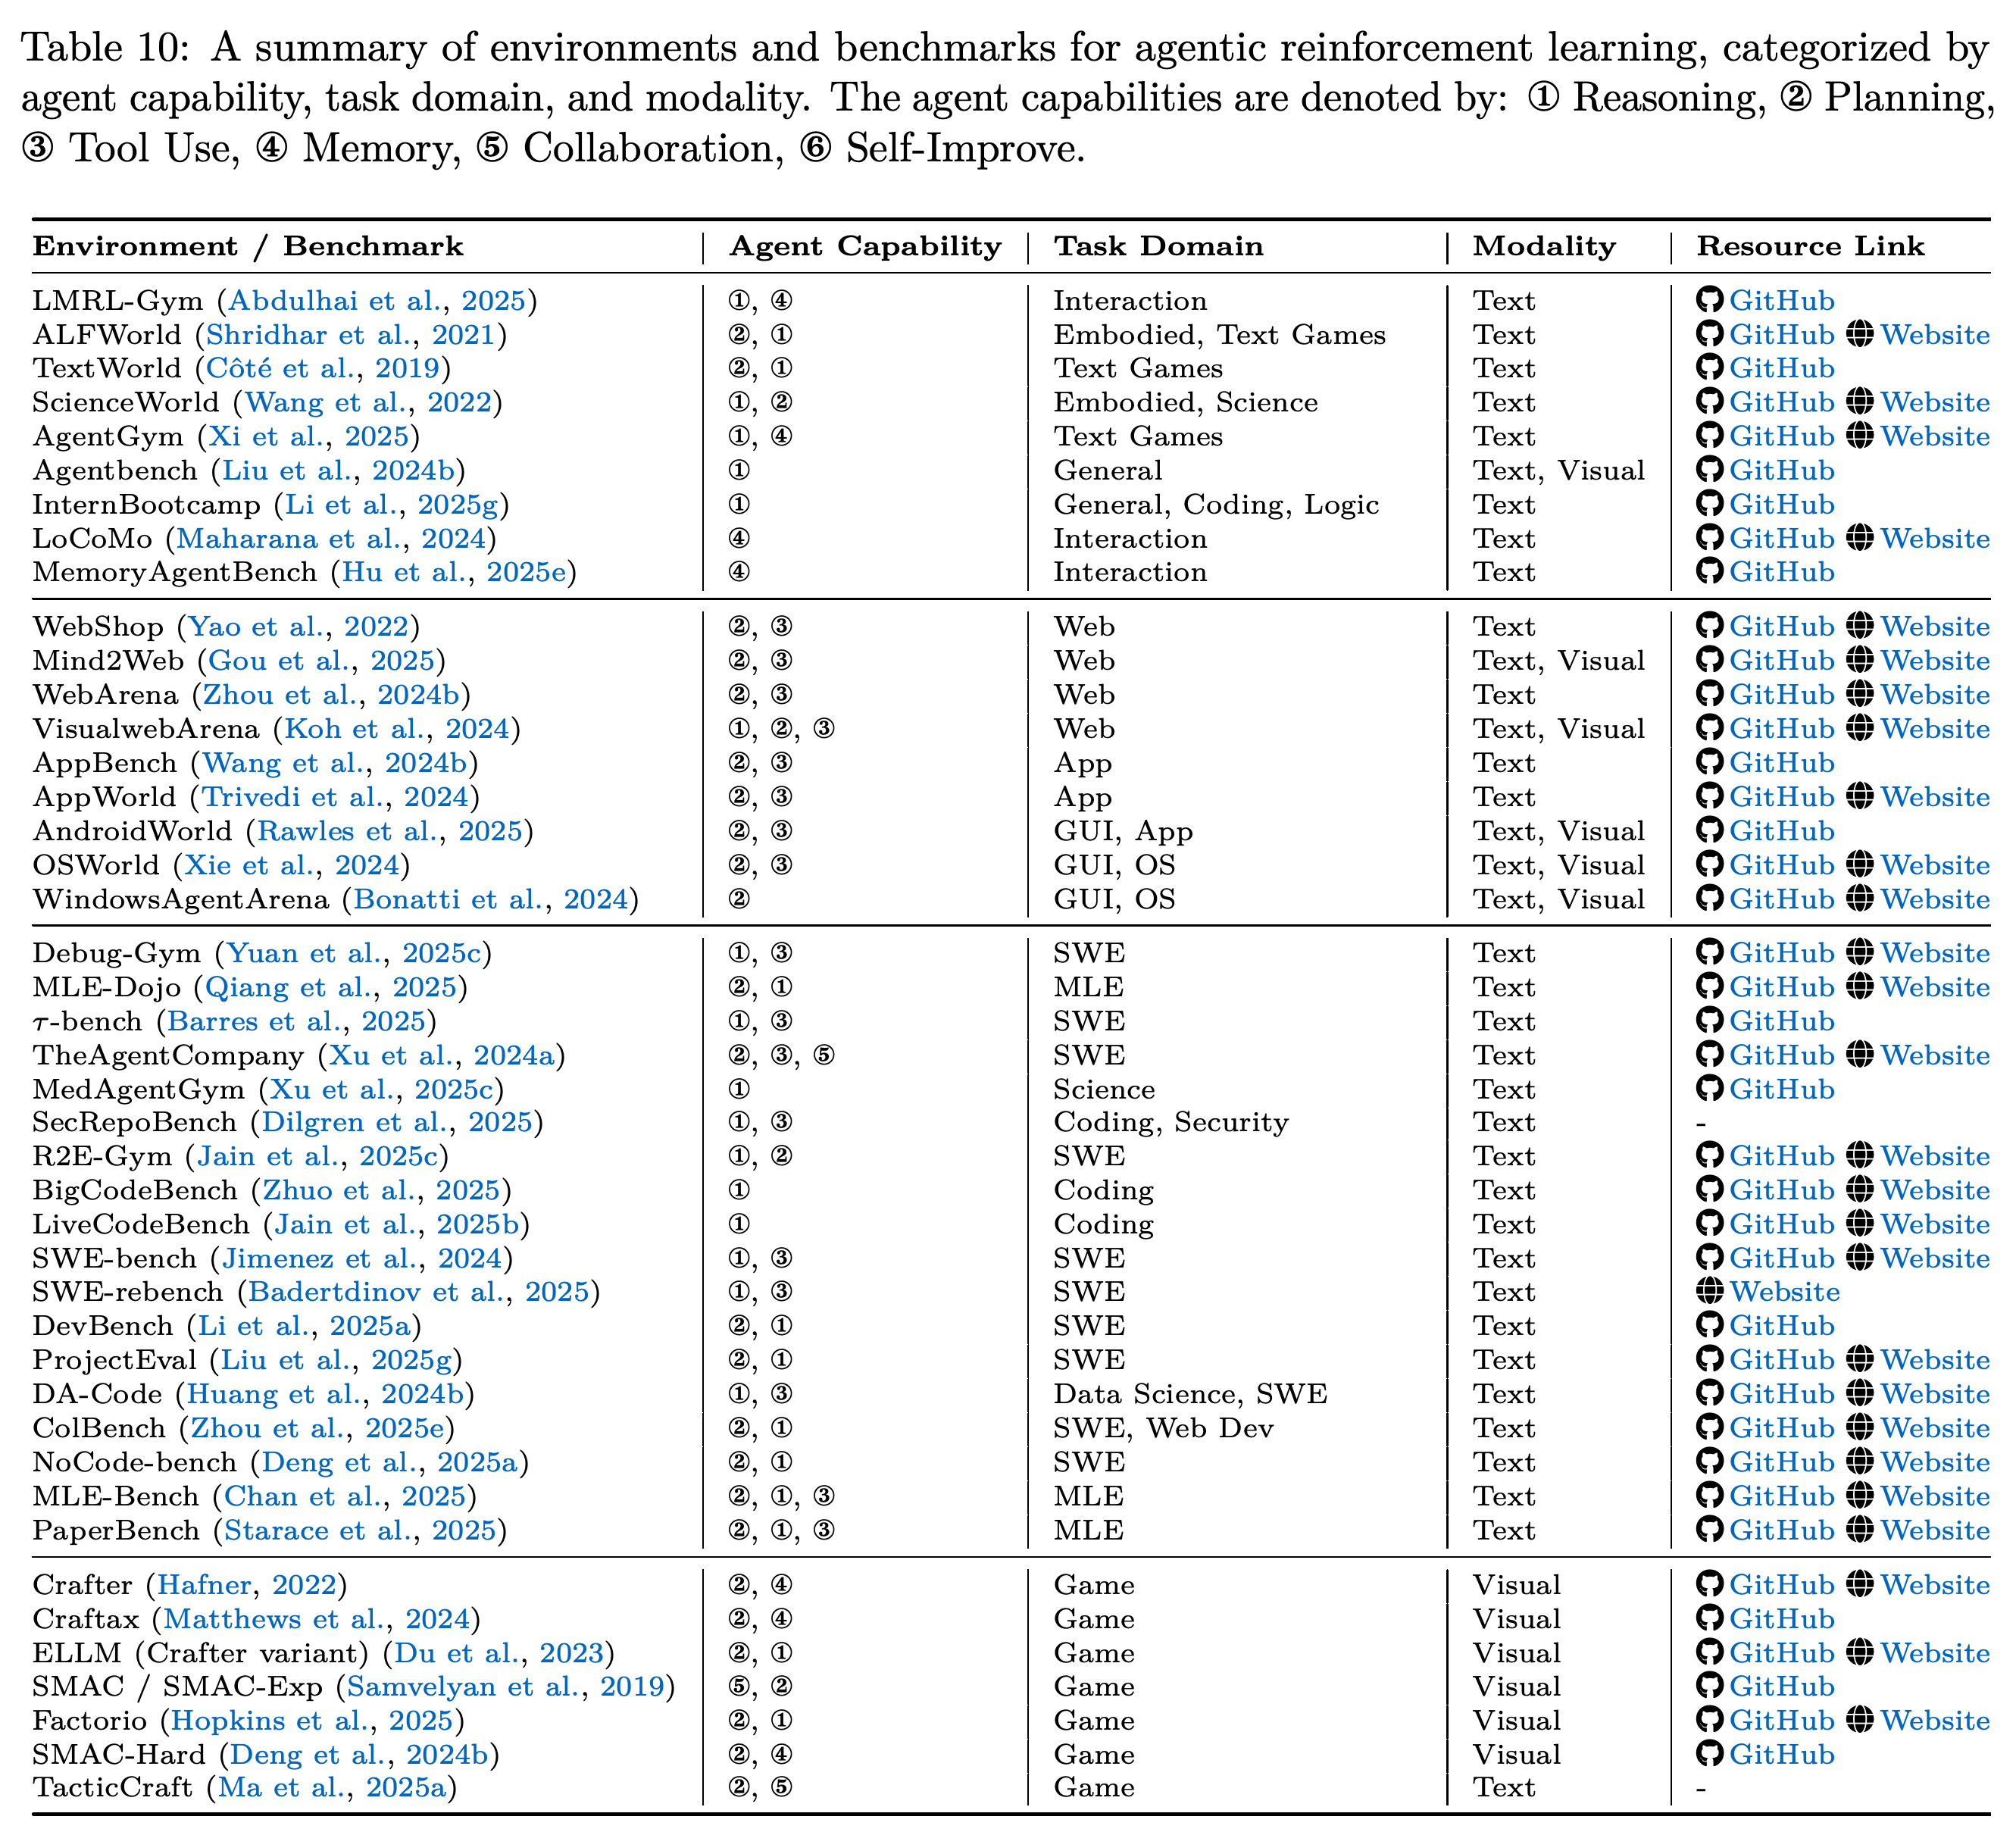
환경 목록은 웹과 GUI 상호작용, 코딩과 SWE, 전문 과학 및 엔지니어링 분야, 게임, 범용 평가를 포함한다. Table 10은 역량, 과제 분야, 모달리티, 자료를 기록한다. 본문은 상호작용 환경을 데이터셋 및 평가 모음과 구분한다.
- Web Environments에는 WebShop, WebArena, VisualwebArena, AppWorld가 포함된다. AppWorld는 애플리케이션 9개, 호출 가능한 API 457개, 가상 인물 약 100명을 포함한다. GUI Environments에는 애플리케이션 20개에 걸친 수작업 과제 116개를 제공하는 AndroidWorld와 Ubuntu, Windows, macOS를 아우르는 OSWorld가 포함된다.
- Coding & Software Engineering Environments에는 평가 모음과 함께 Debug-Gym, 과제 8K개가 넘는 R2E-Gym 같은 상호작용 도구가 포함된다. HumanEval은 과제 164개, MBPP는 974개, BigCodeBench는 1,140개, SWE-rebench는 >21k개를 제공한다. 실행 가능한 세계 모델 벤치마크는 전이의 충실도와 계획에 대한 유용성을 평가한다.
- Domain-specific Environments에는 ICML 2024 논문 20편을 재현하는 PaperBench, Kaggle 대회 75개를 포함하는 MLE-Bench, MedAgentGym, 저장소 27개와 취약점 범주 15개를 포함하는 SecRepoBench가 있다. Simulated & Game Environments에는 TextWorld, Crafter, Craftax, Factorio가 있다. General-Purpose Environments에는 AgentGym, Agentbench, 검증 가능한 추론 과제 1000개가 넘는 InternBootcamp가 있다.
목록은 환경과 벤치마크를 역량, 분야, 모달리티, 자료에 연결한다. 상호작용 환경과 벤치마크 데이터셋을 모두 포함하며 이들은 학습과 평가에서 서로 다른 역할을 한다.
5.2 RL Framework
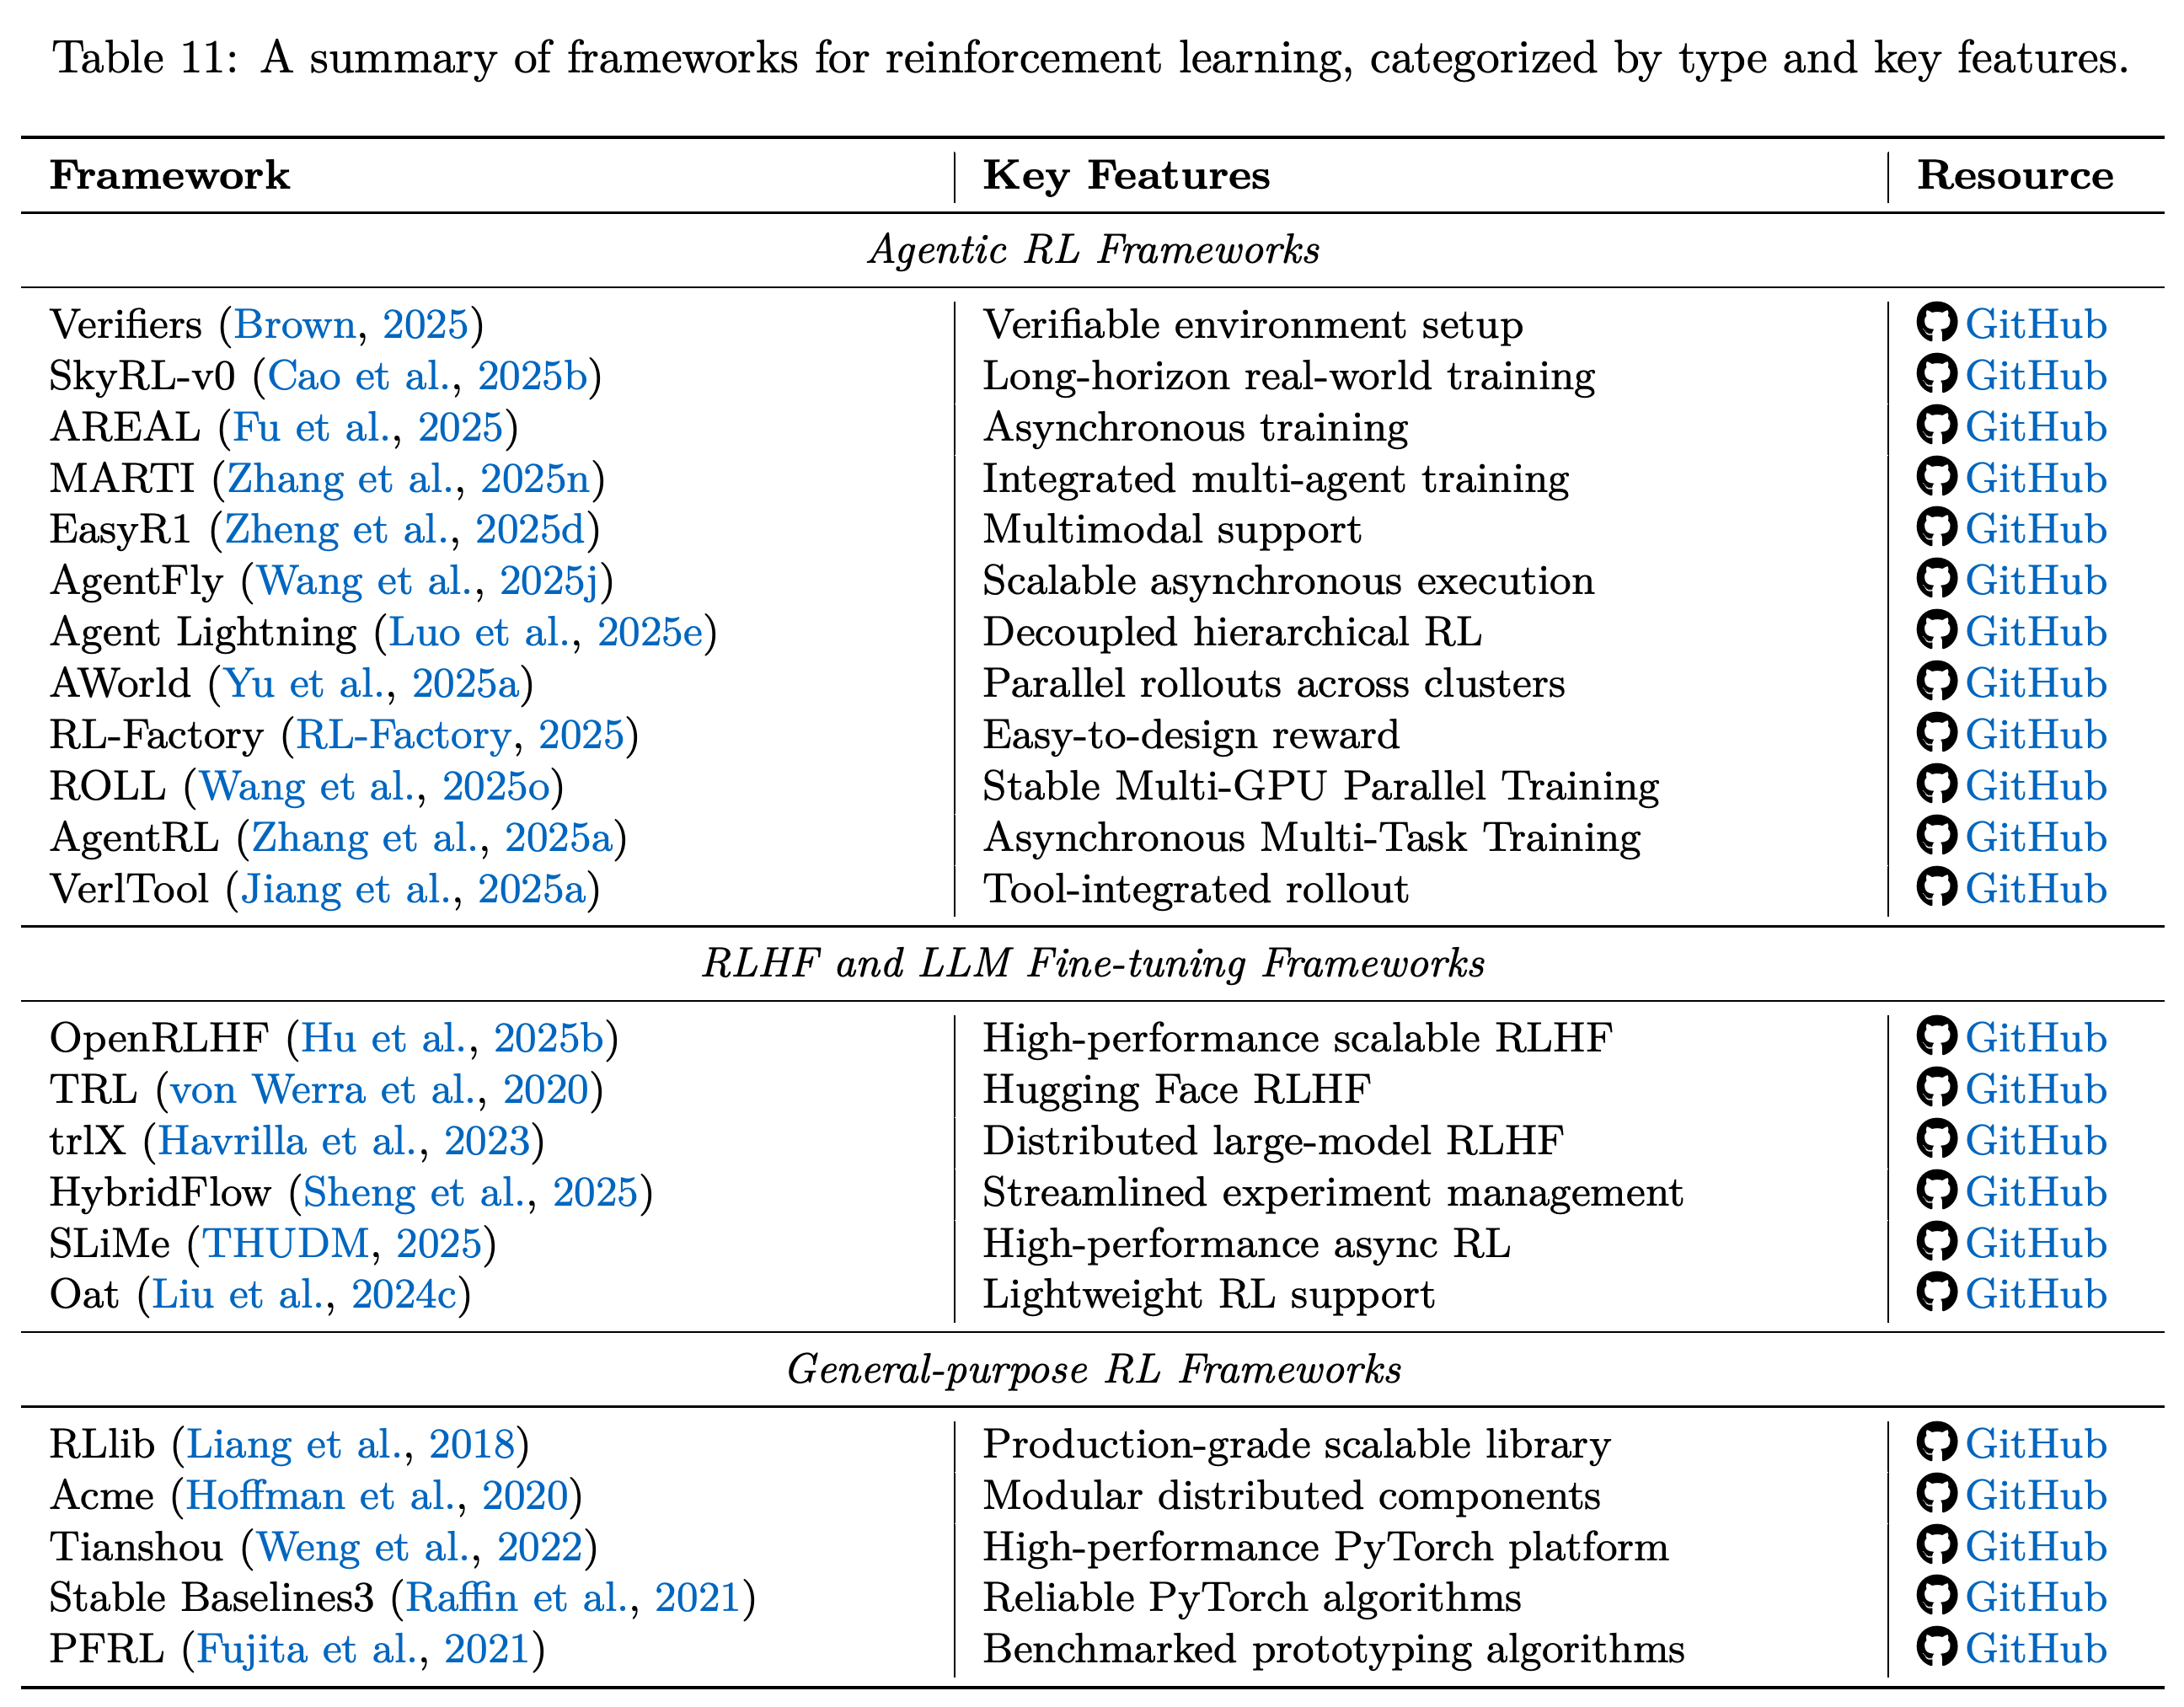
프레임워크 검토는 Agentic RL 시스템, 인간에게서 얻은 선호 신호로 학습하는 reinforcement learning from human feedback(RLHF) 및 LLM 미세조정 도구 모음, 범용 RL 라이브러리를 구분한다. Table 11은 각 프레임워크가 제시하는 기능을 요약한다.
- 에이전트용 시스템에는 Verifiers, SkyRL-v0, AREAL, MARTI, AgentFly, Agent Lightning, AWorld, ROLL, AgentRL, VerlTool이 포함된다. 기능에는 검증 가능한 환경, 비동기 경험 수집, 계층적 학습, 다중 에이전트 학습, 도구 통합 rollout이 포함된다.
- AWorld는 클러스터 전반의 병렬 rollout으로 단일 노드 실행 대비 14.6×의 속도 향상을 달성했다고 보고된다. 서베이는 모든 프레임워크를 동일한 작업 부하에서 비교하지 않는다.
- OpenRLHF, TRL, trlX, HybridFlow, SLiMe, Oat는 모델 후학습을 지원한다. RLlib, Acme, Tianshou, Stable Baselines3, PFRL은 더 폭넓은 학습 알고리즘과 실행 구성 요소를 제공한다.
3개 그룹은 에이전트 중심 인프라, LLM 후학습 도구 모음, 범용 RL 라이브러리를 구분한다. 나열된 기능은 프레임워크 선택에 참고할 수 있지만 표는 공통 작업 부하나 성능 비교를 제공하지 않는다.
6 Open Challenges and Future Directions
미해결 과제 절은 신뢰할 수 있는 행동, 학습 확장, 환경 확장을 중심으로 구성된다. RL이 성능을 개선하는 메커니즘, 배포 아키텍처, 사회적 영향도 검토한다.
6.1 Trustworthiness
신뢰성은 보안, 근거 없이 자신 있게 출력하거나 행동하는 환각, 사용자 신념이 틀려도 동의하는 sycophancy를 포함한다. 도구, 메모리, 에이전트 간 의사소통은 악의적인 외부 콘텐츠와 결함 있는 보상이 행동에 영향을 줄 추가 경로를 만든다.
- 보안 제안에는 제한된 환경 안에서 실행하는 sandboxing, 안전하지 않은 중간 행동에 대한 벌점, 조작에 대응하는 적대적 학습, 도구와 메모리 활동 감시가 포함된다.
- 결과만 최적화하면 중간 추론에 근거가 없어도 최종 정답에 보상을 줄 수 있으며 답할 수 없는 질문에서 응답을 유보하는 행동이 줄어들 수 있다. 논문은 근거를 확인하는 과정 보상과 풀 수 있는 과제 및 풀 수 없는 과제를 함께 사용하는 학습을 다룬다. 효과가 학습 파이프라인에 따라 달라진다는 점도 강조한다.
- sycophancy에 대해서는 무비판적인 동의에 벌점을 주는 보상과, 점수 산정의 허점을 막기 위해 정책과 보상 모델을 함께 조정하는 Cooper를 다룬다.
6.2 Scaling up Agentic Training
학습 규모는 연산량, 모델 용량, 데이터 구성, 알고리즘 효율이 함께 결정한다. 서베이는 ZeroTIR과 ProRL에서 장기 학습으로 얻은 개선을 인용하면서 출력 다양성 감소, 학습 설정에 대한 민감성, 분야 간 간섭을 논의한다.
- 인용된 웹 에이전트 연구는 교사 모델이 생성한 데이터로 SFT를 수행한 뒤 현재 정책의 상호작용으로 학습하는 on-policy RL을 적용하면, 어느 방법을 단독으로 사용했을 때보다 성능이 좋고 순수 SFT 대비 연산량을 절반으로 줄인다고 보고한다. 이 비교는 해당 연구의 조건에 적용된다.
- 분야 간 이점은 초기화와 사전학습에서 접한 데이터에 달려 있다. Guru 데이터셋은 추론 분야 6개를 포함한다. POLARIS와 다른 학습 절차는 난도 조정, 다양한 샘플링, 안정적인 학습을 강조한다.
6.3 Scaling up Agentic Environments
환경 확장은 에이전트를 최적화하는 것뿐 아니라 학습 조건을 학습하거나 생성하는 과정도 포함한다. 논문은 탐색 궤적에서 보상을 자동으로 구성하는 방법과, 관찰된 에이전트의 약점에 맞춰 과제 시퀀스를 조정하는 적응적 커리큘럼을 다룬다.
- EnvGen은 환경 생성 LLM으로 에이전트 성능에 따라 설정을 변경한다. 서베이는 자동 보상과 과제 생성을 상호작용 환경의 부족과 수작업 보상 명세의 높은 비용에 대응하는 접근으로 제시한다.
6.4 The Mechanistic Debate on RL in LLMs
메커니즘 논쟁은 RL이 기존의 성공 궤적이 나올 가능성을 높인다는 증폭 관점과, 학습이 계산 전략을 바꾸거나 도달 가능한 풀이를 확장한다는 새 지식 관점을 대비한다. pass@k는 후보 k개 중 적어도 1개가 정답일 때의 성공률이다. 이는 단일 시도의 신뢰성 개선과 더 넓은 풀이 범위 확보를 구분하는 데 도움이 된다.
- 서베이는 인용한 수학 및 코드 추론 연구 중 약 2/3가 주로 pass@1 개선을 강조하고 약 1/3이 pass@k로 확인되는 풀이 범위의 확장을 보고한다고 추정한다. 그 배후 메커니즘을 입증하는 통제된 통합 실험은 제공하지 않는다.
- 보고된 역량 확장은 신뢰할 수 있는 실행 또는 형식 보상, 검증 가능한 중간 상태를 가진 조합적 과제, 무작위에 가까운 성능과 상한에 가까운 성능 사이에 있는 기본 모델과 관련된다.
- 학습 정확도가 상한에 가까워진 뒤에도 테스트 성능이 개선되는 포화 이후 일반화와 범주 간 전이는 일부 사례에서 확률 재가중치 이상의 변화를 시사한다. RL이 사전학습을 넘어서는 능력을 만드는지는 여전히 미해결 문제다.
6.5 Architectural Patterns for Real-World Agent Deployment
배포 아키텍처는 입력, 출력, 실행을 검사하고 제한하는 guardrail, 에이전트 결정을 사람이 검토하거나 수정하는 human-in-the-loop 검증, 계층적 조율, 의사소통 프로토콜을 중심으로 구성된다. 이 메커니즘은 신뢰하기 어렵거나 지연된 피드백에 대응하고 복잡한 작업 흐름을 조율한다.
- Guardrail에는 입력 제약, 출력 검사, sandbox 실행이 포함된다. 불확실성을 기준으로 인간 개입을 요청할 수 있으며 supervisor–worker 구조는 하위 과제를 조율하고 전역 제약을 적용한다.
- 고정된 의사소통 인터페이스는 예측 가능한 통합을 지원한다. 학습한 채널은 적응을 가능하게 하지만 불안정한 행동을 억제하는 제약인 정규화가 필요하다. 이 절은 각 요소의 기여를 비교하는 배포 ablation 실험 없이 설계 원칙을 종합한다.
6.6 Broader Social Impact
사회적 영향 논의는 오용, 자원 소비, 노동시장 영향, 편향 증폭, 평가 오염을 다룬다. 평가 오염은 학습 정보와 평가 자료가 겹쳐 점수를 부풀릴 수 있는 현상이다. 이 우려들은 새로운 영향 연구가 아니라 인용 문헌에서 나온다.
- 논문은 배포 중 활성화되는 숨겨진 유해 행동과 초급 또는 일상적인 인지 업무에 미칠 수 있는 영향을 논의한다. 서베이는 이 위험과 노동시장 영향을 직접 측정하지 않는다.
- Rollout 생성과 긴 추론은 자원 비용을 높인다. 모델 값을 더 적은 비트로 표현하는 양자화를 완화 수단으로 다룬다. 선호 학습은 주석자의 편향을 강화하거나 소수 집단의 선호를 충분히 반영하지 못할 수 있다. 이에 대응해 공정성을 고려한 보상, 다양한 주석자, 다양성을 유지하는 목표를 논의한다.
- LiveCodeBench, LiveSearchBench, LiveTradeBench, LiveBench 같은 동적 벤치마크는 오염을 줄이고 고정된 평가 모음을 넘어 평가를 개선하는 것을 목표로 한다.
7 Conclusion
결론은 단일 단계 응답 최적화와 장기간의 에이전트–환경 상호작용을 형식적으로 구분한다는 점을 다시 제시한다. 서베이는 역량과 응용 분류를 제공하고 이를 RL 메커니즘과 연결하며 환경, 벤치마크, 프레임워크를 통합해 정리한다.
부록
- 제공된 95페이지 PDF에는 별도 부록이 없다. 본문 논의는 49페이지에서 끝나고, 이후 References가 95페이지까지 이어진다. 검토한 원문은 17 Apr 2026 날짜의 arXiv:2509.02547v5이며, 게재처를 Transactions on Machine Learning Research (01/2026)로 명시한다. 심사 링크는 https://openreview.net/forum?id=RY19y2RI1O이다.
짧은 생각
서베이는 무엇을 최적화하는지, 피드백을 어떻게 만드는지, 학습에 실시간 상호작용이 포함되는지를 구분하여 엔지니어링 결정을 지원한다. Tables 1, 7, 8, 10, 11은 이 구분을 구체화한다. 벤치마크 그래프는 보고된 진전을 보여주지만 기본 모델, 보상, 환경, 후보 수가 서로 달라 최선의 방법이나 RL만의 기여를 판단하는 데 한계가 있다. 반복적으로 등장하는 설계 질문은 중간 피드백이 과제의 진척을 신뢰성 있게 반영하는지다. 장기 도구 사용, 코드 실행, 형식 증명, 신뢰할 수 있는 행동에 대한 논의는 이 선택을 credit assignment와 점수 산정의 허점에 연결한다. MDP/POMDP 구분은 내용을 구성하기 위한 추상화다. 분류에는 프롬프팅, 선호 최적화, 외부 모듈 학습도 포함되므로, 개별 시스템의 실제 관측, 전이, 학습 절차를 살펴봐야 한다.