


Loong: Synthesize Long Chain-of-Thoughts at Scale through Verifiers 요약 설명
03 Sep 2025 | Paper Review Synthetic Data Reasoning LLM-as-a-Judge목차
이번 글에서는 Loong: Synthesize Long Chain-of-Thoughts at Scale through Verifiers 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 3일(Arxiv)
- Huang, Xingyue, Rishabh, Franke, Gregor, Yang, Ziyi, Bai, Jiamu, Bai, Weijie, Bi, Jinhe, Ding, Zifeng, Duan, Yiqun, Fan, Chengyu, et al.
- CAMEL-AI.org
- 논문 링크
- Github
- Project Page
요약
- Loong은 언어 응답을 생성하는 대규모 언어 모델(LLM)을 위해 수학과 프로그래밍 이외 분야에서 검증된 추론 예제가 부족한 문제를 다룬다. GPT-4.1-mini가 질문과 코드를 생성하고 DeepSeek-R1이 결과를 평가하는 설정에서, 시드 예제를 시범으로 제공하는 few-shot prompting은 코드 실행과 평가를 모두 통과한 비율이 Logic에서 92.6%, Physics에서 93.9%에 이른다. 두 분야 모두 Self-Instruct와 Evol-Instruct보다 높은 통과율을 보인다.
- 이 프레임워크는 사람이 검토한 12개 분야의 예제 8,729개로 구성된 시드 데이터셋 LOONGBENCH와 질문, 실행 가능한 코드, 답변을 생성하는 환경 LOONGENV를 결합한다. 검증 과정에서는 코드로 구한 답과 독립적으로 생성한 Chain-of-Thought(CoT) 풀이를 비교한다. CoT는 최종 답에 이르는 자연어 추론이며 정답 여부를 평가하는 언어 모델인 LLM-as-a-judge가 두 답의 의미상 일치 여부를 확인한다.
- Self-Instruct는 다양한 구조화된 프롬프트를 재귀적으로 생성하며 Evol-Instruct는 일반화, 구체화, 복잡도 조정을 통해 시드 질문을 변형한다. 보고된 유사도 측정에서 Evol-Instruct가 생성한 Advanced Physics 질문은 시드에 더 가깝지만 평가한 2개 모델이 풀기에는 더 어렵다. 자동으로 검증한 보상 신호로 학습하는 Reinforcement Learning with Verifiable Reward(RLVR)는 향후 활용 방안으로 남아 있다. 논문은 벤치마크 평가와 생성 평가를 보고하며 생성 데이터를 활용한 후속 학습 실험은 수행하지 않는다.
1 Introduction
서론은 추론 성능을 개선하려면 검증 가능한 답과 충분한 고품질 예제가 모두 필요하다고 주장한다. 논리, 그래프 이론, 물리, 금융 분야는 수학과 프로그래밍만큼 검증된 데이터가 풍부하지 않다. 이에 정제된 시드 데이터를 자동 생성과 검증으로 확장하는 프레임워크를 제안한다.
- 제안한 에이전트와 환경의 반복 과정에서는 질문과 풀이 코드를 생성하고 코드를 실행해 답을 구한 뒤, 학습 가능한 에이전트에 CoT 응답을 요청하여 최종 답 2개를 비교한다.
- 논문이 제시하는 기여는 시드 데이터셋, 모듈식 생성 환경, 모델 유형별 벤치마크 평가, 합성 데이터의 정확성, 다양성, 난이도 분석이다.
생성한 질문은 학습 가능한 에이전트로 전달되며, 합성 답변과 에이전트의 CoT 답변은 검증기로 전달된다. 보상 화살표는 제안한 학습 인터페이스를 나타낸다. 보고된 실험은 이 강화학습 반복 과정을 실행하지 않고 생성과 벤치마크를 평가한다.
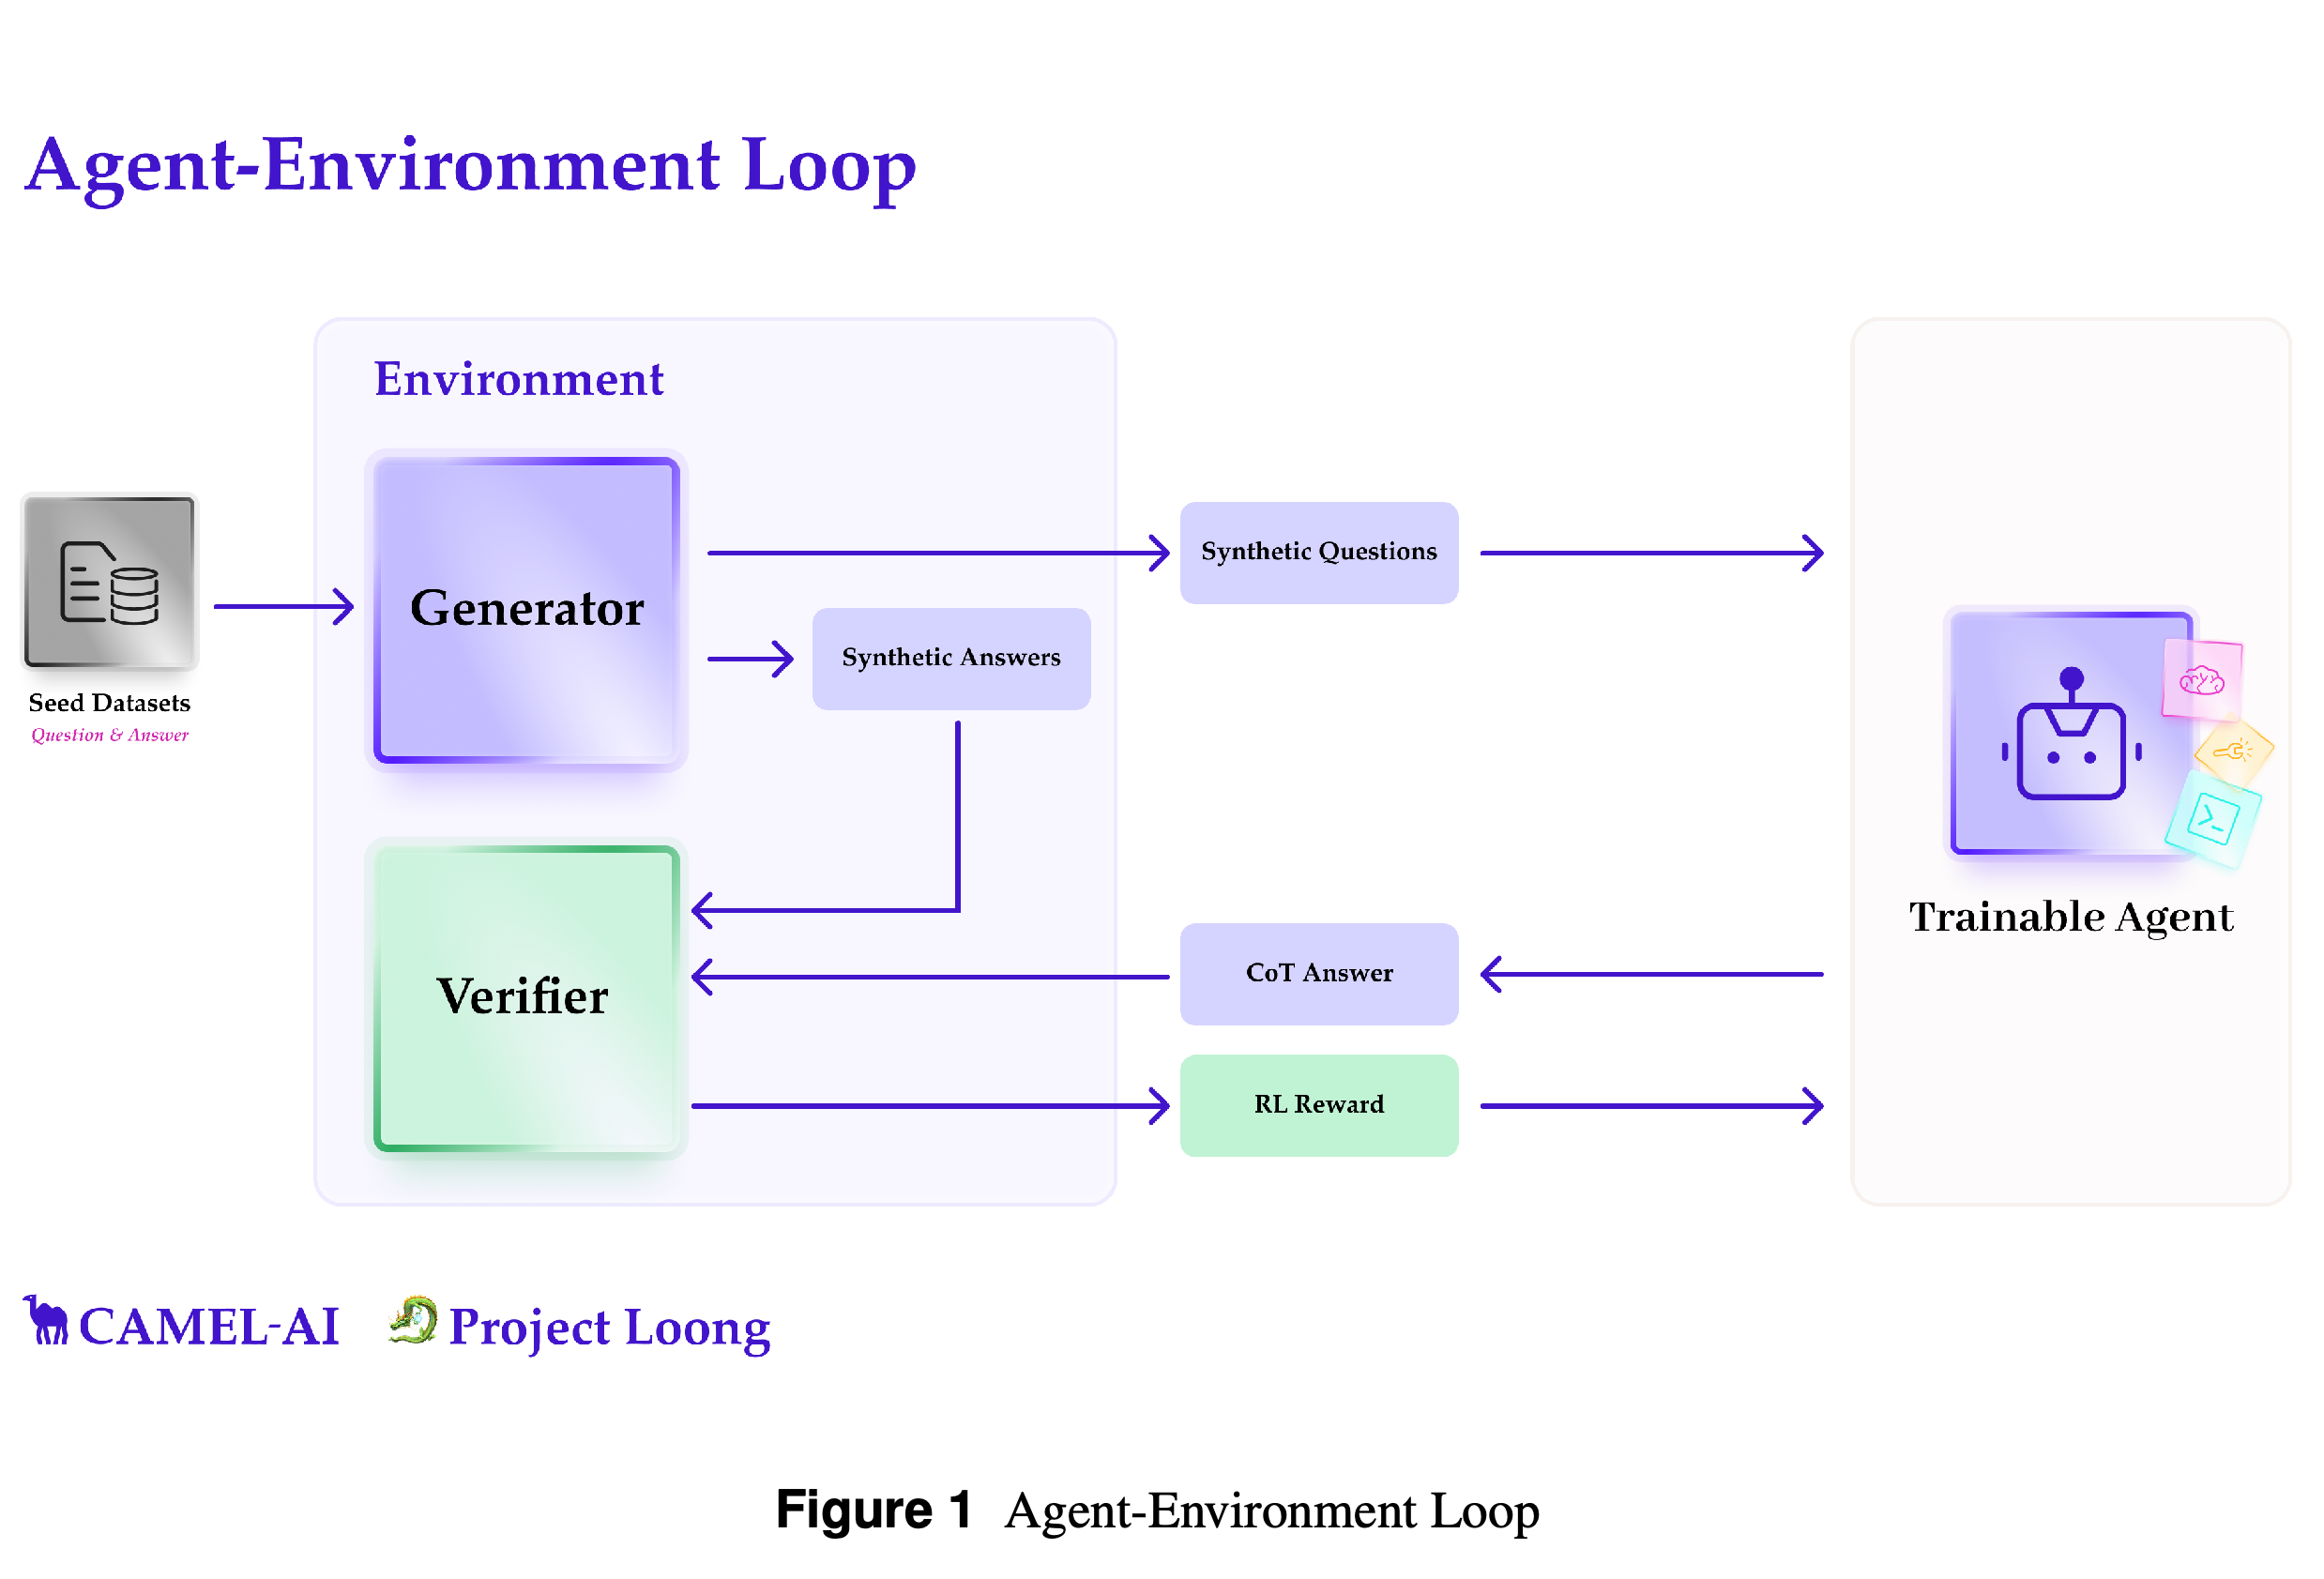
2 Loong Project
Loong Project는 정제된 시드 데이터셋과 이를 확장하는 환경을 분리한다. LOONGBENCH는 분야별 질문과 검증된 코드 기반 풀이를 제공한다. LOONGENV는 생성 정책과 검증기를 교체하면서 추가 예제를 생성할 수 있도록 지원한다.
- 이 설계는 적합한 분야에서 코드 실행이 자연어 추론만 사용할 때보다 더 신뢰할 만한 계산 결과를 제공할 수 있다는 저자들의 전제에 기반한다.
- 검증기는 의미상 일치 여부를 확인하므로, 표현이 달라도 동등한 답이면 통과시킬 수 있다.
2.1 LOONGBENCH: Human-Vetted Seed Datasets Across Multiple Domains
LOONGBENCH는 합성 데이터 생성을 시작하는 시드로 활용하도록 설계되었으며 대규모 학습 코퍼스로 직접 사용하는 것이 목적은 아니다. 논문에 따르면 각 예제는 자연어 질문, 검증된 최종 답, 실행 가능한 Python 풀이 코드, 메타데이터를 포함한다. 메타데이터에는 라이선스, 출처, 분야, 의존성, 이름, 기여자, 생성 날짜, 난이도, 태그가 담긴다.
- Advanced Math: 난이도가 4 또는 5인 MATH 학습 분할에서 문제 1,611개를 가져온다. o3-mini는 기호 수학 라이브러리인 SymPy로 코드를 생성한다. 실행에 성공하고 MathVerifier를 통해 기준 답과 일치한 결과만 남긴다. MathVerifier는 LaTeX 형식의 수학 표현을 파싱하고 평가하는 도구다.
- Advanced Physics: 과학 문제 풀이 벤치마크인 SciBench와 Olympiadbench에서 문제 429개를 가져온다. 생성한 코드의 출력은 단위를 변환한 뒤 검증하며 기본 상대 허용 오차는 0.01이고 기준 답의 정밀도에 따라 조정한다. 각 문제에서 올바른 풀이를 생성하는 시도는 최대 3회로 제한한다.
- Chemistry: 화학 질의응답 데이터셋인 ChemistryQA에서 개념의 명확성과 계산 관련성을 기준으로 예제 3,076개를 선택한다. o3-mini는 화학 개념을 유지하면서 불명확한 예제를 다시 작성하고 구현에 종속된 표현을 제거한다.
- Computational Biology: 생물학 질문을 수집하고 GPT-4o로 코드를 생성한 뒤 실행 여부를 확인한다. GPT-4o-mini는 코드가 질문을 해결하는지, 기준 답과 일치하는지, 답을 하드코딩하는 대신 계산을 수행하는지 평가한다. 이 과정을 거쳐 예제 51개를 남긴다. 텍스트 패턴으로 출력을 비교하는 규칙 기반 정규표현식 매칭으로 추가 검증한다.
- Finance: 금융 모델링 라이브러리인 QuantLib의 자료와 FinAI Financial Reasoning Dataset에서 예제 235개를 가져온다. 금융 추론 과제를 명확히 드러내도록 질문을 유지하거나 다시 작성하고 Python 풀이와 연결한다.
- Board Game: 질문 926개는 Blackjack을 다룬다. 파이프라인은 고정된 상대에게 패배한 서로 다른 라운드 50개를 수집하고 상태와 행동 쌍에 전문가의 풀이 근거와 성찰 지침을 추가한다. 전체 게임 정보를 사용해 후속 진행을 시뮬레이션하고 승리 확률을 추정하는 perfect-information Monte-Carlo roll-outs에서 1위로 평가된 행동만 남긴다.
- Graph & Discrete Math: 네트워크 과학 라이브러리인 networkx 문서에서 예제 178개를 도출한다. 저자들은 함수 896개를 살펴보고 사용 예제가 있는 함수 370개를 확인한다. 무작위 샘플링이나 여러 정답을 허용하는 경우를 제외하고 질문을 다시 작성한 뒤, 실행 여부와 의도한 결과를 수동으로 확인한다.
- Logic: 예제 130개는 연역적으로 항목을 배정하는 Einstein’s Puzzle과 Law School Admission Test의 Analytical Reasoning 질문을 포함한다. 둘 다 주어진 규칙을 만족하는 배정을 찾는 제약 충족 문제다. GPT-4.1-mini는 제약 해결 라이브러리인 python-constraint로 코드를 생성해 풀이 가능성과 해의 유일성을 확인한다.
- Mathematical Programming: 제약 아래에서 목적함수를 최적화하는 문제 76개를 Gurobipy, PySCIPOpt, CVXPY, Statsmodels의 최적화 및 통계 모델링 튜토리얼에서 정제한다. 저자들은 설명이 명확하고 실용적인 노트북을 선택하고 관련 데이터를 유지하거나 다시 생성하며 풀이 코드의 불일치를 수정한다.
- Medicine: 의료 계산 벤치마크인 MedCalc-Bench에서 계산기마다 최대 30개 항목을 샘플링하여 처음에 예제 1,192개를 얻는다. GPT-4.1-generated 풀이 코드는 예제 1,117개에서 실행되며, 출력이 일치한 예제 916개를 남긴다.
- Security & Safety: 예제 516개는 기대한 플래그나 결과를 복원해야 하는 암호학 Capture-The-Flag 문제를 다룬다. 3개 주요 범주와 44개 하위 범주에서 문제를 정제한다. 원래 메시지인 평문과 암호화된 메시지인 암호문을 치환해 다양성을 높이고, 코드 실행으로 검증한 뒤 수동으로 검토한다.
- Programming: 예제 585개는 LeetCode 문제와 모델이 풀이 오류를 찾고 수정을 시도하는 2단계 code-critic 파이프라인을 사용한다. Claude-3.5-Sonnet이 후보 풀이를 생성하고 DeepSeek-R1이 정확성을 평가하며 필요하면 수정을 시도한다.
분야별 예제 수의 합은 8,729개이며 분포는 고르지 않다. Chemistry에는 예제 3,076개가 있지만 Computational Biology에는 51개, Mathematical Programming에는 76개가 있다. 의존성 목록은 각 분야의 계산을 지원하는 도구를 보여주므로, 분야의 범위를 표본 수와 도구 구성과 함께 살펴봐야 한다.
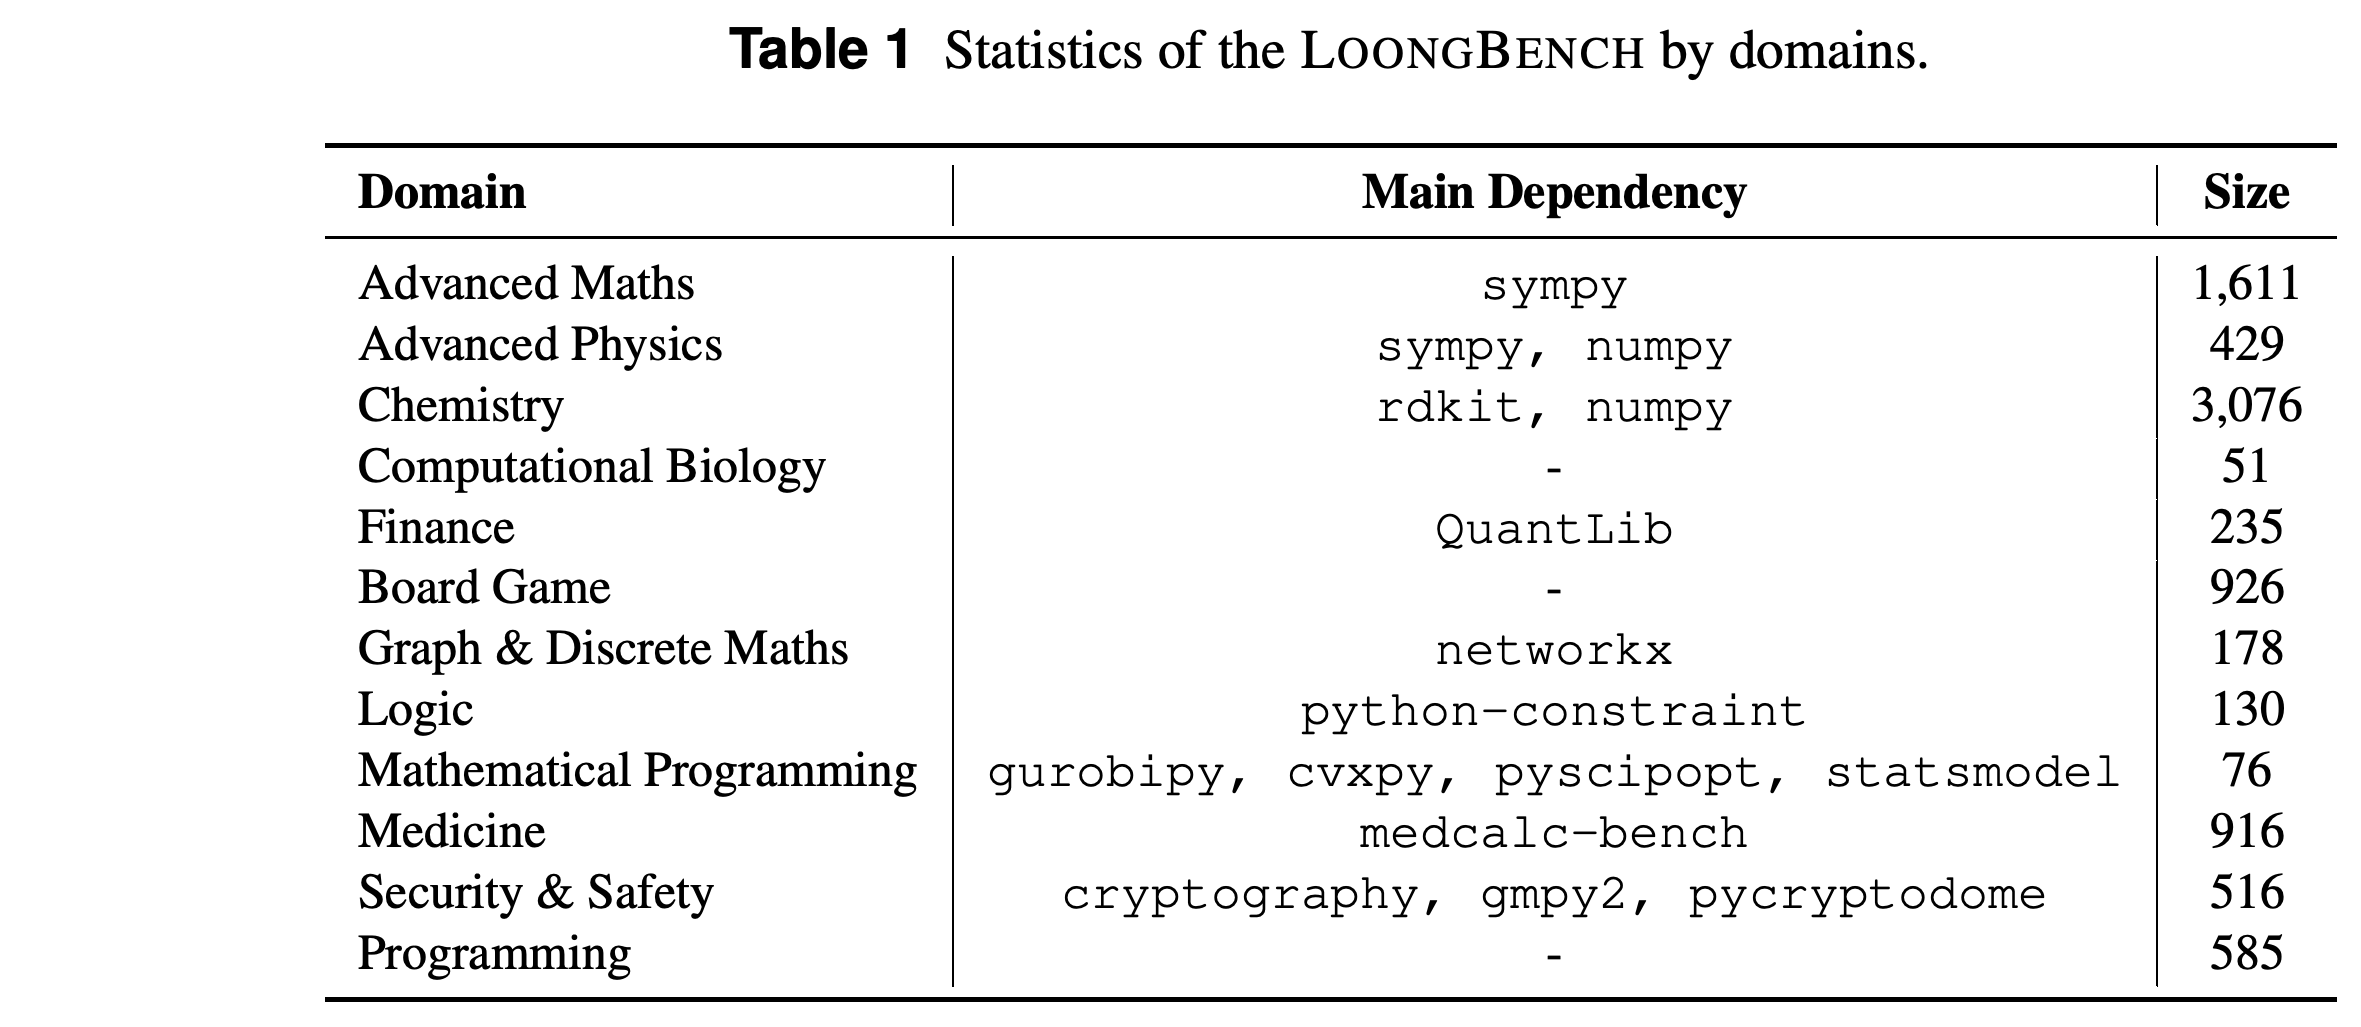
2.2 LOONGENV: Modular Synthetic Generation with Verifiable Supervision
LOONGENV는 질문 합성, 코드 기반 답변 합성, 검증을 분리한다. Few-shot prompting, Self-Instruct, Evol-Instruct를 지원하므로 후속 모듈과 독립적으로 질문 생성 전략을 변경할 수 있다.
- 코드 작성 에이전트는 각 질문에 대한 프로그램을 생성하고 실행한다. 저자들은 실행 성공만으로 정확성이 증명된다고 가정하지 않으며 생성된 합성 답변을 그대로 학습에 직접 사용하지 않는다고 명시한다.
- 검증 설계는 코드로 구한 풀이와 독립적으로 생성한 자연어 풀이를 비교한다. 두 답의 일치는 통과 근거가 되지만 두 방식이 모두 틀린 답에 동의하여 거짓 양성이 발생할 수도 있다.
- 현재 의미 검증기는 LLM-as-a-judge를 사용한다. 분야별 검증기와 검증된 최종 답의 일치 여부에 따른 강화학습 보상은 향후 개발 방안으로 제안한다.
3 Experiments
실험은 LOONGBENCH 분야별 모델 정확도, 생성한 풀이의 실행 가능성과 의미상 타당성, 프롬프팅 전략에 따른 생성 질문의 다양성과 난이도 변화를 살펴본다. 기존 모델과 생성 데이터셋을 평가하며 생성 데이터로 학습한 뒤의 성능 향상은 측정하지 않는다.
3.1 Setup
벤치마크는 전체 12개 분야에서 GPT4.1-mini, o3-mini, Grok-3, Claude-3.7-Sonnet, DeepSeek-r1, Qwen3-8B를 비교한다. 각 프롬프트에서 재시도 없이 응답 1개를 생성한다. 별도 언급이 없으면 함수 및 도구 호출을 비활성화하며 최대 출력 길이는 4096 토큰이다.
- 저자들은 적용 가능한 경우 temperature, top-k, top-p 설정을 일관되게 사용했다고 보고한다. 이 설정들은 각각 샘플링의 변동성을 제어하고 후보 토큰을 개수로 제한하며 누적 확률로 제한한다. 이 절에는 구체적인 설정값이 제시되지 않는다. 공개 모델 추론에는 NVIDIA H100 80GB GPU 1개를 사용한다.
- 정확도는 분야별 문제에서 정답을 맞힌 비율이다. GPT4.1-mini는 값이나 의미가 같은 수학 표현의 기호적 동등성과 답변 형식 차이를 고려해 정답 여부를 평가한다.
- 논문은 일부 Mathematical Programming 응답이 4096 토큰 한도를 넘어 불완전해진다고 인정한다. 따라서 낮은 정확도를 과제 난이도만으로 해석하기 어렵다.
- 구현은 에이전트 워크플로에 CAMEL 프레임워크를 사용하며 프로젝트 코드는 https://github.com/camel-ai/loong 에 공개되어 있다.
3.2 Benchmarking LOONGBENCH
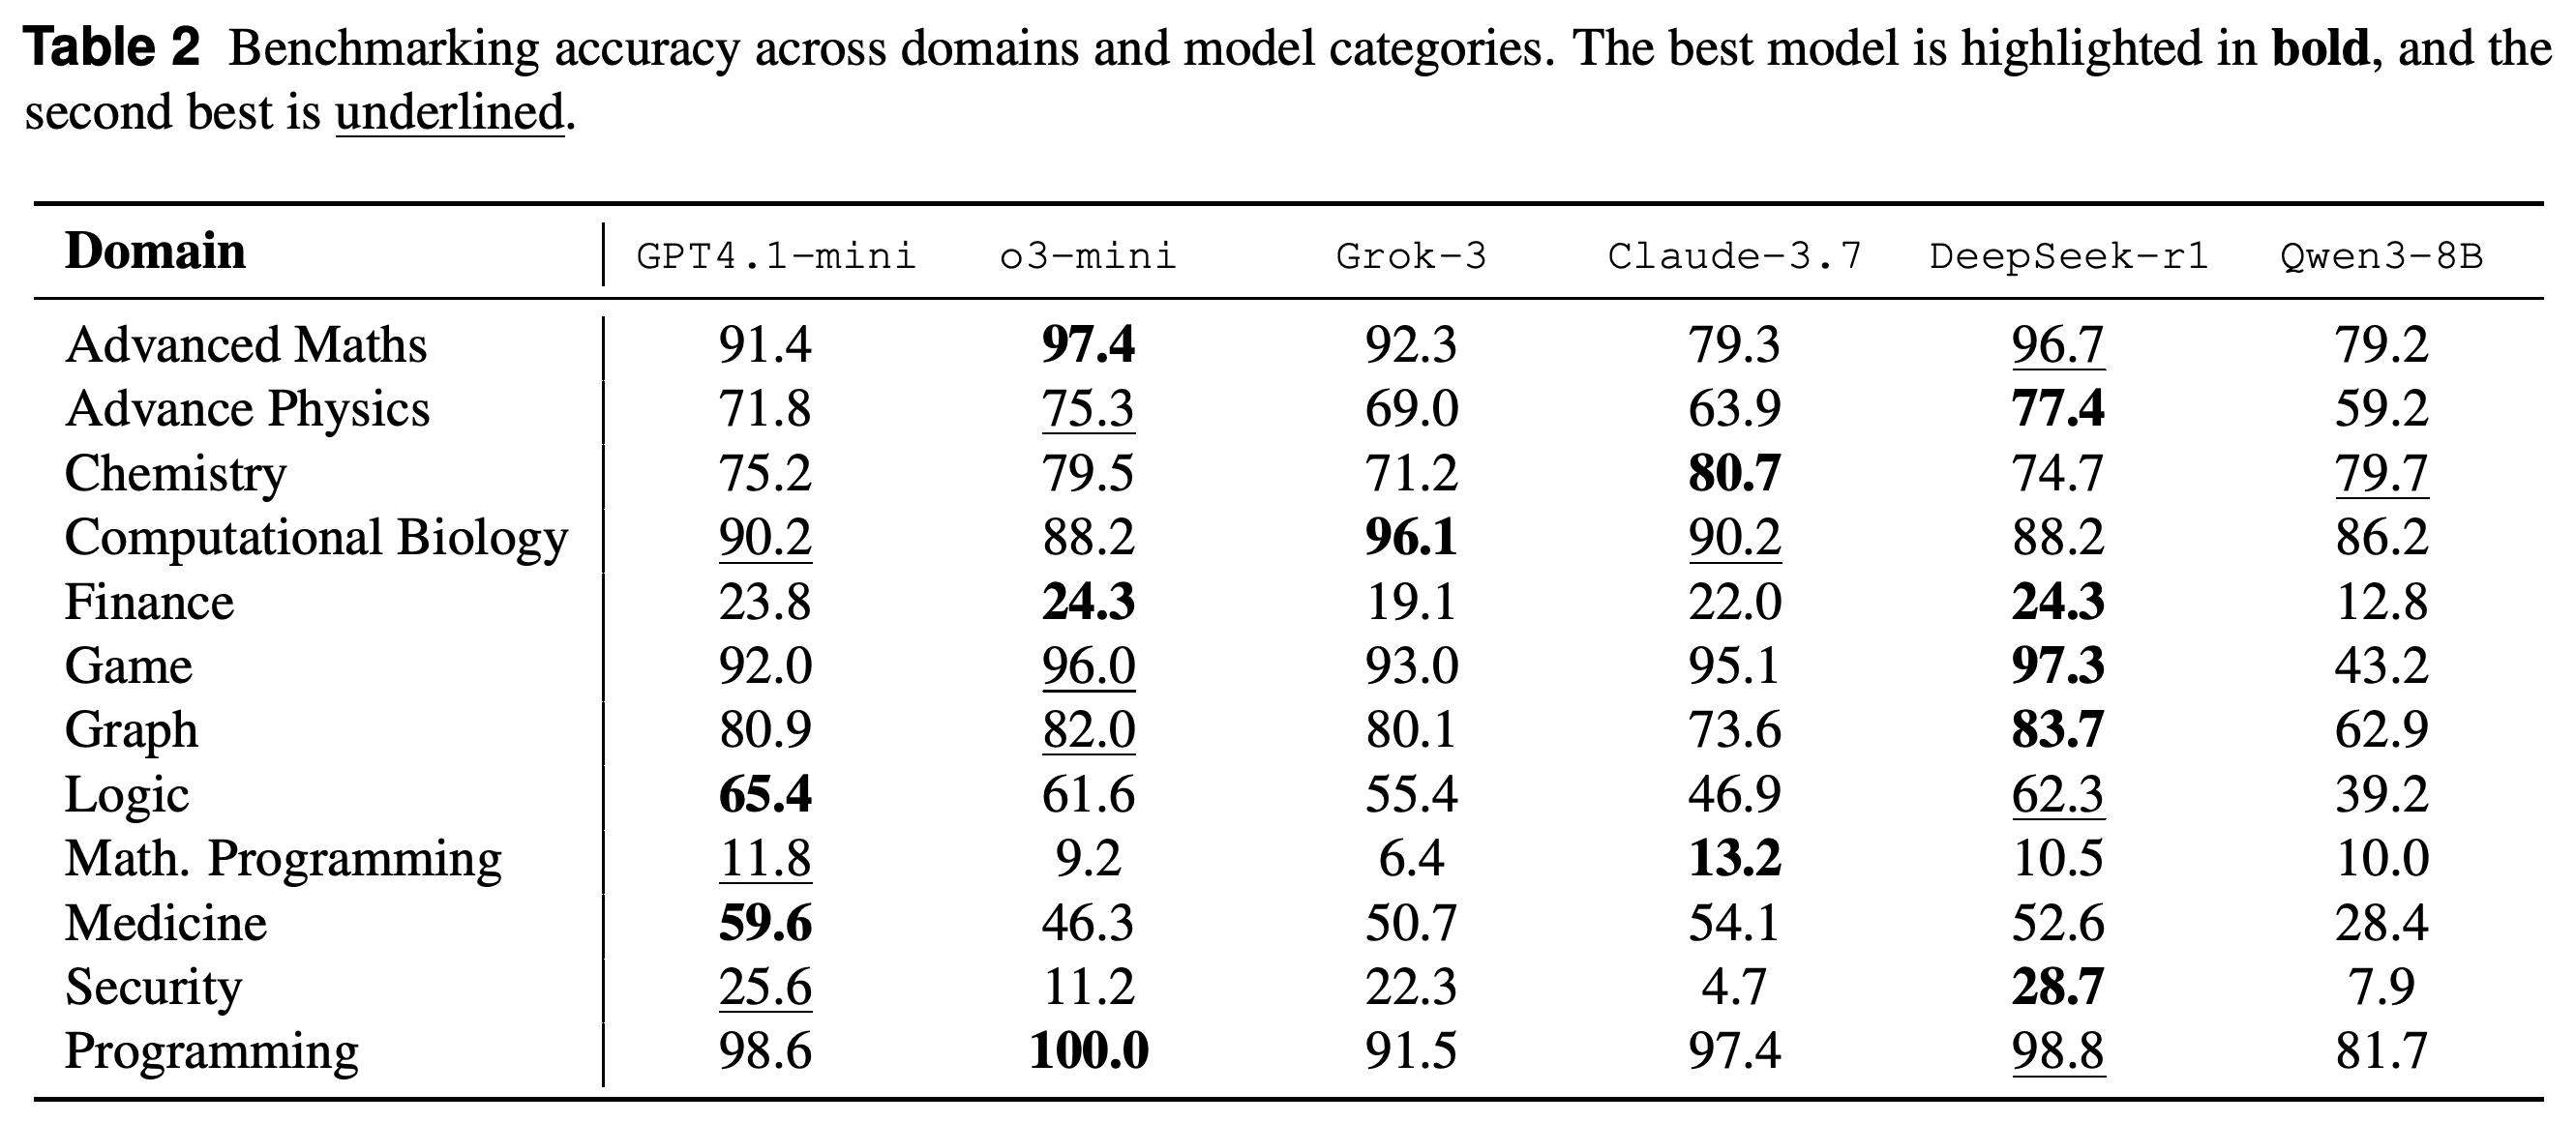
LOONGBENCH에서는 분야별 성능 차이가 크다. Programming 정확도는 81.7%에서 100.0%인 반면, Mathematical Programming은 6.4%에서 13.2%다. Finance와 Security도 점수가 낮으며 보고된 최고 정확도는 각각 24.3%와 28.7%다.
- DeepSeek-r1은 Advanced Physics에서 77.4%, Game에서 97.3%, Graph에서 83.7%, Security에서 28.7%로 가장 높은 정확도를 보이며 Finance에서는 24.3%로 o3-mini와 동률이다. o3-mini는 Advanced Maths에서 97.4%, Programming에서 100.0%로 가장 높은 정확도를 보인다.
- 가장 높은 성능을 보이는 모델은 분야마다 다르다. GPT4.1-mini는 Logic에서 65.4%, Medicine에서 59.6%로 앞선다. Grok-3는 Computational Biology에서 96.1%, Claude-3.7은 Chemistry에서 80.7%, Mathematical Programming에서 13.2%로 앞선다.
- 저자들은 DeepSeek-r1이 12개 분야 중 8개에서, o3-mini가 12개 분야 중 6개에서 상위 2위 안에 들었다고 보고한다. 이 집계는 해당 모델들이 여러 분야에서 경쟁력이 있음을 뒷받침하지만 다른 모델이 앞서는 분야도 여럿 있다.
- 본문은 Qwen3-8B가 o3-mini보다 Game에서 50%p, Logic에서 22%p 뒤처진다고 설명한다. 표에 제시된 점수는 각각 43.2% 대 96.0%, 39.2% 대 61.6%이므로 실제 차이는 각각 52.8%p와 22.4%p다. DeepSeek-r1의 결과를 보면 Qwen3-8B의 성능 열세를 오픈소스 모델 전반으로 일반화할 근거는 없다.
모든 분야에서 앞서는 모델은 없다. Programming 점수는 100.0%에 이르지만 Mathematical Programming 점수는 6.4%에서 13.2%에 머문다. DeepSeek-r1은 여러 분야에서 앞서고, GPT4.1-mini는 Logic과 Medicine에서 앞선다. 이 표는 분야별 비교에 직접적인 근거를 제공하며 오픈소스 모델과 독점 모델의 전반적인 순위를 정하는 근거는 그보다 약하다.
3.3 Synthesizing Data with LOONGENV
합성 데이터 생성에서는 별도의 질문 에이전트와 코드 에이전트가 모두 GPT-4.1-mini를 사용하며 DeepSeek-R1이 검증 평가자를 맡는다. 구현 설명에 따르면 무작위로 선택한 시드 예제로 분야와 전략마다 합성 질문 100개를 생성한다.
- 각 프로그램은 생성 코드를 격리해 실행하는 샌드박스 Python 환경에서 실행된다. 실행 성공 여부는 오류 없이 실행되는지를 측정한다. 평가자는 질문이 의미 있는지, 코드가 해당 질문을 해결하는지를 별도로 평가한다.
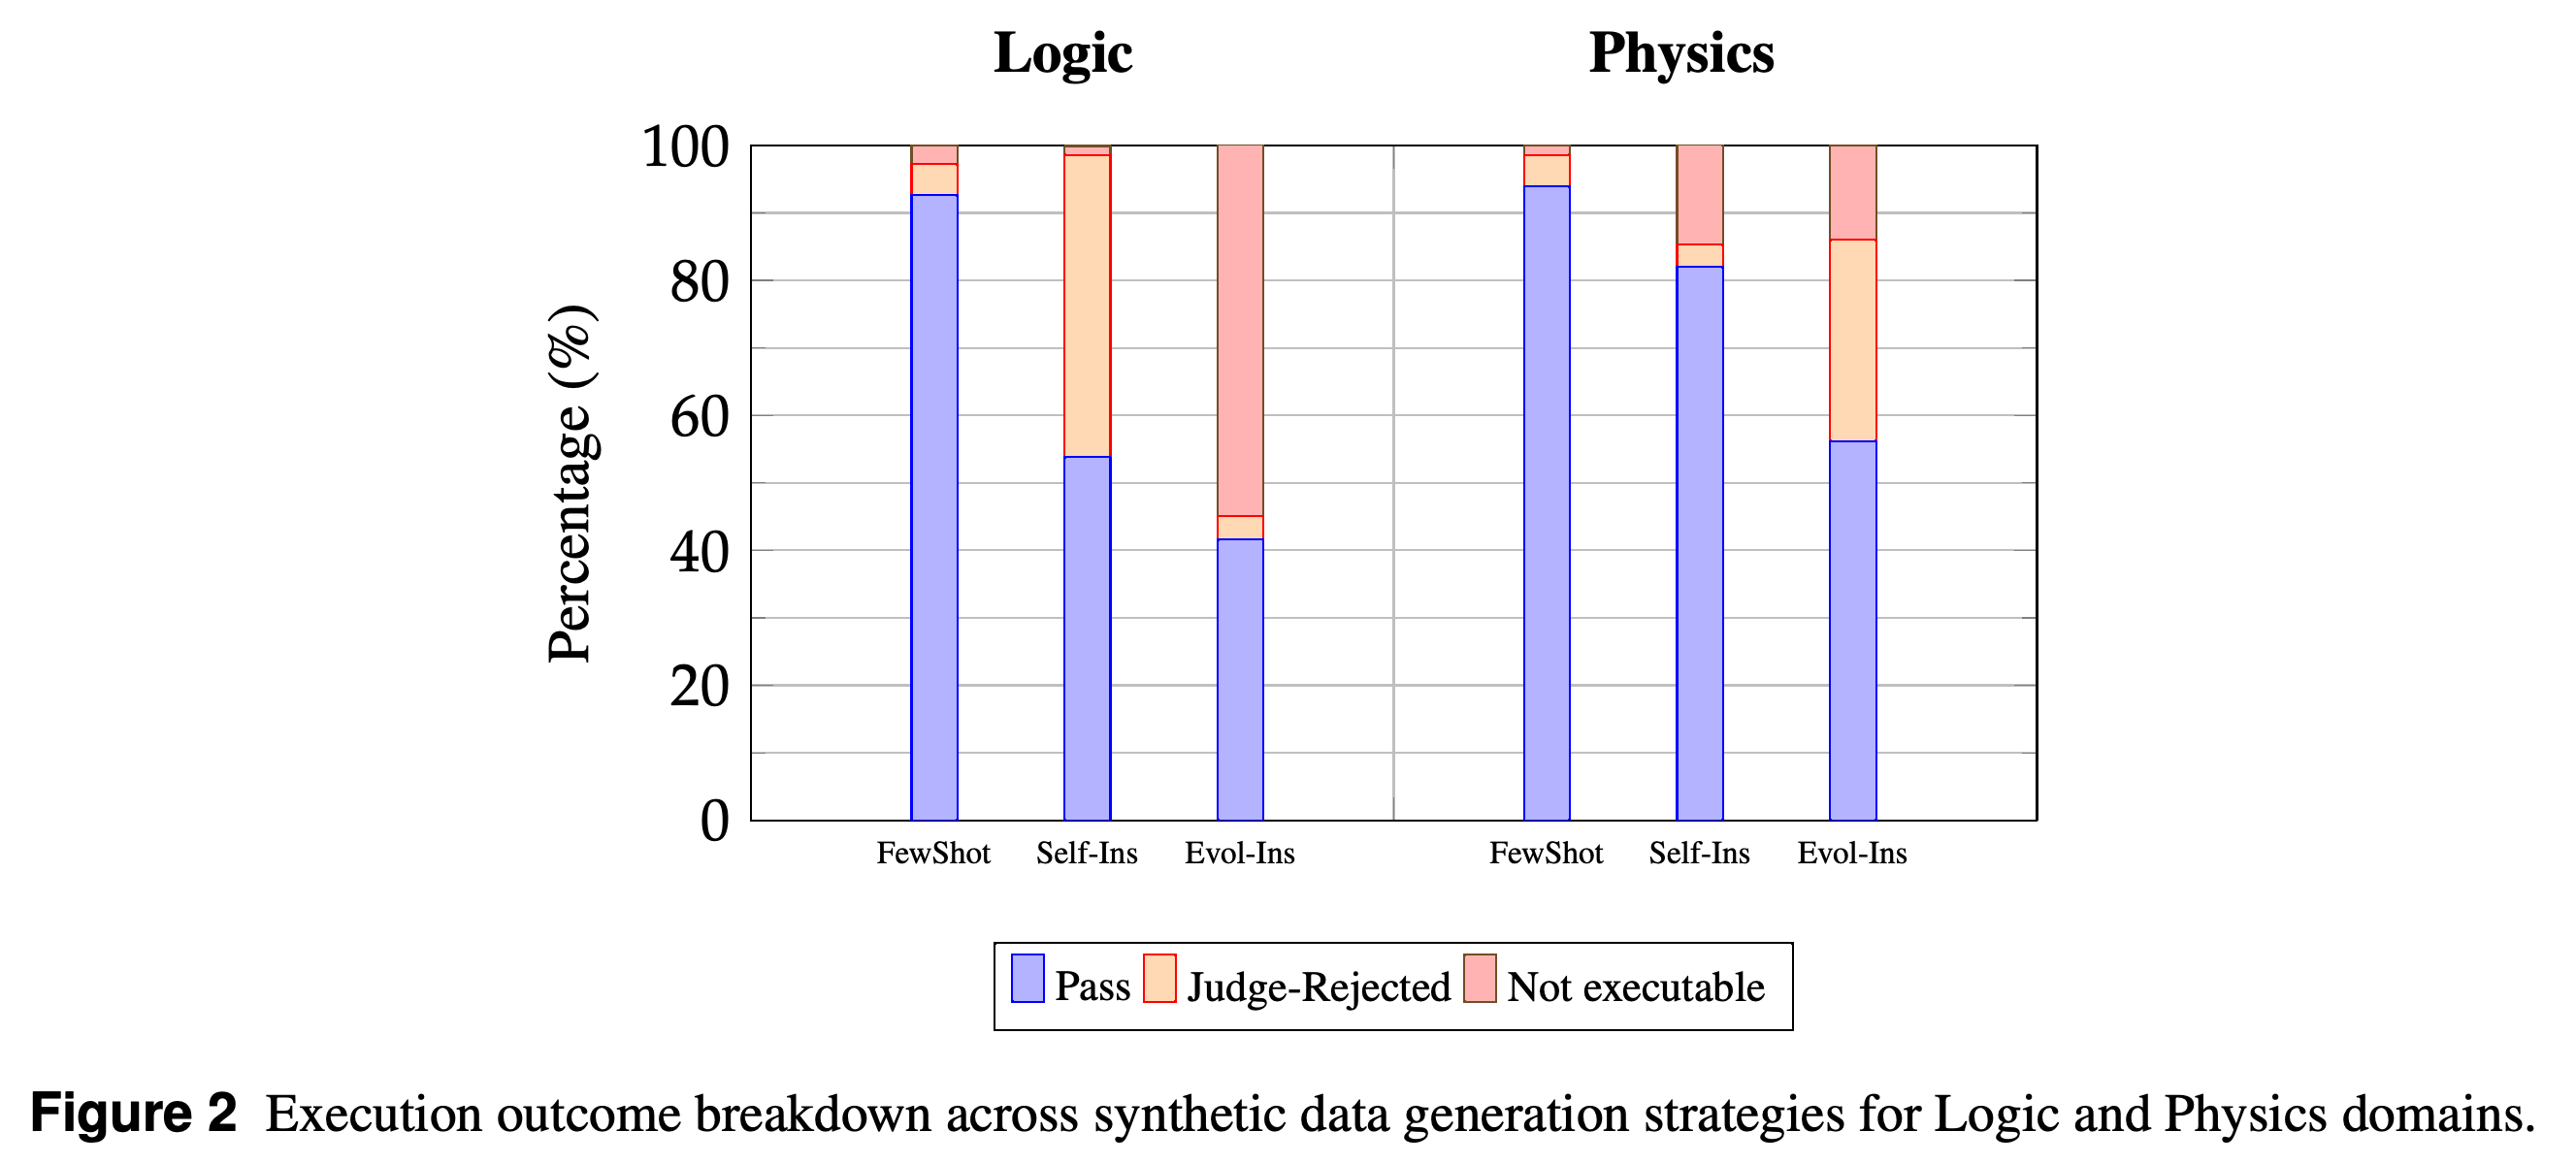
3.3.1 Execution and Verification Outcomes는 결과를 Pass, Judge-Rejected, Not Executable로 구분한다. Pass는 코드가 실행되고 평가자가 답을 승인한 경우다. Judge-Rejected는 코드가 실행되지만 평가자가 결과를 거부한 경우이며 Not Executable은 코드 실행에 실패한 경우다. FewShot의 Pass 비율은 Logic에서 92.6%, Physics에서 93.9%다. Self-Instruct는 Logic에서 평가자 거부 비율이 44.8%이며, Physics에서 Pass 비율이 82.0%다.
- Evol-Instruct는 Logic에서 코드의 55.0%가 실행 불가능하다. Physics에서는 예제의 29.8%가 평가자에게 거부되고 14.0%가 실행에 실패한다.
- FewShot은 보고된 두 분야에서 모두 가장 높은 통과 비율을 보인다. 별도의 거부 범주는 코드가 실행에 성공해도 질문을 해결했다고 볼 수 없음을 보여준다.
누적 막대는 실행에 실패한 코드와 실행되었지만 평가자가 거부한 코드를 구분한다. FewShot은 두 분야에서 모두 통과한 비중이 가장 크다. Evol-Instruct의 Logic 실패는 실행 불가능한 코드가 대부분이며 Physics 실패에서는 평가자가 거부한 결과도 상당한 비중을 차지한다.
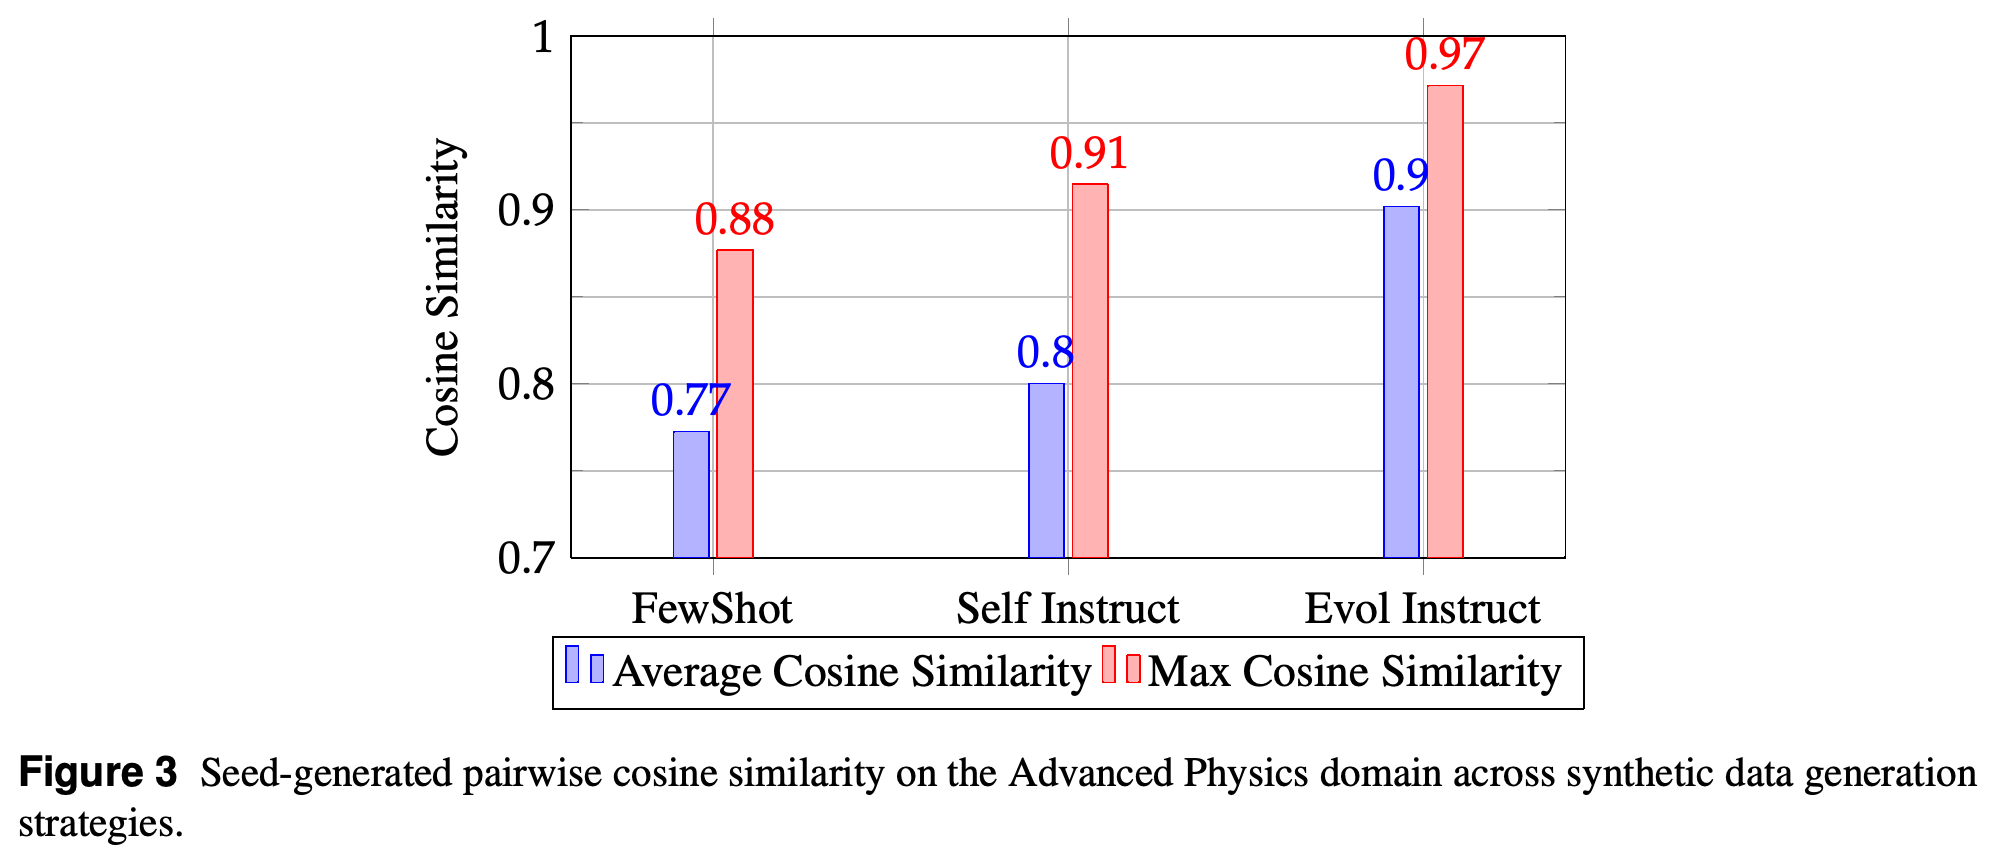
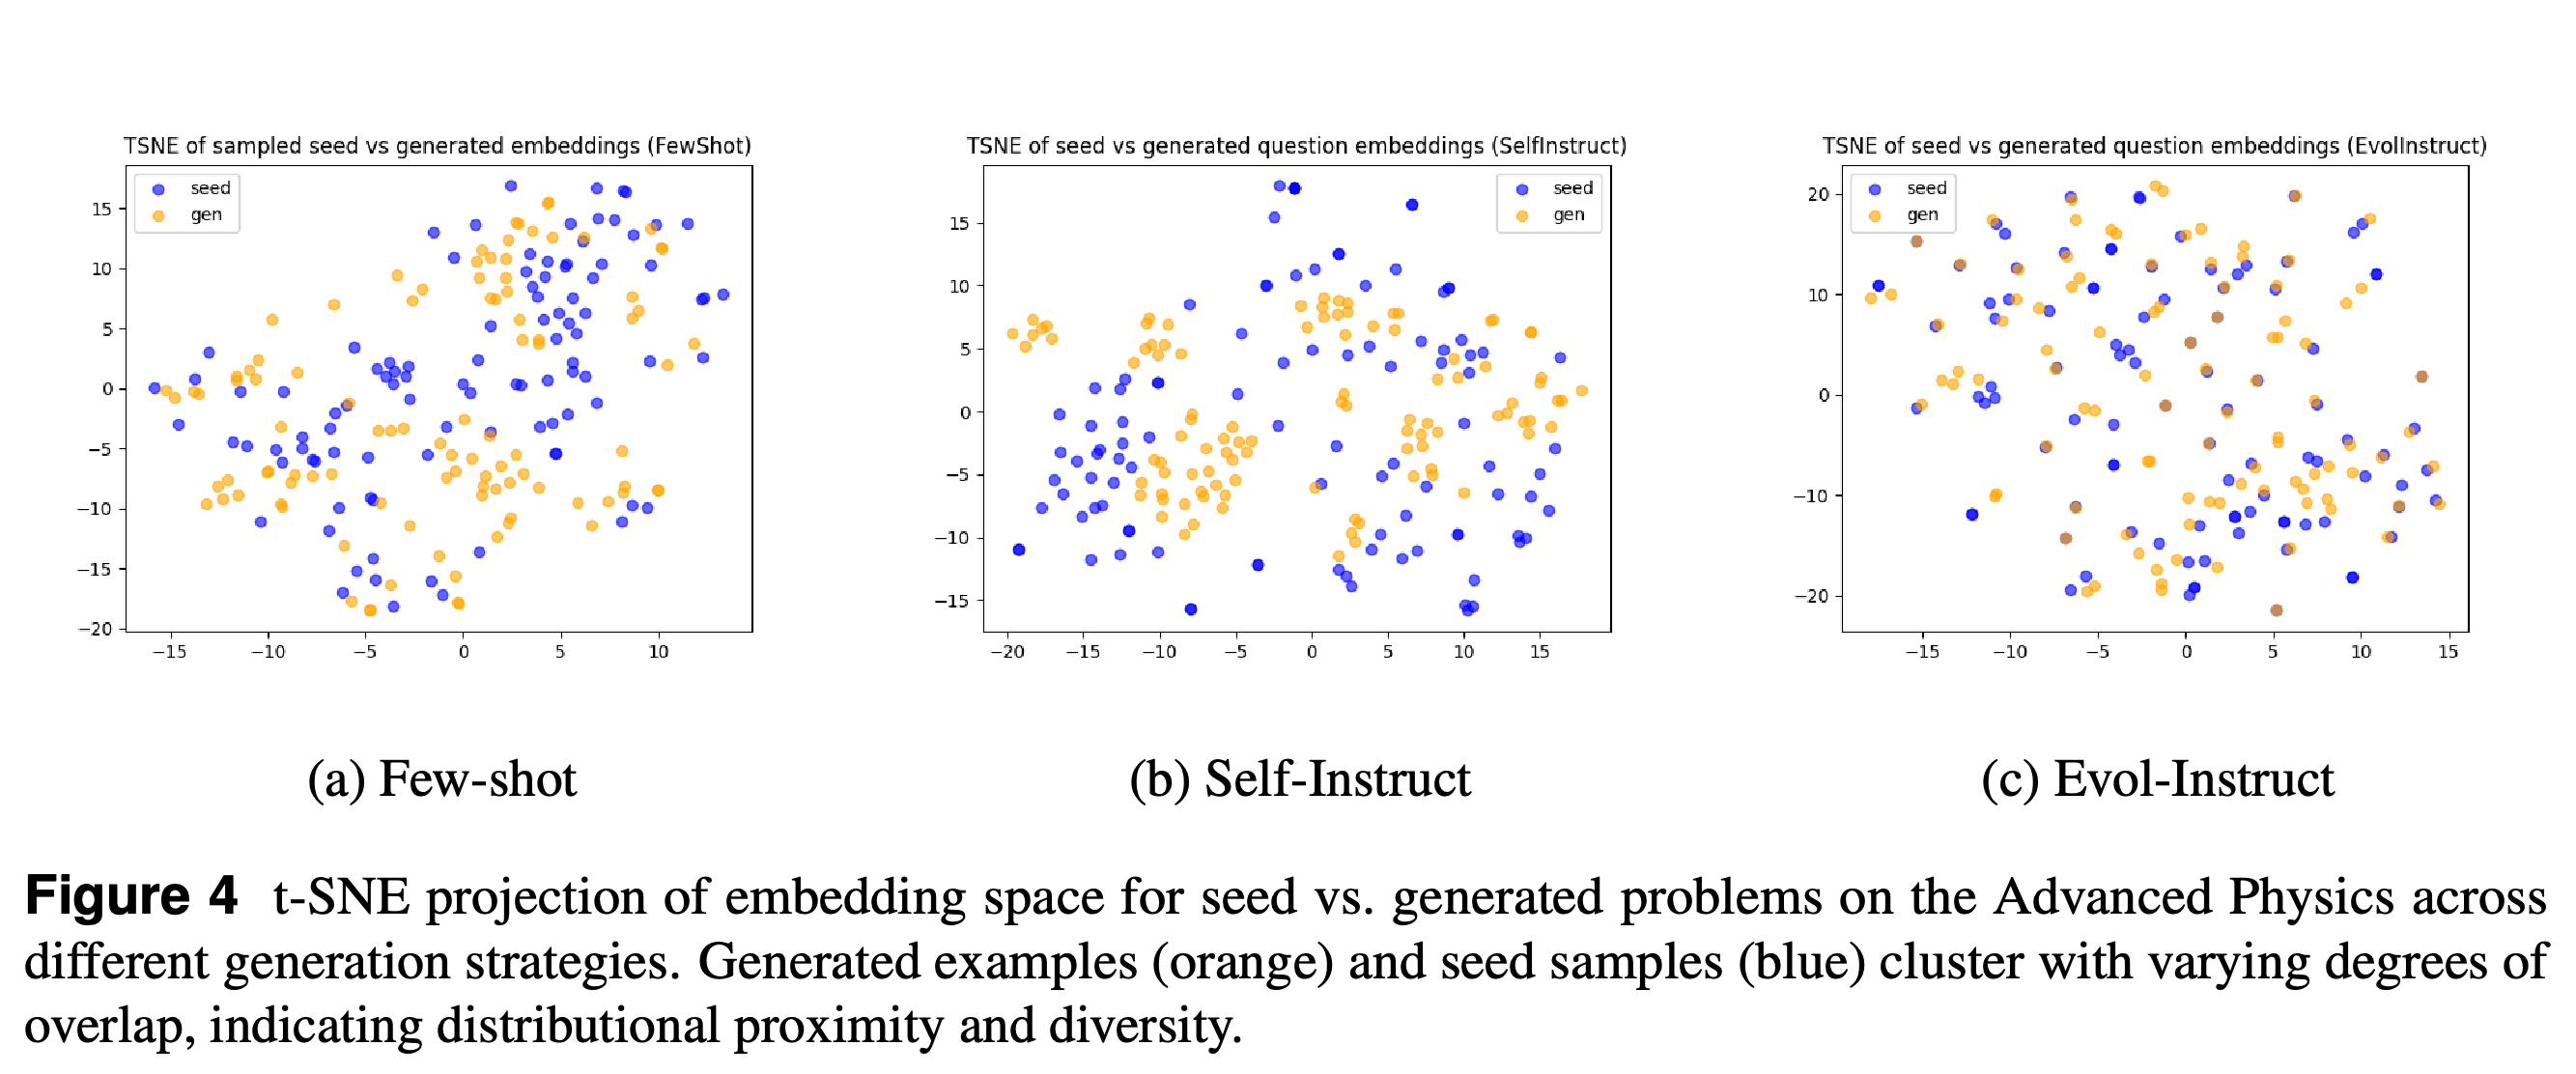
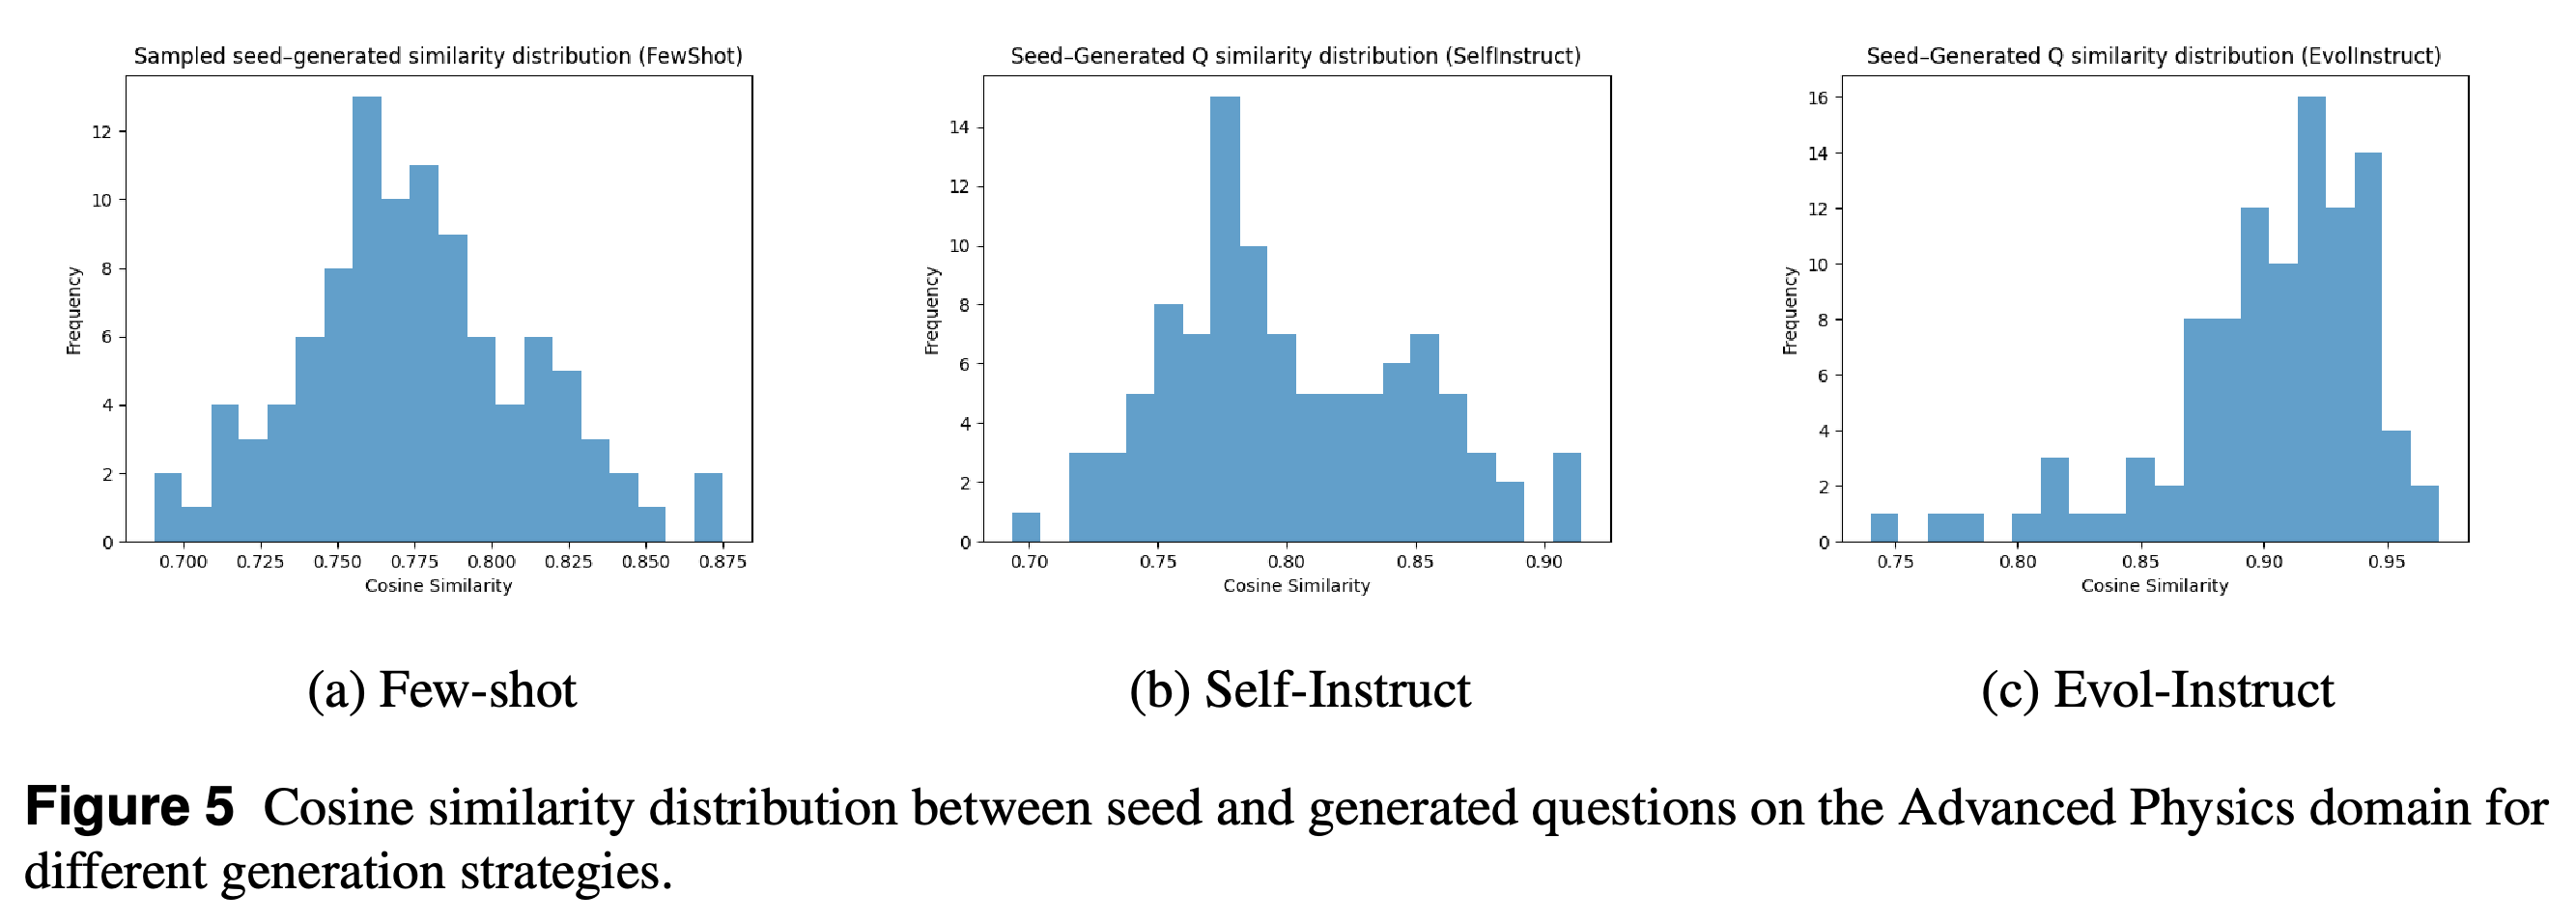
3.3.2 Diversity는 Advanced Physics 질문의 의미를 비교하는 벡터 표현인 임베딩을 사용해 다양성을 평가한다. 벡터의 방향이 얼마나 일치하는지를 나타내는 cosine similarity와 임베딩의 근접성을 시각화하는 2차원 투영인 t-SNE를 사용한다. 전략마다 시드와 생성 질문 쌍 100개를 비교한 결과, 평균/최대 유사도는 FewShot이 0.77/0.88, Self-Instruct가 0.80/0.91, Evol-Instruct가 0.90/0.97이다.
- 측정된 시드 유사도는 FewShot이 가장 낮고, Evol-Instruct가 시드 질문에 가장 가깝다. 저자들은 Evol-Instruct가 핵심 의미를 유지하면서 구조와 복잡도를 바꿀 수 있다고 해석한다.
- t-SNE 시각화와 유사도 히스토그램은 분포에 관한 정성적 근거를 제공한다. 추론의 깊이나 후속 학습 효과를 직접 측정하지는 않는다.
- 논문은 Self-Instruct의 의미적 다양성이 더 높다고 설명하지만 평균 시드 유사도는 FewShot보다 높다. 따라서 다양성에 관한 정성적 해석은 보고된 평균 유사도 비교만으로 뒷받침되는 범위를 넘어선다.
시드와 생성 질문의 평균 및 최대 cosine similarity는 FewShot의 0.77과 0.88에서 Self-Instruct의 0.80과 0.91, Evol-Instruct의 0.90과 0.97로 증가한다. 이 비교는 Evol-Instruct의 임베딩이 시드에 더 가깝다는 점을 보여준다. 난이도에 관한 근거는 별도의 풀이 모델 정확도에서 얻는다.
투영 결과는 각 전략에서 파란색 시드 예제와 주황색 생성 예제를 비교한다. 두 집단이 겹치거나 떨어지는 양상은 분포의 근접성에 관한 저자들의 정성적 논의를 뒷받침한다. 다만 2차원 배치가 과제의 복잡도를 직접 측정하지는 않는다.
히스토그램은 평균만으로 알 수 없는 시드와 생성 질문 사이의 유사도 분포를 보여준다. Evol-Instruct는 높은 유사도에 더 집중되며, Few-shot과 Self-Instruct는 유사도가 낮은 쌍을 더 많이 포함한다. 이는 측정 결과에서 Evol-Instruct가 시드 질문에 더 가깝다는 점과 일치한다.
3.3.3 Difficulty는 생성된 Advanced Physics 질문에서 GPT4.1-mini와 DeepSeek-r1의 정확도를 난이도의 대리 지표로 사용한다. 정확도는 Few-shot 질문에서 각각 92.0%와 93.2%, Self-Instruct 질문에서 83.0%와 87.4%, Evol-Instruct 질문에서 62.0%와 70.3%다. 시드 데이터셋에서는 각각 71.8%와 77.4%다.
- Evol-Instruct 질문은 임베딩이 시드와 더 유사한데도 평가한 두 모델 모두에서 더 어렵다. 이는 질문의 의미를 유지하면서 풀이 복잡도를 높일 수 있다는 저자들의 가설과 일치한다.
- 이 비교는 서로 다른 데이터셋에서 성능을 측정한다. 더 어려운 예제로 학습하면 일반화 성능이 개선되는지는 검증하지 않았다.
4 Related Work
Related Work는 사람의 선호를 반영한 post-training, 모델이 생성한 지시 데이터, 자동 검증 가능한 보상을 사용하는 강화학습과 연결하여 Loong을 설명한다. Post-training은 기존 언어 모델을 추가로 학습하는 과정이다. Self-Instruct와 WizardLM 및 WizardCoder가 사용한 Evol-Instruct 방법은 Loong의 생성 전략에 배경을 제공한다.
- Post-training 논의는 사람의 피드백을 통한 학습, 평가가 높은 응답을 선호하도록 모델을 최적화하는 방법, 보상 기반 추론 방법을 다룬다.
- 합성 데이터 논의는 지시 생성을 제어 가능성, 다양성, 사실성을 다루는 프레임워크와 연결한다.
- 보상 학습 논의는 추론, 지시 이행, 코딩 과제에서 자동 검증한 감독 신호를 다룬다. 이러한 학습 방법은 Loong의 활용 목적에 배경을 제공하며 이 논문에서 수행한 학습 실험은 아니다.
5 Conclusion
결론은 LOONGBENCH와 LOONGENV를 여러 분야의 합성 추론 데이터와 검증 가능한 감독 신호를 연구하기 위한 기반으로 제시한다. 실험으로 보여준 기여는 정제된 시드 데이터셋, 벤치마크 비교, 생성 데이터의 정확성, 다양성, 난이도 측정이다.
- 향후 연구에는 합성 질문을 활용한 강화학습, 도구의 도움을 받는 생성, 형식적 추상화, 여러 언어와 입력 모달리티를 다루는 다국어 및 멀티모달 과제로의 확장이 포함된다.
- Alignment는 모델이 원하는 행동을 하도록 학습하는 과정이다. Loong을 alignment에 활용하는 방안은 학습 평가 없이 제안된 활용 목적에 머문다.
부록
- A System Prompt for Benchmarking Experiments는 표준화된 풀이 모델과 평가자의 응답 형식을 기록한다. Solver System Prompt는 {{DOMAIN}} 자리표시자를 사용하며 응답 끝의 \boxed{} 안에는 최종 답만 넣도록 요구한다. 허용되는 형식으로 \boxed{\frac{1}{4}}를, 허용되지 않는 형식으로 \boxed{x = \frac{1}{4}}를 제시한다. 최종 boxed 답변 앞에 추론을 작성하는 것은 금지하지 않는다.
- LLM-as-Judge System Prompt는 앞선 추론을 무시하고 최종 boxed 답변을 기준 답과 비교한다. 수학적으로 동등하면 \boxed{1}을, 답이 없거나 동등하지 않으면 \boxed{0}을 반환한다. 따라서 벤치마크 정확도는 최종 답의 일치 여부를 평가하며 전체 추론 과정의 정확성을 평가하지 않는다.
짧은 생각
Loong은 정제된 분야별 예제, 실행 가능한 풀이, 의미 검증을 연결하는 구체적인 워크플로를 제공한다. 실행 실패와 평가자 거부를 구분한 결과는 생성 전략 사이의 신뢰성 차이를 드러낸다. Advanced Physics 결과는 시드 유사도가 높으면서도 풀이 모델의 정확도가 낮을 수 있음을 보여준다. 검증에는 중요한 한계가 남아 있다. 2개 풀이가 모두 틀린 답에 동의할 수 있으며 논문은 합성 출력을 독립적으로 사람이 검토한 결과와 비교하여 평가자의 오류를 정량화하지 않는다. 생성에 관한 근거는 12개 분야를 다룬 벤치마크보다 범위가 좁다. 실행 결과는 Logic과 Physics에서 제시하며 다양성과 난이도 분석은 Advanced Physics에 집중한다. 질문 100개를 생성한다는 설정만으로는 92.6%, 93.9%처럼 소수점이 있는 통과율을 산출한 집계 방식을 설명할 수 없다. 신뢰구간, 측정된 대규모 생성 비용, 후속 학습 효과는 보고하지 않는다. 4096 토큰 한도와 최종 답만 평가하는 방식은 이 실험이 긴 CoT 합성에 대해 입증할 수 있는 범위를 제한한다. 전체 추론 과정을 직접 검증하거나 학습 후의 장문 추론을 평가하지 않는다.