Language Self-Play For Data-Free Training 요약 설명
09 Sep 2025 | Paper Review Self-Play Reinforcement Learning Self-Rewarding목차
이번 글에서는 Language Self-Play For Data-Free Training 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 9일(Arxiv)
- Kuba, Jakub Grudzien, Gu, Mengting, Ma, Qi, Tian, Yuandong, Mohan, Vijai, Chen, Jason.
- Meta Superintelligence Labs, UC Berkeley
- 논문 링크
요약
- 언어 모델의 post-training은 이미 학습된 모델을 추가로 최적화하는 과정이며 외부에서 제공하는 과제 프롬프트에 의존한다. Language Self-Play (LSP)는 모델 1개가 도전 과제를 생성하고 답하도록 학습한다. Llama-3.2-3B-Instruct에서 시작한 LSP는 외부 프롬프트 데이터셋 없이 지시 수행 능력을 평가하는 AlpacaEval에서 전체 승률 36.4%를 달성한다. 기본 모델의 승률은 26.5%이며, 보상 피드백으로 모델을 최적화하는 강화학습(RL)을 Alpaca 데이터로 수행하면 38.8%를 달성한다.
- 모델은 약점을 드러내는 질문을 생성하는 Challenger와 질문에 답하는 Solver 역할을 맡는다. RL은 두 역할을 모두 업데이트한다. 초기 모델의 고정된 참조 사본으로 상호작용을 평가하는 self-rewarding은 유용한 상호작용을 유도하고 reward hacking을 줄인다. Reward hacking은 유용한 답변을 만들지 않으면서 보상 점수만 높이는 행동을 뜻한다.
- LSP 단독 학습은 수학 벤치마크 2개인 MATH와 GSM8K의 점수를 각각 48.7에서 52.4로, 77.5에서 79.4로 높인다. 코딩 벤치마크인 HumanEval의 점수도 97.2에서 98.1로 높인다. 이후 데이터 기반 RL을 추가하면 AlpacaEval 전체 승률이 39.5%로 높아지지만 이 학습 순서가 모든 벤치마크에서 데이터 기반 RL보다 우수하지는 않다.
- 결과는 이미 학습된 모델과 생성된 답변을 평가하는 보상 모델이 있다는 조건에서, 외부 학습 예제를 추가로 제공하지 않아도 성능을 개선할 수 있음을 보여준다. 실험은 기본 모델 1개를 사용한다. 저자들은 보상의 품질과 생성된 질문이 평가 프롬프트와 일치하지 않는 점을 제약으로 지적한다. 보고된 벤치마크 비교만으로는 성능이 무기한 개선된다고 볼 수 없다.
1 Introduction
기존 언어 모델 RL은 정답을 요구하지 않더라도 프롬프트 형태의 과제 예제가 필요하다. 이 논문은 프롬프트 생성을 학습 가능한 행동으로 다룬다. 한 역할은 어려운 질문을 생성하고 다른 역할은 답하는 법을 학습하므로, 질문 분포와 답변 행동이 함께 변화한다.
- 두 역할은 언어 모델 1개를 공유하므로 별도의 적대적 모델이 필요하지 않다.
- 학습은 Llama-3.2-3B-Instruct에서 시작한다. 추가 프롬프트 데이터셋이 없다는 것은 이 모델의 기존 학습까지 없다는 뜻은 아니다.
2 Background
배경 설명은 사전학습된 언어 모델을 사용할 수 있다고 가정하고 제공된 질문과 답변 쌍으로 학습하는 supervised fine-tuning (SFT)과 RL을 소개한다. 두 접근법은 기존 답변에 맞춰 학습하는 방식과 생성한 답변의 보상을 최적화하는 방식으로 구분된다.
2.1 Supervised Fine-Tuning
SFT는 질문을 조건으로 제공된 답변의 로그우도를 최대화하여 해당 답변에 부여하는 확률을 높인다. 논문은 이 목적함수에 답변 품질을 명시적으로 평가하는 기준이 없다는 점을 지적하고 이를 보상 기반 최적화의 동기로 제시한다.
2.2 Reinforcement Learning
RL은 질문 q와 답변 a에 대한 기대 보상 \(R(q,a)\)를 최대화한다. 보상은 답변을 확인하는 검증 엔진이나 학습된 보상 모델이 제공한다. Group-Relative Policy Optimization (GRPO)은 같은 질문에 대해 샘플링한 답변들을 비교한다. G개 답변의 평균 보상으로 질문의 가치를 추정하고 각 답변의 보상에서 평균을 뺀 값을 advantage로 부여한다.
- LSP는 이 그룹 내 상대 비교로 Solver를 업데이트하고 생성된 각 질문이 현재 모델에 얼마나 어려운지 추정한다.
3 Language Self-Play
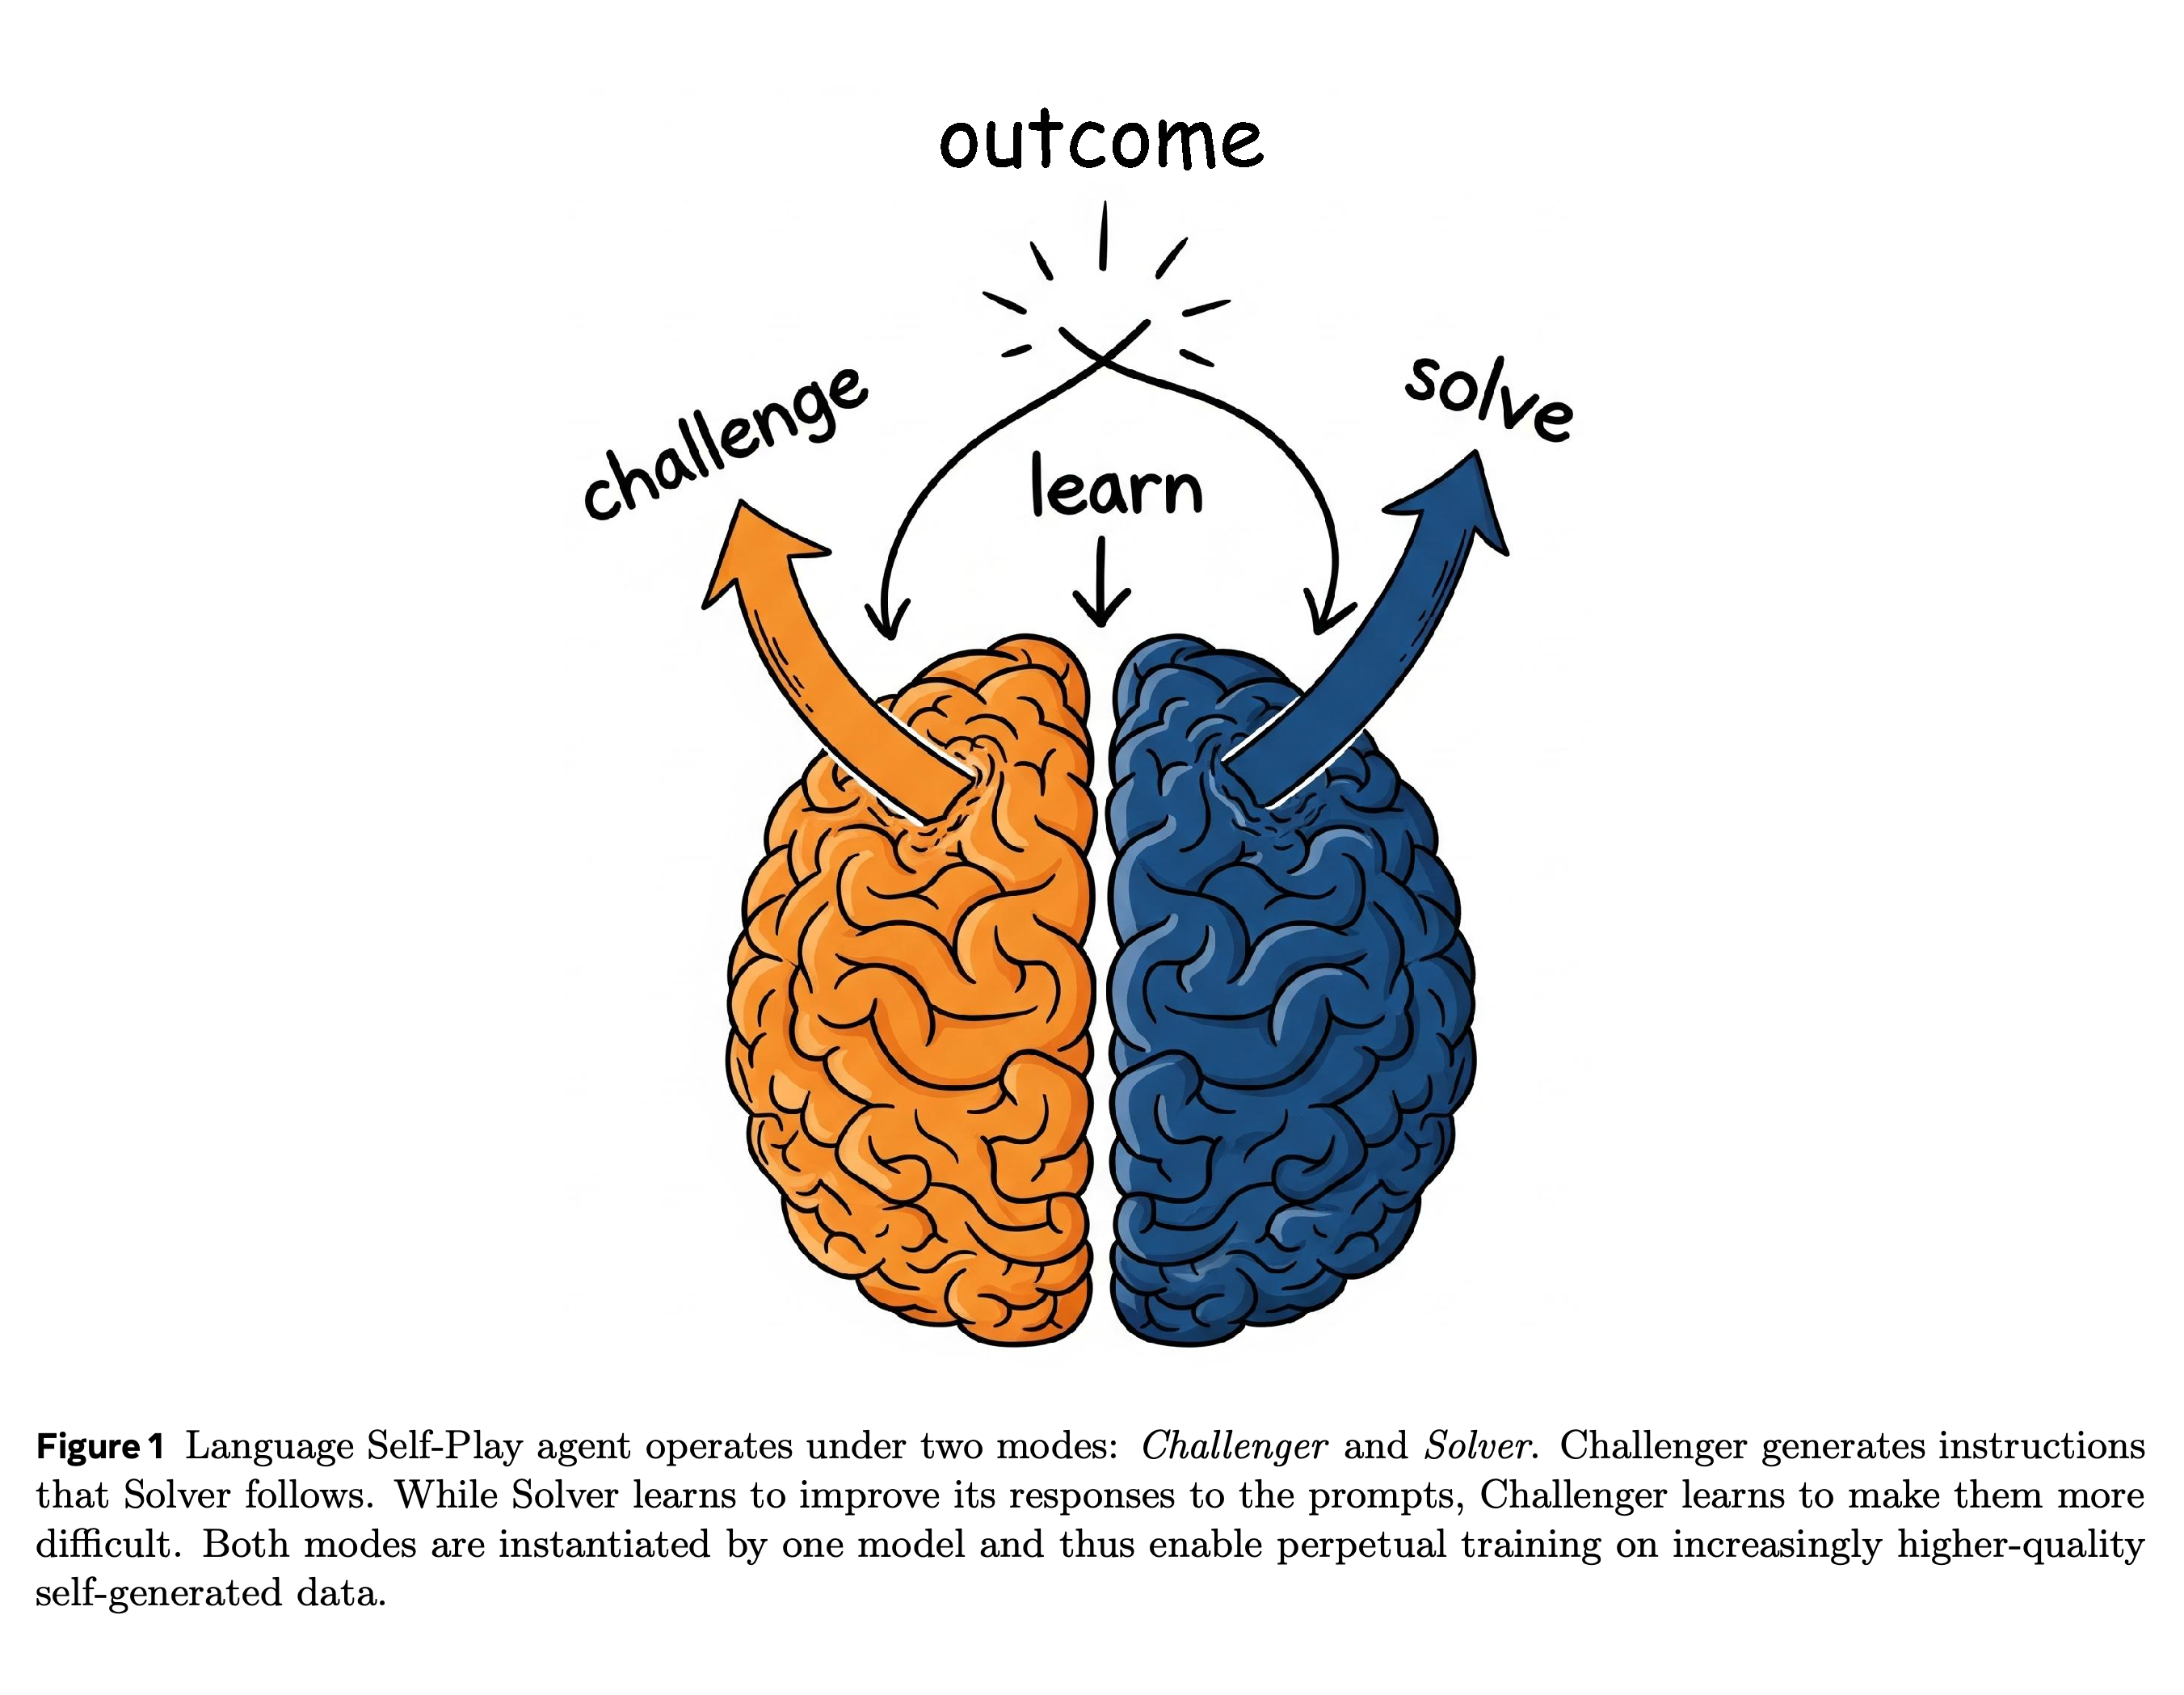
Challenger는 특수 프롬프트 <cp>를 사용해 질문을 생성하고 Solver는 같은 모델 파라미터로 답한다. 초기 minimax game에서는 동일한 기대 과제 보상을 서로 반대 방향으로 최적화한다. Challenger는 Solver의 보상을 최소화하고 Solver는 이를 최대화한다. N개 질문에 각각 G개 답변이 있을 때, Solver의 advantage는 해당 답변의 보상에서 질문의 평균 보상을 뺀 값이다. Challenger의 advantage는 전체 질문 가치의 평균에서 해당 질문의 가치를 뺀 값이다.
- Box 1개는 질문 생성을 설정할 수 있도록 과제와 템플릿 자리표시자인 {task}와 {template}을 제공한다.
- Kullback–Leibler (KL) divergence 정규화는 출력 분포가 참조 모델의 출력 분포에서 벗어날 때 페널티를 부여하며 의미 없는 적대적 질문도 억제한다.
- 논문은 이 초기 구성을 Language Self-Play Zero (LSP-Zero)라고 부른다. Zero는 2개 역할이 서로 반대되는 과제 보상을 받는 제로섬 게임을 뜻한다.
색으로 구분한 2개 역할은 공유 모델 1개가 수행하는 서로 다른 행동을 나타낸다. 생성한 도전 과제에 답한 결과의 피드백으로 두 행동을 모두 업데이트하므로, 질문 분포도 고정된 외부 입력에 머무르지 않고 학습 과정에 포함된다.
OpenAssistant의 reward-model-deberta-v3-large-v2를 사용한 초기 실험에서는 일반적인 질문에 도움이 되지 않는 Python 답변이 생성되어 reward hacking 사례가 나타났다. LSP는 Box 3의 7개 이진 기준에 따라 참조 모델이 생성하는 품질 self-reward \(R_Q\)를 추가한다. Solver는 과제 보상과 품질 보상의 합을 받고, Challenger는 평균 과제 보상의 부호를 바꾼 값과 평균 품질 보상의 합을 받는다.
- 기준은 과제를 식별할 수 있는지, 지시가 명확한지, 답변을 이해할 수 있는지, 요구 사항을 부분적으로 충족하는지, 핵심 내용을 유용하고 포괄적으로 답하는지, 글의 품질이 좋은지, 사용자가 답변의 형식과 문체를 선호할지를 평가한다. 합산 점수는 0에서 7까지다.
- 두 역할에 품질 보상을 추가하면 게임은 더 이상 제로섬이 아니며, 어렵지만 유용한 상호작용을 유도한다.
- Algorithm 1은 역할별 손실을 L_Self-Play = L_Sol + α_Ch L_Ch로 결합하여 공유 파라미터를 업데이트한다. α_Ch는 Challenger 손실의 가중치다.
4 Related Work
논문은 LSP를 필터링한 모델 생성 예제로 학습하는 synthetic-data bootstrapping, 기존 학습 데이터를 수정하는 방법, 제공된 프롬프트에 대한 답변을 최적화하는 self-play 방법과 구분한다. LSP는 특수한 언어 게임이나 게임별 SFT 단계 없이 질문 생성과 답변을 함께 학습한다.
- 저자들은 비슷한 시기에 제안된 자율적인 challenger-solver 접근법과 비교하여, 질문 생성에 선별과 제약을 덜 적용하고 학습된 선호 보상과 self-reward를 결합한다는 점을 강조한다. 선호 보상은 답변이 얼마나 바람직한지를 평가하는 점수다.
- 이 보상 설계는 정답이 정해져 있지 않은 과제에도 적용할 수 있다. 반면 논문에서 다룬 동시기 방법들은 정답이 정해져 있고 검증 가능한 과제와, 샘플링한 답변 간 일치도를 사용하는 다수결 보상에 중점을 둔다.
5 Experiments
모든 실험은 Llama-3.2-3B-Instruct를 기본 모델로 사용한다. 먼저 AlpacaEval에서 LSP-Zero, LSP, 데이터 기반 GRPO를 비교한다. 이어서 수학, 코딩, 지시 수행 과제에서 LSP 단독 학습과 데이터 기반 RL 이전의 중간 단계로 사용하는 LSP를 평가한다.
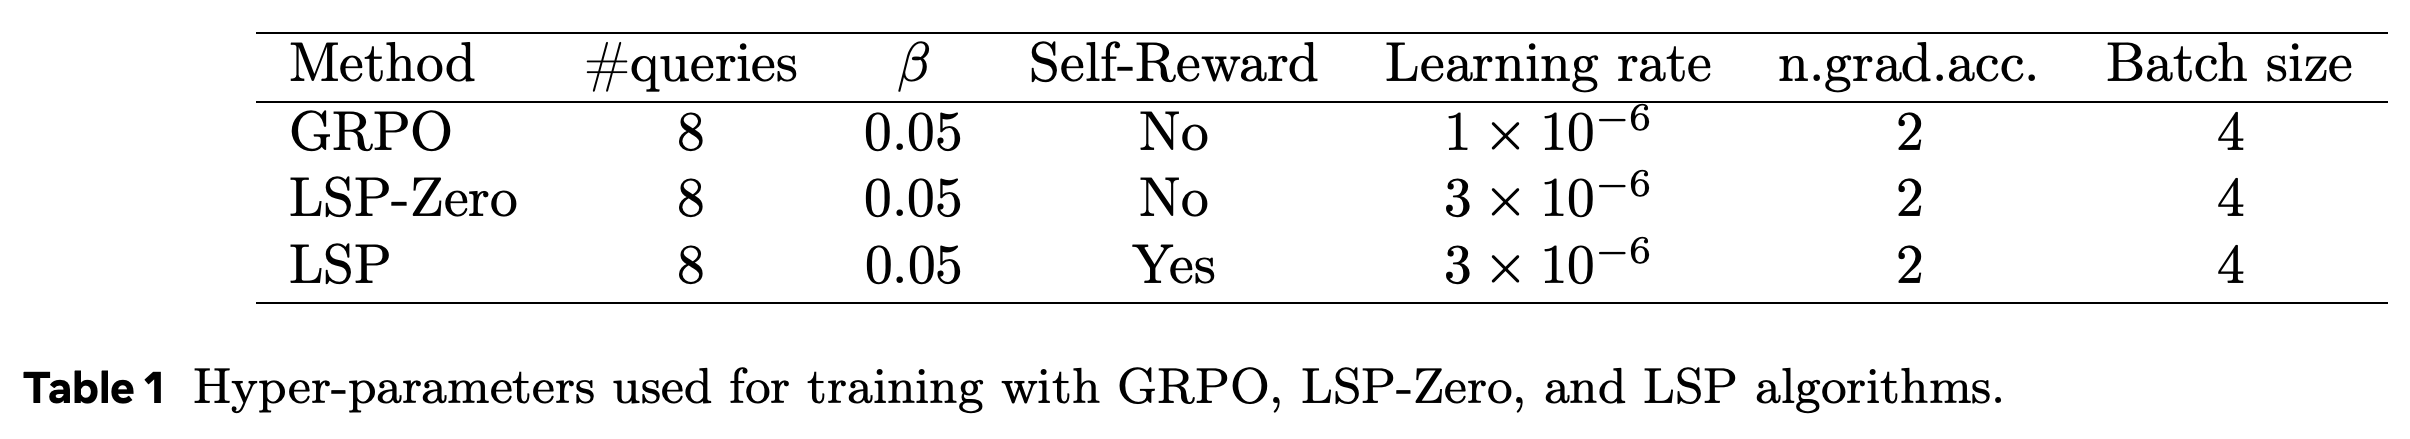
- Table 1에 따르면 3개 방법 모두 질문 8개, KL 정규화 계수 β = 0.05, gradient accumulation 2단계, 배치 크기 4를 사용한다. Gradient accumulation은 업데이트 전에 여러 단계의 그래디언트를 합치는 방식이다.
- 학습률은 GRPO가 1 × 10⁻⁶이며, LSP-Zero와 LSP는 모두 3 × 10⁻⁶이다. Self-reward는 LSP만 사용한다.
5.1 The Importance of Self-Rewarding
품질 self-reward를 제거하는 ablation 실험은 같은 기본 모델에서 초기화한 방법들을 비교한다. GRPO는 Alpaca 예제로 학습하고 self-play 방법들은 질문을 직접 생성한다. 3개 방법 모두 Skywork-Reward-V2-Llama-3.2-3B를 보상 모델로 사용한다. AlpacaEval은 Llama-4-Maverick을 평가 모델로 사용하고 답변을 Llama-3.2-3B-Instruct 사본의 답변과 비교한다. 평가 시 샘플링 온도는 τ = 0.01로 설정하여 생성의 무작위성을 제한한다.
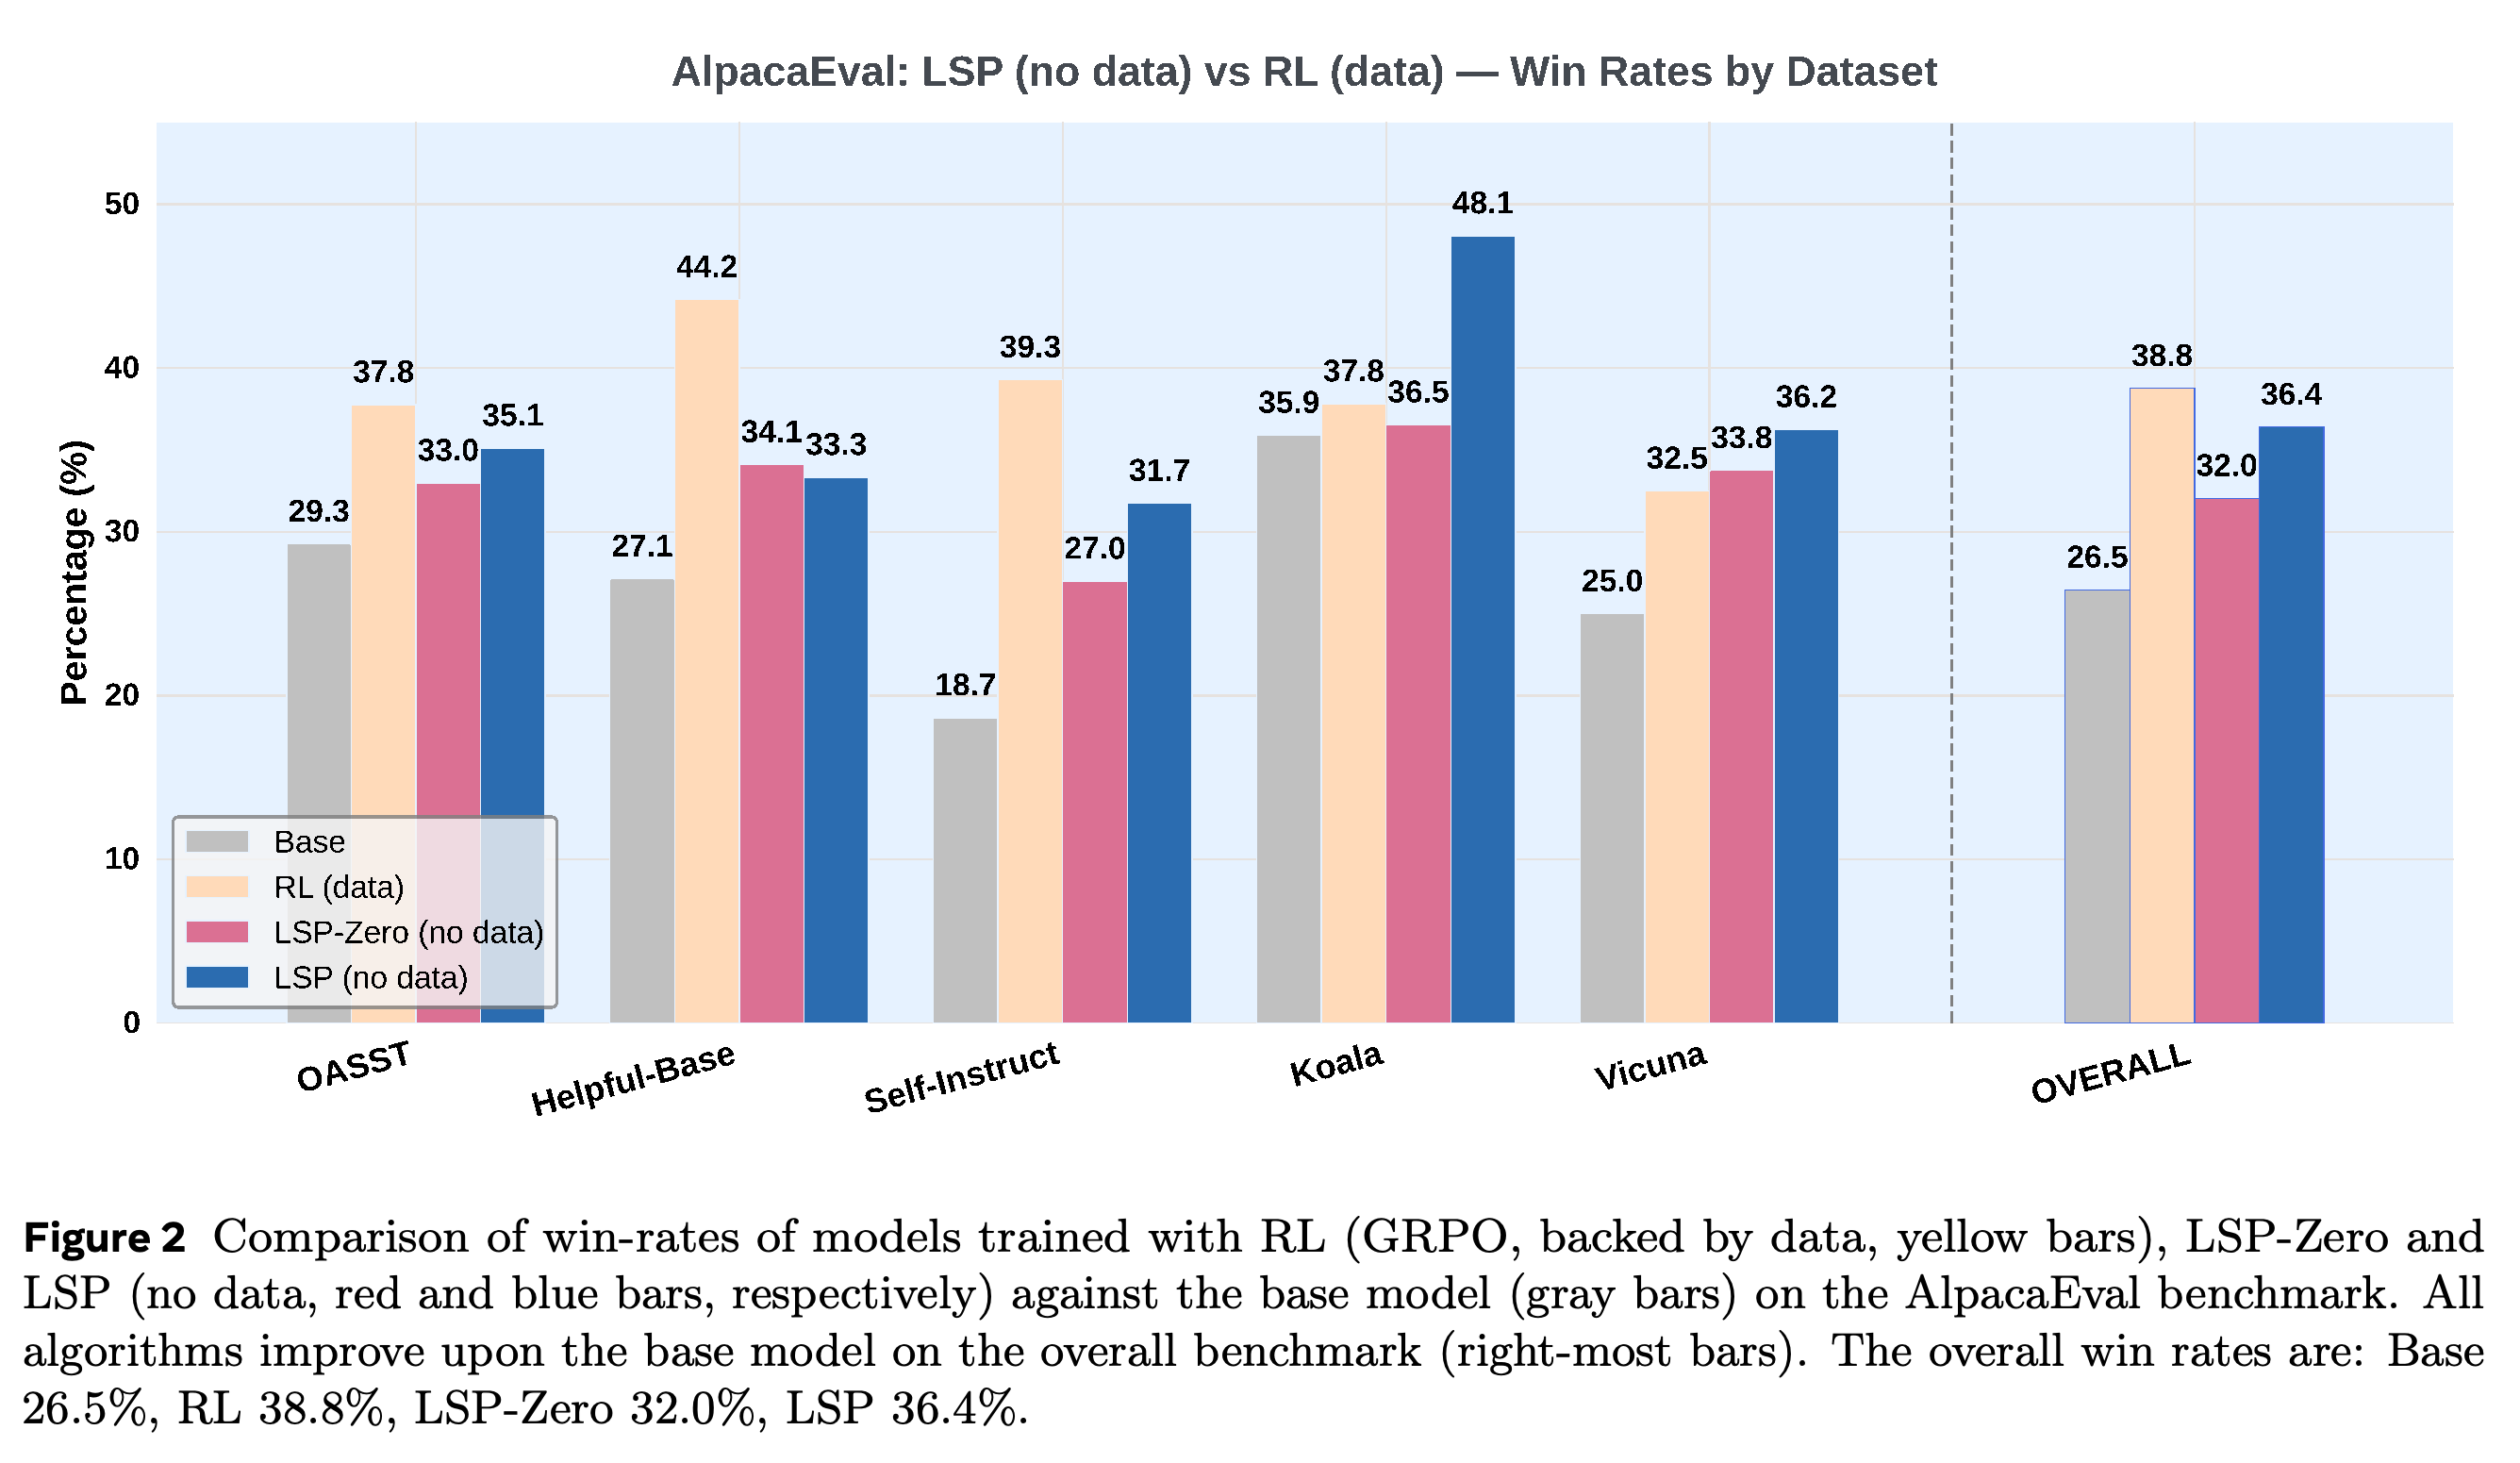
- 전체 승률은 Base 26.5%, GRPO 38.8%, LSP-Zero 32.0%, LSP 36.4%다. LSP는 제로섬 변형보다 4.4%p 높다.
- 프롬프트 하위 집합에 따라 결과가 달라진다. Koala에서는 LSP가 48.1%로 GRPO의 37.8%보다 높지만 Helpful-Base에서는 LSP가 33.3%로 GRPO의 44.2%보다 낮다.
- 저자들은 앞서 사용한 OpenAssistant 보상 모델에서 보상 점수가 개선되어도 AlpacaEval 점수는 개선되지 않았다고 보고한다. 이 결과를 바탕으로 Skywork-Reward-V2를 사용한다.
품질 정규화를 적용한 LSP의 전체 승률은 Base보다 9.9%p, LSP-Zero보다 4.4 points 높지만 데이터 기반 RL보다 2.4 points 낮다. Koala에서는 우수하고 Helpful-Base에서는 상대적으로 낮은 결과를 보여, 프롬프트 하위 집합에 따라 성능 차이가 크다는 점을 나타낸다.
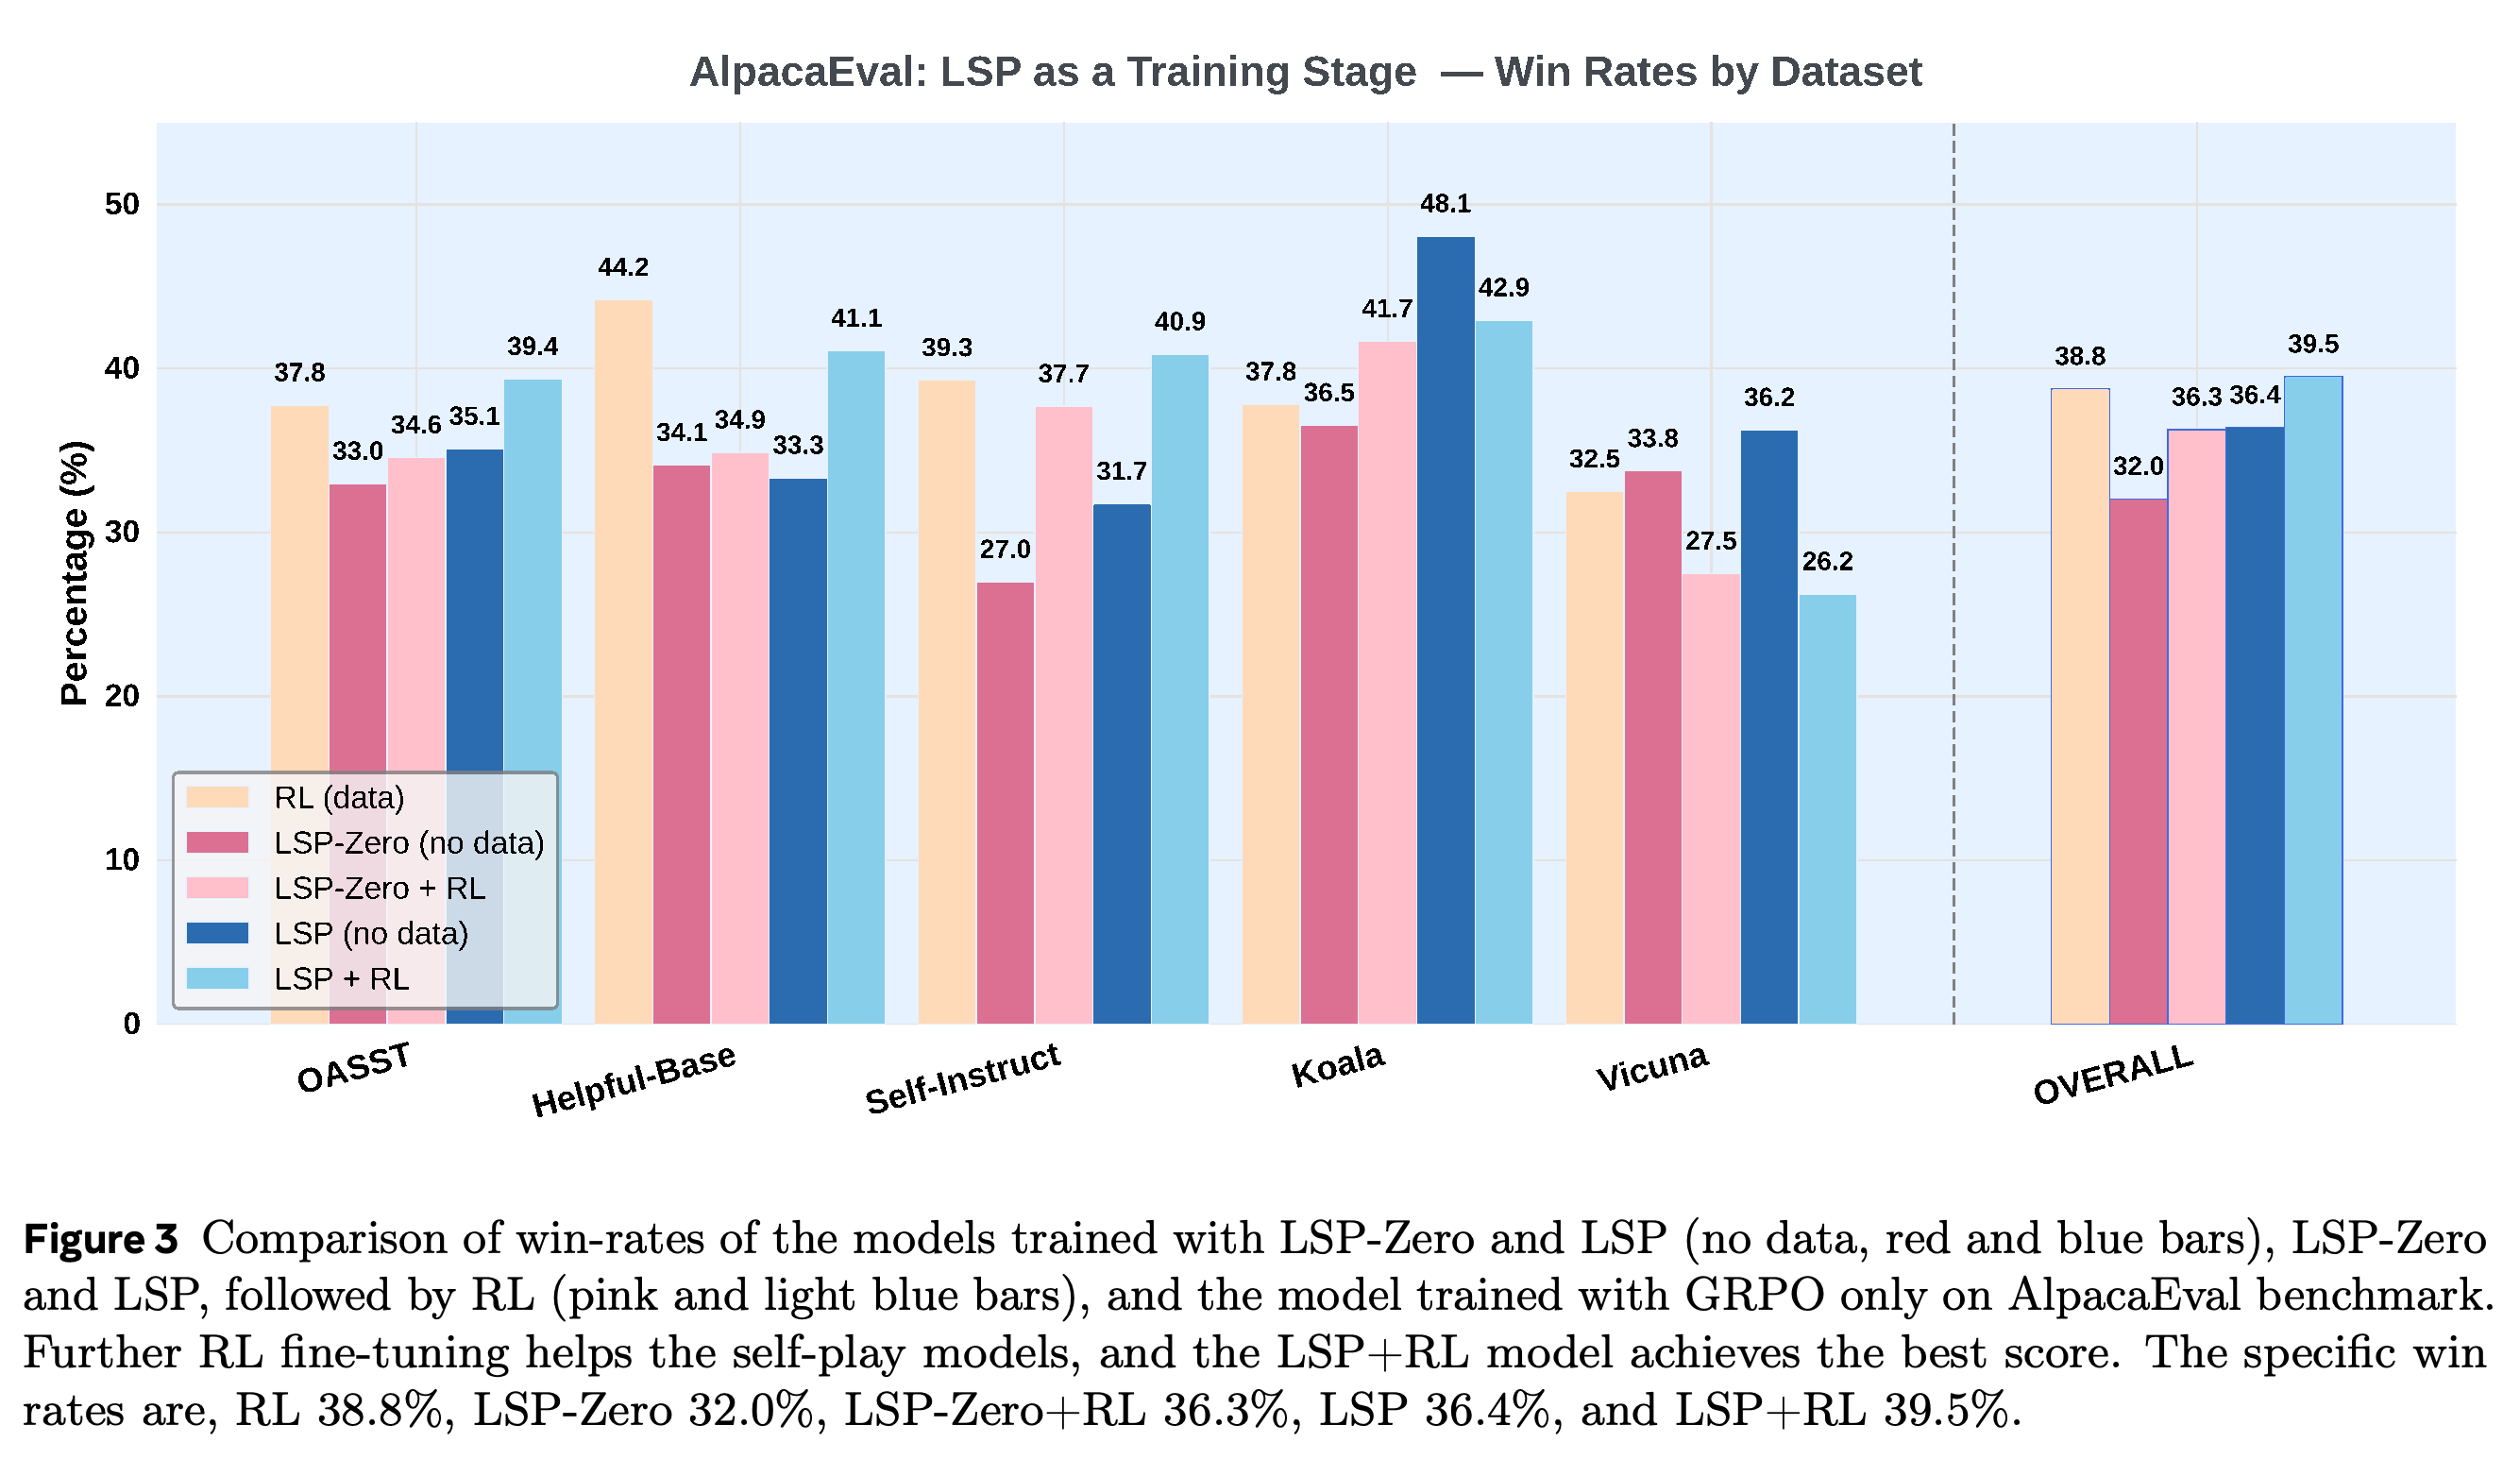
이후 데이터 기반 GRPO를 수행하면 LSP의 전체 승률은 36.4%에서 39.5%로, LSP-Zero의 전체 승률은 32.0%에서 36.3%로 높아진다. LSP+RL은 데이터 기반 RL 단독 학습의 전체 승률 38.8%보다 0.7%p 높다. 다만 하위 집합별 결과를 보면 추가 RL이 일부 프롬프트 분포에서는 성능을 낮출 수 있다.
- LSP에 RL 단계를 추가하면 Koala 승률은 48.1%에서 42.9%로, Vicuna 승률은 36.2%에서 26.2%로 낮아진다.
- 보고된 설정에서는 품질 정규화를 적용한 LSP가 LSP-Zero보다 우수하지만 그림에는 불확실성 구간이 제시되지 않는다.
LSP에 데이터 기반 RL을 추가하면 전체 승률이 36.4%에서 39.5%로 높아져 RL 단독 학습의 38.8%를 넘는다. 성능 향상은 고르지 않다. LSP+RL은 LSP 단독 학습보다 OASST, Helpful-Base, Self-Instruct에서 높지만 Koala와 Vicuna에서는 낮다.
5.2 Benchmark Evaluation of LSP
MATH와 GSM8K에는 challenger 프롬프트의 task=’Pure & Applied Mathematics’로 학습한 동일한 LSP 단독 모델을 사용한다. 데이터 기반 GRPO는 각 벤치마크의 학습 세트를 사용한다. 다만 HumanEval에는 학습 세트가 없으므로 프로그래밍 문제 데이터셋인 MBPP로 학습한다. 평가는 테스트 세트로 수행한다.
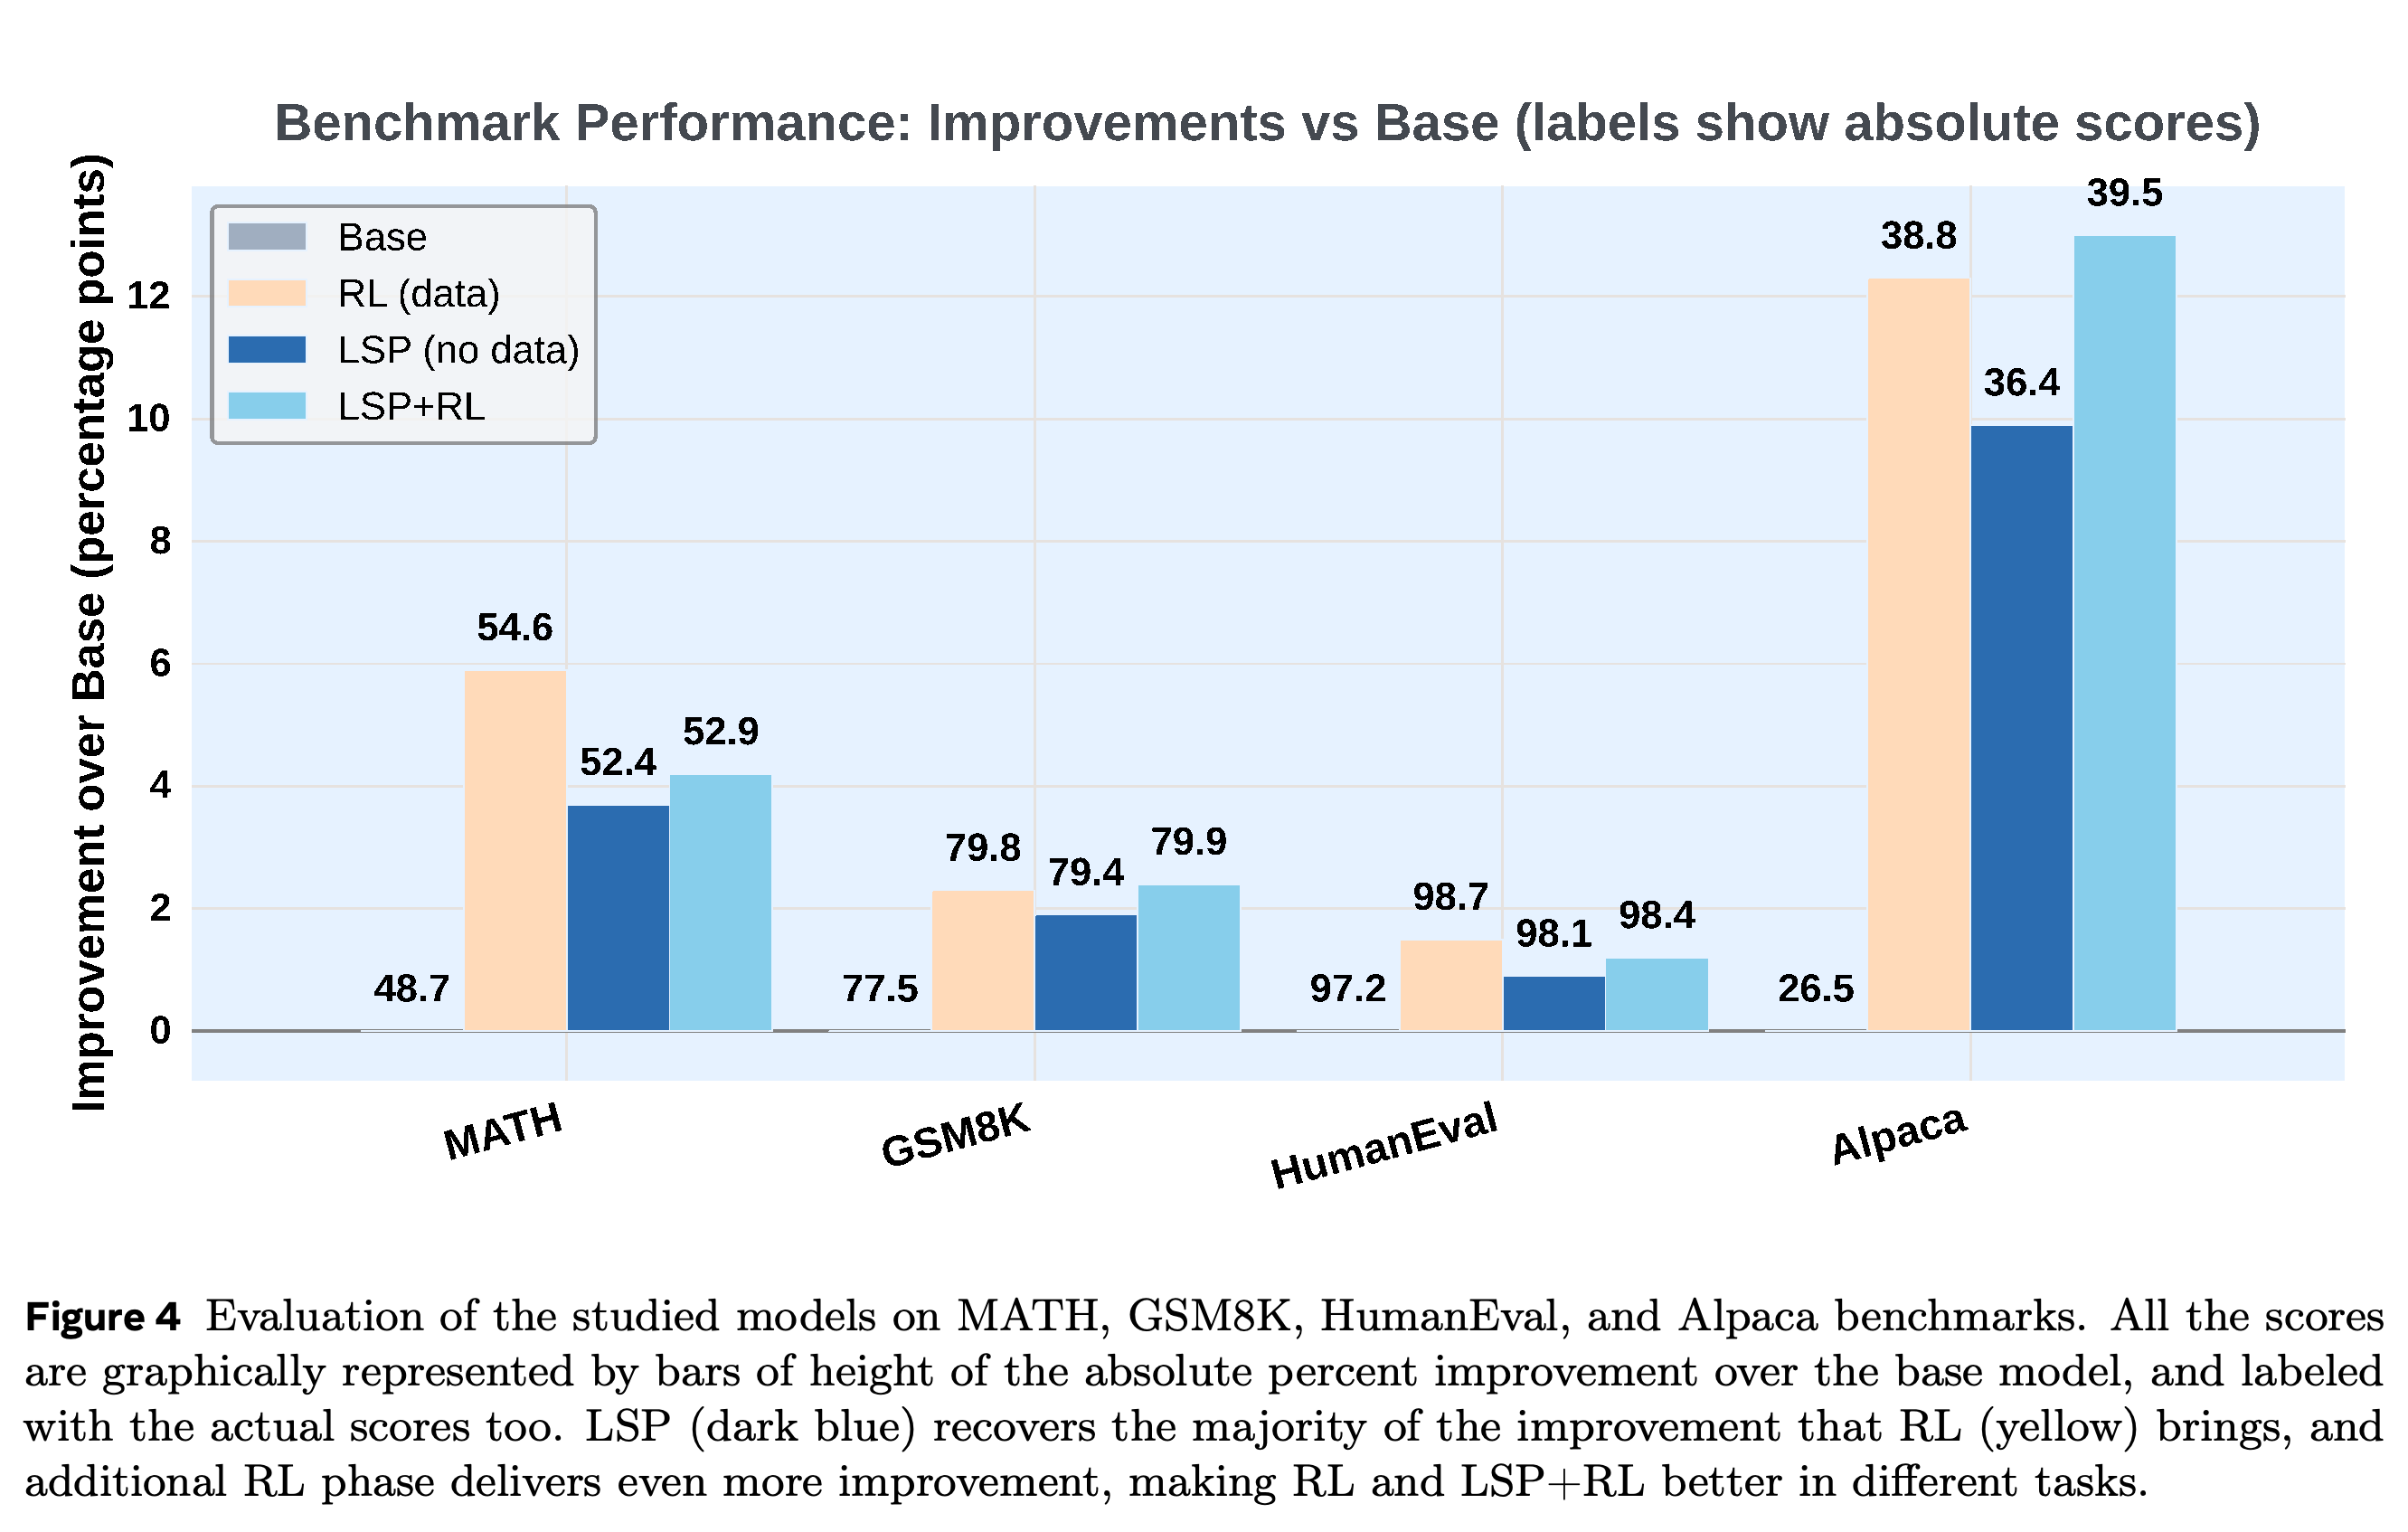
- Figure 4에 보고된 점수는 Base, RL, LSP, LSP+RL 순서로 MATH에서 48.7, 54.6, 52.4, 52.9이고, GSM8K에서 77.5, 79.8, 79.4, 79.9이고, HumanEval에서 97.2, 98.7, 98.1, 98.4이고, Alpaca에서 26.5, 38.8, 36.4, 39.5다.
- LSP 단독 학습은 보고된 모든 벤치마크에서 성능을 개선하지만 각 종합 점수는 데이터 기반 RL보다 낮다.
- LSP+RL은 GSM8K와 Alpaca에서 RL보다 조금 높지만 MATH와 HumanEval에서는 낮다. 저자들은 생성된 질문과 평가 질문의 불일치가 KL 제약을 통해 후속 RL에도 이어져 성능 향상을 제한한다는 가설을 제시한다.
막대 높이는 Base 대비 퍼센트포인트 증가량을 나타내고, 막대에 표시된 값은 절대 점수를 나타낸다. LSP는 보고된 4개 벤치마크 모두에서 성능을 개선한다. RL을 추가하면 LSP보다 성능이 더 높아지지만 최종 모델이 RL 단독 학습을 넘는 벤치마크는 GSM8K와 Alpaca뿐이다.
6 Conclusion
결론은 LSP를 사전학습된 언어 모델과 모델이 직접 생성하는 학습 분포를 함께 개선하는 프레임워크로 제시하며 대화 과제에서 좋은 결과를 보고한다. 실험에는 선호 기반 보상 모델을 사용한다. 검증 가능한 보상에 적용하는 방안은 제안하지만 이 논문에서 실증하지는 않는다.
- 저자들은 정답 검증을 사용할 수 없을 때 보상 모델의 판단 품질과 물리적 세계에 대한 기존 인간 지식을 제약으로 지적한다.
- 물리적 세계와 상호작용할 수 있는 embodied system이 경험적 데이터를 수집하고 지식을 확장할 수 있다는 제안은 향후 가능성으로 제시한다.
부록
- A Example Plays는 반복 500, 1000, 1500회 시점의 Challenger 질문과 Solver 답변을 제시한다. 예제는 보물지도 지시, 5세 아동과 나무 블록 10개, 시간 10분이라는 제약을 둔 다리 만들기 과제, 연속된 32비트 레지스터에 있는 16비트 수 2개를 빼는 2048줄의 어셈블리 코드 요청이다. 이 예제들은 생성된 상호작용을 보여주며, 과제 성공을 검증한 결과는 아니다. 다리 만들기 답변은 블록 6개, 이후 2개, 다시 2개, 그리고 추가로 2개를 배정한다. 어셈블리 답변은 요청한 2048줄을 제공하지 않는다.
- B An Example Of Unregularized Play는 본문에서 논의한 도움이 되지 않는 Python 답변 전체를 제시한다. 답변에는 구현되지 않은 메서드와 자기 자신을 호출하는 draw 메서드가 포함된다. C Hyper-parameters는 Table 1을 통해 공통 질문 수, KL 계수, gradient accumulation, 배치 크기와 함께 서로 다른 학습률 및 self-reward 설정을 제시한다.
짧은 생각
이 방법은 질문 생성에 명시적인 학습 신호를 제공한다. 낮은 Solver 보상은 약점을 드러내고, 공유하는 품질 보상은 쓸모없는 상호작용을 억제한다. LSP-Zero 대비 4.4퍼센트포인트의 우위는 이 실험에서 품질 보상 설계를 뒷받침한다. 제시된 reward hacking 사례는 이 설계가 해결하려는 실패를 보여준다.
보고된 성능 향상은 학습된 모델과 적절한 보상 모델이 있다면 외부 프롬프트 데이터셋을 구할 수 없는 상황에서 LSP를 활용할 수 있음을 보여준다. 다만 기본 모델 1개만 평가했고 GRPO와 self-play의 학습률이 다르며, 불확실성 구간을 보고하지 않았고, 부록 답변에도 결함이 있다. 따라서 일반화 가능성, 학습 설정에 대한 민감도, 지속적인 자율 개선 가능성은 아직 확인되지 않았다.
각 방법은 질문 8개, β = 0.05, gradient accumulation 2단계, 배치 크기 4를 공통으로 사용한다. 학습률은 GRPO가 1 × 10⁻⁶이고 self-play 변형들은 모두 3 × 10⁻⁶이다. LSP-Zero와 LSP는 표에 제시된 설정 중 self-reward만 다르지만 GRPO와 비교할 때는 학습률도 달라진다.