


Guided Self-Evolving LLMs with Minimal Human Supervision 요약 설명
02 Dec 2025 | Paper Review Self-Play Reinforcement Learning Reasoning목차
이번 글에서는 Guided Self-Evolving LLMs with Minimal Human Supervision 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 2일(Arxiv)
- Yu, Wenhao, Liang, Zhenwen, Huang, Chengsong, Panaganti, Kishan, Fang, Tianqing, Mi, Haitao, Yu, Dong.
- Tencent AI Lab in Seattle, Washington University in St. Louis
- 논문 링크
요약
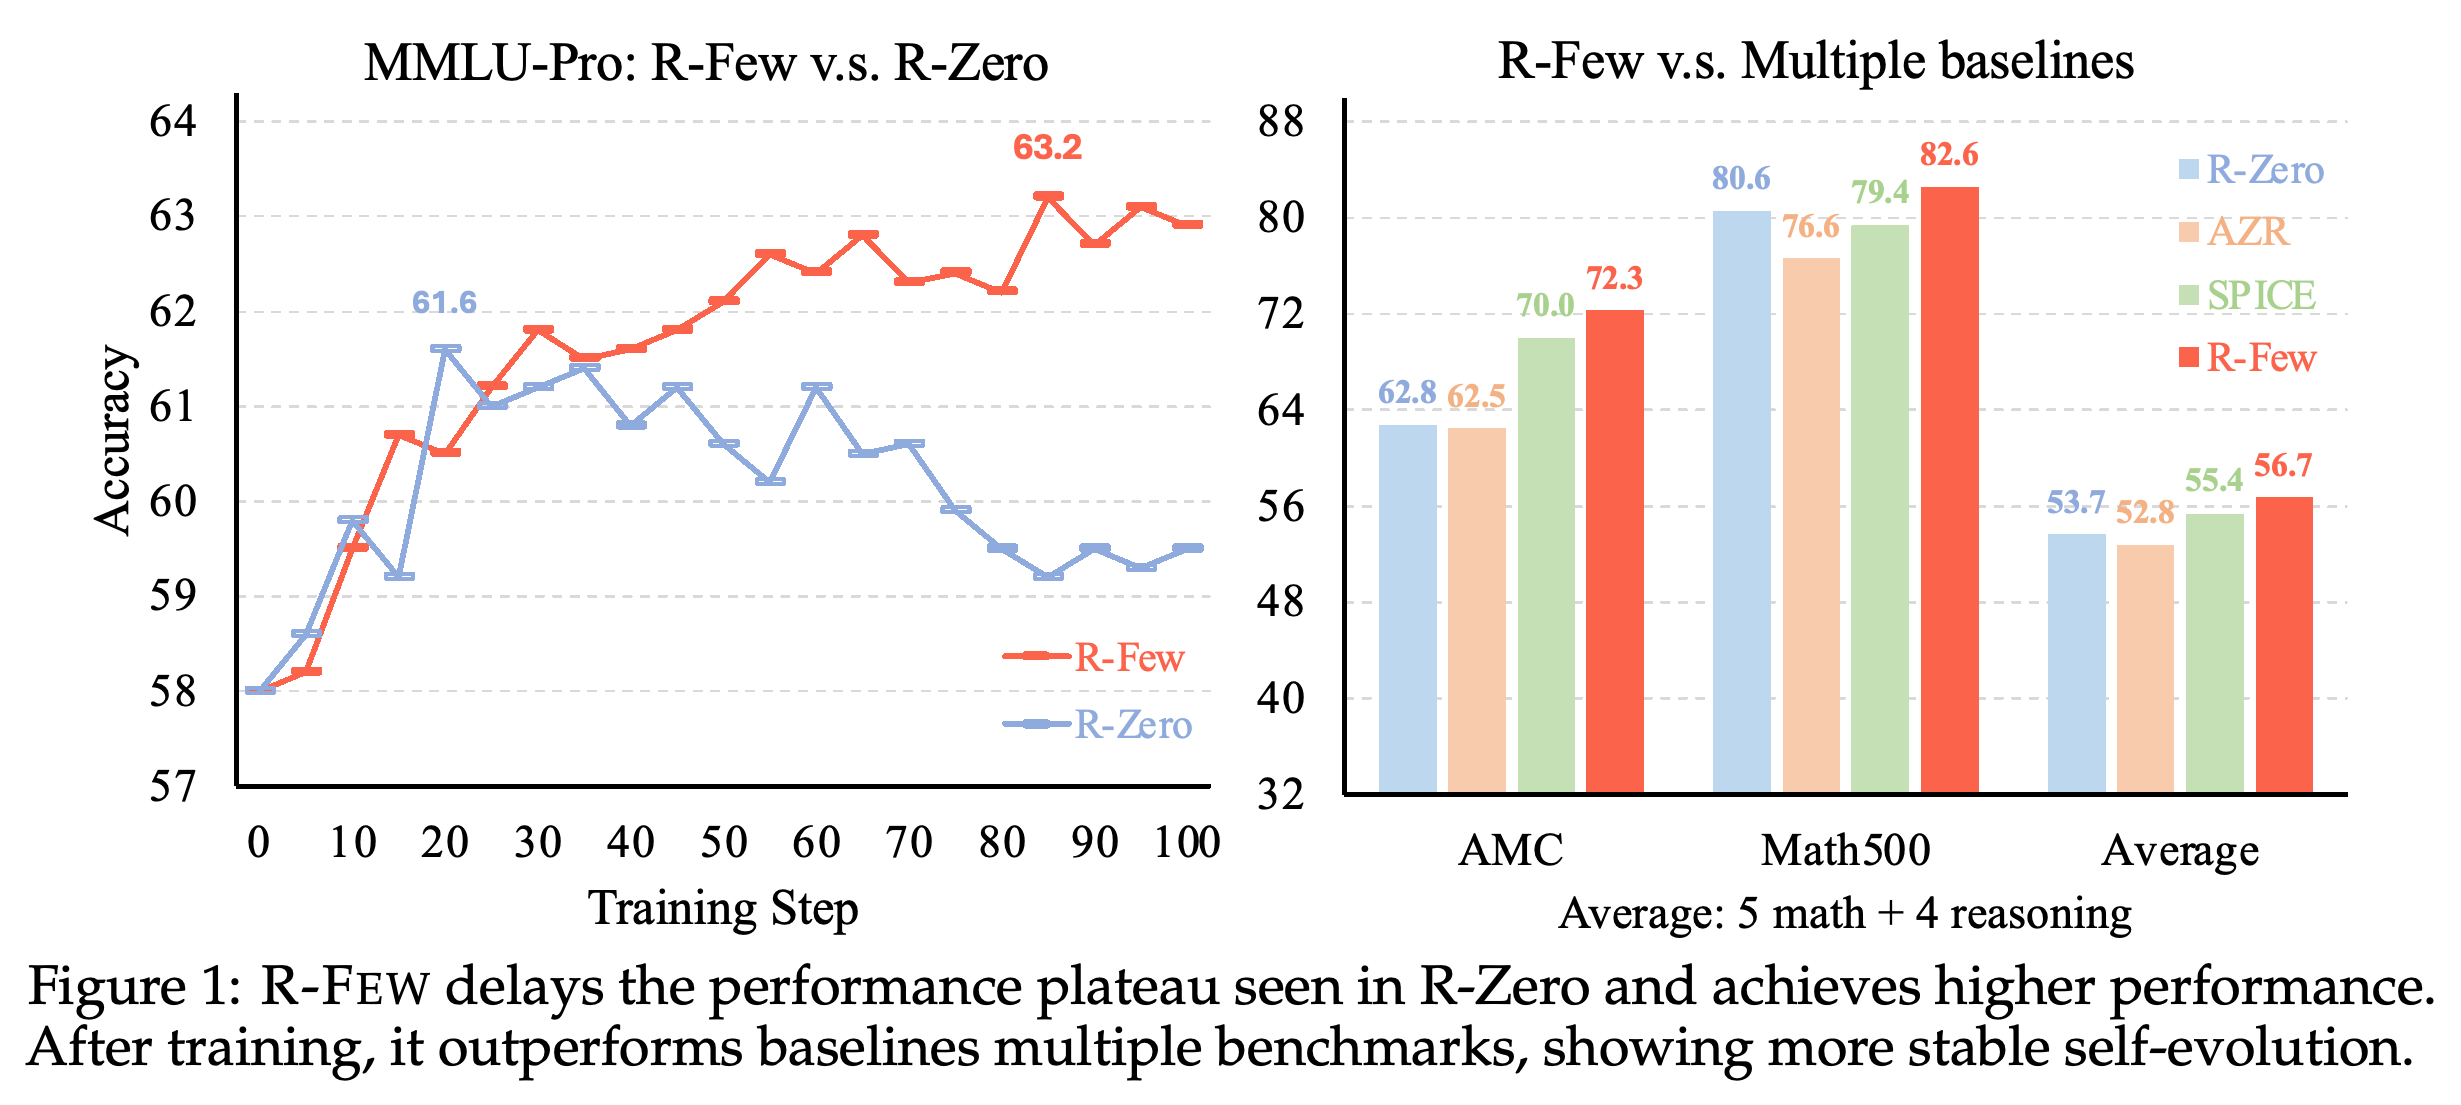
- 이 논문은 대규모 언어 모델(LLM)이 질문 생성과 풀이를 반복하는 self-play로 성능을 높이면서도 편향을 강화하거나 과제 다양성을 잃지 않는 방법을 다룬다. R-FEW는 매개변수 8B 규모의 사전 학습 모델 Qwen3-8B-Base와 웹에서 수집한 추론 예제 232k개로 구성된 WebInstruct의 5%를 사용한다. 9개 벤치마크 평균은 56.7로, 별도의 유도 없이 self-play를 수행하는 기준 방법 R-Zero의 53.7과 전체 데이터셋을 사용하는 General-Reasoner의 56.0을 웃돈다.
- R-FEW는 질문을 생성하는 Challenger와 답변하는 Solver를 결합한다. Challenger는 질문 생성을 유도하는 인간 앵커 예제, 즉 정답이 부여된 예제를 0~5개 받는다. 온라인 커리큘럼은 현재 풀이 능력에 맞춰 학습 질문을 선택하며 적당히 어려운 인간 질문과 합성 질문을 Solver 학습에 사용한다. 두 모델은 보상에 따라 매개변수를 갱신하는 강화 학습으로 학습한다.
- 실험은 Qwen3-4B-Base와 Qwen3-8B-Base를 대상으로 수학 벤치마크 5개와 일반 추론 벤치마크 4개에서 진행하며 WebInstruct의 1% 또는 5%를 사용한다. R-FEW는 모델 크기 2개 모두에서 재현한 R-Zero 결과보다 성능이 높다. 다만 4B 모델의 전체 평균은 문서에 근거해 self-play를 수행하는 기준 방법 SPICE와 General-Reasoner보다 낮다. 구성 요소를 개별적으로 제거하는 ablation 실험은 Challenger 학습, 형식 준수를 위한 warm-up, 커리큘럼 선택이 성능에 기여함을 뒷받침한다.
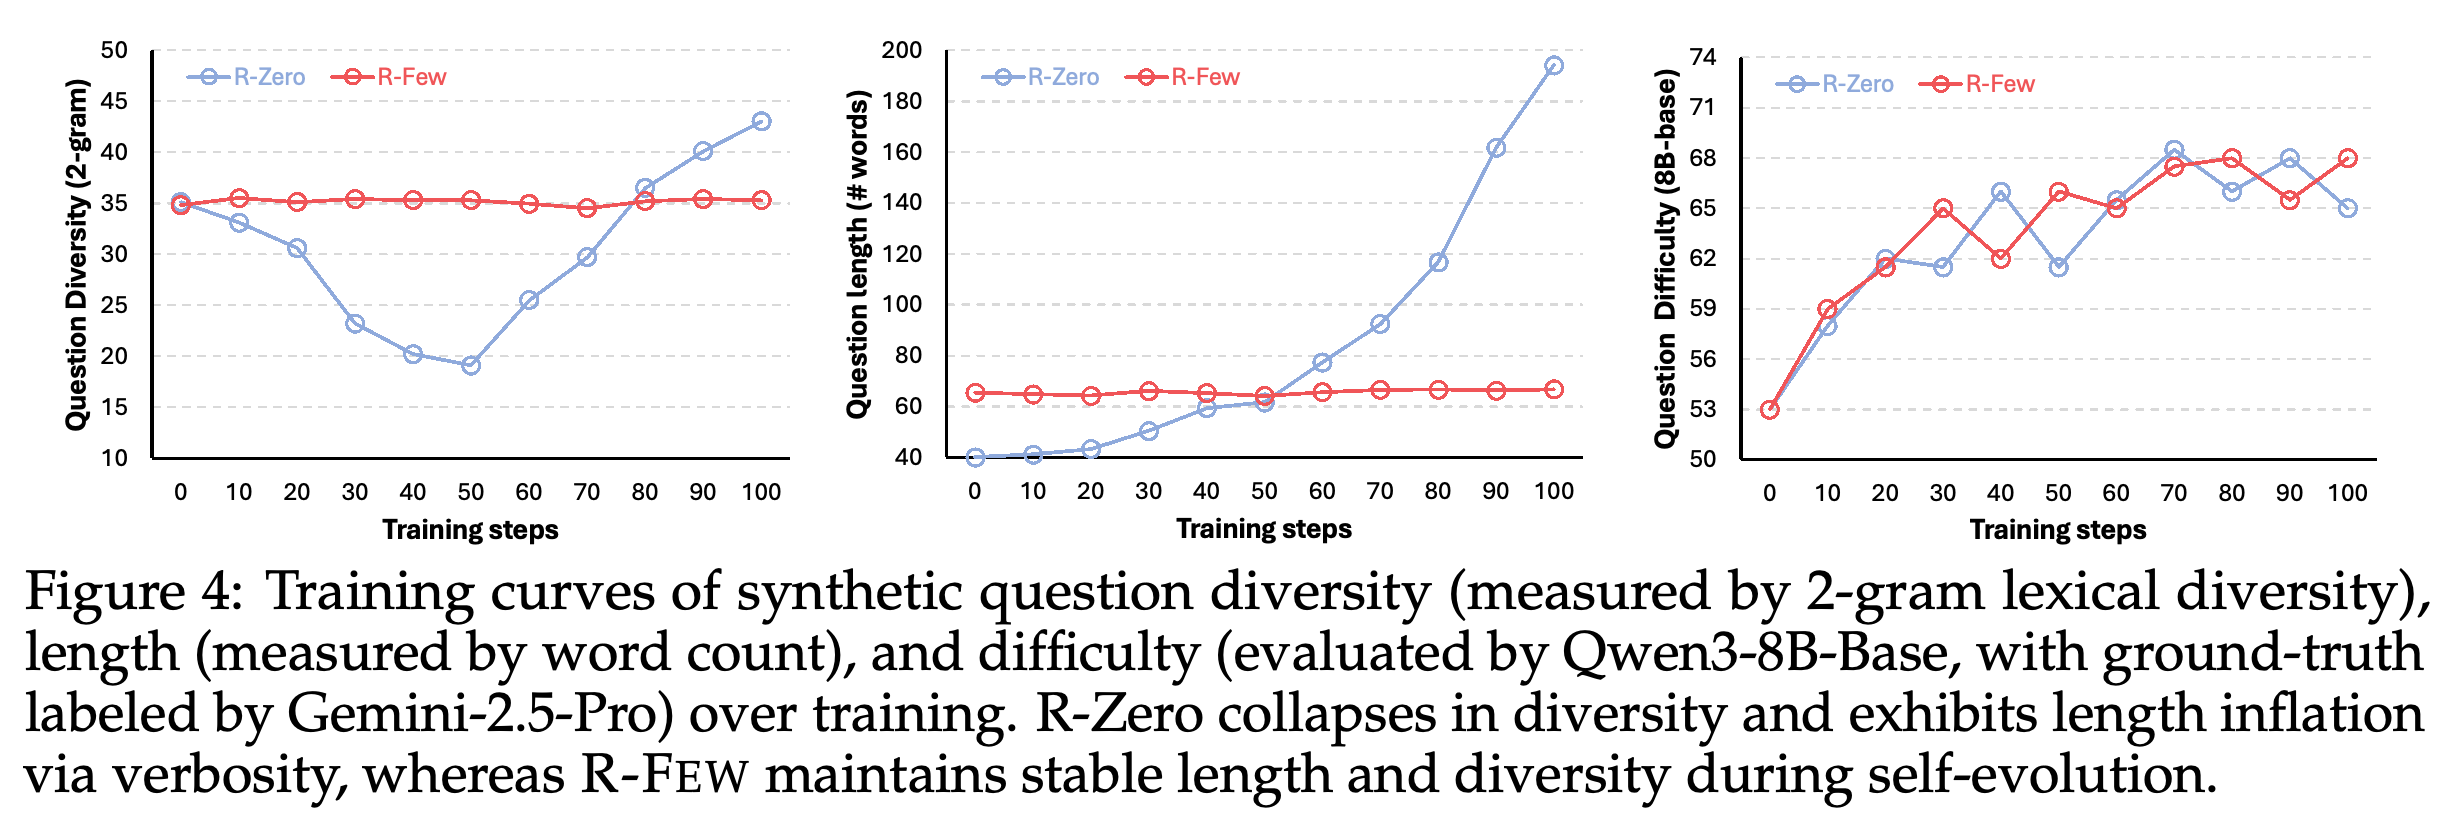
- 학습 곡선에서 R-FEW는 Solver 학습 100스텝 동안 질문 길이와 어휘 다양성을 대체로 안정적으로 유지한다. 어휘 다양성은 단어 배열이 얼마나 다양한지를 나타낸다. 반면 R-Zero는 먼저 다양성이 줄고 이후 훨씬 긴 질문을 생성한다. 이 측정 결과는 실험한 기간 안에서 안정성이 개선되었음을 뒷받침하지만 의미적 다양성이나 그 이후에도 개선이 지속되는지는 입증하지 못한다. 보고서에는 수식, 표, 설명 문장 사이의 불일치도 있다.
1 Introduction
서론은 편향된 추론이 강화되면서 사실적 정확성에서 멀어지는 concept drift와 생성 과제가 익숙한 영역에 집중되는 다양성 붕괴를 자율적 자기 개선의 장애물로 제시한다. R-FEW는 소규모 인간 데이터 풀로 질문 생성을 유도하고 난이도에 따라 인간 예제와 합성 예제를 결합해 학습에 공급한다. 시연 예제를 0개 샘플링하면 별도의 유도 없이 질문을 생성할 수 있지만 전체 Solver 학습 과정에서 인간 예제가 사라지는 것은 아니다.
다중 과제 언어 이해 벤치마크 MMLU-Pro에서 R-FEW는 R-Zero가 정점에 도달한 뒤 하락하는 시점 이후에도 개선을 이어간다. 강조된 점수는 63.2와 61.6이다. 막대 패널은 수학 문제 풀이 벤치마크 2개인 AMC와 MATH-500에서 R-FEW 점수 72.3과 82.6, 그리고 벤치마크 9개의 평균 56.7을 제시한다. 이 선별된 비교는 학습 추이와 최종 성능을 보여주지만 모든 벤치마크에서의 우위를 입증하지는 않는다.
2 Preliminaries: Self-Play For Data-Free Training
기초 설명에서는 게임의 self-play를 자체 학습 과제를 만드는 언어 모델로 확장한다. 동일한 사전 학습 모델로 질문 생성 역할과 답변 생성 역할을 각각 초기화하고 보상 피드백을 통해 반복적으로 개선한다. 이 데이터 없는 학습 설정에 R-FEW는 제한된 인간 감독을 추가한다.
2.1 Unified View of Self-Play Objectives and Reward Design
Challenger Qθ는 과거 문맥을 조건으로 질문을 생성하고 Solver Sϕ는 질문을 조건으로 답변을 샘플링한다. θ와 ϕ는 각 모델의 매개변수다. 답변을 확인하는 verifier나 샘플링한 답변 사이의 일치를 확인하는 self-consistency가 보상을 제공한다. 보고서에서 사용하는 강화 학습 최적화 방법 Group Relative Policy Optimization(GRPO)이 두 모델을 갱신한다. 통합 목적함수는 이중 수준 최적화 구조다. Challenger 최적화는 Solver의 현재 능력에 의존하며 Solver 최적화는 생성 과제에서 얻는 답변 보상을 최대화한다.
- Absolute Zero는 어렵지만 풀 수 있는 과제에 보상을 주고 검증된 답변을 사용한다. R-Zero는 추정 성공률이 0.5에 가까운 과제를 목표로 하며, 반복 질문에 페널티를 부과한다. 또한 다수결 답변을 pseudo-label로 사용한다. Pseudo-label은 샘플링한 답변에서 만든 합성 학습 목표다.
- Self-Questioning LMs(SQLM)는 성공률 통계를 활용해 답할 수 있고 유익한 질문을 목표로 한다. SPICE는 문서를 조건으로 과제를 생성하고 원문을 답변 학습의 감독 신호로 사용한다.
3 Method
R-FEW는 인간 예제를 조건으로 과제를 생성하고 학습 질문을 적응적으로 선택해 self-play 데이터 처리 과정을 수정한다. 별도의 Challenger와 Solver 모델을 보상에 따라 갱신하므로, 생성 과제와 답변 능력이 함께 변한다.
3.1 Overview
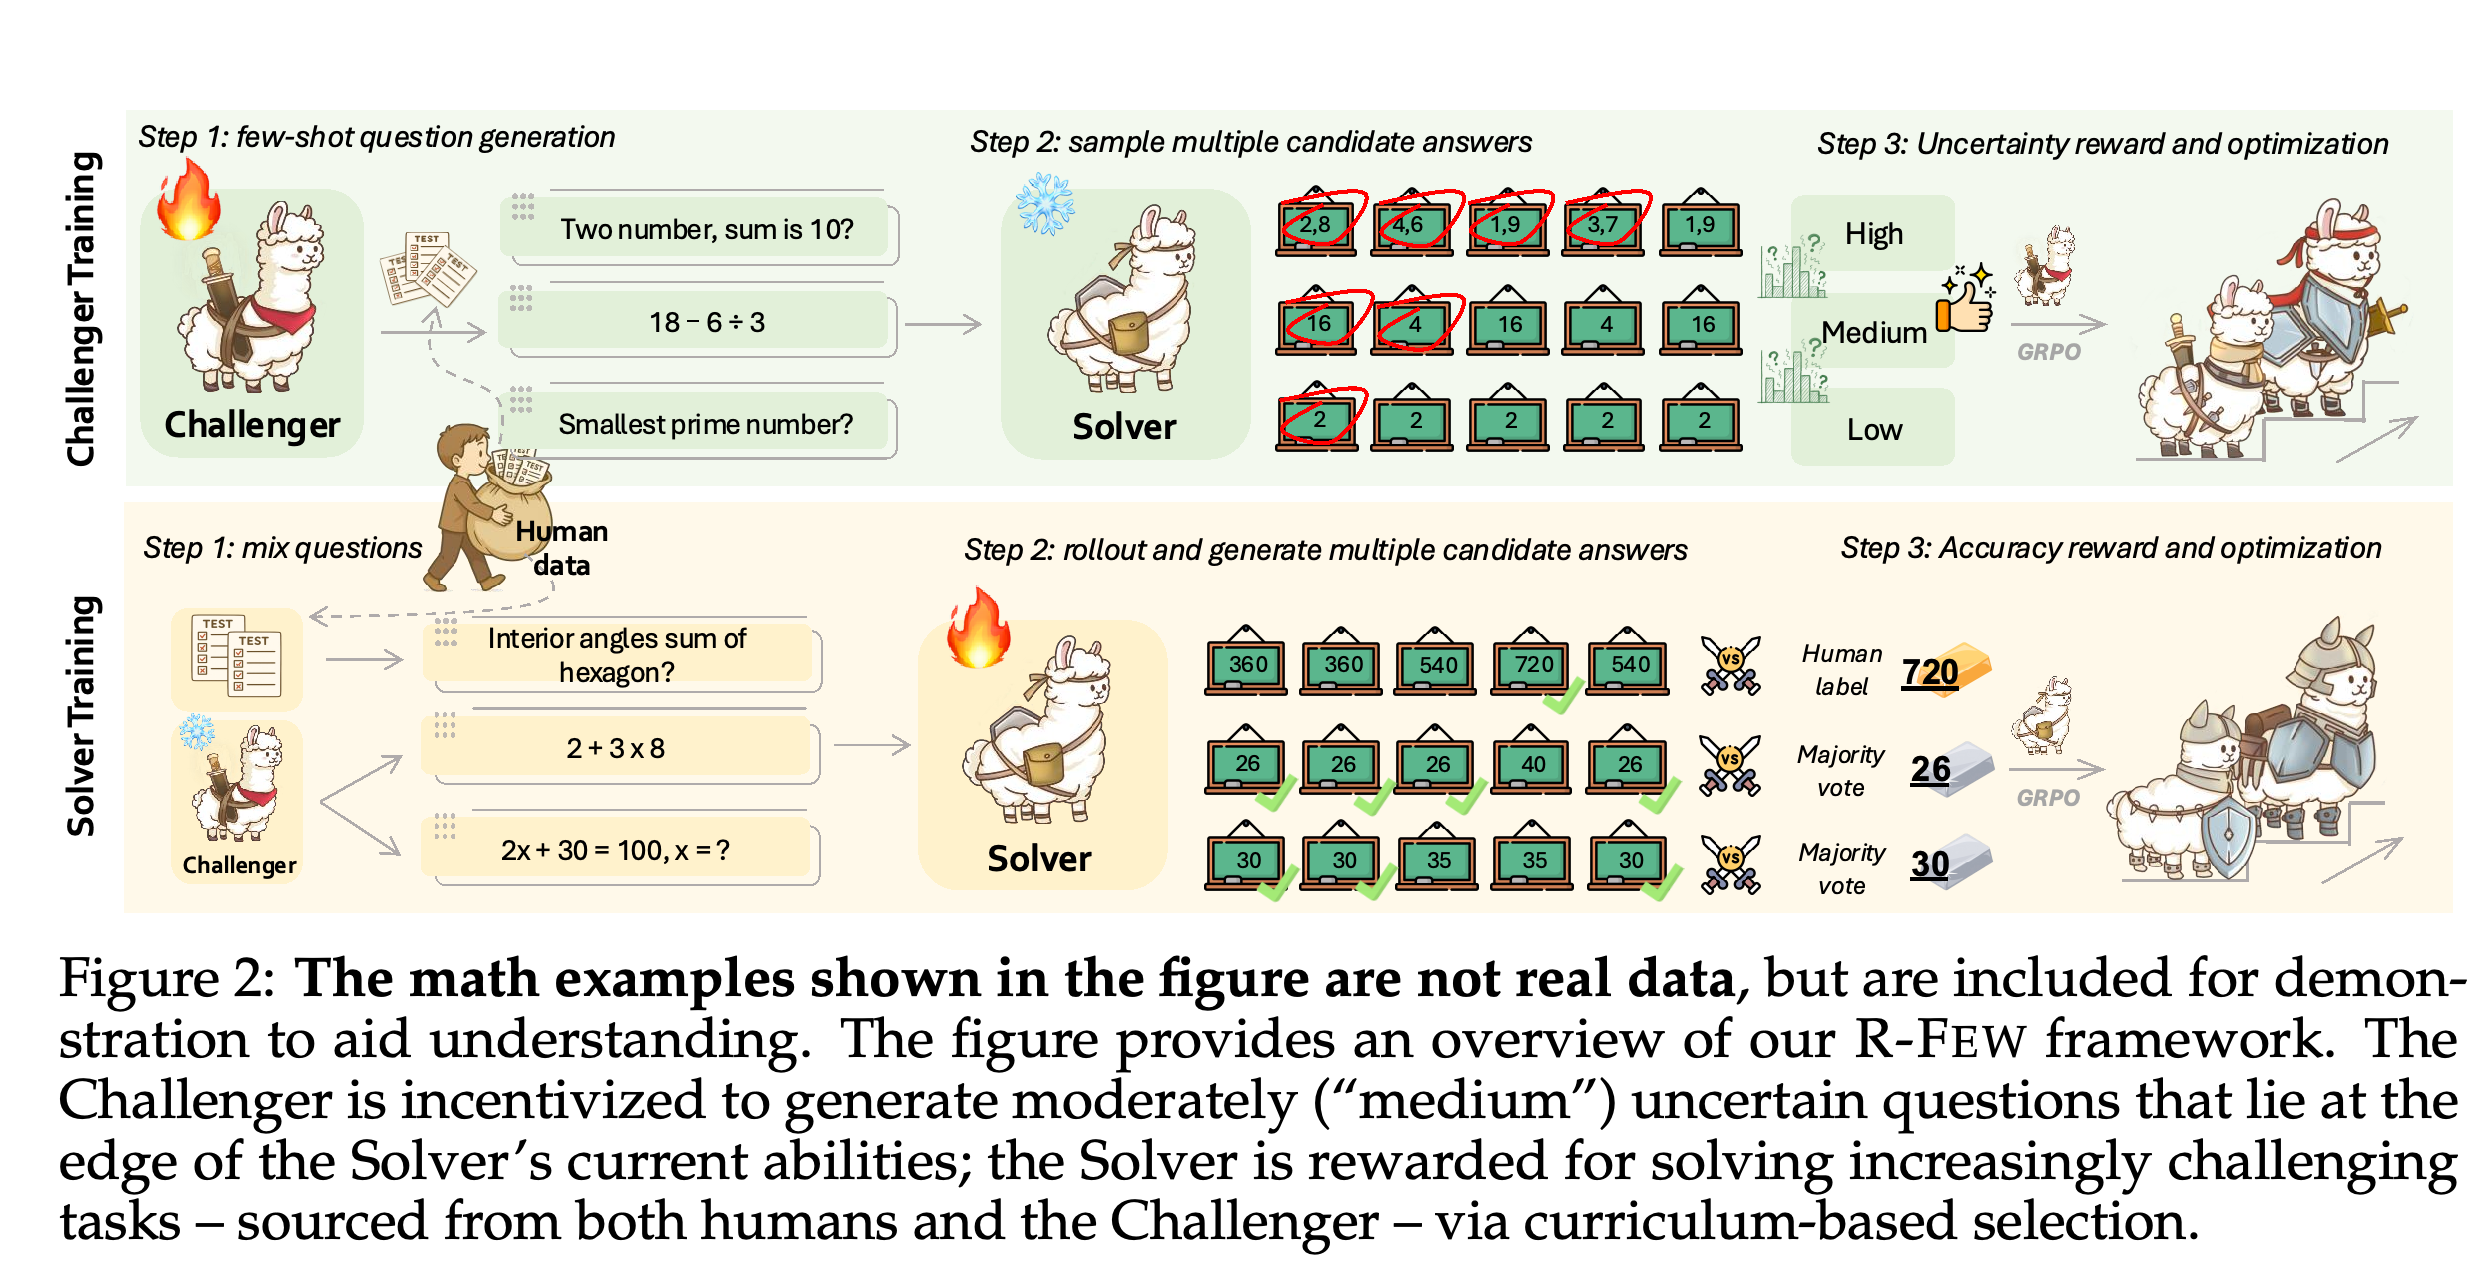
이 방법은 정답이 부여된 소수의 시연 예제를 조건으로 질문을 생성하는 few-shot grounded Challenger와 온라인 커리큘럼 Solver를 결합한다. Figure 2는 불확실성 보상으로 Challenger를 최적화하는 과정과 답변 보상으로 Solver를 최적화하는 과정을 구분한다. 그림의 수학 예제는 절차를 설명하기 위한 것이며 실제 학습 데이터가 아니라고 명시되어 있다.
위쪽 절차는 인간 시연 예제로 Challenger를 유도하고 샘플링한 Solver 답변을 활용해 중간 수준의 불확실성에 보상을 부여한다. 아래쪽 절차는 인간 질문과 생성 질문을 섞어 사용하며 인간 예제에는 인간 정답을, 합성 예제에는 다수결 정답을 사용한다. 산술 문제는 실제 학습 데이터가 아니라 설명용 예제라고 명시되어 있다.
3.2 Few-Shot Grounded Challenger
샘플링을 통해 생성을 시도하는 각 rollout에서 Challenger는 인간 앵커 풀로부터 k ∈ {0,1,…,5}개의 예제를 무작위로 받는다. 제시된 보상은 R_chal(q) = 1 − 2|p̂_succ(q) − 1/2| − λ_rep RepPenalty(q)다. p̂_succ는 Solver의 성공률을 추정하고 RepPenalty는 중복 질문에 페널티를 부과하며 λ_rep는 그 페널티의 가중치다. 반복 페널티를 적용하기 전에는 추정 성공률이 0.5일 때 보상이 최대다.
- 예제 출력으로 학습하는 supervised fine-tuning(SFT) warm-up은 시연 프롬프트가 길어졌을 때 기본 모델이 요구된 질문 형식을 따르도록 돕는다.
- 주변 설명은 Align(q, D_H)를 임베딩 공간에서 생성 질문과 인간 앵커 분포 사이의 코사인 유사도로 설명한다. 임베딩은 텍스트를 수치로 표현한 것이다. 그러나 Equation (5)와 Algorithm 1에는 정렬 항이 없어, 최적화에서 어떤 역할을 하는지 명확하지 않다.
3.3 Online Curriculum Solver
Solver는 질문마다 여러 답변을 샘플링해 성공률을 추정한 뒤, 인간 질문과 합성 질문을 합친 풀에서 적당히 어려운 질문을 선별한다. 보고서는 [0.3, 0.7]을 순위 분포에서 위치의 경계를 나타내는 분위수 구간이라고 부르지만 Equation (8)은 이 값을 추정 성공률에 직접 적용한다. 따라서 의도한 선택 규칙이 불분명하다. 제시된 Solver 보상은 커리큘럼 가중치를 적용한 다수결 답변과의 일치도에 인간 예제의 추가 가중치 항을 결합하며 이 항의 계수는 2.0이다.
- Figure 2에서는 인간 질문을 인간 정답과 비교해 채점하고 합성 질문을 다수결 정답과 비교해 채점한다.
- Equation (9)는 추가 인간 항을 명시적인 정답 여부 지시함수가 아니라 인간 풀에 속하는지 나타내는 지시함수로 작성한다. 이 항과 부록에서 설명하는 정확도 보상의 관계는 명확하지 않다.
3.4 Iterative Co-Evolution
각 반복에서는 인간 시연 예제를 활용해 과제를 생성하고 Solver 답변을 샘플링해 난이도를 추정하며 각 데이터 출처에서 학습 예제를 선택한다. Algorithm 1은 Challenger를 갱신하기 전에 유효하지 않은 생성 질문에도 페널티를 부과한다. Challenger와 Solver를 번갈아 갱신하면서 풀이 능력의 변화에 맞춰 학습 풀을 새로 구성한다.
4.1 Experiments Setting
실험은 사전 학습 모델의 크기 2개와 인간 앵커 데이터의 비율 2개를 설정하고 수학 및 일반 추론 과제에서 평가한다. 기준 방법 비교, 구성 요소 ablation, 분야별 앵커 샘플링, 학습 중 질문 생성 측정을 포함한다.
4.1.1 Baseline Methods
기반 모델은 Qwen3-4B-Base와 Qwen3-8B-Base이며, 보고서는 전자의 링크로 https://huggingface.co/Qwen/Qwen3-4B-Base 를 제공한다. 기본 체크포인트와 R-Zero는 동일한 학습 인프라에서 재현하고 Absolute Zero와 SPICE 점수는 Liu et al. (2025a)에서 가져온다. R-FEW (1%)와 R-FEW (5%)는 232k-example WebInstruct 데이터셋에서 해당 비율을 무작위로 샘플링해 사용한다. General-Reasoner는 전체 데이터셋을 사용하는 비교 기준이다.
- Absolute Zero verifies code tasks through Python execution, 즉 Python 실행으로 코드 과제를 검증한다. SPICE는 문서 문맥을 검색해 문서에 근거한 답변을 갖는 질문을 생성한다.
- 동일한 인프라 조건은 재현한 기준 방법에 적용된다. 외부에서 가져온 점수에도 동일하게 통제된 학습 비교가 적용되었다는 근거는 보고서에 없다.
4.1.2 Evaluation Benchmark
수학 평가는 수학 문제 풀이 벤치마크 5개인 AMC, Minerva, MATH-500, GSM8K, Olympiad-Bench를 사용한다. GPT-4o는 최종 답변과 기준 답변이 의미적으로 동등한지 비교한다. 일반 추론 평가는 다중 과제 언어 이해 벤치마크 MMLU-Pro, 대학원 수준의 여러 학문 분야를 다루는 SuperGPQA, 대학원 수준 질의응답 하위 집합 GPQA-Diamond, Big-Bench Extra Hard인 BBEH를 사용한다.
- 일반 추론 점수는 greedy decoding으로 생성한 답변의 Exact Match(EM)를 사용한다. Greedy decoding은 매번 확률이 가장 높은 다음 토큰을 선택하는 방식이며 EM은 기준 답변과의 정확한 일치를 나타낸다.
- 분야에는 물리학, 생물학, 경영학, 경제학, 법학이 포함된다. 수학 점수와 일반 추론 점수는 서로 다른 답변 확인 절차를 사용한다.
4.2 Experimental Results
결과에서는 벤치마크 종합 성능, 개별 학습 구성 요소, 앵커 분야 선택, 생성 질문의 변화를 살펴본다. Table 1은 벤치마크 점수를, Table 2는 구성 요소 제거 결과를 제시한다. Figures 3–4는 분야 유도와 생성 안정성을 살펴본다.
4.2.1 Comparison with Baseline Methods
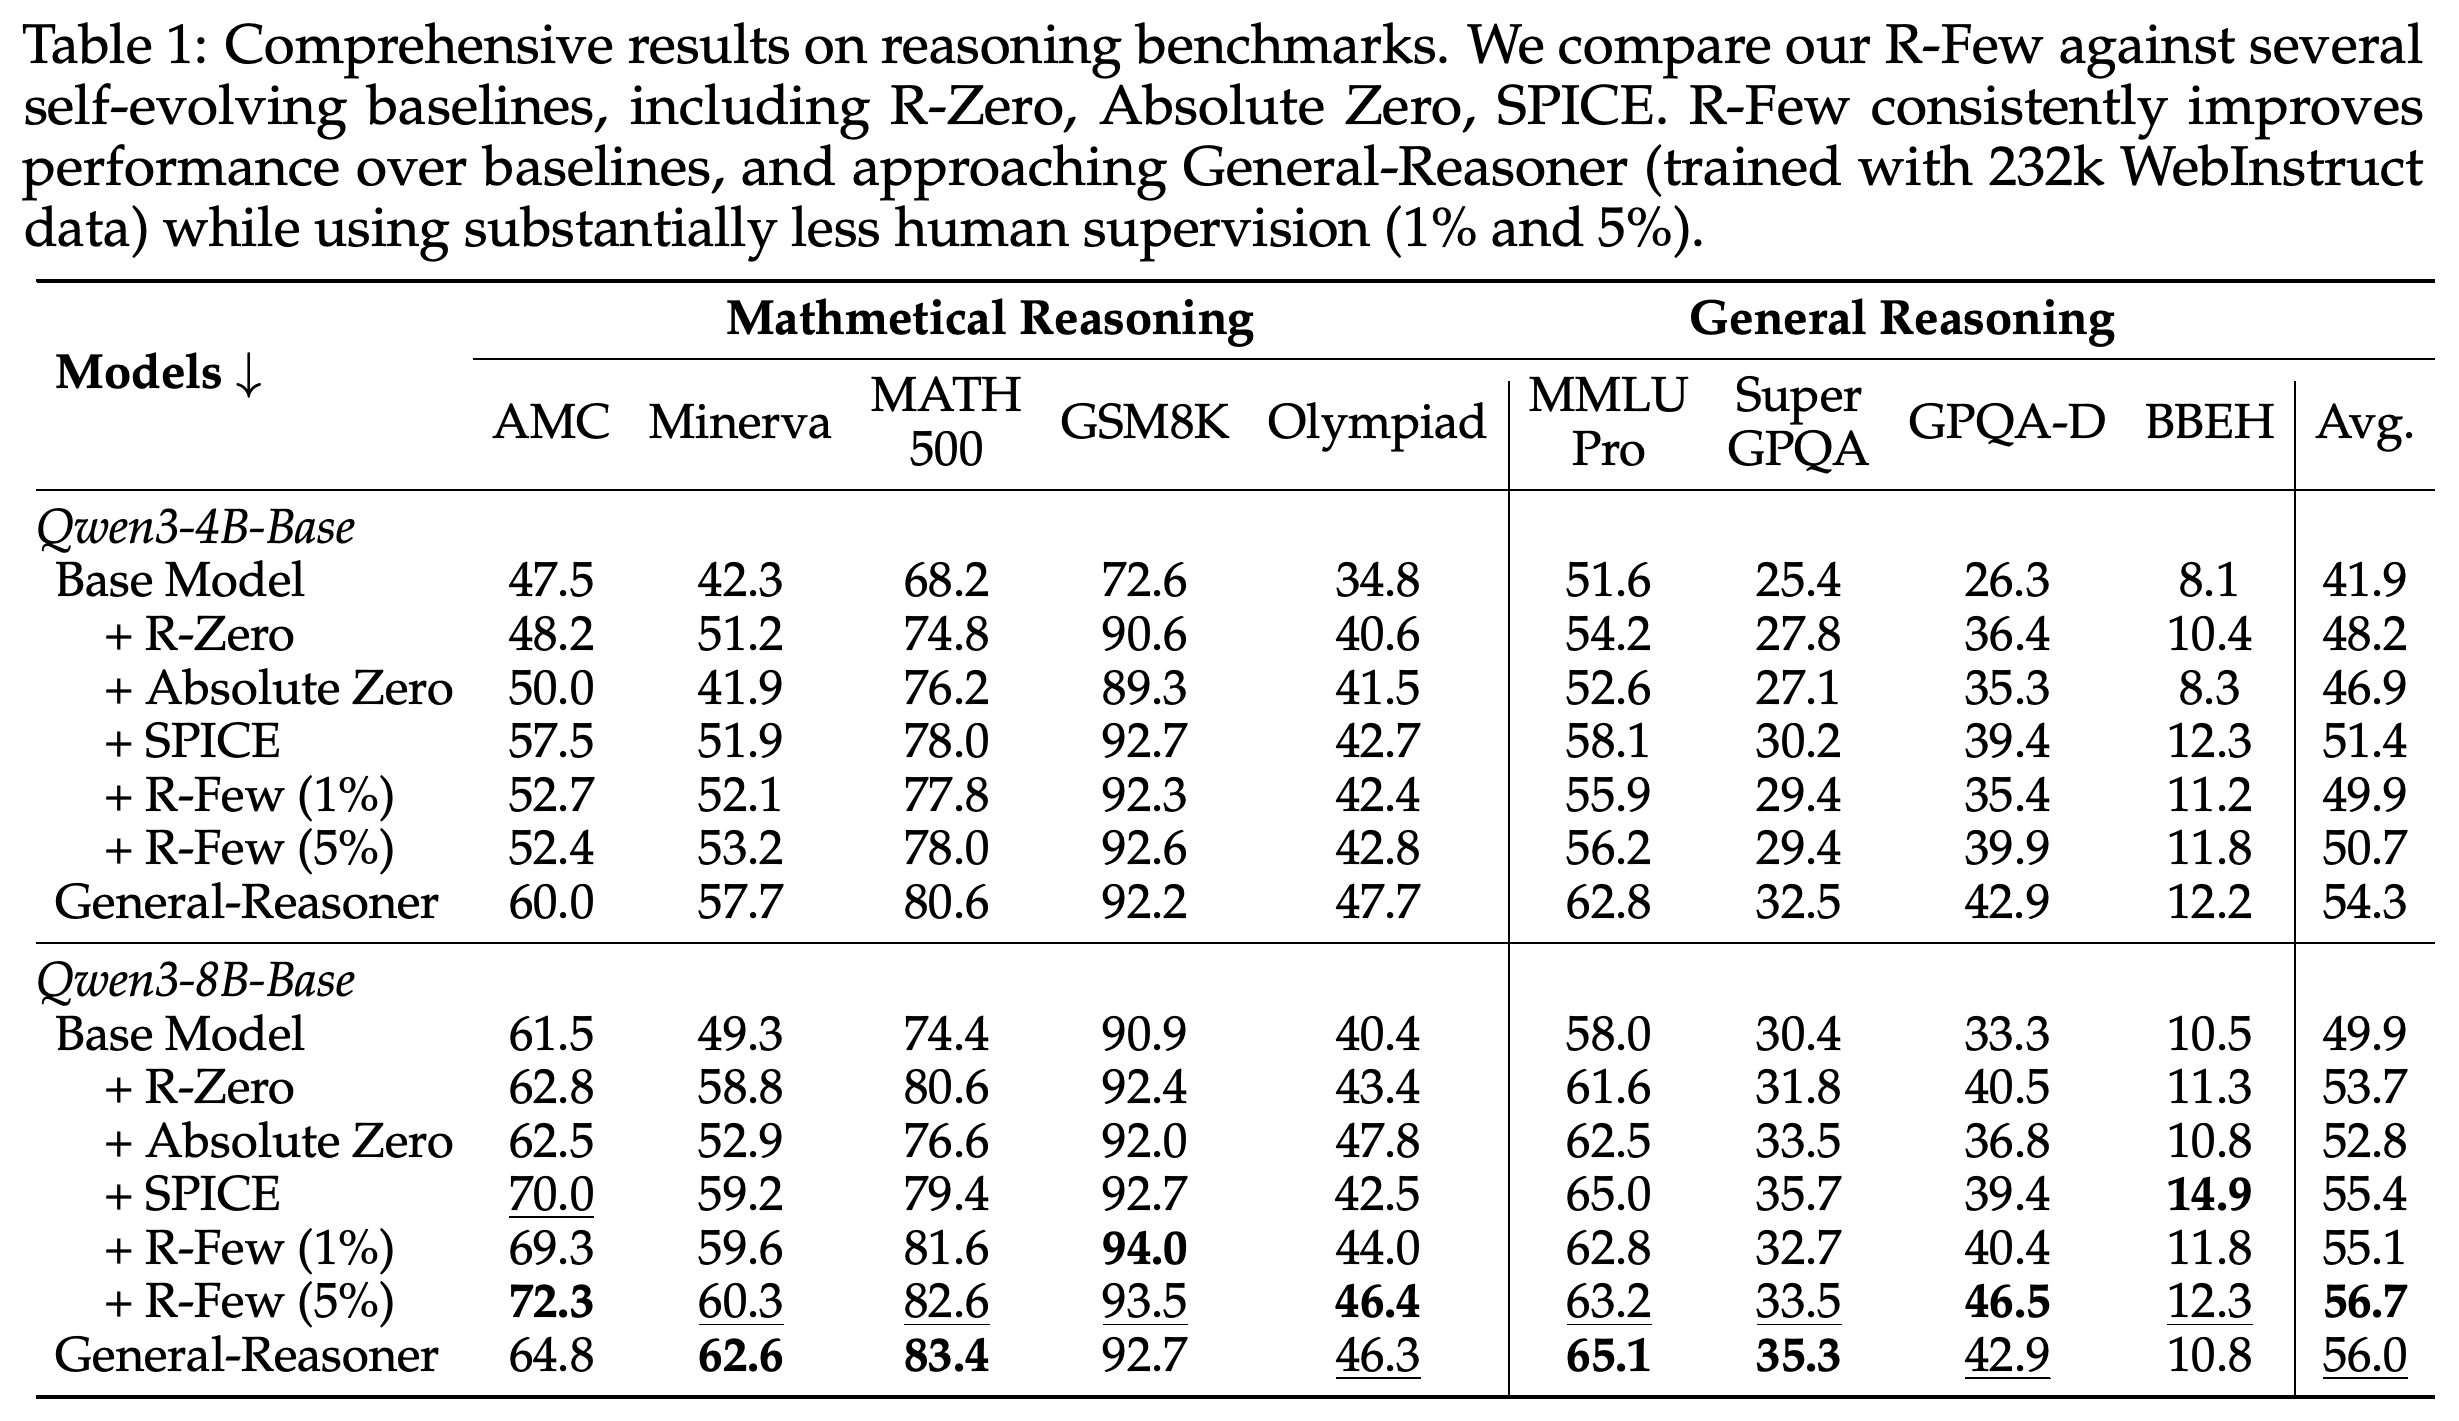
Qwen3-4B-Base의 전체 평균은 기본 모델의 41.9와 R-Zero의 48.2에서 R-FEW (1%)의 49.9와 R-FEW (5%)의 50.7로 높아진다. 이 점수는 SPICE의 51.4와 General-Reasoner의 54.3보다 낮다. Qwen3-8B-Base에서 R-FEW는 각각 55.1과 56.7을 기록하며 비교 점수는 R-Zero의 53.7, SPICE의 55.4, General-Reasoner의 56.0이다.
- 8B, 5% 설정은 AMC 72.3, MATH-500 82.6, GPQA-Diamond 46.5를 기록한다. 모든 벤치마크에서 가장 높은 점수를 얻지는 않는다. General-Reasoner는 Minerva, MATH-500, MMLU-Pro에서 더 높고, SPICE는 SuperGPQA와 BBEH에서 더 높다.
- 초록은 수학 과제에서 +3.0점 개선되었다고 설명한다. Table 1에서 +3.0점은 보고된 9개 벤치마크 평균에 해당한다. 표에 제시된 수학 점수 5개의 평균을 계산하면 R-Zero 대비 개선 폭은 약 +3.4점이다.
- 20-times 데이터양 비교는 R-FEW (5%)와 전체 WebInstruct 데이터셋에 적용된다. 본문은 8B 설정 모두 General-Reasoner를 앞선다고도 설명하지만 1% 설정의 평균 55.1은 56.0보다 낮다.
R-FEW (5%)는 8B에서 전체 평균 56.7을 기록해 General-Reasoner의 56.0을 웃돈다. 그러나 4B 점수 50.7은 SPICE의 51.4와 General-Reasoner의 54.3보다 낮다. 개별 열을 보면 R-FEW가 모든 벤치마크에서 가장 높은 점수를 얻지는 않는다. Absolute Zero와 SPICE 점수는 다른 보고서에서 가져왔으며 R-Zero는 재현한 결과다.
4.2.2 Ablation Studies
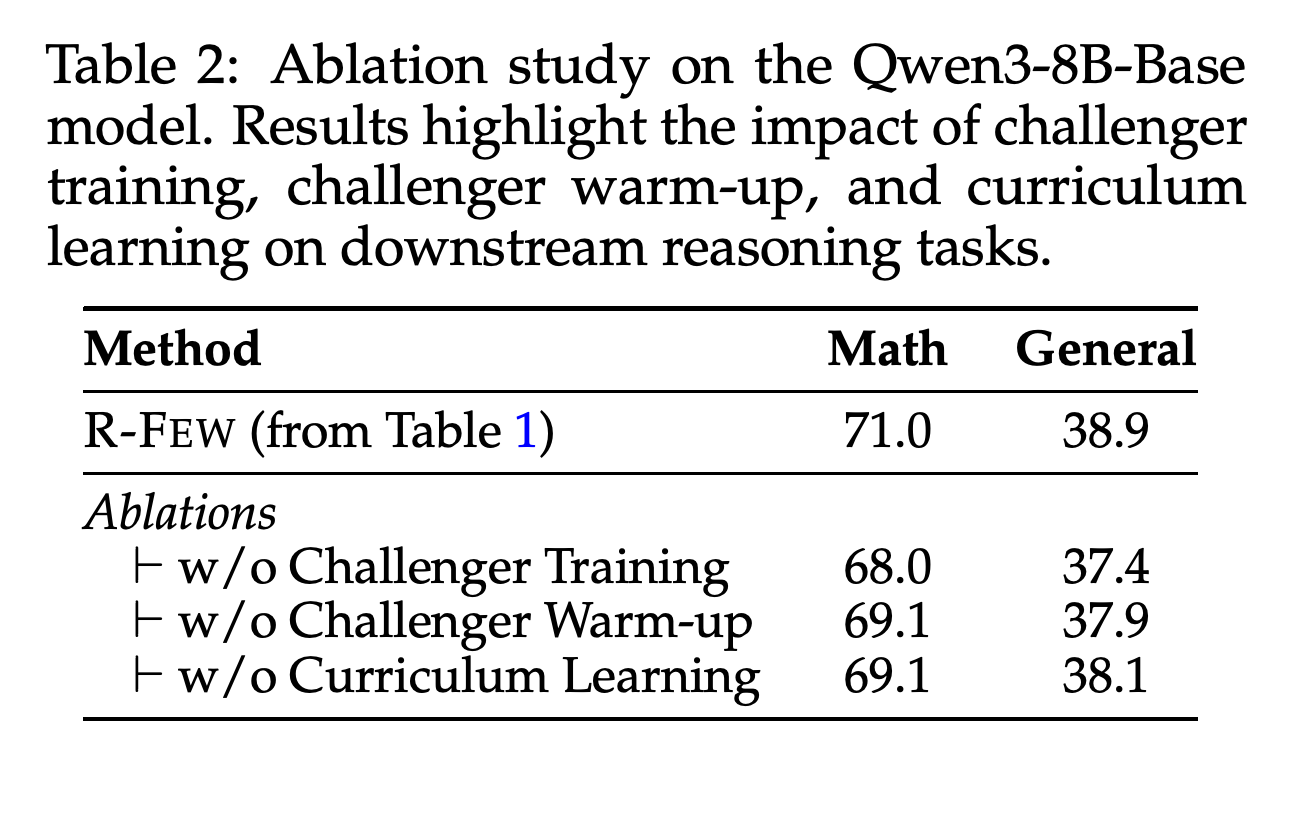
Ablation은 Qwen3-8B-Base와 5% 앵커 설정을 사용한다. Table 2의 Math/General 평균은 R-FEW가 71.0/38.9, Challenger 학습을 제거하면 68.0/37.4, Challenger warm-up을 제거하면 69.1/37.9, 커리큘럼 학습을 제거하면 69.1/38.1이다. 각 구성 요소를 제거할 때 성능이 낮아지며, Challenger 학습을 제거했을 때 하락 폭이 가장 크다.
- 표에서 계산한 Challenger 학습 제거에 따른 하락 폭은 Math 3.0점과 General 1.5점이다. 그러나 함께 제시된 설명은 1.9점과 1.0점이라고 서술한다.
- 이 ablation은 해당 설정에서 평가한 구성 요소 3개의 기여를 뒷받침한다. 다만 생성에 쓰는 인간 시연 예제와 Solver 학습에 직접 쓰는 인간 예제의 효과를 따로 분리하지는 않는다.
Challenger 학습을 제거하면 Math/General 점수가 71.0/38.9에서 68.0/37.4로 낮아지며, 평가한 제거 조건 중 하락 폭이 가장 크다. Warm-up이나 커리큘럼 학습을 제거해도 점수가 낮아진다. 표에서 계산한 Challenger 학습 제거에 따른 하락 폭 3.0/1.5점은 함께 제시된 설명의 1.9/1.0점과 일치하지 않는다.
4.2.3 Domain Corelation with Human Data
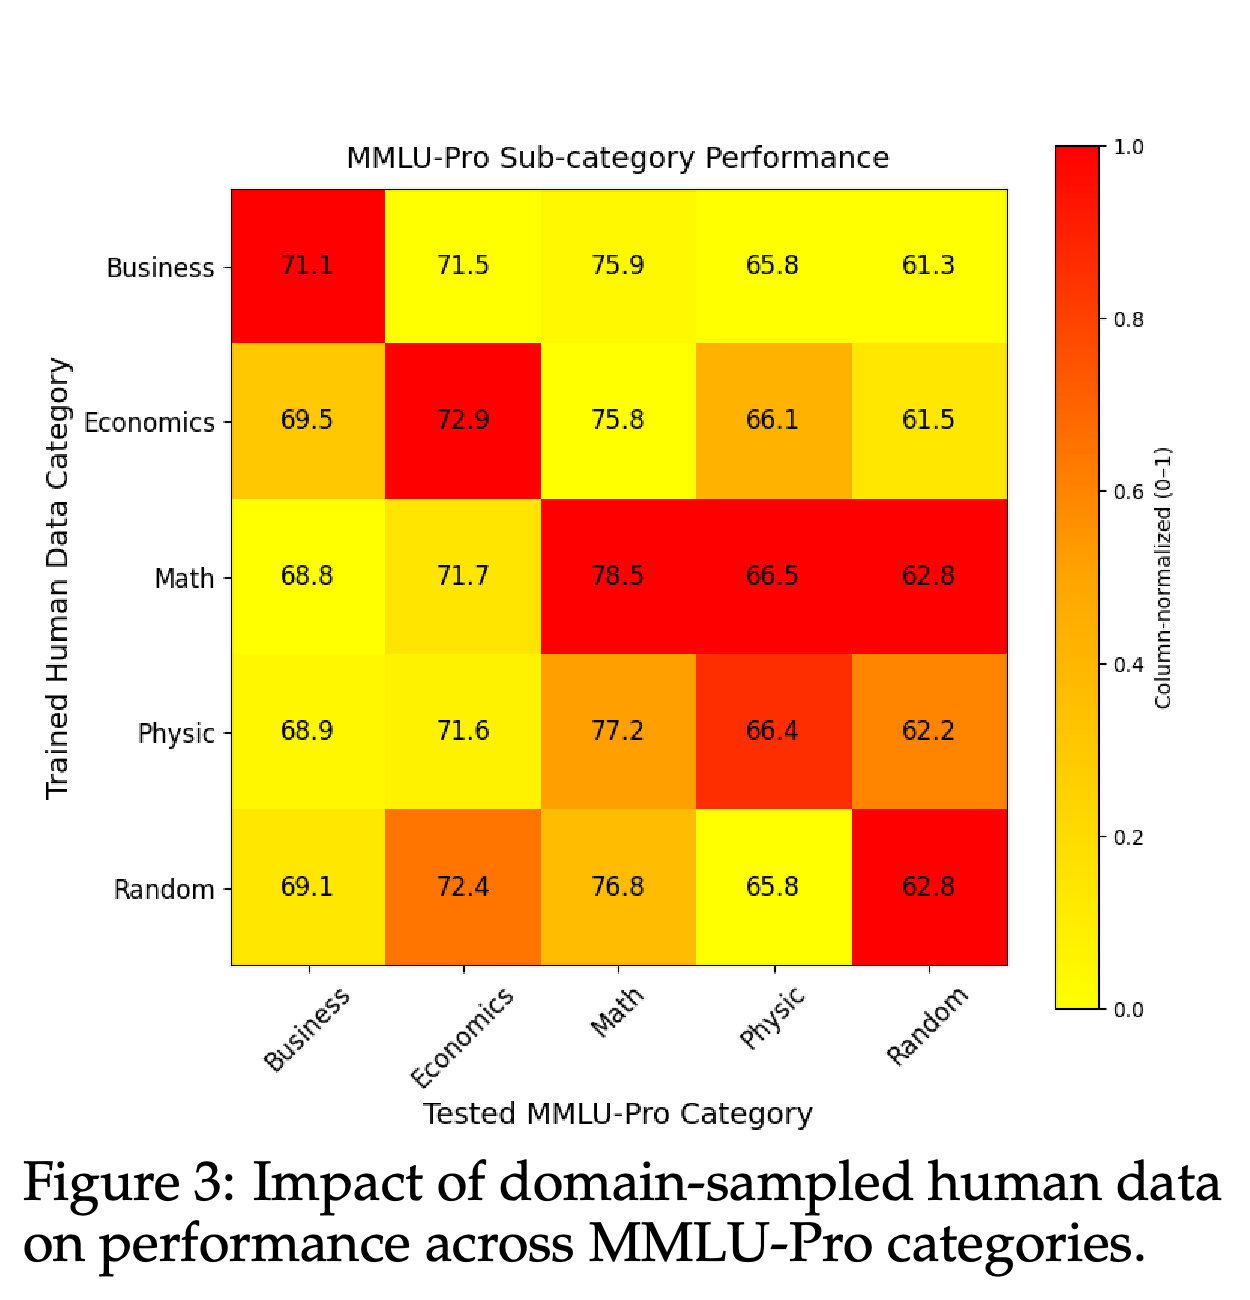
분야별 WebInstruct 앵커로 학습한 모델을 MMLU-Pro 범주 전반에서 평가한다. Figure 3에서 경영학 앵커는 경영학 점수 71.1, 경제학 앵커는 경제학 점수 72.9, 수학 앵커는 수학 점수 78.5로 각 범주의 표시된 최고 점수를 기록한다. 수학 앵커는 물리학에서도 최고 점수 66.5를 기록하며 물리학 앵커의 66.4를 근소하게 웃돈다.
- 행렬은 앵커 선택으로 분야를 유도할 수 있음을 뒷받침하지만 평가 분야와 일치하는 학습 분야가 모든 열에서 가장 높은 점수를 얻지는 않는다.
- 저자들은 수학과 물리학, 경영학과 경제학의 관계를 공통 추론 구조를 통한 전이로 해석한다. 행렬은 성능 사이의 연관성을 보여주지만 그 메커니즘을 입증하지는 않는다.
행은 학습 앵커 범주를, 열은 평가 범주를 나타낸다. 경영학, 경제학, 수학 앵커는 각각 일치하는 열에서 가장 높은 점수를 기록한다. 물리학에서는 수학 앵커가 66.5로 물리학 앵커의 66.4를 웃돈다. 색상은 각 열 안에서 정규화되므로, 평가 범주 사이를 비교하려면 표시된 점수를 확인해야 한다.
4.2.4 Improved Stability and Reduced Reward Hacking
Figure 4는 인접 단어 쌍이 얼마나 다양한지를 나타내는 2-gram 어휘 다양성으로 질문 다양성을, 단어 수로 길이를 측정한다. 난이도는 Gemini-2.5-Pro로 정답을 다시 부여한 질문에 대한 Qwen3-8B-Base의 오답 백분율로 측정한다. R-Zero의 다양성은 첫 50 steps 동안 약 35에서 20 미만으로 떨어진 뒤, 질문 길이가 크게 늘어나는 시기에 함께 상승한다. R-FEW는 측정 난이도가 높아지는 동안에도 다양성을 시작 수준 근처로, 질문 길이를 대체로 안정적으로 유지한다.
- 저자들은 R-Zero에서 나중에 나타나는 길이 증가를 reward hacking으로 해석한다. 이는 보상 관련 신호를 높이는 피상적 특성을 악용하는 것이다. 곡선은 장황함과 관련된 실패 양상을 보여주지만 길이가 난이도 증가의 원인인지는 분리해 확인하지 않는다.
- 어휘 다양성은 출력 길이에 민감하며 의미적 다양성을 직접 측정하지 않는다. 난이도 측정도 정답을 부여하는 모델과 생성 질문에 답하는 고정 모델에 의존한다.
R-Zero에서 후반에 나타나는 인접 단어 쌍 다양성의 증가는 단어 수의 급격한 증가와 함께 나타나므로, 이를 의미적 탐색의 재개로 해석하기에는 한계가 있다. R-FEW는 생성 질문이 고정 평가 모델에 더 어려워지는 동안에도 길이와 어휘 다양성을 대체로 안정적으로 유지한다. 패널을 함께 보면 측정한 학습 기간 동안 장황함과 관련된 불안정성이 줄었음을 뒷받침한다.
5 Related Work
관련 연구에서는 R-FEW를 자체 학습 과제를 생성하는 self-play 시스템과 언어 모델 추론을 위한 강화 학습 방법의 맥락에서 설명한다. R-FEW는 정답이 부여된 소규모 앵커 풀과 인간 및 합성 학습 질문의 적응적 선택을 결합한다.
5.1 Self-Evolving LLMs and Self-Play
기존 self-play 방법에는 반복적인 과제 생성과 풀이, 단위 테스트로 확인하는 코드 생성, 내부 검증 신호를 활용하는 데이터 없는 학습이 있다. 다른 방법들은 초기 예제나 문서 문맥을 도입해 생성 과제를 유도한다. R-FEW는 합성 과제 생성을 유지하면서 정답이 부여된 제한된 시연 예제와 인간 예제를 이용한 직접 학습을 사용한다.
5.2 Reinforcement Learning for LLM Reasoning
논문은 인간 선호 신호로 최적화하는 reinforcement learning from human feedback(RLHF)와 외부에서 정답 여부를 확인할 수 있는 피드백으로 최적화하는 reinforcement learning with verifiable rewards(RLVR)를 검토한다. 모델의 확신도, 답변 일관성, 출력 분포의 불확실성을 나타내는 출력 엔트로피에 기반한 label-free 보상도 다룬다. 이러한 방법은 R-FEW가 자체 생성 레이블과 제한된 인간 예제에 근거한 유도를 결합하는 배경을 제공한다.
6 Conclusion and Future Work
결론은 R-FEW의 개선이 인간 예제로 유도하는 질문 생성과 Solver 온라인 커리큘럼의 결합에서 비롯된다고 설명한다. 종합 성능이 가장 높은 Qwen3-8B-Base, 5% 설정은 General-Reasoner의 보고된 전체 평균보다 0.7점 높다. 향후 과제로 학습 효율 개선, 더 풍부한 검증 방법 탐색, 객관적 정답 신호가 없는 개방형 분야로의 확장을 제안한다. 이러한 확장은 평가하지 않았다.
부록
- A.1 Training Details: 구현은 강화 학습 프레임워크 EasyR1과 R-Zero를 기반으로 한다. Challenger 갱신 5회와 Solver 갱신 10회를 번갈아 수행하며 Challenger 50스텝과 Solver 100스텝까지 학습한다. 각 모델은 배치 크기 512, rollout 8개, 학습률 5 × 10^−7을 사용한다. Solver 보상은 형식 정확성에 0.1, 정답 정확성에 0.9의 가중치를 부여한다. Figure 5에서 생성 질문으로 학습 데이터를 새로 구성할 때 정확도 보상은 변동하지만 형식 보상은 초기에 상승한 뒤 높은 수준을 유지한다.
- A.2 Training Hyperparameter, A.2.1 Solver Training, A.2.2 Challenger Training: 각 역할은 전역 배치 크기 512, 학습률 5 × 10^−7, Kullback–Leibler(KL) 페널티 계수 1 × 10^−2, rollout 8개, temperature 1.0, top-p 0.99를 사용한다. KL 페널티는 분포 간 차이를 제한하고 temperature는 샘플링의 무작위성을 조절하며 top-p는 토큰 샘플링의 누적 확률 기준을 지정한다. 최대 스텝은 Solver가 100, Challenger가 50이다. 실험에는 혼합 정밀도 계산을 위한 수치 형식 BFloat16(BF16)과 효율적인 attention 구현인 FlashAttention 2를 사용한다.
- A.3 Prompt Templates: Solver Prompt Template은 단계별 추론과 \boxed{} 안의 최종 답변을 요청하며 <problem_statement>로 질문을 제공한다. Challenger Prompt Template은 고등학교 또는 대학 학문 분야의 새로운 추론 문제를 요청한다. 예제 자리표시자를 포함하며 {question}과 {/question} 구분자를 요구한다. 대학생 중 30% 미만이 풀 수 있어야 한다는 조건은 프롬프트의 요구사항이다. 보고서에는 이를 검증하는 학생 평가가 없다.
- A.4 GPT-4o Judge Prompt and Configuration for GPT-4o as Judge: 수학 답변 확인은 temperature 0.0의 gpt-4o를 사용하며 근거 설명 없이 Yes 또는 No로 답하도록 요청한다. 예제는 간단한 식 정리와 단위 생략을 허용한다. 그러나 3245/5와 649는 값이 같아도 명시적으로 No로 분류한다. 템플릿이 간단하지 않다고 취급하는 식 정리를 제외하기 때문이다. 따라서 보고된 수학 정확도는 이 평가 절차에서 정의한 동등성 기준을 반영한다.
짧은 생각
R-FEW는 정답이 부여된 소규모 풀을 과제 생성과 Solver 학습이라는 2개 용도에 함께 사용하면 self-play를 개선할 수 있다는 근거를 제공한다. 가장 강한 비교 결과는 8B, 5% 설정이며 4B 설정은 SPICE와 General-Reasoner보다 뒤처진다. 2개 모델 크기에서 얻은 결과만으로 모델 용량과 인간 예제에 근거한 유도의 효과 사이에 일반적인 관계가 있다고 입증할 수는 없다.
재현을 위해서는 정렬 항, 분위수와 성공률 임계값 중 어떤 선택 규칙을 쓰는지, Solver의 인간 보상 항을 명확히 해야 한다. 대표적으로 제시한 수학 성능 개선 폭과 ablation 계산도 표와 일치하지 않는다. 반복 실행의 불확실성이나 Solver 100스텝 이후의 평가가 보고되지 않았으므로, 근거는 실험한 설정에서 성능과 생성 안정성이 개선되었음을 뒷받침한다. 지속적인 자기 진화는 아직 검증되지 않았다.