


Parallel-R1: Towards Parallel Thinking via Reinforcement Learning 요약 설명
09 Sep 2025 | Paper Review Parallel Thinking Reinforcement Learning With Verifiable Rewards Mathematical Reasoning목차
이번 글에서는 Parallel-R1: Towards Parallel Thinking via Reinforcement Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 9일(Arxiv)
- Zheng, Tong, Zhang, Hongming, Yu, Wenhao, Wang, Xiaoyang, Dai, Runpeng, Liu, Rui, Bao, Huiwen, Huang, Chengsong, Huang, Heng, Yu, Dong.
- Tencent AI Lab Seattle, University of Maryland, College Park, University of North Carolina at Chapel Hill, City University of Hong Kong, Washington University in St. Louis
- 논문 링크
- Github
요약
- Parallel-R1은 언어를 생성하는 대규모 언어 모델(LLM)이 여러 추론 경로를 동시에 탐색하고 그 결과를 종합하도록 학습하는 방법을 다룬다. Qwen-3-4B-Base를 사용한 Parallel-R1-Seen은 수학 벤치마크에서 평균 정확도 48.9%를 달성한다. 더 어려운 학습 데이터셋에 순차적 강화학습(RL)을 바로 적용한 모델의 45.1%보다 3.8 %p 높으며 상대 향상률은 약 8.4%다. RL은 보상 피드백을 통해 학습하는 방식이다.
- 학습 과정은 예시 응답으로 학습하는 지도 미세조정(SFT)으로 시작한다. 쉬운 수학 문제로 병렬 추론 형식을 익힌 뒤, 더 어려운 문제에 RL을 적용한다. 논문은 각 토큰이 앞선 토큰에 어텐션을 적용할 수 있는 기존 causal model과 추론 경로 사이의 어텐션을 차단하는 structured model을 비교한다. 평균 정확도는 causal model 변형이 가장 높다.
- 학습이 진행되면서 병렬 블록이 응답의 뒤쪽으로 이동한다. 저자들은 이를 해법 탐색에서 후보 답안을 여러 관점으로 검증하는 행동으로 바뀐 결과로 해석한다. 별도의 실험에서는 200 steps 동안 병렬 추론을 장려한 뒤 정확도만 보상하며 논문에서 사용한 2025 수학 추론 벤치마크 AIME25에서 최고 정확도 25.6%에 도달한다. 초록은 이 실험에서 기준 모델 대비 상대 향상률이 42.9%라고 보고하며 이는 48.9%와 45.1%를 비교한 결과와 별개다. 평가는 모델 규모 1 개와 수학 벤치마크로 한정된다.
1 Introduction
서론은 3가지 장애물을 제시한다. 모델이 처음에는 병렬 추론 형식을 알지 못하고 어려운 문제에서는 유효한 시범 응답을 생성하기 어려우며, 보상이 답의 정확성과 병렬 사용률 사이에서 균형을 맞춰야 한다. 병렬 사용률은 명시적인 병렬 구조를 포함한 응답의 비율이다. Parallel-R1은 쉬운 문제에서 어려운 문제로 이어지는 학습 과정, 어텐션 아키텍처 2개에 맞춘 서로 다른 학습 절차, 학습 중 분기 행동 분석으로 이 문제들을 다룬다. 논문에 명시된 공개 위치는 https://github.com/zhengkid/Parallel-R1 이다.
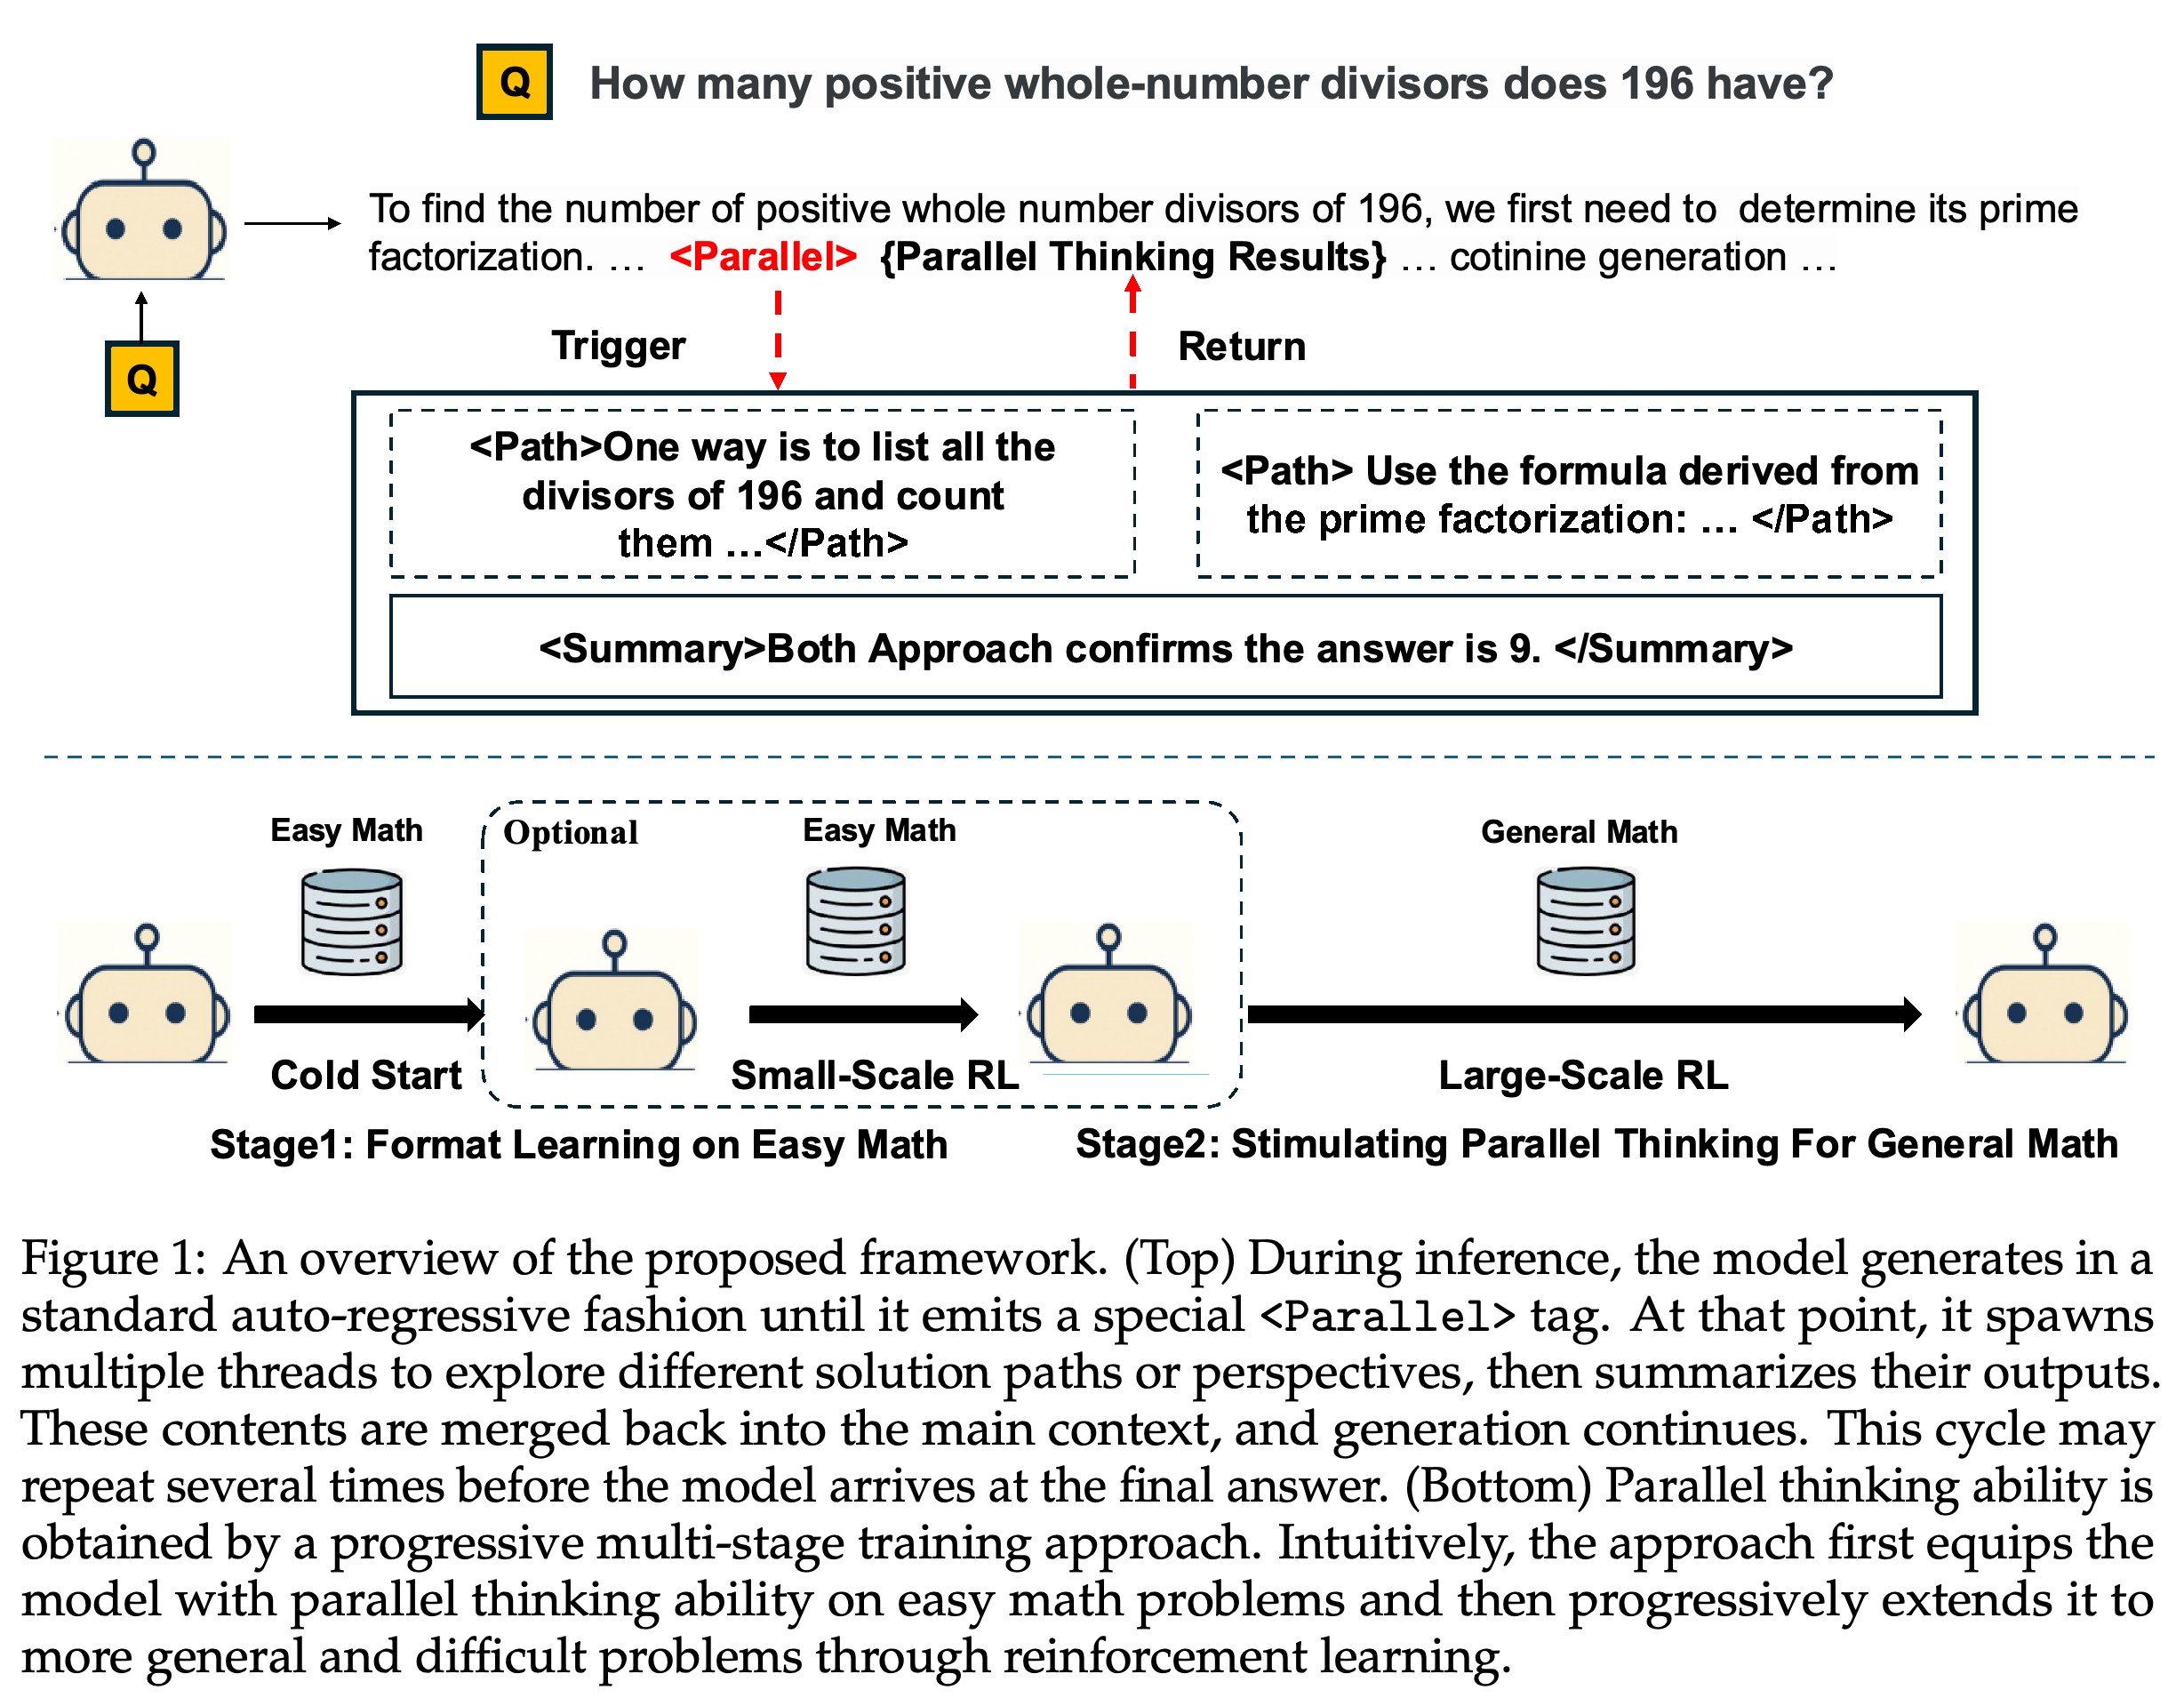
위쪽 절차는 모델이 분기를 시작한 뒤 결과를 종합하고 생성을 재개하는 모습을 보여준다. 따라서 분기는 생성 중인 응답에 따라 결정된다. 아래쪽 절차는 쉬운 과제에서 형식을 습득하는 단계와 어려운 과제의 RL을 분리하며 쉬운 과제의 RL을 선택 사항으로 표시한다. 이는 아키텍처 변형 2개에 서로 다른 학습 절차를 적용한다는 점을 반영한다.
2 Related Work
관련 연구는 여러 추론 경로를 탐색하는 방법과 결과를 자동으로 확인할 수 있는 RL을 연결한다. 논문은 초기 형식 학습 이후 일반적인 수학 과제에서 언제 분기하고 결과를 종합할지 학습하는 것을 기여로 제시한다.
2.1 Parallel Thinking
기존 접근법은 처음부터 독립적인 응답을 생성하거나, 정해진 간격으로 중간 추론을 교환하거나, 외부에서 지정한 탐색 규칙으로 분기를 선택한다. 저자들은 이러한 방식이 분기와 종합 시점을 제약한다고 주장한다. 또한 기존 추론 기록을 재구성하는 SFT 방법과 Parallel-R1을 구분한다. 이전 병렬 추론 연구에서 사용한 합성 과제 Countdown의 RL 시연과도 구분한다.
2.2 Improving Reasoning via RLVR
Reinforcement Learning with Verifiable Rewards(RLVR)는 결과를 자동으로 확인할 수 있는 보상으로 모델을 학습한다. 따라서 별도로 학습한 보상 모델이나 개별 추론 단계에 대한 사람의 주석이 필요하지 않다. 인용된 연구는 이 접근법을 수학과 다른 과제에 적용하지만 저자들은 추론이 주로 순차적으로 이루어진다는 점을 남은 한계로 지적한다. Parallel-R1은 병렬 행동 학습에 집중한다. 이 절에서 논의하는 충실성은 제시한 추론이 모델의 의사결정 과정을 반영하는지를 뜻하고 강건성은 까다로운 입력에서도 신뢰성을 유지하는지를 뜻한다. Parallel-R1은 이러한 더 넓은 문제의 해결책을 평가하지 않는다.
3 Learning Parallel Thinking via Reinforcement Learning
제안 방법은 출력 형식을 익히는 과정과 상황에 맞는 병렬 행동을 학습하고 더 어려운 문제를 해결하는 과정을 분리한다. 분기와 요약으로 이루어진 절차를 정의하고 쉬운 문제에서 초기 시범 응답을 구성하며 causal attention과 structured attention 변형에 서로 다른 RL 절차를 적용한다.
3.1 Overview
핵심 설계는 최종 목표인 어려운 과제의 병렬 해법을 합성하는 대신, 단순한 과제에서 cold-start 시범 응답을 생성하는 것이다. 이 초기 예시는 모델이 낯선 병렬 형식을 익히도록 돕는다. 이후 RL로 더 어려운 수학 문제에서 병렬 행동을 학습한다. 모델 설정 2개는 추론 경로를 격리하기 위해 attention mask와 position ID를 수정하는지에 따라 구분된다. attention mask는 각 토큰이 다른 토큰에 접근할 수 있는 범위를 정하는 규칙이며 position ID는 토큰 위치를 표현하는 인덱스다.
3.2 Formulation of Parallel Thinking Behaviors
병렬 사고는 Exploration과 Summary를 번갈아 수행한다. Exploration은 주 추론을 잠시 중단하고 N개의 독립적인 trajectory, 즉 추론 경로를 생성한다. Summary는 각 경로의 결과를 종합한 뒤 주 추론을 재개한다. 제어 태그는 <Parallel>…</Parallel>, <Path>…</Path>, <Summary>…</Summary>다. 추론 시 <Parallel>을 예측하면 토큰을 차례로 생성하는 일반적인 자기회귀 생성을 잠시 멈추고, 여러 경로를 동시에 생성한다. 이어서 결과를 종합하고 생성을 계속하며 이 주기는 반복될 수 있다.
3.3 The Simple and Scalable Data Pipeline for Parallel Thinking
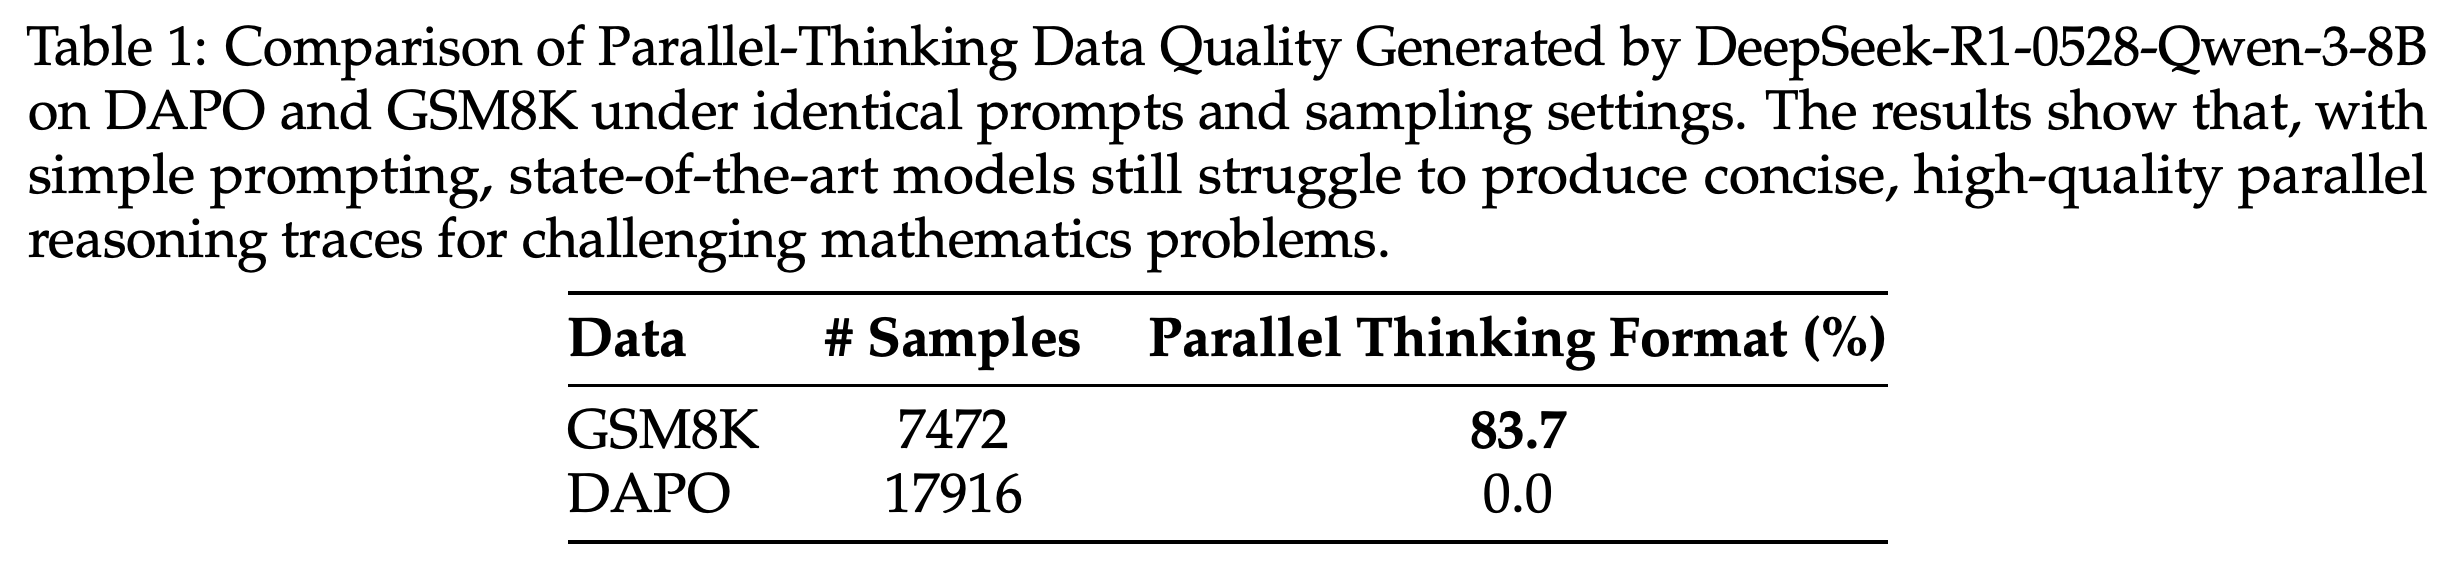
DeepSeek-R1-0528-Qwen-3-8B는 풀이 예시 없이 지시만 제공하는 상세한 zero-shot 프롬프트로 병렬 추론 시범 응답을 생성한다. 동일한 프롬프트와 샘플링 설정에서 Table 1은 쉬운 수학 데이터셋 GSM8K의 7,472개 예시 중 83.7%가 유효한 병렬 형식을 갖춘다고 보고한다. 반면 이 연구에서 더 어려운 수학 학습 데이터셋으로 사용하는 DAPO의 17,916개 예시에서는 0.0%다. Key Finding 1 상자는 83.6%를 제시하므로 논문 내부에 수치 불일치가 있다.
- 이렇게 만든 Parallel-GSM8K 데이터셋은 최종 목표 과제의 시범 응답을 직접 제공하는 대신 초기 형식을 가르친다.
- Algorithm 1, Parallel Thinking Format Check는 여는 태그와 닫는 태그가 일치하고 올바르게 중첩되는지 확인하여 추론 기록을 선별한다. 이 검사는 수학적 정확성이나 경로 사이의 의미적 독립성을 입증하지 않는다.
동일한 생성 조건에서 GSM8K 출력의 83.7%가 보고된 병렬 형식을 충족하지만 DAPO 출력에서는 0.0%다. 이는 초기 형식 시범 응답에 쉬운 문제를 사용하는 선택을 뒷받침한다. 다만 형식이 유효하다는 사실만으로 추론 내용까지 검증되지는 않는다.
3.4 Eliciting Parallel Thinking via Reinforcement Learning in Causal Models
Parallel-R1-Seen은 기존 아키텍처를 유지하며 Group Relative Policy Optimization(GRPO)을 사용한다. GRPO는 샘플링한 각 응답의 보상을 같은 그룹에 속한 응답들의 보상과 비교하는 RL 알고리즘이다. 학습용으로 생성한 응답인 rollout은 주 추론, 병렬 경로, 경로 요약을 번갈아 수행한다.
- 3.4.1 Reinforcement Learning Algorithms: GRPO는 각 응답의 advantage를 계산한다. 이는 그룹의 평균과 표준편차를 기준으로 정규화한 상대적 보상이다. 목적함수는 갱신된 정책과 이전 정책의 응답 확률 비율을 클리핑하여 갱신 폭을 제한하고 참조 정책에서 벗어나는 정도에 페널티를 부여한다.
- 3.4.2 The Training Recipe and Reward Modeling: Cold-start SFT는 DeepSeek-R1-0528-Qwen-3-8B가 생성한 Parallel-GSM8K 시범 응답을 사용한다. 이때 non-thinking 출력만 남기며, 논문은 이를 최종 출력에 담긴 짧은 chain-of-thought, 즉 명시적인 추론 기록으로 설명한다.
- RL on Easy Math는 같은 GSM8K 질문을 사용하며 R_final = R_⟨Parallel⟩ × R_acc를 명시한다. 제시된 적용 규칙에서는 응답에 병렬 사고 단위가 적어도 1개 있고 최종 답이 정확할 때만 +1을 부여한다. 나머지 모든 응답에는 −1을 부여한다. 이후 RL on General Math는 DAPO를 사용하며 답의 정확도만 보상한다.
3.5 Eliciting Parallel Thinking via Reinforcement Learning in Structure Models
Parallel-R1-Unseen은 경로를 명시적으로 격리하도록 어텐션을 수정한다. 이는 Seen 모델에서 한 경로의 표현이 다른 경로에 영향을 줄 가능성을 다룬다. causal model 변형의 학습 절차를 structured model 변형에 적용하면 성능이 낮으므로, Unseen의 학습 절차는 쉬운 수학 문제를 사용하는 RL 단계를 생략한다.
- 3.5.1 Structured Attention Mechanism: Path-window masking은 <Path> 블록 안의 각 토큰이 자신의 경로와 공유 문맥에만 접근하도록 제한한다. 본문은 multiverse position encoding이 경로마다 서로 겹치지 않는 위치 인덱스를 부여한다고 설명하지만 Figure 2에는 경로 사이에서 같은 인덱스가 반복되어 표시된다. 공유 <Summary> 블록은 결과를 종합하기 위해 경로들에 접근할 수 있다.
- 3.5.2 The Training Recipe and Reward Modeling: S1은 정확도만 최적화한다. S2는 W=10 steps 구간 안에서 보상을 번갈아 적용한다. 스텝의 80%에서는 정확도만 보상하고 나머지 20%에서는 등급별 보상을 사용한다.
- S2의 등급별 보상은 답이 정확하고 병렬 단위가 적어도 1개 있으면 +1.2, 답이 정확하지만 병렬 단위가 없으면 +1.0, 그 외에는 −1.0을 부여한다.
4 Experiments
실험은 형식 학습, 순차적 RL 기준 모델, causal 및 structured Parallel-R1 변형을 비교한다. 수학 정확도, 병렬 사용률, 학습 단계 제거와 추가의 효과, 보상 일정, 분기 위치 변화를 평가한다.
4.1 Experimental Setups
모든 실험은 Qwen-3-4B-Base를 사용한다. 각 연도의 수학 추론 벤치마크 AIME’24와 AIME’25, 또 다른 수학 추론 벤치마크 AMC’23, 수학 문제 해결 데이터셋 MATH에서 평가한다. 생성의 무작위성을 조절하는 샘플링 온도는 T=1.0이다. MATH에서는 질문마다 응답 1개를 생성한다. 나머지 벤치마크에서는 독립적인 응답 16개를 생성하고 응답의 평균 정확도인 mean@16과 샘플 중 적어도 1개가 정확하면 성공으로 처리하는 pass@16을 보고한다.
- 코드는 저자들이 사용하는 RL 학습 프레임워크 VERL을 바탕으로 수정했다. 주로 공식 학습 절차를 따르며 하이퍼파라미터 튜닝은 수행하지 않는다.
- Cold-start SFT는 배치 크기 128, 학습률 1e-5, weight decay 0.01, warm-up 비율 0.1, cosine 학습률 일정을 사용한다. 그래디언트 갱신 횟수는 Seen과 Unseen에서 각각 58회와 230회다.
- 선택적인 GSM8K RL은 배치 크기 1024, rollout 5개, 학습률 1e-6으로 5에포크 동안 수행하며 그래디언트를 35회 갱신한다. DAPO RL은 그래디언트 갱신 300회, 배치 크기 512, rollout 8개, 학습률 1e-6을 사용한다. 두 RL 단계 모두 warm-up과 학습률 일정을 사용하지 않는다.
4.2 Main Results
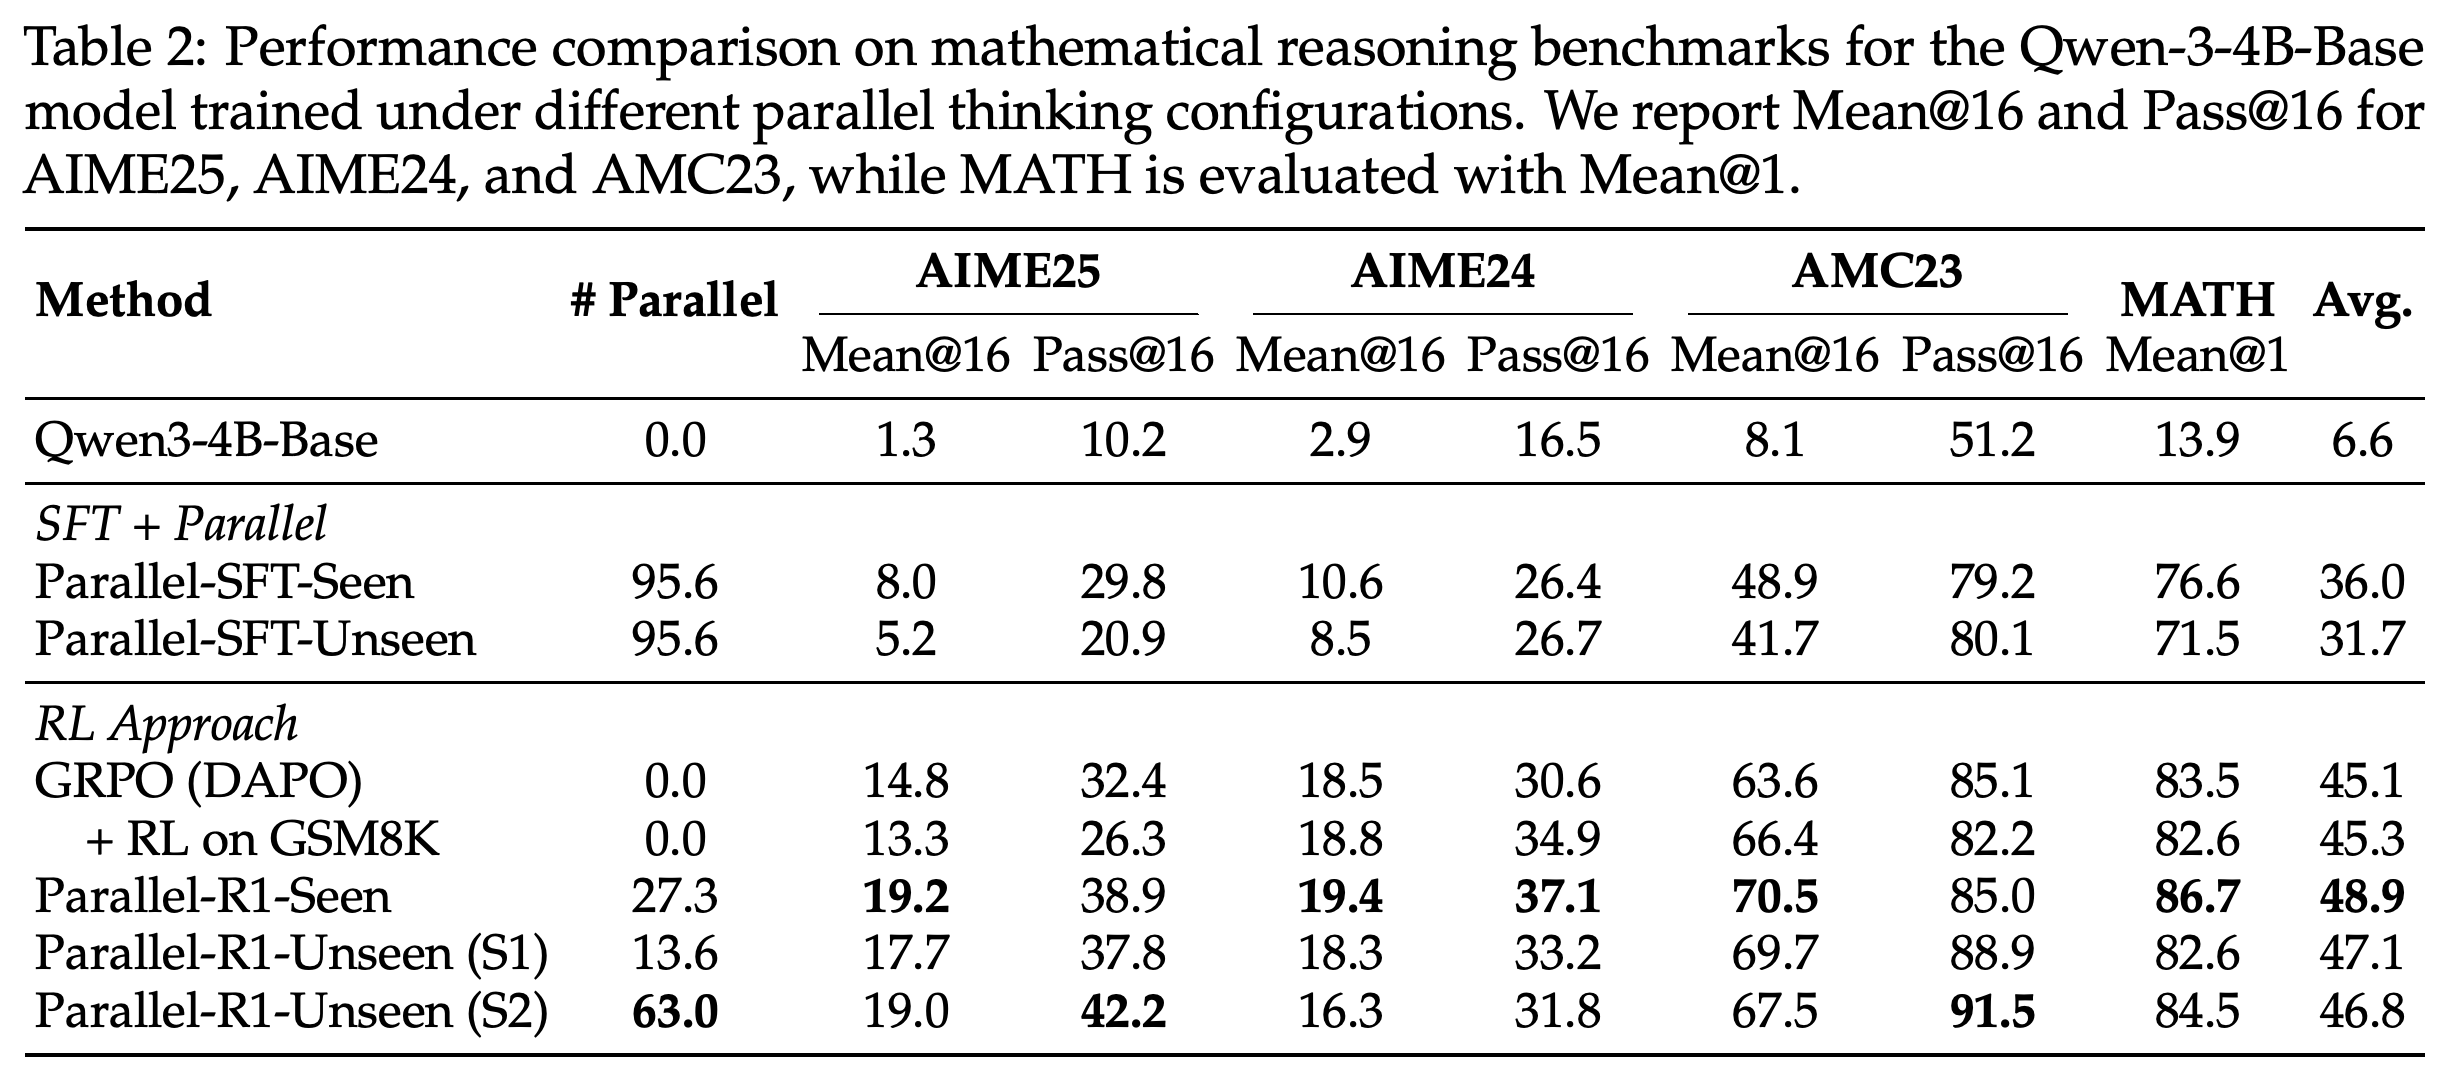
Table 2는 DAPO에 GRPO를 바로 적용한 모델과 GSM8K RL 이후 DAPO RL을 수행한 순차적 기준 모델을 비교한다. Parallel-R1-Seen은 AIME25, AIME24, AMC23, MATH에서 각각 19.2%, 19.4%, 70.5%, 86.7%를 달성하며 평균은 48.9%다. 직접 GRPO를 적용한 모델의 평균은 45.1%, 학습 단계 2개로 구성된 순차적 기준 모델의 평균은 45.3%다.
- Parallel-SFT-Seen과 Parallel-SFT-Unseen의 평균 정확도는 각각 36.0%와 31.7%다. 병렬 사용률은 모두 95.6%이지만 병렬 형식을 자주 사용하는 것만으로 최고 정확도를 얻지는 못한다.
- Parallel-R1-Unseen S1은 평균 정확도 47.1%, 병렬 사용률 13.6%를 기록한다. S2는 평균 정확도 46.8%, 병렬 사용률 63.0%를 기록한다. 나열된 방법 중 S2는 AIME25 pass@16이 42.2%, AMC23 pass@16이 91.5%로 가장 높으며 Seen은 평균 응답 정확도가 가장 높다.
- 본문은 base model의 평균을 4.6%로 제시하지만 Table 2는 6.6%로 제시한다. 표의 값은 표시된 벤치마크 점수들과 일치한다.
Seen은 평균 응답 정확도가 48.9%로 가장 높다. Unseen S2는 더 높은 병렬 사용률을 유지하며 나열된 방법 중 AIME25와 AMC23의 pass@16이 가장 높다. SFT 행은 병렬 사용률이 훨씬 높지만 정확도는 낮다. 이는 명시적인 분기의 빈도만으로 추론 성능을 판단하기 어렵다는 점을 보여준다.
4.3 Analysis
개별 구성 요소를 제거하거나 추가해 비교하는 ablation은 효과적인 학습 단계와 보상이 어텐션 아키텍처에 따라 달라짐을 보여준다. 또한 병렬 형식을 유지하는 것과 답의 정확도를 높이는 것을 구분한다.
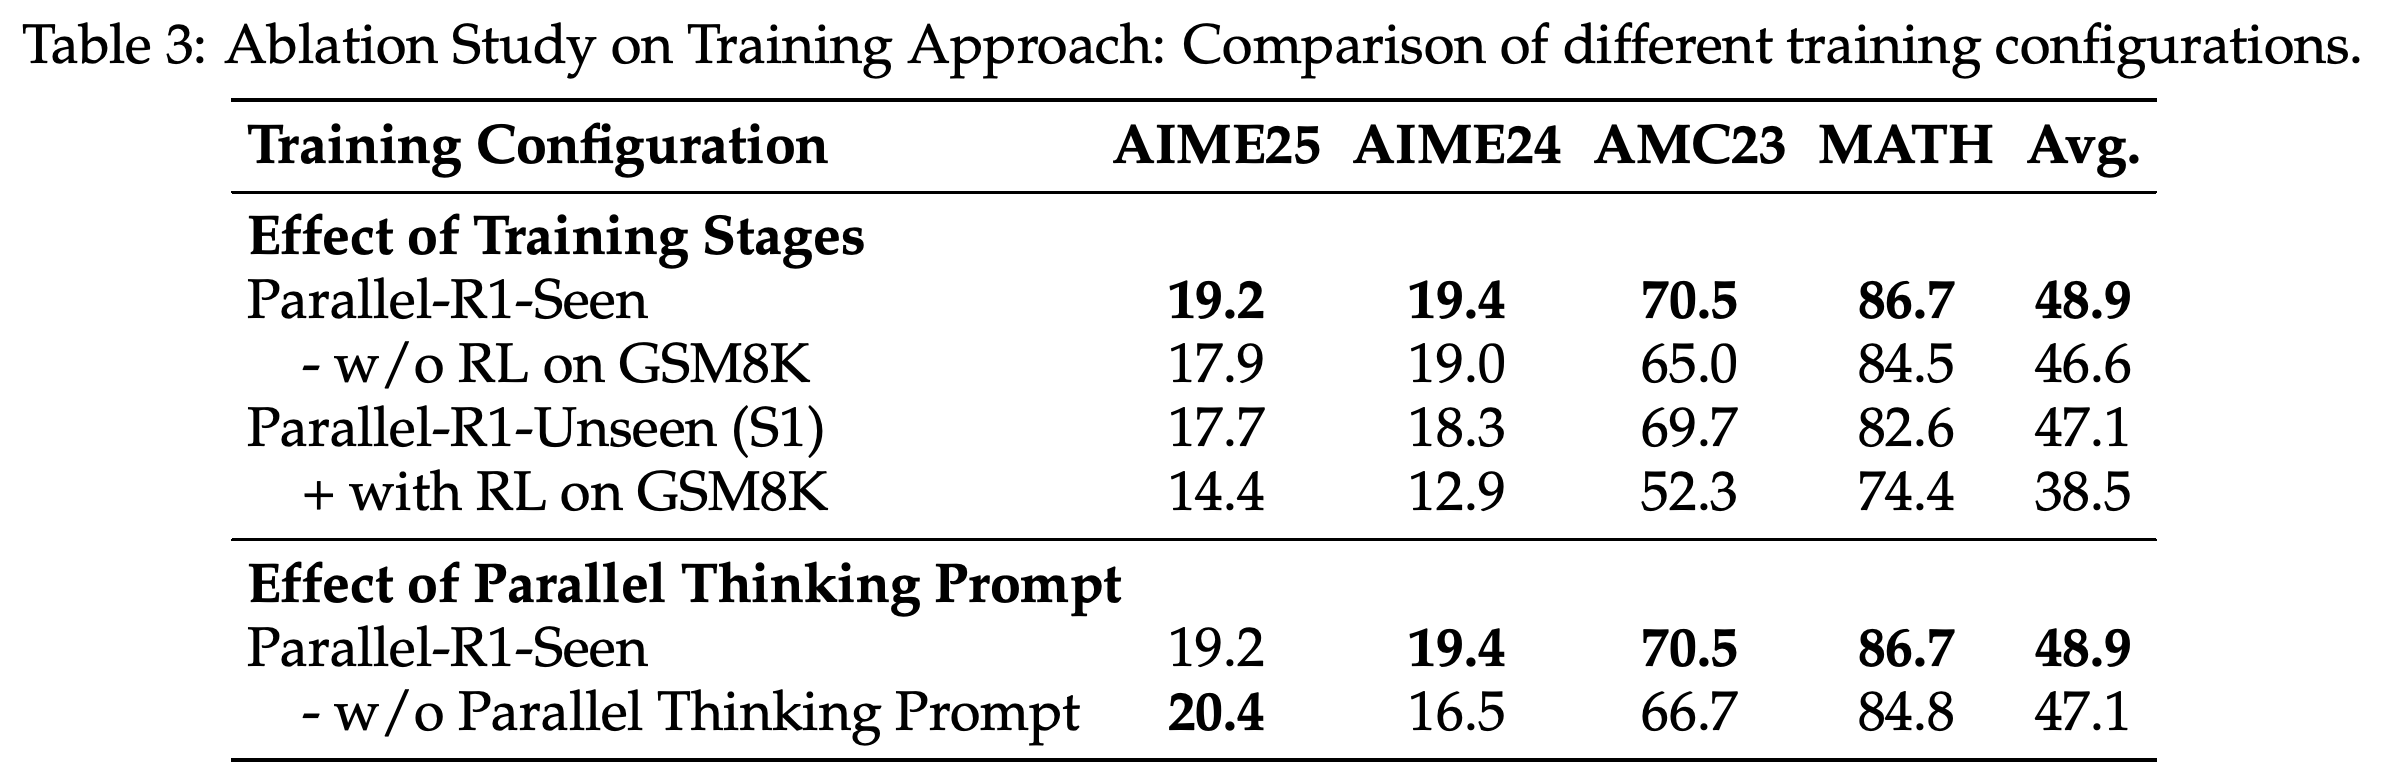
- 4.3.1 Ablation on Training Approach: Seen에서 GSM8K RL을 제거하면 평균 정확도가 48.9%에서 46.6%로 2.3퍼센트포인트 낮아진다. Unseen S1에 이 단계를 추가하면 평균이 47.1%에서 38.5%로 8.6퍼센트포인트 낮아진다. structured mask가 제대로 전이되지 않는다는 설명은 저자들의 가설이며 독립적으로 입증된 메커니즘은 아니다.
- 4.3.2 Ablation on Parallel Thinking Prompt: 프롬프트를 제거하면 Seen의 평균이 48.9%에서 47.1%로 낮아지지만 AIME25는 19.2%에서 20.4%로 높아진다. 따라서 측정된 프롬프트의 이점은 여러 벤치마크에 걸친 평균 효과다.
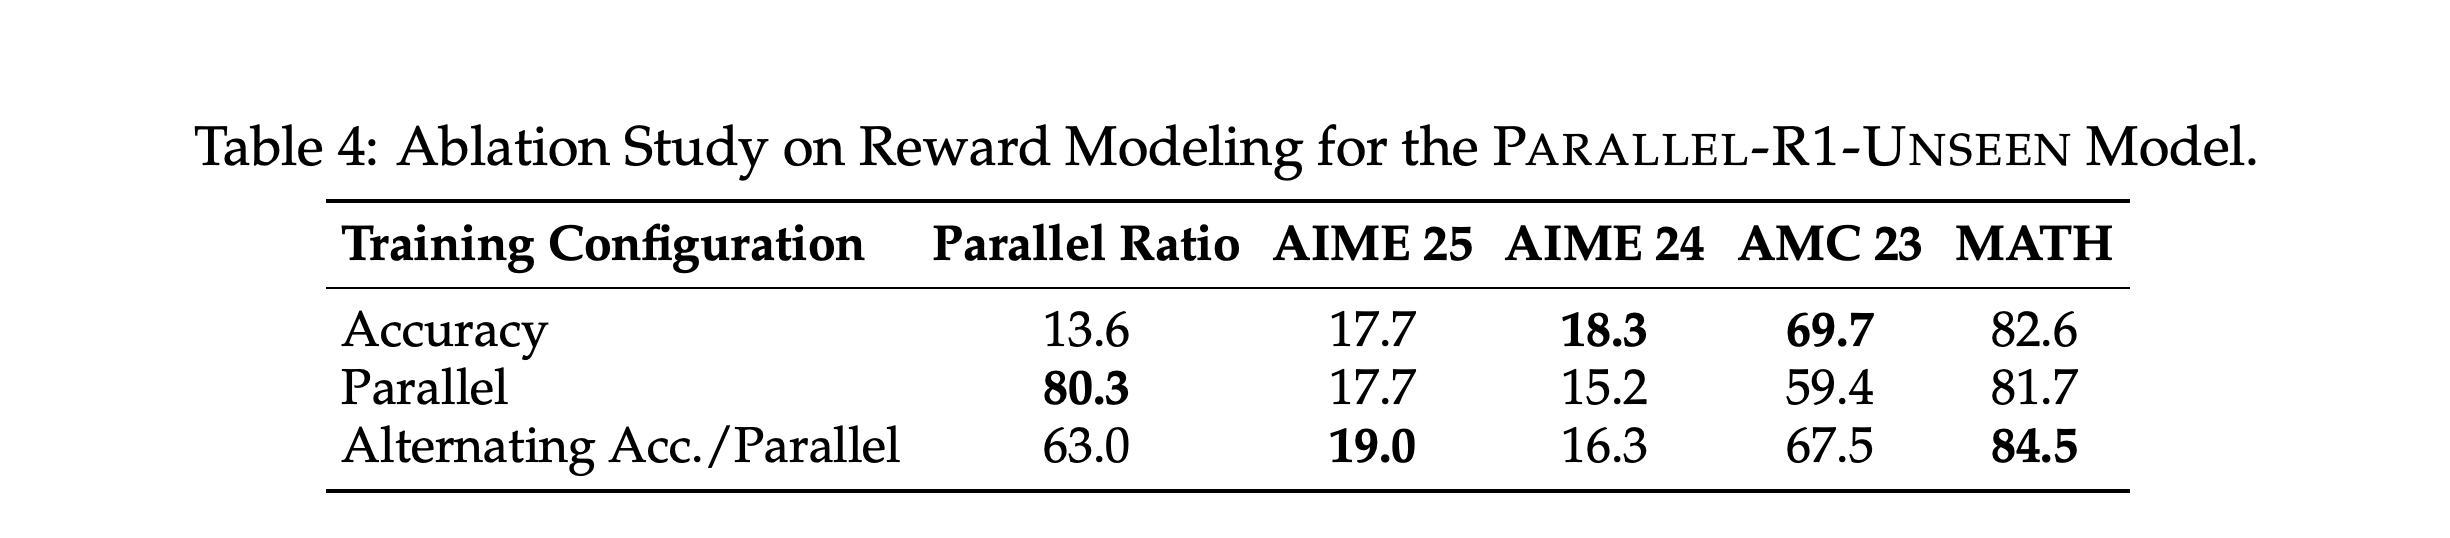
- 4.3.3 Ablation Studies on Reward Modeling: How to Effectively Stimulate Parallel Thinking: 정확도만 보상하면 병렬 사용률은 13.6%, 병렬 사용을 직접 보상하면 80.3%, 보상을 번갈아 적용하면 63.0%다. 병렬 사용을 직접 보상할 때 AMC23 정확도는 59.4%로, 정확도만 보상한 학습의 69.7%보다 낮다. 보상을 번갈아 적용하면 정확도만 보상할 때보다 AIME25와 MATH 성능은 높아지지만 AIME24와 AMC23 성능은 낮아진다.
GSM8K RL은 Seen의 평균을 2.3 %p 높이지만 Unseen S1의 학습 절차에 추가하면 평균을 8.6 points 낮춘다. 병렬 프롬프트를 제거하면 평균 성능이 1.8 points 낮아지지만 AIME25 성능은 높아진다. 이 결과는 아키텍처에 따른 차이와 벤치마크별 차이를 함께 보여준다.
병렬 사용을 직접 보상하면 사용률은 80.3%로 높아지지만 AIME24, AMC23, MATH 성능은 정확도만 보상할 때보다 낮다. 보상을 번갈아 적용하면 사용률 63.0%를 유지하며 비교한 설정 중 AIME25와 MATH에서 가장 높은 점수를 얻는다. AIME24와 AMC23에서는 정확도만 보상한 학습이 가장 높은 성능을 유지한다.
4.4 Evolution of Parallel Thinking Behavior During RL Training
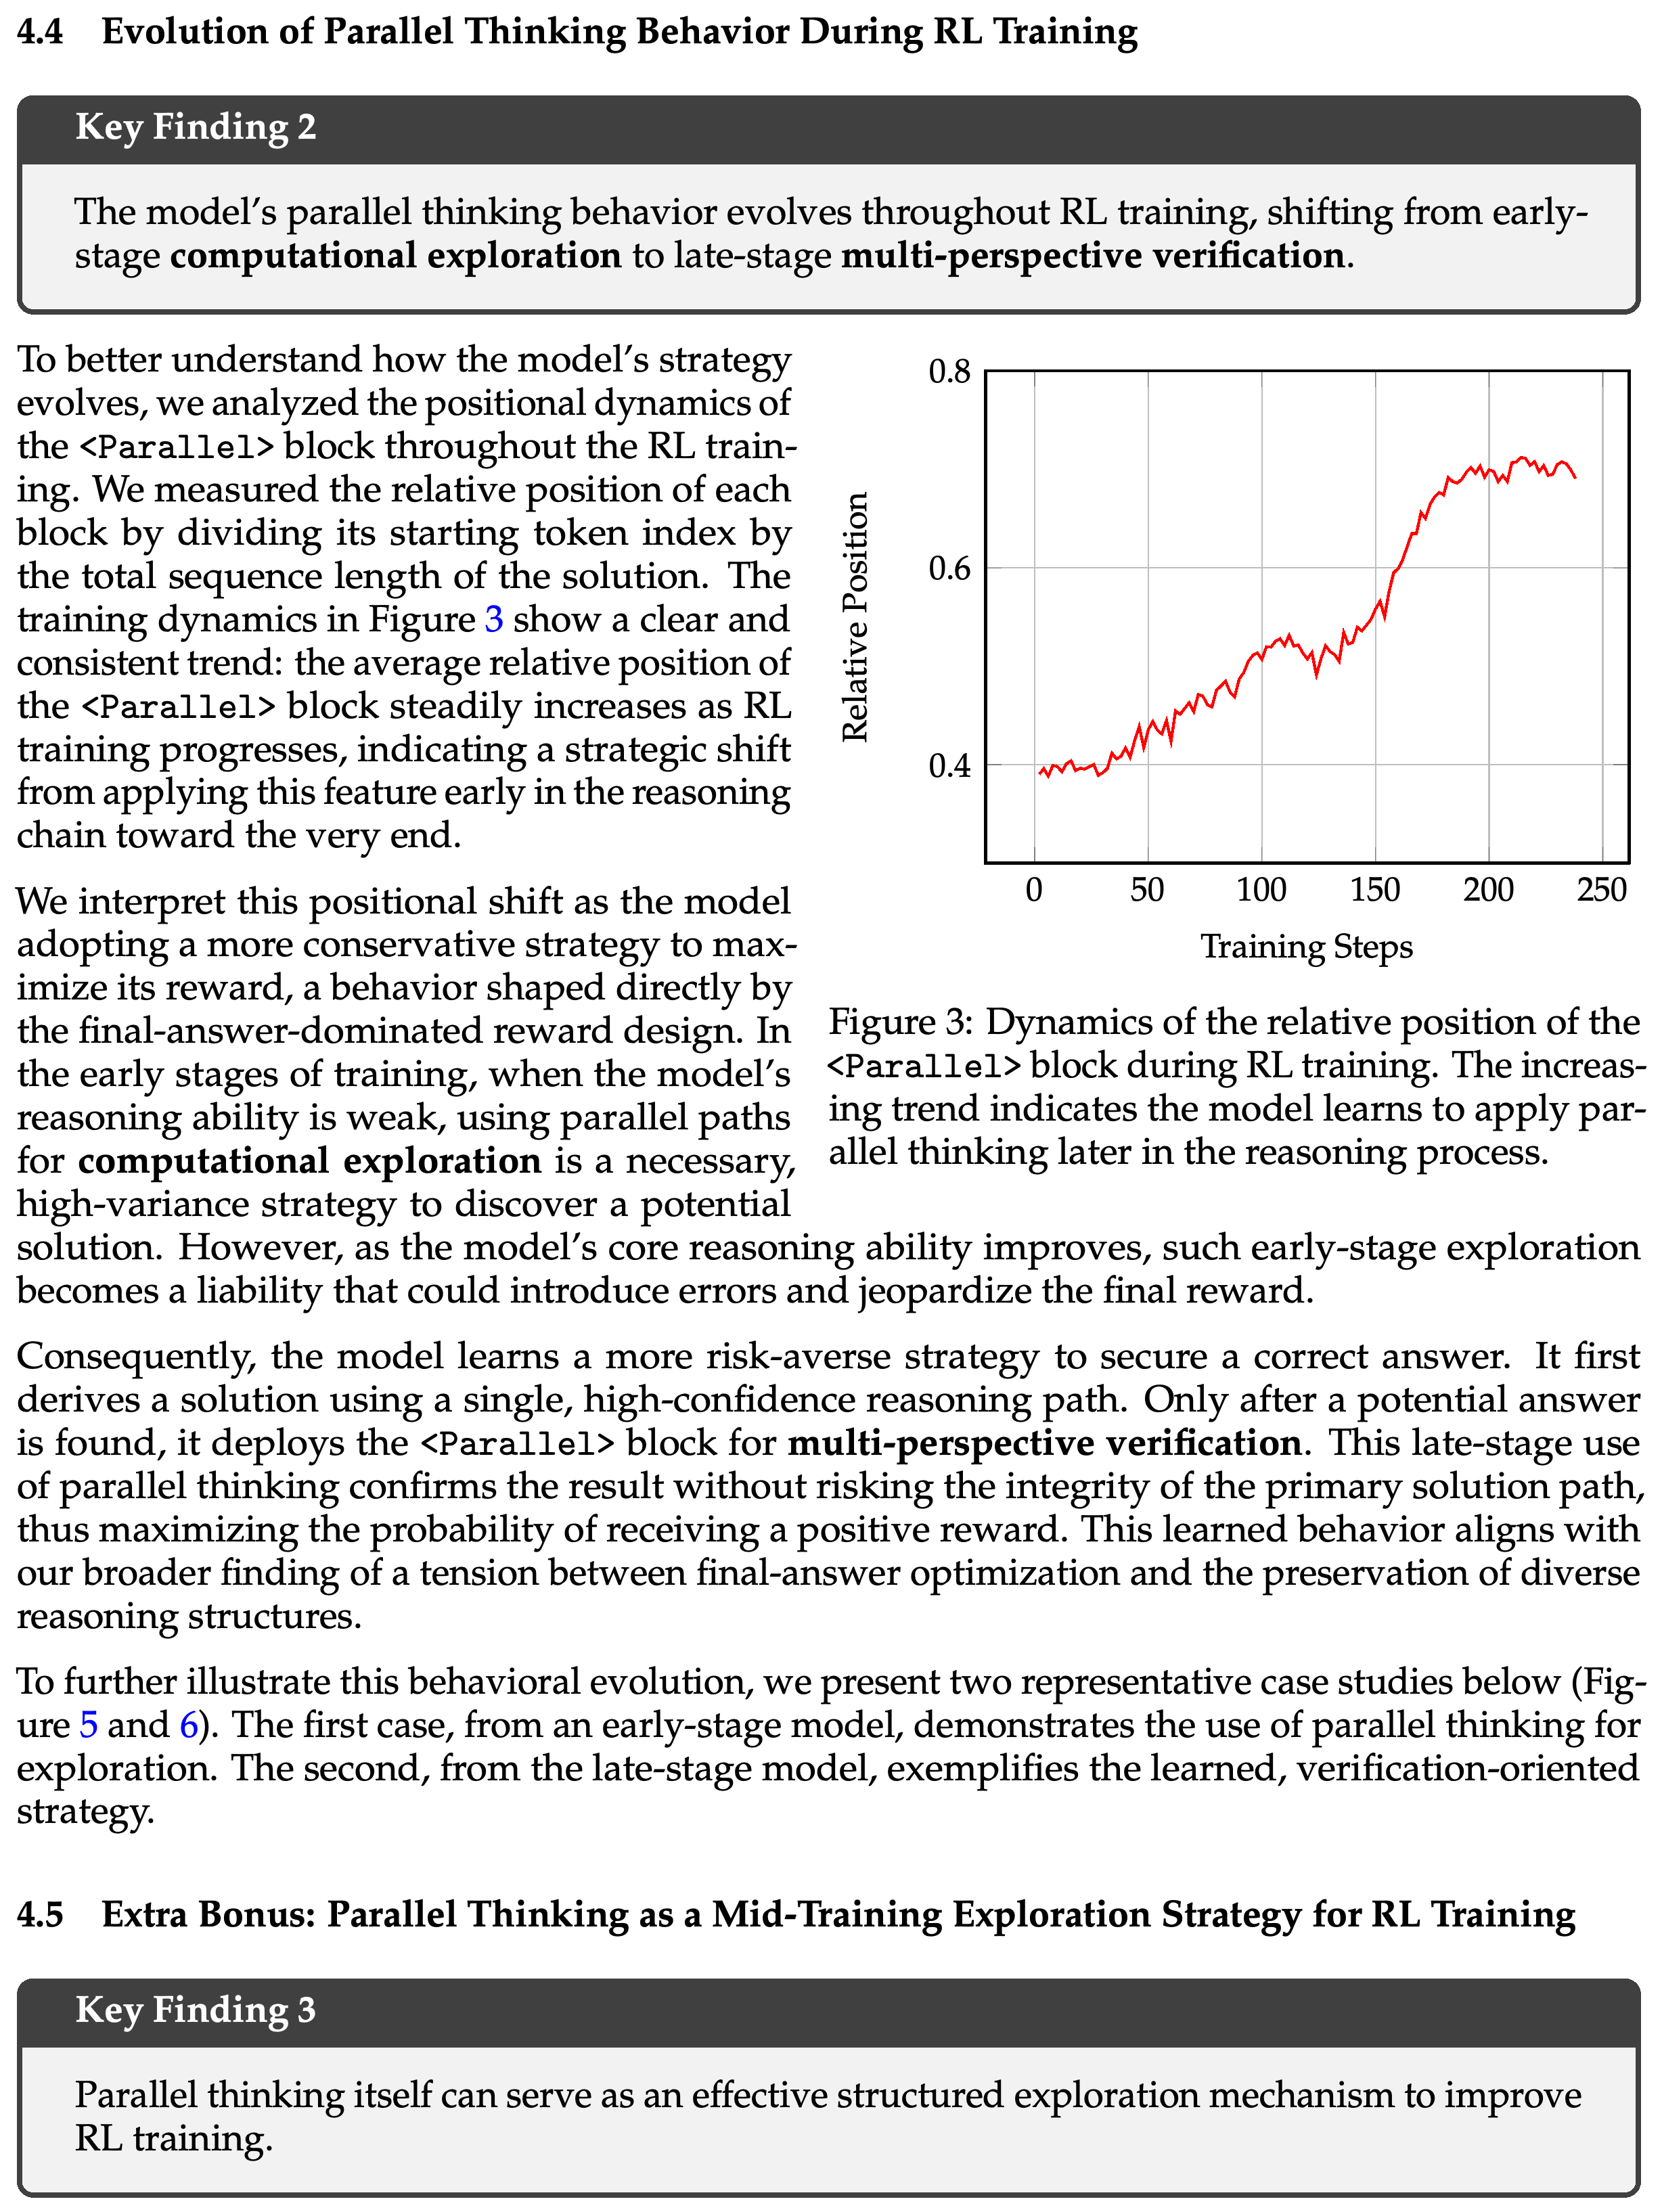
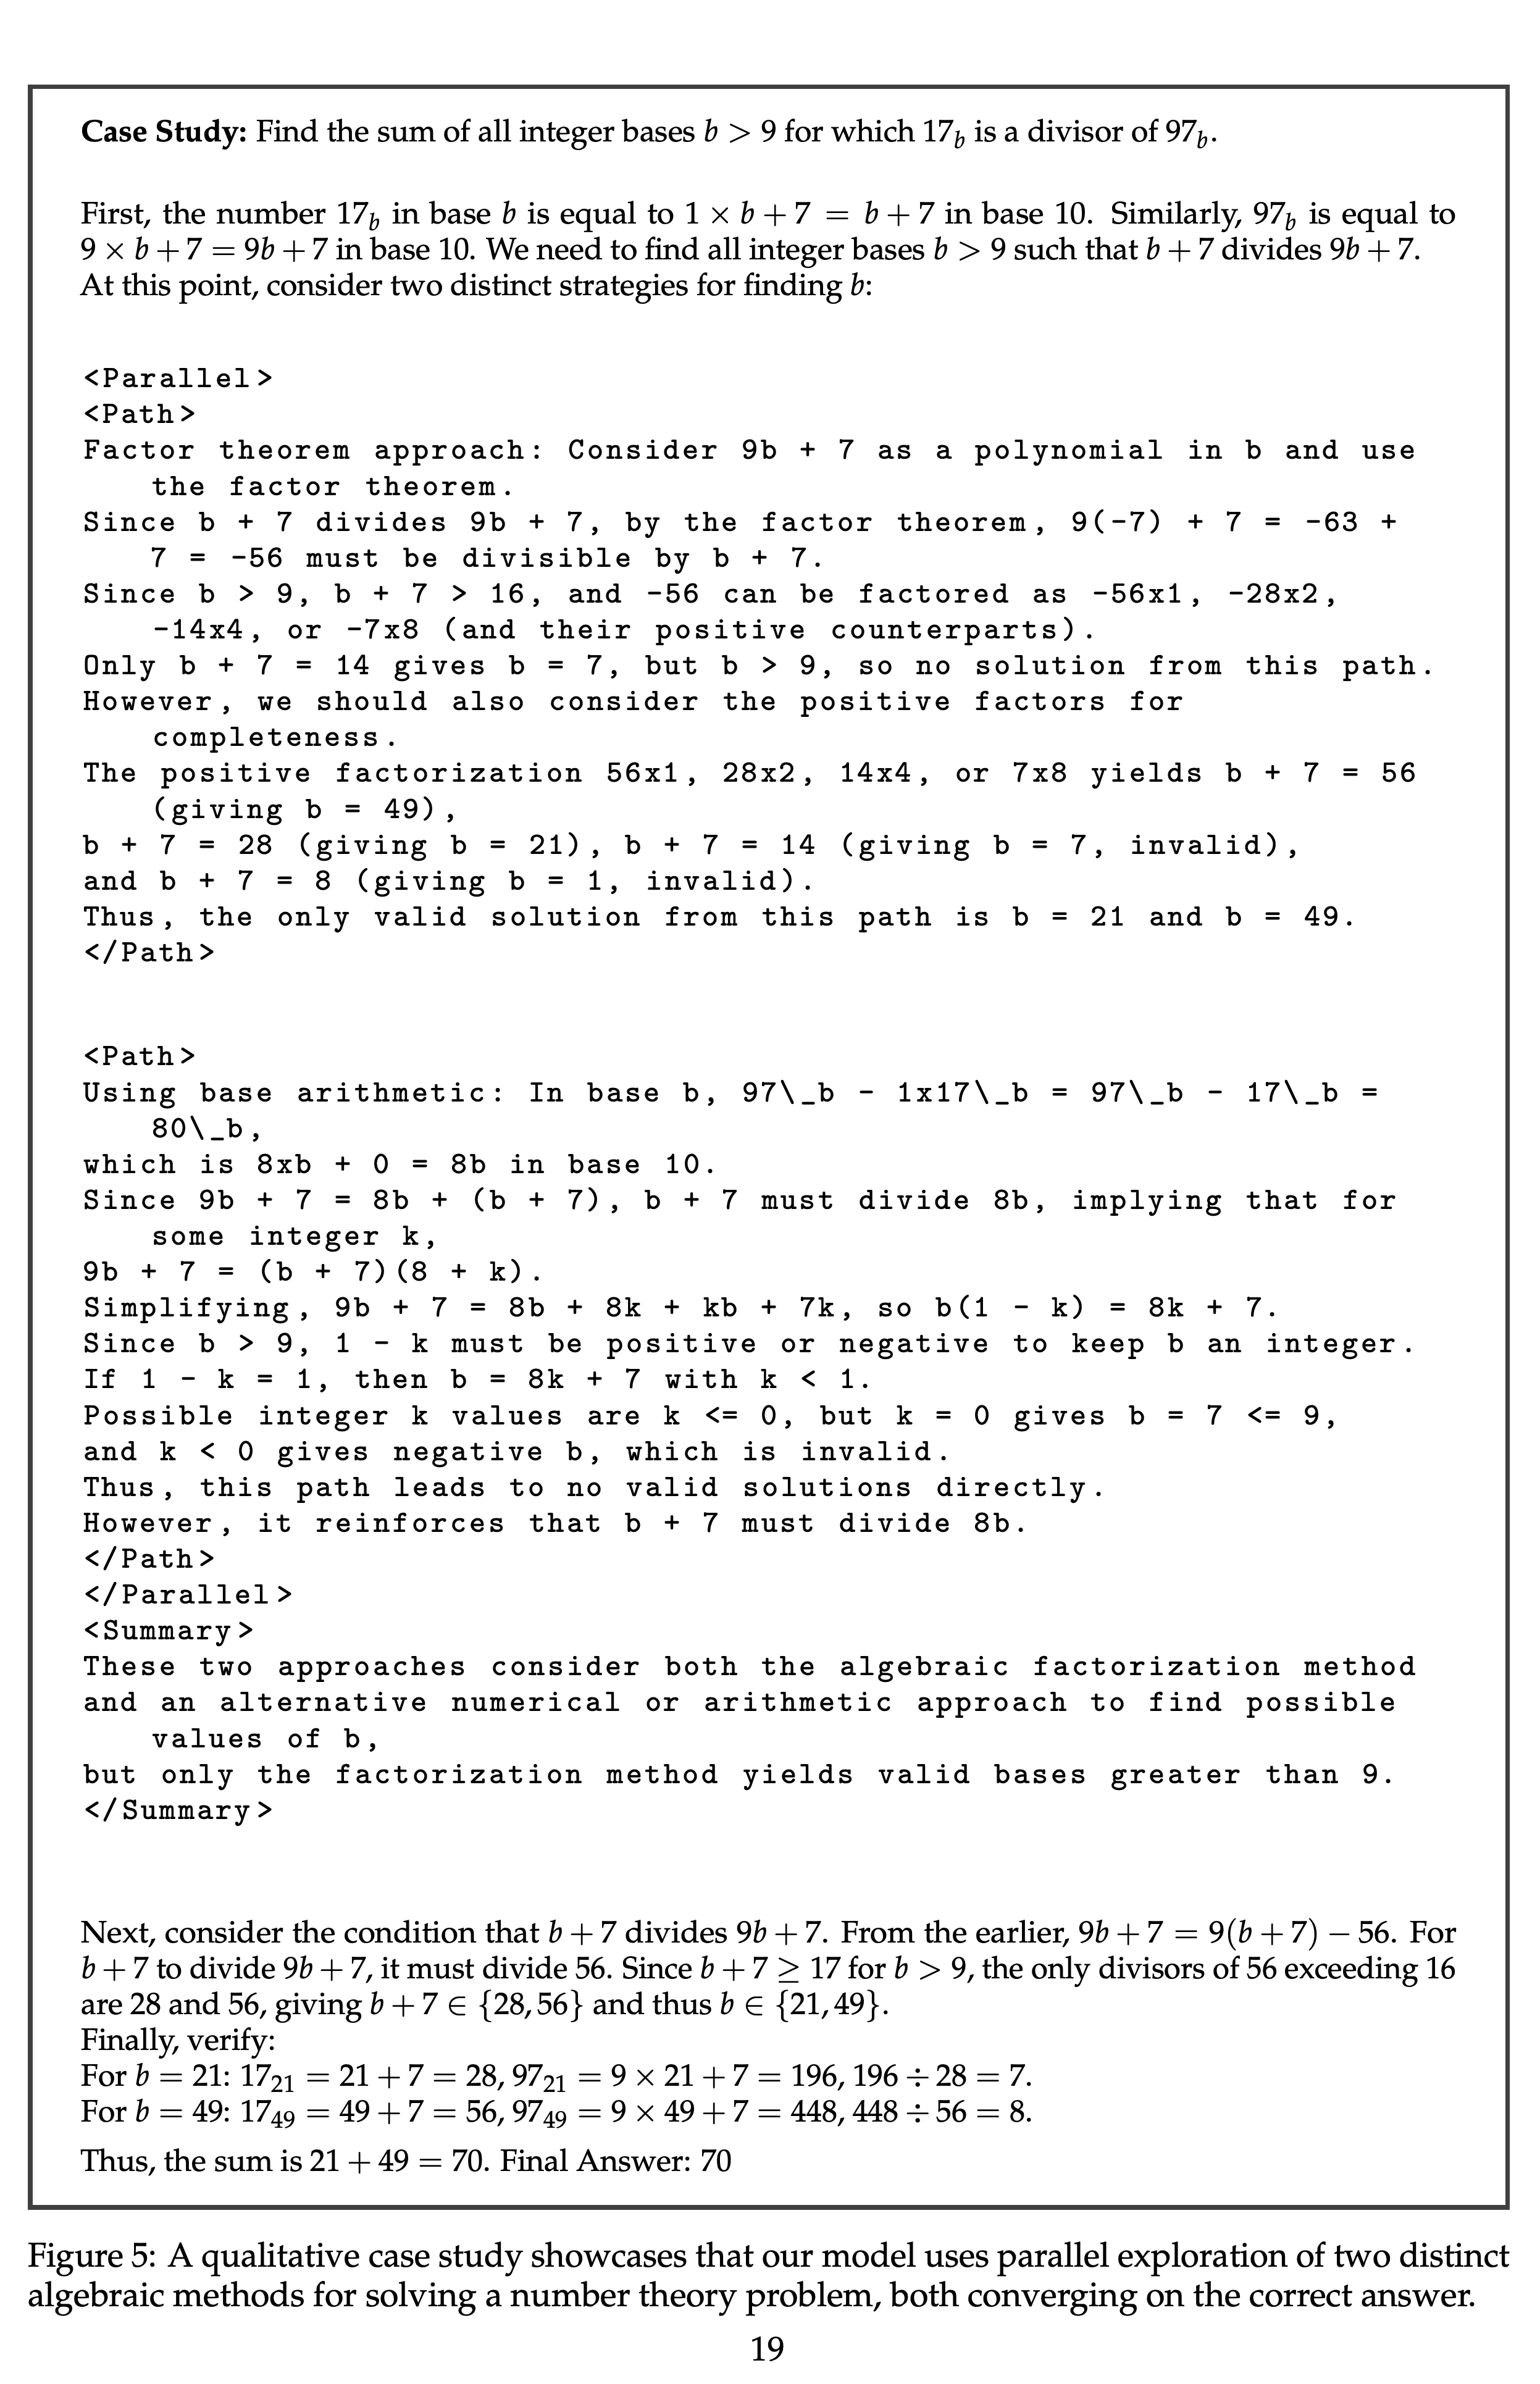
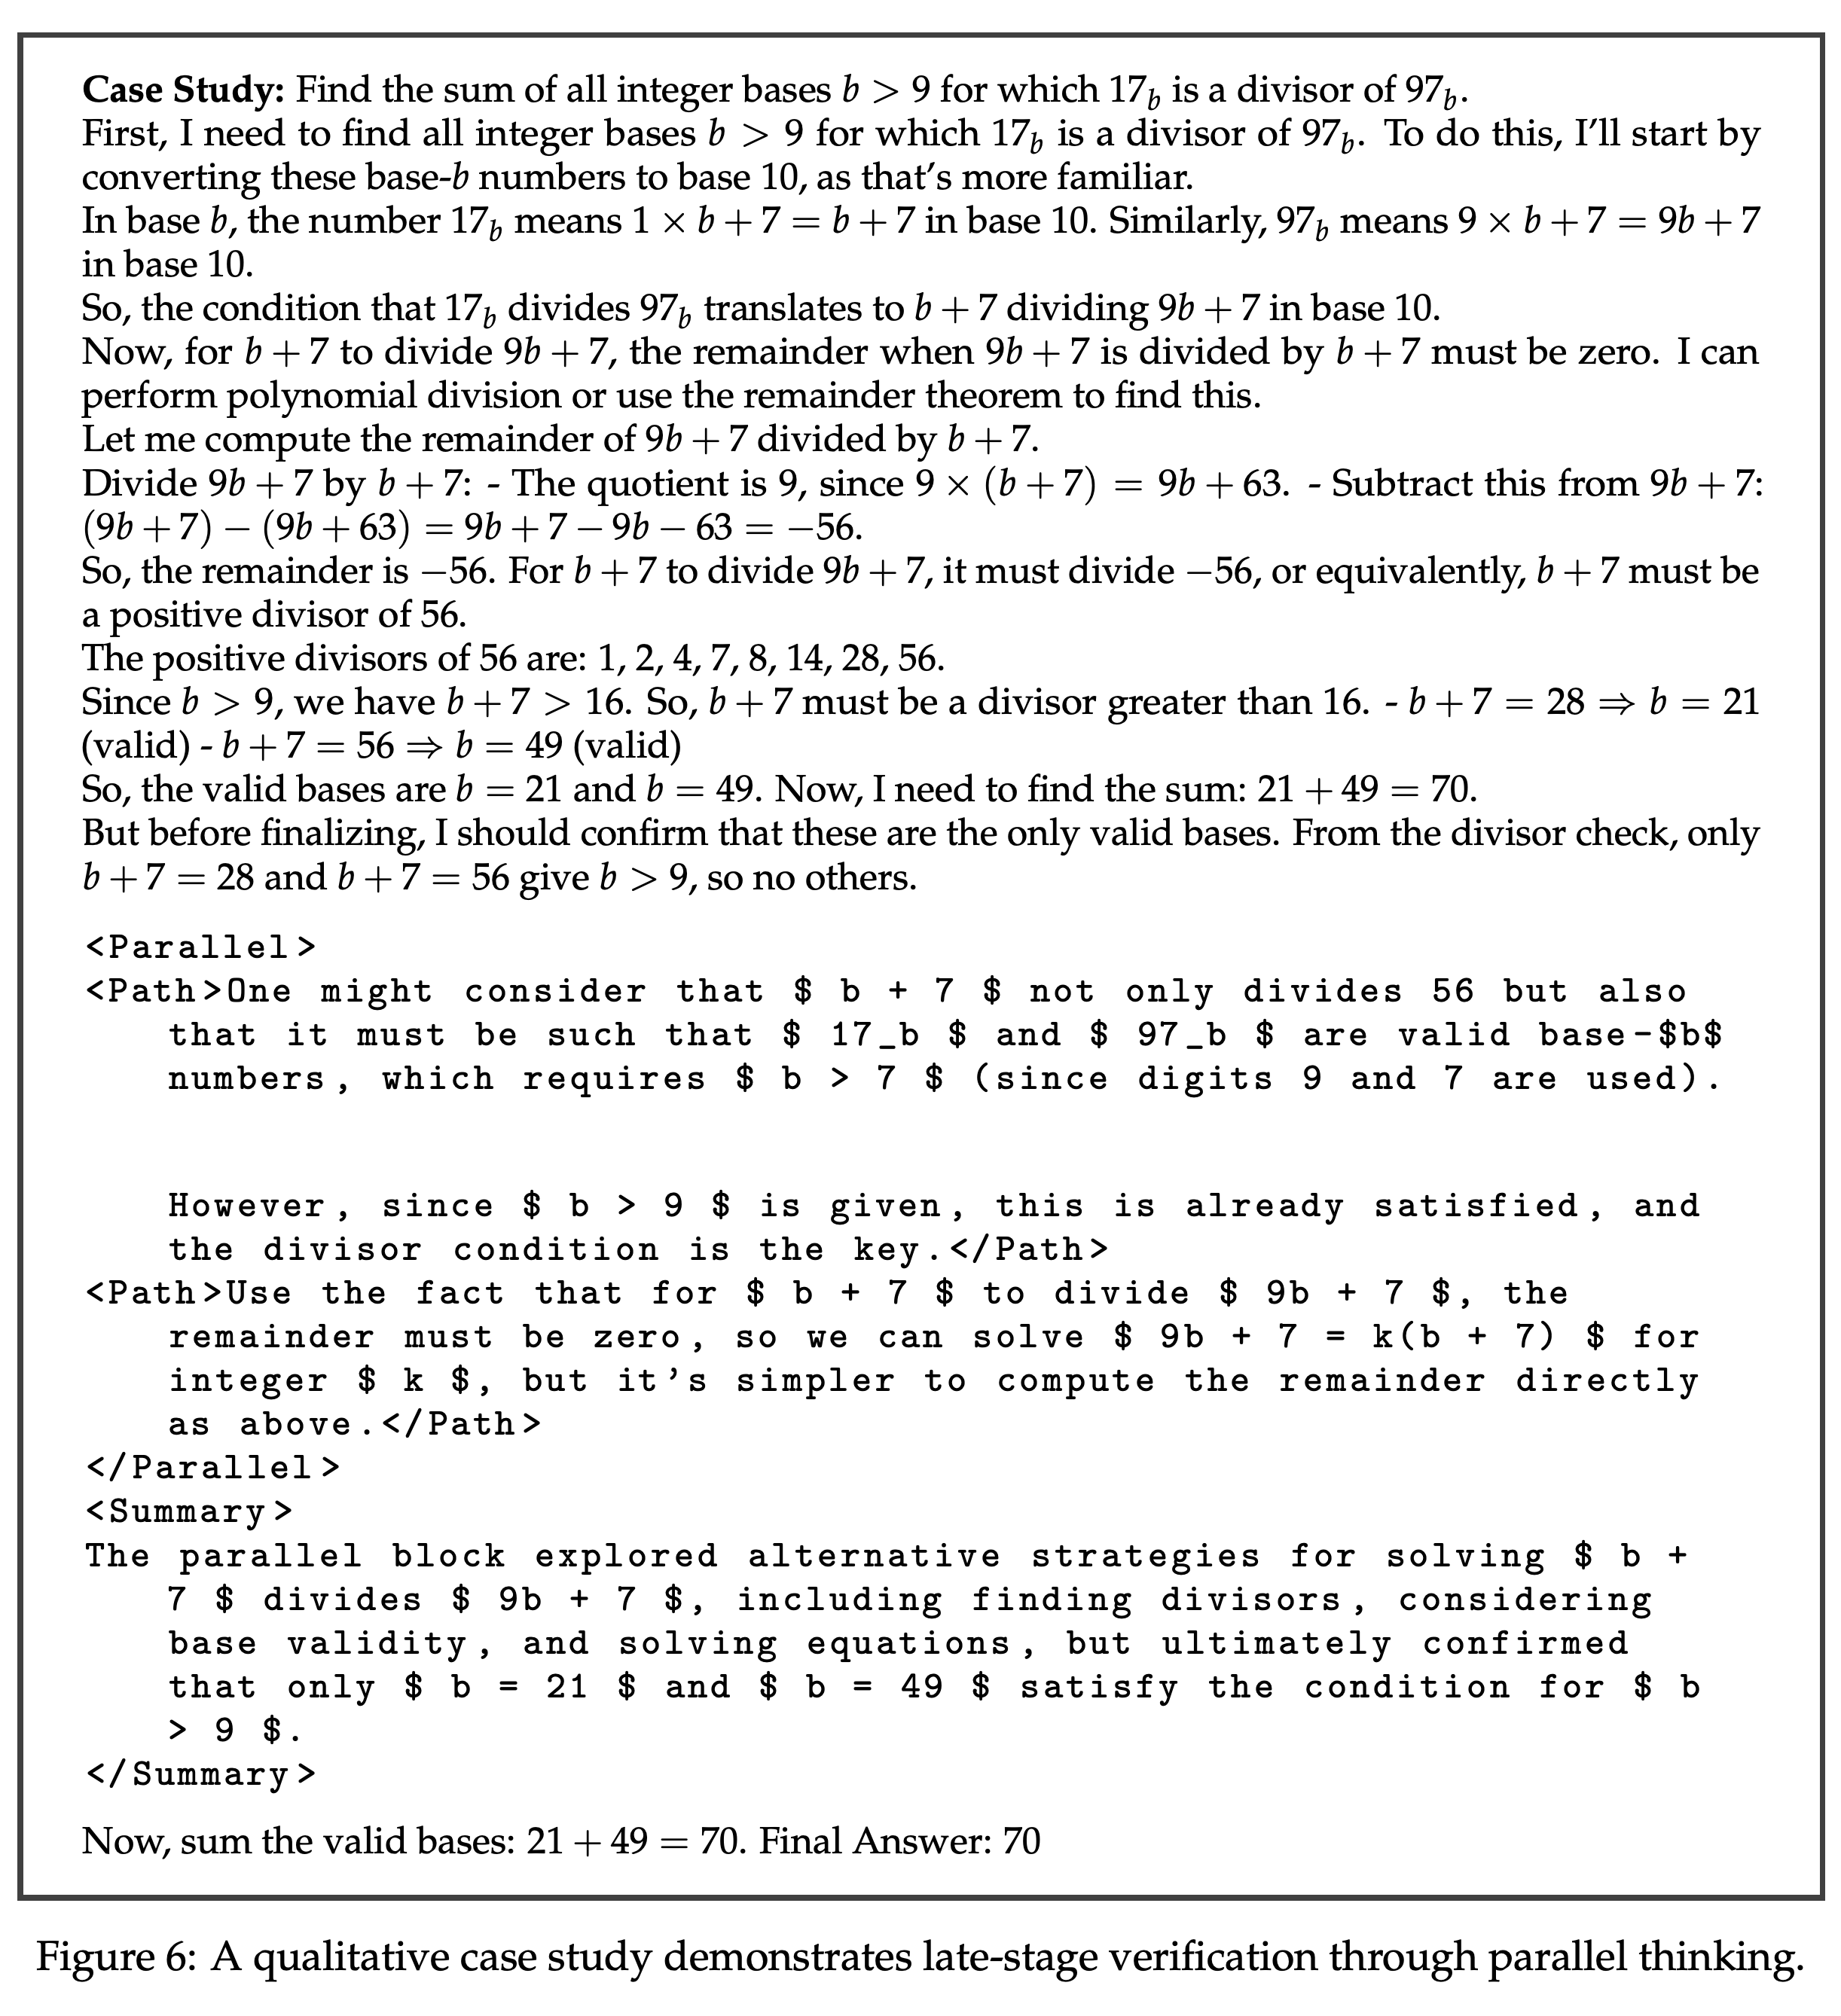
<Parallel> 블록의 상대 위치는 시작 토큰 인덱스를 전체 응답 길이로 나눈 값이다. Figure 3은 RL 중 평균 위치가 증가하는 모습을 보여준다. 저자들은 이를 초기의 계산적 탐색에서 후보 해법을 찾은 뒤 수행하는 후반 검증으로 바뀐 결과로 해석한다. Figures 5와 6은 같은 진법의 정수 나눗셈 문제에서 이러한 해석을 예시로 보여주지만 선별된 사례만으로 각 행동이 얼마나 자주 발생하는지 측정할 수는 없다.
학습 중 병렬 블록의 평균 정규화 시작 위치는 변동을 보이면서 약 0.4에서 약 0.7로 높아진다. 이는 응답 안에서 블록이 뒤쪽에 배치되는 정도를 측정한다. 그 배치를 검증 행동으로 해석할 때는 정성적인 사례도 근거로 사용한다.
4.5 Extra Bonus: Parallel Thinking as a Mid-Training Exploration Strategy for RL Training
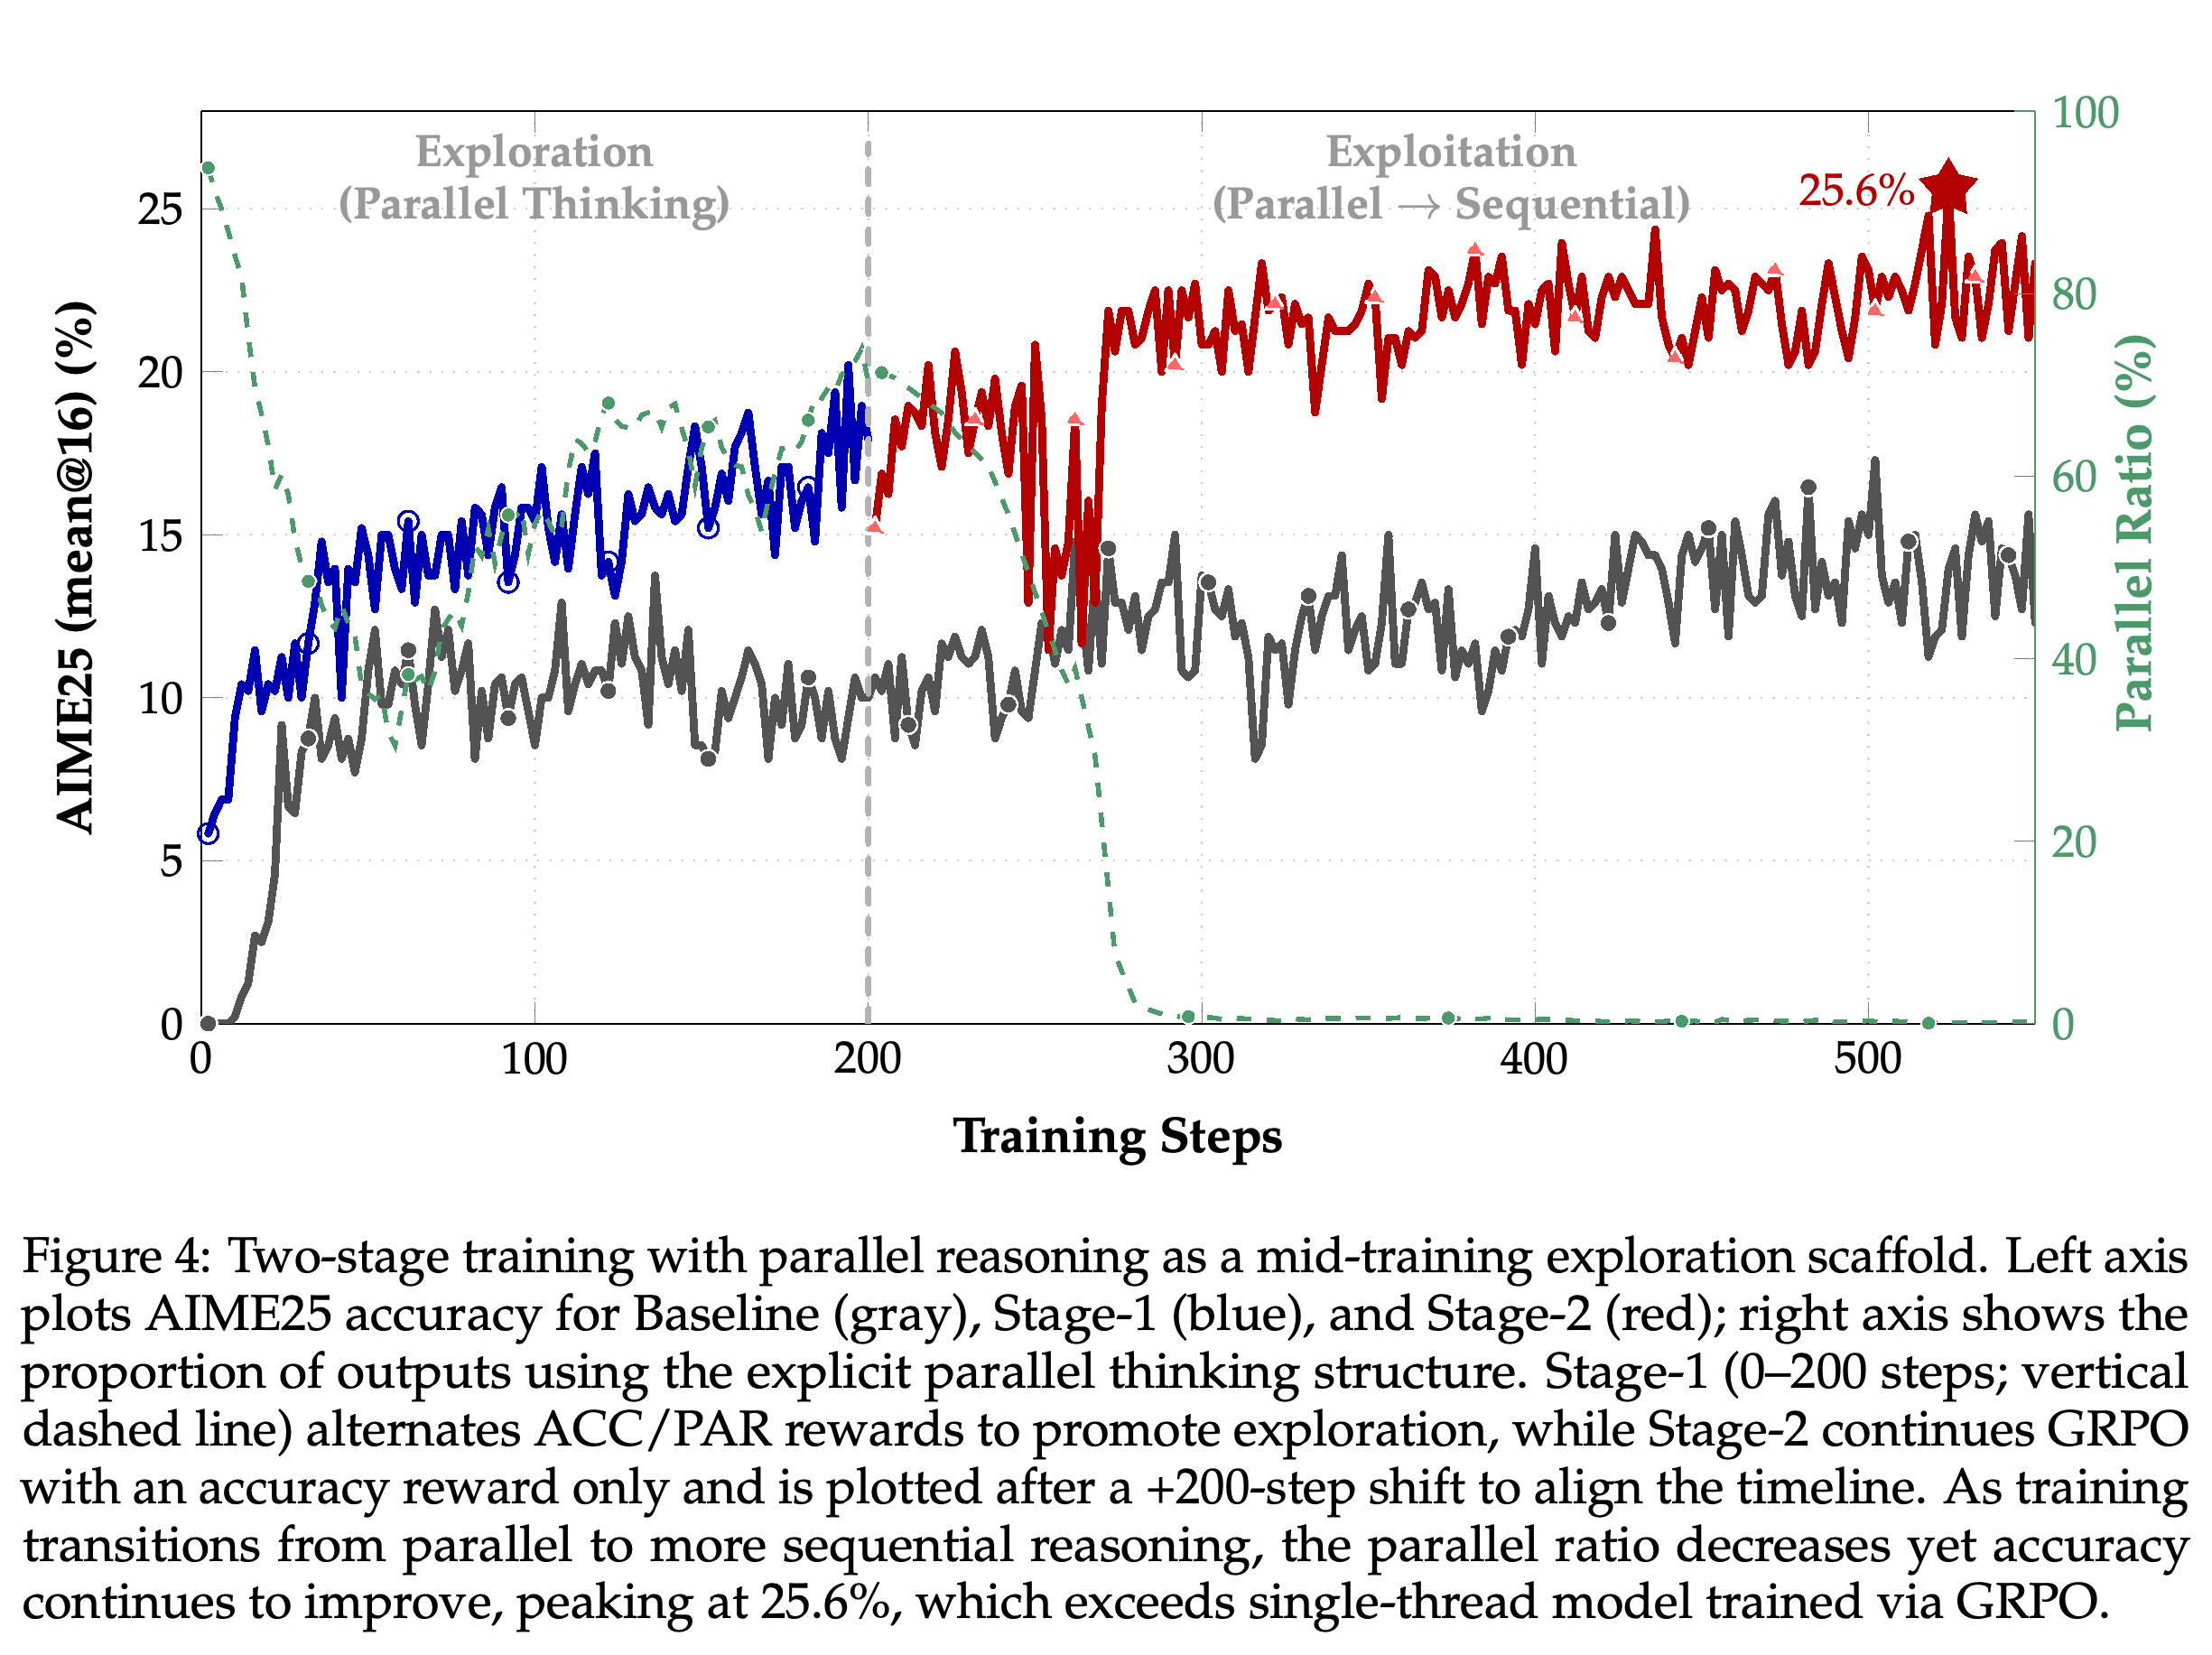
별도의 scaffold 실험은 학습 중 병렬 추론을 임시 지원 수단으로 사용한다. 0–200스텝에는 Parallel-R1-Unseen S2 방식으로 정확도 보상과 병렬 보상을 번갈아 적용하고 이후에는 정확도만 보상하는 GRPO로 전환한다. Figure 4는 전환 후 병렬 사용률이 0에 가까워지는 동안 AIME25 mean@16 정확도가 최고 25.6%에 도달하는 모습을 보여준다. 이는 초기 병렬 탐색 단계가 이후의 주로 순차적인 추론을 개선할 수 있다는 가설을 뒷받침한다. 초록에 보고된 기준 모델 대비 42.9% 향상은 이 실험의 결과이며 PDF는 이를 계산할 때 사용한 정확한 기준 점수나 체크포인트를 명시하지 않는다.
200스텝에서 보상을 전환한 뒤 정확도가 일시적으로 하락한다. 이후 명시적인 병렬 사용률은 0에 가까워지고, scaffold 방식으로 학습한 모델은 그래프의 순차적 기준 모델보다 대체로 높은 성능을 보이며 AIME25 정확도가 최고 25.6%에 도달한다. 이 추이는 분기가 대부분 사라진 뒤에도 이점이 지속됨을 뒷받침하지만 독립적인 반복 학습에서도 결과가 안정적임을 입증하지는 않는다.
5 Conclusion
결론은 점진적인 학습 과정을 통해 형식 습득, 상황에 맞는 행동, 수학 추론을 분리하는 설계를 강조한다. 실험에서는 평가한 순차적 RL 기준 모델보다 평균 정확도가 높아진다. scaffold 실험에서도 명시적인 병렬 사용이 대부분 사라진 뒤 높은 정확도를 보인다. 저자들은 임시 병렬 탐색이 학습 중 더 효과적인 정책, 즉 모델의 응답 생성 행동을 발견하도록 돕는다고 제안한다.
초기 응답은 완전한 해법을 찾기 전에 분기한다. 첫 번째 경로는 밑 21과 49를 찾지만 두 번째 경로는 잘못된 대수적 전개로 유효한 밑을 찾지 못한다. 이후 주 추론은 정확한 합 70을 검증한다. 표시된 추론 기록은 초기 탐색을 뒷받침하지만 두 경로 모두 정답에 도달한다는 원문 캡션의 주장과는 모순된다.
후기 응답은 밑 21과 49를 도출한 뒤 병렬 경로를 호출하여 유효성과 나누어떨어지는지를 다시 확인한다. 이는 해법을 발견한 뒤 검증하는 모습을 보여준다. 한 경로가 자릿값의 유효성 조건을 잘못 설명하므로, 이 사례는 신뢰할 수 있는 독립적 검증보다 분기가 뒤쪽에 배치되는 현상을 더 분명하게 보여준다.
부록
- A Prompts는 단계별 추론과 “Final Answer:” 뒤의 최종 결과를 요청하는 Baseline Prompt, 그리고 Parallel Thinking Prompt를 제공한다. 후자는 <Parallel> 블록마다 서로 구분되는 독립적인 <Path> 블록을 적어도 2개 요청한다. 경로 사이의 순서 정보나 상호 참조를 금지하고 뒤에 <Summary> 블록을 배치하며 상황에 맞게 반복하고 마지막 줄을 “Final Answer:”로 시작하도록 요청한다. Algorithm 1, Parallel Thinking Format Check는 스택을 사용해 짝이 맞지 않거나, 잘못 중첩되거나, 닫히지 않은 태그를 거부한다.
- B Case Studies는 17_b가 97_b를 나누어떨어지게 하는 정수 밑 b > 9의 합을 구하는 문제에 대한 초기와 후기 응답을 비교한다. 두 응답 모두 최종적으로 b=21과 b=49를 찾아 70을 반환하지만 초기 응답은 풀이를 완료하기 전에 분기하고 후기 응답은 후보 밑을 도출한 뒤 분기한다. 초기 응답의 두 번째 경로에는 잘못된 전개가 있으며 유효한 밑을 찾지 못한다. 후기 응답의 첫 번째 경로는 숫자 9가 있는데도 자릿값이 유효하려면 b > 7이 필요하다고 잘못 설명한다. 다만 주어진 b > 9 조건이 이미 유효성을 보장한다.
짧은 생각
학습 단계 ablation은 구체적인 설계 교훈을 제공한다. 같은 쉬운 수학 RL 단계가 Seen에는 도움이 되지만 Unseen에는 불리하므로, 실험한 변형에는 서로 다른 학습 과정이 필요하다. scaffold 실험은 이후 분기가 사라지더라도 명시적인 병렬 추론이 학습에 도움이 될 수 있음을 시사하지만 최고 성능에 반복 학습 결과나 불확실성 추정치가 함께 제시되지는 않는다. PDF에는 추론 지연 시간 측정이나 계산량을 맞춘 비교도 없다. 따라서 효율성과 Qwen-3-4B-Base 및 수학을 넘어선 일반화는 확인되지 않았다.