


Towards a Unified View of Large Language Model Post-Training 요약 설명
04 Sep 2025 | Paper Review Reinforcement Learning With Verifiable Rewards Supervised Fine-Tuning Mathematical Reasoning목차
이번 글에서는 Towards a Unified View of Large Language Model Post-Training 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 4일(Arxiv)
- Lv, Xingtai, Zuo, Yuxin, Sun, Youbang, Liu, Hongyi, Wei, Yuntian, Chen, Zhekai, Zhu, Xuekai, Zhang, Kaiyan, Wang, Bingning, Ding, Ning, et al.
- Tsinghua University, Shanghai AI Laboratory, WeChat AI
- 논문 링크
- Github
요약
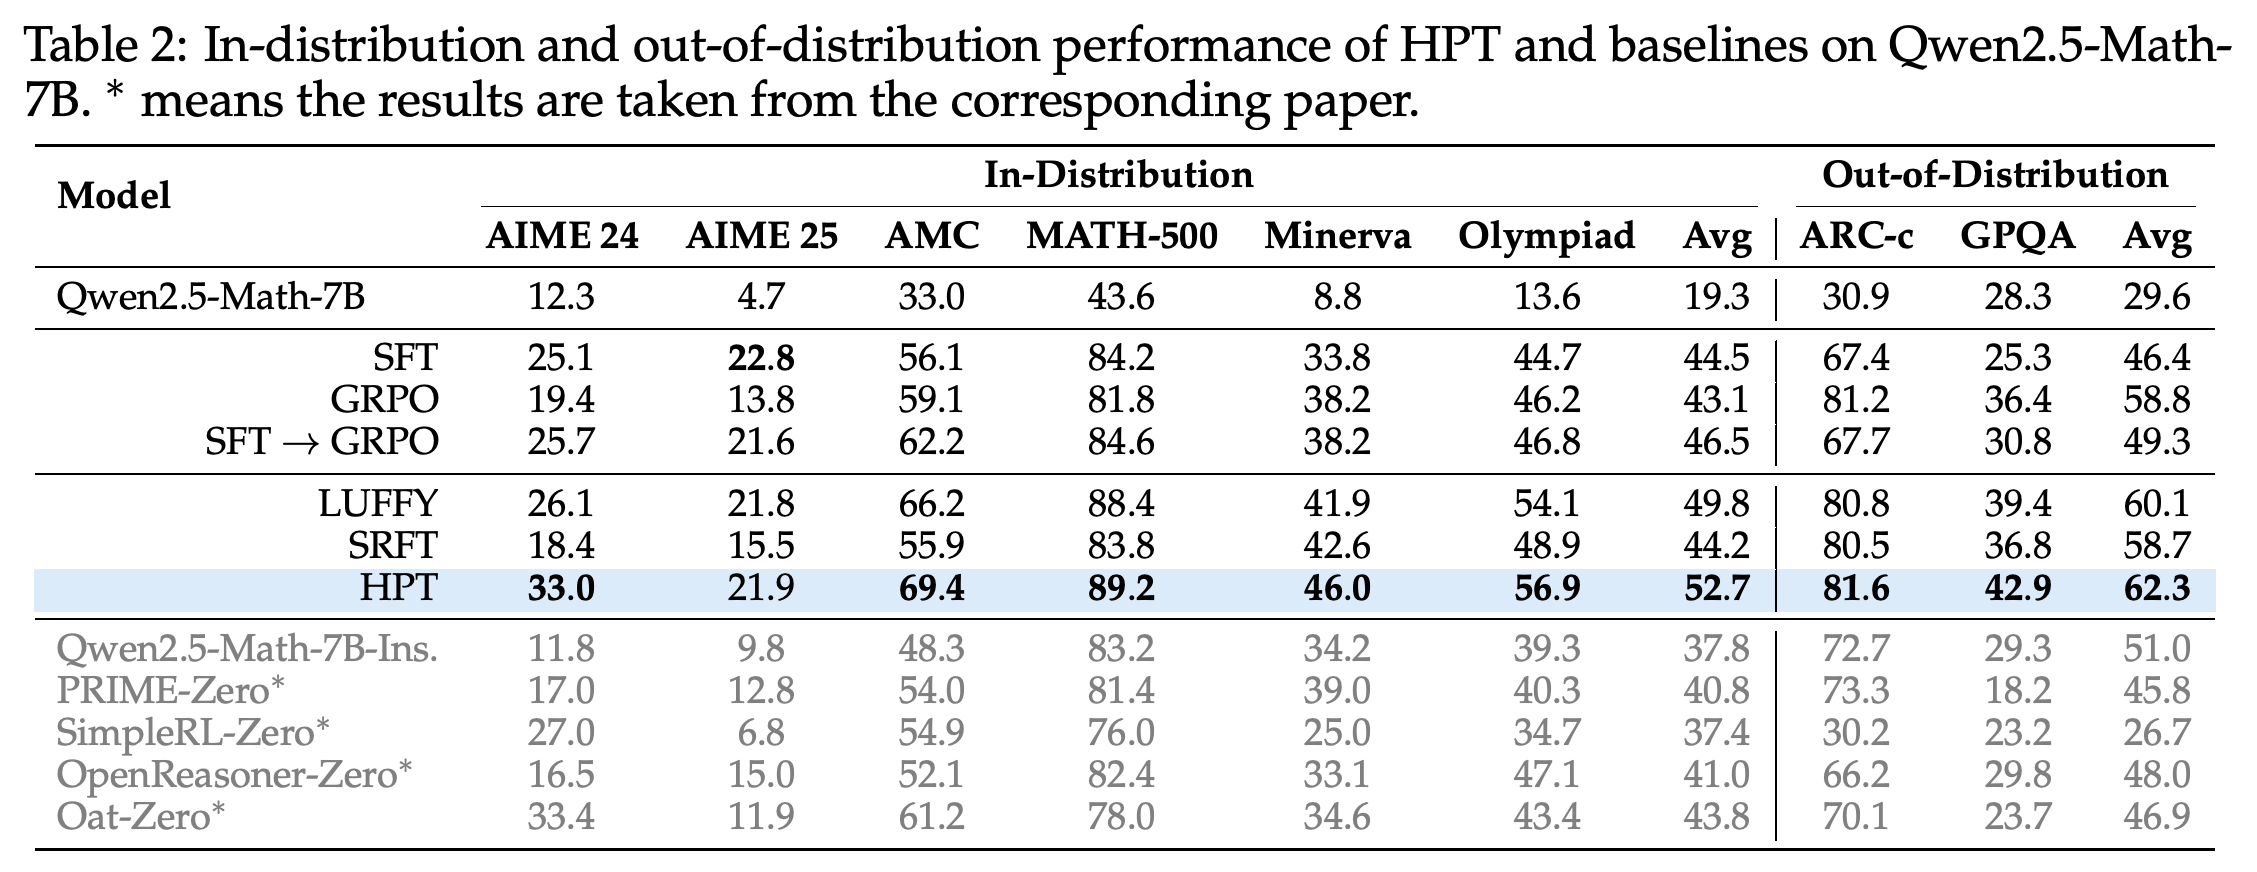
- 사전학습 이후에 수행하는 post-training에서는 시연을 통한 학습과 언어 모델이 직접 생성한 응답의 보상을 통한 학습을 결합해야 한다. 질문별로 샘플링한 응답의 정확도를 기준으로 학습 신호를 선택하는 Hybrid Post-Training(HPT)은 논문에서 보고한 평가 방식에 따라 Qwen2.5-Math-7B에서 6개 수학 추론 벤치마크 평균 52.7을 달성한다. 모델이 생성한 응답과 외부 시연을 결합하는 기준 방법인 LUFFY의 평균은 49.8이다.
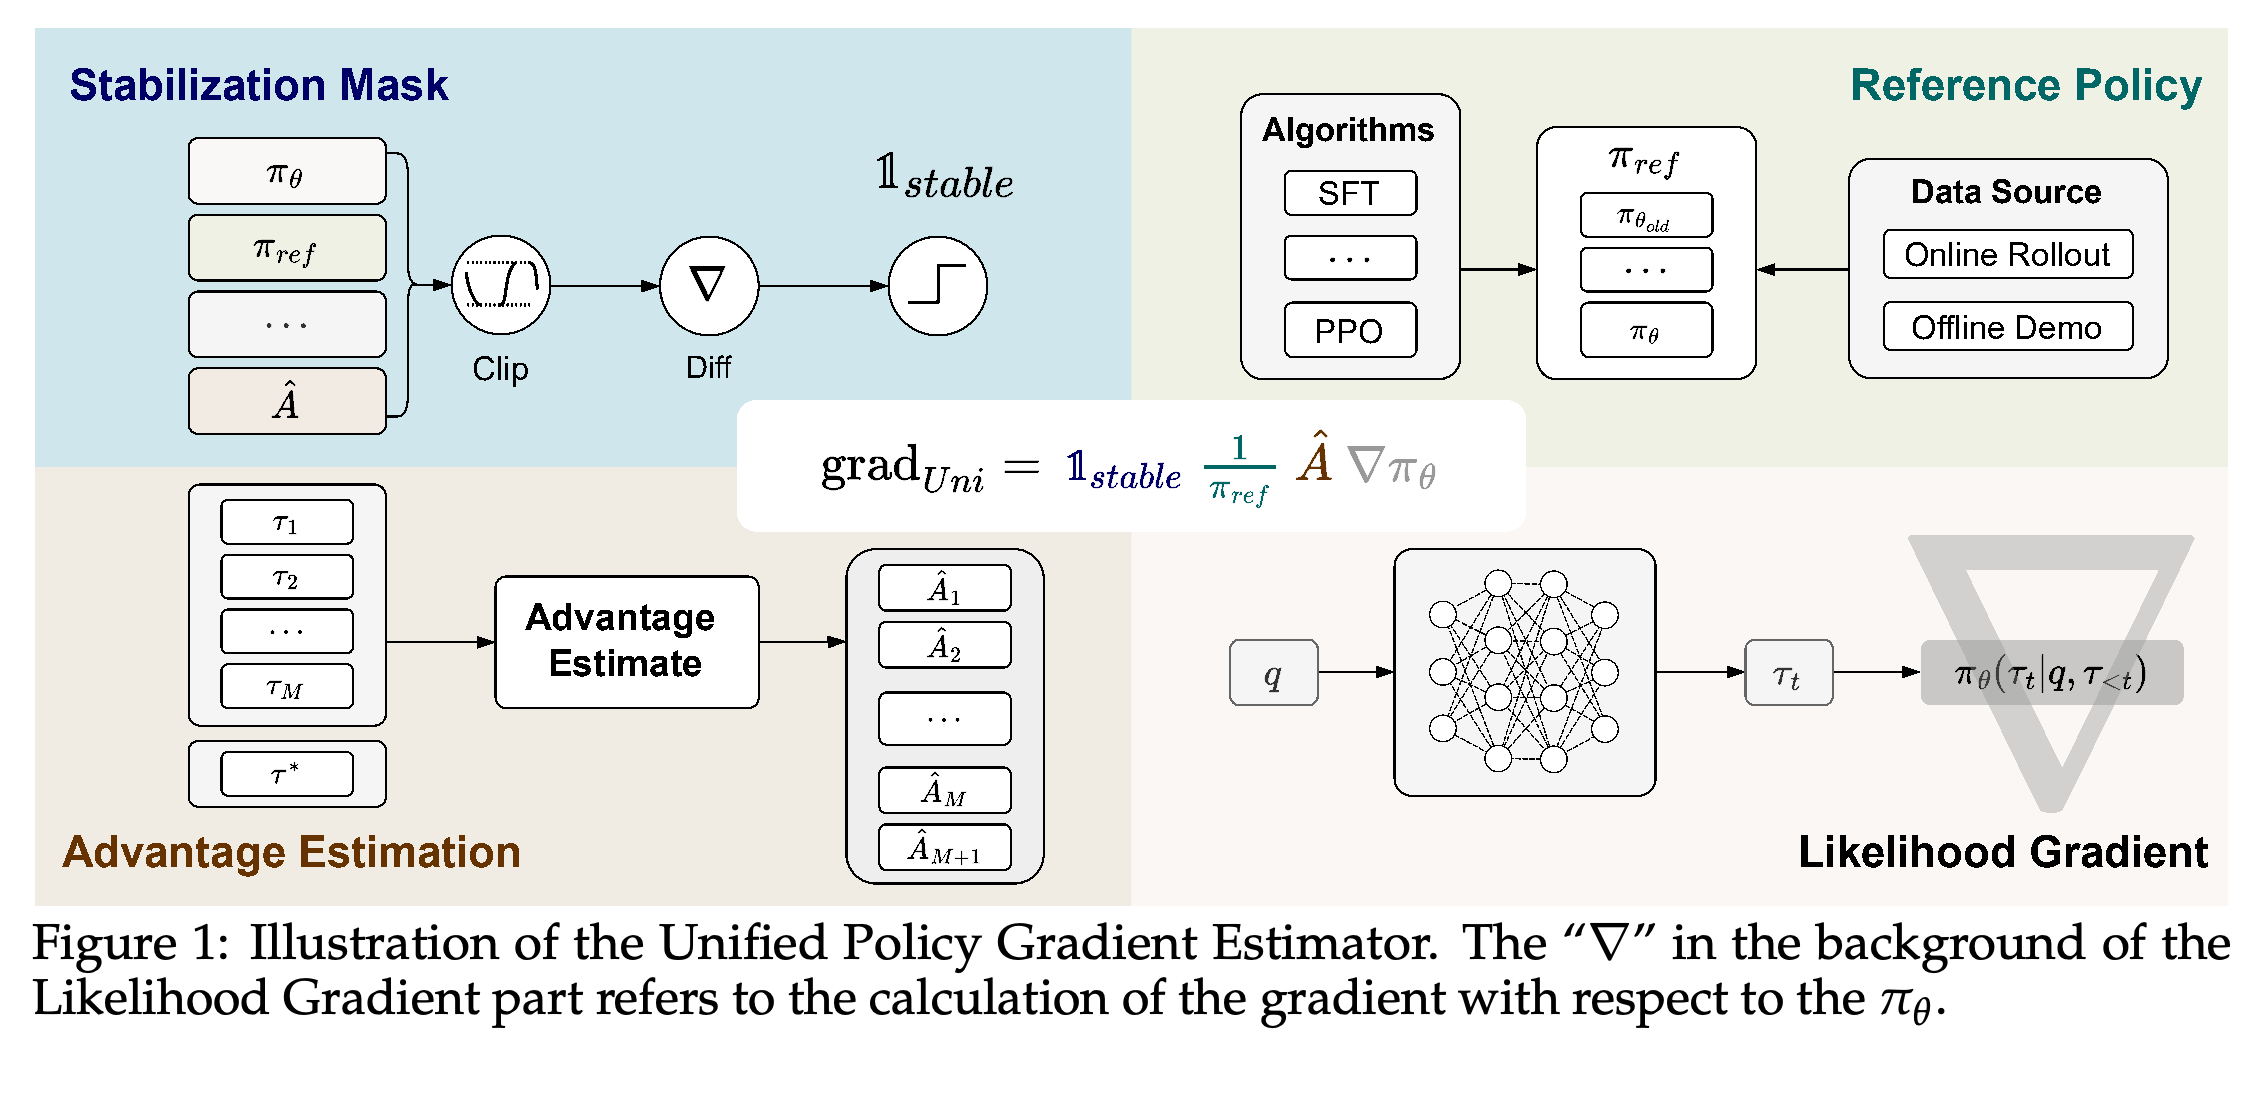
- 파라미터 갱신 신호를 공통 수식으로 표현하는 Unified Policy Gradient Estimator(UPGE)는 시연을 재현하도록 학습하는 지도 미세조정(SFT)과 보상을 통해 학습하는 강화학습(RL)을 연결한다. UPGE의 4개 구성 요소는 일부 갱신을 억제하는 안정화 마스크, 샘플의 가중치를 조정하는 참조 정책 분모, 응답 품질을 평가하는 advantage 추정값, 이러한 신호를 모델 파라미터에 전달하는 likelihood gradient이다. 여기서 정책은 토큰이나 응답에 대한 모델의 조건부 확률분포를 뜻한다.
- HPT는 질문마다 이진 결정을 내려 샘플링한 응답의 성능이 낮으면 SFT를 선택하고 그렇지 않으면 RL을 선택한다. 학습의 출발점으로 사용하는 사전학습 backbone 3개에서 얻은 결과는 실험한 전환 전략을 뒷받침한다. 다만 학습 데이터 명세가 불완전하고 불확실성 추정치가 없으며 RL 구현 설명이 일관되지 않아 재현성과 결과를 더 넓은 범위로 해석하는 데 한계가 있다.
1 Introduction
서론은 서로 보완할 수 있는 학습 실패 사례를 제시한다. 사전학습 모델에 RL을 바로 적용하면 생성한 응답에서 유용한 보상을 전혀 얻지 못해 학습이 실패할 수 있다. 반면 SFT는 시연에 과적합하여 학습 분포 밖의 입력에 대한 일반화 성능을 떨어뜨릴 수 있다. 순차적인 SFT→RL은 별도의 학습 단계를 추가하며 기존의 결합 목적함수는 각 학습 신호의 관계를 충분히 설명하지 못한다.
- 온라인 데이터는 학습 중인 모델이 생성한 응답이고, 오프라인 데이터는 사람이나 다른 모델이 제공한 시연이다. Rollout은 모델 정책에서 샘플링한 응답이다.
- 이 논문은 gradient 수준의 해석과 질문별 학습 방식 선택을 결합하여, 모델 성능이 변함에 따라 학습 신호도 바꿀 수 있도록 한다.
2 A Unified View on Post-Training Algorithms
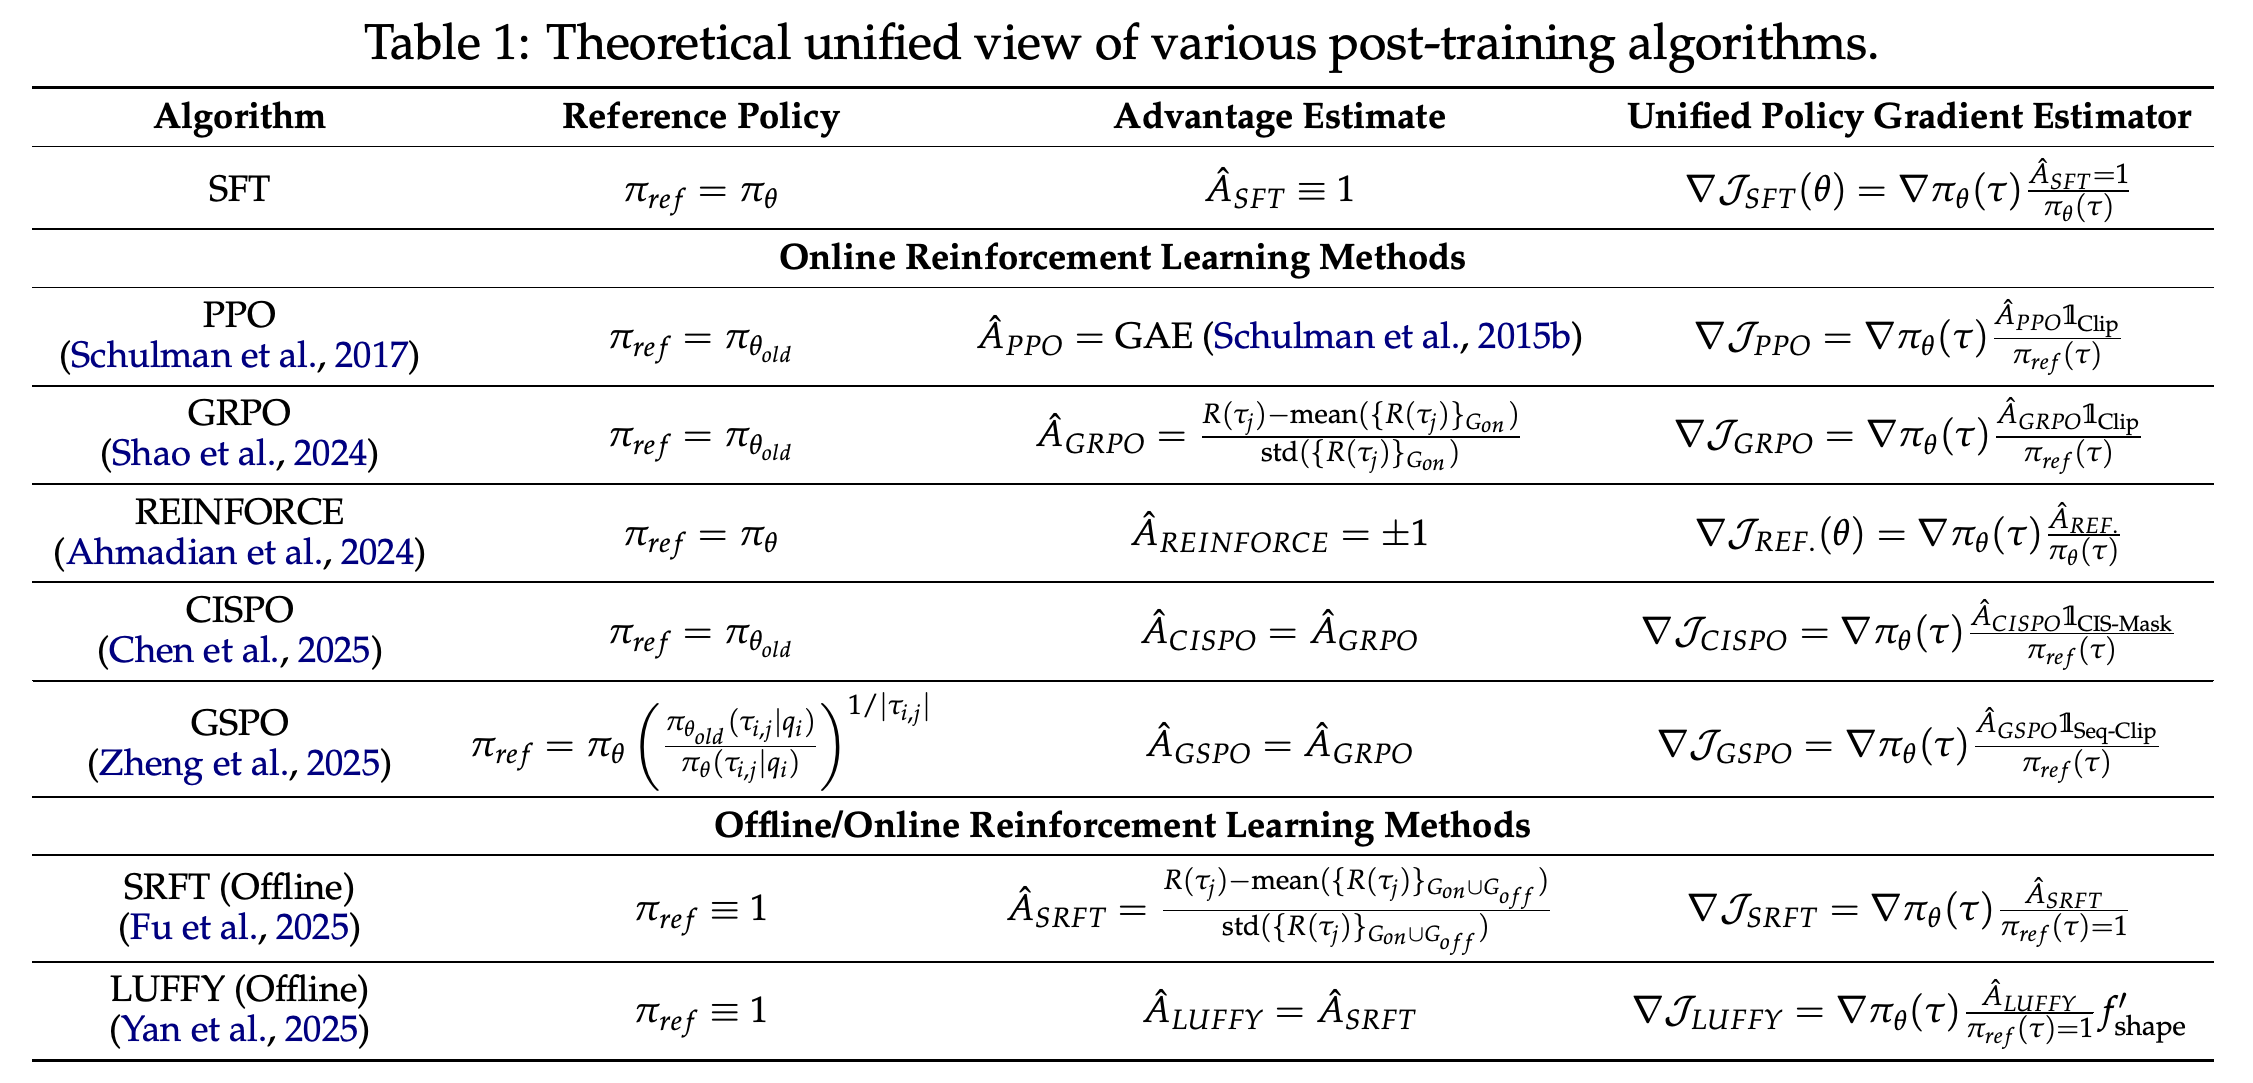
논문은 SFT와 여러 온라인, 오프라인 RL 알고리즘의 gradient를 공통된 곱셈 형태로 표현한다. Table 1은 분모, advantage, 마스크 선택에 따라 각 방법의 차이를 정리하며 명시된 가정 아래에서 gradient 계산을 비교하는 틀을 제공한다. 이 형태를 공유한다고 해서 실제 갱신의 통계적 특성까지 모두 같아지는 것은 아니다.
2.1 Components of the Unified Policy Gradient Estimator
UPGE는 gradient를 역할이 다른 4개 구성 요소로 나눈다. 각 요소는 일부 갱신을 억제하고 토큰의 가중치를 조정하고 응답 품질을 평가하고 학습 신호를 모델 파라미터에 전달한다. 비교한 계산 방식은 likelihood gradient를 공유하며 나머지 구성 요소가 각 응답의 기여도를 결정한다.
- SFT의 분모는 현재 정책의 확률이다. 정책 확률 비율을 clipping하여 갱신을 제한하는 RL 알고리즘인 Proximal Policy Optimization(PPO)에서는 일반적으로 응답을 생성한 정책의 확률을 분모로 사용한다.
- 오프라인 RL 방법은 시연을 생성한 확률을 알 수 없어 분모를 1로 설정하는 경우가 많다. 논문에서 말하는 참조 정책 분모는 가중치를 정하는 구성 요소이며 rollout 정책과 다를 수 있다.
- Advantage는 기준값에 비해 행동이 얼마나 유리한지를 나타낸다. 여기서 다루는 언어 모델 환경에서는 일반적으로 응답 전체를 평가한다.
이 도식은 갱신을 서로 교체할 수 있는 4개 부분으로 나눈다. 각 방법은 likelihood gradient를 공유하면서도 데이터에 따른 가중치 조정, 응답 품질 추정, 불안정한 갱신 억제 방식에서는 차이를 보일 수 있다.
각 행은 SFT와 온라인, 오프라인 RL 방법을 공통 gradient 구조에 대응시킨다. SFT는 현재 정책 확률의 역수로 가중치를 부여하고 PPO 계열 방법은 rollout 정책에 따른 가중치와 clipping을 사용하며 표에 제시된 오프라인 구성 요소는 상수 분모를 사용한다.
2.2 Derivation of the Unified Policy Gradient Estimator
Common Objective는 기대 보상을 최대화하면서 시연 정책에서 현재 모델로 향하는 Kullback–Leibler(KL) divergence에 페널티를 부과한다. KL divergence는 분포 간 불일치를 측정한다. 이를 미분하면 현재 정책에서 샘플링한 RL 항과 시연 정책에서 샘플링한 SFT 항을 얻는다. 샘플링 분포의 변화를 보정하는 중요도 재가중을 적용하면, 필요한 지지집합 조건 아래에서 통합 수식을 얻는다.
- Equation 1은 J_μ(θ) = E_{τ∼π_θ(·|q)}[r(τ|q)] − μ KL(π_β(·|q) ∥ π_θ(·|q)), μ ≥ 0이다. 여기서 q는 질문, τ는 생성한 응답 궤적, r은 응답 점수, π_β는 시연 정책이다.
- Equation 4는 Â_uni(τ,q) = r(τ|q) + μ π_β(τ|q)/π_θ(τ|q)로 정의한다. 마스크를 적용한 추정값을 간결하게 쓰면 grad_uni = 1_stable (1/π_ref) Â ∇π_θ이다.
- 공통 목적함수는 공동 최적화를 가능하게 하지만 개별 SFT와 RL gradient가 항상 같은 방향이라는 점을 입증하지는 않는다. 그룹 상대 advantage와 clipping은 다음 절에서 살펴볼 실제 추정 방식의 차이를 만든다.
2.3 Gradient Component Analysis
구성 요소 분석에서는 데이터 출처, 역확률 가중치, clipping, advantage 계산이 유발하는 편향과 분산을 살펴본다. 편향은 체계적인 추정 오차이고, 분산은 추정한 gradient의 변동성이다. 제한된 오프라인 데이터셋은 일부 RL 해석에 필요한 폭넓은 상태와 행동의 조합을 포괄한다는 가정을 충족하지 못한다. 상수 분모는 수치적 안정성을 높이지만 중요도 가중에 따른 해석을 기준으로 보면 편향을 도입한다.
- Clipping은 정책 확률 비율이 불리한 방향으로 지나치게 변할 때 갱신을 억제한다. 학습을 안정화할 수 있지만 유용한 신호를 버리고 편향을 도입할 수도 있다.
- 샘플링한 응답 그룹 안에서 보상을 비교하는 RL 방법인 Group Relative Policy Optimization(GRPO)은 보상을 중심화하고 정규화하여 advantage를 계산한다. 논문에서 다루는 다른 방법들은 고정된 부호를 사용하거나 표준편차 정규화 없이 중심화만 수행한다.
- 저자들은 데이터 분포에 관한 가정과 충분한 샘플을 전제로, 가중 결합을 잡음이 있는 gradient 측정값의 결합으로 설명한다. 최적 가중치 규칙을 유도하거나 편향과 분산을 정량적으로 추정하지는 않는다.
2.4 Hybrid Post-Training with Performance Feedback
HPT는 질문마다 n개 응답을 생성하고 이진 검증기로 최종 답의 정답 여부를 확인한 뒤, 검증 점수의 평균을 성능 P로 정의한다. 실험에서 사용한 gate는 P ≤ γ이면 SFT를, P > γ이면 RL을 선택한다. 따라서 혼합 손실 \(\mathcal L=\alpha\mathcal L_{RL}+\beta\mathcal L_{SFT}\)는 질문별 이진 선택이 된다.
- γ = 0이면 샘플링한 응답이 모두 오답일 때만 해당 질문에 SFT를 적용한다. 샘플 정확도가 양수이면 RL을 선택한다. 생성한 응답은 RL 손실에 사용하고 시연은 SFT의 학습 목표로 사용한다.
- 더 일반적인 틀에서는 피드백 함수 α = f(P)와 β = g(P)를 허용하지만 실험에서는 어느 한쪽만 활성화하는 이진 계수를 사용한다.
- Section 2.4는 RL 구현을 Dr. GRPO라고 부른다. 앞부분에서는 이 변형이 표준편차 정규화 없이 중심화한 보상을 사용한다고 설명하지만 Section 3.1에서는 구현을 GRPO라고 부른다. Equation 11은 표준편차로 정규화한 advantage를 명시하므로 정확히 어떤 변형을 사용했는지 모호하다.
3 Experiments
실험은 성능에 따른 학습 방식 전환이 서로 다른 크기와 계열의 모델에서 수학 추론을 개선하는지 검증한다. 비교 대상에는 시연만 사용하는 학습, 보상만 사용하는 학습, 순차 학습, 온라인 신호와 오프라인 신호를 결합하는 방법이 포함된다.
3.1 Experimental Setup
Backbone은 Qwen2.5-Math-1.5B, Qwen2.5-Math-7B, LLaMA-3.1-8B이다. 평가는 AIME 2024, AIME 2025, AMC12 2022와 AMC12 2023의 AMC 문제, MATH-500, Minerva, OlympiadBench로 구성된 6개 수학 추론 벤치마크를 사용한다. Qwen2.5-Math-7B에는 수학 학습 영역을 벗어난 분포 외 평가도 수행한다. 이 평가에는 개방형 도메인 추론 벤치마크인 ARC-c와 대학원 수준의 질의응답 부분집합인 GPQA-Diamond를 사용한다.
- 평가에서는 최대 생성 길이를 8,192토큰으로 설정하고 샘플링의 무작위성을 조절하는 temperature는 0.6, 누적 확률 임계값으로 샘플링 대상을 제한하는 top-p는 0.95로 설정한다. 주요 결과에서는 샘플링한 응답 1개가 정답일 확률인 Pass@1을 추정한다. AIME 2024, AIME 2025, AMC에는 응답 32개의 정확도를 평균한 avg@32를 사용하고 나머지 벤치마크에는 avg@1을 사용한다.
- 학습에서는 temperature 1.0으로 질문마다 응답 8개를 샘플링한다. 가중치 감쇠를 적용하는 optimizer인 AdamW를 사용하고 학습률은 5 × 10⁻⁶으로 고정하며 8 × NVIDIA A800 80GB GPU에서 실행한다. 주요 실험의 gate는 Qwen 모델에서 γ = 0이고 LLaMA에서 γ = 2/8이다.
- 기준 방법은 SFT, GRPO, SFT→GRPO, LUFFY와 단일 단계에서 지도학습 및 강화학습 기반 fine-tuning을 수행하는 SRFT이다. 일부 결과는 기존 논문에서 가져왔으며 SRFT는 공식 코드가 공개되지 않아 저자들이 구현한 버전을 사용한다.
- PDF에는 주요 학습 데이터셋, 시연의 출처, 배치 크기, 비교 방법 간에 맞춘 계산 예산이 완전히 명시되어 있지 않다. 코드는 https://github.com/TsinghuaC3I/Unify-Post-Training 에서 제공한다.
3.2 Main Results
Qwen2.5-Math-7B에서 HPT의 6개 벤치마크 평균은 52.7이다. SFT는 44.5, GRPO는 43.1, SFT→GRPO는 46.5, LUFFY는 49.8, SRFT는 44.2이다. HPT의 AIME 2024 점수는 33.0으로 LUFFY의 26.1보다 6.9 points 높다. 분포 외 평가 평균은 HPT가 62.3이고 LUFFY가 60.1이다.
- HPT가 모든 개별 비교에서 앞서는 것은 아니다. AIME 2025에서는 SFT가 22.8로 HPT의 21.9보다 높고, 외부에서 보고한 Oat-Zero 기준 방법은 AIME 2024에서 33.4를 기록한다.
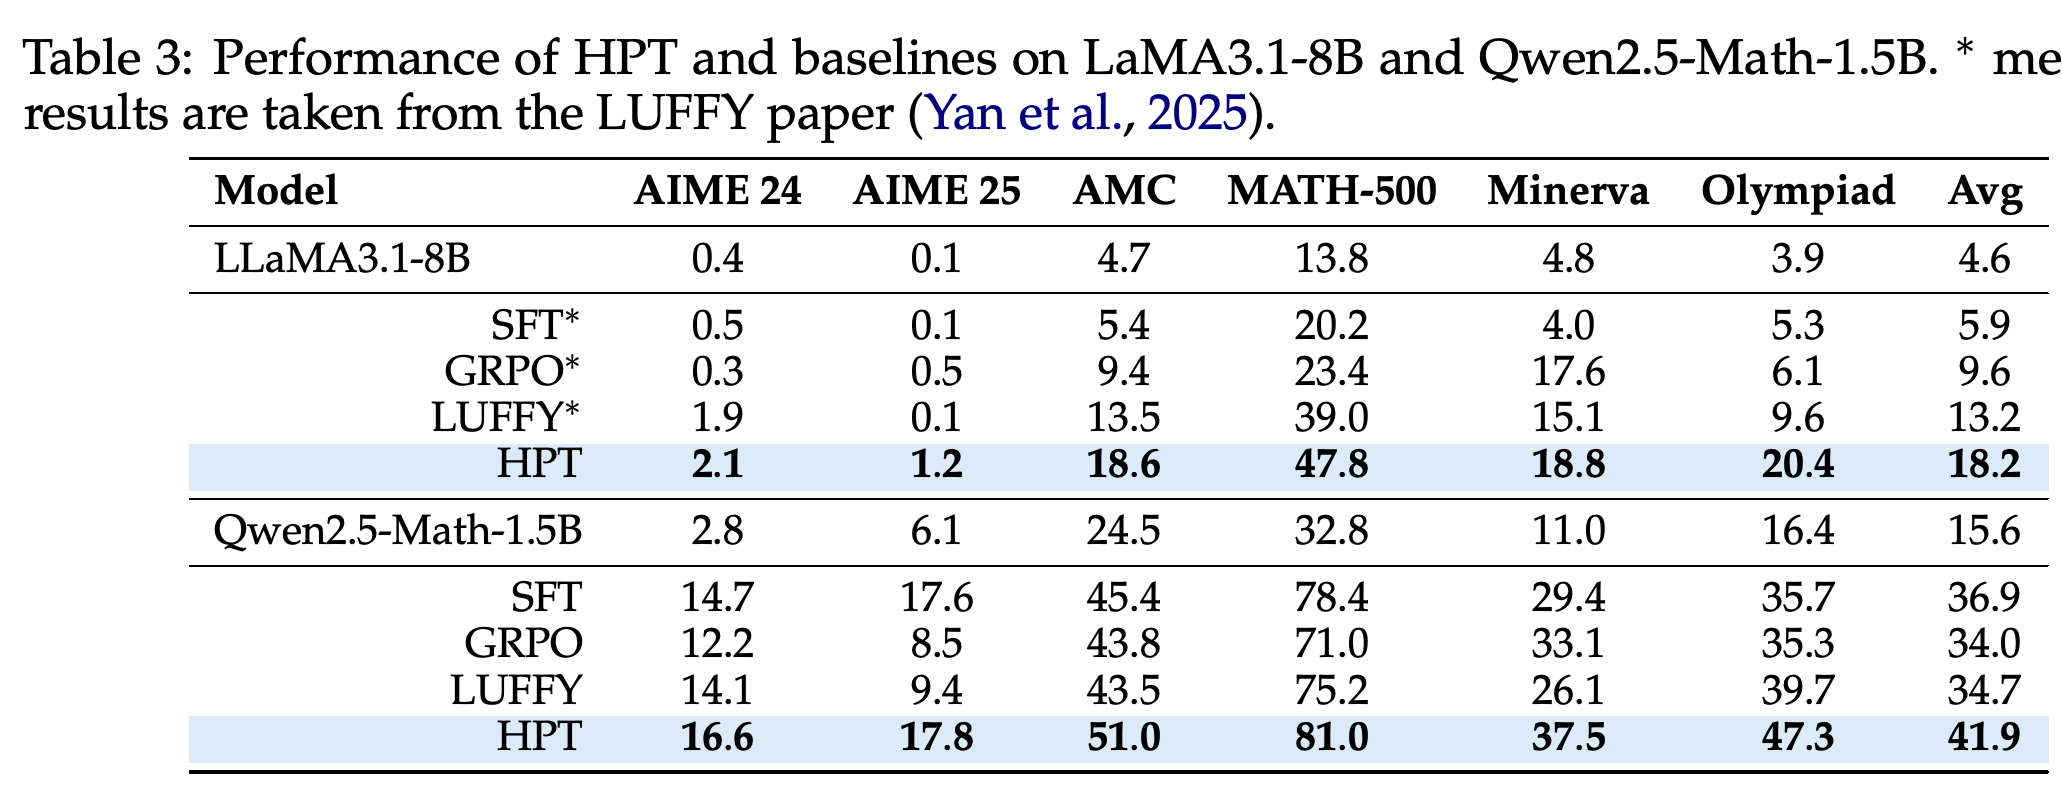
- LLaMA3.1-8B에서는 HPT의 평균이 18.2이고 LUFFY는 13.2이다. Qwen2.5-Math-1.5B에서는 HPT가 41.9, SFT가 36.9, LUFFY가 34.7이다. LLaMA 기준 방법의 점수는 LUFFY 논문에서 가져왔다.
- 표는 신뢰구간이나 학습 seed별 변동 없이 점추정치만 보고한다. 순차 학습보다 계산 효율이 높다는 주장에는 실제 실행 시간이나 계산 비용 측정 결과가 제시되지 않는다.
HPT는 보고된 수학 평가 평균 52.7과 분포 외 평가 평균 62.3에서 가장 높은 성능을 보인다. AIME 2025에서는 SFT가 HPT보다 높고, AIME 2024에서는 외부에서 보고한 Oat-Zero가 HPT를 근소하게 앞선다. 별표가 붙은 행은 다른 논문에서 가져온 결과이다.
HPT는 추가 backbone 모두에서 평균 점수를 높이며 LLaMA3.1-8B에서 18.2, Qwen2.5-Math-1.5B에서 41.9를 기록한다. LLaMA 비교에는 새로 실행한 기준 방법의 결과가 아니라 LUFFY 논문에서 보고한 기준 방법의 결과를 사용한다.
4 Empirical Analysis
실증 분석에서는 샘플링을 통해 성공적인 응답을 찾는 탐색과 시연에서 학습하는 활용을 살펴본다. 샘플링으로 해결할 수 있는 문제의 범위, 개별 문제에서 새로 해결하거나 더 이상 해결하지 못하는 사례, 학습 데이터에서의 학습 추이, 검증 정확도, 출력 다양성, 응답 길이, 시연 사용량을 측정한다. 이어서 다른 오프라인 목적함수와 전환 임계값을 실험한다.
4.1 Exploration and Exploitation
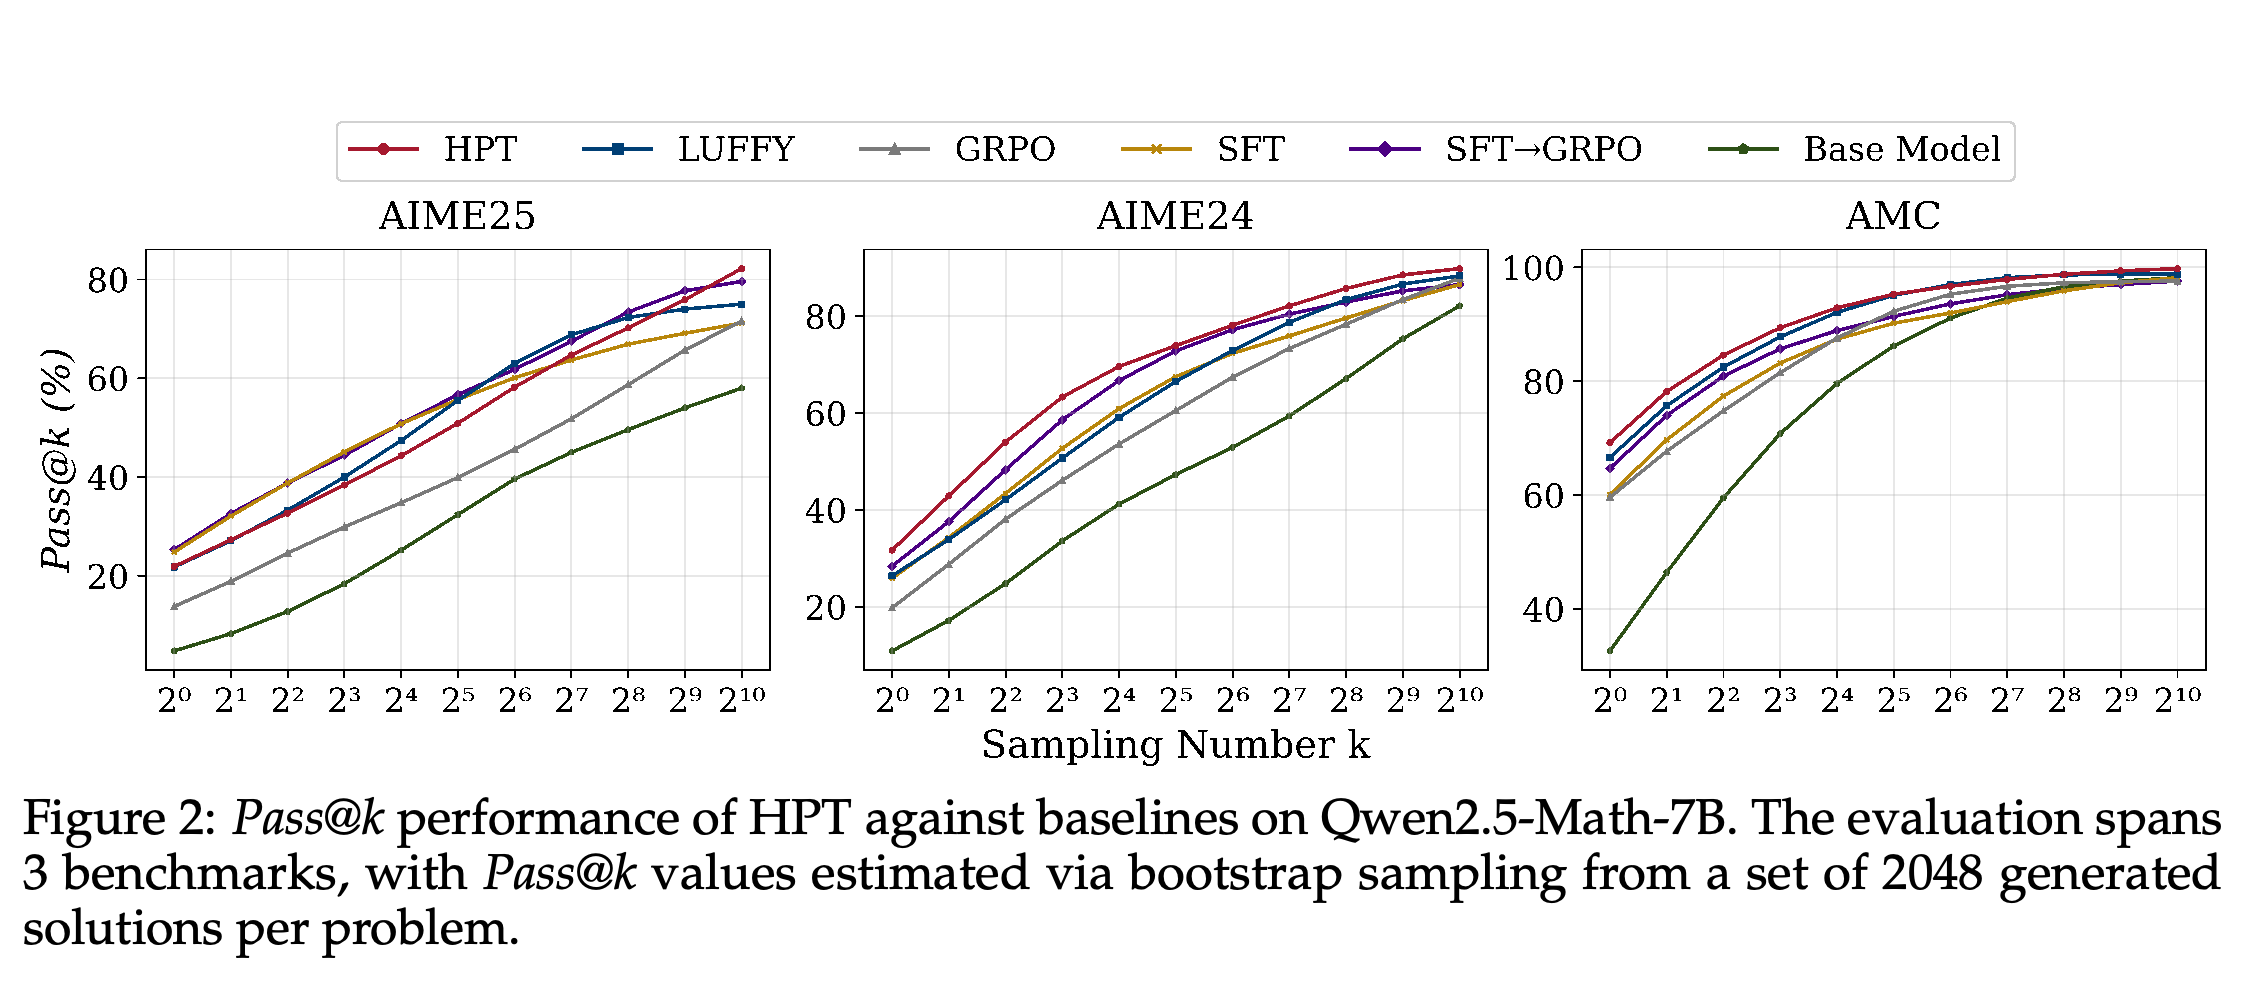
탐색은 Qwen2.5-Math-7B의 AIME 2025, AIME 2024, AMC에서 Pass@k로 측정한다. Pass@k는 샘플링한 응답 k개 중 적어도 1개가 문제를 해결할 확률이다. Figure 2는 문제마다 생성한 풀이 2048개를 재표본추출하여 성공 확률을 추정하는 bootstrap sampling으로 k = 1024까지의 값을 추정한다. 이 그래프에서 HPT는 큰 k에 대해 전반적으로 가장 높은 성능을 보인다.
- 곡선은 이 평가 방식에서 샘플링으로 해결할 수 있는 문제의 범위가 개선되었음을 뒷받침한다. 저자들은 시연이 유용한 지식과 다양성을 제공할 수 있다고 설명하지만 곡선만으로는 그 인과적 기여를 분리해 확인할 수 없다.
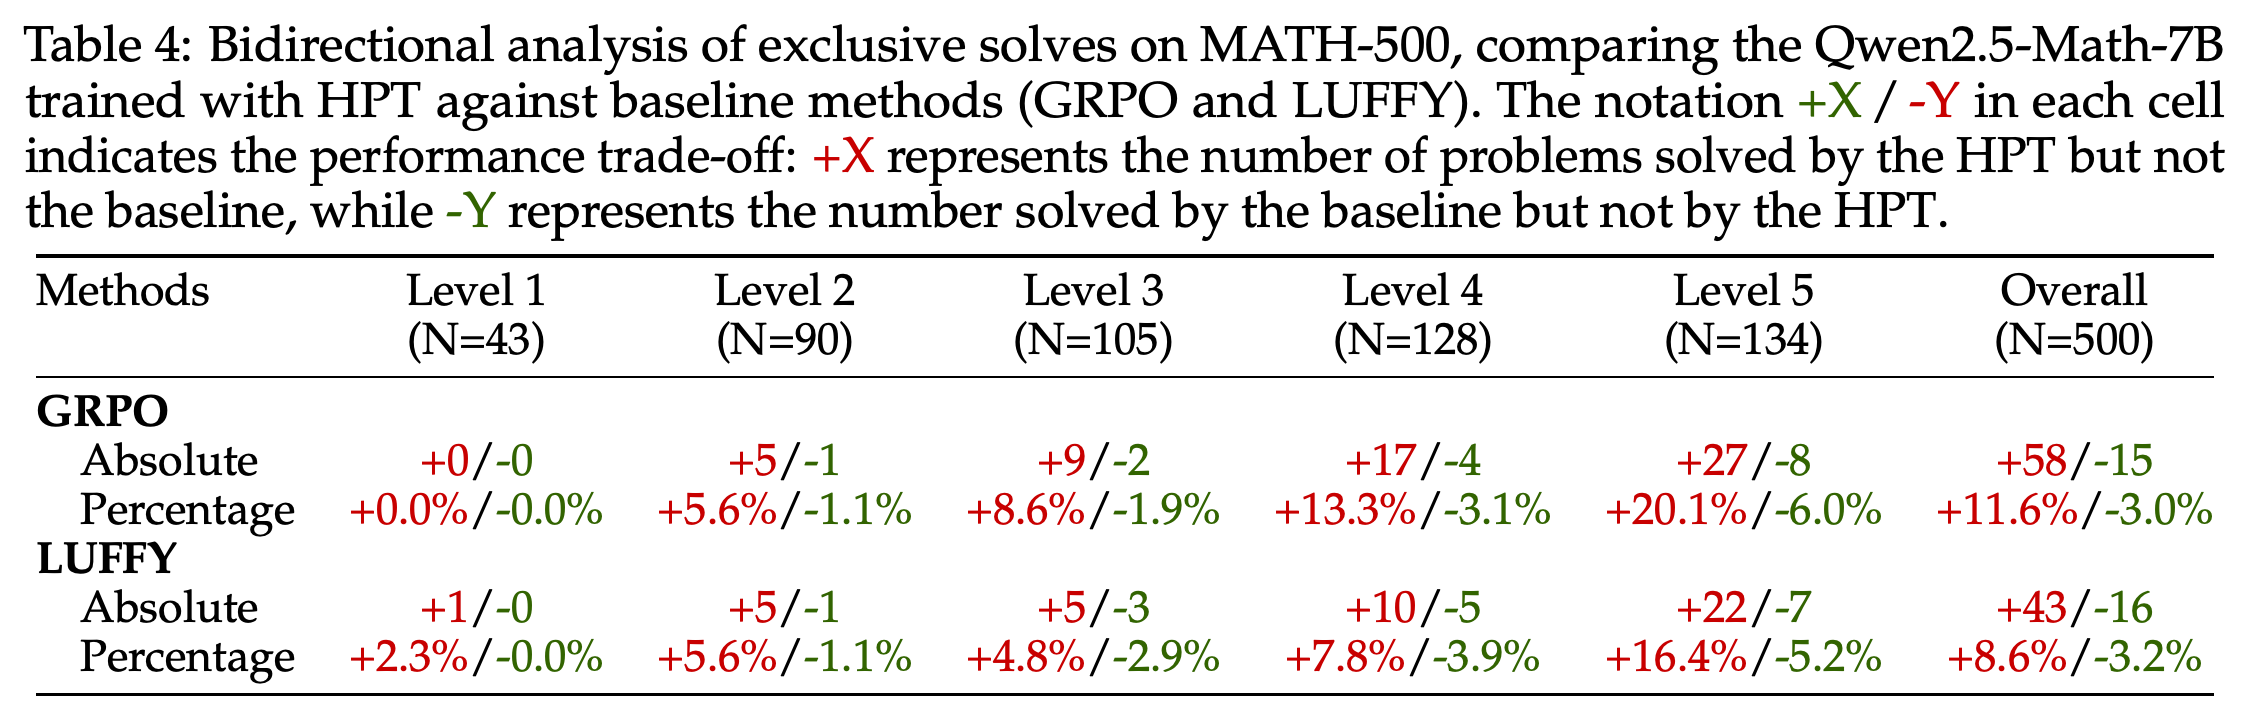
- Table 4는 MATH-500에서 비교 대상 중 1개 방법만 해결한 문제를 비교한다. HPT는 GRPO가 해결하지 못한 문제 58개를 해결하고 GRPO는 HPT가 해결하지 못한 문제 15개를 해결한다. LUFFY와 비교하면 해당 개수는 각각 43개와 16개이다.
- 난이도 Level 5에서 HPT만 해결한 문제와 기준 방법만 해결한 문제의 수는 GRPO 대비 +27/−8이고 LUFFY 대비 +22/−7이다. 이 수치는 어려운 문제에서의 개선을 뒷받침하면서도 기준 방법이 해결했던 일부 문제를 HPT가 해결하지 못한다는 점을 보여준다.
샘플링 예산이 늘어나면 해결할 수 있는 문제의 범위가 넓어지며, HPT는 큰 k에서 전반적으로 가장 높은 결과를 보인다. 문제별 응답 2048개에서 얻은 bootstrap 추정값은 k = 1024까지 확장되며, 이 평가 방식에서 샘플링으로 해결할 수 있는 범위를 측정한다.
HPT만 해결한 문제는 기준 방법만 해결한 문제보다 많다. 전체 문제에서 GRPO 대비 +58/−15, LUFFY 대비 +43/−16을 기록한다. 난이도가 높아지면 HPT만 해결한 문제 수가 증가하지만 손실이 0이 아니라는 점은 기준 방법이 해결한 문제를 완전히 보존하지 못함을 보여준다.
4.2 Training Visualization
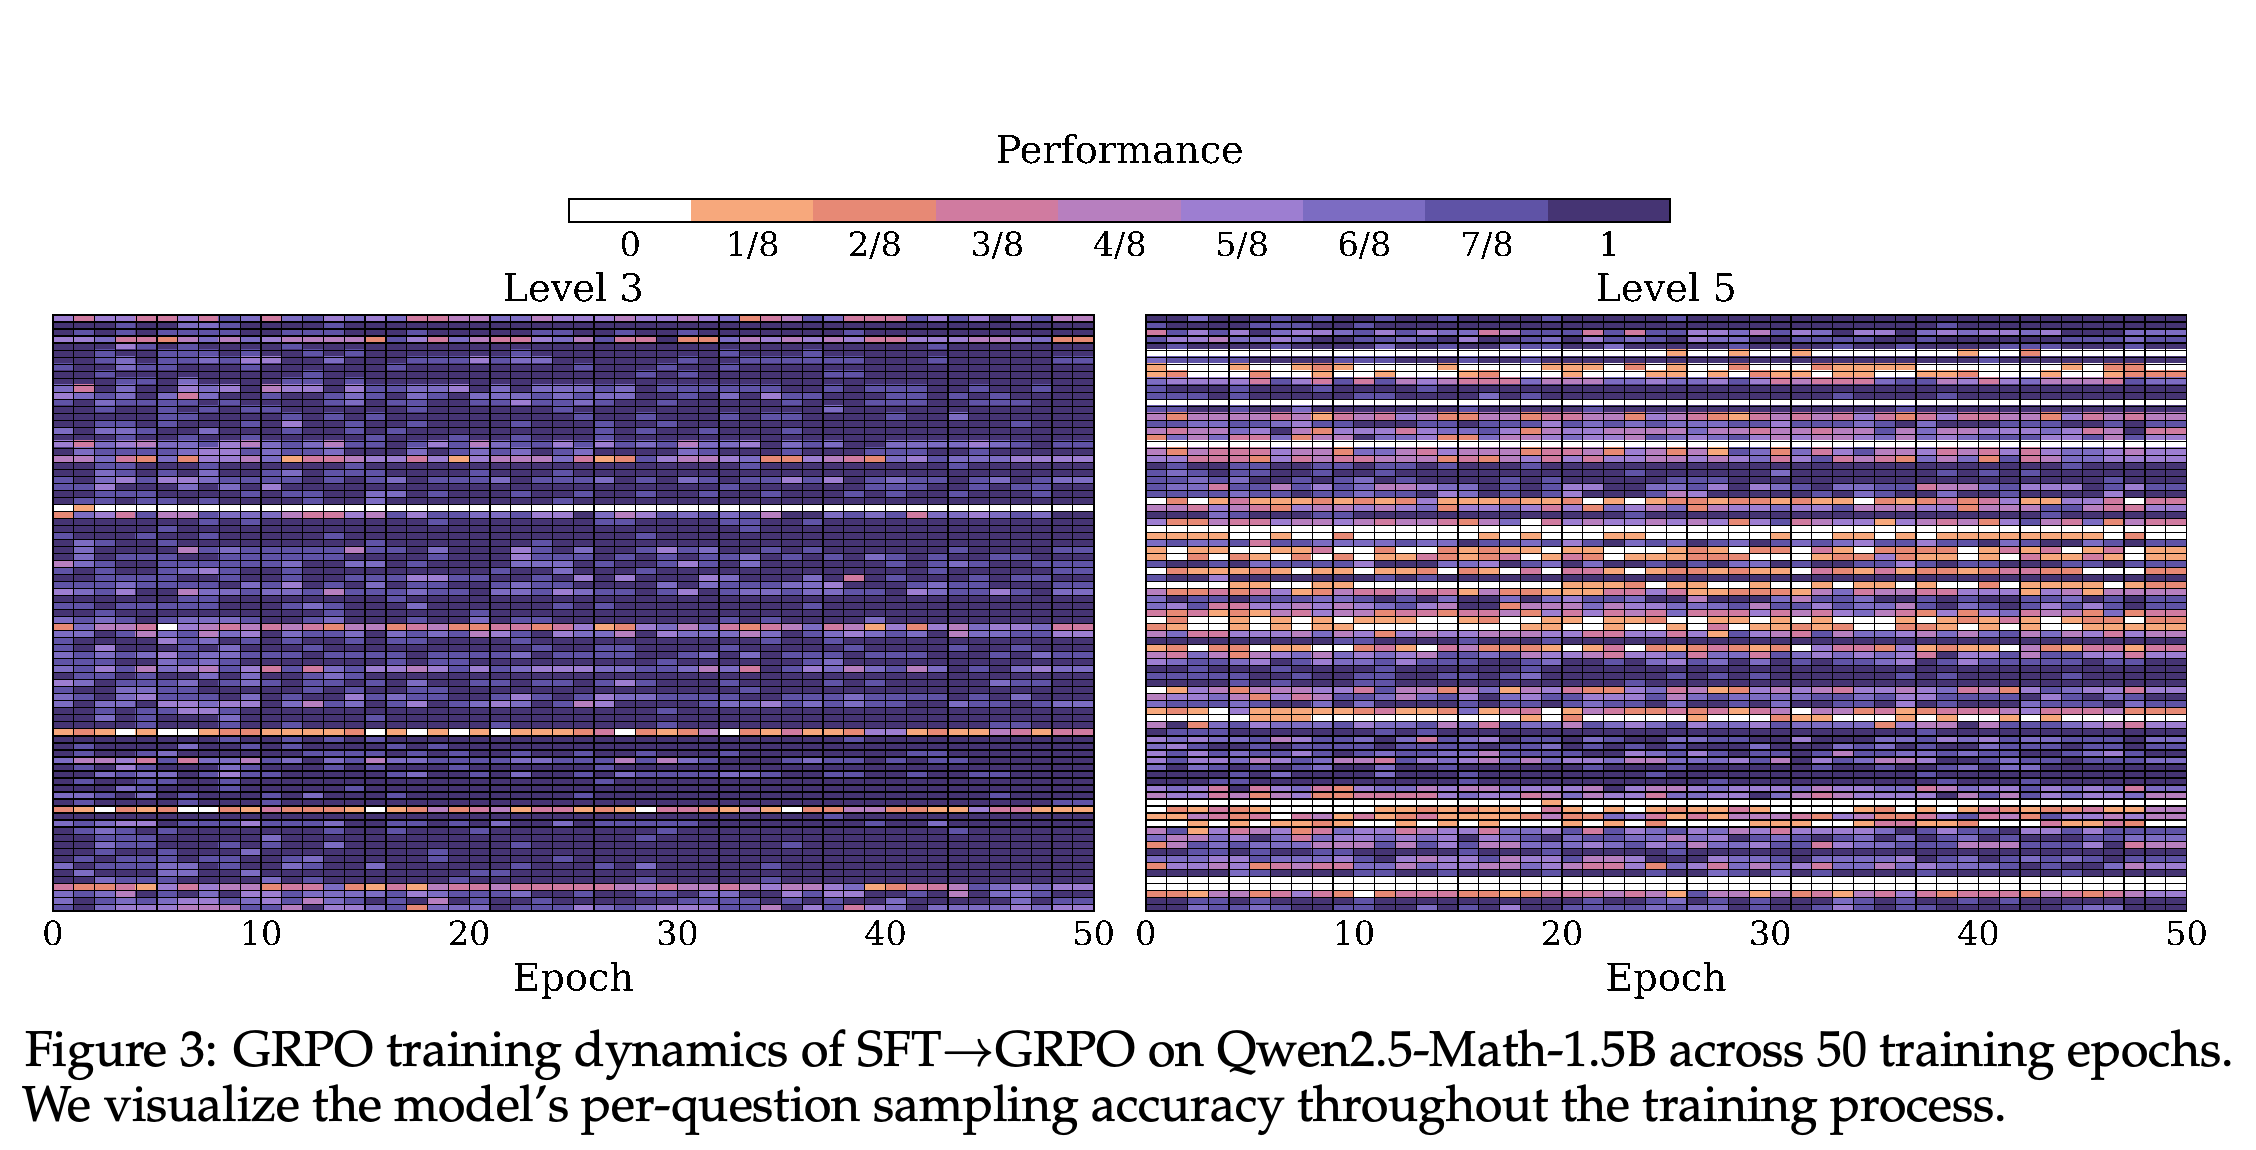
학습 시각화에서는 MATH 문제 255개를 사용하며 Levels 3, 4, 5에서 각각 85개를 선택한다. Qwen2.5-Math-1.5B의 학습을 50 epochs 동안 추적한다. 순차 학습 기준 방법은 SFT를 마친 뒤 GRPO 단계를 시작하지만 HPT는 선행 SFT 단계 없이 사전학습 backbone에서 시작한다.
- Figure 3에는 정확도가 지속적으로 0인 행이 있으며 특히 Level 5에서 두드러진다. 이는 순차 학습 기준 방법이 해당 질문에서 샘플링한 응답을 계속 틀린다는 점을 보여준다.
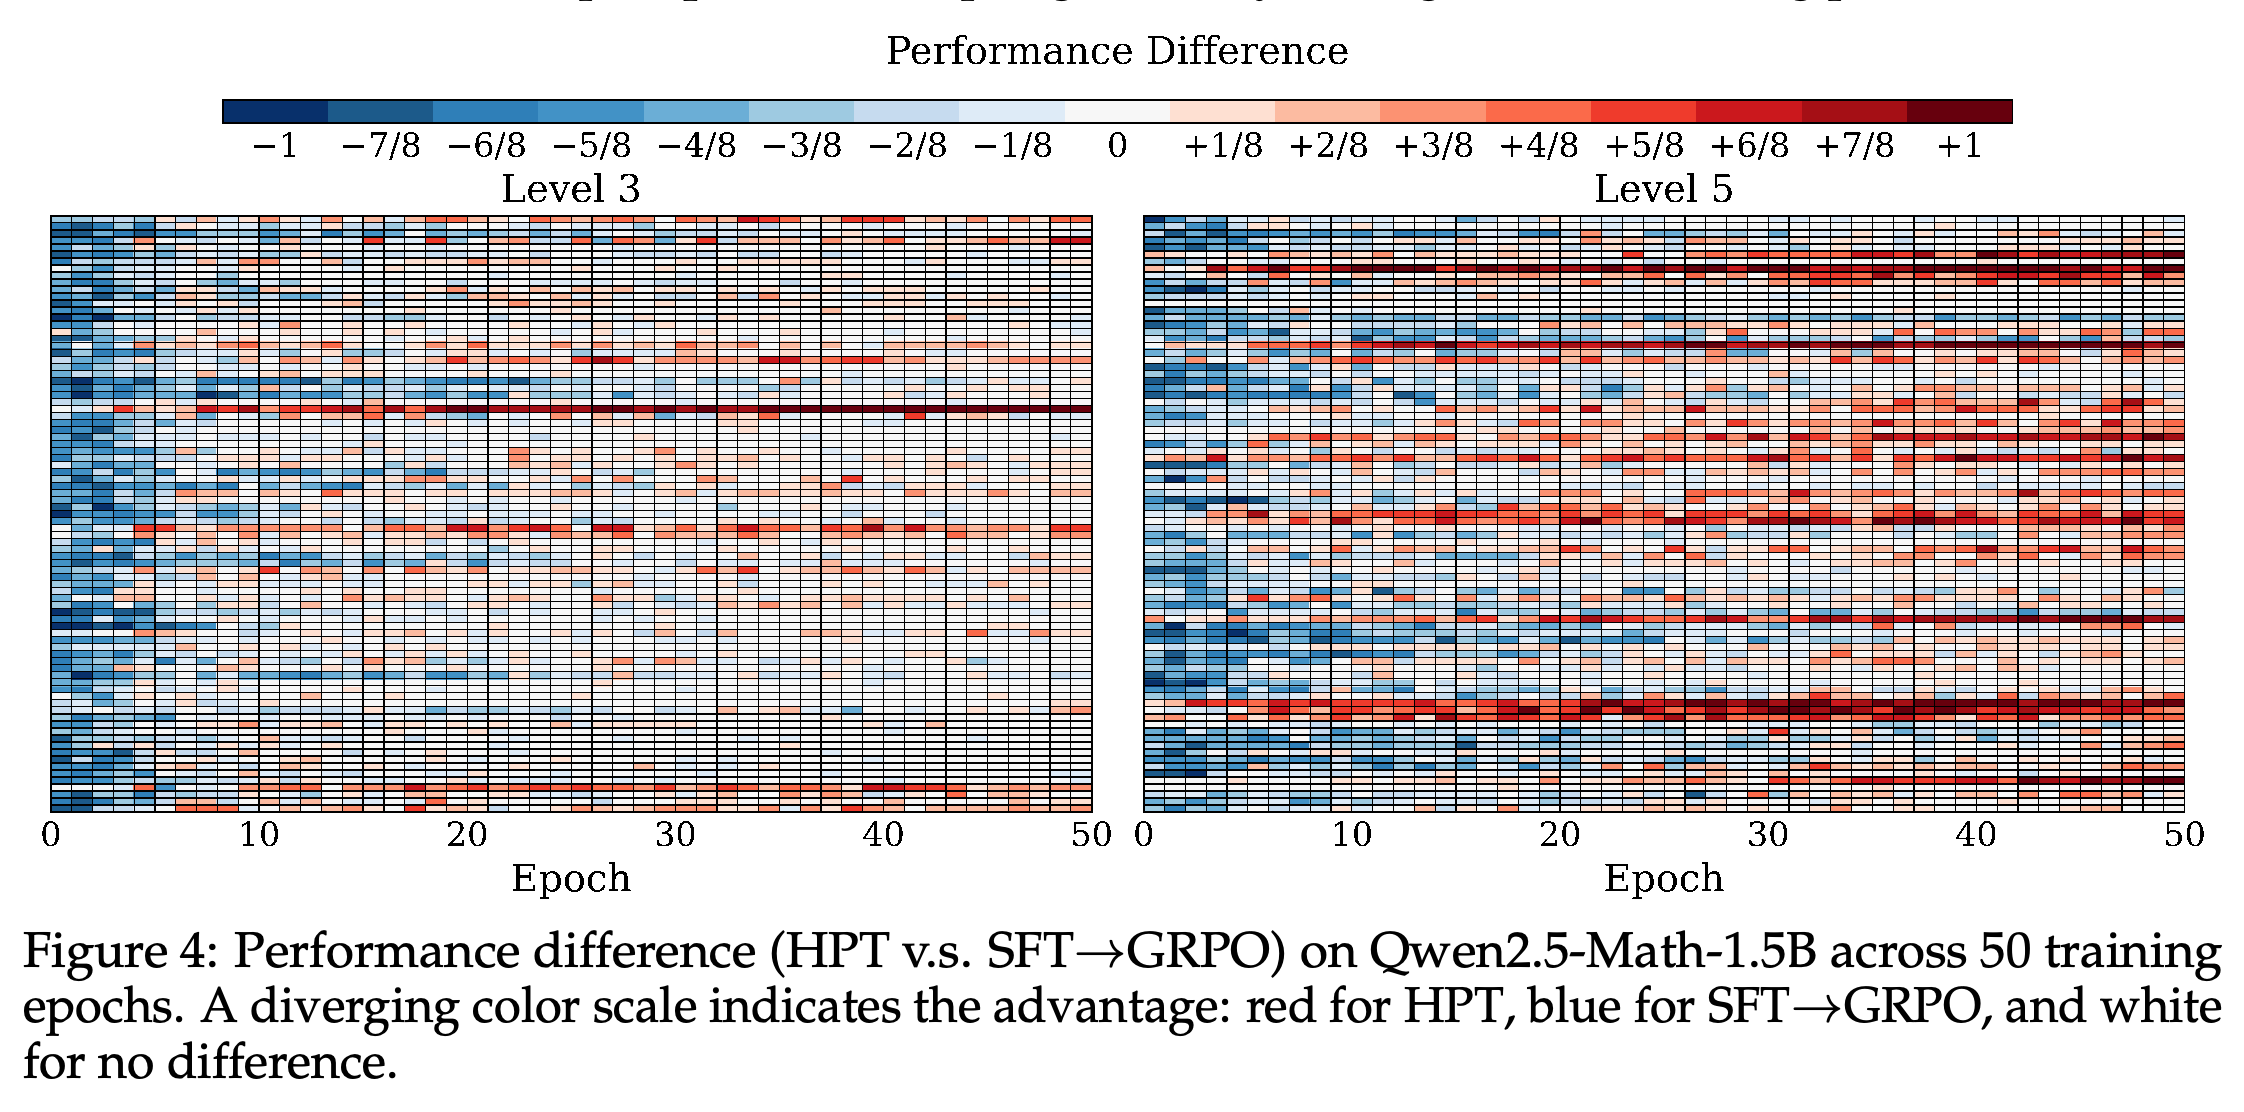
- Figure 4는 같은 질문과 학습 step에서 정확도를 비교한다. 초기에는 순차 학습 기준 방법이 앞서지만 후반에는 특히 Level 5에서 HPT가 앞선다. 학습 데이터에서 측정한 이러한 결과만으로 일반화를 입증할 수는 없다.
- 선행 SFT 단계로 인해 기준 방법은 추가 학습을 거치고 다른 출발점에서 시작한다. Section 4.2는 HPT가 SFT 갱신 중 rollout을 피한다고도 주장하지만 Algorithm 1에서는 gate를 결정하려면 샘플링이 필요하다. PDF는 이 비용을 어떻게 피하는지 설명하지 않는다.
지속적으로 흰색을 띠는 행은 순차 학습 기준 방법의 GRPO 학습 중 일부 구간에서 샘플 정확도가 0인 질문을 나타낸다. 이러한 행이 Level 5 질문에서 더 많이 나타나는 현상은 어려운 학습 예제에서 샘플링한 정답 응답이 부족함을 보여준다.
초기 파란 영역에서는 이미 SFT를 마친 기준 방법이 앞서고, 후반 빨간 영역에서는 특히 Level 5에서 HPT가 앞선다. 그래프는 이 학습 질문들에서 학습이 개선되었음을 뒷받침하지만 각 방법의 출발점과 학습 예산이 다르다.
4.3 Training Dynamics
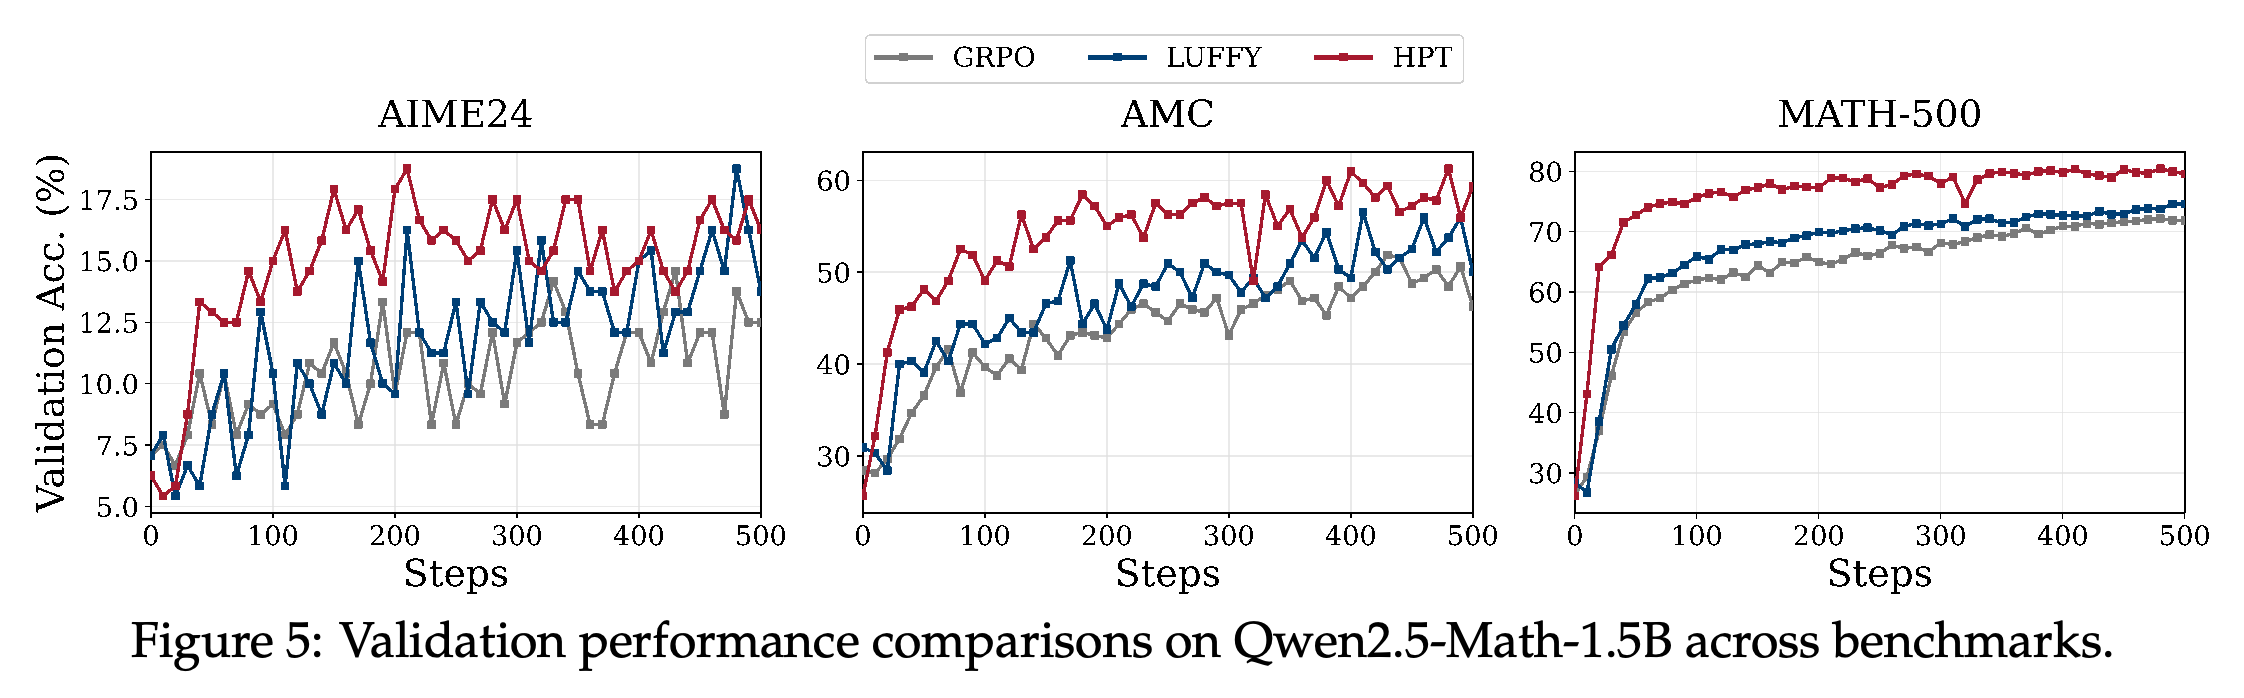
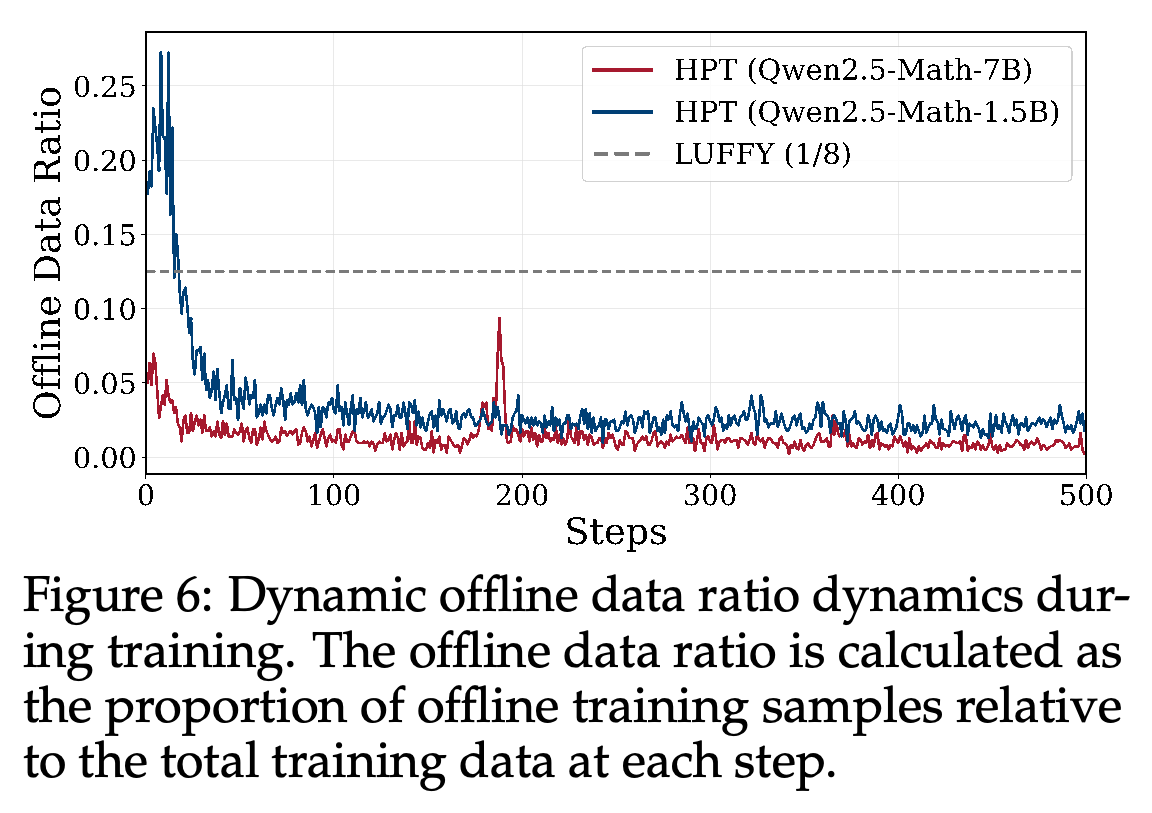
500 training steps 동안 검증 곡선은 대체로 HPT가 GRPO와 LUFFY보다 높다. 학습 샘플 중 시연이 제공한 샘플의 비율인 오프라인 데이터 비율은 0이 아닌 작은 값으로 감소한다. Qwen2.5-Math-1.5B는 Qwen2.5-Math-7B보다 초기에 오프라인 데이터를 더 많이 사용하고 전환도 늦게 이루어진다.
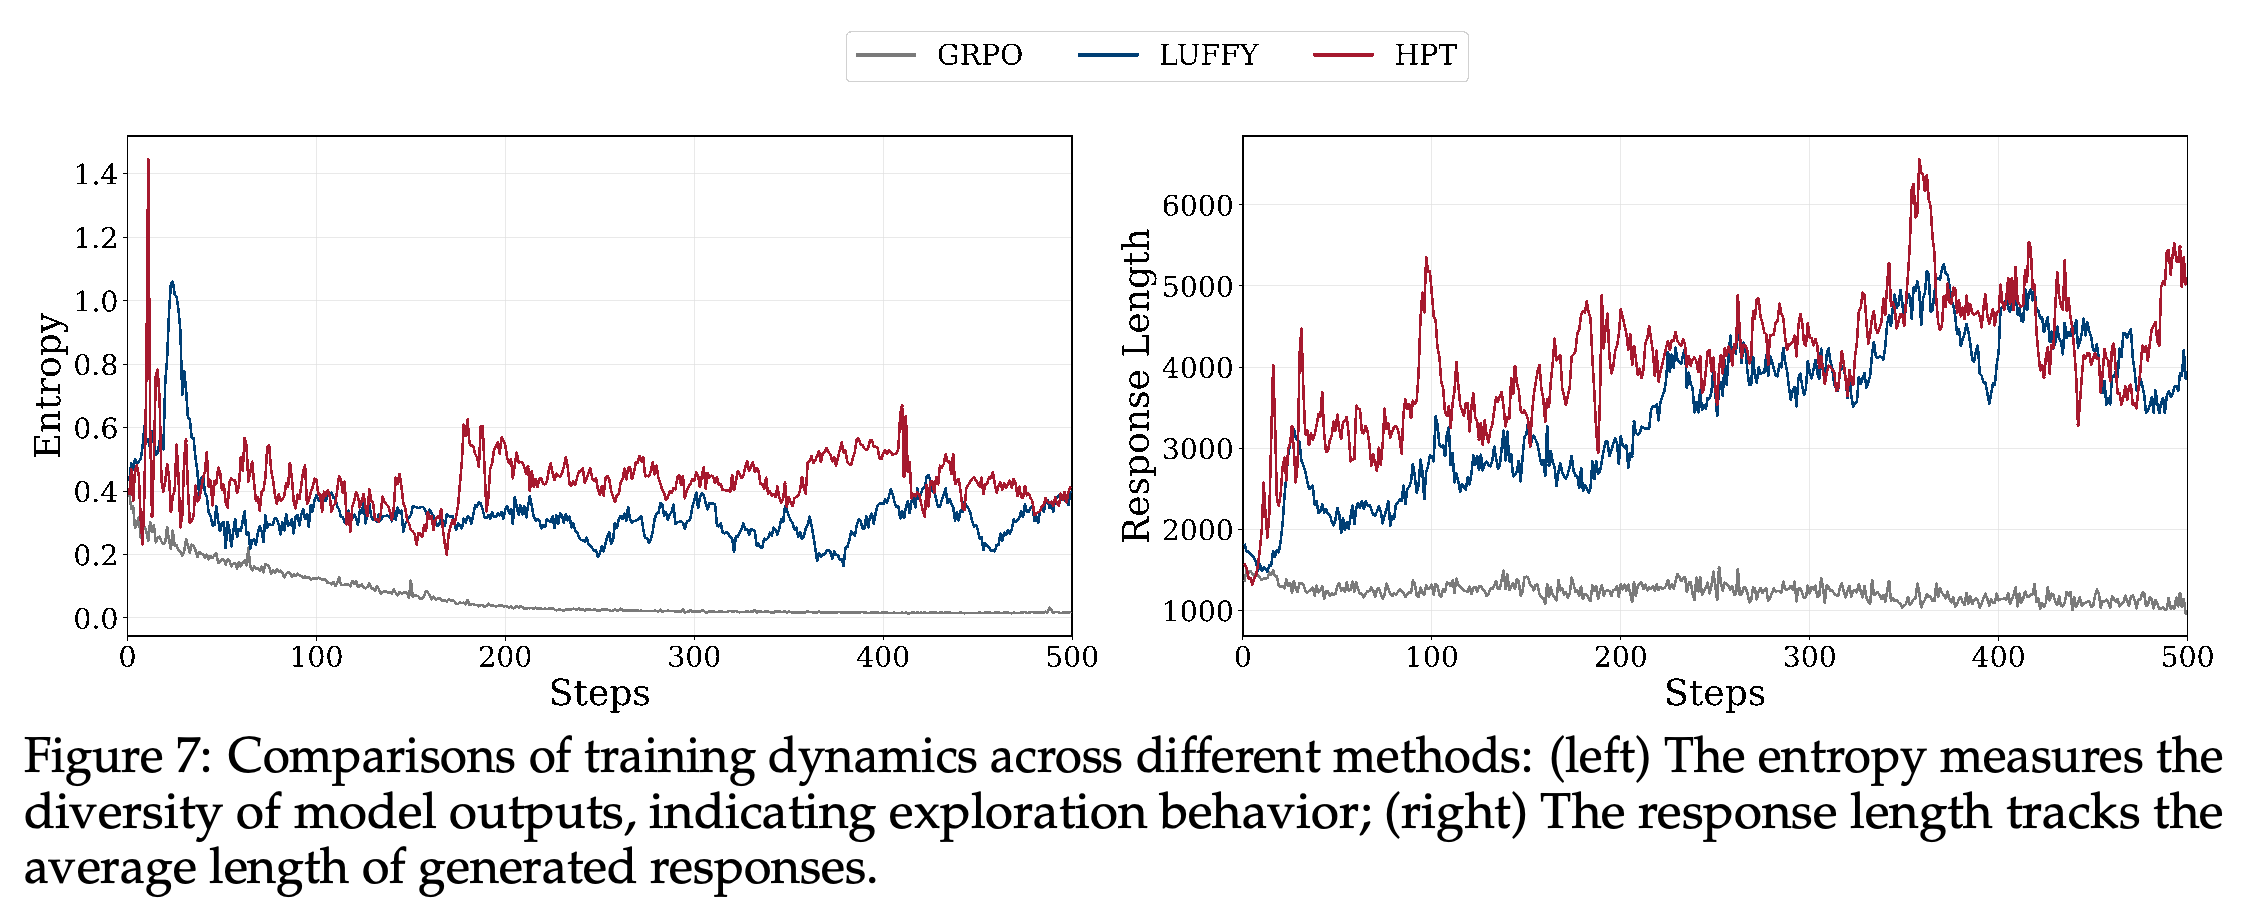
- Figure 7은 토큰 확률의 불확실성을 나타내는 엔트로피를 추적하며 여기서는 출력 다양성의 지표로 사용한다. HPT는 곡선이 0에 가까워지는 GRPO보다 높은 엔트로피를 유지한다.
- HPT의 평균 응답 길이는 초기에 증가하고 시연 비중이 감소한 이후에도 긴 상태를 유지한다. 저자들은 이를 학습한 추론 패턴이 유지되는 현상으로 해석하지만 길이만으로 그 내용이나 정확성을 입증할 수는 없다.
- Figure 6은 오프라인 비율을 샘플 기준으로 정의하지만 주변 본문에서는 프롬프트도 언급한다. 따라서 그래프의 비율을 SFT에 배정한 질문의 비율로 바로 해석할 수 없다.
HPT는 학습 중 대체로 더 높은 검증 정확도를 보이며 AMC와 MATH-500에서는 차이가 뚜렷하다. 변동이 큰 AIME 2024 곡선에서는 모든 checkpoint에서 우위를 보이지는 않는다.
HPT의 시연 샘플 비중은 고정된 1/8을 사용하는 LUFFY 참조값과 달리 학습 진행과 backbone 크기에 따라 변한다. 1.5B 모델은 7B 모델보다 초기 비중이 높으며 이후에는 모두 0이 아닌 작은 비중으로 안정된다.
HPT는 500 steps 동안 GRPO보다 높은 토큰 불확실성과 훨씬 긴 응답을 유지한다. 이 측정값은 행동의 차이를 보여주지만 정확도 개선에 기여한 추론 절차가 무엇인지는 밝히지 않는다.
4.4 Impact of Off-policy RL
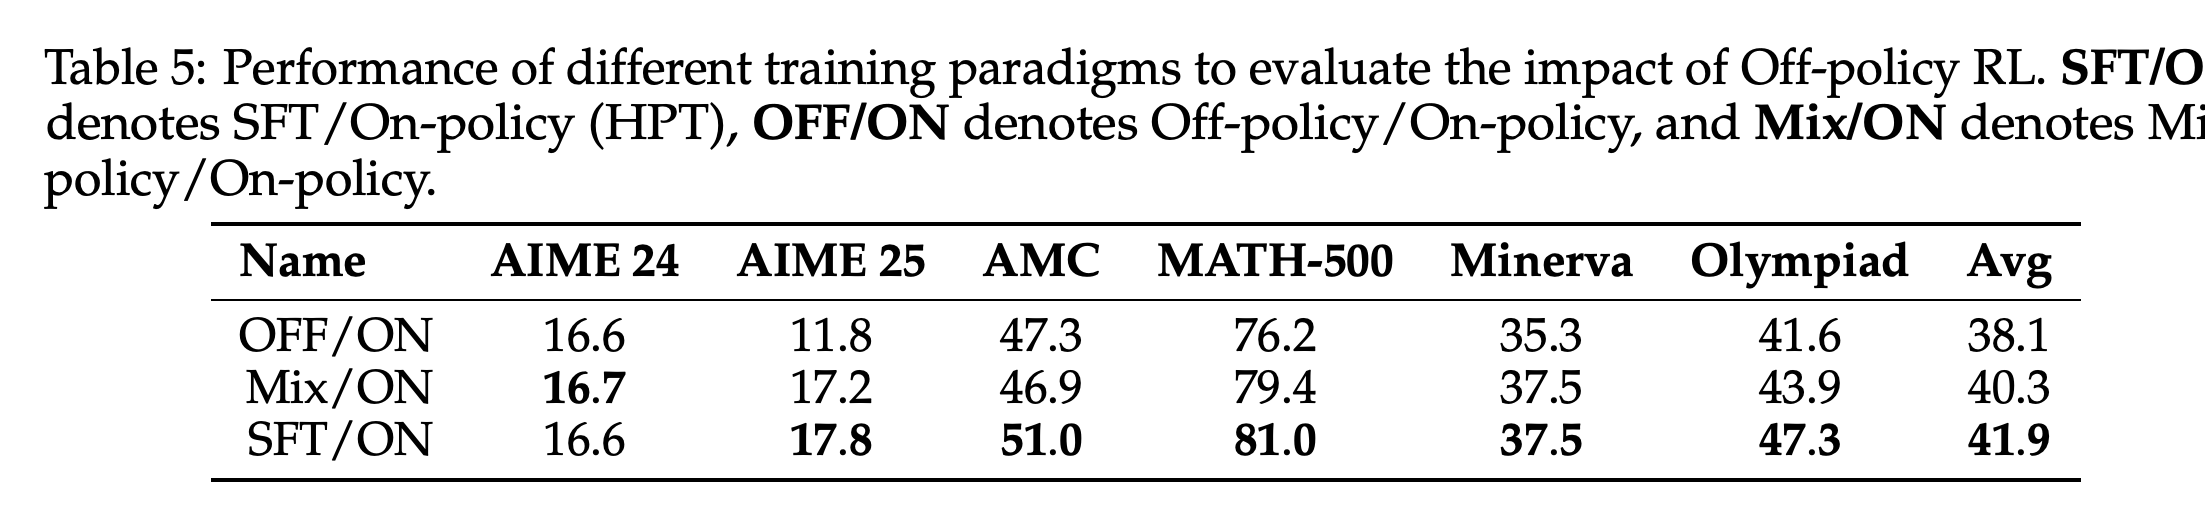
오프라인 데이터 ablation에서는 SFT/ON, OFF/ON, Mix/ON을 비교한다. SFT/ON은 현재 모델의 응답을 사용하는 on-policy RL과 SFT를 번갈아 적용하는 HPT 방식이다. OFF/ON은 외부 시연을 사용하는 off-policy RL과 on-policy RL을 번갈아 적용한다. Mix/ON은 결합한 오프라인 목적함수와 on-policy RL 사이를 전환한다. 각 방법의 6개 벤치마크 평균은 각각 41.9, 38.1, 40.3이다.
- Mix/ON에서 선택한 SFT/OFF 가중치 비율은 1/10이며, 계수 0.1과 1.0으로 구현한다. Off-policy 구현은 LUFFY를 따르며, 논문은 실험 설정이 동일하다고 명시한다.
- 이 설정에서 실험한 오프라인 구성 요소 중 SFT가 평균 점수 기준으로 더 좋다. 이 비교는 다른 데이터 분포, 모델, 구현에서도 off-policy RL이 불필요하다는 점을 입증하지 않는다.
SFT/ON의 평균은 41.9로 Mix/ON의 40.3과 OFF/ON의 38.1보다 높다. 따라서 명시된 공통 설정에서 실험한 off-policy 대안은 HPT의 SFT 구성 요소에 비해 평균을 개선하지 못한다.
4.5 Gate Threshold Ablation
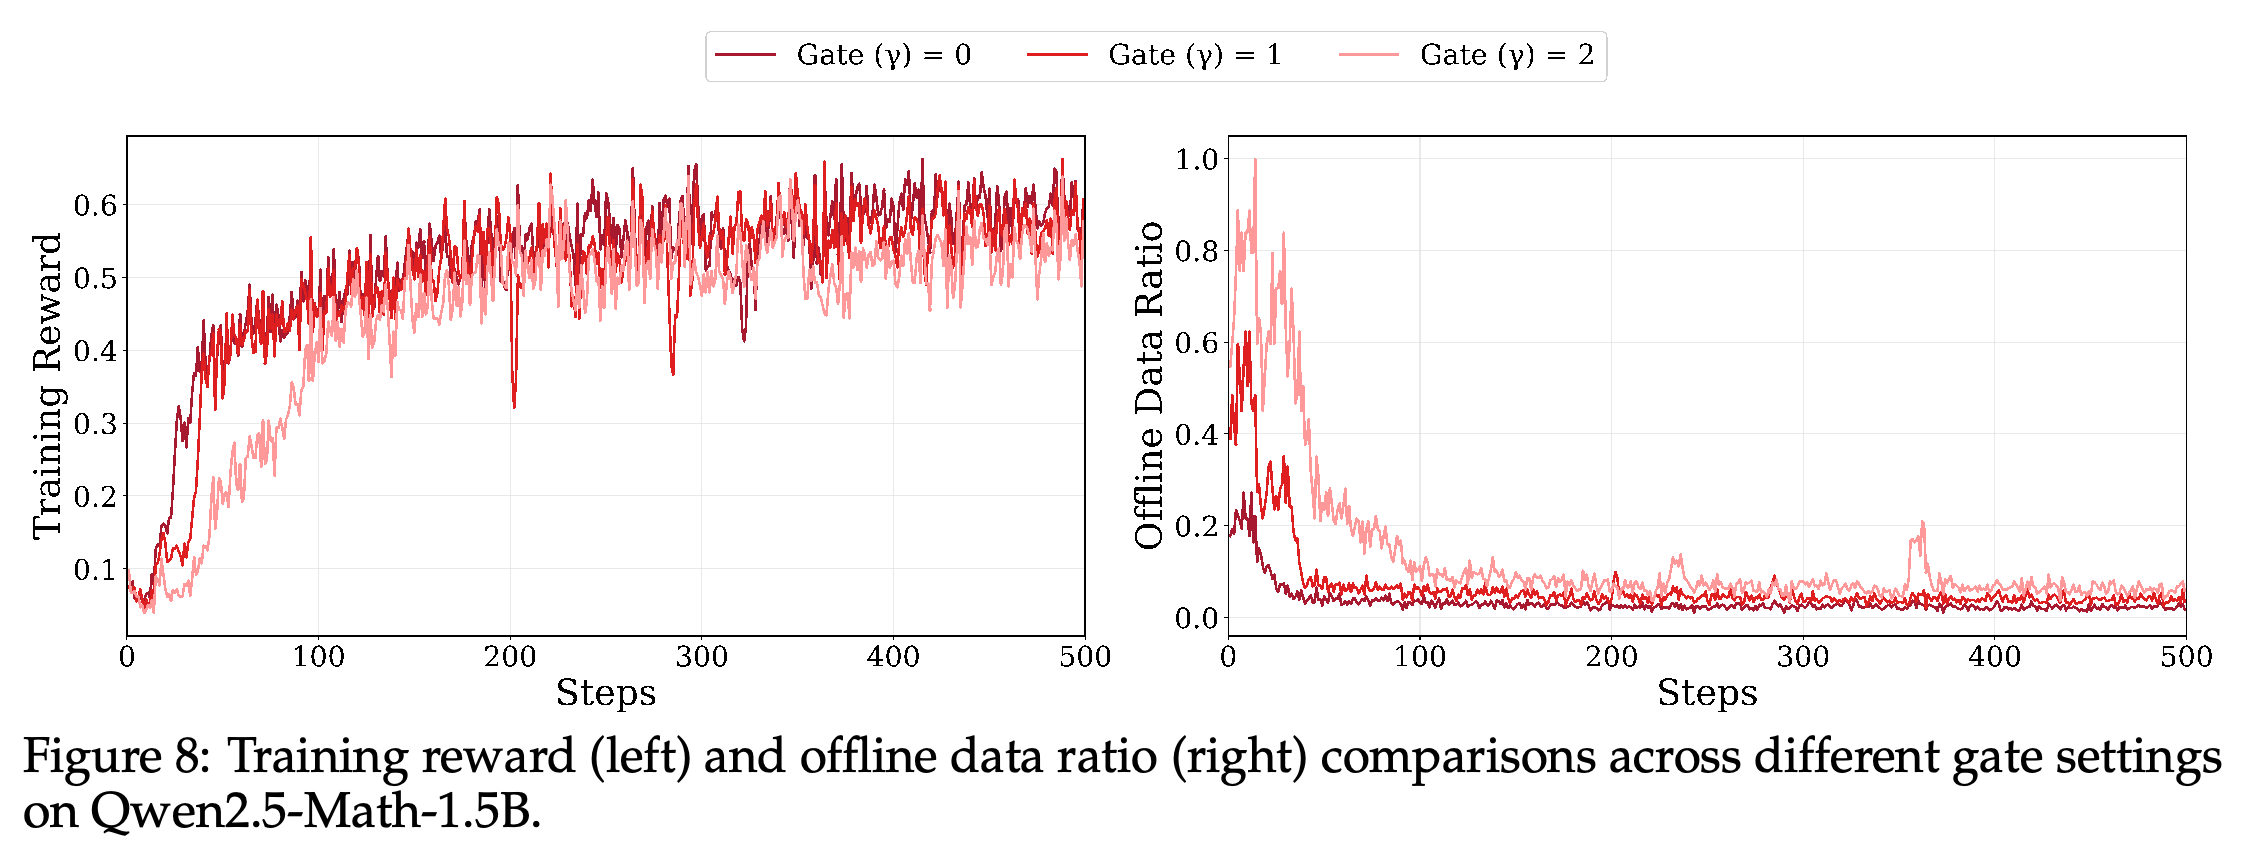
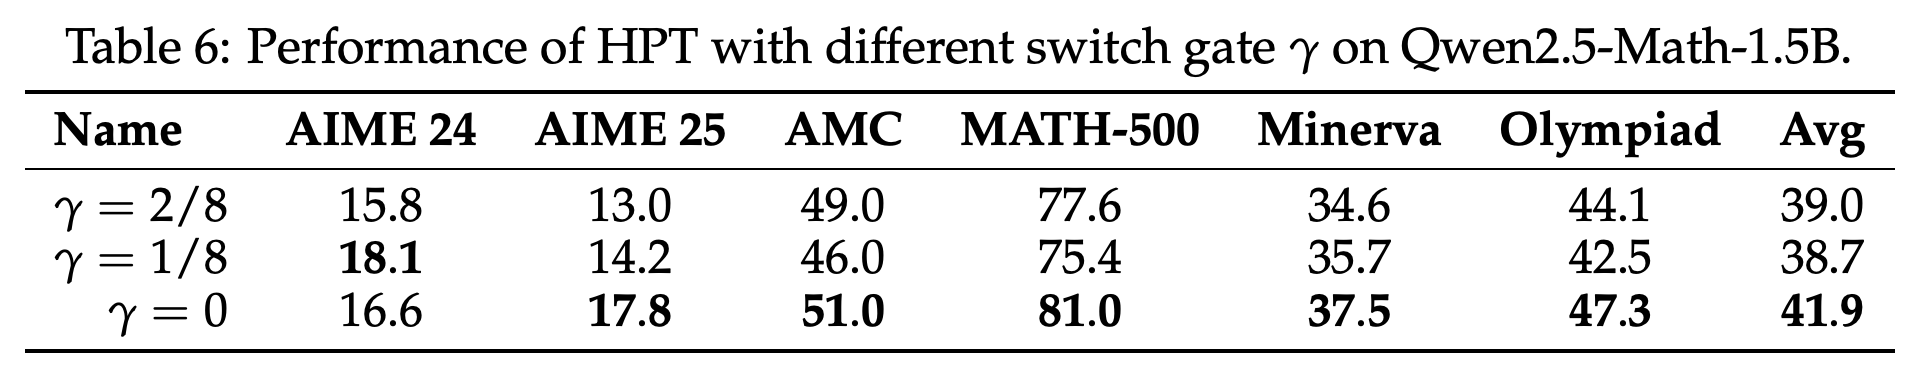
Qwen2.5-Math-1.5B에서 임계값 γ = 0, γ = 1/8, γ = 2/8의 6개 벤치마크 평균은 각각 41.9, 38.7, 39.0이다. 임계값이 높아지면 시연 사용량이 늘어나지만 전체 평균은 개선되지 않는다. 다만 γ = 1/8은 AIME 2024에서 가장 높은 점수인 18.1을 기록한다.
- gate 수식은 P > γ일 때만 RL을 사용한다. 질문마다 응답 8개를 생성하므로 임계값 0, 1/8, 2/8에서는 각각 최소 1개, 2개, 3개의 정답 응답이 필요하다. Section 4.5의 본문은 뒤쪽 임계값의 경계를 일관되지 않게 설명하며 응답을 뜻하는 부분에서 질문이라고 표현한다.
- Figure 8은 임계값이 높으면 초기에 오프라인 데이터를 더 많이 사용하고 초기 보상 개선이 늦어질 수 있음을 보여준다. 이 ablation은 Qwen2.5-Math-1.5B에서 실험한 임계값 중 최선의 값을 확인한다. 주요 LLaMA 실험은 대응하는 임계값 비교 없이 2/8을 사용한다.
Gate 임계값이 높아지면 초기에 시연을 더 많이 사용하고 보상 추이가 달라진다. 그래프는 임계값이 학습 구성 비율을 어떻게 바꾸는지 보여주며, 성능은 최종 벤치마크 점수로 비교한다.
γ = 0의 평균은 41.9로 가장 높으며 γ = 1/8은 38.7, γ = 2/8은 39.0이다. AIME 2024에서는 γ = 1/8이 18.1로 가장 높으므로, 평균 기준 최선의 임계값이 모든 벤치마크에서도 최선인 것은 아니다.
5 Conclusion
결론은 공통 gradient 수식과 현재 성능에 따라 시연 기반 학습이나 보상 기반 학습을 선택하는 알고리즘을 결합한다. 결과는 실험한 추론 backbone과 벤치마크에서 HPT의 효과를 뒷받침한다. 이론적 해석은 샘플링 가정과 실제 gradient 추정 방식 사이의 차이를 전제로 한다.
부록
- A Gradient Derivation for Classical Algorithms는 비교의 근거가 되는 구체적인 gradient 계산을 제공한다. A.1 Gradient of SFT는 시연 토큰의 음의 로그 확률인 토큰 수준 교차 엔트로피를 미분하여 현재 정책 확률의 역수를 사용하는 가중치를 얻고, SFT를 시연 응답을 모방하는 behavioral cloning으로 해석한다. A.2 Gradient of Online RL: PPO, GRPO and Beyond는 KL 및 엔트로피 정규화 항을 생략한 상태에서 clipping을 적용한 정책 비율 gradient와 GRPO의 그룹 정규화 보상을 유도한다. A.3 Gradient of Offline RL은 오프라인 데이터가 필요한 범위를 포괄한다는 가정 아래에서 상수 분모를 사용하고 clipping을 적용하지 않는 SRFT 갱신을 유도한다.
- B Additional Theoretical Details for Section 2.2는 유도에 필요한 수학적 조건을 제시한다. B.1 Deriving Equation 2 from Equation 1은 로그 확률 gradient를 통해 정책의 기댓값을 미분하는 score-function 항등식과 측도 변경 항등식을 사용한다. 여기에는 현재 정책이 양수인 모든 곳에서 샘플링 밀도도 양수여야 한다는 조건이 포함된다. B.2 Extension: Adding a Trust-Region Regularizer는 큰 정책 변화를 억제하는 페널티를 추가하고 로그 정책 비율 항으로 advantage를 수정한다. B.3 PPO Clipping and the Stabilization Mask는 clipping을 적용한 대리 목적함수의 구간별 도함수가 신뢰 범위를 넘어 불리한 방향으로 이루어지는 갱신을 어떻게 억제하는지 보여준다.
짧은 생각
HPT는 구체적인 학습 실패에 간단히 대응한다. Qwen의 기본 gate에서 어떤 질문에 대해 샘플링한 정답 응답을 전혀 얻지 못하면, 시연이 학습 신호를 제공한다. Backbone 3개의 결과, 각 방법만 해결한 문제의 분석, 임계값 ablation은 이 설계를 뒷받침한다. 다만 이진 gate가 편향된 gradient 추정값을 최적으로 결합한다는 점까지 입증하지는 않는다. 재현하려면 GRPO와 Dr. GRPO의 설명 차이를 해소하고 학습 데이터 파이프라인을 명시하며 gate 수식에 따라 임계값의 경계를 해석해야 한다. 높은 엔트로피, 긴 응답, 큰 k에서의 성공은 행동에 관한 상호 보완적인 근거를 제공하지만 특정 추론 메커니즘이 유지된다는 점을 직접 입증하지는 않는다. 공통 정규화 목적함수도 각 구성 gradient가 모두 같은 방향임을 보장하지 않는다.