


Towards General Agentic Intelligence via Environment Scaling 요약 설명
16 Sep 2025 | Paper Review Environment Scaling Tool Use Supervised Fine-Tuning목차
이번 글에서는 Towards General Agentic Intelligence via Environment Scaling 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 16일(Arxiv)
- Fang, Runnan, Cai, Shihao, Li, Baixuan, Wu, Jialong, Li, Guangyu, Yin, Wenbiao, Wang, Xinyu, Wang, Xiaobin, Su, Liangcai, Zhang, Zhen, et al.
- Tongyi Lab, Alibaba Group
- 논문 링크
요약
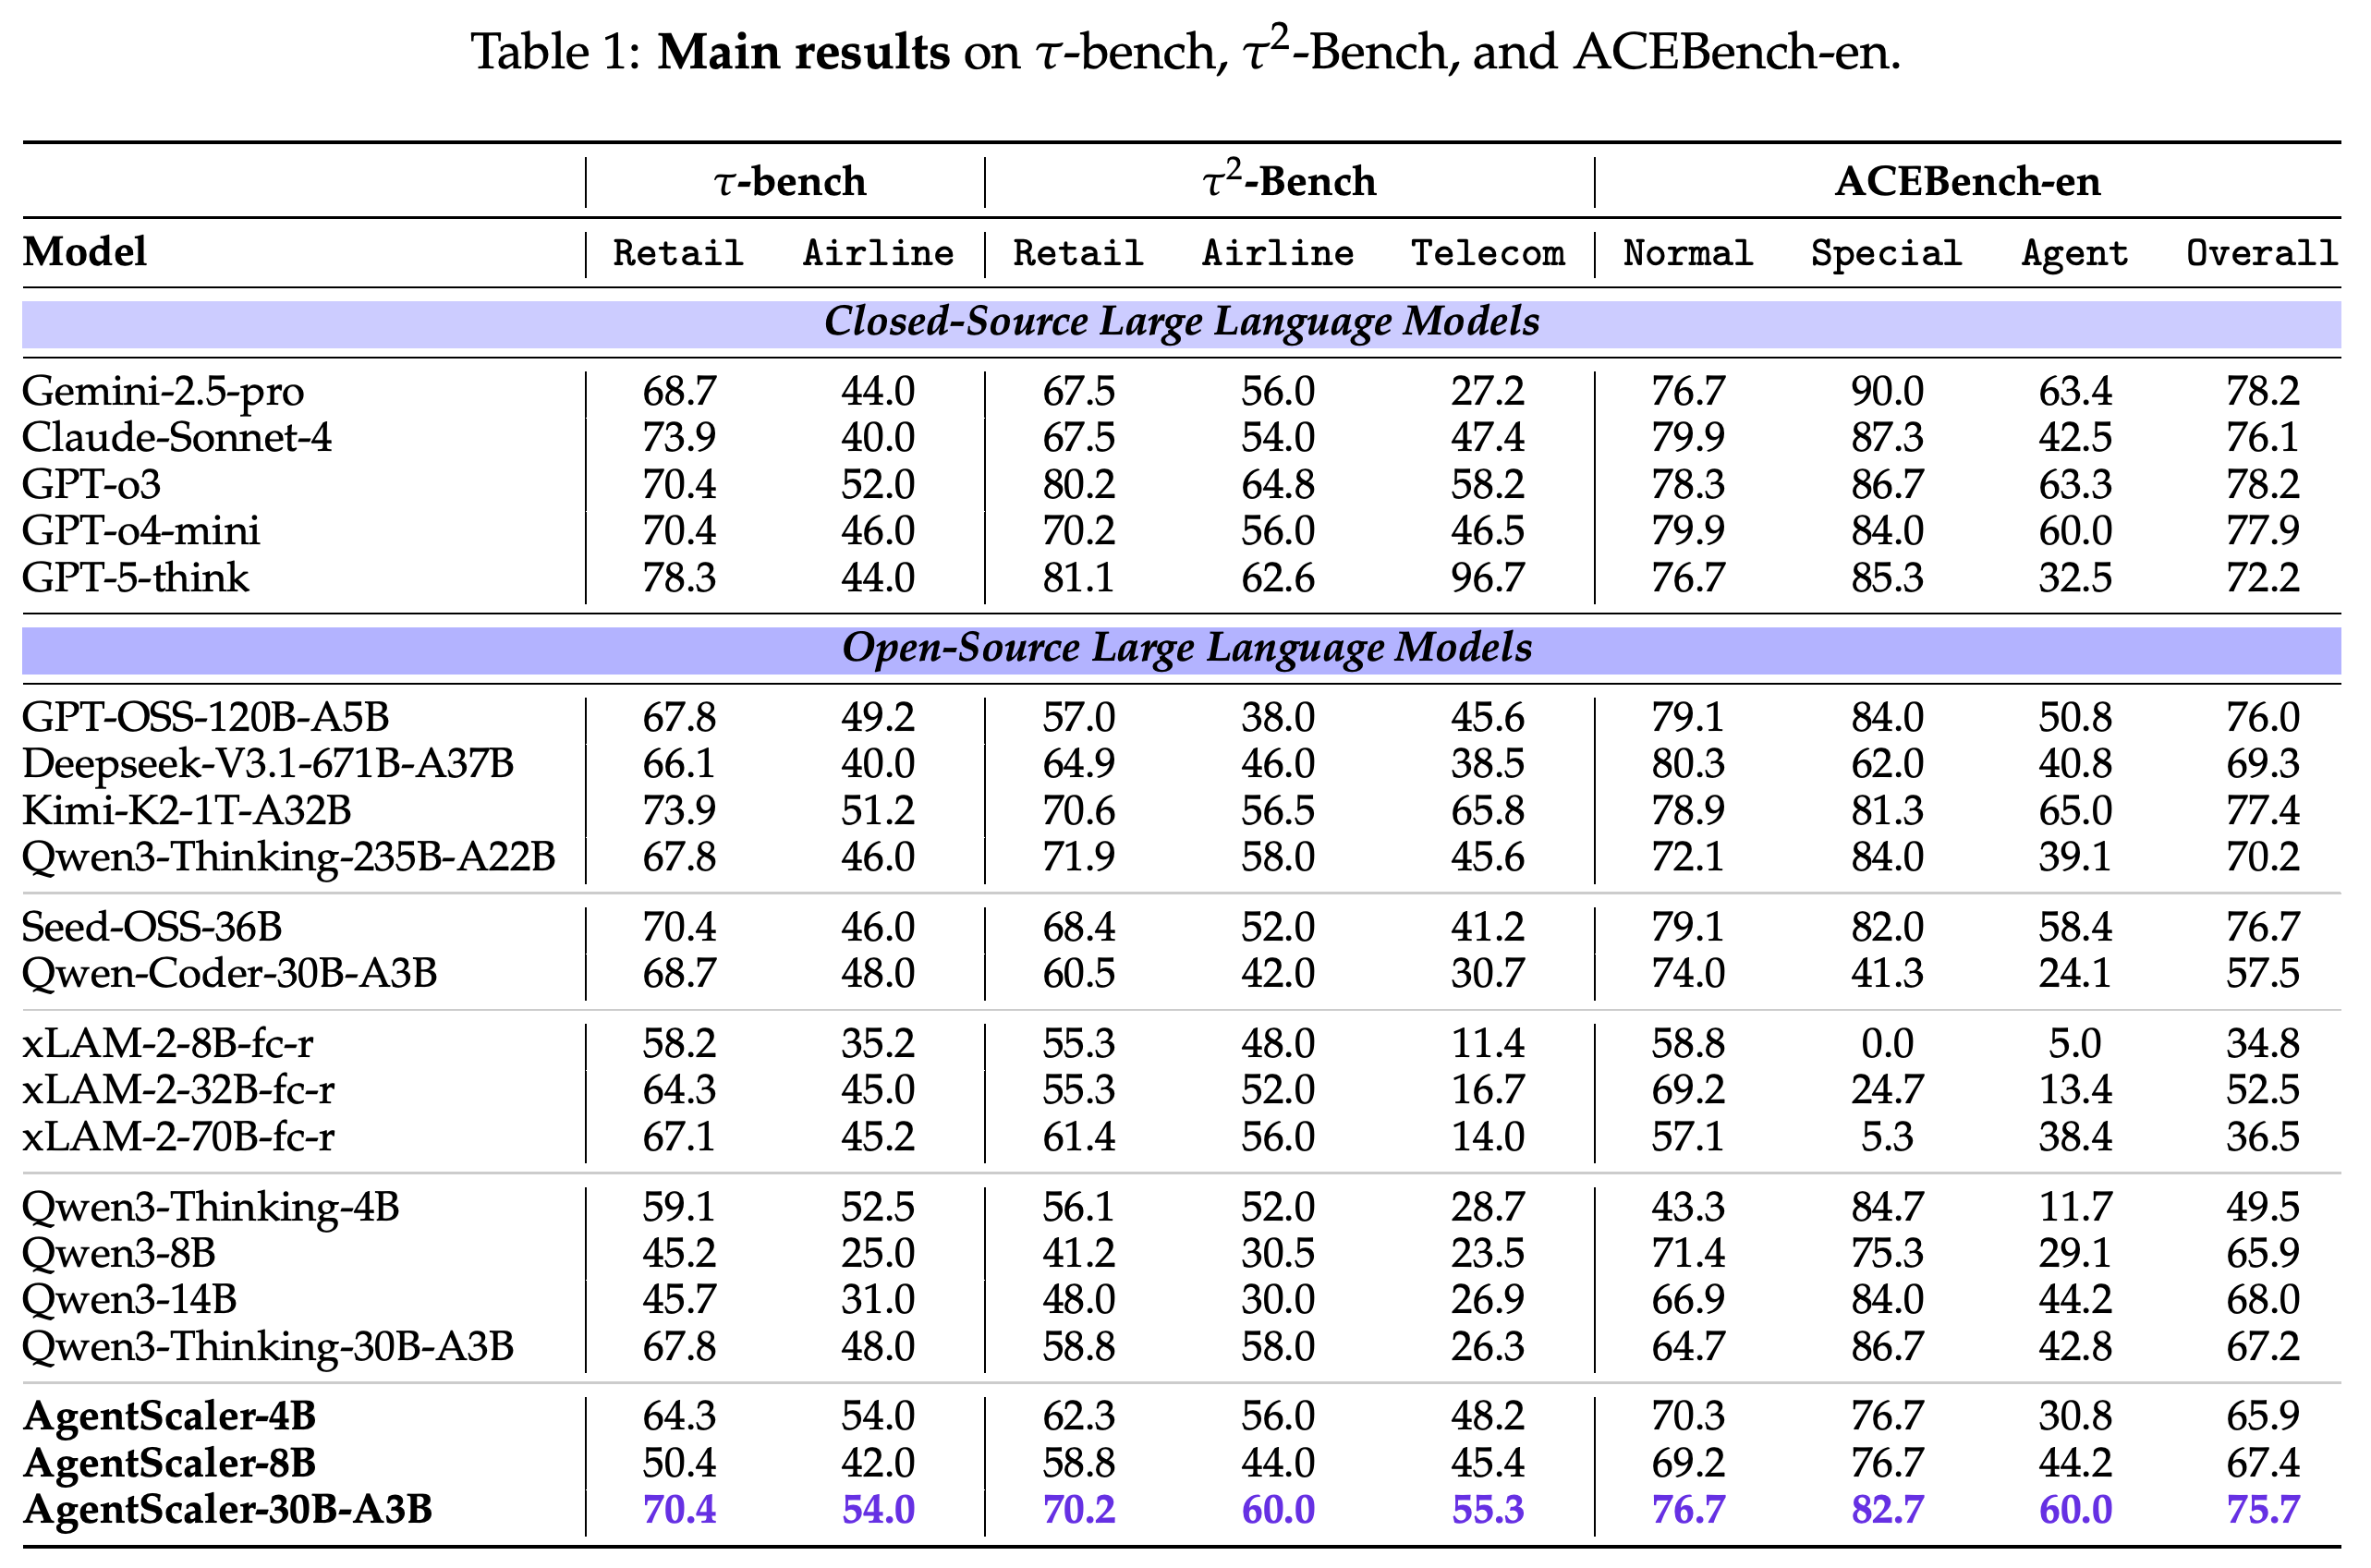
- 언어 에이전트에는 function calling, 즉 지정된 인자로 도구를 실행하는 능력을 학습할 검증 가능한 상호작용 데이터가 부족하다. 논문의 평가 절차에서 AgentScaler-30B-A3B는 영어 도구 사용 벤치마크인 ACEBench-en의 전체 정확도를 학습 출발점인 백본 Qwen3-Thinking-30B-A3B의 67.2에서 75.7로 높인다. 대화형 도구 사용 벤치마크인 τ²-Bench에서는 telecom 성능을 26.3에서 55.3으로 높인다.
- 이 파이프라인은 도구로 제공되는 응용 프로그램 인터페이스인 API 30,000개 초과를 1,000개 초과의 도메인으로 분류하고 각 연산을 데이터베이스 상태에 작용하는 실행 가능한 Python 코드로 구현한다. 모의 사용자와 에이전트의 상호작용은 대화의 유효성, 최종 상태의 일치 여부, 도구 호출의 정확한 일치 여부로 필터링한다. 이후 검증을 통과한 어시스턴트 출력을 학습하는 2단계 지도 미세조정을 수행한다. 먼저 일반 도메인에서 학습하고 다음으로 전문 도메인에서 학습한다.
- 결과는 도구 사용 능력의 향상과 중국어 벤치마크인 ACEBench-zh로의 전이를 뒷받침하지만 개선 폭은 하위 평가 항목과 모델에 따라 다르다. 반복 시행의 신뢰성과 긴 도구 호출 시퀀스의 정확도에는 여전히 한계가 있다. 또한 Table 1만으로는 1T parameters, 즉 1조 개의 파라미터 미만인 오픈소스 모델 전반에서 선두라는 논문의 포괄적인 주장을 입증할 수 없다.
1 Introduction
서론은 실행된 도구 호출을 포함하는 상호작용 궤적, 즉 agentic data의 부족을 언어 에이전트 학습의 병목으로 지목한다. 기존 호출에 맞춰 사용자 질의를 생성하는 역방향 합성과 사용자 의도에서 시작해 상호작용을 모사하는 순방향 합성을 구분하며 저자들은 현실적인 데이터 생성과 환경의 자동 구축이 여전히 어렵다고 주장한다. 이 연구는 확장 가능한 실행 환경, 필터링을 거친 경험 수집, AgentScaler 학습을 결합한다. 모델 규모는 4B, 8B, 30B-A3B다. 여기서 B는 파라미터 수를 billions 단위로 나타낸다.
2 Environment Build and Scaling
이 설계는 함수 호출을 환경의 데이터베이스를 조회하는 읽기 연산이나 상태를 바꾸는 쓰기 연산으로 다룬다. 읽기와 쓰기 구조가 비슷한 도구는 저장 상태의 구조를 정의하는 도메인별 데이터베이스 스키마를 공유한다. 따라서 환경 구축은 도구를 도메인으로 나누고 각 도메인에 데이터베이스 스키마와 실행 가능한 도구를 배정하는 문제로 정리된다.
2.1 Environment Automatic Build
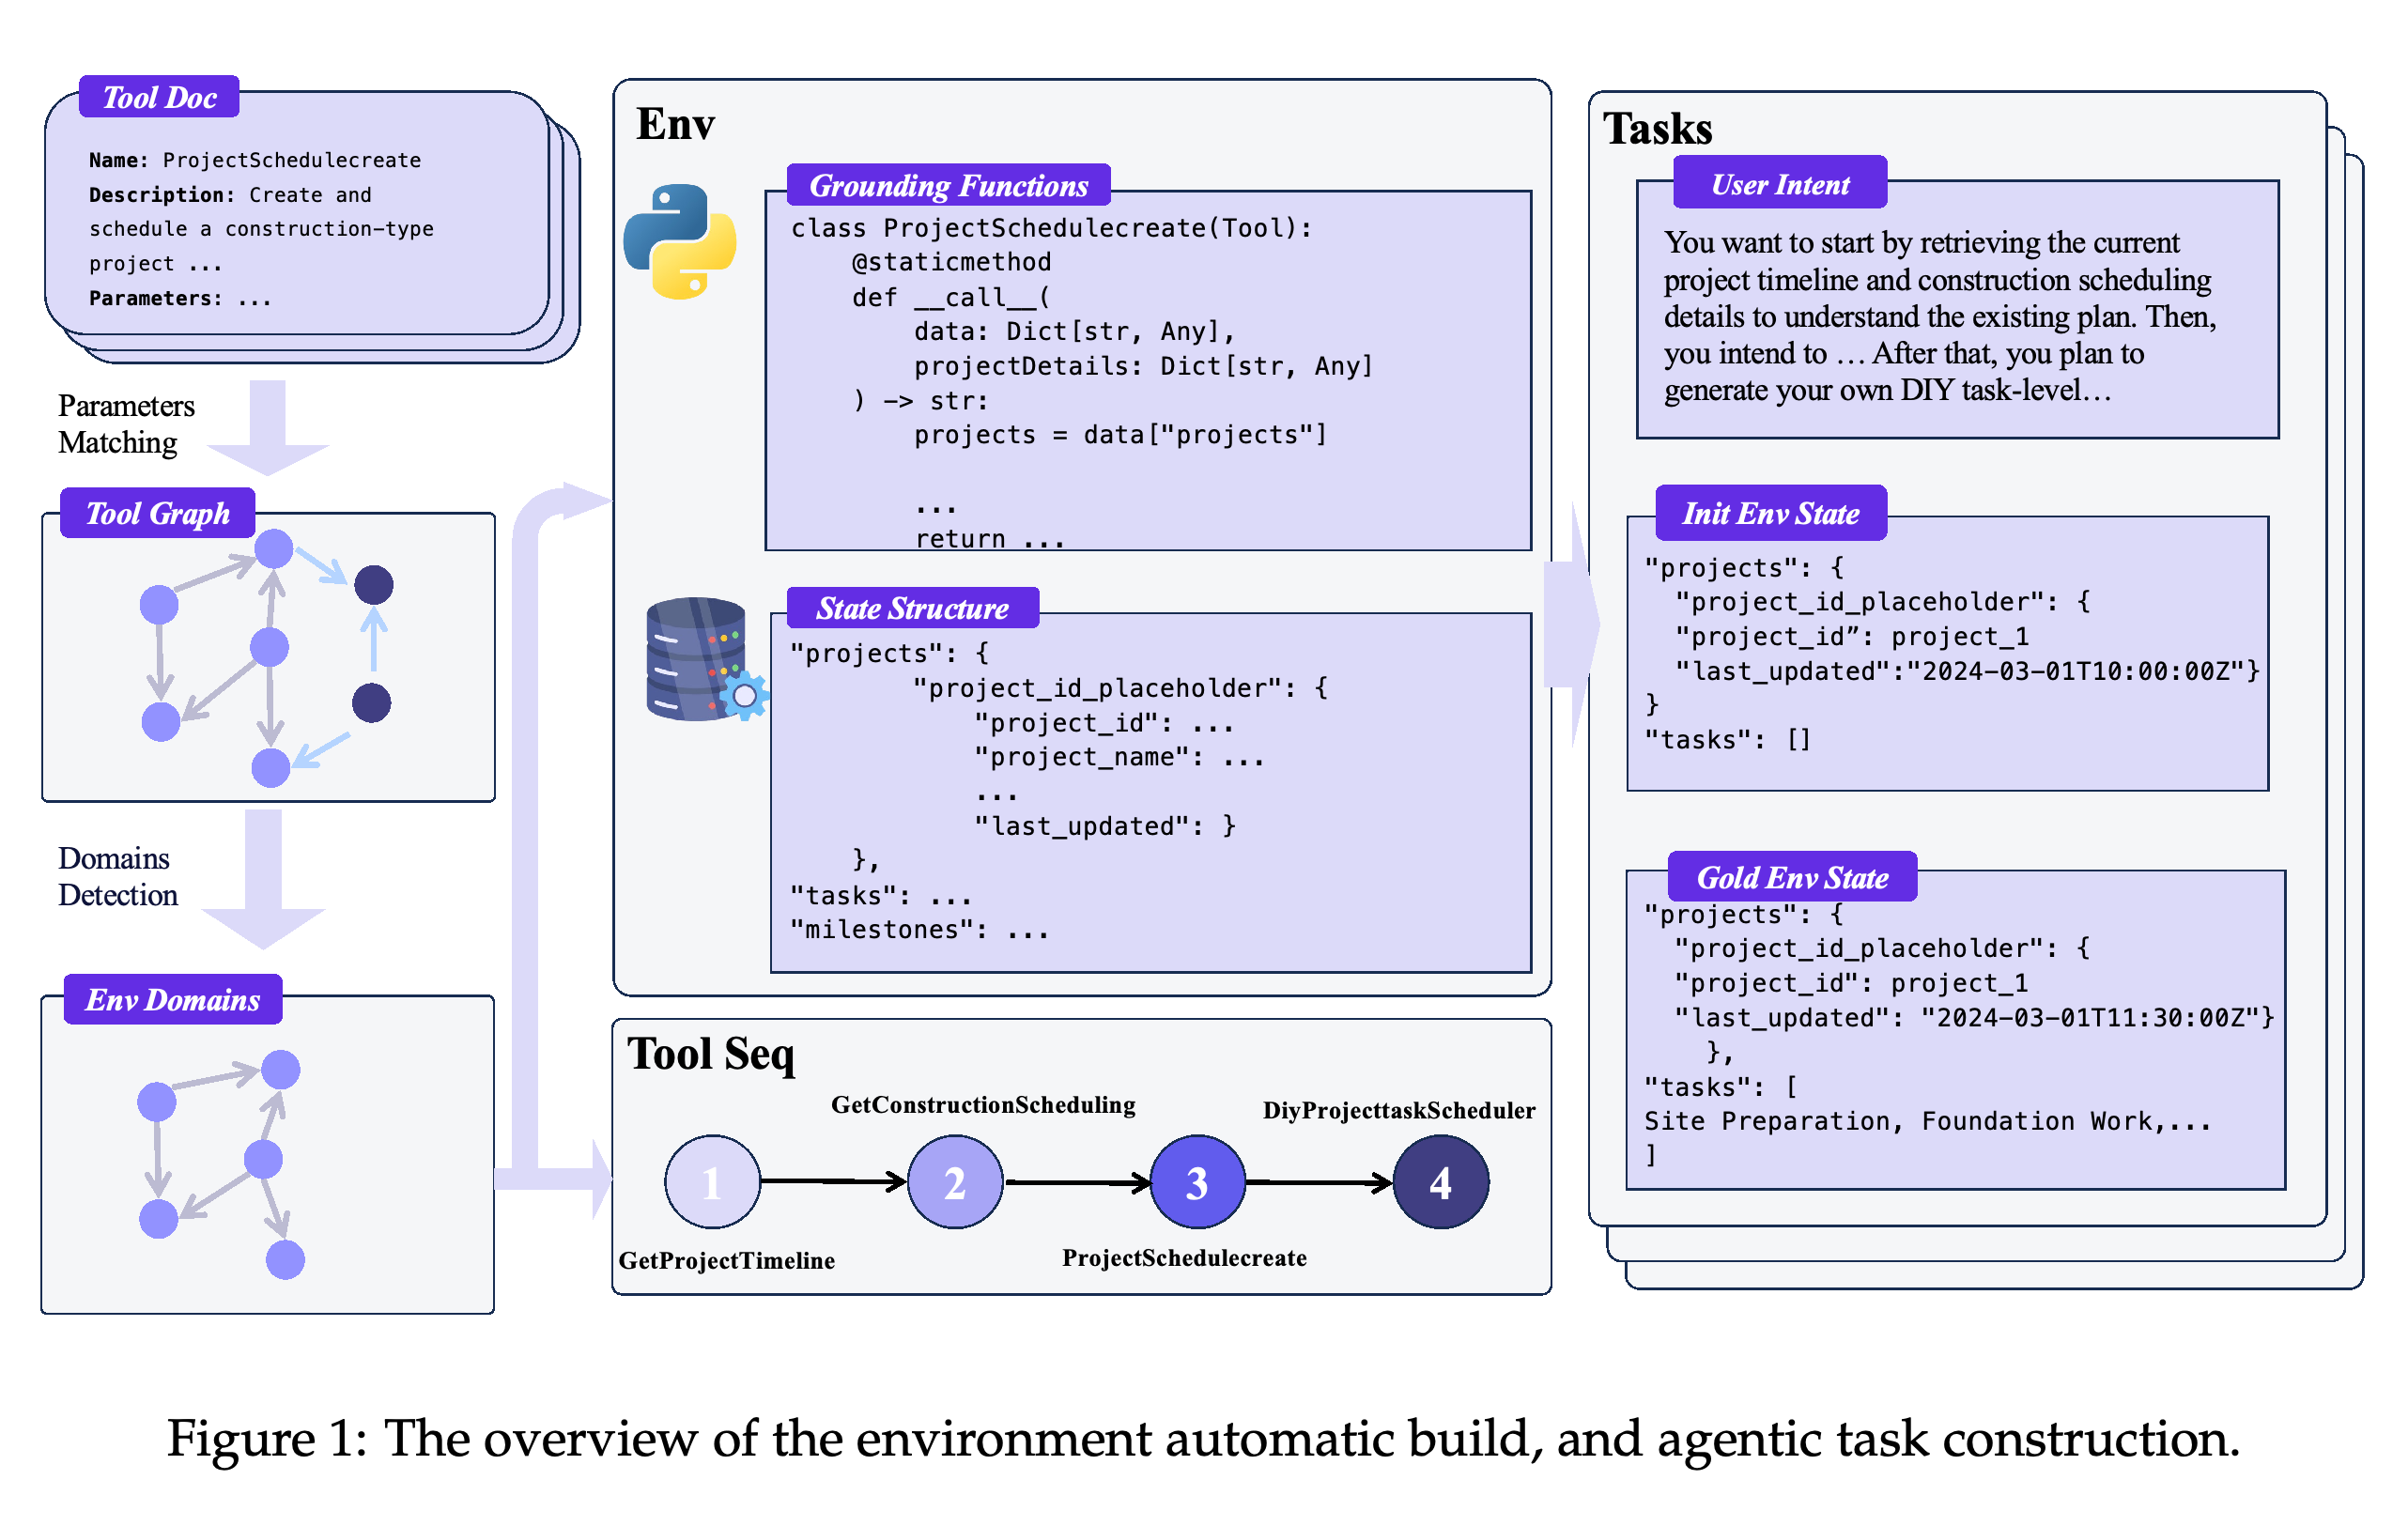
저자들은 기존 도구와 function calling 데이터를 제공하는 ToolBench, API-Gen과 내부 저장소에서 API 30,000개 초과를 수집한다. 품질이 낮은 도구를 제거하고 일부 설명에는 명시적인 입출력 명세를 추가한다. 파라미터 벡터의 정렬 정도를 나타내는 코사인 유사도를 미리 정한 임계값과 비교해, 연결 가능한 도구 조합을 간선으로 나타내는 도구 의존성 그래프를 구축한다. 그래프 군집화 방법인 Louvain 커뮤니티 탐지로 도메인을 식별하고 대규모 언어 모델로 각 도메인 내부의 의존성을 확인한다. 이렇게 얻은 1,000개 초과의 도메인에 데이터베이스 구조와 Python 도구 구현을 생성해 Figure 1의 실행 환경을 구성한다.
이 도식은 도구 문서에서 의존성 그래프, 도메인 분할, 실행 가능한 함수, 데이터베이스 구조로 이어지는 과정을 보여준다. 구축 예시는 샘플링한 시퀀스로 사용자 의도, 초기 상태, 기준 최종 상태를 함께 생성하는 방법을 보여준다. 이 과정을 통해 실행하고 검증할 수 있는 과제를 생성한다.
2.2 Agentic Task Construction
과제를 생성할 때는 도메인별 데이터베이스 상태를 초기화하고 도구 그래프의 의존성 간선을 따라 이동하는 방향성 보행으로 도구 시퀀스를 샘플링한다. 무작위로 선택한 도구에서 시작해 최대 실행 길이에 도달하거나 나가는 간선이 없는 노드를 만나면 이동을 멈춘다. 이후 생성한 인자로 각 호출을 실행하고 상태 변화를 추적한다. 이렇게 얻은 기준 시퀀스와 최종 상태는 데이터베이스 상태의 일관성, 도구 호출의 정확한 일치라는 2가지 검증 기준을 제공한다.
3 Agent Experience Learning
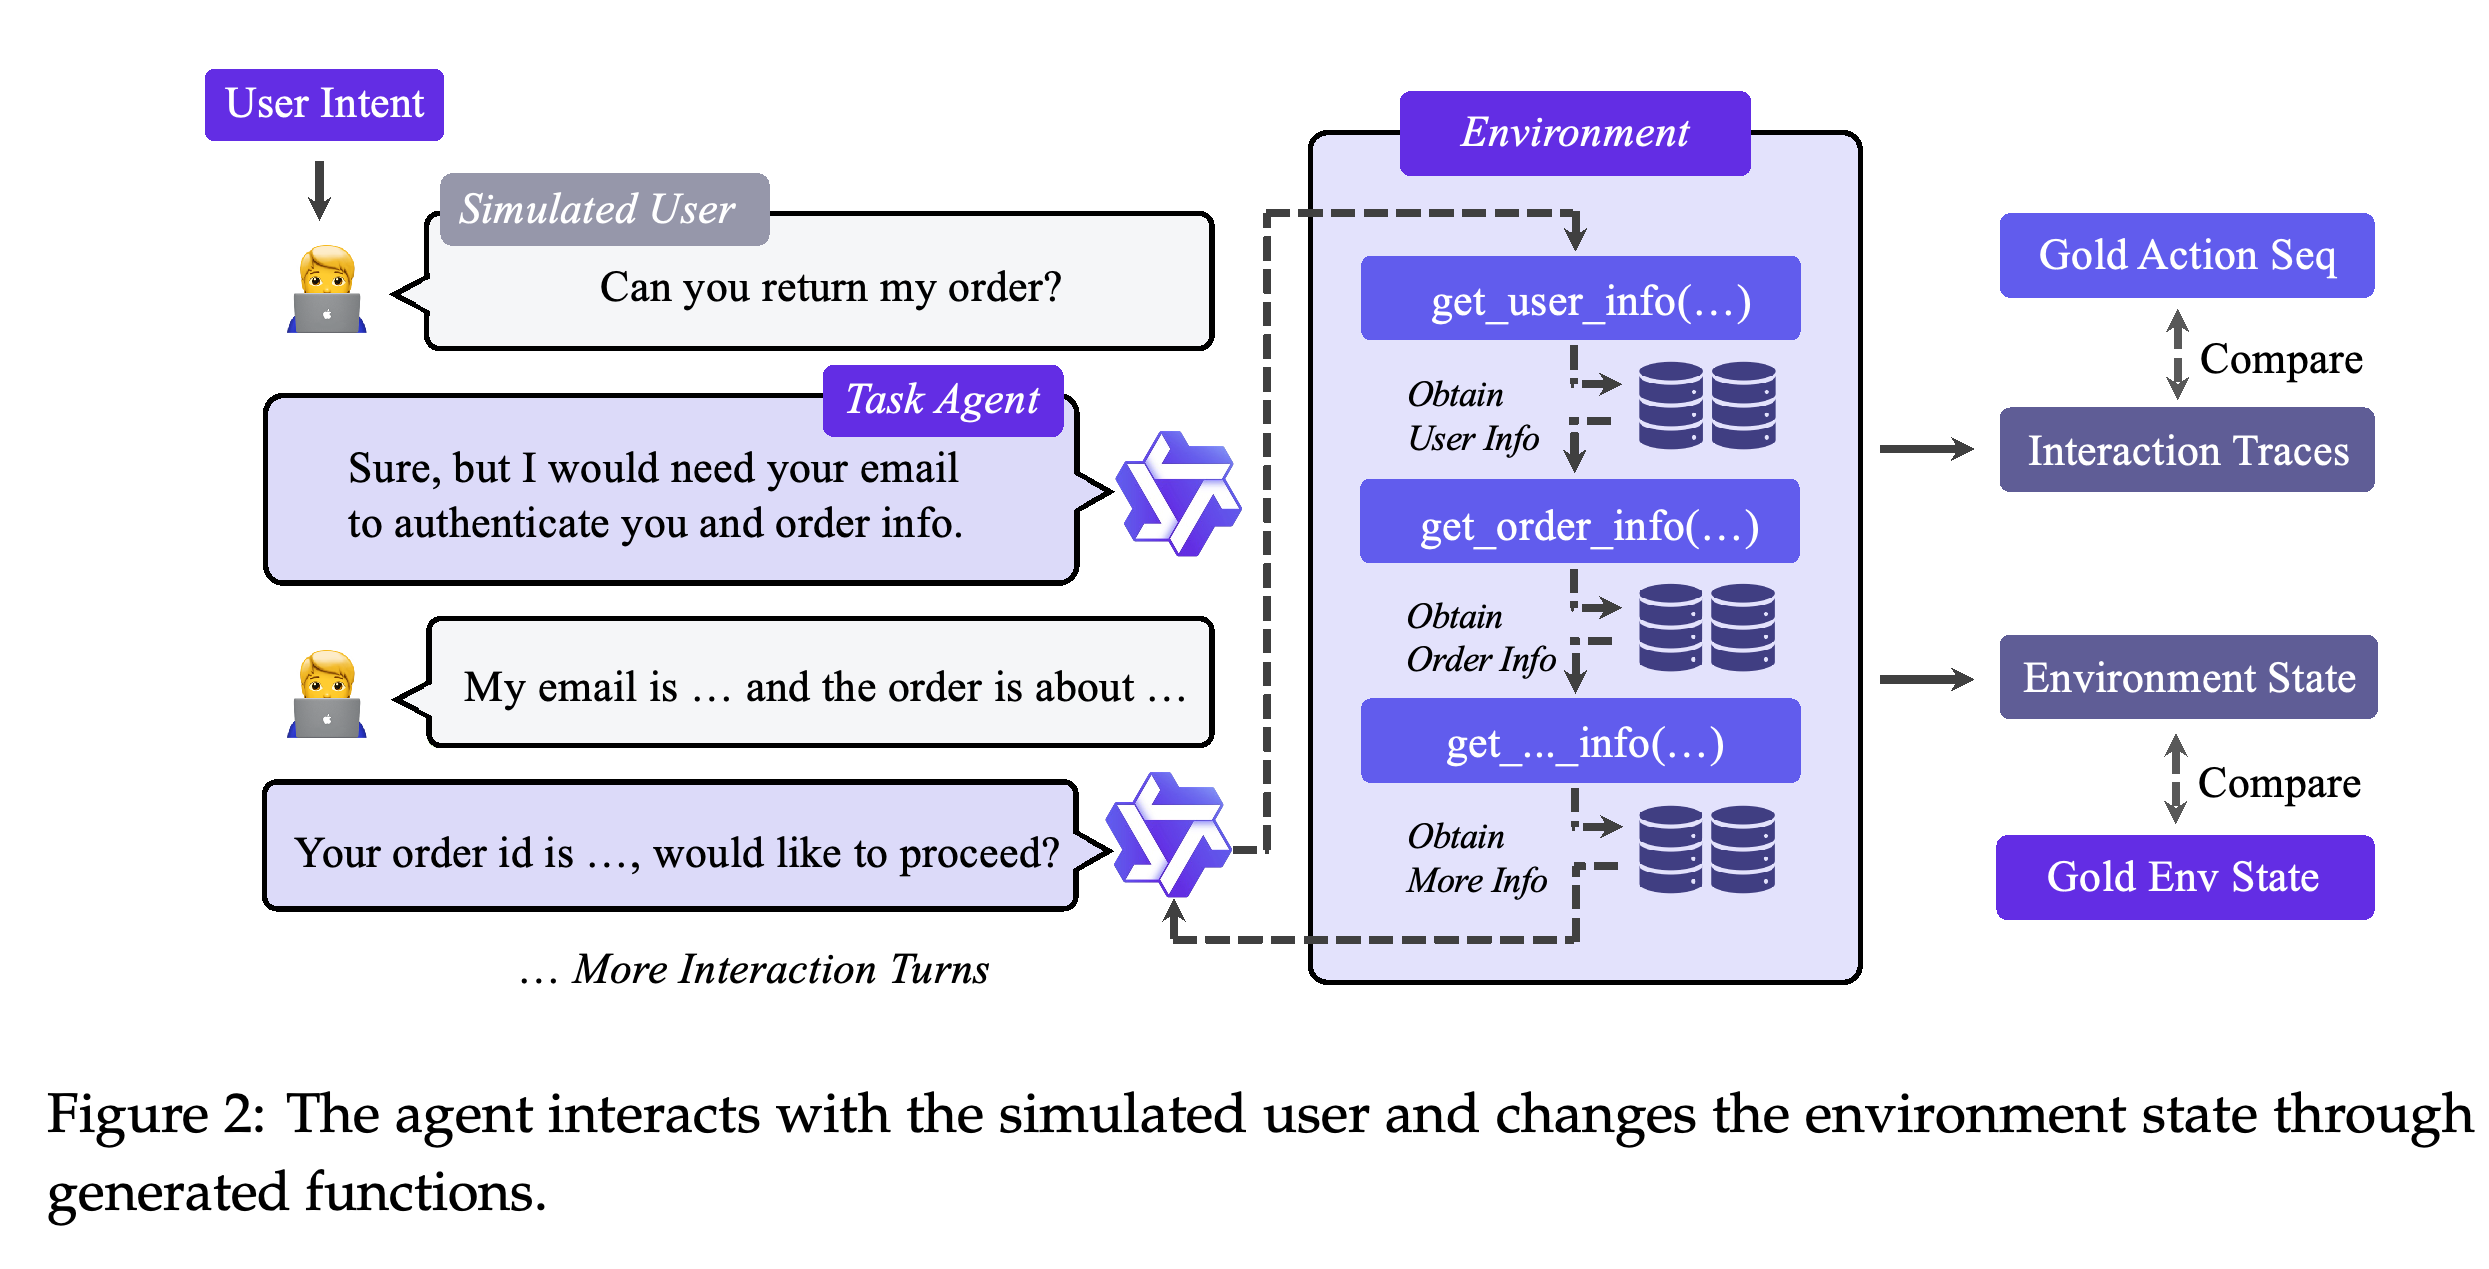
Agent Experience Learning은 전체 사용자 의도를 바탕으로 생성된 환경 안에서 모의 사용자와 에이전트가 상호작용하도록 한다. Figure 2는 상호작용 기록과 환경 상태를 기준 도구 시퀀스, 기준 최종 상태와 비교하는 과정을 보여준다. 검증을 통과한 경험은 2단계 학습에 사용된다.
상호작용 예시는 대화와 실행을 구분한다. 에이전트는 생성된 함수를 통해 정보를 얻고, 시스템은 실행 기록과 데이터베이스 상태를 저장한다. 이 기록과 상태를 각각 기준과 비교하는 과정은 파이프라인이 도구 시퀀스와 상태를 바꾸는 과제의 완료 여부를 함께 확인하는 방법을 설명한다.
3.1 Human–Agent Interplay for Experience Collection
모의 사용자는 주어진 의도를 달성하려 하고 에이전트는 도메인별 도구를 호출하며 모의 사용자가 과제를 완료했다고 판단할 때까지 상호작용을 이어간다. 필터링 과정에서는 형식이 잘못된 대화와 지나치게 반복되는 추론을 제거하고 기준 최종 데이터베이스 상태와의 일치 여부를 확인하며 도구와 인자의 정확한 일치 여부를 검사한다. 이 일치 검사는 특히 상태 변화만으로 성공 여부를 판단할 수 없는 읽기 전용 과제에 적용한다. 중간에 도구 오류가 발생해도 의도한 목표를 달성하고 해당 검사를 통과하면 그 궤적을 자동으로 탈락시키지 않는다.
3.2 Agentic Experience Learning
학습 손실은 어시스턴트가 생성한 도구 호출과 자연어 응답에 적용한다. 사용자 지시와 도구 응답은 마스킹해 손실 계산에서 제외하지만 문맥으로 유지한다. Stage 1에서는 폭넓은 도메인에서 일반적인 도구 선택, 인자 생성, 사용자 상호작용을 학습한다. Stage 2에서는 도메인별 요구사항이 있는 목표 응용 분야의 과제, 도구, 사용자 의도를 사용해 이 능력을 전문화한다.
4 Experiments
실험은 AgentScaler 계열을 Qwen3 백본 및 여러 오픈소스, 비공개 모델과 비교한다. 영어 평가를 수행하는 도구 사용 벤치마크 3개에서 성능을 보고하고 일반 도메인 학습과 전문화 학습을 순차적으로 적용했을 때 각 단계가 기여하는 정도를 살펴본다.
4.1 Setup
도구를 사용하는 사용자와 에이전트의 상호작용 벤치마크인 τ-bench는 retail과 airline 과제를 평가하며 τ²-Bench는 retail, airline, telecom을 평가한다. 논문은 단일 시행의 과제 성공률인 pass^1을 보고하고 동일 과제를 독립적인 k회 시행에서 모두 성공하는 지표인 pass^k를 분석한다. ACEBench-en은 Normal, Special, Agent 하위 항목의 정확도와 Overall 점수를 보고한다. AgentScaler-4B와 AgentScaler-30B-A3B는 각각 Qwen3-Thinking-4B-2507과 Qwen3-Thinking-30B-A3B-2507을 사용하며 AgentScaler-8B는 Qwen3-8B를 사용한다. 비교 대상에는 Gemini-2.5-pro, Claude-Sonnet-4, GPT-o3, GPT-o4-mini, GPT-5-think와 Table 1에 제시된 오픈소스 모델이 포함된다.
4.2 Experimental Results
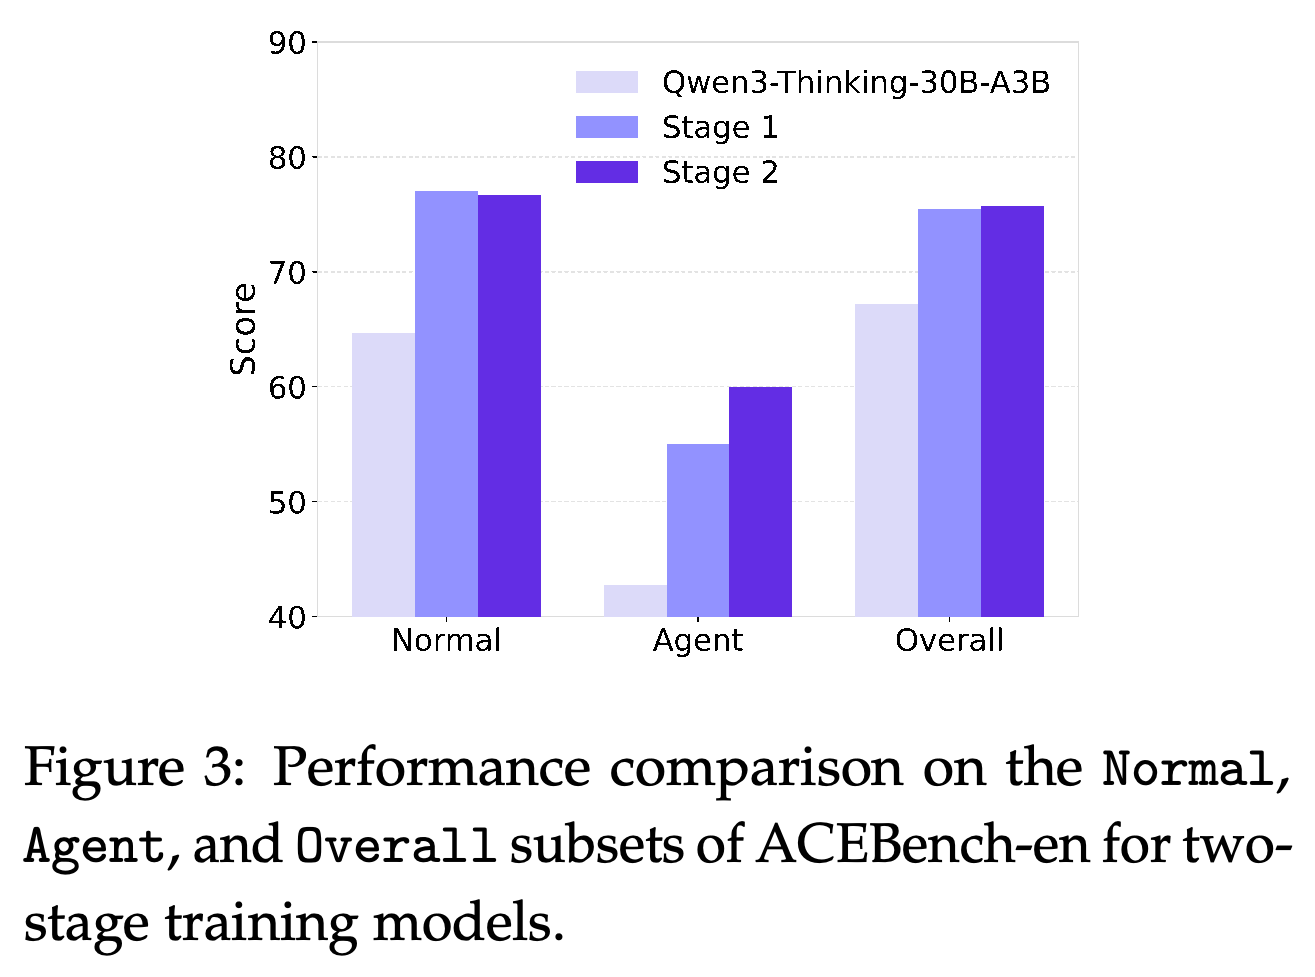
Table 1에서 AgentScaler-30B-A3B는 τ-bench의 retail과 airline에서 70.4와 54.0을 기록한다. τ²-Bench의 retail, airline, telecom에서는 70.2, 60.0, 55.3을, ACEBench-en Overall에서는 75.7을 기록한다. 이는 백본의 해당 점수인 67.8, 48.0, 58.8, 58.0, 26.3, 67.2보다 높지만 ACEBench-en Special 정확도는 86.7에서 82.7로 떨어진다. Figure 3에서는 전체 개선의 대부분이 Stage 1에서 발생하며 Stage 2는 전체 정확도를 거의 바꾸지 않으면서 Agent 하위 항목을 추가로 개선한다.
그룹 막대는 ACEBench-en의 Normal, Agent, Overall 항목에서 백본, Stage 1, Stage 2를 비교한다. Stage 1은 성능을 크게 높이고, Stage 2는 Overall보다 Agent에서 더 뚜렷한 추가 개선을 보인다. Normal 성능은 2단계에 걸쳐 일관되게 증가하지 않는다.
더 작은 모델도 ACEBench-en 전체 정확도가 향상된다. AgentScaler-4B는 백본의 49.5 대비 65.9를, AgentScaler-8B는 65.9 대비 67.4를 기록한다. 다만 4B 모델의 Special 점수는 84.7에서 76.7로, 8B 모델의 Normal 점수는 71.4에서 69.2로 떨어진다. Table 1에는 ACEBench-en Overall에서 76.7을 기록한 Seed-OSS-36B를 비롯해 더 높은 점수를 받은 1T parameters 미만의 오픈소스 모델이 여러 개 포함되므로, 논문의 포괄적인 최고 성능 주장은 범위를 한정해야 한다.
이 표는 AgentScaler 백본 대비 성능 향상을 보여주며, 특히 τ²-Bench telecom과 ACEBench-en Agent에서 개선이 크다. 동시에 핵심 주장의 범위를 제한하는 근거도 제시한다. AgentScaler-30B-A3B의 ACEBench-en 전체 점수 75.7은 GPT-OSS-120B-A5B의 76.0과 Seed-OSS-36B의 76.7보다 낮으며 일부 하위 항목의 점수는 학습 후 하락한다.
5 Analysis
Table 2는 학습 설정과 다른 평가 조건인 분포 외 설정에서 ACEBench-zh를 평가하며 학습한 모든 모델 규모에서 전체 점수가 향상되었다고 보고한다. 4B는 43.9에서 65.6으로, 8B는 71.3에서 73.7로, 30B-A3B는 74.2에서 81.5로 상승한다. 개선은 균일하지 않다. 4B와 30B-A3B의 Special 점수는 하락하고 8B의 Normal 점수도 하락한다. 이 결과는 보고된 전체 지표에서의 전이를 뒷받침하지만 모든 항목의 성능이 개선되었음을 입증하지는 않는다.
AgentScaler 모델 3개 모두 각 백본보다 ACEBench-zh 전체 정확도가 높다. 가장 큰 전체 개선 폭은 4B의 21.7 points다. 다만 4B와 30B-A3B의 Special, 8B의 Normal에서는 점수가 하락하므로 전이 효과는 하위 항목에 따라 다르다.
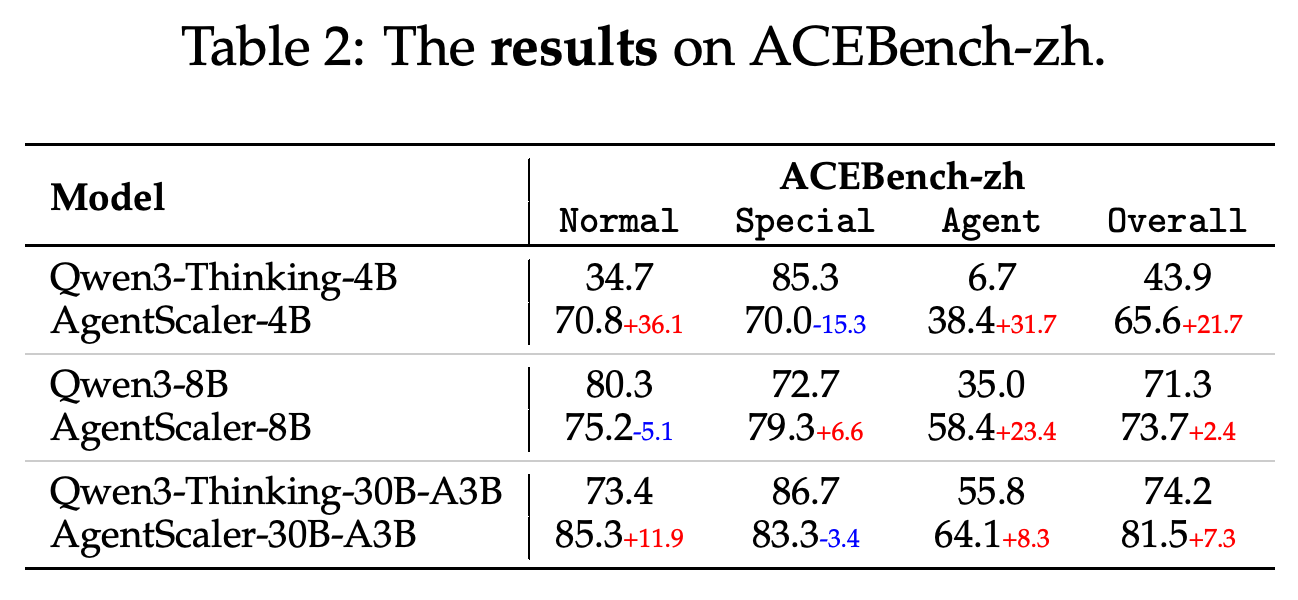
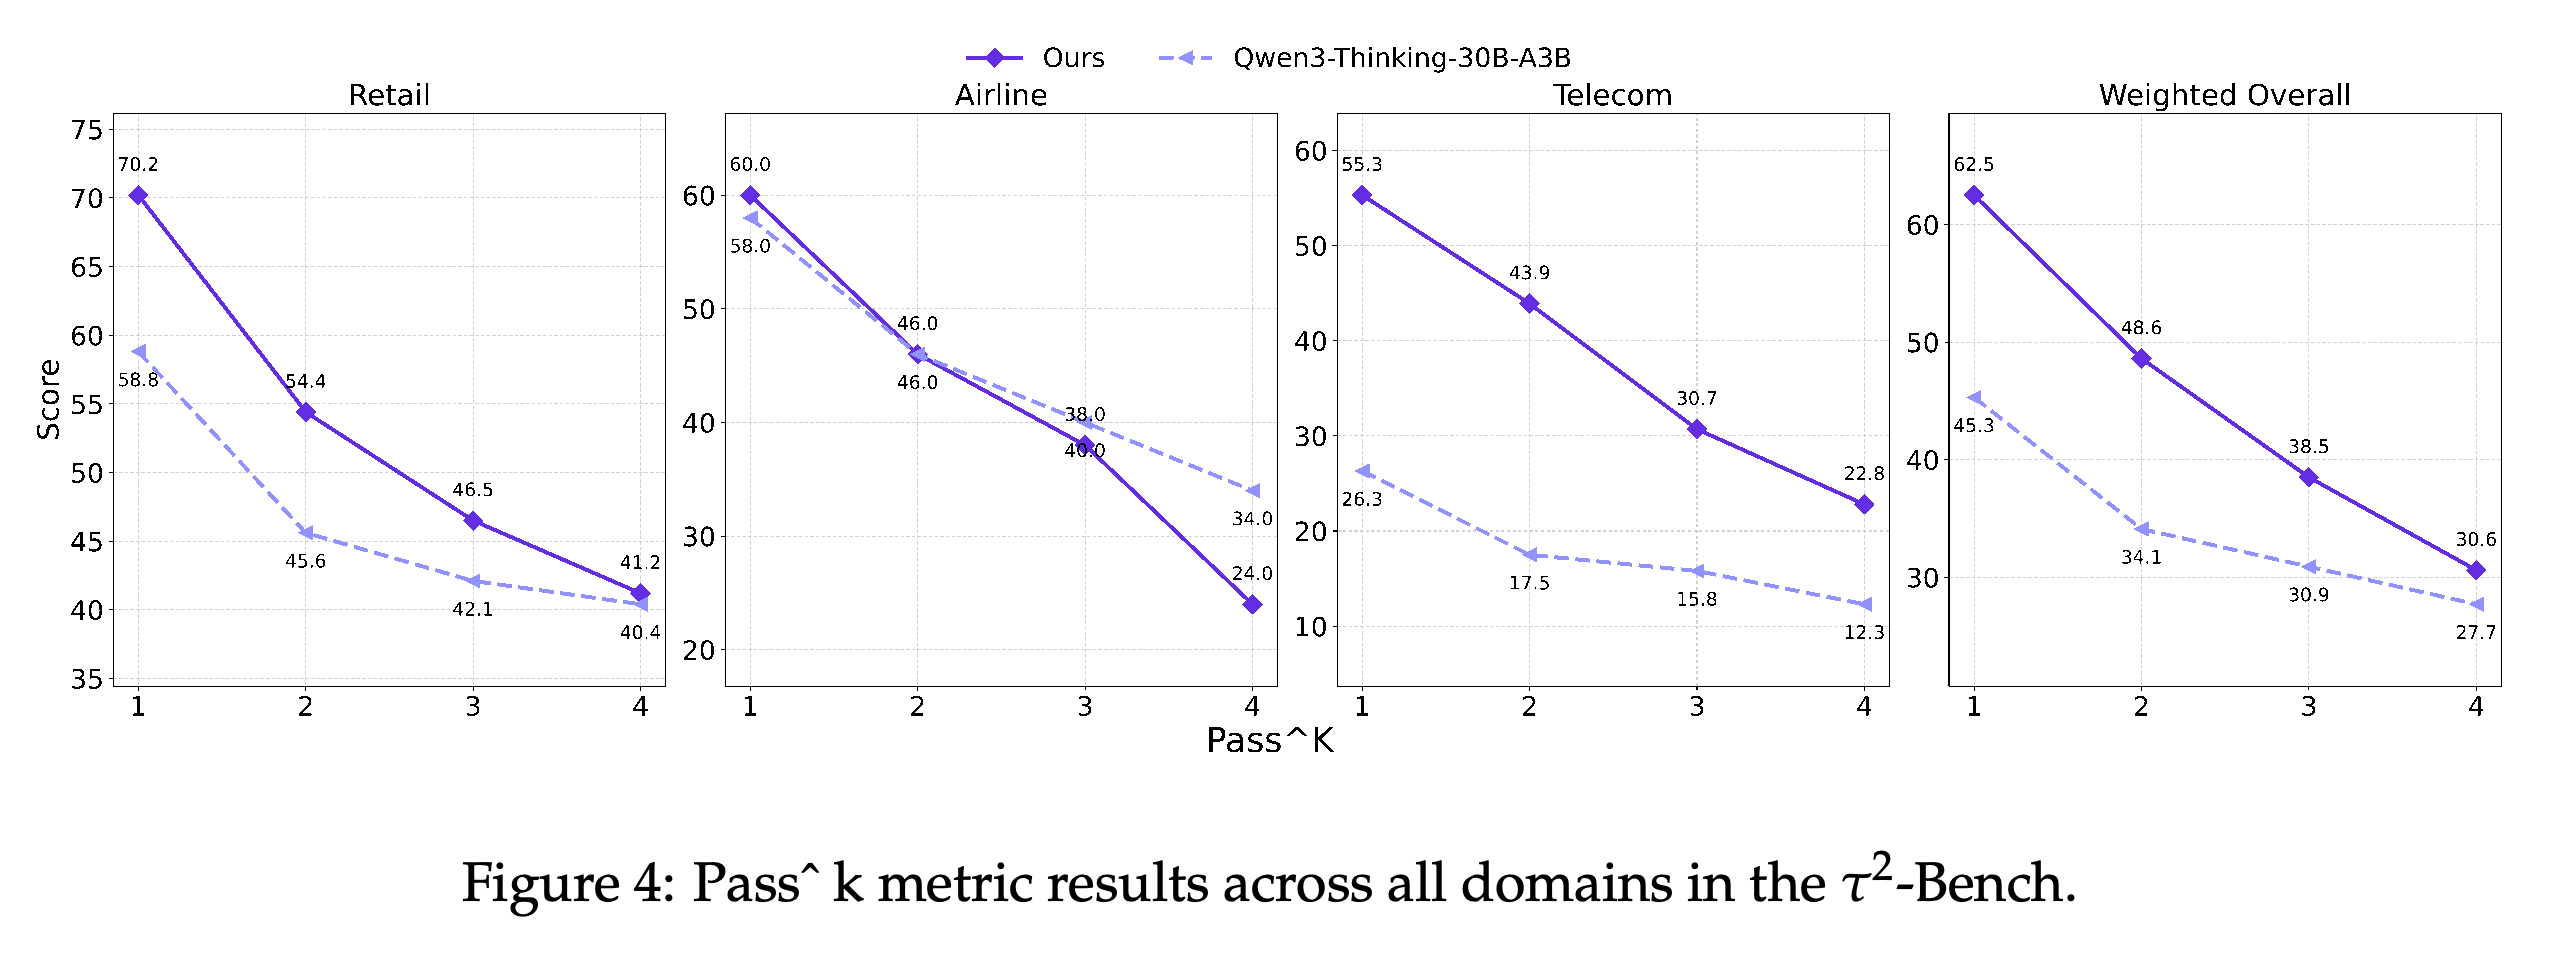
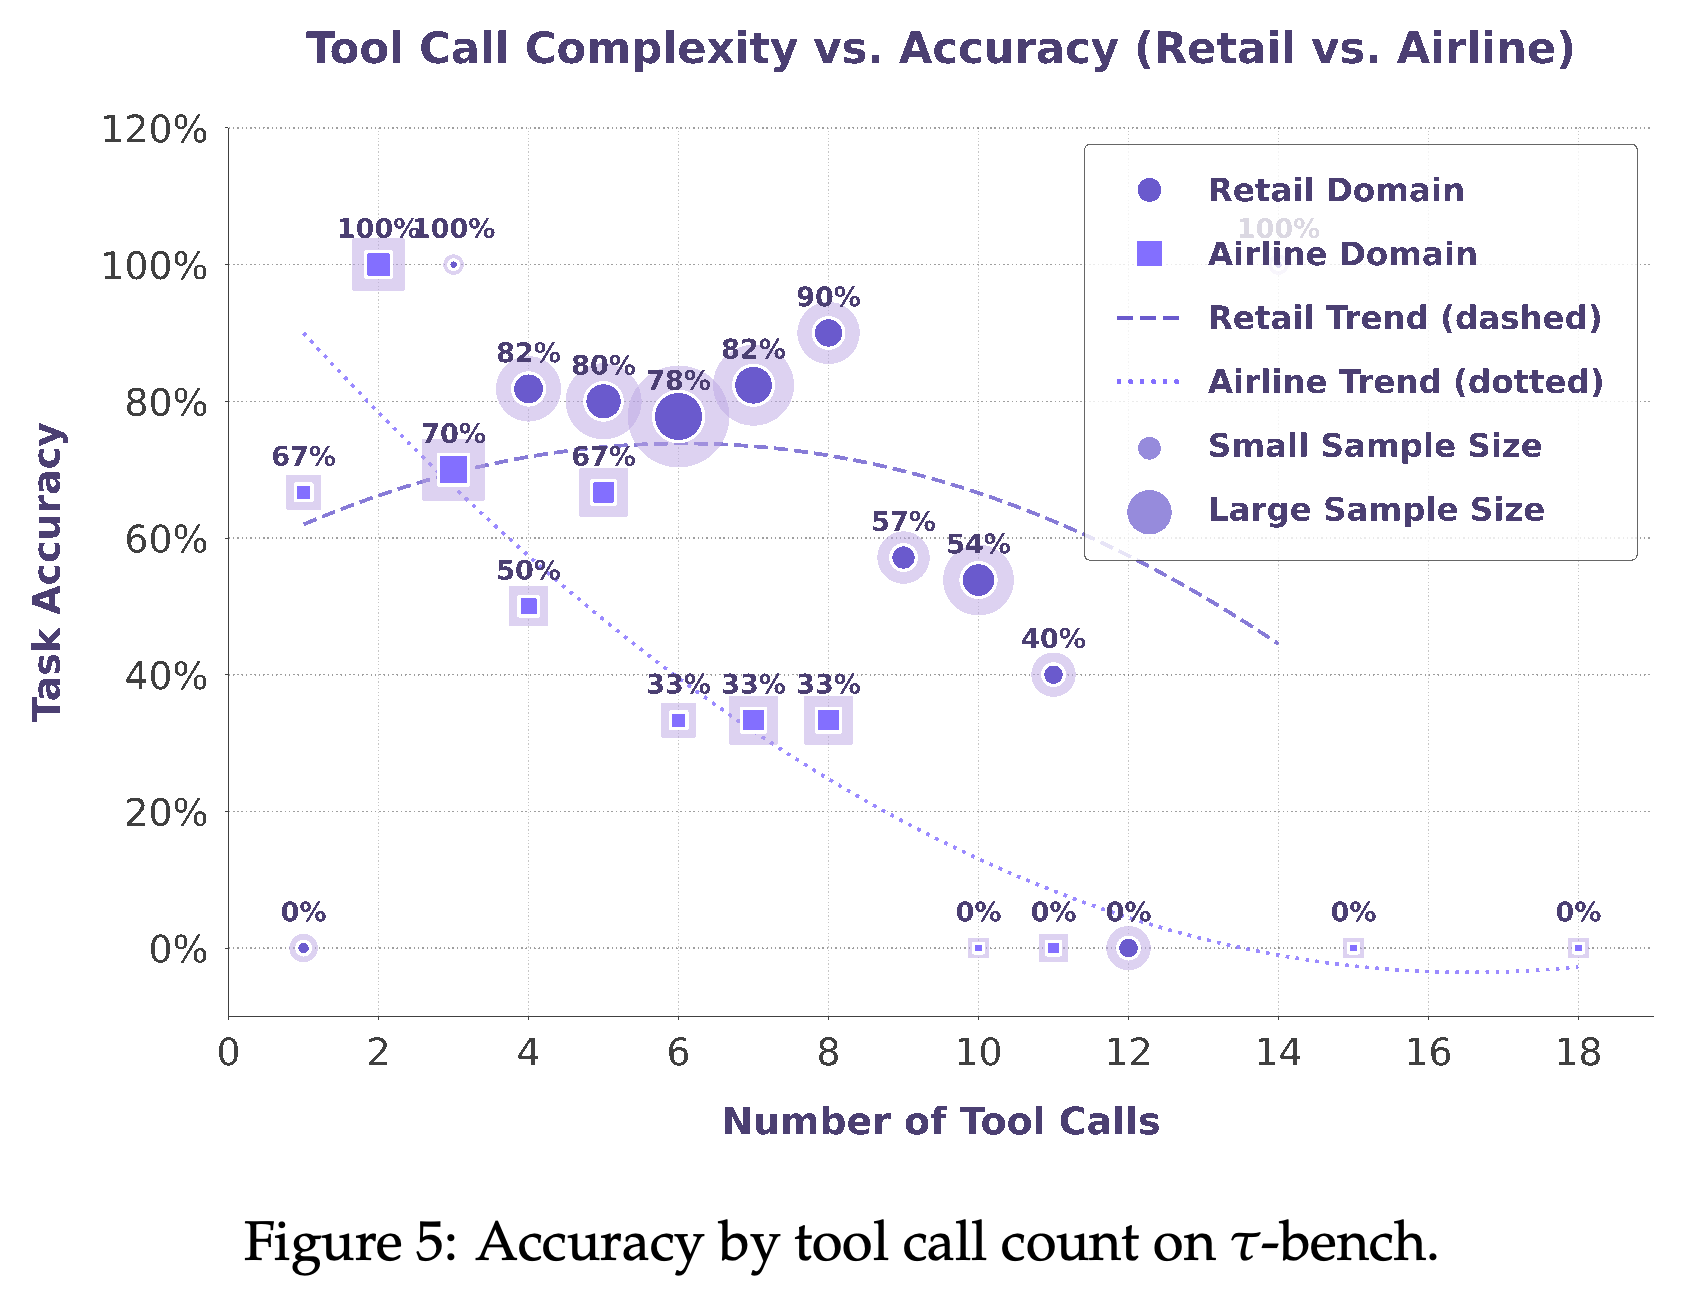
Figure 4에서 AgentScaler-30B-A3B는 k = 1, 2, 3, 4 모두에서 백본보다 높은 가중 전체 pass^k 점수를 기록하지만 성공 조건이 엄격해질수록 점수가 62.5에서 30.6으로 떨어진다. 도메인별로는 항상 우세하지 않다. airline의 k = 4에서 AgentScaler는 24.0을 기록해 백본의 34.0보다 낮다. Figure 5에서도 도구 호출 시퀀스가 길어질수록 정확도가 하락한다. 긴 호출 연쇄를 성공적으로 실행하는 장기 도구 사용 문제는 여전히 해결되지 않았다.
가중 전체 성능은 반복 시행의 성공 조건 4개 모두에서 백본보다 높다. AgentScaler 점수는 62.5에서 30.6으로, 백본 점수는 45.3에서 27.7로 떨어진다. 도메인별 곡선은 이러한 우세가 모든 조건에서 성립하지 않음을 보여준다. AgentScaler의 airline 점수는 k = 3과 k = 4에서 백본보다 낮다.
이 산점도는 retail과 airline에서 도구 호출 수와 과제 정확도의 관계를 보여주며, 마커 크기는 상대적인 표본 수를 나타낸다. 호출 수가 늘수록 데이터에 맞춘 추세선이 하락하며 특히 airline에서 하락이 뚜렷하다. 다만 마커 크기가 다르고 정확도가 높은 개별 점도 있으므로, 이 그림은 관찰된 연관성을 뒷받침하며 통제된 인과 효과를 입증하지는 않는다.
6 Related Work
관련 연구는 환경 구축과 도구 사용 학습 방법을 구분해 논의한다. 이 연구는 자동으로 구축한 실행 환경과 검증 가능한 상태 변화를 통해 합성 상호작용 데이터를 필터링한다는 점을 기여로 제시한다.
6.1 Tool-Use Environments
논문은 실제 도구 환경, 언어 모델이 생성한 도구 응답, 데이터베이스나 상태 파일에 기반한 오프라인 실행 환경을 구분한다. 실제 서비스에는 비용과 가용성 제약이 있고, 생성된 응답에는 환경이 뒷받침하지 않는 출력을 만드는 환각과 일관성 문제가 있으며 수동으로 구축한 오프라인 환경에는 확장성 한계가 있다고 설명한다. 제안한 대안은 도구 그래프 샘플링과 규칙 기반 검증을 사용해 환경과 과제 구축을 자동화한다.
6.2 Tool Learning
논문은 xLAM과 ToolAce 같은 합성 데이터 방법, 선호하는 상호작용 궤적과 선호하지 않는 궤적에서 학습하는 DiaTool-DPO의 직접 선호 최적화, 상호작용 피드백을 통해 최적화하는 Tool-RL과 Tool-N1의 강화학습을 검토한다. 이러한 접근에는 안정적인 실행 환경이 필요하다고 주장하며 Kimi-K2가 여러 턴의 데이터를 합성하기 위해 도구 시뮬레이터를 사용하는 방식도 다룬다. AgentScaler는 지도학습 전에 데이터베이스 상태 변화와 기준 도구 시퀀스로 수집한 상호작용을 검증한다.
7 Conclusion
결론은 데이터베이스에 기반한 실행 도구, 검증 가능한 상호작용 궤적, 2단계 경험 학습을 언어 에이전트의 도구 사용 능력을 개선하는 파이프라인으로 연결한다. 벤치마크 표는 평가한 백본 대비 개선을 뒷받침하지만 일부 비교 모델이 더 높은 점수를 기록하므로 포괄적인 선두 주장은 범위를 한정해야 한다. 강화학습, 더 다양한 모달리티, 실제 환경 배포는 향후 연구 방향으로 제안되며, 평가된 성과는 아니다.
Limitation
Lack of Reinforcement Learning에서 저자들은 일반 도메인 학습과 전문화 학습으로 구성된 지도 미세조정만 사용했으며 모의 환경에서의 강화학습은 향후 과제로 남겼다고 인정한다. Model Scale에서는 200B를 넘거나 파라미터 수가 1,000,000,000,000에 이르는 모델을 포함해 30B보다 큰 규모의 검증이 없다는 점을 한계로 제시한다. 이 문단은 30B 규모의 아키텍처만 검증했다고 서술하지만 실험에는 4B와 8B 모델도 포함된다. 따라서 근거가 뒷받침하는 한계는 학습한 가장 큰 모델이 30B-A3B라는 점이다.
부록
- 제공된 14페이지 PDF에는 부록이 없으며 11–14페이지에는 References가 있다. 논문 식별자는 arXiv:2509.13311v1이며, 프로젝트 링크로 https://tongyi-agent.github.io/blog 와 https://github.com/Alibaba-NLP/DeepResearch 를 제공한다.
짧은 생각
구체적인 검증 방식은 유용하다. 실행 가능한 도구는 상태 변화를 드러내고, 기준 호출 시퀀스는 최종 상태 검사로 구별할 수 없는 읽기 전용 과제에 감독 신호를 제공한다. 실험 결과는 벤치마크에서 도구 사용 능력이 향상되었음을 뒷받침하지만 환경 수를 통제하며 늘리는 실험을 보고하지 않았으므로 환경 다양성을 개선의 원인으로 분리해 확인할 수는 없다. 학습 데이터 수, 최적화 설정, 생성 비용, 측정된 지연 시간이 보고되지 않아 재현과 배포 가능성을 평가하는 데 제약이 있다. 하위 항목의 성능 하락과 긴 호출 시퀀스의 실패도 일반적인 에이전트 지능을 달성했다는 주장을 제한한다.