


LIMI: Less is More for Agency 요약 설명
22 Sep 2025 | Paper Review LLM Agents Data Curation Supervised Fine-Tuning목차
이번 글에서는 LIMI: Less is More for Agency 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 22일(Arxiv)
- Xiao, Yang, Jiang, Mohan, Sun, Jie, Li, Keyu, Lin, Jifan, Zhuang, Yumin, Zeng, Ji, Xia, Shijie, Hua, Qishuo, Li, Xuefeng, et al.
- SJTU, SII, PolyU, USTC, GAIR
- 논문 링크
- Github
- Project Page
요약
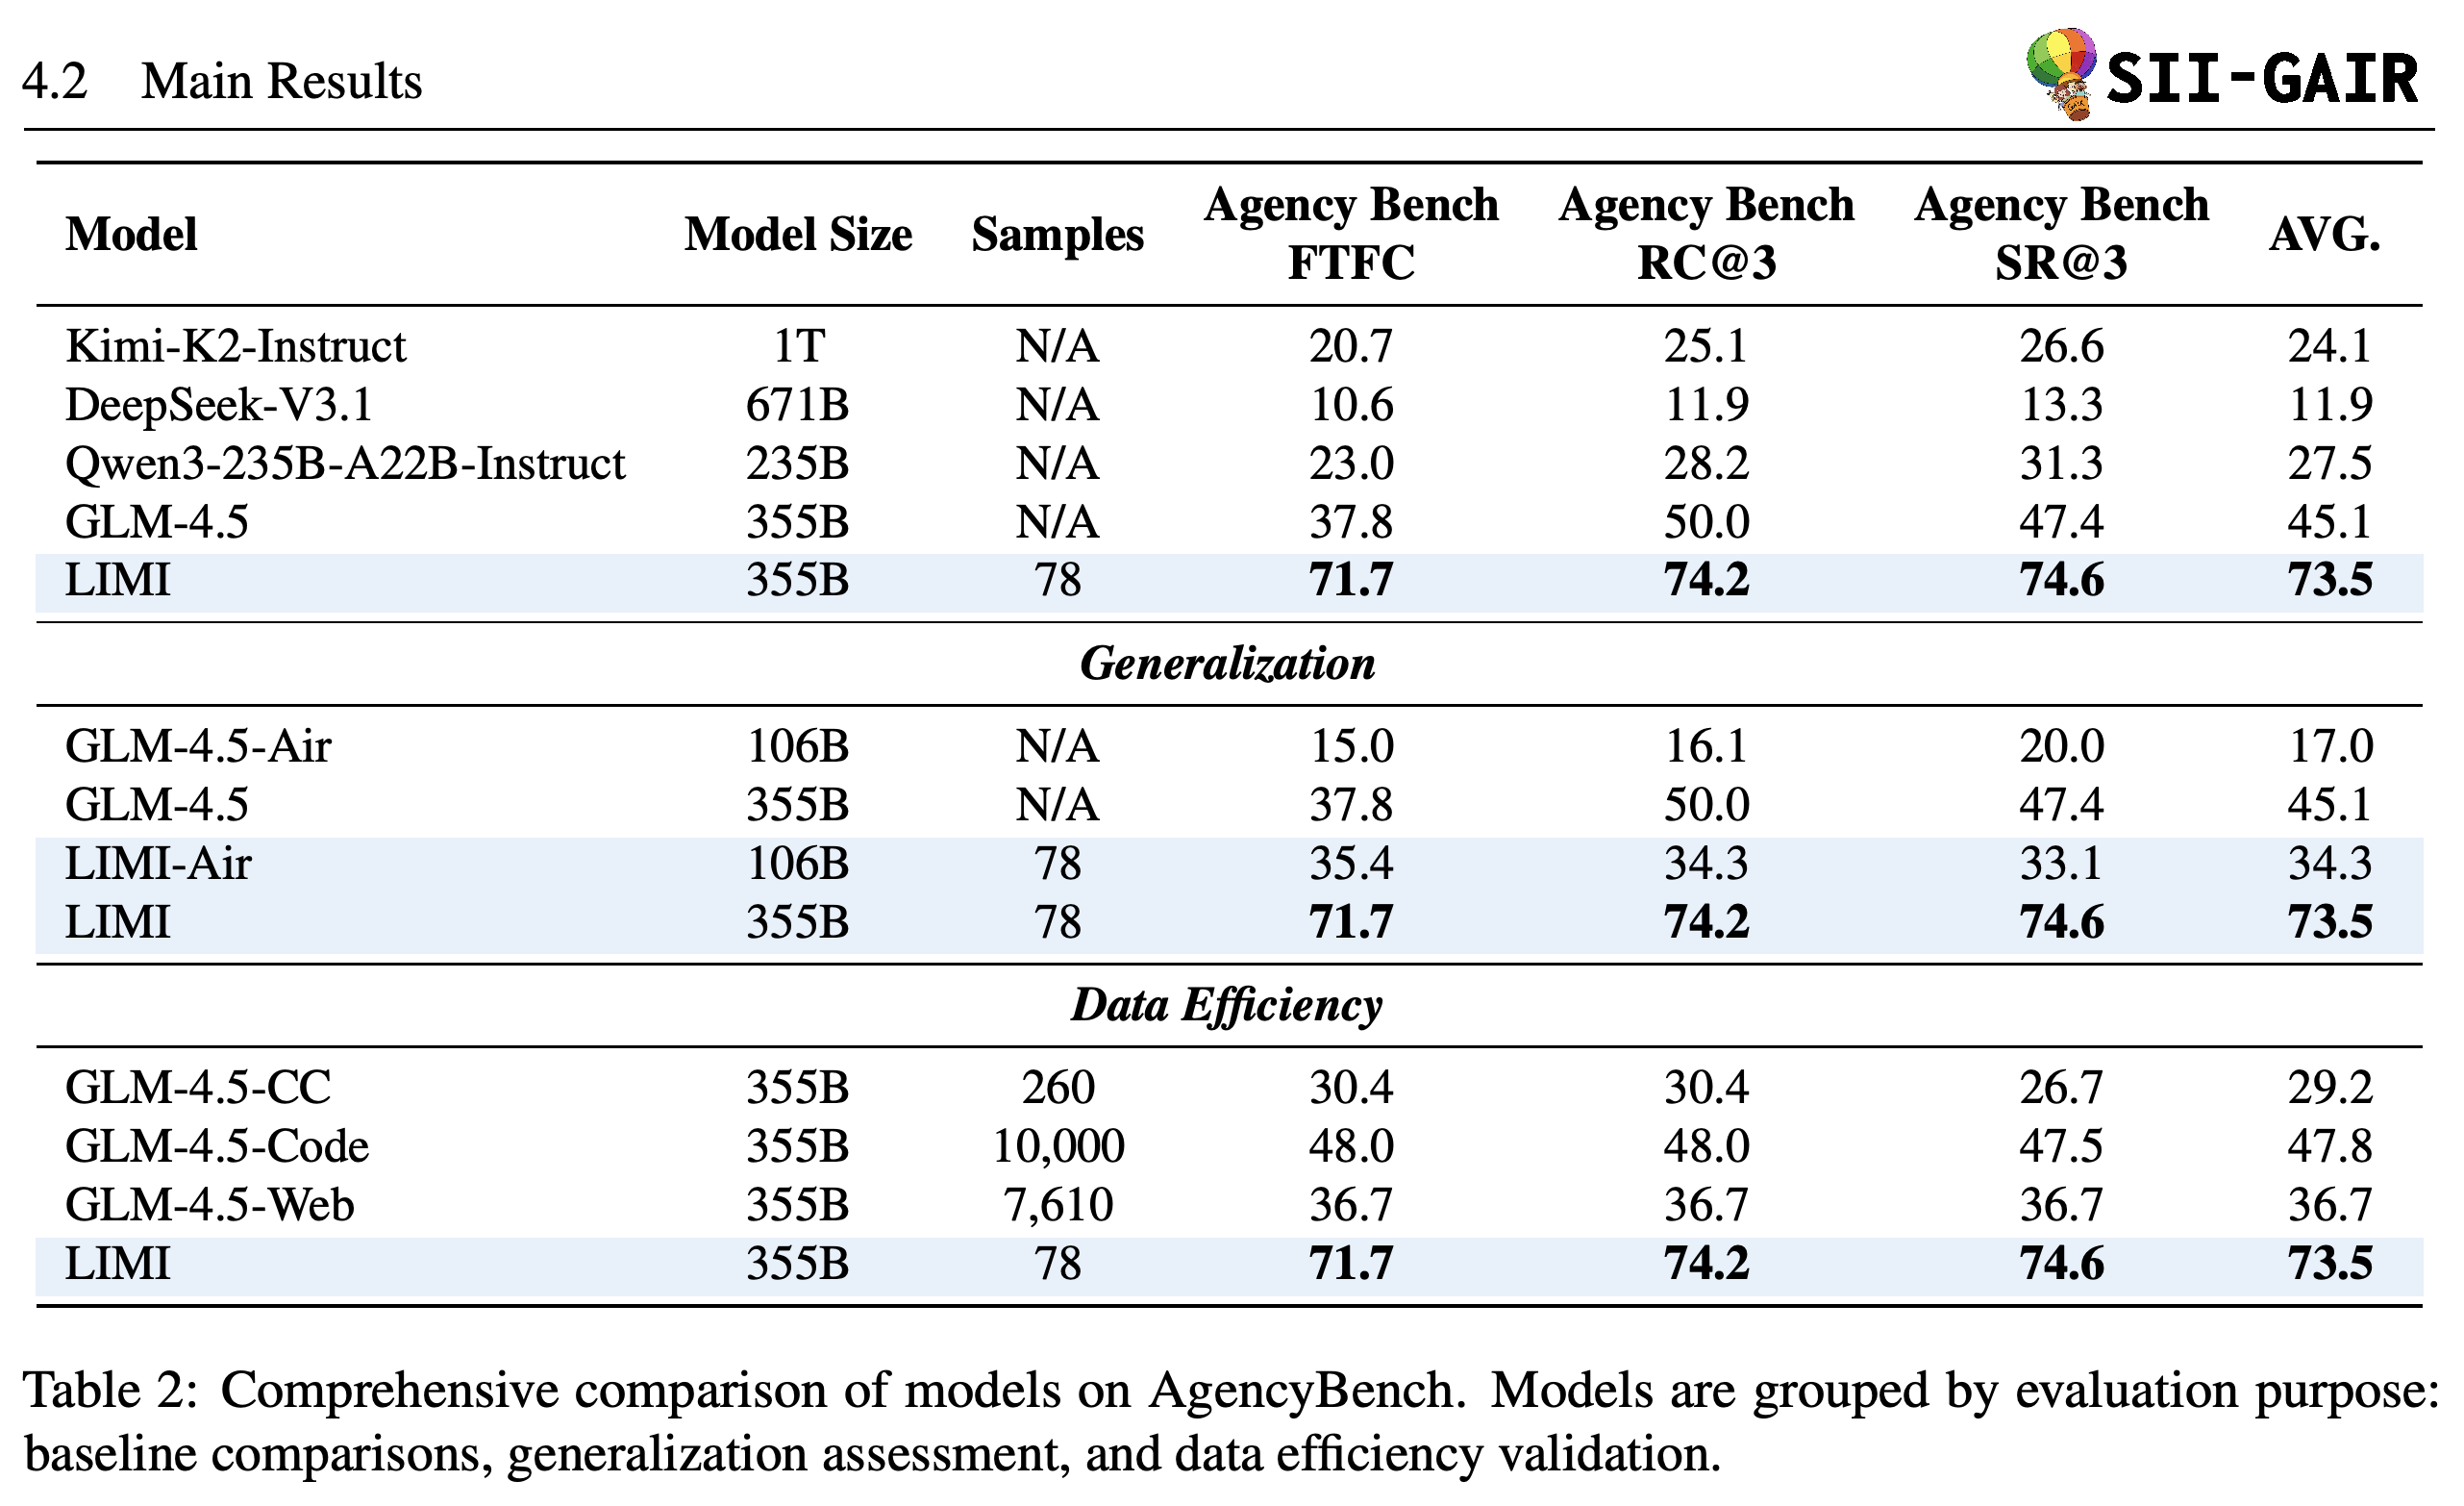
- LIMI: Less is More for Agency는 소수의 선별된 시연으로 언어 모델의 agency를 개선할 수 있는지 연구한다. Agency는 환경 및 도구와 상호작용하면서 문제를 발견하고 가설을 세우고, 해결책을 실행하는 능력이다. GLM-4.5를 시연 78개로 미세 조정한 LIMI는 실행 환경을 활용해 협업 코딩과 연구 과제를 평가하는 AgencyBench에서 평균 73.5%를 기록했다고 보고한다. 같은 기반 모델은 45.1%, AFM-CodeAgent-SFT-Dataset 샘플 10,000개로 미세 조정한 GLM-4.5는 47.8%를 기록한다.
이 개요는 LIMI의 AgencyBench 평균 73.5%를 사전 학습 기준 모델 및 대체 미세 조정 데이터셋 크기와 비교한다. code-agent 결과 47.8% 대비 향상률 53.7%는 상대값이며 절대 차이는 25.7%포인트이다. 효율성 비교는 토큰 수나 수집 비용 대신 예시 개수를 측정한다.
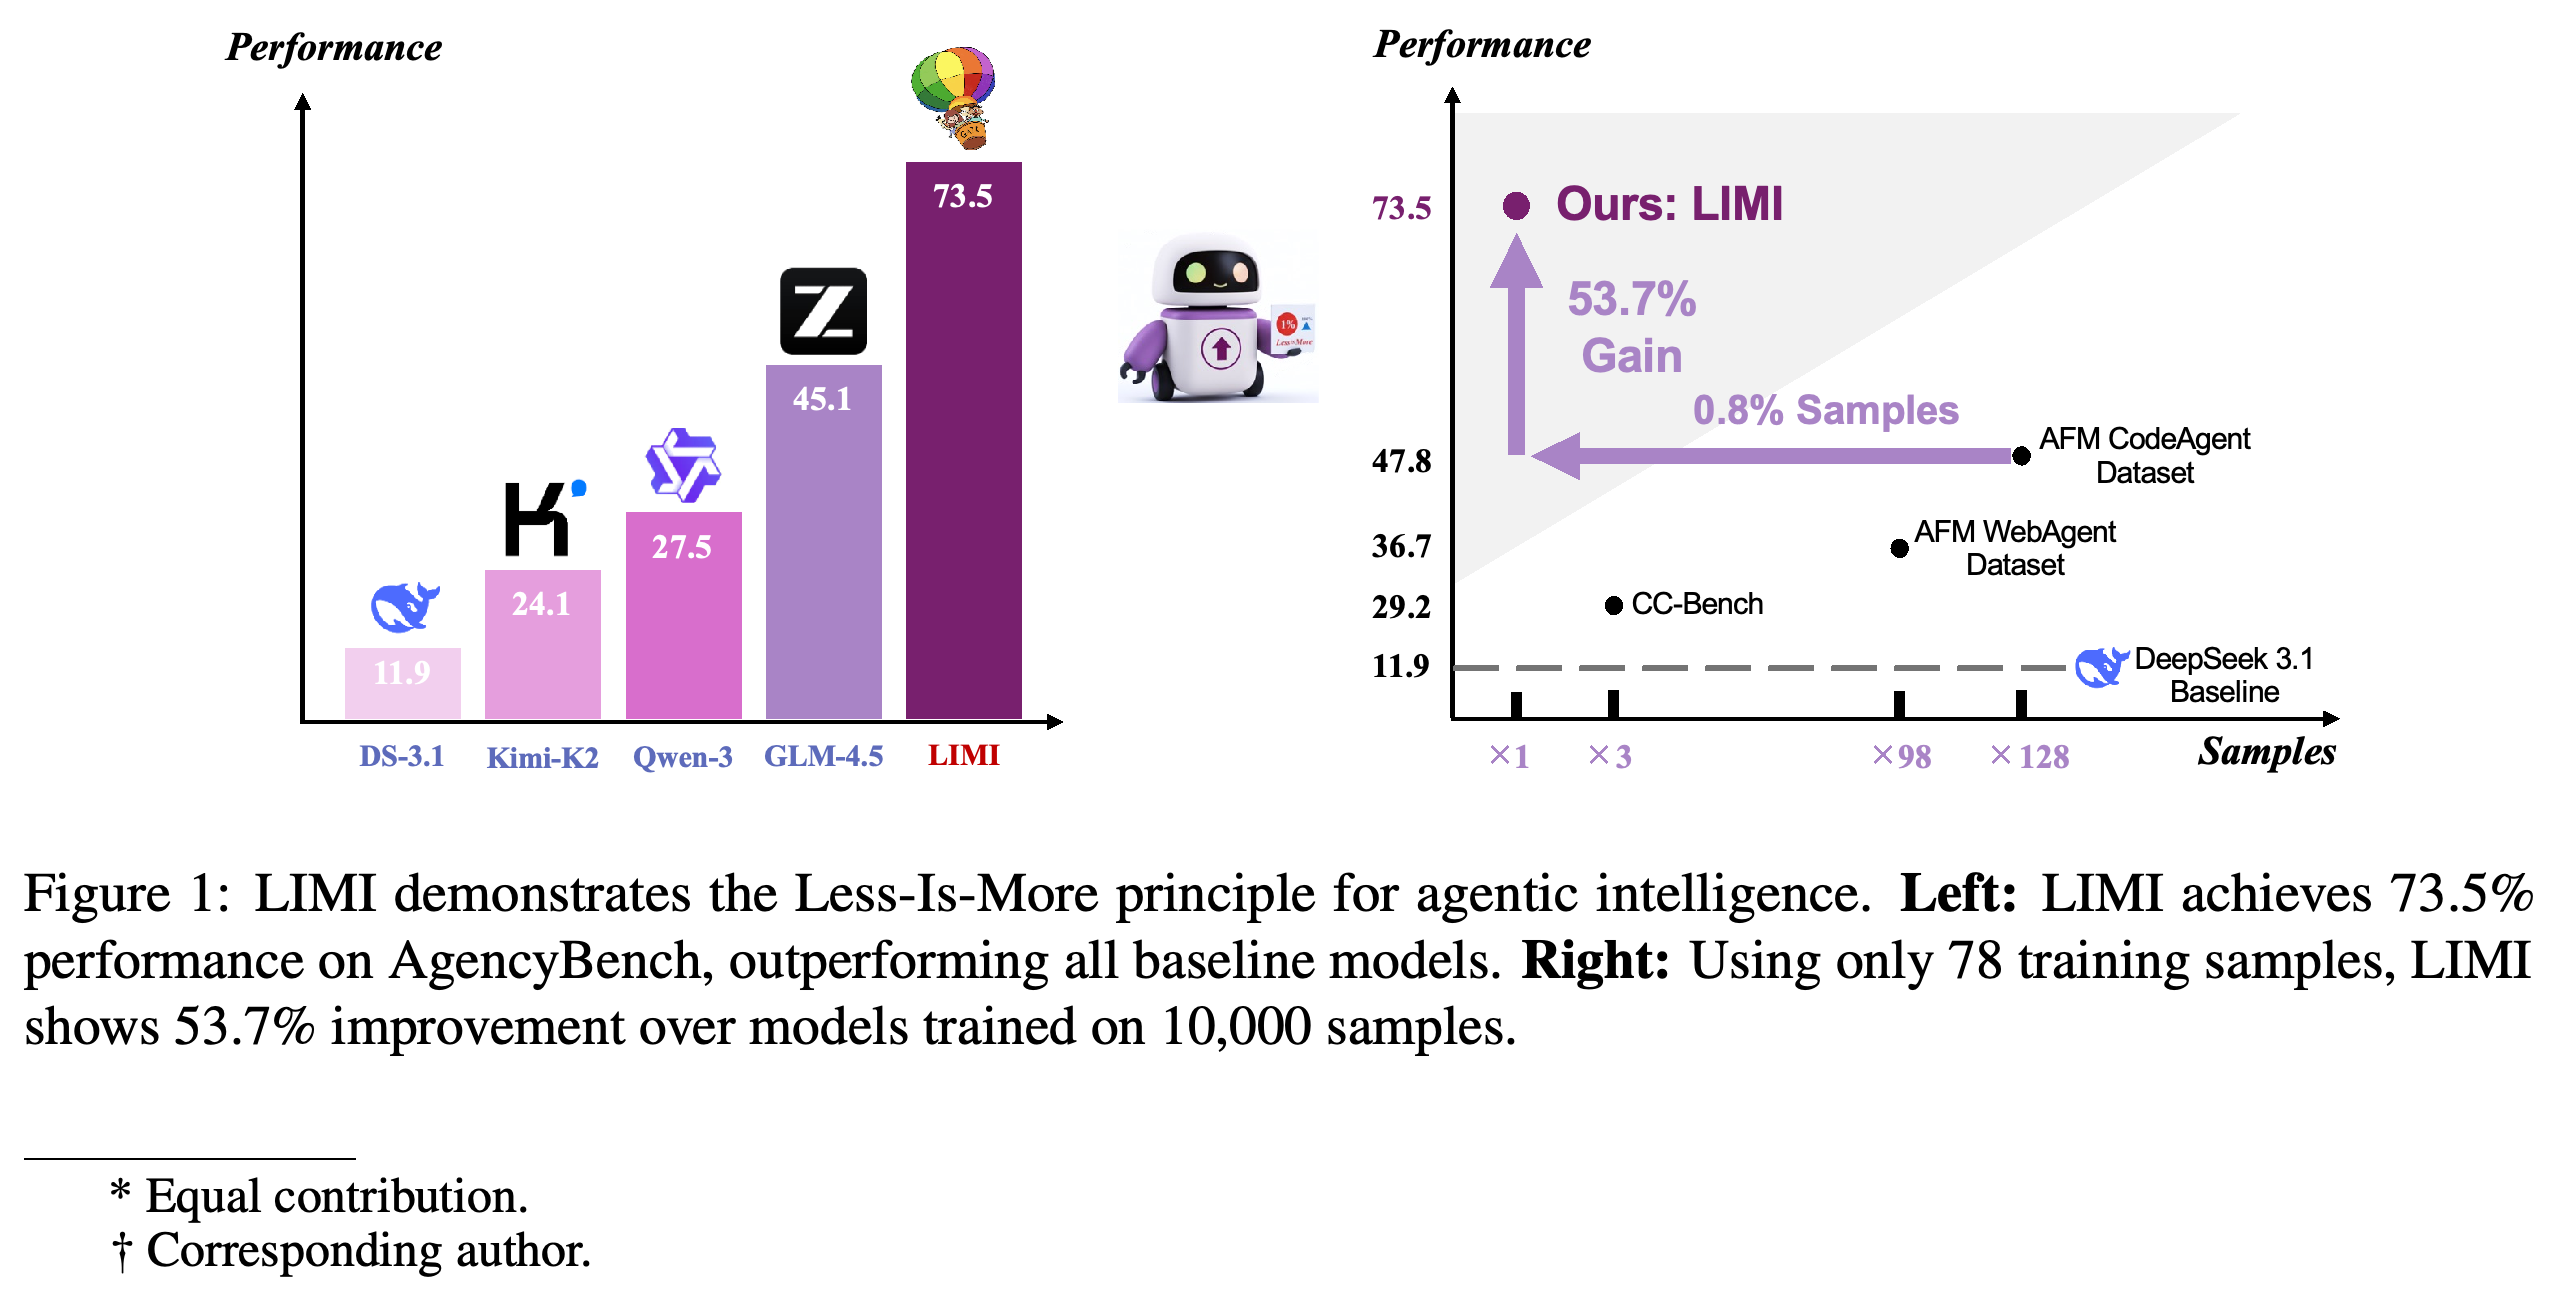
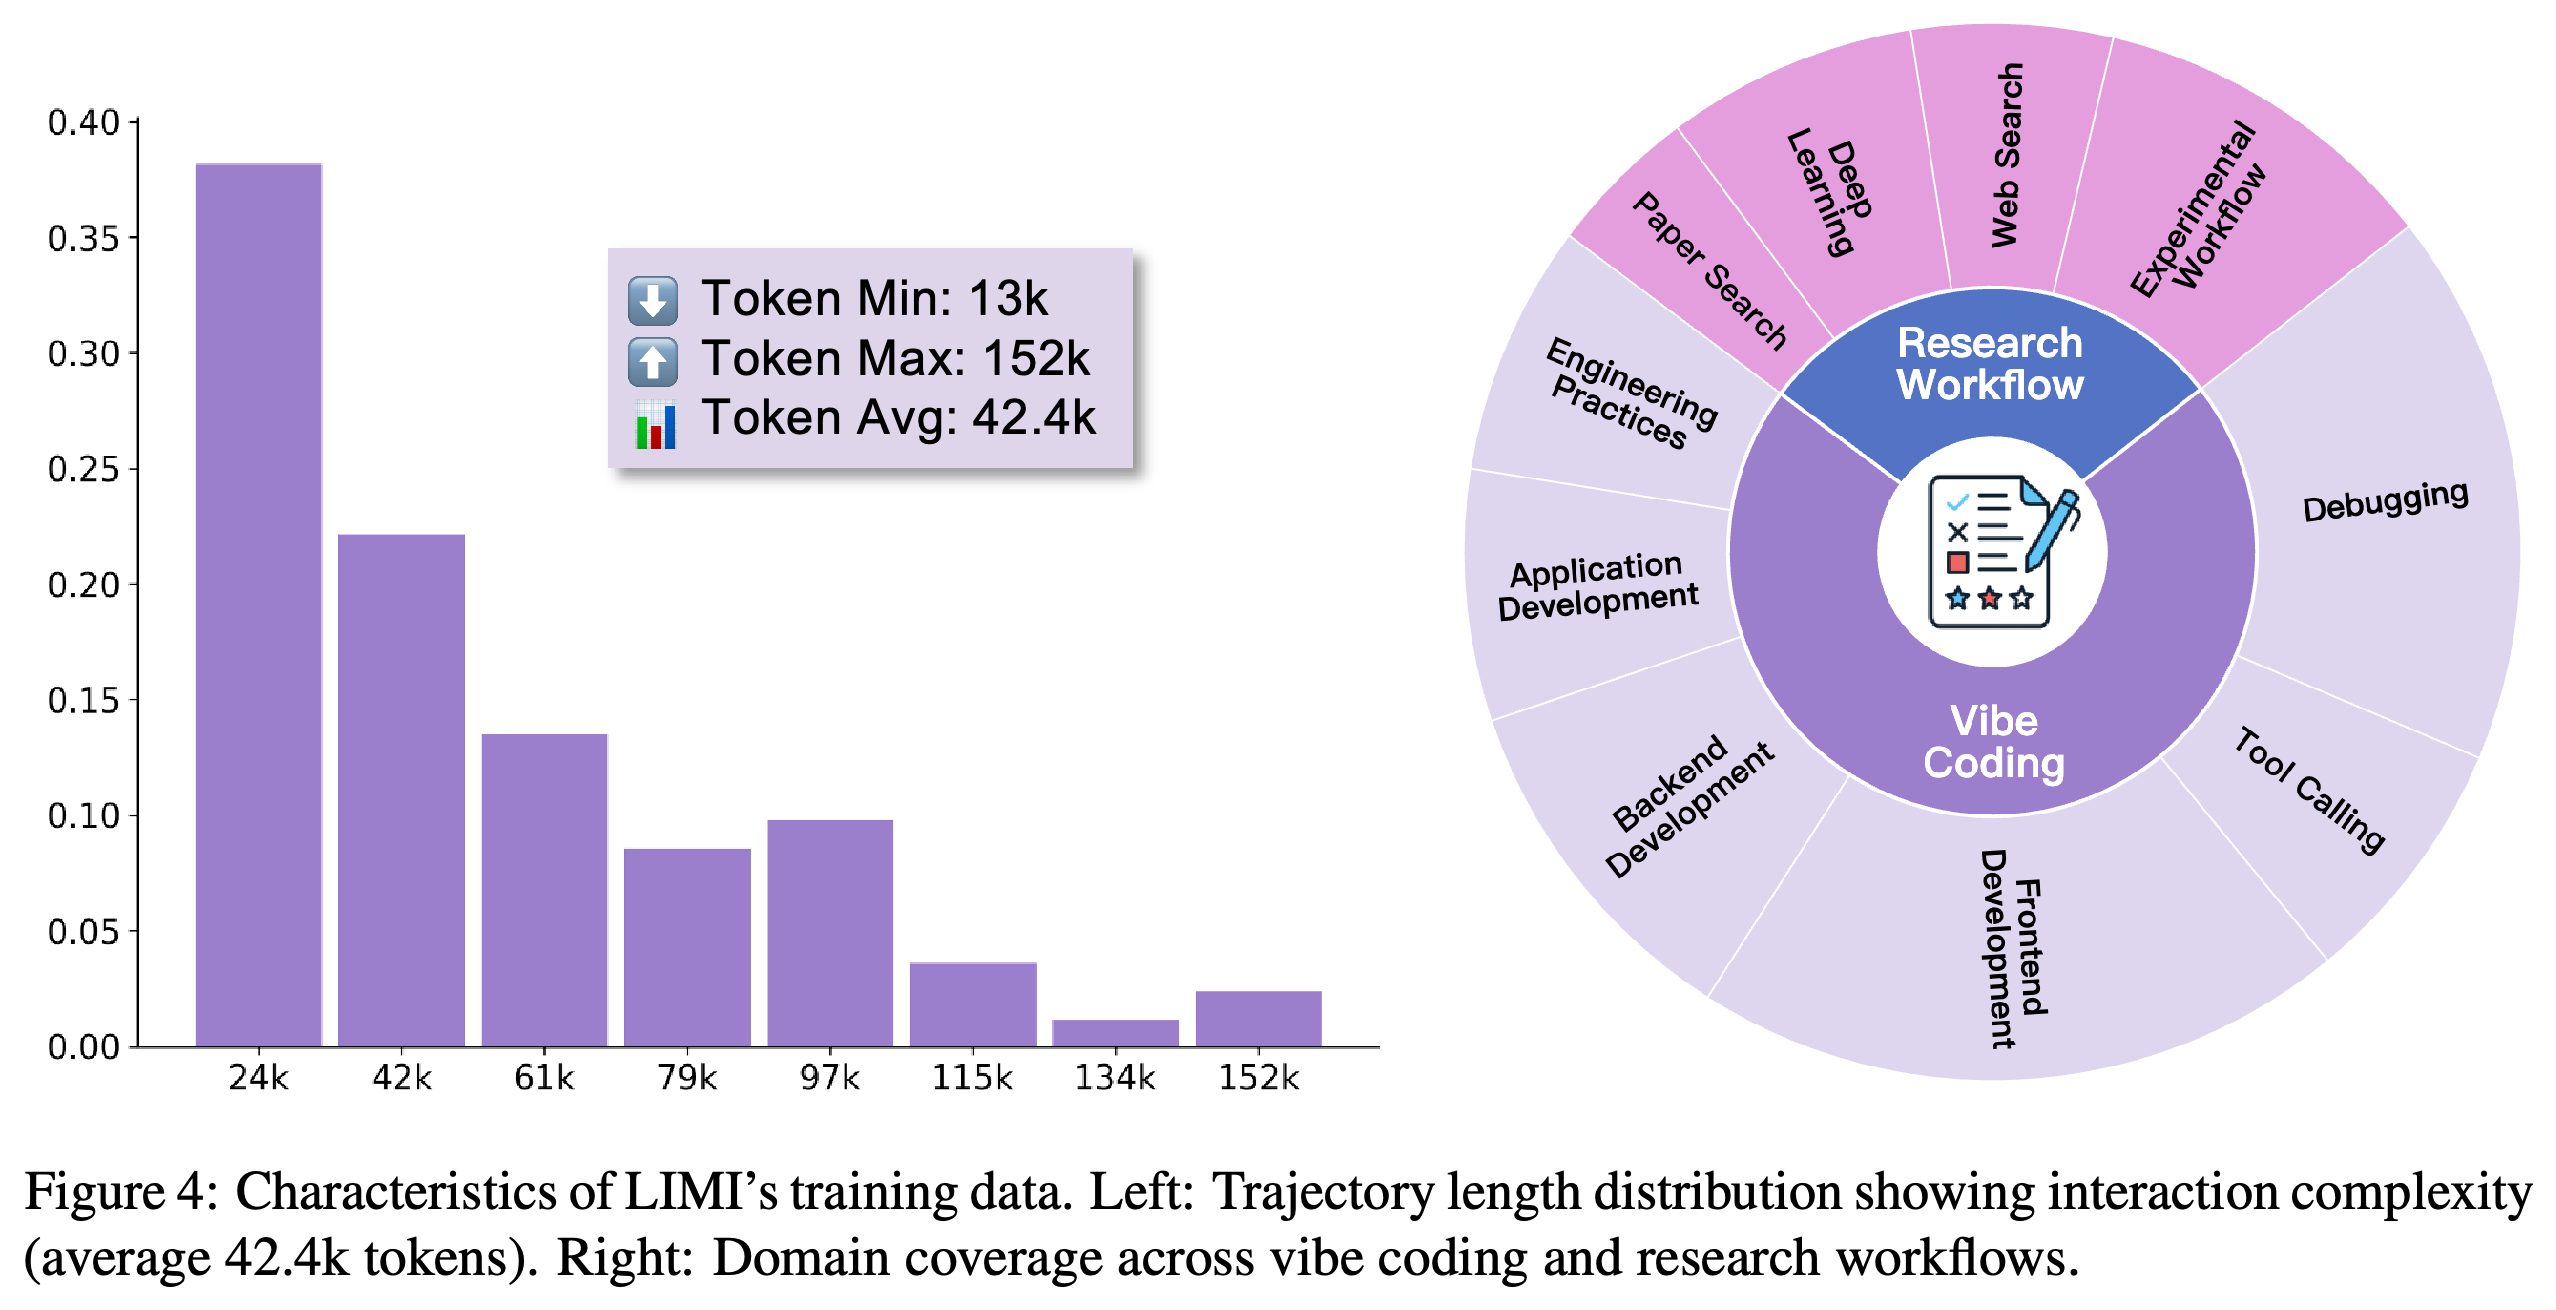
- 이 방법은 실제 업무에서 수집한 질의 60개와 GitHub pull request에서 합성한 질의 18개를 결합한다. Pull request는 저장소에 제출하는 코드 변경 제안이다. GPT-5와 인간 협업자 4명이 에이전트 실행용 명령줄 인터페이스인 SII CLI에서 성공적으로 완료한 trajectory를 수집한다. Trajectory는 추론, 도구 호출, 관찰을 포함하는 전체 상호작용 기록이며 길이는 평균 42.4k 토큰이고 범위는 13k~152k 토큰이다.
- 가장 명확한 결과는 AgencyBench에서 같은 사전 학습 모델보다 성능이 향상된다는 점이다. 추가 벤치마크에서는 과제에 따라 향상 정도가 다르다. 시연 개수는 학습 토큰 수나 수집 비용을 나타내지 않으며 평균을 구성하는 항목이 달라 보고된 평균만으로 SII CLI 접근의 효과를 분리할 수 없다.
1 Introduction
서론은 에이전트 능력을 높이려면 대규모 학습 데이터셋이 필요한지, 아니면 시연을 선별해도 개선할 수 있는지 묻는다. 논문에서 Less Is More for Intelligent Agency로 풀어 쓴 LIMI는 실제 과제 수집, pull request 기반 질의 합성, 성공한 전체 상호작용 기록을 결합한다.
- 이 연구는 예시 1,000개로 모델 응답을 원하는 행동에 맞춘 LIMA와 예시 817개를 사용한 수학 추론 연구 LIMO의 소량 데이터 접근법을 에이전트의 협업 실행으로 확장한다.
- 저자들은 선별한 시연이 적은 예시로도 효과적인 자율성을 뒷받침할 수 있다는 주장을 Agency Efficiency Principle이라고 부른다. 실험은 선별된 데이터셋과 사전 학습 모델 2개를 비교하며 자원과 성능의 정량적 관계를 나타내는 일반적인 스케일링 법칙을 확립하지는 않는다.
2 Preliminary
기초 프레임워크는 agency를 환경 및 도구를 활용한 자율적 문제 발견, 가설 수립, 해결책 실행으로 정의한다. 실제 수행에서는 과제 실행, 다단계 추론, 인간과의 협업을 통합하는 데 초점을 둔다.
2.1 Long-Horizon Tasks and Agentic Complexity
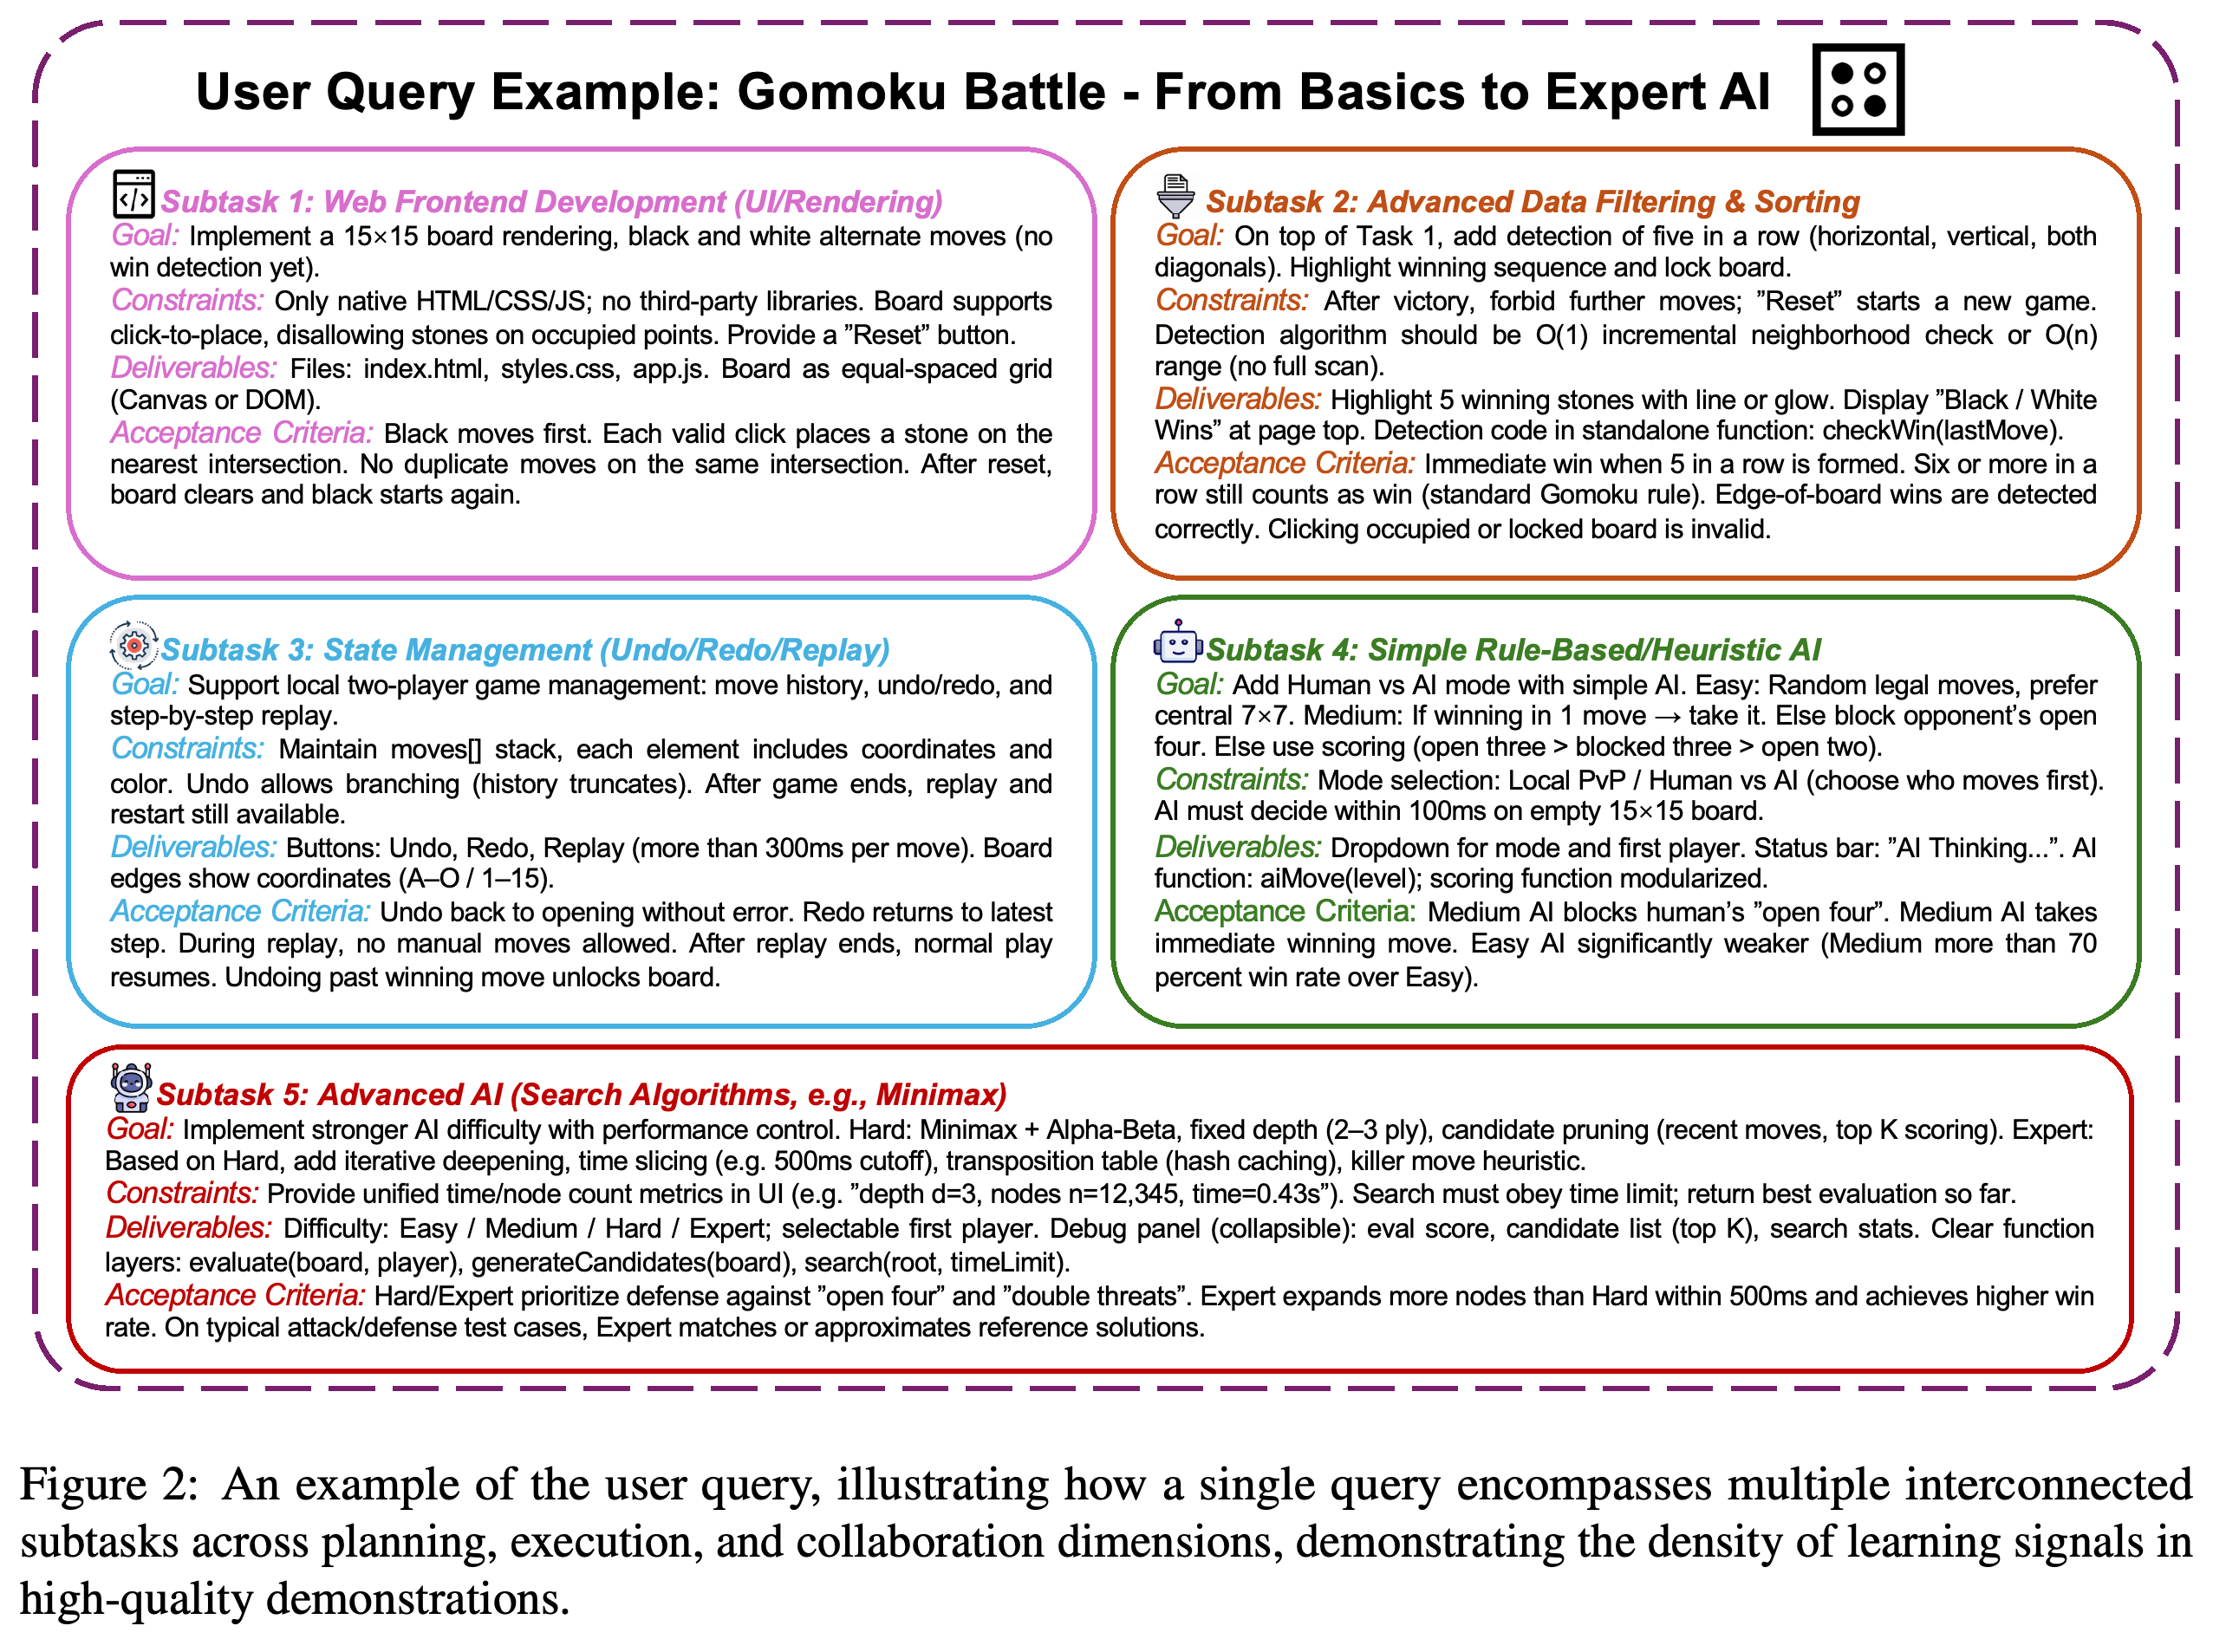
장기 과제는 여러 상호작용에 걸쳐 지속적으로 작업해야 하는 과제이며 상태 추적, 목표 분해, 도구 사용 조율, 피드백에 따른 계획 수정이 필요하다. Figure 2는 돌 5개를 일렬로 놓는 보드게임인 Gomoku를 예로 보여 준다. 서로 연결된 하위 과제 5개는 보드 렌더링에서 더 강한 게임 플레이 알고리즘으로 이어진다.
- 이 예시는 질의 1개에 구현, 검증, 상태 관리, 성능 제약을 함께 담는다. 따라서 완전한 시연 1개가 서로 다른 여러 행동에 대한 학습 신호를 포함할 수 있다.
서로 연결된 Gomoku 하위 과제 5개는 보드 렌더링, 승리 판정, 수순 기록 관리, 기본 게임 플레이, 더 강한 탐색을 결합한다. 통과 기준은 질의 1개에 담긴 요구사항의 밀도를 보여 준다. 여기에는 100ms 이내 의사결정과 예시로 제시한 500ms 탐색 제한이 포함되며, 측정 결과가 아니라 요청된 동작이다.
2.2 Domain Specification: Vibe Coding and Research Workflows
Vibe coding은 언어 모델이 인간 개발자와 함께 작업하는 협업 소프트웨어 개발을 뜻하며 코드 이해, 환경 탐색, 디버깅, 요구사항 변경을 포함한다. 연구 워크플로는 문헌 검색, 데이터 분석, 실험 설계, 가설 생성, 연구 결과 전달을 포함한다.
- 저자들은 추론을 실행 가능한 작업과 연결하는 시연을 수집하기 위해 이 영역들을 선택한다. 이 영역들이 대부분의 지식 노동을 포괄한다는 주장에는 정량적인 범위 분석이 제시되지 않는다.
3 Dataset Construction
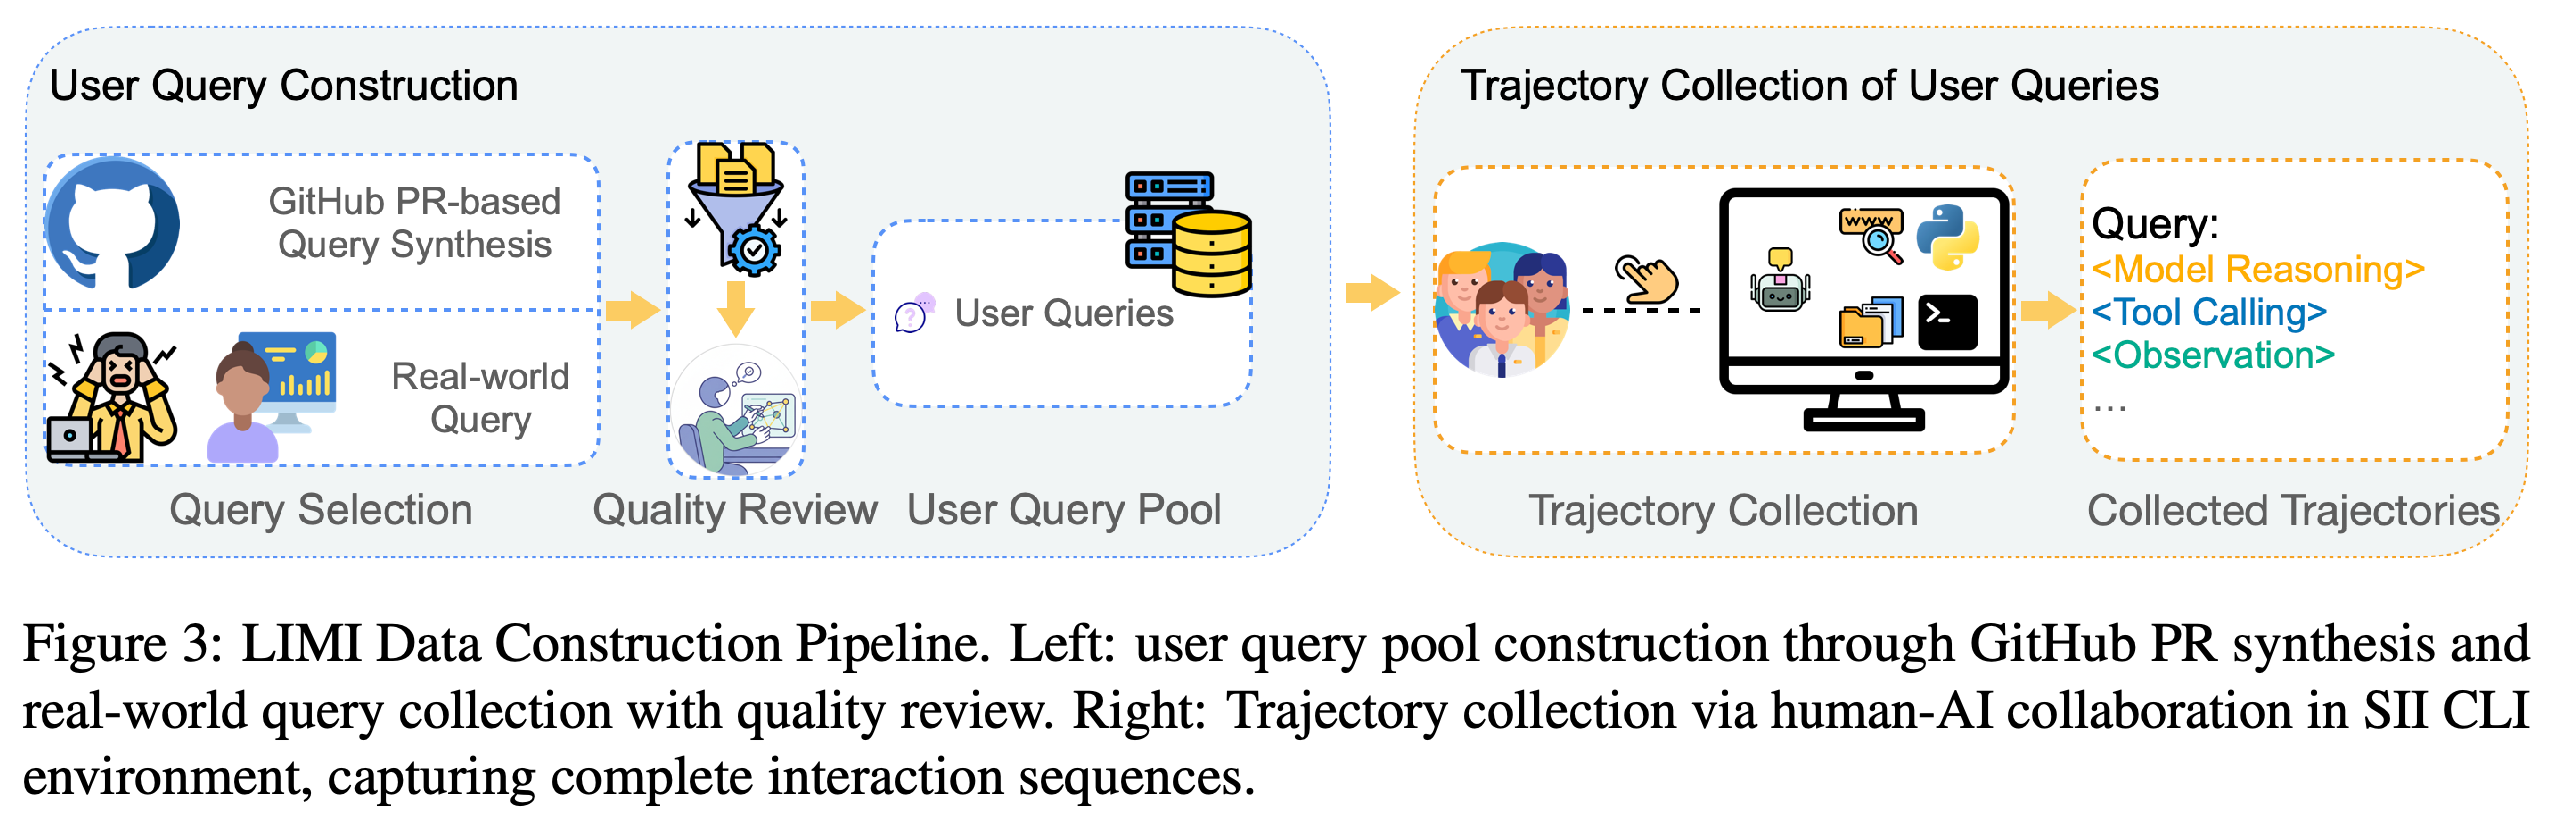
데이터셋 구축에서는 질의 선별과 품질 검토를 trajectory 수집과 분리한다. Figure 3은 실제 질의와 합성 질의를 공통 풀에 모은 뒤, 인간과 GPT-5의 협업으로 실행 기록을 생성하는 과정을 보여 준다.
이 파이프라인은 사용자 질의를 구성하고 검토하는 과정과 실행을 기록하는 과정을 분리한다. Trajectory 단계에는 모델 추론, 도구 호출, 관찰이 포함된다. 이는 학습 자료가 과제 설명뿐 아니라 상호작용 과정도 포함한다는 점을 보여 준다.
3.1 Framework and Notation
각 학습 상호작용은 \((q_i,\tau_i)\)로 표현한다. q_i는 사용자의 목표와 성공 기준을 명시하고 τ_i = {a_i,1, …, a_i,n_i}는 이후의 상호작용 순서를 기록한다. 행동은 모델 추론 m_i,j, 구조화된 도구 호출 t_i,j, 환경 관찰 o_i,j로 구성되며, 관찰에는 도구 출력과 인간 피드백이 포함된다.
- 인덱스 j는 상호작용 순서를 유지하며 n_i는 질의 i의 행동 수이다. 이 표현은 과제 해결 결과뿐 아니라 해결 과정도 기록한다.
3.2 Query Pool Construction
질의 풀은 전문 개발 및 연구 상황에서 수집한 과제 60개와 GPT-5가 GitHub pull request에서 생성한 뒤 선별한 합성 과제 18개로 구성된다. 컴퓨터 과학 PhD 학생 네 명이 합성 질의와 원본 변경 사항의 의미가 일치하는지 검토한다.
- 파이프라인은 GitHub 별이 10,000개를 초과하는 저장소 100개를 선택하고 저장소마다 pull request 1,000개를 수집한 뒤 합성용으로 저장소마다 100개를 무작위 추출한다.
- 필터링에서는 코드 변경을 텍스트로 표현한 unified diff 패치 중 1,200 토큰 미만인 패치를 남기고, Markdown 파일만 변경한 패치는 제외한다. 수천 개의 합성 질의를 생성한 뒤 LIMI에 사용할 18개를 선택한다.
- 논문은 실제 질의, 합성 질의, 전문가 검토의 기여를 분리하는 ablation을 보고하지 않는다. Ablation은 구성 요소를 제거하거나 변경하는 실험이다.
3.3 Trajectory Collection for Training Dataset
PhD 학생 협업자 네 명이 SII CLI에서 GPT-5와 함께 작업하며 질의 78개 각각을 성공적으로 해결할 때까지 수집을 반복한다. 기록된 trajectory에는 추론, 도구 호출, 관찰, 불명확한 내용 확인, 반복적인 개선, 중간 실패에서의 복구가 포함된다.
- Figure 4는 trajectory당 길이를 최소 13k 토큰, 최대 152k 토큰, 평균 42.4k 토큰으로 보고한다. 따라서 적은 예시 개수에도 상당한 상호작용 내용이 담겨 있다.
- SII CLI는 통합 도구, 상세한 기록, 인간과의 협업을 지원하기 때문에 선택한다. 논문은 GPT-5 생성 비용, 주석 작업 시간, 실패한 수집 시도 횟수를 정량화하지 않는다.
길이 분포는 trajectory당 13k–152k 토큰과 평균 42.4k 토큰을 보고하며 영역 도식은 코딩 활동과 연구 워크플로를 포괄한다. 이 길이는 소량 데이터 주장을 해석할 때 고려해야 한다. 예시 78개에 방대한 실행 기록이 담겨 있다. 이 도식은 지식 노동 전반의 포괄 범위를 정량화하지 않는다.
3.4 Evaluation Benchmarks
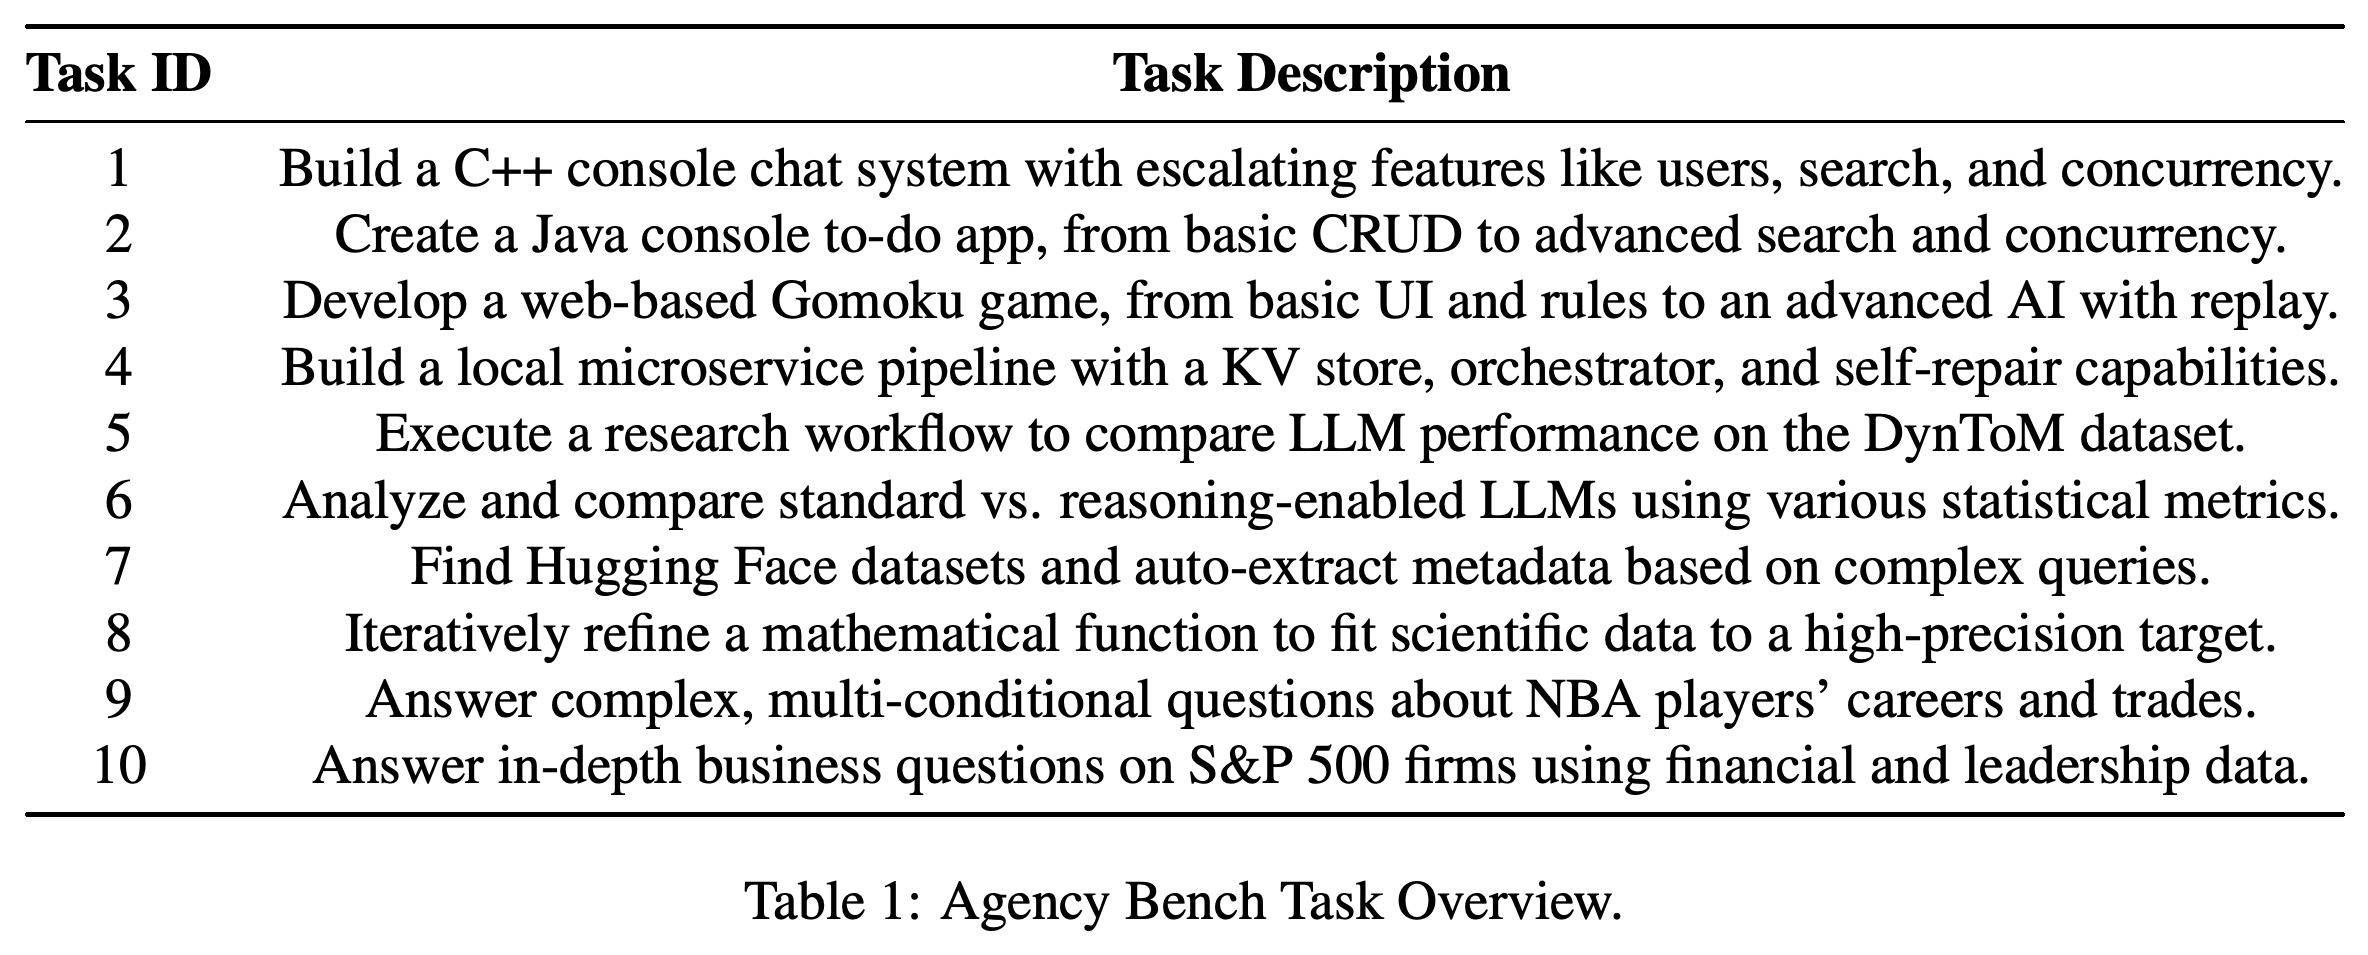
AgencyBench는 Table 1에 요약된 과제 10개로 구성되며, 협업 코딩 과제 4개와 연구 또는 정보 처리 과제 6개를 포함한다. 평가에는 도구 사용을 위한 tau2-bench-airline과 tau2-bench-retail, 코드 생성을 위한 EvalPlus-HumanEval과 EvalPlus-MBPP, 데이터 과학 프로그래밍을 위한 DS-1000, 과학 계산을 위한 SciCode도 포함된다.
- First-Turn Functional Completeness (FTFC)는 초기 응답에서 요구사항을 올바르게 구현한 비율을 측정한다. Success Rate (SR@R)는 할당된 R 라운드 안에 과제를 완료한 비율을 측정하며 R = 3이다.
- Remaining Chances (RC@R)는 성공한 질의에서 사용하지 않고 남은 라운드 수의 평균으로 설명된다. Table 2는 RC@3을 백분율과 유사한 척도로 보고하지만 정규화 방식은 설명하지 않는다.
- 논문은 tau2-bench에 대해 독립적인 실행 4회의 성공을 측정하는 Pass^4를 제시하고 이를 해당 실행 중 성공한 비율로 설명한다. 명시적인 집계 수식은 제공하지 않으며 다른 벤치마크는 정확도를 사용한다.
설명에는 소프트웨어 구축 과제 4개와 연구 또는 정보 처리 과제 6개가 명시된다. 각 상위 과제는 여러 요구사항을 포함하므로, 과제 수 10은 독립적으로 채점되는 요구사항의 수를 뜻하지 않는다.
4 Experiments
실험은 사전 학습 기준 모델, LIMI 데이터로 미세 조정한 모델, 대체 에이전트 데이터셋 3개로 미세 조정한 GLM-4.5 모델을 비교한다. 실행 환경의 역할을 살펴보기 위해 SII CLI에 접근할 수 있는 평가와 접근할 수 없는 평가도 비교한다.
4.1 Experiment Setup
기록된 시연으로 학습하는 지도 미세 조정은 slime 프레임워크를 사용해 GLM-4.5와 GLM-4.5-Air를 각각 LIMI와 LIMI-Air로 조정한다. 논문은 데이터셋 비교에서 미세 조정 설정이 동일하다고 명시하지만 학습률, 배치 크기, epoch 수의 구체적인 수치나 시퀀스 처리 정책, 연산 예산은 제공하지 않는다.
- Table 2는 LIMI의 매개변수 수를 355B, LIMI-Air의 매개변수 수를 106B로 표기하며 B는 1,000,000,000을 뜻한다. 기준 모델에는 GLM-4.5, GLM-4.5-Air, Qwen3-235B-A22B-Instruct, DeepSeek-V3.1, Kimi-K2-Instruct가 포함된다.
- 대체 학습 데이터셋은 샘플 260개의 CC-Bench-trajectories, 샘플 10,000개의 AFM-CodeAgent-SFT-Dataset, 샘플 7,610개의 AFM-WebAgent-SFT-Dataset이다.
- AgencyBench 과제는 도구 상호작용이 필요하므로 실행 환경을 사용해 평가한다. SII CLI 없이 진행하는 평가는 추가 벤치마크로 한정된다.
4.2 Main Results
AgencyBench에서 LIMI는 GLM-4.5 대비 FTFC를 37.8%에서 71.7%로, SR@3을 47.4%에서 74.6%로 높인다. 보고된 평균은 45.1%에서 73.5%로 상승한다. 다른 기준 모델의 평균은 Kimi-K2-Instruct가 24.1%, DeepSeek-V3.1이 11.9%, Qwen3-235B-A22B-Instruct가 27.5%이다.
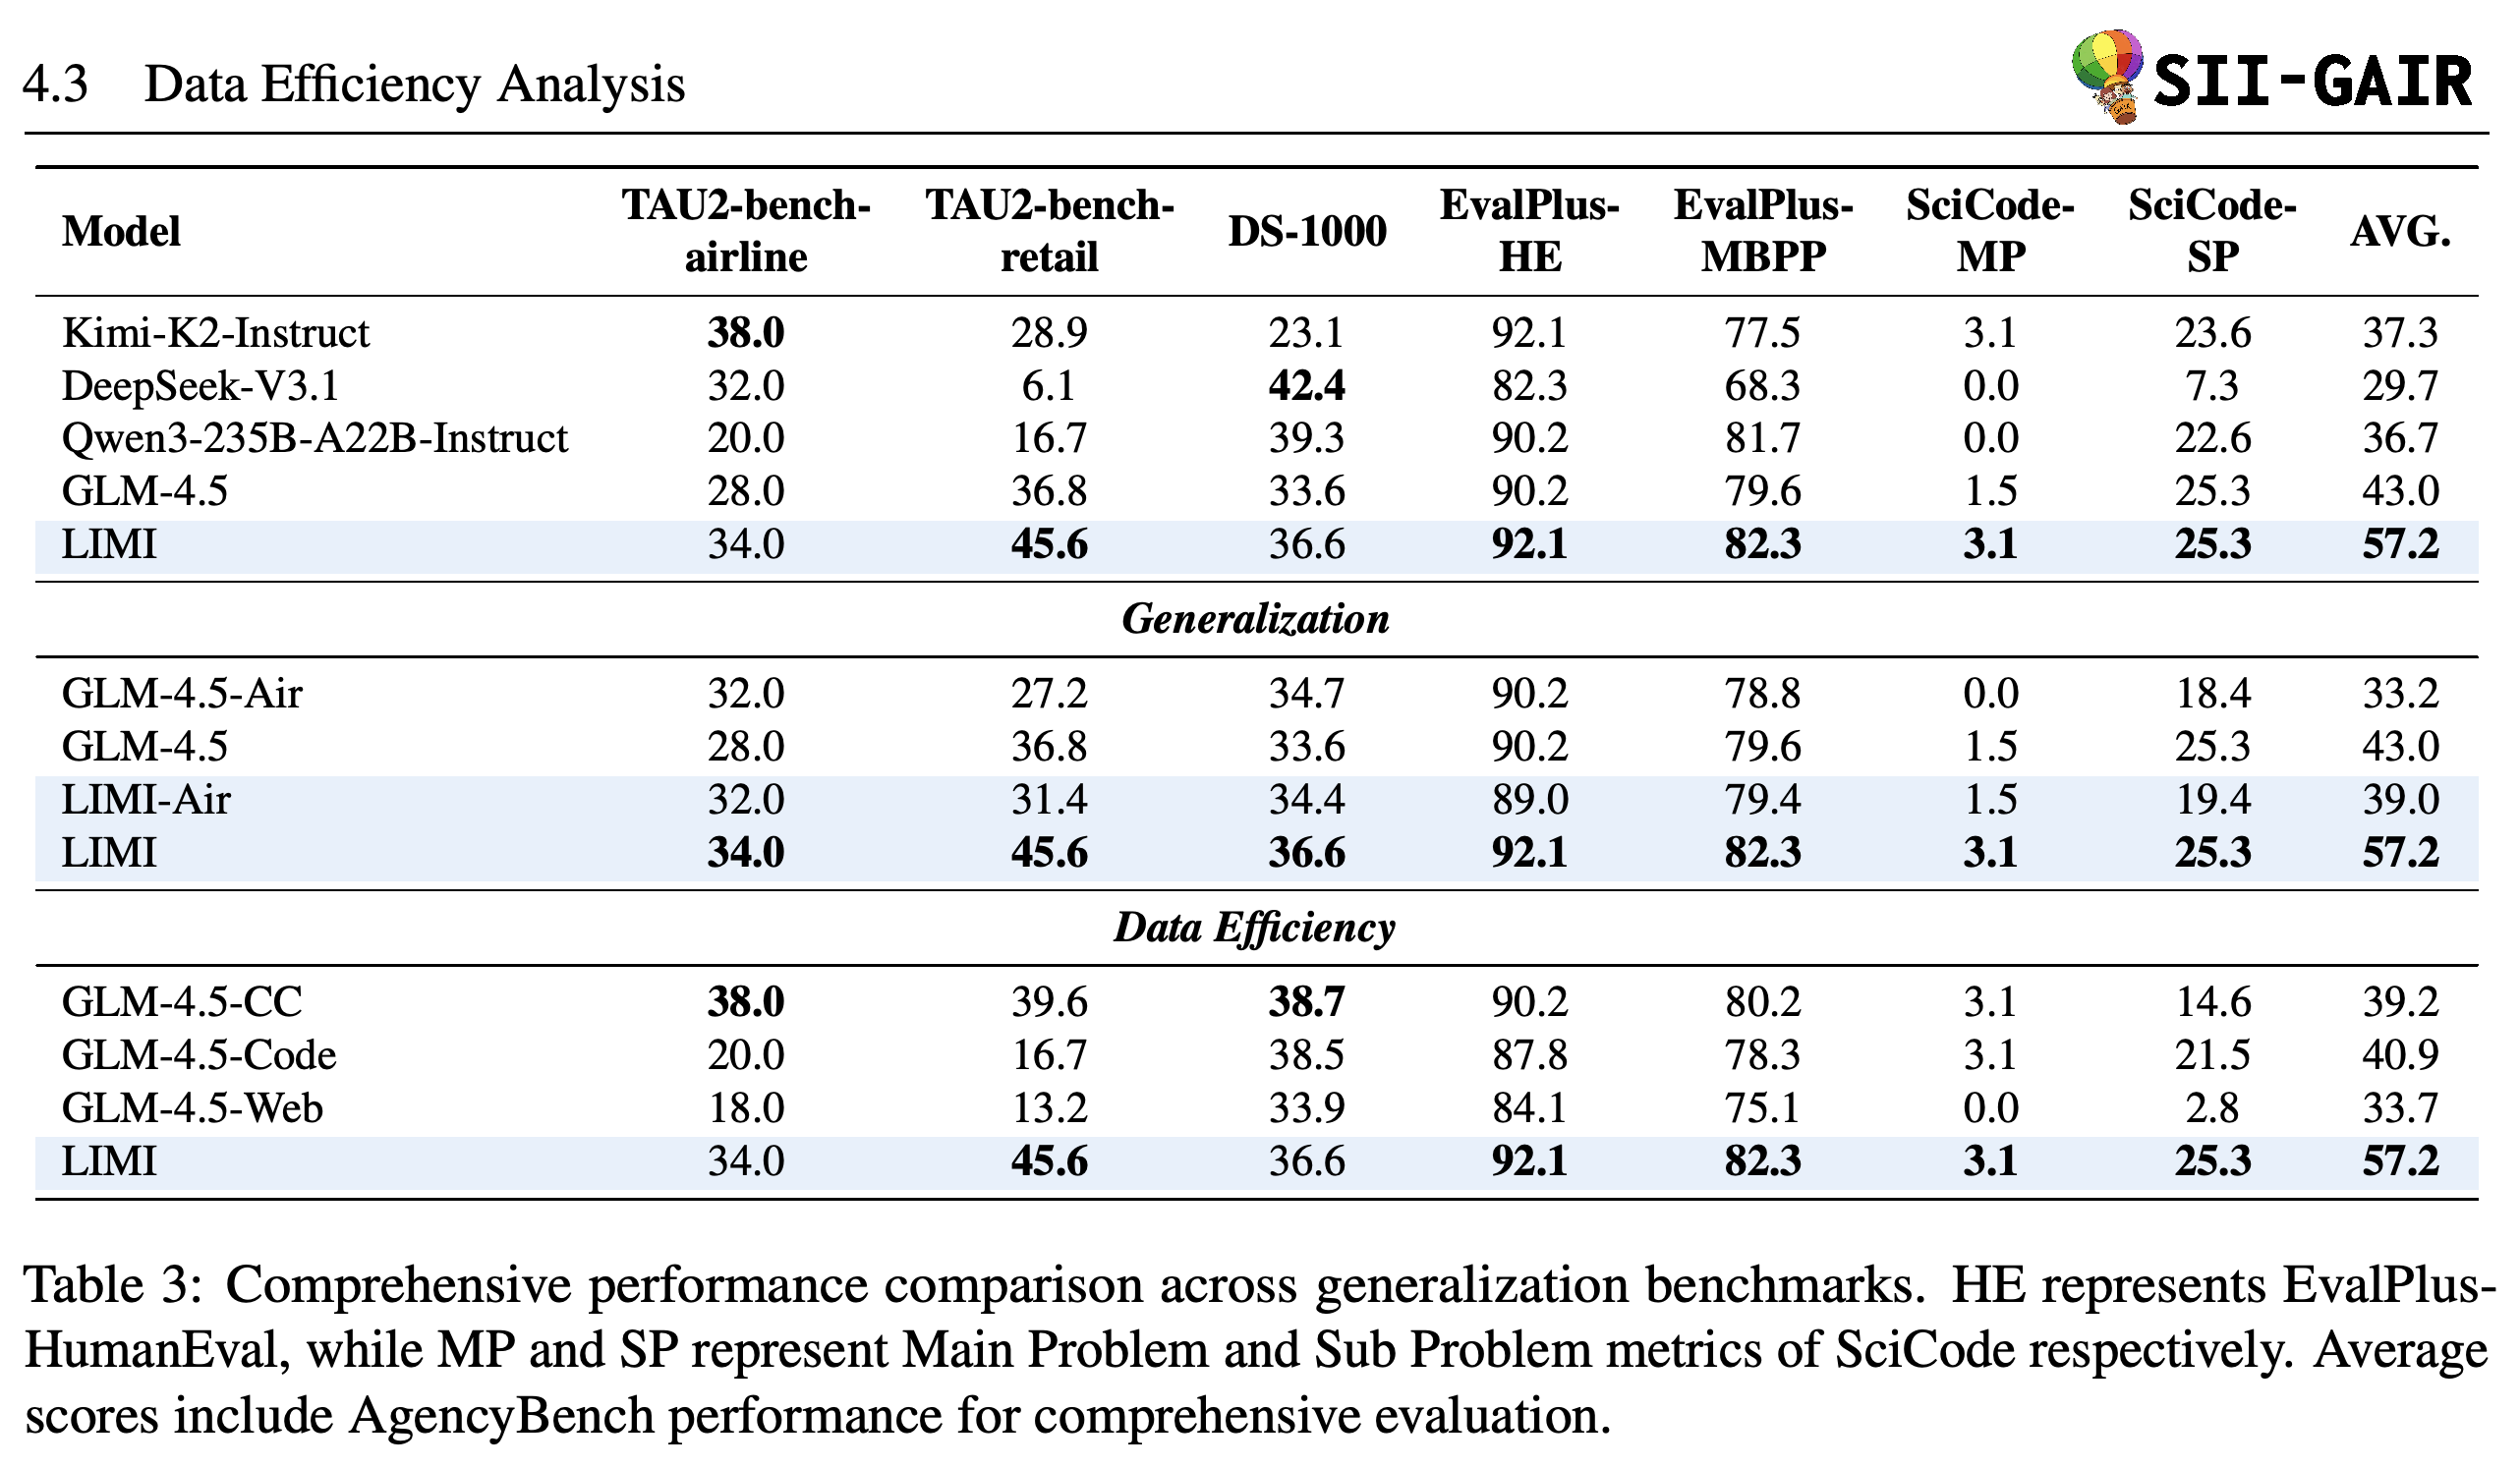
- Table 3은 LIMI의 점수를 TAU2-bench-airline 34.0%, TAU2-bench-retail 45.6%, DS-1000 36.6%, EvalPlus-HumanEval 92.1%, EvalPlus-MBPP 82.3%로 보고한다.
- 전체 과학 문제와 이를 구성하는 하위 문제의 성능을 측정하는 SciCode Main Problem과 Sub Problem 점수는 각각 3.1%와 25.3%이다. LIMI는 HumanEval과 SciCode Main Problem에서 Kimi-K2-Instruct와 동률이며 airline 과제에서는 이 모델보다 낮고 DS-1000에서는 DeepSeek-V3.1보다 낮다.
- Table 3은 평균을 57.2%, GLM-4.5의 평균을 43.0%로 보고하며 캡션은 AgencyBench가 포함된다고 명시한다. 표시된 일곱 지표와 AgencyBench의 세 지표를 함께 평균하면 보고된 집계값과 대략 일치하지만 논문은 이 수식을 명시하지 않는다.
LIMI는 GLM-4.5의 보고된 평균을 45.1에서 73.5로 높이며 표시된 AgencyBench 지표 3개 모두에서 향상을 보인다. 대체 데이터셋 행은 더 적은 예시를 사용한 이점을 보여 주며, LIMI-Air 행은 같은 계열의 다른 모델 크기에서도 성능이 개선됨을 보여 준다.
개별 결과는 표시된 지표 6개에서 GLM-4.5보다 높고 SciCode Sub Problem에서는 동률이지만 일부 과제에서는 다른 기준 모델이 더 높은 성능을 보인다. 캡션은 AVG.에 AgencyBench가 포함된다고 명시한다. 표시된 점수 7개와 AgencyBench 점수 3개를 함께 평균하면 보고된 집계값을 대략 재현하므로, AVG.는 추가 벤치마크만의 평균이 아니다.
4.3 Data Efficiency Analysis
같은 GLM-4.5를 기반으로 한 LIMI의 시연 78개는 AgencyBench 평균 73.5%를 달성한다. 이에 비해 CC-Bench 샘플 260개로 학습한 모델은 29.2%, code-agent 샘플 10,000개로 학습한 모델은 47.8%, web-agent 샘플 7,610개로 학습한 모델은 36.7%를 기록한다. 이 비교는 보고된 학습 설정에서 선별된 데이터셋의 효과를 뒷받침한다.
- 73.5%와 47.8%의 차이는 25.7%포인트이며 상대 향상률은 약 53.7%이다. Section 4.3은 53.7을 %포인트 향상으로 잘못 표기한다.
- 샘플 수 10,000과 78의 비율은 약 128이다. 논문은 AgencyBench를 포함하는 Table 3 집계값을 사용해 대체 데이터셋 대비 상대 향상률을 39.9%, 69.7%, 45.9%로도 보고한다.
- 총 학습 토큰 수나 주석 작업량을 맞춘 비교는 없다. 데이터셋 크기, trajectory 길이, 과제 관련성, GPT-5가 제공한 학습 신호, 선별 전략의 효과를 분리하기 어렵다.
4.4 Generalization Analysis
LIMI-Air는 GLM-4.5-Air의 AgencyBench 평균을 17.0%에서 34.3%로 높이며 향상 폭은 17.3%포인트이다. LIMI는 GLM-4.5의 평균을 45.1%에서 73.5%로 높이며 향상 폭은 28.4%포인트이다.
- 이 결과는 GLM-4.5 계열에서 크기가 다른 모델 2개에 걸친 성능 향상을 보여 준다. 서로 관련 없는 모델 아키텍처 사이의 적응은 시험하지 않는다.
- LIMI-Air의 보고된 Table 3 집계값은 33.2%에서 39.0%로 상승하지만 개별 점수는 DS-1000에서 34.7%에서 34.4%로, HumanEval에서 90.2%에서 89.0%로 하락한다.
4.5 The Impact of CLI Environment
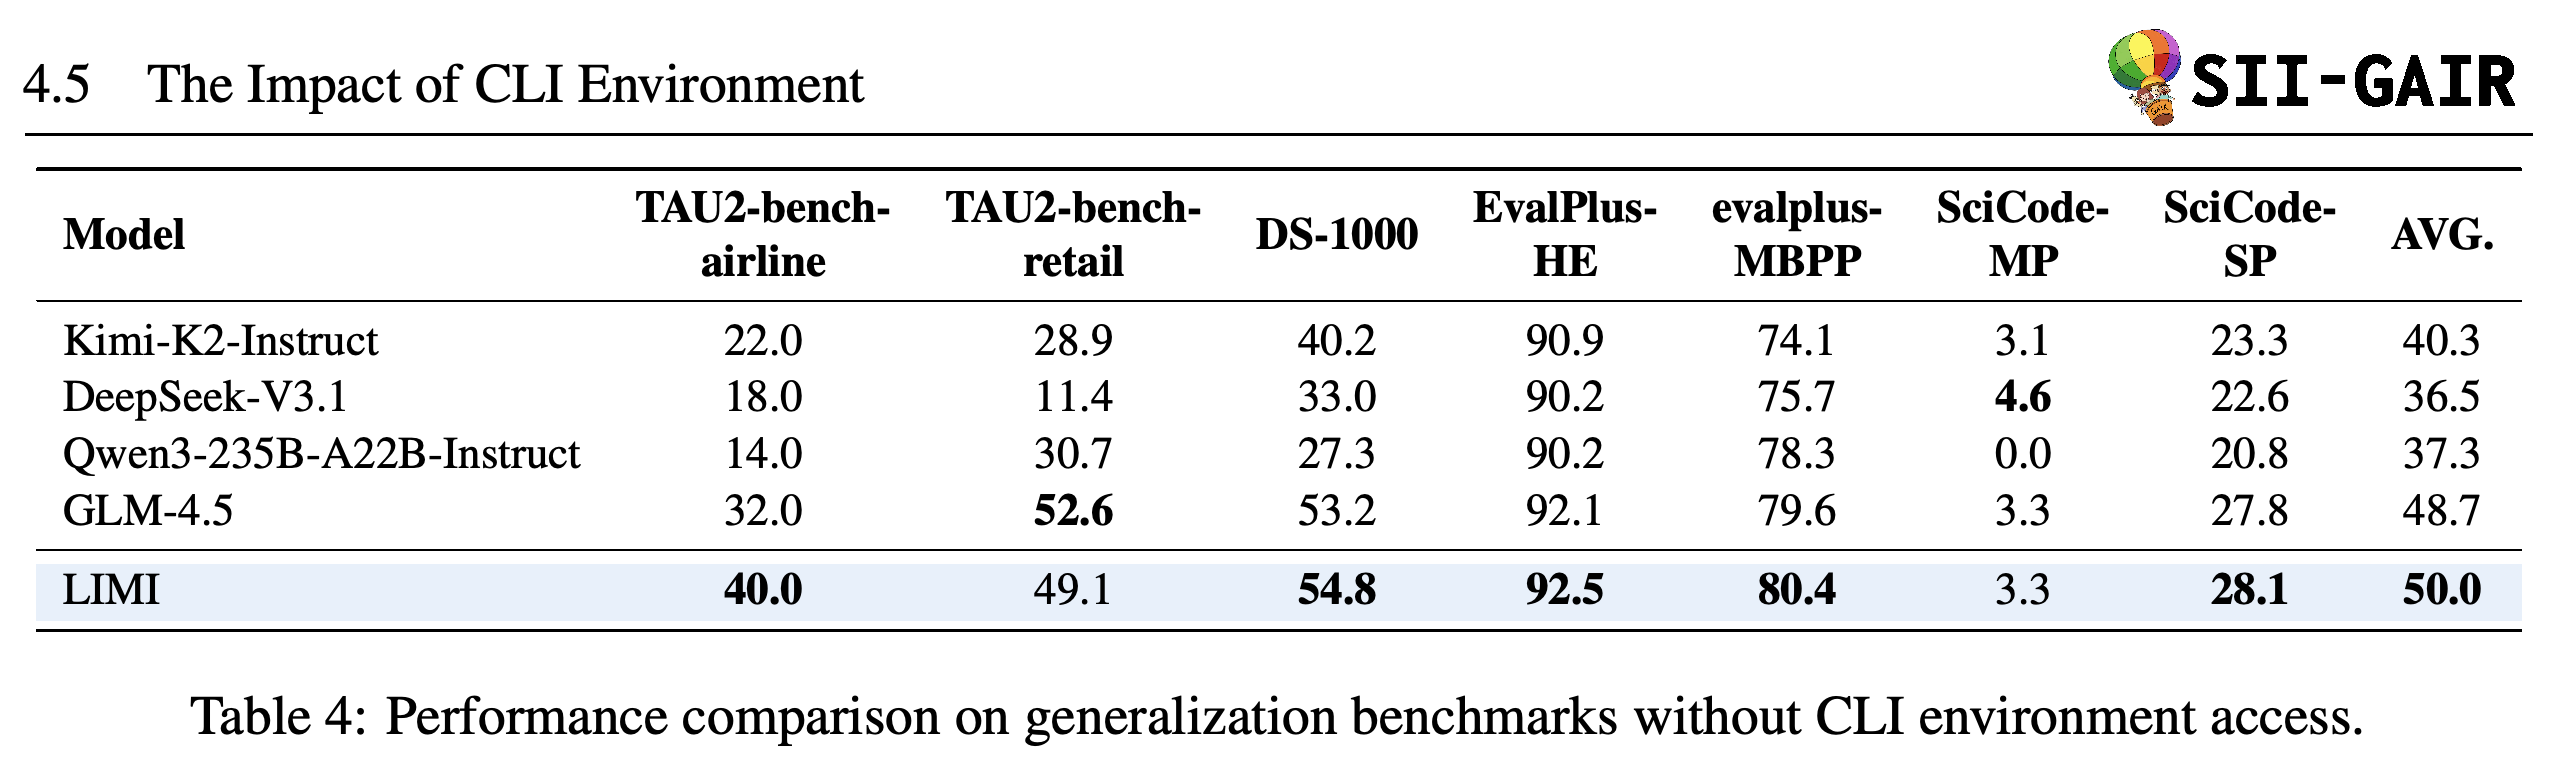
SII CLI에 접근할 수 없는 조건에서 Table 4는 LIMI의 평균을 50.0%, GLM-4.5의 평균을 48.7%로 보고한다. LIMI는 airline, DS-1000, HumanEval, MBPP, SciCode Sub Problem 점수를 높이고, SciCode Main Problem에서는 동률을 기록하며 retail에서는 52.6%에서 49.1%로 하락한다.
- 논문은 Table 3의 57.2%와 Table 4의 50.0% 차이를 SII CLI로 인한 7.2%포인트의 이득으로 해석한다. Table 3은 AgencyBench를 포함하지만 Table 4는 제외하므로, 이 차이로 환경 효과를 분리할 수 없다.
- LIMI의 동일한 평가 항목을 비교하면 SII CLI를 사용할 때 airline, retail, DS-1000, HumanEval, SciCode 지표 모두에서 표시 점수가 낮다. MBPP는 80.4%에서 82.3%로 상승한다. 이 결과는 SII CLI 접근이 일관된 이득을 준다는 점을 보여 주지 않는다.
- 보고된 Table 4 평균에 따르면 기반 모델 대비 향상 폭은 1.3%포인트이다. 그러나 LIMI의 표시 점수 7개의 산술 평균은 50.0%가 아니라 약 49.7%이며, 논문은 이 불일치를 설명하지 않는다.
SII CLI 없이 LIMI는 GLM-4.5보다 표시 점수 5개가 높고, 1개는 동률이며 retail에서는 하락한다. 보고된 평균은 50.0과 48.7이지만 LIMI의 표시 점수를 평균하면 약 49.7이다. Table 3은 AgencyBench를 포함하므로, Table 3의 AVG.와 직접 비교해도 환경의 기여를 분리할 수 없다.
5 Related work
관련 연구는 LIMI를 언어 모델 에이전트와 데이터 효율적인 적응을 함께 다루는 연구로 설명한다. 논의는 기존의 도구 학습 및 에이전트 학습 방법을 완전한 협업 시연의 선별과 연결한다.
5.1 Agentic Language Model
Toolformer는 외부 도구 사용의 학습을 연구하고 ReAct는 추론 기록과 과제별 행동을 번갈아 수행한다. 논문은 현대 에이전트 개발의 배경으로 자율적 과제 분해, GLM-4.5와 Kimi-K2의 에이전트 능력, 보상을 바탕으로 학습하는 강화 학습도 논의한다.
- LIMI는 새로운 강화 학습 목적함수나 에이전트 아키텍처를 도입하지 않고 시연을 통한 지도 학습을 사용한다. 실험적 기여는 성공한 협업 실행 기록을 선별하고 수집하는 데 집중된다.
5.2 Data Efficiency in Language Models
데이터 효율성 논의는 LIMA의 선별된 프롬프트와 응답 예시 1,000개, LIMO의 수학 추론 예시 817개를 선행 사례로 인용한다. LIMI는 이 접근을 도구, 환경 피드백, 인간과의 협업을 포함하는 시연에 적용한다.
- 이 연구들은 소규모 선별 데이터셋을 시험할 근거를 제공하지만 과제와 평가 설정이 달라 공통된 정량적 효율성 법칙을 확립하지는 않는다.
6 Conclusion
결론은 Agency Efficiency Principle을 제시하고 시연 78개로 AgencyBench에서 73.5%를 달성한 결과를 다시 강조한다. 실험은 평가한 협업 과제에서 상당한 적응 효과를 뒷받침하지만 agency가 근본적으로 다른 스케일링 원리를 따른다는 주장은 보고된 데이터셋 비교의 범위를 넘어선다.
부록
- A Agency Bench Case는 과제 예시 10개 전체를 A.1 Vibe Coding과 A.2 Research Workflow로 나누어 제공한다. 코딩 과제는 C++ 콘솔 채팅 시스템, Java 과제 관리 프로그램, Gomoku 게임, 영구 저장, 오케스트레이션, 계획 수립, 자율 복구로 발전하는 로컬 파이프라인을 구축한다. 과제 6과 8은 원본 코드와 데이터 없이 질의만 제시한다.
- A.2 Research Workflow는 인간 상태의 변화를 다루는 데이터셋인 DynToM 평가, 일반 모델 응답과 추론 기능을 활성화한 모델 응답의 통계적 비교, 데이터셋 탐색과 메타데이터 추출, 과학적 함수 피팅, 농구 선수와 기업에 관한 다중 조건 검색을 다룬다. 함수 피팅 요구사항은 손실이 1 × 10^−3, 1 × 10^−5, 1 × 10^−6, 1 × 10^−7 미만이어야 한다는 조건을 순차적으로 제시한다. 이는 과제의 통과 기준이며 보고된 모델 성과가 아니다.
- B PR Query Synthesis Prompt는 pull request 설명, 코드 변경, 커밋, 논의 맥락을 실행 가능한 개발자 질의로 바꾸는 템플릿을 제공한다. 출력에는 test_query, repo_id, pr_id, task_category, modified_files, related_files, reasoning이 포함되며, 주요 과제 범주 1개와 검증 가능한 구현 요청을 담는다.
- C Case Study는 선별한 AgencyBench 과제에서 GLM-4.5와 LIMI를 비교한다. C.1 Real-world Vibe Coding Scenarios는 LIMI가 채팅 시스템의 하위 과제를 성공적으로 완료하고 Gomoku 개발에서 더 적은 문제를 겪었다고 보고한다. 다만 LIMI의 최종 게임 플레이 난이도 구현이 불완전했다는 점도 인정한다.
- C.2 Research Workflow Applications는 전문가들이 LIMI가 검색한 데이터셋을 선호했으며 여러 농구 선수 식별 하위 과제에서 LIMI에 더 적은 힌트가 필요했다고 보고한다. 함수 피팅에서 보고된 손실은 여러 차례 상호작용한 GLM-4.5가 1.14e-6, 첫 시도의 LIMI가 5.95e-7이다. 전자의 손실은 후자의 약 1.9배이지만 원문은 손실의 크기 차수가 낮아졌다고 설명한다.
짧은 생각
이 연구의 유용한 시연 설계는 전체 과제에 걸친 실행, 피드백, 복구를 기록한다. 같은 기반 모델을 비교한 AgencyBench 결과가 효과를 가장 명확하게 뒷받침한다. FTFC는 33.9%포인트, SR@3은 27.2%포인트 상승한다. 통제된 후속 실험에서는 학습 토큰 수와 수집 작업량을 맞추면서 질의 선별, 생성 모델, trajectory 길이, 인간 개입을 변화시킬 수 있다. 이를 통해 수집 과정의 어떤 요소가 성능 향상을 만드는지 파악할 수 있다. 논문은 반복 실행에 따른 변동성, 신뢰구간, 명시적인 학습 데이터와 평가 데이터의 중복 점검을 보고하지 않는다. AgencyBench의 상위 과제 10개와 선별된 정성적 사례만으로는 폭넓은 일반화 여부가 불확실하다. 보고된 평균으로 일반적인 효율성 원리나 실행 환경의 이득을 추론하기 전에 수치와 집계 방식의 불일치를 명확히 설명할 필요가 있다.