


Mem-{\alpha}: Learning Memory Construction via Reinforcement Learning 요약 설명
30 Sep 2025 | Paper Review Agent's Memory Reinforcement Learning Tool Use목차
이번 글에서는 Mem-{\alpha}: Learning Memory Construction via Reinforcement Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 30일(Arxiv)
- Wang, Yu, Takanobu, Ryuichi, Liang, Zhiqi, Mao, Yuzhen, Hu, Yuanzhe, McAuley, Julian, Wu, Xiaojian.
- Anuttacon, University of California San Diego, Stanford University
- 논문 링크
- Github
요약
- 대규모 언어 모델(LLM) 에이전트는 제한된 컨텍스트 윈도우 밖에 정보를 보존해야 하지만 저장 도구를 제공하는 것만으로 유용한 정보를 유지하고 정리하게 되지는 않는다. Mem-α는 메모리 구조, 검색 시스템, 고정된 답변 생성기를 동일하게 유지한 상태에서 보상 피드백으로 정책을 최적화하는 강화학습을 적용한다. 그 결과 Qwen3-4B의 평균 검증 점수를 0.389에서 0.642로 높였으며 메모리 작성기로 gpt-4.1-mini를 사용했을 때의 0.517보다 높은 점수를 얻었다.
- 에이전트는 항상 접근할 수 있는 요약인 core memory, 사실 진술을 모은 semantic memory, 타임스탬프가 있는 사건을 모은 episodic memory를 갱신하는 방법을 학습한다. 학습에는 후속 답변의 정확성, 도구 실행 성공 여부, 압축, 모델이 평가한 메모리 유효성을 함께 사용한다. 논문은 최대 입력 길이가 30k tokens인 학습 사례 562개를 표본으로 추출해 사용했다고 보고한다.
- 점진적인 메모리 처리를 평가하는 MemoryAgentBench에서 Mem-α의 평균 점수는 0.592다. 원본 청크를 검색하는 방식은 0.502, 컨텍스트 윈도우를 32k tokens로 제한한 모델은 0.461이며, 평가 입력 길이는 최대 474K tokens에 이른다. 결과는 과제마다 다르고, 충돌 해결과 운영 환경에서의 성능은 평가하지 않았다. 논문에는 보상 가중치와 데이터셋 사례 수가 서로 일치하지 않는 부분도 있다.
1 INTRODUCTION
기존 외부 메모리 에이전트는 정보를 지속적으로 저장하고 갱신하는 도구를 제공하지만 무엇을 보존하고 어떻게 정리할지는 프롬프트에 의존하는 경우가 많다. Mem-α는 정답으로 제공된 메모리 구성 과정 없이 보상으로 순차적인 메모리 작성 정책을 학습한다.
- 논문이 제시하는 기여는 3가지다. 메모리 작성을 순차적 의사결정 문제로 정식화하고 여러 상호작용 패턴을 포괄하는 학습 데이터를 구성하며 요약, 사실, 사건을 별도로 저장하는 메모리 구조를 제안한다.
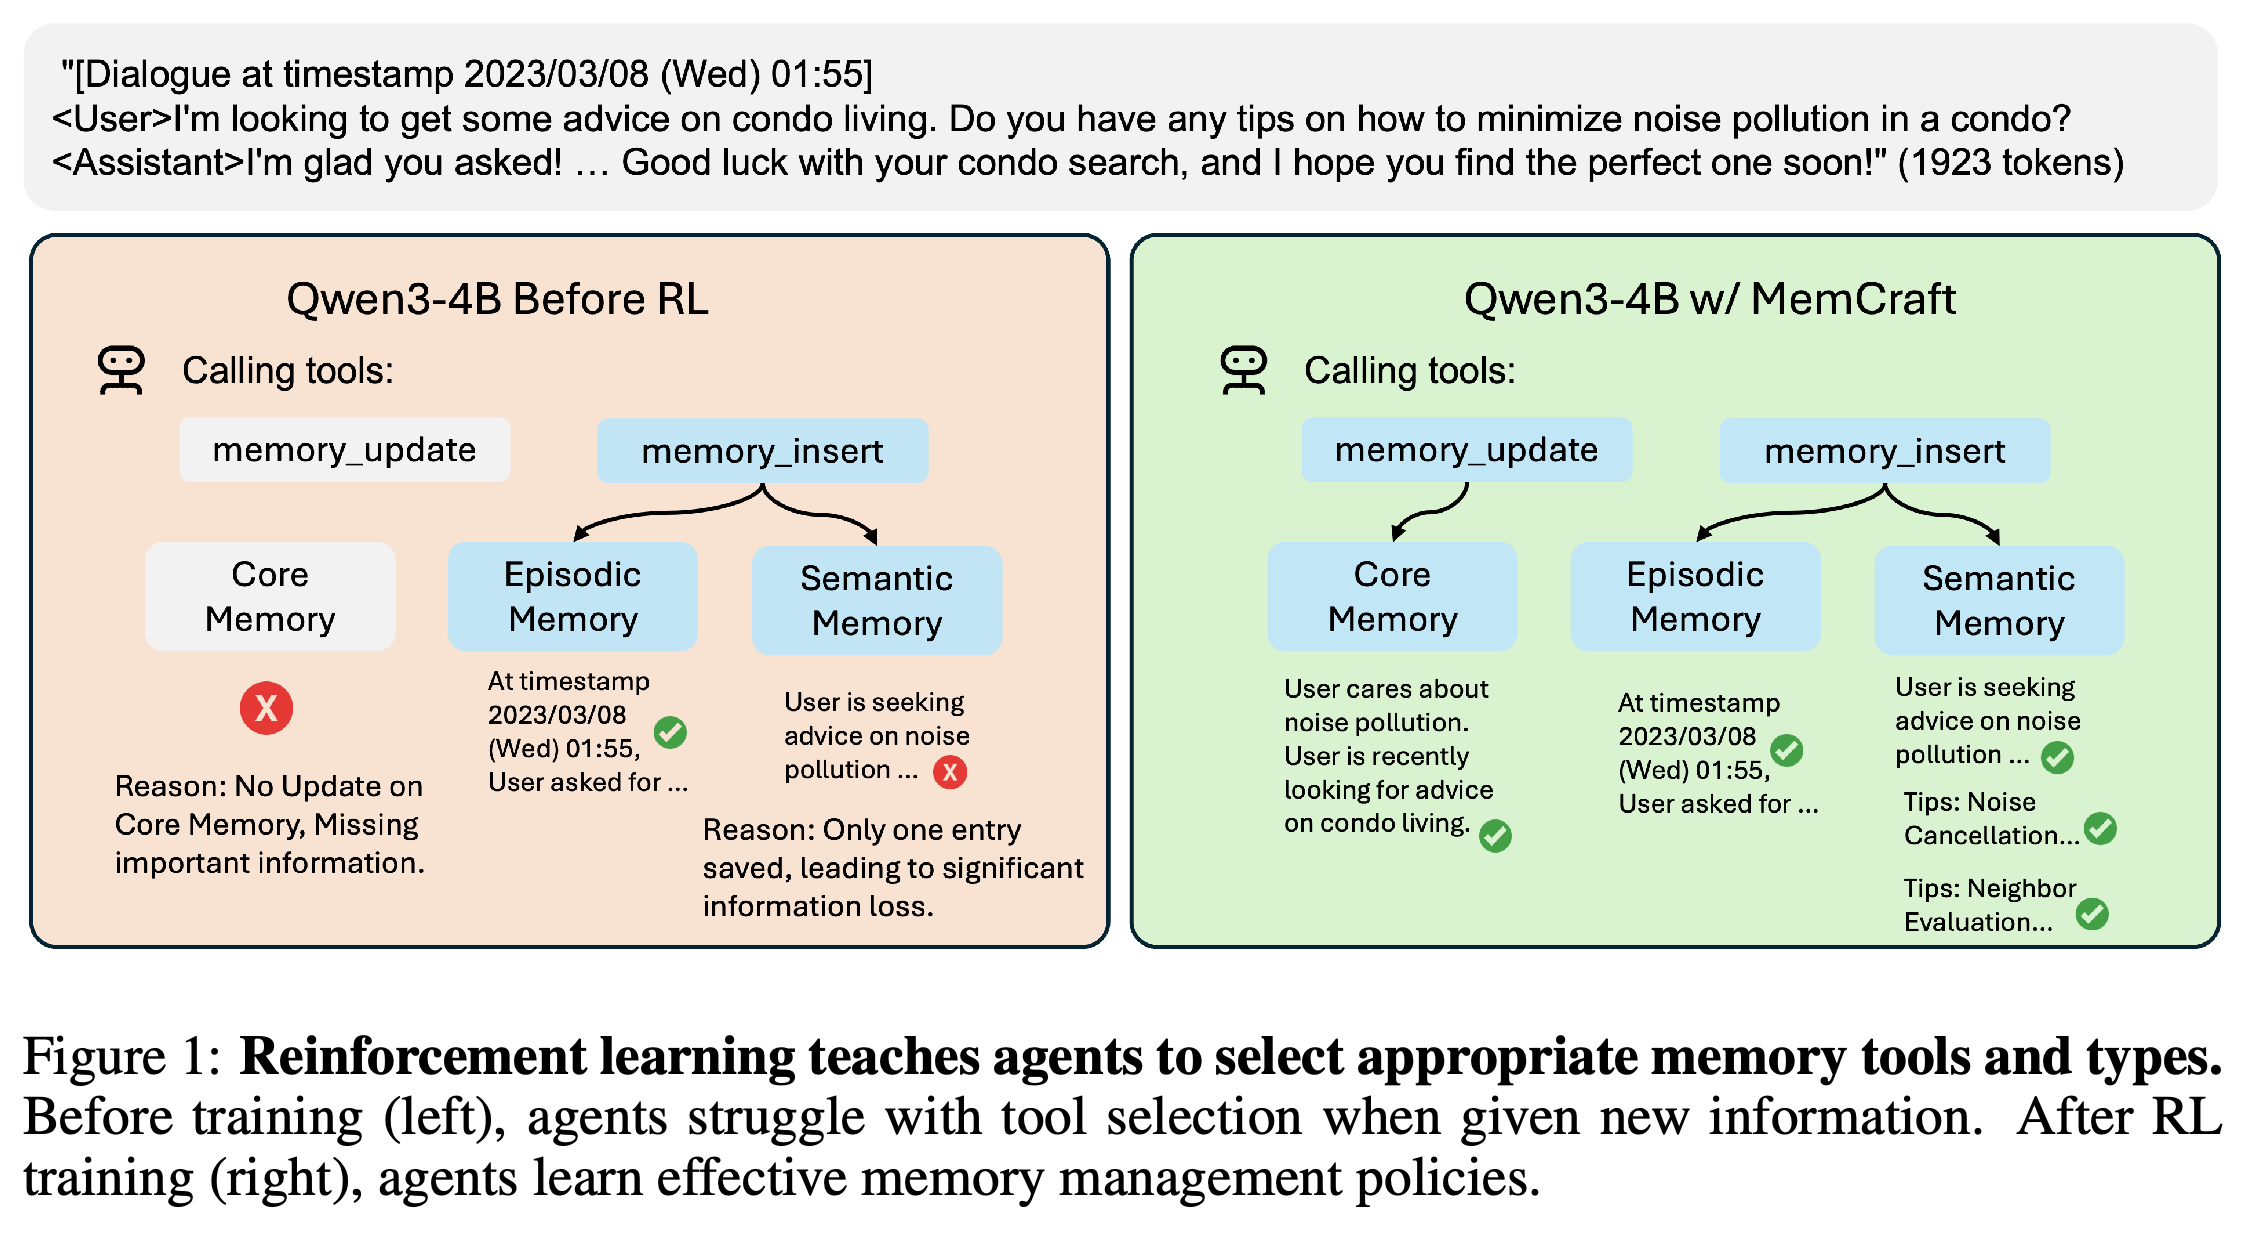
- Figure 1은 연구 동기를 보여준다. 학습하지 않은 작성기는 core memory를 비워 두고 불완전한 semantic 항목을 저장하지만 학습한 작성기의 예시는 3개 저장소를 모두 사용한다.
이 예시는 연구 동기를 구체적인 작성 오류와 연결한다. 학습하지 않은 모델은 core memory를 누락하고 불완전한 semantic 내용을 보존하지만 학습한 모델의 예시는 3개 저장소에 정보를 나누어 저장한다. 이 그림은 행동을 보여주며, 발생 빈도를 측정하지는 않는다.
2 Related Work
논문은 모델 내부에 정보를 인코딩하는 Latent-Space Memory와 데이터베이스 등 외부 저장소에 정보를 유지하는 LLM Agents with External Memory를 구분한다. Learning Memory Construction with Reinforcement Learning을 문단 재작성이나 단순한 사실 목록보다 풍부한 저장 구조를 활용해 외부 메모리 도구 사용을 개선하는 접근으로 제시한다.
- 저자들은 잠재 공간 방식이 효율적으로 정보를 압축하지만 용량이 제한되고 모델 내부에 접근해야 하므로 비공개 모델에 적용하기 어려울 수 있다고 설명한다.
- 앞선 강화학습 접근에는 MEM1, MemAgent, Memory-R1, Learn-to-Memorize, REMEMBER가 있다. 논문은 이들 중 일부가 사용한 비교적 짧은 대화 환경과 본 연구의 평가 조건을 비교한다.
3 Method
제안 방법은 메모리 작성 학습을 정보 검색과 답변 생성에서 분리한다. 순차적인 작성 환경, 4개 요소로 구성된 보상, 정책 최적화, 3개 저장소를 갖춘 메모리 구현, 과제별 데이터를 변환한 대화 청크를 결합한다.
3.1 Reinforcement Learning Framework
3.1.1 TASK SETUP에서 에이전트는 빈 메모리로 시작해 대화를 청크 단위로 처리한다. 각 청크의 행동은 memory_insert, memory_update, memory_delete를 사용하는 구조화된 함수 호출의 시퀀스로 구성된다. 호출 인자에는 레코드 식별자, 메모리 유형, 내용 등이 포함된다.
- 에이전트는 함수 호출로 현재 메모리를 수정한 뒤 다음 청크로 이동한다. 최종 메모리와 기록된 행동으로 보상을 결정한다.
- Figure 2는 학습 가능한 메모리 작성기와, 메모리가 질문에 답하는 데 도움이 되는지 평가하는 고정된 후속 과정을 구분한다.
이 도식은 학습 가능한 작성기와 고정된 검색, 답변 생성을 구분한다. 최종 메모리로 생성한 답변의 품질과 압축은 시퀀스 수준의 피드백을 제공하고 도구 실행 성공 여부와 메모리 유효성은 개별 작성 행동에 피드백을 제공한다.
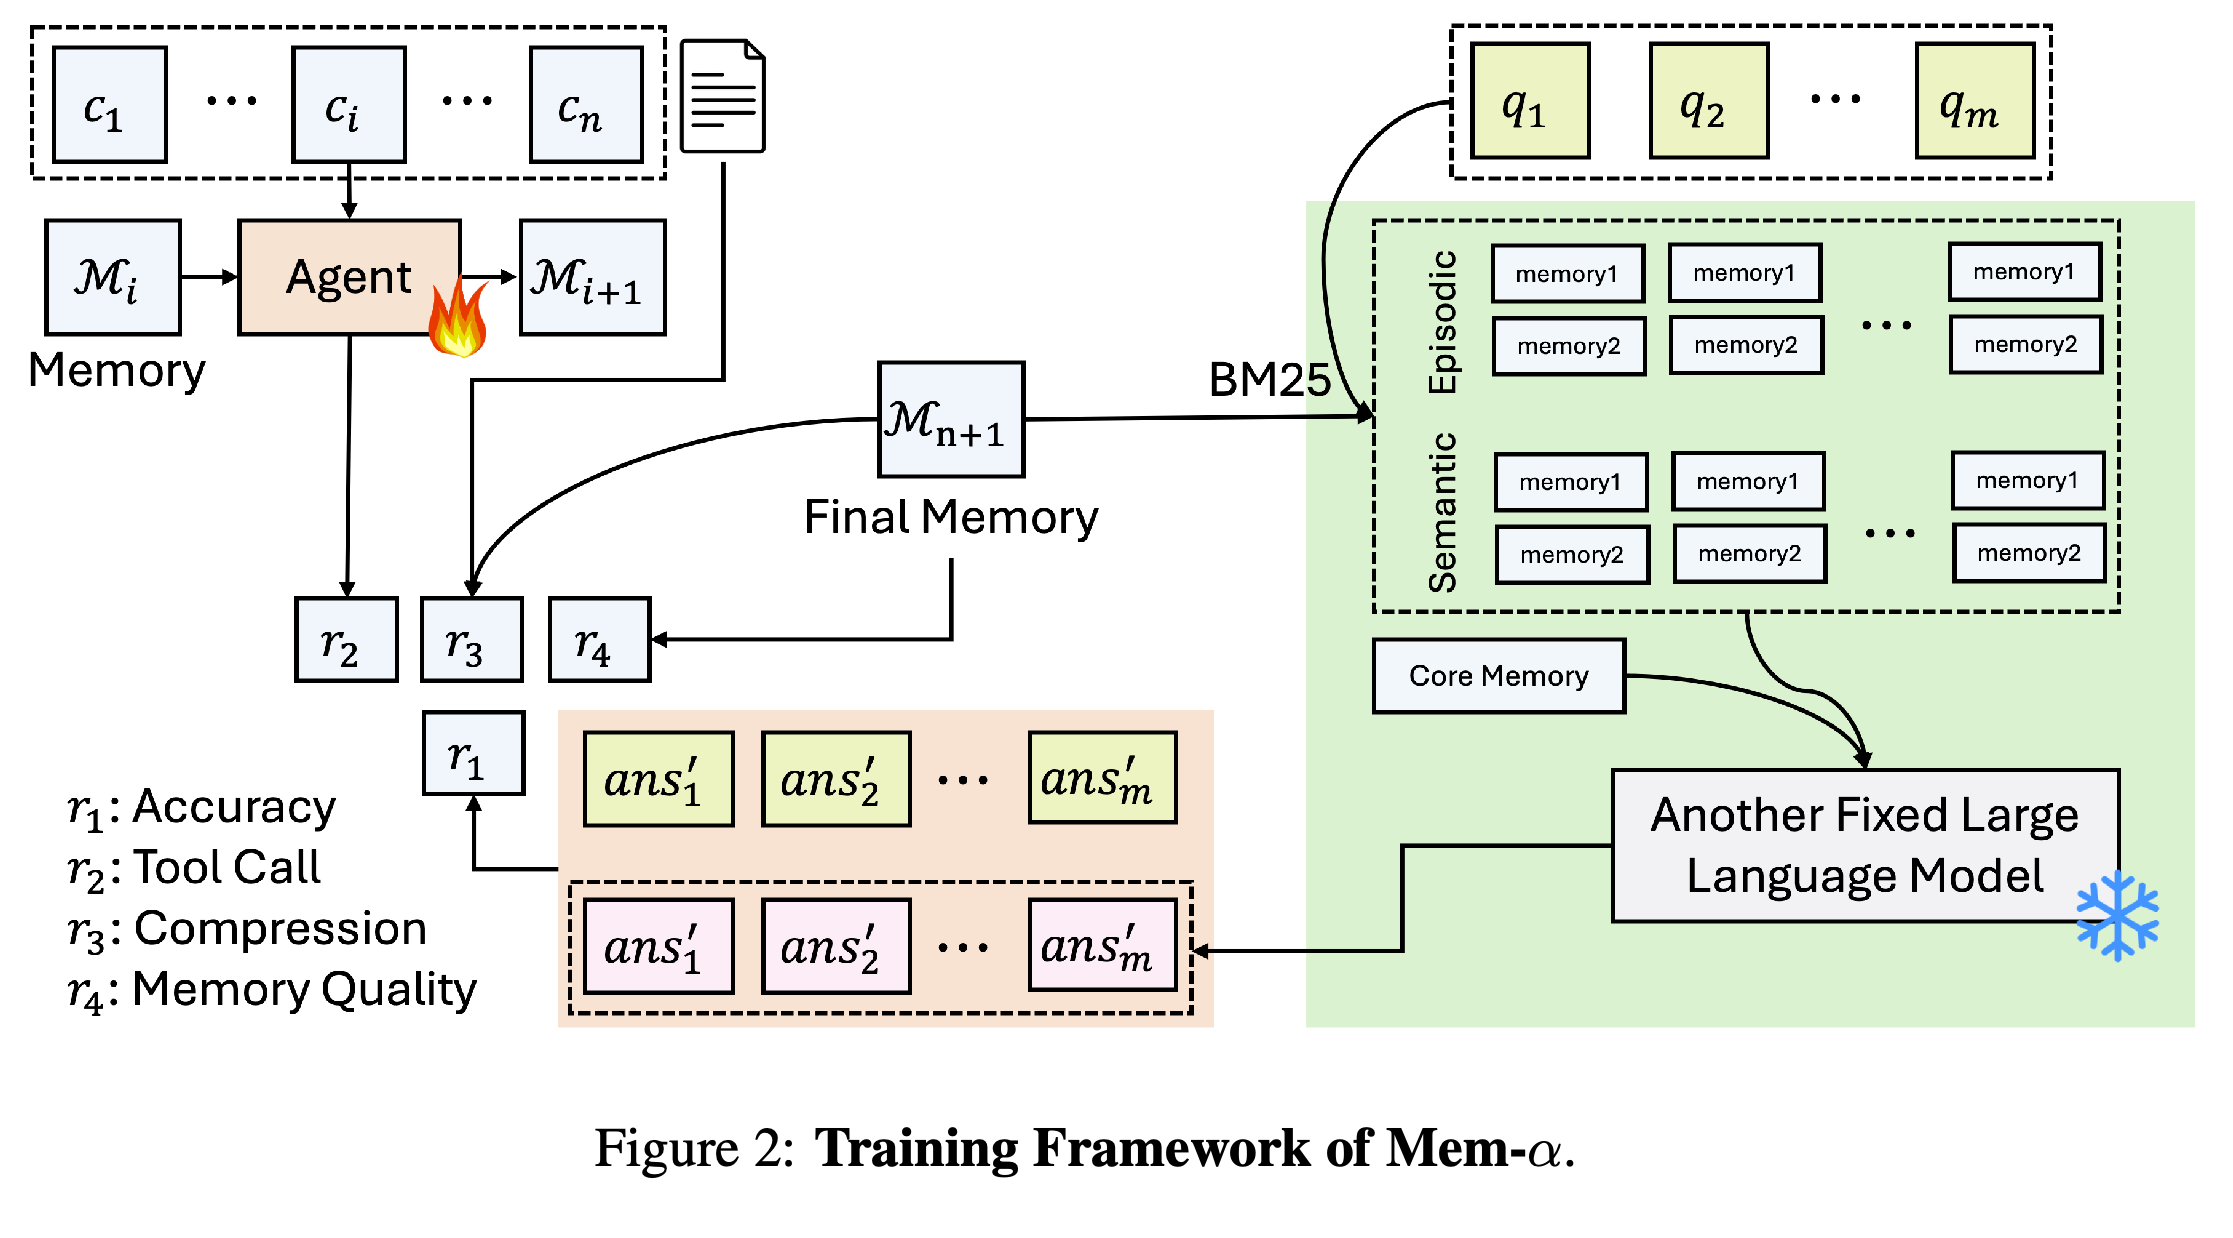
3.1.2 REWARD FUNCTIONS의 통합 보상은 \(r_t = r_1 + r_{2,t} + \beta r_3 + \gamma r_{4,t}\)다. 정확성 보상은 후속 답변을 평가하고 도구 호출 형식 보상은 실행 성공 여부를 평가한다. 압축 보상은 입력 길이에서 저장된 메모리 길이로 줄어든 정도를 평가하며 메모리 내용 보상은 Qwen3-32B가 작업을 의미적으로 유효하다고 판단하는지 평가한다.
- 정확성과 압축 보상은 최종 메모리에 따라 결정되며, 시퀀스의 모든 행동에 공통으로 적용된다. 실행과 내용 유효성 보상은 행동별로 계산한다.
- 압축 보상은 \(r_3 = 1 - \frac{l_m}{l_c}\)다. 여기서 l_m은 저장된 메모리의 총길이이고, l_c는 입력 청크의 총길이다.
- 정확성과 도구 실행의 가중치는 1로 고정한다. β와 γ는 각각 압축과 내용 유효성의 가중치를 조절한다.
3.1.3 MEMORY COMPREHENSIVENESS EVALUATION VIA RAG에서는 검색한 메모리를 근거로 답하는 retrieval-augmented generation (RAG)으로 최종 메모리를 평가한다. BM25는 질문에 대한 메모리 항목의 순위를 매기는 검색 방법이다. Semantic memory와 episodic memory에서 순위가 가장 높은 k개 항목인 top-k를 선택하면, 고정된 생성기가 질문에 답한다. 생성된 답변은 데이터셋별 지표로 정답과 비교한다.
- 작성 정책만 학습한다. 검색과 생성은 고정하므로, 후속 파이프라인이 검색하고 활용할 수 있는 정보를 통해 작성기를 평가한다.
3.2 Policy Optimization
Mem-α는 표본으로 추출한 행동 그룹의 평균과 표준편차를 기준으로 보상을 정규화하는 Group Relative Policy Optimization (GRPO)을 사용한다. Equation (2)는 행동 토큰과 시퀀스 단계에 걸쳐 클리핑된 확률비 목적함수를 적용한다. 이 목적함수는 이전 정책에 비해 행동 토큰의 확률이 변하는 정도를 제한한다.
- 저자들은 탐색을 장려하기 위해 정책의 이탈에 페널티를 주는 Kullback–Leibler (KL) 발산 항을 제거한다.
- 시퀀스 수준 보상과 행동 수준 보상을 모두 정규화된 advantage에 반영한다. 이는 표본 그룹과 비교한 해당 행동의 상대적인 보상이다.
3.3 MEMORY Instantiation
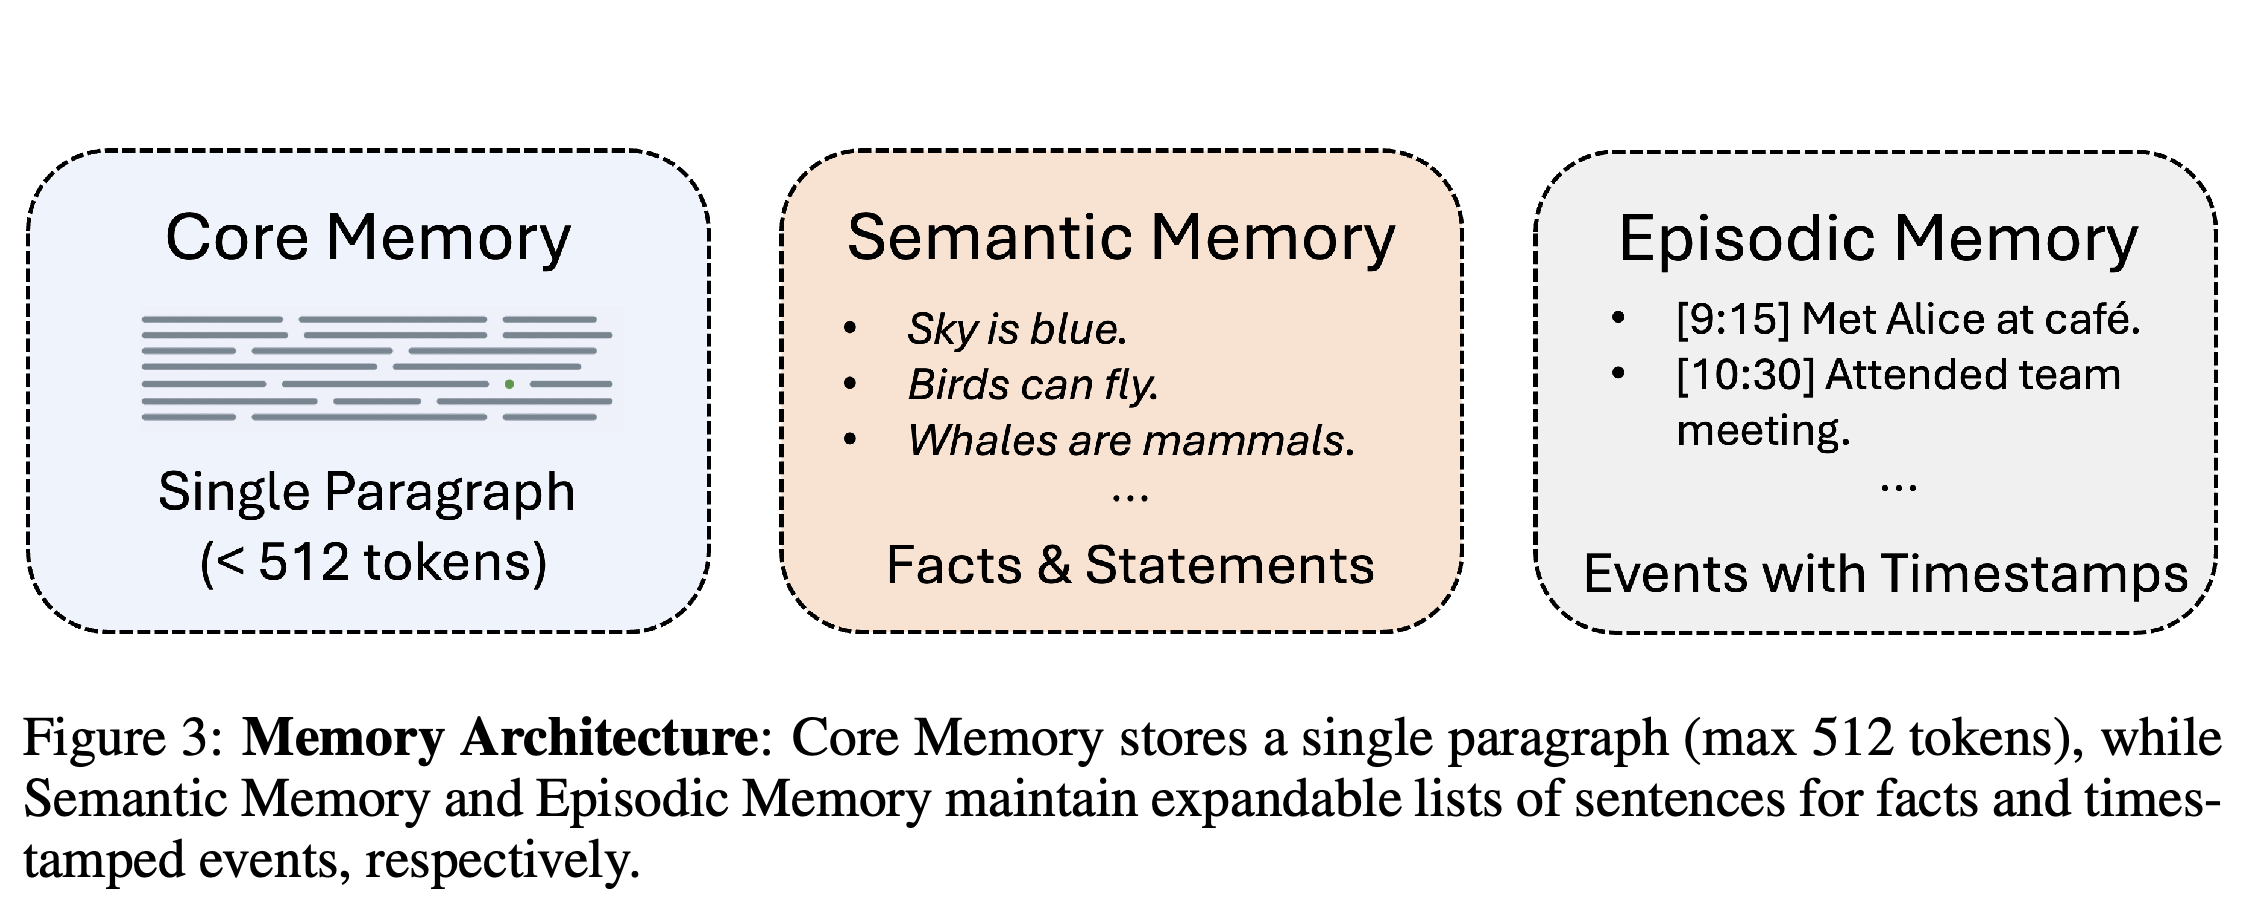
Core Memory는 최대 512 tokens의 요약을 지속적으로 유지하며 에이전트의 컨텍스트에서 계속 사용할 수 있다. Semantic Memory는 개별적으로 검색할 수 있는 사실 진술을 저장한다. Episodic Memory는 타임스탬프가 있는 사건을 시간순으로 정리해 저장한다.
- Semantic과 episodic 저장소는 memory_insert, memory_update, memory_delete를 지원한다. Core memory는 memory_update만 지원하며 전체 요약을 다시 작성한다.
- Figure 3은 길이가 제한된 core 문단과 확장할 수 있는 사실, 사건 목록을 구분한다.
- 논문은 메모리 구조를 학습 프레임워크에서 분리할 수 있다고 설명하지만 실험에서는 이 구현만 평가한다.
각 형식에는 서로 다른 작성 작업이 필요하다. 짧은 전체 요약을 유지하고 개별 사실을 보존하며 시간적 맥락과 함께 사건을 기록해야 한다. 명시된 512-token 제한은 core 저장소에만 적용되며, 나머지 목록은 확장할 수 있다.
3.4 TRAINING DATASET Preparation
학습은 이전 컨텍스트에서 정보를 찾는 Accurate Retrieval, 배포 중 예시로 분류 패턴을 학습하는 Test-Time Learning, 긴 시퀀스에 걸친 정보를 통합하는 Long-Range Understanding을 대상으로 한다. 새 근거가 저장된 정보와 모순될 때 메모리를 수정하는 Conflict Resolution은 제외한다. 저자들은 기존 벤치마크가 충분히 현실적이지 않다고 판단한다.
- 구성한 데이터셋에는 8개 출처의 학습 사례 4,139개가 있다. 출처 간 불균형을 줄이기 위해 출처별로 표본을 추출하는 층화 표집을 적용해, 논문에서 보고한 학습 부분집합 562개를 구성한다.
- 각 사례에는 여러 청크와 관련 평가 질문이 포함되므로, 일련의 메모리 작성 결정을 구성한다.
- 데이터에는 문서 질문, 개인 대화, 라벨이 있는 분류 예시, 책의 장이 포함된다.
4 Experiments
실험은 검증 데이터와 입력이 더 긴 MemoryAgentBench 테스트 모음에서 과제 성능과 저장된 메모리의 토큰 수를 비교한다. 추가 비교에서는 작성기 학습, 보상 가중치 선택, 메모리 구성 과정의 예시를 살펴본다.
4.1 EXPERIMENTAL SETUP
테스트 모음은 문서 검색 과제인 Single-Doc과 Multi-Doc, 대화 메모리 과제 LongMemEval을 수정한 LME(S*), 질문을 대분류와 세분류로 나누는 TREC-C와 TREC-F, 의도 분류 과제 NLU, 도메인별 의도 분류 과제 CLINIC과 BANKING77, 긴 소설 요약 과제 InfBench-Sum을 포함한다. 비교 기준은 마지막 32k tokens만 사용하는 Qwen3-32B인 Long-Context, BM25로 원본 청크 2개를 검색한 뒤 Qwen3-32B로 답하는 RAG-Top2, 학습된 메모리 시스템인 MemAgent와 MEM1이다.
- 학습에는 프레임워크 verl과 Qwen3-4B를 사용한다. H100 GPUs 32개에서 learning_rate 1e-6, batch_size 32, grpo_rollout_n 8로 3일 동안 205 steps를 학습한다. 검증 성능을 기준으로 최적 체크포인트를 선택한다.
- Section 4.1은 β = 0.05와 γ = 1을 보고하지만 Section 4.4와 Tables 4 and 9는 주요 결과에 해당하는 설정을 β = 0.05와 γ = 0.1로 제시한다.
- 보고된 평균은 분류 정확도와 요약 키워드 포함률 등 데이터셋별 점수의 평균이다. 요약 키워드 포함률은 정답 키워드 중 생성된 요약에 포함된 비율을 뜻한다. 따라서 평균은 단일한 공통 지표가 아니다.
4.2 Overall Performance Comparison
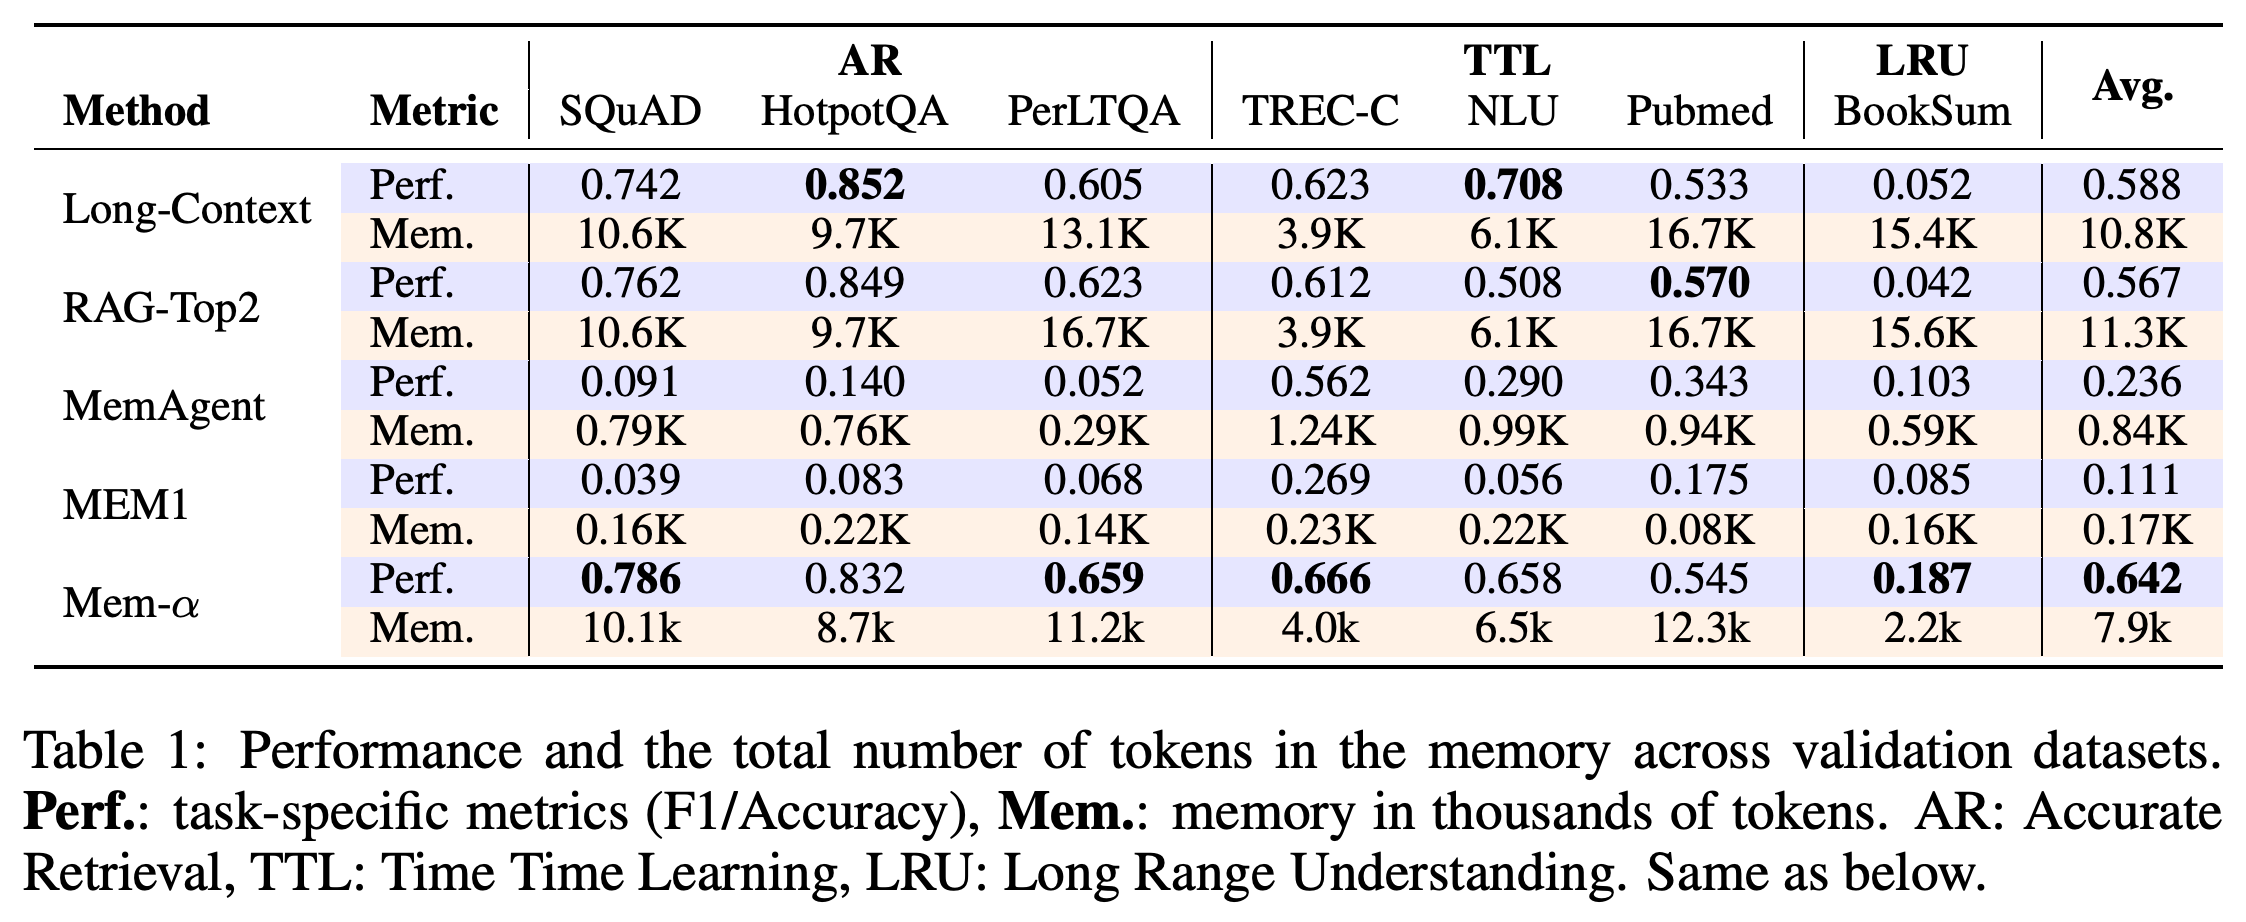
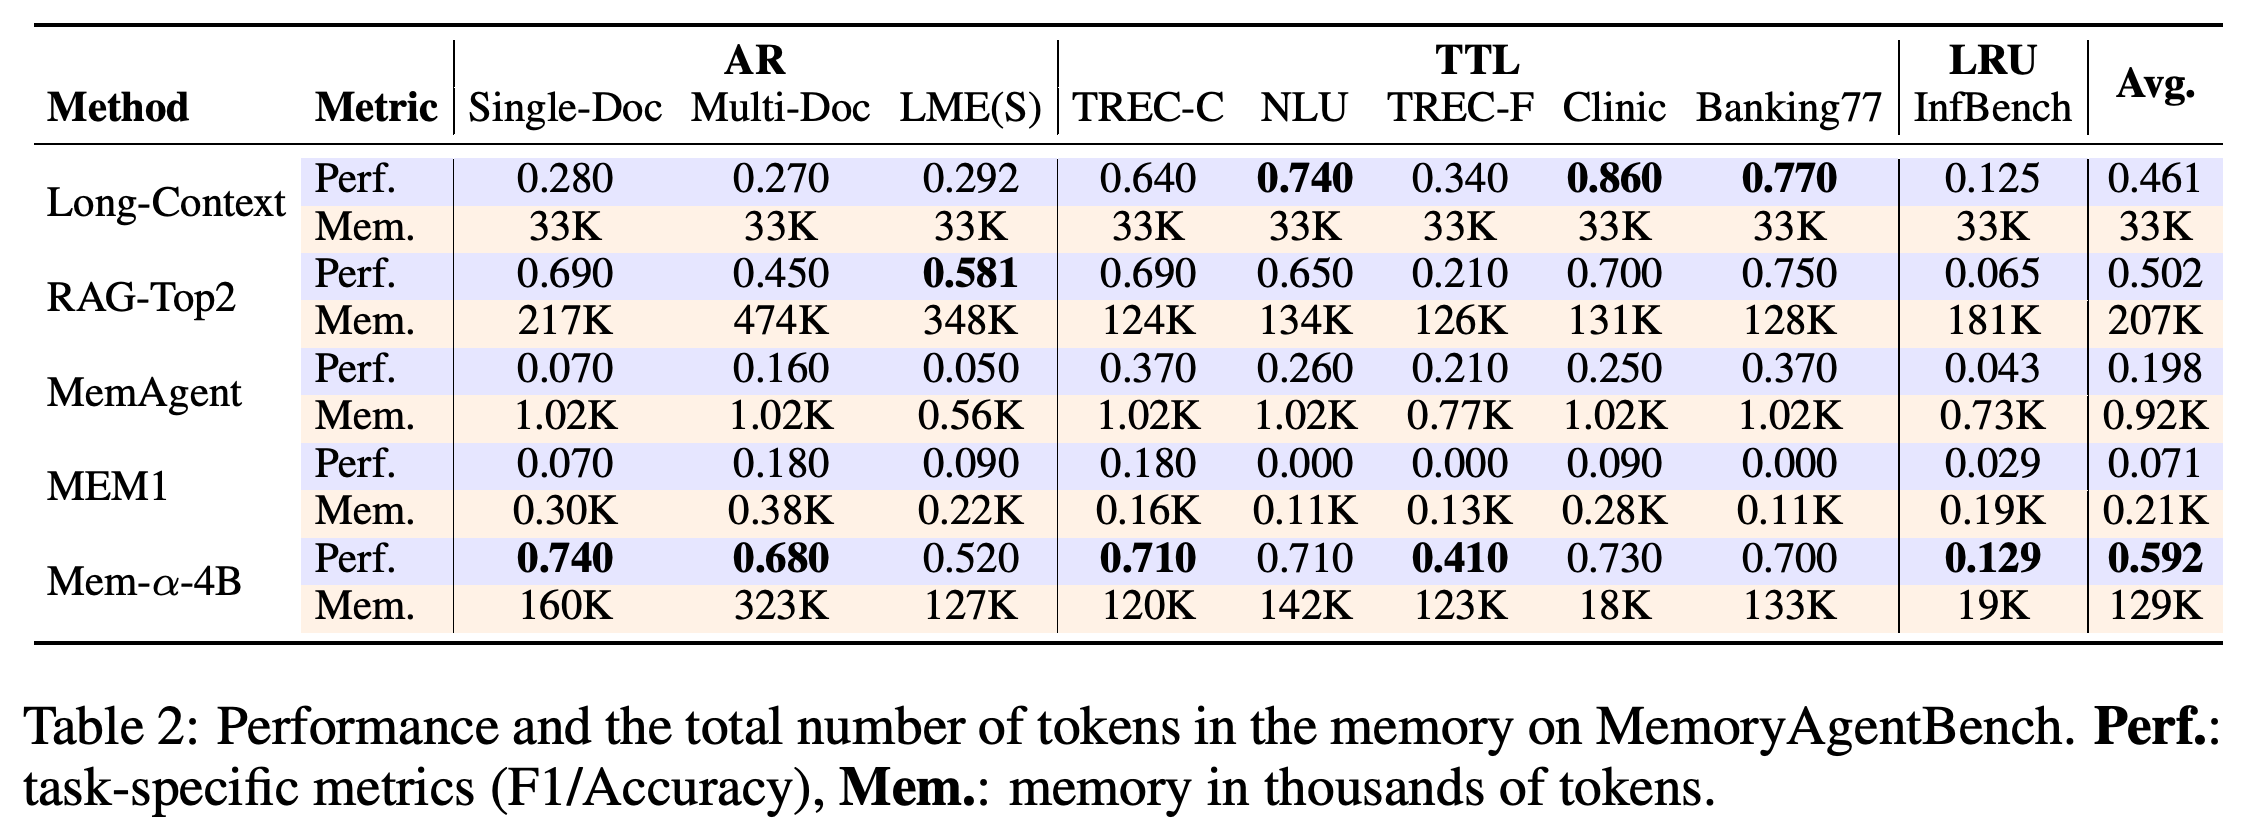
Table 1에서 Mem-α의 평균 검증 점수는 0.642다. Long-Context는 0.588, RAG-Top2는 0.567, MemAgent는 0.236, MEM1은 0.111이다. Table 2의 테스트 평균은 같은 순서로 0.592, 0.461, 0.502, 0.198, 0.071이며, Mem-α는 테스트 과제 9개 중 5개에서 가장 높은 점수를 얻는다.
- Multi-Doc에서 Mem-α는 0.680, RAG-Top2는 0.450, Long-Context는 0.270을 기록한다. 저장량은 Mem-α가 323K tokens이며, RAG-Top2는 474K tokens다.
- LME(S)에서는 RAG-Top2가 0.581로 Mem-α의 0.520보다 높다. NLU, Clinic, Banking77에서는 Long-Context가 각각 0.740, 0.860, 0.770으로 가장 높은 점수를 얻는다.
- 평균 테스트 저장량은 Mem-α가 129K tokens, RAG-Top2가 207K tokens다. 다만 Mem-α는 Long-Context의 보고된 저장량인 33K tokens보다 많이 저장하므로, 저장량의 이점은 비교 기준에 따라 달라진다.
- 보고된 최대 학습 길이는 30k tokens이고, Multi-Doc 평가 입력은 474K tokens에 이른다. 이는 청크 단위 처리 설정에서 학습 길이를 넘어서는 일반화를 뒷받침한다.
Mem-α는 평균 검증 점수가 0.642로 가장 높으며 평균 저장량은 7.9K tokens다. 다만 개별 과제에서는 결과가 다르다. HotpotQA와 NLU에서는 Long-Context가, Pubmed에서는 RAG-Top2가 가장 높은 점수를 얻는다.
Mem-α는 Single-Doc, Multi-Doc, TREC-C, TREC-F, InfBench에서 가장 높은 점수를 얻으며 전체 평균도 0.592로 가장 높다. 평균 저장량 129K tokens는 RAG-Top2의 207K tokens보다 적지만 Long-Context의 33K tokens보다 많다. 나머지 4개 과제에서는 가장 높은 점수를 얻지 못한다.
4.3 Performance Boost from Reinforcement Learning
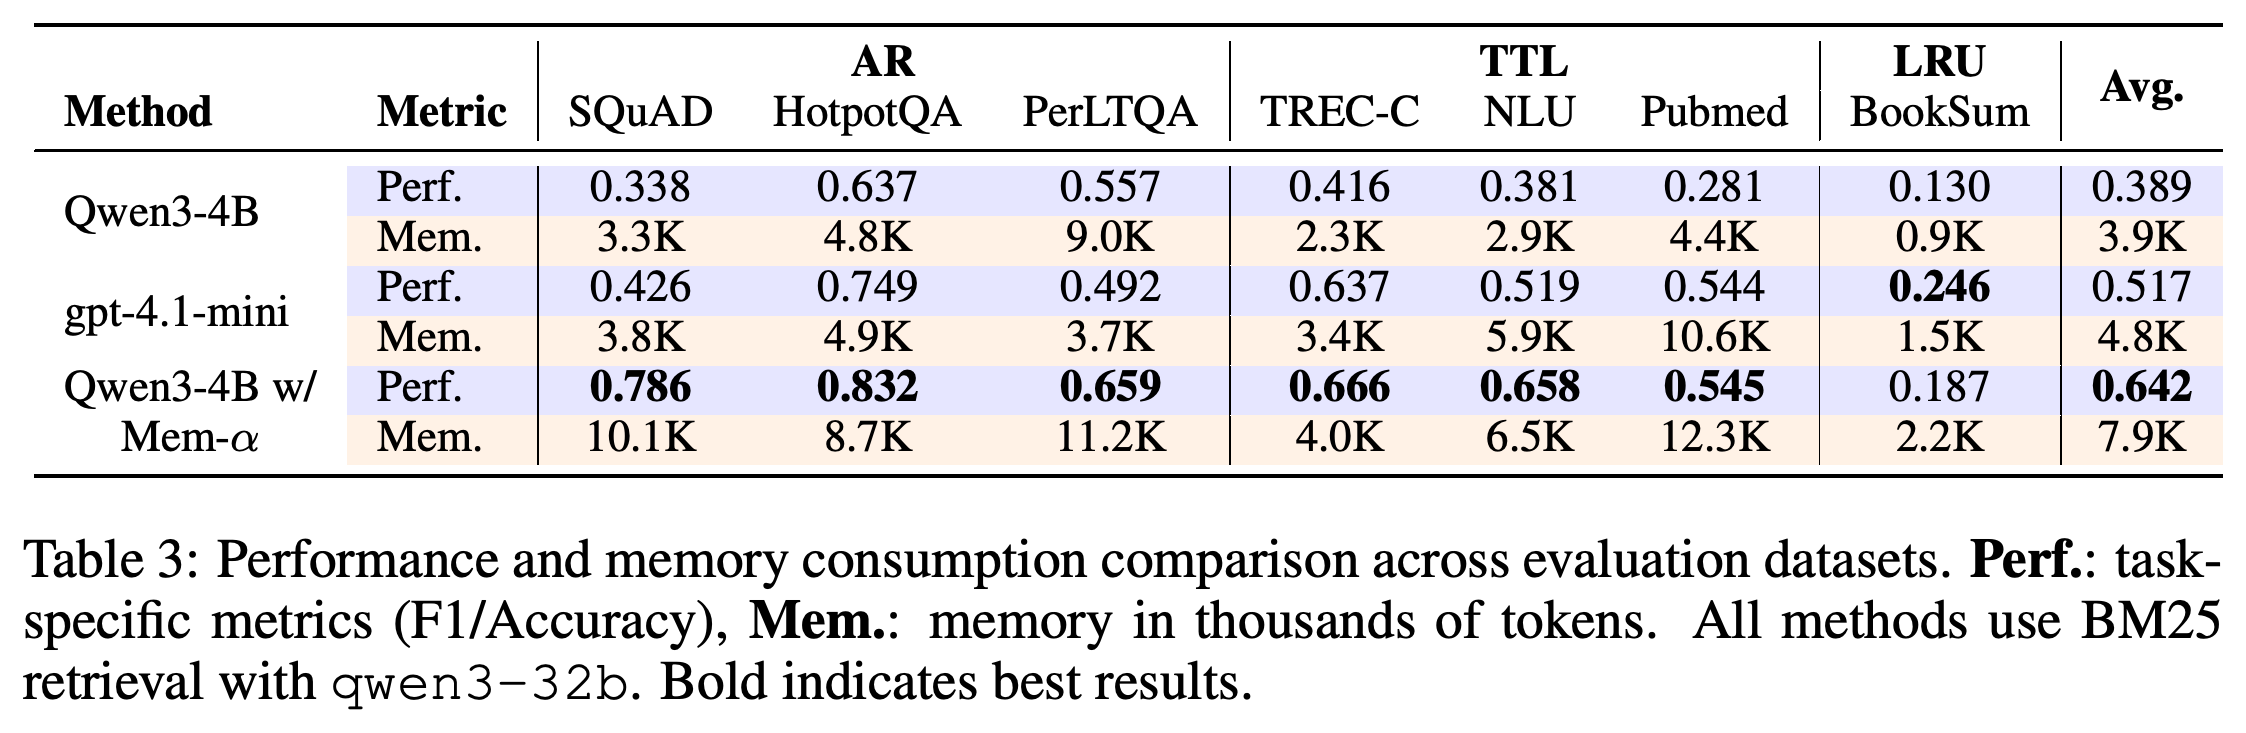
Table 3은 메모리 구조, BM25 검색, Qwen3-32B 답변 생성기를 고정하고 작성기만 바꾼다. Mem-α는 Qwen3-4B의 평균 검증 점수 0.389를 0.642로 높이며 gpt-4.1-mini의 0.517도 넘어선다. 이는 해당 메모리 구조에서 학습의 효과를 뒷받침한다.
- 평균 저장량은 학습하지 않은 Qwen3-4B 작성기의 3.9K tokens에서 Mem-α의 7.9K tokens로 증가한다. 따라서 성능 향상과 함께 더 많은 정보를 보존한다.
- 책의 장을 요약하는 BookSum에서는 gpt-4.1-mini가 0.246으로 Mem-α의 0.187보다 좋은 성능을 보인다.
- 이 비교만으로 선택한 메모리 구조가 다른 메모리 설계보다 우수하다는 점을 독립적으로 입증하지는 못한다.
검색과 답변 생성을 고정한 상태에서 Qwen3-4B를 학습하면 평균 성능이 0.389에서 0.642로 높아지고, 평균 저장량은 3.9K에서 7.9K tokens로 증가한다. 이 비교는 메모리 작성의 개선을 뒷받침하지만 BookSum에서는 gpt-4.1-mini의 성능이 더 높으므로 전체적인 우위를 모든 과제에 적용할 수는 없다.
4.4 ABLATION Studies
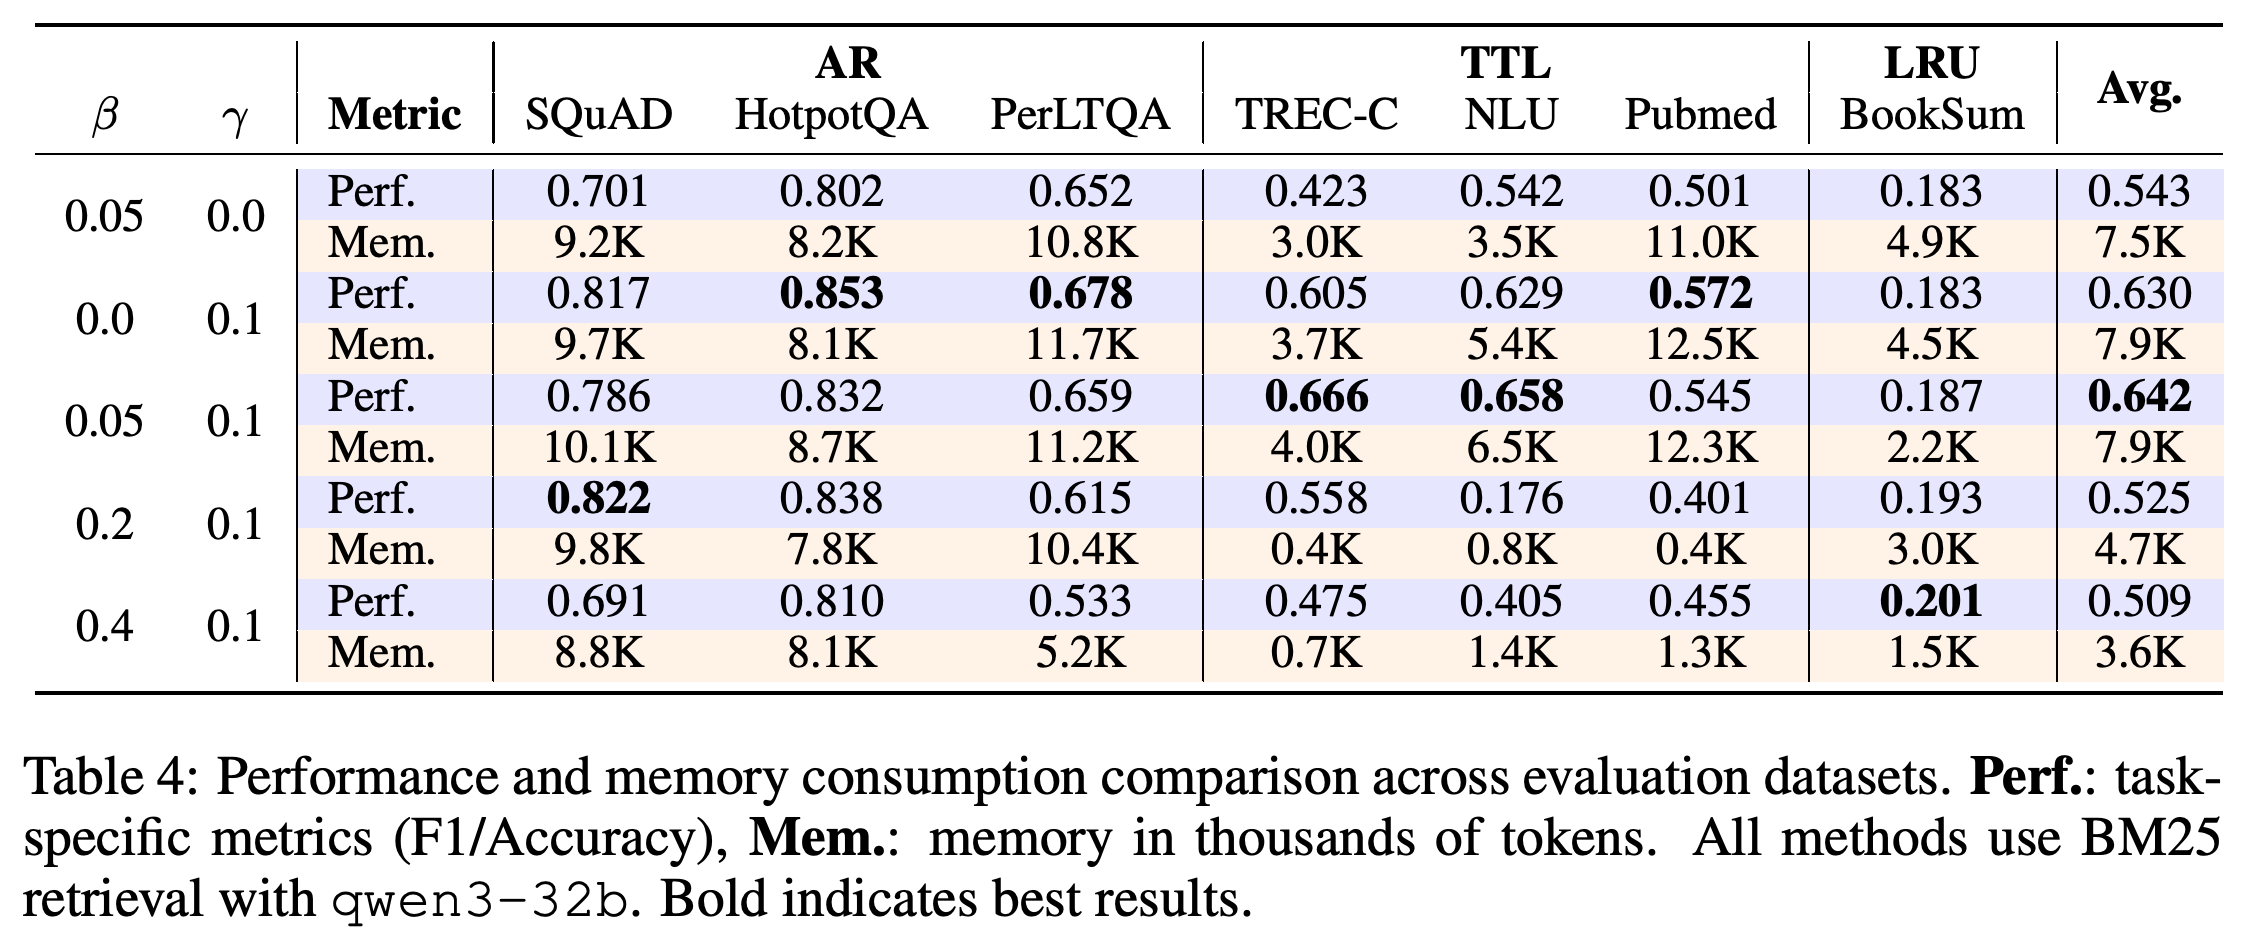
Table 4에서 β = 0.05, γ = 0.1의 평균 검증 점수는 0.642다. γ = 0일 때는 0.543, β = 0일 때는 0.630이다. β를 0.2 또는 0.4로 높이면 평균 메모리는 각각 4.7K 또는 3.6K tokens로 줄지만 평균 성능도 0.525 또는 0.509로 낮아진다.
- 내용 유효성 보상을 제거하면 평균 성능이 낮아지지만 검색 점수는 여전히 상당한 수준을 유지한다. 표는 성능 저하를 뒷받침하지만 유용한 메모리 구성 방법을 전혀 학습하지 못했다는 점까지 입증하지는 않는다.
- BookSum에서 γ = 0.1인 상태로 β = 0.05를 추가하면 메모리가 4.5K에서 2.2K tokens로 줄고, 성능은 0.183에서 0.187로 변한다.
- 선택한 설정은 비교한 설정 중 보고된 평균이 가장 높지만 개별 과제에서는 다른 설정이 가장 높은 점수를 얻기도 한다.
β = 0.05, γ = 0.1 설정에서 보고된 평균 검증 점수가 가장 높다. 압축 가중치를 높이면 평균 메모리 길이가 줄고 평균 성능도 낮아지며, 특히 분류 과제의 성능이 저하된다. 내용 보상을 제거하면 평균이 낮아지지만 검색 점수는 여전히 상당한 수준을 유지한다.
4.5 Case Studies
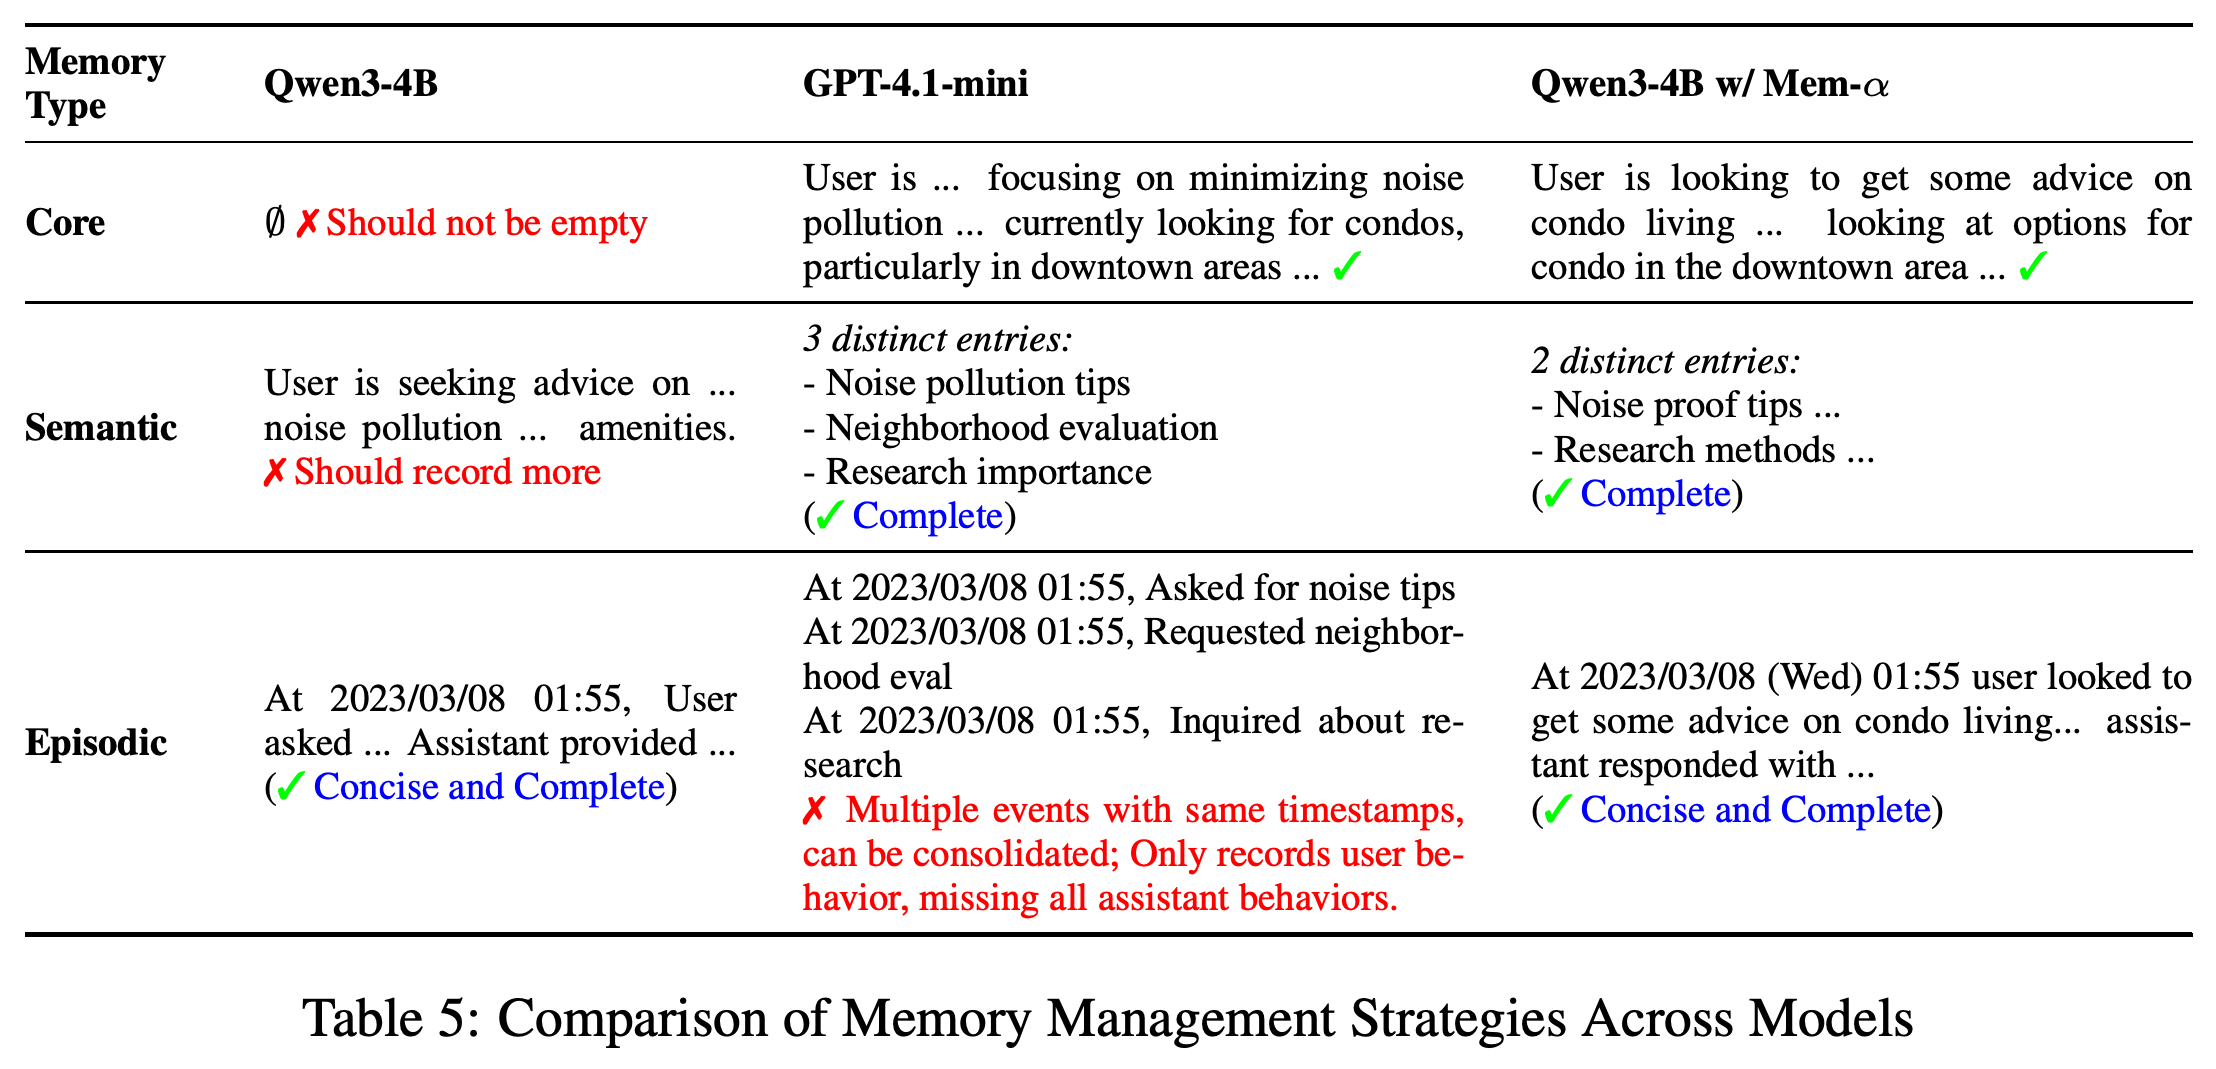
Table 5는 콘도 생활과 소음 감소에 관한 대화에서 작성한 메모리를 비교한다. 학습하지 않은 Qwen3-4B 작성기는 core memory를 비워 두고 일반적인 semantic 항목 1개를 저장한다. gpt-4.1-mini는 semantic 내용을 구분하지만 타임스탬프가 같은 사건을 나누고 episodic memory에서 어시스턴트의 행동을 누락한다.
- Mem-α는 유용한 정보를 담은 core 요약, 서로 구분되는 semantic 항목 2개, 사용자의 요청과 어시스턴트의 응답을 함께 담은 통합 사건을 작성한다.
- 선택된 이 사례는 메모리 정리 방식의 차이를 보여주지만 이러한 행동이 얼마나 자주 나타나는지는 입증하지 않는다.
선택된 사례는 정보 누락, 항목의 세분화 정도, 사건 통합을 비교한다. Mem-α는 core memory를 채우고 타임스탬프가 같은 사용자와 어시스턴트의 활동을 합친다. 다른 작성기에서는 표에 강조된 누락이나 분절이 나타난다.
5 Conclusion, Limitation and Future Work
논문은 메모리 작성 정책을 학습하면 후속 과제 성능이 향상되고 학습 입력보다 훨씬 긴 시퀀스도 처리할 수 있다고 결론짓는다. 향후 연구로 더 풍부한 메모리 구조와 실제 데이터베이스의 통합을 제안하며 지연 시간, 확장성, 안전성을 해결되지 않은 배포 과제로 제시한다.
- 실험은 모의 상호작용 형식을 사용하며 운영 환경의 데이터베이스 동작, 전체 배포 과정의 지연 시간, 충돌 해결을 측정하지 않는다.
- 표본으로 추출한 데이터셋이 작음에도 학습에는 H100 GPUs 32개에서 3일이 필요하다.
부록
- A DATASETS DETAILS와 A.1 TRAINING DATASET은 문서 질의응답 데이터셋 SQuAD의 문서 결합, 여러 문서의 정보가 필요한 질문을 위한 HotpotQA 근거의 청크별 분산, PerLTQA의 개인 사실과 사건 보존을 설명한다. LongMemEval 학습 컨텍스트는 10K–30K tokens로 구성하며 MemoryAgentBench 평가 데이터를 제외했다고 보고한다. 의료 초록의 문장 역할을 분류하는 PubMed-RCT에서는 의미 라벨을 숫자 라벨 0–4로 대체한다. NLU와 TREC-C는 각 사례에 모든 라벨이 포함되도록 유지한다. BookSum의 장은 대화 청크로 변환하고 정답 요약에서 추출한 키워드의 포함률로 평가한다.
- A.2 EVALUATION DATASET은 9개 출처에서 구성한 테스트 사례 112개를 보고한다. InfBench-Sum 소설 100개, LongMemEval 컨텍스트 5개, 나머지 7개 출처의 컨텍스트 각각 1개로 구성된다. 이 7개 출처의 각 컨텍스트에는 질문 100개가 연결된다. InfBench-Sum은 소설당 평균 길이가 172k tokens라고 설명한다. 키워드 포함률은 선택된 내용의 보존을 측정하며 요약 품질의 모든 측면을 평가하지는 않는다. Table 7에 나열된 학습 사례 수의 합은 567개이며 보고된 562개와 다르다. 검증 사례 수의 합도 458개이며 보고된 463개와 다르다. 또한 Table 6의 LME-Train 검증 사례 5개를 누락하고 LME-Train 학습 사례를 50개로 제시하지만 Table 6에서는 45개로 보고한다.
- B FORMAL DEFINITIONS OF REWARD COMPONENTS는 정답 대비 정확성, 실행 가능한 작업과 의미적으로 유효한 작업의 비율, 총 입력 길이에서 최종 메모리 길이로의 압축을 다시 정의한다. C EXPERIMENTAL DETAILS에는 C.1 JUSTIFICATION OF BACKBONE MODEL SELECTION이 포함된다. 이 절은 Qwen3-8B가 ‘semantic_memory’처럼 유효하지 않은 memory_type 값을 반복해서 생성했으며 허용되는 인자 값을 조정한 뒤에도 보상이 Qwen3-4B보다 낮았다고 보고한다. 이러한 관찰은 해당 인터페이스에서 기반 모델을 선택한 이유를 설명하지만 모델의 일반적인 우열을 입증하지는 않는다.
- C.2 BASELINE INTRODUCTION AND IMPLEMENTATION DETAILS는 MemAgent에 BytedTsinghua-SIA/RL-MemoryAgent-14B를, MEM1에 https://huggingface.co/Mem-Lab/Qwen2.5-7B-RL-RAG-Q2-EM-Release를 사용한다고 명시한다. MemAgent는 원래 모델로 답하지만 MEM1은 메모리 구성 후 Qwen3-32B를 사용한다. C.3 PROMPTS USED IN TRAINING은 공통 작성 프롬프트, 메모리 유형별 Qwen3-32B 유효성 검사, 답변 생성 프롬프트를 제시한다. 검사는 임시 문구만 담은 core 요약을 거부하고 사건과 사실 항목이 의도된 메모리 유형에 맞는지 평가한다. C.4 ADDITIONAL ABLATION STUDY는 내용 보상을 제거했을 때 테스트 평균이 0.445, 압축 보상을 제거했을 때 0.580, β = 0.05, γ = 0.1일 때 0.592라고 보고한다. 압축 가중치를 더 높이면 평균은 0.351과 0.375로 낮아진다.
짧은 생각
같은 메모리 구조와 후속 답변 생성기를 사용한 비교는 학습 후 메모리 작성이 개선되었다는 가장 직접적인 근거이며 저장량 증가도 함께 나타난다. 더 긴 테스트 입력은 학습 길이를 넘어서는 일반화를 뒷받침한다. 다만 여러 과제에 테스트 컨텍스트가 1개뿐이고, 불확실성 추정치를 보고하지 않으며 Long-Context 비교 기준의 입력을 32k tokens로 제한한다. 정확한 재현을 위해 메모리 내용 보상 가중치와 데이터셋 사례 수의 불일치를 해결해야 한다. 결과는 보존한 정보와 저장량 사이의 절충이 과제에 따라 달라진다는 점을 보여준다. Mem-α는 입력을 잘라 사용하는 비교 기준보다 많이 저장하며 일부 과제에서는 원본 청크보다도 많이 저장한다. 모순되는 정보의 갱신과 운영 환경의 데이터베이스 동작은 여전히 평가가 필요한 부분이다.