


Kimi Linear: An Expressive, Efficient Attention Architecture 요약 설명
30 Oct 2025 | Paper Review Linear Attention Transformer Architectures Long-Context Language Models목차
이번 글에서는 Kimi Linear: An Expressive, Efficient Attention Architecture 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 30일(Arxiv)
- Kimi Team, Zhang, Yu, Lin, Zongyu, Yao, Xingcheng, Hu, Jiaxi, Meng, Fanqing, Liu, Chengyin, Men, Xin, Yang, Songlin, Li, Zhiyuan, et al.
- Moonshot AI, Soochow University, China, The Hong Kong University of Science and Technology (Guangzhou), Massachusetts Institute of Technology, Hangzhou Institute of Medicine, CAS
- 논문 링크
요약
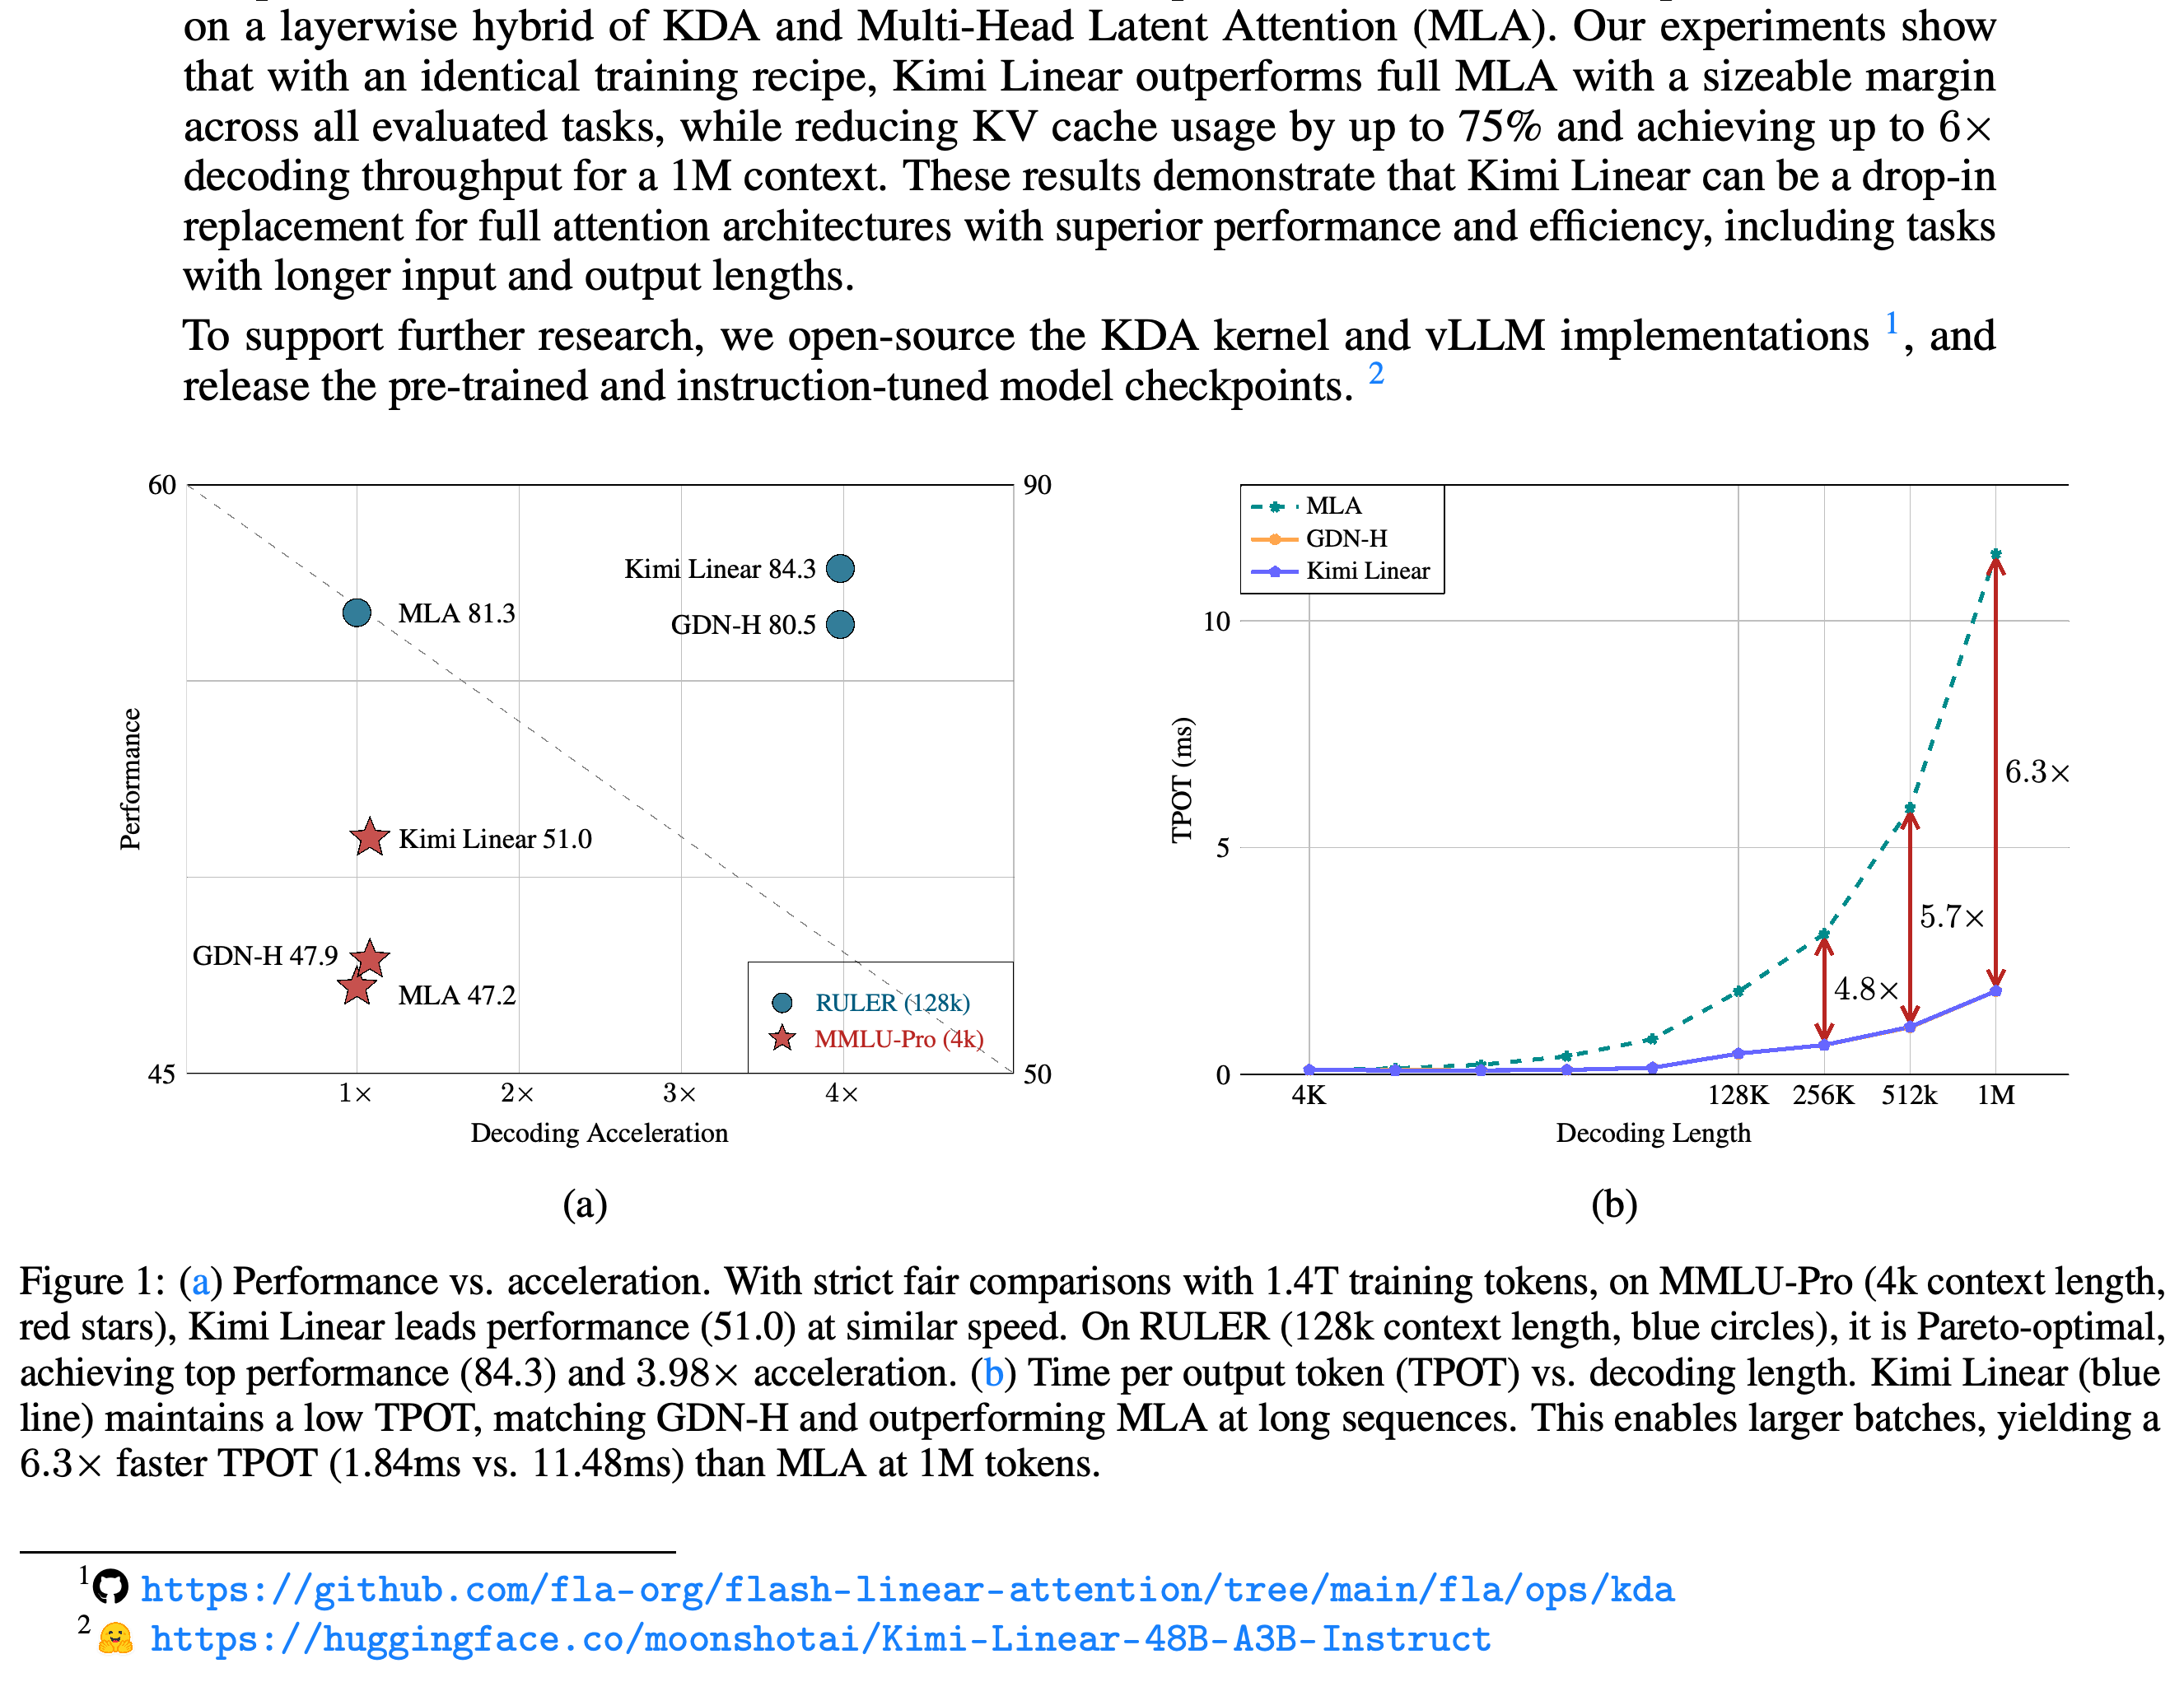
- 언어 모델이 긴 시퀀스를 처리하고 생성할수록 연산량과 메모리 비용이 증가한다. 학습 방식, 1.4T 학습 토큰, 파라미터 수를 맞춘 비교에서 Kimi Linear는 논문의 전역 어텐션 기준 모델인 full Multi-Head Latent Attention (MLA)보다 높은 성능을 보인다. 여러 과제의 언어 이해 능력을 평가하는 MMLU-Pro 점수는 47.2에서 51.0으로, 128k-context 평가의 평균 점수는 52.2에서 54.5로 높아진다.
- Kimi Delta Attention (KDA)은 토큰 이력을 고정 크기의 순환 메모리로 압축하는 선형 어텐션이다. 메모리를 감쇠시키고 델타 규칙으로 저장된 키–값 연결을 수정하는 Gated DeltaNet에 특징 채널별로 독립적으로 학습하는 망각률을 추가한다. Kimi Linear는 KDA 계층 3개 뒤에 full MLA 계층 1개를 배치하는 구조를 반복한다. 이 구조는 전역 어텐션을 유지하면서 어텐션 이력을 저장하는 키–값 (KV) 캐시 사용량을 최대 75% 줄인다.
- 모델은 전체 파라미터 48B와 순전파마다 사용하는 활성 파라미터 3B를 갖는다. 토큰 블록을 처리하는 청크 단위 커널은 비교 대상인 일반 Diagonal-Plus-Low-Rank (DPLR) 커널보다 거의 2× 빠르다. DPLR의 전이 행렬은 대각 행렬과 저랭크 보정으로 구성된다. 논문은 1M 문맥에서 프롬프트 처리가 2.9×, 배치 크기 1의 디코딩이 약 2.2× 빠르다고 보고한다. 메모리 절감으로 더 큰 배치를 사용할 때는 디코딩 가속이 최대 6.3×에 이른다. 품질 개선에는 벤치마크별 예외가 있으며 공개된 5.7T-token model과 Moonlight의 비교에서는 어텐션 구조뿐 아니라 전체 파라미터 수도 달라진다.
품질–속도 패널에서 Kimi Linear는 1.4T 토큰 학습 조건의 MMLU-Pro와 RULER 모두에서 MLA보다 높은 점수를 기록한다. 128k RULER 조건에서는 3.98× 가속을 보고한다. 디코딩 패널은 메모리 사용량 감소로 더 큰 배치를 사용할 때 긴 문맥에서 이점이 더 커짐을 보여준다. 1M 비교는 생성 토큰당 1.84 ms와 11.48 ms를 보고하며 가속을 6.3×로 표시한다.
1 Introduction
표준 softmax 어텐션은 쿼리–키 점수를 이전 토큰에 대한 가중치로 정규화한다. 시퀀스 처리 비용은 길이의 제곱에 비례해 증가하고 KV 캐시는 시퀀스 길이에 비례해 커진다. 선형 어텐션은 순환 메모리로 이러한 비용을 줄이지만 메모리 용량이 유한하므로 긴 이력에서 정확히 복사하고 검색하는 능력에 한계가 있다. 논문은 더 선택적인 순환 업데이트와 주기적으로 배치한 전역 어텐션 계층을 결합해 이 한계를 다룬다.
Contributions
논문의 기여는 채널별 게이트를 적용한 델타 규칙, 이를 하드웨어에서 효율적으로 실행하는 구현, 조건을 맞춘 1.4T-token training runs로 평가한 3:1 계층별 혼합 구조다. 공개 산출물에는 KDA 커널, 추론 프레임워크인 vLLM과의 통합, 사전 학습 및 지시 튜닝 체크포인트가 포함된다.
- 프로젝트: https://github.com/MoonshotAI/Kimi-Linear
- KDA 커널: https://github.com/fla-org/flash-linear-attention/tree/main/fla/ops/kda
- 지시 튜닝 체크포인트: https://huggingface.co/moonshotai/Kimi-Linear-48B-A3B-Instruct
2 Preliminary
기초 설명에서는 선형 어텐션을 행렬 형태의 연상 메모리를 온라인으로 학습하는 과정으로 제시한다. 이 메모리는 키를 값에 임시로 대응시킨다. 델타 규칙과 망각 게이트는 연결을 수정하고 오래된 정보를 제거하는 수단으로 설명한다.
2.1 Notation
쿼리, 키, 값, 출력은 토큰 단위 열벡터이며 \(\mathbf{S}_t\)는 키 차원과 값 차원에 해당하는 \(d_k\times d_v\) 크기의 메모리 행렬이다. 길이가 L인 시퀀스를 길이 C인 L/C개 청크로 나눈다. 대문자로 표시한 변수는 청크 안의 벡터를 쌓은 것이며 각 청크는 이전 청크의 최종 상태에서 시작한다.
- M과 M−는 각각 대각 원소를 포함하는 하삼각 마스크와 포함하지 않는 하삼각 마스크다. 논문에서는 이를 Tril과 StrictTril이라고도 부른다.
- 누적 감쇠 곱은 위치 사이에서 정보가 얼마나 감쇠하는지 나타내며, Diag(α_t)는 메모리 채널마다 서로 다른 망각률을 적용한다.
2.2 Linear Attention and the Gated Delta Rule
일반 선형 어텐션은 각 키–값 외적을 메모리에 더해 연결을 강화하지만 무엇을 지울지는 결정하지 않는다. DeltaNet은 재구성 손실 L_t(S) = ½‖Sᵀk_t − v_t‖²에 대해 온라인 경사 하강법을 수행한다. 이를 통해 저장된 대응 관계를 현재 값에 가깝게 수정하는 rank-1 보정 업데이트를 만든다.
- Gated DeltaNet (GDN)은 어텐션 헤드마다 스칼라 망각 게이트 \(\alpha_t\in[0,1]\)을 사용해 이전 상태를 추가로 감쇠시킨다. 어텐션 헤드는 독립적으로 파라미터화된 어텐션 구성 요소다.
- 논문은 이 게이트를 fast weights에 적용하는 데이터 의존적 가중치 감쇠로 해석한다. fast weights는 토큰이 들어올 때마다 갱신하는 임시 메모리 파라미터다.
3 Kimi Delta Attention: Improving Delta Rule with Fine-grained Gating
KDA는 GDN의 스칼라 감쇠를 채널별 대각 게이트로 바꿔 각 특징 차원이 서로 다른 기간 동안 정보를 유지하게 한다. 핵심 점화식은 S_t = (I − β_t k_t k_tᵀ) Diag(α_t) S_{t−1} + β_t k_t v_tᵀ이며, 이후 o_t = S_tᵀq_t를 계산한다. 메모리를 먼저 감쇠시킨 뒤 델타 규칙 보정을 적용한다.
- β_t는 보정 업데이트의 강도를 조절하고 벡터 α_t는 키 차원마다 망각을 따로 조절한다.
- 이 방법은 rank-1 보정 구조를 유지하면서 메모리 감쇠를 더 세밀하게 조절하고 암묵적인 위치 정보를 도입한다.
3.1 Hardware-Efficient Chunkwise Algorithm
청크 단위 알고리즘은 점화식을 청크에 들어오는 상태에 작용하는 전이와 청크 내부 토큰의 누적 기여로 전개한다. 연속된 rank-1 변환을 간결하게 나타내는 WY 표현은 보조 벡터로 이 항들을 표현한다. 삼각 행렬로 구성된 연립방정식을 풀도록 식을 재구성하는 UT 변환은 행렬 곱 이외의 연산을 줄인다.
- 필요한 하삼각 역행렬은 전진 대입으로 계산한다. 전진 대입은 연립방정식을 행별로 푸는 방법이다.
- 출력은 들어오는 순환 상태의 정보와 인과적 마스크를 적용한 청크 내부 항을 결합한다. 이 마스크는 미래 토큰을 제외한다. 청크 사이에서는 순환 계산을 하고 청크 내부에서는 병렬 계산을 하므로 가속기의 행렬 곱 하드웨어를 더 많이 활용한다.
3.2 Efficiency Analysis
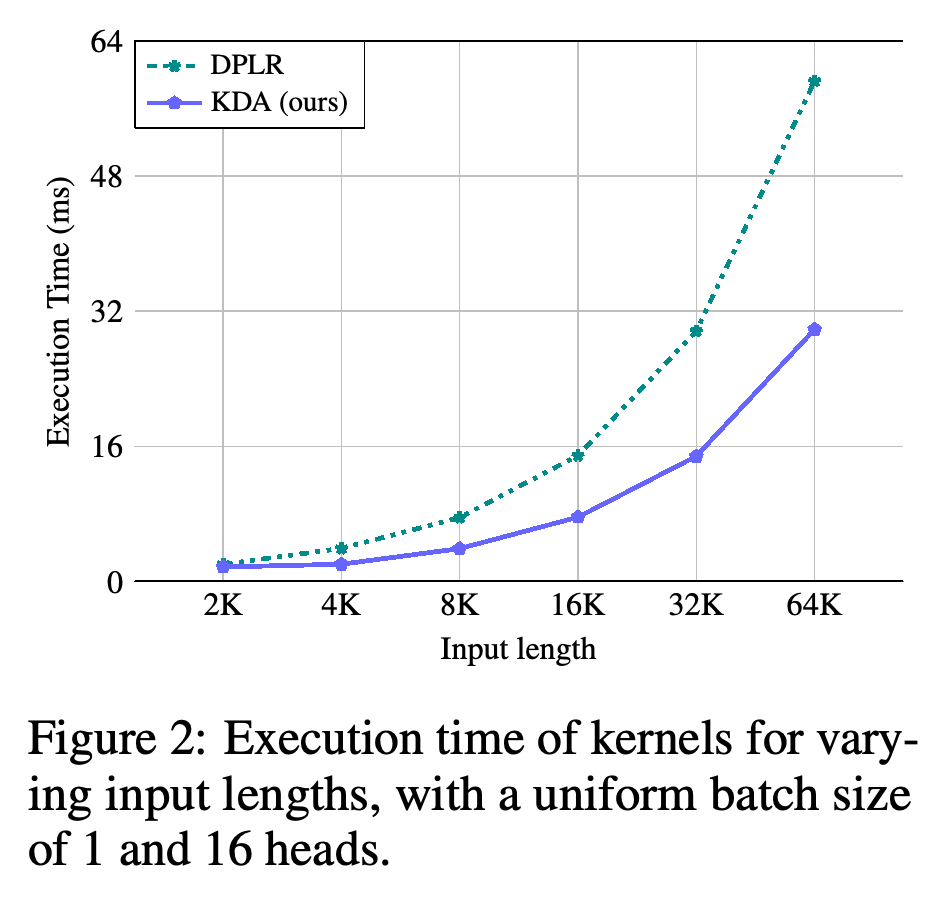
채널별 감쇠는 누적 감쇠의 역수 항을 수치적으로 불안정하게 만들 수 있으므로, 수치 안정성을 위해 계산을 더 작은 단위로 나누는 보조 청크 분할이 필요하다. KDA는 전이 구조에 제약을 두어 관련 보조 청크 행렬을 4개에서 2개로 줄이고, 일반 DPLR보다 추가 행렬 곱을 약 3회 줄인다. 측정한 커널 비교에서는 배치 크기 1, 헤드 16개로 최대 64k 시퀀스 길이까지 거의 2× 가속을 보인다.
KDA는 2K부터 64K까지의 입력 길이에서 비교 대상인 일반 DPLR 구현보다 커널 실행 시간이 짧다. 배치 크기 1과 헤드 16개를 사용한 긴 입력 결과는 논문의 거의 2× 커널 가속 주장을 뒷받침한다. 이 비교는 어텐션 연산자의 실행 시간을 측정하며 모델 전체의 디코딩 시간을 측정하지는 않는다.
4 The Kimi Linear Model Architecture
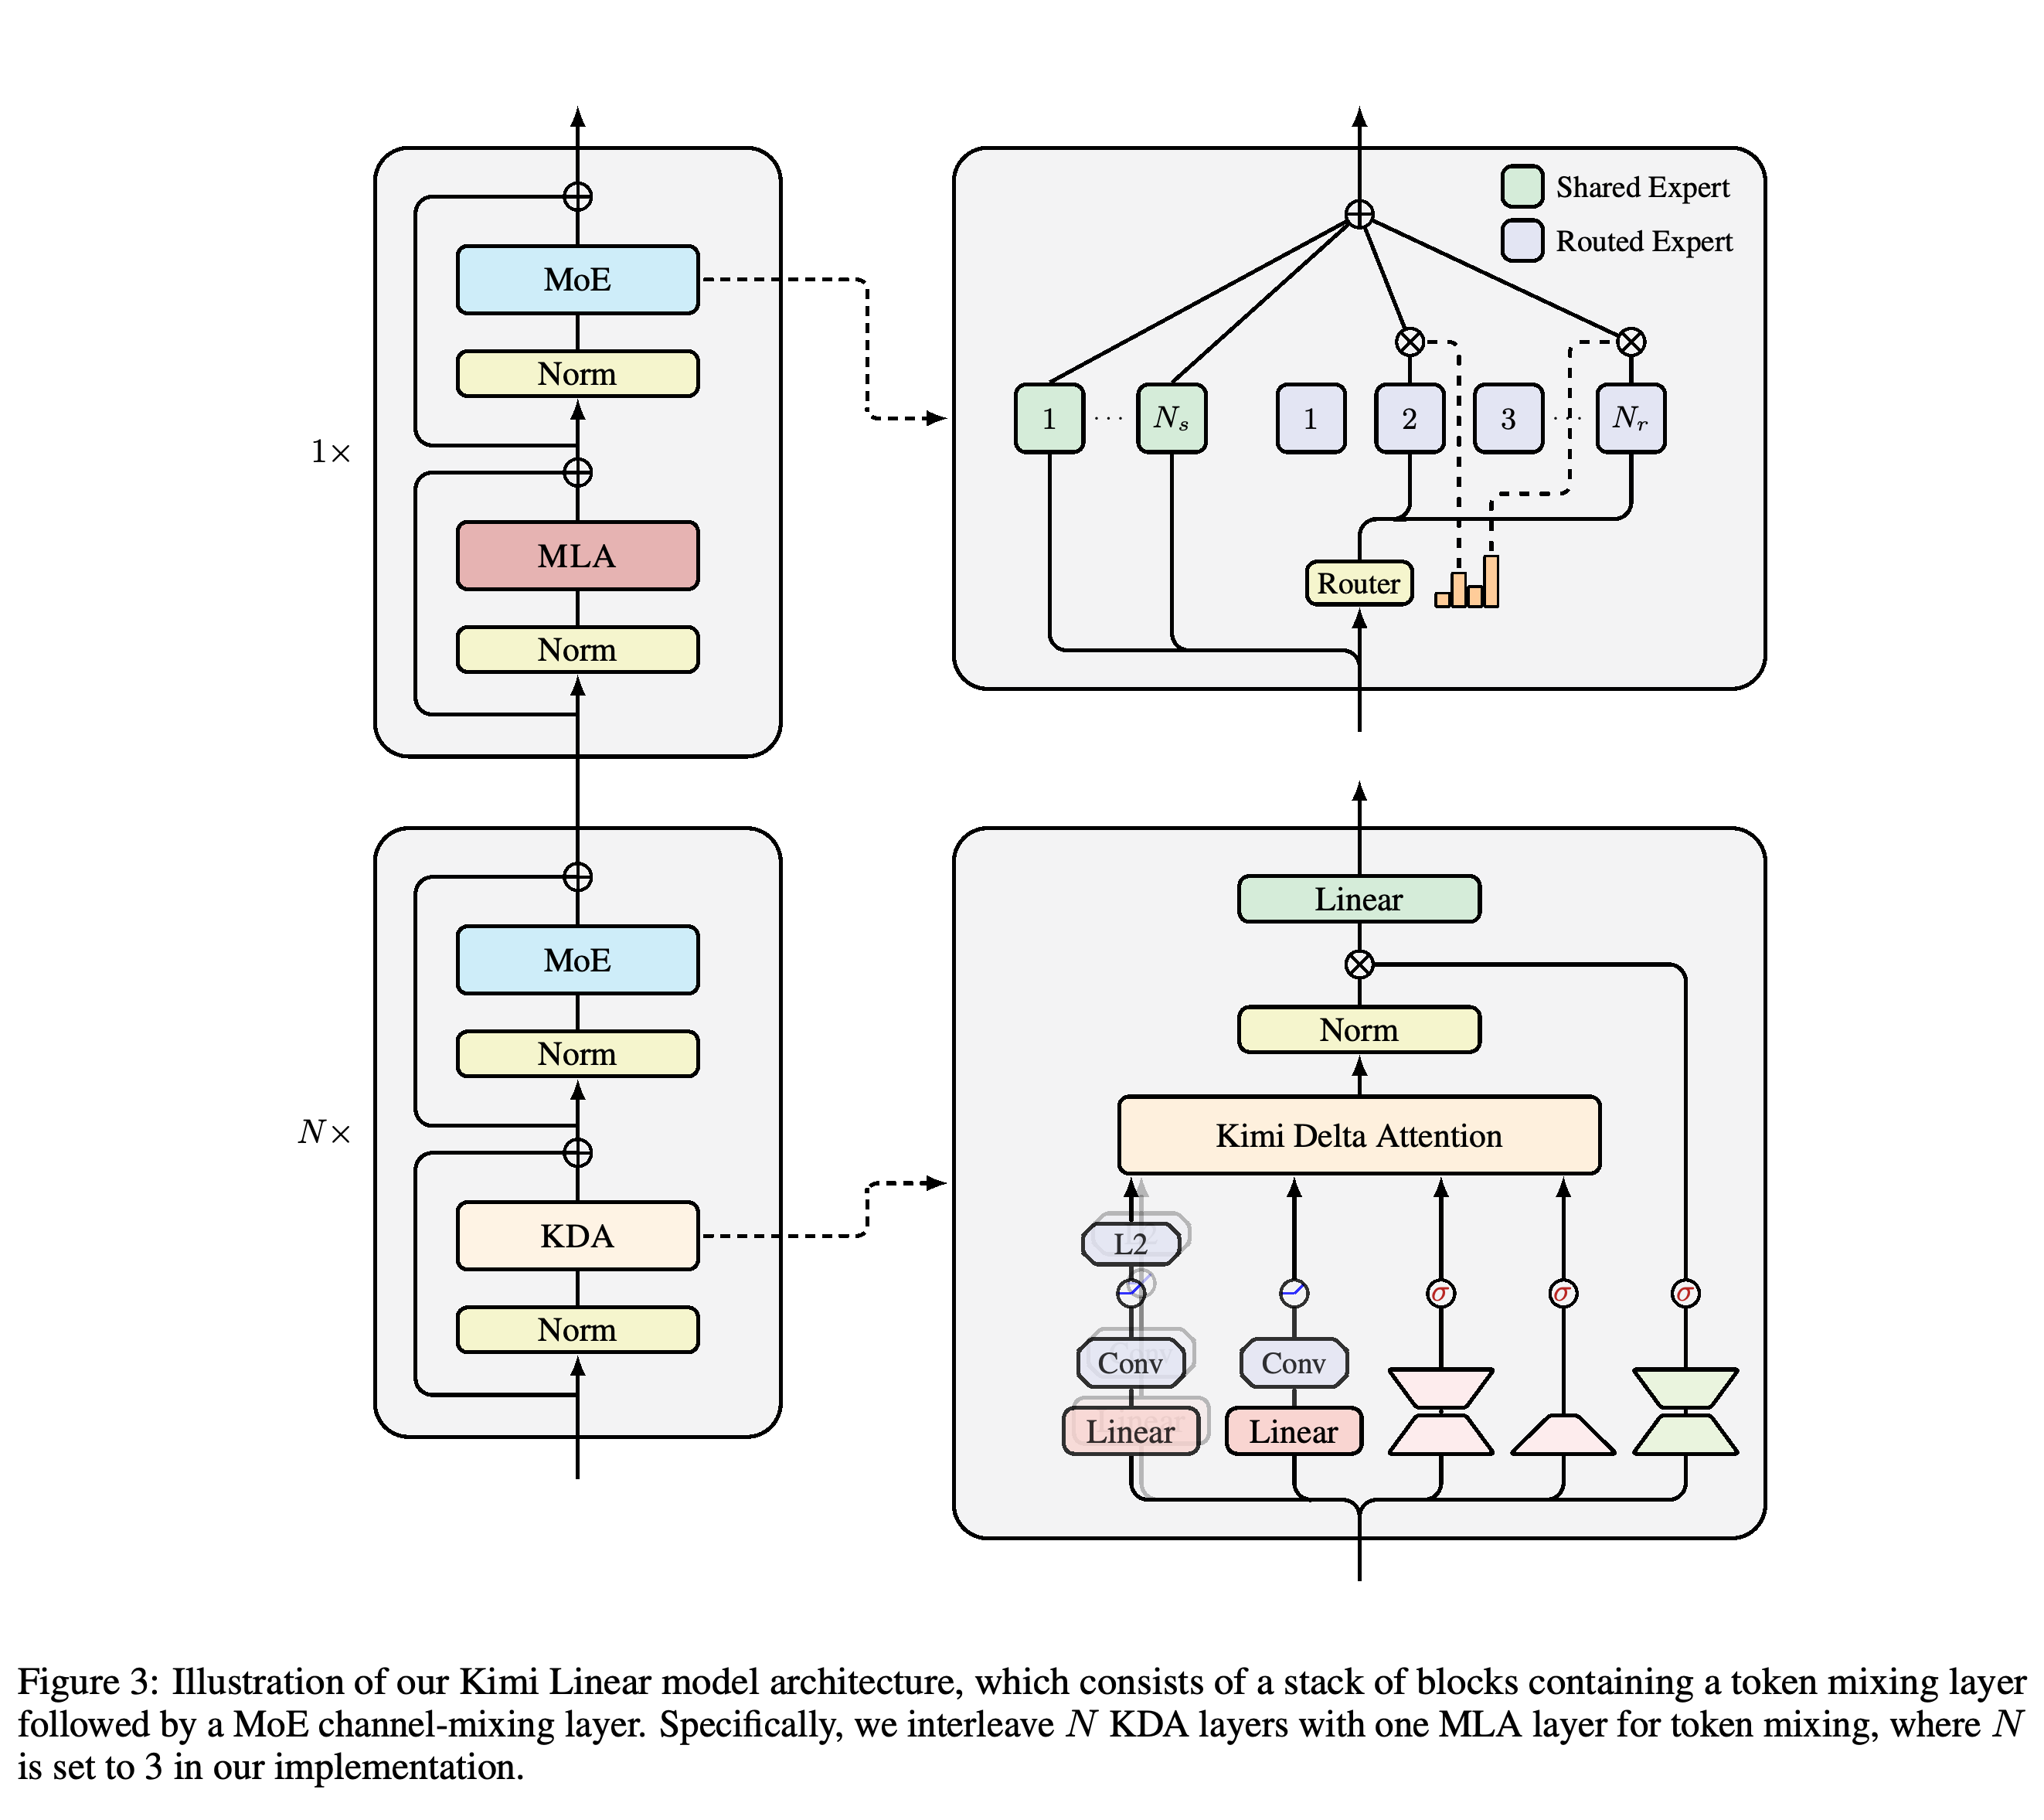
기본 구조는 초기 설정으로 사용한 언어 모델 구조인 Moonlight를 따른다. 토큰 혼합과 mixture-of-experts (MoE) 계층을 번갈아 배치하며 MoE는 토큰을 전문화된 피드포워드 네트워크의 일부로 라우팅한다. KDA는 짧은 합성곱으로 인접 토큰의 의존성을 포착하고 쿼리, 키, 값에 Swish 비선형 활성화를 적용한다. 쿼리와 키는 단위 길이로 정규화하며 키와 값의 헤드 차원은 모두 128로 설정한다. 출력에는 특징의 크기를 기준으로 정규화하는 헤드별 root mean square normalization (RMSNorm)을 적용한다. 이어서 특징을 0과 1 사이로 조절하는 데이터 의존적 Sigmoid 게이트와 출력 투영을 적용한다.
- 망각 게이트와 출력 게이트는 저랭크 투영을 사용해 파라미터 수를 비슷하게 유지한다. 구조는 KDA 계층 3개와 MLA 계층 1개를 반복한다. 인프라 구현을 단순하게 하고 학습을 안정화하기 위해 계층 전체를 번갈아 배치한다.
- 모든 MLA 계층은 No Position Encoding (NoPE)을 사용해 명시적 위치 인코딩을 받지 않는다. KDA가 위치 정보와 최근 토큰에 대한 편향을 제공한다.
- 논문은 NoPE를 사용하면 MLA를 Multi-Query Attention (MQA)으로 변환할 수 있고, 문맥 확장 시 rotary position embedding (RoPE)의 주파수를 조정할 필요가 없다고 설명한다. MQA는 어텐션 헤드들이 키와 값을 공유하는 추론 형태이며 RoPE는 특징 회전으로 위치를 인코딩한다.
도식은 계층 전체를 번갈아 배치하는 구조를 보여준다. KDA 토큰 혼합 블록 3개 뒤에 MLA 블록 1개가 오며, 각 블록 뒤에는 전문가 기반 채널 혼합이 이어진다. 확대한 KDA 블록은 합성곱 전처리, 정규화, 망각 및 업데이트 게이트, 출력 게이트를 보여주며, 점화식과 함께 평가하는 구성 요소를 명시한다.
5 Experiments
실험은 합성 메모리 과제, 개별 구조 요소, 학습 연산량에 따른 스케일링, 조건을 맞춘 대형 모델 벤치마크, 추론 시간을 평가한다. 합성 테스트는 순환 연산자를 평가하고 대형 모델 비교는 전체 혼합 구조를 평가한다.
5.1 Synthetic tests
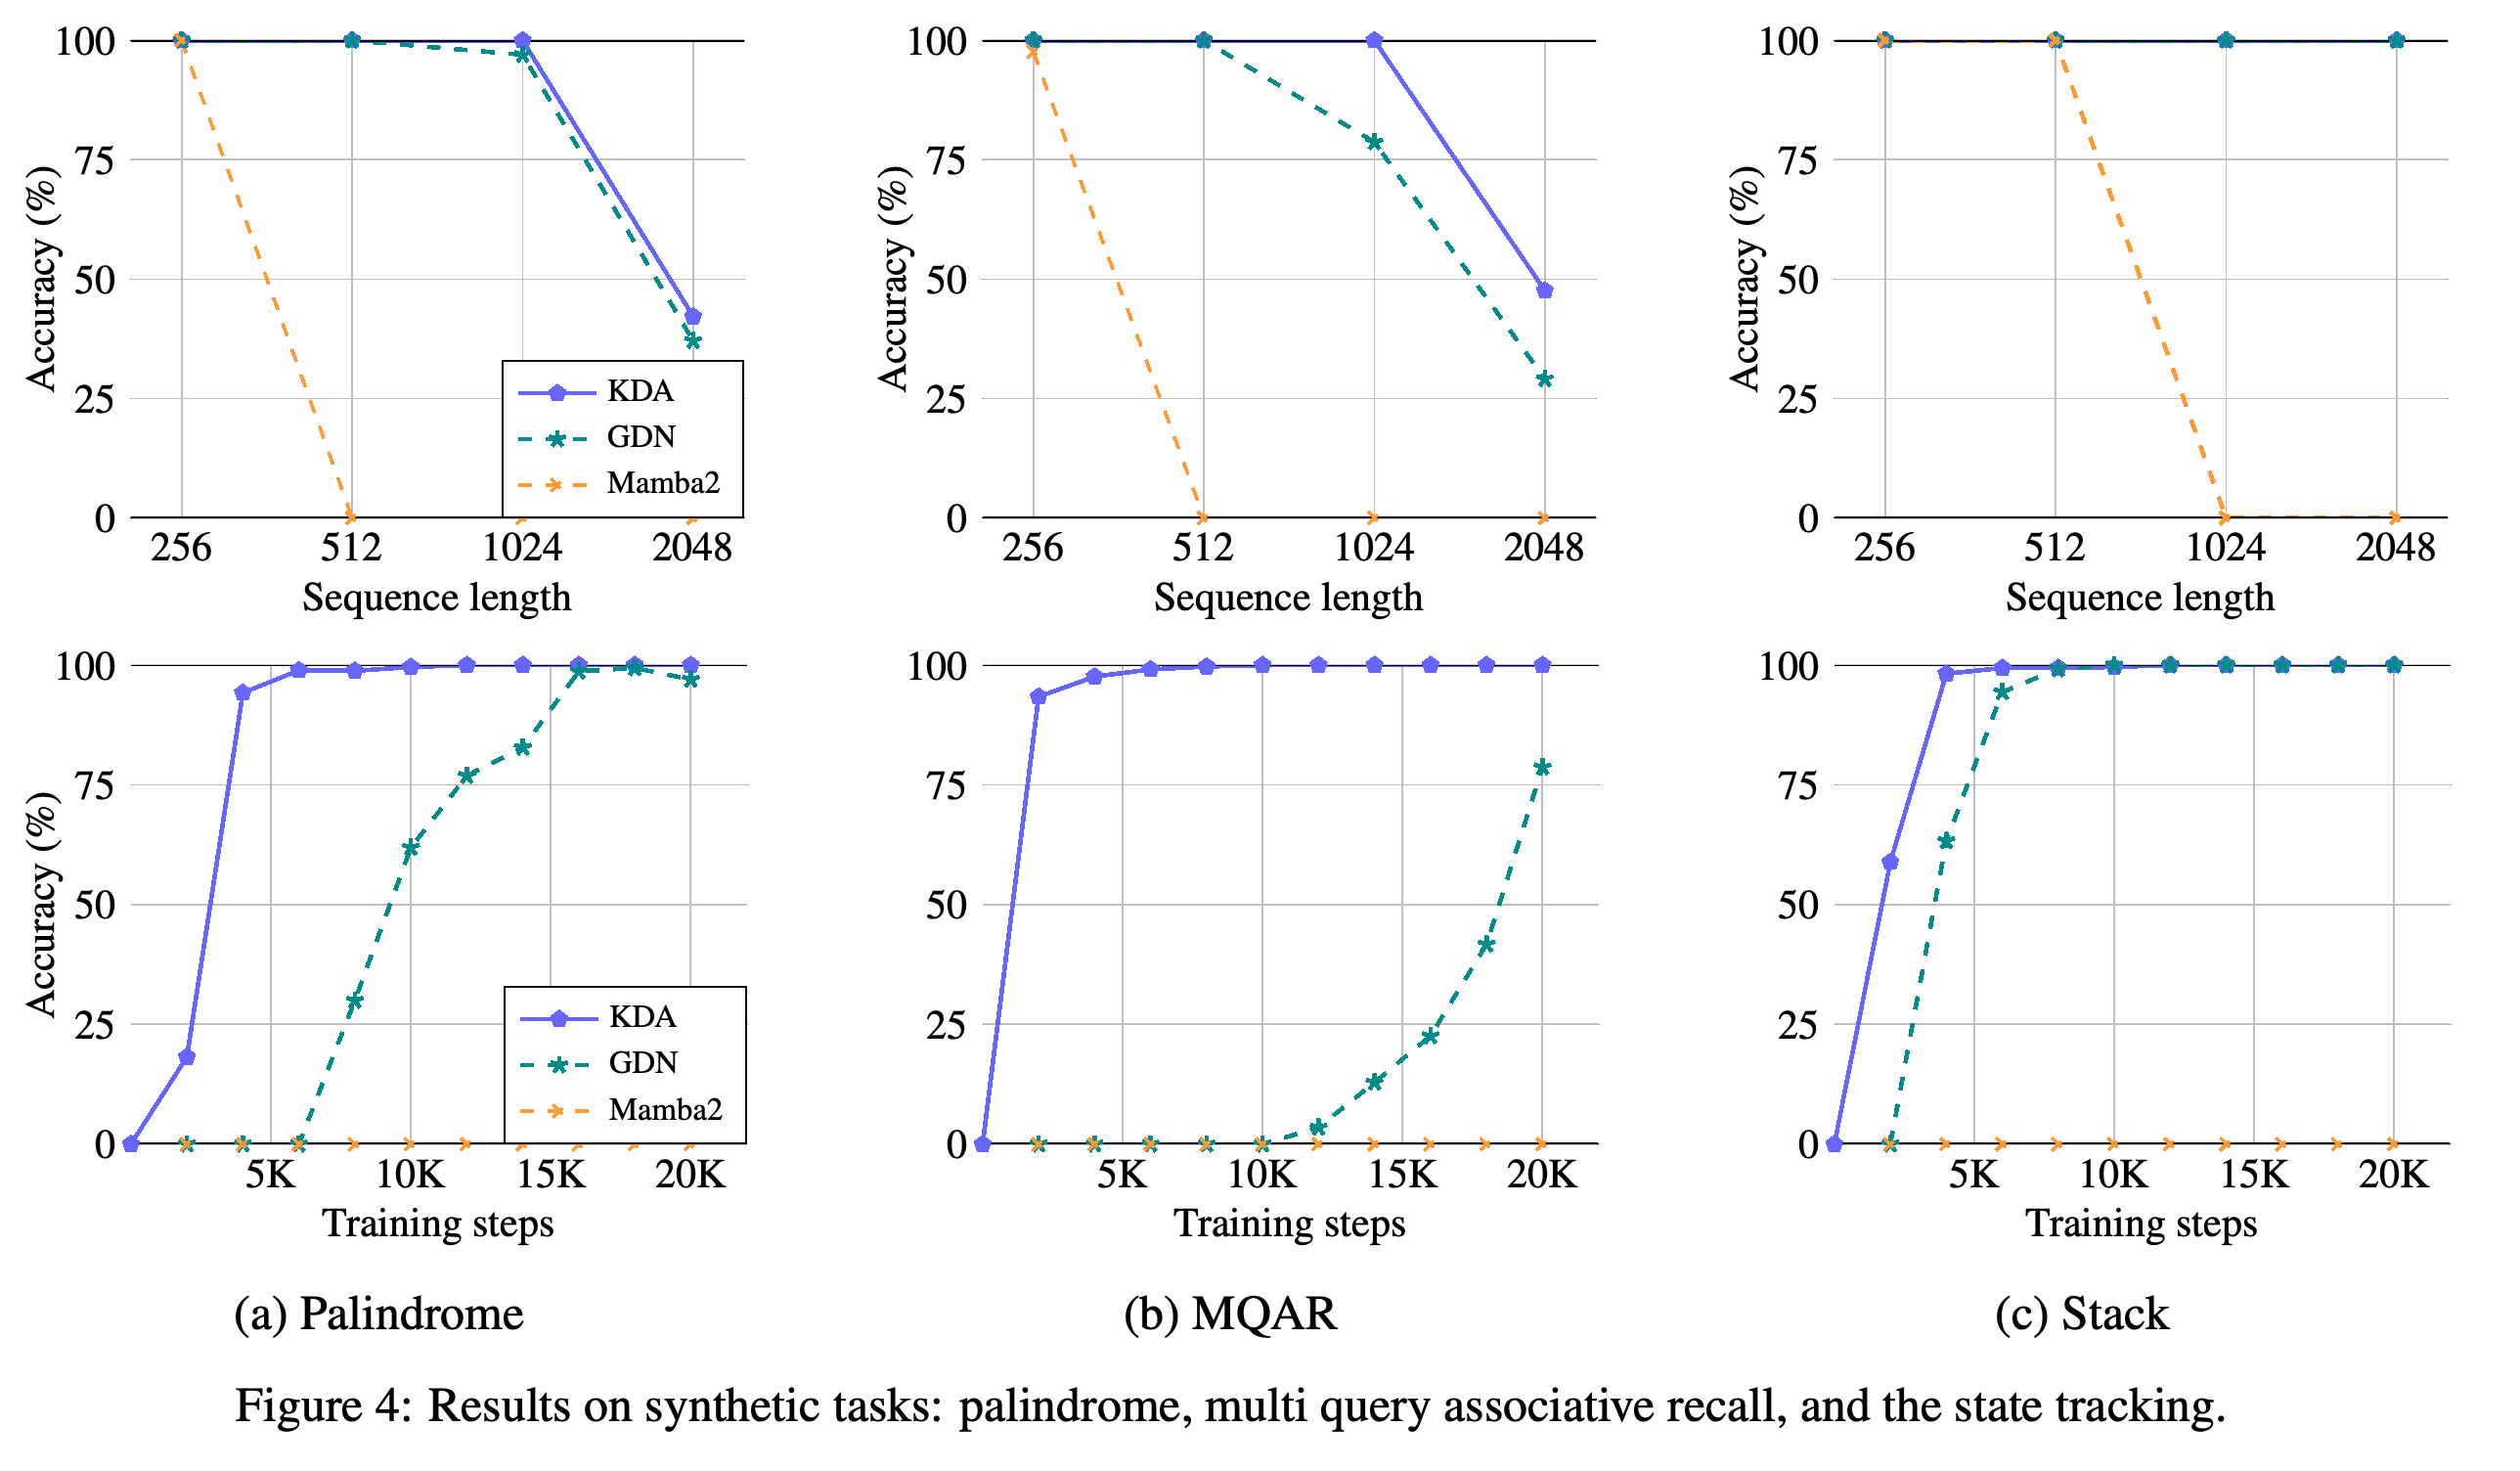
합성 테스트는 KDA, GDN, 이 비교에서 델타 규칙 없이 곱셈 감쇠를 사용하는 순환 모델인 Mamba2를 비교한다. 모든 모델은 계층 2개, 어텐션 헤드 2개, 헤드 차원 128을 갖는다. 최대 20,000 steps 동안 학습하며 학습률을 {5 × 10⁻⁵, 1 × 10⁻⁴, 5 × 10⁻⁴, 1 × 10⁻³}에서 탐색한다. 연구는 가장 좋은 학습 정확도 곡선을 보고하며 256부터 2,048토큰까지의 길이에서 최고 정확도를 측정하고 1,024토큰으로 고정한 길이에서 수렴을 측정한다.
- Palindrome은 무작위 토큰 시퀀스를 정확히 역순으로 출력해야 하는 과제다. Multi Query Associative Recall (MQAR)은 이력의 서로 다른 위치에 등장한 여러 키에 대응하는 값을 검색해야 하는 과제다.
- Stack은 PUSH와 POP 연산을 통해 독립적인 후입선출 스택 64개의 상태를 추적하는 능력을 평가한다.
- KDA는 역순 출력과 연상 회상 과제를 GDN보다 훨씬 빠르게 학습하며 스택 추적에서는 모두 좋은 성능을 보인다. 역순 출력과 회상 정확도는 여전히 2,048토큰에서 떨어진다. Mamba2의 낮은 성능은 테스트한 소형 모델 설정에 해당한다.
위쪽 패널은 시퀀스 길이별 최고 학습 정확도를 비교하고 아래쪽 패널은 1,024토큰에서의 수렴을 비교한다. KDA는 palindrome 역순 출력과 MQAR를 GDN보다 훨씬 빠르게 학습하지만 KDA와 GDN 모두 2,048토큰에서 해당 과제의 정확도가 떨어진다. 스택 추적 성능은 높게 유지된다. Mamba2 결과는 명시된 계층 2개, 헤드 2개 실험에 해당한다.
5.2 Ablation on Key Components of Kimi Linear
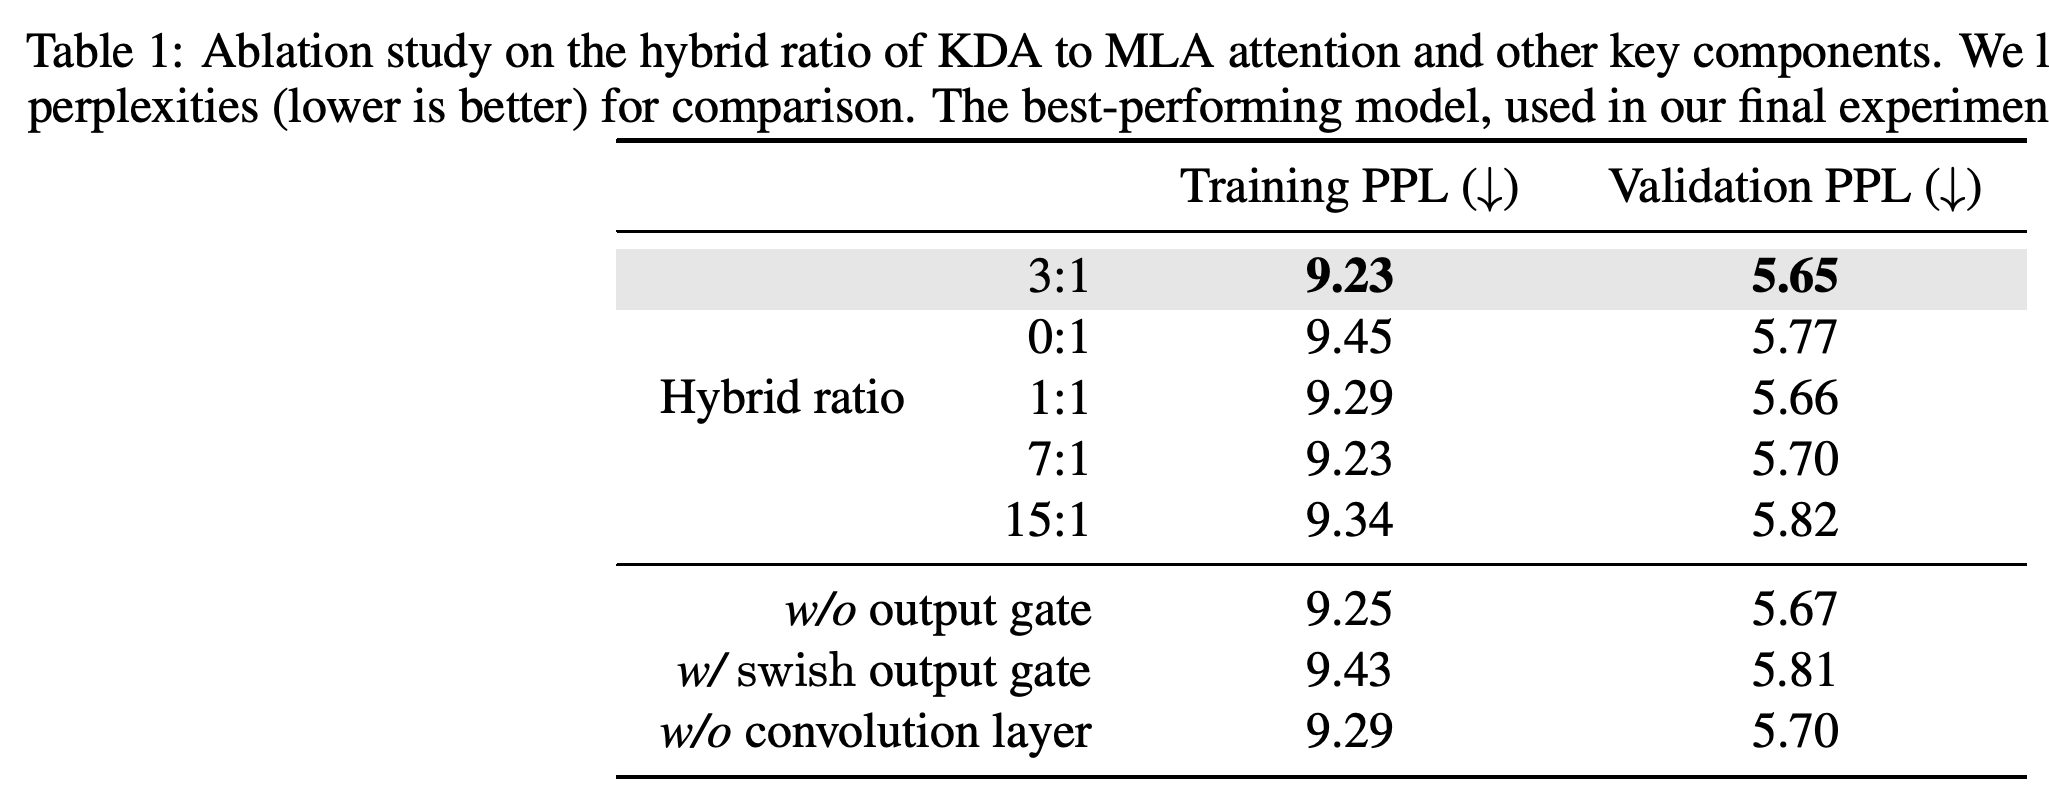
구성 요소 비교 실험은 헤드 16개와 계층 16개를 갖는 가장 작은 스케일링 법칙 설정에서 동일한 부동소수점 연산 (FLOPs) 예산과 하이퍼파라미터를 사용한다. Perplexity (PPL)는 언어 모델의 예측 오류를 나타내며 낮을수록 좋은 지표다. 학습 데이터와 사전 학습 데이터와 분포가 크게 다른 검증 데이터에서 PPL을 평가한다. 3:1 혼합 구조의 학습/검증 PPL은 9.23/5.65다. full attention은 9.45/5.77, 1:1 혼합 구조는 9.29/5.66을 기록한다.
- 비율을 7:1로 높이면 학습 PPL은 9.23으로 유지되지만 검증 PPL은 5.70으로 악화된다. 15:1에서는 9.34/5.82를 기록한다.
- 출력 게이트를 제거하면 9.25/5.67, Sigmoid를 Swish로 바꾸면 9.43/5.81, 합성곱을 제거하면 9.29/5.70을 기록한다. 저자들은 혼합 GDN 기준 모델을 포함한 모든 실험에서 Sigmoid 출력 게이트를 사용한다.
- 긴 문맥 평균에서는 NoPE가 RoPE 혼합 구조보다 높은 54.5를 기록하며 RoPE는 51.8을 기록한다. 저자들은 계층별 위치 편향 분포로 이 차이를 설명하지만 이 비교는 제안한 작동 원리를 따로 검증하지 않는다.
3:1 비율은 보고된 검증 perplexity 중 가장 낮은 5.65를 기록한다. 1:1은 더 많은 전역 어텐션 계층을 사용하며 5.66으로 근접한다. 7:1에서 학습 perplexity를 같게 유지해도 검증 품질은 유지되지 않는다. 출력 게이트나 합성곱을 제거하거나 Sigmoid를 Swish로 바꿔도 검증 perplexity가 높아진다.
5.3 Scaling Law of Kimi Linear
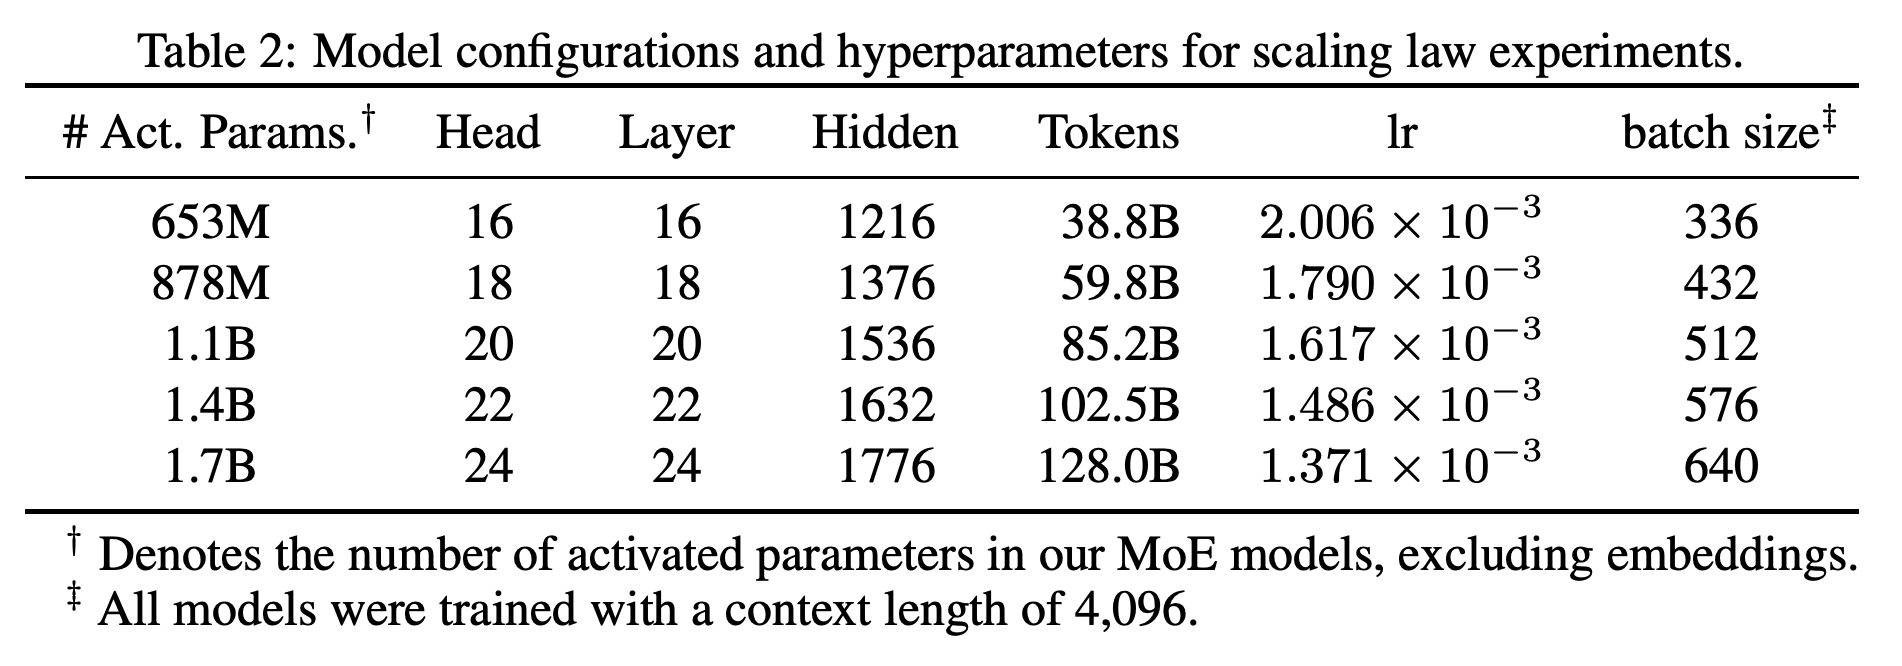
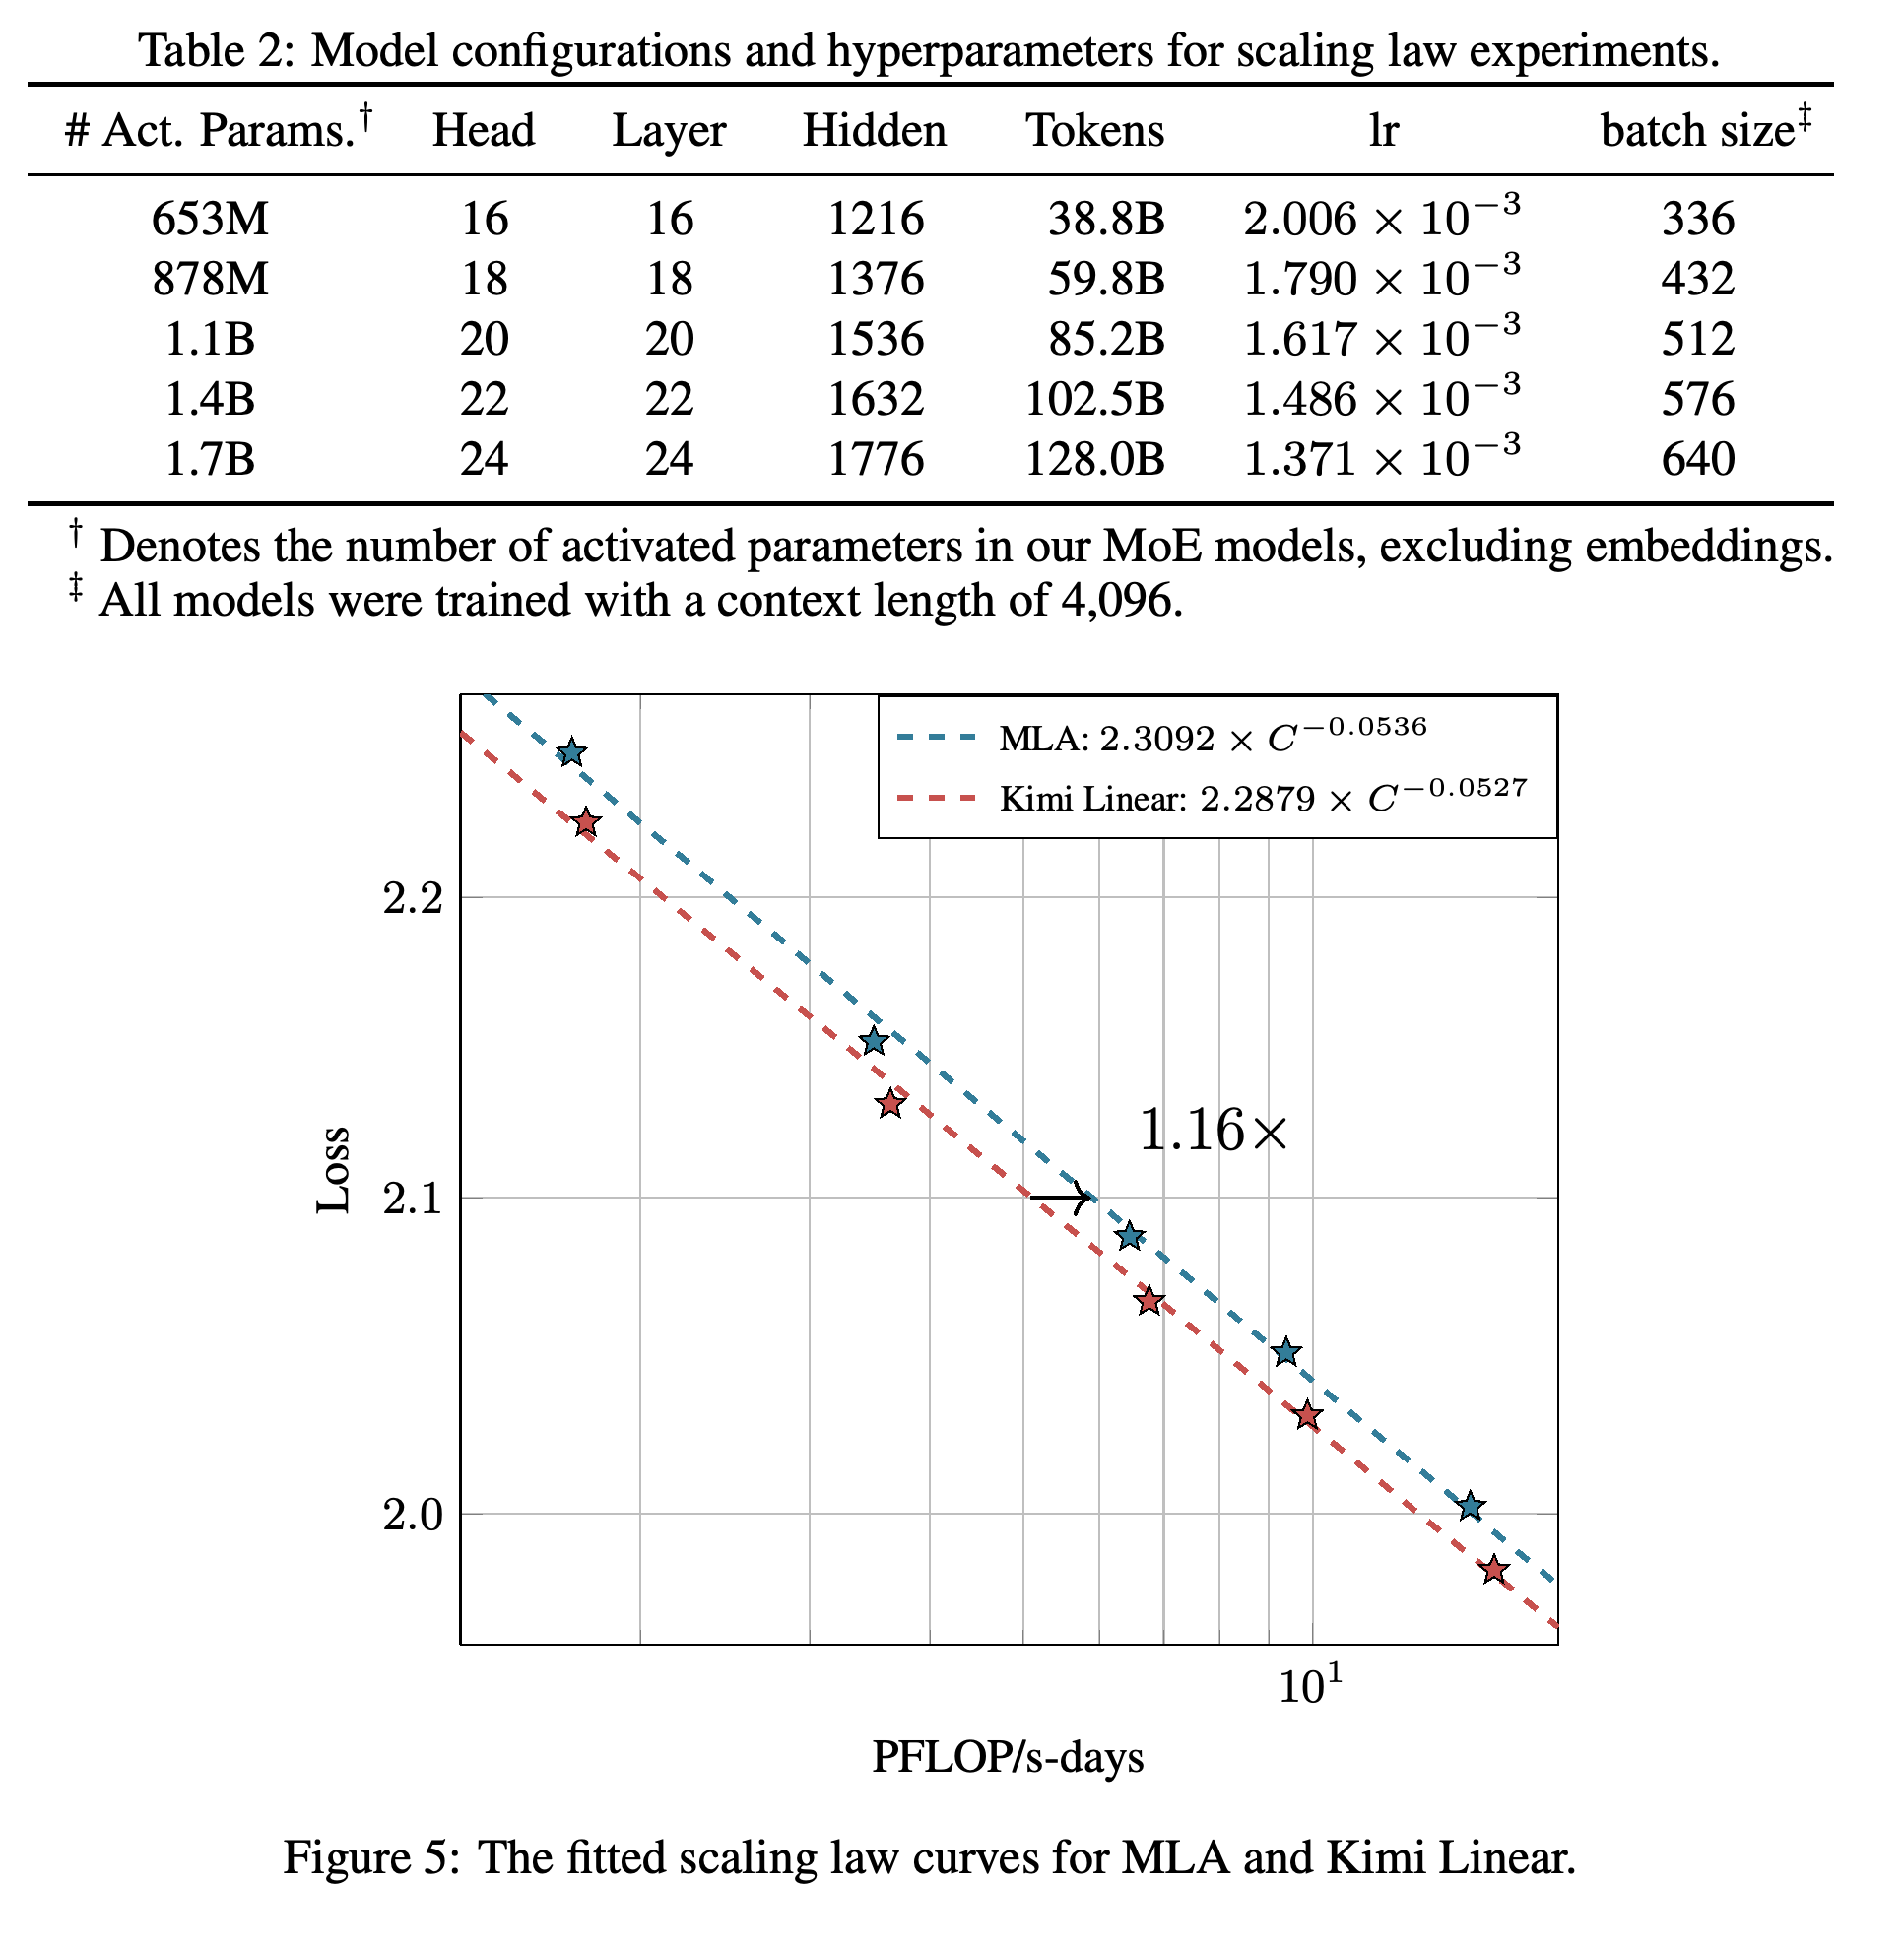
스케일링 실험은 임베딩을 제외한 활성 파라미터가 653M, 878M, 1.1B, 1.4B, 1.7B인 MoE 모델 5개를 각각 38.8B, 59.8B, 85.2B, 102.5B, 128.0B 토큰으로 학습한다. 전문가 64개 중 8개를 활성화하고 Moonlight 학습 설정에서 채택한 옵티마이저인 Muon을 사용하며 문맥 길이 4,096으로 학습한다. MLA 하이퍼파라미터는 연산 예산에 맞춰 모델 크기와 학습 토큰을 배분하는 Chinchilla 방법론에 따라 그리드 탐색한다. Kimi Linear는 이 설정을 3:1 혼합 비율에 그대로 사용한다.
- 데이터에 맞춰 추정한 손실 곡선은 MLA가 \(2.3092\times C^{-0.0536}\), Kimi Linear가 \(2.2879\times C^{-0.0527}\)다. 여기서 C는 이 스케일링 분석의 학습 연산량이다.
- 추정한 곡선의 비교는 연구 범위 안에서 동일한 손실에 도달하는 연산 효율이 약 1.16×임을 시사한다. KDA에 맞춘 튜닝으로 추가 개선이 가능하다고 제안하지만 이를 측정하지는 않는다.
스케일링 설정 5개는 활성 파라미터 수, 헤드 수, 깊이, 은닉 차원, 토큰 예산, 배치 크기를 함께 늘리면서 학습률을 낮춘다. 모두 4,096토큰 문맥을 사용하며 활성 파라미터 수에서는 임베딩을 제외한다. 이 조건들이 추정한 스케일링 곡선으로 비교하는 범위를 정한다.
연구한 연산량 범위에서 Kimi Linear의 측정값과 추정한 곡선은 MLA보다 아래에 있다. 수평 방향의 차이는 동일한 손실에서 약 1.16× 연산 효율로 요약한다. 이는 추정한 곡선에 따른 학습 연산량 요구를 측정하며 커널 가속이나 서빙 처리량을 측정하지는 않는다.
5.4 Experimental Setup
주요 비교에는 파라미터 수와 학습 설정을 맞춘 full MLA, 혼합 Gated DeltaNet (GDN-H), Kimi Linear가 포함된다. Kimi Linear (RoPE) 변형은 명시적 위치 인코딩을 테스트한다. 각 모델은 공유 전문가 1개를 포함해 전문가 256개 중 8개를 활성화하며 전체 파라미터 48B와 활성 파라미터 3B를 갖는다. 첫 계층은 MoE 대신 dense 계층을 사용한다.
- 평가는 언어 이해, 추론, 수학, 코드 생성, 중국어 과제, 긴 문맥 과제를 다룬다. 코드 생성 벤치마크인 LiveCodeBench v6는 2024.8부터 2025.5까지의 문제를 사용한다.
- 응답의 무작위성을 조절하는 샘플링 파라미터인 temperature는 1.0이다. 분산이 큰 벤치마크에서는 k회 샘플링 평가의 평균 점수인 Avg@k를 사용한다. 대학원 수준의 질의응답 벤치마크인 GPQA-Diamond는 독립 실행 8회의 평균을 사용한다.
- 기본 모델 평가에서는 여러 과제의 언어 이해 벤치마크인 MMLU, 그 변형인 MMLU-Redux, GPQA-Diamond, 중국어 평가 모음인 C-Eval에 perplexity를 사용한다. 나머지는 생성 기반으로 평가한다. 모든 모델은 언어 모델 평가 도구인 LM-Harness-Evaluation에서 파생된 동일한 내부 프레임워크를 사용한다.
5.4.1 Pre-training recipe: 통제 실험은 4,096토큰 문맥 창, MuonClip 옵티마이저, WSD라는 학습률 스케줄, Kimi K2에 사용한 K2 사전 학습 말뭉치의 1.4 trillion 토큰을 사용한다. 학습률은 1.1 × 10⁻³이고 전역 배치는 32 million 토큰으로 구성한다. 어닐링과 긴 문맥 활성화 절차도 동일하게 적용한다. 공개 체크포인트는 학습량을 5.7 trillion 토큰으로 늘리고 최대 1 million 토큰의 문맥을 지원한다.
5.4.2 Post-training recipe: 지시–응답 예시로 학습하는 supervised fine-tuning (SFT)은 Kimi K2 데이터에 추론 과제를 추가한다. 먼저 다양한 지시 수행 데이터를 다루고, 이후 추론, 수학, 코딩에 집중한다. 생성한 응답에 대한 보상으로 학습하는 reinforcement learning (RL)은 초기 체크포인트에 적당한 난도의 수학, 코드, 과학, 기술, 공학, 수학을 뜻하는 science, technology, engineering, and mathematics (STEM) 프롬프트를 사용한다.
- 여기서 지도 학습을 병행하는 방식으로 구현한 보조 PTX 손실은 다양한 추론 및 범용 과제를 사용해 일반 능력의 저하를 제한한다. 사후 학습 데이터는 K2 학습 방식에서 가져온 부분집합이다.
- RL 알고리즘은 이전 Kimi 추론 모델의 학습 방법인 K1.5를 따른다. 수치 정밀도 차이로 발생하는 롤아웃 정책과 학습 정책의 불일치를 다루기 위해 확률비 보정 범위를 제한하는 truncated importance sampling을 사용한다.
- 정책의 차이를 제한하는 Kullback–Leibler (KL) 페널티와 미니배치 크기를 동적으로 조정해 학습을 안정화하고 응답 다양성의 손실을 방지한다.
5.5 Main results
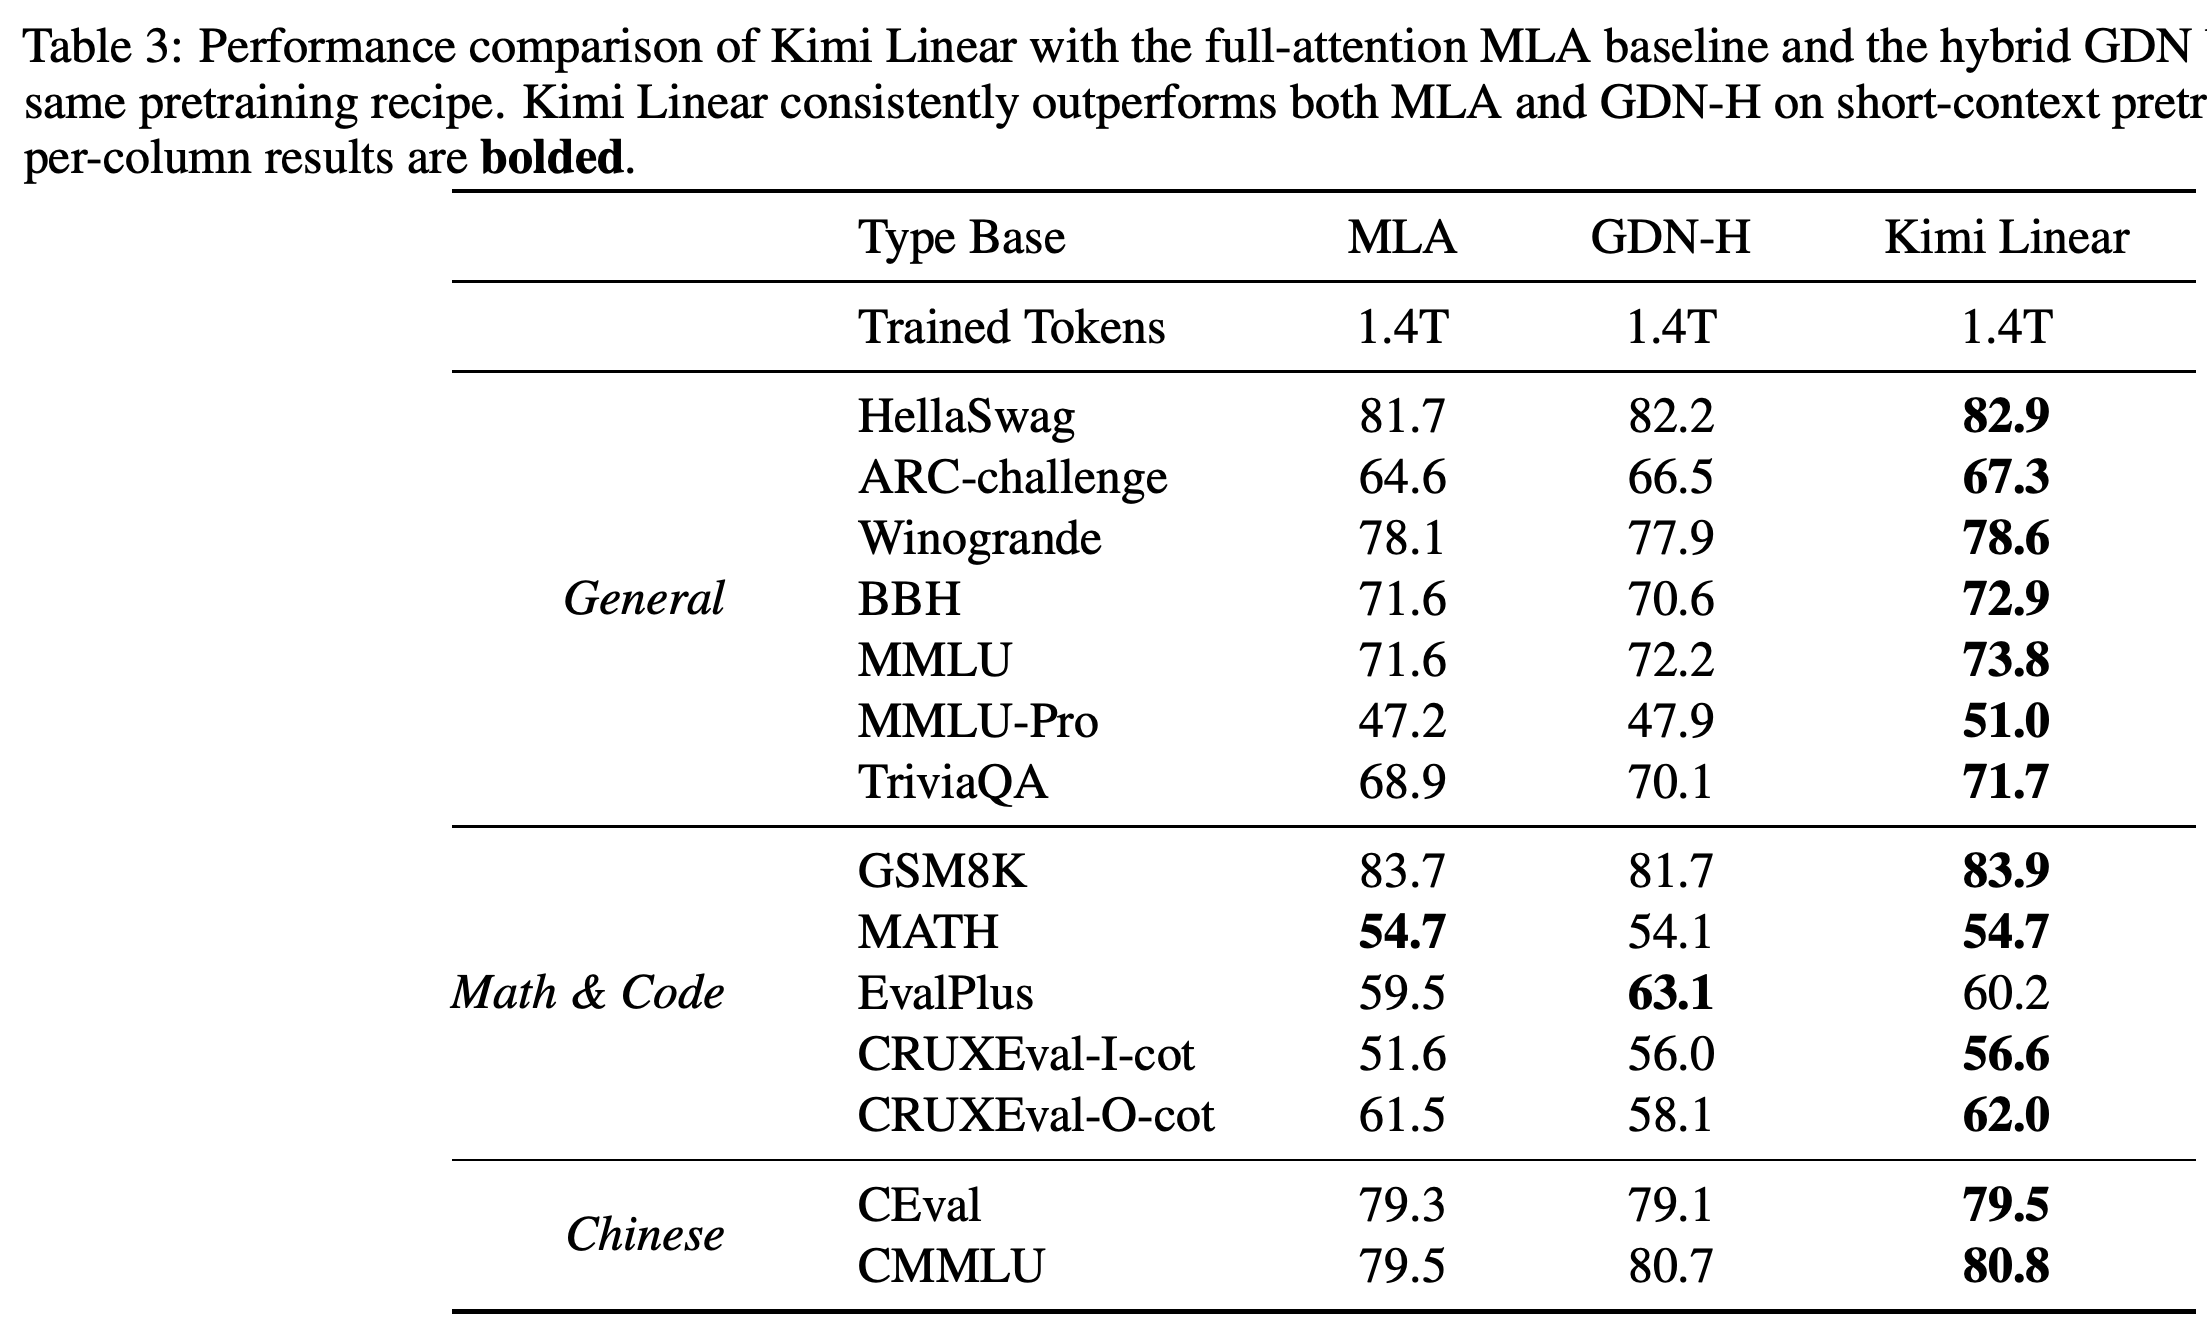
5.5.1 Kimi Linear@1.4T results: 사전 학습 조건을 맞춘 뒤 Kimi Linear는 보고된 일반 지식 벤치마크에서 가장 높은 점수를 기록한다. 문장 완성 벤치마크인 HellaSwag에서는 82.9로 MLA의 81.7과 GDN-H의 82.2를 앞선다. MMLU-Pro에서는 51.0으로 47.2와 47.9를 앞선다. 중국어 과제에서도 보고된 점수 중 가장 높은 CEval 79.5와 중국어 다중 과제 언어 이해 벤치마크인 CMMLU 80.8을 기록한다.
- 수학 벤치마크인 MATH에서는 54.7로 MLA와 같고, 코드 정확도 벤치마크인 EvalPlus에서는 60.2로 GDN-H의 63.1보다 낮다.
- 수학 벤치마크인 GSM8K에서는 83.9로 MLA의 83.7보다 소폭 높다. MMLU-Pro에서 더 큰 차이를 보인다는 점은 벤치마크마다 개선 폭이 상당히 다름을 보여준다.
조건을 맞춘 1.4T 토큰 기본 모델 비교에서 Kimi Linear는 보고된 일반 지식과 중국어 과제 전반에서 개선을 보인다. MMLU-Pro는 51.0으로 MLA의 47.2보다 높다. MATH는 54.7로 MLA와 같으며 EvalPlus는 GDN-H가 63.1로 Kimi Linear의 60.2를 앞선다.
동일한 SFT 방식으로 학습한 뒤 Kimi Linear는 MMLU-Pro에서 67.4로 MLA의 65.7과 GDN-H의 64.8을 앞선다. GPQA-Diamond (Avg@8)에서는 62.1로 57.1과 58.6을 앞선다. 보고된 표에서는 수학 벤치마크인 AIME 2025, HMMT 2025, PolyMath-en과 LiveCodeBench v6에서도 가장 높은 점수를 기록한다.
- 예외로는 범용 언어 모델 벤치마크인 LiveBench가 있다. Kimi Linear는 45.2로 45.7과 46.4보다 낮다. EvalPlus에서도 61.0으로 62.6과 62.5보다 낮다.
- 수학 테스트 세트인 MATH500에서는 81.2로 MLA의 80.8보다 높지만 GDN-H의 83.0보다 낮다. 이 결과는 여러 지표에서 개선을 보이지만 모든 과제에서 순위가 같지는 않음을 보여준다.
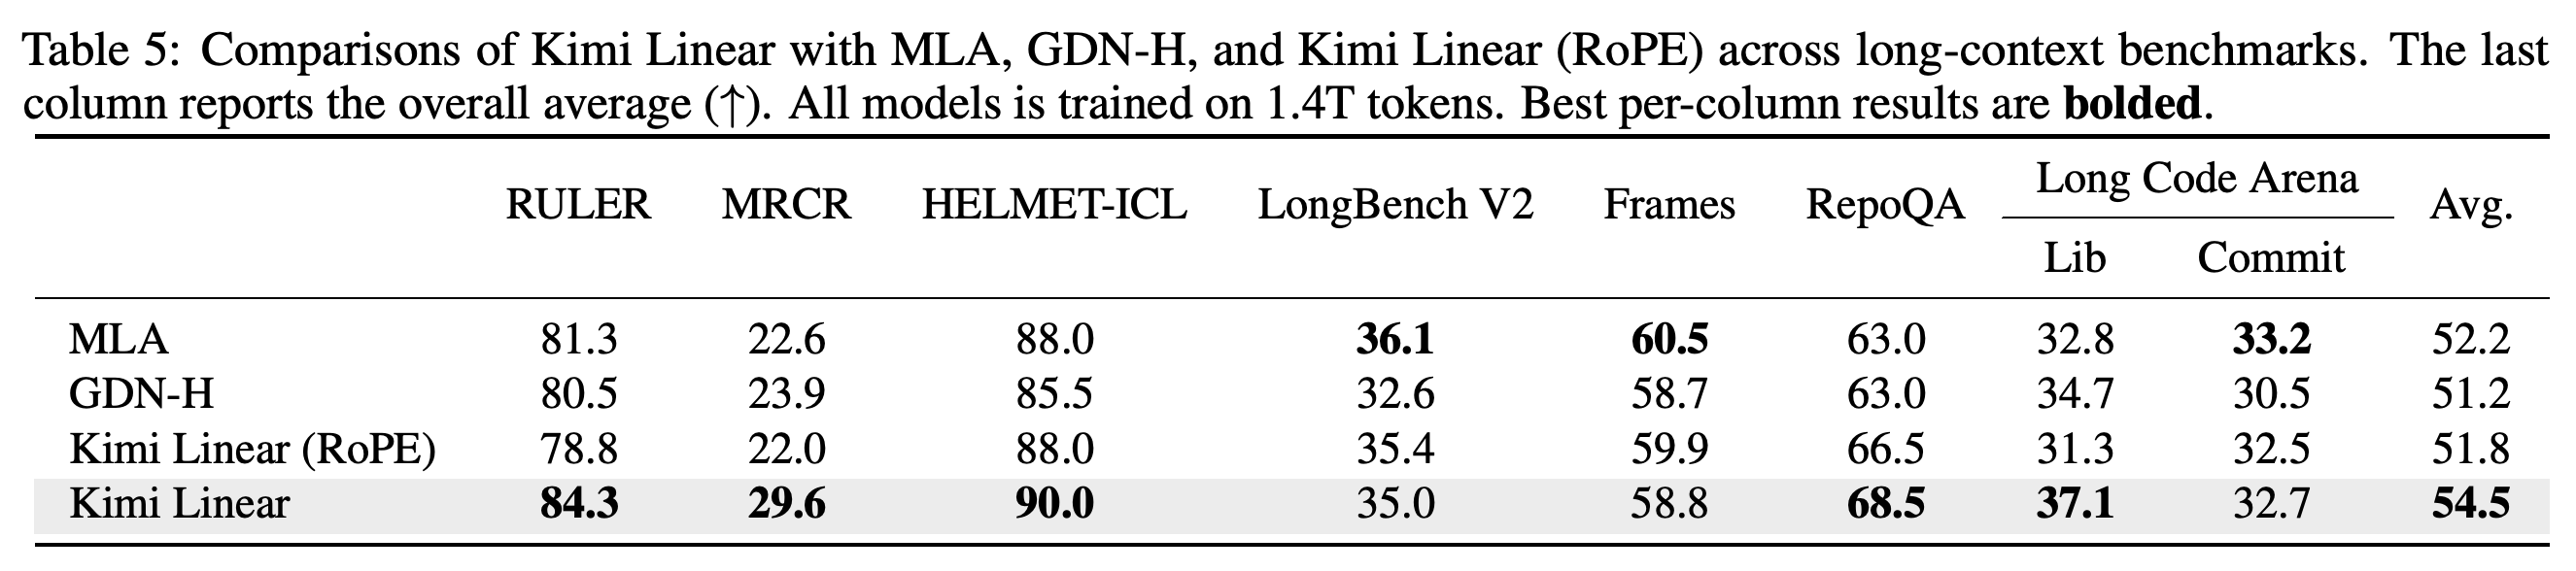
128k 문맥에서 Kimi Linear는 긴 문맥 지표 8개의 보고된 평균 중 가장 높은 54.5를 기록한다. MLA는 52.2, GDN-H는 51.2, Kimi Linear (RoPE)는 51.8이다. 긴 문맥 회상 벤치마크인 MRCR에서는 MLA의 22.6보다 높은 29.6을, 저장소 코드 이해 벤치마크인 RepoQA에서는 MLA의 63.0보다 높은 68.5를 기록한다. 긴 문맥 벤치마크 모음인 RULER는 81.3에서 84.3으로 높아진다.
- Kimi Linear는 긴 문맥 벤치마크 프레임워크에서 문맥 내 학습을 평가하는 HELMET-ICL에서도 90.0으로 가장 높다. 긴 문맥 코드 과제인 Long Code Arena Lib에서도 37.1로 가장 높다.
- MLA는 긴 문맥 다중 과제 벤치마크인 LongBench V2에서 35.0 대비 36.1, 사실 검색 및 추론 벤치마크인 Frames에서 58.8 대비 60.5, 다른 코드 과제인 Long Code Arena Commit에서 32.7 대비 33.2로 더 높은 점수를 유지한다.
128k 문맥에서 보고된 지표 8개의 평균은 Kimi Linear가 54.5로 가장 높다. 회상과 저장소 코드 과제에서 개선을 보이지만 LongBench V2, Frames, Commit 과제에서는 MLA보다 점수가 낮다. RoPE 혼합 구조의 평균 51.8은 이 비교 안에서 선택한 NoPE 설정을 뒷받침한다.
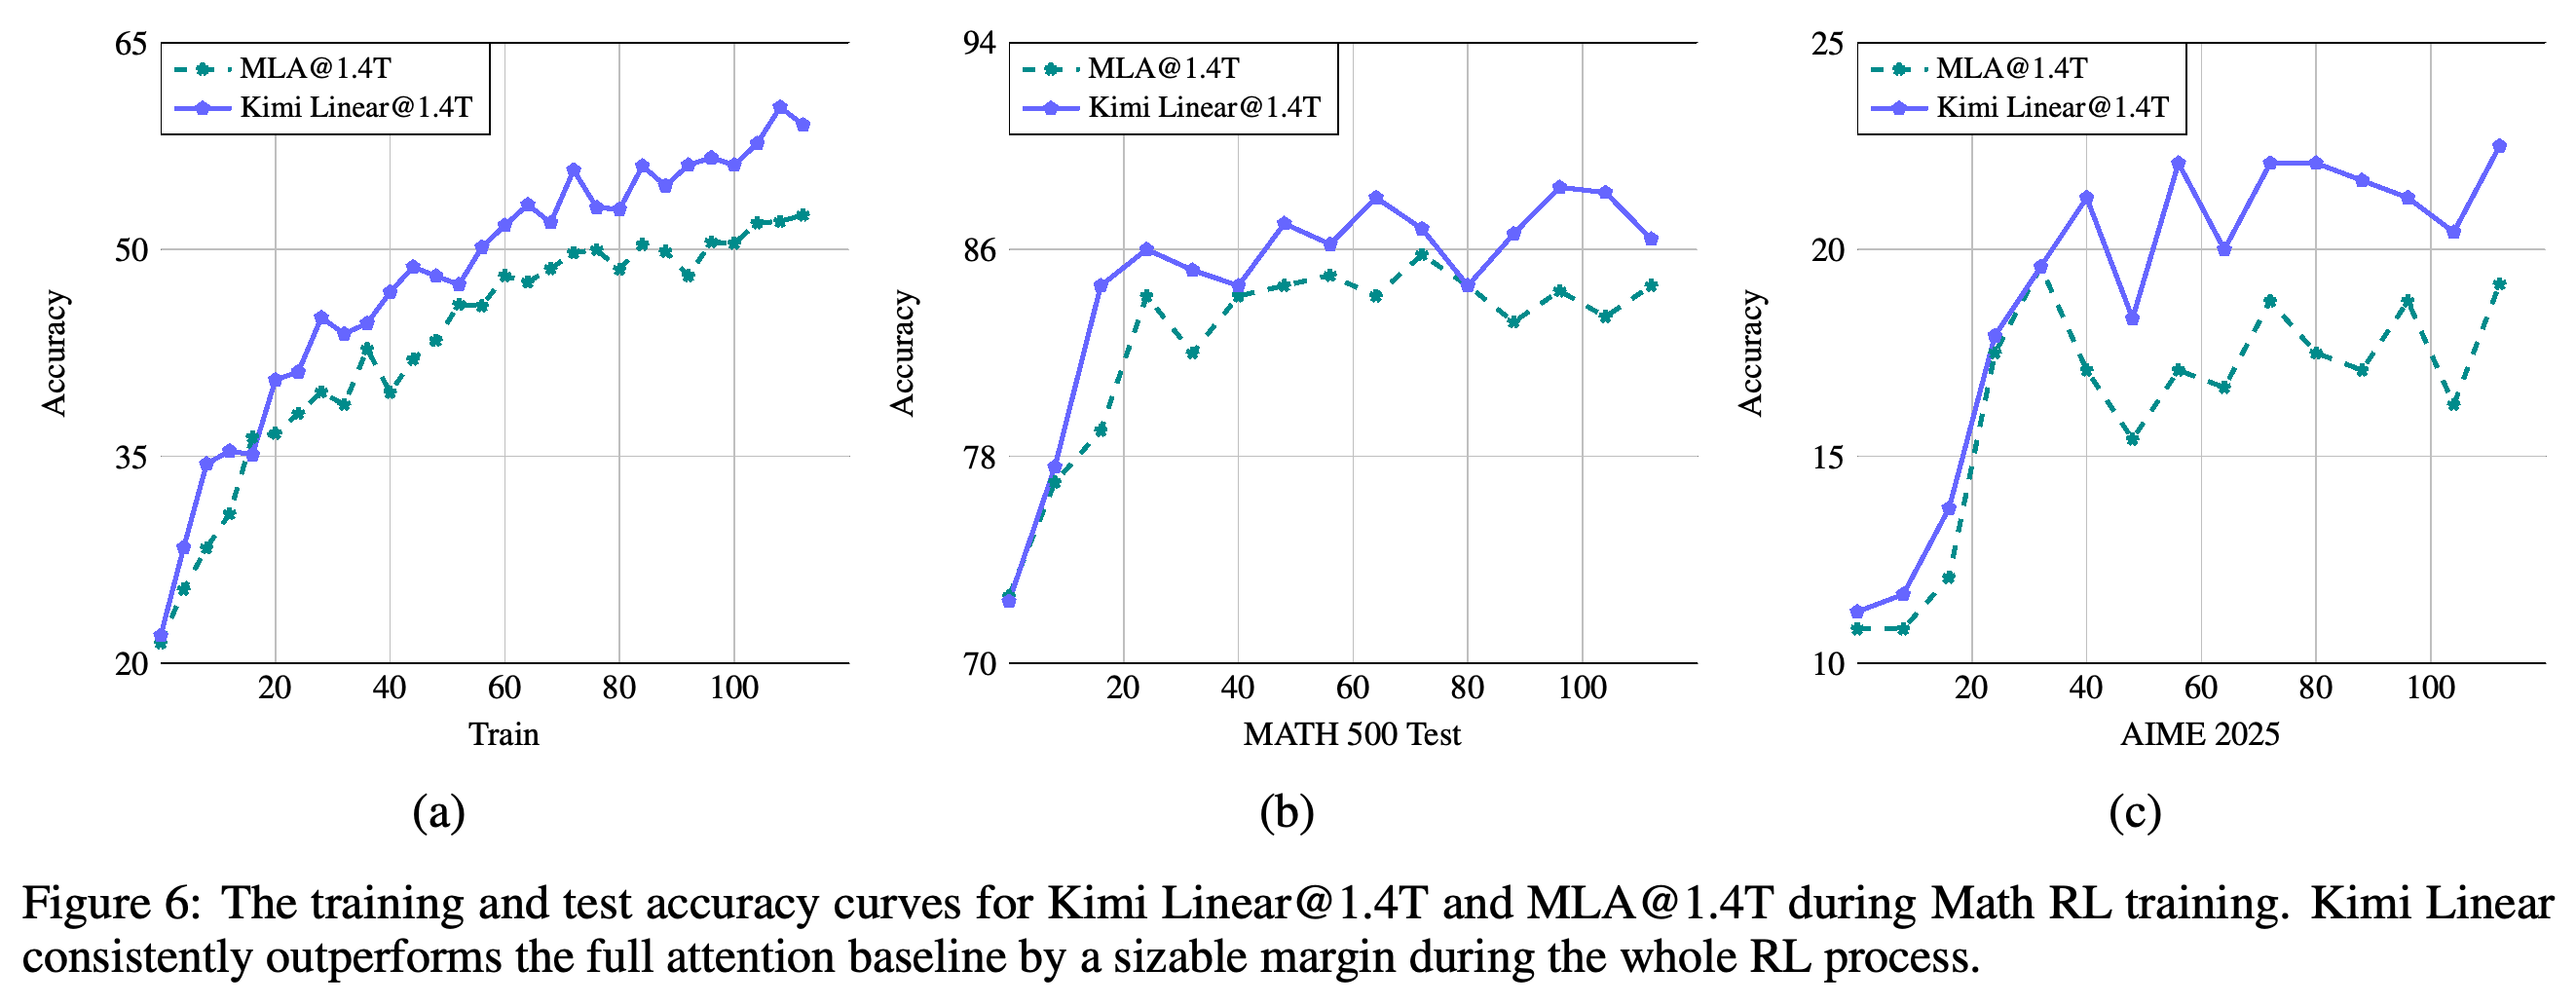
응답의 정답 여부를 검증해 보상을 주는 수학 reinforcement learning with verifiable rewards (RLVR) 실험은 동일한 알고리즘과 하이퍼파라미터로 1.4T 토큰 Kimi Linear 및 MLA 체크포인트를 비교한다. Kimi Linear의 학습 정확도는 더 빠르게 높아지고, MATH500과 AIME 2025 테스트 곡선도 대체로 MLA보다 높게 유지된다. 이 비교는 수학 RL 학습 중 수렴을 측정하며 실제 소요 시간 기준의 학습 효율을 측정하지는 않는다.
조건을 맞춘 RL 실험에서 비슷한 학습 정확도로 시작한 Kimi Linear는 더 빠르게 개선되고 대체로 학습 데이터와 학습에 사용하지 않은 수학 평가 데이터에서 더 높은 정확도를 유지한다. 테스트 곡선은 특히 AIME 2025에서 변동한다. 따라서 근거는 곡선 사이의 전반적인 차이이며 모든 평가 시점에서 단조롭게 개선된다는 뜻은 아니다.
5.6 Efficiency Comparison
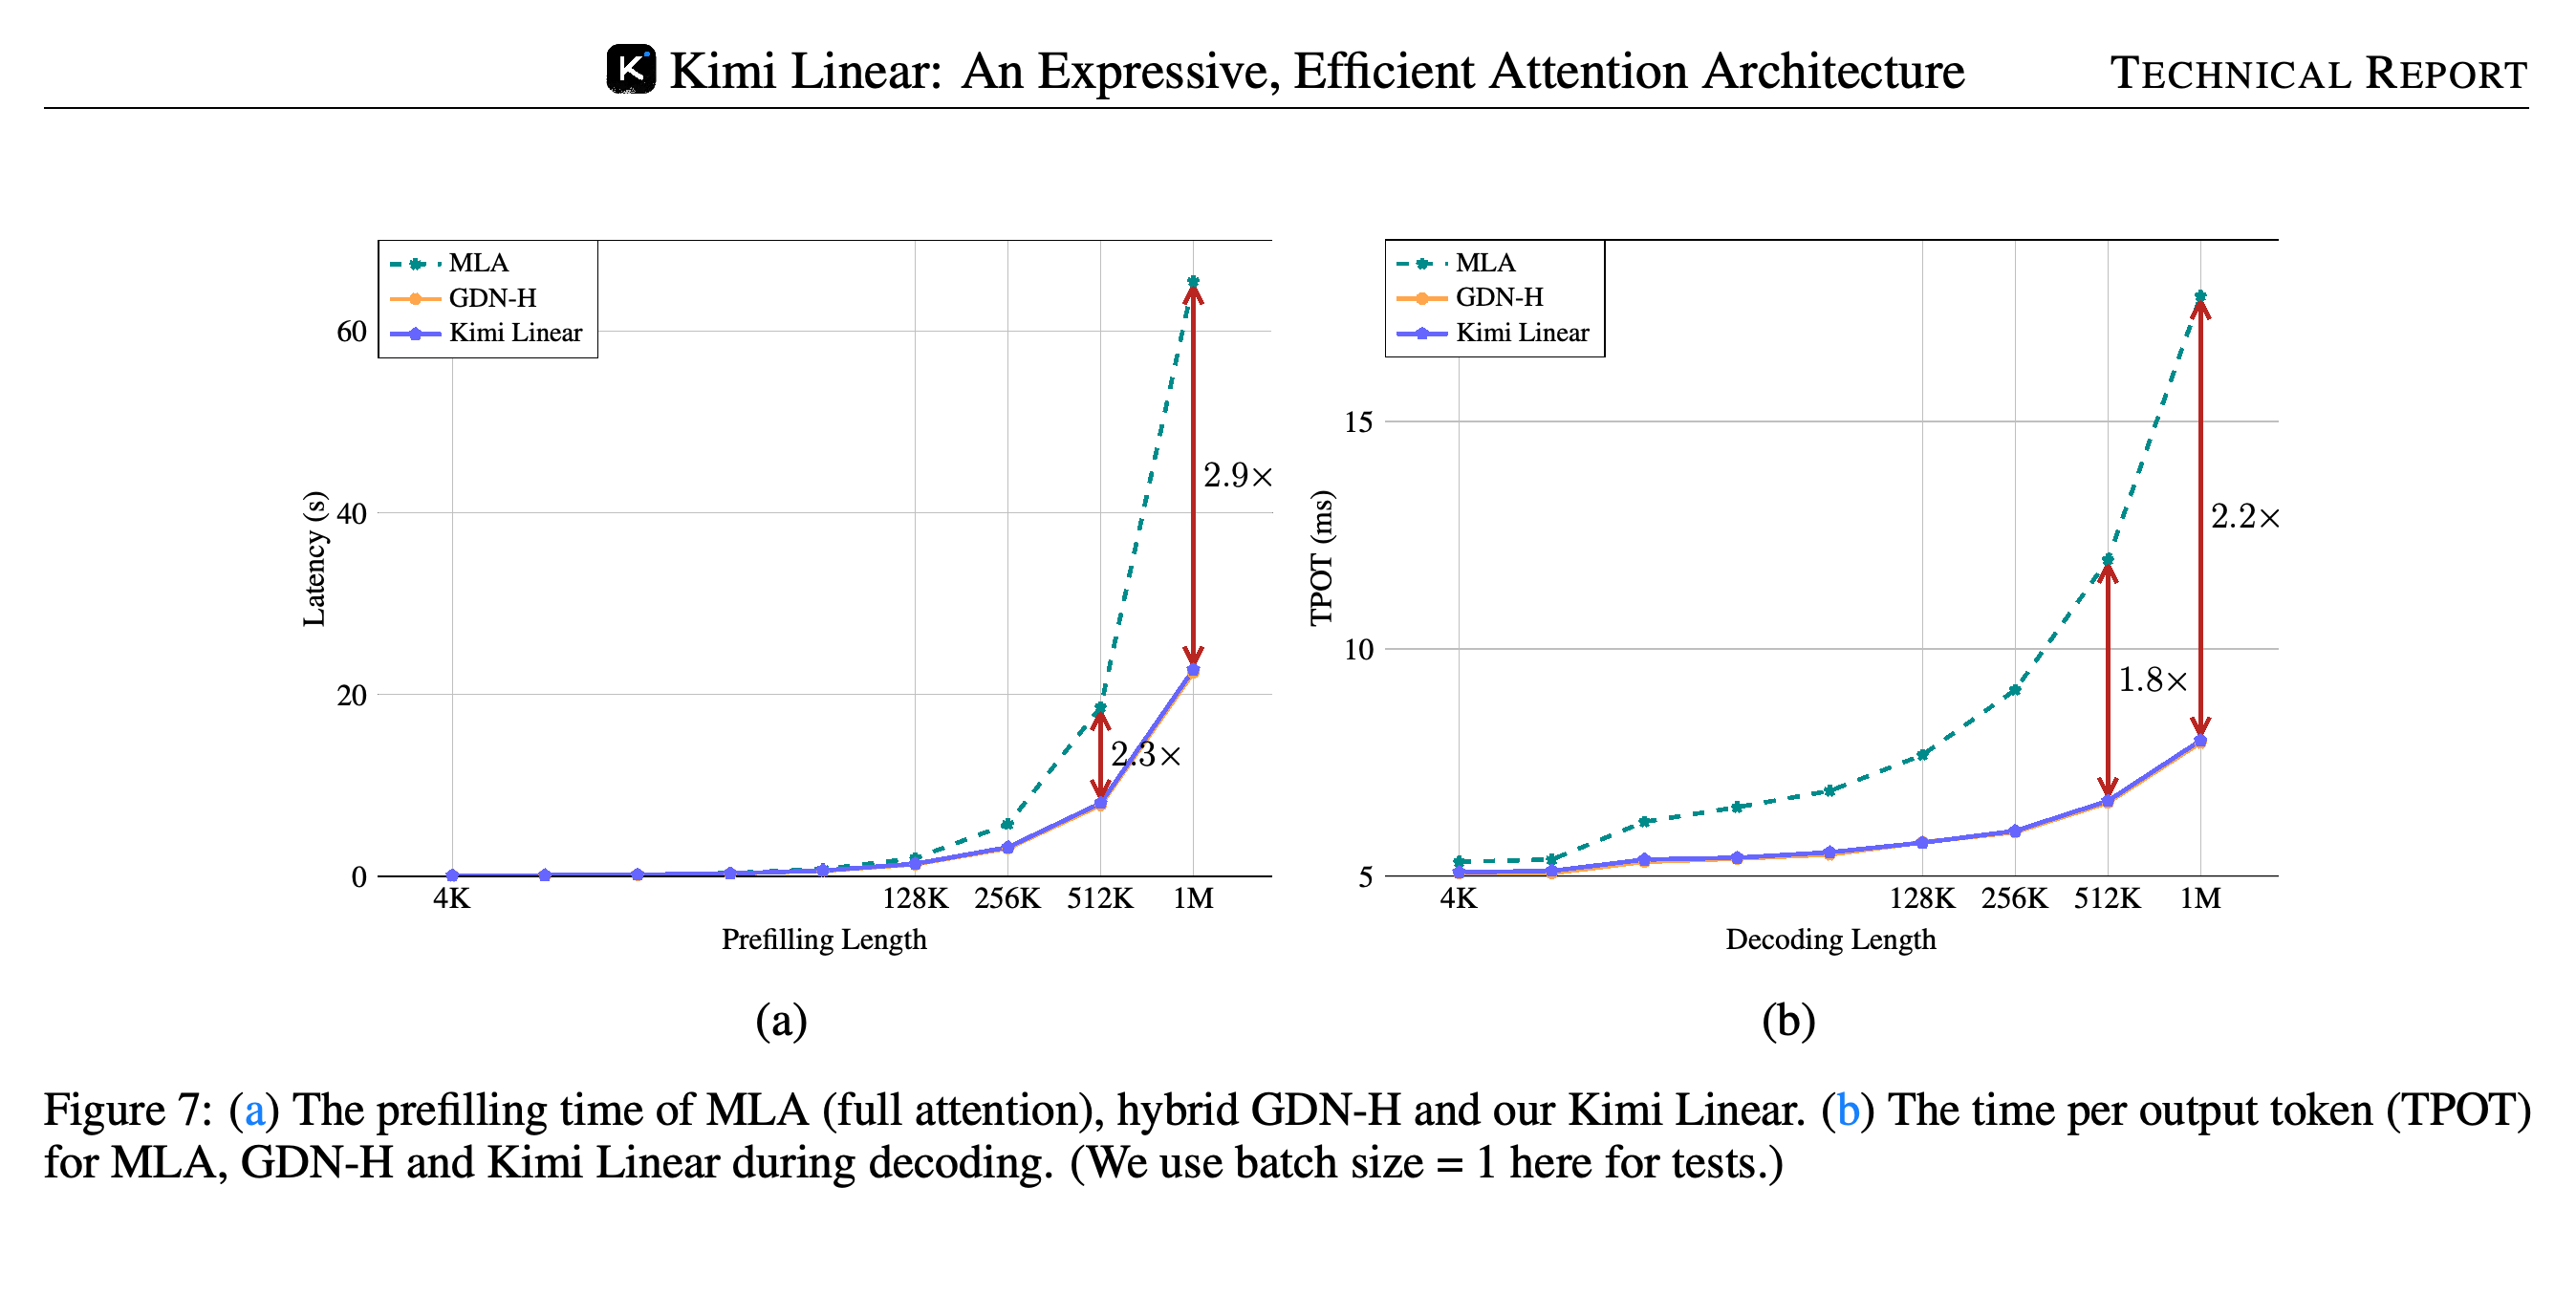
시간 비교는 계층 수와 헤드 수를 맞춘 48B 모델 설정을 사용한다. 생성 전에 입력 프롬프트를 처리하는 prefilling은 Kimi Linear와 GDN-H가 비슷하다. 긴 입력에서는 MLA보다 훨씬 빨라져 512k에서 2.3×, 1M에서 2.9× 가속을 보인다. 배치 크기 1에서 Figure 7은 1M의 time per output token (TPOT)이 약 2.2× 짧다고 보고한다. TPOT는 각 토큰을 생성하는 데 걸리는 시간이다.
- Figure 1의 큰 배치 비교는 1M에서 TPOT가 1.84 ms와 11.48 ms라고 보고하며 가속을 6.3×로 표시한다. 여기에는 KV 메모리 감소로 가능해진 배치 확대의 이점이 포함된다.
- 시간 그래프는 짧은 문맥에서 이점이 작고 Kimi Linear와 GDN-H의 곡선이 거의 겹침을 보여준다. 이는 이 설정에서 채널별 게이트의 측정된 추가 비용이 작다는 뜻이다.
- PDF는 큰 배치 비교의 가속기 하드웨어나 정확한 배치 크기를 명시하지 않아, 해당 재현 조건은 확인되지 않는다.
배치 크기 1에서 Kimi Linear와 GDN-H의 시간 곡선은 거의 겹치며, 긴 문맥에서 MLA 대비 이점이 가장 크다. 1M에 표시된 주석은 prefilling이 2.9×, 디코딩이 2.2× 빠름을 보여준다. 단일 요청의 이점은 큰 배치 비교의 6.3×보다 작다.
6 Discussions
논의에서는 KDA를 학습된 위치 정보 처리 방식으로 해석하고 전이를 제약된 DPLR과 연결하며 학습 연산 횟수와 추론 메모리 비용을 비교한다. 이 분석은 채널별 게이트, 청크 단위 구현, 전역 어텐션 계층의 NoPE 선택을 연결한다.
6.1 Kimi Delta Attention as learnable position embeddings
논문은 위치 간 상호작용을 과거 키와 현재 쿼리 사이의 전이 행렬 누적 곱으로 표현한다. RoPE는 고정 회전을 사용하고 게이트를 적용한 델타 모델은 망각과 보정 업데이트를 결합한 데이터 의존적 전이를 사용한다. KDA의 채널별 게이트는 특징마다 서로 다른 전이를 가능하게 하며, 이를 근거로 전역 어텐션 계층에 NoPE를 사용한다.
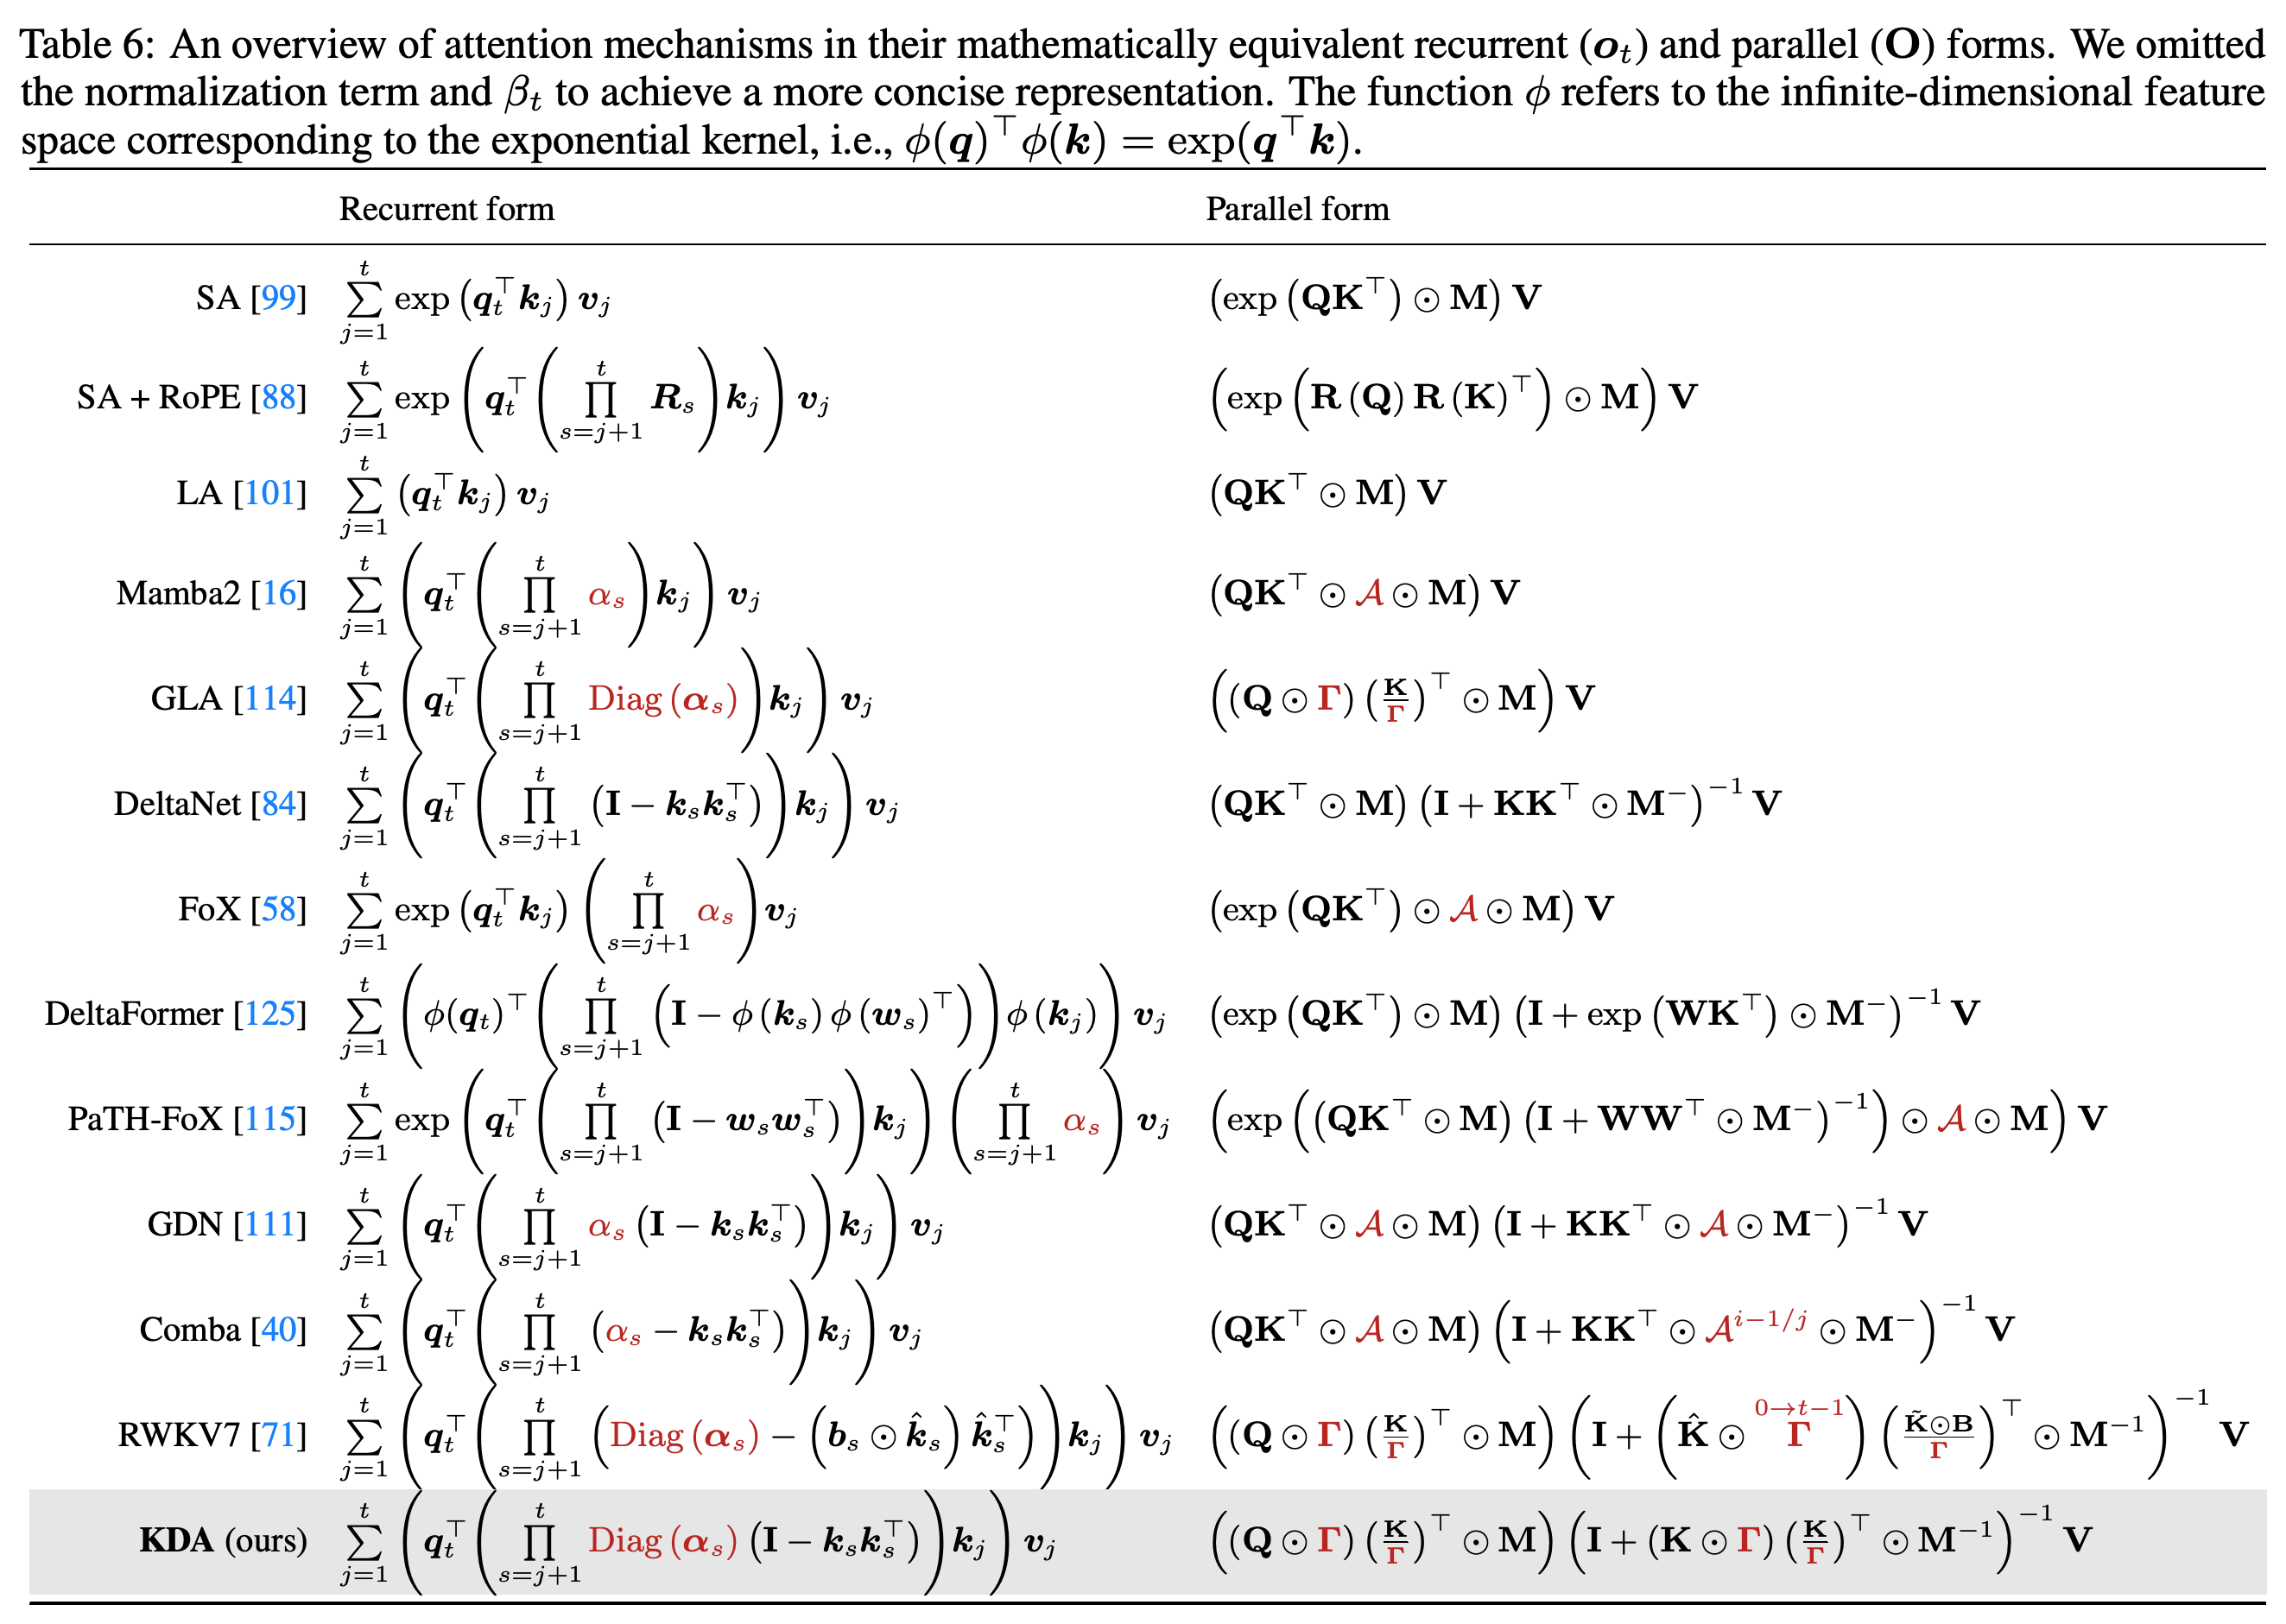
- Table 6은 어텐션 기법의 순환식과 병렬식을 비교해 공통 대수적 틀 안에서 감쇠와 델타 규칙 보정이 어떻게 나타나는지 보여준다.
- 저자들은 학습된 전이가 문맥 길이 외삽을 개선할 수 있다고 제안한다. NoPE와 RoPE의 비교는 128k 문맥에서 선택한 설계를 뒷받침하지만 제안한 설명을 직접 입증하지는 않는다.
순환식과 병렬식은 공통 수학적 틀 안에서 스칼라 감쇠, 채널별 감쇠, 보정 전이를 비교한다. 간결한 표현을 위해 정규화와 β_t를 생략하므로, 각 항목은 단순화한 대수적 관계를 제공하며 완전한 구현 명세를 제공하지는 않는다.
6.2 Relation to DPLR
KDA의 전이는 제약된 DPLR 행렬인 Diag(α_t) − β_t k_t k_tᵀ Diag(α_t)로 다시 쓸 수 있다. 저랭크 인자는 독립적으로 파라미터화하지 않고 키와 감쇠에 연결한다. 이에 따라 채널별 망각과 뒤이은 델타 규칙 보정이 중간 계산을 공유할 수 있다.
- 나란히 제시한 chunk_dplr와 chunk_kda 의사코드는 보조 청크 행렬을 4개에서 2개로 줄인다.
- 추가 단순화는 청크 간 계산과 출력 계산에서 행렬 곱을 약 3회 줄인다. Figure 2는 측정한 커널 비교를 제시한다.
6.3 Complexity Analysis
어텐션 헤드 1개와 고정 청크 크기 C = 64에 대해 논문은 FLOPs_KDA(T; C, d_h) = 6T d_h² + 3TC d_h + TC²를 제시한다. full attention의 지배적인 항은 FLOPs_Attn(T; d_h) = 2T² d_h다. 여기서 T는 시퀀스 길이이고 d_h는 헤드 차원이다. 투영 비용은 비슷한 것으로 취급하며 이 분석은 시퀀스 길이가 가변적이지 않다고 가정한다.
- 프롬프트 처리는 청크 단위 커널을 사용한다. 이전 토큰을 조건으로 토큰 1개를 생성하는 자기회귀 생성은 순환 업데이트를 사용한다.
- 각 KDA 헤드는 시퀀스 길이와 무관하게 고정된 128 × 128 상태를 저장한다. 전체 혼합 구조에는 KV 캐시가 계속 커지는 full-attention 계층도 포함된다.
- 본문은 1M에서 배치 크기 1의 가속을 2.3×로 언급하지만 Figure 7은 2.2×로 표시한다. 더 큰 6.3× 가속 비교는 메모리를 더 큰 배치에 재할당하는 데에도 의존한다.
7 Related Works
관련 연구는 시퀀스 처리 비용이 길이의 제곱보다 느리게 증가하는 효율적인 어텐션과 서로 다른 토큰 혼합 기법을 결합하는 혼합 모델로 나누어 설명한다. Kimi Linear는 계층 유형 전체를 번갈아 배치하는 계층 간 혼합 구조를 사용하며 보정 기능을 갖춘 순환 연산자와 최적화한 추론 구현을 결합한다.
7.1 Efficient Subquadratic Attention
선형 어텐션은 이력을 순환 메모리로 압축하고 희소 어텐션은 과거 토큰 중 선택한 부분집합과의 상호작용을 계산한다. 학습된 게이트는 순환 모델의 정보 유지와 망각을 개선하고 델타 규칙 업데이트는 개별 연결을 수정한다. 희소 방식은 과거 KV 캐시를 유지하면서 토큰 선택을 개선한다.
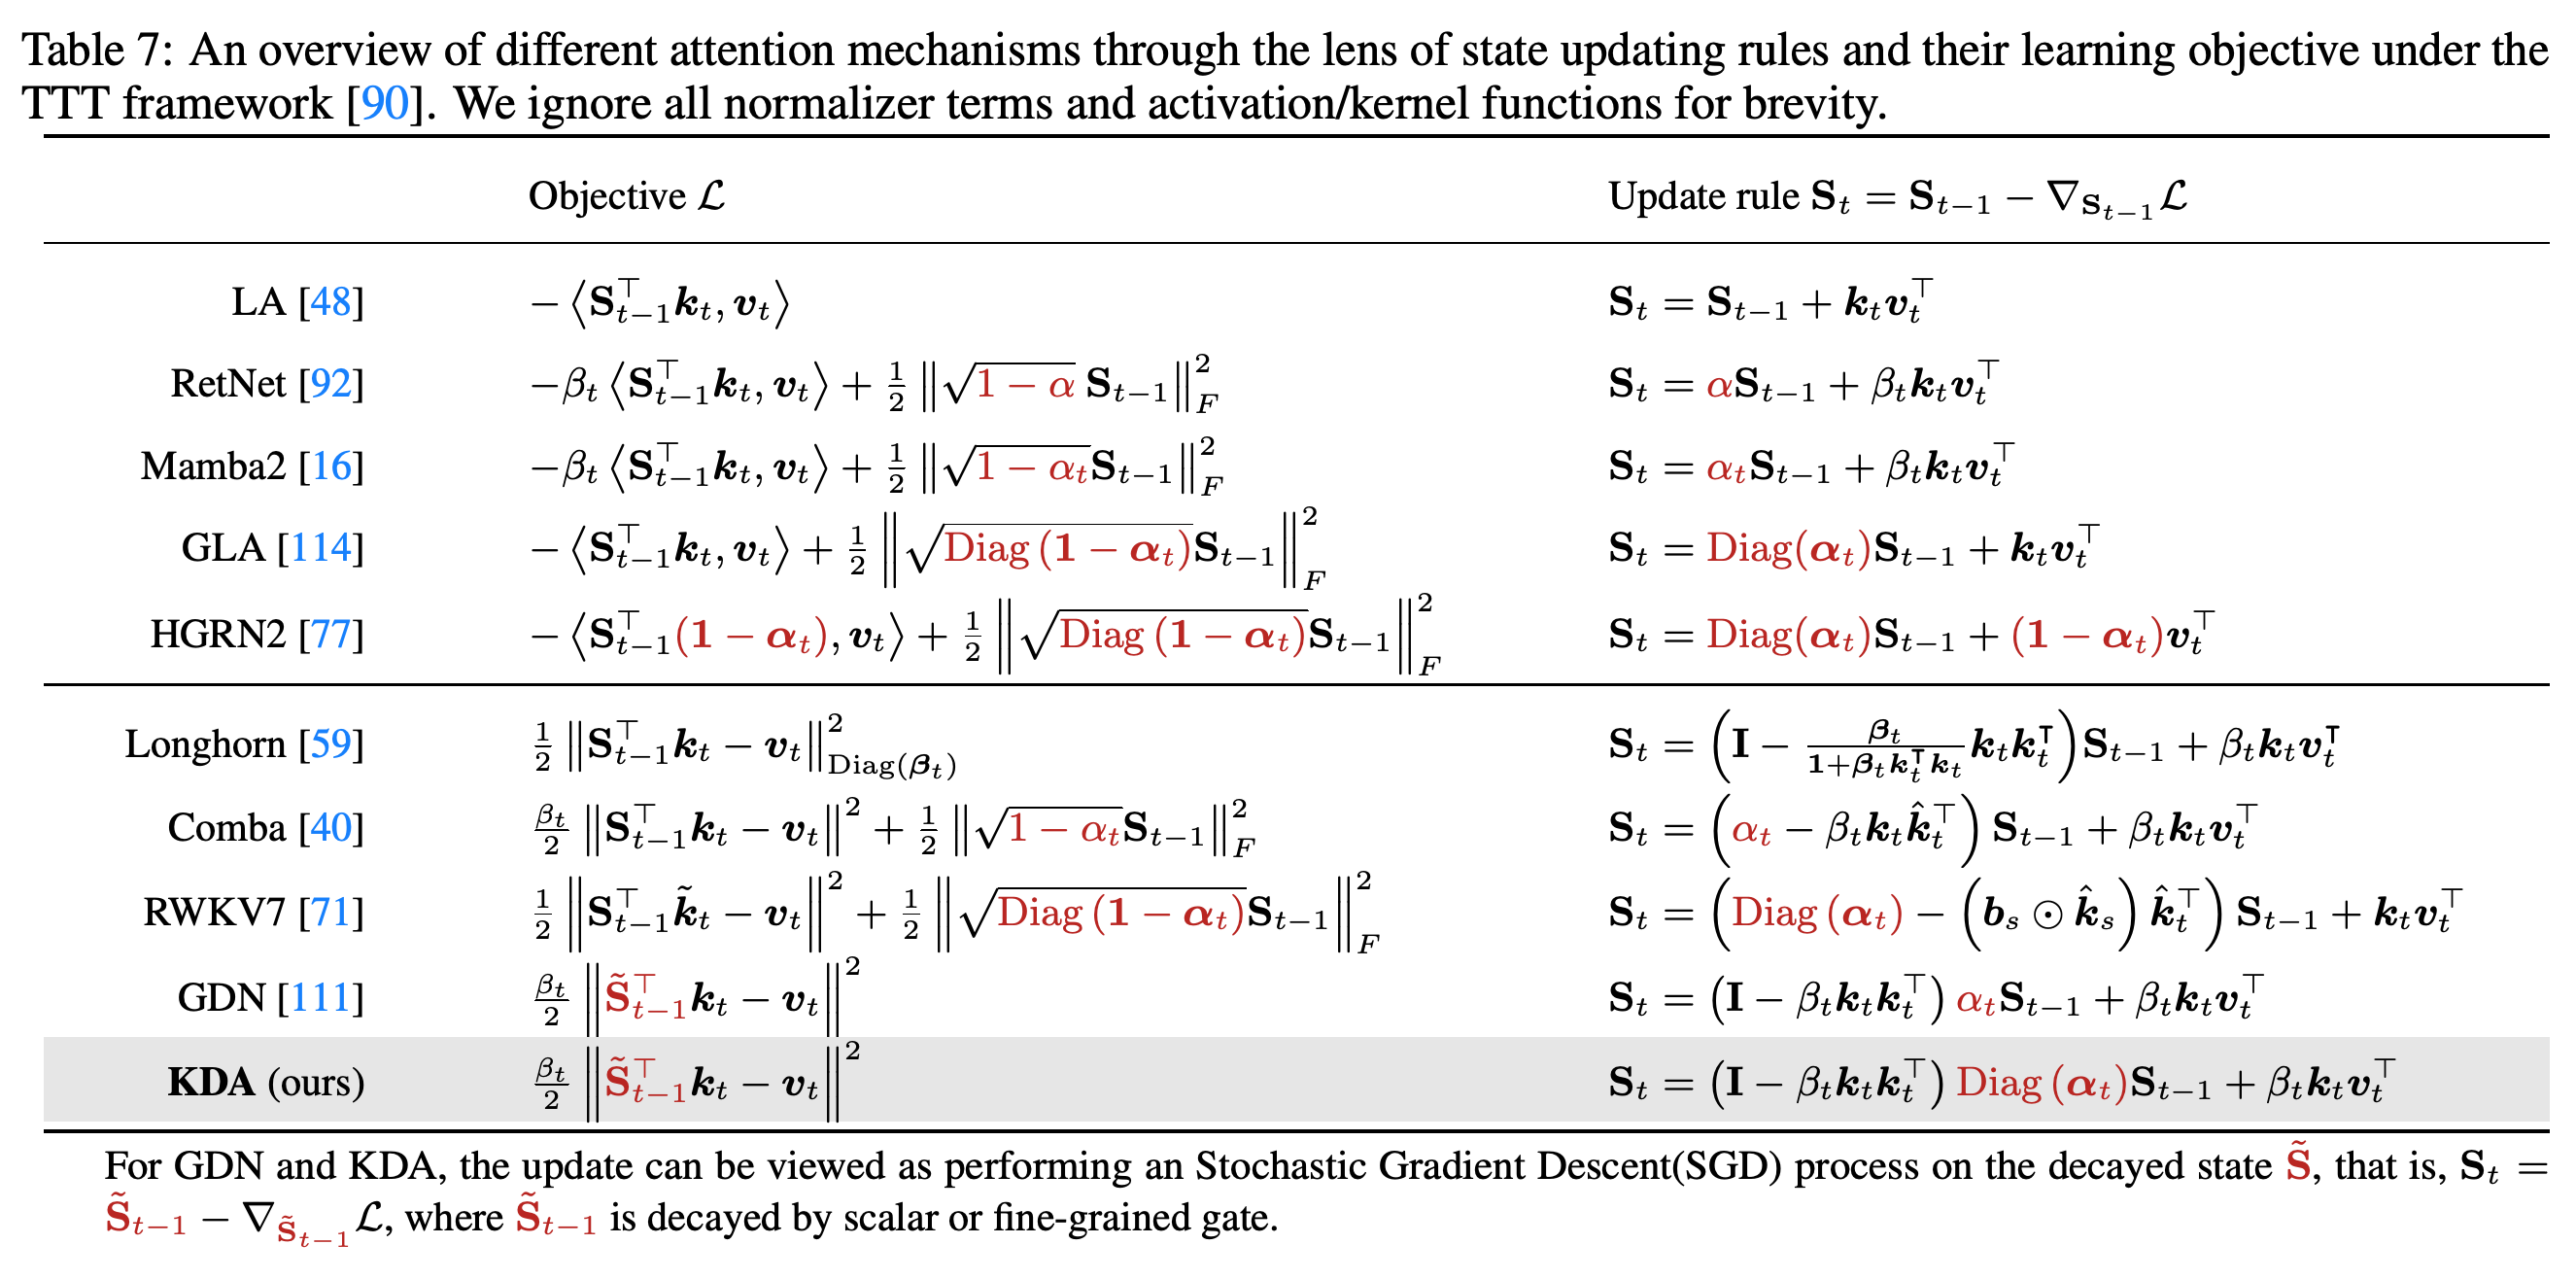
- Table 7은 메모리 업데이트를 들어오는 토큰에 대한 최적화 단계로 해석하는 test-time training (TTT) 틀을 사용해 학습 목적과 상태 업데이트 규칙을 비교한다. KDA와 GDN은 감쇠된 상태의 재구성 오류를 최소화한다.
- 논문은 정적인 희소 패턴, 문맥 의존적 선택, 하드웨어를 고려한 청크 및 토큰 단위 선택을 검토한다. Kimi Linear와 이러한 희소 구조 사이의 조건을 맞춘 실험 비교는 보고하지 않는다.
- 정확한 복사와 세밀한 검색은 순수 선형 메모리의 한계로 여전히 인정한다. 저자들은 이를 다룰 방법으로 혼합 어텐션, 상태 확장, 희소 어텐션과의 결합을 논의한다.
학습 목적 관점은 연결을 더하는 업데이트와 재구성 기반 보정을 구분한다. GDN과 KDA는 후자의 해석을 공유하지만 보정 전에 각각 스칼라 감쇠와 채널별 감쇠를 적용한다. 이를 통해 KDA가 도입한 차이를 확인할 수 있다. 표는 개념적 관계를 비교하며 벤치마크 성능을 비교하지는 않는다.
7.2 Hybrid Model
계층 내 혼합 구조는 한 계층 안이나 시퀀스의 일부 구간에 서로 다른 기법을 결합한다. 이 방식은 별도의 계산 경로가 필요할 수 있고 추론을 복잡하게 만들 수 있다. 계층 간 혼합 구조는 미리 정한 비율로 계층 유형 전체를 번갈아 배치한다. Kimi Linear는 캐시 관리와 표준 최적화의 통합을 단순하게 하기 위해 규칙적인 3:1 패턴을 채택한다.
- 저자들은 관찰한 검색 및 복사 성능을 근거로 KDA를 순환 구성 요소로 선택한다.
- 논의는 NoPE 전역 어텐션을 문맥 확장을 쉽게 하려는 다른 혼합 설계와 연결한다. 보고된 NoPE 구성 요소 비교는 Kimi Linear의 테스트 설정 안에서 이 선택을 뒷받침한다.
Conclusion
논문은 채널별 델타 규칙 메모리, 주기적 전역 어텐션, 전용 커널이 품질과 효율의 절충을 개선한다고 결론짓는다. 조건을 맞춘 1.4T 토큰 비교는 여러 벤치마크의 개선을 보여주며, 시간 측정 실험은 긴 문맥에서 더 큰 추론 이점을 보여준다. 보고된 최대 75% KV 캐시 감소와 6.3× 디코딩 가속은 혼합 구조와 메모리 절감으로 배치를 확대한 비교 조건에 의존한다.
부록
- A Contributions는 개별 기여자를 나열하고 프로젝트를 Moonshot AI에서 개발했다고 명시한다. 외부 협력자를 밝히고 Soochow University, China, The Hong Kong University of Science and Technology (Guangzhou), Massachusetts Institute of Technology, Hangzhou Institute of Medicine, CAS의 소속 정보를 제공한다.
- B Derivations for Chunkwise Parallelism of KDA는 누적 전이와 토큰의 누적 기여를 간결하게 표현하는 식을 귀납적으로 유도한다. 이를 통해 순차적인 rank-1 업데이트를 병렬화 가능한 청크 계산으로 재구성하는 데 사용하는 보조 벡터 점화식을 도출한다.
- C Pseudo Code for chunkwise KDA는 입력 q, k, v, g, beta, 선택적 initial_state, chunk_size: int = 64를 받는 PyTorch 스타일의 chunk_kda 함수를 제공한다. PyTorch는 이 의사코드에 사용한 텐서 연산 프레임워크다. 함수는 로그 감쇠 항을 누적하고 전진 대입으로 삼각 역행렬을 계산하며 보조 행렬을 구성한다. 이어서 순환 청크 상태 업데이트와 병렬 출력 계산을 결합한다. 수치 안정성을 위해 보조 청크 분할을 유지한다.
- D Kimi Linear@5.7T results는 공개 모델과 Moonlight를 비교한다. 모델 모두 학습 토큰 5.7T와 활성 파라미터 3B를 사용하지만 전체 파라미터는 Kimi Linear가 48B이고 Moonlight는 16B다. 기본 모델의 MMLU-Pro는 54.8과 42.4이며, 지시 튜닝 모델의 MMLU-Pro는 72.7과 43.8이다. Kimi Linear는 RULER@128k에서 95.4, RULER@1M에서 94.8도 기록한다. Moonlight-Instruct는 8K 문맥 한도를 넘는 과제에서 평가하지 않으므로, 해당 누락 항목은 직접적인 비교 근거가 되지 않는다.
짧은 생각
조건을 맞춘 실험은 전체 혼합 설계를 뒷받침한다. 이 설계는 여러 벤치마크 점수를 높이면서 긴 문맥의 추론 비용을 줄인다. Kimi Linear와 GDN-H의 시간 곡선이 가깝다는 점은 보고된 설정에서 더 세밀한 망각 제어가 측정된 지연 시간의 큰 증가 없이 품질을 개선할 수 있음을 보여준다.
대형 모델의 개선은 3:1 비율, NoPE, 출력 게이트, 합성곱을 포함한 전체 구조의 효과를 반영한다. 실험은 이 모든 개선을 채널별 게이트만의 효과로 귀속하지 않는다. 구조를 비교할 때는 파라미터를 맞춘 1.4T runs가 전체 용량도 달라지는 5.7T Moonlight 비교보다 더 강한 근거를 제공한다. 서빙 평가에서는 배치 크기 1의 지연 시간과 더 큰 배치로 얻을 수 있는 처리량 증가를 따로 측정해야 한다.