


In-Place Test-Time Training 요약 설명
07 Apr 2026 | Paper Review Inference-Time Learning Long-Context Language Models Fast Weights목차
- 요약
- 1 Introduction
- 2 Preliminary: Test-Time Training
- 3 In-Place Test-Time Training
- 4 Experiments
- 5 Related Work
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 In-Place Test-Time Training 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 7일(Arxiv)
- Feng, Guhao, Luo, Shengjie, Hua, Kai, Zhang, Ge, He, Di, Huang, Wenhao, Cai, Tianle.
- ByteDance Seed, Peking University
- 논문 링크
- Github
요약
- In-Place Test-Time Training은 attention을 유지하면서 문맥에 따라 기존 Transformer MLP 블록의 마지막 projection 행렬을 갱신한다. 처음부터 사전학습해야 하는 아키텍처로 attention을 대체하는 대신, 기존 체크포인트와 호환되는 fast-weight 메커니즘을 제공한다.
- 이 방법은 각 청크에 현재 가중치를 먼저 적용한 뒤, 이후 청크를 위해 가중치를 갱신한다. 토큰 임베딩에서 생성한 Language Modeling-Aligned target은 parallel prefix scan으로 누적할 수 있는 가산적 업데이트를 만든다. Induction 유형의 이론 분석은 현재 토큰을 복원하기보다 다음 토큰 정보를 사용하는 근거를 제시한다.
- 동일한 지속 학습 조건에서 Qwen3-4B-Base의 RULER 정확도는 64k에서 74.3%에서 78.7%로, 128k에서 74.8%에서 77.0%로, 256k에서 41.7%에서 43.9%로 높아진다. 처음부터 학습한 실험에서도 장문 문맥 perplexity가 낮아지고 RULER 점수가 높아진다. 다만 문서 경계에서 상태를 초기화하므로, 실험으로 입증한 적응은 무한한 스트림 전반에 걸친 지속적 학습이 아니라 문서 내부의 기억으로 한정된다.
1 Introduction
논문은 사전학습된 LLM에 Test-Time Training을 적용할 때의 장애 요인 3가지를 제시한다. 기존 체크포인트를 쉽게 활용할 수 없는 특수 아키텍처, 가속기를 충분히 활용하지 못하는 순차적 업데이트, 다음 토큰 예측을 명시적으로 지원하지 않는 복원 목적함수다. 이를 해결하기 위해 MLP 파라미터를 재사용하고, 큰 청크 단위로 갱신하며, 예측에 유용한 target을 구성한다.
- Attention이 토큰 간 정보 결합을 계속 담당하므로, 적응형 MLP는 사전학습된 attention을 대체하지 않고 보완한다.
- 언어 모델링과 장문 문맥 벤치마크를 장기 적응의 대리 평가로 사용한다. 도입부에서 동기로 제시한 변화하는 에이전트 과제는 실험에서 직접 평가하지 않는다.
- 공개 코드 URL은 https://github.com/ByteDance-Seed/In-Place-TTT 이다.
2 Preliminary: Test-Time Training
Test-Time Training은 선택한 파라미터를 문맥에 따라 변화하는 기억으로 사용한다. 예비 설명에서는 업데이트와 정보 검색 메커니즘을 사전학습된 자기회귀 언어 모델에 통합하기 위한 요구사항과 구분한다.
The TTT mechanism.
기존 정식화에서는 토큰 표현으로 query, key, value를 생성한다. 먼저 자기지도 손실을 통해 key와 value를 연결하도록 fast weights를 갱신한 뒤, 갱신된 네트워크로 query를 처리한다. 자기지도에 대해서는 이 글을 참조하라.
- 업데이트는 Wi ← Wi−1 − η∇W L(fWi−1(ki), vi)이며, 이후 oi = fWi(qi)를 계산한다.
- 손실함수, 옵티마이저, 기억의 파라미터화 방식에 따라 이 상태가 어떤 정보를 저장하고 검색하며 잊는지가 달라진다.
- In-Place TTT는 청크 단위에서 이 순서를 뒤집는다. 먼저 적용한 뒤, 이후 청크를 위해 갱신한다.
Desiderata for TTT within the LLM ecosystem.
논문이 제시하는 요구사항은 Architectural Compatibility, Computational Efficiency, Tailored Learning Objective for Language Modeling이다. 호환성은 사전학습된 체크포인트에서 시작할 수 있어야 한다는 뜻이다. 효율성을 확보하려면 토큰별 순차 업데이트에서 벗어나야 하며, 목적함수를 언어 모델링에 맞추려면 예측에 유용한 target을 선택해야 한다.
- 이 요구사항을 바탕으로 Transformer backbone은 유지하되, 추론 중 기존 MLP 가중치가 동작하는 방식을 바꾼다.
- 복원 목적함수에 대한 비판은 예측에 얼마나 유용한지를 다룬다. 복원으로 문맥 정보를 저장할 수 있는지 자체를 문제 삼지는 않는다.
3 In-Place Test-Time Training
In-Place Test-Time Training은 적응 가능한 MLP down projection, 청크 단위 업데이트, LM-Aligned Objective, context-parallel 구현을 결합한다. Attention과 사전학습된 MLP 초기값은 유지하고, 온라인 업데이트 target을 생성하는 구성요소를 추가한다.
3.1 Overall Framework
Repurposing MLP Blocks for In-Place Adaptation에서는 gated MLP의 Wdown을 fast-weight 상태로 사용한다. 온라인 적응 중 Wup과 Wgate는 slow weights로 유지하며, 중간 활성값을 마지막 projection을 갱신하는 key로 사용한다.
- Gated MLP는 O = (ϕ(HWgateᵀ) ⊙ (HWupᵀ))Wdownᵀ를 계산한다.
- 기존 projection을 사용하므로 attention을 대체하거나 토큰 간 정보 결합을 주로 담당하는 새 층을 도입할 필요가 없다.
- Target을 생성하는 Conv1D와 Wtarget은 추가로 학습하는 구성요소다. 따라서 체크포인트 호환성이 파라미터를 전혀 추가하지 않는다는 뜻은 아니다.
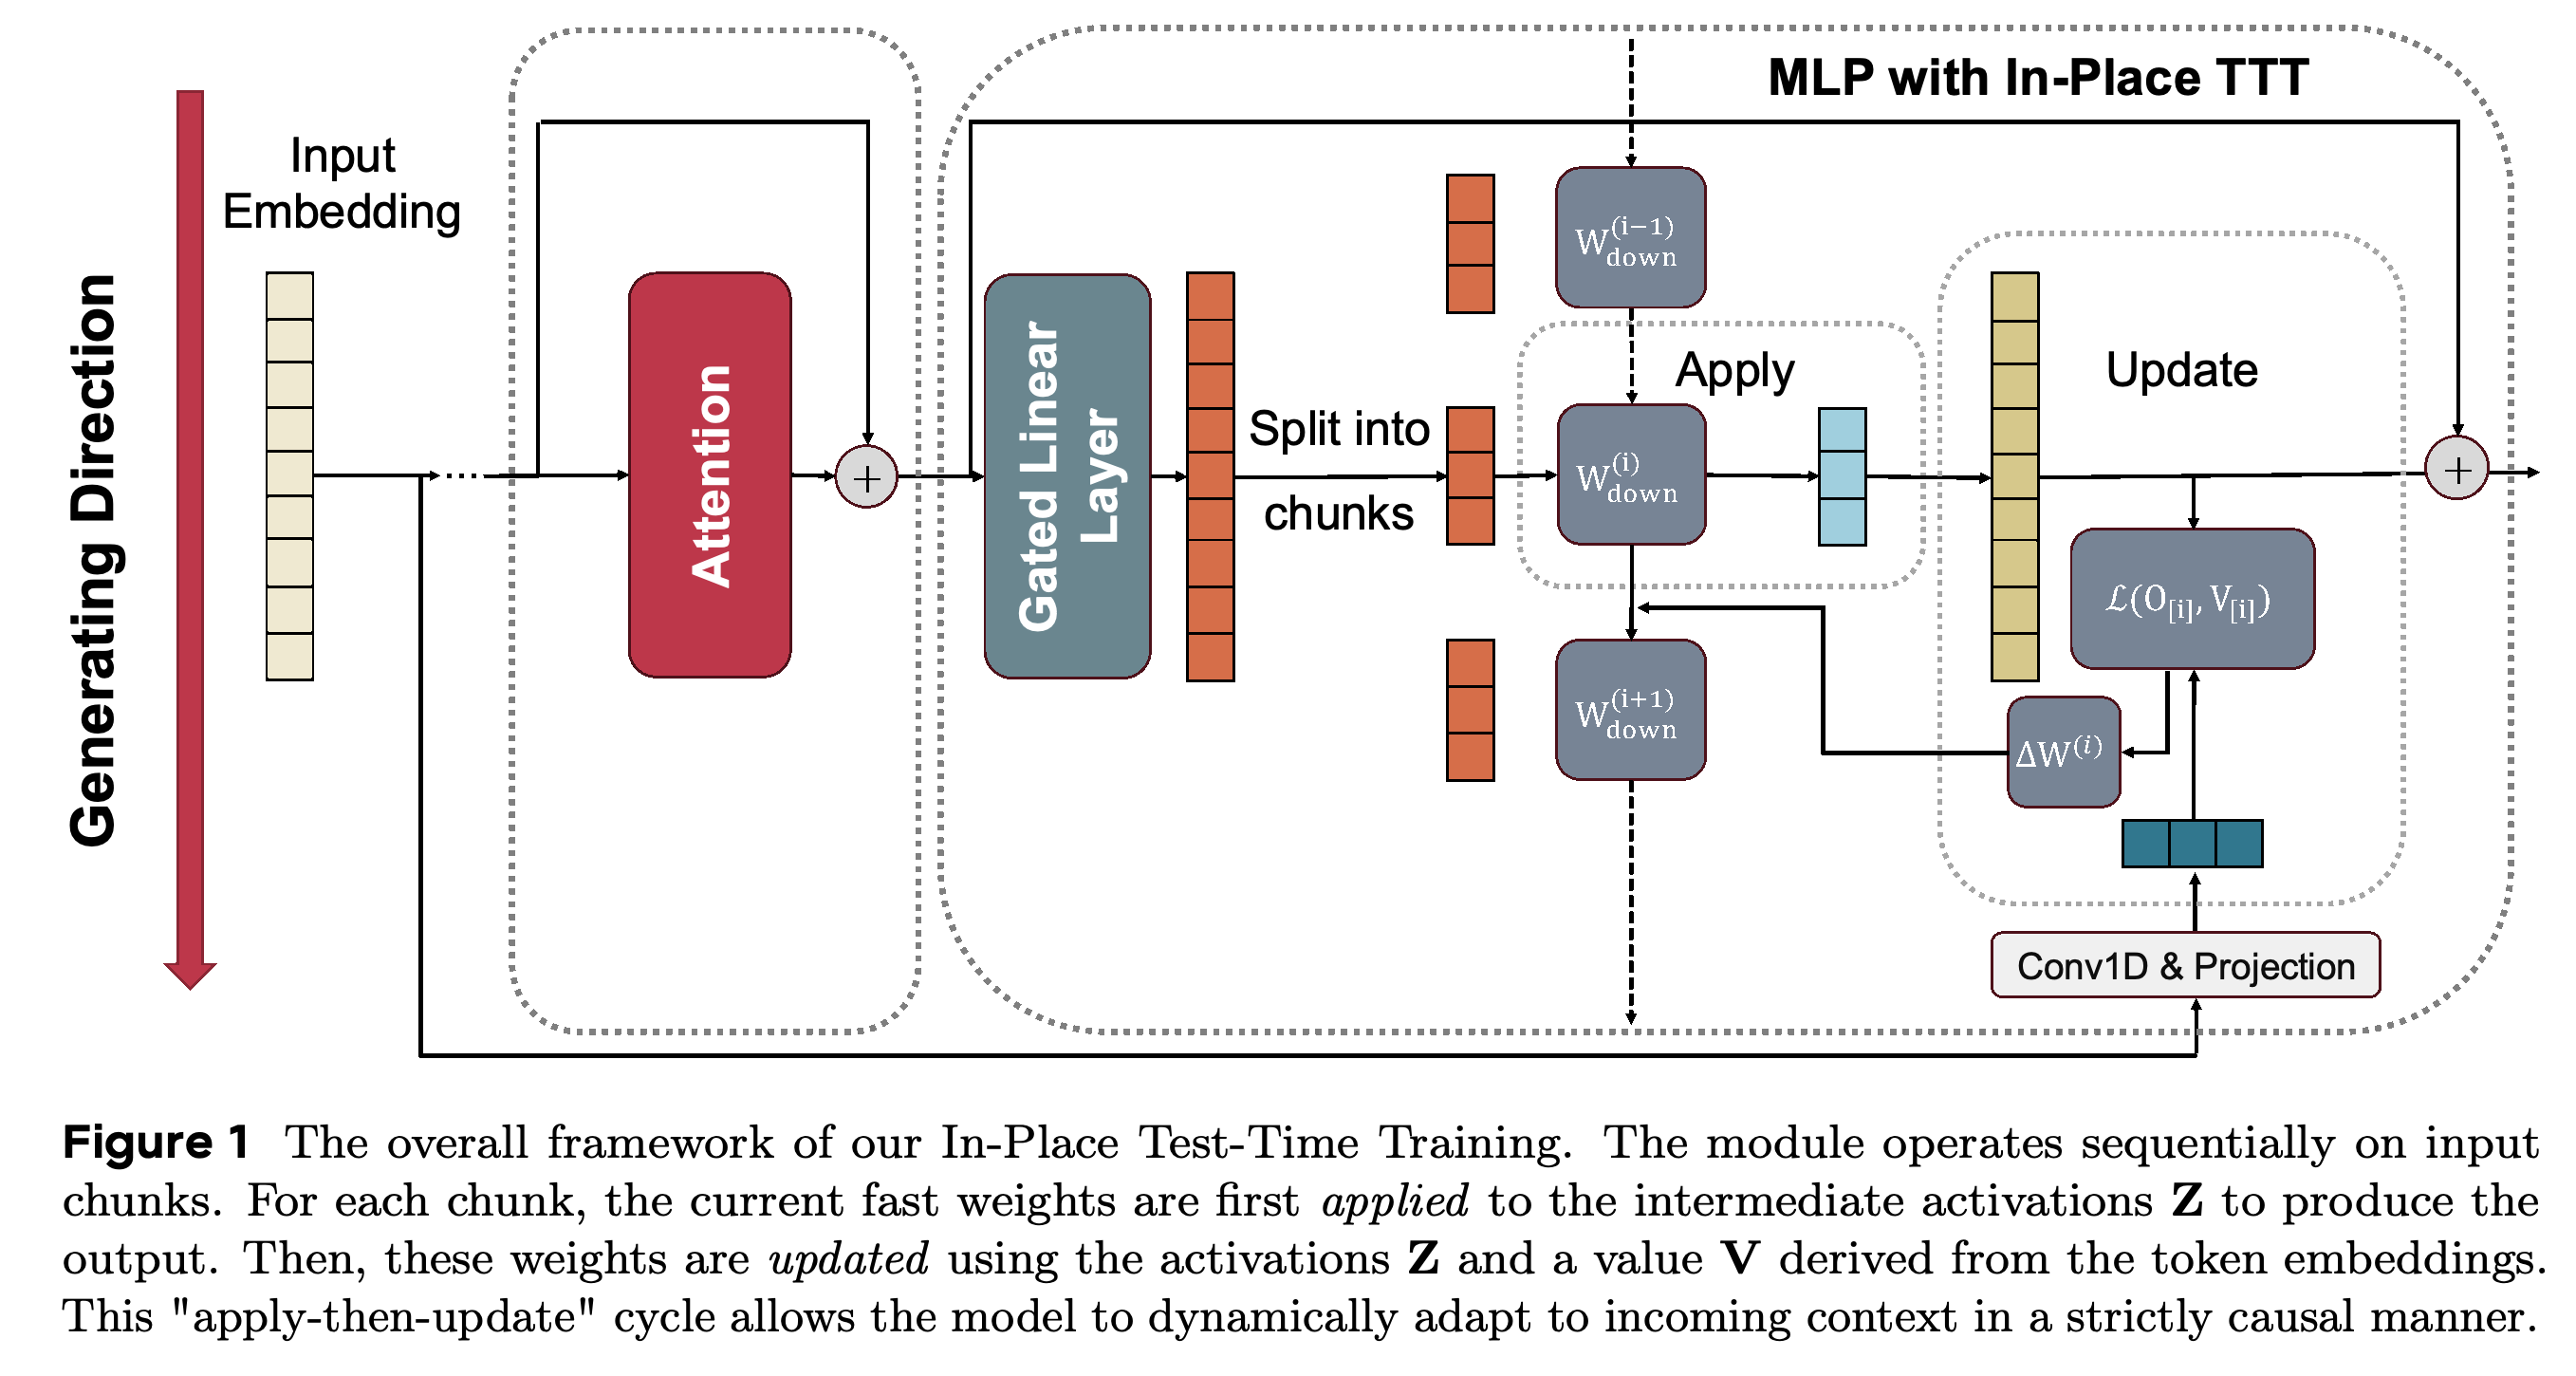
Efficient Adaptation with Chunk-Wise Updates에서는 활성값과 target을 크기 C의 겹치지 않는 청크로 나눈다. 각 청크를 이전 청크에서 얻은 fast-weight 상태로 처리한 뒤, gradient step으로 그 상태를 갱신한다.
- 적용 연산은 O[i] = Z[i](Wdown(i))ᵀ다. 업데이트에서는 Z[i]와 V[i]를 사용해 Wdown(i+1)을 구성한다.
- Attention이 청크 내부 상호작용을 담당하므로, 적응형 MLP는 TTT가 유일한 token mixer일 때 필요한 작은 청크를 사용할 필요가 없다.
- 보고된 ablation에서는 C = 512와 C = 1024가 유리하며, C = 1024가 효율성 면에서 더 낫다.
3.2 LM-Aligned Objective
LM-Aligned Objective는 V̂ = Conv1D(X0)Wtarget으로 target을 정의하며, X0는 토큰 임베딩을 담는다. 이 target은 현재 토큰을 복원하는 대신 국소적인 미래 토큰 정보를 포함하도록 설계한다. 다음 토큰 임베딩은 그 특수한 경우다.
- L(·, ·) = −⟨·, ·⟩F를 사용하면 식 (1)의 가산적 업데이트 Wdown(i) = Wdown(i−1) + ηV̂[i]ᵀZ[i]를 얻는다.
- 이 gradient는 현재 fast-weight 상태에 의존하지 않으므로, 업데이트 변화량을 독립적으로 계산하고 결합법칙에 따라 누적할 수 있다.
- 온라인 목적함수는 표현 수준의 유사도 손실이다. 언어 모델 전체를 통과하는 cross-entropy 업데이트가 아니다.
3.3 Theoretical Analysis
Setup에서는 적응 기능을 추가한 단일 Transformer 블록을 induction 과제로 분석한다. 앞서 key-value 쌍 (k*, v*)이 등장하고, 이후 k*가 다시 등장하면 v*를 예측해야 한다. 현재 토큰 임베딩 target과 다음 토큰 임베딩 target을 비교한다. 일치하는 key의 업데이트는 이전 청크에서 이루어져야 하며, 복원 방식과의 비교에서는 k*와 v*가 서로 다르다고 가정한다.
- 문맥에 따른 업데이트는 query 위치의 logit을 Δℓn[w] = EwᵀΔWdownZn만큼 바꾼다.
- Assumptions에서는 서로 다른 토큰 임베딩이 근사적으로 직교하여 |ewiᵀewj| ≤ ϵ를 만족하고, 제곱 노름이 ‖ewi‖² ≥ cnorm² > 0을 만족한다고 가정한다.
- 일치하는 key와 query 활성값은 E[zt*ᵀzn] = calign > 0을 만족한다. 관련 없는 위치의 기대 기여도는 0이며, E[(VtZtᵀ)Zn] = 0이다.
Theorem 1에 따르면 LM-Aligned target은 정답 토큰의 기대 logit을 최소 λlr · cnorm² · calign만큼 높인다. 다른 각 토큰의 기대 logit 변화의 절댓값은 최대 λlr · ϵ · calign이다. 복원 방식에서는 정답 토큰의 기대 logit 변화의 절댓값도 후자의 값으로 제한된다.
- 이 결과는 일치하는 key 다음에 등장하는 토큰을 저장하면 induction 유형의 예측에 도움이 되는 이유를 설명한다.
- 이론의 범위는 명시된 단일 블록 설정과 표현에 대한 가정으로 한정된다. 학습된 convolution target을 사용하는 다층 LLM의 일반적인 성능 향상을 증명하지는 않는다.
- 실제 target은 다음 토큰을 사용하는 경우를 확장하여, 미래 토큰을 학습된 방식으로 국소적으로 결합한다.
3.4 Implementation Details
Efficient Implementation with Context Parallelism에서는 각 청크의 활성값과 업데이트 변화량을 병렬로 계산한다. Exclusive prefix sum으로 이전 변화량을 누적한 뒤, 그 결과로 얻은 유효 가중치를 병렬로 적용한다. Figure 1은 이에 해당하는 적용 후 업데이트의 데이터 흐름을 보여준다.
- Prefix 상태는 ΔSi = ∑j=1…i−1 ΔWj이며, 유효 projection은 Wdown(0) + ηΔSi다.
- Causality and Boundary Handling에서는 causal padding으로 청크 내부의 target을 생성하고, 문서 경계에서 fast weights를 사전학습 상태로 초기화한다고 명시한다.
- Discussion에서 저자들은 이 scan이 순차적 인과 업데이트와 동등하다고 설명하며, 다른 손실함수와 옵티마이저는 향후 과제로 남긴다.
이 그림은 그대로 유지하는 attention과 적응형 MLP down projection을 구분한다. 토큰 임베딩은 target 생성기로 들어가고, gated MLP 활성값은 업데이트 key를 제공한다. 각 청크의 출력은 현재 projection을 사용하며, 이후 그 청크의 변화량으로 다음 청크를 위한 상태를 갱신한다. 이 순서 덕분에 청크가 자신의 target에 의존하는 업데이트를 사용하지 않는다.
4 Experiments
실험에서는 In-Place TTT가 사전학습된 LLM을 개선하는지, 처음부터 학습할 때 기존 방법과 어떻게 비교되는지, 어떤 설계 선택이 성능에 영향을 주는지를 검증한다. 평가는 4B–14B 규모의 지속 학습, 500M·1.5B·4B 모델을 처음부터 학습하는 실험, 1.7B 모델의 ablation을 포함한다.
- 주요 장문 문맥 지표는 RULER 정확도와 Sliding Window Perplexity다.
- 상식 추론 평가로 4B 모델의 능력을 추가로 확인한다.
4.1 In-Place TTT as a Drop-in Enhancement for Pre-trained LLMs
Training and Evaluation에서는 Qwen3-4B-Base와 In-Place TTT 버전에 동일한 지속 학습 과정을 적용한다. 32k 문맥에서 ∼20B 토큰을 학습한 뒤, 128k 문맥에서 ∼15B 토큰을 학습한다. Stage 2에서는 YaRN을 사용한다. OpenCompass로 4k부터 256k까지 RULER를 평가하며, 256k는 학습 길이를 넘어선 외삽을 검증한다.
- 두 단계 모두 학습률 5e-6, weight decay 0.1의 AdamW를 사용한다. 정확한 시퀀스 길이는 32,768과 131,072다.
- 이 방법은 체크포인트와 호환되는 개선 방식이지만, 상당한 지속 학습이 필요하다. 추가 학습량이 0인 변경으로 효과를 입증한 것은 아니다.
- 보고된 Qwen3-4B 평가에서는 수치적 안정성을 위해 각 업데이트 변화량의 Frobenius norm을 τ = 1e-5로 제한한다.
Results and Discussion에서 Table 1의 절대 향상 폭은 64k에서 가장 크며, 정확도는 74.3%에서 78.7%로 높아진다. 128k와 256k 점수는 각각 74.8%에서 77.0%로, 41.7%에서 43.9%로 높아진다. 평가한 7개 길이 중 6개에서 성능이 개선되지만, 4k에서는 baseline의 96.6%보다 낮은 96.1%를 기록한다.
- 긴 문맥에서의 향상은 동일한 학습 과정에서 문맥 적응이 유용하게 작동함을 뒷받침한다.
- 논문은 향상 폭이 커지는 추세라고 설명하지만, 문맥 길이에 따라 우위가 단조롭게 증가하지는 않는다.
- 256k에서는 두 모델 모두 128k 성능보다 크게 낮다. 따라서 결과는 상대적인 외삽 성능 향상을 보여주며, 신뢰할 수 있는 무제한 문맥 처리를 입증하지는 않는다.
Extension to More Models에서 Table 2는 LLaMA-3.1-8B와 Qwen3-14B-Base가 평가한 모든 길이에서 개선됨을 보여준다. 64k에서는 각각 81.6%에서 83.7%로, 67.9%에서 70.6%로 높아진다. YaRN을 적용한 Qwen3-14B의 64k 정확도는 81.3%에서 82.5%로 높아진다.
- 이 비교는 체크포인트 계열과 파라미터 규모가 달라도 효과가 있음을 뒷받침한다.
- 본문은 동일한 지속 학습 절차를 적용했다고 설명하지만, Table 7에는 추가 모델 각각을 시퀀스 길이 32,768에서 ∼20B 토큰으로 학습했다고 명시한다. 이는 Qwen3-4B의 전체 2단계 학습 과정과 다르다.
- YaRN을 적용해도 성능 향상이 유지되므로 위치 외삽 기법과의 호환성을 뒷받침한다.
4.2 Pre-training from Scratch: A Comparative Analysis
Experimental Setup에서는 500M과 1.5B 규모에서 In-Place TTT를 Sliding-Window Attention (SWA), Gated Linear Attention (GLA), DeltaNet, Large Chunk Test-Time Training (LaCT)과 비교한다. In-Place TTT와 LaCT는 모두 SWA backbone을 사용하며, 모든 모델을 시퀀스 길이 32,768로 학습한다.
- 500M 모델은 attention window 2,048토큰으로 20B 토큰을 학습한다. 1.5B 모델은 window 4,096토큰으로 60B 토큰을 학습한다.
- AdamW 학습률은 각각 5e-4와 3e-4이며, 배치 크기는 각각 2M 토큰과 4M 토큰이다. 둘 다 weight decay 0.1, gradient clipping 1.0, warmup 1024 step을 사용한다.
- 4B에서는 시퀀스 길이 8,192로 학습량 120B를 사용한 뒤, full-attention 및 SWA backbone을 각각의 개선 버전과 비교한다.
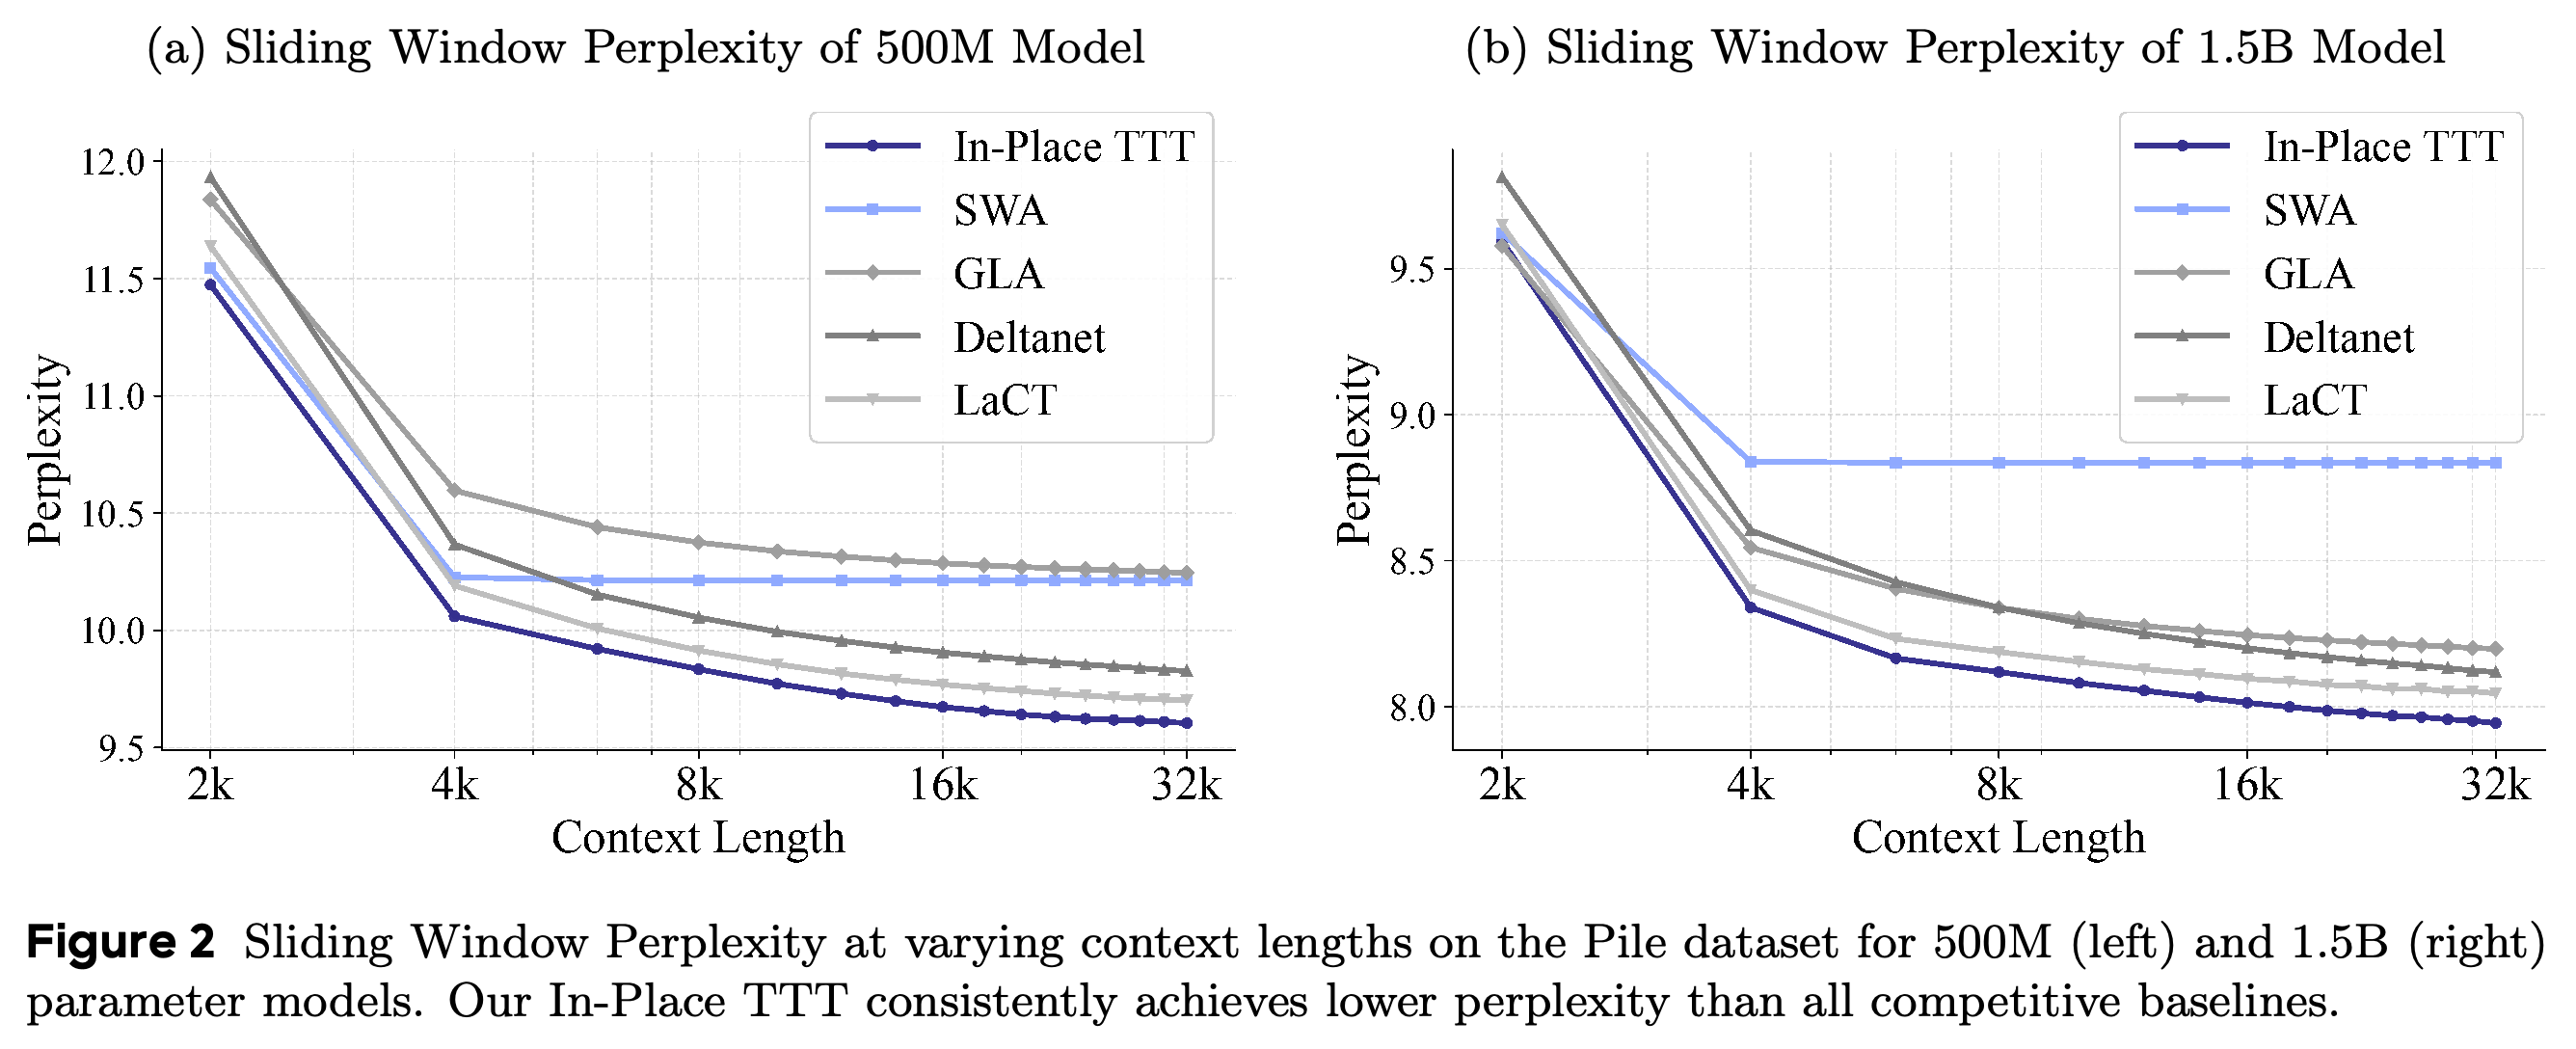
Evaluation에서는 Pile과 Proof-Pile-2로 구성한 검증 세트를 사용한다. Sliding Window Perplexity는 앞선 문맥을 늘리면서 고정된 마지막 토큰 블록을 평가한다. Figure 2는 Pile 결과를 보여준다. In-Place TTT는 두 모델 규모 모두에서 그래프상 perplexity가 가장 낮으며, 문맥이 32k까지 늘어날 때 계속 이점을 얻는다.
- SWA는 국소 attention window 이후 성능이 대체로 정체되지만, 적응형 모델은 window 밖의 정보도 활용할 수 있다.
- Perplexity가 계속 낮아지는 추세는 장문 문맥 활용을 뒷받침한다. 다만 그래프만으로는 어떤 저장 정보가 향상에 기여했는지 분리할 수 없다.
- 정확한 perplexity 값은 표로 제공하지 않으므로, 비교는 그래프에서 보이는 순서와 추세로 설명한다.
500M과 1.5B 규모 모두에서 문맥이 길어져도 In-Place TTT 곡선은 SWA, GLA, DeltaNet, LaCT보다 낮게 유지된다. Perplexity는 32k까지 계속 낮아지는 반면, SWA는 추가 문맥이 attention window 밖에 놓이면 정체된다. 이 그림은 짧은 문맥 모델링의 개선뿐 아니라 더 먼 문맥의 활용을 뒷받침한다.
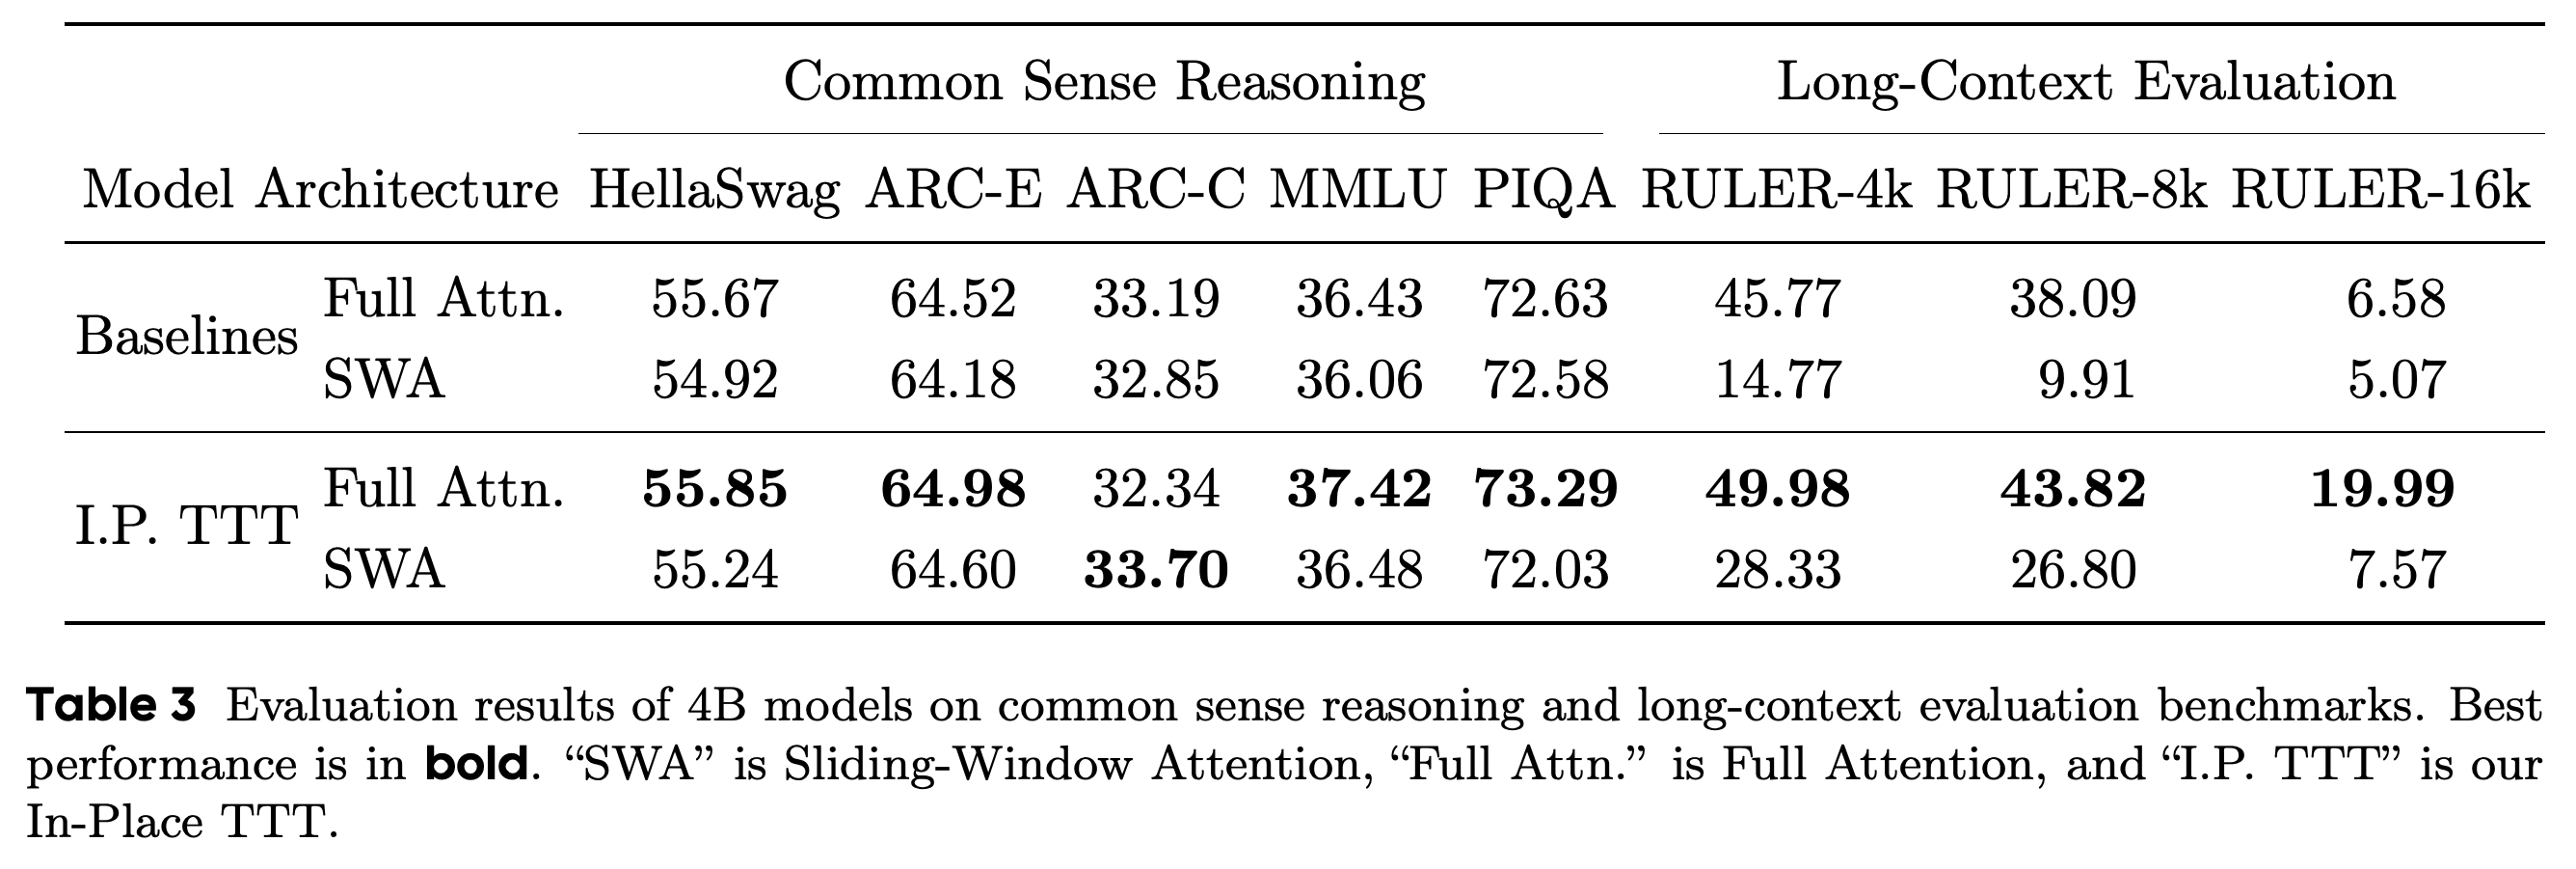
Results and Discussion에서 Table 3은 4B full-attention 모델의 RULER-16k 점수가 6.58에서 19.99로, SWA 모델의 RULER-8k 점수가 9.91에서 26.80으로 높아짐을 보여준다. 대부분의 상식 추론 점수도 높아지지만, full-attention의 ARC-C는 33.19에서 32.34로, SWA의 PIQA는 72.58에서 72.03으로 낮아진다.
- Full attention과 SWA 모두에서 장문 문맥 성능이 개선되므로, 이 메커니즘이 attention을 보완한다는 주장을 뒷받침한다.
- 이 모델의 16k RULER 평가는 학습 길이 8k를 넘어선 평가지만, 절대 점수는 여전히 낮다.
- 상식 추론 결과는 과제 대부분에서의 개선을 뒷받침하지만, downstream 능력 전반에서 일관된 개선을 보여주지는 않는다.
In-Place TTT는 attention backbone 모두에서 모든 RULER 항목을 개선한다. Full-attention의 RULER-16k는 6.58에서 19.99로, SWA의 RULER-8k는 9.91에서 26.80으로 높아진다. 상식 추론의 향상 폭은 더 작고 모든 과제에서 개선되지는 않는다. Full-attention의 ARC-C와 SWA의 PIQA는 낮아진다. 가장 강한 근거는 장문 문맥 성능에 있으며, downstream 성능의 일관된 개선에 있지는 않다.
4.3 Ablation Studies: On the Impact of Key Design Choices
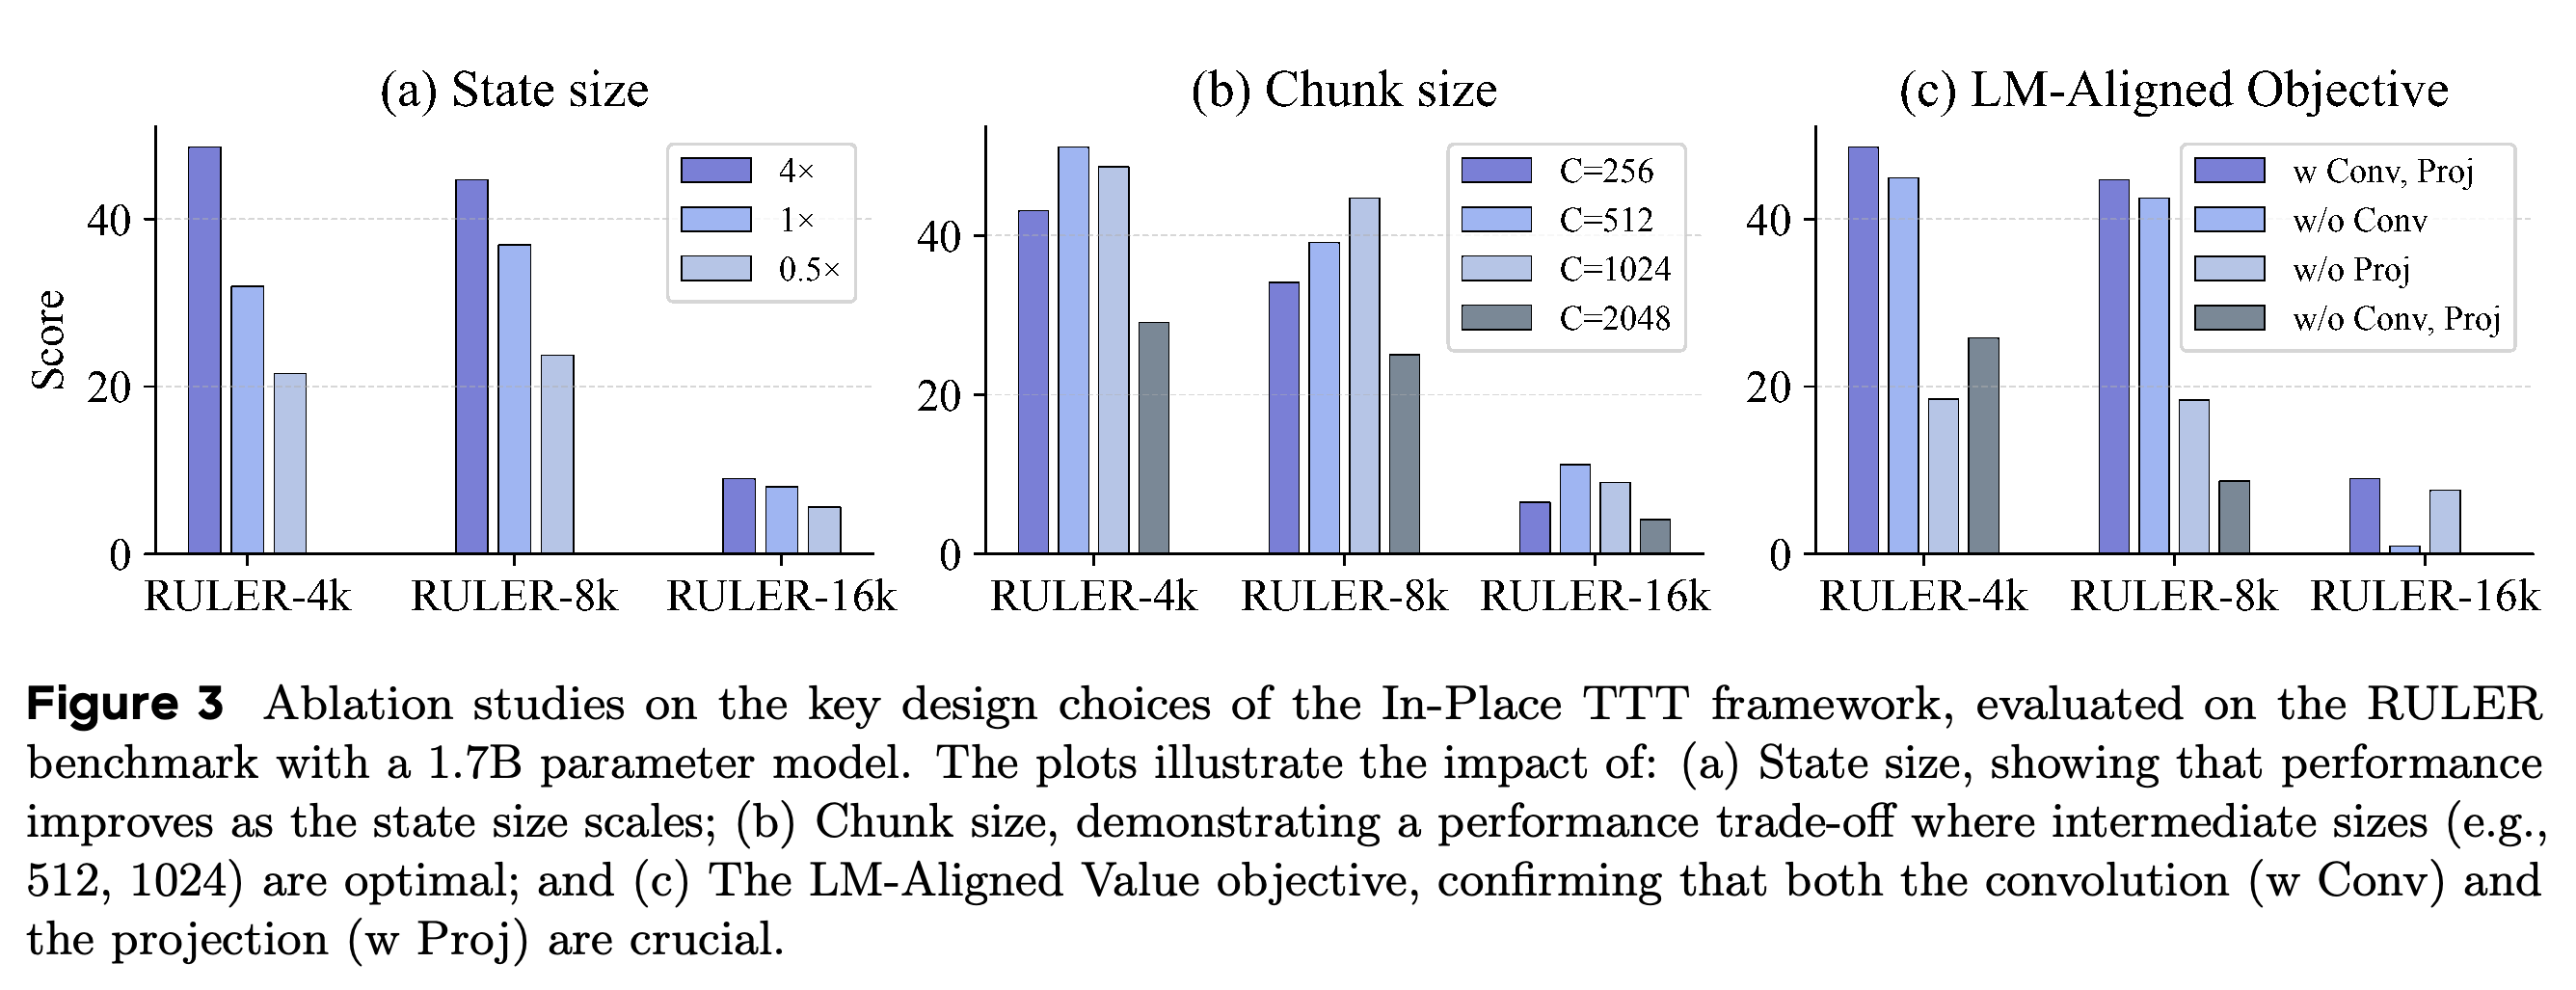
Figure 3은 1.7B 모델의 RULER 평가로 fast-weight 상태 크기, 청크 크기, target 구성을 검증한다. TTT를 활성화한 층이 많을수록 그래프의 점수가 높아지며, C = 512와 C = 1024가 C = 256과 C = 2048보다 좋은 성능을 보인다.
- Impact of State Size에서 그래프에 제시한 설정은 4×, 1×, 0.5×다. 활성화한 층의 수를 바꾸어 적응 상태의 크기를 늘린다.
- Impact of Chunk Size에서 중간 크기가 유리한 결과는 적응 빈도와 병렬 효율성 사이의 절충을 보여준다. 청크가 작을수록 항상 좋다는 일반 규칙은 아니다.
- Impact of LM-Aligned Objective에서 Conv1D를 제거하면 특히 장문 문맥 점수가 낮아진다. Wtarget을 제거하면 짧은 문맥 점수가 크게 낮아진다. 전체 target 구성이 전반적으로 가장 좋은 결과를 보인다.
상태 크기 패널에서는 TTT를 활성화한 층이 많을수록 유리하다. 청크 크기 패널에서는 양극단보다 중간 업데이트 간격이 유리하다. Convolution을 제거하면 특히 긴 문맥에서 성능이 크게 낮아지고, projection을 제거하면 짧은 문맥 점수가 크게 낮아진다. 이 ablation은 해당 설정에서 결합된 target 설계를 뒷받침하지만, 일반적인 성능 보장은 아니다.
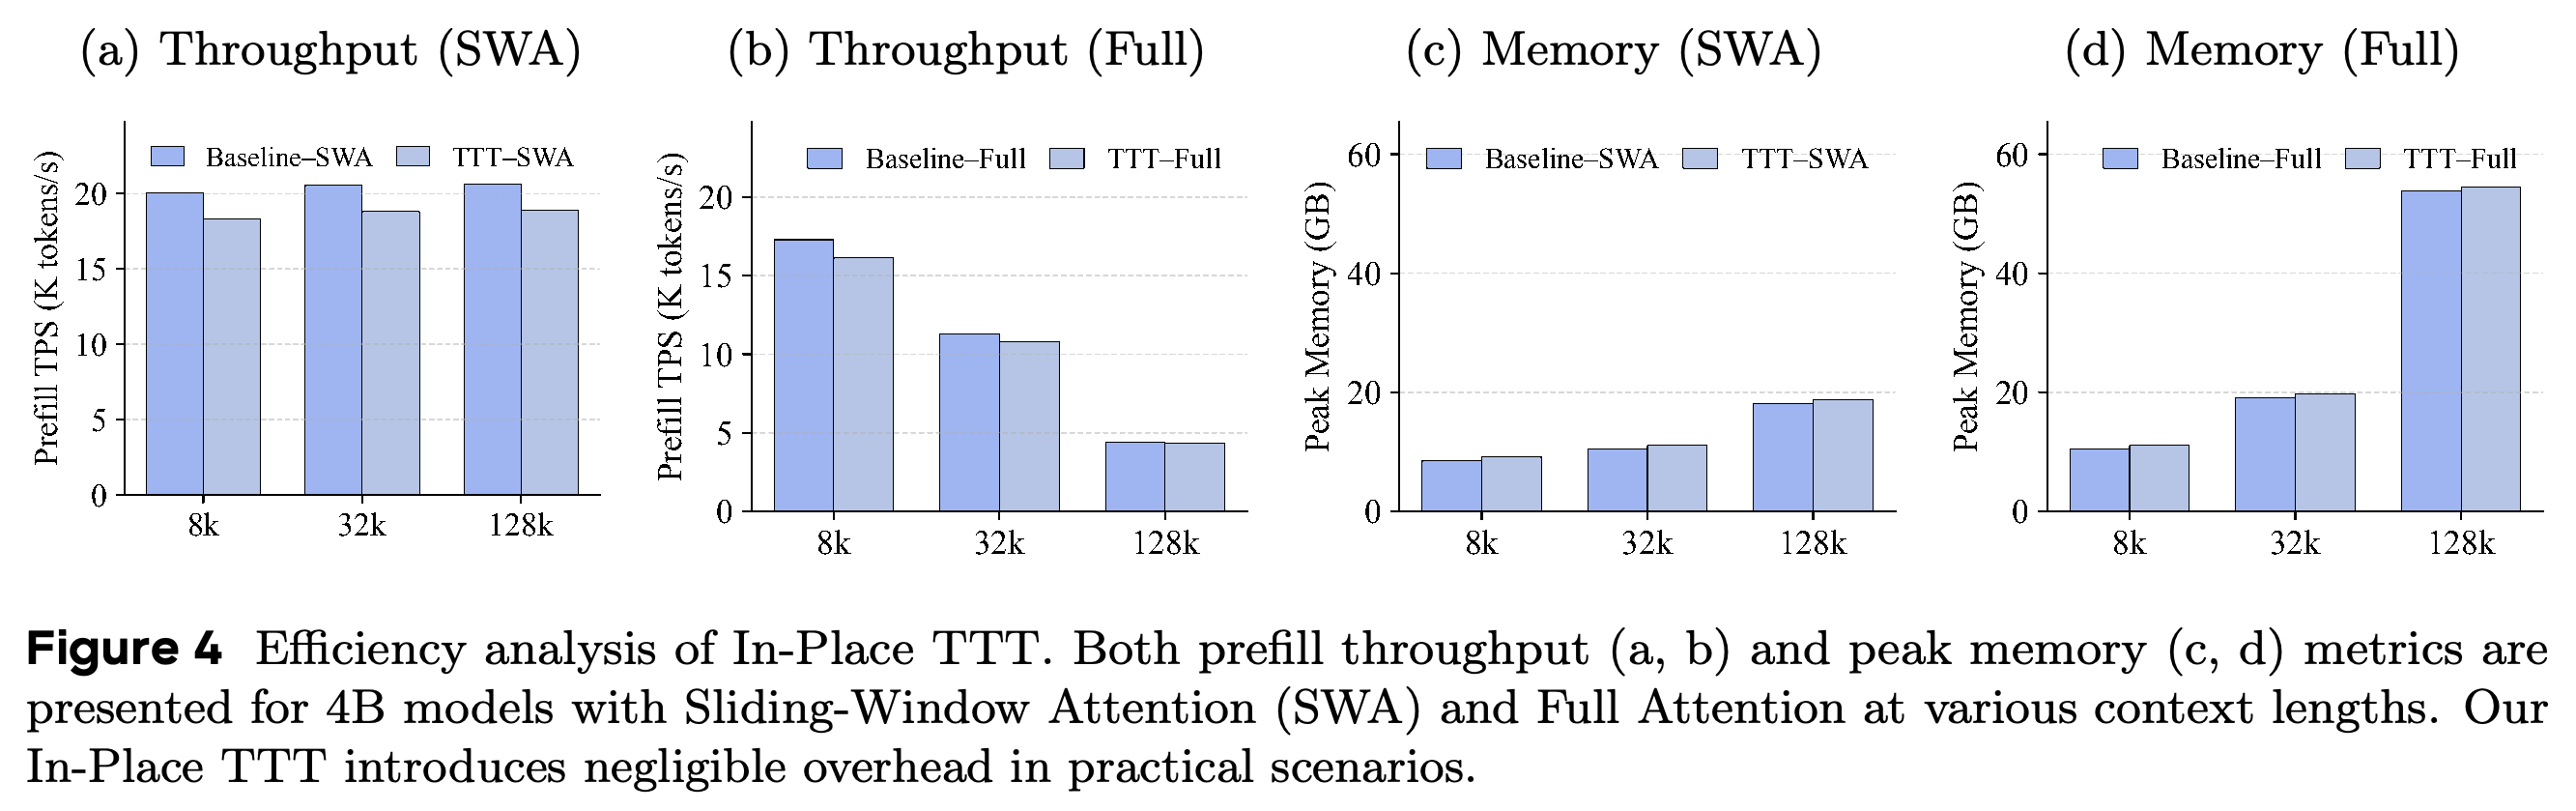
Efficiency Impact of In-Place TTT에서 Figure 4는 지속 학습한 Qwen3-4B 기반 체크포인트의 prefill 처리량과 최대 메모리를 보고한다. Nvidia H800 GPU에서 배치 크기 1, 문맥 길이 8k·32k·128k로 측정한다. 개선 모델은 대응하는 baseline보다 처리량이 소폭 낮고 최대 메모리가 조금 더 크다.
- 효율성 평가에만 사용한 SWA 설정에서는 attention을 1024토큰 sliding window로 직접 변경한다.
- Full attention에서는 문맥이 길어질수록 baseline과 개선 모델의 2개 모델 모두 처리량이 크게 낮아지고 메모리가 늘어난다. In-Place TTT는 attention의 장문 문맥 비용을 없애지 않는다.
- 이 근거는 해당 하드웨어와 배치 크기에서의 prefill에 한정된다. 디코딩 지연 시간이나 일반적인 서빙 처리량을 평가한 것은 아니다.
평가한 설정에서 개선 모델은 눈에 띄지만 크지 않은 prefill 처리량 감소와 적은 최대 메모리 증가를 보인다. Full-attention 비용은 여전히 시퀀스 길이에 따라 크게 증가하지만, SWA의 처리량은 비교적 안정적으로 유지된다. 이 측정은 적응으로 추가되는 비용이 작다는 점을 뒷받침하며, backbone의 attention 비용을 없앴다는 뜻은 아니다.
5 Related Work
관련 연구에서는 온라인 fast-weight 적응, 효율적인 장문 문맥 아키텍처, 문맥 기억 설계를 다룬다. In-Place TTT는 기존 attention backbone을 유지하면서 사전학습된 MLP projection을 적응시킨다.
Test-Time Training (TTT).
기존 Test-Time Training 연구는 vision, language, video, audio에서 자기지도 적응, 옵티마이저 설계, 표현력이 높은 신경망 기억을 탐구한다. 청크 단위 정식화는 순차 실행 문제를 해결하지만, TTT를 주요 token mixer로 사용하면 청크 크기와 국소적인 정보 교환이 더 밀접하게 연결된다.
- In-Place TTT는 국소적인 정보 결합을 위해 attention을 유지하고, MLP fast weights에 보완적인 기억 역할을 맡긴다.
- 기여는 청크 단위 업데이트 자체가 아니라, 이를 체크포인트와 호환되는 MLP 적응 및 LM-Aligned target과 결합한 데 있다.
Efficient Long-Context Architectures.
Sparse attention, linear attention, gated recurrent 방식, State-Space Models는 긴 시퀀스의 처리 비용을 줄인다. 논문은 이 아키텍처들을 온라인 적응과 상호 보완적인 방식으로 보고, MLP 기반 메커니즘을 다른 효율적인 backbone으로 확장할 것을 제안한다.
- 실험은 full attention 및 SWA와의 호환성을 직접 보여준다.
- 여기서 논의한 더 다양한 효율적 backbone과의 통합은 향후 과제로 남아 있다.
Memory Design and Augmentation.
기억에 대한 논의에서는 오래 유지되며 특정 과제에 종속되지 않는 외부 지식과 일시적인 문맥 정보를 구분한다. In-Place TTT는 후자에 속한다. 모델 파라미터가 문서를 처리하는 동안 갱신되는 상태로 일시적으로 기능한다.
- RNN의 활성값 벡터와 달리, 이 상태는 모델 내부의 projection 행렬이다.
- 문서 경계에서 이 행렬을 초기화하므로 문맥 적응은 문서 간에 지식을 오래 축적하는 과정과 구분된다.
6 Conclusion
결론에서는 기존 MLP projection의 재활용, 확장 가능한 청크 단위 업데이트, 언어 모델링에 맞춘 업데이트 target을 성능 향상의 요인으로 제시한다. 실험은 체크포인트와 호환되는 문맥 적응과 처음부터 학습했을 때의 경쟁력 있는 성능을 뒷받침한다. 지식을 지속적으로 유지하는 continual learning을 직접 검증하지는 않는다.
부록
- A Proof of theorem 1에서는 logit 변화를 임베딩과 target의 유사도에 key와 query 활성값의 유사도를 곱한 항들의 합으로 전개한다. 기여도가 0이라는 가정으로 관련 없는 위치를 제거하고, 임베딩의 근사적 직교성을 통해 다음 토큰 target과 복원 target에 대한 상한과 하한을 얻는다. 복원 target의 상한에는 key 토큰과 value 토큰이 서로 달라야 한다는 조건이 필요하다. B Context Parallel Algorithm for In-Place TTT는 Algorithm 1을 제공한다. 유효 가중치는 청크 < i의 업데이트를 사용하며, 문서 경계에서 초기화한다.
- C Experiment Details와 C.1 Details of Datasets는 처음부터 사전학습하기 위해 내부에서 수집한 데이터 구성을 설명한다. 영어·중국어 텍스트, 다국어 자료, 코드, 수학, 지식이나 추론이 풍부한 데이터를 포함한다. 지속 사전학습 데이터는 유사한 짧은 문서에 책, repository 수준의 코드, 합성 retrieval-augmented 데이터와 장문 문맥 QA 데이터를 결합하며, 32k와 128k 학습에 맞게 구성한다. 본문은 500M과 1.5B 비교에 TogetherAI 데이터를 사용했다고 추가로 명시하지만, 부록의 데이터셋 요약과 이 설명의 관계를 완전히 해명하지는 않는다.
- C.2 Details of Training and Evaluation에서는 Nvidia H800 GPU, 상식 추론용 lm-evaluation-harness, 장문 문맥 평가용 OpenCompass를 명시한다. Tables 4–7은 학습 일정을 제공한다. Table 5는 1.7B 및 4B 사전학습 설정으로 AdamW, 학습률 3e-4, 배치 크기 8M 토큰, weight decay 0.1, gradient clipping 1.0, 1.6B warm-up tokens, 시퀀스 길이 8,192, 학습량 120B를 명시한다. Qwen3-4B 평가에서는 Frobenius norm이 τ = 1e-5를 넘는 업데이트 변화량을 해당 임계값에 맞게 재조정한다.
- C.3 Details of Model Configuration에서는 SwiGLU와 RoPE를 사용하는 decoder-only Transformer를 명시한다. Table 8의 작은 모델 2개는 모두 24개 층을 사용한다. Hidden size는 1024와 2048, FFN size는 3072와 6144, attention head 수는 8과 16이며, vocabulary size는 32,000, RoPE base는 1e6이다. 1.7B와 4B backbone은 Qwen3-1.7B-Base와 Qwen3-4B-Base를 따른다. 표준 통합 설정에서는 여섯 번째 층마다 In-Place TTT를 활성화한다.
- Initialization of In-Place TTT Modules에서는 kernel size 5, causal padding, bias 없는 depthwise Conv1D를 0으로 초기화한다. Wtarget은 대각 원소를 N(0, σ²)에서 추출한 희소 대각행렬로 시작한다. 이에 따라 초기 업데이트는 0이며, target 생성기가 학습하기 전까지 사전학습된 동작을 유지한다. D Usage of LLMs에서는 문법과 가독성 개선에 LLM의 도움을 받았으며, 원고의 책임은 저자들에게 있다고 보고한다.
짧은 생각
동일한 조건의 Qwen3-4B 비교가 이 개선 방식의 가장 명확한 근거다. 두 버전은 동일한 지속 학습 과정을 거치며, 적응형 버전은 대부분의 RULER 길이에서 성능이 높다. 다만 “drop-in”은 학습 비용이 거의 없다는 뜻이 아니라 아키텍처 호환성을 뜻한다. 주요 실험에는 ∼35B 지속 학습 토큰을 사용한다. 보고된 256k 성능 향상 이후에도 정확도는 43.9%에 머물러, 외삽 성능에 대한 주장의 강도가 제한된다. 이 비교에는 불확실성 구간이나 반복 실행에 따른 변동성을 보고하지 않는다. 내부 수집 데이터에 대한 설명만으로는 데이터셋을 완전히 재현할 수 없다.
이론 분석은 예측형 target의 근거를 제시하지만, 구현 설명은 더 명확해야 한다. 3.2절에서는 Conv1D target이 미래 토큰 정보를 담도록 요구하는 반면, 3.4절과 Algorithm 1에서는 causal padding을 명시한다. 완료된 청크 내부의 미래 정보는 이후 청크에만 적용하는 업데이트와 양립할 수 있다. 다만 원고는 두 설명을 함께 구현하는 정확한 convolution 인덱싱을 해명하지 않는다. Prefix scan은 exclusive 방식이어야 한다. 본문의 합과 Algorithm 1의 청크 < i 주석이 이를 명시하지만, 의사코드에서는 연산 이름을 Cumsum으로 표기한다. 문서 경계에서 초기화하며 문서 간 기억 유지 실험이 없으므로, 입증한 메커니즘은 문맥 기억으로 한정된다. 효율성 결론은 배치 크기 1의 H800 prefill 측정에 한정된다. 디코딩 성능과 무한한 스트림에서의 안정성은 입증되지 않았다.