


Hybrid Architectures for Language Models: Systematic Analysis and Design Insights 요약 설명
06 Oct 2025 | Paper Review Transformer Architectures State Space Models Long-Context Language Models목차
이번 글에서는 Hybrid Architectures for Language Models: Systematic Analysis and Design Insights 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 6일(Arxiv)
- Bae, Sangmin, Acun, Bilge, Lin, Chien-Yu, Habeeb, Haroun, Kim, Seungyeon, Luo, Liang, Wang, Junjie, Wu, Carole-Jean.
- FAIR at Meta, Meta, KAIST AI
- 논문 링크
요약
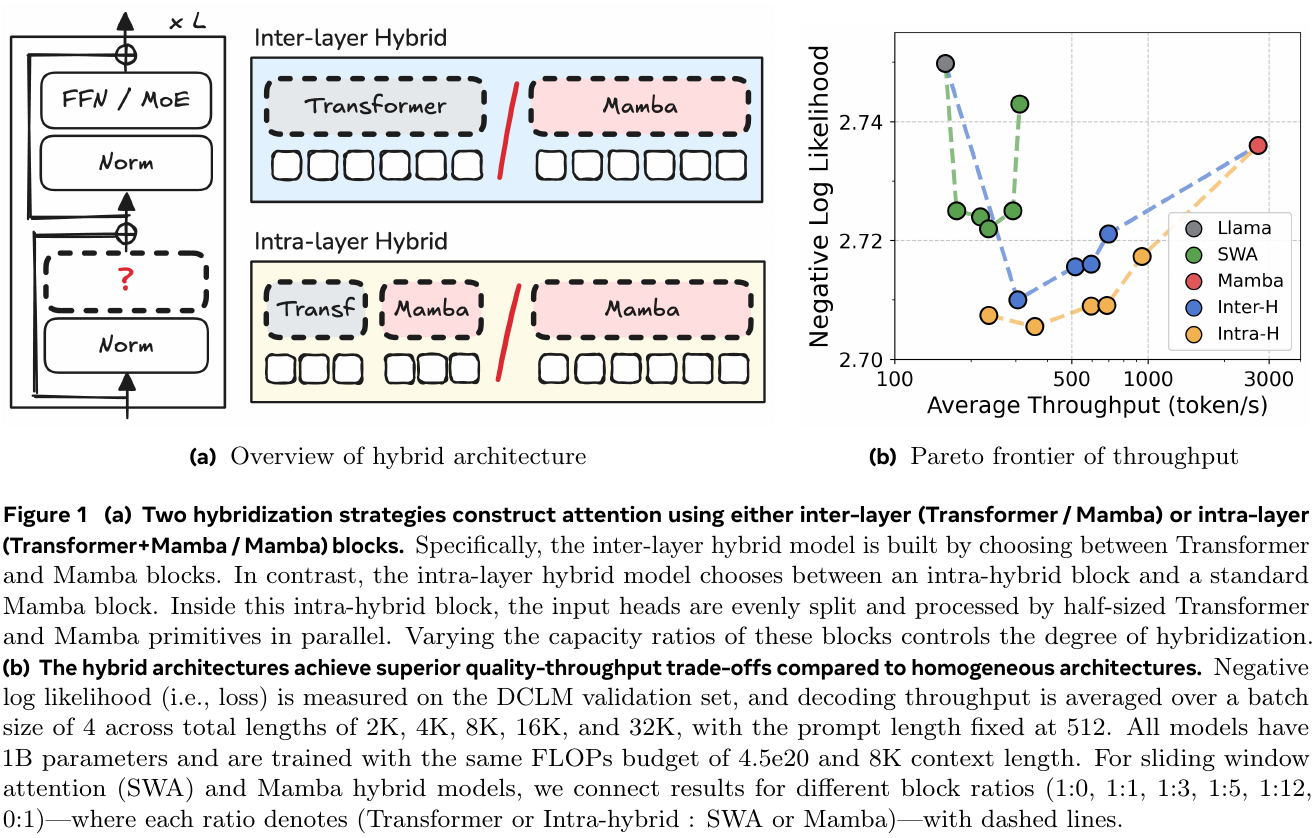
- 이 논문은 문맥 안의 토큰을 비교하는 Transformer self-attention과 이전 문맥을 유한 차원 상태로 압축하는 Mamba 상태 공간 모델을 결합해, 언어 예측 성능을 높이면서 연산량을 줄이는 방법을 연구한다. 약 1B-parameter 모델을 8K-token 학습 문맥과 동일한 4.5e20 부동소수점 연산(FLOPs) 예산으로 비교하면, 선택한 층 안에서 구성 요소를 결합하는 intra-layer hybrid는 평균 few-shot 정확도 54.9%를 달성하고 Llama는 52.0%를 기록한다. Few-shot 정확도는 평가 문맥에 과제 예시를 제공해 측정한다. 다음 토큰 예측 손실인 negative log-likelihood(NLL)는 DCLM-Baseline 사전학습 말뭉치에서 Llama의 2.750에서 2.709로 낮아진다. self-attention에 대해서는 Linformer(Self-Attention with Linear Complexity) 요약 설명 글을 참조하라.
- 이 연구는 완전한 Transformer 블록과 Mamba 블록을 번갈아 배치하는 inter-layer hybrid도 평가한다. 개별 설계 선택을 바꾸는 ablation 실험에서는 Mamba 블록 5개당 attention을 포함한 블록 약 1개를 배치하는 구성이 품질과 속도의 절충안으로 유리하다. 또한 attention을 중간 깊이에 배치하고 intra-layer 결합에서는 각 구성 요소의 출력을 정규화하면서 별도로 학습한 출력 변환을 적용하는 구성이 유리하다.
- Hybrid는 Llama보다 생성 속도가 빠르고 8K 학습 문맥을 넘어선 구간에서도 더 우수한 검색 성능을 유지하지만 일부 외삽 구간에서는 검색 성능이 저하된다. 실험은 최대 약 3B 파라미터 모델과 최대 32K 학습 문맥까지 다룬다. 더 큰 모델, 새로운 시퀀스 처리 구성 요소, 언어 이외의 영역으로의 확장은 향후 검증 과제로 남는다.
1 Introduction
기존 hybrid language model에서는 통제된 비교 실험과 설계 근거가 충분히 공개되지 않았다. Transformer attention의 연산량은 시퀀스 길이에 대해 이차적으로 증가하지만 Mamba는 선형 연산량과 고정 크기의 순환 상태를 사용한다. 이들을 결합하려면 블록 비율, 깊이별 배치, 층 내부의 결합 방식을 선택해야 한다.
- 비교 기준에는 Llama, Mamba만으로 구성한 모델, global attention과 sliding window attention(SWA)을 혼합한 모델이 포함된다. SWA는 attention 범위를 지역 윈도우와 attention sink라고 부르는 보존된 초기 토큰으로 제한한다.
- 평가는 언어 모델링 손실, few-shot 정확도, 과제별 fine-tuning, 긴 문맥 검색, scaling, 학습 시간, decoding throughput, cache 메모리를 다룬다. Decoding throughput은 초당 생성 토큰 수이며 cache 메모리는 decoding 중 재사용하는 상태를 저장하는 메모리다.
Architecture 패널은 완전한 Transformer/Mamba 블록을 번갈아 배치하는 방식과 primitive별로 head를 나누는 블록을 구분한다. 품질과 throughput을 비교한 패널은 실험한 약 1B 설정에서 intra-layer의 유리한 절충 관계를 보여 준다. 동일한 4.5e20 FLOPs 예산에서는 architecture마다 학습 토큰 수가 달라질 수 있다. 각 점은 블록 비율 구성을 나타내므로, 이 그래프는 품질과 속도의 절충안을 선택할 근거를 제공하며 모든 조건에서 최적인 architecture를 제시하지는 않는다.
2 Background
Transformer는 여러 attention head로 의존 관계를 처리하는 multi-head attention과 각 토큰의 표현을 변환하는 feed-forward network(FFN)를 결합한다. Attention 수식은 Attention(Q, K, V) = softmax(QKᵀ / √d_k)V이다. Q, K, V는 학습되는 query, key, value projection으로, 입력에 적용하는 선형 변환이며 d_k는 key 차원이다. Softmax는 query-key 유사도 점수를 attention 가중치로 변환한다.
- Grouped-query attention(GQA)은 query head 그룹들이 key head와 value head를 공유하게 해 key-value cache를 줄인다.
- Mamba는 \(h_t=\bar{A}h_{t-1}+\bar{B}x_t\)로 잠재 상태를 갱신하고 \(y_t=Ch_t+Dx_t\)로 출력을 생성한다. h_t는 상태, x_t는 입력, y_t는 시점 t의 출력이다. 입력에 따라 달라지는 파라미터가 정보를 유지하고 반영하는 정도를 제어한다.
- 실험은 주로 Mamba 2를 사용한다. 이 모델의 state space duality는 상태 공간 연산을 하드웨어에서 효율적으로 실행할 수 있는 행렬 곱셈으로 재구성한다. 각 시퀀스 처리 블록 뒤에는 FFN이 있으며 선택한 FFN expert로 토큰을 라우팅하는 Mixture-of-Experts(MoE) 층으로 대체할 수도 있다.
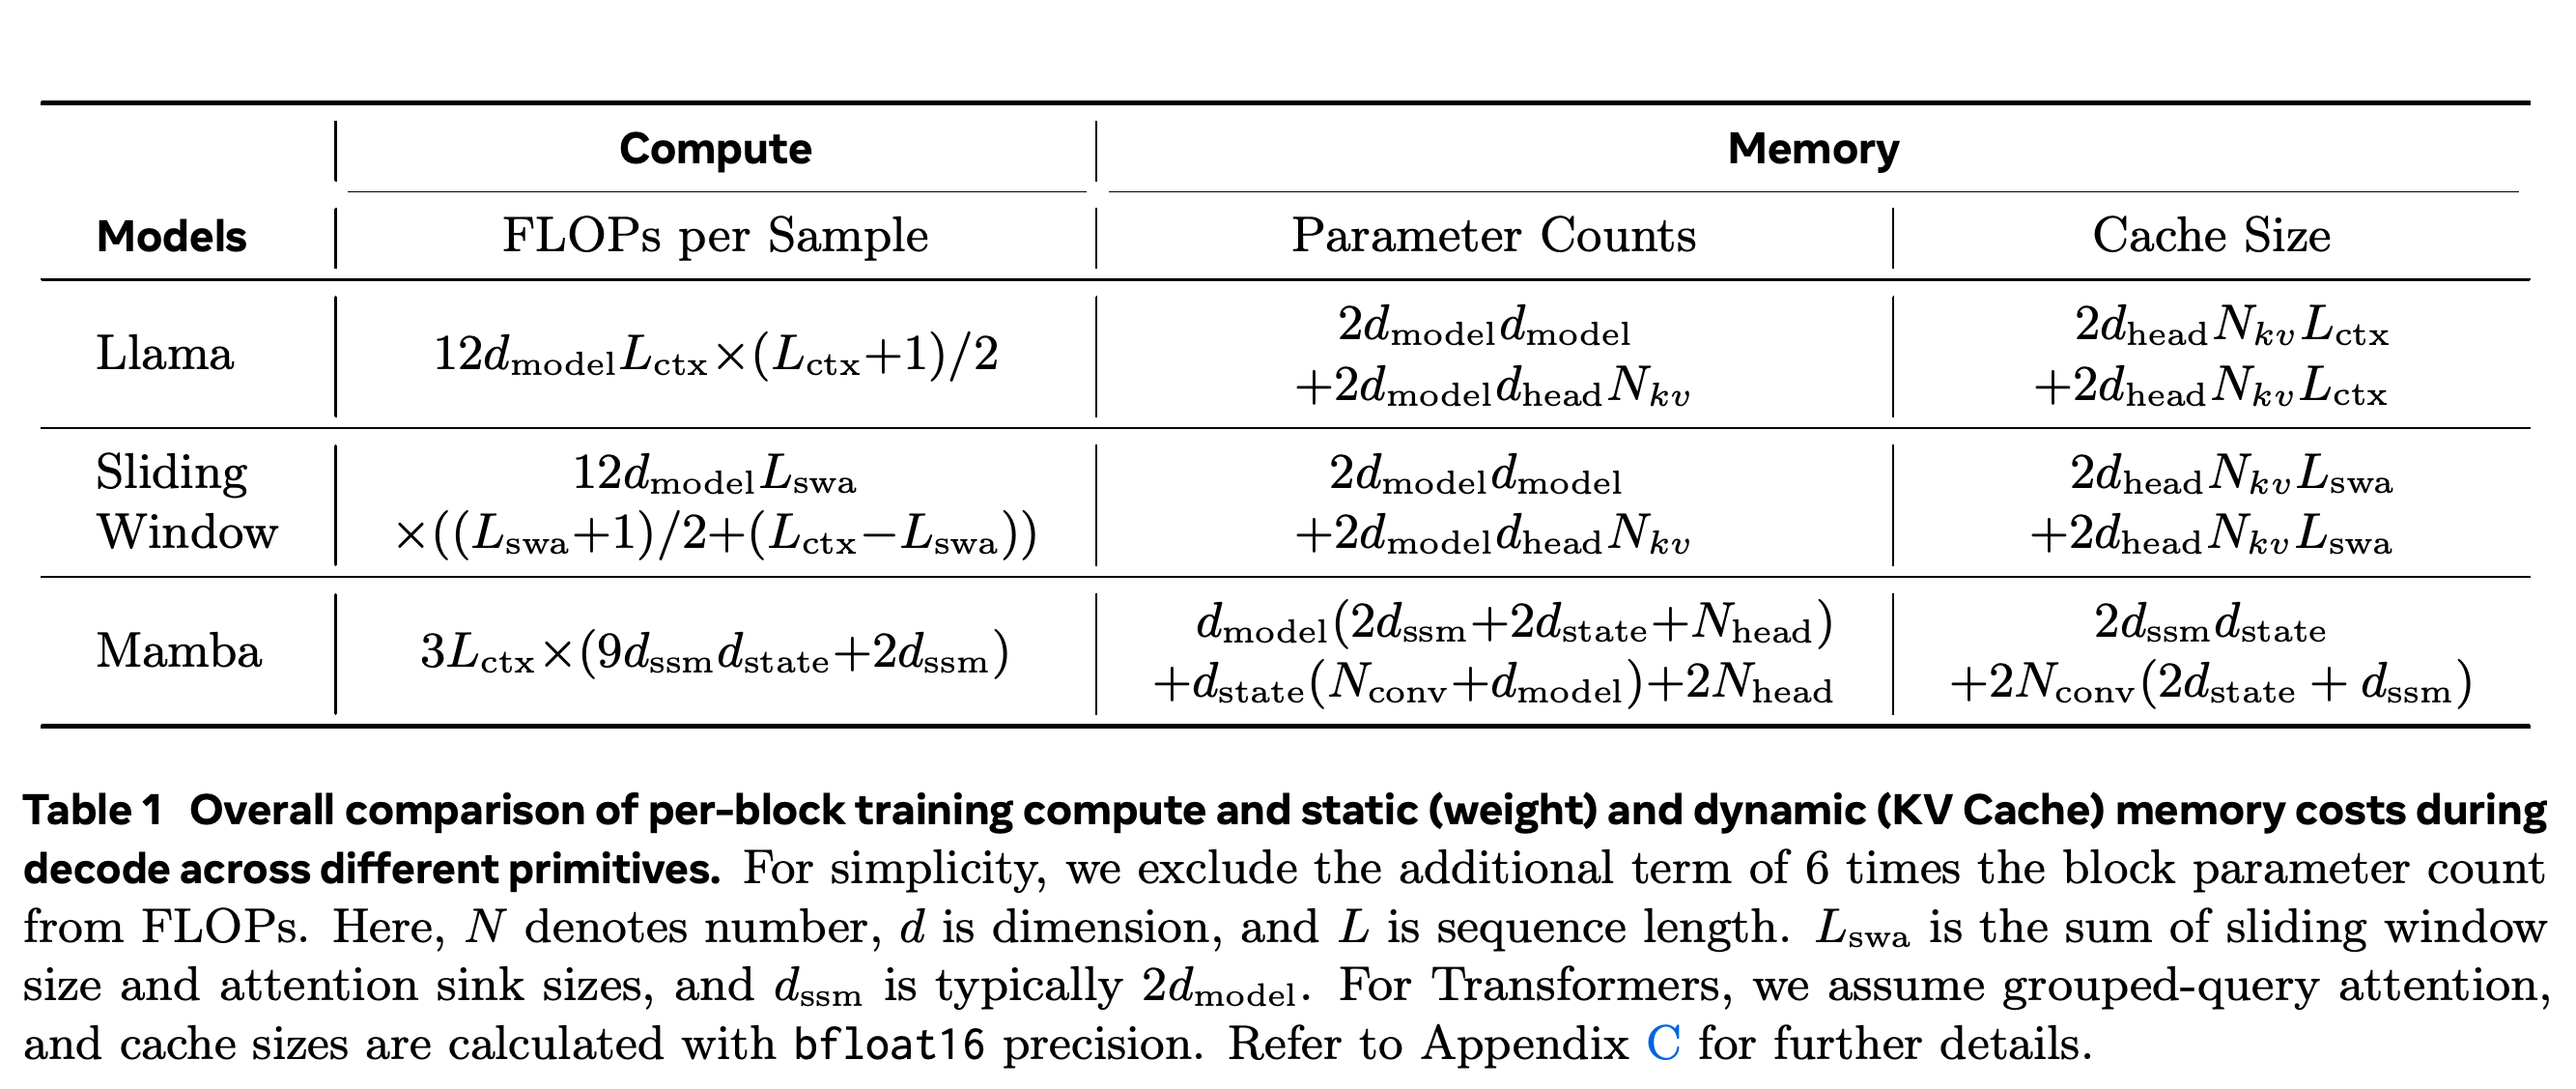
분석적 비교는 파라미터 수, 시퀀스 처리 연산량, decoding cache 비용을 구분하고 표시한 FLOPs 수식에서는 공통적인 선형 가중치 연산량을 제외한다. Mamba의 고정 크기 cache는 문맥이 길수록 추론 이점이 커지는 이유를 설명한다. 한편 Mamba는 시퀀스 처리 파라미터 수가 더 크므로, 같은 파라미터 예산에서도 필요한 층 수가 달라질 수 있다.
3 Hybrid Architecture
논문은 통합 위치에 따라 hybrid architecture를 층 사이에서 결합하는 방식과 층 안에서 결합하는 방식으로 구분한다. 두 방식 모두 블록을 구성하는 시퀀스 처리 요소인 computational primitive의 비율과 배치를 바꾼다. 이를 통해 attention 비중이 큰 구성부터 Mamba만으로 구성한 모델까지 비교한다.
3.1 Inter-layer Hybrid Model
Inter-layer hybrid는 선택한 깊이에 완전한 softmax-attention 블록과 Mamba 블록을 번갈아 배치한다. 연구 질문 2개는 Transformer 대 Mamba 블록 비율과 Transformer 블록의 배치에 관한 것이며 여러 비율과 모델 크기에서 평가한다.
- Jamba와 Samba 같은 기존 hybrid model은 Mamba 비중이 큰 구성의 근거가 되지만 이 논문은 기존의 특정 설계법을 그대로 채택하지 않고 더 넓은 비율 범위를 실험한다.
- 배치 실험은 같은 attention 용량도 깊이에 따라 다르게 작동하는지 확인하기 위해 초기, 중간, 후기 attention 블록을 비교한다.
3.2 Intra-layer Hybrid Model
Intra-layer hybrid는 head를 Transformer 그룹과 Mamba 그룹으로 나누고 1개 블록 안에서 출력을 결합한다. 이러한 블록 사이에 표준 Mamba 블록을 배치할 수도 있다. Transformer 분기는 확장된 value 표현을 유지하면서 query와 key 차원을 줄이고, Mamba 분기는 할당한 용량에 맞춰 은닉 차원을 줄인다.
- Architecture ablation은 350M과 1B 규모에서 정규화, 구성 요소의 출력에 가중치를 부여하는 학습 가능한 scaling 또는 gate, 덧셈, 뺄셈, concatenation, output projection, value-state 공유를 살펴본다. Concatenation은 feature 차원을 따라 출력을 이어 붙인다.
- 차원 비율 실험은 2개 분기에 할당하는 용량을 바꾼다. 분기를 동시에 실행할 때 기대하는 이점은 병렬 구현에 달려 있으며 더 느린 Transformer 분기가 throughput의 상한을 결정할 것으로 예상한다.
- 별도 실험에서는 intra-hybrid 대 Mamba 블록 비율과 intra-hybrid 블록의 깊이별 분포를 바꾼다.
4 Experiments
모델은 PyTorch 학습 프레임워크인 TorchTitan에서 Llama 3.2와 Mamba 2 구성을 사용해 H200 그래픽 처리 장치(GPU)로 처음부터 학습한다. 기본 설정은 DCLM-Baseline에서 60B 토큰을 샘플링하고 8K 문맥을 사용한다. Architecture는 동일한 토큰 예산 또는 동일한 학습 FLOPs로 비교한다.
- 보고된 모델 크기는 대부분 어휘 토큰을 표현으로 매핑하는 파라미터를 제외한 non-embedding 파라미터 수다. 약 1B 모델에는 embedding 파라미터도 포함된다.
- 언어 모델링 평가는 DCLM 검증 샘플 8,000개와 PG19 테스트 샘플 150개를 사용한다. PG19는 긴 문서 말뭉치다.
- Few-shot 평가는 논문에서 언어 예측과 질의응답 benchmark로 사용하는 LAMBADA, HellaSwag, PIQA, ARC, OpenBookQA를 사용한다. ARC에는 Easy와 Challenge가 포함된다. 논문은 이들의 종합 정확도를 보고한다.
4.1 Main Results on Quality
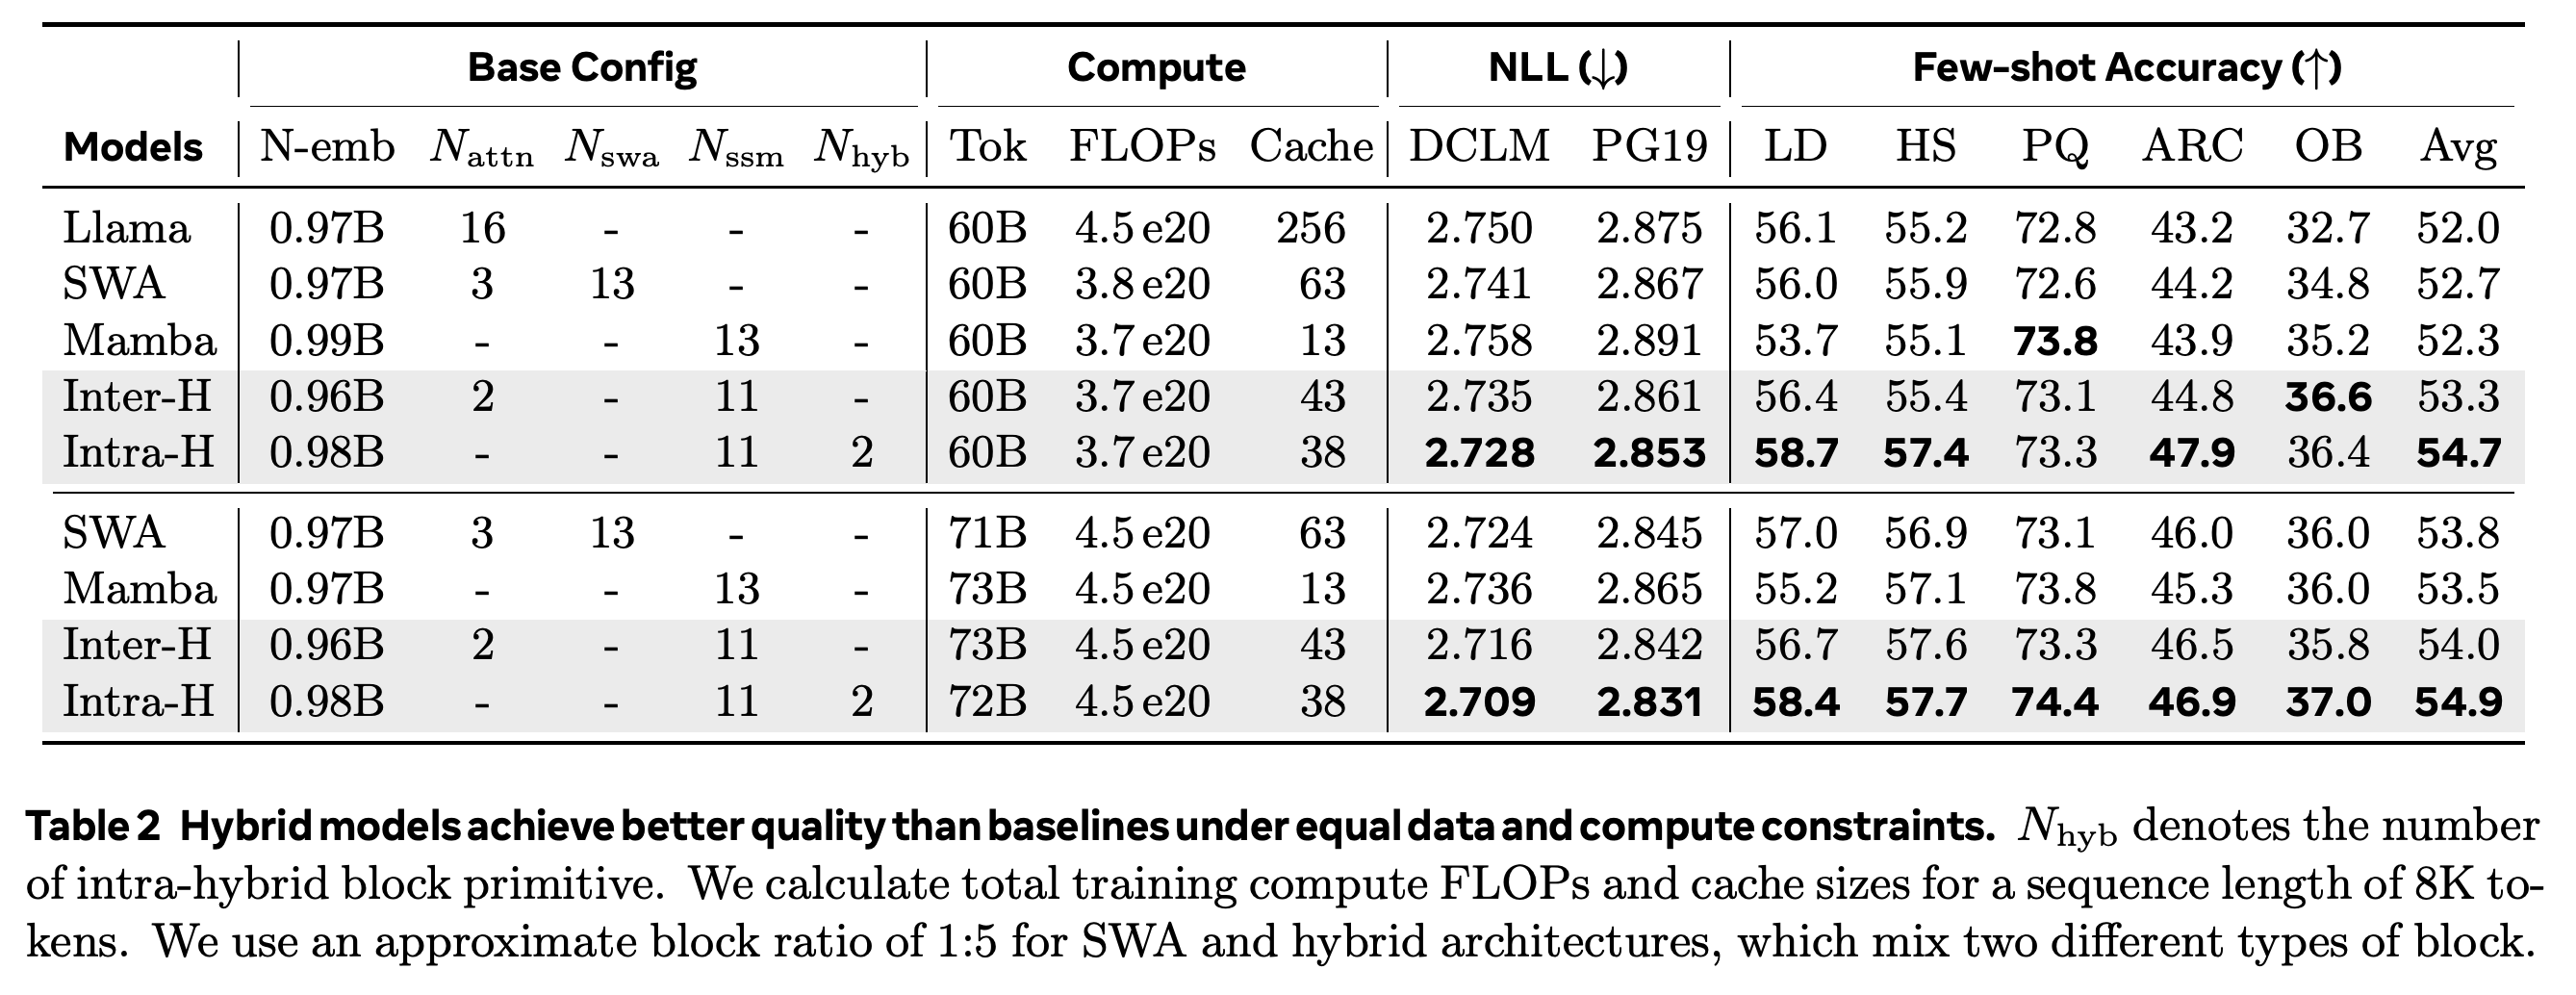
60B 학습 토큰에서 약 1:5 intra-layer hybrid는 DCLM/PG19 NLL 2.728/2.853과 평균 few-shot 정확도 54.7%를 달성한다. Llama는 2.750/2.875와 52.0%를 기록하며 intra-layer hybrid는 Llama의 4.5e20보다 적은 3.7e20 FLOPs를 사용한다. 동일한 4.5e20 예산에서는 학습량을 72B 토큰으로 늘려 NLL 2.709/2.831과 정확도 54.9%를 달성한다. Inter-layer hybrid는 54.0%, SWA는 53.8%, Mamba는 53.5%를 기록한다. 이 비교에서 intra-layer hybrid의 정확도는 Llama보다 2.9 percentage points 높다.
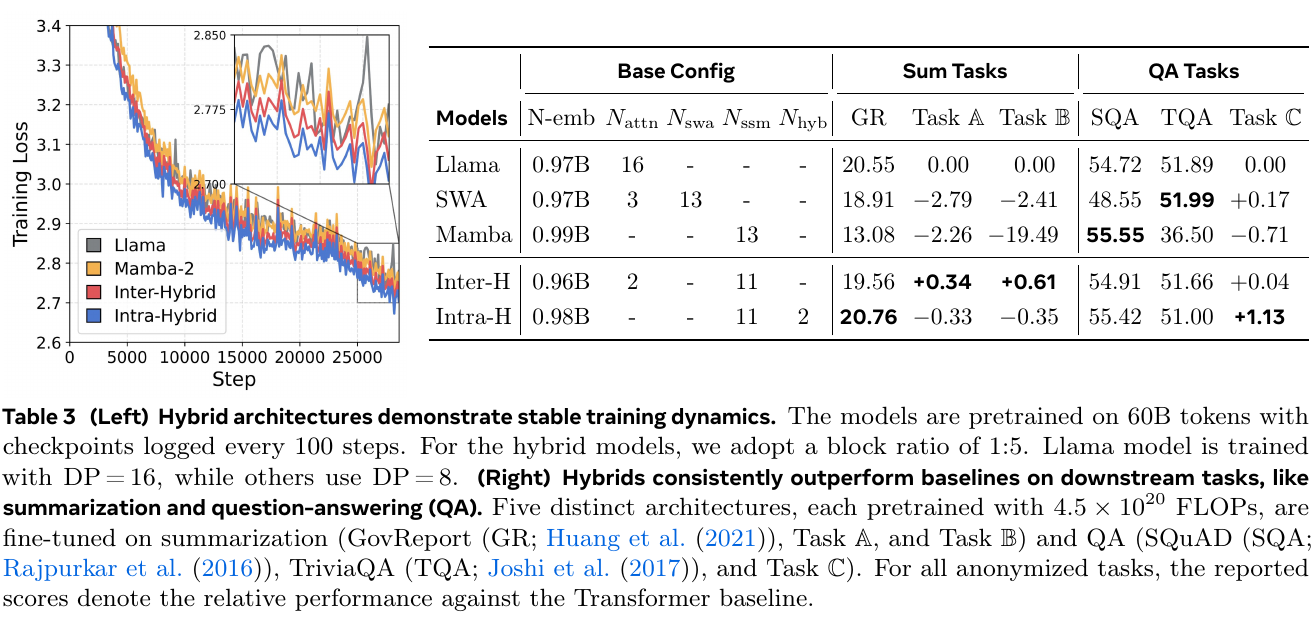
- 학습 곡선에서 hybrid는 초기에 Llama와 비슷한 추이를 보이다가 학습 중반부터 더 낮은 손실에 도달하며 그래프에 나타난 변동 양상도 비슷하다. Llama는 데이터 분할별로 학습을 복제하는 data parallelism의 병렬화 수준으로 다른 모델의 8 대신 16을 사용하므로, 손실 변동을 엄밀히 비교하는 데에는 한계가 있다.
- Fine-tuning 결과에서 hybrid는 검색 의존도가 높은 요약 과제에서 Mamba가 보이는 큰 성능 저하를 피한다. 요약 데이터셋 GovReport에서 Mamba는 13.08, Llama는 20.55를 기록하며 Mamba는 익명화된 Task B에서 상대 점수 −19.49를 기록한다.
- Downstream 표에서 hybrid가 모든 과제에서 Llama보다 우수한 것은 아니다. 질의응답 데이터셋 TriviaQA에서 inter-layer와 intra-layer hybrid는 각각 51.66과 51.00을 기록하고 Llama는 51.89를 기록한다. Intra-layer hybrid는 Tasks A와 B에서도 음의 상대 점수를 기록한다.
비교 그룹 2개는 60B-token 제약과 4.5e20 FLOPs 제약을 구분한다. Intra-layer hybrid는 더 적은 학습 연산량으로 평균 정확도를 Llama의 52.0%에서 54.7%로 높인다. 72B 학습 토큰을 통해 연산 예산을 Llama와 같게 늘리면 54.9%에 도달한다. 후자의 차이는 2.9 percentage points이며 추가 학습 데이터의 이점도 포함한다.
왼쪽 패널은 그래프에 나타난 학습 변동 양상이 비슷하고 학습 후반의 hybrid 손실이 더 낮음을 보여 준다. Llama와 다른 모델의 data-parallel 병렬화 수준은 다르다. 오른쪽 패널은 hybrid가 Mamba와 SWA의 일부 큰 성능 저하를 피하지만 여러 과제에서는 Llama보다 낮은 점수를 기록함을 보여 준다. Caption은 사전학습 FLOPs를 4.5 × 10^20으로 명시하지만 Appendix I는 4e20으로 명시한다.
4.2 Main Results on Efficiency
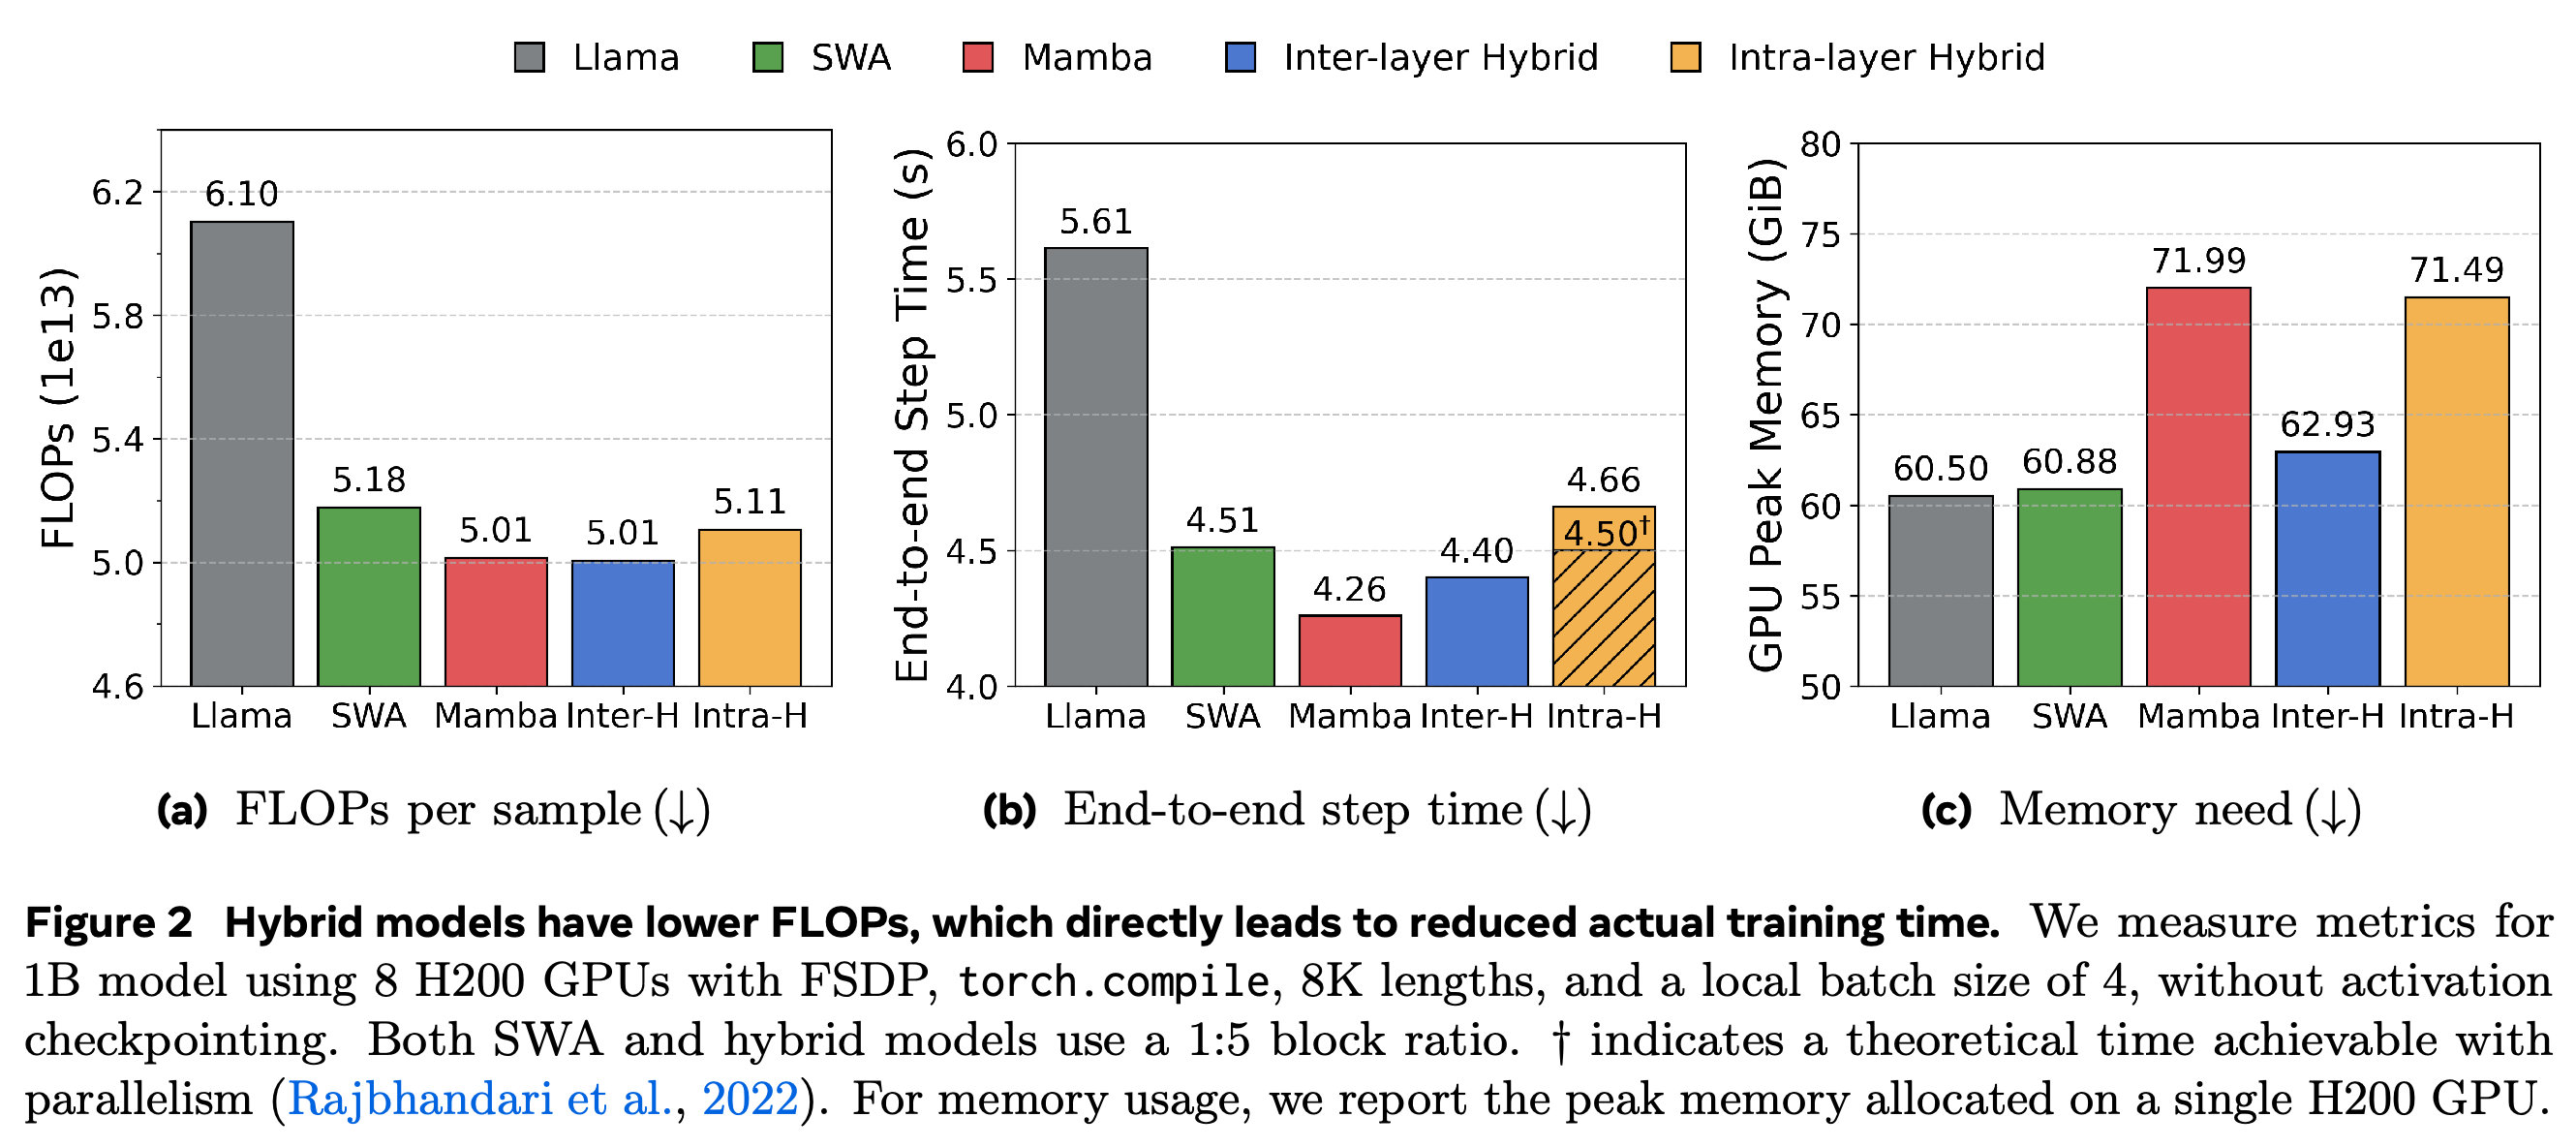
8K 문맥의 약 1B 모델에서 측정한 학습 step 시간은 Llama가 5.61 s, inter-layer hybrid가 4.40 s, intra-layer hybrid가 4.66 s이다. 이 측정은 H200 GPU 8개, 모델 학습 상태를 장치들에 분산하는 fully sharded data parallelism(FSDP), PyTorch 연산을 컴파일해 실행을 가속하는 torch.compile, local batch size 4를 사용한다. 중간 activation을 재계산해 메모리를 절약하는 activation checkpointing은 사용하지 않는다.
- 분기 병렬 실행을 적용한 intra-layer hybrid의 4.50 s는 이론값이며 4.66 s는 측정값이다. 최대 학습 메모리는 Llama가 60.50 GiB, inter-layer hybrid가 62.93 GiB, intra-layer hybrid가 71.49 GiB이므로, 이 비교에서는 두 hybrid 모두 최대 학습 메모리를 더 많이 사용한다.
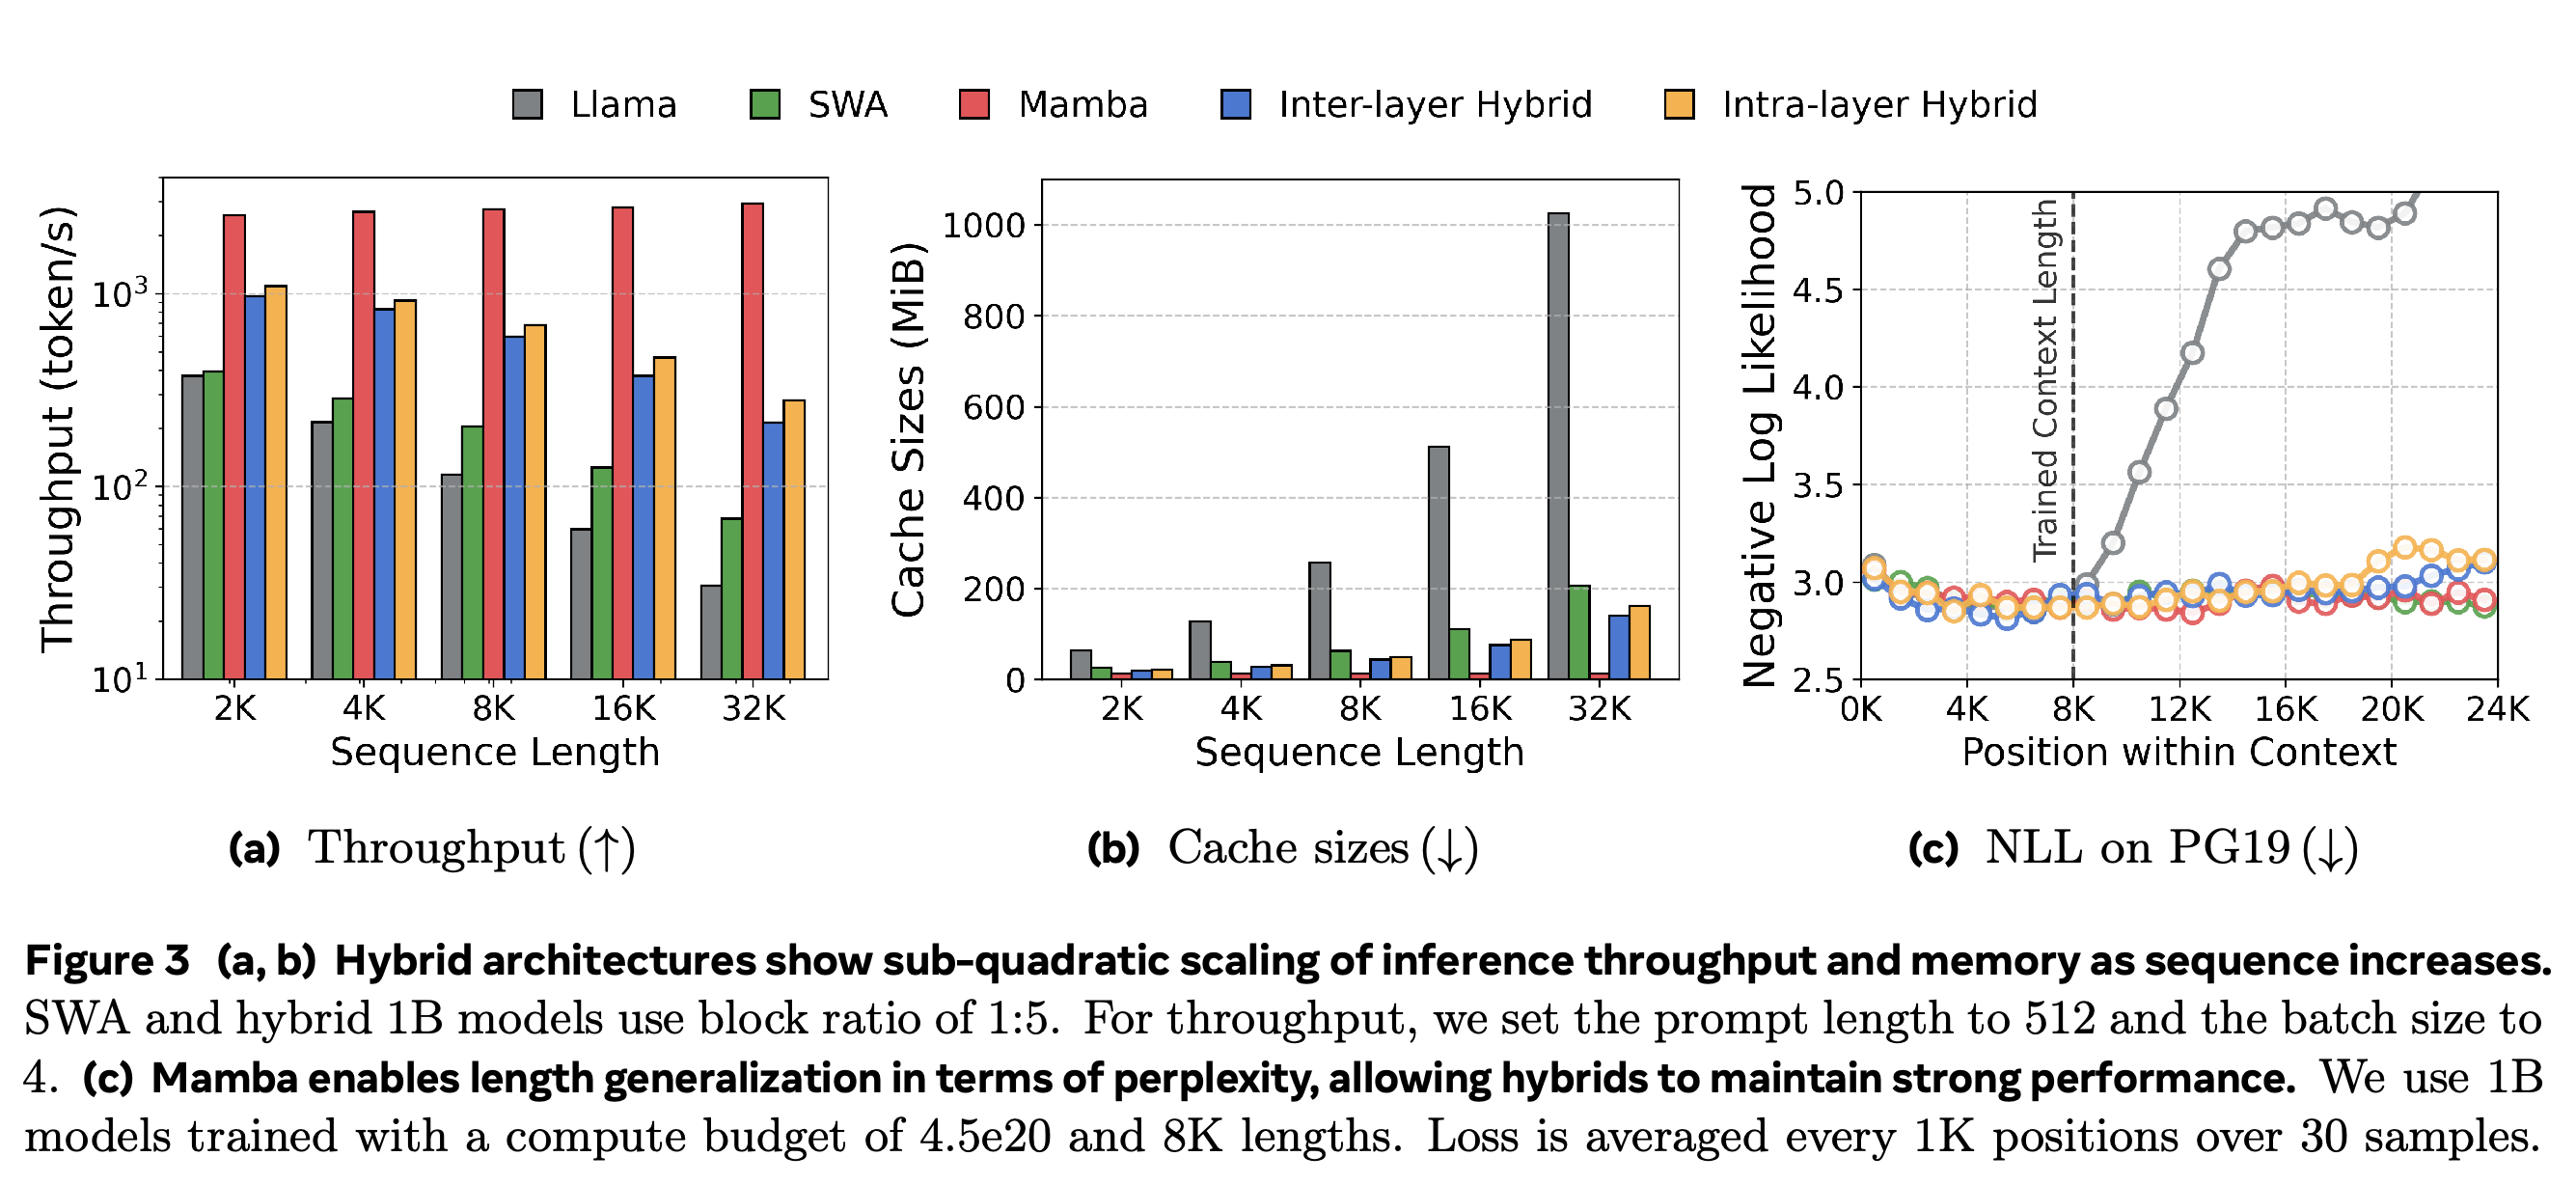
- Batch size 4와 512-token prompt에서 8K decoding throughput은 Llama가 115 token/s, SWA가 241 token/s, 약 1:5 inter-layer hybrid가 595 token/s, 대응하는 intra-layer hybrid가 683 token/s이다.
- 전체 길이가 32K이면 throughput은 각각 30, 110, 213, 280 token/s이다. Mamba만으로 구성한 모델이 2917 token/s로 가장 빠르며, architecture를 선택할 때에는 품질과 검색 측정 결과도 함께 고려해야 한다.
측정한 hybrid 학습 step은 Llama보다 빠르지만 최대 메모리 사용량은 더 높다. Inter-layer는 62.93 GiB, intra-layer는 71.49 GiB이며 Llama는 60.50 GiB이다. 표시된 intra-layer의 4.50 s 결과는 이론적인 분기 병렬 실행을 가정하며 측정값 4.66 s와 구분된다.
4.3 Long-context Capability Evaluation
위치별 PG19 손실은 Mamba와 hybrid에서 8K 학습 길이를 넘어도 비교적 안정적이지만 Llama에서는 급격히 증가한다. 이 평가는 packing하지 않은 긴 문서 30개를 학습 시퀀스처럼 이어 붙이지 않고 개별적으로 평가한다. 매 1K 위치마다 손실을 평균하고 Transformer 구성 요소의 최대 positional-encoding 길이를 24K로 확장한다. Positional encoding은 토큰 위치 정보를 제공한다.
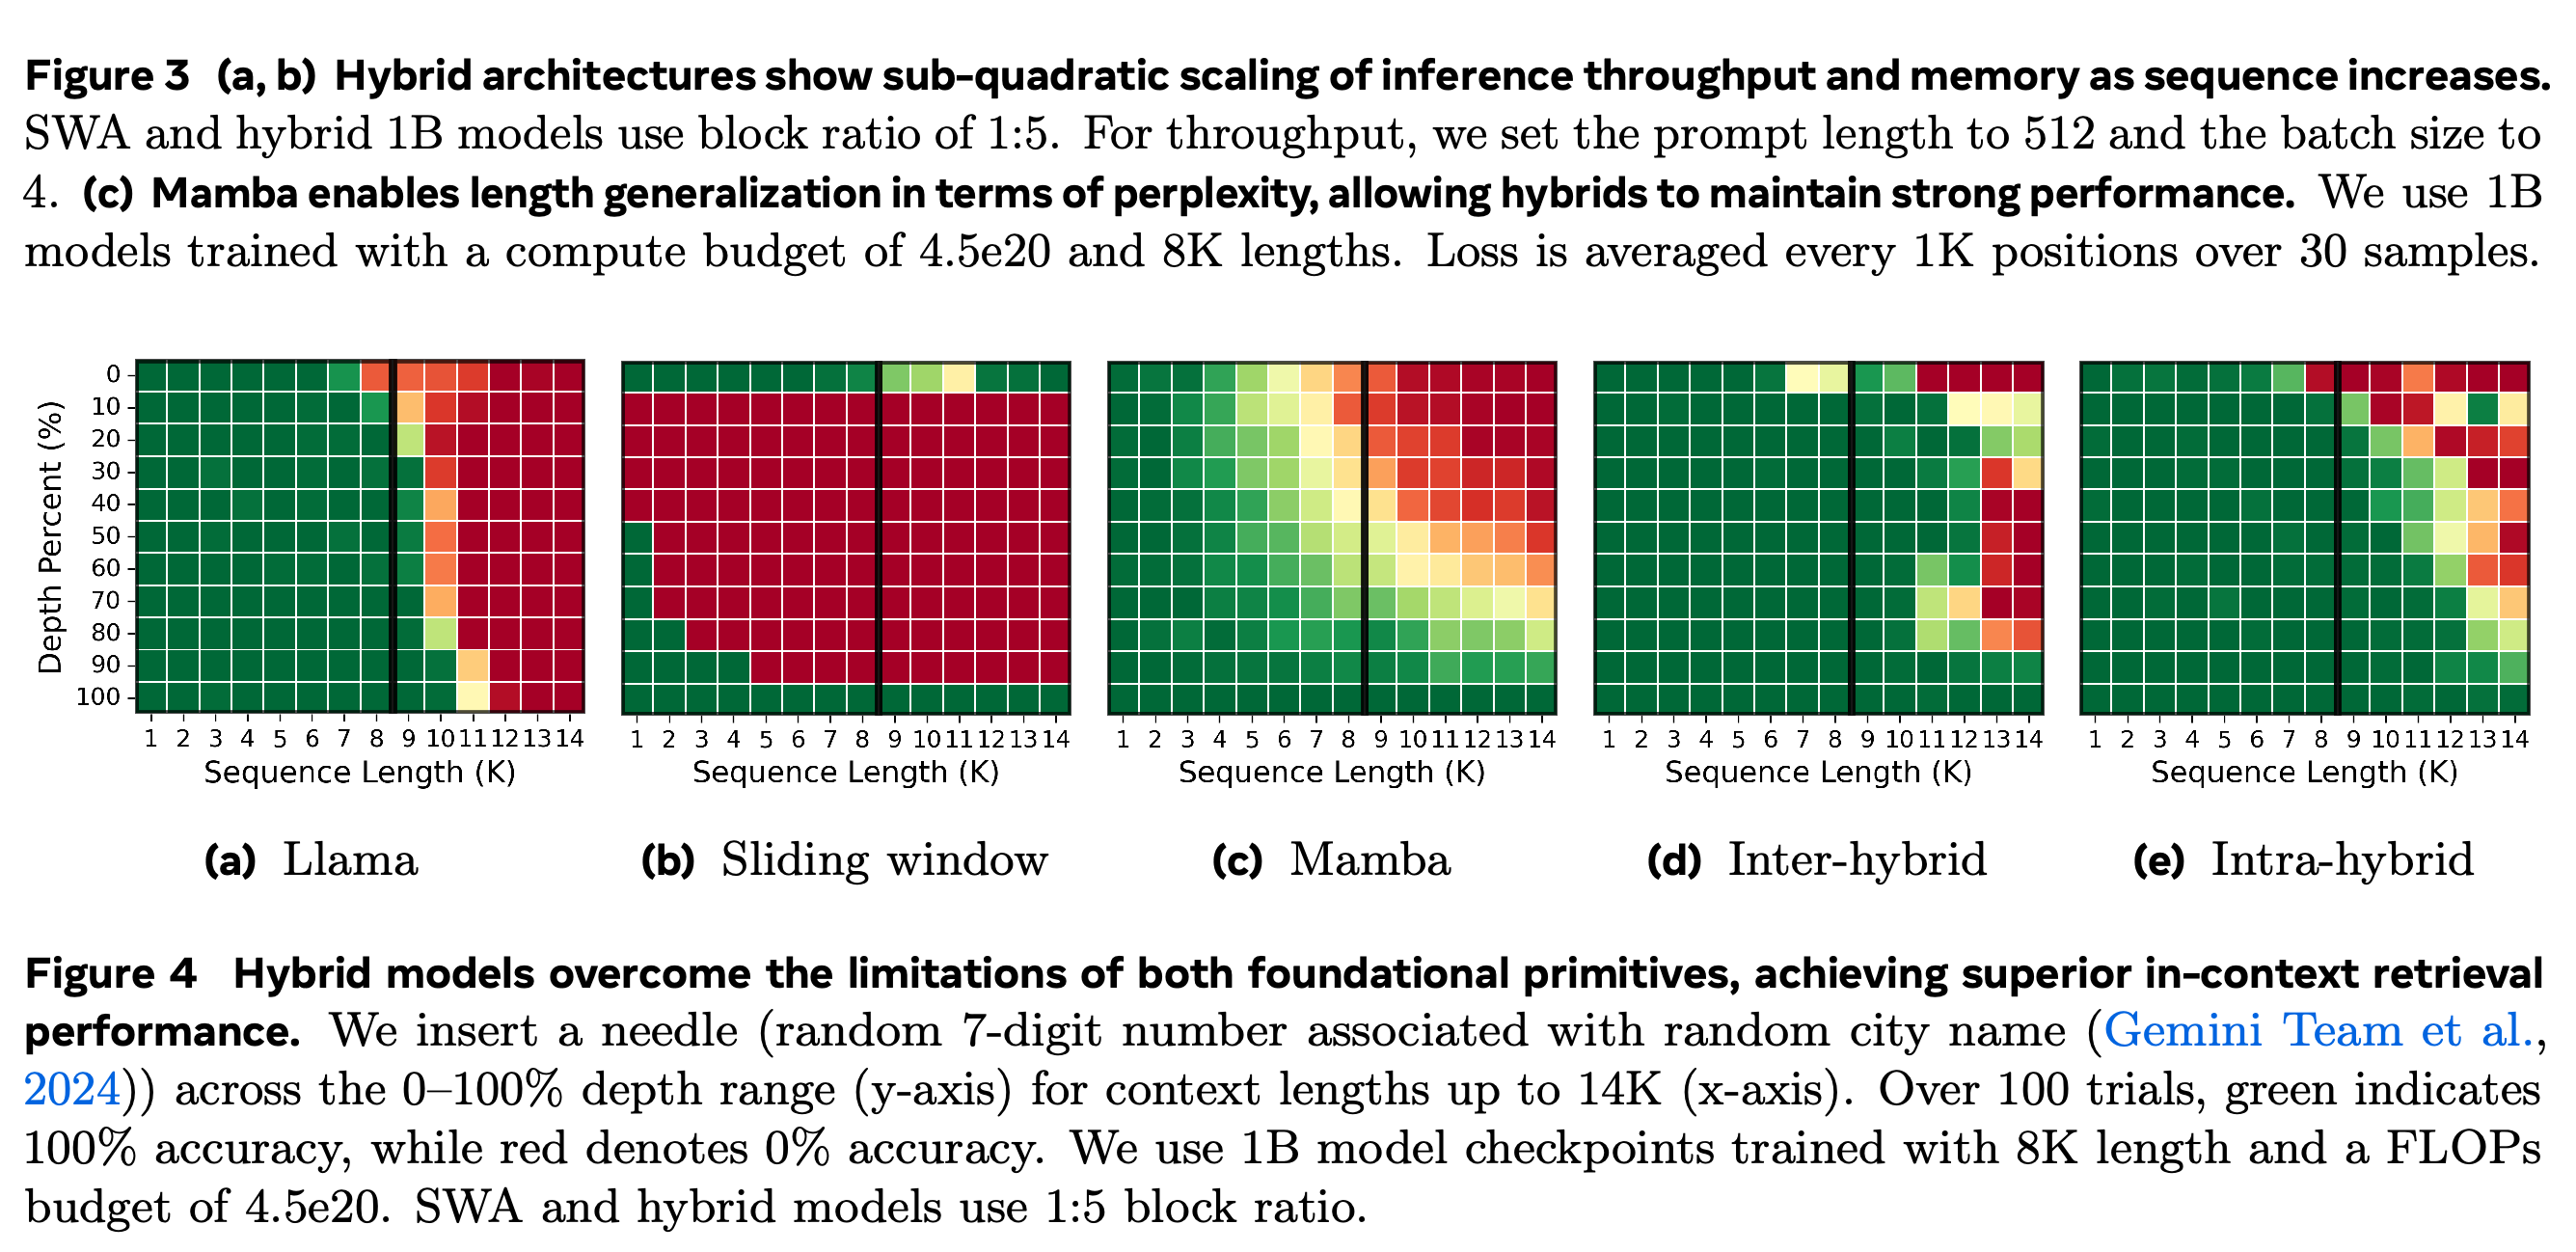
- 긴 문맥에 삽입한 정보를 복원하는 과제인 Needle-In-A-Haystack은 무작위 도시와 연결된 무작위 7자리 숫자를 여러 깊이에 삽입해 평가한다. Hybrid는 사전학습 길이의 약 1.5×까지 우수한 검색 성능을 유지하지만 Llama는 학습 문맥을 넘으면 실패하며 SWA와 Mamba는 위치에 따라 상당한 실패를 보인다.
- Hybrid의 검색 성능도 외삽 문맥의 일부 구간, 특히 중간에서 저하된다. 따라서 안정적인 언어 모델링 손실만으로 모든 위치에서 신뢰할 만한 회상 성능을 입증할 수는 없다.
- 논문은 명시적인 위치 정보를 제거하는 No Positional Encoding(NoPE)을 길이 일반화의 한계를 해결할 방법으로 논의한다. Appendix K는 보고된 평가에서 positional-encoding 길이를 확장했다고 명시하며 주요 비교를 NoPE 실험으로 규정하지 않는다.
문맥이 길어질 때 hybrid의 decoding throughput은 Llama보다 완만하게 감소하며 decoding cache도 더 작다. Mamba와 hybrid의 손실은 8K 학습 길이를 넘어도 비교적 안정적이지만 Llama의 손실은 급격히 증가한다. 검색 heatmap과 함께 보면, 외삽 구간의 언어 모델링 손실과 회상 성능을 별도로 평가해야 하는 이유를 알 수 있다.
Heatmap은 서로 다른 실패 양상을 보여 준다. Llama는 학습 문맥을 넘으면 성능이 저하되고 SWA는 유리한 지역 구간 밖의 정보를 잃으며 Mamba는 깊이에 따라 장거리 검색에 실패한다. 두 hybrid는 검색에 성공하는 영역이 더 넓지만 긴 문맥의 일부 구간에서는 정확도가 낮아진다. 이 결과는 논문의 도시와 숫자를 연결한 pattern-completion 과제에 관한 것이다.
4.4 Scaling Analysis
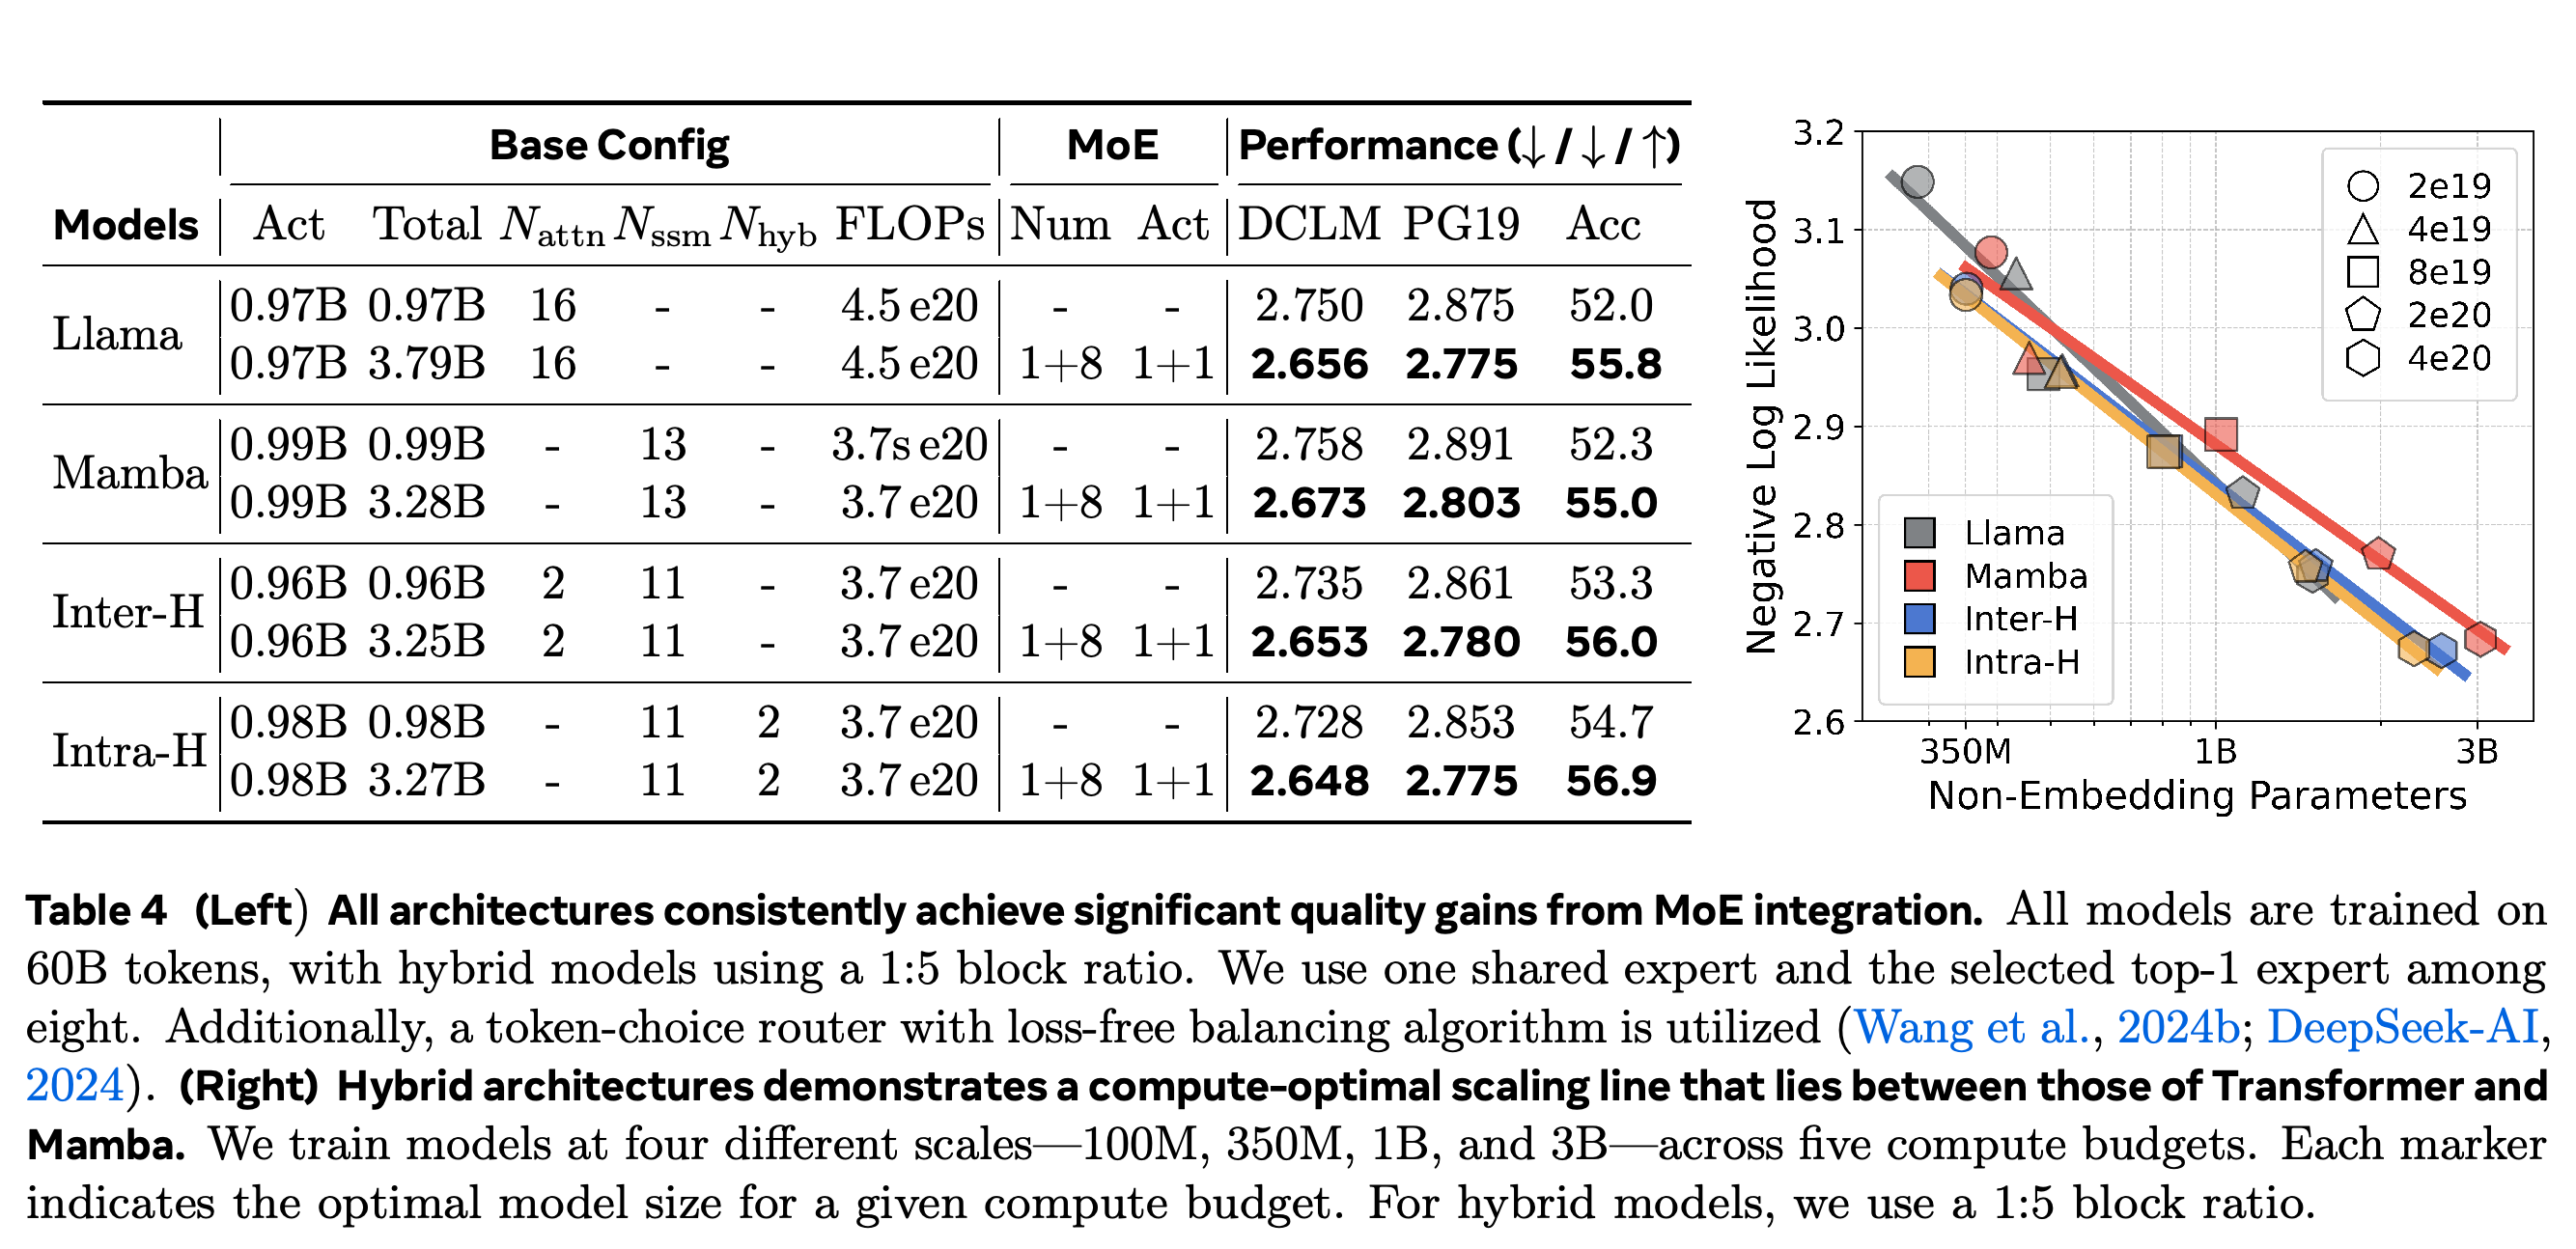
FFN을 MoE 층으로 대체하면 토큰마다 사용하는 activated 파라미터 수와 연산량을 dense 모델과 거의 같게 유지하면서 실험한 모든 architecture의 성능이 개선된다. 60B 토큰에서 intra-layer hybrid의 DCLM NLL은 2.728에서 2.648로 낮아지고 평균 few-shot 정확도는 54.7%에서 56.9%로 높아진다. 전체 non-embedding 파라미터는 0.98B에서 3.27B로 증가한다.
- 각 토큰은 shared expert 1개와 후보 8개 중 top-1으로 선택한 expert를 사용한다. 따라서 MoE는 저장하는 전체 모델 크기를 늘리면서 측정된 품질을 개선한다.
- 고정된 학습 예산에서 가장 낮은 손실을 내는 모델 크기를 선택하는 compute-optimal scaling은 100M, 350M, 1B, 3B와 2e19부터 4e20 FLOPs까지의 예산 5개에서 연구한다.
- 곡선 적합으로 추정한 최적점은 Mamba에 대해 더 큰 모델과 더 적은 파라미터당 토큰 수를, hybrid에 대해서는 중간 수준의 배분을 지지한다. 이 추정은 실험한 크기와 예산 범위에 적용된다.
MoE 결과는 activated capacity를 거의 고정한 상태에서 품질이 개선되고 저장하는 전체 파라미터가 증가함을 보여 준다. Intra-layer hybrid의 평균 정확도는 54.7%에서 56.9%로 높아져 2.2-percentage-point의 개선을 보인다. 옆의 scaling 그래프는 architecture별 최적 모델 크기를 추정하며 실험 범위에서 hybrid의 배분 추세가 Transformer와 Mamba 사이에 있음을 보여 준다.
4.5 Ablation Studies for Inter-layer Hybridization
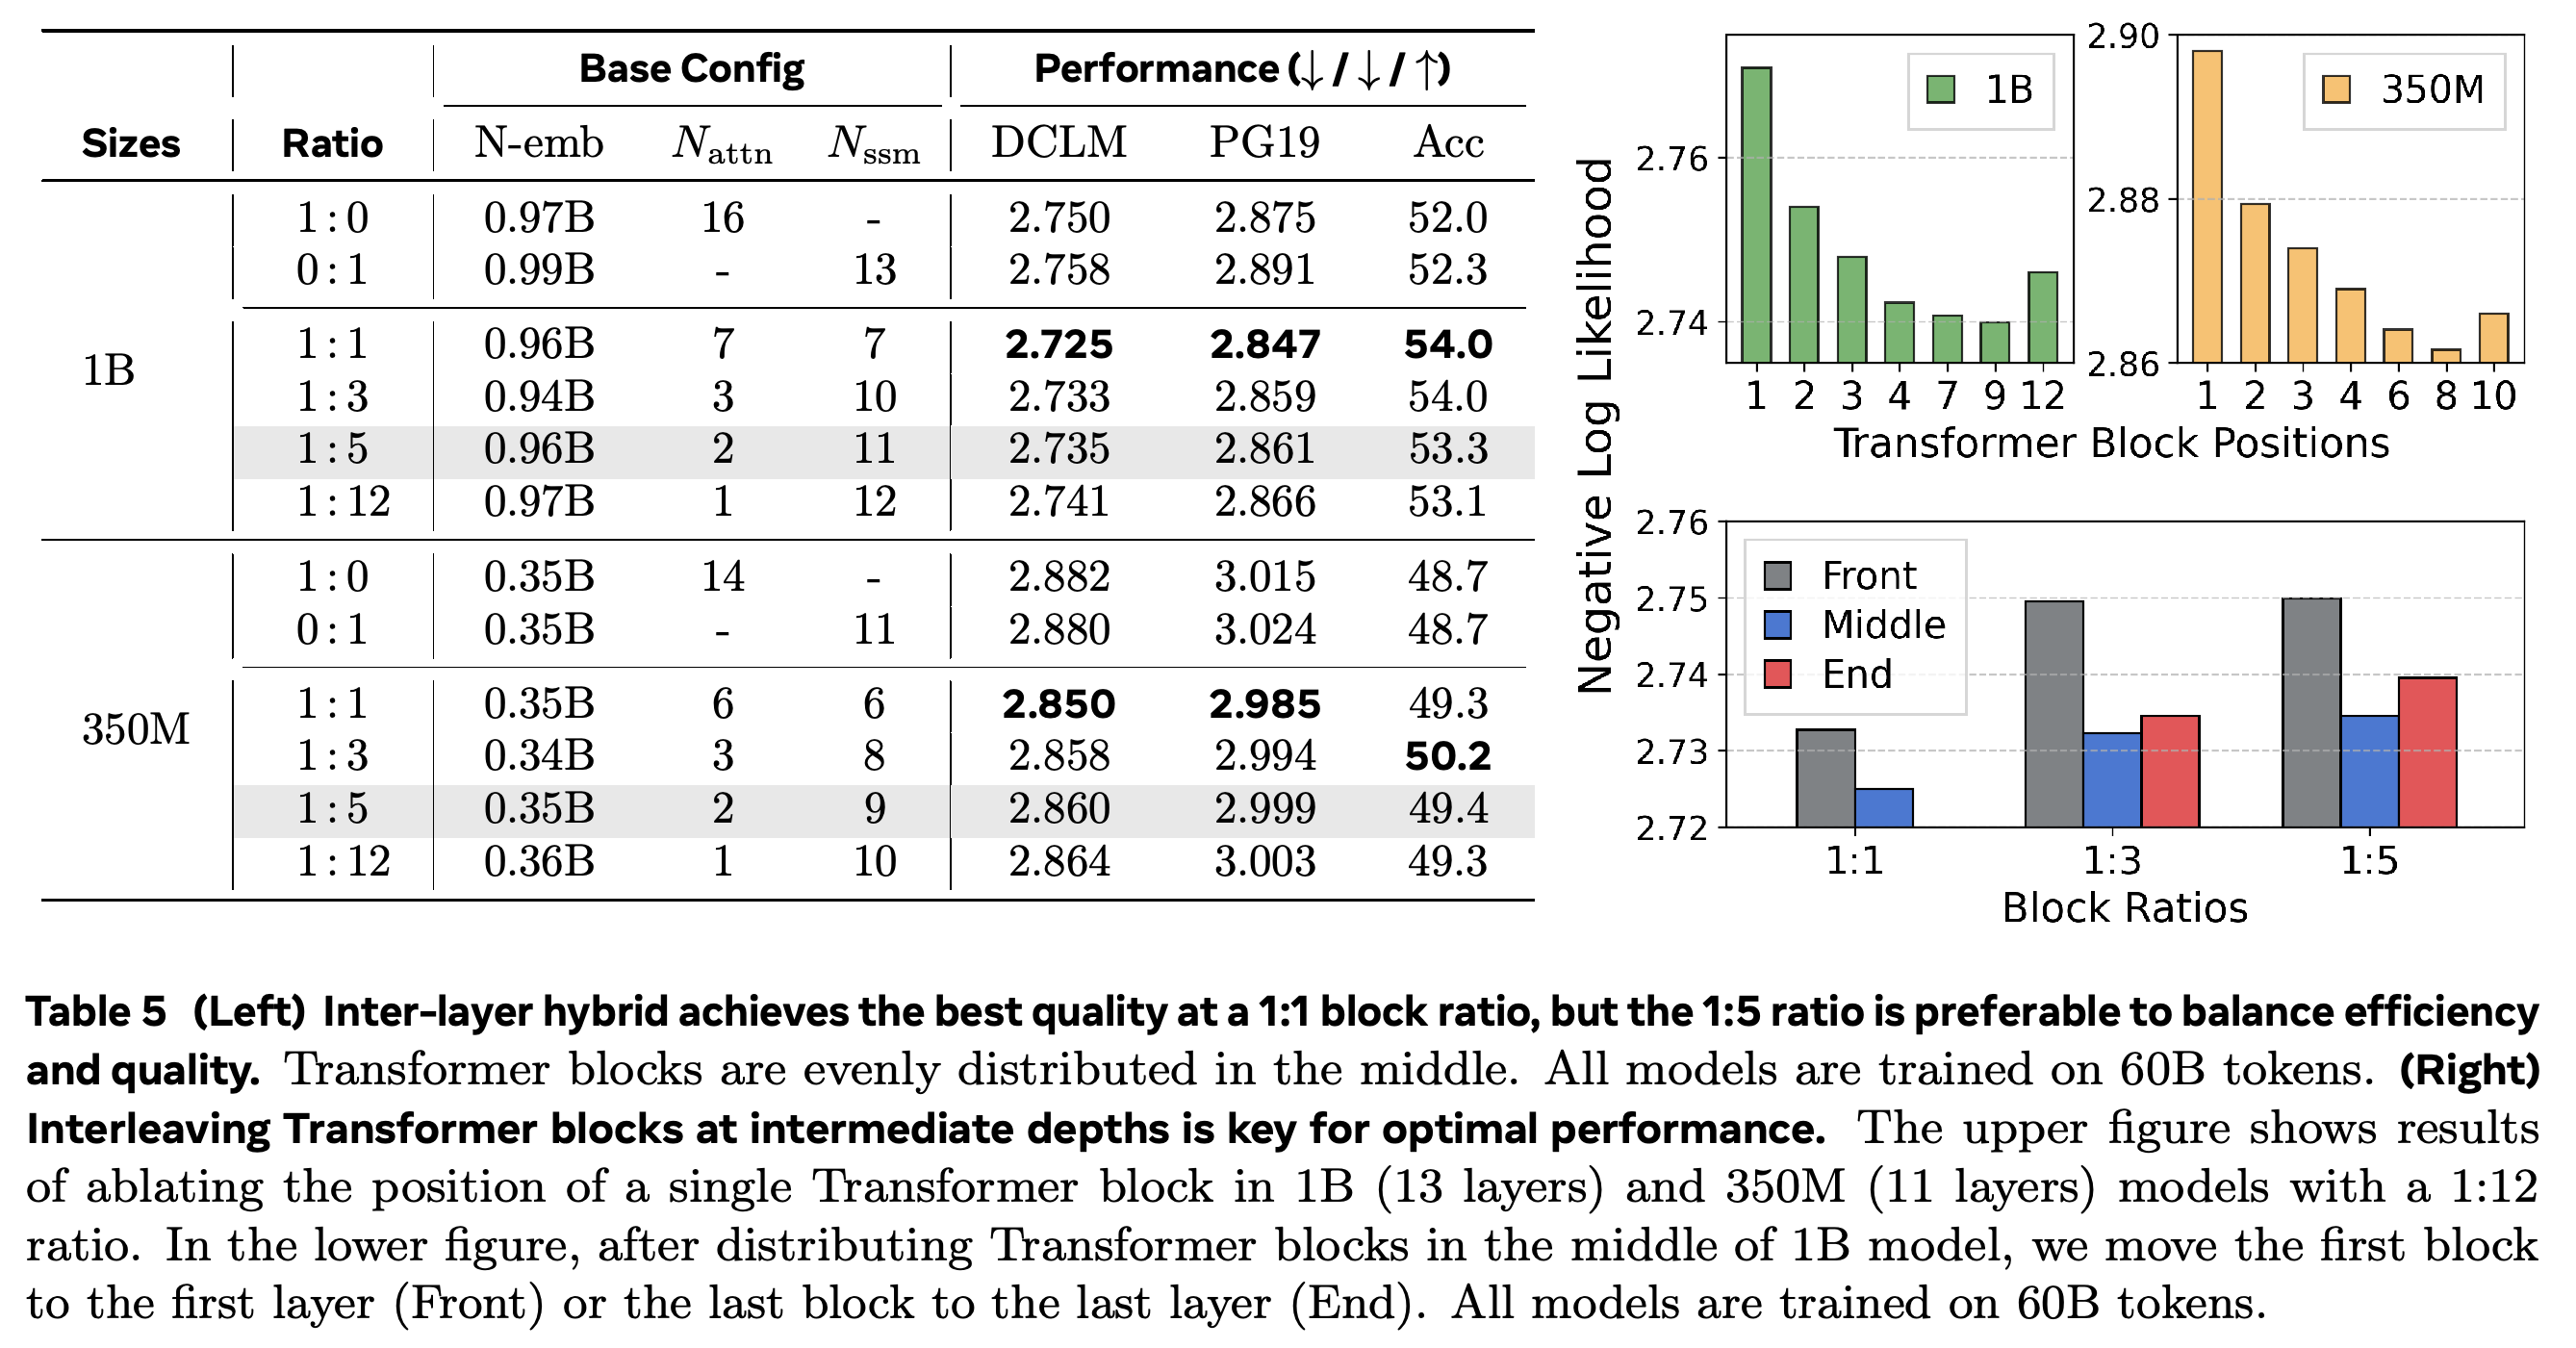
Inter-layer 비율 ablation에서는 언어 모델링 손실에 1:1이 유리하며 손실, cache 크기, 추론 속도를 절충하는 구성으로 약 1:5가 유리하다. 1B 모델과 60B 토큰에서 비율을 1:1에서 1:5로 바꾸면 DCLM NLL은 2.725에서 2.735로 변한다. 8K cache는 119에서 43 MiB로 줄고 평균 few-shot 정확도는 54.0%에서 53.3%로 변한다.
- 1B 모델에 Transformer 블록 1개를 배치할 때, 층 1에 배치하면 DCLM NLL은 2.771이며 층 7에서는 2.741, 층 9에서는 2.740이다. 이 결과는 실험한 구성에서 앞부분 배치를 피하는 선택을 지지한다.
- 가장 낮은 손실과 가장 높은 few-shot 정확도가 항상 일치하지는 않는다. 350M에서 1:3은 정확도 50.2%, 1:1은 49.3%를 기록하지만 손실은 1:1이 더 낮다.
- 저자들은 초기 attention의 거의 균일한 전역 정보 집계가 지역 정보를 선호하는 Mamba와 충돌한다는 가설을 제시한다. Attention 시각화는 이러한 차이를 보여 주지만 그 충돌이 인과적 메커니즘이라는 점을 입증하지는 않는다.
비율 비교에서는 언어 모델링 손실에 1:1이 유리하지만 350M의 정확도 순위는 다르다. 배치 그래프는 초기 Transformer 블록이 손실에 불리하며 중간 깊이에서 더 좋은 결과를 보임을 보여 준다. 이는 실험한 모델에 대한 권고를 뒷받침하며 앞부분 배치를 보편적으로 금지할 근거는 아니다.
4.6 Ablation Studies for Intra-layer Hybridization
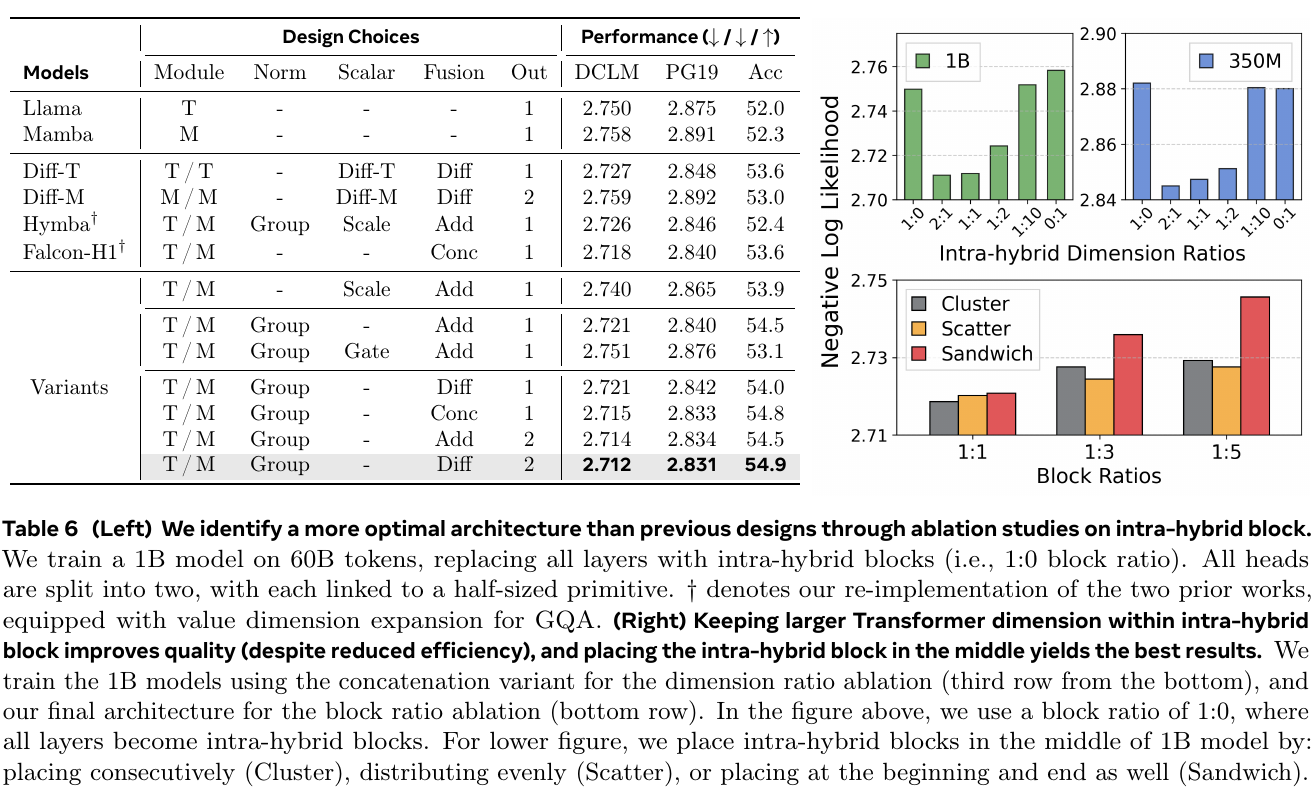
Intra-layer ablation은 그룹별 feature를 정규화하는 module-wise Group normalization, 추가적인 학습 가능한 scaling을 사용하지 않는 구성, 별도의 value와 output projection, 뺄셈 결합을 선택한다. 1B 모델의 모든 층을 intra-hybrid 블록으로 바꾸고 60B 토큰으로 학습하면, 이 구성은 DCLM/PG19 NLL 2.712/2.831과 평균 정확도 54.9%를 달성한다.
- 기존 intra-layer hybrid 설계인 Hymba와 Falcon-H1과의 비교에는 GQA의 value 차원을 확장한 저자들의 재구현을 사용한다. Concatenation도 경쟁력 있는 결과를 보이며 부록은 결합 방식이 projection 및 value 공유 선택과 상호작용함을 보여 준다.
- Attention 용량을 늘리면 일반적으로 Mamba 비중이 매우 큰 분기보다 손실이 개선되지만 모든 규모에서 단조로운 추세를 보이지는 않는다. 품질과 연산량의 절충안으로 1:1 차원 배분을 선택한다.
- Intra-hybrid 블록을 깊이 전반에 분산하는 Scatter는 연속해서 배치하는 Cluster와 양 끝을 포함해 배치하는 Sandwich보다 평균 정확도가 높다. 약 1:5에서 Scatter는 정확도 54.7%와 DCLM NLL 2.728을 달성하며 Sandwich는 52.4%와 2.746을 기록한다.
- 별도의 350M 모델은 2개 구성 요소의 출력을 결합하는 가중치인 interpolation coefficient를 학습한다. 이 모델은 초기에는 Mamba에 더 큰 가중치를, 선택된 중간 층에서는 Transformer에 더 큰 가중치를 부여하는 깊이별 양상을 보인다. 이 계수는 다음 토큰 예측을 위해 학습된다.
선택한 구성인 별도 projection을 사용하는 정규화한 뺄셈 변형은 DCLM NLL 2.712와 평균 정확도 54.9%를 달성하며 정규화한 concatenation도 비슷한 결과를 보인다. 함께 제시한 그래프는 분기 용량과 블록 배치의 영향을 보여 준다. Hymba와 Falcon-H1 비교는 수정한 재구현을 사용하며 일부 재구현 점수는 확장된 부록 표의 점수와 다르다.
5 Distinctions from Prior Works
논문의 차별화된 기여는 품질, 효율, architecture ablation 전반에서 inter-layer와 intra-layer 설계를 통제된 조건으로 비교했다는 점이다. 최종 architecture만 보고하는 대신 블록 비율, 깊이별 배치, 분기 차원, 정규화, scaling, 결합, value 공유, output projection을 실험한다.
- 논문이 주장하는 새로움은 체계적인 비교 분석과 공개된 설계법에 있다. 이 연구는 기존 Transformer, Mamba, hybrid 구성 요소를 바탕으로 한다.
6 Conclusion and Future Work
실험은 hybrid architecture가 품질과 효율의 절충안이 될 수 있음을 뒷받침하며 특히 주요 약 1B 비교에서는 intra-layer hybrid가 우수하다. 저자들은 더 큰 모델, 더 긴 학습, 더 폭넓은 평가, 새로운 attention 또는 순환 구성 요소, 추가 modality를 향후 검증 과제로 제시한다.
- Architecture 연구는 약 3B 모델 규모까지 다루고 기본적으로 60B-token 학습을 사용하지만 동일 연산량 비교와 scaling 실험에서는 다른 토큰 수를 사용한다.
- 논문은 결론에서 논의한 새로운 시퀀스 처리 구성 요소나 비디오와 오디오에도 설계법을 적용할 수 있는지 실험으로 입증하지 않는다. 적용 가능성에 대한 기대는 가설로 남는다.
부록
- A The Use of Large Language Models: 저자들은 직접 작성한 원고를 다듬고 버그 수정과 초기 그림 초안 작성을 보조하는 데 Llama 3.2와 Llama 4를 사용했다고 보고한다. B Broader Impact Statement: 효율 개선에 따른 접근성과 환경 측면의 잠재적 이점, 허위정보 유포에 악용될 가능성을 논의한다. 이는 측정한 결과가 아니라 예상되는 영향이다.
- C Details for Computational and Memory Costs Comparison: 부록은 파라미터 수에 6L_ctx를 곱해 선형 가중치의 학습 연산량을 추정한 뒤 시퀀스 처리 비용을 더하고 2-byte 수치 형식인 bfloat16의 cache 요구량을 유도한다. Transformer cache 크기는 4N_L d_head N_kv L_ctx이고 Mamba cache 크기는 2N_L(d_ssm d_state + N_conv(2d_state + d_ssm))이다. N_L은 층 수, N_kv는 key-value head 수, N_conv는 convolution width, d는 차원, L_ctx는 문맥 길이다. Mamba cache는 시퀀스 길이와 무관하며 1B, 8K 예시에서는 Mamba가 13.4 MiB, Transformer가 256 MiB를 사용한다.
- D Details for Intra-layer Hybrid Architectures: 일반화한 결합 수식에서는 module-wise 정규화, scaling factor, 덧셈, 뺄셈, concatenation, 공유 또는 독립 value, 통합 또는 별도 output projection을 바꾼다. Value 공유는 Mamba가 attention의 value projection을 재사용하게 한다. 제안된 잡음 감소 또는 상호보완적 결합 효과는 여러 변형을 통해 검토하는 가설이다.
- E Detailed Experimental Setup: 기본 학습은 H200 GPU 8개, 텍스트를 128K-token 어휘로 매핑하는 Llama 3.2 tokenizer, packing한 8K 시퀀스, 2M-token batch, 학습 optimizer인 AdamW, gradient 크기를 제한하는 gradient clipping, FSDP, activation checkpointing, torch.compile을 사용한다. 사다리꼴 learning-rate schedule은 warmup, stable, cooldown 단계로 구성되며, warmup은 약 25%, cooldown은 약 20%이다. 100M, 350M, 1B, 3B의 learning rate는 각각 6e-3, 3e-3, 6e-4, 3e-4이다. Mamba의 상태 전이 파라미터 A는 [1, 16] 대신 [0.01, 2.0]에서 샘플링하며 dt_bias는 원래의 무작위 초기화를 유지한다.
- E Detailed Experimental Setup은 회전으로 위치 정보를 인코딩하는 Rotary Positional Embeddings(RoPE)도 명시한다. Scaling factor는 32, low/high frequency factor는 1.0/4.0, 원래 문맥은 8K, base frequency는 500,000이다. SWA는 base frequency 10,000, window 512, sink token 64개를 사용한다. 평가는 H200 GPU 1개에서 실행하며 few-shot 점수는 LAMBADA를 제외하고 정답 문자열의 byte 길이로 정규화한다.
- F Expanded Main Results on Quality: Tables 9와 10은 350M과 1B의 여러 비율에 대해 동일 데이터 및 동일 FLOPs 비교를 확장한다. 정확도 순위는 규모와 비율에 따라 달라진다. 350M과 동일한 1.9e20 FLOPs에서 1:1 inter-layer hybrid는 평균 정확도 50.7%를 달성해 보고된 intra-layer 구성들을 앞선다. 1B의 동일 연산량 비교에서 Table 9는 SWA만으로 구성한 모델의 정확도도 54.9%로 보고한다. 이 모델은 언어 모델링 손실이 더 높지만 약 1:5 intra-layer hybrid와 같은 정확도를 기록한다.
- G Expanded Results of Sliding Window Attention Ablation: SWA baseline은 512-token window와 sink token 64개를 사용하고 1:1, 1:3, 1:5 비율에서 global-attention 배치를 실험해 최적화한다. 실험한 1:3과 1:5 비율에서는 Middle 배치가 검증 손실에 유리하지만 모든 정확도 점수를 최대화하지는 않는다. 1:5에서 Middle의 평균 정확도는 52.7%이고 End는 52.9%이다.
- H Expanded Results on Longer Context Pretraining: 16K와 4.5e20 FLOPs에서 intra-layer와 inter-layer hybrid의 평균 정확도는 각각 55.7%와 55.6%이며, Llama는 54.0%이다. 32K에서 평균 정확도는 inter-layer 54.0%, intra-layer 53.5%, Mamba 53.4%, Llama 50.7%이다. DCLM NLL은 Mamba가 2.716으로 가장 낮고 두 hybrid는 모두 2.722이다. 이 비교에서도 hybrid의 정확도 이점은 유지되지만 가장 좋은 architecture는 지표와 학습 문맥에 따라 달라진다.
- I Experimental Setup for Downstream Fine-tuning Tasks: Fine-tuning은 global batch size 16, peak learning rate 1e-4, warmup 100 steps, cooldown 200 steps로 1,000 steps 동안 실행한다. 최대 시퀀스 길이는 독해 기반 질의응답 데이터셋 SQuAD의 2K를 제외하면 8K이다. 평가는 데이터셋마다 1,000개 사례를 사용하며 SQuAD는 검증 세트에서 평가한다. 이 부록은 사전학습 예산을 4e20으로 명시하지만 Table 3의 caption은 4.5 × 10^20 FLOPs로 명시하므로, downstream 비교의 정확한 사전학습 예산은 PDF 안에서 일치하지 않는다.
- J Expanded Main Results on Efficiency: Table 13은 batch size 4와 512-token prompt에서 전체 길이 2K, 4K, 8K, 16K, 32K에 따른 decoding throughput과 생성에 걸린 시간인 latency를 보고한다. 약 1:5 intra-layer hybrid는 2K에서 1089 token/s, 32K에서 280 token/s를 달성한다. Inter-layer는 각각 969와 213 token/s, Llama는 373과 30 token/s를 기록한다. Mamba 블록 비중을 높이면 일반적으로 throughput이 증가하며 품질 변화는 비율 ablation에서 제시한다.
- K Experimental Setup for Long-context Evaluation Tasks: PG19 외삽은 독립적으로 평가하는 문서 30개와 8K에서 4.5e20 FLOPs로 학습한 1B checkpoint를 사용한다. Needle-In-A-Haystack은 이어 붙인 Paul Graham 에세이, 길이 L ∈ {960, 1984, …, 16320}, 깊이 d ∈ {0%, 10%, …, 100%}, 삽입 형식 “The special magic {city} number is: {number}”를 사용한다. 모델은 명시적 요청을 따르도록 학습하는 instruction tuning을 거치지 않았으므로, 평가는 삽입 형식과 일치하는 pattern-completion prompt를 사용한다. 모델은 이어지는 토큰 20개를 생성하며 생성 텍스트에 목표 무작위 7자리 숫자가 포함되면 정답으로 처리한다.
- L Experimental Setup for Integration of Mixture-of-Experts: 모든 FFN을 router가 토큰마다 expert를 선택하는 token-choice MoE 층으로 대체한다. Shared expert 1개와 routed expert 8개 중 top-1을 사용한다. Expert의 중간 차원은 절반으로 줄이고, router 점수는 sigmoid로 일정 범위 안의 값에 매핑한다. Auxiliary-loss-free balancing은 balancing loss를 추가하지 않고 routing bias를 조정하며 bias update coefficient는 1e-3이다. 구현은 grouped matrix multiplication에 torch._grouped_mm을 사용한다. Table 4는 activated capacity를 거의 같게 맞췄음에도 저장하는 전체 파라미터가 증가함을 보여 준다.
- M Expanded Results of Scaling Laws Experiment: 100M, 350M, 1B, 3B 모델을 예산 2e19, 4e19, 8e19, 2e20, 4e20 FLOPs에서 0.5M tokens/step과 8K 문맥으로 연구한다. 가장 큰 예산의 학습 실행에서 얻은 중간 checkpoint를 재사용하며 이차함수 적합으로 각 예산의 최적 파라미터 수를 추정한다. Tables 14와 15는 학습한 구성과 손실을 제시한다. 가장 작은 모델의 행은 모든 예산을 보고하지 않으며 적합으로 얻은 최적 배분은 직접 학습한 구성과 구분해야 한다.
- N Expanded Results of Inter-layer Hybridization Ablation, N.1 Insights for Block Ratios: 상세 결과에서는 attention이 많을수록 손실이 낮고 Mamba가 많을수록 cache가 작아, 약 1:5를 절충안으로 선택하는 근거가 된다. N.2 Insights for Positioning of Computational Primitives: 350M과 1B의 Front, Middle, End 및 단일 블록 배치 실험은 대체로 손실 측면에서 중간 또는 후기 attention 배치를 지지한다. 정확도에는 예외가 있으며 350M의 1:1 Front는 49.6%로 End의 49.3%보다 높다.
- O Visualization of Attention Scores: 정성 분석은 256-token PG19 문맥과 60B 토큰으로 학습한 1B 모델을 사용한다. 초기 Transformer attention은 앞선 위치들에 비교적 균일하게 분포하지만 과거 입력이 상태 공간 출력에 영향을 주는 방식을 표현한 Mamba의 implicit attention은 대각선 부근에 집중된다. Mamba 점수는 절댓값으로 변환하고 각 행의 최댓값으로 정규화한다. 이 관찰은 배치 가설의 근거가 되지만 정성 비교와 서로 다른 점수 처리 방식만으로 인과적 설명을 입증하지는 않는다.
- P Expanded Results of Intra-layer Hybridization Ablation, P.1 Insights for Architectural Variants: Tables 18과 19는 1B와 350M에서 primitive 유형, 정규화, scaling, 결합, value 공유, output projection을 살펴본다. 저자들은 few-shot 정확도의 변동성 때문에 NLL과 층 수를 우선해 후속 실험에 뺄셈을 선택한다. 다만 350M에서 정규화한 concatenation의 DCLM/PG19 손실은 2.846/2.978로, 정규화한 뺄셈의 2.847/2.983보다 낮다. Table 6과 Table 18은 Hymba와 Falcon-H1의 재구현 결과도 서로 다르게 보고하므로, 각 점수는 해당 표의 비교 조건 안에서 해석해야 한다.
- P.2 Insights for Dimension Ratios: 실험은 정규화한 concatenation, 별도 value, 공동 output projection을 사용해 명목상 Transformer 대 Mamba 용량 배분 1:0, 2:1, 1:1, 1:2, 1:10, 0:1을 평가한다. 선택한 1:1 배분은 품질과 비용을 절충하며 350M에서는 명목상 attention 배분이 더 큰 2:1보다 손실이 낮다. P.3 Insights for Block Ratios and Positioning of Primitives: Scatter는 실험한 각 비율에서 평균 정확도가 가장 높지만 개별 손실의 최솟값은 간혹 Cluster나 Sandwich에서 나온다.
- Q Analysis of Component Contributions in Hybrid Architectures: 약 4B 토큰으로 학습하고 12개 층으로 구성한 350M intra-layer 모델은 Mamba에 α, attention에 \(1-\alpha\)를 부여하는 가중 결합을 학습한다. 약 100개 DCLM 샘플에서 평가한 계수는 깊이에 따라 크게 달라진다. 토큰 수준 예시 3개에서는 일부 구문 경계, 수치 정보, 문맥상 핵심어와 더 큰 attention 가중치 사이의 연관성이 나타난다. 이는 다음 토큰 예측 가중치에 관한 탐색적 근거이며 global reasoning을 직접 입증하거나 구성 요소의 역할 분화에 대한 인과적 설명을 확립하지는 않는다.
짧은 생각
토큰 예산과 연산량 예산이라는 2가지 제약을 각각 맞춘 조건에서 품질, throughput, architecture 선택을 함께 측정하므로 설계 비교가 유용하다. Table 2와 배치 ablation은 중간 깊이에 attention 블록을 적게 배치하는 구성과 intra-layer 결합을 시험할 근거를 제공한다. Figure 2는 decoding cache 절감과 최대 학습 메모리 요구량을 별도로 측정해야 함을 보여 준다.
제시한 설계법은 실험한 범위에서 초기 구성으로 활용할 수 있다. 상세 표는 몇 가지 포괄적인 주장의 적용 범위를 제한한다. Intra-layer hybrid가 모든 규모와 문맥에서 앞서지는 않고, 앞부분 배치가 항상 정확도를 낮추지는 않으며 Scatter가 모든 손실을 최소화하지는 않는다. 제한된 모델 규모, 익명화된 downstream 과제, 일치하지 않는 downstream 연산 예산, 저자들이 인정한 few-shot 변동성 때문에 이 설계법을 실제 서비스용 학습 설정에 적용할 수 있다고 확신하기에는 한계가 있다.