


Diffusion Language Models are Super Data Learners 요약 설명
05 Nov 2025 | Paper Review Diffusion Language Models LLM Pretraining Scaling Laws목차
이번 글에서는 Diffusion Language Models are Super Data Learners 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 11월 5일(Arxiv)
- Ni, Jinjie, Liu, Qian, Dou, Longxu, Du, Chao, Wang, Zili, Yan, Hang, Pang, Tianyu, Shieh, Michael Qizhe.
- National University of Singapore, Sea AI Lab, StepFun, Shanghai Qiji Zhifeng Co., Ltd.
- 논문 링크
- Github
- Project Page
요약
- 고유 학습 데이터가 제한되면 언어 모델은 같은 토큰을 반복해서 학습해야 한다. 모델 크기, 학습 설정, 총 학습 토큰 예산을 맞춘 실험에서 무작위로 마스킹한 토큰을 복원하는 masked diffusion language model(DLM)은 충분한 반복 학습 이후 앞선 문맥으로 토큰을 예측하는 autoregressive(AR) 모델보다 높은 성능을 보인다. 이 결과는 실험한 데이터 제한 조건에서 관찰된다.
- 고유 데이터가 많거나 품질이 높으면 성능 역전이 늦어지고, 모델이 크면 빨라진다. 성능 역전은 dense 모델과 토큰마다 일부 파라미터만 활성화하는 mixture-of-experts 모델 모두에서 나타난다. 1B-parameter DLM을 1B 고유 토큰으로 480 epochs 학습하면, 즉 데이터셋 전체를 480회 학습하면, 객관식 benchmark인 HellaSwag와 MMLU에서 본문에 보고된 정확도 56%와 33%에 도달한다. 보고된 AR 결과는 각각 41%와 29%다. 함께 비교한 1.7B-parameter 코드 모델을 약 1.5T 총 토큰으로 학습한 실험에서도 코드 생성 benchmark인 MBPP와 MBPP+에서 diffusion이 AR을 앞선다. 다른 코드 생성 benchmark인 HumanEval과 HumanEval+에서는 훨씬 늦게 비슷한 성능에 도달한다.
- 저자들은 이러한 성능 향상을 임의의 가시 문맥으로 토큰을 예측하는 any-order modeling, 과제마다 더 많은 연산을 수행한다는 뜻으로 명명한 super-density, 같은 시퀀스를 반복해서 제시할 때 서로 다른 마스킹 패턴을 표본으로 뽑는 Monte Carlo augmentation으로 설명한다. 입력 마스킹과 뉴런 출력을 무작위로 0으로 만드는 dropout은 AR 성능을 높이지만 관찰된 격차를 없애지는 못한다. 실험한 조건에서 diffusion은 고유 토큰당 더 높은 성능을 보인다. 다만 상당한 연산 비용이 들고, 결국 diffusion도 과적합되며, 제안한 메커니즘의 기여를 완전히 분리하지는 못한다.
1. Introduction
서론은 언어 모델을 말뭉치로 처음 학습하는 사전학습을 반복할 수 있을 때 어떤 모델링 방식이 제한된 고품질 데이터에서 더 많은 학습 신호를 얻는지 묻는다. 데이터가 제한된 실험에서 AR은 초기 학습이 빠르지만 AR 성능이 정체된 뒤에도 DLM은 계속 개선된다. 고유 데이터가 풍부하여 연산량이 주된 제약이 되는 경우에는 관찰한 학습 예산 안에서 AR이 더 높은 성능을 유지한다.
Key takeaways.
핵심 결과에서는 고정된 고유 데이터셋으로 달성할 수 있는 성능인 data potential과 연산 효율을 구분한다. 저자들은 AR 대비 data potential이 대략 >3×이며, 데이터 양과 품질, 모델 크기, 희소성에 따라 성능 역전 시점이 체계적으로 달라진다고 보고한다. AR에 잡음을 주입하면 성능이 개선되지만 diffusion에는 미치지 못한다. 또한 검증 손실이 높아져도 downstream 정확도가 개선될 수 있으며 diffusion의 잠재력을 실현하려면 학습과 추론 모두에서 더 많은 부동소수점 연산 수(FLOPs)가 필요하다고 지적한다. FLOPs는 연산량을 나타내는 척도다.
2. Preliminaries
배경에서는 정규화된 왼쪽에서 오른쪽 방향의 예측과 양방향 문맥을 활용한 무작위 마스킹 토큰 복원을 비교한다. 모델들이 학습하는 조건부 분포가 다르므로 보고된 손실도 동일한 우도 값을 나타내지 않는다.
2.1. Autoregressive Language Models
AR 모델링은 시퀀스 확률을 pθ(x1:T) = ∏i=1…T pθ(xi | x<i)로 분해한다. Causal attention은 각 예측에 앞선 토큰만 사용하도록 제한한다. 학습 중 실제 앞선 토큰을 문맥으로 제공하는 teacher forcing을 사용하면 모든 다음 토큰 예측을 1회의 forward pass에서 학습할 수 있다. 추론에서는 토큰을 순차적으로 생성하며 이전 attention 연산을 저장하는 key-value(KV) cache로 전체 문맥을 반복 처리하는 일을 줄인다.
- 수식 (2)는 정답인 다음 토큰에 대한 음의 로그 확률을 합산한 뒤 그 기댓값을 최소화한다. 이 방식은 정확하게 정규화된 우도와 효율적인 학습을 제공한다. 다만 논문은 단방향 문맥의 제약과 exposure bias를 지적한다. Exposure bias는 학습에서는 실제 prefix를 사용하지만 생성에서는 모델이 만든 prefix를 사용하면서 생기는 차이다.
2.2. Masked Diffusion Language Models
Masked diffusion은 감소하는 비마스킹 토큰 확률 αt에 따라 원본 토큰을 독립적으로 mask 토큰으로 바꾸며, α0 = 1과 α1 = 0을 사용한다. 생성은 모든 위치가 마스킹된 시퀀스에서 시작하여 토큰을 점진적으로 드러낸다. 제시된 역과정에서는 이미 드러난 토큰을 고정한다. Bidirectional attention을 사용하면 각 예측에 양쪽의 가시 토큰을 활용할 수 있다. 원본 토큰의 조건부 분포는 가시 문맥에 의존하므로 잡음 수준을 나타내는 명시적인 time embedding이 필요하지 않다.
- 수식 (3)은 잡음 수준과 마스킹 구성에 걸쳐 복원 손실을 평균하며 마스킹된 위치의 손실만 합산한다. 스케줄 가중치는 \(w(t;\alpha)=\frac{\alpha’_t}{\alpha_t-1}\)이며, \(\alpha_t=1-t\)이면 \(w(t)=1/t\)가 된다.
- 목적 함수는 AR이 사용하는 정확하게 정규화된 왼쪽에서 오른쪽 방향의 우도 대신 시퀀스 로그 확률의 변분 하한을 최대화한다. 반복 학습에서는 같은 시퀀스를 추가로 손상한 변형을 표본으로 뽑는다.
3. The Intelligence Crossover
The Intelligence Crossover 실험은 일반적인 웹 토큰으로 학습한 masked diffusion과 AR 모델을 비교하며 고유 데이터 예산, 품질, 파라미터 수, 희소성, 잡음 주입을 바꾼다. 주요 관찰 대상은 학습에 따른 downstream benchmark 성능과 검증 손실이다. 학습 곡선은 충분히 반복해서 학습하면 diffusion의 초기 열세가 역전될 수 있음을 보여 준다.
3.1. Experimental Settings
대부분의 성능 역전 실험은 무작위로 추출한 Nemotron-CC 웹 데이터와 수정한 Megatron-LM 학습 코드를 사용한다. 소형 모델의 장기 과적합 연구는 영어 웹 말뭉치인 c4-en을 사용하며 코드 실험은 이 절에서 RefinedCode라고 부르는 말뭉치를 사용한다. 기본 설정은 batch size 256, sequence length 2048이다. 학습률을 높이고, 유지한 뒤, 낮추는 warmup-stable-decay(WSD) 스케줄을 사용하며 warmup은 1000 steps, 최고 학습률은 2e-4다. 마지막 10% 구간에서는 학습률을 지수적으로 낮춰 2e-5에 도달하게 한다. 파라미터는 표준편차 0.02인 정규분포로 초기화한다.
- 모델 구조는 텍스트를 토큰으로 나누는 GPT-2 tokenizer, 위치를 표현하는 rotary position embeddings(RoPE), SwiGLU 활성화 함수, pre-layer RMSNorm 정규화, bias가 없는 층, attention의 query-key 정규화를 사용한다. 비교하는 모델들은 이러한 구조적 선택을 공유한다.
- Token-choice routing은 각 토큰에 사용할 expert를 선택하며 routing 관련 학습 항으로 auxiliary-loss coefficient 1e-2와 z-loss coefficient 1e-3을 사용한다. 검증에는 평가할 때마다 c4-en validation set에서 서로 다른 100M-token 부분집합을 사용한다.
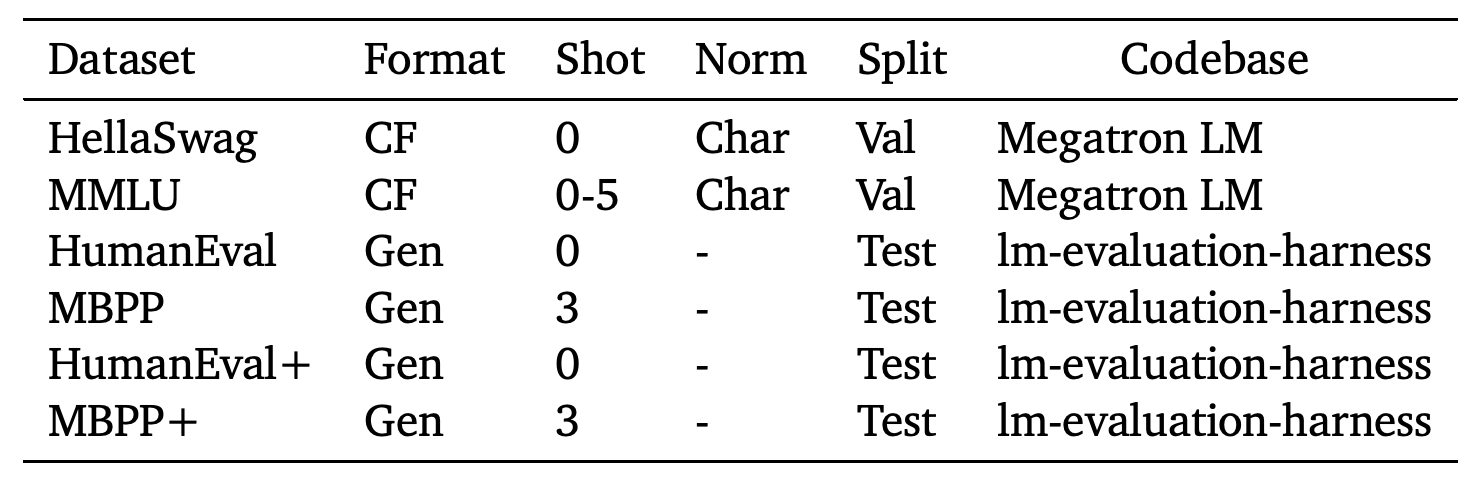
- Table 1은 HellaSwag와 MMLU에 답변 점수를 문자 수로 나누는 character-normalized completion scoring을 적용하고 HumanEval, MBPP와 확장 테스트 변형에는 생성한 코드를 평가하도록 명시한다. 저자들은 공통 하이퍼파라미터가 주로 기존 AR 튜닝을 반영한다고 지적한다. 이로 인해 diffusion 성능이 낮게 평가될 수 있다는 주장은 별도로 검증하지 않는다.
평가 프로토콜은 character-normalized completion scoring과 생성 코드 평가를 구분한다. HumanEval 변형은 0-shot prompt를 사용하고 MBPP 변형은 3-shot prompt를 사용한다. 이 방법상의 차이는 서로 다른 성능 역전 시점을 해석할 때 고려할 요소지만 표가 이를 원인으로 확립하지는 않는다.
3.2. Data Budget Decides the Crossover Timing
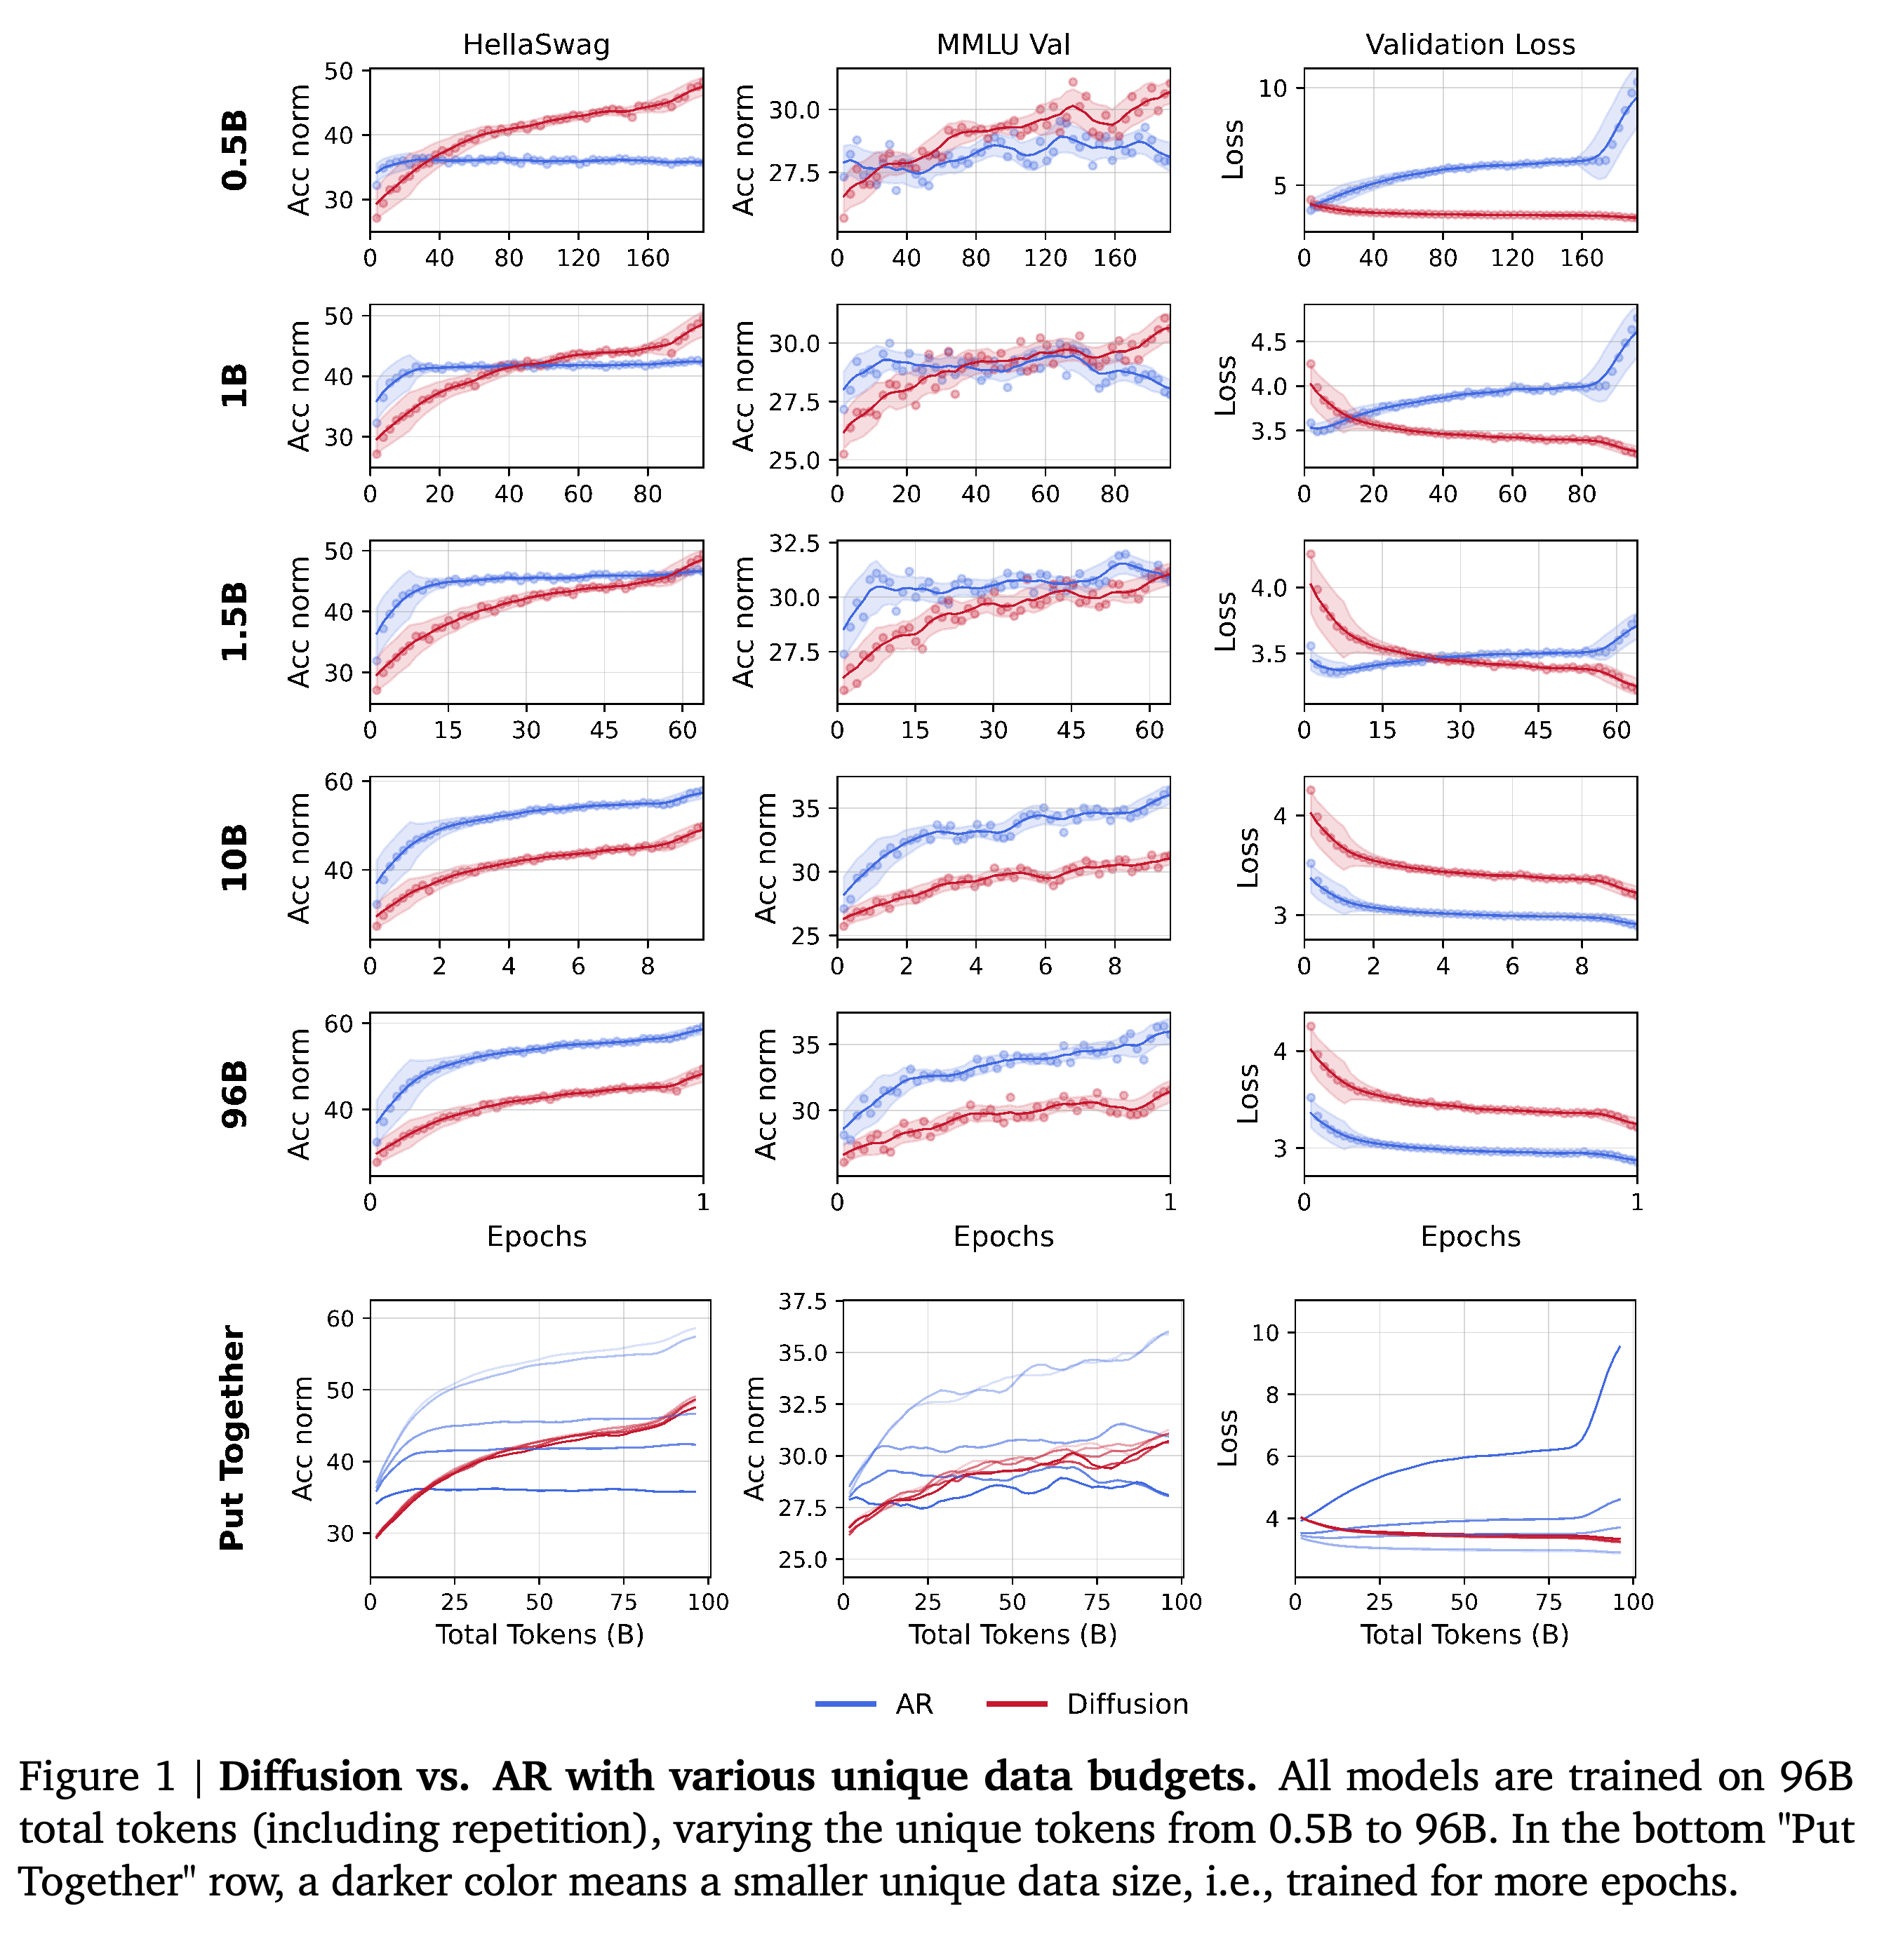
모델 크기를 1B 파라미터, 총 학습량을 96B tokens로 고정하고 고유 데이터를 0.5B에서 96B tokens까지 바꾼다. Figure 1에서는 고유 데이터 예산이 작을 때 diffusion이 AR을 앞서지만 고유 토큰이 10B와 96B일 때는 관찰한 학습 구간에서 AR이 더 높은 성능을 유지한다. 0.5B 고유 토큰으로 학습하여 아직 완전히 수렴하지 않은 DLM은 1.5B 고유 토큰으로 학습한 수렴된 AR 모델과 비슷한 성능에 도달한다. 이 비교는 유효 데이터 효율이 약 3배임을 뒷받침한다.
- 고유 데이터가 많아지면 성능 역전이 늦어지거나 관찰한 학습 구간 밖으로 밀려난다. 통합 그래프에서는 고유 데이터 예산에 따른 diffusion 결과의 차이가 AR보다 작게 나타난다.
- 저자들은 AR이 약 10B tokens를 약 10 epochs 반복할 때 단기적인 성능 저하가 경미하다고 관찰한다. 이 관찰은 기존 연구에서 논의한 4 epochs 반복 결과의 적용 조건을 한정하며 보편적인 반복 한계를 확립하지는 않는다.
고유 토큰이 0.5B와 1B일 때 diffusion은 AR 정확도가 정체된 뒤에도 계속 개선되며, 결국 초기 순위를 뒤집는다. 고유 토큰이 10B와 96B일 때는 96B-total-token 학습 구간에서 AR이 앞선다. 이는 성능 역전이 제한된 데이터의 반복 사용에 의존함을 보여 준다.
3.3. Varying Data Quality
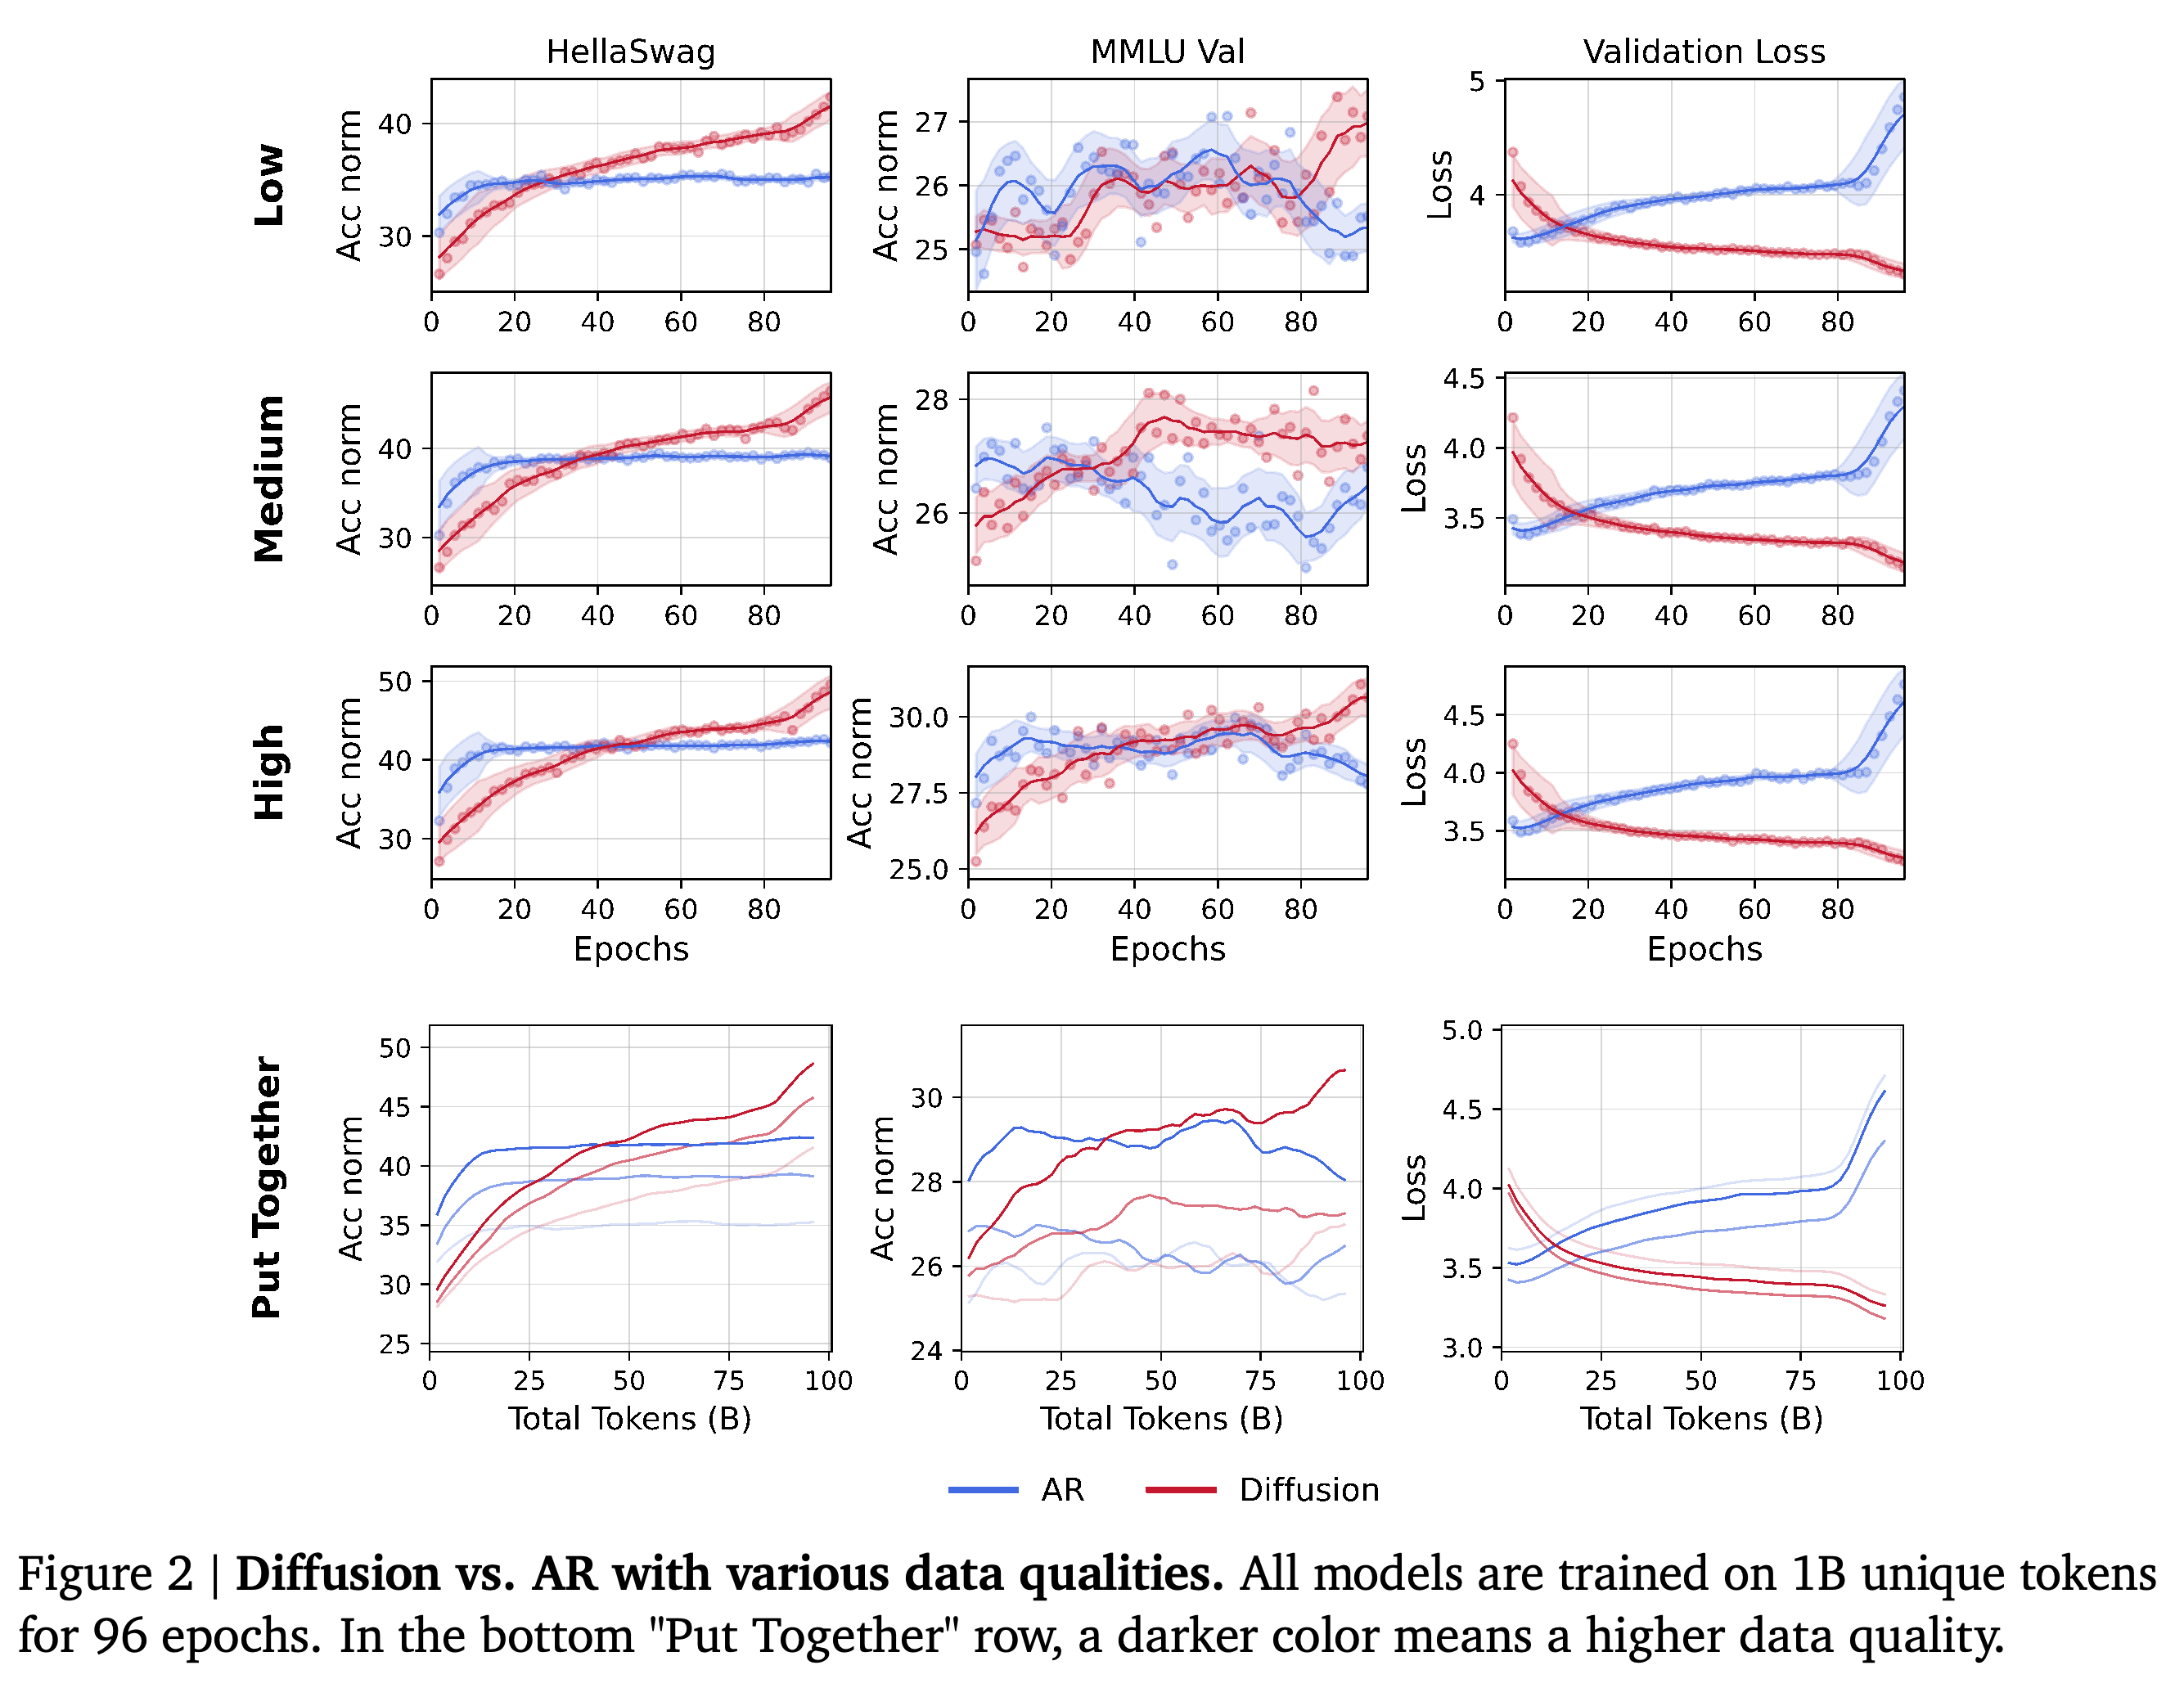
품질 ablation에서는 같은 원본 분포에서 얻은 저품질, 중품질, 고품질 부분집합을 사용하여 1B-parameter 모델을 1B 고유 토큰으로 96 epochs 학습한다. 두 모델 계열 모두 데이터 품질이 높을수록 성능이 좋아지지만 Figure 2에서는 품질이 높아질수록 성능 역전 시점이 조금 늦어진다. 고품질 데이터의 downstream 성능이 더 높은데도 중품질 diffusion 실험의 검증 손실이 가장 낮다. 이는 손실 순위와 benchmark 순위가 달라질 수 있음을 보여 준다.
고품질 데이터는 두 모델 계열의 최종 benchmark 정확도를 높이고 diffusion의 성능 역전을 조금 늦춘다. 중품질 diffusion 실험은 고품질 실험보다 benchmark 성능이 낮은데도 검증 손실이 더 낮다. 따라서 검증 손실 순위가 과제 성능 순위와 일치하지 않는다.
3.4. How Much Does Model Size Impact the Data-Constrained Training?
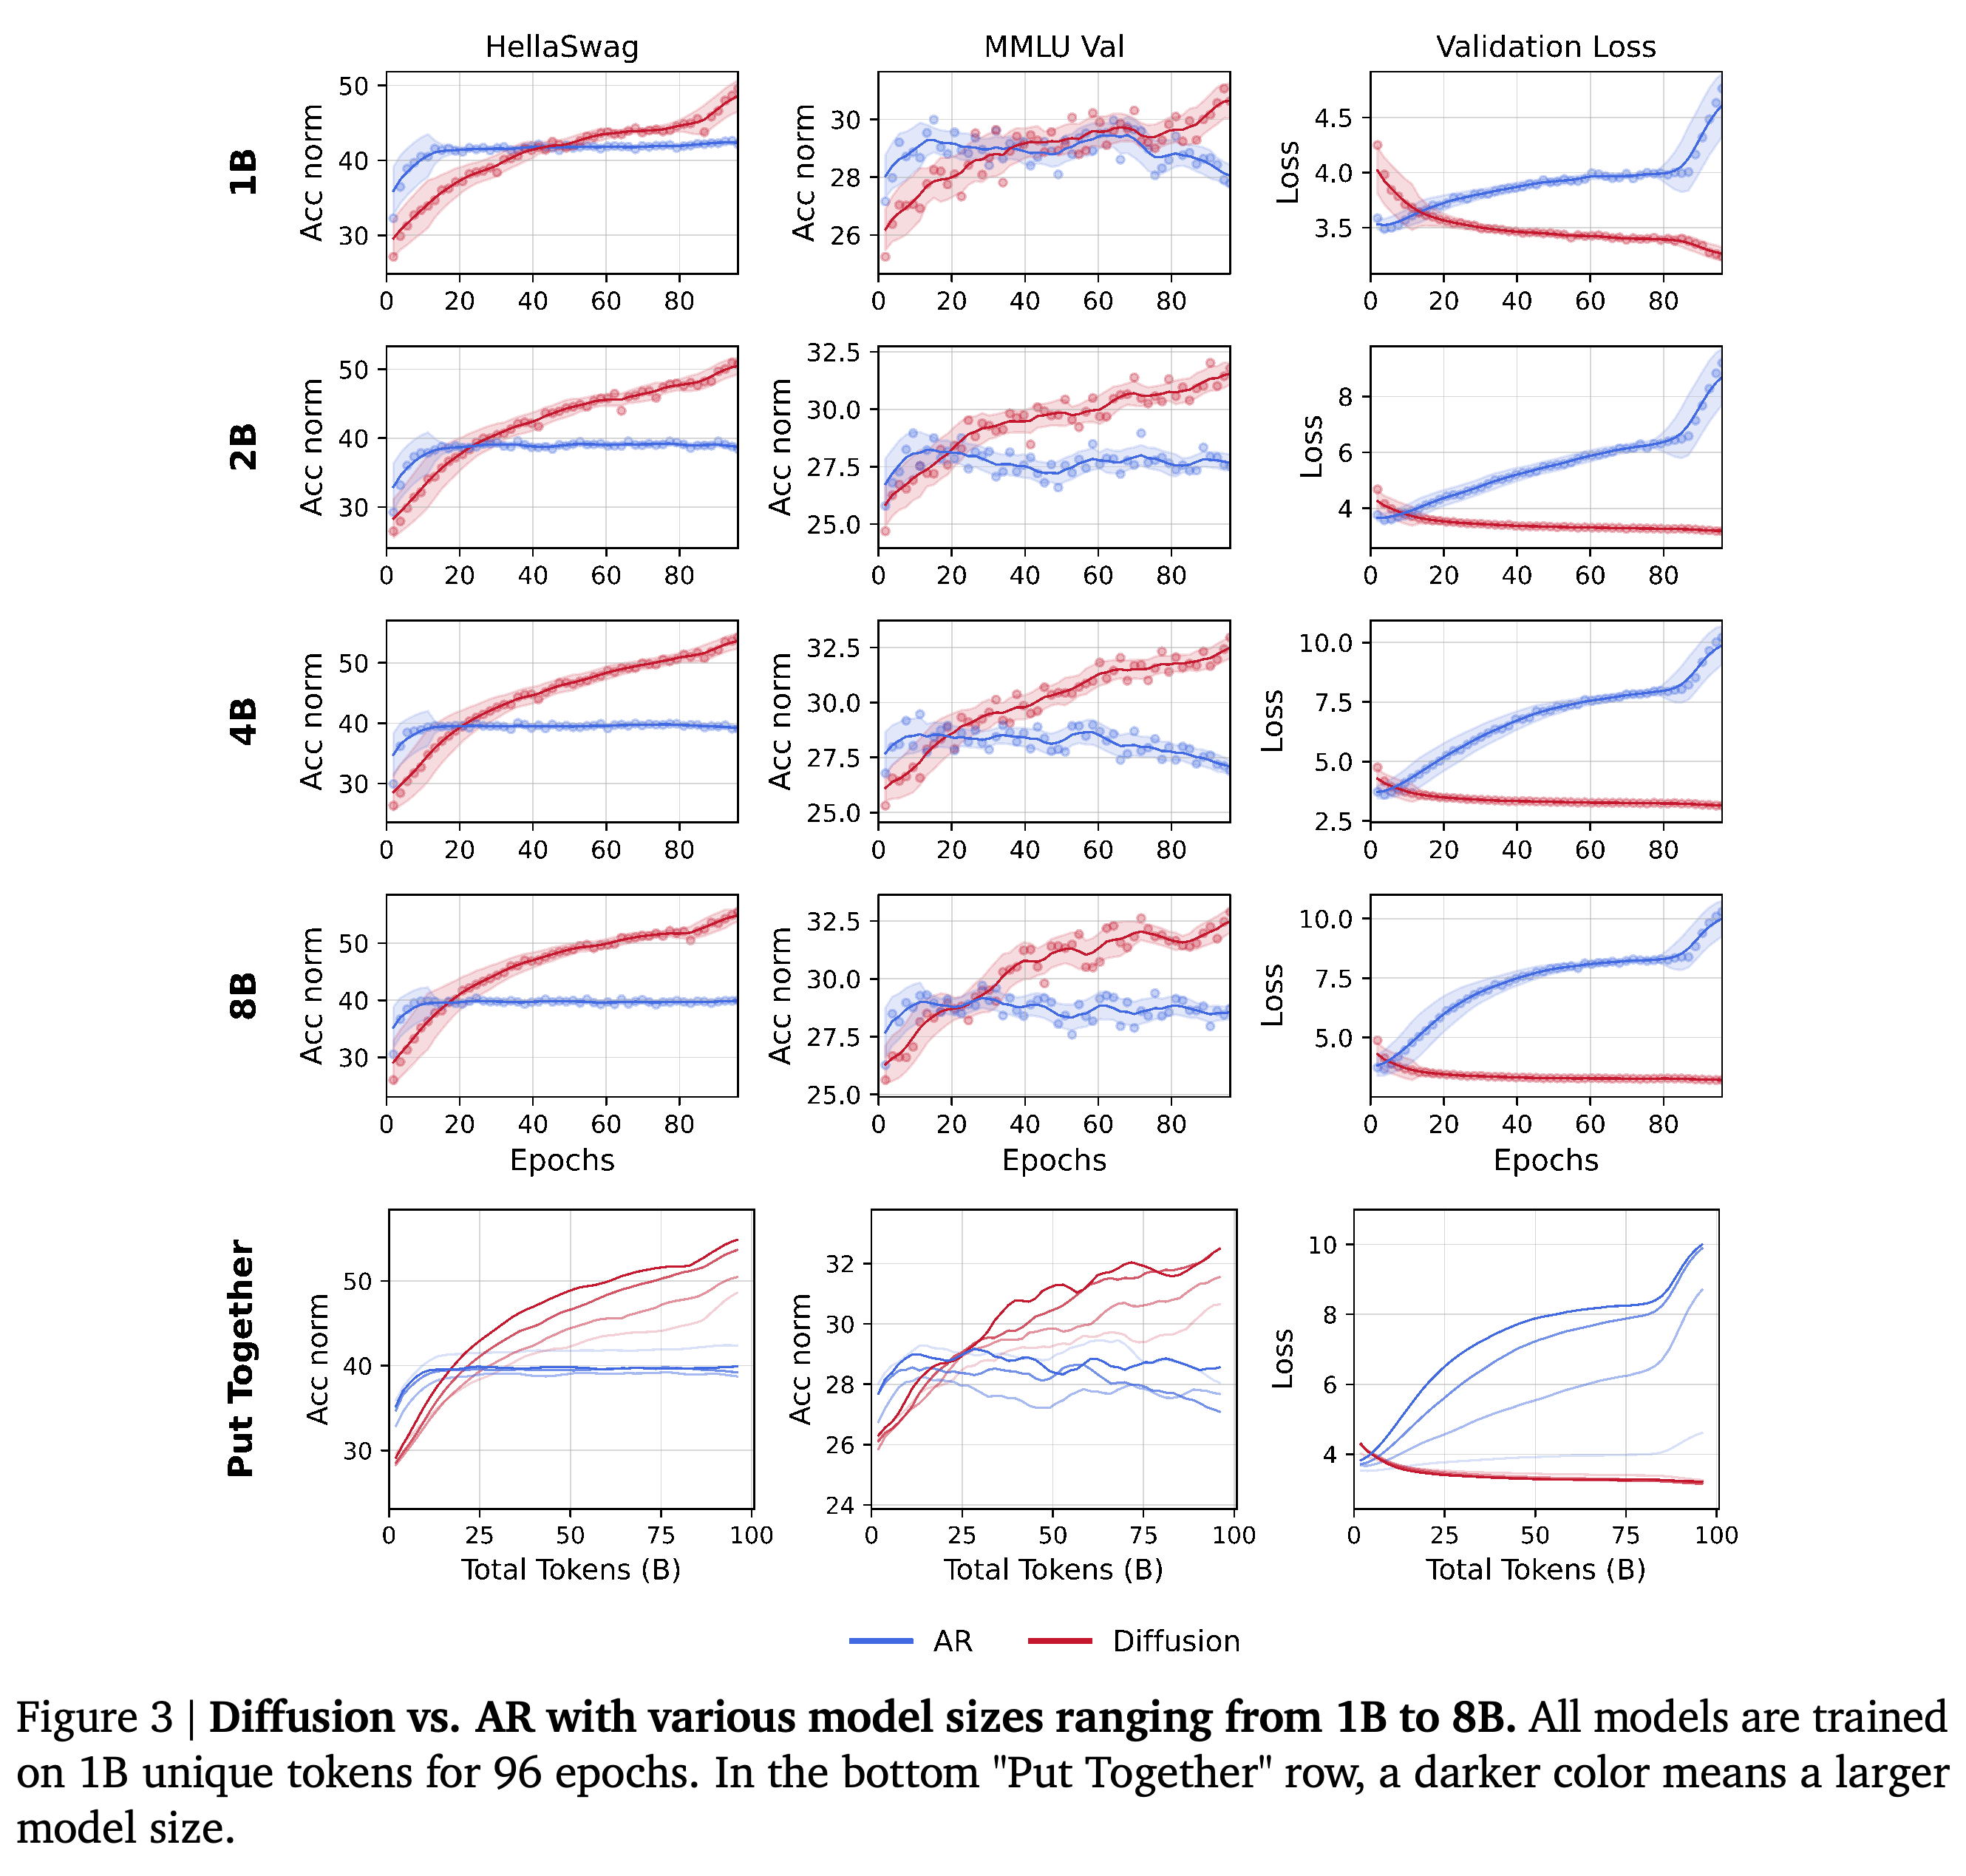
다른 설정을 고정하고 1B, 2B, 4B, 8B 파라미터 모델을 1B 고유 토큰으로 96 epochs 학습한다. Figure 3에서는 diffusion 모델이 클수록 더 빠르게 학습하고 최종 benchmark 성능도 높다. 반면 큰 AR 모델은 일찍 정체되며 검증 손실도 높다. 이 조건에서는 1B diffusion 모델도 최종적으로 실험한 모든 크기의 AR 모델을 앞선다.
- 저자들은 diffusion이 활용할 수 있는 조건부 예측 문제의 집합이 더 크다는 점으로 이 차이를 설명한다. 길이가 L인 시퀀스에는 \(2^L\)개의 이진 마스킹 구성이 가능하지만 causal prefix는 L개다. 다만 이 구성들이 모두 서로 다른 학습 신호를 제공하지는 않는다고 인정하므로, 이 개수는 독립적인 정보량을 측정하지 않는다.
Diffusion 모델의 크기를 늘리면 최종 benchmark 성능이 개선되고 성능 역전이 빨라진다. 같은 소규모 데이터 조건에서 AR 크기를 늘리면 downstream 이득이 작고, 학습 후반의 검증 손실은 크게 높아진다.
3.5. Sparse, Dense, Super-Density
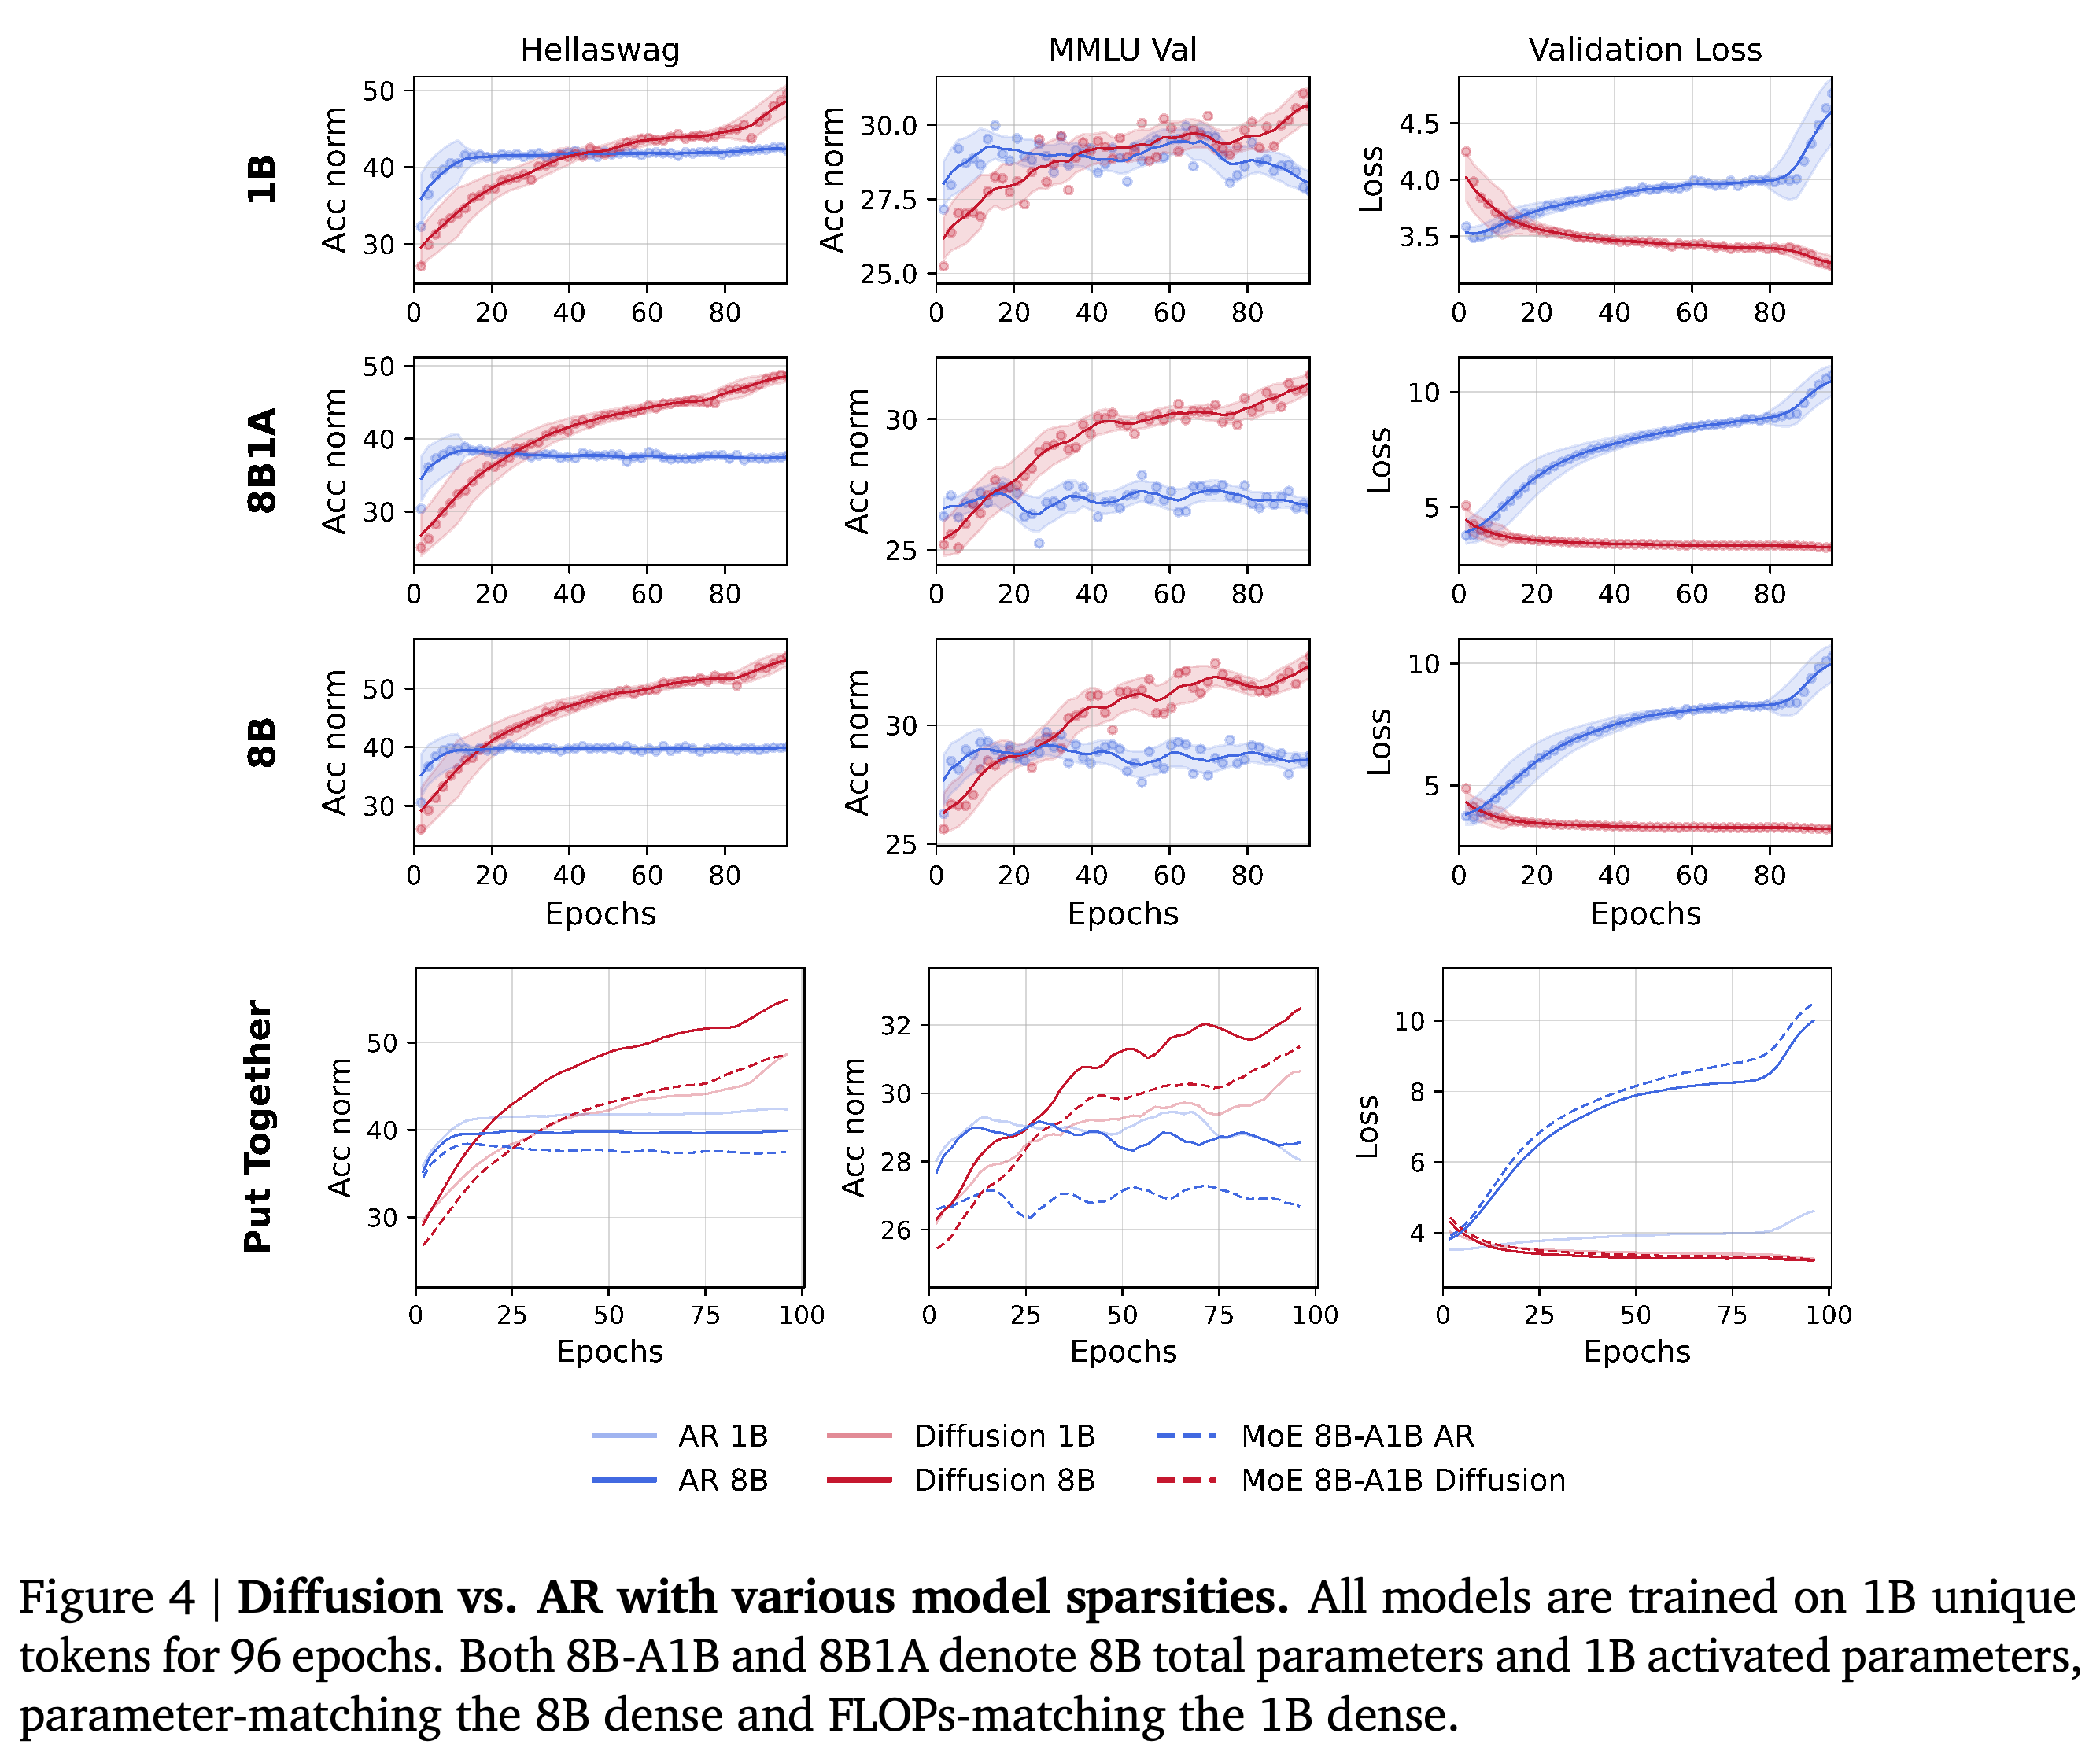
희소성 실험은 전체 파라미터를 활성화하는 1B dense 모델, 8B dense 모델, 총 8B와 활성 1B 파라미터를 가진 mixture-of-experts 모델을 비교한다. 마지막 모델은 8B1A 또는 8B-A1B로 표기한다. 모두 1B 고유 토큰으로 96 epochs 학습한다. Sparse 모델의 활성 파라미터 수는 1B dense 모델과 같고, 총 파라미터 수는 8B dense 모델과 같다. Figure 4에서는 실험한 모든 구성에서 diffusion이 AR을 앞선다. 성능 역전은 8B dense, 8B1A mixture-of-experts, 1B dense 순서로 발생한다.
- 이 조건에서 AR의 총 파라미터를 1B에서 8B로 늘리면 최종 성능이 낮아지며, sparse 확장의 성능이 가장 낮다. 총 파라미터를 8B로 고정하면 두 모델 계열 모두 dense 모델이 sparse 모델보다 높은 성능을 보인다.
- Diffusion의 sparse 모델은 대체로 1B와 8B dense 모델 사이의 성능을 보이며 특히 MMLU에서 이러한 경향이 나타난다. 이 관찰은 데이터가 제한될 때 활성 연산량이 성능에 영향을 준다는 해석을 뒷받침한다. 다만 희소성을 바꾸면 routing과 모델 구조도 바뀐다.
Diffusion은 dense와 sparse 구성 모두에서 AR을 앞선다. 8B-total, 1B-active diffusion 모델은 대체로 dense diffusion 모델들 사이의 성능을 보이지만 대응하는 sparse AR 모델의 성능은 낮다. 이 실험에서는 총 파라미터 수를 고정할 때 dense 연산이 더 높은 성능을 낸다.
3.6. Is Noise Deciding the Game?
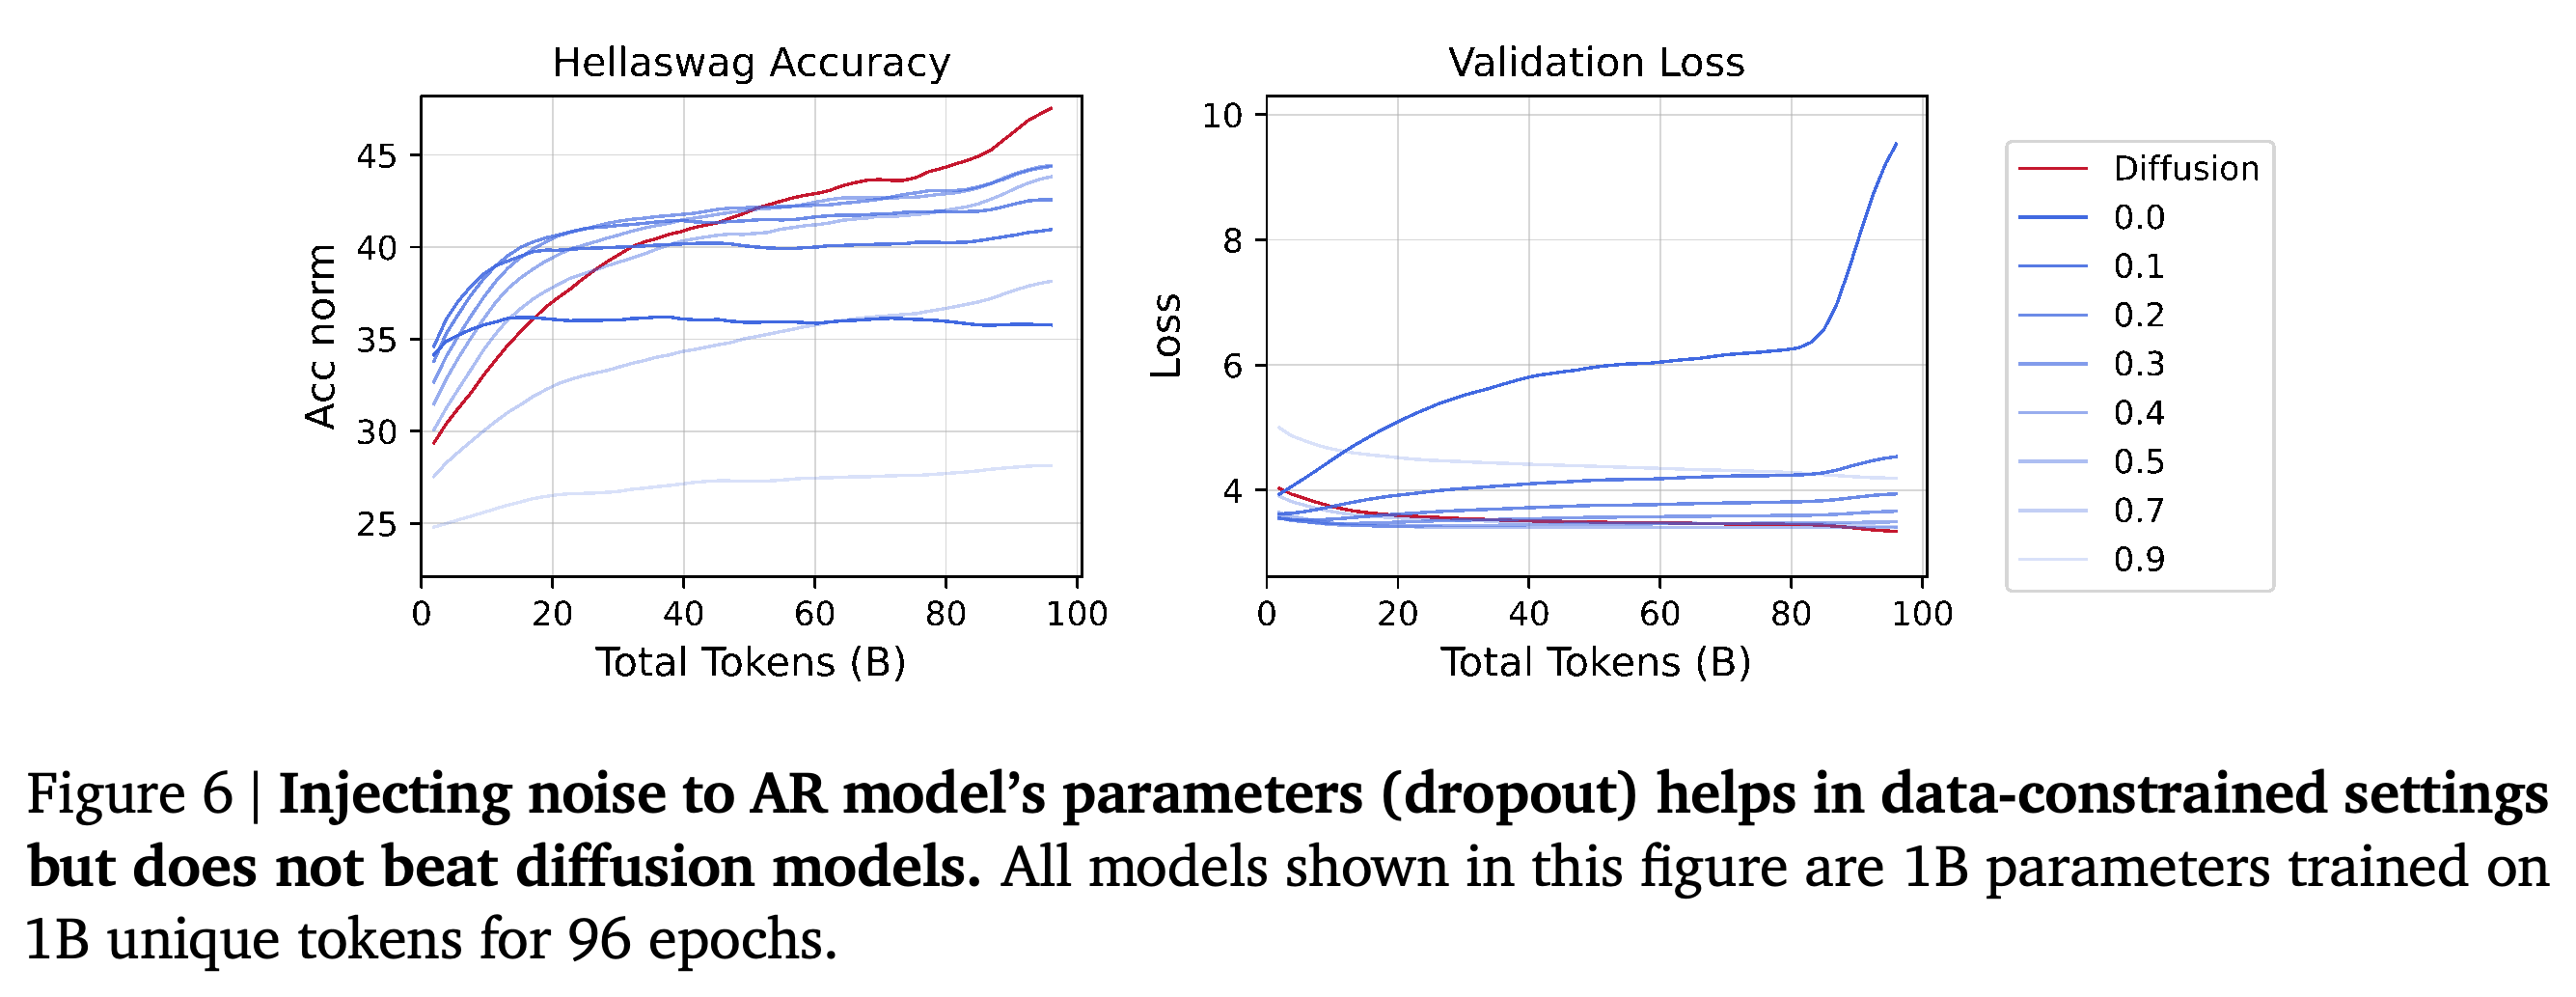
잡음 ablation은 1B-parameter 모델을 1B 고유 토큰으로 96 epochs 학습하여 augmentation만으로 diffusion의 우위를 설명할 수 있는지 검증한다. 10%에서 90%까지 무작위 입력 마스킹을 적용하면 손상이 적은 수준에서는 AR 성능이 개선되며, 실험한 설정 중 10%가 가장 좋다. 그러나 손상이 심하면 성능이 낮아진다. Dropout도 AR 성능을 높이지만 Figures 5와 6에서는 어느 방법도 diffusion의 최종 HellaSwag 성능에 도달하지 못한다.
- 이 결과는 데이터가 부족할 때 잡음이 과적합을 줄이는 학습 기법인 정규화로 유용함을 보여 준다. 그러나 any-order modeling과 추가 연산의 기여를 각각 정량화하지는 않는다. 논문도 이 요인들을 통제하여 ablation하기 어렵다고 인정한다.
여러 dropout 설정이 AR 정확도를 높이고 검증 손실 증가를 억제하지만 어느 설정도 diffusion의 최종 HellaSwag 결과에 도달하지 못한다. 따라서 손실 양상이 개선되어도 downstream 성능 격차는 사라지지 않는다.
4. Scaling Crossovers to Trillion-Level Total Tokens
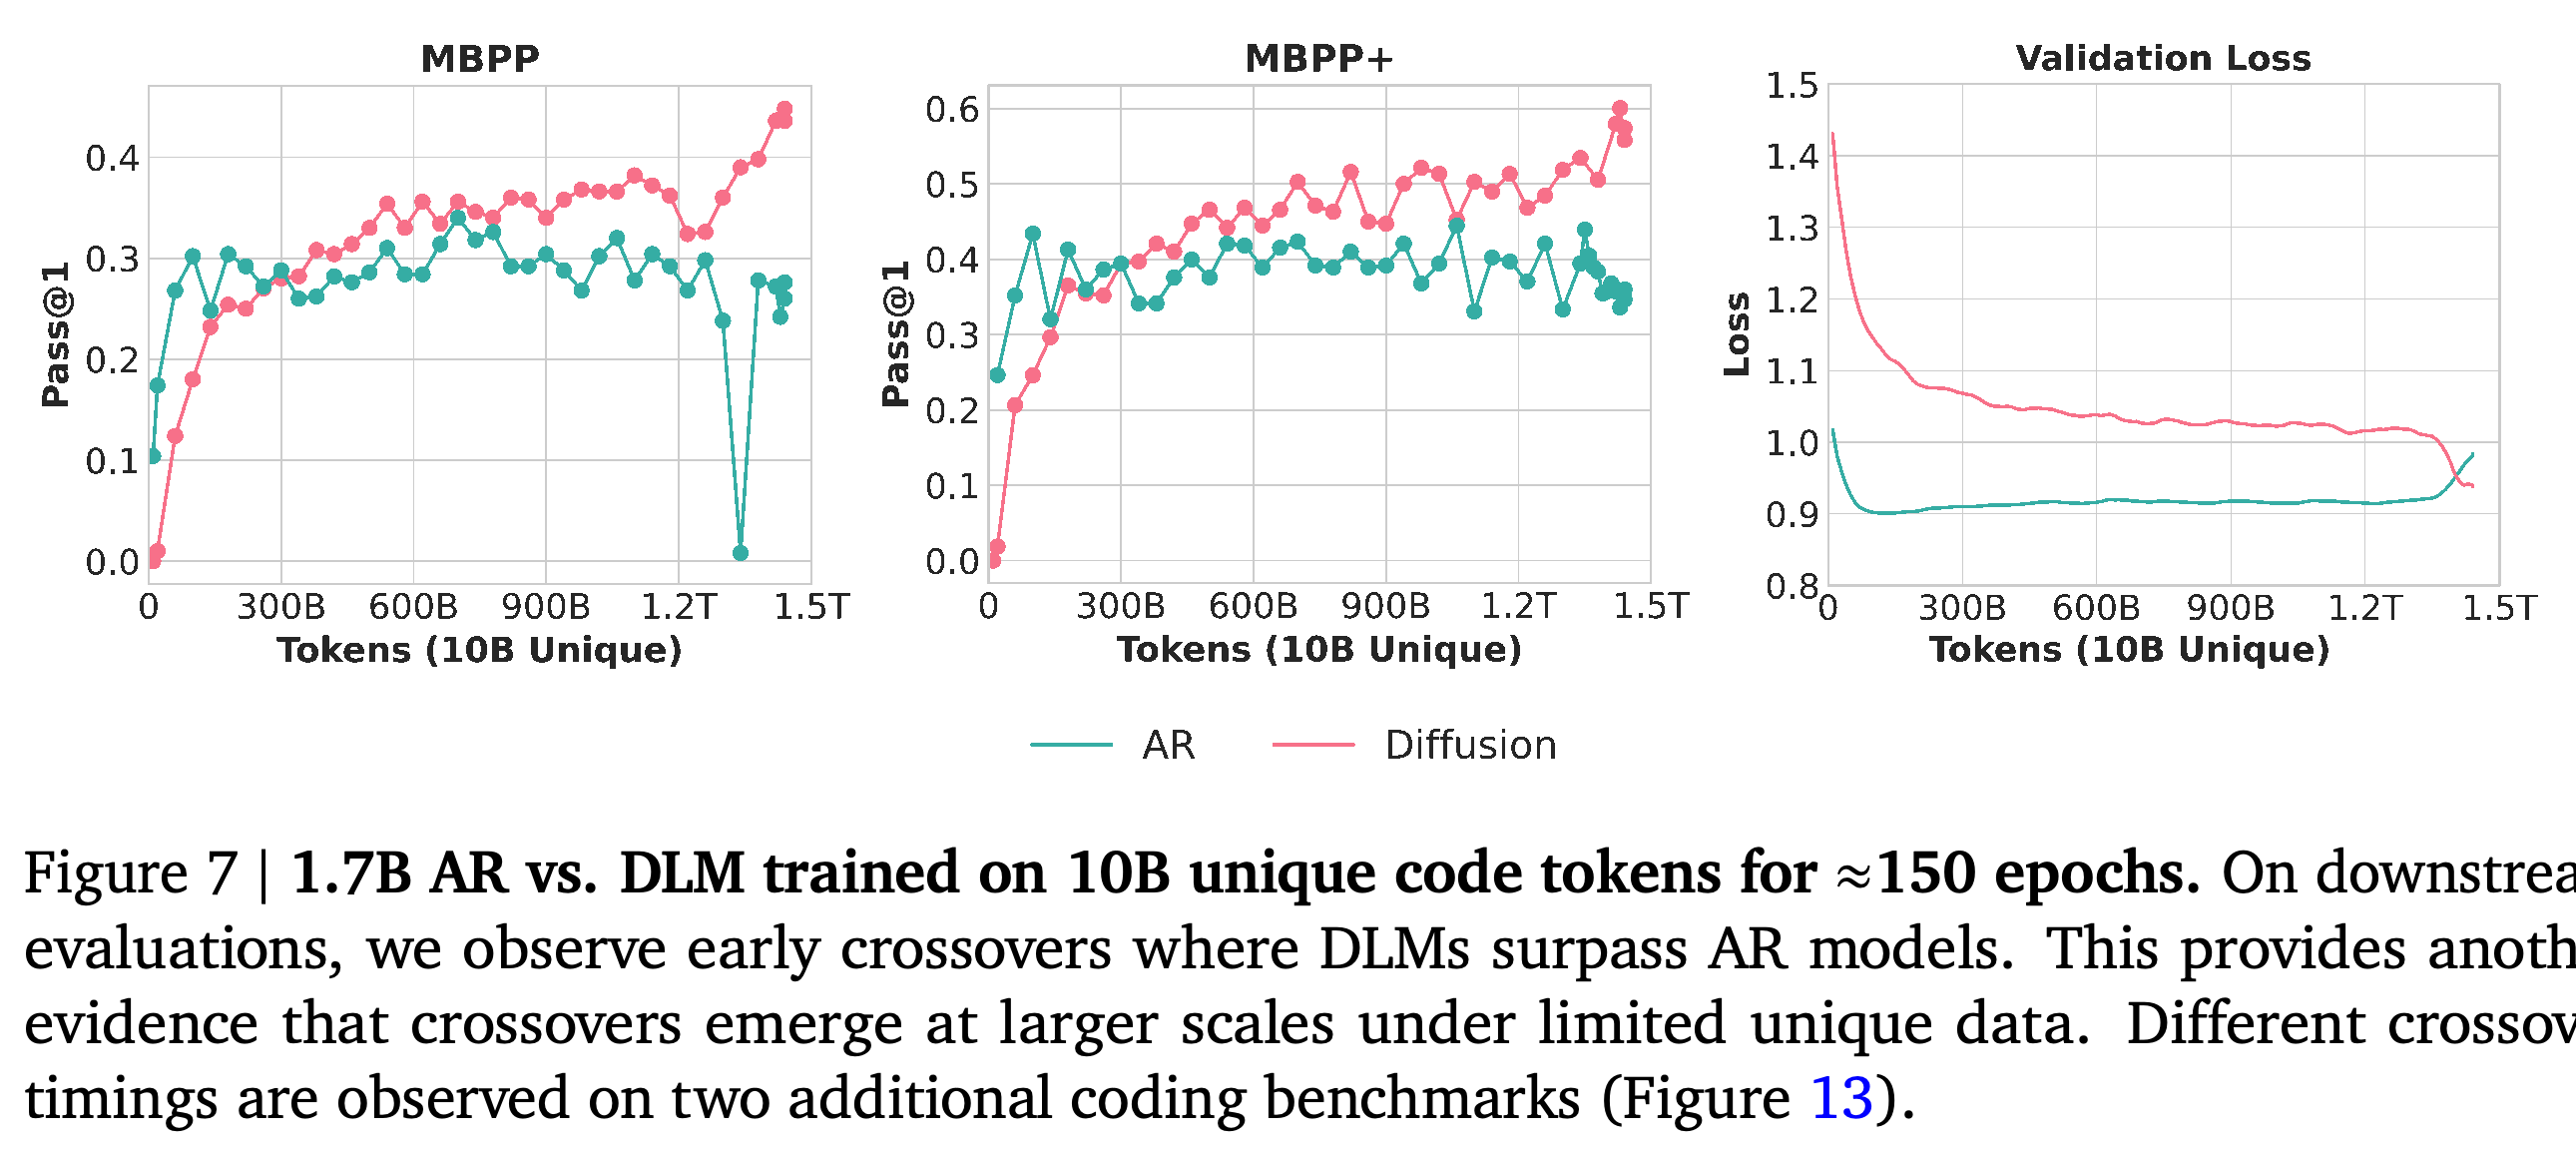
규모를 확대한 코드 실험에서는 함께 비교하는 1.7B-parameter 모델을 약 150 epochs 학습한다. 말뭉치는 9B 고유 Python tokens와 마지막 학습률 감소 구간에 사용하는 1B annealing tokens로 구성되며, 총 학습 예산은 약 1.5T tokens다. 설정은 sequence length 4096, global batch size 1024, 파라미터 정규화 계수인 weight decay 0.1, GPT-NeoX tokenizer를 포함한다. WSD 스케줄은 2000 warmup steps와 100B tokens에 걸친 학습률 감소를 사용한다. Figure 7은 1회의 생성 시도로 해결한 문제의 비율인 Pass@1로 평가한 MBPP와 MBPP+에서 diffusion의 성능 역전이 일찍 나타남을 보여 준다.
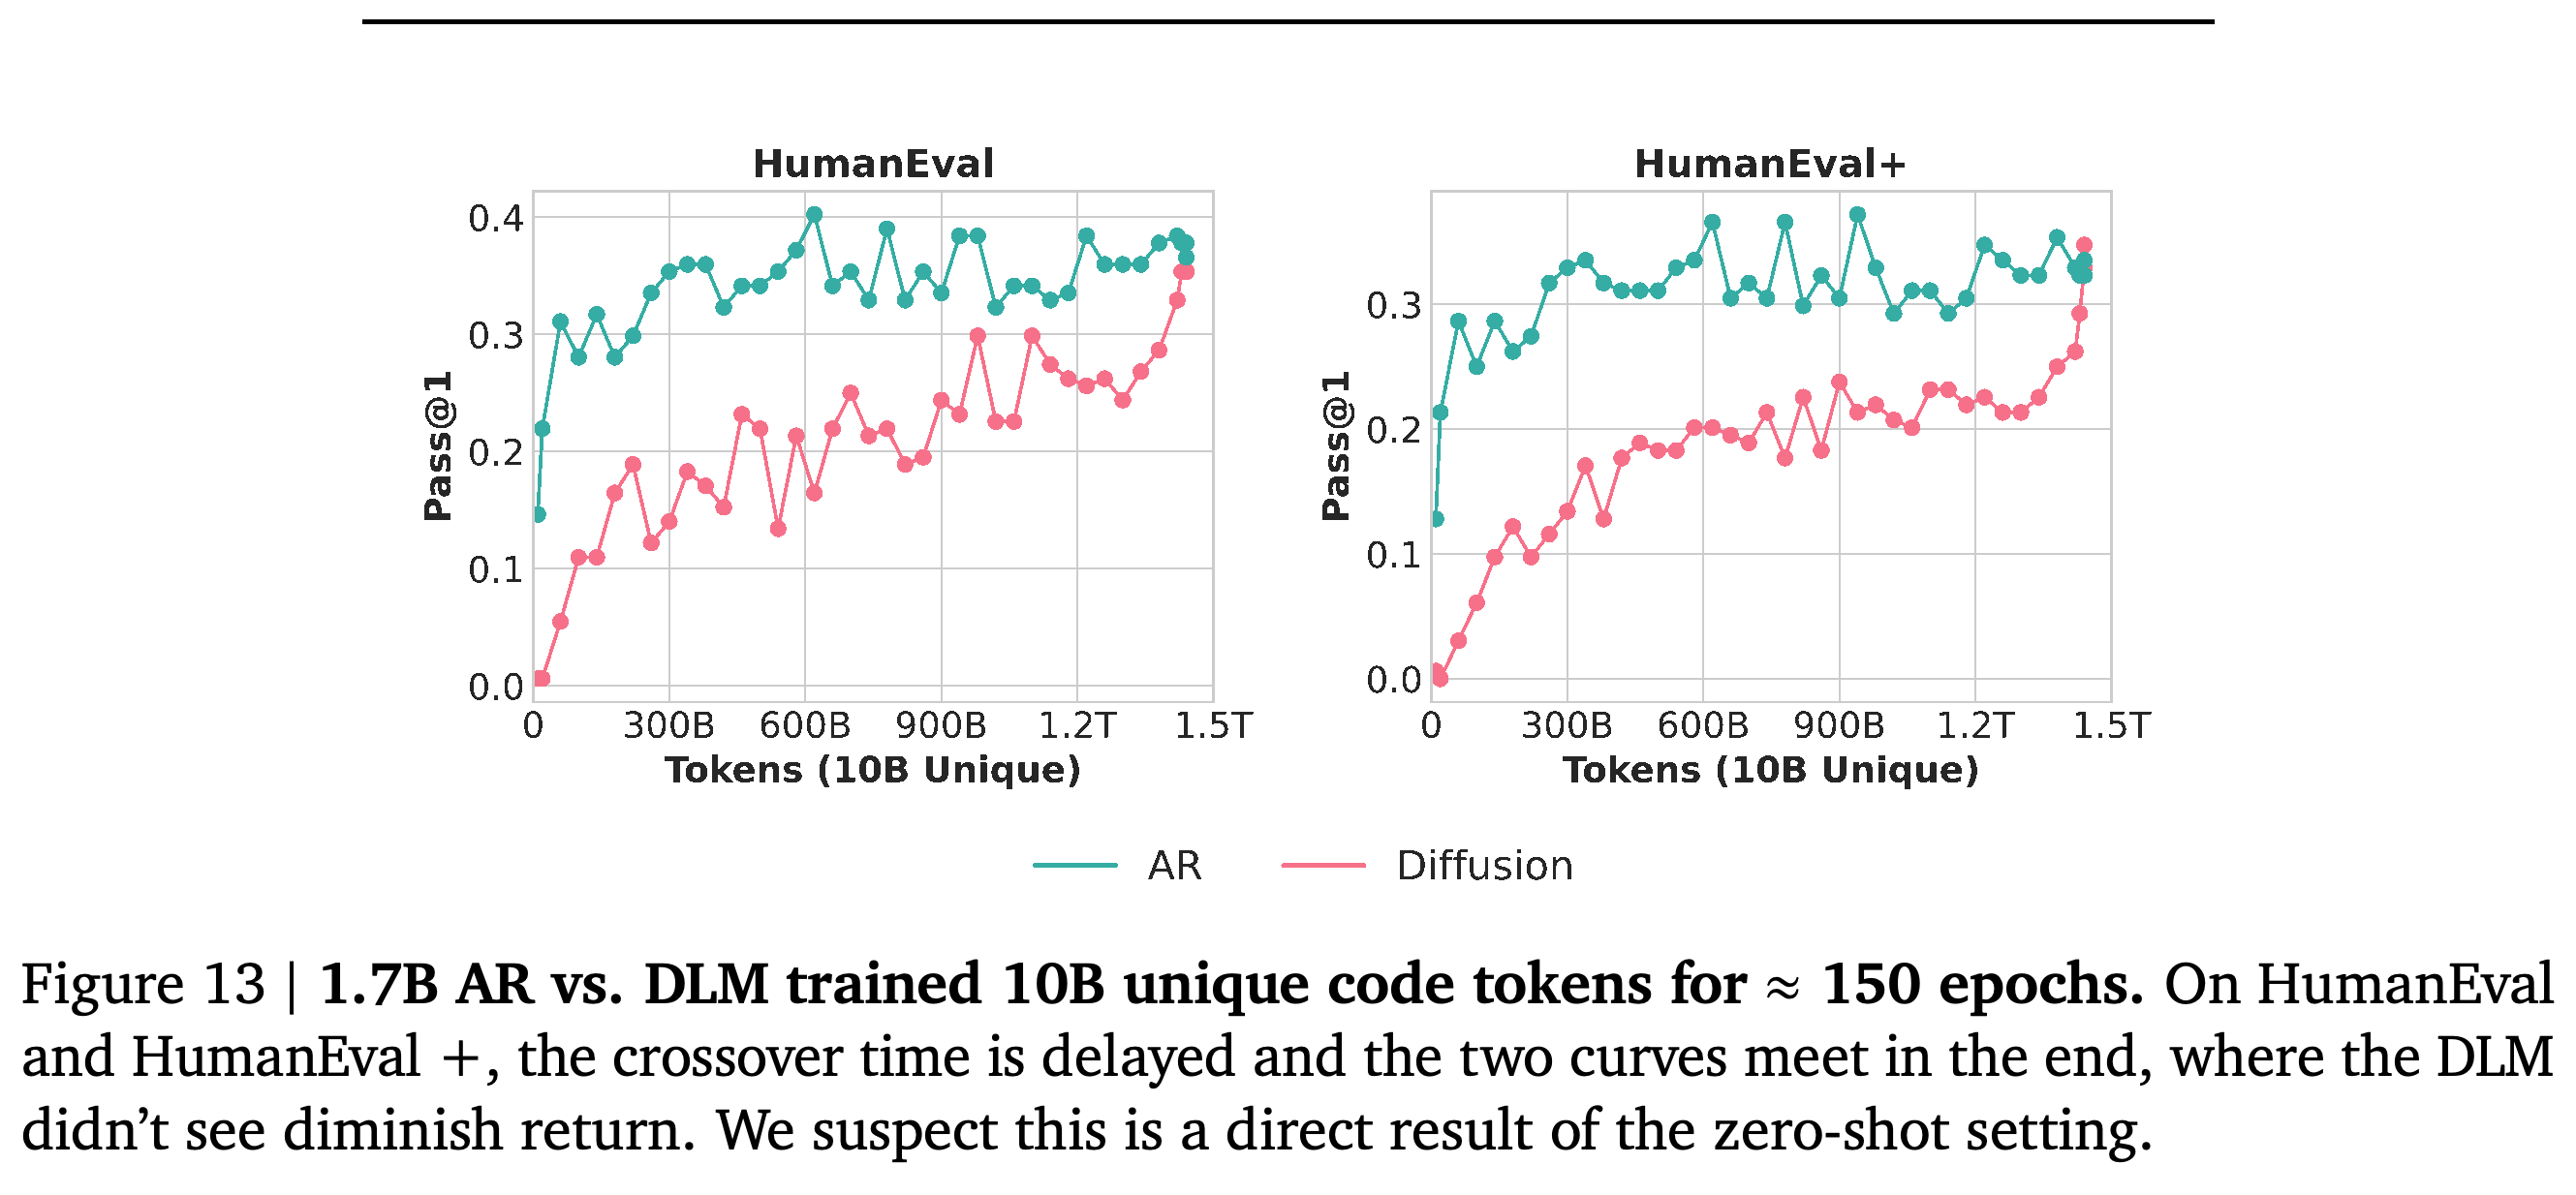
- Figure 13의 HumanEval과 HumanEval+에서는 annealing이 끝날 무렵에야 비슷한 성능에 도달한다. MBPP 변형은 prompt 예시 세 개를 사용하고 HumanEval 변형은 예시를 사용하지 않는다. 저자들은 이 차이가 성능 역전 시점에 영향을 준다는 가설을 제시하지만 실험에서 이를 따로 분리하지는 않는다.
- 마지막 checkpoint에서도 diffusion은 뚜렷하게 수렴하지 않는다. 이 연구는 더 큰 토큰 예산과 생성 과제에서도 성능 역전이 나타남을 보여 준다. 다만 benchmark별 성능 변화가 다르므로 일률적인 역전 시점을 정할 수는 없다.
Diffusion은 약 1.5T-token 학습 종료 시점보다 훨씬 앞서 MBPP와 MBPP+에서 AR을 추월하고 마지막까지 더 높은 성능을 유지한다. AR은 학습 대부분에서 더 낮은 검증 손실을 유지한다. 이는 생성 benchmark 순위와 손실 순위가 달라질 수 있음을 보여 준다.
Diffusion은 HumanEval과 HumanEval+ 학습 대부분에서 AR보다 낮은 성능을 보이며 마지막 annealing 구간에 가까워져서야 비슷한 성능에 도달한다. 이 늦은 성능 변화는 MBPP 변형의 초기 성능 역전이 모든 benchmark에 적용되지 않음을 보여 준다. Prompt 조건을 독립적으로 바꾸지 않았으므로 0-shot에 근거한 설명은 가설로 남는다.
5. High Validation Loss ≠ Degraded Intelligence
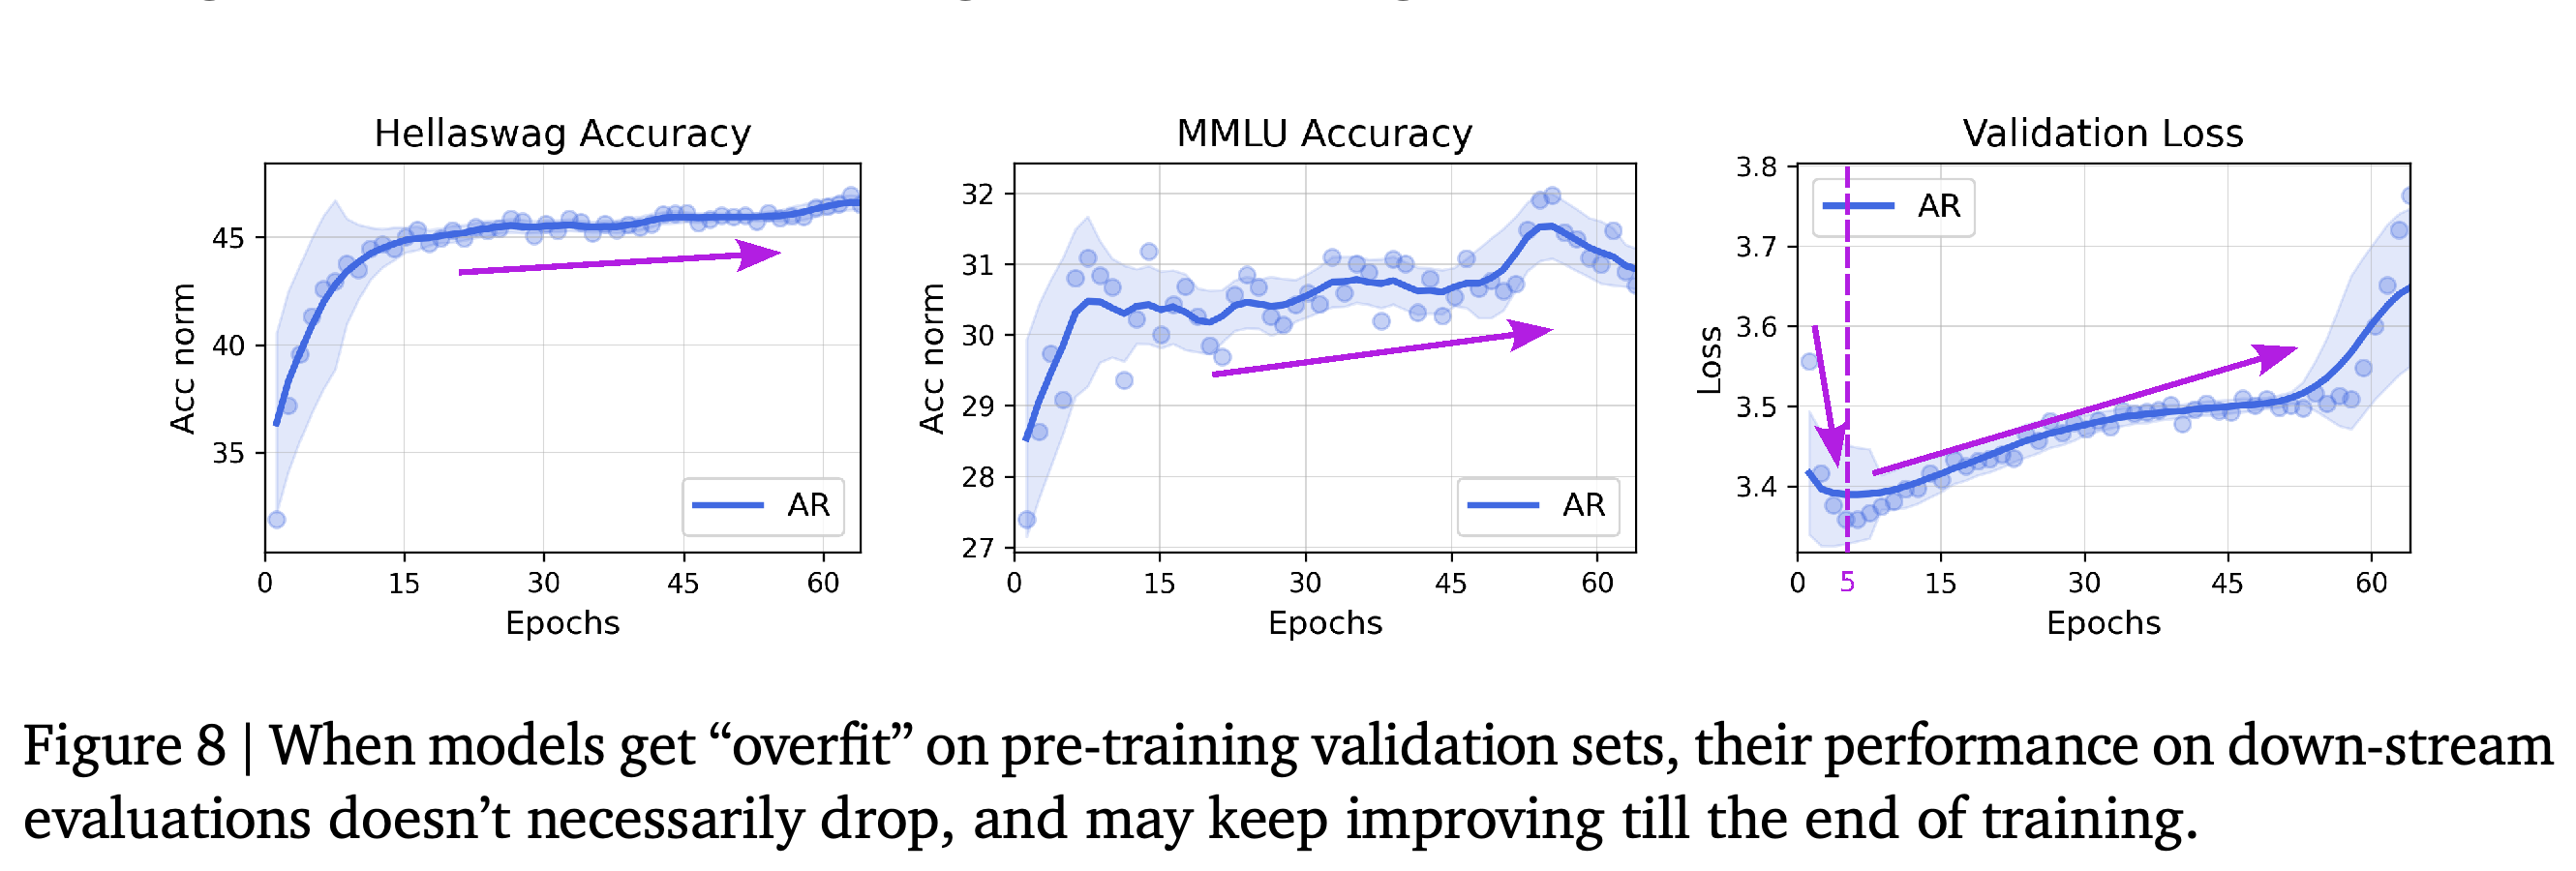
관찰된 토큰에 부여한 확률을 바탕으로 계산하는 검증 교차 엔트로피가 높아져도 객관식 정확도가 반드시 낮아지는 것은 아니다. 절대적인 음의 로그 우도(NLL)는 나빠지면서 답변 간 상대 점수는 개선될 수 있다. Figures 8과 9에서는 AR의 검증 손실이 증가해도 정답 NLL이 다른 선택지의 NLL보다 낮게 유지되고 그 차이도 대체로 커진다. 상세 분석에서는 1B-parameter AR 모델을 1.5B 고유 토큰으로 64 epochs 학습하며 Nemotron-CC 학습과 c4 검증, c4 학습과 c4 검증을 모두 포함한다.
- 3,600 training steps 이후 처음 보고된 검증 checkpoint에서도 이미 정답 선택지에 유리한 점수가 나타난다. 이후 정답과 오답의 NLL이 모두 높아져도 상대적인 순위는 유지되거나 개선될 수 있다.
- 저자들은 일부 텍스트 구간에 지나치게 높은 확신을 보이는 현상을 설명으로 제안하며 이 논리를 생성 과제로 확장하는 가설도 제시한다. 관찰 결과는 손실과 함께 downstream 성능을 평가해야 한다는 점을 뒷받침한다.
검증 손실이 epoch 5 부근에서 최솟값에 도달한 뒤 증가해도 HellaSwag 정확도는 계속 개선되며, MMLU 정확도도 이에 대응하여 단조롭게 감소하지 않는다. 따라서 검증 손실에 나타나는 과적합 시작 시점은 downstream 능력에 보편적으로 적용할 학습 중단 시점을 알려 주지 않는다.
6. Diffusion Language Models also Overfit the Data
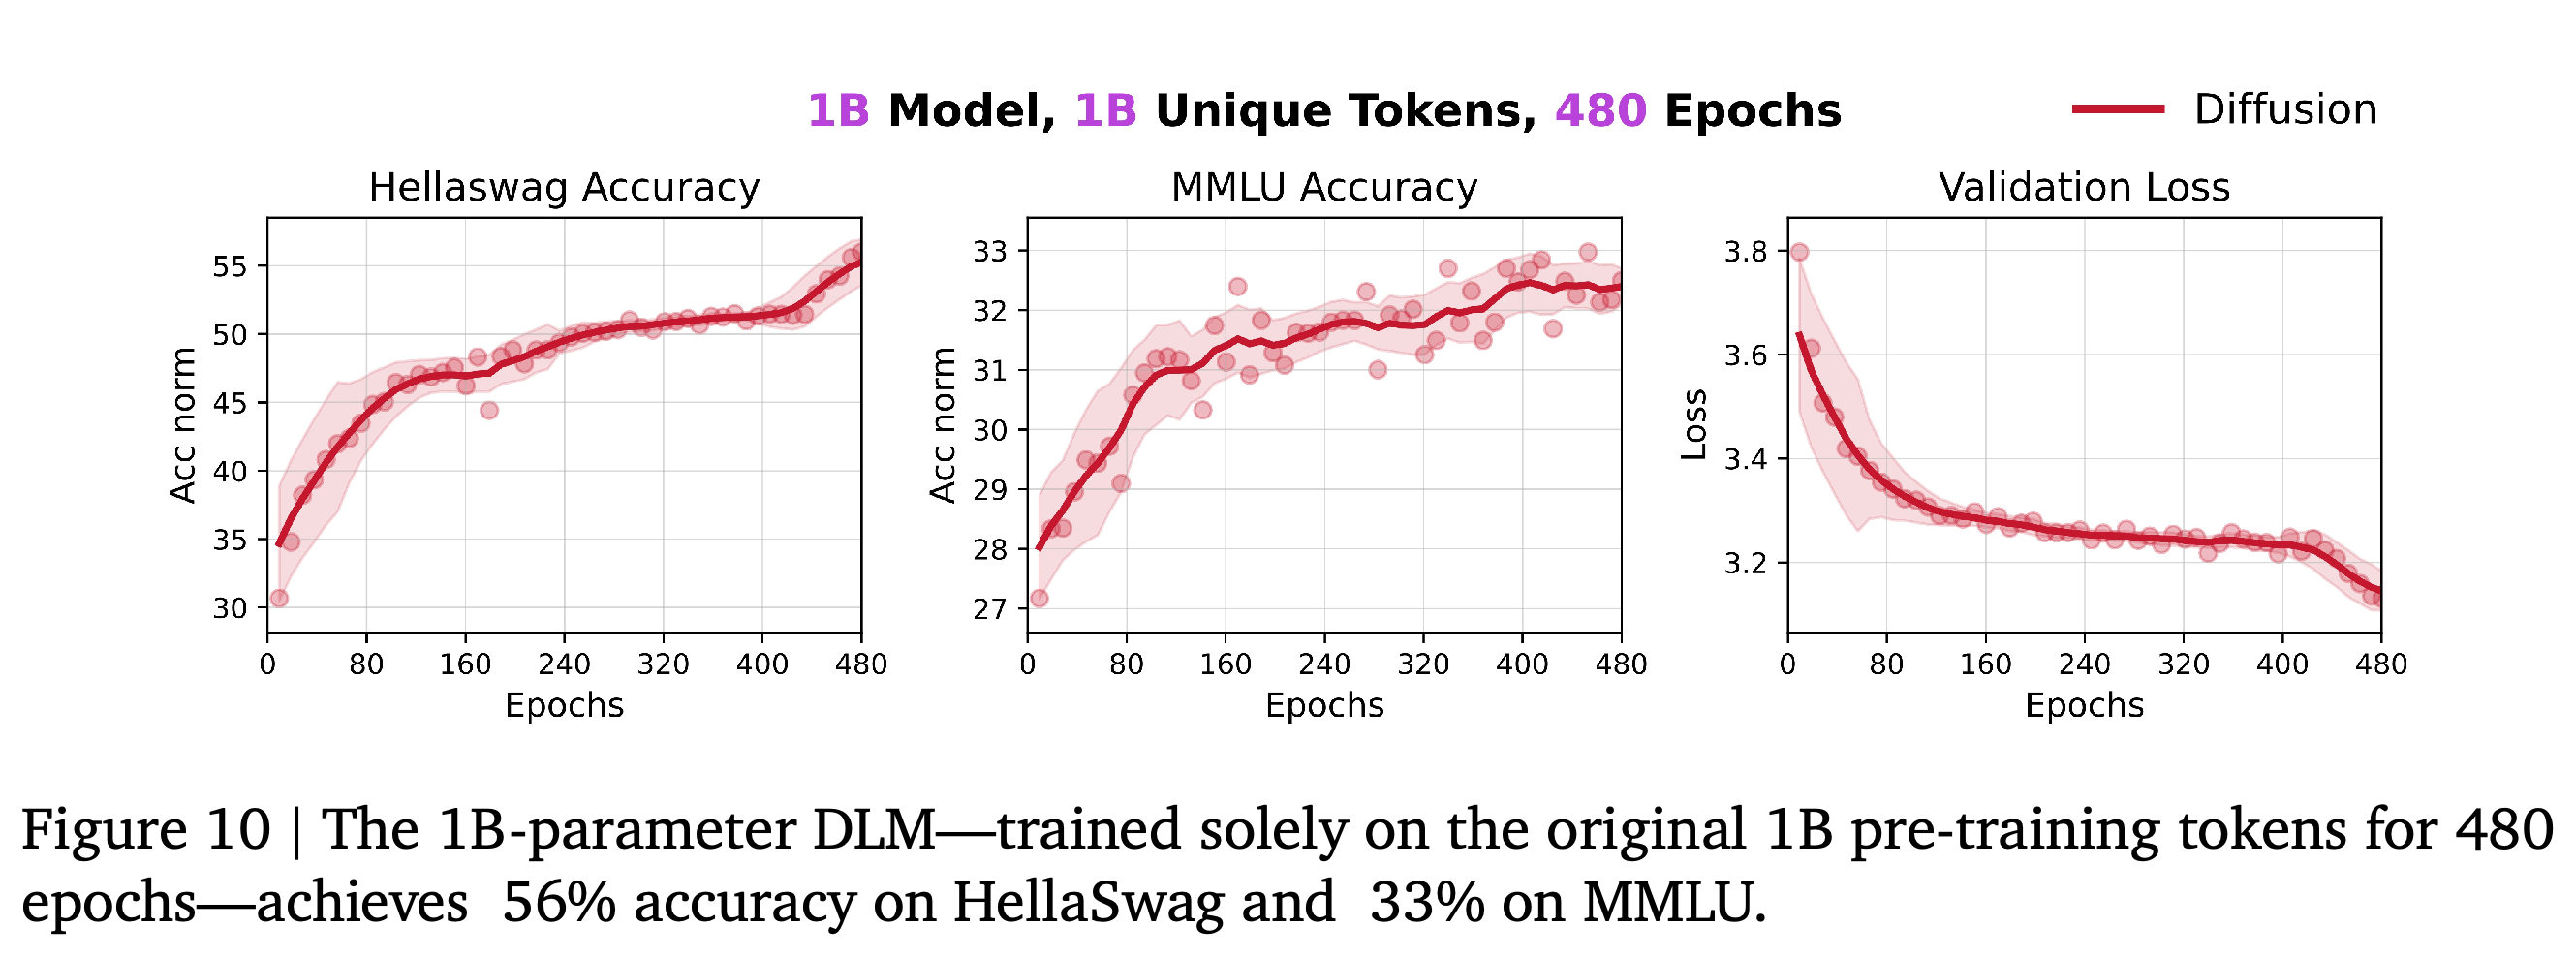
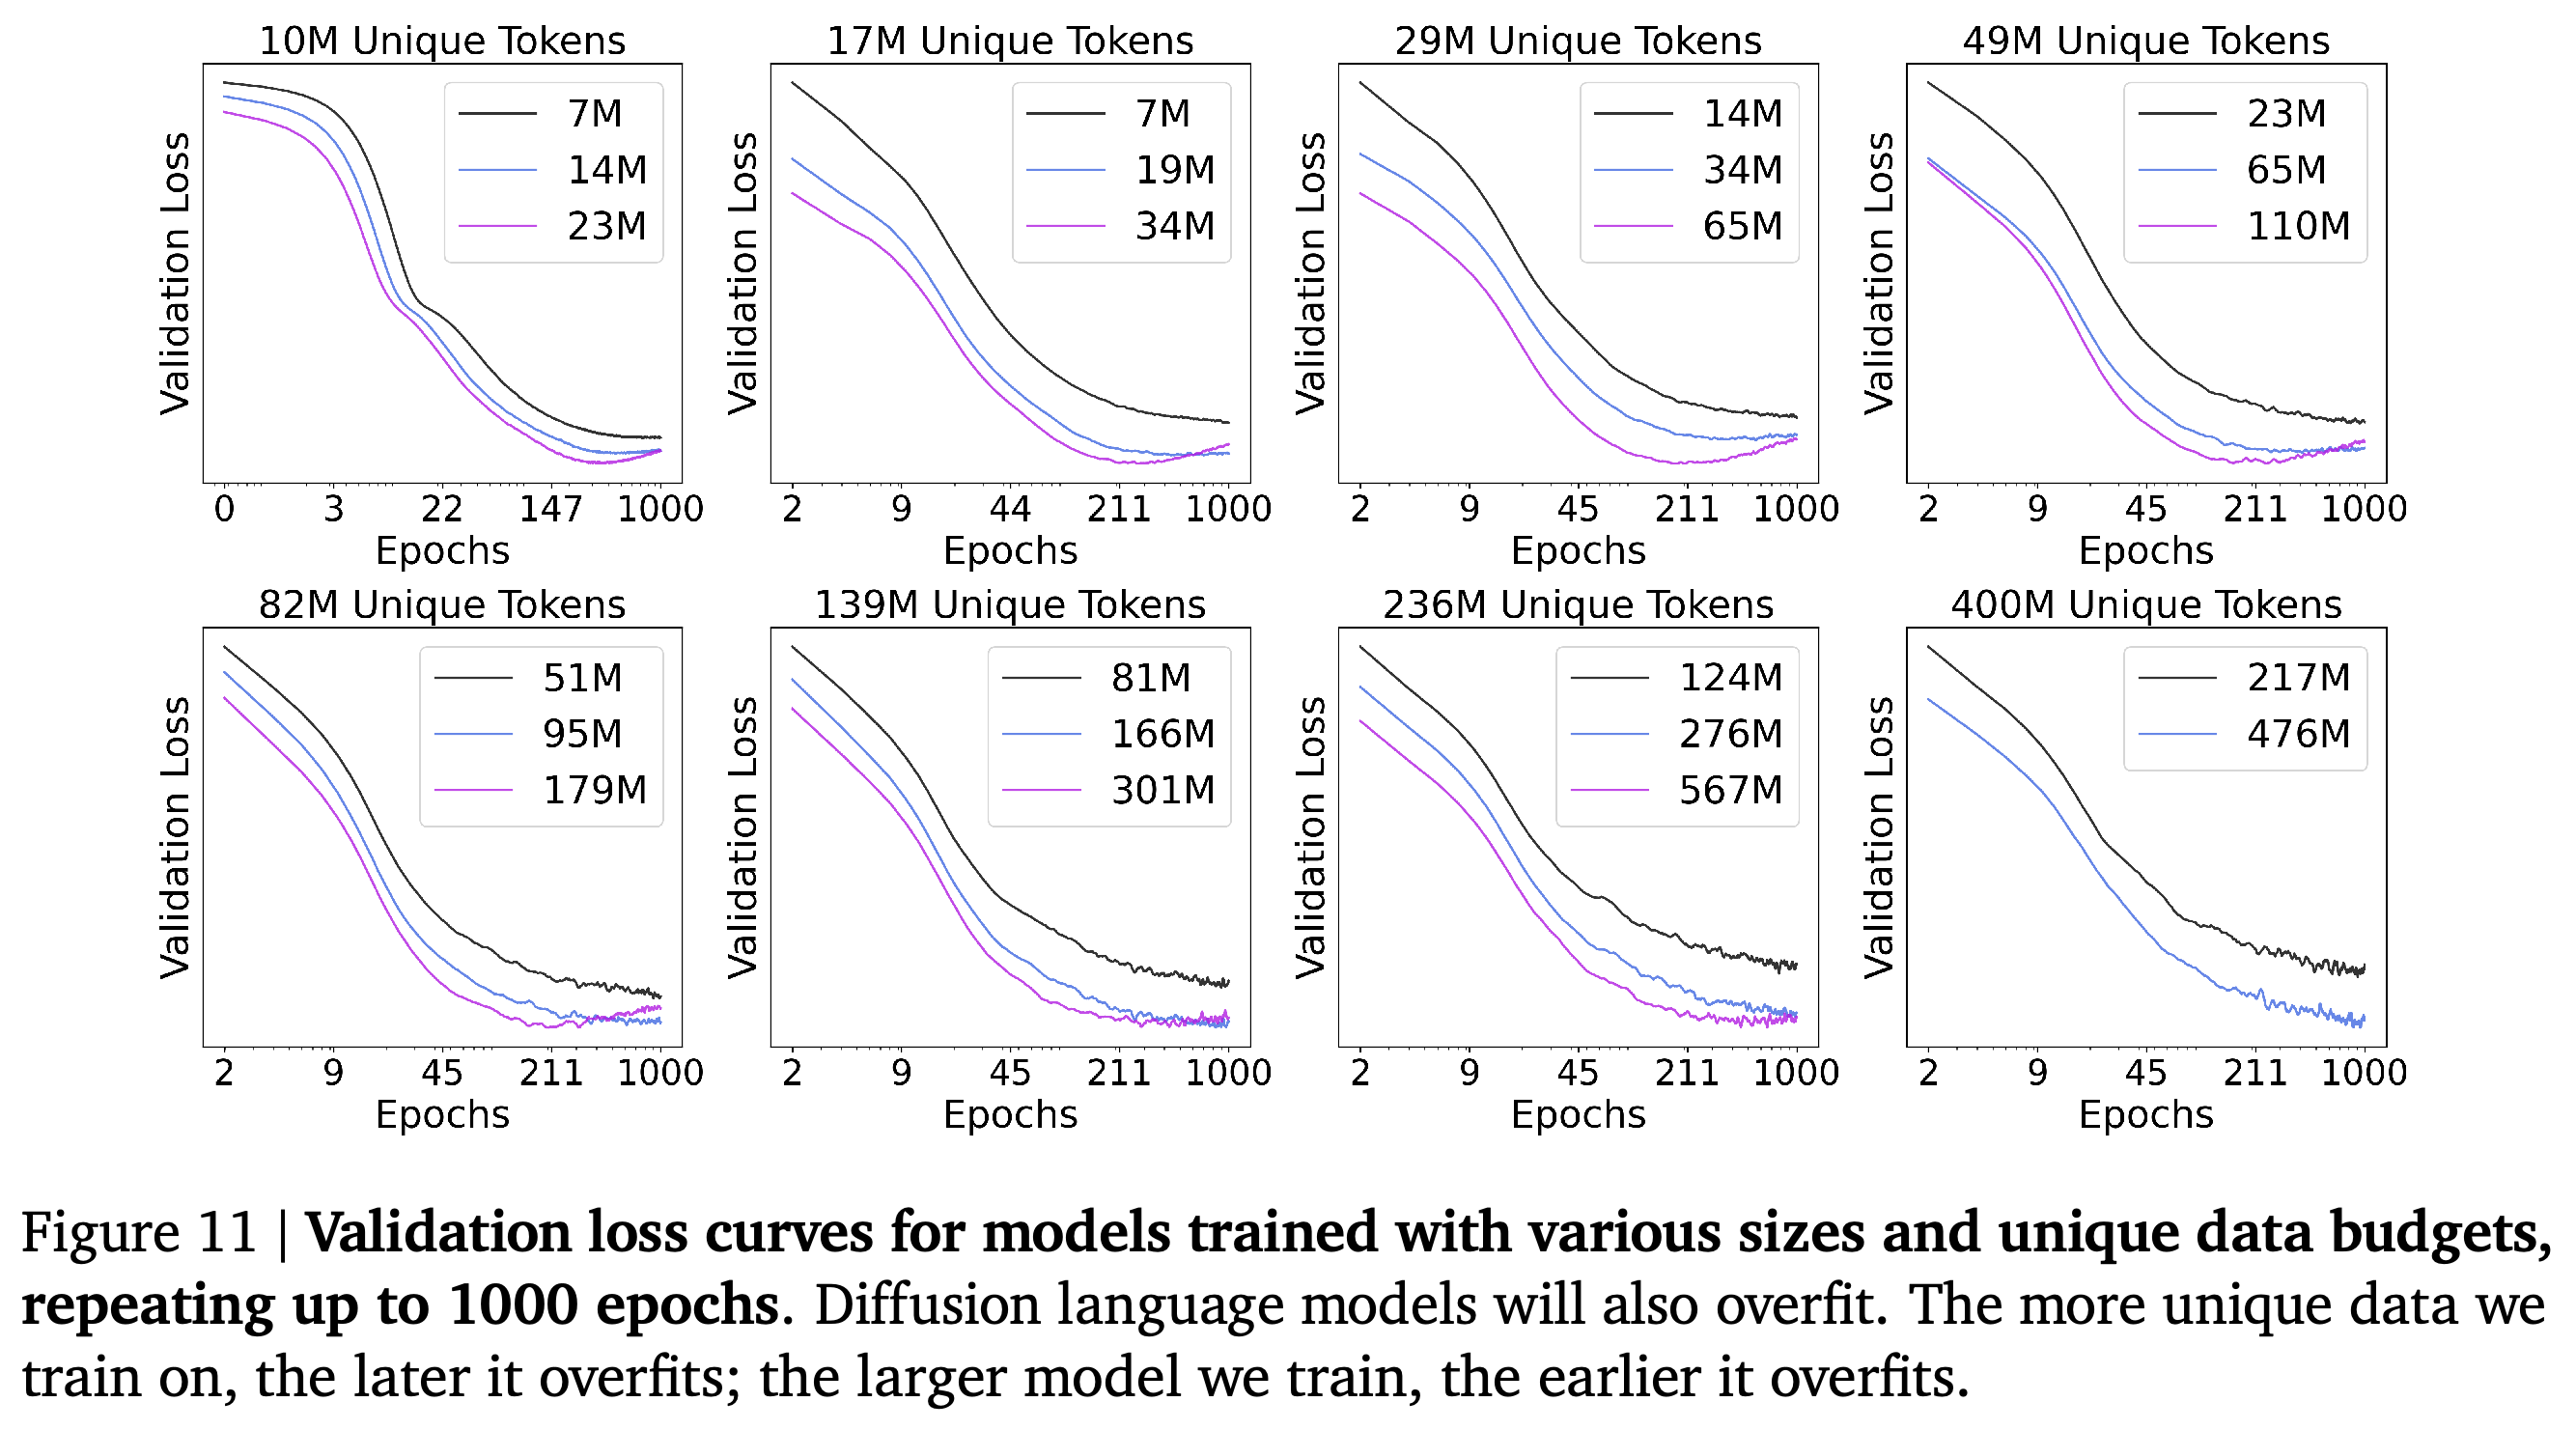
1B-parameter DLM을 같은 1B-token 데이터셋으로 480 epochs까지 학습하면 총 480B training tokens를 사용하며 Figure 10에 보고된 HellaSwag 정확도 56%와 MMLU 정확도 33%에 도달한다. 이 절은 이를 보고된 AR 결과 41%와 29%에 비교하지만 대응하는 480 epochs AR 실험을 제시하지는 않는다. 별도의 c4-en 실험을 1000 epochs까지 연장하면 고유 데이터셋이 충분히 작고 모델이 충분히 클 때 diffusion의 검증 손실도 결국 높아진다.
- Figure 11은 10M에서 400M tokens까지의 고유 데이터 예산을 다루며, 각 예산에서 여러 모델 크기를 비교한다. 고유 데이터가 많으면 검증 손실에 나타나는 과적합이 늦어지고, 모델이 크면 더 일찍 시작된다.
- 장기 학습 실험은 diffusion도 과적합된다는 점을 확인한다. 손실 증가만으로 downstream 성능이 언제 낮아지는지 판단할 수는 없다.
수백 회 반복하는 동안 benchmark 정확도가 개선되며, 마지막 학습 구간에서는 검증 손실이 더 낮아진다. 보고된 HellaSwag 56%와 MMLU 33% 결과는 실험한 480 epochs 안에서 같은 1B-token 데이터셋으로 추가 학습이 이루어졌음을 보여 준다.
가장 작은 데이터셋으로 학습한 일부 대형 모델에서는 오랜 반복 이후 검증 손실이 증가한다. 고유 데이터 예산이 커지면 이 현상이 늦어지므로 diffusion도 결국 과적합됨을 보여 준다. 다만 이 그림은 과적합 시작 시점의 downstream 정확도를 직접 측정하지 않는다.
7. Discussions
논의에서는 실험 결과를 고정된 데이터에서 더 많이 학습하는 것과 연산량을 최소화하는 것 사이의 상충 관계로 해석한다. Diffusion의 제안된 장점을 임의 문맥 예측, 반복 연산, 손상된 데이터의 표본 추출로 정리하고 AR의 효율적인 학습 및 서비스 방식과 비교한다.
7.1. What is the Real Advantage of Diffusion Language Models?
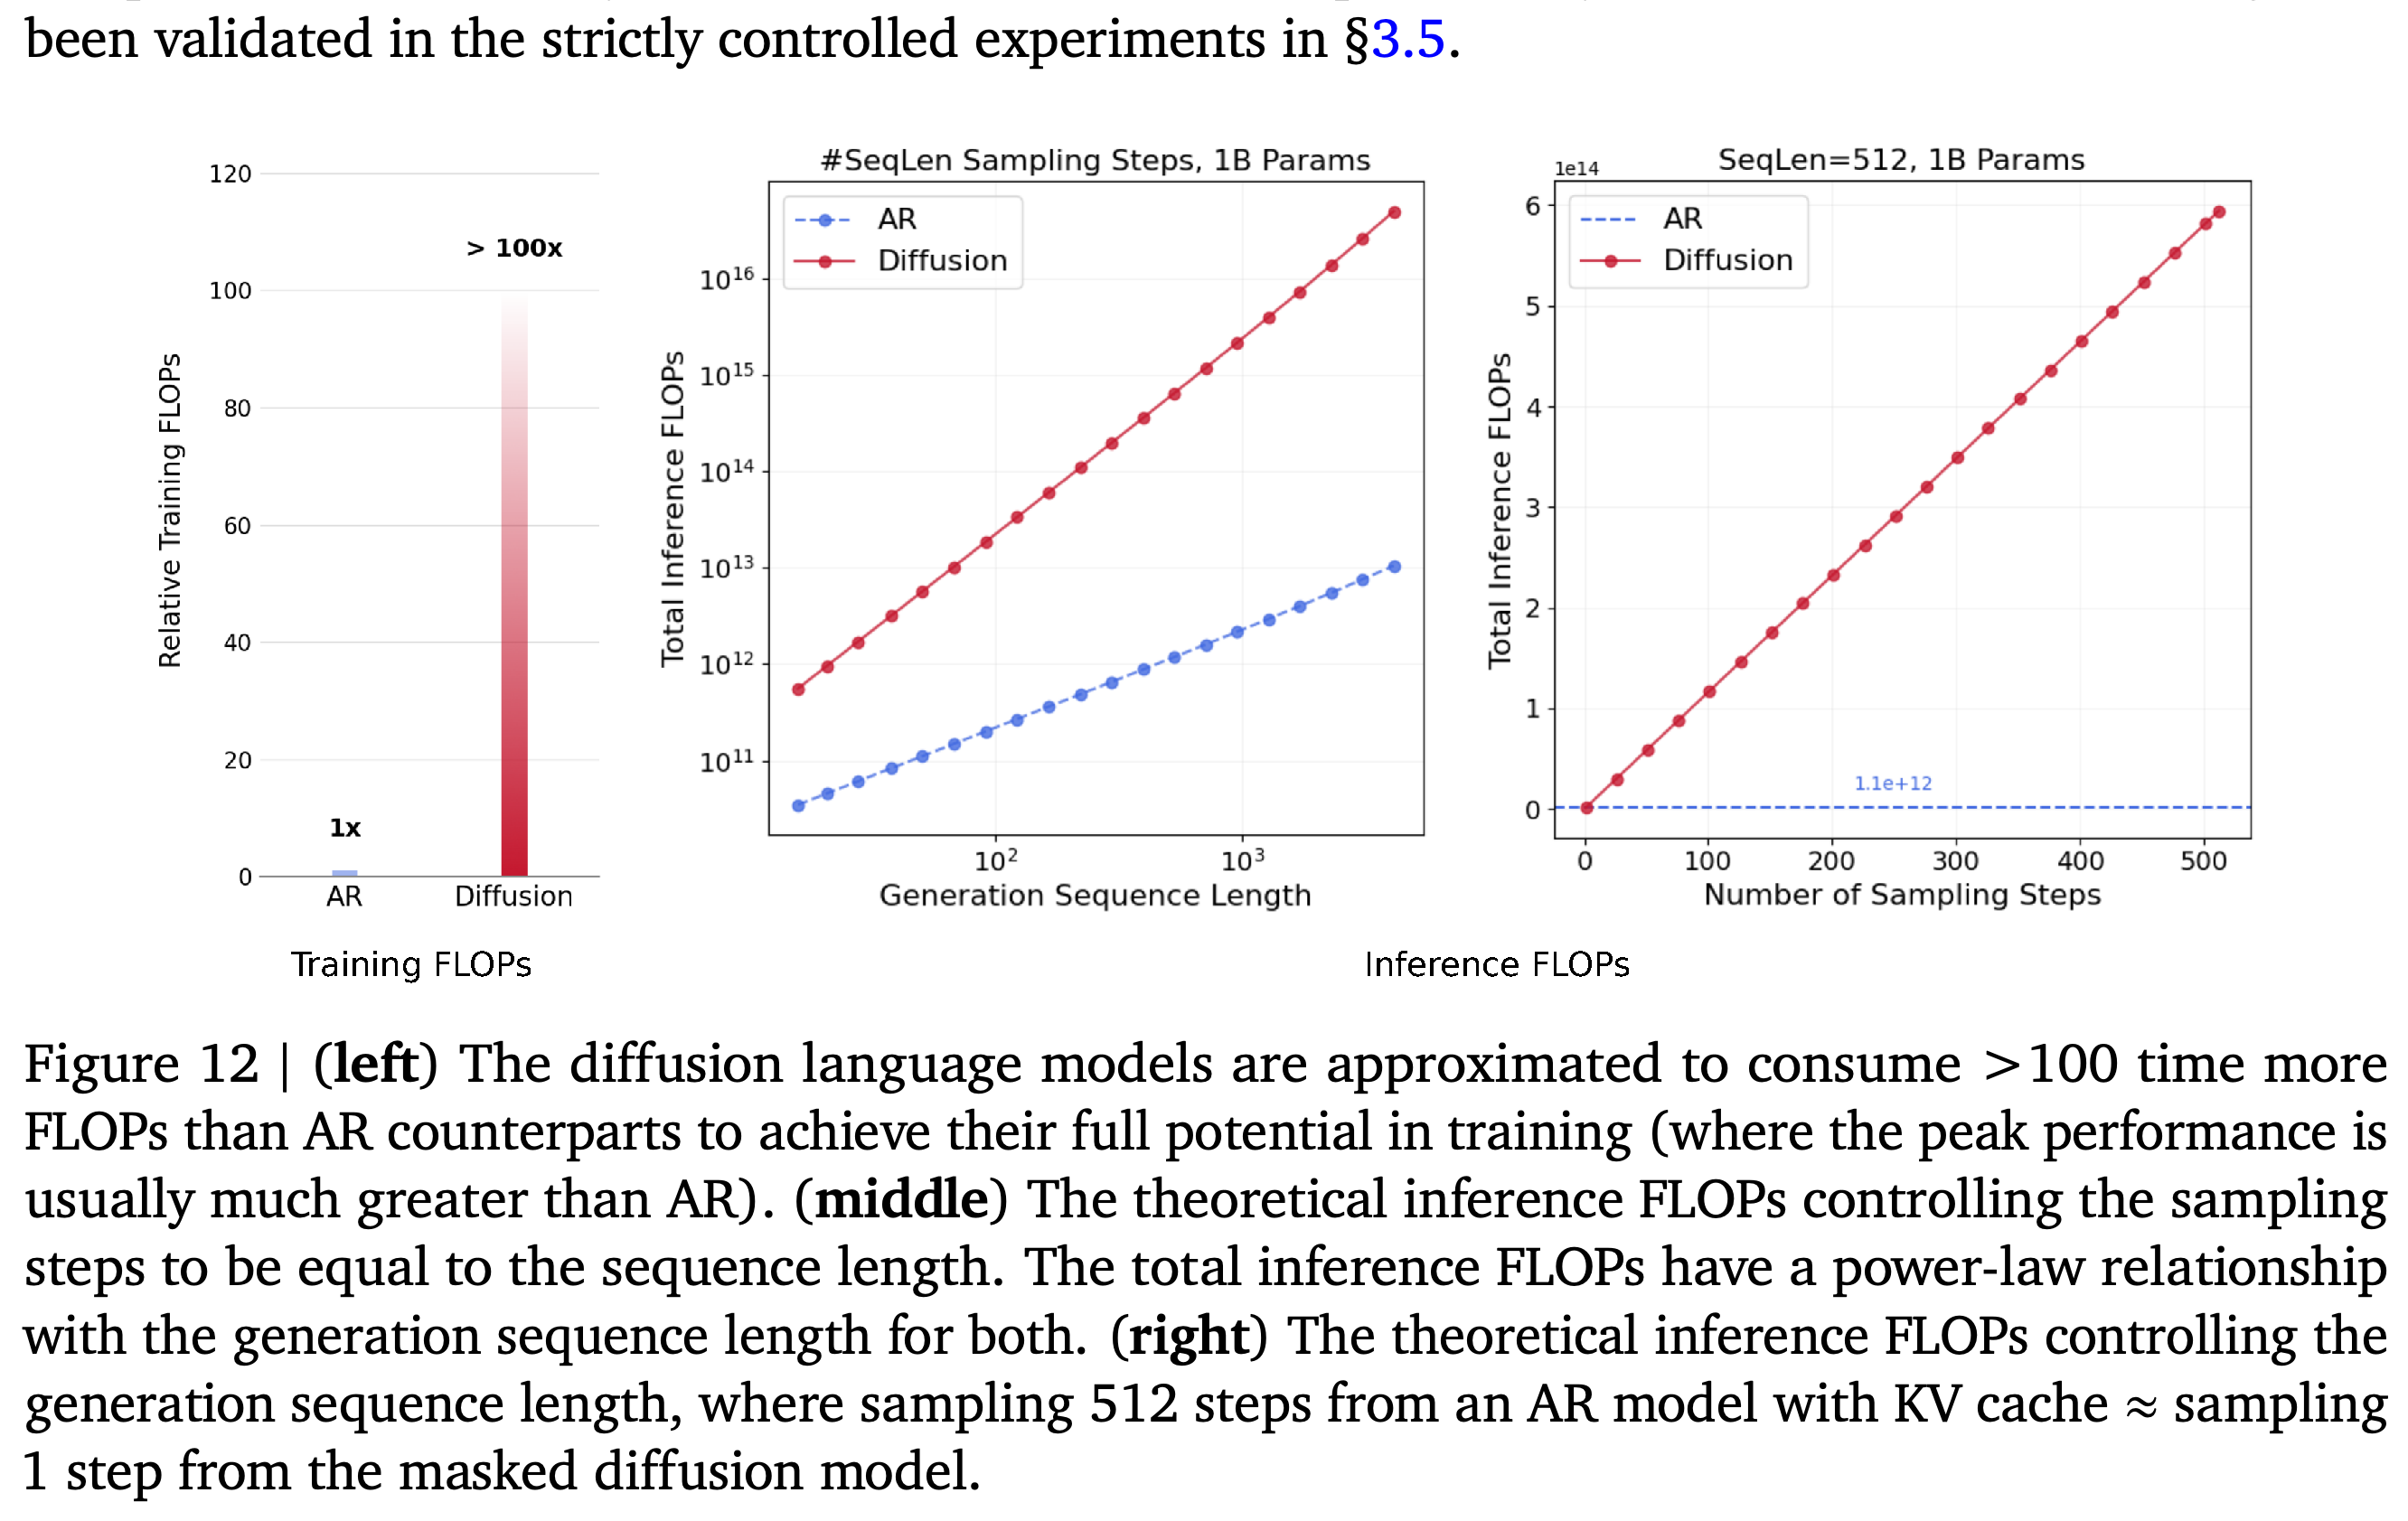
저자들은 any-order prediction이 엄격한 causal prediction에서는 활용할 수 없는 관계를 드러내고, 반복 마스킹이 diffusion 목적 함수의 기댓값을 추정할 표본을 늘린다고 주장한다. Super-density 설명에서는 AR의 KV cache를 통한 연산 재사용과 비교하여 반복 denoising이 표현을 거듭 계산한다는 점을 강조한다. Figure 12는 diffusion의 잠재력을 완전히 실현하는 데 필요한 학습 FLOPs가 AR 대비 >100×라는 예비 추정과 이론적인 추론 계산을 함께 제시한다.
- 가운데 패널은 1B-parameter 모델에서 sampling steps 수를 생성 시퀀스 길이와 같게 설정한다. 길이 16–4096에 걸쳐 논의에서 보고한 추론 FLOP 비율은 16×에서 4700×다. 이는 측정한 서비스 지연 시간이 아니라 이론적인 계산이다.
- 시퀀스 길이가 512인 오른쪽 패널에서는 diffusion 연산량이 denoising steps에 따라 선형으로 증가한다. 또한 diffusion step 1회의 연산량을 cache를 사용하는 AR로 전체 시퀀스를 생성하는 연산량과 대략 같게 본다. 병렬 실행은 지연 시간에 영향을 줄 수 있으므로 FLOP 비율만으로 실제 소요 시간을 정할 수는 없다.
- >100× 학습 추정은 각 모델 계열의 잠재력에 도달하는 데 필요한 비용을 다루며, 모델 크기와 데이터 예산에 따라 달라진다. 논문에서 토큰 수를 맞춘 모든 비교의 FLOP 비율을 뜻하지는 않는다.
학습 패널은 diffusion의 잠재력을 완전히 실현하는 데 필요한 비용을 >100×로 예비 추정하며 추론 패널은 전체 시퀀스를 반복 처리할 때의 FLOP 비용을 계산한다. 가운데 패널은 sampling steps 수를 시퀀스 길이와 같게 설정하고 오른쪽 패널은 길이를 512로 고정한다. 이 조건들을 함께 확인해야 비율을 해석할 수 있다.
7.2. Autoregressive Models are Trading Data Potential for Compute Efficiency
AR은 teacher forcing 학습에서 모든 토큰에 지도 신호를 제공하고 순차 추론에서는 연산을 재사용한다. 논문은 선형 마스킹 스케줄에서 AR이 학습 batch마다 masked diffusion보다 기댓값 기준으로 약 2배의 지도 토큰 신호를 받는다고 설명한다. 또한 왼쪽에서 오른쪽 방향의 모델링이 다른 단일 시퀀스 순서보다 낮은 웹 텍스트 손실을 보인다는 기존 근거를 인용한다. 앞선 원본 문맥을 조건으로 diffusion을 사용하여 블록을 생성하는 block diffusion은 중간적인 접근법으로 논의하지만 학습 효율을 확보하는 데 여전히 어려움이 있다고 본다.
7.3. Limitations
논문은 반복적인 양방향 연산으로 에너지 비용, 처리 시간, 메모리 부담이 커지며, 마스킹 스케줄, denoising 가중치, step 수, decoding 정책에도 민감하다고 지적한다. Diffusion의 변분 목적 함수 때문에 우도 기반 예측 척도인 perplexity를 정규화된 AR 우도와 직접 비교하기는 어렵다. 실험은 streaming, 도구 사용, 장기 생성, 다국어 학습, 멀티모달 학습, 긴 문맥에서의 동작도 충분히 규명하지 못한다.
- 중복 제거나 점검이 불완전하면 데이터를 많이 재사용하는 과정에서 암기와 benchmark 오염 위험이 커질 수 있다. 논문은 이러한 위험을 지적하지만 그 규모를 측정하지는 않는다.
- DLM 배포 체계는 AR 배포 체계보다 성숙도가 낮다. 논문은 여러 토큰을 생성하여 지연 시간을 줄이는 방식을 논의하지만 FLOP 분석만으로 특정 하드웨어와 decoding 설정에서 실제 지연 시간을 확인할 수는 없다.
8. Related Work
관련 연구는 masked diffusion 이론, 처음부터 학습한 대규모 DLM, 상용 diffusion 시스템, AR–diffusion 혼합 방법을 다룬다. 고유 데이터가 부족할 때 사용하는 반복 학습, dropout, 말뭉치 정제, 재작성, 합성 데이터, 검색, 가지치기, 특정 도메인의 학습 비중을 높이는 domain upsampling도 검토한다. 이 논문은 모델 계열 간 반복 사전학습을 연구하며 검토한 모든 데이터 개선 전략을 diffusion과 실험적으로 비교하지는 않는다.
부록
- 제공된 PDF에는 별도 제목이 붙은 부록이 없다. 마지막 페이지에는 참고문헌 뒤에 Table 1과 Figure 13이 실려 있다. Table 1은 평가 프로토콜을 기록하고 Figure 13은 본문에서 논의한 HumanEval과 HumanEval+의 늦은 성능 변화를 보여 준다. 프로젝트 자료는 https://github.com/JinjieNi/dlms-are-super-data-learners 에 있고, 학습 backend는 https://github.com/JinjieNi/MegaDLMs 에 있다. 제공된 버전은 https://arxiv.org/abs/2511.03276v1 이다.
짧은 생각
가장 강한 근거는 데이터 양과 품질, 모델 크기, 희소성을 통제한 실험에서 성능 역전이 반복해서 관찰되고 더 큰 학습 예산의 코드 생성에서도 확인된다는 점이다. 엔지니어링 관점에서 이 결과는 고유 데이터가 부족할 때 학습 및 서비스 비용을 고려하면서 downstream 지표로 더 긴 데이터 재사용을 평가할 근거가 된다. 인과적 설명은 경험적으로 관찰한 패턴만큼 확립되지 않았다. 잡음은 직접 ablation했지만 any-order modeling과 추가 연산은 독립적으로 분리하지 않았으며 이론적인 비용 분석으로 실제 서비스 지연 시간을 확인할 수는 없다.