


Llama-Embed-Nemotron-8B: A Universal Text Embedding Model for Multilingual and Cross-Lingual Tasks 요약 설명
10 Nov 2025 | Paper Review Text Embeddings Multilingual Learning Contrastive Learning Synthetic Data이번 글에서는 Llama-Embed-Nemotron-8B: A Universal Text Embedding Model for Multilingual and Cross-Lingual Tasks 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 11월 10일(Arxiv)
- Babakhin, Yauhen, Osmulski, Radek, Ak, Ronay, Moreira, Gabriel, Xu, Mengyao, Schifferer, Benedikt, Liu, Bo, Oldridge, Even.
- NVIDIA
- 논문 링크
요약
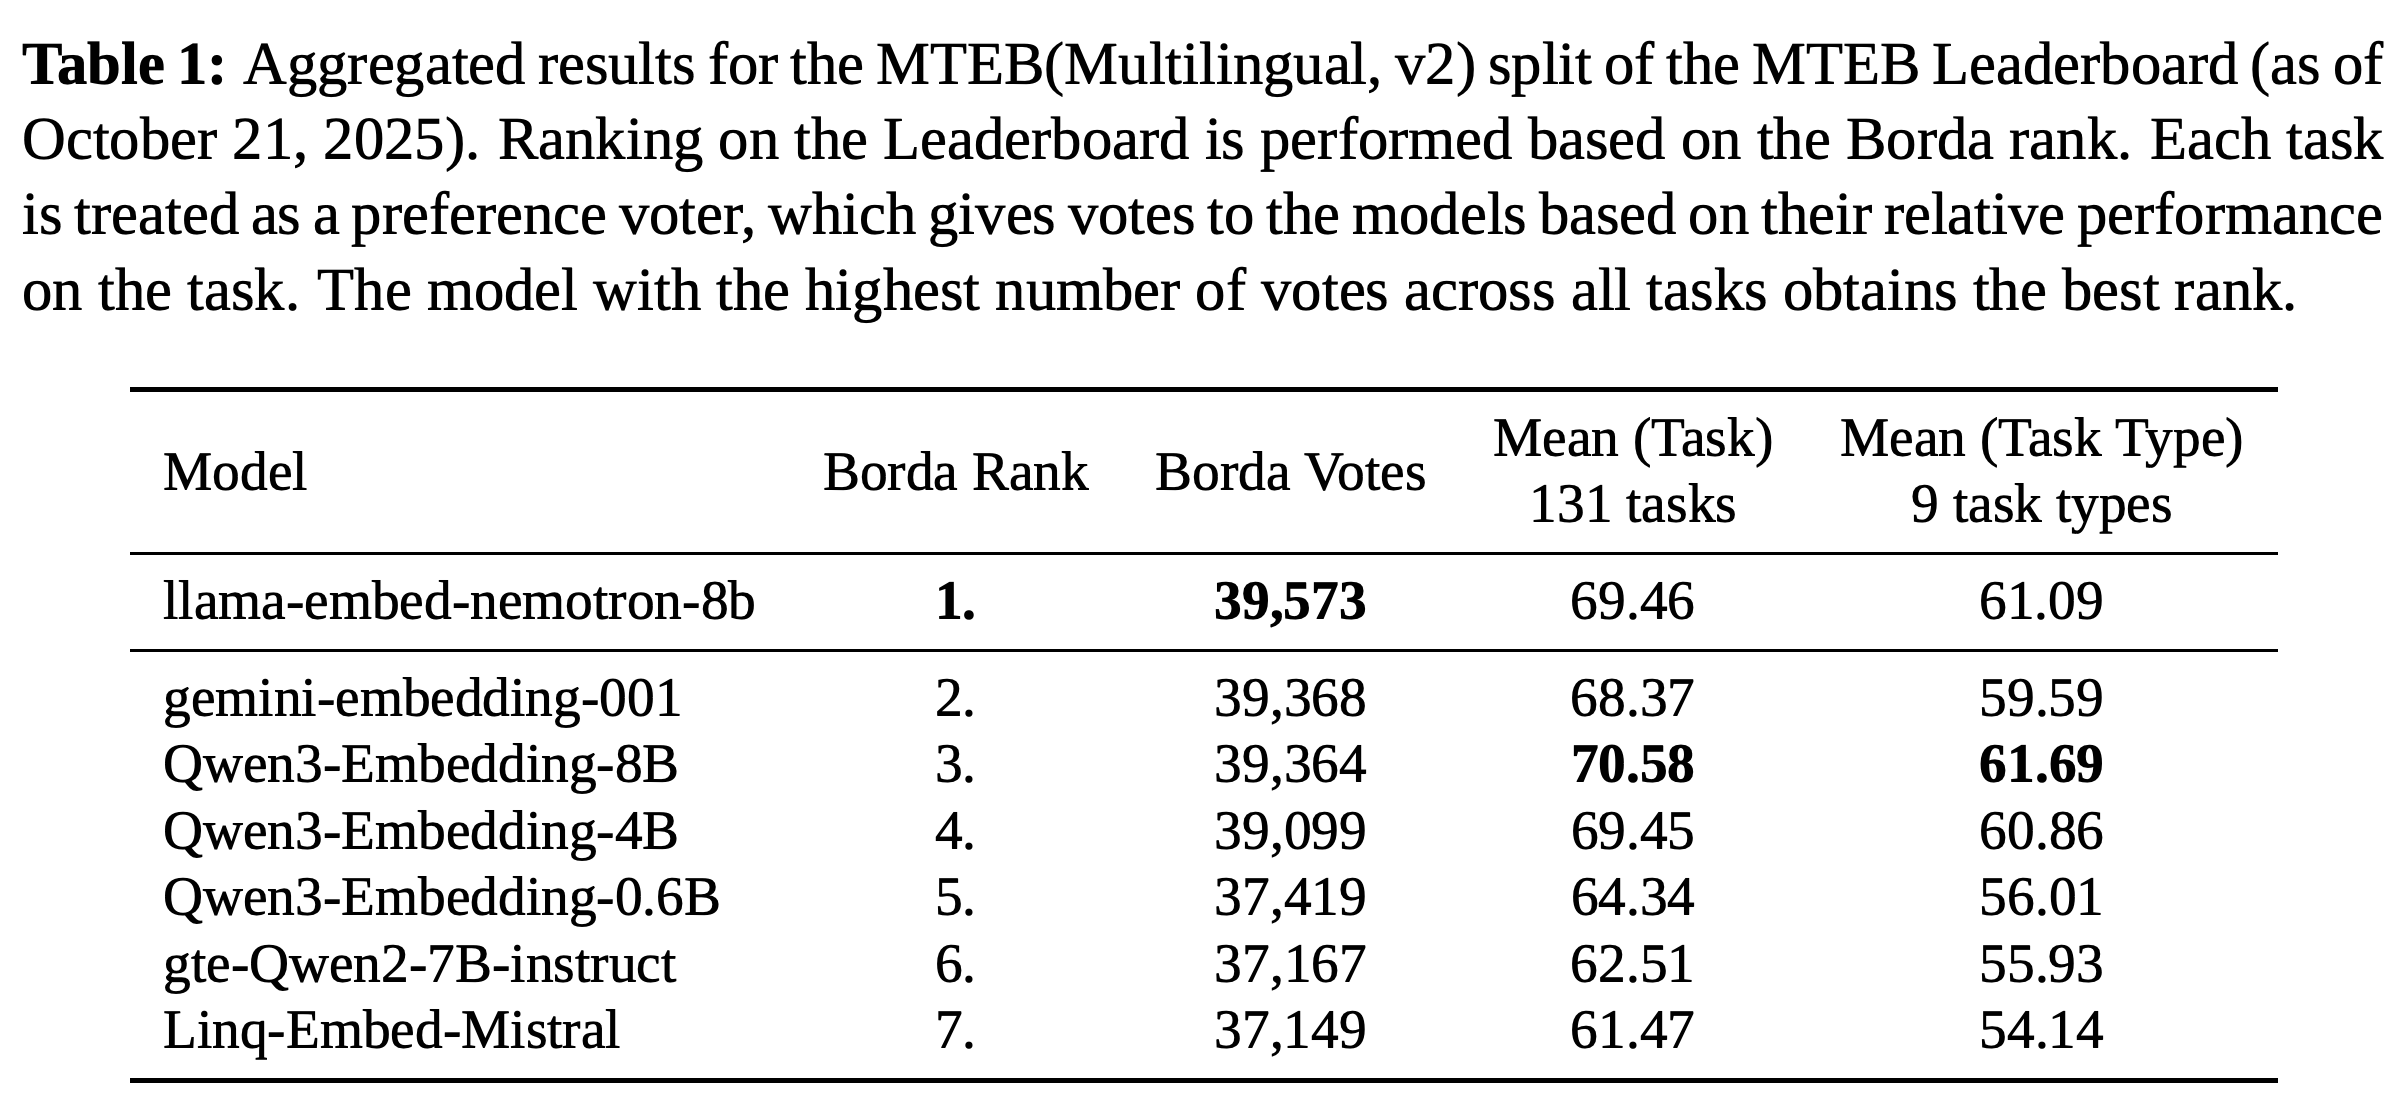
- 이 논문은 텍스트를 수치 벡터로 변환하고 다양한 과제와 언어에서 사용할 수 있는 텍스트 임베딩 모델 1개를 만드는 방법을 다룬다. Massive Text Embedding Benchmark의 다국어 평가인 MTEB(Multilingual, v2)에서 llama-embed-nemotron-8b는 2025년 10월 21일 기준 Borda count 39,573표로 1위를 기록한다. Borda count는 과제별 상대 순위를 합산하는 방식이며 gemini-embedding-001은 39,368표, Qwen3-Embedding-8B는 39,364표를 기록한다.
- 이 모델은 Llama-3.1-8B를 양방향 인코더로 바꿔 모든 입력 토큰이 전체 시퀀스를 참조하도록 하고, 토큰 표현을 평균해 4096차원 벡터를 만든다. 학습에는 공개 데이터 쌍 7.7 million개와 언어 모델로 생성한 합성 데이터 쌍 8.4 million개를 함께 사용한다. 대조 학습으로 관련 있는 텍스트는 가깝게, 관련 없는 텍스트는 멀게 배치한다. 최종 모델은 서로 다른 학습 실행에서 저장한 모델 상태인 체크포인트 6개의 파라미터를 평균해 만든다. 대조 학습에 대해서는 Contrastive Learning, SimCLR 논문 설명(SimCLRv1, SimCLRv2) 글을 참조하라.
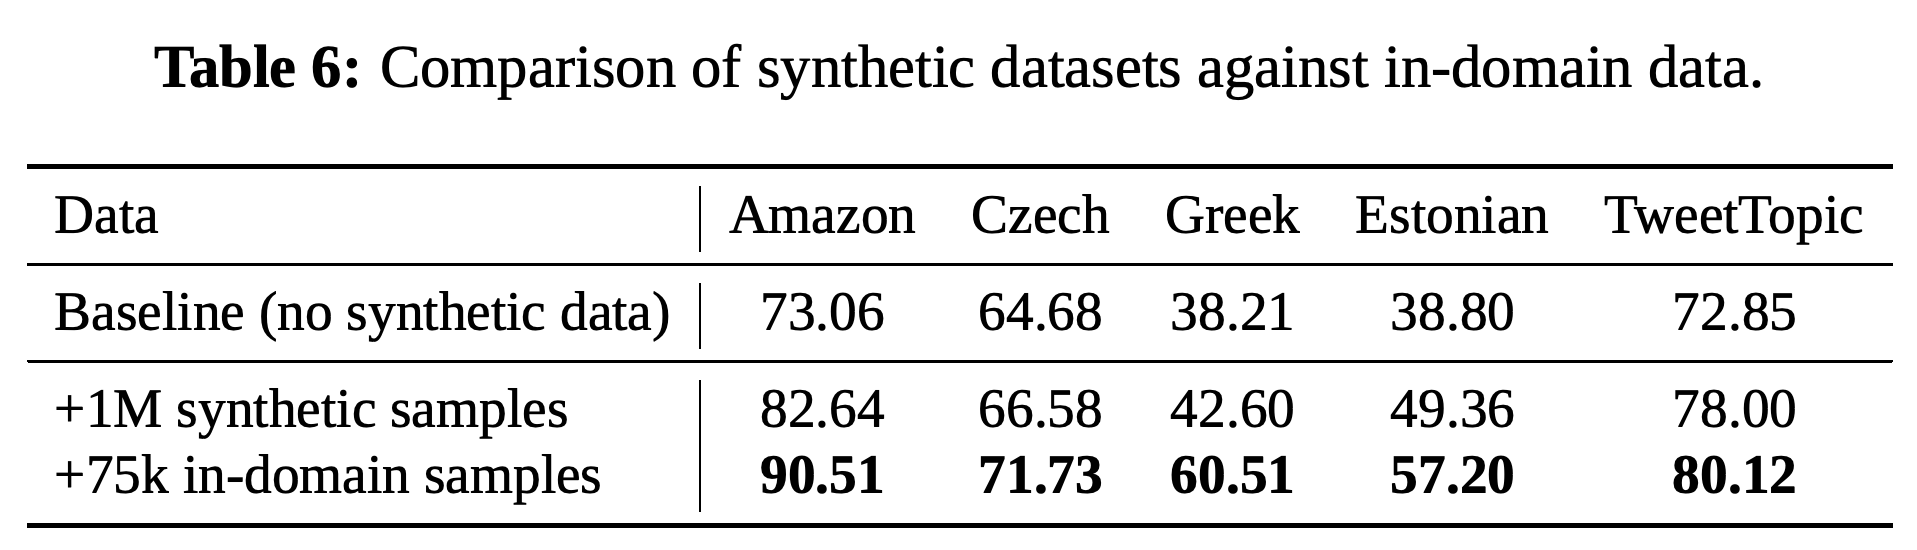
- 설계 선택을 비교하는 ablation 실험에서는 유사도를 기준으로 선별한 까다로운 비관련 예시인 hard negative만 사용하는 손실 함수가 경쟁력 있는 성능을 보인다. 여러 생성기로 만든 합성 분류 데이터를 혼합하는 방식도 유리하다. 대부분의 ablation은 파라미터가 1B개인 1B 모델을 사용하며 Qwen3-Embedding-8B의 평균 벤치마크 점수는 최종 모델보다 높다. 분류 ablation에서는 평가 데이터셋 다섯 개의 학습 분할에서 얻은 약 75k개의 도메인 내 예시가 약 1M개의 합성 예시보다 다섯 개 데이터셋 모두에서 높은 성능을 보인다.
1 Introduction
“Llama-Embed-Nemotron-8B: A Universal Text Embedding Model for Multilingual and Cross-Lingual Tasks”는 서로 다른 언어의 텍스트 비교를 포함해 다양한 과제, 도메인, 언어에서 사용할 텍스트 표현을 목표로 한다. 서론은 질의와 관련된 문서를 찾는 검색, 질의응답, 텍스트의 의미 유사도를 측정하는 semantic textual similarity(STS), 언어 모델에 외부 맥락을 제공하는 Retrieval-Augmented Generation(RAG)을 통해 텍스트 임베딩의 필요성을 설명한다. 텍스트로 작성된 문서와 스캔 문서를 텍스트로 변환하는 파이프라인에서도 텍스트 전용 모델이 계속 유용하다고 설명한다.
이 표는 Borda 순위에서 1위임을 보여주는 동시에, 가장 높은 순위와 가장 높은 평균 점수를 서로 다른 모델이 차지한다는 점을 보여준다. llama-embed-nemotron-8b는 gemini-embedding-001보다 205표, Qwen3-Embedding-8B보다 209표 앞서지만 과제별 평균과 과제 유형별 평균은 Qwen3-Embedding-8B가 더 높다.
2 Model
저자들은 Llama-3.1-8B로 모델을 초기화하고 모든 Transformer 층에서 각 토큰의 참조 범위를 자신과 앞선 토큰으로 제한하는 causal attention mask를 제거한 뒤 전체 모델 가중치를 미세 조정한다. 최종 층의 토큰 표현을 시퀀스 전체에 걸쳐 평균하는 global average pooling으로 4096차원 임베딩을 만든다. 과제 지시문에는 정확히 Input = f”Instruct: {task_instruction}\nQuery: {T}” 템플릿을 사용한다.
- 검색에는 공유 모델로 질의와 문서를 각각 독립적으로 인코딩하는 bi-encoder를 사용한다. 질의에는 지시문을 붙이고 문서에는 별도의 형식을 요구하지 않는다. 벡터 방향을 비교하는 코사인 유사도로 관련성 점수를 계산한다.
- STS와 텍스트에 레이블을 부여하는 분류에서는 각 텍스트에 적절한 지시문을 붙여 개별적으로 인코딩한다. 임베딩은 유사도 비교에 사용하거나 분류기의 특징으로 활용한다.
3 Training
학습은 과제에 맞춘 대조 목적 함수, 검색 사전 학습, 다중 과제 미세 조정, 체크포인트 평균을 결합한다. 공유 인코더는 검색, 분류, STS와 언어 간 대응 텍스트를 찾는 bitext mining 데이터로 학습한다.
3.1 Training Objective
모델은 양성 항목의 유사도가 경쟁하는 음성 항목보다 높아지도록 하는 대조 손실인 InfoNCE를 사용한다. 손실 함수는 \(\mathcal{L}(q,d^+,D_N)=-\log\frac{\exp(\operatorname{sim}(q,d^+)/\tau)}{\sum_{d_i\in\{d^+\}\cup D_N}\exp(\operatorname{sim}(q,d_i)/\tau)}\)다. 여기서 q는 기준점 임베딩, d+는 양성 임베딩, DN은 음성 집합, sim은 코사인 유사도이며 τ는 유사도 점수의 척도를 조절하는 온도다.
- 검색에서는 지시문을 붙인 질의, 수정하지 않은 양성 문서, 선별한 음성 문서를 사용한다. 손실에는 배치 내 다른 학습 예시에서 가져오는 in-batch negative와 질의끼리 또는 문서끼리 비교하는 same-tower negative를 포함하지 않는다.
- 분류에서는 입력 텍스트를 기준점으로, 정답 레이블 이름을 양성으로, 무작위로 선택한 오답 레이블 이름을 음성으로 사용한다. 기준점에는 과제 지시문을 붙이고 레이블 이름은 그대로 사용한다.
- STS에서는 양성 텍스트 쌍을 대칭적으로 처리하고 데이터셋 코퍼스에서 음성을 선별한다. 모든 텍스트에 동일한 지시문인 “Retrieve semantically similar text.”를 붙인다.
3.2 Training Stages
Stage 1: Retrieval Pretraining에서는 웹에서 얻은 질의와 문서 쌍마다 hard negative 1개를 사용해 기반 모델을 양방향 어텐션과 임베딩 생성에 적응시킨다. 논문은 이 단계가 전체 데이터 구성의 약 70%를 차지한다고 설명한다. Stage 2: Fine-Tuning에서는 검색, 분류, STS, bitext mining 데이터를 사용하며 나머지 30%를 차지한다고 설명한다. 초기 Llama-3.1-8B 모델은 약 15T개의 다국어 토큰으로 사전 학습되었다.
3.3 Model Merging
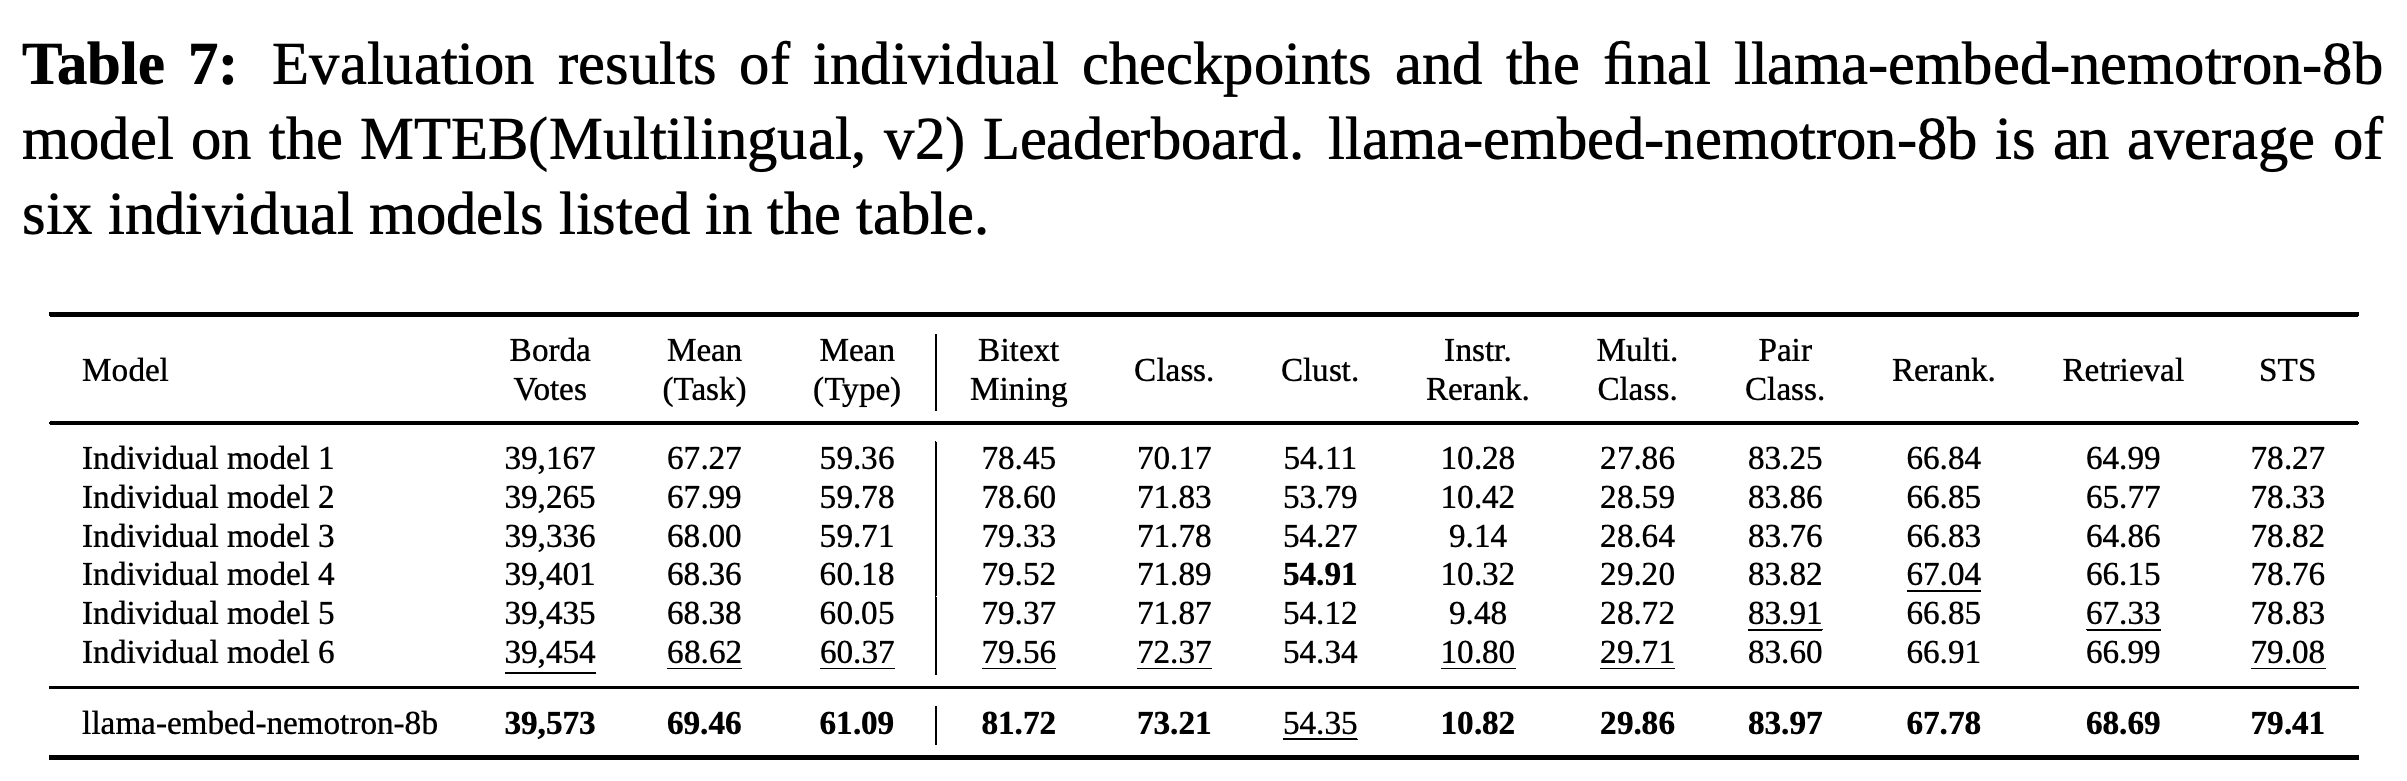
모델 병합은 학습한 모델들의 파라미터를 평균해 결합하는 방식이다. 최종 모델은 데이터 구성과 하이퍼파라미터가 다른 학습 실행에서 얻은 체크포인트 6개를 평균한다. 저자들에 따르면 이 방식은 아키텍처를 유지하며 추론 시간을 늘리지 않는다. Section 6.4에서는 병합 모델과 이를 구성하는 개별 체크포인트를 비교한다.
4 Datasets
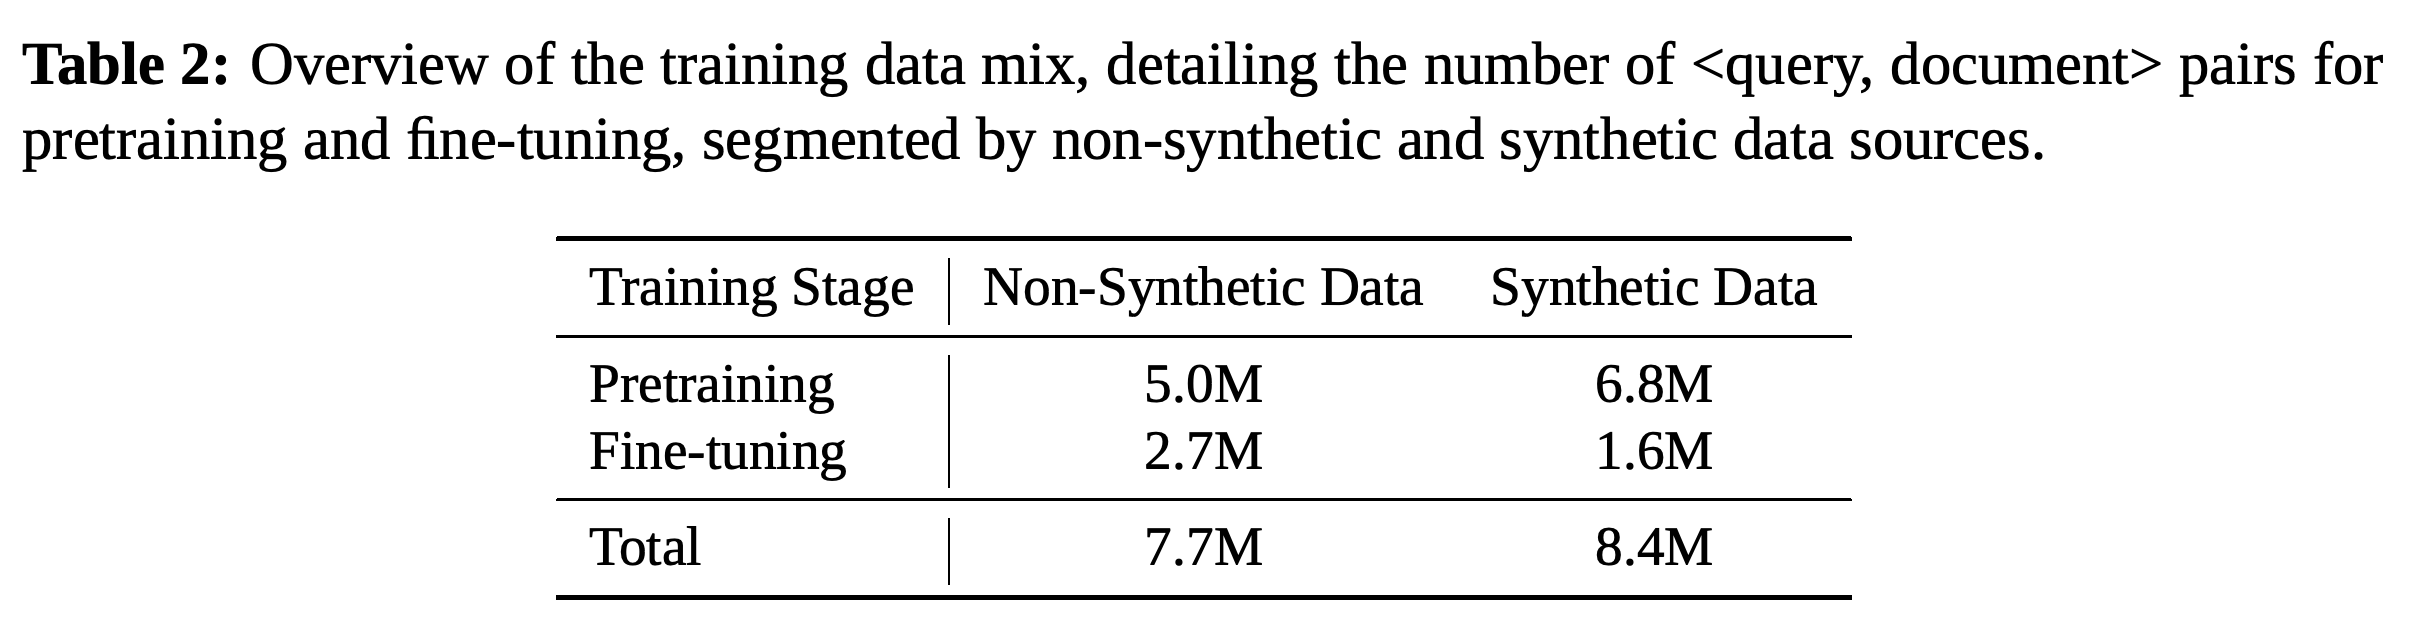
초록과 Table 2에서 전체 학습 데이터는 질의와 문서 쌍 16.1 million개이며 본문에서는 이를 약 16 million개라고도 표현한다. 비합성 데이터 쌍 7.7 million개와 합성 데이터 쌍 8.4 million개로 구성된다. 저자들은 정제한 데이터를 https://huggingface.co/collections/nvidia/nemotron-rag 에 공개할 계획이며 논문에서는 이 공개를 향후 작업으로 설명한다.
보고된 데이터 수는 사전 학습 쌍 11.8M개와 미세 조정 쌍 4.3M개이며 총 16.1M개다. 합성 데이터는 사전 학습 쌍 6.8M개와 미세 조정 쌍 1.6M개를 제공하므로, 검색 사전 학습 단계에 가장 많은 예시를 제공한다.
4.1 Pretraining Data Mix
사전 학습 데이터는 이 단계의 원천 코퍼스인 Nemotron-CC-v2의 Diverse-QA 분할을 기반으로 하며, 약 11.8M개의 쌍으로 구성된다. 기존 질문과 양성 문서에서 5.0M개의 쌍을 얻고, 같은 코퍼스에서 추출한 문서 청크 1M개를 후보 집합으로 삼아 음성을 선별한다. 기존 문서에 대해 새로 생성한 질문으로 6.8M개의 쌍을 추가하며 음성은 같은 절차로 선별한다.
4.2 Fine-tuning Data Mix
미세 조정 데이터는 NV-Embed의 데이터 구성을 바탕으로 하며, 공개 데이터 예시 약 2.7M개와 합성 예시 약 1.6M개를 포함한다. 공개 데이터에는 다국어 검색 데이터셋 MIRACL, 여러 단계의 추론이 필요한 질의응답 데이터셋 HotpotQA, 기계 독해 데이터셋 MS MARCO, 질의응답 벤치마크 Natural Questions, 텍스트 독해 데이터셋 SQuAD가 포함된다. 저자들은 평가 데이터셋의 분할을 학습에 사용하지 않는 zero-shot 평가의 범위를 넓히기 위해 MTEB(Multilingual, v2)와 MTEB(eng, v2)에서 유래한 데이터 대부분을 제거한다. 이 절에서는 관련 데이터를 완전히 제거했다고 밝히지 않으며 정확한 zero-shot 비율도 보고하지 않는다.
4.3 Synthetic Data Generation
합성 데이터 생성(Synthetic Data Generation, SDG)은 다국어와 언어 간 예시에 중점을 두고 검색, 분류, STS, bitext mining 데이터를 생성한다. 한 전략은 질의, 양성, 음성으로 구성된 완전한 삼중항을 처음부터 생성한다. 다른 전략은 기존 텍스트 모음인 시드 코퍼스에서 양성 문서를 추출하고 해당 문서에 대한 질의를 생성한 뒤 같은 코퍼스에서 음성을 선별한다. 기존 데이터셋을 목표 언어로 번역하기도 한다.
- 생성기로 gpt-oss-20b, gpt-oss-120b, Mixtral-8x22B-Instruct-v0.1, Llama-3.3-70B-Instruct, Llama-4-Scout-17B-16E-Instruct, Llama-4-Maverick-17B-128E-Instruct를 사용한다.
- 과제, 예시, 번역을 생성하는 데 사용하는 이 대규모 언어 모델(LLM)들은 가중치가 공개되어 있다. Section 6.2에서는 분류에 한정해 생성기 선택의 영향을 실험한다.
4.4 Hard Negative Mining
Hard negative mining에는 NV-Retriever의 top-k with percentage to positive threshold 전략을 사용하며 임계값은 0.95다. 각 질의에 대해 질의와 양성 간 유사도의 95%보다 낮은 질의 유사도를 갖는 음성 후보 중 관련성이 가장 높은 상위 K개를 선택한다. 이는 관련 있는 예시를 비관련 예시로 잘못 취급하는 false negative를 제외하려는 방식이다. 음성 선별에는 e5-mistral-7b-instruct와 Qwen3-Embedding-8B를 함께 사용한다.
5 Results
평가에는 Massive Multilingual Text Embedding Benchmark(MMTEB)에서 소개한 MTEB(Multilingual, v2)를 사용하며 이는 과제 131개, 과제 유형 9개, 250+개 언어를 포함한다. 평가 데이터셋에서 지시문을 제공하면 이를 사용하고 그렇지 않으면 https://github.com/QwenLM/Qwen3-Embedding 의 지시문을 수정해 사용한다. 모델은 2025년 10월 21일 리더보드에서 Borda 표 수가 가장 높다. 다만 과제별 평균인 Mean (Task)는 69.46, 과제 유형별 평균인 Mean (Type)은 61.09로, Qwen3-Embedding-8B의 70.58과 61.69보다 낮다.
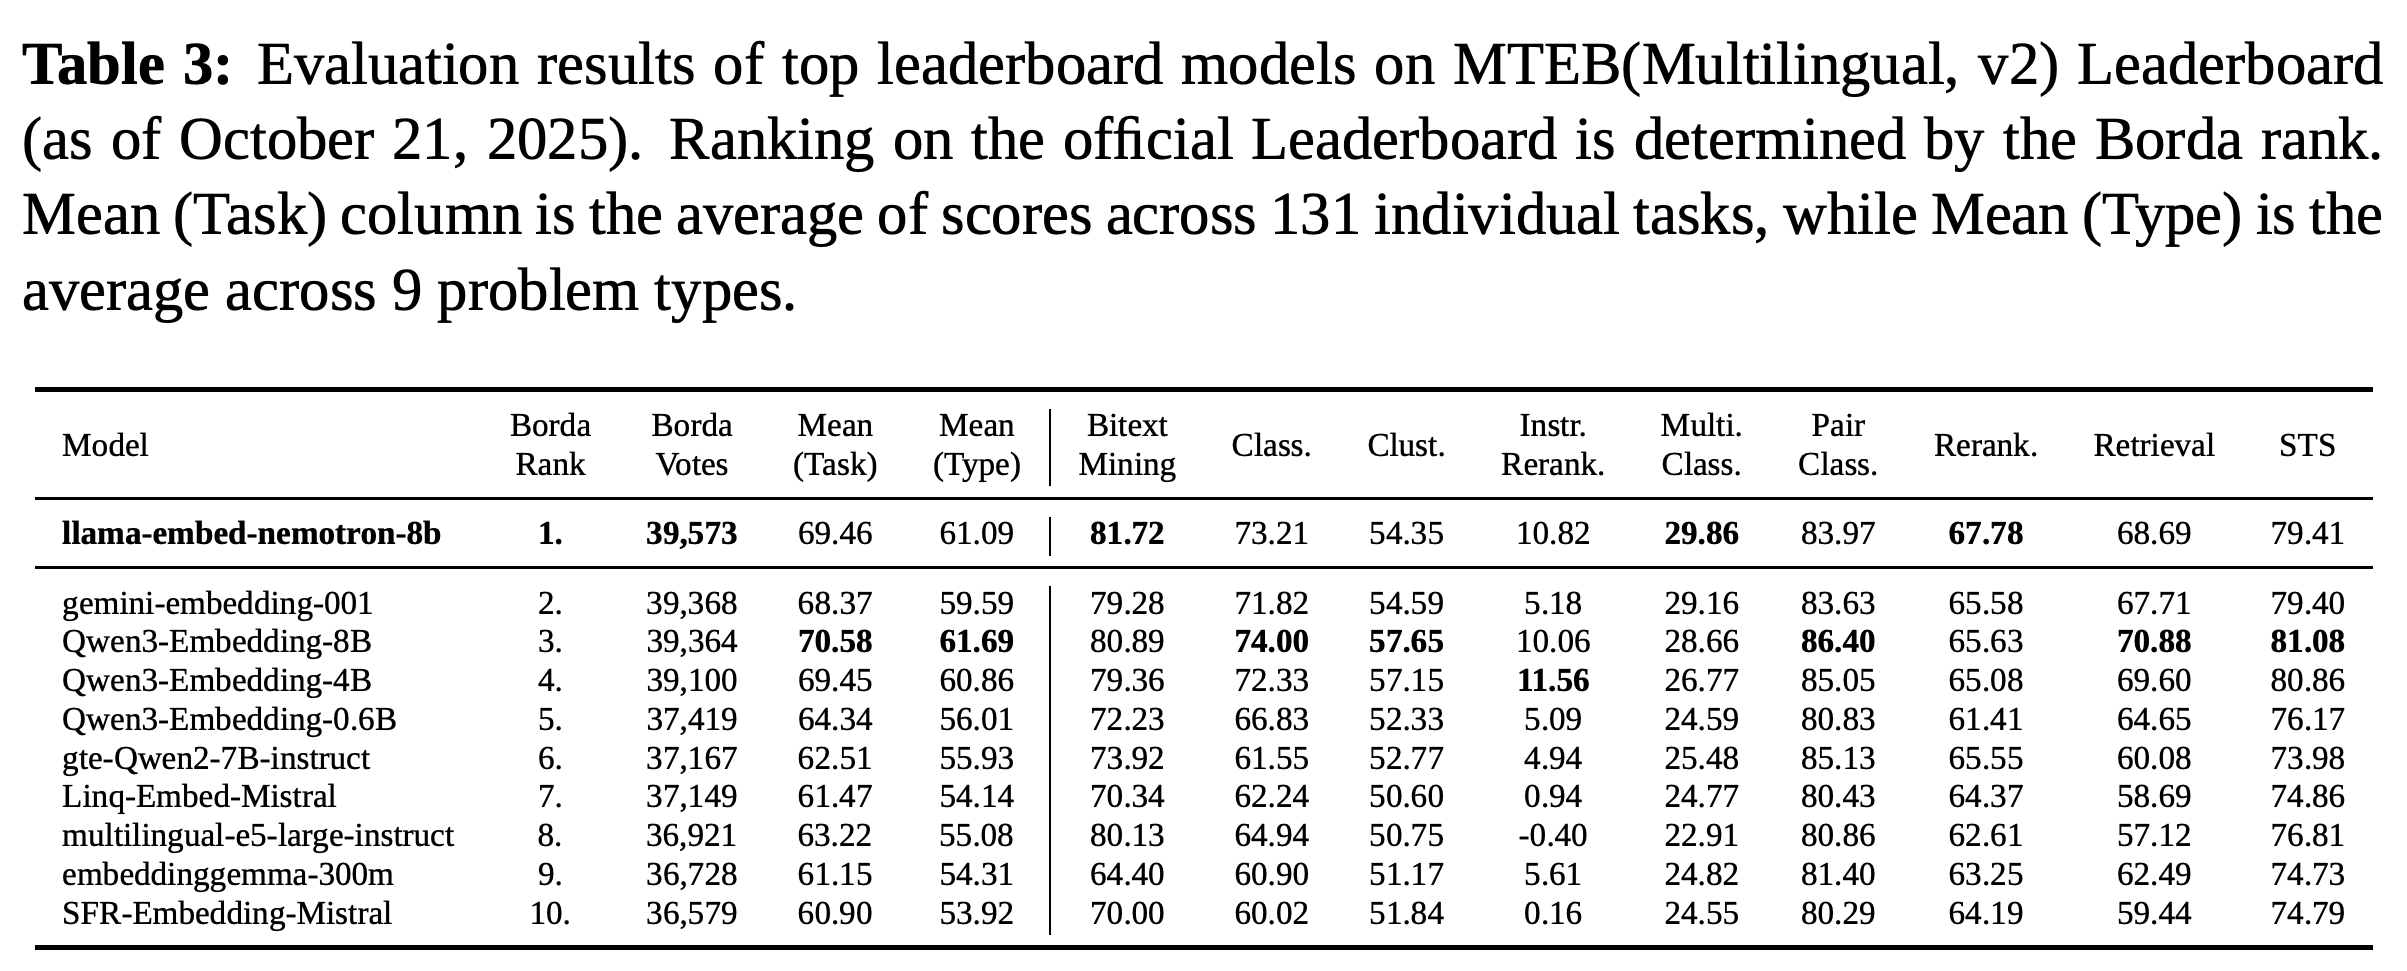
- Table 3에서 이 모델은 나열된 모델 중 bitext mining(81.72), 텍스트에 여러 레이블을 부여하는 multilabel classification(29.86), 관련성에 따라 후보 결과의 순서를 바꾸는 reranking(67.78)에서 과제 유형별 평균이 가장 높다. Qwen3-Embedding-8B는 분류, 관련 텍스트를 묶는 clustering, 텍스트 쌍에 레이블을 부여하는 pair classification, 검색, STS에서 가장 높다. Qwen3-Embedding-4B는 지시문에 따라 순위를 다시 매기는 instruction reranking에서 가장 높다.
- Borda count는 과제별 상대 순위를 합산하고 평균 열은 수치 점수를 평균한다. 1위라는 주장은 리더보드의 순위 산정 규칙에 따른 결과이며 모델이 모든 과제 유형이나 종합 지표에서 가장 높은 성능을 보이는 것은 아니다.
과제 유형별 결과를 보면 전체 순위 1위를 모든 과제에서의 우위로 해석할 수 없다. llama-embed-nemotron-8b는 나열된 모델 중 bitext mining, multilabel classification, reranking에서 가장 높지만 Qwen3-Embedding-8B는 과제 유형 5개와 평균 열 모두에서 가장 높다.
6 Ablation Study
별도 언급이 없는 ablation에서는 8B 규모의 실험 비용이 크기 때문에 Llama-3.2-1B를 미세 조정 데이터로 학습한다. 이 실험들은 최종 학습 설계의 근거가 되지만 모든 설계 선택이 8B 규모에서도 같은 효과를 낸다는 점을 독립적으로 입증하지는 않는다.
6.1 Contrastive Loss Formulations
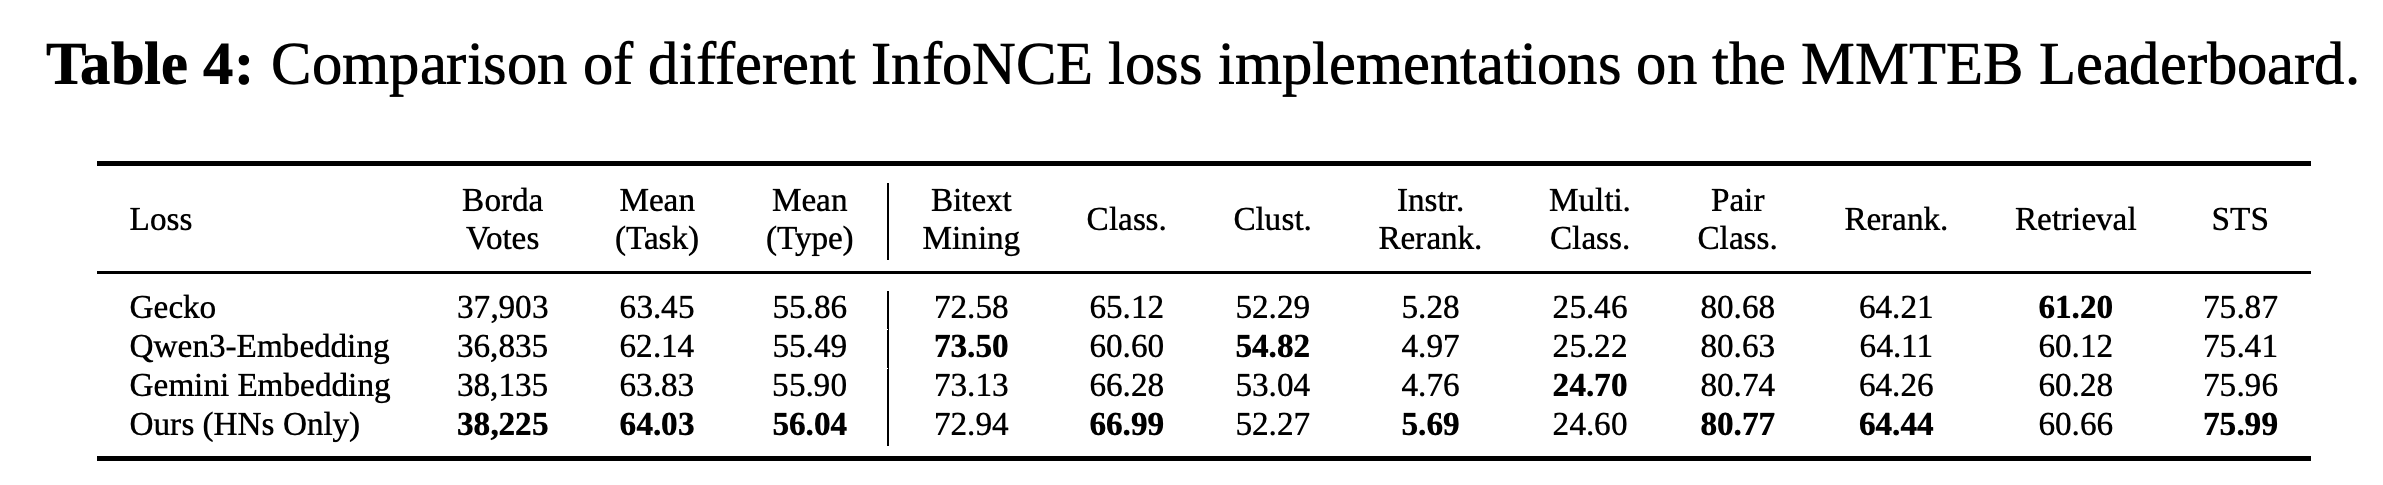
손실 비교에서는 Gecko, Qwen3-Embedding, Gemini Embedding, 저자들의 hard-negative-only 방식이 사용하는 음성 집합을 바꾼다. 다른 하이퍼파라미터는 고정하고 학습률은 손실별로 따로 조정한다. 저자들의 방식은 Borda 38,225표와 Mean (Task) 64.03을 기록하며 Gemini 방식은 38,135표와 63.83을 기록한다.
- Gecko는 hard negative, 배치 내 다른 양성 구절, 다른 질의를 포함한다. Qwen3-Embedding은 양성 문서와 음성 문서에도 same-tower 비교를 적용한다. Gemini는 same-tower negative를 제외하지만 배치 내 다른 양성 구절은 유지한다.
- 제안한 음성 집합에는 hard negative만 포함하며 사전 학습에서는 1개, 미세 조정에서는 4개를 사용한다. InfoNCE의 분모에는 양성 항목을 유지한다.
- 이 단순한 방식은 Table 4의 종합 지표에서 가장 높지만 일부 과제 유형에서는 다른 방식이 가장 높다. 비교 결과에는 불확실성 추정치나 유의성 검정이 없다.
1B ablation 조건에서 hard-negative-only 방식은 Borda 표 수와 평균 점수 모두 가장 높다. 이 방식의 38,225표는 Gemini 방식의 38,135표보다 높지만 과제 유형별 최고 성능을 기록한 방식은 서로 다르며 불확실성 추정치는 보고하지 않는다.
6.2 Choice of LLM for Synthetic Data Generation
1B 생성기 ablation에서는 각 학습 조건에 영어 합성 분류 예시 100k개를 추가한다. 먼저 분류 과제를 제안한 뒤 텍스트, 정답 레이블, 그럴듯한 오답 레이블을 생성한다. 혼합 조건에서는 생성기 6개에서 각각 약 16.7k개의 예시를 동일한 비율로 가져온다. 이 혼합은 Borda 37,812표와 Mean (Task) 62.89를 기록하며 합성 분류 데이터를 사용하지 않는 기준 모델보다 +464표, +0.94점 높다.
- 혼합 데이터는 Table 5에서 분류, clustering, multilabel classification의 평균도 가장 높다. 개별 생성기 중 Borda 표 수가 가장 높은 모델은 Mixtral-8x22B-Instruct-v0.1이며, 37,797표를 기록한다.
- 이 실험에서는 생성기 크기만으로 후속 과제 성능을 일관되게 예측할 수 없다. 저자들은 생성한 과제 목록의 다양성이 혼합 조건의 우위를 설명할 수 있다고 제안하지만 이 원인을 분리해 검증하지는 않는다.
- 전체 학습 파이프라인에서는 한 모델이 과제를 제안하고 다른 모델이 예시를 생성하는 cross-model generation도 사용한다. 이 확장 방식에 대한 별도의 정량 비교는 제시하지 않는다.
6.3 Impact of Synthetic vs. In-Domain Data
1B 실험에서는 합성 분류 데이터가 없는 기준 모델을 합성 분류 예시 약 1M개를 사용한 모델, 평가 데이터셋 5개의 학습 분할에서 얻은 도메인 내 예시 약 75k개를 사용한 모델과 비교한다. 합성 데이터는 5개 점수를 모두 높이지만 도메인 내 데이터로 학습한 모델이 모든 데이터셋에서 가장 높은 점수를 얻는다. 이 도메인 내 예시는 해당 ablation에만 사용하며 최종 제출한 llama-embed-nemotron-8b 모델에서는 제외한다.
- 데이터셋은 AmazonCounterfactualClassification(학습 예시 17.7k개), CzechProductReviewSentimentClassification(24.0k개), GreekLegalCodeClassification(28.5k개), EstonianValenceClassification(3.3k개), TweetTopicSingleClassification(1.5k개)다.
- GreekLegalCodeClassification의 점수는 기준 모델 38.21, 합성 데이터 사용 시 42.60, 도메인 내 데이터 사용 시 60.51이다. TweetTopicSingleClassification의 점수는 각각 72.85, 78.00, 80.12다.
- 도메인 내 모델은 5개 데이터셋을 모두 함께 학습한다. 따라서 TweetTopic의 결과는 해당 데이터셋이 제공한 1.5k개의 예시만으로 학습한 효과를 분리해 보여주지 않는다. 다만 해당 데이터셋이 제공한 예시 수는 1.5k개다.
합성 예시 약 1M개는 평가한 모든 분류 데이터셋의 성능을 높이지만 5개 데이터셋에서 얻은 도메인 내 예시 약 75k개를 함께 학습하면 성능이 더 높아진다. 그리스어 점수는 38.21에서 합성 데이터 사용 시 42.60, 도메인 내 데이터 사용 시 60.51로 높아져 남아 있는 성능 차이를 보여준다.
6.4 Model Merging
최종 모델 규모에서는 체크포인트 6개를 동일한 가중치로 평균하면 Borda 표 수가 가장 좋은 개별 체크포인트의 39,454표에서 39,573표로 +119표 증가한다. Mean (Task)는 68.62에서 69.46으로 +0.84점 증가한다. 병합 모델은 과제 유형별 평균 9개 중 8개에서 모든 구성 체크포인트보다 높다. Clustering은 Individual model 4가 54.91로 병합 모델의 54.35보다 높다.
최종 병합 모델은 가장 좋은 구성 체크포인트보다 Borda 119표, 평균 과제 점수 0.84개 높다. 구성 모델끼리 비교한 과제 유형별 열 여덟 개에서도 가장 높지만 clustering 점수는 Individual model 4가 가장 높다.
7 Conclusion
논문은 Llama-3.1-8B를 양방향 인코더로 바꾸고, 공개 데이터와 합성 데이터를 혼합하며 체크포인트를 평균해 보고된 시점의 다국어 리더보드에서 Borda 순위가 가장 높은 모델을 얻었다고 결론짓는다. 모델 가중치는 https://huggingface.co/nvidia/llama-embed-nemotron-8b 에 공개되어 있다. 정제한 학습 데이터의 공개는 논문에서 여전히 계획으로 제시한다.
부록
- A Implementation Details는 사전 학습에 25.0시간, 미세 조정에 21.5시간이 걸렸으며 해당 단계 모두 NVIDIA A100 80GB GPU 64개를 사용했다고 보고한다. 사전 학습/미세 조정 설정은 최대 학습률 1e-5/2e-6, 배치 크기 2,048/128, 학습 스텝 수 5,773/33,668 steps, hard negative 1/4개다. 해당 단계 모두 AdamW 옵티마이저, 선형 학습률 감소, 워밍업 100스텝, 가중치 감쇠 0.01, 온도 0.02를 사용하며 질의와 문서의 최대 길이는 512다.
- B Fine-Tuning Data Mix for llama-embed-nemotron-8b는 총 4,309,502개의 예시를 나열한다. 합성 데이터는 bitext mining 예시 169,534개, 분류 예시 1,044,212개, 검색 예시 182,814개, STS 예시 239,997개로 구성된다. 나열된 공개 데이터 중 가장 큰 구성 요소는 각각 예시 500,000개를 제공하는 MS MARCO와 생성 질문 모음인 PAQ이며, 그다음은 317,180개를 제공하는 MAmmoTH2 stackexchange다.
짧은 생각
학습 설계를 가장 강하게 뒷받침하는 근거는 예시 수를 고정한 100k-example 생성기 비교와 최종 모델 규모의 병합 실험이다. 생성기를 혼합하면 보고된 종합 점수가 높아지고, 체크포인트를 평균하면 Borda 표 수와 평균 과제 점수가 모두 높아진다. Hard-negative-only 손실은 보고된 1B 조건에서 경쟁력이 있지만 Gemini 방식에 대한 작은 우위에는 불확실성 추정치가 없다. 모델이 모든 과제군에서 가장 높은 성능을 보이지 않고, 합성 분류 데이터와 도메인 내 데이터 사이에 성능 차이가 남으며 논문에 추론 처리량이나 지연 시간 비교가 없으므로 용도별 평가는 여전히 필요하다.