


TiDAR: Think in Diffusion, Talk in Autoregression 요약 설명
12 Nov 2025 | Paper Review Diffusion Language Models Speculative Decoding Parallel Decoding목차
이번 글에서는 TiDAR: Think in Diffusion, Talk in Autoregression 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 11월 12일(Arxiv)
- Liu, Jingyu, Dong, Xin, Ye, Zhifan, Mehta, Rishabh, Fu, Yonggan, Singh, Vartika, Kautz, Jan, Zhang, Ce, Molchanov, Pavlo.
- NVIDIA, University of Chicago, Georgia Institute of Technology
- 논문 링크
- Project Page
요약
- TiDAR는 앞선 토큰을 바탕으로 각 토큰을 예측하는 자기회귀(AR) 모델의 품질을 유지하면서 여러 언어 토큰을 병렬로 생성하는 문제를 다룬다. NVIDIA H100 그래픽 처리 장치(GPU) 1개와 batch size = 1 조건에서 Qwen2.5 1.5B보다 4.71×, Qwen3 8B보다 5.91× 높은 디코딩 처리량을 보고하며 다운스트림 과제 점수도 경쟁력 있는 수준이다.
- 동일한 모델이 마스킹된 위치를 병렬로 예측하는 1단계 마스크 확산으로 초안 토큰을 생성하고 앞선 위치만 참조하도록 제한하는 인과적 어텐션으로 이전 초안을 검증한다. 이 과정은 1회의 순전파에서 이루어진다. 구조화된 어텐션 마스크는 수락된 접두부 토큰의 어텐션 상태를 저장하고 재사용하는 정확한 key-value(KV) 캐시도 지원한다.
- 기존 모델에 언어 모델 학습을 추가로 수행하는 지속 사전학습에는 TiDAR 1.5B에서 50B 토큰, TiDAR 8B에서 150B 토큰을 사용한다. 생성 평가에서는 network function evaluation(NFE)당 평균 7.45와 8.25 토큰을 생성한다. NFE는 모델 1개의 순전파를 뜻한다. 전체 마스킹은 측정된 품질과 효율의 절충 관계를 개선하지만 통제된 비교에서는 동일한 조건으로 학습한 AR 모델보다 품질이 낮다. 대표 처리량 측정은 batch size = 1 조건에 한정된다.
1. Introduction
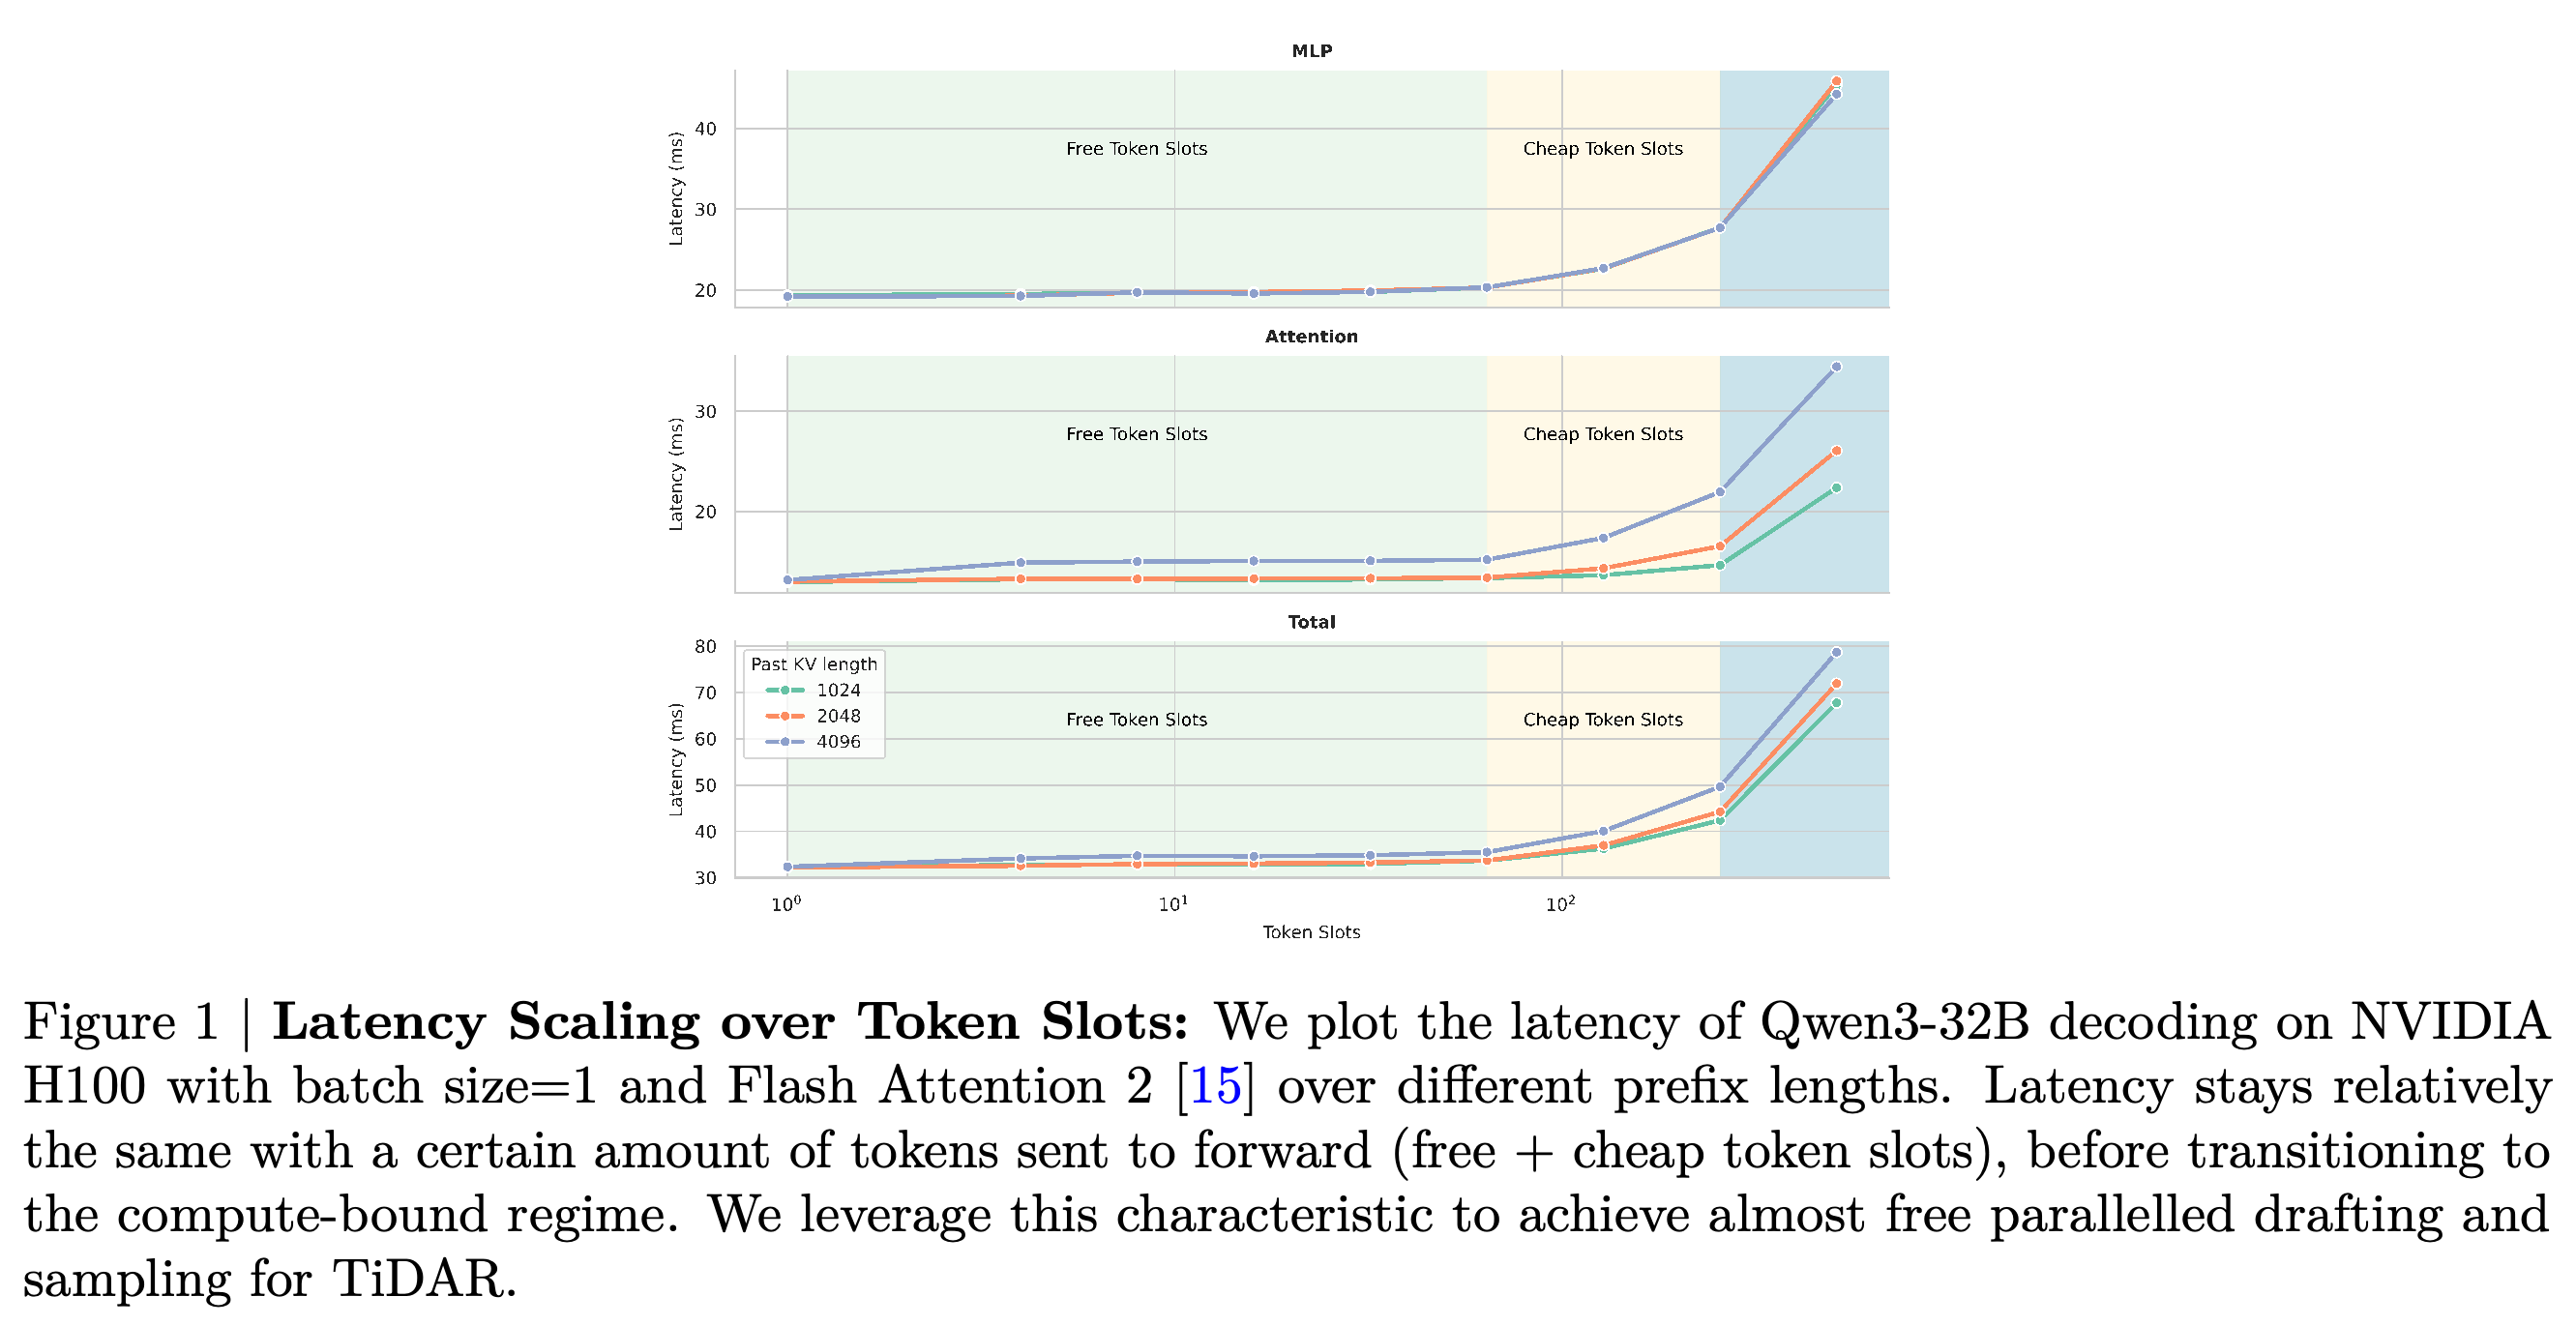
작은 배치에서 AR 디코딩은 메모리 병목의 영향을 받는다. 모델 가중치와 캐시된 어텐션 상태를 불러오는 시간이 지연 시간의 대부분을 차지한다. Figure 1은 H100에서 Qwen3-32B를 프로파일링하고 연산이 병목이 되기 전까지 지연 시간을 거의 늘리지 않고 추가할 수 있는 토큰 위치인 “free token slots”를 확인한다.
- 병렬 확산 샘플링은 같은 단계에서 생성하는 토큰들을 조건부 독립으로 취급한다. AR 확률 분해는 각 예측이 앞선 토큰에 의존하도록 한다.
- TiDAR는 병렬 예측을 후보로 사용하고 인과적 검증으로 출력을 결정하면서 다음 단계의 초안도 준비한다. 추가 비용을 낮게 유지하려면 이러한 활성 위치가 사용 가능한 free token slots 안에 들어가야 한다.
H100에서 batch size = 1과 최적화된 어텐션 구현인 Flash Attention 2를 사용한 Qwen3-32B 프로파일링은 토큰 슬롯이 증가해도 지연 시간이 비교적 일정한 구간을 보인 뒤 지연 시간이 증가함을 보여준다. 접두부 KV 길이 1024, 2048, 4096은 접두부 길이가 어텐션 지연 시간에 미치는 영향을 보여준다. 이는 TiDAR를 직접 측정하지는 않지만 하드웨어 측면의 전제를 뒷받침한다.
2. Background and Related Work
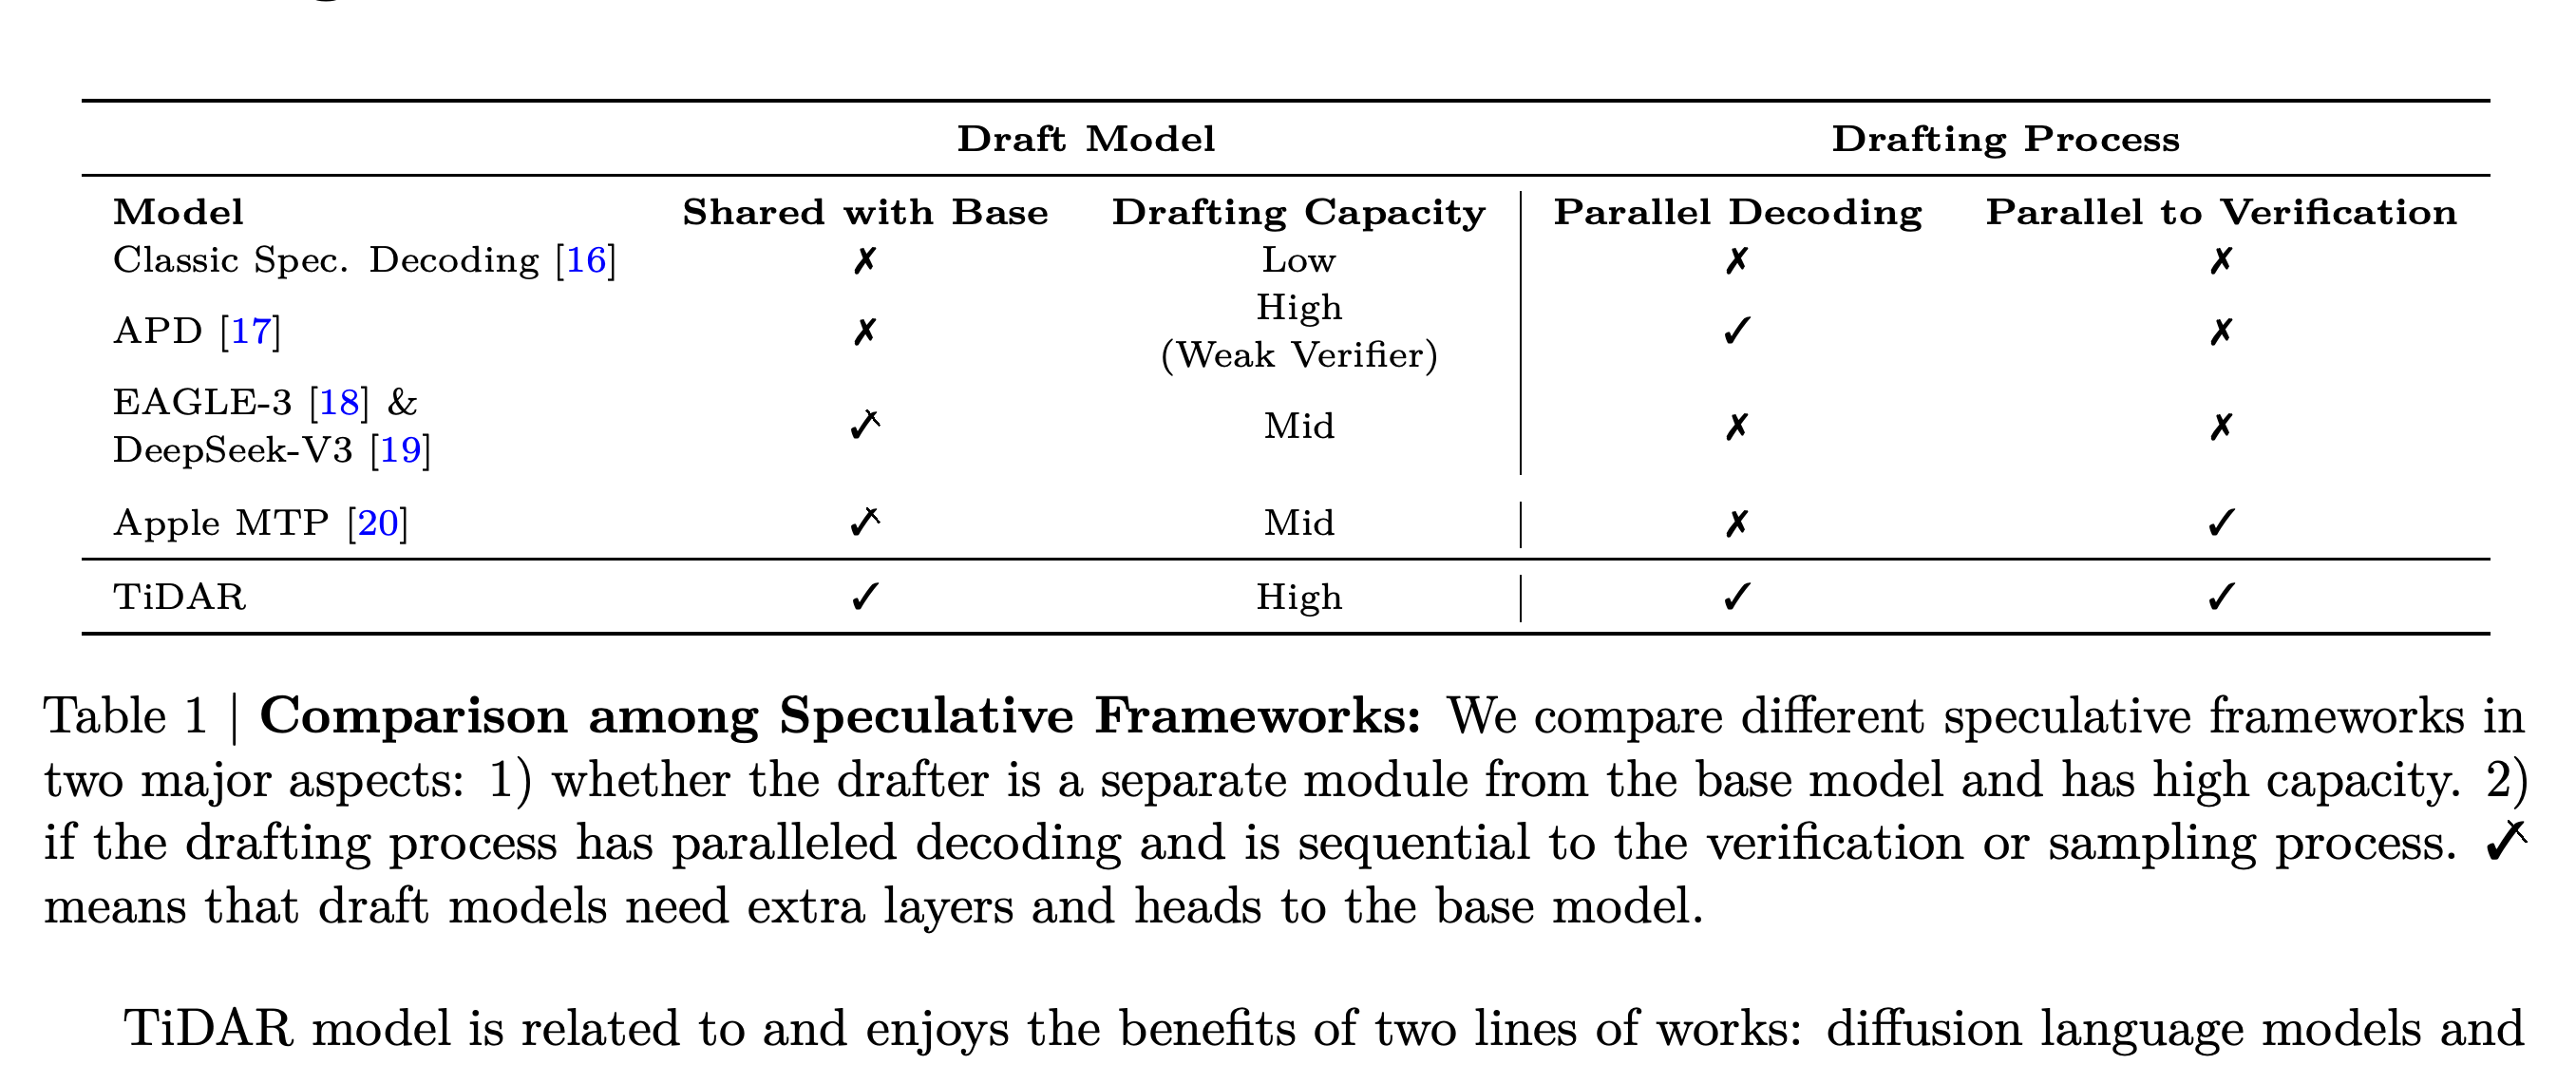
논문은 TiDAR를 확산 언어 모델 및 후보 토큰을 제안한 뒤 목표 모델로 검증하는 speculative decoding과 연결한다. Table 1은 초안 생성 능력, 기반 모델과의 공유 여부, 병렬 토큰 초안 생성, 초안 생성과 검증의 동시 수행 여부를 비교한다.
- TiDAR는 전체 모델로 초안을 생성하며 초안 생성과 검증을 1회의 순전파에서 수행한다. 이 표는 측정 속도가 아니라 아키텍처 특성을 정리한다.
이 비교는 TiDAR를 기반 모델을 공유하고 초안 생성 능력이 높으며 토큰을 병렬로 생성하고 초안 생성과 검증을 동시에 수행하는 방법으로 분류한다. 다른 프레임워크들은 이러한 특성 중 일부를 갖는다. 이 분류는 처리량을 정량화하는 대신 설계 근거를 설명한다.
2.1. Diffusion Language Models
확산 언어 모델은 여러 위치를 동시에 예측할 수 있지만 같은 단계 안에서 독립적으로 샘플링하면 일관성과 정확성이 낮아질 수 있다. 논문은 예측 불확실성으로 토큰 선택을 유도하는 엔트로피 기반 디코딩에서 단계당 토큰 수를 1개에서 2개로 늘렸을 때 Dream-7B의 GSM8K 정확도가 10% 하락한 결과를 인용한다. GSM8K는 수학 문장제 벤치마크이며 이 결과는 선행 연구에서 가져온 것이다.
- 각 위치가 앞뒤 위치를 모두 참조할 수 있는 양방향 어텐션은 캐시된 상태를 정확하게 재사용하기 어렵게 한다. 관련 방법들은 마스킹되지 않은 토큰의 인코딩과 노이즈가 있는 토큰의 디코딩을 분리하거나, 학습과 샘플링의 불일치를 보정하거나, 상태를 선택적으로 캐시한다.
- Block Diffusion은 블록 사이에는 인과적 의존성을, 블록 안에는 양방향 어텐션을 사용한다. 정확한 캐싱을 지원하지만 블록 내부의 품질과 병렬성 사이에는 여전히 절충 관계가 있다.
2.2. Speculative Decoding
일반적인 speculative decoding에서는 저렴한 초안 생성과 후보 수락률 사이에 절충 관계가 있다. 초안 모델의 성능이 낮으면 수락되는 토큰 수가 줄어 속도 이점이 사라질 수 있다. Medusa는 예측 헤드를 추가하며 EAGLE과 DeepSeek-V3 Multi-Token Prediction(MTP)은 기반 모델의 은닉 상태를 재사용한다. MTP는 추가 모듈로 미래 토큰을 예측한다.
- 논문은 이러한 방법이 초안 생성 능력을 제한하거나 순차적인 초안 생성을 유지한다고 주장한다. TiDAR는 전체 백본을 공유하고 병렬 초안 생성과 검증을 동시에 수행한다.
- 일반적인 speculative decoding은 기반 모델의 목표 분포를 보존한다. 백본을 TiDAR로 변환하면 샘플링 대상 모델 자체가 달라진다.
3. Method
TiDAR는 동일한 시퀀스 안에서 인과적 어텐션과 블록 단위 양방향 어텐션을 결합한다. 방법은 이중 모드 백본 학습, 모델 1개가 자신의 후보를 생성하고 검증하는 병렬 self-speculative generation, 마스크 재사용과 정확한 캐싱을 위한 최적화로 구성된다.
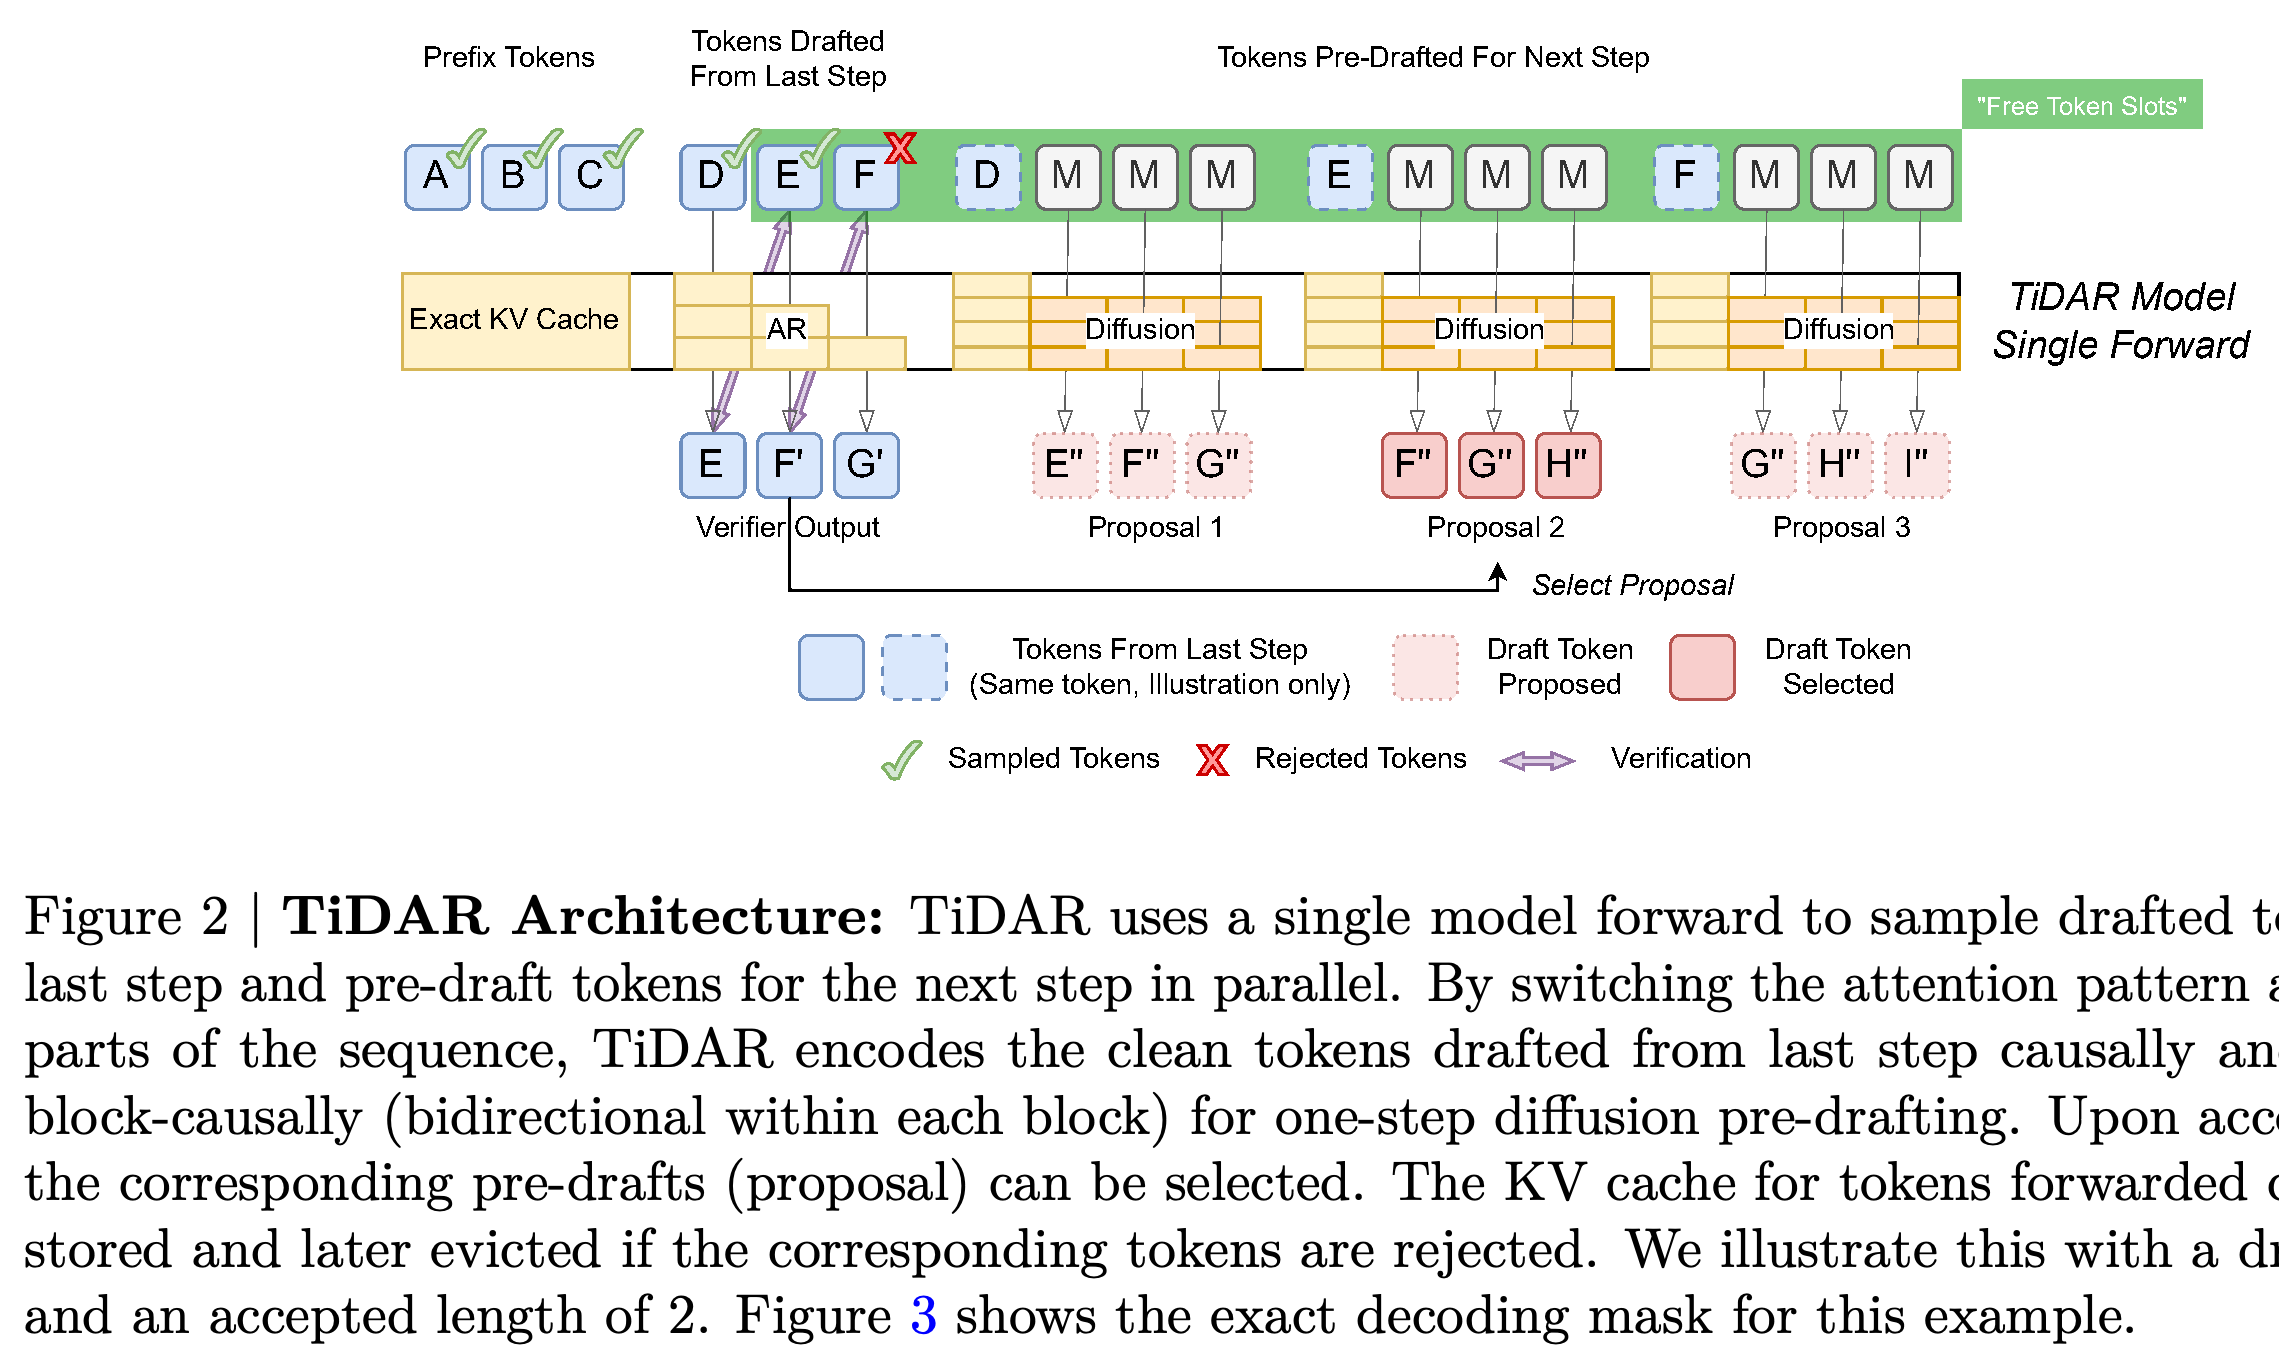
- Figure 2는 수락된 접두부가 동일한 순전파에서 계산한 다음 단계 후보 중 하나를 선택하는 과정을 보여준다.
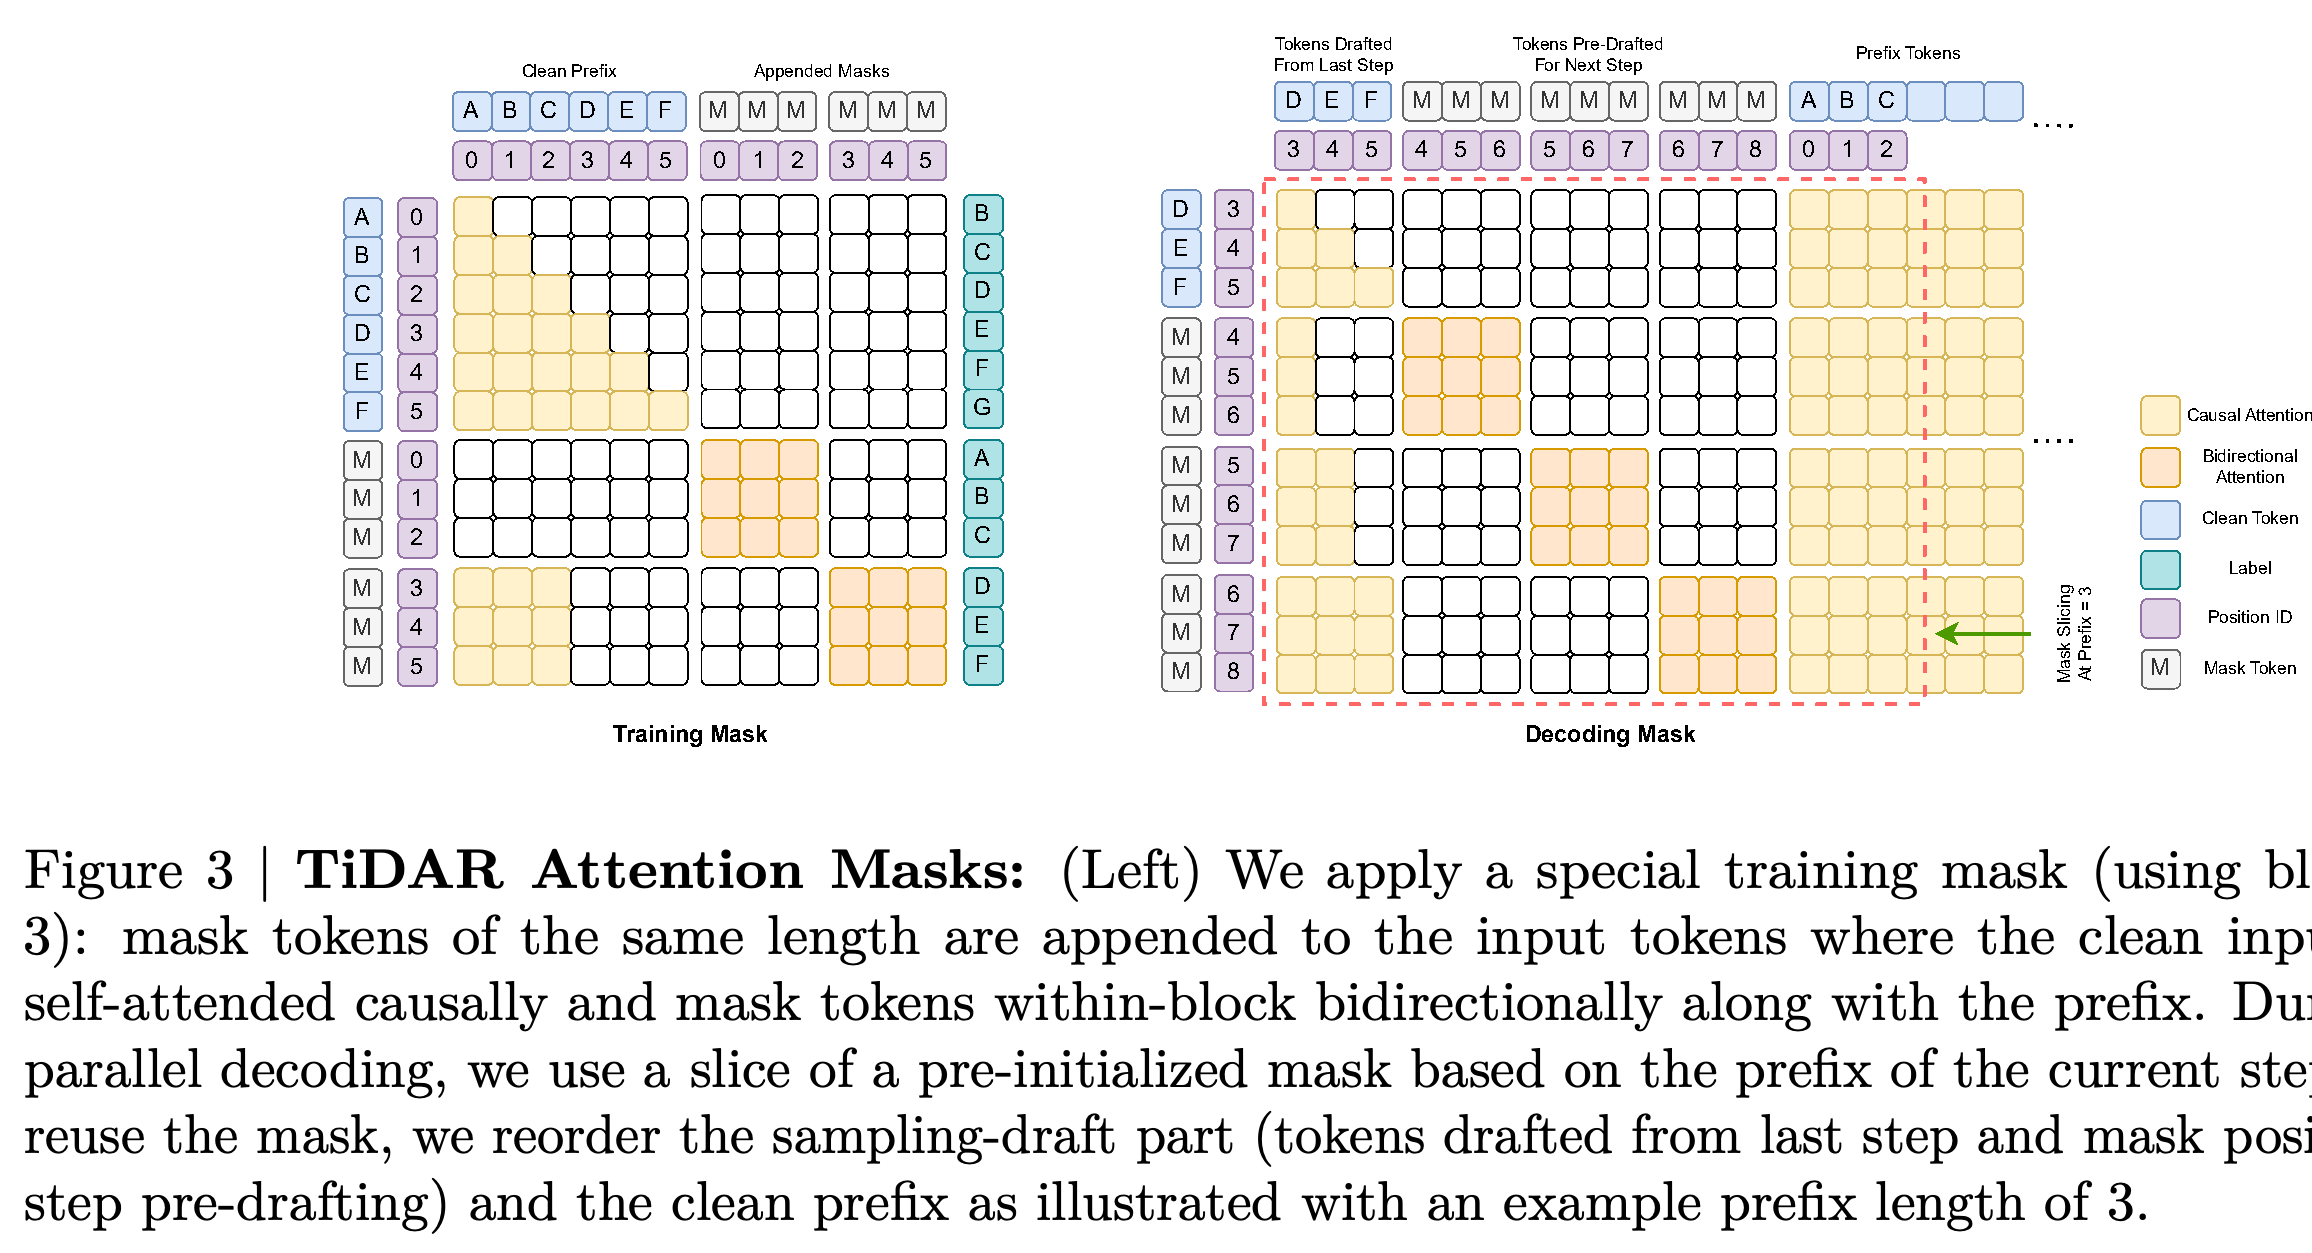
- Figure 3은 인과적 검증과 양방향 초안 생성을 분리하는 학습 및 디코딩 마스크를 보여준다.
초안 길이 3과 수락 길이 2를 사용한 이 도식은 이전 후보를 검증하면서 여러 다음 단계 후보를 계산하는 과정을 보여준다. 수락된 접두부가 해당 후보를 선택하며 거부된 토큰의 인과적 어텐션 상태는 캐시에서 제거할 수 있다.
3.1. Diffusion-AR Dual-mode Backbone Training
학습에서는 입력을 완전히 마스킹한 사본을 뒤에 붙여 시퀀스 길이를 2배로 늘린다. 마스킹되지 않은 토큰에는 인과적 어텐션을 적용하고 다음 토큰 예측(NTP)을 위해 레이블을 1개 위치만큼 이동한다. 마스킹된 위치에는 블록 내부 양방향 어텐션을 적용하고 레이블을 입력 위치에 맞춘다.
- 인과적 접두부는 AR 손실을 계산할 때 레이블 누출을 방지한다. 레이블 누출은 특정 위치가 자신의 미래 정답을 참조할 수 있을 때 발생한다.
- 전체 마스킹은 모든 마스킹된 위치에 확산 손실을 제공하고 모드 사이의 손실 항 개수를 같게 맞추며, 추론 시 1단계 초안 생성과 일치한다.
- 목적 함수는 \(\mathcal{L}_{TiDAR}(\theta)=\frac{1}{1+\alpha}\left[\sum_{i=1}^{S-1}\frac{\alpha}{S-1}\mathcal{L}_{AR}(x_i,x_{i+1};\theta)+\sum_{i=1}^{S-1}\frac{1}{S-1}\mathcal{L}_{Diff}([mask],x_i;\theta)\right]\)이다. S는 입력 시퀀스 길이이며 2개의 손실은 정답 토큰의 예측 확률이 낮을수록 커지는 교차 엔트로피 손실이다. 수식에 딸린 설명에는 \(\alpha\in[0,1]\)로 명시되어 있지만 Figure 6에서는 AR 손실 가중치 1.2도 평가한다.
학습 마스크는 마스킹되지 않은 토큰의 인과적 예측과 확산 레이블을 입력 위치에 맞춘 양방향 마스크 토큰 블록을 분리한다. 디코딩 마스크는 활성 위치와 캐시된 접두부 위치를 재배열해 마스크 슬라이스를 재사용할 수 있게 하면서 후보 분기가 자신과 양립할 수 없는 미래 토큰을 참조하지 못하게 한다.
3.2. Fully Parallelizable Self-Speculative Generation
생성은 프롬프트를 인과적으로 인코딩하고 마스킹된 위치에서 초안 블록을 생성하는 것으로 시작한다. 이후 각 순전파는 이전 초안을 검증하고 수락될 수 있는 접두부들에 조건을 둔 다음 단계 후보들을 계산한다. 검증이 끝나면 해당 접두부에 맞는 후보를 선택한다.
- 논문은 rejection sampling을 후보 토큰을 검증 모델의 예측과 대조하고 수락된 접두부를 유지하는 과정으로 설명한다.
- 1단계 확산은 마스킹된 위치를 예측값으로 점진적으로 대체하는 노이즈 제거 순전파를 반복하지 않는다. 초안 품질은 독립적으로 샘플링한 최종 블록을 직접 사용하는 방식이 아니라 수락률을 통해 영향을 미친다.
- 아키텍처 예시는 초안 길이 3과 수락 길이 2를 사용하며 검증과 후보 선택을 함께 보여준다.
3.3. Training and Inference Optimization
대부분의 실험은 α = 1을 사용해 AR 손실과 확산 손실의 균형을 맞춘다. 디코딩 구현은 초안 위치와 접두부 위치를 재배열한다. 이를 통해 여기서 사용하는 어텐션 구현인 Flex Attention이 매 단계 마스크를 다시 만드는 대신 초기화된 마스크의 일부를 잘라 재사용할 수 있다.
- 디코딩 마스크의 크기는 (q_len, q_len + max_sequence_len)이며, \(\mathrm{q\_len}=\mathrm{block\_len}\cdot(1+\mathrm{block\_len})\)이다. 따라서 활성 위치의 수는 초안 길이에 대해 제곱으로 증가한다.
- 인과적으로 계산한 상태는 캐시하고 거부된 토큰에 해당하는 상태는 제거한다. 수락된 상태는 다시 계산할 필요가 없다.
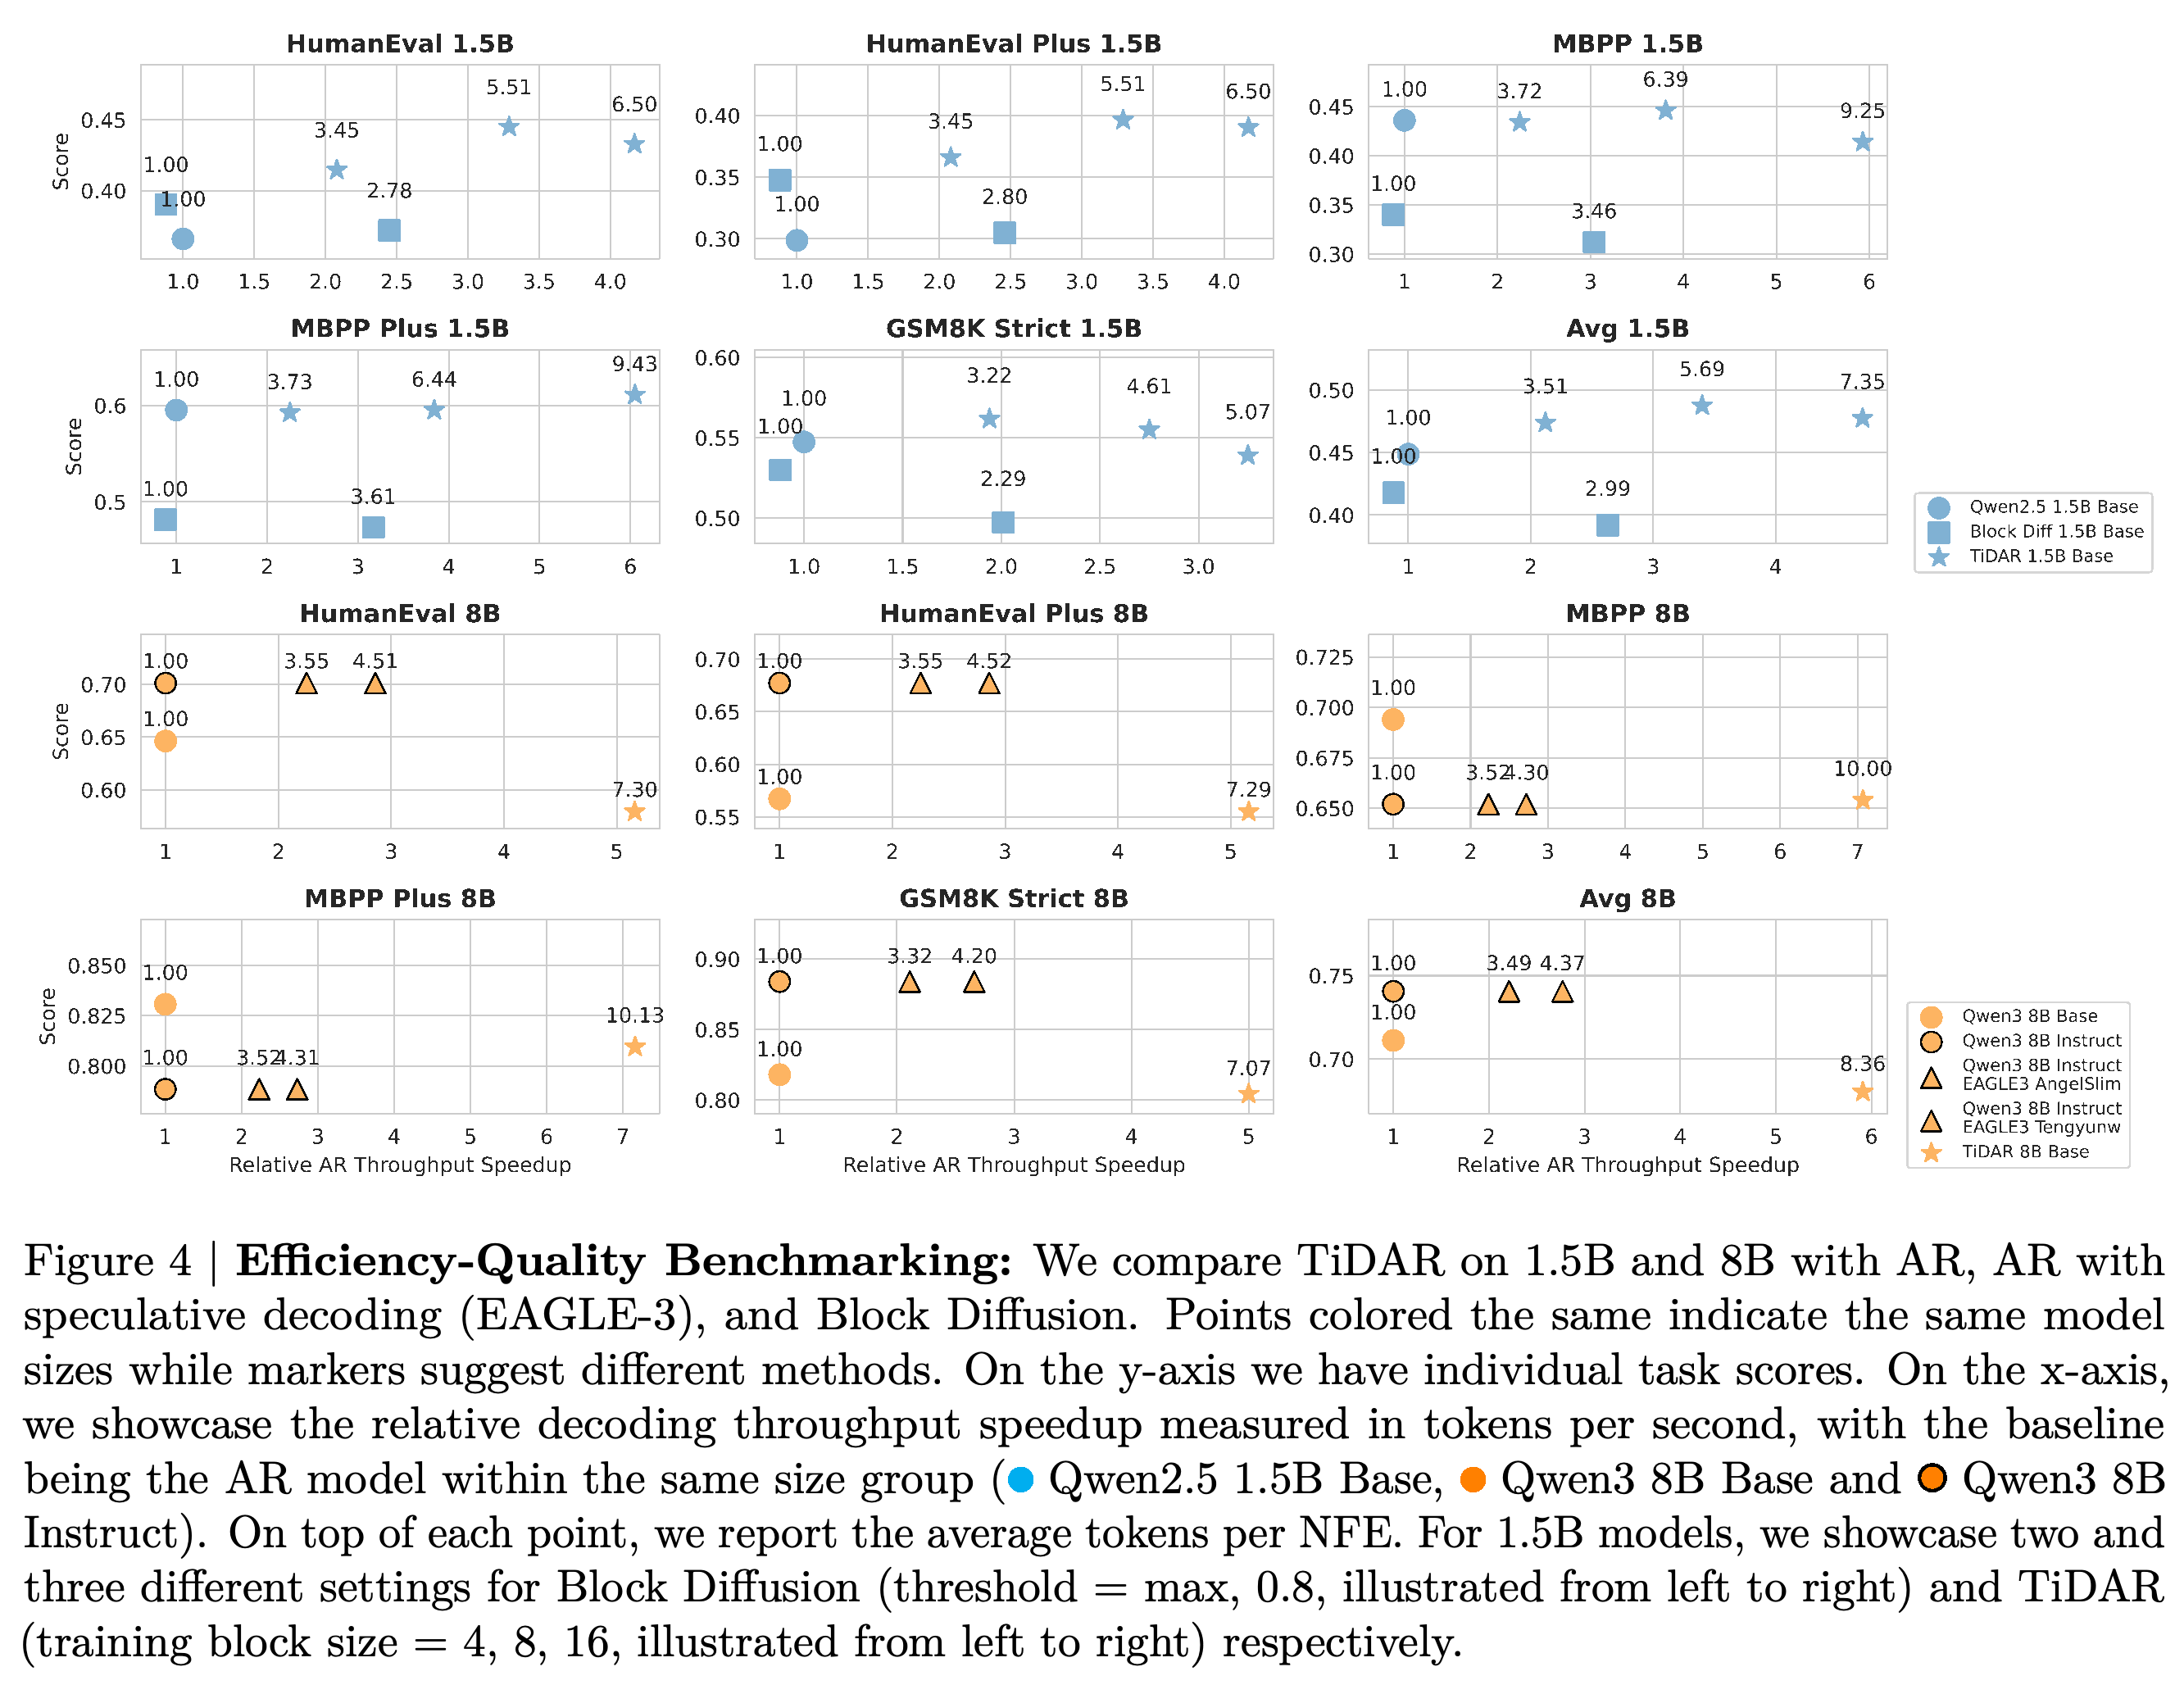
- Figure 4는 순전파당 토큰 수가 실제 시간 기준 처리량으로 이어지는지 평가한다. Appendix B는 Figure 7처럼 마스크 슬라이싱을 최초 프롬프트 처리 단계인 프리필에 적용한다.
과제 점수를 실제 시간 기준 상대 디코딩 처리량에 대해 표시하고 NFE당 토큰 수는 별도로 표기한다. TiDAR는 평가한 대안보다 높은 처리량을 달성한다. 8B 패널에서는 EAGLE-3에 사용한 Instruct 모델보다 HumanEval, HumanEval+, GSM8K 점수가 낮으며 MBPP와 MBPP+는 대체로 비슷하다. 처리량 비율은 각 모델 변형에 대응하는 AR 비교 기준을 바탕으로 한다.
Experimental Setup
실험은 Qwen2.5 1.5B, Qwen3 4B, Qwen3 8B로 모델을 초기화하고 언어 모델 평가 프레임워크인 lm_eval_harness로 코딩, 수학, 사실 지식, 상식 추론을 평가한다. 주요 TiDAR 결과는 1.5B와 8B를 다루며, 절제 실험은 주로 1.5B를 사용한다.
- TiDAR 1.5B는 50B 규모의 지속 사전학습 토큰을 블록 크기 4, 8, 16으로 학습한다. TiDAR 8B는 블록 크기 16으로 150B 토큰을 학습한다. 학습에는 H100과 2M 토큰의 전역 배치를 사용하며 학습 배치를 장치들에 분산하는 분산 데이터 병렬화를 적용한다.
- 설정에는 코사인 학습률 스케줄링, max_lr = 1e−5, min_lr = 3e−6, 1% 워밍업, 최대 시퀀스 길이 4096, 분산 Adam 최적화, BFloat 16 수치 정밀도가 포함된다. 8B 모델은 중간 활성값을 다시 계산해 학습 메모리를 줄이는 gradient checkpointing을 사용한다.
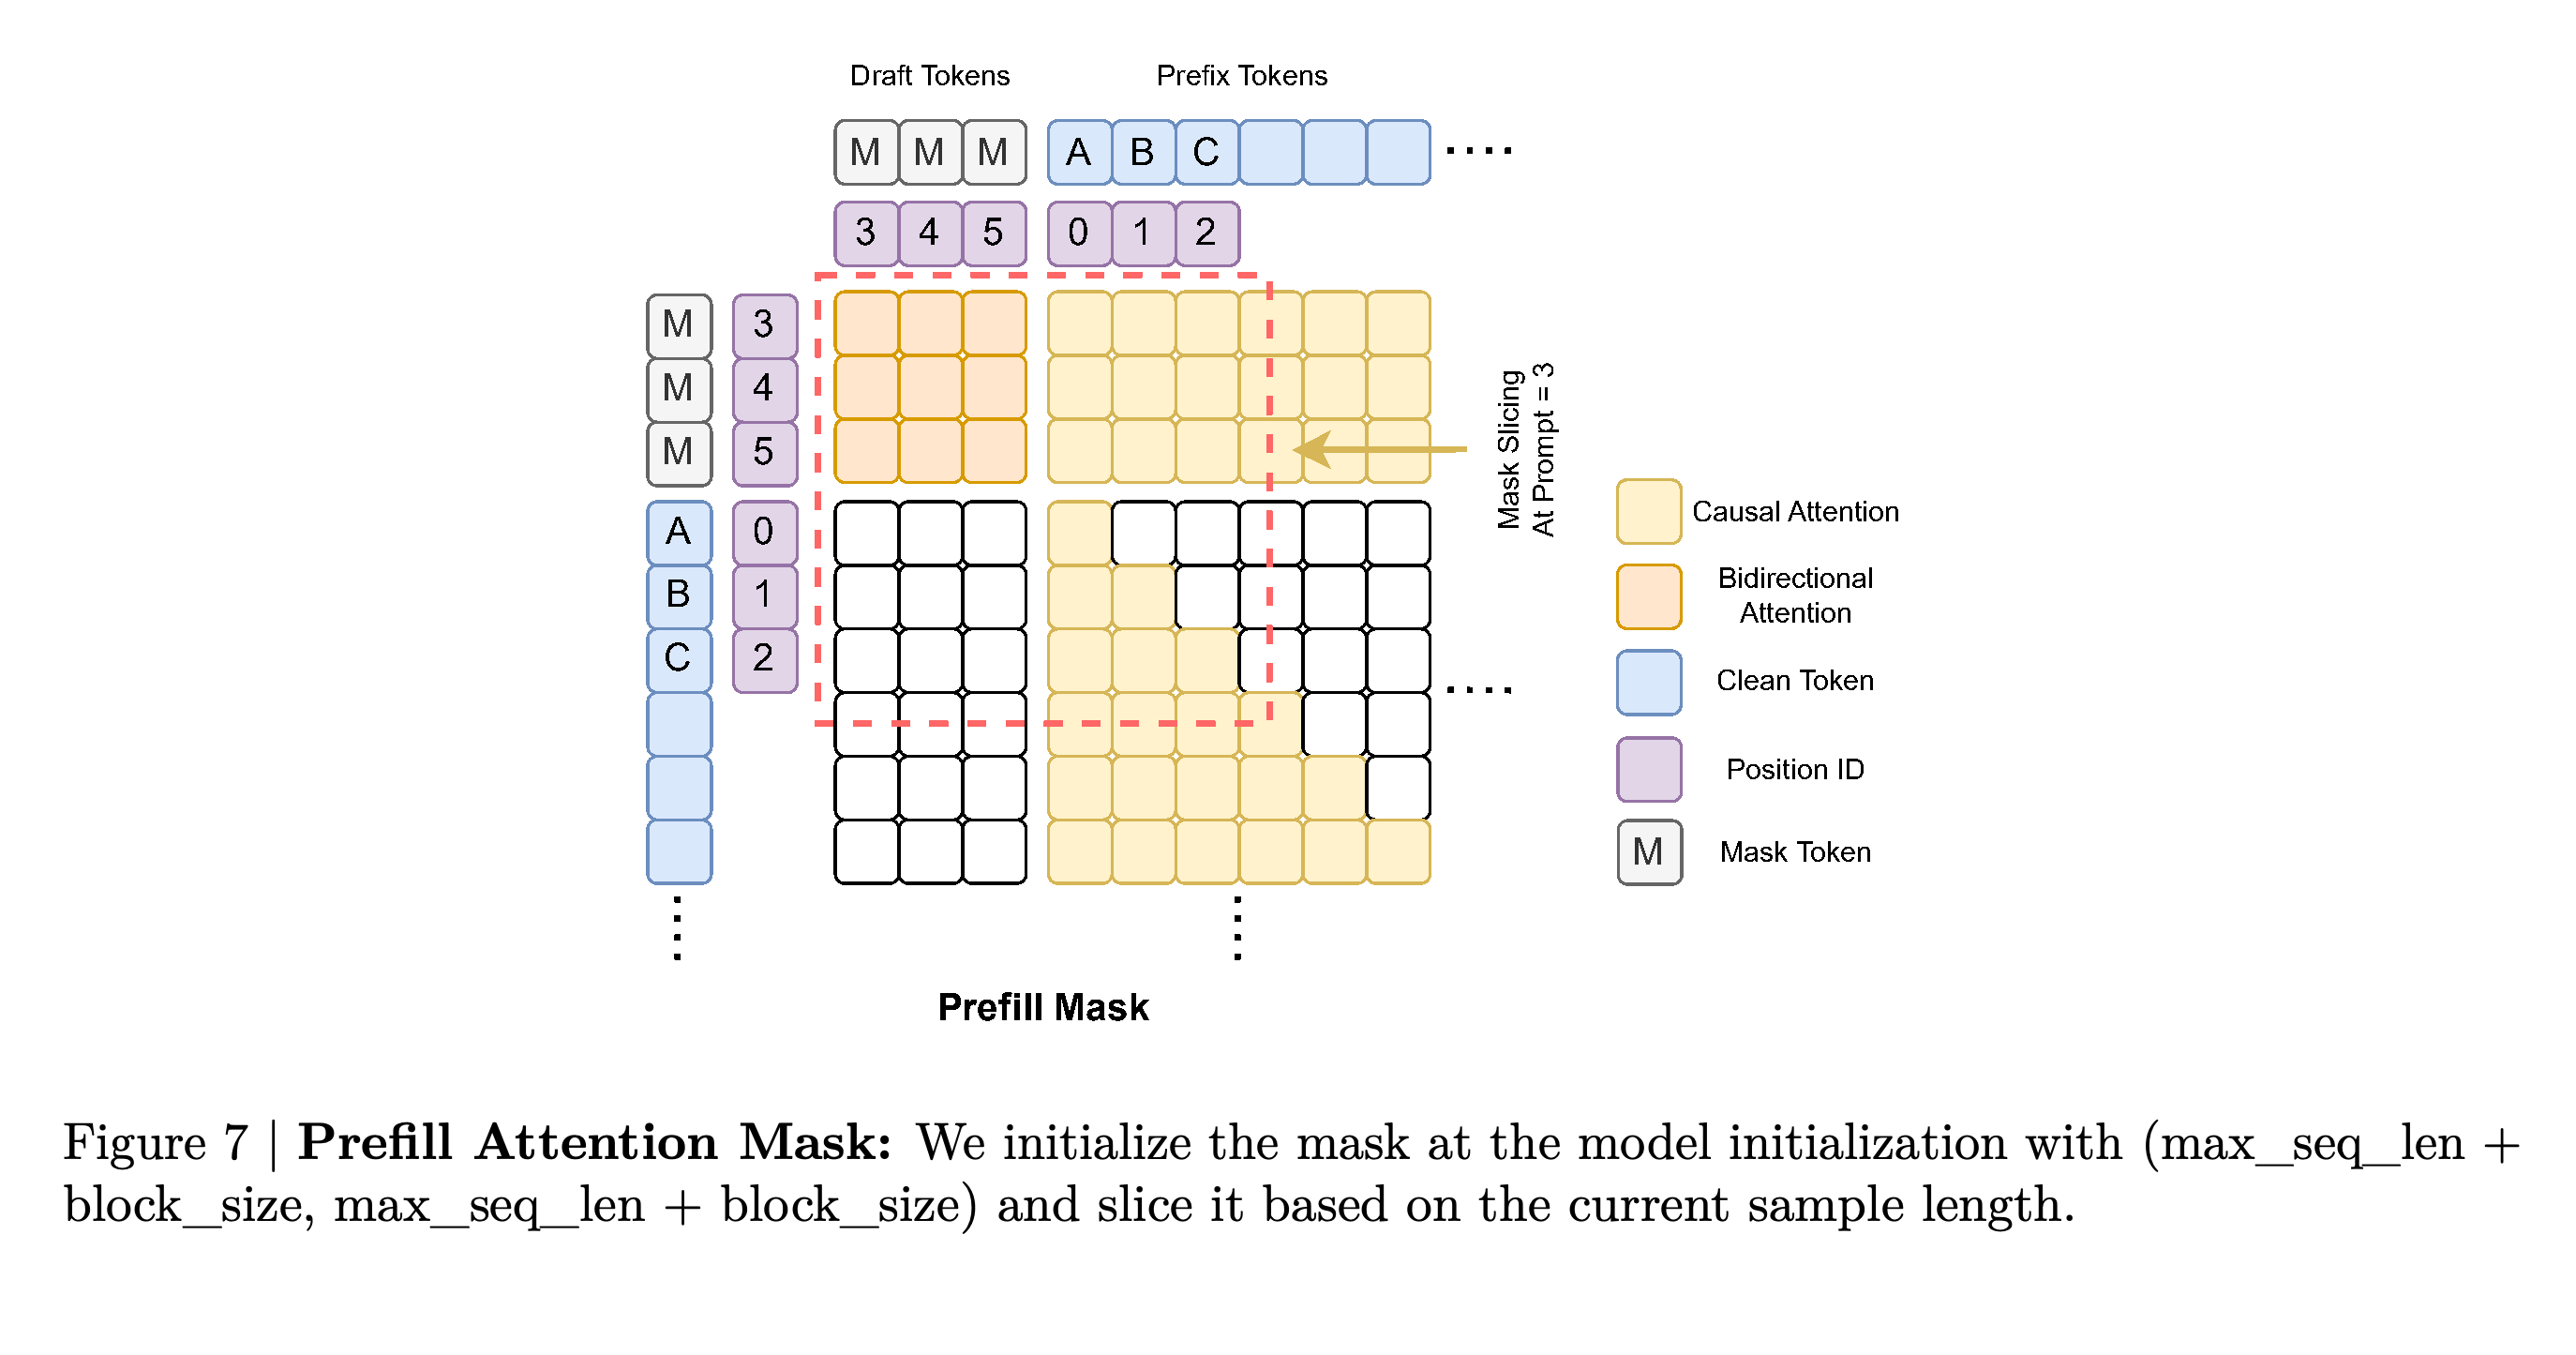
- 비교 기준에는 Llama3.2, SmolLM2, Qwen2.5, Qwen3, Dream, LLaDA, 별도로 학습한 Block Diffusion 모델이 포함된다. Appendix Table 6은 과제별 프롬프트, 생성 한도, 채점 조건을 명시한다.
4.2. Main Results
주요 결과는 생성 품질과 우도 기반 답변 채점을 구분한다. 우도 기반 채점은 모델이 부여한 확률로 후보 답변의 순위를 정한다. 생성 품질 평가는 생성된 코드와 수학 답변을 측정하며 우도 기반 평가는 확산 우도를 추정하지 않고 TiDAR의 인과적 모드를 사용한다.
4.2.1. Generative Task Evaluation
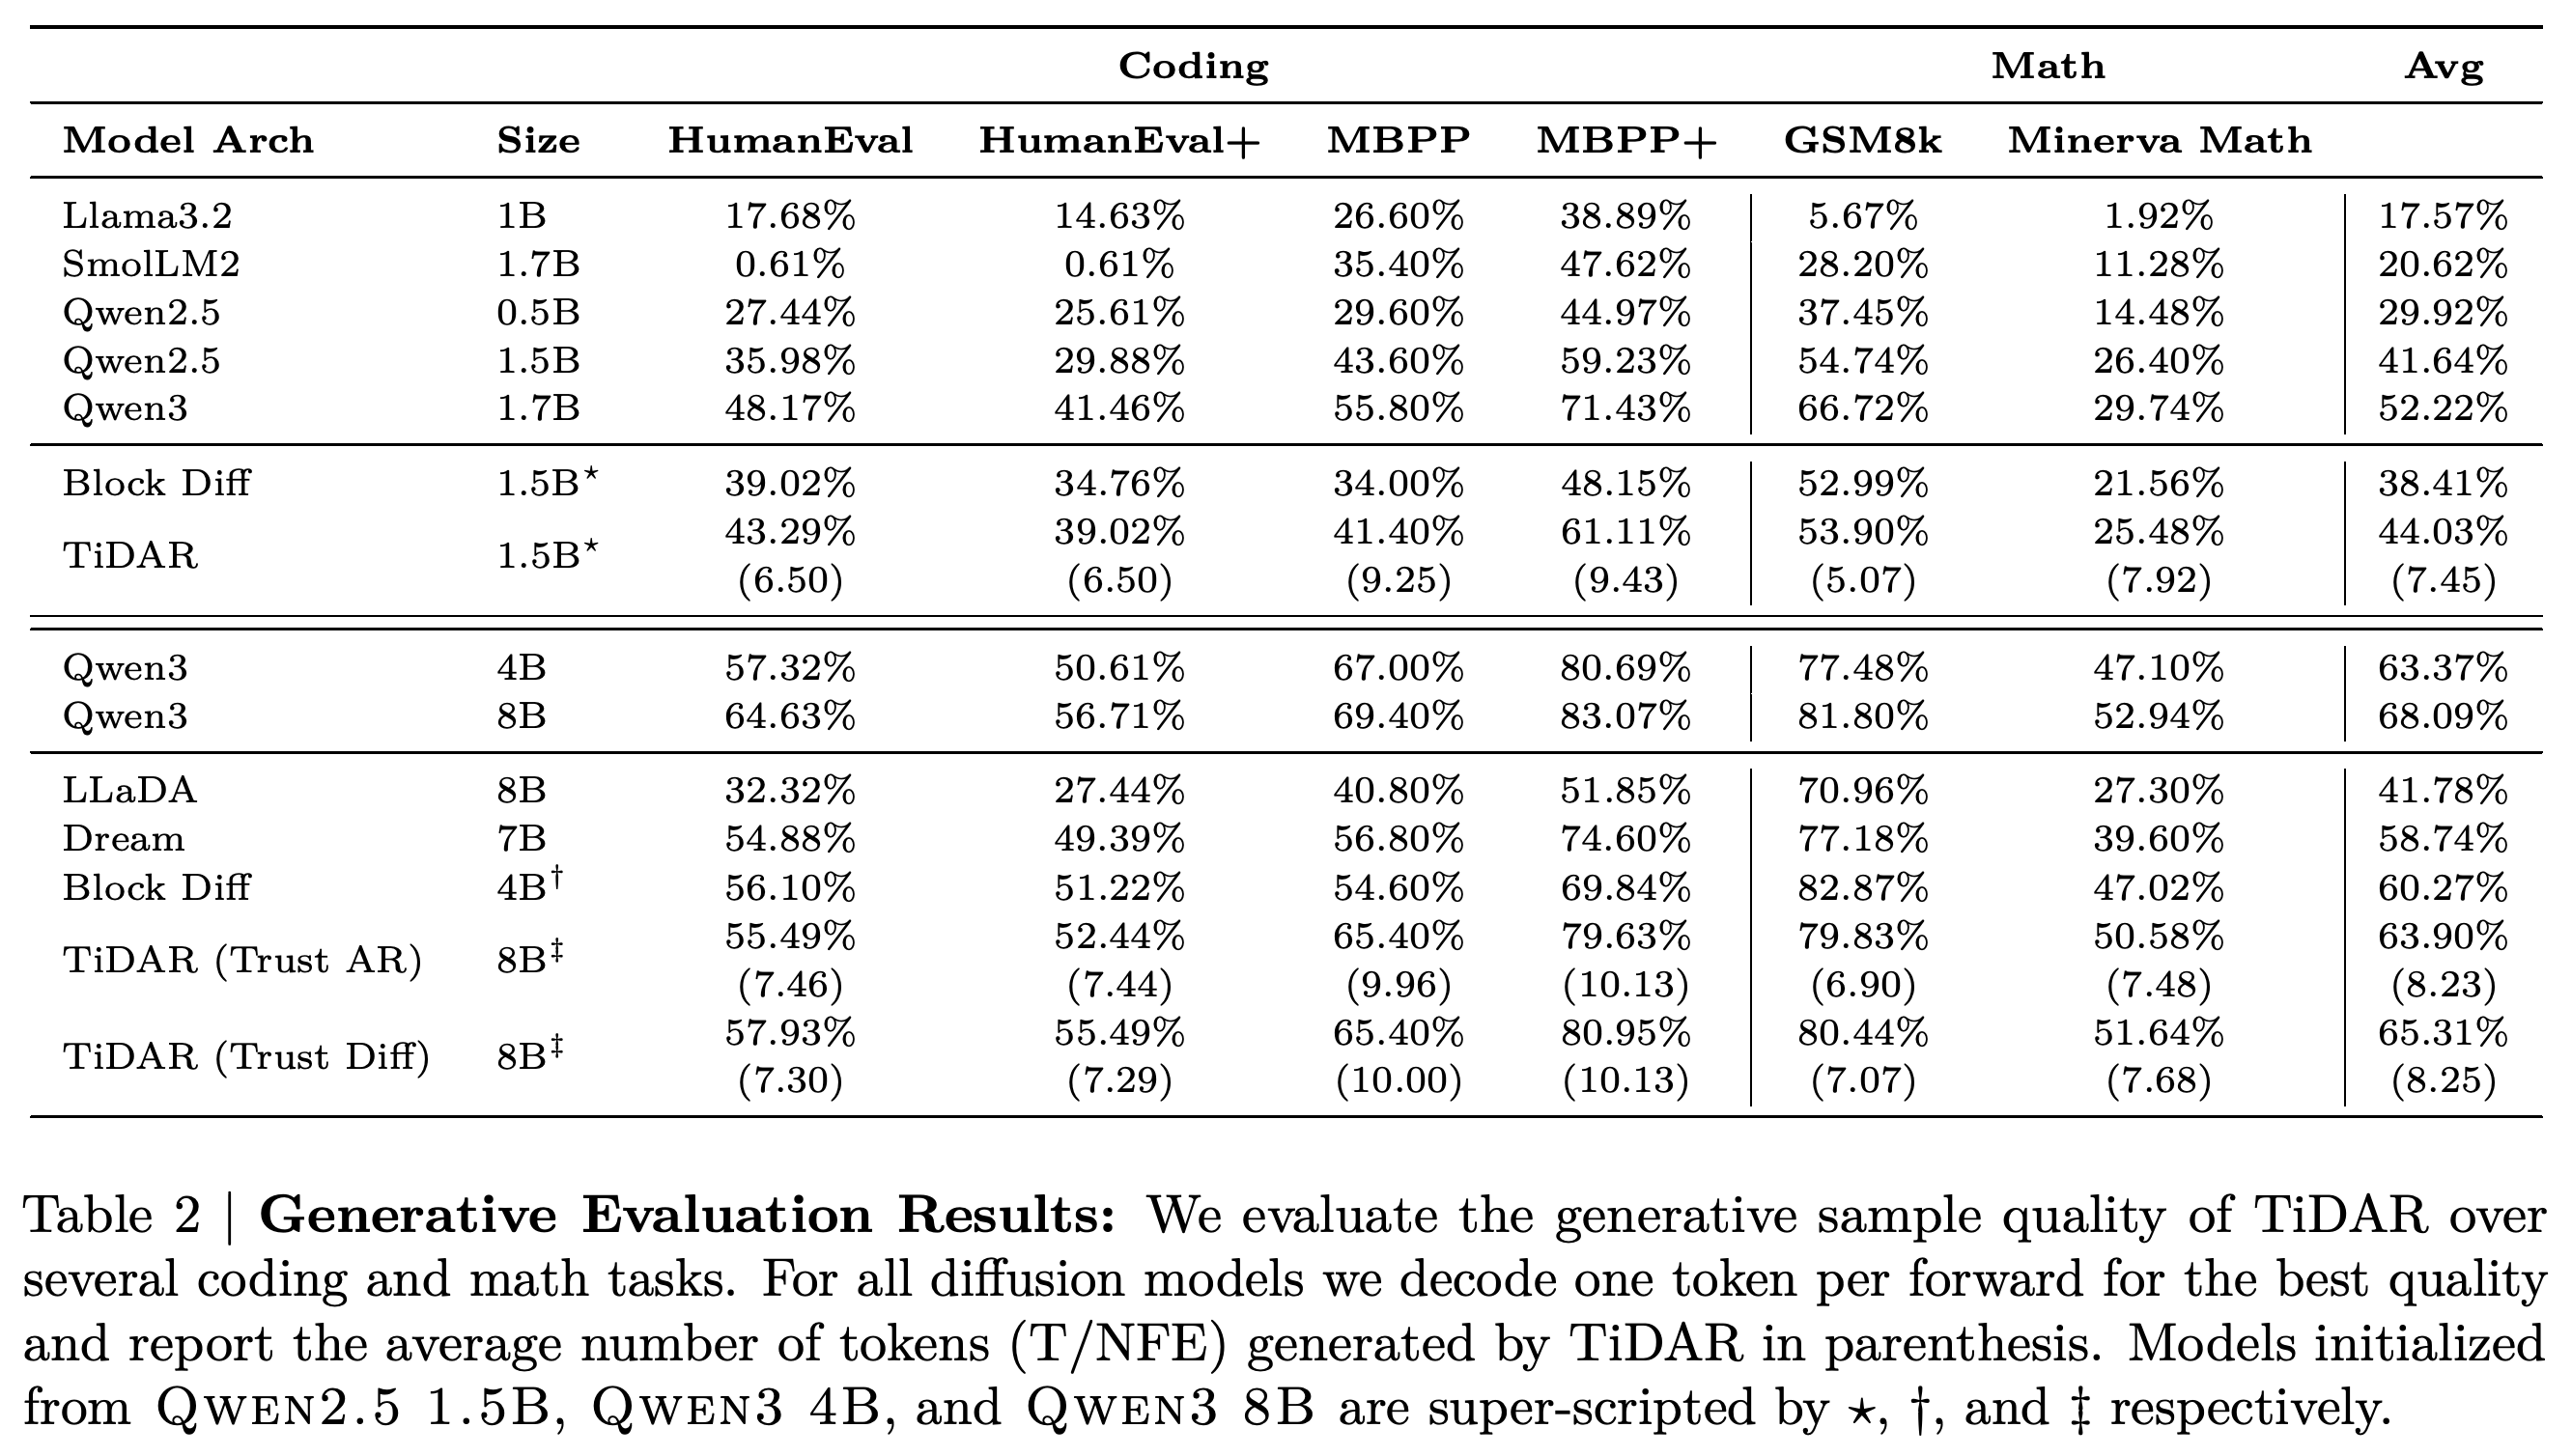
Table 2에서 TiDAR 1.5B의 6개 생성 과제 평균은 44.03%다. 초기화에 사용한 Qwen2.5 1.5B는 41.64%, Block Diffusion 1.5B는 38.41%다. TiDAR는 NFE당 평균 7.45 토큰을 생성하지만 개선 폭은 과제마다 다르다. 코드 생성 벤치마크인 HumanEval은 35.98%에서 43.29%로 상승하고 GSM8k는 54.74%에서 53.90%로 하락한다.
- 확산 예측으로 검증하는 TiDAR 8B의 평균은 65.31%이며, Qwen3 8B는 68.09%, Dream 7B는 58.74%, LLaDA 8B는 41.78%다. TiDAR 8B는 NFE당 평균 8.25 토큰을 출력한다.
- AR 예측을 사용하면 TiDAR 8B의 평균은 63.90%이며, NFE당 8.23 토큰을 생성한다. 확산 검증은 6개 과제 가운데 다섯 과제의 점수를 개선하고 나머지 한 과제의 점수는 유지한다.
- TiDAR 이외의 확산 비교 모델은 품질을 우선해 순전파당 1개 토큰을 디코딩한다. 대형 모델 비교에 사용한 Block Diffusion 비교 모델은 4B이므로, TiDAR 8B와의 비교는 모델 크기를 맞춘 상태에서 아키텍처만 비교한 결과가 아니다.
TiDAR 1.5B는 6개 과제 평균을 초기화 모델의 41.64%에서 44.03%로 높이고 NFE당 7.45 토큰을 생성한다. 확산 검증을 사용하는 TiDAR 8B는 NFE당 8.25 토큰과 평균 점수 65.31%를 기록한다. 이는 Qwen3 8B의 68.09%보다 낮지만 표에 제시된 공개 확산 모델보다 높다.
4.2.2. Likelihood Task Evaluation
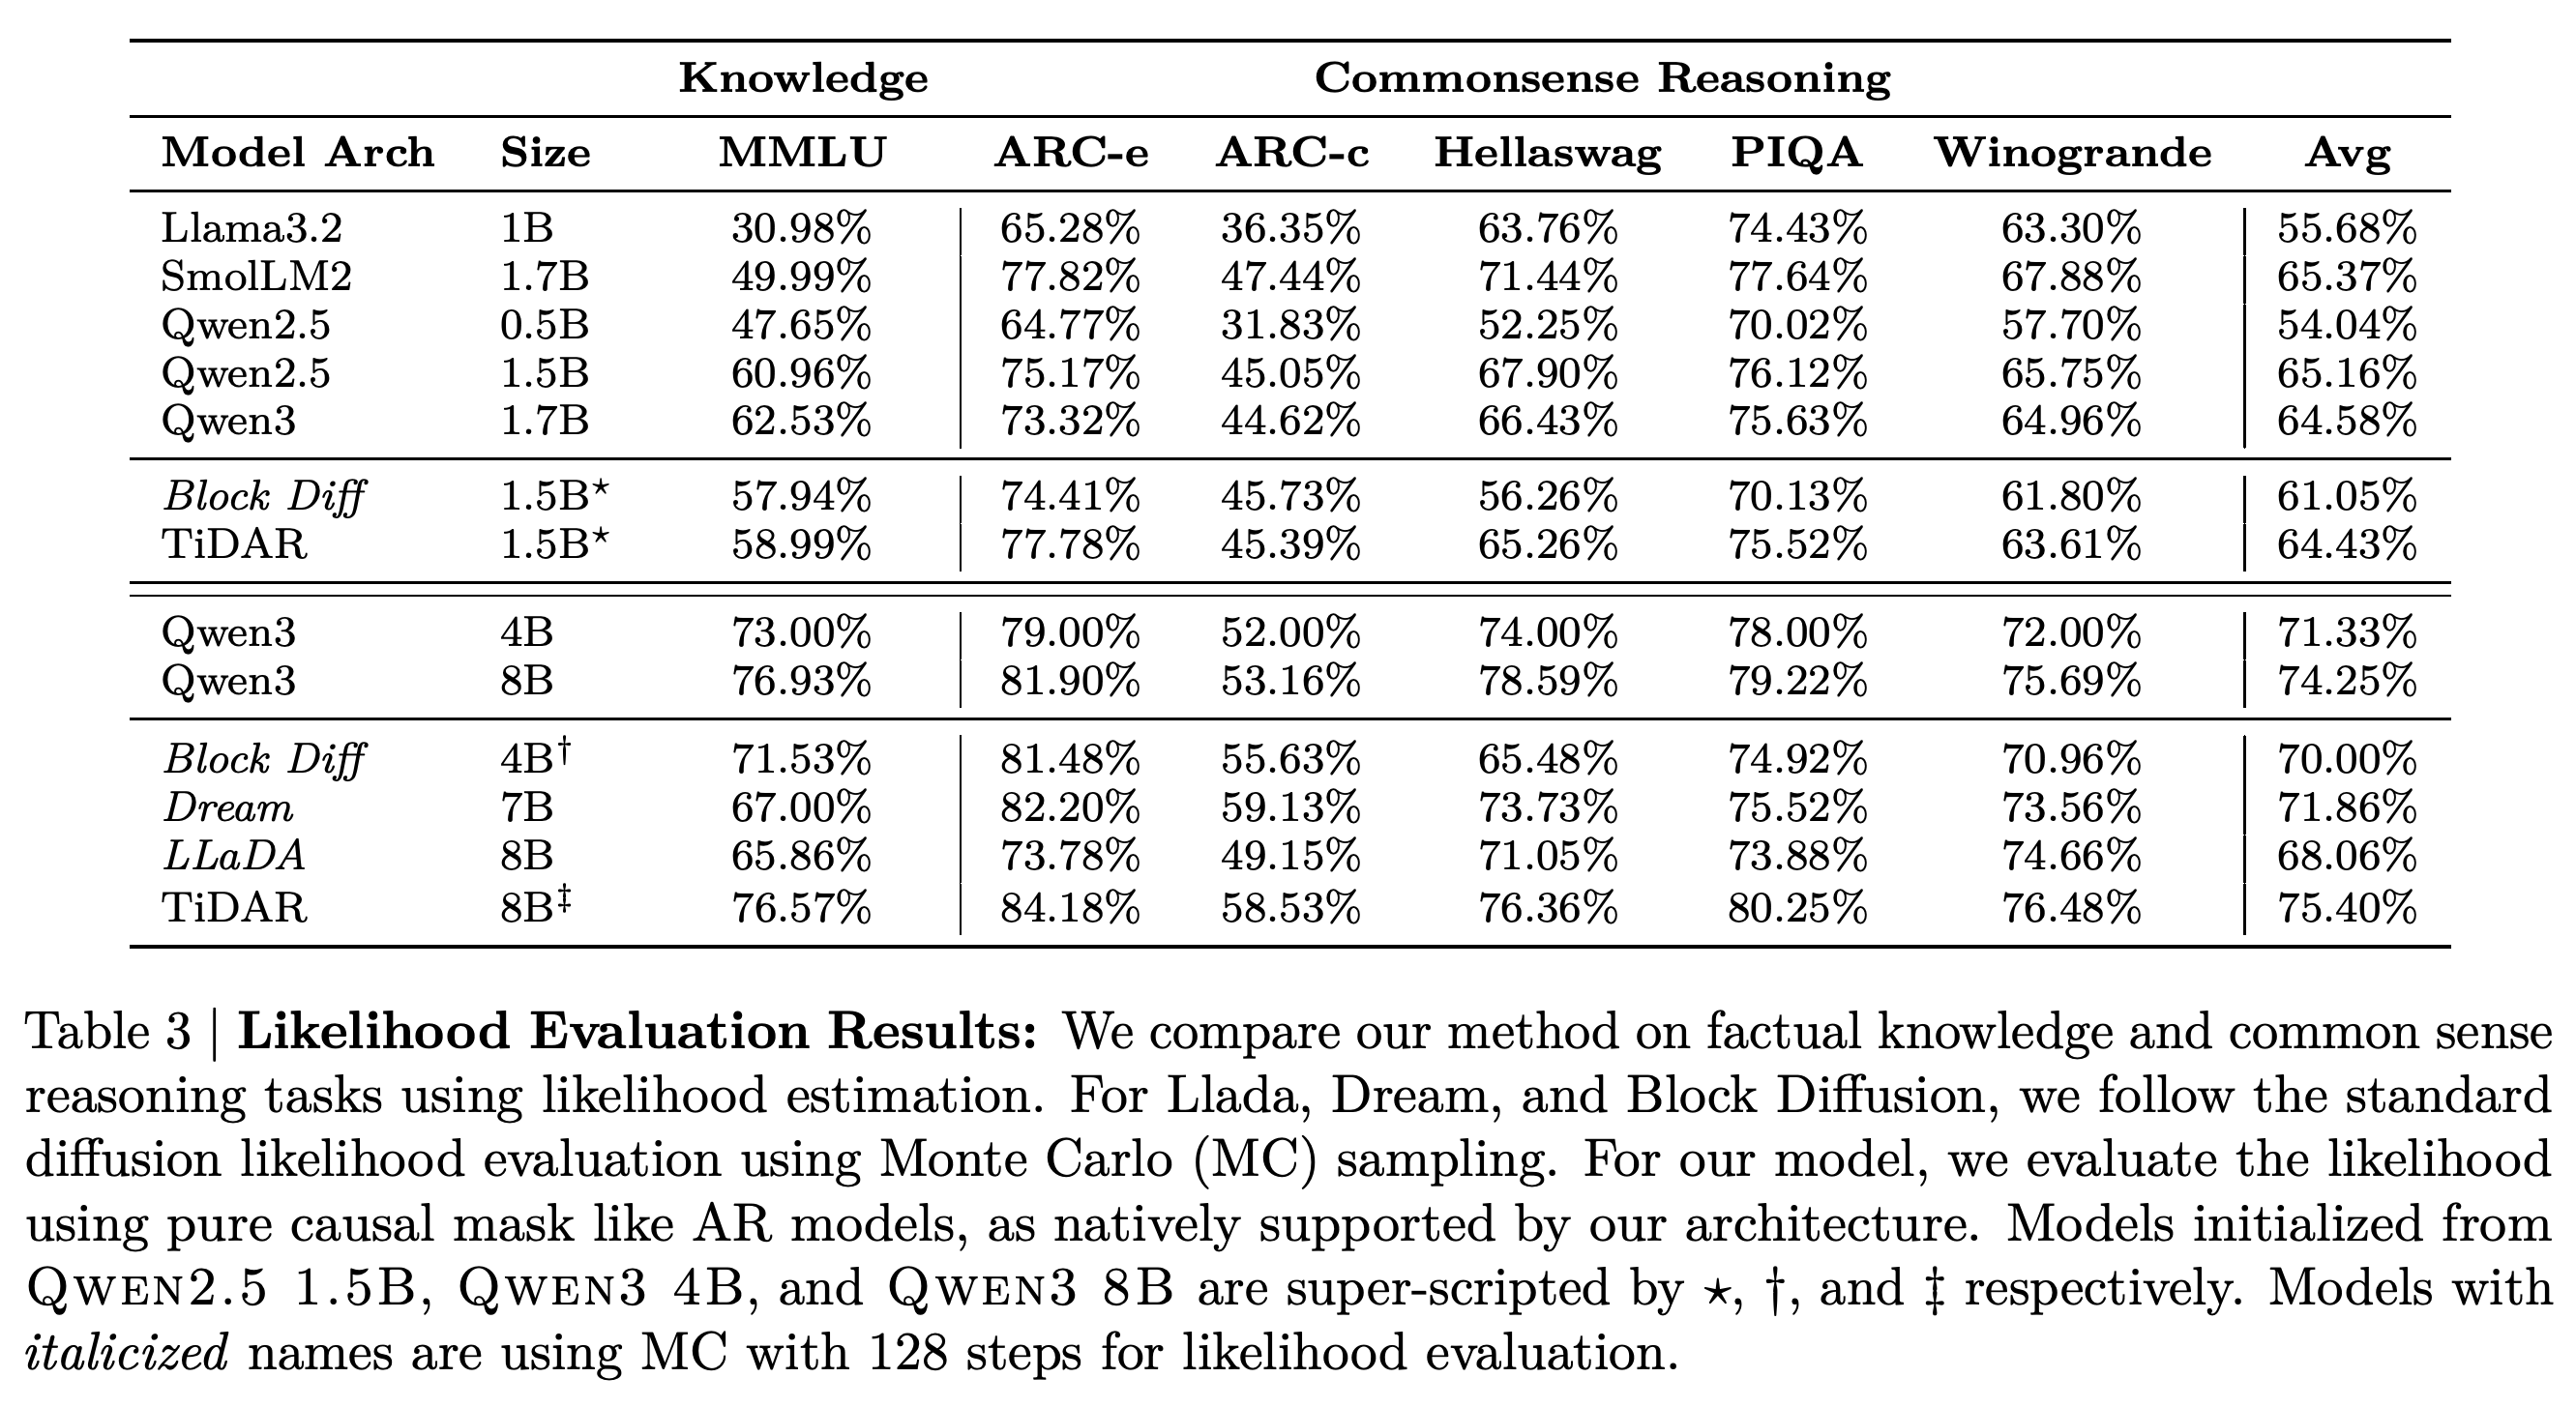
TiDAR는 AR 채점 절차에 따라 인과적 어텐션으로 1 NFE에 답변 우도를 계산한다. 확산 비교 모델은 샘플링한 손상 입력들의 점수를 평균하는 몬테카를로(MC) 샘플링으로 우도를 추정한다. Table 3은 128 MC 단계를 사용하는 모델을 표시한다.
- 사실 지식과 상식 평가의 평균은 TiDAR 1.5B가 64.43%, Qwen2.5 1.5B가 65.16%이며, TiDAR 8B가 75.40%, Qwen3 8B가 74.25%다.
- 표는 사실 지식 벤치마크인 MMLU와 논문에서 상식 추론으로 분류한 ARC, Hellaswag, PIQA, Winogrande를 다룬다. 저자들은 서로 다른 우도 추정기를 직접 비교하는 문제에 논쟁이 계속되고 있음을 인정한다.
TiDAR의 인과적 우도 채점은 1.5B에서 평균 64.43%, 8B에서 75.40%를 기록한다. 대응하는 AR 초기화 모델은 65.16%와 74.25%다. 이탤릭체로 표시한 확산 비교 모델은 128단계 몬테카를로 우도 추정을 사용하므로, 이 표는 모델뿐 아니라 서로 다른 채점 절차도 비교한다.
4.3. Efficiency Benchmarking
실제 시간 측정에는 H100 1개, batch size = 1, 다운스트림 생성 과제의 프롬프트, 정확한 캐싱, 기본 PyTorch 구현을 사용한다. TiDAR는 Qwen2.5 1.5B 대비 평균 디코딩 처리량 4.71×, Qwen3 8B 대비 5.91×를 보고하며 평가한 Block Diffusion과 EAGLE-3 설정을 앞선다.
- EAGLE-3는 대응하는 기반 모델용 초안 가중치를 사용할 수 없어 지시 학습을 거친 Qwen3-8B Instruct를 사용한다. 체크포인트는 https://huggingface.co/AngelSlim/Qwen3-8B_eagle3 및 https://huggingface.co/Tengyunw/qwen3_8b_eagle3 에서 제공한다.
- 따라서 EAGLE-3 비교에는 다른 모델 변형과 다른 품질 수준이 포함된다. Figure 4는 각 설정에 대응하는 AR 비교 기준을 바탕으로 처리량을 정규화한다.
- 저자들은 처리량 향상을 NFE당 수락 토큰 증가와 순전파당 토큰 수를 초당 토큰 수로 더 효율적으로 전환한 결과로 설명한다. 커널, 캐시 관리, 요청 스케줄링은 모든 방법에서 추가로 최적화할 여지가 있다.
4.4. Ablation Studies
절제 실험은 동일한 학습 조건, 디코딩 전략, 선택 전 토큰 점수인 검증 로짓의 선택, 전체 마스킹과 무작위 마스킹을 살펴본다. 이 실험들은 1.5B 설정에서 개별 설계 선택을 검증한다.
4.4.1. Pareto Frontier under the Same Training Recipe
Figure 5는 Qwen2.5 1.5B로 초기화한 모델들을 동일한 학습 설정과 50B 토큰 예산으로 비교한다. TiDAR는 Block Diffusion과 원래 AR 모델보다 우수한 품질과 효율의 파레토 경계를 제공하지만 추가로 학습한 AR 모델은 더 높은 평균 품질을 유지한다.
- 파레토 경계는 측정한 목적 중 어느 하나를 개선하려면 다른 하나를 희생해야 하는 설정들로 구성된다. 여기서 목적은 과제 점수와 NFE당 토큰 수다.
- 초안 블록을 늘리면 순전파당 토큰 수는 증가하지만 정확성이 일관되게 개선되지는 않는다. 학습 데이터를 늘리면 남아 있는 AR 품질 격차를 줄일 수 있다는 저자들의 제안은 검증되지 않았다.
4.4.2. Comparing TiDAR with Other Decoding Strategy
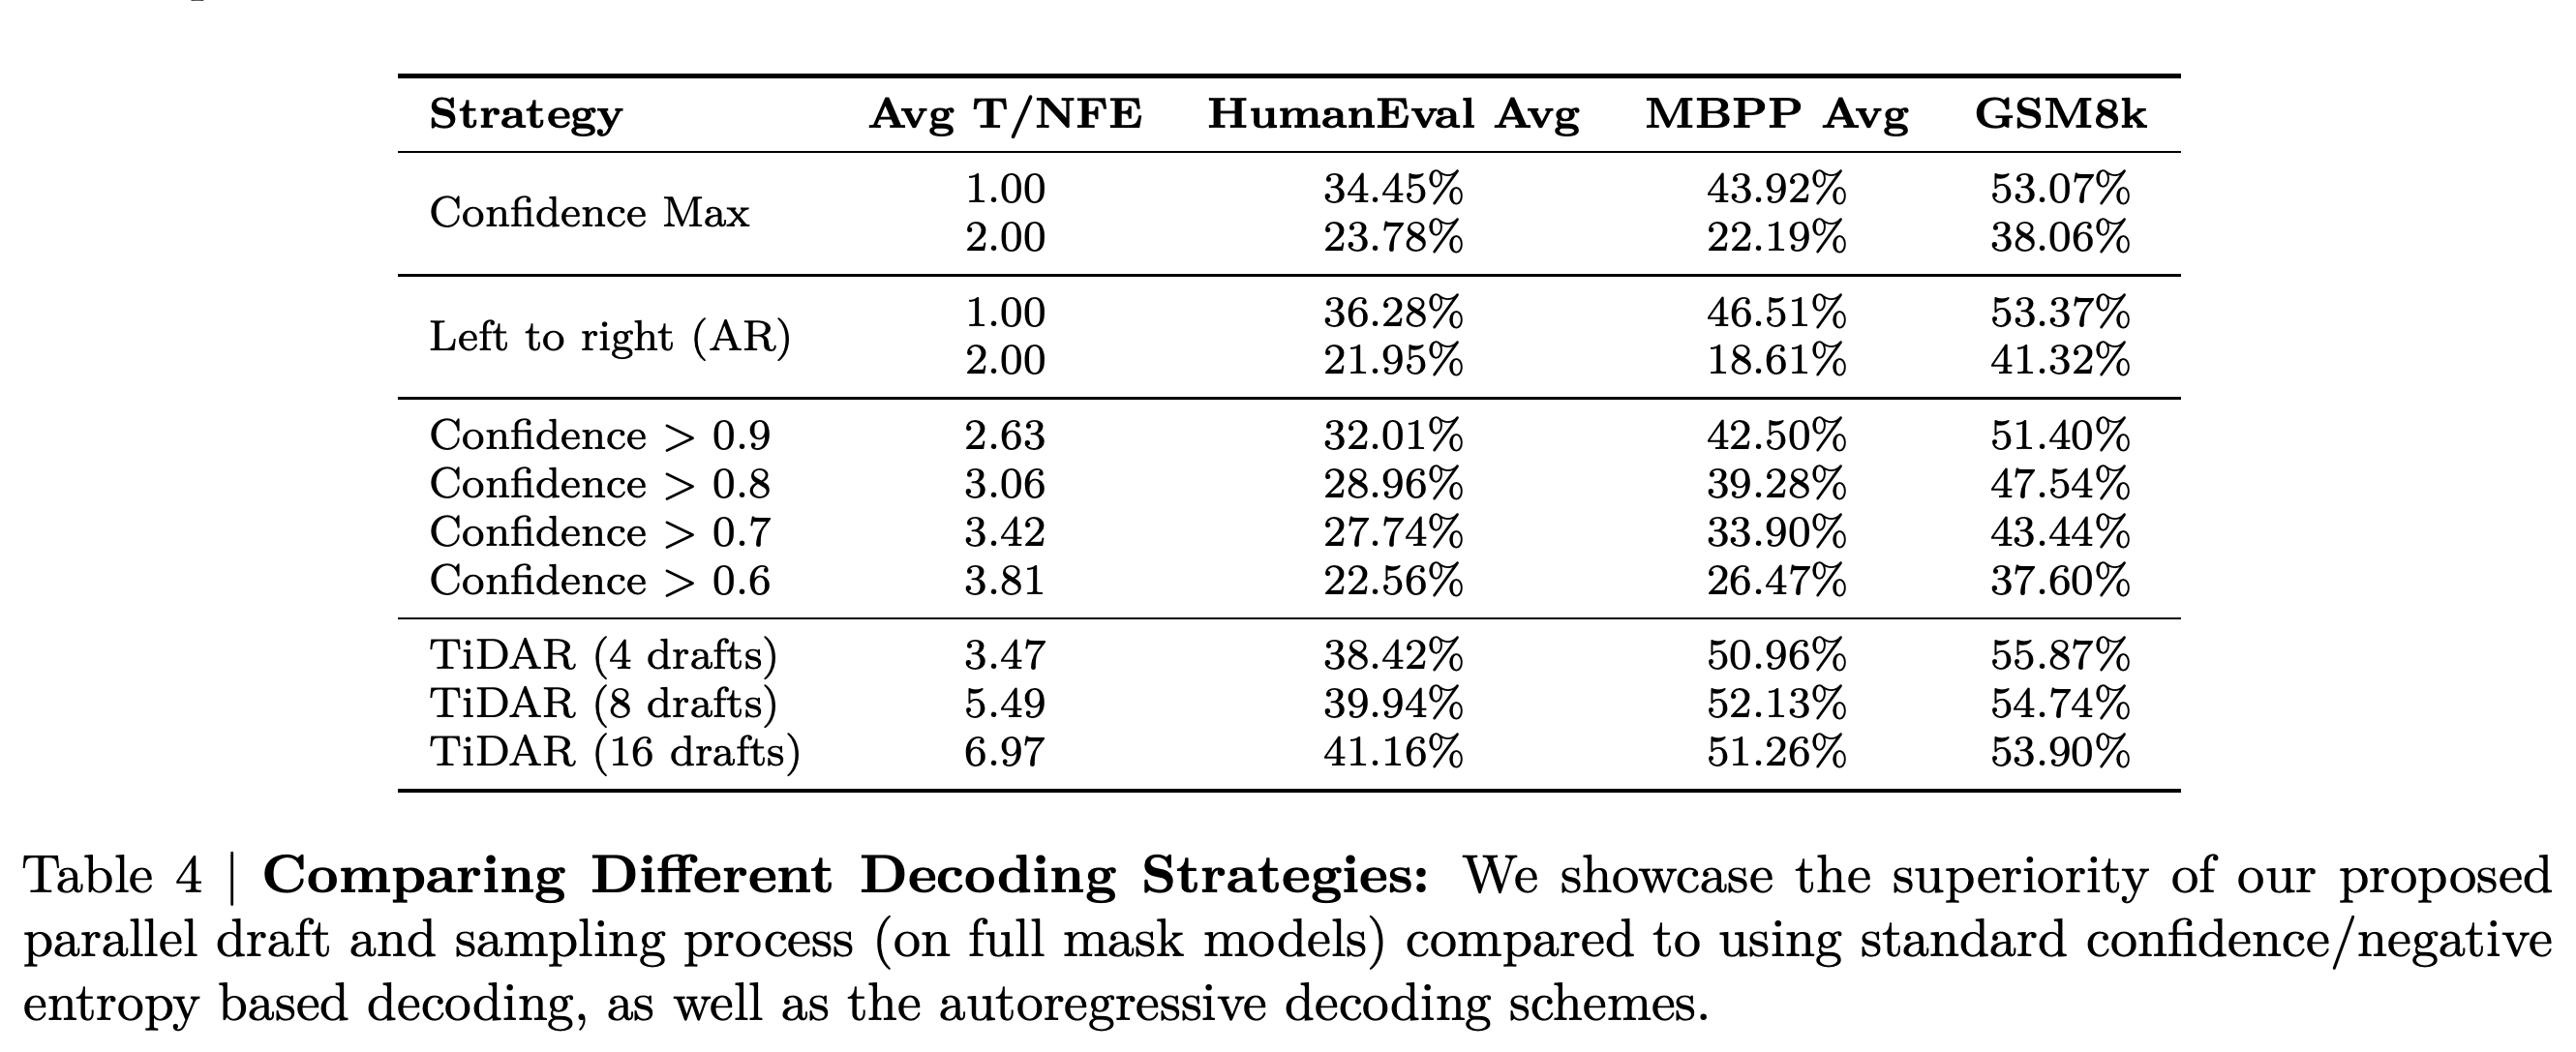
Table 4는 전체 마스킹 모델에서 TiDAR를 고정 개수 신뢰도 기반 디코딩, 신뢰도 임계값 기반 디코딩, 블록 내부 왼쪽에서 오른쪽으로 진행하는 디코딩과 비교한다. 고정 개수 신뢰도 기반 디코딩은 지정한 개수만큼 신뢰도가 높은 예측을 선택한다. 초안 8개를 사용하는 TiDAR는 NFE당 5.49 토큰, HumanEval Avg 39.94%, MBPP Avg 52.13%, GSM8k 54.74%를 달성한다. MBPP도 코드 생성 벤치마크다.
- Confidence > 0.6은 NFE당 3.81 토큰을 생성하지만 동일한 과제 그룹에서 점수는 22.56%, 26.47%, 37.60%다.
- Confidence Max 디코딩을 NFE당 1.00 토큰에서 2.00 토큰으로 늘리면 HumanEval Avg가 34.45%에서 23.78%로 하락한다. TiDAR의 검증은 이러한 대안보다 측정된 품질과 효율의 절충 관계가 우수하다.
신뢰도 임계값을 낮추면 병렬 출력은 늘지만 과제 점수는 크게 하락한다. 초안 8개를 사용하는 TiDAR는 NFE당 5.49 토큰을 생성하면서 HumanEval Avg 39.94%와 MBPP Avg 52.13%를 유지한다. 평가한 전체 마스킹 모델에서는 신뢰도만으로 선택하는 방법보다 측정된 품질과 효율의 절충 관계가 우수하다.
4.4.3. Sampling with AR v.s. Diffusion Prediction
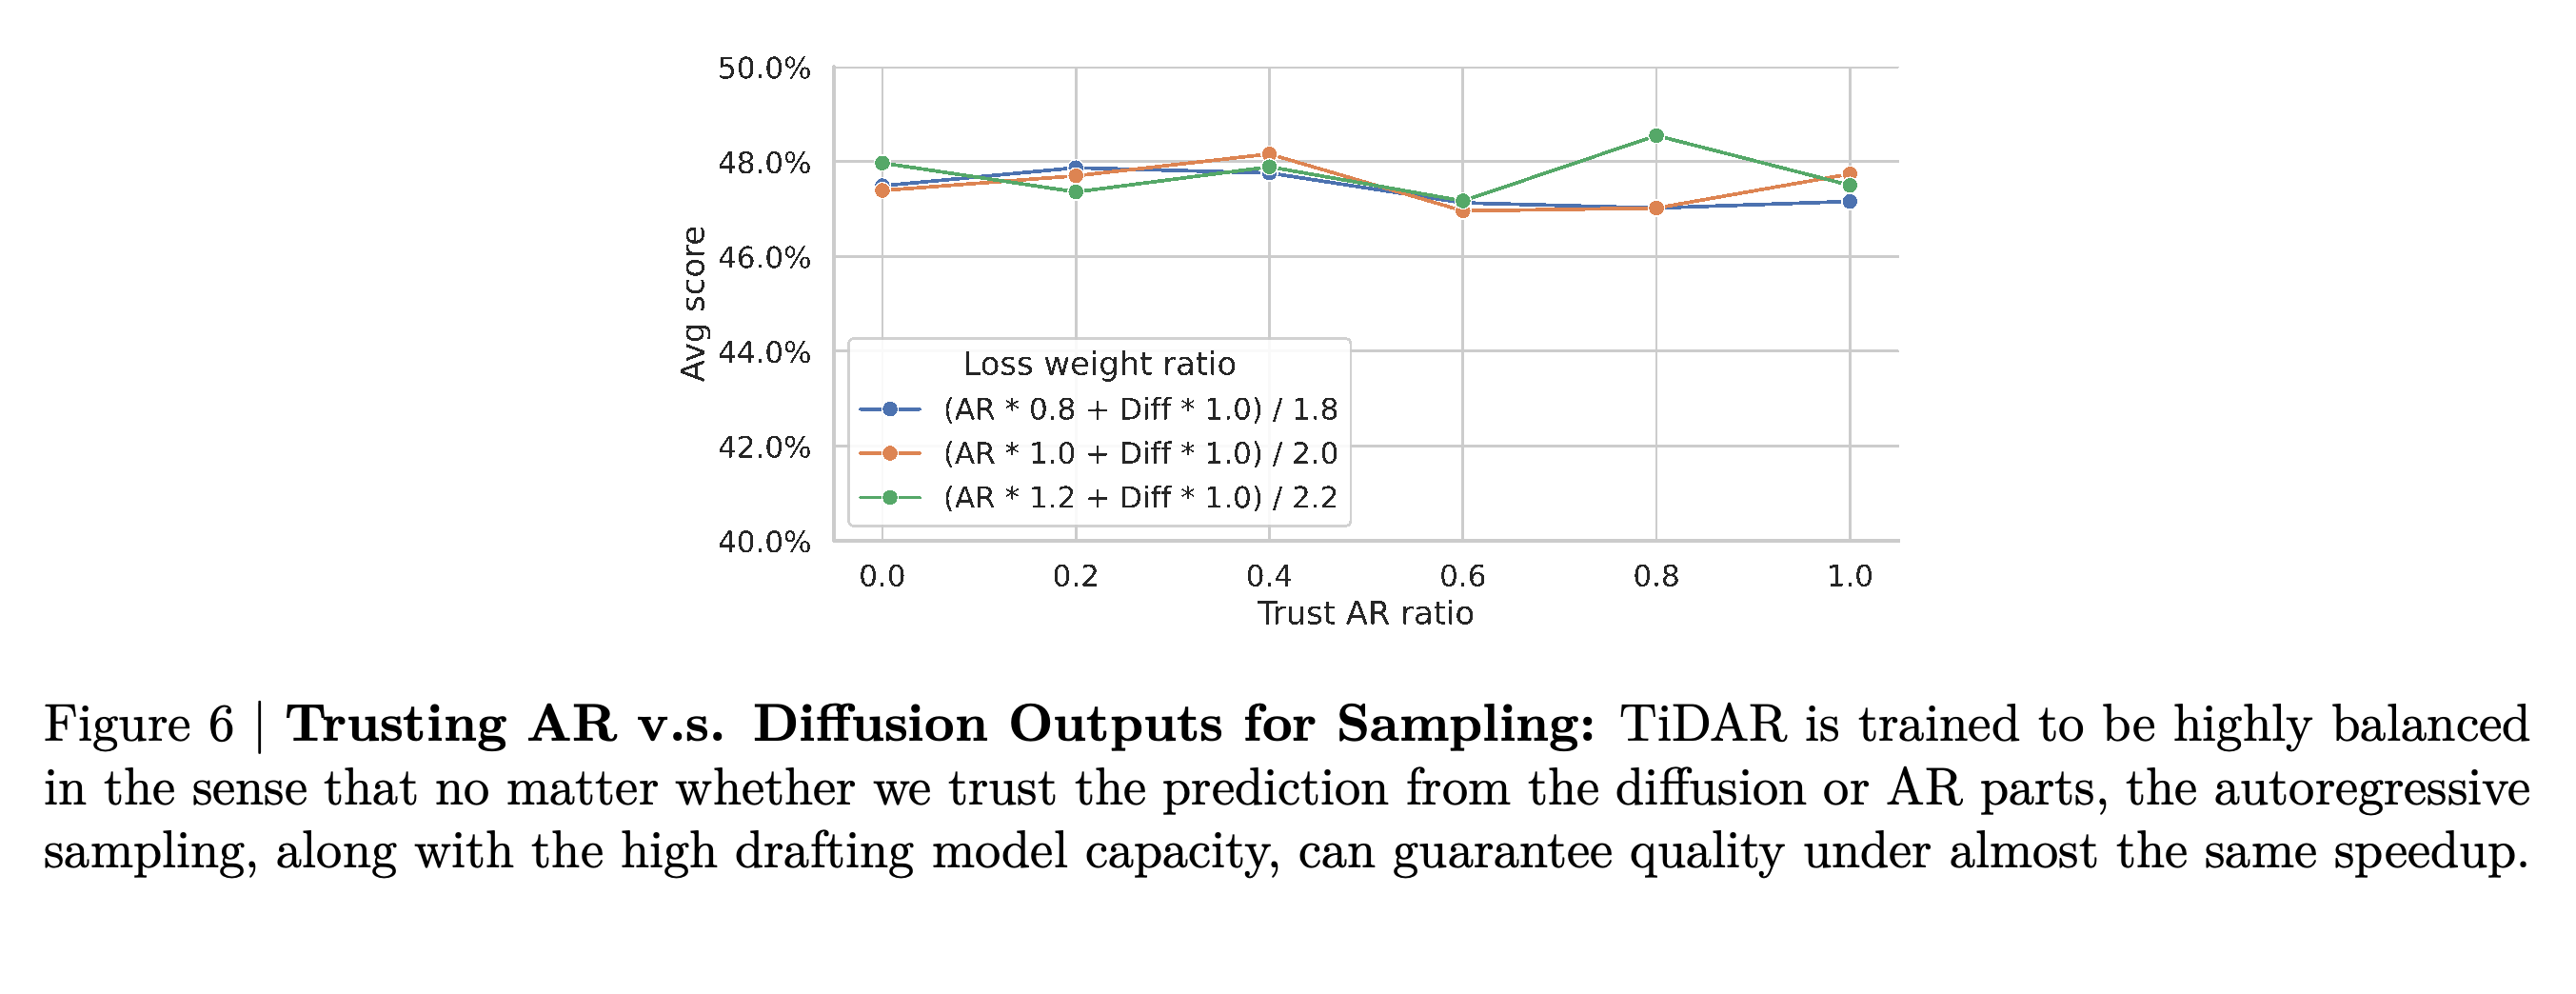
AR 예측과 각 확산 후보의 첫 위치는 동일한 출력 위치를 예측할 수 있다. 논문은 argmax_i{β * logits_i^ar + (1−β) * logits_i^diff, i ∈ |V|}로 로짓을 혼합한다. Argmax는 점수가 가장 높은 토큰을 선택하며 β는 AR의 기여도를 조절하고 |V|는 어휘 집합의 크기를 나타낸다.
- Figure 6은 β를 0.0부터 1.0까지 바꾸고, AR 대 확산 손실 가중치 0.8:1.0, 1.0:1.0, 1.2:1.0을 비교한다. 평균 점수는 약 47%–49%를 유지한다.
- 이 절제 실험은 해당 설정에서 가중치에 대한 민감도가 제한적임을 보여준다. AR 예측과 확산 예측이 동일하다는 근거는 아니다. Table 2는 8B에서 2개의 검증 방식 사이에 측정 가능한 차이가 있음을 보여준다.
Trust-AR 비율 0.0부터 1.0까지와 3개의 손실 가중치 설정에서 평균 점수는 47%–49% 부근을 유지한다. 이 결과는 해당 절제 실험에서 검증 로짓 가중치에 대한 민감도가 제한적임을 뒷받침한다. 그래프의 변동은 2개의 예측 모드가 정확히 동일하다는 근거는 아니다.
4.4.4. How Useful is the Full Mask Strategy?
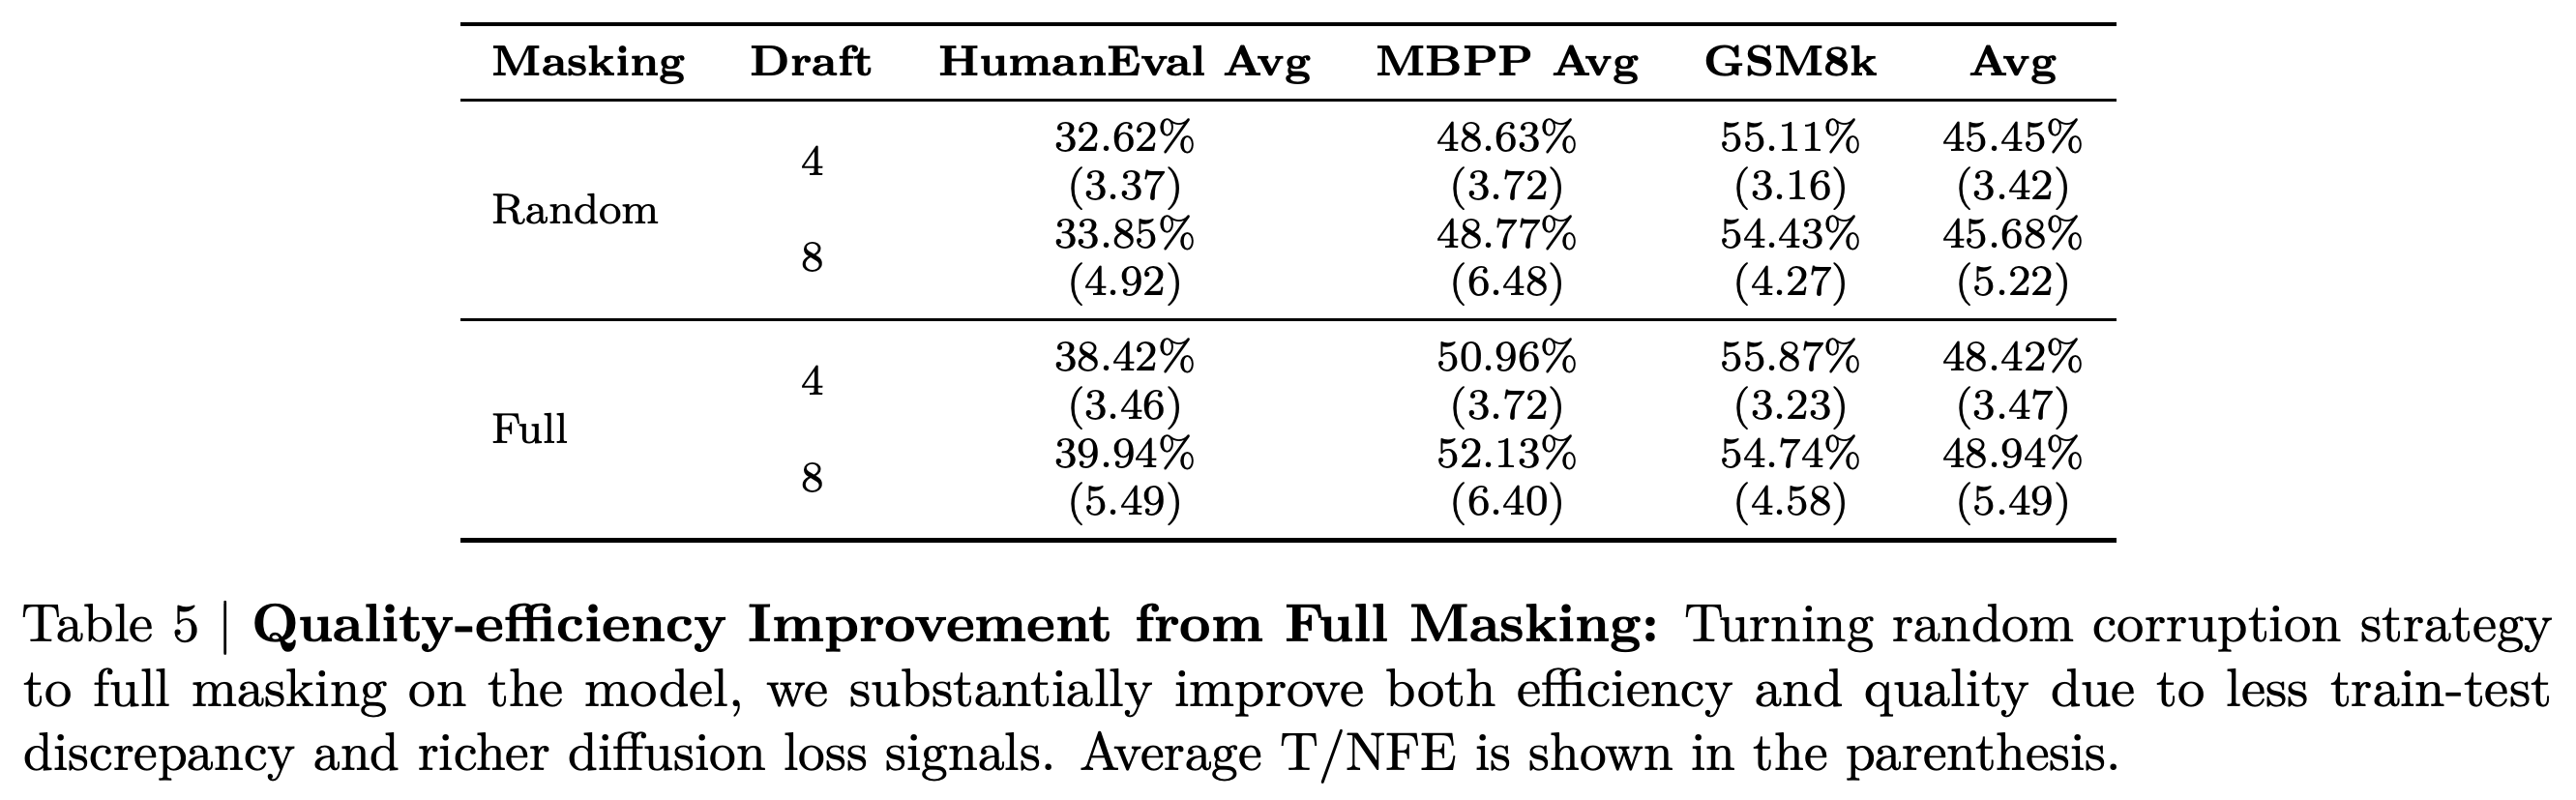
전체 마스킹은 초안 위치에 일부 공개된 원본 토큰이 없는 1단계 추론과 일치하며 더 촘촘한 확산 학습 신호를 제공한다. Table 5에서 무작위 마스킹을 전체 마스킹으로 바꾸면 초안 4개일 때 평균 점수가 45.45%에서 48.42%로, 초안 8개일 때 45.68%에서 48.94%로 상승한다.
- NFE당 평균 토큰 수는 초안 4개일 때 3.42에서 3.47로, 초안 8개일 때 5.22에서 5.49로 증가한다.
- 초안 8개에서는 HumanEval Avg가 33.85%에서 39.94%로, GSM8k가 54.43%에서 54.74%로 상승한다. 품질 개선 폭은 코딩에서 더 크다.
전체 마스킹은 초안 길이 4와 8에서 평균 과제 점수와 NFE당 평균 토큰 수를 모두 개선한다. 길이 8에서는 점수가 45.68%에서 48.94%로, NFE당 토큰 수가 5.22에서 5.49로 증가한다. 과제 점수 개선 폭은 HumanEval Avg에서 가장 크다.
5. Limitations
처리량 근거는 batch size = 1에 집중되어 있으며 큰 배치로 서빙할 때도 같은 수준의 향상이 있는지는 확인하지 않았다. 저자들은 다른 연산 조건에 맞춰 초안 길이를 조절할 것을 제안하지만 이에 대응하는 큰 배치의 처리량 평가는 제공하지 않는다.
- 마스크 토큰을 추가하면 학습 시퀀스 길이가 배로 늘어나며, 효율적인 긴 문맥 확장은 향후 과제로 남는다. 보고된 최대 학습 시퀀스 길이는 4096이다.
- 측정에는 Flex Attention을 사용하는 기본 PyTorch 구현을 사용한다. 맞춤형 커널과 스케줄링은 입증된 결과가 아니라 개선 제안이다.
- TiDAR는 백본 변환이 필요하며 일반적인 speculative decoding처럼 원래 초기화 모델의 목표 분포를 보존하지 않는다.
6. Conclusions
논문은 1단계 확산 초안과 인과적 검증을 함께 계산하면 경쟁력 있는 다운스트림 품질을 유지하면서 생성 효율을 높일 수 있다고 결론짓는다. 핵심 근거는 1.5B와 8B에서 각각 NFE당 7.45와 8.25 토큰, 디코딩 처리량 4.71×와 5.91× 향상이다.
- 처리량 향상은 평가한 모델, 과제, H100 하드웨어, batch size = 1 조건에 해당한다. 더 큰 배치, 더 긴 문맥, 더 최적화된 서빙 구현은 평가하지 않았다.
이 설정은 프롬프트 예시 수, 생성 한도, 채점 지표를 고정한다. 코딩은 길이 512와 Pass@1을 사용한다. GSM8K-CoT는 예시 8개와 길이 256을 사용하며 우도 평가 과제는 생성 길이 설정 없이 정확도 또는 정규화 정확도를 사용한다.
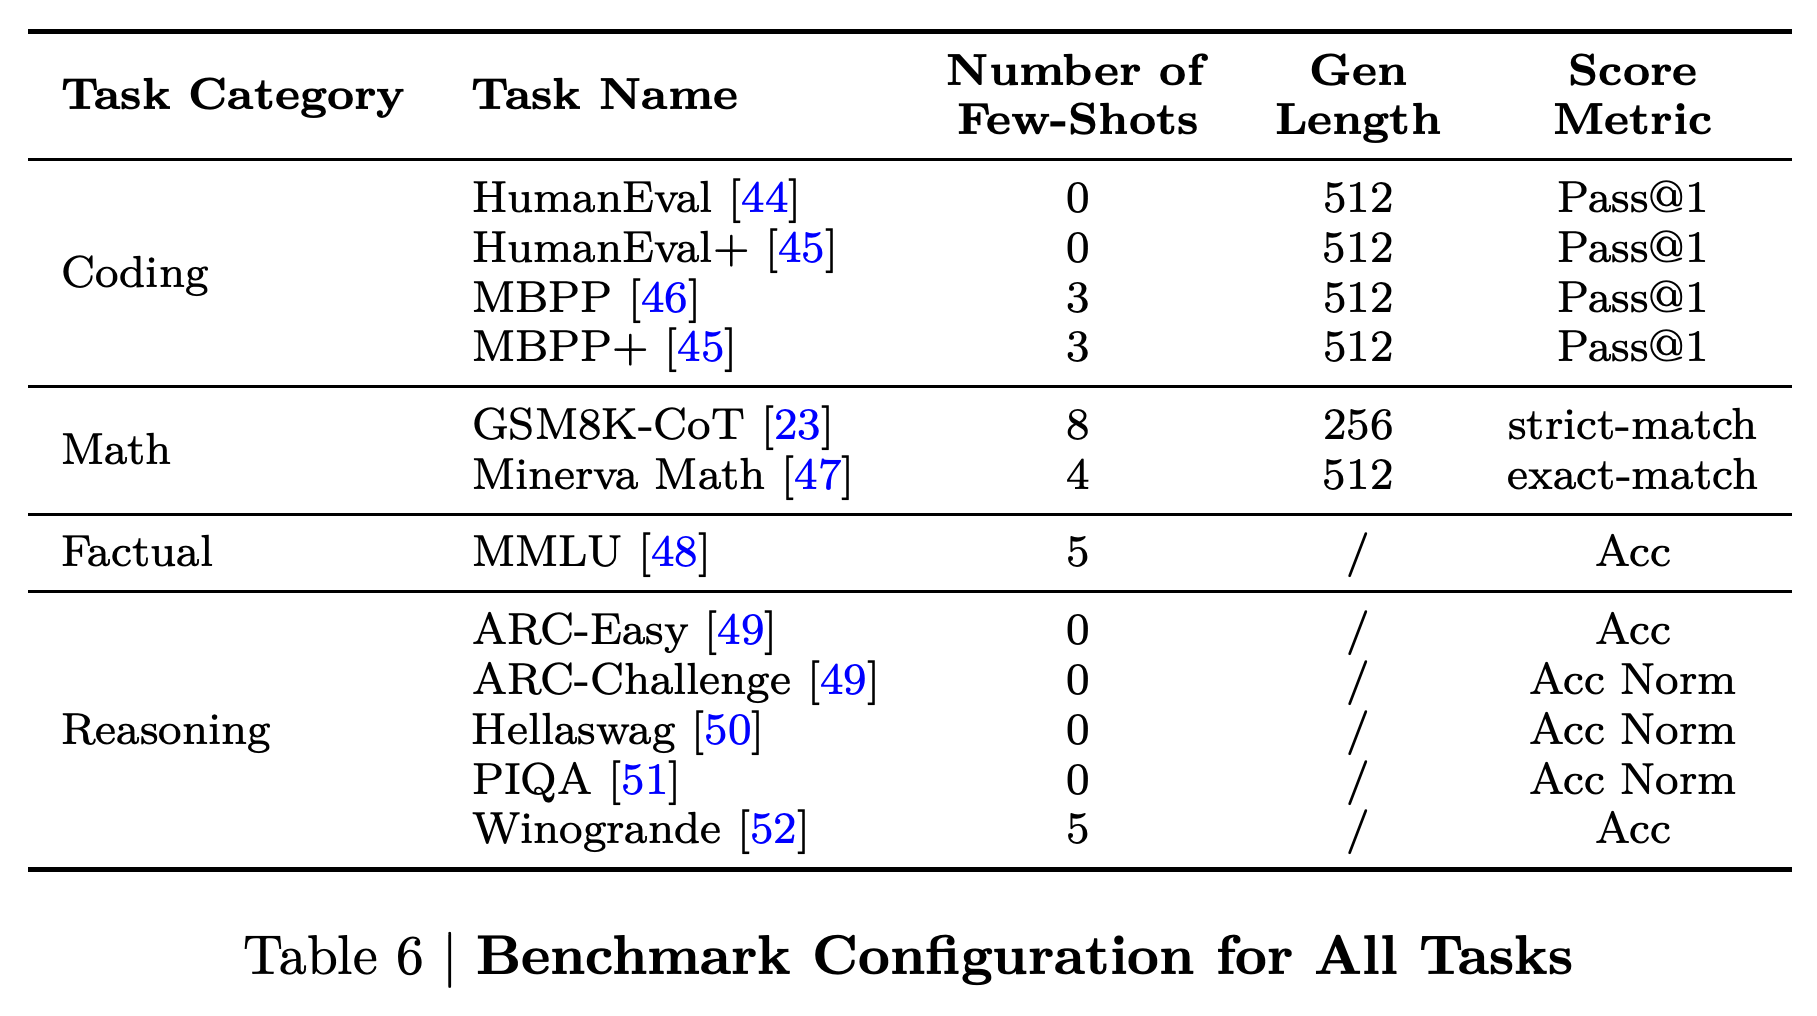
프리필 예시는 논리적인 위치 ID를 유지하면서 구현상의 배치에서는 초안 마스크를 접두부 위치 앞에 둔다. 길이 3인 프롬프트에 맞춰 초기화된 마스크를 슬라이싱하면 접두부는 인과적 어텐션을 유지하고 초안 블록은 자신의 마스킹된 위치들에 양방향으로 어텐션을 적용하면서 프롬프트도 참조할 수 있다.
부록
- A. Evaluation Task Configuration은 lm_eval_harness 버전 0.4.8과 표준 HumanEval/HumanEval+ 후처리를 명시한다. HumanEval과 HumanEval+는 프롬프트 예시 0개와 생성 길이 512를, MBPP와 MBPP+는 예시 3개와 길이 512를 사용한다. 모두 생성한 해답 1개가 테스트를 통과하는지 측정하는 Pass@1로 채점한다. 중간 추론을 포함하는 chain-of-thought 프롬프트를 사용하는 수학 과제인 GSM8K-CoT는 예시 8개, 길이 256, strict-match를 사용한다. Minerva Math는 예시 4개, 길이 512, exact-match를 사용한다.
- Table 6은 MMLU와 Winogrande의 예시 수를 5개로, ARC-Easy, ARC-Challenge, Hellaswag, PIQA는 0개로 지정한다. 이 과제들은 정확도 또는 답변 길이에 맞춰 후보 점수를 조정하는 정규화 정확도를 사용한다. B. Inference Prefill Mask는 초안과 접두부 위치를 재배열하고 크기 (max_seq_len + block_size, max_seq_len + block_size)로 초기화한 마스크를 슬라이싱한다. 이를 통해 인과적 접두부 어텐션과 양방향 초안 어텐션을 유지하면서 서로 다른 프롬프트 길이에서도 마스크를 재사용한다.
짧은 생각
핵심 기여는 전체 백본을 사용하는 초안 생성과 인과적 검증을 동시에 수행한 데 있으며 실제 시간 측정과 통제된 마스킹 절제 실험이 이를 뒷받침한다. 배포를 평가할 때는 품질의 절충 관계를 고려해야 한다. TiDAR 8B는 생성 평균에서 Qwen3 8B보다 낮고, 동일한 학습 조건의 실험에서도 AR과의 품질 격차가 남는다. 보고된 속도 향상은 H100에서 단일 요청을 디코딩하는 조건에 해당한다. 다른 서빙 조건에서의 이점을 평가하려면 더 큰 배치에서의 측정과 모든 비교 모델의 최적화된 구현이 필요하다.